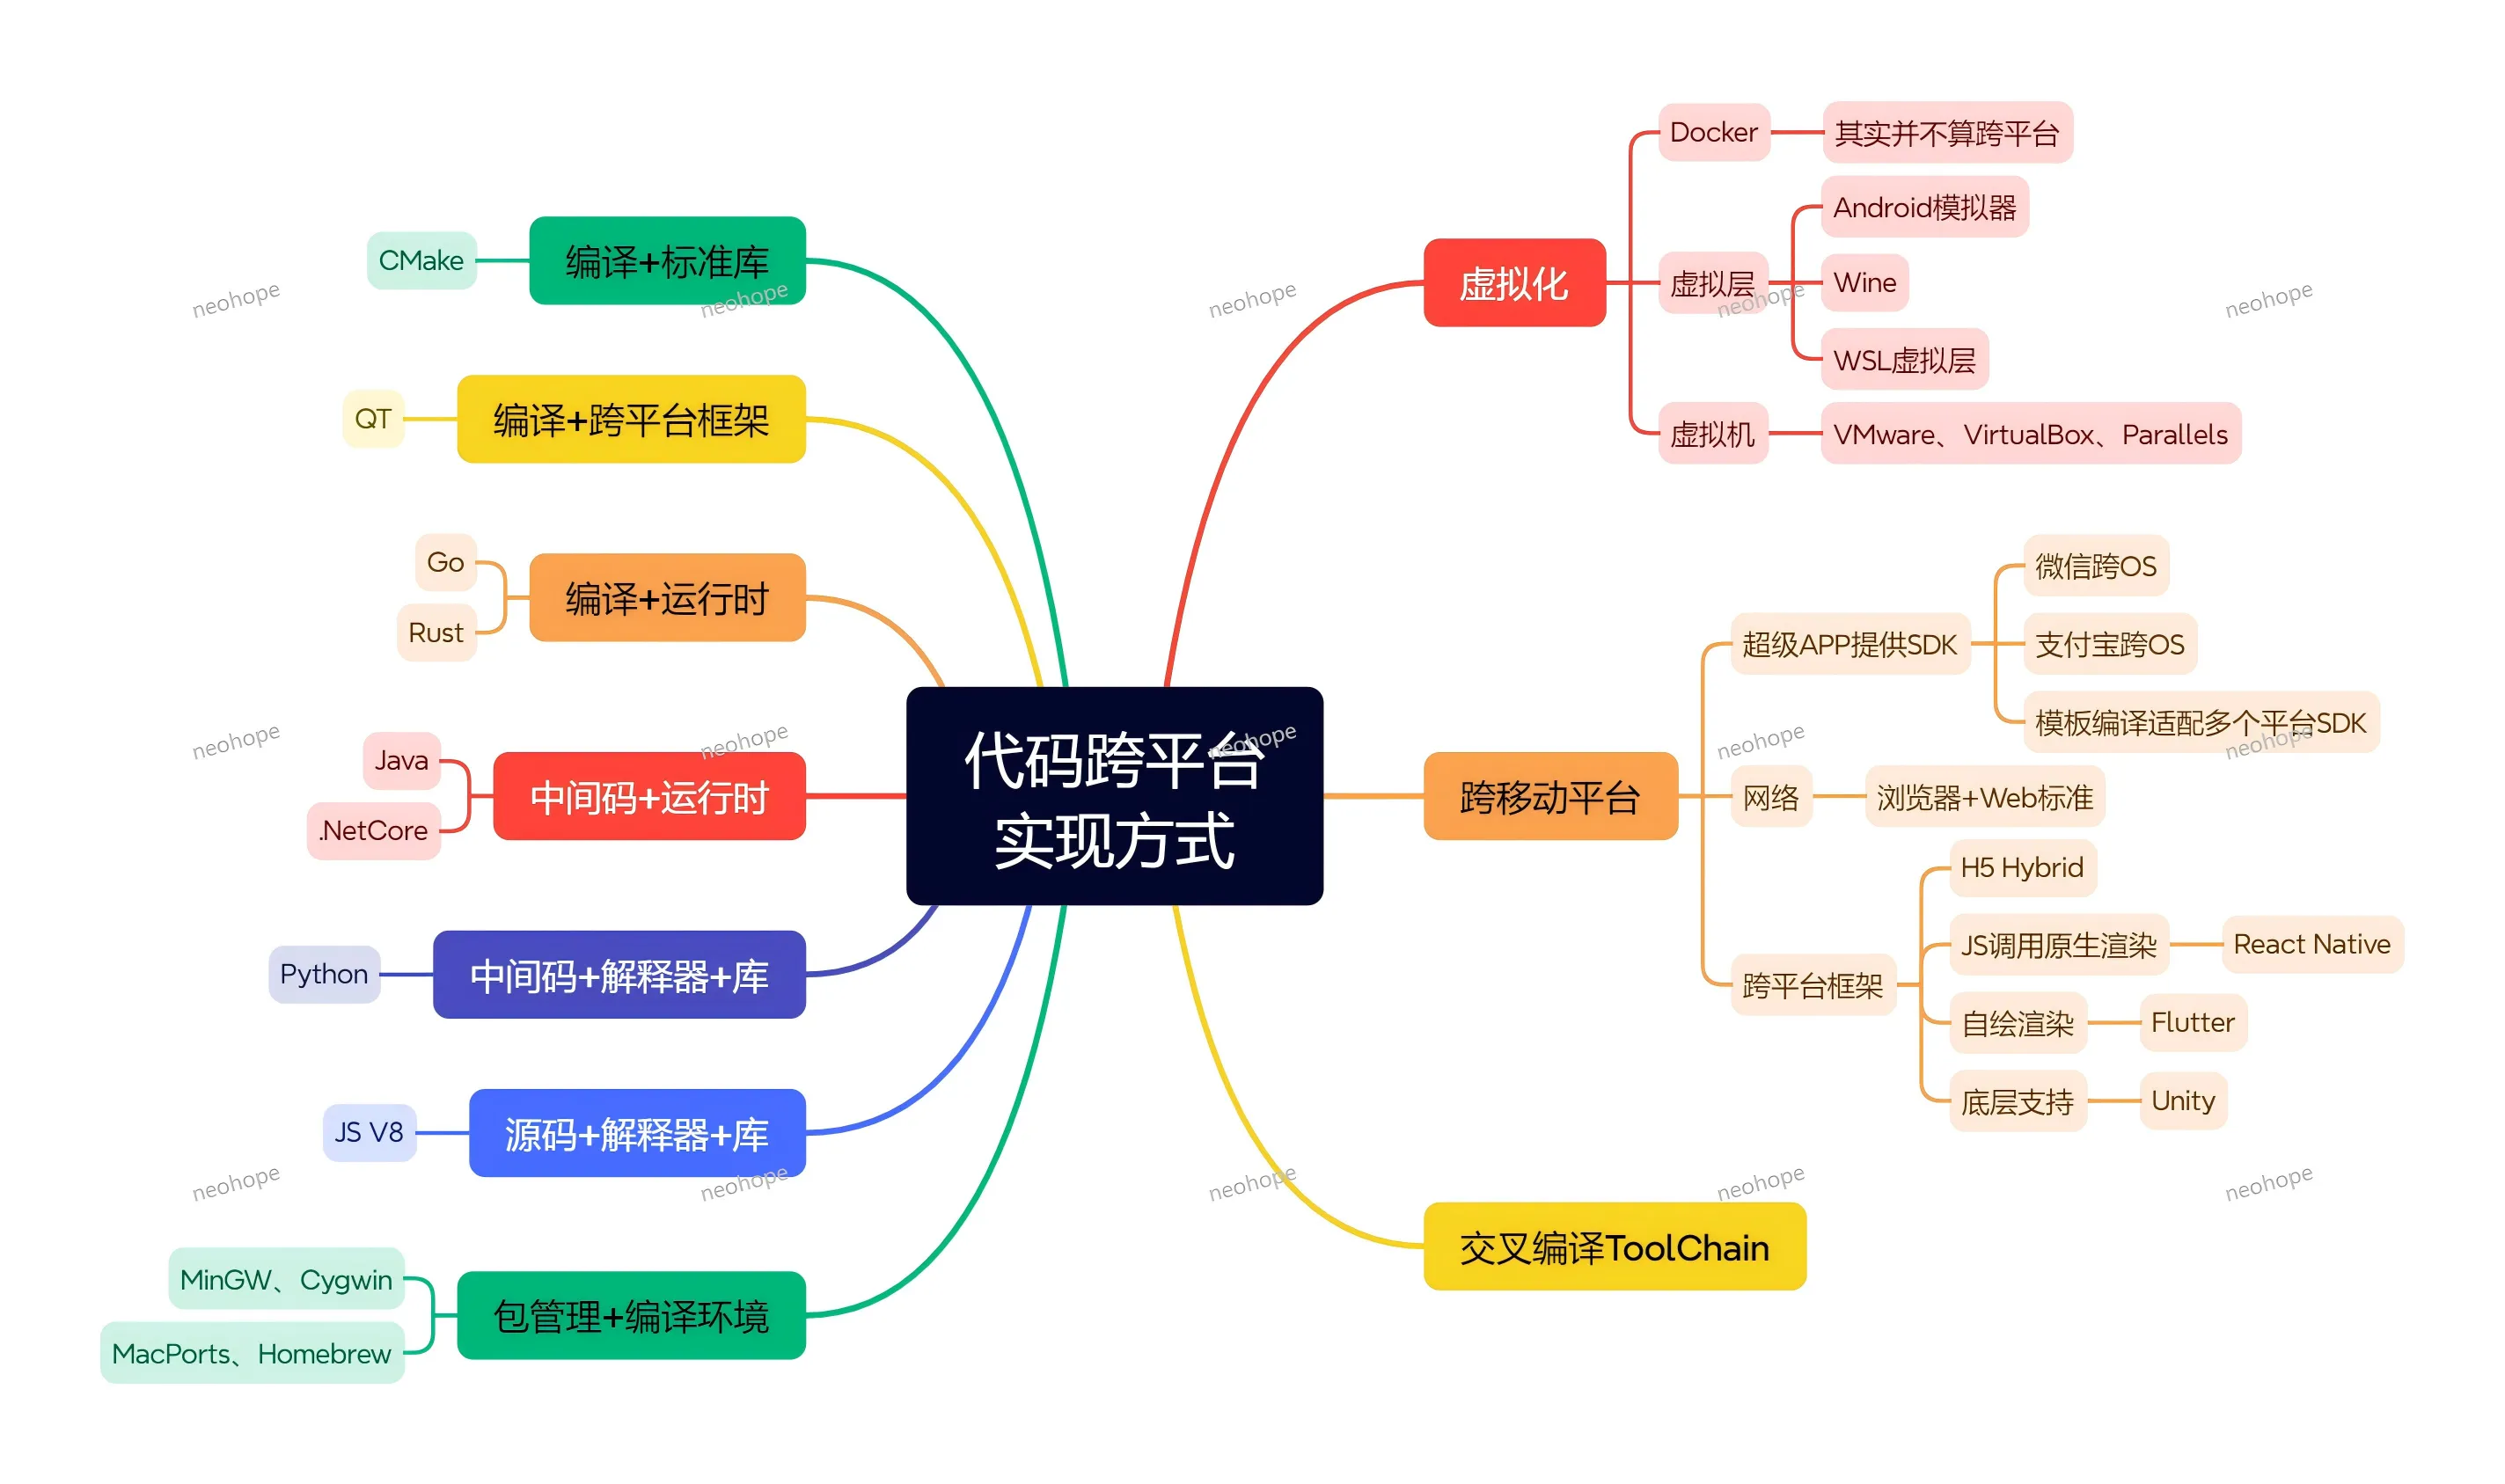
代码跨平台怎么实现?6大核心方案+场景选型,告别重复开发

代码跨平台实现方式


代码跨平台怎么实现?6大核心方案+场景选型,告别重复开发

做开发时最头疼的莫过于 “一套代码多端适配”——Windows、Mac、Linux 要适配,iOS、Android 要兼容,甚至还要兼顾浏览器和小程序。重复写多套代码不仅效率低,还容易出现兼容性 bug。其实跨平台开发早已不是新鲜事,不同技术方案各有优劣,关键是选对适配场景。今天就拆解代码跨平台的核心实现方式,帮你快速找准适合自己的方案。

一、编译适配型:一次编码,多平台编译
核心逻辑:编写统一源码,通过专用编译工具或语言特性,直接编译出不同平台的可执行文件,性能接近原生。
代表技术:
语言原生支持:Go(编译 + 运行时,直接编译为各平台二进制文件)、Rust(跨平台编译工具链,适配多系统)、Java(中间码 + JVM 运行时,一次编译多平台运行)、.NET Core(中间码 + 运行时,跨 Windows/Mac/Linux);
编译工具辅助:CMake(搭配标准库,统一管理多平台编译流程)、交叉编译 ToolChain(如 MinGW、Cygwin,实现跨系统编译);
优势:性能强,接近原生应用;代码复用率高,无需大幅修改;
适用场景:后端服务、工具类软件、高性能应用(如 Go 开发的跨平台服务器,C+++CMake 开发的桌面工具)。

二、跨平台框架型:框架封装,屏蔽平台差异
核心逻辑:基于统一框架开发,框架底层适配不同平台的 API,开发者无需关注平台细节,专注业务逻辑。
代表技术:
桌面 / 多端框架:QT(编译 + 跨平台框架,适配桌面 + 嵌入式,支持 C++/QML);
移动跨平台框架:React Native(JS 调用原生渲染,兼顾跨平台与原生体验)、Flutter(自绘渲染引擎,跨 iOS/Android/ 桌面 / 网页,UI 一致性强);
优势:开发效率高,一套代码覆盖多端;UI 适配性好,框架已处理平台差异;
适用场景:移动 APP(如电商 APP、工具类 APP)、桌面应用(如 QT 开发的跨平台客户端)、中小型项目(Flutter 快速迭代上线)。

三、虚拟层/模拟型:通过虚拟环境兼容多平台
核心逻辑:在目标平台上搭建虚拟层或模拟器,让原本不兼容的代码在虚拟环境中运行,无需修改源码。
代表技术:
虚拟机:VMware、VirtualBox、Parallels(在 Windows/Mac上虚拟出其他操作系统,运行对应平台软件);
兼容层:Wine(在Linux/Mac上模拟 Windows 运行环境,运行 Windows 程序)、WSL(Windows子系统,在Windows上运行 Linux 环境及软件);
模拟器:Android 模拟器(在PC上模拟Android环境,运行APP);
优势:无需修改原有代码,直接复用现有应用;门槛低,快速实现兼容;
注意点:性能有损耗,不如原生流畅;部分复杂应用可能出现兼容性问题;
适用场景:现有应用跨平台运行(如Windows软件在Linux上通过Wine运行)、开发测试(Android模拟器调试APP)。

四、超级APP生态型:依托生态,跨OS运行
核心逻辑:在微信、支付宝等超级APP提供的SDK或生态内开发,借助超级APP的跨平台能力,实现 “一次开发,多OS适配”。
代表技术:微信跨OS、支付宝跨OS(通过其提供的 SDK 开发小程序或内嵌应用,自动适配 iOS/Android);
优势:无需考虑底层平台适配,超级 APP 已完成兼容;流量红利,可直接触达超级 APP 的海量用户;
适用场景:小程序、内嵌应用(如微信小程序、支付宝生活号应用)、轻量级交互场景。

五、Web标准型:基于浏览器,跨平台无压力
核心逻辑:采用 HTML/CSS/JS 开发,依托浏览器的 Web 标准,实现 “一次开发,所有浏览器兼容”,间接跨所有支持浏览器的平台。
代表技术:浏览器 + Web 标准、H5 Hybrid(APP 内嵌 WebView,混合原生与 Web 页面);
优势:兼容性极强,覆盖 PC / 移动 / 平板所有浏览器;开发成本低,技术栈普及;
注意点:性能依赖浏览器,复杂交互体验不如原生;部分原生 API 需通过桥接调用;
适用场景:网页应用、轻量级 APP、跨平台展示型场景(如官网、数据可视化页面、Hybrid APP 的展示模块)。

六、包管理与环境配置型:统一环境,简化适配
核心逻辑:通过包管理工具统一管理依赖,确保不同平台的开发环境一致,减少因环境差异导致的适配问题。
代表技术:MacPorts、Homebrew(Mac 平台包管理工具,快速安装适配 Mac 的开发依赖);
优势:简化环境配置,快速搭建跨平台开发所需依赖;统一依赖版本,避免 “本地能跑,线上报错”;
适用场景:辅助跨平台开发(如通过 Homebrew 在 Mac 上安装 CMake、MinGW 等跨平台编译依赖)。

总结:跨平台方案选型核心逻辑 ——“场景决定方案”
不用盲目追求 “万能方案”,选型时重点关注3点:
1、性能需求:高性能场景(后端、工具软件)选编译适配型(Go/Rust/CMake);中低性能需求(展示型 APP、小程序)选 Web 标准或超级 APP 生态;
2、多端覆盖范围:需覆盖移动 + 桌面选 Flutter/QT;仅移动端选 React Native/Flutter;仅桌面端选 QT/Go 编译;
3、开发效率:快速迭代选 Flutter/React Native;追求长期稳定、低维护成本选编译适配型或 QT。

跨平台开发的核心是 “用最低成本实现多端兼容”,不同方案没有绝对优劣,只有是否适配场景。选对方案,既能减少重复开发,又能保证产品体验。

你在跨平台开发中遇到过哪些兼容性坑?或者你更倾向于哪种实现方案?欢迎在评论区留言交流~

导致惨重代价的运维事故2025

2025年11月:Cloudflare大规模故障
事件经过:11月18日,Cloudflare CDN、安全服务等多款产品宕机,团队误判为DDoS攻击,回滚旧文件后,于19日凌晨01:06全部恢复。
事故原因:数据库权限调整后生成错误配置文件,引发核心代理系统异常。
造成损失:全球大量依赖Cloudflare服务的网站及业务受影响,平台承诺加速系统韧性升级。

2025年11月:亚马逊云服务重大事故
事件经过:美国太平洋时间凌晨2:01,AWS因运营问题导致近70项自有服务受影响,亚马逊、迪士尼+、Canva等平台及多款云游戏瘫痪。
事故原因:未公开披露具体技术原因,确认与美国东部1号区域相关。
造成损失:全球多家知名平台服务中断,影响用户使用及企业业务营收。

2025年10月:亚马逊AWS北弗吉尼亚区域崩溃
事件经过:AWS US-EAST-1区域中断长达15小时,波及全球。
事故原因:核心依赖服务失效,DynamoDB DNS解析异常引发连锁故障。
造成损失:数千个服务瘫痪,潜在经济损失高达百亿美元。

2025年10月 微软Azure配置错误,导致全球中断
事件经过:Azure Front Door错误配置变更,Azure全网瘫痪,引发Office 365、Teams等核心服务全球性中断,持续数小时。
事故原因:网络配置变更失误,触发底层逻辑缺陷致级联故障。
造成损失:全球用户无法使用核心服务,企业远程办公中断,微软赔付客户,声誉受损。

2025年9月:韩国政府数据中心火灾
事件经过:数据中心锂离子电池迁移维护时爆炸起火,858TB核心数据丢失,160多项公共服务受影响,一周仅恢复18%系统。
事故原因:运维操作引发的基础设施事故。
造成损失:政府服务瘫痪,修复成本高,公信力受损。

2025年8月:上海医保系统故障
事件经过:8月11日,上海医保系统因电信云平台机房供电故障无法正常结算,应急备份系统接管后,本地门急诊结算恢复,大病、住院及异地结算受影响。
事故原因:电信运营管理的云平台机房供电系统故障。
造成损失:患者就医结算受阻,异地参保人需自费后报销,影响民生服务。

2025年6月:谷歌云全球性服务中断
事件经过:6月12日,谷歌云遭遇全球性服务中断,持续约13小时。期间,谷歌工作空间(Google Workspace)、安全运营产品等外部API请求大量失败。
事故原因:服务控制组件高负载处理失效。“服务控制”组件是谷歌云策略检查系统的核心,负责读取配额和政策信息。该组件未能有效应对高负载情况,导致API请求处理堵塞,进而引发了全局性的服务中断。
造成损失:大量企业客户业务受阻,谷歌为此向客户致歉并推出了服务控制改进计划,重建客户信任。

2025年3月:华金期货交易系统长达7.5小时宕机
事件经过:3月10日,华金期货的交易系统突发异常,客户无法通过文华财经等主流交易端登录账户。故障持续了整整7小时26分钟,直到半日过去才被修复。
事故原因:软件故障与应急处置不当。虽然具体技术原因因“证据灭失”未能完全查清,但监管调查发现其在应急处置中未妥善保护现场,且暴露出灾备系统性能不足、过度依赖外部供应商等问题。
造成损失:达到“一般网络安全事件”标准;期货市场瞬息万变,长时间的交易中断导致客户面临巨大的穿仓风险和亏损,公司也因此收到监管罚单。

2025年1月:埃隆·马斯克旗下X公司数据中心火灾
事件经过:X公司租用的俄勒冈州希尔斯伯勒数据中心发生火灾。
事故原因:储能设备管理问题,电池房间存在运维漏洞。
造成损失:影响X平台部分服务稳定性。

当“锚”切断数字动脉:红海光缆中断事件复盘

当“锚”切断数字动脉:红海光缆中断事件复盘

一、事件始末:一艘货轮的失控,三条光缆的毁灭

2024年2月18日,伯利兹籍万吨散货轮”鲁比玛号”(MV Rubymar)满载4.1万吨化肥,在红海曼德海峡航道通行时,遭遇武装导弹袭击。船体严重受损,船员第一时间紧急弃船撤离,船舶彻底失去动力与人为操控能力。

按常规认知,遇袭失能船舶会快速沉没。但”鲁比玛号”并没有立刻倾覆,而是出现了极具特殊性的次生风险———它在洋流作用下持续漂移,船体全程拖拽着巨型船锚,在红海海域缓慢漂流超过70公里。坚硬锋利的锚爪如同一柄失控的犁刀,持续剐蹭、切割海底地层。

2024年2月24日,导弹袭击发生整整六天后,船锚斩断了红海海底三条核心跨境互联网通信光缆(相互之间距离很近):
Seacom/Tata TGN-Eurasia
Asia Africa Europe-1(AAE-1)
Europe India Gateway(EIG)

2024年3月2日,这艘失事货轮才最终完全沉没,彻底结束漂移破坏过程。

二、红海走廊:全球互联网的”单点瓶颈”

红海海底光缆是欧亚、非欧跨境数据传输的核心骨干链路,承担着全球互联网的核心流量承载任务,其战略传输地位无可替代。具体来看:

指标 数据
欧亚跨境网络数据经红海传输比例 约80%
红海光缆承载全球互联网流量比例 约17%
红海光缆支撑日均跨境金融交易量 超6万亿美元

在高可用的分布式系统架构设计中,总流量汇聚于一条物理走廊(狭窄的海峡、活跃冲突、复杂的地缘政治环境),这本身就构成了一个高风险单点故障区域(Single Point of Failure)。

虽然红海海底铺设了多条不同的光缆(EIG、AAE-1、SEA-ME-WE 5等),但它们几乎都经由同一条狭窄水道。这意味着,一次大范围的物理事件(无论是地震、船锚拖拽还是蓄意破坏),都有可能同时影响多条线路,导致物理层面的”集中导致的冗余失效”。”鲁比玛号”事件恰好验证了这个假设:一条失控的货轮,一次漂流,就切断了三条光缆。

从运维的视角来看,本次事件是这样的:一个高可用集群,全部副本都在同一个机房。机房对外有三根线路,但三根线路沿着同一个管道铺设。一台挖掘机一铲子把管道挖断了,对整个机房网络造成了难以预期的、不可逆的灾难性破坏。

三、故障传播:从物理层到业务层的级联崩塌

三条核心光缆同步断裂,直接触发了区域性骨干网络的带宽断崖式衰减与链路稳定性骤降。红海主干链路可用数据传输量直接缩减四分之一,也就是欧亚大陆的网络带宽减少了四分之一,欧亚大陆的网络”集体降速”。

从维度角度分析,本次故障的影响具备影响范围广、持续时间长、级联效应明显三大特征:

1、全域性——覆盖范围极广
东非、西亚、欧洲、东亚跨境通信全面受影响。政企专线、跨境云计算、国际结算系统、跨境办公网络均出现运行异常。具体表现为:
欧亚之间网络延迟显著上升,部分路由延迟大幅上升;
东非、中东部分区域互联网连接近乎中断;
跨国企业实时通信、视频会议、金融数据传输出现严重抖动与丢包;
云服务提供商跨区域同步和灾备系统面临更高的数据一致性风险。

2、持续性——故障层级极高
这是骨干核心链路的物理性损毁,而非边缘节点故障,无法通过局部设备重启、带宽扩容、节点切换等常规运维手段修复。光缆修复历时5个月,全网降级运行状态持续近半年。

3、连锁性——单点故障引发全网失衡*
根据BGP(边界网关协议)的路由收敛机制,受影响的流量会尝试切换到可用路径。故障发生后,运维团队通过非洲西海岸的Equiano、Peace、WACS等备用光缆进行流量迂回调度,缓解主干链路带宽压力。

但备用链路传输距离更长、带宽容量有限,无法完全抵消主干光缆断裂带来的性能损耗。这就好比一条八车道高速公路突然断了六条车道,所有车辆被强制并入两车道乡间公路。剩余备用链路长期高负荷运行,进一步加剧了网络抖动与服务不稳定,运维团队需持续监控全网流量、动态调整路由策略、处置突发拥堵,运维值守压力达到极值。

从维度角度来看,这是一次典型的“降级服务”事件:系统没有完全宕机,但核心性能指标严重劣化,用户体验大面积受损,且故障恢复的时间窗口完全不可控。

四、修复难题:最令人绝望的不是修复要多久时间,而是”什么时候能开始修”

海底光缆修复的技术流程本身是成熟的:派出专业维修船(cable ship),用ROV(水下机器人)定位断裂点,捞起光缆,进行熔接、测试,然后重新铺设回海床。在正常条件下,一次标准的海底光缆修复作业需要2–4周。

但”鲁比玛号”造成的这次故障,修复耗时长达5个月——从2024年2月故障发生,直至2024年7月才完成全部修复、链路调试与全网恢复。

不是因为技术难度,而是因为拿不到施工许可。

断裂点位于红海海域,该海域地缘冲突持续、海域局势高度紧张,无任何安全施工条件。各大国际通信运营商、运维团队无法直接进驻海域开展勘查、打捞、熔接、修复作业,所有施工行为必须提前与红海当地实际控制方谈判沟通,申请专属施工许可。漫长的地缘博弈、流程洽谈、权限审批,成为阻碍故障修复的核心卡点。

此外,全球可用的深海光缆维修船仅约60艘,排期本就紧张。同期红海地区已有多条光缆受损,维修资源被多任务挤占,进一步加剧了修复延迟。

这给系统运维领域带来了一个极为深刻的教训:故障恢复时间(MTTR,Mean Time To Repair)的瓶颈,不仅在技术层面,更多时候卡在在组织和环境层面。你可以拥有全世界最先进的熔接设备和最优秀的工程师团队,但如果一枚导弹让整片海域变成了”施工禁区”,你的SLA(服务等级协议)就是一张废纸。

在全网降级运行的5个月中,运维团队处于长期高度戒备状态,需要持续执行流量监控、路由动态优化、突发拥堵处置等工作。这不是一次”修复完成即可恢复常态”的标准事件,而是一场漫长而消耗极大的运维持久战。

五、行业启示:重构极端场景下的网络稳定保障体系

2024年7月,三条光缆陆续恢复服务。互联网继续运转,仿佛什么都没有发生过。但它不应该被当作一个”偶发事件”而被轻易遗忘。我们应该好好的做一次复盘,复盘报告(Post-Mortem)如下:

1、故障根因(Root Cause)
船舶遭受武装袭击后失控漂移,船锚物理性破坏海底光缆。直接原因是地缘军事冲突,间接原因是缺乏对失控船舶的有效拦截或预警机制。这是一起典型的非技术性运维灾难——故障诱因不在设备、软件或人为操作失误,而在于外部不可控的地缘事件引发的基础设施次生损毁。

2、暴露的系统性弱点

弱点 说明
物理路径冗余不足 多条光缆经由同一走廊,易被同一次事件批量破坏,形成”集中导致的冗余失效”
地缘风险未纳入架构评估 光缆铺设和路由规划长期忽视冲突区风险,运维风险模型缺乏非技术变量
维修能力全球稀缺 专业维修船约60艘,大型故障修复排队周期长
跨组织协同机制缺失 光缆运维团队与军事/外交系统之间无标准化协作流程,冲突海域处置无先例可循
备用链路性能差距大 迂回链路带宽有限、延迟高,无法有效承接主干溢出流量

3、行业启示:重构极端场景下的网络稳定保障体系

“货轮漂移断缆”是一次罕见的非技术性运维灾难,彻底暴露了传统跨境网络运维体系的结构性短板:过往运维风险防控多聚焦于技术故障、自然天灾、施工风险,完全忽略了地缘冲突引发的次生基础设施损毁风险,全网冗余架构、应急预案、故障处置机制存在明显盲区。从系统运维与网络稳定维度复盘,本次事件带来三大核心启示:

第一,风险评估模型必须升级
跨境骨干网络稳定性风险已全面多元化。地缘政治、海域冲突等非技术因素,已成为威胁全球数字基础设施安全的核心变量。传统以设备故障率、链路可用性为核心的风险评估体系,必须纳入地缘安全、冲突烈度、海域管控状态等非技术维度,构建更全面的风险预判能力。

第二,全球光缆冗余架构亟待重构
核心通道过度集中、备用链路绕行成本高、性能损耗大,单点损毁即可引发全网降级。未来应推动跨洋光缆路径的真正物理分散化布局,增加跨极地、跨大洋的替代路由建设,同时提升卫星通信(如低轨卫星星座)在应急场景下的带宽兜底能力。

第三,跨境基础设施运维需要治理创新
冲突海域的故障处置无标准化流程、无安全保障机制,技术修复能力完全受制于地缘局势。国际社会需要建立跨境数字基础设施的保护性国际框架,将海底光缆纳入关键基础设施保护范畴,为冲突区域的应急修复提供制度性保障。

希望未来,光缆线路不需要军舰巡航,数据中心附近不需要导弹防护,期待和平。

记一次存储Inode数量引发的生产故障

前一段时间,突然收到了系统报警,某上传服务异常。

经过排查,上传服务正常,但存储无法正常写入,一直写入失败,表现为:
1、一块新盘,32T,已使用2T,可用30T,控制台和命令行操作结果一直
2、服务写入时,一直报“no space left on device”
3、没有收到任何存储报警

立刻找了云服务厂商的老师,解决了问题:
1、除了限制写入文件总量的大小、并发写入的速度,同时还限制了inode数量
2、上传服务,写入了大量小文件,耗尽了inode数量
3、上传服务,再次写入后,inode申请失败,导致写入失败
4、存储组的老师,紧急扩展了inode数量,解决了问题

经排查,云服务商反馈:
1、为了控制成本,我们之前买了一块较小的硬盘,然后进行了扩容
2、而存储的底层协议为FlexGroup
3、而FlexGroup的普通卷,在扩容的时候,只要超过了1T,默认的Inode数量就一直为21251126,不再提升
4、而我们的上传服务,一个小文件只有几百k,很快就把Inode数量耗尽了
5、对于Inode数量限制,云服务商没有提供任何监控

虽然FlexGroup的超大卷默认会提升Inode数量,但我们一开始购买的服务确是普通卷,然后进行扩容,扩容后仍是普通卷,就触发了Inode数量不会自动增加这个问题。

后续,我们做了两个约定:
1、尽量采购超大卷
2、如果要采购普通卷,同时提单,增加Inode数量
3、云服务商同步进行产品更新,后续产品迭代时,从根源上解决这个问题

PS:
最近发现,他们居然做了一个inode扩容的功能,默认是最小值,可以手工扩展,也能设置为自动扩展。
不知道是谁定的需求,默认选项不应该是自动扩展吗?

导致惨重代价的运维事故2024

2024年12月:OpenAI故障
事件经过:12月11日,OpenAI发生故障,影响依赖其服务的用户及企业。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,干扰AI相关业务及研发工作。

2024年11月:华为云华南地域部分服务异常
事件经过:因网络设备升级失误,导致华为云华南地域部分云服务访问异常,持续约2小时。
事故原因:内部设备升级操作失误。
造成损失:客户业务短暂中断,华为云快速修复并致歉。

2024年11月:支付宝交易故障
事件经过:11月11日,支付宝发生交易故障,影响用户支付及交易行为。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,干扰用户日常支付及商业交易。

2024年11月:Snowflake云服务逻辑故障
事件经过:11月,云数据平台Snowflake发生严重的服务中断,持续长达13小时。
事故原因:软件更新引发的逻辑冲突。软件更新引入了向后不兼容的数据库架构更新,导致版本不匹配错误。更糟糕的是,其“区域冗余”机制在逻辑故障面前失效,导致10个区域同时瘫痪。
造成损失:大量企业无法执行数据查询,暴露了云服务在面对“逻辑层面”故障时,物理冗余机制可能完全失效的风险。

2024年9月:甲骨文云基础设施故障
事件经过:甲骨文云某区域存储系统故障,导致部分客户数据无法访问,持续超6小时。
事故原因:存储系统运维故障。
造成损失:客户业务中断,甲骨文面临索赔,声誉下滑。

2024年9月:阿里云新加坡数据中心火灾
事件经过:9月10日上午,阿里云新加坡可用区C数据中心发生火灾,导致17项服务异常,Lazada、字节跳动等业务中断。
事故原因:锂电池起火引发故障。
造成损失:多家企业业务中断,阿里云海外服务稳定性受质疑。

2024年9月:上交所交易故障
事件经过:9月27日,上海证券交易所发生交易故障,影响证券交易正常开展。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,干扰资本市场交易秩序。

2024年8月:网易云音乐故障
事件经过:8月19日,网易云音乐发生故障,排查耗时近2小时后恢复。
事故原因:疑似与云存储扩容、贵州机房迁移相关,官方未披露确切原因。
造成损失:用户无法正常使用音乐服务,平台用户体验受影响。

2024年8月:上海电信城域网设备故障
事件经过:8月26日,上海电信城域网设备发生故障,影响区域网络服务。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,干扰民众网络使用及商业活动。

2024年7月:微软系统蓝屏事件
事件经过:7月19日,使用了Windows操作系统的设备大面积蓝屏,导致850万设备受到影响。
事故原因:微软安全供应商CrowdStrike推送了错误的软件配置。
造成损失:成为2024年主要信息系统故障之一,对大量用户工作及使用造成影响。

2024年7月:阿里云故障
事件经过:7月2日,阿里云发生故障,具体影响范围覆盖多款服务。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,影响依赖阿里云服务的客户业务。

2024年4月:腾讯云控制台故障
事件经过:4月8日15点23分,腾讯云云API服务异常,导致云函数、文字识别等依赖服务无法使用,持续87分钟,1957个客户报障。
事故原因:配置数据错误,经紧急数据修复恢复服务。
造成损失:影响客户业务正常开展,平台服务可靠性受质疑。

导致惨重代价的运维事故2023

2023年12月:谷歌云新加坡区域故障
事件经过:因网络配置错误,导致谷歌云新加坡区域服务中断超3小时,影响大量企业客户。
事故原因:内部网络配置失误。
造成损失:客户业务中断,谷歌云赔付客户,市场竞争力受影响。

2023年11月:阿里云全线产品故障
事件经过:11月12日下午,阿里产品全线崩溃,波及全球多个地域全部云用户,持续事件达3.5小时。
事故原因:具说是鉴权服务出了问题。
造成损失:凸显云计算集中化部署风险,影响全球多地客户业务。
小插曲:两周后,在2023年11月27日,阿里云再次遭遇了近两小时的中断,影响到中国和美国的客户。然后当天晚上,滴滴就来了个大的。

2023年11月:滴滴崩溃
事件经过:11月27日晚间,滴滴崩溃,致APP地图无法加载、无法叫车,持续约12小时,影响多地用户。
事故原因:底层系统软件故障。
造成损失:订单流失,品牌形象和用户信任度下降。

2023年10月:新加坡Equinix数据中心制冷故障
事件经过:新加坡Equinix数据中心承包商误关闭冷冻水阀门,导致制冷系统误操作,造成2.5万笔银行交易失败、8.1万次登录失败。
事故原因:承包商操作失误,误关冷冻水阀门。
造成损失:金融交易及用户登录受严重影响,暴露运维管理漏洞。

2023年10月:语雀重大服务故障
事件经过:10月23日14时左右,语雀发生重大服务中断,在线文档和官网无法访问,当晚22时完全恢复,持续近8小时。
事故原因:内部运维工具缺陷,新上线升级工具bug导致华东生产环境存储服务器误下线,造成大面积服务中断。
造成损失:定性为P0级重大事故,影响数千万用户工作与知识管理,引发对运维自动化工具安全性的反思。

2023年6月:中国电信广东网络故障
事件经过:6月8日中国电信广东区域遭遇大规模网络服务中断,用户普遍无信号、无法通话上网,故障约4小时后恢复。
事故原因:网络设备故障。
造成损失:影响广东省内商务活动和民众生活,具体损失数据未公布。

2023年5月:苹果iCloud全球服务中断
事件经过:5月11日,苹果全球服务遭遇“史诗级”宕机,持续约55分钟。大量用户的Apple ID突然登出,无法访问iCloud照片、文件和备忘录等关键数据。
事故原因:数据中心严重故障。虽然苹果未详细披露,但此类核心服务中断通常源于数据中心底层存储或认证服务的配置错误或硬件集群故障。
造成损失:数千万苹果用户数据访问受阻,打破了苹果生态“稳定可靠”的神话,引发了对苹果云服务能力的广泛质疑。

2023年5月:微软Azure故障
事件经过:5月24日,微软Azure DevOps在巴西的一处scale-unit发生故障,导致宕机约10.5个小时。
事故原因:导致该中断的原因为一个简单的拼写错误,最终导致17个生产级数据库被删除。
造成损失:大量用户无法使用云服务。

2023年4月:中信证券APP交易阻塞
事件经过:4月期间,中信证券APP出现严重的交易阻塞现象,客户无法正常下单或撤单。
事故原因:系统软件缺陷与容量规划不足。在市场交易活跃期,系统未能有效处理高并发请求,暴露出软件逻辑缺陷和灾备能力的不足。
造成损失:直接影响客户交易,导致客户资金错失交易时机,引发大量客户投诉,对券商的声誉造成了直接的负面影响。

2023年3月:推特全球大规模宕机
事件经过:平台代码更新错误,导致全球用户无法登录或使用推特功能,持续超5小时。
事故原因:内部代码更新失误。
造成损失:用户体验差,广告收入受损,平台声誉下滑。

2023年3月:广州某电信机房制冷故障
事件经过:广州某电信机房水冷系统破裂引发制冷故障,微信、QQ及政务云系统瘫痪,机房被迫采用冰块临时降温。
事故原因:水冷系统破裂,制冷功能失效。
造成损失:国民级应用及政务服务中断,影响范围广、社会影响大。

2023年3月:腾讯云机房事故
事件经过:23年3月29日凌晨,腾讯云广州五区部分云服务异常,导致微信、QQ、支付等核心功能受到影响,故障在当天中午基本恢复。
事故原因:官方反馈为“本次事故由广州电信机房冷却系统故障导致”。
造成损失:核心应用不可用。

2023年3月:B站双重崩溃
事件经过:2023年B站经历了两次较为严重的全站级宕机。一次是3月5日,用户无法访问视频详情页、收藏夹;另一次是8月4日,视频封面无法加载、视频缓冲失败。
事故原因:底层服务依赖故障与机房电力问题。虽然具体细节未完全公开,但此类大型视频平台的崩溃通常源于核心微服务依赖失效或机房电力/网络架构的单点故障。
造成损失:数亿用户无法正常观看视频,严重影响用户体验和社区活跃度,尤其在流量高峰期的崩溃对品牌形象损害较大。

2023年3月:唯品会P0级宕机事故
事件经过:3月29日凌晨00:14至中午12:01,唯品会南沙IDC冷冻系统故障,机房温度骤升导致大规模宕机,线上商城停服12小时。
事故原因:制冷设备故障。
造成损失:影响800万人次客户,直接业绩损失超亿元,定性为最高级别P0级故障。
小插曲:事故后,对基础平台部负责人予以免职。

2023年2月:甲骨文多日长故障
事件经过:2月13日至15日,甲骨文云基础设施(OCI)遭遇持续长达数天的服务中断,这是OCI历史上罕见的长时间故障。同时,其子公司NetSuite也因关联故障停摆。
事故原因:DNS后端基础设施性能问题。支持OCI公共域名系统的后端API基础设施出现性能瓶颈,导致无法处理传入的服务请求;此外,NetSuite的故障还叠加了合作伙伴数据中心(Cyxtera)的物理电力故障。
造成损失:客户业务连续数天无法使用云资源,甲骨文“永不宕机”的宣传口号受挫,大量依赖其数据库服务的企业陷入停滞。

2023年1月:美国民航系统瘫痪
事件经过:1月11日美国联邦航空管理局飞行任务通知系统因关键文件损坏瘫痪,备份系统也检测到相同损坏,重启系统导致全美航班禁飞。
事故原因:系统文件损坏。
造成损失:超4000架次航班延误,698架次取消,数十万旅客受阻,经济损失巨大,暴露单点故障风险。

导致惨重代价的运维事故2022

2022年12月:阿里云香港Region大规模宕机
事件经过:12月18日,阿里云香港Region可用区C发生大规模服务中断,持续数小时,为其运营十多年来最长大规模故障,新购ECS等管控操作全部失败,整个处置过程超过15小时。
事故原因:机房冷却系统失效,现场包间温度逐渐升高,导致一机房包间温度达到临界值触发消防系统喷淋,电源柜和多列机柜进水,部分机器硬件损坏。
造成损失:严重影响香港及澳门客户业务,品牌信誉受损,事后发布事故说明及改进措施。
小插曲:事故后,阿里云总裁、CTO都被更换。

2022年12月:达美航空(Delta)行李系统故障
事件经过:12月28日,达美航空的行李处理系统突发严重故障,导致全球多个主要机场的行李传送带停摆,大量行李无法被正确分拣和装载。
事故原因:硬件维护不当与软件集成失效。由于行李处理系统的物理传感器和分拣机械臂出现故障,且后台管理系统未能及时切换至备用模式,导致系统“死锁”。
造成损失:数千名旅客的行李丢失或延误,圣诞节假期返程高峰受阻,达美航空被迫手动处理行李,运营陷入混乱。

2022年12月:腾讯云北京地域部分服务器故障
事件经过:因网络设备故障,导致北京地域部分云服务器、数据库等服务访问异常,持续约3小时。
事故原因:网络设备故障引发的运维事故。
造成损失:部分企业业务中断,腾讯云紧急修复并赔付客户。

2022年8月:谷歌爱荷华州数据中心电气爆炸
事件经过:谷歌美国爱荷华州数据中心发生电气爆炸,造成3名电工严重烧伤,全球1338台服务器中断,谷歌地图、搜索服务宕机。
事故原因:电弧闪光引发爆炸。
造成损失:人员受伤,设施损毁,核心服务中断影响全球用户。

2022年7月:Twitter全球大规模宕机
事件经过:7月14日上午8:10左右开始,Twitter突发全球性大规模服务中断,持续约1小时。
事故原因:内部系统配置与软件故障,引发了连锁反应。
造成损失:全球数万用户受影响。
小插曲:正值Twitter起诉马斯克违约的敏感时期,加剧了外界对其内部管理混乱的猜测。

2022年7月:B站713事故
事件经过:2022年7月13日,B站崩了5个小时。
事故原因:根据B站的事故分析报告,是SLB故障导致。本次SLB故障,是OpenResty中,计算gcd的lua代码传入了0值,被lua判定为nan,陷入了死循环。这段lua代码已经稳定运行了一段事件,但一个新发布模式,却触发了这个bug。
造成损失:B站核心业务中断。

2022年7月:Oracle Cloud(甲骨文)核心故障
事件经过:7月19日,甲骨文云服务(Oracle Cloud Infrastructure, OCI)发生严重故障,导致其核心金融、ERP等SaaS服务在全球范围内无法访问。
事故原因:关键配置错误。运维人员在对核心网络基础设施进行配置更新时,引入了错误的路由策略,导致控制平面(Control Plane)瘫痪,客户无法管理或访问其云端资源。
造成损失:依赖甲骨文系统的大型企业财务和运营流程中断,凸显了传统企业级云服务在运维操作上的风险。

2022年3月~5月:招商证券交易系统连环崩溃
事件经过:3月14日开盘后系统突发故障,用户无法成交、撤单;5月16日系统再次崩溃,电脑端、手机端均无法登录。
事故原因:交易系统技术缺陷。
造成损失:严重扰乱交易秩序,引发投资者不满和监管关注,母公司对相关负责人问责,质疑券商IT系统稳定性。

2022年3月:富途证券(Futu)全球大宕机
事件经过:3月14日,互联网券商富途证券(牛牛APP)发生全球范围内的服务中断。用户无论是通过网页端还是手机APP,都无法登录交易系统,也无法查看持仓和进行交易,故障持续了数小时。
事故原因:底层架构扩容引发的连锁故障。在进行系统扩容升级时,运维团队对流量预估不足,且核心网关组件未能正确处理扩容带来的配置变更,导致负载均衡失效,流量无法分发至后端服务器。
造成损失:正值美股交易时段,大量投资者无法操作,引发用户强烈不满和投诉,对券商口碑造成负面影响。

Mininet+ONOS网络模拟环境搭建

1、下载mininet虚拟机:

http://mininet.org/download/#option-1-mininet-vm-installation-easy-recommended

2、导入并运行虚拟机

用户名/密码:mininet/mininet

3、安装docker

sudo apt-get update
sudo apt install curl ssh
curl -fsSL https://get.docker.com | bash -s docker --mirror Aliyun

4、拉取onos镜像

sudo docker pull onosproject/onos

5、运行ones容器

#运行
sudo docker run -t -d -p 8181:8181 --name onos1 onosproject/onos

#查看容器运行情况
sudo docker ps

6、连接容器,启用服务

#查看ip地址
sudo docker inspect --format '{{ .NetworkSettings.IPAddress }}' onos1

#ssh连接到容器
ssh -p 8101 karaf@172.17.0.2

#启用OpenFlow Provider Suite
app activate org.onosproject.openflow

#启用 Reactive Forwarding
app activate org.onosproject.fwd

#退出
ctrl+d

7、创建网络

#创建临时网络
sudo mn --topo tree,2 --controller remote,ip=172.17.0.2 --switch=ovsk,protocols=OpenFlow13
*** Creating network
*** Adding controller
Connecting to remote controller at 172.17.0.2:6653
*** Adding hosts:
h1 h2 h3 h4
*** Adding switches:
s1 s2 s3
*** Adding links:
(s1, s2) (s1, s3) (s2, h1) (s2, h2) (s3, h3) (s3, h4)
*** Configuring hosts
h1 h2 h3 h4
*** Starting controller
c0
*** Starting 3 switches
s1 s2 s3 ...
*** Starting CLI:

mininet> nodes
available nodes are:
c0 h1 h2 h3 h4 s1 s2 s3

mininet> links
s1-eth1<->s2-eth3 (OK OK)
s1-eth2<->s3-eth3 (OK OK)
s2-eth1<->h1-eth0 (OK OK)
s2-eth2<->h2-eth0 (OK OK)
s3-eth1<->h3-eth0 (OK OK)
s3-eth2<->h4-eth0 (OK OK)

mininet> net
h1 h1-eth0:s2-eth1
h2 h2-eth0:s2-eth2
h3 h3-eth0:s3-eth1
h4 h4-eth0:s3-eth2
s1 lo: s1-eth1:s2-eth3 s1-eth2:s3-eth3
s2 lo: s2-eth1:h1-eth0 s2-eth2:h2-eth0 s2-eth3:s1-eth1
s3 lo: s3-eth1:h3-eth0 s3-eth2:h4-eth0 s3-eth3:s1-eth2
c0

mininet> h1 ping h2
PING 10.0.0.2 (10.0.0.2) 56(84) bytes of data.
64 bytes from 10.0.0.2: icmp_seq=1 ttl=64 time=43.2 ms

mininet> pingall
*** Ping: testing ping reachability
h1 -> h2 h3 h4
h2 -> h1 h3 h4
h3 -> h1 h2 h4
h4 -> h1 h2 h3
*** Results: 0% dropped (12/12 received)

#退出
ctrl+d

8、网络访问

http://172.17.0.2:8181/onos/ui/login.html
账号/密码:karaf/karaf

然后就可以看到拓扑图了

如何解决内存碎片问题


如何解决内存碎片问题?
————NEOHOPE的内存碎片优化手册

其实无论采用哪种分配方式,内存的碎片化都是难以彻底避免的。无论是操作系统、虚拟机还是应用,都要面对这个问题。
业界有多种思路来解决或缓解此问题:

一、操作系统层面
1、把不可移动内存集中管理,内存分区其实在一定程度上解决了这些问题
从操作系统的角度来说,有些内存页面是可以移动的,有些是无法移动的。如果无法移动的页面过于分散,整个系统内存的连续性就很差,碎片化就更严重,而且更加不容易管理。所以在操作系统设计的时候,一般会根据功能用途对内存进行分区,一定程度上避免此类问题。

2、linux采用了buddy system来缓解内存碎片问题
buddy system是一个很巧妙的设计,将内存连续页面按2的n次方进行分组。
申请时会匹配第一个大于等于所需页面的2的n次方连续页面,并将多余页面拆分后挂载到对应的2的x方组。
释放内存页面时,仍按2的n次方进行归还,并尝试将内存进行合并。

3、linux中为了处理特别小的内存请求,引入了slab技术,来辅助buddy system
类似于对象池的概念,系统先申请一部分页面用于对象池。
申请时划分一部分出来给应用使用,如果内存不足会进行主动扩容。
归还时对象还给对象池,如果空闲对象比较多时,会主动释放部分内存。

4、windows有一种LFH(Low Fragmentation Heap)技术,缓解内存碎片问题
在应用程序启动时,操作系统会额外分配一定的连续内存LFH给这个进程备用
如果应用需要使用内存,会优先从LFH中申请,从而降低系统层面的内存管理负担

5、windows在进程退出后,不会立即释放dll文件内存
一方面提速,如果关闭一个应用,再开启,就会感觉很快
另一方面也缓解了操作系统内存管理负担。
其实,看下你手机的APP,切换到后台时,就是这个效果

6、内存整理服务
无论是linux还是windows都有低优先级线程,在后台默默做着内存规整工作,类似于磁盘碎片清理
比如linux内核中的kcompactd线程。

7、类似与LFH,可以考虑在内存分配时额外预留一部分,下次分配在预留的地方继续分配
windows在xp时代,需要应用自行开启LFH功能,但vista之后,操作系统会同一进行管理

8、为了内存规整方便,可以考虑靠近应用已分配内存区域进行分配
其实可操作性不高,还不如上一条可行性好一些

9、还有一种思路,就是将不连续的内存,转换为逻辑上连续的内存,来绕过碎片化问题
但一些情况下性能难以保证

二、虚拟机层面
1、JVM整体内存会被划分为多个部分,类似于做了分区:
一部分是虚拟机共有的【方法区、堆】,一部分是线程私有的【虚拟机栈、本地栈、程序计数器】

2、同时,JVM虚拟机也会根据对象的生命周期,类似进一步做了分区,而且不同分区采用不同GC策略
最常用的就是年代划分法,新生代、老年代、永久代【后来的Metaspace】

3、JVM虚拟机,GC时会通过标记-整理(比如CMS)或复制-清除(比如G1)的方法来解决部分碎片问题

三、应用层面
1、redis在处理内存的时候,申请时会额外申请一部分先备着【记得是jemalloc】

2、redis释放时也不会立即释放,有单独的线程进行处理,在应用层面去降低系统内存管理负担

3、redis在数据结构上也做了很多努力

4、在写程序时,如果需要频繁创建和释放对象,可以尝试使用对象池

5、在写程序的时候,尽量不要零零散散的去申请大量小内存;

6、除了标准库以外,可以试一下 jemalloc或Doug Lea’s malloc

7、感兴趣可以看下redis内存管理的代码

如何写出让CPU跑得更快的代码


如何写出让 CPU 跑得更快的代码?
————NEOHOPE的代码优化手册

一、需求阶段

1、过早优化是魔鬼。业务能运行,比业务响应速度更重要。能用的慢代码,比不能用的快代码好的多

2、搞清楚业务类型,是重IO,还是重CPU,还是重GPU,明确具体需求

3、这个需求,确定是要通过代码优化解决吗?
是不是一个业务问题无法解决,想通过系统去限制业务呢?

4、这个需求,是否可以通过花钱或其他方式解决,比如增加硬件

5、搞清楚为何要优化代码,不优化问题是什么?优化代码的风险是什么?时间周期大概是剁手?代价和受益如何?

6、对比4、5的各种方案,确定用哪个

二、分析阶段

1、一旦明确了要进行优化,不要一头扎入细节。考虑整个系统的架构是否合理,看下全局,看下上下游的影响。

2、遵从Ahmdal定律,确定优化范围;

3、咱们要优化的东西,业界是否已有解决方案,不要重复造轮子

4、如果涉及面比较广,别急着动手,做好分析,制定方案,再动手

三、架构阶段

1、调整不合理的架构

2、调整不合理的数据流

3、进行必要的组件替换

四、算法提升阶段

1、遵从80-20法则,程序80%的时间在运行20%或更少的代码,针对热代码进行优化,才容易产出效果;

2、评估当前算法,是否有高效的算法
比如:用DP或贪婪算法替代暴力算法,将算法的时间复杂度尽量降低

3、使用合理的数据结构
比如哈希表、红黑树

4、使用数学公式,替代低效计算

5、缓存重复出现的中间结果,空间换时间

五、编码提升阶段

1、遵从数据访问的局部性法则,按数据存放顺序访问内存效率远高于乱序访问内存效率,也就是尽量帮助CPU做好数据Cache的预测工作。同样根据Cache大小,做好数据结构的优化工作,进行数据压缩或数据填充,也是提升Cache效率的好方式;

2、遵从指令访问的局部性法则,减少跳转指令,同样是尽量帮助CPU做好数据Cache的预测工作;现代CPU都有一些预测功能【如分支预测】,利用好CPU的这些功能,也会提升Cache命中率;

3、减少内存的重复申请和释放

4、 减少函数调用层数
使用INLINE等关键字,同样是减少调用层数
使用宏展开,也有类似效果

5、减少数据传递个数,合理封装

6、数据传递,以引用为主,减少传值

7、减少数据类型转换

10、调整运算顺序,减少CPU低效运算。
比如除法运算。

11、调整运算顺序,尽早结束循环,避免无效操作

12、 少用高级语言的多重继承等特性

13、使用汇编和C语言,而不是更高级的语言,很多时候可以提速运算效率;

14、直接使用昂贵的寄存器作为变量,可以变相提供加速效果;

15、采用性能高的函数,批量处理数据,如memset等

16、能在编译阶段完成的任务,不要留到运行阶段完成。
比如,CPP的泛型是编译阶段完成的,比运行时再做处理的语言效率更高
比如,不要用反射,不要动态类型绑定
比如,初始化工作尽早完成

六、编译阶段

1、开启编译器优化,速度最大化

2、使用Intel自家的编译器,开启性能优化,很多时候可以提速运算效率;

3、考虑指令级并行性(IPL)

七、运行阶段

1、避免计算线程在多个核心之间漂移,避免缓存重复加载,可以绑定核心【物理核即可,不用到逻辑核】,提高效率;

2、去除伪共享缓存:在多核环境下,减少多个核心对同一区域内存的读写并发操作,减少内存失效的情况的发生;

3、合理提高进程优先级,减少进程间切换,可以变相提供Cache提速的效果;

4、关闭Swap,可以变相提供内存提速、Cache提速的效果;

八、测试阶段

1、合适的手段及工具进行性能评估

2、要符合实际情况,不要片面追求指标

先总结这些吧。