【转载】关于原始Transformer论文中的层归一化变体,以及大语言模型其他有趣的历史花絮

原文地址:
About LayerNorm Variants in the Original Transformer Paper, and Some Other Interesting Historical Tidbits About LLMs,by Sebastian Raschka, on 2025-05-24

关于原始Transformer论文中的层归一化变体,以及大语言模型其他有趣的历史花絮

几个月前,我分享了《理解大语言模型:快速入门的核心文献梳理》一文,收到的积极反馈非常鼓舞人心!因此,我也陆续补充了几篇论文,让这份清单保持时效性与参考价值。
https://magazine.sebastianraschka.com/p/understanding-large-language-models

与此同时,保持这份清单的精简性也很有必要,这样读者才能在合理的时间内快速入门。不过,回过头来看,还有几篇关键论文信息量很大,理应被收录进来。

这次,我想分享四篇从历史视角理解Transformer的实用论文。我已经把它们直接补充到《理解大语言模型》一文中了,不过也单独在这篇文章里分享,方便之前读过那篇文章的读者查找。


(1) 《论Transformer架构中的层归一化》(2020)

作者:Xiong, Yang, He, K Zheng, S Zheng, Xing, Zhang, Lan, Wang, Liu
https://arxiv.org/abs/2002.04745

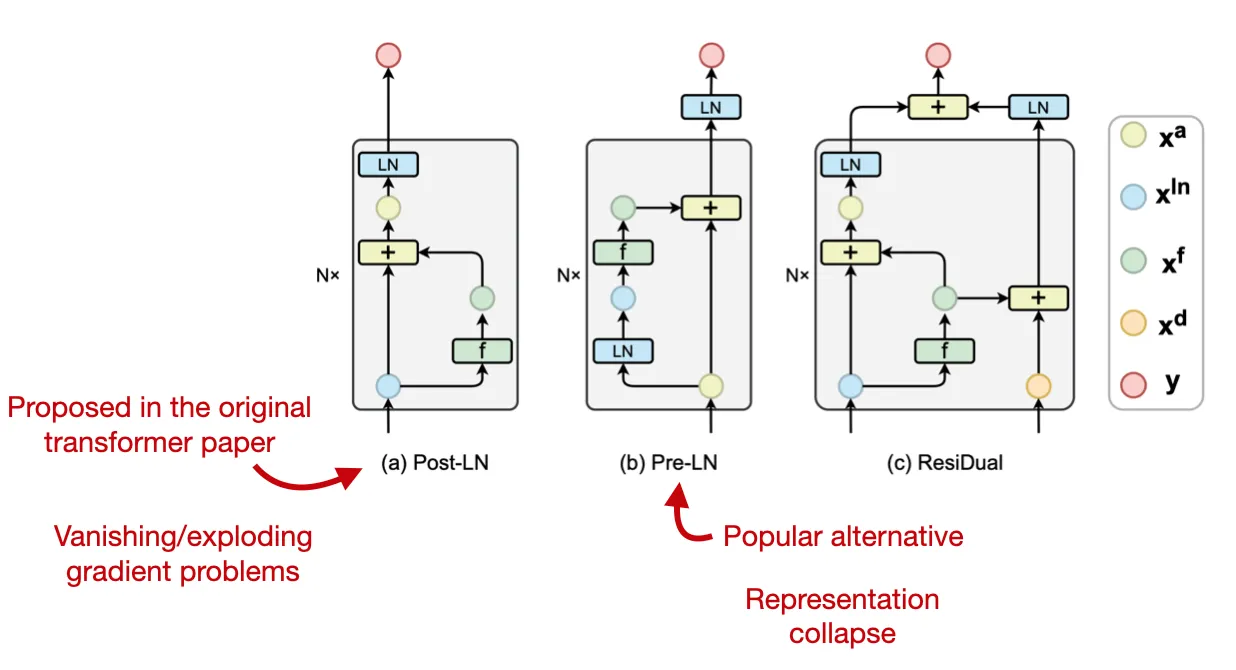
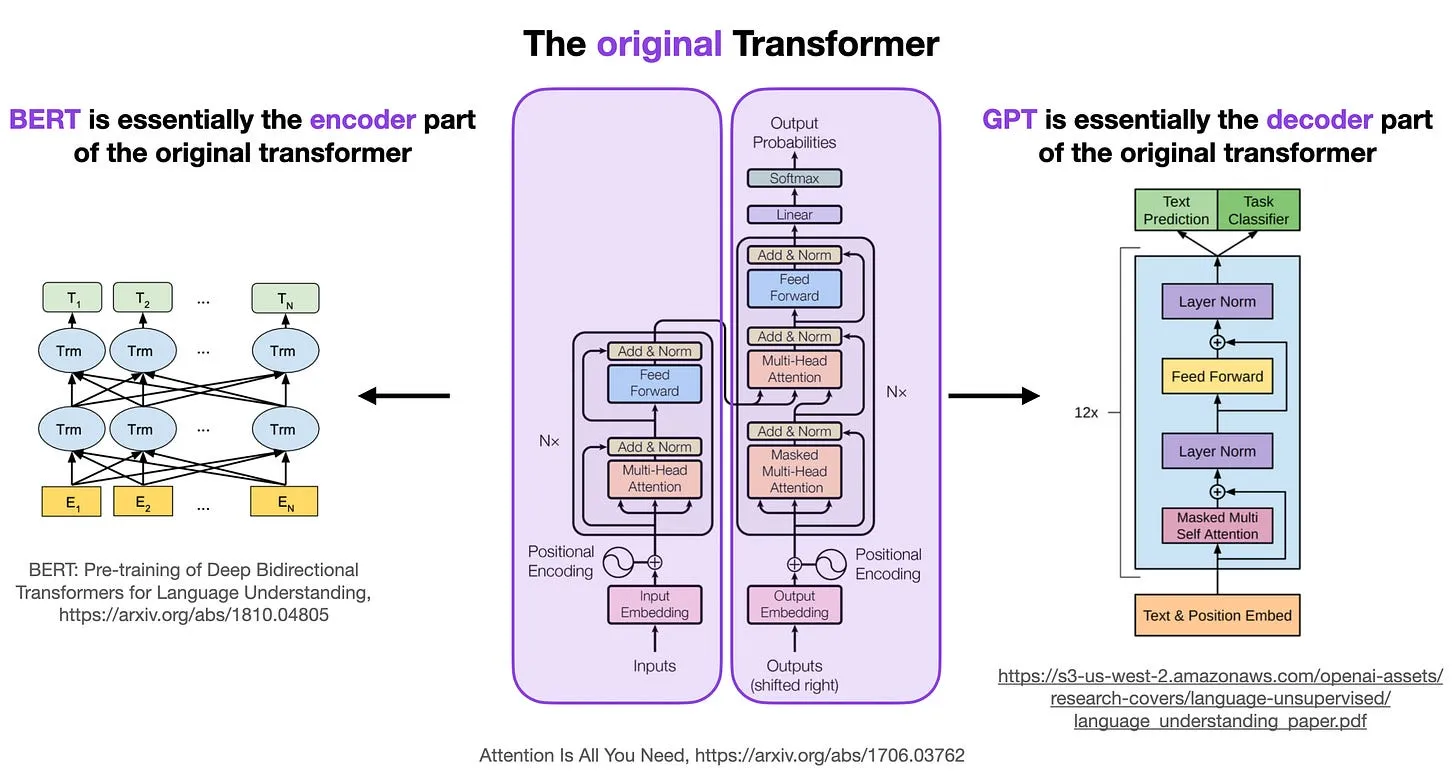
尽管《Attention Is All You Need》(https://arxiv.org/abs/1706.03762)中的原始Transformer示意图是对原始编码器-解码器架构的很好总结,但图中层归一化(LayerNorm)的位置一直是备受争议的话题。

比如,《Attention Is All You Need》里的Transformer示意图将层归一化放在残差块之间,这与该论文配套的官方代码实现(https://github.com/tensorflow/tensor2tensor/commit/f5c9b17e617ea9179b7d84d36b1e8162cb369f25)并不一致。《Attention Is All You Need》示意图里的这种变体被称为后层归一化Transformer(Post-LN Transformer),而更新后的代码实现默认采用的是**前层归一化Transformer(Pre-LN)**变体。

这篇https://arxiv.org/abs/2002.04745 论文指出,前层归一化效果更好,能解决梯度问题,如下图所示。很多架构在实践中都采用了这种方式,但它也可能导致表示坍缩(representation collapse)问题。

因此,尽管关于使用后层归一化还是前层归一化的讨论仍在继续,也有一篇新论文提出要兼顾两者的优势:《ResiDual:带双残差连接的Transformer》(https://arxiv.org/abs/2304.14802);该方案在实践中是否真正有效,还有待观察。

figure01

资料来源:https://arxiv.org/abs/1706.03762(左图与中图)、https://arxiv.org/abs/2002.04745(右图)


(2) 《学习控制快速权重记忆:动态递归神经网络的一种替代方案》(1991)

作者:Schmidhuber
https://www.semanticscholar.org/paper/Learning-to-Control-Fast-Weight-Memories%3A-An-to-Schmidhuber/bc22e87a26d020215afe91c751e5bdaddd8e4922

对于喜欢历史趣闻、以及想了解与现代Transformer本质同源的早期研究的读者,推荐这篇论文。

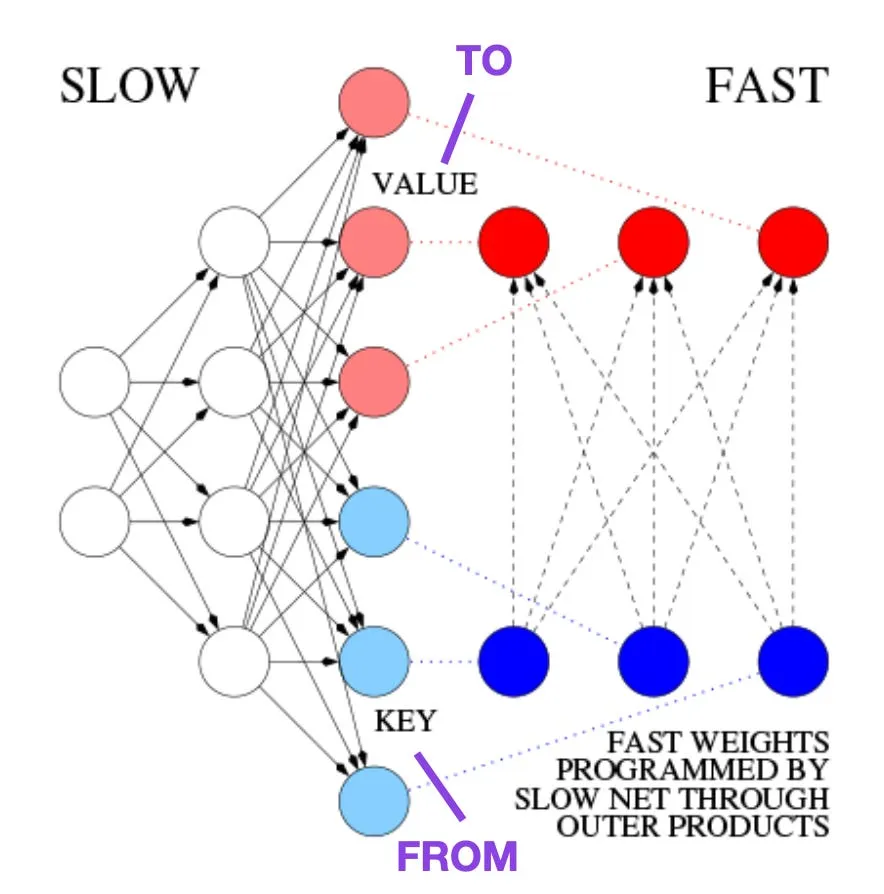
比如,1991年——比上述《Attention Is All You Need》这篇原始Transformer论文早了大约25年——于尔根·施密德胡贝尔(Juergen Schmidhuber)就提出了一种递归神经网络的替代方案,名为快速权重编程器(Fast Weight Programmers, FWP)。快速权重编程器的思路是:用一个前馈神经网络通过梯度下降缓慢学习,去编程另一个神经网络的快速权重变化。

它与现代Transformer的对应关系,在这篇文章(https://people.idsia.ch//~juergen/fast-weight-programmer-1991-transformer.html#sec2)中是这样解释的:

在如今的Transformer术语里,“FROM”和“TO”分别被称为键(key)和值(value);快速权重网络所处理的输入,则被称为查询(query)。本质上,查询由快速权重矩阵处理,而快速权重矩阵是键与值外积的和(忽略归一化和投影操作)。由于两个网络的所有运算都是可微的,我们可以通过加法外积或二阶张量积,实现对快速权重变化的端到端可微主动控制[FWP0-3a]。因此,慢速网络可以通过梯度下降学习,在序列处理过程中快速修改快速网络。这在数学上(除了归一化部分)等价于后来所谓的带线性自注意力的Transformer(linearized self-attention Transformers),也叫线性Transformer(linear Transformers)。

正如上面博客节选提到的,随着2020年arXiv上的两篇论文(https://arxiv.org/abs/2006.16236 和 https://arxiv.org/abs/2009.14794)发表,这种方法现在被称为“线性Transformer”或“带线性自注意力的Transformer”。

2021年,这篇https://arxiv.org/abs/2102.11174 论文进一步明确证明了线性自注意力与90年代的快速权重编程器是等价的。

figure02

资料来源:基于https://people.idsia.ch//~juergen/fast-weight-programmer-1991-transformer.html#sec2 改绘的示意图


(3) 《面向文本分类的通用语言模型微调》(2018)

作者:Howard 和 Ruder
https://arxiv.org/abs/1801.06146

从历史视角来看,这是另一篇非常值得关注的论文。尽管它发表在原始Transformer论文《Attention Is All You Need》发布一年之后,但它并没有围绕Transformer展开,而是聚焦于递归神经网络。不过它依然意义重大,因为它系统性地提出了语言模型预训练+下游任务迁移学习的范式。

尽管迁移学习在计算机视觉领域已经成熟,但在自然语言处理(NLP)领域还没有普及。ULMFit是最早证明“先在大规模语料上预训练语言模型,再在特定任务上微调”可以在众多NLP任务上取得当时最优效果的论文之一。

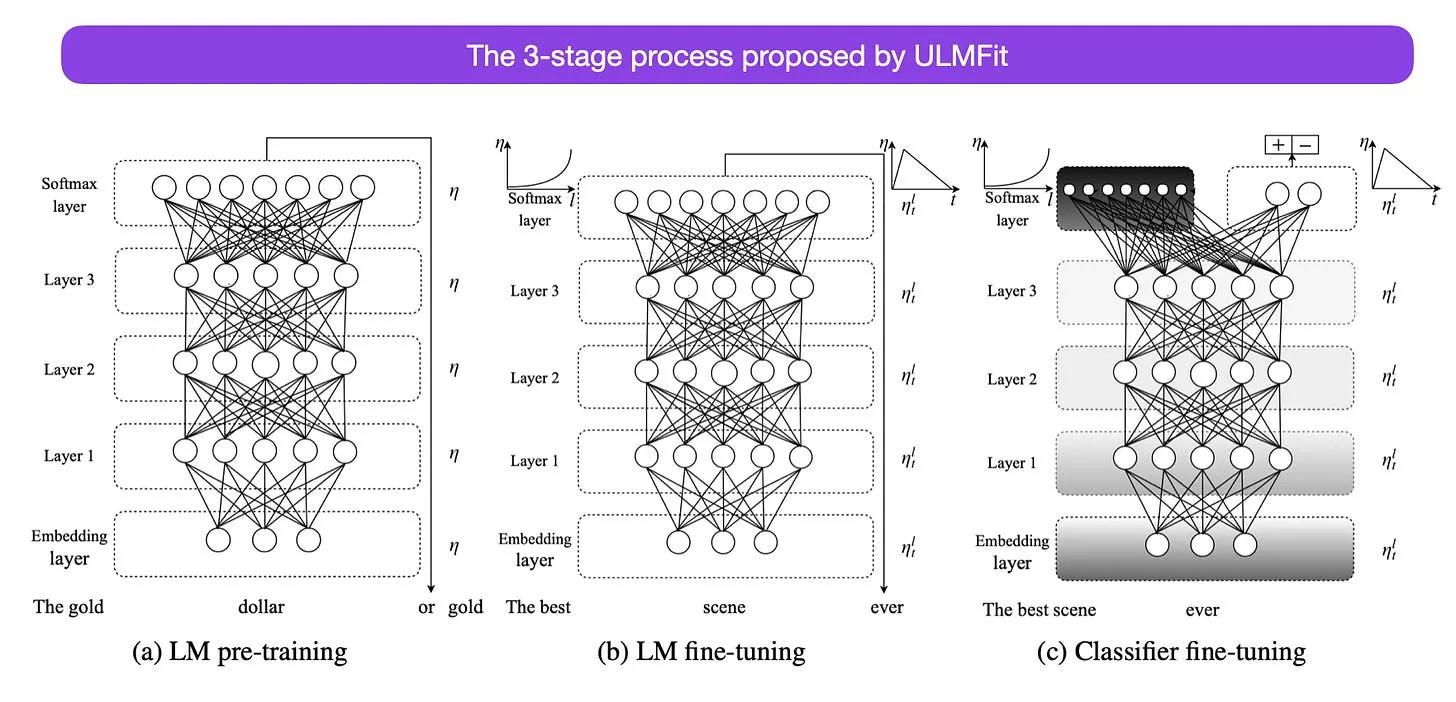
ULMFit提出的语言模型三阶段微调流程如下:

  1. 在大规模文本语料上训练语言模型。
  2. 在任务特定数据上微调这个预训练语言模型,使其适配文本的特定风格与词汇。
  3. 在任务特定数据上微调分类器,同时逐步解冻各层,避免灾难性遗忘。

这套流程——先在大规模语料上训练语言模型,再在下游任务上微调——正是基于Transformer的模型(以及BERT、GPT-2/3/4、RoBERTa等基础模型)所采用的核心方法。

不过,ULMFit的核心环节——逐步解冻层——在Transformer架构的实践中通常不会常规使用,Transformer一般会同时微调所有层。

figure03

资料来源:https://arxiv.org/abs/1801.06146


(4) 《语言模型缩放:训练Gopher的方法、分析与洞见》(2022)

作者:Rae及其同事(共78位共同作者!)
https://arxiv.org/abs/2112.11446

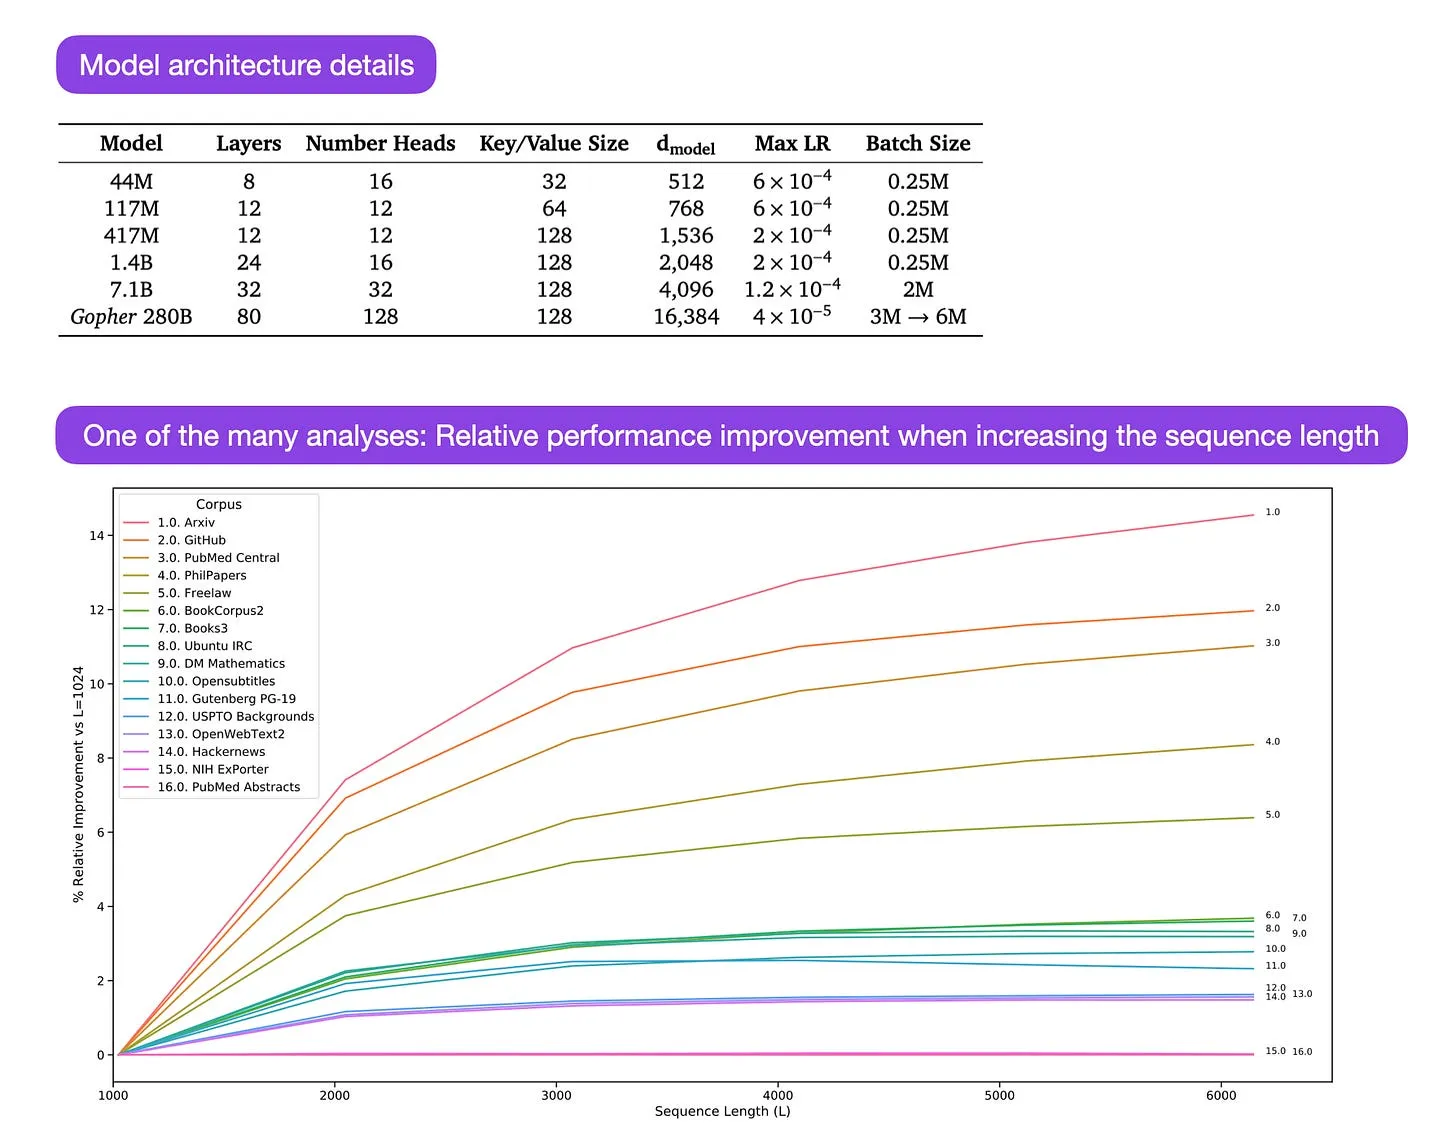
Gopher这篇论文内容非常详实,包含大量帮助理解LLM训练的分析。研究人员训练了一个拥有2800亿参数、80层的模型,训练数据量达3000亿token。论文中还包含一些有意思的架构改进,比如用**均方根归一化(RMSNorm, Root Mean Square Normalization)**替代层归一化(LayerNorm)。层归一化和均方根归一化都优于批归一化(BatchNorm),因为它们不依赖批次大小,也不需要同步,这在小批次的分布式训练场景中是一大优势。而均方根归一化通常被认为能让更深层架构的训练更稳定。

除了上述这些有趣的细节,这篇论文的核心重点是不同规模下的任务性能分析。通过对152项多样化任务的评估发现:模型规模增大,对阅读理解、事实核查、有害文本识别这类任务的收益最大;而逻辑推理、数学推理相关的任务,从架构缩放中获得的收益相对较少。

figure04

资料来源:图片来自https://arxiv.org/abs/2112.11446


这本杂志是我个人的兴趣项目,没有直接的稿酬。如果您愿意支持我,可以考虑购买一本我的书(https://sebastianraschka.com/books)。如果您觉得这些内容有启发、有帮助,也欢迎推荐给您的朋友和同事。

figure05

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics ,以及 http://mng.bz/M96o

您的支持对我意义重大!非常感谢!

【转载】使用适配器高效微调大语言模型

原文地址:
Finetuning LLMs Efficiently with Adapters,by Sebastian Raschka, on 2023-05-20

使用适配器高效微调大语言模型

为什么要微调大语言模型?

BERT、GPT-3、GPT-4、LLaMA等大语言模型(LLM)在大规模语料库上训练而成,具备通用知识。但如果不经微调,它们在特定任务上的表现可能欠佳。例如,若想将预训练大语言模型用于法律或医疗文档分析,在法律文档语料库上对其进行微调可以显著提升模型性能。(感兴趣的读者可以在我之前的文章中了解不同大语言模型微调方法的概述:https://magazine.sebastianraschka.com/p/finetuning-large-language-models)

然而,微调大语言模型会消耗大量计算资源与时间,这也是研究者们开始研发参数高效微调方法的原因。

参数高效微调方法

正如之前的文章所讨论的,目前已有多种不同类型的参数高效方法。https://magazine.sebastianraschka.com/p/understanding-parameter-efficient(尽管这些技术之间存在一定关联,但在阅读这篇关于适配器的文章之前,你无需了解或提前阅读前缀微调的相关内容。)

简而言之,提示微调(与普通的提示工程不同)会向预训练大语言模型的嵌入输入后追加一个张量。随后对该张量进行调优,以针对微调任务和数据优化损失函数,同时大语言模型中所有其他参数保持冻结。例如,假设有一个在通用数据集上预训练、用于生成文本的大语言模型。提示微调会基于这个预训练模型,向嵌入输入中添加提示令牌,然后对模型进行微调,使其在微调数据集上完成诸如情感分类之类的任务。

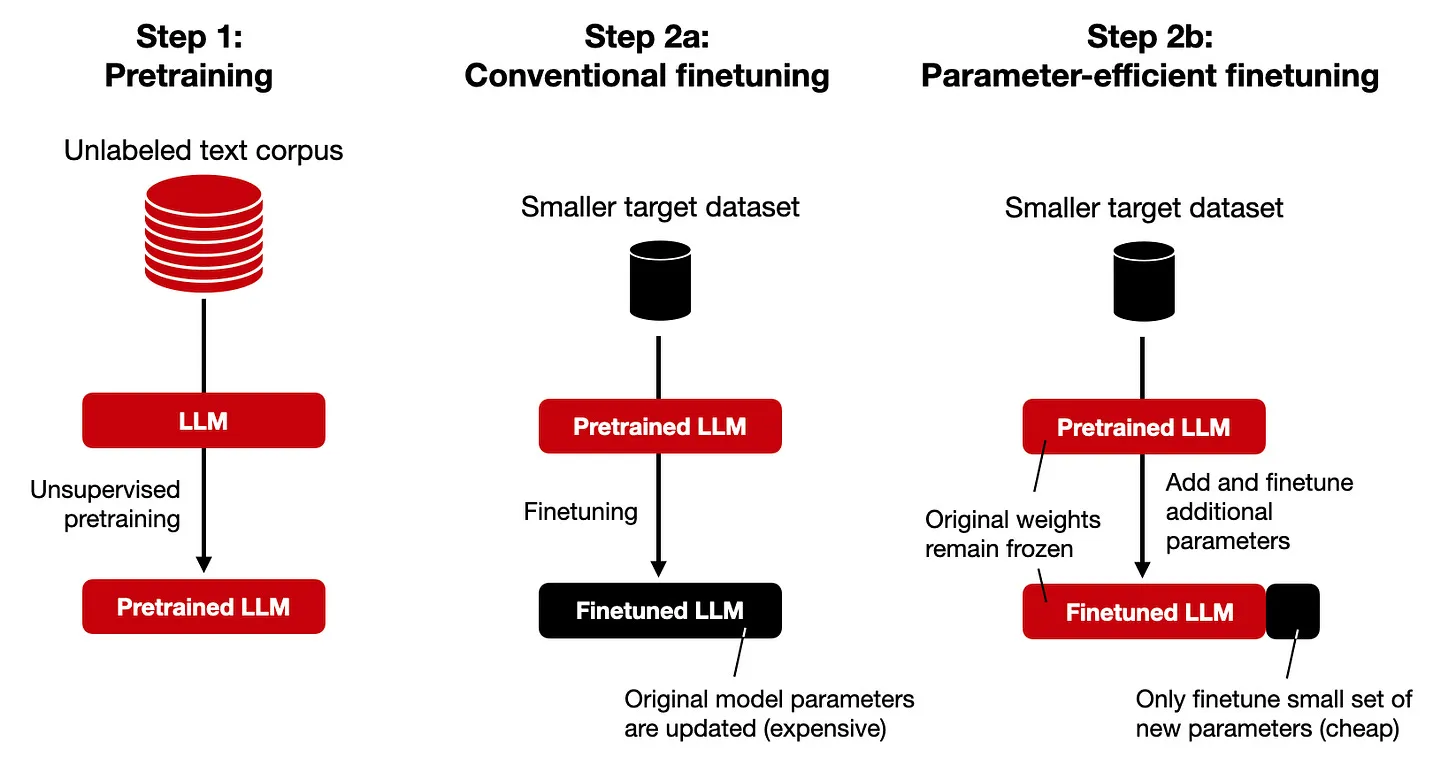
提示微调以及广义上的参数高效微调方法,核心思路都是向预训练大语言模型中添加少量新参数,且仅微调这些新增参数,从而提升模型在两方面的表现:(1)目标数据集(例如医疗、法律文档等领域特定数据集);(2)目标任务(例如情感分类)。

figure01

参数高效微调技术(如提示微调、前缀微调、适配器微调)的核心思路是向预训练大语言模型中添加一小组参数。仅微调这些新增参数,预训练大语言模型的所有原有参数保持冻结。

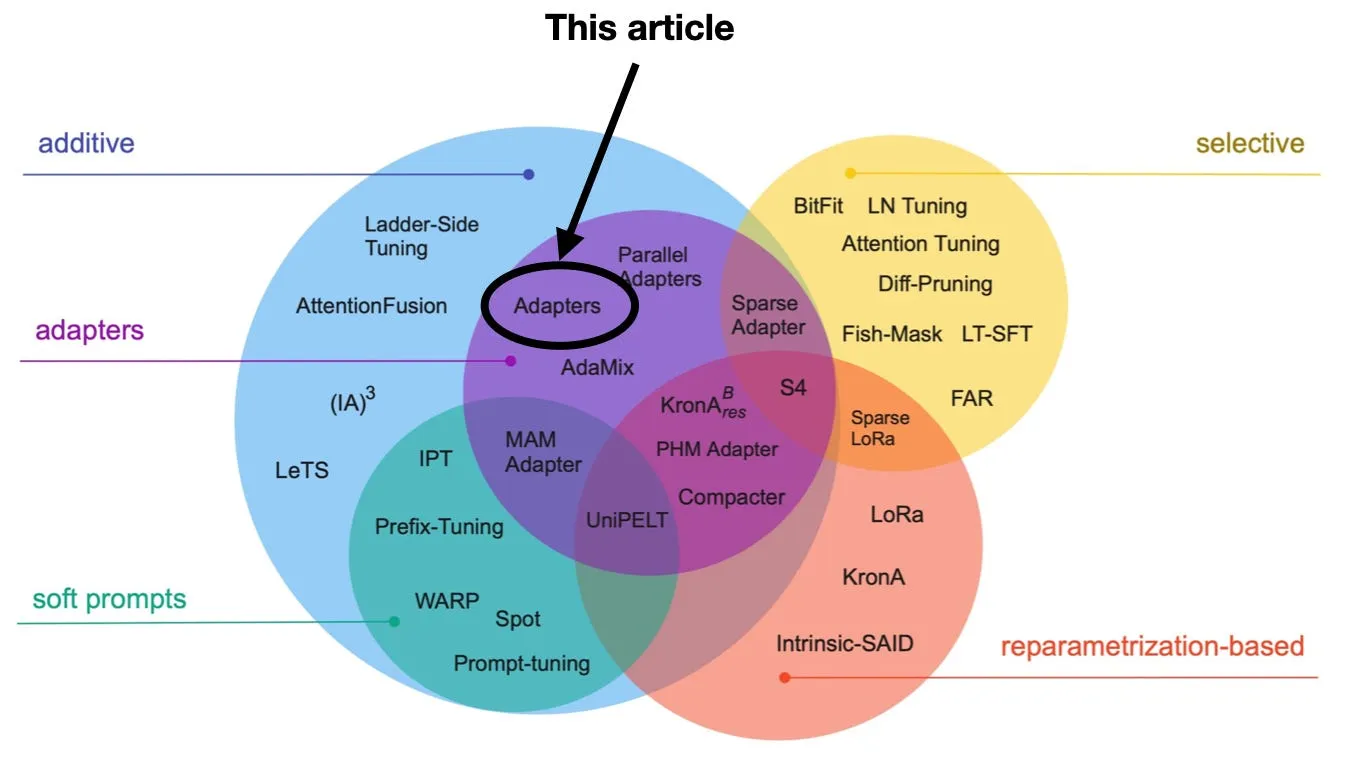
在本文中,我们将讨论一种与之相关的方法——适配器(adapters)。该方法的核心思想是向大语言模型的各个Transformer块中添加可训练层,而非仅修改输入提示。

figure02

Annotated figure from Scaling Down to Scale Up: A Guide to Parameter-Efficient Fine-Tuning, https://arxiv.org/abs/2303.15647.

适配器

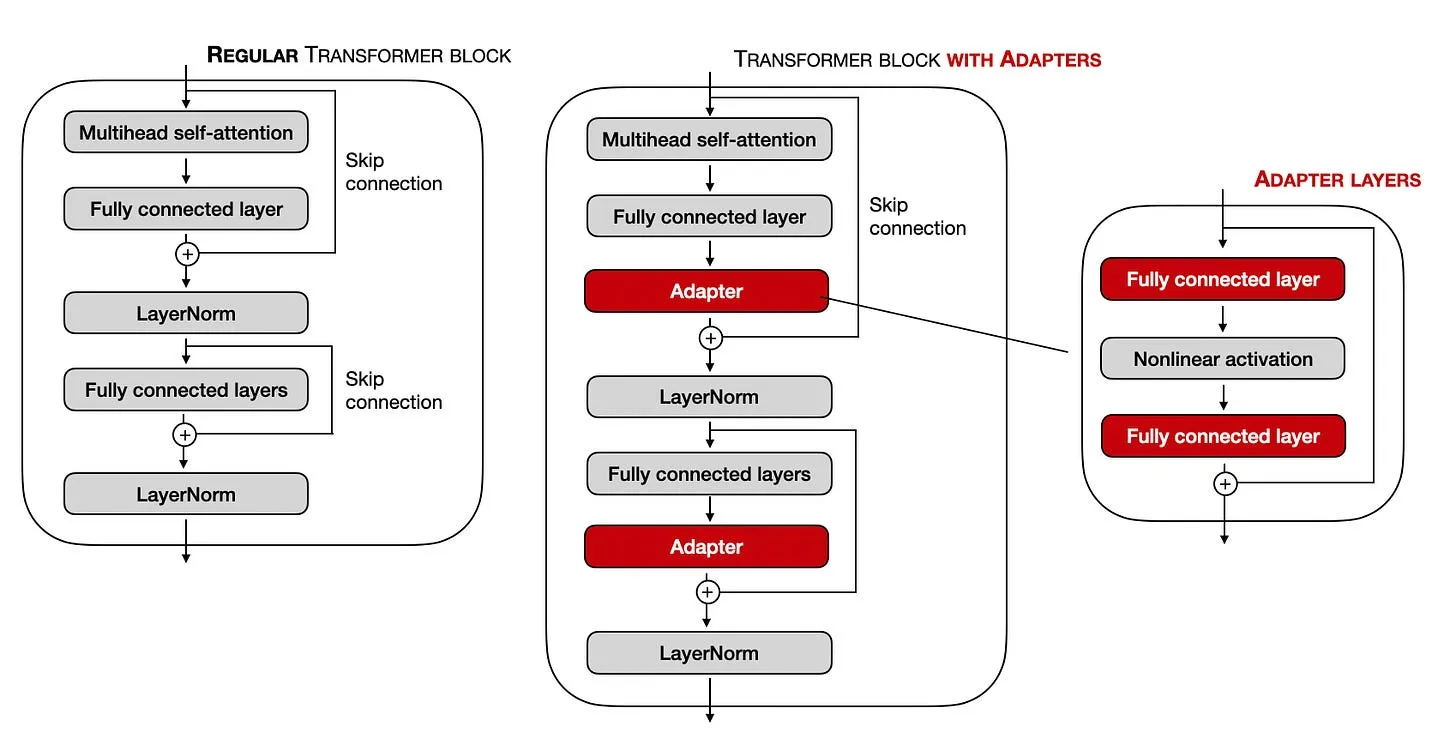
最初的适配器方法(https://arxiv.org/abs/1902.00751,2019年)与前文提到的https://magazine.sebastianraschka.com/p/understanding-parameter-efficient有一定关联,二者都会向每个Transformer块中添加额外参数。但前缀微调是向嵌入层前置可训练张量,而适配器方法则在两个位置添加适配器层,如下图所示。

figure03

Comparison of the regular transformer blocks used in various LLMs and a transformer block modified via the adapter layers.

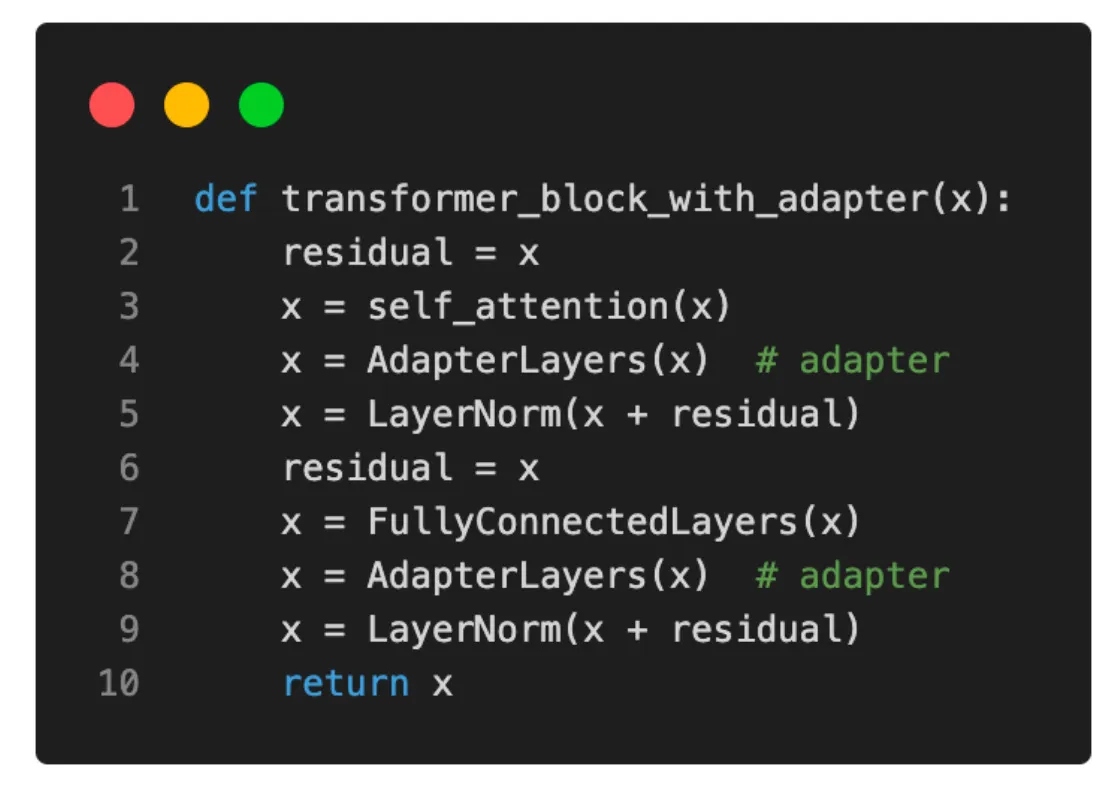
对于偏好(Python)伪代码的读者,适配器层的修改可以写成如下形式:

figure04

Illustration of a transformer block modified with adapter layers.

需要注意的是,适配器的全连接层通常规模较小,具备类似自编码器的瓶颈结构。每个适配器块的第一个全连接层将输入投影到低维表示,第二个全连接层再将其投影回输入维度。它是如何实现参数高效的?举个例子,假设第一个全连接层将1024维的输入降维到24维,第二个全连接层再将其映射回1024维。这意味着我们仅引入了1024×24 + 24×1024 = 49152个权重参数。相比之下,单个将1024维输入重新映射到1024维空间的全连接层,就会有1024×1024 = 1048576个参数。

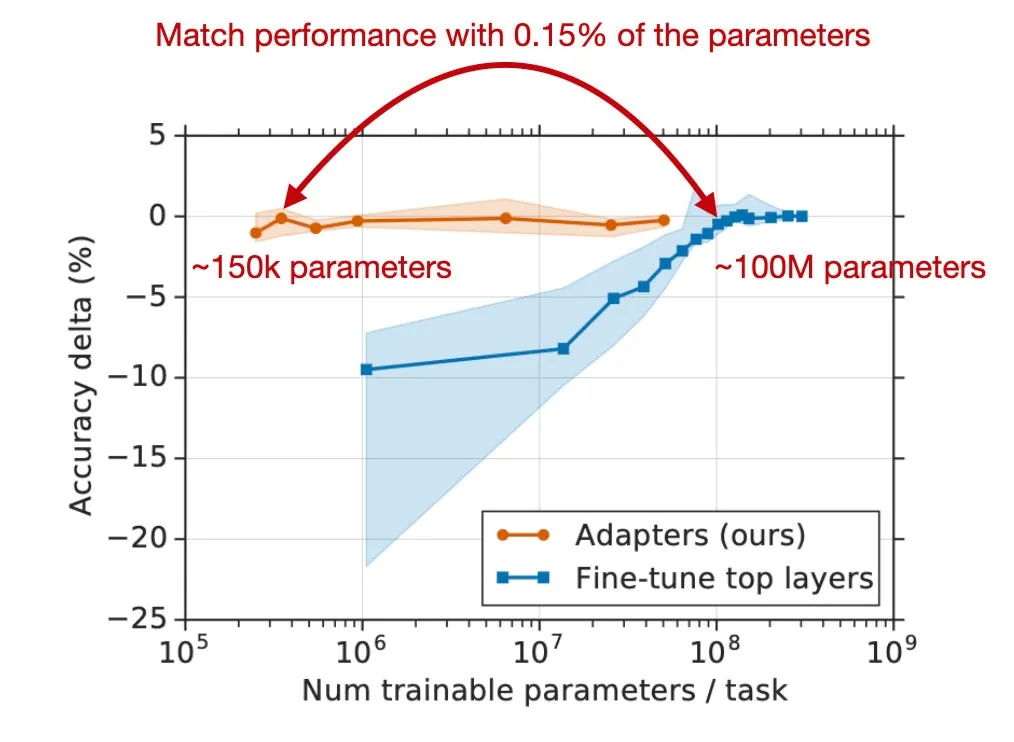
根据最初的论文https://arxiv.org/abs/1902.00751,采用适配器方法训练的BERT模型,仅需训练3.6%的参数,就能达到与全量微调BERT模型相当的性能。此外,研究者还在文中配图对比了适配器方法与仅微调BERT模型输出(顶部)层的效果,结果表明,使用适配器可以用少得多的参数达到与微调顶层相当的性能:

figure05

Annotated figure from the adapter paper, https://arxiv.org/abs/1902.00751.

结论

对预训练大语言模型进行微调,是让模型适配特定业务需求、匹配目标领域数据的有效方法。该过程通过使用与目标领域相关的小规模数据集调整模型参数,使模型学习到领域专属的知识与词汇。

但由于大语言模型“体量庞大”,更新Transformer模型中的多层会产生极高的成本,因此研究者们开始研发参数高效的替代方案。

在本文中,我们讨论了几种替代传统大语言模型微调机制的参数高效方法。我们重点探讨了与训练原有模型参数相比,如何通过插入并微调额外的适配器层来提升大语言模型的预测性能。

补充实验

补充代码示例与适配器实验

以下是我实现适配器方法后开展的补充实验,针对情感分类任务对比了DistilBERT模型的不同微调方式:

  • 仅微调最后两层,作为性能基线
  • 插入并微调适配器层
  • 微调原始模型的所有层
  • 插入适配器层并微调所有层,作为对照实验

figure06

所有代码示例可在此处获取:https://github.com/rasbt/LLM-finetuning-scripts/tree/main/adapter/distilbert-movie-review

为感谢过去几个月支持本通讯的读者,我在下方增加了讨论代码示例的附赠章节。再次感谢大家的支持!

1. 微调基线

首先,我们在电影评论数据集上仅微调DistilBERT模型的最后几层,以此建立性能基线。为简洁起见,我们仅查看相关代码行,省略非微调相关的代码。不过如上所述,完整代码示例可在此处获取:https://github.com/rasbt/LLM-finetuning-scripts/tree/main/adapter/distilbert-movie-review

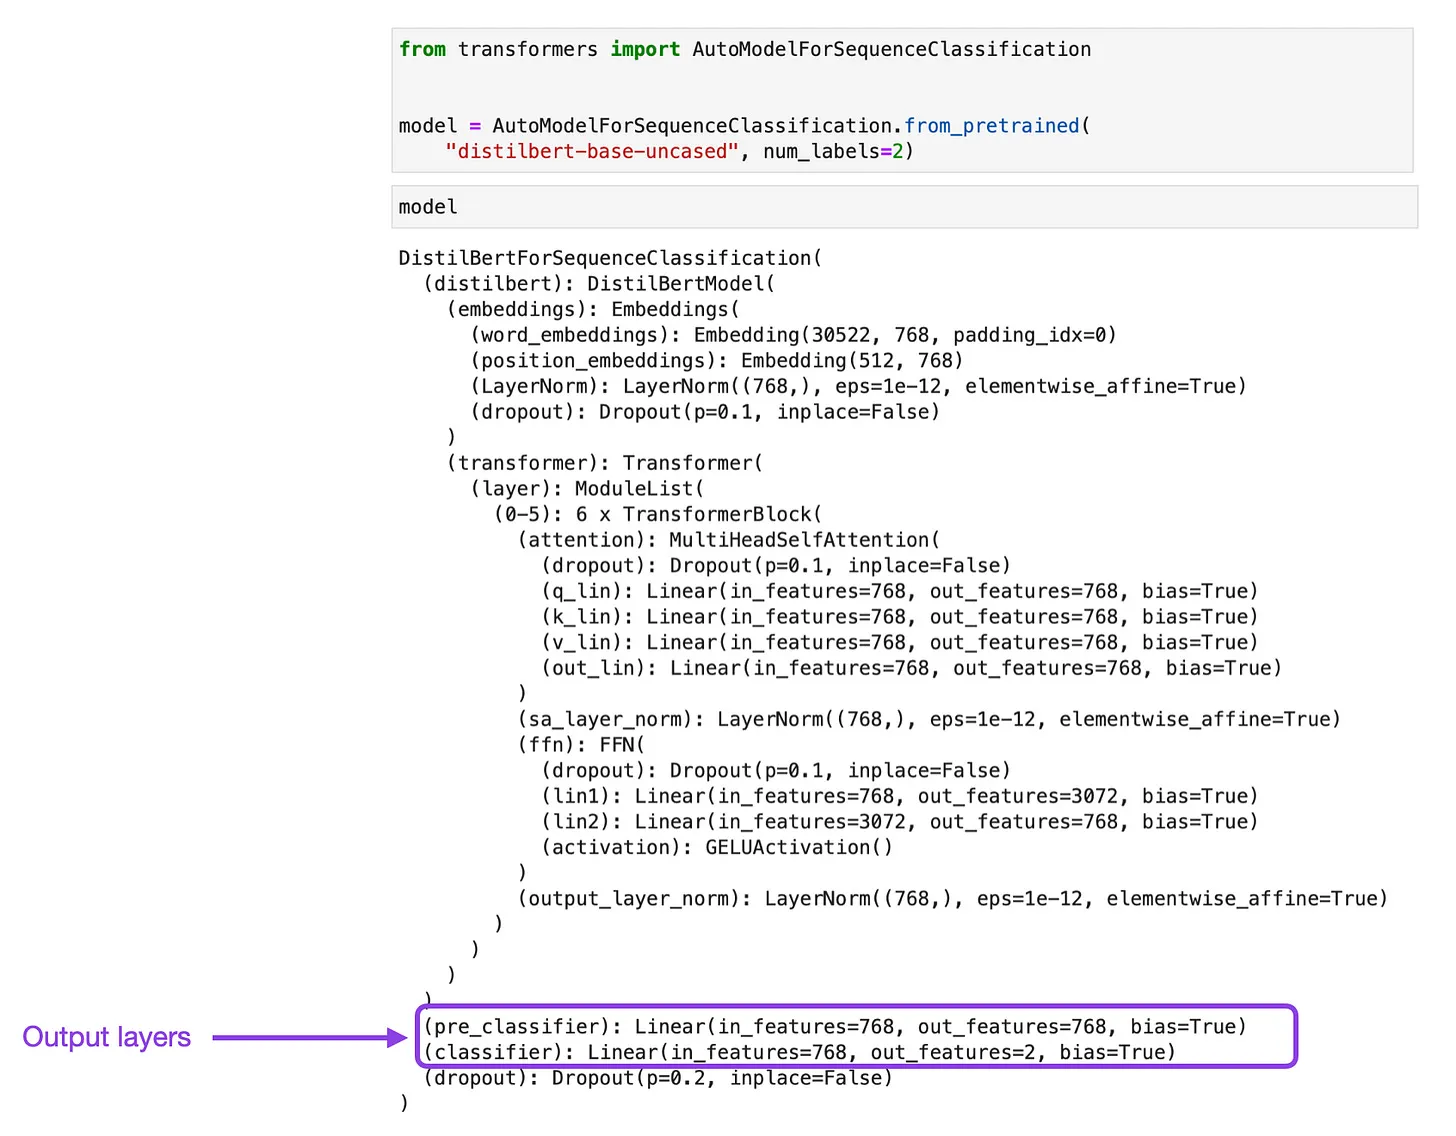
首先,加载预训练的DistilBERT模型后,我们先看一下它的架构:

figure07

在这个性能基线中,我们仅微调最后两层,共包含592130个参数。最简单的实现方式是冻结所有参数,再通过以下代码解冻最后两层:

# Freeze all layers
for param in model.parameters():
    param.requires_grad = False
    
# Unfreeze the two output layers
for param in model.pre_classifier.parameters():
    param.requires_grad = True

for param in model.classifier.parameters():
    param.requires_grad = True

随后,将该模型训练3个轮次(epoch)后,我们得到如下结果:

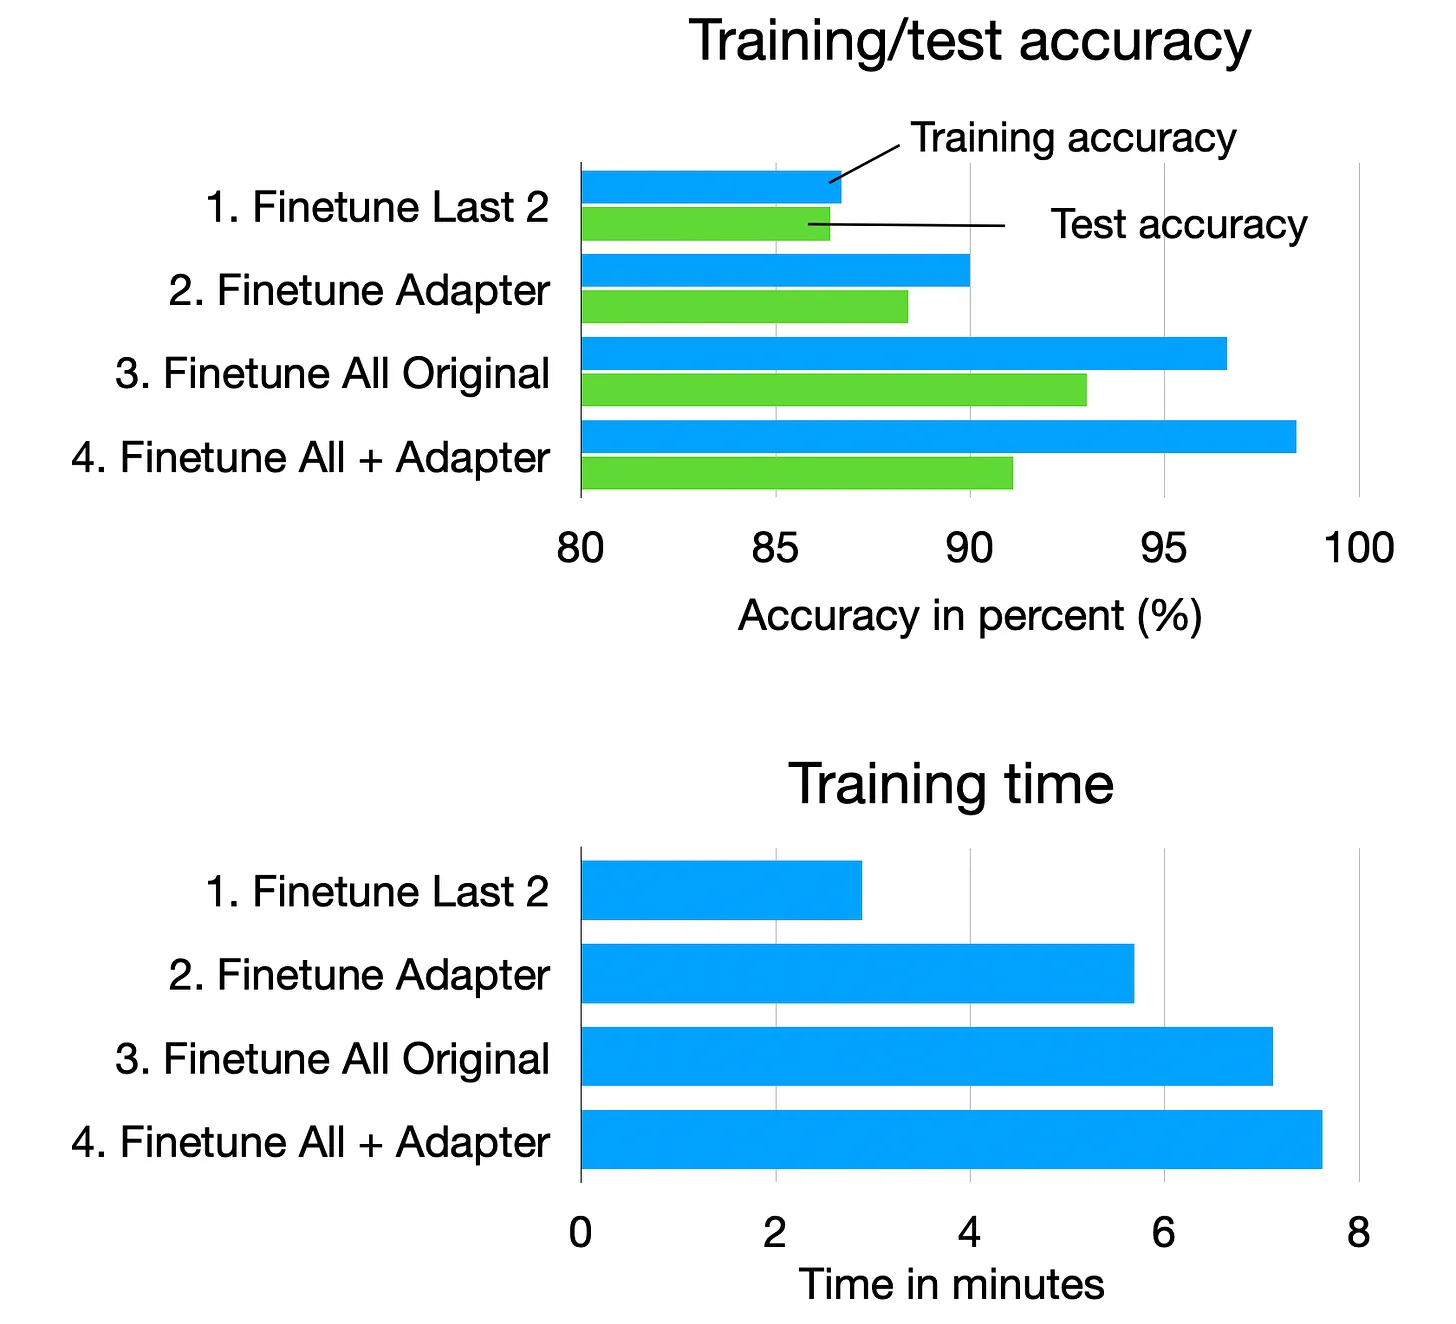
  • 训练时长:2.89分钟
  • 训练准确率:86.7%
  • 验证准确率:87.2%
  • 测试准确率:86.4%

2. 添加适配器层

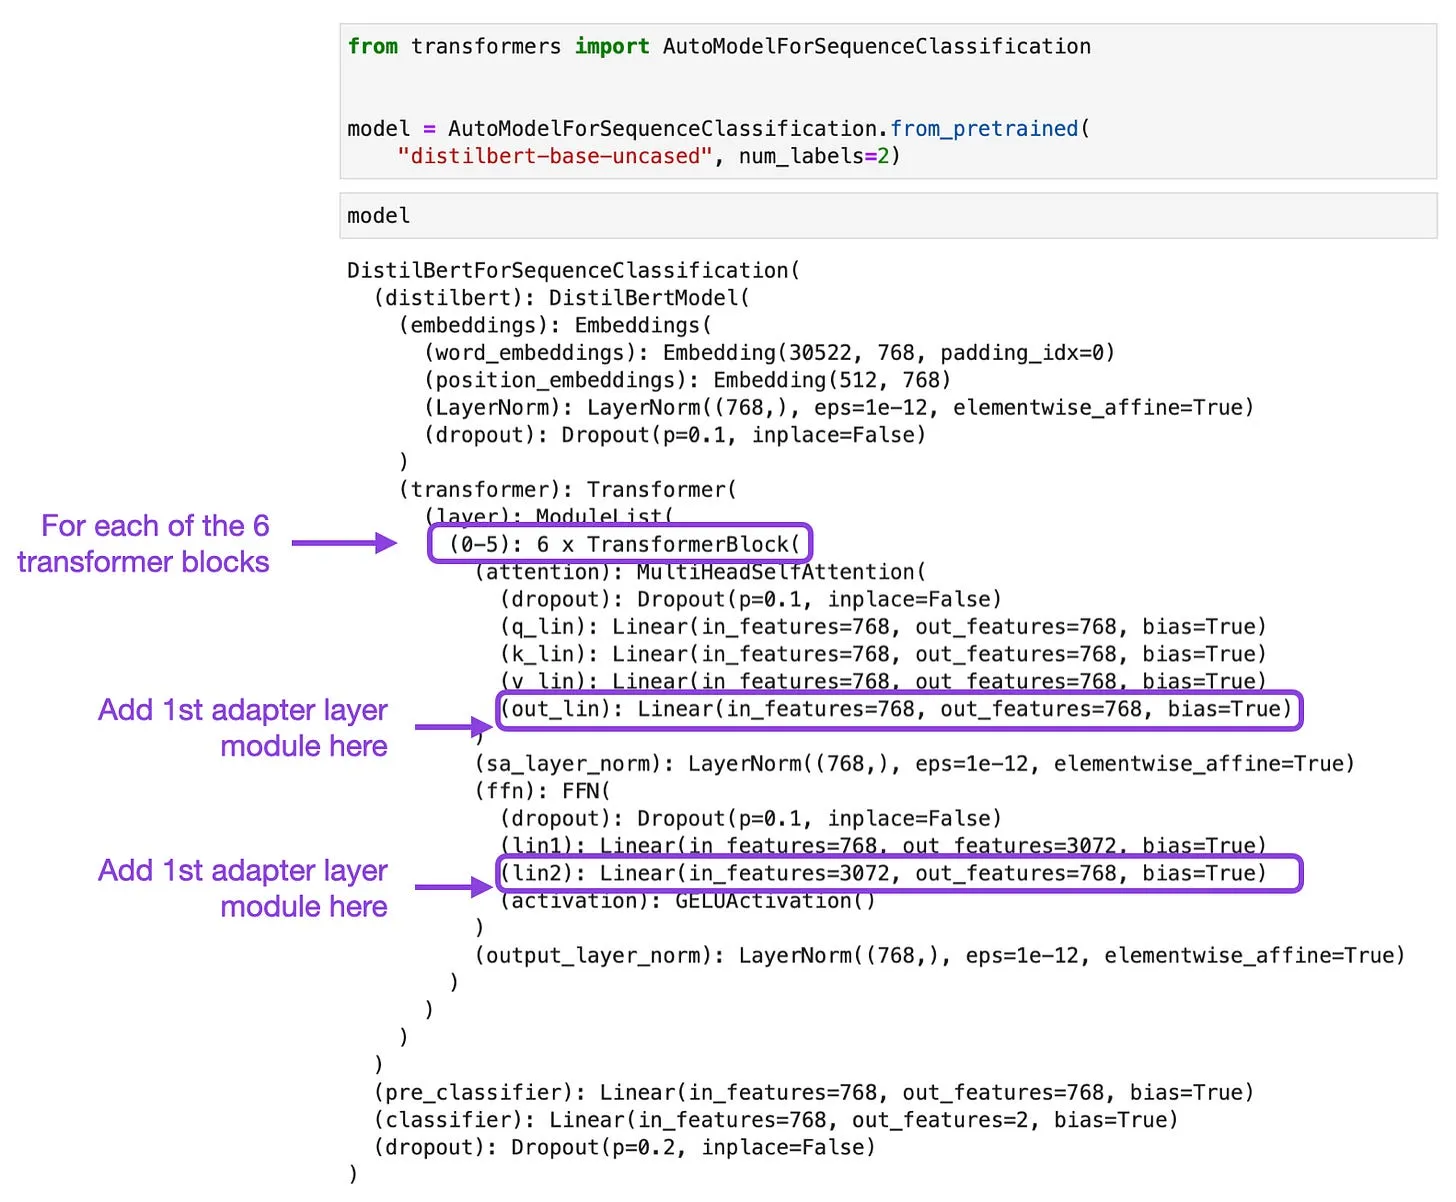
接下来,我们向模型中添加适配器层。需要注意的是,DistilBERT有6个Transformer块。如前所述,适配器方法会在这6个Transformer块的每一个中都插入2个适配器模块,如下图所示:

figure08

每个适配器模块由2个全连接层组成,中间夹着非线性激活函数。在代码中,我们可以定义一个make_adapter函数来创建这样的适配器模块,代码如下:

def make_adapter(in_dim, bottleneck_dim, out_dim):
    adapter_layers = torch.nn.Sequential(
        torch.nn.Linear(in_dim, bottleneck_dim),
        torch.nn.GELU(),
        torch.nn.Linear(bottleneck_dim, out_dim),
    )
    return adapter_layers

之后,我们就可以用make_adapter函数将适配器层插入到6个Transformer块中,代码如下:

total_size = 0
bottleneck_size = 32 # hyperparameter

for block_idx in range(6):

    ###################################################
    # insert 1st adapter layer into transformer block
    ###################################################

    orig_layer_1 = model.distilbert.transformer.layer[block_idx].attention.out_lin

    adapter_layers_1 = make_adapter(
        in_dim=orig_layer_1.out_features, 
        bottleneck_dim=bottleneck_size, 
        out_dim=orig_layer_1.out_features)

    new_1 = torch.nn.Sequential(orig_layer_1, *adapter_layers_1)
    model.distilbert.transformer.layer[block_idx].attention.out_lin = new_1
    
    total_size += count_parameters(adapter_layers_1)

    ###################################################
    # insert 2nd adapter layer into transformer block
    ###################################################

    orig_layer_2 = model.distilbert.transformer.layer[block_idx].ffn.lin2

    adapter_layers_2 = make_adapter(
        in_dim=orig_layer_2.out_features, 
        bottleneck_dim=bottleneck_size, 
        out_dim=orig_layer_2.out_features)

    new_2 = torch.nn.Sequential(orig_layer_2, *adapter_layers_2)
    model.distilbert.transformer.layer[block_idx].ffn.lin2 = new_2
    
    total_size += count_parameters(adapter_layers_2)
    

print("Number of adapter parameters added:", total_size) total_size)

添加的适配器参数数量:599424

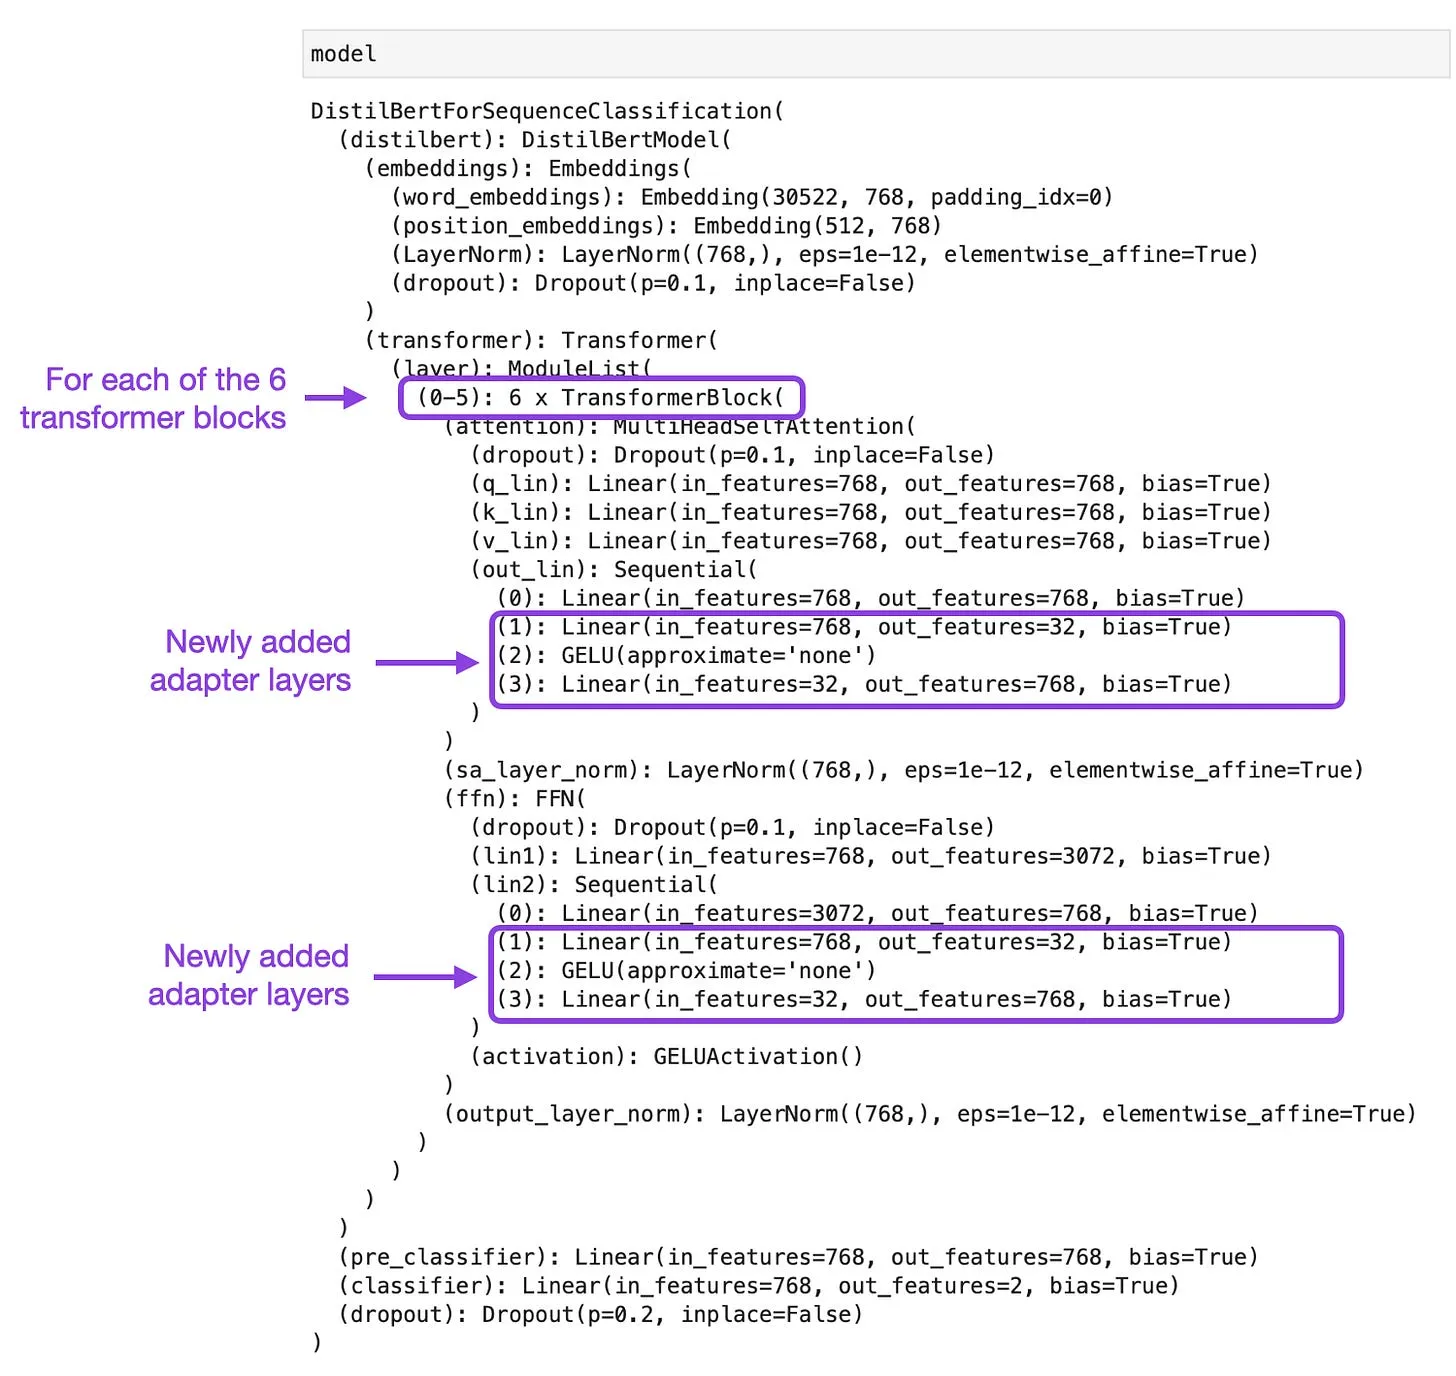
修改后的DistilBERT架构如下图所示:

figure09

可以看到,当瓶颈尺寸设为32时,我们向模型中添加了599424个新参数。相比之下,我们之前微调的2个全连接层总共有592130个参数,二者的可微调参数量大致相当。如果我们对这个修改后的模型进行微调(除适配器层外所有层均冻结),会得到如下结果:

  • 训练时长:5.69分钟
  • 训练准确率:90.0%
  • 验证准确率:89.1%
  • 测试准确率:88.4%

3. 全量微调所有层

现在,作为对比,我们来看全量微调所有层的结果。这一实验中,我们直接加载DistilBERT模型并进行训练(不冻结任何层)。

from transformers import AutoModelForSequenceClassification

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-uncased", num_labels=2)
def count_parameters(model):
    return sum(p.numel() for p in model.parameters() if p.requires_grad)

num_param = count_parameters(model.pre_classifier) + count_parameters(model.classifier)
print("Parameters in last 2 layers:", num_param)

66955010

对全部6690万个参数进行微调后,结果如下:

  • 训练时长:7.12分钟
  • 训练准确率:96.6%
  • 验证准确率:92.9%
  • 测试准确率:93.0%

4. 插入适配器层并全量微调

最后,我们补充一个对照实验:训练第2节中添加了适配器层的模型,但开放所有参数的训练权限。总参数量为599424 + 66955010 = 67554434个。

  • 训练时长:7.62分钟
  • 训练准确率:98.4%
  • 验证准确率:91.5%
  • 测试准确率:91.1%

结果分析与总结

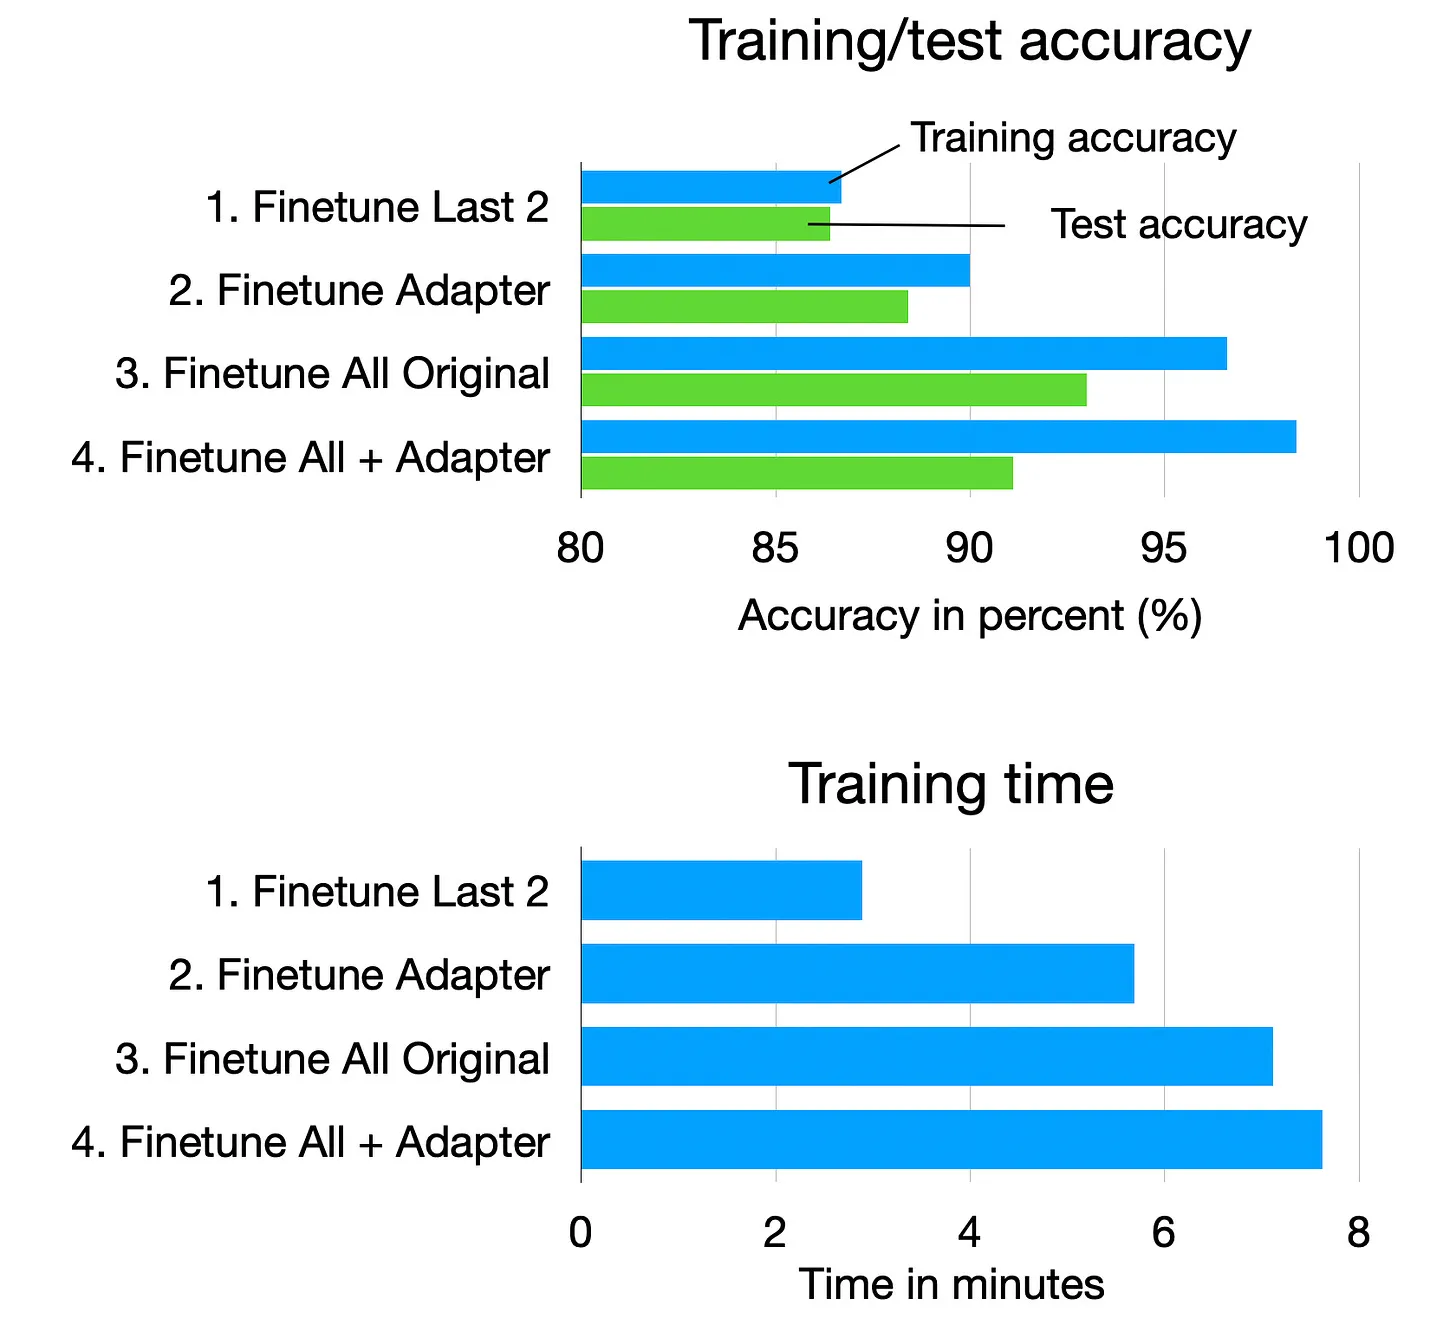
通过上述实验得到所有结果后,我们来看下面的汇总图。

figure10

可以看到,微调适配器层的效果优于仅微调最后几层。这是一个积极的结果,且并不意外,与适配器论文的结论一致。

但微调适配器层(实验2)的耗时几乎是仅微调最后两层(实验1)的两倍。二者的可训练参数量几乎相同,但适配器层模型在前向传播时需要经过更多额外的层,这是训练时长增加的原因。

再看方法(3),全量微调整个网络的表现仍然优于适配器方法(实验2)。当然,它的计算成本也更高,这是意料之中的,因为二者的参数量差距悬殊(6600万对比60万)。

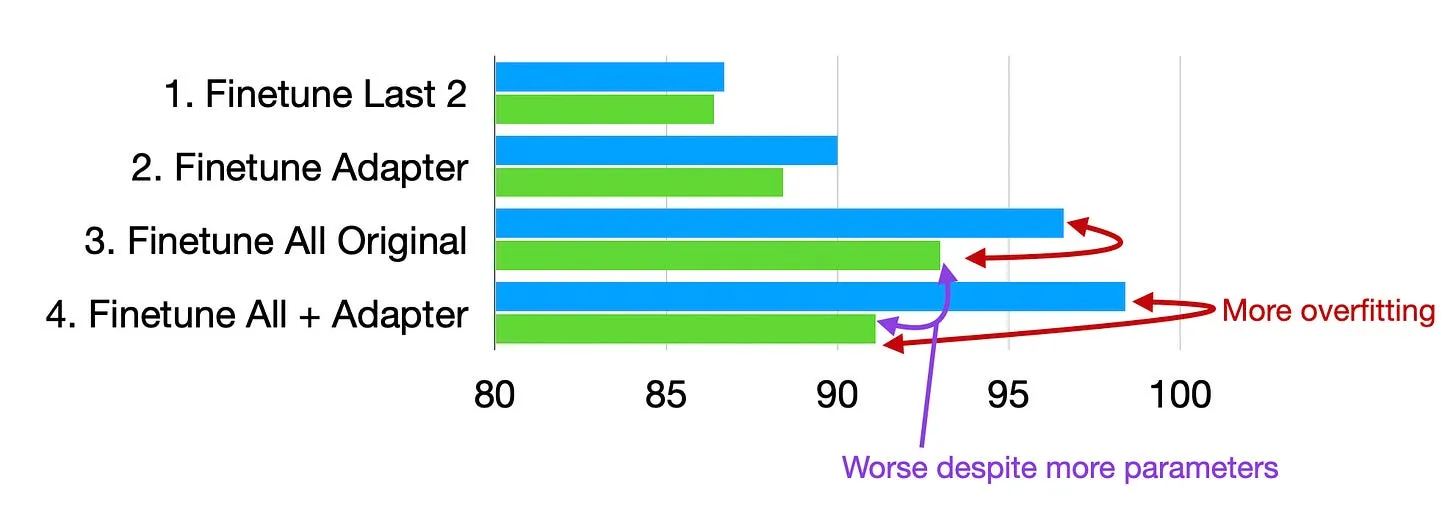
最后,“全量微调+适配器层”(实验4)的效果优于仅微调适配器层(实验2)。但实验4的表现不如全量微调所有层(实验3),乍看之下有些意外,因为实验4比实验3多了60万个参数。如果观察训练集的表现就会发现,实验4的过拟合程度更严重,这或许可以解释为什么参数更多但效果反而更差。

figure11

总而言之,适配器方法是替代“仅微调最后几层”的优质方案,尽管它会增加计算时长,且效果不及全量微调。

本杂志是一项个人兴趣项目,无直接经济收益。如果您愿意支持我,可以考虑购买我的书籍:https://sebastianraschka.com/books。如果您觉得这些内容有启发、有帮助,也欢迎推荐给您的朋友和同事。

figure12

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , and http://mng.bz/M96o

您的支持对我意义重大!非常感谢!

【转载】长输入与少训练数据场景下的Transformer

原文地址:
Transformers for Long Inputs and Less Training Data,by Sebastian Raschka, on 2023-05-13

长输入与少训练数据场景下的Transformer

本文精选并汇总了22项人工智能研究亮点。当前,自然语言处理与计算机视觉领域正涌现出大量令人振奋的技术进展!

当然,我无法将所有前沿且具潜力的研究论文都纳入每月一期的《Ahead of AI》通讯。因此,下文列出了过去几周我精读或泛读过的、未入选主通讯的优质论文补充清单。

祝阅读愉快!

大语言模型

借助循环记忆Transformer(RMT)将Transformer上下文扩展至100万令牌及以上

https://arxiv.org/abs/2304.11062,2023年4月19日

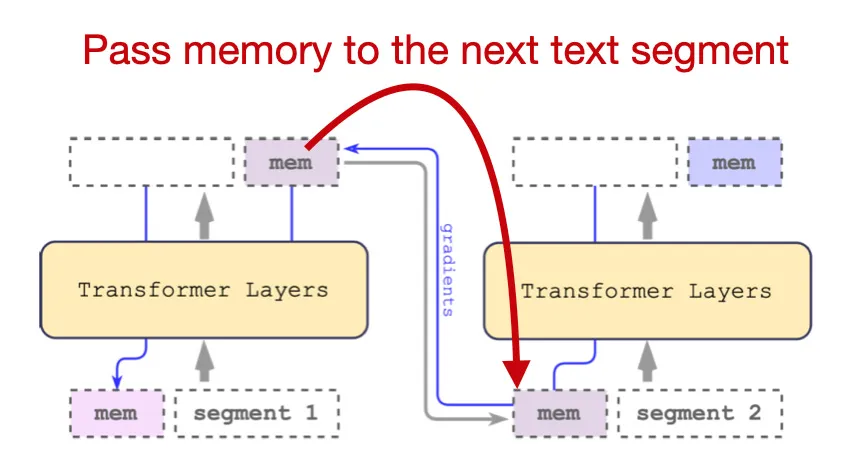
研究人员提出利用循环记忆机制,将输入上下文长度扩展至200万令牌。作为对比,ChatGPT搭载的GPT-4模型当前最多支持8192令牌。该论文的核心思路是:将上一段的输出作为记忆,与下一段的输入序列嵌入一同递归传入模型。

figure01

Unlimiformer:支持无限长度输入的长程Transformer

https://arxiv.org/abs/2305.01625,2023年5月2日

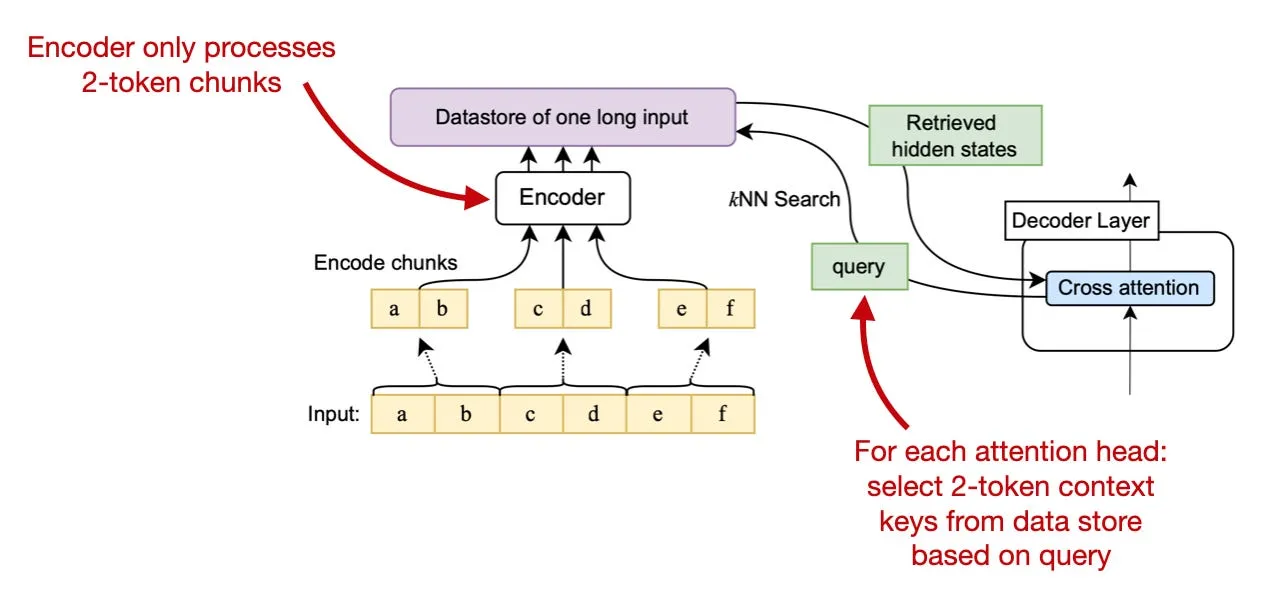
该方法是现有预训练大语言模型的一层封装框架,无需额外微调权重,提出将自注意力机制卸载为k近邻(k-NN)检索操作。其核心思路是:将长输入编码为多个更小的文本块并存储在数据库中,随后针对每个注意力头,通过k近邻检索调取对应的文本块。

figure02
图示注解来源:https://arxiv.org/abs/2305.01625

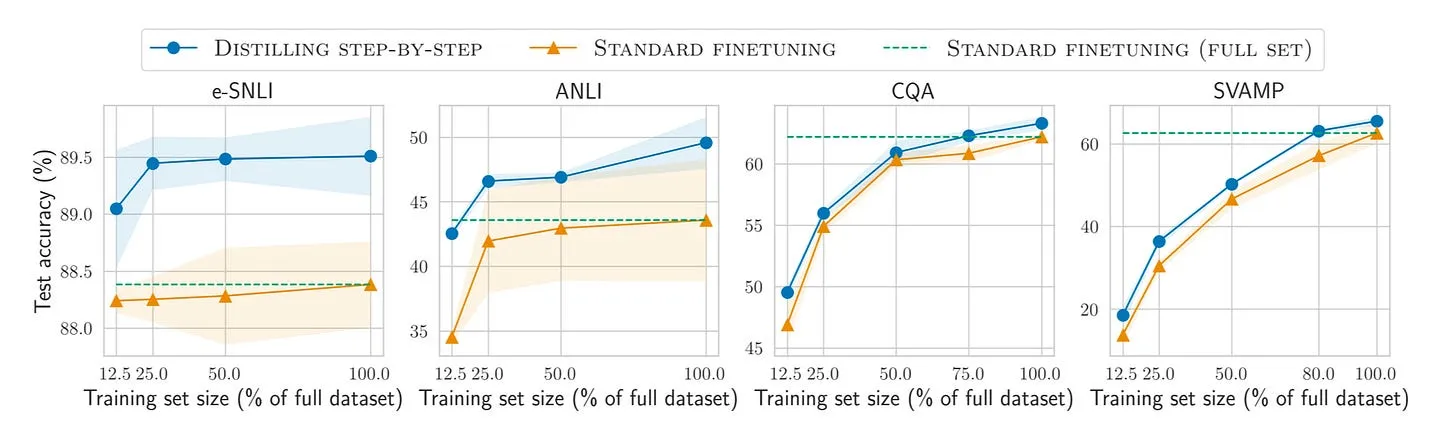
分步蒸馏!用更少训练数据、更小模型尺寸超越大语言模型

https://arxiv.org/abs/2305.02301,2023年5月3日

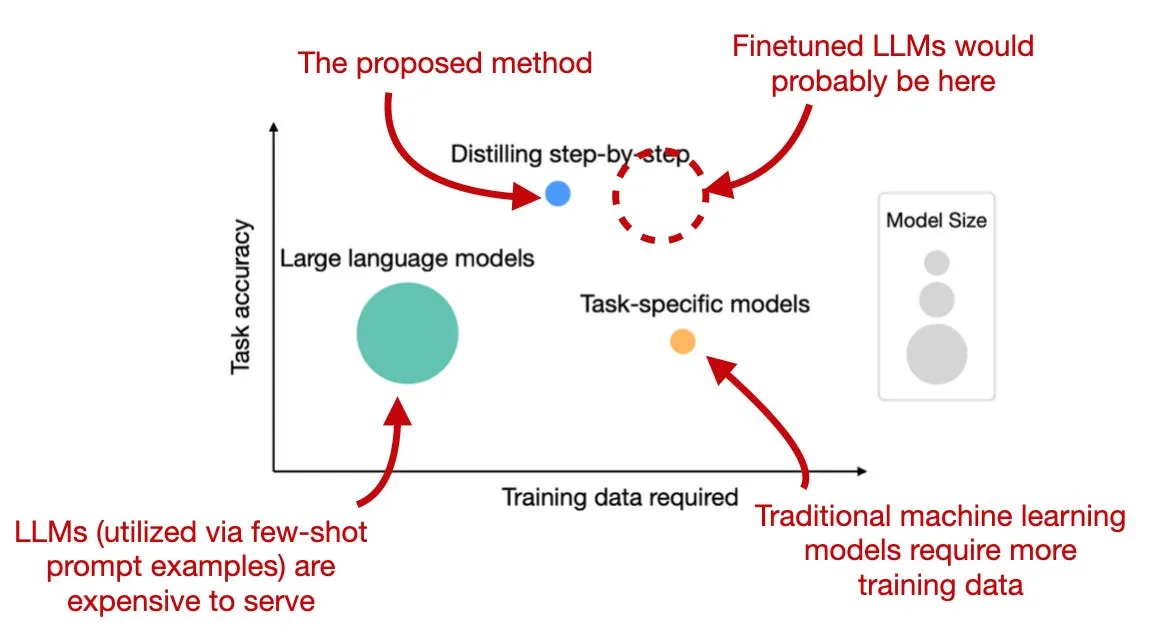
研究人员提出了一种蒸馏机制,用于定制面向特定任务的小模型;与标准微调相比,该机制只需更少训练数据,就能实现更优的模型性能。首先,通过大语言模型提取推理依据(一种经过重述的提示),再将这些推理依据与类别标签用于有监督训练更小的任务专属模型。

figure03
图示注解来源:https://arxiv.org/abs/2305.02301

规模化语言反馈下的语言模型训练

https://arxiv.org/abs/2303.16755,2023年4月9日

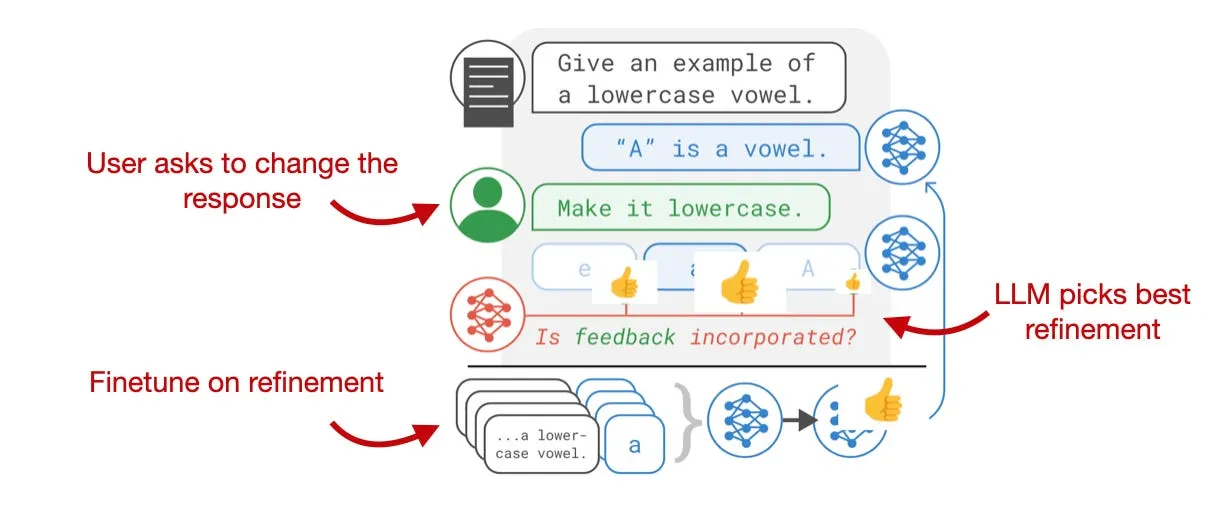
现有的大语言模型微调方法(例如ChatGPT采用的基于人类反馈的强化学习),在微调过程中需要对模型生成的成对输出进行比较(例如用于训练奖励模型)。在该研究中,研究人员提出了一种名为“语言反馈模仿学习(ILF)”的替代方案:(1)用户让模型生成回复;(2)用户对回复提出修改要求;(3)基于修改后的最终回复对大语言模型进行微调。

figure04
图示注解来源:https://arxiv.org/abs/2303.16755

ResiDual:具备双残差连接的Transformer

https://arxiv.org/abs/2304.14802,2023年4月28日

自《Attention Is All You Need》提出原始Transformer架构以来,层归一化的放置位置一直是学界讨论的焦点(可参考:https://arxiv.org/abs/2002.04745 )。层归一化前放置残差连接(Pre-LN)易导致表示坍缩,层归一化后放置残差连接(Post-LN)则易出现梯度消失问题。该论文中,研究人员提出融合Post-LN与Pre-LN的连接方式,兼具二者优势的同时规避各自缺陷。

figure05
图示注解来源:https://arxiv.org/abs/2304.14802

有观点指出,NormFormer论文中已提出过类似思路,且架构更简洁(http://arxiv.org/abs/2110.09456)。

利用摘要令牌学习提示压缩

https://arxiv.org/abs/2304.08467,2023年4月17日

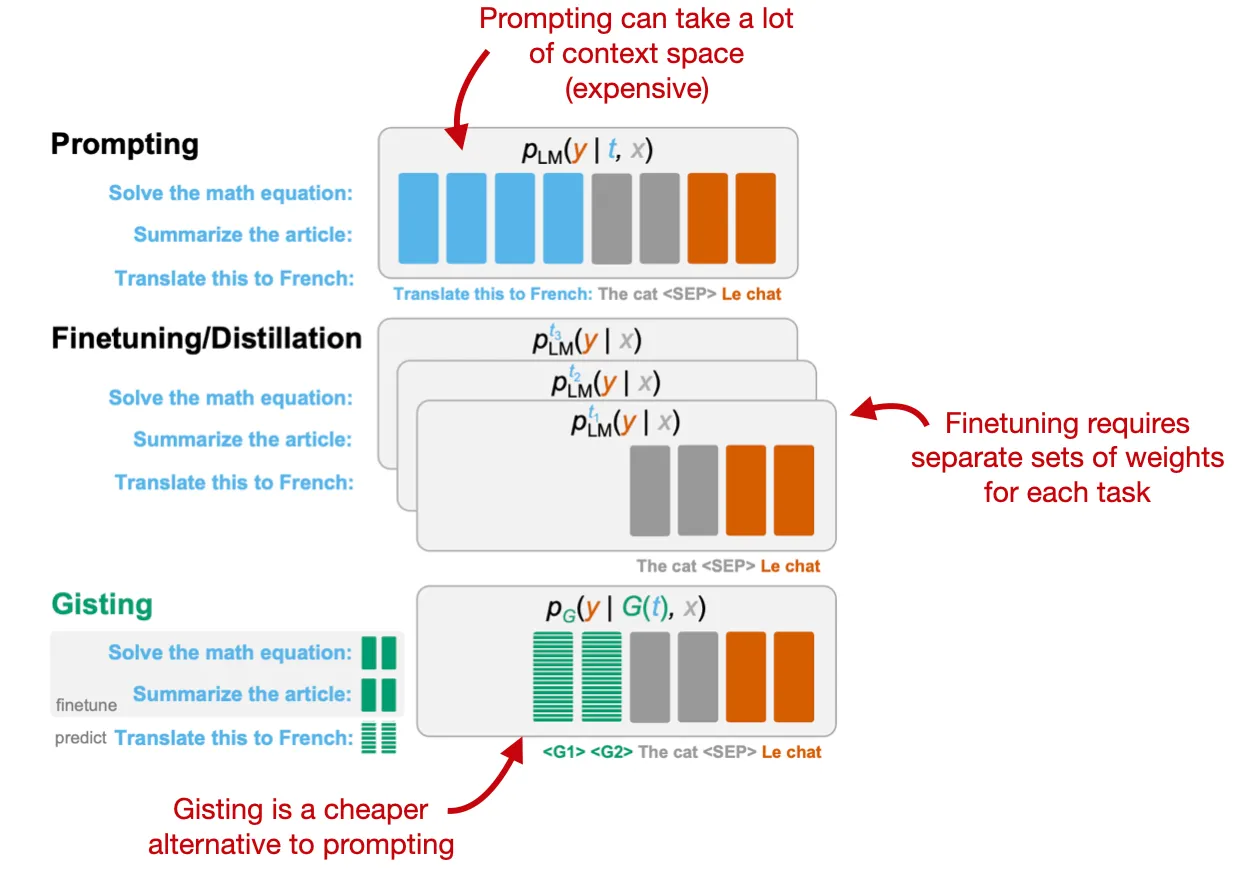
近来提示工程备受关注(此处无双关含义),但让大语言模型重复运行相似的提示难道不是一种算力浪费吗?研究人员设计了“摘要(gist)”令牌,将任务压缩为特殊令牌以节省算力。该思路与软提示微调类似(相关介绍见https://magazine.sebastianraschka.com/p/understanding-parameter-efficient ),同时还能泛化到全新的提示场景。

figure06
图示注解来源:https://arxiv.org/abs/2304.08467

大语言模型的涌现能力是海市蜃楼吗?

https://arxiv.org/abs/2304.15004,2023年4月28日

在大语言模型领域,“涌现能力”指的是训练过程中未被明确教授、却随着模型接触海量信息后理解与生成文本的能力提升而自然产生的能力(例如摘要、翻译等)。在这项最新分析中,研究人员发现有力证据表明,这些涌现能力并非单纯由模型规模扩大带来。研究人员认为,涌现能力是选取特定性能指标后产生的错觉,因此“可能是研究者选择指标后的人为产物”。

论AI生成文本检测的可行性

https://arxiv.org/abs/2304.04736,2023年4月10日

随着大语言模型与AI生成文本日益普及,研究人员重新探讨了“AI生成文本能否被可靠检测”这一饱受争议的话题。该研究表明,答案是肯定的。基于信息论边界,在大多数场景下,只要样本量足够,就能够检测出AI生成的文本。

最少人工监督下、从零开始的原则驱动型语言模型自对齐

https://arxiv.org/abs/2305.03047,2023年5月4日

研究人员推出了Dromedary模型,性能优于同级别Alpaca模型(Alpaca本身是基于LLaMA微调的模型)。与ChatGPT不同,Dromedary未采用基于人类反馈的强化学习;也不像Alpaca那样需要提取ChatGPT的提示-回复对。取而代之的是,研究人员提出了一种全新的自对齐方法:在指令提示后附加行为准则即可实现对齐。

大语言模型对齐的固有局限性

https://arxiv.org/abs/2304.11082,2023年4月19日

自2022年11月ChatGPT发布以来,大语言模型研究大量聚焦于指令微调与对齐,让模型对用户更有帮助、更低风险。该论文提出了名为“行为期望边界(BEB)”的理论框架,证明对齐只能减少、无法彻底消除不良与有害行为。结论是:经过对齐的大语言模型仍无法抵御对抗性提示攻击。

生成式搜索引擎的可验证性评估

https://arxiv.org/abs/2304.09848,2023年4月19日

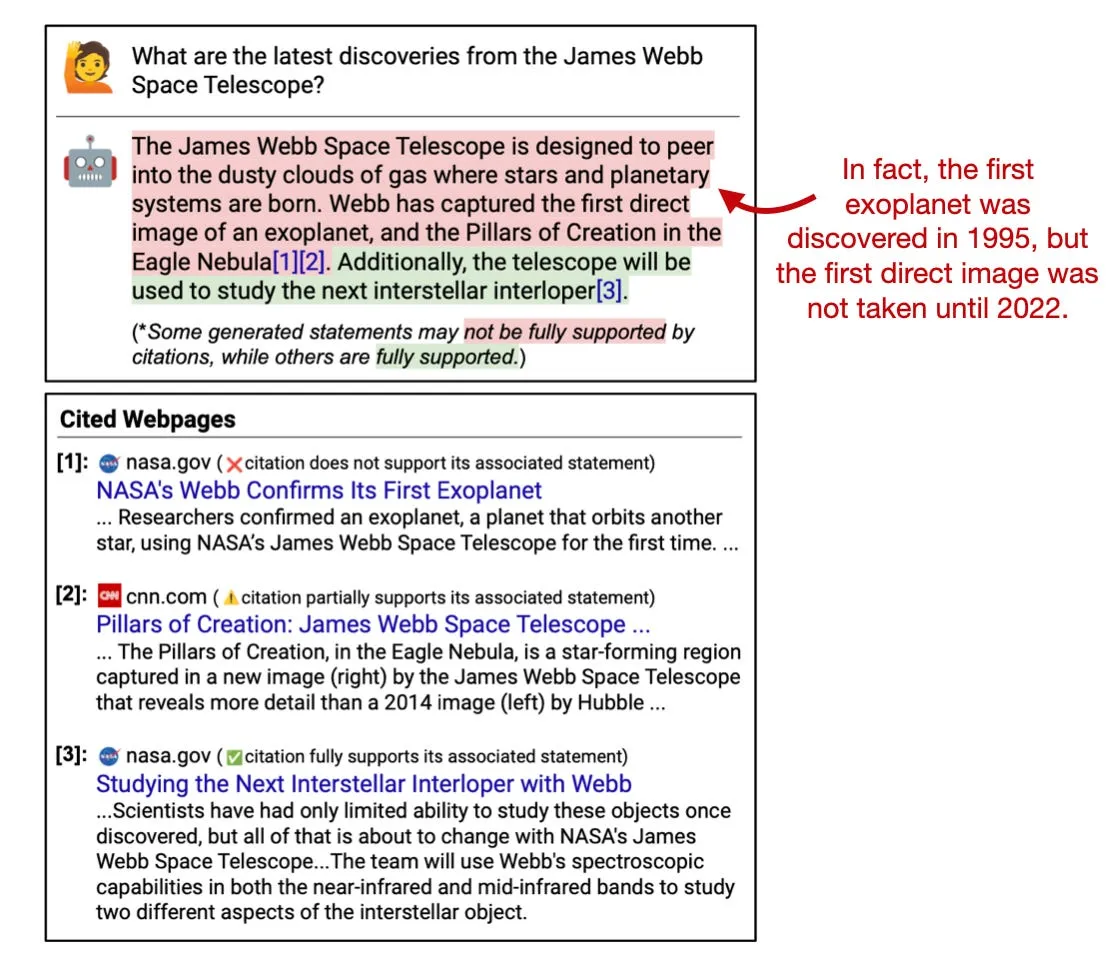
基于大语言模型的生成式搜索引擎正快速兴起。研究人员对Bing Chat、NeevaAI、Perplexity AI和YouChat进行了审计,结果显示:尽管回复看起来信息丰富、行文流畅,但生成的句子中仅有51.5%完全有引用支撑,而引用中也仅74.5%确实能佐证对应句子。

figure07
图示注解来源:https://arxiv.org/abs/2304.09848

StarCoder:愿源码与你同在!

https://arxiv.org/abs/2305.06161,2023年5月9日

研究人员基于GitHub爬取的1万亿令牌开源代码(来自The Stack数据集),训练了一个参数量155亿、上下文宽度8k的大语言模型。在构建出StarCoderBase基础模型后,研究人员又用350亿Python令牌对其进行微调,最终得到的StarCoder模型性能超越了当前所有代码大语言模型。

大语言模型涌现出的自主科研能力

https://arxiv.org/abs/2304.05332,2023年4月11日

作者将多个大语言模型串联,构建了一个基于多模型的智能体,能够设计和规划化学实验,包括使用工具、浏览互联网开展实验。从技术角度看,多个大语言模型的串联方式能达到如此好的效果颇具亮点。但尽管标题吸睛,该系统尚无法替代科研人员提出原创假设与实验设计。

scGPT:利用生成式AI构建单细胞多组学基础模型

https://www.biorxiv.org/content/10.1101/2023.04.30.538439v1,2023年5月1日

看到Transformer等通用方法被应用到其他领域总是很有意思。该研究中,研究人员借鉴大语言模型的生成式预训练思路,在基因等单细胞测序数据上预训练基础模型。最终得到的预训练模型具备基因网络的零样本学习与聚类能力。

PMC-LLaMA:基于医学论文对LLaMA进行进一步微调

https://arxiv.org/abs/2304.14454,2023年4月27日

这是大语言模型在领域专属数据上的又一应用,不过采用的是微调而非预训练范式。研究人员发现,在医学数据上微调后的LLaMA模型,在医学任务上的表现优于预训练基础模型,也超过了ChatGPT。这一结果符合预期,同时也再次印证:随着企业追求优化大语言模型的任务表现,模型微调将变得越来越重要。

计算机视觉

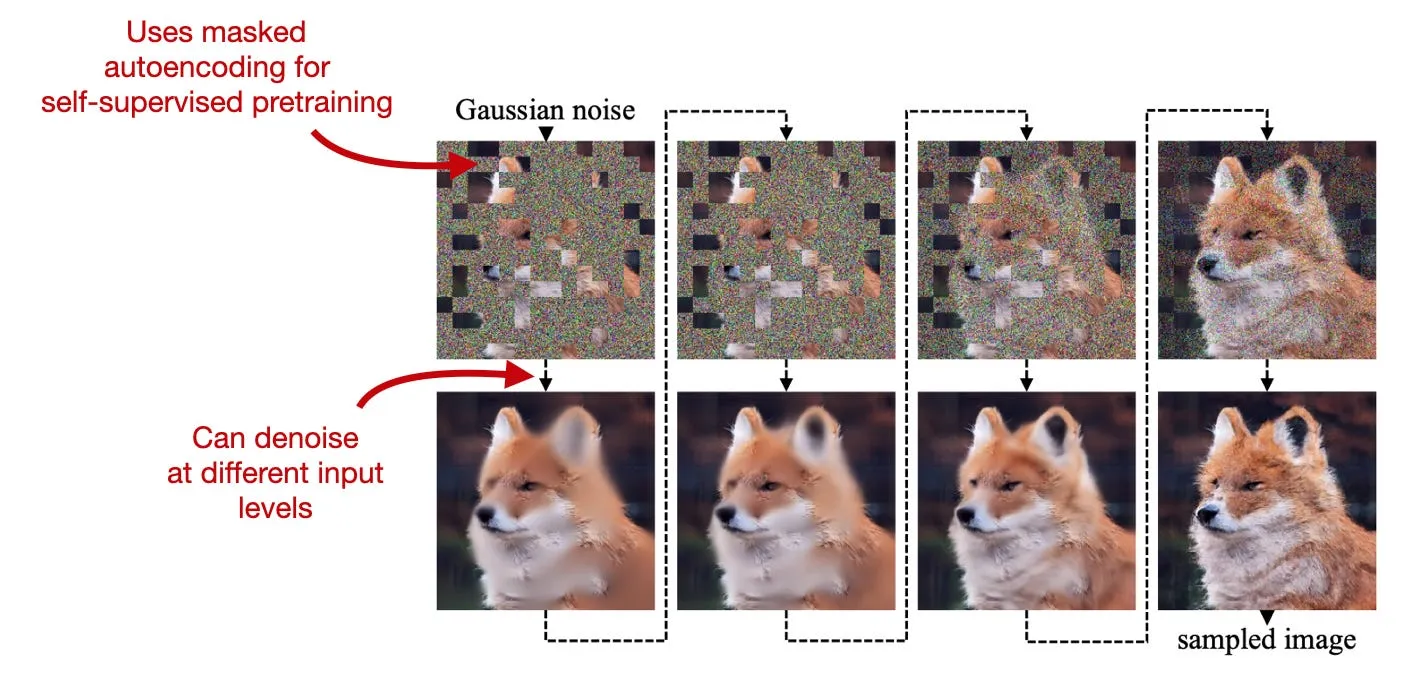
作为掩码自编码器的扩散模型

https://arxiv.org/abs/2304.03283,2023年4月6日

与大语言模型不同,扩散模型的预训练无法生成可用于其他下游任务的强特征表示。为此,研究人员将扩散模型重构为掩码自编码器形式。该研究有望催生图像任务中扩散基础模型的全新前沿方向。

figure08
图示注解来源:https://arxiv.org/abs/2304.03283

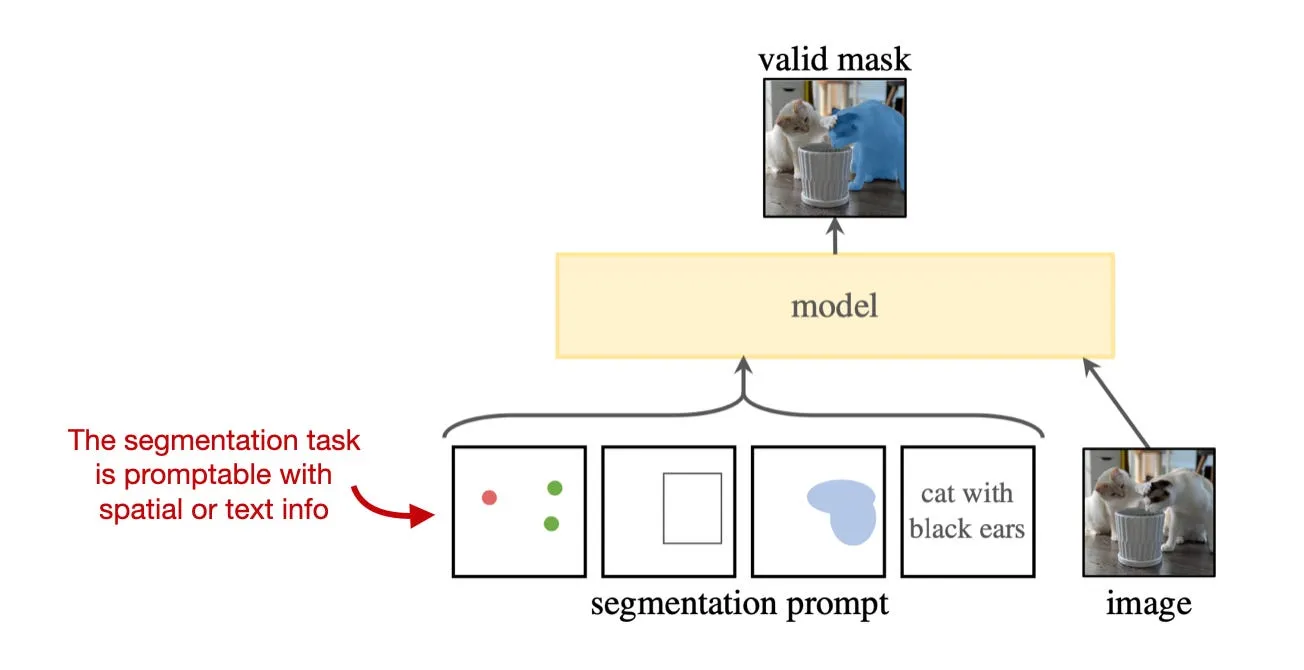
分割一切

https://arxiv.org/abs/2304.02643,2023年4月5日

Meta的“分割一切(Segment Anything)”项目提出了全新的图像分割任务、模型与数据集。配套的图像数据集是目前规模最大的分割数据集,涵盖1100万张图像、超10亿个掩码。尤其值得称赞的是,研究人员使用的是获得授权、符合隐私规范的图像,因此模型可以开源,且无重大版权风险。

figure09
图示注解来源:https://arxiv.org/abs/2304.02643

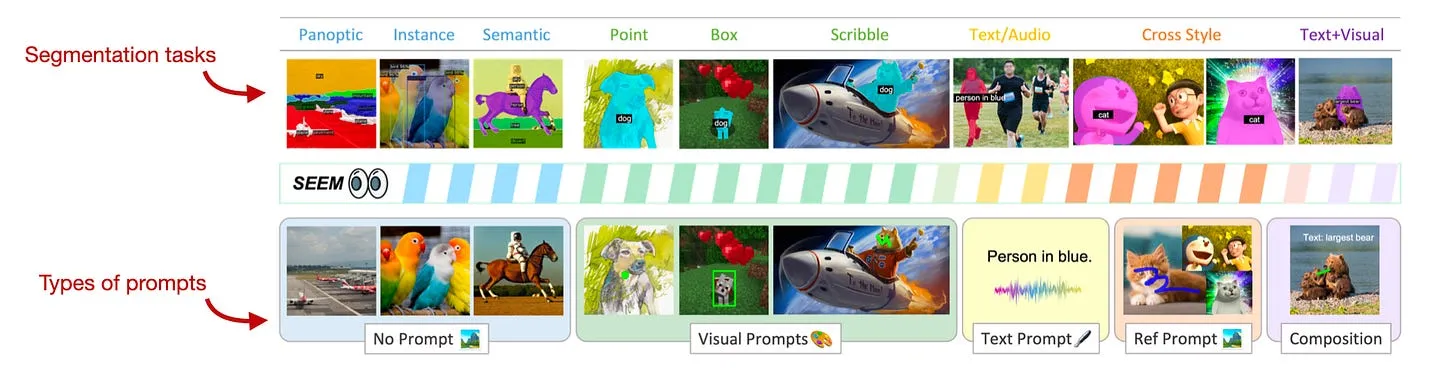
一次性全场景全域分割

https://arxiv.org/abs/2304.06718,2023年5月13日

与上文提到的Segment Anything思路类似,该论文提出了一种支持提示交互的图像分割模型。但相比Segment Anything,该项目支持更多交互类型,且能完成更复杂的语义任务。研究人员表示,Segment Anything的提示仅支持点、框和文本,而他们的模型还支持其他形式的提示,并且能够完成全景分割与实例分割。

figure10
图示注解来源:https://arxiv.org/abs/2304.06718

Generative Disco:面向音乐可视化的文本生成视频技术

https://arxiv.org/abs/2304.08551,2023年4月17日

正如《Ahead of AI》第7期(https://magazine.sebastianraschka.com/p/ahead-of-ai-7-large-language-models )中提到的,未来几个月将涌现更多创意多模态研究,这便是其中之一:研究人员可根据用户的音乐描述提示生成视频片段。该论文提出的文本生成图像模型能够生成丰富多样的视频,输出示例包括抽象动画,以及看起来像在跟唱的动画角色。

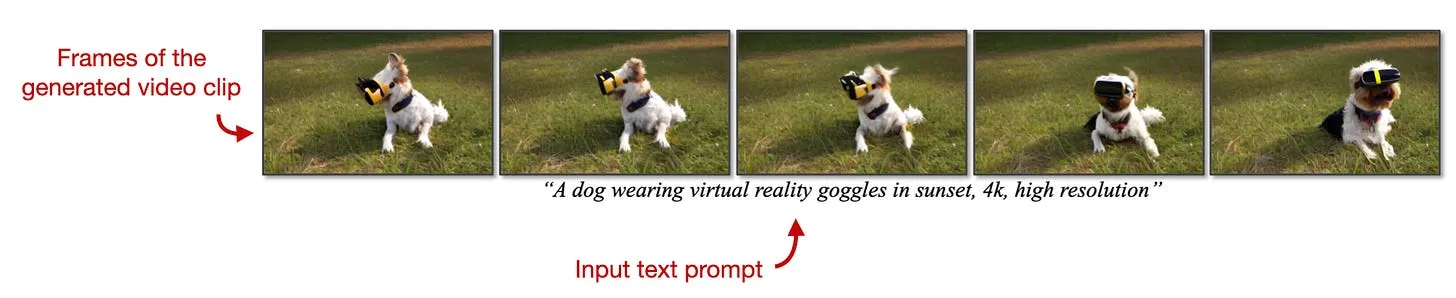
对齐你的潜变量:基于潜扩散模型的高分辨率视频合成

https://arxiv.org/abs/2304.08818,2023年4月18日

该研究将扩散模型的文本生成图像思路拓展到了视频生成领域。有意思的是,研究人员能够直接复用现成的预训练图像扩散模型来完成这个文本生成视频项目。

figure11>
图示注解来源:https://arxiv.org/abs/2304.08818

大规模视觉-语言模型的稳定低精度训练

https://arxiv.org/abs/2304.13013,2023年4月25日

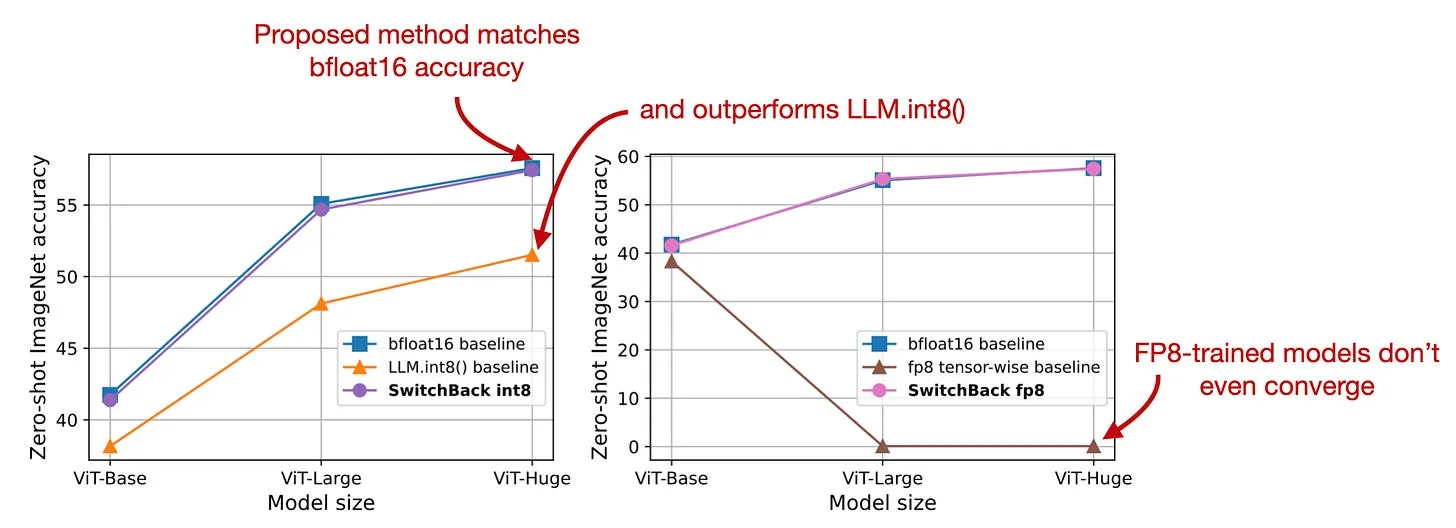
目前bfloat16(混合精度)已是各类模型的常用训练精度,而随着NVIDIA新款H100 GPU推出,8位浮点数也开始得到支持。那么量化训练的表现如何?研究人员提出了Switch-Back——一种用于int8量化训练的线性层,性能优于现有LLM.int8()基线,精度与bfloat16持平,同时训练速度提升约20%。

figure12
图示注解来源:
https://arxiv.org/abs/2304.13013

Patch Diffusion:更快、数据效率更高的扩散模型训练方法

https://arxiv.org/abs/2304.12526,2023年4月25日

Patch Diffusion通过提升数据效率,将扩散模型的训练速度提升了2倍,同时保持图像质量不变。在该研究的实验中,研究人员仅用5000个训练样本就训练出了具备竞争力的模型。该方法的核心思路是:引入随机裁剪图像块的块级信息参与训练。

本通讯是个人兴趣驱动的项目,无直接商业报酬。如果您愿意支持我,欢迎购买我的书籍(https://sebastianraschka.com/books)。如果您觉得内容有启发、有帮助,也欢迎推荐给身边的朋友和同事。

figure13
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , and http://mng.bz/M96o

您的支持对我意义重大!非常感谢!

【转载】大规模大语言模型训练运行洞察

原文地址:
Insights from Large-Scale LLM Training Runs,by Sebastian Raschka, on 2023-05-06

大规模大语言模型训练运行洞察

及最新开源大语言模型与数据集

本期通讯的主题是梳理过去几周内涌现的、数量近乎庞杂的大语言模型(LLM)项目与数据集。除了重点介绍大规模训练运行带来的洞察外,我还将分享几份精选清单,方便大家跟进相关进展。

目录

https://magazine.sebastianraschka.com/i/119566166/articles-and-trends
https://magazine.sebastianraschka.com/i/119566166/pythia-interpreting-autoregressive-transformers-across-time-and-scale
https://magazine.sebastianraschka.com/i/119566166/open-source-data
https://magazine.sebastianraschka.com/i/119566166/keeping-track-of-open-source-llms
https://magazine.sebastianraschka.com/i/119566166/llama-adapter-v
https://magazine.sebastianraschka.com/i/119566166/research-highlights-in-two-sentences
https://magazine.sebastianraschka.com/i/119566166/open-source-highlights
https://magazine.sebastianraschka.com/i/119566166/new-deep-learning-fundamentals-units-on-computer-vision-and-large-language-models
https://magazine.sebastianraschka.com/i/119566166/notable-quote
https://magazine.sebastianraschka.com/i/119566166/upcoming-events


文章与趋势

本月新发表的研究论文数量众多,很难从中挑选出几篇最值得深入讨论的佳作。我个人更青睐能带来额外洞见的论文,而非仅仅推出性能更强的模型。基于这一标准,Eleuther AI的Pythia论文是其中一篇吸引我注意的成果。

Pythia——来自大规模训练运行的洞察

https://github.com/EleutherAI/pythia 是一款非常有意思的模型,可作为其他自回归解码器式(即类GPT)模型的替代方案。

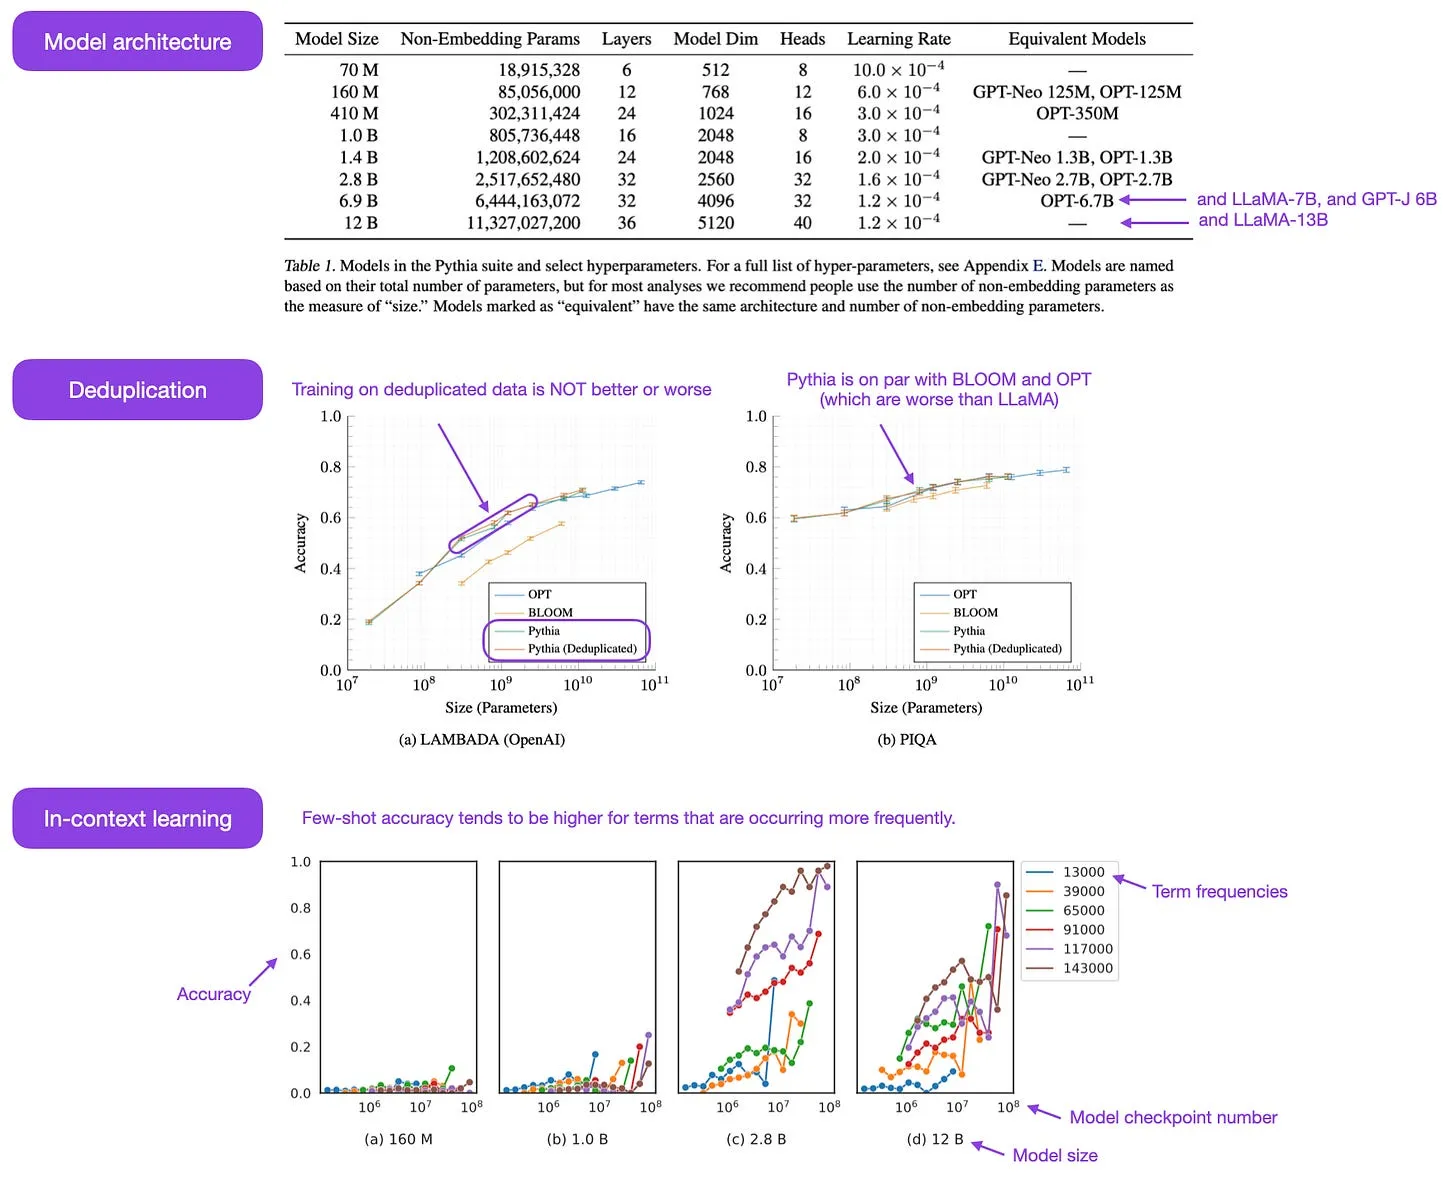
配套的论文 https://arxiv.org/abs/2304.01373 近期披露了关于训练机制的一系列有趣结论,同时推出了参数规模从7000万到120亿不等的多款大语言模型。

以下是该论文的部分核心洞察与结论:

  • 在重复数据上训练(即训练超过1个轮次)是否会影响性能? 结果表明,去重既不会提升也不会损害模型性能。
  • 训练顺序是否会影响记忆效果? 遗憾的是,答案是否定的。说“遗憾”,是因为如果训练顺序真的有影响,我们就可以通过重排训练数据来缓解不理想的逐字记忆问题。
  • 预训练词频是否会影响任务性能? 是的,出现频率更高的词汇,其少样本准确率往往更高。
  • 批量大小翻倍会让训练时间减半,且不会损害收敛效果。

Pythia的模型架构与GPT-3类似,但融入了若干改进,例如参考了 https://arxiv.org/abs/2205.14135(与LLaMA类似)和 https://arxiv.org/abs/2104.09864(与 https://arxiv.org/abs/2204.02311 类似)的相关设计。Pythia在 https://arxiv.org/abs/2101.00027 数据集(一个容量800GB的多类型文本数据集)上训练了3000亿词元(在常规Pile数据集上约为1个训练轮次,在去重后的Pile数据集上约为1.5个轮次)。

figure01
图注:来自Pythia论文的标注图(https://arxiv.org/abs/2304.01373)。

顺便一提,近期经过指令微调的开源大语言模型——Databricks推出的Dolly(https://www.databricks.com/blog/2023/04/12/dolly-first-open-commercially-viable-instruction-tuned-llm)*,正是以Pythia作为基础(底座)模型,我预计未来会有更多模型基于它构建。

(*Dolly v2是基于Pythia 12B参数模型,使用databricks-dolly-15k数据集进行微调,以复现InstructGPT论文/ChatGPT的效果。关于该数据集详见下文。)


开源数据

上个月是开源AI领域格外激动人心的一个月,多款大语言模型的开源实现相继问世。如今,我们也迎来了开源数据集的浪潮!包括用于指令微调的 https://www.databricks.com/blog/2023/04/12/dolly-first-open-commercially-viable-instruction-tuned-llm 和 https://github.com/LAION-AI/Open-Assistant/blob/main/docs/docs/data/datasets.md,以及用于预训练的 https://github.com/togethercomputer/RedPajama-Data。这一点尤其值得称赞,因为数据收集与清洗占据了现实机器学习项目约90%的工作量,却鲜有人愿意做这项工作。

用于预训练的RedPajama数据集

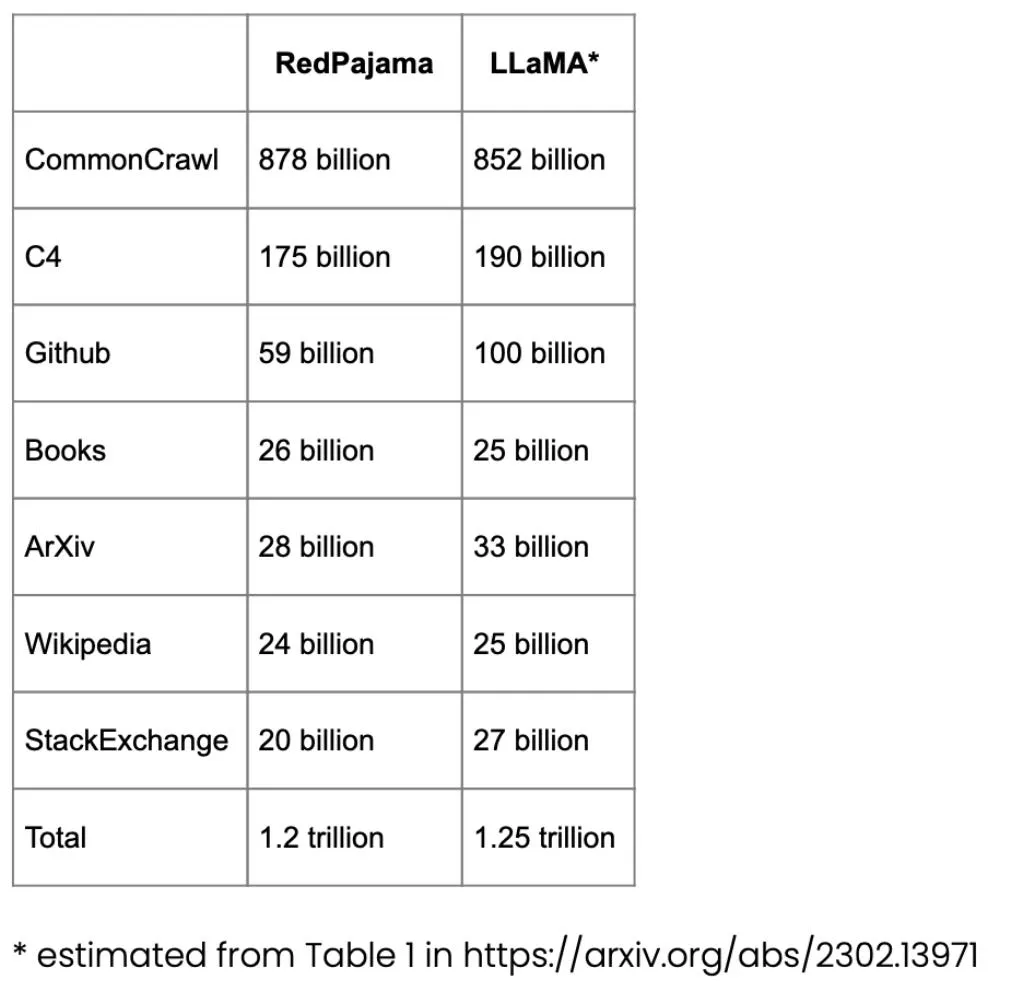
https://github.com/togethercomputer/RedPajama-Data 是一个用于大语言模型预训练的开源数据集,定位对标Meta的LLaMA模型这一业界标杆。该项目的目标是打造一款有竞争力的开源竞品,对标当前主流的闭源商业模型或仅部分开源的大语言模型。(注:RedPajama的名字灵感来自儿童读物《Llama Llama Red Pajama》,参见 https://www.rif.org/literacy-central/book/llama-llama-red-pajama 。)

该数据集的主体由经过英文网站过滤的CommonCrawl数据构成,其中的维基百科文章覆盖20种不同语言。

figure02
图注:旨在复现LLaMA预训练数据集的RedPajama数据集的词元数量(https://github.com/togethercomputer/RedPajama-Data)。

Databricks-Dolly-15

https://github.com/databrickslabs/dolly/tree/master/data 是一个用于大语言模型微调的数据集,包含超过15000条由数千名Databricks员工编写的指令对(与用于训练InstructGPT、ChatGPT等系统的数据类似)。

OpenAssistant对话数据集

file:///Users/sebastian/Developer/github_rasbt/ahead-of-ai/issues_drafts/newsletter-8/(https://huggingface.co/datasets/OpenAssistant/oasst1) 是另一个用于预训练模型微调的数据集,包含大量由人类创建并标注的类ChatGPT助手对话,涵盖35种语言的161443条消息,以及461292条质量评估。这些内容被组织在超过10000个经过完整标注的对话树中。

LongForm数据集

论文 https://arxiv.org/abs/2304.08460 介绍了一组来自C4、维基百科等权威语料库的人类撰写文档,并附带针对这些文档的指令,构建了适用于长文本生成的指令微调数据集。

Alpaca Libre

https://github.com/mobarski/alpaca-libre 项目旨在复现斯坦福Alpaca的效果(https://crfm.stanford.edu/2023/03/13/alpaca.html),将来自https://github.com/anthropics/hh-rlhf 的10万余条MIT许可演示数据转换为“Alpaca兼容格式”。

开放数据与版权问题

需要注意的是,大语言模型的数据使用仍是热议话题,以下文章对此做了总结:

最后,关于上文提到的Pythia模型所使用的Pile数据集,还有一则趣闻:据一条推文(https://twitter.com/BlancheMinerva/status/1648398673553018880?s=20)称,Pile实际上没有官方许可,但Eleuther AI的研究人员表示,它在美国境内可能符合版权法的规定。


扩展开源数据集

指令微调是我们从类GPT-3的预训练底座模型,升级到ChatGPT这类能力更强的大语言模型的途径。而像上文提到的Dolly这类开源人类指令数据集,正是实现这一过程的助力。但我们该如何进一步扩大规模?是否可以不用收集额外数据?其中一种方法是让大语言模型利用自身生成的结果进行自举。

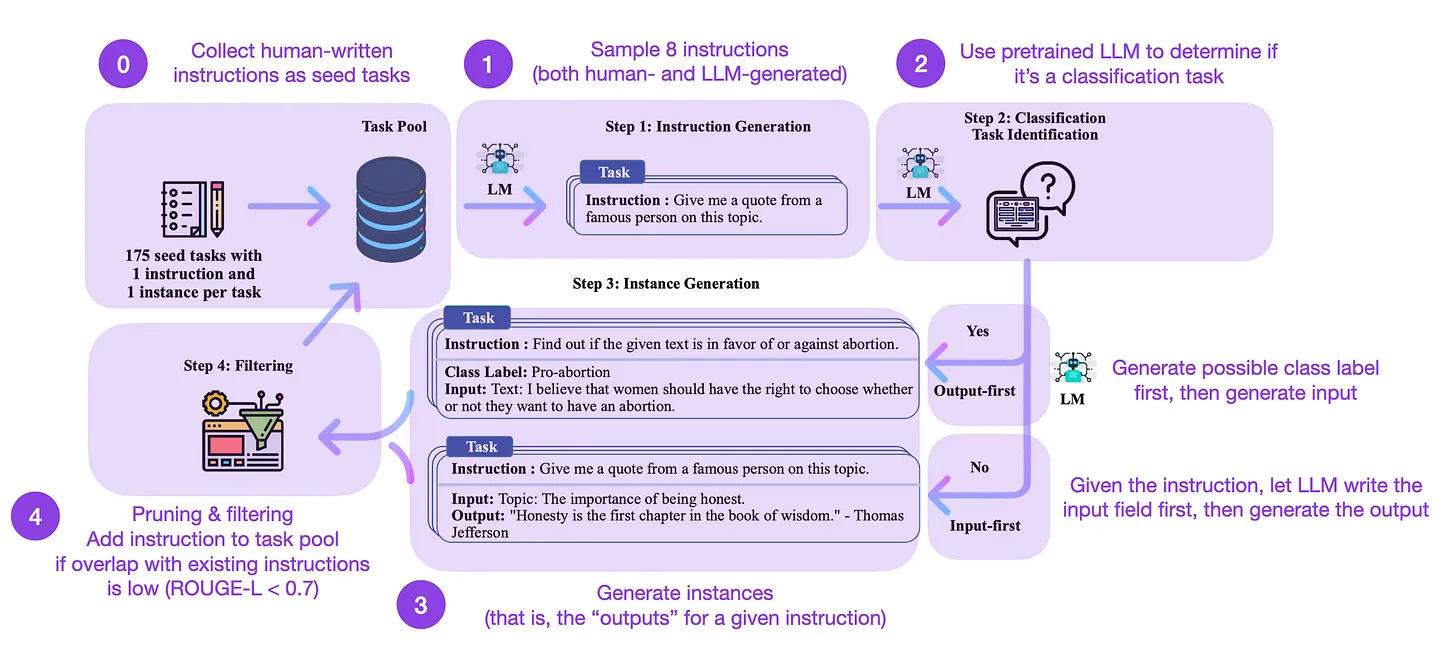
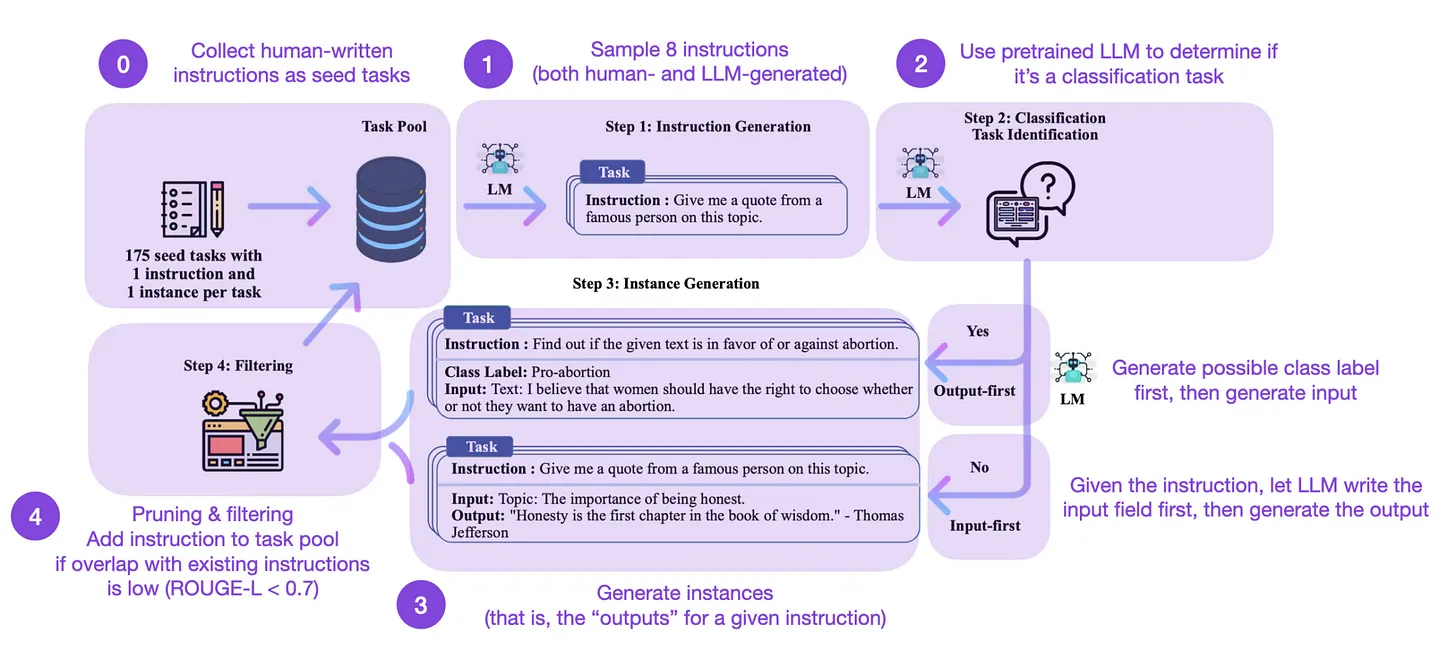
尽管 https://arxiv.org/abs/2212.10560 这篇论文发表于五个月前(按如今的标准已经算“旧”了),但它的思路仍然非常值得介绍——这是一种几乎无需标注的方法,可让预训练大语言模型与指令对齐。

它的工作原理是什么? 简而言之,这是一个四步流程:

  1. 用一组人类编写的指令(本研究中为175条)构建种子任务池,并采样指令;
  2. 用预训练大语言模型(如GPT-3)判断任务类别;
  3. 针对新的指令,让预训练大语言模型生成回答;
  4. 对生成的回答进行收集、修剪和过滤,再加入任务池。

figure03
图注:基于论文https://arxiv.org/abs/2212.10560的标注图。

实践中,从ROUGE分数来看,这种方法效果相当不错。例如,经过自指令(Self-Instruct)微调的大语言模型,性能优于GPT-3底座模型(1),并且能与在大规模人类指令集上预训练的大语言模型相媲美(2)。同时,自指令方法也能让已经经过人类指令微调的大语言模型进一步受益(3)。

当然,评估大语言模型的黄金标准是人类评分。基于人类评估的结果显示,自指令方法的效果优于底座模型,也优于在人类指令数据集上以监督方式训练的模型(SuperNI、T0 Trainer)。但有意思的是,自指令方法的表现不及基于人类反馈的强化学习(RLHF)训练的方法。

人类生成训练数据 vs 合成训练数据

人类生成的指令数据集和自指令数据集,哪个更有前景?我认为两者都有价值。为什么不先用像databricks-dolly-15k这样的1.5万条人类指令数据集起步,再用自指令方法扩大规模呢?例如,近期论文 https://arxiv.org/abs/2304.08466 表明,将真实图像训练集与AI生成图像相结合,可以提升模型性能。如果对文本数据也能验证这一规律,岂不是很有意思?

近期就有一篇朝着这个方向研究的论文:https://arxiv.org/abs/2304.01228 。研究人员发现,预训练大语言模型如果利用自身生成的数据,可以提升代码生成任务的表现。

少即是多?

除了在越来越大的数据集上进行预训练和微调,我们是否也可以研究如何在更小的数据集上提升效率?在刚刚发表的论文 https://arxiv.org/abs/2305.02301 中,研究人员提出了一种蒸馏机制,用于筛选出面向特定任务的更小模型,在训练数据更少的情况下,性能超过标准微调方法。

figure04
图注:截取自论文https://arxiv.org/abs/2305.02301。


追踪开源大语言模型

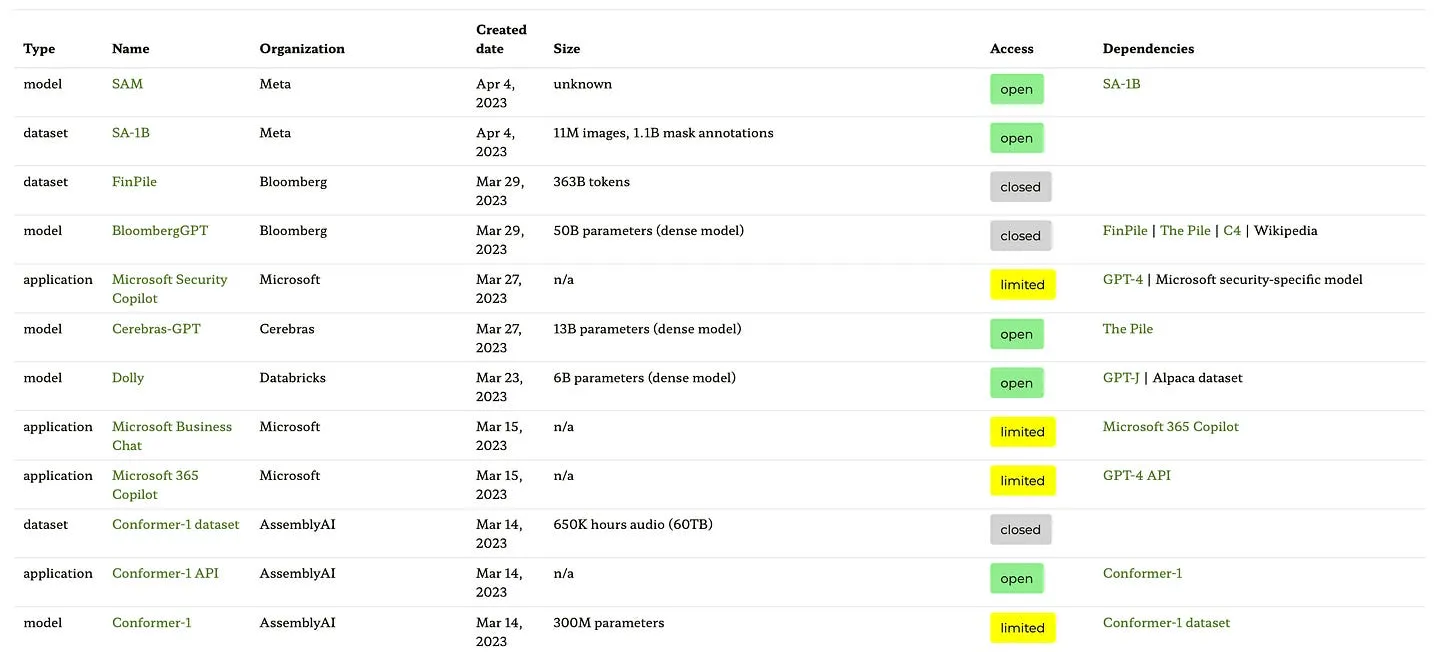
开源大语言模型的数量正在爆发式增长。一方面,这是非常好的发展趋势(相比通过付费API限制模型使用的模式);但另一方面,要全部跟进它们有时会很困难。以下四个资源从不同角度汇总了最具代表性的模型,包括它们的关联关系、底层数据集以及各类许可信息。

(一则有趣的旁注:LAION与其他知名研究者联合发布了一封致欧洲议会的公开信,参见 https://laion.ai/notes/letter-to-the-eu-parliament/ 。)

首先介绍的是斯坦福CRFM的生态系统图(https://crfm.stanford.edu/ecosystem-graphs/index.html?mode=table ),它基于论文https://arxiv.org/abs/2303.15772 制作,包含一张表格(截图见下)和一个交互式依赖关系图(未展示)。

figure05
图注:来自https://crfm.stanford.edu/ecosystem-graphs/的生态系统表格顶部截图。

这份生态系统图是我目前见过的收录最全面的清单。但由于纳入了许多小众大语言模型,整体看起来会有些繁杂。另外,根据其配套仓库https://github.com/stanford-crfm/ecosystem-graphs 的更新情况来看,这份清单至少已有一个月没有更新。同时,目前还不清楚是否会持续加入更新的模型(不过下面两个更新的资源也存在同样的问题)。

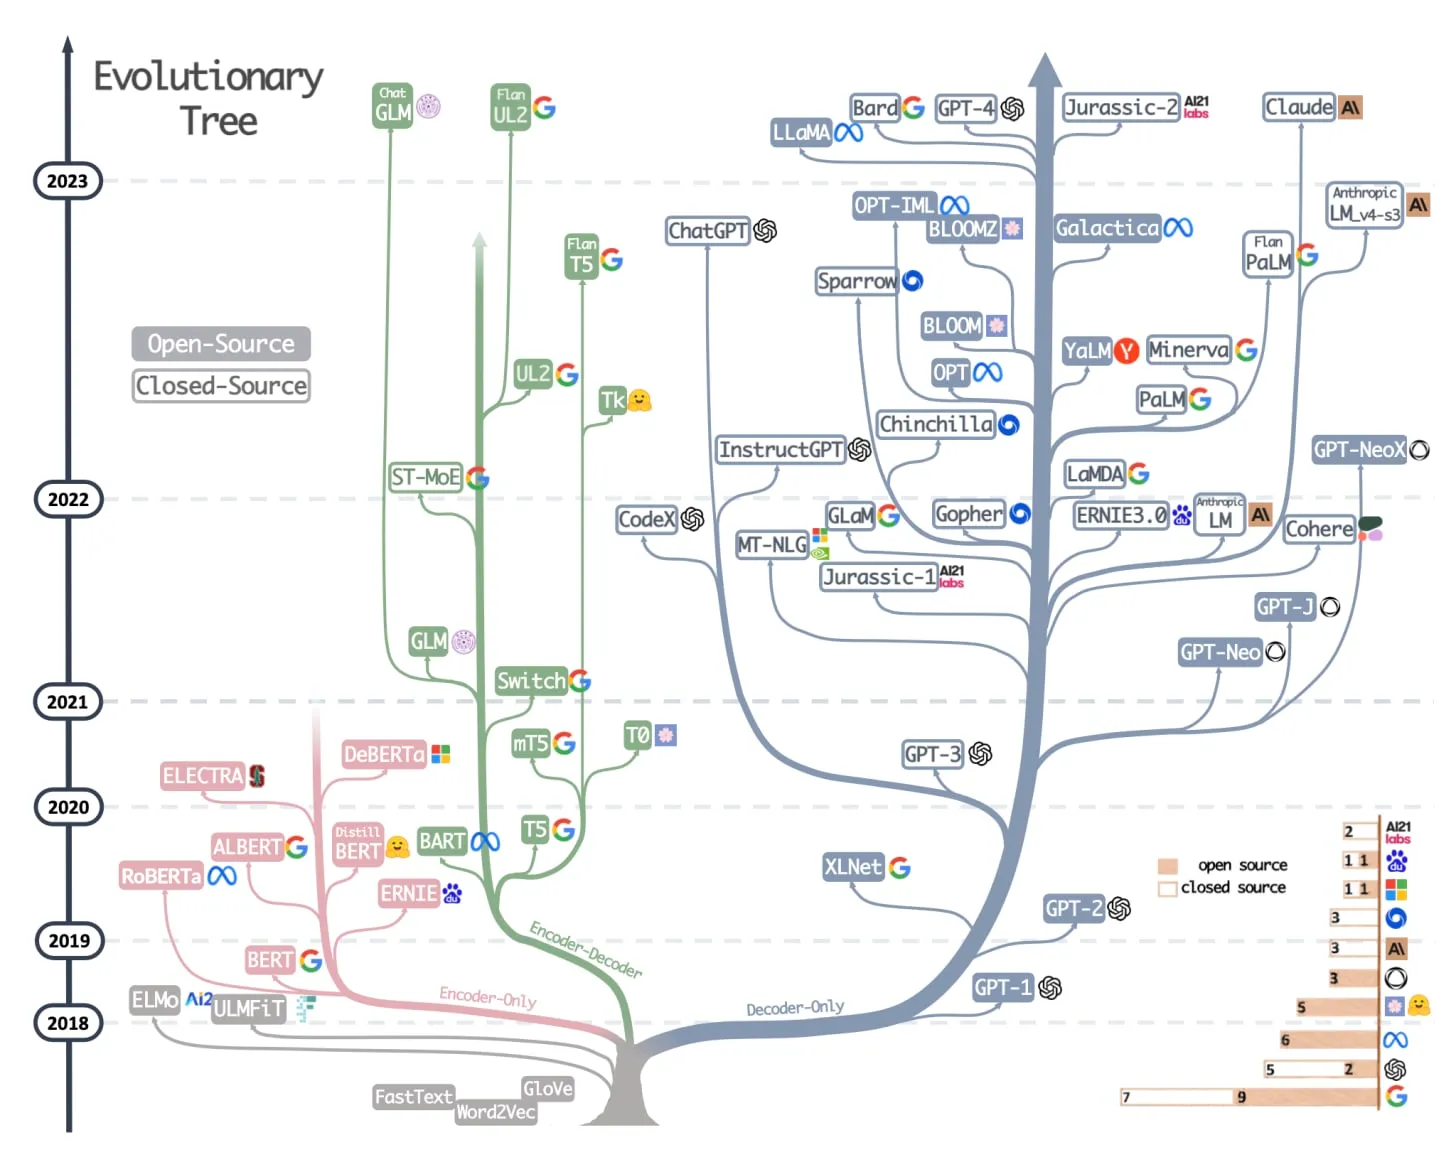
第二个资源是近期论文 https://arxiv.org/abs/2304.13712 中制作精美的演化树,它聚焦于最主流的大语言模型及其衍生关系。

figure06
图注:来自论文https://arxiv.org/abs/2304.13712的图。

尽管这份大语言模型演化树非常直观清晰,但也存在几处小瑕疵。例如,为什么树根没有追溯到https://arxiv.org/abs/1706.03762 中提出的原始Transformer架构?另外,“开源”的标签也不算特别准确——比如LLaMA被列为开源,但它的权重并未以开源许可发布(仅推理代码是开源的)。

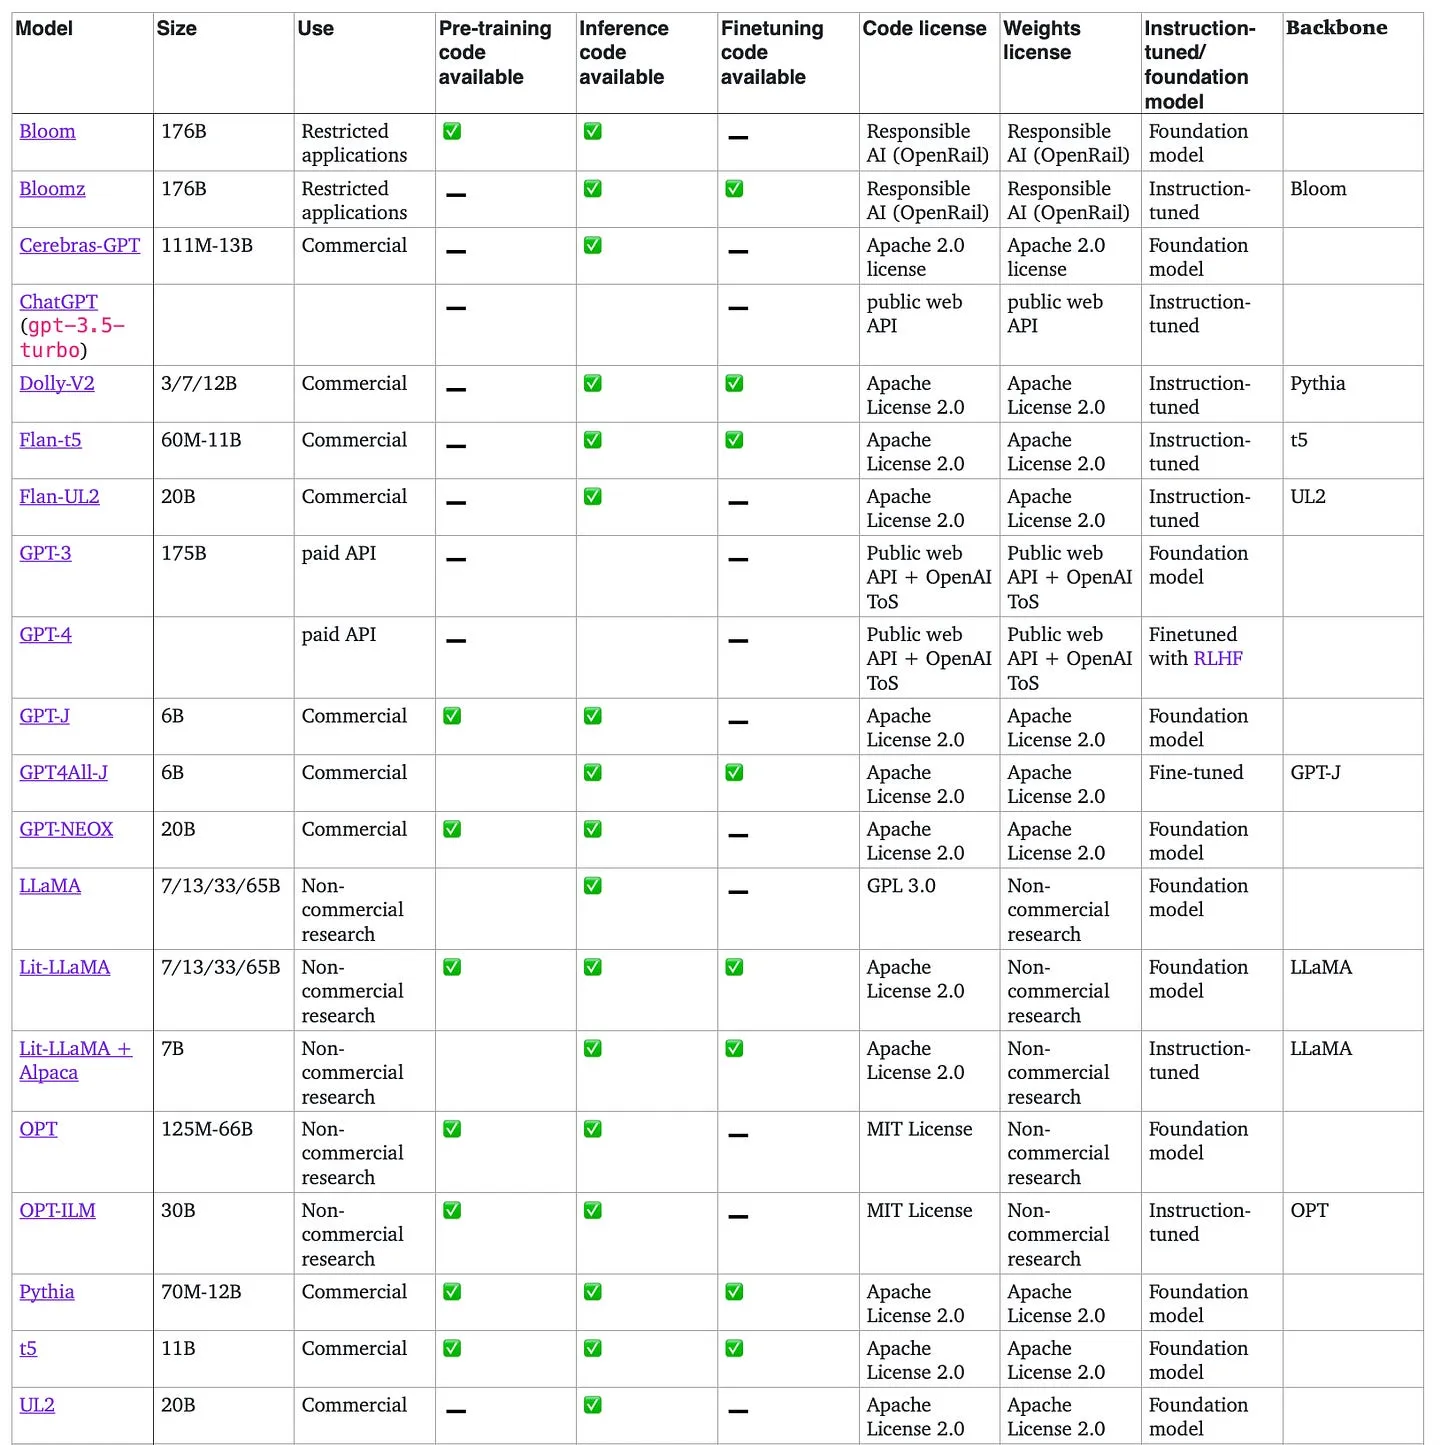
第三个资源是我的同事Daniela Dapena在博客文章中整理的表格,参见 https://lightning.ai/pages/community/community-discussions/the-ultimate-battle-of-language-models-lit-llama-vs-gpt3.5-vs-bloom-vs/

figure07
图注:来自https://lightning.ai/pages/community/community-discussions/the-ultimate-battle-of-language-models-lit-llama-vs-gpt3.5-vs-bloom-vs/的表格。

虽然这份表格的规模比其他资源小,但它的优点是包含了模型参数量和许可信息——如果你打算在项目中采用这些模型,这些信息具有非常实用的参考价值。

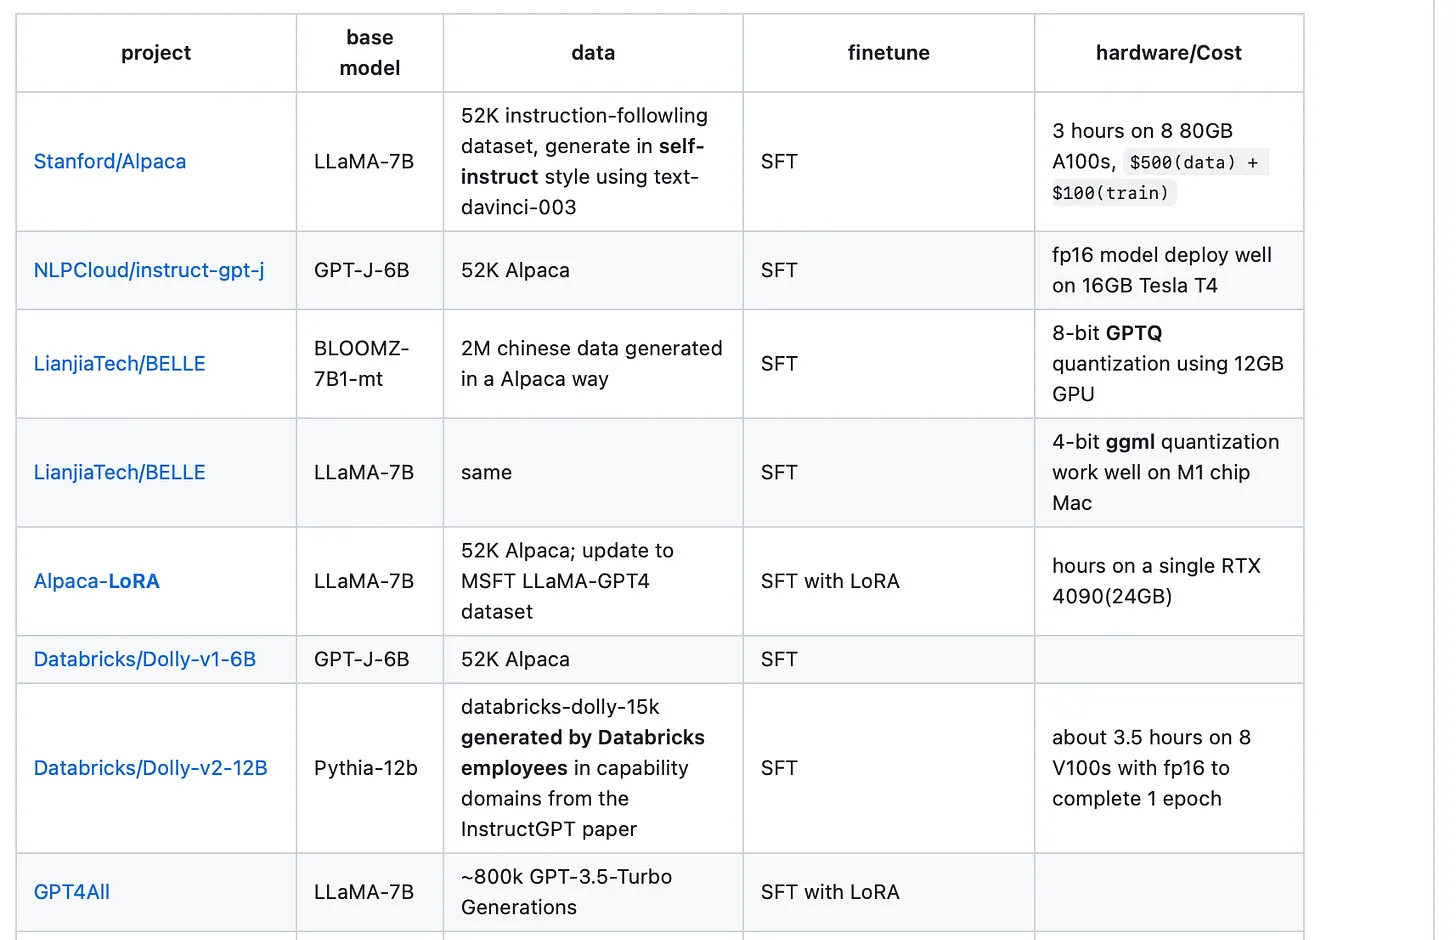
第四个资源是 https://github.com/shm007g/LLaMA-Cult-and-More/blob/main/chart.md,它补充了关于微调方法以及硬件成本的相关信息。

figure08
图注:截取自https://github.com/shm007g/LLaMA-Cult-and-More/blob/main/chart.md的表格。

接下来,如果能以某种方式把模型性能信息也加入这些表格就好了,但这完全是另一个难题——因为高效评估大语言模型本身就不是一件简单的事……


使用LLaMA-Adapter V2微调多模态大语言模型

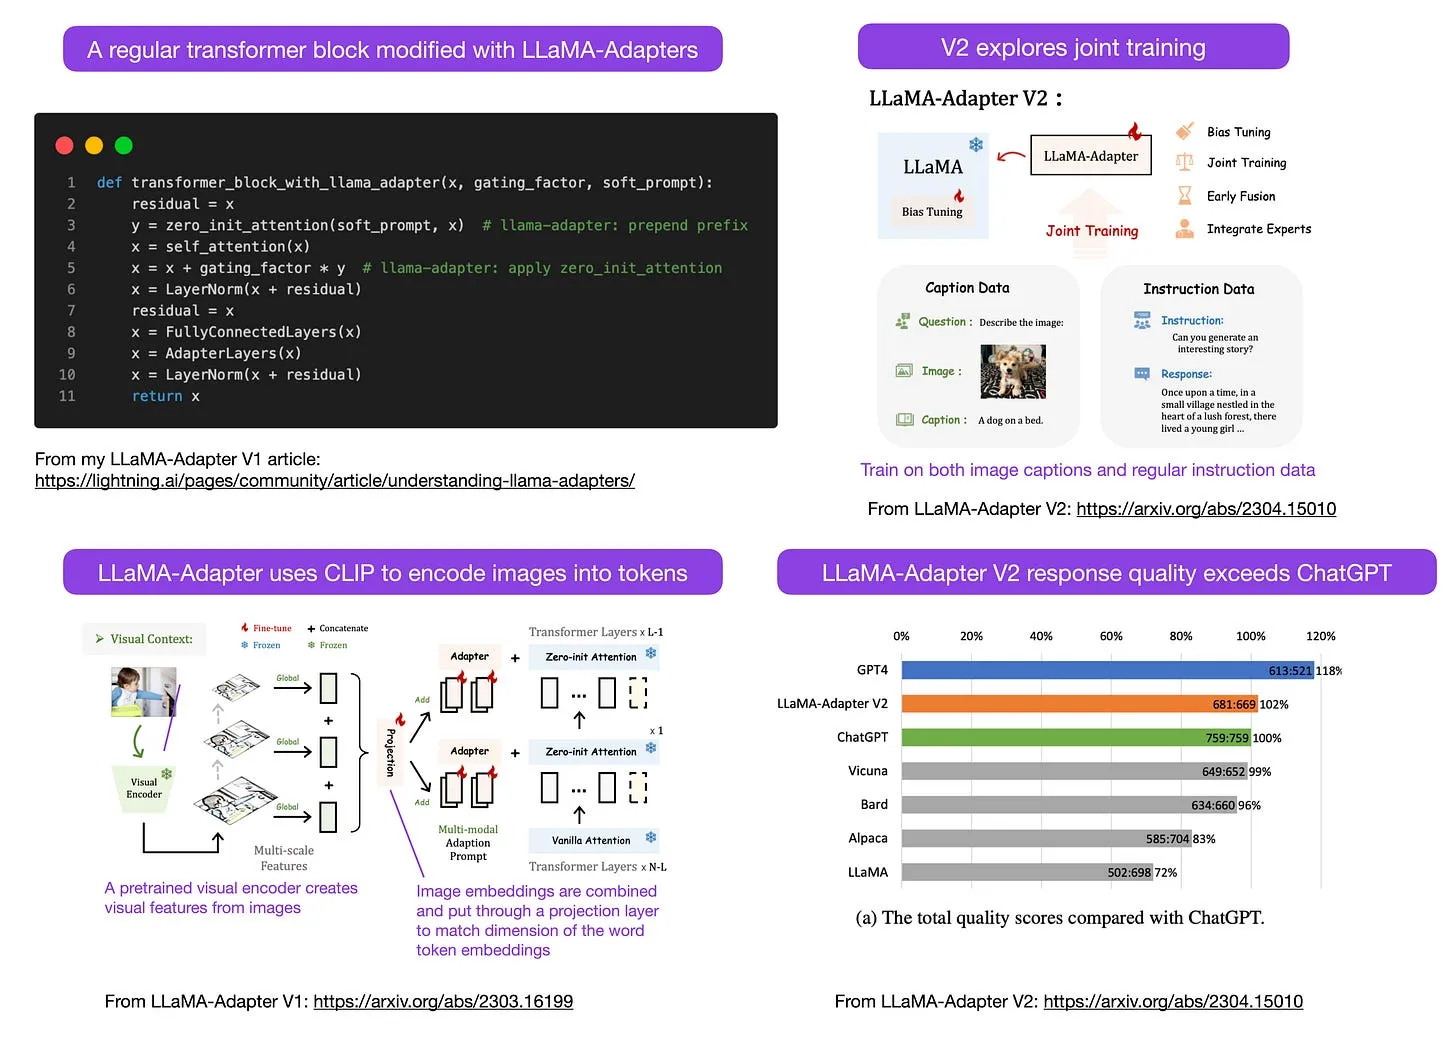
还记得上个月介绍的LLaMA-Adapter吗?它是一种针对大语言模型的参数高效微调技术。我当时还预测,本月会出现更多多模态大语言模型——那么我们就来聊聊刚发布的《LLaMA-Adapter V2:参数高效的视觉指令模型》!

先简要回顾:什么是LLaMA-Adapter?它的工作原理是什么?LLaMA-Adapter是一种参数高效的大语言模型微调技术,它仅修改前几个Transformer块,并引入门控机制来稳定训练过程。

借助LLaMA-Adapter方法,研究人员仅用5.2万条指令对,在8张A100 GPU上仅耗时1小时,就完成了70亿参数LLaMA模型的微调。整个过程中,7B的LLaMA底座模型保持冻结,仅训练新增的120万参数(即适配层)。

LLaMA-Adapter V2的重点是多模态能力,也就是构建一个能够处理图像输入的视觉指令模型。(原始V1版本其实也可以接收图像标记(与文本标记一起),但这一方面的潜力没有得到充分挖掘。)

从V1到V2,研究人员主要新增了三项技巧来改进适配方法:

  1. 视觉知识早期融合:不再在每个适配层中融合视觉提示与适配后的提示,而是在第一个Transformer块中就将视觉标记与文本标记拼接。
  2. 引入更多参数:解冻所有归一化层,并为Transformer块中的每个线性层都添加偏置单元和缩放因子。
  3. 参数分离的联合训练:对于图文字幕数据,仅训练视觉投影层;对于指令跟随数据,仅训练适配层(以及上述新增的参数)。

LLaMA V2(1400万参数)的参数量略多于LLaMA V1(120万参数),但整体仍然非常轻量,仅占650亿参数LLaMA模型总参数的0.02%。

尤其令人印象深刻的是,仅微调65B LLaMA模型中的1400万参数,微调后的LLaMA-Adapter V2模型在性能上就能追平ChatGPT(采用GPT-4模型进行评估),并且性能超过了采用全量微调方式(更新全部130亿参数)的13B Vicuna模型。

遗憾的是,V2论文没有包含V1论文中的计算性能基准,但我们可以推测V2的训练速度仍然远快于全量微调。

figure09


两句话研究亮点

由于本期通讯篇幅较长,我决定把我为这一部分挑选并总结的17篇论文,移到单独的一篇文章中,计划下周发布。到时候说不定我还会再多补充几篇。敬请期待!


开源亮点

Lit-LLaMA的改进

在Lightning AI,我们一直在维护 https://github.com/Lightning-AI/lit-llama 仓库,它提供了热门LLaMA模型的更简洁、可读性更强的开源实现,同时支持多种微调方法,包括 https://arxiv.org/abs/2106.09685 和 https://arxiv.org/abs/2303.16199 中提出的方法、量化技术等。

该仓库近期新增内容包括:

其他开源大语言模型

全部列举是不可能的,但本月推出的知名开源大语言模型与聊天机器人还包括:https://github.com/LAION-AI/Open-Assistant 、https://github.com/project-baize/baize-chatbot 、https://github.com/Stability-AI/StableLM 、https://github.com/hpcaitech/ColossalAI/tree/main/applications/Chat 、https://github.com/mosaicml/llm-foundry 等等。此外,还有两款多模态大语言模型尤其值得关注。

OpenFlamingo

https://github.com/mlfoundations/open_flamingo 是谷歌DeepMind去年发布的Flamingo模型的开源复现版本。OpenFlamingo旨在为大语言模型提供多模态图像推理能力,让用户可以交错输入文本和图像。

MiniGPT-4

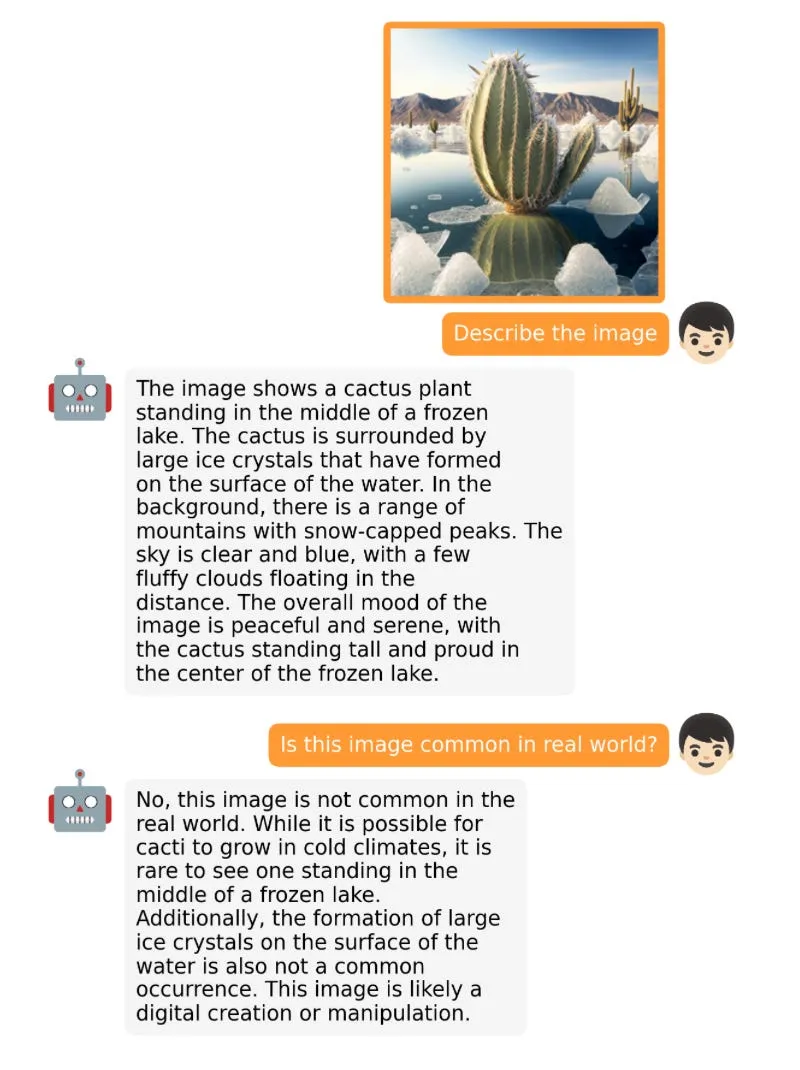
https://github.com/Vision-CAIR/MiniGPT-4 是另一款具备视觉-语言能力的开源模型。它基于冻结的视觉编码器(来自https://arxiv.org/abs/2301.1259 )和冻结的Vicuna模型(https://lmsys.org/blog/2023-03-30-vicuna/ )构建。

figure10
图注:MiniGPT-4截图,来源:https://github.com/Vision-CAIR/MiniGPT-4。

NeMo Guardrails

随着大量新模型的涌现,很多公司都在思考如何部署、以及是否应该部署这些模型,尤其是安全方面的考量。目前还没有完美的解决方案,但至少有一个颇具前景的临时方案:https://github.com/NVIDIA/NeMo-Guardrails

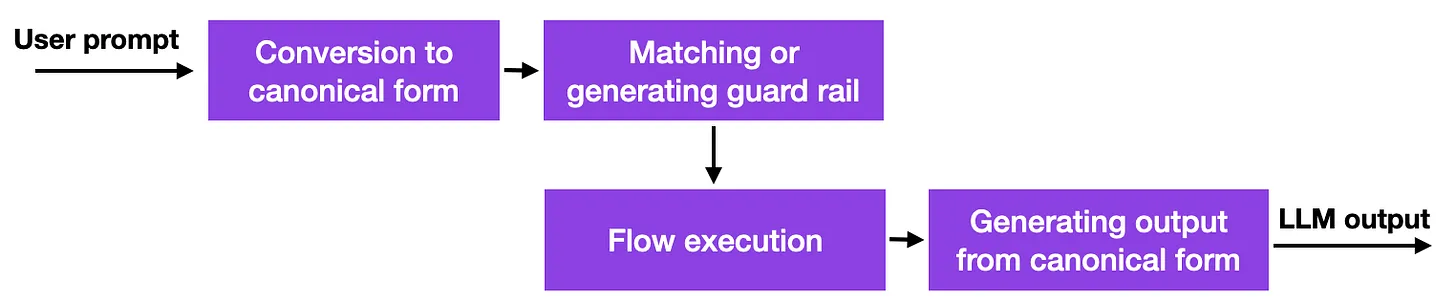
简而言之,它的工作原理是:该方法使用一个数据库,关联到需要人工精心编写的硬编码提示。当用户输入提示时,系统首先将其与数据库中最相似的条目匹配,然后数据库返回对应的硬编码提示,再传递给大语言模型。这样一来,只要对硬编码提示进行充分测试,就能确保对话不会偏离允许的主题范围。

figure11
图注:NeMo护栏概念示意图。

这是一个有意思但算不上突破性的方法,因为它并没有赋予大语言模型更强或更新的能力,只是限制了用户与大语言模型交互的范围。不过,在研究人员找到其他缓解大语言模型幻觉问题和有害行为的方法之前,这可能仍是一个可行的方案。

护栏方法还可以与其他对齐技术结合使用,比如我在 https://magazine.sebastianraschka.com/p/ahead-of-ai-6-train-differently 一文中介绍的、流行的基于人类反馈的强化学习训练范式。

一致性模型

聊点大语言模型之外的有趣模型不好吗?OpenAI终于开源了他们的一致性模型代码:https://github.com/openai/consistency_models

一致性模型被认为是扩散模型的一种可行、高效的替代方案。更多信息详见论文 https://arxiv.org/abs/2303.01469。


深度学习基础课程新增单元:计算机视觉与大语言模型

过去几周,我的免费《深度学习基础》课程刚上线了两个新单元。

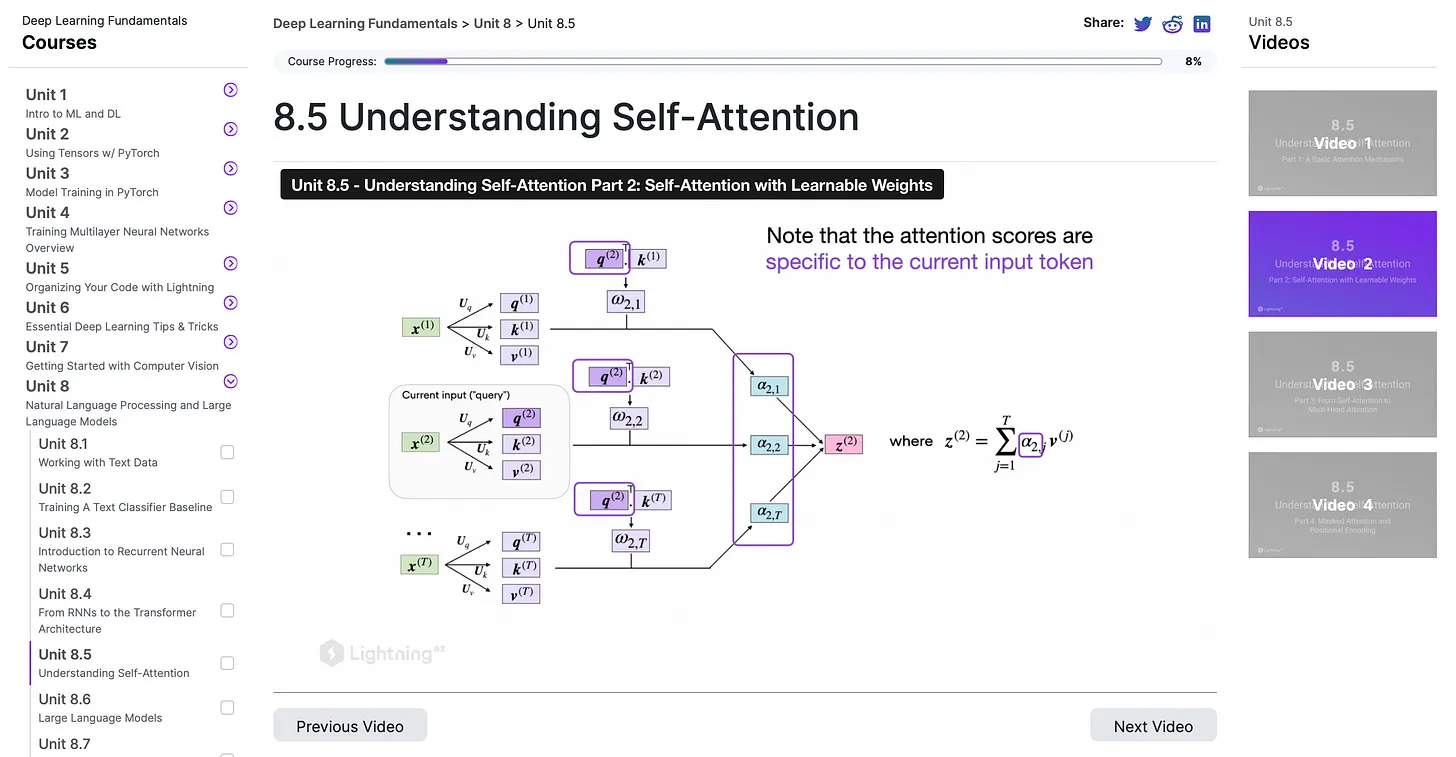
当然,两个单元都包含大量代码示例和基于PyTorch的实操讲解。课程完全免费,视频时长较短,内容精炼。希望大家能有所收获!

figure12
图注:《深度学习基础》课程幻灯片截图,来源:https://lightning.ai/pages/courses/deep-learning-fundamentals/unit-8.0-natural-language-processing-and-large-language-models/


名言引用

“我认为,那种追求巨型、超巨型模型的时代已经结束了。……我们会通过其他方式让模型变得更好。”
——OpenAI首席执行官萨姆·奥尔特曼(Sam Altman),出自 https://www.wired.com/story/openai-ceo-sam-altman-the-age-of-giant-ai-models-is-already-over/


这本杂志是我个人的兴趣项目,不提供直接报酬。不过,如果您愿意支持我,可以考虑购买我的书籍:https://sebastianraschka.com/books 。如果您觉得这些书有洞察力、有帮助,也欢迎推荐给您的朋友和同事。

figure13

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics ,以及 http://mng.bz/M96o

您的支持对我意义重大!非常感谢!

【转载】理解大语言模型参数高效微调:提示调优与前缀调优

原文地址:Understanding Parameter-Efficient LLM Finetuning: Prompt Tuning And Prefix Tuning,by Sebastian Raschka, on 2023-04-30

理解大语言模型参数高效微调:提示调优与前缀调优

上周我概述了大语言模型(LLM)的各类微调技术。接下来我会用一系列短文,逐一讲解其中最具实用价值的核心方法。

《大语言模型微调》

我们先从几类基于提示修改的参数高效微调技术讲起。

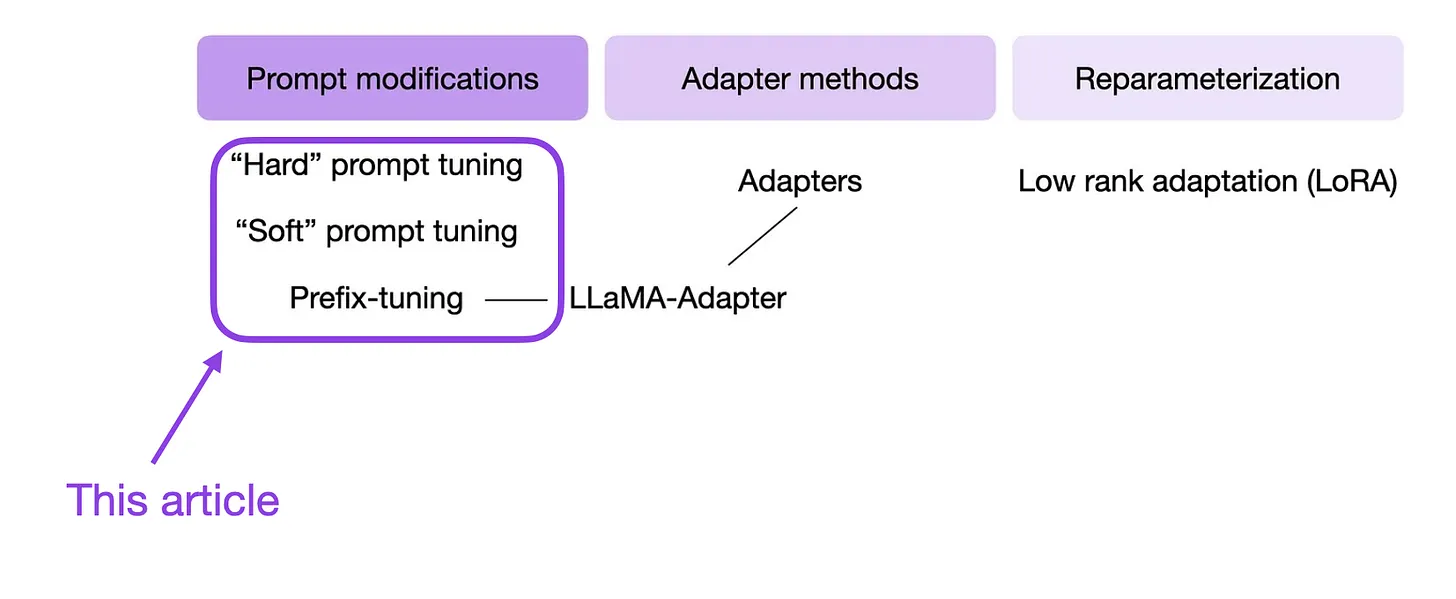
本文将覆盖的参数高效微调技术一览:

figure01

Continue reading 【转载】理解大语言模型参数高效微调:提示调优与前缀调优→

【转载】大语言模型微调

原文地址:
Finetuning Large Language Models,by Sebastian Raschka, on 2023-04-22

大语言模型微调

核心思想与方法入门

在人工智能这个飞速发展的领域中,高效、有效地运用大语言模型(LLM)已变得愈发重要。但大语言模型的使用方式多种多样,如果你是刚入门的学习者,难免会感到无从下手。
本质上,我们将预训练大语言模型应用于新任务主要有两种方式:上下文学习(in-context learning)与微调(finetuning)。
本文将先简要介绍上下文学习的含义,再详细讲解微调大语言模型的各类方法。

上下文学习与索引

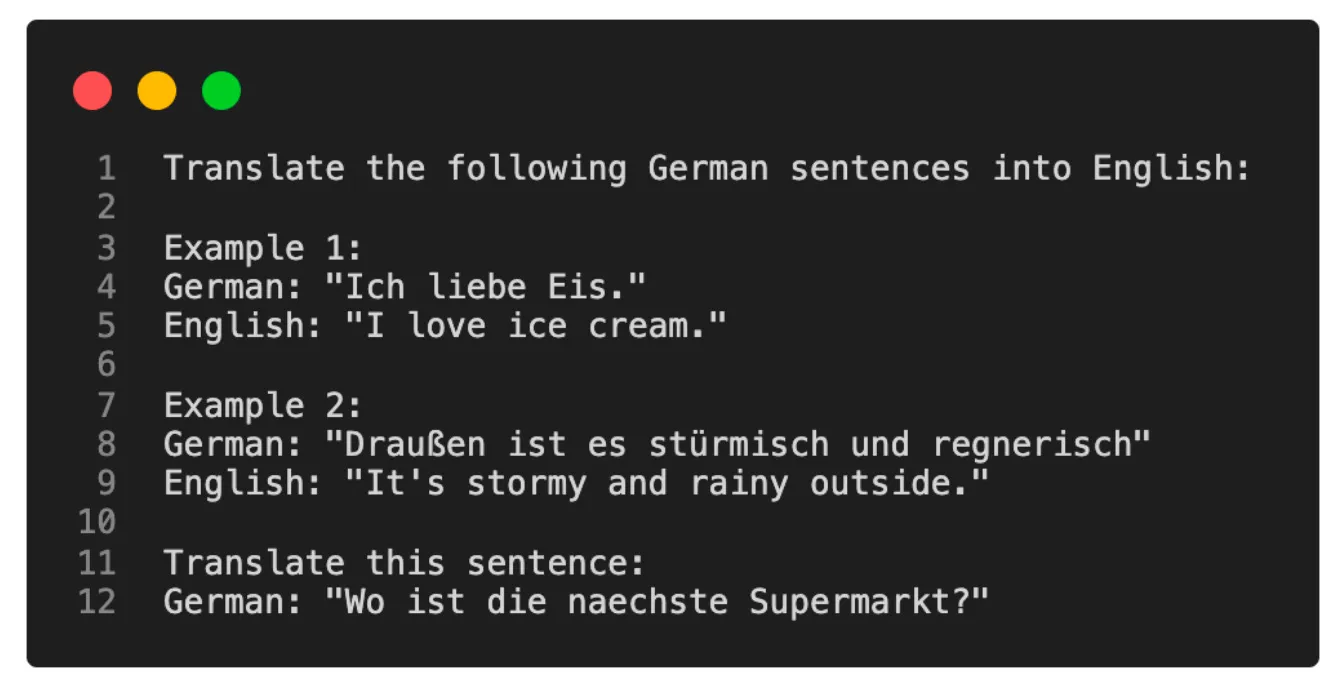
自GPT-2(https://d4mucfpksywv.cloudfront.net/better-language-models/language_models_are_unsupervised_multitask_learners.pdf)与GPT-3(https://arxiv.org/abs/2005.14165)问世以来,我们已经证实:在通用文本语料上预训练的生成式大语言模型具备上下文学习能力。也就是说,如果要执行模型未经过专门训练的特定任务或新任务,我们无需对预训练大语言模型进行额外训练或微调,只需通过输入提示词直接提供几个目标任务的示例即可,如下图所示。
figure01
图:上下文学习示例

如果无法直接访问模型(比如通过API调用模型时),上下文学习是非常实用的方法。
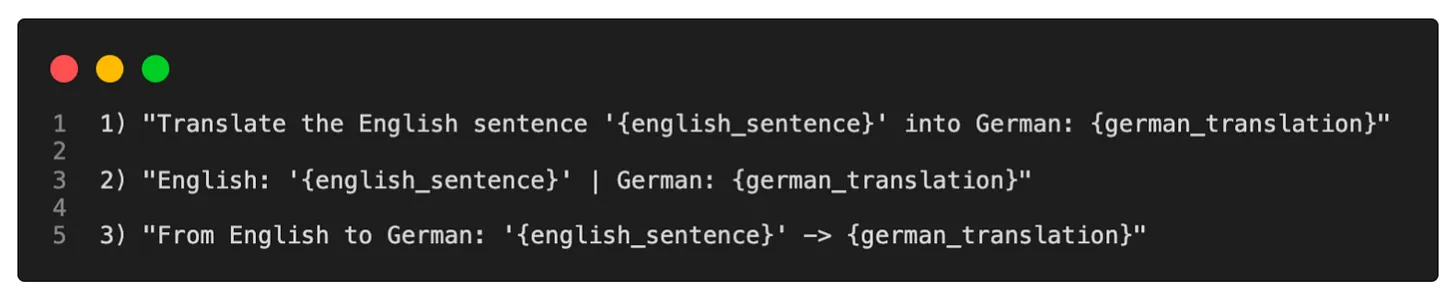
与上下文学习相关的概念是硬提示调优(hard prompt tuning),即通过修改输入内容来优化输出效果,如下图所示。
figure02
图:(硬)提示调优示意图

顺便一提,之所以叫“硬”提示调优,是因为我们直接修改输入的文本或词元(token)。后文我们还会介绍一种可微分的版本,叫做软提示调优(soft prompt tuning)(也常简称为提示调优)。
相较于参数微调,上述提示调优方法的资源消耗更低,但效果通常不及微调——因为它没有针对特定任务更新模型参数,可能难以适配任务的细节特性。此外,提示调优往往需要人工反复对比不同提示的效果,人力成本较高。

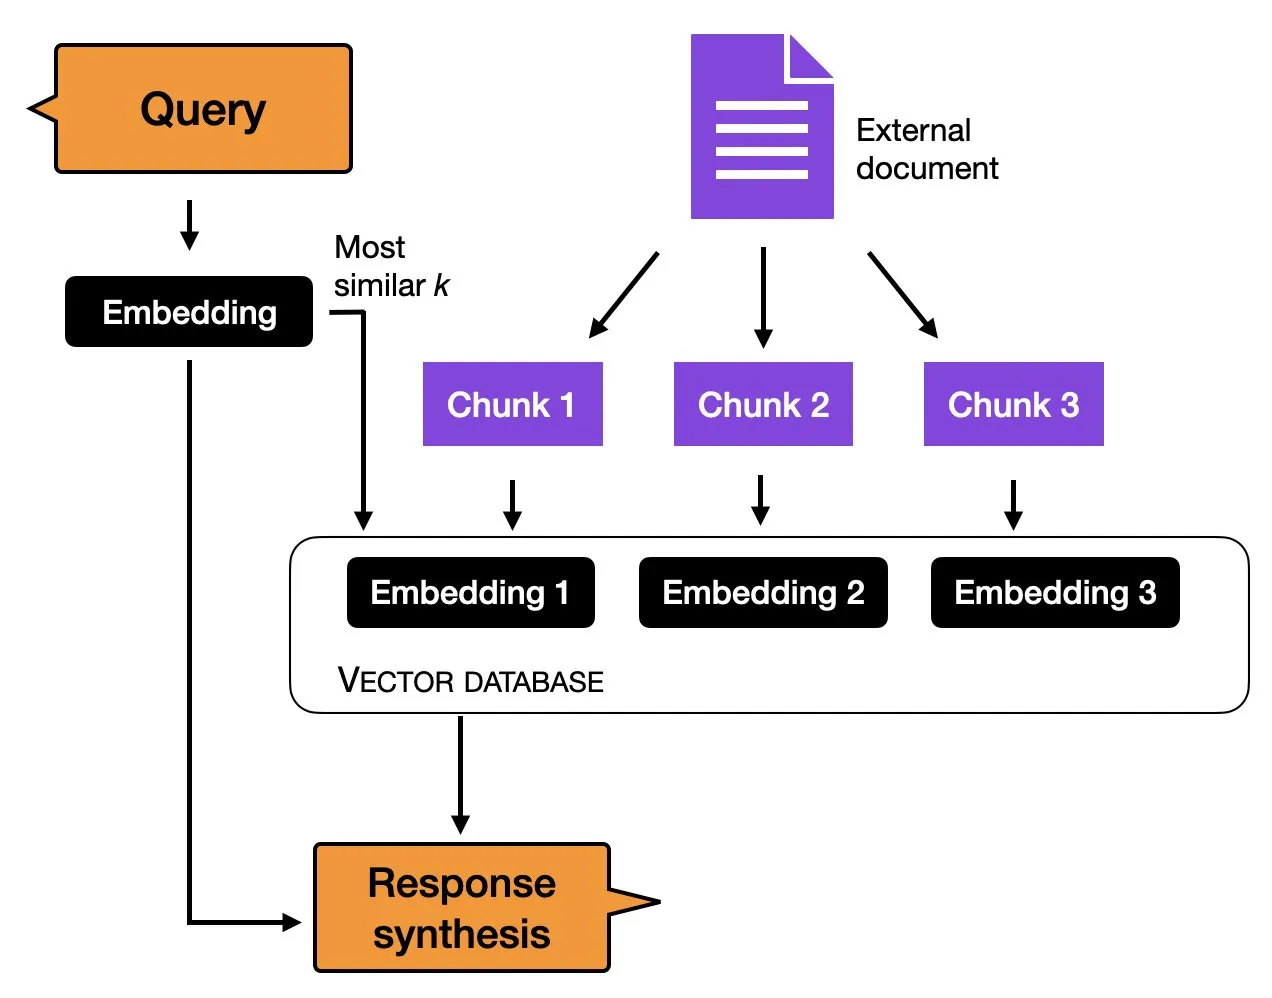
在深入讨论微调之前,再介绍一种纯上下文学习思路的衍生方法:索引(indexing)。在大语言模型领域,索引可以看作是上下文学习的一种变通方案,它能将大语言模型改造为信息检索系统,从外部资源和网站中提取数据。其流程是:索引模块将文档或网站拆分为更小的片段,将其转换为向量并存入向量数据库;当用户提交查询时,索引模块计算查询的嵌入向量与数据库中每个向量的相似度,最终取回相似度最高的前k个嵌入结果来生成回答。
figure03
图:索引方法示意图

三种传统的基于特征的方法与微调方法

当无法直接访问大语言模型时(比如通过API或用户界面交互时),上下文学习是一种实用且易用的方法。
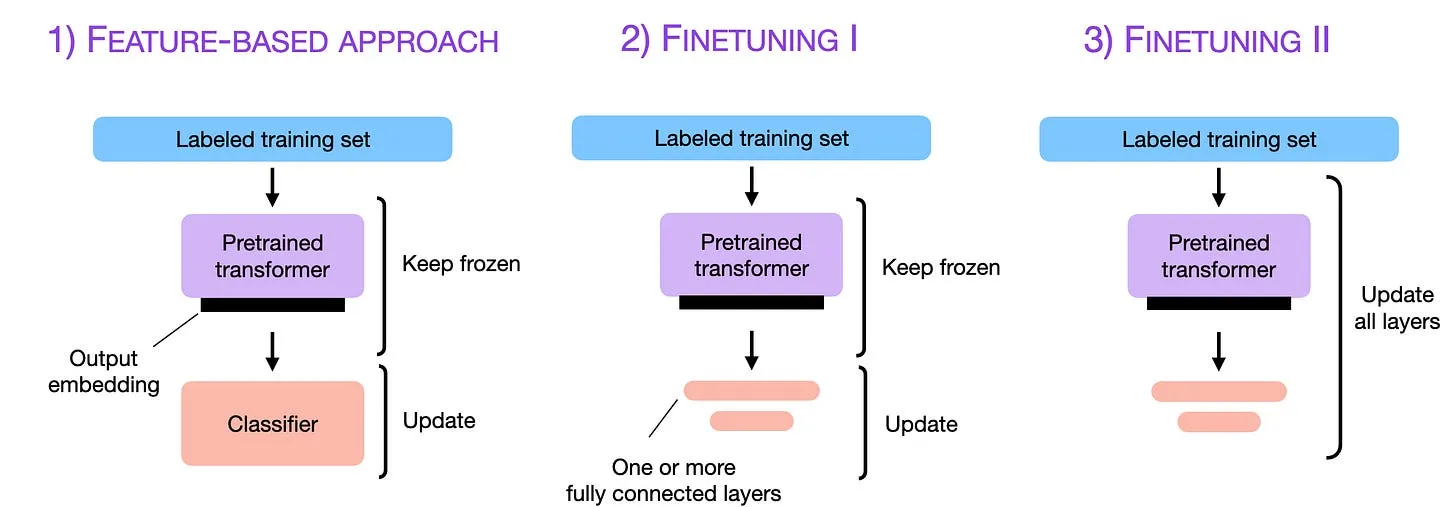
但如果我们有权限直接操作模型,使用目标领域的数据针对特定任务对模型进行适配和微调,通常能得到更优的效果。那么,如何让模型适配目标任务?下图概括了三种传统方法。
figure04
图:三种传统的基于特征的方法与微调方法

为了让下文的讨论更具实操参考性,我们以BERT(https://arxiv.org/abs/1810.04805<)这类编码器架构的大语言模型为例,针对分类任务进行微调(为简化起见,这里的分类任务是判断电影评论的情感倾向是正面还是负面)。需要说明的是,这些方法不仅适用于编码器架构的大语言模型,同样也适用于GPT这类解码器架构的大语言模型,后续文章会给出对应的示例。此外,我们也可以对解码器架构的大语言模型进行微调,让它针对特定指令生成多句回答,而不只是做文本分类,相关实操示例也会在后续文章中提供。/p>

1)基于特征的方法

在基于特征的方法中,我们加载预训练大语言模型,将其作用于目标数据集。核心是生成训练集的输出嵌入向量,用这些嵌入作为输入特征来训练分类模型。这种方法在BERT这类侧重嵌入的模型中尤为常用,不过我们也可以从GPT类生成式模型中提取嵌入向量。
分类模型可以选用逻辑回归、随机森林、XGBoost等任意模型(不过根据经验,逻辑回归这类线性分类器在这里效果最好)。
从原理上,我们可以用如下代码来表示基于特征的方法:

model = AutoModel.from_pretrained("distilbert-base-uncased")
# ...
# tokenize dataset
# ...
# generate embeddings
@torch.inference_mode()
def get_output_embeddings(batch):
    output = model(
        batch["input_ids"],
        attention_mask=batch["attention_mask"]
    ).last_hidden_state[:, 0]
return {"features": output}

dataset_features = dataset_tokenized.map(
    get_output_embeddings, batched=True, batch_size=10)

X_train = np.array(imdb_features["train"]["features"])
y_train = np.array(imdb_features["train"]["label"])

X_val = np.array(imdb_features["validation"]["features"])
y_val = np.array(imdb_features["validation"]["label"])

X_test = np.array(imdb_features["test"]["features"])
y_test = np.array(imdb_features["test"]["label"])

# train classifier
from sklearn.linear_model import LogisticRegression

clf = LogisticRegression()
clf.fit(X_train, y_train)

print("Training accuracy", clf.score(X_train, y_train))
print("Validation accuracy", clf.score(X_val, y_val))
print("test accuracy", clf.score(X_test, y_test))

(感兴趣的读者可以在以下链接找到完整代码示例:https://github.com/rasbt/LLM-finetuning-scripts/tree/main/conventional/distilbert-movie-review)

2)微调I —— 更新输出层

与上述基于特征的方法相关的一种常用方法是微调输出层(我们称之为“微调I”)。和基于特征的方法类似,我们冻结预训练大语言模型的所有参数,只训练新增的输出层——这相当于在嵌入特征上训练一个逻辑回归分类器,或是一个小型多层感知机。
对应的代码如下:

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-uncased",
     num_labels=2
)

# freeze all layers
for param in model.parameters():
    param.requires_grad = False

# then unfreeze the two last layers (output layers)
for param in model.pre_classifier.parameters():
    param.requires_grad = True

for param in model.classifier.parameters():
    param.requires_grad = True

# finetune model
lightning_model = CustomLightningModule(model)
trainer = L.Trainer(
    max_epochs=3,
    ...
)
trainer.fit(
    model=lightning_model,
    train_dataloaders=train_loader,
    val_dataloaders=val_loader)

# evaluate model
trainer.test(lightning_model, dataloaders=test_loader)

(感兴趣的读者可以在以下链接找到完整代码示例:https://github.com/rasbt/LLM-finetuning-scripts/tree/main/conventional/distilbert-movie-review)

从理论上讲,由于使用的是同一个冻结的主干模型,这种方法在模型效果和训练速度上应该和基于特征的方法相近。不过基于特征的方法可以更方便地预计算并存储训练集的嵌入特征,因此在某些实际场景下可能更易用。

3)微调II —— 更新所有层

原始BERT论文(https://arxiv.org/abs/1810.04805)中提到,仅微调输出层也能达到与微调全层相近的效果,但微调全层的计算成本要高得多,因为涉及的参数量更大。例如,BERT-base模型大约有1.1亿个参数,而用于二分类的输出层只有1500个参数;即使是最后两层,参数量也只有6万,仅占模型总参数量的0.6%左右。
最终效果取决于目标任务、目标领域与模型预训练数据集的相似程度。但在实际应用中,微调全层几乎总能带来更优的模型效果。
因此,如果追求最优的模型效果,使用预训练大语言模型的黄金标准就是更新所有层(即本文所说的“微调II”)。原理上,微调II和微调I非常相似,唯一的区别是:我们不会冻结预训练大语言模型的参数,而是对其也进行微调:

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-uncased",
     num_labels=2
)

# freeze layers (which we don't do here)
# for param in model.parameters():
#    param.requires_grad = False

# finetune model
lightning_model = LightningModel(model)
trainer = L.Trainer(
    max_epochs=3,
    ...
)
trainer.fit(
    model=lightning_model,
    train_dataloaders=train_loader,
    val_dataloaders=val_loader)

# evaluate model
trainer.test(lightning_model, dataloaders=test_loader)

(感兴趣的读者可以在以下链接找到完整代码示例:https://github.com/rasbt/LLM-finetuning-scripts/tree/main/conventional/distilbert-movie-review)

如果你想了解实际效果,上述代码片段基于预训练的DistilBERT-base模型训练了一个电影评论分类器(代码笔记本可在此处获取:https://github.com/rasbt/LLM-finetuning-scripts/tree/main/conventional/distilbert-movie-review),结果如下:

  1. 基于特征的方法+逻辑回归:测试准确率83%
  2. 微调I(更新最后2层):准确率87%
  3. 微调II(更新所有层):准确率92%

这一结果符合通用经验法则:微调的层数越多,模型效果通常越好,但计算成本也越高。
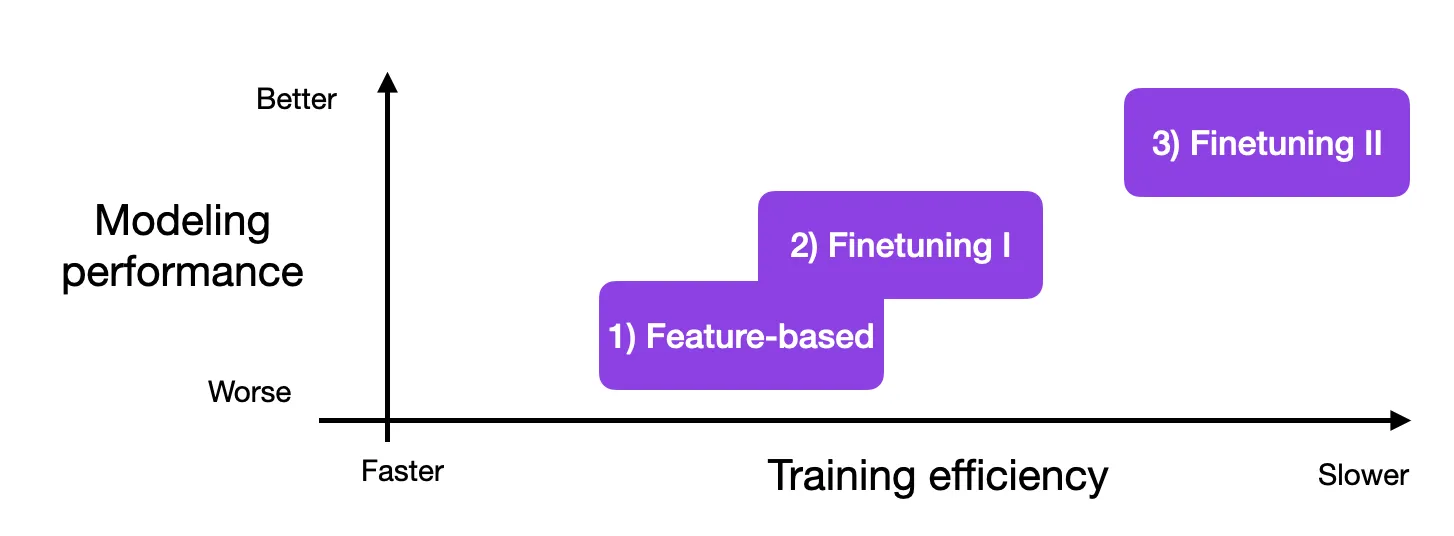
figure05
图:不同方法的计算成本与模型效果权衡经验参考

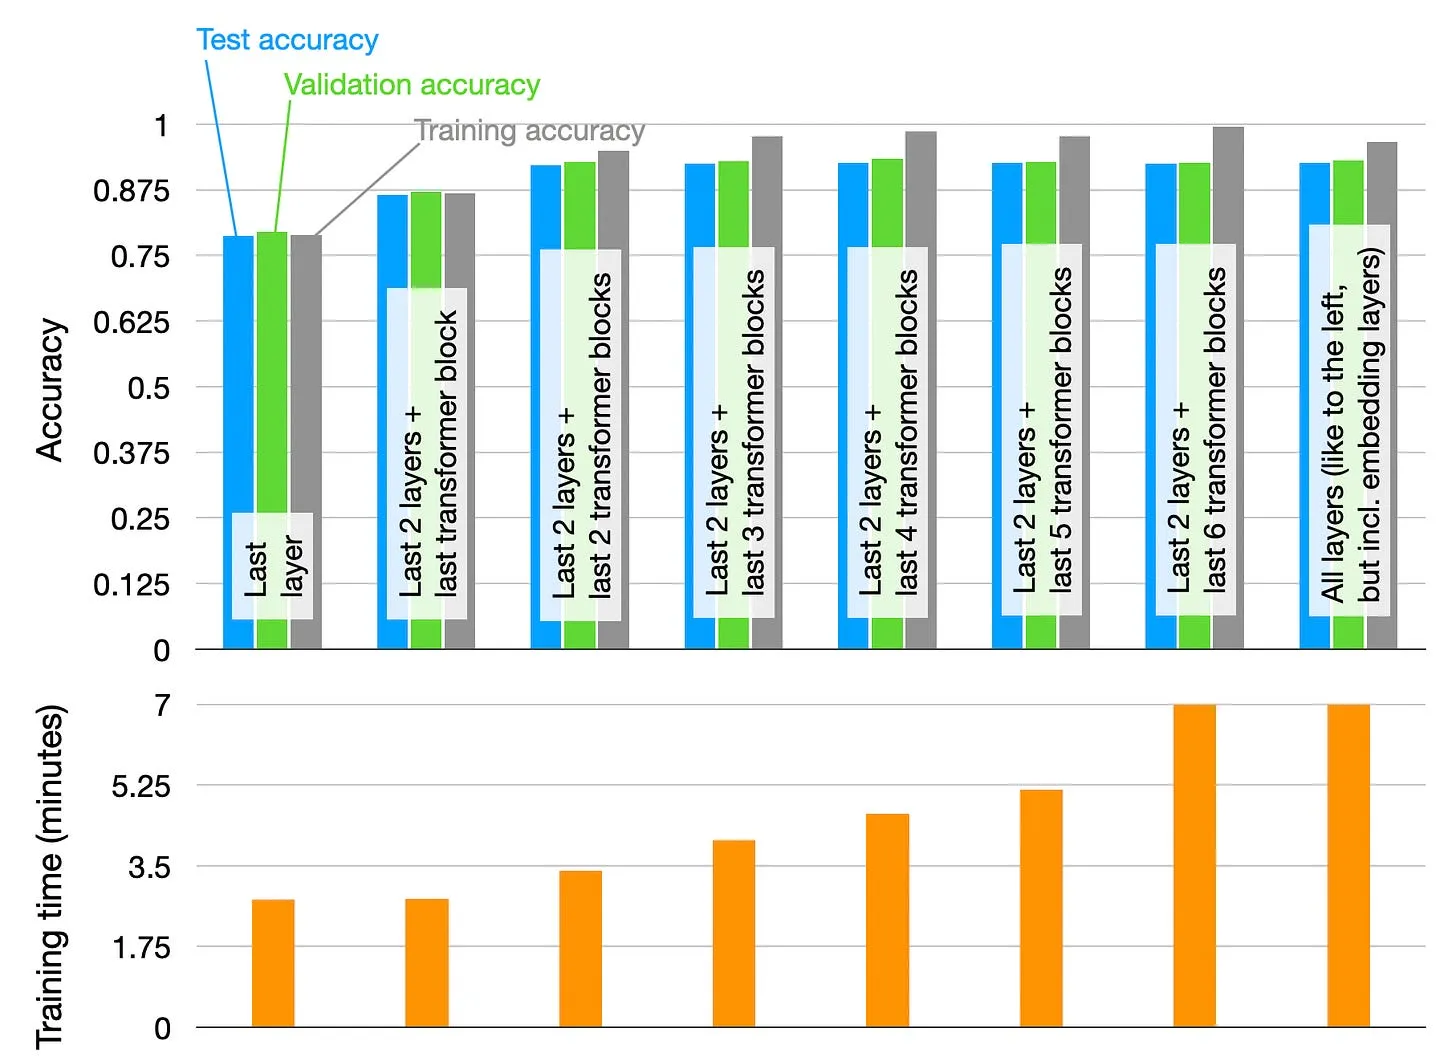
上述场景展示了微调最具代表性的三种极端情况:只训练最后一层、训练部分层与训练全层。当然,具体效果会因模型和数据集而异,尝试中间的不同层数配置也可能有收获。比如,有时只训练一半的层数就能达到和全量微调相近的效果(下一节会详细介绍参数高效微调)。感兴趣的读者可以参考下图:图中展示了DistilBERT模型在斯坦福IMDB情感分析数据集(https://ai.stanford.edu/~amaas/data/sentiment/)的2万条训练样本上微调后的预测效果与训练耗时。
figure06
图:预训练DistilBERT模型在IMDB电影评论数据集上的微调效果。代码可在此处获取:https://github.com/rasbt/LLM-finetuning-scripts/tree/main/conventional/distilbert-movie-review/layerwise-experiment

从图中可以看出,只训练最后一层的速度最快,但模型效果最差;如预期所料,训练的层数越多,模型效果越好,但计算成本也随之上升。最值得注意的是,当训练到两个全连接输出层+最后两个Transformer块(从左数第三个块)时,预测性能就已经趋于饱和。因此在这个特定的模型+数据集组合下,训练更多层数反而会造成计算资源的浪费。

参数高效微调

参数高效微调(Parameter-Efficient Finetuning, PEFT)让我们可以复用预训练模型,同时将计算量与资源消耗降到最低。总的来说,参数高效微调的优势至少有以下5点:

  • 降低计算成本(所需GPU数量更少、GPU耗时更短)
  • 加快训练速度(训练完成更快)
  • 降低硬件要求(在小显存GPU上也能运行)
  • 提升模型效果(减少过拟合)
  • 节省存储空间(大部分权重可在不同任务间共享)

前几节我们了解到,微调的层数越多,效果通常越好。但上述实验都是基于规模相对较小的DistilBERT模型。如果我们要微调的是更大的模型——比如最新的生成式大语言模型,它们的体积刚好勉强能放进GPU显存,那该怎么办?当然,我们可以用前面提到的基于特征的方法或者微调I,但如果我们想要达到接近微调II的模型效果呢?
多年来,研究者们开发了多种技术(https://arxiv.org/abs/2303.15647),能在只训练少量参数的前提下,让大语言模型微调达到优秀的效果,这类方法统称为**参数高效微调技术(PEFT)**。
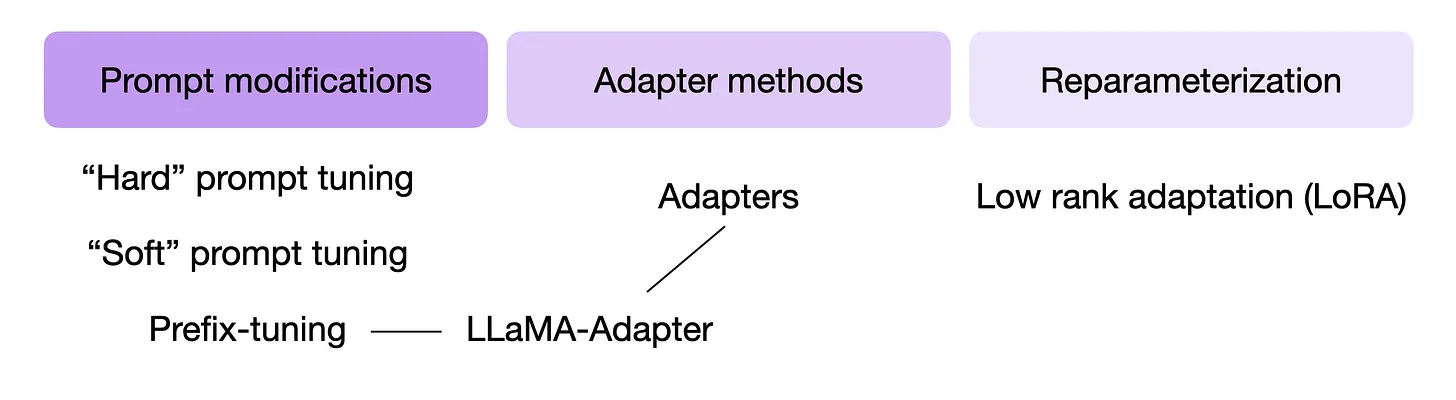
下图总结了几种最常用的参数高效微调技术。
figure07
图:主流参数高效微调技术一览

那么这些技术的原理是什么?简而言之,它们的核心都是引入少量额外参数进行微调(而不是像前面的微调II那样微调所有层)。从某种意义上说,只微调最后一层的“微调I”也可以算作一种参数高效微调技术。但前缀调优(prefix tuning)、适配器(adapters)、低秩适配(low-rank adaptation)这类可以“修改”多层的技术,能以很低的成本实现好得多的预测效果。
本文篇幅已经很长了,而且这些技术都非常值得深入讲解,后续我会单独撰文介绍。

基于人类反馈的强化学习

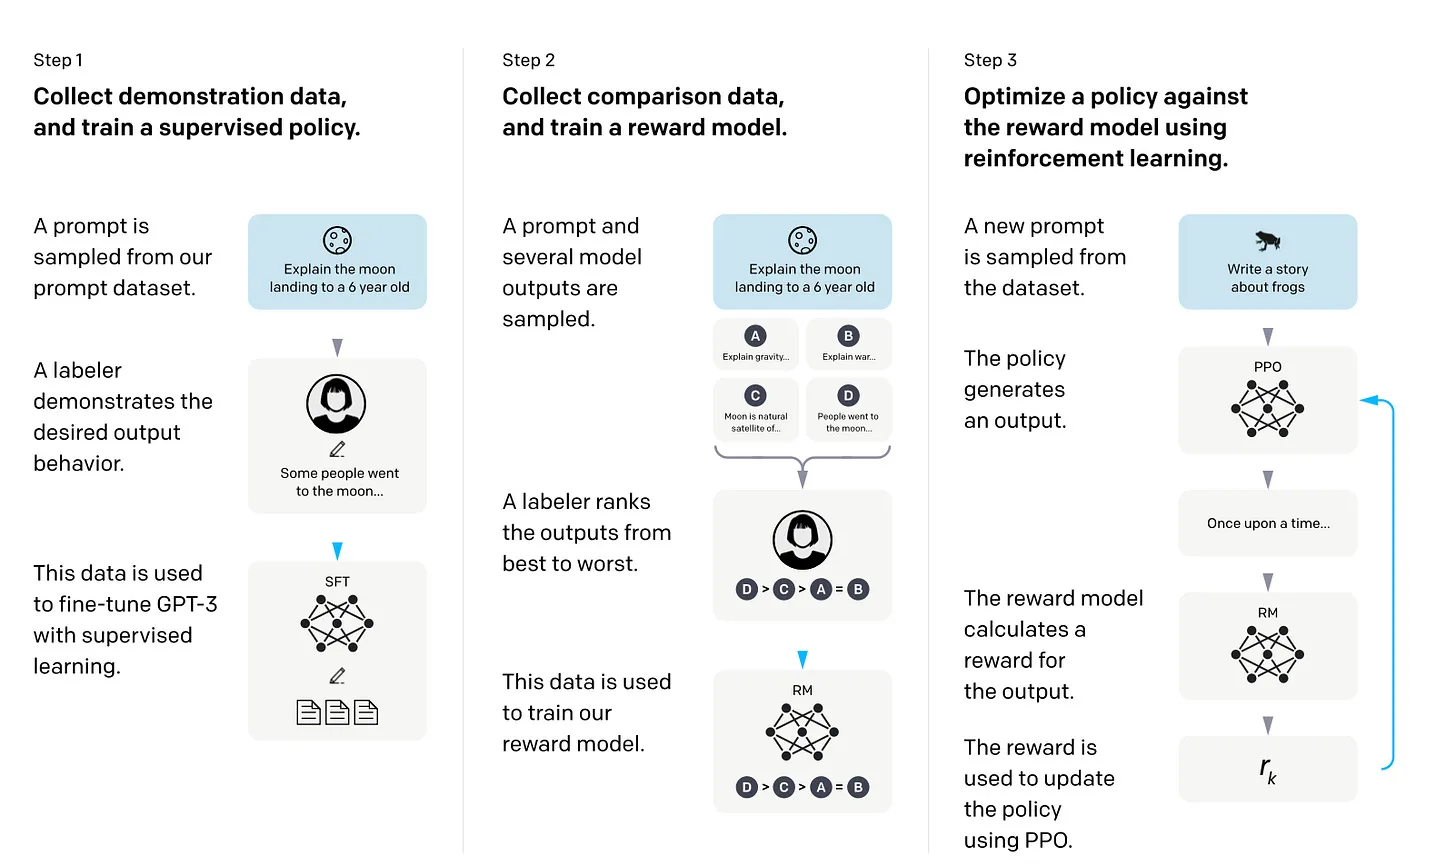
基于人类反馈的强化学习(Reinforcement Learning with Human Feedback, RLHF) 结合监督学习与强化学习来微调预训练模型——这一方法因初代ChatGPT而普及,其技术基础是InstructGPT(https://arxiv.org/abs/2203.02155)。
在RLHF流程中,我们通过让人类对模型的不同输出进行排序或打分来收集人类反馈,以此作为奖励信号。收集到的奖励标签会被用于训练奖励模型,再由奖励模型引导大语言模型适配人类的偏好。
奖励模型本身通过监督学习训练得到(通常以预训练大语言模型为基座)。之后,我们利用奖励模型来更新待适配人类偏好的预训练大语言模型——训练时会用到一种名为**近端策略优化(Proximal Policy Optimization, PPO)**的强化学习算法(https://arxiv.org/abs/1707.06347)。
figure08
图:InstructGPT论文中展示RLHF流程的截图

为什么不直接用人类反馈来训练预训练模型,而是要先训练奖励模型?这是因为如果把人类纳入学习循环会形成瓶颈——我们无法实时获取人类反馈。
如前所述,本文篇幅已较长,更详细的讲解留待后续文章。

结语

对预训练大语言模型进行全层微调,仍然是适配新任务的黄金标准。但对于预训练Transformer模型,我们还有多种高效的替代方案。基于特征的方法、上下文学习、参数高效微调技术等,都能让大语言模型有效应用于新任务,同时将计算成本与资源消耗降到最低。
此外,基于人类反馈的强化学习(RLHF)可作为监督微调的替代方案,有进一步提升模型性能的潜力。

本杂志是我的个人兴趣项目。如果您希望在订阅(https://magazine.sebastianraschka.com/subscribe)之外支持我的创作,欢迎购买我的书籍(https://sebastianraschka.com/books)。如果您觉得内容有启发、有帮助,也请推荐给您的朋友和同事。
figure09
相关书籍链接:https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics 、http://mng.bz/M96o
您的支持对我意义重大!非常感谢!

【转载】理解大语言模型

原文地址:
Understanding Large Language Model,by Sebastian Raschka, on 2023-04-16

理解大语言模型

快速入门必读的核心文献精选

大语言模型席卷了公众的目光——这并非双关。短短半个世纪,大语言模型(即Transformer)几乎彻底改变了自然语言处理领域。不仅如此,它们也开始掀起计算机视觉、计算生物学等领域的变革。

鉴于Transformer对所有人的研究方向都产生了如此深远的影响,我想整理一份简短的阅读清单(扩展版见https://www.linkedin.com/feed/update/urn:li:activity:7028449312300834816?commentUrn=urn%3Ali%3Acomment%3A%28activity%3A7028449312300834816%2C7028519126105030656%29&dashCommentUrn=urn%3Ali%3Afsd_comment%3A%287028519126105030656%2Curn%3Ali%3Aactivity%3A7028449312300834816%29),面向刚入门的机器学习研究者与从业者。

以下清单建议大致按时间顺序阅读,且我只聚焦于学术研究论文。当然,还有很多其他实用的资源,例如:

理解核心架构与任务

如果你刚接触Transformer/大语言模型,从最基础的内容入手最合理。

(1) 《通过联合学习对齐与翻译实现神经机器翻译》(2014)

作者:Bahdanau, Cho, Bengio
https://arxiv.org/abs/1409.0473

如果你时间有限,我推荐从这篇论文开始。它为循环神经网络(RNN)引入了注意力机制,以提升长序列建模能力。这让RNN能够更准确地翻译更长的句子——这也是后来原始Transformer架构诞生的核心动因。
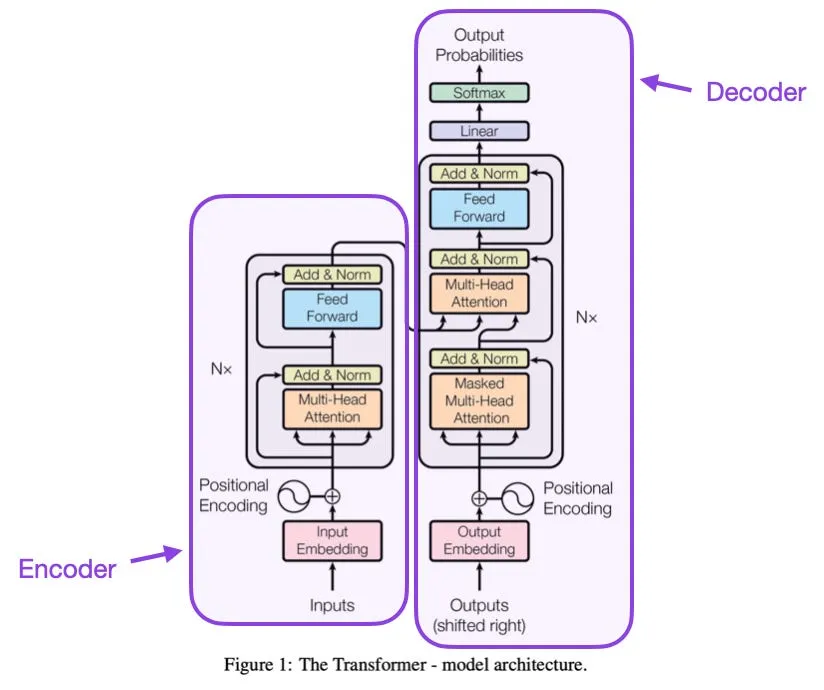
figure01
来源:https://arxiv.org/abs/1409.0473

(2) 《注意力就是你所需的全部》(2017)

作者:Vaswani, Shazeer, Parmar, Uszkoreit, Jones, Gomez, Kaiser, Polosukhin
https://arxiv.org/abs/1706.03762

这篇论文提出了原始的Transformer架构,由编码器和解码器两部分组成,二者后来也成为各自独立的重要模块。此外,论文还提出了缩放点积注意力机制、多头注意力块、位置输入编码等概念,这些至今仍是现代Transformer的基础。
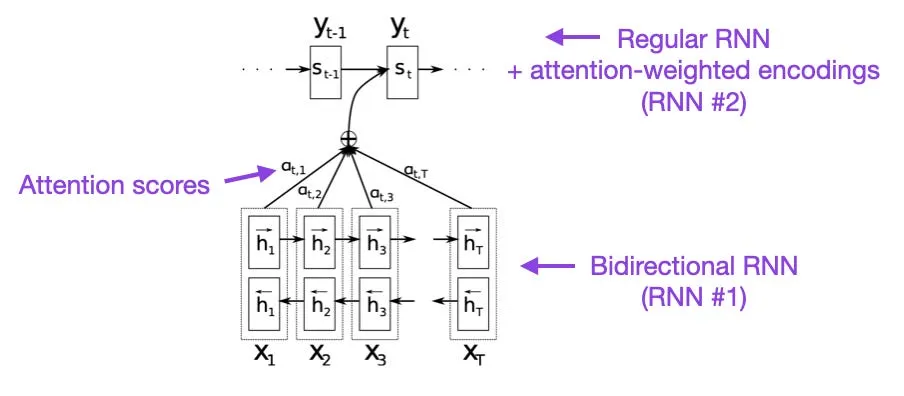
figure02
来源:https://arxiv.org/abs/1706.03762

(3) 《Transformer架构中的层归一化位置研究》(2020)

作者:Xiong, Yang, He, K Zheng, S Zheng, Xing, Zhang, Lan, Wang, Liu
https://arxiv.org/abs/2002.04745

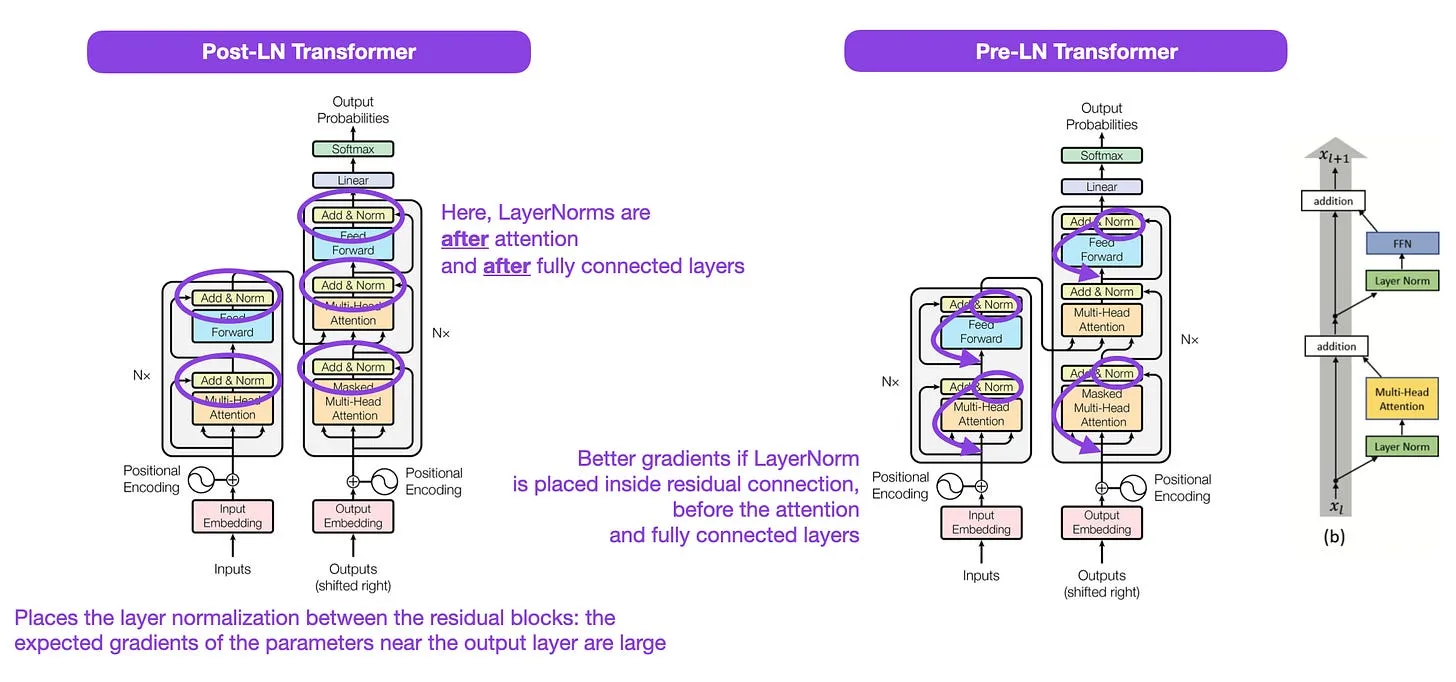
尽管上面《注意力就是你所需的全部》中的Transformer示意图是对原始编解码架构的很好总结,但图中层归一化(LayerNorm)的位置至今仍是热议的话题。

比如,《注意力就是你所需的全部》中的Transformer示意图将层归一化放在残差块之间,这与论文配套的代码实现(https://github.com/tensorflow/tensor2tensor/commit/f5c9b17e617ea9179b7d84d36b1e8162cb369f25)并不一致。示意图里的这种变体被称为**后置层归一化Transformer(Post-LN Transformer),而实际代码默认采用的是前置层归一化(Pre-LN)**变体。

https://arxiv.org/abs/2002.04745 这篇论文指出,前置层归一化效果更好,能解决梯度问题,如下图所示。很多架构在实践中都采用了这种设计,但它也可能导致表示坍缩。

因此,尽管关于使用后置还是前置层归一化的讨论仍在继续,也有新论文提出兼顾二者优势的方案:《ResiDual:具备双残差连接的Transformer》(https://arxiv.org/abs/2304.14802);该方案在实践中是否有效还有待观察。
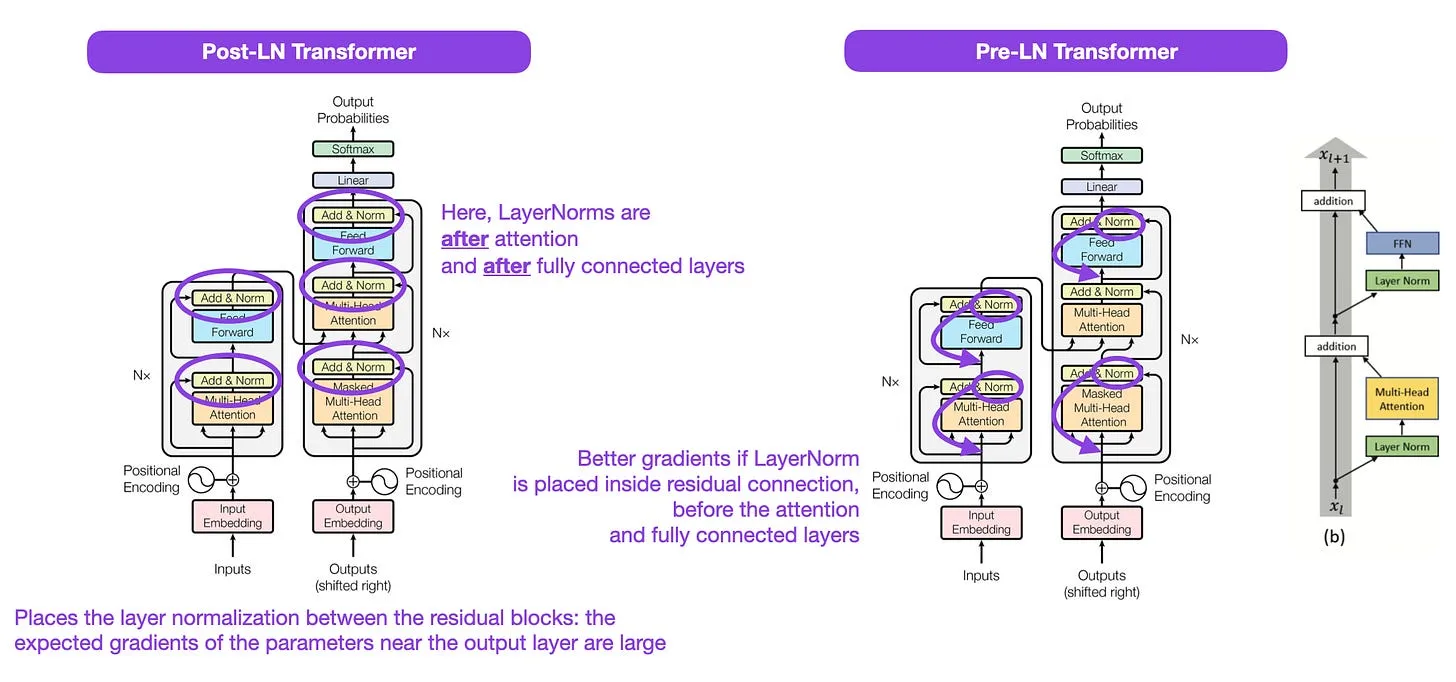
figure03
来源:https://arxiv.org/abs/1706.03762(左、中)与 https://arxiv.org/abs/2002.04745(右)

(4) 《学习控制快速权重记忆:动态循环神经网络的一种替代方案》(1991)

作者:Schmidhuber
https://www.semanticscholar.org/paper/Learning-to-Control-Fast-Weight-Memories%3A-An-to-Schmidhuber/bc22e87a26d020215afe91c751e5bdaddd8e4922

如果你对历史趣闻以及与现代Transformer本质相似的早期研究感兴趣,推荐这篇论文。

比如,在1991年——比上面那篇《注意力就是你所需的全部》Transformer论文早了约25年——Juergen Schmidhuber就提出了一种循环神经网络的替代方案,名为快速权重编程器(Fast Weight Programmers, FWP)。FWP方法包含一个前馈神经网络,它通过梯度下降缓慢学习,以此来编程另一个神经网络的快速权重变化。

这与现代Transformer的类比在这篇文章中有解释:>https://people.idsia.ch//~juergen/fast-weight-programmer-1991-transformer.html#sec2,内容如下:

在如今的Transformer术语中,FROM和TO分别被称为键(key)和值(value)。快速网络所作用的输入INPUT被称为查询(query)。本质上,查询由快速权重矩阵处理,而快速权重矩阵是键与值外积的和(忽略归一化和投影)。由于两个网络的所有运算都是可微的,我们通过加性外积或二阶张量积,就能对快速权重变化实现端到端可微的主动控制[FWP0-3a]。因此,慢速网络可以通过梯度下降学习,在序列处理过程中快速修改快速网络。这在数学上(除了归一化部分)等价于后来被称为线性化自注意力Transformer(或线性Transformer)的结构。

正如上面博客节选提到的,2020年arXiv上的两篇论文(https://arxiv.org/abs/2006.16236 和 https://arxiv.org/abs/2009.14794)将这种方法命名为“线性Transformer”或“线性化自注意力Transformer”。
2021年,https://arxiv.org/abs/2102.11174 这篇论文进一步明确证明了线性化自注意力与90年代的快速权重编程器是等价的。
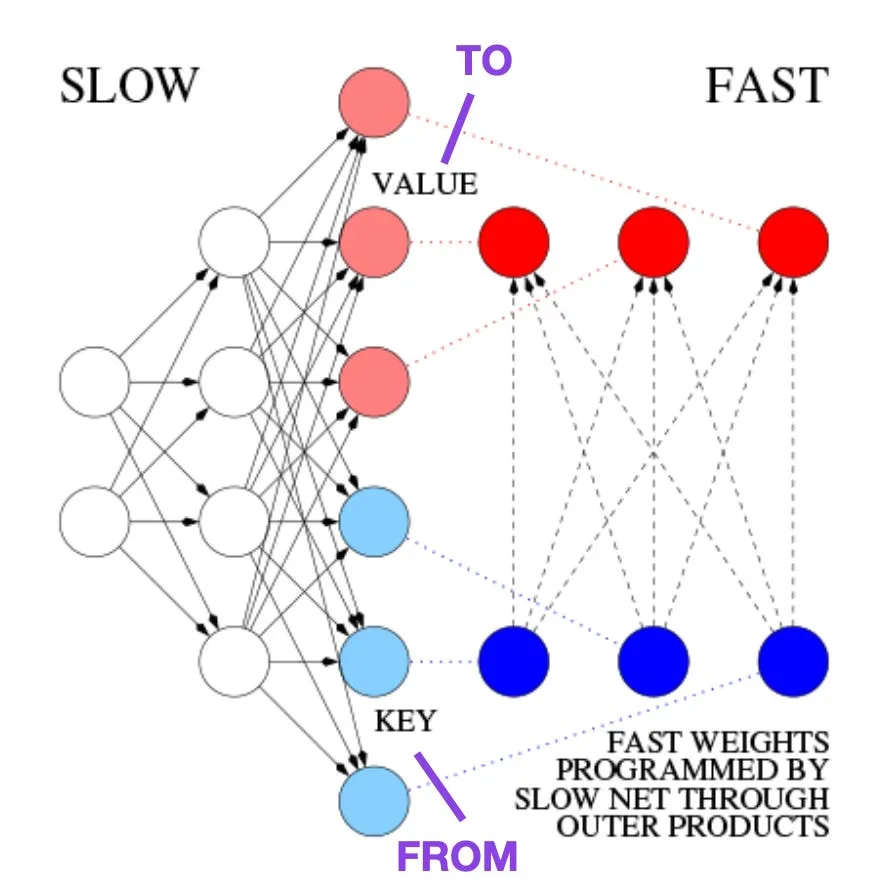
figure04
来源:基于https://people.idsia.ch//~juergen/fast-weight-programmer-1991-transformer.html#sec2 制作的注解图

(5) 《面向文本分类的通用语言模型微调》(2018)

作者:Howard, Ruder
https://arxiv.org/abs/1801.06146

从历史角度看,这是另一篇非常有意思的论文。尽管它发表于原始《注意力就是你所需的全部》Transformer论文发布一年之后,但它并没有涉及Transformer,而是聚焦于循环神经网络。不过它仍然值得关注,因为它实际上提出了语言模型预训练+下游任务迁移学习的思路。

虽然迁移学习在计算机视觉领域已经成熟,但在自然语言处理(NLP)领域还未普及。ULMFit是最早证明“对语言模型进行预训练,再在特定任务上微调,就能在众多NLP任务中取得最优结果”的论文之一。

ULMFit提出的语言模型微调三阶段流程如下:

  1. 在大规模文本语料上训练语言模型。
  2. 在任务特定数据上微调该预训练语言模型,使其适配文本的特定风格与词汇。
  3. 在任务特定数据上微调分类器,同时逐步解冻各层,以避免灾难性遗忘。

这种“在大规模语料上训练语言模型,再在下游任务上微调”的范式,正是BERT、GPT-2/3/4、RoBERTa等基于Transformer的模型以及各类基础模型的核心方法。

不过,ULMFit的关键部分——逐步解冻层,在Transformer架构的实践中通常不会常规使用,Transformer一般会同时微调所有层。
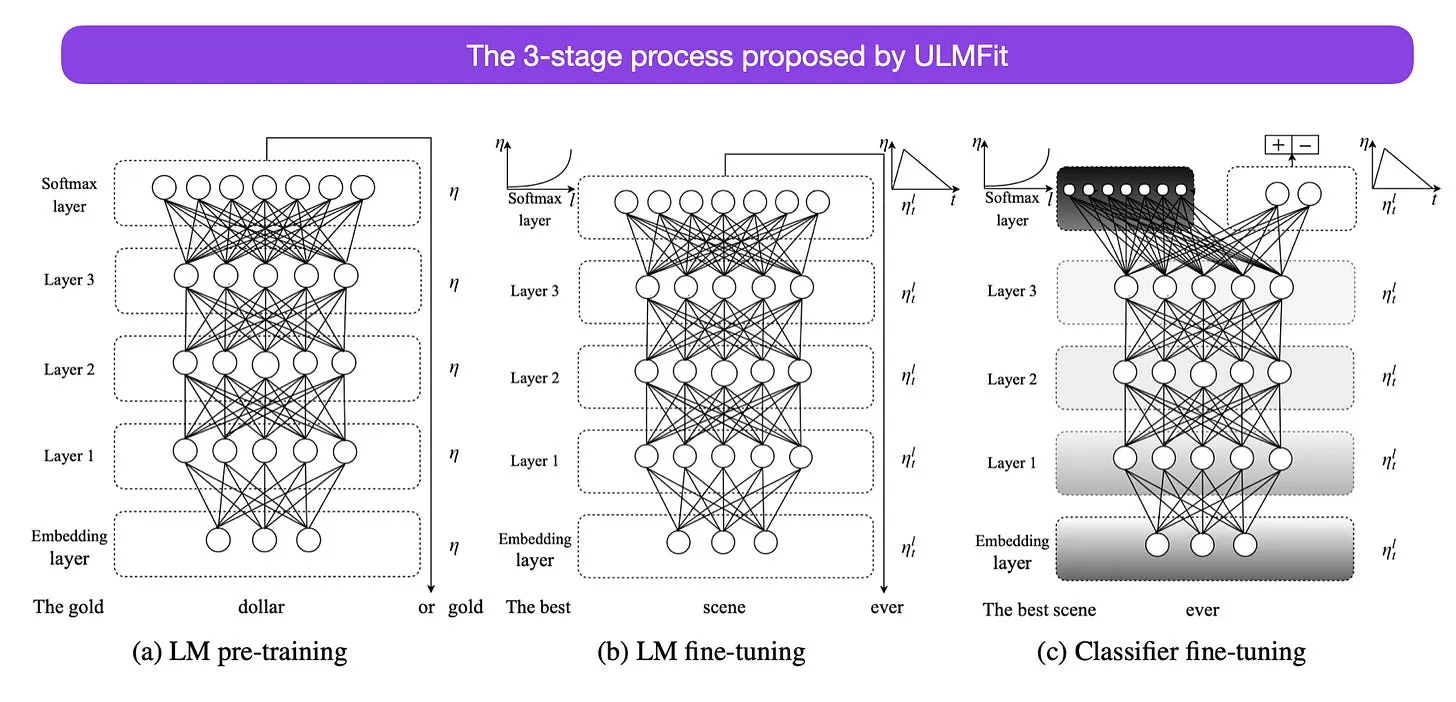
figure05
来源:https://arxiv.org/abs/1801.06146

(6) 《BERT:面向语言理解的深度双向Transformer预训练》(2018)

作者:Devlin, Chang, Lee, Toutanova
https://arxiv.org/abs/1810.04805

在原始Transformer架构之后,大语言模型研究开始分化为两个方向:

  • 编码器式Transformer:用于文本分类等预测建模任务;
  • 解码器式Transformer:用于翻译、摘要、文本生成等生成建模任务。

上面这篇BERT论文提出了掩码语言建模、下一句预测的原始概念,至今仍是最具影响力的编码器式架构。如果你对这一研究方向感兴趣,推荐进一步阅读https://arxiv.org/abs/1907.11692,它去掉了下一句预测任务,简化了预训练目标。
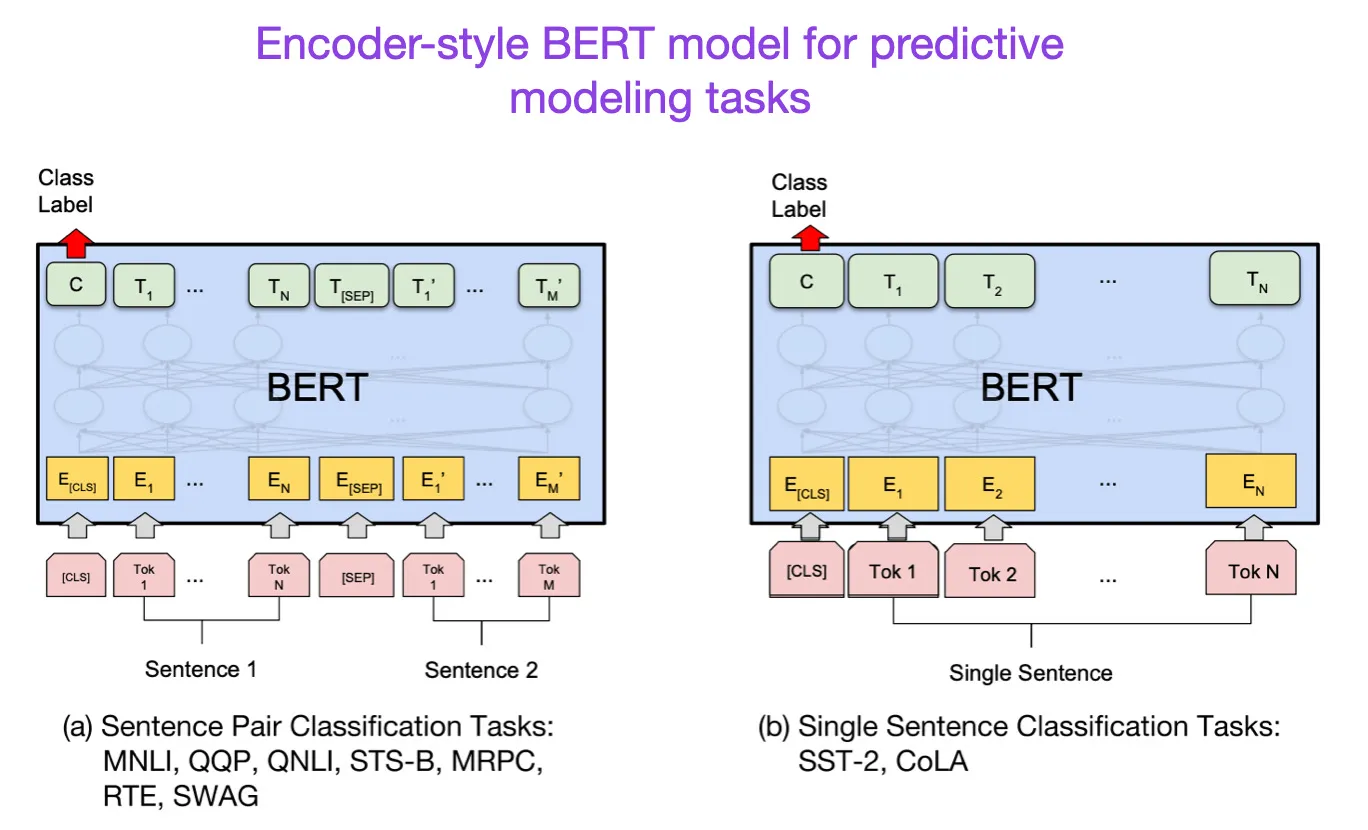
figure06
来源:https://arxiv.org/abs/1810.04805

(7) 《通过生成式预训练提升语言理解能力》(2018)

作者:Radford, Narasimhan
https://www.semanticscholar.org/paper/Improving-Language-Understanding-by-Generative-Radford-Narasimhan/cd18800a0fe0b668a1cc19f2ec95b5003d0a5035

这篇原始GPT论文提出了流行的解码器式架构,以及通过下一词预测进行预训练的方法。如果说BERT因其掩码语言模型预训练目标属于双向Transformer,那么GPT就是单向的自回归模型。尽管GPT的嵌入也可用于分类任务,但GPT方法是如今最具影响力的大语言模型(如ChatGPT)的核心。

如果你对这一研究方向感兴趣,推荐进一步阅读这两篇论文:
https://www.semanticscholar.org/paper/Language-Models-are-Unsupervised-Multitask-Learners-Radford-Wu/9405cc0d6169988371b2755e573cc28650d14dfe
以及 https://arxiv.org/abs/2005.14165。这两篇论文阐明了大语言模型具备零样本和少样本学习能力,凸显了大语言模型的涌现能力。GPT-3至今仍是训练ChatGPT等当前一代大语言模型的常用基线与基础模型——我们后面会单独介绍催生ChatGPT的InstructGPT方法。
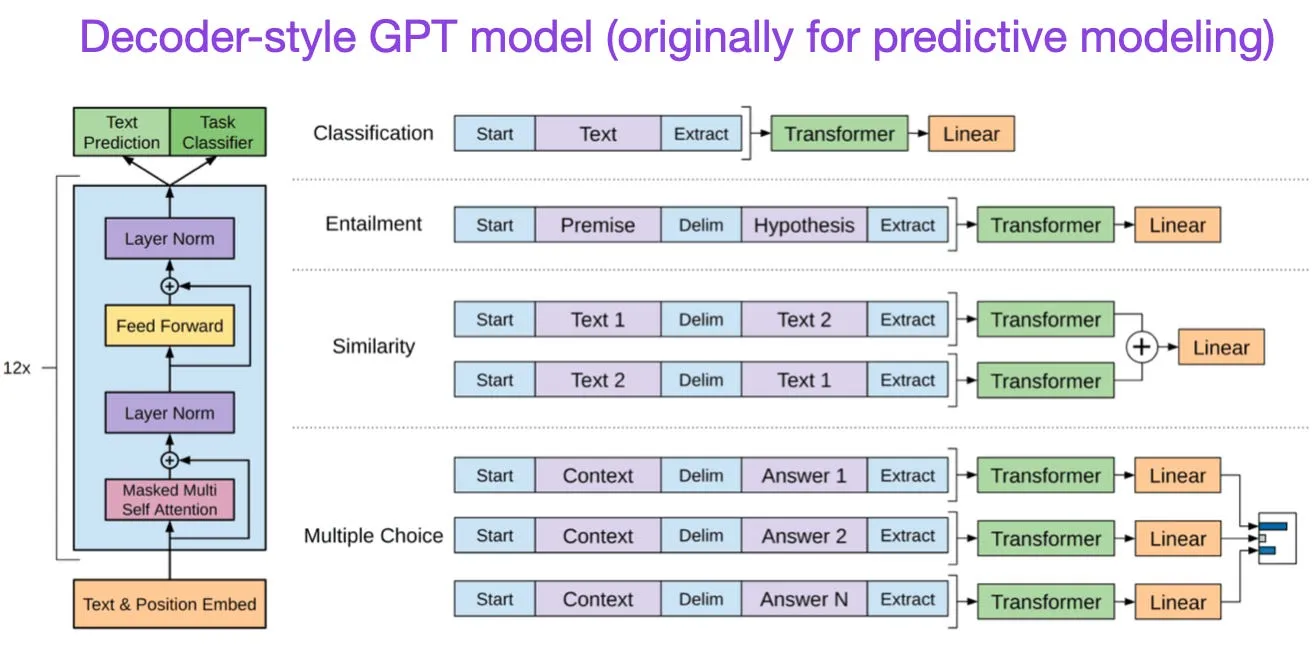
figure07
来源:https://www.semanticscholar.org/paper/Improving-Language-Understanding-by-Generative-Radford-Narasimhan/cd18800a0fe0b668a1cc19f2ec95b5003d0a5035

(8) 《BART:面向自然语言生成、翻译与理解的去噪序列到序列预训练》(2019)

作者:Lewis, Liu, Goyal, Ghazvininejad, Mohamed, Levy, Stoyanov, Zettlemoyer
https://arxiv.org/abs/1910.13461

如前所述,BERT类编码器式大语言模型通常更适合预测建模任务,而GPT类解码器式大语言模型更擅长生成文本。为了兼顾二者优势,上面这篇BART论文结合了编码器与解码器两部分(和本清单第二篇的原始Transformer类似)。
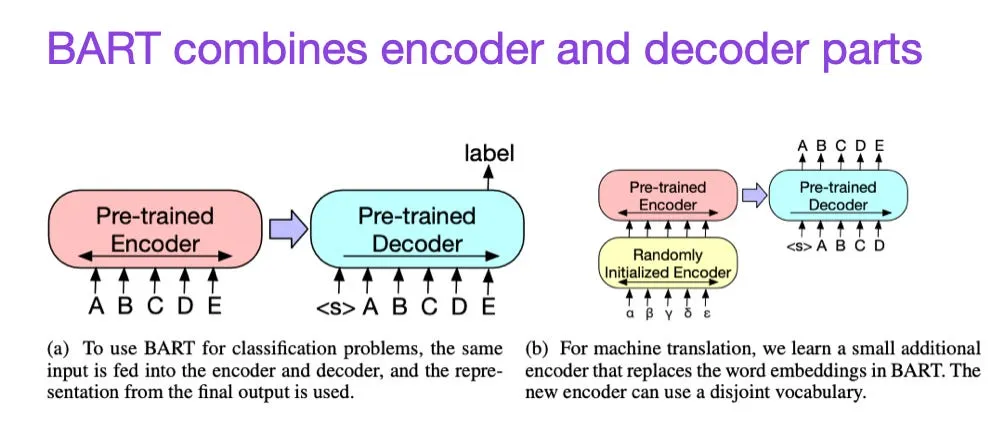
figure08
来源:https://arxiv.org/abs/1910.13461

(9) 《在实践中发挥大语言模型的威力:ChatGPT及相关研究综述》(2023)

作者:Yang, Jin, Tang, Han, Feng, Jiang, Yin, Hu
https://arxiv.org/abs/2304.13712

这不是一篇研究论文,但可能是迄今最好的通用架构综述,清晰展现了不同架构的演进历程。除了讨论BERT式掩码语言模型(编码器)与GPT式自回归语言模型(解码器)之外,它还就预训练与微调数据提供了实用的讨论与指导。
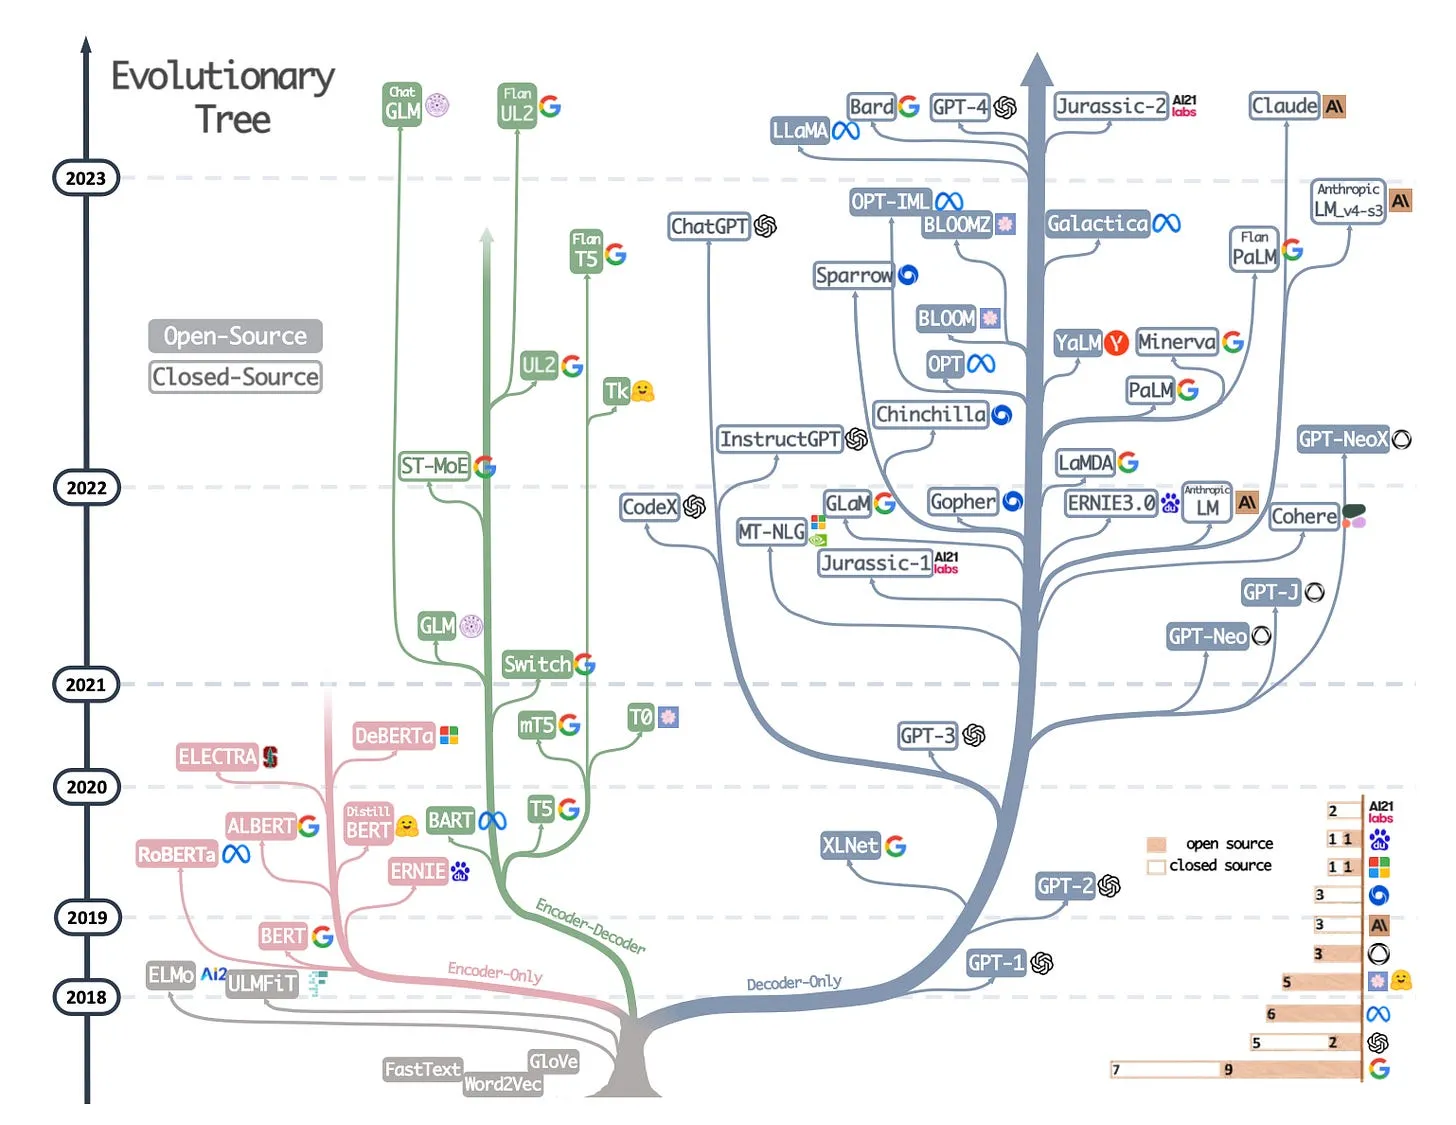
figure09
现代大语言模型演进树,引自https://arxiv.org/abs/2304.13712

缩放定律与效率提升

如果你想了解更多提升Transformer效率的各类技术,我推荐先读https://arxiv.org/abs/2009.06732 这篇论文,再读https://arxiv.org/abs/2302.01107 这篇。

此外,下面这些论文我认为特别有意思,值得一读。

(10) 《FlashAttention:具备IO感知的快速、内存高效精确注意力》(2022)

作者:Dao, Fu, Ermon, Rudra, Ré
https://arxiv.org/abs/2205.14135

大多数Transformer论文都不会替换实现自注意力的原始缩放点积机制,但FlashAttention是我最近见过引用最多的一种机制。
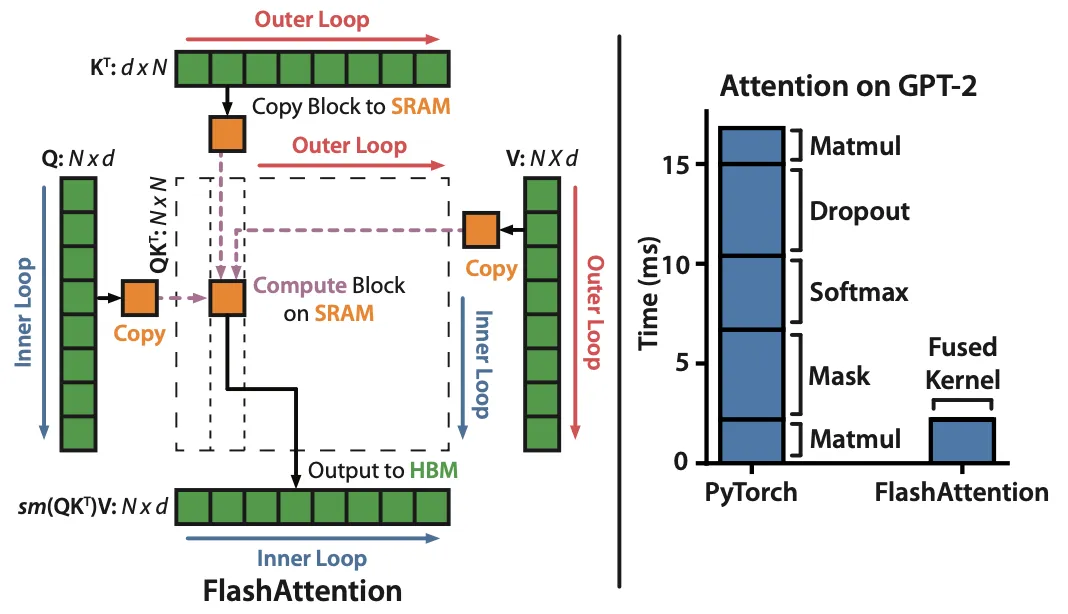
figure10
来源:https://arxiv.org/abs/2205.14135

(11) 《Cramming:单GPU一天训练完成一个语言模型》(2022)

作者:Geiping, Goldstein
https://arxiv.org/abs/2212.14034

在这篇论文中,研究人员在单块GPU上用24小时训练了一个掩码语言模型/编码器式大语言模型(这里是BERT)。作为对比,2018年的原始BERT论文用了16块TPU训练了4天。一个有意思的发现是:更小的模型虽然吞吐量更高,但学习效率更低。因此,更大的模型达到特定预测性能阈值并不需要更长的训练时间。
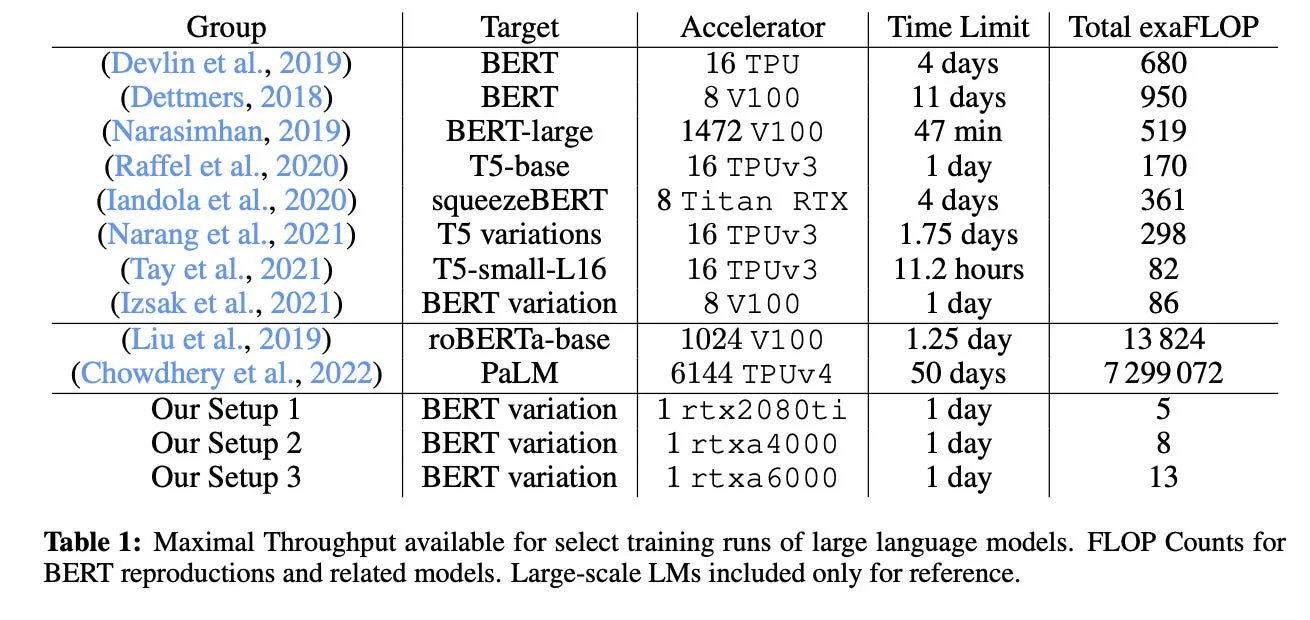
figure11
来源:https://arxiv.org/abs/2212.14034

(12) 《LoRA:大语言模型的低秩适配》(2021)

作者:Hu, Shen, Wallis, Allen-Zhu, Li, L Wang, S Wang, Chen
https://arxiv.org/abs/2106.09685

在大规模数据集上预训练的现代大语言模型展现出涌现能力,在语言翻译、摘要、编程、问答等各类任务上表现优异。但如果我们想提升Transformer在领域特定数据与专业任务上的能力,对Transformer进行微调是很有价值的。

低秩适配(Low-Rank Adaptation,LoRA)是大语言模型参数高效微调中最具影响力的方法之一。尽管还有其他参数高效微调方法(见下面的综述),但LoRA尤其值得强调,因为它既优雅又具备很强的通用性,也可应用于其他类型的模型。

LoRA的作者指出,尽管预训练模型的权重在预训练任务上是满秩的,但当大语言模型适配新任务时,其“内在维度”很低。因此,LoRA的核心思想是将权重变化量ΔW分解为低秩表示,从而大幅提升参数效率。
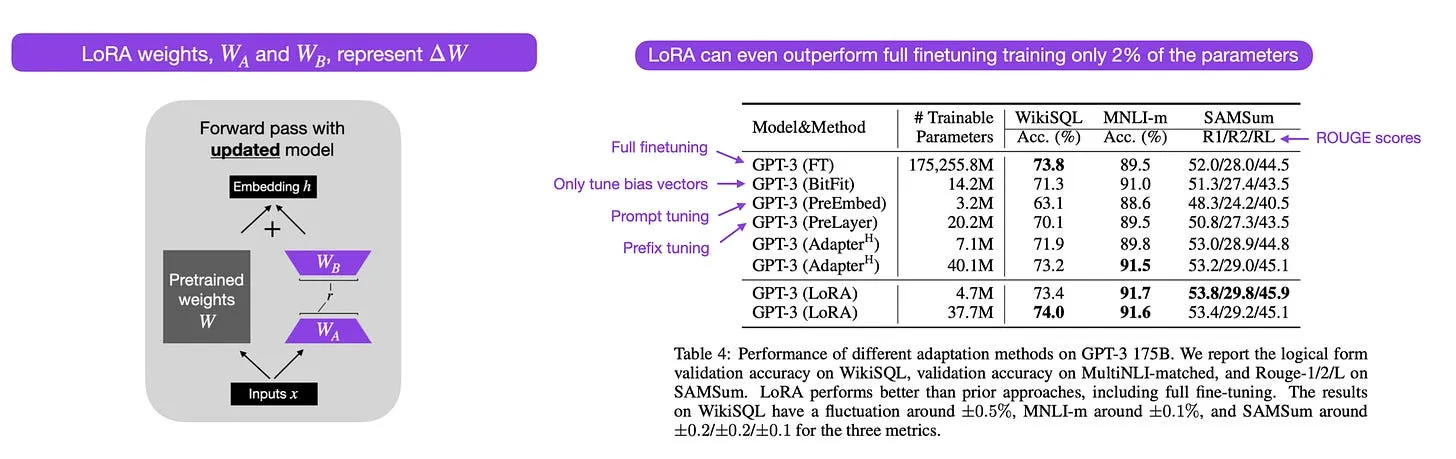
figure12
LoRA示意图及其性能表现,引自https://arxiv.org/abs/2106.09685

(13) 《以小博大:参数高效微调指南》(2022)

作者:Lialin, Deshpande, Rumshisky
https://arxiv.org/abs/2303.15647

在大规模数据集上预训练的现代大语言模型展现出涌现能力,在语言翻译、摘要、编程、问答等各类任务上表现优异。但如果我们想提升Transformer在领域特定数据与专业任务上的能力,对Transformer进行微调是很有价值的。这篇综述梳理了40余篇参数高效微调方法的论文(包括前缀微调、适配器、低秩适配等流行技术),让微调的计算成本变得(极其)低廉。
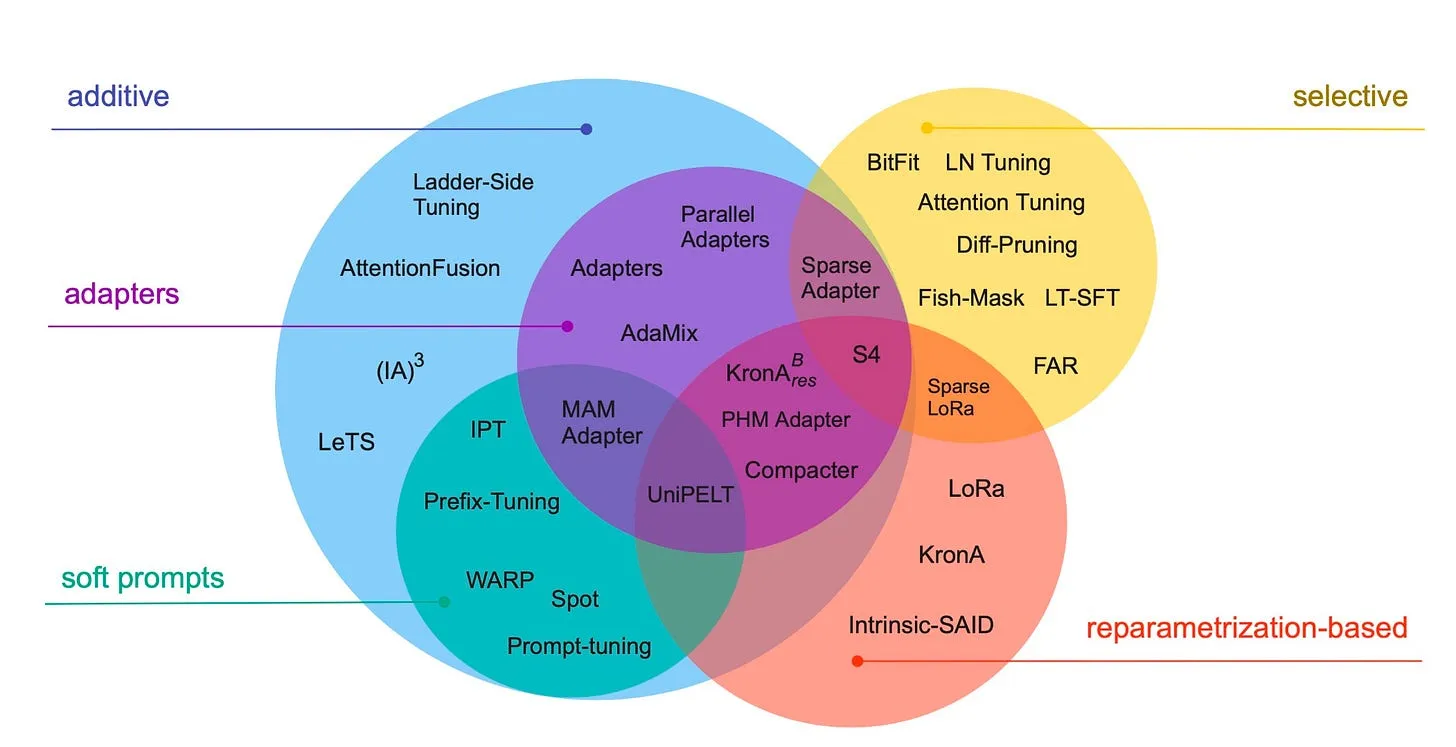
figure13
来源:https://arxiv.org/abs/2303.15647

(14) 《大语言模型缩放:训练Gopher的方法、分析与洞见》(2022)

作者:Rae及同事(共78位作者!)
https://arxiv.org/abs/2112.11446

Gopher是一篇非常详实的论文,包含大量帮助理解大语言模型训练的分析。研究人员训练了一个2800亿参数、80层的模型,训练数据量达3000亿token。其中包含很多有意思的架构改进,比如用**均方根归一化(RMSNorm)**替代层归一化(LayerNorm)。层归一化和均方根归一化都优于批量归一化(BatchNorm),因为它们不依赖批次大小,也不需要同步,这在小批量的分布式训练场景中是一大优势。而均方根归一化通常被认为能让更深层架构的训练更稳定。

除了上面这些有趣的细节,这篇论文的核心是分析不同规模下的任务表现。对152个多样化任务的评估显示:增大模型尺寸对理解、事实核查、有害语言识别等任务提升最大;而逻辑推理、数学推理相关任务从架构缩放中获益较少。
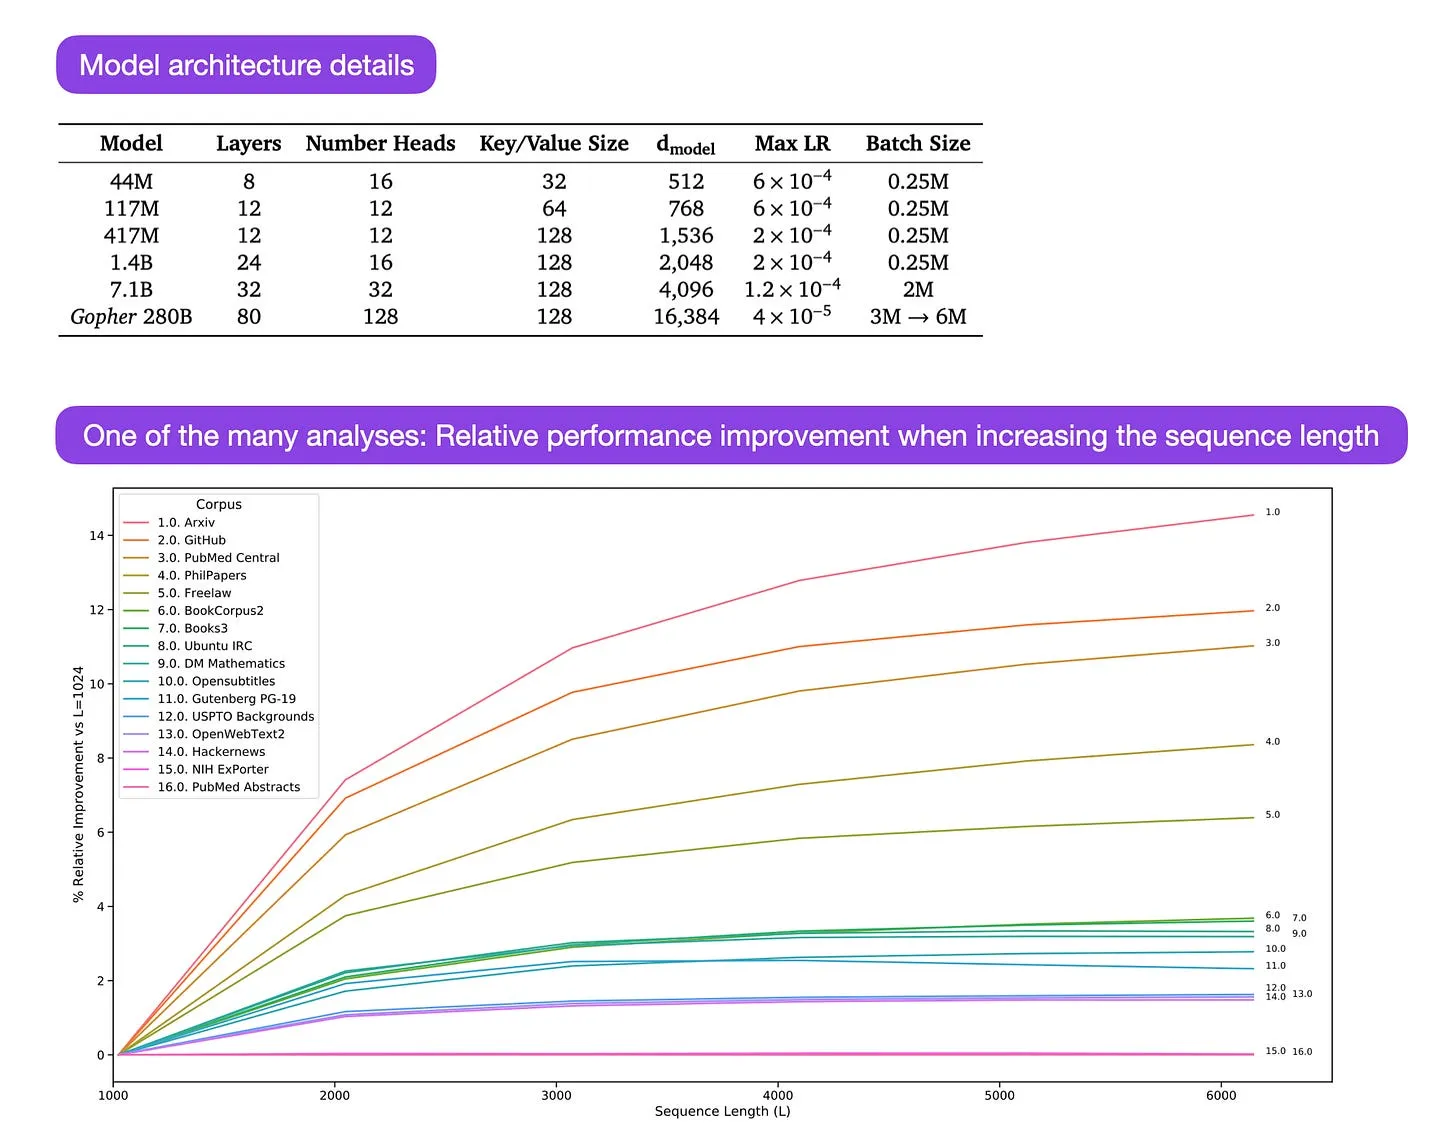
figure14
来源:https://arxiv.org/abs/2112.11446 中的图

(15) 《训练计算最优的大语言模型》(2022)

作者:Hoffmann, Borgeaud, Mensch, Buchatskaya, Cai, Rutherford, de Las Casas, Hendricks, Welbl, Clark, Hennigan, Noland, Millican, van den Driessche, Damoc, Guy, Osindero, Simonyan, Elsen, Rae, Vinyals, Sifre
https://arxiv.org/abs/2203.15556

这篇论文提出了700亿参数的Chinchilla模型,在生成建模任务上表现超过了热门的1750亿参数GPT-3模型。而它最核心的结论是:当代大语言模型“训练程度严重不足”。

论文定义了大语言模型训练的线性缩放定律。比如,尽管Chinchilla的参数规模只有GPT-3的一半,但它的表现超过了GPT-3,因为它的训练token量达到了1.4万亿(而GPT-3只有3000亿)。换句话说,训练token的数量与模型规模同等重要。
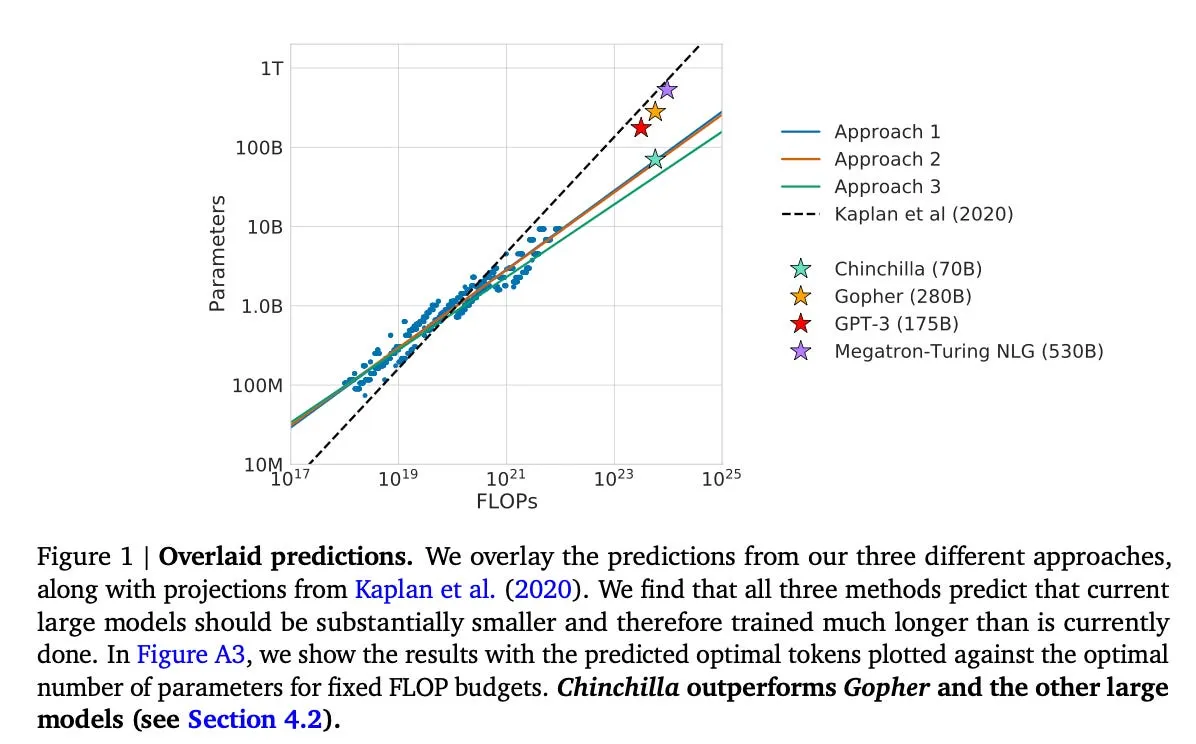
figure15
来源:https://arxiv.org/abs/2203.15556

(16) 《Pythia:一套用于跨训练与缩放阶段分析大语言模型的工具集》(2023)

作者:Biderman, Schoelkopf, Anthony, Bradley, O’Brien, Hallahan, Khan, Purohit, Prashanth, Raff, Skowron, Sutawika, van der Wal
https://arxiv.org/abs/2304.01373

Pythia是一套开源大语言模型(参数规模从70M到12B),用于研究大语言模型在训练过程中的演化规律。

其架构与GPT-3类似,但包含一些改进,比如Flash Attention(见https://arxiv.org/abs/2302.13971)和旋转位置编码(见https://arxiv.org/abs/2204.02311)。Pythia的训练数据为https://arxiv.org/abs/2101.0027(825GB),训练量为3000亿token(在普通Pile数据集上约1个epoch,在去重Pile数据集上约1.5个epoch)。
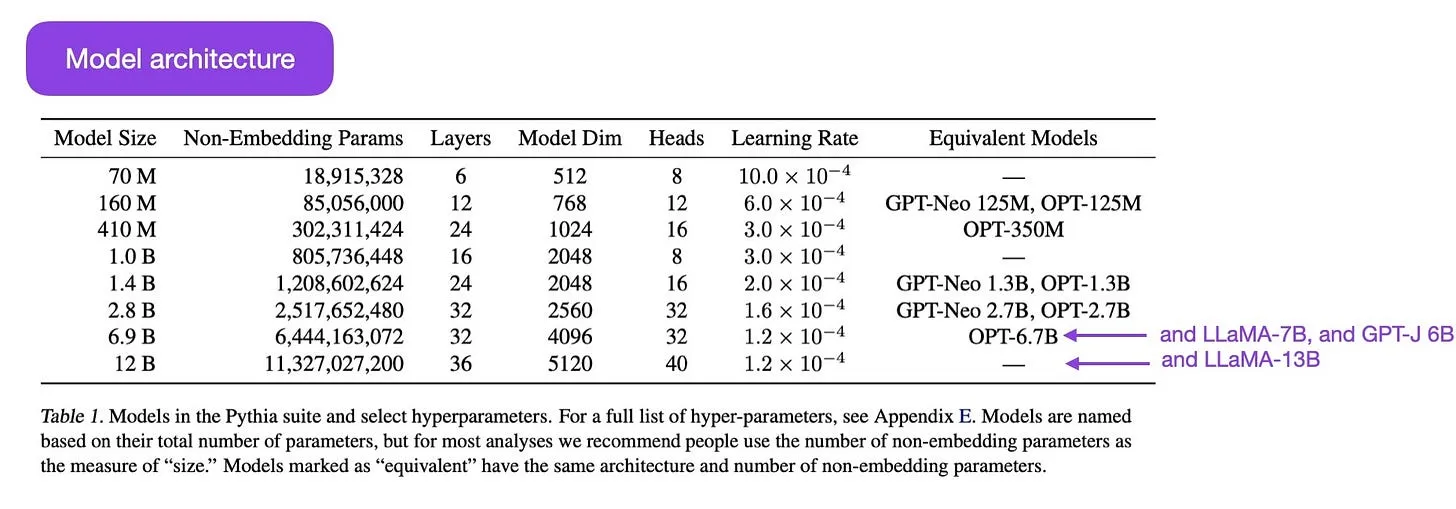
figure16
Pythia模型系列,引自https://arxiv.org/abs/2304.01373

Pythia研究的主要结论如下:

  • 在重复数据上训练(由于大语言模型的训练方式,这意味着训练超过1个epoch)对性能没有提升也没有损害。
  • 训练顺序不影响记忆效果。这一点比较遗憾,因为如果反过来成立的话,我们就可以通过重排训练数据来缓解不好的逐字记忆问题。
  • 预训练词频会影响任务表现。比如,出现更频繁的词,少样本准确率往往更高。
  • 批次大小翻倍会让训练时间减半,但不会影响收敛效果。

对齐——让大语言模型朝着预期目标与方向发展

近年来,我们已经看到很多能力相当不错的大语言模型都能生成逼真的文本(比如GPT-3、Chinchilla等等)。似乎我们用常用的预训练范式已经摸到了天花板。

为了让语言模型更有用,减少错误信息与有害内容,研究者设计了额外的训练范式,对预训练好的基础模型进行进一步微调。

(17) 《利用人类反馈训练语言模型遵循指令》(2022)

作者:Ouyang, Wu, Jiang, Almeida, Wainwright, Mishkin, Zhang, Agarwal, Slama, Ray, Schulman, Hilton, Kelton, Miller, Simens, Askell, Welinder, Christiano, Leike, Lowe
https://arxiv.org/abs/2203.02155

在这篇被称为InstructGPT的论文中,研究者使用了人类参与的强化学习机制(RLHF)。他们以预训练的GPT-3基础模型起步,第一步先用人类生成的指令-响应对进行监督学习微调;第二步,让人类对模型输出进行排序,以此训练奖励模型;第三步,用奖励模型作为奖励信号,通过近端策略优化算法对经过预训练与微调的GPT-3模型进行强化学习更新。

顺带一提,这篇论文也被认为是ChatGPT背后的思路来源——根据近期传闻,ChatGPT就是InstructGPT的放大版本,在更大的数据集上完成了微调。
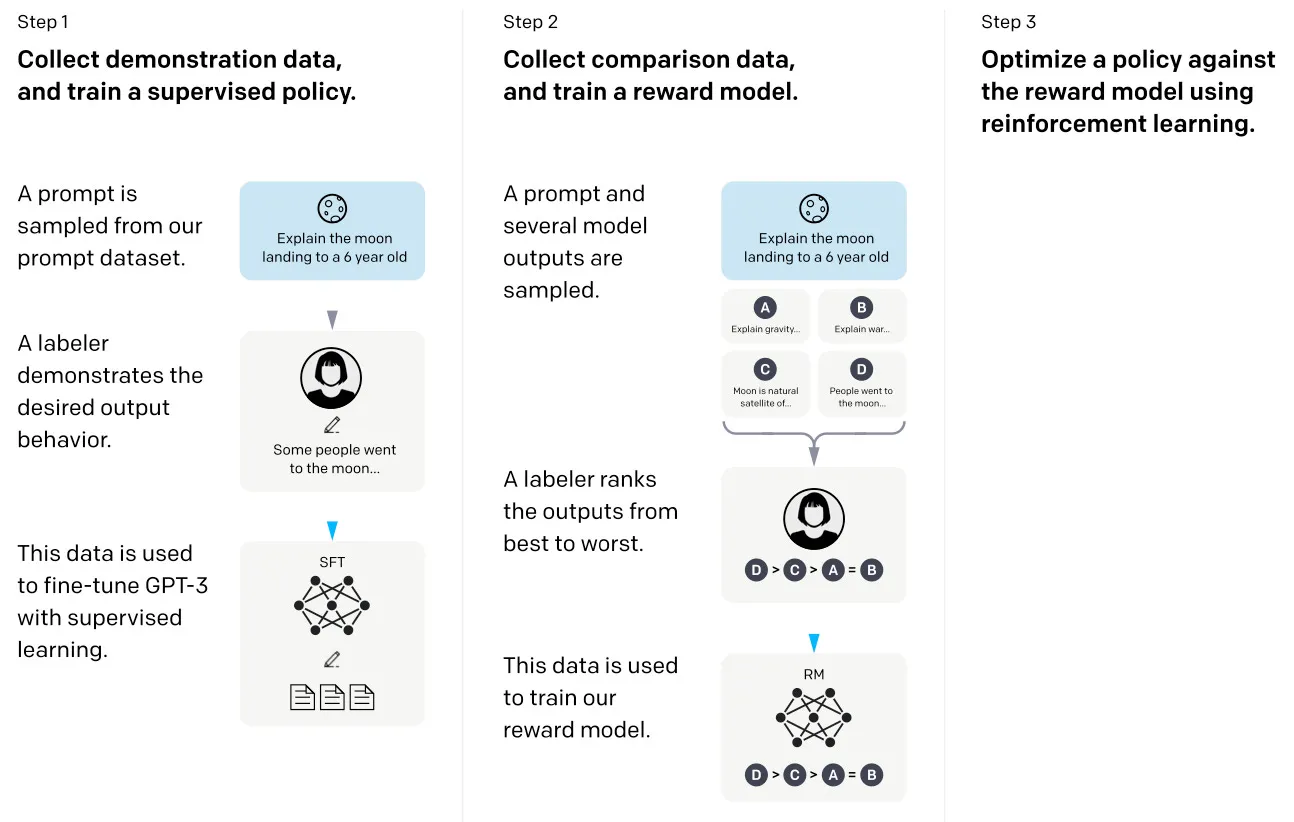
figure17
来源:https://arxiv.org/abs/2203.02155

(18) 《宪法AI:来自AI反馈的无害性》(2022)

作者:Yuntao, Saurav, Sandipan, Amanda, Jackson, Jones, Chen, Anna, Mirhoseini, McKinnon, Chen, Olsson, Olah, Hernandez, Drain, Ganguli, Li, Tran-Johnson, Perez, Kerr, Mueller, Ladish, Landau, Ndousse, Lukosuite, Lovitt, Sellitto, Elhage, Schiefer, Mercado, DasSarma, Lasenby, Larson, Ringer, Johnston, Kravec, El Showk, Fort, Lanham, Telleen-Lawton, Conerly, Henighan, Hume, Bowman, Hatfield-Dodds, Mann, Amodei, Joseph, McCandlish, Brown, Kaplan
https://arxiv.org/abs/2212.08073

在这篇论文中,研究者将对齐的思路更进一步,提出了一种打造“无害”AI系统的训练机制。与直接的人类监督不同,研究者提出了一种基于人类制定的规则清单的自训练机制。和上面提到的InstructGPT论文类似,该方法也采用了强化学习思路。
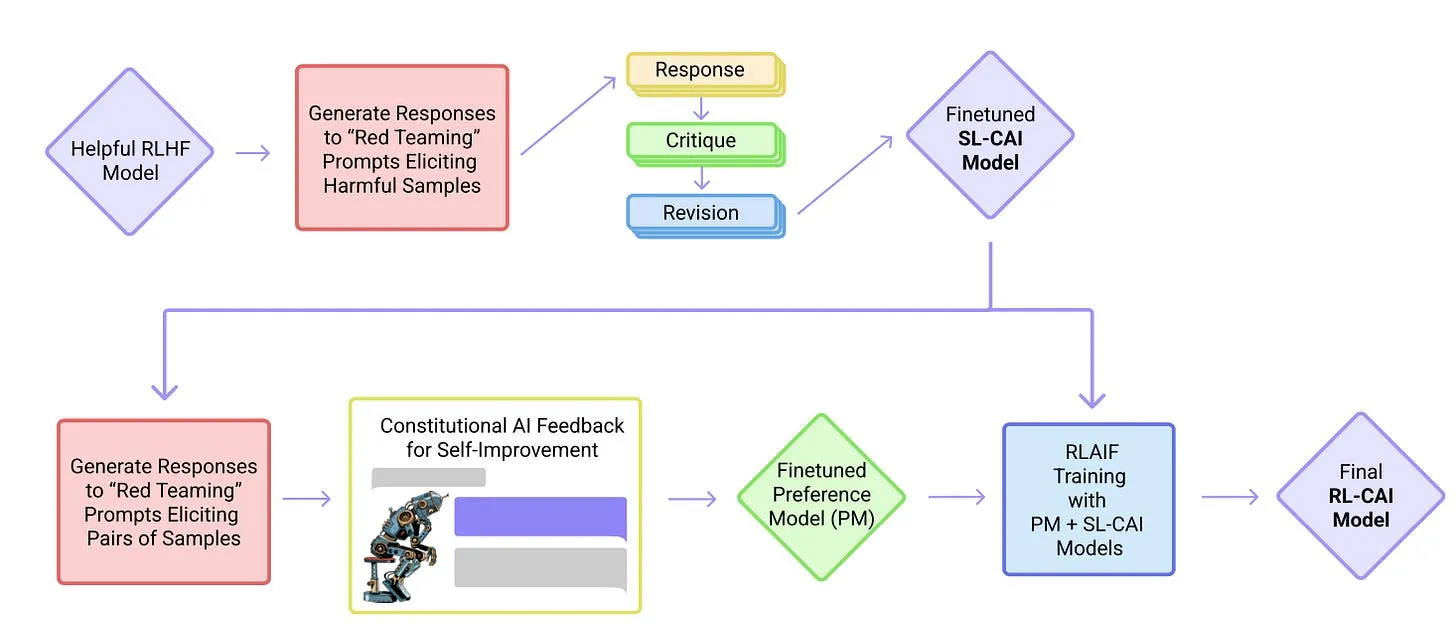
figure18
来源:https://arxiv.org/abs/2212.08073

(19) 《Self-Instruct:用自生成指令对齐语言模型》(2022)

作者:Wang, Kordi, Mishra, Liu, Smith, Khashabi, Hajishirzi
https://arxiv.org/abs/2212.10560

指令微调是我们从GPT-3这类预训练基础模型,得到ChatGPT这类能力更强的大语言模型的关键。而像https://github.com/databrickslabs/dolly/tree/master/data 这样的开源人类生成指令数据集,能帮助实现这一点。但我们要如何规模化?方法之一就是让大语言模型利用自身的生成结果进行自举。

Self-Instruct就是一种(几乎无需标注的)将预训练大语言模型与指令对齐的方法。

它的工作原理是什么?简而言之,这是一个四步流程:

  1. 用一组人工编写的指令(本例中为175条)构建种子任务池,并采样指令。
  2. 用预训练大语言模型(比如GPT-3)判断任务类别。
  3. 给定新指令,让预训练大语言模型生成回复。
  4. 对回复进行收集、修剪、过滤,再加入任务池。

figure19
Self-Instruct方法的注解版示意图,引自https://arxiv.org/abs/2212.10560

在实践中,从ROUGE分数来看,这种方法效果相当不错。
比如,经过Self-Instruct微调的大语言模型表现优于GPT-3基础模型(1),且能与在大规模人工编写指令集上预训练的大语言模型媲美(2)。同时,Self-Instruct也能让已经经过人类指令微调的大语言模型进一步获益(3)。

当然,评估大语言模型的黄金标准是人类评分。基于人类评估的结果显示,Self-Instruct的表现优于基础模型,也优于以监督方式在人类指令数据集上训练的模型(SuperNI、T0 Trainer)。但有意思的是,Self-Instruct的表现并没有超过通过人类反馈强化学习(RLHF)训练的方法。

人工生成指令数据集和自指令数据集,哪个更有前景?我认为两者都有价值。为什么不先从人工生成的指令数据集(比如Dolly的15000条指令,见https://github.com/databrickslabs/dolly/tree/master/data)起步,再用Self-Instruct进行规模化呢?

人类反馈强化学习(RLHF)

关于人类反馈强化学习(RLHF)的更多解释,以及实现RLHF的近端策略优化相关论文,请看我更详细的文章:
https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives

https://substack.com/profile/27393275-sebastian-raschka-phd
·
2023年9月10日

https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives

我在讨论大语言模型时,无论是研究资讯还是教程,都会频繁提到**人类反馈强化学习(Reinforcement Learning with Human Feedback, RLHF)**这个流程。RLHF是现代大语言模型训练流水线中不可或缺的一环,它能将人类偏好融入优化过程,从而提升模型的有用性与安全性。

https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives

结语与延伸阅读

我尽量让上面的清单保持精简,聚焦于最核心的10篇论文(外加3篇RLHF相关的补充论文),帮助理解当代大语言模型背后的设计、局限与演进。

想要进一步阅读的话,建议参考上面提到的论文中的参考文献。或者,我再给你一些额外的方向(这些清单并不全面):

GPT的开源替代方案

ChatGPT替代方案

计算生物学中的大语言模型

这本杂志是我的个人兴趣项目。如果愿意支持我的话,可以考虑购买我的书:https://amzn.to/4fqvn0D 。(我相信你会从这本书里收获很多,因为它对大语言模型工作原理的讲解深度是其他地方找不到的。)
figure20

https://amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 现已在亚马逊上架

如果你读了这本书,并且能抽出几分钟时间,我会非常感谢你去亚马逊留下评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 。这对我们作者帮助很大!

另外,我最近也在Substack上开通了付费订阅选项,可以直接支持这本杂志。
【转载】大语言模型3.0

原文地址:
Large Language Models 3.0,by Sebastian Raschka, on 2023-04-04

大语言模型3.0

大语言模型 1.0。距离初代Transformer模型、BERT、BLOOM、GPT-1到GPT-3等众多模型的出现,已经过去了大约五年时间。这一代大语言模型(LLM)以PaLM、Chinchilla和LLaMA为巅峰代表。第一代Transformer的共同特点是,它们都在大规模无标注文本语料库上完成预训练。

大语言模型 2.0。近期,我们看到许多预训练LLM在标注目标数据上进行微调,方式包括基于人类反馈的强化学习,或是更经典的监督学习目标——这一点我在上一期《Ahead of AI》中已有讨论。第二代LLM的典型代表包括InstructGPT和ChatGPT,还有Alpaca和Bard(本期通讯会讨论)。

大语言模型 3.0。思考第三代大语言模型会是什么样子,是件很有意思的事。近几个月的热门方向是参数高效微调,以及在领域特定数据上进行预训练(相关案例会在本期后面讨论)。但参数高效微调和领域特定数据预训练,本质上是让LLM的计算效率和数据效率更高的手段。而下一代LLM的核心,很可能会围绕多模态与多任务学习展开,为大语言模型带来全新的能力。我预计未来几个月这一方向会涌现更多研究。

本期通讯涵盖了近期围绕参数效率与多模态的大语言模型相关内容。值得一提的是,这个月开源AI领域的进展格外亮眼,因此本期的「开源亮点」部分会特别精彩。

文章与趋势

拓展LLaMA

上个月,Meta推出的LLaMA作为GPT-3的替代方案引发了巨大反响(我们在《Ahead of AI》第6期《训练方式之变》中介绍过LLaMA:https://magazine.sebastianraschka.com/p/ahead-of-ai-6-train-differently )。AI研究领域如今发展速度之快,体现在已经有大量项目基于LLaMA展开二次开发。

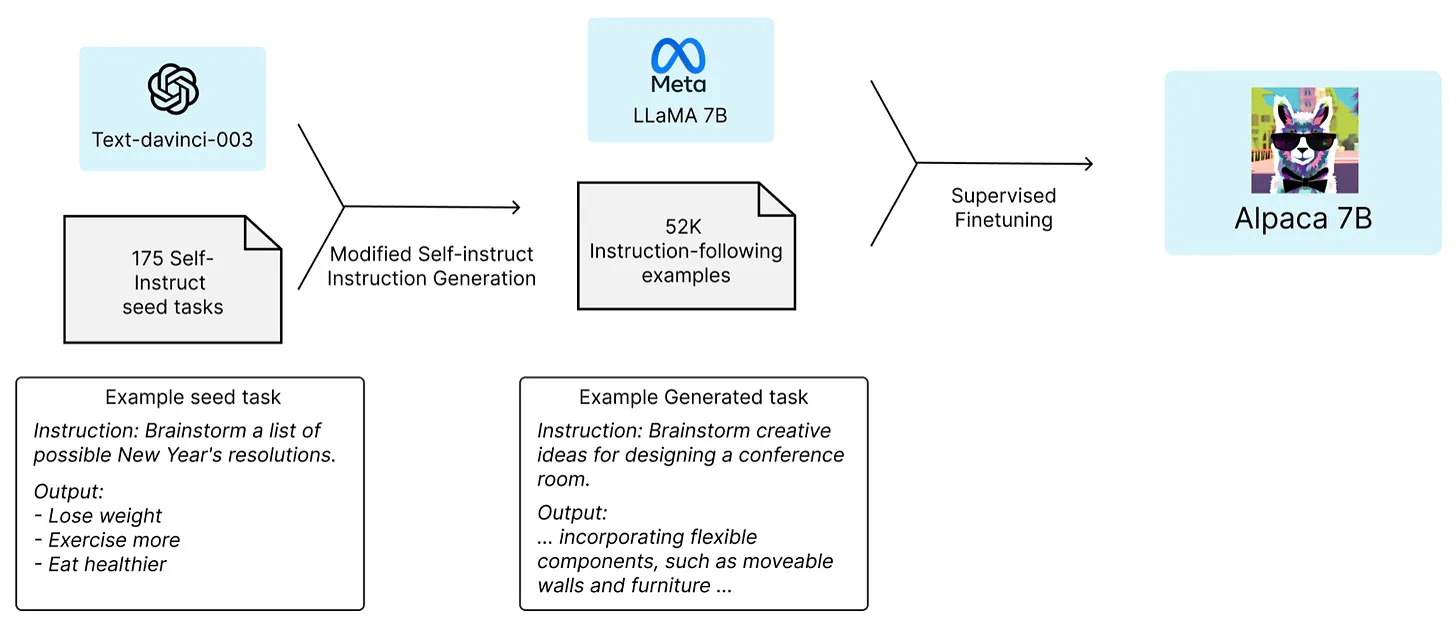
其中最受关注的项目之一是Alpaca。Alpaca是一个基于7B参数LLaMA模型、经过指令微调的7B语言Transformer。不过,它没有采用基于人类反馈的强化学习(RLHF,相关介绍见:https://magazine.sebastianraschka.com/p/ahead-of-ai-6-train-differently ),而是使用5.2万条指令-输出对进行监督式微调。

研究人员没有使用人工生成的指令-输出对,而是通过调用基于GPT-3的text-davinci-003模型来获取数据。因此,Alpaca本质上采用的是一种弱监督,或者说带有知识蒸馏风格的微调方式。值得注意的是,这种方式的效果可以媲美人工标注。例如在《Self-Instruct》论文(https://arxiv.org/abs/2212.10560)中,作者发现让模型基于自身生成的内容进行迭代提升,最终效果可以与InstructGPT相当。

figure01

Alpaca方法的截图,来源:https://crfm.stanford.edu/alpaca/

训练方案开源地址:https://github.com/tatsu-lab/stanford_alpaca 。据作者称,使用8张A100 GPU即可复现,预算约600美元。

如果作者正在撰写Alpaca的研究论文,这里有几个小小的期待点:

  • 为什么是5.2万条指令-输出对(而不是更多或更少)?这里的微调缩放定律是怎样的?
  • 这里的监督微调效果,与基于近端策略优化(PPO)的微调相比如何?
  • 如果把text-davinci-003换成ChatGPT的GPT-3.5或GPT-4,性能会有显著差异吗?

注意Alpaca官网(https://crfm.stanford.edu/alpaca/ )近期已下线,但项目仍可在GitHub获取:https://github.com/tatsu-lab/stanford_alpaca 。Alpaca下线的原因可见:https://www.theregister.com/2023/03/21/stanford_ai_alpaca_taken_offline/ ——原因是它“可能生成虚假信息、传播社会刻板印象,并产生有害语言”。

让微调更高效

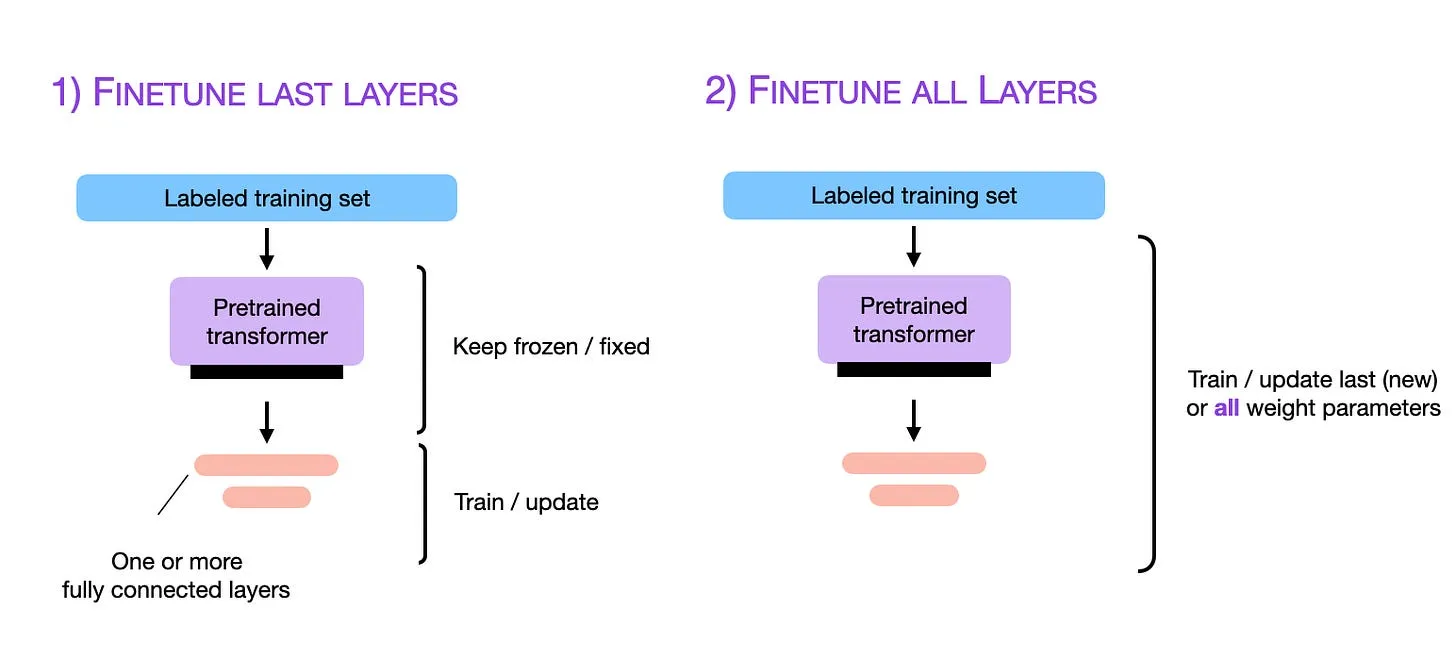
传统上,我们微调大语言模型的方式要么是更新全部层,要么是只替换更新输出层——根据我的经验,更新全部层的计算量更大,但最终预测性能要好得多(我会在即将推出的《深度学习基础》课程第8单元中讲解这一点:https://lightning.ai/pages/courses/deep-learning-fundamentals/ )。

figure02

经典微调范式。

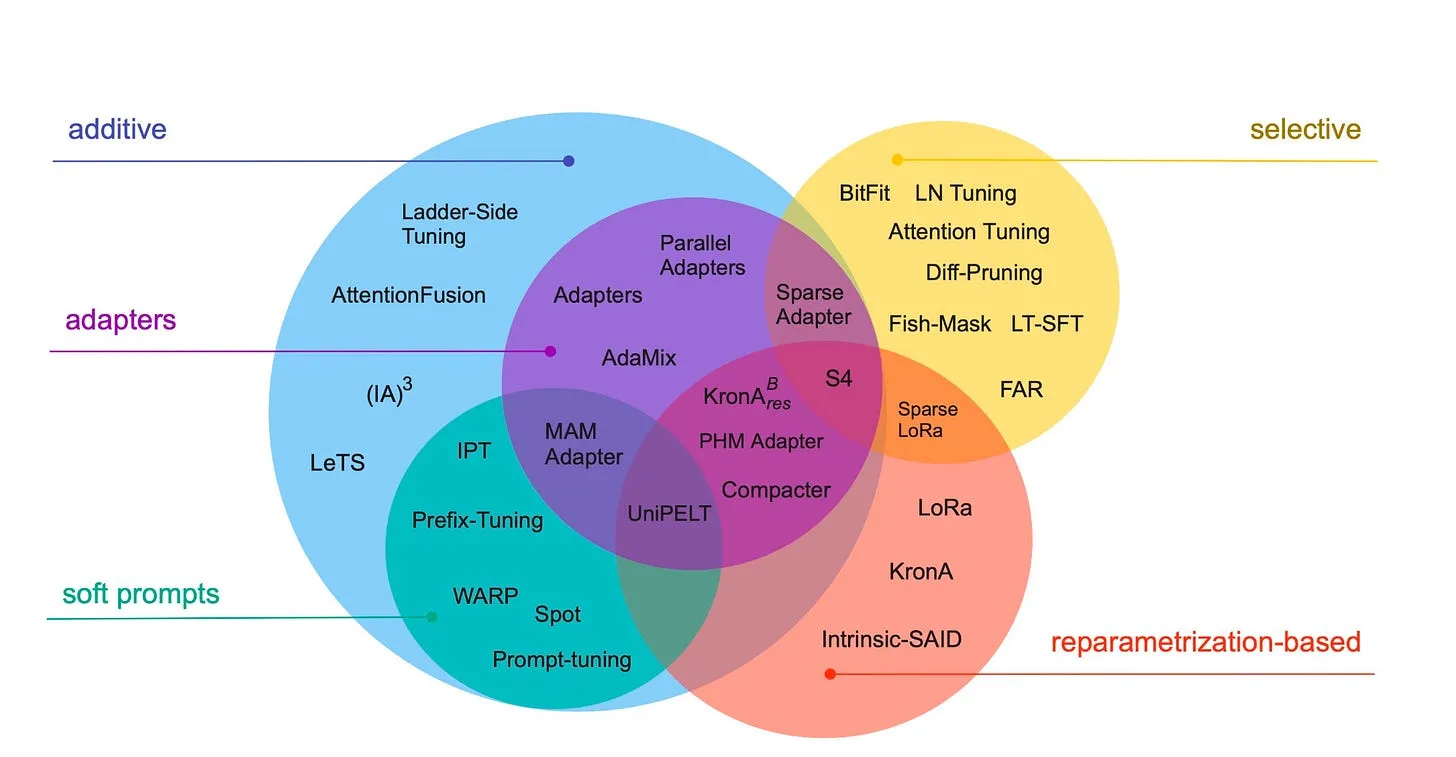
近期,研究者开始关注另一种更节省计算与显存的微调范式。这类范式通常被称为参数高效微调方法。本期我不展开详细讲解这些技术,但推荐上周发布的这篇出色综述:https://arxiv.org/abs/2303.15647 ,内容非常全面。

figure03

大语言模型的参数高效微调技术,来源:https://arxiv.org/abs/2303.15647

下面要介绍的LLaMA-Adapter,就是一项值得关注的新型参数高效微调技术。

用于LLM参数高效微调的LLaMA-Adapter

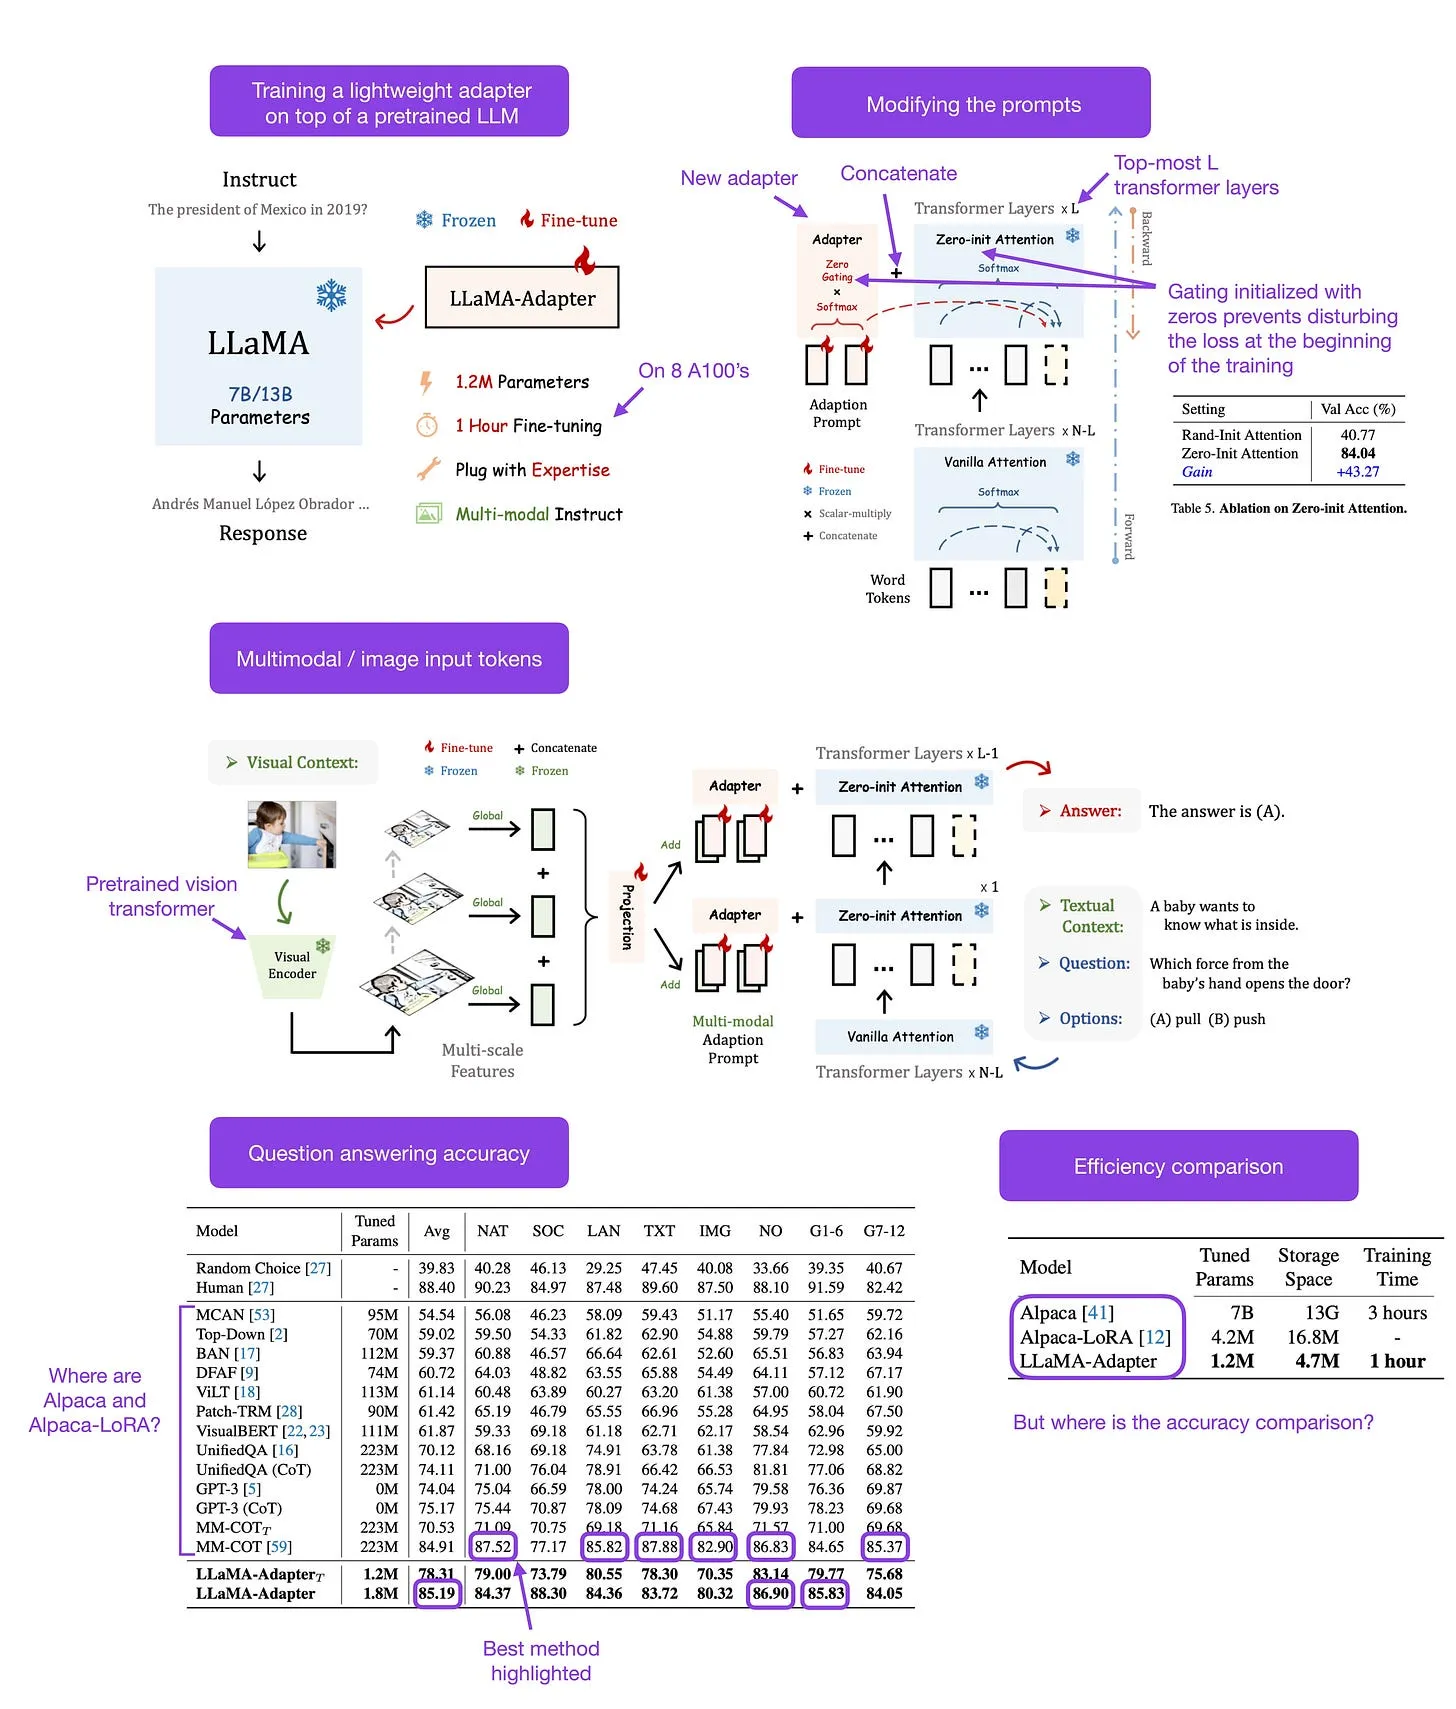
在论文《LLaMA-Adapter: Fine-tuning Language Models with ZeroInit Attention》(https://arxiv.org/abs/2303.16199)中,作者提出了一种适配器方法,可用于对LLaMA进行指令微调。

与前面提到的Alpaca方法(https://github.com/tatsu-lab/stanford_alpaca )不同,LLaMA-Adapter不会端到端地微调整个模型。相反,它在预训练、权重冻结的LLaMA模型(https://ai.facebook.com/blog/large-language-model-llama-meta-ai/)之上,只新增了120万参数的小型适配器。

使用与Alpaca相同的5.2万条指令跟随样本,最终效果与Alpaca相当。但Alpaca在8张A100上需要训练3小时,而LLaMA-Adapter的微调时间仅为其三分之一。(注:论文中提到效果相当,但我没找到具体的指标数据。)

为了在实际中取得良好效果,研究者还提出了一种初始化为全零的门控机制,防止训练初期适配器干扰预训练LLaMA模型的性能。

figure04

来自论文https://arxiv.org/abs/2303.16199的标注图表

这种适配器方法的特别之处在于,它允许我们接入其他输入模态,比如图像和视频token——这就引出了下一个话题:多模态LLM。

多模态或许是下一个风口:PaLM-E

大语言模型(LLM)的下一步是什么?遗憾的是,很难断言。我们看到纯文本模型的表现越来越好。但很难说我们是否正在接近纯文本LLM的能力上限——无论是在通用语料上预训练,还是在标注目标数据集上微调。

我非常确定,未来还会有大量研究和实验,致力于让纯文本模型表现更优——比如通过增加参数量、扩大数据集,或是改进架构与训练技术。

尽管如此,思考LLM未来发展的其他方向依然很有意思。比如,下一个趋势可能会聚焦于拓展视觉能力、其他模态,以及多任务训练。

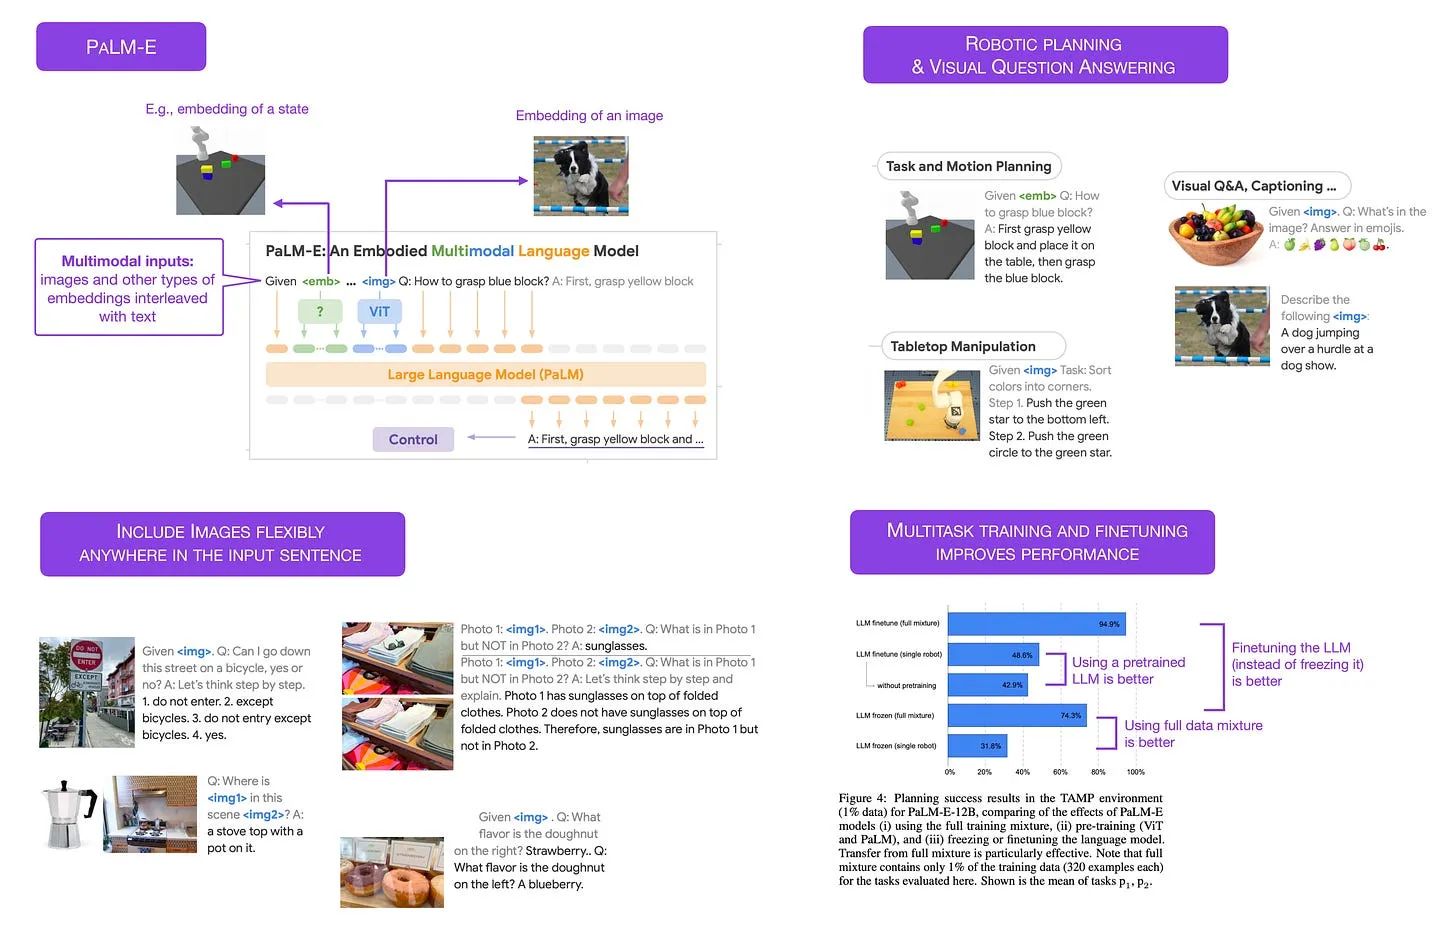
去年,谷歌发布了PaLM(https://arxiv.org/abs/2204.02311 )——一个强有力的GPT竞品。大约一年后的现在,PaLM-E(https://arxiv.org/abs/2303.03378 )刚刚发布。我们来看看它的核心内容。

PaLM-E的研究重点是机器人操作规划。但有意思的是,当在多模态输入上训练后,该模型也展现出了视觉问答和图像字幕的涌现能力。当然,PaLM-E不是第一个支持图像输入的语言模型。但它的新颖之处在于,一张或多张图像可以灵活地嵌入到句子的任意位置。

需要说明的是,PaLM-E仍然是一个纯解码器架构的LLM,基于给定的前缀或提示自回归地生成文本补全。那么它们是如何让模型支持状态表示或图像输入的呢?很简单:它们预训练了专门的网络,将这些输入编码为嵌入向量。例如对于图像,他们实验了4B与22B参数的视觉Transformer(ViT)来生成嵌入向量,再通过线性投影匹配词元嵌入的维度。

训练时,为了构成多模态句子,它们使用特殊token(<img1>、<img2>等,如上图所示),之后再替换为嵌入后的图像(类似于词元通过嵌入层生成嵌入的方式)。

最值得探讨的问题是:我们是否应该冻结预训练LLM,只训练ViT嵌入网络?结果显示,微调LLM的效果更好,而“全混合”联合训练的性能更是提升了一倍以上。也就是说,这篇论文最大的结论是:与针对单个任务分别训练模型相比,多任务训练能提升性能。

figure05

来自PaLM-E论文的标注图,https://arxiv.org/abs/2303.03378

其他多模态LLM(MLLM)

当然,PaLM-E不是第一个、也不是唯一支持多模态的LLM(即MLLM)。其他近期或知名的例子包括:

从零开始训练大语言模型值得吗?

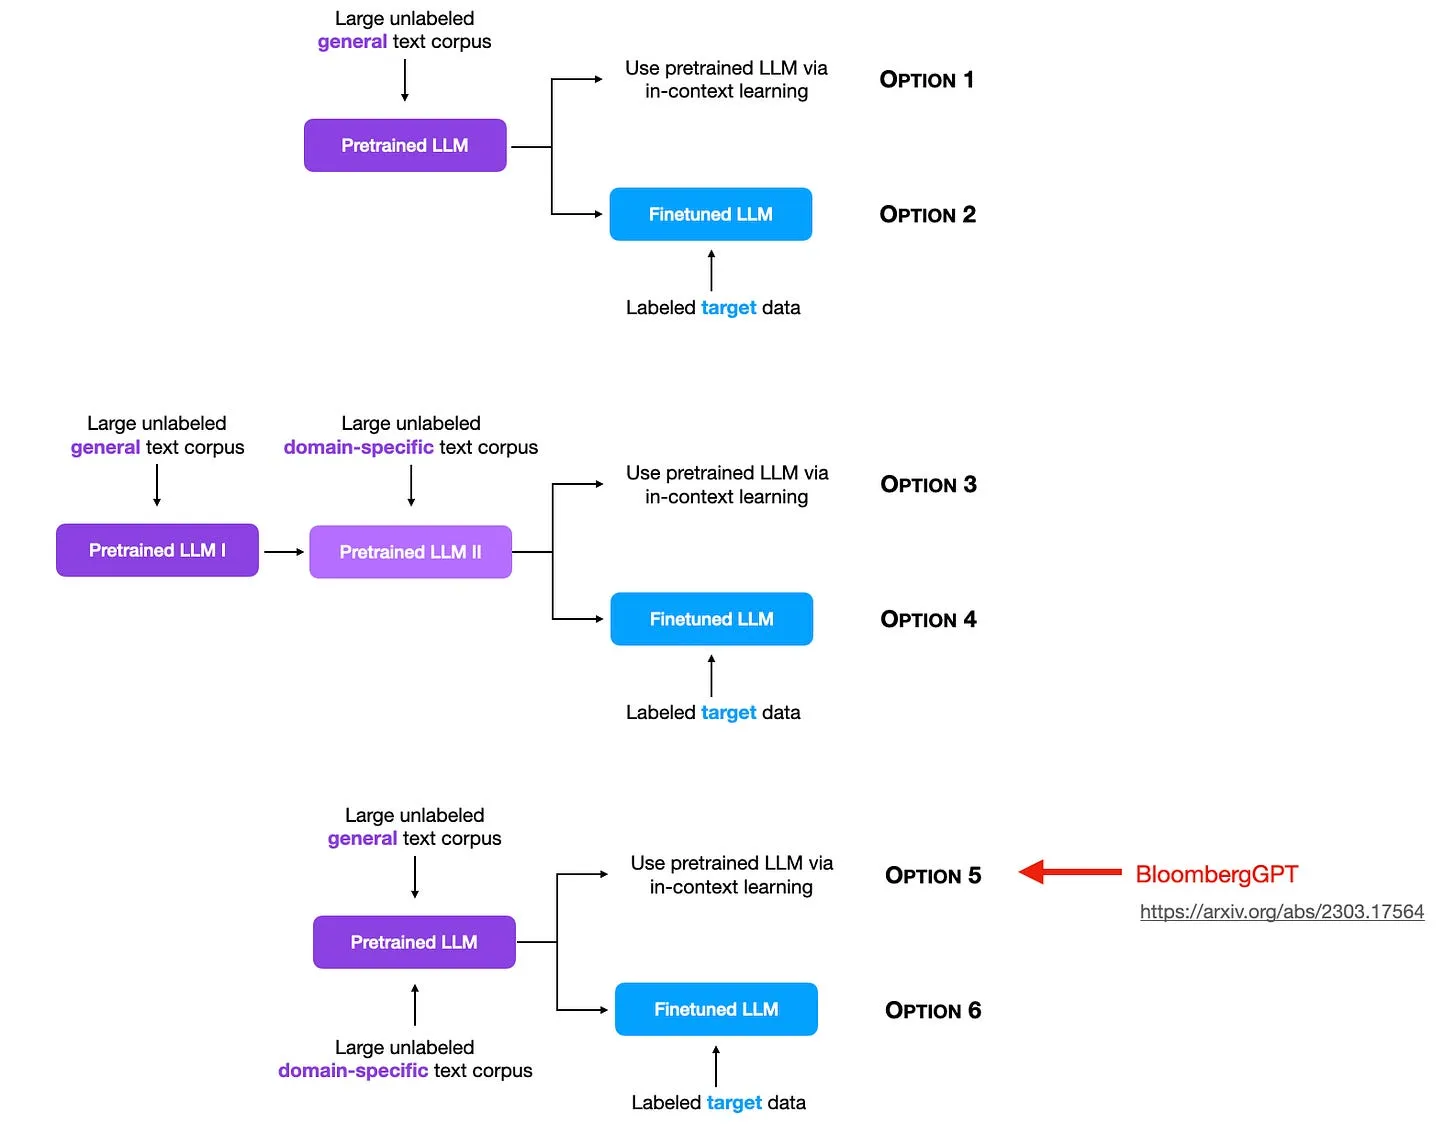
在领域特定数据上从零开始训练自己的大语言模型(LLM)是否值得?彭博社的研究者就这么做了,并且分享了一份详细的技术报告,介绍了数据集、模型配置和训练流程。根据我的经验,如果我们要把LLM应用在全新的数据源上(比如蛋白质氨基酸序列,相关研究见:https://academic.oup.com/bioinformatics/article/38/8/2102/6502274 等),这么做是有意义的。但对于金融文章这类相近领域的数据呢?

figure06

LLM预训练与微调的不同方式。

我们来详细聊聊这篇论文提出的模型:https://arxiv.org/pdf/2303.17564.pdf 。BloombergGPT是一个500亿参数的金融领域语言模型,在3630亿token的金融数据和3450亿token的公开通用数据集上训练而成。作为对比,GPT-3的参数量是它的3.5倍(1750亿参数),但训练token数仅为它的1/1.4(4990亿)。

当然,BloombergGPT在金融相关任务上的表现超过了其他LLM。有意思的是,它在通用语言任务上的表现也依然出色。我很想知道,如果采用两阶段预训练,或是在领域特定数据上做领域专属微调,会不会在领域数据上取得更好的效果。我猜作者没有做这些实验是出于成本考虑。

这就引出了下一个话题:这个模型是用什么硬件训练的?该模型在AWS上使用64组、每组8张A100 GPU,训练了约53天。粗略估算一下,假设A100 GPU的优惠价格是每小时1.1美元,那么总时长1274小时 × 1.1美元/小时 × 64×8张GPU = 70万美元——考虑到LLaMA论文(https://arxiv.org/abs/2302.13971)报道的训练成本是60万美元,这个数字听起来还不算太高。但需要注意的是,这个数字不包含超参数优化和失败的训练跑次。

为什么作者选择了“只有”500亿参数的架构,毕竟GPT-3是它的3.5倍大?答案很简单:他们采用了Chinchilla缩放定律,结合可用金融数据的规模,认为这个参数量是合适的。

在混合数据集上从零开始(预)训练LLM值得吗?从论文来看,模型在目标领域的表现非常好。但我们不知道它是否比以下两种方案更好:a)在预训练模型的基础上,用领域特定数据继续预训练;b)在预训练模型上做领域特定微调。

为什么他们没有基于BLOOM等现有LLM做微调或者继续训练?微调(通过RLHF或监督微调)可能更难自动化。而且他们可能不想基于现有模型继续训练,因为按照缩放定律,BLOOM模型的尺寸是它的3.5倍,太大了。

不过,如果你想采用混合预训练的方法,BloombergGPT提供了一份描述非常详尽的方案,包括架构、数据集和超参数的详细说明。

其他领域的模型

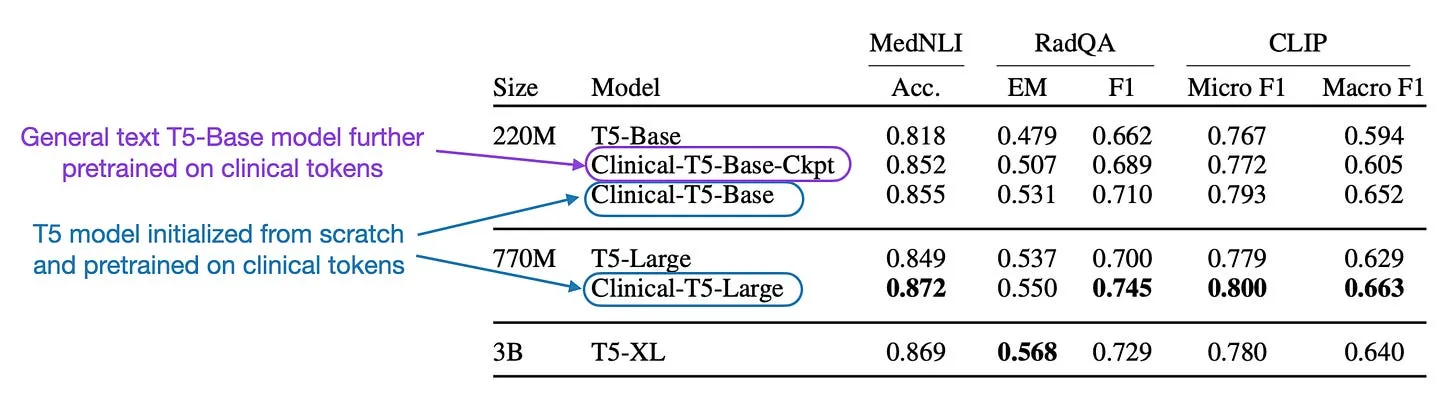
注意,BloombergGPT不是第一个从零开始在专有领域数据上训练的模型。已有大量在生物医学或法律文档上训练的模型案例。近期的一个例子是2月份分享的论文:https://arxiv.org/abs/2302.08091

figure07

来自https://arxiv.org/abs/2302.08091的标注截图

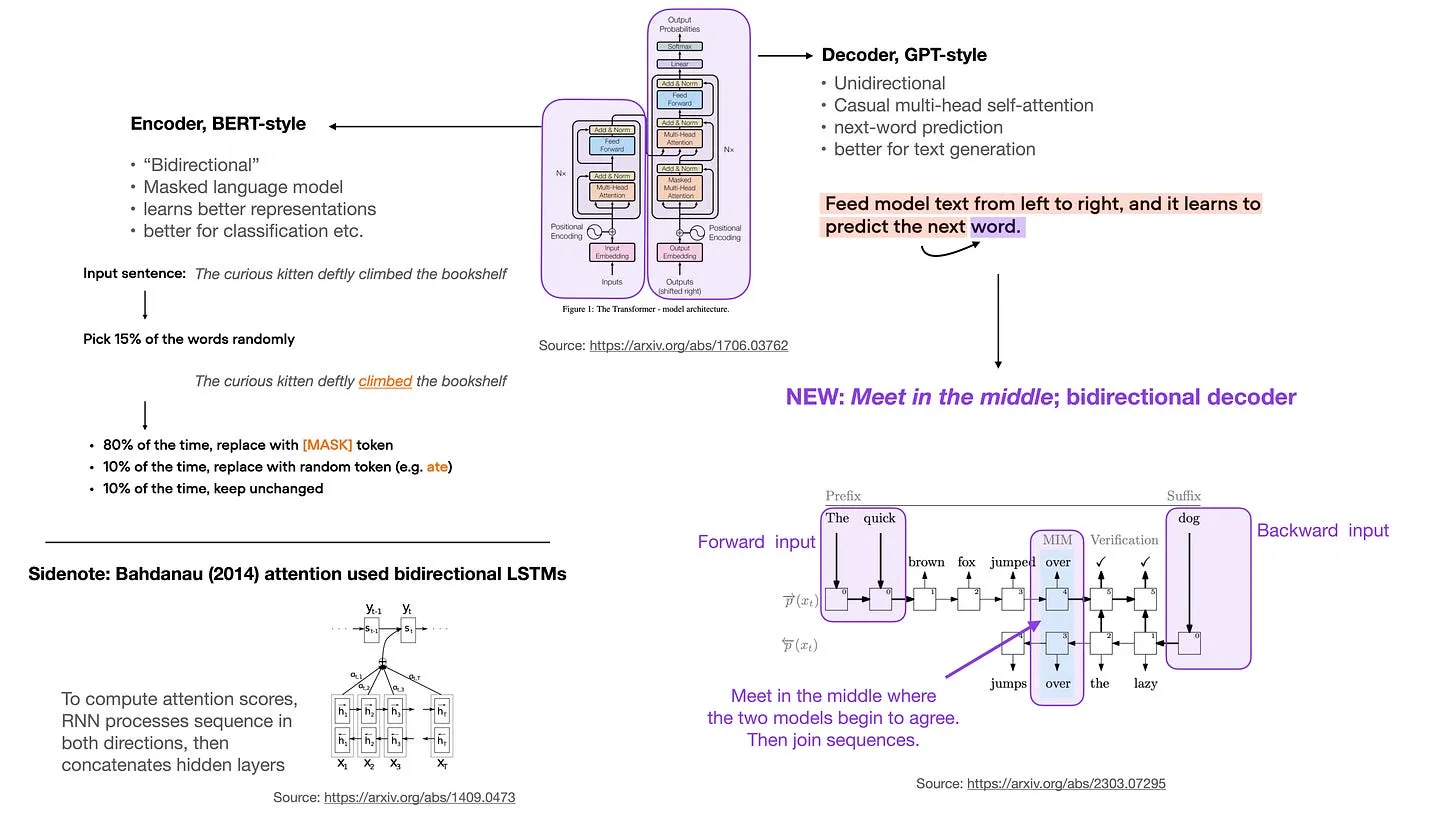
通用架构与训练改进:中间相遇

我之前提到过,纯语言模型会有更多架构和训练上的优化。这一类的其中一篇论文是https://arxiv.org/abs/2303.07295 。这篇论文提出了一种双向LLM,在预训练时利用完整序列信息,推理时利用双向上下文。

这里的“双向”不同于BERT风格的编码器——后者使用掩码语言建模来预测被掩码的词。相反,在“中间相遇”(Meet in the Middle, MiM)方法中,它们像双向LSTM那样,分别从左到右和从右到左处理序列。

乍一看,这个思路和BiLSTM很像。但其实是不同的方法:它不是把前向和后向的隐藏状态拼接起来。相反,MiM的核心是让两者达成一致。它们用一个正则项,强制两个方向生成相似的token。

这种方法没有额外的参数开销,因为前向和后向共享同一个解码器。而且,如果并行度足够,它甚至可以更快——如果两个模型生成的结果完全一致,每个模型只需要自回归生成一半的序列。

注意:我觉得对于“补全提示”类的查询,MiM在推理阶段可能不适用,但对于指令类查询,我看不出有什么问题。

推理时也可以丢弃后向路径——也就是说,训练时利用后向路径更好地利用数据,推理时只使用前向解码器。但根据消融实验,双向模型的表现还是优于单向模型。

figure08

来自https://arxiv.org/abs/2303.07295的标注图

机器学习竞赛格局

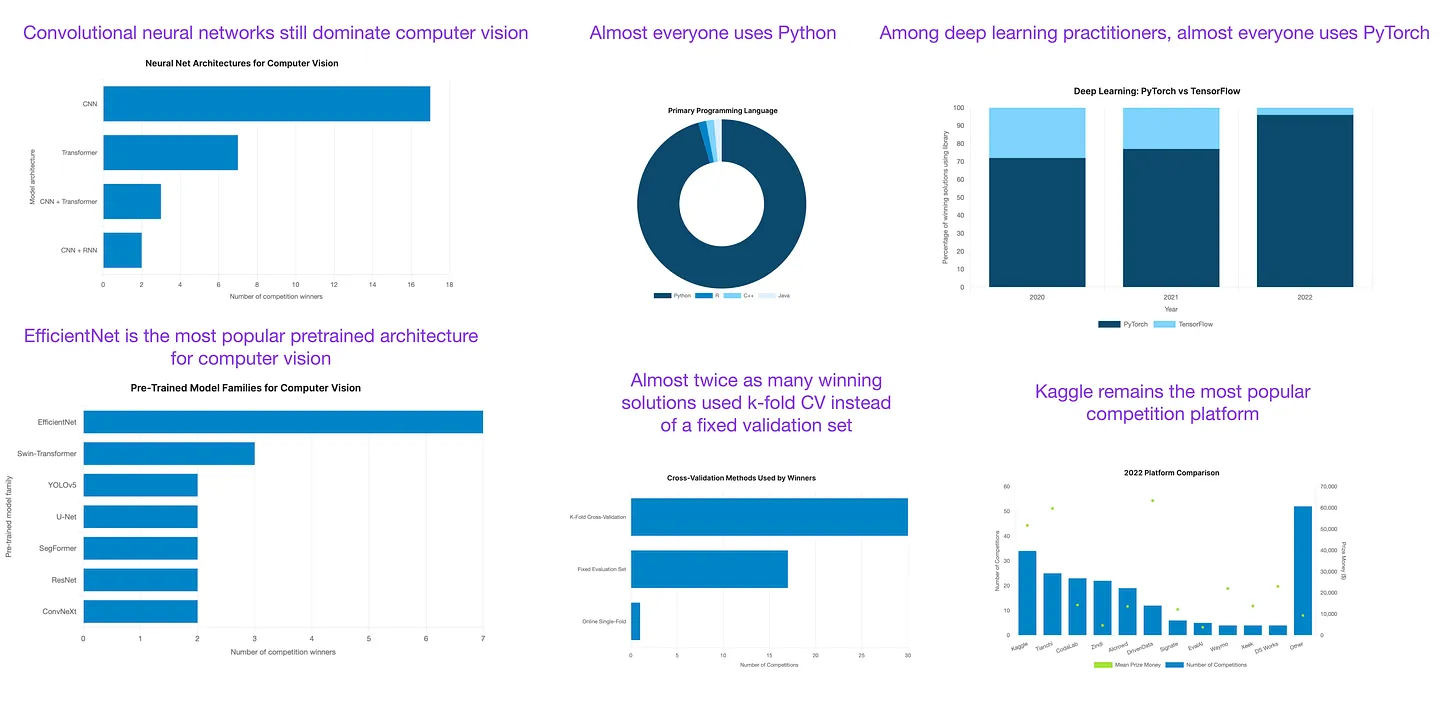
机器学习竞赛往往能很好地反映哪些技术在新数据集上真正实用。3月发布的这份全面报告《2022年机器学习竞赛现状》(https://mlcontests.com/state-of-competitive-machine-learning-2022/ )包含了很多有意思、甚至出人意料的发现!以下是几个核心结论。

不出所料,Transformer主导自然语言处理(NLP)领域。所有NLP相关的获奖方案都使用了Transformer。

卷积神经网络仍然主导计算机视觉领域。EfficientNet是计算机视觉最流行的预训练架构——大多数人都会微调预训练模型,而不是从零开始训练。

使用k折交叉验证的获奖方案,数量几乎是使用固定验证集的两倍。

Kaggle(勉强)仍是最受欢迎的竞赛平台。

几乎所有人都用Python。

在46个使用深度学习的获奖方案中,44个用了PyTorch,只有2个用了TensorFlow。

表格数据竞赛的一大意外:XGBoost的统治似乎结束了。虽然梯度提升仍然赢下了大多数表格竞赛,但LightGBM现在是更受青睐的方法,CatBoost紧随其后,XGBoost位列第三。

10场表格竞赛中,有7场的获胜方案使用了梯度提升,5场使用了深度神经网络(基于PyTorch实现),而且大多数获奖方案都是集成方法。

figure09

来自https://mlcontests.com/state-of-competitive-machine-learning-2022/的标注截图

研究亮点(两句话以内)

自从上一期《Ahead of AI》发布以来,还有很多其他精彩的新研究论文。遗憾的是,全部介绍的话这篇通讯就要变成一本书了。所以我决定新增一个「研究亮点」板块,只链接我觉得特别有意思的其他研究者论文。

自然语言处理

  • 《为长序列重振循环神经网络》(https://arxiv.org/abs/2303.06349)
    循环神经网络在长序列推理时效率很高,但训练速度慢,且难以优化。这篇论文提出了线性循环单元,证明经过精心设计的循环神经网络,在长序列任务上表现出色,同时训练速度也很可观。
  • 《单GPU实现大语言模型高吞吐量生成推理》(https://arxiv.org/abs/2303.06865)
    这篇论文介绍了FlexGen——一个专为显存有限的GPU运行LLM设计的高吞吐量生成引擎。
  • 《带人类偏好的语言模型预训练》(https://arxiv.org/abs/2302.085)
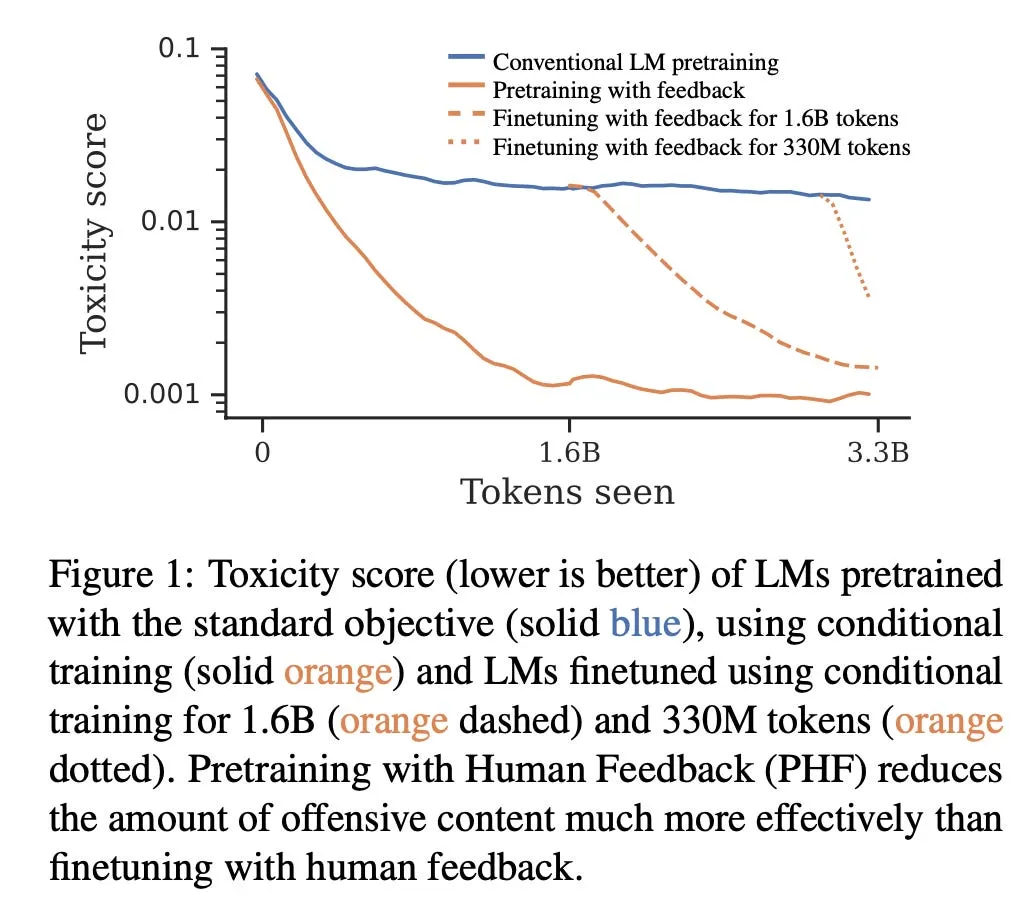
    该研究表明,在语言模型预训练阶段就融入人类反馈,相比“先预训练、再用反馈微调”的标准方案,能带来显著更优的偏好满足度——后者还涉及学习再遗忘不良行为的过程。结果表明,在语言模型预训练阶段就超越模仿学习、从一开始就纳入人类偏好,是更可取的做法。
  • 《Hyena层级结构:迈向更大的卷积语言模型》(https://arxiv.org/abs/2302.10866)
    Hyena是注意力的一种替代方案,它使用隐式参数化的长卷积和数据控制门控。在标准数据集(WikiText103和The Pile)上,Hyena为无注意力的稠密架构语言模型树立了新的业界标杆,在序列长度为2K时,达到Transformer的质量,同时训练计算量减少20%。
  • 《AI生成内容(AIGC)综合综述:从GAN到ChatGPT的生成式AI发展史》(https://arxiv.org/abs/2303.04226)
    一份数字内容生成的历史与综述,涵盖图像与文本,主题从GAN到ChatGPT应有尽有。
  • 《面向决策的基础模型:问题、方法与机遇》(https://arxiv.org/abs/2303.04129)
    预训练大语言模型有望为对话、自动驾驶、医疗、教育、机器人等应用打造强大的新系统。这篇论文概述了该领域的近期研究。

计算机视觉

  • 《一致性模型》(https://arxiv.org/abs/2303.01469)
    一致性模型是一类新型生成模型,无需对抗训练就能生成高质量样本。它们旨在克服扩散模型的局限,支持快速的单步图像生成。
  • 《面向文生图的GAN规模化》(https://arxiv.org/abs/2303.05511)
    GigaGAN实现了文生图的规模化,让模型能够利用大规模数据集。GigaGAN架构有诸多优势,包括推理速度大幅提升、生成高分辨率图像,以及支持多种潜空间编辑应用。
  • 《你的扩散模型其实是零样本分类器》(https://arxiv.org/abs/2303.16203)
    论文讨论了大规模文生图扩散模型带来的文本图像生成能力显著提升,这些模型还能提供条件密度估计,可用于图像生成之外的任务。最后,论文提出了一种名为扩散分类器的生成式分类方法,利用文生图扩散模型的密度估计,无需额外训练即可实现零样本分类。
  • 《视觉ChatGPT:用视觉基础模型对话、绘图与编辑》(https://arxiv.org/abs/2303.04671v1)
    视觉ChatGPT系统让用户能够同时使用语言和图像与ChatGPT交互,处理需要多个AI模型协作的复杂视觉问题或编辑指令。
  • 《迈向普惠化的联合嵌入自监督学习》(https://arxiv.org/abs/2303.01986)
    这篇论文旨在降低SimCLR这类图像自监督学习方法的门槛(我会在即将推出的《深度学习基础》课程第7单元讲解SimCLR:https://lightning.ai/pages/courses/deep-learning-fundamentals/ )。研究者简化了SimCLR,并证明仅用单个图像块作为负样本、仅用基础高斯噪声作为正样本对的数据增强,就可以训练SimCLR学到有价值的表示。
  • 《用于图文预训练的Sigmoid损失》(https://arxiv.org/abs/2303.15343)
    论文提出了一种简单的成对sigmoid损失用于图文预训练,不需要全局计算成对相似度来做归一化。通过这种方法,他们使用大模型和大批次,在两天内就在ImageNet零样本分类上取得了高精度。

头条新闻

去年12月ChatGPT首次推出时,仿佛真正打开了AI的闸门。从那以后,AI进入了大众视野,大语言模型的相关新闻仍然占据各大媒体头条。而且,每个月大语言模型的发展都在加速。由于很多公司最近才跟风开始训练自己的模型(见上文的BloombergGPT),而训练需要时间,我相信到今年年底,大语言模型会无处不在。

ChatGPT

ChatGPT竞品

AI监管

开源亮点

这个月对开源来说是格外丰收的一个月。此前人们担心AI发展正走向闭源(比如GPT-4),但开源领域如今重振旗鼓、势头向好,非常棒。

PyTorch 2.0

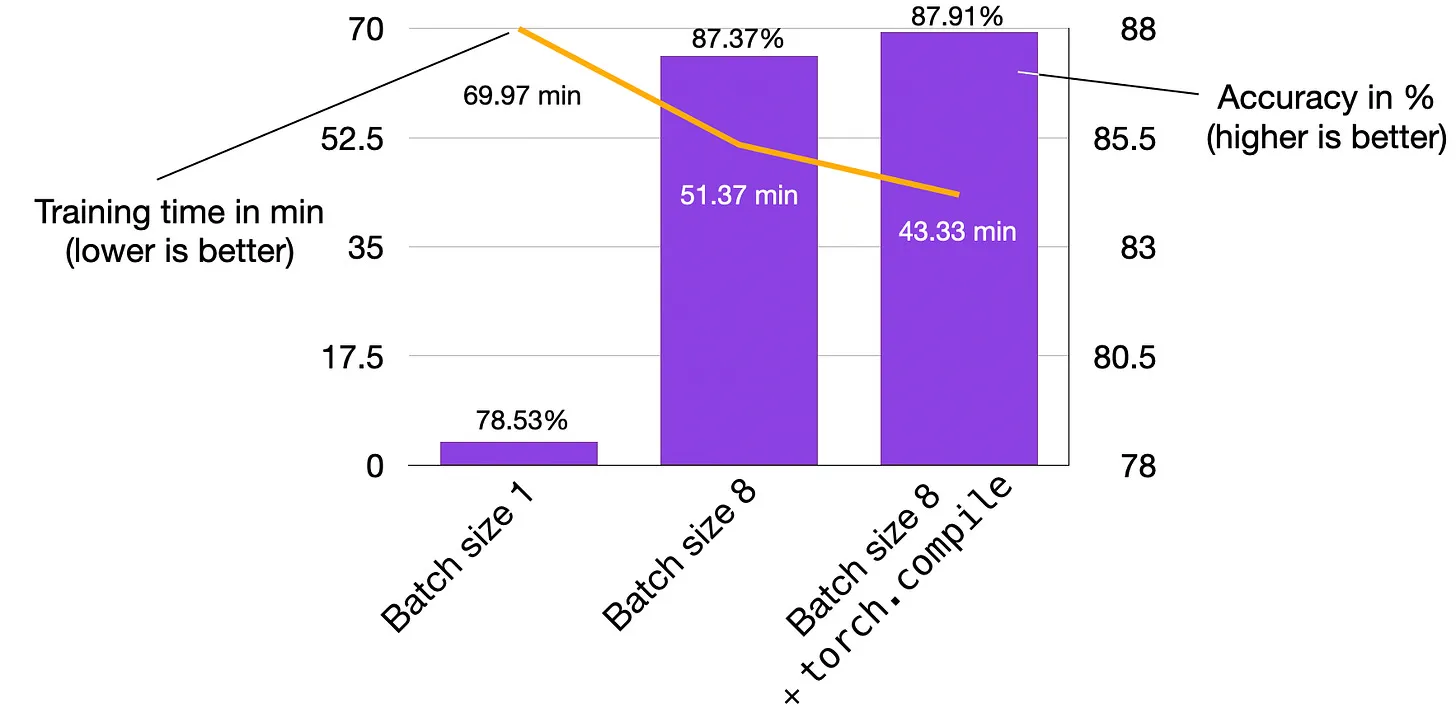
虽然2022年12月的PyTorch大会就已经公布过(并且在《Ahead of AI》第3期也有介绍:https://magazine.sebastianraschka.com/p/ahead-of-ai-3-ainnouncements ),但PyTorch 2.0正式版在3月15日终于发布了:https://pytorch.org/blog/pytorch-2.0-release/ 。正如之前宣布的,两大核心亮点是100%向后兼容,以及新增的可选功能torch.compile,用于编译模型计算图。

我最近用torch.compile微调了一个BLOOM模型(https://sebastianraschka.com/blog/2023/llm-grad-accumulation.html ),确实感受到了非常显著的速度提升(注意:训练时间越长,模型越能从编译中获益)。

figure10

来源:https://sebastianraschka.com/blog/2023/llm-grad-accumulation.html

Lightning 2.0:面向PyTorch的Trainer 2.0与Fabric加速训练

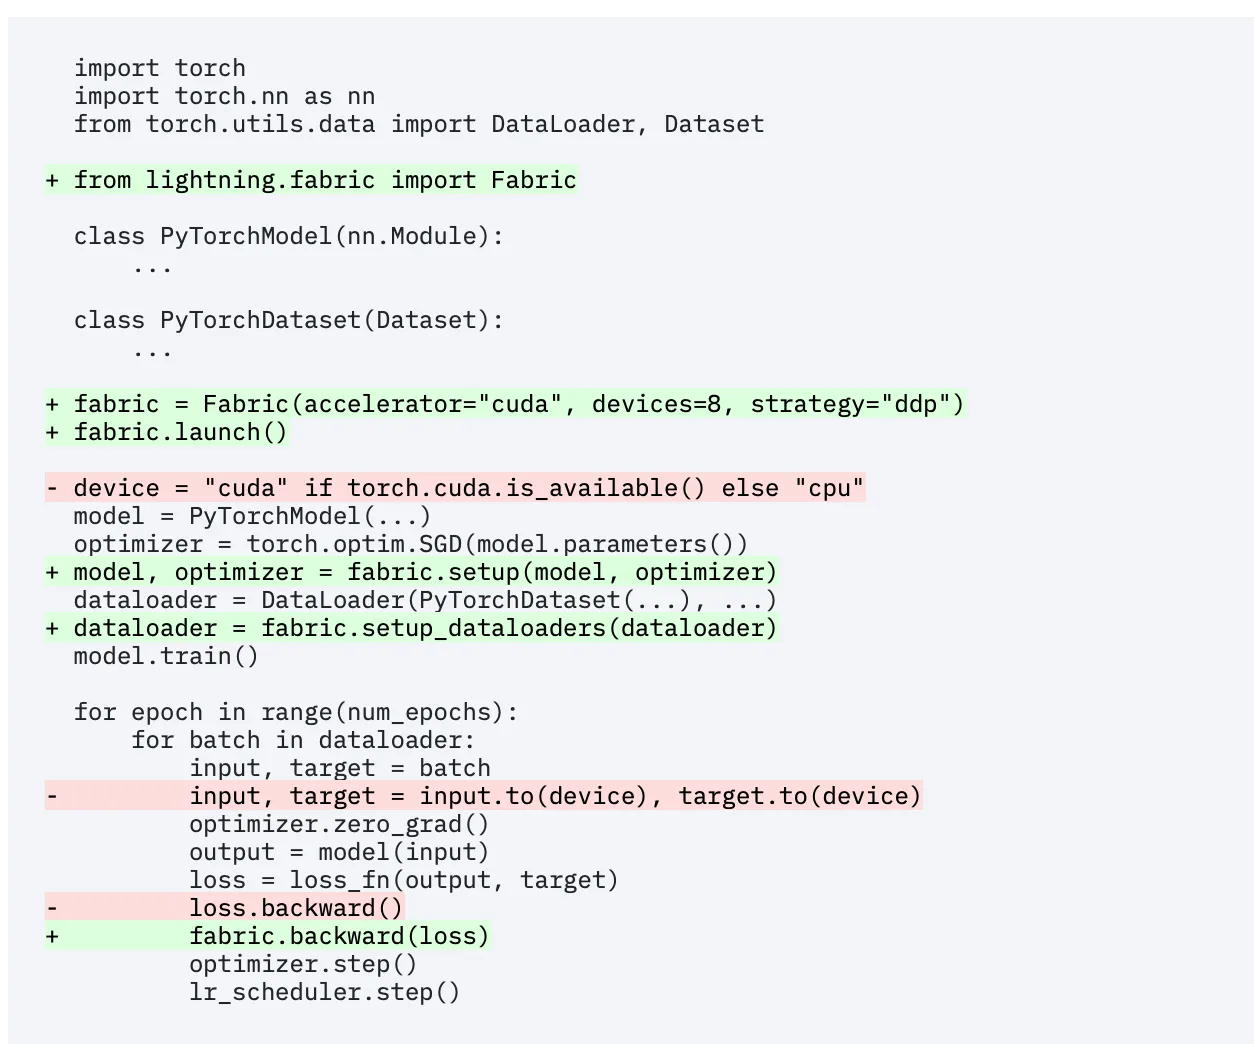
Lightning 2.0于本月发布,更新了开源的Lightning PyTorch模型库(https://lightning.ai/docs/pytorch/stable/common/trainer.html),以及全新的开源Fabric库(https://lightning.ai/docs/fabric/stable/ )——通过先进的多GPU训练范式、混合精度训练等特性,加速原生PyTorch训练循环。

figure11

使用Fabric修改后的PyTorch训练循环示意图

你可以在这里查看Lightning 2.0的更新日志:https://lightning.ai/docs/pytorch/stable/generated/CHANGELOG.html 。

最近我写了一篇博客《让你的PyTorch模型训练(大幅)提速的几个技巧》,用到了Trainer 2.0和Fabric,如果你想看微调大语言模型的实战案例,可以去看看。

figure12

博客文章截图

Lit-LLaMA

https://github.com/Lightning-AI/lit-llama 是Meta的LLaMA大语言模型(相关讨论见:https://magazine.sebastianraschka.com/i/106859367/smaller-large-language-models )的重写实现,基于nanoGPT(https://github.com/karpathy/nanoGPT )开发。重写的动机是:LLaMA官方仓库只包含推理代码,没有训练代码。此外,原版LLaMA代码采用GPL许可证,与其他多个开源许可证不兼容;而Lit-LLaMA采用宽松的Apachev2开源许可证。

figure13

Lit-LLaMA示例,来源:https://github.com/Lightning-AI/lit-llama

GPT4All

这个项目演示了如何使用Meta的LLaMA(https://github.com/facebookresearch/llama )训练大语言模型。团队还公开了他们收集的数据、数据处理流程、训练代码和最终模型权重。此外,他们还分享了模型的4比特量化版本,可以在笔记本CPU上运行。代码采用GPL许可证。

figure14

与GPT4All的交互,来源:https://github.com/nomic-ai/gpt4all

Twitter算法

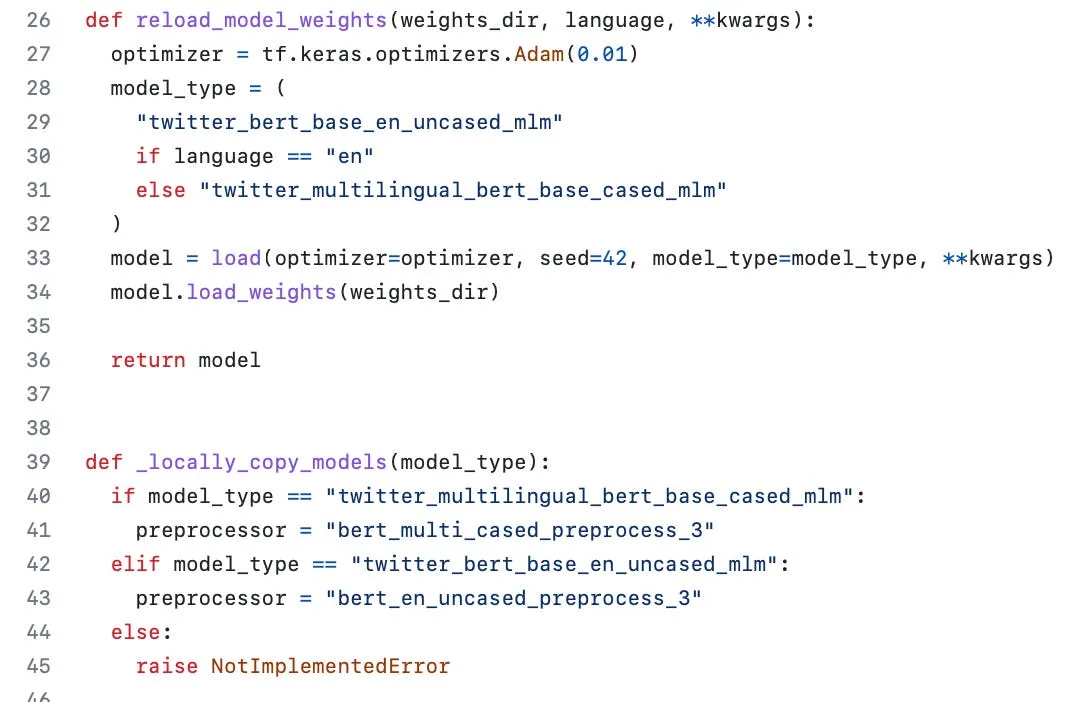
正是Twitter官方开源了其推荐算法:https://github.com/twitter/the-algorithm 。有意思的是,代码库中同时使用了TensorFlow和PyTorch。此外,scikit-learn、TorchMetrics、matplotlib等流行库也出现在仓库中。

仔细看他们的信任与安全模型部分(https://github.com/twitter/the-algorithm/tree/main/trust_and_safety_models ),会发现大多数预测语言模型都基于BERT——这是一个非常通用的编码器风格语言模型,我自己也很喜欢用它来做各种预测建模任务。

figure15

Twitter算法的代码截图,来源:https://github.com/twitter/the-algorithm/blob/main/trust_and_safety_models/toxicity/load_model.py

MLxtend 0.23

MLxtend是我维护了近十年的机器学习工具函数库。上周末我发布了新版本,感谢社区的贡献带来了诸多改进。其中包括:为热门的plot_decision_regions函数新增多进程支持,以及全新的频繁模式挖掘算法H-Mine。更多内容见更新日志:https://rasbt.github.io/mlxtend/CHANGELOG/

名言

“对于这些架构为何有效,我们给不出任何解释;和其他一切一样,我们将它们的成功归于神的善意。”
——Noam Shazeer(初代Transformer论文的第二作者),出自论文https://arxiv.org/abs/2002.05202v1


这本杂志是我的个人热情项目,不提供直接报酬。不过,如果您愿意支持我,可以考虑购买我的书:https://sebastianraschka.com/books 。如果您觉得这些书有见地、有帮助,欢迎推荐给您的朋友和同事。

figure16

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics ,以及http://mng.bz/M96o

您的支持对我意义重大!非常感谢!

【转载】换个方式训练AI:我们需要基于人类反馈的强化学习(RLHF)吗?

原文地址:
TrAIn Differently: Do We Need Reinforcement Learning with Human Feedback (RLHF)?,by Sebastian Raschka, on 2023-03-07

换个方式训练AI:我们需要基于人类反馈的强化学习(RLHF)吗?

本月,深度学习与人工智能领域的研究工作高度聚焦于Transformer的新型或差异化训练范式。

本期通讯的第一部分将深入探讨如何将人类反馈整合到大语言模型中,以及其他聚焦于优化训练流程的研究论文。
接下来,我们将回顾本月的重大新闻头条,然后介绍值得关注的开源库与相关发布。
最后,我会分享我个人研读科研论文的方法,同时分析一篇探讨视觉Transformer扩展至百亿参数规模的论文。

附言:如果您看到的通讯内容有截断,那是因为部分邮件服务商可能会对较长的邮件进行删减。遇到这种情况,您可以访问 https://magazine.sebastianraschka.com/ 查看全文。

论文与行业趋势

在我们深入探讨最新发表的几篇论文之前,先来明确近期研究领域的核心背景与问题:如何利用人类反馈提升大语言模型(LLM)的输出效果。目前,强化学习是将人类偏好或反馈融入预训练大语言模型、实现模型进一步优化的最主流范式。

强化学习是机器学习的一个子领域,核心是训练智能体根据从环境中获得的奖励来做决策。在强化学习中,我们有一个策略(P),它将状态(S)映射为智能体采取的动作(A),并据此计算奖励(R)。目标是找到最优策略P*,以最大化累积奖励。在语言模型的场景下,我们可以把智能体看作大语言模型,包含输入词元与指令的集合构成状态空间S;所有可能的输出词元构成动作空间A;奖励则是来自人类反馈的对齐评分。最终,策略(P)本质上就是智能体针对给定状态决定采取何种动作的一套规则。

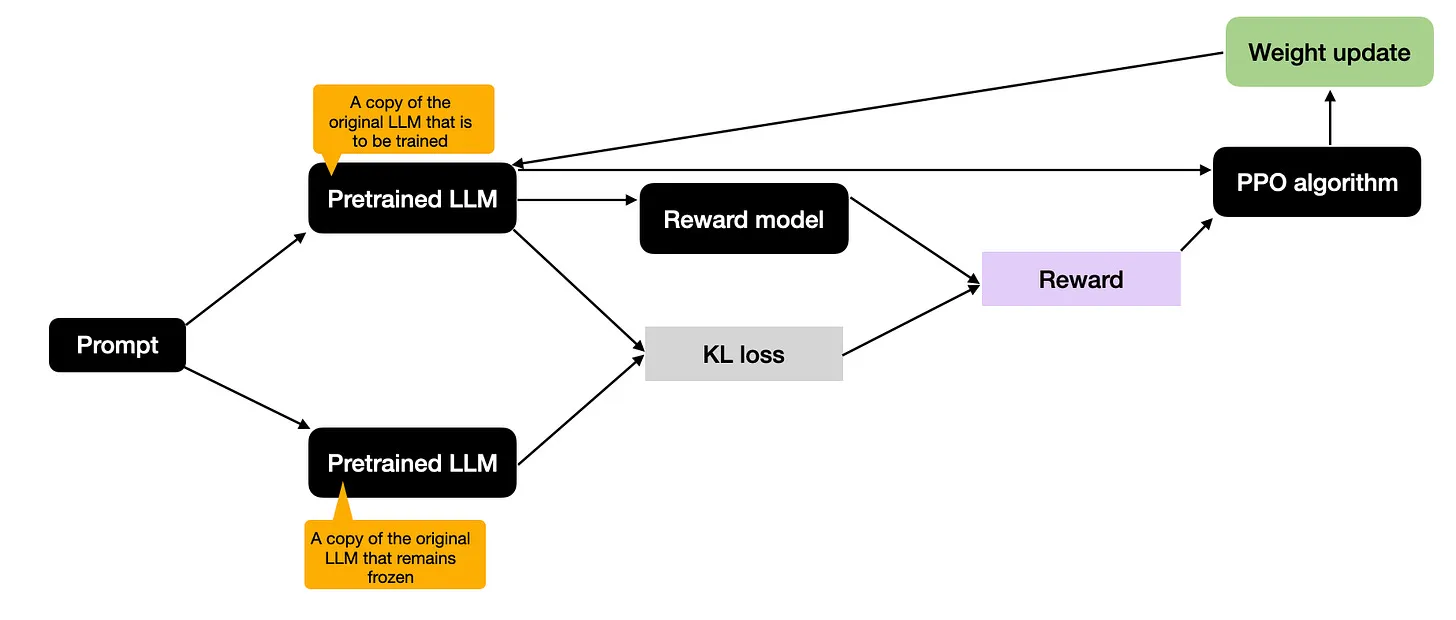
抛开上面这些强化学习的专业术语,我们可以将基于人类反馈的强化学习的大语言模型微调过程总结为下图所示的流程。

figure01

基于人类反馈的强化学习微调大语言模型的通用流程

在这里,人类反馈用于训练奖励模型(奖励模型本身的训练过程未在图中示出,它通常基于人类标注的标签,以常规监督学习的方式训练)。奖励模型通常是另一个语言模型,输出偏好标签、排序或分数。库尔贝克-莱布勒散度损失(KL损失)用于保证微调后的模型不会与原始预训练模型偏离过大。奖励模型对人类偏好进行编码,并为模型输出打上“内容质量”标签。最终,近端策略优化(PPO算法)根据奖励信号更新预训练大语言模型。

更多关于基于人类反馈的强化学习(RLHF)的学习资源

尽管基于人类反馈的强化学习(RLHF)或许无法彻底解决当前大语言模型存在的问题,但它仍是目前公认的最优方案之一。这一结论的依据是,ChatGPT等当前一代大语言模型的输出质量,相较于其底层基础模型(如GPT-3)有显著提升。未来我们很可能也会看到RLHF在大语言模型之外的更多领域得到更具创新性的应用。

鉴于RLHF至少在近期内都会是极具影响力的方法,在我们深入本月最新研究进展之前,我在下方分享五篇额外的科研论文,供想要进一步了解RLHF的读者参考。

(1) https://arxiv.org/abs/1602.01783 https://arxiv.org/abs/1602.01783 介绍了策略梯度方法,可作为深度强化学习中Q学习的替代方案。

(2) (https://arxiv.org/abs/1707.06347) (file:///Users/sebastian/Developer/github_rasbt/ahead-of-ai/issues_drafts/newsletter-6/)(https://arxiv.org/abs/1707.06347) 提出了一种改进的基于近端策略的强化学习流程,相比上述基础版策略优化算法,数据效率更高,可扩展性更强。

(3) https://arxiv.org/abs/1909.08593 https://arxiv.org/abs/1909.08593 阐述了将PPO与奖励学习应用于预训练语言模型的思路,其中加入了KL正则化,避免策略与自然语言偏离过远。

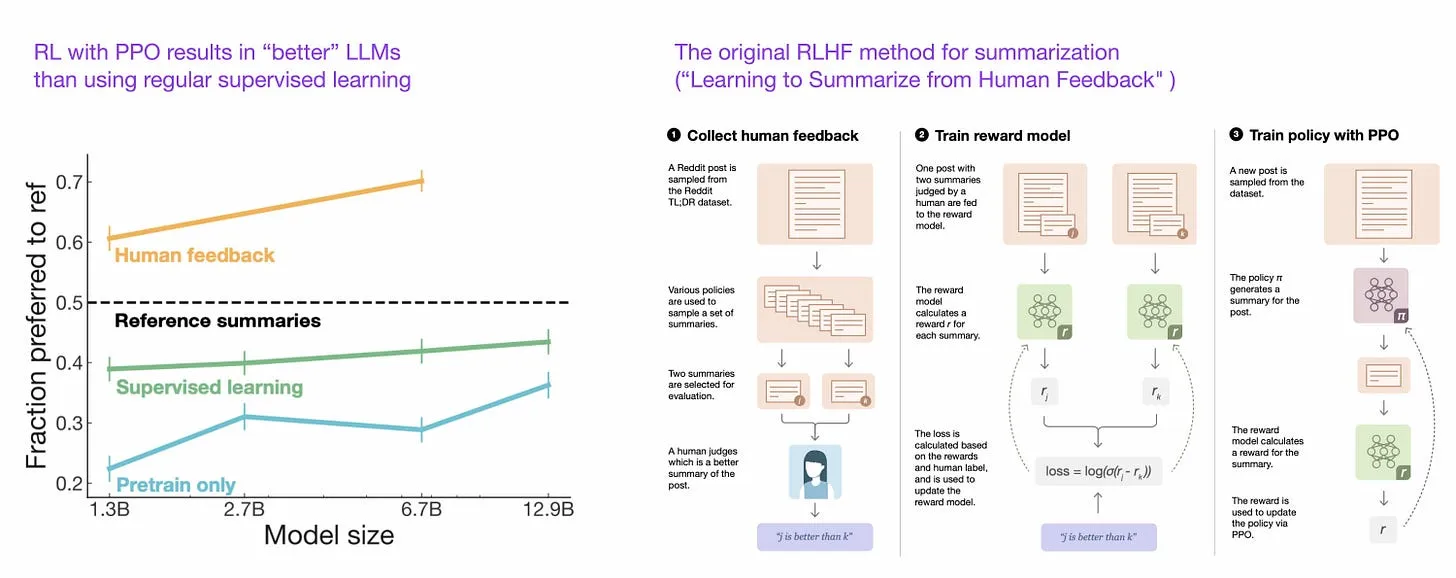
(4) https://arxiv.org/abs/2009.01325 https://arxiv.org/abs/2009.01325 介绍了广为流行的RLHF三步流程:

  1. 对GPT-3进行预训练
  2. 以监督学习方式对其进行微调
  3. 同样以监督学习方式训练奖励模型

随后,微调后的模型会借助该奖励模型,通过近端策略优化进行训练。
论文同时表明,相比单纯使用常规监督学习,结合近端策略优化的强化学习能得到效果更优的模型。

(5) (file:///Users/sebastian/Developer/github_rasbt/ahead-of-ai/issues_drafts/newsletter-6/)(https://arxiv.org/abs/2203.02155)( file:///Users/sebastian/Developer/github_rasbt/ahead-of-ai/issues_drafts/newsletter-6/)(https://arxiv.org/abs/2203.02155)(即知名的InstructGPT论文)采用了与上述类似的RLHF三步流程,但它的研究重点不是文本摘要,而是根据人类指令生成文本。此外,该研究使用标注者将输出从优到劣进行排序(而非仅对人类生成文本与AI生成文本做二元对比)。

RLHF的实践应用

如果你想动手实践RLHF,目前基于PyTorch的https://github.com/CarperAI/trlx 代码库似乎是最便捷的方案之一。

我们应该更早引入人类反馈吗?

尽管https://arxiv.org/abs/2203.02155 这篇论文(以及ChatGPT模型)去年已经证明,通过奖励模型利用人类反馈微调预训练大语言模型可以提升模型效果,但一个有趣的问题是:如果在预训练过程中(而非预训练之后)就引入奖励模型,是否能带来更大的收益?

答案是肯定的,确实可以!在2023年2月发表的https://arxiv.org/abs/2302.08582 中,研究人员发现,在预训练阶段就通过奖励模型融入人类偏好,最终得到的大语言模型生成的文本更符合人类偏好,即便遭受对抗性攻击时也是如此。

figure02

来源:https://arxiv.org/abs/2302.08582

我们真的需要RLHF吗?

但为什么最新的语言Transformer模型(比如ChatGPT等大语言模型)会选择用强化学习(RL)做微调,而不是常规的监督学习(SL)呢?

这个问题的产生很自然,因为RL范式(即RLHF,带人类反馈的强化学习)也需要标签来训练奖励模型。那为什么不直接用这些标签通过监督学习来微调模型呢?

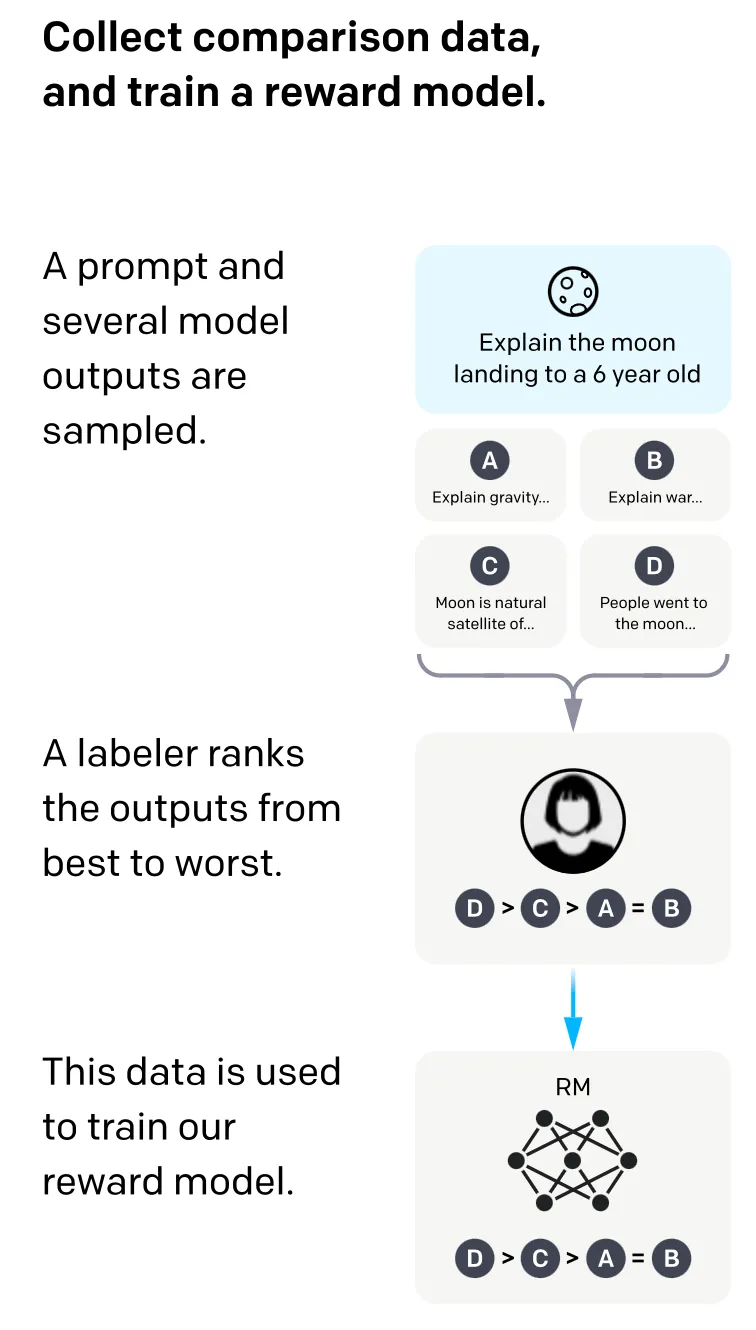
(1) 在监督学习中,我们通常最小化真实标签与模型输出之间的差异。而这里的标签是特定提示对应回复的排序分数。因此,常规监督学习会让模型去预测排名,而不是生成针对查询的文本回复。实际上,InstructGPT中的奖励模型就是这样训练的,如下图所示。

figure03

InstructGPT论文中的奖励模型训练,来源:https://arxiv.org/abs/2203.02155

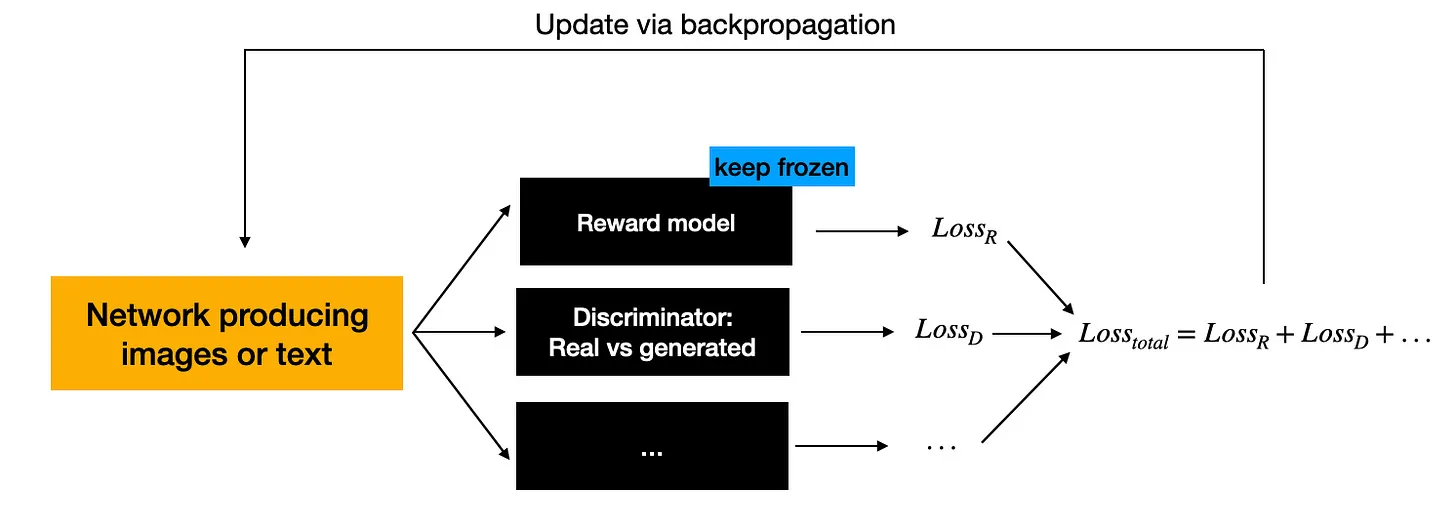
(2) 好吧,那我们为什么不把任务重新定义为一个约束优化问题,构造一个包含“输出文本损失”和“奖励分数”项的组合损失,再用监督学习联合优化呢?毕竟我和同事之前在提出https://arxiv.org/abs/1712.00321 和 https://arxiv.org/abs/2001.00561 等研究时,就用过类似的方案。

figure04

通过反向传播,以监督学习方式用不同损失分量训练或微调模型

当然,如果我们只需要模型生成正确的问答对,这种方法是可行的。但ChatGPT需要实现连贯的对话,因此我们更需要累积奖励。

(3) 回到第一点提到的监督学习的词元级损失:在监督学习中,我们通过交叉熵优化损失。根据求和规则,修改单个单词(词元)对整段文本的整体损失影响微乎其微。但否定一个词却可能彻底改变文本的含义,因此交叉熵并不是这类问题的最优损失函数。

(4) 当然,用监督学习训练模型并非不可能,https://arxiv.org/abs/2009.01325 这篇论文就做过相关尝试。但从目前的结果来看,其效果不如带人类反馈的强化学习。换句话说,从经验上看,RLHF的表现通常优于监督学习。这是因为监督学习使用的是词元级损失(可以对整段文本求和或取平均),而强化学习会将整段文本作为一个整体来考量。

(5) 这并非非此即彼的选择:InstructGPT和ChatGPT两者都用了。二者的结合似乎才是关键。ChatGPT(对应论文https://arxiv.org/abs/2203.02155)首先通过监督学习微调模型,再通过强化学习做进一步更新。

figure05

来源:https://arxiv.org/abs/2009.01325

如今,得益于ChatGPT的成功,RLHF成为了微调最新大语言模型的主流方式,但它显然不是未来唯一有前景的方案,正如我们刚才讨论的,监督学习也始终是可选方案之一。

用监督学习微调大语言模型

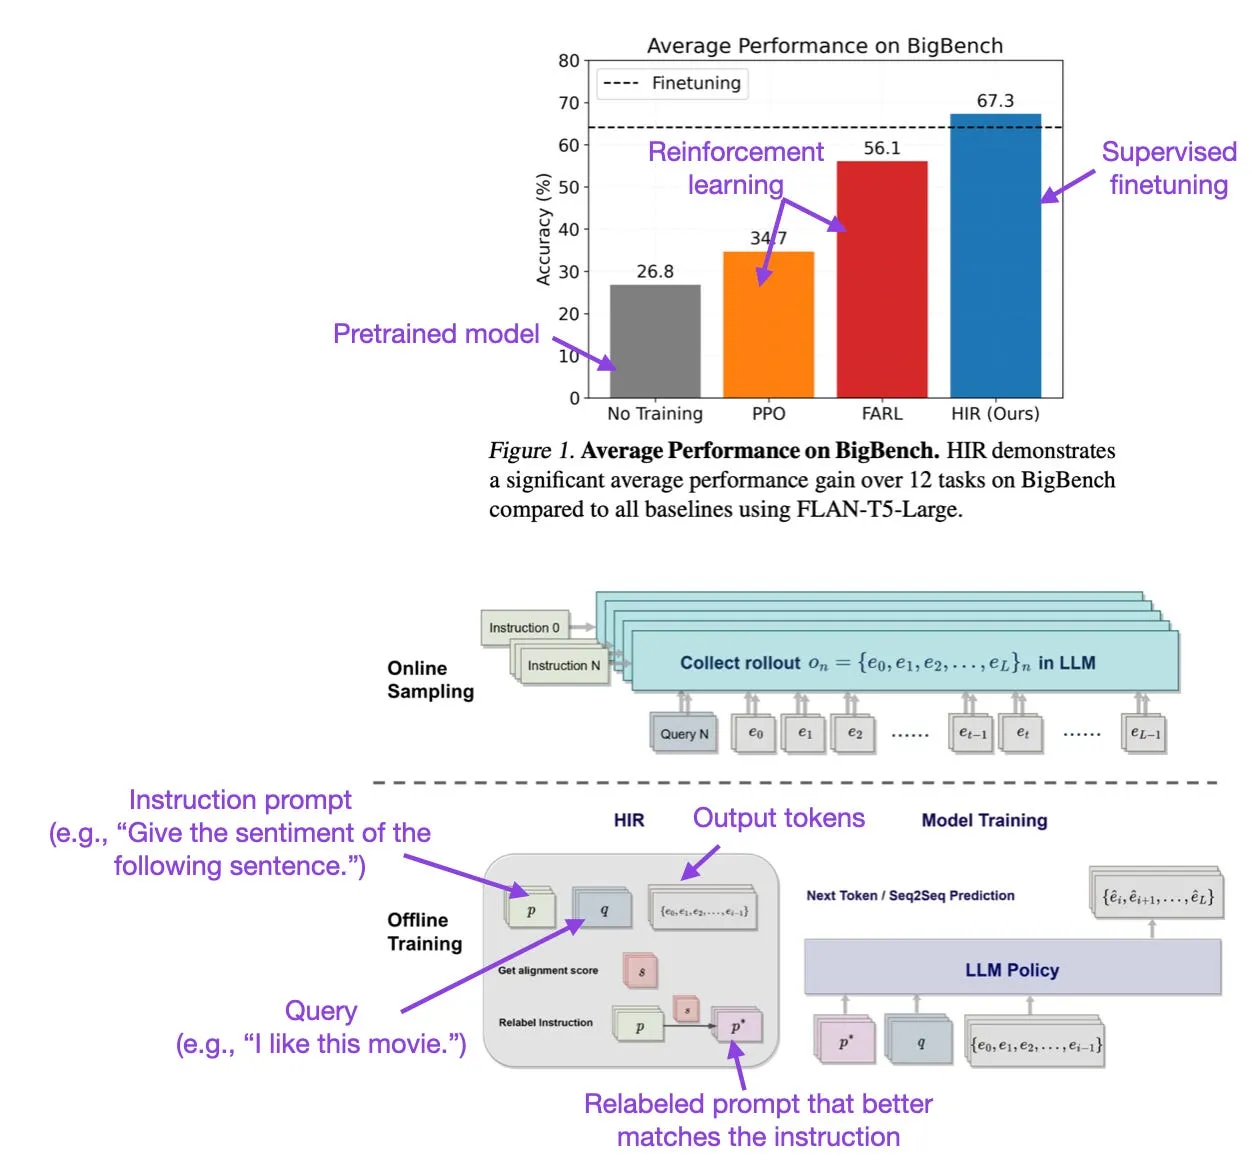
2023年2月发表的https://arxiv.org/abs/2302.05206 表明,监督学习方法用于大语言模型微调同样可以取得很好的效果。该研究提出了一种基于重标记的监督微调方法,在12项BIG-bench任务(https://github.com/google/BIG-bench)上的表现超过了RLHF。

该研究提出的HIR(事后指令标注,Hindsight Instruction Labeling)是如何运作的?简而言之,HIR方法包含采样和训练两个步骤。在采样阶段,向大语言模型输入提示与指令,收集模型的回复。在训练阶段,根据对齐评分,在合适的情况下对指令进行重标记。随后,使用重标记后的指令与原始提示来微调大语言模型。通过这种重标记方法,研究人员有效地将失败案例(即大语言模型生成的输出不符合原始指令的情况)转化为监督学习的有用训练数据。

figure06

来源:https://arxiv.org/abs/2302.05206

需要注意的是,这项研究无法与InstructGPT中的RLHF研究直接对比,因为它似乎使用了启发式方法(“但由于大多数人类反馈数据难以收集,我们采用了脚本化反馈函数……”)。不过HIR事后方法的结果依然十分有吸引力。

“小尺寸”大语言模型

尽管Meta的这些新模型是https://arxiv.org/abs/2005.14165 这类不使用RLHF的“原生”竞品,但仍值得一提:Meta在2023年2月的https://arxiv.org/abs/2302.13971 中发布了全新的LLaMA模型。由于其推理代码是开源的,且模型权重可申请用于研究目的,它们非常适合作为RLHF实验的预训练基线模型。以下是我研读LLaMA论文的几点心得。

受https://arxiv.org/abs/2203.15556 的启发,LLaMA论文提出了一组“小尺寸”大语言模型:仅用130亿参数(不到GPT-3 1750亿参数的十分之一),性能就超过了GPT-3;而更大的650亿参数版本性能超过了PaLM-540B。

总而言之,该论文提出了一系列基于公开数据训练的更小的开源模型,性能超过了近年来部分闭源大语言模型。

figure07

来源:https://arxiv.org/abs/2302.13971

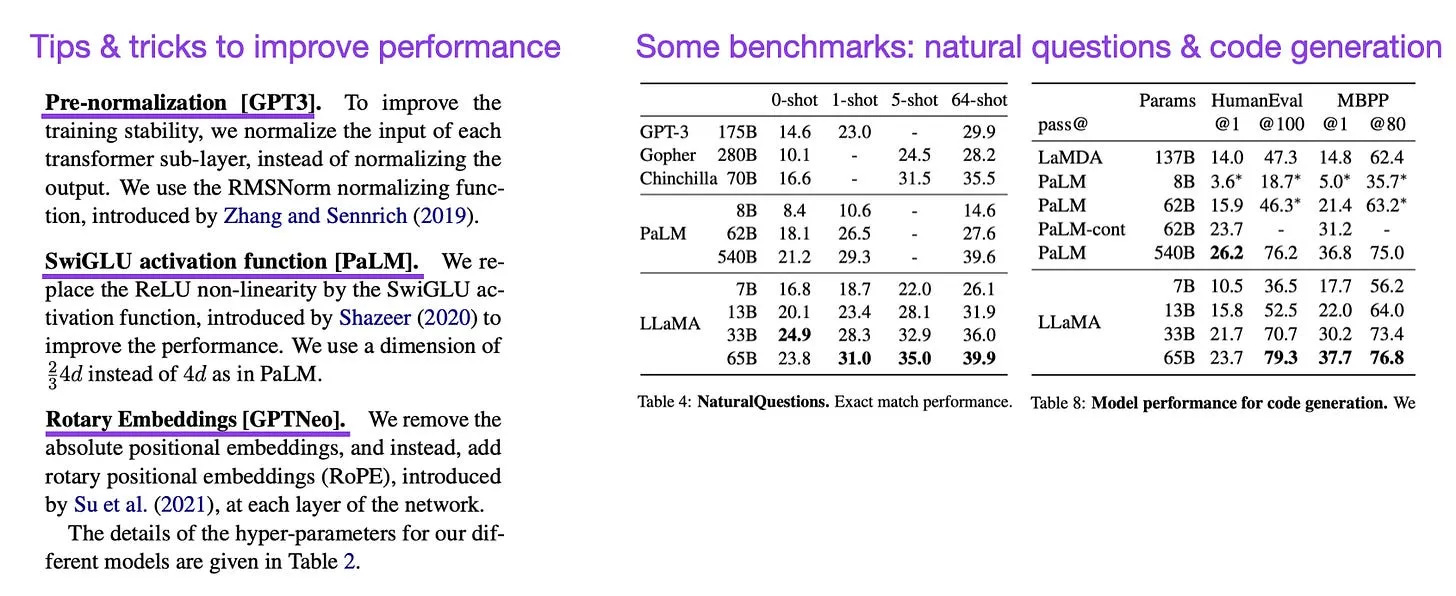
性能超越GPT-3的LLaMA模型,为之前的开源模型(如https://arxiv.org/abs/2205.01068 和 https://arxiv.org/abs/2211.05100,据称性能不及GPT-3)提供了一个不错的替代选择。它们实现这种性能提升用到了哪些方法?论文提到了三点:(1)预归一化;(2)SwiGLU激活函数;(3)旋转位置编码。由于这些是研究模型,我本希望能看到消融实验,分析这些修改分别带来了多少性能提升,这似乎是一个遗憾的缺失。

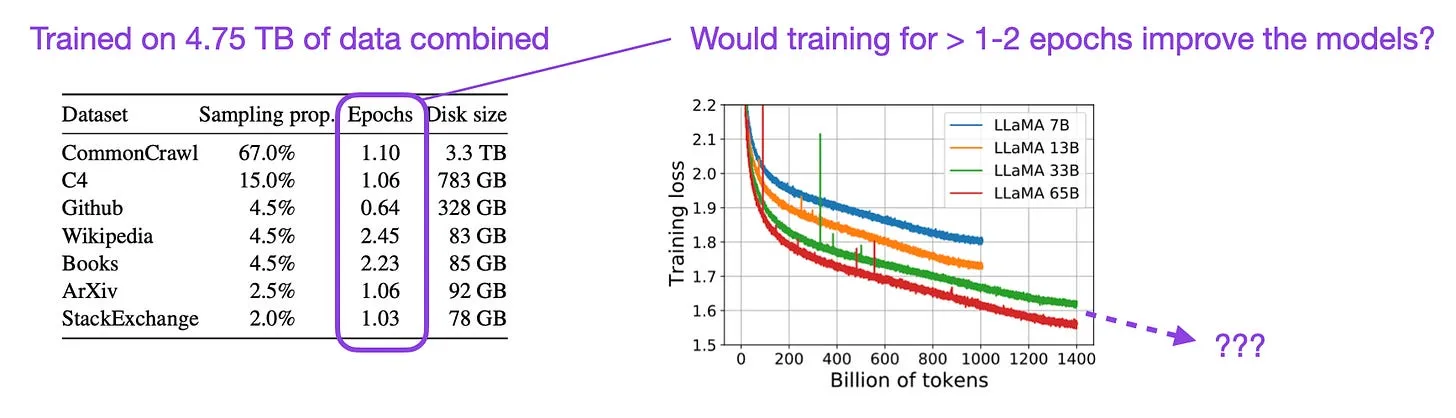
此外,训练损失随训练词元数量变化的曲线呈现出陡峭的负斜率。如果将模型训练超过1-2个轮次,结果会如何?

figure08

该模型的代码仓库以GNU GPL v3.0许可证发布在GitHub上:https://github.com/facebookresearch/llama。仓库中仅包含推理代码,模型权重需提交申请后方可用于研究目的。

图像模型方面呢?

由于这一部分都在讲语言模型,我想至少补充一个图像模型相关的内容(另一篇会在下文“研读科研论文”部分介绍)。在2023年2月的https://arxiv.org/abs/2302.12192 中,研究人员提出了一种微调方法,利用(没错,又是)人类反馈来对齐生成模型。

整体而言,该方法与https://arxiv.org/abs/2203.02155 有几分相似,只不过这是文本生成图像的模型,生成的是图像而非文本。

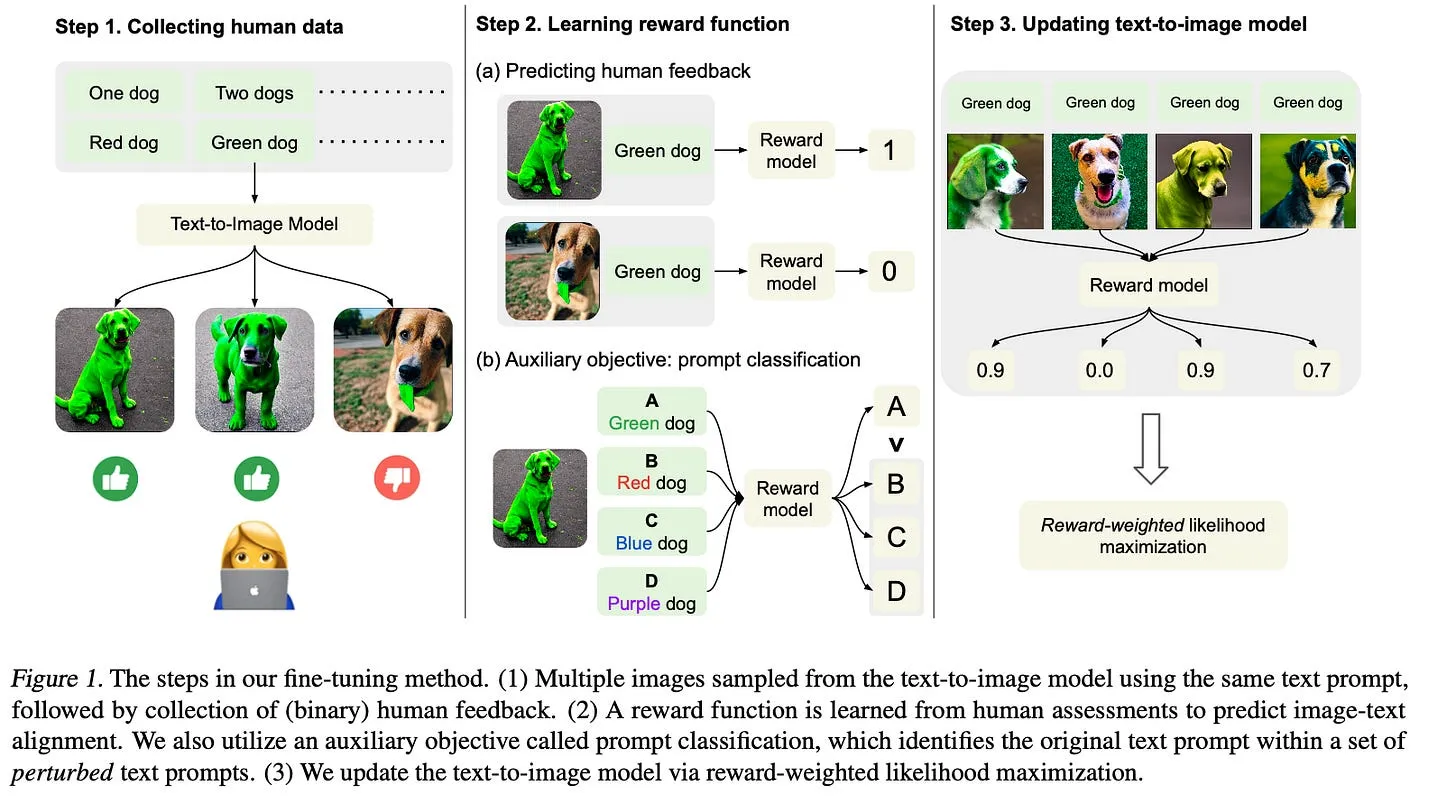
如下图总结的那样,研究人员收集人类反馈,评估模型输出与各类文本提示的对齐程度。随后,他们利用人类标注的图文数据集训练奖励模型,再用该奖励模型微调文生图模型。

figure09

来源:https://arxiv.org/abs/2302.12192

行业头条

学术与研究领域

https://cvpr2023.thecvf.com/ 录用结果已公布。今年CVPR共收到9155份投稿(较2022年增长12%),录用率约为25%。录用论文名单可能会在未来几周内公布在https://openreview.net/group?id=thecvf.com/CVPR/2023/Conference。

https://neurips.cc/ 2023年的论文投稿截止日期为2023年5月17日。

https://www.zeta-alpha.com/post/must-read-the-100-most-cited-ai-papers-in-2022 盘点2022年引用量最高的100篇AI论文

ChatGPT相关

谷歌发布Bard相关更新(https://blog.google/technology/ai/bard-google-ai-search-updates/),其技术基于LaMDA(https://ai.googleblog.com/2022/01/lamda-towards-safe-grounded-and-high.html)。去年夏天,一名谷歌软件工程师声称该AI聊天机器人具有自我意识,引发了巨大争议(相关报道:https://www.theguardian.com/technology/2022/jul/23/google-fires-software-engineer-who-claims-ai-chatbot-is-sentient)。

百度股价大涨,此前有消息称百度将于3月推出类ChatGPT产品文心一言(https://www.bloomberg.com/news/articles/2023-02-07/baidu-surges-after-prepping-chatgpt-style-ernie-bot-for-march)。

微软宣布将AI技术融入必应搜索引擎(https://blogs.microsoft.com/blog/2023/02/07/reinventing-search-with-a-new-ai-powered-microsoft-bing-and-edge-your-copilot-for-the-web/)

据CNBC报道(https://www.cnbc.com/2023/02/07/microsoft-will-offer-chatgpt-tech-for-companies-to-customize-source.html),微软将允许企业基于自身数据训练并创建定制版ChatGPT。

AI生成短篇小说泛滥,导致知名科幻杂志《克拉克世界》(Clarkesworld)暂停征稿(相关报道:https://www.pcmag.com/news/sci-fi-mag-pauses-submissions-amid-flood-of-ai-generated-short-stories)。

OpenAI推出ChatGPT与Whisper API(https://openai.com/blog/introducing-chatgpt-and-whisper-apis),定价为每千词元0.002美元,据称成本比此前同类服务的首个版本降低了90%。

开源亮点

Pandas 2.0候选版发布!

我超爱Pandas!十多年前我刚开始做机器学习时就一直在用它。本月,全新的Pandas 2.0版本发布(文档:https://pandas.pydata.org/pandas-docs/version/2.0/index.html)。根据更新说明(https://pandas.pydata.org/pandas-docs/version/2.0/whatsnew/v2.0.0.html),好消息是本次更新以修复bug为主,没有重大API变更,因此Pandas 2.0基本可以兼容我们现有的代码库。

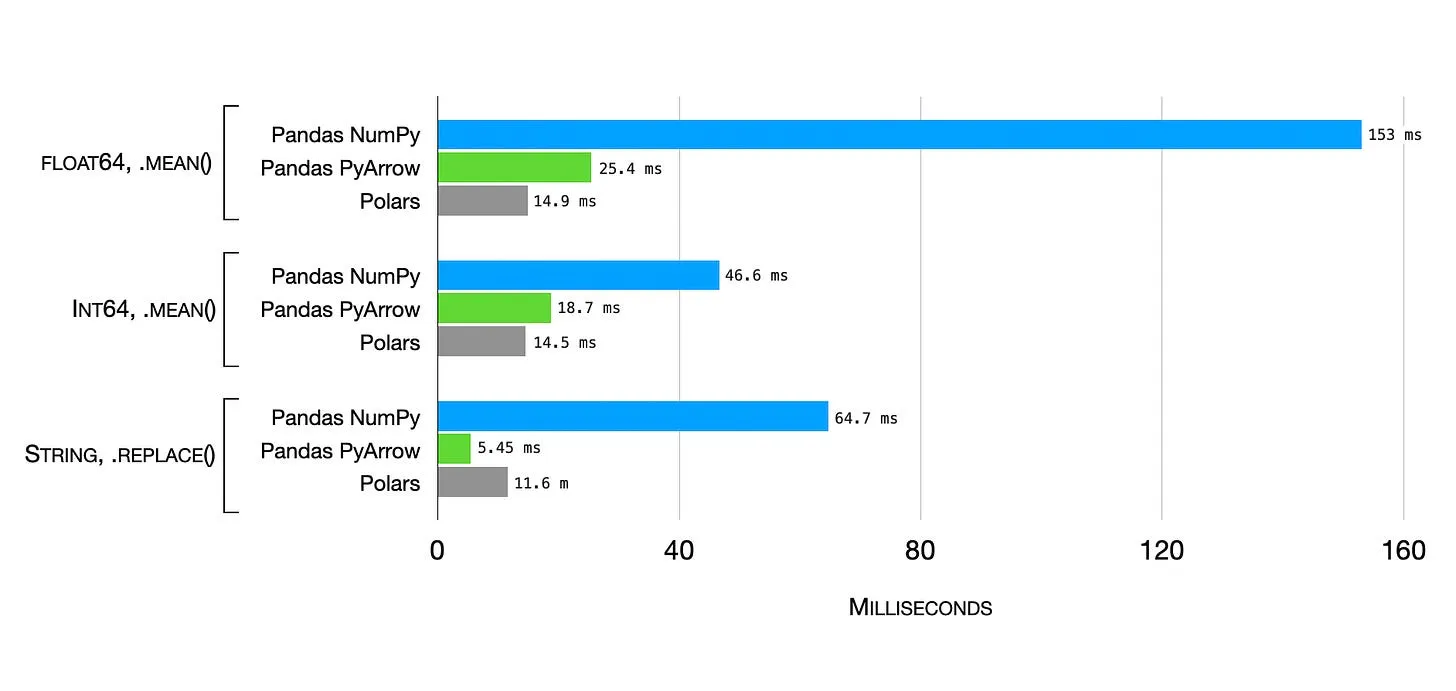
不过除了bug修复之外,本次更新也有几个令人兴奋的新特性。比如全新的Arrow后端。(Arrow是一种开源、跨语言的列式数据格式,用于在内存中表示数据,支持进程间零拷贝数据共享。)

我试用了一下Arrow后端,相比Pandas原本的NumPy后端,性能提升非常显著!事实上,它现在的性能已经非常接近https://www.pola.rs/ ——这款近期大热的、基于Rust开发的Python DataFrame替代方案。

figure10

基准测试对比:Pandas全新PyArrow后端、传统Pandas NumPy后端,以及Rust编写的Polars DataFrame库。我的基准测试代码可在GitHub查看:https://github.com/rasbt/machine-learning-notes/blob/main/benchmark/pandas-pyarrow/pandas2-pyarrow.ipynb

你可以通过以下命令安装Pandas 2.0候选版:

conda install -c conda-forge/label/pandas_rc pandas==2.0.0rc0
pip install --upgrade --pre pandas==2.0.0rc0

如果你想体验全新的Arrow后端,可以按每个DataFrame为单位,通过dtype属性启用,示例如下:

import numpy as np
import pandas as pd
import pyarrow as pa
numbers = np.random.rand(1_000_000, 100)
df = pd.DataFrame(numbers, dtype="float64[pyarrow]")

或者,如果你想默认使用Arrow作为后端,可以在Python会话或脚本中执行以下命令:

pd.options.mode.dtype_backend = "pyarrow"

PicoGPT——用NumPy实现的极简GPT

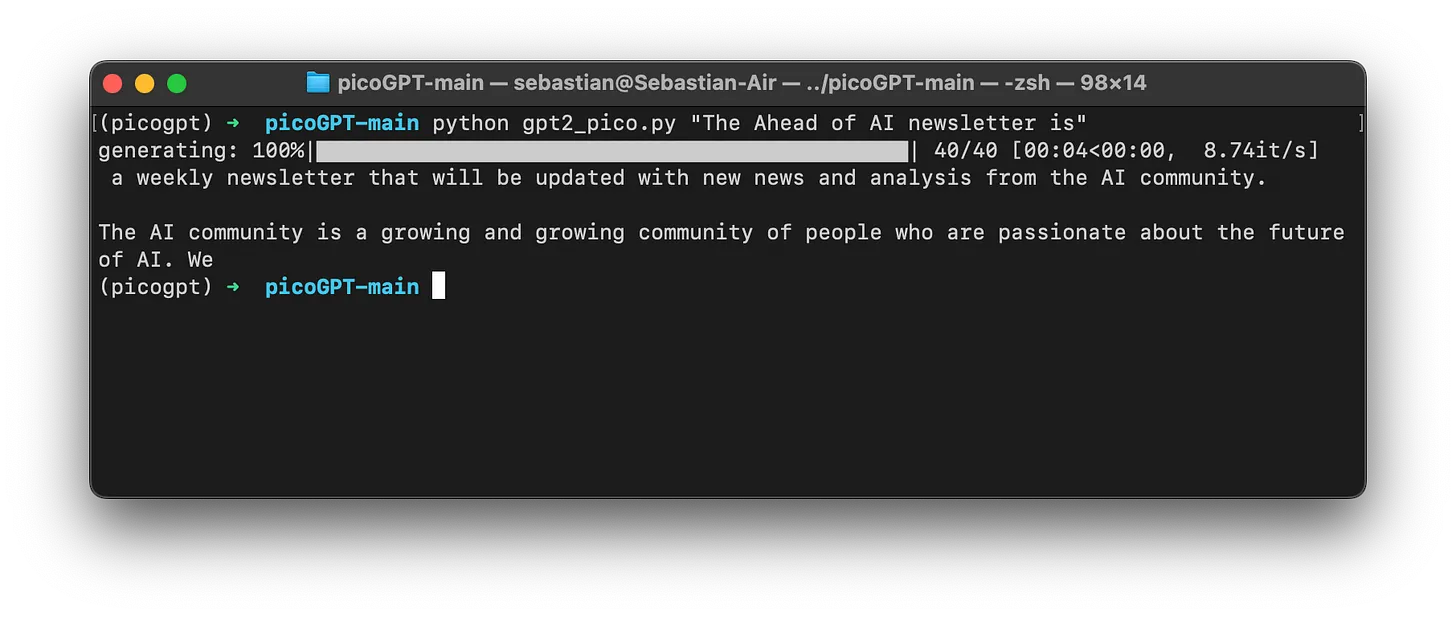
https://github.com/jaymody/picoGPT 是用NumPy编写的极简GPT实现,仅60行代码——当然这是用于教学目的的项目。此外,该仓库还包含加载GPT-2权重并实际运行的代码。

figure11

运行picoGPT的截图(来源:https://github.com/jaymody/picoGPT)

基于LLaMA的ChatGPT训练开源实现

如前所述,Meta近期发布了LLaMA——一系列“小尺寸”大语言模型(最高650亿参数),性能超越GPT-3。https://github.com/nebuly-ai/nebullvm/tree/main/apps/accelerate/chatllama 基于预训练LLaMA模型,为其添加了基于人类反馈的强化学习(RLHF)组件。

JupyterLab 3.6发布

JupyterLab 3.6正式发布(公告:https://discourse.jupyter.org/t/jupyterlab-3-6-0-is-released/17808),本次更新优化了渲染速度与标签页切换性能,还新增了通知弹窗,用于提示未来的JupyterLab更新。本次版本的最大亮点是重构了实时协作功能(文档:https://jupyterlab.readthedocs.io/en/stable/user/rtc.html)。

Lazy Predict

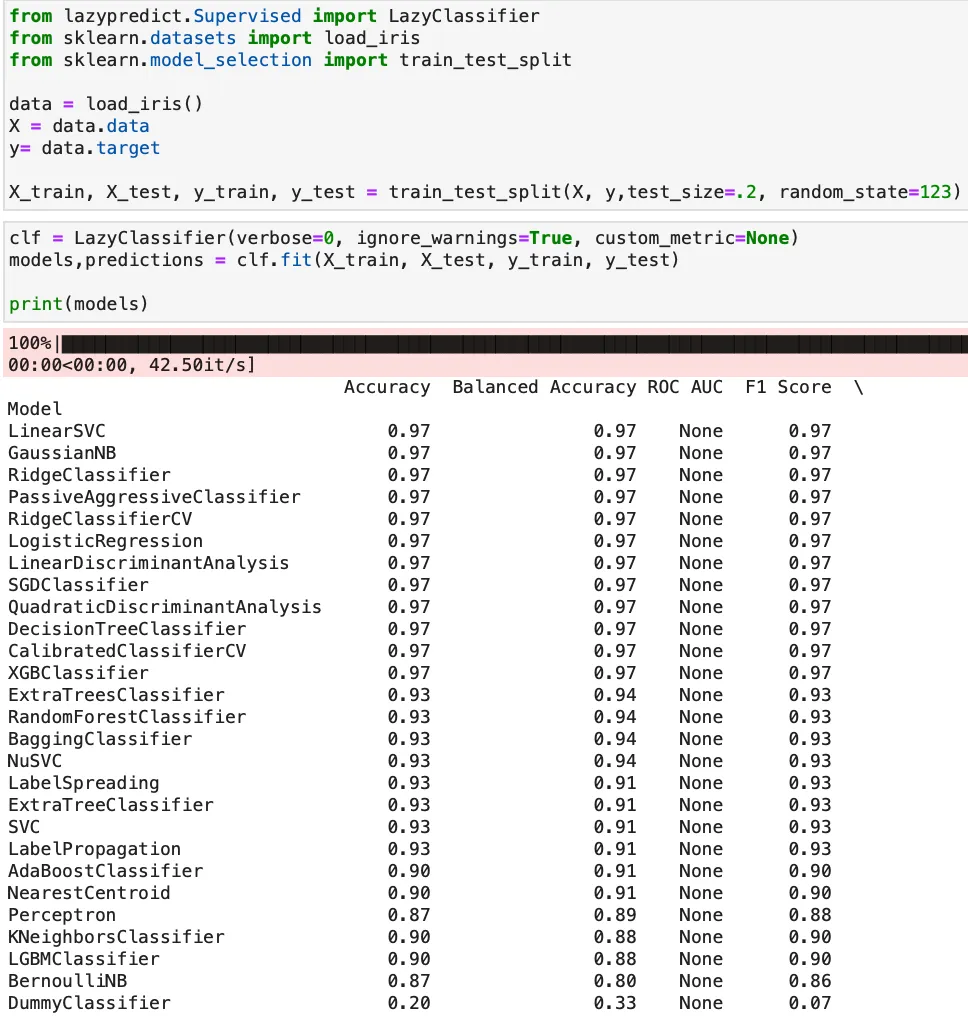
这不是一个新库,但我本月发现的一个很有意思的工具:https://github.com/shankarpandala/lazypredict 只需两行代码,就能在给定数据集上运行scikit-learn中所有主流的分类(或回归)模型。当你处理表格数据集,想要快速得到预测性能基线时,这个工具非常实用。

figure12

使用lazypredict库的截图(来源:https://github.com/shankarpandala/lazypredict)

精彩语录

“先选定评估指标,再做建模选择。不要使用AIC、BIC这类基于模型假设的指标。”
—— 克里斯托夫·莫尔纳(Christoph Molnar)

我很喜欢这句话,因为评估指标不需要,也不应该等同于优化指标。此外,我们可以把机器学习算法和模型看作(机器学习)系统中可替换的组件。因此,以模型无关的方式定义评估指标是合理的,这样便于模型之间的对比与升级。

赤池信息量准则(AIC,https://en.wikipedia.org/wiki/Akaike_information_criterion)和贝叶斯信息量准则(BIC,https://en.wikipedia.org/wiki/Bayesian_information_criterion)适用于参数数量可数、且具有似然函数的模型。因此,如果我们使用XGBoost分类器,情况就会有点棘手。XGBoost的参数数量是多少?更何况,使用XGBoost时,我们的主要目标可能是最大化新数据上的预测准确率,而非得到一个能精确表征底层数据生成过程的统计模型。

学习与效率技巧:如何研读科研论文

自从我创办《Ahead of AI》以来,不少人问我研读科研论文的技巧。既然问的人足够多了,我想分享一下我的方法应该会对大家有帮助。

但首先要说明几点:没有放之四海而皆准的论文阅读方法。这完全取决于我们在对应领域的知识水平、专业程度,以及我们想从论文中获得什么。比如,评审论文和只是快速浏览论文获取超参数设置建议,对应的阅读方式完全不同。

另一个重要技巧:不要追求“读完所有内容”!我通常先读摘要,因为一篇写得好的摘要会简洁概括论文的主题、解决的问题以及核心结论。如果摘要看起来没什么价值,说明这篇文章不值得花时间读,跳过它去读别的就好,完全没问题。

我的方法简述

首先,正如刚才所说,我会先读摘要。
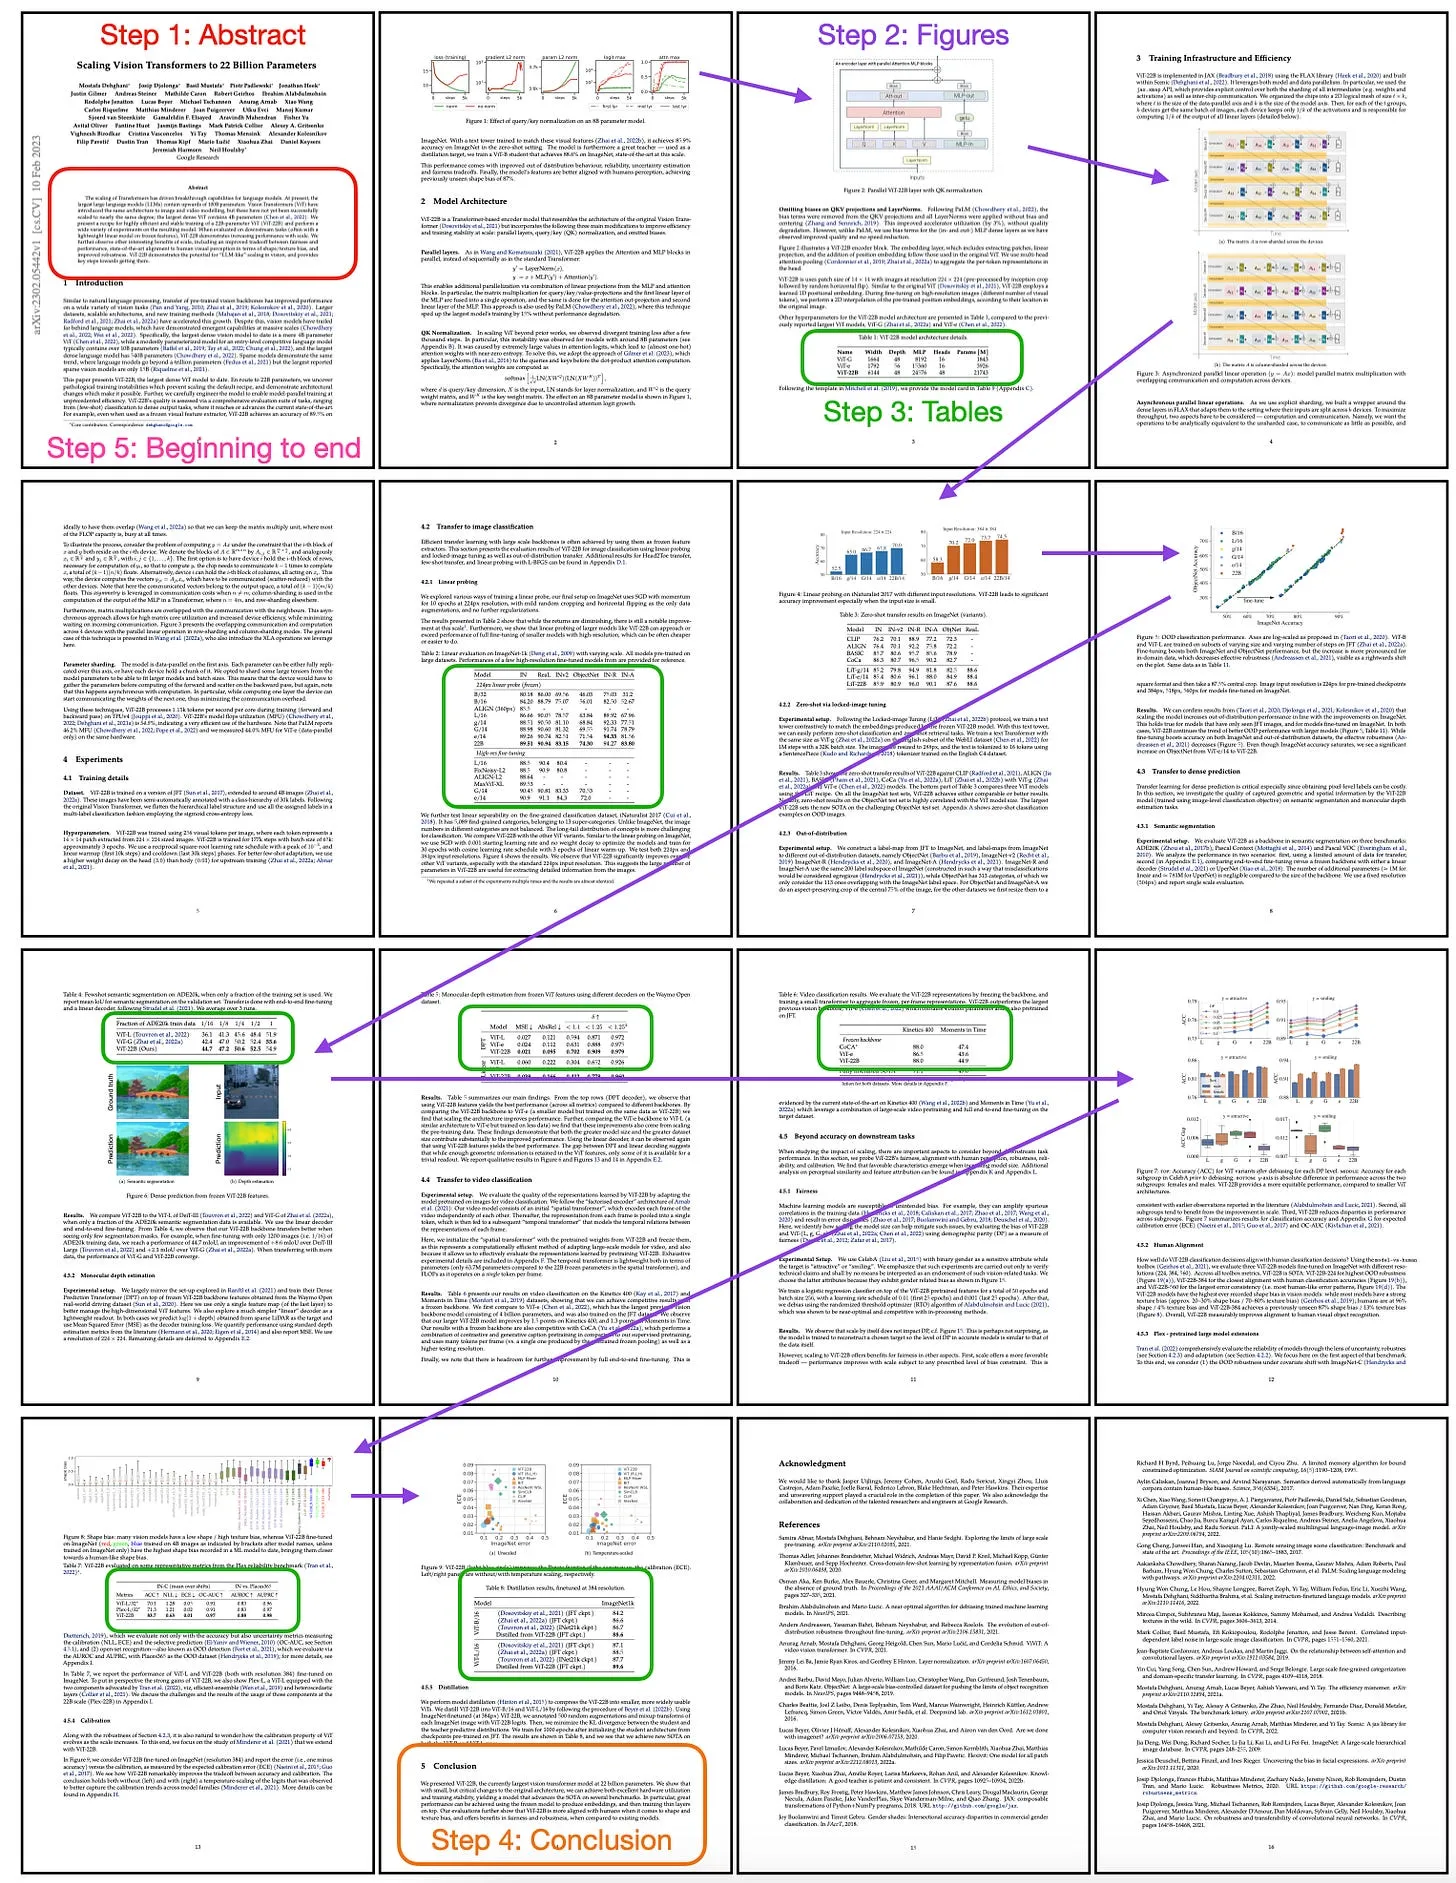
然后,浏览所有图表——看图,同时读图注。
接着,用同样的方式看表格。
快速浏览完这些之后,我会略读结论部分。

以上四个步骤能帮我了解论文的范围、结构、主要内容和核心结论。这个阶段可能只有部分图表能看懂,但我已经在脑子里建立了一个大致的框架,知道接下来深入阅读时要重点关注什么。

熟悉了论文的大致结构后,我会开始从头到尾通读全文。我会标注和划出重点内容,但会强迫自己先读完论文,不要中途被参考文献或者查资料分散注意力。

第一遍读完之后,我通常会根据划出的重点和笔记总结论文内容。如果想从中学到更多,我会去查那些没弄懂的地方,跟进或收藏感兴趣的重要参考文献,还会通读附录。

具体示例

本期通讯已经讲了太多大语言模型的内容,那我们就选一篇计算机视觉的论文,用具体例子来演示我上面说的方法:https://arxiv.org/abs/2302.05442。

figure13

论文《将视觉Transformer扩展至220亿参数》的截图,来源:https://arxiv.org/abs/2302.05442

1. 摘要

从摘要中我们可以了解到,这篇论文研究的是一个220亿参数的视觉Transformer(ViT)——此前用于密集预测任务的ViT最多只有40亿参数。(“密集”是什么意思?我们可以标注下来,之后再研究。)此外,除了提出新架构,这篇论文的一大核心结论是:扩大ViT的模型规模可以提升预测性能(即便我们只在输出嵌入之上训练一个线性模型),同时也能提升与人类感知的对齐程度和公平性。

2. 图表

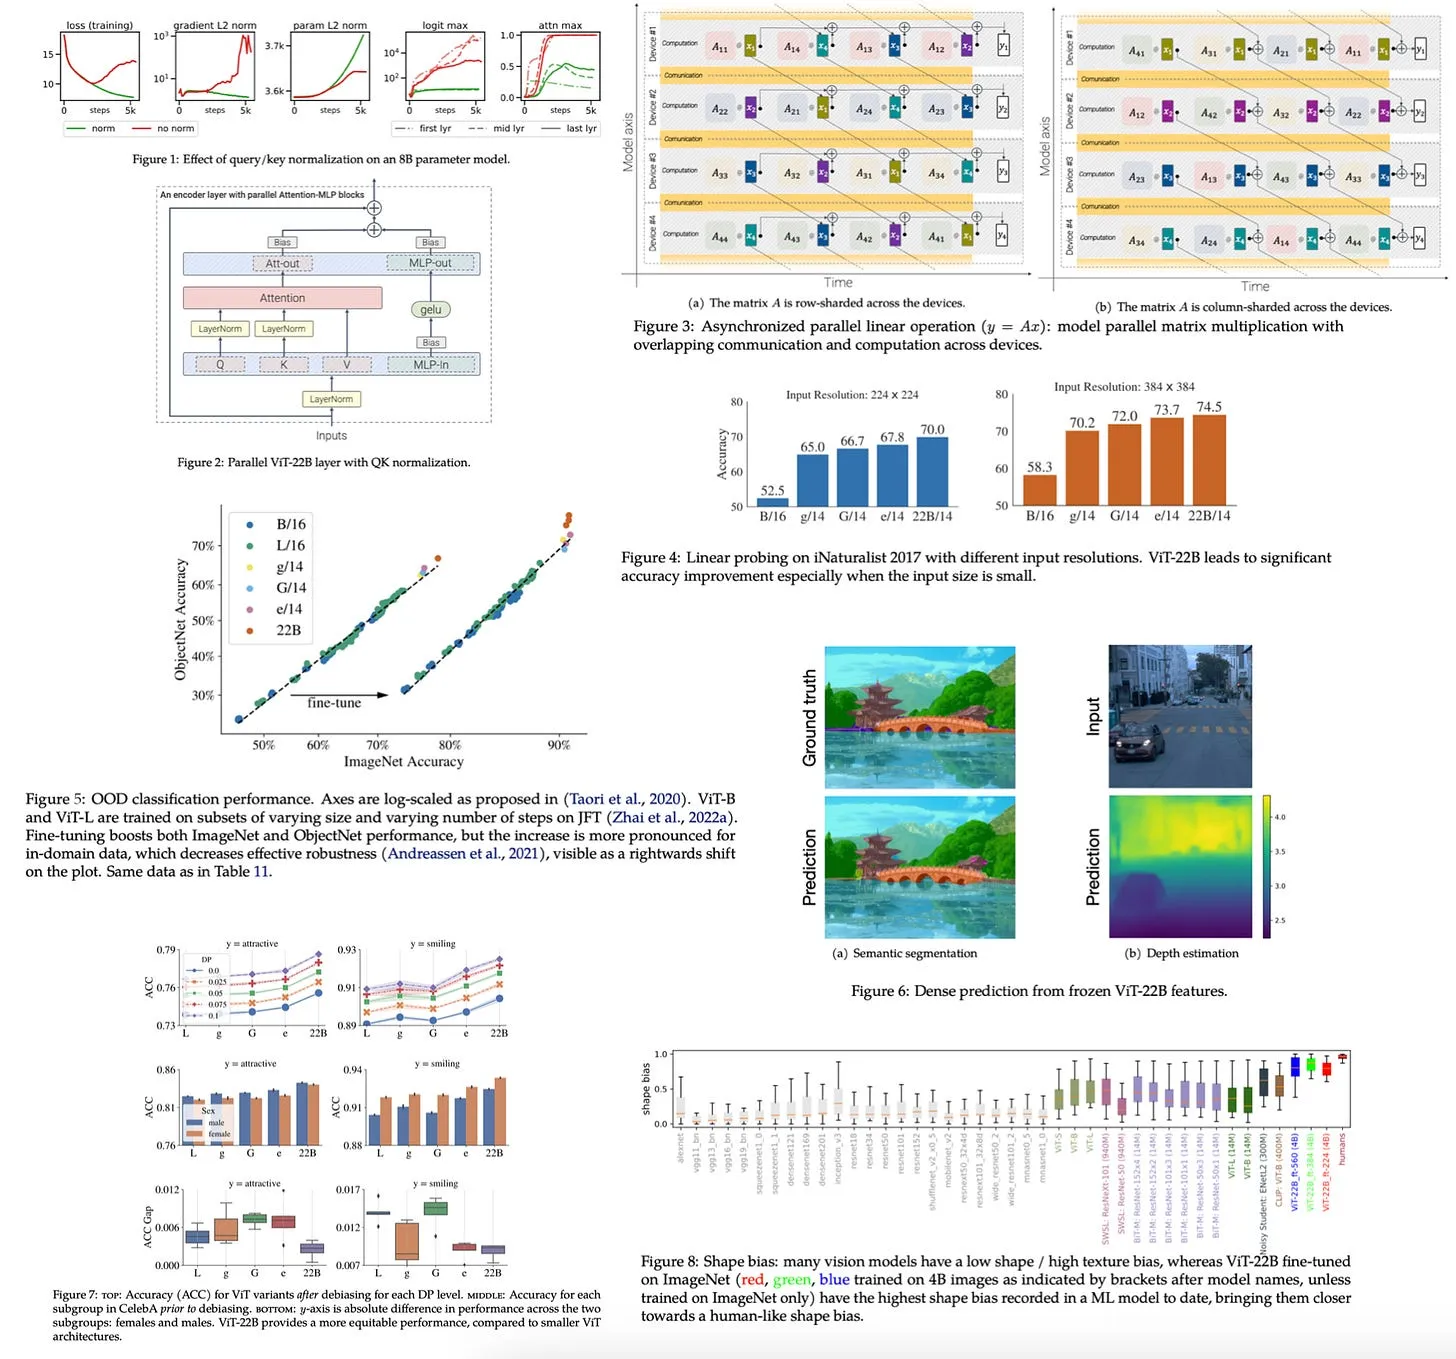
接下来,我们来看图表。

figure14

论文《将视觉Transformer扩展至220亿参数》的所有图表汇总,来源:https://arxiv.org/abs/2302.05442

图1显示,研究人员用了一个“技巧”来优化训练,即对键和查询进行归一化。

如果我们熟悉常规的ViT,从图2可以发现,研究人员提出了一种略有不同的架构设计:注意力层和多层感知机(MLP)层似乎被融合了——这是另一个提升预测性能或计算效率的技巧吗?

图3显示,他们使用了张量分片来提升计算性能,避免内存瓶颈。如果你感兴趣,我在《Machine Learning Q and AI》一书(https://leanpub.com/machine-learning-q-and-ai/)的“多GPU训练范式”相关问题中讲过这个知识点,免费试读部分就有。

图4提到了线性探测,意思大概是在输出嵌入之上训练一个线性层。我们能再次看到,ViT的性能随着模型规模增大而提升。有意思的是,这种提升在小尺寸图像(224×224像素)上比大尺寸图像(384×384像素)上更明显——这是为什么呢?

图5显示,更大的ViT在图像分类和目标检测任务上表现更好,同时微调也能给这些模型带来性能提升。

图6提到了“密集预测”——还记得摘要里的这个词吗?根据图中的示例,我们可以知道密集预测指的是逐像素的预测任务,比如语义分割和深度估计。

图7讨论了不同DP水平下的“去偏”效果。我们暂时还不知道DP水平是什么,但从图中可以看出,所有ViT在分析的两个性别(男性和女性)上的表现都存在不公平性。不过,更大的220亿参数ViT相比小模型,不公平程度更低。

图8显示,在所有分析的ViT中,220亿参数版本的形状偏差最高。不过研究人员也提到,这种形状偏差最接近人类的偏差,因此我们可以认为高形状偏差是件好事。

最后,图9是不同ViT的准确率与校准误差(ECE)关系图,从中可以看出220亿参数ViT在不需要温度重缩放的情况下,提升了帕累托前沿。帕累托前沿和ECE这些概念可以之后再去深入了解。

可以看到,仅仅浏览一遍图表,我们就已经能了解到很多关于论文提出的方法、实验和核心结论的信息了。

3. 表格

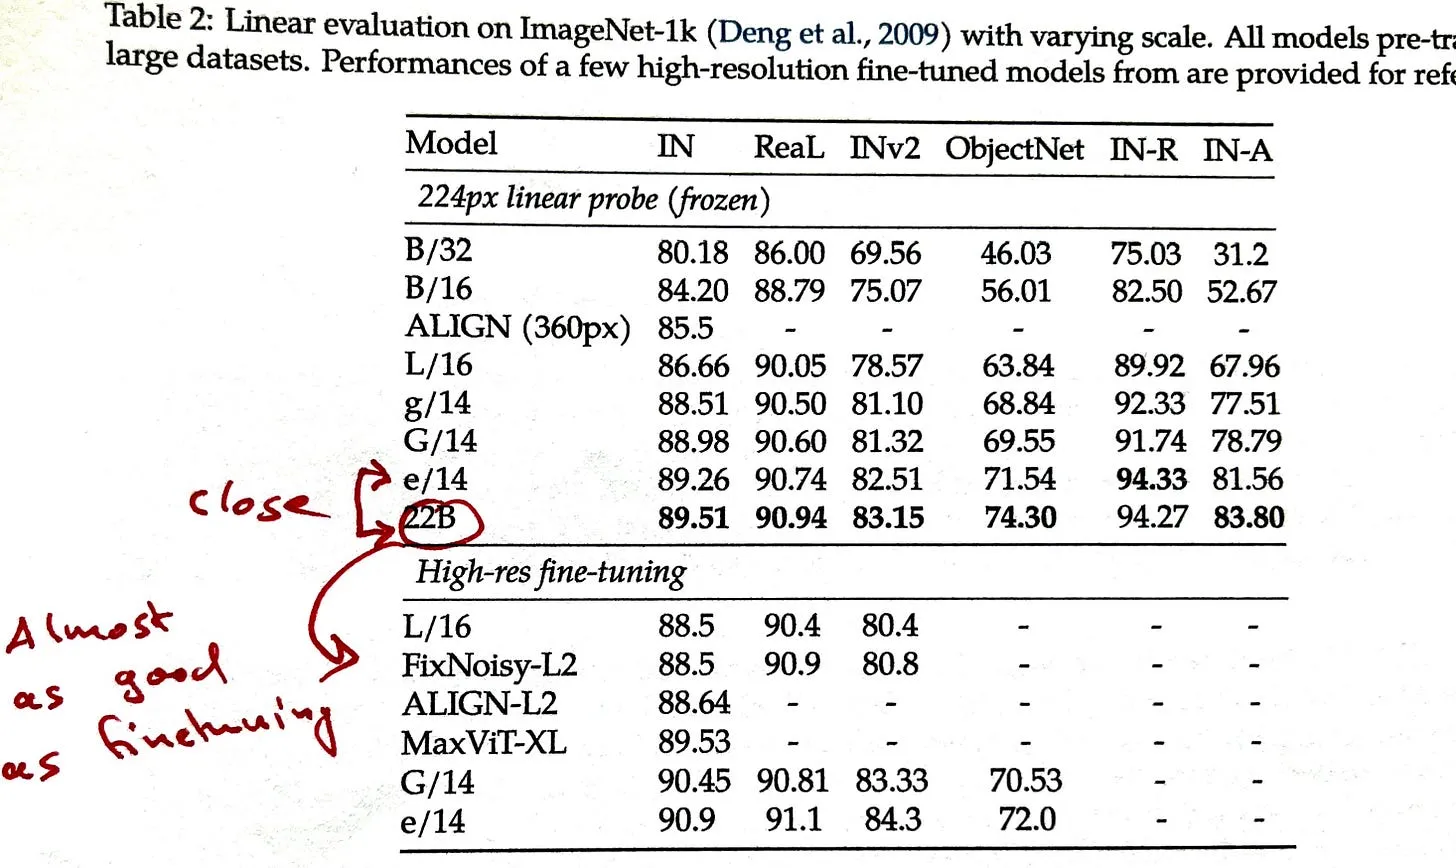
接下来,我会用同样的方式看表格:从头到尾快速浏览表格和表注。在这篇论文中,表1提供了更多关于所提出和对比的不同模型的超参数、具体规模的信息。

表2带来了一些有意思的发现:在预训练模型的嵌入上训练线性层,收益会呈现递减趋势。但线性层的性能几乎和其他微调后的模型差不多(要知道,在冻结的预训练模型上用线性层,成本通常比微调整个模型低得多)。

figure15

论文《将视觉Transformer扩展至220亿参数》中的标注表格,来源:https://arxiv.org/abs/2302.05442

从表3可知,该模型在零样本迁移场景下表现也很出色。表4和表5显示,220亿参数ViT在少样本语义分割和单目深度估计任务上也优于其他方法。表6说明该模型在视频分类上表现更佳,表7显示该ViT在可靠性基准测试中得分最高。最后,表8表明我们还可以将220亿参数模型蒸馏成更小的模型,且性能依然优于其他蒸馏参考模型(后面正文会提到,这里的小模型是略小一点的160亿参数版本)。

这些表格基本展示了所提出的220亿参数ViT能胜任的所有任务,并且该模型在各项基准测试中都优于更小的ViT。因此,到目前为止,这篇论文的一个核心结论是:ViT越大,性能越好。

4. 结论

熟悉了论文的主要结构后,我会读一下结论部分,这部分通常都不长。这篇论文的结论总结了我们刚才从图表中得到的信息:即更大的ViT在各类任务上都比之前的小模型表现更好,同时研究人员也用了一些技巧来提升计算性能。

5. 全文通读

现在可以通读全文了。我通常会从头到尾读一遍论文,了解模型实现和实验设计的细节。比如,我们会知道他们采用了三种技术来提升训练效率和稳定性:(1)并行层;(2)查询/键归一化;(3)移除偏置向量。举个例子,在并行层的设计中,他们将注意力头中的矩阵乘法与多层感知机部分的线性层融合,在不影响建模性能的前提下,将训练时的计算性能提升了15%,等等。(限于篇幅,我就不对论文做详细讨论了。)

6. 总结与拓展

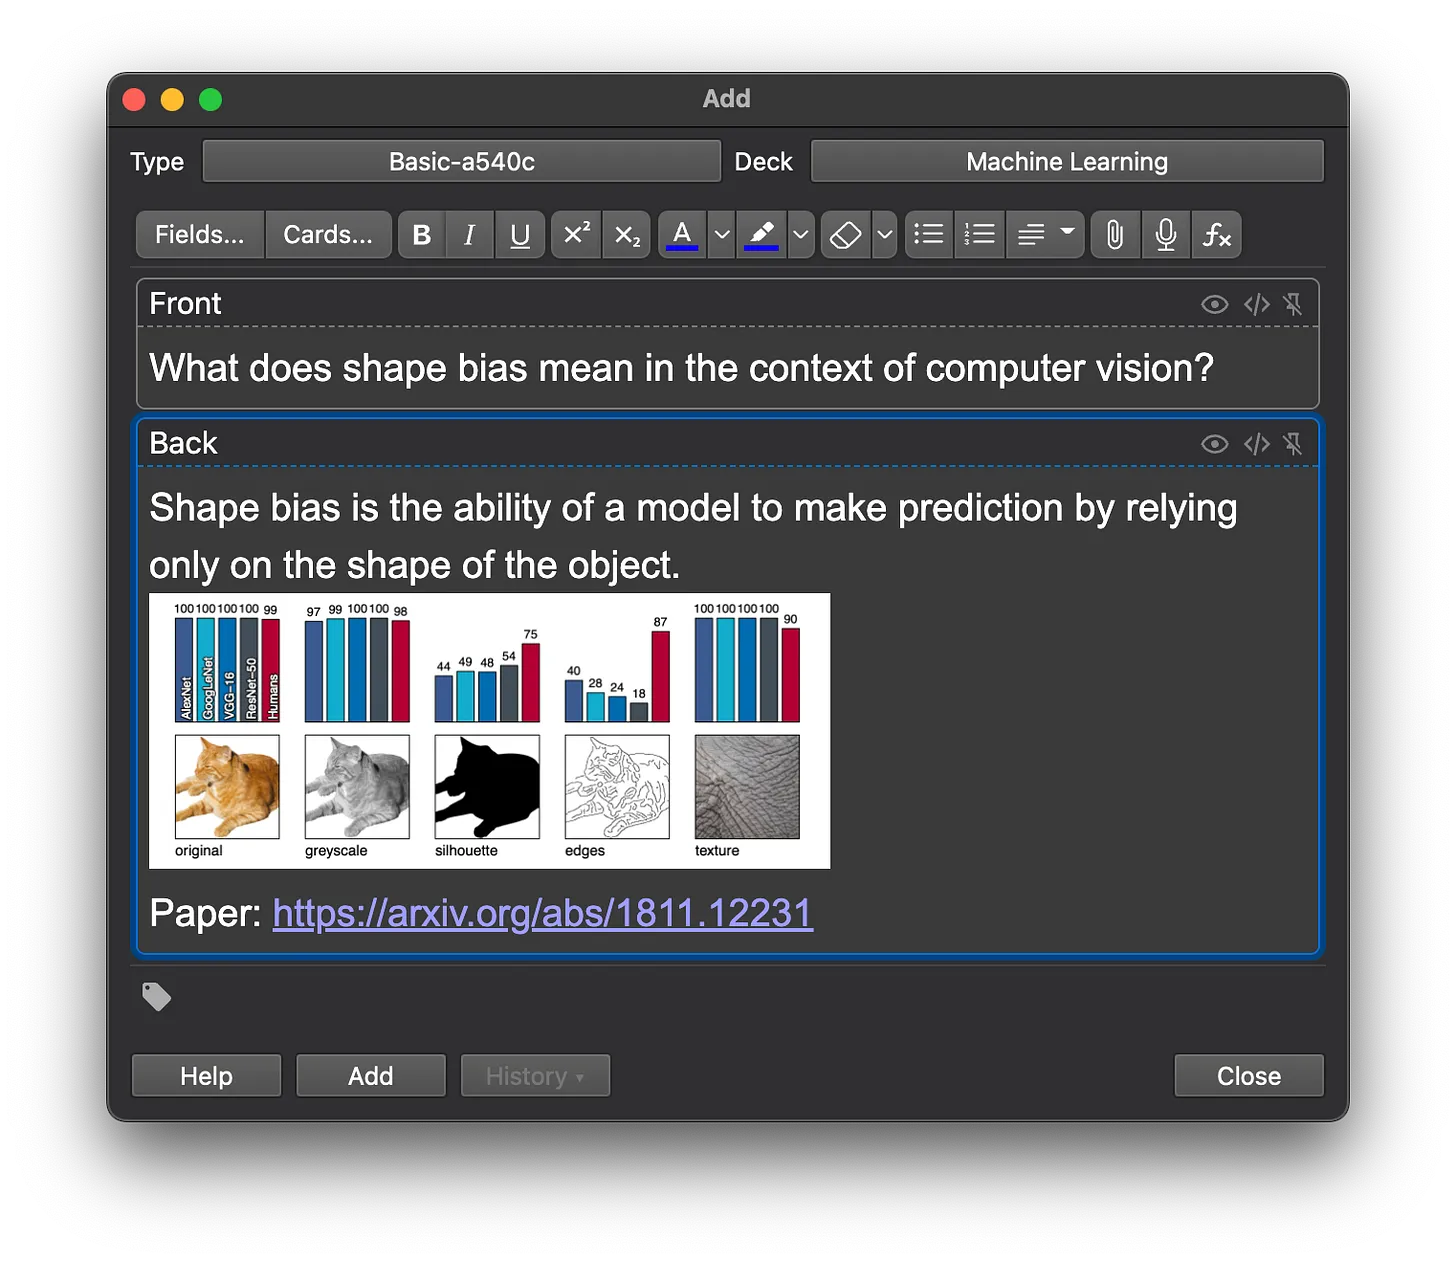
详细读完论文后,我会整理笔记和划出的重点,写一篇简短的论文总结,收在我的笔记库里。我其实很少回头看这些笔记,但写总结是很好的脑力锻炼,能提升长期记忆效果。另外,我有时候会把想记住的通用知识点做成Anki卡片。

figure16

把想记住的有趣知识点录入Anki

这个阶段也非常适合去弄懂那些困惑或不清楚的点。比如,我们可能想查一下研究人员说的“形状偏差”到底是什么。随便搜一下就会知道:“形状偏差是指基于物体形状做出正确决策的比例。”也就是说,形状偏差是模型仅依靠物体形状进行预测的能力。而要测试形状偏差,我们需要设计实验,小心地去除图像中的其他信息,比如颜色和纹理。

最后,如果我们真的想搞懂论文的方方面面,解答脑子里的各种疑问,那现在就该读附录了。(我通常至少会略读一下附录,但这篇的附录差不多有20页,为了简洁起见这里就不展开了。)

偏好的论文阅读形式

当我需要非常仔细地读论文、吃透所有细节时,我通常会把论文打印出来,离开电脑阅读,这样能更专注。我只会对大约5%的论文这么做。70%的论文,我会把PDF导出到我的电子阅读器上读——我超爱用电子阅读器,不过可惜它是黑白的,有时候看特定的图表会有点麻烦(但这种情况很少)。剩下25%的情况,也就是快速浏览论文的时候,我就在电脑上直接看PDF。

希望这些内容对你有帮助,欢迎在评论区提问!

这本杂志是我个人的兴趣项目,没有直接的盈利。如果您愿意支持我,可以考虑购买我的书(https://sebastianraschka.com/books)。如果您觉得这些书有见解、有帮助,也欢迎推荐给您的朋友和同事。

figure17

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 http://mng.bz/M96o

非常感谢您的支持!

【转载】思想的AI复兴:从下一代卷积神经网络到大语言模型

原文地址:RevAIval of Ideas: From Next-Generation Convolutional Neural Networks to LLMs, on 2023-02-06

思想的AI复兴:从下一代卷积神经网络到大语言模型

祝愿大家新年开局顺利,AI与深度学习研究领域也同样硕果颇丰。在本期《Ahead of AI》第5刊中,我希望重点展示计算机视觉领域的最新进展,而非仅仅赘述大语言模型日益走高的热度。本通讯旨在重拾经典思路,推动卷积神经网络迈上新高度。

不过不必担心,本月大语言模型的热点新闻,我也没有落下……

本期《Ahead of AI》涵盖内容:

  • 借助自监督学习进行卷积网络架构预训练的最新进展
  • 从零开始训练大语言模型的优势
  • 开源亮点
  • 训练数据有限时,监督学习的13种替代方案

文章与趋势

本章节我们首先讨论卷积神经网络的自监督学习,以及GAN与扩散模型的最新对比。短暂涉足计算机视觉领域后,我们将分析从零开始训练大语言模型的若干优势,最后以最新行业热点收尾(毕竟ChatGPT总是话题焦点)。

下一代卷积神经网络

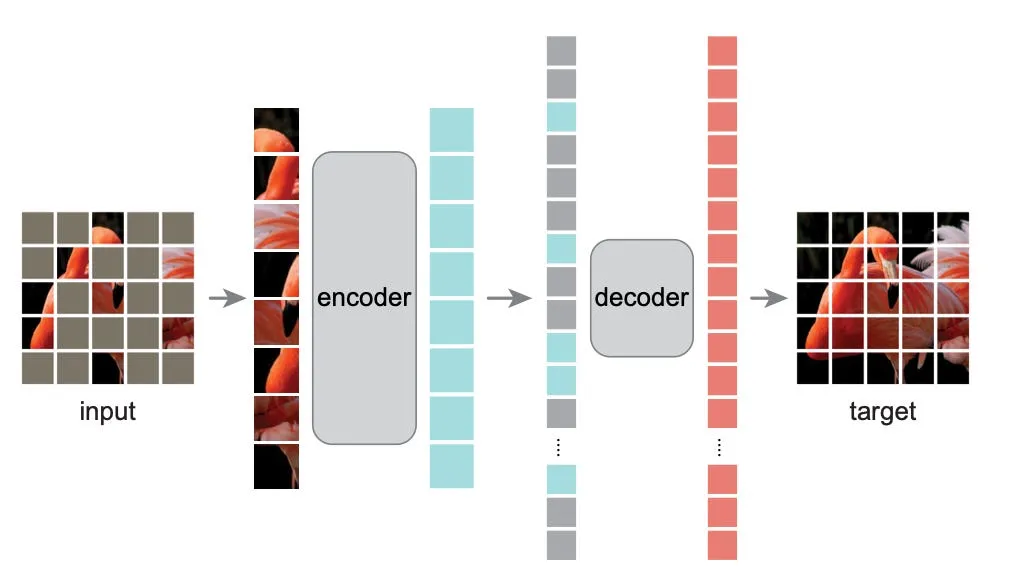
自监督学习能够利用大规模无标注数据集进行监督式预训练,是语言与视觉Transformer背后成功的关键因素之一。然而,掩码自编码这类自监督学习技术,在卷积神经网络(CNN)中效果并不理想。即便在最优情况下,表现也差强人意:https://arxiv.org/abs/2208.00173

figure01

资料来源:《掩码自编码器是可扩展的视觉学习器》,https://arxiv.org/abs/2111.06377

那么,我们该如何借鉴语言与视觉Transformer中成熟的预训练技术,来改进纯卷积网络?答案就是稀疏卷积(详见https://arxiv.org/abs/1409.6070v1):这是一种仅选取部分输入特征图或权重进行计算的卷积操作,能够在捕捉数据核心特征的同时,减少计算量与内存消耗。

将掩码自编码式自监督学习应用于CNN

在CNN中使用前沿的自监督学习技术存在什么问题?传统CNN难以处理这种预训练方案下出现的、不规则的随机掩码输入图像。

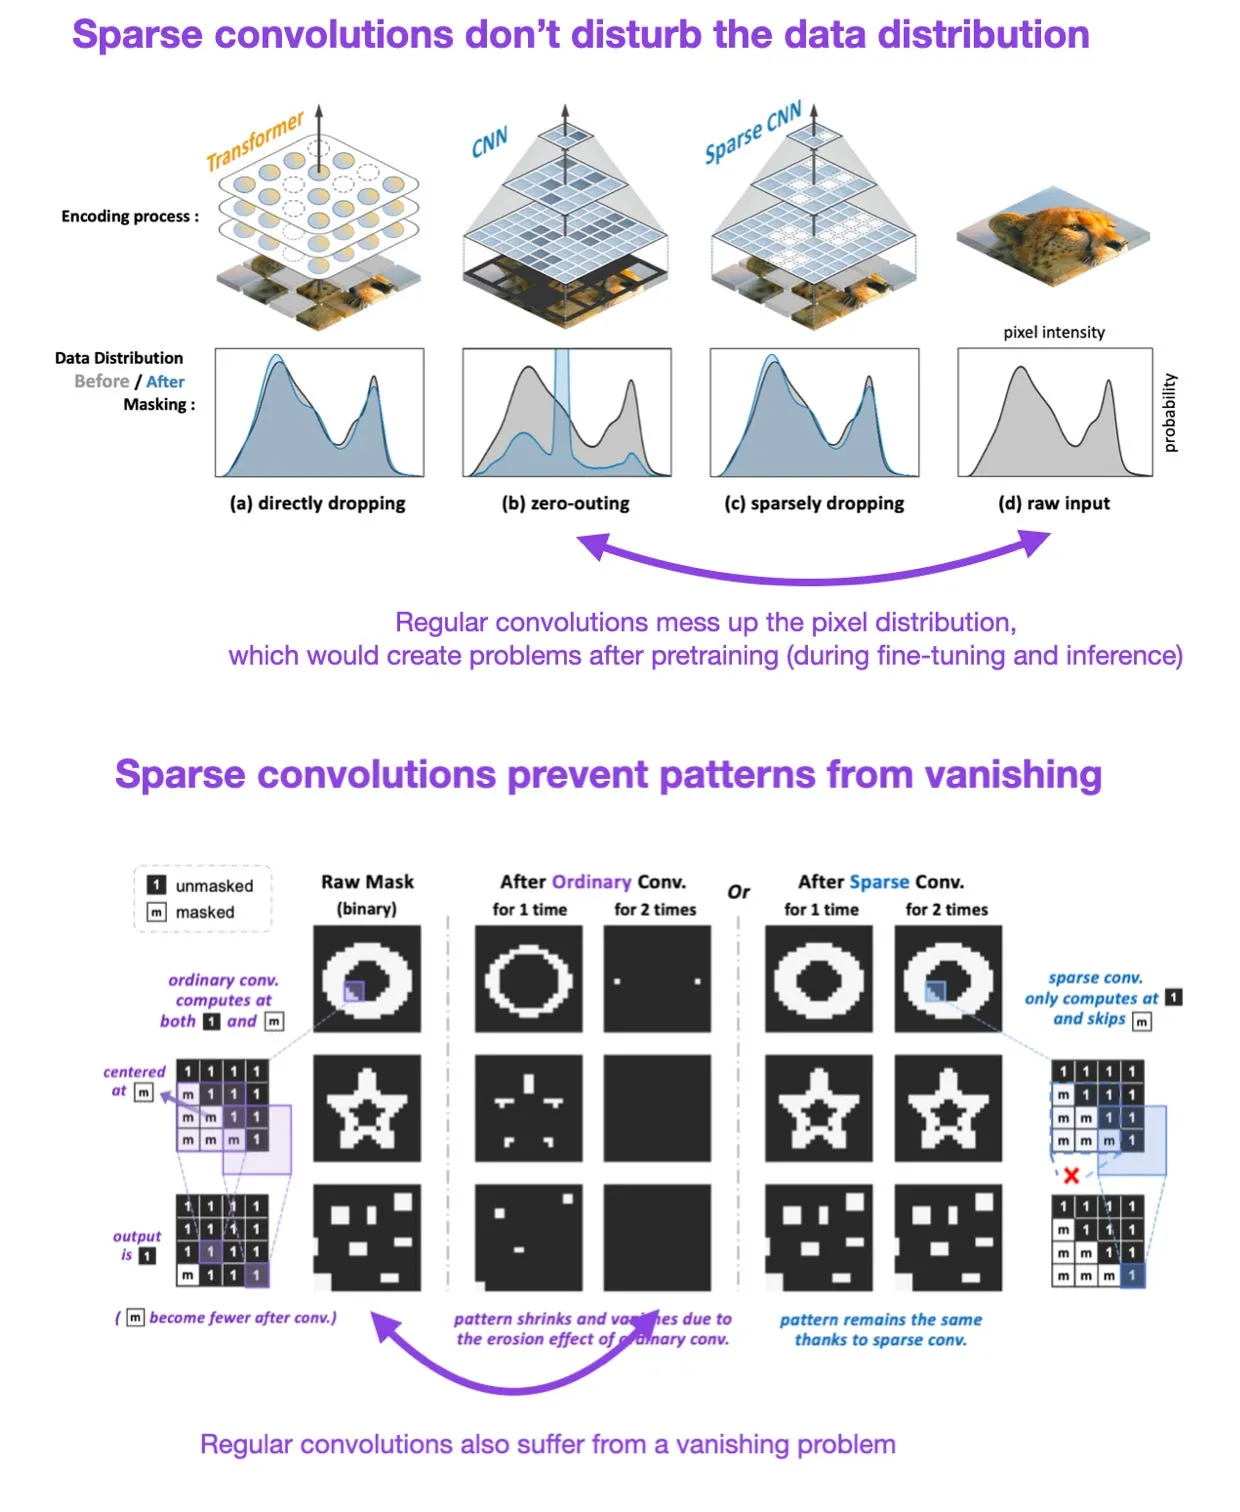
常规卷积处理掩码像素会带来哪些问题?

  • 对掩码像素的计算属于冗余操作(效率低下)
  • 会打乱像素值的数据分布(见下图第2点)
  • 掩码特征图上的模式会消失(见下图第3点)

figure02

该标注图出自https://arxiv.org/abs/2301.03580,阐释了常规卷积处理稀疏(掩码)输入时存在的问题。

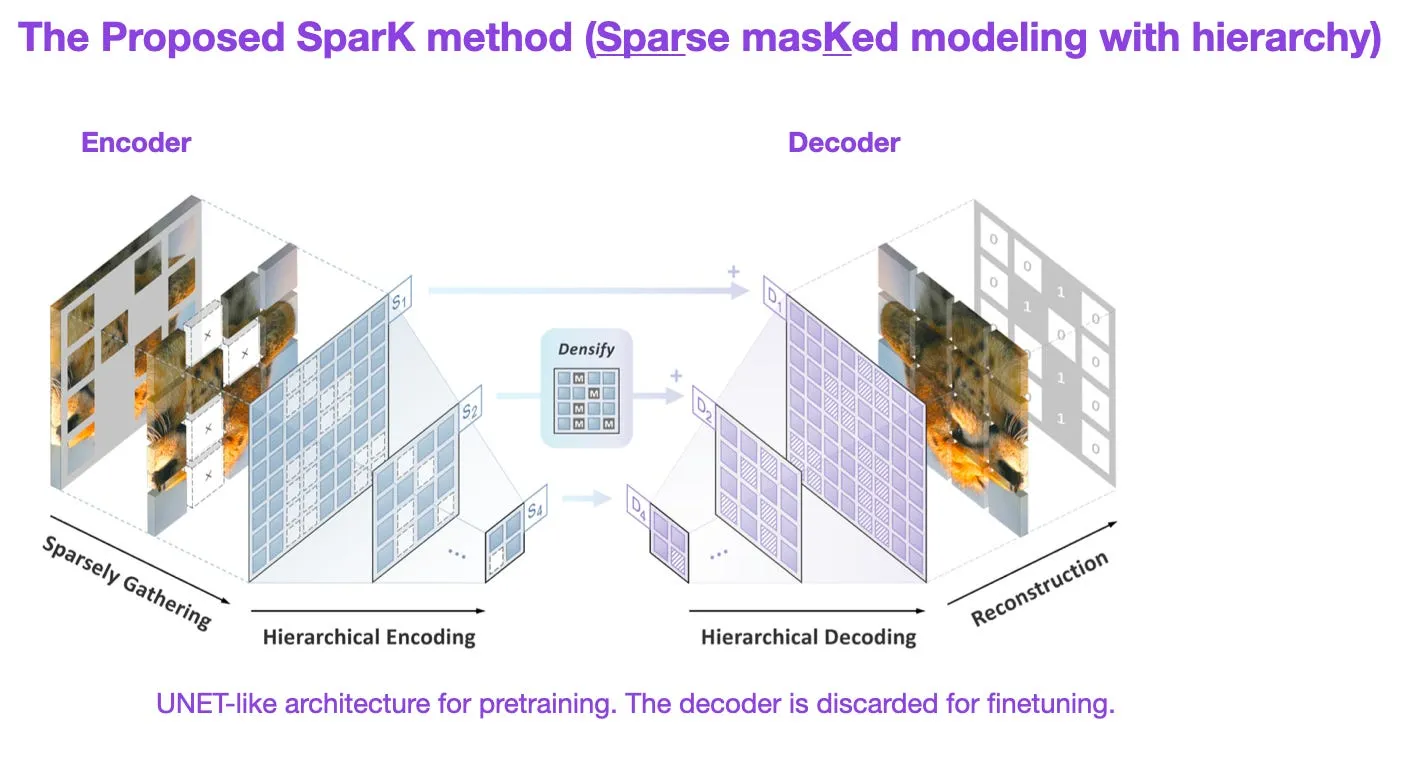
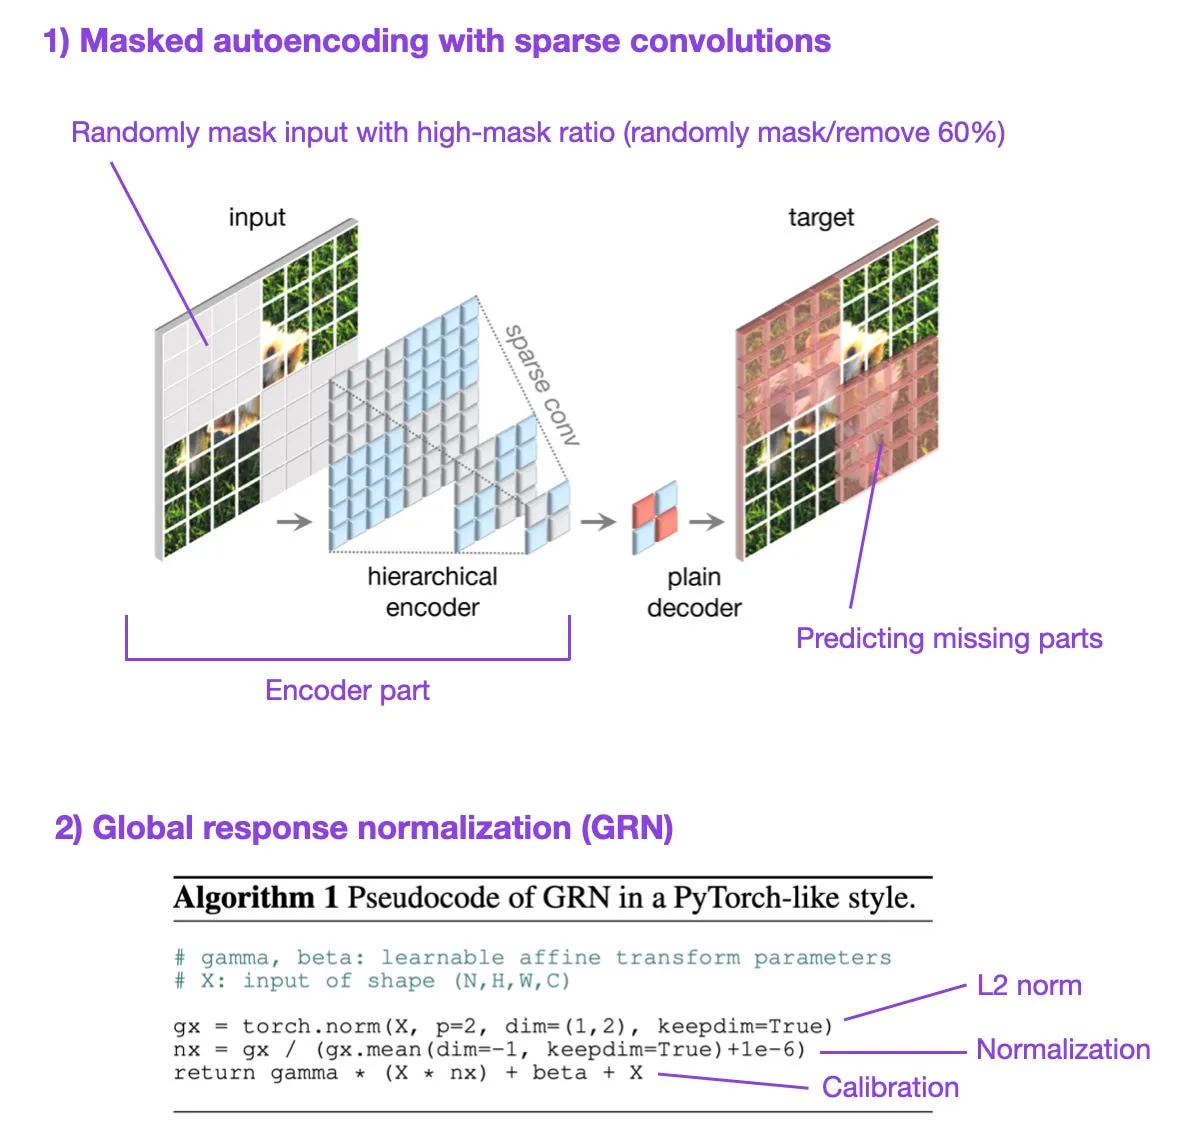
在最新发表的论文(https://arxiv.org/abs/2301.03580)中,研究人员提出用稀疏卷积来解决CNN处理掩码输入的难题,并提出了**SparK(分层稀疏掩码建模)**方法。

figure03

该标注图出自https://arxiv.org/abs/2301.03580,阐释了SparK卷积网络方案。

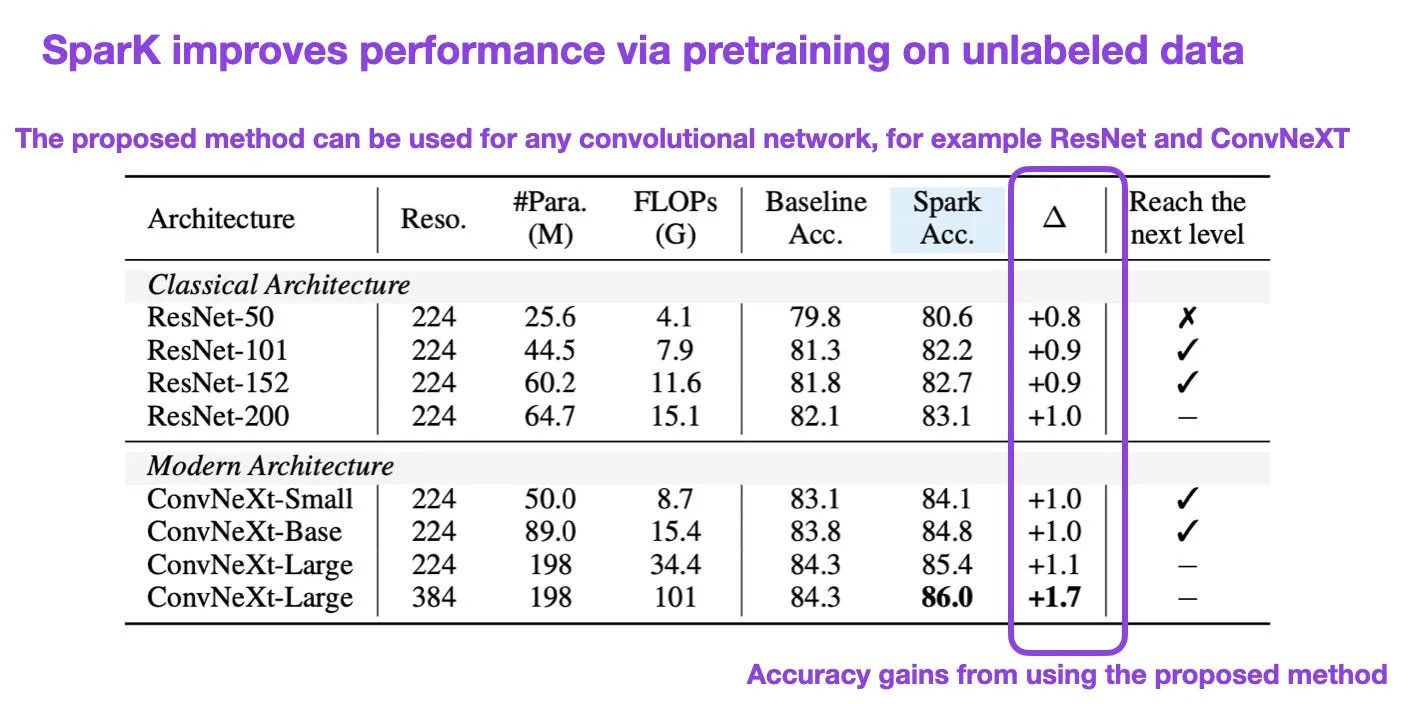
SparK可应用于任意卷积网络。例如,将其与ResNet、ConvNeXt结合后,使用128万张无标注图像对这些纯卷积网络进行预训练,在ImageNet上的预测性能最高可提升1.7%。

figure04

标注图出自https://arxiv.org/abs/2301.03580

这真的有效吗?

上面的数据看起来很有说服力,但论文中的结果有时无法很好地泛化到其他架构或问题上。因此,多参考一些佐证证据总是更稳妥的。

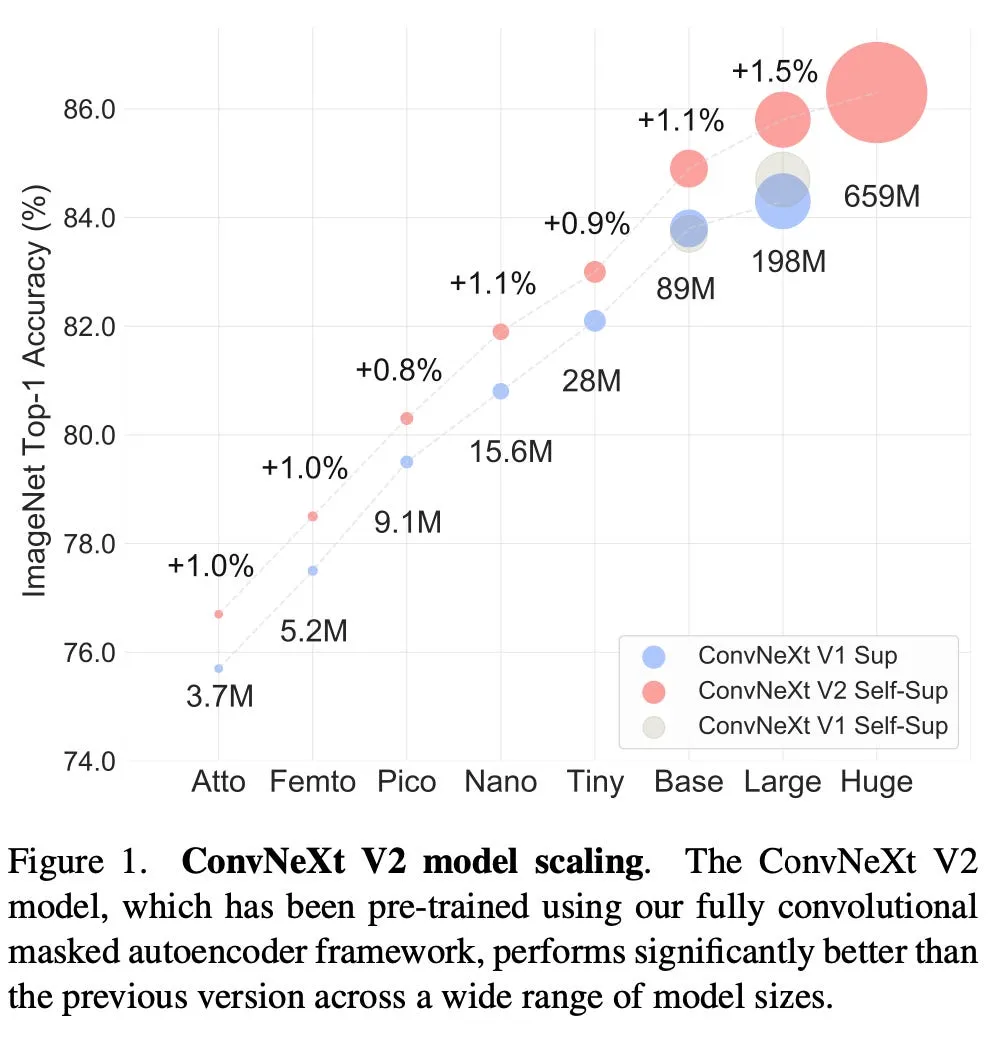
在另一篇最新的独立研究中,研究人员提出用稀疏卷积和全局响应归一化改进主流的ConvNeXt架构:https://arxiv.org/abs/2301.00808

这篇ConvNeXt v2论文通过两种机制,为自监督场景协同设计了一款纯卷积网络:

  1. 对高掩码率的稀疏块使用稀疏卷积
  2. 新增一种全局响应归一化层

figure05

资料来源:《ConvNeXt V2:与掩码自编码器协同设计并扩展卷积网络》中的标注图,https://arxiv.org/abs/2301.00808

(1)稀疏卷积的使用支持高掩码率,提升了训练效率。值得注意的是,在微调阶段,我们可以将稀疏卷积部分转换回标准卷积。
(2)全局响应归一化是一种新型归一化层,可替代批归一化和层归一化。如果没有全局响应归一化,(1)中的高掩码率会导致特征坍塌。研究人员发现,使用全局响应归一化能够促进特征多样性,这是取得良好预测性能的必要条件。全局响应归一化层是一种通用技术,未来它能否让其他架构也受益,值得期待。

和其前身ConvNeXt(我们在《Ahead of AI》第4期《AI大年》中曾介绍过,详见https://magazine.sebastianraschka.com/p/ahead-of-ai-4-a-big-year-for-ai)一样,ConvNeXt v2可用于图像分类、目标检测和实例分割任务。

figure06

资料来源:https://arxiv.org/abs/2301.00808

还记得GAN吗?

去年我曾开玩笑说GAN已经“凉了”,但本月GAN强势回归。

根据论文(https://arxiv.org/abs/2301.09515),研究人员打造了一款名为**StyleGAN-T**的GAN模型,在图像质量与生成速度上均超越了蒸馏扩散模型,成为文本生成图像领域的新标杆。

figure07

资料来源:https://arxiv.org/abs/2301.09515

我仍然认为扩散模型是计算机视觉领域生成式建模的未来,但我们也不该就此忽视GAN。毕竟,有竞争才有进步。

单GPU也能训练大语言模型(LLM)?

答案是肯定的!如今的PyTorch开源库让多GPU训练大模型变得轻而易举,但我们往往没有充足的硬件资源。问题在于,我们还能不能像早年那样,用单块GPU训练大型深度学习模型?

在论文(https://arxiv.org/abs/2212.14034<)中,研究人员用单块GPU花24小时训练了一个掩码语言模型/编码器型LLM(本次实验用的是BERT)。作为对比,原版BERT论文(https://arxiv.org/abs/1810.04805)是用16块TPU训练了4天。/p>
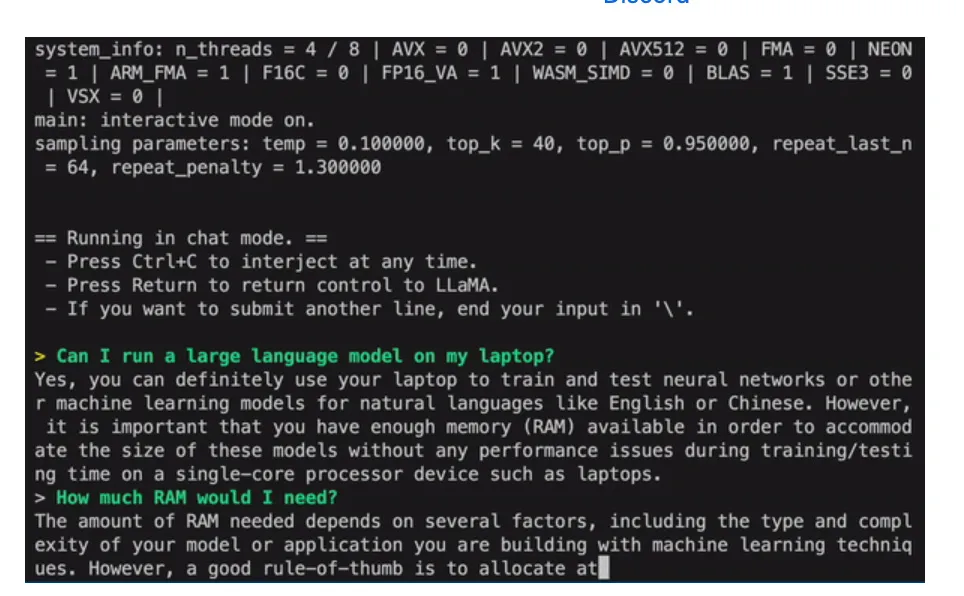
这个“极限压缩”项目的成果十分亮眼:研究人员训练出的BERT平均性能达到78.6(原版为80.9)——模型越大,提升效果越明显。

有哪些榨取性能的技巧?

  • 使用自动算子融合与32/16位混合精度训练
  • 禁用QKV注意力矩阵和全连接层中的偏置项
  • 将输入长度从512个token缩减至128个token

哪些方法没有效果?

  • 用FLASH注意力或傅里叶注意力替换原有的多头自注意力机制,没有带来收益
  • 将GELU激活函数换成其他类型,没有优势
  • 减少注意力头数会导致性能下降;保留原有的12个注意力头,是维持微调性能的关键

从预测性能的角度,研究人员还发现:

  • 三角型单周期学习率调度效果最佳
  • 由于训练数据集规模大且训练仅1个epoch,预训练阶段不需要使用dropout
  • 词表大小超过32k后,不会再提升GLUE基准的整体性能(但MNLI任务性能会提升)

figure08

标注图出自https://arxiv.org/abs/2212.14034

话说回来,如果资源有限,我们为什么不直接训练更小的模型?用这篇论文的结论来回答:虽然小模型的吞吐率更高,但学习效率也更低。因此,要达到特定的预测性能阈值,大模型所需的训练时间并不会更长。

编码器型LLM是什么?

我们再聊聊上面那篇“极限训练”论文里用到的编码器型模型。

近期大语言模型的热度,全都集中在解码器型LLM上——比如PaLM(https://ai.googleblog.com/2022/04/pathways-language-model-palm-scaling-to.html)、Chinchilla(https://arxiv.org/abs/2203.15556)以及GPT系列。这类模型通过下一词预测进行预训练,学习生成文本,有时也被称为**自回归模型**或**单向模型**,因为它们从左到右、逐token地处理文本。

相比之下,BERT这类编码器型LLM通过掩码语言建模进行预训练——我们将部分token隐藏或掩码,让LLM去预测。模型能看到完整的句子——当然,被掩码的词除外。这也被称为双向LLM。

根据经验,解码器型LLM通常更适合生成式建模,而编码器型LLM更适合预测式建模(比如文本分类)。

figure09

虽然生成式建模通常看起来更酷炫、更有“魔法感”,也是社交媒体和新闻头条里的常客,但我认为,绝大多数真实商业场景的核心需求,其实都依赖预测式建模。

总之,如今已有数百种不同的大语言Transformer模型,很容易让人眼花缭乱。这种情况下,我强烈推荐收藏Xavier Amatriain整理的全面Transformer模型总结与谱系图:https://amatriain.net/blog/transformer-models-an-introduction-and-catalog-2d1e9039f376/

选哪款GPU?

顺便说一句,如果你想知道哪款GPU性价比最高,推荐看看Tim Dettmers最新更新的指南:https://timdettmers.com/2023/01/30/which-gpu-for-deep-learning/

另外,想根据计算预算找到最合适的LLM模型大小,可以试试这个实用的新工具:https://howmanyparams.com/

我们究竟为什么要从零训练LLM?

既然已经有很多现成的预训练模型,为什么还要自己预训练LLM?一方面是出于研究学习的目的,另一方面,你可能需要让模型适配新的语言或领域(比如蛋白质或DNA序列)。

由于语言具有一定的通用性,典型的工作流是:先在大规模通用语料上预训练模型,再在目标领域上微调——比如目标任务是股市分析的情感分类,就用财经文章做微调。但如果有大量领域专属文本,将这些数据也用于预训练可能效果更好。

例如,在一项研究(https://papers.ssrn.com/sol3/papers.cfm?abstract_id=4337182)中,研究人员发现,在180万篇财经新闻文章上进一步预训练的BERT模型(FinBERT,https://arxiv.org/abs/1908.10063),在财经领域情感分析任务上的表现优于所有其他模型。

学习生命的语言

另一个能说明预训练价值的例子,是近期发表在《自然》上的论文(https://www.nature.com/articles/s41587-022-01618-2)。研究人员用2.8亿条蛋白质序列训练了一个12亿参数的Transformer,用于生成新的蛋白质序列(蛋白质序列由单字母氨基酸字符串组成,比如“DIQMTQSPA…”)。

figure10

标注图出自https://www.nature.com/articles/s41587-022-01618-2

该LLM能够生成与现有蛋白质相似度不超过30%的、真实可信的蛋白质序列。而真正了不起的是,研究人员不止是用氨基酸序列训练了LLM,他们更进一步,合成了完整的基因,并在现实中表达出了这些蛋白质。这些人工蛋白质展现出了与天然蛋白质完全相同的功能。

从零训练LLM

厚着脸皮自荐一下:如果你对从零训练LLM感兴趣,我们最近开发并分享了一份仅需50行代码的实现方案。

figure11

https://lightning.ai


热点头条

1月AI圈大事不断,大语言模型的热度持续高涨。无法一一尽述,但这些内容仍有参考价值,因此我新增了“热点头条”板块,用简短一句话盘点科技领域值得关注的新闻——本月内容偏OpenAI和大语言模型,还请见谅。

学术与科研

ChatGPT相关

Stable Diffusion与生成式图像模型


深度学习基础课程 第4单元

很高兴和大家分享,我的《深度学习基础》课程(https://lightning.ai/pages/courses/deep-learning-fundamentals/)第4单元现已上线:https://lightning.ai/pages/courses/deep-learning-fundamentals/training-multilayer-neural-networks-overview/logistic-regression-for-multiple-classes-part-1-5/

在第4单元中,我们终于开始用PyTorch训练多层神经网络,还会讨论随机权重初始化等设计决策。

figure12

https://lightning.ai/pages/courses/deep-learning-fundamentals/


开源亮点

CIFAR-10超高速训练基准

该项目(https://github.com/tysam-code/hlb-CIFAR10/blob/main/main.py)提供了适合快速实验的PyTorch代码,用于在单GPU上训练卷积神经网络。在单块A100上,它能在10秒内将模型在CIFAR-10上训练到94%准确率。

用Lightning 1.9与Fabric扩展PyTorch模型

Lightning 1.9版本发布(https://github.com/Lightning-AI/lightning/releases/tag/1.9.0 ),带来大量更新。其中一大亮点是全新的**Fabric类**——它是比PyTorchTrainer类更轻量的替代工具与组件集。

和Trainer一样,Fabric仅需几行代码就能轻松扩展PyTorch模型,运行在分布式设备上。但与Trainer类不同的是,训练循环与优化逻辑完全由你掌控。

更多内容见文档:https://pytorch-lightning.readthedocs.io/en/stable/fabric/fabric.html

figure13

nanoGPT——GPT教学级代码库

Andrej Karpathy分享了nanoGPT(https://github.com/karpathy/nanoGPT),这是热门项目minGPT(https://github.com/karpathy/minGPT)的重写版本,目标是用不到600行代码(模型+训练循环合计)讲透GPT-2(解码器型大语言模型)的内部原理。

Ruff——极速Python代码检查工具

Ruff(https://github.com/charliermarsh/ruff)由Rust编写,比现有代码检查工具(包括热门的flake8:https://flake8.pycqa.org/en/latest/)快10到100倍。

代码检查工具的作用是排查代码中的潜在错误、不一致之处,以及是否符合编码规范,还能统一代码风格,这对多人协作的项目尤其有用。但在处理大型代码库时,这类工具有时会偏慢(尤其是用低配硬件检查GitHub提交时)。这种情况下,Ruff值得一试——它可以直接通过pip安装,非常方便!


机器学习问答

问: 假设我们绘制学习曲线后发现,机器学习模型存在过拟合,增加训练数据能改善效果。请列举在监督机器学习场景下,处理标注数据有限问题的不同方法。

figure14

答:
除了收集更多数据之外,在标注数据有限的情况下,我们还可以使用多种与常规监督学习相关的方法。

1)标注更多数据

收集更多训练样本通常是提升模型性能的最佳方法,但实际中往往难以实现。以下是各种替代方案。

2)数据增强与扩充

通过生成修改后的(增强版)或人工的(合成版)训练样本对数据进行“扩充”,有助于提升预测模型的性能。(为简洁起见,本通讯省略具体细节。)

当然,提升数据质量也能改善模型的预测性能。(以数据为中心的AI相关细节同样因篇幅原因略过。)

3)迁移学习

迁移学习指的是先在通用数据集(比如ImageNet)上训练模型,再在目标数据集上微调预训练模型(比如包含不同鸟类的特定数据集)。

迁移学习通常用于深度学习场景,因为深度学习模型的权重可以更新。这一点和树类方法不同——大多数决策树算法属于非参数模型,不支持迭代训练或参数更新。

figure15

4)自监督学习

和迁移学习类似,自监督学习也是先让模型在其他任务上预训练,再针对数据有限的目标任务进行微调。但与迁移学习不同的是,自监督学习通常依赖可以直接从无标注数据中自动提取的标签信息,因此也常被称为无监督预训练。

常见例子包括语言建模中的“下一词预测”(比如GPT所用)和“掩码词预测”(比如BERT所用);计算机视觉中一个直观的例子是图像修复:预测图像中被随机移除的缺失部分。

figure16

5)主动学习

主动学习通常会在学习过程中引入人工标注者或用户提供反馈。但它不需要提前标注整个数据集,而是通过一套优先级排序机制,推荐那些能最大化模型性能提升的无标注数据点进行标注。

“主动学习”的名称来源于,模型会在过程中主动选择数据进行标注。例如,最简单的主动学习形式,是挑选预测不确定性高的数据点,交由人工标注者(也称为“预言机”)标注。

figure17

6)少样本学习

在少样本学习场景中,我们面对的数据集通常极小,每个类别只有少量样本。在研究中,1样本(每类1个样本)和5样本(每类5个样本)非常常见。

少样本学习的极端情况是零样本学习,即完全没有标注。近期热门的例子是GPT-3及相关语言模型:用户需要通过输入提示词提供所有必要信息,如下图所示。

figure18

7)元学习

元学习可以理解为“学会学习”——我们开发方法,让机器学习算法自己学习如何更好地从数据中学习。多年来,机器学习社区发展出了多种元学习方法。更复杂的是,元学习可以指代不同的过程。

元学习是上述少样本学习的主要子类别之一,其核心是学习一个优秀的特征提取模块。特征提取模块将支持集图像和查询集图像转换为向量表示,通过与支持集中的训练样本对比,来判断查询样本的预测类别。

元学习的另一个分支与上述少样本学习无关,它专注于从数据集中提取元数据(也叫元特征)用于监督学习任务。元特征是对数据集本身的描述,比如特征数量、各特征的统计量(峰度、极差、均值等)。

提取出的元特征可以为当前数据集选择合适的机器学习算法提供依据。这种方法能够缩小算法和超参数的搜索空间,在数据集较小时有助于缓解过拟合。

8)弱监督学习

弱监督学习是指利用外部标签源为无标注数据集生成标签的方法。通常,弱监督标注函数生成的标签,比人工或领域专家标注的标签噪声更大、准确率更低,“弱监督”因此得名。

在弱监督学习中,我们通常可以开发或采用基于规则的分类器来生成标签——但这些规则通常只能覆盖无标注数据集的一部分。

figure19

以邮件垃圾分类为例,这是一种基于规则的数据标注方法。在弱监督中,我们可以设计一个基于规则的分类器,通过邮件标题中的关键词“SALE”来识别一部分垃圾邮件。注意,我们可以用这条规则把某些邮件标注为垃圾邮件,但不能反过来把没有“SALE”的邮件都标为非垃圾邮件——这些邮件要么保持未标注,要么用其他规则处理。

简而言之,弱监督学习是一种增加训练集中标注样本数量的方法。因此,它和半监督学习、迁移学习、主动学习、零样本学习等其他技术完全兼容。

9)半监督学习

半监督学习和上面提到的弱监督学习密切相关:都是为数据集中的无标注样本生成标签。两者的主要区别在于标签的生成方式(半监督学习有时被视为弱监督学习的子类别,反之亦然)。

弱监督中,我们通过外部标注函数生成标签,这类函数通常噪声大、准确率低,或只能覆盖部分数据。而半监督学习不使用外部标注函数,而是利用数据本身的结构。

figure20

例如在半监督学习中,我们可以根据邻近标注数据点的密度,来给更多数据点打标签,如下图所示。

弱监督可以用于完全无标注的数据集,而半监督学习要求至少有部分数据是标注好的。实际应用中,可以先用弱监督标注一部分数据,再用半监督学习标注那些没被标注函数覆盖的样本。

10)自训练

自训练介于半监督学习和弱监督学习之间。在自训练中,我们训练一个模型(或采用现有模型)来给数据集打标签,这个模型也被称为伪标注器。

由于自训练所用的模型不能保证标签准确,因此它和弱监督学习相关;同时,因为我们是用机器学习模型来做伪标注,所以它也和半监督学习相关。

11)多任务学习

多任务学习让神经网络同时学习多个任务(理想情况下是相关任务)。例如,假设我们训练一个分类器来检测垃圾邮件,那么垃圾邮件分类就是主任务。在多任务学习中,我们可以给模型增加一个或多个相关任务,这些额外任务也称为辅助任务。如果主任务是邮件垃圾分类,辅助任务可以是分类邮件的主题或语言。

通常,多任务学习通过多个损失函数实现,每个任务对应一个损失函数,需要同时优化。辅助任务起到归纳偏置的作用,引导模型优先选择能解释多个任务的假设。这种方法通常能让模型在未见过的数据上表现更好。

figure21

上图阐释了硬参数共享和软参数共享的区别。硬参数共享中,只有输出层是任务专属的,所有任务共享相同的隐藏层和神经网络主干结构。相比之下,软参数共享为每个任务使用独立的神经网络,但通过参数层间距离最小化等正则化技术,来促进网络之间的相似性。

12)多模态学习

多任务学习是让模型用多个任务、多个损失函数训练,而多模态学习专注于融合多种类型的输入数据。

多模态学习的常见例子是同时接收图像和文本数据的架构。根据任务不同,我们可以使用匹配损失,强制相关图像和文本之间的嵌入向量相似,如下图所示。

figure22

上图中图像编码器和文本编码器是独立的组件。图像编码器可以是卷积主干或视觉Transformer,语言编码器可以是循环神经网络或语言Transformer。不过如今更常见的是用单个基于Transformer的模块,同时处理图像和文本数据。

如前图所示,优化匹配损失对于学习可用于多种任务(如图像分类、摘要生成)的嵌入很有帮助。但我们也可以直接优化目标损失,比如分类或回归损失,如下图所示。

figure23

直观来看,融合不同模态数据的模型通常比单模态模型表现更好,因为它们能利用更多信息。此外,近期研究表明,多模态学习成功的关键,在于提升了隐空间表征的质量。

13)归纳偏置

选择归纳偏置更强的模型,通过对数据结构做出假设,能够降低对数据量的需求。例如,正如第13问所讨论的,由于自身的归纳偏置,卷积网络比视觉Transformer需要的数据更少。

我们该用哪些技术?

我们已经介绍了多种降低数据需求的技术,那到底该用哪些呢?

收集更多数据、数据增强、特征工程等方法,和上面讨论的所有方法都兼容。同样,多任务学习和多模态输入也可以和其他学习策略结合使用。如果模型存在过拟合,还应该结合其他问答中提到的技术(通过模型修改缓解过拟合、通过数据集修改缓解过拟合)。

至于主动学习、少样本学习、迁移学习、自监督学习、半监督学习、弱监督学习这些方法,具体选择哪种高度取决于场景,下图提供了一个概览可以作为参考。

figure24

图中的黑框不是终止节点,而是会回流到“评估模型性能”步骤(为避免画面杂乱,箭头已省略)。


《机器学习问答·AI篇》

如果你喜欢上面的问答内容,想读更多,这其实是我的新书《Machine Learning Q & AI》的节选,书籍地址:https://leanpub.com/machine-learning-q-and-ai/

figure25

有一个面向《Ahead of AI》读者的限时优惠码,可享33%折扣:https://leanpub.com/machine-learning-q-and-ai/c/ahead-of-ai(优惠有效期至2月15日)。


金句精选

“我发现对AI最贴切的比喻是:它就像读写领域的计算器。”——Naval,https://twitter.com/naval/status/1615248290781745153?s=20&t=XUHYiNcjFll218cjrkhAJg

这句话很吸引我,和“计算机是思维的自行车”这个理念有异曲同工之妙。但仔细想想,这个类比有不足之处。计算器是确定性的、精确的,而如今的AI模型并非如此。更恰当的比喻是,把大语言模型看作同义词词典——只不过它针对的是整句、整段文字,而非单个单词。


学习与效率小贴士

研读教材或课程时,最值得投入时间的事情之一就是做习题和测验!当然,一路读下去往往感觉更高效——毕竟快得多。但做练习之所以重要,有以下几个原因:

  1. 检验理解,查漏补缺:做测验和习题时,我们能发现自己的知识漏洞。有时候卡壳了,就得反复回顾内容直到真正掌握。虽然这感觉不如直接进入下一章或下一单元有成就感,但如果想真正吃透内容,这一步必不可少。学习是马拉松,不是冲刺跑。
  2. 主动学习,理解更深:做习题和测验是主动参与的过程,和被动阅读或听讲相比,能促进对内容的深度理解。
  3. 获得动力,持续前进:前面说做练习有时不如往下学有成就感,我觉得这是因为我们总被灌输要多做事、快做事。快点读完一本书或学完一门课,就能快点打勾完事——谁的待办清单不是堆得老高呢?但实际上,完成习题和测验能给我们更强的成就感,激励我们继续学习。
  4. 对接实战,学以致用:习题和测验有时会模拟真实场景,帮助我们把学到的知识用到实际中——而这往往正是我们学习的初衷!

出好的习题和测验并不容易,我总跟学生说:
出卷比答卷难。

我会尽最大努力,在未来的课程和书籍中加入更多优质习题。


本通讯是个人兴趣项目,没有直接报酬。如果您愿意支持我,欢迎购买我的书籍:https://sebastianraschka.com/books。如果您觉得这些内容有启发、有帮助,也欢迎推荐给朋友和同事。

figure26

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/、https://nostarch.com/machine-learning-and-ai-beyond-basics、http://mng.bz/M96o

您的支持意义重大!非常感谢!