原文地址:Looking Back at 2022: A Big Year For AI,by Sebastian Raschka, on 2023-01-02
回望2022:AI的大年
新年快乐!我很高兴看到《Ahead of AI》仅发行3期就收获了超过2万名订阅者。这是我持续写作的巨大动力,也祝愿大家2023年身体健康、顺遂圆满!
我踏入机器学习领域至今已有十年,但2022年无疑是最令人兴奋、大事频出的一年。机器学习与人工智能领域每天都有新的突破与进展,新趋势与新挑战也不断涌现。
为迎接新年,本期将盘点我2022年读过的十大论文。
Articles & Trends(文章与趋势)
2022年1月,扩散模型首次进入公众视野 https://twitter.com/rasbt/status/1487907110105006091?lang=en,我当时就预感一场大变革即将到来。但我从未料到,短短数月内,DALL·E 2、Imagen、Stable Diffusion等一众模型会接连问世。
同样,大语言模型也迎来了爆发式发展,近期ChatGPT的横空出世更是将这股热潮推向顶峰。这真是波澜壮阔的一年!
不过,我们已经在 https://magazine.sebastianraschka.com/p/ahead-of-ai-1-a-diffusion-of-innovations 中讨论过扩散模型,在 https://magazine.sebastianraschka.com/p/ahead-of-ai-2-transformers-fast-and 中探讨过各类语言模型,而且大家现在可能已经对“ChatGPT”这个词耳熟能详了,所以这部分我就长话短说。接下来,我们先来看12月的亮点研究,再解读麦肯锡发布的一份人工智能现状报告与行业调研,最后盘点今年5篇值得关注的论文。
December Highlights(12月亮点)
上文提到的那些里程碑式成果密集发布,后续很难超越。但这并不代表12月平淡无奇。简而言之,以下两篇论文吸引了我的注意。
What do vision transformers (ViTs) learn?(视觉Transformer(ViT)究竟学到了什么?)
https://arxiv.org/abs/2212.06727 研究表明,视觉Transformer学到的归纳偏置或特征,与卷积神经网络(CNNs)学到的内容相似。例如,视觉Transformer的浅层捕捉边缘与纹理,深层则学习更复杂的表征,以覆盖更宽泛的概念。
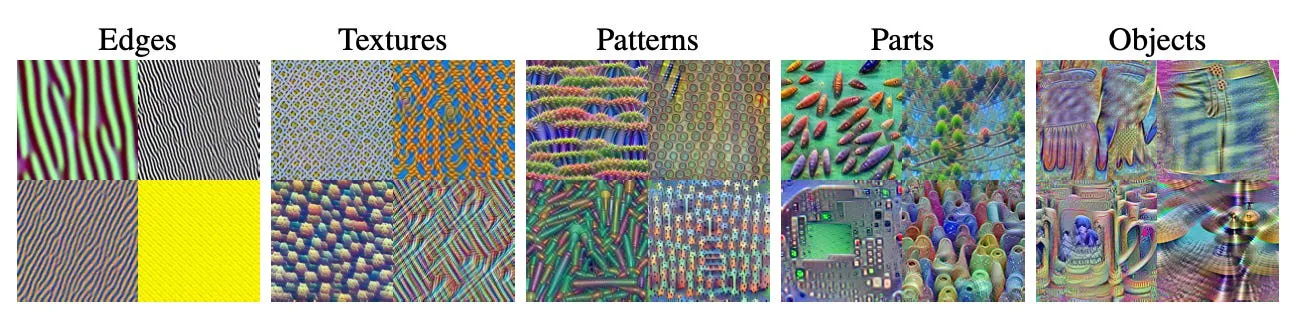
视觉Transformer从浅层(左)到深层(右)的视觉特征演进过程。来源:https://arxiv.org/abs/2212.06727
在生成建模方面,视觉Transformer生成的背景质量往往优于卷积神经网络。这引出了一个问题:在预测任务中,视觉Transformer是如何处理背景与前景的?研究发现,当移除背景时,视觉Transformer对目标类别的预测效果优于CNNs;移除前景时,其表现同样更优。这表明,视觉Transformer在依赖特征时更具选择性,会根据特征是否存在来调整权重,或者说它们整体鲁棒性更强。
论文:https://arxiv.org/abs/2212.06727
A diffusion model for generating proteins(用于生成蛋白质的扩散模型)
扩散模型在图像生成领域已取得突破性进展,那它能否用于生成蛋白质结构呢?研究人员开发了一款名为 https://www.biorxiv.org/content/10.1101/2022.12.09.519842v1 的扩散模型,用于从头合成蛋白质——这类蛋白质完全从零构建,而非衍生自自然界中已有的蛋白质。
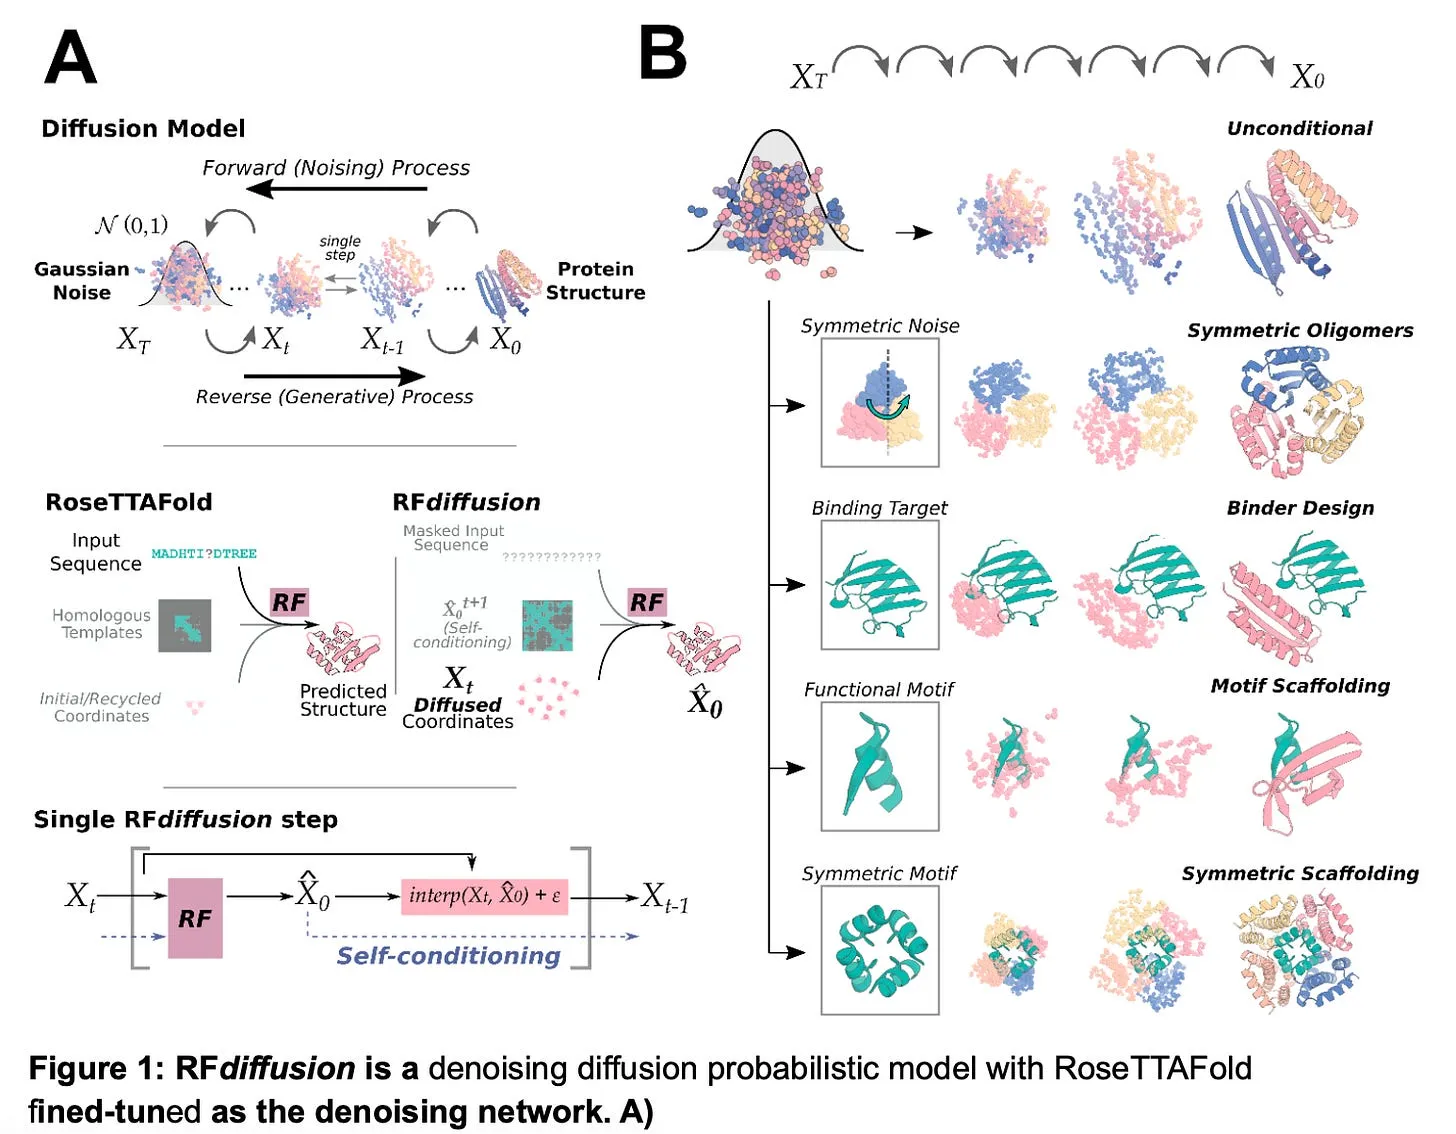
来源:https://www.biorxiv.org/content/10.1101/2022.12.09.519842v1
需要明确区分的是:从头合成蛋白质是在实验室中利用无进化历史的氨基酸序列合成的;而AlphaFold、AlphaFold2这类系统是利用已有的氨基酸序列数据来预测蛋白质的三维结构。不过值得注意的是,该研究使用AlphaFold2来验证RDiffusion的生成结果。
论文:https://www.biorxiv.org/content/10.1101/2022.12.09.519842v1
Industry Trends(行业趋势)
作为研究人员,我们通常研究和关注的都是人工智能领域的前沿技术。但如今行业内实际应用的是什么技术呢?根据 https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai-in-2022-and-a-half-decade-in-review ,答案并非大语言模型(transformers)。*
(*注:由于样本量与代表性的局限,该报告的结论可能无法准确反映所有企业的实际情况。)
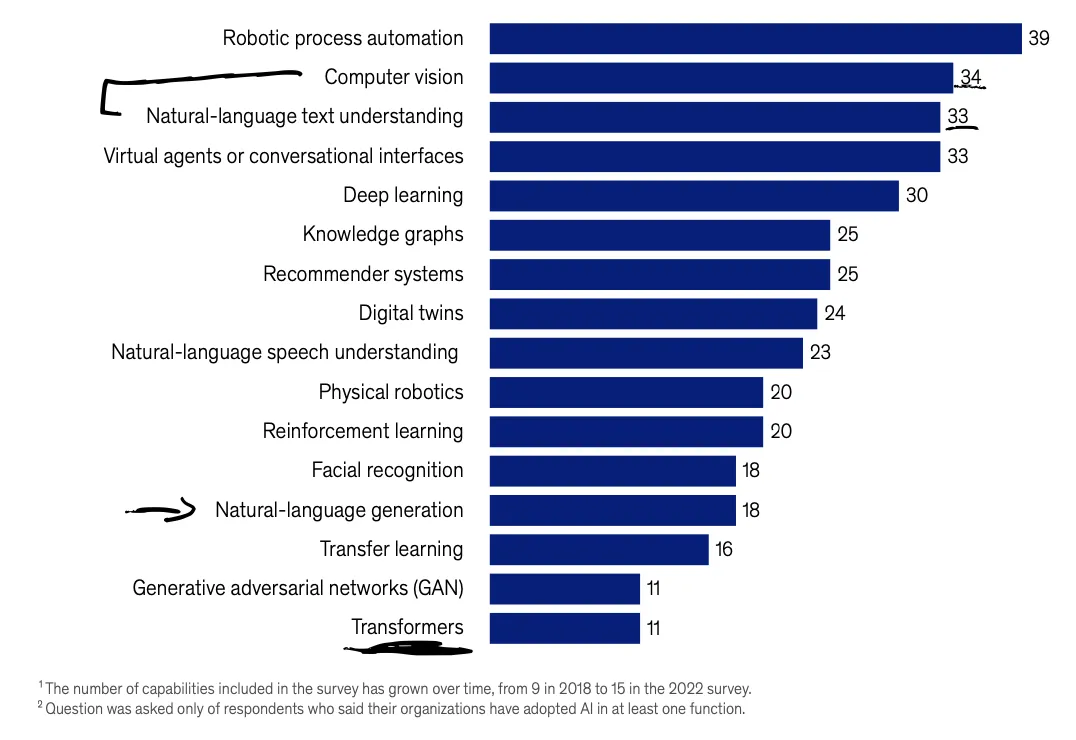
我从上图中总结了几个有意思的发现:
- 自然语言处理在行业中一直很受欢迎,但此前其应用规模远不及计算机视觉。而如今,计算机视觉与自然语言处理的应用规模几乎持平,这是有史以来第一次。
- 自然语言文本理解(可能指文本分类*)的普及度几乎是自然语言“生成”的两倍。值得注意的是,自然语言生成往往占据新闻头条:GPT-3、Galactica、ChatGPT等模型皆属此类。
- Transformer排名垫底。
- 看来很多企业尚未采用BERT类语言模型编码器来做文本理解与分类(1),仍在使用基于词袋的分类器或循环神经网络。同样,GPT类模型解码器似乎也尚未广泛应用于语言生成,文本生成可能仍高度依赖循环神经网络等传统方法。
(*文本理解可能包含摘要。摘要本质上也属于“生成式”任务,因此我推测这里主要指类似分类的任务。另一方面,各类技术的范畴本身也存在重叠。)
Data set sizes, getting data to production, and model explainability(数据集规模、数据落地生产与模型可解释性)
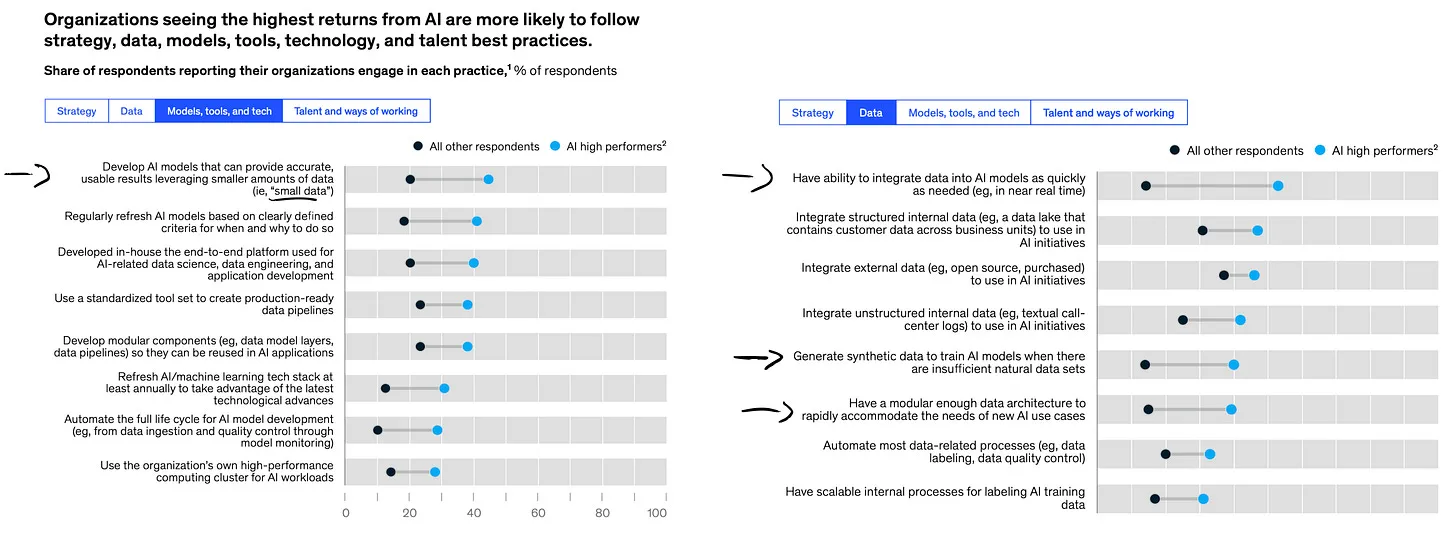
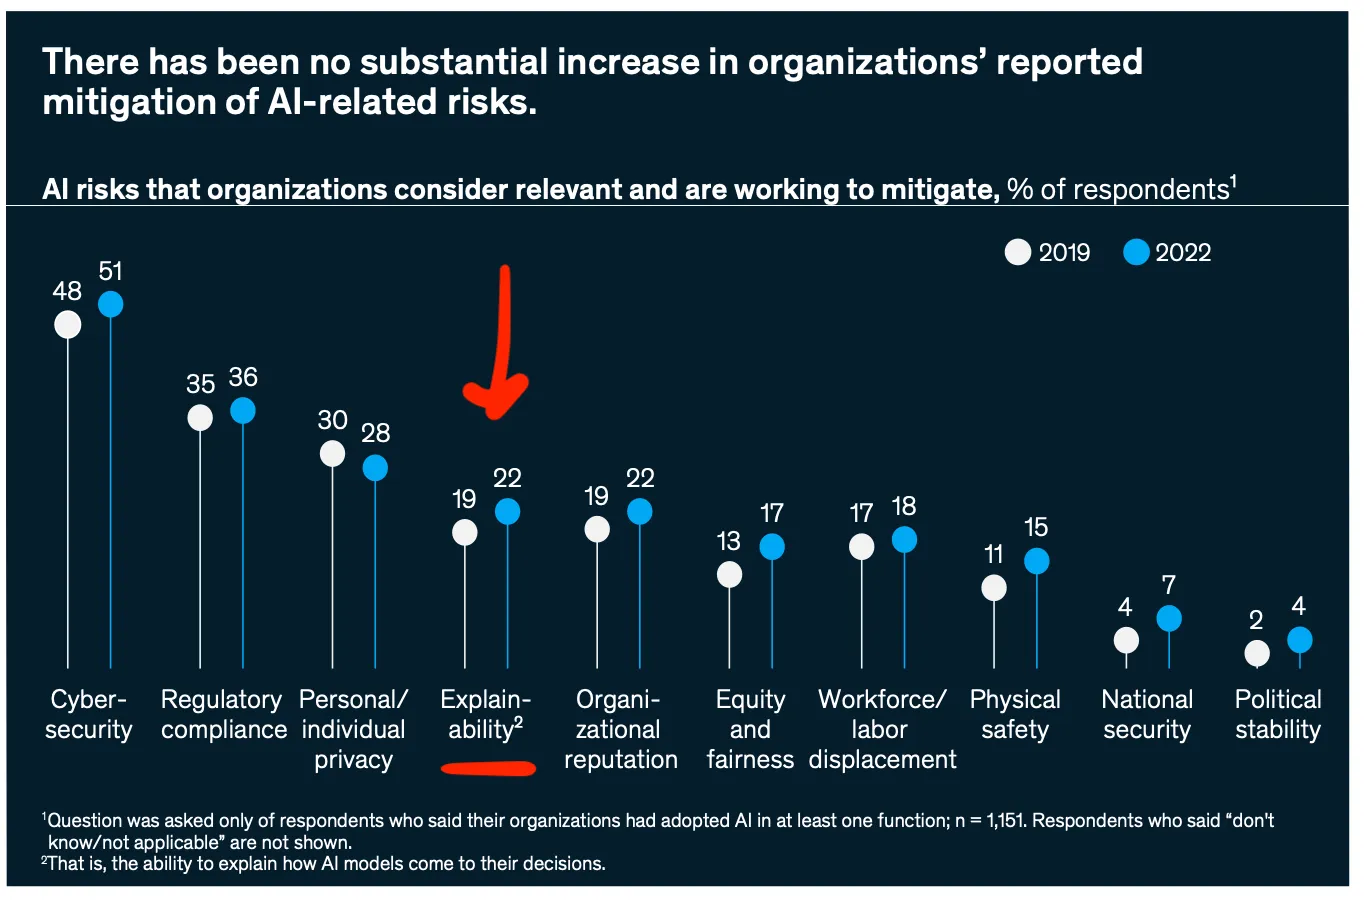
我还从下图中发现了一些值得关注的洞见:
- 利用“小数据”的能力至关重要(关键词:数据驱动型AI)。当数据不足时,生成合成数据的能力就很有价值。
- 能否将数据快速整合到AI模型中,是区分头部企业与其他竞争者的核心。完善的软件框架与基础设施搭建对此可能至关重要。
- 遗憾的是,大多数头部企业目前并不在意模型的可解释性。
Papers of the Year(年度论文)
以下是我2022年读过的前三甲论文,每篇都附上简短解读。当然,今年还有许许多多令人振奋、可能足以载入史册、影响深远的论文。
今年要选出“仅”前三甲尤其困难,因此我还在后面附上了拓展榜单,收录了我心目中前十的另外七篇论文。
1) ConvNeXt
https://arxiv.org/abs/2201.03545 这篇论文对我而言是一大亮点,因为作者设计出了一种纯卷积架构,其性能超越了主流的视觉Transformer,比如 https://arxiv.org/abs/2103.14030(当然也超越了此前所有的卷积神经网络)。
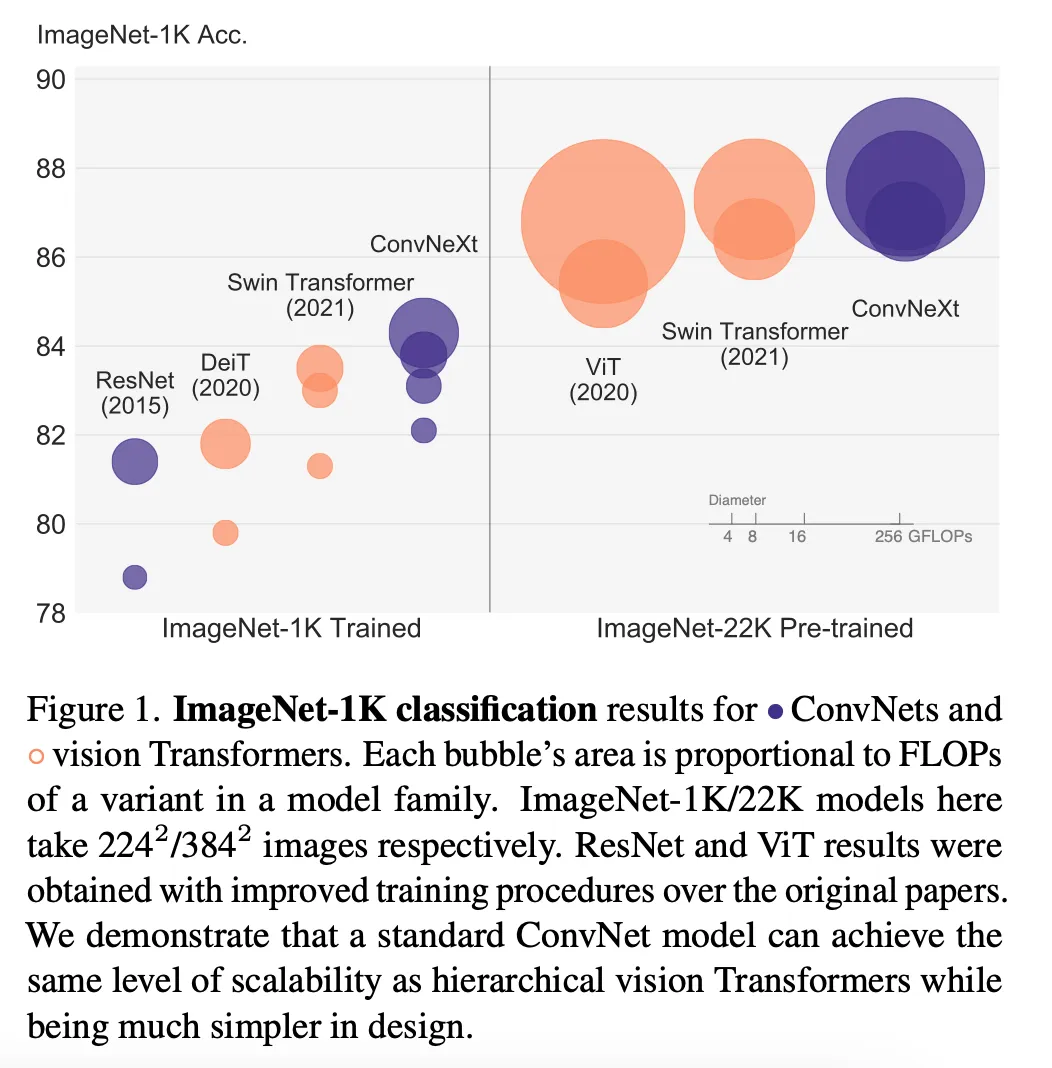
来源:https://arxiv.org/abs/2201.03545
这种名为ConvNeXt的架构,很可能成为卷积神经网络的新基准,不仅适用于图像分类,还可用于目标检测与实例分割——例如,它可以作为 https://arxiv.org/abs/1703.06870 的骨干网络。
正如作者在论文中提到的,他们的灵感来自现代视觉Transformer的训练范式,以及Swin Transformer混合架构所证明的一个事实:卷积层仍有其价值。这是因为纯视觉Transformer架构缺少一些有用的归纳偏置,比如平移等变性与参数共享(也就是卷积中的“滑动窗口”特性)。
为开发ConvNeXt,作者以 https://arxiv.org/abs/1512.03385 -50 为基础架构,采纳了现代视觉Transformer训练范式中的架构改进与训练方法。需要注意的是,这些技术本身并非首创,即便在卷积神经网络领域也早有应用。但本文的创新之处在于,作者将这些技术有效结合、深入分析并落地应用。
他们具体采用了哪些技术?清单很长,包括 https://medium.com/@zurister/depth-wise-convolution-and-depth-wise-separable-convolution-37346565d4ec、倒瓶颈层设计、https://arxiv.org/abs/1711.05101、https://arxiv.org/abs/1607.06450 等等。下图中做了总结。此外,作者还使用了现代数据增强技术,比如 https://arxiv.org/abs/1710.09412、https://arxiv.org/abs/1905.04899 等等。
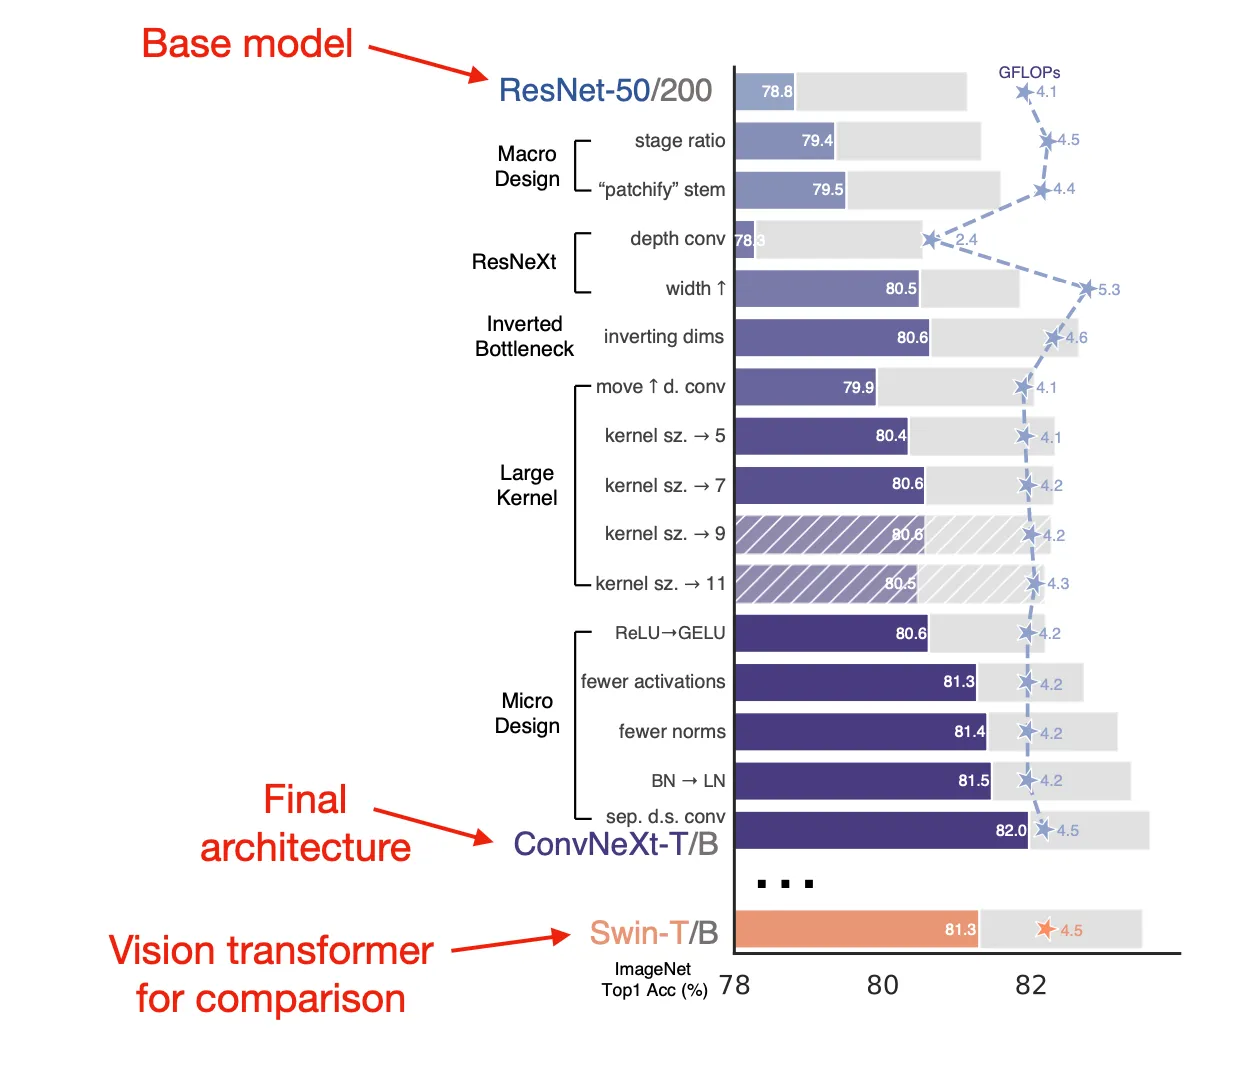
带标注的版本改绘自 https://arxiv.org/abs/2201.03545 中的配图
2) MaxViT
尽管卷积神经网络凭借上文的ConvNeXt强势回归,但目前视觉Transformer才是万众瞩目的焦点(双关语,无意冒犯)。
https://arxiv.org/abs/2204.01697 这篇论文展现了视觉Transformer近年来的长足进步。早期的视觉Transformer存在二次复杂度的问题,而如今人们已经探索出诸多技巧,让视觉Transformer能以线性复杂度处理更大尺寸的图像。
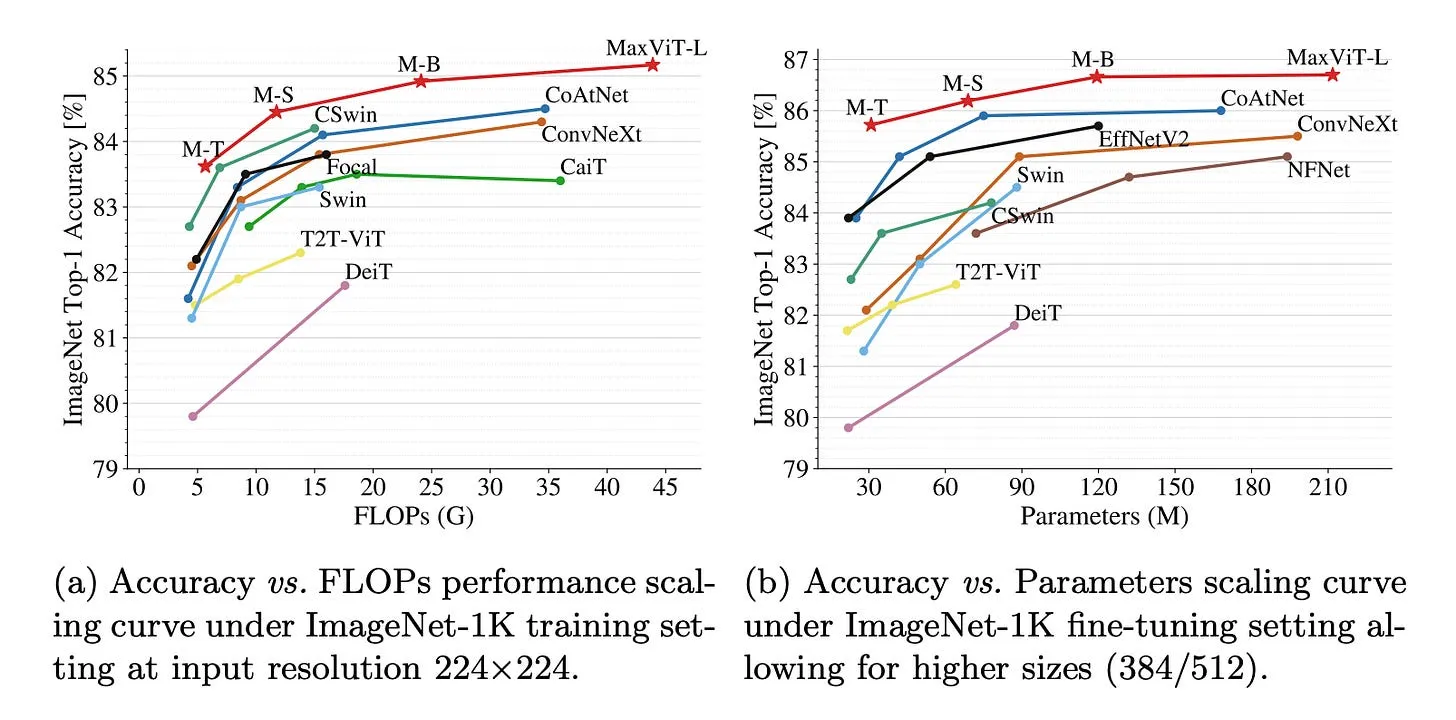
MaxViT于9月发布,目前在ImageNet基准测试中处于顶尖水平。来源:https://arxiv.org/abs/2204.01697
在MaxViT中,这一突破是通过将注意力模块拆解为两部分、实现局部-全局交互达成的:
- 局部注意力(“块注意力”);
- 全局注意力(“网格注意力”)。
值得一提的是,MaxViT是一种卷积-Transformer混合架构,同时包含卷积层。
它既可用于预测建模(包括分类、目标检测、实例分割),也可用于生成建模。
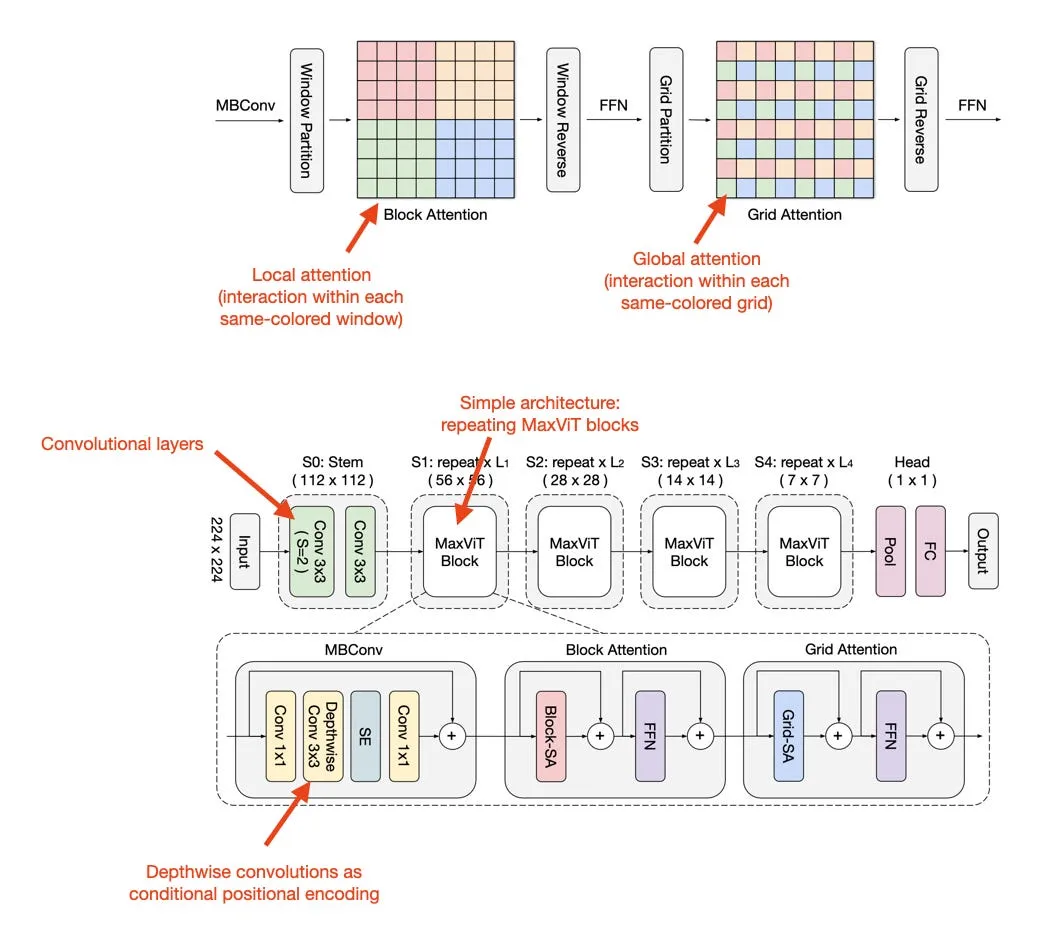
带标注的版本改绘自 https://arxiv.org/abs/2204.01697 中的配图
顺带一提,https://scholar.google.de/scholar?as_ylo=2022&q=vision%20transformer&hl=en&as_sdt=0%2C5&utm_campaign=The%20Batch&utm_source=hs_email&utm_medium=email&_hsenc=p2ANqtz-8HbXG-ZkwAj82Nv49uUrBwOHz4zUj3mkyjIfEd5lU7h3JHZR0pEG5OpkUCPPqwWvqMbjWl 显示,仅2022年就有超过5000条关于视觉Transformer的研究结果。这个数字虽然可能包含误检,但也足以体现视觉Transformer的普及程度与受关注程度。
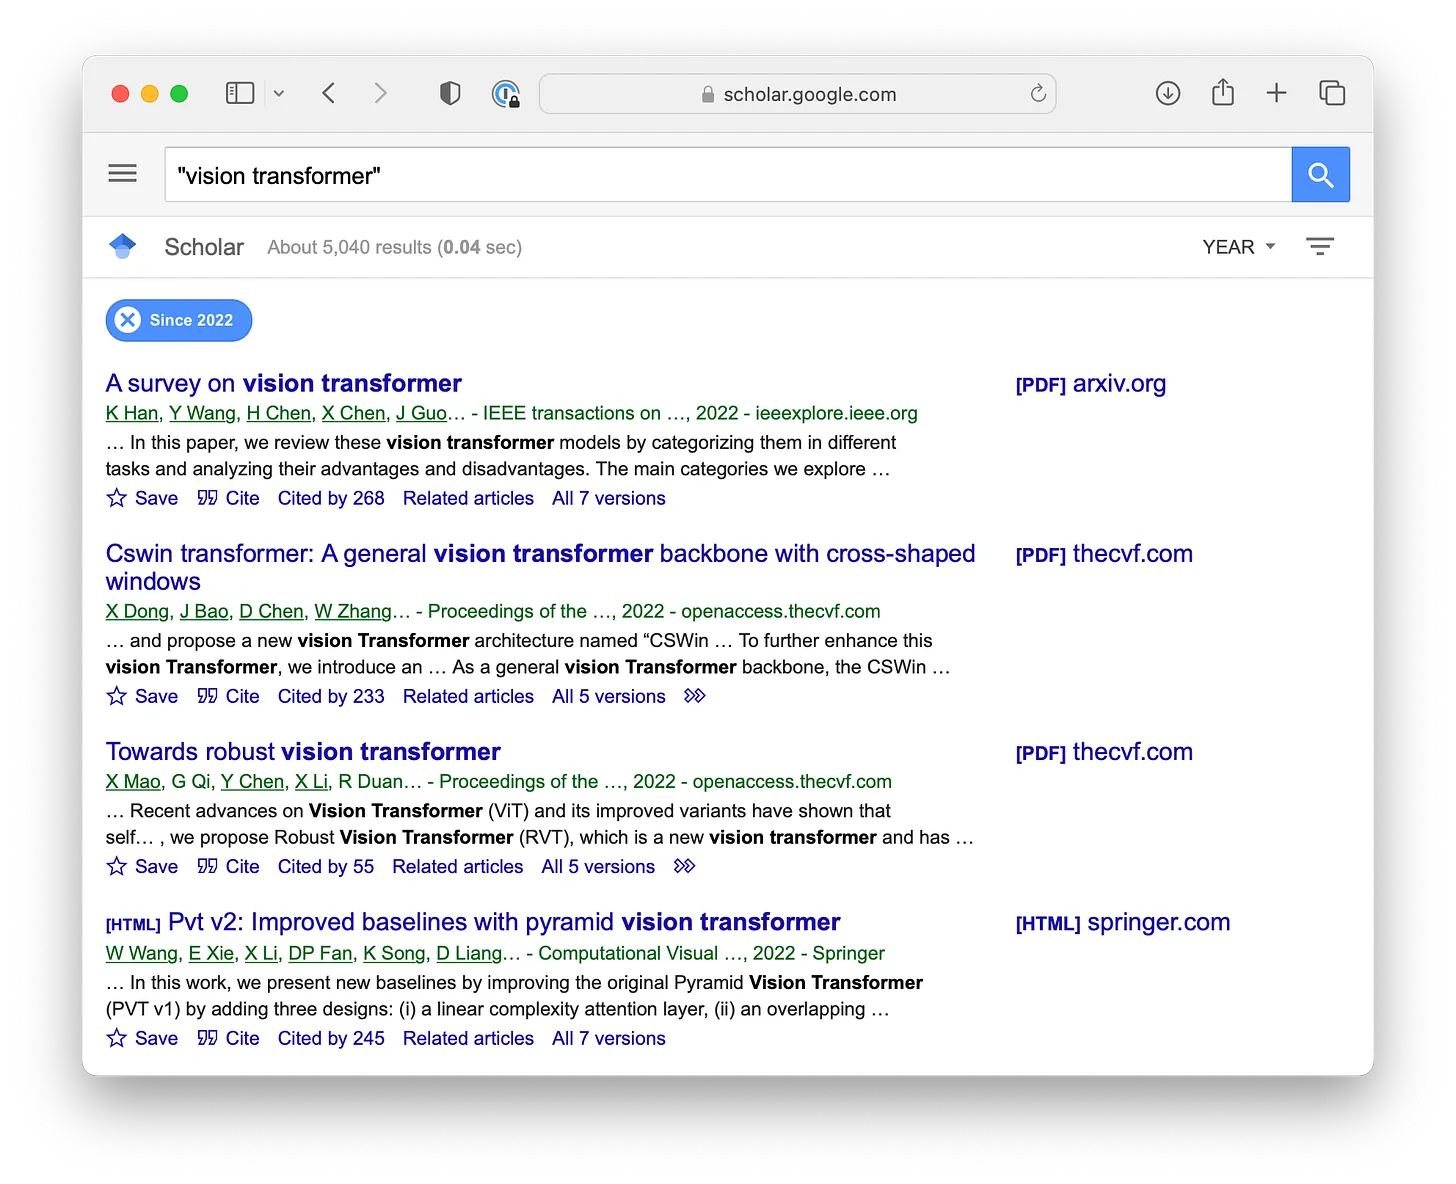
不过不用担心,视觉Transformer不会完全取代我们钟爱的卷积神经网络。相反,正如MaxViT所展现的,当前的趋势是将视觉Transformer与卷积网络融合为混合架构。
3) Stable Diffusion
在ChatGPT成为全场焦点之前不久,https://github.com/CompVis/stable-diffusion 曾刷屏全网与社交媒体。Stable Diffusion基于论文 https://arxiv.org/abs/2112.10752,该论文于2021年12月上传。但鉴于它在 https://cvpr2022.thecvf.com/ 上正式发表,并在8月随Stable Diffusion的开源爆火,我认为将它纳入2022年的榜单合情合理。
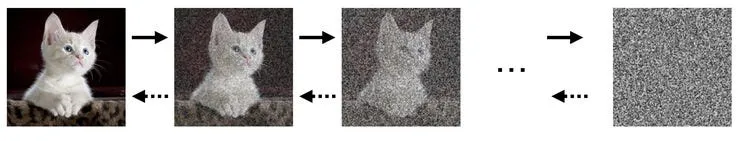
扩散模型(https://magazine.sebastianraschka.com/p/ahead-of-ai-1-a-diffusion-of-innovations)是一类概率模型,其原理是通过逐步对一个正态分布变量去噪,来学习数据集的分布。这一过程对应于学习一个长度为T的固定马尔可夫链的逆过程。
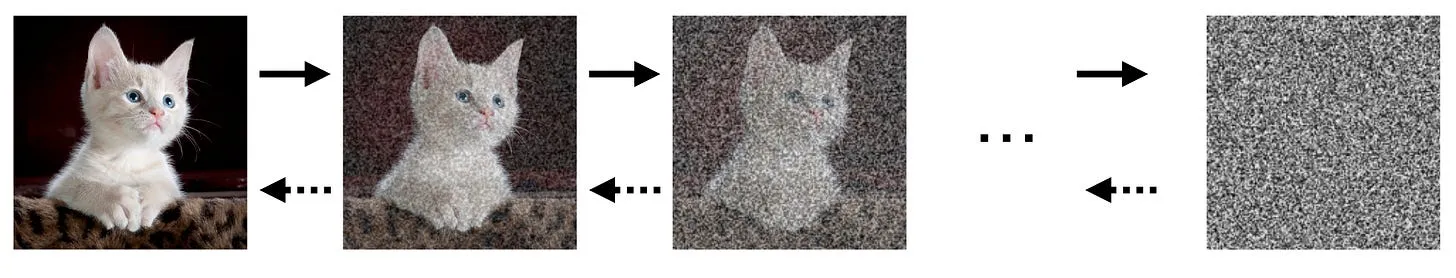
扩散模型示意图
与GANs不同——GAN通过生成器与判别器的极小极大博弈进行训练,扩散模型是基于似然的模型,通过极大似然估计(MLE)训练。这有助于避免模式崩溃等训练不稳定问题。
扩散模型其实早已存在(可参考 https://arxiv.org/abs/1503.03585),但此前无论是训练还是推理,采样成本都极其高昂。上述2022年那篇论文的作者提到,当时采样5万张图像需要5天的运行时间。
而 https://arxiv.org/abs/2112.10752 这篇论文的创新之处在于,它不再直接使用原始图像的全分辨率像素输入空间,而是利用预训练自编码器在隐空间中应用扩散过程。
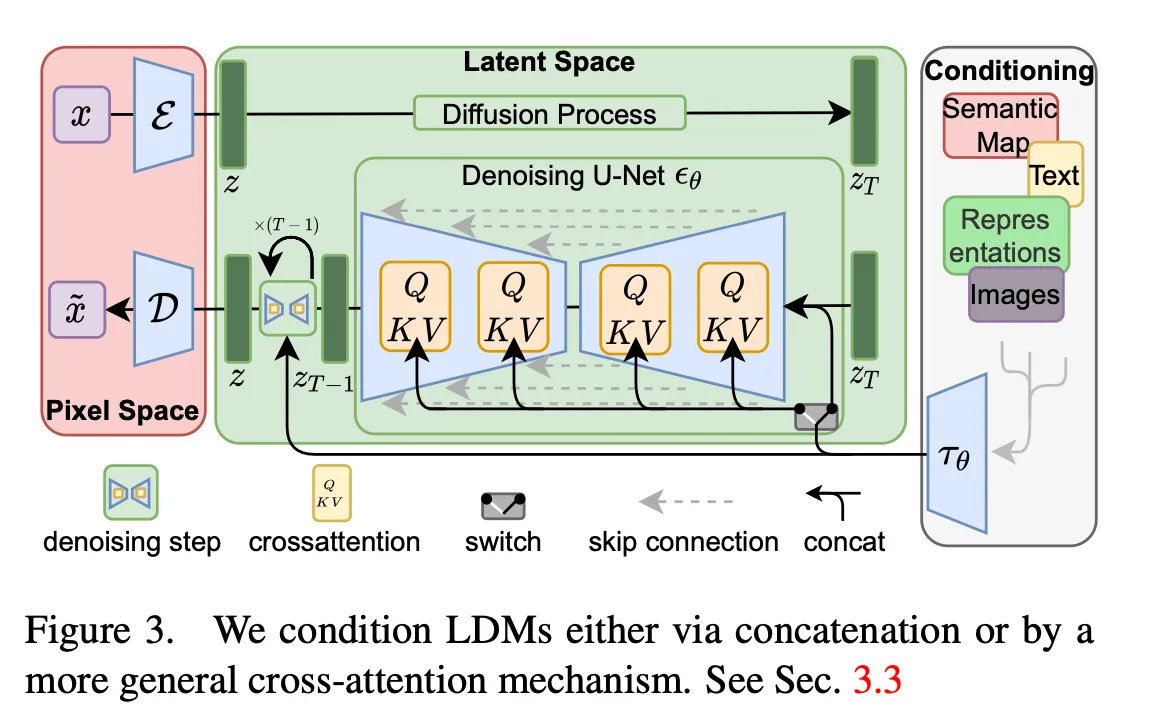
来源:https://arxiv.org/abs/2112.10752
其训练过程可分为两个阶段:首先,预训练一个自编码器,将输入图像编码到低维隐空间以降低复杂度;其次,在预训练自编码器的隐表示上训练扩散模型。
在隐空间中运行大幅降低了扩散模型训练与推理的计算成本和复杂度,同时还能生成高质量的结果。
该论文的另一大贡献是提出了用于通用条件控制的交叉注意力机制。因此,除了无条件图像生成,这种隐扩散模型还能实现图像修复、类别条件图像合成、超分辨率以及文本生成图像——最后这项正是DALL·E 2与Stable Diffusion名声大噪的原因。
Seven Other Paper Highlights of 2022(2022年另外七篇亮点论文)
以下是我最初前十榜单中另外七篇论文的简要概述:
- https://arxiv.org/abs/2205.06175 :研究人员推出了Gato模型,它能执行超过600种任务,从玩游戏到控制机器人无所不能。
- https://arxiv.org/abs/2203.15556 :研究人员发现,要在训练中实现最优计算效率,需要按相同比例同时缩放模型规模与训练token数量。他们打造的Chinchilla模型就是例证:比如,它用仅为Gopher四分之一的参数量、四倍的数据量,性能就超越了Gopher。
- https://arxiv.org/abs/2204.02311 :提出的PaLM模型在各类BIG-bench任务上展现了出色的自然语言理解与生成能力,在一定程度上甚至能识别因果关系。
- https://arxiv.org/abs/2212.04356 :介绍了Whisper模型,该模型在多语言任务上接受了68万小时的训练,在各类基准测试中都表现出极强的泛化能力。Whisper模型给我留下了非常深刻的印象,我已经用它为我的 https://lightning.ai/pages/courses/deep-learning-fundamentals/ 和 https://sebastianraschka.com/blog/2021/ml-course.html 两门课程生成字幕。
- https://arxiv.org/abs/2207.03208 :我曾大量研读 https://sebastianraschka.com/blog/2022/deep-learning-for-tabular-data.html 的相关内容。我尤其欣赏这篇论文的一点是,它强调并提醒我们,在额外的(通常是无标注的)数据上预训练模型至关重要。(而像XGBoost这类树模型很难做到这一点。)
- https://arxiv.org/abs/2207.08815 :核心结论是,在中等规模数据集(1万训练样本)上,树模型(随机森林与XGBoost)的表现优于表格数据深度学习方法。但随着数据集规模增大(从1万增至5万),树模型与深度学习方法之间的差距会缩小。遗憾的是,该论文没有纳入太多前沿的表格深度网络,但它的分析扎实、讨论深入,绝对值得一读。
- https://www.biorxiv.org/content/10.1101/2022.07.20.500902v3 :该论文提出了当时规模最大的蛋白质三维结构预测语言模型。它在保持同等精度的同时,速度远超此前的方法。基于该模型还构建了 https://esmatlas.com/explore,这是首个大规模的宏基因组蛋白质结构表征数据库,收录了超过6.17亿个蛋白质结构。
Open Source Highlights(开源亮点)
Scikit-learn 1.2
我最喜爱的机器学习库之一scikit-learn的1.2版本于12月发布 https://scikit-learn.org/1.2/whats_new/v1.2.html#changes-1-2。我最关注的亮点是HistGradientBoostingClassifier(它是LightGBM的一种实现)。
HistGradientBoostingClassifier现在支持:
- 交互约束(在树中,沿特定路径出现的特征被视为“存在交互”);
- 类别权重;
- 类别特征的特征名称。
PaLM + RLHF – Pytorch (WIP)
https://github.com/lucidrains/PaLM-rlhf-pytorch 是在上述前十榜单提到的PaLM架构基础上,实现的带人类反馈的强化学习(RLHF)方案。它可能是首个开源的ChatGPT等效实现。但最大的限制是,它(目前)不包含预训练权重。
Echo
还记得 https://magazine.sebastianraschka.com/p/ahead-of-ai-1-a-diffusion-of-innovations 中提到的OpenAI的 https://github.com/openai/whisper 模型吗?Whisper(同样入选了前十论文榜单)是一款用于生成高质量字幕的大语言模型。
这些年我试过很多字幕生成工具,Whisper生成的字幕质量真的让我惊艳。我甚至用它为 https://lightning.ai/pages/courses/deep-learning-fundamentals/ 课程生成了字幕!(补充一句:它也是少数能很好处理非母语口音的模型之一!)
上个月我们发布了 https://lightning.ai/echo/,它为Whisper提供了友好的用户界面,你可以直接从电脑拖拽视频文件使用。和运行Stable Diffusion的 https://lightning.ai/app/HvUwbEG90E-Muse 一样,Echo是又一个将大模型落地生产、借助Lightning AI框架实现多用户扩展的范例。
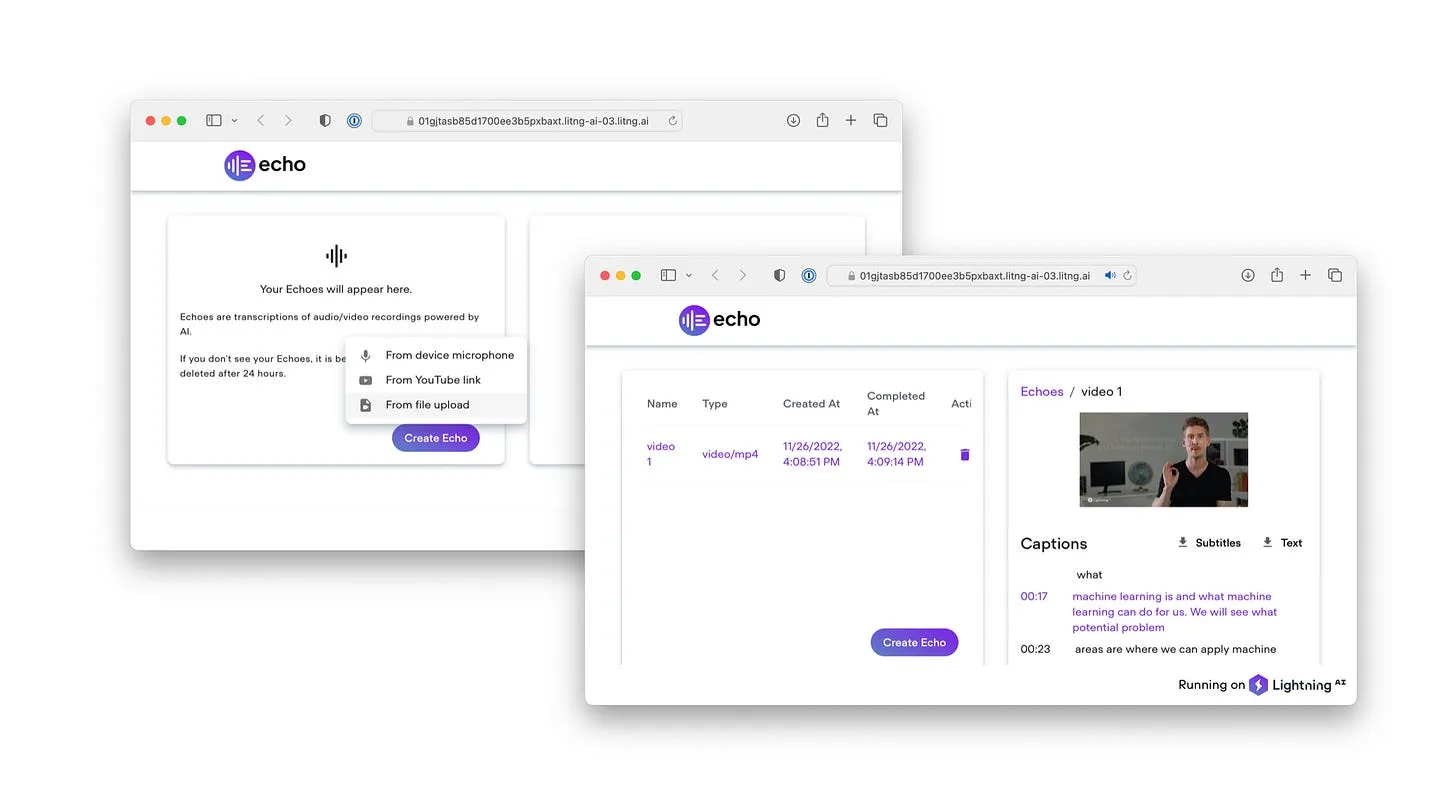
当然,Echo是完全开源的。查看 https://lightning.ai/pages/community/tutorial/deploy-openai-whisper/ 教程可以了解它的构建过程。
Notable Quote(金句)
任何事,只要你潜心钻研十年,都能成为专家。(这差不多是拿到两个硕士学位和一个博士学位的时间。)
——伊丽莎白·吉尔伯特
Announcement: Deep Learning Fundamentals, Unit 3(公告:深度学习基础课程 第3单元)
我一直在全力筹备 https://lightning.ai/pages/courses/deep-learning-fundamentals/
这门免费课程从零开始教你深度学习,从机器学习基础,到用PyTorch在多GPU上训练前沿深度神经网络,应有尽有。
我很高兴地宣布 https://lightning.ai/pages/courses/deep-learning-fundamentals/3-0-overview-model-training-in-pytorch/ 现已上线。在第2单元中,我们介绍了作为张量/数组库的PyTorch。在第3单元中,我们更进一步,讲解自动微分!
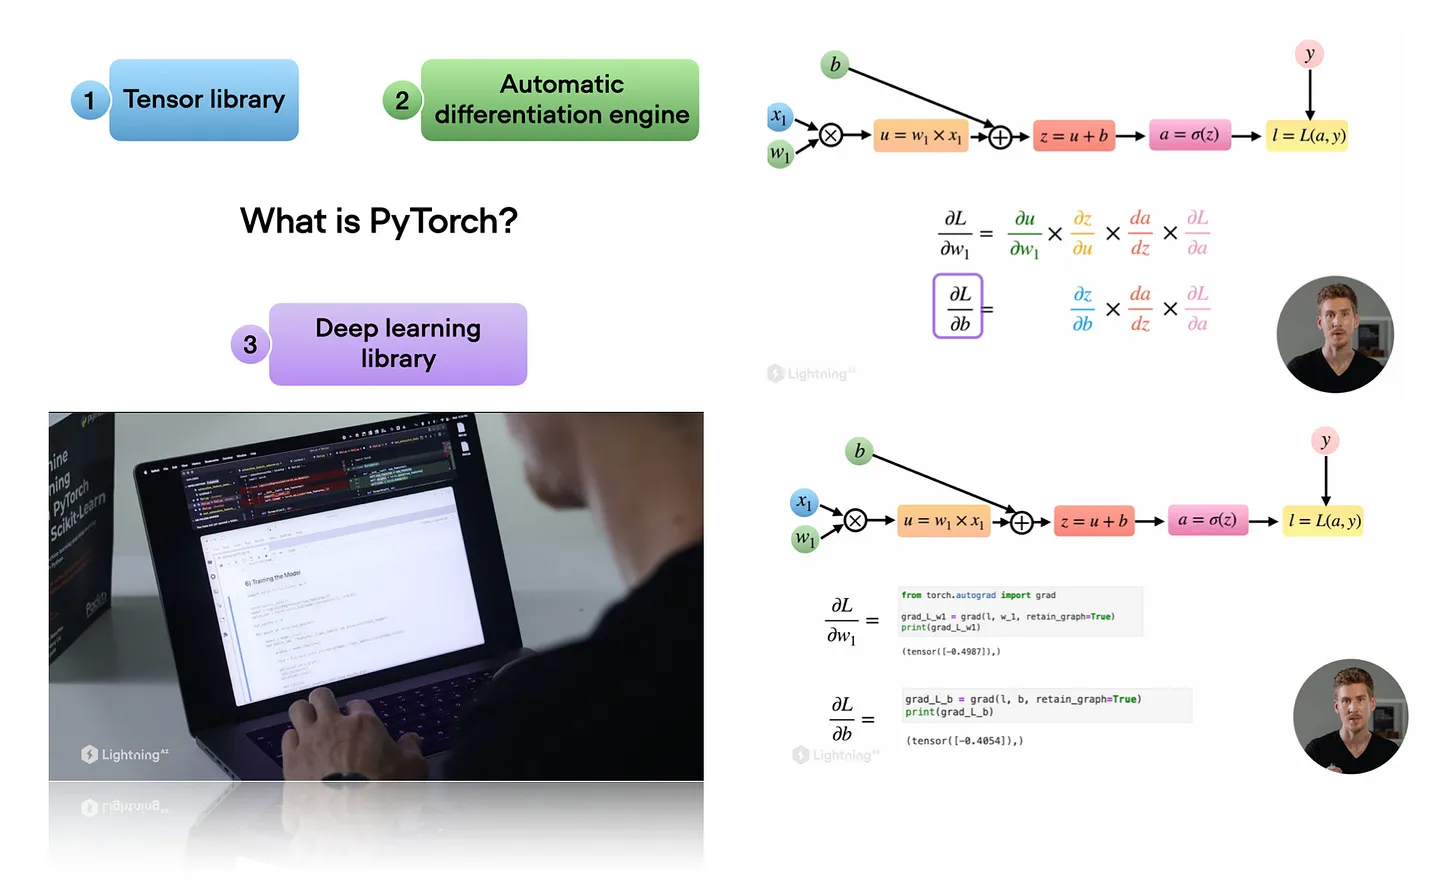
欢迎大家反馈!https://twitter.com/rasbt/status/1600181629145665537?s=20&t=Sgp0F-It9XuWU7PrNf4ySA 或者 https://github.com/Lightning-AI/dl-fundamentals/discussions,期待听到你的声音!
Study & Productivity Tips(学习与效率技巧)
A Yearly Review(年度复盘)
让我保持心态平和的方法之一,就是每周做复盘(以后的通讯再详聊)。恰逢年末,我想借此机会分享一下我的年度复盘流程——我通常在新年前夜做这件事。
这个练习既能回顾成就(希望能带来动力),也能规划来年目标(帮你保持专注)。
Step 1: Looking Back(第一步:回望过去)
首先,我会收集各项数据,比如复盘整体财务状况(支出、收入、储蓄)、引用量、网站访问量等等,和上一年做对比。我也会回顾这一年读过的书、上过的课。
其次,我会翻一遍日历和项目文件夹(这个话题以后的通讯再讲,我之前也在博客里写过:https://sebastianraschka.com/blog/2021/project-management.html),为每个月写下2-4件高光事件。
第三,我会浏览这一年拍的所有照片,每个月挑1-2张,做成一本小小的日记/相册并打印出来(记录关键事件、旅行等),留下一份简洁清晰的年度总结。
第四,我会花时间反思,回想这一年所有顺利的事和不尽如人意的事,然后为新的一年写下一条关键经验。
Step 2: Looking Forward(第二步:展望未来)
复盘完成后,我会花时间思考这一年最想达成的事。这是年度复盘最有挑战的部分,我建议多花点时间。
对我来说,定下2-3个年度核心目标是保持专注的绝佳方法。一年下来,我总会积攒很多细碎但有意思的项目和事务,比如维护一些小型的业余开源项目。放手很难,但有时候腾出空间才能容纳新事物,这很重要。
在这个过程中,我也会规划全年的学习计划,通常包括想读的教科书和想上的课程。我总是对自己能完成的量过于乐观,但有计划总归是好事。
这本杂志是我的个人兴趣项目,没有直接报酬。不过,如果大家愿意支持我,可以考虑购买 https://sebastianraschka.com/books。如果你觉得这些内容有洞见、有帮助,也欢迎推荐给你的朋友和同事。
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/、https://nostarch.com/machine-learning-and-ai-beyond-basics、以及 http://mng.bz/M96o
你的支持对我意义重大!非常感谢!