关于原始Transformer论文中的层归一化变体,以及大语言模型其他有趣的历史花絮
几个月前,我分享了《理解大语言模型:快速入门的核心文献梳理》一文,收到的积极反馈非常鼓舞人心!因此,我也陆续补充了几篇论文,让这份清单保持时效性与参考价值。
https://magazine.sebastianraschka.com/p/understanding-large-language-models
与此同时,保持这份清单的精简性也很有必要,这样读者才能在合理的时间内快速入门。不过,回过头来看,还有几篇关键论文信息量很大,理应被收录进来。
这次,我想分享四篇从历史视角理解Transformer的实用论文。我已经把它们直接补充到《理解大语言模型》一文中了,不过也单独在这篇文章里分享,方便之前读过那篇文章的读者查找。
(1) 《论Transformer架构中的层归一化》(2020)
作者:Xiong, Yang, He, K Zheng, S Zheng, Xing, Zhang, Lan, Wang, Liu
https://arxiv.org/abs/2002.04745
尽管《Attention Is All You Need》(https://arxiv.org/abs/1706.03762)中的原始Transformer示意图是对原始编码器-解码器架构的很好总结,但图中层归一化(LayerNorm)的位置一直是备受争议的话题。
比如,《Attention Is All You Need》里的Transformer示意图将层归一化放在残差块之间,这与该论文配套的官方代码实现(https://github.com/tensorflow/tensor2tensor/commit/f5c9b17e617ea9179b7d84d36b1e8162cb369f25)并不一致。《Attention Is All You Need》示意图里的这种变体被称为后层归一化Transformer(Post-LN Transformer),而更新后的代码实现默认采用的是**前层归一化Transformer(Pre-LN)**变体。
这篇https://arxiv.org/abs/2002.04745 论文指出,前层归一化效果更好,能解决梯度问题,如下图所示。很多架构在实践中都采用了这种方式,但它也可能导致表示坍缩(representation collapse)问题。
因此,尽管关于使用后层归一化还是前层归一化的讨论仍在继续,也有一篇新论文提出要兼顾两者的优势:《ResiDual:带双残差连接的Transformer》(https://arxiv.org/abs/2304.14802);该方案在实践中是否真正有效,还有待观察。
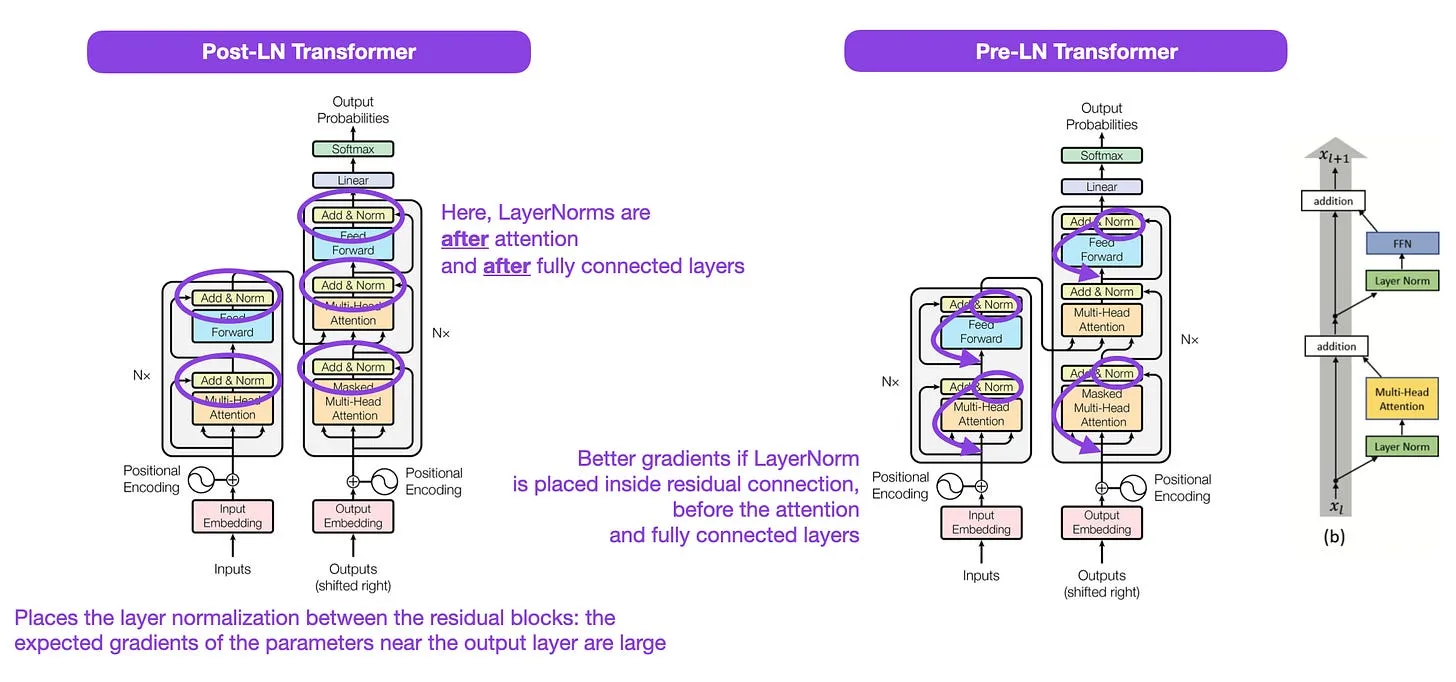
资料来源:https://arxiv.org/abs/1706.03762(左图与中图)、https://arxiv.org/abs/2002.04745(右图)
(2) 《学习控制快速权重记忆:动态递归神经网络的一种替代方案》(1991)
对于喜欢历史趣闻、以及想了解与现代Transformer本质同源的早期研究的读者,推荐这篇论文。
比如,1991年——比上述《Attention Is All You Need》这篇原始Transformer论文早了大约25年——于尔根·施密德胡贝尔(Juergen Schmidhuber)就提出了一种递归神经网络的替代方案,名为快速权重编程器(Fast Weight Programmers, FWP)。快速权重编程器的思路是:用一个前馈神经网络通过梯度下降缓慢学习,去编程另一个神经网络的快速权重变化。
它与现代Transformer的对应关系,在这篇文章(https://people.idsia.ch//~juergen/fast-weight-programmer-1991-transformer.html#sec2)中是这样解释的:
在如今的Transformer术语里,“FROM”和“TO”分别被称为键(key)和值(value);快速权重网络所处理的输入,则被称为查询(query)。本质上,查询由快速权重矩阵处理,而快速权重矩阵是键与值外积的和(忽略归一化和投影操作)。由于两个网络的所有运算都是可微的,我们可以通过加法外积或二阶张量积,实现对快速权重变化的端到端可微主动控制[FWP0-3a]。因此,慢速网络可以通过梯度下降学习,在序列处理过程中快速修改快速网络。这在数学上(除了归一化部分)等价于后来所谓的带线性自注意力的Transformer(linearized self-attention Transformers),也叫线性Transformer(linear Transformers)。
正如上面博客节选提到的,随着2020年arXiv上的两篇论文(https://arxiv.org/abs/2006.16236 和 https://arxiv.org/abs/2009.14794)发表,这种方法现在被称为“线性Transformer”或“带线性自注意力的Transformer”。
2021年,这篇https://arxiv.org/abs/2102.11174 论文进一步明确证明了线性自注意力与90年代的快速权重编程器是等价的。
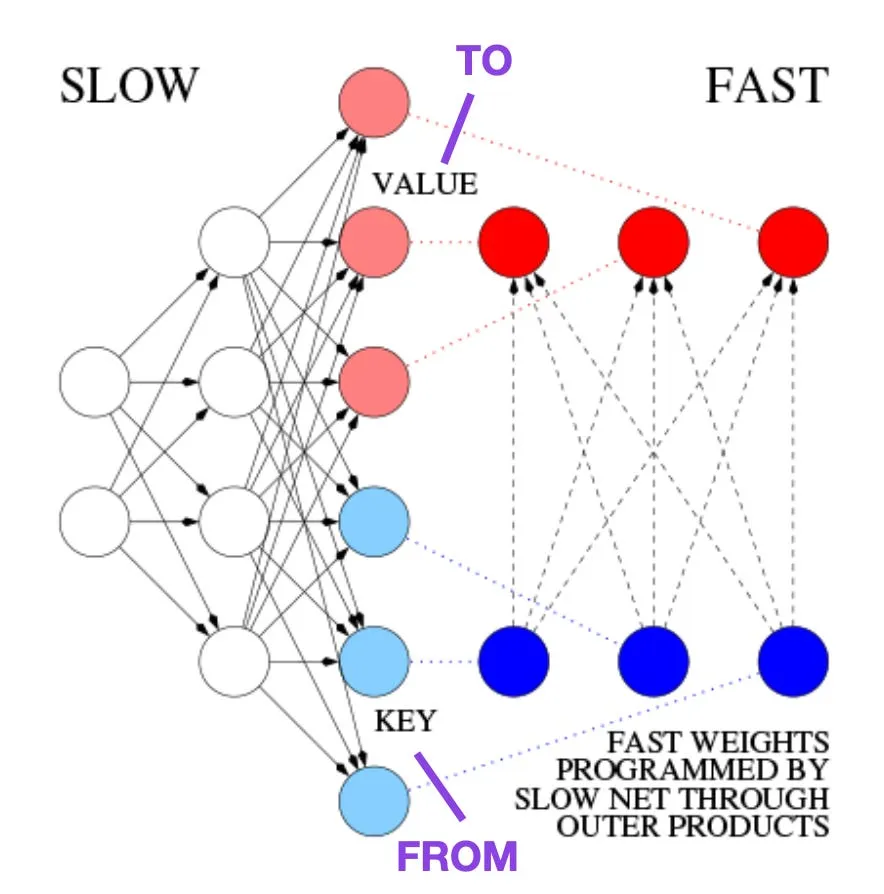
资料来源:基于https://people.idsia.ch//~juergen/fast-weight-programmer-1991-transformer.html#sec2 改绘的示意图
(3) 《面向文本分类的通用语言模型微调》(2018)
作者:Howard 和 Ruder
https://arxiv.org/abs/1801.06146
从历史视角来看,这是另一篇非常值得关注的论文。尽管它发表在原始Transformer论文《Attention Is All You Need》发布一年之后,但它并没有围绕Transformer展开,而是聚焦于递归神经网络。不过它依然意义重大,因为它系统性地提出了语言模型预训练+下游任务迁移学习的范式。
尽管迁移学习在计算机视觉领域已经成熟,但在自然语言处理(NLP)领域还没有普及。ULMFit是最早证明“先在大规模语料上预训练语言模型,再在特定任务上微调”可以在众多NLP任务上取得当时最优效果的论文之一。
ULMFit提出的语言模型三阶段微调流程如下:
- 在大规模文本语料上训练语言模型。
- 在任务特定数据上微调这个预训练语言模型,使其适配文本的特定风格与词汇。
- 在任务特定数据上微调分类器,同时逐步解冻各层,避免灾难性遗忘。
这套流程——先在大规模语料上训练语言模型,再在下游任务上微调——正是基于Transformer的模型(以及BERT、GPT-2/3/4、RoBERTa等基础模型)所采用的核心方法。
不过,ULMFit的核心环节——逐步解冻层——在Transformer架构的实践中通常不会常规使用,Transformer一般会同时微调所有层。
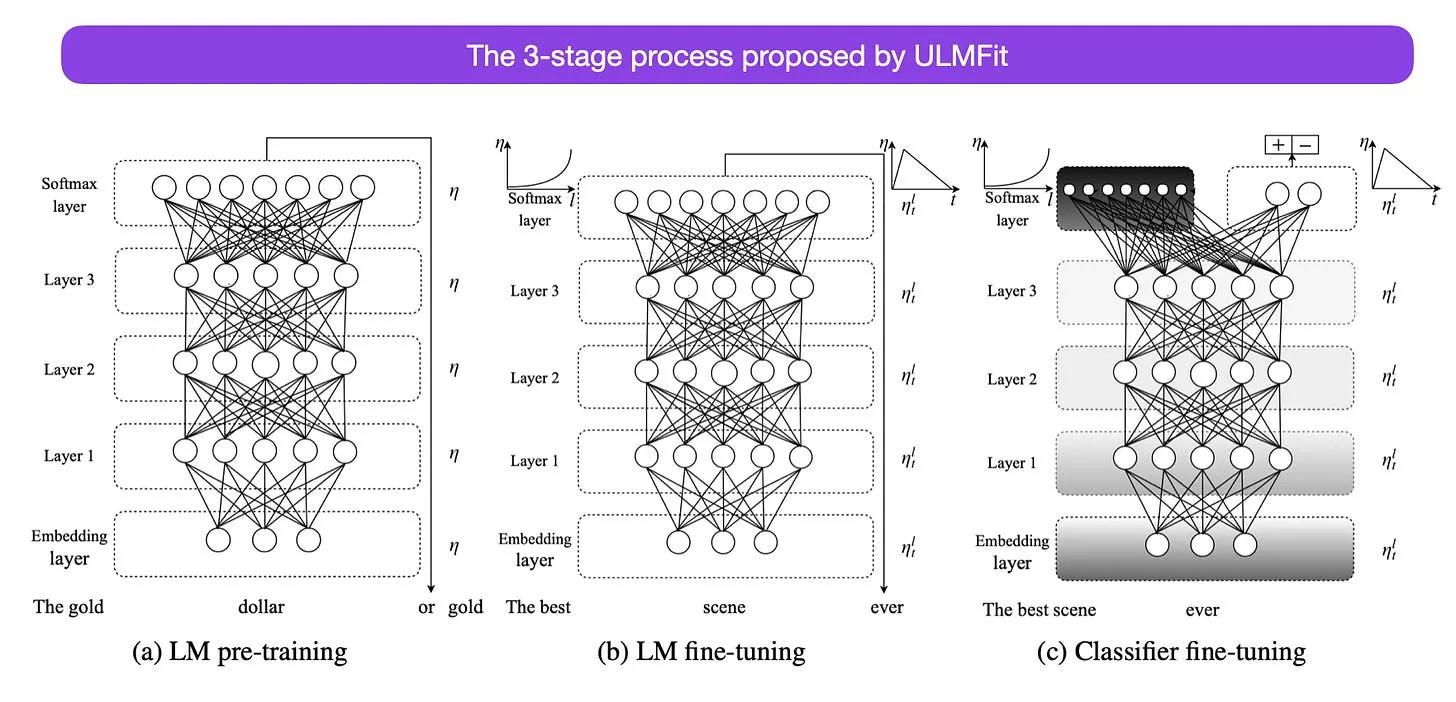
资料来源:https://arxiv.org/abs/1801.06146
(4) 《语言模型缩放:训练Gopher的方法、分析与洞见》(2022)
作者:Rae及其同事(共78位共同作者!)
https://arxiv.org/abs/2112.11446
Gopher这篇论文内容非常详实,包含大量帮助理解LLM训练的分析。研究人员训练了一个拥有2800亿参数、80层的模型,训练数据量达3000亿token。论文中还包含一些有意思的架构改进,比如用**均方根归一化(RMSNorm, Root Mean Square Normalization)**替代层归一化(LayerNorm)。层归一化和均方根归一化都优于批归一化(BatchNorm),因为它们不依赖批次大小,也不需要同步,这在小批次的分布式训练场景中是一大优势。而均方根归一化通常被认为能让更深层架构的训练更稳定。
除了上述这些有趣的细节,这篇论文的核心重点是不同规模下的任务性能分析。通过对152项多样化任务的评估发现:模型规模增大,对阅读理解、事实核查、有害文本识别这类任务的收益最大;而逻辑推理、数学推理相关的任务,从架构缩放中获得的收益相对较少。
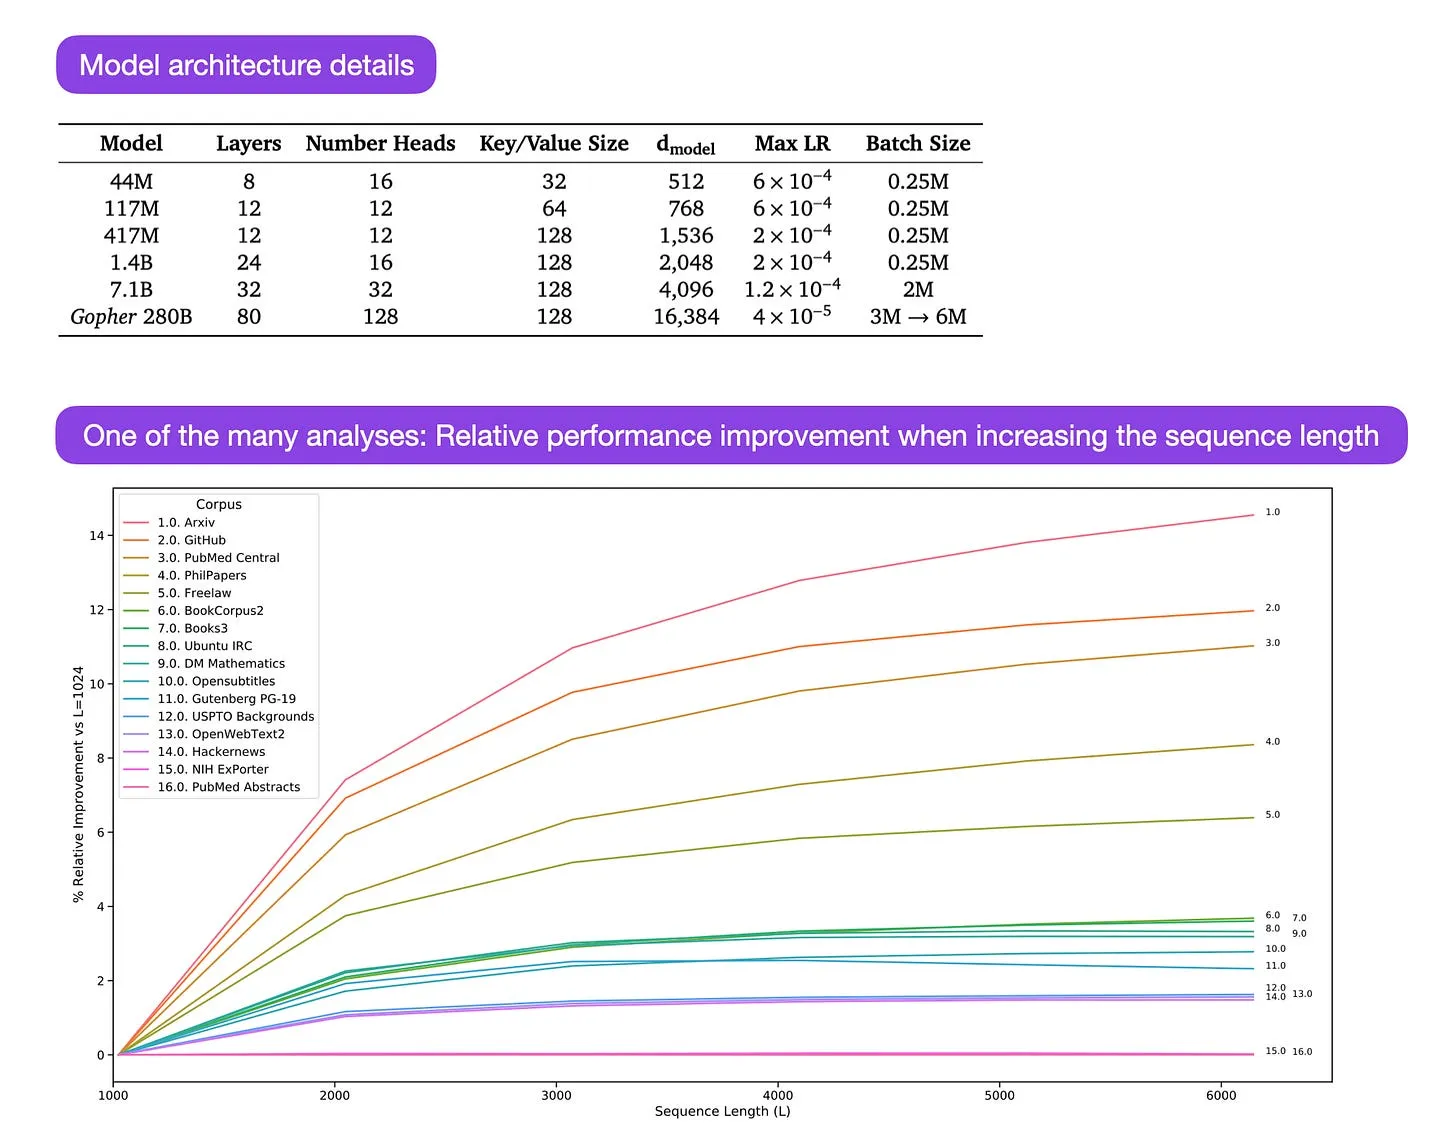
资料来源:图片来自https://arxiv.org/abs/2112.11446
这本杂志是我个人的兴趣项目,没有直接的稿酬。如果您愿意支持我,可以考虑购买一本我的书(https://sebastianraschka.com/books)。如果您觉得这些内容有启发、有帮助,也欢迎推荐给您的朋友和同事。
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics ,以及 http://mng.bz/M96o
您的支持对我意义重大!非常感谢!