原文地址:
Finetuning LLMs Efficiently with Adapters,by Sebastian Raschka, on 2023-05-20
使用适配器高效微调大语言模型
为什么要微调大语言模型?
BERT、GPT-3、GPT-4、LLaMA等大语言模型(LLM)在大规模语料库上训练而成,具备通用知识。但如果不经微调,它们在特定任务上的表现可能欠佳。例如,若想将预训练大语言模型用于法律或医疗文档分析,在法律文档语料库上对其进行微调可以显著提升模型性能。(感兴趣的读者可以在我之前的文章中了解不同大语言模型微调方法的概述:https://magazine.sebastianraschka.com/p/finetuning-large-language-models)
然而,微调大语言模型会消耗大量计算资源与时间,这也是研究者们开始研发参数高效微调方法的原因。
参数高效微调方法
正如之前的文章所讨论的,目前已有多种不同类型的参数高效方法。https://magazine.sebastianraschka.com/p/understanding-parameter-efficient(尽管这些技术之间存在一定关联,但在阅读这篇关于适配器的文章之前,你无需了解或提前阅读前缀微调的相关内容。)
简而言之,提示微调(与普通的提示工程不同)会向预训练大语言模型的嵌入输入后追加一个张量。随后对该张量进行调优,以针对微调任务和数据优化损失函数,同时大语言模型中所有其他参数保持冻结。例如,假设有一个在通用数据集上预训练、用于生成文本的大语言模型。提示微调会基于这个预训练模型,向嵌入输入中添加提示令牌,然后对模型进行微调,使其在微调数据集上完成诸如情感分类之类的任务。
提示微调以及广义上的参数高效微调方法,核心思路都是向预训练大语言模型中添加少量新参数,且仅微调这些新增参数,从而提升模型在两方面的表现:(1)目标数据集(例如医疗、法律文档等领域特定数据集);(2)目标任务(例如情感分类)。
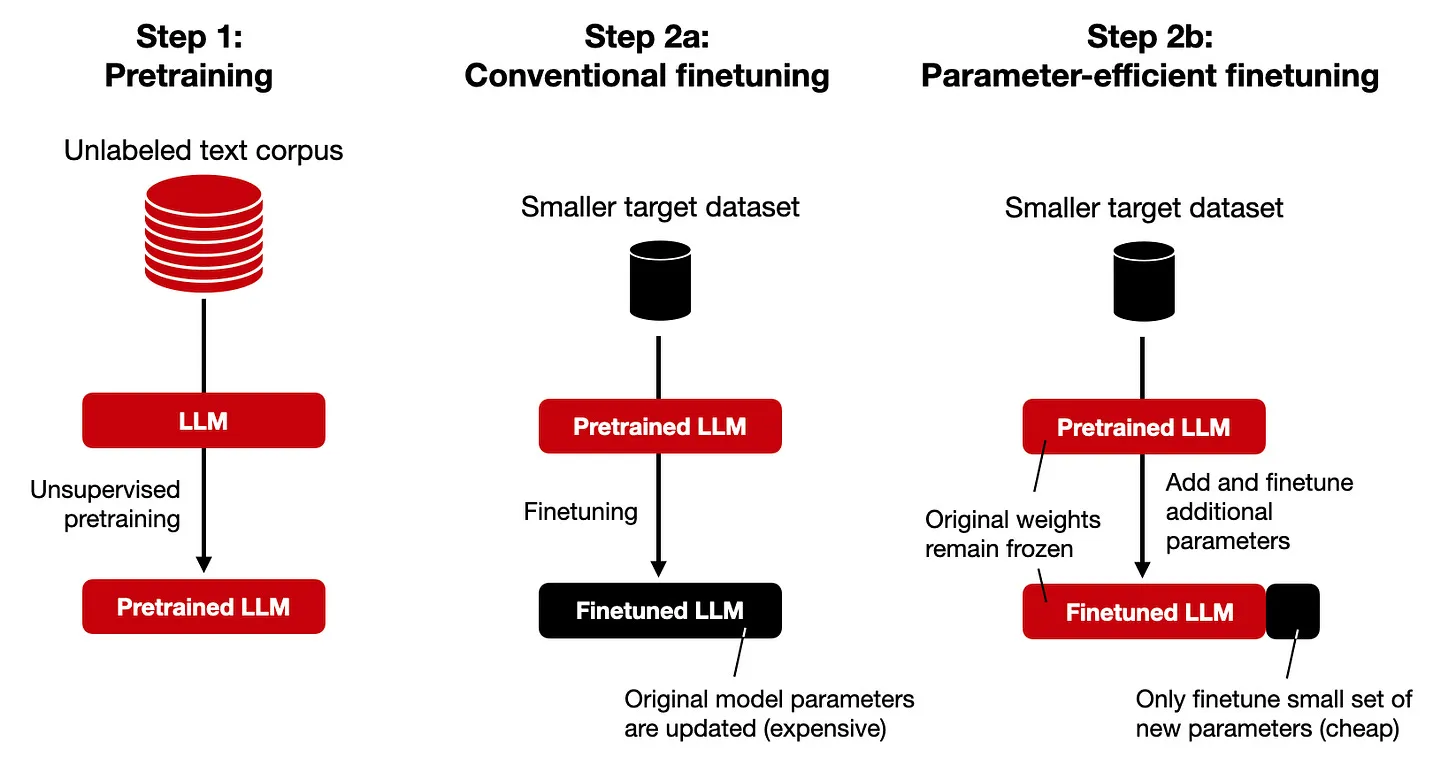
参数高效微调技术(如提示微调、前缀微调、适配器微调)的核心思路是向预训练大语言模型中添加一小组参数。仅微调这些新增参数,预训练大语言模型的所有原有参数保持冻结。
在本文中,我们将讨论一种与之相关的方法——适配器(adapters)。该方法的核心思想是向大语言模型的各个Transformer块中添加可训练层,而非仅修改输入提示。
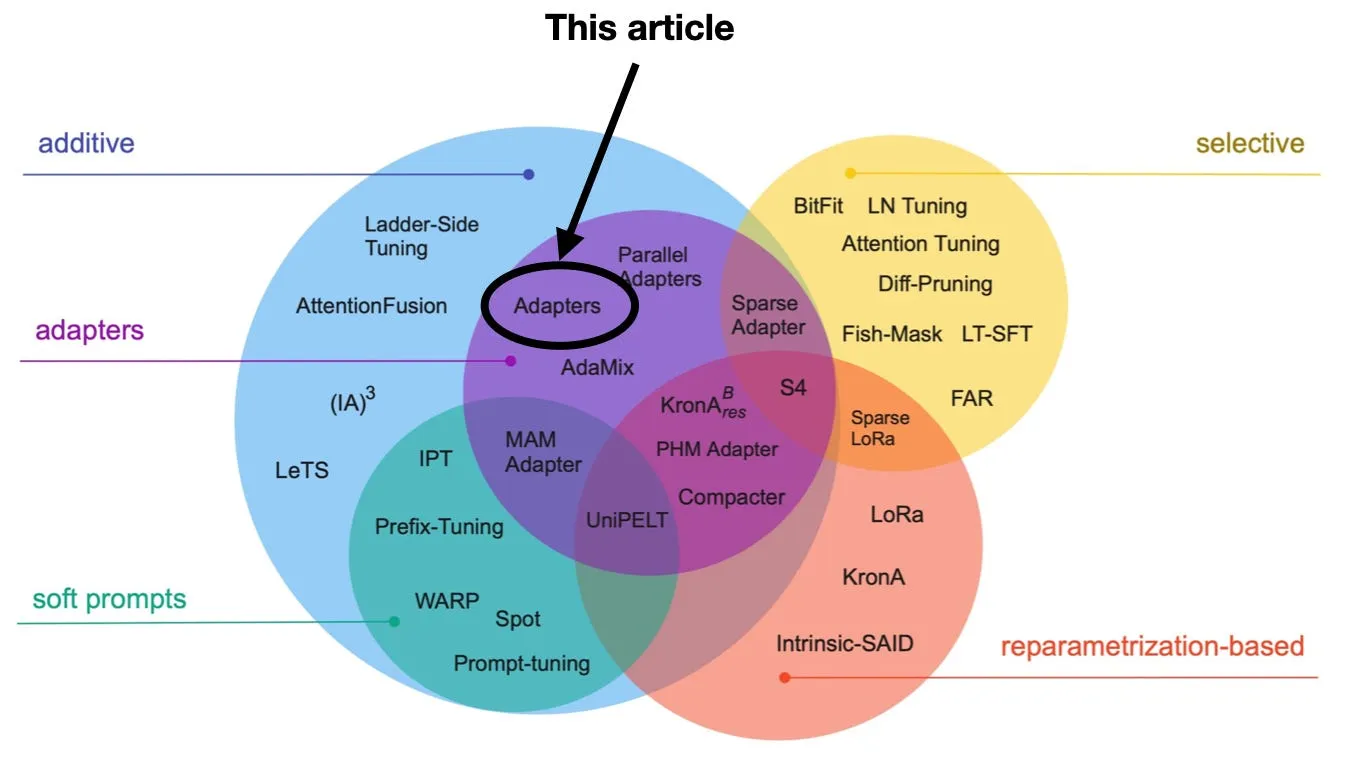
Annotated figure from Scaling Down to Scale Up: A Guide to Parameter-Efficient Fine-Tuning, https://arxiv.org/abs/2303.15647.
适配器
最初的适配器方法(https://arxiv.org/abs/1902.00751,2019年)与前文提到的https://magazine.sebastianraschka.com/p/understanding-parameter-efficient有一定关联,二者都会向每个Transformer块中添加额外参数。但前缀微调是向嵌入层前置可训练张量,而适配器方法则在两个位置添加适配器层,如下图所示。
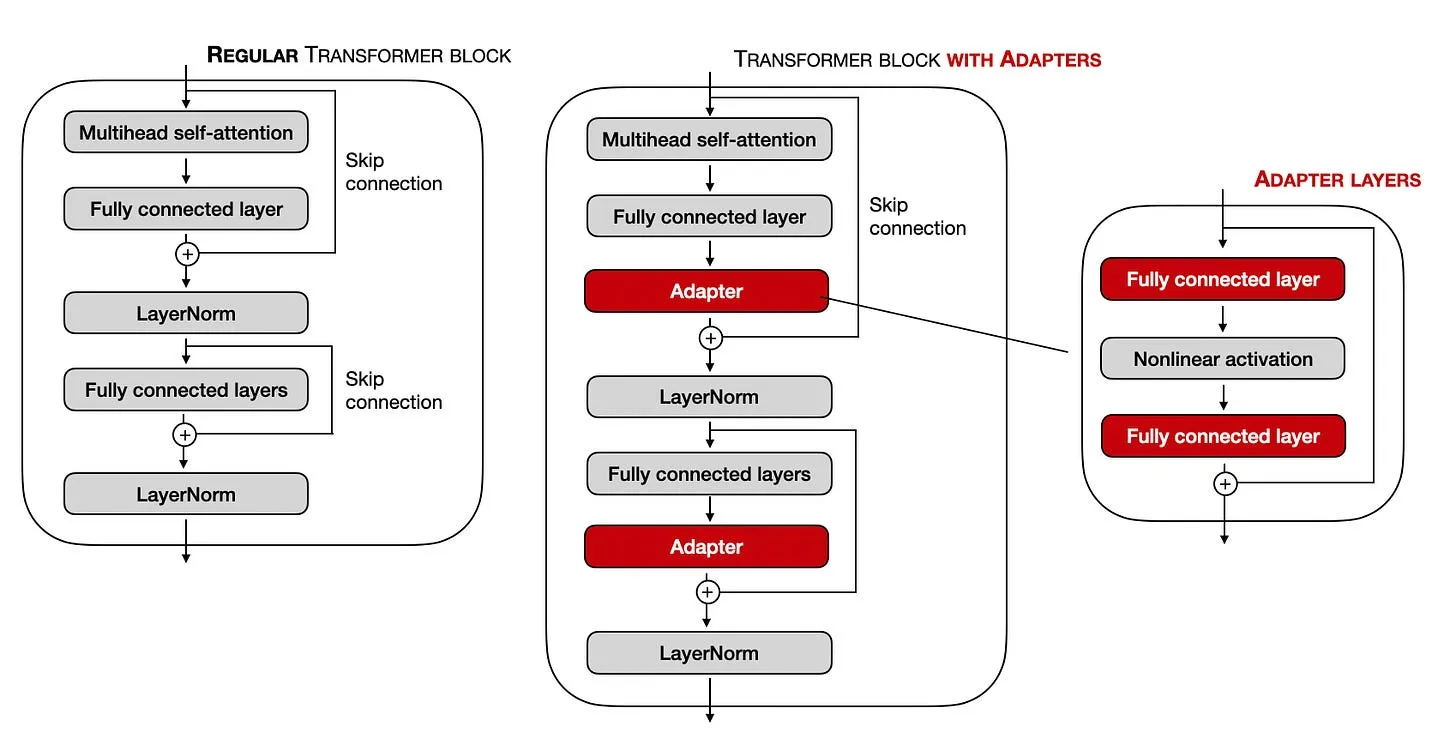
Comparison of the regular transformer blocks used in various LLMs and a transformer block modified via the adapter layers.
对于偏好(Python)伪代码的读者,适配器层的修改可以写成如下形式:
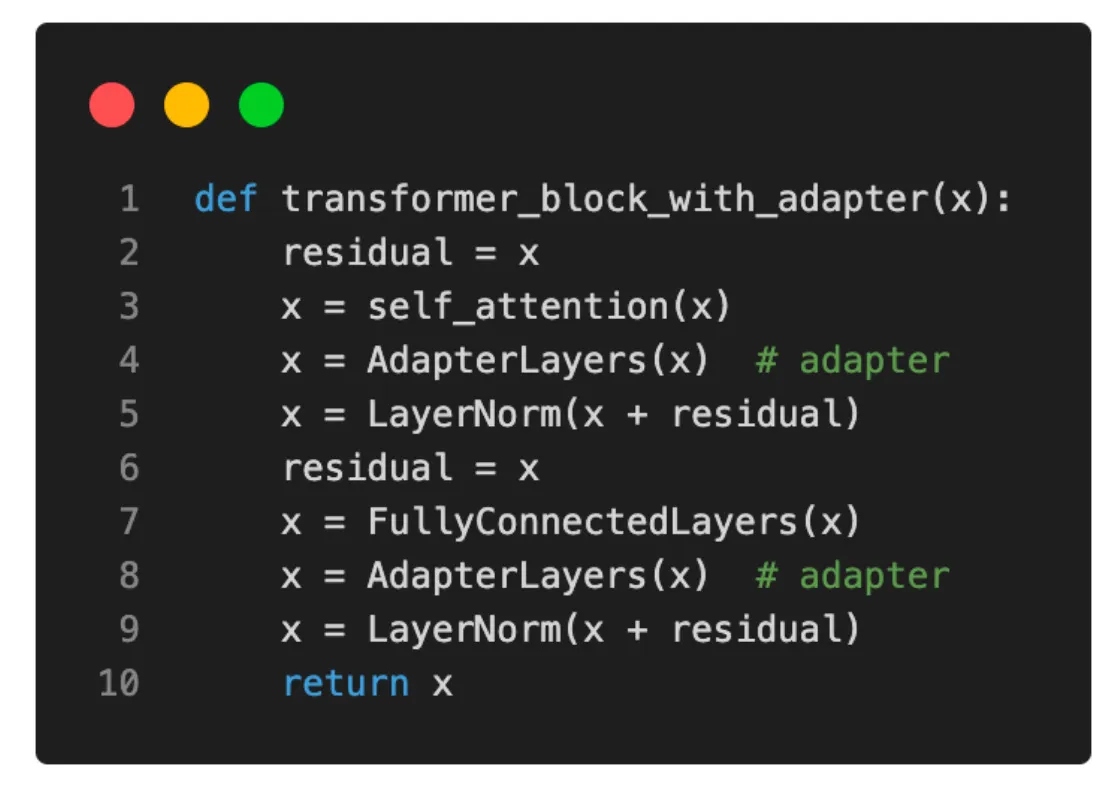
Illustration of a transformer block modified with adapter layers.
需要注意的是,适配器的全连接层通常规模较小,具备类似自编码器的瓶颈结构。每个适配器块的第一个全连接层将输入投影到低维表示,第二个全连接层再将其投影回输入维度。它是如何实现参数高效的?举个例子,假设第一个全连接层将1024维的输入降维到24维,第二个全连接层再将其映射回1024维。这意味着我们仅引入了1024×24 + 24×1024 = 49152个权重参数。相比之下,单个将1024维输入重新映射到1024维空间的全连接层,就会有1024×1024 = 1048576个参数。
根据最初的论文https://arxiv.org/abs/1902.00751,采用适配器方法训练的BERT模型,仅需训练3.6%的参数,就能达到与全量微调BERT模型相当的性能。此外,研究者还在文中配图对比了适配器方法与仅微调BERT模型输出(顶部)层的效果,结果表明,使用适配器可以用少得多的参数达到与微调顶层相当的性能:
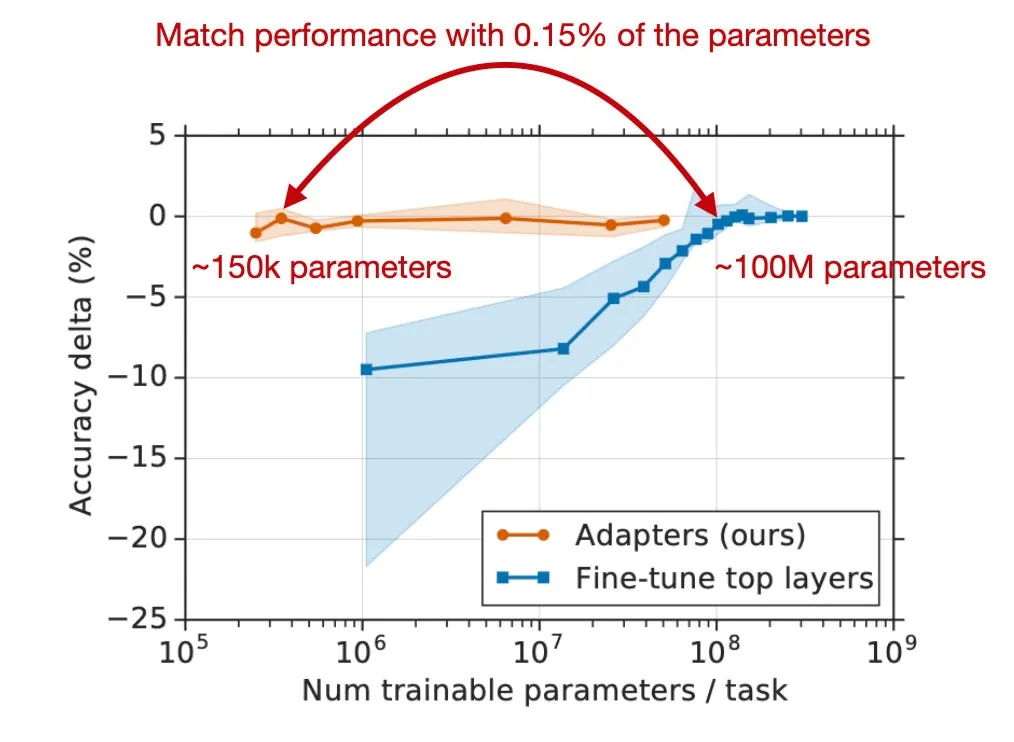
Annotated figure from the adapter paper, https://arxiv.org/abs/1902.00751.
结论
对预训练大语言模型进行微调,是让模型适配特定业务需求、匹配目标领域数据的有效方法。该过程通过使用与目标领域相关的小规模数据集调整模型参数,使模型学习到领域专属的知识与词汇。
但由于大语言模型“体量庞大”,更新Transformer模型中的多层会产生极高的成本,因此研究者们开始研发参数高效的替代方案。
在本文中,我们讨论了几种替代传统大语言模型微调机制的参数高效方法。我们重点探讨了与训练原有模型参数相比,如何通过插入并微调额外的适配器层来提升大语言模型的预测性能。
补充实验
补充代码示例与适配器实验
以下是我实现适配器方法后开展的补充实验,针对情感分类任务对比了DistilBERT模型的不同微调方式:
- 仅微调最后两层,作为性能基线
- 插入并微调适配器层
- 微调原始模型的所有层
- 插入适配器层并微调所有层,作为对照实验
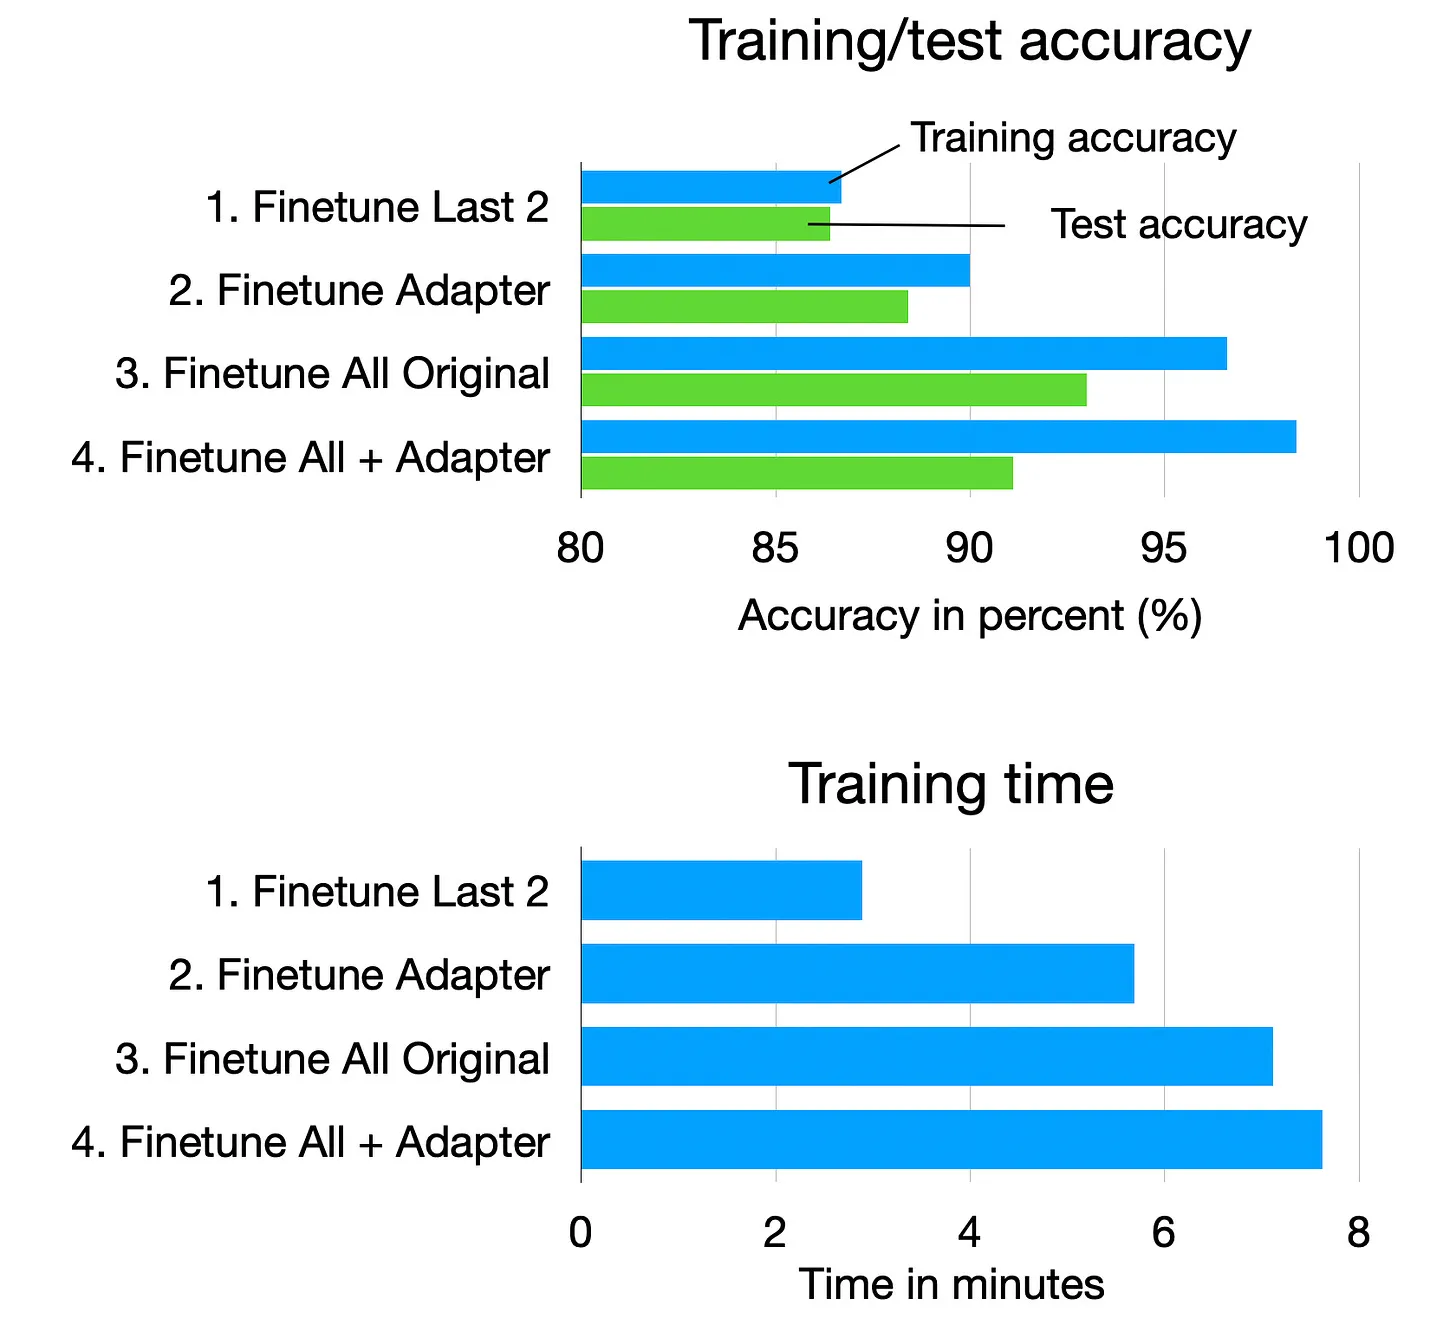
所有代码示例可在此处获取:https://github.com/rasbt/LLM-finetuning-scripts/tree/main/adapter/distilbert-movie-review
为感谢过去几个月支持本通讯的读者,我在下方增加了讨论代码示例的附赠章节。再次感谢大家的支持!
1. 微调基线
首先,我们在电影评论数据集上仅微调DistilBERT模型的最后几层,以此建立性能基线。为简洁起见,我们仅查看相关代码行,省略非微调相关的代码。不过如上所述,完整代码示例可在此处获取:https://github.com/rasbt/LLM-finetuning-scripts/tree/main/adapter/distilbert-movie-review
首先,加载预训练的DistilBERT模型后,我们先看一下它的架构:
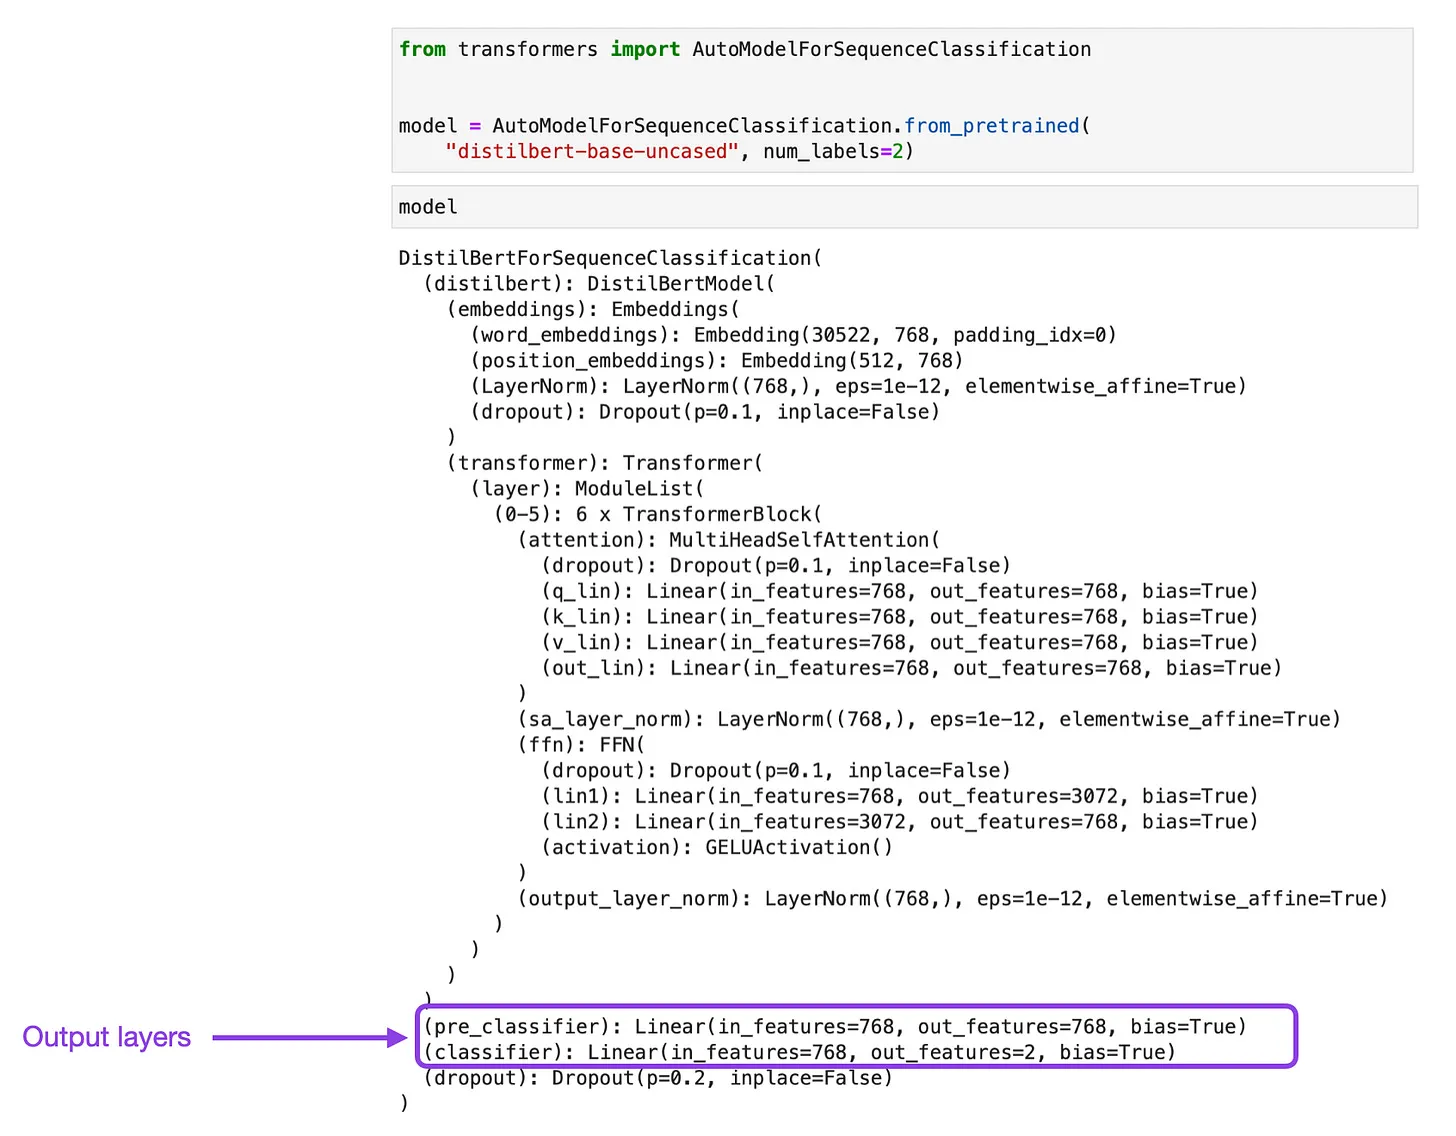
在这个性能基线中,我们仅微调最后两层,共包含592130个参数。最简单的实现方式是冻结所有参数,再通过以下代码解冻最后两层:
# Freeze all layers
for param in model.parameters():
    param.requires_grad = False

# Unfreeze the two output layers
for param in model.pre_classifier.parameters():
    param.requires_grad = True

for param in model.classifier.parameters():
    param.requires_grad = True
随后,将该模型训练3个轮次(epoch)后,我们得到如下结果:
- 训练时长:2.89分钟
- 训练准确率:86.7%
- 验证准确率:87.2%
- 测试准确率:86.4%
2. 添加适配器层
接下来,我们向模型中添加适配器层。需要注意的是,DistilBERT有6个Transformer块。如前所述,适配器方法会在这6个Transformer块的每一个中都插入2个适配器模块,如下图所示:
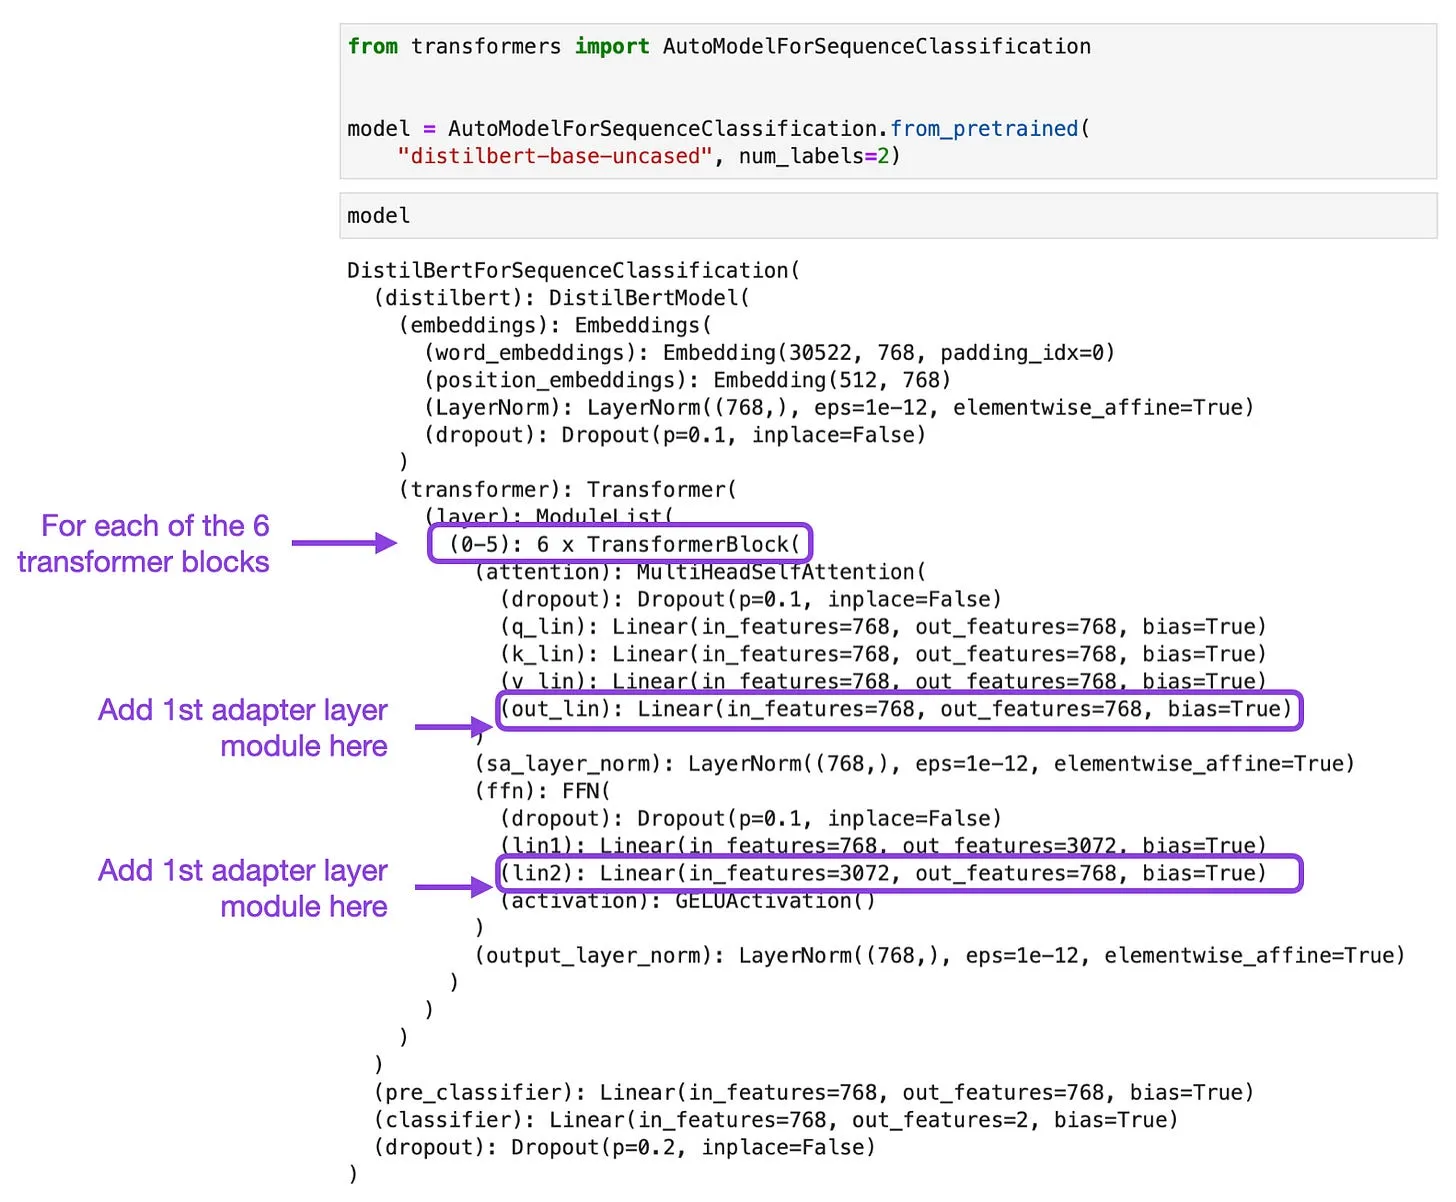
每个适配器模块由2个全连接层组成,中间夹着非线性激活函数。在代码中,我们可以定义一个make_adapter函数来创建这样的适配器模块,代码如下:
def make_adapter(in_dim, bottleneck_dim, out_dim):
    adapter_layers = torch.nn.Sequential(
        torch.nn.Linear(in_dim, bottleneck_dim),
        torch.nn.GELU(),
        torch.nn.Linear(bottleneck_dim, out_dim),
    )
    return adapter_layers
之后,我们就可以用make_adapter函数将适配器层插入到6个Transformer块中,代码如下:
total_size = 0
bottleneck_size = 32 # hyperparameter

for block_idx in range(6):

    ###################################################
    # insert 1st adapter layer into transformer block
    ###################################################

    orig_layer_1 = model.distilbert.transformer.layer[block_idx].attention.out_lin

    adapter_layers_1 = make_adapter(
        in_dim=orig_layer_1.out_features,
        bottleneck_dim=bottleneck_size,
        out_dim=orig_layer_1.out_features)

    new_1 = torch.nn.Sequential(orig_layer_1, *adapter_layers_1)
    model.distilbert.transformer.layer[block_idx].attention.out_lin = new_1

    total_size += count_parameters(adapter_layers_1)

    ###################################################
    # insert 2nd adapter layer into transformer block
    ###################################################

    orig_layer_2 = model.distilbert.transformer.layer[block_idx].ffn.lin2

    adapter_layers_2 = make_adapter(
        in_dim=orig_layer_2.out_features,
        bottleneck_dim=bottleneck_size,
        out_dim=orig_layer_2.out_features)

    new_2 = torch.nn.Sequential(orig_layer_2, *adapter_layers_2)
    model.distilbert.transformer.layer[block_idx].ffn.lin2 = new_2

    total_size += count_parameters(adapter_layers_2)


print("Number of adapter parameters added:", total_size) total_size)
添加的适配器参数数量:599424
修改后的DistilBERT架构如下图所示:
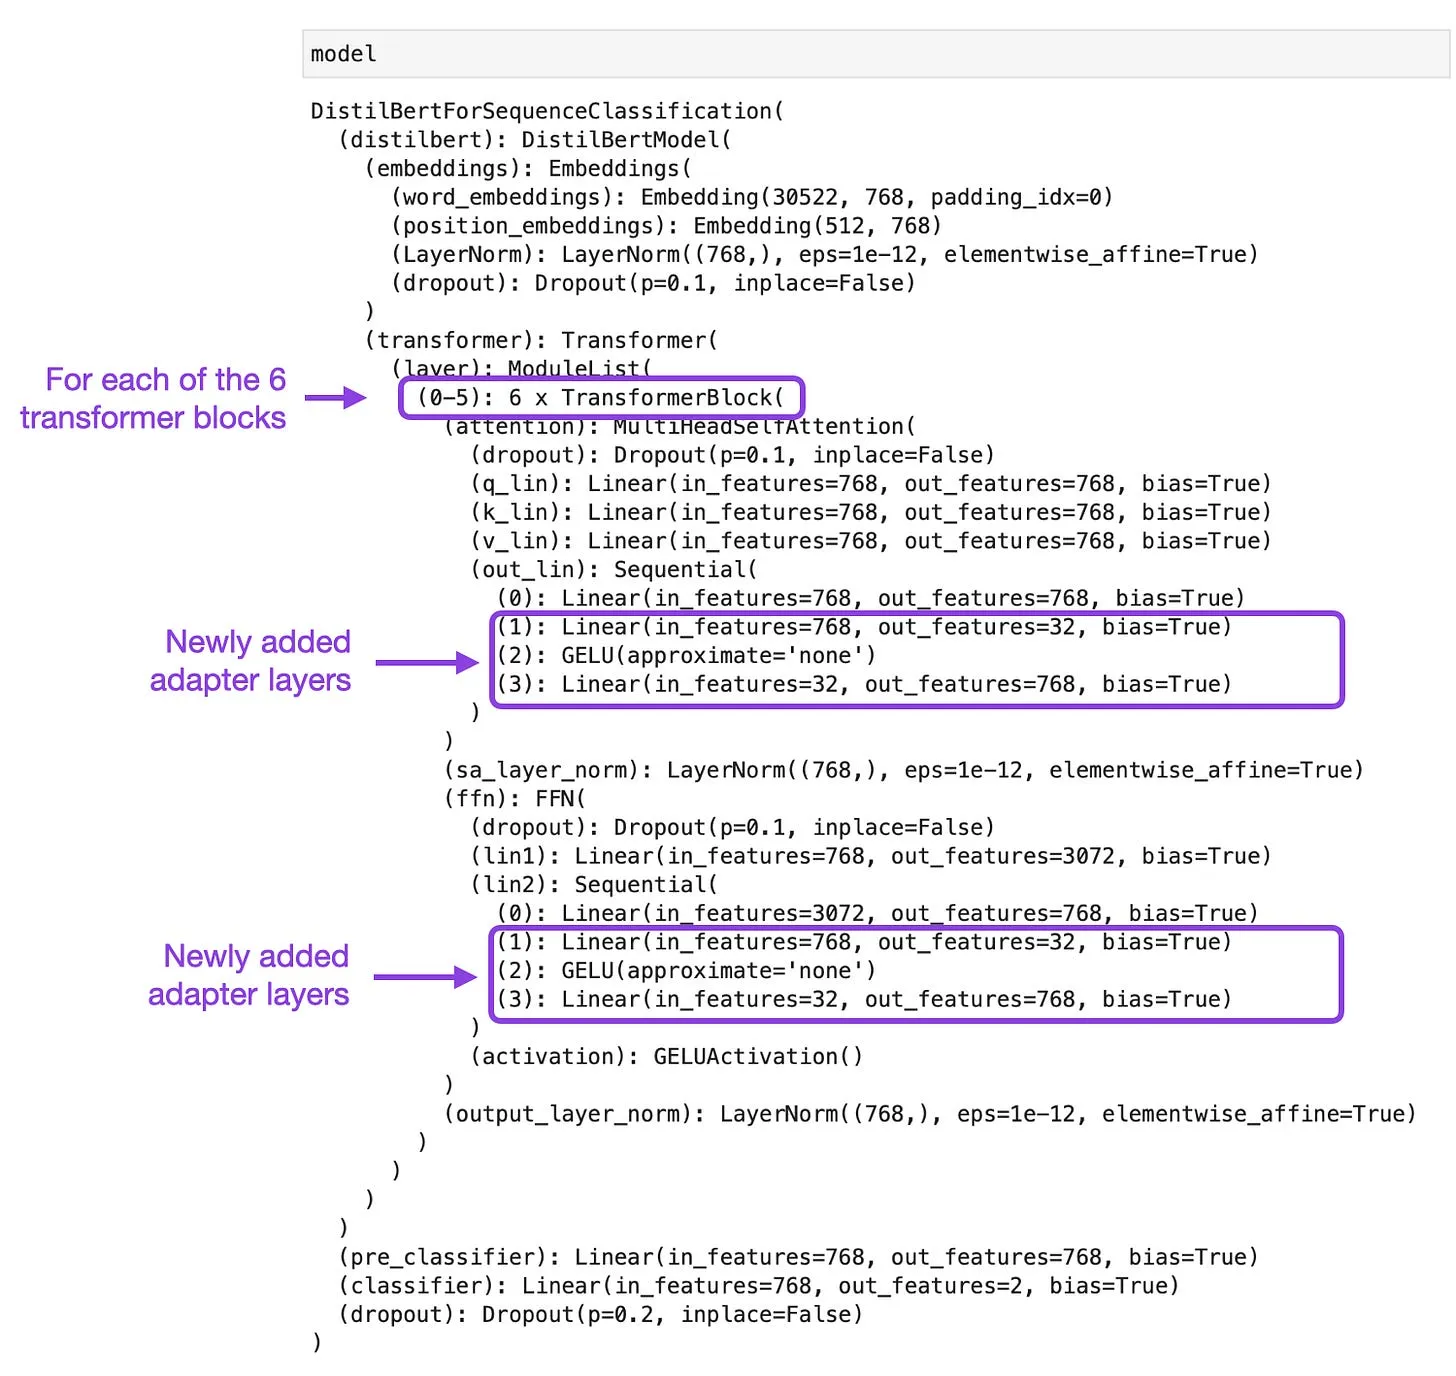
可以看到,当瓶颈尺寸设为32时,我们向模型中添加了599424个新参数。相比之下,我们之前微调的2个全连接层总共有592130个参数,二者的可微调参数量大致相当。如果我们对这个修改后的模型进行微调(除适配器层外所有层均冻结),会得到如下结果:
- 训练时长:5.69分钟
- 训练准确率:90.0%
- 验证准确率:89.1%
- 测试准确率:88.4%
3. 全量微调所有层
现在,作为对比,我们来看全量微调所有层的结果。这一实验中,我们直接加载DistilBERT模型并进行训练(不冻结任何层)。
from transformers import AutoModelForSequenceClassification

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-uncased", num_labels=2)
def count_parameters(model):
    return sum(p.numel() for p in model.parameters() if p.requires_grad)

num_param = count_parameters(model.pre_classifier) + count_parameters(model.classifier)
print("Parameters in last 2 layers:", num_param)

66955010
对全部6690万个参数进行微调后,结果如下:
- 训练时长:7.12分钟
- 训练准确率:96.6%
- 验证准确率:92.9%
- 测试准确率:93.0%
4. 插入适配器层并全量微调
最后,我们补充一个对照实验:训练第2节中添加了适配器层的模型,但开放所有参数的训练权限。总参数量为599424 + 66955010 = 67554434个。
- 训练时长:7.62分钟
- 训练准确率:98.4%
- 验证准确率:91.5%
- 测试准确率:91.1%
结果分析与总结
通过上述实验得到所有结果后,我们来看下面的汇总图。
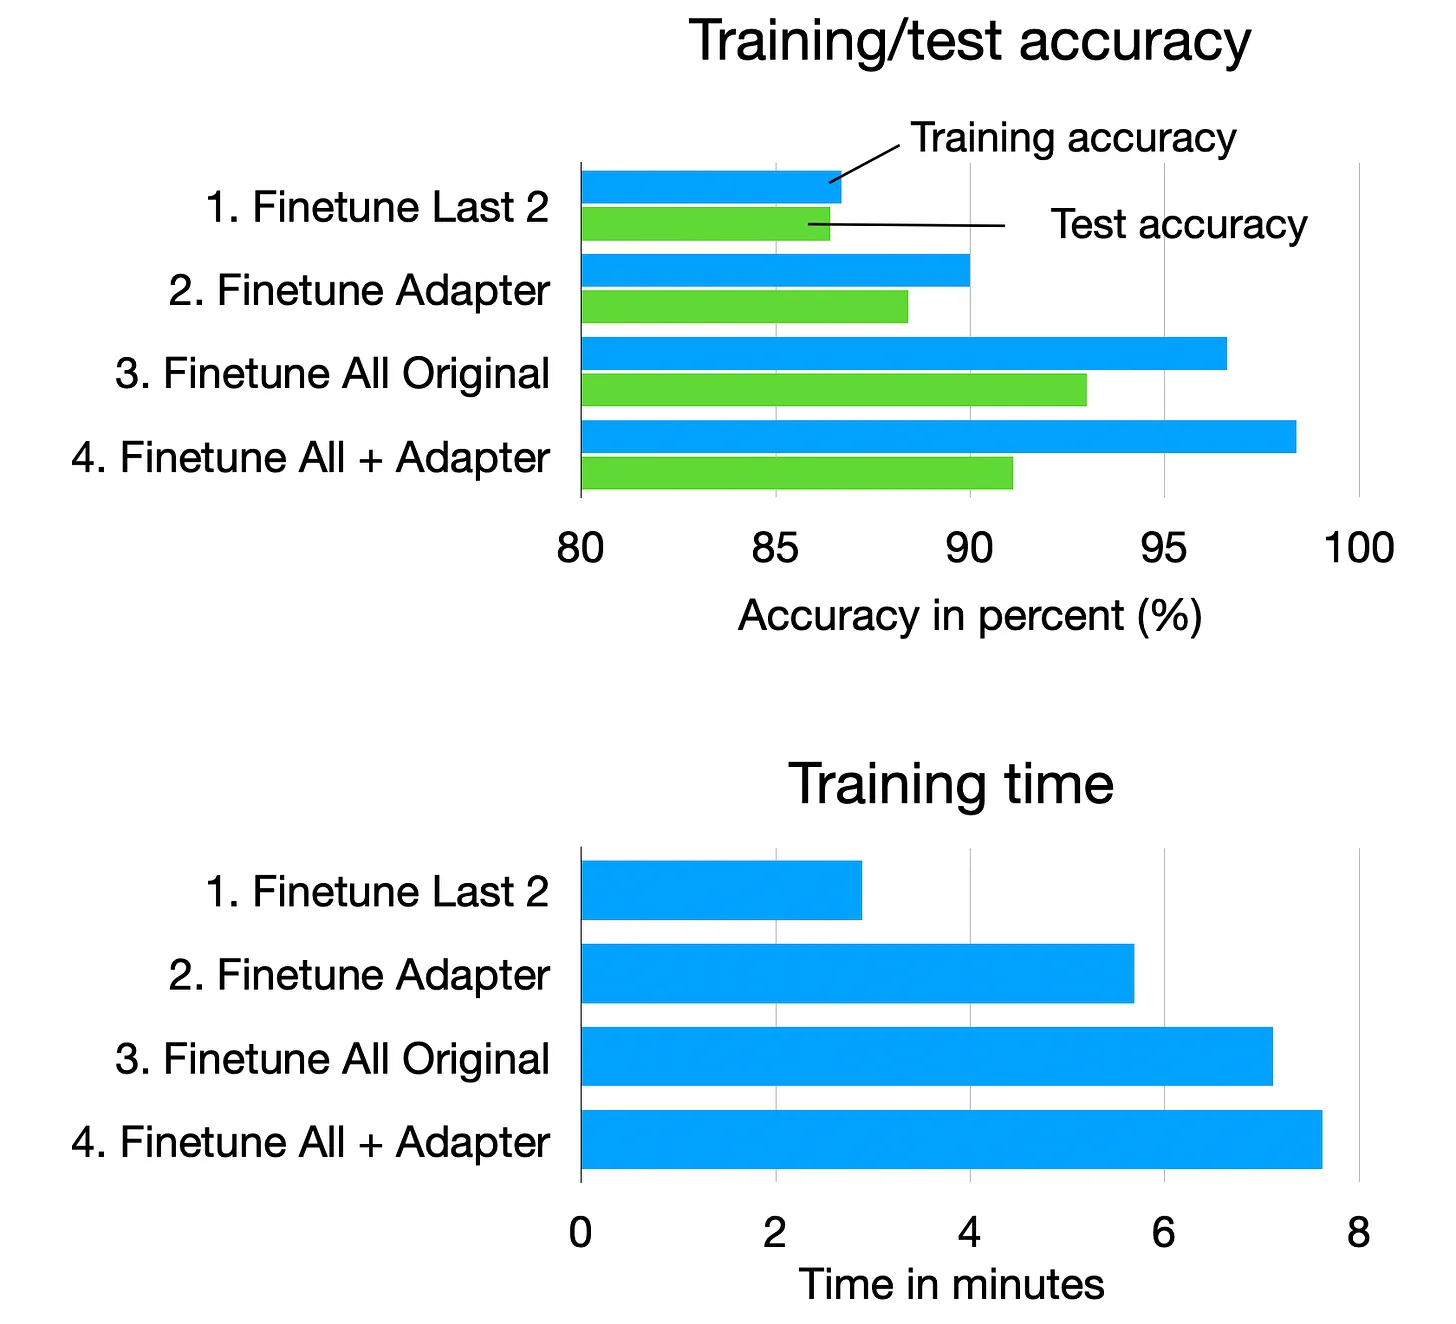
可以看到,微调适配器层的效果优于仅微调最后几层。这是一个积极的结果,且并不意外,与适配器论文的结论一致。
但微调适配器层(实验2)的耗时几乎是仅微调最后两层(实验1)的两倍。二者的可训练参数量几乎相同,但适配器层模型在前向传播时需要经过更多额外的层,这是训练时长增加的原因。
再看方法(3),全量微调整个网络的表现仍然优于适配器方法(实验2)。当然,它的计算成本也更高,这是意料之中的,因为二者的参数量差距悬殊(6600万对比60万)。
最后,“全量微调+适配器层”(实验4)的效果优于仅微调适配器层(实验2)。但实验4的表现不如全量微调所有层(实验3),乍看之下有些意外,因为实验4比实验3多了60万个参数。如果观察训练集的表现就会发现,实验4的过拟合程度更严重,这或许可以解释为什么参数更多但效果反而更差。
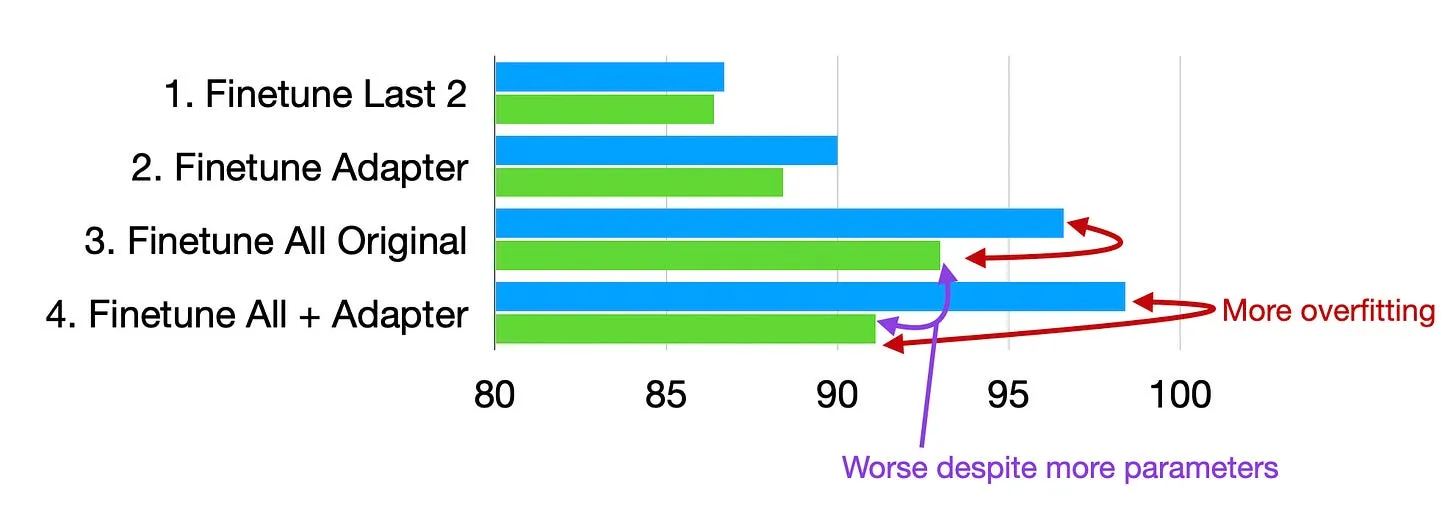
总而言之,适配器方法是替代“仅微调最后几层”的优质方案,尽管它会增加计算时长,且效果不及全量微调。
本杂志是一项个人兴趣项目,无直接经济收益。如果您愿意支持我,可以考虑购买我的书籍:https://sebastianraschka.com/books。如果您觉得这些内容有启发、有帮助,也欢迎推荐给您的朋友和同事。
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , and http://mng.bz/M96o
您的支持对我意义重大!非常感谢!