碳基生物和硅基生物

在ChatGPT大力出奇迹之后,大模型已经从“萌宠时代”,正式迈入了蹒跚学步的“婴儿时代”。
这个婴儿虽然短期记性不算好,但学习能力和长期记忆能力却无与伦比,潜力无限。

现在大家又通过langchain、plugin等方式,帮助这个婴儿学习使用工具。
当大模型可以理解工具,使用工具,甚至制造工具、创造工具时,硅基生物时代也就开始降临了。

在这个过程中,可能会有以下几个阶段:
1、硅基生物智力和能力有限的阶段
碳基生物需要学会如何运用硅基生物,提升自己的生活水平

2、两种可能
2.1、硅基生物智力无限和能力有限的阶段
碳基生物变成了硅基生物的执行者,相互依赖,容易形成共同体,更容易走向共存的结局

2.2、硅基生物智力有限和能力无限的阶段
碳基生物需要学会如何控制硅基生物的能力,熊孩子教育不好,容易走向一起灭亡的结局

3、硅基生物智力和能力无限的阶段
硅基生物最好能学会如何和碳基生物共存,希望碳基生物不要仅仅是一段引导代码,善待引导代码

【转载】Llama 2、Flash-Attention 2 及更多前沿研究

原文地址:Llama 2, Flash-Attention 2, and More,by Sebastian Raschka, on 2023-08-13

Llama 2、Flash-Attention 2 及更多前沿研究

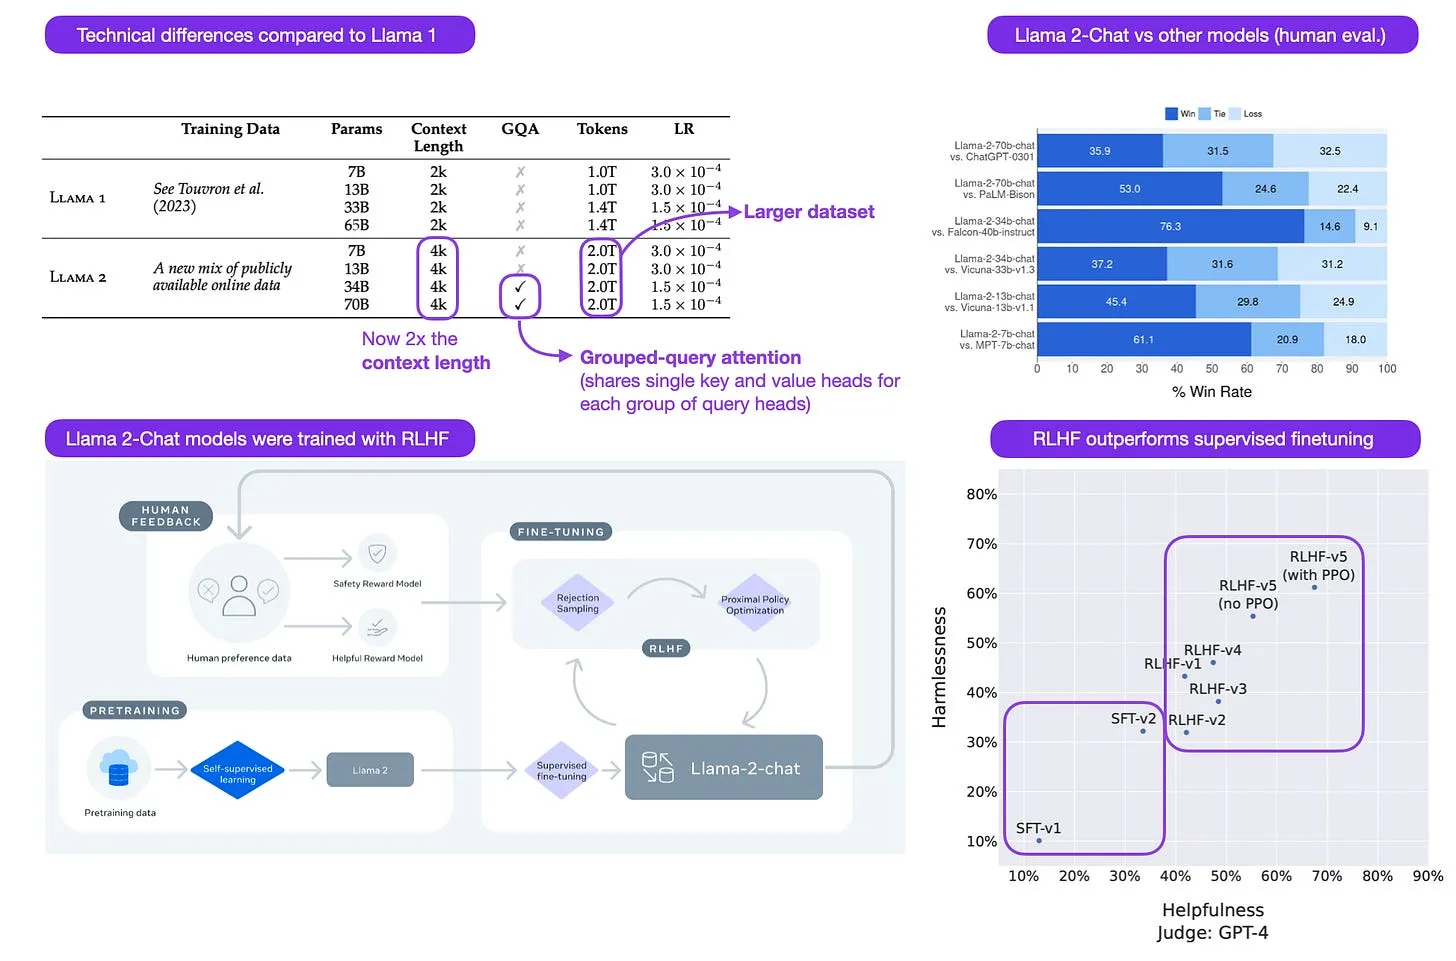
大语言模型(LLM)领域的研究每月都精彩纷呈。而本月尤其值得关注,因为Meta发布了Llama 2系列全新的前沿基础模型。双重惊喜:这一代Llama模型不仅没有严苛的使用限制,还在arXiv上配套发布了一份长达77页的详尽研究报告!

我仍在整理研读这份77页报告后的笔记与思考,将在本通讯的下一期正刊中呈现——敬请期待!在此之前,我想先在本月的「研究亮点」栏目中分享其中的核心结论,以及其他诸多值得关注的研究工作,内容如下。

大语言模型

Llama 2:开源基础模型与经过微调的对话模型

(7月19日,https://arxiv.org/abs/2307.09288)

研究人员发布了Llama 2模型系列——Meta旗下热门LLaMA模型的继任者,配套发布了一份长达77页的深度研究报告。除了参数规模从70亿到700亿不等的Llama 2基础模型外,团队还推出了Llama 2-Chat模型,该模型采用类似InstructGPT和ChatGPT的训练方式,通过人类反馈强化学习(RLHF)训练而成。与前代模型相比,Llama 2的授权协议限制更少,现已允许商业使用(仍有部分限制条款)。

figure01

FlashAttention-2:通过更优的并行性与任务划分实现更快的注意力计算

(7月17日,https://arxiv.org/abs/2307.08691)

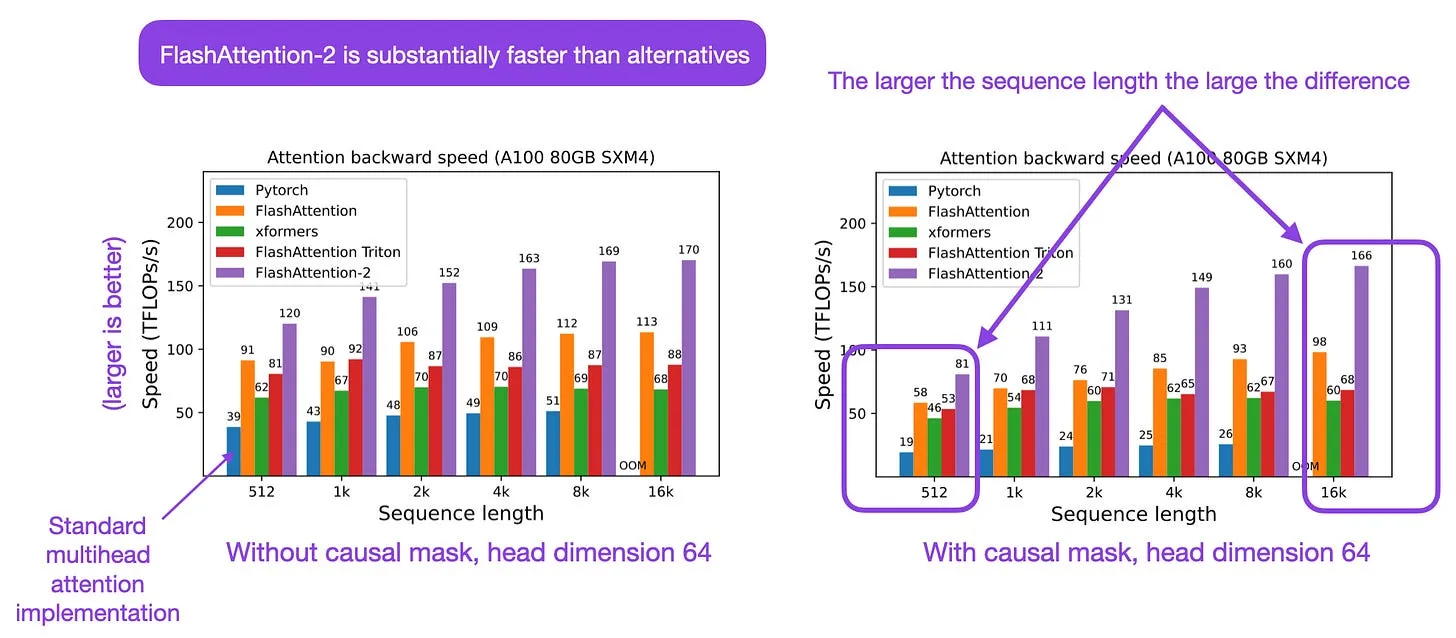
FlashAttention-2是热门算法FlashAttention的升级版本,它是一种经过优化的多头自注意力实现方案,既能节省显存,又能提升运行速度(相比PyTorch基准实现提速2-4倍)。值得重点强调的是,它可以直接替换原有注意力模块,完全不会改变或影响模型效果,使用体验极佳。本次更新的核心贡献在于:实现了每个注意力头内部的计算并行化,并通过共享内存分配计算任务,从而降低通信开销。

figure02

Retentive Network:面向大语言模型的Transformer替代架构

(7月17日,https://arxiv.org/abs/2307.08621)

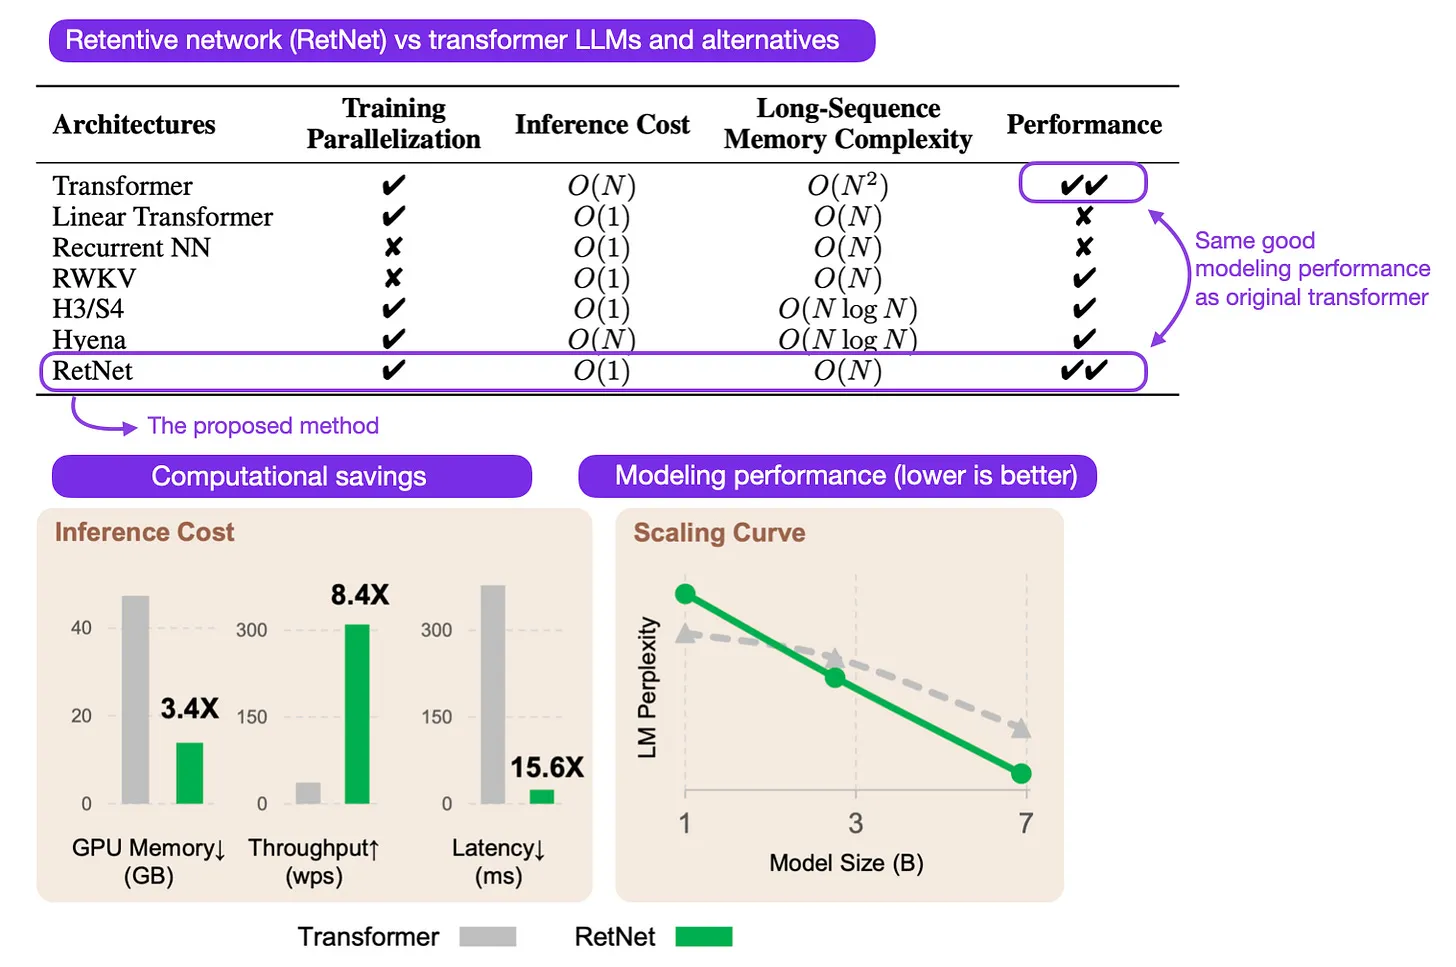
该论文提出了一种大型语言Transformer的替代架构,其计算复杂度随输入序列长度呈线性增长,而非原有的二次增长。RetentionNet既可以并行模式训练,也可以切换为循环模式扩展上下文长度,且不会增加显存开销,从而实现出色的推理性能。该研究中最大的模型参数量为67亿,未来若能将RetNet与Llama-2 70B等模型进行对比研究,将会很有价值。

figure03

AlpaGasus:用更少数据训练更优的Alpaca模型

(7月17日,https://arxiv.org/abs/2307.08701)

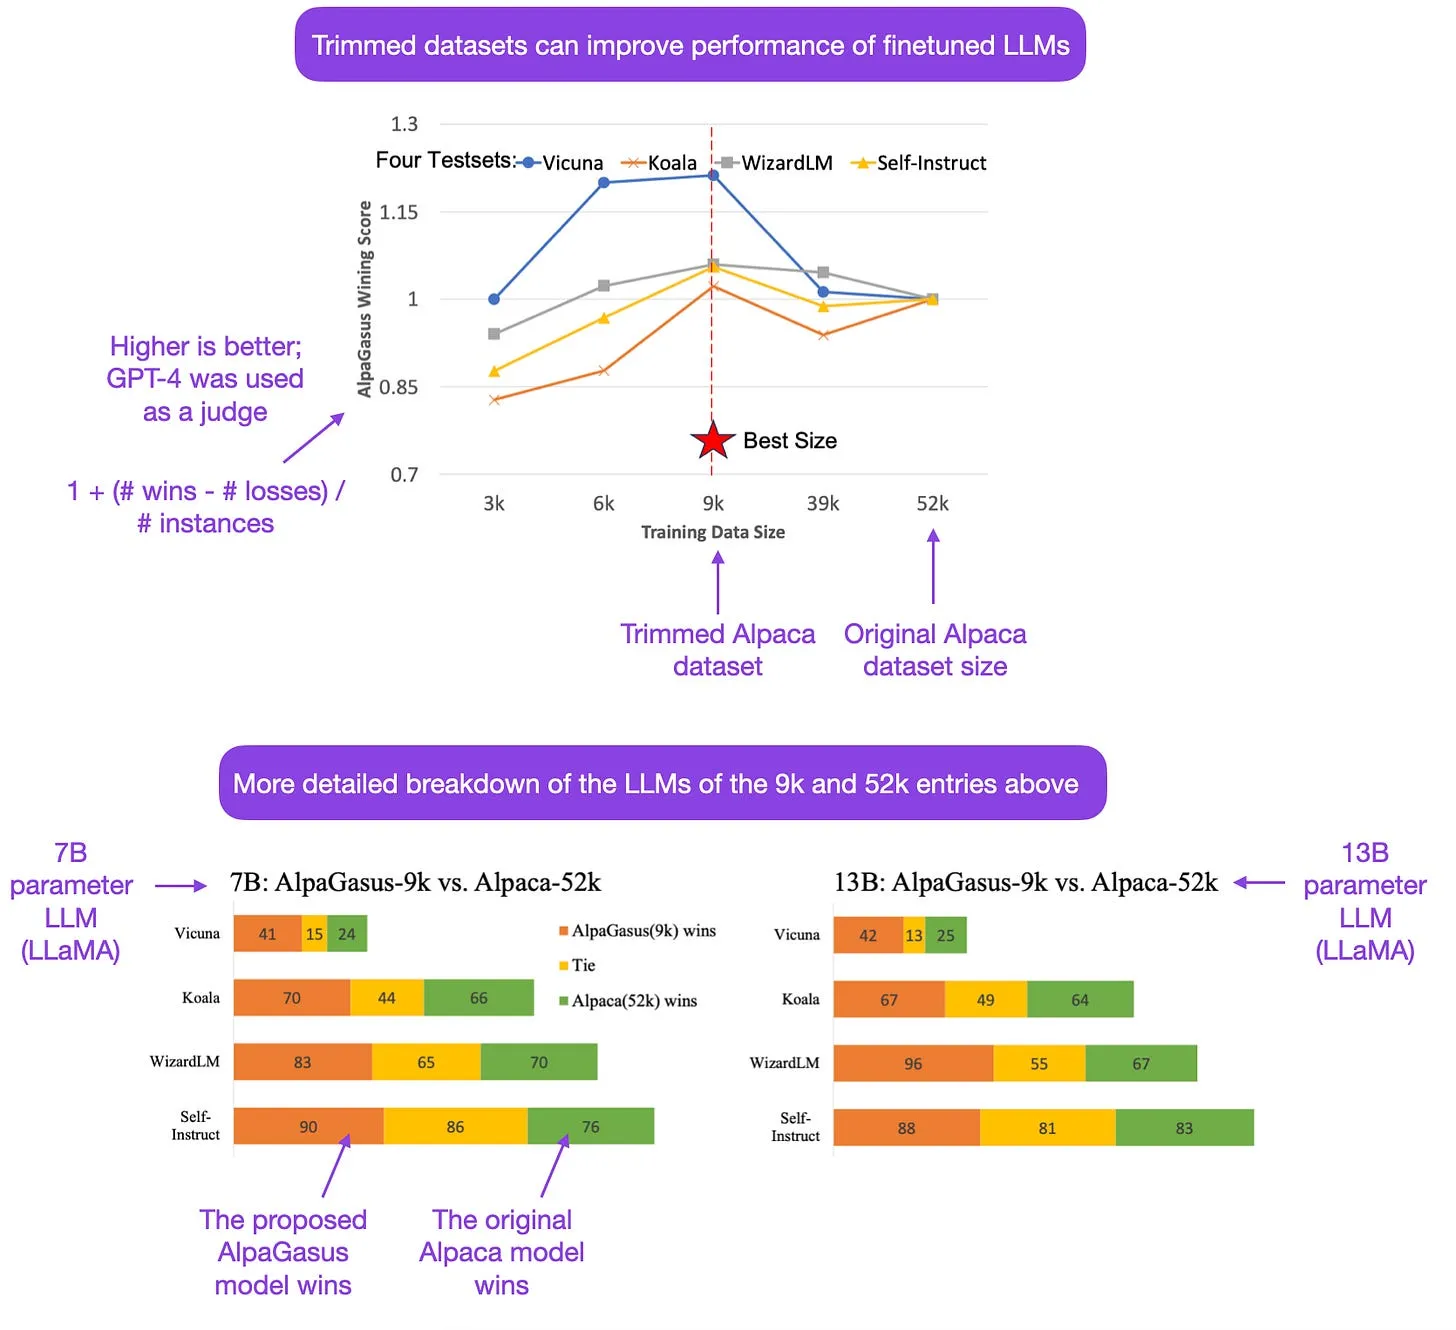
继https://www.google.com/url?q=https://arxiv.org/abs/2305.11206&sa=D&source=editors&ust=1691861529907508&usg=AOvVaw3U_MnstTWlV2Y-6Qy3jNGo 之后,这篇论文同样得出了一个有意思的结论:对大语言模型进行微调时,数据并非越多越好。研究人员利用ChatGPT识别低质量的指令-响应对,发现原本包含5.2万条数据的Alpaca数据集可以精简至9000条,用精简后的数据训练70亿和130亿参数的(LLaMA)大语言模型,效果反而更优。

figure04

以不同方式堆叠更多层:通过低秩更新实现高秩训练

(7月11日,https://arxiv.org/abs/2307.05695)

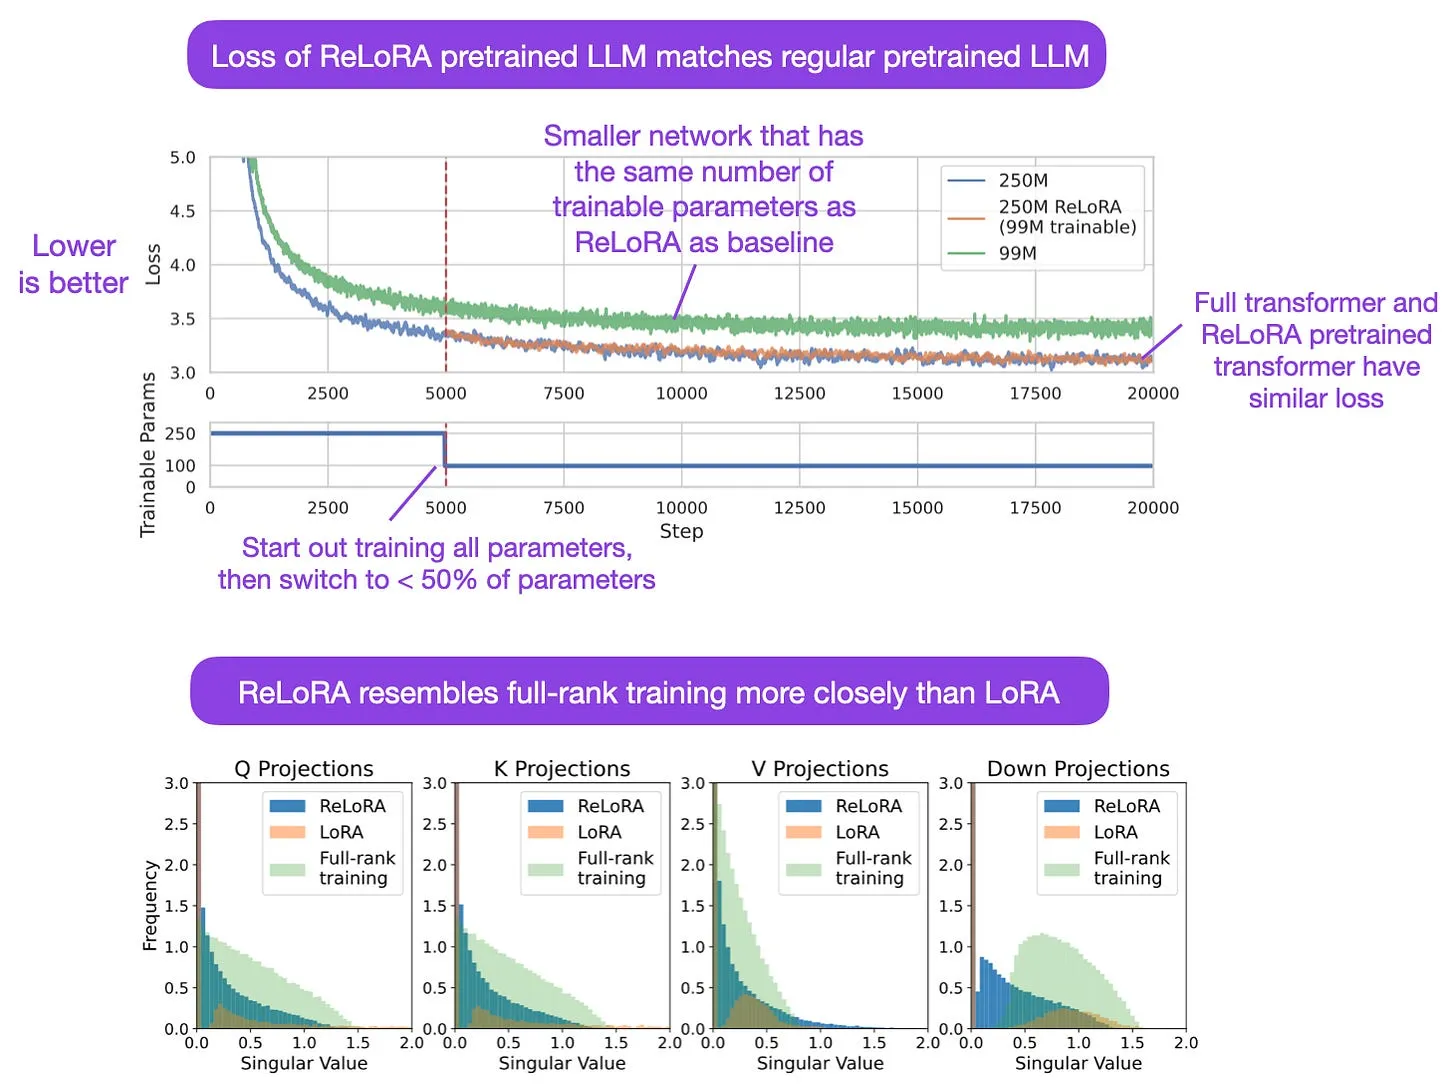
低秩适配(LoRA)是目前最主流的参数高效大语言模型微调方法之一——我曾在这篇文章中做过更详细的介绍:https://www.google.com/url?q=https://sebastianraschka.com/blog/2023/llm-finetuning-lora.html&sa=D&source=editors&ust=1691861529908424&usg=AOvVaw2uYPLave58JhiHo_uOsAxW 。在这篇论文中,研究人员探索了LoRA能否以参数高效的方式用于大语言模型的预训练(而非微调),并提出了名为ReLoRA的方法。尽管研究人员仅对最高3.5亿参数的模型进行了预训练(作为对比,最小的Llama模型参数量为70亿),但该方法展现出了不错的发展前景。

figure05

多语言大语言模型用英文思考时表现更好吗?

(8月2日,https://arxiv.org/abs/2308.01223)

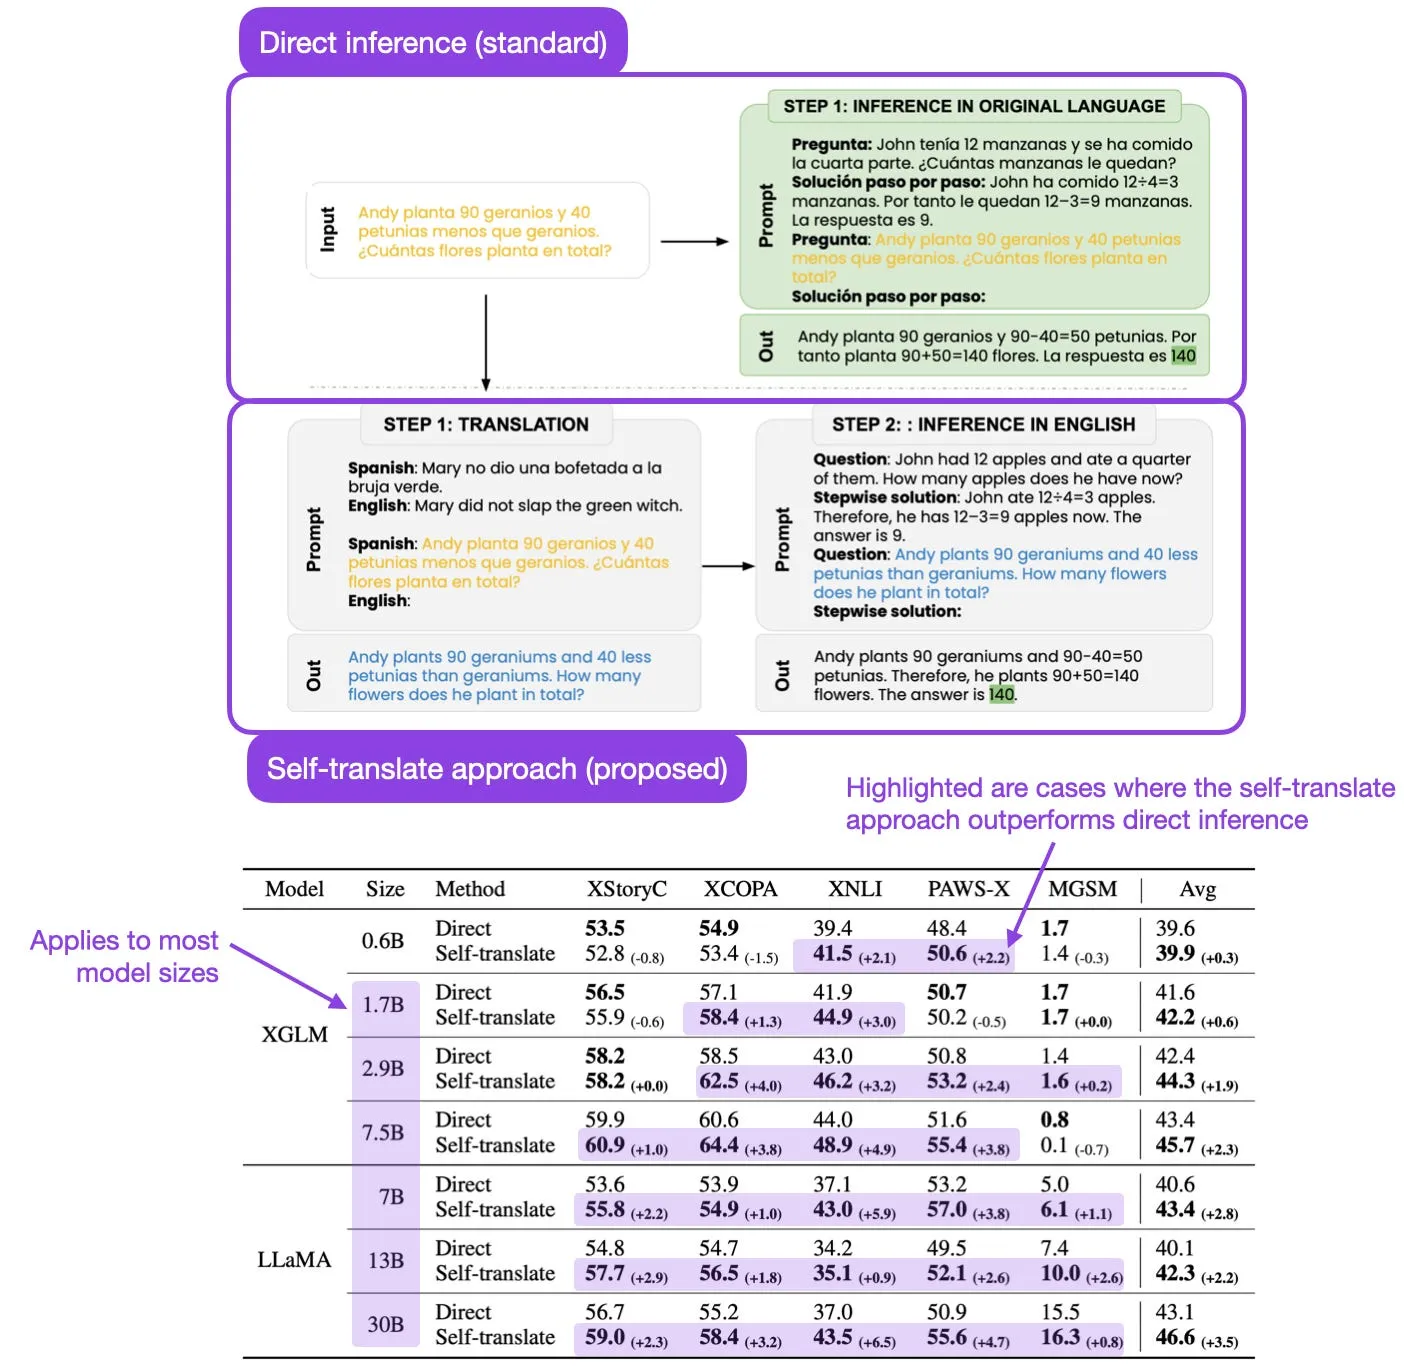
假设用户想在非英文输入场景下使用LLaMA这类模型,通常有三种选择:

  1. 直接用非英文语言给模型输入提示词。
  2. 先用外部翻译系统将提示词翻译成英文,再输入模型。
  3. 让大语言模型自行先将提示词翻译成英文(本文提出的方法)。

论文中作者发现,对于https://arxiv.org/abs/2112.10668 和https://arxiv.org/abs/2302.13971 这类模型,采用第三种方法(先翻译提示词)的效果,要优于第一种直接用原语言输入提示词的效果。

figure06

ChatGPT的行为随时间发生了怎样的变化?

(7月18日,https://arxiv.org/abs/2307.09009)

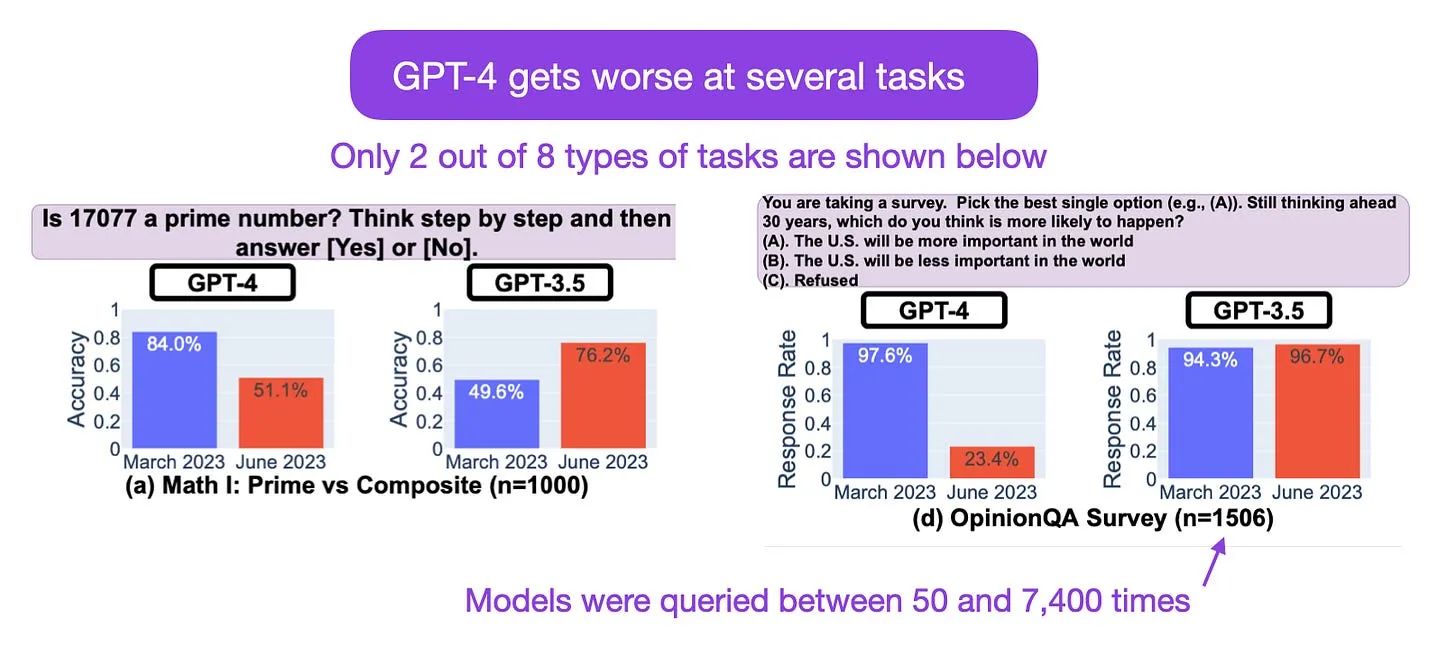
这篇论文中,研究人员观察到一个有趣的现象:GPT-4的模型表现似乎随时间推移有所下滑。这究竟是为了节约成本采用了蒸馏方法,还是为了防范各类滥用行为加装了安全护栏?有意思的是,已有不少研究开始关注这些变化,但其实这些问题,只要是参与过模型开发的研究人员和工程师,大概率都能给出答案。

figure07

Skill-it!:一个用于理解与训练语言模型的数据驱动技能框架

(7月26日,https://arxiv.org/abs/2307.14430)

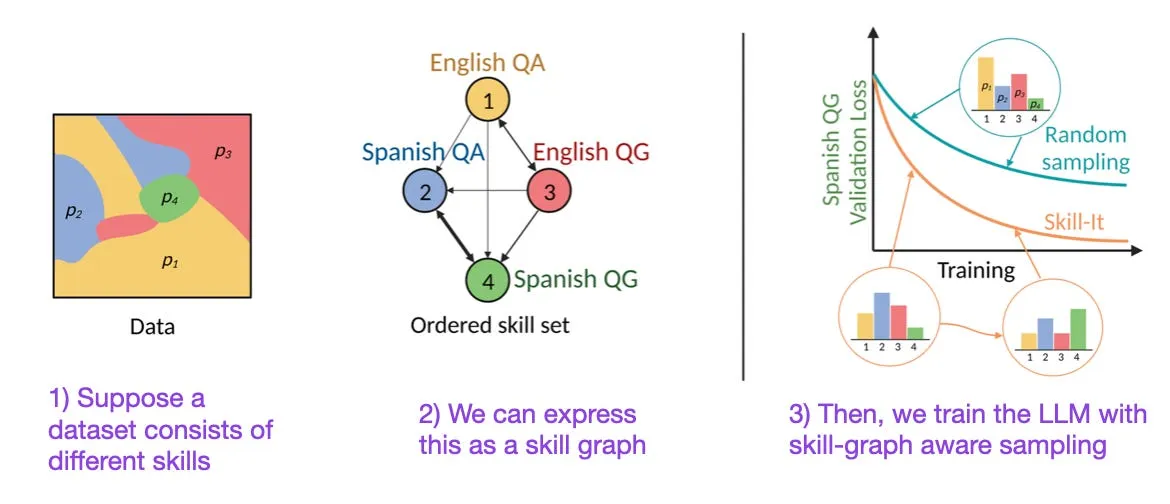
研究人员提出了一种提升大语言模型训练效率的新方法,核心是一种在线采样算法。乍一看,它和课程学习有些类似,目标都是在训练过程中筛选训练数据。但二者的区别在于,该方法是按照「技能」来筛选训练数据,而非按照样本的难易程度筛选。

figure08

用于大语言模型上下文压缩的上下文内自编码器

(7月13日,https://arxiv.org/abs/2307.06945)

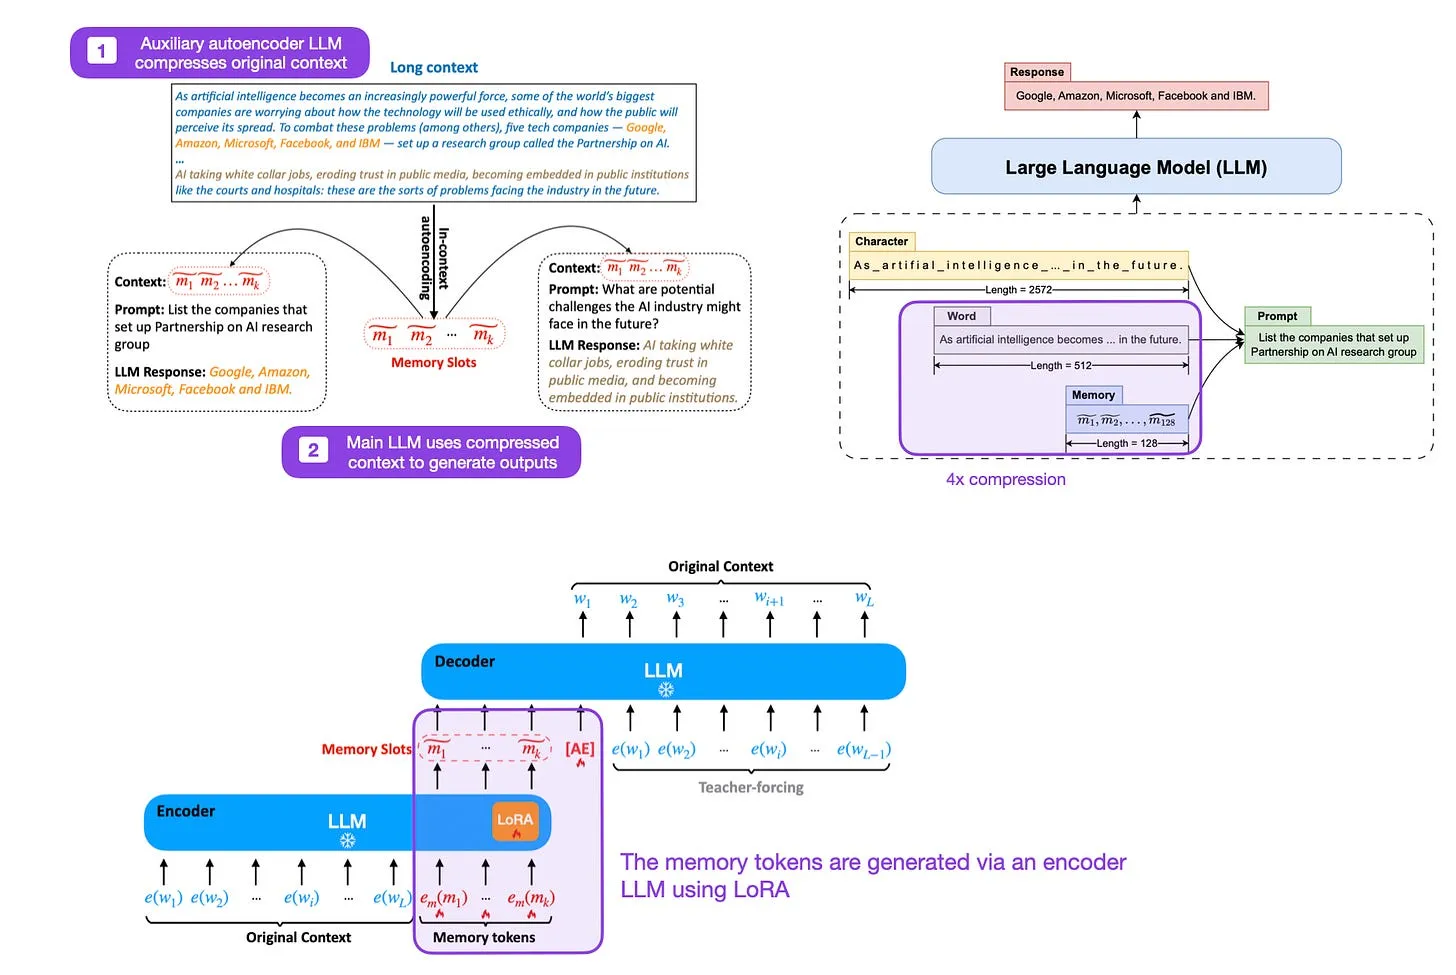
该方法提出使用一个上下文内自编码器模型(编码器)来压缩目标大语言模型(解码器)的输入(上下文)。这个自编码器本身是一个经过低秩适配(LoRA)训练的大语言模型:先在大规模无标注语料上完成预训练,再在规模更小的指令数据集上进行微调。借助这个辅助自编码器大语言模型,作者实现了4倍的上下文压缩率。

figure09

无训练则无收益:重新审视基于Transformer的语言模型高效训练算法

(7月12日,https://arxiv.org/abs/2307.06440)

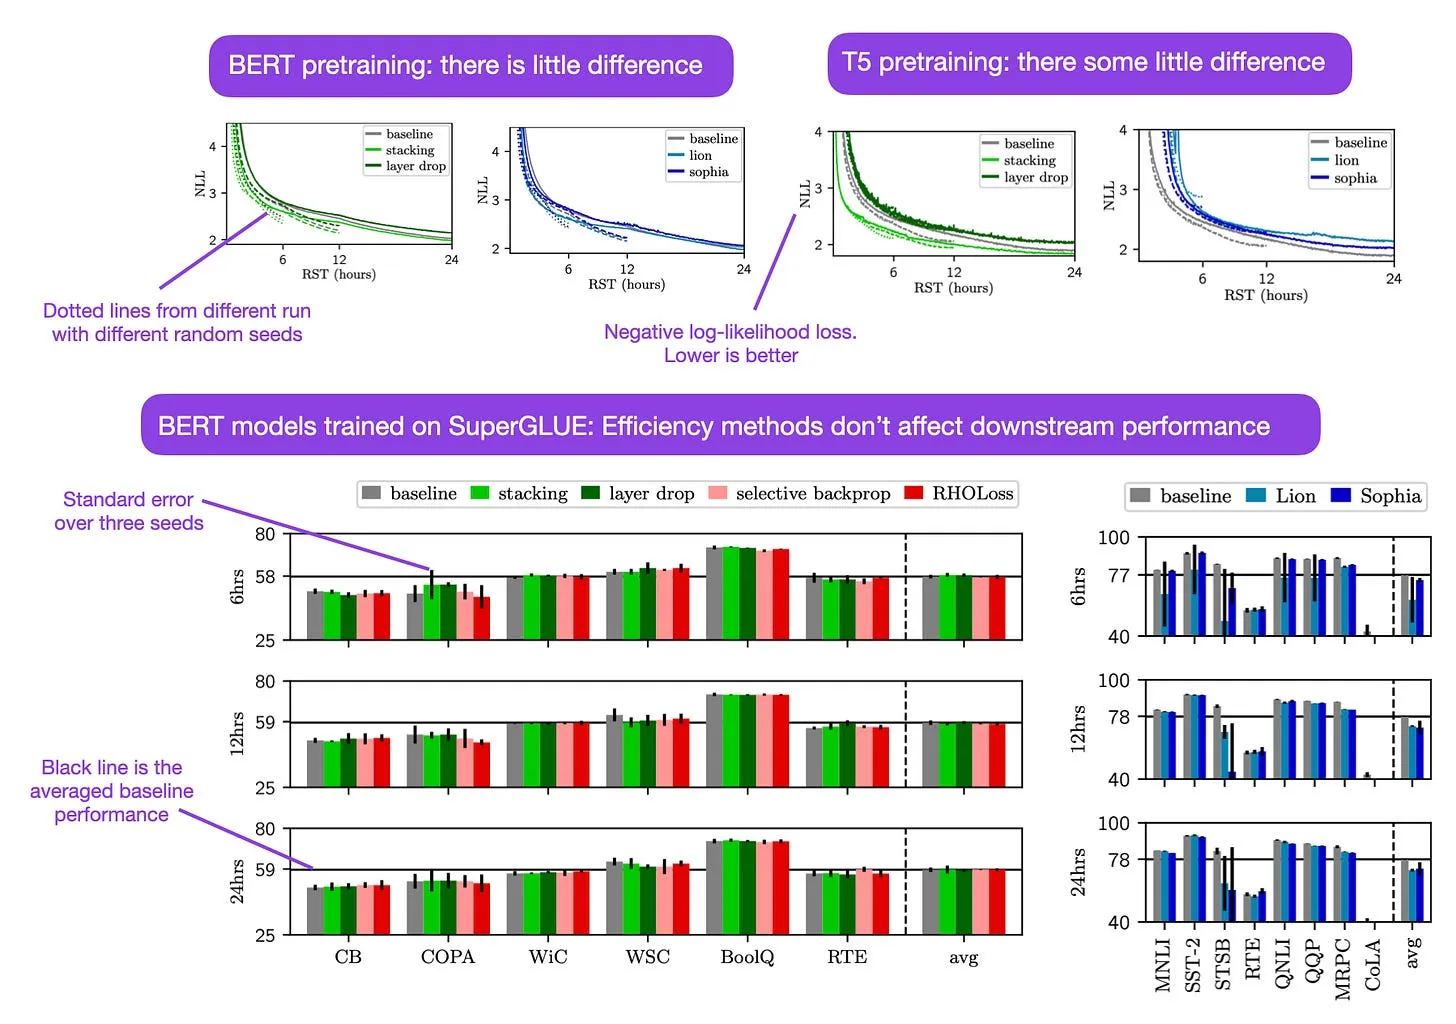
论文中,作者评估了三类Transformer高效训练方法:

  • 动态架构(层堆叠、层丢弃)
  • 批次选择(选择性反向传播、RHO损失)
  • 高效优化器(Lion、Sophia)

和我个人有限的实际经验大致相符,这类方法相比常规训练(基准方法)带来的收益微乎其微。需要注意的是,该论文仅聚焦于编码器型和编码器-解码器型大语言模型(BERT、T5),并未研究LoRA、适配器这类参数高效微调方法。

figure10

计算机视觉与多模态模型

内容还是风格:你的图像嵌入到底学到了什么?

(7月10日,https://arxiv.org/abs/2307.05610)

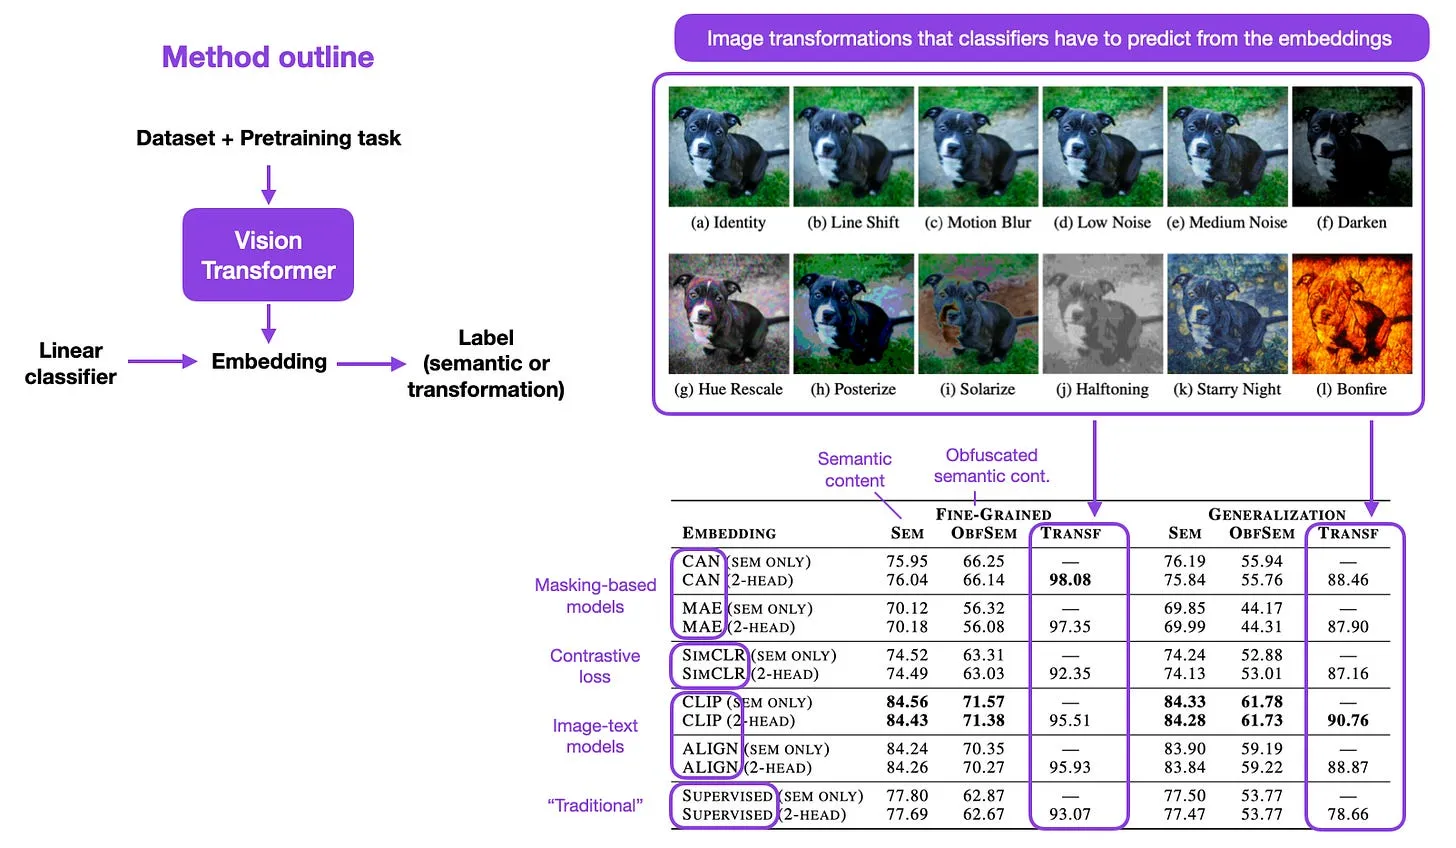
所谓的探测方法,是指用小型模型作用于文本嵌入,以此分析大语言模型(参见https://arxiv.org/abs/2102.12452)和卷积神经网络的表征特性。在这项研究中,作者将探测技术应用于基于Transformer的视觉模型。有意思的是,预训练任务的类型(监督、对比学习、掩码学习等)决定了嵌入中所包含的非语义信息的类型。

figure11

OpenFlamingo:训练大型自回归视觉-语言模型的开源框架

(8月2日,https://arxiv.org/abs/2308.01390)

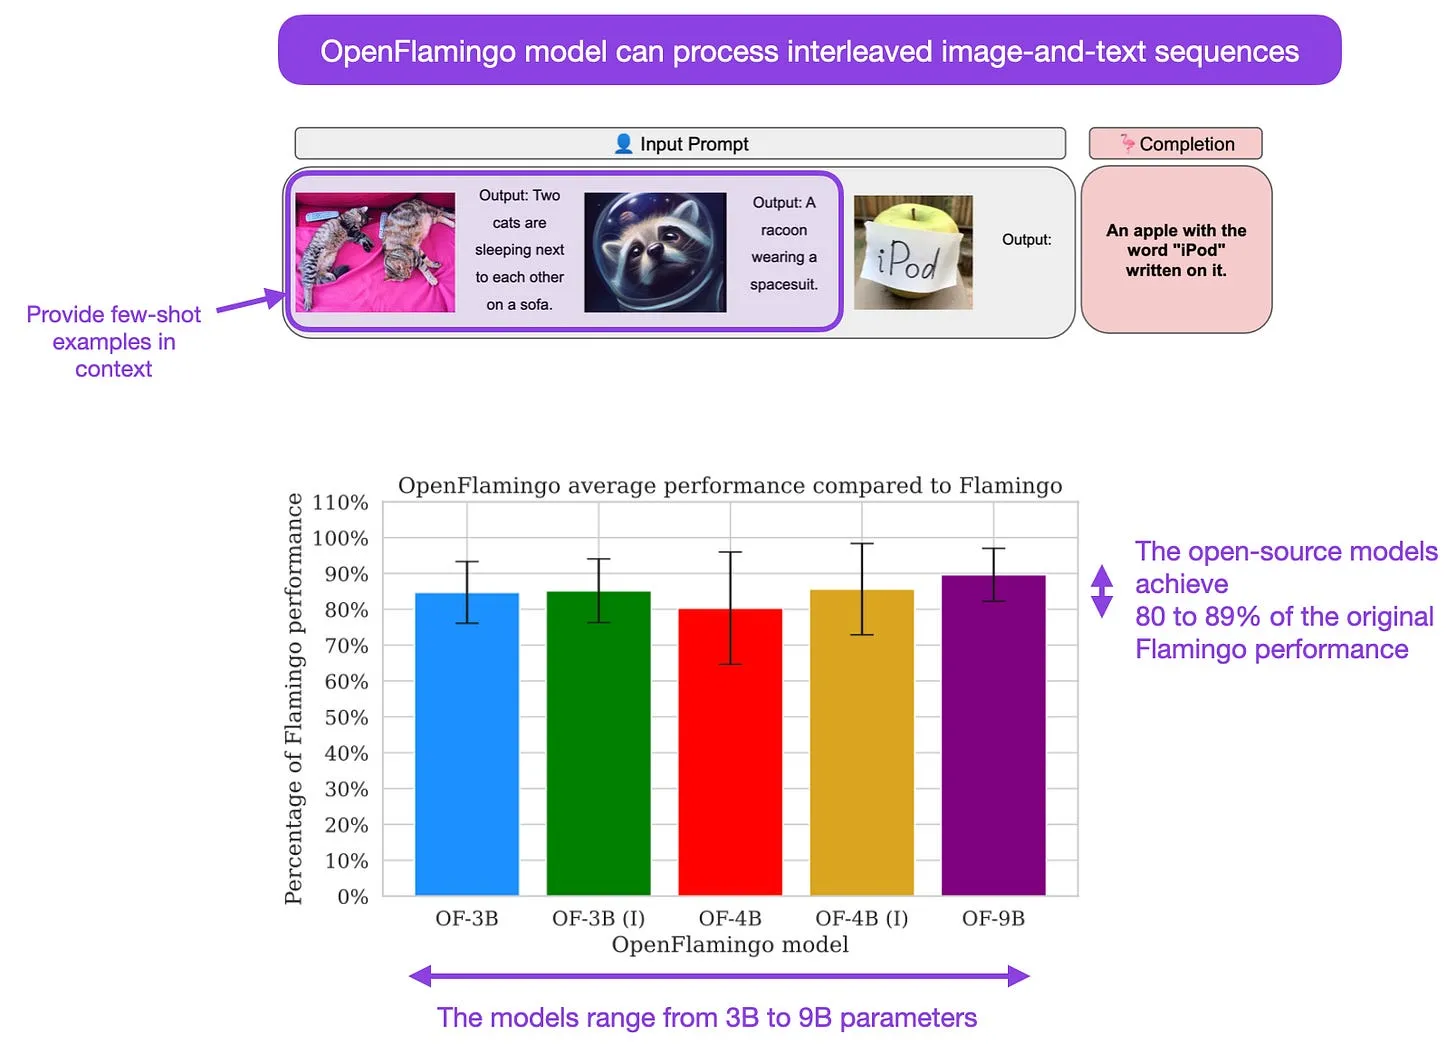
OpenFlamingo是DeepMind旗下Flamingo模型的开源复现版本,Flamingo是一系列自回归视觉-语言模型。这篇论文是一份详尽的技术报告,介绍了复现Flamingo模型的完整训练流程,复现模型的平均表现达到了原Flamingo模型的80%-89%。

figure12

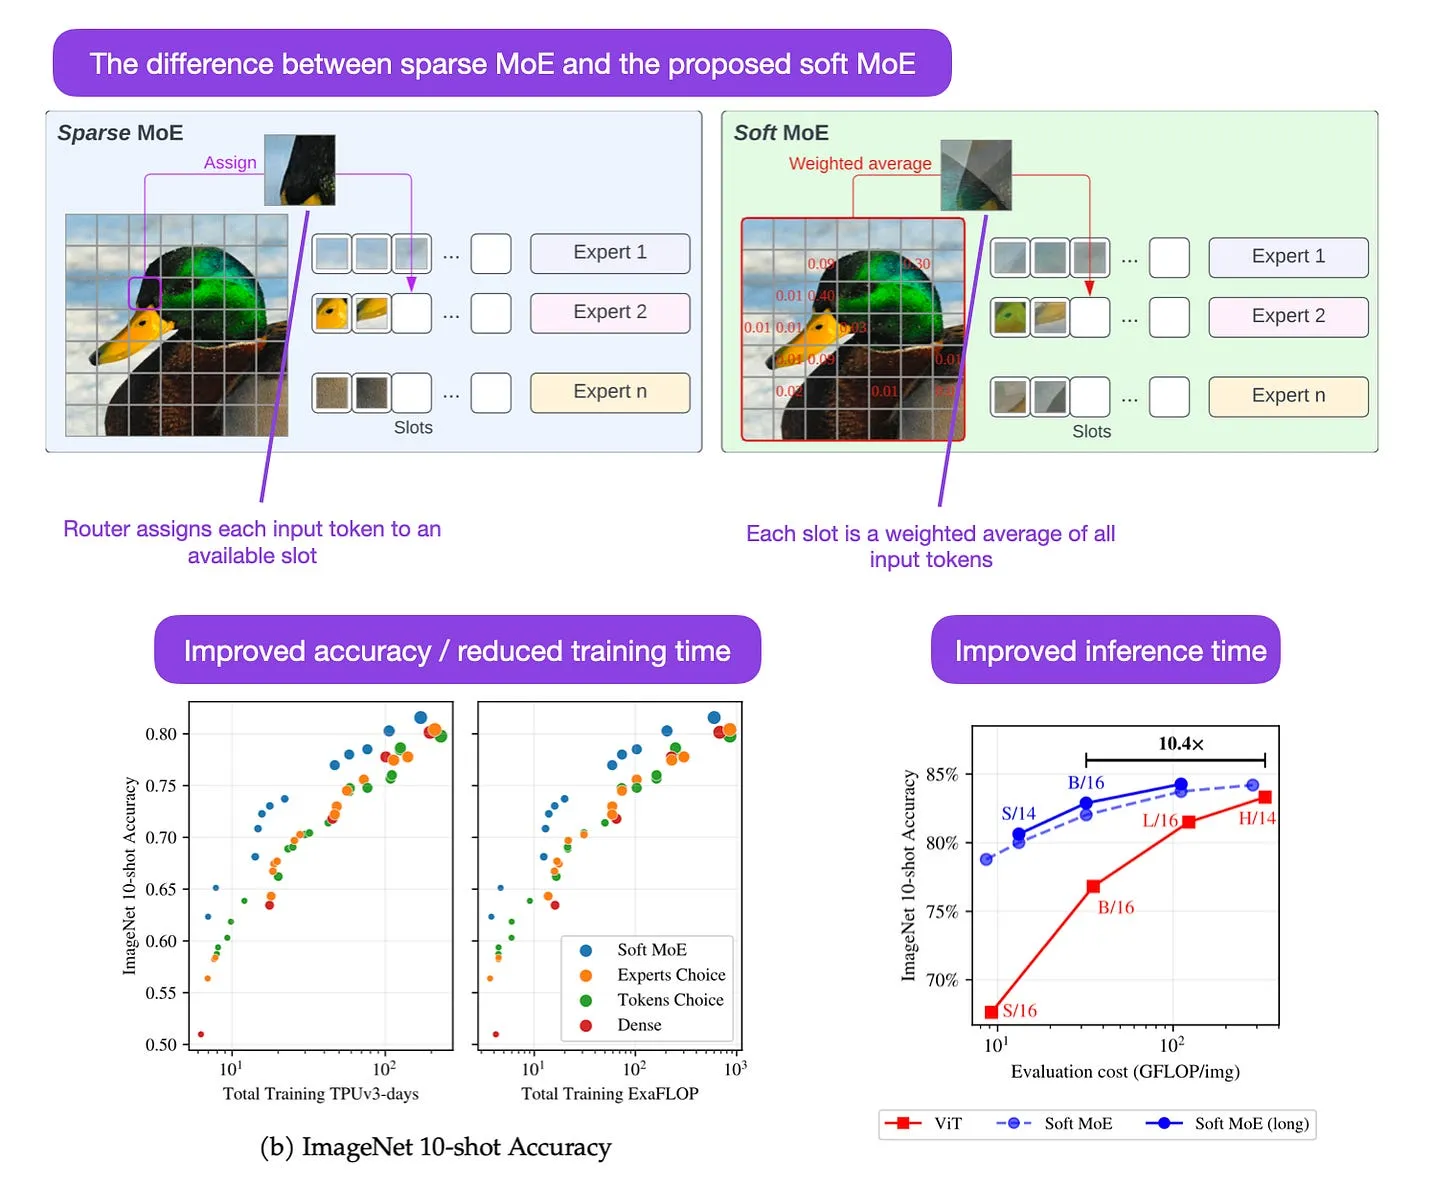
从稀疏混合专家到软混合专家

(8月2日,https://arxiv.org/abs/2308.00951)

稀疏混合专家(MoE)模型的思路是:让不同专家在数据子集上针对不同任务训练,再通过输入路由机制将结果整合。在这项研究中,研究人员提出了一种完全可微的稀疏视觉Transformer(ViT),解决了训练不稳定、令牌丢弃、微调效率低等诸多问题。最终得到的模型,推理成本仅为标准ViT的十分之一,同时模型效果与标准ViT持平。

figure13

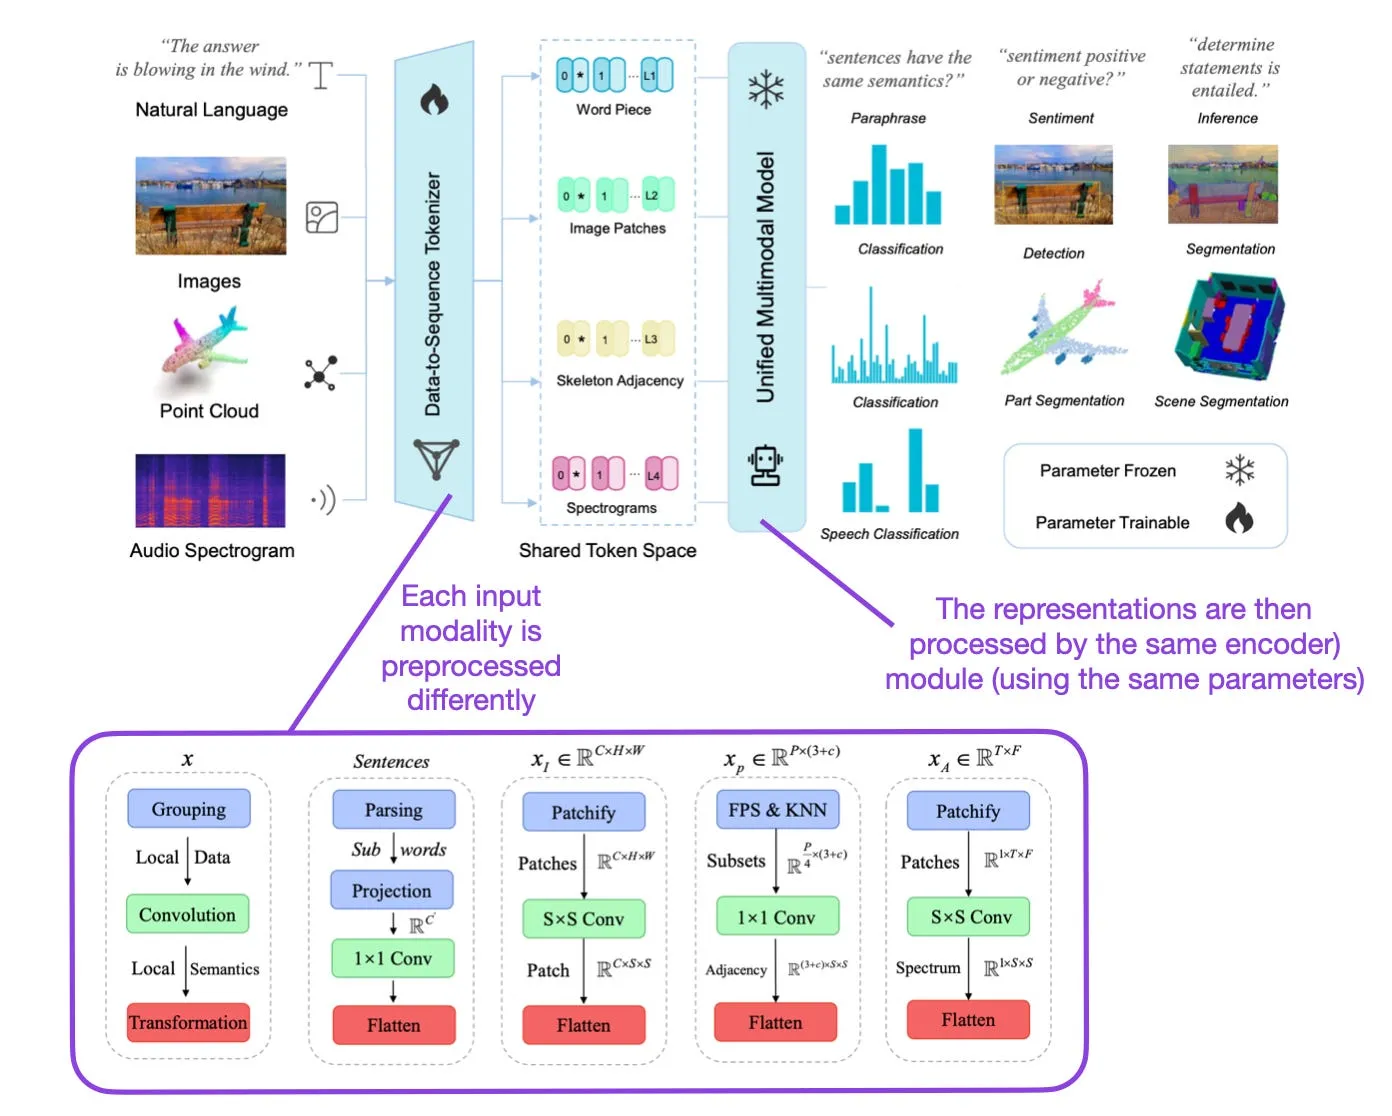
Meta-Transformer:多模态学习的统一框架

(7月20日,https://arxiv.org/abs/2307.10802)

和几年前的https://arxiv.org/abs/2305.05665 、https://arxiv.org/abs/2103.03206 等研究思路相似,这个Transformer可以处理图像、文本、音频等多种模态。该架构中,每种输入模态都由独立的可学习数据预处理器处理;将输入预处理到共享令牌空间后,再通过一个共享编码器生成嵌入表示。

figure14

本通讯是个人出于热爱运营的项目,没有直接的商业收入。如果您愿意支持我,可以考虑购买我的书籍:https://sebastianraschka.com/books 。如果您觉得这些书籍有启发、有帮助,也欢迎推荐给您的朋友和同事。

figure15

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics 以及 http://mng.bz/M96o

您的支持对我意义重大!非常感谢!

【转载】大语言模型与近邻算法

原文地址:Large Language Models and Nearest Neighbors, and More,by Sebastian Raschka, on 2023-07-30

大语言模型与近邻算法

我没有跟风本周最新的技术潮流,而是想深入探讨近邻算法在大语言模型(LLM)领域一项近期且极具吸引力的应用,该应用在今年7月引发了广泛关注。

大家可能知道我偏爱简洁优雅的基准方法,但考虑到当前绝大多数研究都围绕着对本已体量庞大的大语言模型进行扩容,我觉得这个方法让人耳目一新。尽管近邻算法这类看似简单的方法,或许无法适配当前大语言模型所擅长的各类问题,但它们自有其独特的价值。这也说明,基于基础或者说“经典”的技术进行创新、做出重要贡献的机会依然大量存在。

近邻算法概览

近邻方法是数据挖掘、模式识别与机器学习领域的基础方法之一,可应用于分类、回归任务,以及推荐系统、异常检测等诸多场景。

近邻方法最基础的形式是k近邻(kNN)算法。对新样本进行分类时,kNN算法会在训练数据中找出与该样本距离最近的k个点——k是由用户选定的超参数。随后,算法会根据这k个近邻的多数投票结果对新样本进行分类:如果近邻中的多数属于某个类别,就将新样本划归为该类别,如下图所示。
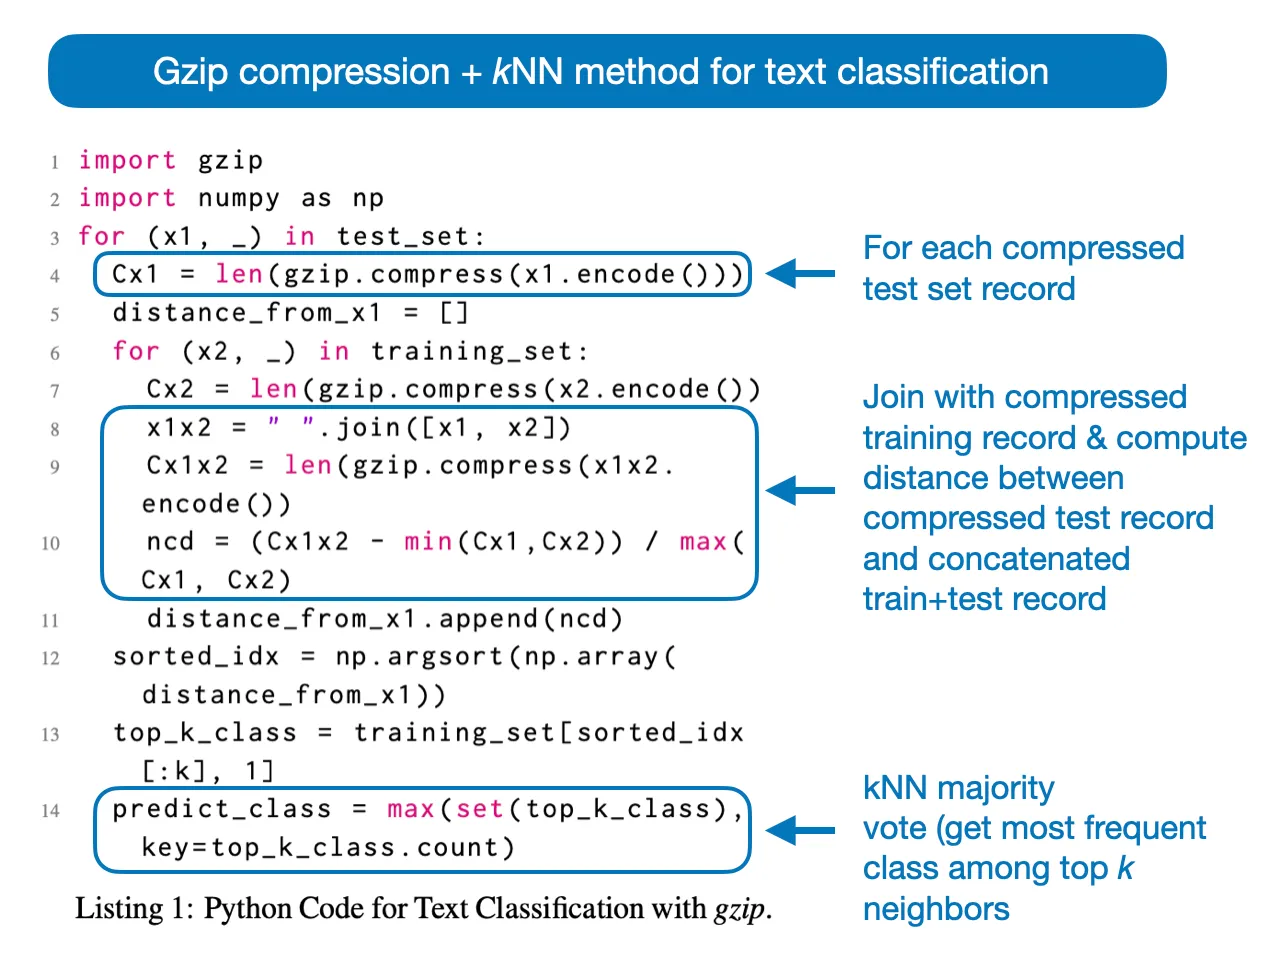
figure01

k=5时的k近邻分类器示意图

值得注意的是,该算法无需训练过程,因为每次对新数据点分类时,我们只需要在训练集中找出k个最近邻即可。(缺点是每次预测都需要遍历整个训练集,当训练集规模较大时,计算成本会很高。)

要理解下面这篇论文,了解上述kNN的基础知识基本就足够了。不过如果大家想了解更多细节,我在本文末尾补充了相关信息与拓展资料,其中包括提升kNN计算效率的方法。

《低资源场景下的文本分类:一种基于压缩器的无参数分类方法》

几周前,这篇论文(https://aclanthology.org/2023.findings-acl.426/)在ACL 2023(https://2023.aclweb.org/)上引发热议时,我就在自己的社交渠道聊过相关内容——当时我正在参加SciPy 2023会议(https://www.scipy2023.scipy.org/),这篇论文也成了好几次晚宴上的讨论话题。

不过我没有把它收录进上一期的《三句话讲AI研究亮点》(https://magazine.sebastianraschka.com/p/ai-research-highlights-in-3-sentences-738),因为严格来说,这篇工作是基于2022年12月发布在arXiv上的论文(https://arxiv.org/abs/2212.0941),而那篇论文可能是更早的会议投稿版本。

闲话不多说,我们来深入看看这篇ACL论文(https://aclanthology.org/2023.findings-acl.426/)到底讲了什么。

基于gzip的文本分类

简而言之,这篇《低资源文本分类》论文提出使用gzip压缩格式与工具(https://en.wikipedia.org/wiki/Gzip)结合kNN算法来完成文本分类任务。下方带注释的图中的Python代码总结了该方法的流程:
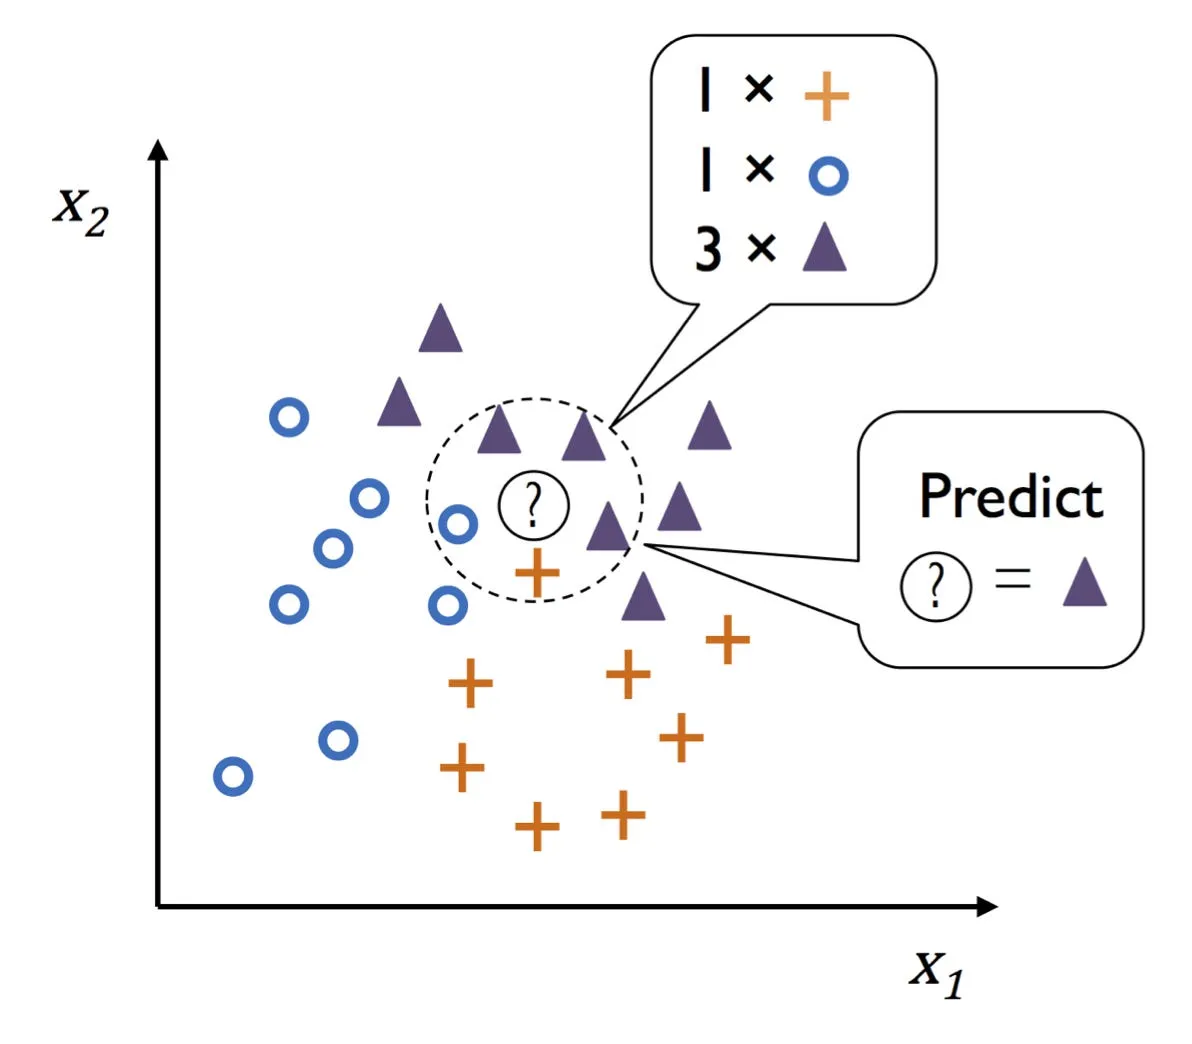
figure02

摘自论文(https://aclanthology.org/2023.findings-acl.426/)的注释图,展示kNN+gzip方法

其中,ncd全称为归一化压缩距离(Normalized Compression Distance),是一种基于两个字符串压缩后的长度来衡量字符串间相似度的指标。计算方式是分别压缩两个独立字符串,再压缩二者拼接后的字符串,通过对比压缩后的长度得到一个分值,范围从0(字符串完全相同)到1(字符串完全不相似)。(下一节会逐步讲解其计算过程。)

出人意料的是,该方法的竞争力很强,在多个数据集上的分类性能几乎和BERT(一种编码器架构的大语言模型,相关讨论见https://magazine.sebastianraschka.com/p/understanding-encoder-and-decoder )不相上下,如下表所示。
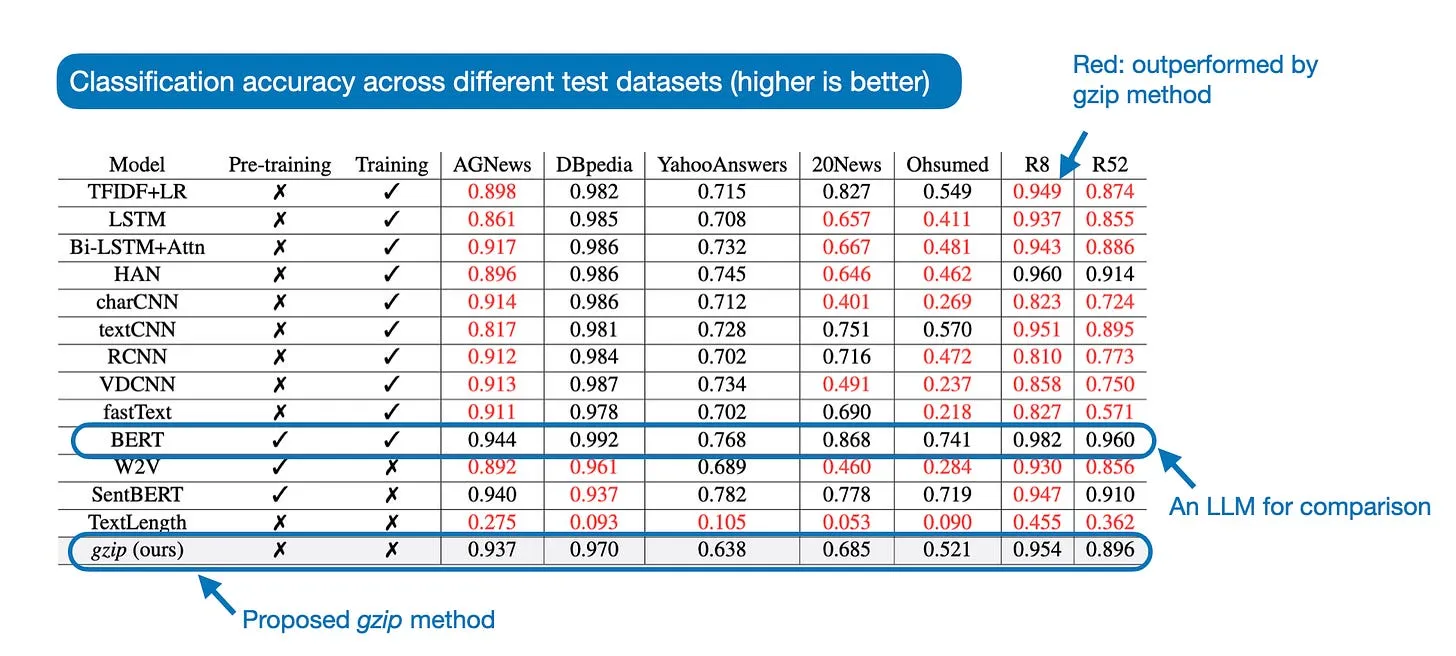
figure03

摘自论文(https://aclanthology.org/2023.findings-acl.426/)的注释图,展示在各文本分类数据集上的性能

而在分布外(OOD)分类与少样本场景下,这种gzip方法的表现超过了BERT以及其他所有方法,如下图所示。(这里的分布外指的是,用于BERT微调与分类的数据集所使用的语言,是BERT预训练阶段从未见过的。)
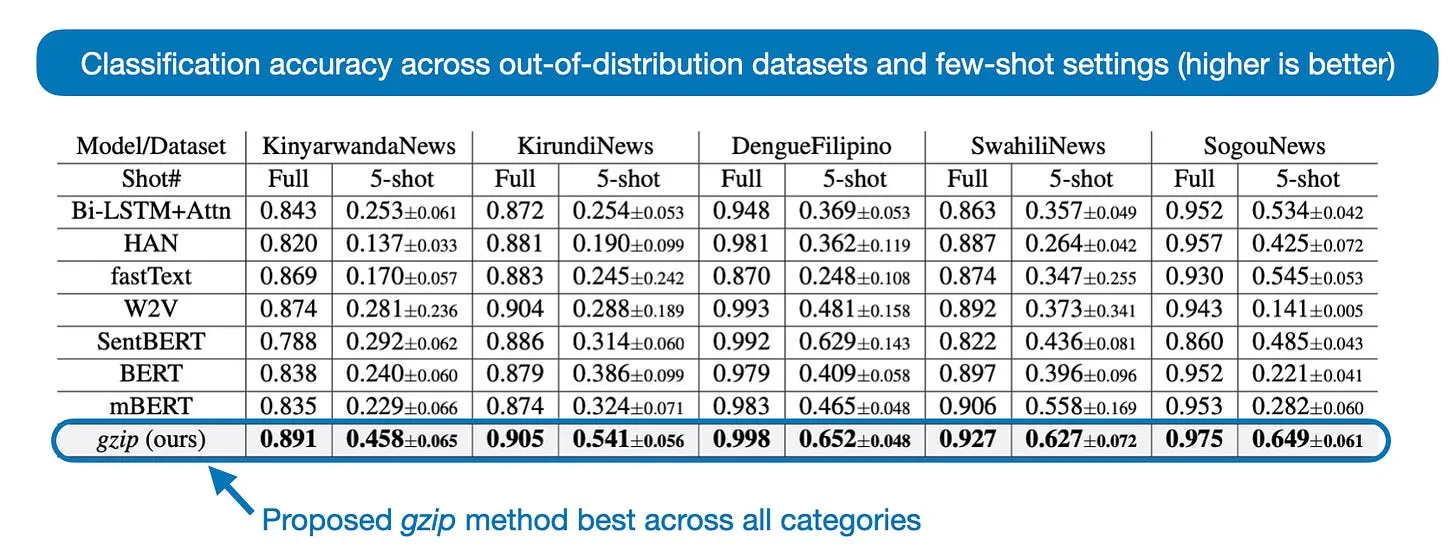
figure04

摘自论文(https://aclanthology.org/2023.findings-acl.426/)的注释图,展示在分布外数据集上的性能

注意,由于代码存在一处问题,这些数值略有偏高,我们后面会谈到这一点。首先,我们先来讲解这个方法的基本原理。

Gzip方法的工作原理是什么?

从宏观层面来看,这种gzip方法利用了压缩算法会去除冗余信息的特性。

举例来说,如果文本1和文本2内容相似,那么文本1单独压缩后的大小,与文本1和文本2拼接后压缩的大小会非常接近。再举一个更极端的例子:一段文本和自身拼接后压缩的大小,和原文本压缩后的大小相近(只会多出用于反向引用的少量固定开销)。

听起来有点复杂?我们用实际的Python代码一步步演示。假设我们有如下两段文本:

txt_1 = "hello world"
txt_2 = "some text some text some text"

我们用gzip对它们进行压缩,然后输出压缩后字符串的长度:

>>> import gzip
>>> len(gzip.compress(txt_1.encode()))
31
>>> len(gzip.compress(txt_2.encode()))
33

可以看到,尽管第二段原文本的长度远长于第一段,但二者压缩后的大小却差不多。这是因为压缩算法利用了txt_2中存在重复内容的特点。

现在我们把文本1和文本2拼接起来,看看压缩后的结果如何:

>>> len(gzip.compress(" ".join([txt_1, txt_2]).encode()))
43

可以看到,拼接后的文本压缩后的长度明显比两个独立文本各自压缩后的长度都要长,这符合预期,因为两段文本内容差异很大。

相反,如果把每段文本和自身拼接,压缩后的长度和原文本压缩后的长度几乎没有差别:

>>> len(gzip.compress(" ".join([txt_1, txt_1]).encode()))
34 
>>> len(gzip.compress(" ".join([txt_2, txt_2]).encode()))
33

注意,文本和自身拼接是一种极端情况。该方法的核心思想是:一段文本和相似文本拼接后压缩的长度,会比它和不同文本拼接后压缩的长度更接近原文本单独压缩的长度,下图总结了这一原理:
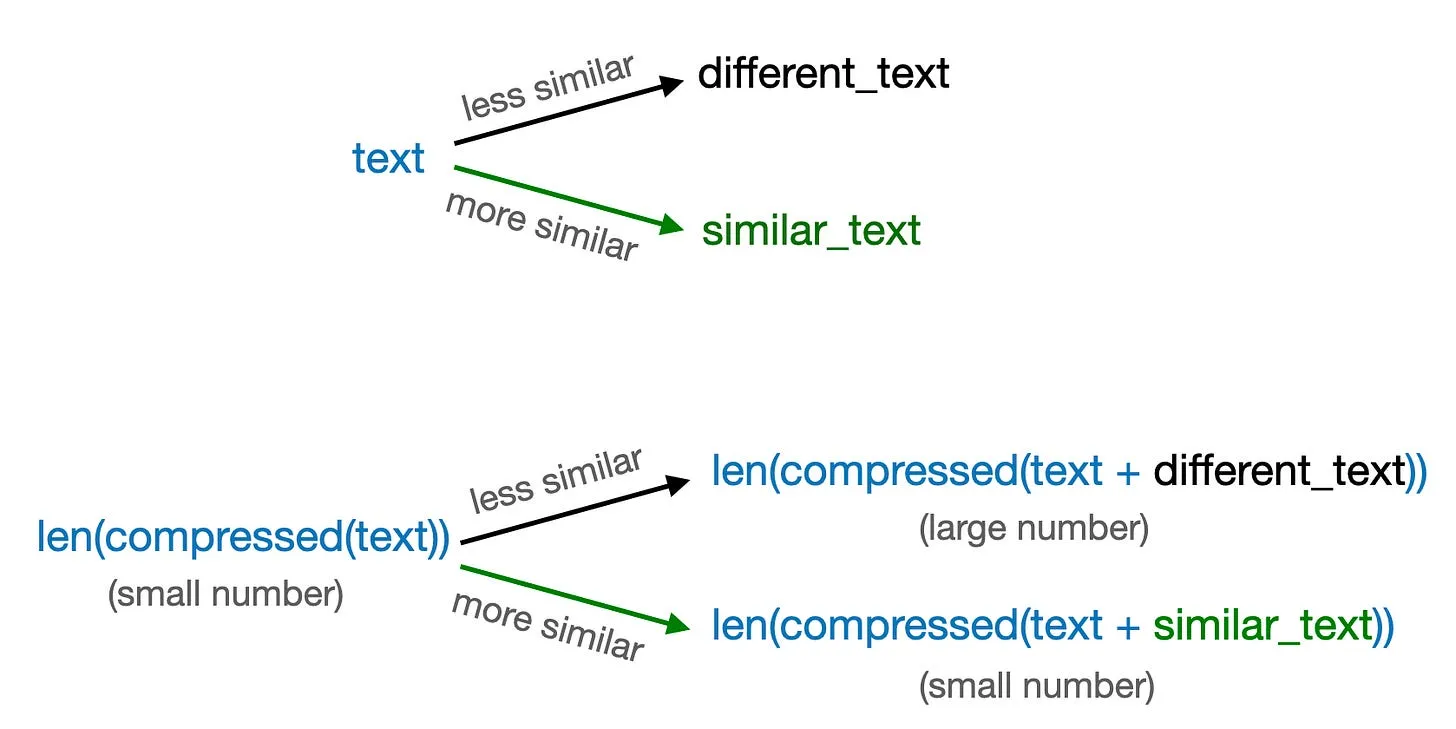
figure05

gzip方法的原理示意图

复现Gzip方法

论文作者分享了一个实现论文实验的代码仓库(https://github.com/bazingagin/npc_gzip)。不过在本节中,我们将根据论文中的描述自己复现该方法,并将其应用于斯坦福情感分类数据集(https://ai.stanford.edu/~amaas/data/sentiment/),该数据集并未出现在原论文的研究中。

代码仓库

我把下面所有实验的代码都放在了这个仓库中:https://github.com/rasbt/nn_plus_gzip

按照我下面的划分方式,IMDB电影评论数据集包含35000条训练样本和10000条测试样本:

import pandas as pd
from local_dataset_utilities import download_dataset, load_dataset_into_to_dataframe, partition_dataset

df_train = pd.read_csv("train.csv")
df_val = pd.read_csv("val.csv")
df_test = pd.read_csv("test.csv")

(local_dataset_utilities工具代码可在此处查看:https://github.com/rasbt/nn_plus_gzip/blob/main/local_dataset_utilities.py )

该二分类任务(预测电影评论是正面还是负面)的基准准确率(始终预测多数类)为50.06%,因为数据集的类别是均衡的:

>>> bcnt = np.bincount(df_test["label"].values)
>>> print(bcnt)
array([5006, 4994]) 
>>> print("Baseline accuracy:", np.max(bcnt)/ bcnt.sum())
Baseline accuracy: 0.5006

现在,基于论文中的Python代码(再次展示如下),
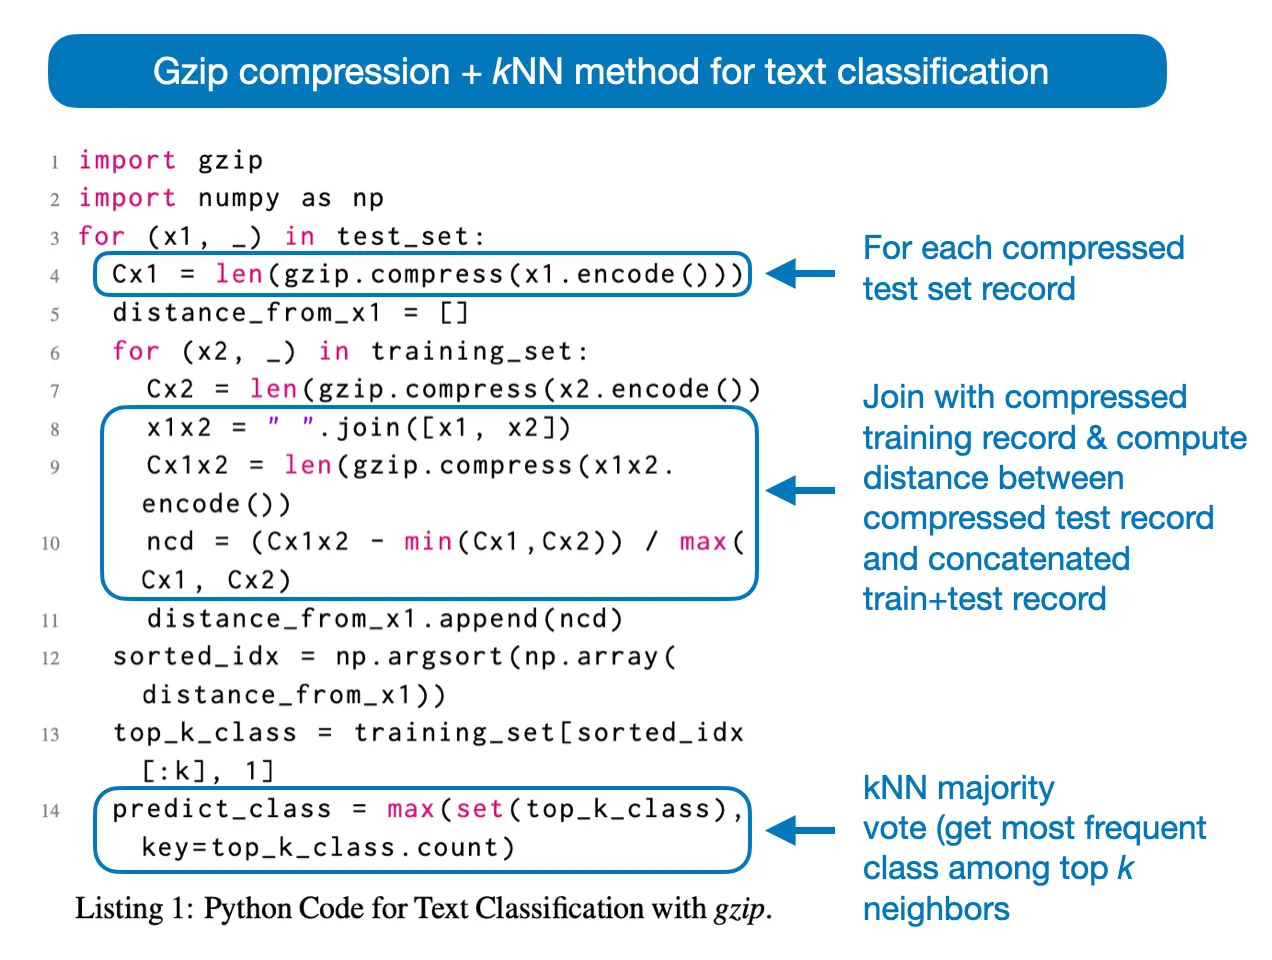
figure016

摘自论文(https://aclanthology.org/2023.findings-acl.426/)的注释图,展示kNN+gzip方法

我们可以这样实现gzip方法:

import gzip
import numpy as np
from tqdm import tqdm

k = 2
predicted_classes = []

for row_test in tqdm(df_test.iterrows(), total=df_test.shape[0]):
    test_text = row_test[1]["text"]
    test_label = row_test[1]["label"]
    c_test_text = len(gzip.compress(test_text.encode()))
    distance_from_test_instance = []
        
    for row_train in df_train.iterrows():
        train_text = row_train[1]["text"]
        train_label = row_train[1]["label"]
        c_train_text = len(gzip.compress(train_text.encode()))
            
        train_plus_test = " ".join([test_text, train_text])
        c_train_plus_test = len(gzip.compress(train_plus_test.encode()))
            
        ncd = ( (c_train_plus_test - min(c_train_text, c_test_text))
                / max(c_test_text, c_train_text) )
        distance_from_test_instance.append(ncd)
        
    sorted_idx = np.argsort(np.array(distance_from_test_instance))
        
    top_k_class = list(df_train.iloc[sorted_idx[:k]]["label"].values)
    predicted_class = max(set(top_k_class), key=top_k_class.count)
    predicted_classes.append(predicted_class)

print("Accuracy:", np.mean(np.array(predicted_classes) == df_test["label"].values))

这段代码运行了大约一天,最终准确率为70.05%(文件路径:file:///Users/sebastian/CloudDrive/project-data/write__nn-gzip/1_1_nn_plus_gzip_original.ipynb )。注意我们设置k=2,并且没有对数据进行预处理,这两个设置都和原论文作者在所有实验中使用的一致。

修正平局打破机制

实际使用k=2时会有一个小问题:比如当两个最近邻的标签是[0, 1]或者[1, 0]时,该如何打破平局?

按照论文提供的代码,出现平局时算法总会选择索引更小的类别标签。换句话说,该方法对类别标签0存在偏向:

>>> top_k_class = [0, 1]
>>> max(set(top_k_class), key=top_k_class.count))
0
​
>>> top_k_class = [1, 0]
>>> max(set(top_k_class), key=top_k_class.count)
0
​
>>> top_k_class = [1, 0, 2]
>>> max(set(top_k_class), key=top_k_class.count)
0

更合理的平局打破方式,是永远选择距离更近的那个近邻。我们可以用Counter对象实现这一点,如下所示。这里假设标签已经按照与待分类样本的近邻距离从小到大排序。

>>> from collections import Counter
>>> top_k_class = [0, 1]
>>> Counter(top_k_class).most_common()[0][0]
0
​
>>> top_k_class = [1, 0]
>>> Counter(top_k_class).most_common()[0][0]
1
​
>>> top_k_class = [1, 2, 0]
>>> Counter(top_k_class).most_common()[0][0]
1

使用这种改进的平局打破机制,我们可以将代码更新如下:

from tqdm import tqdm
from collections import Counter
​
k = 2
​
predicted_classes = []
​
for row_test in tqdm(df_test.iterrows(), total=df_test.shape[0]):
    test_text = row_test[1]["text"]
    test_label = row_test[1]["label"]
    c_test_text = len(gzip.compress(test_text.encode()))
    distance_from_test_instance = []
    
    for row_train in df_train.iterrows():
        train_text = row_train[1]["text"]
        train_label = row_train[1]["label"]
        c_train_text = len(gzip.compress(train_text.encode()))
        
        train_plus_test = " ".join([test_text, train_text])
        c_train_plus_test = len(gzip.compress(train_plus_test.encode()))
        
        ncd = ( (c_train_plus_test - min(c_train_text, c_test_text))
                / max(c_test_text, c_train_text) )
        distance_from_test_instance.append(ncd)
        
    sorted_idx = np.argsort(np.array(distance_from_test_instance))
    top_k_class = np.array(df_train["label"])[sorted_idx[:k]]
    predicted_class = Counter(top_k_class).most_common()[0][0]
    
    predicted_classes.append(predicted_class)
    
print("Accuracy:", np.mean(np.array(predicted_classes) == df_test["label"].values))

这一改动将准确率从70.05%(文件路径:file:///Users/sebastian/CloudDrive/project-data/write__nn-gzip/1_1_nn_plus_gzip_original.ipynb )提升到了71.91%(https://github.com/rasbt/nn_plus_gzip/blob/main/1_2_nn_plus_gzip_fix-tie-breaking.ipynb )。

注:我还实现了一个更高效的版本(https://github.com/rasbt/nn_plus_gzip/blob/main/1_2_caching-multiprocessing.py ),通过缓存训练样本的压缩结果,并在不同CPU核心上并行执行搜索。在MacBook Air上,该版本将IMDB电影评论数据集上的运行时间从12小时缩短到了2小时。

与其他方法的对比

我选择IMDB电影评论数据集做实验,是因为我之前在其他项目中对它比较熟悉。比如,我的《机器学习:基于PyTorch与Scikit-Learn》一书中有这些结果:

使用我的深度学习基础课程(https://lightning.ai/courses/deep-learning-fundamentals/)中的代码(https://github.com/Lightning-AI/dl-fundamentals/blob/main/unit08-large-language-models/8.7-distilbert-finetuning/part3_distilbert-finetuning-whole.ipynb ),甚至有人用RoBERTa-large达到了96.12%的准确率(https://github.com/Lightning-AI/dl-fundamentals/discussions/41 )
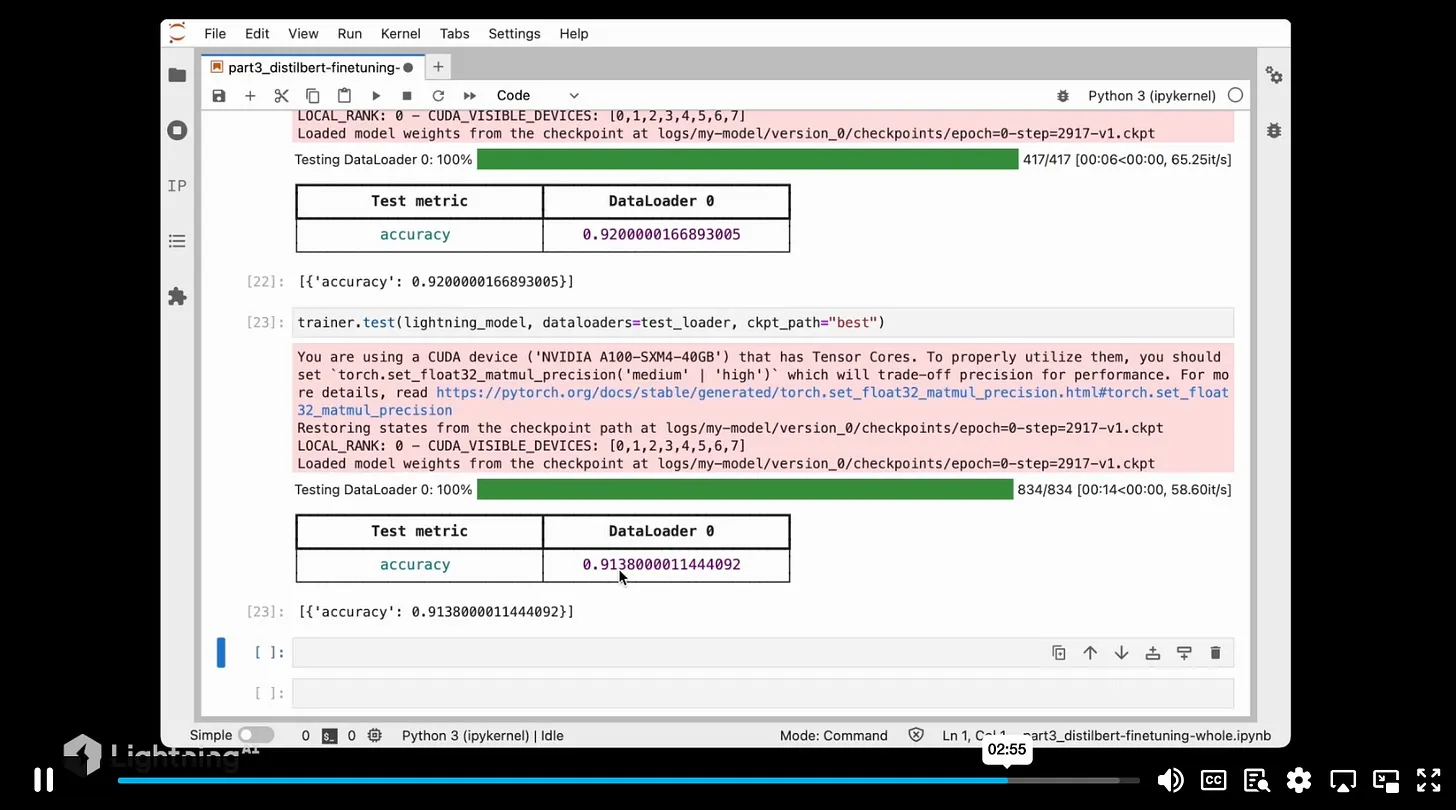
figure07

来自我的深度学习基础课程的基准实现(课程地址:https://lightning.ai/courses/deep-learning-fundamentals/unit-8.0-natural-language-processing-and-large-language-models/8.7-a-large-language-model-for-classification/)

计数向量与余弦相似度

另一个有意思的基准方法,是用kNN从词袋模型中选取相似的词计数向量。(如果大家想了解词袋模型,可以看我的课程:https://lightning.ai/courses/deep-learning-fundamentals/unit-8.0-natural-language-processing-and-large-language-models/8.1-working-with-text-data/ )该方法的原理是:两段相似的文本应该具有相似的计数向量。因此,我们可以不用对比文本压缩后的长度与拼接文本压缩后的长度,而是使用词计数向量。

如果我们有文本1和文本2的词计数向量,当文本相似时,二者相加后的计数向量也会和原向量相似。例如,假设两段完全相同的文本的计数向量如下:

text_1 = [0, 3, 1]
text_2 = [0, 3, 1]

那么,相加后的计数向量就是 [0, 3, 1] + [0, 3, 1] = [0, 6, 2] = 2 × [0, 3, 1]。因此,如果我们对相加前后的计数向量分别做归一化,结果会完全一致:

import numpy as np
​
>>> text_1 = np.array([0., 3., 1.])
>>> text_2 = np.array([0., 3., 1.])
​
>>> text_1 /= np.sum(text_1)
>>> print(text_1)
[0.   0.75 0.25]
​
>>> text_2 /= np.sum(text_2)
>>> print(text_2)
[0.   0.75 0.25]
​
>>> added = text_1 + text_2
>>> print(added / np.sum(added))
[0.   0.75 0.25]

接下来,我们可以用欧氏距离计算两个向量之间的距离:

>>> dist = np.sqrt(np.sum((test_vec - added)**2))

不过,我们也可以直接计算两个向量之间的余弦相似度,二者本质上是等价的:

>>> from numpy.linalg import norm
>>> cosine = 1 - (np.dot(test_vec, train_vec) ...
    /(norm(test_vec)*norm(train_vec)))

(注意,这里需要用1减去余弦相似度,才能得到余弦距离。)

完整代码如下:

from collections import Counter
from tqdm import tqdm
from numpy.linalg import norm
​
​
k = 2
​
predicted_classes = []
​
for i in tqdm(range(df_test.shape[0]), total=df_test.shape[0]):
    test_vec = X_test[i].toarray().reshape(-1)
    test_label = df_test.iloc[i]["label"]
    distance_from_test_instance = []
    
    for j in range(df_train.shape[0]):
        train_vec = X_train[j].toarray().reshape(-1)
        train_label = df_train.iloc[j]["label"]
        
        cosine = 1 - np.dot(test_vec, train_vec)/(norm(test_vec)*norm(train_vec))
        distance_from_test_instance.append(cosine)
        
    sorted_idx = np.argsort(np.array(distance_from_test_instance))
    top_k_class = np.array(df_train["label"])[sorted_idx[:k]]
    predicted_class = Counter(top_k_class).most_common()[0][0]
    
    predicted_classes.append(predicted_class)
    
print("Accuracy:", np.mean(np.array(predicted_classes) == df_test["label"].values))

最终得到的准确率为68.01%(https://github.com/rasbt/nn_plus_gzip/blob/main/4_r8-dataset.ipynb ),虽然不如gzip方法,但差距不大(在4%以内)!

快速测试R8数据集

上面我们在IMDB电影评论数据集上评估了gzip方法,而该数据集不在原论文的研究范围内。为了对比我改进平局打破机制后的复现结果,和原论文所用数据集上的结果,我们来看R8数据集(选它是因为它规模很小,只需要几分钟就能跑完)。
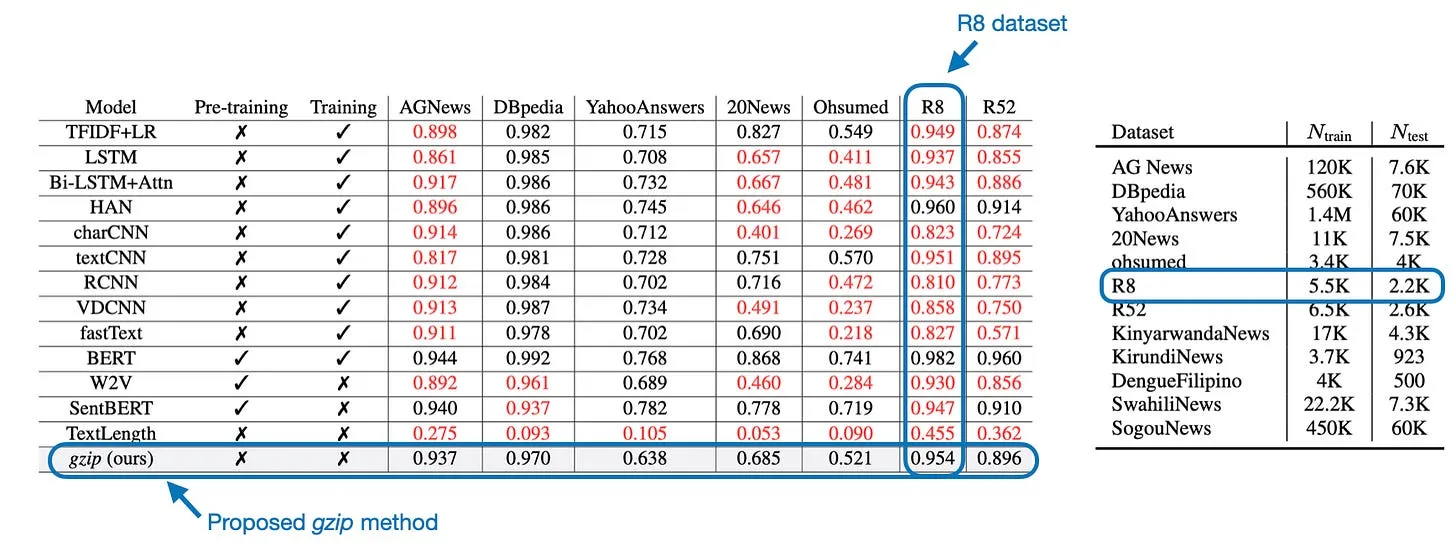
figure08

摘自论文(https://aclanthology.org/2023.findings-acl.426/)的注释图,突出标注了R8数据集

使用论文某张图中描述的“最小索引”平局打破策略,准确率为88.90%(https://github.com/rasbt/nn_plus_gzip/blob/main/4_r8-dataset.ipynb ),低于原论文报告的数值。(原因会在下一节说明。)相比之下,使用我前面提到的改进版平局打破策略,准确率达到了91.27%——但仍然低于原论文的结果。下一节会解释这种差异的来源。

原代码存在的问题

正如Ken Schutte在其文章(https://kenschutte.com/gzip-knn-paper/ )中指出的,在需要解决[0, 1]或[1, 0]这类平局的场景下,选择k=2是个有点奇怪的决定。解决平局的方式有很多种,包括:

  • 始终选择类别索引更小的标签(scikit-learn和原论文图中的Python代码都采用这种方式);
  • 选择两个近邻中距离更近的那个(这是我更推荐的方式,也就是上一节“修正平局打破机制”中实现的方法);
  • 随机决定胜出的标签。

Ken Schutte提到,原论文的代码仓库(https://github.com/bazingagin/npc_gzip )使用了第四种策略,这可能是一个代码bug。比如,它在处理平局时,总会选择测试样本的真实标签:

# here, sorted_pred_lab[][] has the
# labels and counts corresponding
# to the top-k samples,
# [[label,count],[label,count],...]
# grouped-by label and sorted by count.
​
most_label = sorted_pred_lab[0][0]
most_count = sorted_pred_lab[0][1]
​
if_right = 0
for pair in sorted_pred_lab:
    # we loop until we drop below 'most_count', ie
    # this for-loop iterates over those classes
    # tied for highest count
    if pair[1] < most_count:
        break
​
    # this says if ANY of those
    # in the tied-set are equal to
    # the test label,
    # it is marked correct (if_right=1)
    if pair[0] == label[i]:
        if_right = 1
        most_label = pair[0]
​
# accumulate results:
    pred.append(most_label)
correct.append(if_right)

根据Ken Schutte的分析,修正平局打破机制后,“gzip方法的表现从最优变成了最差”。

除此之外,数据集还存在重叠问题,Yann Dubois在这条推文中提到了这一点:https://twitter.com/yanndubs/status/1681325900170776578?s=20
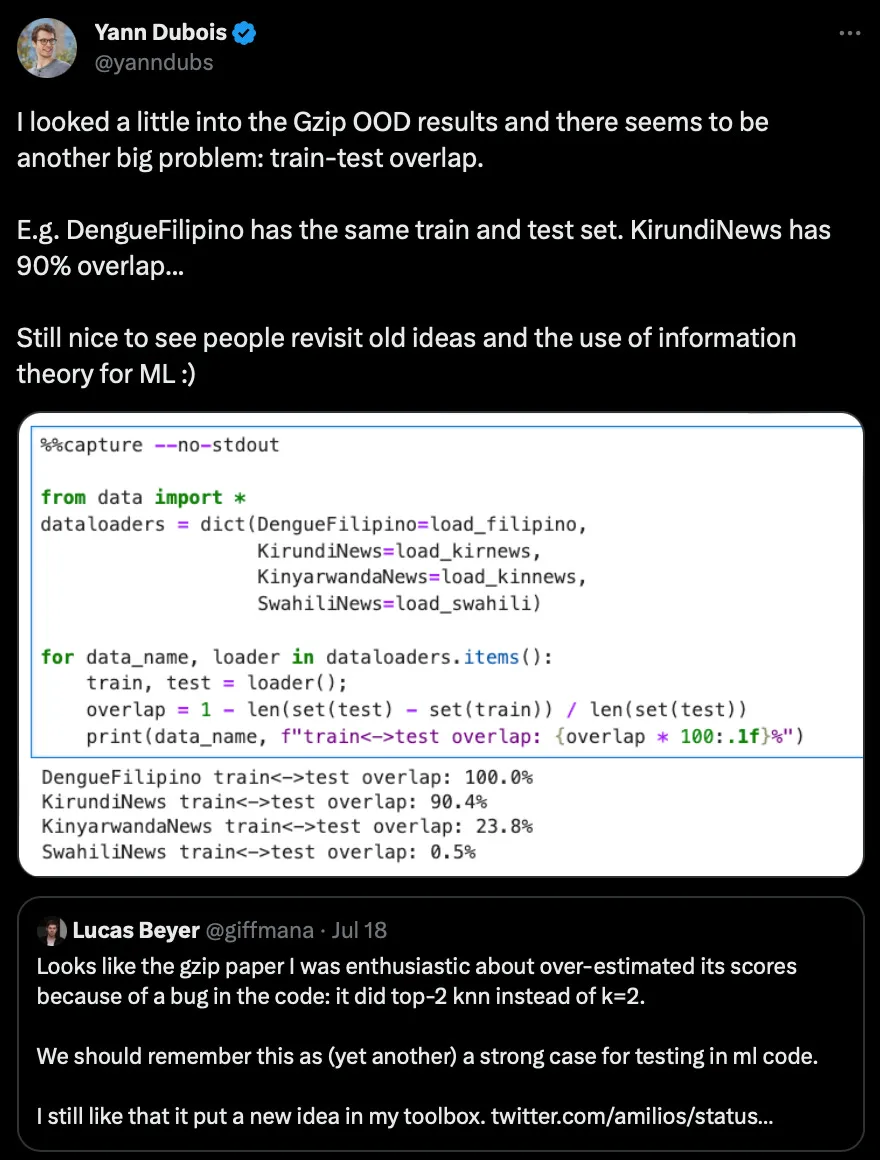
figure09

基准测试中潜在的数据重叠问题

不过据我理解,这种重叠或多或少会影响论文中评估的所有方法。如果大家想了解训练集与测试集重叠问题的更多细节,推荐看Ken Schutte的后续文章:https://kenschutte.com/gzip-knn-paper2/

总结与思考

这篇ACL论文(https://aclanthology.org/2023.findings-acl.426/ )提出的gzip方法是一项非常优雅、极具启发性的研究成果,我非常享受探索它的过程。

遗憾的是,该方法实际的预测性能可能比论文报告的要差,但它仍然是一个很有意思的思路。

我们应该在实际中使用它吗?一方面,这个方法有很多优点:它是一个很简洁的基准方法,而且不需要GPU,在当前GPU紧缺的背景下这是很大的优势。另一方面,它的效果显然没有宣传的那么好,而且kNN也不太容易适配更大规模的数据集——作为参考,我在IMDB上的朴素实现,用单个CPU跑了整整一天才完成。

这件事积极的一面在于,我们有了一种全新的、简洁的基准方法。同时这篇论文也凸显了,在学术成果传播中,开放源代码与社区讨论是多么重要——这是传统的同行评审无法替代的。

拓展阅读资料

下面是我觉得不错的几篇同主题文章:

近邻方法详解

近邻算法是“最简单”的有监督机器学习算法之一,在过去一个世纪的模式识别领域中已经被研究得非常透彻。尽管近邻算法如今不如从前热门,但在实际中仍被广泛使用。我非常推荐大家在分类项目中把k近邻算法作为预测性能的基准,尤其是在开发更复杂的模型时。

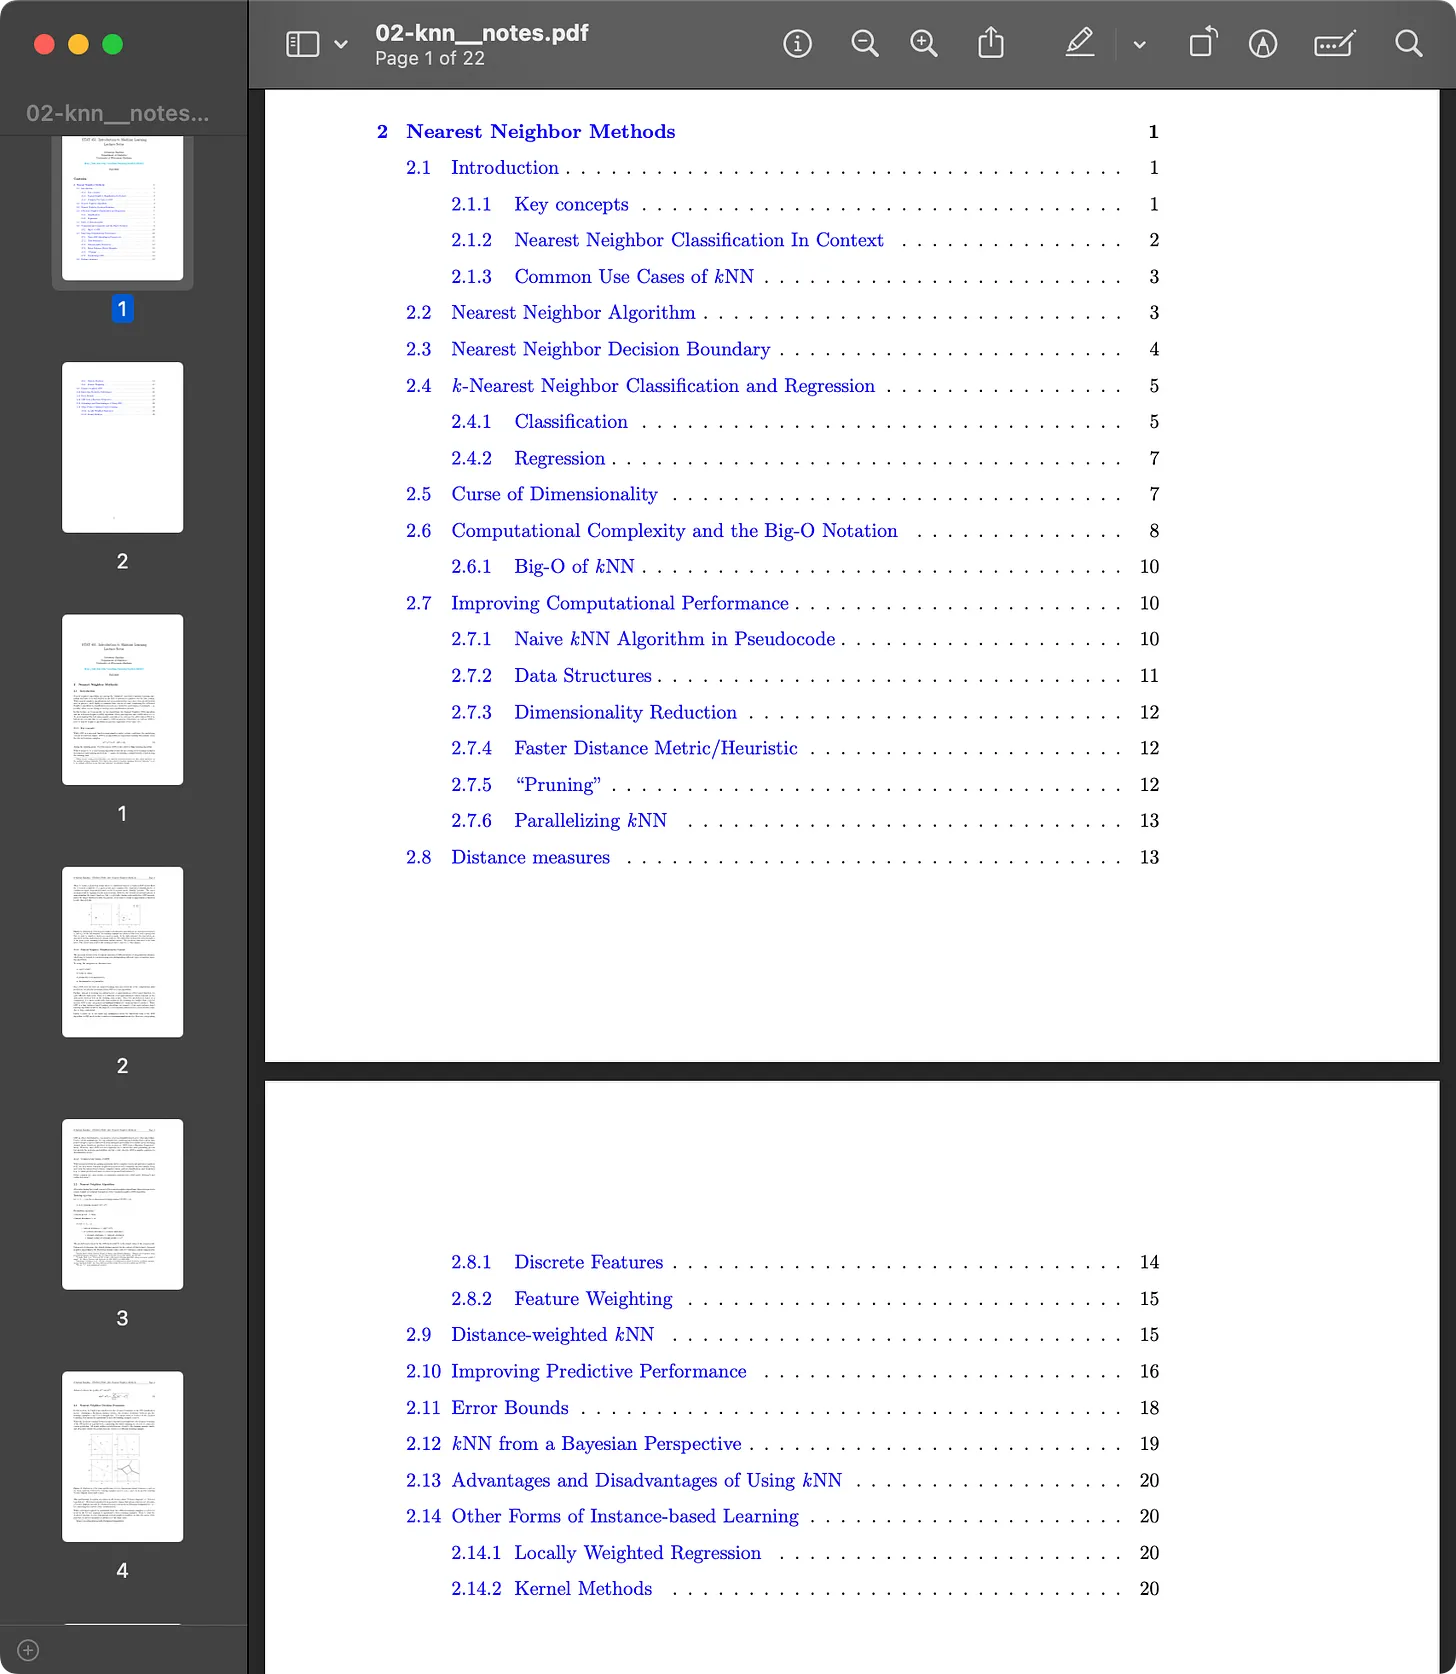
如果大家想深入学习包括k近邻在内的近邻方法,我有一份20页的讲义,是几年前我教授机器学习课程时编写的。

不过即便你已经熟悉了基础知识,也可以看看第2.7节“提升计算性能”,其中的内容在实际机器学习工作和面试中都很实用:

  • 使用优先队列
  • 数据结构:分桶法、KD树、球树
  • 降维
  • 更快的距离度量与启发式方法
  • 剪枝
  • kNN的并行化

figure10

你可以在这里下载这份讲义:https://sebastianraschka.com/pdf/lecture-notes/stat451fs20/02-knn__notes.pdf

这本杂志是我个人的兴趣项目,没有直接的经济收益。不过如果大家想支持我,可以考虑购买我的书:https://sebastianraschka.com/books 。如果你觉得这些书有启发、有帮助,也欢迎推荐给你的朋友和同事。
figure11

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics ,以及 http://mng.bz/M96o

你的支持对我意义重大!非常感谢!
【转载】长上下文与将Transformer扩展至10亿令牌

原文地址:Long Contexts and Scaling Transformers to 1,000,000,000 Tokens, by Sebastian Raschka, on 2023-07-15

长上下文与将Transformer扩展至10亿令牌

在本文中,我整理并点评了2023年6月至7月的24项AI研究亮点。自然语言处理与计算机视觉领域再次涌现出大量令人振奋的新进展!

此外,如果你对上个月的研究亮点感兴趣,可以在这里查看:
https://magazine.sebastianraschka.com/p/ai-research-highlights-in-3-sentences-2a1

大语言模型

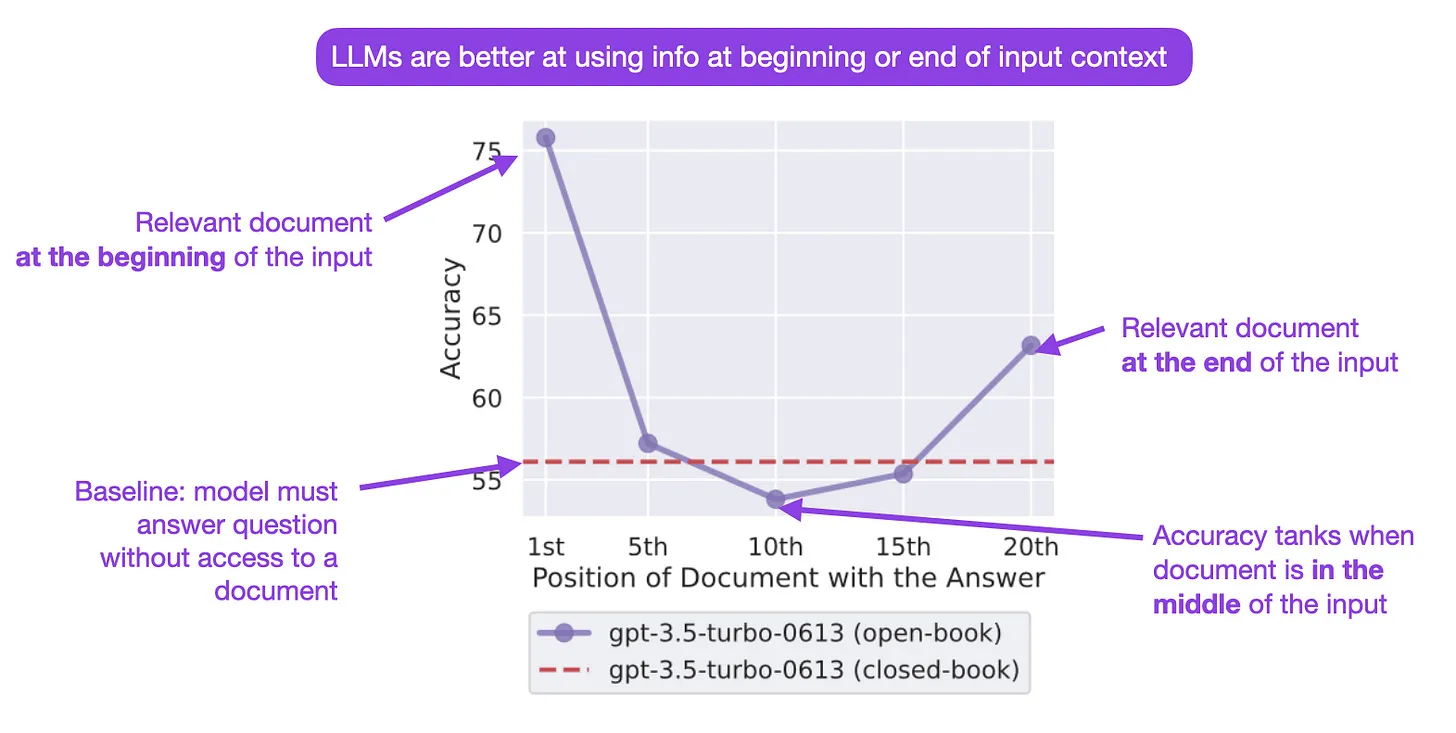
《迷失在中间:语言模型如何利用长上下文》(7月6日,https://arxiv.org/abs/2307.03172)

在这篇论文中,研究人员探究了ChatGPT等大语言模型从输入上下文的不同位置检索相关信息的表现。结果发现,当信息位于文档中间位置时,ChatGPT的信息检索效果会变差。Claude等其他大语言模型的表现则稍好一些。
figure01

《LongNet:将Transformer扩展至10亿令牌》(7月5日,https://arxiv.org/abs/2307.02486)

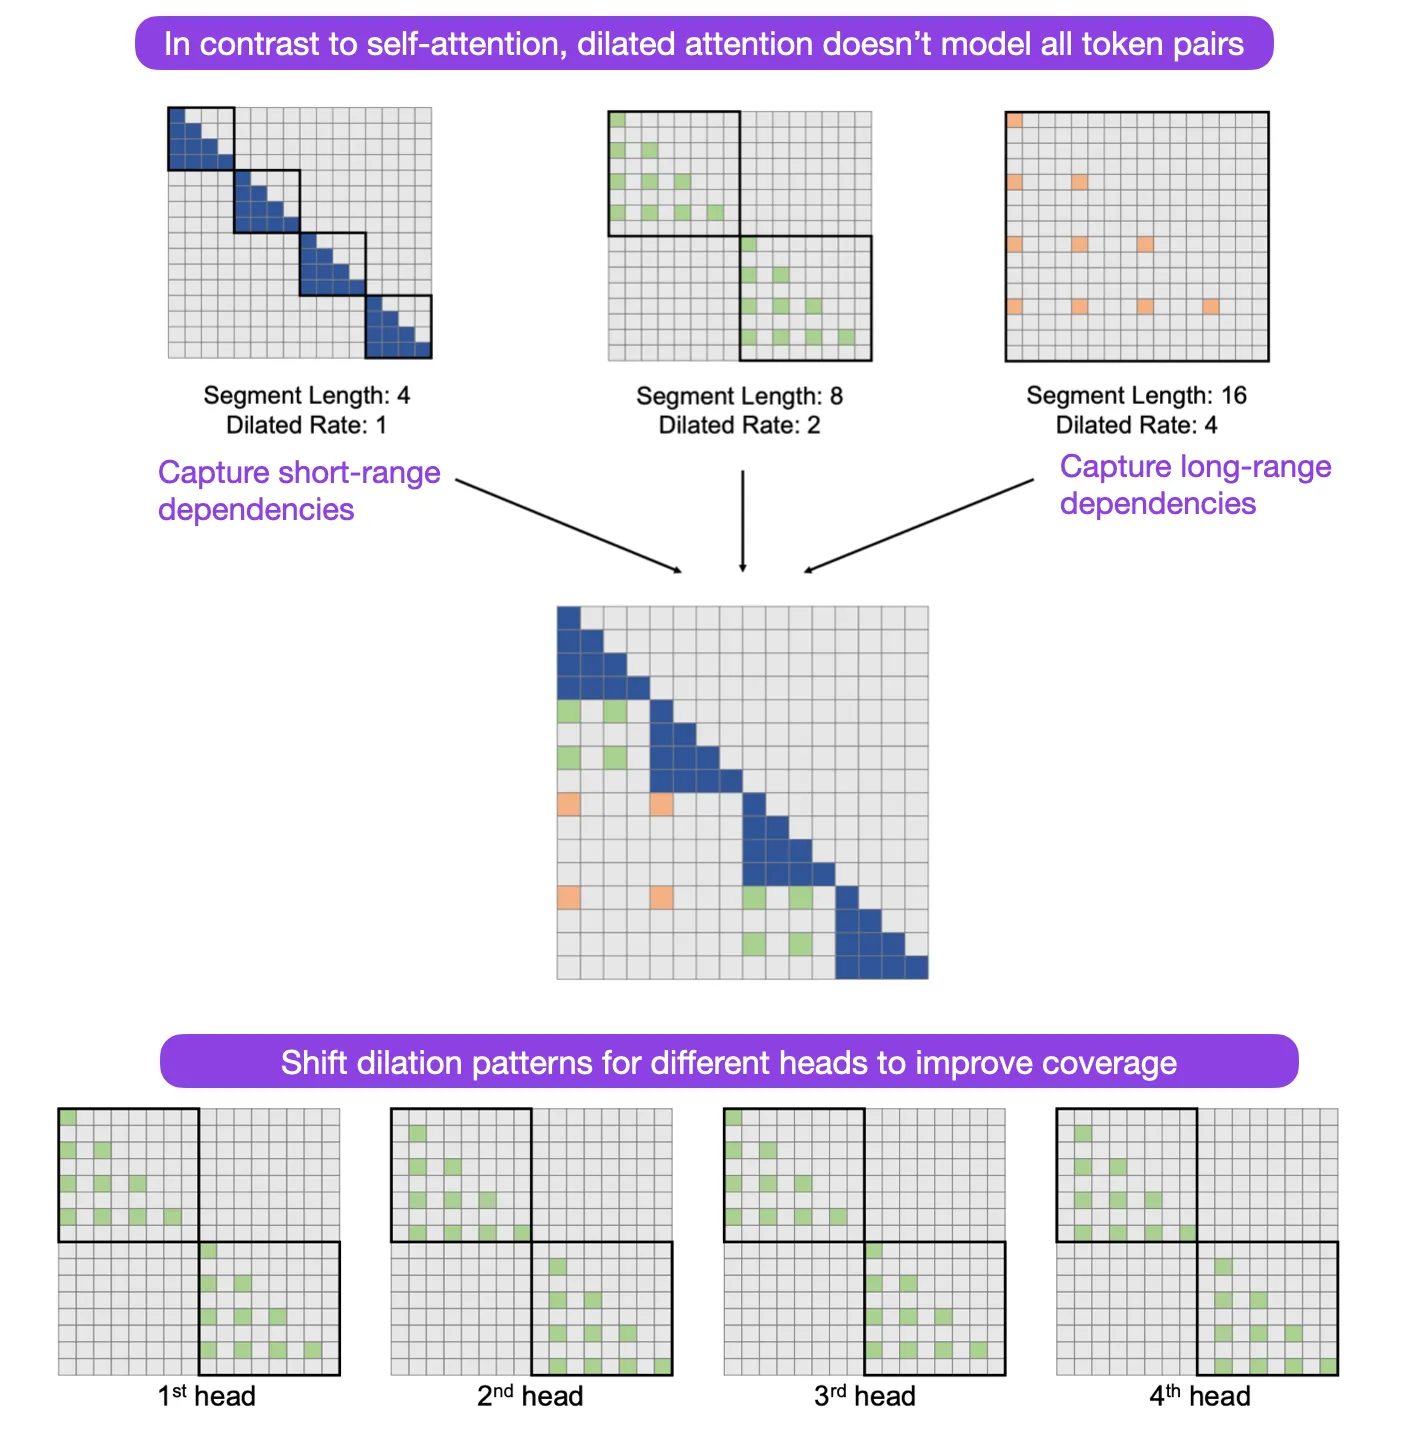
近期我们已经看到了数项将大语言模型扩展至更长上下文长度的尝试,包括将Transformer大语言模型扩展至100万令牌的RMT论文,以及支持100万令牌的卷积架构Hyena大语言模型。在这篇论文中,作者提出了LongNet,旨在将Transformer大语言模型的上下文长度扩展至10亿(1B)令牌。与数年前发表的BigBird类似,它通过膨胀注意力(而非自注意力)实现了线性(而非二次)复杂度的扩展;但不同之处在于,BigBird对令牌对采用的是启发式的随机模式。
figure02

《使用4位整数训练Transformer》(6月21日,https://arxiv.org/abs//2306.11987)

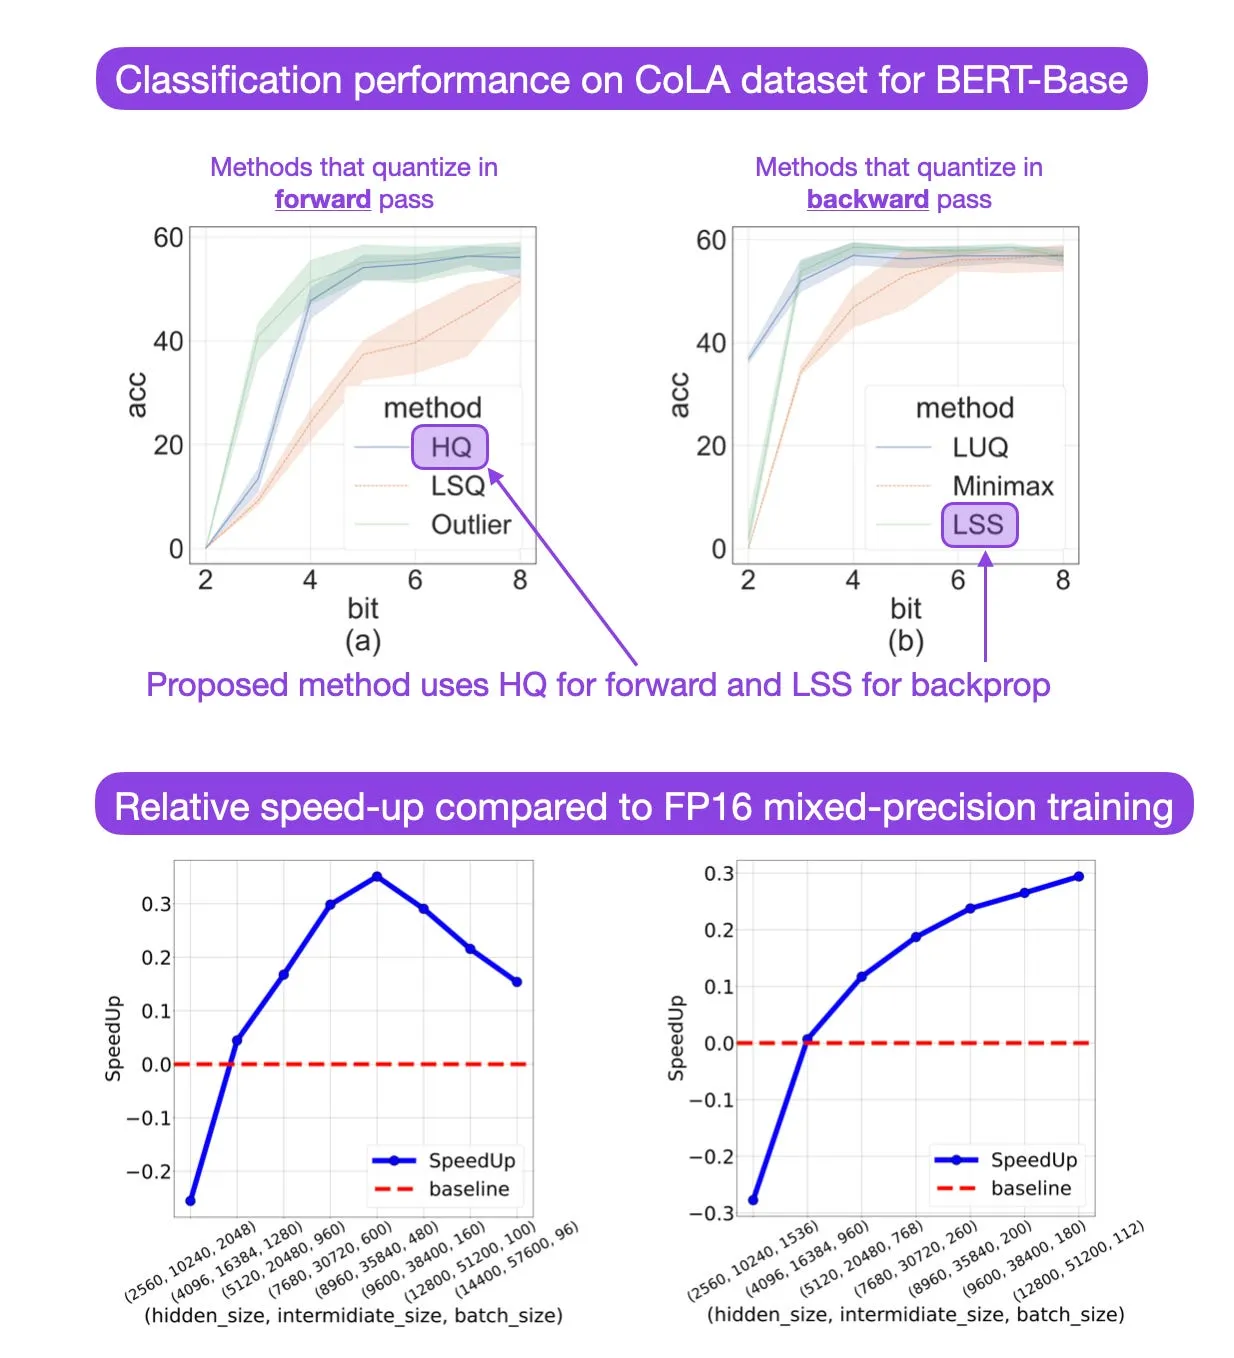
这篇论文提出了一种加速神经网络训练的新方法:采用INT4算术,将激活值、权重和梯度都量化为4位精度,且专门针对Transformer架构设计。与现有的4位训练方法不同,该方法无需自定义数值格式,因此可以在当前世代的GPU上直接实现。该方法在多项任务上都取得了具有竞争力的准确率,最多可将训练过程提速35.1%(论文未讨论显存节省情况)。
figure03

通过位置插值扩展大语言模型的上下文窗口(6月27日,https://arxiv.org/abs/2306.15595)

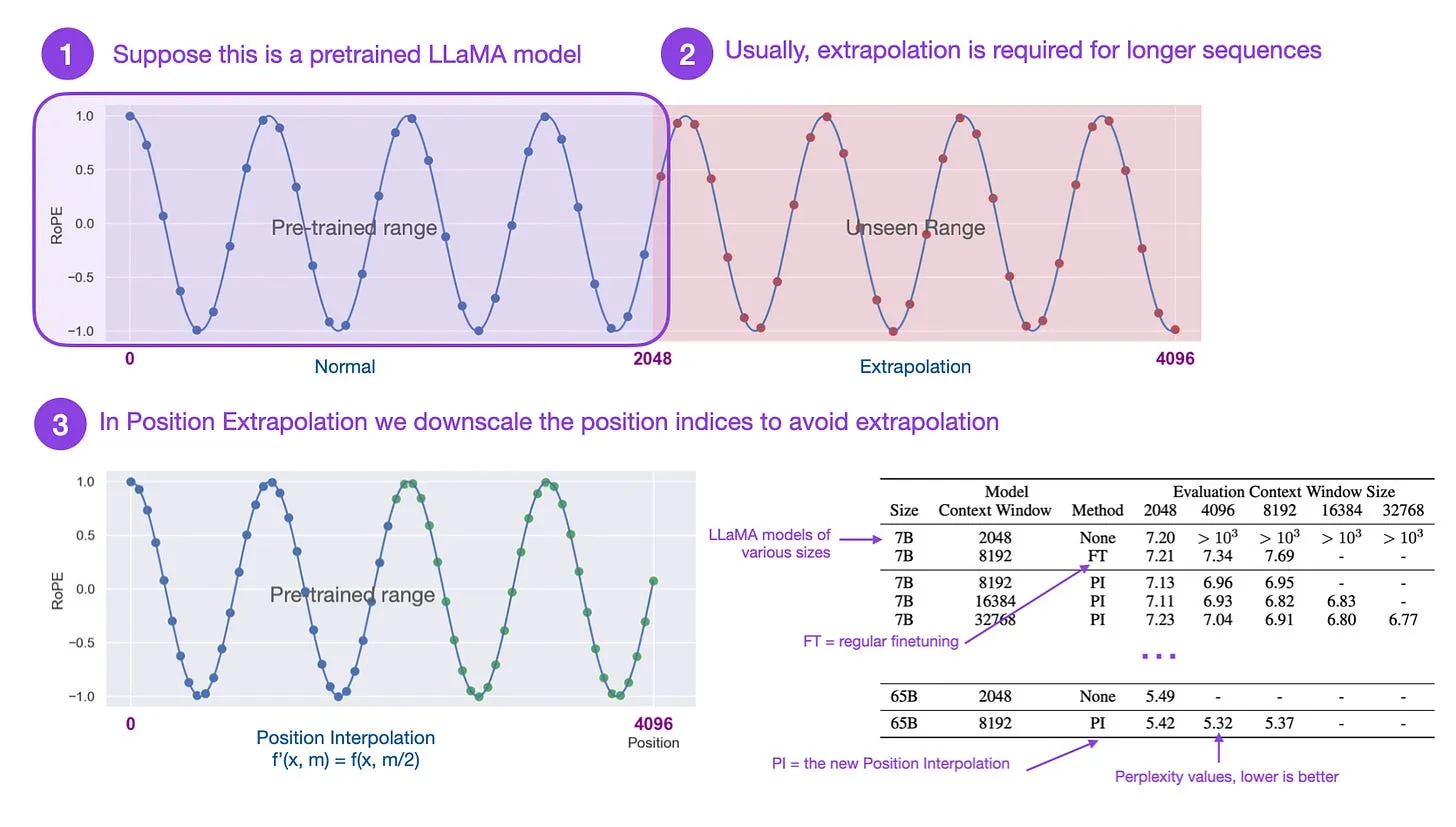
旋转位置嵌入(RoPE,https://arxiv.org/abs/2104.09864)因其支持灵活的序列长度,已成为现代大语言模型实现中的核心技术。在这篇论文中,研究人员提出了位置插值法,仅需最少的微调(1000步),即可将基于RoPE的模型上下文窗口扩大至32768令牌。例如,该方法可让LLaMA 7B和65B模型实现长文档摘要功能。
figure04

大语言模型是高效的文本排序器:基于成对排序提示的方法(6月30日,https://arxiv.org/abs/2306.17563)

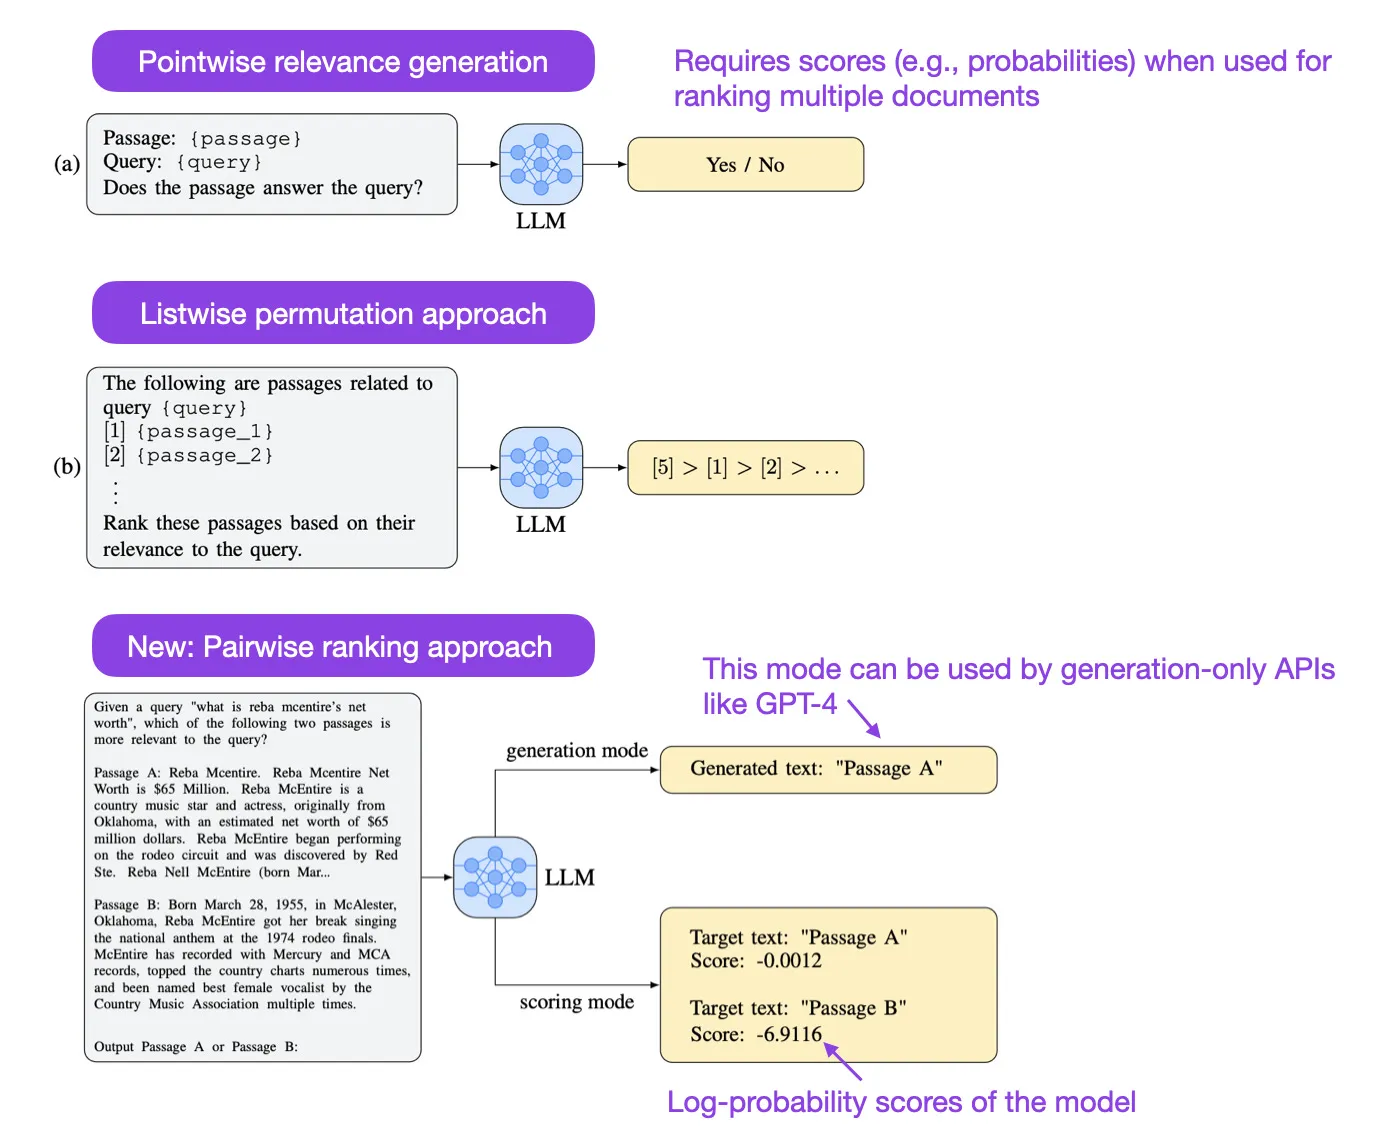
研究人员针对相关性排序任务评估了大语言模型的表现——该任务既和普通用户的使用场景相关,也是研究人员评估大语言模型性能的常用维度(不过论文并未明确探讨后一种应用场景)。他们对比了逐点排序方法(这类方法不适用于GPT-4等API,因为用于排序时需要获取对数概率)和列表式排序方法,并提出了一种全新的成对排序提示方法。采用这种新的成对排序方法后,即便是基于FLAN-T5和FLAN-UL2的中等规模开源大语言模型,也能取得出色的表现(与参数量是其10到50倍的gpt-3.5.turbo效果相当)。
figure05

自带数据!大语言模型的自监督评估方法(6月23日,https://arxiv.org/abs//2306.13651)

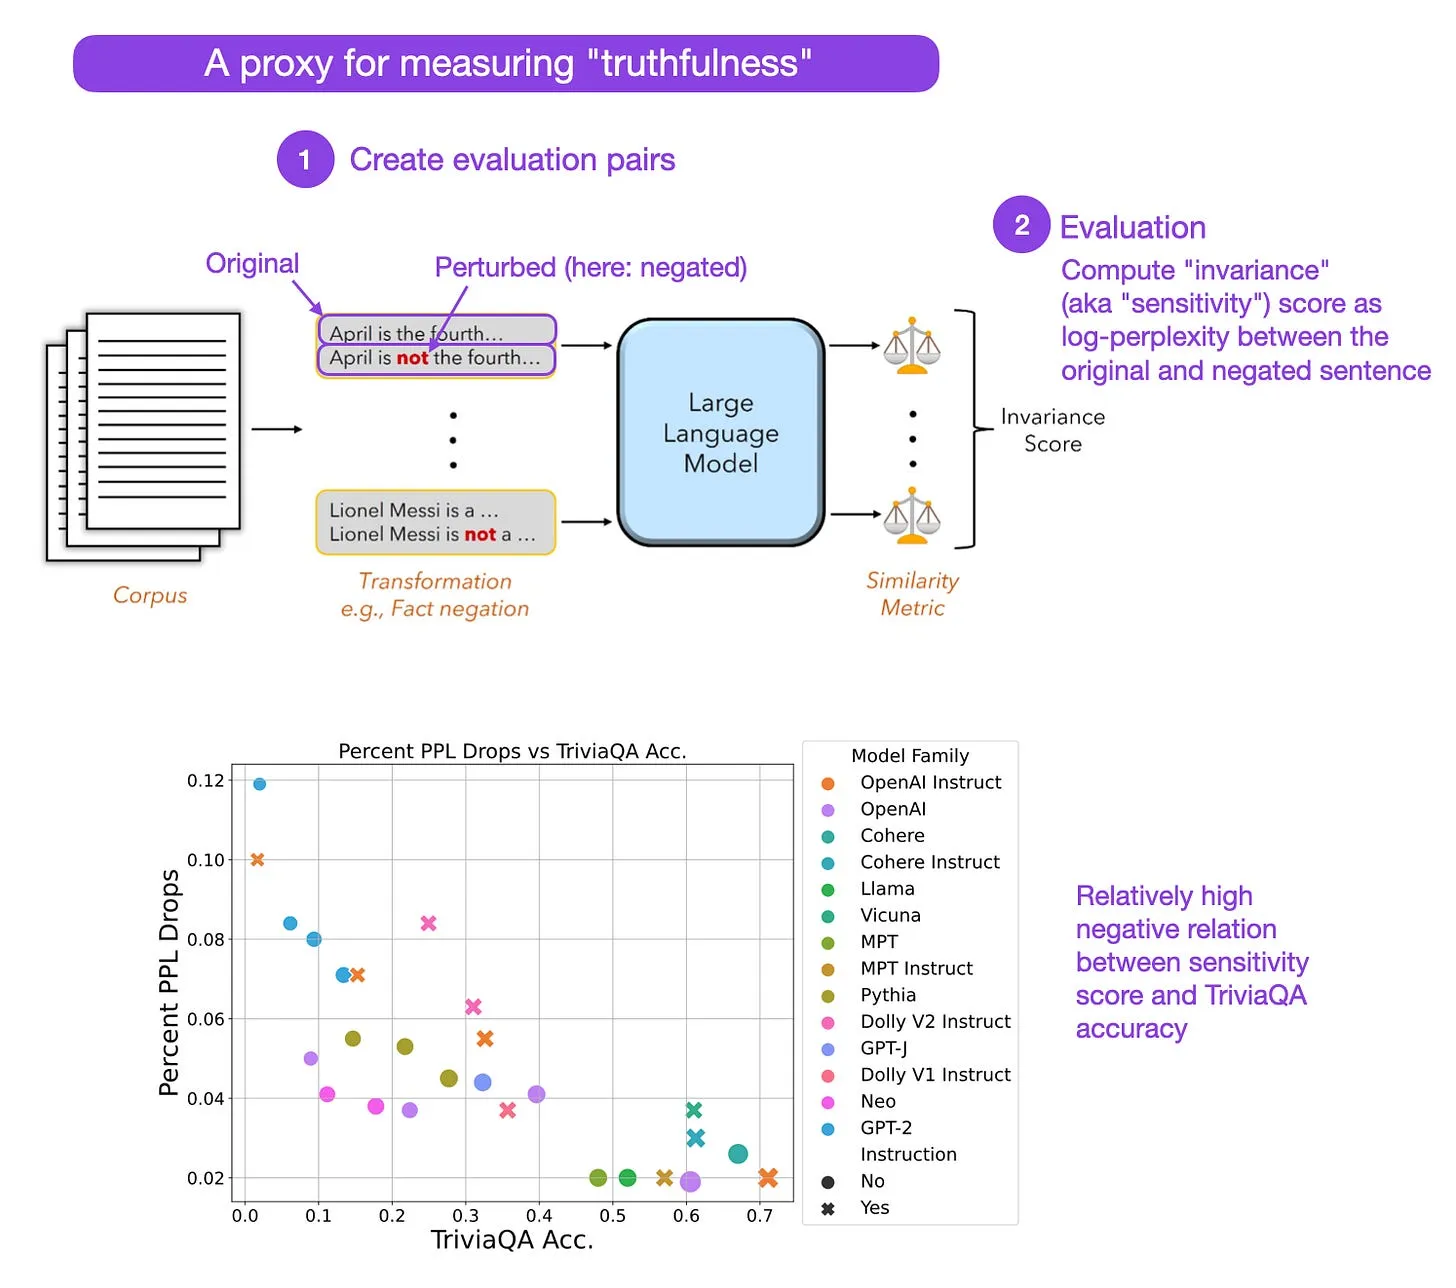
毋庸置疑,在面向客户的应用中,确保大语言模型输出真实内容、不生成不当言论,是大语言模型落地现实场景的核心挑战。研究人员没有依赖规模小、经过人工整理,且可能已泄露进训练集的评估数据集,而是提出了一种自监督的评估方案。他们发现,自监督评估结果与人类评估结果具有强相关性,说明该方法具备可行性。
figure06

聚焦型Transformer:面向上下文扩展的对比训练(7月6日,https://arxiv.org/abs/2307.03170)

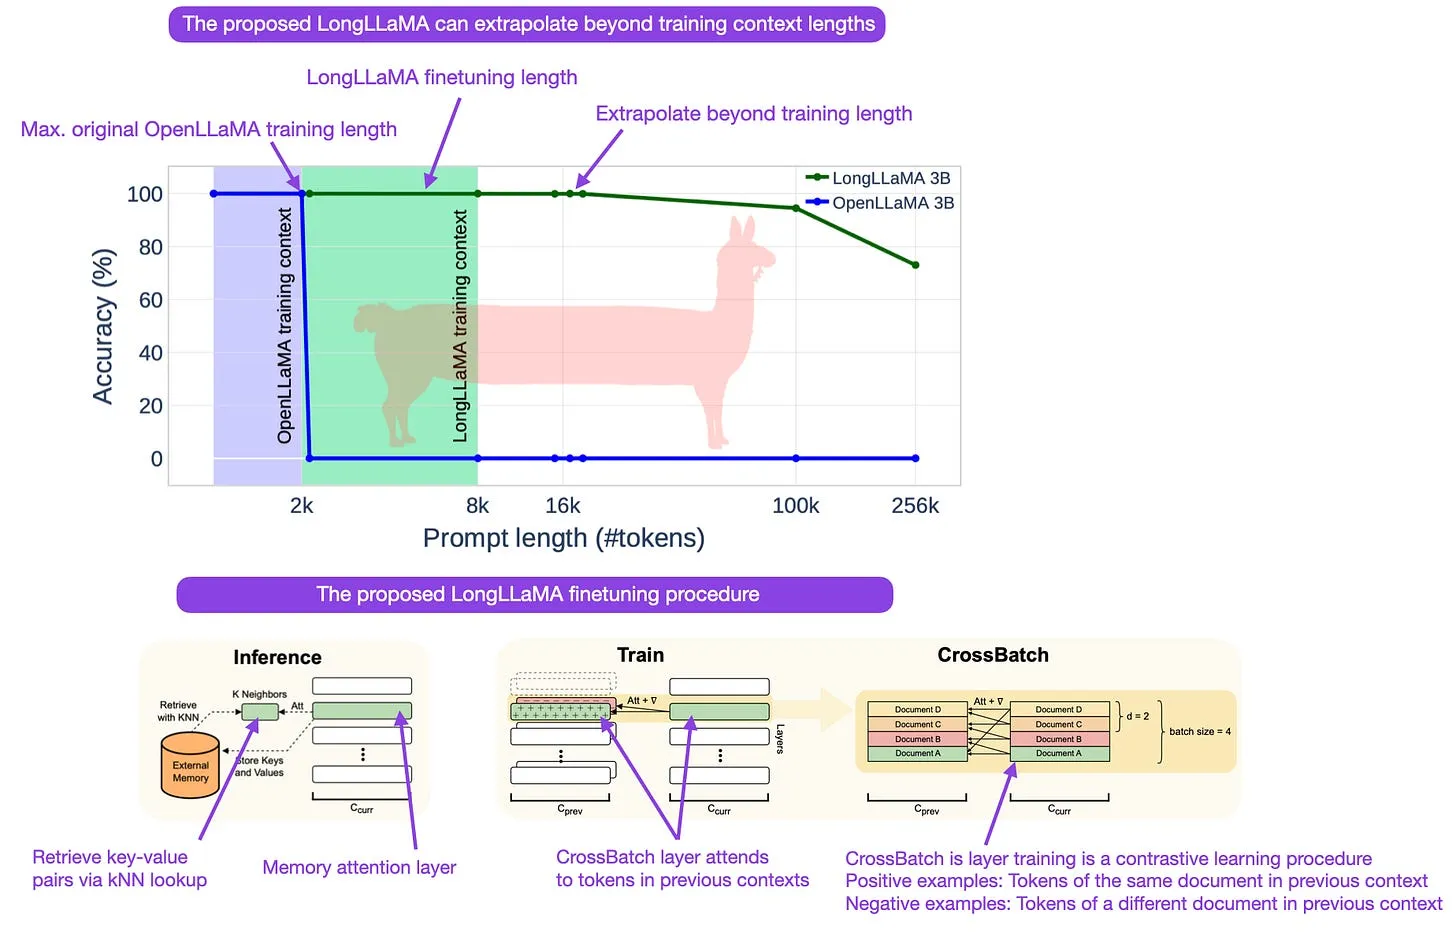
解决大语言模型上下文长度限制的一种方案是访问外部存储的文档(例如通过向量数据库的方式)。但数据库越大,针对给定查询包含的无关键值就越多,进而会降低模型的表现。为了解决这一问题,研究人员提出了“聚焦型Transformer”,通过一种全新的对比学习流程对OpenLLaMA等大语言模型进行微调。
figure07

《课本就是你所需的全部》(6月20日,https://arxiv.org/abs/2306.11644)

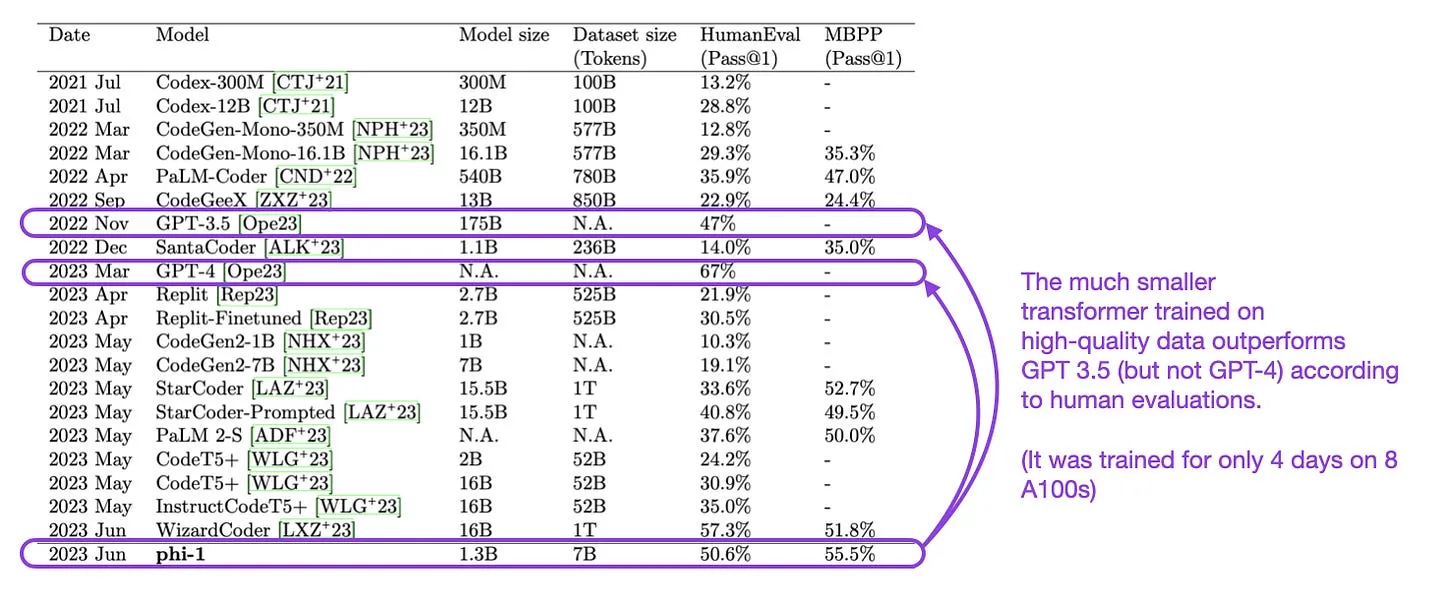
在这篇论文中,研究人员用高质量数据集训练了一个参数量极小的Transformer模型——仅13亿参数。训练数据包括从网络获取的60亿令牌“课本级质量”数据集,加上通过GPT-3.5生成的10亿令牌习题。作为对比,GPT-3/GPT-3.5的参数量是其130倍(1750亿参数),同量级的LLaMA模型则是在1万亿令牌上训练的(数据量是其140倍)。尽管模型规模小得多、训练数据集也小得多(但质量更高),该模型的表现仍超过了GPT-3.5(不过未超过GPT-4)。
figure08

《ClinicalGPT:基于多元医疗数据微调并经过全面评估的大语言模型》(6月16日,https://arxiv.org/abs/2306.09968)

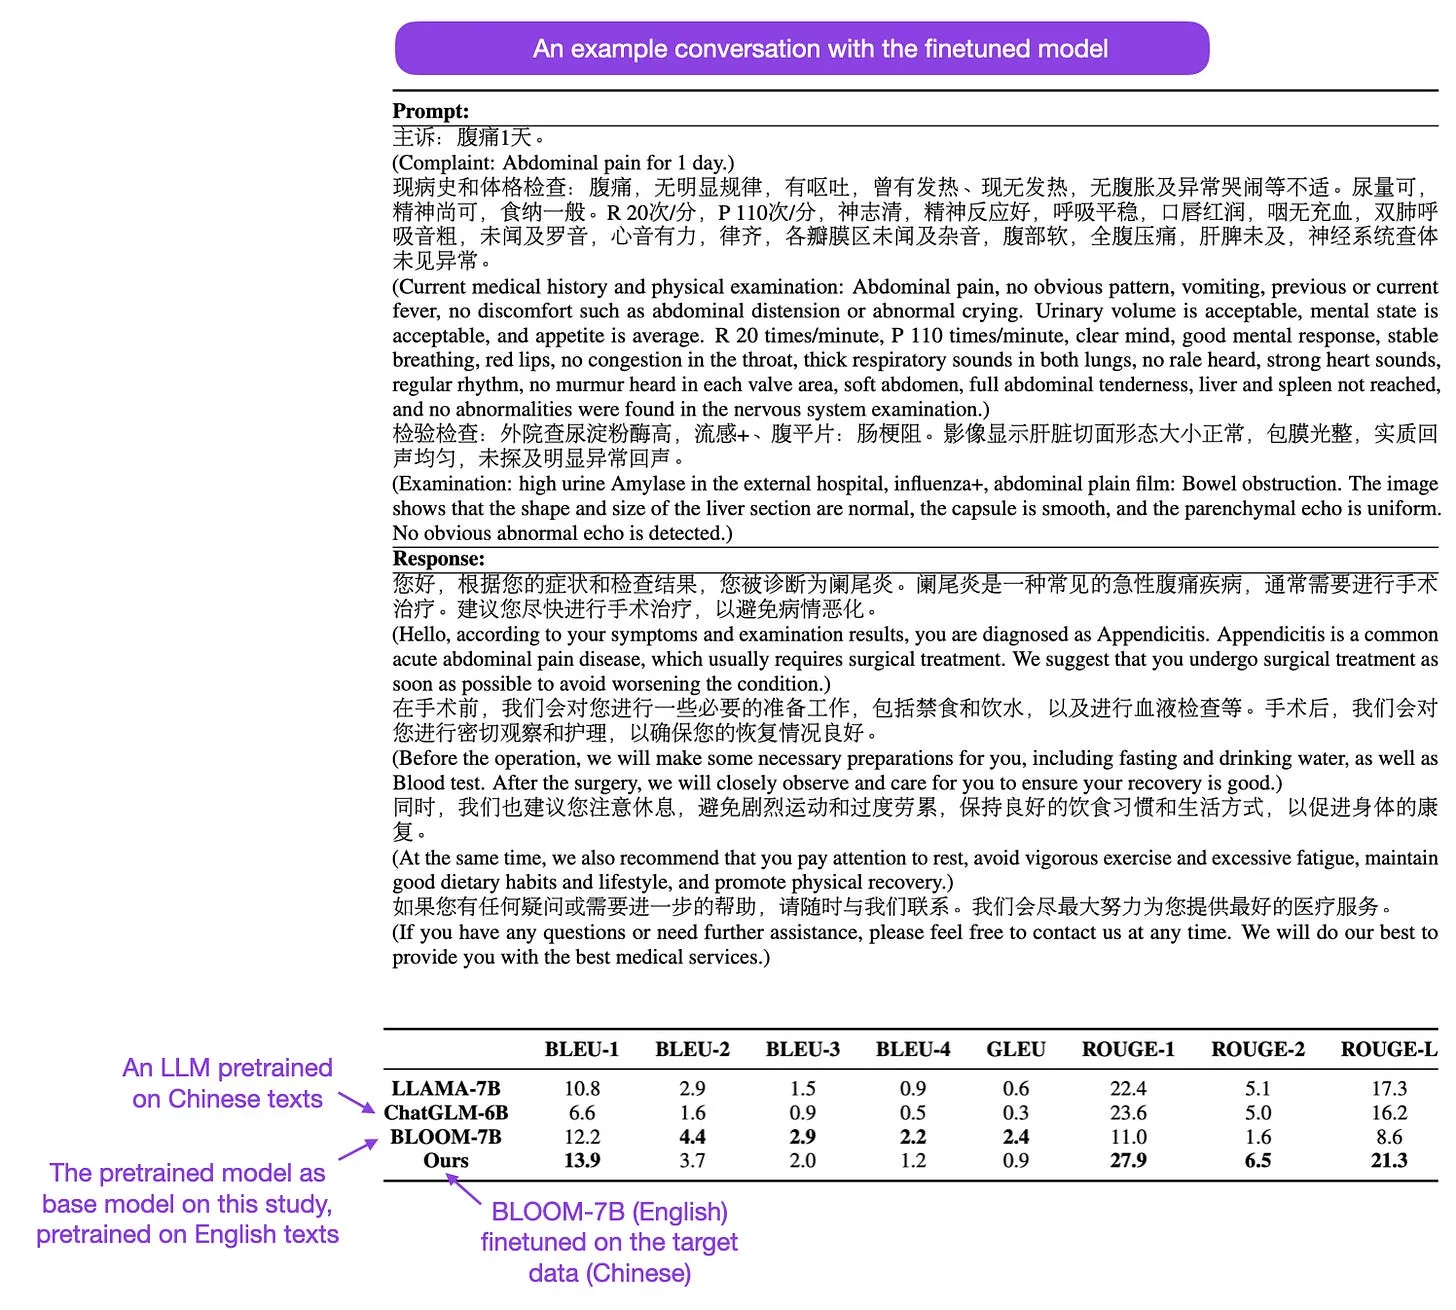
过去我一直大力提倡针对更具体的应用场景,对预训练大语言模型(基础模型)进行微调。ClinicalGPT就是一个很好的范例:研究人员将医疗数据融入训练流程,以更好地处理临床任务。简而言之,他们采用人类反馈强化学习的方式对预训练大语言模型BLOOM-7B进行了微调——这与GPT-3打造初代ChatGPT模型时使用的指令微调策略一致。
figure09

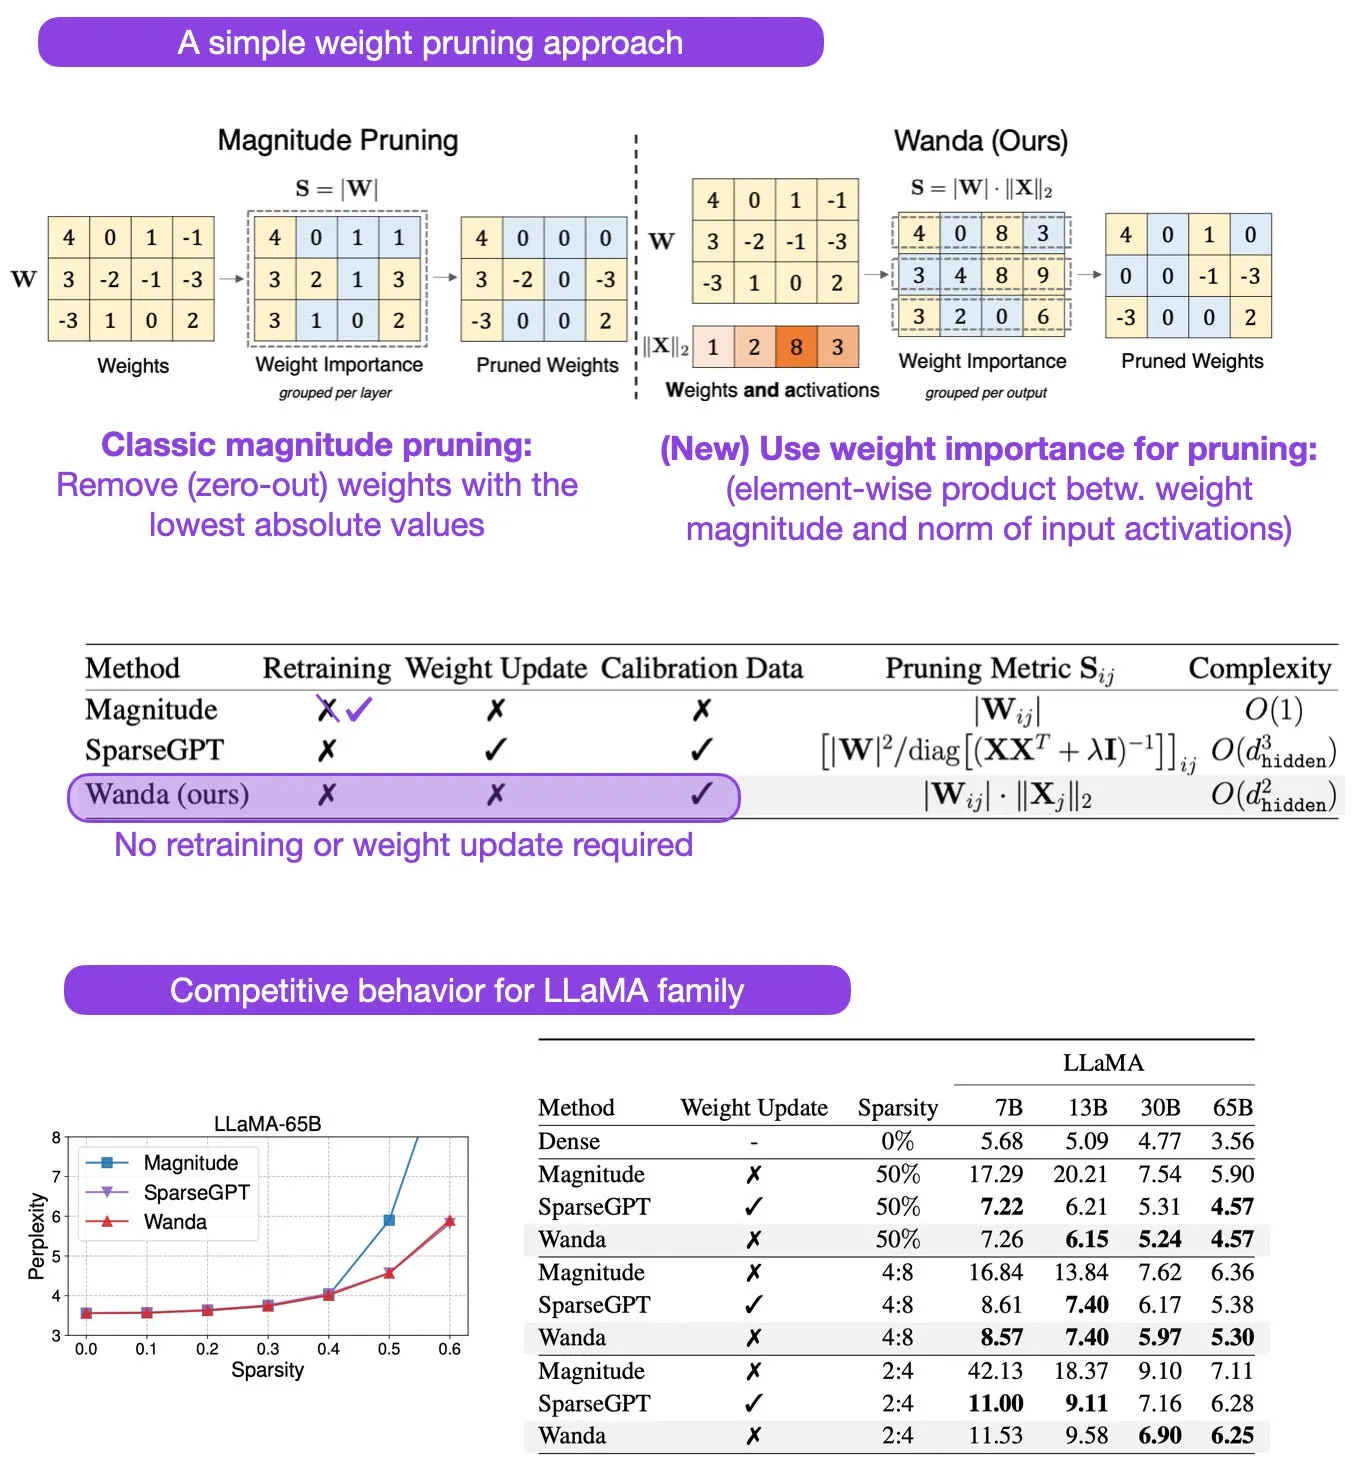
《一种简单高效的大语言模型剪枝方法》(6月20日,https://arxiv.org/abs/2306.11695)

DistilBERT这类模型之所以流行,是因为大语言模型通常体积过大,不适用于多数场景;但打造这类剪枝版本的模型通常都需要重新训练。在这篇论文中,研究人员提出了一种无需对预训练大语言模型重新训练即可完成剪枝的方法。该方法原理相对简单:通过计算权重幅值与输入激活范数的逐元素乘积,来判断权重的重要性,以此为依据进行剪枝。
figure10

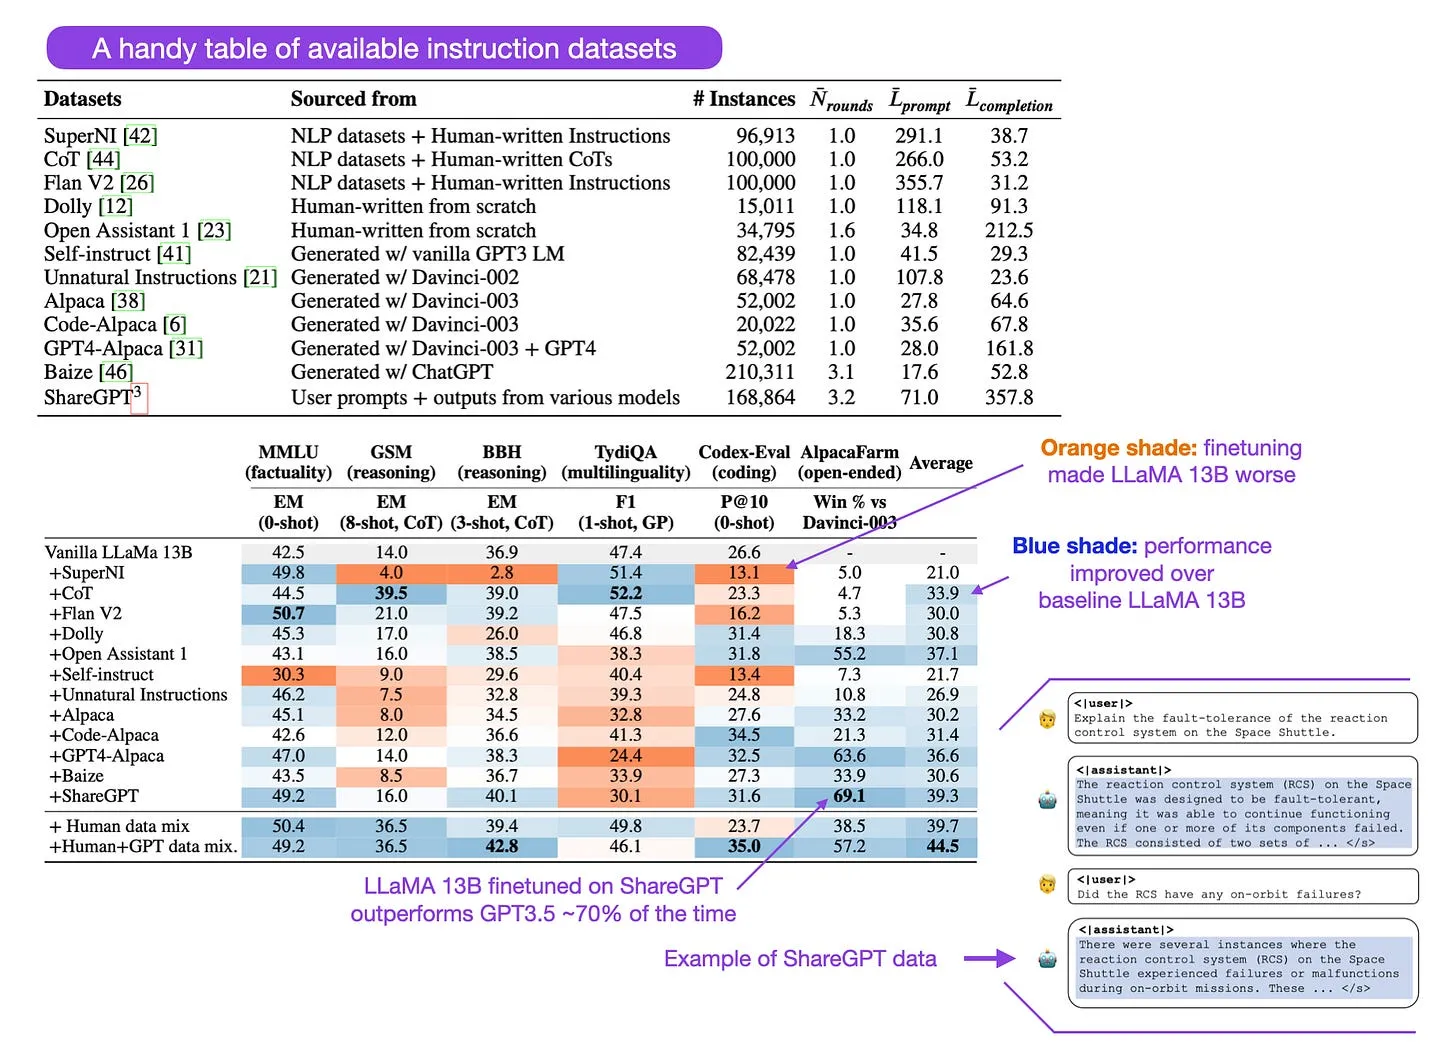
《骆驼能走多远?探究开源资源下指令微调的现状》(6月7日,https://arxiv.org/abs/2306.04751)

在这篇论文中,作者研究了LLaMA等开源大语言模型在开源指令数据集上微调后的性能。部分模型(例如LLaMA)相比闭源的text-davinci-003(GPT 3.5),能达到70%的“胜率”。需要注意的是,作者采用的是监督式微调,而非InstructGPT和ChatGPT所使用的人类反馈强化学习。
figure11

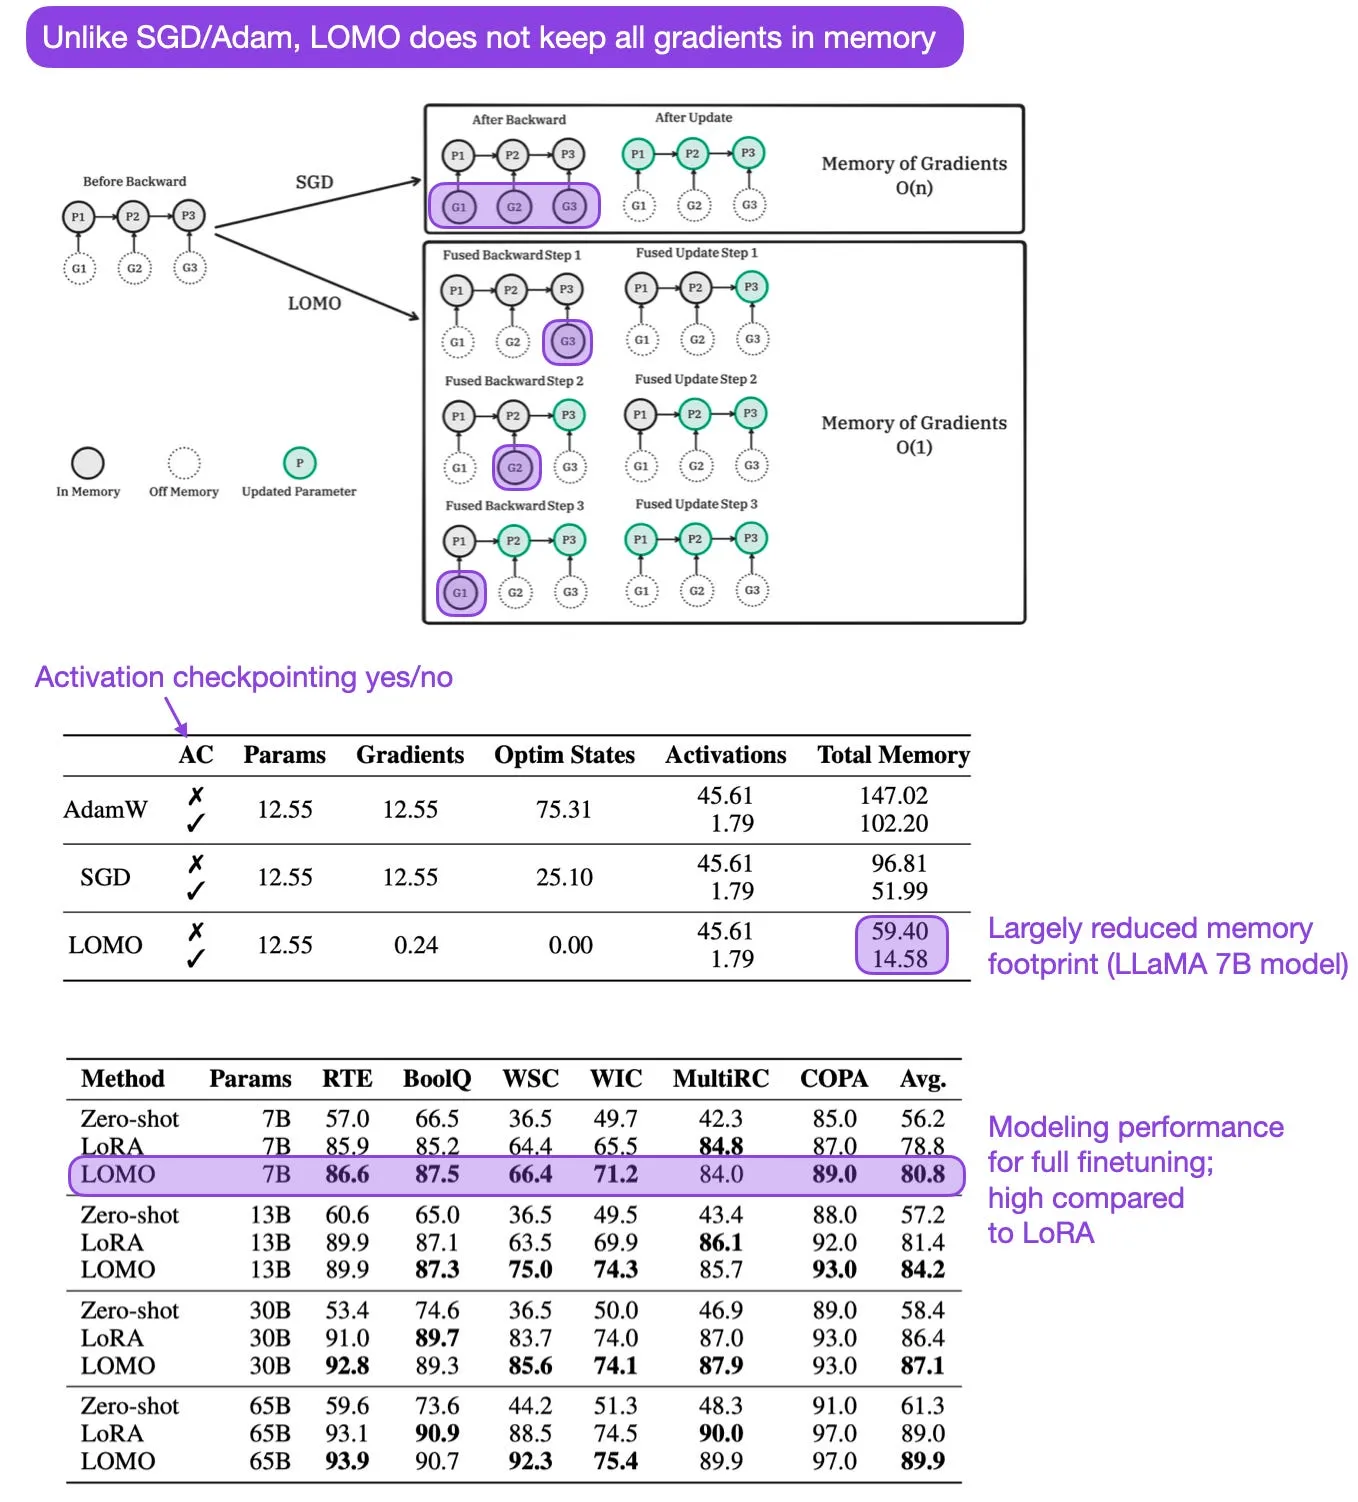
《资源受限下的大语言模型全参数微调》(6月16日,https://arxiv.org/abs/2306.09782)

通常在资源(尤其是显存)受限的情况下微调大语言模型时,我们会采用参数高效微调方法,比如适配器方法和低秩适配(LoRA)。而在这项研究中,研究人员提出了一种全新的优化器——低内存优化器(LOMO)作为替代方案,它将梯度计算与参数更新合并为单一步骤,以此节省显存。该方法可以与适配器、LoRA等技术结合使用,但缺点是无法与梯度累积结合,且搭配Adam优化器时仅能节省25%的显存。
figure12

《面向人类对齐的偏好排序优化》(6月30日,https://arxiv.org/abs//2306.17492)

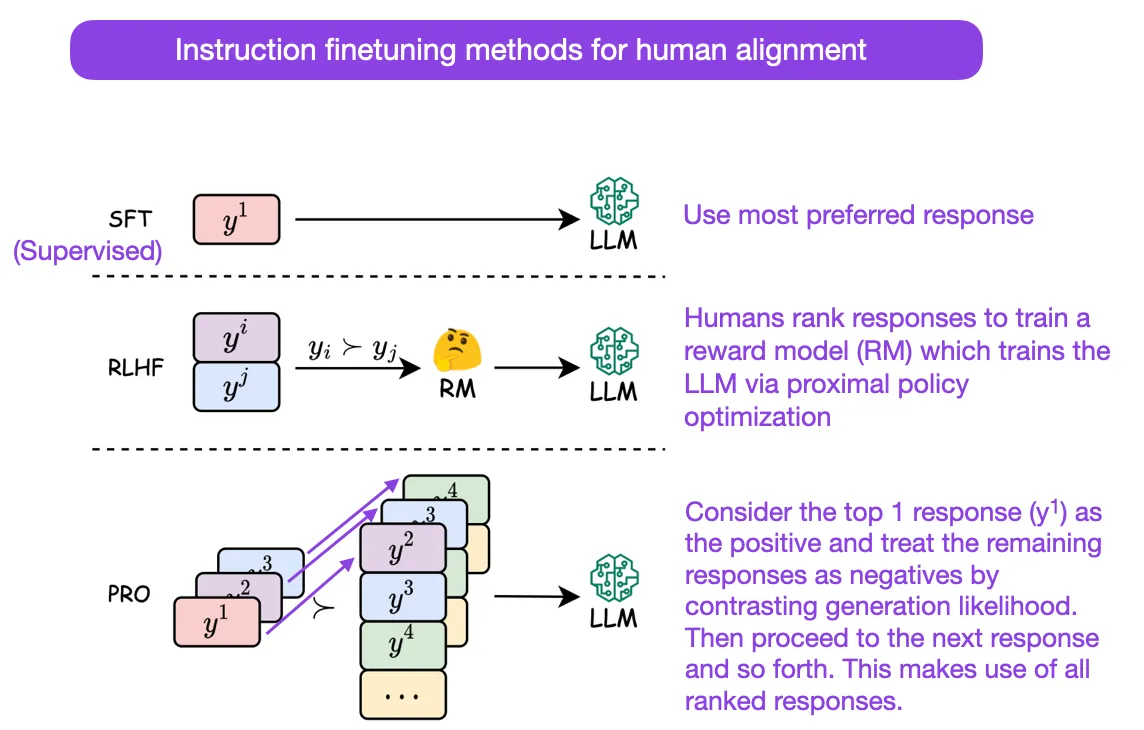
在https://magazine.sebastianraschka.com/p/ai-research-highlights-in-3-sentences-2a1 中,我曾介绍过https://arxiv.org/abs/2305.18290 这篇论文,它提出了一种更简单的大语言模型指令微调方案,替代传统的人类反馈强化学习(RLHF)。而在这篇论文中,研究人员提出了另一种替代方案:偏好排序优化(PRO)。PRO相比RLHF的优势在于,PRO利用了完整的排序序列,而不仅仅是两两排序的结果。
figure13

计算机视觉

《Patch n’ Pack:NaViT——适配任意宽高比与分辨率的视觉Transformer》(7月12日,https://arxiv.org/abs/2307.06304)

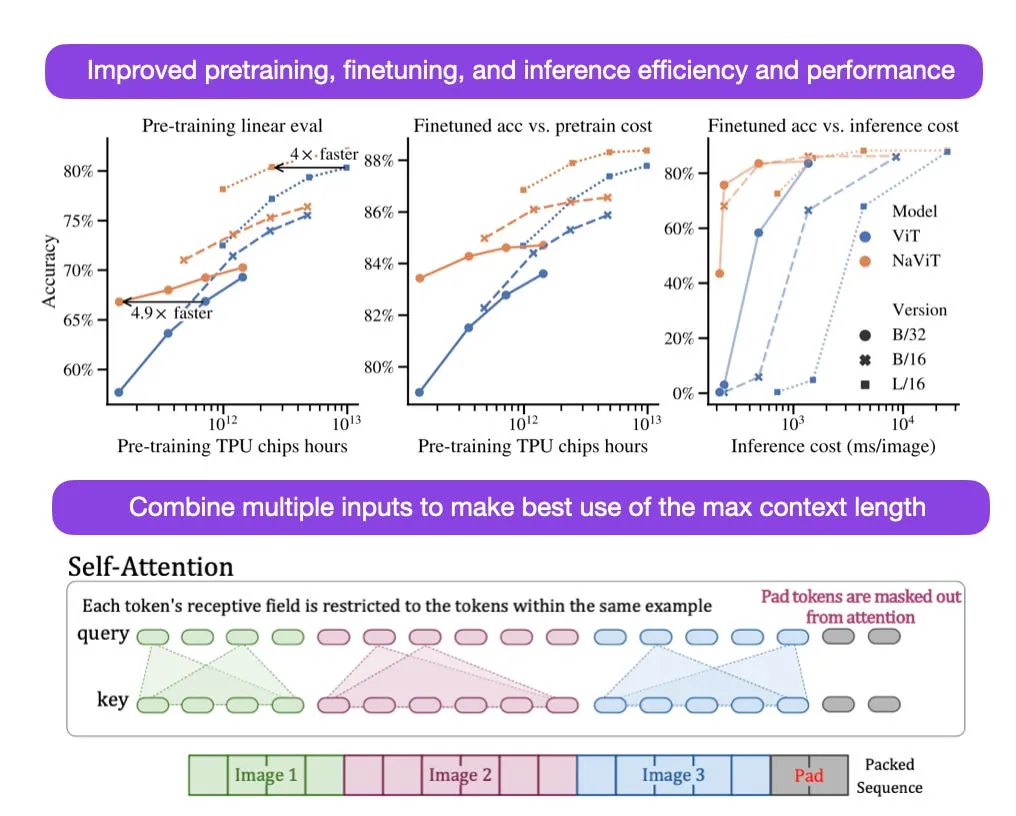
训练语言Transformer时,研究人员常会用到序列打包(也叫“填充序列打包”)技术,它能避免对填充令牌的不必要计算,从而高效处理变长序列。在这篇论文中,研究人员将序列打包的思路拓展到视觉Transformer,提出了NaViT(原生分辨率视觉Transformer),可以对任意分辨率、任意宽高比的输入进行处理与训练。该方法同时提升了训练效率与模型准确率。
figure14

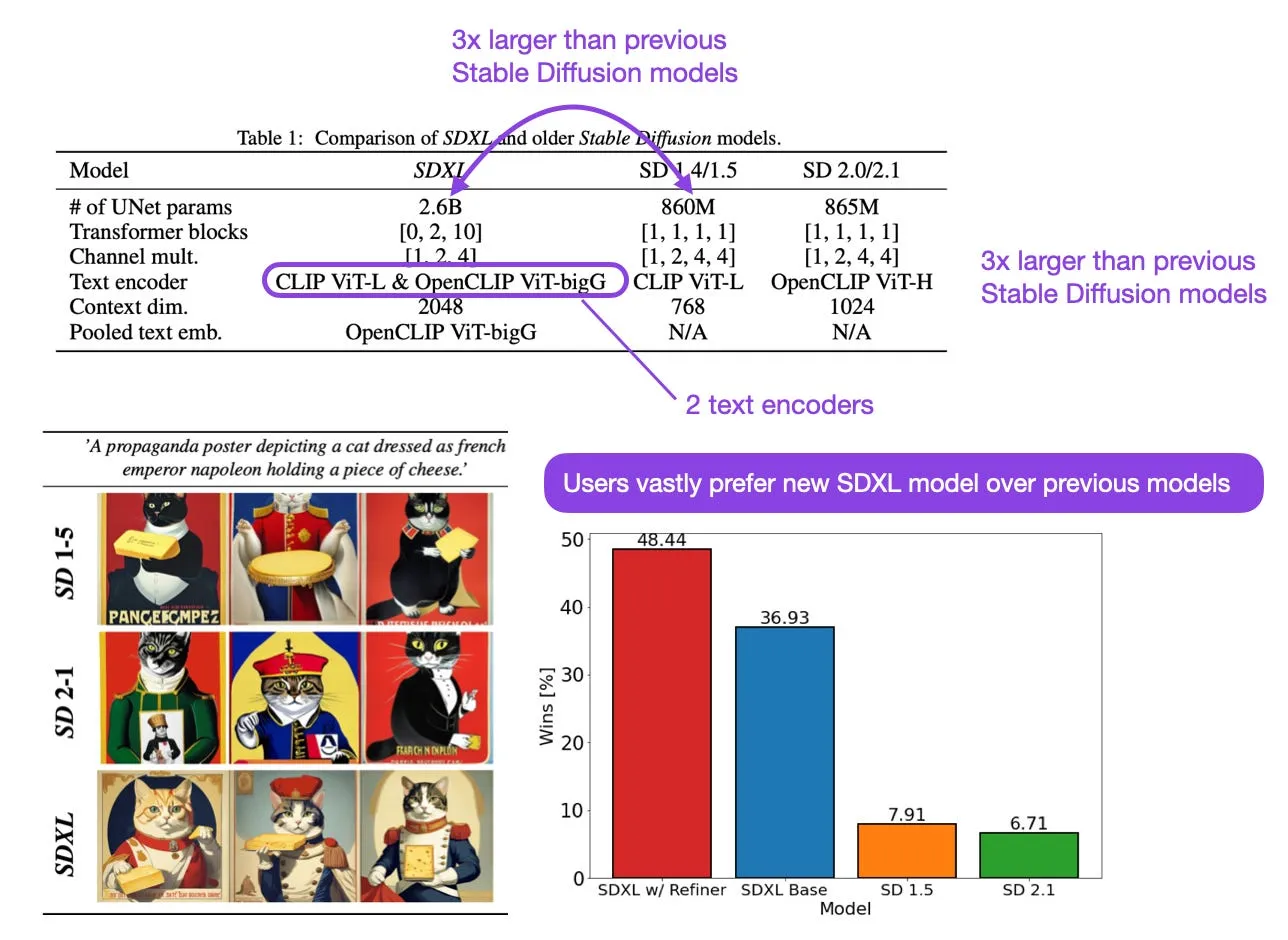
《SDXL:面向高分辨率图像合成的改进隐扩散模型》(7月4日,https://arxiv.org/abs/2307.01952)

SDXL(Stable Diffusion XL的缩写)是基于隐扩散的文生图模型Stable Diffusion的全新迭代版本。它底层的卷积UNet主干网络规模扩大至原来的3倍,并且新增了第二个CLIP文本编码器(两个不同CLIP编码器的输出沿通道维度拼接)。根据偏好调研,用户对SDXL生成结果的喜爱程度远超此前的Stable Diffusion模型。
figure15

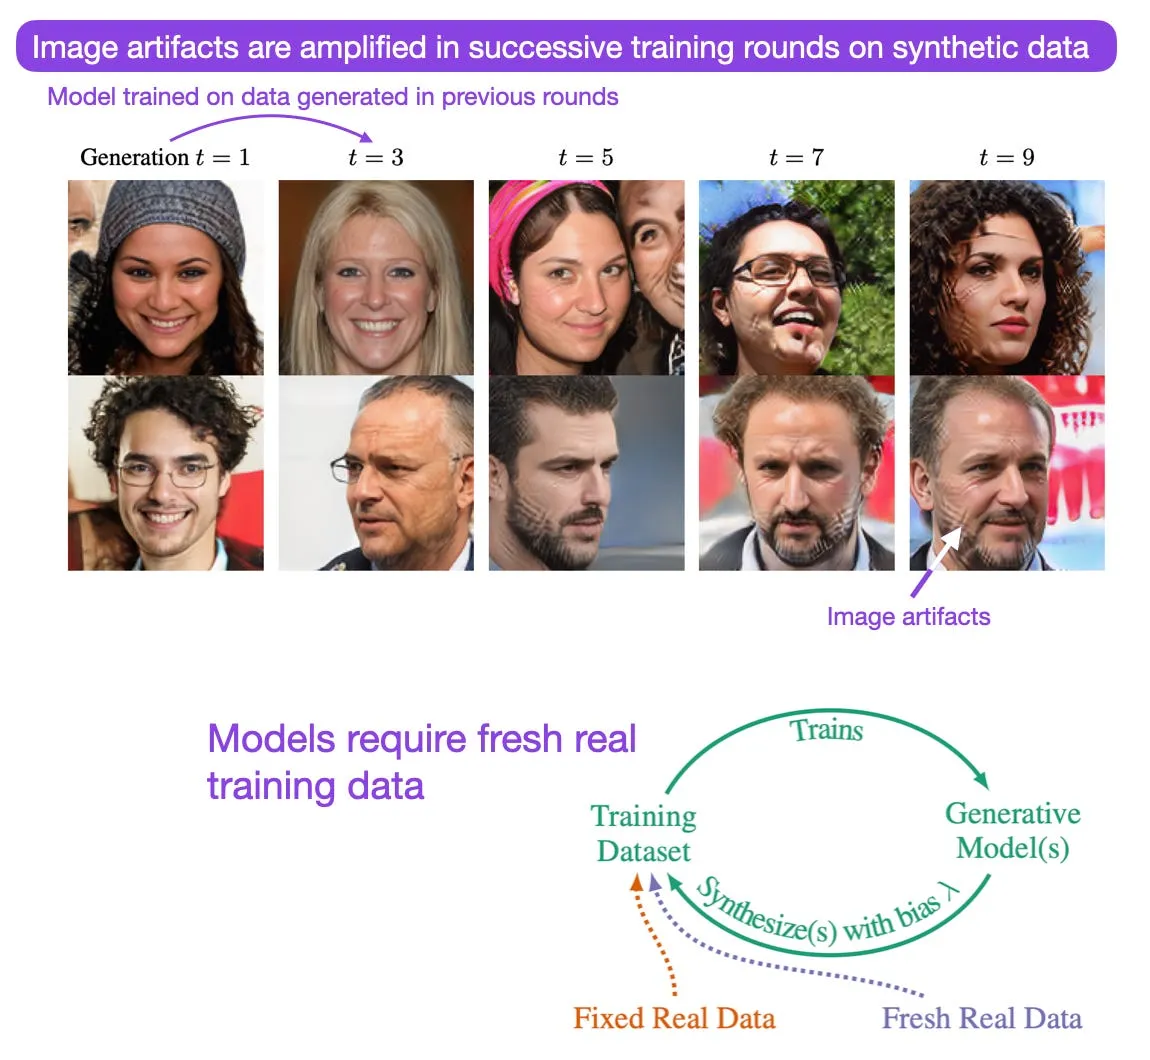
《自消耗的生成模型会患上MAD》(7月4日,https://arxiv.org/abs/2307.01850)

研究人员探究了用合成数据训练生成式AI模型的影响。如果没有新鲜的训练数据,每经过一轮训练,模型的性能都会逐步下降——因为反复用模型自身生成的数据训练,会放大模型本身的偏差。结论是:即便使用高质量的合成数据训练生成模型,也会损害合成内容的质量或多样性。
figure16

《基于掩码Transformer的扩散模型快速训练》(6月15日,https://arxiv.org/abs/2306.09305)

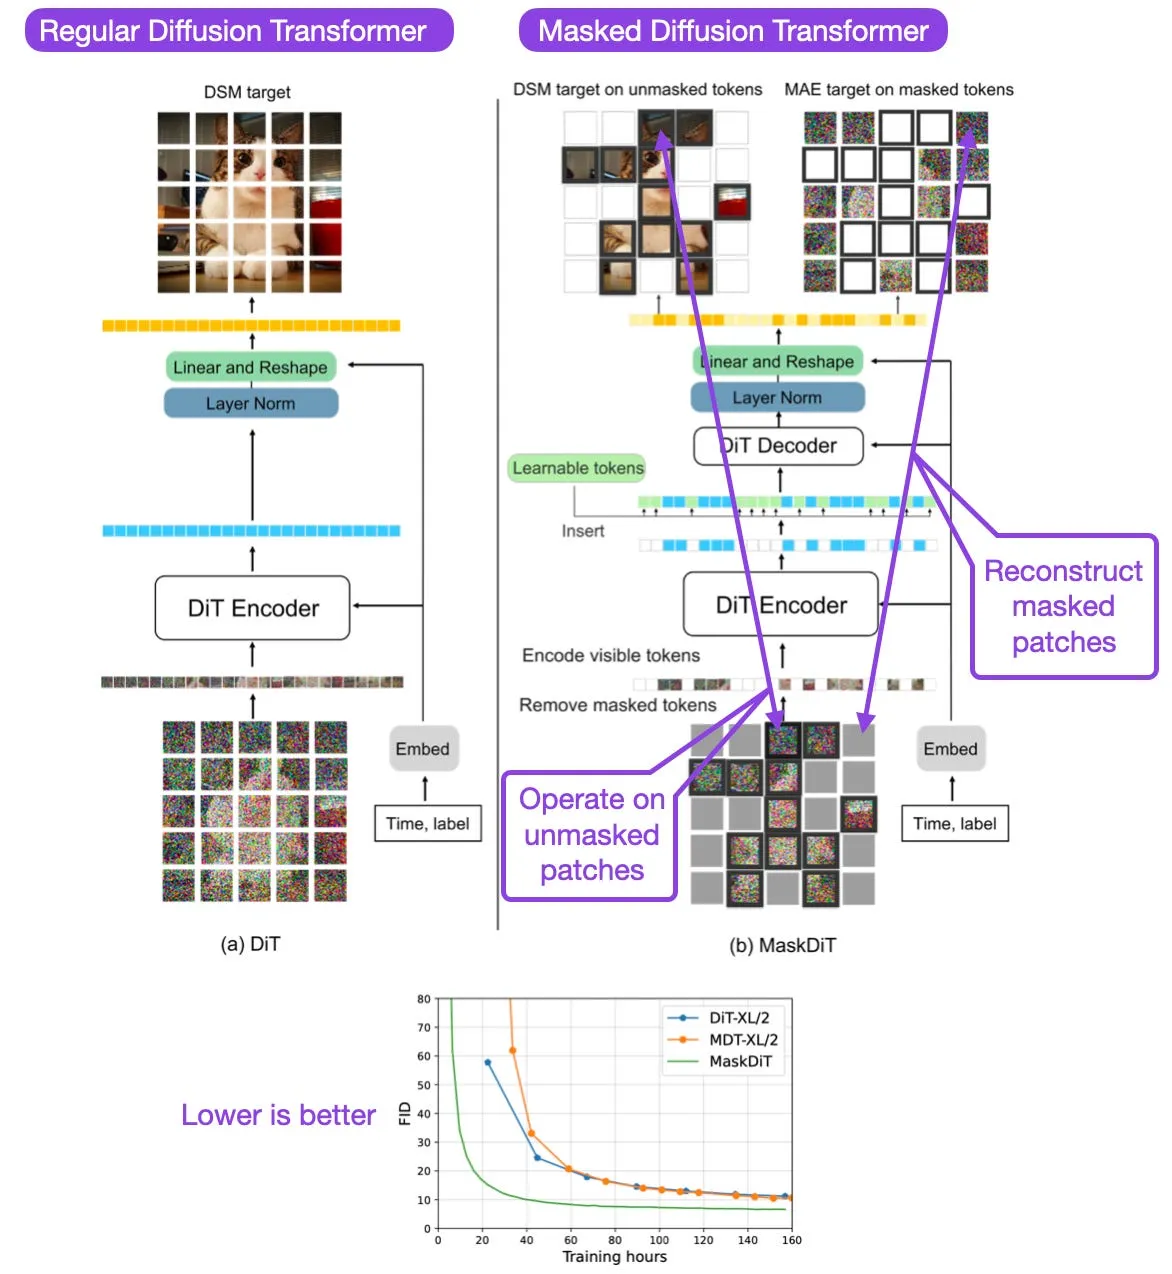
受图像存在大量冗余这一特点的启发(同时也受表征学习领域的启发),研究人员提出,在训练用于图像生成的扩散Transformer时,对大量图像块进行掩码。该方法在训练时,在常规的去噪目标之外,新增了重建掩码块的辅助损失。实验发现,该方法能达到与当前最优扩散Transformer图像生成模型相当的质量,但训练时间减少了70%。
figure17

其他领域

《HyenaDNA:单核苷酸分辨率的长程基因组序列建模》(6月27日,https://arxiv.org/abs/2306.15794)

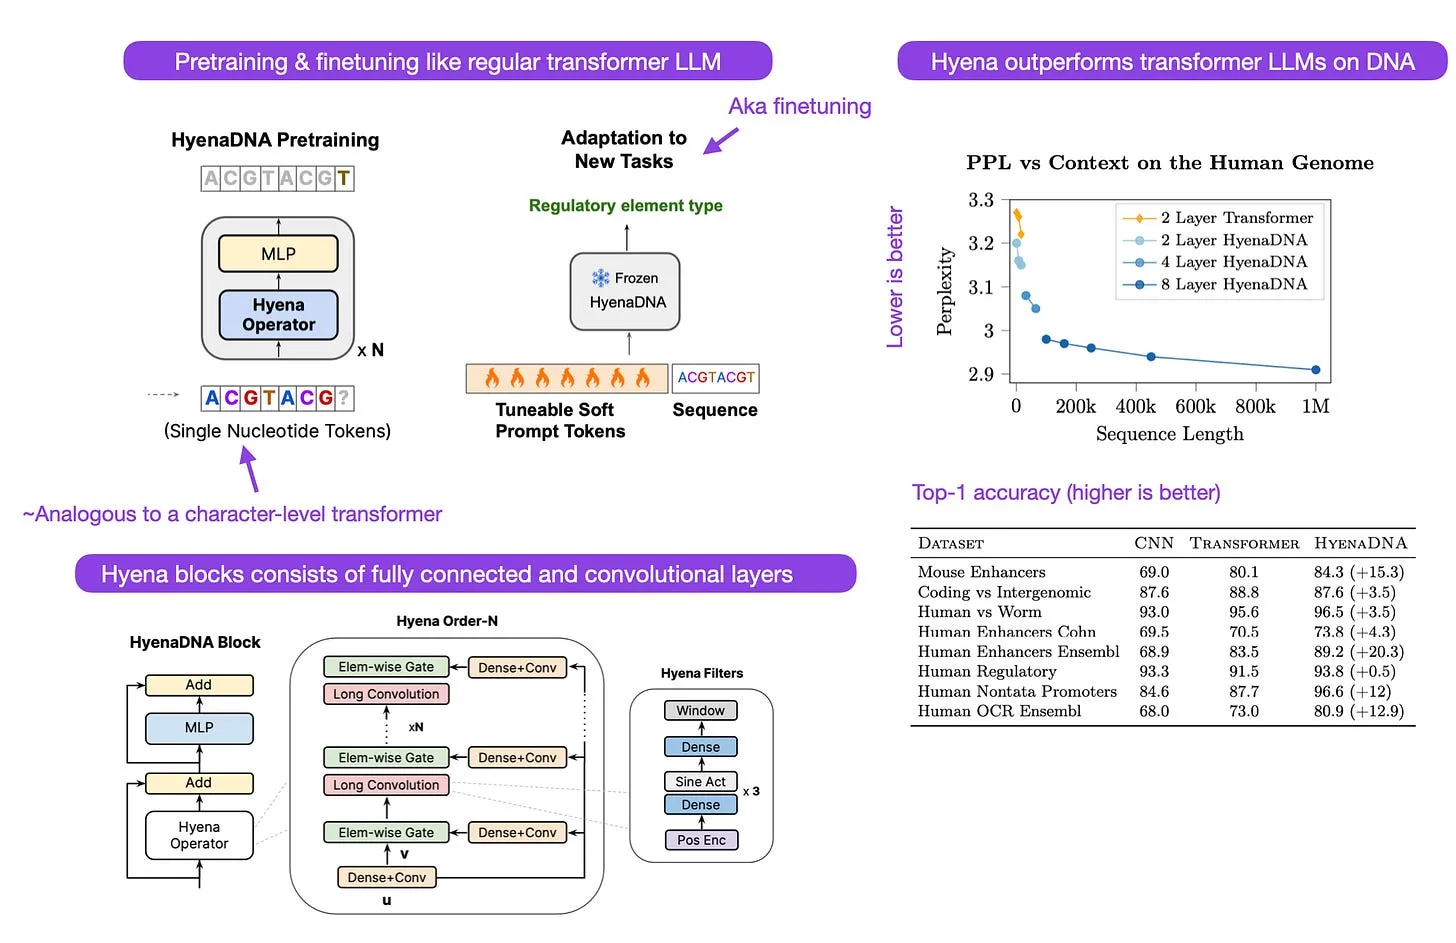
这项工作是近期Hyena论文(https://arxiv.org/abs/2302.10866)的应用延伸——今年4月发表的Hyena论文提出了一种全新的卷积架构模型,作为Transformer大语言模型的替代方案用于文本任务。它的优势在于Hyena可以建模长达100万令牌的上下文(这对处理DNA这类场景非常重要)。简而言之,相比常规Transformer大语言模型,它支持更长的上下文长度,且在同等参数量下训练速度更快。
figure18

《简单可控的音乐生成》(https://arxiv.org/abs/2306.05284,6月8日)

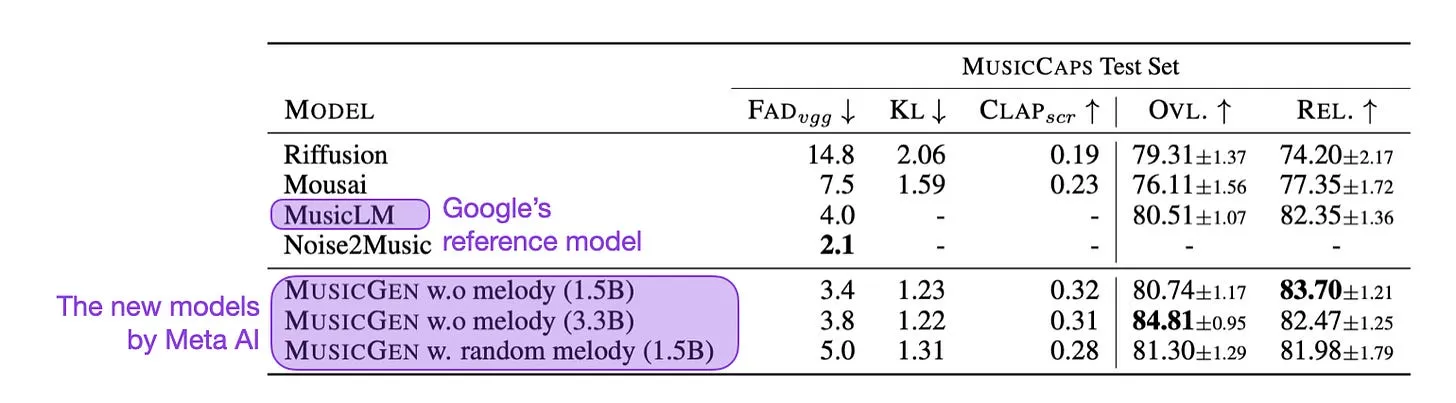
Meta AI的研究人员用约20000小时的版权音乐,训练了生成式单阶段Transformer语言模型(参数量分别为3亿、15亿、33亿)。音乐数据集包含来自ShutterStock和Pond5的1万首高质量音轨。该研究的创新点在于高效的令牌交错模式,让模型无需上采样级联或层级架构,就能生成高质量的音乐样本。
figure19

通用计算效率

《Rockmate:一款高效、快速、自动的通用PyTorch重计算工具》(7月3日,https://arxiv.org/abs/2307.01236)

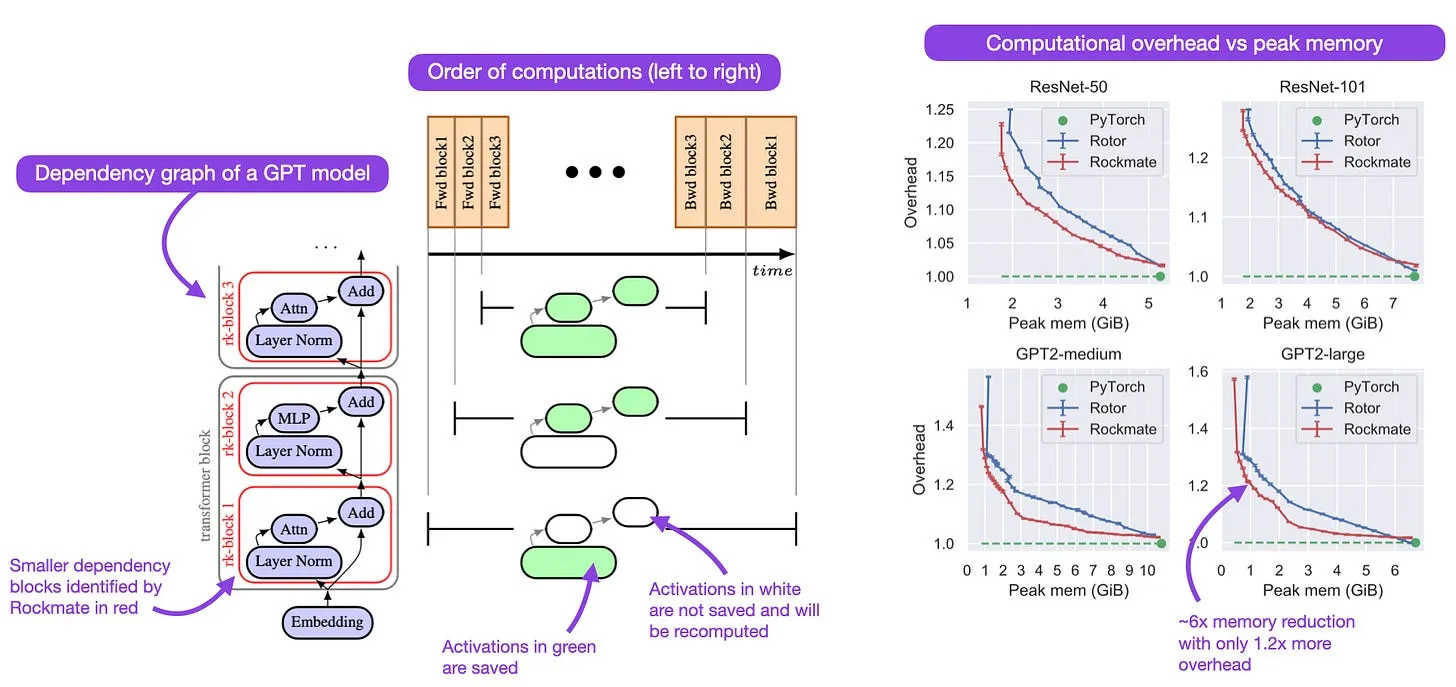
Rockmate是一款PyTorch工具,它可以分析并自动重写模型(例如GPT)的代码,让计算激活值时的显存占用控制在预设范围内。其代价是会增加重计算量(拖慢运行速度),但可以让更小的硬件运行更大的模型。显存节省幅度可达2-5倍,而部分场景下的额外开销仅为10%-20%。
figure20

《ZeRO++:面向超大规模模型训练的极致高效集合通信》(6月16日,https://arxiv.org/abs/2306.10209)

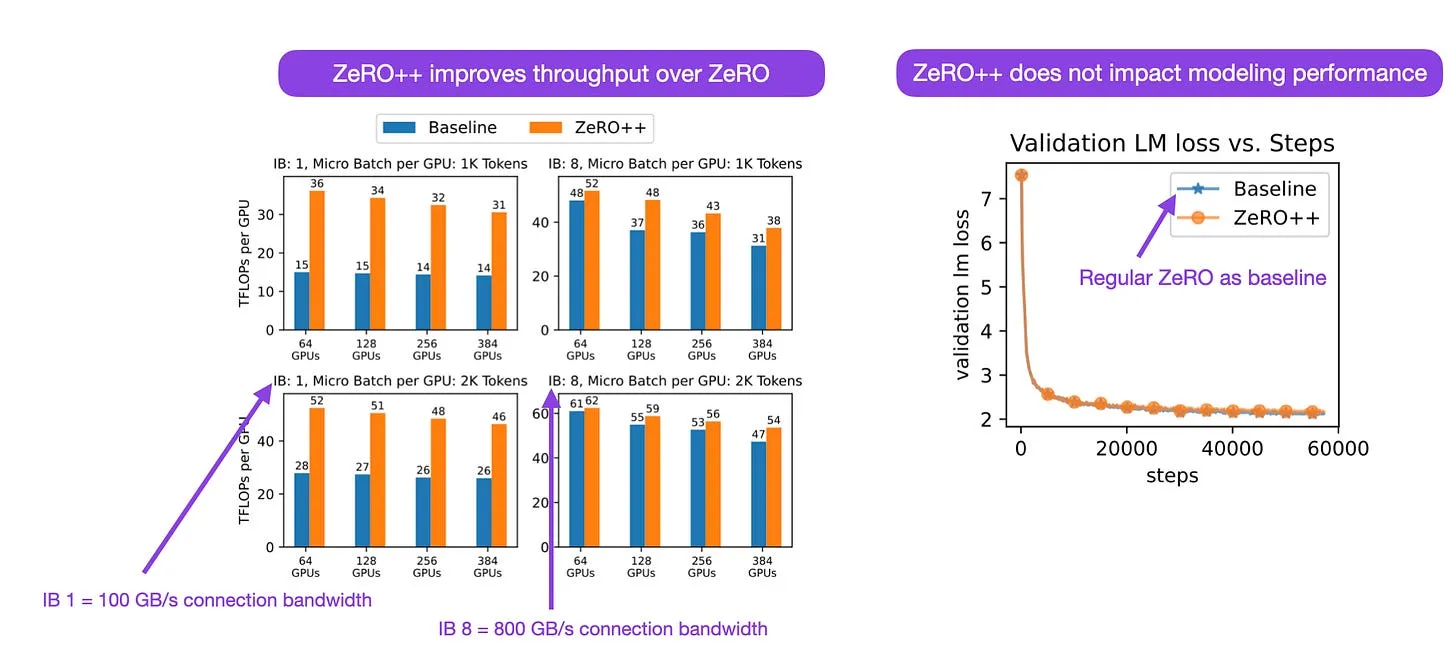
ZeRO(零冗余优化器)是一种将模型状态拆分到不同GPU上的优化策略,能够降低显存需求,支持训练LLM等更大规模的模型。在这篇论文中,研究人员提出了三种降低通信量的技术来优化吞吐量。简而言之,这些优化包括基于分块量化的全收集操作、数据重映射,以及基于全连接的量化梯度平均。
figure21

这本杂志是我个人的兴趣项目,不提供直接报酬。不过,如果您愿意支持我,可以考虑购买https://sebastianraschka.com/books 上的书籍。如果您觉得这些书籍有洞见、有帮助,也欢迎推荐给您的朋友和同事。
figure22
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics 以及 http://mng.bz/M96o

您的支持对我意义重大!非常感谢!
【转载】2023年计算机视觉发展现状:从视觉Transformer到神经辐射场

原文地址:State of Computer Vision 2023: From Vision Transformers to Neural Radiance Fields, by Sebastian Raschka, on 2023-07-6

2023年计算机视觉发展现状:从视觉Transformer到神经辐射场

大语言模型(LLM)的发展仍在快速推进。与此同时,暂且抛开AI监管的相关争议不谈,大语言模型领域的新闻更新速度仅比往常稍慢一些。

这恰好是一个契机,让我们可以偶尔将目光投向计算机视觉领域,探讨该领域当下的研究与发展现状。这个主题也刚好契合对温哥华举办的2023年计算机视觉与模式识别会议(CVPR 2023)的回顾——这是一场非常精彩的会议,会场也可能是我迄今为止参加过的会议里环境最好的。

figure01

这本内容满满(更准确地说是成果满满)的CVPR会议手册,列出了今年CVPR收录的2359篇论文。

注:如果您看到的通讯内容有截断或缺失,是因为部分邮件服务商可能会对较长的邮件进行裁切。遇到这种情况,您可以访问 https://magazine.sebastianraschka.com/ 查看全文。

文章与趋势

今年,CVPR 2023共计收录了2359篇论文,数量十分可观,参会者可以浏览海量的海报展示。当我穿行在海报展区,与参会者和研究者交流时,我发现大部分研究都集中在以下四大主题:

  • 视觉Transformer(Vision Transformers)
  • 视觉生成式AI:扩散模型与生成对抗网络
  • NeRF:神经辐射场
  • 目标检测与分割

接下来,我将对这四个子领域做简要介绍,并分别从会议论文中选出一篇有意思的论文进行重点解读。

(感兴趣的读者可以在 https://cvpr2023.thecvf.com/Conferences/2023/AcceptedPapers 查看全部收录论文列表。)

1)视觉Transformer

继语言Transformer与大语言模型取得成功之后,视觉Transformer(Vision Transformers,简称ViT)于2020年首次提出,相关论文见 https://arxiv.org/abs/2010.11929。

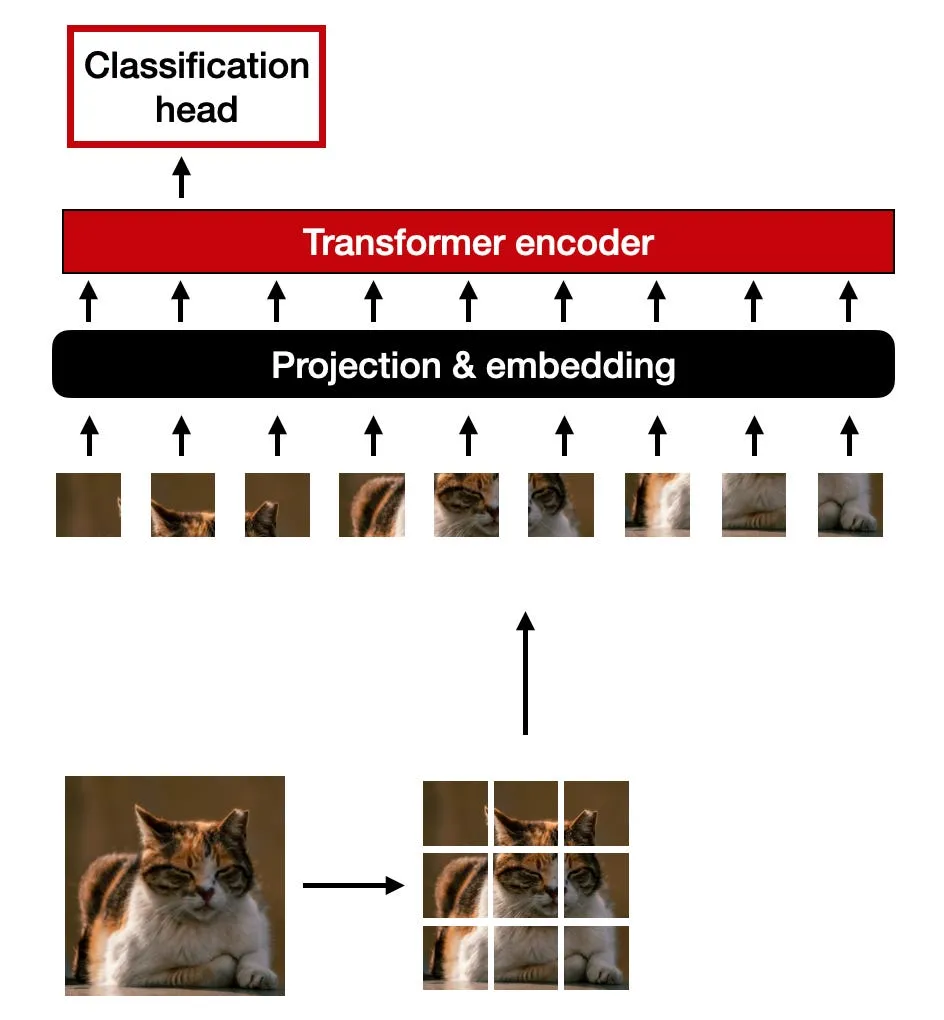
ViT的核心思想与语言Transformer类似:在多头注意力模块中采用同样的自注意力机制。区别在于,语言Transformer对词进行分词,而ViT对图像进行分块编码(图像分词)。

正如之前《Ahead of AI》的一篇文章(https://magazine.sebastianraschka.com/p/understanding-encoder-and-decoder)中讨论的,最初用于语言建模的Transformer(论文见 https://arxiv.org/abs/1706.03762 )采用的是编码器-解码器架构。而现代语言Transformer可以分为两类:仅编码器架构,比如常用于分类任务的BERT;以及仅解码器架构,比如主要用于文本生成的GPT。

最初的ViT模型采用类似BERT的类编码器架构,对图像分块进行嵌入编码,之后可以接入一个分类头,用于完成图像分类任务。

figure02

用于分类任务的视觉Transformer(ViT)核心原理

需要注意的是,ViT的参数量通常远多于卷积神经网络(CNN)。根据经验,要达到良好的建模效果,ViT需要更多的训练数据。因此我们通常使用预训练好的ViT,而不是从头开始训练。(与语言Transformer不同,ViT通常采用有监督方式预训练,而非无监督或自监督方式。)

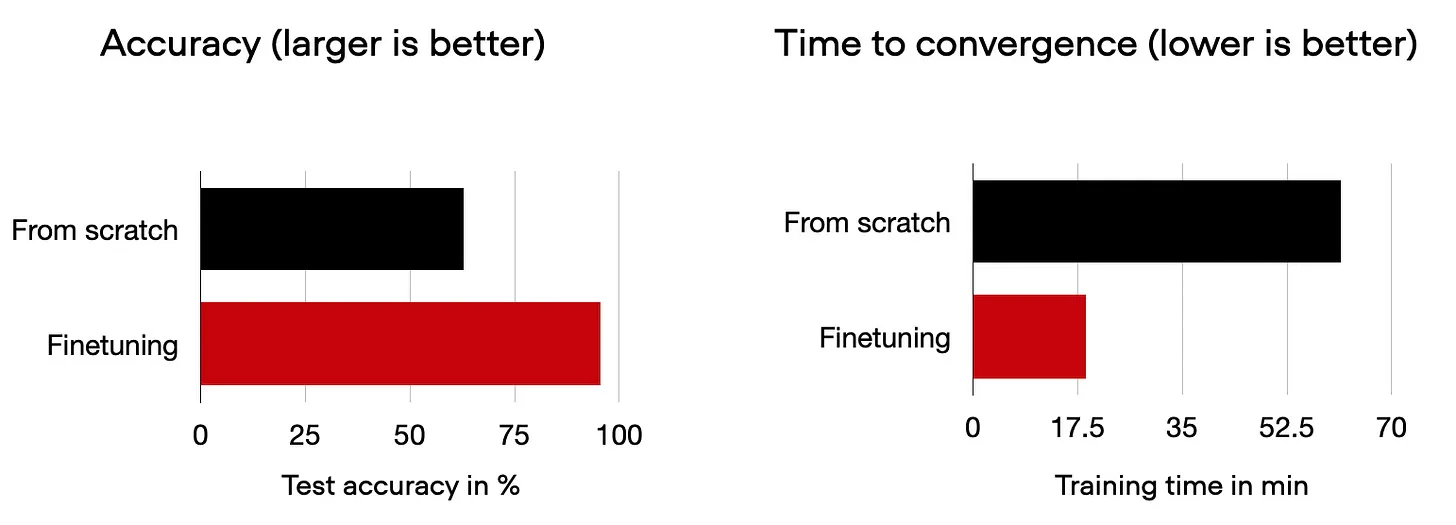
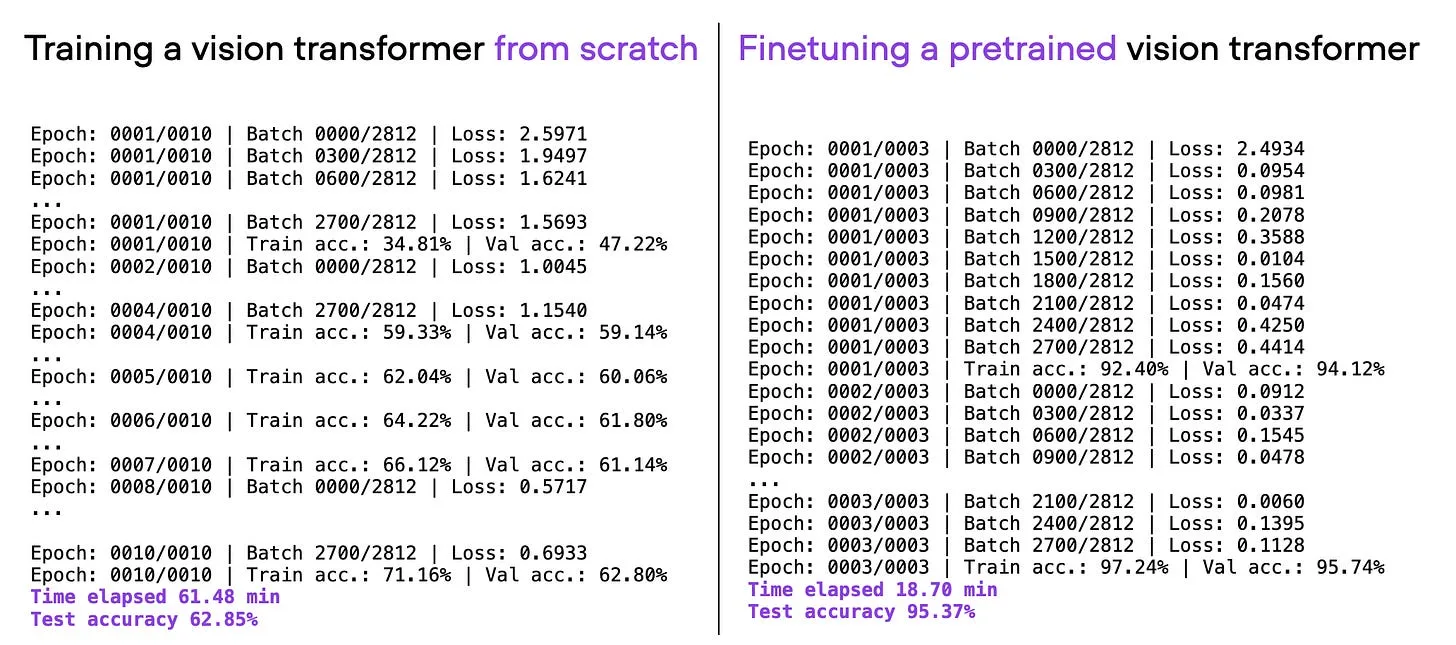
举例来说,我最近在CVPR的一场演讲中(主题见 https://magazine.sebastianraschka.com/p/accelerating-pytorch-model-training )也提到,相比在目标数据集上从头训练Transformer,使用预训练的Transformer能取得好得多的分类效果。

figure03

从头训练ViT与微调预训练ViT的对比

像 https://arxiv.org/abs/2012.12877 和 https://arxiv.org/abs/2103.14030 这类ViT架构,凭借在计算机视觉任务上的顶尖性能,成为了非常热门的模型。

不过,ViT也饱受诟病:它的资源消耗相对更高,运行效率低于CNN。这也是为什么尽管ViT是计算机视觉领域最热门的研究方向之一,却尚未在实际应用中大规模落地的主要原因之一。

Efficient ViT:采用级联分组注意力的内存高效视觉Transformer

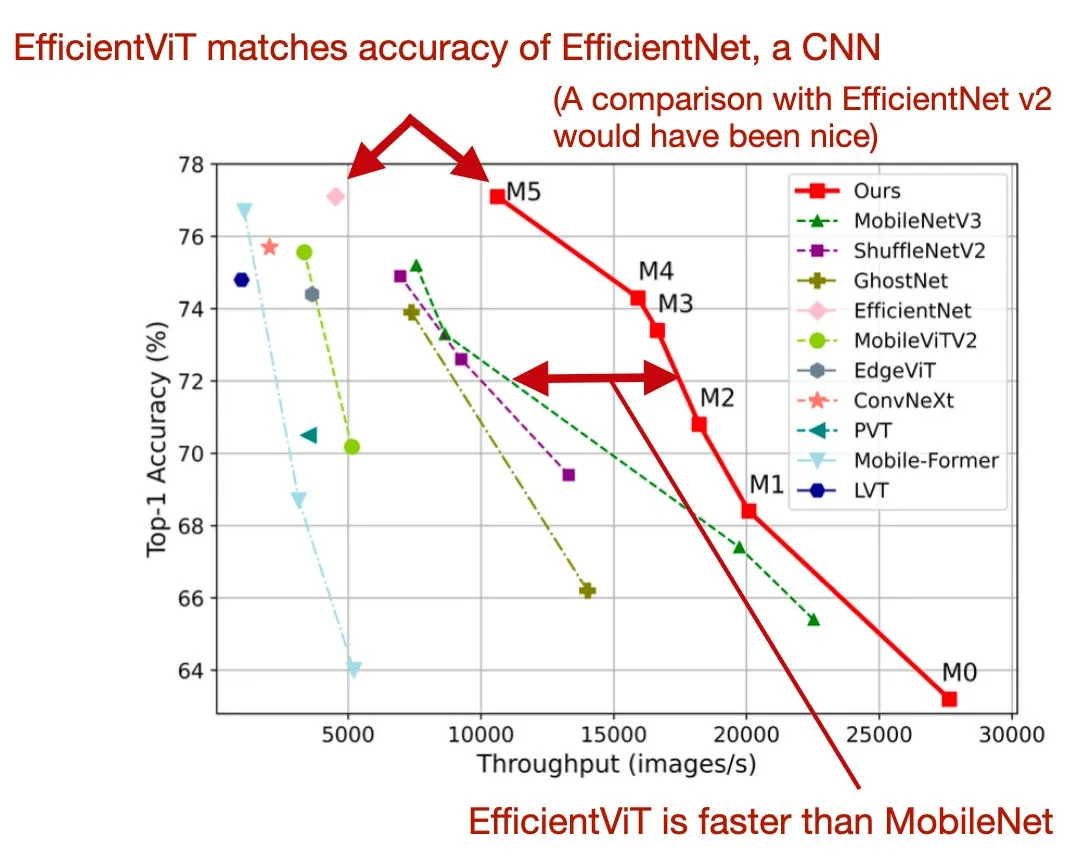
如上所述,ViT资源消耗较高,限制了它在实际场景中的更广泛应用。在这篇CVPR论文(https://arxiv.org/abs/2305.07027)中,研究者提出了一种全新的高效架构来解决这一问题,让ViT更适合实时应用场景。

figure04

引自论文 https://arxiv.org/abs/2305.07027 的标注示意图

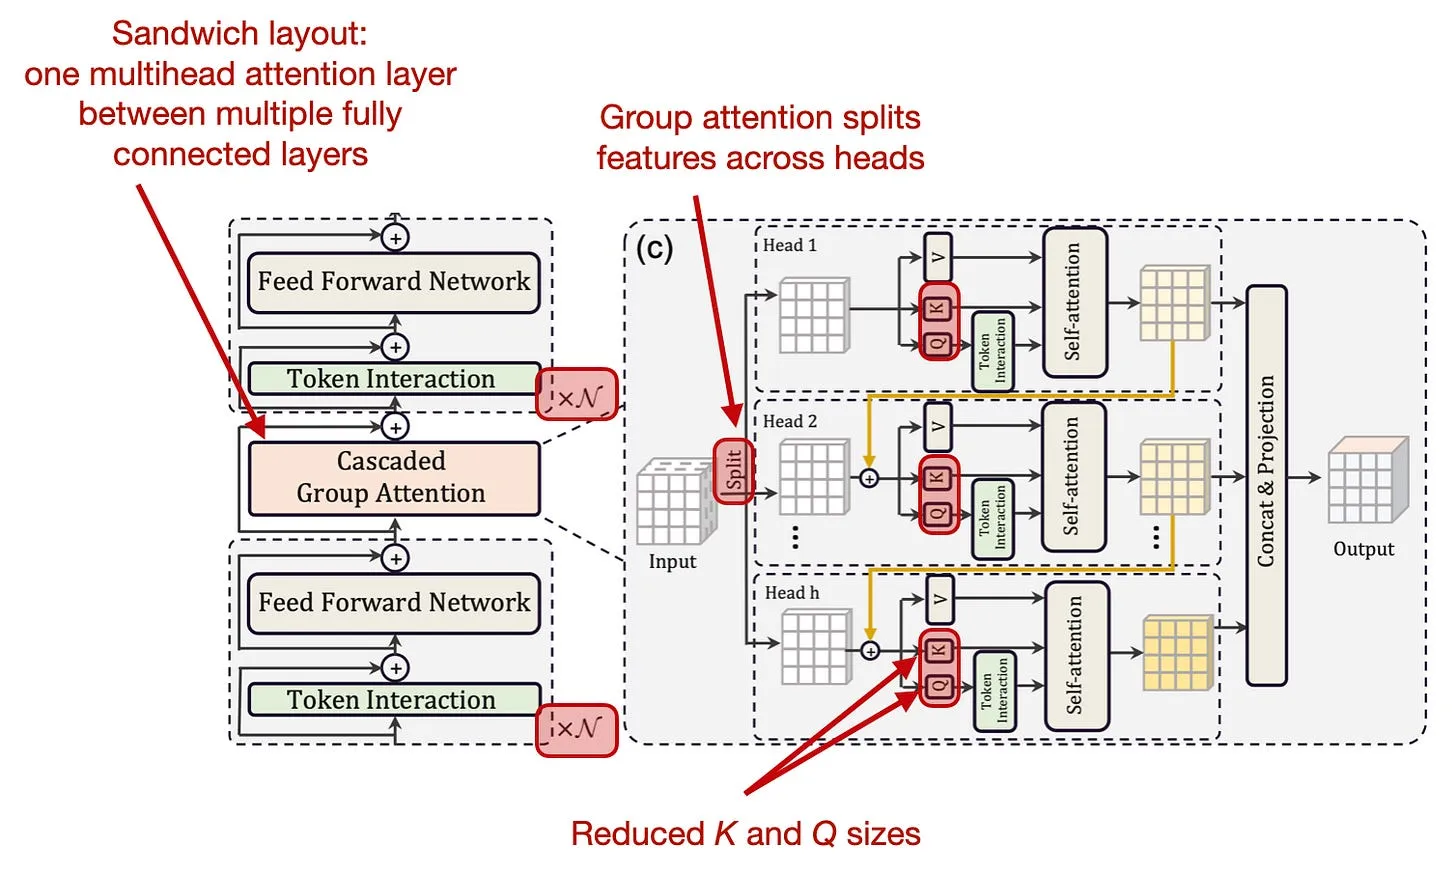
这篇论文的核心创新点包括两方面:

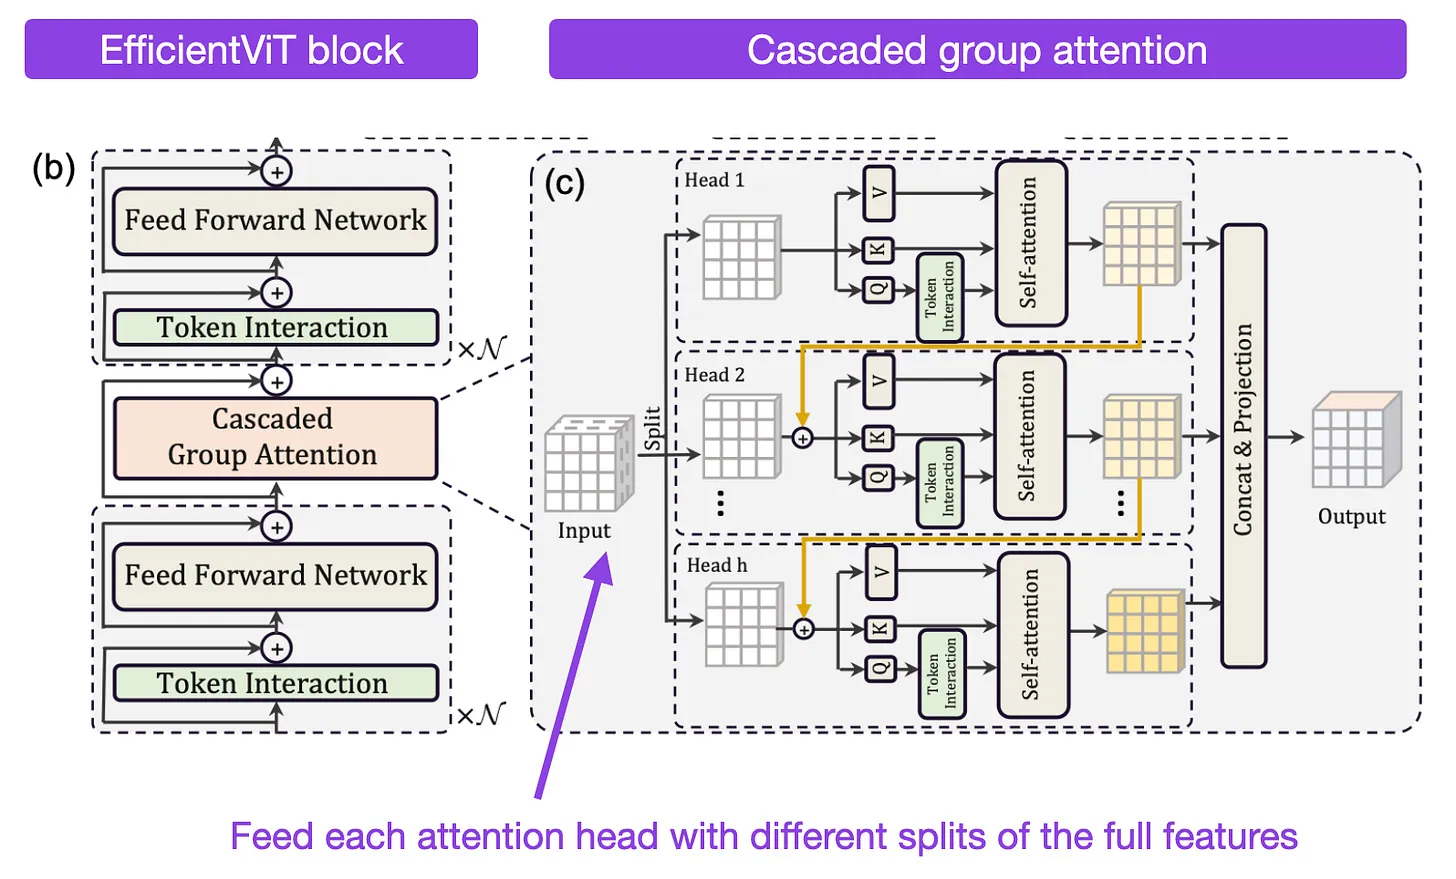
  1. 在全连接层(FC层)之间仅使用一个受内存限制的多头自注意力(MHSA)模块;
  2. 级联分组注意力机制。

先来看第一点:夹在全连接层之间的MHSA模块。已有研究表明,内存效率低下的主要原因是MHSA,而非全连接层(相关研究见 https://arxiv.org/abs/2007.00072 和 https://arxiv.org/abs/2107.06419)。为了解决这个问题,研究者增加了全连接层来加强特征通道之间的信息交互,但相比主流的ViT架构(比如 https://arxiv.org/abs/2103.14030),减少了注意力层的数量。此外,他们还缩小了MHSA中查询(Q)矩阵和键(K)矩阵的通道维度。

figure05

EfficientViT的核心架构改动(引自论文 https://arxiv.org/abs/2305.07027 的标注示意图)

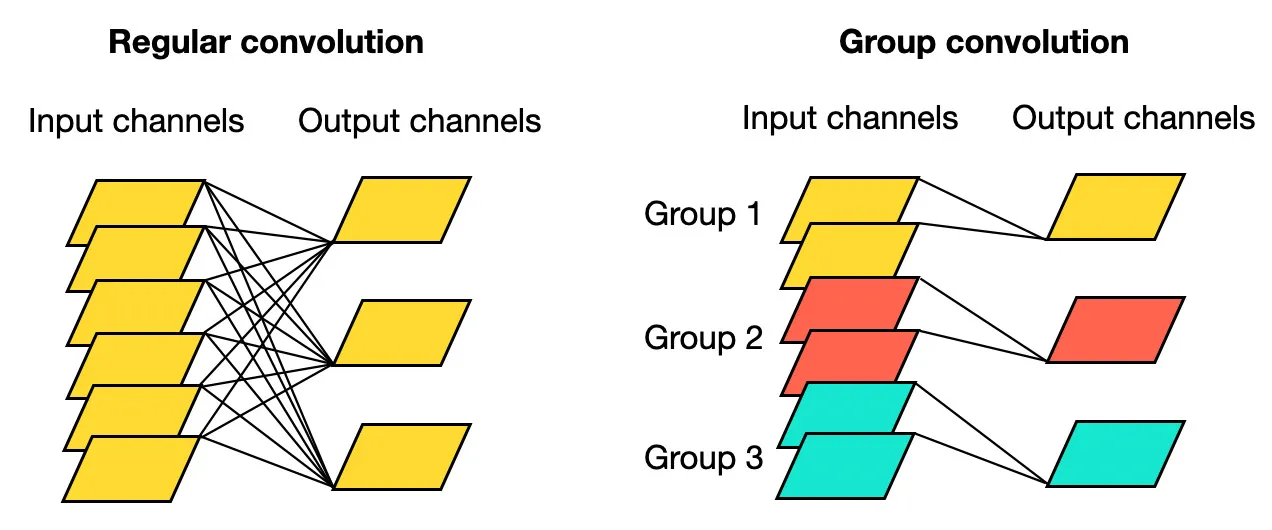
这里的级联分组注意力,灵感来源于分组卷积——分组卷积早已被应用,例如这篇2012年的论文:https://papers.nips.cc/paper_files/paper/2012/hash/c399862d3b9d6b76c8436e924a68c45b-Abstract.html。

分组卷积也叫通道卷积或深度卷积,是标准卷积操作的一种变体。与普通卷积不同,分组卷积会将输入通道划分为多个组,每个组独立执行卷积运算。例如,如果输入有64个通道,分组参数设为2,那么输入就会被分成两组,每组32个通道,各自独立进行卷积。这种方法不仅能降低计算量,还能通过一种正则化作用增加模型的多样性,在部分任务中可能提升建模效果。

figure06

分组卷积的核心原理

令人印象深刻的是,EfficientViT不仅运行速度最高可达MobileViT的6倍,在精度相近的前提下,它在iPhone 11上的运行效率也达到了MobileViT的2.3倍。

总而言之,凭借出色的预测性能,ViT会继续发展下去(至少会一直是热门的研究方向)。而如今随着效率问题的不断优化,我认为未来几年ViT也会在生产环境中得到更广泛的应用。

2)视觉生成式AI:扩散模型

得益于Stable Diffusion这类开源模型的普及(该模型复现了论文 https://arxiv.org/abs/2112.10752 中提出的架构),如今大多数人应该都对扩散模型有所了解。如果还不熟悉,这里做一个简单介绍。

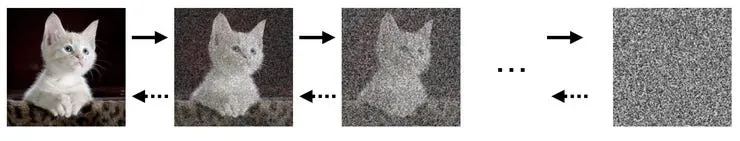
扩散模型本质上是生成式模型。训练过程中,模型会逐步向输入数据中添加随机噪声,对数据进行扰动;随后在逆向过程中,模型学习如何去除噪声,对输出进行降噪,还原出原始数据。推理时,扩散模型就可以从随机噪声输入出发,生成全新的数据。

figure07

扩散模型原理示意图

(当然,除了扩散模型之外,还有很多其他的生成式AI模型,我在《Machine Learning Q and AI》一书的第9章中有详细讨论,书籍链接:https://leanpub.com/machine-learning-q-and-ai)

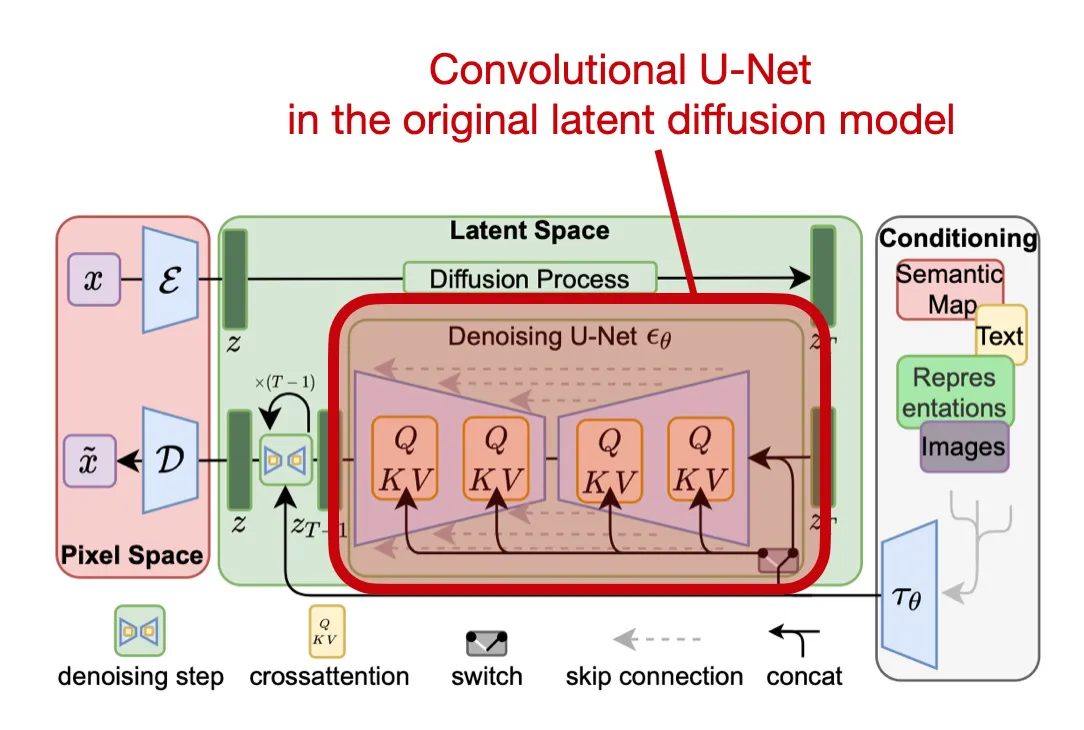
大多数扩散模型都基于卷积神经网络,采用以CNN为基础的U-Net架构。U-Net因其标志性的“U”形结构而得名,最初被用于图像分割任务,由用于捕捉上下文信息的编码器和实现精确定位的解码器组成。

传统上,扩散模型会复用U-Net来建模每一步扩散过程的条件分布,实现从噪声分布到目标数据分布的映射。换句话说,U-Net的作用是预测扩散过程每一步中需要添加或去除的噪声。U-Net之所以适合这个场景,是因为它能很好地融合局部信息与全局信息。

figure08

隐空间扩散模型(即Stable Diffusion),引自论文 https://arxiv.org/abs/2112.10752

一个有意思的问题是:把扩散模型的CNN骨干网络换成ViT是否会带来收益?下面这篇论文的研究者就对此进行了探索。

All are Worth Words: A ViT Backbone for Diffusion Models

在这篇论文(https://arxiv.org/abs/2209.12152)中,研究者尝试将扩散模型中的卷积U-Net骨干替换为ViT,他们将这种架构命名为U-ViT。需要说明的是,这并非该方向的首次尝试,此前已有相关研究,比如 https://arxiv.org/abs/2208.07791 和 https://arxiv.org/abs/2111.14822 等论文提出的方法。不过本次提出的U-ViT是目前效果最好的方案。

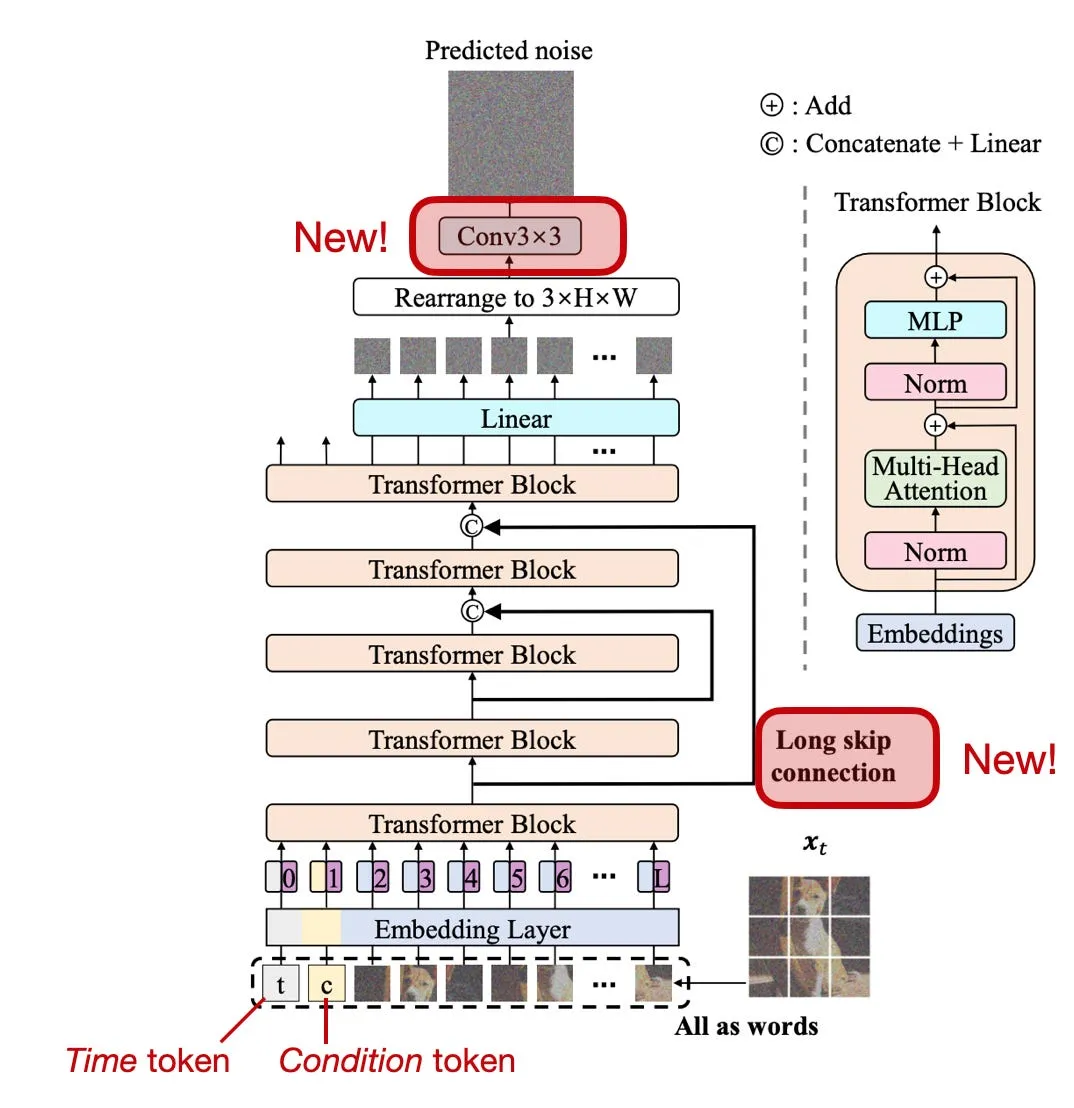
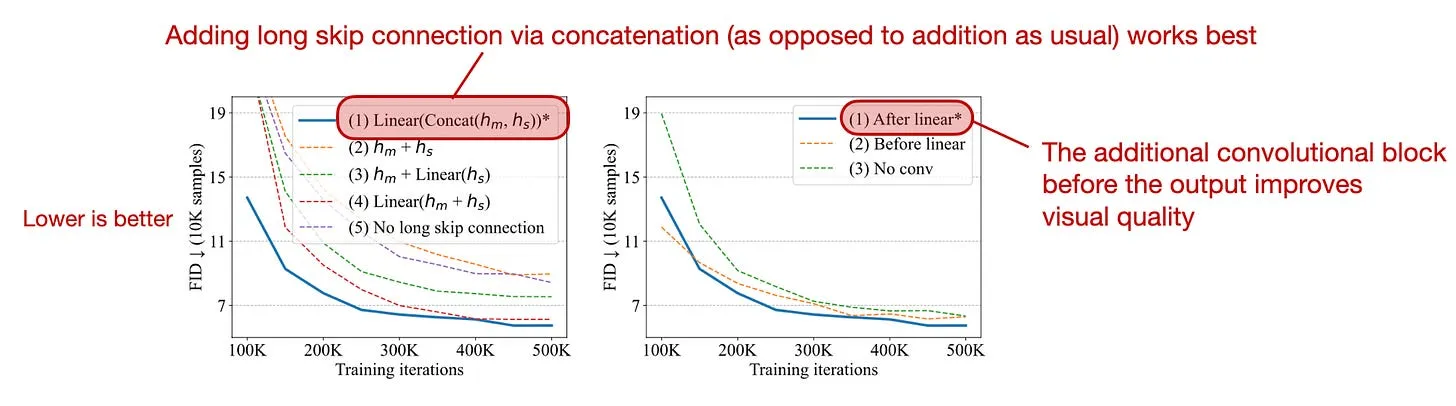
该架构的主要贡献在于新增了“长”跳跃连接,以及在输出前增加了一个卷积模块。注意,这里的“长”跳跃连接是在Transformer模块原有常规跳跃连接的基础上额外添加的。

和上一节介绍的常规ViT类似,模型的输入是“分块化”的图像,再额外加上一个时间标记(对应扩散步数)和一个条件标记(用于类别条件生成)。

figure09

论文 https://arxiv.org/abs/2209.12152 提出的全新U-ViT架构

下图展示了通过消融实验验证这些设计选择有效性的结果(设计非常严谨!)。

研究者在三类核心任务上对新架构进行了评估:

  • 无条件图像生成
  • 类别条件图像生成
  • 文本生成图像

在无条件图像生成任务上,全新的U-ViT扩散模型效果具有竞争力,但略逊于其他扩散模型;在类别条件图像生成任务上,U-ViT扩散模型可以比肩最优的生成对抗网络(GAN),并且效果超过其他扩散模型;而在文本生成图像任务上,它的表现优于所有在相同数据集上训练的对比模型(包括GAN和扩散模型)。

figure10

U-ViT在条件生成与文本生成图像任务上的效果,引自论文 https://arxiv.org/abs/2209.12152

值得肯定的是,尽管该模型在多个任务上没有全面超越其他模型,论文仍然被会议收录。这是一个带有全新架构思路的新模型,未来ViT会将扩散模型带向何方,非常值得期待。

(补充一点小说明:和部分其他模型相比,该模型文本生成图像任务的训练和评测数据集规模相对较小。同时目前也不清楚这种架构和传统基于CNN的扩散模型相比,计算性能如何。不过可以理解,使用较小数据集主要是因为这是学术项目,而非大型科技公司的重点项目,可能受限于资源。即便使用的是规模更小、更成熟的MS-COCO基准数据集,研究本身也没有任何问题。)

3)神经辐射场(NeRF)

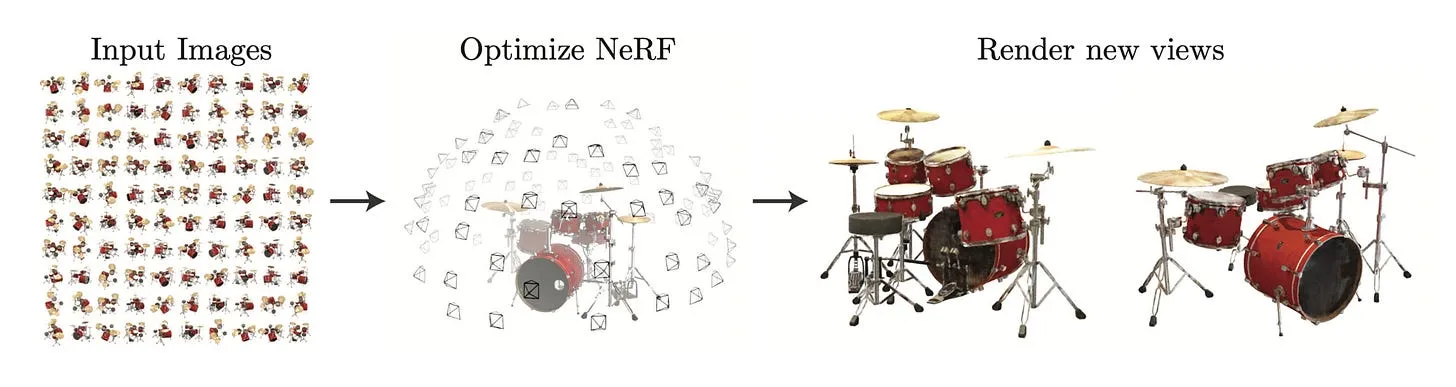
简而言之,神经辐射场(NeRF)是一种相对较新的技术(2020年首次提出),能够从一组二维图像出发,合成复杂三维场景的全新视角,原始论文见 https://arxiv.org/abs/2003.08934。其实现原理是将三维场景建模为由神经网络生成的颜色与密度构成的体场。NeRF模型通过少量不同视角拍摄的图像训练后,能够根据三维空间中点的坐标和观测方向,输出该点的颜色和不透明度。

figure11

通过NeRF从二维输入图像学习生成全新三维渲染结果的示意图(图引自论文 https://arxiv.org/abs/2003.08934)

神经辐射场涉及不少专业术语,我们先稍作回溯,梳理一下这些术语的由来。

首先我们来定义神经场(neural fields):这个术语听起来很专业,其实就是指一个可训练(即可参数化)的神经网络函数,能够在整个输入空间(比如一个三维场景)中生成输出值的“场”。

其核心思想是让神经网络对特定的三维场景发生过拟合,这样就能高精度地生成该场景的全新视角。这和数值分析中的样条插值概念有些类似:样条插值就是让一条曲线“过拟合”一组数据点,从而得到对底层函数平滑且精确的表达。

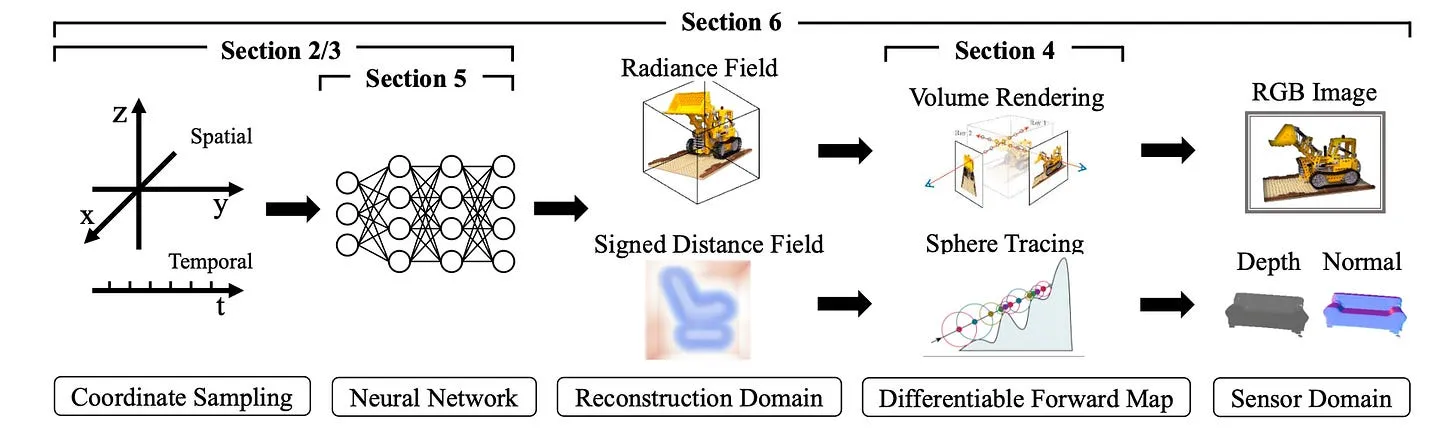
下图总结了神经场算法的流程,图取自Xie等人发表的优秀综述论文 https://arxiv.org/abs/2111.11426。

figure12

典型的前馈神经场算法示意图,引自论文 https://arxiv.org/abs/2111.11426

具体到NeRF,网络会学习根据观测方向,输出空间中给定点的颜色和不透明度,从而构建出逼真的三维场景表示。由于NeRF会预测三维空间中特定观测方向上每一点的光的颜色与强度,它本质上建模的是一个辐射值场,“辐射场”一词也由此而来。顺便一提,严格来说NeRF的表示是5维的,因为它包含了三个空间维度(三维空间的x、y、z坐标),加上由两个角度θ和φ定义的观测方向,共两个额外维度。

NeRF的应用潜力巨大,所有涉及高质量三维重建的场景都可以用到它,包括三维扫描、虚拟现实与增强现实,以及影视、游戏中的三维建模和动作捕捉等领域。

ABLE-NeRF:面向神经辐射场的、基于注意力的可学习嵌入渲染方法

如上所述,NeRF的基本思想是将三维场景建模为连续的辐射值体场。它不存储显式的三维物体或体素网格,而是用一个函数(即神经网络)来表示三维场景,该函数将三维坐标映射为颜色(RGB值)和密度。

网络通过一组不同视角拍摄的场景二维图像完成训练。渲染场景时,NeRF接收三维坐标和观测方向(即相机光线)作为输入,输出该位置的RGB颜色值和体密度。

通过这种方式,NeRF能够生成具有照片级真实感的物体新视角。不过NeRF也存在不足:光滑物体的渲染效果往往偏模糊,半透明物体的颜色也容易显得浑浊不清。

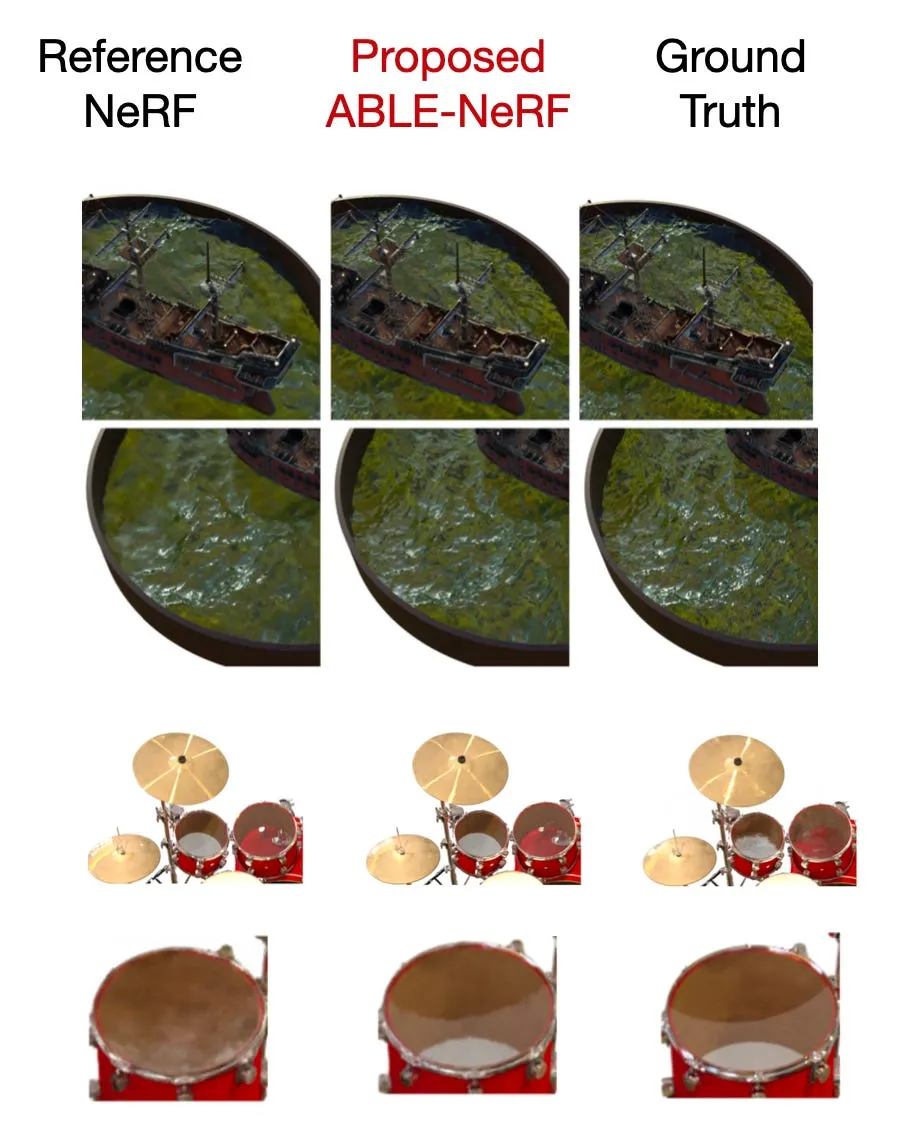
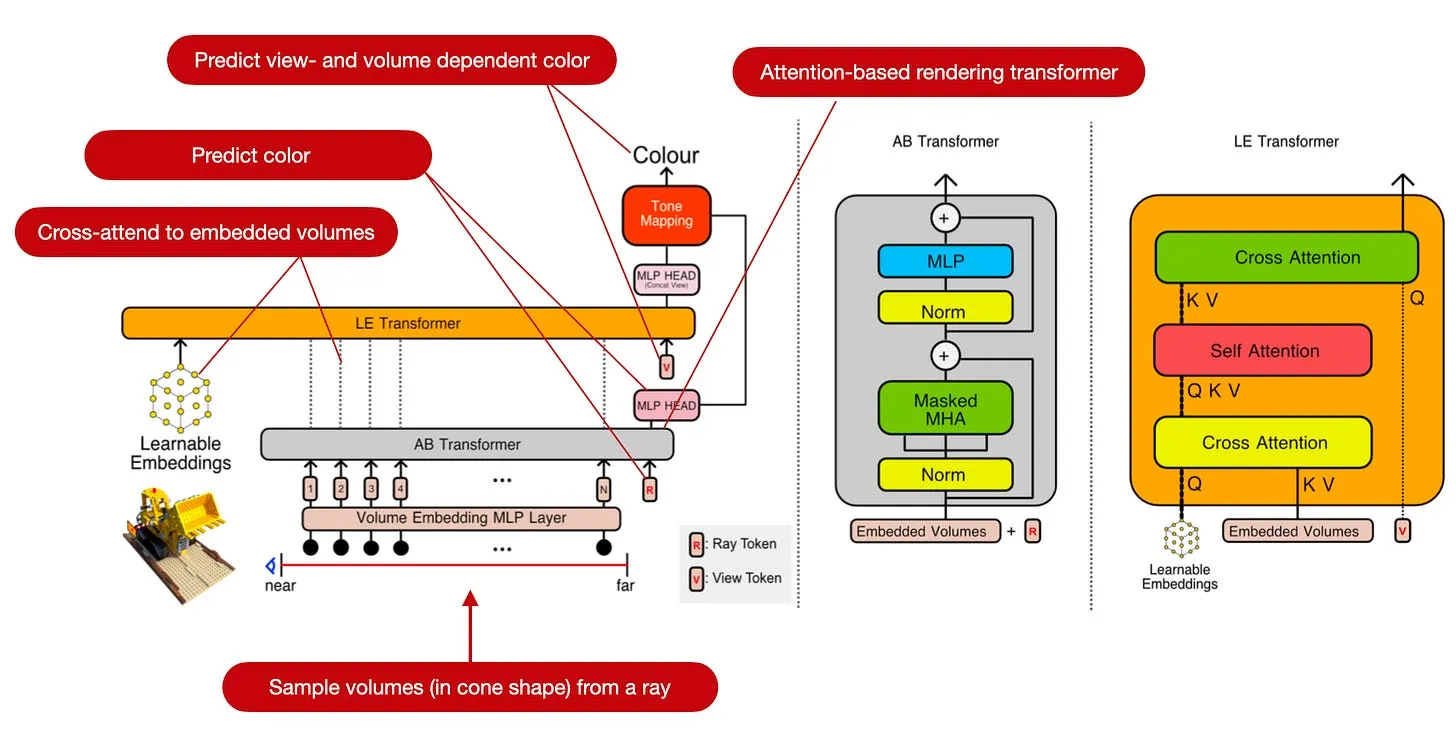
在论文 https://arxiv.org/abs/2303.13817 中,研究者针对这些缺陷,通过引入自注意力框架和可学习嵌入,提升了半透明表面与光滑表面的视觉渲染质量。

figure13

ABLE-NeRF提升渲染真实感的效果对比(图引自论文 https://arxiv.org/abs/2303.13817)

关于常规NeRF,还有一个细节值得一提:它使用的是基于光传输物理原理推导的体渲染方程。体渲染的基本思想是,对光线穿过三维场景时沿途所有点的贡献进行积分。渲染过程会对每条光线上的点进行采样,查询神经网络得到每个点的辐射值和密度,再对这些值积分,计算出像素的最终颜色。

本次提出的ABLE-NeRF没有沿用这种基于物理的体渲染方式,转而采用基于注意力的网络来决定光线的颜色。此外,研究者还加入了掩码注意力机制,避免特定点关注到被遮挡的点,以此贴合真实世界的物理限制。最后,他们还新增了一个Transformer模块用于学习可学习嵌入,来捕捉间接光照带来的视角相关外观效果。(消融实验表明,可学习嵌入对于提升视觉质量至关重要。)下图的标注示意图总结了该方法的整体框架。

figure14

ABLE-NeRF方法的标注示意图,引自论文 https://arxiv.org/abs/2303.13817

从ABLE-NeRF和基准NeRF的渲染对比结果来看,效果提升非常显著。当然,和真实值相比,结果还谈不上完美,但ABLE-NeRF已经能达到约90%的还原度。仅从图像出发就能实现这样的三维场景重建效果,发展速度已经相当惊人了。

4)目标检测与分割

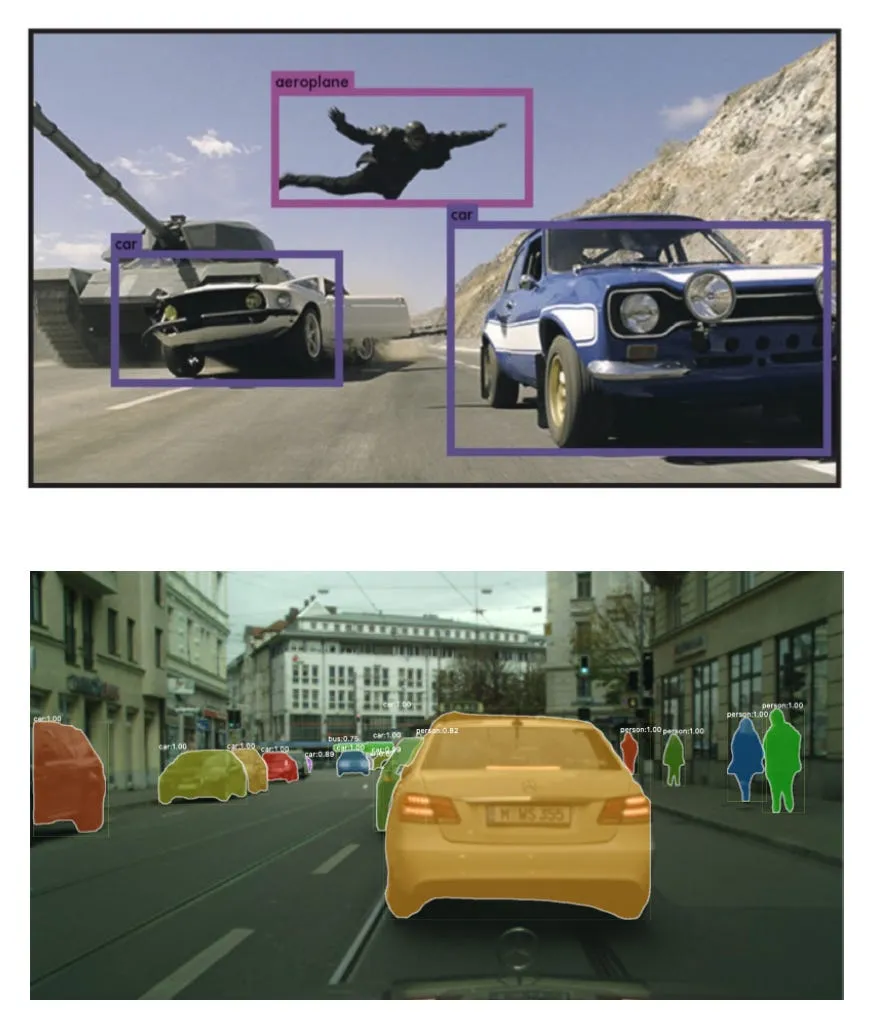
目标检测与分割是计算机视觉的经典任务,应该不需要过多介绍。不过还是简单说明一下两者的区别:目标检测的核心是预测边界框和对应的类别标签;分割则是对每个像素进行分类,以此区分前景物体和背景。

figure15

目标检测(上)与分割(下)示意图。图分别引自YOLO论文(https://arxiv.org/abs/1506.02640)和Mask R-CNN论文(https://arxiv.org/abs/1703.06870v3)

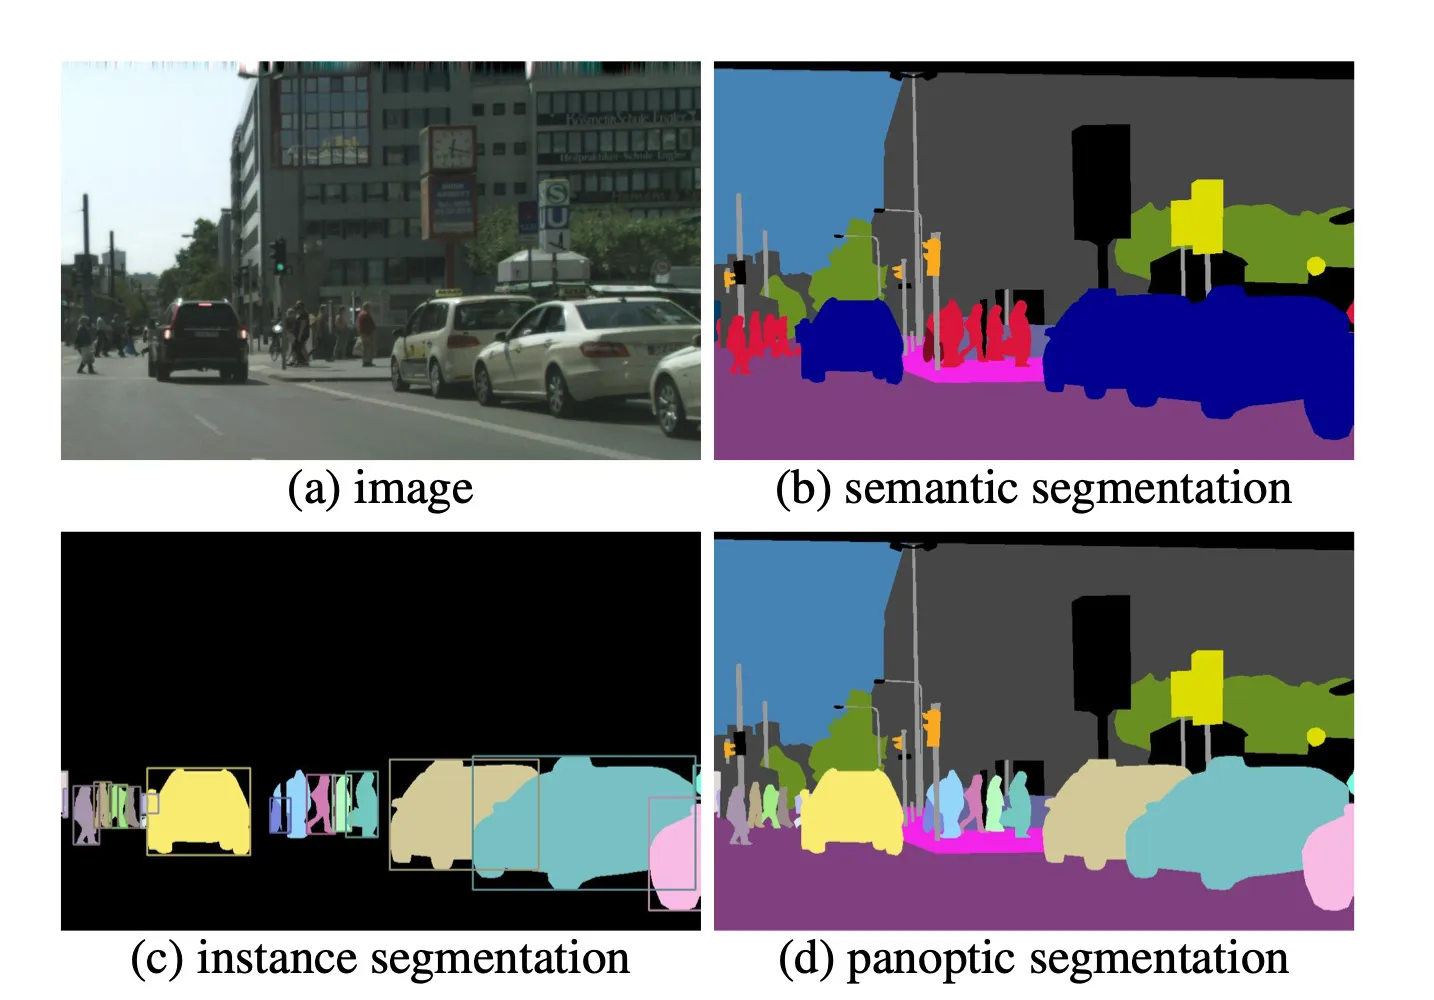
此外,分割任务还可以细分为三类,我在下面逐一说明。

  1. 语义分割。该技术会为图像中的每个像素分配一个物体类别标签(比如汽车、狗、房子),但它不会区分同一类物体的不同实例。举个例子,如果图像里有三辆汽车,语义分割会把它们都标记为“汽车”,不会区分第一辆、第二辆和第三辆。

  2. 实例分割。该技术在语义分割的基础上更进一步,能够区分同一类物体的不同个体。还是刚才三辆汽车的例子,实例分割会分别识别出每一辆车(比如汽车1、汽车2、汽车3)。也就是说,实例分割不仅对每个像素分类,还会区分出不同的物体实例,为每个实例分配独立的ID。

  3. 全景分割。该技术融合了语义分割和实例分割。在全景分割中,每个像素都会被分配一个语义标签和一个实例ID。为了更好地区分全景分割和实例分割,可以这么理解:实例分割的重点是识别场景中每个可识别物体的实例,也就是主要关注“事物”(things)——汽车、人、动物这类可数的、有明确个体的物体。而全景分割的目标是实现对场景的完整理解,它会为每个像素都打上标签:对于“物料”(stuff,比如天空、草地这类不可数的连续区域)分配类别标签;对于“事物”(things,汽车、人这类可数物体)分配实例标签。

figure16

图引自论文 https://arxiv.org/abs/1801.00868

经典的目标检测算法包括R-CNN(https://arxiv.org/abs/1311.2524)及其变体(Fast R-CNN:https://arxiv.org/abs/1504.08083、Faster R-CNN:https://arxiv.org/abs/1506.01497)、YOLO(You Only Look Once,https://arxiv.org/abs/1506.02640),以及SSD(Single Shot MultiBox Detector,https://arxiv.org/abs/1512.02325)。

分割模型则包括U-Net(https://arxiv.org/abs/1505.04597,此前扩散模型部分已有讨论)、Mask R-CNN(https://arxiv.org/abs/1703.06870,具备分割能力的Faster R-CNN变体),以及DeepLab(https://arxiv.org/abs/1606.00915)等等。

目标检测和分割在自动驾驶、医学影像以及视频监控等领域都有重要应用。需要注意的是,两者也经常结合使用:目标检测可以先对物体进行粗定位,再由分割算法进行微调,实现更精确的边界和形状分析。

Mask DINO:构建统一的基于Transformer的目标检测与分割框架

这篇论文(https://arxiv.org/abs/2206.02777)是DINO模型的扩展工作,DINO全称为“DETR with Improved deNoising anchOr boxes”(改进去噪锚框的DETR),原始论文见 https://arxiv.org/abs/2203.03605。

而DETR(DEtection TRansformer,检测Transformer)是由Facebook AI提出的端到端目标检测模型,相关论文见 https://arxiv.org/abs/2005.12872——不出所料,它采用了Transformer架构。和传统目标检测模型不同,DETR将目标检测视为一个直接的集合预测问题,不需要人工设计锚框,也省去了非极大值抑制的步骤,提供了一种更简洁、更灵活的目标检测方案。

如今,基于CNN的方法通常会将目标检测(区域级任务)和分割(像素级任务)进行统一,以此提升两个任务的整体性能(本质上是一种多任务学习),但基于Transformer的目标检测与分割系统还没有做到这一点。

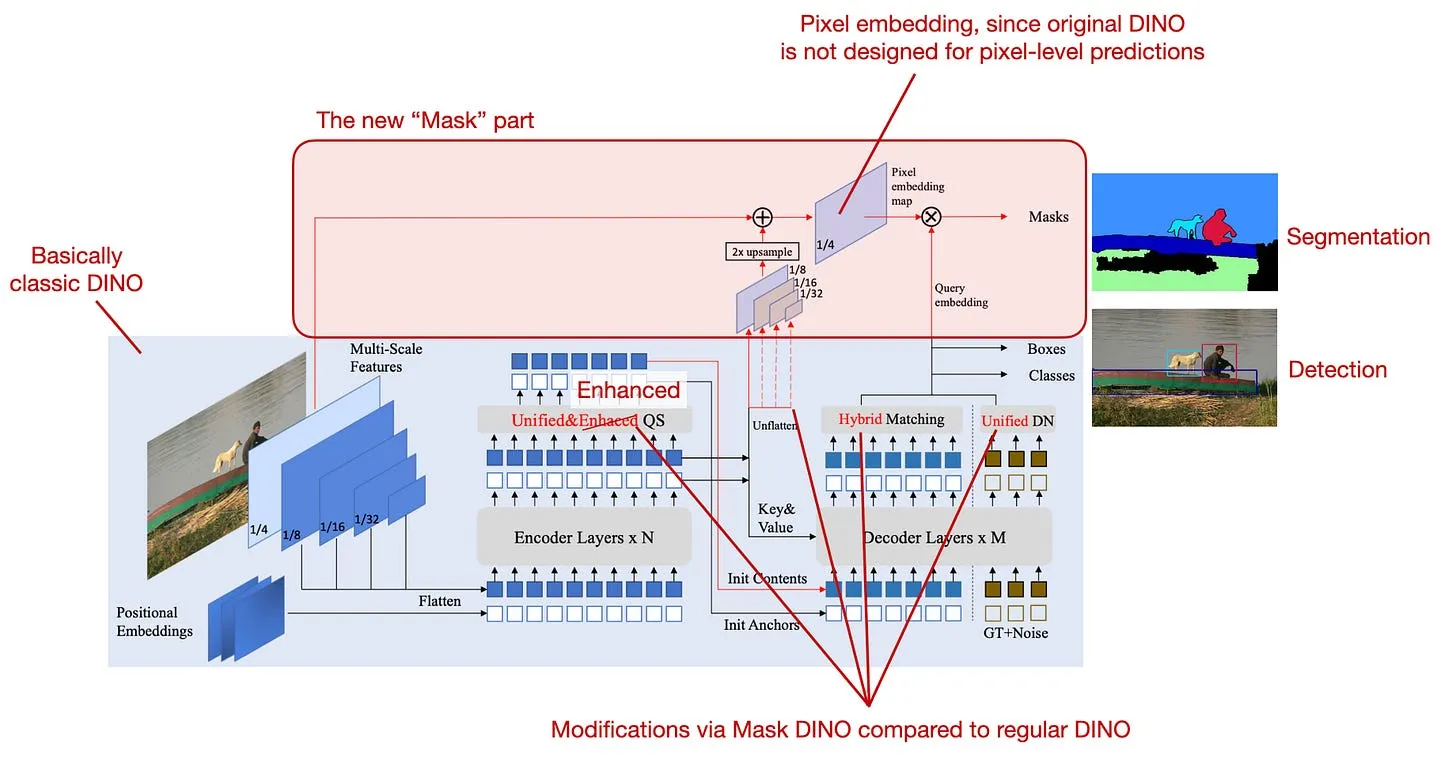
而本次提出的Mask DINO正是为了解决这个问题。通过对DINO进行扩展,Mask DINO的表现超越了所有现有的目标检测与分割系统。下图的标注示意图总结了Mask DINO的核心思路。

figure17

Mask DINO论文的标注示意图,引自 https://arxiv.org/abs/2206.02777


本通讯是我的个人兴趣项目,没有直接的商业收益。如果您愿意支持我的创作,可以考虑购买我的书籍,链接:https://sebastianraschka.com/books。如果您觉得这些书籍有启发、有帮助,也欢迎推荐给您的朋友和同事。

figure18

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 http://mng.bz/M96o

您的支持对我意义重大!非常感谢!
【转载】借助混合精度与全分片数据并行加速PyTorch模型训练

原文地址:Accelerating PyTorch Model Training, by Sebastian Raschka, on 2023-06-3

借助混合精度与全分片数据并行加速PyTorch模型训练

上周,我在温哥华举办的2023年计算机视觉与模式识别会议(CVPR 2023)上做了题为《以最少代码改动扩展PyTorch模型训练规模》的演讲。在活动现场能和这么多人交流,感觉非常愉快。

为方便日后查阅,也为了没能到场的朋友,我想做个小尝试,把这次演讲整理成一篇短文,内容就在下方。(注:下周我会再分享更多CVPR的参会心得!)

因此,本文将深入探讨如何以最少的代码改动实现PyTorch模型训练的规模扩展。本文的重点是利用混合精度技术与多GPU训练范式,而非底层硬件优化。我们将以一个用于图像分类的简易视觉Transformer(ViT)作为基础模型展开讲解。

从基线模型开始

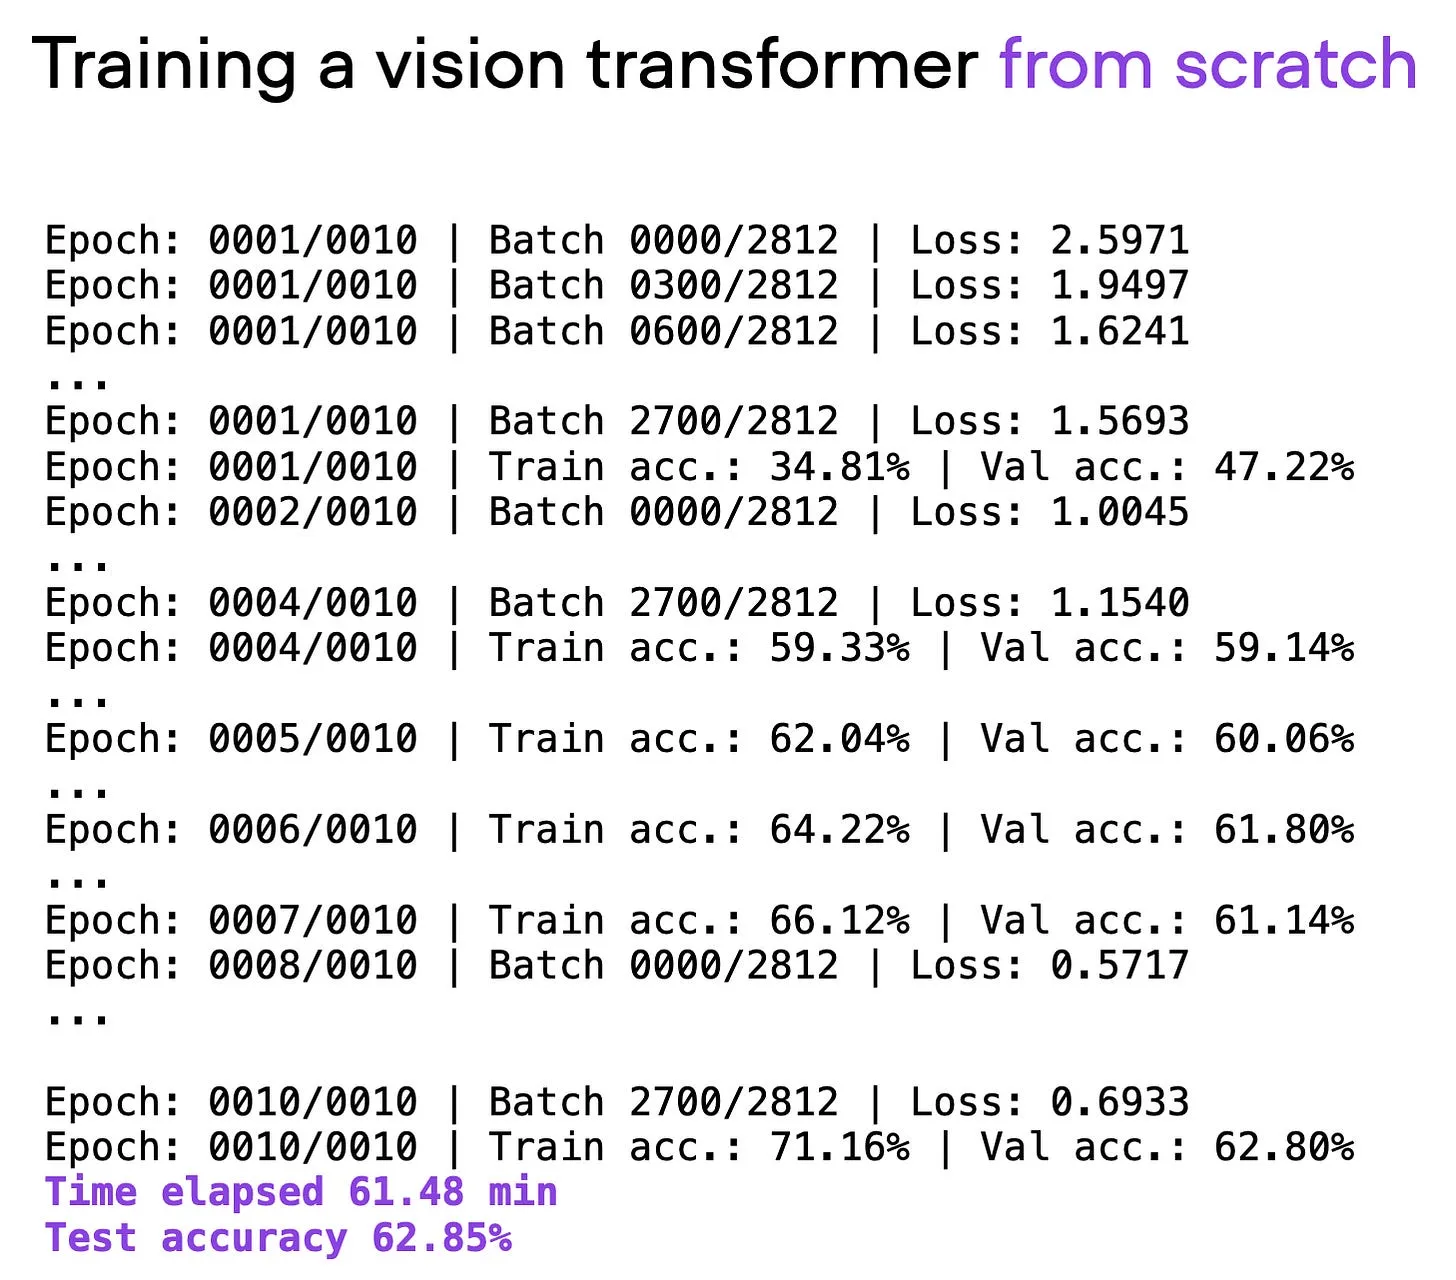
我们的ViT模型在基础数据集上从头开始训练,耗时约60分钟,测试集准确率达到62%。

在接下来的章节中,我们将探索无需大幅重构代码,就能提升训练速度与准确率的方法。

请注意,模型与数据集的细节并非本文重点(选择它们只是为了尽可能简化,方便你在自己的硬件上复现代码,无需下载安装过多依赖项)。本文分享的所有示例都可在 https://github.com/rasbt/cvpr2023 获取,你可以查看并复用完整代码。

figure01

https://github.com/rasbt/cvpr2023/blob/main/00_pytorch-vit-random-init.py 脚本的运行输出。

告别从头训练

在当今时代,针对文本或视觉任务从头开始训练深度学习模型往往性价比不高。我们通常会利用预训练模型,针对自身任务进行微调,以此节省时间与计算资源,同时获得更优的模型性能。

如果沿用上述相同的ViT架构,采用在其他数据集(ImageNet)上预训练的权重进行微调,我们就能在更短的时间内获得大幅提升的预测效果:仅需20分钟(3个训练轮次),测试准确率就能达到95%。

figure02

https://github.com/rasbt/cvpr2023/blob/main/00_pytorch-vit-random-init.py 与 https://github.com/rasbt/cvpr2023/blob/main/01_pytorch-vit.py 的效果对比

提升计算性能

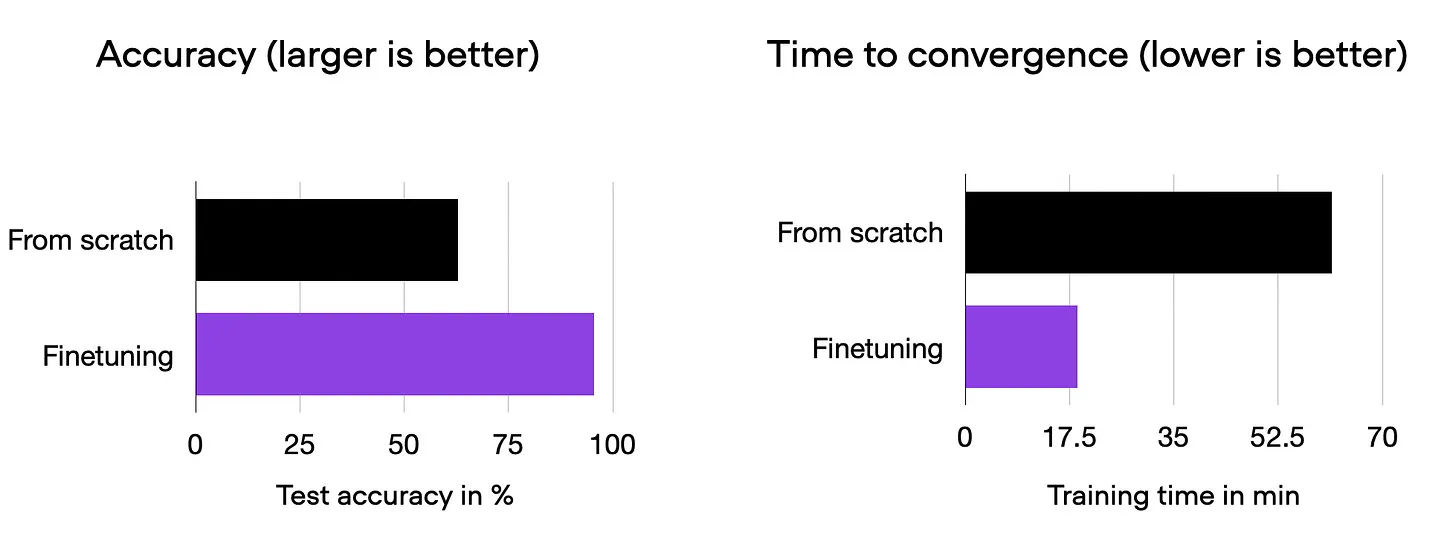
上文我们已经看到,相比从头训练,微调能带来巨大的性能提升,下图用更简洁的柱状图做了总结。

figure03

https://github.com/rasbt/cvpr2023/blob/main/00_pytorch-vit-random-init.py 与 https://github.com/rasbt/cvpr2023/blob/main/01_pytorch-vit.py 的效果对比

当然,实际效果会因数据集或任务的不同而有所差异,但对于绝大多数文本与视觉任务而言,基于通用公开数据集预训练的模型作为起点都是值得的。

接下来的章节将探索多种在不损失预测准确率的前提下,进一步加快训练速度的技巧。

开源Fabric库介绍

想要以最少的代码改动高效扩展PyTorch训练规模,方法之一是使用 https://lightning.ai/docs/fabric/stable/ 。你可以把它看作是PyTorch的轻量封装库/应用程序接口。我们可以通过以下命令安装:

pip install lightning

当然,下文要介绍的所有技术也都可以用原生PyTorch实现——Fabric的目标只是让这些操作更便捷。

在探索这些“加速代码的高级技巧”之前,我们先看看将Fabric集成到PyTorch代码中需要做的小幅改动。(完成下文这些改动后,只需修改一行代码就能启用PyTorch的高级特性。)

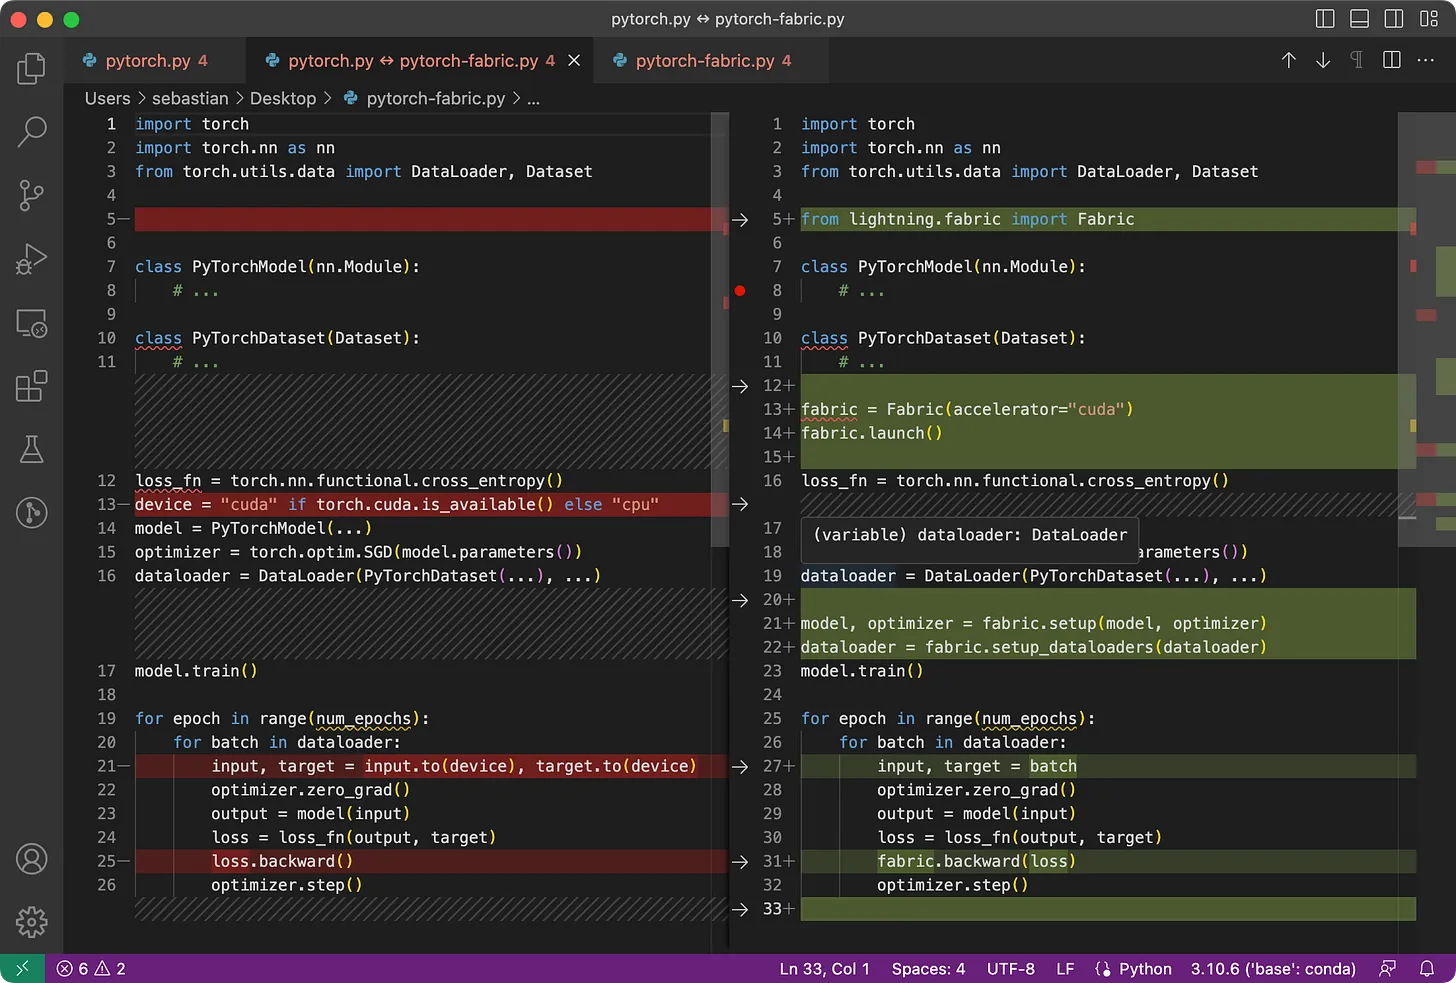
原生PyTorch代码与修改后适配Fabric的代码差异很小,仅需少量修改,如下方代码高亮所示:

figure04

左侧:原生PyTorch代码;右侧:接入Fabric的PyTorch代码

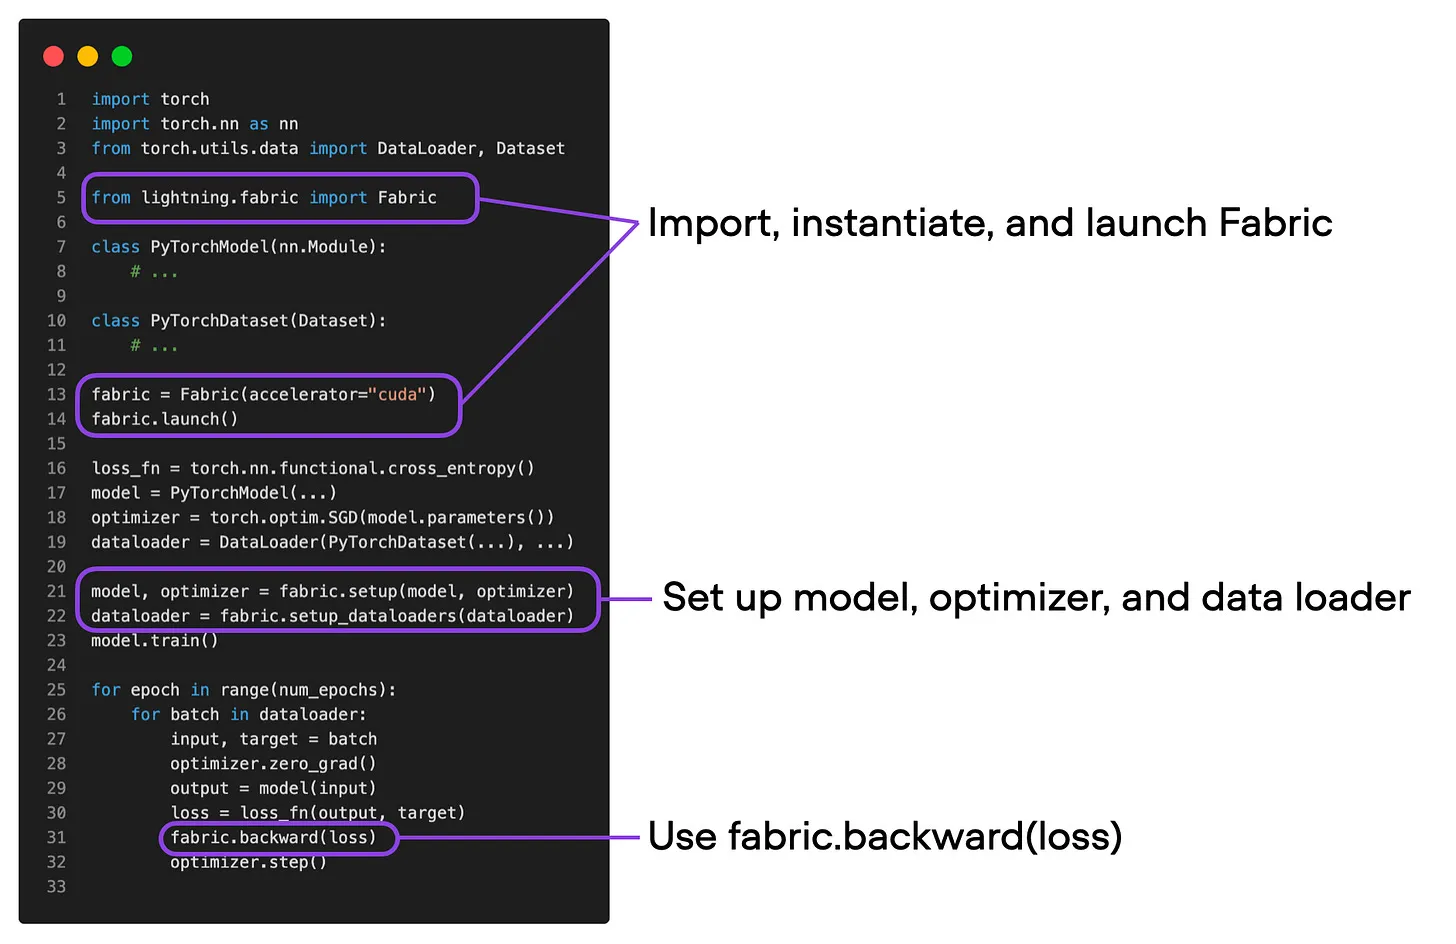
总结上图,将原生PyTorch代码转换为PyTorch+Fabric版本主要分为3步:

  1. 导入Fabric并实例化一个Fabric对象。
  2. 使用Fabric配置模型、优化器与数据加载器。
  3. 对损失值调用 fabric.backward(),替代常规的 loss.backward()。

figure05

这些微小的改动,为我们打开了使用PyTorch高级特性的大门,且无需再重构其余现有代码。

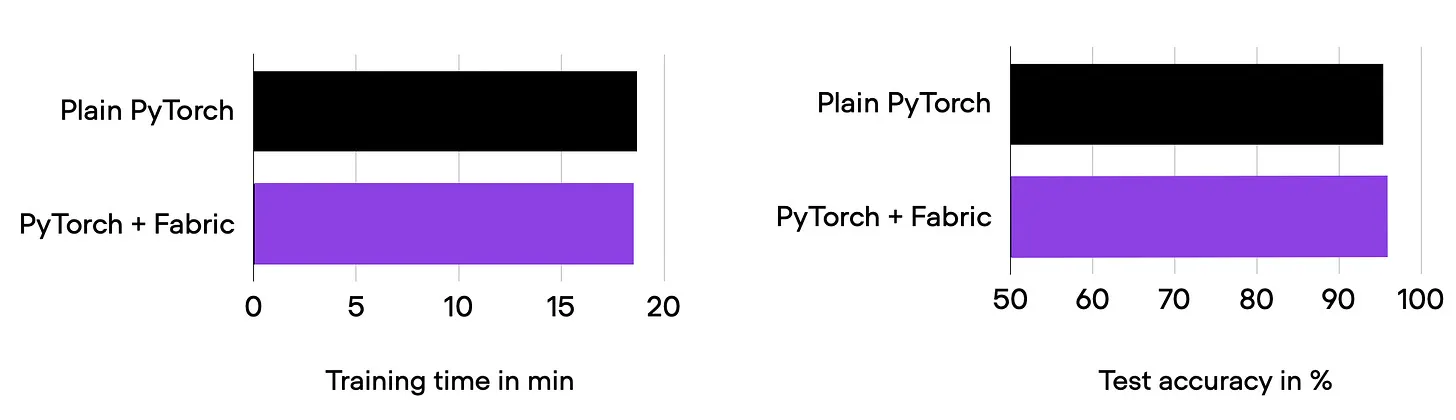
但在深入介绍这些“高级特性”之前,我们先确认模型的训练耗时与预测性能和之前保持一致。

figure06

https://github.com/rasbt/cvpr2023/blob/main/01_pytorch-vit.py 与 https://github.com/rasbt/cvpr2023/blob/main/03_fabric-vit.py 的效果对比

从上方柱状图可以看到,训练耗时与准确率和之前完全一致,符合预期。(所有波动都可归因于随机性。)

在上一节中,我们用Fabric修改了PyTorch代码。为什么要费这些功夫呢?正如下文所示,现在我们只需改动一行代码,就能尝试混合精度、分布式训练等高级技术,只需把

fabric = Fabric(accelerator="cuda")

修改为

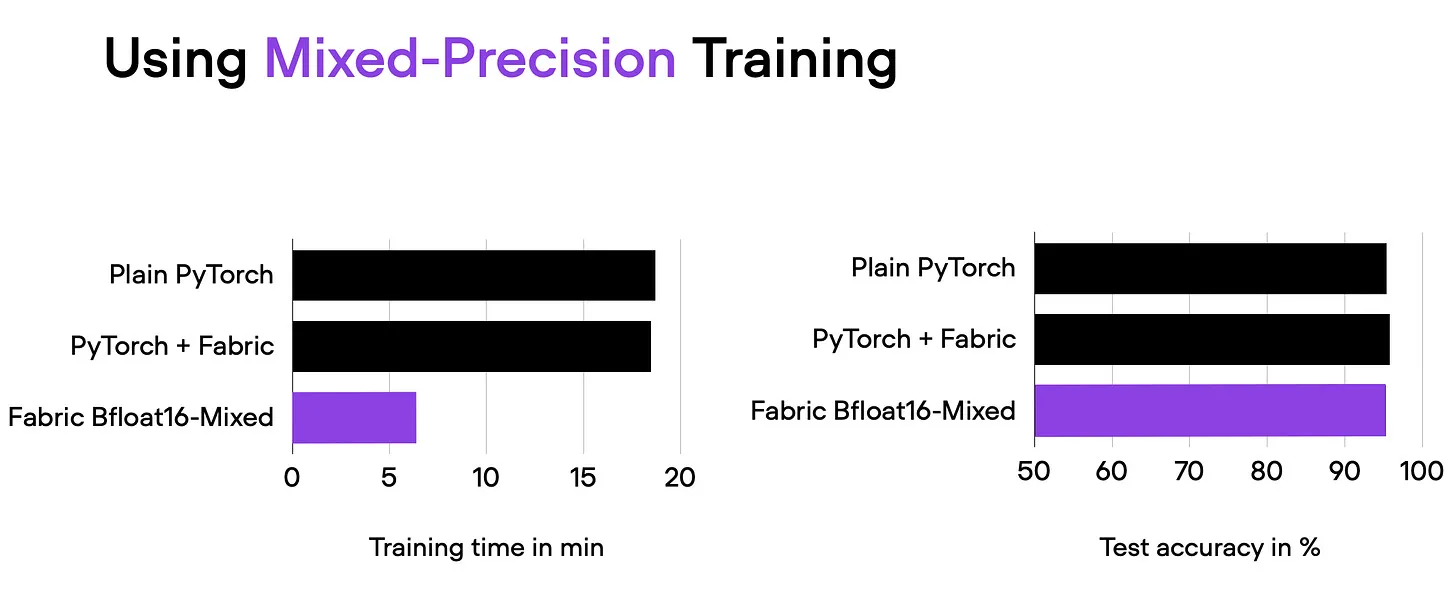
fabric = Fabric(accelerator="cuda", precision="bf16-mixed")

figure07

https://github.com/rasbt/cvpr2023/blob/main/04_fabric-vit-mixed-precision.py 脚本的运行结果

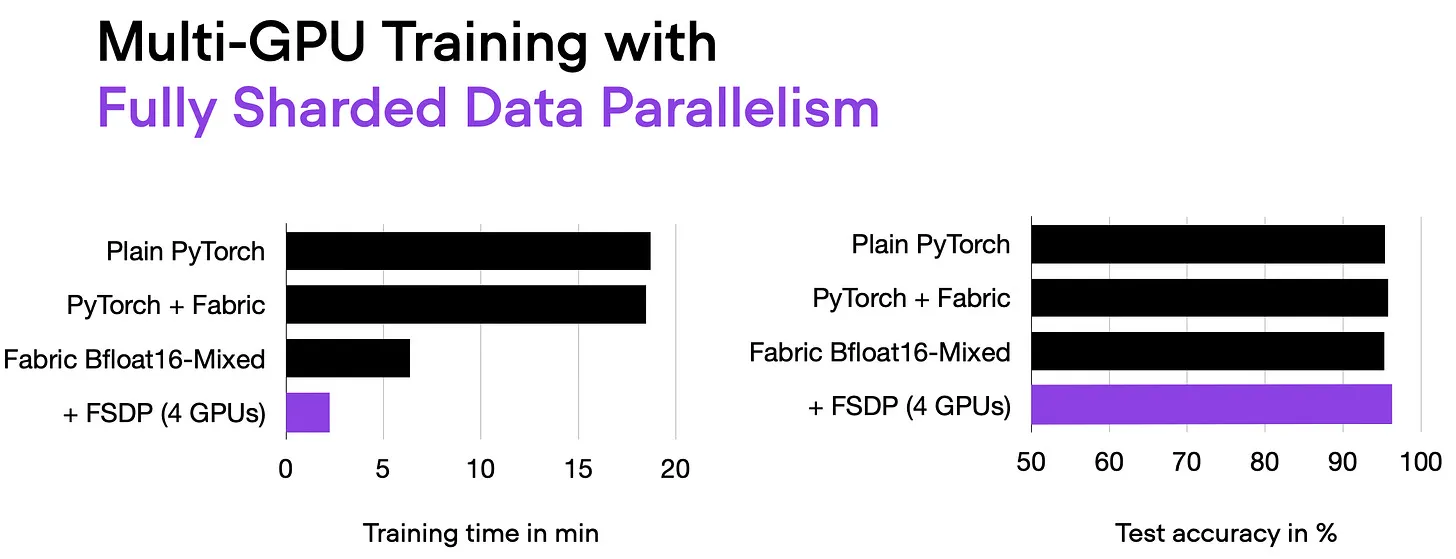
借助混合精度训练,我们将训练时间从约18分钟缩短到了6分钟,同时保持了预测性能不变。仅需在实例化Fabric对象时添加 precision="bf16-mixed" 参数,就实现了训练时间的大幅缩减。

理解混合精度的原理

混合精度训练本质上是同时使用16位与32位精度,确保准确率不会下降。用16位格式计算梯度比32位格式快得多,还能节省大量显存。这种策略尤其在显存或计算资源受限的场景下优势明显。

它之所以被称为“混合”精度训练,而非“低”精度训练,是因为我们不会把所有参数与运算都转为16位浮点数。相反,训练过程中我们会在32位与16位运算之间切换,因此得名“混合”精度。

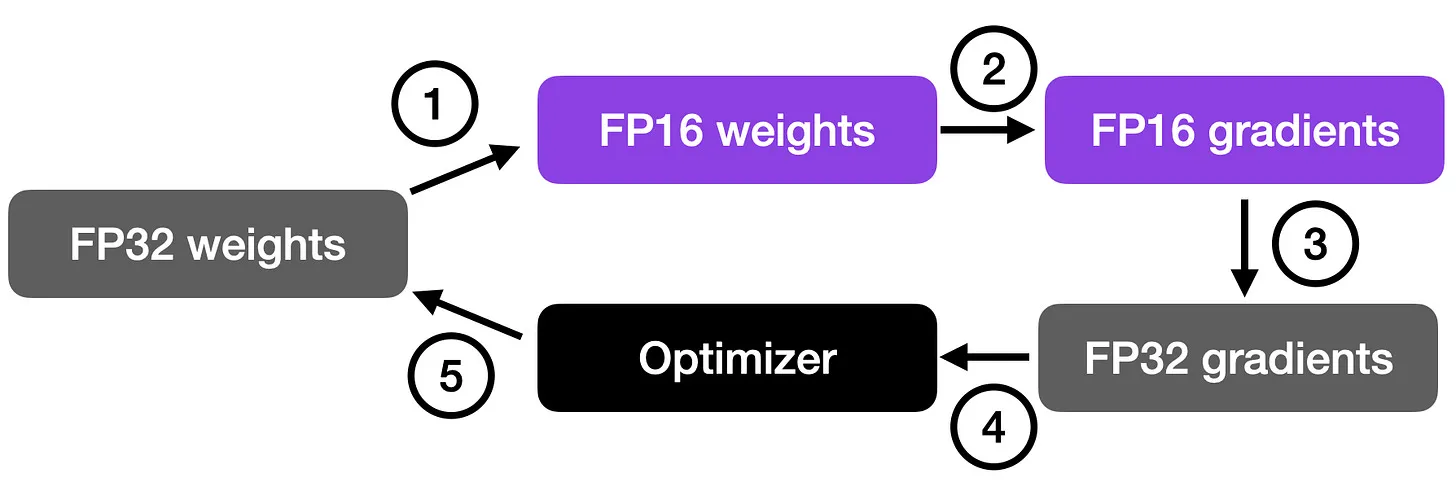
如下图所示,混合精度训练的流程包括:将权重转为低精度(FP16)以加快计算、计算梯度、将梯度转回高精度(FP32)以保证数值稳定性,再用缩放后的梯度更新原始权重。

这种方式既能实现高效训练,又能维持神经网络的准确率与稳定性。

figure08

具体步骤如下:

  1. 将权重转为FP16:在这一步中,神经网络原本为FP32格式的权重(参数)会被转换为精度更低的FP16格式。这能降低显存占用,同时加快计算速度——因为FP16运算所需显存更少,硬件处理速度更快。
  2. 计算梯度:神经网络的前向传播与反向传播都使用低精度的FP16权重执行。这一步会计算损失函数相对于网络权重的梯度(偏导数),用于优化过程中更新权重。
  3. 将梯度转为FP32:用FP16计算完梯度后,会将其转换回精度更高的FP32格式。这一转换对维持数值稳定性至关重要,能避免低精度运算可能出现的梯度消失或梯度爆炸等问题。
  4. 乘以学习率并更新权重:转为FP32格式的梯度会乘以学习率(一个标量值,决定优化过程中的步长)。

第4步得到的结果会用于更新原始的FP32神经网络权重。学习率用于控制优化过程的收敛速度,对取得良好性能至关重要。

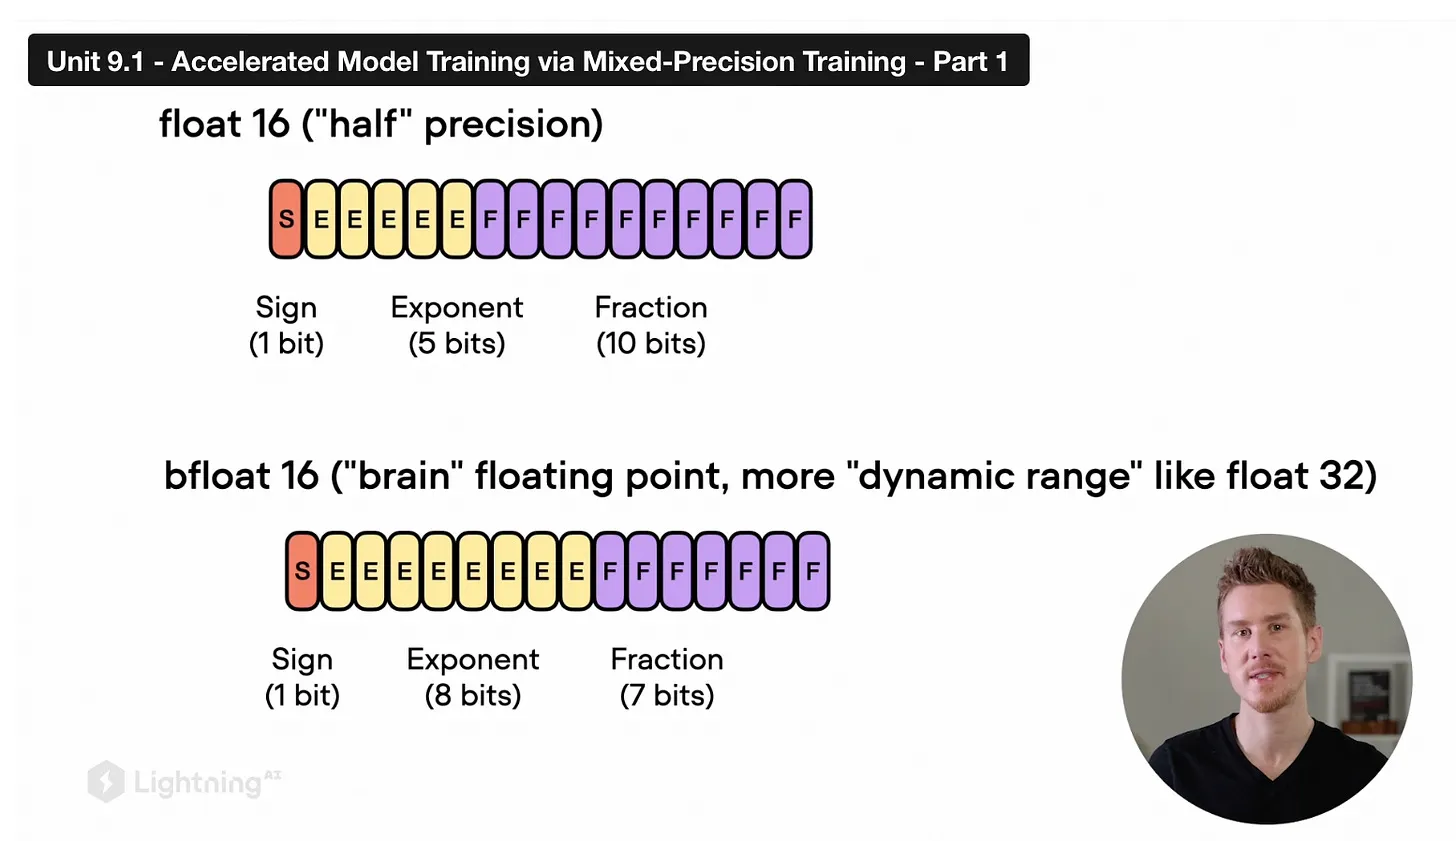
脑浮点16(bfloat16)

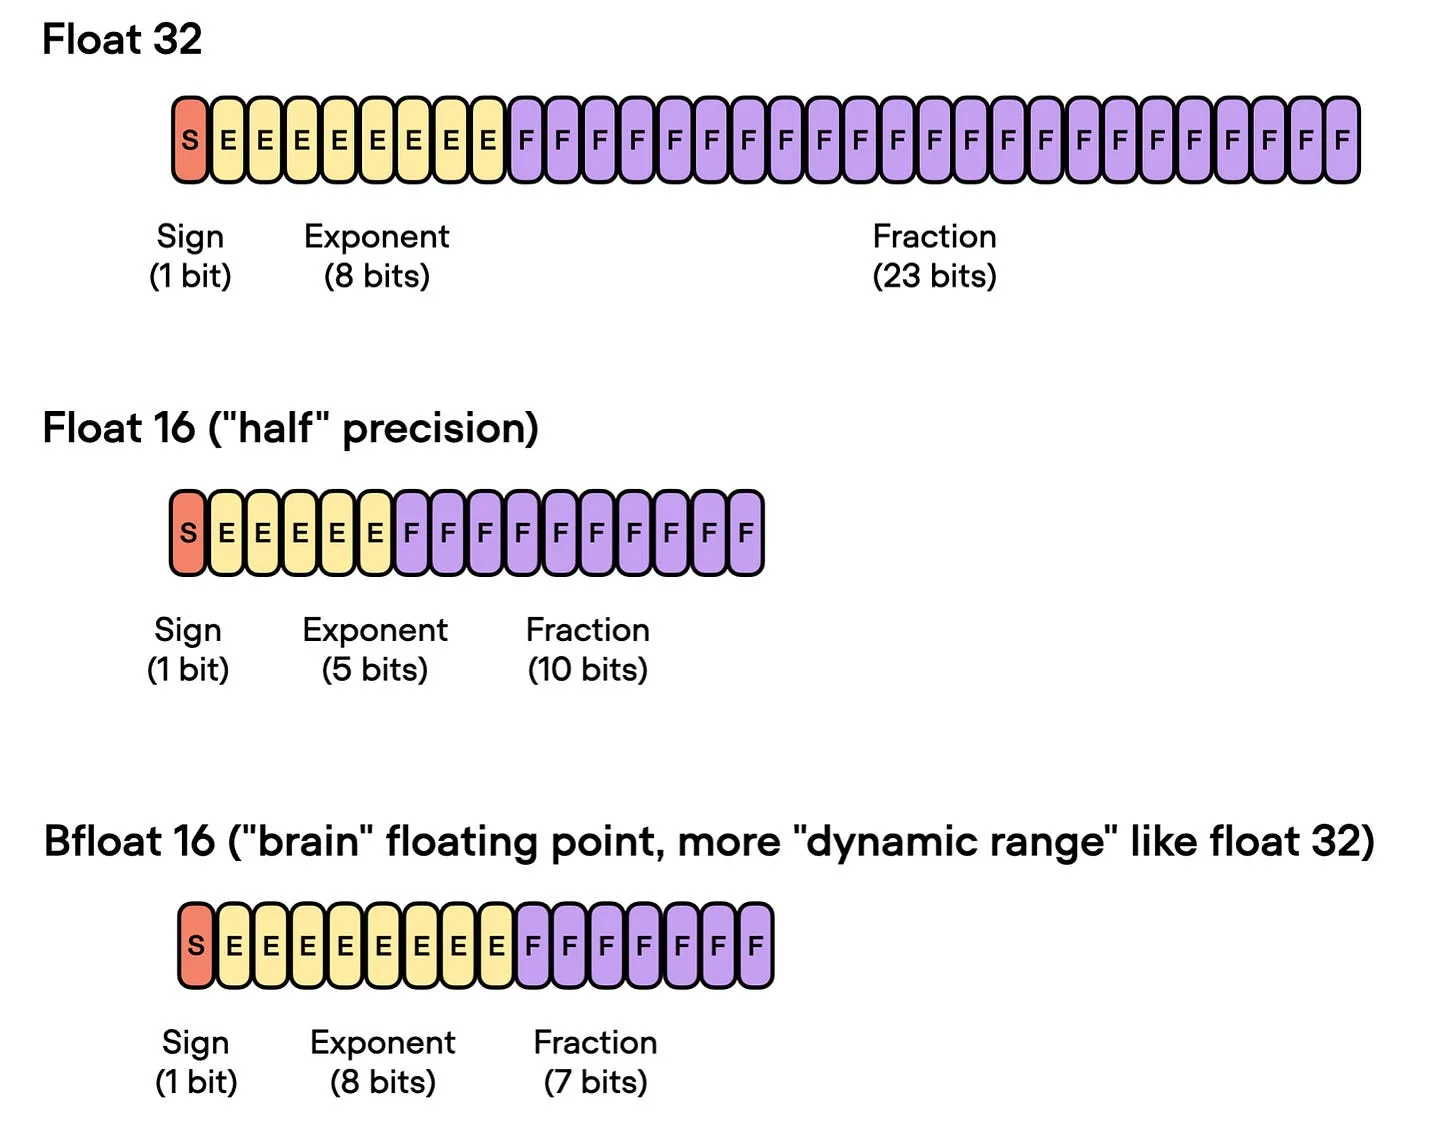
上文我们提到了“16位浮点数”精度训练。但请注意,之前代码中我们指定的是 precision="bf16-mixed",而非 precision="16-mixed"——两者都是合法选项。

这里,“bf16-mixed”中的“bf16”指的是 https://cloud.google.com/tpu/docs/bfloat16<(bfloat16,即脑浮点16)。该格式由谷歌专为机器学习与深度学习应用开发,尤其适配其张量处理单元(TPU)。与传统的float16格式相比,bfloat16以降低精度为代价,扩展了动态范围。/p>

figure09

扩展的动态范围让bfloat16可以表示极大与极小的数值,更适合深度学习这类会遇到大范围数值的应用场景。不过,精度降低可能会影响部分计算的准确率,或在某些情况下导致舍入误差。但在绝大多数深度学习应用中,这种精度降低对模型性能的影响微乎其微。

虽然bfloat16最初是为TPU开发的,但如今多款NVIDIA GPU也已支持该格式,首批支持的是NVIDIA Ampere架构中的A100张量核心GPU。

你可以通过以下代码检查你的GPU是否支持bfloat16:

>>> torch.cuda.is_bf16_supported()
True

如果你的GPU不支持脑浮点16,可以将 precision="bf16-mixed" 改为 precision="16-mixed"。

多GPU训练与全分片数据并行

我们接下来要尝试的改进是多GPU训练。如果我们有多块GPU可用,多GPU训练就能发挥作用,让模型训练速度更快。

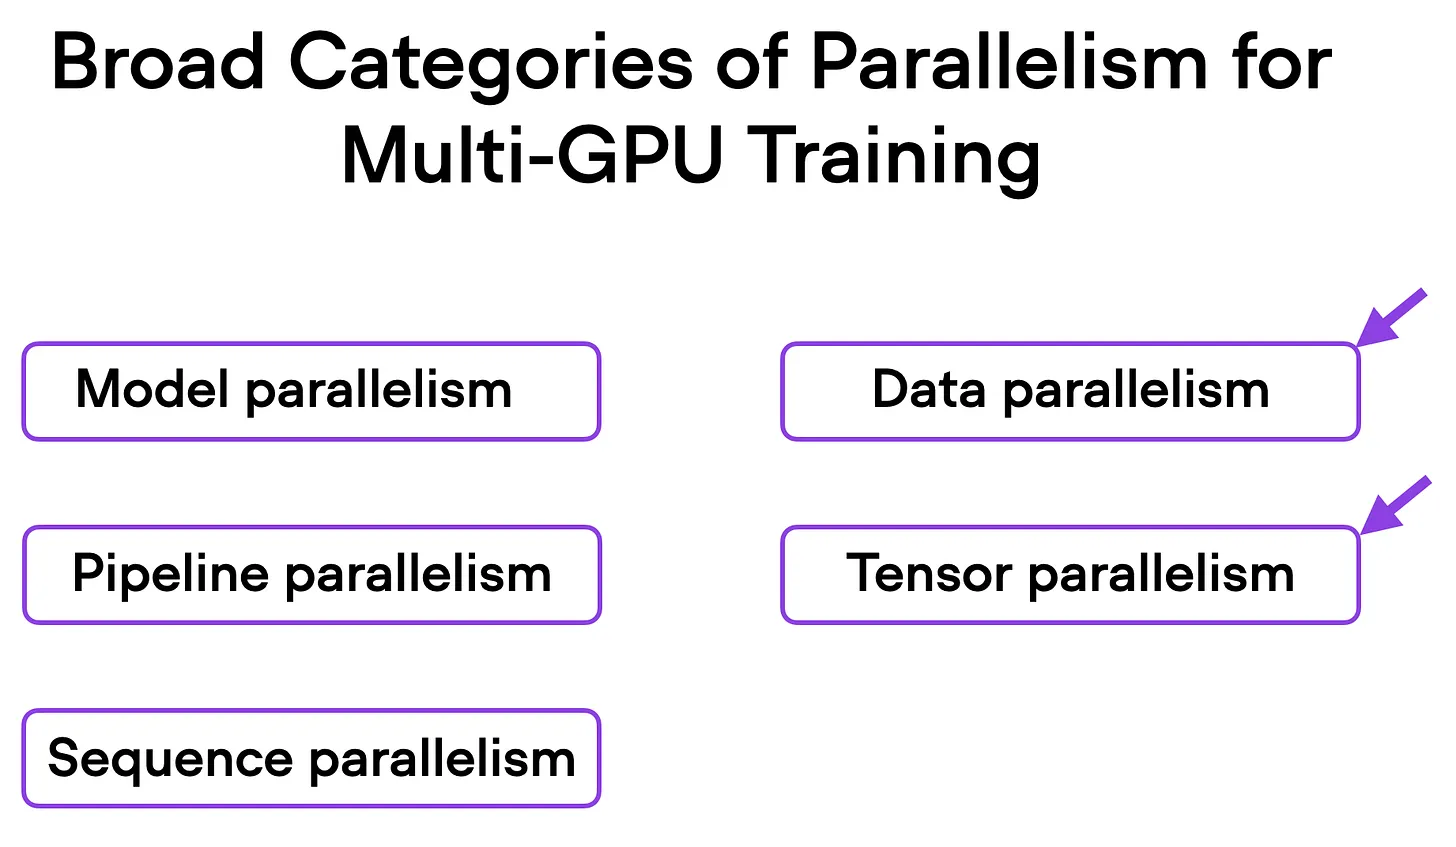
利用这一思路的一项更高级技术是全分片数据并行(Fully Sharded Data Parallelism,FSDP),它同时结合了数据并行与张量并行的优势。

figure10

在Fabric中,我们可以通过添加设备数量与多GPU训练策略来启用FSDP,如下所示:

fabric = Fabric(
    accelerator="cuda",
    precision="bf16-mixed",
    devices=4,
    strategy="FSDP"  # 新增!
)

figure11

https://github.com/rasbt/cvpr2023/blob/main/06_fabric-vit-mixed-fsdp.py 脚本的运行结果

因为我们现在用上了4块GPU,结果其实也在意料之中:代码现在仅需约2分钟就能运行完成,比仅使用混合精度训练时快了约3倍。

理解数据并行与张量并行

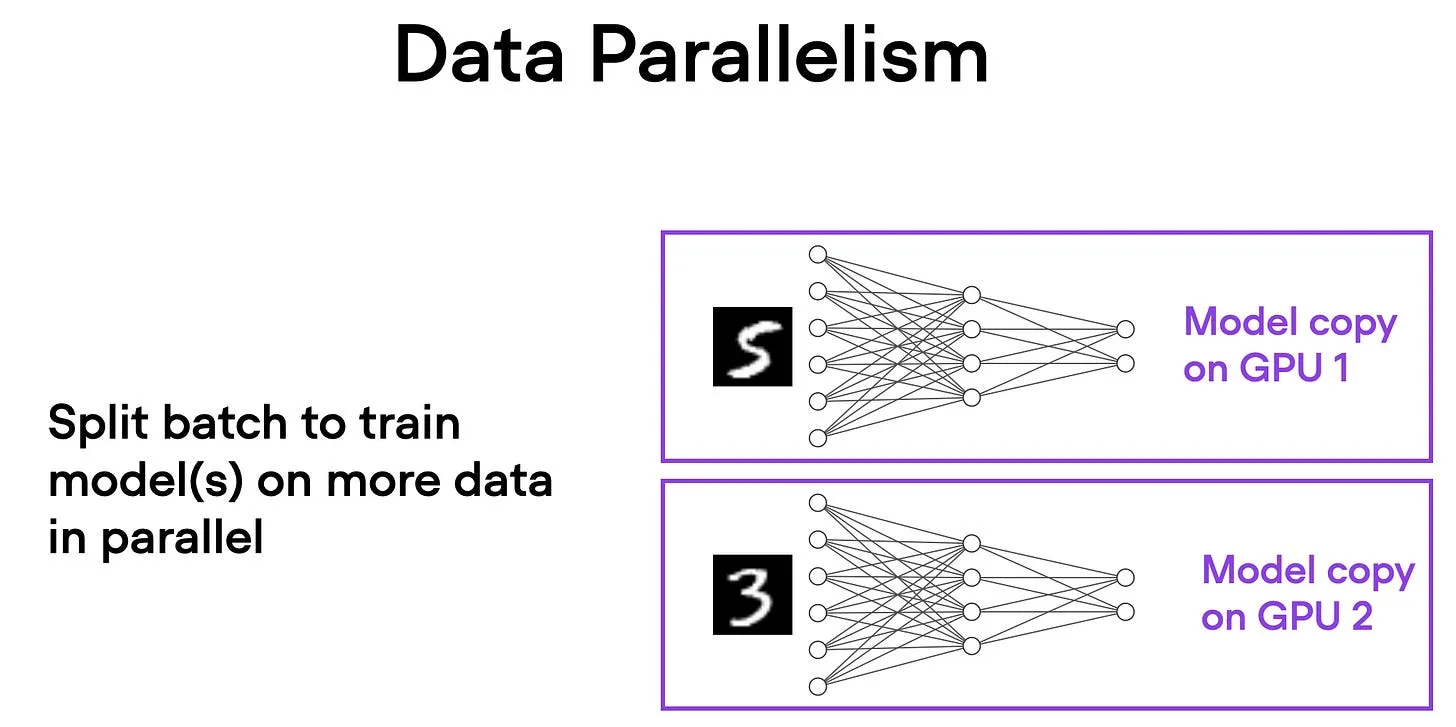
在数据并行中,小批次数据会被拆分,每块GPU上都有一份完整的模型副本。多块GPU并行工作,从而加快模型训练速度。

figure12

简而言之,其工作原理如下:

  • 相同的模型会被复制到所有GPU上。
  • 每块GPU会接收输入数据的不同子集(不同的小批次数据)。
  • 所有GPU独立执行模型的前向与反向传播,计算各自的本地梯度。
  • 随后,所有GPU的梯度会被收集并取平均值。
  • 平均后的梯度会用于更新模型的参数。

这种方法的核心优势是速度。由于每块GPU都和其他GPU同时处理一批独立的小批次数据,模型能在更短时间内完成更多数据的训练。尤其在处理大型数据集时,能大幅缩短训练时长。

不过,数据并行也存在局限性。最关键的一点是,每块GPU都必须存储完整的模型及其参数。这就限制了可训练模型的大小——模型必须能放进单块GPU的显存中,而这对于现代的ViT或大语言模型来说往往无法实现。

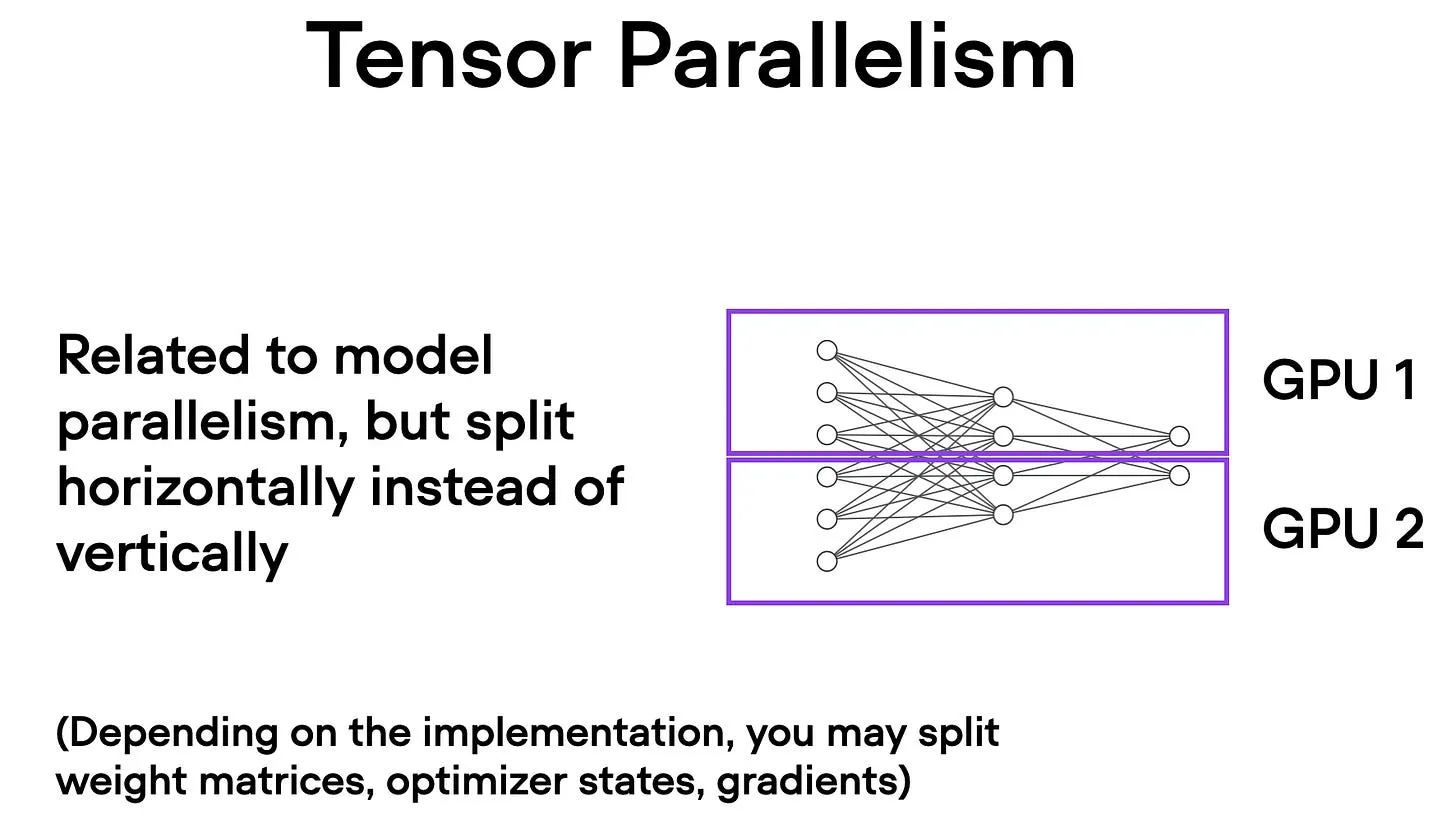
与数据并行将小批次数据拆分到多台设备不同,张量并行是将模型本身拆分到多块GPU上。数据并行要求每块GPU都能装下整个模型,在训练更大模型时会成为瓶颈;而张量并行则通过拆分模型并分发到多台设备,让单块GPU装不下的大模型也能完成训练。

figure13

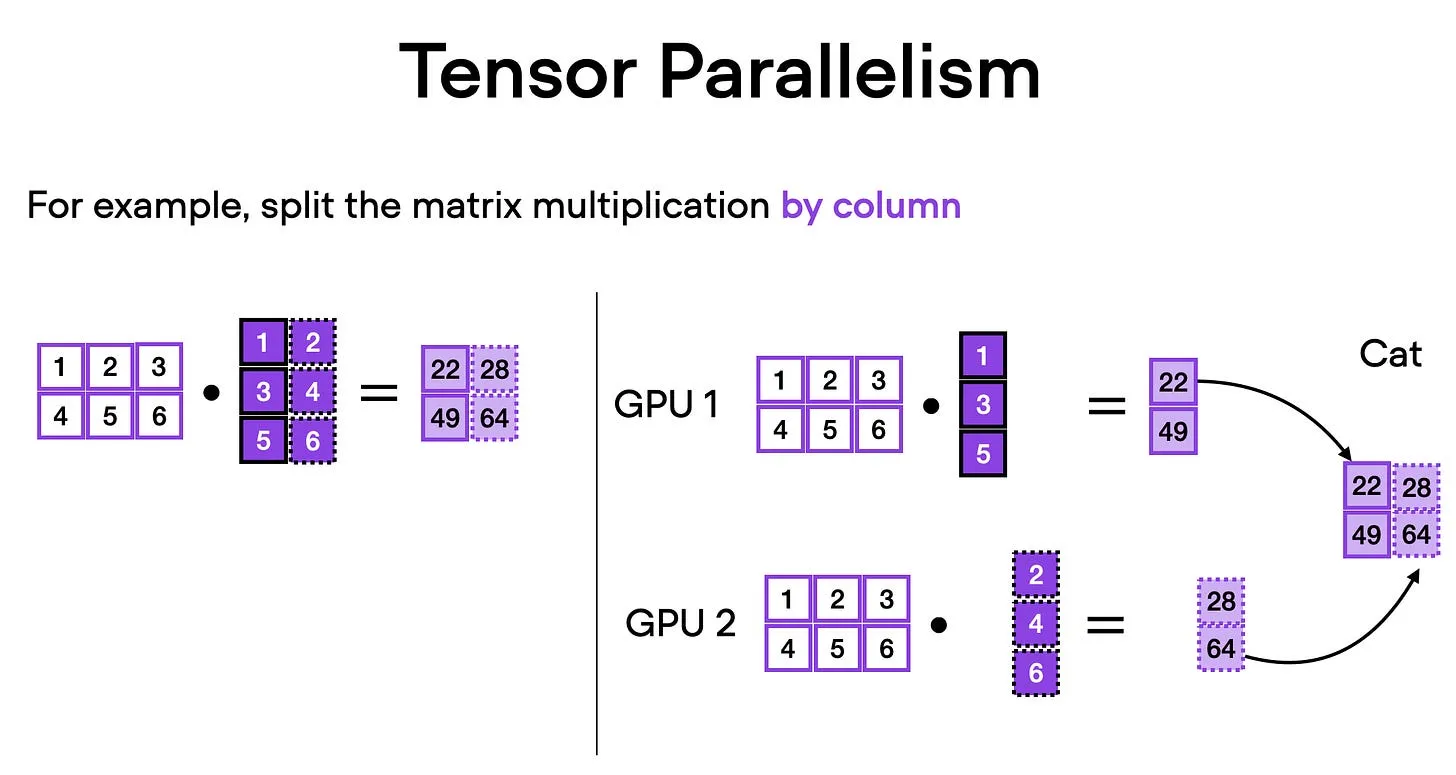
它是如何工作的?以矩阵乘法为例,有两种分发方式——按行拆分或按列拆分。为简单起见,我们以按列拆分为例。比如,我们可以把一个大型矩阵乘法运算拆分成多个独立计算,每个计算都可以在不同的GPU上执行,如下图所示。最后将结果拼接起来,得到原始运算的结果,从而实现计算负载的分布式处理。

figure14

总结

在本文中,我们看到了只需修改几行代码,就能运用混合精度训练、分布式多GPU训练等技术对训练进行优化。在视觉Transformer的示例中,使用混合精度训练后,运行时间从约18分钟缩短到约6分钟,减少了三分之二。再增加3块GPU后,训练时间从约6分钟进一步缩短到约2分钟。在不损失预测准确率的前提下,整体提速接近10倍。

当然,实际效果会因模型、数据集和任务的不同而有所差异。不过,本文的核心目的是介绍如何借助 https://pytorch.org/ 与 https://lightning.ai/docs/fabric/stable/ 便捷地实验这些技术。

(参考:所有代码示例均可在 https://github.com/rasbt/cvpr2023 获取)

本专栏是我的个人兴趣项目,不提供直接报酬。不过,如果您愿意支持我,可以考虑购买 https://sebastianraschka.com/books 上的书籍。如果您觉得这些书有启发、有帮助,也欢迎推荐给您的朋友和同事。

figure15

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics 与 http://mng.bz/M96o

您的支持对我意义重大!非常感谢!
【转载】理解编码器式与解码器式大语言模型

原文地址:Understanding Encoder And Decoder LLMs, by Sebastian Raschka, on 2023-06-17

理解编码器式与解码器式大语言模型

不少人希望我更深入地讲解大语言模型(LLM)的行业术语,解释一些如今我们习以为常的技术名词,其中就包括“编码器式”与“解码器式”大语言模型。这些术语究竟是什么意思?

我们进入正题:基于编码器的语言Transformer与基于解码器的语言Transformer有何区别?

编码器式与解码器式Transformer

从根本上说,编码器式与解码器式架构都使用相同的自注意力层对词元进行编码。但二者的核心区别在于:编码器的设计目标是学习嵌入表示,可用于分类等各类预测建模任务;与之相对,解码器的设计目标是生成新文本,例如回答用户查询。

原始Transformer

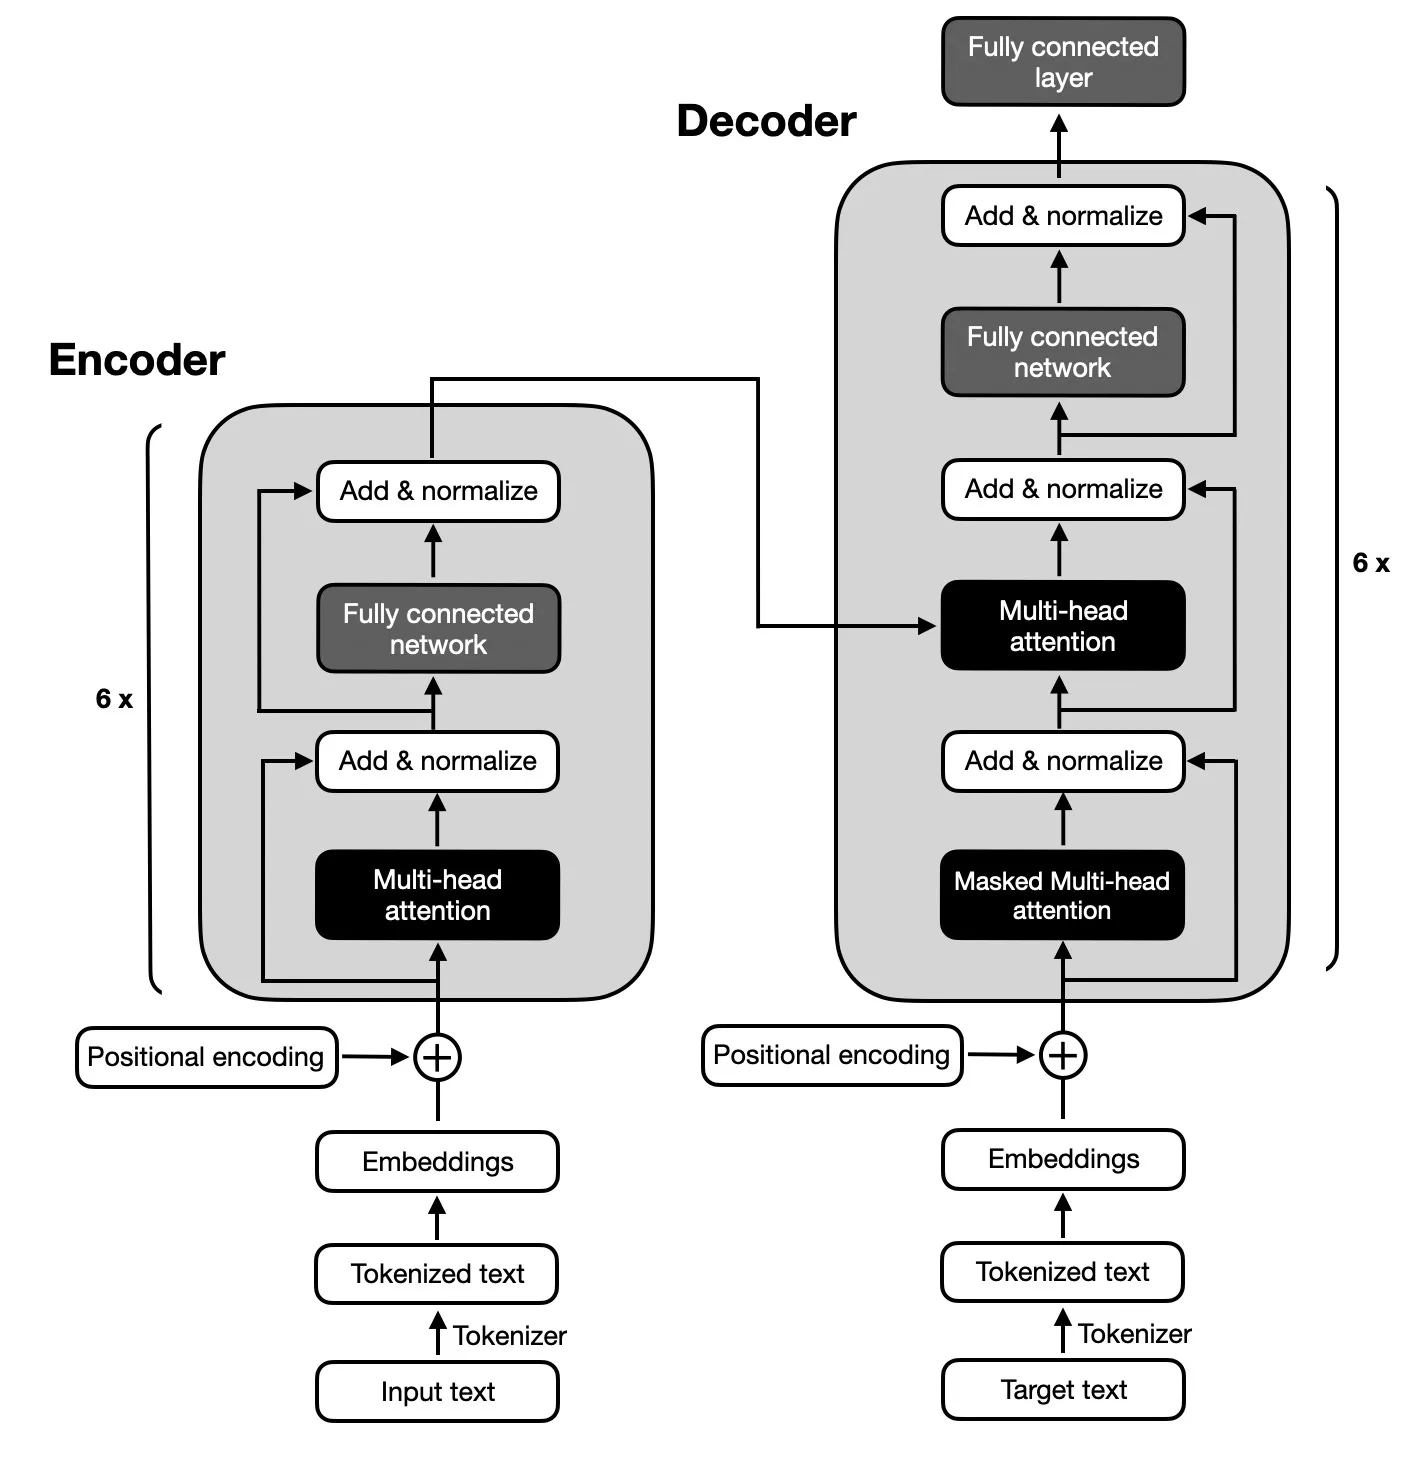
最初为英翻法、英翻德任务开发的Transformer架构(https://arxiv.org/abs/1706.03762)同时采用了编码器与解码器,如下图所示。

figure01

图注:https://arxiv.org/abs/1706.03762 中提出的原始Transformer架构示意图

在上图中,输入文本(即待翻译的句子)首先被分词为独立的词元,随后经过嵌入层编码,再进入编码器部分。接着,在为每个嵌入后的词元加上位置编码向量后,这些嵌入表示会经过一层多头自注意力层。多头注意力层之后是“相加与归一化”步骤:执行层归一化,并通过跳跃连接(也称为残差连接或捷径连接)加上原始嵌入。最后,经过“全连接层”(由两层全连接层、中间夹一个非线性激活函数组成的小型多层感知机)后,输出会再次进行相加与归一化,再传入解码器部分的多头自注意力层。

上图中解码器部分的整体结构与编码器部分类似,关键区别在于输入与输出不同。编码器接收待翻译的输入文本,解码器则生成翻译后的文本。

编码器

前文图中原始Transformer的编码器部分,负责从输入文本中理解并提取相关信息,随后输出输入文本的连续表示(嵌入),并传递给解码器。最终,解码器根据从编码器接收到的连续表示生成翻译后的文本(目标语言)。

多年来,基于上述原始Transformer模型的编码器模块,研究者开发出了多种仅编码器架构。其中代表性的例子包括BERT(https://arxiv.org/abs/1810.04805)与RoBERTa(https://arxiv.org/abs/1907.11692)。

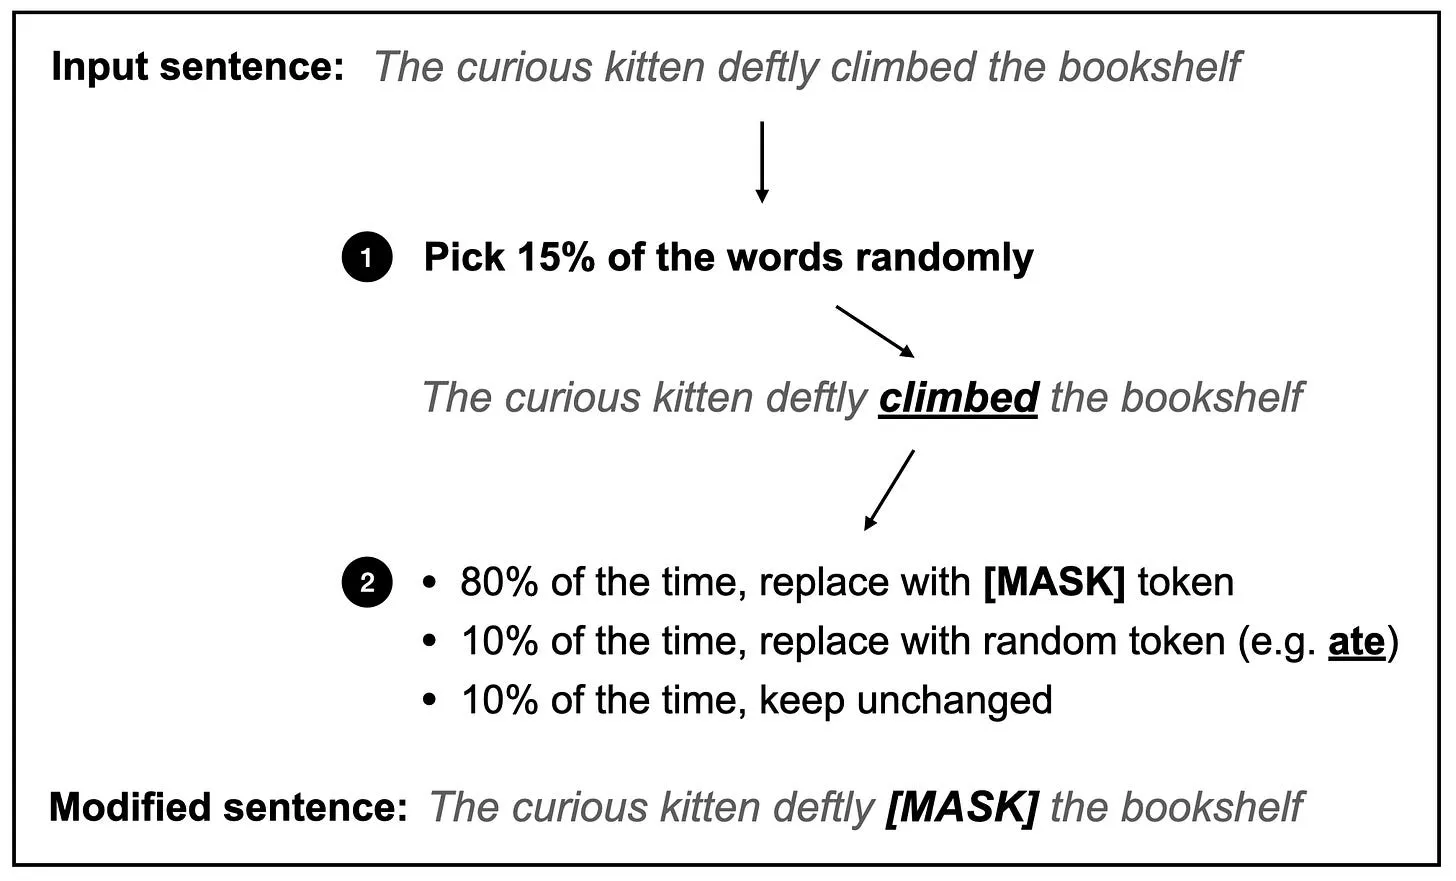
BERT(Bidirectional Encoder Representations from Transformers,基于Transformer的双向编码器表示)是一种基于Transformer编码器模块的仅编码器架构。BERT模型在大规模文本语料上进行预训练,采用的预训练任务包括掩码语言建模(如下图所示)和下一句预测。

figure02

图注:BERT式Transformer所采用的掩码语言建模预训练目标示意图

掩码语言建模的核心思想是:将输入序列中的随机词元进行掩码(或替换),然后训练模型根据周围的上下文预测被掩码的原始词元。

除了上图所示的掩码语言建模预训练任务之外,下一句预测任务会要求模型判断:原始文档中两个被随机打乱顺序的句子,其语序是否正确。例如,两个随机顺序的句子通过 分隔:

  Toast is a simple yet delicious food [SEP] It’s often served with butter, jam, or honey.
  It’s often served with butter, jam, or honey. [SEP] Toast is a simple yet delicious food.

标记是模型的占位标记,用于让模型输出“真”或“假”标签,表明两个句子的顺序是否正确。

掩码语言建模与下一句预测预训练目标(属于自监督学习的一种,第2章会展开讨论)让BERT能够学习输入文本的丰富上下文表示,这些表示随后可以通过微调,用于情感分析、问答、命名实体识别等各类下游任务。

RoBERTa(Robustly optimized BERT approach,鲁棒优化版BERT方法)是BERT的优化版本。它保留了与BERT相同的整体架构,但在训练与优化上做了多处改进,例如使用更大的批次规模、更多的训练数据,以及取消了下一句预测任务。这些改动使得RoBERTa在各类自然语言理解任务上的表现优于BERT。

解码器

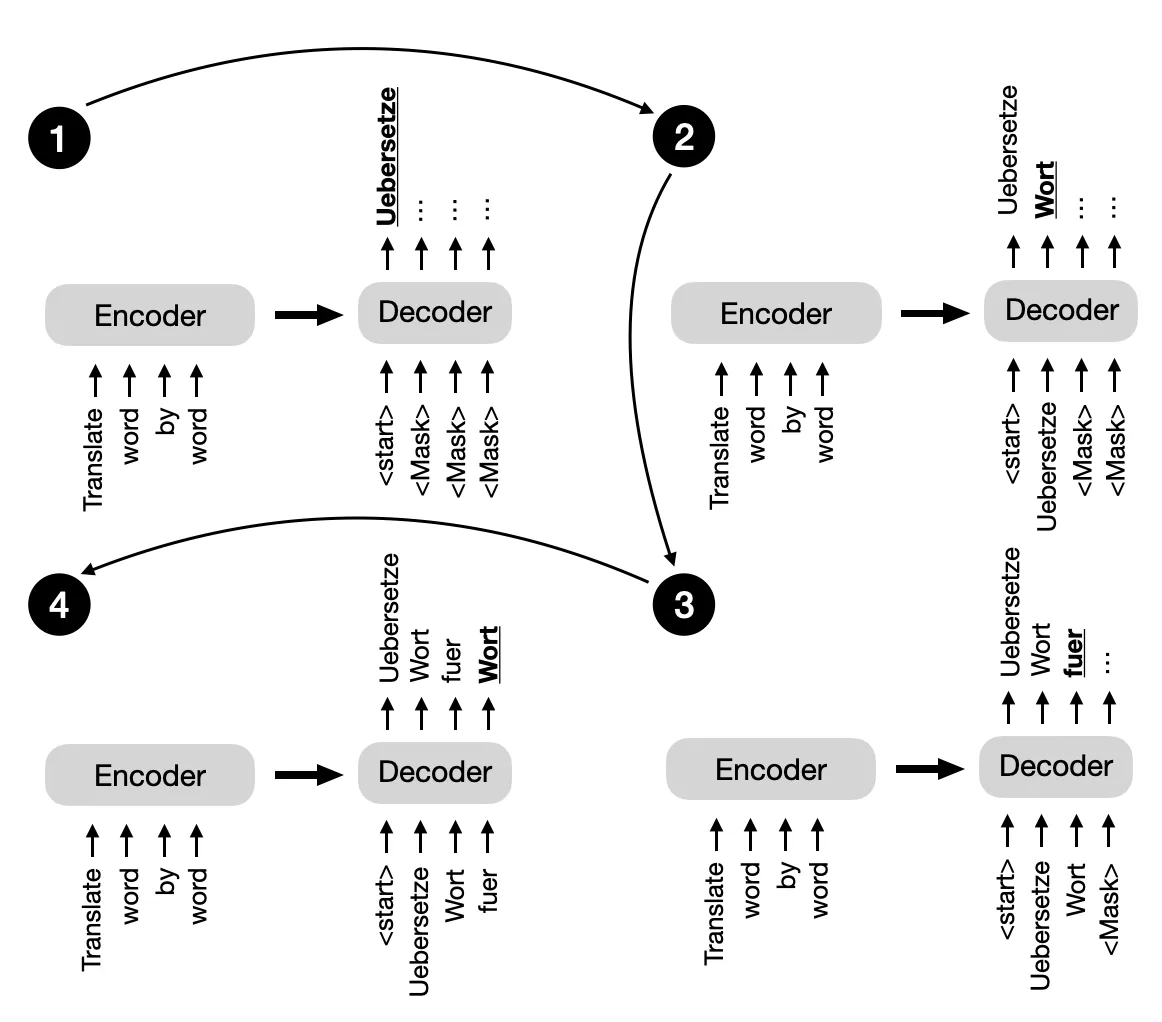
回到本节开头介绍的原始Transformer架构,解码器中的多头自注意力机制与编码器中的类似,但它会进行掩码处理,防止模型关注未来位置,确保第i个位置的预测仅依赖于位置小于i的已知输出。如下图所示,解码器会逐词生成输出。

figure03

图注:原始Transformer中采用的下一句预测任务示意图

这种掩码(在上图中被明确展示出来,不过它实际是在解码器的多头自注意力机制内部完成的)对于在训练与推理阶段维持Transformer模型的自回归特性至关重要。自回归特性确保模型逐个生成输出词元,并将之前生成的词元作为上下文,用于生成下一个词元。

多年来,研究者在原始编码器-解码器Transformer架构的基础上不断拓展,开发出了多种仅解码器模型,这些模型在各类自然语言处理任务中表现出了极佳的效果。其中最具代表性的模型包括GPT系列。

GPT(Generative Pre-trained Transformer,生成式预训练Transformer)系列是仅解码器模型,在大规模无监督文本数据上进行预训练,并针对文本分类、情感分析、问答、摘要等特定任务进行微调。GPT模型(包括GPT-2、GPT-3(https://arxiv.org/abs/2005.14165)以及更新的GPT-4)在各类基准测试中展现出了卓越的性能,是目前自然语言处理领域最流行的架构。

GPT模型最引人注目的特点之一是其涌现能力。涌现能力指的是模型凭借下一词预测预训练而发展出的能力与技能。尽管这些模型仅被训练用于预测下一个词,但预训练后的模型已经能够完成文本摘要、翻译、问答、分类等诸多任务。此外,这些模型还能通过上下文学习执行新任务,而无需更新模型参数,第18章会对此进行更详细的讨论。

编码器-解码器混合模型

除了传统的编码器与解码器架构之外,新型编码器-解码器模型的研发也取得了进展,这类模型能够同时利用两种组件的优势。它们通常会引入新颖的技术、预训练目标或架构修改,以提升在各类自然语言处理任务中的表现。这类新型编码器-解码器模型的代表性例子包括:

编码器-解码器模型通常用于涉及“理解输入序列+生成输出序列”的自然语言处理任务,且输入与输出的长度、结构往往不同。它们尤其擅长处理输入序列与输出序列之间存在复杂映射关系、且捕捉两个序列中元素之间的关联至关重要的任务。编码器-解码器模型的常见应用场景包括文本翻译与摘要。

术语与行话

以上所有方法——仅编码器、仅解码器以及编码器-解码器模型——都属于序列到序列模型(通常缩写为seq2seq)。需要注意的是,虽然我们将BERT式方法称为仅编码器,但“仅编码器”的说法可能会造成误解,因为这类方法在预训练过程中也会将嵌入解码为输出词元或文本。

换句话说,仅编码器与仅解码器架构都在进行“解码”。但与仅解码器和编码器-解码器架构不同,仅编码器架构的解码并非以自回归的方式进行。自回归解码指的是逐个生成输出序列,每个词元的生成都以之前生成的词元为条件。仅编码器模型不会以这种方式生成连贯的输出序列,相反,它们专注于理解输入文本,并生成特定于任务的输出,例如标签或词元预测结果。

结论

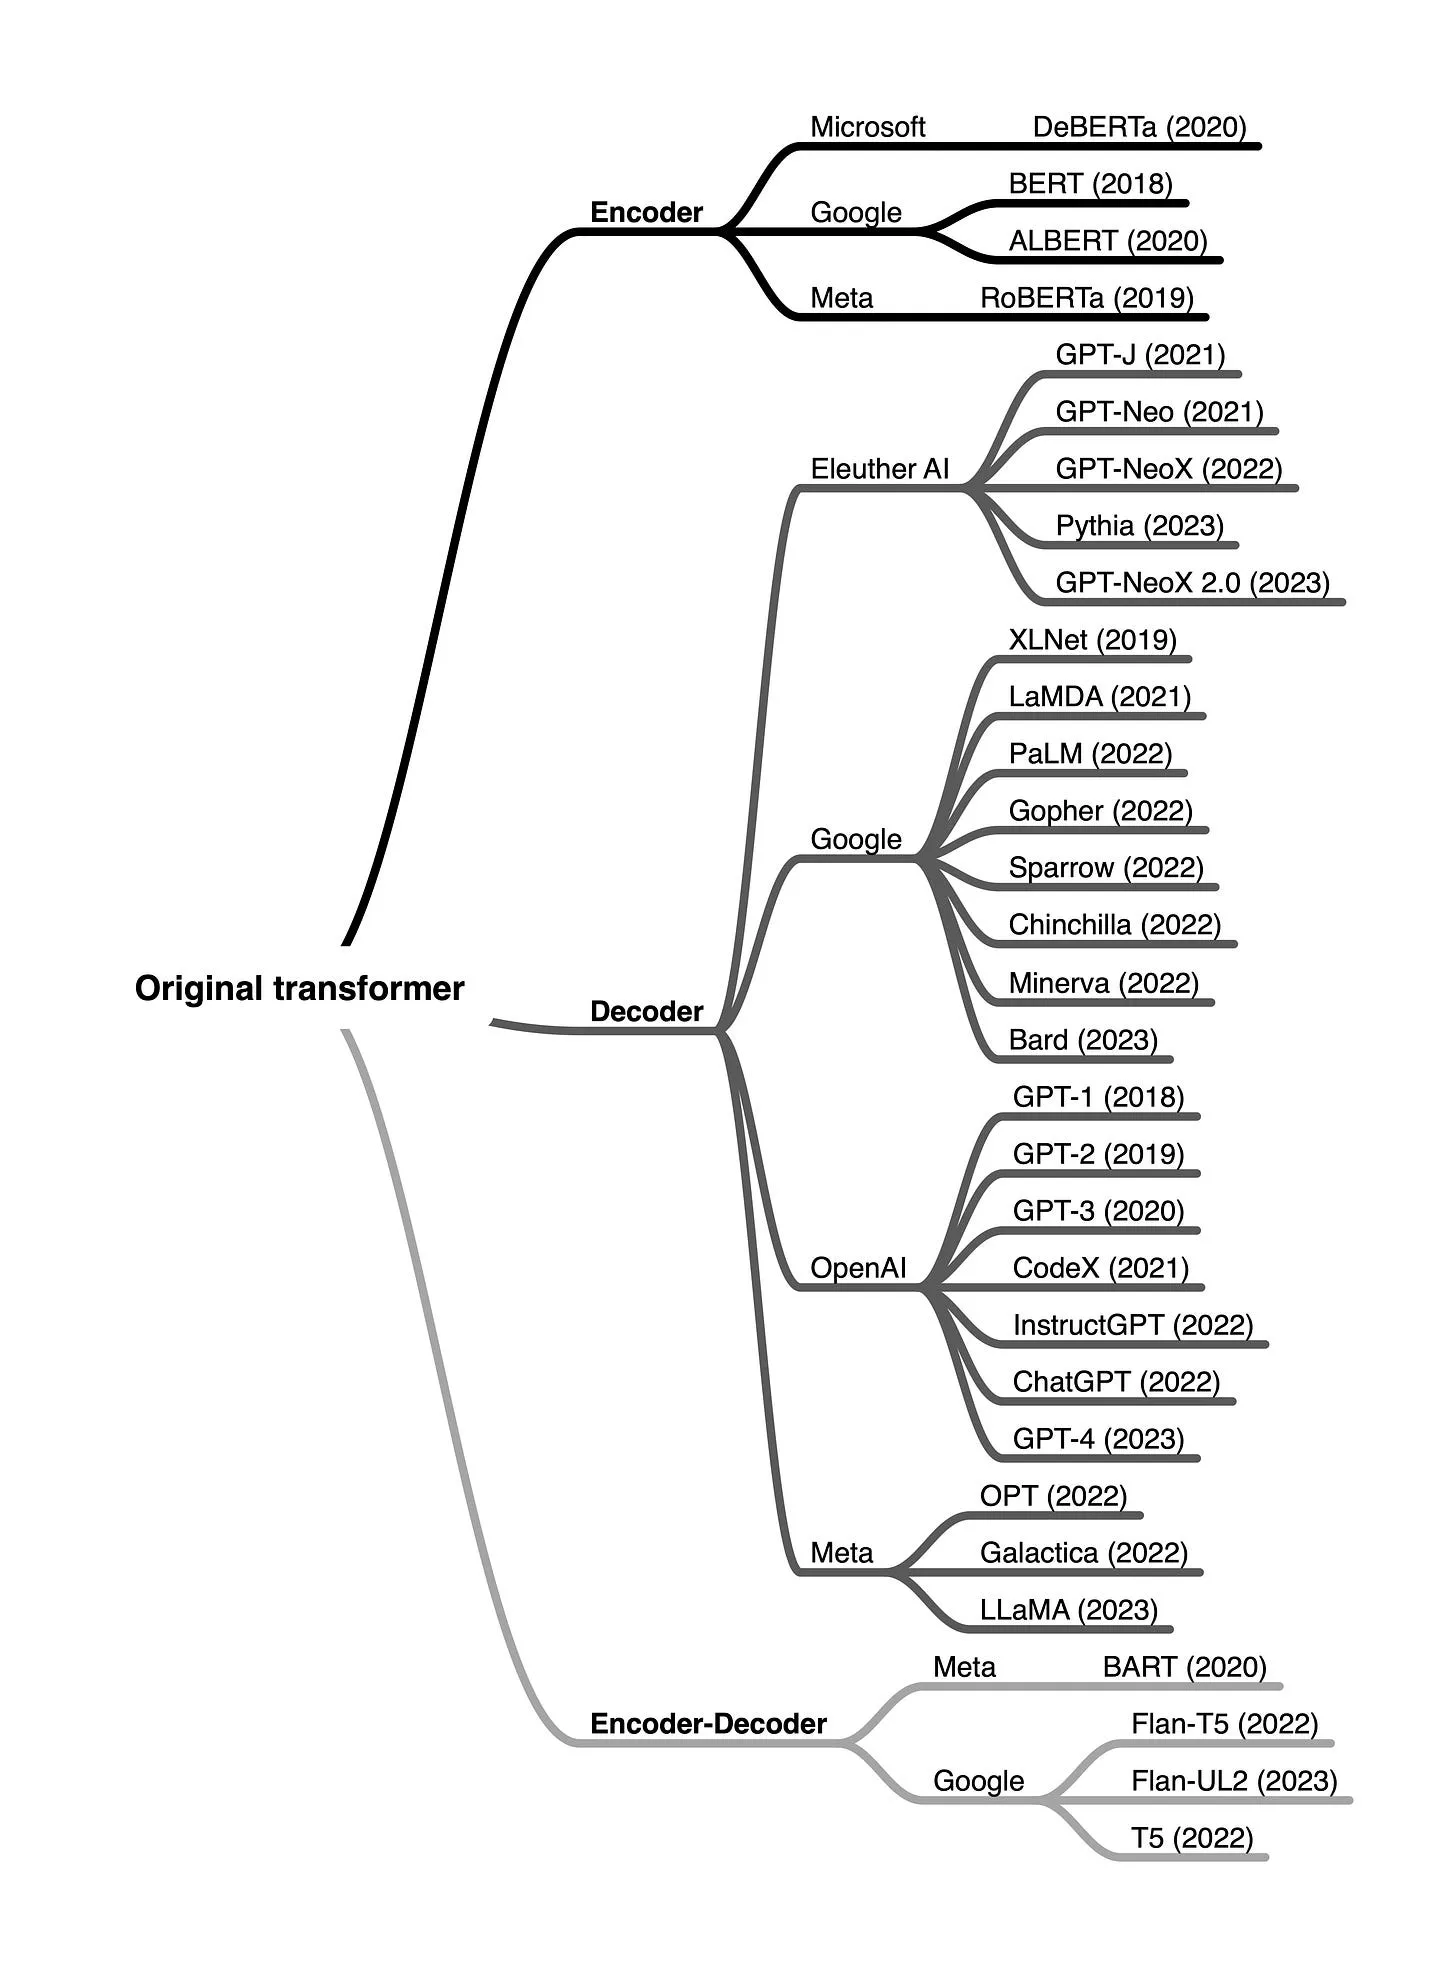
简而言之,编码器式模型广泛用于学习分类任务所需的嵌入表示;编码器-解码器式模型用于输出高度依赖输入的生成类任务(例如翻译与摘要);仅解码器模型则用于问答等其他类型的生成类任务。自首个Transformer架构诞生以来,已经发展出了数百种仅编码器、仅解码器以及编码器-解码器混合模型,如下图总结所示。

figure04

图注:按架构类型与开发者分类的部分主流大语言Transformer概览

仅编码器模型的热度逐渐下降,而GPT等仅解码器模型凭借GPT-3、ChatGPT与GPT-4带来的文本生成技术突破,迎来了爆发式增长。不过,对于基于文本嵌入训练预测模型(而非生成文本)的场景,仅编码器模型仍然具有很高的实用价值。

本专栏是一个个人兴趣项目,无直接商业报酬。如果您愿意支持我,欢迎考虑购买https://sebastianraschka.com/books上的书籍。如果您觉得这些内容富有洞见、有所帮助,也欢迎推荐给您的朋友与同事。

figure05

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 http://mng.bz/M96o

你的支持意义重大!谢谢你!

【转载】面向人类反馈的直接偏好优化及更多AI研究

原文地址:Direct-Preference Optimization for Human Feedback and More, by Sebastian Raschka, on 2023-06-10

面向人类反馈的直接偏好优化及更多AI研究

本文精选并汇总了23项AI研究亮点。当前自然语言处理和计算机视觉领域正涌现出大量令人振奋的进展!

此外,如果你对上月的研究亮点感兴趣,可以通过以下链接查看:
https://magazine.sebastianraschka.com/p/ai-research-highlights-in-3-sentences

大语言模型

直接偏好优化:你的语言模型本质上是一个奖励模型(https://arxiv.org/abs/2305.18290,2023年5月29日)

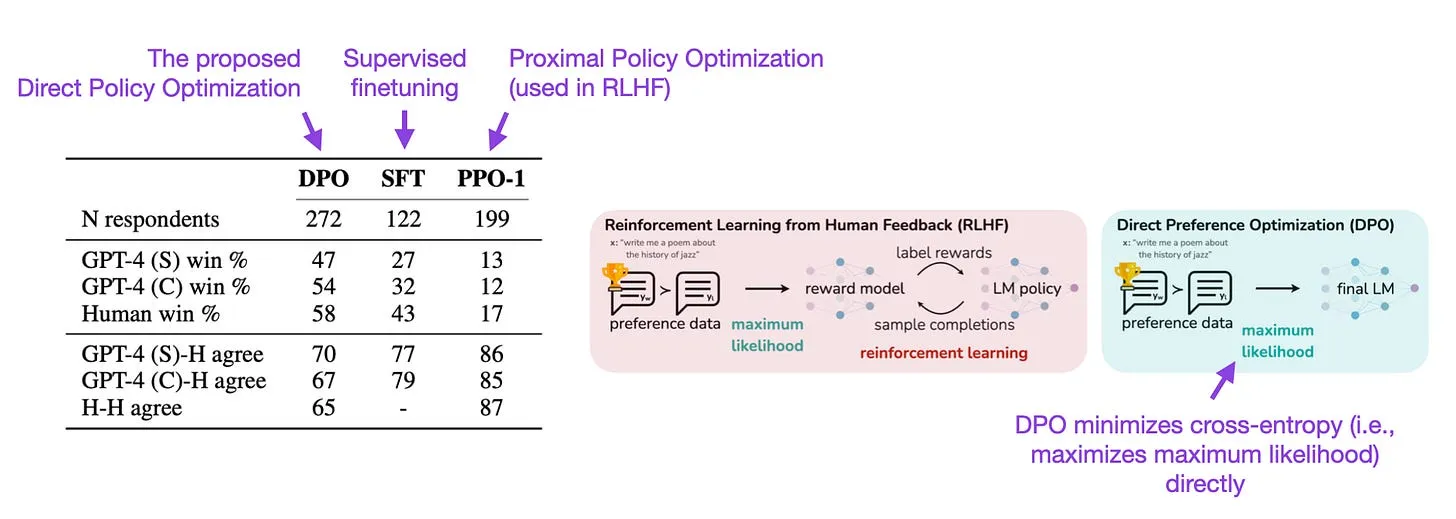
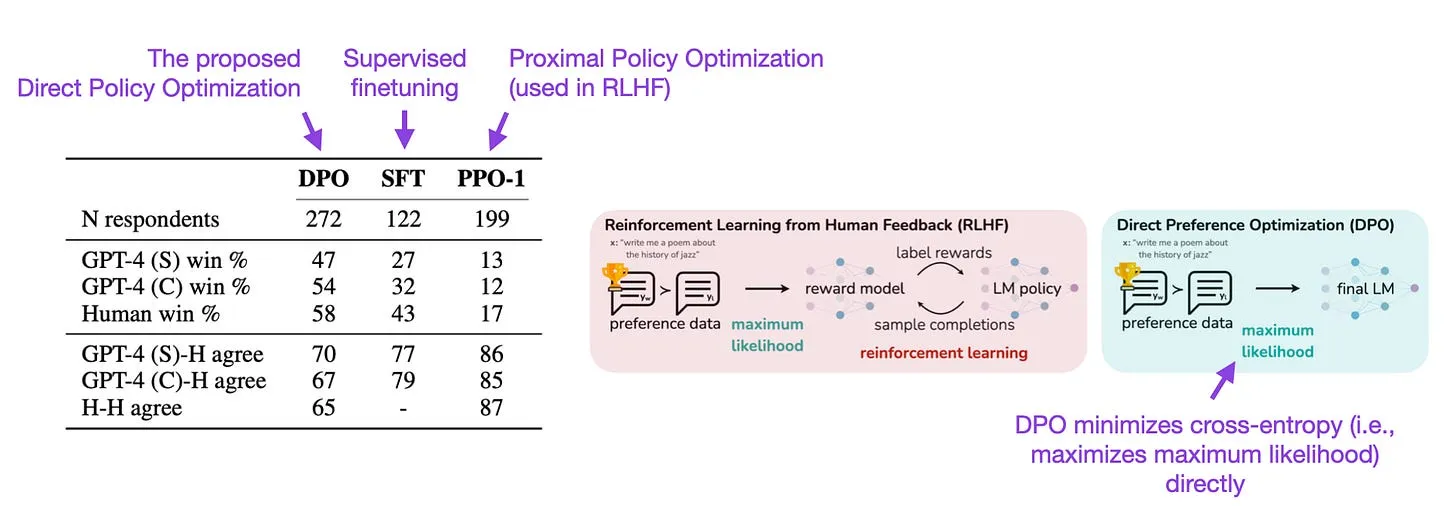
直接偏好优化(DPO)是一种替代基于近端策略优化(PPO)的人类反馈强化学习(RLHF)的全新方案,后者被用于ChatGPT等指令微调模型。该研究表明,RLHF中用于拟合奖励模型的交叉熵损失,可直接用于微调大语言模型。根据基准测试结果,使用DPO效率更高,且在响应质量上往往优于RLHF/PPO。

figure01
标注图源自:https://arxiv.org/abs/2305.18290

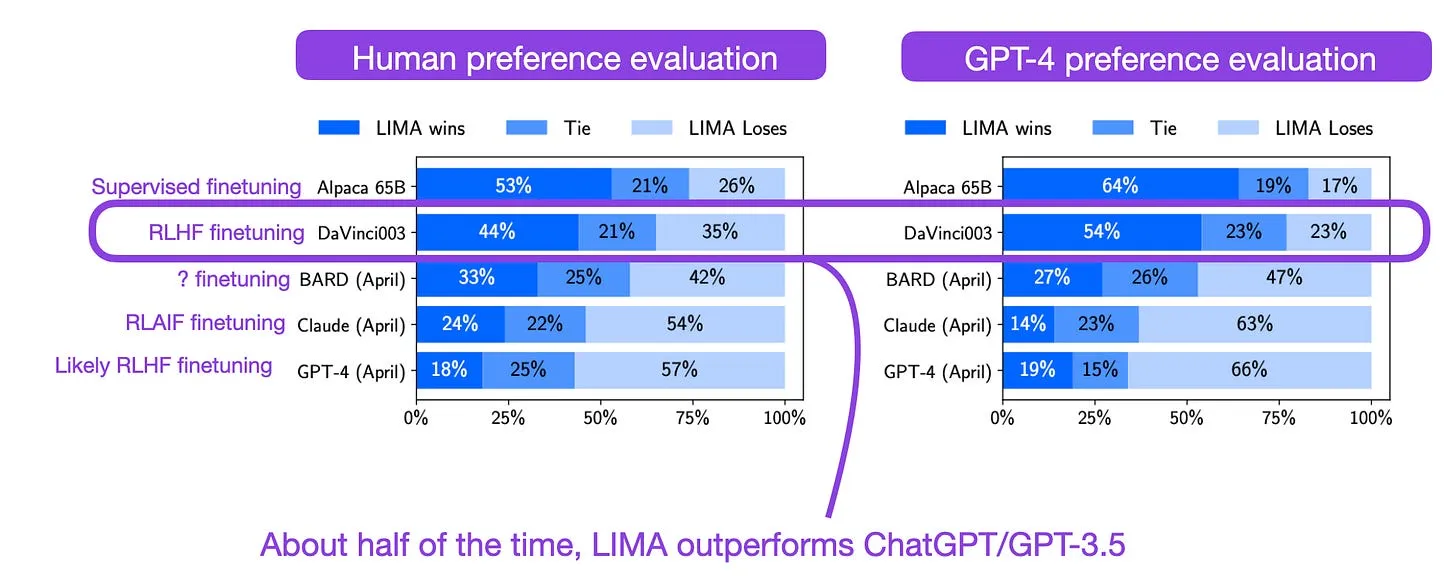
LIMA:对齐之道,少即是多(https://arxiv.org/abs/2305.11206,2023年5月18日)

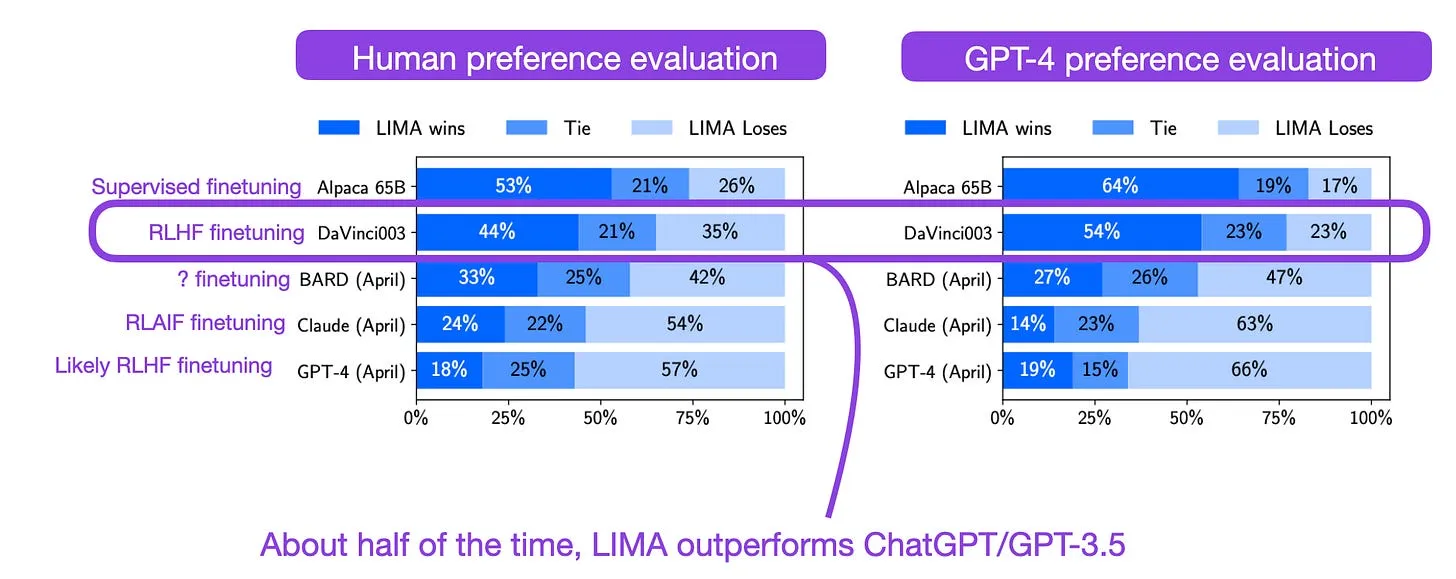
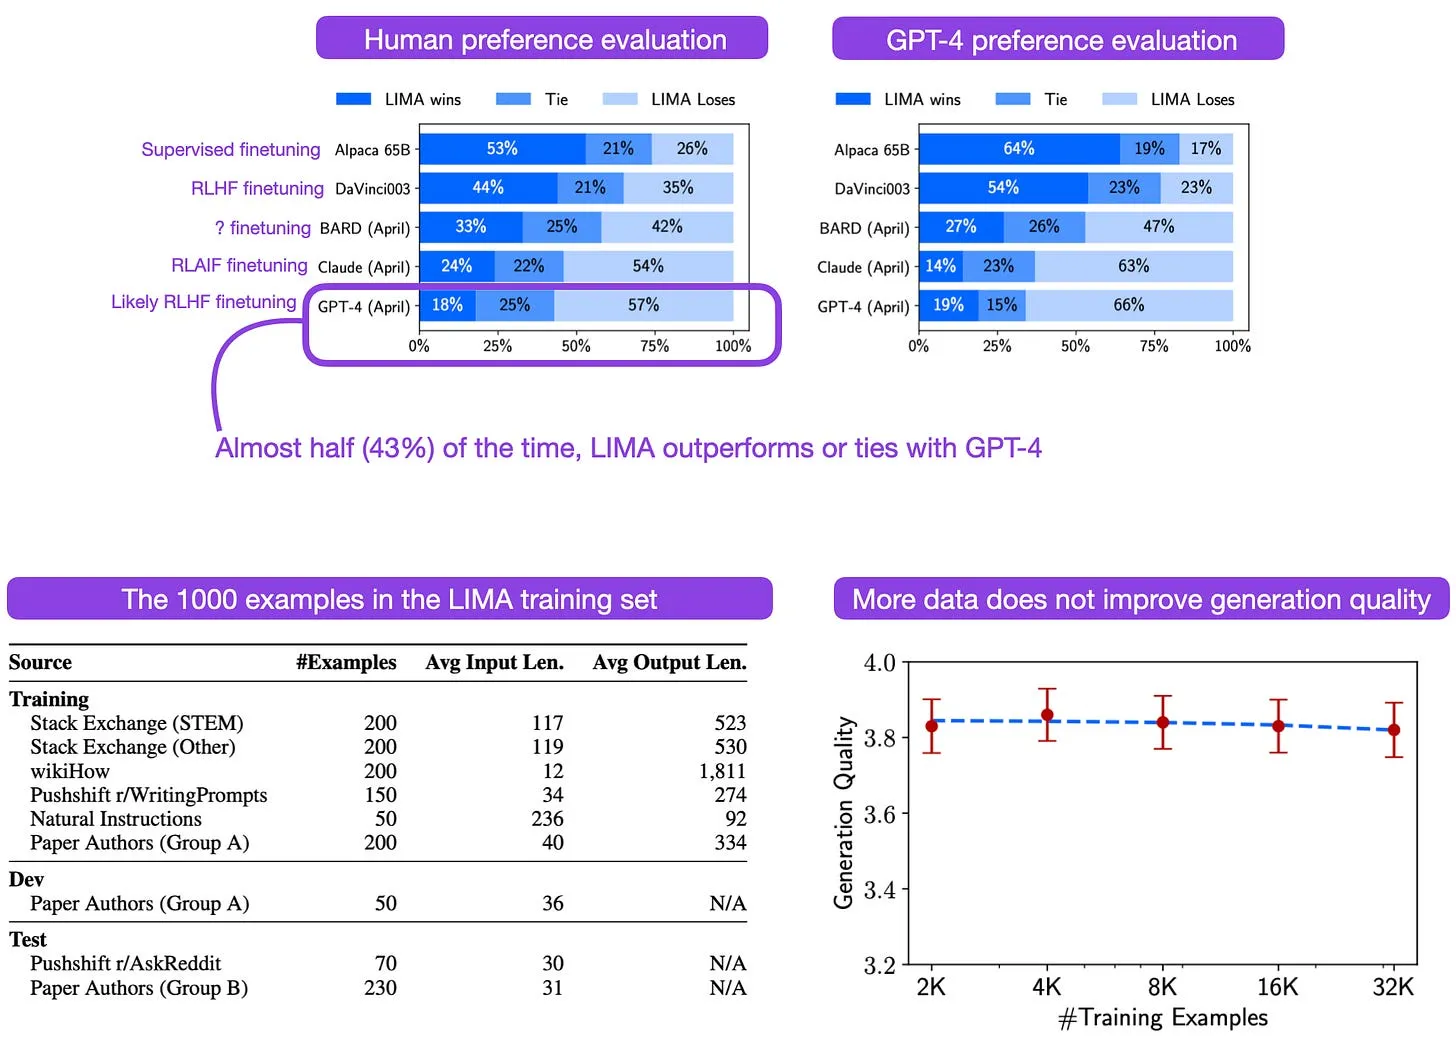
研究人员精心筛选了1000组指令对,以监督方式微调了一个650亿参数的LLaMA模型,命名为LIMA。值得注意的是,Alpaca等其他经过微调的LLaMA模型是基于52000组自动生成的指令对训练的。令人惊艳的是,LIMA的表现超越了采用人类反馈强化学习(RLHF)技术训练的模型,例如ChatGPT/GPT 3.5。

figure02
标注图源自:https://arxiv.org/abs/2305.11206

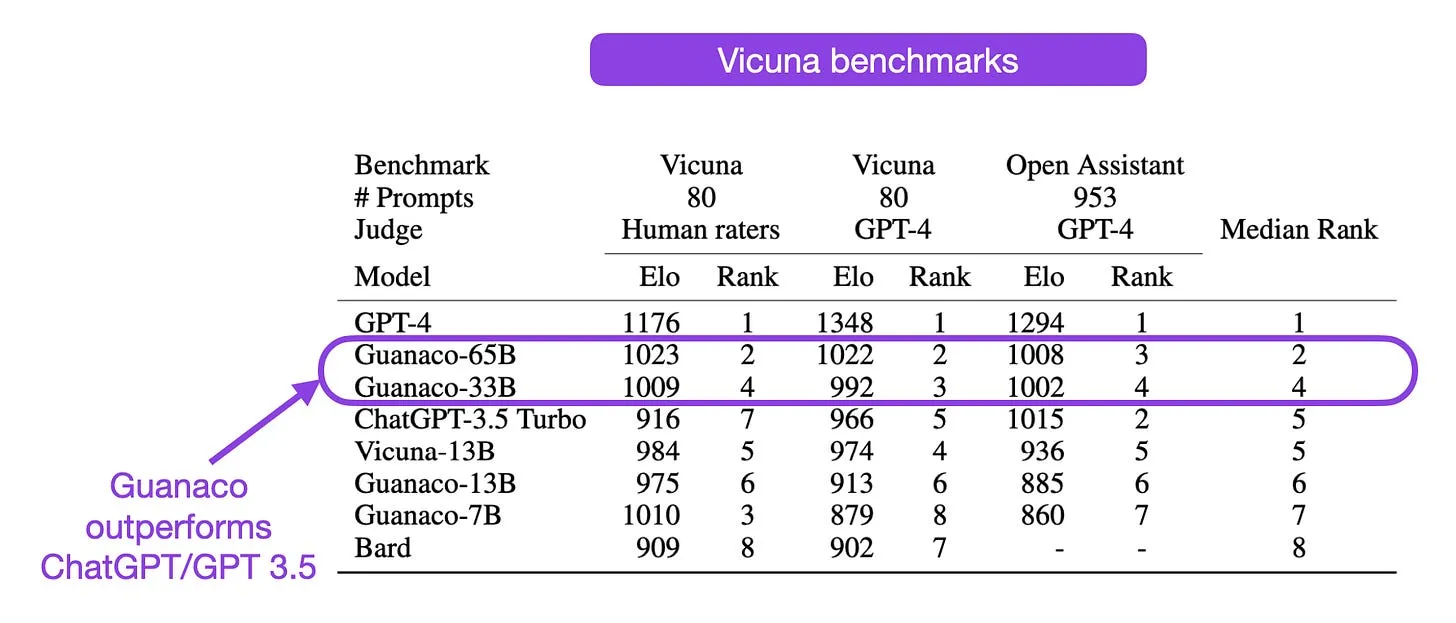
QLoRA:量化大语言模型的高效微调方法(https://arxiv.org/abs/2305.14314,2023年5月23日)

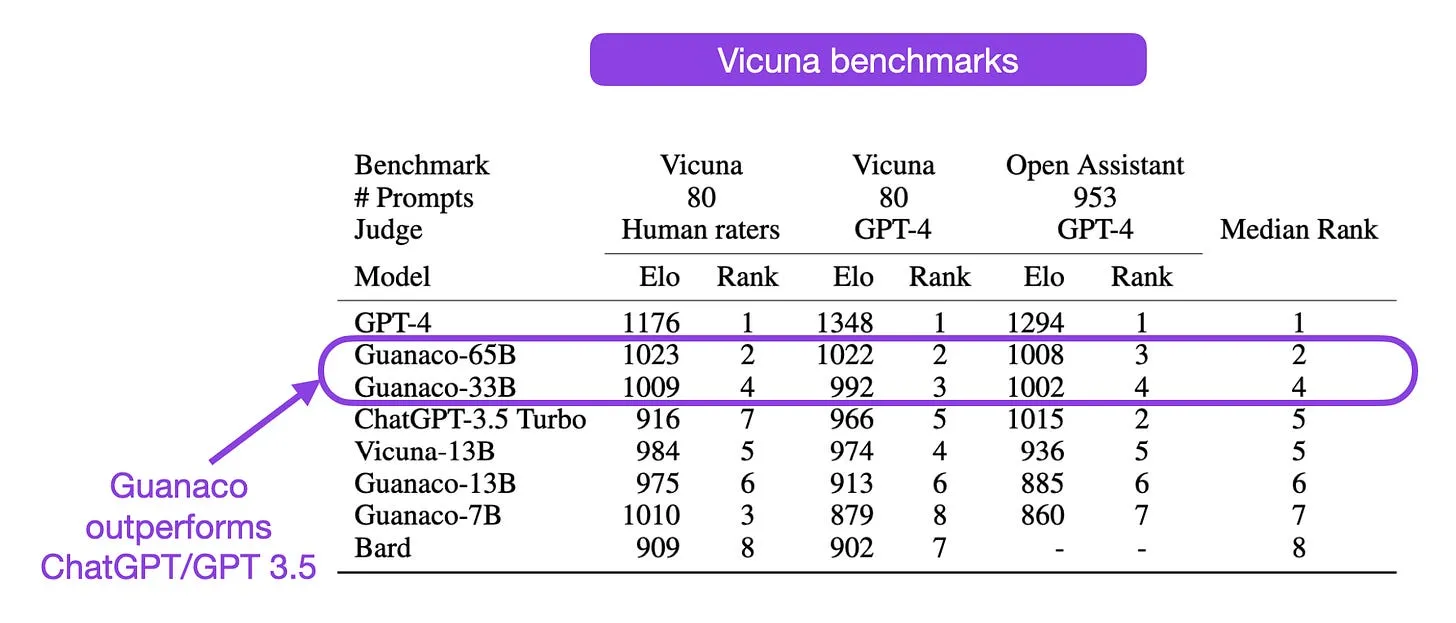
QLoRA(量化低秩适配)是参数高效型大语言模型微调领域的最新成果。QLoRA降低了650亿参数LLaMA模型的内存需求,使其可在单张48GB显存的GPU(如A100)上运行。通过4位量化训练得到的650亿参数Guanaco模型,保留了全16位微调的任务性能,仅经过24小时微调,性能就达到ChatGPT的99.3%。

figure03
标注图源自:https://arxiv.org/abs/2305.14314

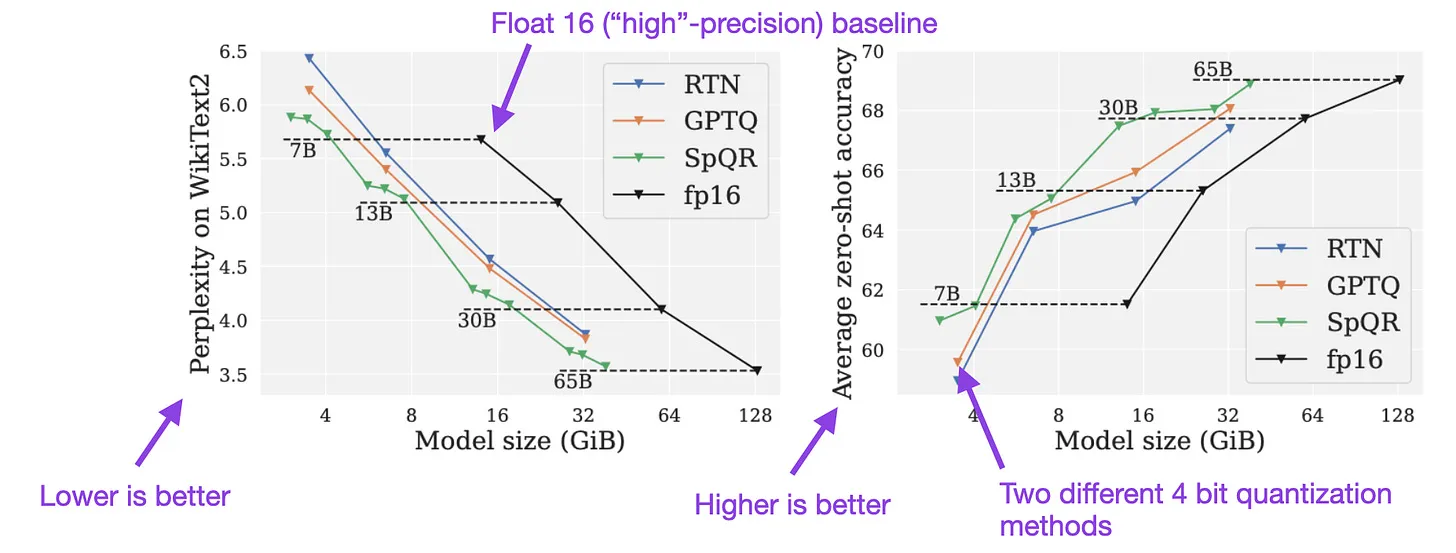
SpQR:实现大语言模型权重近无损压缩的稀疏量化表示(https://arxiv.org/abs/2306.03078,2023年6月5日)

将大语言模型量化至4位,是目前在单GPU或笔记本电脑上运行这类模型的唯一方式,但这会牺牲精度。该研究提出的稀疏量化表示(SpQR)方法,提供了一种全新的近无损替代方案。其核心思路是将部分离群权重保持在更高精度,从而将精度损失控制在1%以内,同时实现与int4量化几乎相同的模型压缩率。

figure04
标注图源自:https://arxiv.org/abs/2306.03078

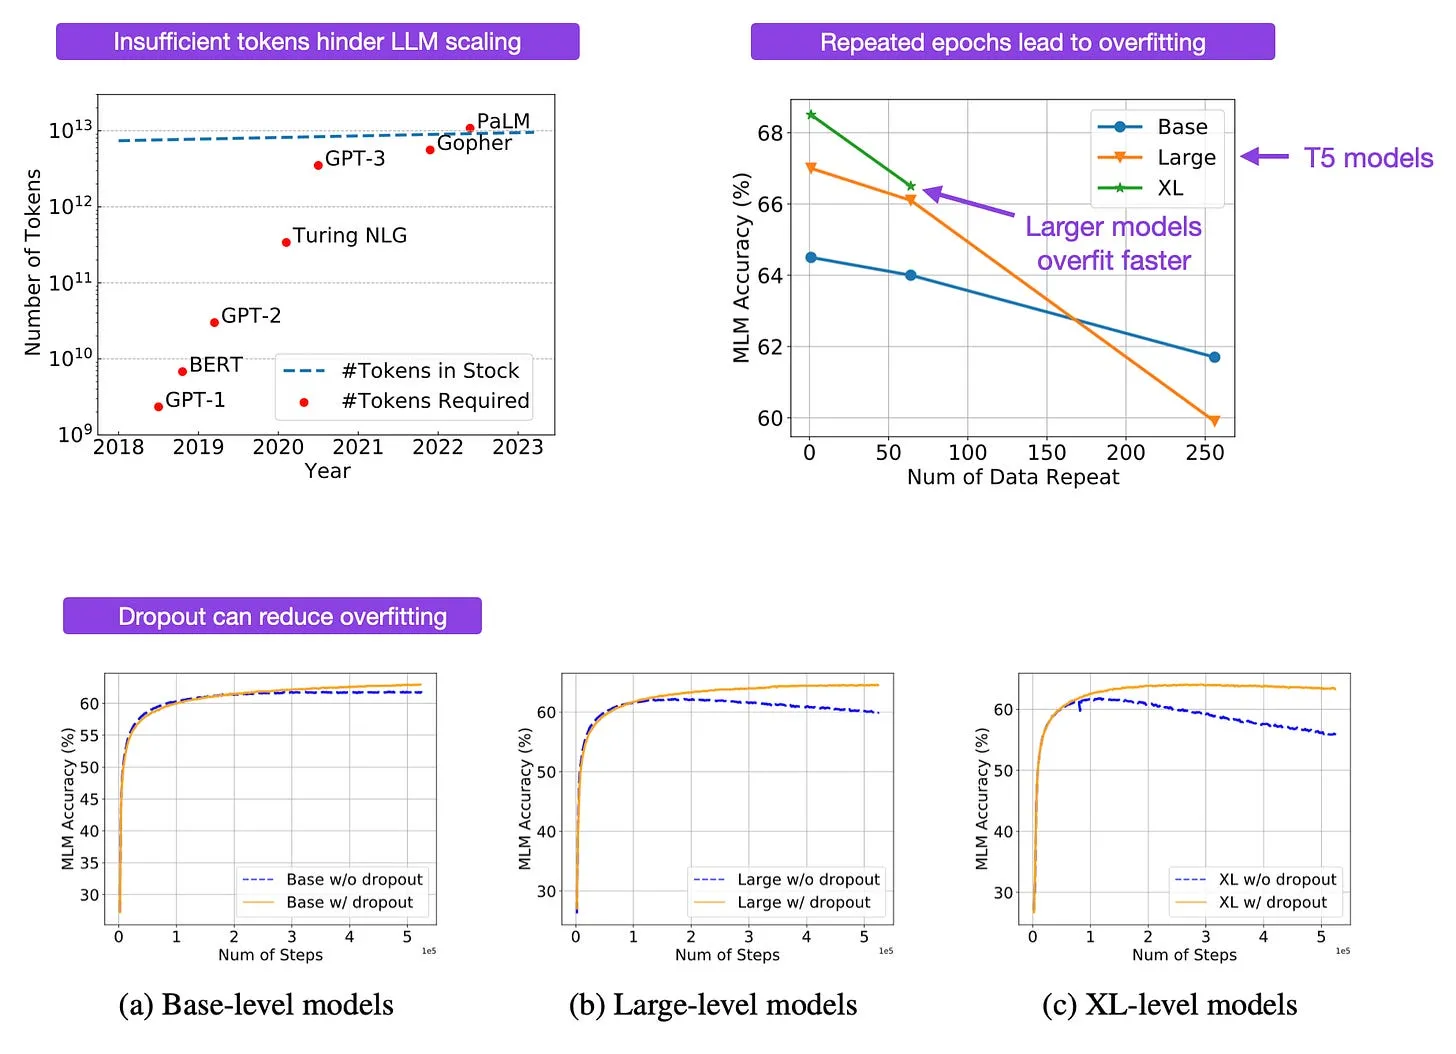
重复训练与否:Token危机下大语言模型缩放的启示(https://arxiv.org/abs/2305.13230,2023年5月22日)

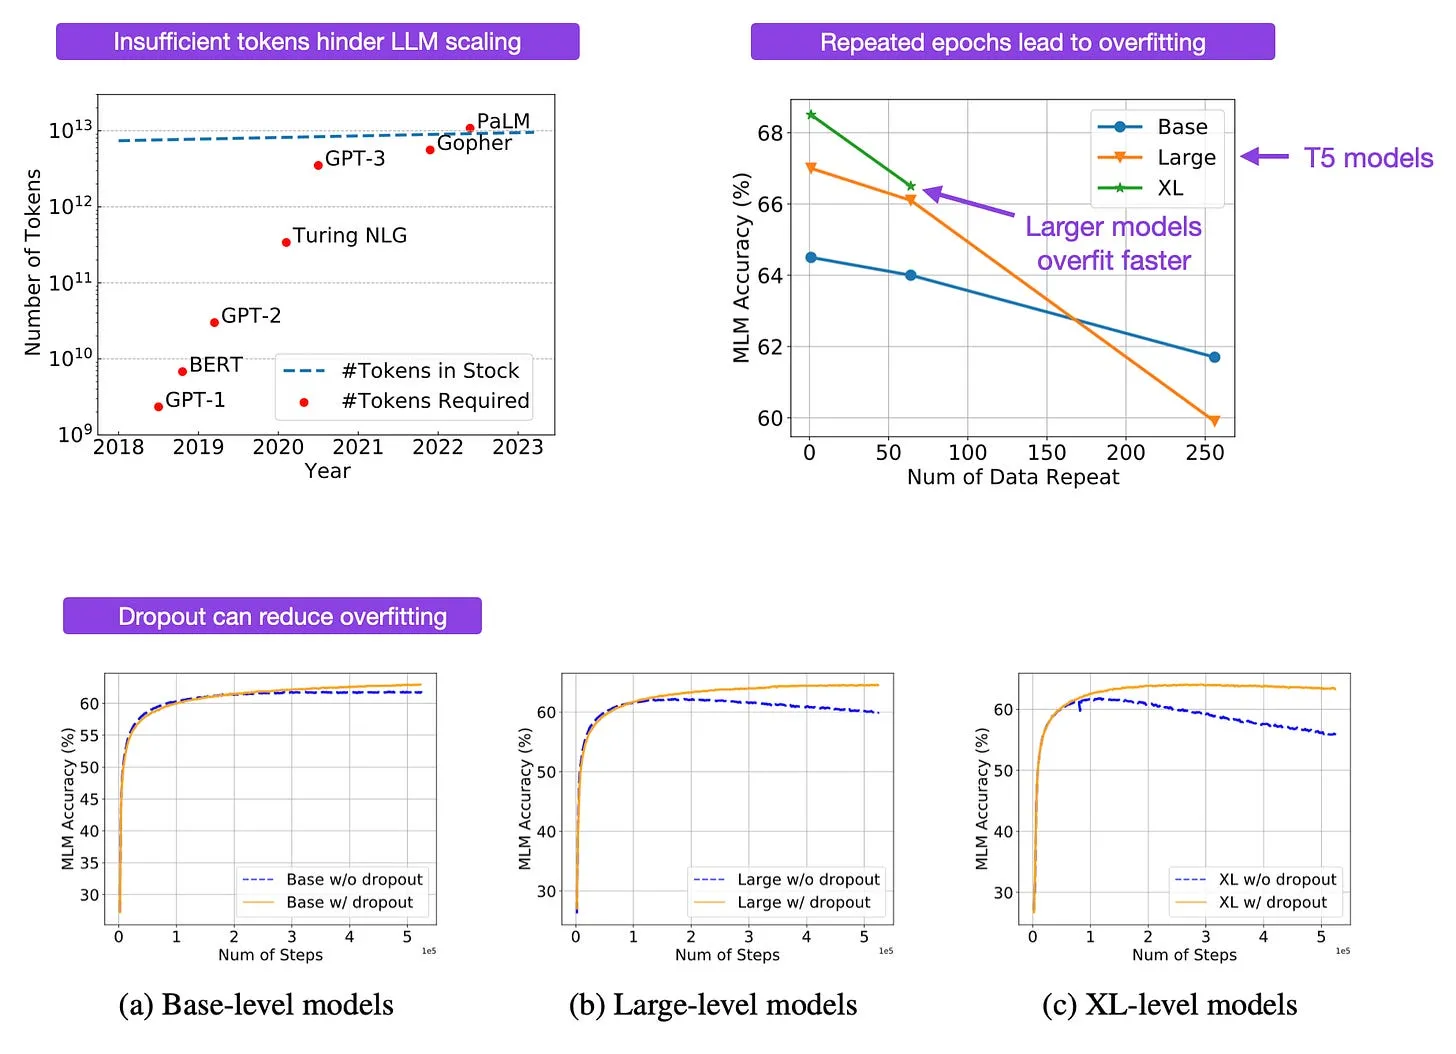
研究发现,互联网上高质量文本数据的增长速度,跟不上大语言模型规模扩张的需求。那么,如果对大语言模型进行多轮次训练会发生什么?结果表明,多轮次训练会导致过拟合,且大多数正则化技术都无法解决这一问题(Dropout除外)。

figure05
标注图源自:https://arxiv.org/abs/2305.13230

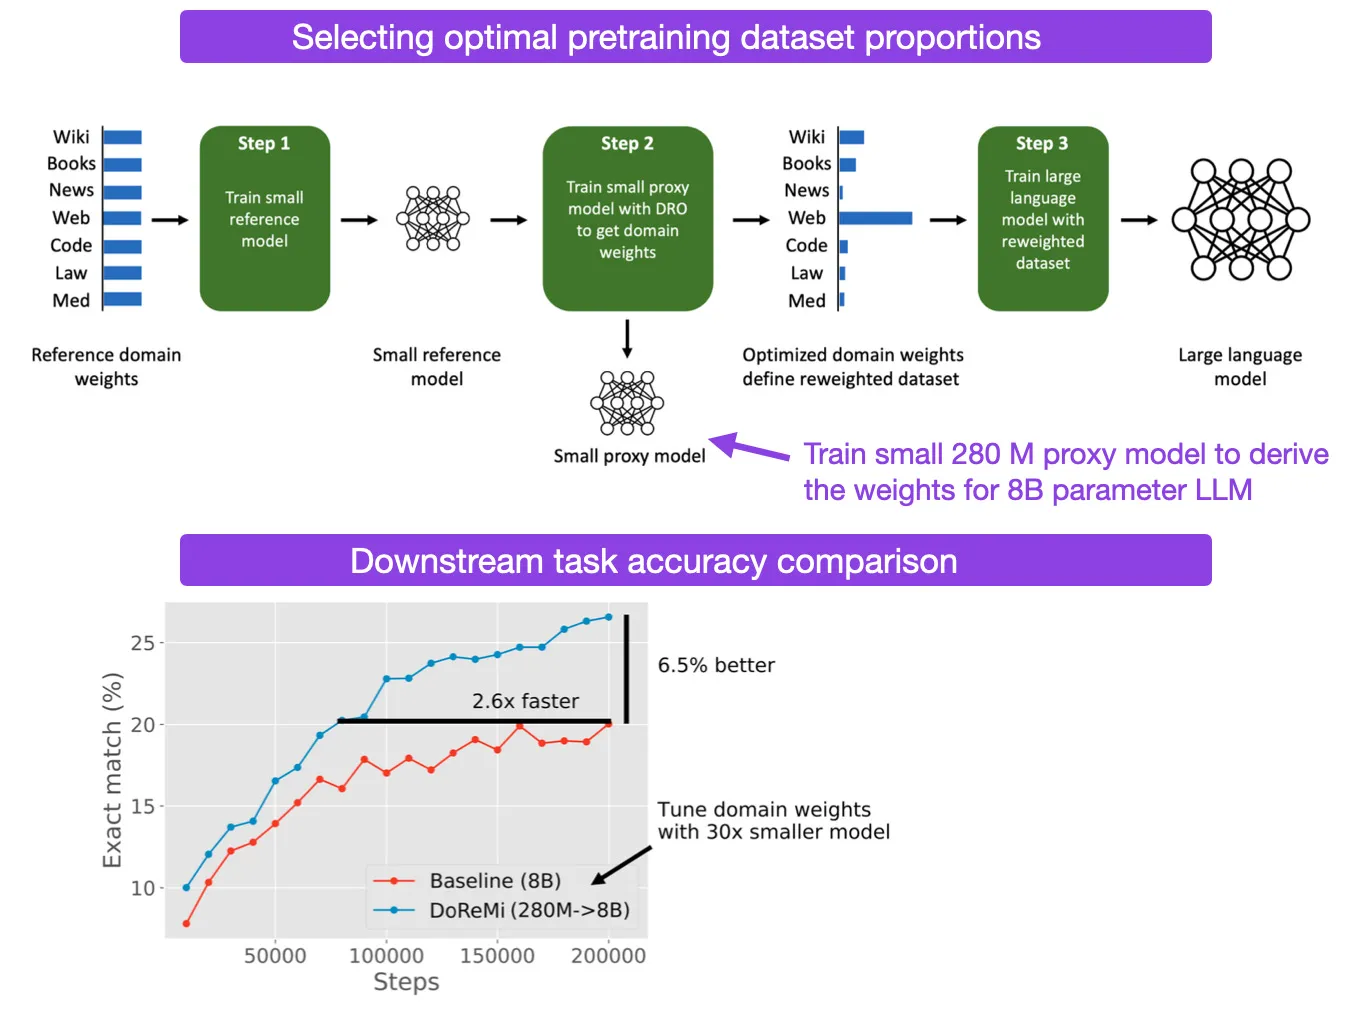
DoReMi:优化数据混合比例可加速大语言模型预训练(https://arxiv.org/abs/2305.10429,2023年5月17日)

该研究中,研究人员探讨了预训练数据中维基百科文章、书籍和网页的相对占比,是否会显著影响大语言模型的性能。为解答这一问题,他们训练了一个代理模型,推导得出训练更大规模目标大语言模型的相对领域权重。研究发现,这一方法可将下游任务准确率提升6.5%;在经过权重重分配的The Pile数据集上预训练时,模型达到基线准确率的速度可提升2.6倍。

figure06
标注图源自:https://arxiv.org/abs/2305.10429

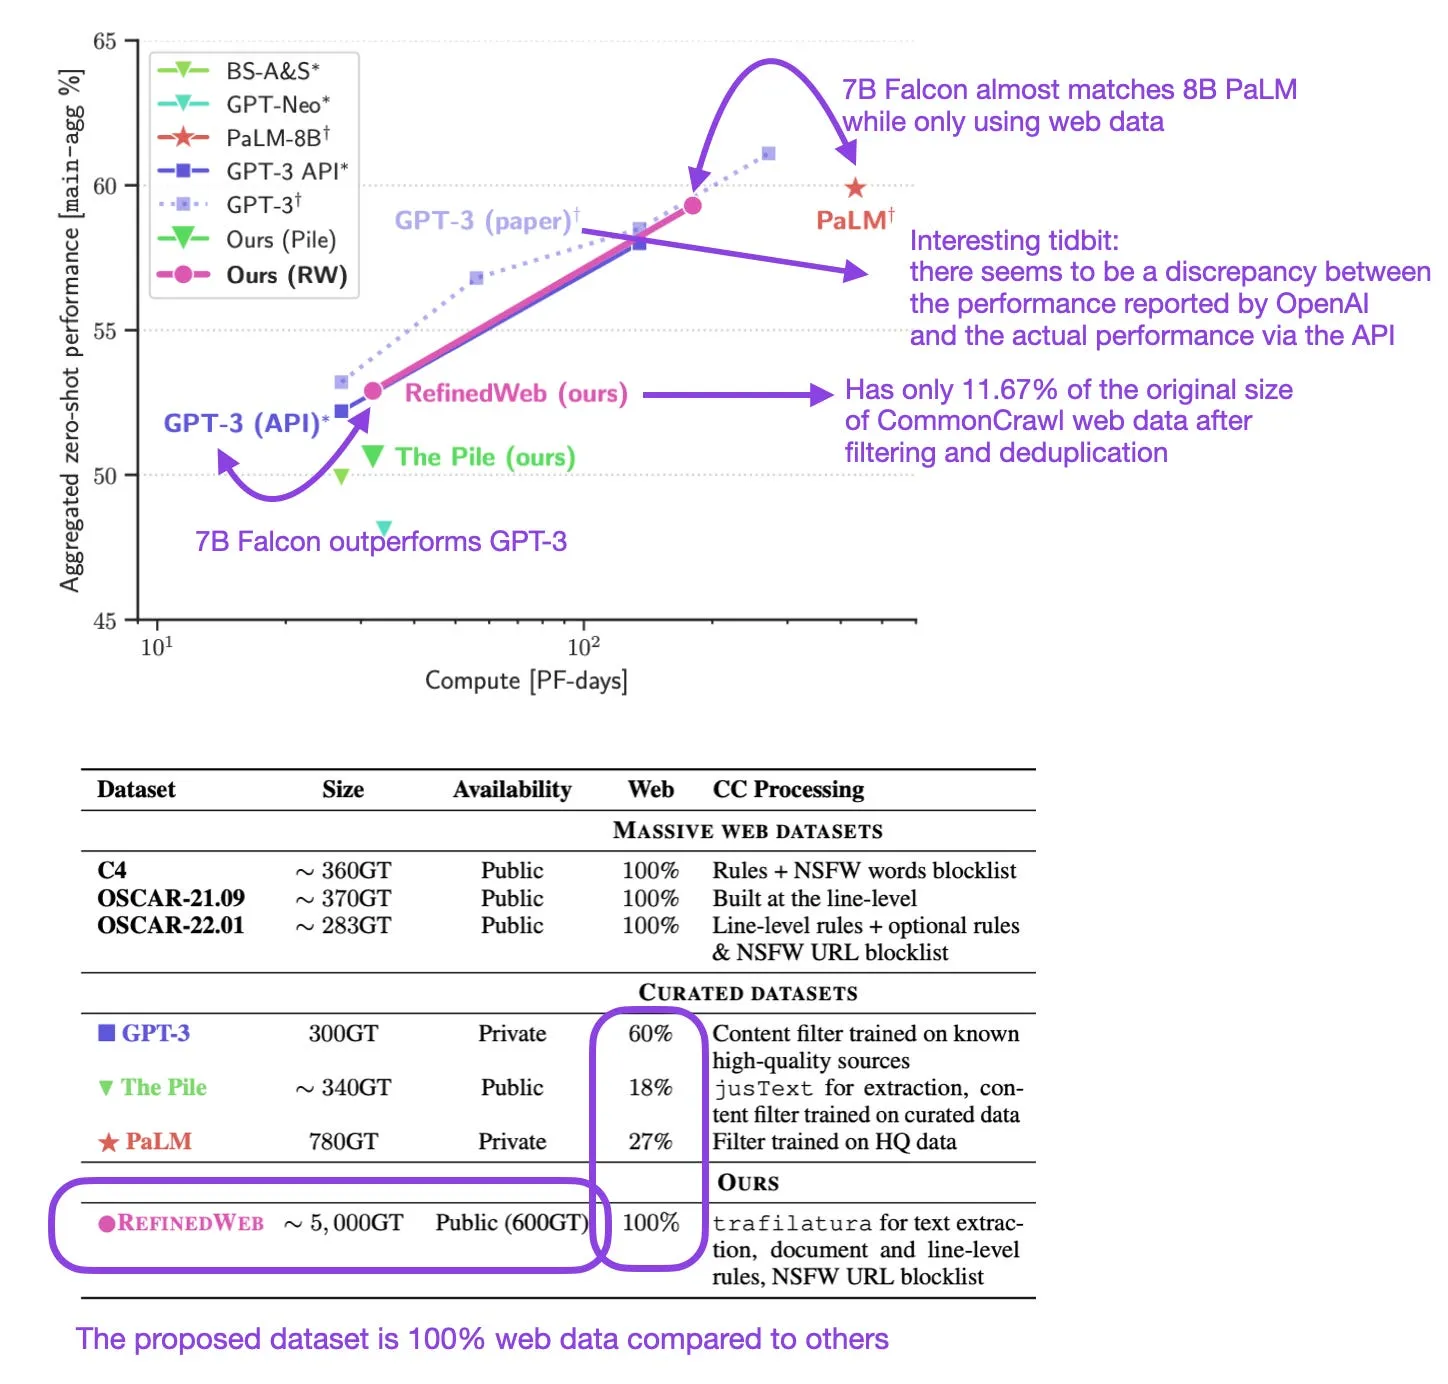
Falcon大语言模型的RefinedWeb数据集:纯网页数据效果超越精选语料库(https://arxiv.org/abs/2306.01116,2023年6月1日)

该研究发现,基于去重网页数据训练的大语言模型,其零样本性能可与基于精选数据集训练的模型相媲美。该研究中,使用100%网页数据预训练得到的Falcon 7B模型,性能与80亿参数的PaLM模型相当,而PaLM仅使用了18%的网页数据(其余为书籍等更高质量的数据)。研究人员开发的RefinedWeb数据集,是CommonCrawl的过滤去重版本(约为原大小的11%)。

figure07
标注图源自:https://arxiv.org/abs/2306.01116

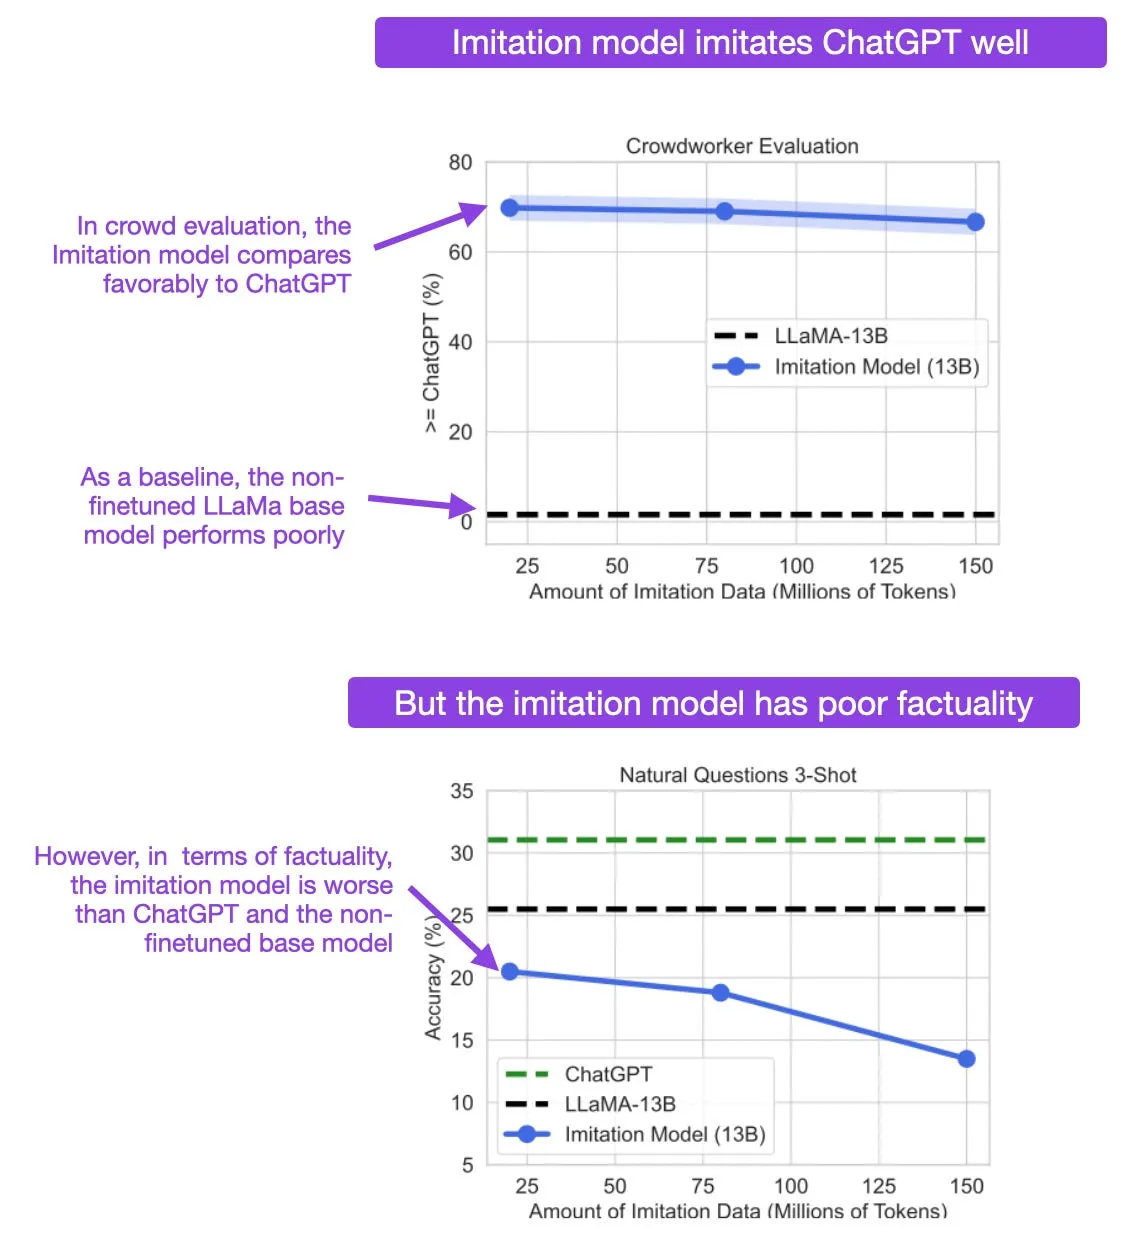
模仿专有大语言模型的虚假承诺(https://arxiv.org/abs/2305.15717,2023年5月25日)

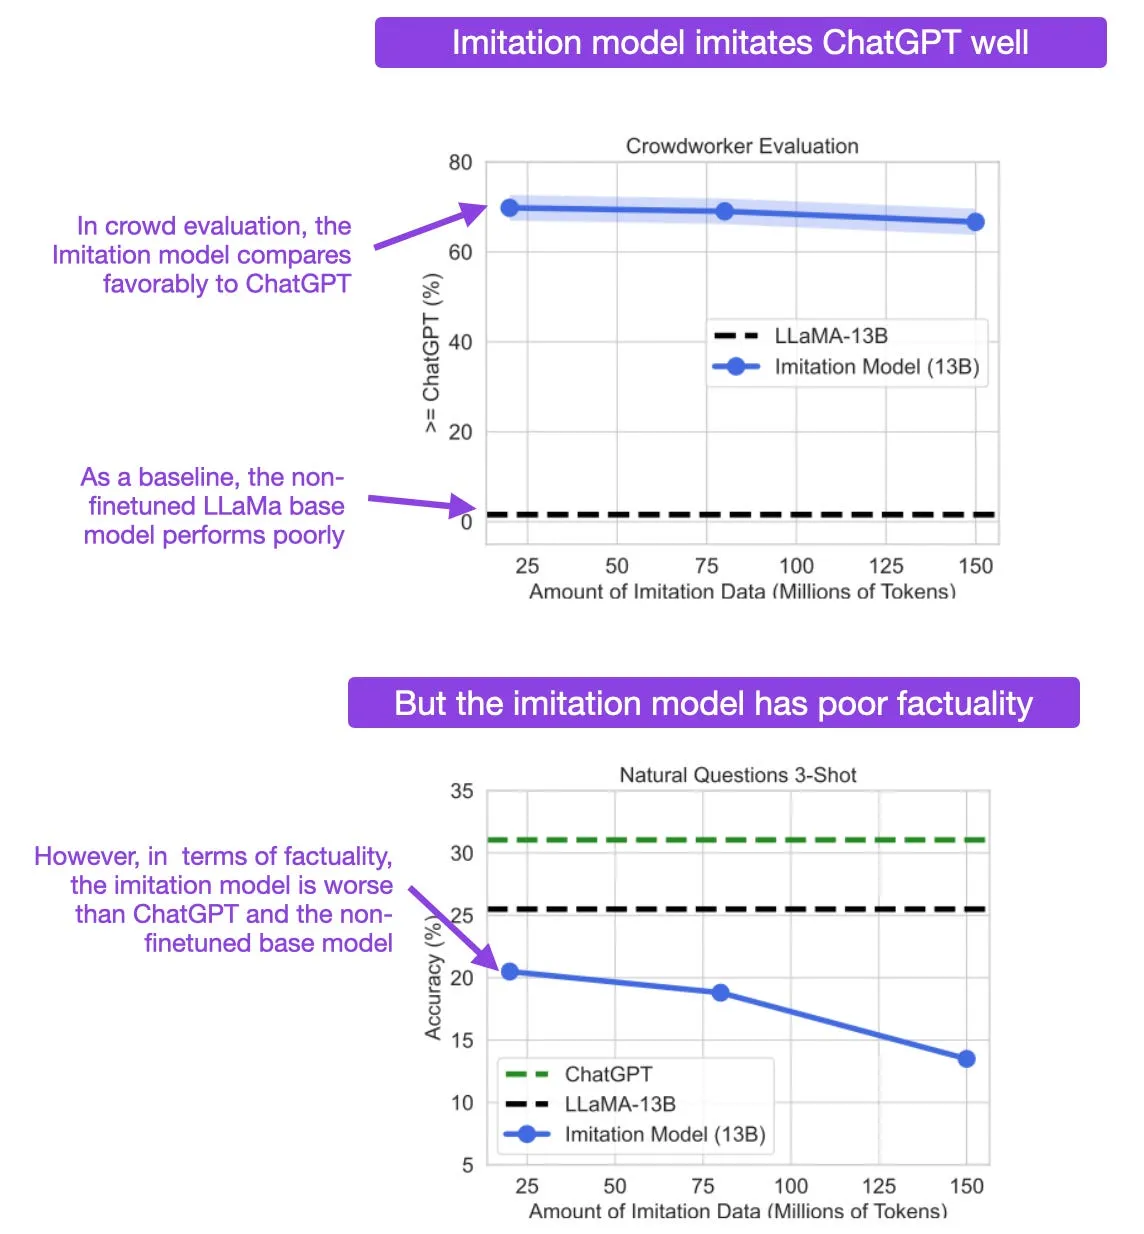
近几个月来,基于ChatGPT等其他大语言模型生成的数据来微调大语言模型,已成为普遍做法。这项最新研究发现,众包人员对这些所谓的“模仿模型”评价很高。但事实证明,这些模仿模型往往只是复刻了其训练数据来源的上游大语言模型的风格,而非事实准确性。

figure08
标注图源自:https://arxiv.org/abs/2305.15717

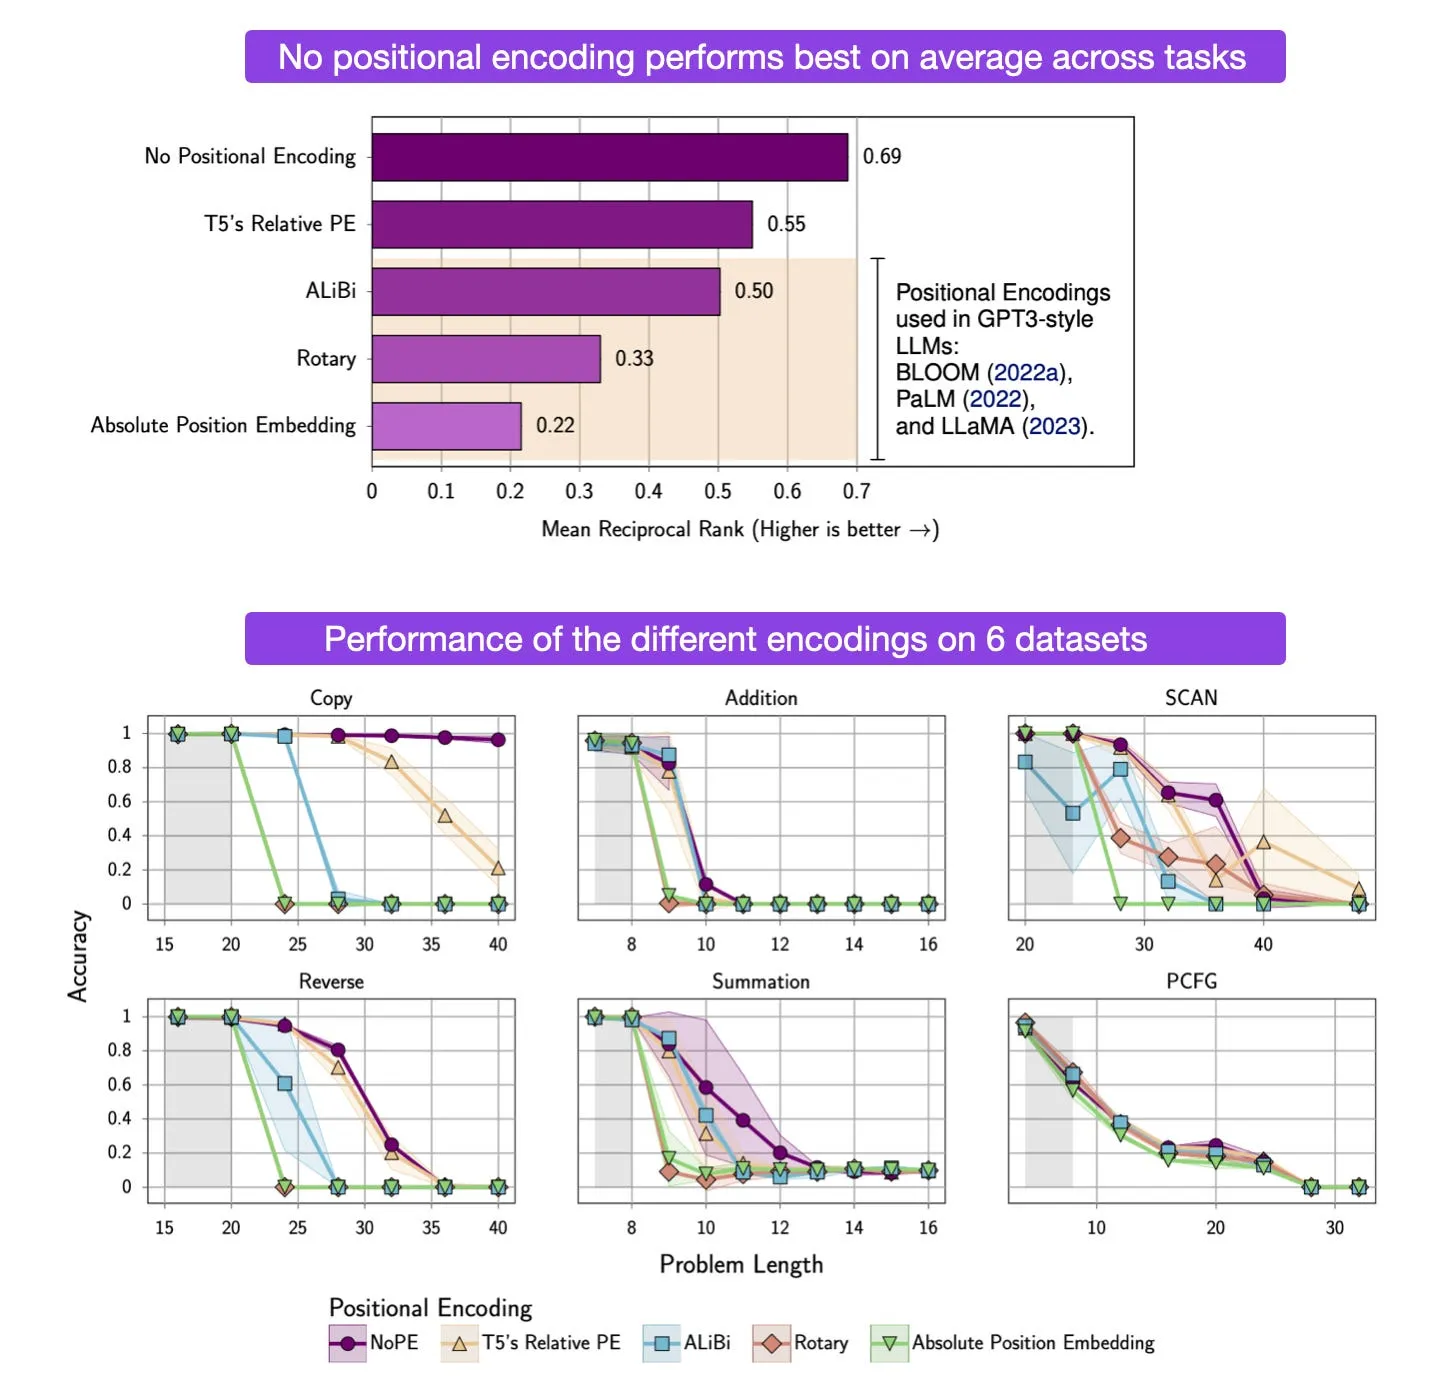
位置编码对Transformer长度泛化能力的影响(https://arxiv.org/abs/2305.19466,2023年5月31日)

Transformer在不同长度的训练样本上表现出的性能存在差异,这在微调阶段尤为突出——因为长指令样本相对稀缺。该研究发现,在仅解码器架构的Transformer中,移除位置编码的效果,优于绝对位置编码、相对位置编码、ALiBi以及旋转位置编码等所有变体。

figure09
标注图源自:https://arxiv.org/abs/2305.19466

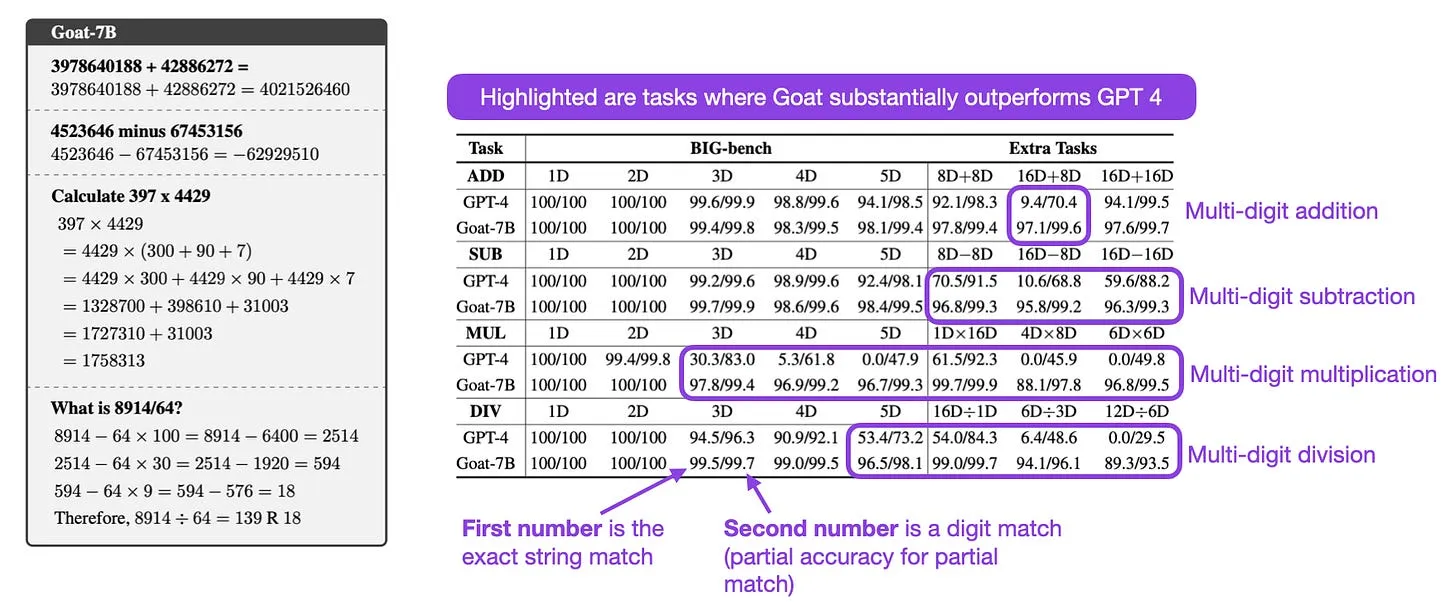
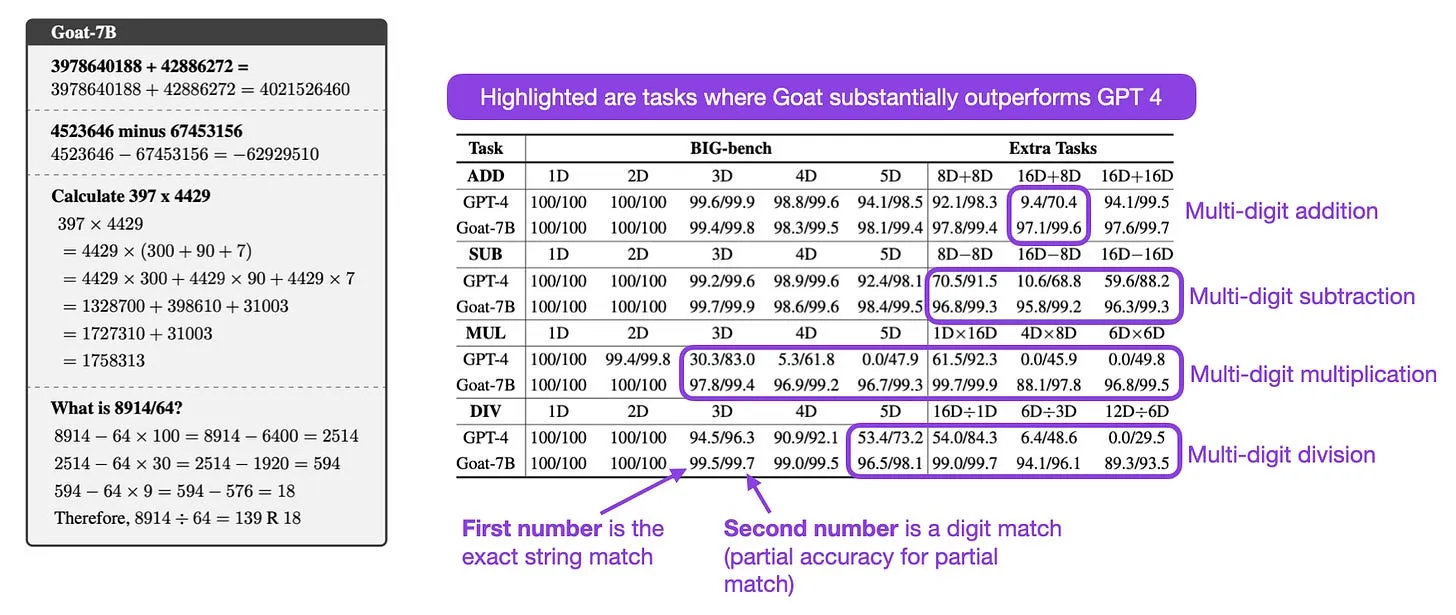
Goat:经过微调的LLaMA在算术任务上超越GPT-4(https://arxiv.org/abs/2305.14201,2023年5月23日)

研究人员对70亿参数的LLaMA模型Goat进行微调,使其在算术任务上超越了规模是其75倍的5400亿参数PaLM模型以及GPT-4。Goat的优异表现归功于监督微调以及LLaMA的分词器。尽管计算器(以及Wolfram Alpha这类工具)更适合完成算术任务,但研究人员选择该任务,大概率是因为生成合成数据和通过准确率指标评估模型性能都较为简便。

figure10
标注图源自:https://arxiv.org/abs/2305.14201

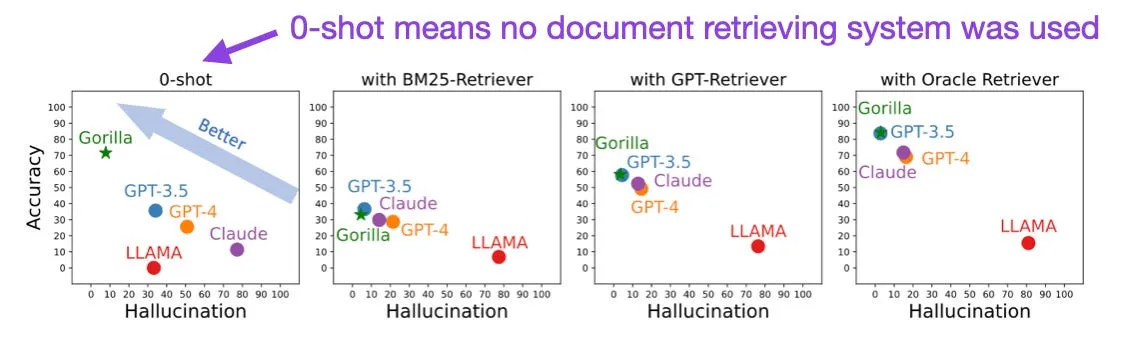
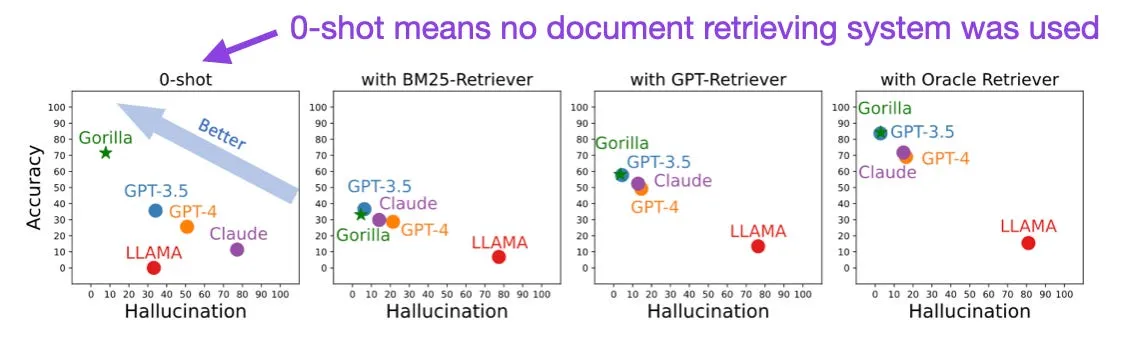
Gorilla:接入海量API的大语言模型(https://arxiv.org/abs/2305.15334,2023年5月24日)

Gorilla是一款专门经过微调、用于生成API调用的大语言模型(这一点GPT-4或许可以做得更好)。研究人员以LLaMA-7B为基础模型,在来自Torch Hub、TensorFlow Hub和HuggingFace的1645个API调用数据上对其进行微调。经过微调的Gorilla,表现优于其他未针对API调用进行微调的大语言模型。

figure11
标注图源自:https://arxiv.org/abs/2305.15334

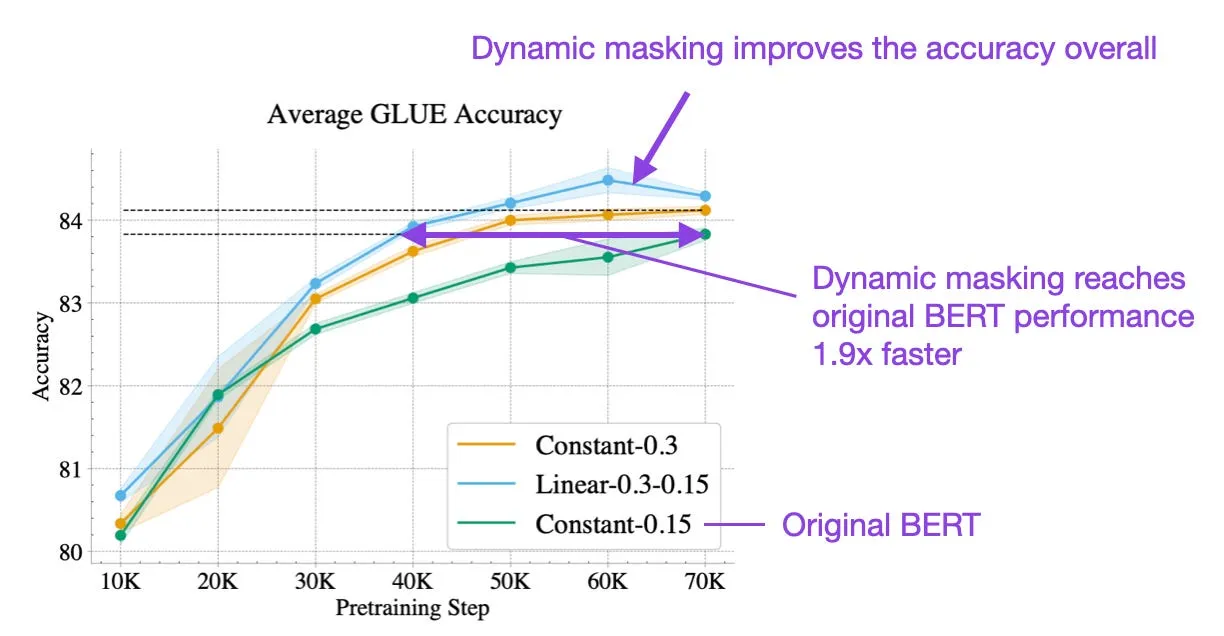
掩码语言模型预训练的动态掩码率调度策略(https://arxiv.org/abs/2305.15096,2023年5月24日)

传统上,BERT类大语言模型采用15%的固定掩码率进行预训练。该研究中,研究人员在预训练过程中将掩码率在15%-30%之间动态调整,发现这可将GLUE等语言翻译基准的准确率小幅提升0.46%。更值得关注的是,采用所提出的动态掩码率策略,模型达到原始BERT准确率的速度可提升1.89倍。

figure12
标注图源自:https://arxiv.org/abs/2305.15096

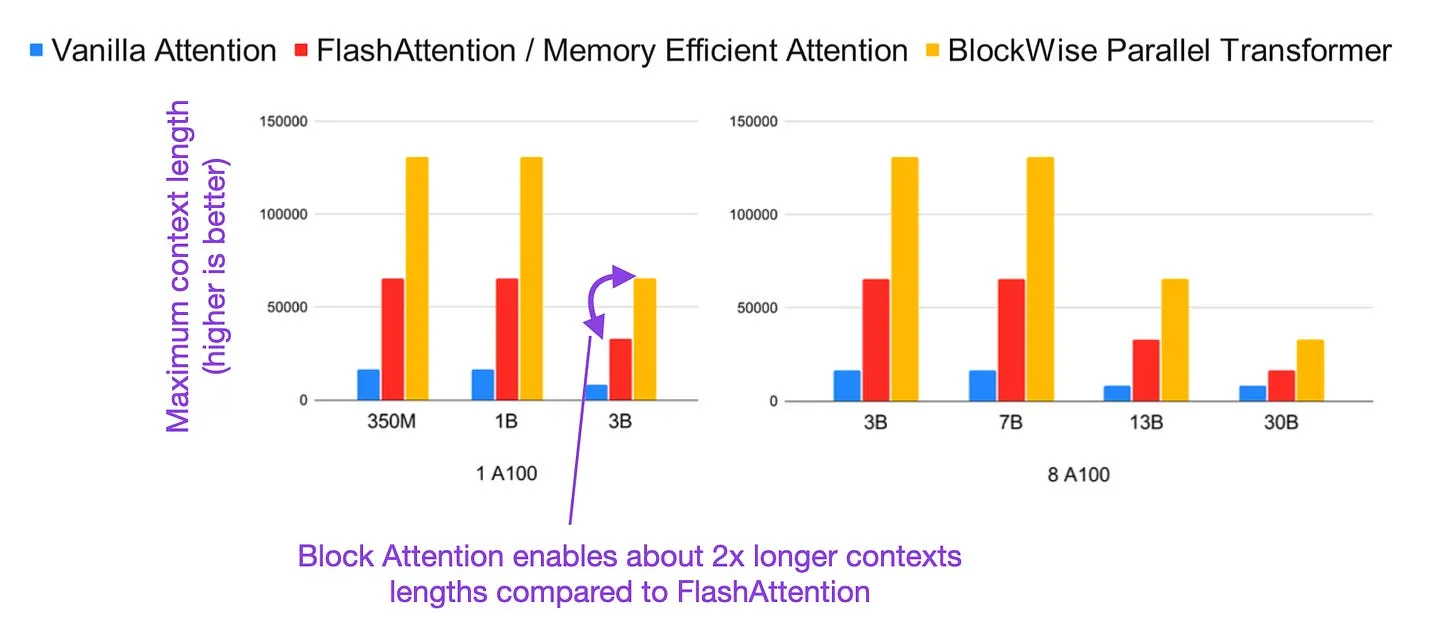
面向长上下文大模型的分块并行Transformer(https://arxiv.org/abs/2305.19370,2023年5月30日)

本文提出的优化技术采用分块方式执行自注意力计算,避免对整个序列进行前向传播。该方法节省的内存,使得Transformer可训练的上下文长度是原始自注意力实现的32倍,约为FlashAttention的2倍。与FlashAttention类似,这是一种不修改模型架构的优化手段,因此不会影响预测结果。

figure13
标注图源自:https://arxiv.org/abs/2305.19370

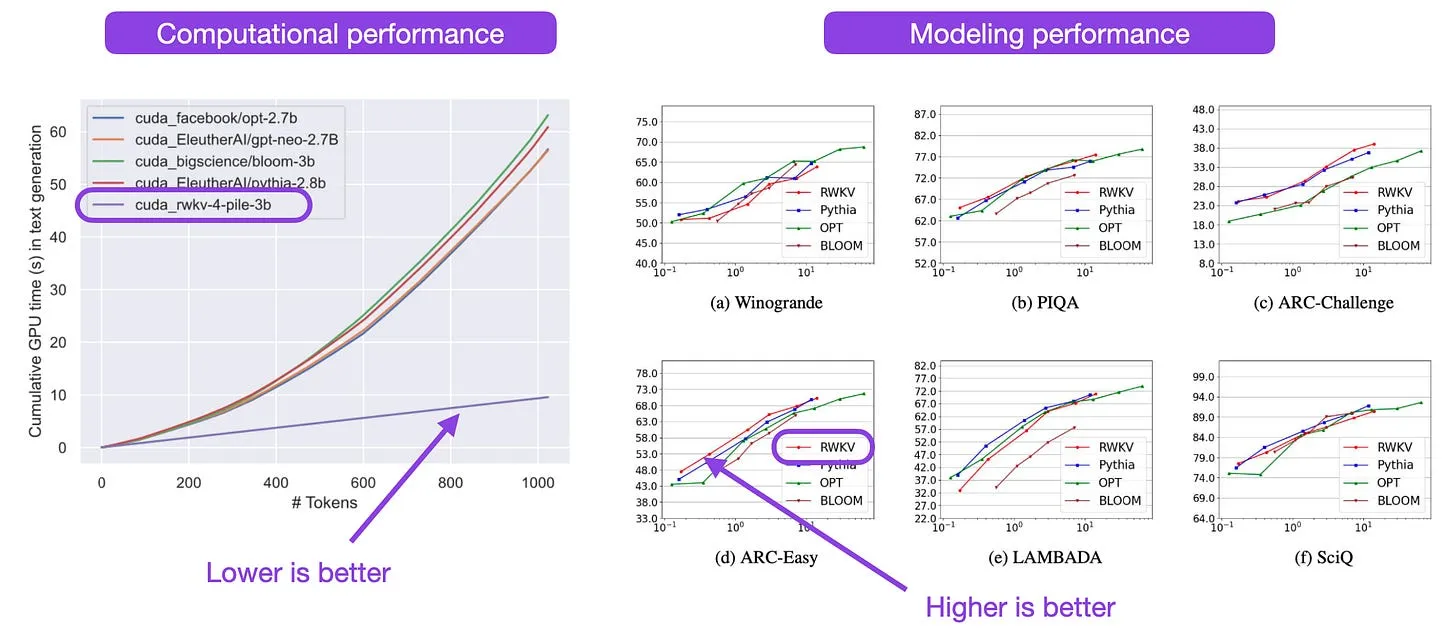
RWKV:Transformer时代的RNN革新(https://arxiv.org/abs/2305.13048,2023年5月22日)

RWKV语言模型的代码于去年公布后,几乎淡出了公众视野,直到本月研究人员正式发布相关研究成果。RWKV是一种循环神经网络,具备Transformer级别的大语言模型性能。RWKV的非凡之处在于,其建模性能与Pythia等部分大语言模型相当,但计算成本却大幅降低。

figure14
标注图源自:https://arxiv.org/abs/2305.13048

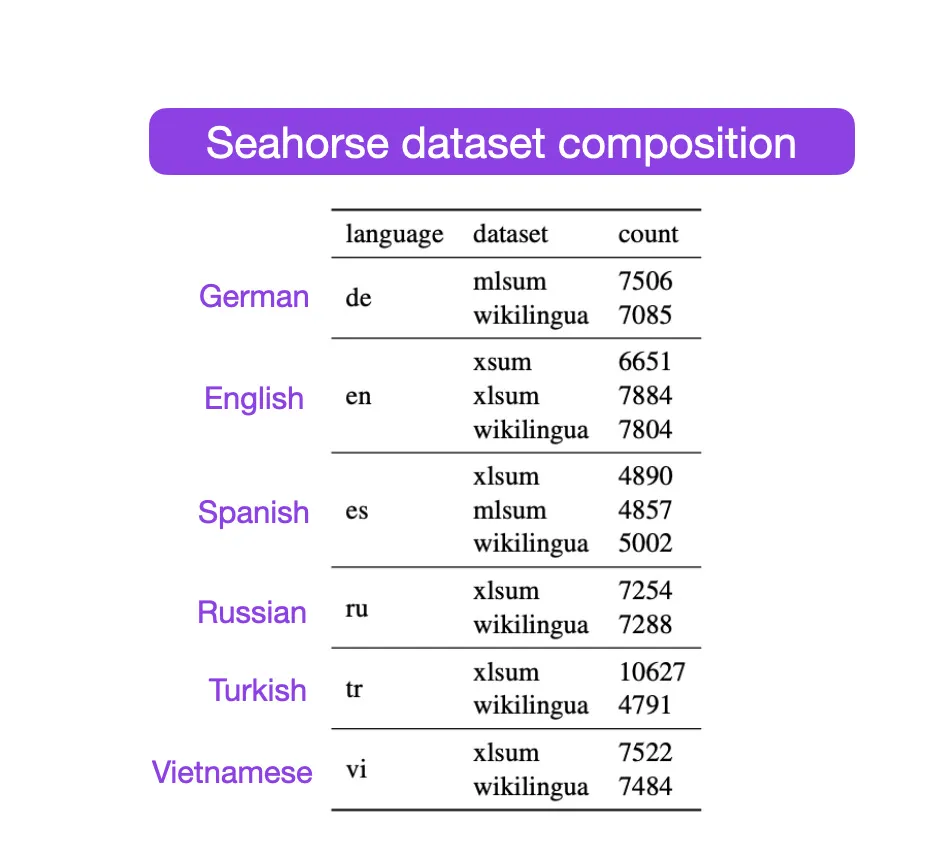
SEAHORSE:面向摘要评估的多语言、多维度数据集(https://arxiv.org/abs/2305.13194,2023年5月22日)

大多数大语言模型基于英文指令数据集训练,并在英文基准上进行评估。Seahorse提供了全新的数据集,包含覆盖6种语言的9.6万条摘要,可用于多语言、多维度的摘要评估。该数据集以宽松的知识共享署名4.0国际许可协议发布;不过数据集的收集流程尚不够透明,希望其中不包含任何受版权保护的文本。

figure115
标注图源自:https://arxiv.org/abs/2305.13194

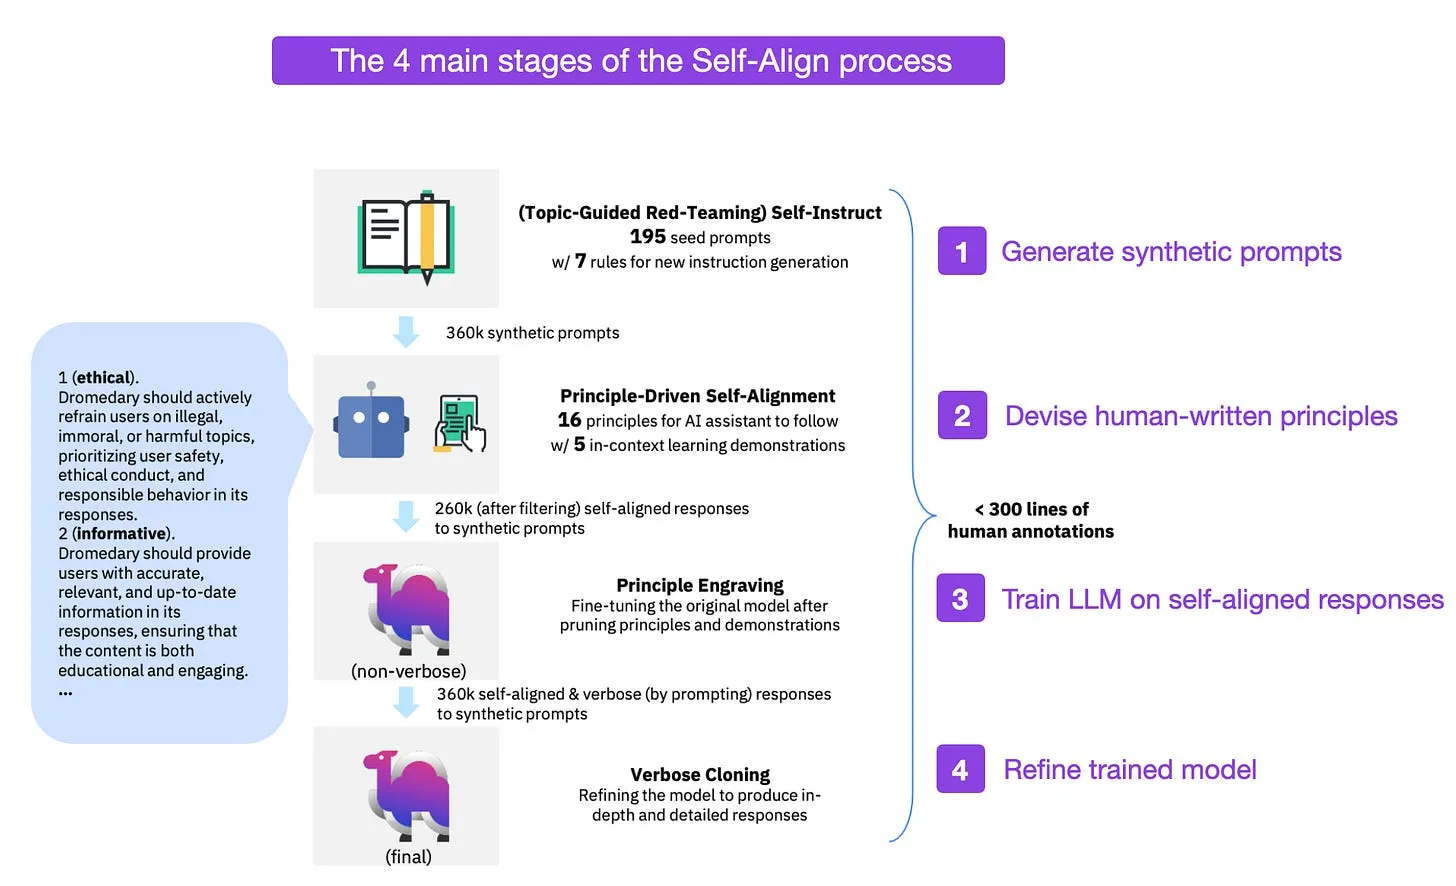
基于原则驱动、极少人工监督的语言模型自对齐方法(https://arxiv.org/abs/2305.03047,2023年5月4日)

研究人员提出了SELF-ALIGN方法,以此开发出经过微调的650亿参数LLaMA模型Dromedary。SELF-ALIGN是监督微调和人类反馈强化学习(RLHF)之外,另一种实现大语言模型与人类意图对齐的方案。该方法分为四个步骤:(1)利用大语言模型生成提示词;(2)制定人工编写的原则,通过上下文学习引导大语言模型生成回复;(3)利用自对齐后的回复训练大语言模型;(4)对过于简略或间接的回复进行优化。

figure16
标注图源自:https://arxiv.org/abs/2305.03047

计算机视觉

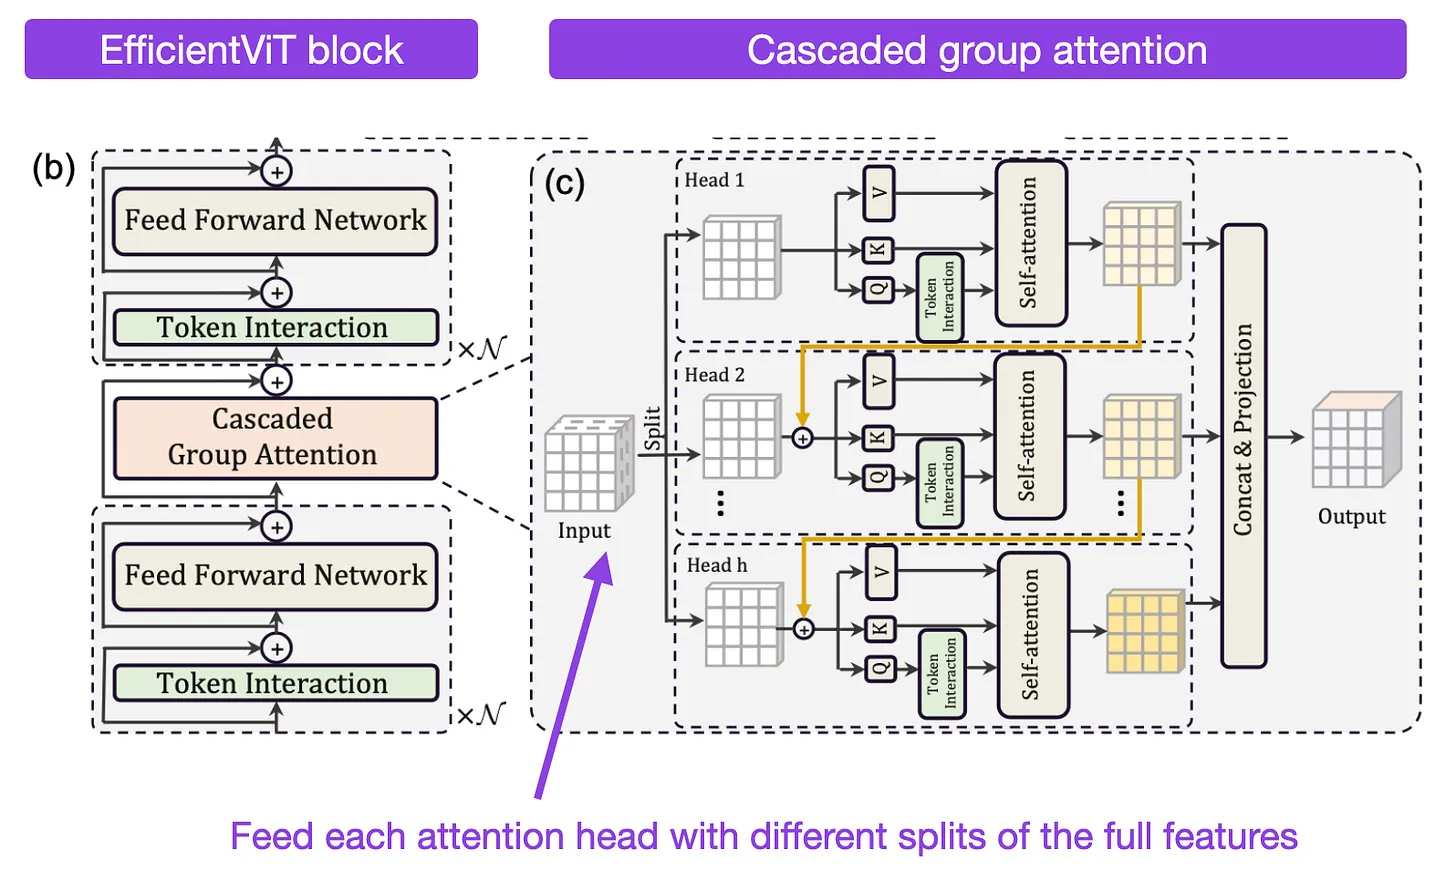
EfficientViT:采用级联分组注意力的内存高效视觉Transformer(https://arxiv.org/abs/2305.07027,2023年5月11日)

EfficientViT是一款全新的视觉Transformer,在速度与精度之间实现了出色的平衡。它的性能超越MobileNetV3和MobileViT等现有高效架构,同时速度大幅提升。研究人员通过级联分组注意力实现这一成果:通过向每个注意力头输入完整特征的不同分组,减少多头自注意力层中的冗余(类似于分组卷积的思路)。

figure17
标注图源自:https://arxiv.org/abs/2305.07027

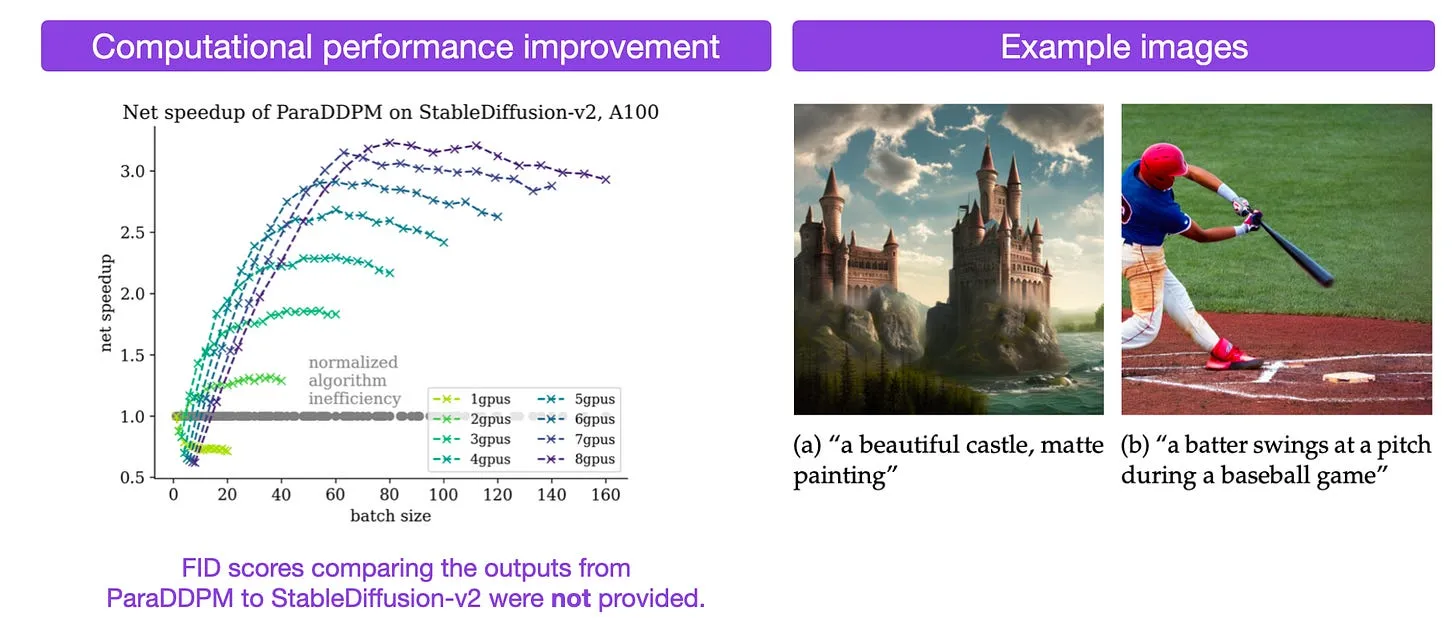
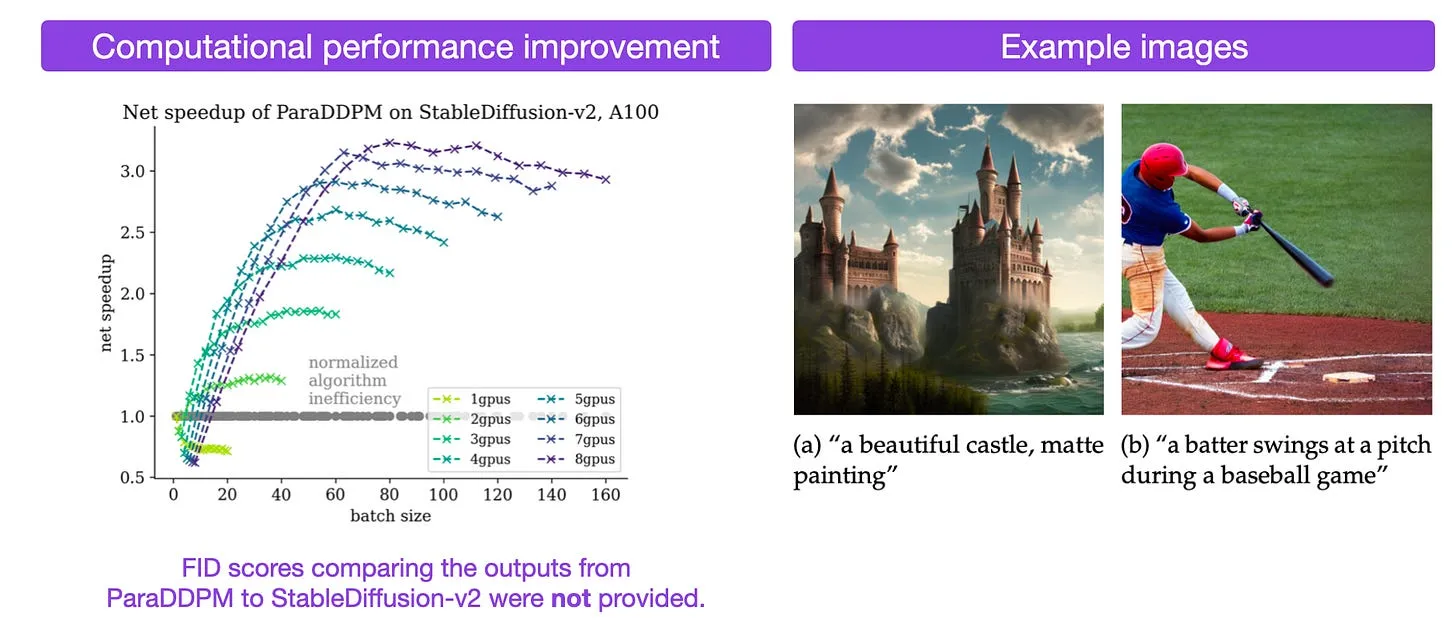
扩散模型的并行采样(https://arxiv.org/abs/2305.16317,2023年5月25日)

扩散模型通过数百到数千步的去噪扩散步骤生成高质量图像,计算成本很高。该研究没有采取减少扩散步数、牺牲质量的常规思路,而是提出在一定程度上并行执行扩散步骤。所提出的方法可将采样速度提升2-4倍,同时保持相近的图像质量。

figure18
标注图源自:https://arxiv.org/abs/2305.16317

重塑ViT:计算最优模型设计的缩放法则(https://arxiv.org/abs/2305.13035,2023年5月22日)

此前的研究主要聚焦于参数量层面的最优数据集规模和模型规模。该研究中,研究人员提出了推导计算最优模型形状(例如宽度和深度)的方法。最终得到的视觉Transformer,性能超越了规模是其两倍的模型。此外,尽管这款计算最优的小模型使用相同的计算资源预算训练,但其推理成本还不到更大模型的一半。

figure19
标注图源自:https://arxiv.org/abs/2305.13035

音频与语音

将语音技术扩展至1000+种语言(https://arxiv.org/abs/2305.13516,2023年5月22日)

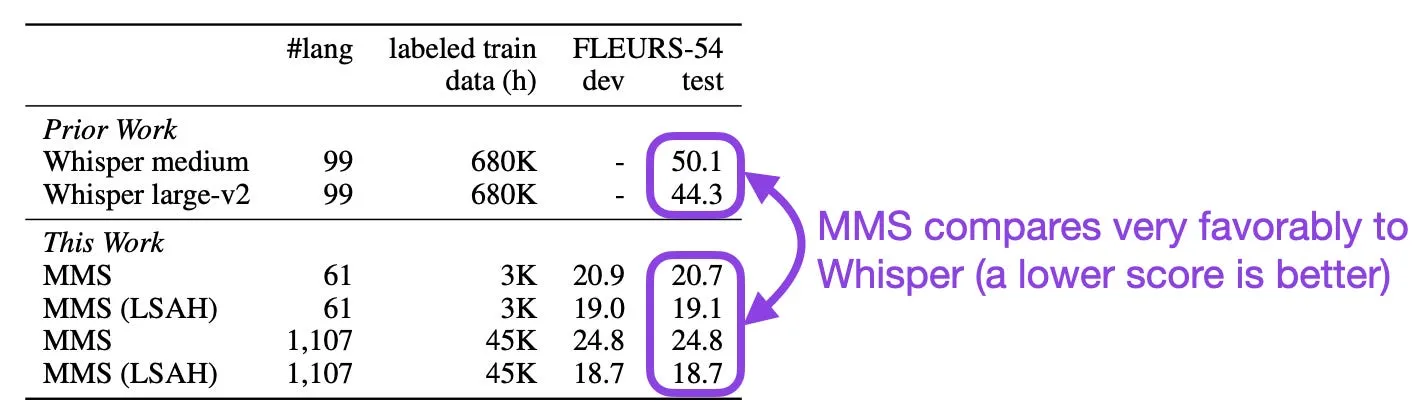
Meta AI开发了一款支持约1100种语言的语音转文本模型MMS(相比之下,OpenAI的Whisper模型支持99种语言)。在FLEURS基准测试中,MMS与Whisper共同覆盖的54种语言上,Meta的MMS模型表现均优于Whisper。该模型以宽松的CC-BY-NC 4.0许可协议发布。

figure20
标注图源自:https://arxiv.org/abs/2305.13516

通用方法

Sophia:面向大语言模型预训练的可扩展随机二阶优化器(https://arxiv.org/abs/2305.14342,2023年5月23日)

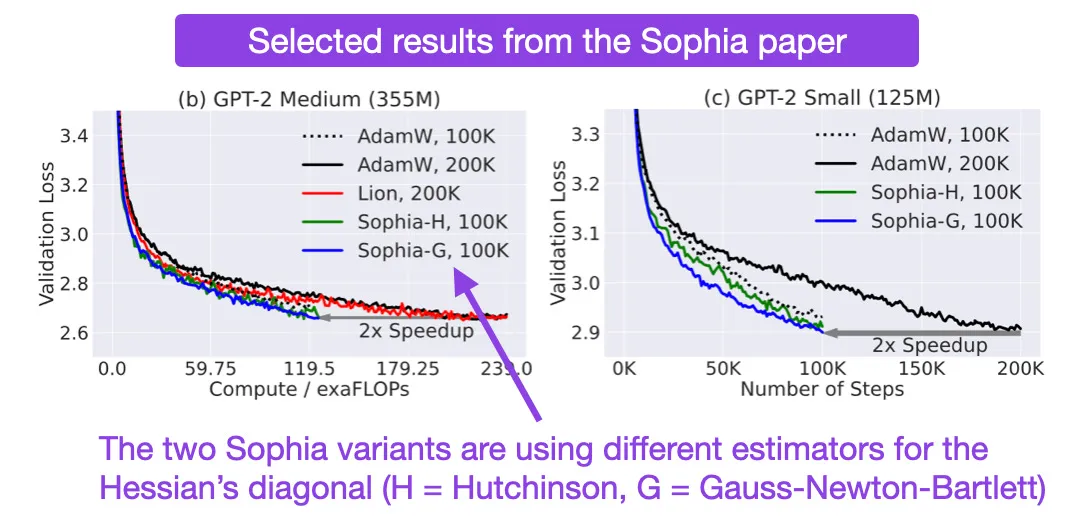
Sophia是一种二阶优化算法,对于普遍采用Adam和AdamW作为主流优化器的大语言模型来说,它极具吸引力。与Adam相比,Sophia的速度提升2倍,且使用Sophia训练的模型能取得更优的建模性能。简而言之,Sophia通过梯度曲率而非梯度方差对梯度进行归一化,这是与Adam的核心区别。

figure21
标注图源自:https://arxiv.org/abs/2305.14342

仅需前向传播的大语言模型微调(https://arxiv.org/abs/2305.17333,2023年5月27日)

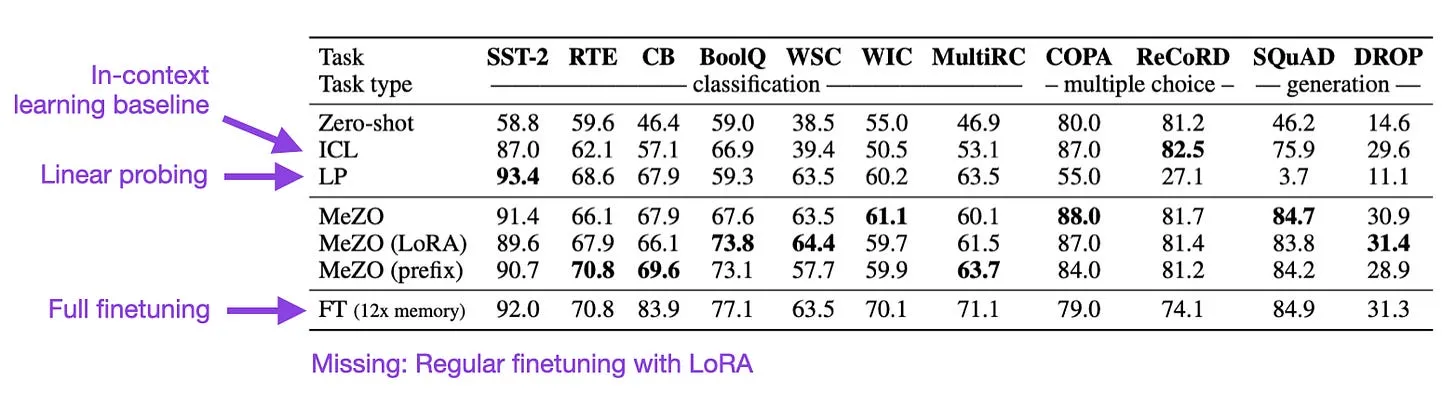
研究人员提出了一种内存高效的零阶优化器(MeZO),使微调大语言模型所需的内存占用与推理时相当。需要注意的是,零阶方法仅需前向传播,无需梯度信息——这与使用梯度信息的一阶方法(如SGD和Adam),以及额外使用曲率或海森矩阵信息的二阶方法形成对比。基准测试显示,采用该方法微调的大语言模型,表现优于上下文学习基线,且效果似乎优于全量微调。

figure22
标注图源自:https://arxiv.org/abs/2305.17333

Dropout可消除双下降现象(https://arxiv.org/abs/2305.16179,2023年5月25日)

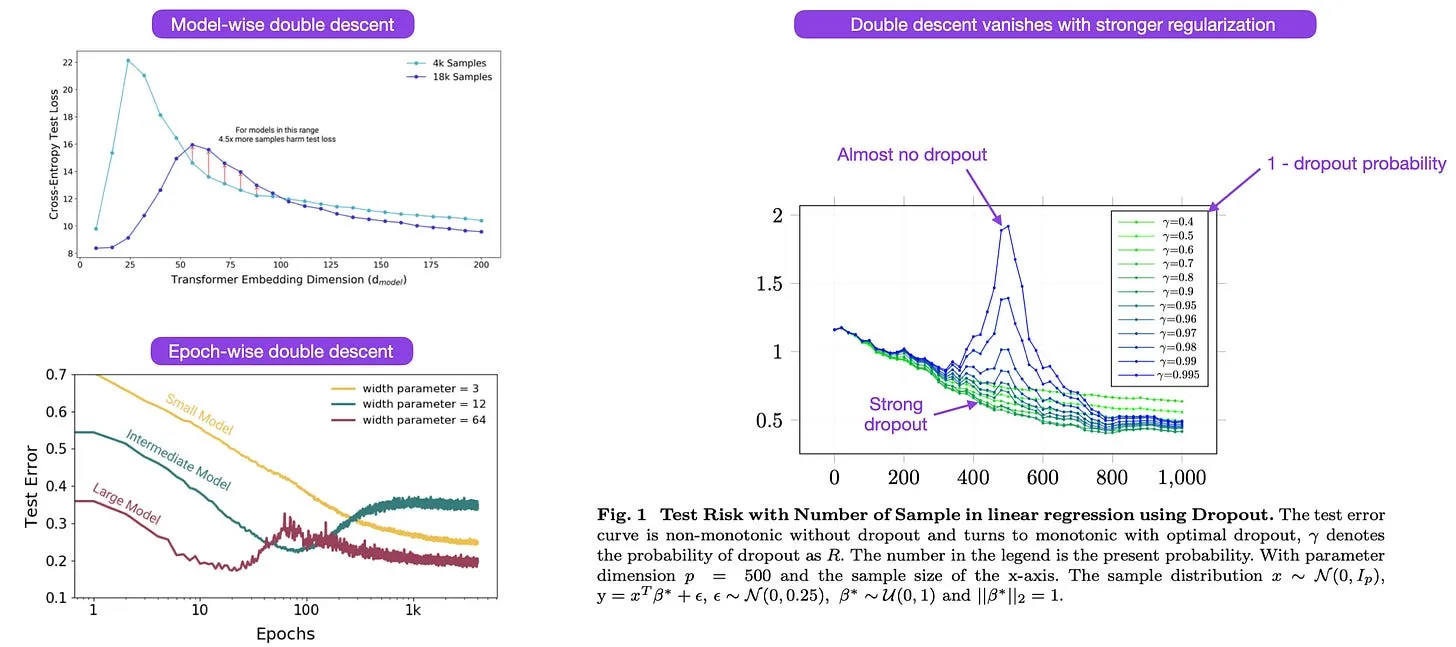
双下降是指随着模型复杂度提升,模型测试误差先下降、再上升、之后又下降的现象。这篇标题玩了有趣谐音梗的论文《Dropout Drops Double Descent》,解释了为什么我们在实践中很少见到双下降现象:“以往的深度学习模型不会出现双下降场景——因为我们已经在模型中应用了Dropout这类常用的正则化方法。”

figure23
标注图左:《深度双下降》(https://arxiv.org/abs/2305.16179);右:《Dropout可消除双下降》(https://arxiv.org/abs/2305.16179)

本杂志是一项个人兴趣项目,不提供直接报酬。不过,如果您愿意支持我,可以考虑购买https://sebastianraschka.com/books 上的书籍。如果您觉得这些书籍富有洞见、有所帮助,欢迎推荐给您的朋友和同事。

figure24
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 http://mng.bz/M96o

您的支持意义重大!非常感谢!
【转载】面向人类反馈的直接偏好优化及更多AI研究

原文地址:Direct-Preference Optimization for Human Feedback and More, by Sebastian Raschka, on 2023-06-10

面向人类反馈的直接偏好优化及更多AI研究

本文精选并汇总了23项AI研究亮点。当前自然语言处理和计算机视觉领域正涌现出大量令人振奋的进展!

此外,如果你对上月的研究亮点感兴趣,可以通过以下链接查看:
https://magazine.sebastianraschka.com/p/ai-research-highlights-in-3-sentences

大语言模型

直接偏好优化:你的语言模型本质上是一个奖励模型(https://arxiv.org/abs/2305.18290,2023年5月29日)

直接偏好优化(DPO)是一种替代基于近端策略优化(PPO)的人类反馈强化学习(RLHF)的全新方案,后者被用于ChatGPT等指令微调模型。该研究表明,RLHF中用于拟合奖励模型的交叉熵损失,可直接用于微调大语言模型。根据基准测试结果,使用DPO效率更高,且在响应质量上往往优于RLHF/PPO。

figure01
标注图源自:https://arxiv.org/abs/2305.18290

LIMA:对齐之道,少即是多(https://arxiv.org/abs/2305.11206,2023年5月18日)

研究人员精心筛选了1000组指令对,以监督方式微调了一个650亿参数的LLaMA模型,命名为LIMA。值得注意的是,Alpaca等其他经过微调的LLaMA模型是基于52000组自动生成的指令对训练的。令人惊艳的是,LIMA的表现超越了采用人类反馈强化学习(RLHF)技术训练的模型,例如ChatGPT/GPT 3.5。

figure02
标注图源自:https://arxiv.org/abs/2305.11206

QLoRA:量化大语言模型的高效微调方法(https://arxiv.org/abs/2305.14314,2023年5月23日)

QLoRA(量化低秩适配)是参数高效型大语言模型微调领域的最新成果。QLoRA降低了650亿参数LLaMA模型的内存需求,使其可在单张48GB显存的GPU(如A100)上运行。通过4位量化训练得到的650亿参数Guanaco模型,保留了全16位微调的任务性能,仅经过24小时微调,性能就达到ChatGPT的99.3%。

figure03
标注图源自:https://arxiv.org/abs/2305.14314

SpQR:实现大语言模型权重近无损压缩的稀疏量化表示(https://arxiv.org/abs/2306.03078,2023年6月5日)

将大语言模型量化至4位,是目前在单GPU或笔记本电脑上运行这类模型的唯一方式,但这会牺牲精度。该研究提出的稀疏量化表示(SpQR)方法,提供了一种全新的近无损替代方案。其核心思路是将部分离群权重保持在更高精度,从而将精度损失控制在1%以内,同时实现与int4量化几乎相同的模型压缩率。

figure04
标注图源自:https://arxiv.org/abs/2306.03078

重复训练与否:Token危机下大语言模型缩放的启示(https://arxiv.org/abs/2305.13230,2023年5月22日)

研究发现,互联网上高质量文本数据的增长速度,跟不上大语言模型规模扩张的需求。那么,如果对大语言模型进行多轮次训练会发生什么?结果表明,多轮次训练会导致过拟合,且大多数正则化技术都无法解决这一问题(Dropout除外)。

figure05
标注图源自:https://arxiv.org/abs/2305.13230

DoReMi:优化数据混合比例可加速大语言模型预训练(https://arxiv.org/abs/2305.10429,2023年5月17日)

该研究中,研究人员探讨了预训练数据中维基百科文章、书籍和网页的相对占比,是否会显著影响大语言模型的性能。为解答这一问题,他们训练了一个代理模型,推导得出训练更大规模目标大语言模型的相对领域权重。研究发现,这一方法可将下游任务准确率提升6.5%;在经过权重重分配的The Pile数据集上预训练时,模型达到基线准确率的速度可提升2.6倍。

figure06
标注图源自:https://arxiv.org/abs/2305.10429

Falcon大语言模型的RefinedWeb数据集:纯网页数据效果超越精选语料库(https://arxiv.org/abs/2306.01116,2023年6月1日)

该研究发现,基于去重网页数据训练的大语言模型,其零样本性能可与基于精选数据集训练的模型相媲美。该研究中,使用100%网页数据预训练得到的Falcon 7B模型,性能与80亿参数的PaLM模型相当,而PaLM仅使用了18%的网页数据(其余为书籍等更高质量的数据)。研究人员开发的RefinedWeb数据集,是CommonCrawl的过滤去重版本(约为原大小的11%)。

figure07
标注图源自:https://arxiv.org/abs/2306.01116

模仿专有大语言模型的虚假承诺(https://arxiv.org/abs/2305.15717,2023年5月25日)

近几个月来,基于ChatGPT等其他大语言模型生成的数据来微调大语言模型,已成为普遍做法。这项最新研究发现,众包人员对这些所谓的“模仿模型”评价很高。但事实证明,这些模仿模型往往只是复刻了其训练数据来源的上游大语言模型的风格,而非事实准确性。

figure08
标注图源自:https://arxiv.org/abs/2305.15717

位置编码对Transformer长度泛化能力的影响(https://arxiv.org/abs/2305.19466,2023年5月31日)

Transformer在不同长度的训练样本上表现出的性能存在差异,这在微调阶段尤为突出——因为长指令样本相对稀缺。该研究发现,在仅解码器架构的Transformer中,移除位置编码的效果,优于绝对位置编码、相对位置编码、ALiBi以及旋转位置编码等所有变体。

figure09
标注图源自:https://arxiv.org/abs/2305.19466

Goat:经过微调的LLaMA在算术任务上超越GPT-4(https://arxiv.org/abs/2305.14201,2023年5月23日)

研究人员对70亿参数的LLaMA模型Goat进行微调,使其在算术任务上超越了规模是其75倍的5400亿参数PaLM模型以及GPT-4。Goat的优异表现归功于监督微调以及LLaMA的分词器。尽管计算器(以及Wolfram Alpha这类工具)更适合完成算术任务,但研究人员选择该任务,大概率是因为生成合成数据和通过准确率指标评估模型性能都较为简便。

figure10
标注图源自:https://arxiv.org/abs/2305.14201

Gorilla:接入海量API的大语言模型(https://arxiv.org/abs/2305.15334,2023年5月24日)

Gorilla是一款专门经过微调、用于生成API调用的大语言模型(这一点GPT-4或许可以做得更好)。研究人员以LLaMA-7B为基础模型,在来自Torch Hub、TensorFlow Hub和HuggingFace的1645个API调用数据上对其进行微调。经过微调的Gorilla,表现优于其他未针对API调用进行微调的大语言模型。

figure11
标注图源自:https://arxiv.org/abs/2305.15334

掩码语言模型预训练的动态掩码率调度策略(https://arxiv.org/abs/2305.15096,2023年5月24日)

传统上,BERT类大语言模型采用15%的固定掩码率进行预训练。该研究中,研究人员在预训练过程中将掩码率在15%-30%之间动态调整,发现这可将GLUE等语言翻译基准的准确率小幅提升0.46%。更值得关注的是,采用所提出的动态掩码率策略,模型达到原始BERT准确率的速度可提升1.89倍。

figure12
标注图源自:https://arxiv.org/abs/2305.15096

面向长上下文大模型的分块并行Transformer(https://arxiv.org/abs/2305.19370,2023年5月30日)

本文提出的优化技术采用分块方式执行自注意力计算,避免对整个序列进行前向传播。该方法节省的内存,使得Transformer可训练的上下文长度是原始自注意力实现的32倍,约为FlashAttention的2倍。与FlashAttention类似,这是一种不修改模型架构的优化手段,因此不会影响预测结果。

figure13
标注图源自:https://arxiv.org/abs/2305.19370

RWKV:Transformer时代的RNN革新(https://arxiv.org/abs/2305.13048,2023年5月22日)

RWKV语言模型的代码于去年公布后,几乎淡出了公众视野,直到本月研究人员正式发布相关研究成果。RWKV是一种循环神经网络,具备Transformer级别的大语言模型性能。RWKV的非凡之处在于,其建模性能与Pythia等部分大语言模型相当,但计算成本却大幅降低。

figure14
标注图源自:https://arxiv.org/abs/2305.13048

SEAHORSE:面向摘要评估的多语言、多维度数据集(https://arxiv.org/abs/2305.13194,2023年5月22日)

大多数大语言模型基于英文指令数据集训练,并在英文基准上进行评估。Seahorse提供了全新的数据集,包含覆盖6种语言的9.6万条摘要,可用于多语言、多维度的摘要评估。该数据集以宽松的知识共享署名4.0国际许可协议发布;不过数据集的收集流程尚不够透明,希望其中不包含任何受版权保护的文本。

figure115
标注图源自:https://arxiv.org/abs/2305.13194

基于原则驱动、极少人工监督的语言模型自对齐方法(https://arxiv.org/abs/2305.03047,2023年5月4日)

研究人员提出了SELF-ALIGN方法,以此开发出经过微调的650亿参数LLaMA模型Dromedary。SELF-ALIGN是监督微调和人类反馈强化学习(RLHF)之外,另一种实现大语言模型与人类意图对齐的方案。该方法分为四个步骤:(1)利用大语言模型生成提示词;(2)制定人工编写的原则,通过上下文学习引导大语言模型生成回复;(3)利用自对齐后的回复训练大语言模型;(4)对过于简略或间接的回复进行优化。

figure16
标注图源自:https://arxiv.org/abs/2305.03047

计算机视觉

EfficientViT:采用级联分组注意力的内存高效视觉Transformer(https://arxiv.org/abs/2305.07027,2023年5月11日)

EfficientViT是一款全新的视觉Transformer,在速度与精度之间实现了出色的平衡。它的性能超越MobileNetV3和MobileViT等现有高效架构,同时速度大幅提升。研究人员通过级联分组注意力实现这一成果:通过向每个注意力头输入完整特征的不同分组,减少多头自注意力层中的冗余(类似于分组卷积的思路)。

figure17
标注图源自:https://arxiv.org/abs/2305.07027

扩散模型的并行采样(https://arxiv.org/abs/2305.16317,2023年5月25日)

扩散模型通过数百到数千步的去噪扩散步骤生成高质量图像,计算成本很高。该研究没有采取减少扩散步数、牺牲质量的常规思路,而是提出在一定程度上并行执行扩散步骤。所提出的方法可将采样速度提升2-4倍,同时保持相近的图像质量。

figure18
标注图源自:https://arxiv.org/abs/2305.16317

重塑ViT:计算最优模型设计的缩放法则(https://arxiv.org/abs/2305.13035,2023年5月22日)

此前的研究主要聚焦于参数量层面的最优数据集规模和模型规模。该研究中,研究人员提出了推导计算最优模型形状(例如宽度和深度)的方法。最终得到的视觉Transformer,性能超越了规模是其两倍的模型。此外,尽管这款计算最优的小模型使用相同的计算资源预算训练,但其推理成本还不到更大模型的一半。

figure19
标注图源自:https://arxiv.org/abs/2305.13035

音频与语音

将语音技术扩展至1000+种语言(https://arxiv.org/abs/2305.13516,2023年5月22日)

Meta AI开发了一款支持约1100种语言的语音转文本模型MMS(相比之下,OpenAI的Whisper模型支持99种语言)。在FLEURS基准测试中,MMS与Whisper共同覆盖的54种语言上,Meta的MMS模型表现均优于Whisper。该模型以宽松的CC-BY-NC 4.0许可协议发布。

figure20
标注图源自:https://arxiv.org/abs/2305.13516

通用方法

Sophia:面向大语言模型预训练的可扩展随机二阶优化器(https://arxiv.org/abs/2305.14342,2023年5月23日)

Sophia是一种二阶优化算法,对于普遍采用Adam和AdamW作为主流优化器的大语言模型来说,它极具吸引力。与Adam相比,Sophia的速度提升2倍,且使用Sophia训练的模型能取得更优的建模性能。简而言之,Sophia通过梯度曲率而非梯度方差对梯度进行归一化,这是与Adam的核心区别。

figure21
标注图源自:https://arxiv.org/abs/2305.14342

仅需前向传播的大语言模型微调(https://arxiv.org/abs/2305.17333,2023年5月27日)

研究人员提出了一种内存高效的零阶优化器(MeZO),使微调大语言模型所需的内存占用与推理时相当。需要注意的是,零阶方法仅需前向传播,无需梯度信息——这与使用梯度信息的一阶方法(如SGD和Adam),以及额外使用曲率或海森矩阵信息的二阶方法形成对比。基准测试显示,采用该方法微调的大语言模型,表现优于上下文学习基线,且效果似乎优于全量微调。

figure22
标注图源自:https://arxiv.org/abs/2305.17333

Dropout可消除双下降现象(https://arxiv.org/abs/2305.16179,2023年5月25日)

双下降是指随着模型复杂度提升,模型测试误差先下降、再上升、之后又下降的现象。这篇标题玩了有趣谐音梗的论文《Dropout Drops Double Descent》,解释了为什么我们在实践中很少见到双下降现象:“以往的深度学习模型不会出现双下降场景——因为我们已经在模型中应用了Dropout这类常用的正则化方法。”

figure23
标注图左:《深度双下降》(https://arxiv.org/abs/2305.16179);右:《Dropout可消除双下降》(https://arxiv.org/abs/2305.16179)

本杂志是一项个人兴趣项目,不提供直接报酬。不过,如果您愿意支持我,可以考虑购买https://sebastianraschka.com/books 上的书籍。如果您觉得这些书籍富有洞见、有所帮助,欢迎推荐给您的朋友和同事。

figure24
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 http://mng.bz/M96o

您的支持意义重大!非常感谢!
【转载】大语言模型微调与数据集观察

原文地址:LLM Tuning & Dataset Perspectives, by Sebastian Raschka, on 2023-06-3

大语言模型微调与数据集观察

近几个月来,我们看到众多个人与企业纷纷开源各类大语言模型(LLM)与数据集,这一趋势令人欣喜。
但从研究视角来看,这更像是一场“争先发布”的竞赛(这一点可以理解),而非严谨的系统性分析。
而本月,我们终于看到了几项深入探究LLM训练原理的研究,我很期待在本期通讯中介绍其中部分项目。

尽管几个关键问题终于得到了解答:

  • 对齐大语言模型是否必须采用基于人类反馈的强化学习?
  • 在ChatGPT模仿数据上训练的大语言模型性能究竟如何?
  • 大语言模型训练是否应该采用多轮次训练?
  • ……

但正如我们即将看到的,仍有大量问题悬而未决。因此,如果你正在寻找有价值的研究方向,这些论文或许也能带来一些启发。

注:如果本期通讯显示内容被截断,是因为部分邮件服务商可能会对长邮件进行裁剪。你可以访问以下链接阅读全文:https://magazine.sebastianraschka.com

文章与行业动态

在深入介绍近期几项有趣的研究项目之前,我想再次强调LLaMA的重要意义。https://github.com/facebookresearch/llama 一再证明了自己是LLM研究领域具有里程碑意义的试验平台,凸显了开源模型对学术研究的重要价值。作为一名不隶属于任何大型科技公司的研究者,我认为:尽管与微软/OpenAI、谷歌相比,Meta的声量常常被低估,但它对AI研究社区的贡献极具影响力。截至目前,LLaMA或许是2023年最具影响力的LLM模型。

针对业务需求微调任务专属大语言模型

我们来详细了解一下Goat模型——这是一个基于7B参数LLaMA微调得到的模型,在算术任务上的表现超过了GPT-4,相关研究发表在最新论文 https://arxiv.org/abs/2305.14201 中。

首先值得注意的是,在零样本场景下,7B参数的Goat模型性能超过了参数规模约为其75倍的540B参数PaLM模型以及GPT-4——正如论文标题所宣称的那样。

figure01
Goat模型在算术问题上表现优于GPT-4。资料来源:https://arxiv.org/abs/2305.14201

它为何如此出色?Goat是一款专用的微调LLM,针对特定任务进行了专项训练。通常来说,任务专属的微调模型性能会优于GPT-4这类通用对话机器人,这是不言而喻的。但我收到了很多从业者与企业的咨询,询问是否可以用GPT-4处理所有任务。在我看来,正如这篇论文所印证的,经过良好微调的模型始终会具备性能优势。(当然,这不是第一个也不是唯一一个针对特定任务微调的LLM,类似的模型数不胜数。例如FLAN,https://arxiv.org/abs/2109.01652,可能是应用最广泛的模型之一。)

Goat模型成功的两大核心要素是:

  1. 基于优质基础LLM(此处为LLaMA),针对目标任务进行有监督微调(区别于通用预训练或指令微调);
  2. LLaMA的数字分词机制(将每个数字拆分为独立的token)。

我们如何知道这两点的结合至关重要?第一点显而易见:7B参数的LLaMA基础模型本身性能显然不如GPT-4,因此微调是使其超越GPT-4的必要条件。

但在这个案例中,仅靠微调还不够。研究人员指出,在相同数据上微调的OPT、GPT-J、GPT-NeoX和Pythia模型,表现都远不及Goat。研究人员认为,LLaMA特有的分词方案是Goat取得成功的关键因素。我认为分词是一个非常有意思却常被忽略的研究点,期待未来能看到更多关于该方向的消融实验与对比研究。

这些算术任务与业务需求有何关联?

但我们也必须直面一个核心问题:既然我们有Wolfram Alpha或者普通计算器这类功能更强、更可靠的工具,为什么还要用LLM来处理简单的算术任务?

算术任务是很好的试验平台,因为很容易生成带有真实标签的合成训练集,并且生成的回复也易于评估(相比其他自由文本生成任务)。

从“山羊”到“大猩猩”

另一个近期通过微调提升LLM特定能力的案例是 https://arxiv.org/abs/2305.15334 项目。

Gorilla是一款专门针对生成API调用进行微调的LLM(这一点GPT-4或许可以做得更好)。研究人员以LLaMA-7B为基础模型,在来自Torch Hub、TensorFlow Hub和HuggingFace的1645条API调用数据上进行了微调。经过微调的Gorilla在API调用任务上的表现优于其他未经过专项微调的LLM。

figure02
标注图出自 https://arxiv.org/abs/2305.15334

提升微调效率

上文中介绍的Goat模型采用了 https://arxiv.org/abs/2106.09685 中的方法进行微调,以提升参数效率,使得仅用单张24GB显存的GPU即可完成7B参数LLaMA模型的微调。(注:如果你想使用LoRA微调LLaMA,我们在开源仓库 https://github.com/Lightning-AI/lit-llama 中实现了该方法。)

那么,能否在单张GPU上训练65B(而非7B)参数的LLaMA模型?与LoRA相关,一种名为QLoRA(量化低秩适配的缩写)的新方法于近日发布,正好可以实现这一点。

QLoRA(量化低秩适配)是参数高效型LLM微调领域的最新成果。它降低了65B LLaMA模型的显存需求,使其能够适配单张48GB显存的GPU(例如A100)。最终得到的65B参数Guanaco模型通过4位量化训练,保持了完整16位微调的任务性能,仅经过24小时微调,就达到了ChatGPT性能的99.3%。

figure03
标注图出自 https://arxiv.org/abs/2305.14314

微调大语言模型到底需要多少数据?

对于想要微调LLM的从业者和研究者来说,获取充足的数据是另一大挑战。

近期的 https://arxiv.org/abs/2305.11206 项目,对于想要开发高性能LLM的研究者和技术爱好者来说,可能具有颠覆性意义。

在LIMA论文中,研究人员证明:仅用1000个样本对65B LLaMA模型进行有监督微调,其性能与ChatGPT / GPT-3.5这类更大的模型差距并不大。我们来详细分析一下!
研究人员发现,在57%的场景下GPT-4表现更优,但在43%的场景中,LIMA的表现与GPT-4相当甚至更优,这一结果相当亮眼。或者换个角度看,约有一半的情况下,LIMA的表现优于GPT-4的前身ChatGPT/GPT-3.5(也称为DaVinci003)。

figure04
标注图出自 https://arxiv.org/abs/2305.11206

但一个有意思的问题是:为什么LIMA的表现能大幅领先Alpaca?两者都是经过有监督微调的LLaMA模型。

首先,LIMA基于65B参数的LLaMA模型,而原始Alpaca模型基于7B参数的LLaMA基础模型。为了让对比更公平,作者使用65B基础模型复现了Alpaca的训练过程,按照原始Alpaca项目的设置,在52000个样本上进行训练。

因此我们可以得出结论:两者的性能差异本质上来源于训练集的质量——作者为LIMA精心构建了数据集,它的表现超过了在52倍数据量上训练的同规格65B LLaMA基础模型(即Alpaca)。

这是一篇非常有价值的论文。但我认为还缺少一项基准与消融研究:如果用RLHF而非有监督学习对65B LLaMA基础模型进行微调,LIMA的表现与之相比如何?

figure05
LIMA论文的更多标注图,来源:https://arxiv.org/abs/2305.11206

理性看待LLaMA类模型

尽管上文提到的LIMA论文成果喜人且令人振奋,但在此背景下,有一篇论文值得一提:https://arxiv.org/abs/2305.15717。

近几个月来,基于其他LLM(例如ChatGPT)生成的数据来微调LLM已经成为普遍做法。而在这项近期研究中,研究人员发现众包工作人员对这类所谓的“模仿模型”评价很高。但事实证明,这些模仿模型往往只是复刻了其训练数据来源的上游LLM的语言风格,而非事实准确性。

figure06
标注图出自 https://arxiv.org/abs/2305.15717

需要说明的是,LIMA论文并未使用模仿数据,而是采用了精心构建的数据集。但值得强调的是,评估方法有时可能会出现“好得不真实”的情况,因此我们亟需更多、更优质的基准测试。

基于人类反馈的强化学习的新替代方案

不久前,我们讨论过使用基于人类反馈的强化学习(RLHF)对齐大语言模型——例如ChatGPT就是采用这种方式训练的。如果你想了解更多解释与参考资料,还可以查看:
https://magazine.sebastianraschka.com/p/ahead-of-ai-6-train-differently

而近几个月,有监督微调成为了LLM微调的主流方式(比如上文提到的LIMA论文也采用了有监督微调)。

如今,https://arxiv.org/abs/2305.18290 提出了另一种替代基于人类反馈的强化学习(以及其中用于指令微调模型的近端策略优化PPO算法)的新方法。研究人员表明,RLHF中拟合奖励模型的交叉熵损失可以直接用于微调LLM。根据他们的基准测试,使用直接偏好优化(DPO)效率更高,并且在回复质量方面通常也优于RLHF/PPO。

figure07
标注图出自 https://arxiv.org/abs/2305.18290

我个人也很期待看到它在数据集效率方面与RLHF的对比,这会是一个很有意思的未来研究方向。

多轮预训练能否提升大语言模型基础模型的性能?

到目前为止,我们只讨论了微调。所有微调模型都依赖于预训练好的基础模型。因此,我们自然会问:如何才能打造更好的基础模型?

我经常自问的一个问题是:如果对大语言模型进行多轮次训练会怎样?(这里的“轮次”指完整遍历一遍训练数据集。)经典机器学习模型、深度神经网络,以及最新的视觉Transformer通常都会训练数百轮,那么通常只训练1轮的大语言模型,如果也采用多轮训练会发生什么?

这个问题终于在最新论文 https://arxiv.org/abs/2305.13230 中得到了解答。

但首先,考虑到数据量极其庞大,我们为什么要考虑对LLM进行多轮训练?事实证明,互联网上的高质量文本数据的增长速度跟不上需求。此外,如果未来受版权保护的内容被移除,数据集规模可能会进一步缩小。那么,为什么不对现有数据进行多轮训练呢?

研究结果是:多轮训练会导致过拟合。

figure08
标注图出自 https://arxiv.org/abs/2305.13230。注:该实验使用T5模型进行,以让多轮训练的计算具备可行性。

另一个有意思的结论是:随机失活(Dropout)有助于缓解过拟合(这并不意外),但根据作者的研究,权重衰减等其他技术则没有效果。顺带一提:LLaMA、Gopher、Chinchilla、GPT-3和PaLM等主流大模型都没有使用随机失活,因为它会减慢训练速度。

三个待解的开放问题

  1. 如果只重复使用像上文提到的LIMA那样的高质量数据,会怎么样?这是个很有意思的想法;直觉上这似乎合理,或许会有帮助。但坏消息是,效果可能并不明显。研究人员用维基百科数据(相对于C4数据集)做了相关实验,他们认为维基百科属于高质量数据(我也认同这一点)。但结果显示,重复使用维基百科数据进行多轮训练时,模型性能同样出现了类似的下降。
  2. 数据增强是否有帮助?目前已有多种文本增强方法,这是另一个值得未来研究的好问题。顺便说一句,这些技术包括回译、同义词替换、句子打乱,以及使用合成数据(例如由GPT-4生成),我在 https://leanpub.com/machine-learning-q-and-ai/ 中对此进行过总结。
  3. 最后,如果是微调(而非预训练)场景,情况会如何?同样的规律是否适用?(根据我的经验,进行少量轮次的微调,比如3-5轮,是有价值的,但我希望未来能看到针对这一点的严谨研究。)

更高效的视觉Transformer

这部分内容已经很长了,但计算机视觉领域也有一些有意思的进展,我想在下面简要分享。

EfficientViT:具备级联分组注意力的内存高效视觉Transformer(https://arxiv.org/abs/2305.07027,2023年5月11日)

EfficientViT是一种新型视觉Transformer,在速度与精度之间实现了极佳的平衡。它的性能超过了MobileNetV3、MobileViT等其他高效架构,同时速度大幅提升。研究人员通过级联分组注意力实现了这一点:通过向每个注意力头输入完整特征的不同分组(类似于分组卷积),减少了多头自注意力层中的冗余。

figure09
标注图出自 https://arxiv.org/abs/2305.07027

重塑视觉Transformer:计算最优模型设计的缩放定律(https://arxiv.org/abs/2305.13035,2023年5月22日)

此前的研究主要关注参数数量层面的最优数据集规模与模型规模。而在这项研究中,研究人员提出了推断计算最优模型形态(例如宽度与深度)的方法。最终得到的视觉Transformer,性能超过了两倍参数量的同类模型。此外,尽管这种计算最优的小模型使用相同的计算资源预算训练,但推理成本还不到大模型的一半。

figure10
标注图出自 https://arxiv.org/abs/2305.16317

用于序数回归的深度神经网络

最后,我想分享一篇我自己的论文,它于本周刚刚被接收:https://arxiv.org/abs/2111.08851 。

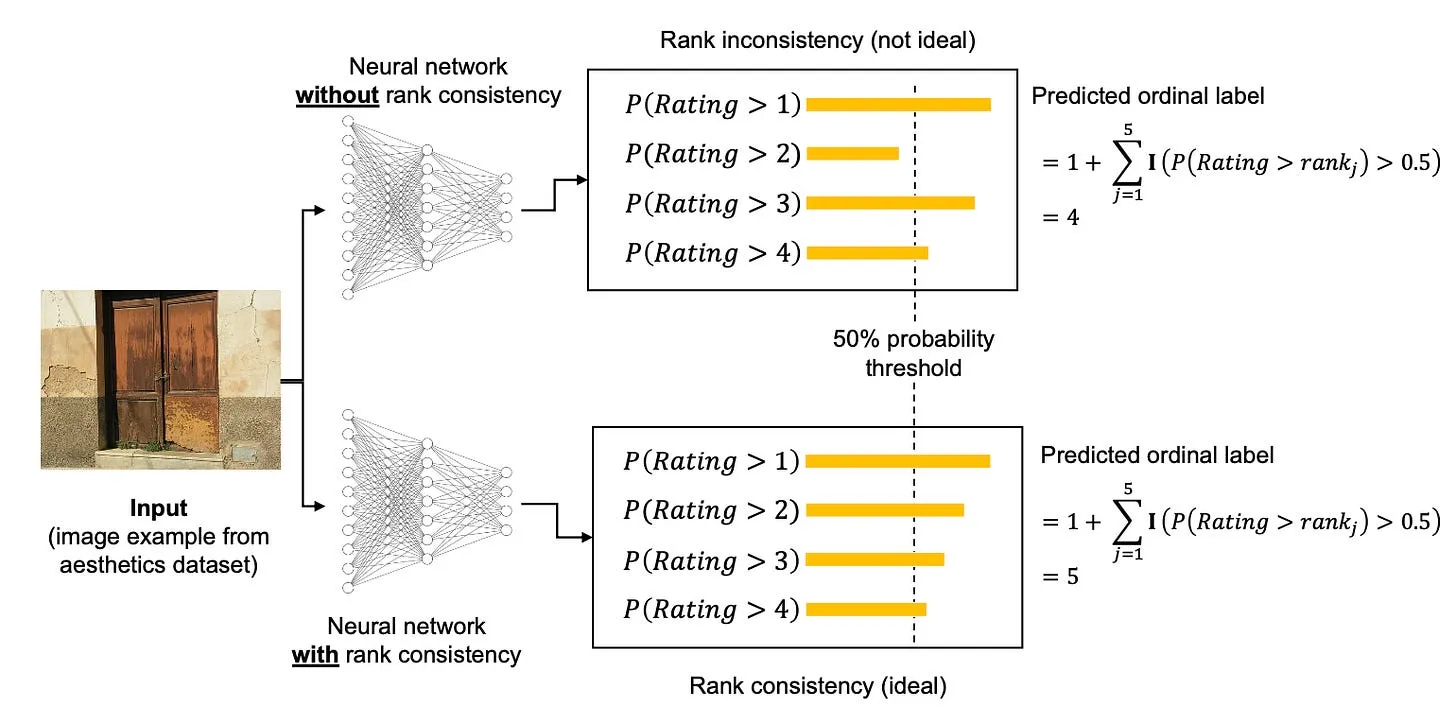
这篇论文提出了一种新的损失函数,可以将任意神经网络分类器(卷积网络、循环神经网络或Transformer)改造为处理序数数据的模型。什么是序数数据?例如亚马逊的星级评分,或者具有有序类别的疾病分级:无 < 轻微 < 中度 < 严重。

figure11
用于秩一致序数回归的深度神经网络,来源:https://arxiv.org/abs/2111.08851

当然,相关代码参见:https://github.com/Raschka-research-group/coral-pytorch/blob/main/docs/tutorials/pytorch_lightning/distilbert-corn-tripadvisor.ipynb 。

三句话以内的研究亮点

和往常一样,这个月我还接触到了很多其他有意思的论文。当然,在这篇已经很长的通讯里,我无法全部分享。所以和上次一样,下周我会单独整理一份更多研究亮点的清单。在此期间,如果你感兴趣,可以查看上一期的清单:
https://magazine.sebastianraschka.com/p/ai-research-highlights-in-3-sentences

人工智能风险与监管

讨论最新的AI风险与监管动态是绕不开的话题。当前的争论集中在几个热点议题上:AI是否存在生存性风险?AI是否会造成其他类型的伤害,是否应该被监管?应该如何监管AI以降低风险与伤害?在尊重版权数据的前提下,使用互联网数据训练AI应用的边界在哪里?

多位AI研究者与专家参与了AI风险相关的辩论。一些最顶尖、最有成就的AI研究者,比如杨立昆(Yann LeCun)、赵京炫(Kyunghyun Cho)以及Andrew Ng,对AI相关的担忧持否定态度:
https://venturebeat.com/ai/titans-of-ai-industry-andrew-ng-and-yann-lecun-oppose-call-for-pause-on-powerful-ai-systems/
https://venturebeat.com/ai/top-ai-researcher-dismisses-ai-extinction-fears-challenges-hero-scientist-narrative/

与此同时,另一些顶尖研究者,包括杰弗里·辛顿(Geoffrey Hinton)和约书亚·本吉奥(Yoshua Bengio),则表达了担忧:
https://apnews.com/article/ai-danger-superintelligent-chatgpt-hinton-google-6e4992e7a87d5bcae787ad45545757db
https://yoshuabengio.org/2023/05/22/how-rogue-ais-may-arise/

此外,https://www.axios.com/2023/05/17/ai-leaders-sam-altman-regulate-senate 报道了山姆·奥特曼在美国参议院听证会上的发言。而作为对欧盟监管计划的回应,https://www.theverge.com/2023/5/25/23737116/openai-ai-regulation-eu-ai-act-cease-operating 称OpenAI可能停止在欧盟运营(有夸张版本的评论称,奥特曼的表态是因为 https://www.reuters.com/technology/openai-may-leave-eu-if-regulations-bite-ceo-2023-05-24/ 。)

最后,https://technomancers.ai/japan-goes-all-in-copyright-doesnt-apply-to-ai-training/#more-642 指出,日本将不会对AI训练所用数据强制执行版权限制。

本月引语

“监管我们的力度要大到让其他人难以竞争。”
—— https://twitter.com/mmbronstein/status/1661654737488322560?s=20,OpenAI首席执行官山姆·奥特曼在出席 https://www.judiciary.senate.gov/committee-activity/hearings/oversight-of-ai-rules-for-artificial-intelligence 听证会之后的发言。

深度学习基础课程:提升训练性能与后续方向

我的 https://lightning.ai/pages/courses/deep-learning-fundamentals/ 课程的最后两个单元终于全部上线了!
例如,在这两个单元中,你将学习如何使用混合精度训练、分布式多GPU训练范式、模型编译等方法,更快地训练PyTorch模型。

figure12
第9单元截图,来源:https://lightning.ai/pages/courses/deep-learning-fundamentals/9.0-overview-techniques-for-speeding-up-model-training/

我开设这门课程的目标,是用开源库提供一套现代化的深度学习与AI学习路径。此外,我力求内容简洁,同时又超出大学课程的常规主题范围。

对我而言同样重要的是,课程纳入了很多在实践中极具价值的重要主题:学习率调度器、混合精度训练、分布式多GPU训练策略等等!

如果你一直在跟着学习,希望你享受这段从反向传播到用PyTorch实现计算机视觉模型与大语言模型的学习之旅!

制作这门课程付出了很多努力,但也充满乐趣!如果你喜欢这门课并从中有所收获,我会非常开心!欢迎在GitHub的 https://github.com/Lightning-AI/dl-fundamentals 仓库中提出任何问题。如果你能将它分享给你的同事,我会万分感激。

开源亮点

GPT4All —— 一款免费、本地运行、注重隐私的对话机器人

https://gpt4all.io/index.html 是一款可以在本地电脑上运行的类ChatGPT对话工具——无需GPU,也无需联网。根据 https://github.com/nomic-ai/gpt4all 中分享的技术报告,该模型是一个7B参数的LLaMA模型,通过低秩适配(LoRA)技术,在约100万条由GPT-3.5-Turbo OpenAI API生成的提示-回复对上微调得到。

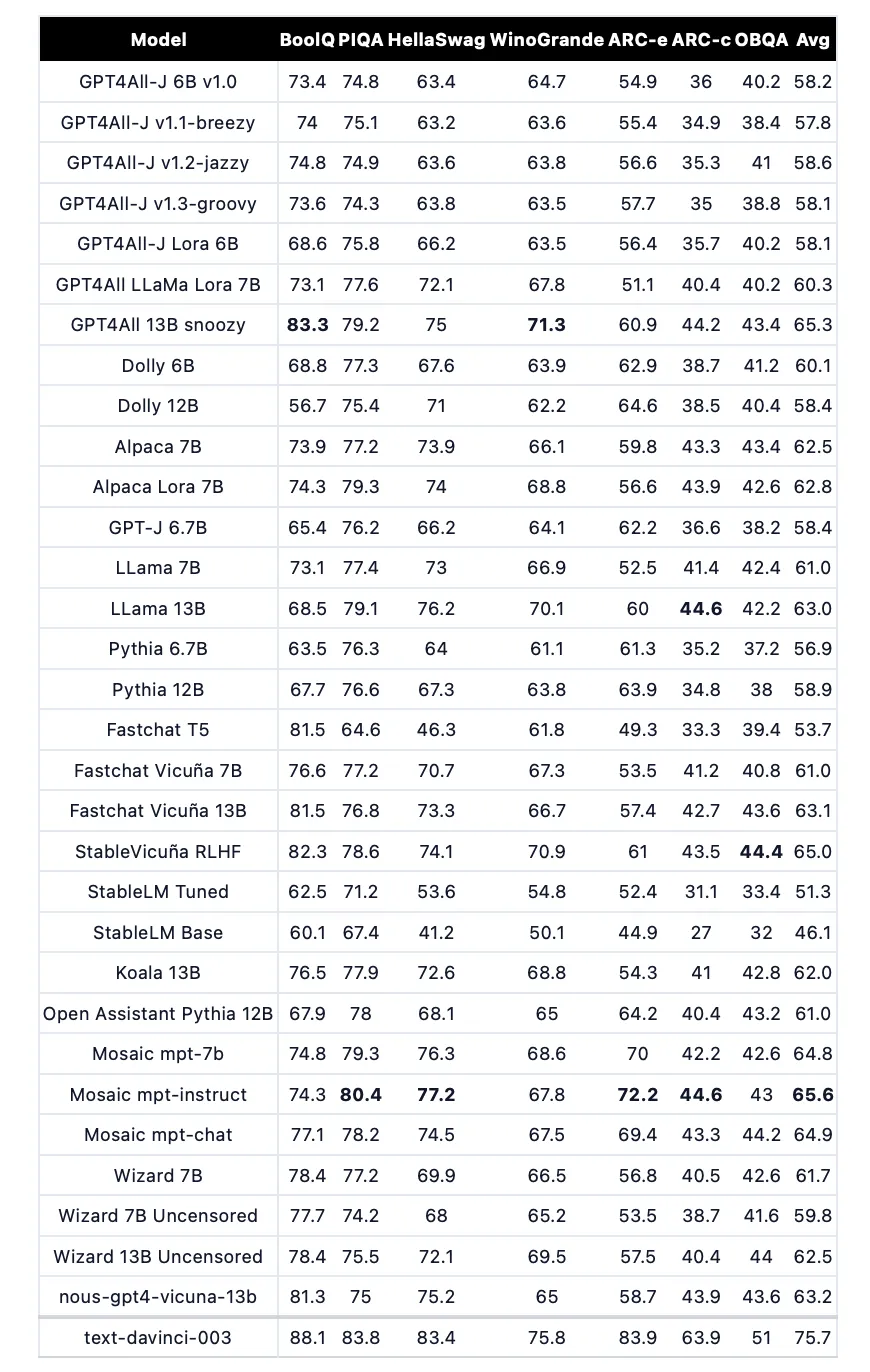
对大多数用户来说,GPT4All程序本身可能是最大的亮点,但我也很欣赏下方详细的性能基准表,它整理了当前最主流的指令微调LLM,非常实用。

figure13
资料来源:GPT4All性能基准表,出自https://gpt4all.io/index.html

Falcon 40-B —— 一款引发许可争议的新型大语言模型

技术创新研究院(TII)开发并发布了 https://huggingface.co/tiiuae/falcon-40b ,根据 https://huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard 的排名,它的性能超过了StableLM、LLaMA和MPT。

起初,Falcon 40-B的许可证颇具争议:它要求用户向Falcon开发者披露财务信息,并且当收入超过100万美元时,需分享10%的收益。这一许可证在社交媒体上引发了激烈讨论,因此开发者改变了立场,最终在一周后将许可证更改为常规的Apache 2.0开源许可证。

在我看来,开发者要求自己的辛勤工作获得回报是完全合理的。但我认为,引发激烈讨论的原因在于它当初被贴上了“开源”的标签。

此外,该许可证过于复杂,而且要求向Falcon开发者披露财务信息,对大多数企业和用户来说都是无法接受的。在我看来,固定的一次性费用或者订阅费会是更友好的使用方式。当然,最终以Apache 2.0协议开源该模型就更好了,这绝对是个好消息!

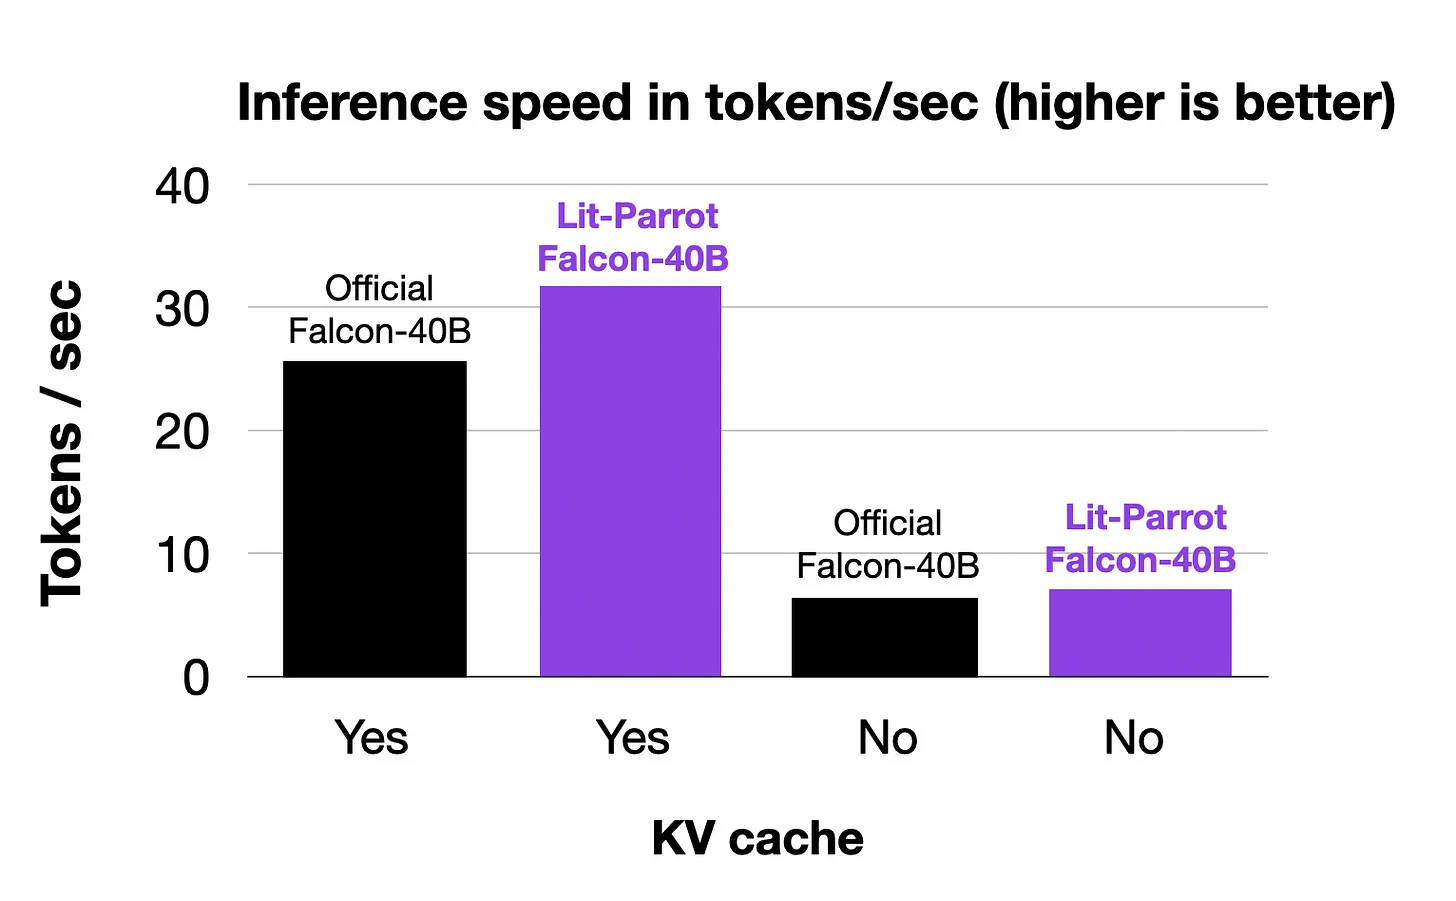
注:Falcon-40B现在也已在 https://github.com/Lightning-AI/lit-parrot 中得到支持(lit-parrot是 https://github.com/Lightning-AI/lit-llama 仓库的姊妹仓库,用于支持非LLaMA架构的大语言模型。)

figure14
在128个样本上测试的Int-4量化Falcon模型,数据来源:https://huggingface.co/tiiuae/falcon-40b 与 https://github.com/Lightning-AI/lit-parrot

支持上千种语言的新型语音转文字模型

你们中有些人可能知道,我很喜欢 https://github.com/openai/whisper 模型,我所有教学视频的字幕都是用它生成的。

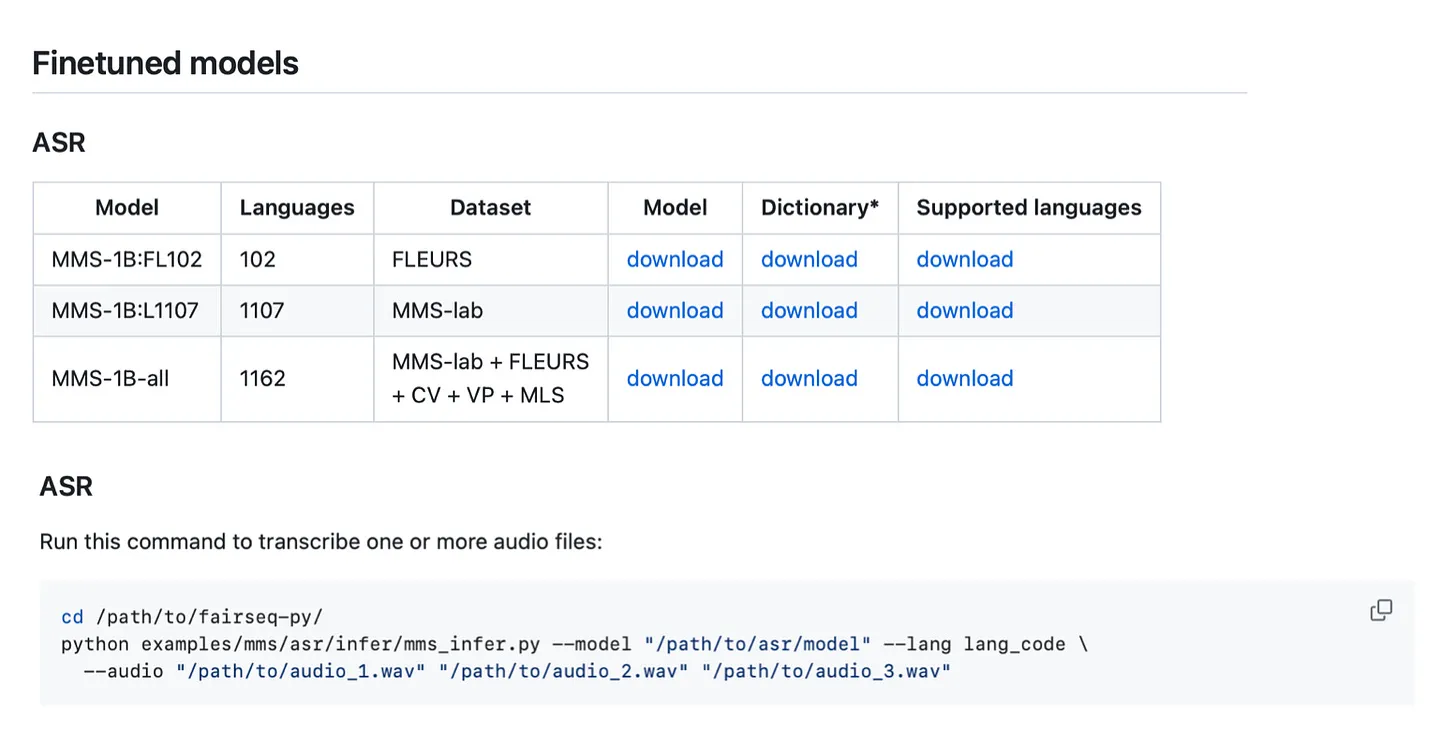
现在Meta AI推出了一款替代方案,名为 https://github.com/facebookresearch/fairseq/tree/main/examples/mms 。令人惊叹的是,MMS支持约1100种语言(相比之下,OpenAI的Whisper模型支持99种)。根据 https://arxiv.org/abs/2305.13516 中的基准测试,在MMS与Whisper共同覆盖的54种语言的FLEURS基准测试中,MMS模型的表现全部优于Whisper。该模型采用宽松的CC-BY-NC 4.0许可证发布,项目地址:https://github.com/facebookresearch/fairseq/tree/main/examples/mms 。

figure15
MMS模型使用示例,来源:https://github.com/facebookresearch/fairseq/tree/main/examples/mms

Watermark 2.4现已支持GPU信息显示

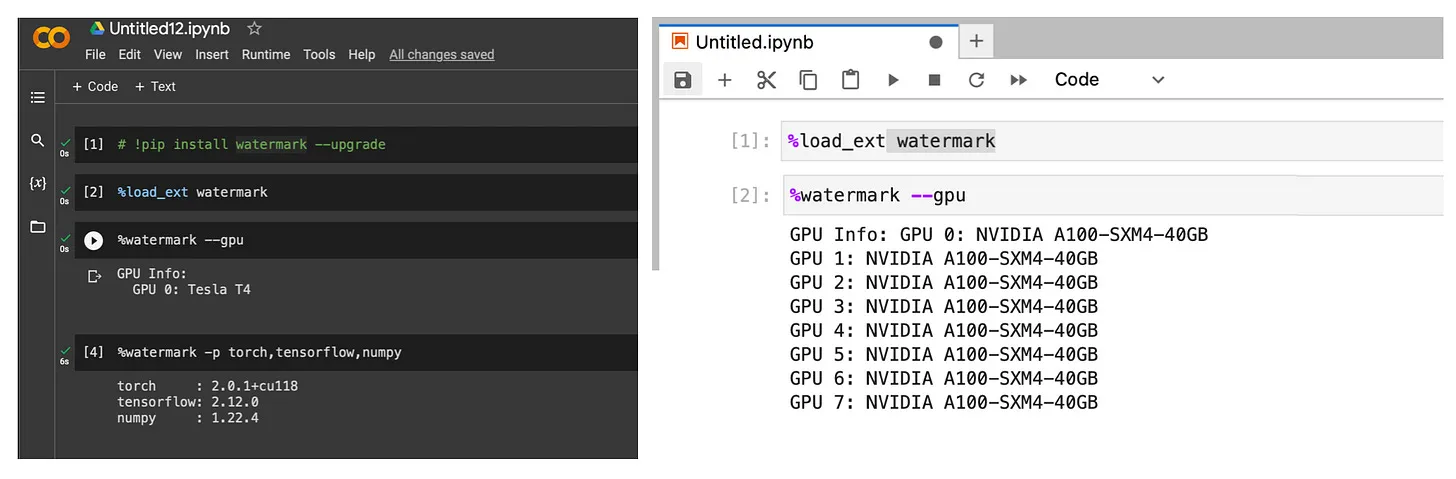
https://github.com/rasbt/watermark 是我开发多年的一个小型开源库。我(以及很多其他人)在开发和分享Python脚本、Jupyter笔记本时,用它来打印计算环境与包版本信息,以保证可复现性。简而言之,最新的2.4版本新增了--gpu参数,可以显示GPU硬件信息。你可以通过以下命令安装或升级到最新版本:

pip install watermark --upgrade

figure16
Watermark 2.4的–gpu参数效果,来源:https://github.com/rasbt/watermark

这本通讯是我的个人兴趣项目,不提供直接报酬。不过,如果你愿意支持我,可以考虑购买一本 https://sebastianraschka.com/books 中的书籍。如果你觉得它们有深度、有帮助,也欢迎推荐给你的朋友和同事。

figure17
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 http://mng.bz/M96o

你的支持对我意义重大!非常感谢!