数据库分类汇总
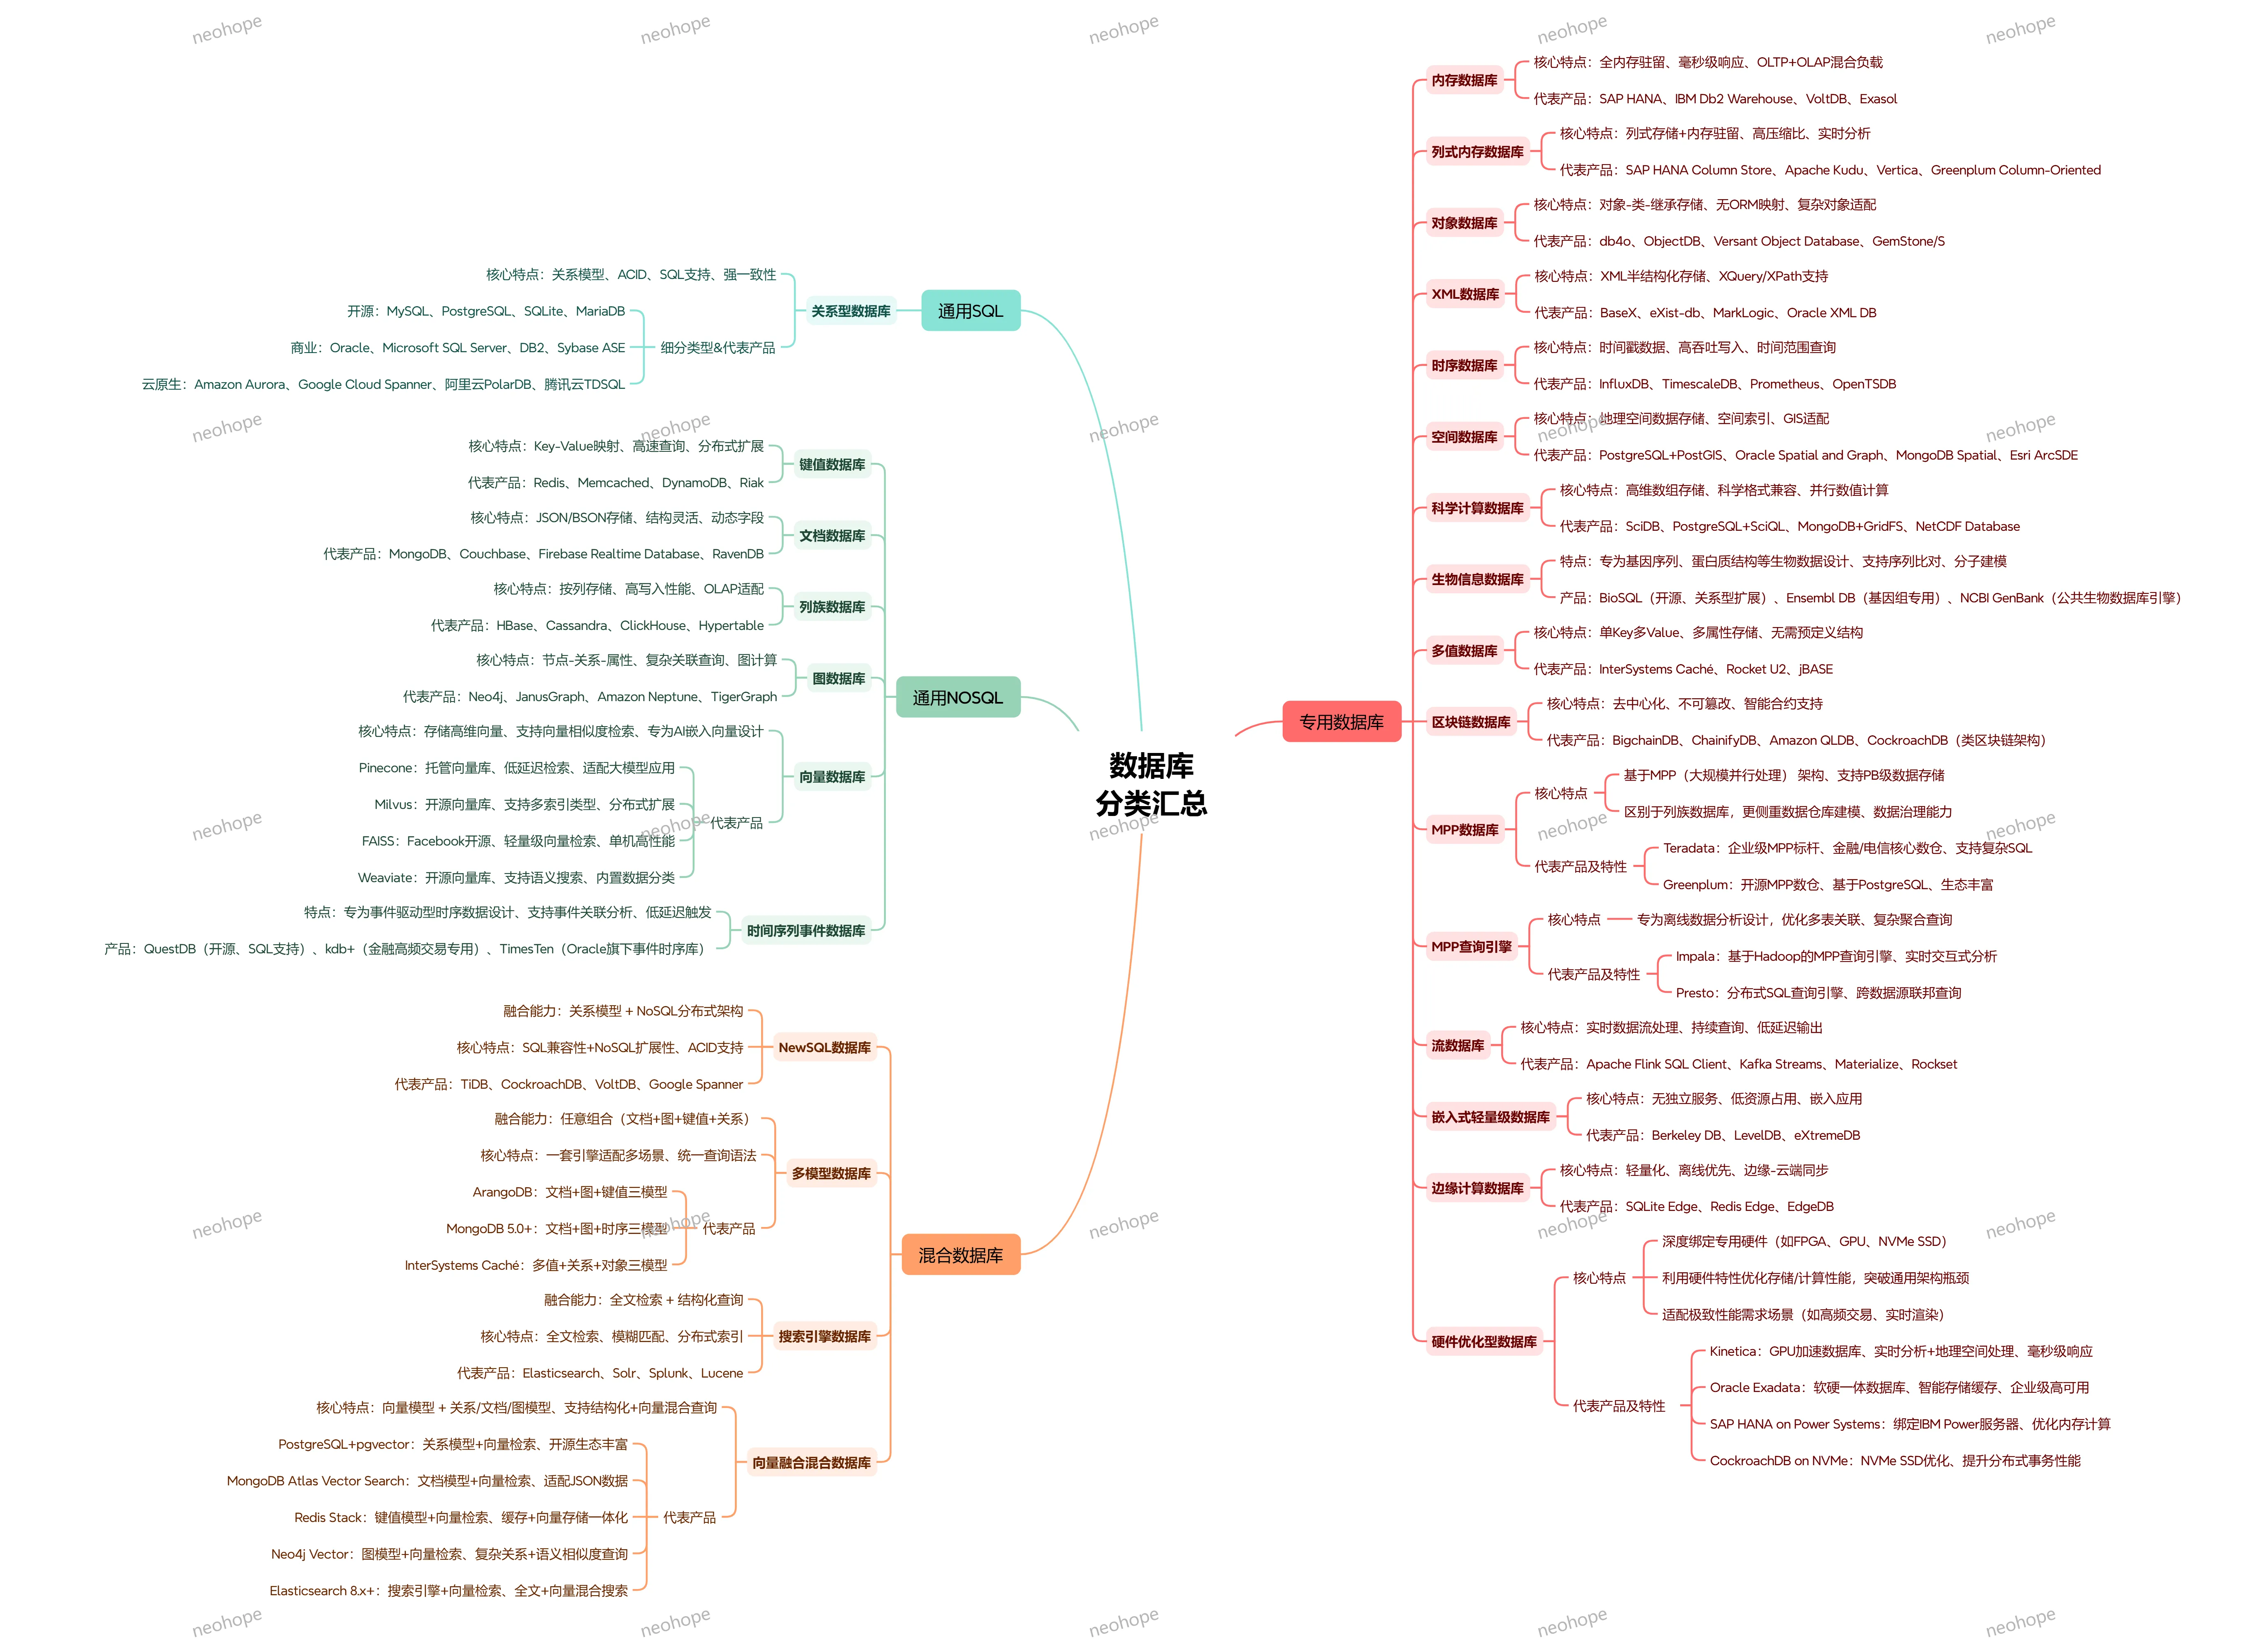
Learn and share.
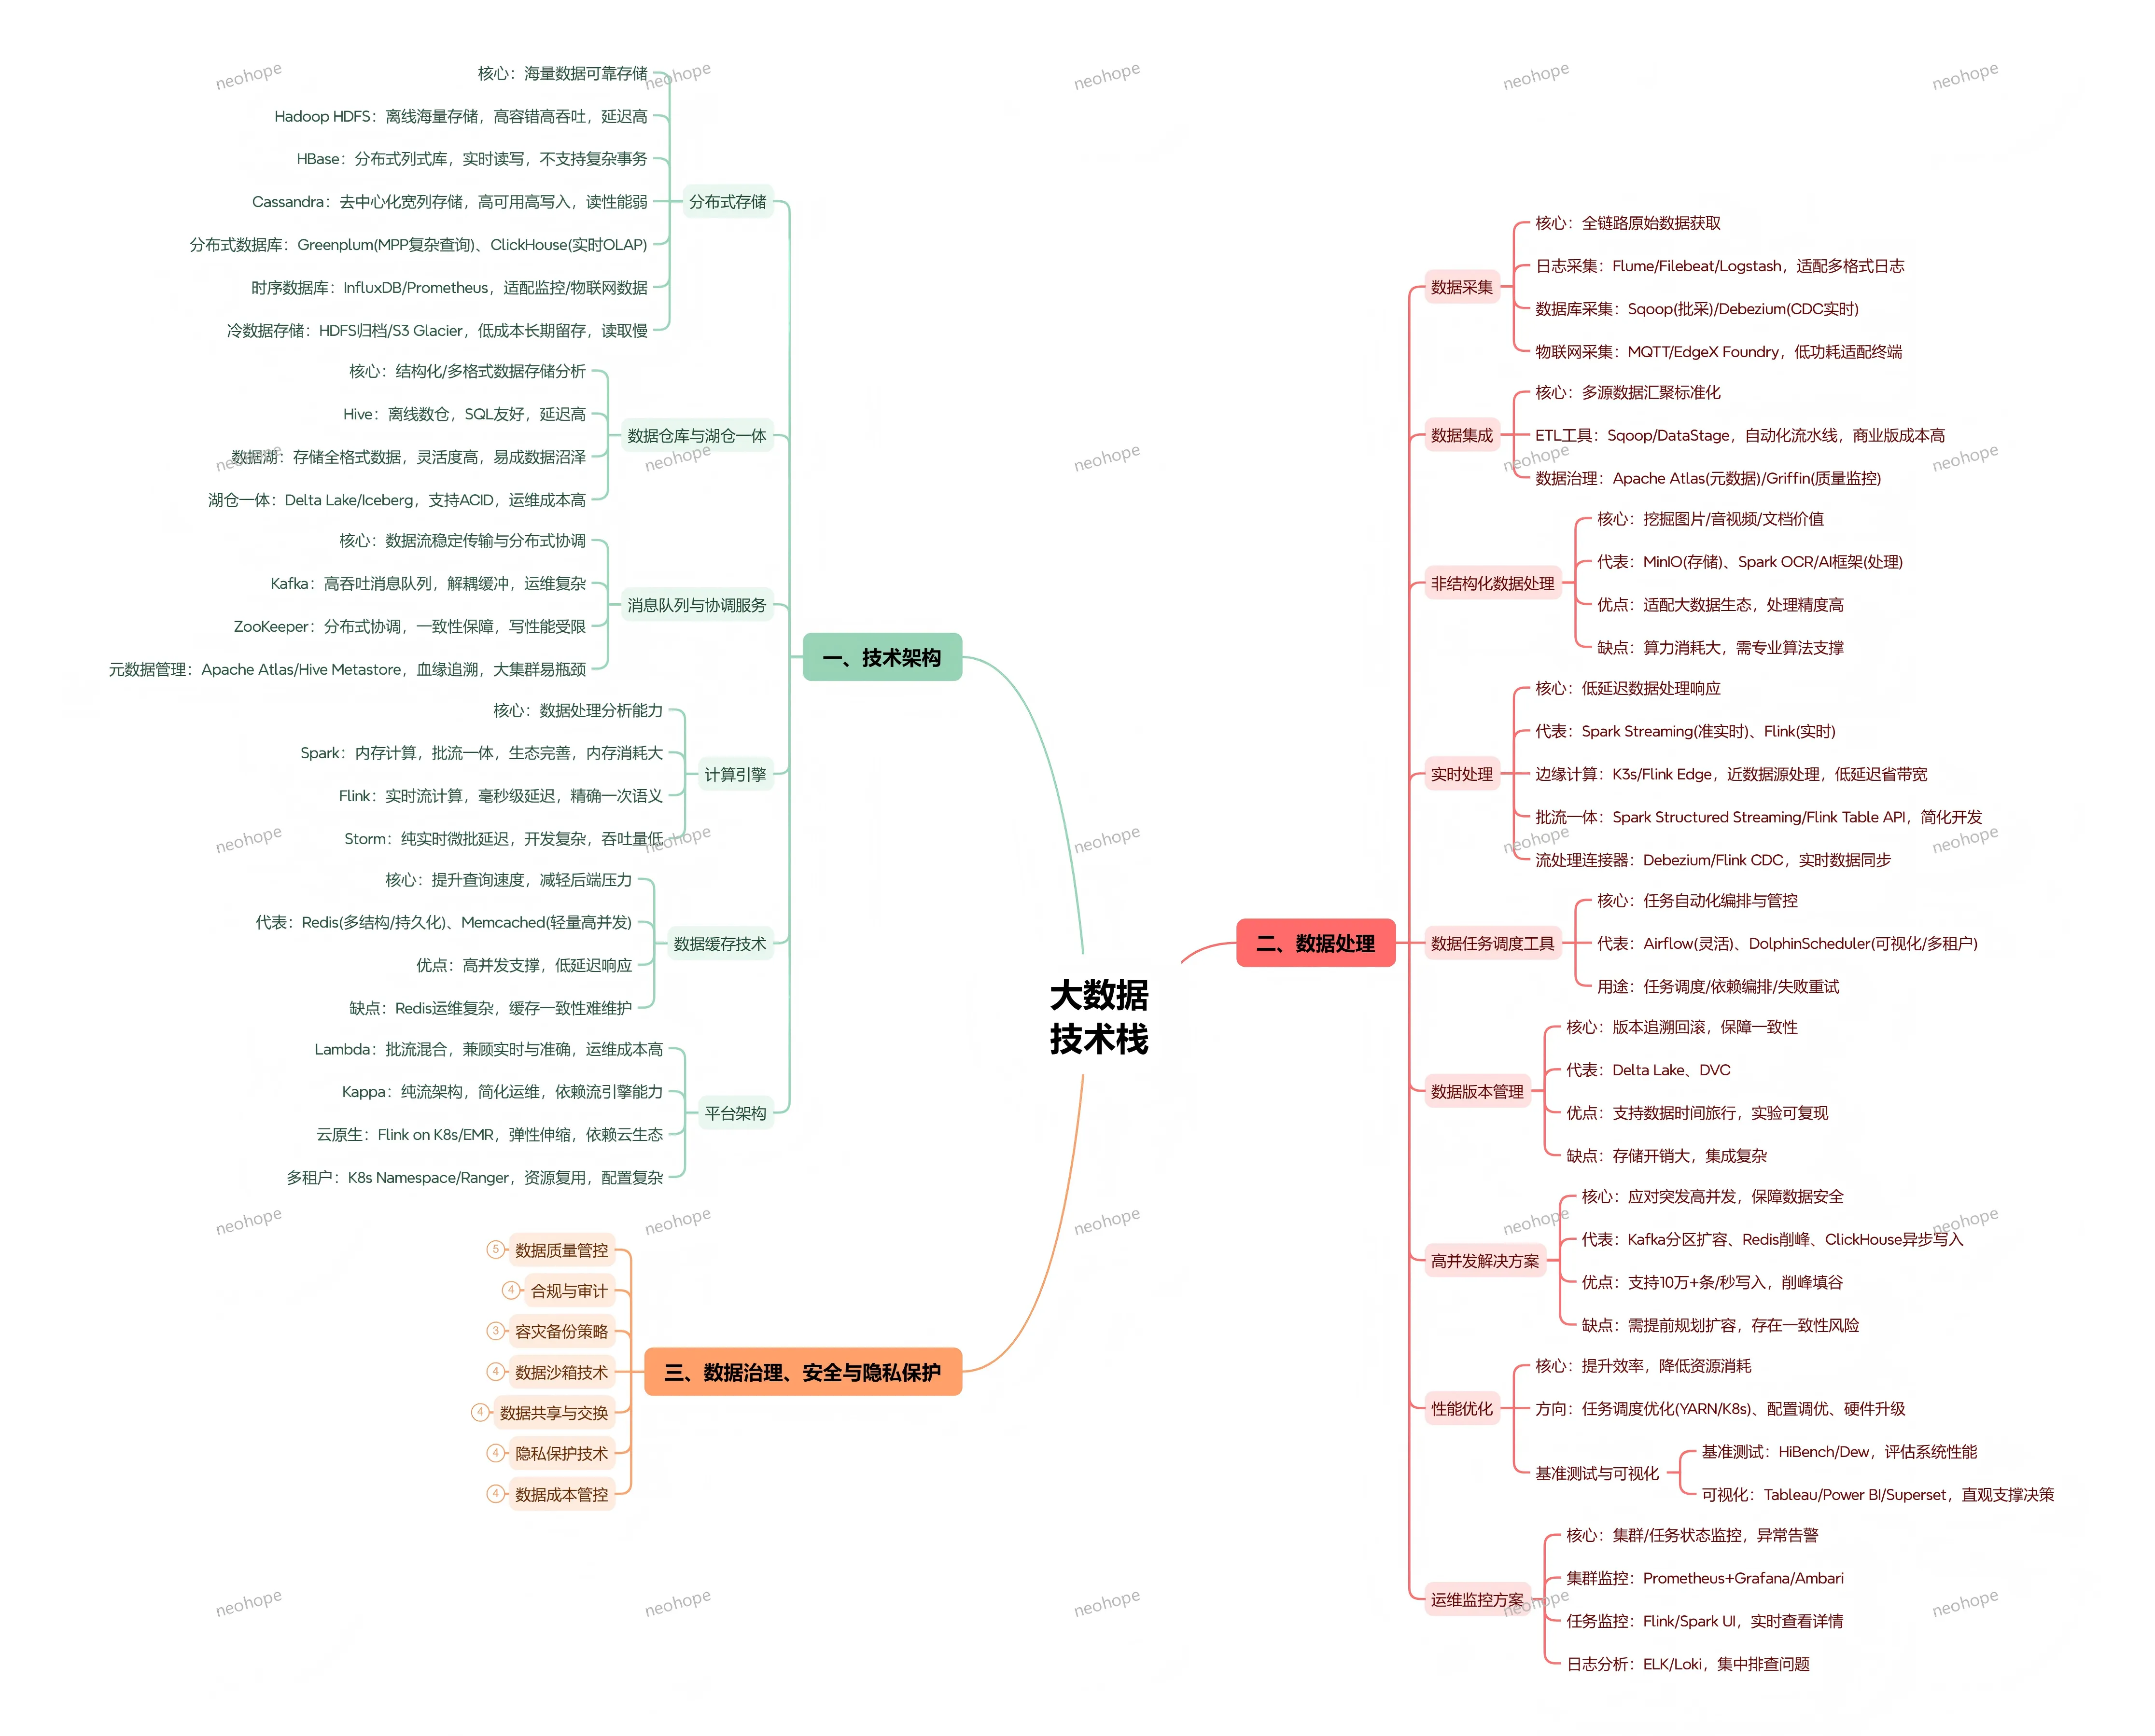
大数据技术栈是支撑海量、多源、异构数据完成从采集、存储、处理、分析到价值落地全生命周期的技术体系,核心解决传统技术无法应对的 “大容量、高速度、多类型” 数据处理难题,整体可分为技术架构、数据处理流程、治理与安全三大核心板块,当前正朝着湖仓一体、批流融合、云原生化的方向持续演进。
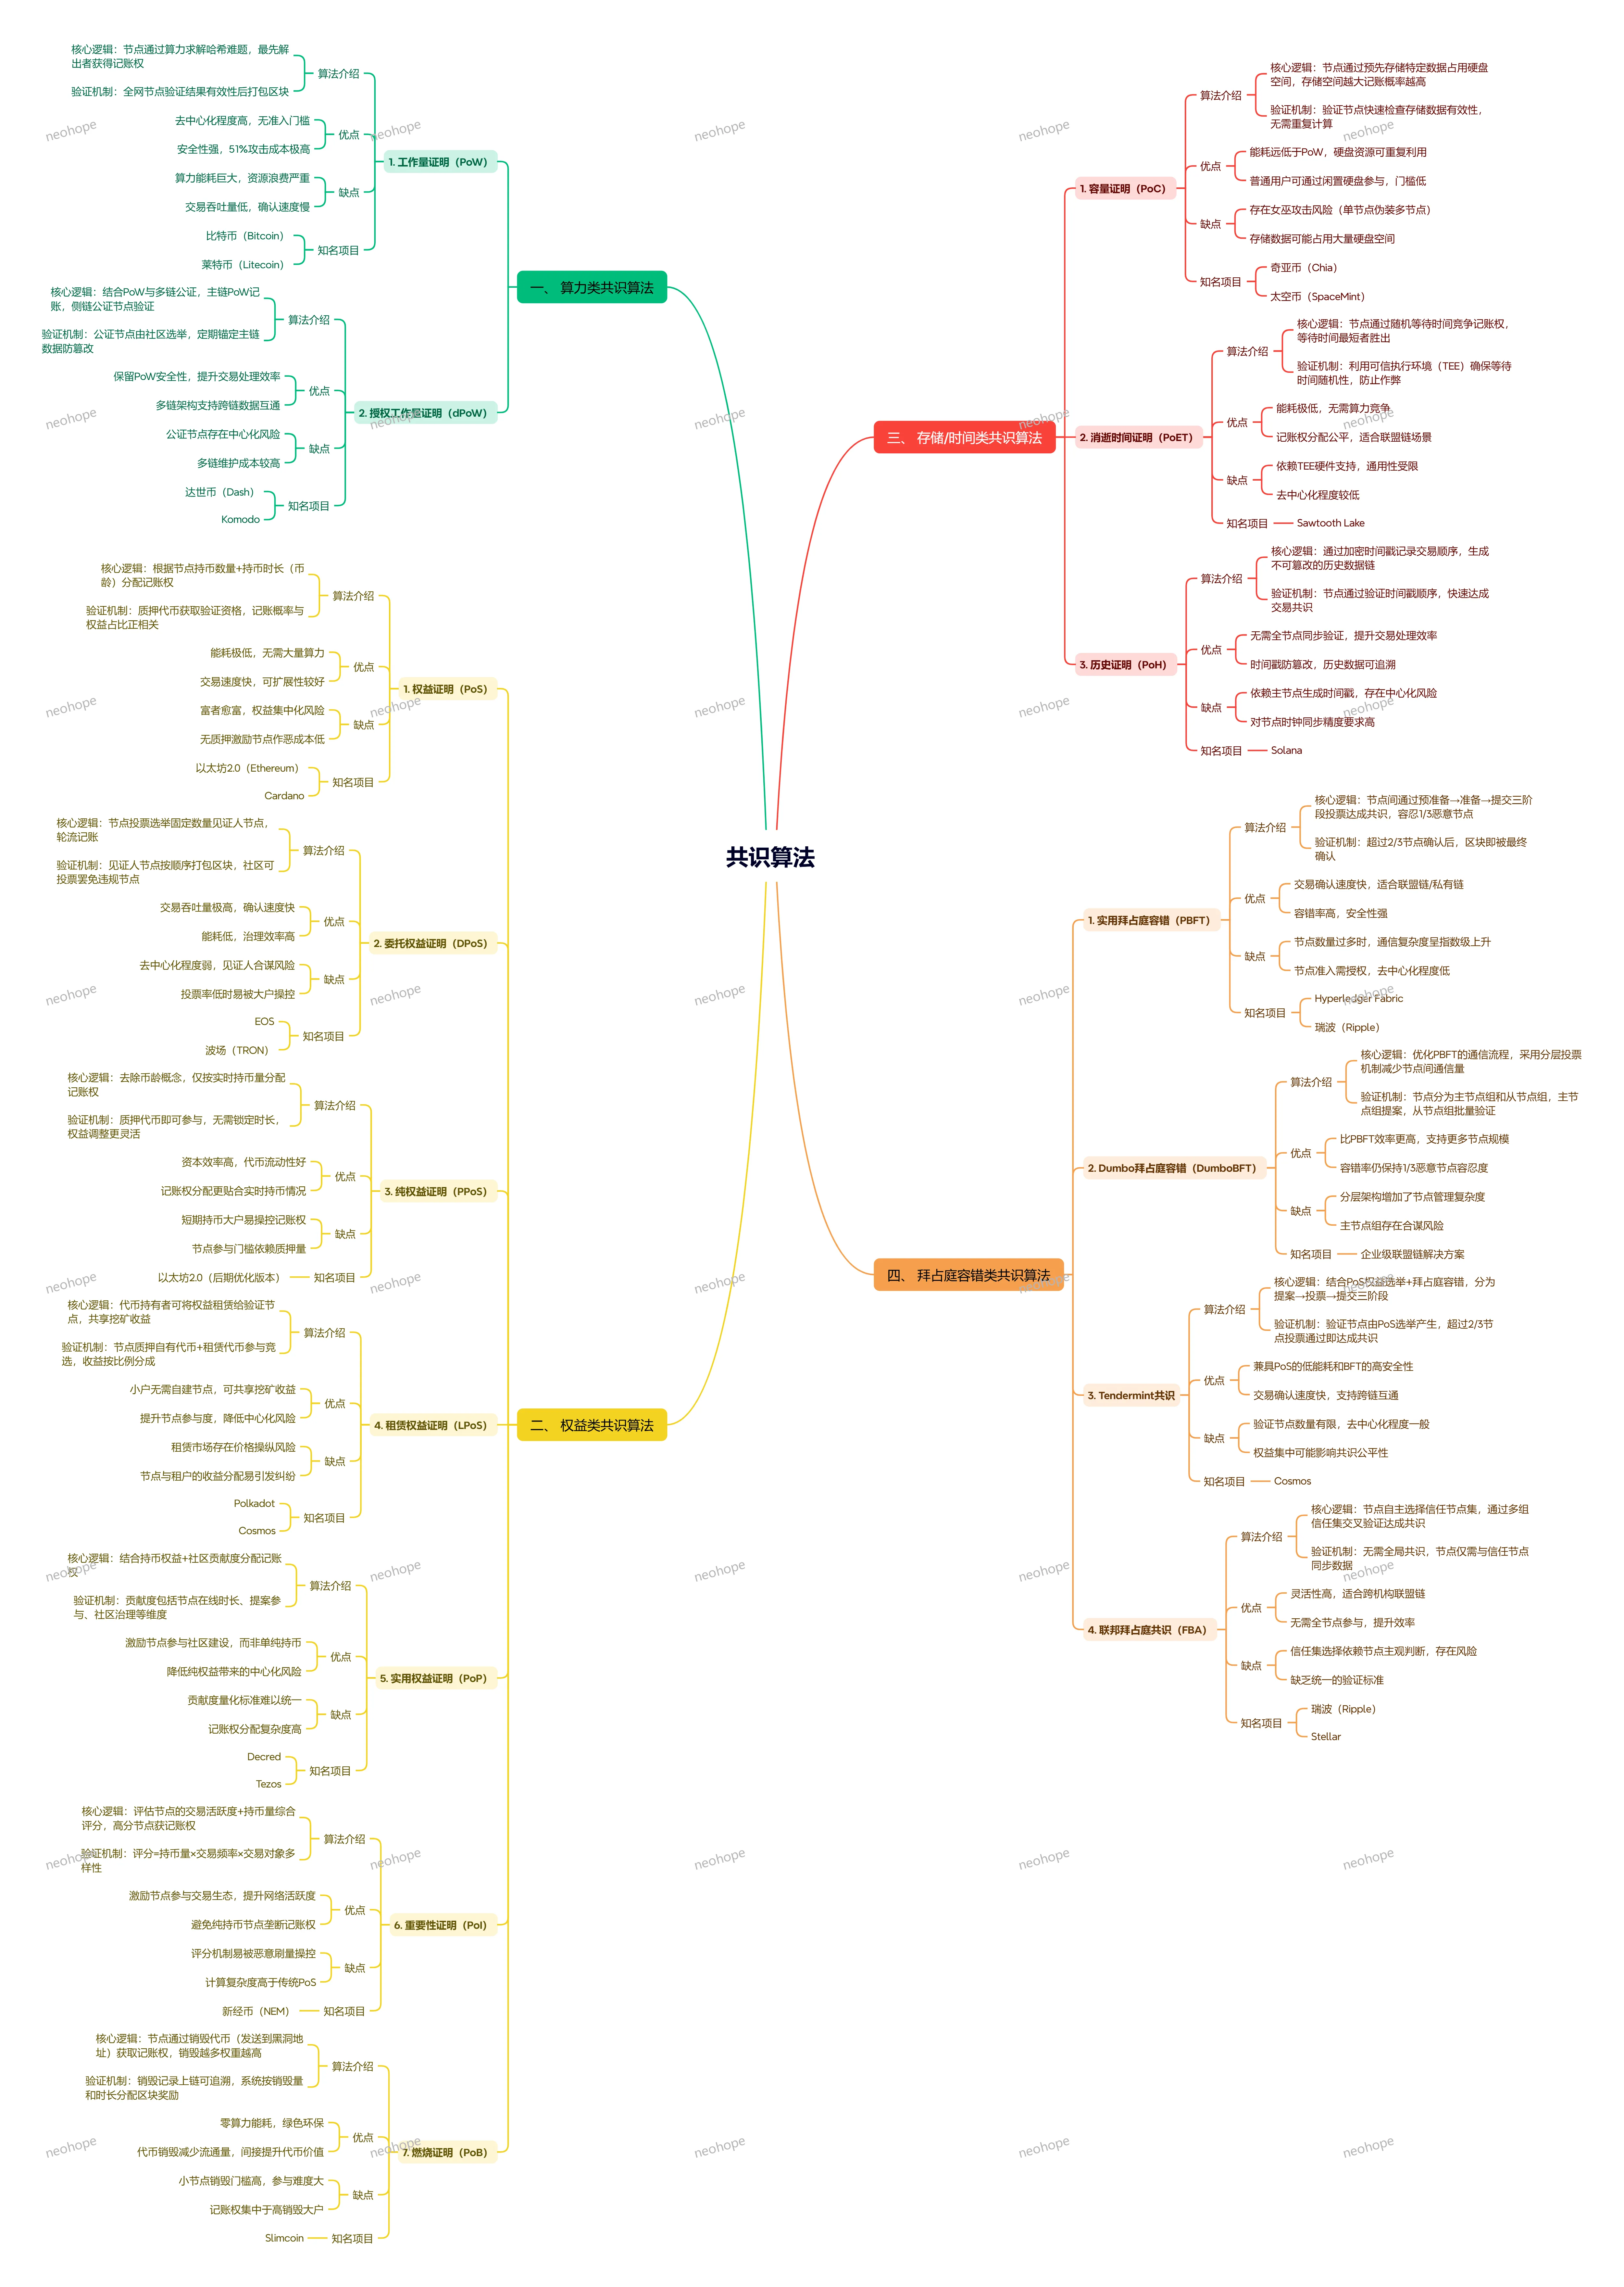
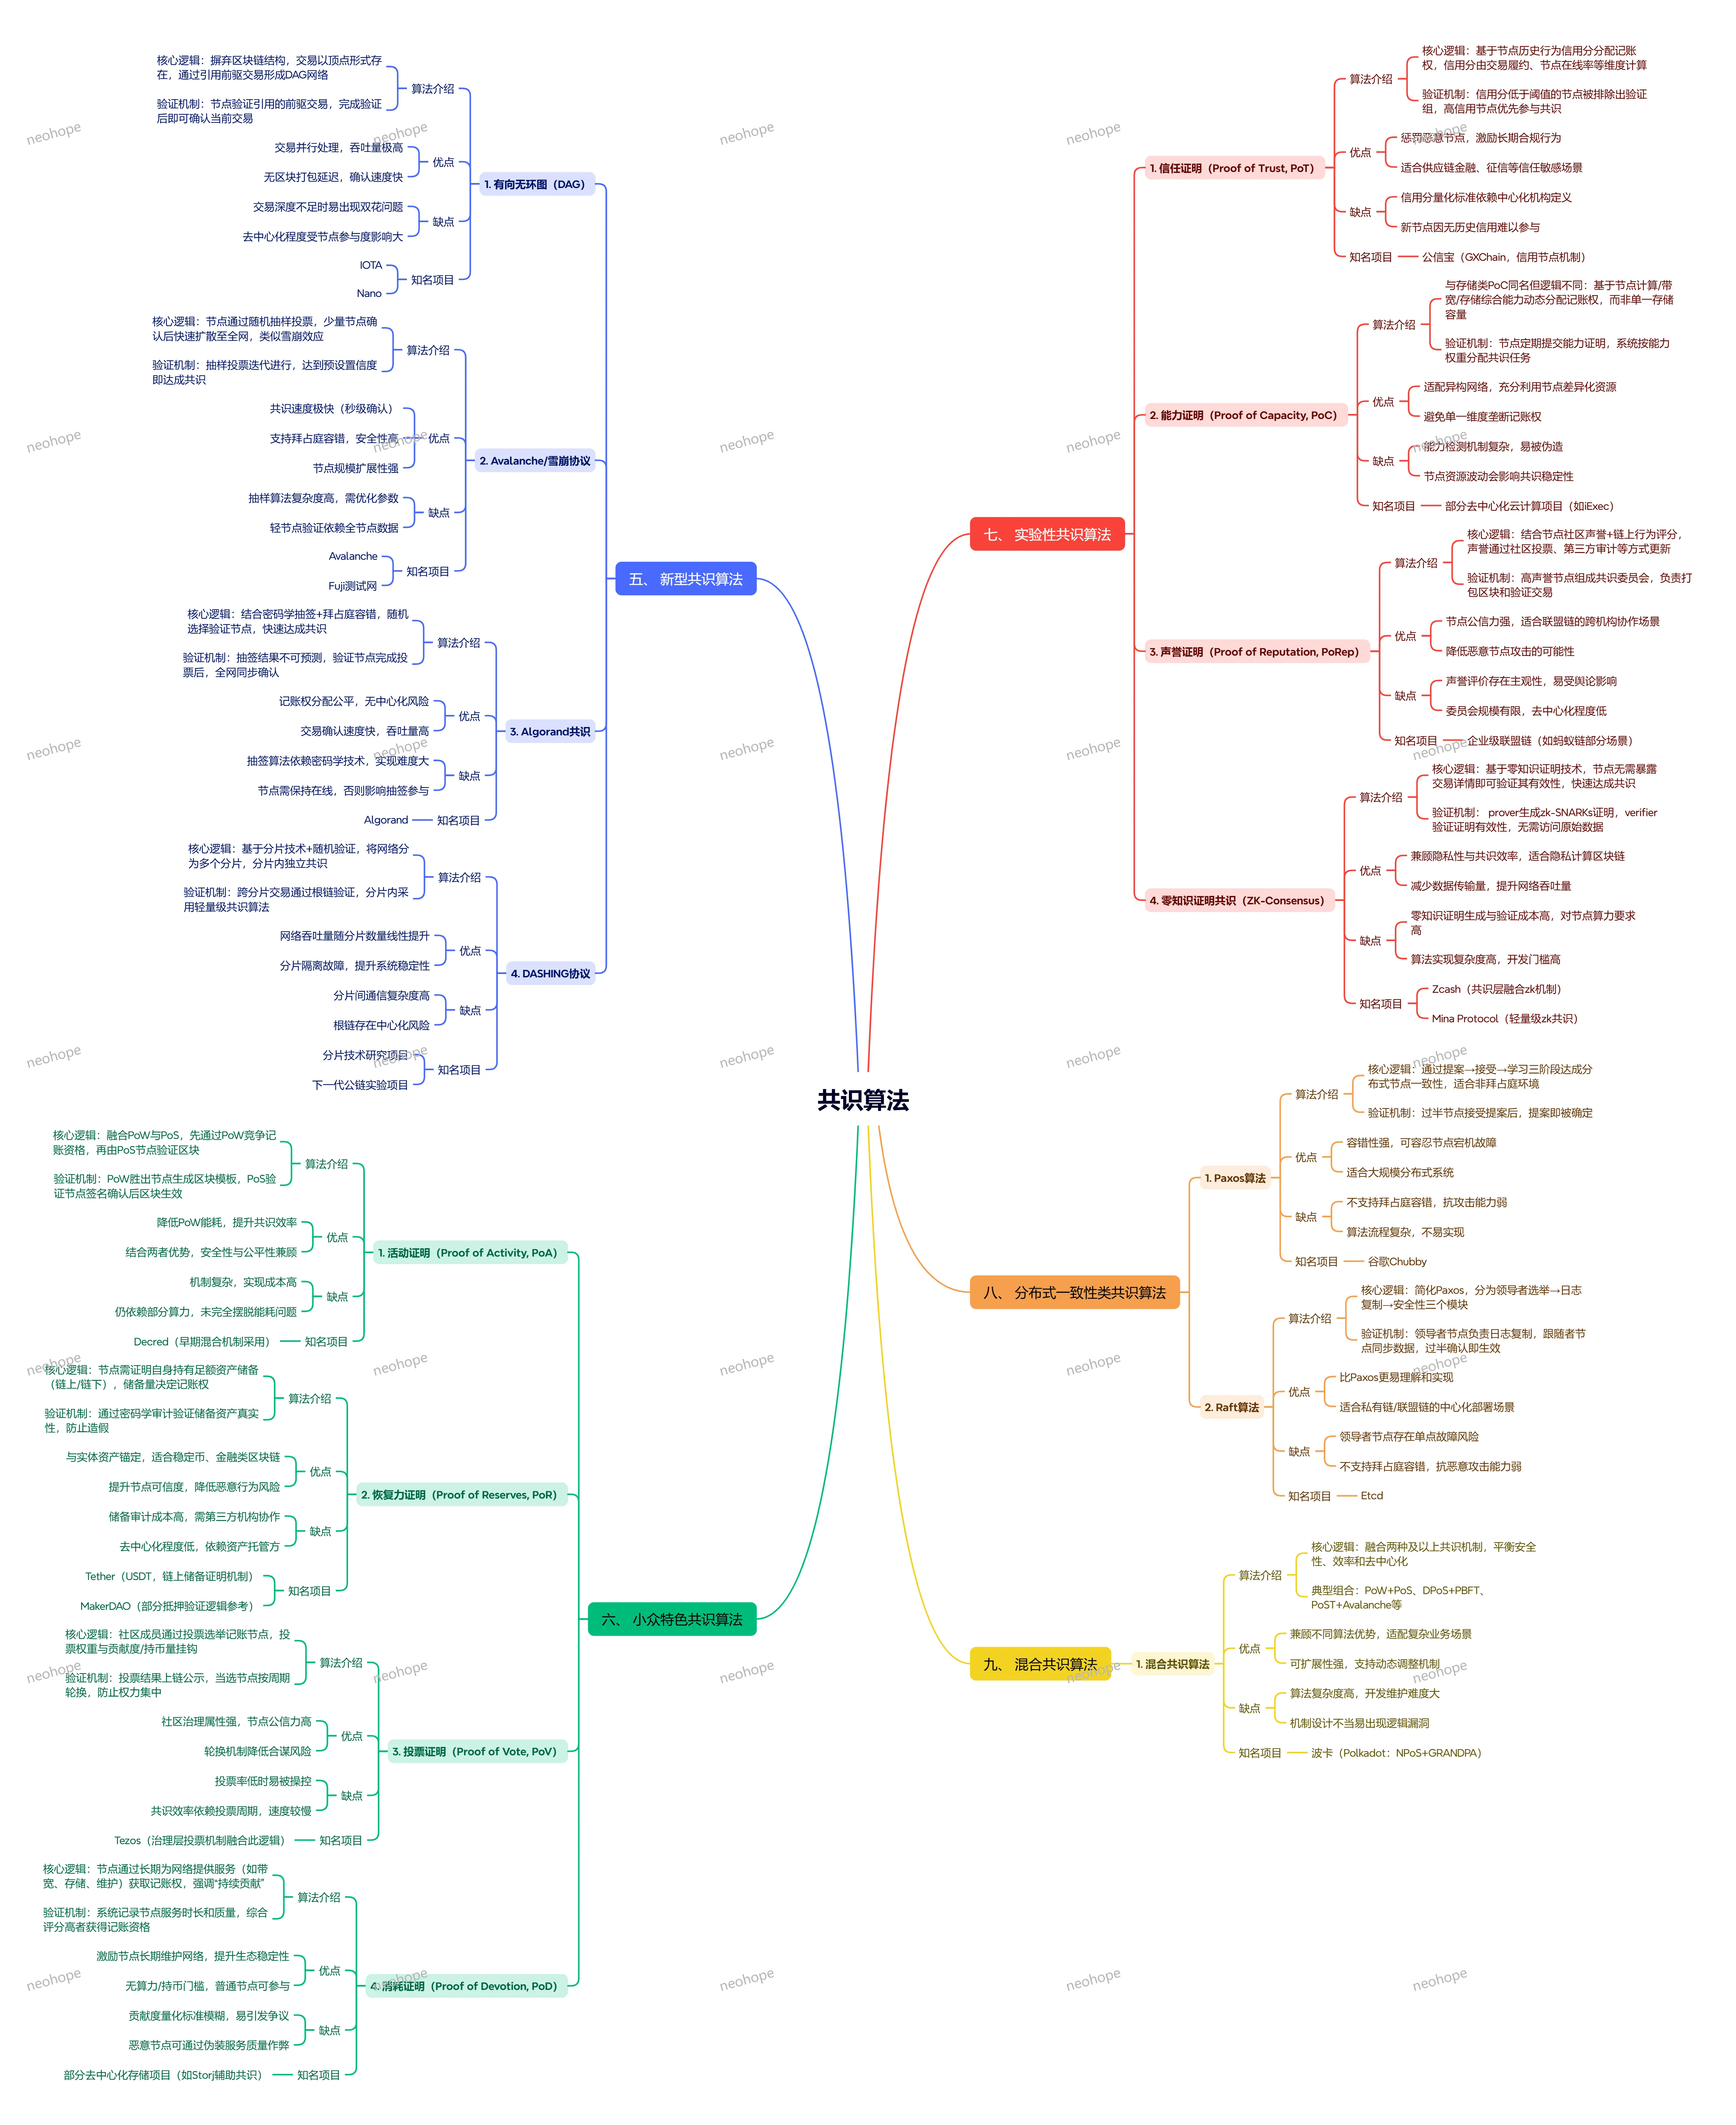
在分布式系统中,多个节点要协同工作,最核心的问题是 “如何达成一致”—— 比如区块链的交易确认、分布式数据库的数据同步、集群节点的状态统一。而共识算法,就是解决 “信任问题” 的核心技术:让互不信任的节点,在无需中心化权威的情况下,对数据或决策达成统一认知。今天就拆解主流共识算法的核心逻辑、适用场景与优劣,帮你理清 “不同系统该选哪种共识”。
一、上限太低
分析:当产品只能通过降低客户成本来证明价值时,定价就难以突破成本节约的边界。
举例:一件事情,客户成本为1000万,物理极限可以做到800万,那该产品理论最高的天花板就是200万。但总要让利给客户吧,那就收一半100万。
结局:客户第二年还会要你降价,同行也会竞相压价,于是第二年到了80万。一路走低,直接到你的盈亏平衡点,大家都没得赚。
二、投产难以衡量
分析:客户降本第一年看得到,第二年就成了应该。而所谓的效率提升,价值很难量化。再加上软硬件成本,投产并不一定划算。
举例:客户买了一个AI的提效工具,把员工每天10个小时的工作,压缩到了8个小时,那客户获得了什么?同时还要买软件、买云服务器、雇运维人员等,又是一堆投入。
结局:客户没看到收益,但投入增加了。说好的降本增效,结果成了增加成本,公司效益并没实际提升。
三、降的过程,阻力重重
分析:降本往往意味着裁员或削减部门预算,阻力重重
举例:一个软件服务公司,能降的最大成本无非是人和云的费用。降本不裁员、不减少云的投入,根本看不到明显的降幅。
结局:人减少了,云投入减少了。做后大家一总结,有没有这个产品,其实降本都达成了。
四、降的趋势,难以持久
分析:降本增效有物理极限的,接近极限后,就难以有大的成绩了
举例:第一年效果显著,第二年效果尚可,第三年后只能保持,越来越难
结局:客户获得感越来越低,要么降价,要么被扫地出门
一个真实的例子是,一个技术团队,通过大量的努力,用了各种各样的技术和非技术手段,将云费用压降了60%,人力费用压降了75%,很了不起对不对。但到了第三年末,在谈预算的时候,财务对该团队的期望是略有增长、保持现状、还是继续可以看到一个显著的降幅呢?
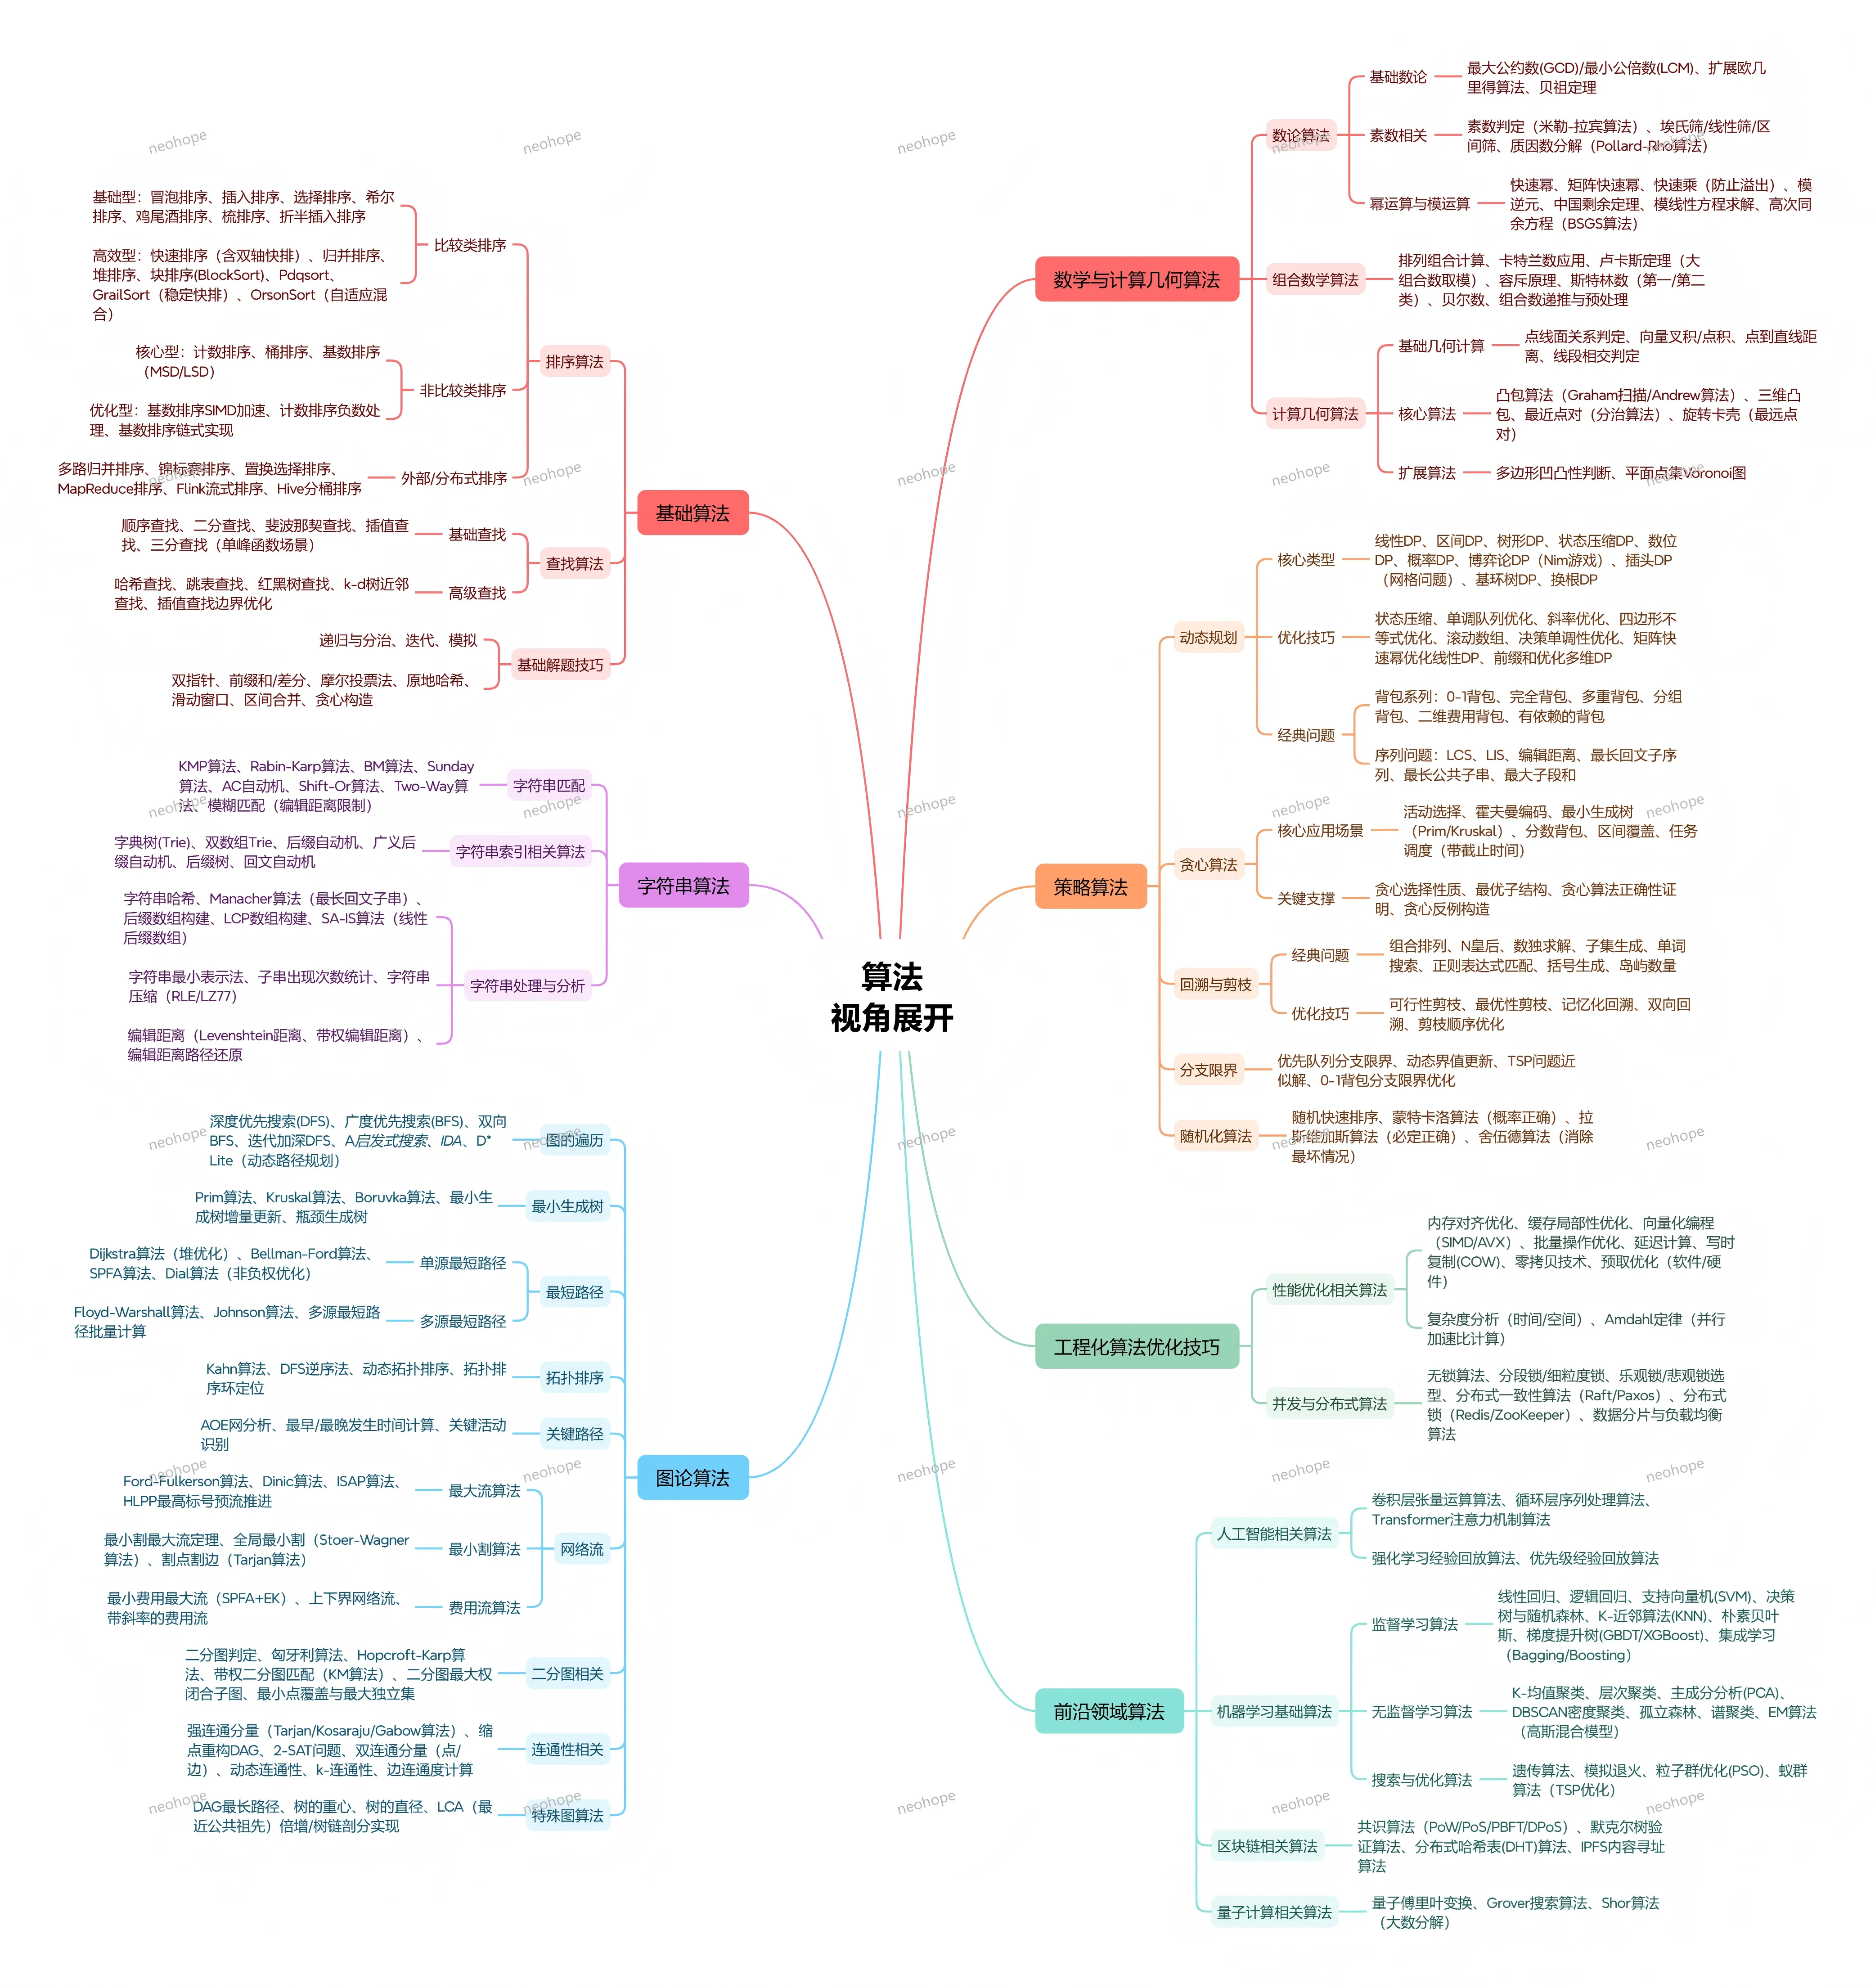
基础型:冒泡排序、插入排序、选择排序、希尔排序、鸡尾酒排序、梳排序、折半插入排序。原理简单,适用于小规模或特殊场景,平均时间复杂度多为 $O(n^2)$。
高效型:快速排序(含双轴快排)、归并排序、堆排序、块排序 (BlockSort)、Pdqsort、GrailSort、OrsonSort。平均时间复杂度 $O(n\log n)$,是工业界标准库的主流实现,多为自适应混合排序,结合多种排序算法优势。
核心型:计数排序、桶排序、基数排序(MSD/LSD)。基于数值范围而非比较排序,数据范围有限时可达线性复杂度。
优化型:基数排序 SIMD 加速、计数排序负数处理、基数排序链式实现:针对非比较排序的工程优化,提示实际性能与适用范围。
多路归并排序、锦标赛排序、置换选择排序:处理内存无法容纳的大数据量排序,基于外存分块处理。
MapReduce 排序、Flink 流式排序、Hive 分桶排序:分布式计算框架下的排序实现,应对海量数据场景。
递归与分治、迭代、模拟:最基础的算法实现范式,分治将大问题拆分为子问题求解。
双指针、前缀和 / 差分、摩尔投票法、原地哈希、滑动窗口、区间合并、贪心构造:算法题中常用的技巧型方法,通过巧妙的遍历与数据组织降低时间复杂度。
KMP 算法:通过前缀函数实现单模式串线性匹配,避免暴力匹配的回溯。
Rabin-Karp 算法:基于字符串哈希的匹配算法,适合多模式匹配与长文本场景。
BM 算法:从模式串尾部反向匹配,配合坏字符与好后缀规则,实际文本中效率高于 KMP。
Sunday 算法:BM 的简化变体,匹配失败时关注文本下一个字符,实现简单且效率优秀。
AC 自动机:多模式串匹配算法,基于 Trie 构建失败指针,可一次性匹配多个模式串。
Shift-Or 算法、Two-Way 算法:两类高效单模匹配算法,前者基于位运算,后者是线性时间的最优算法之一。
模糊匹配(编辑距离限制):允许一定编辑距离内的近似匹配。
字典树 (Trie):以字符为节点的前缀树,用于前缀匹配、词频统计。
双数组 Trie:Trie 的紧凑实现,大幅节省空间同时保持查询效率。
后缀自动机:状态数线性的字符串自动机,可高效处理子串计数、出现次数等问题。
广义后缀自动机:扩展到多个字符串的后缀自动机。
后缀树:基于所有后缀构建的前缀树,功能强大但空间开销大。
回文自动机:专门处理回文子串的自动机,可在线性时间统计所有回文子串。
字符串哈希:将字符串映射为哈希值,用于快速比较与匹配。
Manacher 算法(最长回文子串):线性时间求解字符串的最长回文子串。
后缀数组构建、LCP 数组构建:后缀数组将所有后缀排序,LCP 数组记录相邻后缀最长公共前缀,是字符串处理的强力工具。
SA-IS 算法(线性后缀数组):线性时间构建后缀数组的最优算法之一。
字符串最小表示法:线性时间求解字符串循环同构的最小字典序形式。
子串出现次数统计、字符串压缩(RLE/LZ77):字符串的统计与压缩应用。
编辑距离(Levenshtein 距离、带权编辑距离)、编辑距离路径还原:衡量字符串相似度,可还原具体编辑操作。
深度优先搜索 (DFS)、广度优先搜索 (BFS):图遍历的两种基础方式,是绝大多数图算法的底层框架。
双向 BFS:从起点与终点同时搜索,大幅缩小搜索空间,提升路径查找效率。
迭代加深 DFS:结合 DFS 的空间优势与 BFS 的最优性,逐步加深搜索深度。
A \ 启发式搜索*:引入启发函数估计剩余代价,优先搜索更有希望的分支,提升路径搜索效率。
IDA\:迭代加深与 A \ 结合,兼顾空间效率与启发式优化。
D Lite*:动态路径规划算法,适用于环境动态变化的场景,如机器人导航。
Prim 算法、Kruskal 算法、Boruvka 算法:三种经典最小生成树算法,分别基于加点、加边、分治思想实现。
最小生成树增量更新、瓶颈生成树:扩展应用,前者处理边动态变化的场景,后者求解最大边权最小的生成树。
Dijkstra 算法(堆优化):求解非负权图单源最短路,堆优化后复杂度 $O(m\log n)$。
Bellman-Ford 算法:可处理负权边并检测负环,时间复杂度 $O(nm)$。
SPFA 算法:Bellman-Ford 的队列优化版本,在稀疏图上效率更高。
Dial 算法:针对边权为小整数的非负权图,基于桶排序实现近似线性复杂度。
Floyd-Warshall 算法:动态规划思想,可求解任意两点最短路,支持负权边,复杂度 $O(n^3)$。
Johnson 算法:通过重赋权将负权图转化为非负权图,再多次运行 Dijkstra,适合稀疏图多源最短路。
Kahn 算法、DFS 逆序法:两种求解有向无环图 (DAG) 拓扑序的经典方法,可同时检测图中是否存在环。
动态拓扑排序、拓扑排序环定位:扩展能力,处理边动态变化与环定位场景。
AOE 网分析:在带权有向无环图中求解项目的最短完成工期。
最早 / 最晚发生时间计算、关键活动识别:通过正向递推最早时间、反向递推最晚时间,识别决定工期的关键活动。
Ford-Fulkerson 算法:最大流的基础思想,通过不断寻找增广路增大流量。
Dinic 算法:基于分层图与当前弧优化的增广路算法,是工业界最常用的最大流实现。
ISAP 算法、HLPP 最高标号预流推进:两类更高效的最大流算法,HLPP 在稠密图上优势明显。
最小割最大流定理:建立最大流与最小割的等价关系,可通过最大流求解最小割。
全局最小割(Stoer-Wagner 算法):求解无向图的全局最小割。
割点割边(Tarjan 算法):求解无向图的割点与桥,属于图连通性分析范畴。
最小费用最大流(SPFA+EK):在最大流基础上优化费用,每次寻找费用最小的增广路。
上下界网络流、带斜率的费用流:扩展模型,处理更复杂的流量约束场景。
二分图判定:通过染色法判断图是否为二分图。
匈牙利算法、Hopcroft-Karp 算法:求解二分图最大匹配,后者通过多路增广效率更高。
带权二分图匹配(KM 算法):求解二分图最大权完美匹配。
二分图最大权闭合子图、最小点覆盖与最大独立集:基于二分图匹配的定理应用,可转化为网络流求解。
强连通分量(Tarjan/Kosaraju/Gabow 算法):求解有向图的强连通分量,Tarjan 基于一次 DFS 实现,应用最广。
缩点重构 DAG:将强连通分量缩为单点,把原图转化为 DAG 以简化问题。
2-SAT 问题:布尔可满足性问题的特例,可通过强连通分量高效求解。
双连通分量(点 / 边):求解无向图的点双连通与边双连通分量。
动态连通性、k – 连通性、边连通度计算:连通性的扩展问题,处理动态图与连通度度量。
DAG 最长路径:在有向无环图上基于拓扑序求解最长路径。
树的重心、树的直径:树的两个核心属性,分别对应删除后子树最大规模最小的节点、树上最远两点距离。
LCA(最近公共祖先)倍增 / 树链剖分实现:求解树上两点最近公共祖先的经典算法,倍增易实现,树链剖分查询更快且可结合其他树操作。
最大公约数 (GCD)/ 最小公倍数 (LCM):数论基础运算,求解两整数的最大公共约数与最小公共倍数,核心通过辗转相除法实现。
扩展欧几里得算法:在求解 GCD 的同时算出贝祖等式的整数解,是求解模逆元、线性同余方程的核心工具。
贝祖定理:线性不定方程 ax+by=c 有整数解的充要条件是 gcd(a,b) 整除 c;且一定存在整数解使得 ax+by=gcd(a,b),是数论方程求解的理论基础。
素数判定(米勒 – 拉宾算法):概率性素性测试算法,通过多轮基测试可在极低错误率下快速判定大数素性,是大数素性判断的工业标准。
埃氏筛 / 线性筛 / 区间筛:批量生成素数的三类算法;埃氏筛原理简单,线性筛(欧拉筛)保证每个合数仅被筛一次,达到线性复杂度;区间筛用于求解大数值区间内的素数。
质因数分解(Pollard-Rho 算法):基于随机化与生日悖论的大数分解算法,期望时间复杂度约为 $O(n^{1/4})$,可快速找到合数的非平凡因子,是大数质因数分解的核心方案。
快速幂:通过二进制拆分指数,将幂运算从 $O(n)$ 优化至 $O(\log n)$,几乎所有模运算场景都会配合使用。
矩阵快速幂:将快速幂思想扩展到矩阵运算,用于加速线性递推数列(如斐波那契)的求解。
快速乘:模拟二进制拆分乘法,避免大数相乘时的数值溢出,适用于大模数场景。
模逆元:模运算中的 “除法等价操作”,常用于分数取模,可通过扩展欧几里得算法或费马小定理求解。
中国剩余定理:求解一元线性同余方程组,给出模数互质场景下的通解公式。
模线性方程求解:求解形如 $ax \equiv b \pmod{m}$ 的同余方程,基于扩展欧几里得算法实现。
高次同余方程(BSGS 算法):全称 Baby-Step Giant-Step(大步小步算法),用于求解离散对数问题 $a^x \equiv b \pmod{p}$,时间复杂度 $O(\sqrt{p})$。
排列组合计算:基础计数工具,求解有序排列与无序组合的方案数。
卡特兰数应用:经典组合数列,可用于括号匹配、二叉树结构计数、凸多边形三角划分等场景。
卢卡斯定理:用于大组合数对小质数取模,将大组合数拆解为小组合数的乘积取模。
容斥原理:通过 “加加减减” 对重叠集合计数去重,是处理多约束组合计数的核心方法。
斯特林数(第一 / 第二类):第一类描述将 n 个元素排成 k 个轮换的方案数;第二类描述将 n 个元素划分为 k 个非空集合的方案数。
贝尔数:n 个元素的集合划分总方案数,等于第二类斯特林数的前缀和。
组合数递推与预处理:通过杨辉三角递推或阶乘 + 逆元打表,实现组合数的快速查询。
点线面关系判定、向量叉积 / 点积:计算几何底层工具;点积用于计算投影、夹角,叉积用于判断转向、面积与线段位置关系。
点到直线距离、线段相交判定:基于向量运算的基础几何判定,是复杂几何算法的底层支撑。
凸包算法(Graham 扫描 / Andrew 算法):求解平面点集的最小凸多边形;Graham 基于极角排序扫描,Andrew 按坐标双端扫描,实现更稳定。
三维凸包:将凸包问题扩展到三维空间,求解空间点集的最小凸多面体。
最近点对(分治算法):采用分治思想拆分点集后合并求解,时间复杂度 $O(n\log n)$。
旋转卡壳(最远点对):用一对平行线 “卡住” 凸包并旋转,可在线性时间内求解凸包直径(最远点对)、宽度、最小外接矩形等几何属性。
多边形凹凸性判断:基于顶点叉积符号的一致性,判断多边形是否为凸多边形。
平面点集 Voronoi 图:将平面划分为多个区域,每个区域内的点到对应种子点距离最近,广泛应用于地理、图形学领域。
线性 DP:状态沿线性结构转移,是动态规划最基础的形式,典型如背包、序列问题。
区间 DP:以区间为状态单位,通过小区间合并求解大区间问题,如石子合并、回文子串计数。
树形 DP:在树结构上进行状态转移,通常通过后序遍历自底向上计算。
状态压缩 DP:用二进制表示集合状态,处理小规模集合的选排问题。
数位 DP:针对数字位数设计状态,常用于求解满足特定约束的数字计数问题。
概率 DP:状态转移附带概率,用于求解随机过程中的期望、概率问题。
博弈论 DP(Nim 游戏):基于博弈状态转移求解胜负态,Nim 游戏是其经典模型。
插头 DP(网格问题):高级状压 DP,通过轮廓线与插头记录连通性,求解网格上的回路、路径覆盖等复杂连通性问题。
基环树 DP:针对带一个环的树(基环树)的动态规划,通常先断环成树再处理。
换根 DP:通过两次遍历实现树上所有节点作为根的答案求解,避免重复计算。
状态压缩:用二进制等紧凑形式表示状态,压缩状态空间。
单调队列优化:维护单调队列快速求解滑动窗口最值,优化一类 DP 转移。
斜率优化:将转移方程转化为斜率形式,用凸包维护最优决策点。
四边形不等式优化:利用决策单调性,将区间 DP 从 $O(n^3)$ 降至 $O(n^2)$。
滚动数组:仅保留相邻状态,大幅降低空间复杂度。
决策单调性优化:利用最优决策点的单调性,减少转移枚举量。
矩阵快速幂优化线性 DP:将线性递推 DP 转化为矩阵幂运算,加速大步数求解。
前缀和优化多维 DP:通过前缀和快速计算区间和,优化求和类转移。
背包系列:包含 0-1 背包、完全背包、多重背包、分组背包、二维费用背包、有依赖的背包等,是动态规划的经典模型族。
序列问题:包括最长公共子序列 (LCS)、最长上升子序列 (LIS)、编辑距离、最长回文子序列、最长公共子串、最大子段和等经典线性 DP 问题。
优先队列分支限界:以广度优先为基础,用优先队列按代价排序拓展节点,优先搜索更优分支。
动态界值更新:实时更新上下界,提升剪枝效率。
典型应用:TSP 问题求解、0-1 背包优化,用于求解组合优化问题的精确最优解。
随机快速排序:随机选取基准元素,消除最坏输入场景,平均时间复杂度稳定在 $O(n\log n)$。
蒙特卡洛算法:运行时间固定,结果以一定概率正确,适用于可容忍小概率错误的场景。
拉斯维加斯算法:结果必定正确,运行时间随机,不断重试直到得到正确解。
舍伍德算法:通过随机化消除输入的最坏情况,保证算法平均性能稳定。
内存对齐优化、缓存局部性优化、向量化编程(SIMD/AVX)、批量操作优化、延迟计算、写时复制 (COW)、零拷贝技术、预取优化:从硬件特性、内存访问、计算模式等维度提升程序运行效率,是工业级代码性能优化的核心手段。
复杂度分析(时间 / 空间):评估算法资源消耗的基础方法;Amdahl 定律:计算并行系统的理论加速比上限,指导并行优化方向。
无锁算法、分段锁 / 细粒度锁、乐观锁 / 悲观锁选型:不同粒度的并发控制方案,平衡并发性能与数据一致性。
分布式一致性算法(Raft/Paxos):解决分布式系统多节点数据一致性问题,Raft 更易工程实现。
分布式锁(Redis/ZooKeeper):分布式环境下实现互斥访问的通用方案。
数据分片与负载均衡算法:将数据与流量均匀分配到多节点,提升系统吞吐量与扩展性。
卷积层张量运算算法:卷积神经网络核心,通过卷积核提取空间特征,广泛用于计算机视觉。
循环层序列处理算法:循环神经网络核心,通过门控机制处理序列依赖,用于自然语言、时序数据。
Transformer 注意力机制算法:通过自注意力机制并行处理长序列,是当前大语言模型的核心架构。
强化学习经验回放算法、优先级经验回放算法:通过存储并重放历史经验提升样本利用率,优先级回放优先采样高价值经验。
线性回归、逻辑回归:基础线性模型,分别用于回归与二分类任务。
支持向量机 (SVM):通过最大化分类间隔构建分类器,适用于小样本高维场景。
决策树与随机森林:决策树基于特征分裂做决策,随机森林是多棵决策树的 Bagging 集成。
K – 近邻算法 (KNN):基于邻居样本投票做分类 / 回归,属于惰性学习算法。
朴素贝叶斯:基于贝叶斯定理与特征独立假设的概率分类器,计算高效。
梯度提升树 (GBDT/XGBoost):Boosting 集成算法,通过迭代拟合残差提升模型精度,是表格数据建模的主流方案。
集成学习(Bagging/Boosting):两类集成范式,Bagging 通过并行训练多个基模型投票,Boosting 通过串行迭代逐步优化。
K – 均值聚类、层次聚类:经典聚类算法,分别基于质心迭代与层次合并划分样本。
主成分分析 (PCA):线性降维算法,通过正交变换保留最大方差信息。
DBSCAN 密度聚类:基于密度可达性聚类,可发现任意形状簇并识别噪声点。
孤立森林:基于孤立路径长度检测异常样本,适用于异常检测场景。
谱聚类:基于图论谱理论的聚类算法,对非凸分布数据效果较好。
EM 算法(高斯混合模型):迭代求解含隐变量模型的参数,高斯混合模型是其典型应用。
共识算法(PoW/PoS/PBFT/DPoS):区块链节点达成数据一致性的核心机制,分别基于工作量、权益、拜占庭容错等原理设计。
默克尔树验证算法:通过哈希树结构快速验证数据完整性与存在性,是区块链数据结构的核心。
分布式哈希表 (DHT) 算法:分布式节点存储与寻址方案,无需中心节点即可定位数据。
IPFS 内容寻址算法:基于内容哈希而非地址定位文件,实现分布式文件存储与传输。
量子傅里叶变换:量子版本的快速傅里叶变换,是众多量子算法的基础组件。
Grover 搜索算法:实现无序数据库的二次加速搜索,时间复杂度 $O(\sqrt{n})$。
Shor 算法(大数分解):可在多项式时间内完成大数质因数分解,对传统 RSA 加密体系构成挑战。
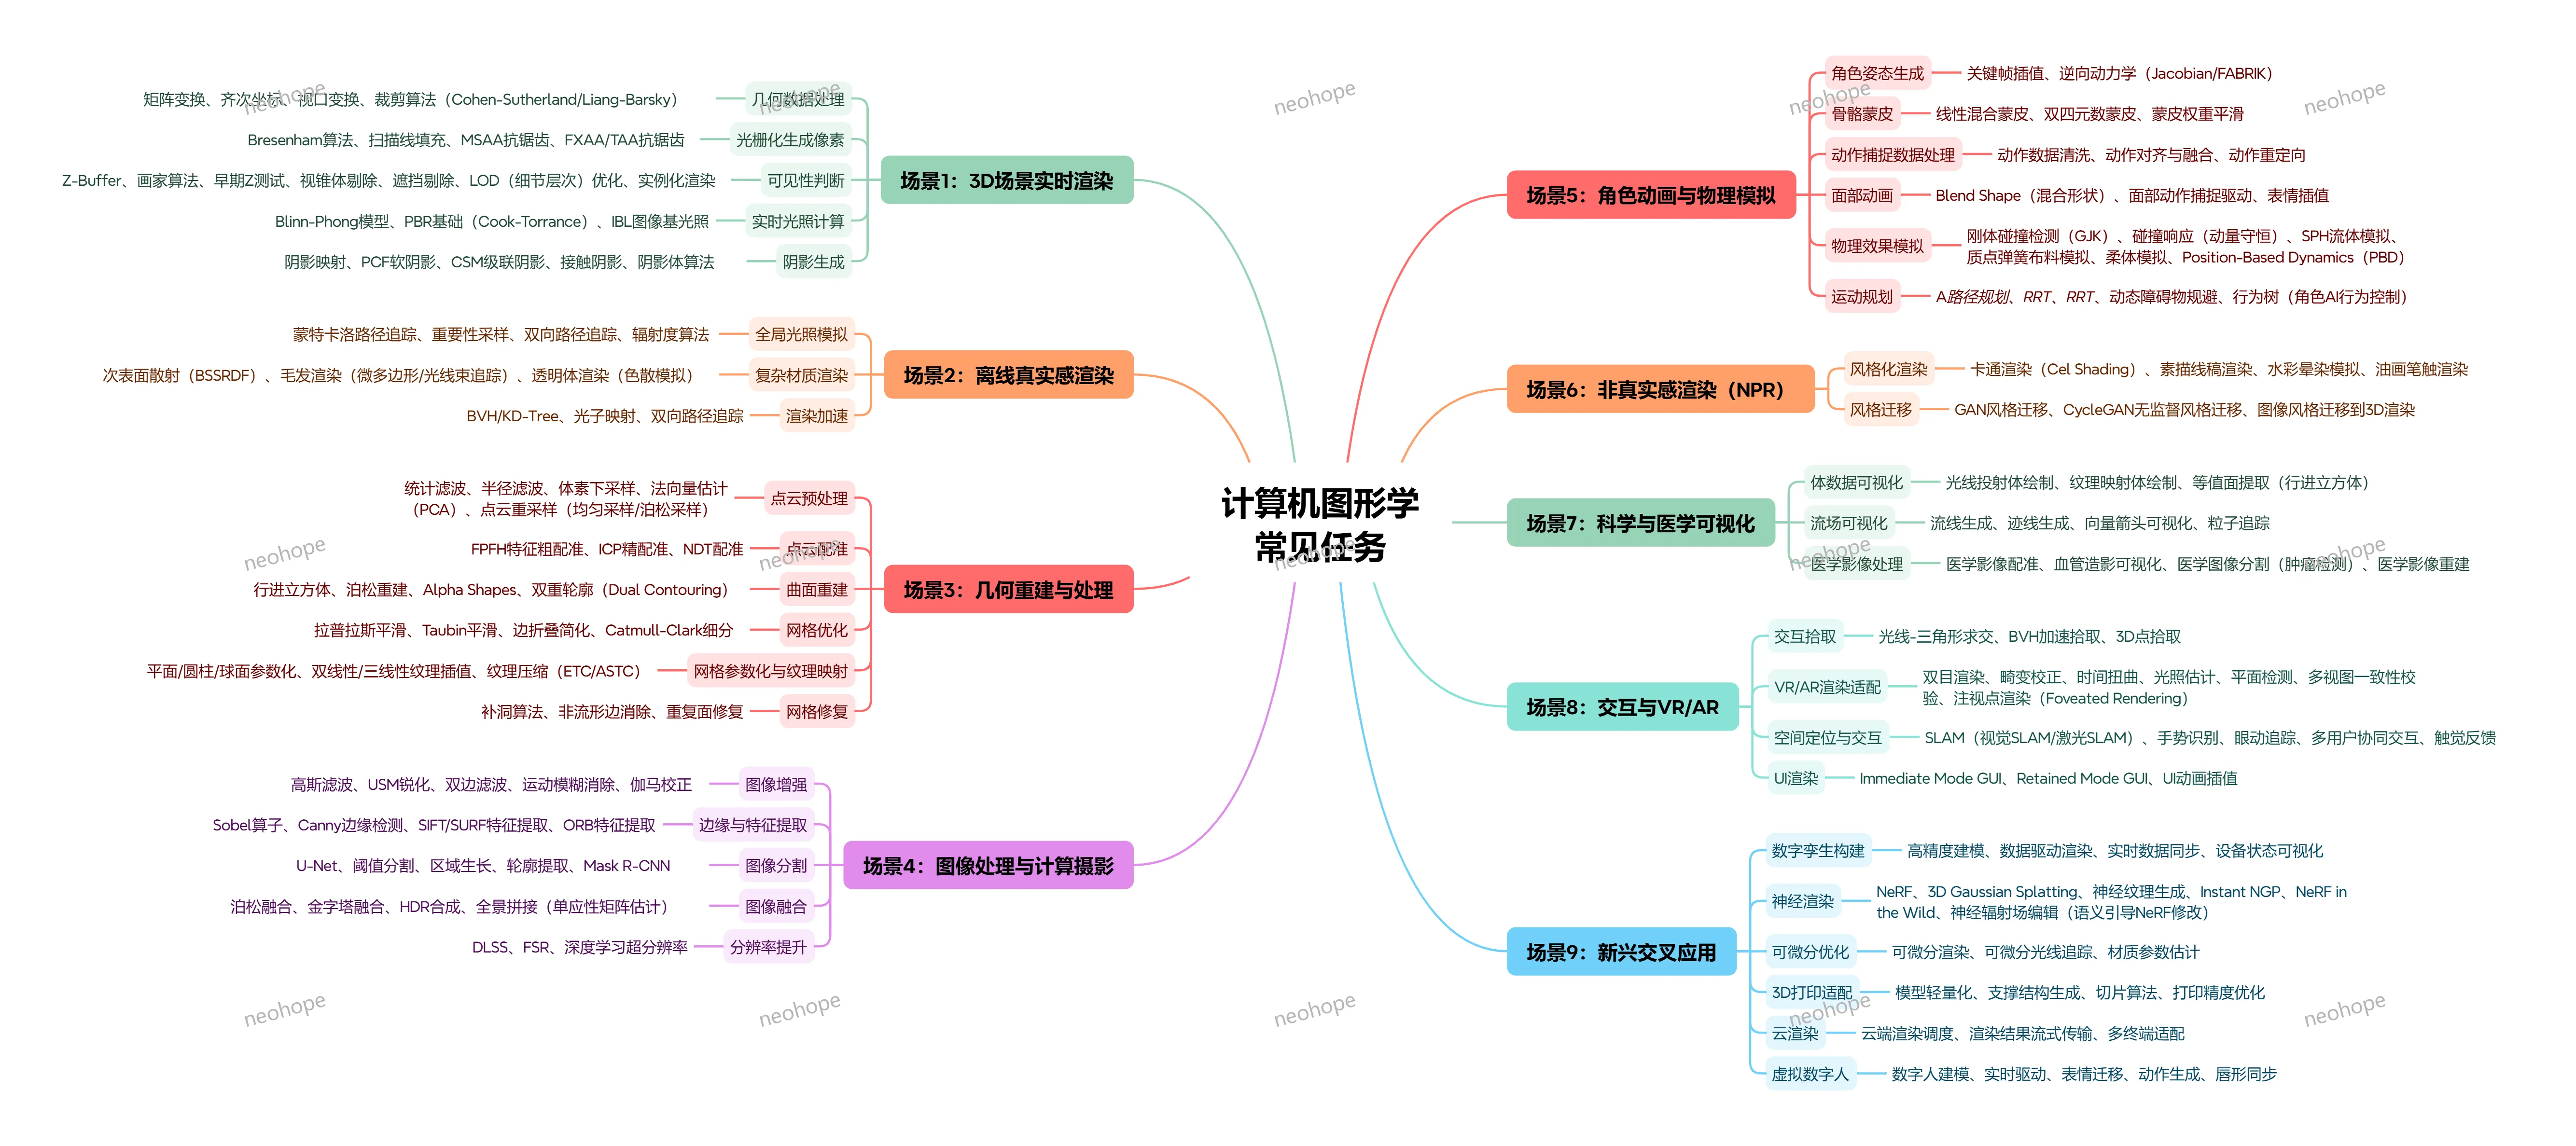
打开3A游戏,沉浸在光影逼真的虚拟世界;刷短视频,被灵动的虚拟数字人吸引;看医疗影像,精准的病灶可视化辅助诊断 —— 这些震撼的视觉体验,背后都离不开计算机图形学(CG)的支撑。从实时渲染到虚拟交互,从科学可视化到数字孪生,计算机图形学早已渗透生活、工业、医疗等多个领域。今天就拆解它的 9 大核心任务,带你看懂视觉魔法背后的技术逻辑。
一、3D场景实时渲染:让虚拟世界 “即时可见”
核心目标:在游戏、VR/AR 等实时场景中,快速生成高质量图像,兼顾流畅度与视觉效果,是图形学最基础也最核心的任务。
1、几何数据处理:通过矩阵变换、齐次坐标转换、视口变换等技术,将 3D 模型映射到 2D 屏幕;用裁剪算法(Cohen-Sutherland/Liang-Barsky)剔除屏幕外的图形,提升效率;
2、光栅化与抗锯齿:用 Bresenham 算法绘制线条、扫描线填充图形,将几何形状转化为像素;通过 MSAA、FXAA/TAA 等抗锯齿技术,解决画面锯齿感,让边缘更平滑;
3、光照与阴影:用 Blinn-Phong 模型、PBR 基础(Cook-Torrance)、IBL 图像基光照模拟真实光影效果;通过阴影映射、PCF 软阴影、CSM 级联阴影等算法,生成自然的阴影,增强场景立体感;
4、可见性优化:用 Z-Buffer、画家算法、早期 Z 测试、LOD 细节层次优化、实例化等技术,只渲染屏幕可见的内容,减少无效计算,保障实时流畅。
二、离线真实感渲染:追求 “以假乱真” 的极致视觉
核心目标:在影视动画、广告特效等非实时场景中,生成照片级真实的图像,不追求速度,只追求视觉精度。
1、全局光照模拟:通过蒙特卡洛路径追踪、重要性采样、双向路径追踪、辐射度算法,模拟光线在场景中的多次反射与折射,还原真实世界的光照效果;
2、复杂材质渲染:针对毛发、布料、透明物体等复杂材质,用次表面散射(SSS)、毛发渲染、微边形 / 光透射体渲染等技术,还原材质的真实质感;
3、渲染加速:用 BVH/KD-Tree、光子映射等算法优化光线追踪效率,在保证效果的同时缩短渲染时间。
三、几何重建与处理:从点云到模型,构建虚拟几何基础
核心目标:将现实世界的物体或数据(如点云)转化为计算机可处理的 3D 模型,并优化模型质量,适配不同场景需求。
1、点云处理:先通过统计滤波、体素下采样等进行点云预处理,再用 ICP 精配准、NDT 配准、FFH 特征点配准等技术,将多帧点云对齐;
2、曲面重建:用行进立方体、泊松重建、Alpha Shapes、双重轮廓(Dual Contouring)等算法,从点云或体数据中生成连续的 3D 曲面;
3、网格优化与修复:通过拉普拉斯平滑、Taubin 平滑优化模型表面;用边折叠简化模型复杂度(适配实时场景),用 Catmull-Clark 细分提升模型细节;还能通过补洞算法、非流形边消除、重复面修复,解决模型破损问题;
4、网格参数化与纹理映射:将平面 / 圆柱 / 球面等参数化到网格上,通过双线性 / 三线性纹理插值、ETC/ASTC 纹理压缩技术,让纹理自然贴合模型。
四、图像处理与计算摄影:优化图像质量,创造特殊视觉效果
核心目标:对 2D 图像进行增强、分割、融合等处理,或通过算法模拟摄影效果,提升图像表现力。
1、图像增强:用高斯滤波降噪、USM 锐化提升细节、双边滤波保留边缘、运动模糊消除、伽马校正调整亮度,优化图像基础质量;
2、边缘与特征提取:通过 Sobel 算子、Canny 边缘检测,快速定位图像边缘;用 SIFT、SURF、ORB 等算法提取图像特征,用于匹配、追踪等场景;
3、图像分割与提取:用阈值分割、区域生长、轮廓提取等传统算法,或 U-Net、Mask R-CNN 等深度学习算法,精准分割图像中的目标(如医疗影像中的病灶);
4、图像融合与特效:实现图像拼接、全景合成、HDR 融合,生成宽视角或高动态范围图像;还能通过深度学习超分辨率(DLSS、FSR)提升图像分辨率,还原更多细节。
五、角色动画与物理模拟:让虚拟角色 “活起来”
核心目标:让 3D 角色拥有自然的动作和物理交互效果,适配游戏、动画、虚拟人等场景。
1、角色姿态与动画生成:通过关键帧插值、逆向动力学(Jacobian/FABRK)生成流畅姿态;用骨骼蒙皮(线性混合蒙皮、双四元数蒙皮)让模型跟随骨骼运动,蒙皮权重平滑技术避免动作变形;
2、面部动画:用 Blend Shape(混合形状)实现丰富表情,通过面部动作捕捉驱动、表情插值,让虚拟角色的表情更自然逼真;
3、动作数据处理:对动作捕捉数据进行清洗、对齐与融合,还能实现动作重定向(将一个角色的动作迁移到另一个角色上);
4、物理效果模拟:用 GJK 算法实现刚体碰撞检测,通过动量守恒计算碰撞响应;用 SPH 流体模拟、质点弹簧布料模拟、柔体模拟、PBD(Position-Based Dynamics)等技术,还原液体、布料、软组织的真实物理行为;
5、运动规划:用 A路径规划、RRT、RRT算法让角色避开障碍物,通过行为树控制角色 AI 行为(如游戏中 NPC 的决策逻辑)。
六、非真实感渲染(NPR):打造 “风格化视觉”
核心目标:跳出真实感框架,生成卡通、素描、水彩等风格化图像,适配动画、插画、游戏等创意场景。
1、基础风格化渲染:用 Cel Shading(卡通渲染)生成动漫质感,通过素描线稿渲染模拟手绘线条,用水彩晕染模拟、油画笔触渲染还原艺术绘画效果;
2、风格迁移:借助 GAN 风格迁移、CycleGAN 无监督风格迁移技术,将 2D 图像的风格迁移到 3D 渲染中(如把照片风格转化为卡通风格的 3D 场景)。
七、科学与医学可视化:让 “无形数据” 可视化
核心目标:将科学计算数据(如流场)、医学影像数据(如 CT/MRI)转化为直观的视觉形式,辅助研究与诊断。
1、体数据可视化:用光线投射体绘制、纹理映射体绘制、等值面提取(行进立方体)等技术,呈现 CT、MRI 等医学体数据,让内部结构一目了然;
2、流场可视化:通过流线生成、迹线生成、向量箭头可视化、粒子追踪,直观展示气流、水流等流场的运动规律;
3、医学影像专项处理:实现医学影像配准(多模态影像对齐)、血管可视化、医学影像分割(肿瘤检测),为临床诊断和治疗提供支持。
八、交互与 VR/AR:打破虚拟与现实的边界
核心目标:实现人与虚拟环境的自然交互,适配 VR/AR、元宇宙等沉浸式场景。
1、空间定位与交互:通过 SLAM(视觉 SLAM、激光 SLAM)实现空间定位,结合手势识别、眼动追踪,让用户无需控制器即可操作;还支持多用户协同交互、触觉反馈,提升沉浸感;
2、VR/AR渲染适配:采用双目渲染模拟人眼视角差,通过畸变校正、时间扭曲解决画面延迟问题;结合光照估计、平面检测、多视图一致性校验,让虚拟物体与现实环境自然融合;注视点渲染(Foveated Rendering)技术可优化性能,只高清渲染注视区域;
3、GUI 与交互拾取:用 Immediate Mode GUI、Retained Mode GUI 构建虚拟界面,通过 GUI 动画插值提升交互体验;通过光线三角形求交、BVH 加速拾取,实现 3D 点精准拾取(如点击虚拟物体触发事件)。
九、新兴交叉应用:图形学与新技术的融合创新
核心目标:结合 AI、云计算、3D 打印等技术,拓展图形学的应用边界,催生新场景、新体验。
1、虚拟数字人:整合数字人建模、实时驱动、表情迁移、动作生成、唇形同步等技术,打造能实时交互的虚拟人(如直播、客服场景);
2、数字孪生:通过高精度建模、数据驱动渲染、实时数据同步、设备状态可视化,构建物理世界的虚拟映射(如工业设备监控、城市规划);
3、神经渲染与可微分优化:用 NeRF 等神经渲染技术,从 2D 图像重建 3D 场景;通过可微分渲染、可微分光线追踪,实现材质参数估计等精准优化;
4、云渲染与 3D 打印适配:云端渲染调度技术可将复杂渲染任务放在云端,渲染结果流式传输到终端,适配低性能设备;3D 打印适配技术则能实现模型轻量化、支撑结构生成、切片算法优化,提升打印精度。
总结:计算机图形学的核心逻辑 ——“将虚拟落地,让现实升级”
从实时渲染到虚拟交互,从数据可视化到数字孪生,计算机图形学的本质是 “用技术构建视觉桥梁”—— 让虚拟世界更逼真、让无形数据更直观、让现实体验更丰富。
随着 AI、云计算、VR/AR 等技术的发展,计算机图形学的应用场景还在不断拓展:从游戏动画到工业制造,从医疗诊断到元宇宙,它正在用视觉魔法改变我们感知世界、交互世界的方式。
你在生活中接触过哪些让你惊艳的图形学应用?欢迎在评论区分享你的体验~
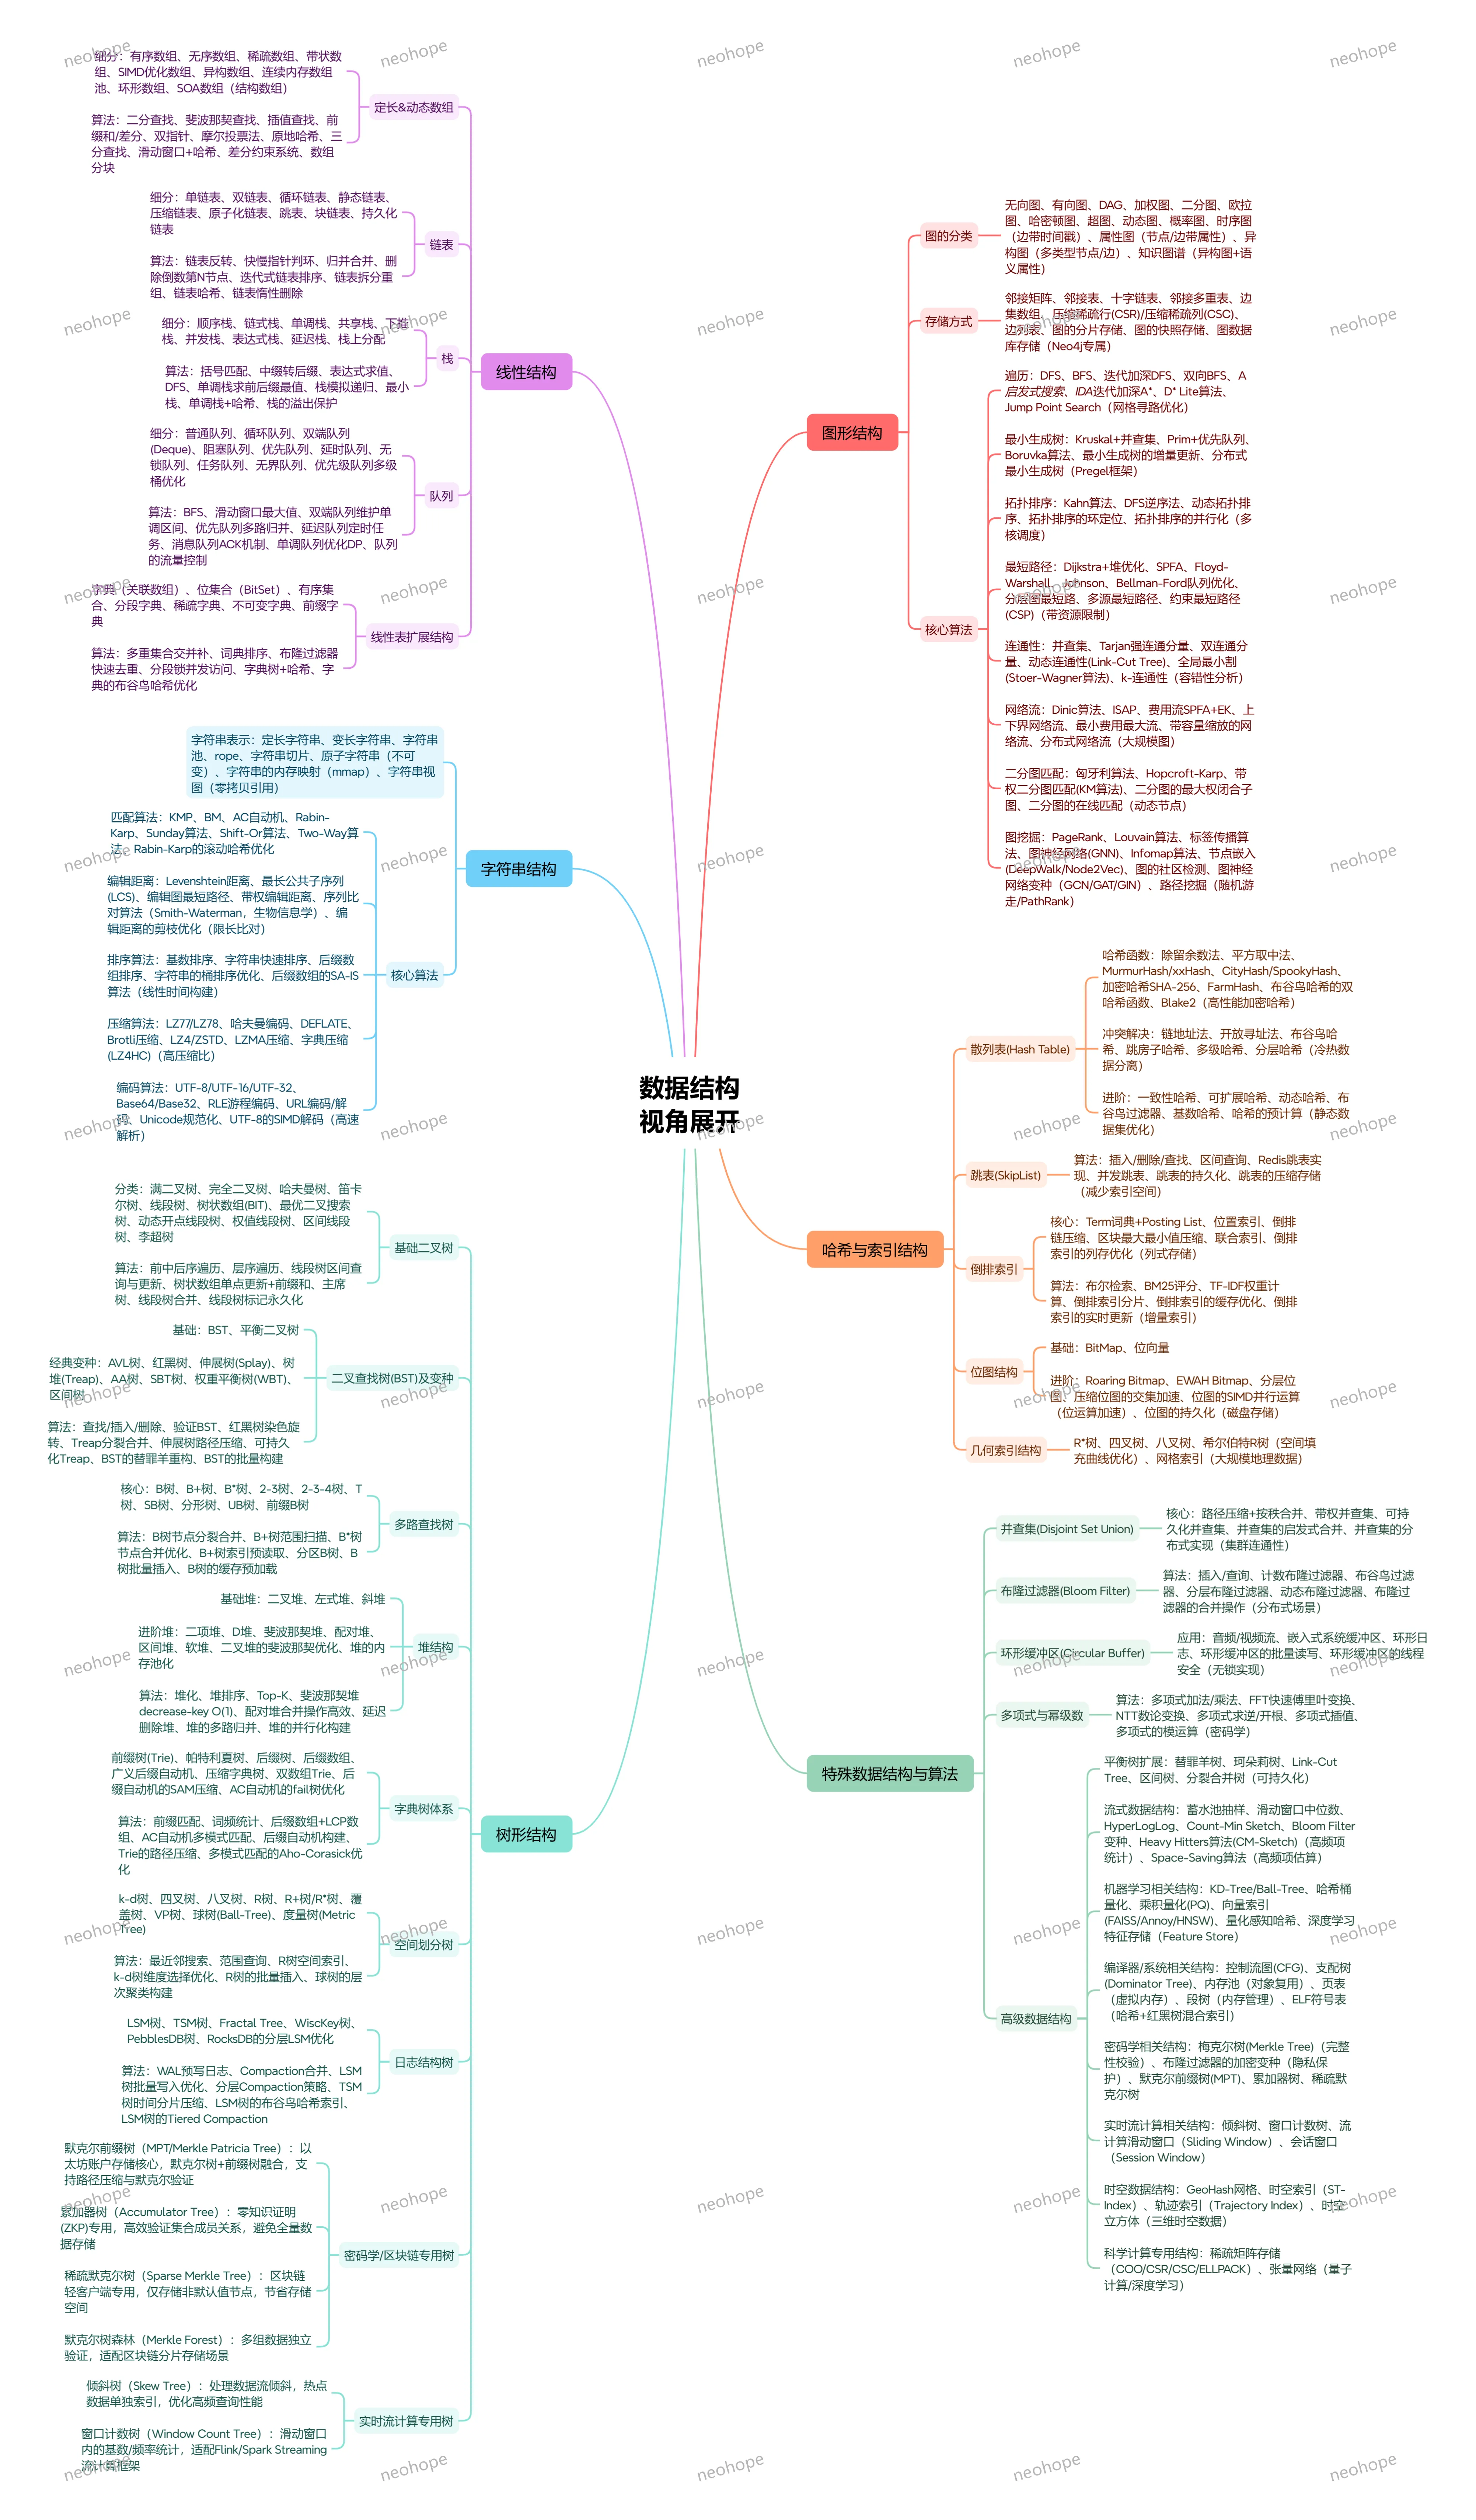
细分类型:有序 / 无序数组、稀疏数组、环形数组、SOA 结构数组、SIMD 优化数组。
核心算法:
查找:二分查找、插值查找、斐波那契查找、三分查找;
预处理:前缀和(O (1) 区间和查询)、差分(O (1) 区间批量更新);
技巧:双指针(对撞 / 快慢)、滑动窗口、摩尔投票法、原地哈希、数组分块。
细分:单链表、双链表、循环链表、静态链表、块链表、持久化链表。
核心算法:链表反转、快慢指针判环 / 找中点、归并排序、删除倒数第 N 节点、拆分重组、惰性删除。
细分:顺序栈、链式栈、单调栈、共享栈、表达式栈。
核心算法:括号匹配、中缀转后缀、表达式求值、模拟 DFS;单调栈求解下一个更大 / 更小元素、柱状图最大矩形等经典问题。
细分:循环队列、双端队列 (Deque)、优先队列、阻塞队列、延时队列、无锁队列。
核心算法:BFS 层序遍历、单调队列求解滑动窗口最值、优先队列多路归并、延时队列定时任务调度。
结构:字典(关联数组)、位集合、有序集合、分段字典、稀疏字典。
核心操作:集合交并补运算、分段锁并发优化、布隆过滤器前置去重、字典树 + 哈希混合索引。
需要我把其中某一类数据结构的算法展开成更详细的原理与时间复杂度对照表吗?
定长字符串、变长字符串、字符串池(常量复用)、rope(大字符串分块拼接)、字符串切片 / 视图(零拷贝引用)、mmap 内存映射大文件。
KMP:预处理 next 数组,主串指针不回溯,单模式匹配线性时间 O (n+m)。
BM:坏字符 + 好后缀规则,从后往前匹配,大文本下平均性能优于 KMP。
AC 自动机:多模式匹配标准,一次扫描匹配所有模式串。
Rabin-Karp:滚动哈希,哈希快速初筛,适合多模式、模糊匹配场景。
进阶:Sunday、Shift-Or、Two-Way 等不同侧重的优化算法。
Levenshtein 距离:增删改操作的最小编辑次数,动态规划求解。
LCS(最长公共子序列):经典二维动态规划问题。
进阶:带权编辑距离、Smith-Waterman 算法(生物信息序列比对)、限长剪枝优化。
字符串排序:基数排序(按字符位线性排序)、字符串快排、SA-IS 线性构建后缀数组。
压缩算法:
LZ77/LZ78:字典式压缩,现代压缩算法的基础;
哈夫曼编码:熵编码,高频字符短编码,最优前缀码;
DEFLATE:LZ77 + 哈夫曼,gzip、PNG 标准;
工业级:LZ4(极速)、ZSTD(高速高压缩比)、Brotli、LZMA。
UTF-8/16/32(Unicode 编码)、Base64/32(二进制转可打印字符)、RLE 游程编码、URL 编码、SIMD 加速编解码。
常见类型:满二叉树、完全二叉树、哈夫曼树(最优前缀编码)、笛卡尔树(堆 + BST 双性质);
区间专用:线段树(区间查询 / 更新,懒标记)、树状数组 (BIT)(单点更新 + 前缀和,实现极简)、主席树(可持久化线段树,历史版本查询)、李超树(线段覆盖最值);
核心算法:前 / 中 / 后序遍历(递归 / 迭代)、层序遍历;线段树区间操作、标记永久化、线段树合并。
基础 BST:左子树 <根 < 右子树,平均 O (log n),最坏退化为链表。
自平衡变种:
AVL 树:严格平衡(左右高度差≤1),查询最优,插入删除旋转开销大。
红黑树:近似平衡,通过着色 + 旋转维持性质,插入删除高效,是工业界标准(STL map、Java TreeMap)。
伸展树 (Splay):访问节点移至根,热点数据访问更快,局部性友好。
Treap:树 + 堆,随机优先级维持平衡,分裂 / 合并操作便捷。
进阶:可持久化 Treap、替罪羊重构、批量构建。
B 树:多叉平衡树,节点存数据,降低树高,适配磁盘存储,减少 IO 次数。
B + 树:仅叶子节点存数据,内部节点仅存索引,叶子通过链表串联,范围查询极优,是数据库、文件系统索引的标准。
B * 树:优化节点合并策略,提升空间利用率;
进阶:2-3 树、2-3-4 树、前缀 B 树、分区 B 树、批量插入优化。
基础:二叉堆(数组实现,完全二叉树,堆排序、Top-K、优先队列)、左式堆、斜堆;
进阶:斐波那契堆(decrease-key O (1),理论最优)、配对堆(合并高效,实现简单)、二项堆;
核心算法:堆化、堆排序、Top-K、延迟删除、多路归并。
前缀树 (Trie):字符串前缀匹配、词频统计,字符路径即字符串。
后缀树 / 后缀数组 / 后缀自动机 (SAM):处理子串、后缀相关问题,SAM 是当前最精简高效的后缀结构。
AC 自动机:Trie + fail 指针,多模式串匹配,一次扫描匹配所有模式串,用于敏感词过滤、入侵检测。
优化:压缩字典树、双数组 Trie、路径压缩。
k-d 树:k 维空间二分划分,低维数据最近邻搜索高效。
R 树 / R * 树:空间对象最小外包矩形索引,支持范围查询、空间连接,是 GIS 核心索引。
球树 (Ball-Tree)、VP 树:高维空间下比 k-d 树更优的最近邻结构。
LSM 树:写优化结构,数据先写内存表,满后顺序刷入磁盘 SSTable,后台异步 Compaction 合并;牺牲部分读性能换取极致写吞吐,是 RocksDB、LevelDB、HBase 的核心。
核心机制:WAL 预写日志(宕机恢复)、分层 / 大小分级 Compaction、布隆过滤器加速点查。
变种:TSM 树(时序数据优化)、WiscKey(键值分离优化)、Fractal Tree。
区块链 / 密码学:MPT、稀疏默克尔树、累加器树、默克尔树森林;
实时流计算:倾斜树(解决数据倾斜)、窗口计数树(滑动窗口统计)。
邻接矩阵:二维数组存储边关系,O (1) 查询边是否存在,适合稠密图,空间复杂度 O (V²)。
邻接表:每个节点维护邻接边链表,空间省,适合稀疏图,是最通用的存储方式。
十字链表:同时存储入边和出边,优化有向图的双向边遍历。
邻接多重表:无向图中每条边仅存储一次,优化边操作的冗余。
边集数组:仅存储所有边的列表,适合 Kruskal 等以边为核心的算法。
CSR/CSC:压缩稀疏行 / 列存储,用数组压缩表示稀疏图,适配矩阵运算与大规模图计算。
分片 / 快照存储:分布式图系统的水平拆分,以及时态图的历史版本存储;图数据库(如 Neo4j)采用原生属性图存储优化。
DFS:深度优先遍历,基于栈 / 递归回溯,用于环检测、连通分量、拓扑排序,时间 O (V+E)。
BFS:广度优先遍历,基于队列层序扩展,天然求解无权图最短路径,时间 O (V+E)。
迭代加深 DFS:限制搜索深度逐层加深,兼顾 DFS 的低空间与 BFS 的最优解特性。
双向 BFS:起点、终点同时向外 BFS,相遇即得到路径,大幅缩减搜索空间。
A\*:启发式搜索,通过 f(n)=g(n)+h(n) 评估节点,启发函数可采纳时保证最优解,广泛用于路径规划。
IDA\:迭代加深 + A\,空间复杂度低,适合状态空间极大的寻路场景。
D Lite*:动态环境增量寻路,环境变化时局部更新路径,适配机器人导航、动态路网。
Jump Point Search:网格寻路专用,通过跳点规则剪枝冗余节点,在 A * 基础上数倍提升网格寻路效率。
Kruskal + 并查集:边按权排序后依次加入,用并查集判环,适合稀疏图,时间 O (E log E)。
Prim + 优先队列:从单点出发,每次选连接已选 / 未选集合的最小边,适合稠密图,时间 O (E log V)。
Boruvka 算法:每个连通分量独立选择最小出边,天然并行友好,适配分布式超大规模图。
进阶支持增量更新、Pregel 框架下的分布式 MST 计算。
Kahn 算法:基于入度统计,入度为 0 的节点入队输出,同步更新邻接点入度,可同步检测环。
DFS 逆序法:DFS 后序遍历的逆序即为拓扑序列。
进阶支持动态拓扑维护、环定位、多核并行化调度。
Dijkstra + 堆优化:单源非负权最短路,贪心 + 优先队列,工业界最常用,时间 O (E log V)。
Bellman-Ford / SPFA:处理负权边,可检测负环;SPFA 为队列优化版,平均效率高,最坏 O (VE)。
Floyd-Warshall:多源最短路,动态规划实现,O (V³),仅适合小规模图。
Johnson:重赋权消除负权后多次 Dijkstra,求解带负权无负环的多源最短路。
进阶:分层图最短路(带状态约束)、多源最短路、带资源限制的约束最短路径 (CSP)。
并查集:无向图动态连通性查询,路径压缩 + 按秩合并后操作近似常数级。
Tarjan 算法:一次 DFS 求解强连通分量、割点、桥、双连通分量,用于图缩点与容错分析。
Link-Cut Tree:动态树结构,支持动态连边 / 断边下的路径连通性与信息查询。
Stoer-Wagner:求解无向图全局最小割,用于网络可靠性分析。
k – 连通性分析:评估图的容错能力,即至少删除 k 个点 / 边才会断开。
Dinic 算法:分层图 + 阻塞流增广,当前工业界最高效的最大流算法之一。
ISAP:Dinic 的优化版本,无需重复 BFS 分层,常数更小。
SPFA+EK 费用流:求解最小费用最大流,用最短路寻找最小费用增广路。
进阶:上下界网络流、容量缩放优化、分布式大规模网络流。
匈牙利算法:基于增广路求解最大匹配,是二分图匹配的基础算法。
Hopcroft-Karp:BFS 批量寻找增广路,时间复杂度 O (E√V),适合大规模二分图。
KM 算法:求解带权二分图的最大权完美匹配。
进阶:最大权闭合子图(转化为最小割)、动态节点在线匹配。
PageRank:基于链接传递的节点重要度迭代计算,用于搜索引擎、社交网络影响力排序。
Louvain 算法:层次化社区检测,基于模块度优化,是当前最高效的社区发现算法之一。
标签传播算法:简单轻量的社区发现,节点向邻居传播标签,收敛快。
GNN 系列(GCN/GAT/GIN):图神经网络,基于消息传递机制学习节点 / 图的低维表征,适配图分类、链路预测等任务。
DeepWalk / Node2Vec:随机游走 + Word2Vec,生成节点嵌入向量,用于下游机器学习。
Infomap:基于信息流的社区检测,对有向图、加权图效果更优。
哈希函数:
基础:除留余数法、平方取中法;
工业级高性能:MurmurHash、xxHash、CityHash、FarmHash;
加密级:SHA-256、Blake2,防碰撞、用于校验与安全场景。
冲突解决:
链地址法:最通用,冲突节点用链表串联;
开放寻址:线性 / 二次探测,无指针,缓存友好;
布谷鸟哈希:多哈希表位置,高负载因子下仍高效;
跳房子哈希:邻域探测,兼顾缓存局部性与负载率。
进阶:一致性哈希(分布式负载均衡,虚拟节点抗倾斜)、可扩展哈希(动态分裂扩容)、布谷鸟过滤器(存在性判断,支持删除)、冷热分层哈希。
核心思想:在有序链表上叠加多层索引,通过高层跳跃、低层精确定位,实现 O (log n) 的查找、插入、删除。
关键特性:概率性平衡(随机决定节点层级),实现比平衡树简单,天然支持区间查询。
工程应用:Redis ZSet 核心实现,支持分值排序、跨度统计;进阶有并发跳表(CAS 无锁)、持久化、压缩索引。
核心结构:Term 词典 + Posting List(倒排链),记录每个词出现的文档 ID 与位置信息。
核心算法:布尔检索(倒排链交并补)、TF-IDF / BM25 相关性评分;
优化手段:倒排链差值压缩、跳表加速求交、列式存储优化、增量实时更新与缓存策略。
典型场景:全文搜索引擎(Elasticsearch)、关键词检索。
基础 BitMap:用二进制位表示状态,位运算极快,适合低基数列的快速筛选、去重统计。
压缩位图:Roaring Bitmap(高低位分桶,兼顾空间与计算速度)、EWAH Bitmap(字对齐压缩);
进阶优化:SIMD 并行位运算、磁盘持久化、分层位图适配大规模数据。
R \ 树*:优化 R 树的节点分裂策略,空间对象范围查询更高效,是 GIS 系统主流索引。
四叉树 / 八叉树:二维 / 三维空间递归四 / 八划分,适合点数据的空间检索。
希尔伯特 R 树:用空间填充曲线排序数据,优化空间局部性与查询性能。
网格索引:地理空间网格化分块,简单高效,适配大规模地理数据。
核心:路径压缩 + 按秩合并,操作均摊复杂度接近常数,用于集合合并与连通性查询。
变种:带权并查集(维护节点到根的权重关系)、可持久化并查集(保留历史版本)、启发式合并、分布式集群连通性实现。
核心:多位图 + 多哈希函数,判断元素 “可能存在 / 一定不存在”,无漏判、有误判,空间效率极高。
变种:计数布隆过滤器(支持删除)、布谷鸟过滤器(更低误判、支持删除)、分层 / 动态布隆过滤器(支持扩容)、分布式合并操作。
典型场景:缓存穿透防护、URL 去重、黑名单前置过滤。
核心:固定大小数组 + 头尾循环指针,FIFO 顺序读写,避免数据搬移,空间复用。
应用:音视频流缓冲、嵌入式系统、环形日志;进阶支持批量读写、无锁线程安全实现。
基础运算:多项式加减乘;
核心加速:FFT(快速傅里叶变换)、NTT(数论变换),将多项式乘法从 O (n²) 优化到 O (n log n);
进阶:多项式求逆、开根、插值、模运算(密码学、信号处理场景)。
替罪羊树:暴力重构维持平衡,实现简单,适合写少读多场景。
珂朵莉树:基于区间赋值的暴力优化,随机数据下区间操作极快。
Link-Cut Tree:动态树,支持路径信息查询、连边 / 断边,用于动态图与树上问题。
蓄水池抽样:流数据等概率抽样,仅需 O (k) 空间。
HyperLogLog:极小空间估算集合基数(去重数量),误差可控。
Count-Min Sketch:多维哈希计数,估算元素频率,结果只高不低。
Space-Saving / Heavy Hitters:流数据中高效统计高频 Top-K 元素。
KD-Tree / Ball-Tree:空间划分树,用于低 / 高维向量的最近邻搜索。
乘积量化 (PQ):高维向量分块压缩,大幅节省向量存储空间。
向量索引(FAISS / HNSW / Annoy):近似最近邻搜索,是向量检索、推荐系统的核心组件。
默克尔树:哈希二叉树,仅用根哈希即可校验数据完整性,可快速定位篡改位置。
默克尔前缀树 (MPT):默克尔树 + 前缀树融合,以太坊状态存储核心,支持路径压缩与默克尔证明。
稀疏默克尔树:仅存储非默认节点,适配区块链轻客户端;累加器树用于零知识证明的集合成员验证。
控制流图 (CFG)、支配树:编译器代码优化、程序分析的基础结构。
内存池、页表、段树:操作系统内存管理的核心数据结构。
倾斜树、窗口计数树:流计算中解决数据倾斜、滑动窗口统计的专用结构。
时空索引、轨迹索引、GeoHash:时空数据与地理信息的索引结构。
稀疏矩阵存储(COO/CSR/CSC):科学计算中稀疏矩阵的高效存储格式。
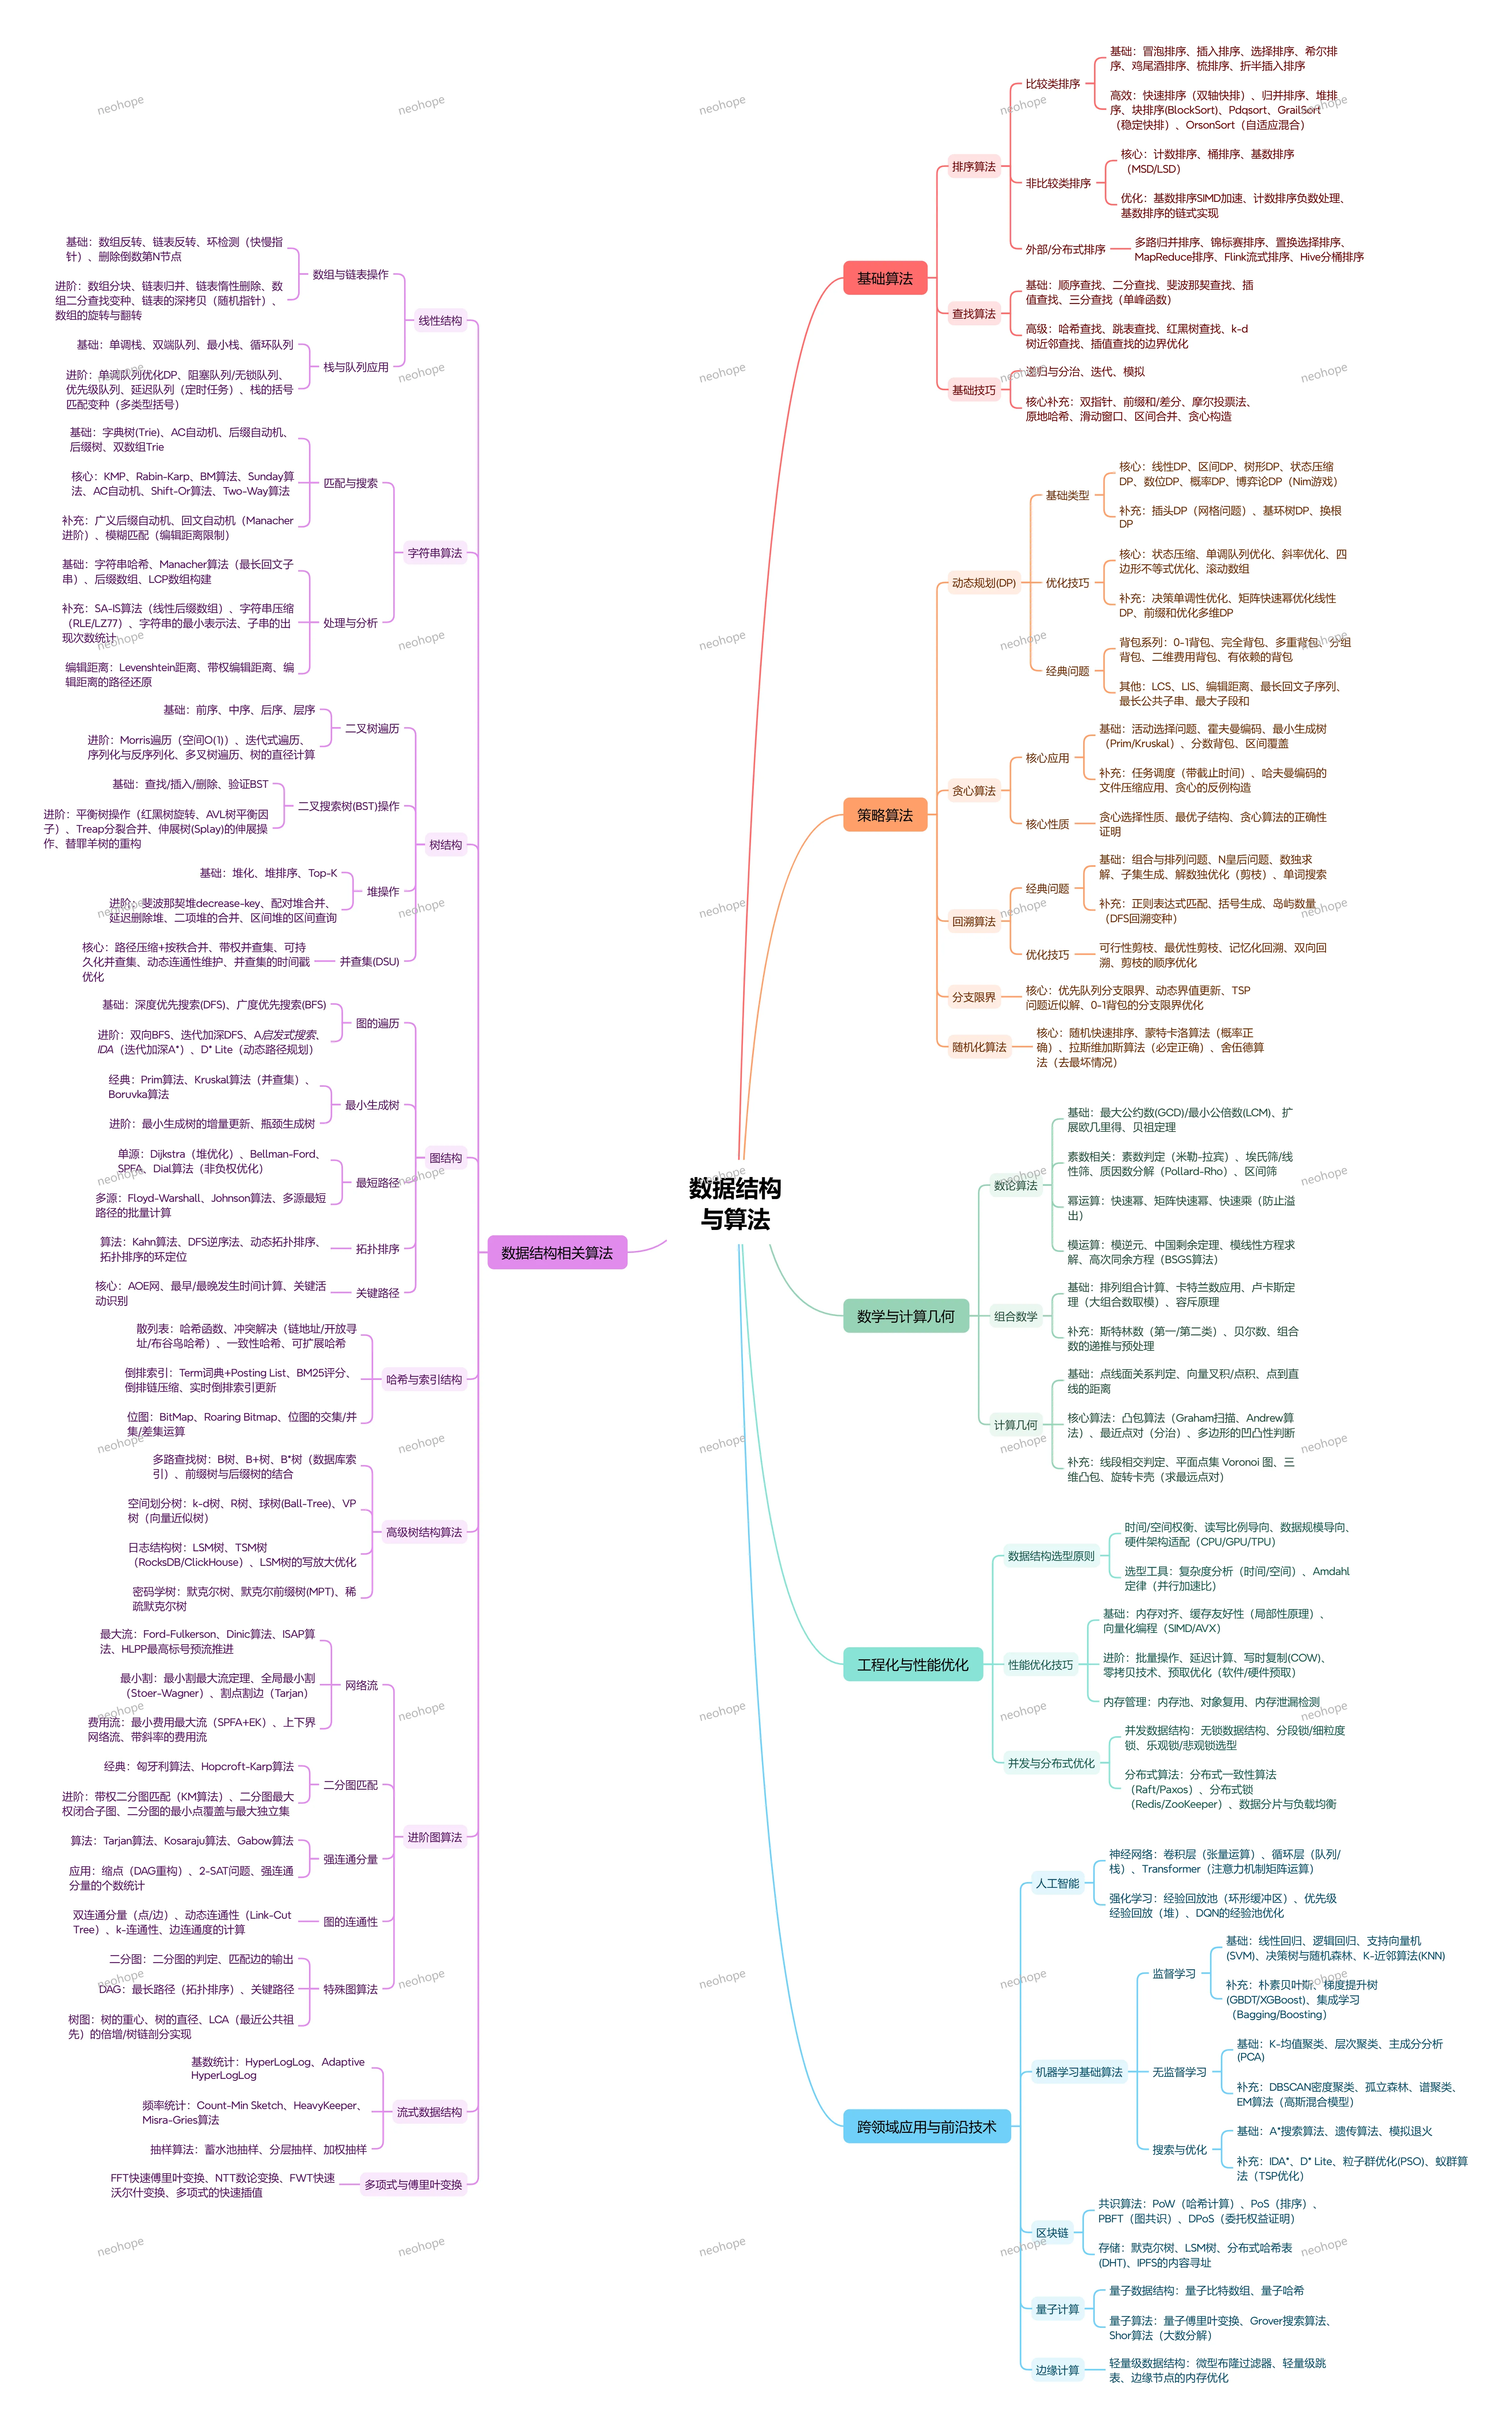
针对不同类型的数据结构,对应专属的操作算法与典型应用场景。
数组与链表:是最基础的线性结构,核心操作包括反转、环检测、节点删除、归并、深拷贝、旋转翻转等;快慢指针、二分查找是常用解题技巧。
栈与队列:栈用于后进先出场景(如括号匹配),队列用于先进先出场景;单调栈、单调队列、双端队列、最小栈、循环队列是经典优化变种;优先级队列、延迟队列、阻塞 / 无锁队列是工程中常用的扩展实现。
专门面向文本处理、信息检索场景:
匹配与搜索:KMP、Rabin-Karp、BM、Sunday 是经典单模式匹配算法;字典树 (Trie)、AC 自动机、后缀自动机用于多模式匹配;双数组 Trie、回文自动机、Shift-Or、Two-Way 算法是进阶优化实现。
处理与分析:字符串哈希、Manacher 算法、后缀数组、LCP 数组用于字符串特征提取与子串统计;SA-IS 是线性时间后缀数组构造算法,基于诱导排序实现,实际性能优异、实现相对简洁;还包括字符串压缩、最小表示法、编辑距离计算等方向。
树是层次化数据的核心组织方式:
二叉树遍历:前序、中序、后序、层序是基础遍历方式;Morris 遍历可实现 O (1) 空间复杂度的遍历;还包括序列化与反序列化、树的直径计算等常用操作。
二叉搜索树 (BST):基础操作包括查找、插入、删除;红黑树、AVL 树、Treap、伸展树、替罪羊树是自平衡 BST 的不同实现,通过旋转 / 重构维持查询效率。
堆:是完全二叉树的典型应用,核心操作包括堆化、Top-K 问题求解;斐波那契堆、配对堆、二项堆、区间堆是进阶堆结构,在合并、降键等操作上性能更优。
并查集 (DSU):用于动态连通性维护,核心优化是路径压缩 + 按秩合并;扩展包括带权并查集、可持久化并查集。
图用于表达实体间的关联关系,是社交网络、路径规划的核心模型。
图的遍历:深度优先搜索 (DFS)、广度优先搜索 (BFS) 是基础;双向 BFS、迭代加深 DFS、A启发式搜索、IDA、D* Lite 是优化与启发式遍历算法。
最小生成树:Prim 算法、Kruskal 算法、Boruvka 算法是经典实现,用于求解无向图的最小权连通子图。
最短路径:堆优化 Dijkstra、Bellman-Ford、SPFA 用于单源最短路径;Floyd-Warshall、Johnson 算法用于多源最短路径。
拓扑排序:Kahn 算法、DFS 逆序法用于有向无环图 (DAG) 的节点排序;可扩展动态拓扑更新、环定位能力。
关键路径:基于 AOE 网计算任务的最早 / 最晚完成时间,识别关键活动,用于工程调度场景。
散列表:通过哈希函数实现快速查找,冲突解决包括链地址、开放寻址、布谷鸟哈希等方案;一致性哈希、可扩展哈希用于分布式存储场景。
倒排索引:是搜索引擎的核心结构,由 Term 词典与倒排列表构成,支持 BM25 相关性评分与倒排链压缩。
位图:BitMap、Roaring Bitmap 用于海量整数的快速去重、集合运算,空间效率极高。
面向数据库、空间索引、存储引擎等专业场景:
多路查找树:B 树、B + 树、B * 树是数据库索引的核心结构,适配磁盘 IO 的读写特性。
空间划分树:k-d 树、R 树、球树 (Ball-Tree)、VP 树用于多维空间数据的索引与近邻查询。
日志结构树:LSM 树、TSM 树是存储引擎的核心写入优化结构,通过批量写入提升写性能,代表应用如 RocksDB、ClickHouse。
密码学树:默克尔树、默克尔前缀树 (MPT)、稀疏默克尔树用于区块链、密码学场景的数据完整性校验。
面向复杂图问题的专业算法:
网络流:Ford-Fulkerson、Dinic、ISAP、HLPP 用于最大流求解;Stoer-Wagner 算法用于全局最小割;最小费用最大流、上下界网络流是扩展应用场景。
二分图匹配:匈牙利算法、Hopcroft-Karp 算法是基础匹配算法;KM 算法用于带权二分图匹配;可延伸至最小点覆盖、最大独立集等问题。
强连通分量:Tarjan、Kosaraju、Gabow 算法用于求解强连通分量,可通过缩点将图重构为 DAG;2-SAT 是典型应用。
图的连通性:双连通分量(点 / 边)、Link-Cut Tree、k – 连通性计算用于动态 / 静态连通性分析。
特殊图算法:包括二分图判定、DAG 最长路径、树的重心与直径、LCA(最近公共祖先)的倍增 / 树链剖分实现等。
面向无法全量加载的流式大数据,通过概率数据结构实现近似统计:
基数统计:HyperLogLog、Adaptive HyperLogLog 用于近似基数统计,空间效率极高。
频率统计:Count-Min Sketch、HeavyKeeper、Misra-Gries 算法用于近似频度统计,识别热点数据。
抽样算法:蓄水池抽样实现流数据的等概率抽样,支持分层、加权等扩展形式。
FFT 快速傅里叶变换、NTT 数论变换、FWT 快速沃尔什变换用于多项式乘法、卷积计算,可将多项式运算的时间复杂度从 O (n²) 降至 O (nlogn),同时支持快速多项式插值。
基础算法是算法体系的底层基石,覆盖排序、查找两类核心操作,以及通用的解题技巧范式。
排序是将无序数据按规则重排的基础操作,按实现原理分为三大类:
比较类排序:通过元素两两比较确定顺序,理论时间复杂度下界为 O (nlogn)。
基础排序:冒泡、插入、选择排序是入门级实现,时间复杂度多为 O (n²);希尔排序是插入排序的分组优化版本;鸡尾酒排序、梳排序是冒泡排序的双向遍历、步长优化变种;折半插入排序通过二分查找优化插入位置的查找过程。
高效排序:快速排序基于分治思想,双轴快排通过双基准值提升分区效率;归并排序是稳定的分治排序;堆排序依托堆结构实现 O (nlogn) 的稳定复杂度。工业级优化算法包括:Pdqsort(模式消除快排)融合快排、堆排与插入排序,可避免快排最坏情况,被 Go、Rust 等语言标准库采用;BlockSort(块排序)是原地稳定排序,内存效率高且具备自适应性;GrailSort 可在常数额外空间内实现稳定排序,适配内存受限场景;OrsonSort 为自适应混合排序,可根据数据分布动态调整策略。
非比较类排序:不通过元素比较,依托数值特征排序,适用于值域有限的整数场景,理想时间复杂度可达 O (n)。核心包括计数排序、桶排序、基数排序(分最高位优先 MSD、最低位优先 LSD 两种实现);优化方向包括 SIMD 向量化加速、负数值域适配、链式存储优化等。
外部 / 分布式排序:面向数据量超内存的场景或分布式集群。多路归并、锦标赛排序、置换选择排序是传统外部排序核心;MapReduce 排序、Flink 流式排序、Hive 分桶排序是大数据生态下的分布式排序实现。
查找是从数据集合中定位目标元素的操作,按策略与数据结构分为两类:
基础查找:顺序查找适用于无序数据,时间复杂度 O (n);二分查找、斐波那契查找、插值查找、三分查找均基于有序数据的分治思想,通过缩小搜索区间提升效率,时间复杂度 O (logn),其中三分查找专门用于单峰函数的极值求解。
高级查找:哈希查找通过哈希函数直接映射存储位置,平均复杂度 O (1);跳表、红黑树通过层级化结构维持有序查找的高效性;k-d 树用于多维空间数据的近邻查找;插值查找可通过边界优化避免极端数据分布下的性能退化。
是各类算法通用的实现思路与优化手段:递归与分治、迭代、模拟是最基础的实现范式;双指针、前缀和 / 差分、滑动窗口、区间合并是数组与区间类问题的核心技巧;摩尔投票法用于线性空间求解众数;原地哈希可实现 O (1) 空间的元素标记;贪心构造用于局部最优可推导全局最优的场景。
策略算法是面向复杂问题的通用求解范式,通过特定决策策略缩小解空间、推导最优解。
核心思想是将问题拆解为重叠子问题,存储子问题解避免重复计算,核心是状态定义与状态转移方程。
基础类型:线性 DP、区间 DP、树形 DP、状态压缩 DP、数位 DP、概率 DP、博弈论 DP(如 Nim 游戏)是主流分类;插头 DP 是基于轮廓线的连通性状压 DP,专门解决网格回路、路径类问题;基环树 DP 针对带单环的树结构,通过破环为树结合环形 DP 求解;换根 DP 通过二次扫描法,以 O (n) 复杂度计算所有节点作为根的 DP 结果。
优化技巧:状态压缩、滚动数组用于空间优化;单调队列优化、斜率优化、四边形不等式优化、决策单调性优化用于降低转移的时间复杂度;矩阵快速幂、前缀和可分别优化线性 DP 与多维 DP 的转移过程。
经典问题:背包系列(0-1 背包、完全背包、多重背包、分组背包、二维费用背包、有依赖的背包)是 DP 最经典的题型;LCS(最长公共子序列)、LIS(最长上升子序列)、编辑距离、最长回文子序列、最大子段和等也是高频应用场景。
每一步做出局部最优选择,最终推导全局最优解,需满足贪心选择性质与最优子结构两个核心前提。
本质是深度优先的暴力枚举,通过 “尝试 – 回退” 的方式遍历所有可行解,适合排列、组合、路径类约束问题。
经典问题:组合与排列、N 皇后、数独求解、子集生成、单词搜索是基础题型;正则表达式匹配、括号生成、岛屿 DFS 是扩展场景。
优化技巧:可行性剪枝、最优性剪枝可提前排除无效路径;记忆化回溯存储子问题结果避免重复计算;双向回溯从问题两端同时搜索缩小范围;调整搜索顺序可提升剪枝触发效率。
以广度优先或最佳优先方式搜索解空间,通过限界函数剪掉不可能得到最优解的分支,常用于组合优化问题。核心包括优先队列式分支限界、动态界值更新,典型应用如 TSP 问题近似解、0-1 背包的分支限界优化。
引入随机因子优化算法性能或正确性:随机快速排序通过随机选择基准避免最坏情况;蒙特卡洛算法以概率保证正确性、运行时间确定;拉斯维加斯算法保证结果正确、运行时间随机;舍伍德算法用于消除最坏情况与输入分布的关联。
是算法的理论基础,为复杂问题提供数学支撑与高效求解方法。
围绕整数性质展开,是密码学、组合优化的核心工具。
基础:最大公约数 (GCD)/ 最小公倍数 (LCM)、扩展欧几里得算法、贝祖定理是数论基石。
素数相关:埃氏筛、线性筛用于批量筛选素数;米勒 – 拉宾是概率性素数判定算法;Pollard-Rho 用于大数质因数分解;区间筛用于大区间内的素数筛选。
幂与模运算:快速幂、快速乘用于大数幂运算的高效计算与溢出规避;模逆元、中国剩余定理、BSGS 算法用于各类同余方程的求解。
研究离散对象的计数与排列规律:排列组合计算、卡特兰数应用、容斥原理是基础内容;卢卡斯定理用于大组合数取模;斯特林数、贝尔数是进阶组合计数工具,通常通过递推预处理实现快速查询。
处理平面 / 空间中的几何对象计算,是图形学、地理信息系统的底层支撑。
基础:向量点积 / 叉积是核心工具,用于点线面关系判定、距离与面积计算。
核心算法:Graham 扫描、Andrew 算法用于求解平面点集的凸包;分治法求解最近点对;旋转卡壳用于求解最远点对;还包括线段相交判定、多边形凹凸性判断、Voronoi 图、三维凸包等进阶内容。
聚焦算法与数据结构在工业场景的落地优化,兼顾理论复杂度与实际运行性能。
选型需结合时间 / 空间权衡、读写比例、数据规模,同时适配 CPU/GPU 等硬件架构;通过复杂度分析、Amdahl 定律评估并行加速比,辅助选型决策。
基础优化:内存对齐、缓存友好设计(利用时间 / 空间局部性)、SIMD/AVX 向量化编程,充分利用 CPU 硬件特性。
进阶优化:批量操作、延迟计算、写时复制 (COW)、零拷贝技术、软硬件预取,减少冗余计算与数据拷贝开销。
内存管理:内存池、对象复用降低内存分配与回收开销;通过专业工具检测内存泄漏。
并发场景下,无锁数据结构、细粒度分段锁、乐观 / 悲观锁选型用于平衡性能与数据一致性;分布式场景中,Raft/Paxos 等一致性算法、分布式锁、数据分片与负载均衡是核心技术。
数据结构与算法是各计算机领域的底层支撑,延伸至 AI、区块链、量子计算等多个前沿方向。
神经网络:卷积层依赖张量运算,循环层依托队列 / 栈结构,Transformer 的注意力机制核心是矩阵运算。
强化学习:经验回放池基于环形缓冲区实现,优先级经验回放依托堆结构优化采样效率。
监督学习:线性回归、逻辑回归、支持向量机 (SVM)、决策树与随机森林、K – 近邻算法 (KNN) 是基础算法;朴素贝叶斯、梯度提升树 (GBDT/XGBoost)、集成学习(Bagging/Boosting)是进阶优化方案,均依托排序、查找、树结构等基础能力。
无监督学习:K – 均值聚类、层次聚类、主成分分析 (PCA) 是基础;DBSCAN 密度聚类、孤立森林、谱聚类、EM 算法(高斯混合模型)用于更复杂的聚类、降维、异常检测场景。
搜索与优化:A搜索算法、遗传算法、模拟退火是启发式优化的代表;IDA、D* Lite、粒子群优化 (PSO)、蚁群算法用于更复杂的路径规划与组合优化问题。
共识算法中,PoW 依托哈希计算,PBFT 基于图论共识;存储层默克尔树、LSM 树、分布式哈希表 (DHT)、IPFS 内容寻址均是数据结构的典型应用。
量子比特数组、量子哈希是新型量子数据结构;Grover 搜索算法、Shor 算法(大数分解)、量子傅里叶变换是标志性量子算法,在特定问题上具备指数级加速能力。
面向边缘节点资源受限的特点,衍生出微型布隆过滤器、轻量级跳表等低内存占用的数据结构,适配边缘硬件的内存约束。
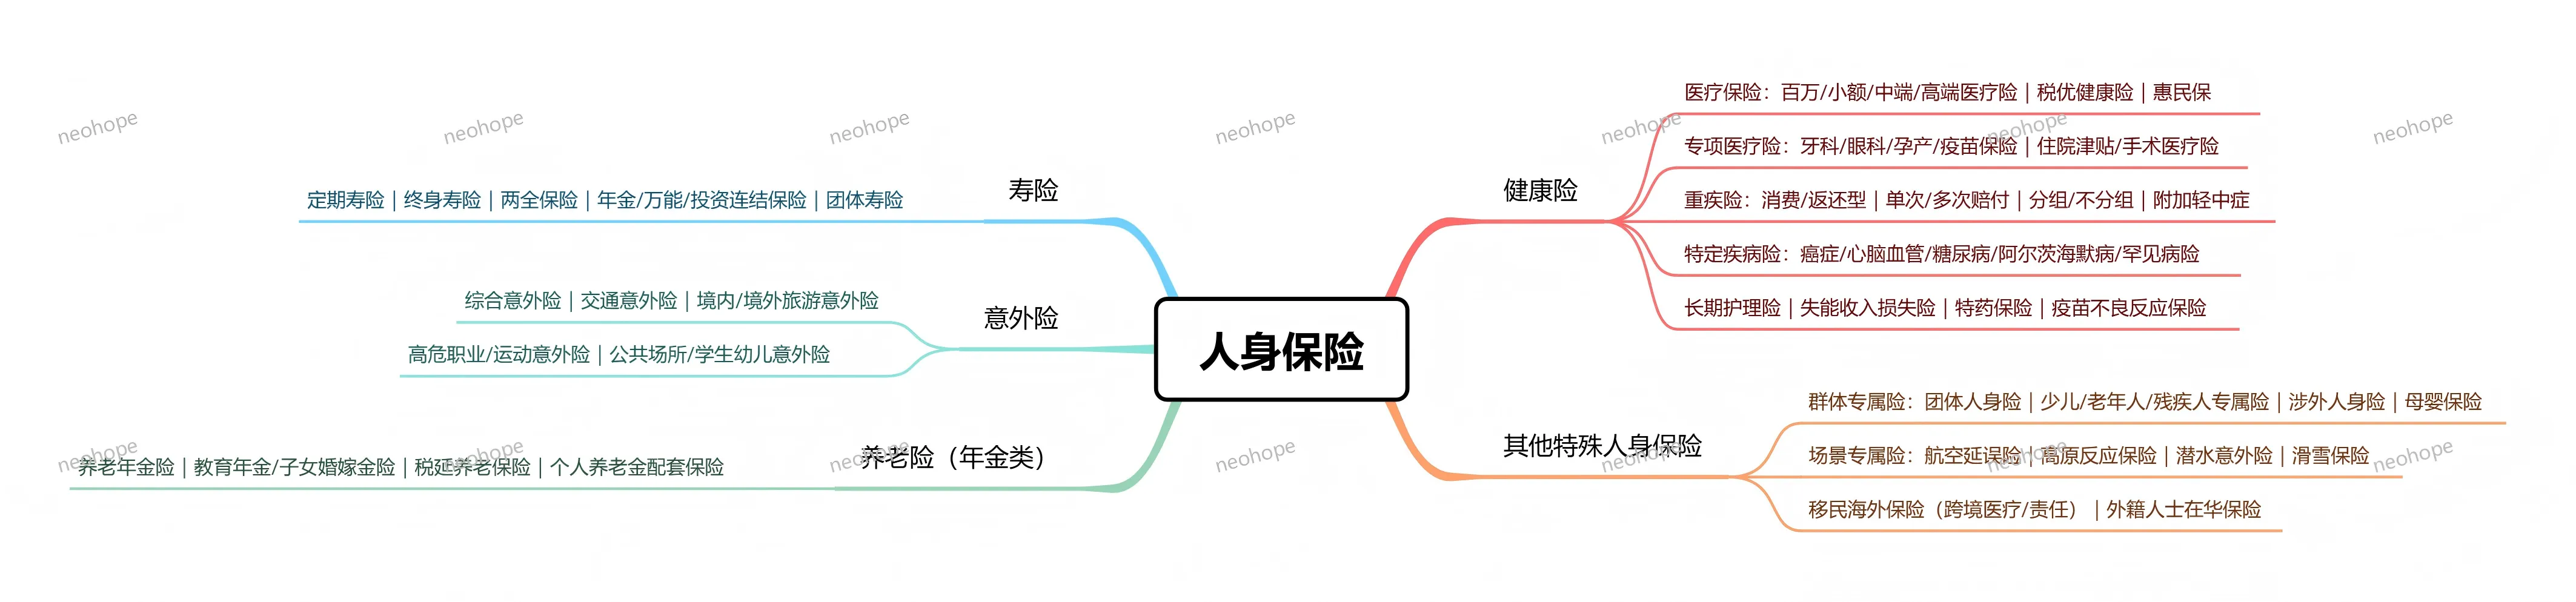
以人的生命或身体为保险标的,覆盖身故、伤残、疾病、养老等人身相关风险。
以人的生命为标的,身故 / 全残为核心赔付条件,核心用于家庭责任覆盖、财富规划。
定期寿险:保障固定期限(如保至 60 岁),期限内身故 / 全残赔付保额,保费低、杠杆高,适合家庭经济支柱覆盖房贷、抚养等责任期。
终身寿险:保障终身,必然发生赔付,兼具身故保障与财富传承、资产隔离功能,保费显著高于定期寿险。
两全保险:生死双赔,保障期内身故赔付保额,满期仍生存则返还约定金额,储蓄属性强,保障属性偏弱。
年金 / 万能 / 投资连结保险:年金险按约定时间定期给付保险金,用于养老、教育现金流规划;万能险设有保底收益账户,资金存取灵活;投连险无保底收益,盈亏由投保人自担,偏投资属性。
团体寿险:企业 / 团体为成员统一投保,保障员工身故 / 全残,保费低、投保门槛宽松,多作为员工福利。
以意外导致的身故、伤残、医疗支出为赔付条件,核心覆盖外来、突发、非本意、非疾病的风险。
综合意外险:覆盖日常全场景意外,含意外身故 / 伤残、意外医疗,保障全面,是普通人的基础配置。
交通意外险:仅保障乘坐飞机、火车、地铁、网约车等公共交通期间的意外,保费极低、保额高,适合高频差旅人群。
境内 / 境外旅游意外险:按出行地域与天数投保,覆盖旅行期间意外医疗、紧急救援、行程取消 / 延误、行李丢失等专属风险。
高危职业 / 运动意外险:针对建筑工人、高空作业等高危职业,或攀岩、潜水等普通意外险免责的高风险运动,定向覆盖对应场景意外。
公共场所 / 学生幼儿意外险:面向校园、托育机构或公共场所经营方投保,覆盖未成年人、公众在特定场所内的意外风险。
属于年金保险范畴,核心功能是强制储蓄、锁定长期现金流,用于特定人生阶段的资金规划。
养老年金险:年轻时缴费,退休后按年 / 月领取养老金,专款专用补充养老,可锁定终身现金流。
教育年金 / 子女婚嫁金险:针对子女成长规划,在大学、婚嫁等约定年龄给付保险金,实现强制储蓄与资金定向使用。
税延养老保险:缴费时可在个人所得税税前扣除,领取时再补缴个税,享受税收优惠,面向纳税人群补充养老。
个人养老金配套保险:纳入个人养老金账户的专属商业养老保险,缴费可享受个税抵扣,账户封闭运行,专用于养老积累。
以人的健康为标的,覆盖疾病、医疗、护理等相关支出与收入损失。
报销型险种,对医疗费用按约定比例报销,是医保的核心补充。
百万医疗险:保额百万级,覆盖住院、特殊门诊等大额医疗支出,通常设 1 万元免赔额,保费低、杠杆高,是大病医疗基础保障。
小额医疗险:保额多为 1-5 万元,免赔额低甚至 0 免赔,覆盖小病住院、门诊费用,弥补百万医疗险的免赔额缺口。
中端医疗险:兼顾高保额与就医体验,可拓展普通门诊、公立医院特需部 / 国际部就医,适配对就医环境有要求的人群。
高端医疗险:覆盖全球范围、私立医院 / 昂贵医院,含门诊、齿科、孕产等全面责任,就医服务与直付体验优质,保费较高。
税优健康险:可享受个税税前扣除,支持带病投保、保证续保,补充医保大额支出,适配健康异常人群。
惠民保:城市定制型普惠医疗险,不限年龄、职业、健康状况,保费极低,仅当地医保参保人可投,补充高额住院与特药费用。
针对特定医疗场景或部位的定向保障。
牙科 / 眼科 / 孕产 / 疫苗保险:分别覆盖牙科治疗、近视手术、孕产并发症与新生儿风险、疫苗接种费用,责任高度聚焦。
住院津贴 / 手术医疗险:定额给付型,按住院天数或手术等级给付津贴,不与医疗费报销挂钩,用于弥补误工、陪护等间接损失。
给付型险种,确诊约定重疾即赔付保额,用于弥补收入损失、康复费用、家庭开支。
消费型 / 返还型:消费型仅承担保障责任,满期无返还,保费低、杠杆高;返还型满期未出险可返还保费 / 保额,储蓄属性强、保费更高。
单次 / 多次赔付:单次赔付重疾仅赔 1 次,赔付后合同终止;多次赔付可赔付多次重疾,适配担心多次患病的需求。
分组 / 不分组:多次赔付的细分类型,分组重疾同组疾病仅赔 1 次,保费更低;不分组重疾无组别限制,赔付门槛更低、保费更高。
附加轻中症:在重疾基础上,增加轻症、中症责任,按比例赔付,大幅降低理赔门槛。
针对单一或一类疾病的定向保障,保费比重疾险更低。
长期护理险:被保险人因年老、疾病失能,无法自主生活时,定期给付护理金,覆盖长期照护费用,应对养老失能风险。
失能收入损失险:因意外或疾病导致完全 / 部分失能、无法工作时,定期给付收入补偿,弥补收入中断损失。
特药保险:专门报销癌症等重疾的院外靶向药、特效药费用,补充普通医疗险的药品保障缺口。
疫苗不良反应保险:保障接种疫苗后出现不良反应、偶合症导致的身故、伤残与医疗费用。
针对特定人群、特定场景设计的小众人身保障。
团体人身险:企业为员工统一投保,整合意外、医疗、寿险等责任,作为员工福利,投保门槛低、人均保费低。
少儿 / 老年人 / 残疾人专属险:适配对应群体的高发风险与投保限制,如少儿专属重疾、老人防癌险、残疾人意外伤害险。
涉外人身险:面向出境工作、长期旅居海外的人群,覆盖境外期间的人身、医疗风险。
母婴保险:覆盖孕期准妈妈的妊娠并发症,以及新生儿的先天疾病、早产等风险。
航空延误险:航班延误、取消达到约定时长 / 条件,定额赔付保险金。
高原反应保险:保障高原旅行中因高原反应引发的医疗、身故等风险。
潜水 / 滑雪保险:针对高风险运动场景,覆盖运动中的意外受伤、救援、设备损失等责任。
移民海外保险:覆盖移民后的跨境医疗、海外法律责任等综合风险。
外籍人士在华保险:为在华工作、生活的外籍人员提供医疗、人身意外等适配保障。
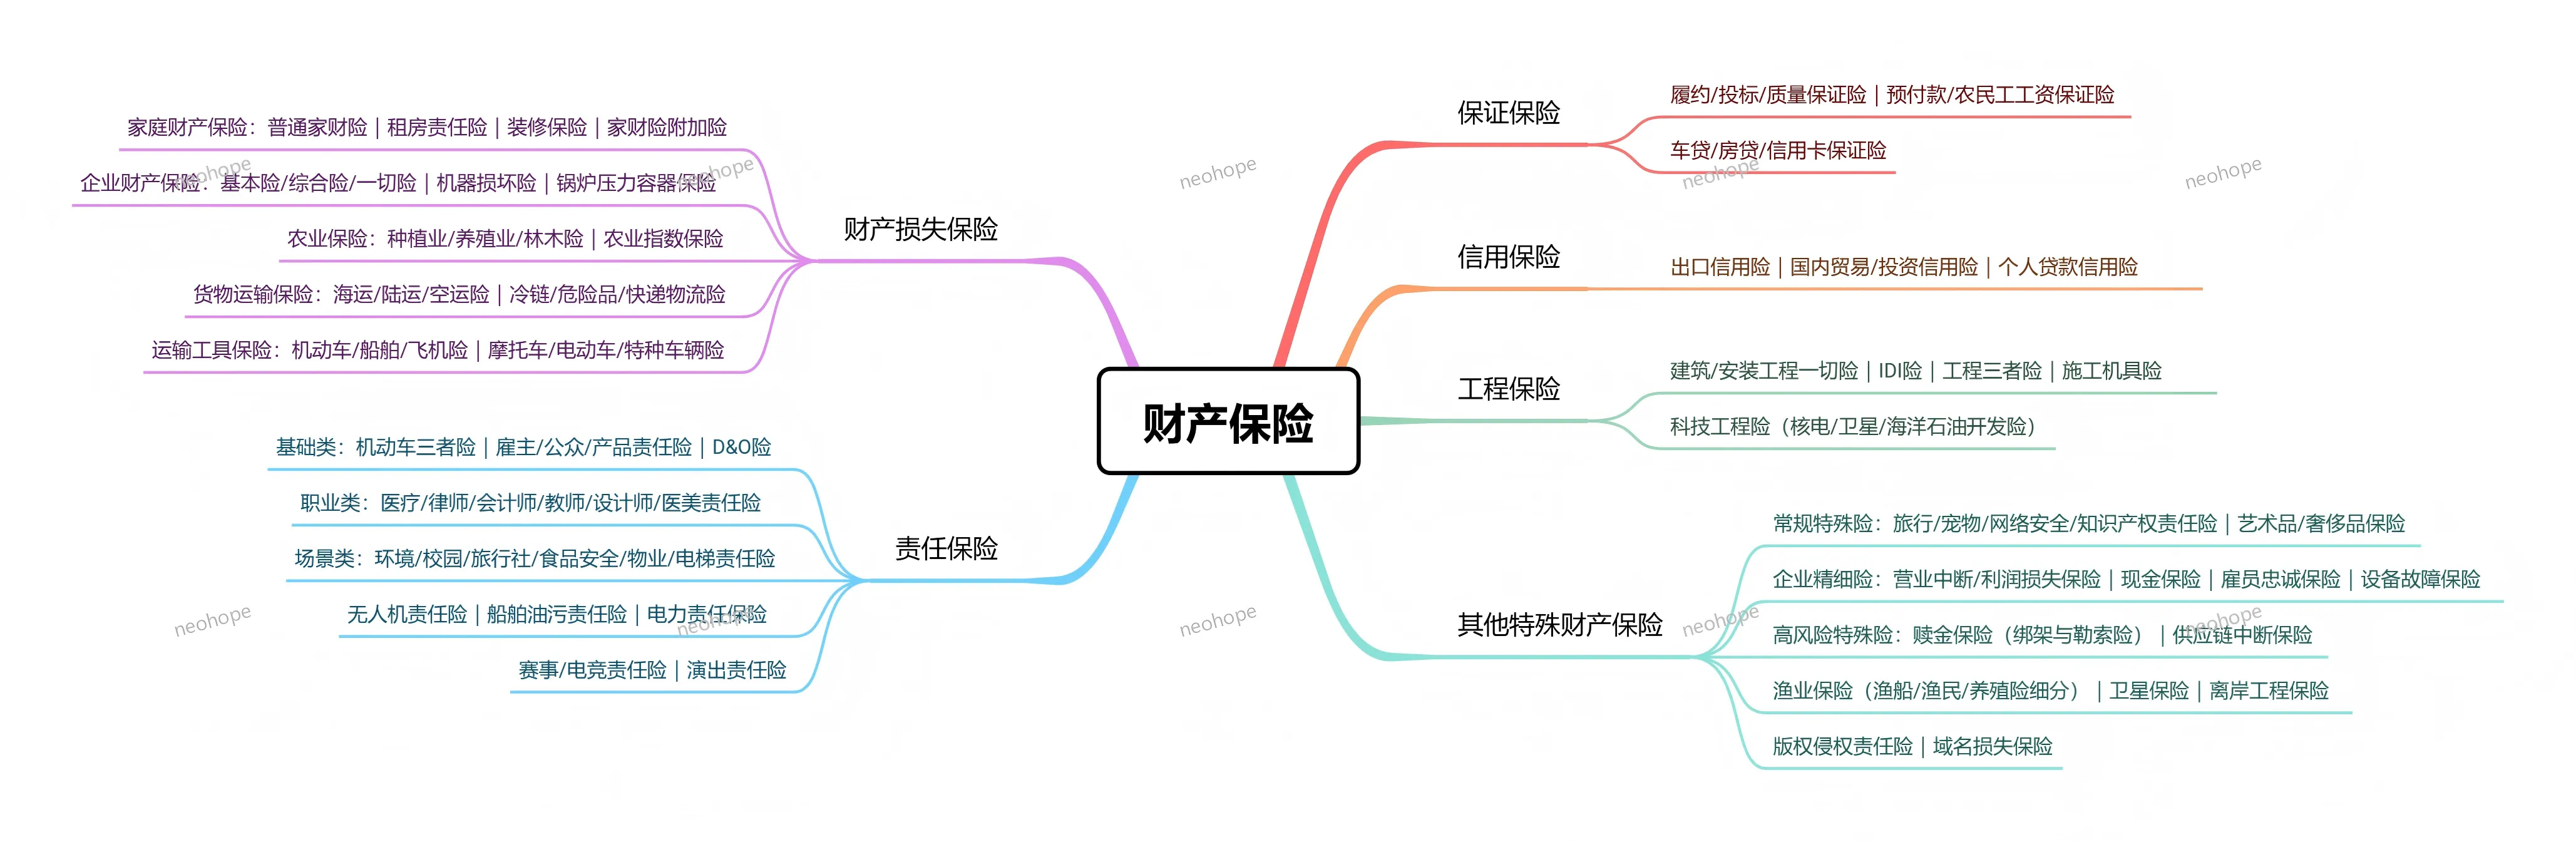
以财产及其相关利益、责任为保险标的,覆盖财产损失、经济赔偿责任等风险。
保障有形财产因灾害、事故造成的直接损失。
面向个人 / 家庭的房屋与室内财产保障。
普通家财险:保障房屋主体、装修、室内家电家具等,因火灾、爆炸、暴雨、盗抢等造成的损失。
租房责任险:租客投保,保障因租客过失导致房东财产损坏,或对第三方造成人身财产损失的赔偿责任。
装修保险:专门保障房屋装修期间,装修材料、施工意外导致的财产损失与第三者责任。
家财险附加险:如水暖管破裂、家用电器用电安全、盗抢、宠物责任等,可按需附加补充。
面向企业的固定资产、流动资产保障。
基本险 / 综合险 / 一切险:保障范围逐级扩大:基本险仅覆盖火灾、爆炸等少数风险;综合险增加暴雨、台风等常见自然灾害;一切险保障列明除外责任外的所有意外风险。
机器损坏险:专门保障企业生产机器因操作失误、设备故障、电气故障等造成的损坏与维修费用。
锅炉压力容器保险:保障锅炉、压力容器等特种设备爆炸、损坏造成的财产损失与第三者赔偿责任。
多含政策补贴,保障农业生产中的财产损失。
种植业 / 养殖业 / 林木险:分别保障农作物、畜禽水产、林木因自然灾害、病虫害、疫病等造成的损失。
农业指数保险:以降雨量、气温、产量等客观指数为赔付依据,达到约定阈值即赔付,理赔流程更高效。
保障运输途中的货物损失。
海运 / 陆运 / 空运险:按运输方式划分,覆盖货物在对应运输途中因自然灾害、意外事故造成的损毁、丢失。
冷链 / 危险品 / 快递物流险:针对特殊货物,分别覆盖冷链货物变质、危险品泄漏损毁、快递包裹丢失破损等专属风险。
保障各类交通工具本身的损失。
机动车 / 船舶 / 飞机险:以对应交通工具为标的,含车辆 / 船体本身损失保障,以及第三者责任保障(如机动车车损险、三者险)。
摩托车 / 电动车 / 特种车辆险:针对非机动车、工程特种车等,覆盖车辆损失与第三者赔偿责任。
保障被保险人因过失造成第三方人身伤亡或财产损失,依法应承担的经济赔偿责任。
机动车三者险:保障机动车事故中,对第三方造成的人身伤亡、财产损失的赔偿责任,是车险核心险种。
雇主责任险:企业投保,保障员工因工受伤、身故时,企业依法应承担的赔偿责任,转移用工风险。
公众责任险:保障经营场所、公共活动中,因管理过失造成第三方人身财产损失的赔偿责任,适用于商场、餐厅、展会等场景。
产品责任险:保障产品存在缺陷,导致使用者人身伤害或财产损失时,生产 / 销售方应承担的赔偿责任。
D&O 险(董事高管责任险):保障公司董事、高管因履职过失被追责时的赔偿责任与法律费用。
环境责任险、校园责任险、旅行社责任险、食品安全责任险、物业责任险、电梯责任险等,分别对应特定场景下的第三方赔偿风险。
此外还有无人机责任险、船舶油污责任险、电力责任保险,以及赛事 / 电竞责任险、演出责任险,覆盖对应领域的责任与活动取消损失。
被保证人(义务人)向保险公司投保,若义务人不履行义务导致权利人受损,由保险公司赔付,本质是 “担保类保险”。
履约 / 投标 / 质量保证险:替代传统保证金,如投标保证险替代投标保证金,履约险保障合同如约履行,质量险保障产品 / 工程质量。
预付款 / 农民工工资保证险:保障预付款按约定返还、农民工工资按时发放,规避拖欠风险。
车贷 / 房贷 / 信用卡保证险:借款人投保,若借款人逾期未还款,保险公司向金融机构赔付欠款,辅助借款人获取信贷。
权利人向保险公司投保,保障因对方信用风险(如拖欠、破产)造成的自身损失。
出口信用险:保障出口企业因海外买方破产、拖欠货款,或进口国政治风险导致的收汇损失,支持外贸发展。
国内贸易 / 投资信用险:分别保障国内贸易应收账款坏账损失,以及境内外投资因政治、信用风险造成的损失。
个人贷款信用险:保障金融机构发放个人贷款后,因借款人违约产生的债权损失。
保障工程建设、运营全周期的财产与责任风险。
建筑 / 安装工程一切险:覆盖建筑、安装工程施工期间,因自然灾害、意外事故造成的工程财产、物料损失。
IDI 险(工程质量潜在缺陷保险):保障住宅工程竣工后,在约定期限内出现地基、主体结构等质量缺陷的维修费用。
工程三者险:保障工程施工期间,因意外造成工地周边第三方人身伤亡、财产损失的赔偿责任。
施工机具险:保障塔吊、挖掘机等施工机械设备在使用、存放中的损坏、丢失损失。
科技工程险:针对核电、卫星、海洋石油开发等高科技工程,覆盖建设、运营中的特殊高风险。
针对小众、高价值或高风险场景的细分财产保障。
营业中断 / 利润损失保险:企业因财产受损导致停产停业,补偿停业期间的利润损失与固定运营开支。
现金保险:保障企业现金、有价证券在库房存放、押运途中的盗抢、丢失损失。
雇员忠诚保险:保障企业因员工贪污、挪用、欺诈等不忠诚行为造成的直接经济损失。
设备故障保险:保障企业核心设备故障导致的生产中断损失与维修费用。
赎金保险(绑架与勒索险):保障遭遇绑架、敲诈勒索时的赎金损失与应急、安保费用,适配高风险地区出行的高净值人群。
供应链中断保险:保障因供应链上游企业灾害、停产等,导致自身生产中断造成的利润与成本损失。
渔业保险(渔船、渔民、水产养殖细分)、卫星保险(发射与在轨运行损失)、离岸工程保险、版权侵权责任险、域名损失保险等,均为对应垂直领域的定向风险保障。
近期豆包发布了“豆包手机助手”,并与中兴联合发布了努比亚M153工程样机,提前完成了苹果画的“新版Siri”大饼。
与苹果、华为的实现路径并不相同(要求各APP厂商根据平台规范,提供AI助手可以调用的能力信息,类A2A协议),豆包手机助手则是通过更底层的系统权限,直接模拟客户操作,引起了部分APP厂商和AI厂商的恐慌,当然也引起了不少关于隐私的讨论。有几点思考,记录一下: