数据库分类汇总
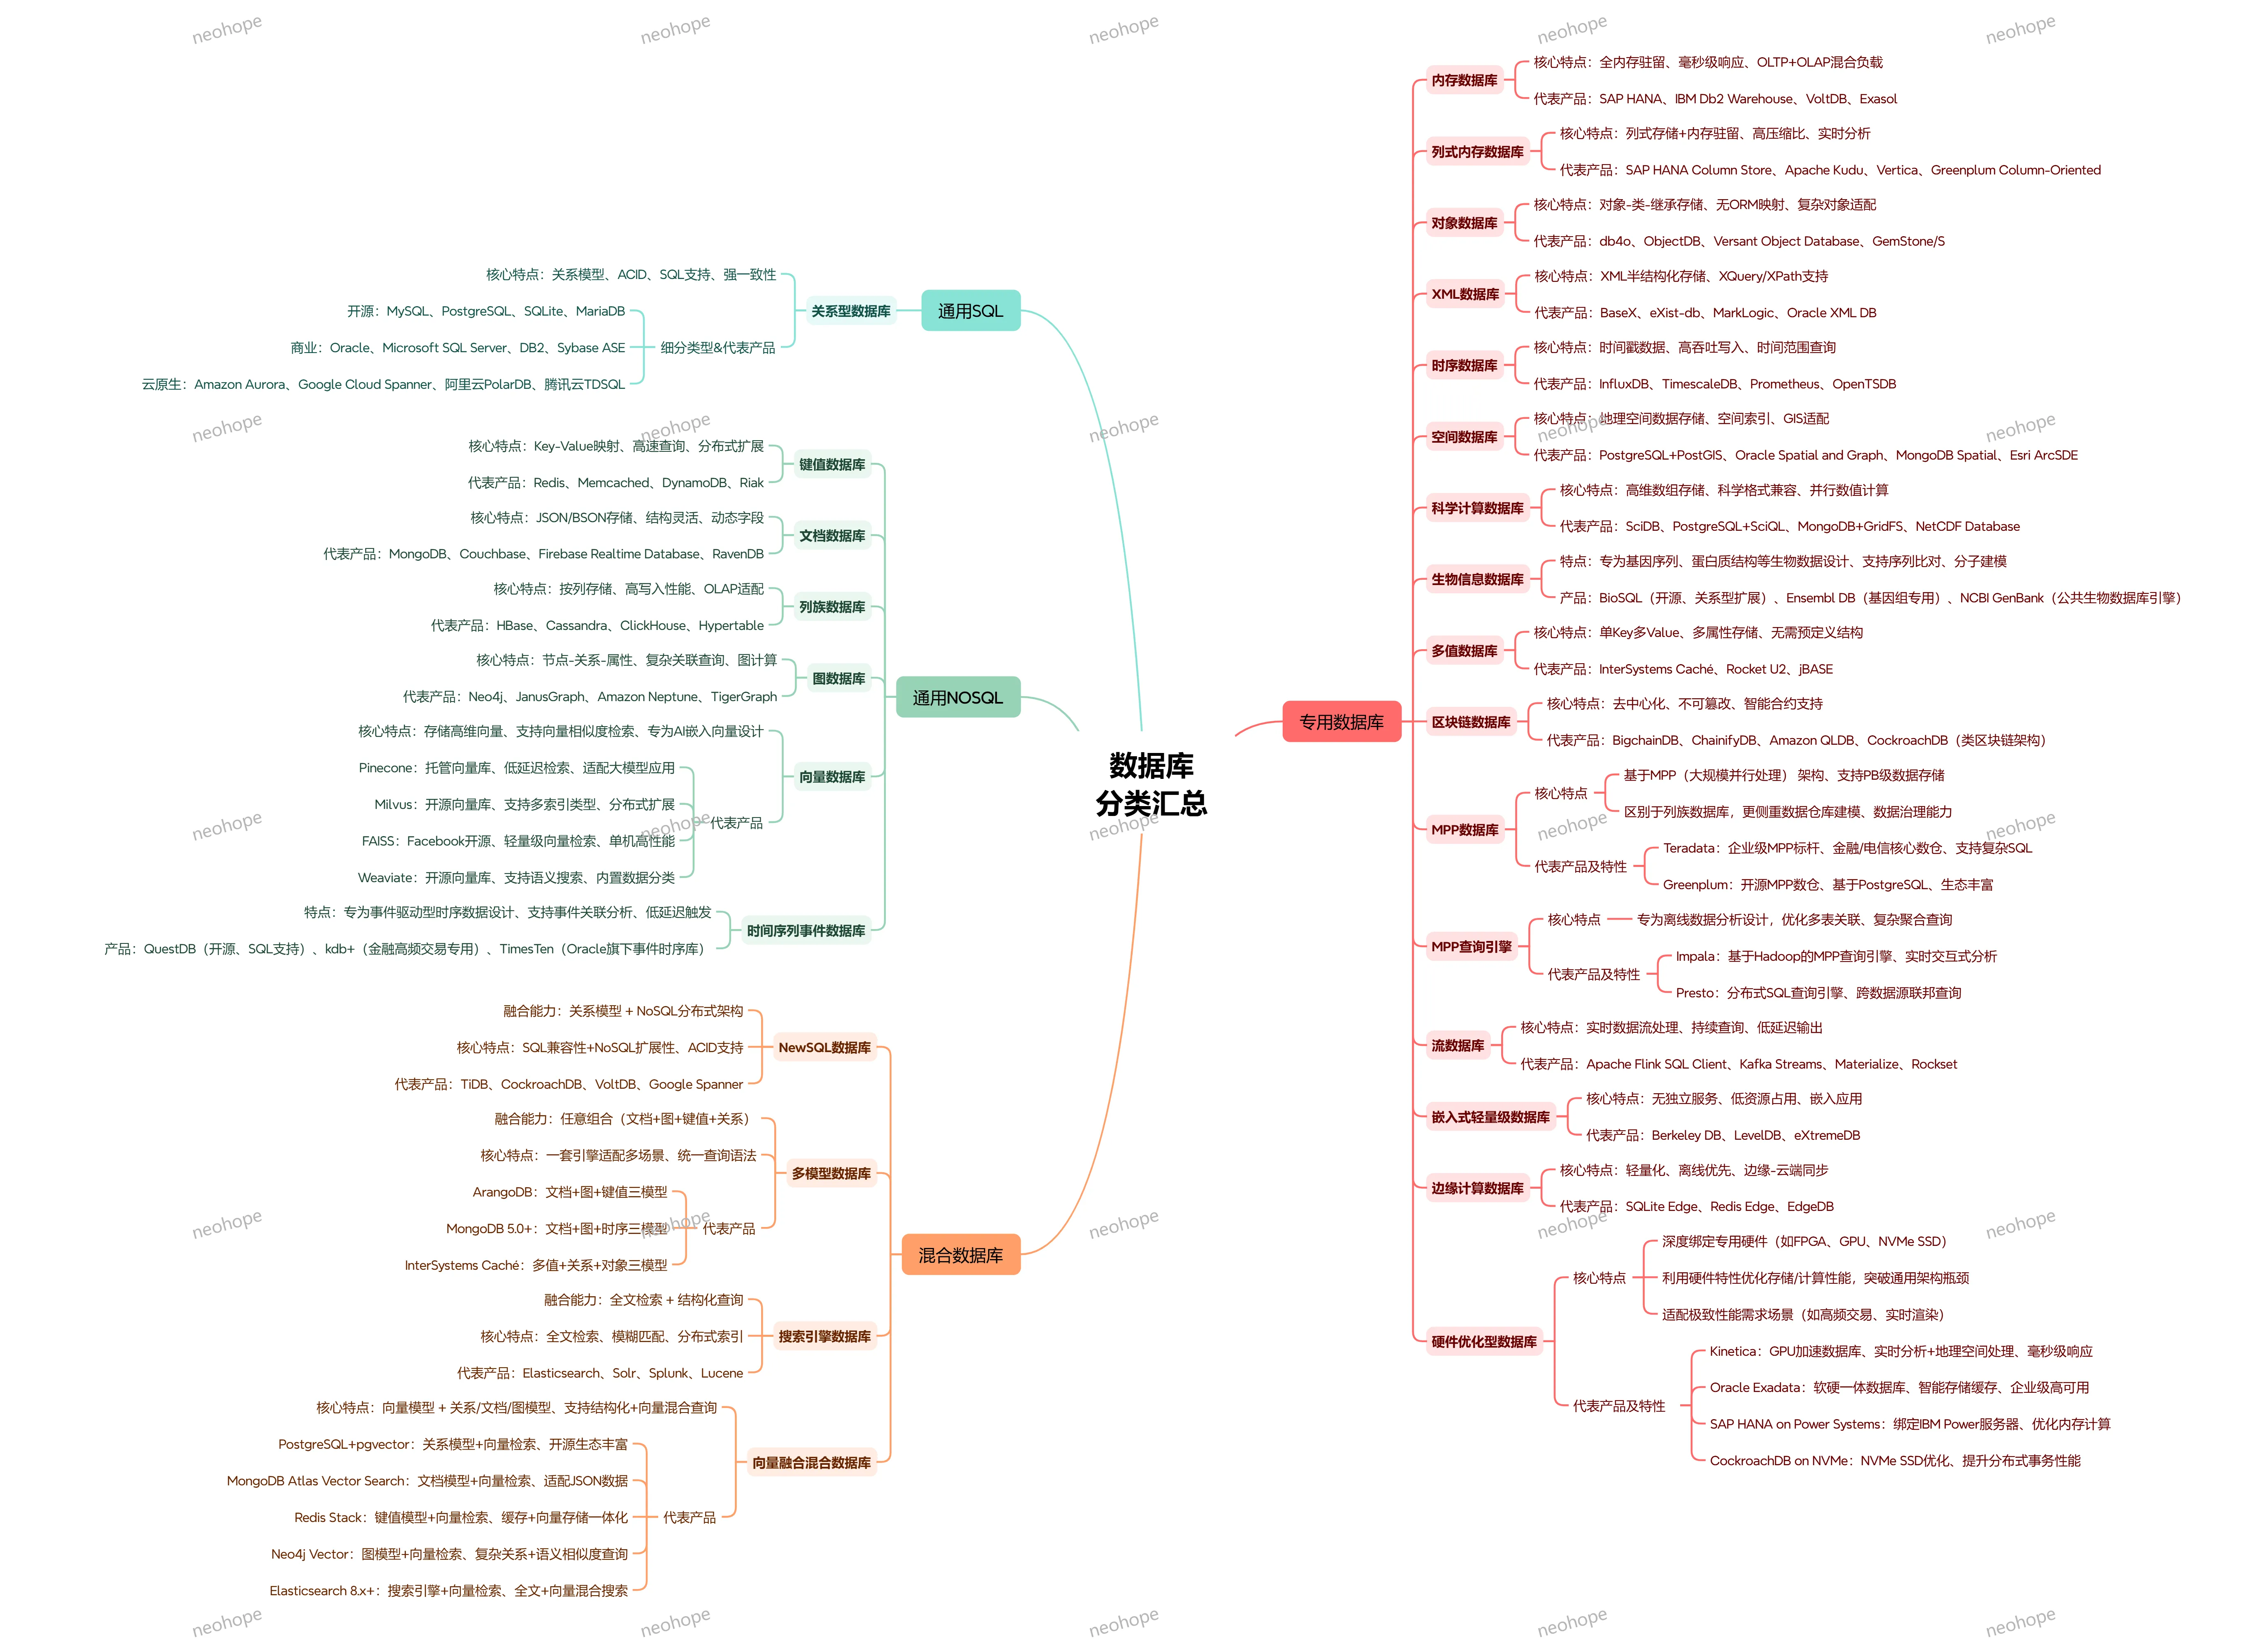
一、通用 SQL:关系型数据库
核心特点:基于二维表关系模型,严格遵循 ACID 事务特性,支持标准 SQL 语法,保障数据强一致性,是结构化业务数据的主流存储方案。
-
开源产品:MySQL(生态最成熟的开源关系库,互联网业务通用)、PostgreSQL(功能丰富的对象 – 关系库,扩展性极强)、SQLite(轻量嵌入式库,无服务端,端侧应用首选)、MariaDB(MySQL 社区分支,原生兼容 MySQL 生态)
-
商业产品:Oracle(企业级商业数据库标杆,金融、政务核心系统标配)、Microsoft SQL Server(微软生态深度适配,企业级管理能力完善)、DB2(IBM 旗下,适配大型机与企业级数仓)、Sybase ASE(老牌商业关系库,传统企业应用广泛)
-
云原生产品:Amazon Aurora(AWS 云原生,兼容 MySQL/PostgreSQL,高可用高性能)、Google Cloud Spanner(全球分布式强一致关系库)、阿里云 PolarDB(计算存储分离的云原生分布式库)、腾讯云 TDSQL(金融级分布式事务数据库)
二、通用 NoSQL
面向高并发、海量数据、灵活结构场景,弱化强事务约束,主打水平扩展能力,按数据模型分为 6 类:
1. 键值数据库
核心特点:以 Key-Value 键值对为存储单元,查询路径极短、速度极快,天然支持分布式扩展,适配缓存、高并发读写场景。
代表产品:Redis(内存型键值库,支持丰富数据结构,缓存 / 会话存储首选)、Memcached(轻量纯内存缓存,架构极简)、DynamoDB(AWS 托管 Serverless 键值库)、Riak(高可用容错分布式键值库)
2. 文档数据库
核心特点:以 JSON/BSON 半结构化文档为存储单位,无需预定义表结构,支持动态字段,适配业务需求频繁变化的场景。
代表产品:MongoDB(最主流分布式文档库,互联网业务广泛应用)、Couchbase(内存优先文档库,高并发低延迟)、Firebase Realtime Database(谷歌托管实时文档库,移动端深度适配)、RavenDB(.NET 生态文档库,支持 ACID 事务)
3. 列族数据库
核心特点:按列族组织数据存储,写入性能优异,适配海量结构化数据的批量分析,主打 OLAP 场景。
代表产品:HBase(基于 Hadoop 的分布式列库,大数据生态核心存储)、Cassandra(跨地域高可用分布式列库)、ClickHouse(列式 OLAP 数据库,聚合查询性能极强)、Hypertable(开源分布式列库,对标 Google Bigtable)
4. 图数据库
核心特点:以「节点 – 关系 – 属性」为核心数据模型,原生优化复杂关联查询与图计算,适配社交关系、知识图谱、风控链路等场景。
代表产品:Neo4j(最主流原生图数据库,Cypher 查询语言生态完善)、JanusGraph(开源分布式图库,适配大数据存储)、Amazon Neptune(AWS 托管图数据库,支持属性图 + RDF)、TigerGraph(分布式高性能图计算引擎)
5. 向量数据库
核心特点:专为高维向量数据设计,支持向量相似度检索,是大模型 RAG、语义搜索、多模态检索的核心基础设施。
代表产品:
-
Pinecone:全托管向量库,低延迟检索,开箱即用,适配大模型应用
-
Milvus:开源分布式向量库,支持多类索引算法,可大规模水平扩展
-
FAISS:Facebook 开源向量检索工具库,轻量高性能,主打单机检索
-
Weaviate:开源向量库,内置语义搜索与数据分类能力
6. 时间序列事件数据库
核心特点:面向事件驱动的时序数据,支持事件关联分析与低延迟触发,适配高频事件流场景。
代表产品:QuestDB(开源高性能时序库,兼容 SQL)、kdb+(金融高频交易专用,极致低延迟)、TimesTen(Oracle 旗下内存事件时序库,适配电信 / 金融实时交易)
三、混合数据库
融合多种数据模型或架构能力,一套系统覆盖多类场景,减少多组件运维成本,分为 5 类:
1. NewSQL 数据库
融合能力:关系模型 + NoSQL 分布式架构
核心特点:既兼容标准 SQL、支持 ACID 强事务,又具备 NoSQL 的水平扩展能力,解决传统关系库的分布式性能瓶颈。
代表产品:TiDB(开源分布式 NewSQL,兼容 MySQL,支持 HTAP 混合负载)、CockroachDB(全球分布式强一致 NewSQL)、VoltDB(内存型 NewSQL,高吞吐 OLTP)、Google Spanner(NewSQL 技术标杆,支持全球级分布式事务)
2. 多模型数据库
融合能力:支持文档、图、键值、关系等多种模型任意组合
核心特点:单一存储引擎适配多类数据场景,统一查询语法,降低多系统协同复杂度。
代表产品:
-
ArangoDB:原生支持文档 + 图 + 键值三模型,统一 AQL 查询语言
-
MongoDB 5.0+:在文档模型基础上,扩展图查询、时序数据能力
-
InterSystems Caché:支持多值 + 关系 + 对象三模型,医疗等行业深度适配
3. 搜索引擎数据库
融合能力:全文检索 + 结构化查询
核心特点:基于倒排索引实现分词检索、模糊匹配,支持分布式索引扩展,适配日志分析、全文搜索场景。
代表产品:Elasticsearch(最主流分布式搜索引擎,日志检索、全文搜索标配)、Solr(基于 Lucene 的企业级搜索引擎)、Splunk(机器数据搜索引擎,运维日志分析)、Lucene(底层全文检索核心引擎库)
4. 向量融合混合数据库
核心特点:在原有数据库模型基础上集成向量检索能力,支持结构化数据与向量的混合查询,无需额外维护独立向量系统。
代表产品:
-
PostgreSQL+pgvector:关系型数据库扩展向量检索,开源生态成熟
-
MongoDB Atlas Vector Search:文档数据库原生向量检索,适配 JSON 数据
-
Redis Stack:键值缓存扩展向量能力,缓存 + 向量存储一体化
-
Neo4j Vector:图数据库结合向量检索,支持关系 + 语义混合查询
-
Elasticsearch 8.x+:搜索引擎融合向量检索,实现全文 + 向量混合搜索
四、专用数据库
面向垂直场景深度优化,针对特定数据形态、负载或硬件做定制化设计,主要类别如下:
1. 内存数据库
核心特点:数据全量驻留内存,磁盘仅做持久化备份,响应延迟低至毫秒级,支持 OLTP+OLAP 混合负载。
代表产品:SAP HANA(企业级内存计算平台,HTAP 混合负载标杆)、IBM Db2 Warehouse(内存加速数仓)、VoltDB(内存 OLTP 数据库)、Exasol(内存列式分析数据库)
2. 列式内存数据库
核心特点:结合列式存储与全内存驻留,具备高压缩比,针对实时聚合分析深度优化。
代表产品:SAP HANA Column Store(HANA 列式内存引擎)、Apache Kudu(列式存储,兼顾实时写入与分析)、Vertica(企业级列式分析数仓)、Greenplum Column-Oriented(MPP 数仓列式引擎)
3. 对象数据库
核心特点:直接以面向对象范式存储数据,支持类、继承、对象引用,无需 ORM 映射,适配复杂对象业务。
代表产品:db4o(轻量开源嵌入式对象库)、ObjectDB(Java 生态对象数据库)、Versant Object Database(企业级对象库)、GemStone/S(Smalltalk 生态对象库)
4. XML 数据库
核心特点:原生存储 XML 半结构化数据,支持 XQuery、XPath 查询,适配以 XML 为核心的企业系统。
代表产品:BaseX(开源轻量 XML 数据库)、eXist-db(开源原生 XML 库)、MarkLogic(企业级 XML / 文档库)、Oracle XML DB(Oracle 原生 XML 存储扩展)
5. 时序数据库
核心特点:专为带时间戳的时序数据设计,支持高吞吐写入,优化时间范围查询与聚合,适配监控、IoT 场景。
代表产品:InfluxDB(主流开源时序库,运维监控场景常用)、TimescaleDB(基于 PostgreSQL 的时序扩展,兼容 SQL)、Prometheus(云原生监控时序数据库)、OpenTSDB(基于 HBase 的分布式时序库)
6. 空间数据库
核心特点:存储地理空间数据,支持空间索引与空间计算,适配 GIS、地图服务、位置业务。
代表产品:PostgreSQL+PostGIS(最主流开源空间数据库,功能全面)、Oracle Spatial and Graph(Oracle 企业级空间扩展)、MongoDB Spatial(文档库空间索引扩展)、Esri ArcSDE(专业 GIS 空间数据引擎)
7. 科学计算数据库
核心特点:面向高维数组、科研数据设计,兼容科学数据格式,支持并行数值计算。
代表产品:SciDB(阵列科学数据库,适配科研大数据)、PostgreSQL+SciQL(关系库扩展科学计算能力)、MongoDB+GridFS(大文件科学数据存储)、NetCDF Database(气象等领域科学数据存储)
8. 生物信息数据库
核心特点:专为基因序列、蛋白质结构等生物数据定制,支持序列比对、分子建模等生物信息分析。
代表产品:BioSQL(开源关系型生物数据库扩展)、Ensembl DB(基因组专用数据库)、NCBI GenBank(公共生物序列数据库引擎)
9. 多值数据库
核心特点:单键对应多属性多值,无需预定义表结构,属于后关系型数据库,适配复杂多层级属性场景。
代表产品:InterSystems Caché(企业级多值库,医疗行业广泛应用)、Rocket U2(多值数据库套件)、jBASE(多值数据库,兼容 Pick 系统)
10. 区块链数据库
核心特点:具备去中心化、数据不可篡改、可追溯特性,部分支持智能合约,适配存证、可信交易场景。
代表产品:BigchainDB(区块链式分布式数据库)、ChainifyDB(可信区块链数据库)、Amazon QLDB(AWS 托管不可篡改账本数据库)、CockroachDB(分布式架构具备类区块链可信特性)
11. MPP 数据库
核心特点:基于大规模并行处理(MPP)架构,支持 PB 级数据存储,侧重数据仓库建模与数据治理能力,更偏向企业级数仓场景。
代表产品:
-
Teradata:企业级 MPP 数仓标杆,金融、电信核心数仓首选,支持复杂 SQL 与完善的数据治理
-
Greenplum:开源 MPP 数仓,基于 PostgreSQL 构建,生态丰富,适配大数据分析
12. MPP 查询引擎
核心特点:专为离线数据分析设计,深度优化多表关联、复杂聚合查询,支持跨数据源联邦查询。
代表产品:
-
Impala:基于 Hadoop 的 MPP 查询引擎,支持交互式实时分析
-
Presto:分布式 SQL 查询引擎,可跨多数据源做联邦查询
13. 流数据库
核心特点:针对实时数据流设计,支持持续查询与增量计算,低延迟输出结果,适配实时数仓、流处理场景。
代表产品:Apache Flink SQL Client(流批一体 SQL 引擎)、Kafka Streams(基于 Kafka 的流处理数据库)、Materialize(增量计算流数据库,兼容标准 SQL)、Rockset(Serverless 实时流分析数据库)
14. 嵌入式轻量级数据库
核心特点:无独立服务进程,直接嵌入应用程序运行,资源占用极低,适配端侧、小型应用。
代表产品:Berkeley DB(甲骨文旗下嵌入式键值库)、LevelDB(谷歌开源高性能嵌入式键值库)、eXtremeDB(嵌入式实时数据库)
15. 边缘计算数据库
核心特点:轻量化设计,支持离线优先运行,具备边缘 – 云端数据同步能力,适配边缘设备、IoT 网关场景。
代表产品:SQLite Edge(SQLite 边缘版本,端侧轻量存储)、Redis Edge(Redis 边缘版本,边缘缓存与实时计算)、EdgeDB(边缘原生数据库)
16. 硬件优化型数据库
核心特点:深度绑定 FPGA、GPU、NVMe SSD 等专用硬件,利用硬件特性突破通用架构性能瓶颈,适配极致性能需求场景。
代表产品:
-
Kinetica:GPU 加速数据库,支持实时分析与地理空间处理,毫秒级响应
-
Oracle Exadata:软硬一体化数据库,智能存储缓存,企业级高可用
-
SAP HANA on Power Systems:绑定 IBM Power 服务器,优化内存计算性能
-
CockroachDB on NVMe:针对 NVMe SSD 优化,提升分布式事务读写性能