大数据常用技术栈
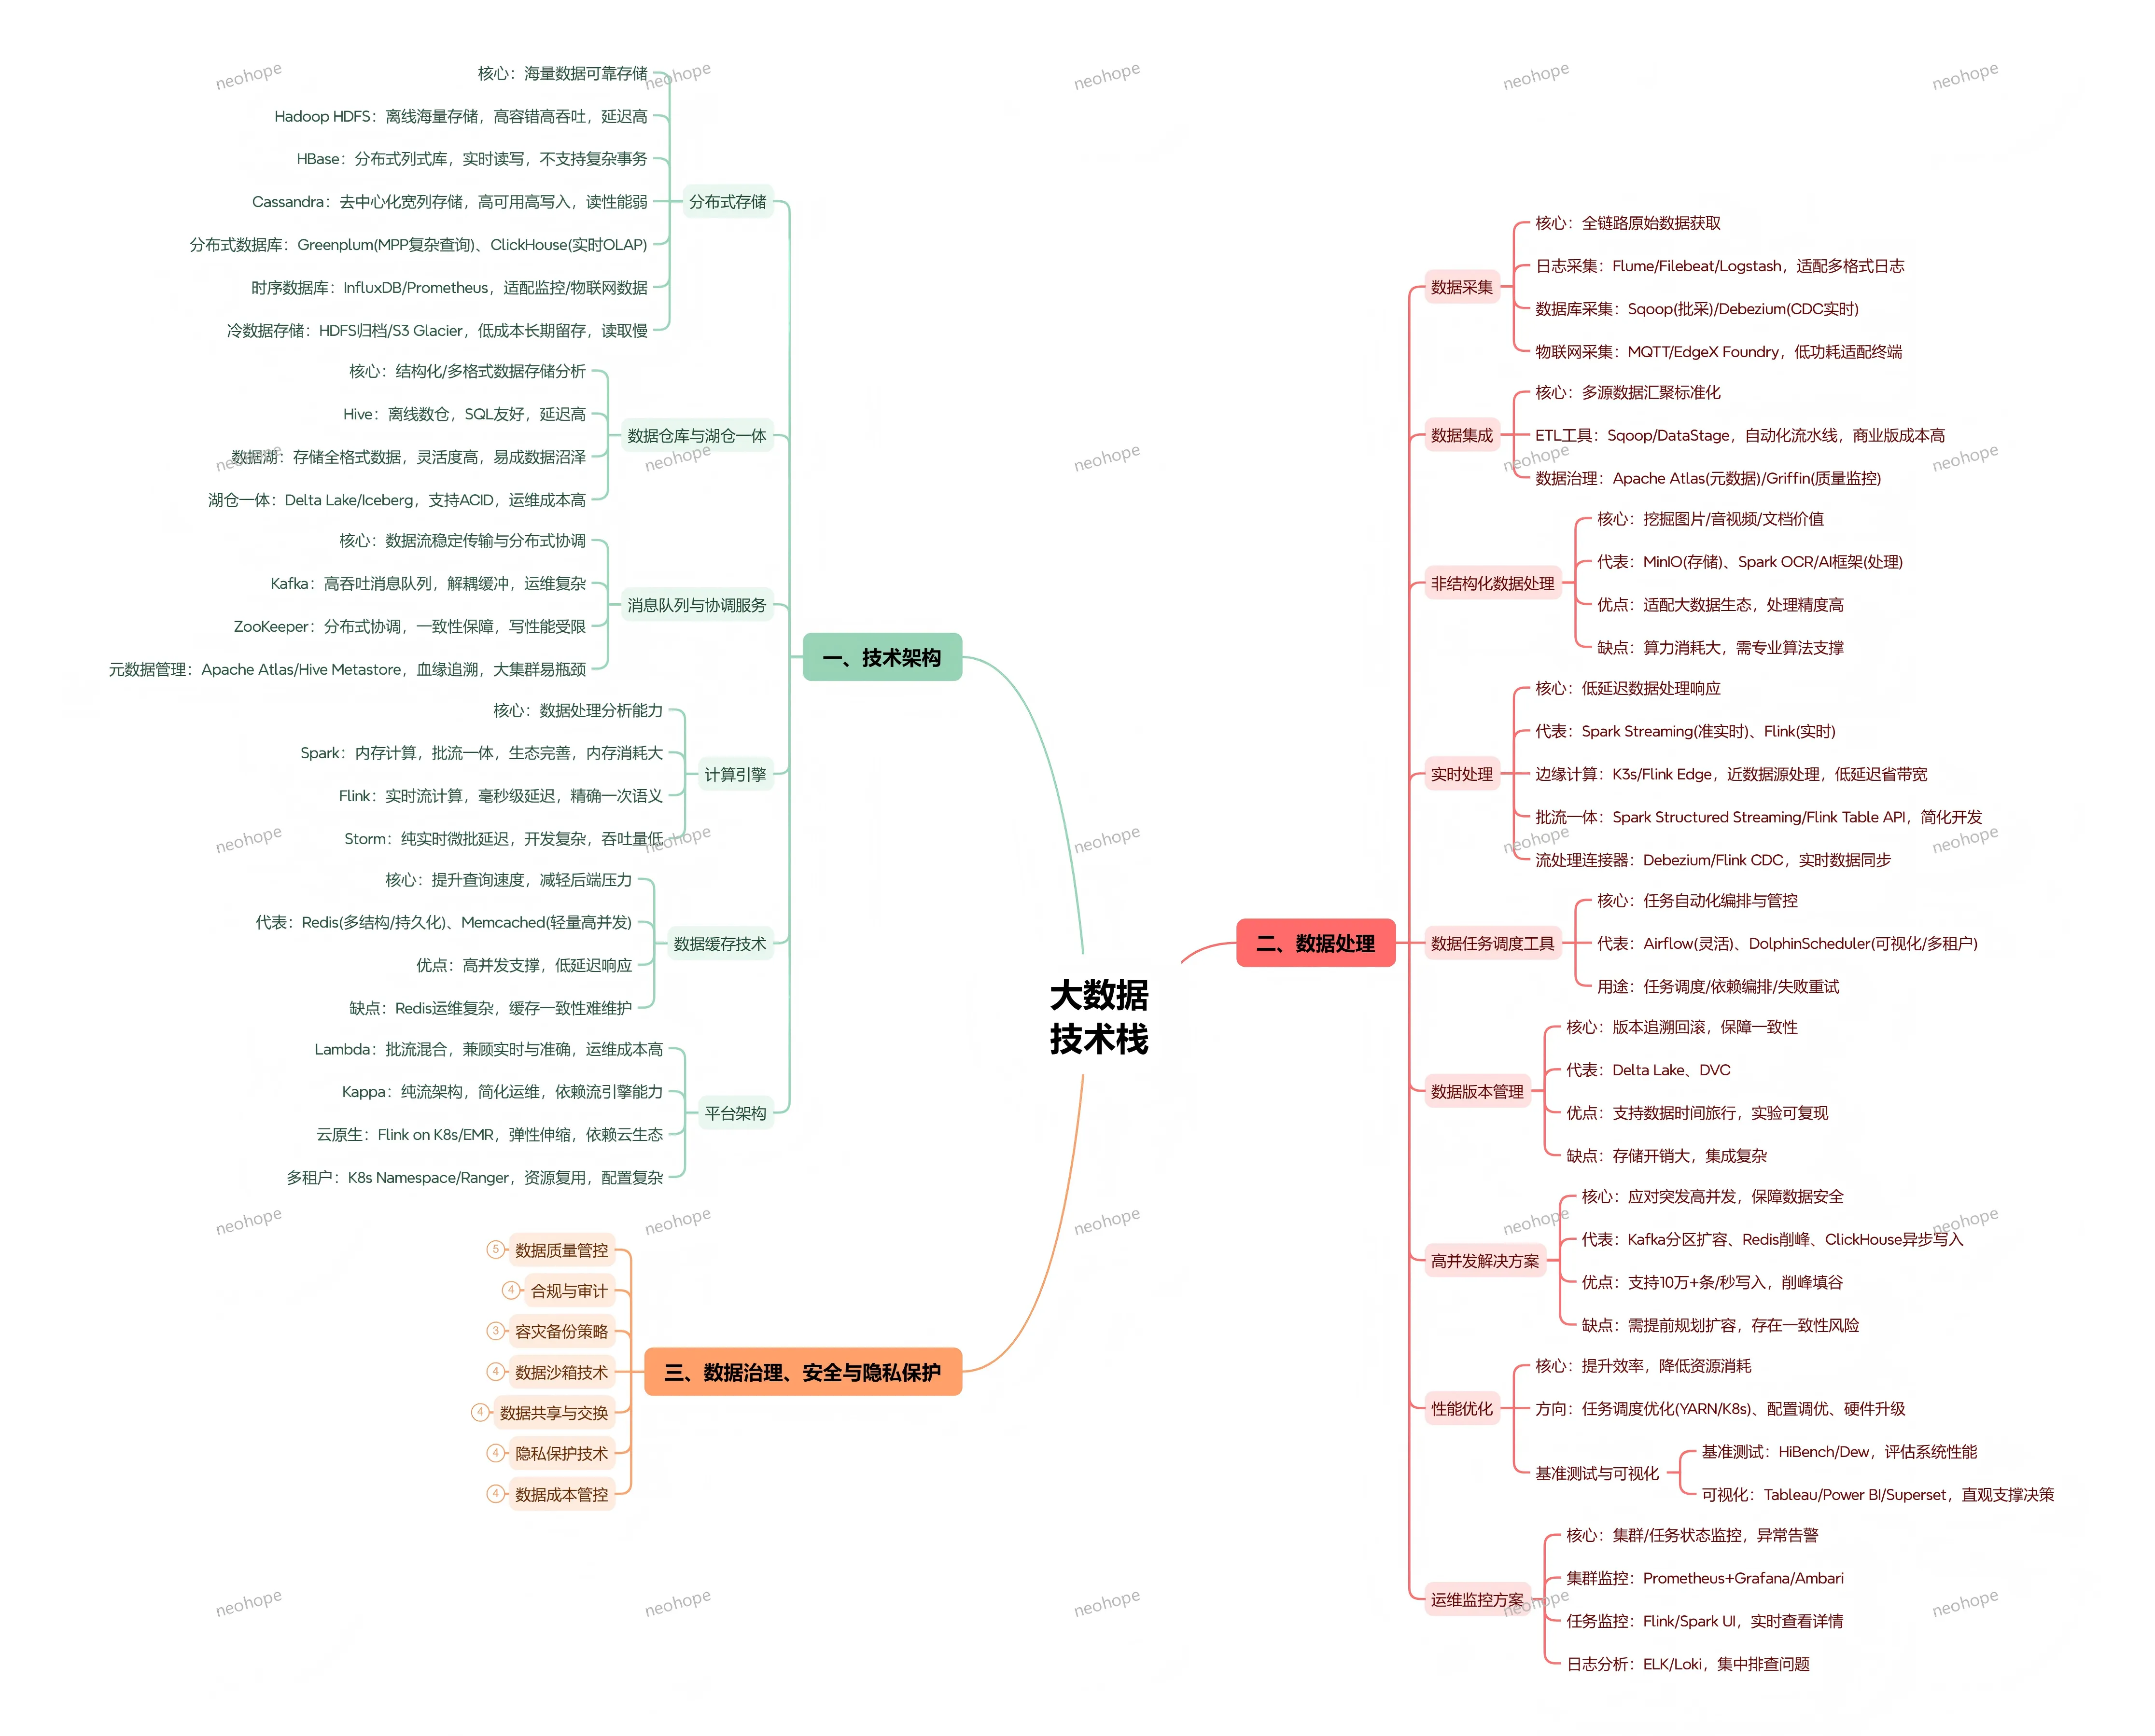
大数据技术栈是支撑海量、多源、异构数据完成从采集、存储、处理、分析到价值落地全生命周期的技术体系,核心解决传统技术无法应对的 “大容量、高速度、多类型” 数据处理难题,整体可分为技术架构、数据处理流程、治理与安全三大核心板块,当前正朝着湖仓一体、批流融合、云原生化的方向持续演进。
一、技术架构:大数据体系的底层能力基座
技术架构是大数据平台的基础设施层,提供存储、计算、传输与架构模式的底层支撑,覆盖全场景数据存储与计算需求。
-
分布式存储
核心目标是实现海量数据的可靠存储,按业务场景形成分层选型:离线海量存储以 HDFS 为代表,依托多副本机制实现高容错、高吞吐,适合冷、温数据批量读写,但延迟较高;实时读写场景有 HBase(分布式列式库)、Cassandra(去中心化宽列存储),前者适配随机读写,后者侧重高可用高写入;分析场景包含 Greenplum(MPP 架构,支持复杂查询)、ClickHouse(高性能实时 OLAP);监控、物联网场景适配 InfluxDB、Prometheus 等时序数据库;长期归档的冷数据则通过 HDFS 归档、对象存储归档层实现低成本留存。 -
数据仓库与湖仓一体
面向结构化与多格式数据的存储与分析,是数据价值挖掘的核心载体。传统离线数仓以 Hive 为代表,基于 SQL 接口降低使用门槛,但仅支持 T+1 级离线分析,延迟较高;数据湖支持全格式原始数据存储,灵活度高但缺乏治理易形成 “数据沼泽”;当前主流的湖仓一体方案(Delta Lake、Iceberg)融合两者优势,在数据湖底座上实现 ACID 事务、Schema 演进与数据版本能力,是架构演进的核心方向。 -
消息队列与协调服务
承担数据流的稳定传输与分布式系统的一致性保障。Kafka 作为高吞吐分布式消息队列,是实时数据流的核心枢纽,实现系统解耦与流量削峰;ZooKeeper 提供分布式协调、配置管理与一致性保障,是众多大数据组件的依赖基础;配套 Apache Atlas、Hive Metastore 等元数据管理工具,实现数据血缘追溯与资产化管理。 -
计算引擎
提供核心数据处理能力,形成离线批处理与实时流处理两大分支。Spark 基于内存计算实现批流一体,生态完善,适配复杂离线分析与准实时场景,但内存资源消耗较大;Flink 主打原生实时流计算,支持毫秒级延迟与精确一次语义,是实时计算的主流选型;Storm 作为早期纯实时引擎,开发复杂度高、吞吐量有限,现已逐步被替代。 -
数据缓存与平台架构
数据缓存以 Redis、Memcached 为代表,通过内存存储提升查询响应速度、承接高并发访问,但存在缓存一致性维护与运维复杂度的问题。
平台架构层面,Lambda 架构通过批流双链路兼顾结果准确性与实时性,但运维成本高;Kappa 架构采用纯流模式简化运维,高度依赖流引擎能力;云原生架构(Flink on K8s、云托管 EMR)实现资源弹性伸缩,是当前部署的主流趋势;同时通过 K8s Namespace、Ranger 等实现多租户资源隔离与复用。
二、数据处理:数据价值落地的全流程能力
数据处理层覆盖数据从原始采集到分析输出的完整链路,是数据从 “原始素材” 转化为 “可用资产” 的核心环节。
-
数据采集与集成
采集层作为数据入口,覆盖多源数据:日志采集通过 Flume、Filebeat、Logstash 适配多格式日志数据;数据库采集分为 Sqoop 批量采集与 Debezium 等 CDC 实时采集;物联网场景通过 MQTT、EdgeX Foundry 实现低功耗终端数据接入。
数据集成通过 ETL 工具完成多源数据的汇聚与标准化,配套元数据、质量监控等治理工具保障数据可用性。 -
多场景数据处理
非结构化数据处理依托 MinIO 等对象存储,结合 Spark OCR、AI 框架挖掘图片、音视频、文档的价值,但算力消耗大,需专业算法支撑。
实时处理以 Flink、Spark Streaming 为核心,结合边缘计算实现近源处理,降低延迟与带宽消耗;批流一体接口统一开发范式,大幅降低实时任务开发门槛;配合 CDC 连接器实现数据库实时数据同步。 -
工程化支撑体系
任务调度通过 Airflow、DolphinScheduler 实现任务自动化编排、依赖管理与失败重试,保障流水线稳定运行;数据版本管理依托 Delta Lake、DVC 实现数据追溯与回滚,支持数据时间旅行与实验可复现,但会增加存储开销。
高并发场景通过 Kafka 分区扩容、Redis 削峰、ClickHouse 异步写入等方案实现十万级每秒的写入支撑,完成流量削峰填谷;性能优化覆盖任务调度、参数配置、硬件升级等维度,搭配基准测试工具与 BI 可视化工具,实现效果评估与决策支撑。 -
运维监控
集群层面通过 Prometheus+Grafana、Ambari 实现资源与服务状态监控告警;任务层面通过 Flink、Spark 原生 UI 实时查看运行详情;日志层面通过 ELK、Loki 实现集中式日志检索与问题排查,形成全链路运维保障。
三、数据治理、安全与隐私保护:数据资产化与合规的保障体系
该板块聚焦数据的可用性、安全性与合规性,是数据实现可持续价值释放的基础支撑。
-
数据质量与合规审计
数据质量管控通过去重补全的数据清洗、统一命名编码的数据标准、按敏感等级的分类分级,以及全链路数据血缘,保障数据准确一致、可追溯可共享。
合规审计依据《数据安全法》《个人信息保护法》、GDPR 等法规要求,通过全链路审计日志记录数据操作,配套完整治理流程,实现数据全生命周期合规可控。 -
容灾与安全隔离
容灾备份通过 HDFS 多副本、跨集群同步、云备份等方式保障数据不丢失;采用本地双活、异地多活、主备等容灾架构保障服务连续性,但架构复杂度与成本显著提升。
数据沙箱通过 Docker、Hive Sandbox 等隔离测试与生产环境,降低测试对生产的影响,但环境差异可能导致结果偏差。 -
隐私保护与数据共享
隐私保护形成多层技术体系:差分隐私、联邦学习实现数据可用不可见;数据脱敏直接降低敏感信息暴露风险;加密技术保障数据传输与存储安全,各类方案均需在安全强度与数据价值间做平衡。
数据共享通过数据门户、API 网关实现安全可控的跨部门、跨组织数据流通,提升数据复用价值,但需统一标准并管控跨组织合规风险。 -
数据成本管控
从存储、计算、传输三维度降本:存储侧通过压缩、冷热分层、纠删码降低单位存储成本;计算侧通过弹性调度、错峰执行、结果复用提升资源利用率;传输侧通过边缘预处理、传输压缩节省带宽开销,实现性价比最优。
整体来看,大数据技术栈正从 “组件堆砌” 向 “一体化架构” 演进,湖仓一体、批流融合、云原生、存算分离成为核心趋势,同时数据治理与安全合规的权重持续提升,支撑大数据从 “规模优势” 向 “价值优势” 转型。