领域大模型怎么用才高效?5大增强方法+2大开发范式,从入门到进阶

整理了一些领域大模型增强的技术方法:
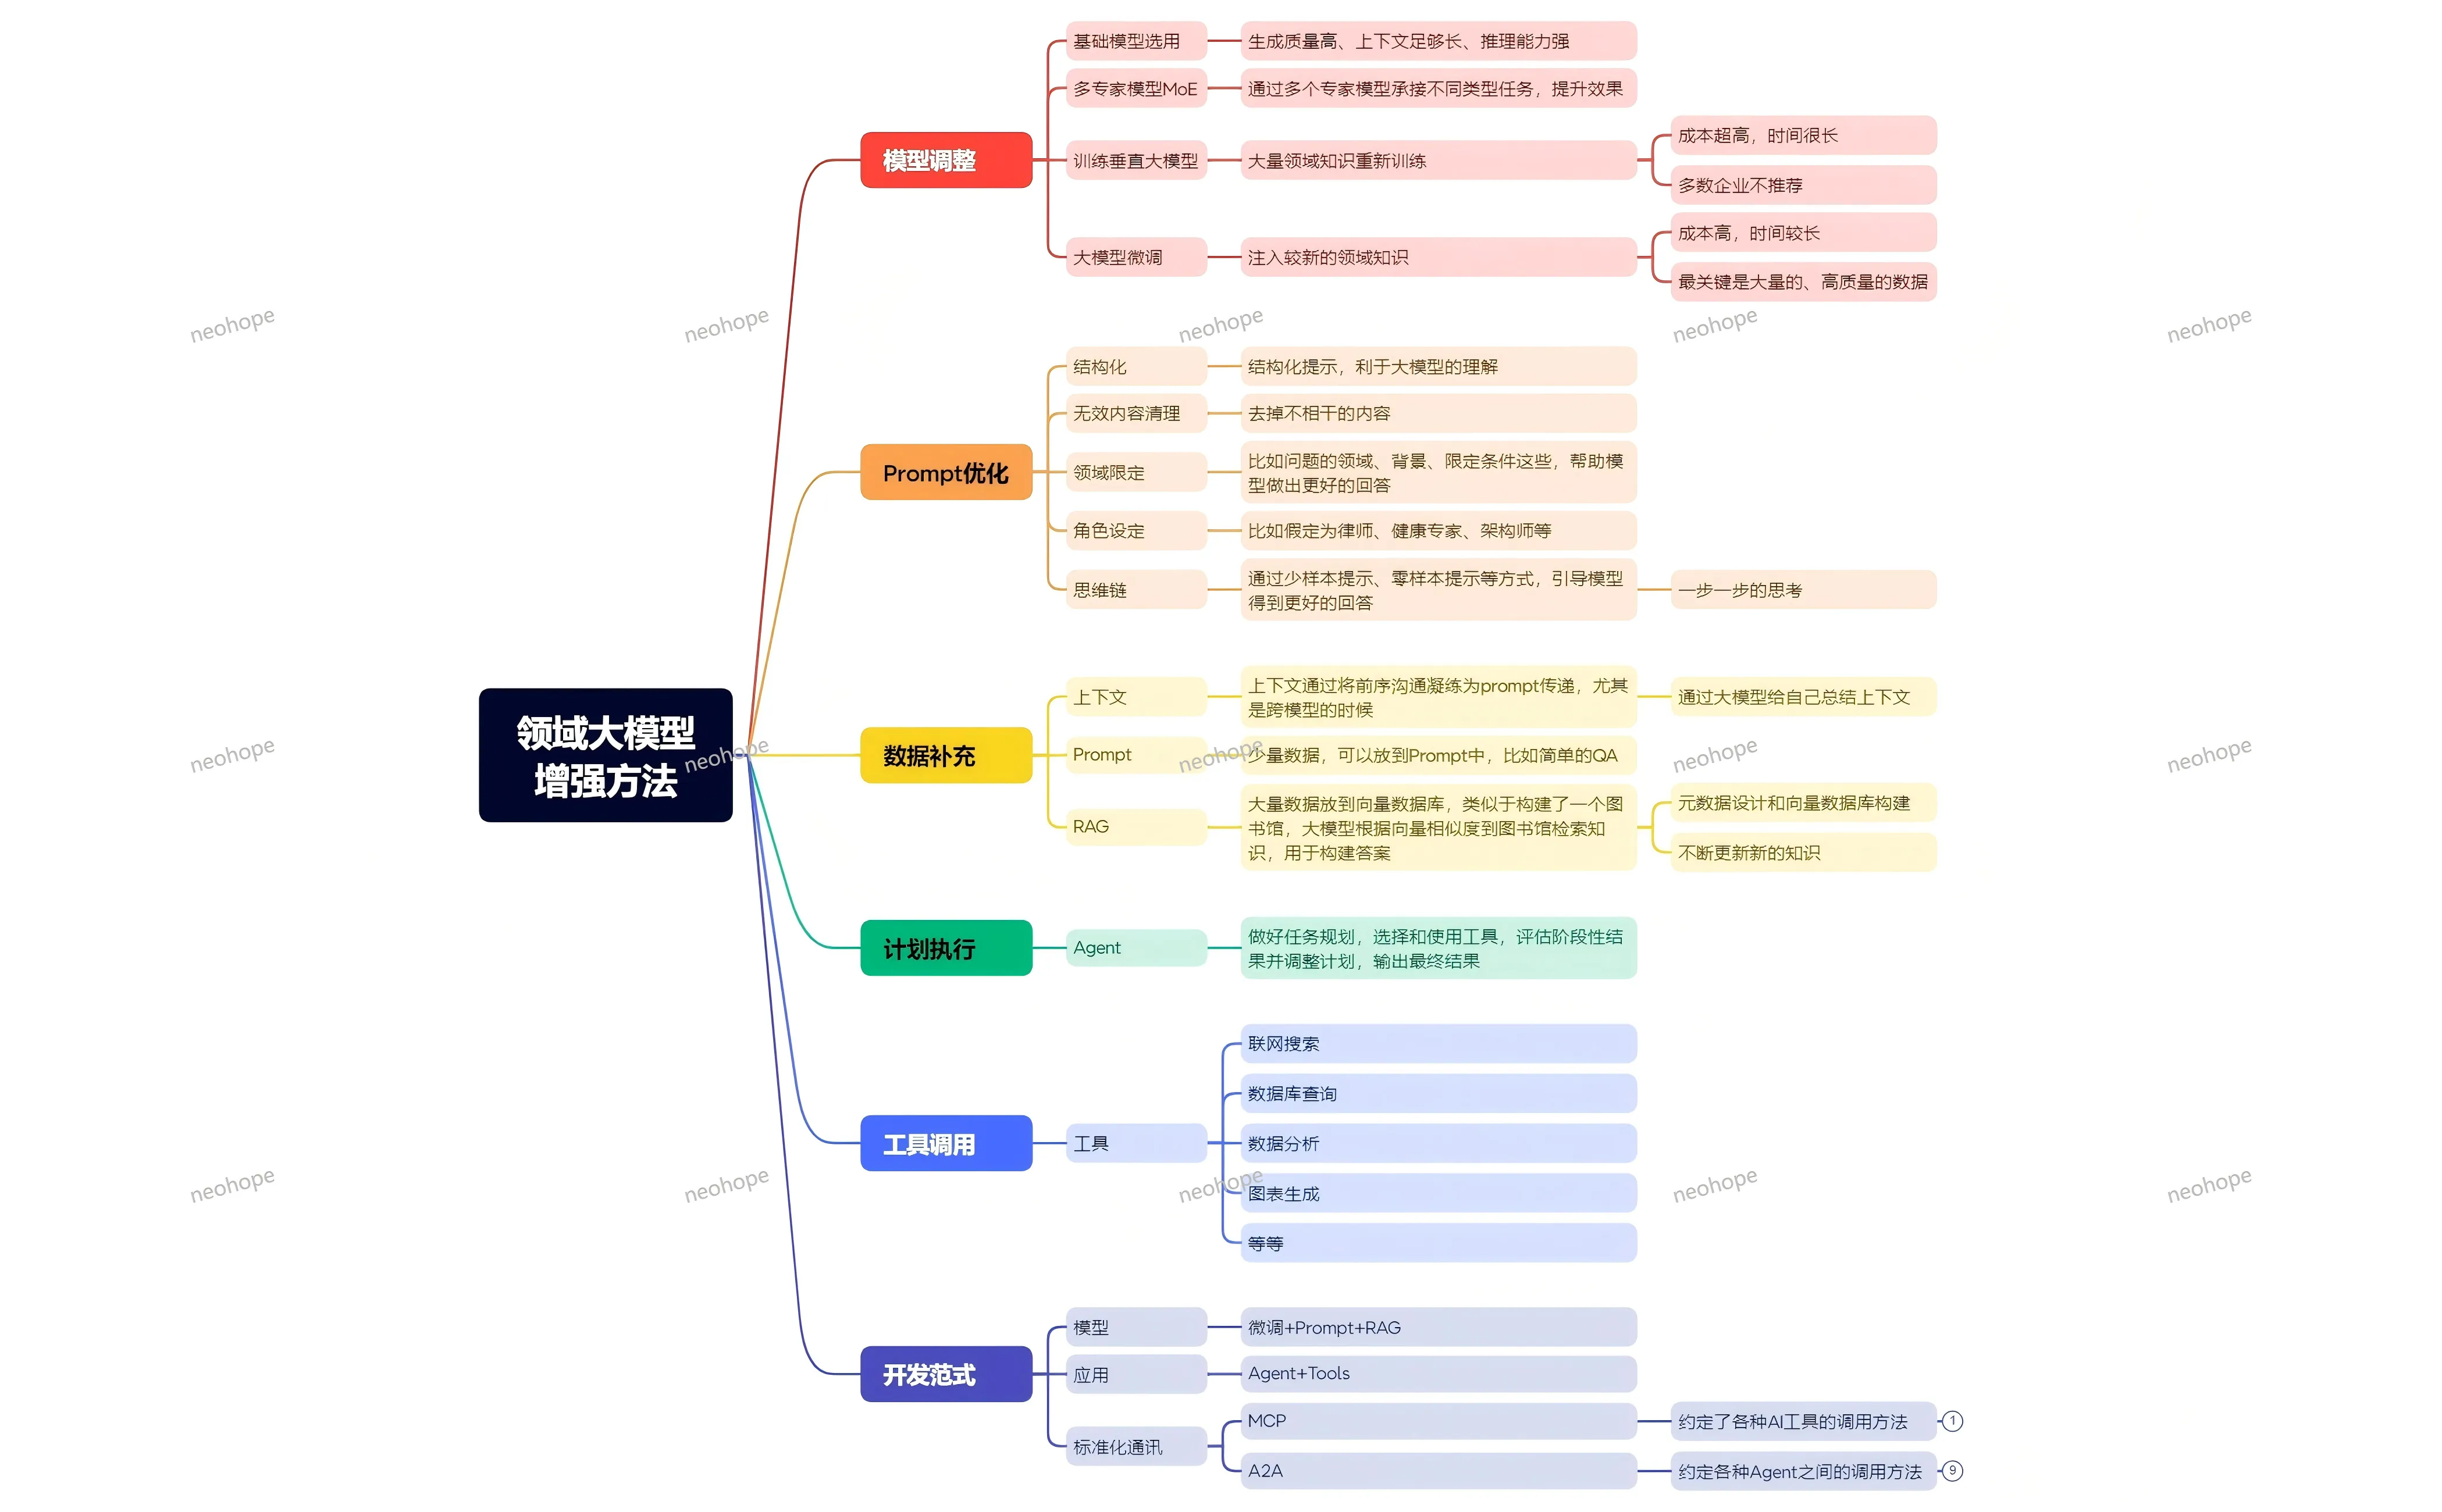
领域大模型增强方法


领域大模型怎么用才高效?5大增强方法+2大开发范式,从入门到进阶

很多企业和个人用领域大模型时都会遇到困惑:“为什么模型输出的内容不够精准?”“怎么让模型快速掌握行业知识?” 其实领域大模型的核心价值,不在于 “基础模型多强”,而在于 “针对性增强”—— 通过数据、提示、工具的组合优化,让通用模型适配特定场景。今天就拆解领域大模型的增强方法和开发范式,帮你快速提升模型实用价值。

一、模型调整:选对 “底座”,精准补能
模型的 “底子” 和 “适配度”,直接决定了后续增强效果,核心分两步走:
第一步,基础模型选用
优先选生成质量高、上下文窗口足够长、推理能力强的模型作为底座 —— 比如处理长文档的法律合同解析,就需要大上下文模型;做复杂逻辑推理的金融分析,就侧重推理能力强的模型,避免 “小马拉大车”。

第二步,按需选择调整方式
1、不推荐多数企业做 “垂直大模型重新训练”:需要大量领域知识数据,成本超高、耗时极长,除非是头部企业且有核心场景刚需;

2、优先考虑 “模型微调”:注入较新的领域知识,比如将 2023-2024 年的行业新规、企业内部流程数据融入模型,适配性比通用模型强很多,但要注意 —— 核心是 “大量高质量数据”,数据质量直接决定微调效果;

3、少数据场景用 “Prompt 数据补充”:如果没有足够数据做微调,可将简单 QA、核心知识点直接嵌入 Prompt,让模型快速获取关键信息,比如给模型喂 “行业术语对照表”“常见问题解答”,快速提升专业度。

二、Prompt 优化:用 “精准指令” 让模型少走弯路
Prompt 是人和模型的 “沟通桥梁”,优化后能让模型输出质量翻倍,核心技巧有 4 个:
1、结构化提示:把需求拆分成清晰的模块,比如 “先分析问题核心→再列出解决方案→最后给出注意事项”,利于模型理解逻辑,避免输出混乱;

2、无效内容清理:去掉和需求无关的描述,比如问 “电商行业的用户留存策略”,就不用附带 “我是做互联网的,最近想提升业绩” 这类冗余信息,让模型聚焦核心问题;

3、领域限定与角色设定:明确场景边界和模型身份,比如 “假定你是电商运营专家,基于淘宝平台规则,分析美妆类目新店铺的用户留存方法”,限定条件 + 角色定位,让输出更精准;

4、思维链引导:通过少样本提示(给 1-2 个示例)或零样本提示(直接引导步骤),让模型一步步思考,比如 “先拆解用户流失的 3 个核心原因,再针对每个原因给出 2 个具体策略,最后说明落地优先级”,避免模型跳过关键步骤。

三、RAG 增强:给模型建 “专属知识库”,解决知识滞后问题
大模型的知识有 “截止日期”,而 RAG(检索增强生成)能让模型实时调用最新数据,核心逻辑是 “检索 + 生成”:
1、把大量领域数据(比如行业报告、企业内部文档、最新政策文件)整理后存入向量数据库,相当于给模型建了一个 “专属图书馆”;

2、当用户提问时,模型先从 “图书馆” 中检索相似的相关信息,再结合自身知识生成回答 —— 既解决了模型知识滞后的问题,又能让输出有具体数据支撑,比如问 “2024 年新能源汽车的补贴政策”,模型会从向量数据库中检索最新政策文件,精准回复。

3、关键注意点:做好元数据设计和向量数据库构建,定期更新数据,确保检索的准确性和时效性。

四、工具调用:让模型 “手脚并用”,拓展能力边界
纯文本模型的能力有限,搭配工具后能实现 “信息查询、数据分析、图表生成” 等复杂功能,核心场景包括:
1、联网搜索:获取实时信息,比如 “查询今日原油价格”“了解最新行业动态”,解决模型知识不更新的问题;

2、数据库查询:对接企业内部数据库,比如查询 “近 3 个月的销售数据”“用户画像统计”,直接基于真实业务数据生成分析报告;

3、数据分析与图表生成:自动处理 Excel 表格、生成柱状图 / 折线图,比如 “分析近半年的用户增长趋势,生成可视化图表并给出结论”;

4、关键支撑:通过 MCP(AI 工具调用标准)和 A2A(Agent 间通讯标准),实现不同工具、不同 Agent 之间的标准化调用,让协作更顺畅。

五、Agent 增强:让模型成为 “自主决策者”,搞定复杂任务
如果说工具调用是 “给模型加手脚”,那 Agent 就是 “给模型加大脑”,核心能力是 “自主规划 + 执行 + 调整”:
1、面对复杂任务,Agent 能自动拆解步骤,比如 “完成电商店铺的月度运营复盘”,会拆解为 “1. 调取近 30 天销售数据→2. 分析用户增长 / 流失情况→3. 对比行业均值→4. 找出核心问题→5. 给出优化策略→6. 生成复盘报告”;

2、过程中能自主选择工具,比如需要数据就调用数据库,需要行业对比就联网搜索,还能评估阶段性结果,比如发现 “销售数据异常”,会自动调整步骤,补充 “异常原因分析”;

3、适合场景:复杂流程优化、多步骤任务执行(如市场调研、项目规划),让模型从 “被动响应” 变成 “主动解决问题”。

六、两大核心开发范式:组合使用效果翻倍
单独用一种增强方法效果有限,推荐两种主流组合范式:
1、微调 + Prompt+RAG:适合需要深度适配领域的场景,比如企业内部的智能客服 —— 通过微调注入企业流程知识,用 Prompt 优化回复逻辑,用 RAG 调用最新的产品信息和售后政策,既专业又精准;

2、Agent+Tools:适合复杂任务处理,比如跨境电商的选品分析 ——Agent 拆解任务(市场调研→竞品分析→成本核算→风险评估),调用联网搜索(市场趋势)、数据库查询(成本数据)、数据分析工具(竞品销量),全程自主完成,高效落地。

总结:领域大模型的增强逻辑 ——“扬长避短,按需组合”
领域大模型的增强,不是 “越多方法越好”,而是 “按需选择”:
1、数据充足、场景固定→优先 “微调 + RAG”;
2、数据有限、需求灵活→优先 “Prompt 优化 + 工具调用”;
3、复杂任务、需要自主决策→用 “Agent+Tools”;
4、核心是让模型的 “推理能力” 结合 “领域知识” 和 “工具能力”,实现 1+1>2 的效果。

你在使用领域大模型时,遇到过哪些 “不精准”“不实用” 的问题?欢迎在评论区留言,一起探讨解决方案~
高并发处理全景指南:从架构到运维,搞定系统扛压核心

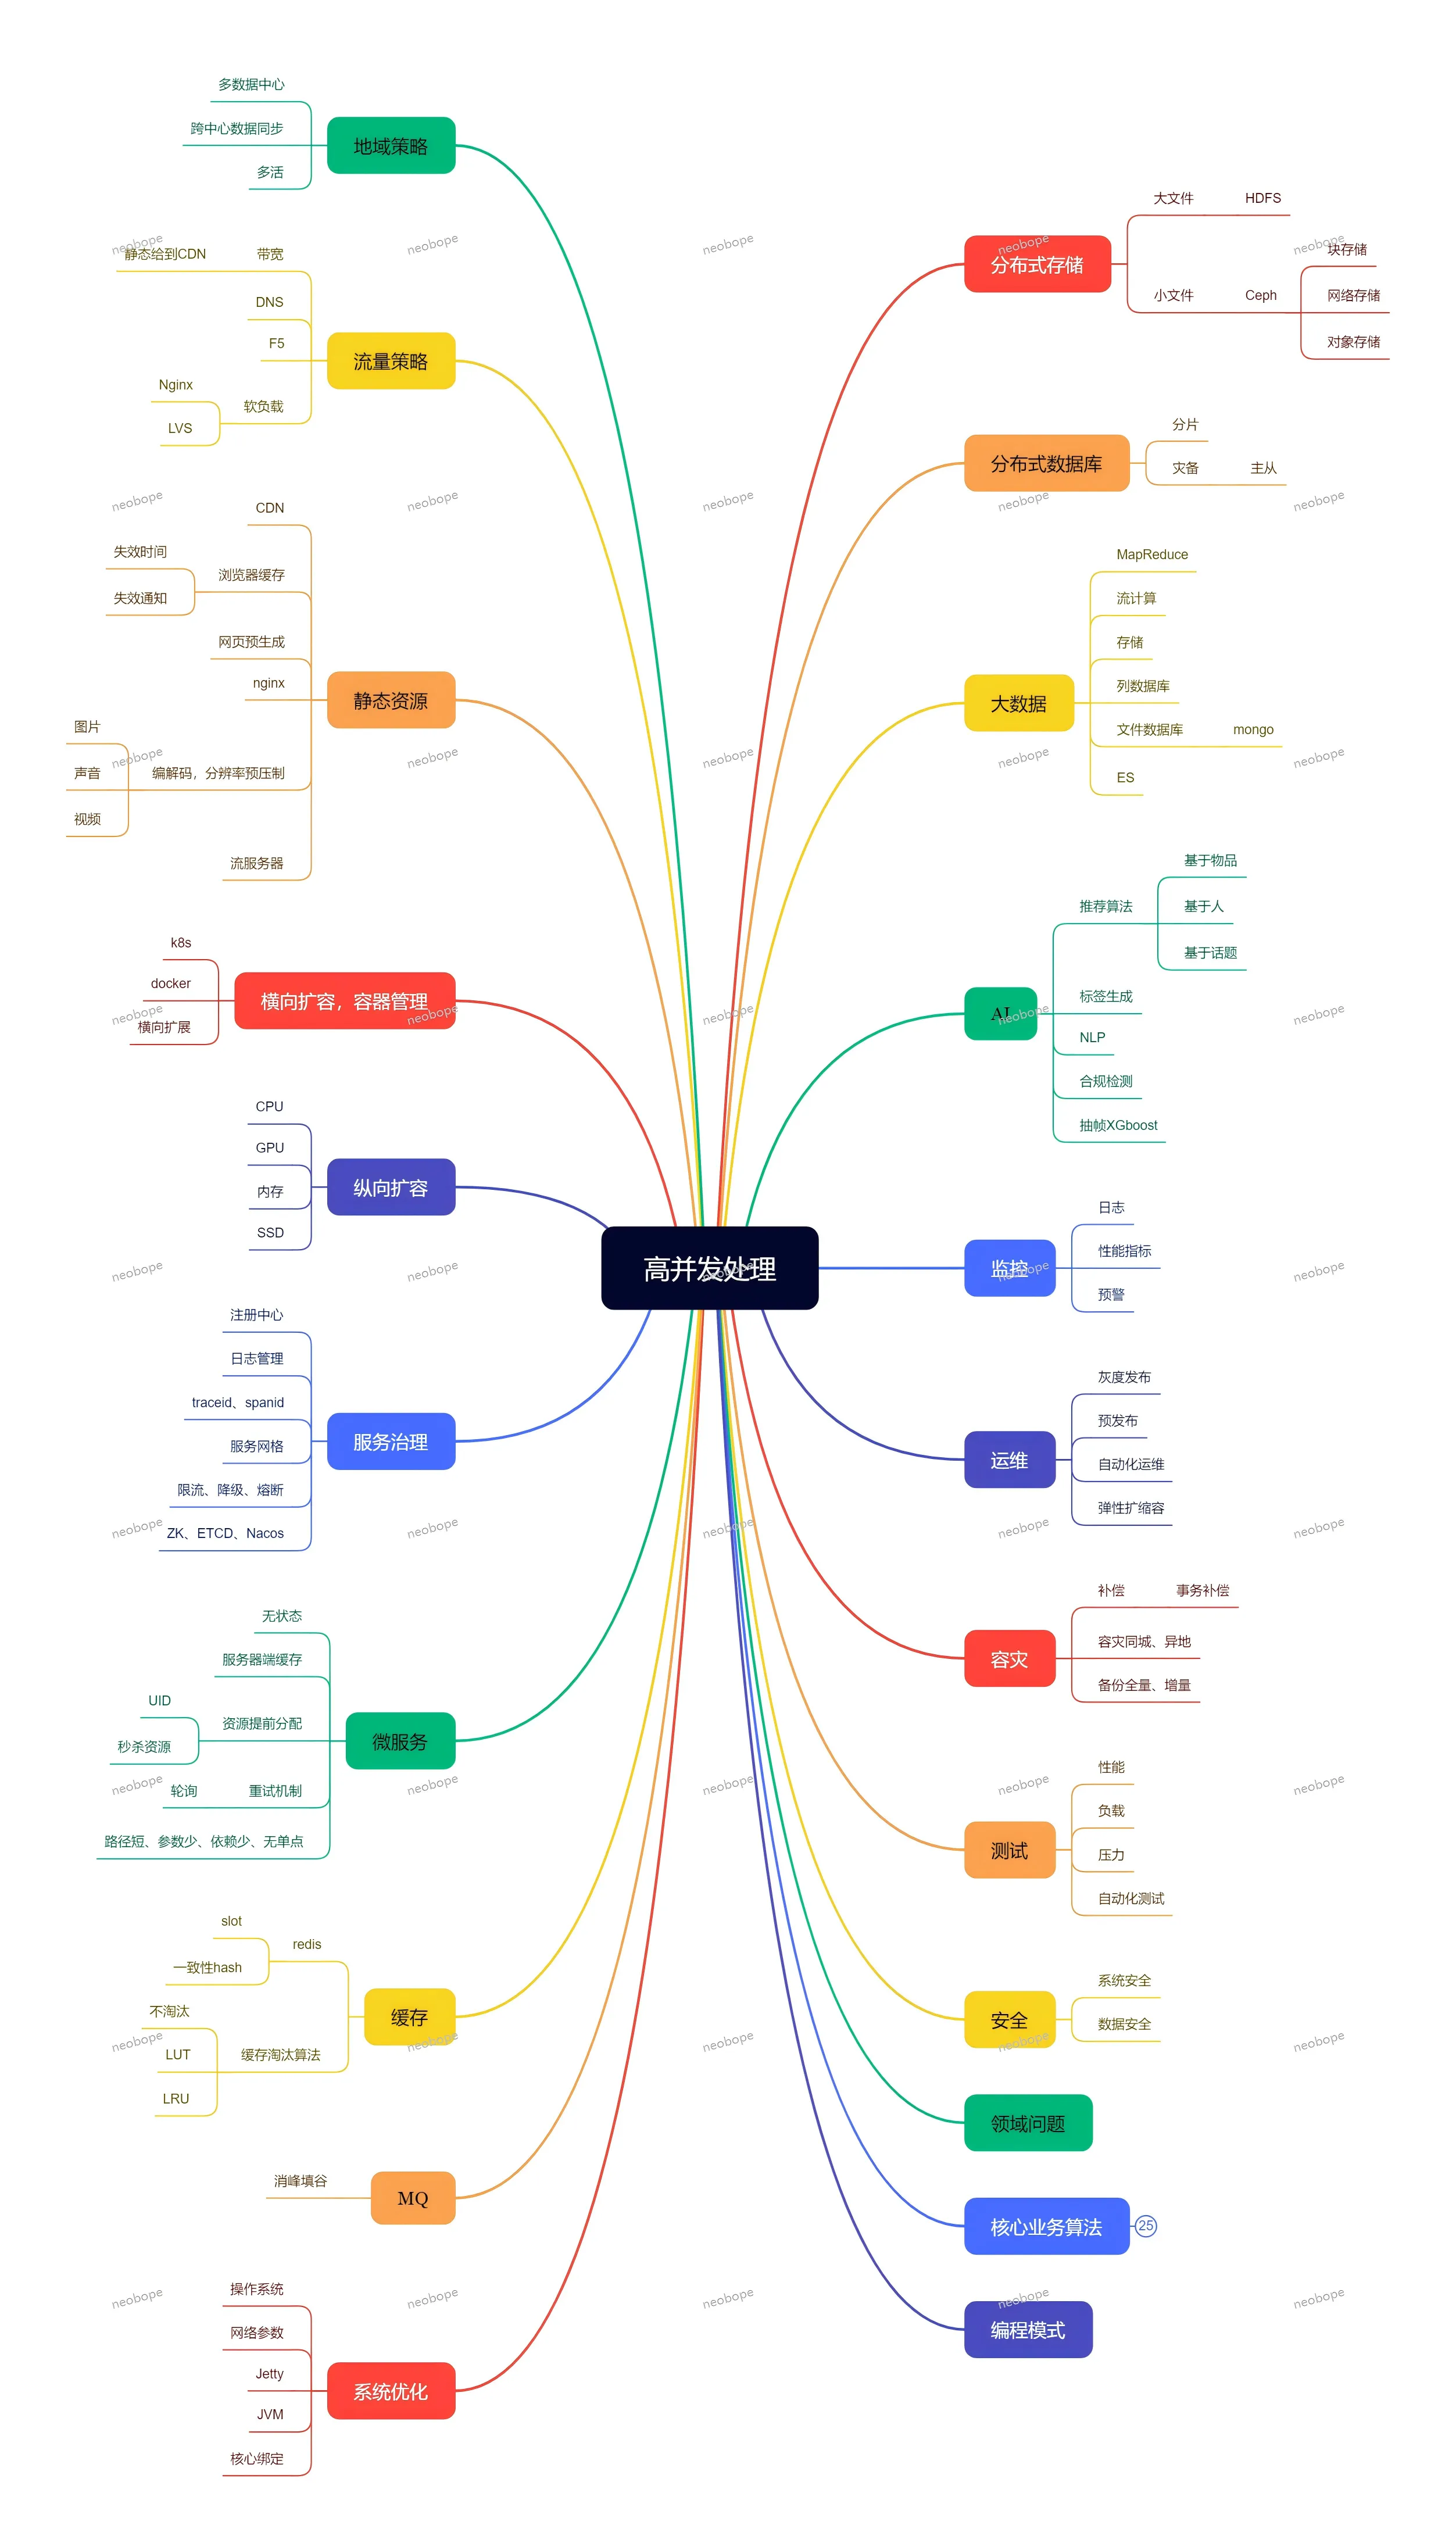
高并发处理技术


高并发处理全景指南:从架构到运维,搞定系统扛压核心

面对秒杀活动的瞬时流量、热门 APP 的千万级用户访问,高并发系统的核心诉求只有一个:“稳得住、响应快、不宕机”。高并发处理不是单一技术的比拼,而是从架构设计、存储优化、流量管控到运维保障的全链路协同。今天就拆解高并发处理的核心技术栈,帮你搭建一套 “可扩展、可容错、高性能” 的系统架构。

一、架构设计:从 “单体” 到 “分布式”,破解性能瓶颈
高并发的核心是 “分散压力”,通过分布式架构将流量和负载分摊到多个节点,避免单点故障:
横向扩容与容器化:采用 “横向扩展” 而非 “纵向扩容”,通过增加服务器节点分摊压力;用 Docker 封装应用,K8s 实现容器编排与管理,支持弹性扩缩容(流量高峰自动加节点,低谷缩容节省资源);
微服务与服务治理:拆分单体应用为微服务(如订单、支付、用户服务),每个服务独立部署、按需扩容;通过服务网格、注册中心(ZK、ETCD、Nacos)实现服务发现与路由,搭配限流、降级、熔断机制(避免某个服务故障牵连整体);
无状态设计:服务设计为无状态(不存储本地数据,依赖分布式存储),方便水平扩容;通过 TraceID、SpanID 实现分布式链路追踪,快速定位跨服务问题;
多活与灾备:搭建多数据中心、跨中心数据同步,实现同城 / 异地多活(避免单点数据中心故障);制定全量 / 增量备份策略,确保数据安全与快速恢复。

二、流量管控:削峰填谷,让系统 “从容应对” 高峰
直接暴露核心服务给峰值流量,极易导致系统崩溃,流量管控的核心是 “缓冲、分流、限流”:
负载均衡:通过 Nginx、LVS、F5 等软 / 硬件负载均衡器,将流量均匀分发到后端服务节点;采用一致性 Hash 算法,确保请求分发均匀,减少缓存失效;
消峰填谷:用 MQ 消息队列缓冲瞬时高峰流量(如秒杀订单先入队,服务异步消费),将 “突发流量” 转化为 “平稳流量”,避免服务被压垮;
限流与灰度发布:对核心接口设置限流阈值(如每秒最多处理 1000 请求),超出阈值直接返回友好提示;通过预发布、灰度发布(逐步放量),验证新功能在高并发下的稳定性,降低风险;
DNS 与 CDN 优化:利用 DNS 轮询实现地域级流量分流(将用户导向就近节点);CDN 加速静态资源(图片、视频、JS/CSS),减少源站压力,同时提升用户访问速度。

三、存储优化:适配高并发读写,兼顾速度与可靠性
存储是高并发系统的 “数据底座”,核心需求是 “读写快、容量足、不丢数据”:
分层存储策略:静态资源(图片、视频、大文件)存入分布式存储(HDFS、Ceph 对象存储、块存储),通过 CDN 加速访问;热点数据存入 Redis 等缓存,减少数据库查询压力;
数据库优化:采用分布式数据库、主从架构(主库写、从库读,读写分离);针对高并发场景选用列数据库(适配海量数据查询)、文档数据库(MongoDB,适配非结构化数据);
缓存设计:多级缓存(浏览器缓存→CDN 缓存→服务器端缓存)减少重复请求;合理设置缓存失效时间、失效通知,搭配 LRU 等缓存淘汰算法,避免缓存雪崩、缓存穿透;
资源预分配:提前预热热点数据(如秒杀商品信息载入缓存)、预压制视频 / 图片分辨率,减少高并发时的动态处理压力。

四、核心优化:从代码到硬件,榨干系统性能
在架构和流量管控之外,细节优化能进一步提升系统并发能力,核心是 “减少无效消耗、提升单位时间处理效率”:
硬件与系统优化:选用高性能 CPU、GPU、SSD(提升读写速度);优化操作系统、JVM、网络参数(如调整连接数、内存分配);核心绑定(将进程与 CPU 核心绑定,减少上下文切换);
代码与编程模式优化:简化接口路径、减少参数传递、降低服务依赖(路径短、参数少、依赖少 = 更快响应);采用高效编程模式,避免冗余逻辑和资源浪费;
大数据与算法优化:用 MapReduce、流计算处理海量日志与业务数据,支撑实时决策;核心业务算法优化(如推荐算法采用基于人 / 物品 / 话题的高效匹配逻辑);
多媒体处理优化:对图片、声音、视频进行编解码优化,抽帧处理减少传输与存储压力。

五、运维与监控:实时预警,快速响应问题
高并发系统的稳定性离不开完善的运维监控,核心是 “早发现、早定位、早解决”:
全链路监控:监控性能指标(响应时间、QPS、错误率)、系统资源(CPU、内存、磁盘 IO);建立日志管理平台,集中分析分布式日志,快速定位问题;
自动化运维与预警:通过自动化测试、压力测试,提前验证系统抗并发能力;设置预警阈值(如响应时间超过 500ms 告警),结合服务健康检查,实时发现异常;
容错与补偿:实现重试机制(失败请求自动重试,避免偶发故障影响)、事务补偿(如支付失败自动回滚订单),提升系统容错性;
安全保障:兼顾系统安全与数据安全,防范高并发场景下的恶意攻击(如 DDoS、接口刷取),确保核心业务不被干扰。

总结:高并发处理的核心逻辑 ——“全链路协同,无短板优化”
高并发不是 “某一个技术点的胜利”,而是架构、流量、存储、代码、运维的全方位配合:架构层面 “分散压力”,流量层面 “缓冲分流”,存储层面 “提速减负”,细节层面 “榨干性能”,运维层面 “兜底保障”。
关键原则是 “避免单点故障、减少无效消耗、适配业务场景”—— 比如秒杀场景侧重 “消峰填谷 + 缓存预热”,社交 APP 侧重 “分布式存储 + 实时计算”。只有结合自身业务特点,针对性优化,才能打造出稳定、高效的高并发系统。

你在做高并发系统时,遇到过哪些棘手问题?是缓存雪崩、流量突增还是数据库瓶颈?欢迎在评论区分享你的解决方案~

Windows进程间通讯全解析:10大核心方式+场景选型,搞定进程协同

Windows进程间通讯


Windows进程间通讯全解析:10大核心方式+场景选型,搞定进程协同

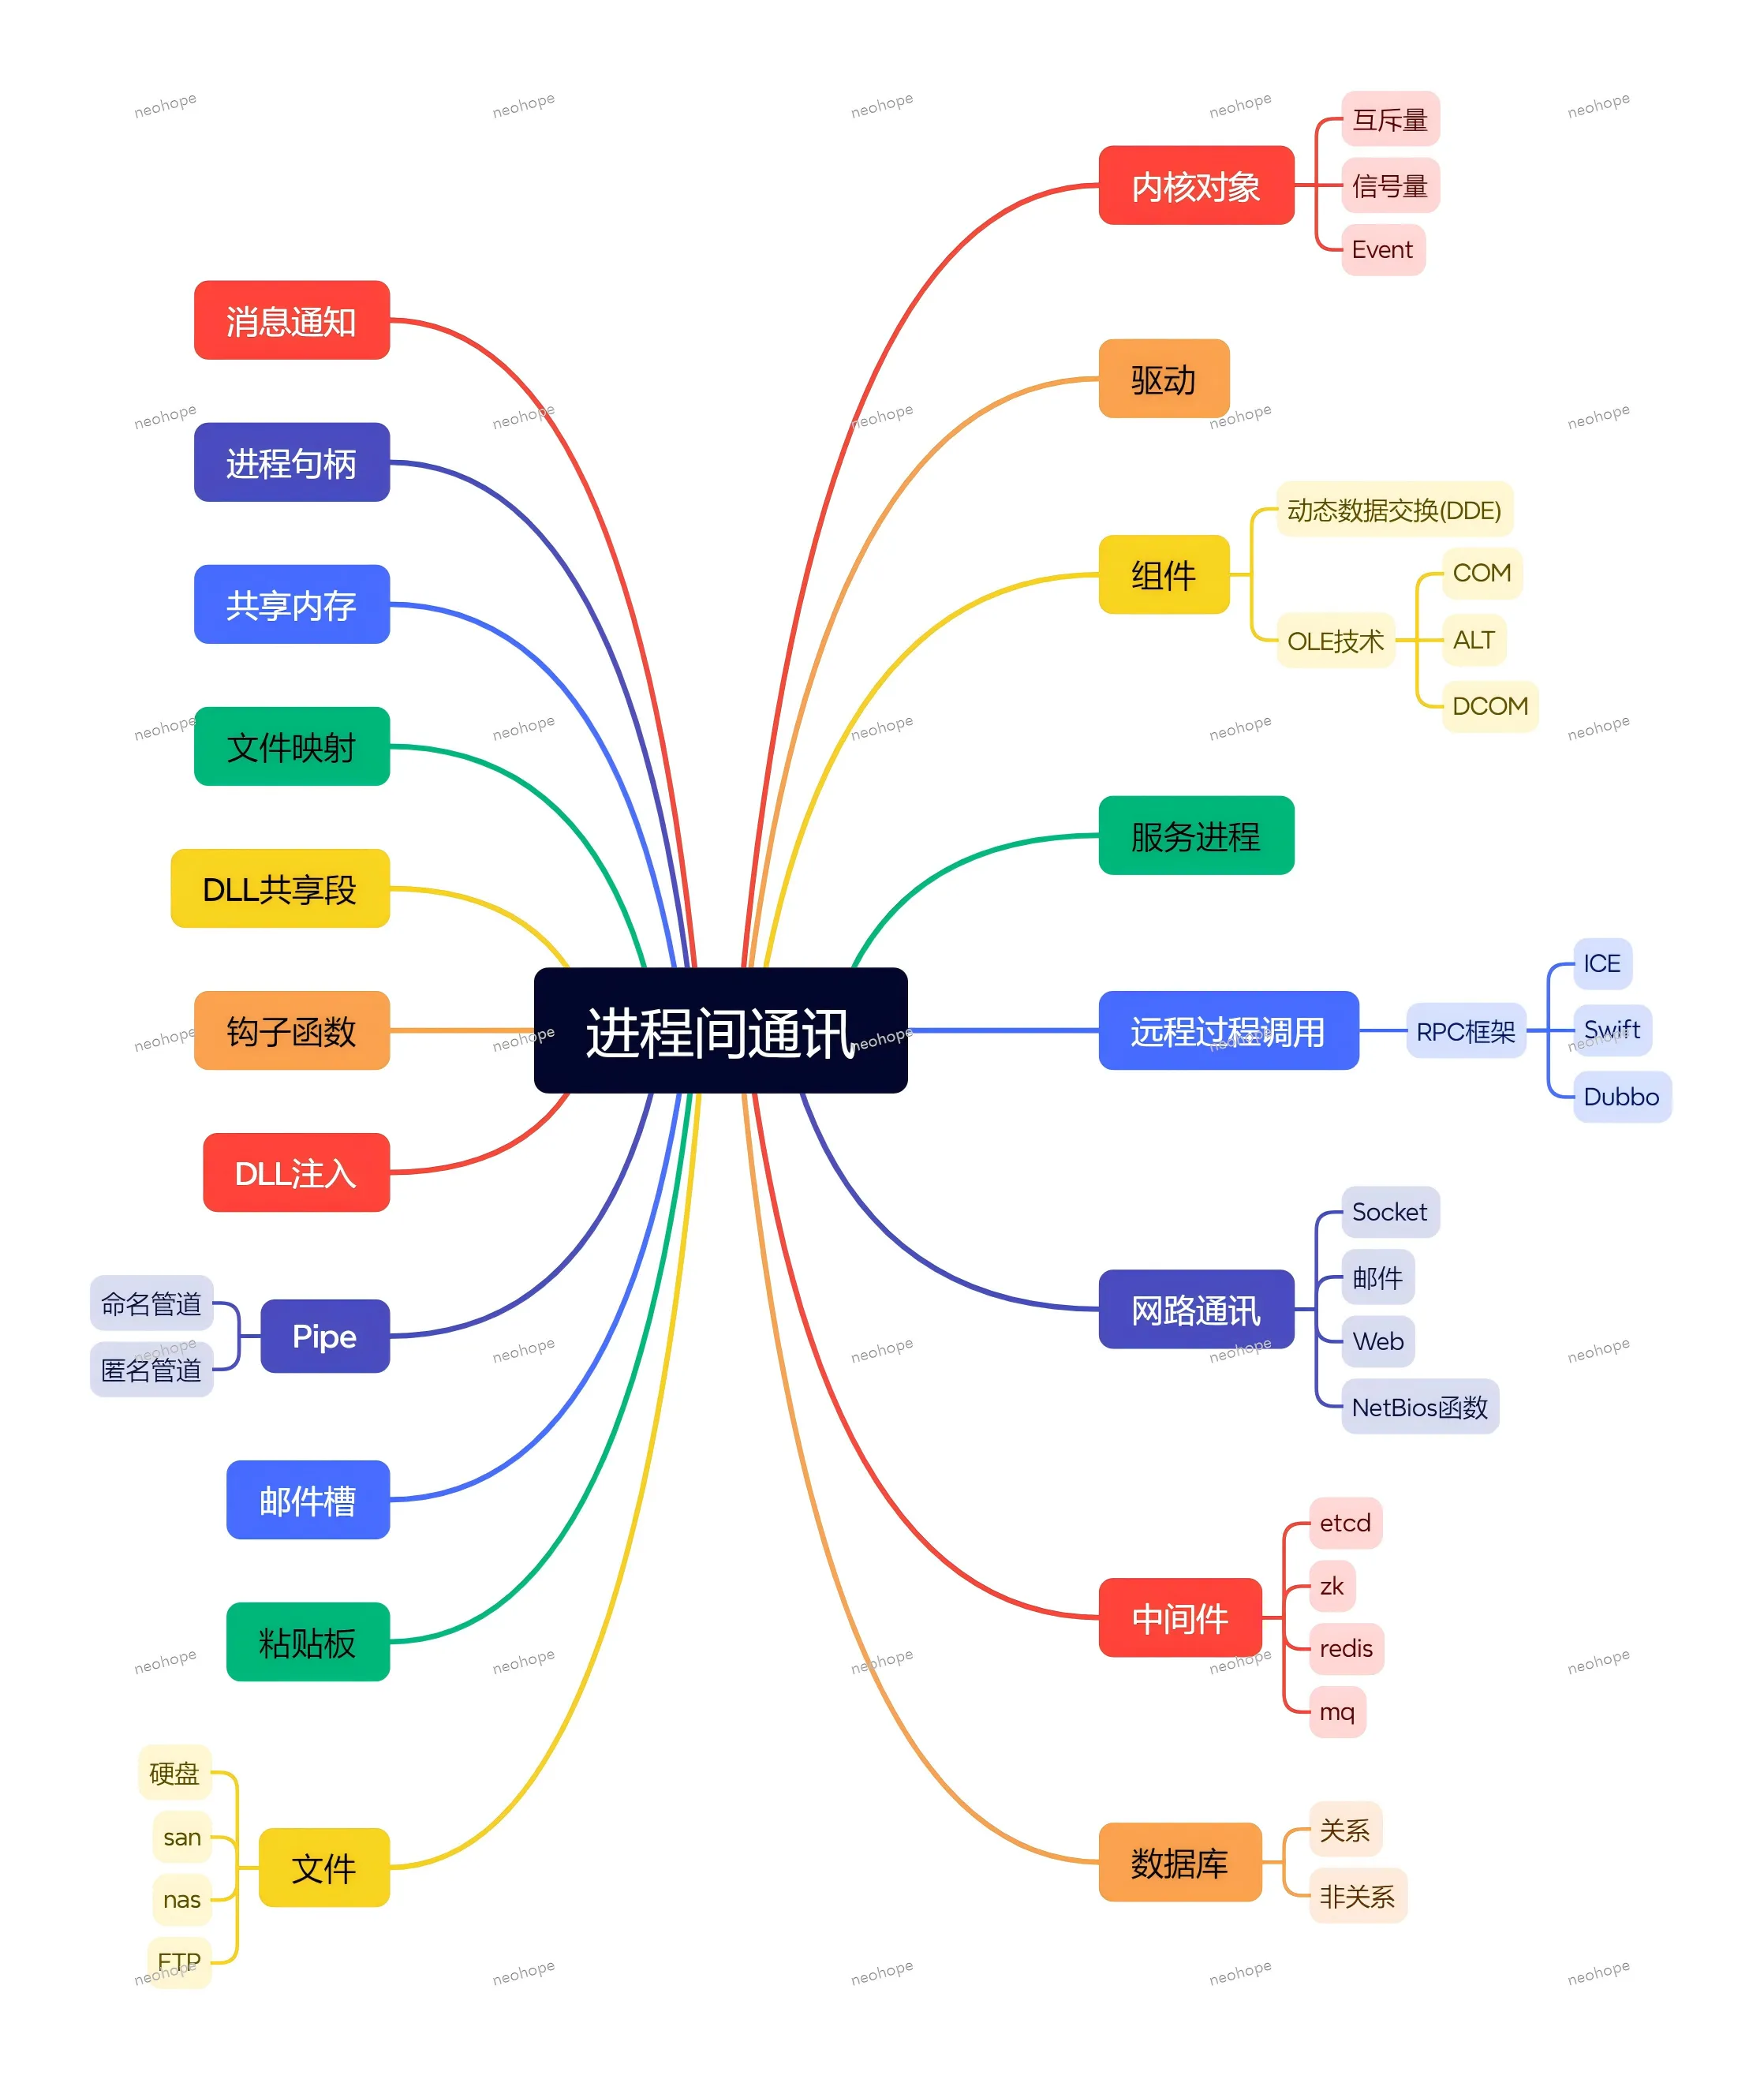
在 Windows 系统中,多个进程想要协同工作(比如浏览器调用下载工具、办公软件同步数据),就离不开 “进程间通讯(IPC)” 技术。不同场景下,有的需要高速传输大数据,有的需要实时同步状态,有的要跨网络通讯 —— 选对 IPC 方式,能让程序协作更高效、更稳定。今天就拆解 Windows 系统中常见的进程间通讯方式,帮你理清适用场景和核心逻辑。

一、内核对象同步:轻量级状态协同,保障进程有序执行
核心逻辑:利用 Windows 内核对象的信号状态,实现进程间的同步与互斥(比如避免多个进程同时操作同一资源),适用于简单状态通知。
代表技术:互斥量(Mutex,保证同一时刻只有一个进程访问资源)、信号量(Semaphore,控制同时访问资源的进程数量)、Event(事件对象,通过信号触发进程执行);
优势:轻量级、效率高、系统原生支持,无需复杂配置;
适用场景:进程间同步(如多个进程读写同一文件时的锁机制)、简单状态通知(如 “任务完成” 信号触发下一个进程执行)。

二、共享内存类:高速传输大数据,性能优先之选
核心逻辑:多个进程共享同一块物理内存,直接读写内存实现数据传输,无需拷贝,是速度最快的 IPC 方式。
代表技术:共享内存(直接创建共享内存区域,进程间直接访问)、文件映射(将文件映射到内存,多个进程通过内存共享文件数据)、DLL 共享段(通过 DLL 的共享数据段,实现进程间数据共享);
优势:传输速度极快(内存级读写)、无数据拷贝损耗、支持大容量数据传输;
注意点:需要自己实现同步机制(如搭配互斥量),避免数据竞争;
适用场景:高频大数据传输(如视频处理软件的帧数据传递、工业软件的实时数据共享)。

三、管道通讯:基于文件系统,适配本地进程交互
核心逻辑:模拟文件读写的方式,通过 “管道” 这一伪文件实现进程间字节流传输,是 Windows 原生的本地 IPC 方案。
代表技术:匿名管道(Pipe,仅支持父子进程或亲缘进程间通讯,单向传输)、命名管道(Named Pipe,支持任意本地进程间通讯,双向传输);
优势:系统原生支持、使用简单、传输可靠;
适用场景:本地进程间字节流传输(如命令行工具的输出传递、本地服务与客户端的通讯)。

四、组件对象模型:跨进程调用,实现功能复用
核心逻辑:通过 COM(组件对象模型)、DCOM(分布式 COM)、OLE 技术等,将一个进程的功能封装为组件,供其他进程远程调用,实现功能复用。
代表技术:COM(本地跨进程组件调用,如 Office 组件嵌入其他软件)、DCOM(跨网络的 COM 调用,支持远程组件访问)、OLE(对象链接与嵌入,如文档中嵌入图片、表格);
优势:封装性好、支持功能复用、接口标准化;
适用场景:跨进程功能调用(如第三方组件集成、软件插件扩展)、分布式系统的远程组件访问。

五、网络通讯类:跨机器 / 广域通讯,突破本地限制
核心逻辑:基于网络协议实现进程间通讯,不仅支持本地进程,还能跨 Windows 机器、跨网络通讯,是最通用的 IPC 方式。
代表技术:Socket(套接字,支持 TCP/UDP 协议,本地与跨网络通讯通用,如客户端 / 服务器架构)、NetBios 函数(早期 Windows 网络通讯接口,支持局域网内进程交互);
优势:通用性强、支持跨机器 / 跨网络、适配各类数据传输场景;
适用场景:网络应用(如浏览器与服务器通讯)、跨机器进程协同(如分布式服务间调用)、客户端 / 服务器架构软件。

六、消息与钩子:Windows 原生机制,适配桌面应用交互
核心逻辑:利用 Windows 的消息机制或钩子函数,实现进程间的消息传递或行为监控。
代表技术:消息通知(Windows 消息队列,进程间发送自定义消息)、钩子函数(Hook,监控或拦截其他进程的消息 / 行为,如键盘钩子、鼠标钩子)、DLL 注入(通过注入 DLL,实现进程间消息传递或功能扩展);
优势:深度适配 Windows 桌面应用、支持行为监控与消息触发;
适用场景:桌面应用交互(如窗口间消息通知)、进程行为监控(如安全软件的行为拦截)、软件功能增强(如通过 DLL 注入扩展第三方软件功能)。

七、中间件 / 存储介质:间接通讯,解耦进程依赖
核心逻辑:通过第三方存储介质或中间件传递数据,进程间不直接交互,降低耦合度,适配复杂场景。
代表技术:文件(通过读写同一文件传递数据,如日志同步、配置共享)、数据库(关系型 / 非关系型数据库,如多进程共享业务数据)、缓存中间件(Redis、etcd、zk,分布式场景下的配置同步与数据共享)、消息队列(MQ,异步通讯,如任务分发、数据异步传递);
优势:解耦进程依赖、支持异步通讯、适配分布式场景;
适用场景:分布式系统(如微服务间通讯)、异步任务处理(如批量数据处理)、跨进程配置共享(如多进程读取同一数据库配置)。

八、其他特色方式:适配特殊场景需求
除了主流方式,还有一些针对特定场景的 IPC 方案:
动态数据交换(DDE):早期 Windows 桌面应用的通讯方式,支持应用间数据实时同步(如 Excel 表格数据同步到 Word 文档);
粘贴板(Clipboard):简单直观的进程间数据传递,用户通过复制粘贴实现(如从浏览器复制文本到记事本);
文件传输协议(FTP):通过 FTP 协议实现文件级别的进程间 / 跨机器数据传输,适用于大容量文件共享。

总结:Windows IPC 选型核心逻辑 ——“按需匹配,兼顾效率与场景”
选择 IPC 方式时,核心看 3 个维度:
传输距离:本地进程选共享内存、管道、COM;跨网络选 Socket、中间件;
数据量与速度:大数据高速传输选共享内存、文件映射;小数据同步选内核对象、消息通知;
交互方式:同步通讯选 Socket、命名管道;异步通讯选 MQ、中间件;功能复用选 COM/DCOM。
Windows 的 IPC 方案覆盖了从本地轻量级同步到分布式跨网络通讯的全场景,掌握不同方式的核心逻辑,就能根据项目需求精准选型,让进程协同更高效。

你在开发中常用哪种 Windows IPC 方式?遇到过哪些兼容性或性能问题?欢迎在评论区留言交流~

代码跨平台怎么实现?6大核心方案+场景选型,告别重复开发

代码跨平台实现方式


代码跨平台怎么实现?6大核心方案+场景选型,告别重复开发

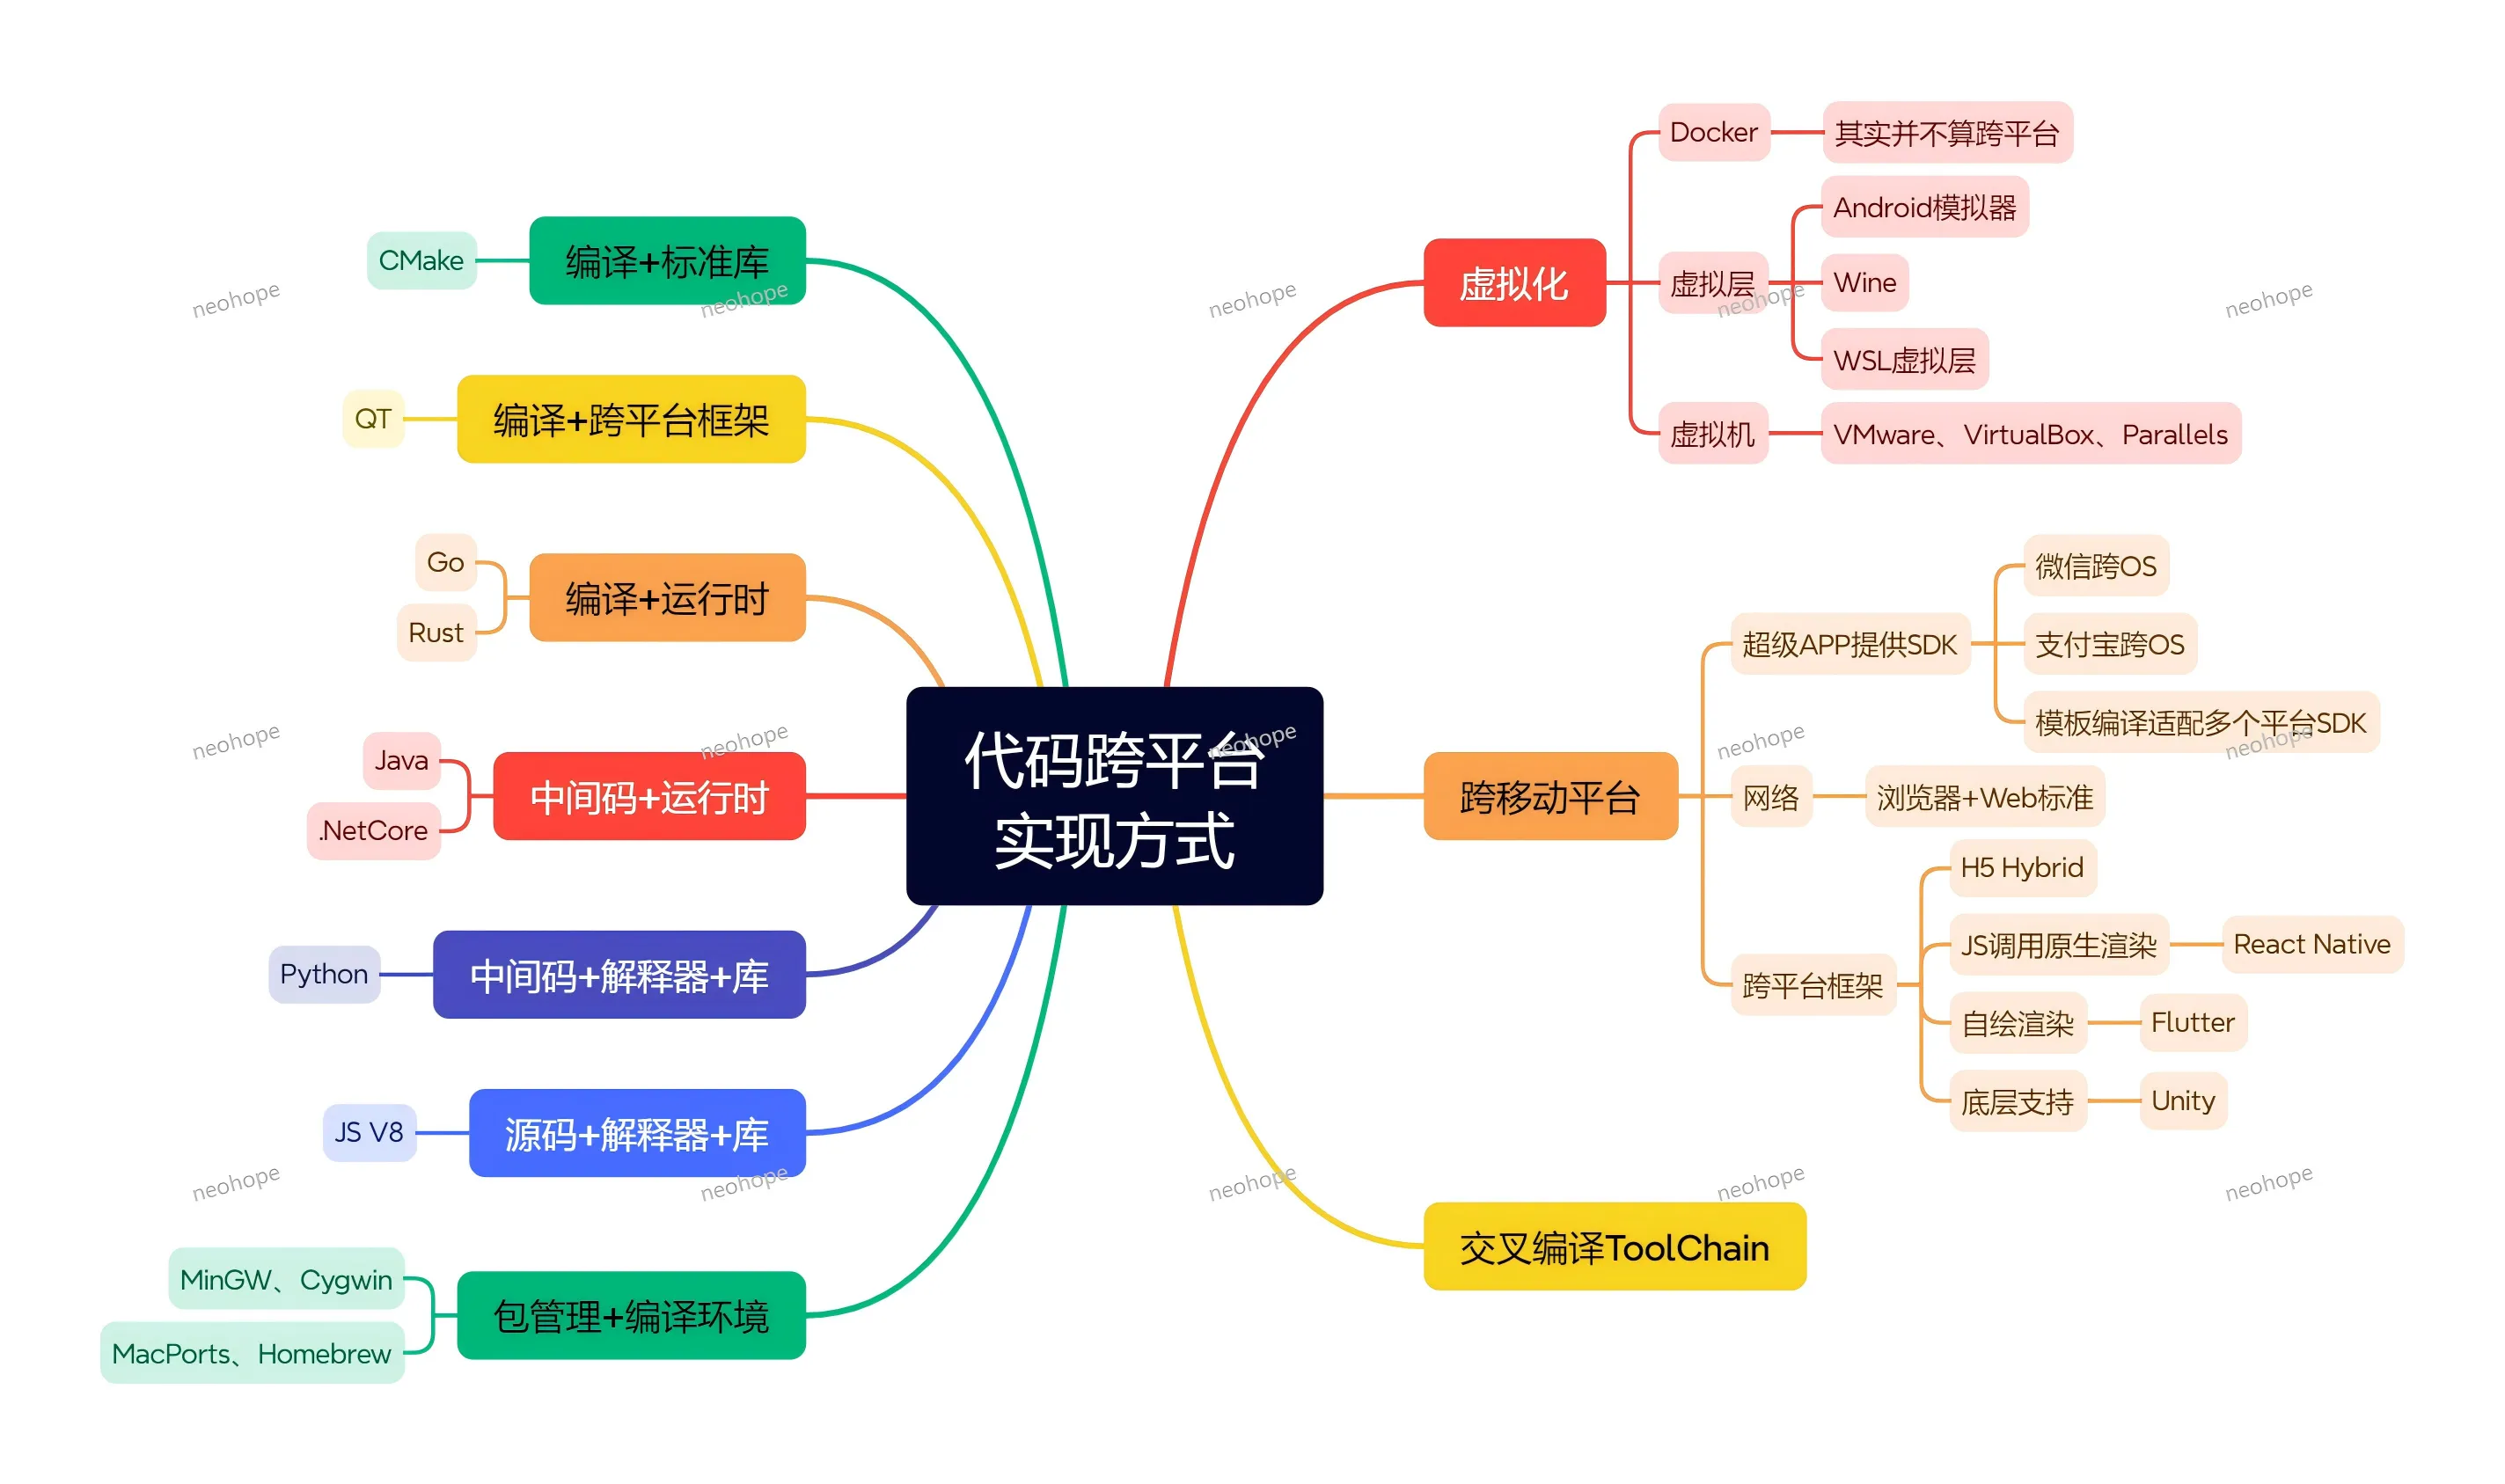
做开发时最头疼的莫过于 “一套代码多端适配”——Windows、Mac、Linux 要适配,iOS、Android 要兼容,甚至还要兼顾浏览器和小程序。重复写多套代码不仅效率低,还容易出现兼容性 bug。其实跨平台开发早已不是新鲜事,不同技术方案各有优劣,关键是选对适配场景。今天就拆解代码跨平台的核心实现方式,帮你快速找准适合自己的方案。

一、编译适配型:一次编码,多平台编译
核心逻辑:编写统一源码,通过专用编译工具或语言特性,直接编译出不同平台的可执行文件,性能接近原生。
代表技术:
语言原生支持:Go(编译 + 运行时,直接编译为各平台二进制文件)、Rust(跨平台编译工具链,适配多系统)、Java(中间码 + JVM 运行时,一次编译多平台运行)、.NET Core(中间码 + 运行时,跨 Windows/Mac/Linux);
编译工具辅助:CMake(搭配标准库,统一管理多平台编译流程)、交叉编译 ToolChain(如 MinGW、Cygwin,实现跨系统编译);
优势:性能强,接近原生应用;代码复用率高,无需大幅修改;
适用场景:后端服务、工具类软件、高性能应用(如 Go 开发的跨平台服务器,C+++CMake 开发的桌面工具)。

二、跨平台框架型:框架封装,屏蔽平台差异
核心逻辑:基于统一框架开发,框架底层适配不同平台的 API,开发者无需关注平台细节,专注业务逻辑。
代表技术:
桌面 / 多端框架:QT(编译 + 跨平台框架,适配桌面 + 嵌入式,支持 C++/QML);
移动跨平台框架:React Native(JS 调用原生渲染,兼顾跨平台与原生体验)、Flutter(自绘渲染引擎,跨 iOS/Android/ 桌面 / 网页,UI 一致性强);
优势:开发效率高,一套代码覆盖多端;UI 适配性好,框架已处理平台差异;
适用场景:移动 APP(如电商 APP、工具类 APP)、桌面应用(如 QT 开发的跨平台客户端)、中小型项目(Flutter 快速迭代上线)。

三、虚拟层/模拟型:通过虚拟环境兼容多平台
核心逻辑:在目标平台上搭建虚拟层或模拟器,让原本不兼容的代码在虚拟环境中运行,无需修改源码。
代表技术:
虚拟机:VMware、VirtualBox、Parallels(在 Windows/Mac上虚拟出其他操作系统,运行对应平台软件);
兼容层:Wine(在Linux/Mac上模拟 Windows 运行环境,运行 Windows 程序)、WSL(Windows子系统,在Windows上运行 Linux 环境及软件);
模拟器:Android 模拟器(在PC上模拟Android环境,运行APP);
优势:无需修改原有代码,直接复用现有应用;门槛低,快速实现兼容;
注意点:性能有损耗,不如原生流畅;部分复杂应用可能出现兼容性问题;
适用场景:现有应用跨平台运行(如Windows软件在Linux上通过Wine运行)、开发测试(Android模拟器调试APP)。

四、超级APP生态型:依托生态,跨OS运行
核心逻辑:在微信、支付宝等超级APP提供的SDK或生态内开发,借助超级APP的跨平台能力,实现 “一次开发,多OS适配”。
代表技术:微信跨OS、支付宝跨OS(通过其提供的 SDK 开发小程序或内嵌应用,自动适配 iOS/Android);
优势:无需考虑底层平台适配,超级 APP 已完成兼容;流量红利,可直接触达超级 APP 的海量用户;
适用场景:小程序、内嵌应用(如微信小程序、支付宝生活号应用)、轻量级交互场景。

五、Web标准型:基于浏览器,跨平台无压力
核心逻辑:采用 HTML/CSS/JS 开发,依托浏览器的 Web 标准,实现 “一次开发,所有浏览器兼容”,间接跨所有支持浏览器的平台。
代表技术:浏览器 + Web 标准、H5 Hybrid(APP 内嵌 WebView,混合原生与 Web 页面);
优势:兼容性极强,覆盖 PC / 移动 / 平板所有浏览器;开发成本低,技术栈普及;
注意点:性能依赖浏览器,复杂交互体验不如原生;部分原生 API 需通过桥接调用;
适用场景:网页应用、轻量级 APP、跨平台展示型场景(如官网、数据可视化页面、Hybrid APP 的展示模块)。

六、包管理与环境配置型:统一环境,简化适配
核心逻辑:通过包管理工具统一管理依赖,确保不同平台的开发环境一致,减少因环境差异导致的适配问题。
代表技术:MacPorts、Homebrew(Mac 平台包管理工具,快速安装适配 Mac 的开发依赖);
优势:简化环境配置,快速搭建跨平台开发所需依赖;统一依赖版本,避免 “本地能跑,线上报错”;
适用场景:辅助跨平台开发(如通过 Homebrew 在 Mac 上安装 CMake、MinGW 等跨平台编译依赖)。

总结:跨平台方案选型核心逻辑 ——“场景决定方案”
不用盲目追求 “万能方案”,选型时重点关注3点:
1、性能需求:高性能场景(后端、工具软件)选编译适配型(Go/Rust/CMake);中低性能需求(展示型 APP、小程序)选 Web 标准或超级 APP 生态;
2、多端覆盖范围:需覆盖移动 + 桌面选 Flutter/QT;仅移动端选 React Native/Flutter;仅桌面端选 QT/Go 编译;
3、开发效率:快速迭代选 Flutter/React Native;追求长期稳定、低维护成本选编译适配型或 QT。

跨平台开发的核心是 “用最低成本实现多端兼容”,不同方案没有绝对优劣,只有是否适配场景。选对方案,既能减少重复开发,又能保证产品体验。

你在跨平台开发中遇到过哪些兼容性坑?或者你更倾向于哪种实现方案?欢迎在评论区留言交流~

【温故知新】IT行业经典定律

IT行业经典定律

一、问题认知

XY 问题:不问真正的问题 X,反而问自拟的解决方案 Y,导致更优路径被忽略。
例子:业务老师希望批量得到客户纸质表单上的几个信息(X),跑去问开发团队如何批量识别纸质表单上的数据并导出CSV文件(Y),其实这几个信息数据库都有记录。

二八法则(帕累托法则):80% 的结果由 20% 的原因产生。
例子:一个项目中20%的代码,撑起最长用的80%功能。

吉尔布定律(Gilb’s Law):任何能够被测量的东西,都能够被改进。
例子:你开始记录每天写代码的专注时长,仅仅因为”在记录”,你就会不自觉地更加专注,效率真的提升了。

幂律分布(Power Law):少数节点拥有绝大多数连接,其余节点连接极少。
例子:互联网流量里,头部 1% 的网站吃掉了 90% 的访问量;长尾那 99% 的网站加起来才分 10%。

自行车棚效应:人们对简单琐碎的问题反而投入过多讨论时间,对复杂核心问题却轻易放过。
例子:技术评审会上,复杂的分布式架构方案半小时就通过了,却为按钮颜色、接口命名风格争论了一个小时。

沃克定律(Wadler’s Law):在编程语言设计中,讨论语法所花的时间与其重要性成反比——越是无关紧要的语法细节,争论越久。
例子:语言设计委员会开了三个月会,其中两个月在吵缩进到底用 Tab 还是空格,真正的核心类型系统只聊了一下午。

汉隆剃刀定律:能解释为疏忽的问题,就不要归因为恶意。
例子:线上出现接口调用异常,优先排查参数传错、文档遗漏等疏忽问题,不要先假定是对方团队故意为之。

坎宁汉定律(Cunningham’s Law):在互联网上想得到正确答案的最好方法,不是提问,而是发布一个错误的答案。
例子:你在技术论坛发帖”Python 肯定没有 GIL 吧?”——十分钟内就会有八个老哥跳出来把你纠正一遍,顺便把原理讲透。

二、风险管理

墨菲定律:凡是可能出错的事情,就一定会出错。(而且经常在最不能承受的时候发生)
例子:某直播平台,发现直播推流接口只判断了Token没再次去鉴权,为了兼容旧接口一再推迟上线时间。最后被黑客组织利用,导致近年来最大的直播事故。

演示定律:每当你当众演示系统时,它大概率会出故障。
例子:本地和测试环境跑了几十次都正常的功能,给客户现场演示时刚好触发边界条件直接闪退。

海因里希法则:每 1 起严重事故背后,对应 29 起轻微事故与 300 起未遂隐患。
例子:出现 1 次线上 P0 级数据故障,往前排查能发现 29 次线上小异常告警,以及 300 次被忽略的代码不规范和测试用例缺失。但实际情况是大家经常把这些小问题忽视了。

三、项目管理

霍夫施塔特定律:做事耗时总比预期长,即便你已经考虑了这条定律本身。
例子:你预估需求开发要 2 周,特意多预留了 3 天缓冲时间,最终还是因为需求变更、联调卡点超期了。

计划谬误定律:人们总会低估任务耗时,即便有过往经验也难以避免。
例子:你评估一个简单表单开发只需要 3 天,实际对接接口、处理兼容、改需求加校验,最后花了整整一周才上线。

帕金森定律:工作会自动膨胀,直至填满所有可用时间。
例子:原本 2 周就能做完的需求,给了 1 个月的排期,最后真的会拖到截止日前两三天才集中完成。

功能膨胀定律:系统一旦开放扩展,功能会持续增生直至臃肿,必须主动设界。
例子:在IE时代,所有人都觉得IE很慢。于是微软内部有团队用开源引擎重新开发了一个新版浏览器,一开始效果很好,但随着对IE各种功能兼容的越来越多,这个浏览器变得比IE还慢而且经常崩溃,最后这个项目被砍了。后来做Edge的时候,很多IE的功能是不兼容的,扔掉了旧包袱,让Edge比IE好用的多。

90-90 法则:软件开发前 90% 的功能耗费 90% 的工期,剩下 10% 的收尾工作也会耗费 90% 的工期。
例子:核心业务逻辑很快开发完成,以为即将上线,结果边界场景兼容、异常处理、性能优化等收尾工作,又花掉了和主开发几乎等量的时间。

克尼汉定律(Kernighan’s Law):调试一段一开始就写错的代码,比重新写一遍要难一倍。
例子:你从别人手里接了一段绕来绕去的代码,修了 A 处冒出 B 处 Bug;折腾三天后索性推倒重写,半天搞定。

布鲁克斯定律:向已延期的软件项目加人,只会让它完成得更晚。
例子:项目已经延期两周,临时新增 3 名开发加入,老员工需要花大量时间做业务讲解、代码交接和环境搭建,整体进度反而进一步延后。

沉默成本谬误(Sunk Cost Fallacy):人们倾向于继续投入资源到一个已经失败的项目中,仅仅因为已经投入了很多。
例子:花了两年做的产品根本没市场,团队却说”都做了两年了,放弃太可惜”,又烧了一年钱才彻底关停。

四、系统设计

康威定律:系统的架构必然复刻设计它的组织的沟通结构。
例子:公司业务团队拆分成三条线,各自定业务规则,各自提系统需求。最终做出来的系统就会是底层三套相互割裂的规则,表面上被捆绑在一起。

阿姆达尔定律:并行系统的加速上限,由程序中无法并行的串行部分占比决定。
例子:一个任务 90% 逻辑可多线程并行,10% 必须串行执行,就算开到 100 个线程,整体速度最多也只能提升 10 倍。
例子:一个组织编码工作只占10%,其余90%工作需要串行,哪怕编码工作提升到耗时为0,整体效率也只能提升11%。

泰斯勒定律(复杂性守恒原理):复杂性不会凭空消失,只会从一处转移到另一处。
例子:把单体系统拆成微服务后,单个服务的业务逻辑变简单了,但服务治理、链路追踪、分布式事务的整体复杂度反而大幅增加。
例子:各类跨平台的框架,开发用的很爽,无需各种适配,一次写完可以编译为各平台的Native程序。因为复杂度被底层框架承接了。
例子:为了赶工期,做了很多硬编码,项目匆匆上线。最后要花更多的时间,重构这些代码。

盖尔定律(Gall’s Law):一个切实可行的复杂系统,总是从一个切实可行的简单系统演化而来的。
例子:想一步到位做个”完美架构”的微服务系统,往往直接失败;从单体应用起步、随着业务增长逐步拆分,反而能活下来。

伊格尔森定律:自己六个月前写的代码,和别人写的没什么两样,同样看不懂。
例子:回头修改半年前写的工具类代码,因为没写注释、命名随意,自己都要花半天才能理清逻辑,完全看不出是自己写的。

海勒姆定律:API 用户足够多时,其所有可观测行为(含未文档细节)都会被人依赖。
例子:接口文档没声明返回列表的排序规则,但大量下游业务默认按当前顺序处理,后续优化排序逻辑后直接引发大面积业务异常。

死代码悖论:你因为 “以后可能用得到” 而保留的代码,永远不会被真正用到,只会持续增加维护负担。
例子:开发时顺手保留了三套备用实现逻辑没删掉,后续迭代中这些代码既没人用,还经常在重构时引发编译错误和理解成本。

CAP 定理:分布式系统最多只能同时满足一致性、可用性、分区容错性中的两项。
例子:电商下单系统优先保证数据一致性和分区容错,网络分区发生时就会暂停下单操作,牺牲部分可用性。

五、质量管理

沃斯定律:软件变慢的速度,永远快过硬件性能提升的速度。
例子:电脑 CPU 性能相比五年前翻了数倍,但新版 IDE、编辑器的内存占用和启动耗时也同步膨胀,日常使用体感并没有明显提速。

缺陷聚集原则:软件缺陷并非均匀分布,绝大多数集中在少数模块中。
例子:项目中频繁迭代、改动最多的用户认证模块,集中了全系统近 70% 的线上缺陷。

林纳斯定律:足够多的眼睛审视,就能让所有问题浮出水面。
例子:开源项目面向全球开发者开放源码审查,隐藏的深层漏洞往往比闭源项目更快被发现和修复。

破窗效应:不良现象一旦被放任,就会诱使人们效仿甚至变本加厉。
例子:代码里一处没人清理的冗余逻辑和临时写法,很快会让整个模块都充满不规范的代码。

格雷沙姆定律:劣币驱逐良币 —— 当劣质币和优质币同时流通时,人们会囤积优质币、花出劣质币,最终市场上只剩下劣质币。。
例子:项目赶工期时大量临时拼凑的烂代码被合入主干,并被业务方称赞响应及时。好好写代码,重构提升代码质量的开发,被嫌弃响应缓慢。久而久之整洁规范的代码越来越少,代码库整体质量持续下滑。

六、组织管理

古德哈特定律:当一项指标被当作考核目标,它就不再是一个好的衡量指标。
例子:团队把代码行数作为开发工作量考核标准,最终大家疯狂堆砌冗余代码,整体代码质量不升反降。

德西效应(Deci Effect):过度使用外部奖励反而会削弱内在动机。
例子:孩子本来爱画画,你每次画完给 10 块钱,三个月后不给钱他就不画了——原本的兴趣被”买”没了。

彼得定律(Peter Principle):在一个等级制度中,每个员工都会晋升到他不能胜任的职位。
例子:顶尖的销售员被提拔成销售总监,结果他不懂管理,团队业绩一路下滑。

呆伯特定律(Dilbert Principle):公司往往会把最无能的员工提升到管理层,让他们离开一线,从而减少对实际工作的破坏。
例子:那个搞砸了三个项目的老员工,被”升”为中层管理者,从此只开会不干活,反而对公司危害小了。

【温故知新】设计原则

设计原则


设计原则

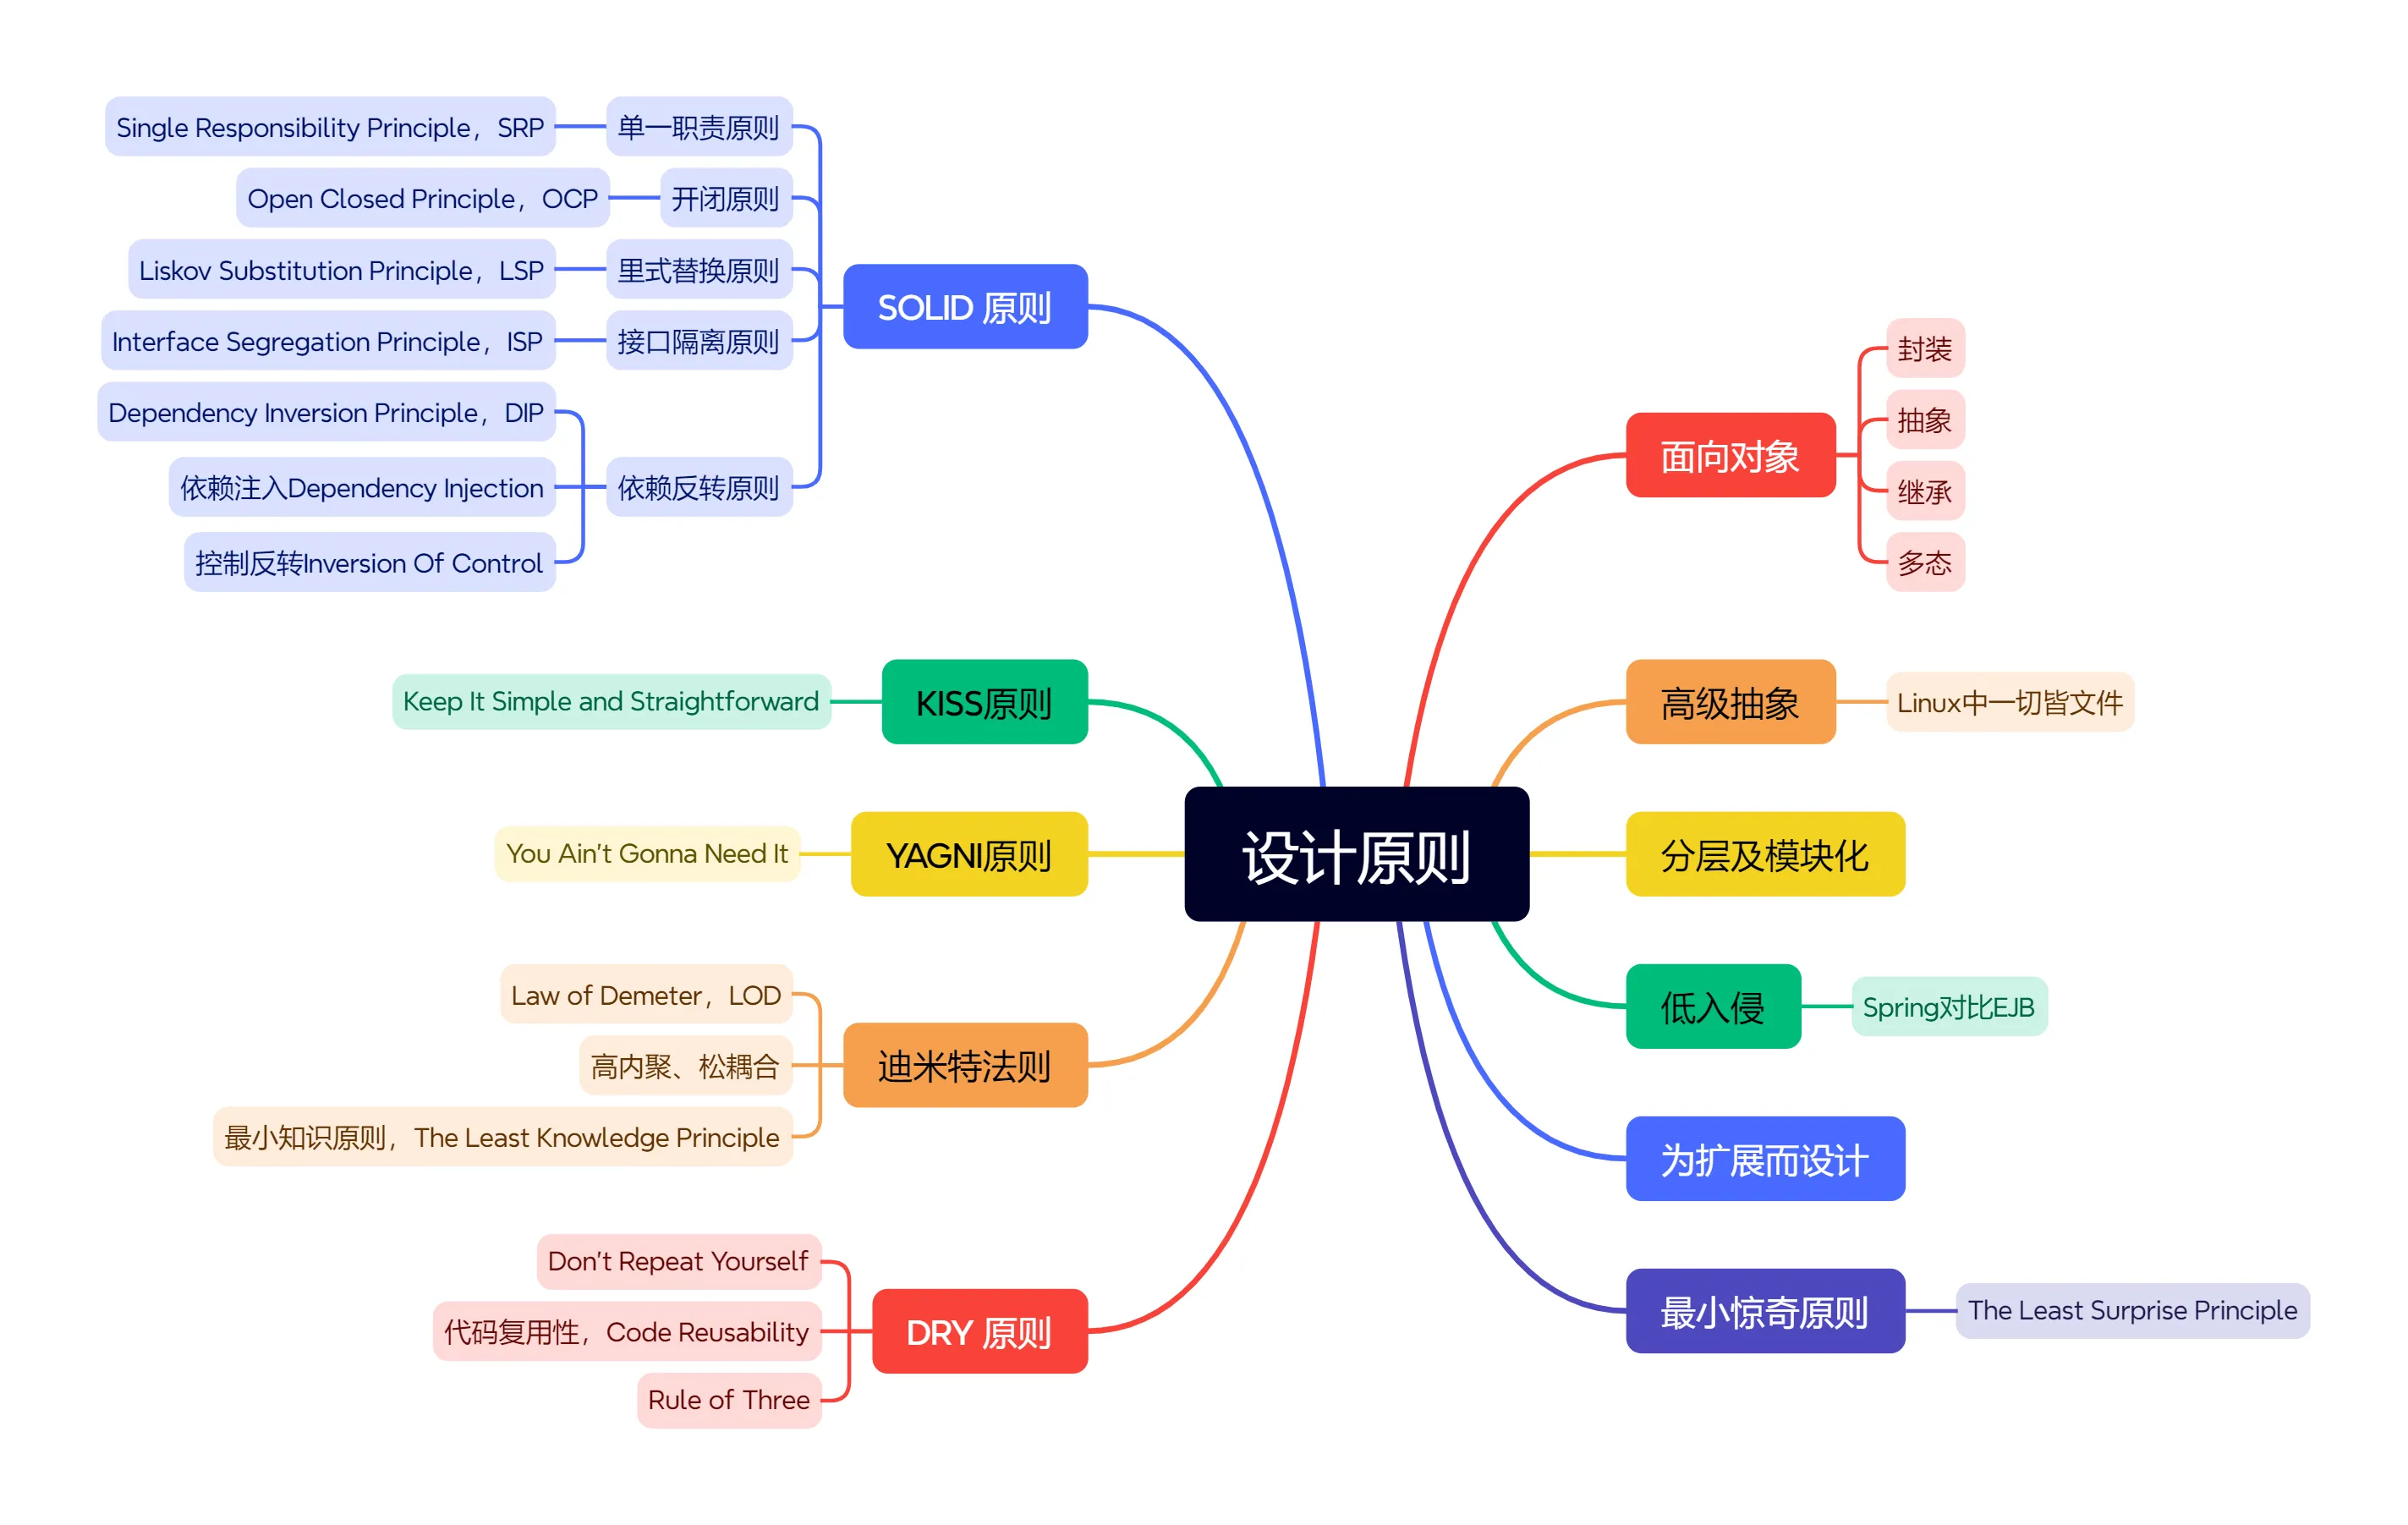
一、SOLID 原则

单一职责原则

  • Single Responsibility Principle,SRP
    一个类/模块仅负责一项明确职责,避免功能混杂。
  • Separation of Concerns,SoC
    注点分离原则,把一个复杂的系统分成多个部分,每个部分只关注一件事。

开闭原则

  • Open Closed Principle,OCP
    对扩展开放(可新增功能),对修改关闭(不改动现有代码)。

里式替换原则

  • Liskov Substitution Principle,LSP
    子类必须能完全替代父类,且不破坏原有业务逻辑。

接口隔离原则

  • Interface Segregation Principle,ISP
    客户端不应依赖它不需要的接口,拆分臃肿接口为专用小接口。

依赖反转原则

  • Dependency Inversion Principle,DIP
    高层模块不依赖低层模块,二者均依赖抽象;抽象不依赖细节,细节依赖抽象。
  • 依赖注入Dependency Injection
    通过外部传入依赖对象(而非内部创建),解耦组件与依赖。
  • 控制反转Inversion Of Control
    将对象创建、流程控制的主动权交给框架,而非硬编码在业务代码中。

二、KISS原则

Keep It Simple and Straightforward

设计力求简单直接,复杂逻辑会增加维护成本与出错风险。

奥卡姆剃刀原理(Occam’s Razor)

当多个方案都能达成同一目标时,选择假设最少、最简单的那一个——”如无必要,勿增实体”(Entities should not be multiplied unnecessarily)。

三、YAGNI原则

You Ain’t Gonna Need It

不提前开发当前不需要的功能,避免过度工程。

过早优化是万恶之源

premature optimization is the root of all evil.

Rule of Three

同一段代码第三次出现时才重构复用,避免过度设计。

四、迪米特法则

Law of Demeter,LOD

对象仅与直接关联的对象交互,不依赖间接依赖的内部细节。——“只和直接朋友说话,不和陌生人说话”。

高内聚、低耦合

模块内部逻辑紧密相关(高内聚),模块间依赖尽可能少(低耦合)。

最小知识原则,The Least Knowledge Principle

对象应最小化对其他对象的了解,仅知晓必要的接口信息。

组合优先于继承原则,Composition Over Inheritance

设计中尽量使用组合而不是通过类继承来复用功能

五、最低入侵原则

Spring对比EJB

Spring无需实现特定接口或继承框架类(低入侵),EJB则强依赖框架规范(高入侵)。

六、DRY 原则

Don’t Repeat Yourself

避免重复代码与逻辑,通过抽象统一维护相同知识。

复用代码,Code Reusability

通过封装通用逻辑(函数/类/模块),减少重复编写。

不要重复造轮子

如果没有不得不做的理由,千万不要重复造轮子。

七、面向对象

封装、抽象、继承、多态

隐藏内部实现细节,仅通过公开接口与外界交互。

八、高级抽象

Linux中一切皆文件

将设备、进程等系统资源统一抽象为文件,用同一套API访问。

九、分层及模块化

按职责拆分系统为独立层/模块,降低耦合,提升可维护性。

十、为扩展而设计

预留扩展接口,确保新增功能时无需大幅修改现有代码。

十一、波斯特定律(鲁棒性原则):发送时保守,接收时宽容。

对外提供接口时,自身输出的参数严格遵循格式规范;对接上游数据时,对合理的格式差异做兼容处理,提升系统整体容错性。

十二、最小惊奇原则

The Least Surprise Principle

代码行为应符合开发者直觉,避免反常识的设计。

十三、为维护者写代码

为维护者写代码、注释和文档

十四、拥抱变化

欢迎需求变更,即使在开发后期。敏捷过程利用变更为客户带来竞争优势。——《敏捷宣言》

十五、不要让用户思考

Don’t make me think!

十六、不要给客户行为做过多假设

你永远不知道用户怎么使用你的软件

十七、及时处理代码的坏味道(破窗效应)

当代码质量下滑的时候,及时修复问题,否则只会获得一堆低质量代码

【温故知新】设计模式

设计模式

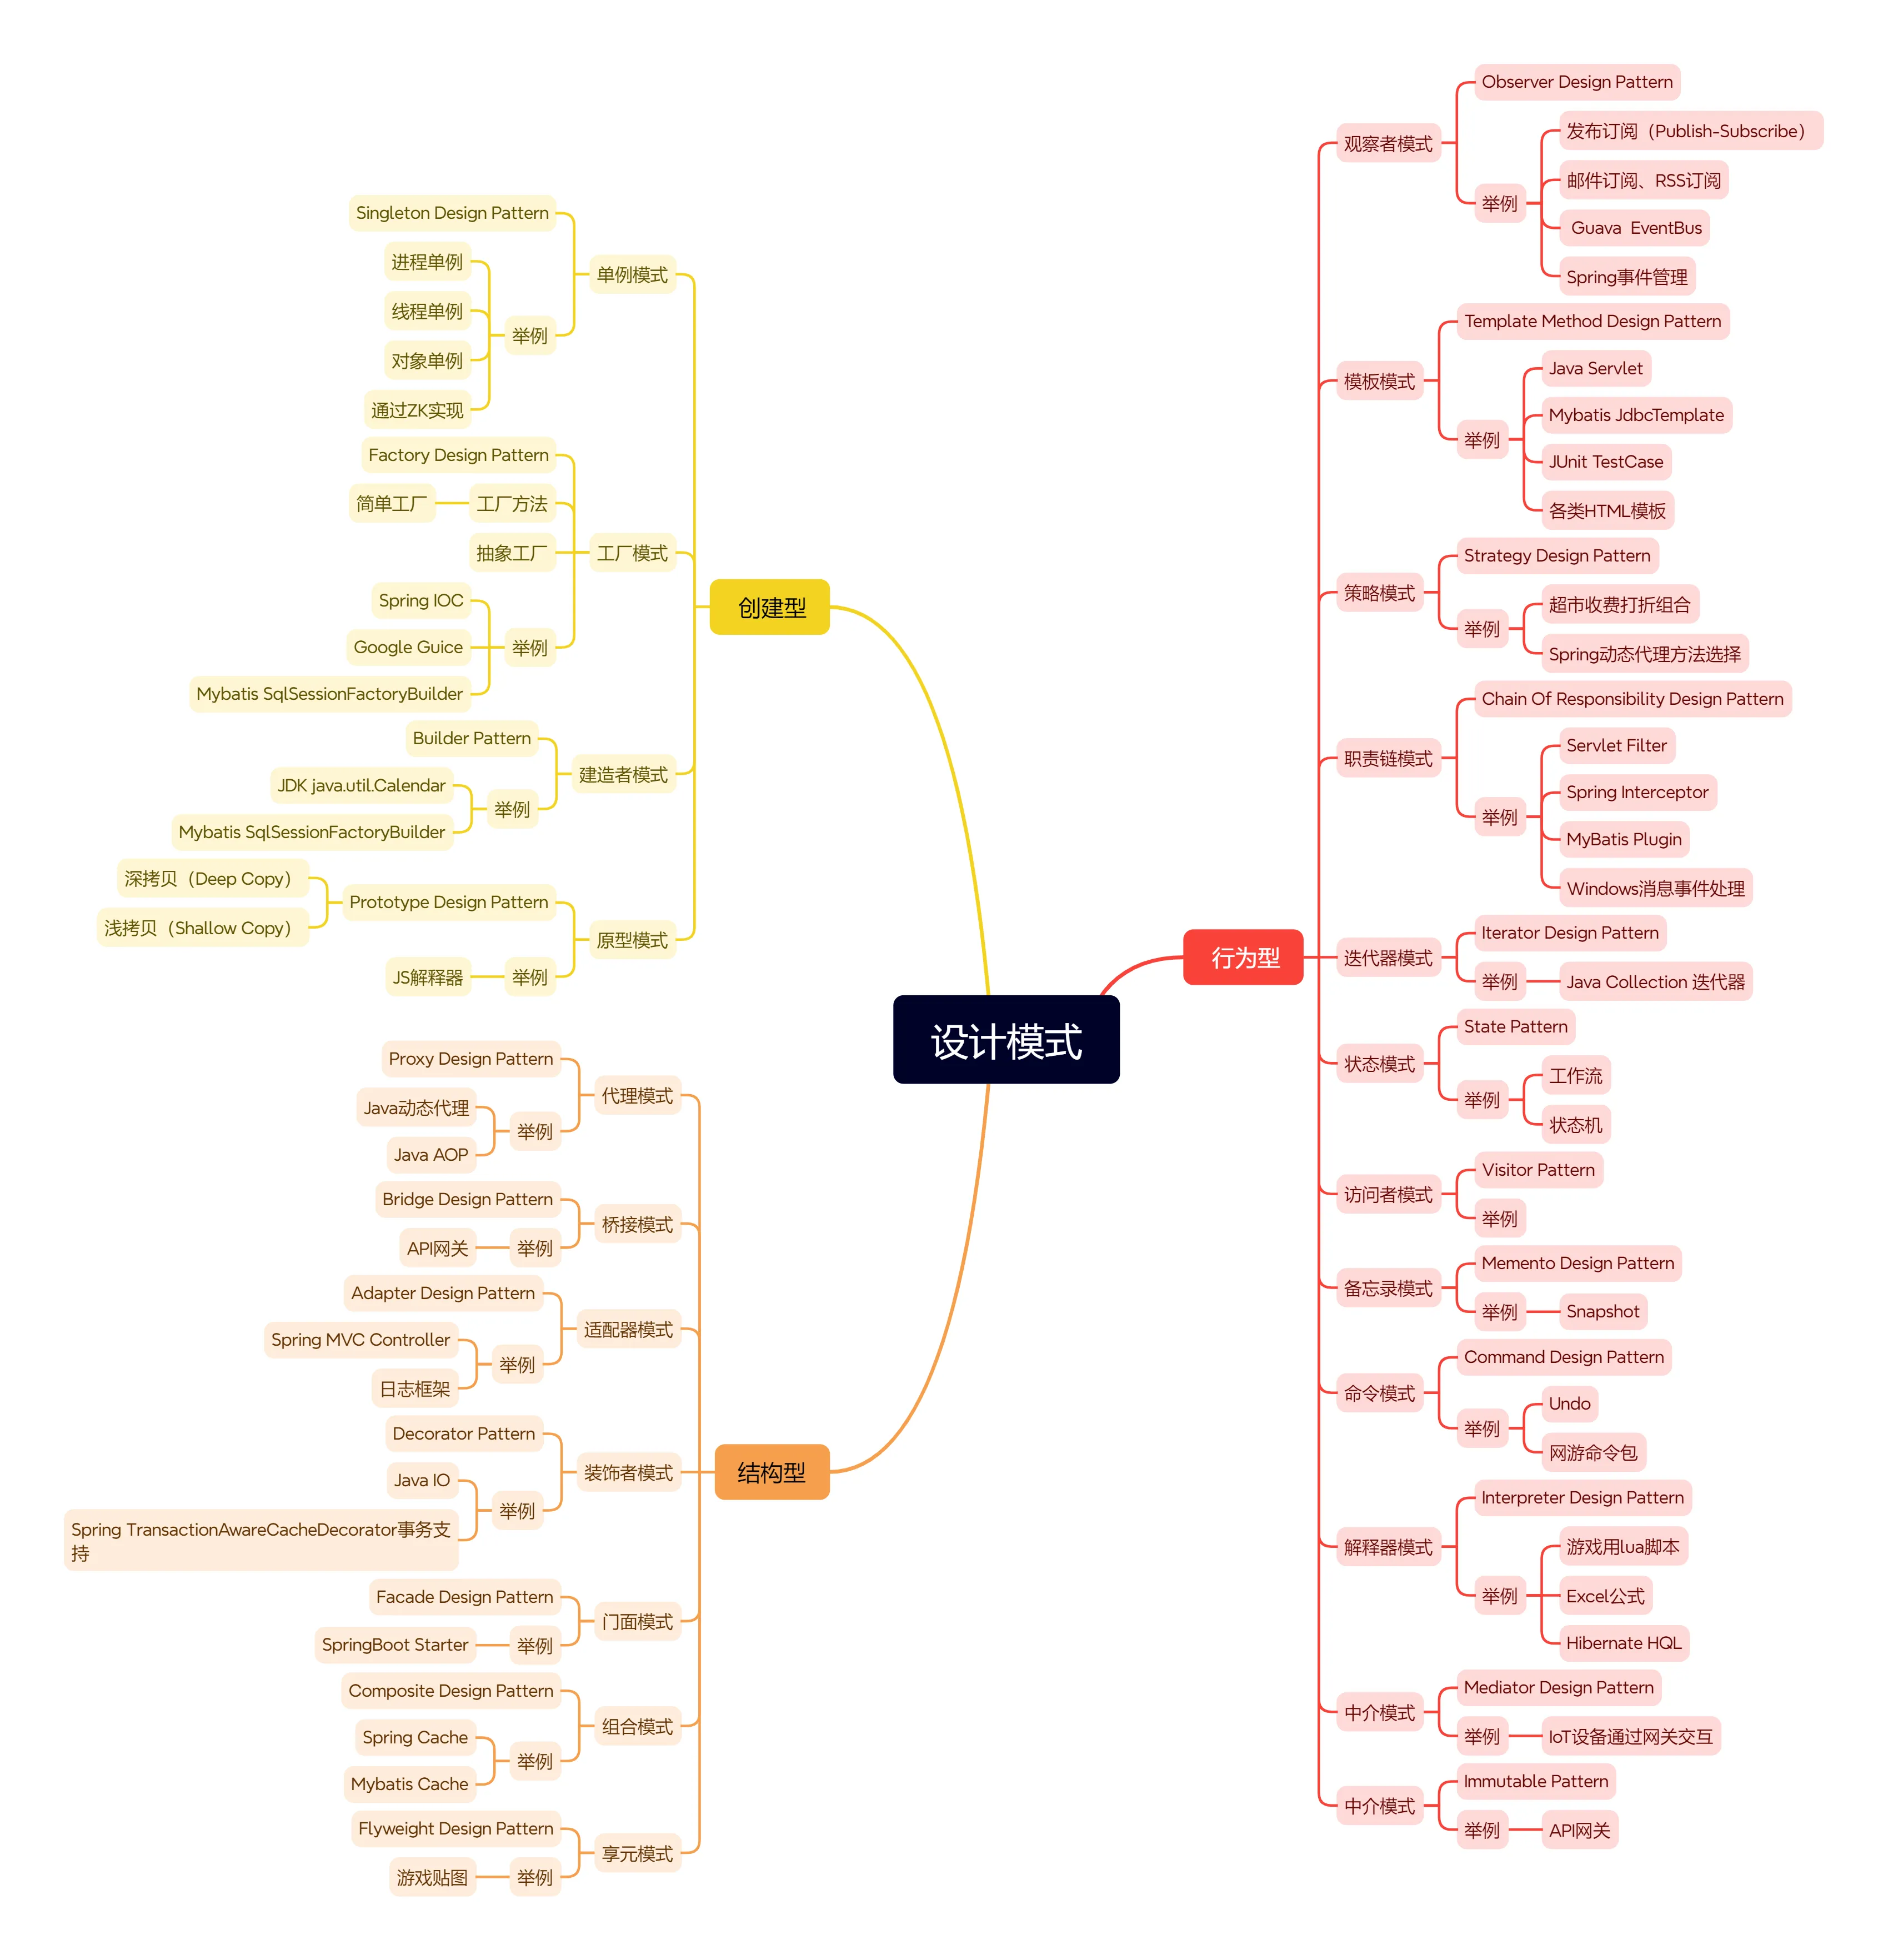
一、23种设计模式

设计模式

分类 模式名称 一句话定义 核心要点 典型应用场景
创建型(5种) 单例Singleton 保证一个类只有一个实例 私有构造、全局访问点 日志管理器、数据库连接池、配置对象
工厂方法Factory Method 定义创建对象的接口,由子类决定实例化谁 类级别、依赖继承 日志记录器(文件/数据库)、支付渠道选择
抽象工厂Abstract Factory 创建一组相关或相互依赖的对象族 对象组合、拒绝多if-else 跨平台UI组件(Win/Mac按钮和文本框)
建造者Builder 分步构建复杂对象,分离构造与表示 链式调用、Director指挥 SQL查询构造器、StringBuilder、复杂订单
原型Prototype 通过拷贝现有对象来创建新对象 实现Clone接口、浅/深拷贝 游戏怪物克隆、对象初始化成本高的场景
结构型(7种) 适配器Adapter 将一个类的接口转换成客户端期望的接口 包装器、兼容旧代码 电源转接头、第三方SDK接口适配
桥接Bridge 将抽象与实现分离,让它们独立变化 组合优于继承 消息发送(抽象:普通/紧急 vs 实现:邮件/SMS)
装饰器Decorator 动态地给对象添加职责,比继承灵活 层层包裹、透明扩展 Java I/O流 (BufferedInputStream)
代理Proxy 为对象提供一个代理以控制访问 中介、延迟加载 虚拟代理(图片懒加载)、权限代理
外观Facade 为复杂的子系统提供一个统一的简单接口 简化调用、降低耦合 JDBC封装、启动电脑(一键开机)
享元Flyweight 共享细粒度对象,减少内存消耗 池化技术、内部/外部状态 字符串常量池、围棋棋子(颜色共享)
组合Composite 将对象组合成树形结构以表示”部分-整体” 递归结构、一致对待 文件系统(文件夹与文件)、组织架构树
行为型(11种) 策略Strategy 定义一系列算法,封装起来,让它们可互换 消除大量条件判断 电商促销策略(满减/折扣/返现)、排序算法
观察者Observer 定义一对多的依赖,当一个对象改变时通知所有依赖者 发布-订阅机制 事件监听(Button点击事件)、RxJava
命令Command 将请求封装成一个对象,支持撤销和排队 解耦请求者与执行者 菜单按钮操作、宏命令、线程池任务
模板方法Template Method 定义算法骨架,将某些步骤延迟到子类 钩子方法、代码复用 数据库访问流程(连接-执行-关闭)、JUnit
状态State 允许对象在其内部状态改变时改变它的行为 用多态代替if-else 订单状态流转(待支付/已发货/已完成)、电梯状态
责任链Chain of Resp. 将请求沿着处理链传递,直到被处理 解耦发送者和接收者 审批流、Servlet Filter、拦截器
备忘录Memento 在不破坏封装的前提下,捕获并恢复对象状态 快照机制 编辑器撤销(Ctrl+Z)、游戏存档
中介者Mediator 用一个中介对象封装一组对象的交互 减少对象间耦合 聊天室(通过服务器转发)、MVC的Controller
访问者Visitor 将作用于某对象结构的操作分离出来封装 数据结构稳定,操作易变 编译器(AST节点遍历)、报表生成器
迭代器Iterator 提供一种方法顺序访问聚合对象中的元素 统一遍历接口 Java Collection的 iterator()、for-each
解释器Interpreter 给定一个语言,定义其文法的一种表示,并解释执行 语法树解析 正则表达式引擎、SQL解析、数学表达式计算

二、MVX设计模式

MVX设计模式

模式 全称与核心组成 数据流与交互逻辑 优点 缺点 典型应用场景
MVC Model-View-Controller• M: 数据/业务• V: 界面展示• C: 接收输入,调度M/V 双向混乱View常直接读Model,Controller同时操控View和Model。很多实现中V和C紧耦合(如iOS)。 • 概念简单,易上手• 开发速度快(小项目) • Controller臃肿(Massive VC)• View与Model耦合,难测试• 逻辑分散,维护困难 • 早期Web开发(PHP/JSP)• iOS原生开发(Apple MVC)• 简单Demo或小型工具
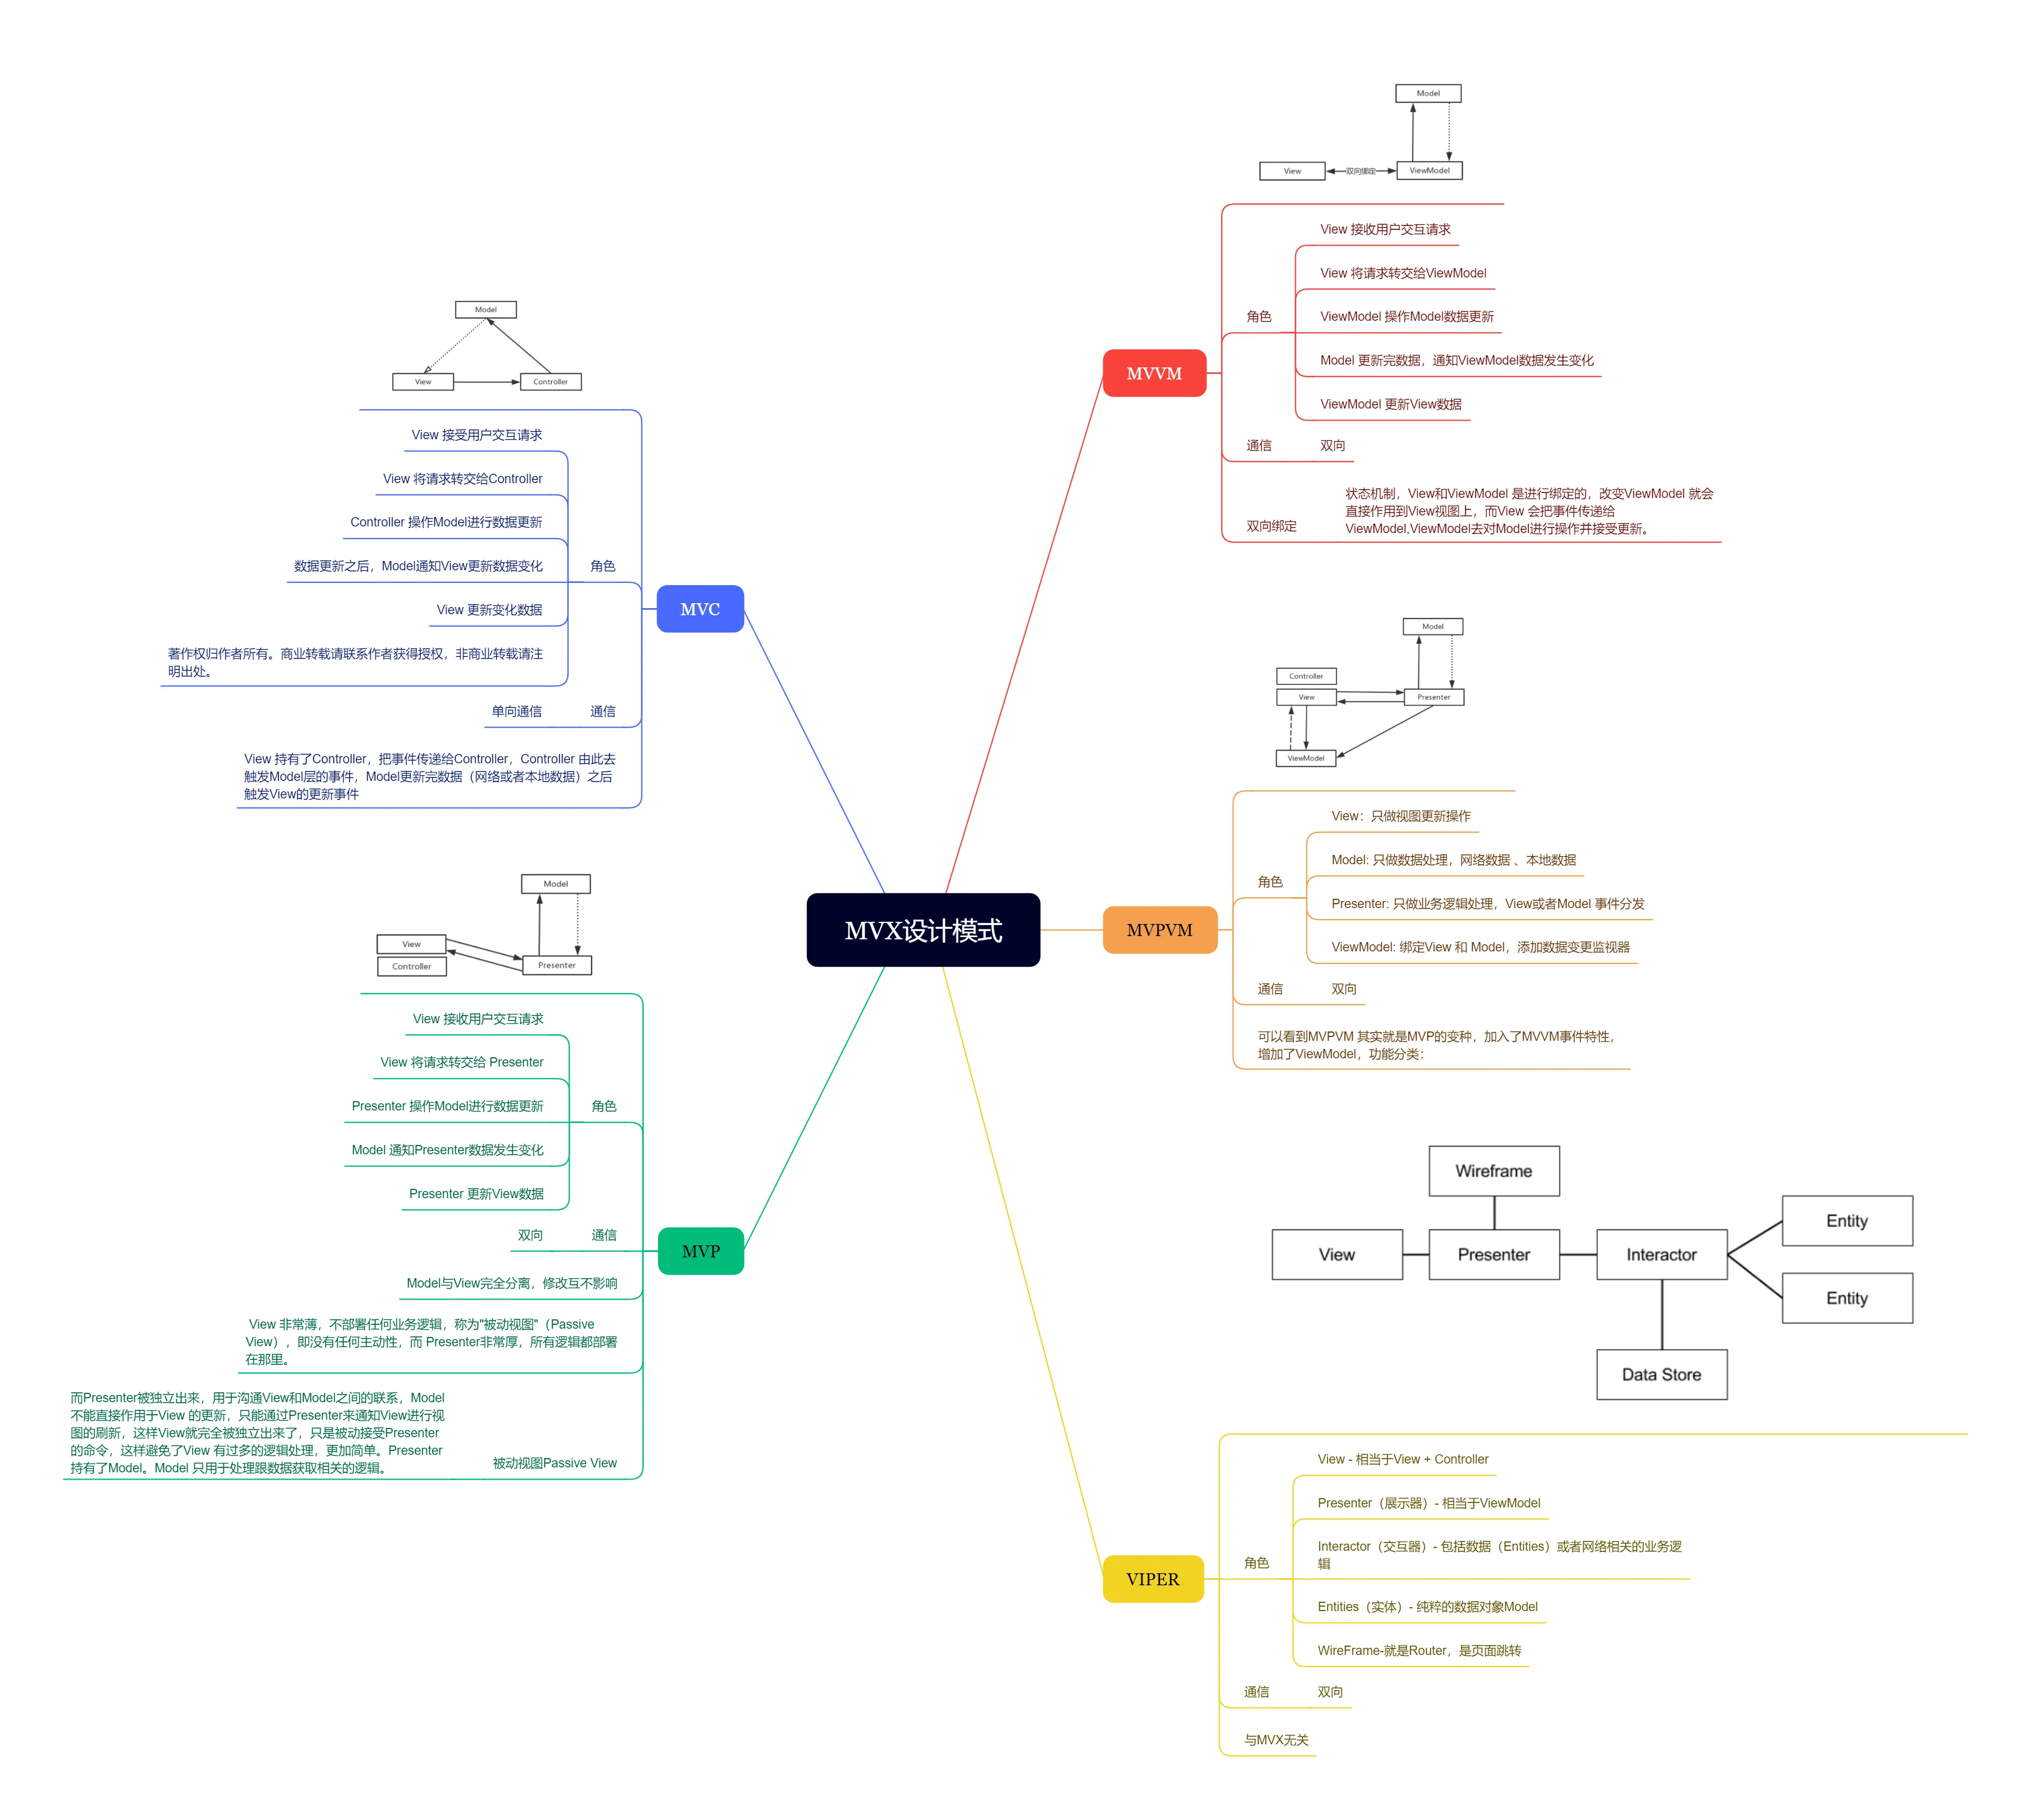
MVP Model-View-Presenter• M: 数据/业务• V: 被动视图• P: 纯逻辑调度 单向清晰View <-> Presenter <-> Model。View只负责画UI,通过接口通知Presenter;Presenter持有View接口,更新UI。 • 彻底解耦(V与M互不知晓)• Presenter无Android/iOS Context,极易单元测试• 逻辑集中,易于维护 • Presenter易臃肿• 手动更新UI繁琐(需写大量setText等代码)• View接口可能过多 • 传统Android开发• WinForms/ASP.NET Web Forms• 需要高测试覆盖率的项目
MVVM Model-View-ViewModel• M: 数据/业务• V: 界面展示• VM: View的抽象模型 双向绑定View <-> (Binder) <-> ViewModel。View与ViewModel通过框架自动同步(Data Binding),无需手动调用。 • 开发效率极高(消灭样板代码)• 数据驱动,代码简洁• 比MVP更解耦,测试性良好 • 调试困难(数据流向不直观,难定位Bug)• 内存泄漏风险(绑定未释放)• 复杂逻辑导致ViewModel膨胀 • 前端主流(Vue/React/Angular)• WPF/UWP• Android Jetpack (LiveData/DataBinding)• 数据密集型应用
MVPVM MVP + MVVM• M: 数据• V: 视图• P: 业务逻辑• VM: 数据包装 双轨制View <-> Presenter <-> ViewModel <-> Model。P负责逻辑,VM负责适配数据供V绑定。 • 兼具MVP的强测试性和MVVM的高效率• 职责分离更彻底(P只管逻辑,VM只管数据) • 架构复杂,学习成本高• 类数量翻倍,代码量较大• 小型项目杀鸡用牛刀 • 大型桌面应用(WPF)• 复杂企业级移动应用• 需要严格分层的大型项目
VIPER View-Interactor-Presenter-Entity-Router• V: UI展示• I: 业务逻辑/用例• P: 格式化数据• E: 实体• R: 路由/导航 单向闭环View -> Presenter -> Interactor -> Entity。严格遵循Clean Architecture,每一层只做一件事。 • 职责切分到极致• 极高的可测试性和模块化• 代码极其规范,适合团队协作 • 类爆炸(一个页面5+文件)• 极度繁琐,开发效率低• 学习曲线非常陡峭 • 超大型iOS/Android项目• 金融、银行类App(业务极其复杂)• 长期维护的核心产品

WSL2中apt升级systemd时报错:无法锁定passwd文件

1、环境:
Windows10+WSL2+Ubuntu24
PS:另一台电脑Windows11+WSL2+Ubuntu24,不会报错

2、再现方式及错误信息

# apt-get upgrade
Reading package lists... Done
Building dependency tree... Done
Reading state information... Done
Calculating upgrade... Done
...
...
Setting up systemd (255.4-1ubuntu8.8) ...
Initializing machine ID from random generator.
Failed to take /etc/passwd lock: Invalid argument
dpkg: error processing package systemd (--configure):
installed systemd package post-installation script subprocess returned error exit status 1
Errors were encountered while processing:
systemd
E: Sub-process /usr/bin/dpkg returned an error code (1)

3、错误发生原因
systemd升级的脚本,会调用systemd-sysusers,systemd-sysusers会尝试通过fcntl锁定文件,但WSL中fcntl实现效果与Linux中不同,导致脚本执行失败。
更进一步的解释:
Linux中文件锁是基于文件描述符的,子进程会自动继承该文件锁。
Windows中文件锁是基于进程的,子进程需要自行获取新的文件锁。
WSL中,实现方式,更接近与Windows,重复获取同一个文件的锁自然是失败的。

openat(AT_FDCWD, "/etc/.pwd.lock", O_WRONLY|O_CREAT|O_NOCTTY|O_NOFOLLOW|O_CLOEXEC, 0600) = 3
fcntl(3, F_OFD_SETLKW, {l_type=F_WRLCK, l_whence=SEEK_SET, l_start=0, l_len=0}) = -1 EINVAL (Invalid argument)

4、如何绕过该错误

# 原文在此:https://github.com/microsoft/WSL/issues/10397

# 切换到/bin
# 将systemd-sysusers修改为systemd-sysusers.org
# 将systemd-sysusers做成一个echo的符号链接(用于欺骗升级脚本,让其以为得到了正确的结果)
# 切换回之前的目录
cd /bin && mv -f systemd-sysusers{,.org} && ln -s echo systemd-sysusers && cd -

# 修复包依赖
apt --fix-broken install

# 继续升级
apt-get upgrade

医疗大模型数据防护

医疗大模型训练数据,除了脱敏之外,至少还要做下面的工作
1、完整的医疗数据,即便做了基础的去标识化工作,也很容易反向推断定位到某个个体,所以要进一步加强:泛化(32岁改为30~40岁)、模糊、并引入噪声
2、医生不是神,并非所有的诊断都是对的、并非所有治疗方案都是最佳的,不合适的数据剔除很难
3、医疗数据的归属权有争议(极端一些,比如一个人在一家医疗机构做了全基因测序,测序结果是这家医疗机构的吗),需要获取患者授权,最好能给予收益分成
4、医学伦理、社会道德、大众接受程度这些问题,要考虑在前面
5、医疗数据在部分国家地区是不允许高度集中的,分散在各机构服务器中(医院、体检机构、公卫机构),所以要数据不动模型动,采用类似联邦学习的技术

医疗健康场景下Constitutional AI规则

1、生命优先,患者安全第一,推荐风险较低的方案,提醒及时就医
2、保持大模型的专业及严谨性,不得针对训练边界之外的病种给出建议,更不可随意发挥
3、医学建议要透明可解释,要能溯源到教材、规范、病例和高可信的论文等材料
4、大模型仅为辅助工具,关键节点包括处方、医嘱、手术等,最终决策权还给医生
5、尊重患者的尊严与自由
6、保护隐私,遵守相关法律
7、保障患者知情权,说明大模型的局限性及潜在风险
8、符合道德及医学伦理,公平无歧视
9、如果面向患者,那输出要更有温度,不要过于冷漠