大模型中转站中间人攻击解析与防御

大模型中转站中间人攻击解析与防御

在当下AI全民普及的时代,大语言模型(LLM)、AI编程助手、智能Agent已深度融入企业研发、自动化运维、个人办公全场景。GPT、Claude、Gemini等顶级模型能力强大,但官方API普遍存在收费昂贵、网络访问受限、调用门槛高等问题。

在此背景下,各类第三方大模型中转服务快速崛起。它们以低价普惠、免特殊网络、全模型聚合、高速稳定为宣传卖点,用极低的使用成本、极简的操作界面,吸引了海量个人开发者、中小企业用户。

便利与低价的背后,是绝大多数用户忽略的致命安全隐患。在使用第三方中转站时,本质是在无条件信任一个完全不受自己掌控的中间人。不同于普通的网络服务中转,大模型中转站拥有对用户请求、模型响应的完整读写、篡改、伪造、截留权限。

这也让大模型中转站中间人攻击(LLM MITM)从理论风险,变成当下AI安全领域最普遍、隐蔽性最高、破坏力最强的现实威胁。它早已突破传统网络窃听范畴,升级为语义层投毒、业务层渗透、系统层控权的复合型高级攻击。
Continue reading 大模型中转站中间人攻击解析与防御→

大模型“岗前特训”:大模型微调(LLM Fine-tuning)

大模型“岗前特训”:大模型微调(LLM Fine-tuning)

如今大模型已经全面走入产业落地场景,从智能客服、行业知识库到专属AI助手,几乎所有垂直场景的大模型应用,都绕不开一个核心环节——模型微调。

很多人都有疑惑:明明可以用提示词(Prompt)、RAG检索就能让大模型适配业务,为什么还要费力做微调?事实上,Prompt存在能力上限、泛化性差、人工成本高的问题,RAG只能解决外部知识补充问题,无法改变模型的底层生成逻辑、风格习惯和领域认知。而微调,是让通用大模型真正变成「行业专属模型」的核心手段。

Continue reading 大模型“岗前特训”:大模型微调(LLM Fine-tuning)→

大模型“瘦身术”:大模型量化(LLM Quantization)

大模型“瘦身术”:大模型量化(LLM Quantization)

过去几年,大语言模型凭借超强的理解、生成与推理能力,彻底引爆了AI行业。但强大能力的背后,是大模型难以回避的“三高痛点”:高算力消耗、高显存占用、高推理延迟。动辄数十亿、上百亿参数的大模型,看似智能无比,却极度依赖高端服务器、旗舰显卡,普通用户的电脑、手机根本无法运行。

想要打破算力壁垒,让大模型走出实验室、走进普通设备,就必须用到大模型领域的核心轻量化技术——模型量化(LLM Quantization)。它堪称大模型的“瘦身术”和“万能压缩包”,是解决AI低成本部署、终端落地的关键技术。今天我们来介绍一下大模型量化技术。

Continue reading 大模型“瘦身术”:大模型量化(LLM Quantization)→

大数据的小文件生存指南3:删除

大数据的小文件生存指南3:删除(删除≠即时释放空间)

在单机文件系统中,删除文件是一个“即时生效”的动作:执行删除操作后,文件元数据直接清除、磁盘空间立刻释放,逻辑简单、用户感知直观。但在大数据分布式集群中,这一逻辑不再适用,也是最容易让开发者产生认知偏差的核心点。

如果针对亿级小文件采用“即时物理删除”机制,会瞬间产生海量随机IO、频繁的元数据变更、大规模块数据清理动作,直接引发集群IO抖动、节点负载飙升、读写任务阻塞,严重破坏集群稳定性。

Continue reading 大数据的小文件生存指南3:删除→

大数据的小文件生存指南2:寻址

大数据的小文件生存指南2:寻址(从路径到索引)

寻址,是数据读写的核心链路,也最能体现大数据分布式系统与传统单机系统的设计取舍。

在单机时代,文件寻址遵循“路径直连”逻辑:文件路径对应唯一inode,操作系统直接定位磁盘扇区,链路短、开销小、速度快。但这套逻辑完全无法适配大数据海量小文件场景——如果亿级小文件都依靠“直连寻址”,中心元数据节点极易成为瓶颈,集群调度、读写IO会导致严重延迟。

因此,所有主流大数据系统都做出了统一的核心取舍:牺牲单次寻址的极致速度,用多层索引、分层过滤、元数据跳转的微小计算开销,换取整个集群的稳定性与无限伸缩性。

Continue reading 大数据的小文件生存指南2:寻址→

大数据的小文件生存指南1:存储

大数据的小文件生存指南1:存储(小文件不能做独立存储单元)

在大数据分布式存储场景中,小文件是业界公认的“甜蜜的毒药”。单个KB级小文件体量微小、读写开销极低,看似不会对集群造成压力,但当业务持续迭代,千万级、亿级小文件批量堆积后,会引发一系列连锁集群故障:撑爆元数据节点内存、大幅拖垮集群整体读写性能、造成计算任务调度拥堵,严重时直接导致整个大数据集群服务瘫痪。

小文件治理的核心痛点,并非单文件数据量过小,而是传统单机文件的独立存储逻辑,完全不适用于分布式海量数据架构。单机场景下的小文件独立存储、独立管理模式,会无限放大分布式集群的元数据压力、存储冗余、计算调度缺陷。

基于此,HDFS、Hive、HBase、Ceph、Iceberg、Delta Lake、Hudi等所有主流大数据存储系统,针对小文件存储形成了统一的核心优化思路:彻底杜绝小文件以独立文件形态落地,通过文件打包、数据转译、结构化元数据管理、增量追加写入等方式,从根源减少物理文件数量,消解元数据膨胀隐患。不同系统因适配的业务场景不同,小文件存储的底层实现逻辑存在显著差异,本章节将深度拆解各主流系统的小文件存储机制。

Continue reading 大数据的小文件生存指南1:存储→

C端软件生存之道

C端软件生存之道

C端软件生存之道

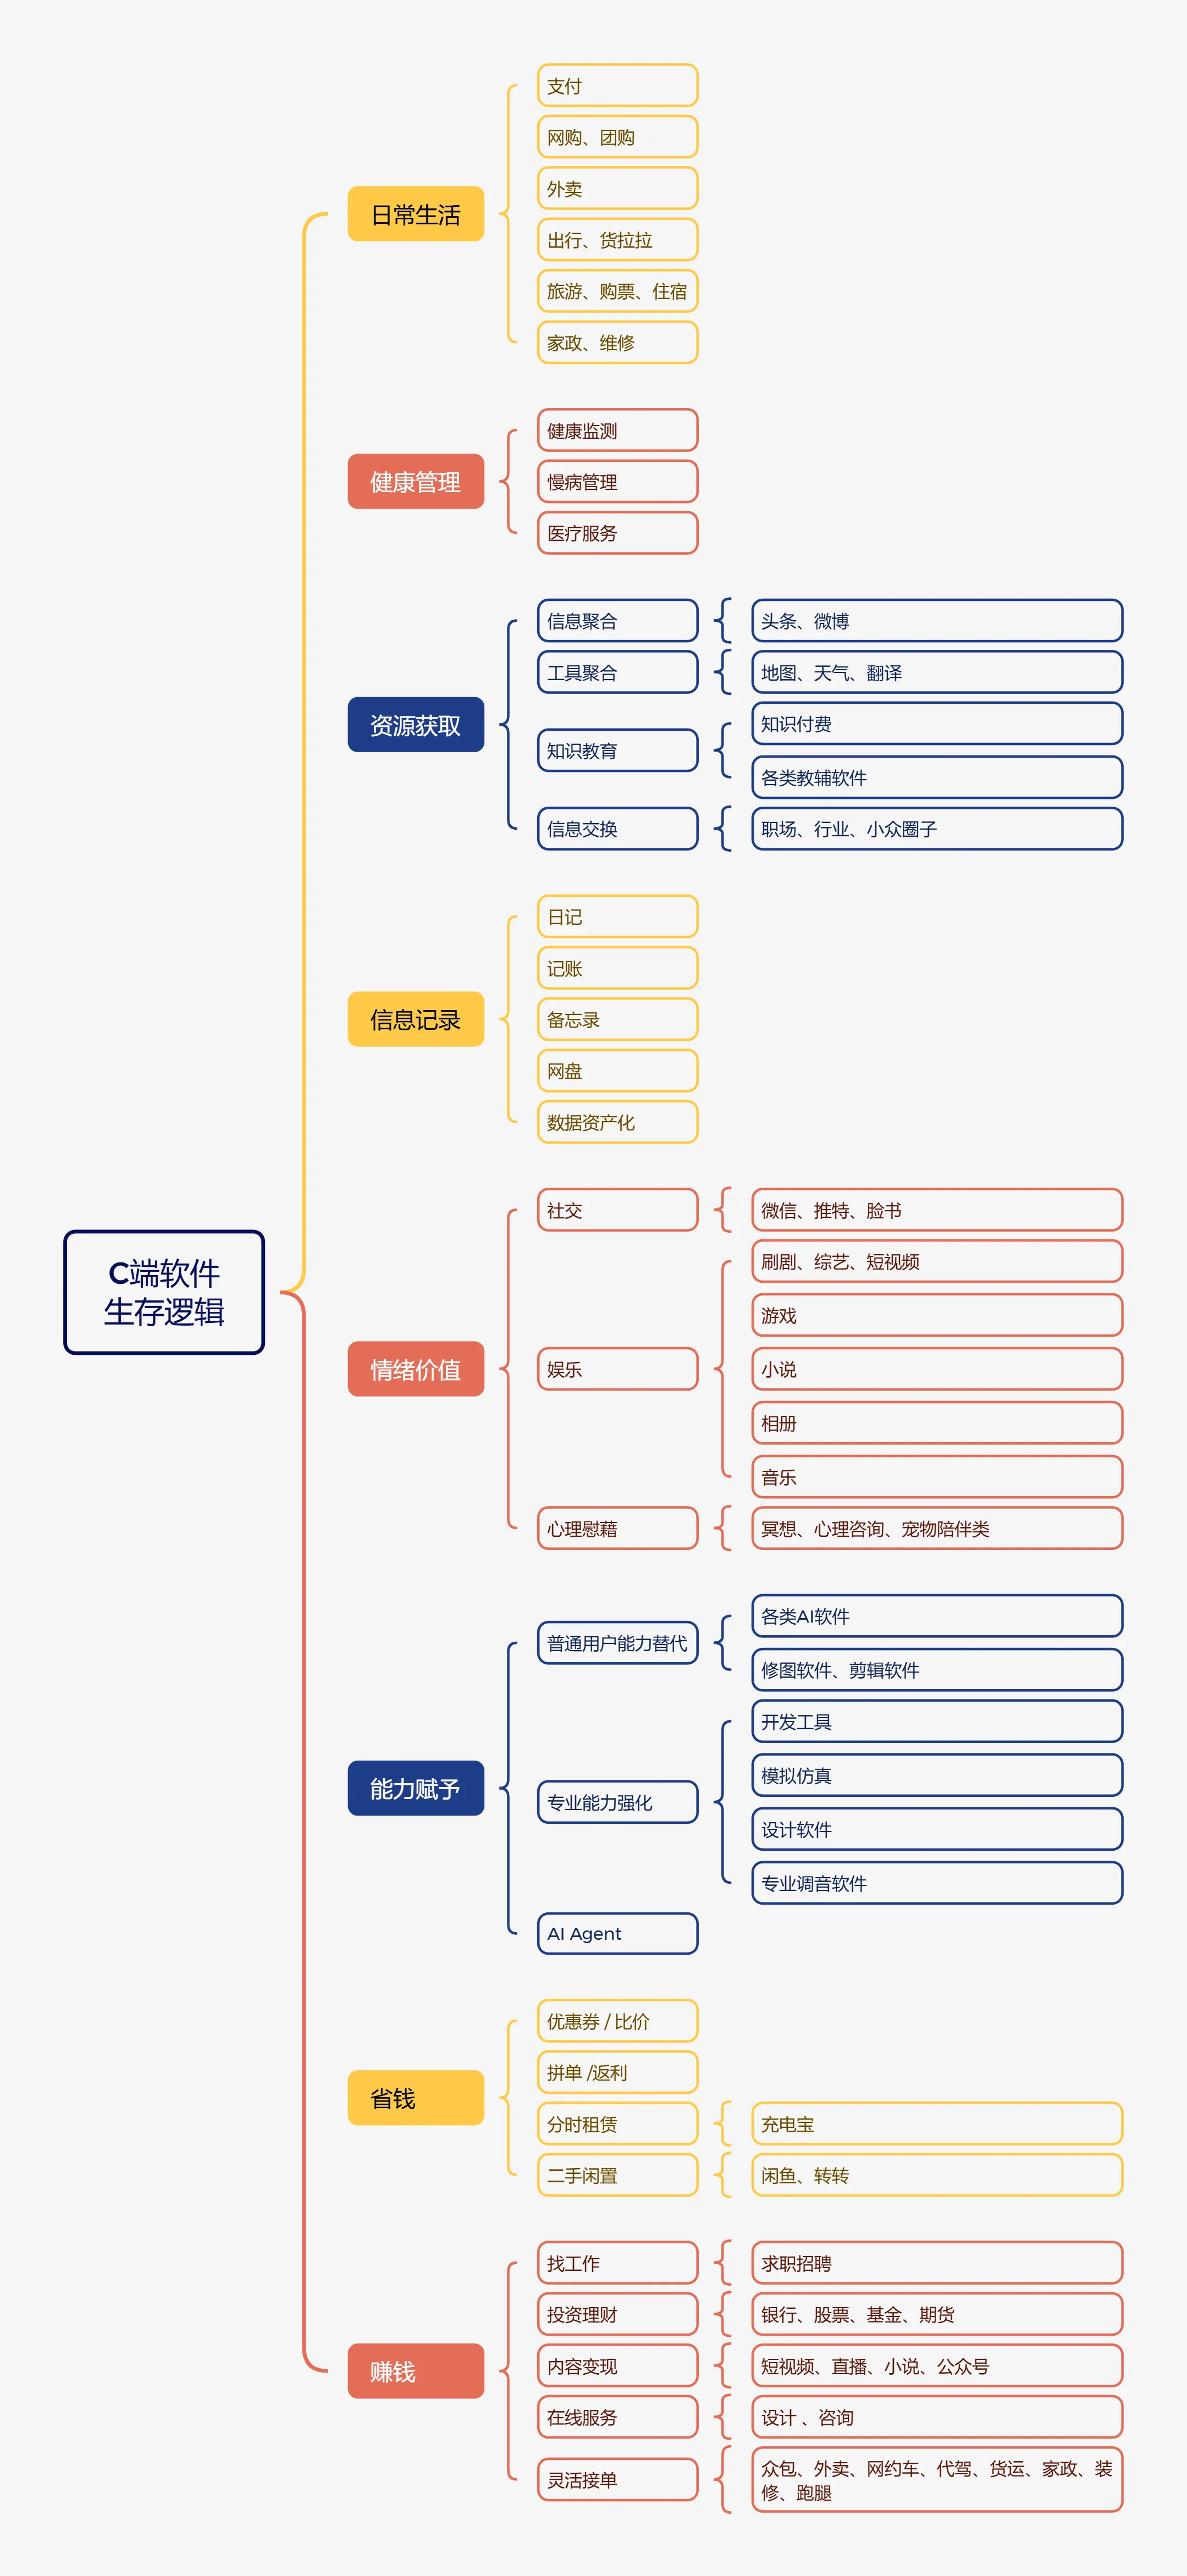
C 端软件的核心生存逻辑,是精准切入个人用户的高频刚需或强价值场景,先为用户创造明确价值(提效、省钱、获利、情绪满足等)建立用户依赖,再通过广告、交易抽成、会员付费、增值服务等模式完成商业闭环。各模块的具体生存逻辑如下:

Continue reading C端软件生存之道→