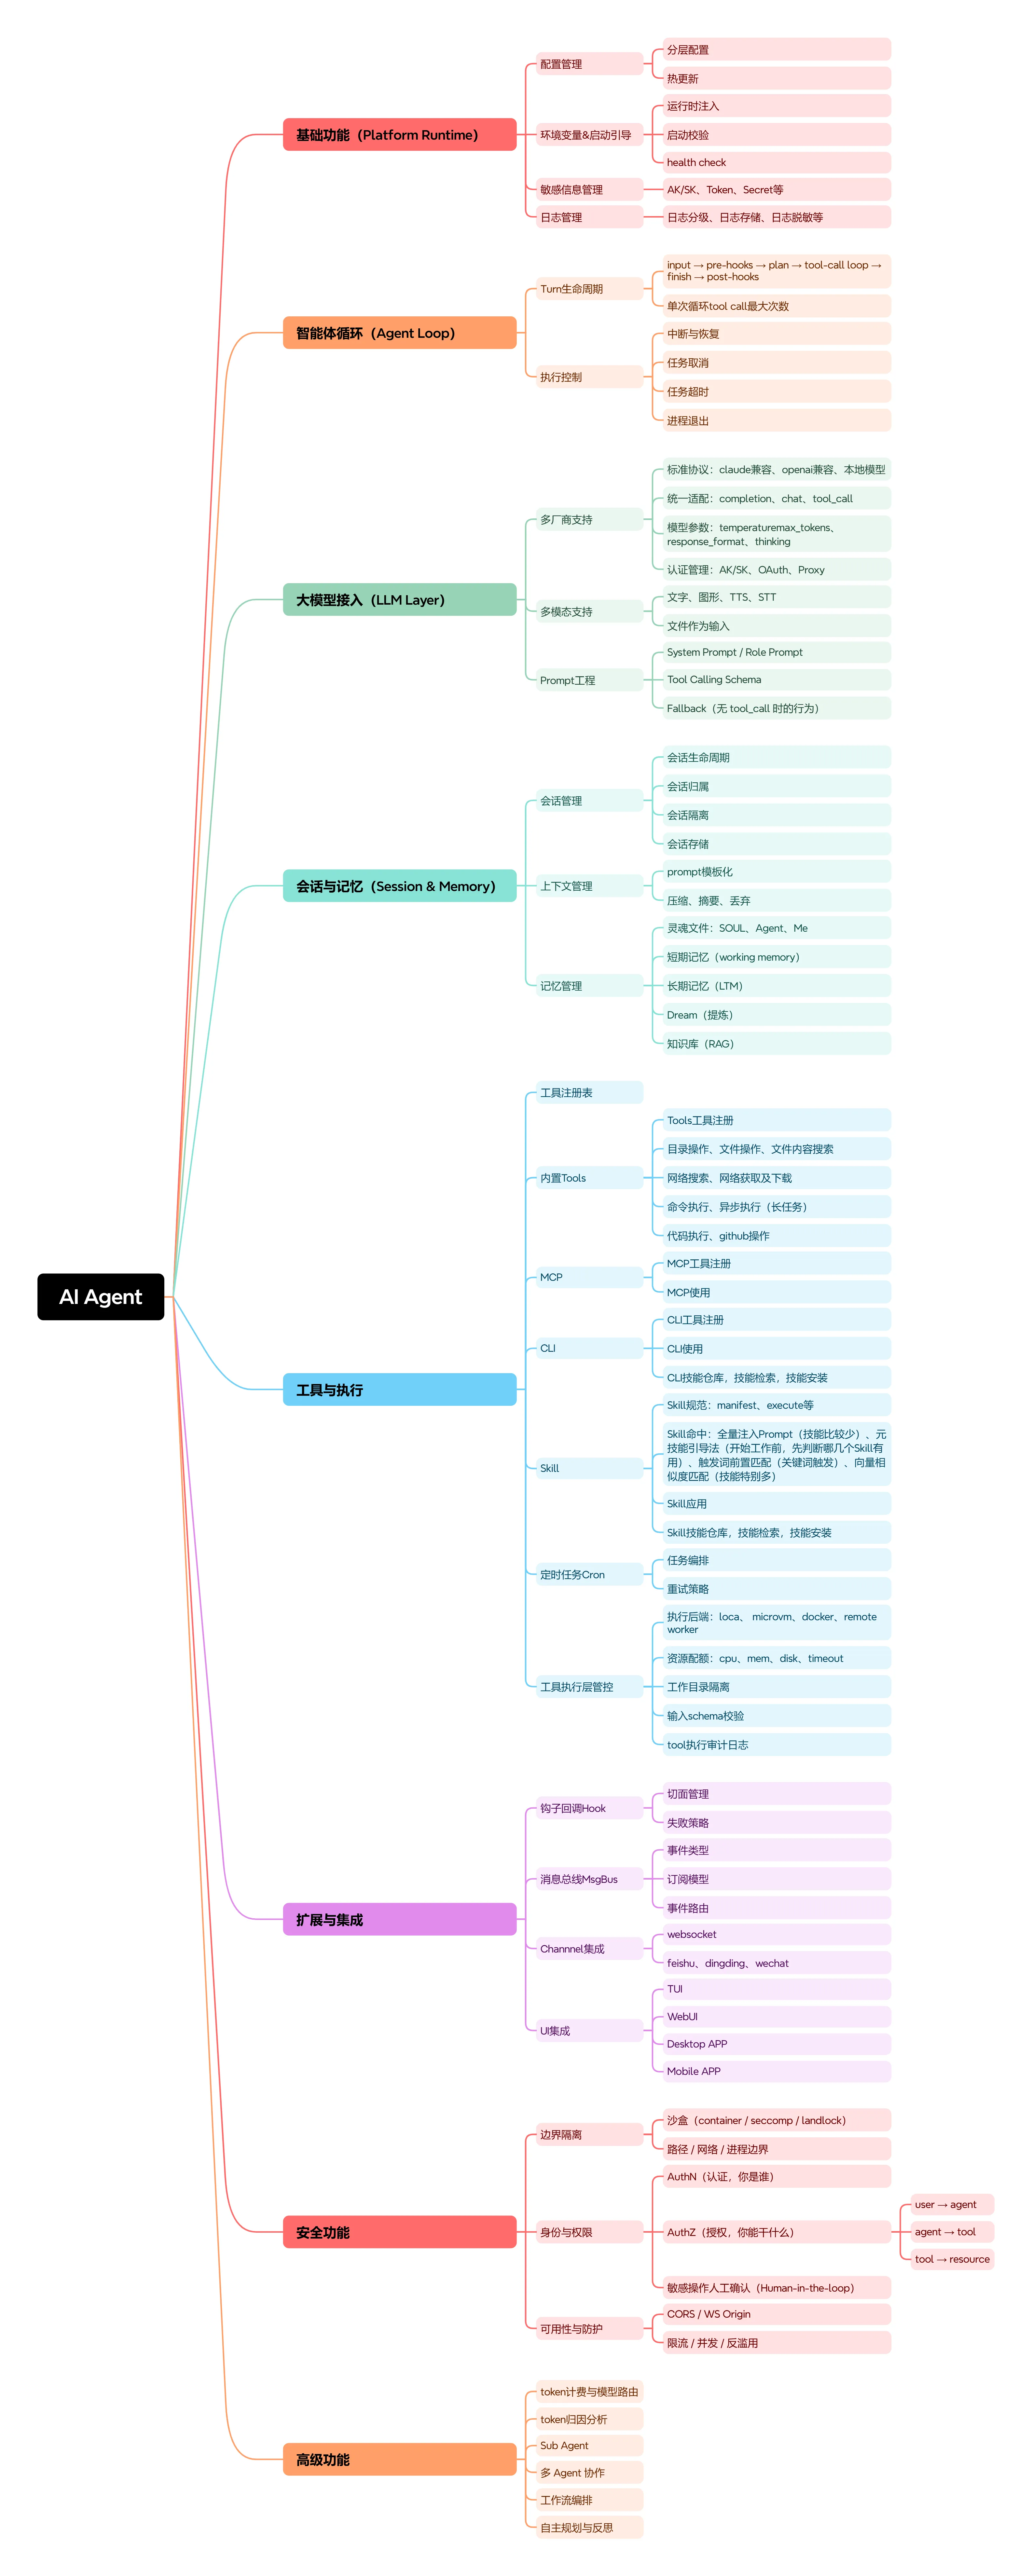
Agent常见沙箱技术解析
最近AI Agent技术火热,大家都很感兴趣,不少同学都已开始实践。在落地的过程中,有一对矛盾始终绕不开:
1、必须给Agent赋能和赋权,否则Agent就没有行动力
2、必须管控好Agent,防止Agent一抽风就把电脑炸了
对于问题1,我们有harness、tools、skills、MCP、sub-agent等等
对于问题2,就要用到沙箱技术了
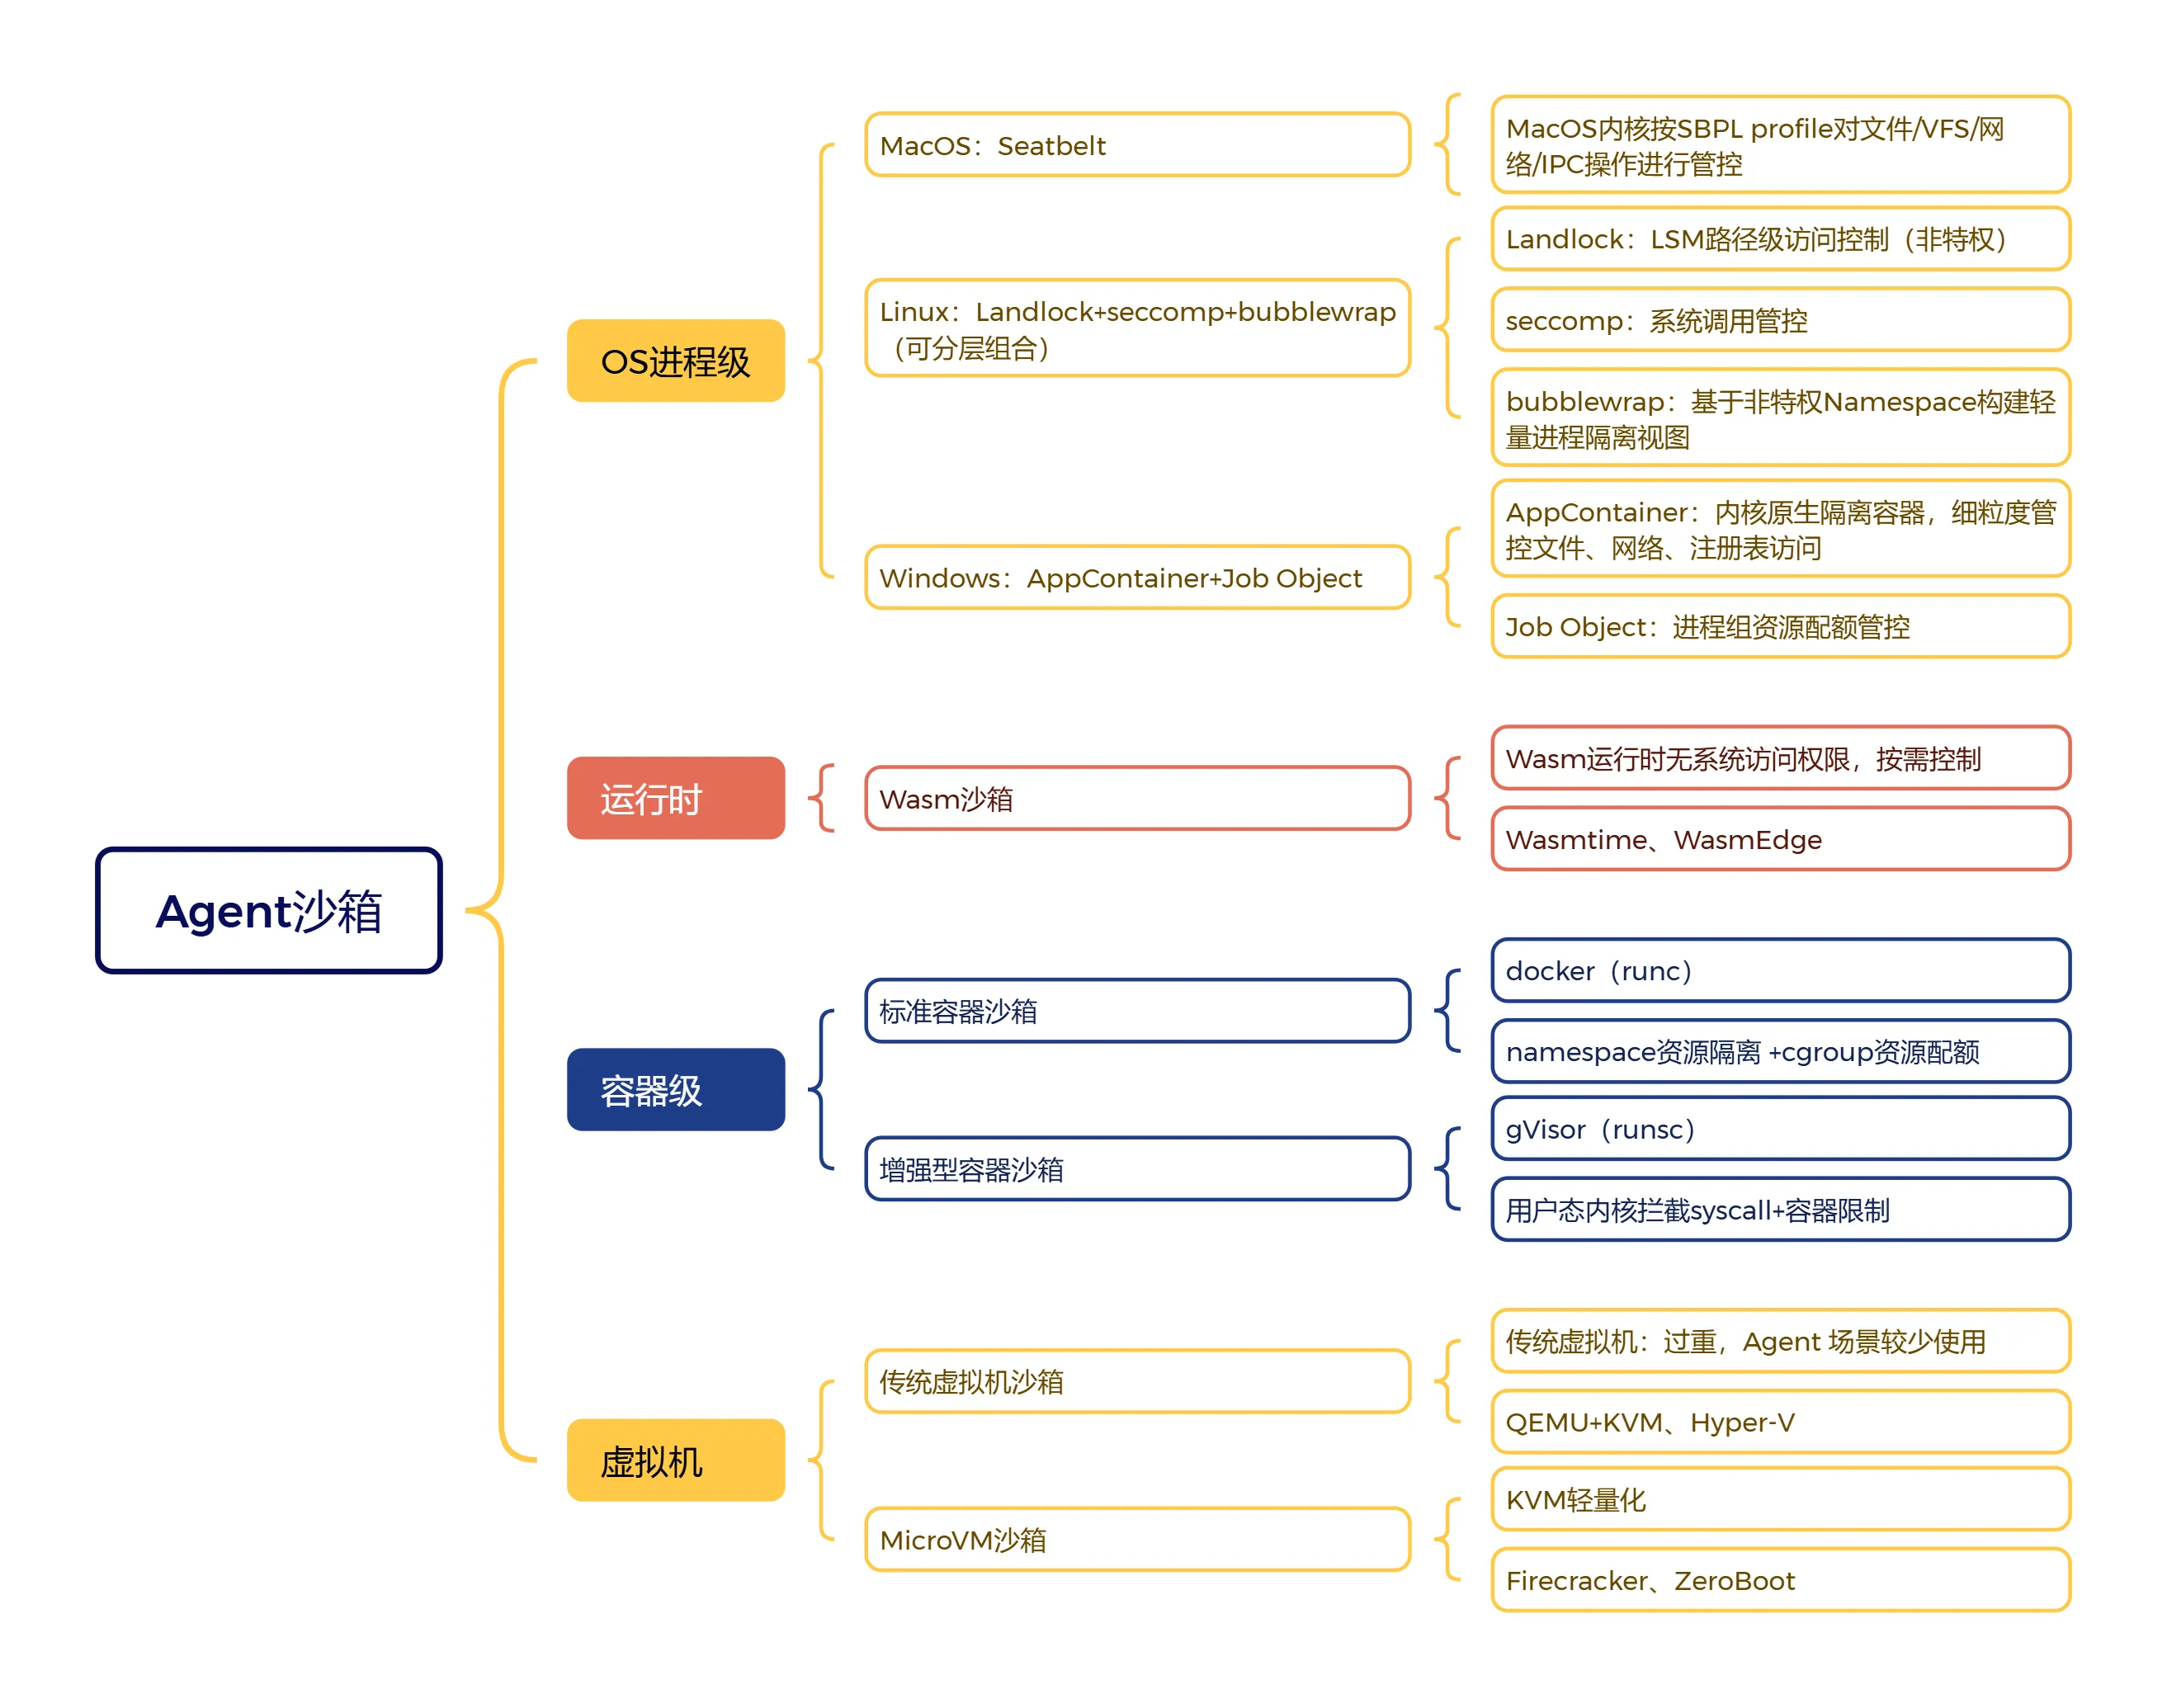
市面上的沙箱技术五花八门,各有千秋。今天咱们就浅聊一下Agent场景下,常见的几类沙箱技术方案。
Learn and share.
最近AI Agent技术火热,大家都很感兴趣,不少同学都已开始实践。在落地的过程中,有一对矛盾始终绕不开:
1、必须给Agent赋能和赋权,否则Agent就没有行动力
2、必须管控好Agent,防止Agent一抽风就把电脑炸了
对于问题1,我们有harness、tools、skills、MCP、sub-agent等等
对于问题2,就要用到沙箱技术了
市面上的沙箱技术五花八门,各有千秋。今天咱们就浅聊一下Agent场景下,常见的几类沙箱技术方案。
如果你是大模型API的重度用户,看着token快速燃烧,大概率会思考过这样一个问题:
每次和大模型对话,都会先有几百个token的固定system prompt(角色设定、工具定义、甚至是一整份文档),然后才是几十个token用户的问题。但我们却要为这段固定不变的system prompt反复付费、反复等它算完。这是一种巨大的浪费,不能想想办法节约一些token吗?
Prompt KV Cache要解决的就是这件事:让完全相同的prompt前缀不要重复计算,可以在后续的对话中,继续复用已经计算好的结果。本文来剖析一下,这个技术是如何实现的。
不得不佩服咱们IT大佬起名字的能力(发明新概念,好像一直是IT圈的执念),由于多位技术大佬的追捧,最近Loop Engineering的概念又突然火爆起来。
简单来说,Loop Engineering的核心理念就是:不要再一轮一轮地手动给AI Agent写提示词了,而是去设计一个自动化循环系统,让AI在这个系统中自主执行、验证和迭代,直到完成目标。
在过去(比如前几个月),大家用AI的方式为“人机乒乓模式”的大循环:
任务开始,人类告诉Agent要做什么 ->
Agent推进任务 -> 人类判断结果,决定方向,告诉Agent要做什么 ->
Agent推进任务 -> 人类判断结果,决定方向,告诉Agent要做什么 ->
......
Agent推进任务 -> 人类判断任务结束
如果说大模型是AI Agent的大脑」,那么工具调用系统就是 Agent 的「双手」。没有工具的Agent,就像一个被关小黑屋的聪明人,空有一堆想法却无法落地。今天咱们基于nanobot开源项目的源码分析,深入解析AI Agent的四种主流工具调用机制。
Continue reading AI Agent是如何使用工具的:Tools、MCP、CLI、Skills四种机制深度解析
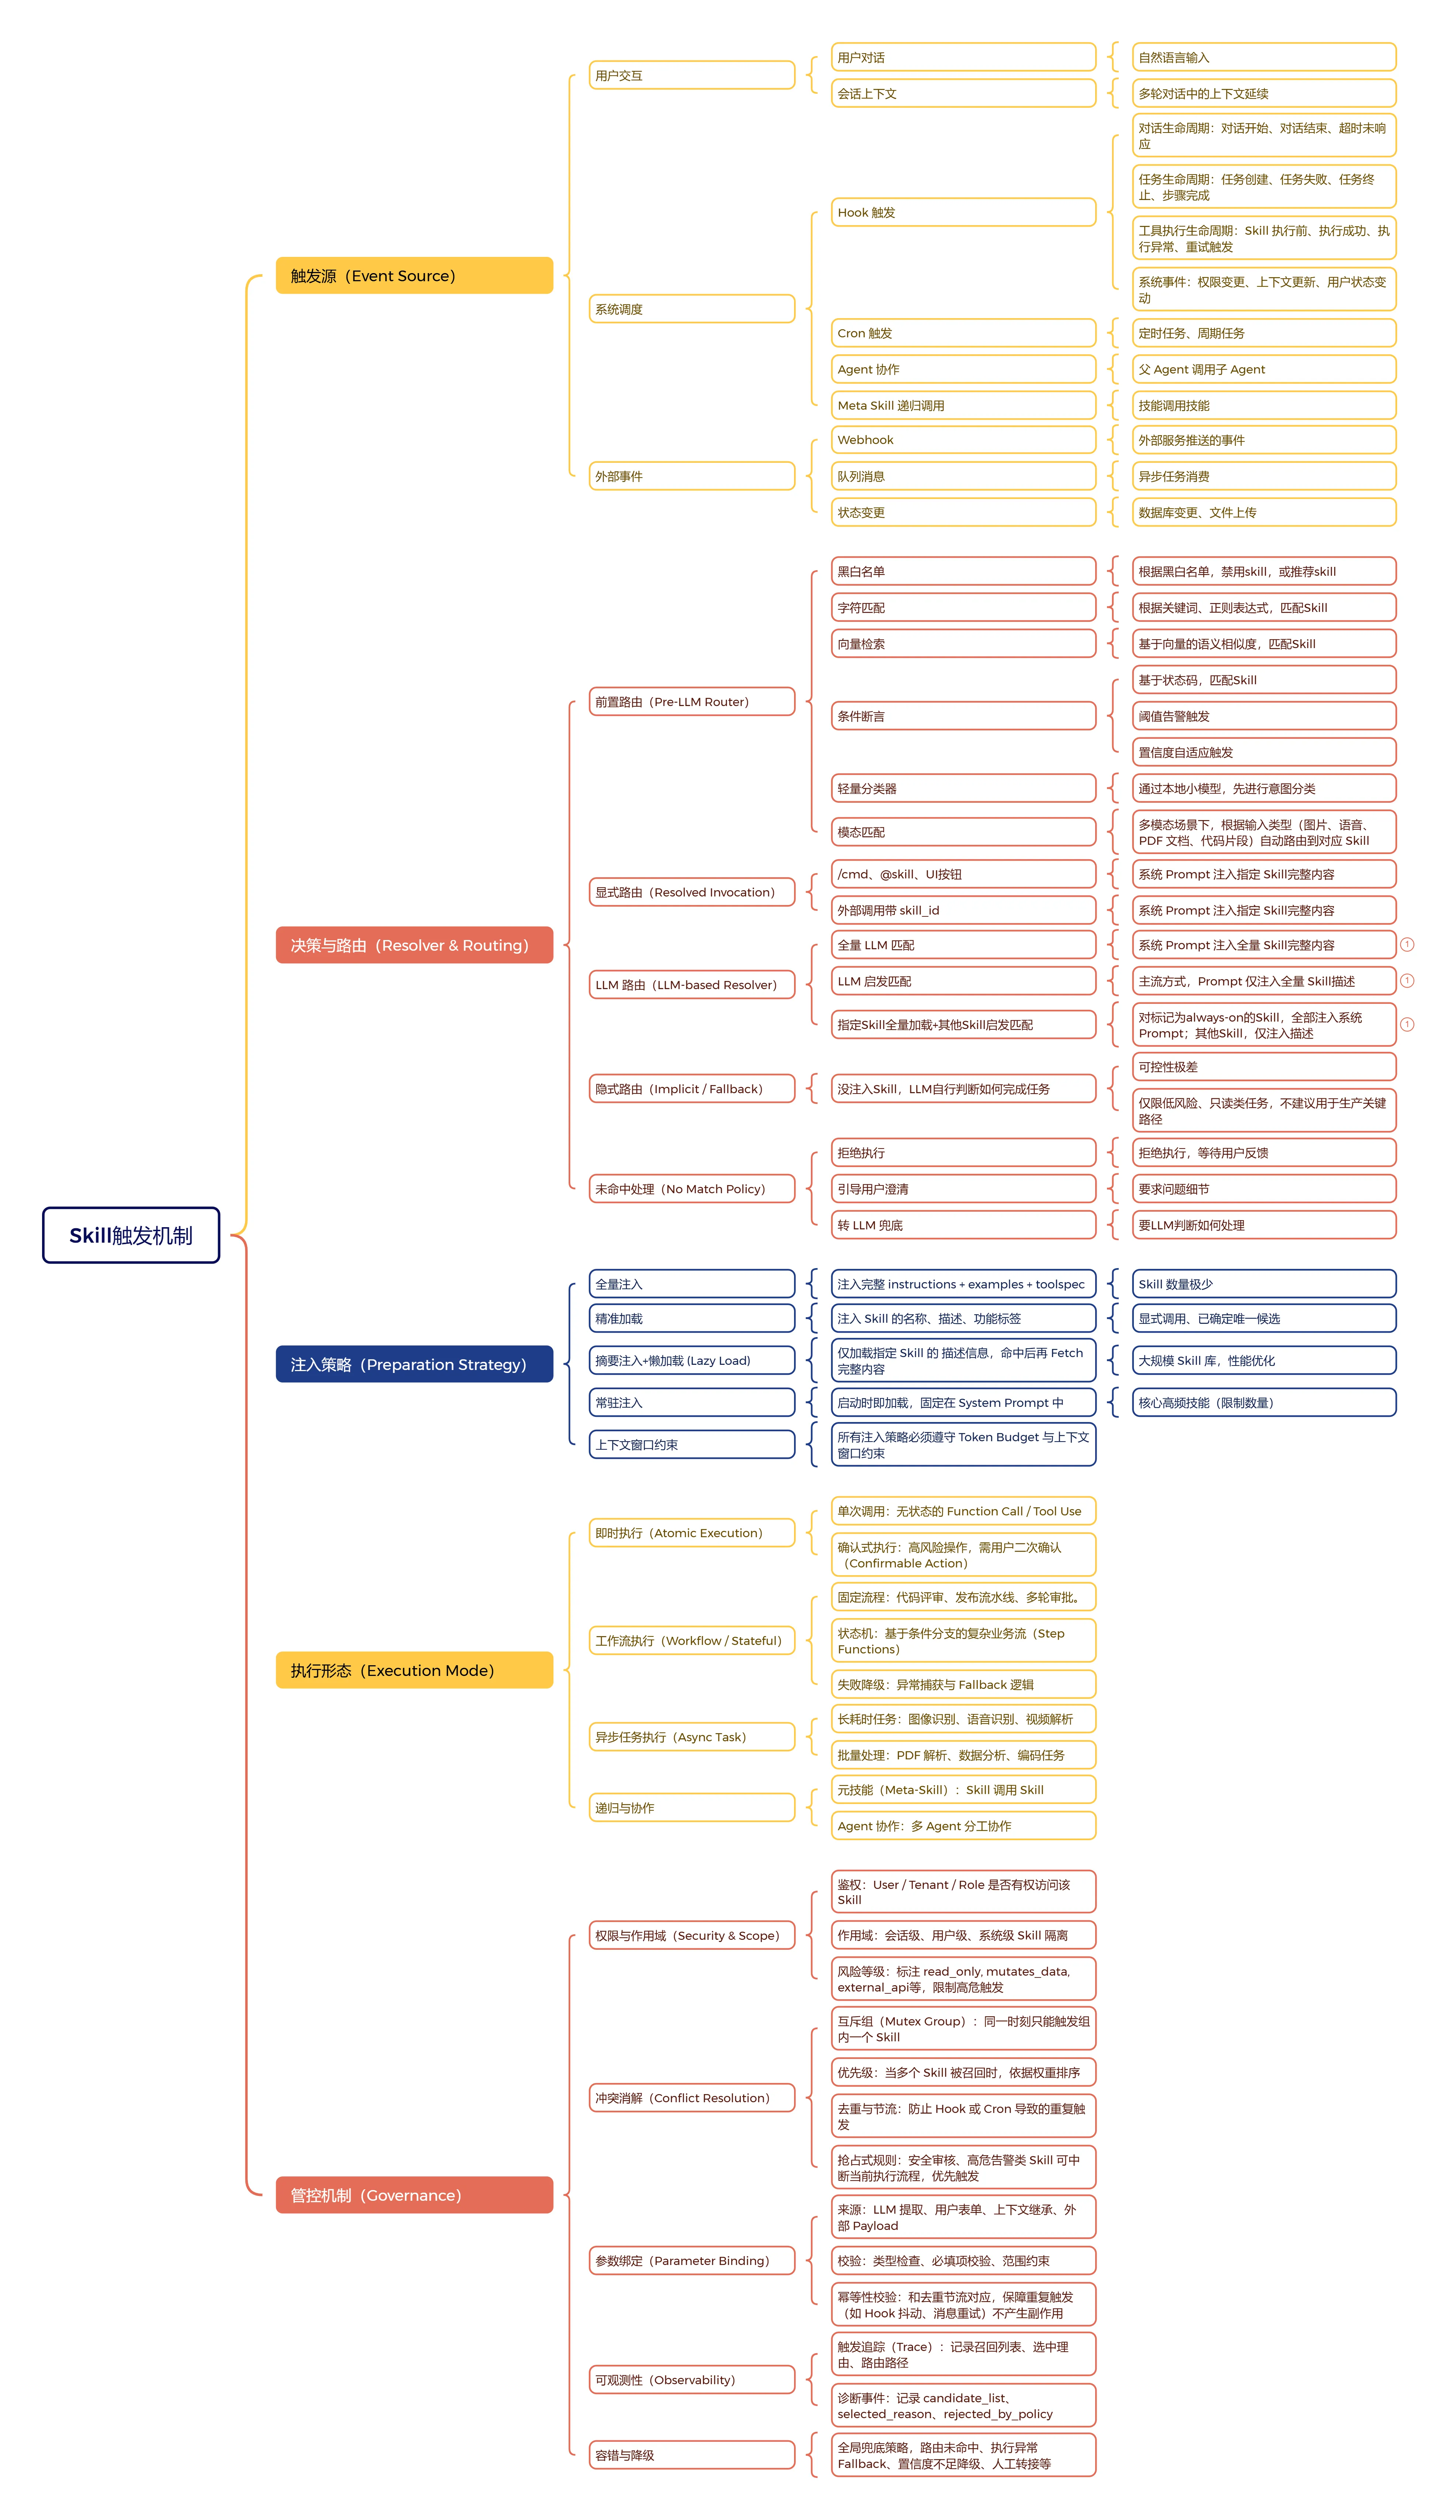
在大模型应用开发中,我们常常过度关注Prompt编写和模型效果,却忽略了一个更底层的问题:Skill(工具/能力)应该在什么时候、以什么方式被触发?
一个成熟的 AI Agent 系统,绝不应该把所有压力都交给 LLM 去“猜”。如果触发机制设计不好,要么上下文爆炸导致成本失控,要么意图误判导致用户体验灾难。
本文将系统性拆解Skill触发的完整生命周期,从事件源头到执行管控,为你提供一套可落地的架构设计参考。
在当下AI全民普及的时代,大语言模型(LLM)、AI编程助手、智能Agent已深度融入企业研发、自动化运维、个人办公全场景。GPT、Claude、Gemini等顶级模型能力强大,但官方API普遍存在收费昂贵、网络访问受限、调用门槛高等问题。
在此背景下,各类第三方大模型中转服务快速崛起。它们以低价普惠、免特殊网络、全模型聚合、高速稳定为宣传卖点,用极低的使用成本、极简的操作界面,吸引了海量个人开发者、中小企业用户。
便利与低价的背后,是绝大多数用户忽略的致命安全隐患。在使用第三方中转站时,本质是在无条件信任一个完全不受自己掌控的中间人。不同于普通的网络服务中转,大模型中转站拥有对用户请求、模型响应的完整读写、篡改、伪造、截留权限。
这也让大模型中转站中间人攻击(LLM MITM)从理论风险,变成当下AI安全领域最普遍、隐蔽性最高、破坏力最强的现实威胁。它早已突破传统网络窃听范畴,升级为语义层投毒、业务层渗透、系统层控权的复合型高级攻击。
如今大模型已经全面走入产业落地场景,从智能客服、行业知识库到专属AI助手,几乎所有垂直场景的大模型应用,都绕不开一个核心环节——模型微调。
很多人都有疑惑:明明可以用提示词(Prompt)、RAG检索就能让大模型适配业务,为什么还要费力做微调?事实上,Prompt存在能力上限、泛化性差、人工成本高的问题,RAG只能解决外部知识补充问题,无法改变模型的底层生成逻辑、风格习惯和领域认知。而微调,是让通用大模型真正变成「行业专属模型」的核心手段。
过去几年,大语言模型凭借超强的理解、生成与推理能力,彻底引爆了AI行业。但强大能力的背后,是大模型难以回避的“三高痛点”:高算力消耗、高显存占用、高推理延迟。动辄数十亿、上百亿参数的大模型,看似智能无比,却极度依赖高端服务器、旗舰显卡,普通用户的电脑、手机根本无法运行。
想要打破算力壁垒,让大模型走出实验室、走进普通设备,就必须用到大模型领域的核心轻量化技术——模型量化(LLM Quantization)。它堪称大模型的“瘦身术”和“万能压缩包”,是解决AI低成本部署、终端落地的关键技术。今天我们来介绍一下大模型量化技术。
脱离模型直接聊Transformer会感觉很空,本文以GPT-2为例(base版,768维维度、12层Transformer、12头自注意力),介绍一下其训练和推理的核心逻辑,以及推理时的具体执行流程。