原文地址:Recent Developments in LLM Architectures: KV Sharing, mHC, and Compressed Attention,by Sebastian Raschka, 2025-05-16
大语言模型架构最新进展:KV共享、mHC与压缩注意力
从 Gemma 4 到 DeepSeek V4:开源大模型如何降低长上下文成本
短暂休假陪伴家人后,我很高兴回归,跟进这几周密集发布的开源大语言模型。其中最突出的一点是,新一代架构都将重心放在了长上下文效率优化上。
随着推理模型与智能体工作流需要保留更多 token(且保留时长更长),KV 缓存大小、内存带宽与注意力计算成本很快成为核心瓶颈。为此,大模型开发者正在引入越来越多的架构技巧来降低这些开销。
本文重点分析四个典型设计:Gemma 4 的 KV 共享与逐层嵌入、Laguna XS.2 的逐层注意力配额、ZAYA1-8B 的压缩卷积注意力,以及 DeepSeek V4 的流形约束超连接(mHC)+ 压缩注意力方案。
在我的架构示意图里,这些改动大多看起来只是微调,但其中不少是相当精巧的设计变更,值得展开详细讨论。
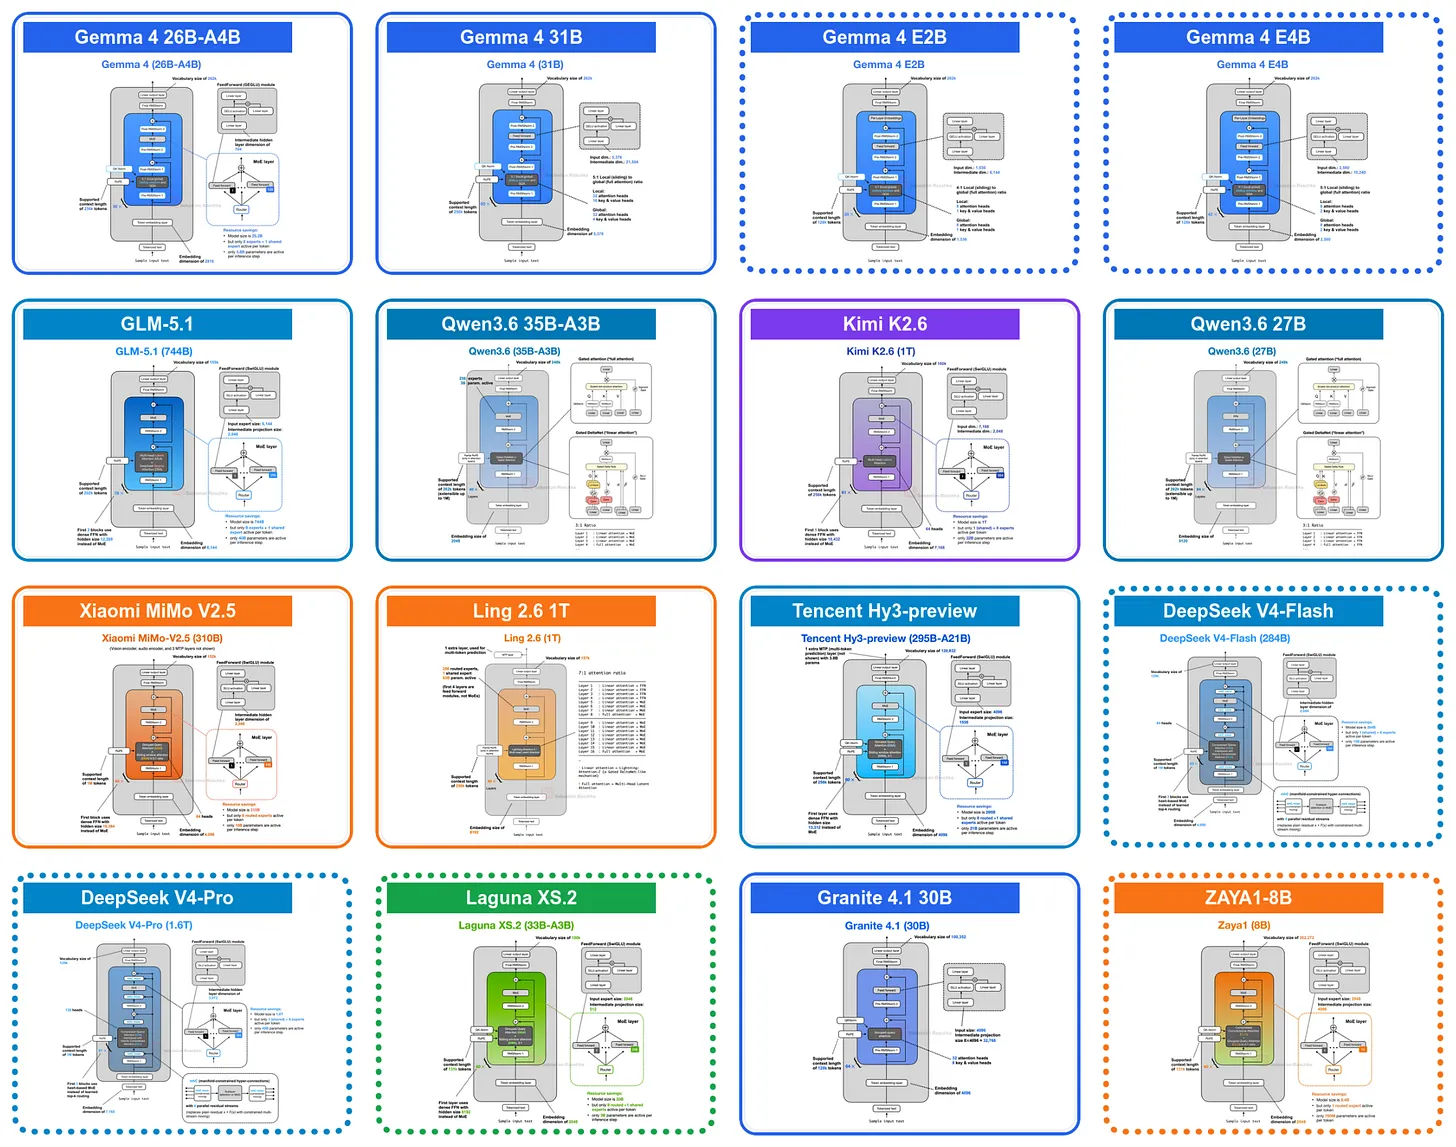
图 1 2026 年 4-5 月发布的主流开源大模型架构示意图。完整图片与更多细节可在我的大模型架构图库中查看。图中未列出所有模型尺寸;Qwen3.6 包含 27B 与 35B-A3B 版本,ZAYA1 以 8B 模型为代表(省略 ZAYA1-base 与 ZAYA1-reasoning-base 版本)。虚线框标注的架构将在本文中详细解读。
Continue reading 【转载】大语言模型架构最新进展:KV共享、mHC与压缩注意力→