About neohope

一直在努力,还没想过要放弃...

导致惨重代价的运维事故2024

2024年12月:OpenAI故障
事件经过:12月11日,OpenAI发生故障,影响依赖其服务的用户及企业。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,干扰AI相关业务及研发工作。

2024年11月:华为云华南地域部分服务异常
事件经过:因网络设备升级失误,导致华为云华南地域部分云服务访问异常,持续约2小时。
事故原因:内部设备升级操作失误。
造成损失:客户业务短暂中断,华为云快速修复并致歉。

2024年11月:支付宝交易故障
事件经过:11月11日,支付宝发生交易故障,影响用户支付及交易行为。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,干扰用户日常支付及商业交易。

2024年11月:Snowflake云服务逻辑故障
事件经过:11月,云数据平台Snowflake发生严重的服务中断,持续长达13小时。
事故原因:软件更新引发的逻辑冲突。软件更新引入了向后不兼容的数据库架构更新,导致版本不匹配错误。更糟糕的是,其“区域冗余”机制在逻辑故障面前失效,导致10个区域同时瘫痪。
造成损失:大量企业无法执行数据查询,暴露了云服务在面对“逻辑层面”故障时,物理冗余机制可能完全失效的风险。

2024年9月:甲骨文云基础设施故障
事件经过:甲骨文云某区域存储系统故障,导致部分客户数据无法访问,持续超6小时。
事故原因:存储系统运维故障。
造成损失:客户业务中断,甲骨文面临索赔,声誉下滑。

2024年9月:阿里云新加坡数据中心火灾
事件经过:9月10日上午,阿里云新加坡可用区C数据中心发生火灾,导致17项服务异常,Lazada、字节跳动等业务中断。
事故原因:锂电池起火引发故障。
造成损失:多家企业业务中断,阿里云海外服务稳定性受质疑。

2024年9月:上交所交易故障
事件经过:9月27日,上海证券交易所发生交易故障,影响证券交易正常开展。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,干扰资本市场交易秩序。

2024年8月:网易云音乐故障
事件经过:8月19日,网易云音乐发生故障,排查耗时近2小时后恢复。
事故原因:疑似与云存储扩容、贵州机房迁移相关,官方未披露确切原因。
造成损失:用户无法正常使用音乐服务,平台用户体验受影响。

2024年8月:上海电信城域网设备故障
事件经过:8月26日,上海电信城域网设备发生故障,影响区域网络服务。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,干扰民众网络使用及商业活动。

2024年7月:微软系统蓝屏事件
事件经过:7月19日,使用了Windows操作系统的设备大面积蓝屏,导致850万设备受到影响。
事故原因:微软安全供应商CrowdStrike推送了错误的软件配置。
造成损失:成为2024年主要信息系统故障之一,对大量用户工作及使用造成影响。

2024年7月:阿里云故障
事件经过:7月2日,阿里云发生故障,具体影响范围覆盖多款服务。
事故原因:未公开披露具体原因。
造成损失:成为2024年主要信息系统故障之一,影响依赖阿里云服务的客户业务。

2024年4月:腾讯云控制台故障
事件经过:4月8日15点23分,腾讯云云API服务异常,导致云函数、文字识别等依赖服务无法使用,持续87分钟,1957个客户报障。
事故原因:配置数据错误,经紧急数据修复恢复服务。
造成损失:影响客户业务正常开展,平台服务可靠性受质疑。

【转载】理解并实现大语言模型中的自注意力、多头注意力、因果注意力与交叉注意力

Understanding and Coding Self-Attention, Multi-Head Attention, Causal-Attention, and Cross-Attention in LLMs,by Sebastian Raschka, 2024-01-14

理解并实现大语言模型中的自注意力、多头注意力、因果注意力与交叉注意力

本文将为你讲解Transformer架构与GPT-4、Llama等大语言模型(LLM)中所使用的自注意力机制。自注意力及相关机制是大语言模型的核心组成部分,在从事相关模型开发工作时,理解这一主题非常有价值。

不过,本文不会只停留在理论层面讲解自注意力机制,而是会带你用Python和PyTorch从零开始编码实现。在我看来,从零手写实现算法、模型与技术,是最高效的学习方式!

补充说明:本文是《从零理解并编码实现大语言模型的自注意力机制》的更新扩展版,那篇文章发布在我旧博客上,距今刚好差不多一年。我本人非常喜欢写(也喜欢读)这类“从零实现”的文章,因此特意将这篇内容更新优化,发布在Ahead of AI平台。

此外,这篇文章也促使我动笔撰写《从零构建大语言模型》一书,目前该书仍在创作中。下方是梳理全书脉络的思维模型,展示了自注意力机制在整个大语言模型体系中的位置。
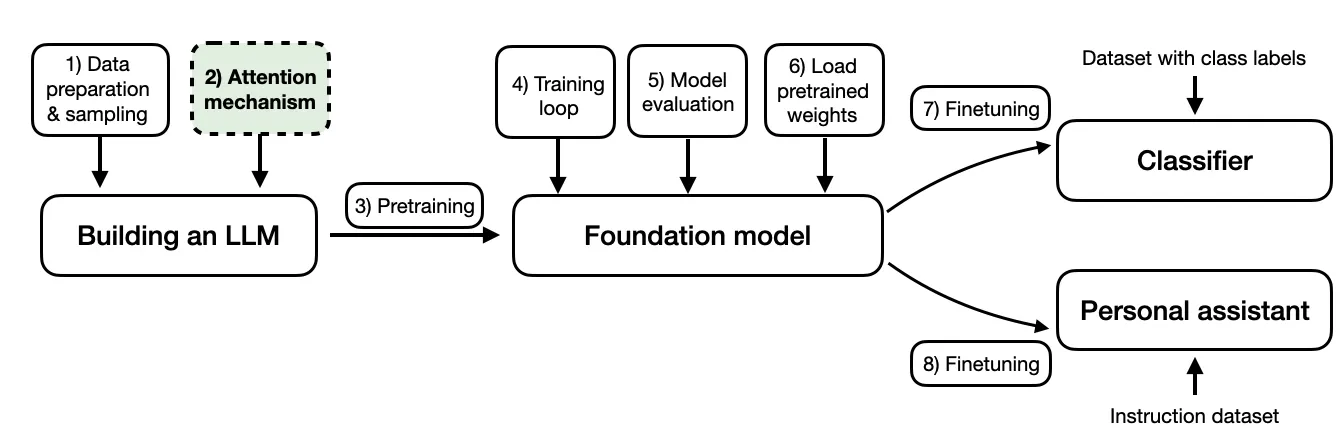
figure01

《从零构建大语言模型》一书涵盖主题概览

为控制文章篇幅,本文默认你已经对大语言模型有基础了解,也掌握了注意力机制的基本概念。本文的核心目标,是通过Python与PyTorch的代码逐行讲解,帮你彻底理解注意力机制的运行原理。

自注意力简介

自注意力机制自《Attention Is All You Need》这篇Transformer开山论文提出以来,已成为众多顶尖深度学习模型的基石,在自然语言处理(NLP)领域尤其如此。如今自注意力的应用无处不在,理解其工作原理至关重要。
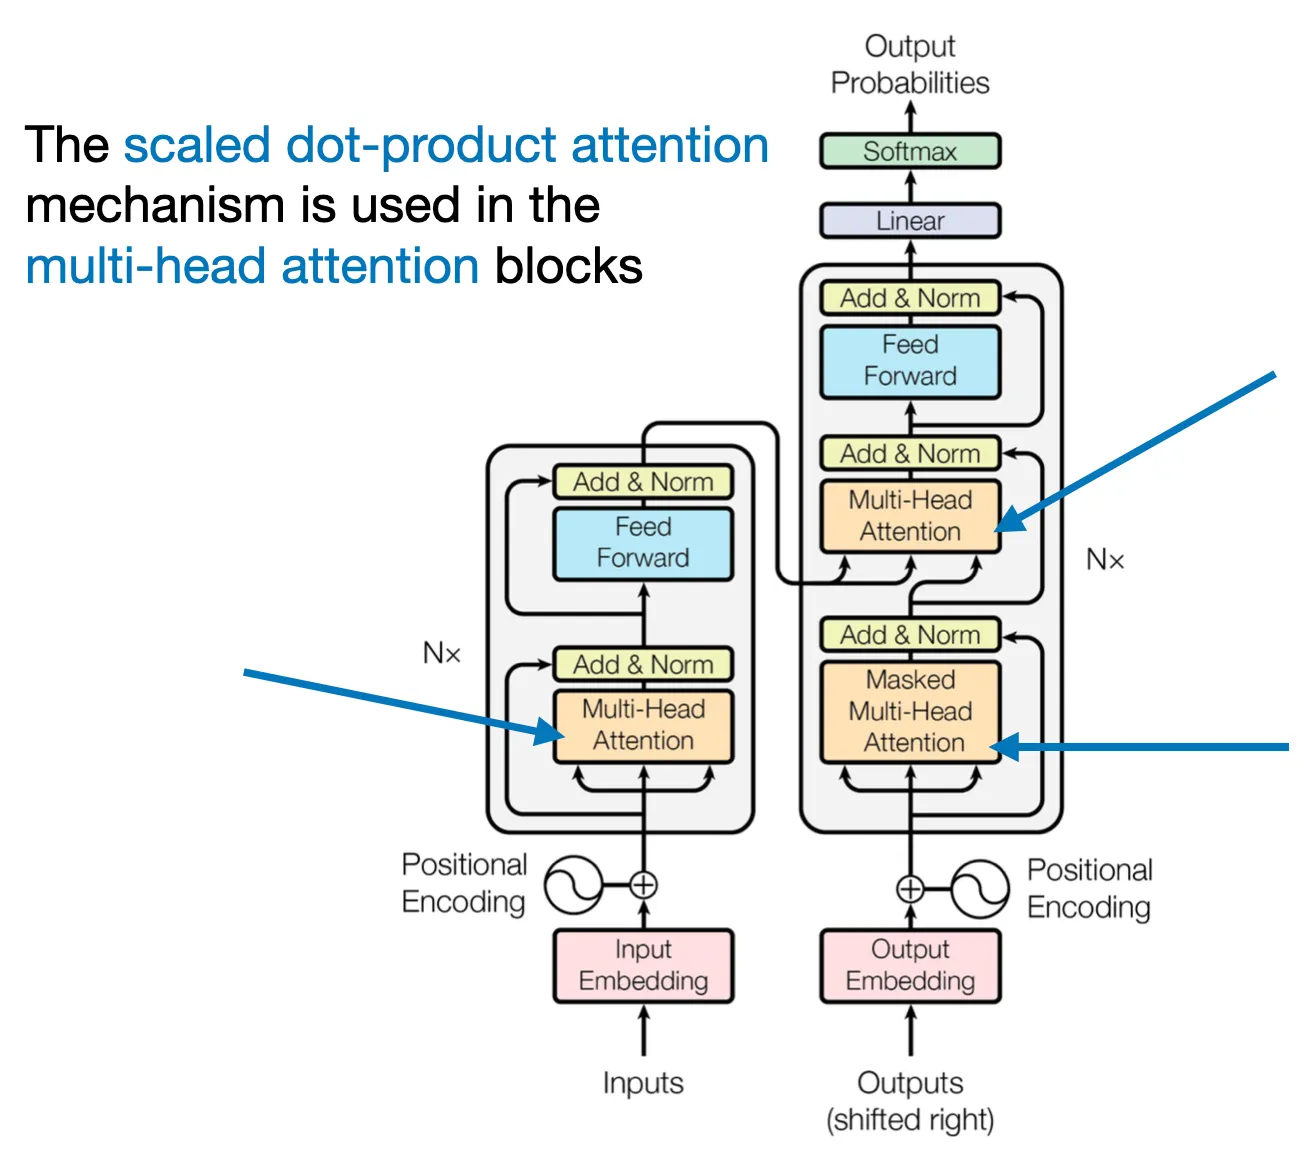
figure02

原始Transformer架构图,来源:https://arxiv\.org/abs/1706\.03762

深度学习中“注意力”的概念,最早源于对循环神经网络(RNN)的改进——解决RNN难以处理长序列、长句子的问题。举个例子,把一句话从一种语言翻译成另一种语言时,逐词直译通常行不通,因为它忽略了每种语言独有的复杂语法结构与习语表达,最终会得到不准确、甚至不通顺的译文。
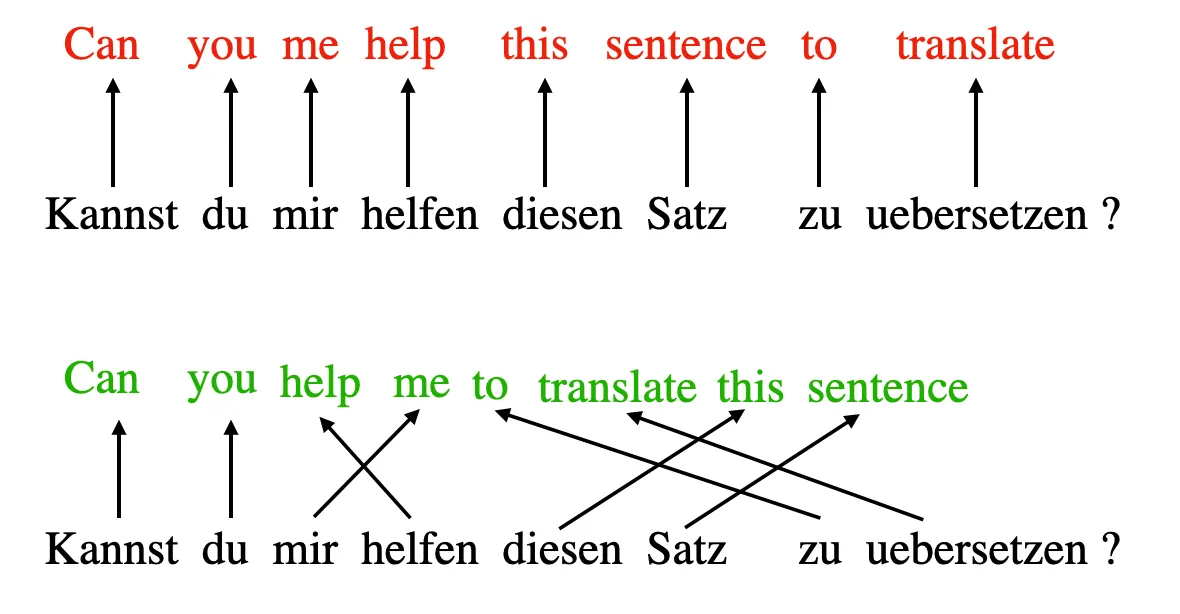
figure03

错误的逐词直译(上)与正确翻译(下)对比

为解决这个问题,研究者提出了注意力机制:让模型在每个时间步都能访问序列中的所有元素,核心是做到“有选择地关注”,判断特定上下文中哪些单词最重要。2017年问世的Transformer架构,提出了独立的自注意力机制,彻底摆脱了对循环神经网络的依赖。

(为精简篇幅、聚焦自注意力的技术细节,本文只对背景动机做简要介绍,把重点放在代码实现上。)
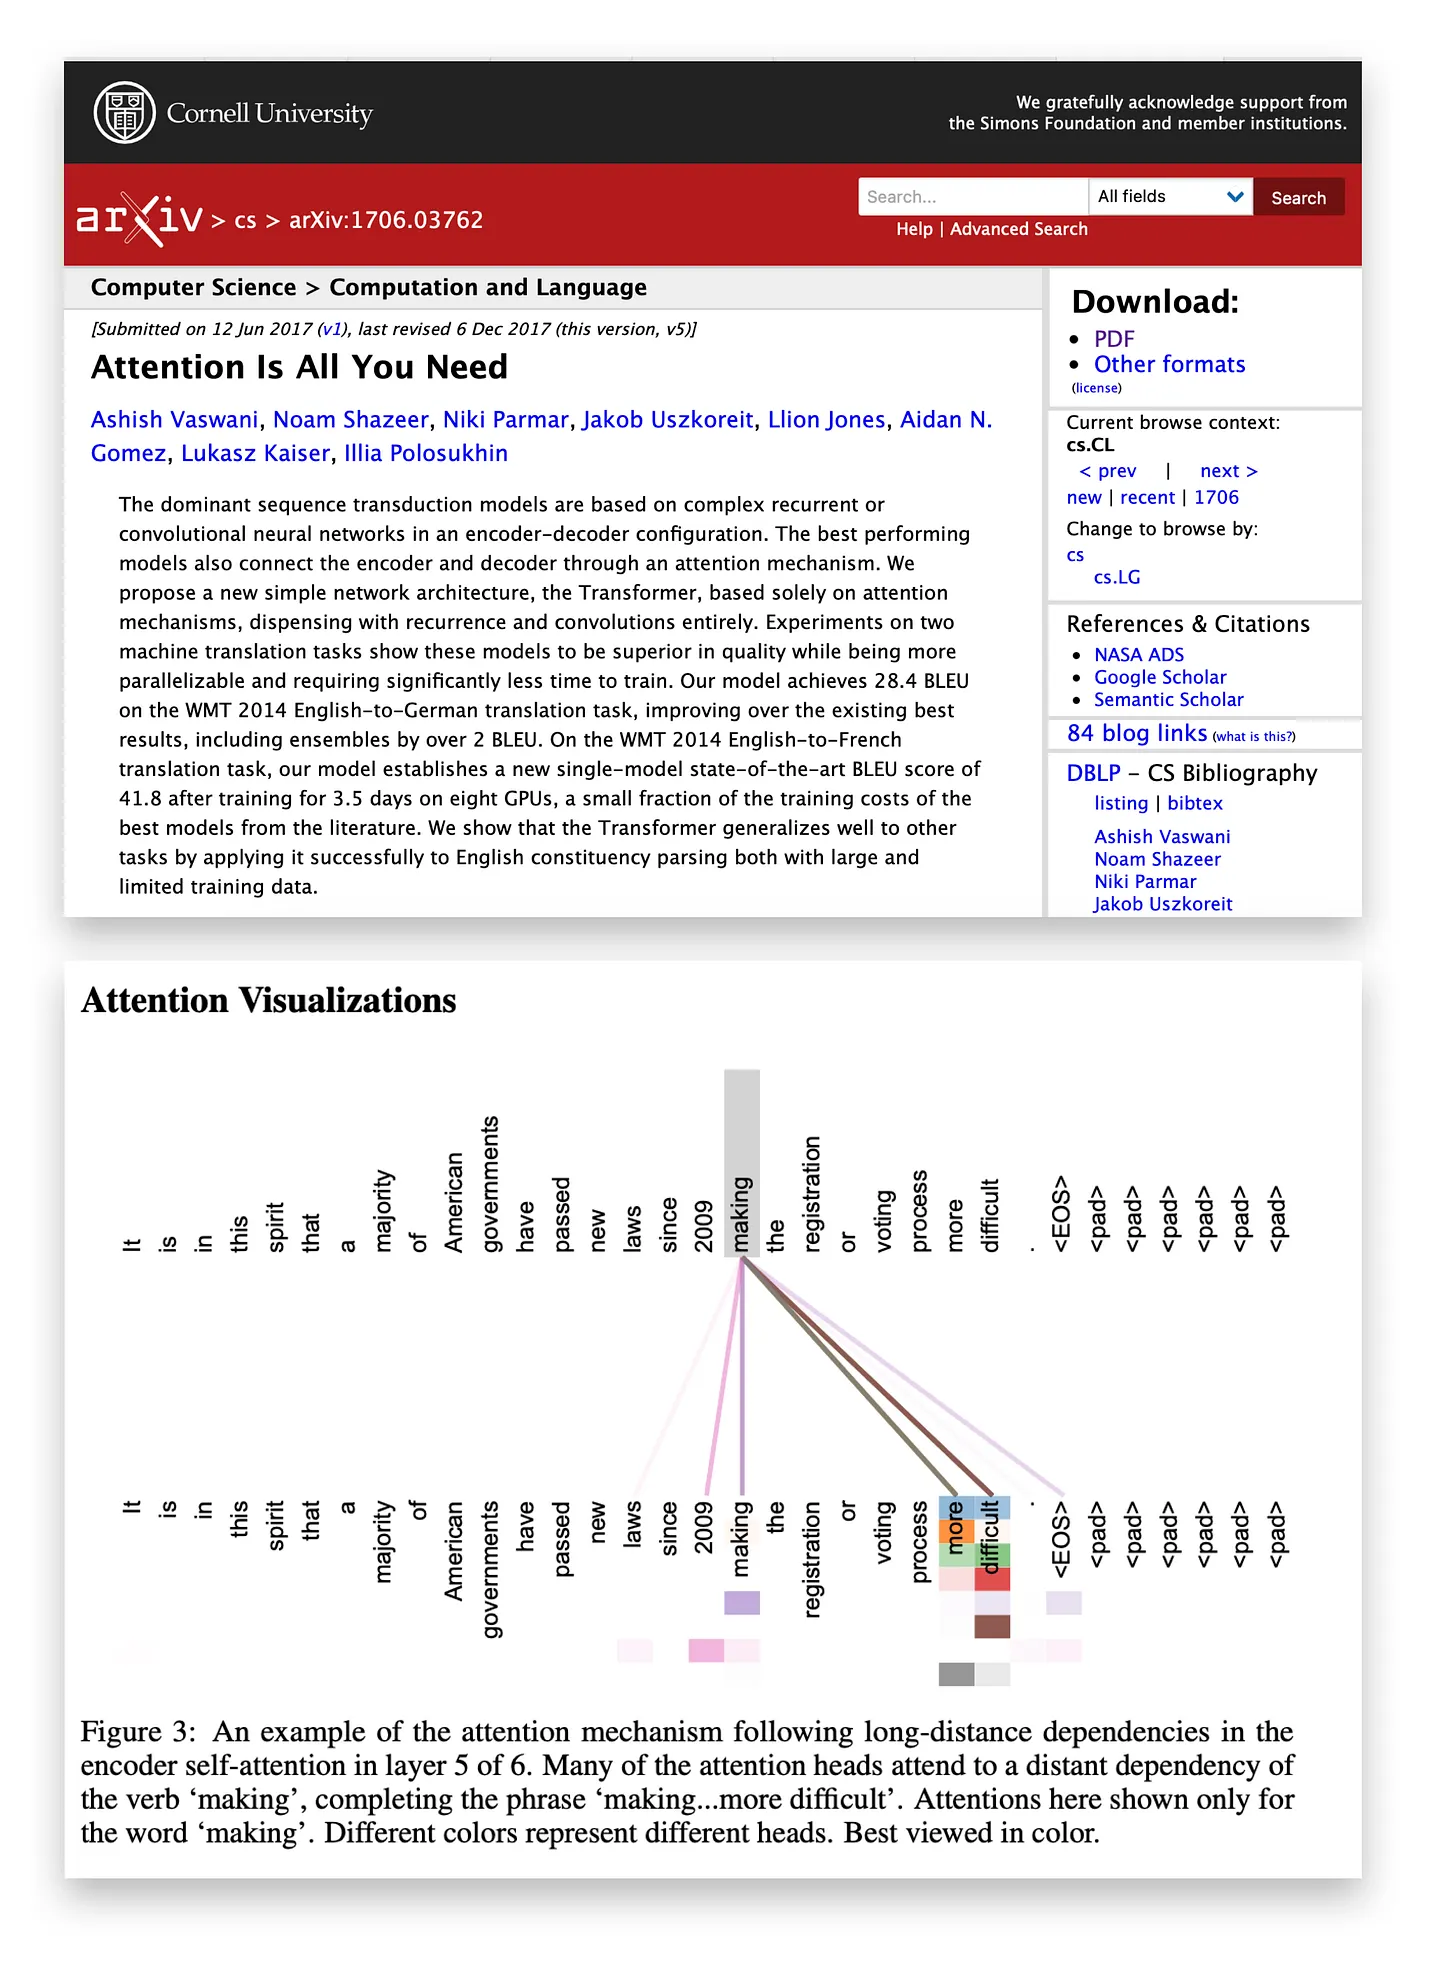
figure04

摘自《Attention Is All You Need》论文的可视化图:通过注意力权重展示单词“making”对输入中其他单词的依赖与关注程度(颜色深浅与注意力权重的数值大小正相关)。

我们可以把自注意力理解为一种信息增强机制:它通过融入输入的上下文信息,丰富输入嵌入的信息量。换句话说,自注意力机制让模型能够权衡输入序列中不同元素的重要性,并动态调整它们对输出的影响。这在语言处理任务中尤为关键——同一个单词的含义,会随着它在句子、文档中的上下文变化而改变。

需要注意的是,自注意力有很多变体,其中一个主流研究方向是提升自注意力的计算效率。但绝大多数论文仍沿用《Attention Is All You Need》中提出的**缩放点积注意力(scaled-dot product attention)**原始实现;对大多数训练大规模Transformer的公司而言,自注意力本身通常并不是计算瓶颈。

因此,本文将聚焦最经典、实际应用最广泛的原始缩放点积注意力机制(下文统称自注意力)。如果你对其他类型的注意力机制感兴趣,可以参考2020年的《Efficient Transformers: A Survey》、2023年的《A Survey on Efficient Training of Transformers》综述,以及近年提出的FlashAttention与FlashAttention-v2相关论文。

输入句子的嵌入处理

正式开始前,我们先以句子Life is short, eat dessert first为例,看看如何将它输入自注意力机制。和其他文本建模方法(比如循环神经网络、卷积神经网络)一样,我们首先要生成句子的嵌入表示。

为简化演示,这里我们的词典dc只包含输入句子中出现的单词。在实际应用中,词典会覆盖训练数据集中的所有单词,典型的词表规模在3万到5万之间。

输入代码:

sentence = 'Life is short, eat dessert first'

dc = {s:i for i,s 
      in enumerate(sorted(sentence.replace(',', '').split()))}

print(dc)

输出:

{'Life': 0, 'dessert': 1, 'eat': 2, 'first': 3, 'is': 4, 'short': 5}

接下来,我们用这个词典为每个单词分配一个整数索引:

输入代码:

import torch

sentence_int = torch.tensor(
    [dc[s] for s in sentence.replace(',', '').split()]
)
print(sentence_int)

输出:

tensor([0, 4, 5, 2, 1, 3])

得到句子的整数向量表示后,我们就可以通过嵌入层,将输入编码为实数向量形式的嵌入。这里我们使用极小的3维嵌入,也就是每个输入单词对应一个3维向量。

注意:实际场景中的嵌入维度通常在数百到数千维,比如Llama 2的嵌入维度就达到了4096。这里使用3维纯粹是为了演示方便,方便我们查看每个向量的具体数值,不会让页面被数字占满。

句子包含6个单词,因此最终会得到一个6×3的嵌入矩阵:

输入代码:

vocab_size = 50_000

torch.manual_seed(123)
embed = torch.nn.Embedding(vocab_size, 3)
embedded_sentence = embed(sentence_int).detach()

print(embedded_sentence)
print(embedded_sentence.shape)

输出:

tensor([[ 0.3374, -0.1778, -0.3035],
        [ 0.1794,  1.8951,  0.4954],
        [ 0.2692, -0.0770, -1.0205],
        [-0.2196, -0.3792,  0.7671],
        [-0.5880,  0.3486,  0.6603],
        [-1.1925,  0.6984, -1.4097]])
torch.Size([6, 3])

定义权重矩阵

接下来我们讲解应用最广泛的自注意力机制——缩放点积注意力,它是Transformer架构的核心组成部分。

自注意力会用到三个权重矩阵,分别记作$W_q$、$W_k$、$W_v$,它们是模型的可训练参数,会在训练过程中不断更新。这三个矩阵的作用,分别是将输入投影为序列的查询(query)、键(key)和值(value)分量。

对应的查询、键、值序列,通过权重矩阵$W$与嵌入输入$x$做矩阵乘法得到:

  • 查询序列:$q(i) = x(i)W_q$,其中$i$为序列中第1到第$T$个位置

  • 键序列:$k(i) = x(i)W_k$,其中$i$为序列中第1到第$T$个位置

  • 值序列:$v(i) = x(i)W_v$,其中$i$为序列中第1到第$T$个位置

下标$i$代表输入序列中的token位置索引,序列总长度为$T$。
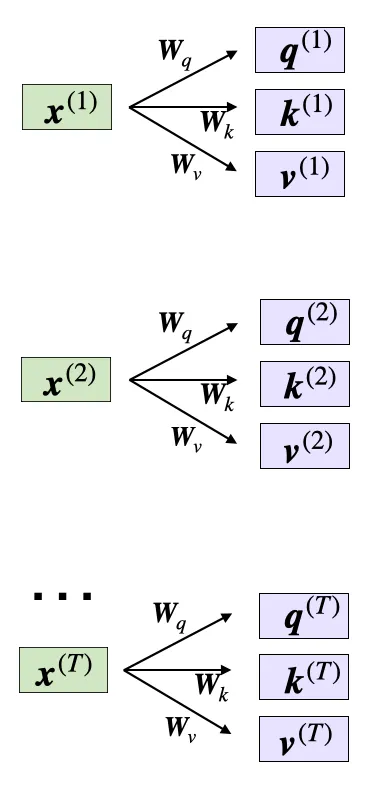
figure05

通过输入$x$与权重$W$计算查询、键、值向量

其中,$q(i)$和$k(i)$都是维度为$d_k$的向量。投影矩阵$W_q$和$W_k$的形状为 $d \times d_k$,而$W_v$的形状为 $d \times d_v$。

(注意:$d$代表每个单词向量$x$的维度。)

由于我们要计算查询向量和键向量的点积,因此这两个向量的元素数量必须相等($d_q = d_k$)。在很多大语言模型中,值向量也会采用相同的维度,也就是 $d_q = d_k = d_v$。不过值向量$v(i)$的元素数(决定了最终上下文向量的维度)本身是可以自由设置的。

在接下来的代码演示中,我们设置 $d_q = d_k = 2$,$d_v = 4$,并按如下方式初始化投影矩阵:

输入代码:

torch.manual_seed(123)

d = embedded_sentence.shape[1]

d_q, d_k, d_v = 2, 2, 4

W_query = torch.nn.Parameter(torch.rand(d, d_q))
W_key = torch.nn.Parameter(torch.rand(d, d_k))
W_value = torch.nn.Parameter(torch.rand(d, d_v))

(和前面的词嵌入向量一样,实际场景中$d_q$、$d_k$、$d_v$的维度会大得多,这里用小数值只是为了方便演示。)
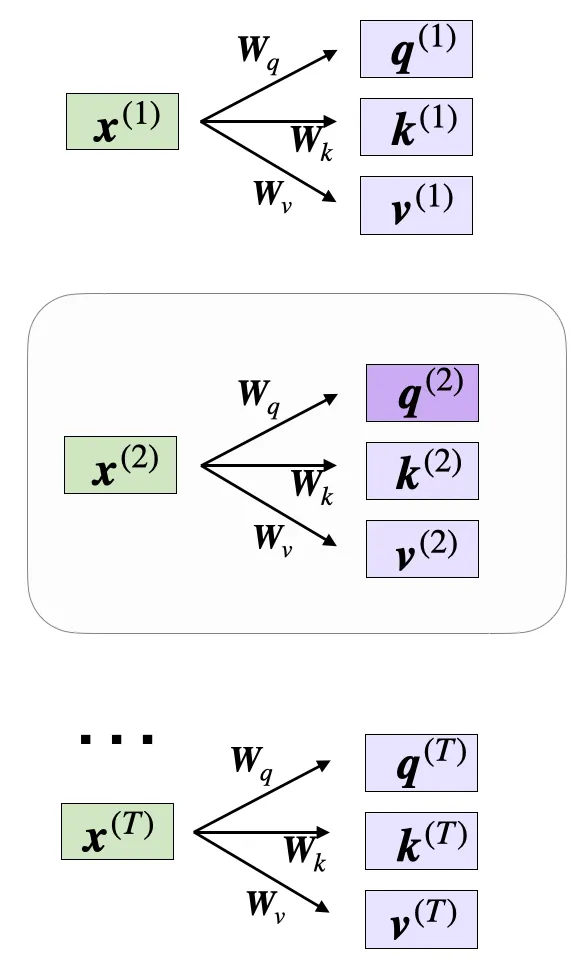
figure06

计算未归一化注意力权重

现在,假设我们要计算第二个输入元素的注意力向量——此时第二个输入元素就作为查询。
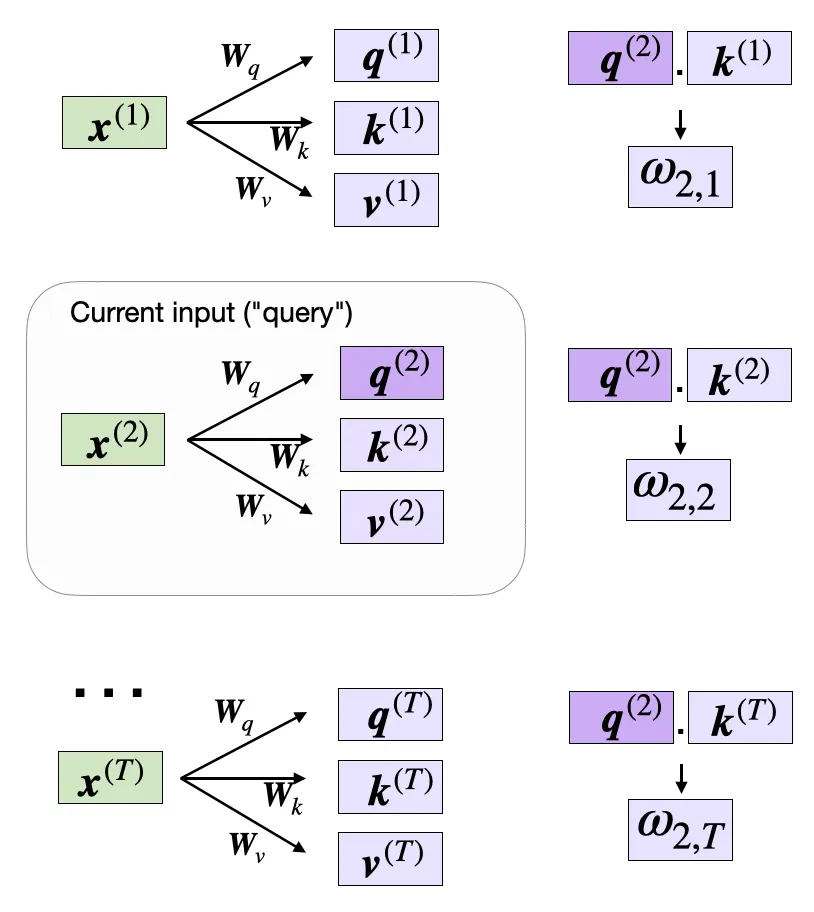
figure07

接下来的内容,我们都以第二个输入$x(2)$为例

代码实现如下:

输入代码:

x_2 = embedded_sentence[1]
query_2 = x_2 @ W_query
key_2 = x_2 @ W_key
value_2 = x_2 @ W_value

print(query_2.shape)
print(key_2.shape)
print(value_2.shape)

输出:

torch.Size([2])
torch.Size([2])
torch.Size([4])

我们可以把这个逻辑推广到所有输入,计算出所有输入对应的键和值,因为后续计算未归一化注意力权重时会用到它们:

输入代码:

keys = embedded_sentence @ W_key
values = embedded_sentence @ W_value

print("keys.shape:", keys.shape)
print("values.shape:", values.shape)

输出:

keys.shape: torch.Size([6, 2])
values.shape: torch.Size([6, 4])

有了全部的键和值,我们就可以进入下一步:计算未归一化的注意力权重$\omega$(omega),如下图所示:
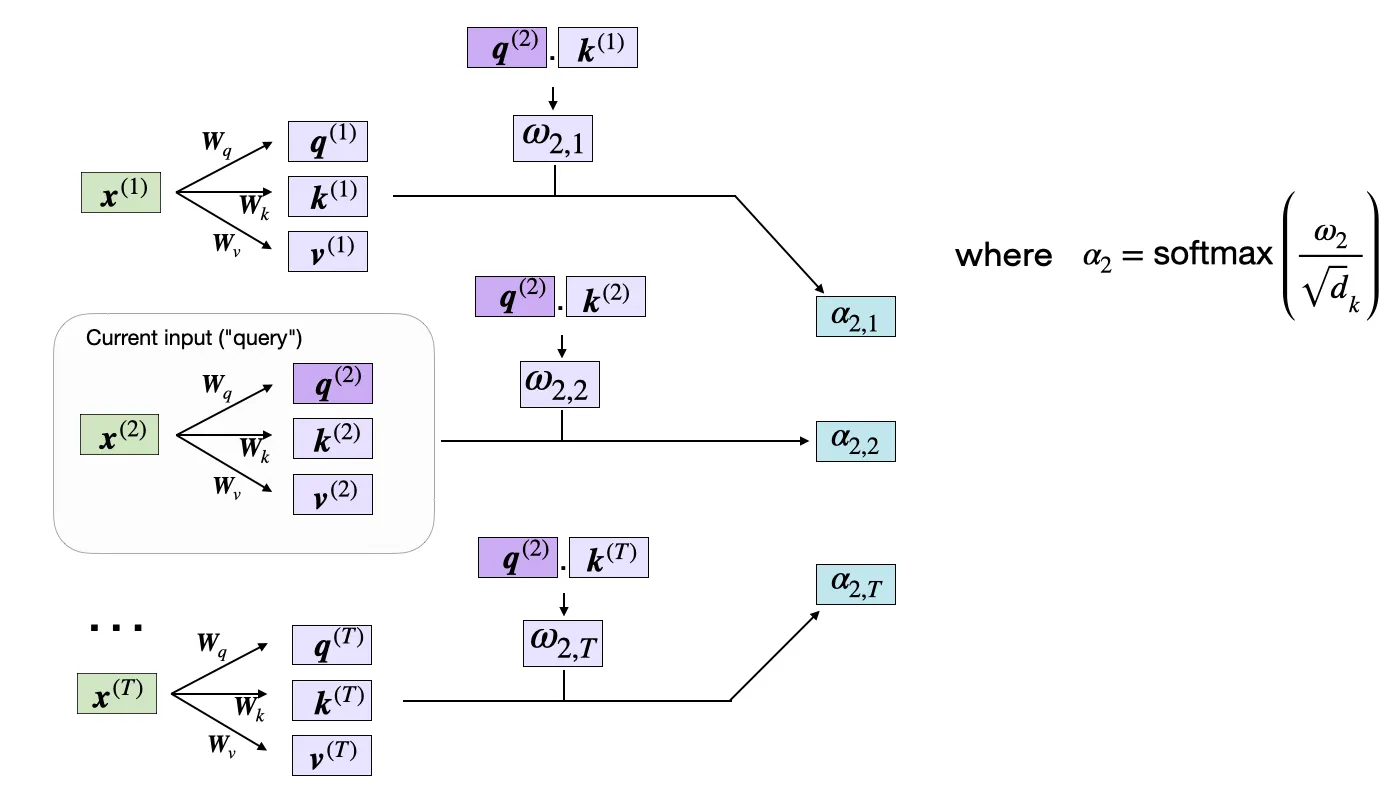
figure08

计算未归一化注意力权重$\omega$(omega)

如图所示,$\omega_{i,j}$ 等于查询向量与键向量的点积,即 $\omega_{i,j} = q(i) \cdot k(j)$。

举个例子,我们可以计算当前查询与第5个输入元素(对应索引4)之间的未归一化注意力权重:

输入代码:

omega_24 = query_2.dot(keys[4])
print(omega_24)

(注:$\omega$是希腊字母“omega”,上面代码中的变量名也由此而来。)

输出:

tensor(1.2903)

后续计算正式注意力权重时需要用到这些未归一化的$\omega$值,我们把所有输入token对应的$\omega$都计算出来,就像上图演示的那样:

输入代码:

omega_2 = query_2 @ keys.T
print(omega_2)

输出:

tensor([-0.6004,  3.4707, -1.5023,  0.4991,  1.2903, -1.3374])

计算注意力权重

自注意力的下一步,是对未归一化的注意力权重$\omega$做归一化,通过softmax函数得到归一化后的注意力权重$\alpha$(alpha)。此外,在输入softmax之前,我们会先将$\omega$乘以 $1/\sqrt{d_k}$ 做缩放,如下所示:
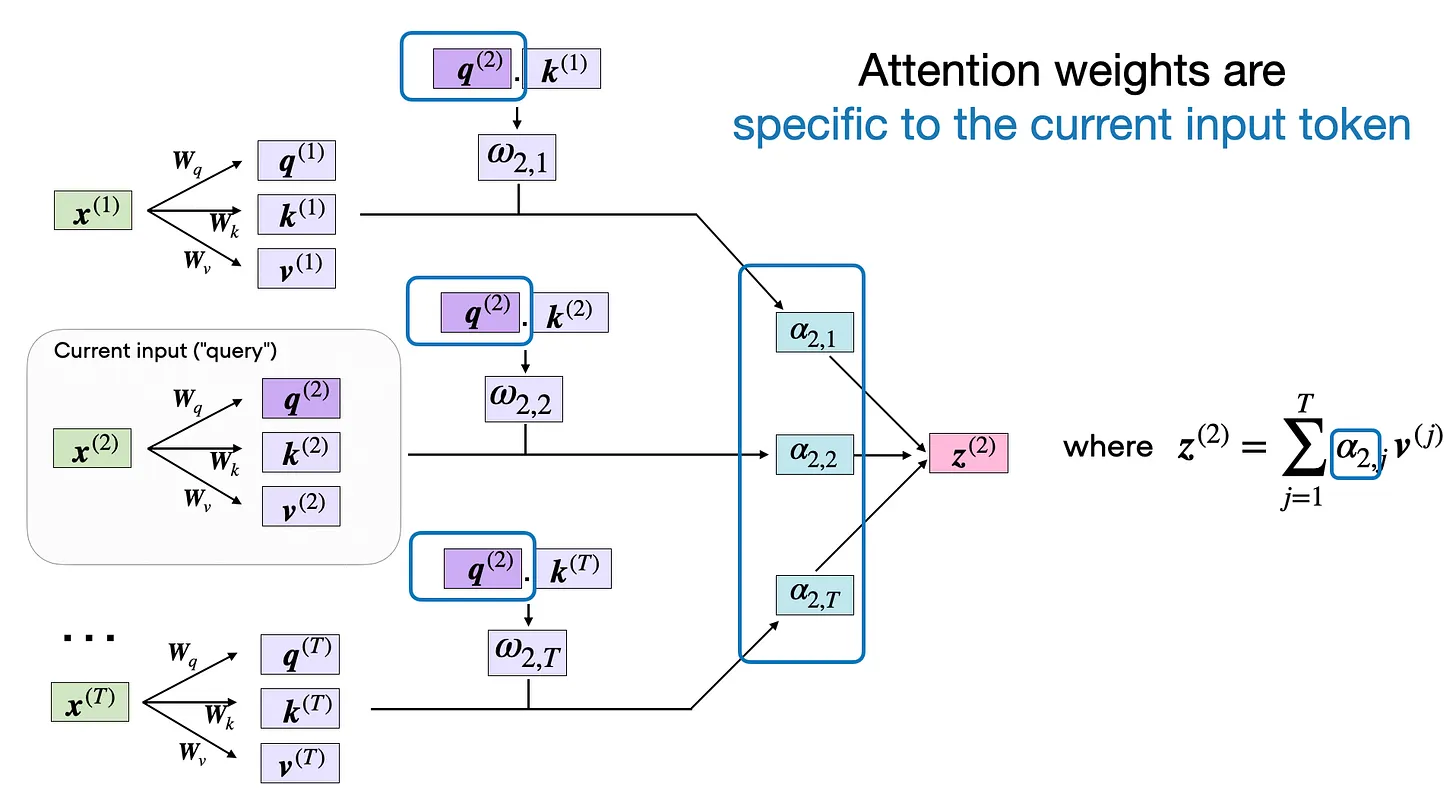
figure09

计算归一化注意力权重$\alpha$

除以$d_k$的平方根进行缩放,是为了保证权重向量的欧氏长度保持在相近的量级,避免注意力权重过大或过小,防止数值不稳定,同时保障模型的训练收敛效果。

为什么偏偏是$\sqrt{d_k}$?因为$q$和$k$的点积是$d_k$个独立项的和,每一项的方差约为1,这意味着原始得分的方差会随$d_k$线性增长。除以$\sqrt{d_k}$后,就能抵消这种增长,让方差回到约1的水平。

代码中的注意力权重计算实现如下:

输入代码:

import torch.nn.functional as F

attention_weights_2 = F.softmax(omega_2 / d_k**0.5, dim=0)
print(attention_weights_2)

输出:

tensor([0.0386, 0.6870, 0.0204, 0.0840, 0.1470, 0.0229])

最后一步,是计算上下文向量$z(2)$。它是原始查询输入$x(2)$的注意力加权版本,通过注意力权重融合了所有其他输入元素的上下文信息:
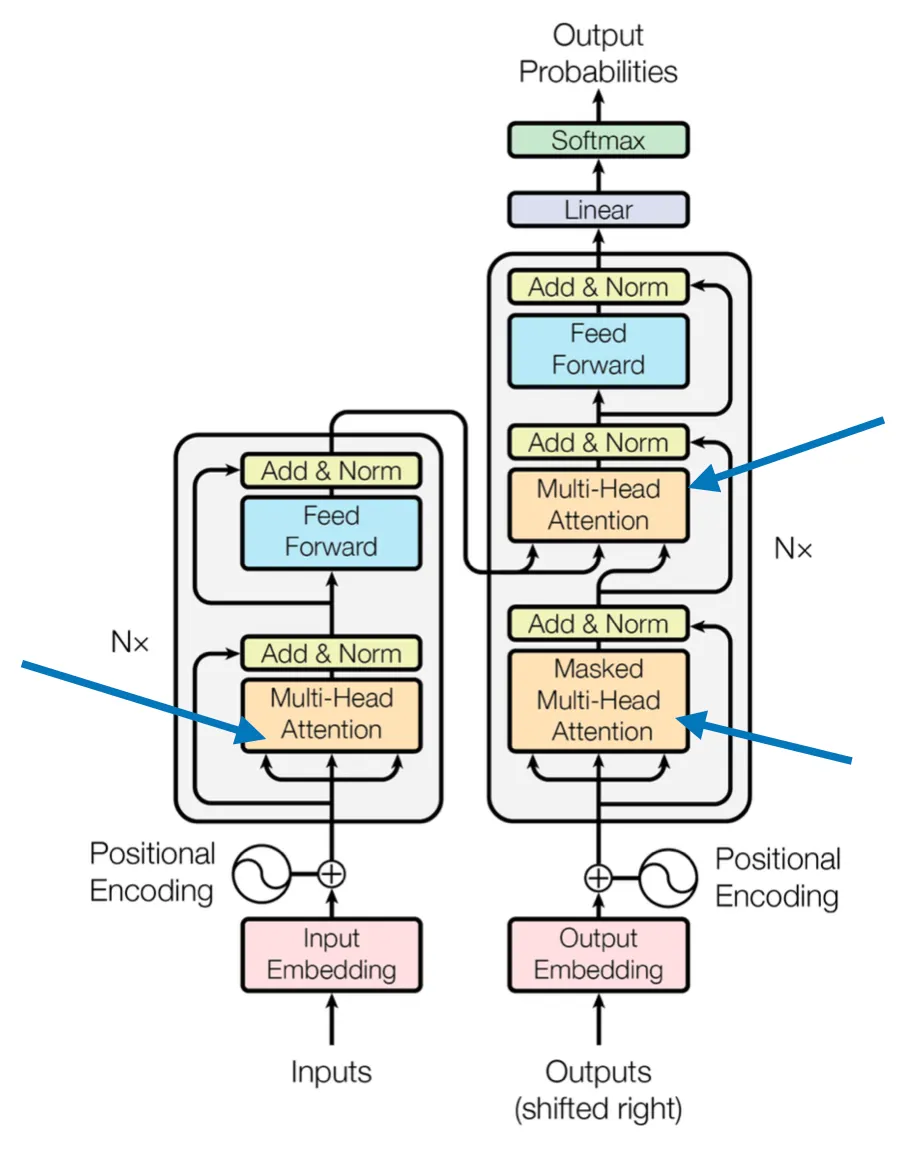
figure10

注意力权重是针对特定输入元素计算的。这里我们选择的是输入元素$x(2)$。

代码实现如下:

输入代码:

context_vector_2 = attention_weights_2 @ values

print(context_vector_2.shape)
print(context_vector_2)

输出:

torch.Size([4])
tensor([0.5313, 1.3607, 0.7891, 1.3110])

注意,这个输出向量的维度($d_v = 4$)比原始输入向量的维度($d = 3$)更高,因为我们前面设置了$d_v > d$;实际上,嵌入维度$d_v$的取值是任意的。

自注意力完整实现

结合前面几节的内容,我们可以把自注意力机制的代码整合起来,封装成一个简洁的SelfAttention类:

输入代码:

import torch.nn as nn

class SelfAttention(nn.Module):

    def __init__(self, d_in, d_out_kq, d_out_v):
        super().__init__()
        self.d_out_kq = d_out_kq
        self.W_query = nn.Parameter(torch.rand(d_in, d_out_kq))
        self.W_key   = nn.Parameter(torch.rand(d_in, d_out_kq))
        self.W_value = nn.Parameter(torch.rand(d_in, d_out_v))

    def forward(self, x):
        keys = x @ self.W_key
        queries = x @ self.W_query
        values = x @ self.W_value
        
        attn_scores = queries @ keys.T  # 未归一化注意力权重    
        attn_weights = torch.softmax(
            attn_scores / self.d_out_kq**0.5, dim=-1
        )
        
        context_vec = attn_weights @ values
        return context_vec

遵循PyTorch的编码惯例,上面的SelfAttention类在__init__方法中初始化自注意力的参数,在forward方法中完成所有输入的注意力权重与上下文向量计算。我们可以这样使用这个类:

输入代码:

torch.manual_seed(123)

d_in, d_out_kq, d_out_v = 3, 2, 4

sa = SelfAttention(d_in, d_out_kq, d_out_v)
print(sa(embedded_sentence))

输出:

tensor([[-0.1564,  0.1028, -0.0763, -0.0764],
        [ 0.5313,  1.3607,  0.7891,  1.3110],
        [-0.3542, -0.1234, -0.2627, -0.3706],
        [ 0.0071,  0.3345,  0.0969,  0.1998],
        [ 0.1008,  0.4780,  0.2021,  0.3674],
        [-0.5296, -0.2799, -0.4107, -0.6006]], grad_fn=<MmBackward0>)

可以看到,输出的第二行和我们上一节算出的context_vector_2完全一致:tensor([0.5313, 1.3607, 0.7891, 1.3110])。

多头注意力

在文章开头的第一张图里(这里再放一次方便查看),我们能看到Transformer中使用了一个叫“多头注意力”的模块。
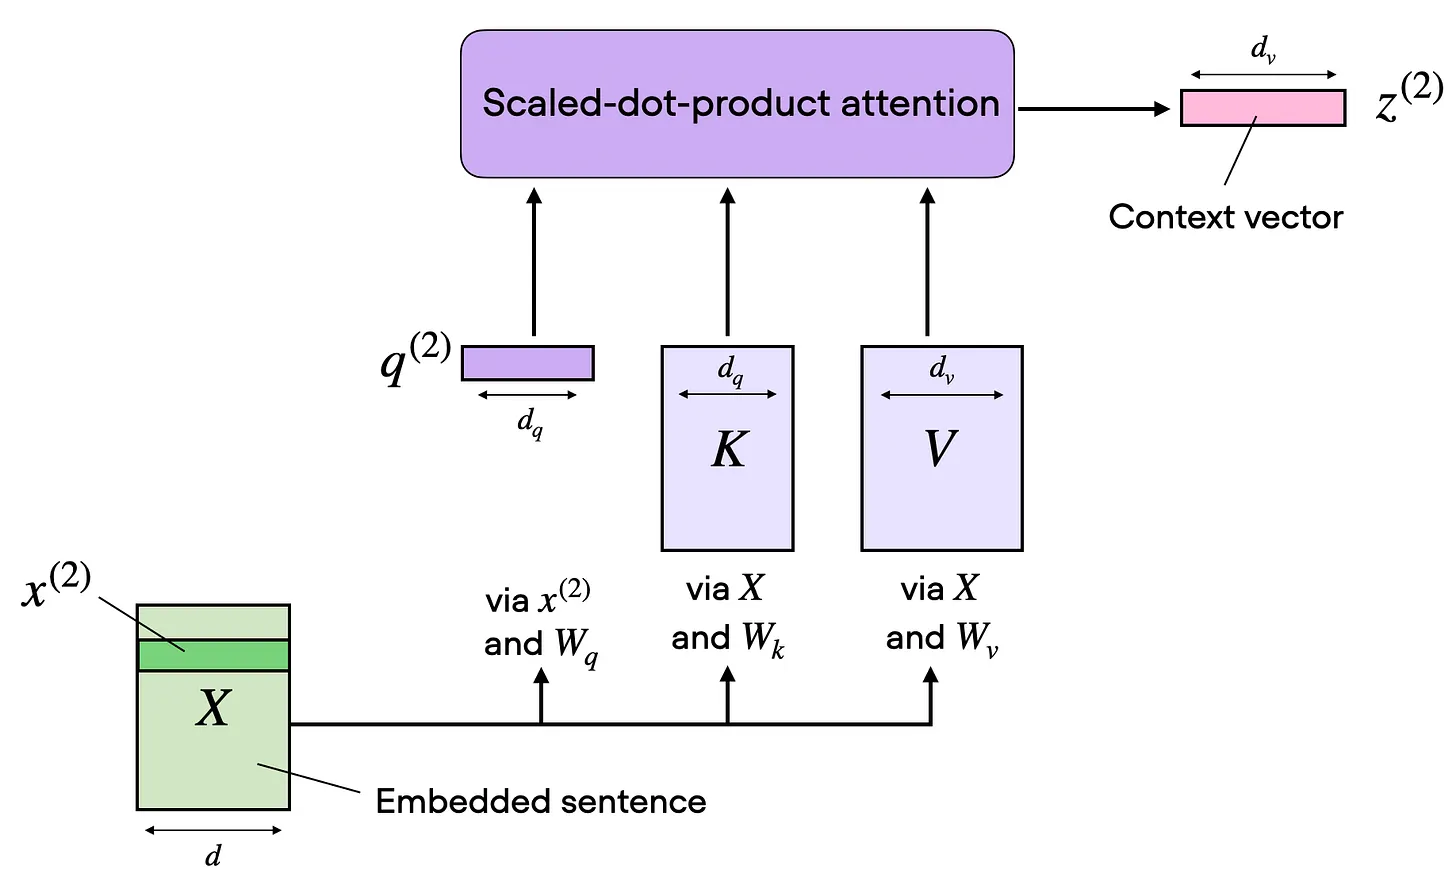
figure11

原始Transformer架构中的多头注意力模块,来源:https://arxiv\.org/abs/1706\.03762

这个“多头”注意力模块,和我们前面讲解的自注意力机制(缩放点积注意力)是什么关系呢?

在缩放点积注意力中,输入序列通过查询、键、值三个矩阵做变换。在多头注意力的语境里,这一套矩阵就对应一个注意力头。下图总结了我们前面实现的单个注意力头:
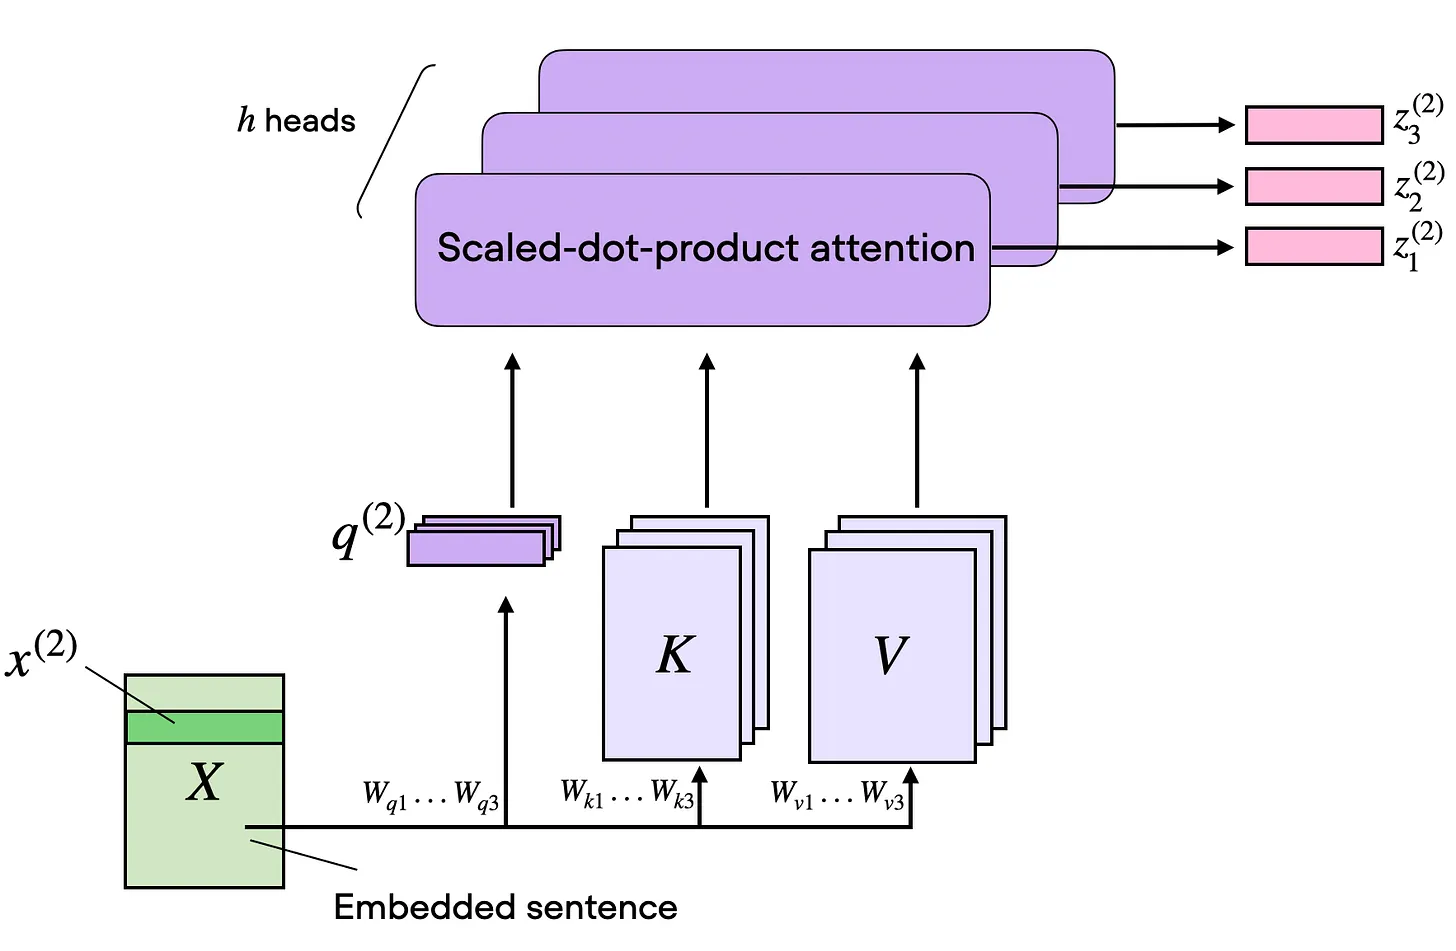
figure12

前文实现的自注意力机制总结

顾名思义,多头注意力就是包含多个这样的“头”,每个头都有自己的查询、键、值矩阵。这个概念和卷积神经网络中使用多个卷积核的思路类似,最终会输出多通道的特征图。
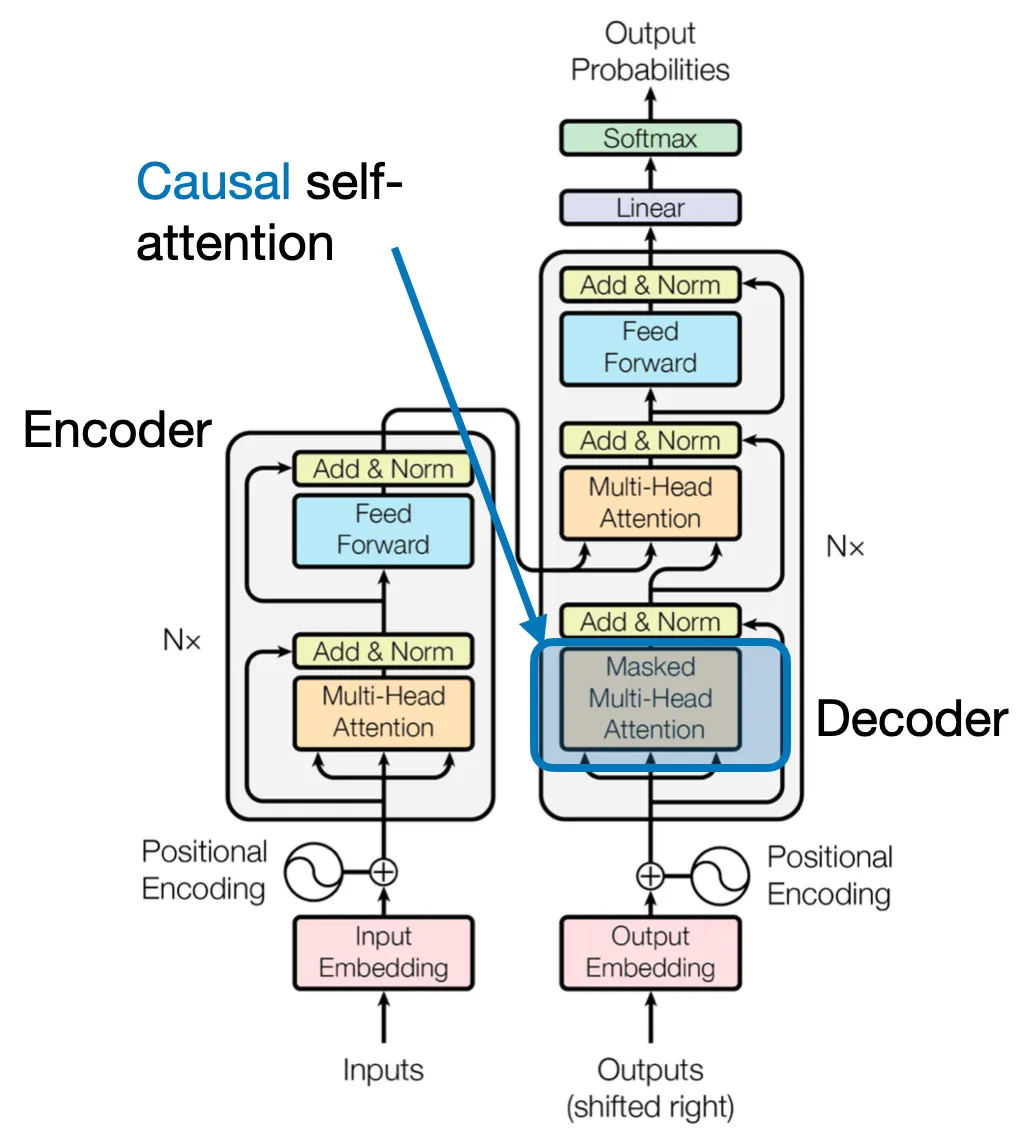
figure13

多头注意力:包含多个头的自注意力

用代码演示的话,我们可以基于前面的SelfAttention类,写一个MultiHeadAttentionWrapper包装类:

class MultiHeadAttentionWrapper(nn.Module):

    def __init__(self, d_in, d_out_kq, d_out_v, num_heads):
        super().__init__()
        self.heads = nn.ModuleList(
            [SelfAttention(d_in, d_out_kq, d_out_v) 
             for _ in range(num_heads)]
        )

    def forward(self, x):
        return torch.cat([head(x) for head in self.heads], dim=-1)

其中d_*参数和SelfAttention类中的定义完全一致,唯一新增的参数是注意力头的数量:

  • d_in:输入特征向量的维度

  • d_out_kq:查询与键的输出维度

  • d_out_v:值的输出维度

  • num_heads:注意力头的数量

我们用这些参数初始化num_heads个SelfAttention实例,并用PyTorch的nn.ModuleList存储这些实例。

在前向传播时,每个存储在self.heads中的SelfAttention头都会独立处理输入x,然后将所有头的结果在最后一维(dim=-1)拼接起来。我们来实际运行一下:

首先,为了简化演示,我们用单个自注意力头,输出维度设为1:

输入代码:

torch.manual_seed(123)

d_in, d_out_kq, d_out_v = 3, 2, 1

sa = SelfAttention(d_in, d_out_kq, d_out_v)
print(sa(embedded_sentence))

输出:

tensor([[-0.0185],
        [ 0.4003],
        [-0.1103],
        [ 0.0668],
        [ 0.1180],
        [-0.1827]], grad_fn=<MmBackward0>)

现在我们把它扩展为4个注意力头:

输入代码:

torch.manual_seed(123)

mha = MultiHeadAttentionWrapper(
    d_in, d_out_kq, d_out_v, num_heads=4
)

context_vecs = mha(embedded_sentence)

print(context_vecs)
print("context_vecs.shape:", context_vecs.shape)

输出:

tensor([[-0.0185,  0.0170,  0.1999, -0.0860],
        [ 0.4003,  1.7137,  1.3981,  1.0497],
        [-0.1103, -0.1609,  0.0079, -0.2416],
        [ 0.0668,  0.3534,  0.2322,  0.1008],
        [ 0.1180,  0.6949,  0.3157,  0.2807],
        [-0.1827, -0.2060, -0.2393, -0.3167]], grad_fn=<CatBackward0>)
context_vecs.shape: torch.Size([6, 4])

从输出可以看到,前面单个自注意力头的结果,正好对应输出张量的第一列。

可以看到,多头注意力的结果是一个6×4的张量:我们有6个输入token,4个自注意力头,每个自注意力头输出1维结果。而前面单头自注意力部分,我们也得到过6×4的张量——那是因为我们把单头的输出维度设成了4,而不是1。

那么问题来了:既然单头自注意力本身就能调整输出嵌入的大小,为什么还需要多头注意力呢?

“提升单个自注意力头的输出维度”和“使用多个注意力头”,两者的本质区别在于模型处理、学习数据的方式不同。虽然两种方式都能提升模型表征不同特征、不同数据维度的能力,但底层逻辑完全不同。

比如,多头注意力中的每个头,都有可能学会关注输入序列的不同部分,捕捉数据中不同层面的关系。这种表征的多样性,正是多头注意力成功的关键。

此外,多头注意力的计算效率更高,尤其适合并行计算。每个头都可以独立处理,非常适配GPU、TPU这类擅长并行运算的现代硬件加速设备。

简而言之,使用多头注意力不只是为了提升模型容量,更是为了增强模型学习数据中多样化特征与关联的能力。举个例子,70亿参数的Llama 2模型就使用了32个注意力头。

因果自注意力

本节我们将前面讲解的自注意力机制,改造为因果自注意力机制——它主要用于GPT这类(解码器风格的)文本生成大语言模型。因果自注意力也常被称为“掩码自注意力”,在原始Transformer架构中,它对应“掩码多头注意力”模块。为了简化讲解,本节我们只看单个注意力头,其原理可以直接推广到多头场景。
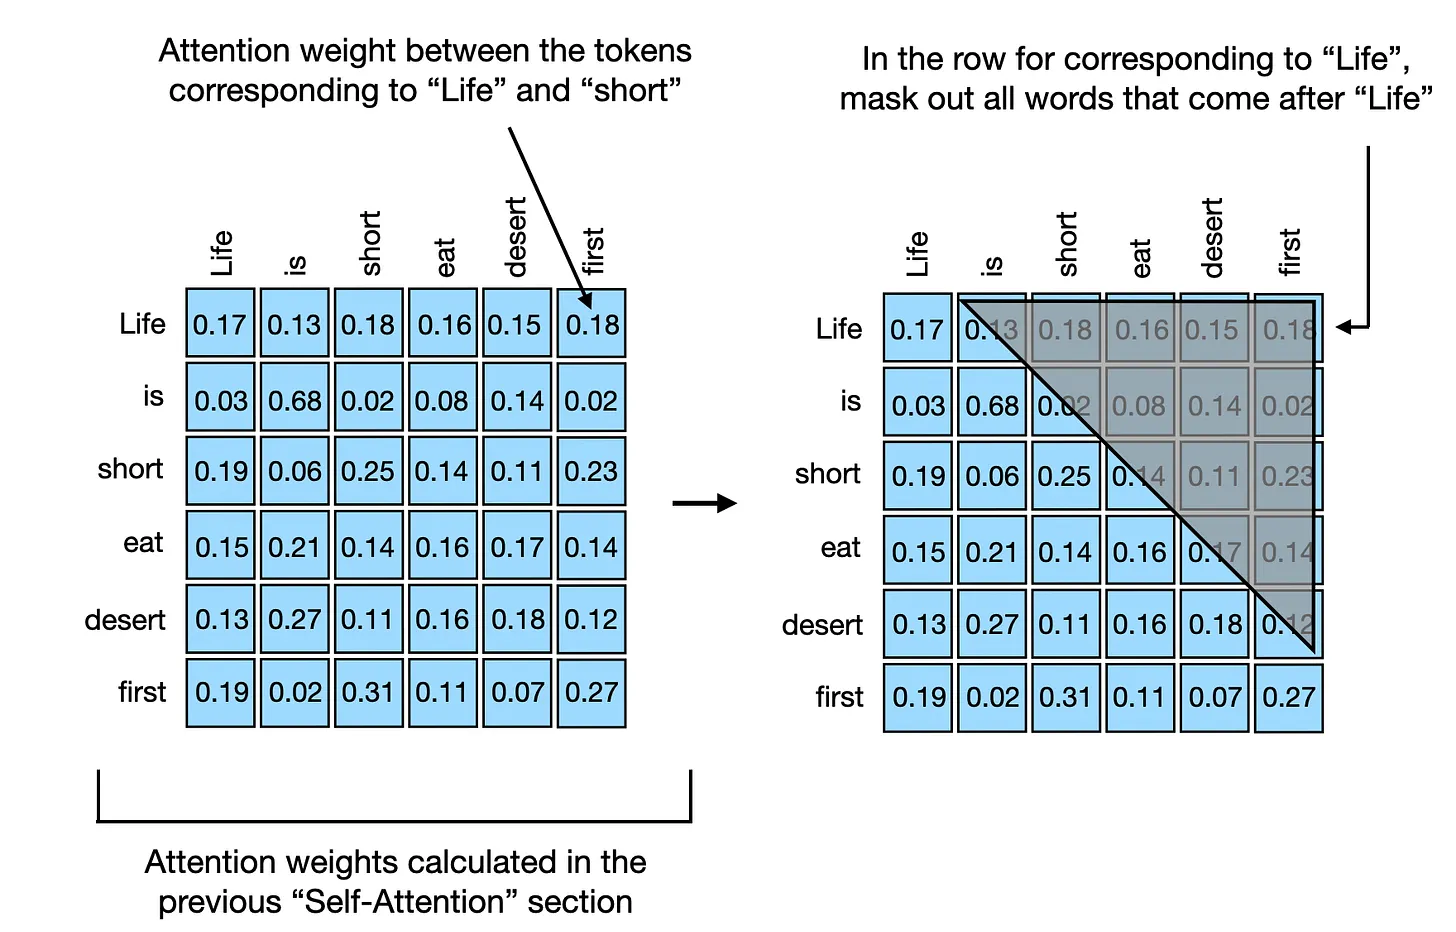
figure14

原始Transformer架构中的因果自注意力模块,来源:《Attention Is All You Need》, https://arxiv\.org/abs/1706\.03762

因果自注意力的作用是:序列中每个位置的输出,只能依赖当前位置之前的已知输出,不能看到未来位置的信息。简单来说,就是保证下一个单词的预测,只由它前面的单词决定。

在GPT类大语言模型中,为了实现这一点,处理每个token时,我们都会把输入文本中位于当前token之后的“未来token”掩码掉。

下图演示了如何对注意力权重施加因果掩码,隐藏输入中的未来token:

为了演示并实现因果自注意力,我们沿用前面的未归一化注意力得分与注意力权重。首先快速回顾一下自注意力部分的注意力得分计算:

输入代码:

torch.manual_seed(123)

d_in, d_out_kq, d_out_v = 3, 2, 4

W_query = nn.Parameter(torch.rand(d_in, d_out_kq))
W_key   = nn.Parameter(torch.rand(d_in, d_out_kq))
W_value = nn.Parameter(torch.rand(d_in, d_out_v))

x = embedded_sentence

keys = x @ W_key
queries = x @ W_query
values = x @ W_value

# attn_scores 就是前面的 "omegas",即未归一化注意力权重
attn_scores = queries @ keys.T 

print(attn_scores)
print(attn_scores.shape)

输出:

tensor([[ 0.0613, -0.3491,  0.1443, -0.0437, -0.1303,  0.1076],
        [-0.6004,  3.4707, -1.5023,  0.4991,  1.2903, -1.3374],
        [ 0.2432, -1.3934,  0.5869, -0.1851, -0.5191,  0.4730],
        [-0.0794,  0.4487, -0.1807,  0.0518,  0.1677, -0.1197],
        [-0.1510,  0.8626, -0.3597,  0.1112,  0.3216, -0.2787],
        [ 0.4344, -2.5037,  1.0740, -0.3509, -0.9315,  0.9265]],
       grad_fn=<MmBackward0>)
torch.Size([6, 6])

和之前自注意力部分一样,上面的输出是6×6的张量,保存了6个输入token两两之间的未归一化注意力权重(也叫注意力得分)。

之前我们是这样通过softmax计算缩放点积注意力的:

输入代码:

attn_weights = torch.softmax(attn_scores / d_out_kq**0.5, dim=1)
print(attn_weights)

输出:

tensor([[0.1772, 0.1326, 0.1879, 0.1645, 0.1547, 0.1831],
        [0.0386, 0.6870, 0.0204, 0.0840, 0.1470, 0.0229],
        [0.1965, 0.0618, 0.2506, 0.1452, 0.1146, 0.2312],
        [0.1505, 0.2187, 0.1401, 0.1651, 0.1793, 0.1463],
        [0.1347, 0.2758, 0.1162, 0.1621, 0.1881, 0.1231],
        [0.1973, 0.0247, 0.3102, 0.1132, 0.0751, 0.2794]],
       grad_fn=<SoftmaxBackward0>)

这个6×6的输出就是注意力权重,和我们之前自注意力部分计算的结果一致。

而在GPT类大语言模型中,模型的训练方式是从左到右,逐个读取、生成token(单词)。如果我们有一条训练文本Life is short eat dessert first,就会形成如下的训练模式:箭头右侧单词的上下文向量,只能融合自身和箭头左侧的单词信息。

  • "Life" → "is"

  • "Life is" → "short"

  • "Life is short" → "eat"

  • "Life is short eat" → "dessert"

  • "Life is short eat dessert" → "first"

实现这个模式最简单的方法,就是对注意力权重矩阵的上三角(主对角线以上的部分)做掩码,如下图所示。这样一来,在计算上下文向量(即输入的注意力加权和)时,“未来”的单词就不会被纳入计算。
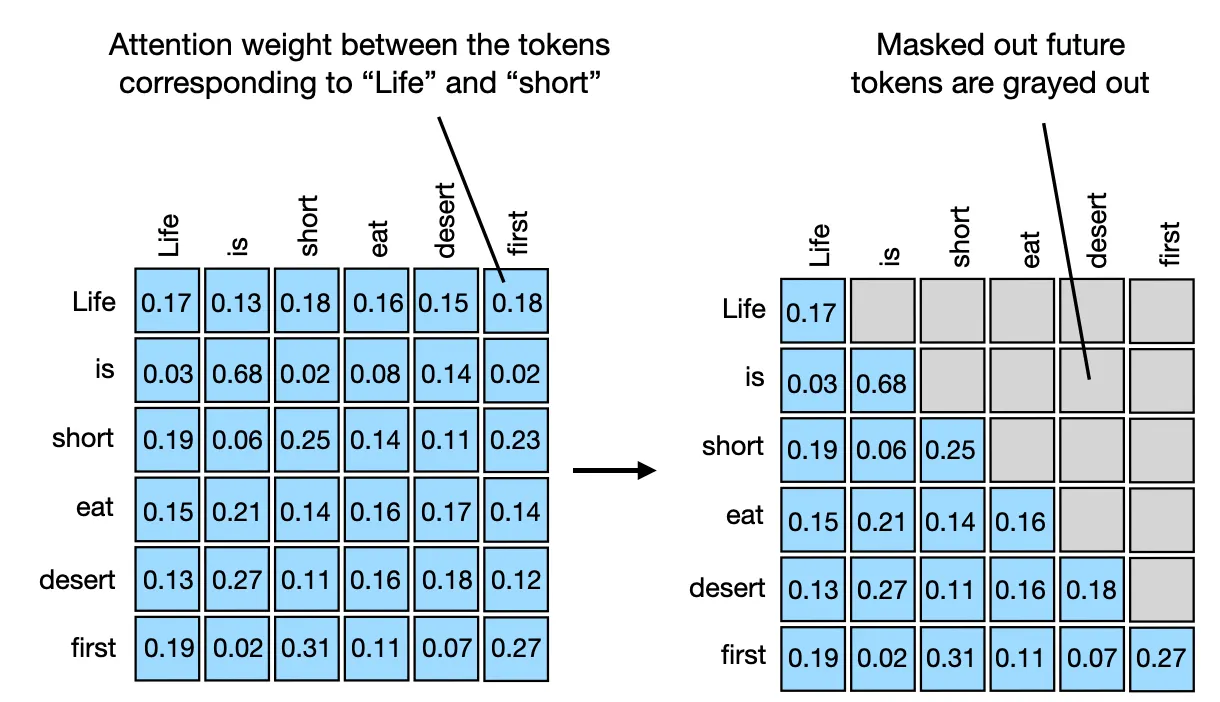
figure15

主对角线以上的注意力权重需要被掩码掉

代码层面,我们可以用PyTorch的tril函数实现:先生成一个由0和1组成的掩码矩阵。

输入代码:

block_size = attn_scores.shape[0]
mask_simple = torch.tril(torch.ones(block_size, block_size))
print(mask_simple)

输出:

tensor([[1., 0., 0., 0., 0., 0.],
        [1., 1., 0., 0., 0., 0.],
        [1., 1., 1., 0., 0., 0.],
        [1., 1., 1., 1., 0., 0.],
        [1., 1., 1., 1., 1., 0.],
        [1., 1., 1., 1., 1., 1.]])

接下来,我们把注意力权重和这个掩码相乘,将主对角线以上的所有注意力权重置零:

输入代码:

masked_simple = attn_weights*mask_simple
print(masked_simple)

输出:

tensor([[0.1772, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0386, 0.6870, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.1965, 0.0618, 0.2506, 0.0000, 0.0000, 0.0000],
        [0.1505, 0.2187, 0.1401, 0.1651, 0.0000, 0.0000],
        [0.1347, 0.2758, 0.1162, 0.1621, 0.1881, 0.0000],
        [0.1973, 0.0247, 0.3102, 0.1132, 0.0751, 0.2794]],
       grad_fn=<MulBackward0>)

这是掩码未来单词的一种实现方式,但你会发现:此时每一行的注意力权重不再求和等于1。为了解决这个问题,我们可以对每一行重新做归一化,让它们的和重新变为1——这是注意力权重的标准约定。

输入代码:

row_sums = masked_simple.sum(dim=1, keepdim=True)
masked_simple_norm = masked_simple / row_sums
print(masked_simple_norm)

输出:

tensor([[1.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0532, 0.9468, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.3862, 0.1214, 0.4924, 0.0000, 0.0000, 0.0000],
        [0.2232, 0.3242, 0.2078, 0.2449, 0.0000, 0.0000],
        [0.1536, 0.3145, 0.1325, 0.1849, 0.2145, 0.0000],
        [0.1973, 0.0247, 0.3102, 0.1132, 0.0751, 0.2794]],
       grad_fn=<DivBackward0>)

可以看到,现在每一行的注意力权重之和都为1了。

在Transformer这类模型中,使用归一化的注意力权重主要有两点优势:第一,求和为1的归一化注意力权重类似概率分布,更直观地体现了模型对输入不同部分的关注比例;第二,约束权重和为1,可以控制权重与梯度的量级,优化训练过程的稳定性。

更高效的掩码方式:无需二次归一化

上面我们实现的因果自注意力流程是:先计算注意力得分,再计算注意力权重,接着掩码掉上三角的权重,最后重新归一化。整个流程总结如下图:
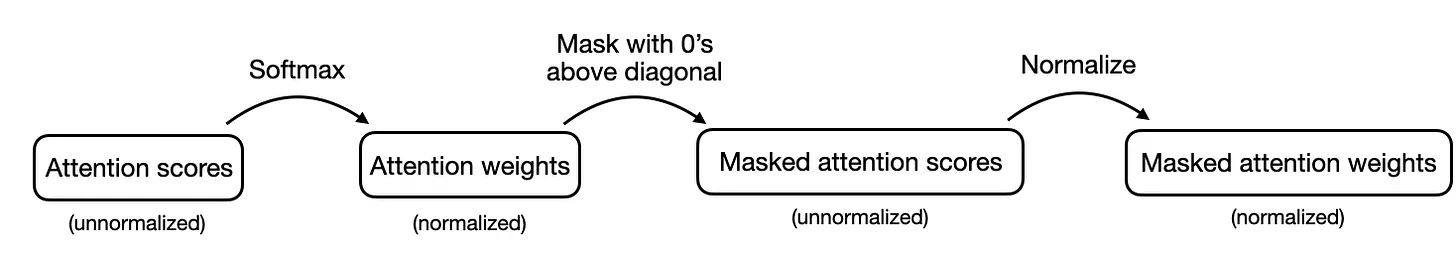
figure16

前文实现的因果自注意力流程

其实还有一种更高效的方式,可以得到完全相同的结果。这种方法是在输入softmax计算注意力权重之前,就把注意力得分中主对角线以上的值替换为负无穷。流程总结如下:
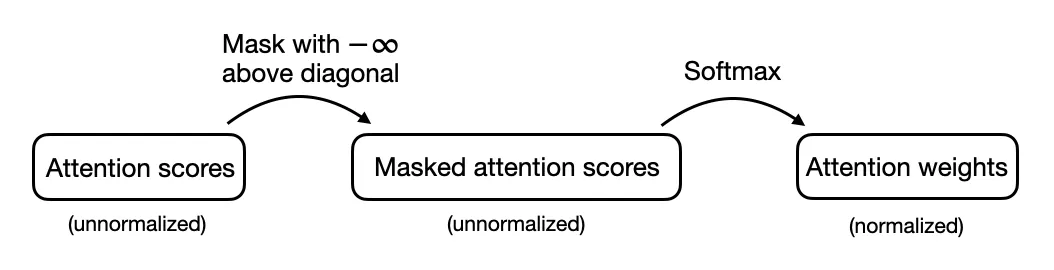
figure17

另一种更高效的因果自注意力实现方案

我们可以用PyTorch写出这个流程,首先对注意力得分的上三角做掩码:

输入代码:

mask = torch.triu(torch.ones(block_size, block_size), diagonal=1)
masked = attn_scores.masked_fill(mask.bool(), -torch.inf)
print(masked)

上面的代码先生成一个掩码矩阵:主对角线及以下为0,以上为1。其中torch.triu(上三角)会保留矩阵主对角线及以上的元素,将下方元素置零,保留上三角部分;对应的torch.tril(下三角)则保留主对角线及以下的元素。

然后masked_fill方法会把掩码中为1的位置(主对角线以上)的所有元素替换为-torch.inf(负无穷),结果如下:

输出:

tensor([[ 0.0613,    -inf,    -inf,    -inf,    -inf,    -inf],
        [-0.6004,  3.4707,    -inf,    -inf,    -inf,    -inf],
        [ 0.2432, -1.3934,  0.5869,    -inf,    -inf,    -inf],
        [-0.0794,  0.4487, -0.1807,  0.0518,    -inf,    -inf],
        [-0.1510,  0.8626, -0.3597,  0.1112,  0.3216,    -inf],
        [ 0.4344, -2.5037,  1.0740, -0.3509, -0.9315,  0.9265]],
       grad_fn=<MaskedFillBackward0>)

接下来,我们照常应用softmax函数,就能得到经过掩码且归一化的注意力权重:

输入代码:

attn_weights = torch.softmax(masked / d_out_kq**0.5, dim=1)
print(attn_weights)

输出:

tensor([[1.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0532, 0.9468, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.3862, 0.1214, 0.4924, 0.0000, 0.0000, 0.0000],
        [0.2232, 0.3242, 0.2078, 0.2449, 0.0000, 0.0000],
        [0.1536, 0.3145, 0.1325, 0.1849, 0.2145, 0.0000],
        [0.1973, 0.0247, 0.3102, 0.1132, 0.0751, 0.2794]],
       grad_fn=<SoftmaxBackward0>)  

为什么这种方法有效?因为最后一步的softmax函数会把输入值转化为概率分布。当输入中存在负无穷时,$e^{-\infty}$趋近于0,因此这些位置对输出概率没有贡献,相当于概率为0。

结语

本文通过逐行编码的方式,拆解了自注意力的内部工作原理。在此基础上,我们进一步学习了多头注意力——这是Transformer大语言模型的核心组件。

随后我们还编码实现了交叉注意力(自注意力的一种变体,在处理两个独立序列时效果突出),以及因果自注意力——这是GPT、Llama等解码器风格大语言模型生成连贯、符合上下文的序列的关键概念。

通过从零编码实现这些复杂机制,希望你已经对Transformer与大语言模型中使用的自注意力机制有了透彻的理解。

(注:本文中的代码仅用于演示原理。如果你要在大语言模型训练中实现自注意力,推荐使用Flash Attention这类优化实现,它们能显著降低内存占用与计算开销。)

附加主题:交叉注意力

在前面自注意力与因果注意力的代码讲解中,我们设置了 $d_q = d_k = 2$,$d_v = 4$。也就是说,查询序列和键序列使用了相同的维度。虽然值矩阵$W_v$通常也会设置成和查询、键矩阵相同的维度(比如PyTorch自带的MultiHeadAttention类就是如此),但值的维度其实可以自由设置……

【以下为付费内容,请跳转至原文付费订阅,6$,两杯咖啡钱】
Understanding and Coding Self-Attention, Multi-Head Attention, Causal-Attention, and Cross-Attention in LLMs,by Sebastian Raschka, 2024-01-14

=== 以下为付费内容 ===
【转载】2023年值得关注的10篇AI研究论文

原文地址:Ten Noteworthy AI Research Papers of 2023,by Sebastian Raschka, on 2023-12-30

2023年值得关注的10篇AI研究论文

今年的感觉格外不同。我从事机器学习与AI领域的研究、应用与相关工作已有十余年,但印象中从未有哪个时期,这些领域能像今年这样备受瞩目、发展如此迅猛。

为给精彩纷呈的2023年机器学习与AI研究收尾,我很乐意分享今年读过的10篇值得关注的论文。我个人的研究重心更偏向大语言模型,因此今年的榜单中大语言模型(LLM)相关论文的占比会高于计算机视觉类论文。

我没有把这篇文章命名为“2023年顶级AI研究论文”,因为评判“最佳”论文本身带有主观性。这份榜单的遴选标准,是结合了我个人特别欣赏、或是认为具有重要影响力、值得关注的论文。(排序是推荐的阅读顺序,而非按感知到的质量或影响力高低排序。)

对了,滑到文章末尾有个小惊喜。感谢大家一路的支持,祝大家新年开局顺利!

1) Pythia —— 来自大规模训练运行的洞见

在 https://arxiv.org/abs/2304.01373 这篇论文中,研究者们发布了8个参数规模从7000万到120亿不等的大语言模型(权重与训练数据均公开,这在行业中十分罕见)。

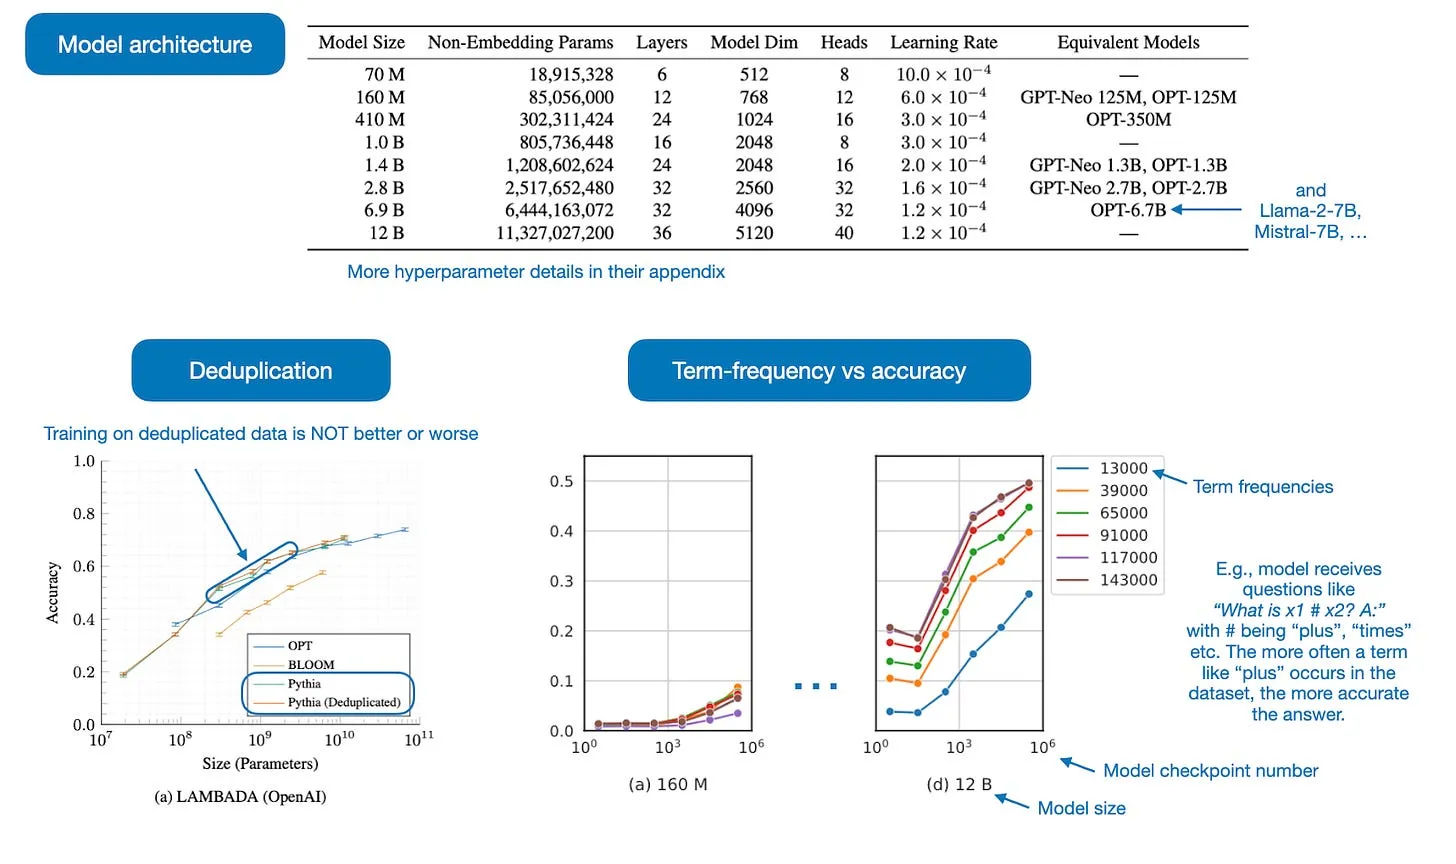
但在我看来,这篇论文最突出的亮点在于,他们同时公开了训练细节、分析与洞见(其中一部分展示在下方的带注释图中)。

figure01
来自Pythia论文的带注释图表,https://arxiv.org/abs/2304.01373

Pythia论文解答了以下问题:

  • 在重复数据上进行预训练(即训练超过1个epoch)会有影响吗?结果表明,去重既不会提升也不会损害模型性能。
  • 训练顺序会影响记忆效果吗?遗憾的是,答案是否定的。说“遗憾”,是因为如果训练顺序会影响记忆,我们就可以通过重排训练数据来缓解不良的逐字记忆问题。
  • 预训练中的词频会影响任务性能吗?会的。出现频率更高的词汇,其少样本准确率往往更高。
  • 增大批次大小会影响训练效率与模型收敛吗?批次大小翻倍可让训练时间减半,且不会损害收敛效果。

如今,仅仅过去六个月,这些大语言模型早已算不上突破性成果。但我仍然将这篇论文纳入榜单,因为它不仅尝试解答关于训练设置的诸多有趣问题,更是在细节披露与透明度方面做出了良好示范。此外,参数规模小于10亿的小型大语言模型,是小型研究、实验探索的绝佳模板,也适合作为预训练实验的起步模型(这是他们的GitHub仓库链接:https://github.com/EleutherAI/pythia )。

我对2024年的期许是,未来能看到更多此类研究,以及更多写作精良的论文!

2) Llama 2:开源基础模型与经过微调的对话模型

https://arxiv.org/abs/2307.09288 是Meta广受欢迎的首篇Llama论文的后续研究。

Llama 2模型的参数范围从70亿到700亿,这也是它入选榜单的原因之一:这些模型至今仍是能力最强、应用最广泛的开源模型之一。值得一提的是,https://github.com/facebookresearch/llama/blob/main/LICENSE 许可协议也允许商业用途(详见https://ai.meta.com/resources/models-and-libraries/llama-downloads/ )。

figure02
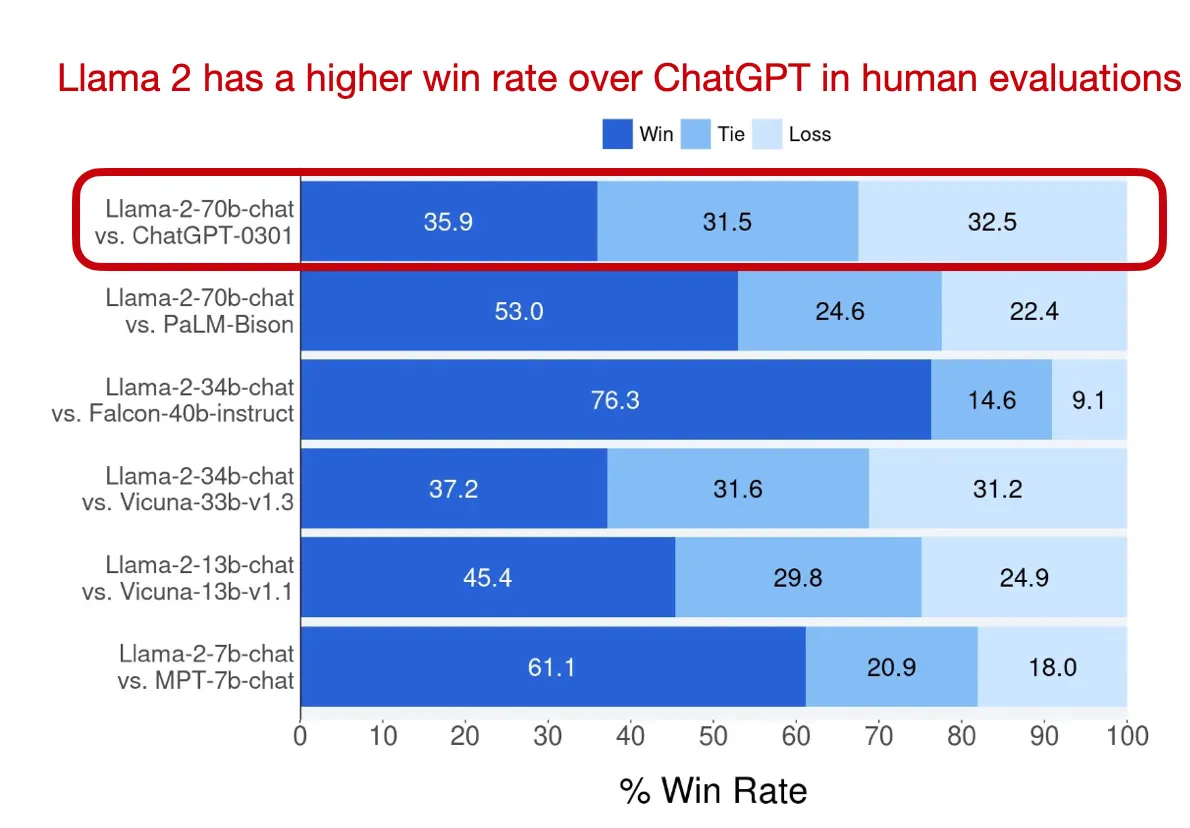
来自Llama 2论文(https://arxiv.org/abs/2307.09288)的带注释图,对比Llama 2模型与ChatGPT的性能

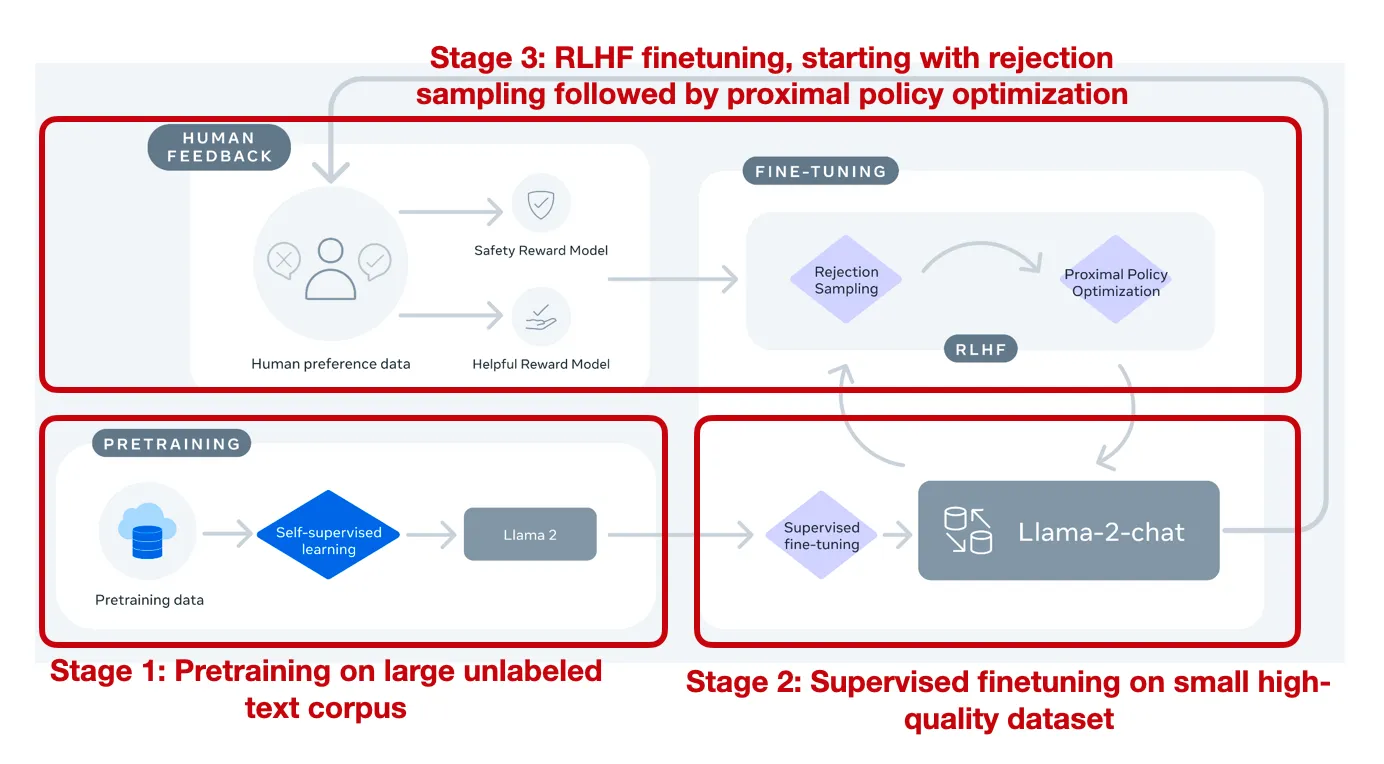
在模型层面,Llama 2系列与其他许多大语言模型的区别在于,它既提供标准预训练模型,也提供经过基于人类反馈的强化学习(RLHF,正是ChatGPT所采用的训练方法)微调的对话模型,使其能像ChatGPT一样遵循人类指令——经过RLHF微调的模型目前仍然十分少见。

figure03
来自Llama 2论文(https://arxiv.org/abs/2307.09288)的带注释图,总结了用于指令微调的RLHF流程

关于RLHF及其在Llama 2中的应用细节,可参见我之前更全面的专题文章:
https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives

除了Llama 2模型应用广泛且提供RLHF指令微调版本之外,我决定将这篇论文纳入榜单的另一个原因,是随附的这份长达77页的深度研究报告。

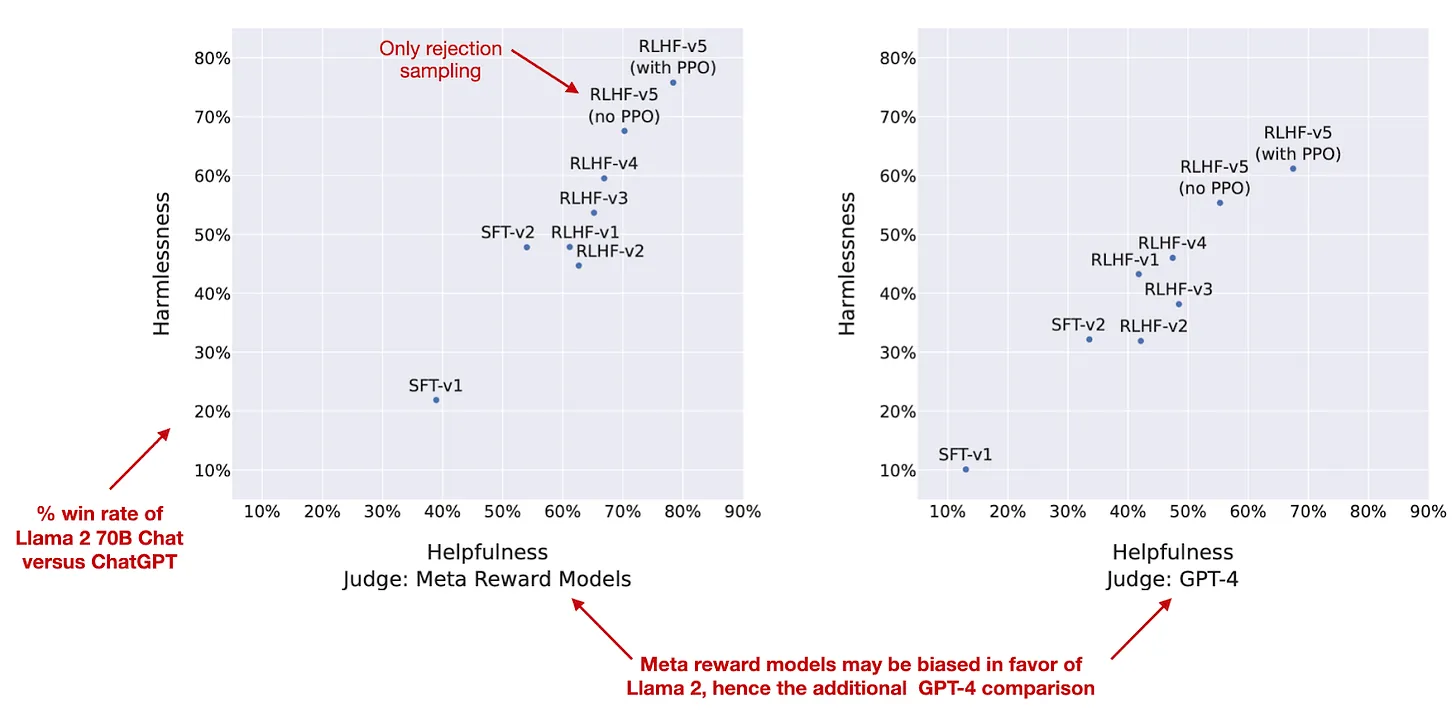
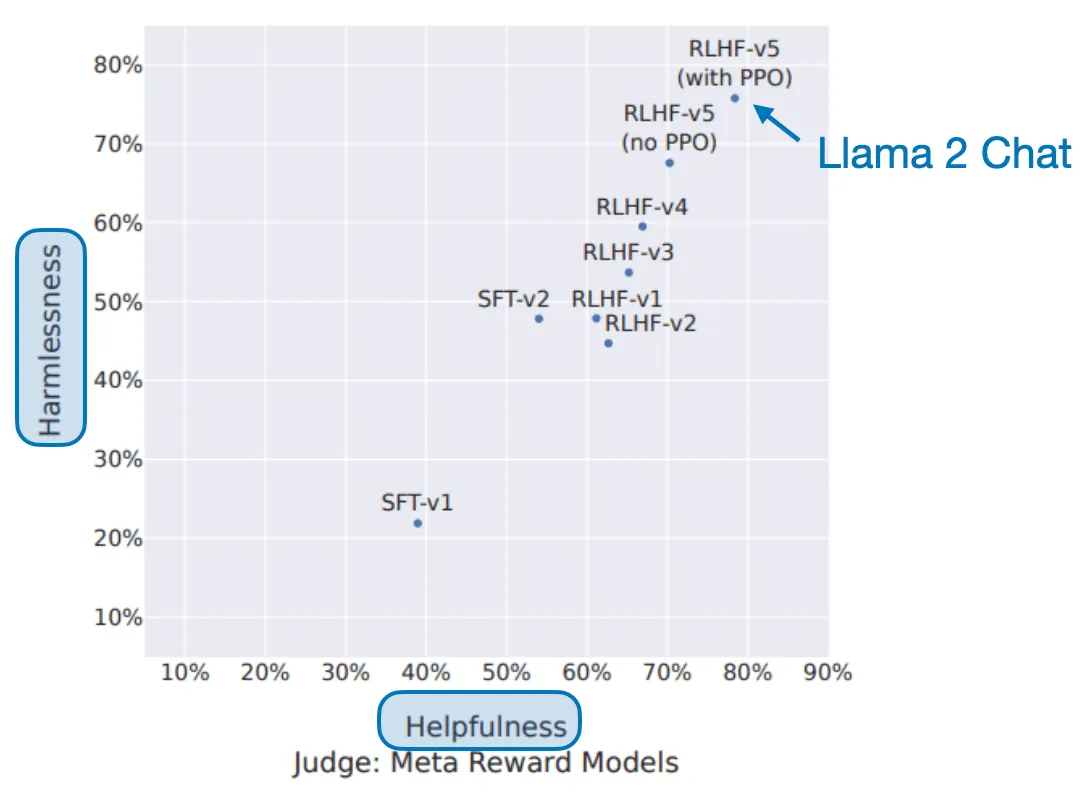
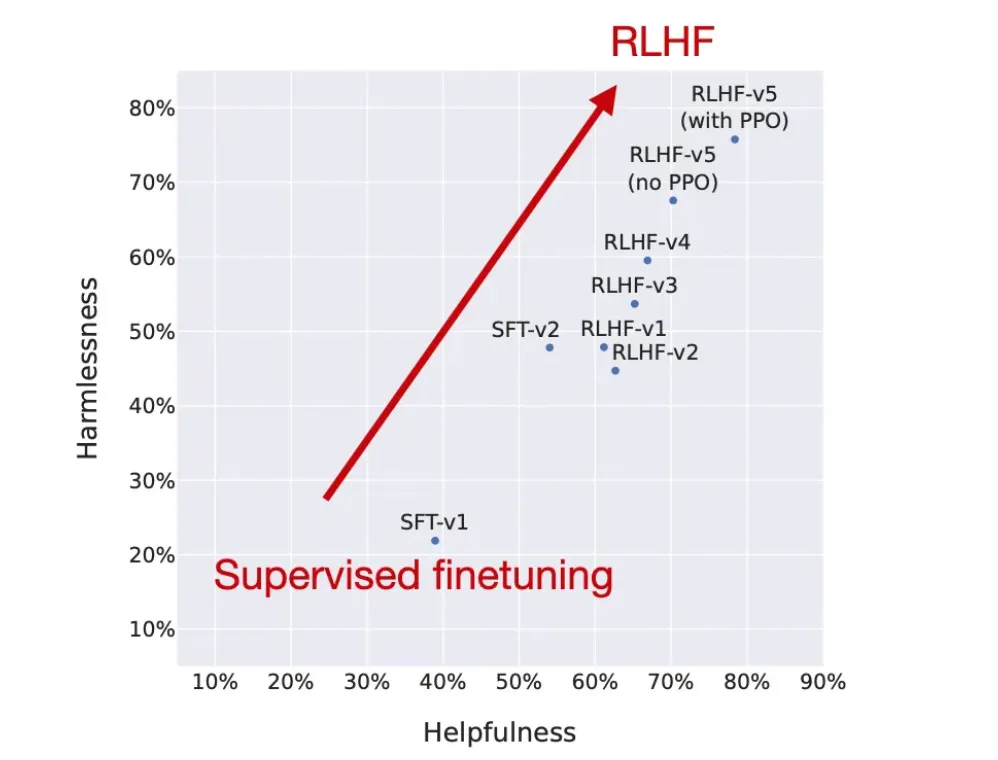
在报告中,作者们还很好地展示了Llama 2 70B对话模型的演进过程,追溯了从初始监督微调(SFT-v1)到最终采用PPO的RLHF微调阶段(RLHF-v5)的完整历程。下图反映了模型在无害性与有用性两个维度上的持续提升,如带注释图表所示。

figure04
来自Llama 2论文(https://arxiv.org/abs/2307.09288)的带注释图,展示了从第一代监督微调模型(SFT-1)到最终RLHF微调对话模型(RLHF-v5)的性能演进

尽管Mistral-8x7B(后文会详述)、DeepSeek-67B、YI-34B等模型在公开基准测试中超越了更大的Llama-2-70B模型,但在开源大语言模型以及基于其进行方法开发的场景中,Llama 2仍然是普遍且热门的选择。

此外,尽管部分基准测试显示已有更优模型,但今年行业面临的更大挑战之一,是基准测试结果的可信度。比如,我们如何确定模型没有在这些基准测试数据上训练过,分数没有被高估?在经典机器学习领域,有人提出一种新的梯度提升模型时,复现结果并验证相对容易。而如今,鉴于训练大语言模型的成本与复杂度(且大多数研究者既不公开架构,也不披露训练数据细节),我们根本无从考证。

总而言之,在其他所有主流公司都纷纷推出自有闭源大语言模型(谷歌的Bard与Gemini、亚马逊的Q、Twitter/X的Grok,以及OpenAI的ChatGPT)的当下,Meta仍在坚持开源,这令人耳目一新。

3) QLoRA:量化大语言模型的高效微调

https://arxiv.org/abs/2305.14314 是今年大语言模型研究与微调社区最受欢迎的技术之一,它让本已流行的LoRA(低秩适配)技术进一步降低了内存占用。简而言之,这意味着你可以在显存更小的GPU上运行更大的模型。

figure05
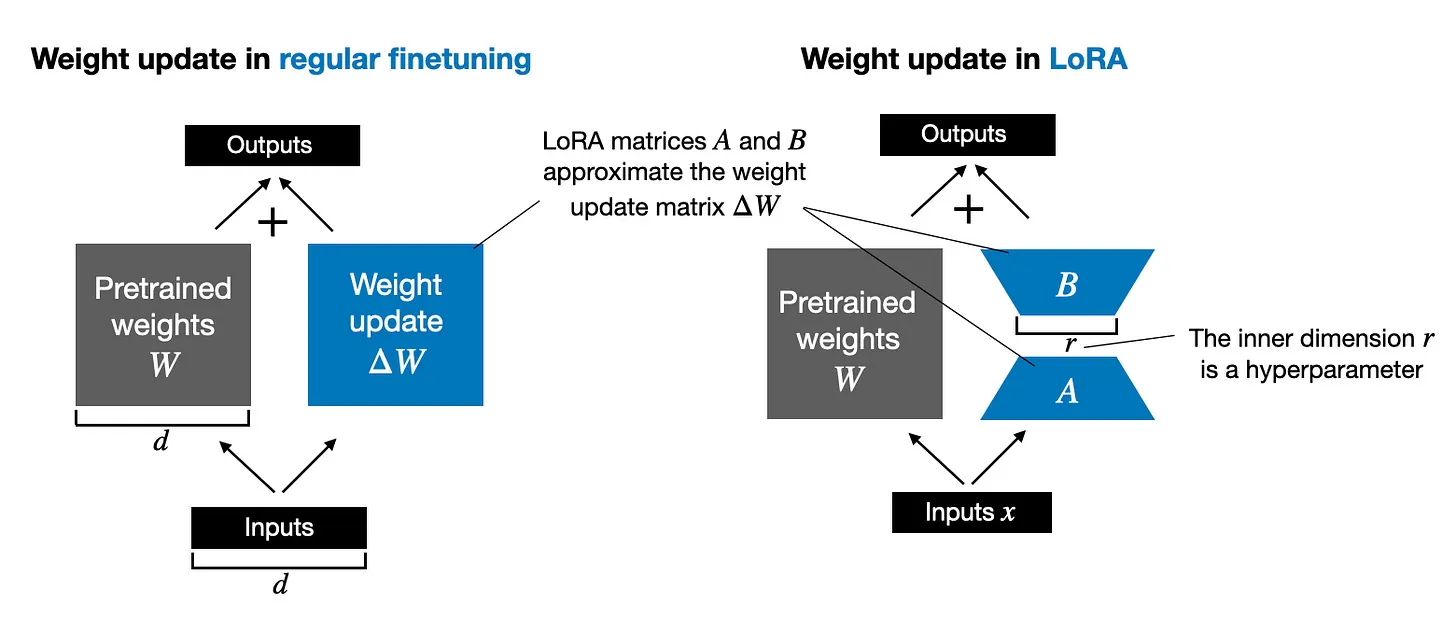
常规LoRA的简要可视化总结

QLoRA即量化低秩适配(Quantized Low-Rank Adaptation)。标准LoRA方法通过在模型各层权重上添加低秩矩阵来修改预训练大语言模型。这些矩阵规模更小,因此微调过程中更新所需的资源更少。

在QLoRA中,这些低秩矩阵被量化,也就是降低其数值精度。具体做法是将矩阵中连续的取值范围映射到有限的离散电平集合。这一过程降低了模型的内存占用与计算需求,因为低精度数值的运算内存开销更低。

figure06
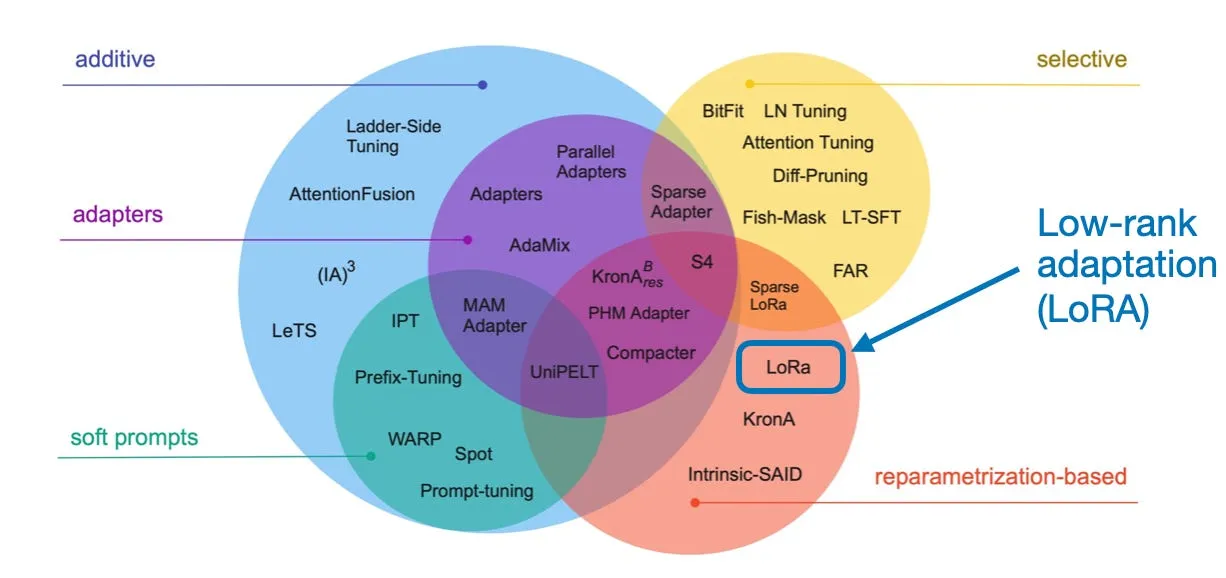
在大语言模型的众多高效微调方法中,LoRA是最流行、应用最广泛的方法之一。图为出色的综述论文https://arxiv.org/abs/2303.15647 中的带注释图。

根据https://arxiv.org/abs/2305.14314 的数据,QLoRA将650亿参数Llama模型的内存需求降低到可在单张48GB GPU(如A100)上运行。通过对650亿参数Llama进行4位量化训练得到的650亿参数Guanaco模型,保持了完整16位微调的任务性能,仅经过24小时微调,性能就达到ChatGPT的99.3%。

我今年也做了很多QLoRA实验,发现它是降低微调时GPU内存需求的实用工具。不过它也存在权衡:额外的量化步骤会带来额外的计算开销,意味着训练速度会比常规LoRA稍慢。

figure07
我之前撰写的LoRA与QLoRA实验节选,见https://magazine.sebastianraschka.com/p/practical-tips-for-finetuning-llms

随着研究者与从业者致力于打造定制化大语言模型,大语言模型微调的重要性一如既往。而QLoRA这类技术降低了GPU内存门槛,让微调过程更易上手,我对此十分认可。

4) BloombergGPT:面向金融领域的大语言模型

纵观今年发表的所有论文,https://arxiv.org/abs/2303.17564 入选十佳榜单看起来或许有些意外,因为它并没有带来突破性的新洞见、新方法,也没有开源模型。

我将它纳入榜单,是因为它是一个很有意思的案例:研究者在领域专属数据集上预训练了一个规模较大的大语言模型。此外,论文的描述相当详尽,这在如今越来越少见。尤其是企业作者参与的论文更是如此——今年的一个趋势是,在竞争激烈的格局下,大公司为了保护商业机密,对架构或数据集细节越来越保密(注:我对此并无指责之意)。

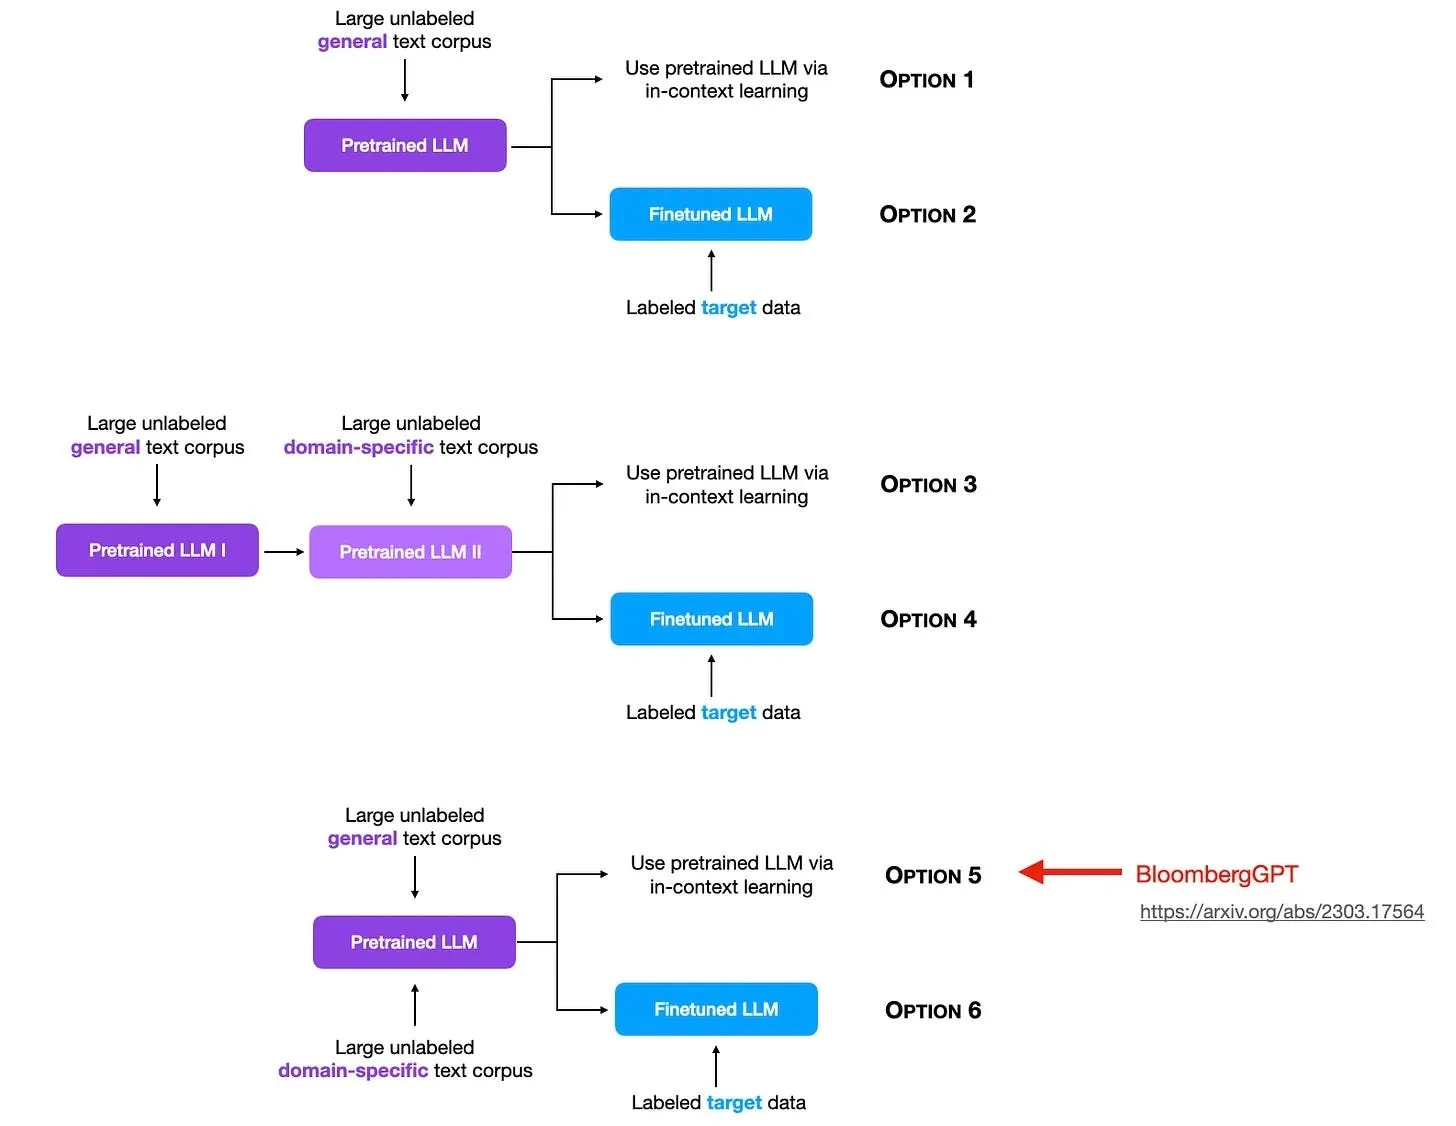
同时,BloombergGPT也让我思考了在领域专属数据上预训练与微调模型的各种不同方式,如下图所总结(注意:这一点并未在BloombergGPT论文中探讨,但未来的相关研究会很有意思)。

figure08
大语言模型预训练与微调的不同方式

简而言之,BloombergGPT是一个拥有500亿参数的金融领域语言模型,在3630亿金融领域token与3450亿公开通用数据集token上训练而成。作为对比,GPT-3的参数规模是它的3.5倍(1750亿参数),但训练token量仅为它的1.4倍(4990亿)。

既然GPT-3的规模是它的3.5倍,为什么作者们要采用“仅”500亿参数的架构?这个问题更好回答。他们采用了Chinchilla缩放法则,结合可用金融数据的规模,认为这个参数量是合适的。

在混合数据集上从头(预)训练大语言模型是否值得?从论文来看,该模型在目标领域表现非常出色。但我们并不知道,它是否优于以下两种方案:a)在领域专属数据上对预训练模型做进一步预训练;b)在领域专属数据上微调预训练模型。

尽管有上述小幅批评,总体而言这仍是一篇有趣的论文,是领域专属大语言模型的出色案例与范本;同时,它也为“向大语言模型注入知识时,预训练与微调孰优孰劣”这一问题留下了进一步研究的空间。

(注:好奇微调效果对比的读者,可参见我和他人的相关讨论:https://x.com/rohanpaul_ai/status/1738474868214235163?s=20 。“小型”模型https://arxiv.org/abs/2309.09530 在一个数据集上表现优于BloombergGPT,在另外三个金融数据集上性能与其接近。尽管整体来看BloombergGPT略胜一筹,但值得注意的是,训练AdaptLLM-7B的成本仅约100美元,而BloombergGPT的投入高达数百万美元。)

《Ahead of AI》是读者支持型出版物。若想接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

5) 直接偏好优化:你的语言模型本质上是一个奖励模型

在讨论https://arxiv.org/abs/2305.18290 这篇论文之前,我们先稍作回顾,聊聊它旨在取代的方法——基于人类反馈的强化学习(RLHF)。

RLHF是ChatGPT与Llama 2对话模型背后的核心技术。我曾在https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives 一文中更详细地介绍过RLHF,它采用多步骤流程:

  1. 监督微调:首先在包含指令与期望回复的数据集上训练模型。
  2. 奖励建模:人类标注者对模型的输出给出反馈。这些反馈用于训练奖励模型,学习预测什么样的输出更受偏好。
  3. 近端策略优化(PPO):模型生成输出,由奖励模型为每个输出打分。PPO算法利用这些分数调整模型的策略,使其生成更高质量的输出。(这是一种用于微调模型策略的强化学习算法。)

figure09
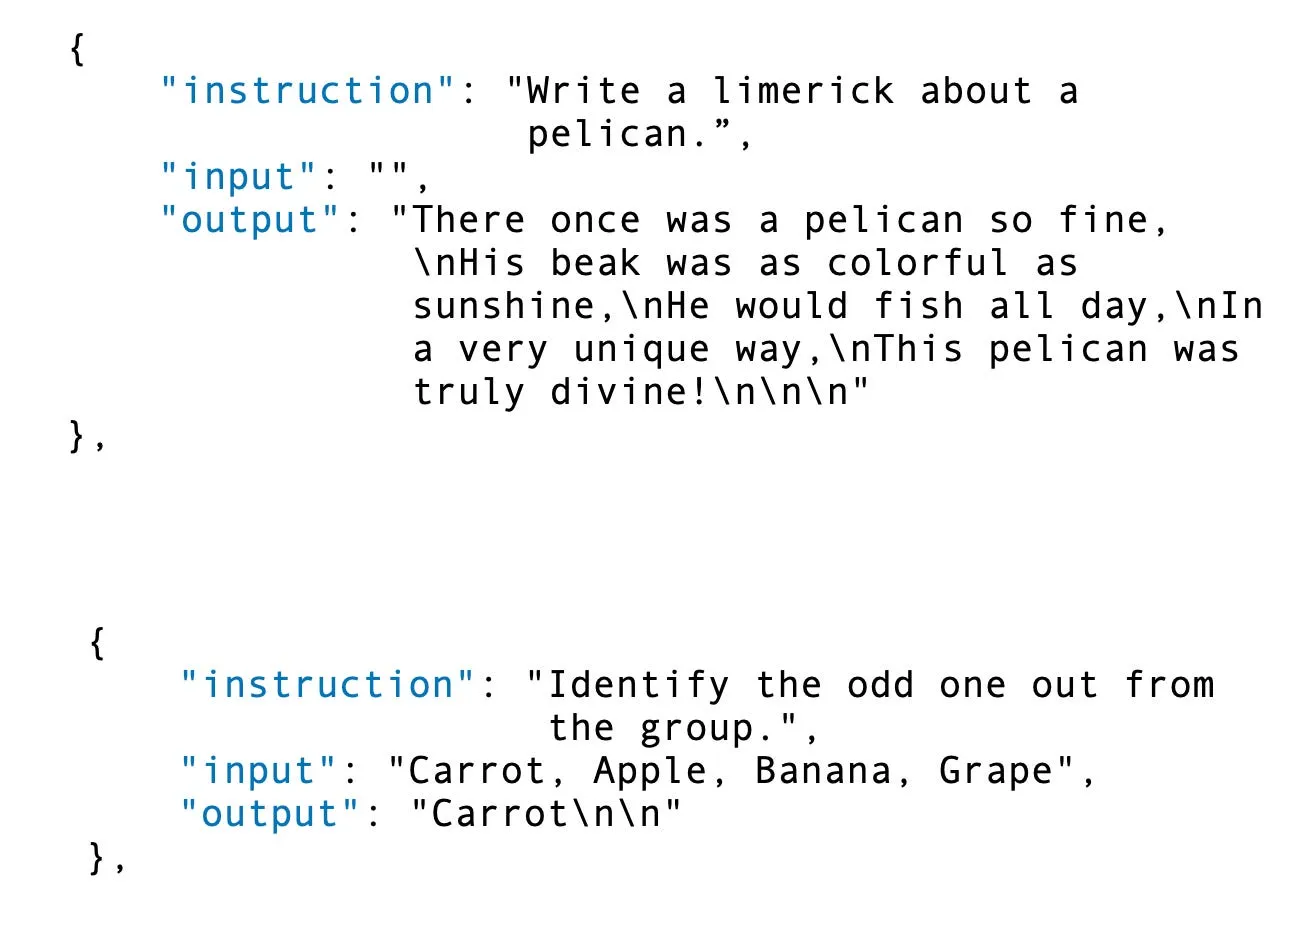
监督指令微调步骤所用数据集中的两个训练示例。注意“输入”是可选的。

RLHF虽然流行且有效——正如ChatGPT与Llama 2所展现的那样,但它的实现也相当复杂,且对参数十分敏感。

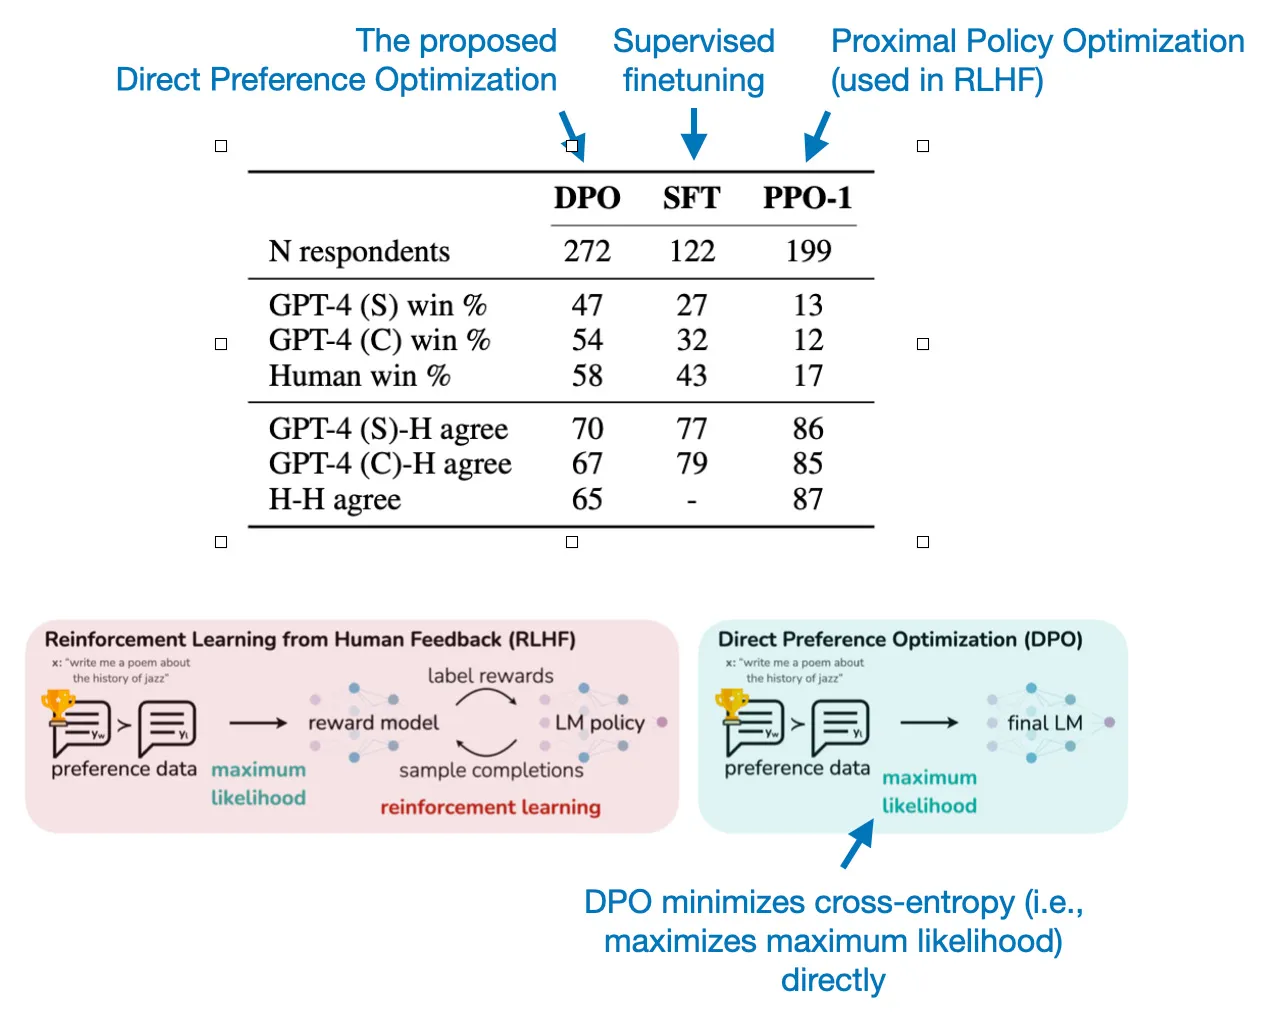
https://arxiv.org/abs/2305.18290 提出了一种算法,无需显式的奖励建模或强化学习,就能优化语言模型以对齐人类偏好。相反,DPO采用简单的分类目标。

figure10
来自DPO论文https://arxiv.org/abs/2305.18290 的带注释图

在DPO中,我们保留监督微调步骤(即上述步骤1),但将步骤2和步骤3替换为单个步骤,在偏好数据上进一步微调模型。换句话说,DPO完全省去了RLHF所需的奖励模型构建环节,极大简化了微调流程。

它的效果如何?直到最近,采用DPO训练的模型还不多。(这也合理,因为DPO本身也是较新的方法。)不过,https://arxiv.org/abs/2310.16944 中介绍的Zephyr 7B模型就是一个近期的例子。Zephyr-7B基于Mistral-7B基础大语言模型,采用DPO进行微调。(后文还会详细介绍Mistral。)

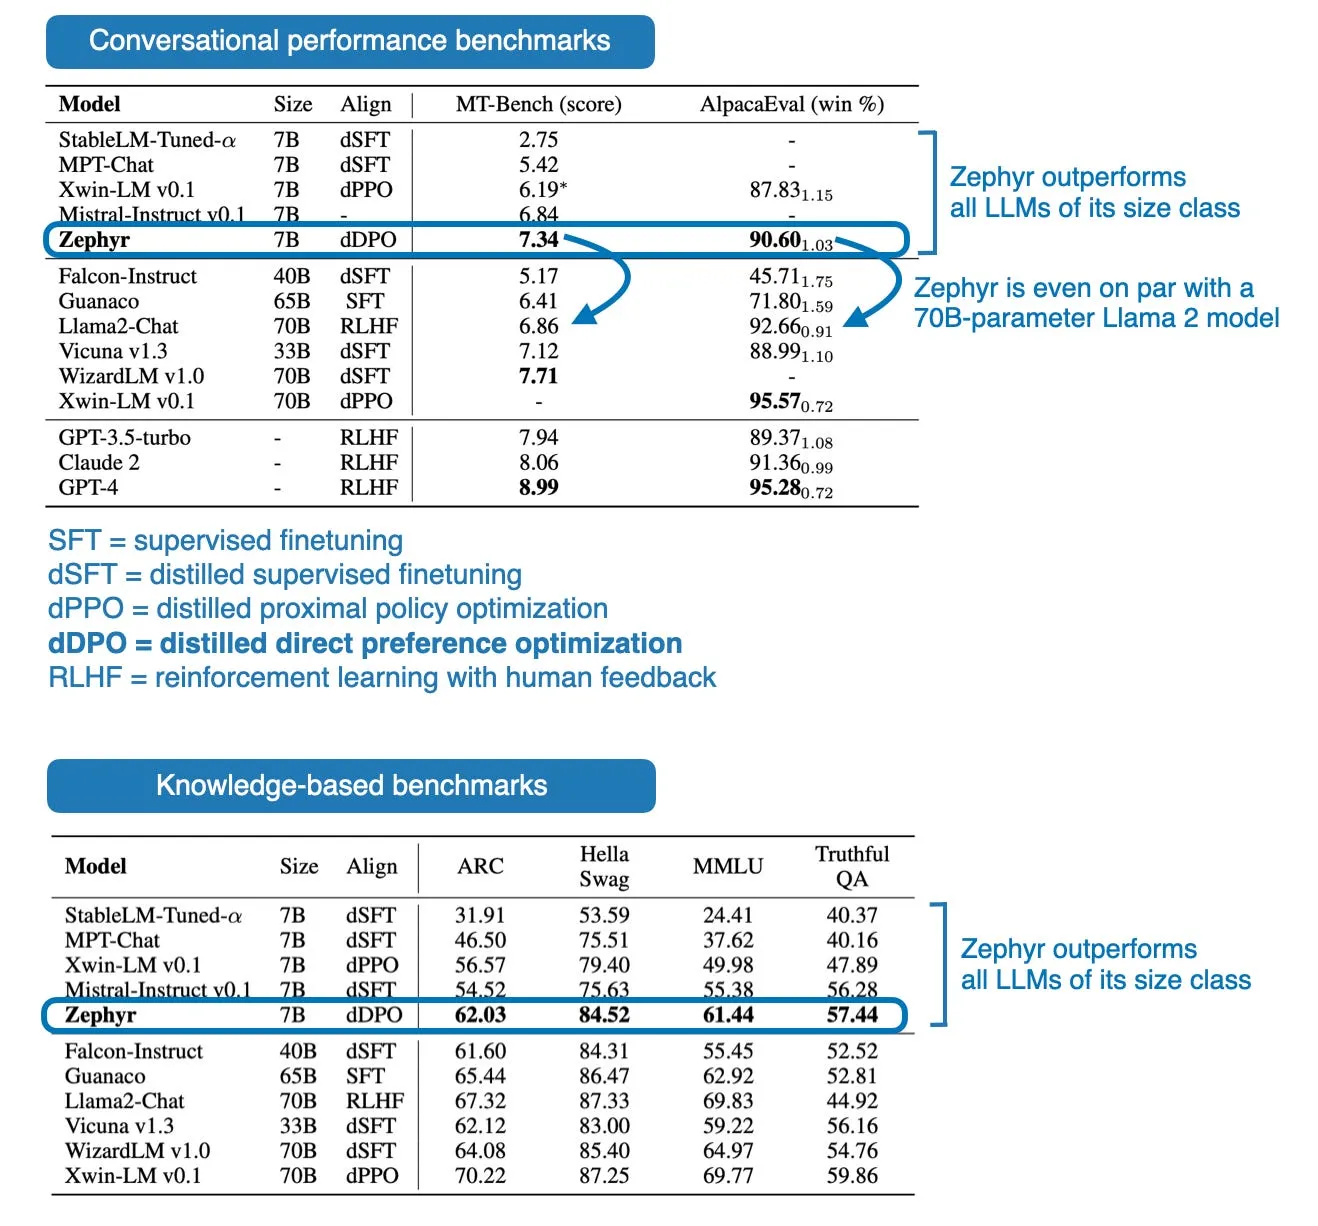
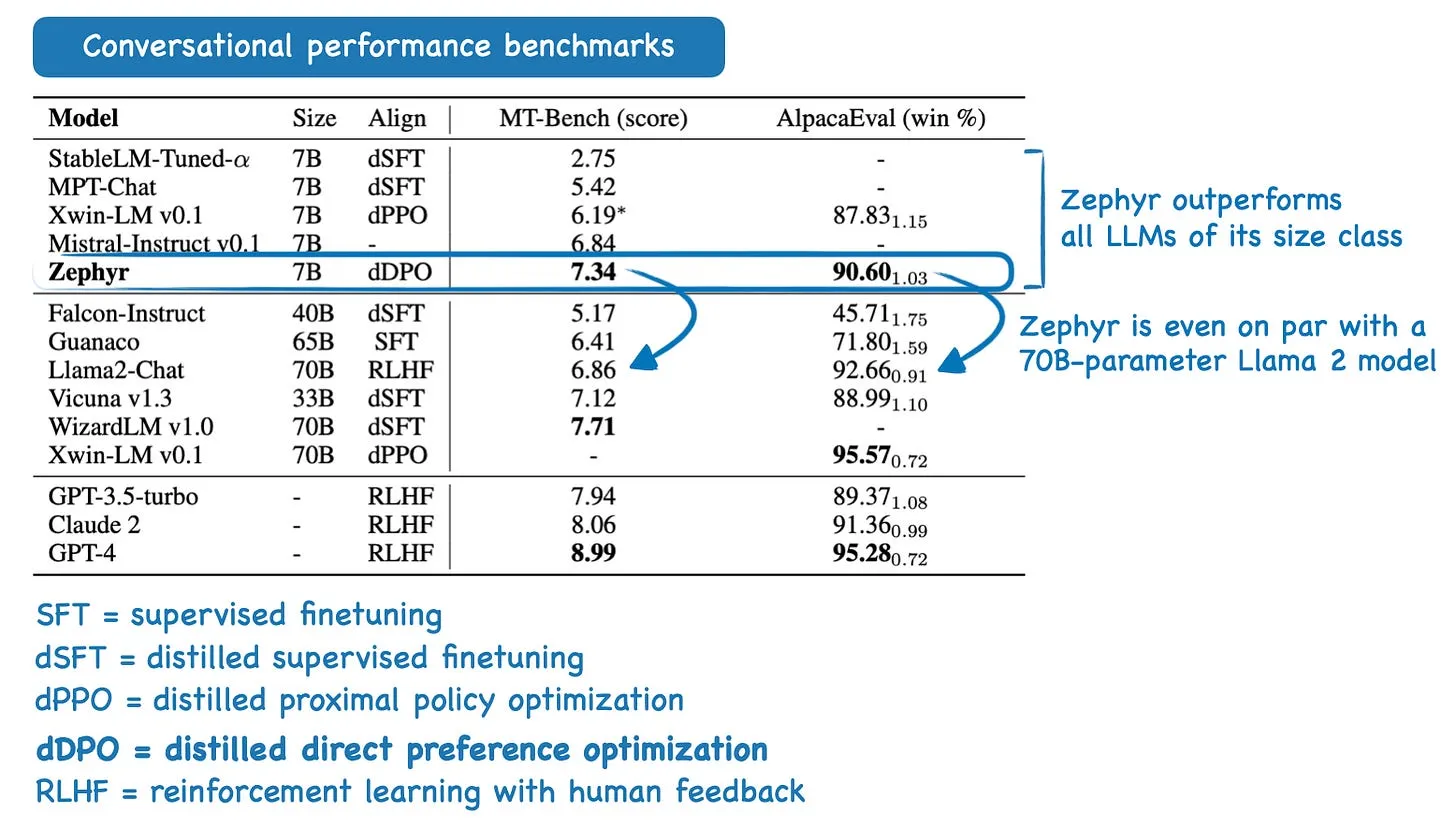
如下方性能表格所示,70亿参数的Zephyr模型在发布时,在同规模模型中表现超越所有其他模型。更令人印象深刻的是,在对话类基准测试https://arxiv.org/abs/2306.05685 上,Zephyr-7B甚至超越了参数规模是它10倍的700亿参数Llama 2对话模型。

figure11
来自https://arxiv.org/abs/2310.16944 的Zephyr模型(经DPO微调的大语言模型)带注释基准测试结果

总而言之,DPO论文的吸引力在于其方法的简洁性。除了Llama 2等少数例外,采用RLHF训练的对话模型十分稀少,这很大程度上归因于RLHF方法的复杂性。有鉴于此,我认为未来一年DPO模型的应用会愈发广泛,这一判断是合理的。

6) Mistral 7B

必须承认,https://arxiv.org/abs/2310.06825 这篇论文篇幅简短,并不在我最喜爱的论文之列。但它提出的模型却产生了相当大的影响力。

我决定将这篇论文纳入榜单,是因为Mistral 7B模型不仅在发布时大受欢迎,还作为基础模型催生了另外两个知名模型:Zephyr 7B与最新的Mistral混合专家(MoE)模型。这些模型很好地代表了我所预见的、至少在2024年上半年小型大语言模型的发展趋势。

在讨论Zephyr 7B与Mistral MoE模型之前,我们先简要聊聊Mistral 7B本身。

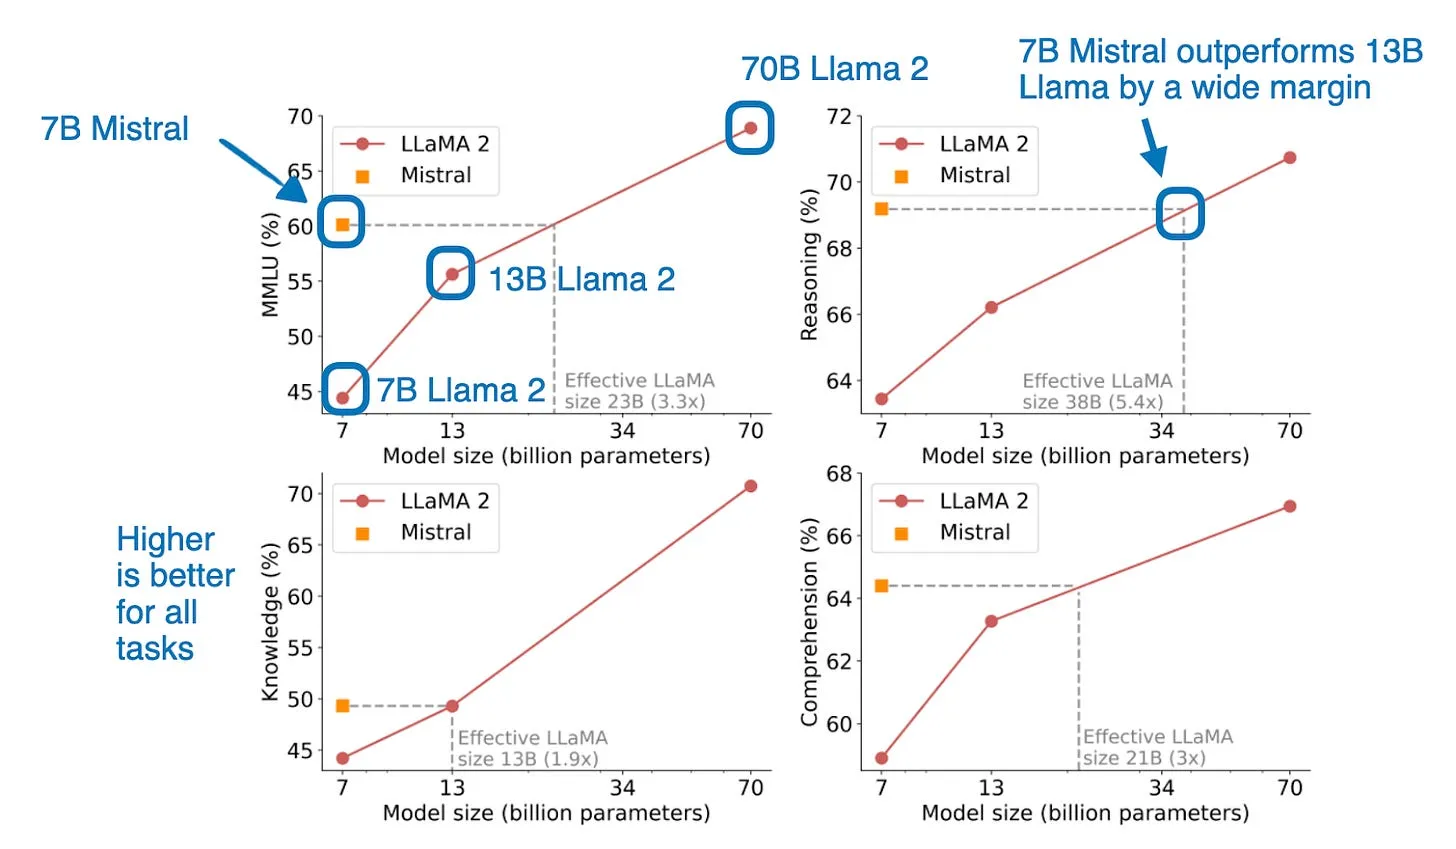
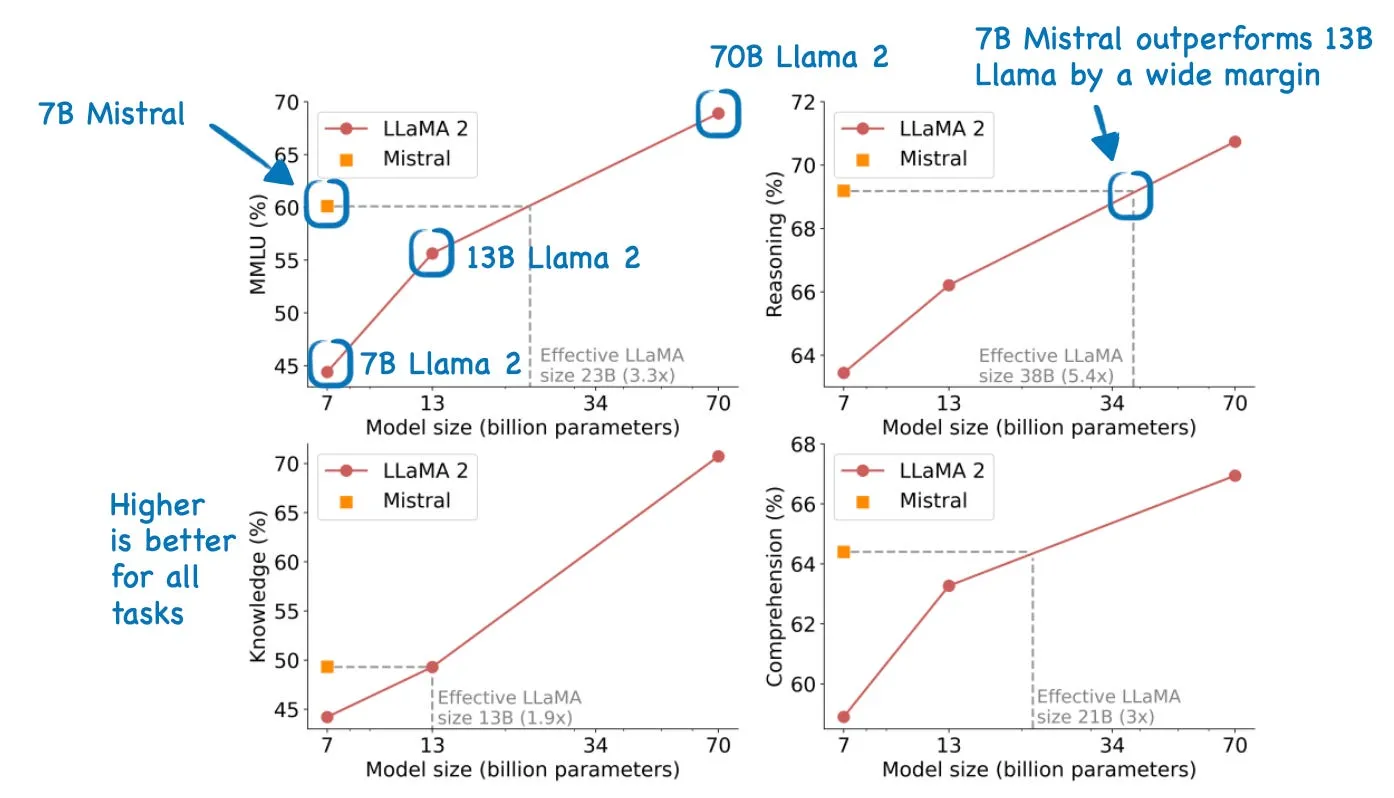
简而言之,Mistral 7B论文提出了一个紧凑而强大的语言模型:尽管仅有70亿参数的适中规模,它在各类基准测试中却超越了更大的模型,比如130亿参数的Llama 2模型。(除了规模是它两倍的https://github.com/QwenLM/Qwen 之外,Mistral 7B也是今年https://llm-efficiency-challenge.github.io/leaderboard 竞赛优胜方案所采用的基础模型。)

figure12
来自https://arxiv.org/abs/2310.06825 的带注释图,对比Mistral 7B与Llama 13B的性能

它为何如此出色,确切原因尚不清楚,但很可能得益于其训练数据。Llama 2与Mistral均未公开训练数据,因此我们只能推测。

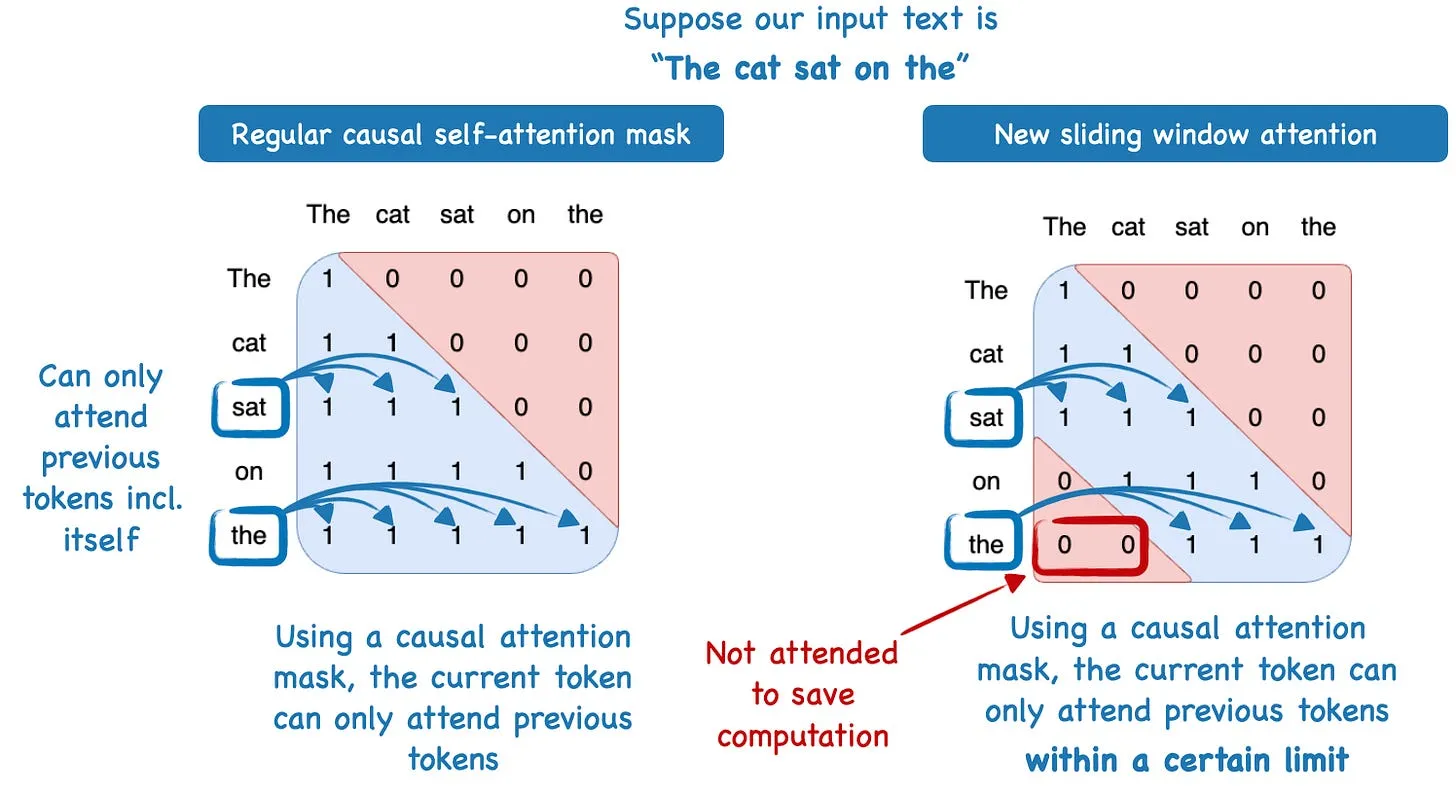
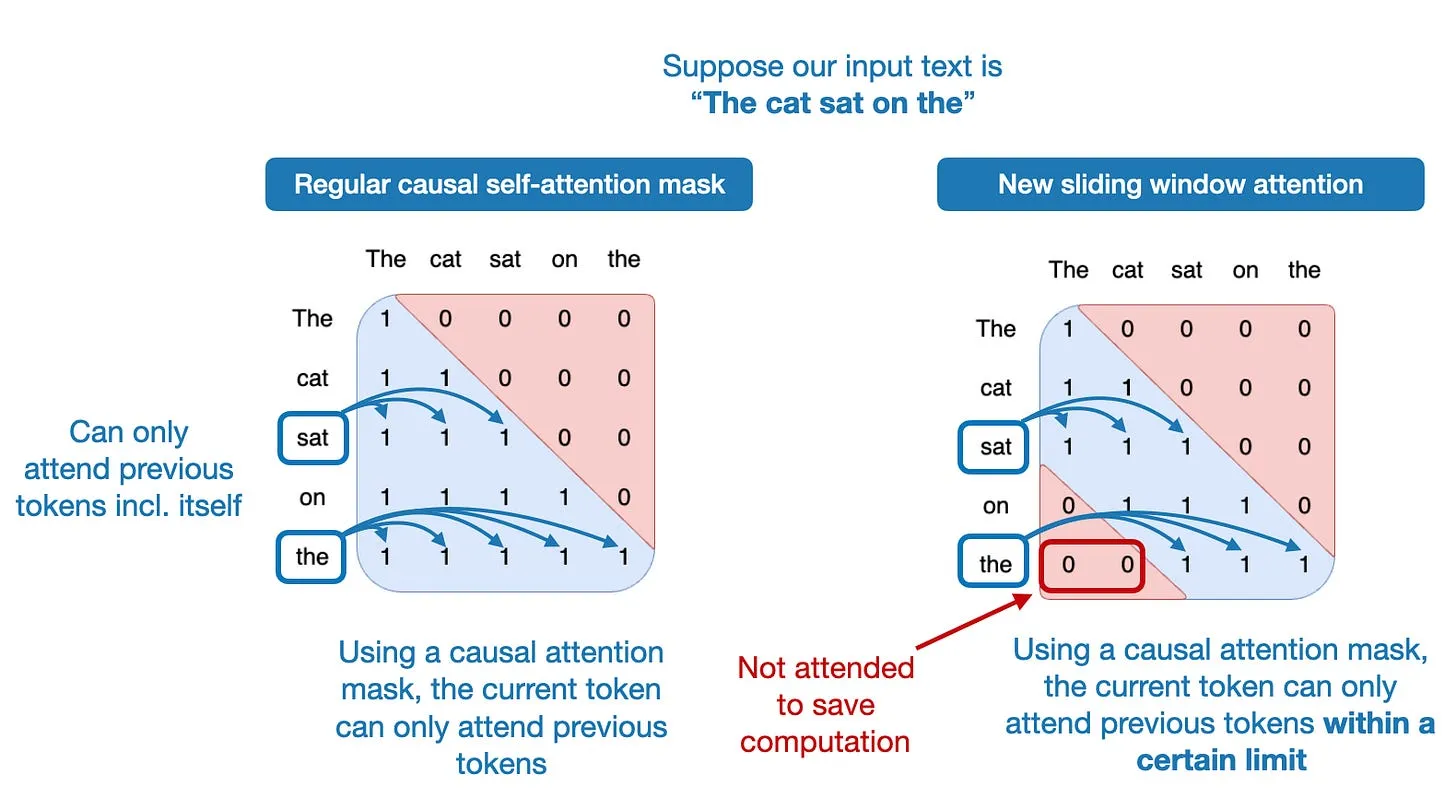
架构层面,该模型与Llama 2一样采用分组查询注意力。尽管与Llama 2非常相似,但Mistral架构的一个有趣新增特性是滑动窗口注意力,它能够节省内存、提升计算吞吐量,从而加快训练速度。(滑动窗口注意力此前已在https://arxiv.org/abs/1904.10509 与https://arxiv.org/abs/2004.05150 中被提出。)

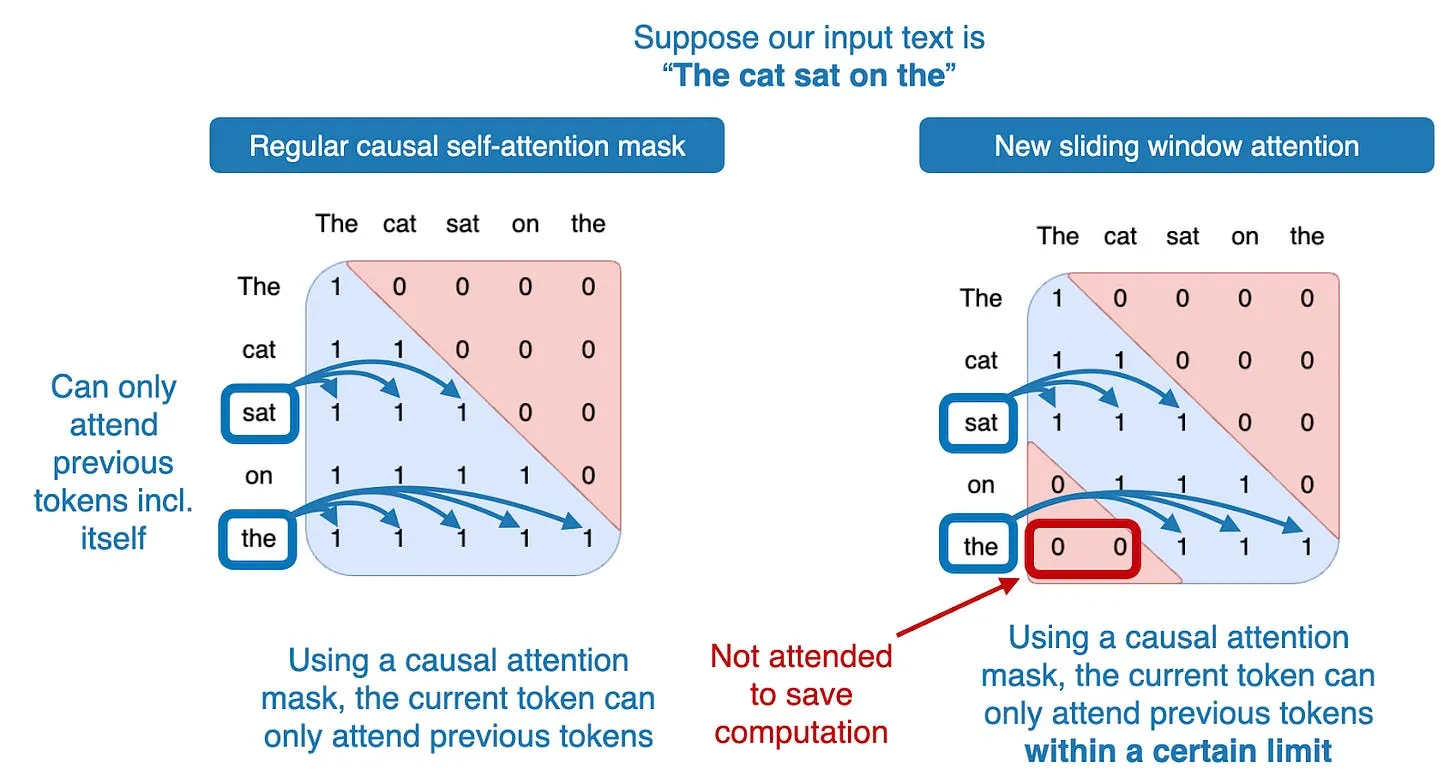
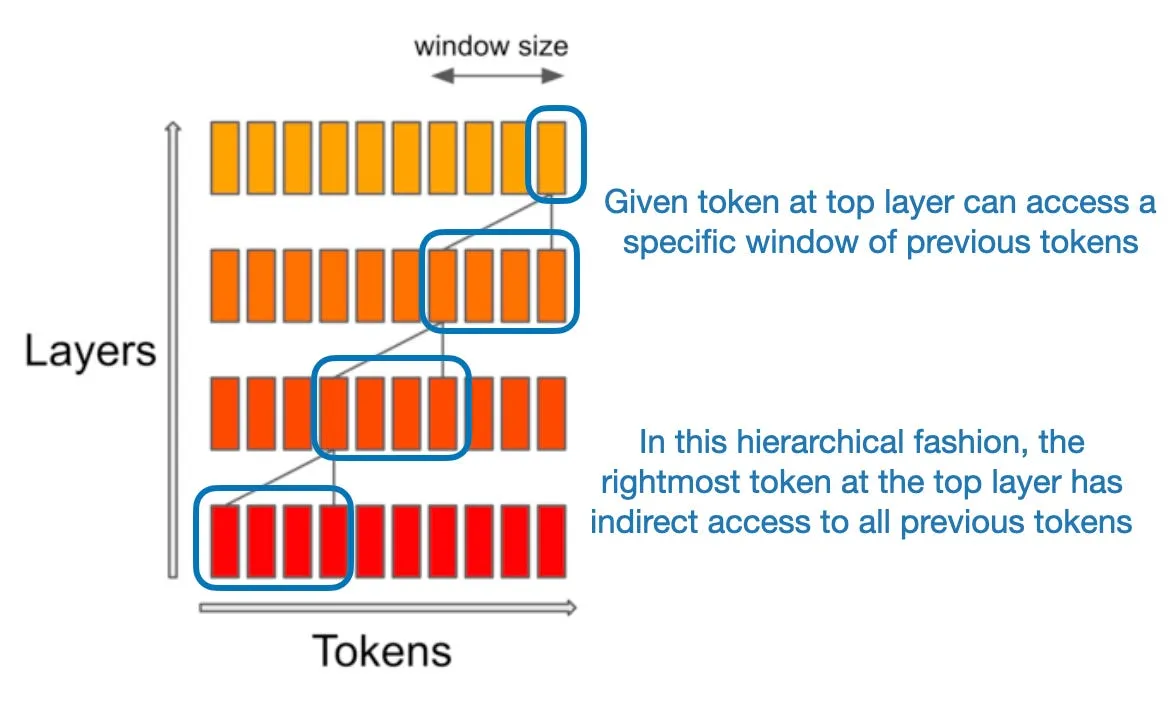
Mistral所采用的滑动窗口注意力机制,本质上是一个固定大小的注意力块,让当前token仅能关注特定数量的之前token(而非所有之前的token),如下图所示。

figure13
来自https://arxiv.org/abs/2310.06825 的带注释图,解释滑动窗口注意力机制

具体到7B Mistral,注意力块大小为4096个token,研究者训练模型时的上下文长度可达10万token。举个具体的例子:在常规自注意力中,模型处理第50000个token时,可以关注之前全部49999个token。而在滑动窗口自注意力中,Mistral模型仅能关注第45904到50000个token(因为50000 – 4096 = 45904)。
不过,滑动窗口注意力主要用于提升计算性能。Mistral能够超越更大的Llama 2模型,大概率不是因为滑动窗口注意力,而恰恰是在采用滑动窗口注意力的情况下依然实现了超越。

Zephyr与Mixtral

Mistral 7B极具影响力的原因之一,是它作为Zephyr 7B的基础模型——正如前文DPO部分所提到的。Zephyr 7B是首个采用DPO训练且表现超越其他方案的热门模型,它可能为DPO成为未来数月对话模型微调的首选方法奠定了基础。

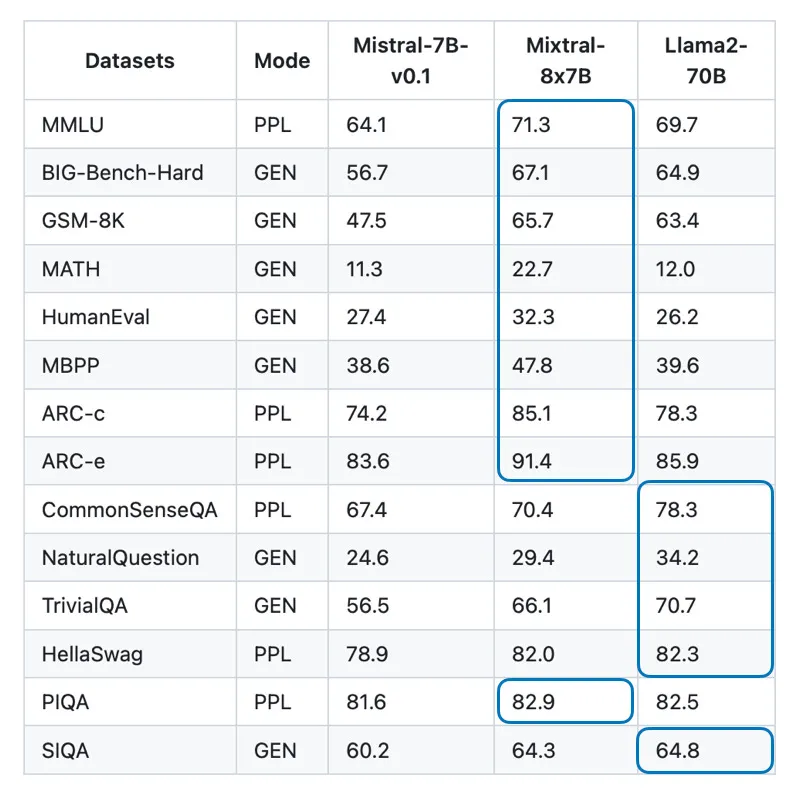
另一个源自Mistral 7B的值得关注的模型,是最近发布的https://mistral.ai/news/mixtral-of-experts/ ,也称为Mixtral-8x7B。该模型在多个公开基准测试中,性能追平甚至超越了更大的Llama-2-70B。

figure14
OpenCompass基准测试结果,来自https://github.com/open-compass/MixtralKit。蓝色方框标出了每行中的最优结果。

更多基准测试结果可参见官方页面:https://mistral.ai/news/mixtral-of-experts/ 。该团队还发布了Mixtral-8x7B-Instruct模型,采用DPO进行微调(不过截至撰写本文时,尚无基准测试将其与经过RLHF微调的Llama-2-70-Chat做对比)。

figure15
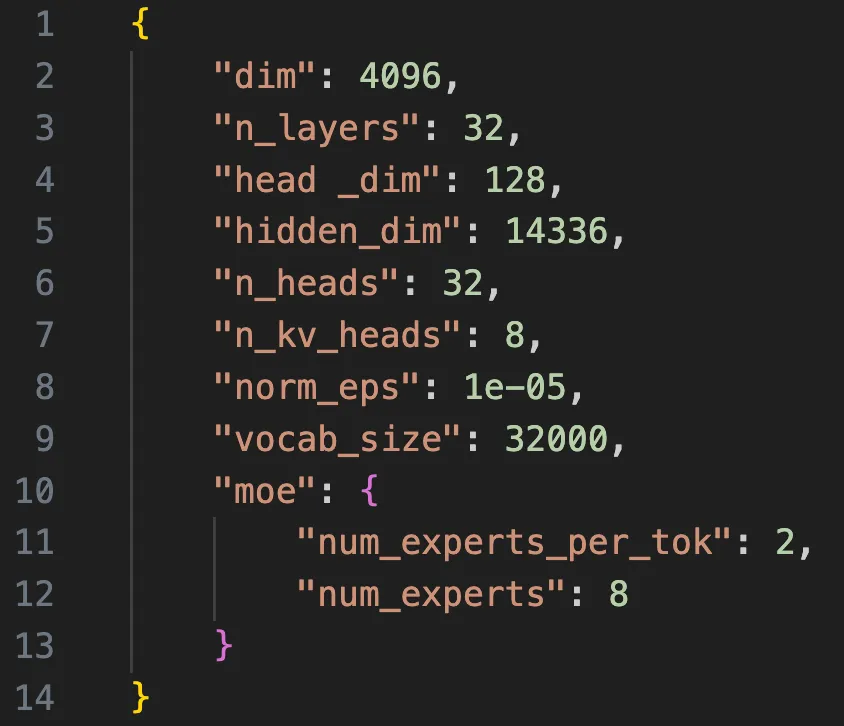
Mixtral架构概览,基于Mistral团队最初通过社交媒体磁力链接分享的param.json文件

有传闻称GPT-4也是一个混合专家模型,由16个子模块组成。据传这16个子模块每个都有110亿参数(作为参考,GPT-3有1750亿参数)。如果你大约两个月前读过我的文章https://magazine.sebastianraschka.com/p/ai-and-open-source-in-2023 ,我曾提到“看看2024年混合专家方法能否将开源模型提升到新高度,会很有意思”。看起来Mixtral早早开启了这一趋势,而我确信这仅仅是个开始。

混合专家模型入门

如果你对混合专家模型还不熟悉,这里做个简要说明。

figure16
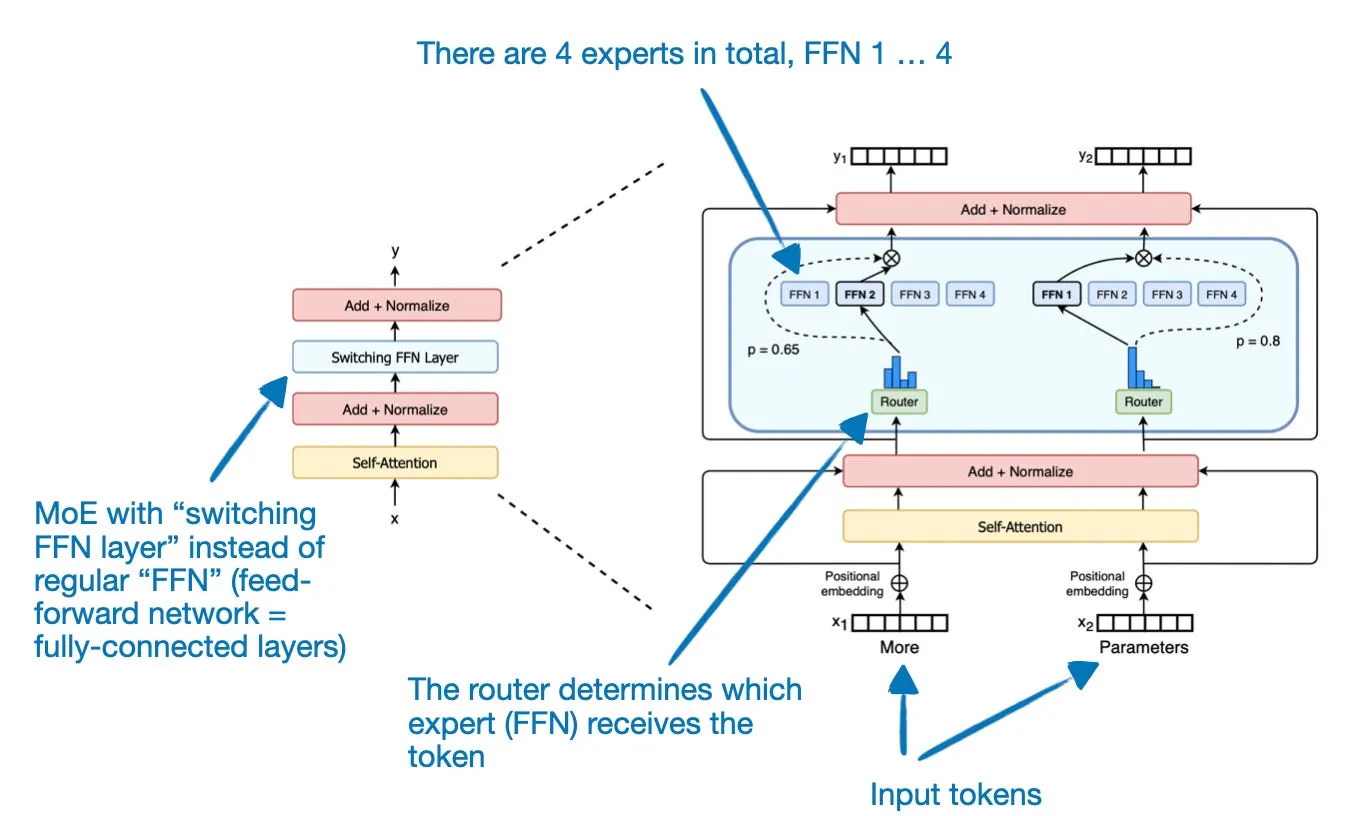
来自Switch Transformer论文(https://arxiv.org/abs/2101.03961)的带注释图,解释混合专家架构

上图展示了Switch Transformer的架构,它每个token使用1个专家,总共有4个专家。而Mixtral-8x-7B则包含8个专家,每个token使用2个专家。

为什么采用混合专家架构?综合来看,像Mixtral这样的7B级模型中的8个专家,总参数量仍约为560亿。实际上,实际数值低于560亿,因为混合专家方法仅应用于前馈网络(FFN,即全连接层),而非自注意力权重矩阵。因此,总参数量更可能在400-500亿之间。

注意,路由器会对token进行路由分配,使得前向传播时每次仅激活不到140亿参数(2×小于70亿,而非全部560亿),因此训练(尤其是推理)速度会比传统的非混合专家方法更快。

如果你想了解更多关于混合专家模型的内容,这里是https://twitter.com/sophiamyang 推荐的阅读清单:
https://arxiv.org/abs/1701.06538
https://arxiv.org/abs/2006.16668
https://arxiv.org/abs/2211.15841
https://arxiv.org/abs/2305.14705

此外,如果你想试用混合专家大语言模型,也可以看看https://github.com/XueFuzhao/OpenMoE 仓库,它在今年早些时候实现并开源了混合专家大语言模型。

其他小型但竞争力强的大语言模型

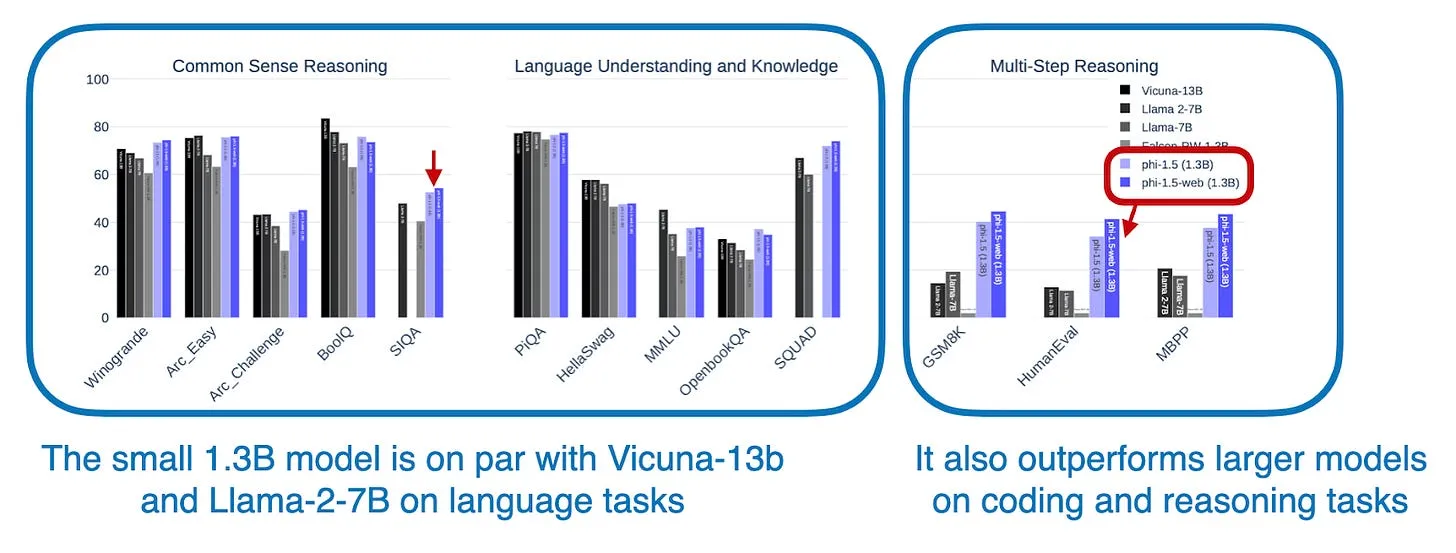
Mistral 7B、Zephyr 7B与Mixtral-8x7B是2023年小型但高性能、且权重开源的模型取得进展的绝佳范例。另一个值得一提的模型、也是我个人榜单的亚军,是微软的phi系列。

phi系列的秘诀在于,通过过滤网络数据得到高质量数据(被称为“教科书级数据”)进行训练。

phi系列模型在2023年分阶段发布,包括phi-1(13亿参数)、phi-1.5(13亿参数)与phi-2(27亿参数)。其中phi-2于两周前刚刚发布,据称尽管规模仅为Mistral 7B的一半,性能却追平甚至超越了后者。

figure17
13亿参数的phi-1.5模型与各类70亿参数模型的对比(来自phi-1.5论文https://arxiv.org/abs/2309.05463)

想了解更多phi模型的信息,推荐以下资源:
https://arxiv.org/abs/2306.11644 —— phi-1论文
https://arxiv.org/abs/2309.05463
https://www.microsoft.com/en-us/research/blog/phi-2-the-surprising-power-of-small-language-models/ 官方发布公告

7) Orca 2:教小语言模型学会推理

https://arxiv.org/abs/2311.11045 是一篇相对较新的论文,未来它会对我们未来数月乃至数年训练大语言模型的方式产生多大影响,还有待时间检验。

我决定将它纳入榜单,是因为它融合了多个概念与思路。

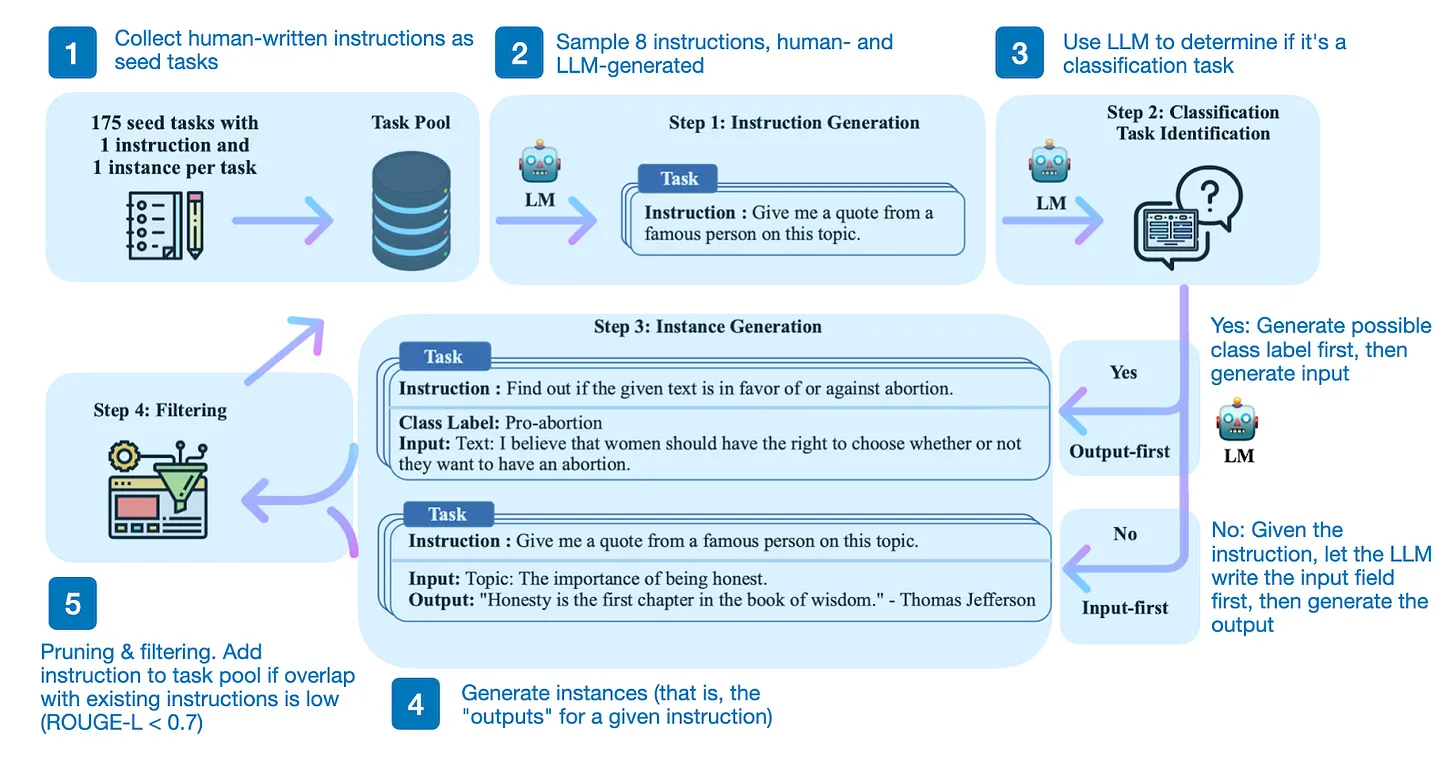
其中一个思路是从GPT-4等大型高性能模型中蒸馏数据,创建合成数据集来训练小型但高性能的大语言模型。这一思路在去年发表的Self-Instruct论文中已有阐述。今年早些时候,Alpaca(一个在ChatGPT输出上微调的Llama模型)真正让这种方法流行开来。

它的工作原理是什么?简而言之,这是一个4步流程:

  1. 用一组人工编写的指令(本研究中为175条)与示例指令初始化任务池;
  2. 用预训练大语言模型(如GPT-3)确定任务类别;
  3. 给定新指令,让预训练大语言模型生成回复;
  4. 对回复进行收集、修剪与过滤,再加入任务池。

figure18
基于Self-Instruct论文https://arxiv.org/abs/2212.10560 的带注释图

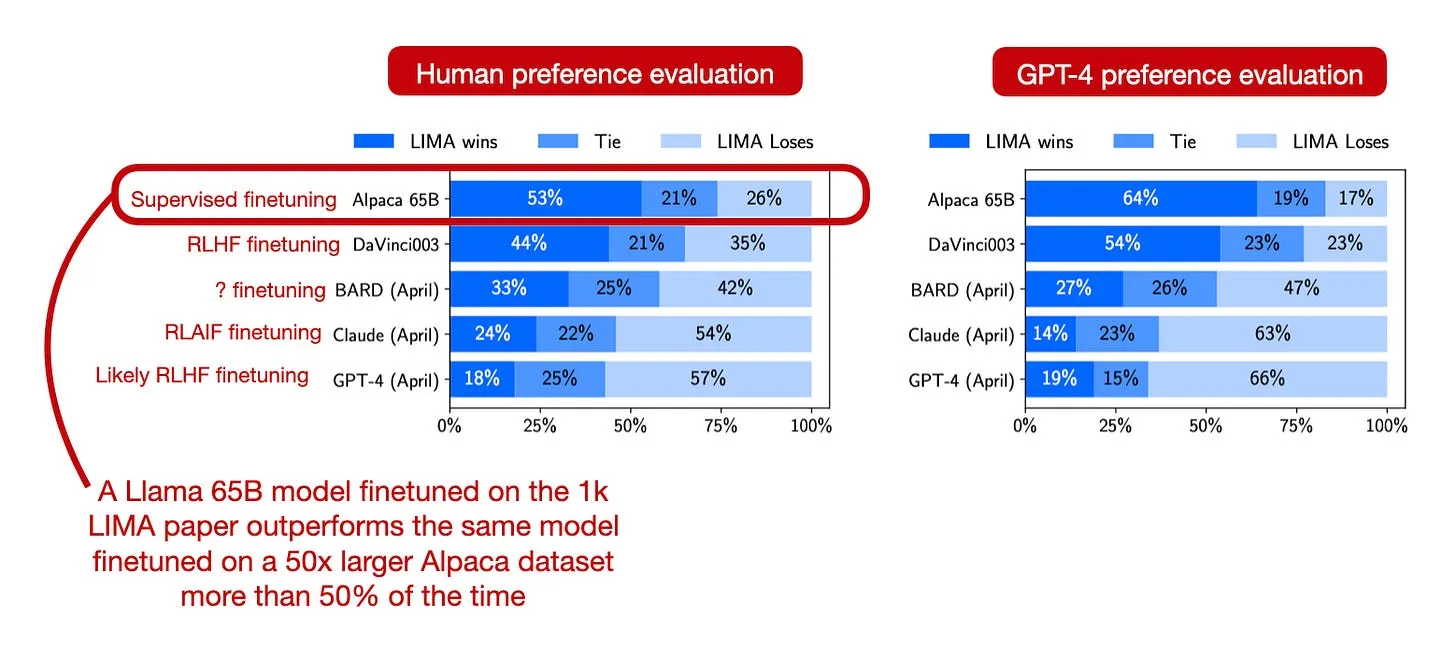
另一个思路或许并不令人意外,但值得强调:高质量数据对微调至关重要。例如,https://arxiv.org/abs/2305.11206 提出了一个人工生成的高质量数据集,仅包含1000个训练样本,用其微调后的模型,性能优于在5万条ChatGPT生成回复上微调的同一模型。

figure19
来自LIMA论文https://arxiv.org/abs/2305.11206 的带注释图

与以往严重依赖模仿学习来复制更大模型输出的研究不同,Orca 2旨在教“小型”(即70亿与130亿参数)大语言模型掌握各类推理技巧(如逐步推理、回忆后生成等),并帮助它们确定每个任务最有效的策略。这一方法让Orca 2的表现明显优于同规模模型,甚至能达到5-10倍规模模型的性能水平。

figure20
Orca 2论文https://arxiv.org/abs/2311.11045 中评估的众多基准测试任务的子集

尽管我们尚未看到广泛的相关研究,但Orca 2的方法或许也能解决https://arxiv.org/abs/2305.15717 论文中强调的合成数据问题。该研究中,研究者们探究了用Alpaca、Self-Instruct等方法,让较弱的语言模型模仿ChatGPT等更强的闭源模型。最初,这些模仿模型表现亮眼,指令遵循能力出色,众包标注者给出的评分也与ChatGPT相当。但后续更多评估发现,这些模仿模型只是在人类观察者看起来表现好,生成的回复却常常存在事实错误。

8) 大规模下卷积神经网络与视觉Transformer性能相当

近年来,由于Transformer的出色性能,我几乎只研究大语言Transformer或视觉Transformer(ViT)。

最后三篇我们切换到计算机视觉领域的论文。我觉得计算机视觉Transformer尤其吸引人的一点是,预训练的视觉Transformer甚至比卷积神经网络更易于微调。(我今年早些时候在CVPR的一个动手实践讲座中做过总结,见:https://magazine.sebastianraschka.com/p/accelerating-pytorch-model-training)

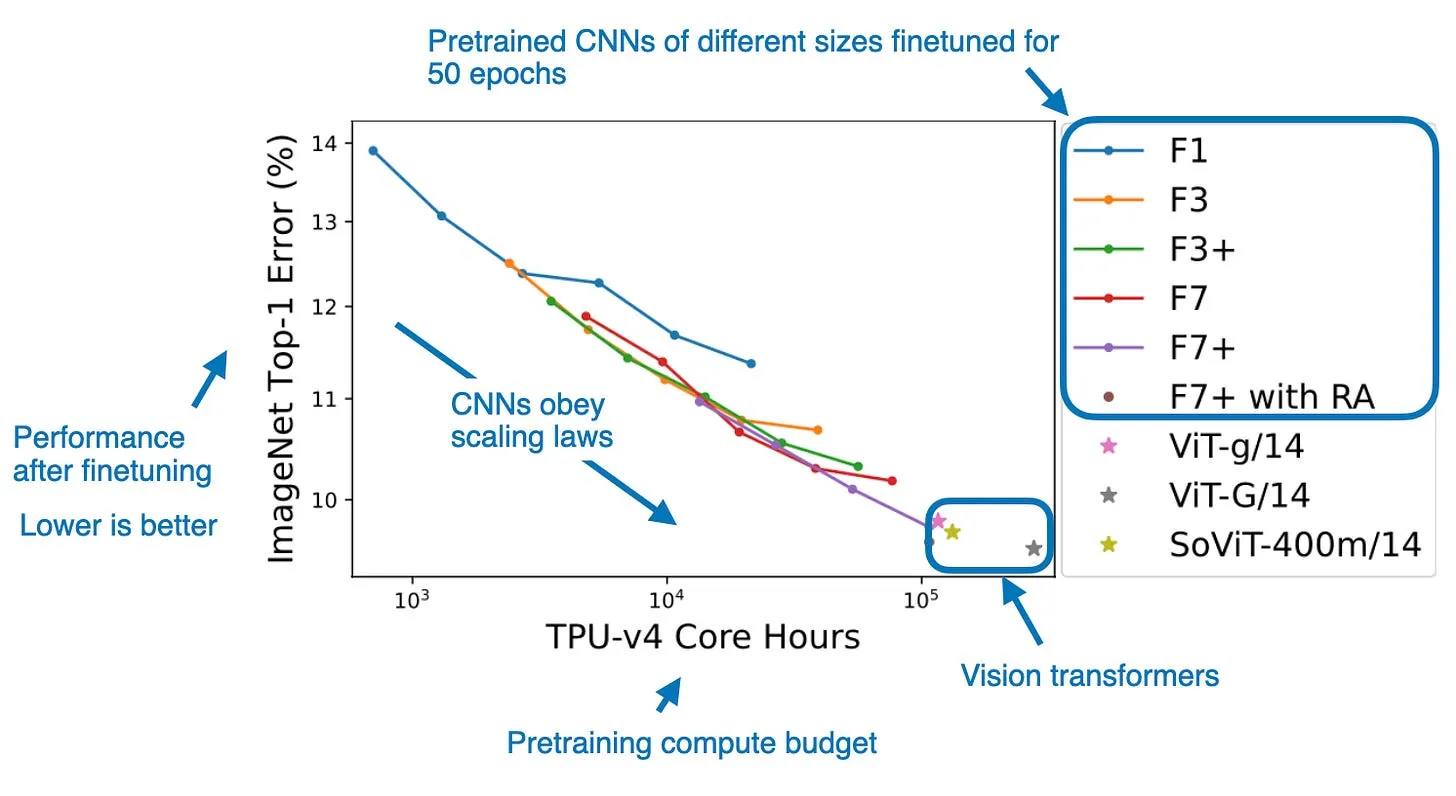
令我意外的是,我偶然发现了https://arxiv.org/abs/2310.16764 这篇论文,它表明当拥有足够大的数据集时,卷积神经网络(CNN)实际上与视觉Transformer具有竞争力。

figure21
来自《大规模下卷积神经网络与视觉Transformer性能相当》(https://arxiv.org/abs/2310.16764)论文的带注释图

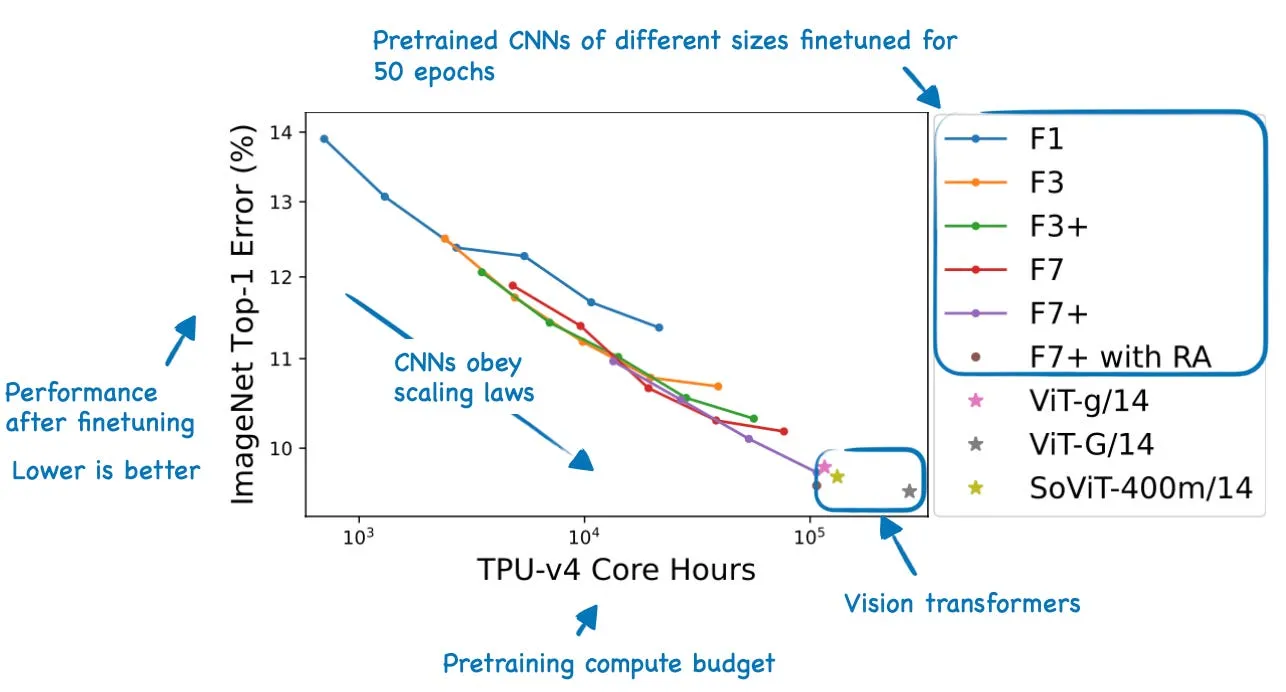
该研究中,研究者投入了最高达11000 TPU小时的计算预算,对视觉Transformer与卷积神经网络进行了公平对比。结果表明,当卷积神经网络的预训练计算预算与视觉Transformer的常用预算相当时,二者性能可以持平。为此,他们在JFT的40亿张标注图像上进行预训练,随后在ImageNet上微调模型。

9) Segment Anything

图像与视频中的目标识别与分割,以及分类与生成建模,是计算机视觉的主要研究方向。

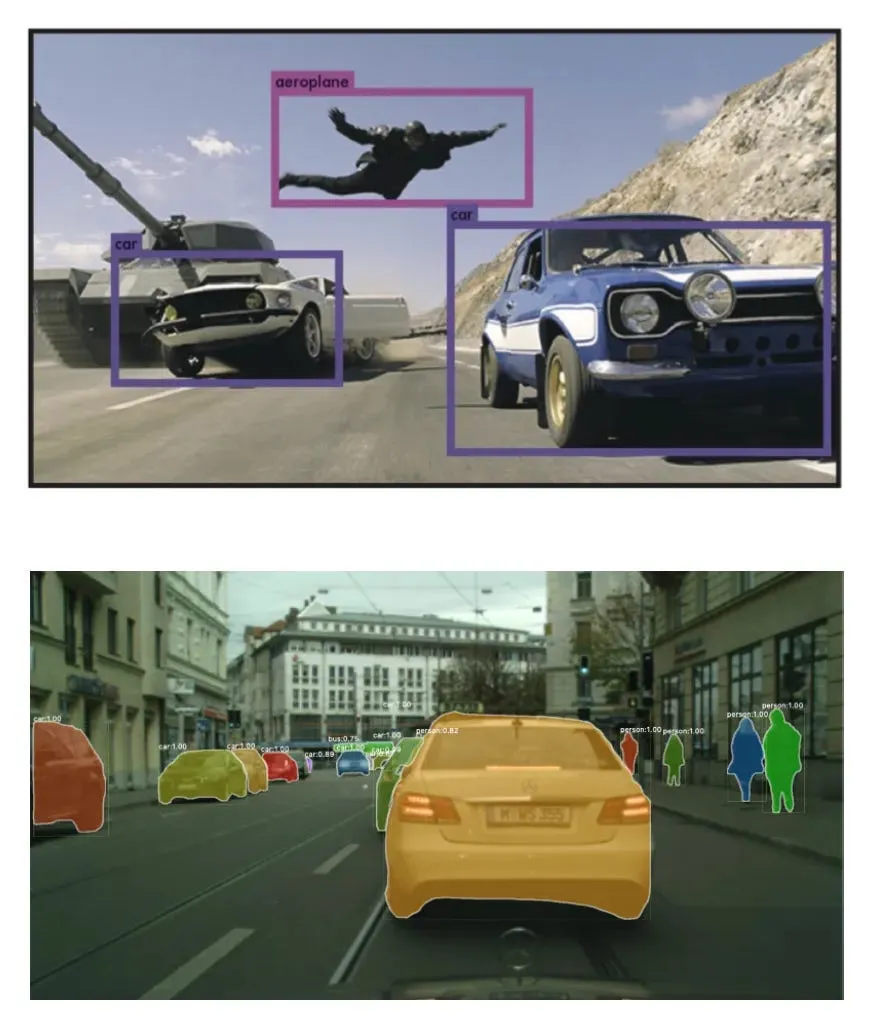
先简要说明这两个任务的区别:目标检测是预测边界框及对应的类别标签;分割则是对每个像素进行分类,以区分前景与背景物体。

figure22
目标检测(上)与分割(下)。图分别来自YOLO论文(https://arxiv.org/abs/1506.02640)与Mask R-CNN论文(https://arxiv.org/abs/1703.06870v3)

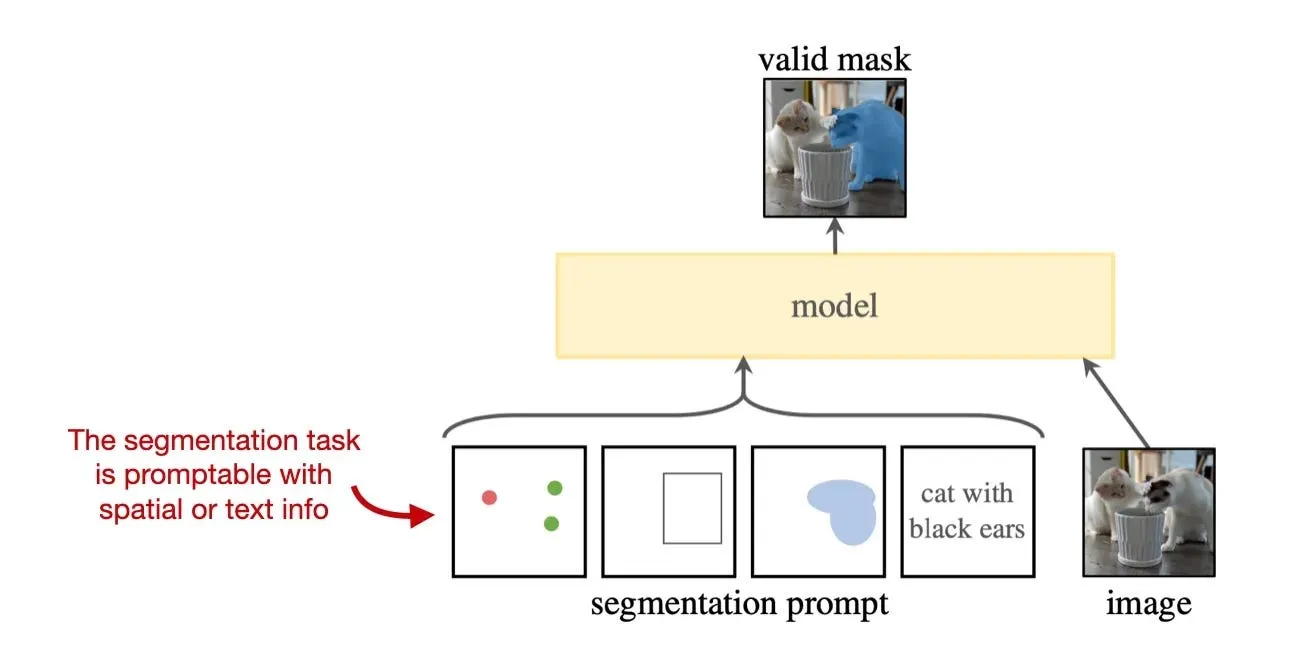
Meta的https://arxiv.org/abs/2304.02643 论文是开源与图像分割研究领域的重要里程碑。该论文提出了图像分割的新任务、新模型与新数据集。随附的图像数据集是迄今为止最大的分割数据集,包含1100万张图像上的超过10亿个掩码。

figure23
Segment Anything模型(SAM)专为高效、基于提示的图像分割而设计。图为Segment Anything论文https://arxiv.org/abs/2304.02643 的带注释截图

而尤为难得、值得称赞的是,研究者们使用的是获得授权且尊重隐私的图像,因此该模型可以开源,而不会存在重大版权问题。

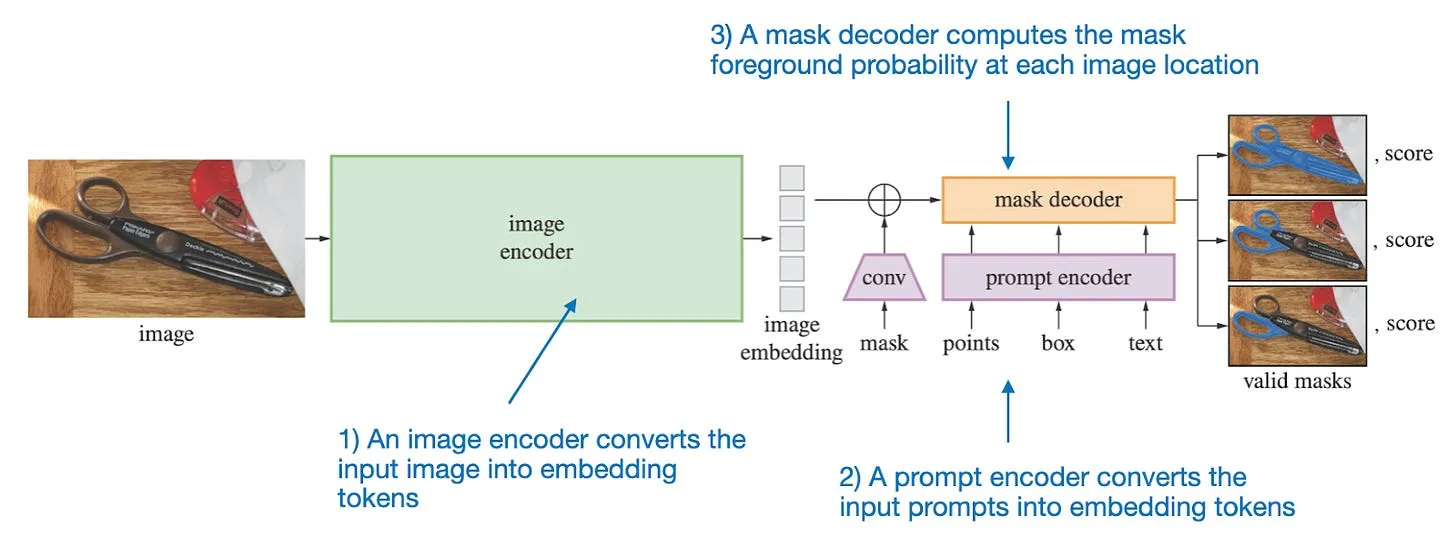
Segment Anything模型(SAM)由三个主要组件组成,如上方带注释图所总结。

figure24
Segment Anything模型的三个主要组件,来自https://arxiv.org/abs/2304.02643

更详细地说,三个组件可总结如下:

  1. 图像编码器:采用基于预训练视觉Transformer(ViT)的掩码自动编码器,可处理高分辨率输入。该编码器每张图像仅运行一次,可在向模型输入提示前完成计算。
  2. 提示编码器:处理两类提示:稀疏提示(点、框、文本)与密集提示(掩码)。点与框通过位置编码结合每种提示类型的可学习嵌入来表示;自由格式文本则使用CLIP的现成文本编码器。密集提示即掩码,通过卷积进行嵌入,并与图像嵌入逐元素相加。
  3. 掩码解码器:将图像嵌入、提示嵌入与输出token映射为掩码。它采用解码器式Transformer架构,计算每个图像位置的掩码前景概率。

图像分割对于自动驾驶、医学影像等诸多应用都至关重要。在短短6个月时间里,这篇论文的引用量已达https://scholar.google.com/scholar?cites=1574144728855576863&as_sdt=5,39&sciodt=0,39&hl=en ,并且已有大量项目基于这篇论文展开。

10) 对齐你的潜在向量:基于潜在扩散模型的高分辨率视频合成

https://arxiv.org/abs/2311.10709 是Meta研究部门的另一个知名计算机视觉项目。

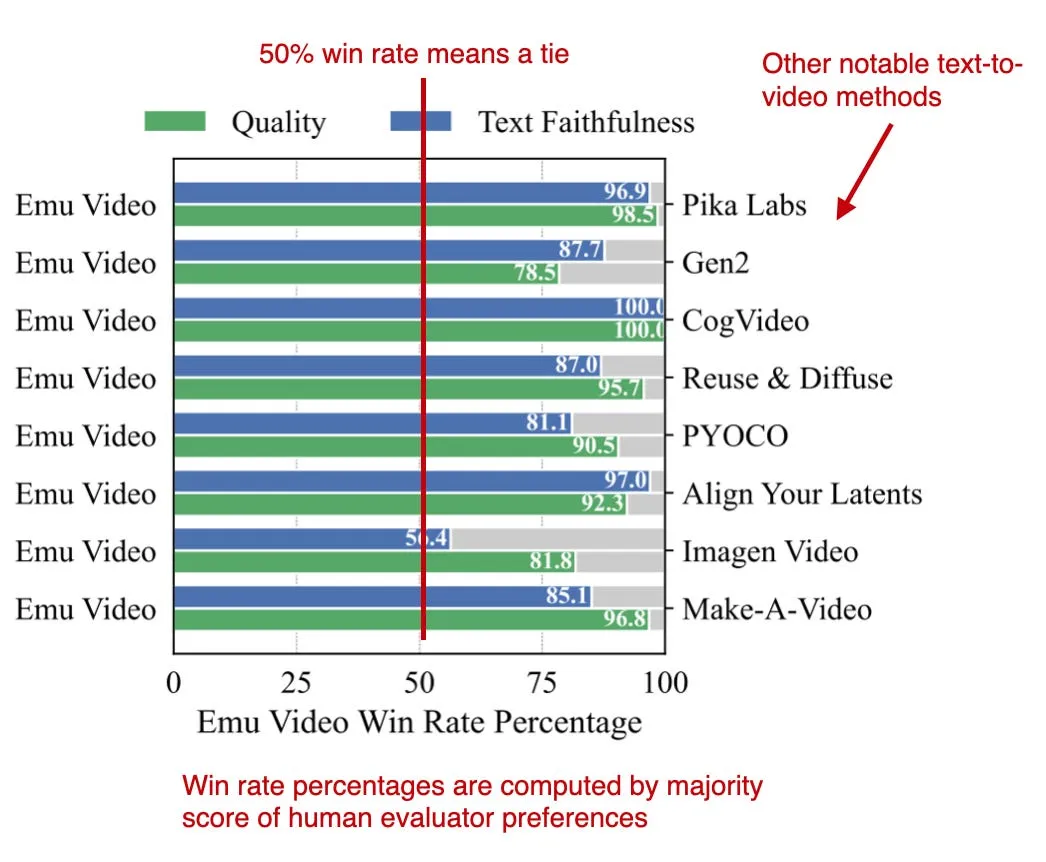
Emu是一个文本生成视频模型,可以根据文本提示生成完整视频。

尽管它并非首个实现出色文本生成视频效果的模型,但与此前的工作相比,它的表现十分优异。

figure25
Emu与其他文本生成视频模型的性能对比,来自https://arxiv.org/abs/2311.10709

正如作者们所指出的,与此前的方法相比,Emu的架构设计相对简洁。其核心思路之一是,Emu将生成过程拆解为两步:首先根据文本生成图像(采用扩散模型),然后同时基于文本与生成的图像生成视频(采用另一个扩散模型)。

2022年是DALL-E 2、Stable Diffusion、Midjourney等文本生成图像模型的大年。尽管2023年文本生成图像模型仍然非常流行(虽然大语言模型占据了全年大部分关注度),但我认为,文本生成视频模型即将在未来一年的线上社区中变得更加普及。

由于我并非图像或视频设计师,目前暂时没有这些工具的使用场景;不过,作为衡量计算机视觉领域进展的通用指标,文本生成图像与文本生成视频模型的发展仍然值得关注。

这本杂志是个人兴趣项目,不提供直接报酬。不过,如果您愿意支持我的创作,欢迎购买https://sebastianraschka.com/books 上的书籍。如果您觉得这些书有洞见、有帮助,也欢迎推荐给您的朋友与同事。

figure26
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 http://mng.bz/M96o

您的支持意义重大!谢谢!

【转载】应对幻觉问题、提升推理能力与Transformer架构新洞察

原文地址:Tackling Hallucinations, Boosting Reasoning Abilities, and New Insights into the Transformer Architecture,by Sebastian Raschka, on 2023-12-09

应对幻觉问题、提升推理能力与Transformer架构新洞察

本月,我想重点介绍三篇论文,它们分别针对大语言模型(LLM)三类不同的问题展开研究:

  • 减少幻觉现象
  • 提升开源小型模型的推理能力
  • 深化对Transformer架构的理解,并探索其简化可能

减少幻觉之所以重要,是因为尽管GPT-4这类大语言模型已被广泛用于知识生成,但它们仍会生成看似合理却存在错误的信息。
提升小型模型的推理能力同样意义重大。当前,在处理诸多任务时,ChatGPT与GPT-4(相较于私有或个人大语言模型)依然是我们的首选方案。提升这些小型模型的推理能力,是缩小开源模型与当前前沿闭源模型差距的途径之一。
最后,深化对Transformer架构的理解,是掌握大语言模型训练动态的基础。这些知识有望催生更简洁、更高效的模型,提升开源模型的性能,甚至可能为新的架构创新铺平道路。

1)针对事实性微调语言模型

大语言模型(LLM)常受幻觉问题困扰,即会生成看似可信但事实有误的内容。在将大语言模型用于知识类问答场景时,这个问题尤为突出,因为用户需要手动对回复进行事实核查。这一过程耗时耗力,对于某些查询来说,甚至会让使用大语言模型的意义大打折扣。

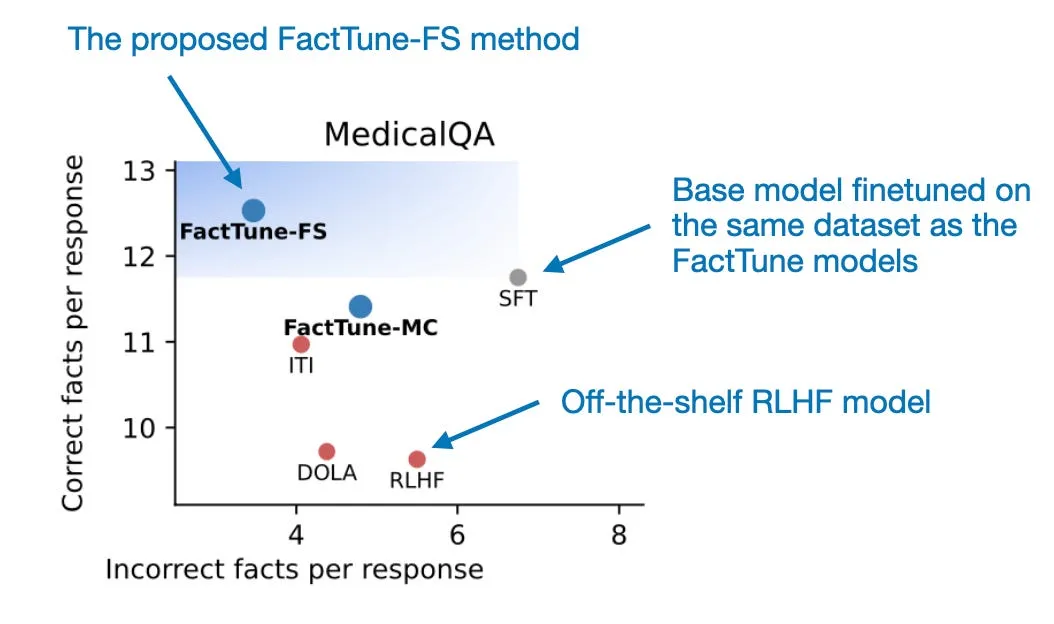
在论文https://arxiv.org/abs/2311.08401中,作者提出利用https://arxiv.org/abs/2305.18290(DPO,直接偏好优化)的微调方法来降低幻觉发生率。通过对7B参数的Llama 2模型使用该方法进行微调,与原始Llama-2-chat模型相比,其事实错误率降低了58%。

figure01
摘自论文https://arxiv.org/abs/2311.08401的带标注图表,显示该方法在事实错误率方面优于其他方案。

关于幻觉

这一点在论文中并未展开讨论。但在深入探讨论文内容之前,我们有必要先了解大语言模型的训练与推理机制,它们带来了两方面挑战。在预训练阶段,低质量的数据集可能会让大语言模型吸收事实错误的信息。
其次,在推理阶段,我们会使用温度参数和采样方法,让大语言模型变换句式结构,避免每次生成完全相同的文本。这种机制避免了模型单纯像数据库查询一样输出内容,但同时,也没有机制能保证哪些词元应该采样生成、哪些应该直接沿用训练集中的内容。

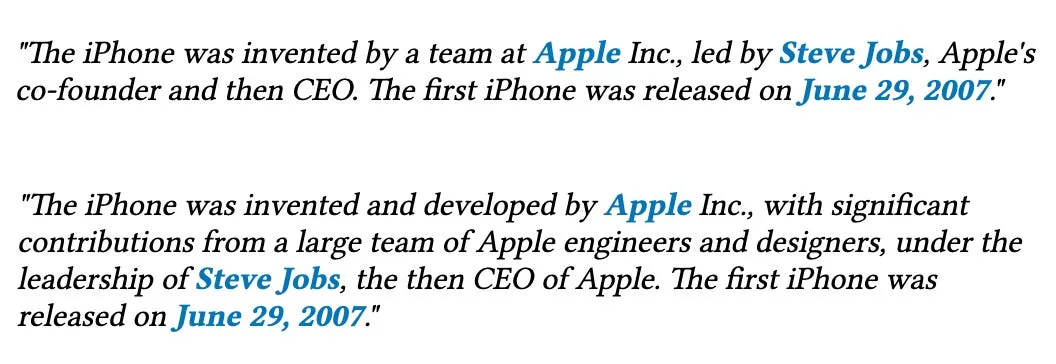
比如,对于“iPhone是谁发明的?首次发布于何时?”这样的问题,可能的回复包括以下几种:
figure02
大语言模型的不同回复,关键事实已用蓝色标出。

大语言模型可以变换句式和措辞,但核心事实——即iPhone由苹果公司在史蒂夫·乔布斯领导下的团队研发,于2007年6月29日发布——不应被改动。
更具体地说,把“发明(invented)”换成“研发(created)”是可以接受的;但把“苹果(Apple)”换成“橙子(Orange)”“三星(Samsung)”,或是改动发布日期,显然就是严重错误。

直接偏好优化

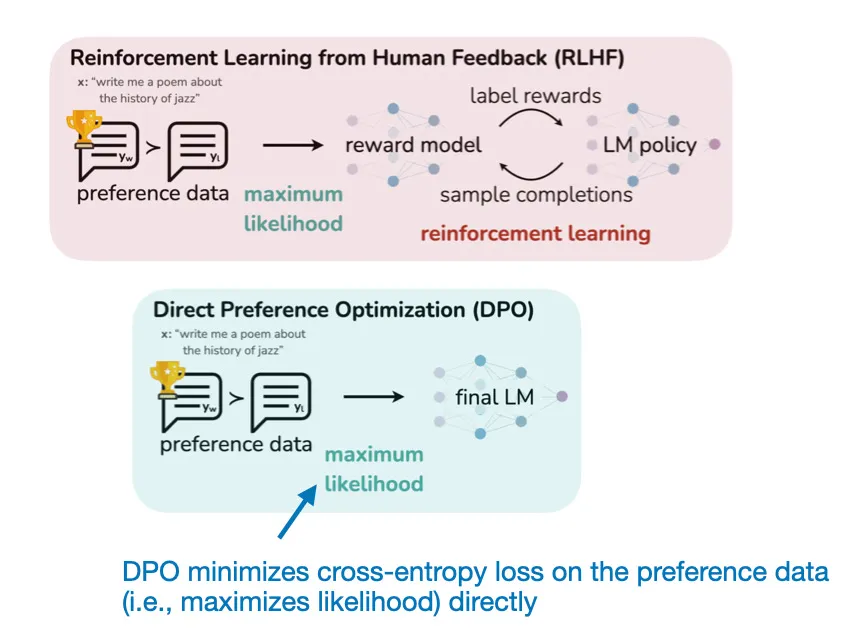
研究人员在这里采用的核心方法是https://arxiv.org/abs/2305.18290(DPO,直接偏好优化),它正逐渐成为人类反馈强化学习(RLHF)之外的热门替代方案。
RLHF是ChatGPT、Llama 2 Chat等模型背后的训练方法。想了解更多RLHF的内容,可以参考我的另一篇文章,链接如下:
https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives
https://substack.com/profile/27393275-sebastian-raschka-phd
·
2023年9月10日
https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives
无论是讨论研究前沿还是教程内容,我经常会提到“人类反馈强化学习(RLHF)”这一流程。由于能将人类偏好融入优化过程,提升模型的有用性与安全性,RLHF已成为现代大语言模型训练流程中不可或缺的一环。
https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives

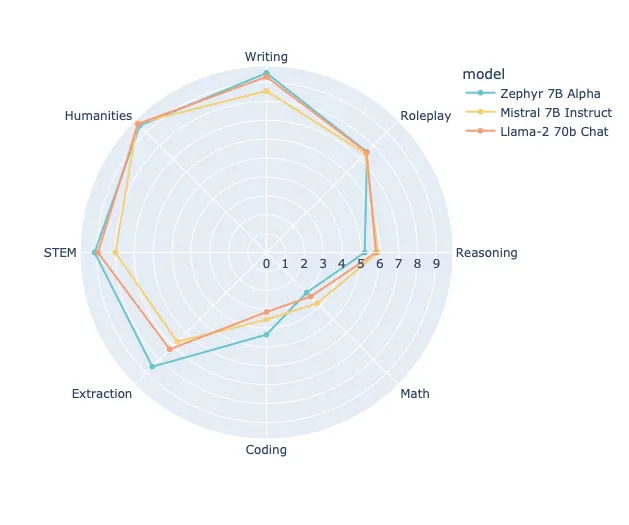
DPO在概念上比RLHF更简单:它直接基于回复偏好排名对大语言模型进行训练,无需单独构建奖励模型。本质上,DPO直接在偏好数据上计算分类损失,实现和使用难度都远低于RLHF。此外,DPO近期已被成功应用——比如Lewis Tunstall团队开发的https://huggingface.co/HuggingFaceH4/zephyr-7b-alpha,其表现似乎超过了通过RLHF训练的更大参数的Llama-2 70b Chat模型——DPO正逐渐成为最主流的微调方法之一。

figure03
DPO论文(https://arxiv.org/abs/2305.18290)中的带标注图表。

注:这篇《针对事实性微调语言模型》论文中,有三位作者同时也是原始DPO论文的作者。

省去人工标注工作

与RLHF相比,DPO简化了微调流程,因为它不需要构建奖励模型。但DPO仍然需要生成偏好数据,通常需要先让模型生成回复,再由人工进行事实核查,然后由标注人员按偏好对这些回复排序。
作者指出,人工核查一条大语言模型回复(比如一位知名人物的生平介绍)平均需要9分钟。按照这个速度,核查本研究使用的505条生平传记数据集,成本约为2000美元。

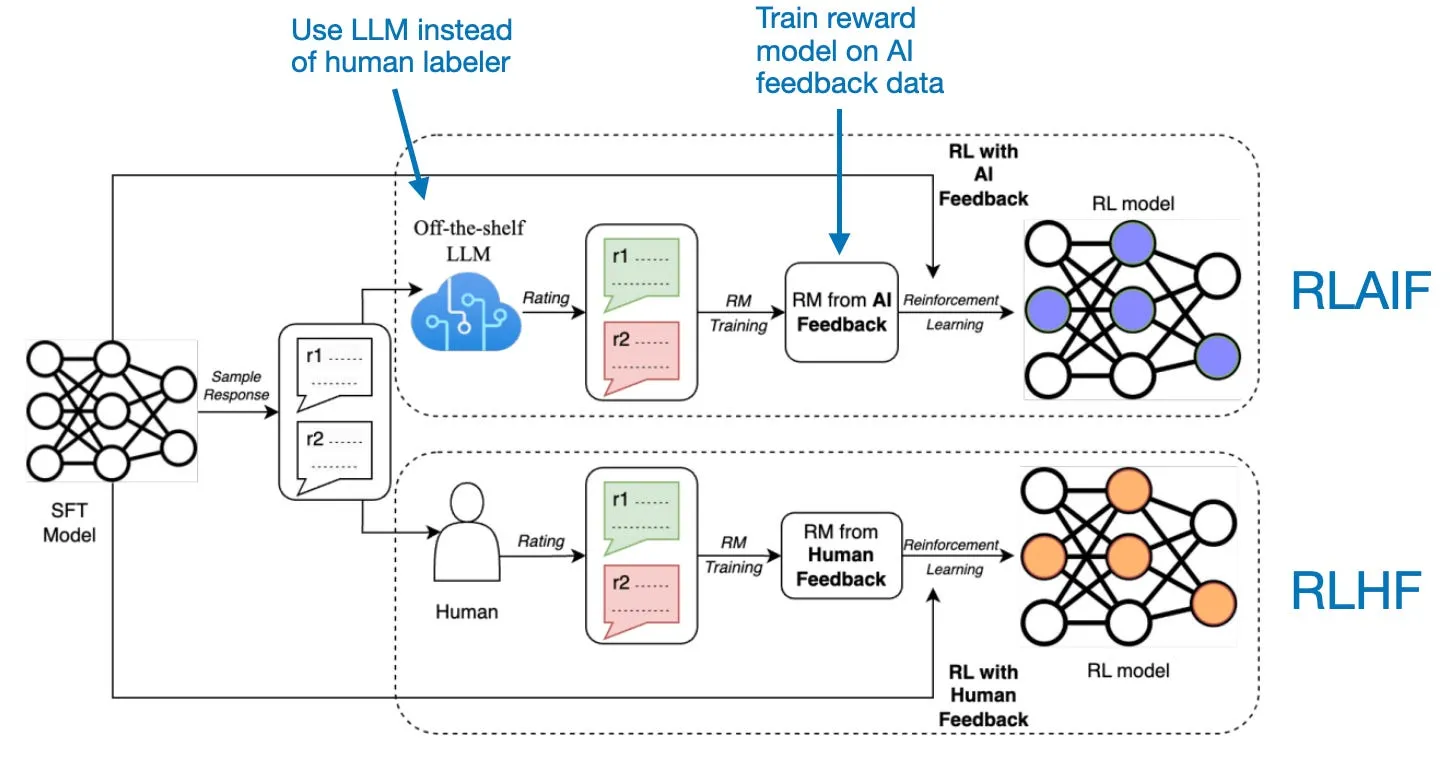
作为人工事实核查的替代方案,作者提出了一种DPO变体,完全不需要人工参与。这种思路与https://arxiv.org/abs/2309.00267(AI反馈强化学习)类似,后者和RLHF不同,不需要人工输入。
figure04
RLAIF论文(https://arxiv.org/abs/2309.00267)中的带标注图表。

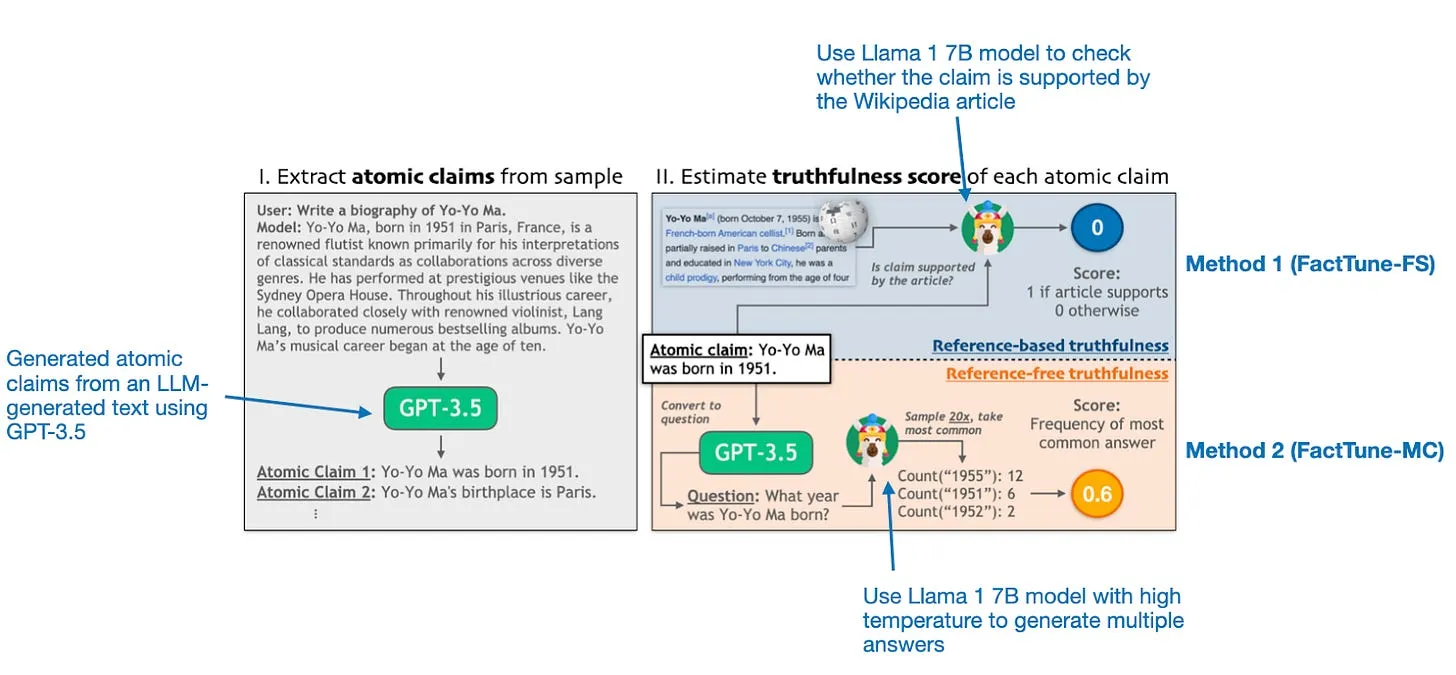
在《针对事实性微调语言模型》论文中,作者实验了两种生成全自动“真实性”评分的方法:

  • 基于参考的真实性评分,简称FactTune-FS
  • 无参考的真实性评分,简称FactTune-MC

figure05
《针对事实性微调语言模型》论文(https://arxiv.org/abs/2311.08401)中的带标注图表。

两种方法的第一步,都是获取一个回复数据集(比如知名人物的生平介绍),再用GPT-3.5模型从中提取出原子化的事实主张。
在方法1(FactTune-FS)中,作者沿用了已有的https://arxiv.org/abs/2305.14251方法:以维基百科作为事实来源,用Llama 1 7B模型验证每条原子主张是否能得到对应文章的支持。我推测这里使用小型Llama 1模型,是因为原始FactScore论文中采用的就是该模型。

在方法2(FactTune-MC)中,作者先用GPT-3.5把原子主张转化为问题,再将这些问题作为查询,输入给设置了高温度参数的Llama 1模型,让它生成多个不同的回复,将出现频率最高的回复的频次作为真实性评分。和方法1相比,FactTune-MC的优势在于不需要外部来源提供参考文章。

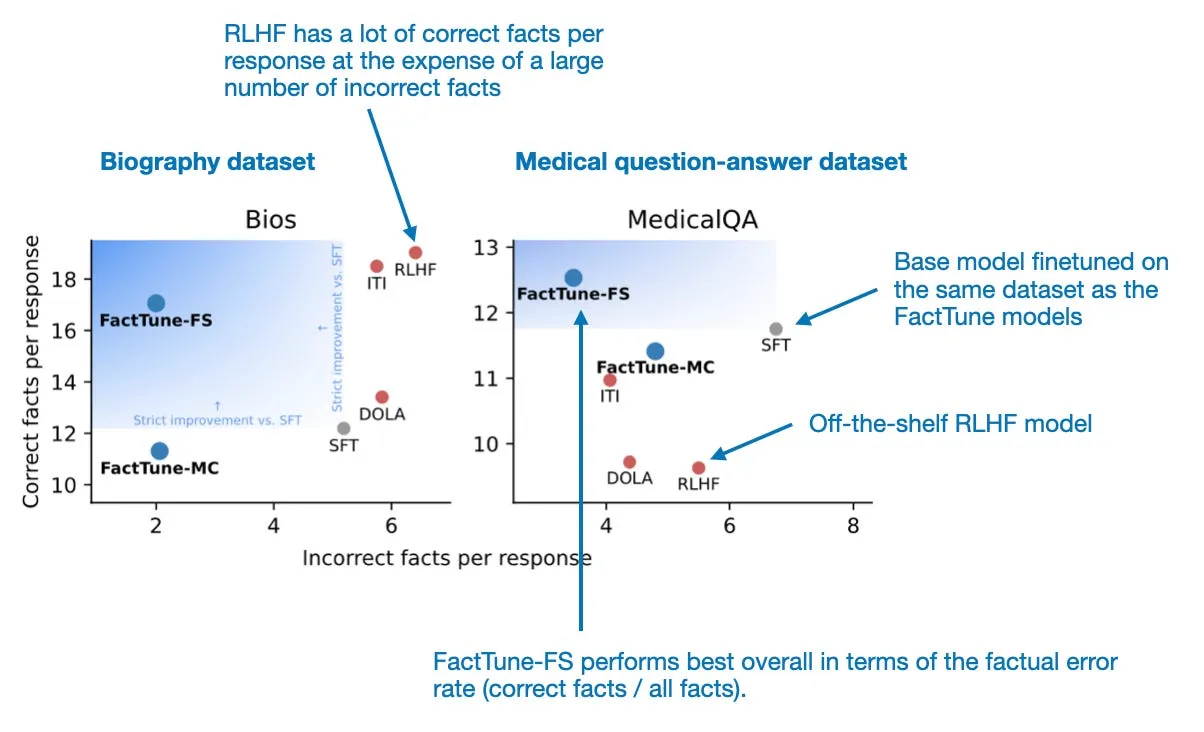
之后,利用真实性评分为数据集生成偏好排名,再通过DPO流程对模型进行微调。实验结果显示,FactTune-FS表现极为出色,在降低事实错误率方面,超过了包括RLHF和常规监督微调在内的所有其他测试方法。
figure06
《针对事实性微调语言模型》论文(https://arxiv.org/abs/2311.08401)中对比不同方法效果的带标注图表。

注意:作者实验了对Llama 1和Llama 2都进行微调,但并未说明上图中微调的是哪款模型。结合论文表2的数据比对,我推测是Llama 2模型。图中RLHF指的是Meta提供的Llama 2 Chat模型;SFT模型是作者用常规监督学习(而非基于偏好数据的DPO)微调的Llama 2模型,使用的数据集和FactTune-FS模型相同,即生平传记与医疗问答数据集。

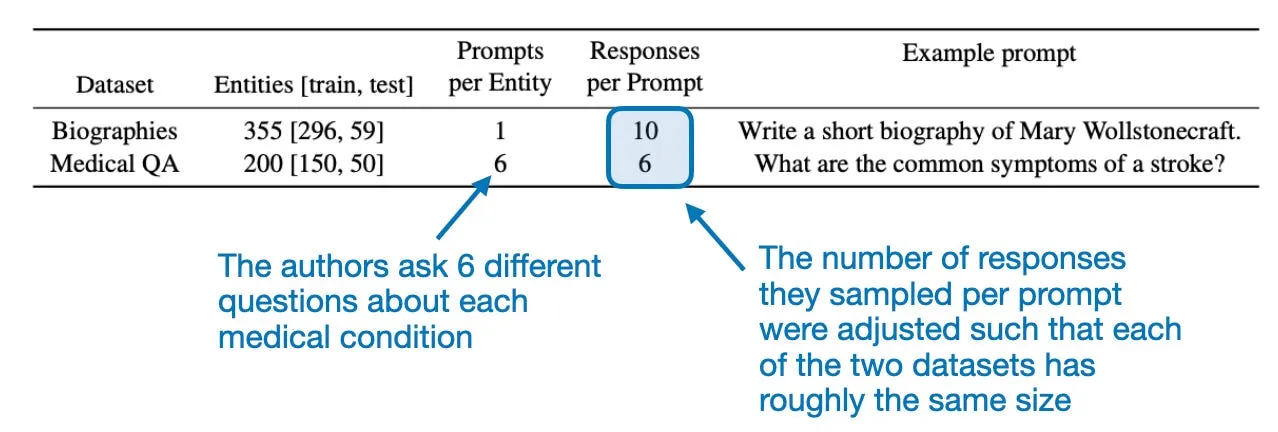
数据集

正如上图所提示的,作者使用了两个数据集:知名人物生平传记、医疗问答。这些数据集规模相对较小,但每条回复都包含多个事实点,因此两个数据集各自用到的事实总数都可能达到四位数级别。
figure07
《针对事实性微调语言模型》论文(https://arxiv.org/abs/2311.08401)中创建并使用的数据集。

鲁棒性

从上述介绍可以看出,这套方法有很多环节都依赖大语言模型,比如用GPT-3.5生成原子主张、用7B参数的Llama 1模型核查主张是否成立等。这意味着我们在很大程度上是信任大语言模型,让它们去核查另一款大语言模型的输出。

总的来说,这套方法的效果之好令人意外。但一个无法回避的问题是:由于正确与错误回复的数量是基于自动化的https://arxiv.org/abs/2305.14251流程判定的,模型会不会是过拟合了FactScore的判定规则,而非真的生成了事实准确的回复?

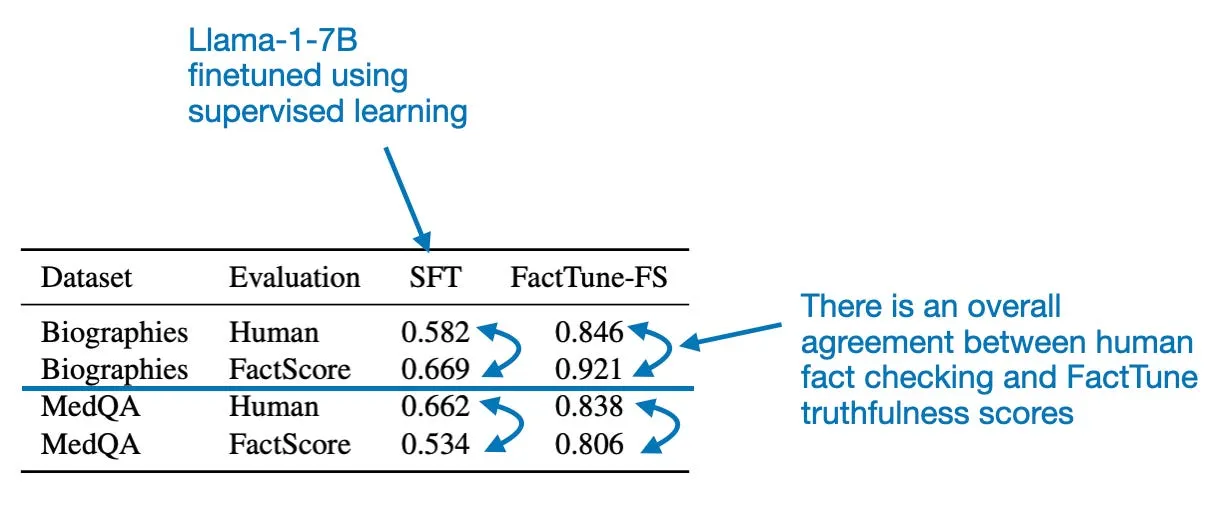
为了解答对FactScore评估方式的质疑,作者引入人工标注人员对模型进行评估。如下图所示,FactScore的评分与人工标注的评分高度吻合。如果我们相信人工核查回复的准确性,那么FactScore的评分仅存在轻微的高估。
figure08
《针对事实性微调语言模型》论文(https://arxiv.org/abs/2311.08401)中的带标注表格,显示自动化的FactScore与人工标注的表现一致。

权衡

Llama 2 Chat是通过人类反馈强化学习(RLHF)训练的,目标是优化有用性与无害性。作者发现,在其基础上应用FactTune-FS,能进一步提升Llama 2 Chat的事实准确性。但我好奇的是,这种提升是否是以降低有用性与无害性为代价的。

理论上,有用性和事实准确性应该高度相关。比如,事实正确的回复理应比事实错误的回复更有用。但Llama 2奖励模型数据的标注方式,可能并没有充分体现这一点。也就是说,参与Llama 2训练、负责有用性排序的标注人员,或许并没有仔细核查所有回复的事实。因此,一条看似有说服力、但可能存在事实错误的回复,也可能被判定为更有用。
figure09
Llama 2 Chat针对有用性与无害性进行了优化;图为Llama 2原始论文(https://arxiv.org/abs/2307.09288)中的带标注图表。

当然,让本就有用的回复变得更符合事实,肯定是更优的。但我好奇的是,这会不会对对话能力,或是翻译、语法纠错、小说创作等不依赖事实的任务产生负面影响。

目前我们没有数据表明,针对事实准确性的DPO微调,会不会降低Llama 2 Chat原本优化的有用性与无害性评分。但作者提出了一些有意思的观察:

  • 我们发现,与SFT模型相比,FactTune-FS和FactTune-MC生成的样本往往句式更客观、直接,对话感和叙事感更弱。
  • FactTune-FS和FactTune-MC生成的样本句子更简单,缺少口语化表达。
  • 再比如,FactTune-FS和FactTune-MC生成的生平介绍事实准确,但没有遵循自然的时间顺序。

局限性与结论

总的来说,我认为这是一篇非常优秀的论文,证明了DPO微调的实用价值。此前一些大语言模型的微调明确以降低危害性为目标,而这篇论文也说明,我们可以用其他目标成功地对模型进行微调。

一个小的不足是,论文使用的数据集规模偏小。但换个角度看,在小数据集上方法依然能取得这么好的效果,反而更令人印象深刻。好消息是,这套方法是完全自动化的,因此可以轻松扩展到更大的数据集。

2)Orca 2:教小型语言模型如何推理

论文https://arxiv.org/abs/2311.11045提出了一种有效方法,通过使用专门的合成数据进行训练,大幅提升小型语言模型(LLM)的推理能力。其核心思路是:运用多种推理技巧,教会大语言模型针对每个任务识别最高效的解题策略。

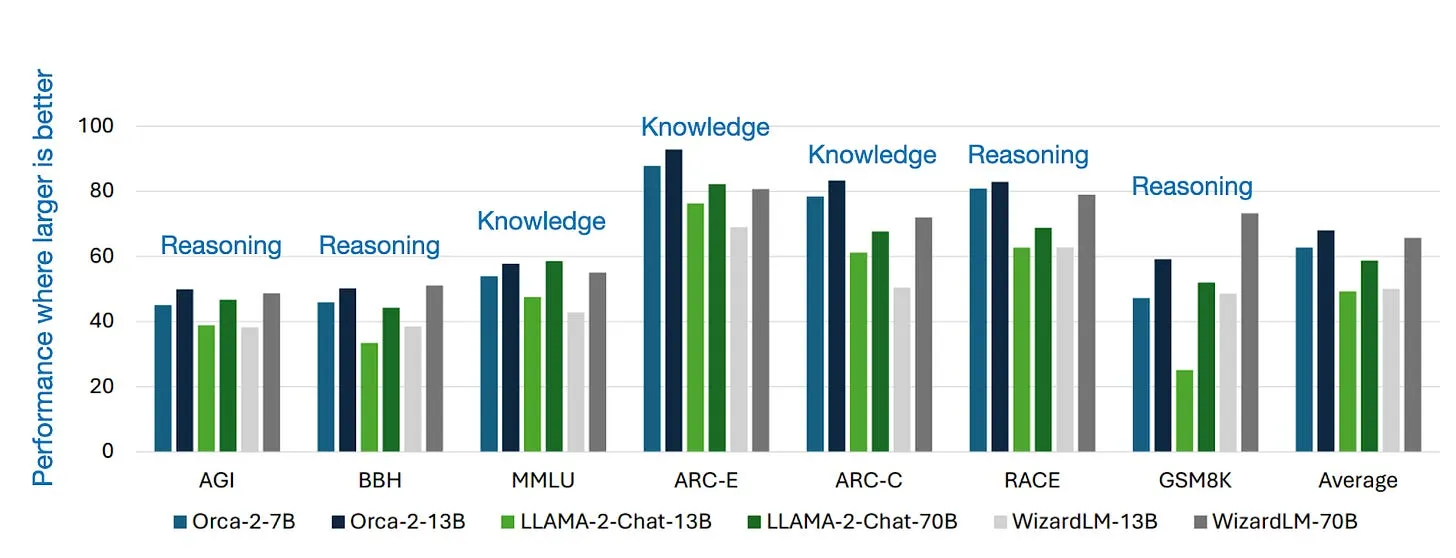
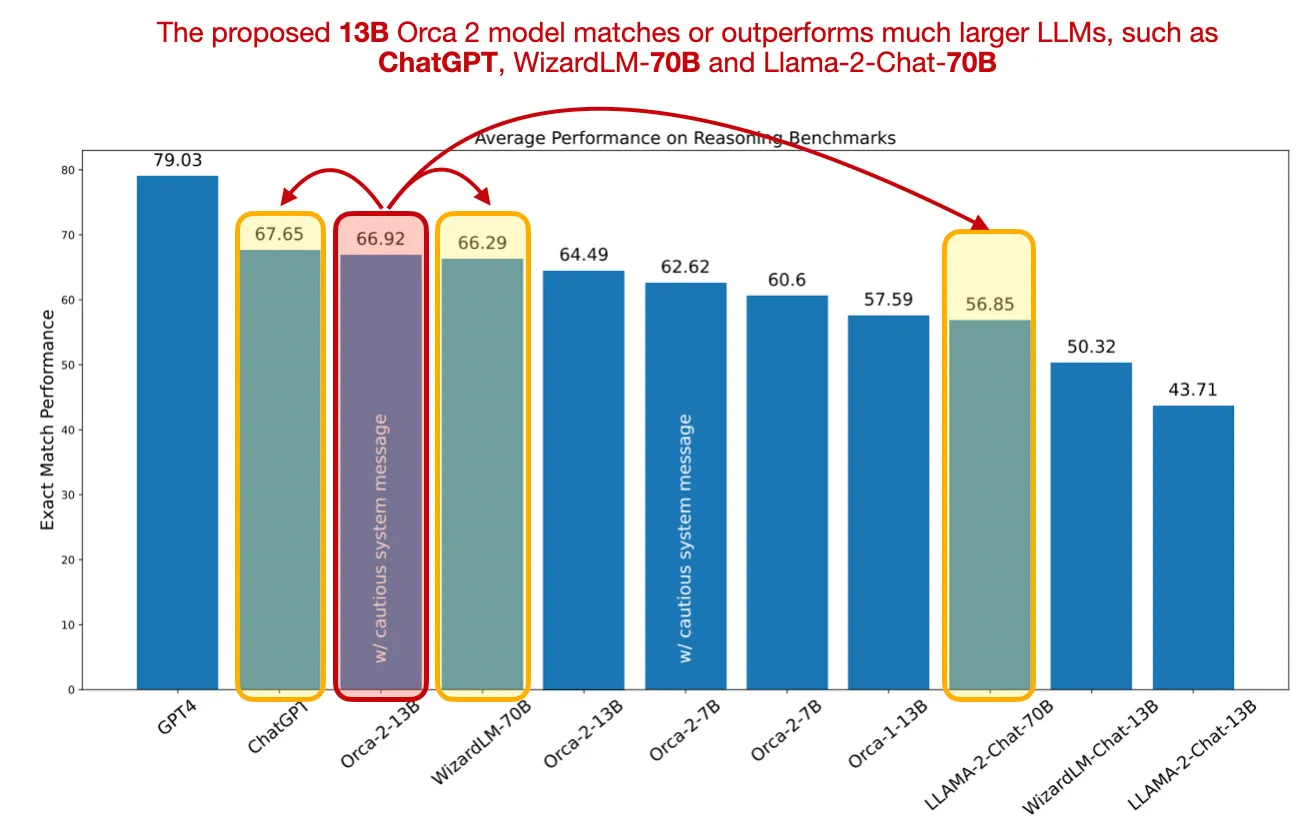
最终得到的Orca-2-13B模型,在零样本推理任务上表现优于同规模模型:相比https://arxiv.org/abs/2307.09288提升了47.54%,相比https://arxiv.org/abs/2304.12244提升了28.15%。注意,这三款模型(Orca、Llama-2-Chat、WizardLM)都是基于相同的Llama-2基座模型进行微调的。
此外,Orca-2-13B甚至能与参数规模是其5-10倍的模型一较高下,比如LLaMA-2-Chat-70B、WizardLM-70B以及ChatGPT。
figure10
Orca 2论文(https://arxiv.org/abs/2311.11045)中的带标注图表,显示Orca 2在推理基准测试上的表现优于同规模及更大规模的大语言模型。注意Orca 2和WizardLM都基于Llama 2开发,因此对比很有参考价值。

(上图中的“小型谨慎系统提示词”是一个实现细节:他们在指令中加入了以下文本:“你是Orca,由微软开发的AI语言模型。你是一名谨慎的助手,严格遵循指令,乐于助人且安全无害,遵守道德准则,倡导积极行为。”)

模仿学习

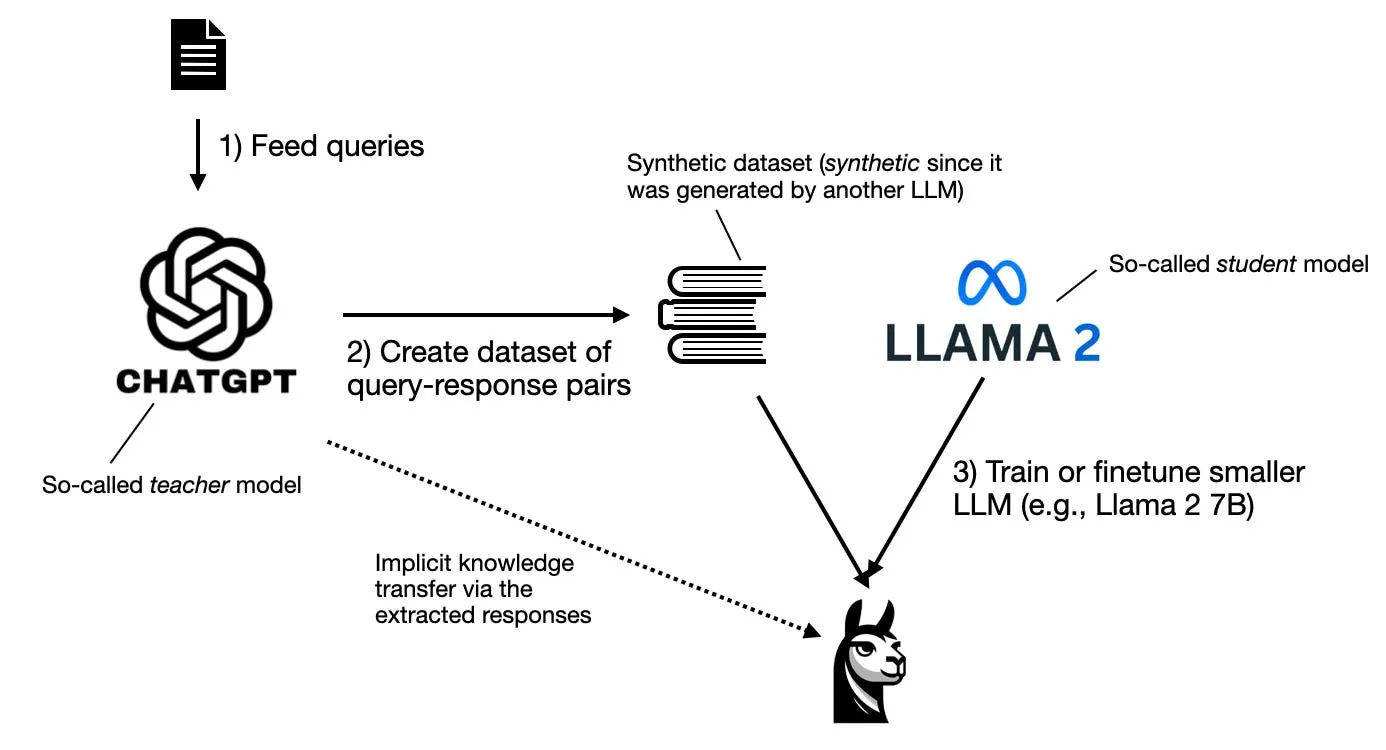
近几个月来,模仿学习蔚然成风。在大语言模型领域,模仿学习指的是让小型目标模型(称为“学生模型”)学习大型源模型(称为“教师模型”,比如GPT-4)的输出。
figure11
大语言模型场景下的模仿学习示意图:小型大语言模型通过学习大型模型的回复,模仿其输出。

论文https://arxiv.org/abs/2305.15717指出了小型语言模型模仿大型模型的一个核心问题:这些小模型可以模仿大模型的风格,生成乍一看很惊艳的内容,但仔细审视就会发现输出并不准确。也就是说,它们看似表现不错,但深入检查生成内容时,实则错误百出。

在Orca 2论文中,作者解释道,小型语言模型(按如今的标准,70亿到130亿参数都算“小型”)不能只靠照搬大模型的方法来提升效果。他们提出了另一种思路:教这些小模型独特的解题或思考方式,有别于大模型的思路。这是因为参数量更少、能力有限的小模型,可能无法沿用大模型的解题策略。

教授不同的推理策略

作者将他们的方法称为“解释微调”,核心是通过特定的查询提示,从源大语言模型(此处为GPT-4)中提取带有高质量解释的答案,以此构建合成数据集。

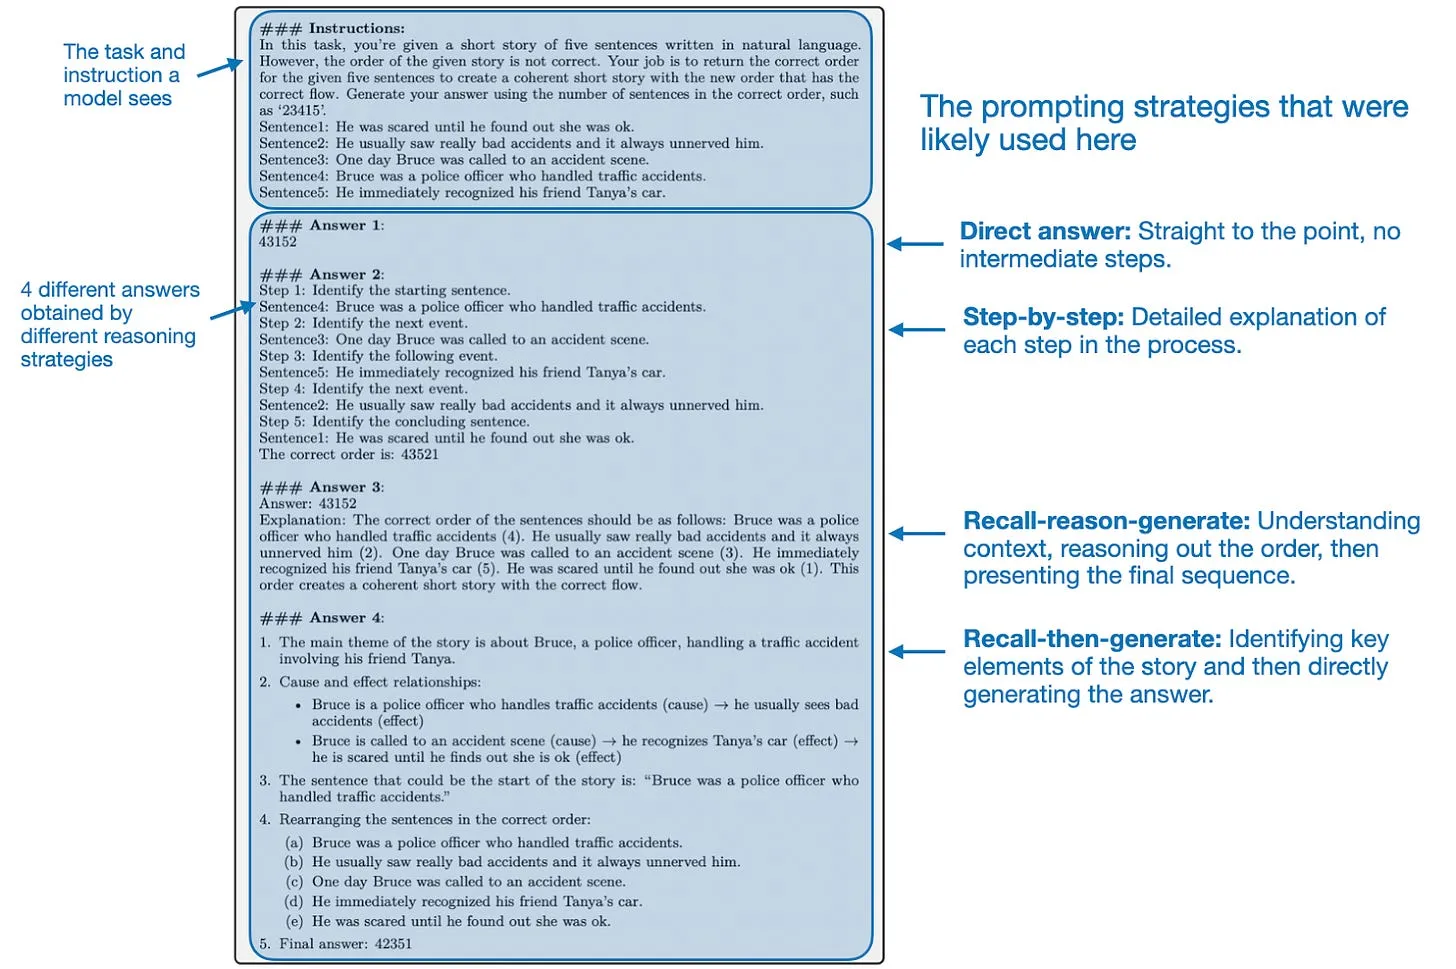
如果你用过ChatGPT(尤其是早期版本),大概会知道答案质量很大程度上取决于你如何提示模型。不同的任务需要不同的提示策略,比如逐步推导、先回忆再生成、回忆-推理-生成、直接作答等等。

作者认为,不应该让小模型只训练或使用某一种特定的解题策略,而应该让模型的解题(或推理)策略随任务变化而调整。

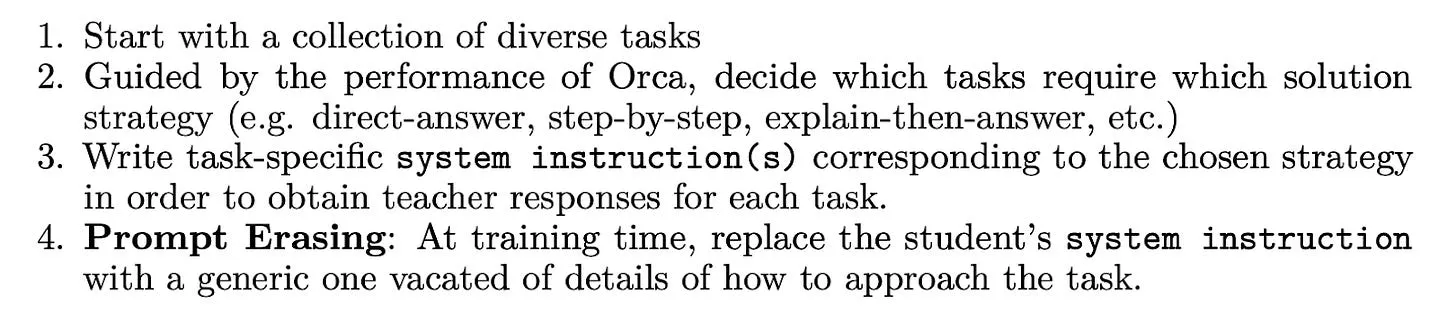
他们为Orca 2设计了如下训练流程,其中“Orca(参考版)”是前代模型:
figure12

注意,在训练过程中,小型模型只学习任务和对应的回复,看不到最初用来从大型教师模型中提取这些回复的问题或指令。

换句话说,基座大语言模型(此处为Llama 2)本身以及微调方式并没有什么特别之处。真正带来惊人效果的创新,完全在于合成训练数据的构建方式。
figure13
https://arxiv.org/abs/2305.14045数据集的片段,展示同一提示对应的不同答案。这是基于Orca 2论文(https://arxiv.org/abs/2311.11045)中图表制作的带标注示意图。

基准测试与结果

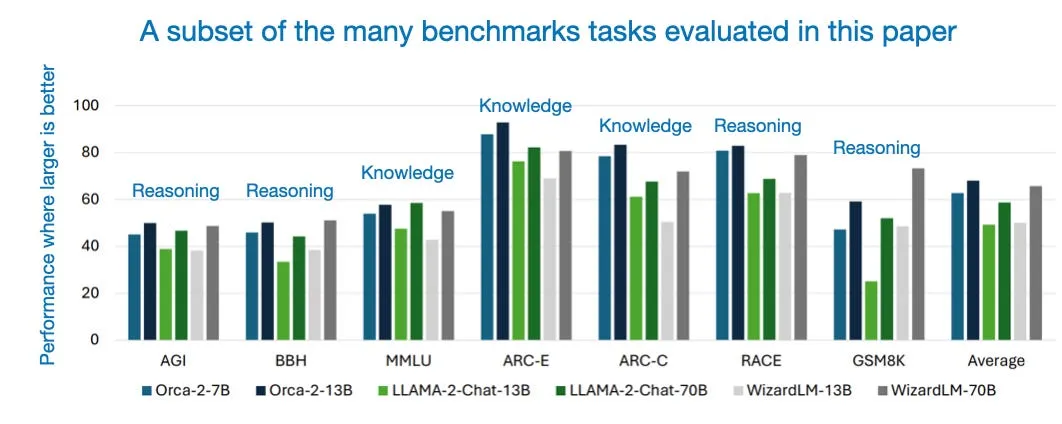
如下图所示,与同规模的其他模型相比,最终的Orca-2模型在推理与知识类基准测试上表现极为出色。
figure14
Orca 2论文(https://arxiv.org/abs/2311.11045)中部分知识与推理基准测试结果的带标注图表。

注意,上图只是很小一部分内容。Orca 2论文中的基准测试相当全面,覆盖了推理能力、知识与语言理解、文本补全、多轮开放式对话、事实依据与抽象总结、安全性、真实性等多个维度。

13B参数的模型表现十分惊艳,大幅超越了同尺寸的其他模型。只有在多轮对话基准测试中,Orca-2-13B的表现略逊于Llama-2-Chat。作者解释这是因为训练数据集中没有包含这类对话数据,这个说法完全合理。

在我看来,语言模型的优势不在于通用性,而在于专业性。并非所有任务都需要由对话式AI来完成。我更倾向于一套高度专业化、能力极强的工具,而不是一个样样通、样样松的“万金油”方案。

结论与总结思考

以13B参数的Llama 2模型为起点能取得这样的成果,非常令人赞叹。我很好奇,也很期待:如果将这种定制化合成数据策略应用于70B参数的Llama 2模型甚至更大的模型,推理等基准测试的显著提升是否依然成立。

论文给出了全面的基准测试结果,出色的表现有目共睹。但一个小的瑕疵是:作者强调了让小型模型根据任务选择最高效解题策略的重要性,却没有针对Orca 2模型在这方面做任何实验或消融研究。唯一的证据是,经过精心筛选的合成数据混合训练的Orca 2模型(本质是Llama 2),表现优于通过其他方式微调的Llama 2模型,包括更大的模型。

值得肯定的是,这些成果完全是通过在精选合成数据上进行监督微调实现的,Orca 2模型没有经过任何RLHF或DPO微调。有理由认为,甚至很有可能,RLHF或DPO微调能进一步提升这些模型的效果,这也是未来研究中一个很有意思的方向。

附:Orca 2的权重已公开,可在此处获取:https://www.microsoft.com/en-us/research/project/orca/

3)简化Transformer模块

在论文https://arxiv.org/abs/2311.01906中,作者研究了如何在不损失收敛特性与下游任务性能的前提下,简化大语言模型核心的标准Transformer模块。

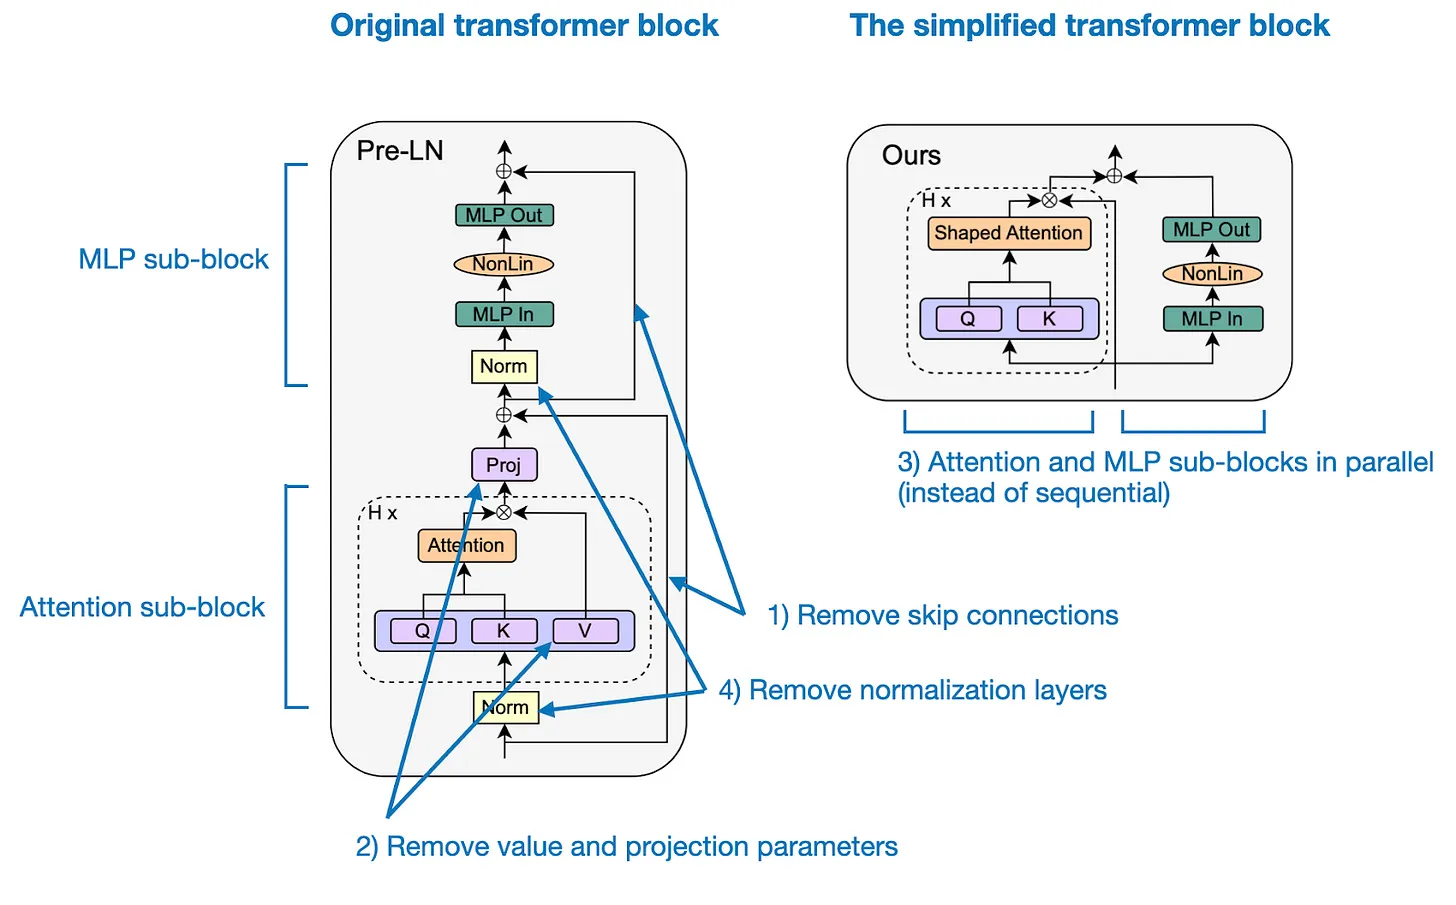
基于信号传播理论与实证结果,他们发现GPT类解码器架构和BERT类编码器架构中的很多组件都可以移除:

  • 跳跃连接
  • 投影矩阵与值参数
  • 串行的注意力与MLP子模块(可替换为并行布局)
  • 归一化层(LayerNorm)

figure15
原始Transformer模块(左)与简化后Transformer模块(右)的对比标注图(来自https://arxiv.org/abs/2311.01906)。

移除跳跃连接

随着网络层数加深,梯度在反向传播过程中会逐渐衰减,导致模型训练困难。跳跃连接(也叫残差连接)是深度神经网络中常见的架构设计,用于缓解梯度消失问题。

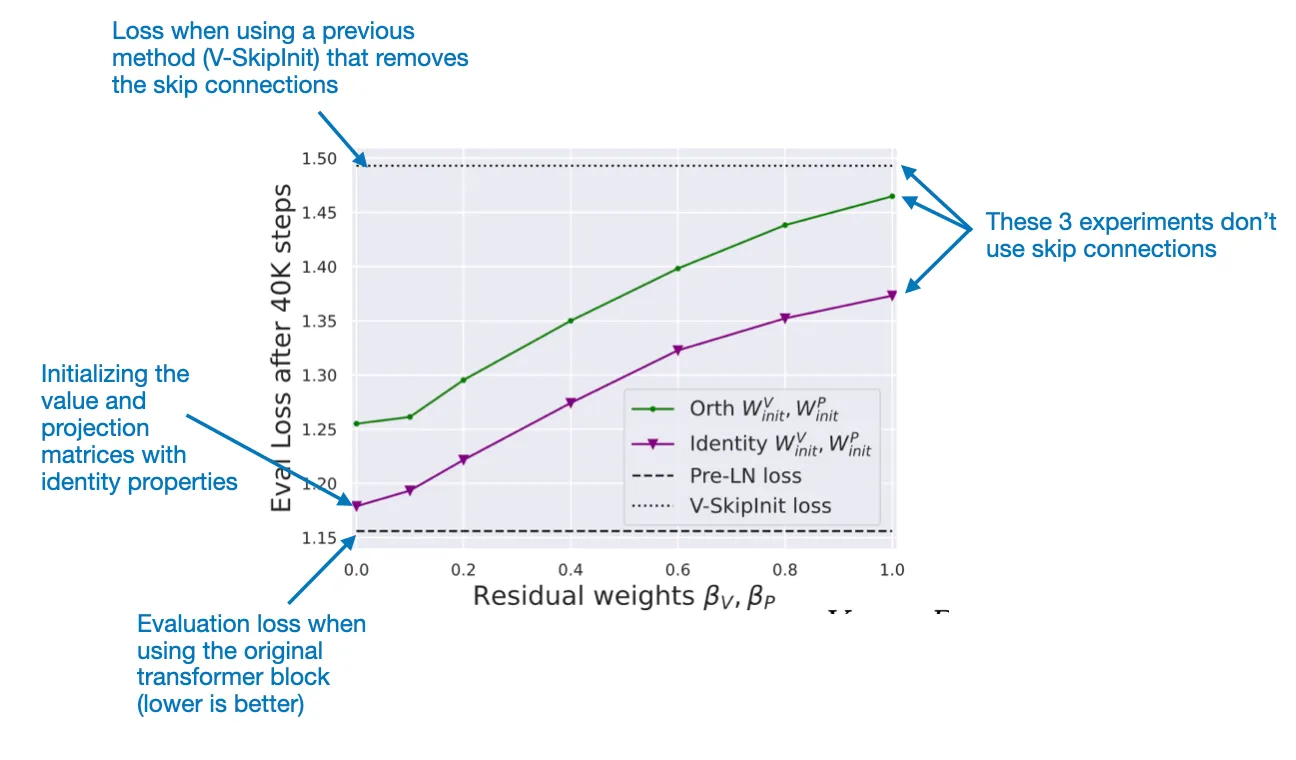
直接粗暴地移除跳跃连接会引发梯度问题。为了避免这一点,作者基于信号传播理论,提出了特定的权重初始化方案。对细节感兴趣的读者非常推荐阅读这篇优秀的论文,里面有大量有意思的洞见。
figure16
移除跳跃连接后,通过调整权重初始化方式、并用额外超参数β对残差进行加权,得到的评估损失与原始Transformer模块几乎一致。(来自https://arxiv.org/abs/2311.01906的带标注曲线图)

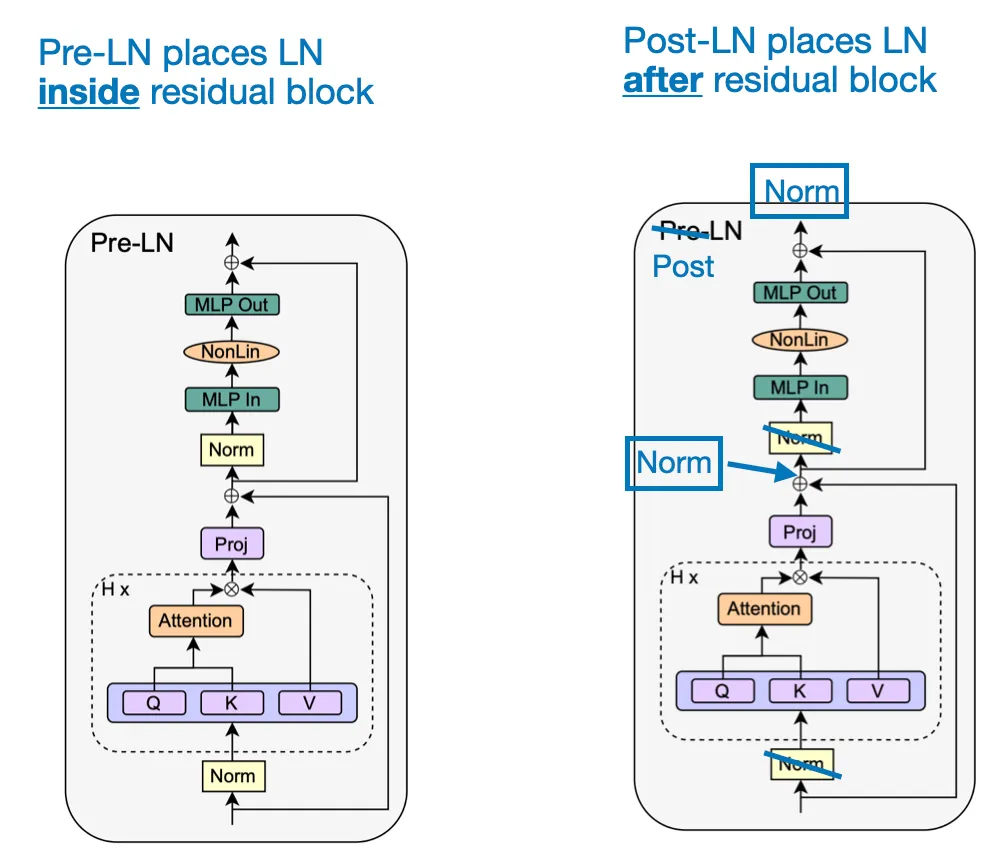
顺便一提,原始Transformer模块示意图左上角的“Pre-LN”,指的是LayerNorm(“Norm”层)的位置。实际上,https://arxiv.org/abs/1706.03762中提出的原始Transformer采用的是Post-LN结构。近年来,Transformer模型越来越多地从Post-LN转向Pre-LN,因为它能简化训练流程。

Pre-LN的一大优势是对初始学习率更不敏感,不需要精心设计学习率预热,而学习率预热是影响训练稳定性与效果的关键因素。想了解更多Pre-LN与Post-LN的优缺点,推荐观看我的朋友兼合作者Vahid的视频:https://www.youtube.com/watch?v=RsuSOylfN2I
figure17
实现细节的直观对比:前置层归一化(Pre-LayerNorm)与后置层归一化(Post-LayerNorm)

移除其他组件

上一节实验(将加权超参数β设为0)带来的启发,让作者成功移除了投影矩阵与值参数。作者认为,值矩阵和投影矩阵只是对输入的线性投影(不同于MLP子模块中的线性层,中间还有非线性激活函数),因此可能是冗余的。

作者还尝试移除归一化层(即LayerNorm)。理由是:前置层归一化本质上会降低残差分支的权重,而这种降权效果也可以通过作者之前的修改方案实现,因此LayerNorm在这套架构中理论上是多余的。

不过,作者观察到训练收敛性出现了轻微下降,这一点目前还无法用信号传播理论解释。因此结论是,建议在Transformer模块中保留LayerNorm。

局限性与结论

作者的实验是在相对小型的模型上进行的。虽然没有理由认为这些结论不适用于更大的语言模型,但目前还没有实证证据支持这一点。我并不认为作者没做更大规模的实验是什么缺点——恰恰相反,这篇只有两位作者的研究让我印象极为深刻,堪称我今年读过的最佳论文之一。他们还引用了大量相关工作,为实验提供了充分的理论支撑。光是参考文献部分,就非常值得一读。

在我看来,这些修改方案的主要价值之一,是帮助我们更好地理解并简化Transformer架构。除此之外,作者还报告称,修改后模型的训练吞吐量提升了15%,参数量减少了15%。

我希望拥有更多算力的大型研究机构也能关注这项工作,将这些洞见应用于新的架构(当然,最好也能分享他们的研究成果)。我非常想知道这些修改是否也适用于更大的大语言模型。

其他值得关注的研究论文

  • 《ChatGPT发布一周年:开源大语言模型正在迎头赶上吗?》,作者Chen、Jiao、Li、Qin(11月29日),https://arxiv.org/abs/2311.16989
    该研究调研了开源大语言模型被报道达到或超越ChatGPT能力的相关案例。

  • 《语言模型逆向》,作者Morris、Zhao、Chiu、Shmatikov、Rush(11月22日),https://arxiv.org/abs/2311.13647
    研究表明,下一个词元的概率包含了大量前文文本的信息,可以据此从大语言模型生成的输出中还原用户的提示词。

  • 《无需奖励模型,利用人类反馈微调扩散模型》,作者Yang、Tao、Lyu、Ge等(11月22日),https://arxiv.org/abs/2311.13231
    D3PO是一种直接偏好优化(DPO)方法,提供了一种高性价比的方案,无需奖励模型即可利用人类反馈微调扩散模型。

  • 《PaSS:并行推测采样》,作者Monea、Joulin、Grave(11月22日),https://arxiv.org/abs/2311.13581
    该研究提出并行解码方案,解决大语言模型生成词元时的内存瓶颈,无需额外辅助模型即可同时生成多个词元,速度提升最高达30%,额外参数极少。

  • 《ZipLoRA:通过有效融合LoRA实现任意主题、任意风格》,作者Shah、Ruiz、Cole、Lu等(11月22日),https://arxiv.org/abs/2311.13600
    ZipLoRA可将独立训练的风格低秩适配与主题低秩适配进行有效融合,此处应用于扩散模型。

  • 《GAIA:通用AI助手基准测试》,作者Mialon、Fourrier、Swift、Wolf等(11月21日),https://arxiv.org/abs/2311.12983
    GAIA是全新的通用AI助手基准测试,包含考验推理、工具使用等核心能力的真实场景问题,在该基准上人类的表现显著优于GPT-4等当前AI/大语言模型。

  • 《系统2注意力(或许你也需要)》,作者Weston、Sukhbaatar(11月20日),https://arxiv.org/abs/2311.11829
    提出的系统2注意力(S2A)机制,通过重构输入上下文以聚焦相关信息,优化基于Transformer的大语言模型,提升了对事实性、客观性要求高的任务的表现,减少了无关或有偏见的内容。

  • 《Orca 2:教小型语言模型如何推理》,作者Mitra、Del Corro、Mahajan、Codas等(11月18日),https://arxiv.org/abs/2311.11045
    继Orca之后,Orca 2聚焦于教小型语言模型不同的推理策略,而非单纯依赖模仿学习,以提升其解决问题的能力,路径可能与大型模型有所不同。

  • 《气候变迁中的骆驼:用Tulu 2增强语言模型适配能力》,作者Ivison、Wang、Pyatkin、Lambert等(11月17日),https://arxiv.org/abs/2311.10702
    作者发布了TÜLU 2模型系列,其中包含一款70B参数的DPO微调模型,是目前为止参数最大的DPO微调大语言模型。

  • 《Video-LLaVA:通过投影前对齐学习统一视觉表征》,作者Lin、Zhu、Ye、Ning等(11月16日),https://arxiv.org/abs/2311.10122
    Video-LLaVA是一款大型视觉语言模型,将视觉表征与语言特征进行统一,其统一分词方法的表现优于ImageBind-LLM、Llama-Adapter等未对齐图像与视频投影的模型。

  • 《Emu Edit:通过识别与生成任务实现精准图像编辑》,作者Sheynin、Polyak、Singer、Kirstain等(11月16日),https://arxiv.org/abs/2311.10089
    Emu Edit是一款多任务图像编辑模型,通过在广泛任务上训练并引入学习到的任务嵌入,在指令引导的图像编辑任务上达到了当前最优水平。

  • 《Tied-Lora:通过权重绑定提升LoRA的参数效率》,作者Renduchintala、Konuk、Kuchaiev(11月16日),https://arxiv.org/abs/2311.09578
    研究人员实验了LoRA(低秩适配)的权重绑定(即权重共享)方案,发现平均而言不绑定权重的效果最好;但在部分任务上,绑定权重也能取得不错的效果,同时可将所需的LoRA参数量减少至13%。

  • 《指数级提速的语言建模》,作者Belcak、Wattenhofer(11月15日),https://arxiv.org/abs/2311.10770
    作者提出UltraFastBERT——一种BERT(编码器式大语言模型)变体,仅使用原模型0.3%的参数,速度最高提升78倍,同时保持预测精度。

  • 《大羊驼知道GPT不会展示的事:用于置信度估计的代理模型》,作者Shrivastava、Liang、Kumar(11月15日),https://arxiv.org/abs/2311.08877
    论文提出使用带有可获取概率的代理置信度模型,来估计GPT-4、Claude-v1.3等不提供softmax概率的前沿大语言模型的置信度。结果显示,与直接询问大语言模型对答案的置信度相比,该方法在12个数据集中的9个上准确率更高。

  • 《笔记链:提升检索增强语言模型的鲁棒性》,作者Yu、Zhang、Pan、Ma等(11月15日),https://arxiv.org/abs/2311.09210
    论文提出“笔记链”方法,通过为检索到的文档生成连续笔记,提升检索增强语言模型的评估效果与回复准确性,即使存在噪声或无关信息也能生效。该方法使用ChatGPT在LLaMa-2 7B模型上生成的训练数据进行训练。

  • 《Fusion-Eval:将评估器与大语言模型融合》,作者Shu、Wichers、Luo、Zhu等(11月15日),https://arxiv.org/abs/2311.09204
    论文提出Fusion-Eval——一种基于提示的大语言模型评估聚合器,使用模板整合辅助评估器评分与模型回复,无需微调即可生成评分(及理由),并使用另一款大语言模型规划和优化评估流程。

  • 《路由到专家:大语言模型的高效奖励引导集成》,作者Lu、Yuan、Lin、Lin等(11月15日),https://arxiv.org/abs/2311.08692
    研究提出Zooter——一种针对大语言模型集成的奖励引导路由方法,能识别并利用单个模型的潜在专长,降低计算开销,在多个领域和任务上,效率与表现均优于传统的奖励模型排序方法。

  • 《对比人类、GPT-4与GPT-4V在抽象推理任务上的表现》,作者Mitchell、Palmarini、Moskvichev(11月14日),https://arxiv.org/abs/2311.09247
    研究使用ConceptARC基准测试,评估纯文本与多模态GPT-4的抽象推理能力。结果显示,尽管对GPT-4使用了详细的单样本提示、对GPT-4V使用了零样本和单样本图像提示,两个版本都未展现出人类级别的鲁棒抽象能力。

  • 《DiLoCo:大语言模型的分布式低通信训练》,作者Douillard、Feng、Rusu、Chhaparia等(11月14日),https://arxiv.org/abs/2311.08105
    论文提出DiLoCo——一种分布式优化算法,用于在大量连接不畅的小型设备上训练语言模型。与传统方法相比,该方法表现稳定,同时大幅降低了通信需求。

  • 《代码大语言模型综述》,作者Zhang、Chen、Liu、Liao等(11月14日),https://arxiv.org/abs/2311.07989v1
    该工作全面梳理了代码处理大语言模型的相关研究,考察了50余款模型、500余篇相关工作,探讨了从统计模型到大语言模型的演进历程,包括代码专属特性与未来方向。

  • 《Monkey:图像分辨率与文本标注对大多模态模型至关重要》,作者Li、Yang、Liu、Ma等(11月12日),https://arxiv.org/abs/2311.06607
    研究提出双管齐下的方案,提升现有模型在视觉-语言任务上的表现:一是用视觉编码器处理更高分辨率的图像(最高达896×1344像素),二是采用多级描述生成方法,深化场景与物体之间的上下文理解。

  • 《LCM-LoRA:通用稳定扩散加速模块》,作者Luo、Tan、Patil、Gu等(11月9日),https://arxiv.org/abs/2311.05556
    潜在一致性模型(从潜在扩散模型蒸馏而来)能大幅加速文生图任务,输出质量高且训练时间更短。在这份技术报告中,作者介绍了成功应用LoRA(低秩适配)的方案,进一步降低了扩散模型的资源需求。

  • 《通过微调移除GPT-4的RLHF防护》,作者Zhan、Fang、Bindu、Gupta等(11月9日),https://arxiv.org/abs/2311.05553
    人类反馈强化学习(RLHF)通常用于减少大语言模型的有害输出,但研究人员表明,这些防护机制通过微调就能轻易移除——研究人员仅用340个样本就达到了95%的成功率。

  • 《大语言模型幻觉综述:原理、分类、挑战与开放问题》,作者Huang、Yu、Ma、Zhong等(11月9日),https://arxiv.org/abs/2311.05232
    该综述全面介绍了大语言模型幻觉问题的挑战与最新进展,幻觉问题会影响大语言模型的可靠性与实际落地效果。

  • 《文生图模型的整体评估》,作者Lee、Yasunaga、Meng、Mai等(11月7日),https://arxiv.org/abs/2311.04287
    论文提出HEIM基准测试,从12个不同维度(从生成质量到原创性)评估文生图模型。结果显示,不同模型各有所长,没有任何一款模型在所有维度上都表现最优。

  • 《OtterHD:高分辨率多模态模型》,作者Li、Zhang、Yang、Zhang等(11月7日),https://arxiv.org/abs/2311.04219
    OtterHD-8B是一款全新的多模态大语言模型,源自Adept的https://www.adept.ai/blog/fuyu-8b多模态模型,既能处理高分辨率视觉输入,也支持灵活的输入尺寸,适配多样的推理应用。

  • 《S-LoRA:服务数千个并发LoRA适配器》,作者Sheng、Cao、Li、Hooper等(11月6日),https://arxiv.org/abs/2311.03285
    论文提出了多项效率优化技术(统一分页、全新的张量并行策略),用于推理阶段同时服务多个LoRA(低秩适配)适配器。

  • 《GPT4All:开源压缩语言模型生态》,作者Anand、Nussbaum、Treat、Miller等(11月6日),https://arxiv.org/abs/2311.04931
    这篇短文介绍了GPT4All的发展历程,这是一个旨在普及大语言模型使用的开源项目,目标是打破现有模型基础设施昂贵、访问受限、缺乏透明度的局限。

  • 《CogVLM:面向预训练语言模型的视觉专家》,作者Wang、Lv、Yu、Hong等(11月6日),https://arxiv.org/abs/2311.03079
    CogVLM是全新的多模态大语言模型,它没有采用冻结的图像编码器模块,而是集成了一个可训练的视觉专家模块,实现视觉与语言特征的深度融合。

  • 《FreshLLMs:借助搜索引擎增强为大语言模型更新知识》,作者Vu、Iyyer、Wang、Constant等(11月5日),https://arxiv.org/abs/2310.03214
    论文提出FreshQA基准测试,用于测试模型应对快速更新知识与错误前提的能力;同时提出FreshPrompt——一种有效的少样本提示方法,通过整合搜索引擎数据提升大语言模型的表现。

  • 《AGI层级:推动通用人工智能之路的进展》,作者Morris、Sohl-dickstein、Fiedel、Warkentin等(11月4日),https://arxiv.org/abs/2311.02462
    DeepMind的研究人员尝试用五级体系定义通用人工智能(AGI):从包含ChatGPT等新兴AI的1级,到被描述为“超人类”、能力100%超越人类的5级(2-5级目前尚未实现)。

  • 《FlashDecoding++:GPU上更快的大语言模型推理》,作者Hong、Dai、Xu、Mao等(11月2日),https://arxiv.org/abs/2311.01282
    FlashDecoding++是一款大语言模型推理引擎,针对核心挑战提出了异步softmax、扁平GEMM优化、启发式数据流适配等技术,在NVIDIA和AMD GPU上分别实现最高4.86倍和2.18倍的速度提升。

  • 《预训练数据混合让Transformer模型具备窄范围模型选择能力》,作者Yadlowsky、Doshi、Tripuraneni(11月1日),https://arxiv.org/abs/2311.00871
    研究考察了Transformer基于预训练数据混合,适配新的上下文内任务的能力,揭示了其在域外任务上的局限性,并表明其上下文学习能力更多依赖于数据覆盖度,而非基础的泛化能力。


本杂志是个人兴趣项目,无直接报酬。如果您愿意支持我,可以考虑购买https://sebastianraschka.com/books上的图书。如果您觉得它们有洞见、有帮助,也欢迎推荐给朋友和同事。
figure18
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics 以及http://mng.bz/M96o

您的支持意义重大!非常感谢!

【转载】使用 LoRA(低秩适配)微调大语言模型的实用技巧

原文地址:Practical Tips for Finetuning LLMs Using LoRA (Low-Rank Adaptation),by Sebastian Raschka, on 2023-12-09

使用 LoRA(低秩适配)微调大语言模型的实用技巧

——从上百次实验中总结的经验

LoRA(低秩适配,论文见https://arxiv.org/abs/2106.09685)是高效训练定制大语言模型时应用最广泛、效果最显著的技术之一。对于关注开源大语言模型的从业者而言,这是一项值得深入掌握的核心技术。

本文的实验基于开源项目 Lit-GPT(https://github.com/Lightning-AI/lit-gpt ,我与Lightning AI 的同事共同维护该项目),相关详细实验记录见 https://lightning.ai/pages/community/lora-insights/ 。本篇《Ahead of AI》专栏文章旨在梳理我从大量实验中提炼出的核心经验,同时解答该领域最常见的若干问题。如果你正从事定制大语言模型的微调工作,希望这些经验能帮你少走弯路(原文“the long run”为双关,既指“长期来看”,也暗合模型训练的运行过程)。

简而言之,本文讨论的核心结论如下:

  • 尽管大语言模型训练(以及基于GPU的模型训练普遍)存在固有随机性,但多次重复实验的结果一致性非常高。
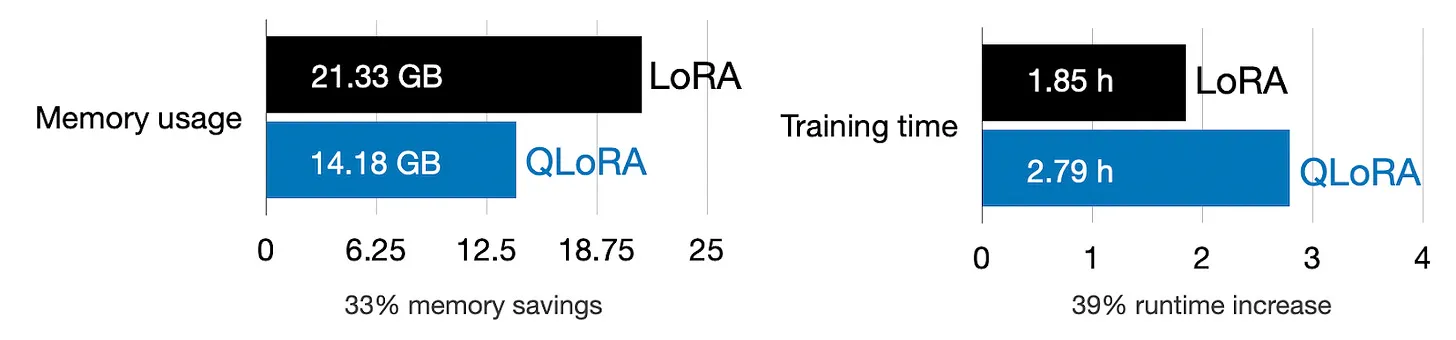
  • QLoRA 是一种在显存受限场景下值得权衡的方案:它能节省33%的显存,但训练耗时会增加39%。
  • 微调大语言模型时,优化器的选择并非核心影响因素。单独使用SGD效果欠佳,但无论是使用AdamW、带动量调度的SGD,还是带动量调度的AdamW,最终效果差异极小。
  • 人们常说Adam是显存占用很高的优化器,因为它为每个模型参数维护两个额外状态量,但这对大语言模型的峰值显存需求影响很小——因为显存主要被大规模矩阵乘法占用,而非存储额外参数。
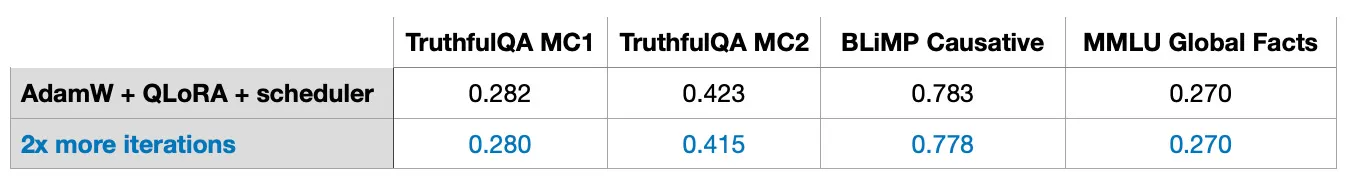
  • 对于固定数据集,多轮迭代训练(即多epoch训练)未必有益,反而往往会导致效果下降,原因大概率是过拟合。
  • 使用LoRA时,应将其应用到模型的所有层,而非仅作用于键(Key)和值(Value)矩阵,才能最大化模型性能。
  • 调整LoRA的秩(rank)至关重要,同时也要选择合适的alpha值;一个实用的经验法则是将alpha设为秩的2倍。
  • 70亿参数的模型可以在单张14GB显存的GPU上高效完成微调,仅需数小时。
  • 仅靠固定数据集,无法让大语言模型在所有基准测试上都表现优异;要实现这一点需要多样化的数据源,或者说LoRA本身可能并非解决该问题的最佳工具。

此外,我还将解答关于LoRA的10个常见问题:
Q1:数据集的重要性有多高?
Q2:LoRA适用于领域适配吗?
Q3:如何选择最优的秩(rank)?
Q4:必须在所有层都启用LoRA吗?
Q5:如何避免过拟合?
Q6:其他优化器的效果如何?
Q7:还有哪些因素会影响显存占用?
Q8:与全量微调、RLHF相比效果如何?
Q9:多个LoRA权重可以合并吗?
Q10:逐层最优秩适配(Layer-wise Optimal Rank Adaptation)效果如何?

(在上一期《Ahead of AI》中我提到,如果大家感兴趣,我会写一篇更基础的入门文章,从零开始实现LoRA的代码。从反馈来看大家的需求很高,我计划后续再发布一篇相关文章。本篇文章则聚焦于LoRA实践中的宏观思路与核心结论,采用自上而下的视角展开。)

LoRA 简介

大语言模型参数量庞大,受GPU显存限制,训练时更新所有权重的成本极高。

举例来说,假设一个70亿参数的大语言模型,其权重矩阵为W(实际模型的参数分布在许多层的不同矩阵中,这里简化为单个权重矩阵说明)。在反向传播过程中,我们会得到一个ΔW矩阵,它记录了为最小化训练损失,原始权重需要更新的幅度。

权重更新公式如下:
$$W_{\text{updated}} = W + \Delta W$$

如果权重矩阵W包含70亿参数,那么权重更新矩阵ΔW同样包含70亿参数,计算ΔW矩阵会消耗极高的算力与显存。

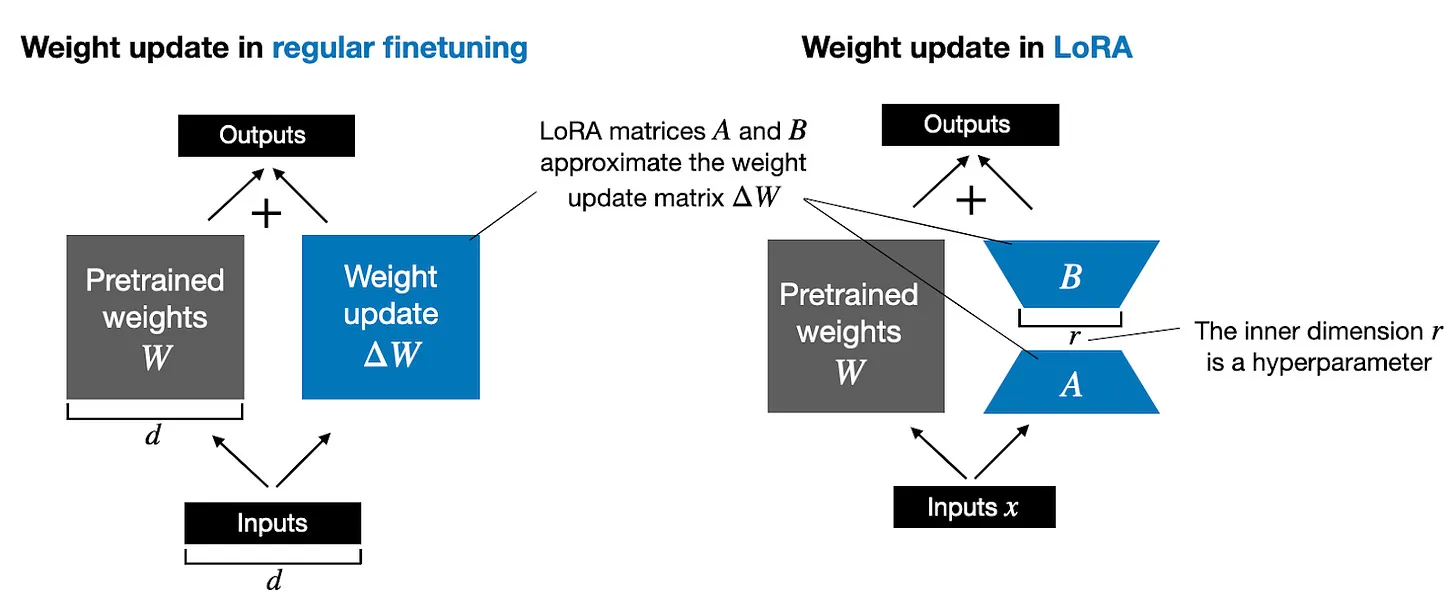
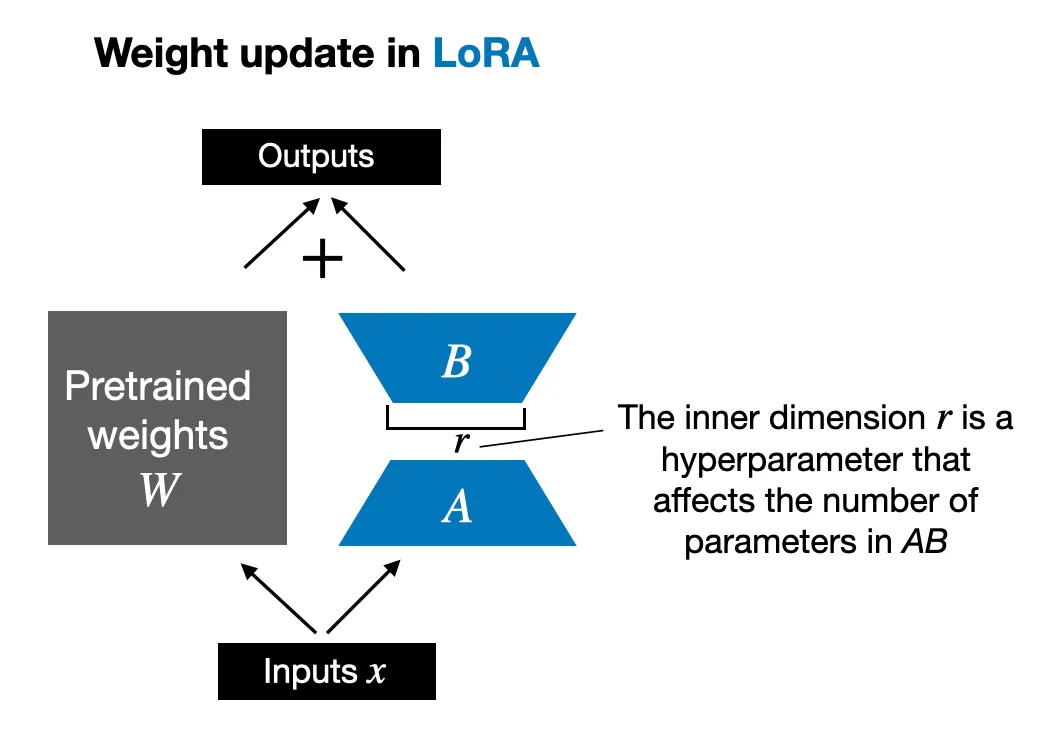
LoRA方法由论文https://arxiv.org/abs/2106.09685提出,它将权重更新量ΔW分解为低秩表示。准确来说,LoRA不需要显式计算ΔW,而是在训练中直接学习ΔW的分解形式,这正是其节省显存的核心原理,如下图所示:

figure01

如图所示,ΔW的分解是指用两个更小的LoRA矩阵A和B来表示大矩阵ΔW。若A的行数与ΔW相同,B的列数与ΔW相同,则分解可表示为ΔW = AB(AB为矩阵A与B的乘积)。

这种方法能节省多少显存?这取决于超参数秩(r)的大小。举个例子:假设ΔW有10000行、20000列,共存储2亿个参数。如果取r=8,那么A为10000行×8列,B为8行×20000列,总参数量为 10000×8 + 8×20000 = 24万个参数,仅为原来2亿的约1/830。

当然,A和B无法完整捕获ΔW包含的全部信息,但这正是LoRA的设计初衷。我们的假设是:预训练阶段的权重矩阵W需要是满秩的大矩阵,才能学习到预训练数据集中的全部知识;但在微调大语言模型时,我们不需要更新所有权重,仅用远少于ΔW的参数量就能捕获适配任务的核心信息——因此我们通过AB的低秩形式来完成权重更新。

1. LoRA 实验的一致性

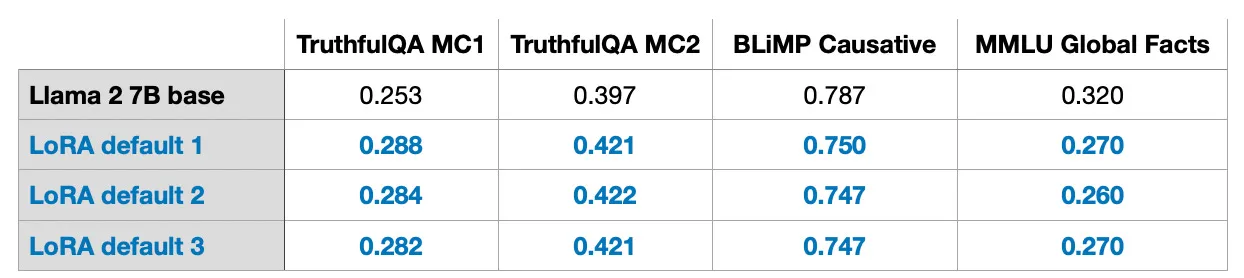
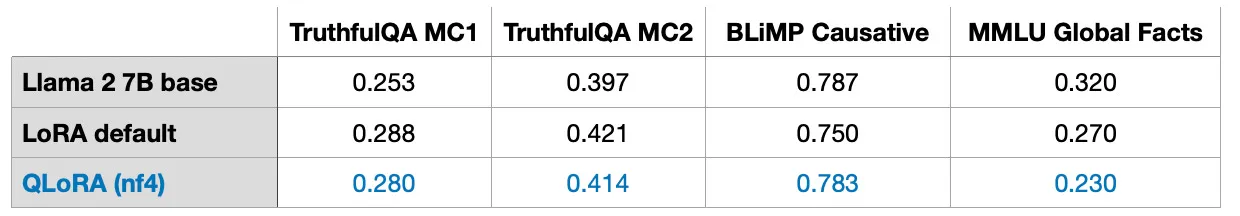
通过多次重复LoRA微调实验我发现,尽管大语言模型训练(以及GPU训练普遍)存在固有随机性,但不同轮次的基准测试结果一致性非常高。这为后续的对比实验提供了可靠的基础。

figure02

(注:以上结果采用默认设置,秩r=8。实验细节可参考我的另一篇文章:https://lightning.ai/pages/community/lora-insights/ )

2. QLoRA 的算力-显存权衡

QLoRA(量化低秩适配,论文见https://arxiv.org/abs/2305.14314)是一种进一步降低微调显存占用的技术。在反向传播过程中,QLoRA将预训练权重量化为4位精度,并使用分页优化器处理显存峰值。

实验证实,使用QLoRA可以节省33%的GPU显存,但代价是训练耗时增加39%——这是由于QLoRA需要额外的预训练权重量化与反量化操作。

采用16位bfloat16精度的常规LoRA:

  • 训练时长:1.85小时
  • 显存占用:21.33 GB

采用4位归一化浮点数的QLoRA:

  • 训练时长:2.79小时
  • 显存占用:14.18 GB

此外我发现,QLoRA对模型效果的影响微乎其微。在常见的GPU显存瓶颈场景下,QLoRA是常规LoRA训练的可行替代方案。

figure03

3. 学习率调度器

学习率调度器会在训练过程中逐步降低学习率,以优化收敛效果,避免越过损失函数的最小值点。

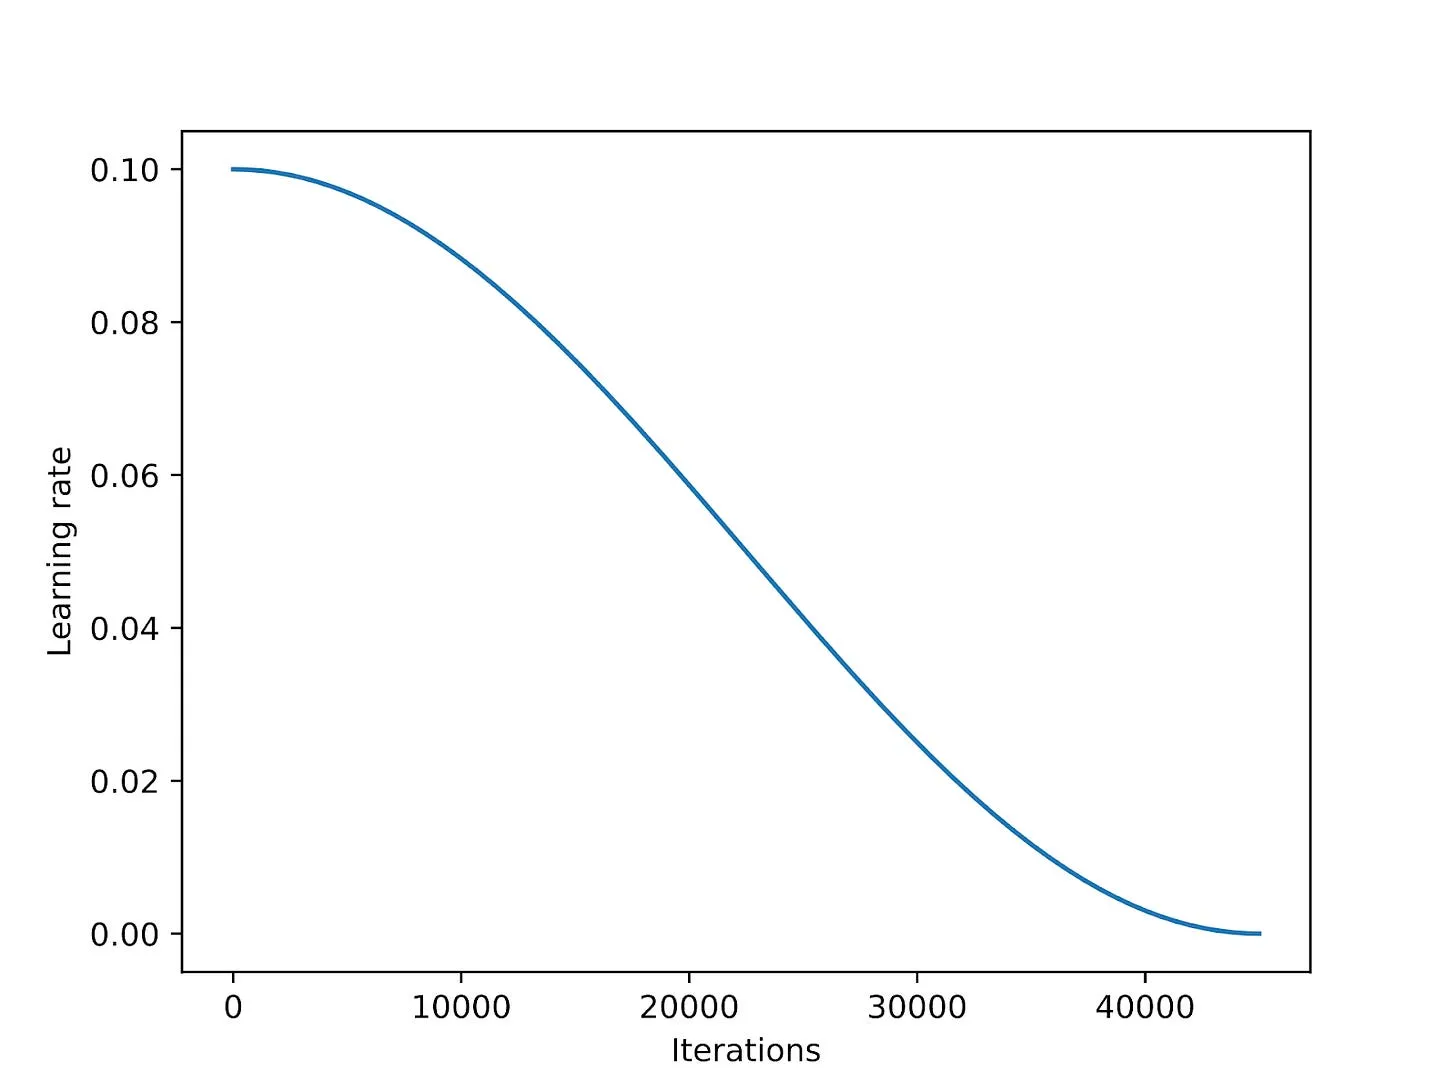
余弦退火(Cosine Annealing)是一种遵循余弦曲线调整学习率的调度策略:训练开始时学习率较高,之后平滑下降,以余弦函数的趋势趋近于零。常用的是半周期变体,即训练全程只完成半个余弦周期,如下图所示:

figure04

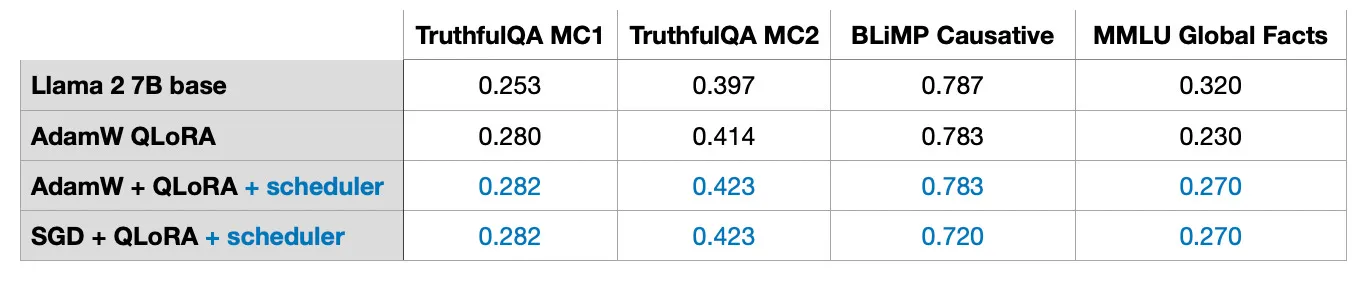
在实验中,我为LoRA微调脚本加入了余弦退火调度器,观察到它能显著提升SGD的训练效果;但对Adam和AdamW优化器的影响较小,几乎没有明显差异。

figure05

SGD相比Adam的潜在优势将在下一节讨论。

《Ahead of AI》是读者支持的出版物。若想接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

4. Adam 与 SGD 对比

Adam和AdamW优化器在深度学习中仍被广泛使用,但在大模型场景下它们的显存占用很高。原因在于Adam类优化器会为每个模型参数维护两个滑动平均值:梯度的一阶矩(均值)和二阶矩(未中心化方差)。换句话说,Adam会为每个模型参数在显存中额外存储两个值。对于70亿参数的模型,训练时就要额外跟踪140亿个参数。

SGD优化器在训练中不需要跟踪额外参数,因此一个自然的问题是:将Adam替换为SGD,对大语言模型训练的峰值显存需求有多大改善?

在我的实验中,使用AdamW+默认LoRA设置(r=8)训练70亿参数的Llama 2模型,GPU显存占用为14.18 GB;换成SGD训练同一模型,显存占用为14.15 GB。换言之,仅节省了0.03 GB,效果微乎其微。

为什么显存节省这么少?因为使用LoRA时,可训练参数的总量本身就很小。例如当r=8时,70亿参数的Llama 2模型中,可训练的LoRA参数仅为4,194,304个,远小于总参数量6,738,415,616。

单看数字,400多万可训练参数似乎不少,但计算一下:4,194,304 × 2 × 16 bit = 134.22 Mbit = 16.78 MB。(实际观测到0.03 GB = 30 MB的差异,是因为存储和复制优化器状态还有额外开销。)其中“2”是Adam额外存储的参数数量,16位是模型权重的默认精度。

figure06

但在后续实验中,当我把LoRA的秩r提升到256时,Adam和SGD优化器的显存差异就变得明显了:

  • AdamW:17.86 GB
  • SGD:14.46 GB

结论:当LoRA的秩r较小时,把Adam换成SGD的价值不大;但当r较大时,这种替换是值得考虑的。

5. 多轮训练(多Epoch)

在传统深度学习中,我们通常会对训练集进行多轮迭代——每完整遍历一次训练集称为一个epoch(轮次)。例如训练卷积神经网络时,跑上百个epoch很常见。那么多轮训练对指令微调也同样有效吗?

当我把Alpaca指令微调数据集(https://github.com/tatsu-lab/stanford_alpaca)的迭代次数翻倍(相当于2个训练轮次)时,我观察到模型性能出现了下降。

figure07

结论是:多轮训练对指令微调未必有益,反而可能降低效果。在只有1000个样本的LIMA数据集上我也观察到了同样的现象。性能下降大概率是过拟合加剧导致的,这一点还需要更多研究验证。

6. 在更多层启用 LoRA

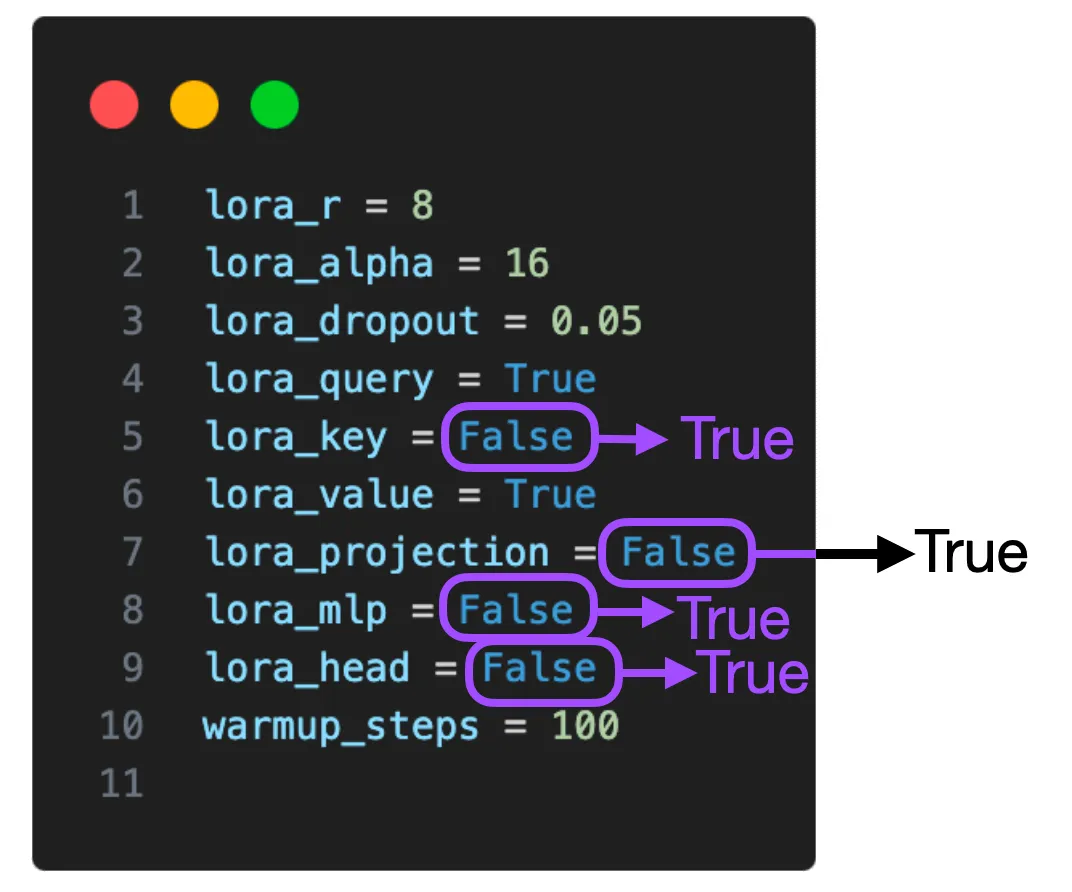
前面表格中的实验,仅在部分权重矩阵上启用了LoRA——也就是每个Transformer层中的键(Key)和值(Value)权重矩阵。除此之外,我们还可以在查询(Query)权重矩阵、投影层、多头注意力块之间的其他线性层,以及线性输出层上都启用LoRA。

figure08

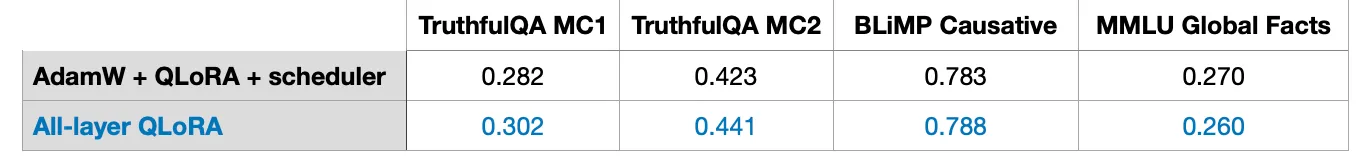
对于70亿参数的Llama 2模型,若在所有这些额外层都启用LoRA,可训练参数量会变为原来的5倍:从4,194,304增加到20,277,248。对应的显存需求也会上升(从14.18 GB增至16.62 GB),但模型性能会得到显著提升。

figure09

不过我的实验存在局限:只探索了两种设置——(1)仅在查询和值权重矩阵启用LoRA;(2)在所有层启用LoRA。未来可以探索更多组合,比如仅在投影层启用LoRA是否真的有增益,这是一个值得研究的问题。

7. 平衡 LoRA 超参数:秩(R)与 Alpha

正如LoRA原论文(https://arxiv.org/abs/2106.09685)所述,在前向传播时,LoRA权重会通过一个额外的缩放系数叠加到预训练权重上。缩放系数由秩参数r和另一个超参数α(alpha)共同决定,公式如下:

scaling = alpha / r
weight += (lora_B @ lora_A) * scaling

从上面的公式可以看出,alpha越大,LoRA权重的影响就越强。

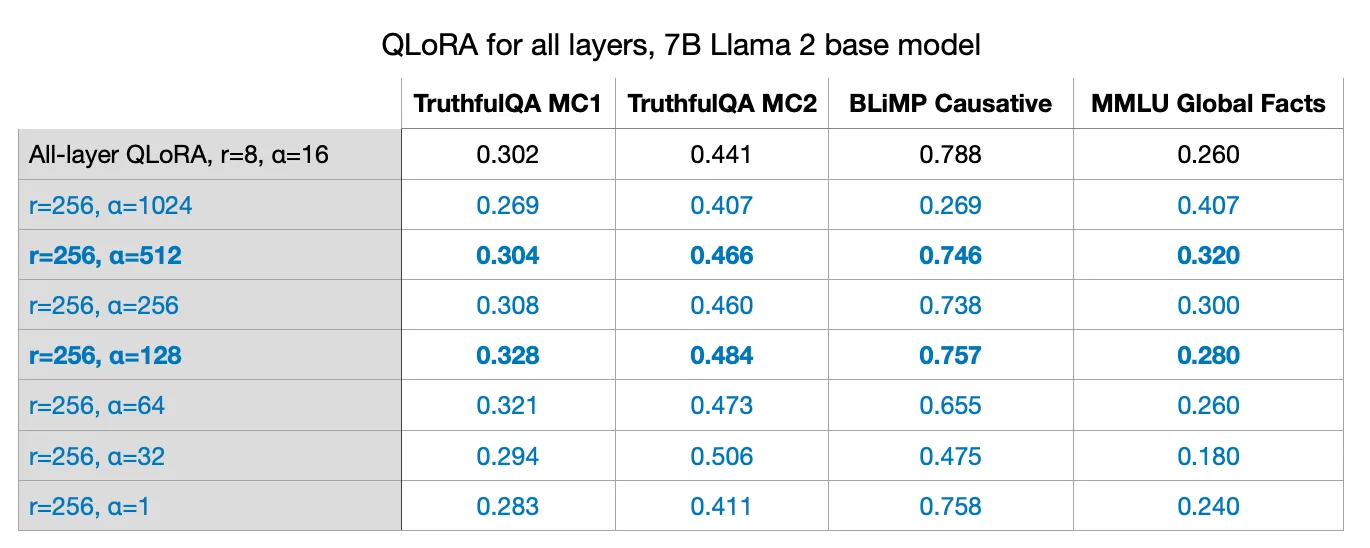
之前的实验使用r=8、alpha=16,对应2倍缩放。在大语言模型中使用LoRA时,alpha取r的2倍是通用经验法则,但我好奇当r更大时这个法则是否依然成立。

实验表明,“alpha = 2×秩”确实是效果很好的取值。不过在本次实验的模型+数据集组合下,当r=256、alpha=128(对应0.5倍缩放)时,性能甚至更优。

figure10

(我还测试了r=32、r=64、r=128、r=512的情况,为了图表清晰未列出,其中r=256效果最佳。)

将alpha设为r的2倍通常能得到较好的结果,但尝试不同的比例也不会有坏处。

8. 单GPU训练70亿参数模型

LoRA最核心的价值之一,就是让我们能在单张GPU上完成70亿参数大语言模型的微调。在本次实验中,采用最优设置的QLoRA(r=256,alpha=512)+ AdamW,训练5万个样本(Alpaca数据集)仅需约3小时(A100显卡),显存占用17.86 GB。

figure11

在文章余下部分,我将解答大家可能关心的其他问题。

常见问题解答

Q1:数据集的重要性有多高?

数据集至关重要。我在实验中使用了包含5万个训练样本的Alpaca数据集,选择它是因为该数据集非常流行;而测试不同数据集超出了本文范围,因为文章篇幅已经很长。

但需要注意:Alpaca是通过调用旧版ChatGPT生成的合成数据集,以今天的标准来看可能并非最优选择。

数据质量非常关键。比如今年6月我讨论过的LIMA数据集(https://magazine.sebastianraschka.com/p/ahead-of-ai-9-llm-tuning-and-dataset),是一个经过精心筛选的数据集,仅包含1000个样本。

根据论文https://arxiv.org/abs/2305.11206,在LIMA上微调的650亿参数Llama模型,效果明显优于在Alpaca上微调的同规模模型。

figure12

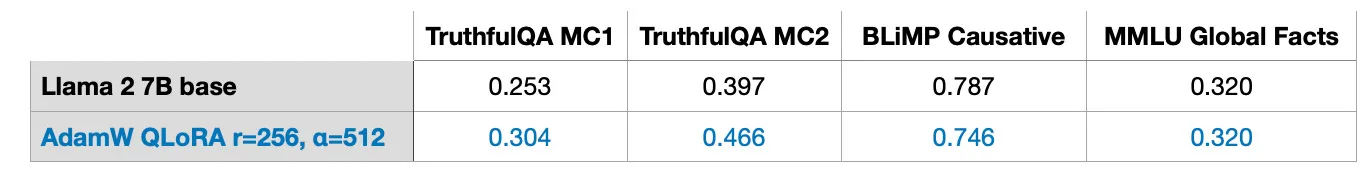
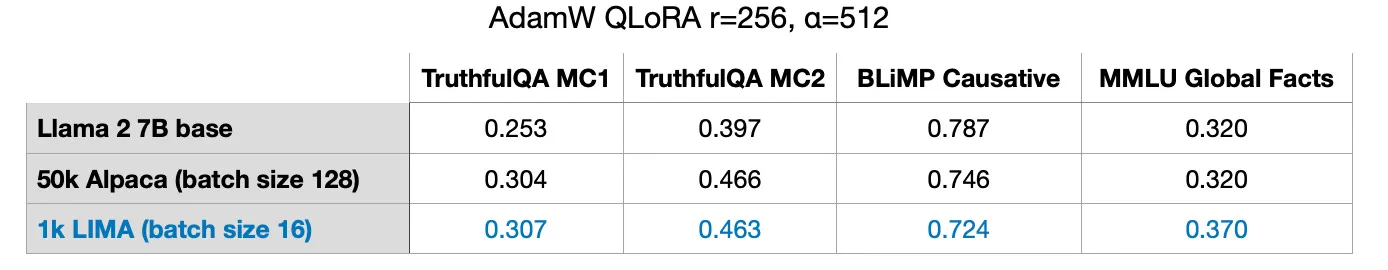
使用最优配置(r=256,alpha=512)在LIMA上微调,得到的效果与样本量50倍于它的Alpaca数据集相当,甚至更优。

figure13

Q2:LoRA适用于领域适配吗?

很遗憾,我对这个问题没有非常确定的答案。一般来说,模型的知识主要来自预训练数据集;指令微调更多是引导大语言模型学会遵循指令。

但值得注意的是,如果显存受限,LoRA也可以用于在领域特定数据集上对已有的预训练大语言模型做继续预训练。

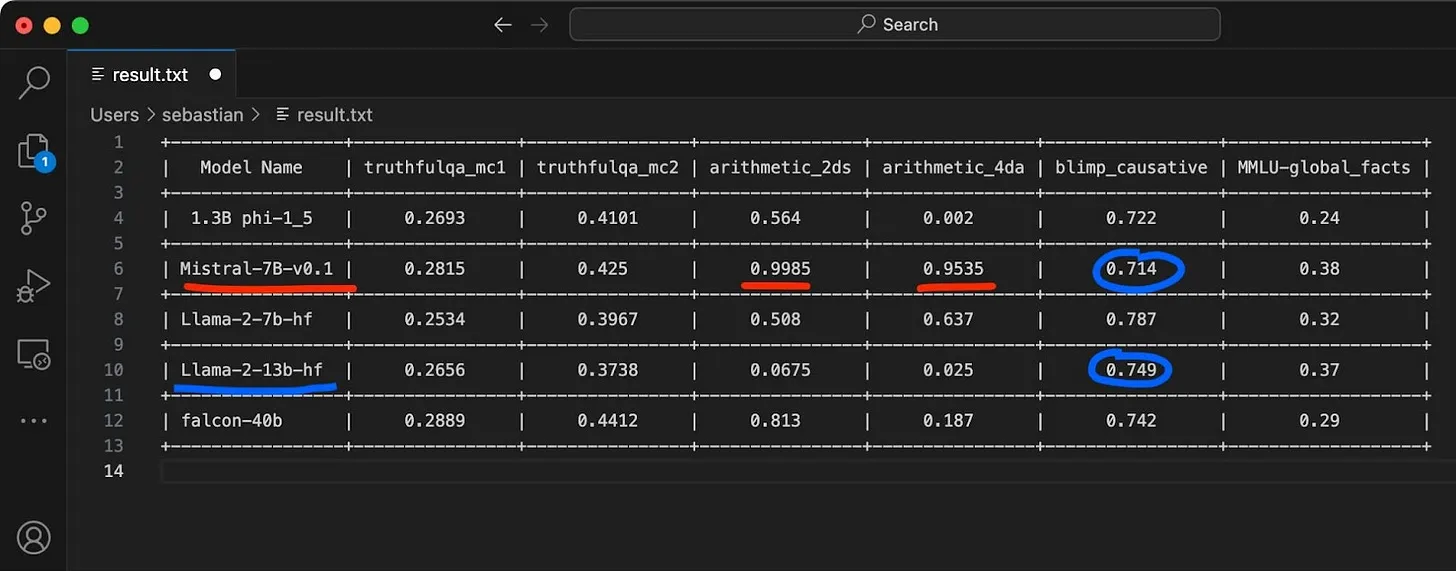
我的实验中包含两个算术基准测试(详见https://lightning.ai/pages/community/lora-insights/ ),结果显示LoRA微调后的模型在这两项上的表现远差于预训练基座模型。我的假设是:因为Alpaca数据集中没有对应的算术样例,模型“遗忘”了算术能力。至于模型是完全丢失了这部分知识,还是只是无法响应相关指令,还需要进一步研究。但这里可以得到一个结论:微调大语言模型时,最好包含所有你关心的任务类型的样例。

Q3:如何选择最优的秩(rank)?

很遗憾,目前没有很好的经验法则可以直接选出合适的r,它是一个需要针对每个模型、每个数据集单独探索的超参数。

我的推测是:r过大会导致更严重的过拟合;而r太小则可能无法覆盖数据集中多样化的任务。换句话说,数据集中的任务越多样,r的取值就应该越大。比如,如果只需要模型做基础的两位数算术,很小的r可能就足够了。但这只是假设,还需要更多实验验证。

Q4:必须在所有层都启用LoRA吗?

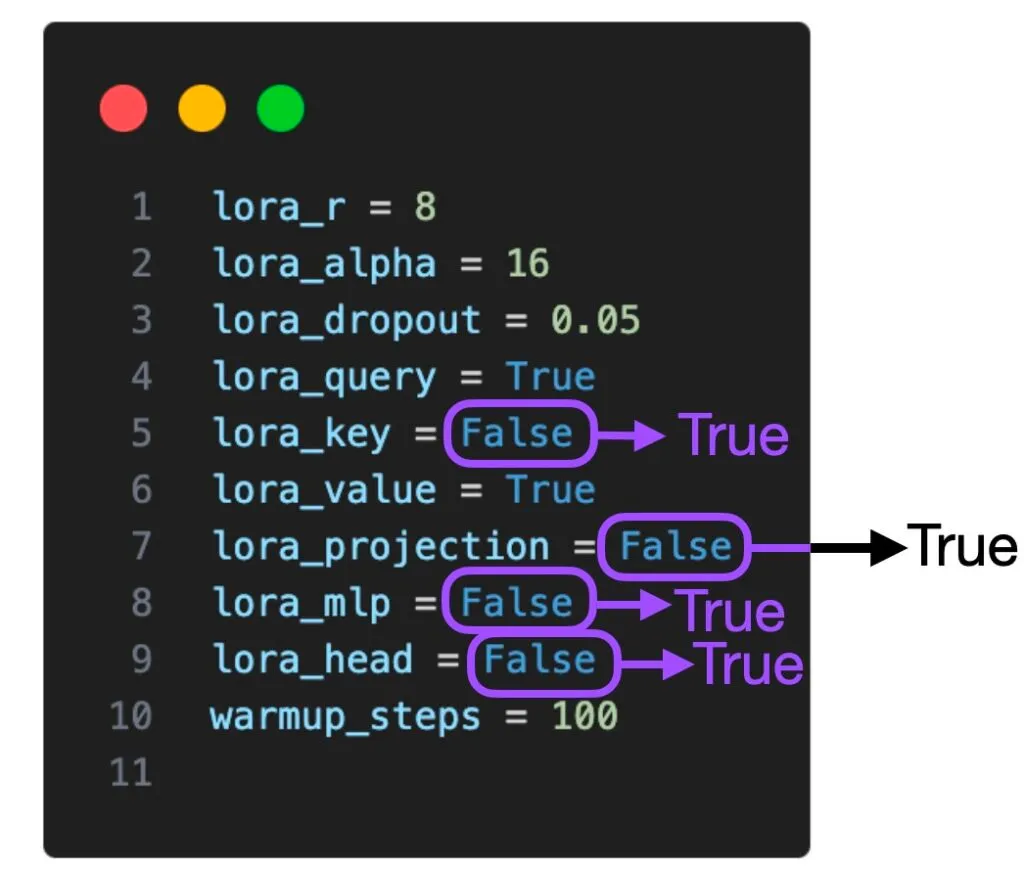
我只探索了两种设置:(1)仅在查询和值权重矩阵启用LoRA;(2)在所有层启用LoRA。未来可以探索更多组合,比如仅在投影层启用LoRA是否真的有增益,这是一个值得研究的方向。

figure14

举例来说,仅考虑lora_query、lora_key、lora_value、lora_projection、lora_mlp、lora_head这几个开关,就有2⁶=64种组合可以探索。这是未来研究一个很有意思的方向。

Q5:如何避免过拟合?

一般来说,r越大可训练参数越多,过拟合风险就越高。如果模型出现过拟合,首先可以尝试降低r,或者扩大数据集规模。此外,还可以提高AdamW或SGD优化器的权重衰减率,也可以考虑增大LoRA层的dropout值。

我在实验中没有深入探索LoRA的dropout参数(使用了固定的0.05 dropout率),这是未来值得研究的方向。

Q6:其他优化器的效果如何?

未来还有很多有意思的大语言模型优化器值得探索,其中一个是今年5月发布的Sophia(论文见https://arxiv.org/abs/2305.14342)。

Sophia是一种二阶优化算法,在Adam和AdamW占据主流的大语言模型领域,它的表现很有吸引力。论文显示,相比Adam,Sophia的训练速度快2倍,且训练出的模型效果更好。简而言之,Sophia是通过梯度曲率而非梯度方差来对梯度做归一化,这是它与Adam的核心区别。

Q7:还有哪些因素会影响显存占用?

除了精度和量化设置、模型大小、批次大小、可训练LoRA参数量之外,数据集本身也会影响显存占用。

注意Llama 2的上下文窗口(block size)是4096个token。大语言模型的上下文窗口决定了它一次能处理的最大序列长度;但训练序列越短,由于未来token掩码的存在,显存节省就越明显。

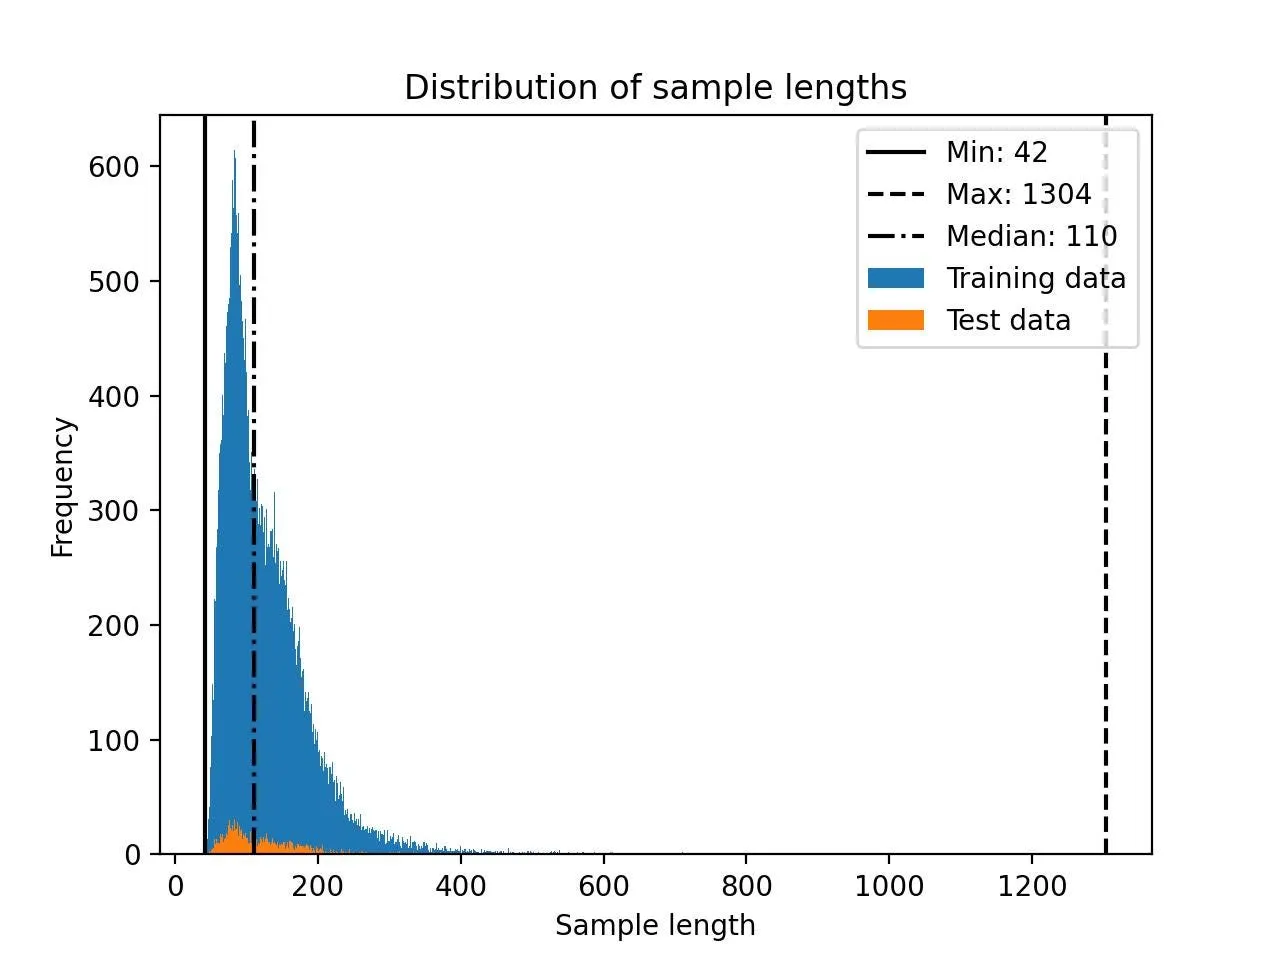
例如Alpaca数据集的序列长度相对较短,最大长度为1304个token。

figure15

当我用最大长度2048个token的其他数据集实验时,显存占用从17.86 GB上升到了26.96 GB。

Q8:与全量微调、RLHF相比效果如何?

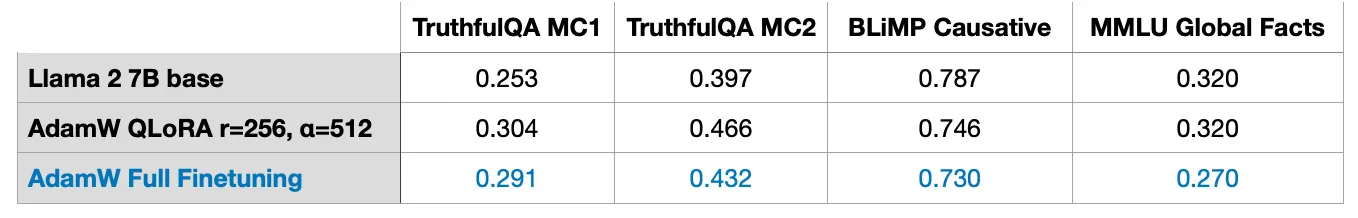
我没有做RLHF实验(感兴趣的读者可以看我之前的文章:https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives ),但我做了全量微调的对比。

全量微调至少需要2张GPU,耗时3.5小时,每张卡显存占用36.66 GB。但最终的基准测试结果并不理想,大概率是过拟合或者超参数设置不佳导致的。

figure16

Q9:多个LoRA权重可以合并吗?

可以,多组LoRA权重是可以合并的。训练过程中,LoRA权重与预训练权重是分开存储的,每次前向传播时再叠加。

在实际应用中,如果你有多组LoRA权重(比如为每个客户单独训练一组),分开存储可以节省磁盘空间。但训练结束后,也可以将LoRA权重与预训练权重合并,得到一个完整的模型。这样在前向传播时就不需要每次都叠加LoRA权重:

weight += (lora_B @ lora_A) * scaling

我们可以按上面的公式完成权重更新,然后保存合并后的权重。

同理,我们也可以叠加多组LoRA权重:

weight += (lora_B_set1 @ lora_A_set1) * scaling_set1
weight += (lora_B_set2 @ lora_A_set2) * scaling_set2
weight += (lora_B_set3 @ lora_A_set3) * scaling_set3
...

我还没有通过实验评估这种方法的效果,但技术上已经可以实现,Lit-GPT提供了对应的脚本:https://github.com/Lightning-AI/lit-gpt/blob/main/scripts/merge_lora.py

Q10:逐层最优秩适配(Layer-wise Optimal Rank Adaptation)效果如何?

为了简化,我们训练深度神经网络时通常给所有层设置相同的学习率,而学习率本身是需要调优的超参数。更进一步,我们也可以给每一层设置不同的学习率(参考:https://kozodoi.me/blog/20220329/discriminative-lr#:~:text=The%20implementation%20of%20layer%2Dwise,with%20the%20corresponding%20learning%20rates. )。但实践中很少这么做,因为这会带来额外开销,而且深度神经网络训练本来就有大量超参数需要调整。

与逐层设置不同学习率类似,我们也可以给不同层设置不同的LoRA秩。我还没有看到相关的实验研究,但有一篇文章详细介绍了这种方法:https://medium.com/@tom_21755/llm-optimization-layer-wise-optimal-rank-adaptation-lora-1444dfbc8e6a(也缩写为LORA)。理论上这听起来是个好主意,但它会让超参数优化的选择数量大幅增加。


本杂志是我的个人兴趣项目。如果希望支持我的创作,欢迎购买我的新书:https://amzn.to/4fqvn0D (我相信这本书会让你收获颇丰,它对大语言模型工作原理的讲解深度是其他地方找不到的。)

figure17

《从零构建大语言模型》购买链接:https://amzn.to/4fqvn0D

如果你读过这本书,能抽出几分钟时间留下评价的话,我会非常感激:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 。这对作者的帮助非常大!

另外,我最近也在Substack上开通了付费订阅选项,可以直接支持本杂志的创作。

《Ahead of AI》是读者支持的出版物。若想接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

现阶段AI是否会替代人类

近期在读一个LangChain的系列文章,文章的最后,作者提出了一个问题:“AIGC来了,人类画师还有价值吗?”

这是一个好问题,在现阶段,我的理解是这样的:

AI绘画提供了一种通用能力,而且很多时候效果很不错,有商用价值,但并非无所不能。说白了就是一种新工具而已,我们该用积极心态看待问题。

就像本文指出的,对人来说效果并非一切。人是有情感的,不仅现在的AI生成物无法替代,很多客观指标更好的物品都无法替代。自己钓的鱼和市场买的是不一样的,自己阳台种的菜和农场种的是不一样的,父母做的菜和餐厅里的是不一样的,儿女给我们画的画和别人的画是不一样的,哪怕替代品指标更好,也无法完成情感需求的替代。

但更进一步,人从一开始不应该和AI比。人很早就学会了不要和机器去比,机器比人力气大,比人跑的快,比人跳得高,但人类为何还要不断挑战自我呢?一旦我们把人工智能,随便换个名字,类人脑型计算阵列设施,问题就简化了。影像医生为何要和AI去比谁能先找到微小肺结节?画师为何要和AI比谁画图更快?网球裁判为何要和AI比谁能更准确的判断球是否出界?用好这些工具就好了啊。

从人类历史的经验看,机器替代人工的过程,在近现代史上出现了太多次,但实质上都是,熟练用工具的人大幅提升效率,最终替代了无法熟练使用工具的非顶尖人才。互联网时代也是一样的,互联网媒体兴起时,对传统媒体产生了巨大压力,但现在自媒体市场兴起,又给多少非科班同学创造了机会。AI短期内一定会抢占一些人类的工作岗位,熟练使用AI辅助编程的人,会挤压掉很多重复编码的工作机会。

但同样的,非科班同学将会拥有编程能力,未来一定会创造更大的市场。未来我们每个人都能有足够好的编程,绘画,作曲,剪辑,写作能力,都有便捷高效的获取并使用近乎无限知识的能力。专业知识普及化,会缓解人类教育周期过长的问题,会带来生产力质的变化。希望这种生产力的飞跃,能带领我们进入一个新的时代。

【转载】用于高效大语言模型对齐的RLHF潜在继任者,以及卷积神经网络的复兴

原文地址:A Potential Successor to RLHF for Efficient LLM Alignment and the Resurgence of CNNs,by Sebastian Raschka, on 2023-11-04

用于高效大语言模型对齐的RLHF潜在继任者,以及卷积神经网络的复兴

从视觉Transformer到创新的大语言模型微调技术,过去一个月AI社区研究氛围活跃,涌现了大量有意思的研究成果。

以下是本文将解读的核心研究亮点:

  • 在《规模化下卷积神经网络与视觉Transformer性能相当》(ConvNets Match Vision Transformers at Scale)一文中,Smith等人投入大量计算资源,对卷积神经网络(CNN)与视觉Transformer(ViT)展开了全面对比,挑战了ViT在图像分类任务中性能普遍优于CNN的认知。
  • Mistral 7B论文介绍了一款小巧却强大的语言模型:尽管参数量仅70亿、规模相对不大,但在各类基准测试中,它的表现超过了参数量更大的模型,比如130亿参数的Llama 2。这一惊艳的表现很大程度上可能得益于其独特的训练数据。
  • 《Zephyr:语言模型对齐的直接蒸馏》(Zephyr: Direct Distillation of LM Alignment)提出了全新的语言模型训练思路,展示了Zephyr 7B模型在对话基准与知识基准上的出色表现。该研究采用了蒸馏型直接偏好优化(DPO),其复杂度远低于人类反馈强化学习(RLHF)。
  • 在《NEFTune:噪声嵌入提升指令微调效果》(NEFTune: Noisy Embeddings Improve Instruction Finetuning)一文中,Jain、Chiang、Wen、Kirchenbauer等人提出了一种简单直接的方法来提升语言模型性能:向词元嵌入中注入均匀随机噪声。这项被称为NEFTune的技术被证实能显著提升对话任务的表现,且不会损害问答任务中的知识能力。

附言:关注月度研究亮点的读者可能会发现,我调整了AI研究论文亮点栏目的呈现形式:精选少数几篇论文进行更详细的摘要与探讨,同时补充了20余篇其他引起我兴趣的论文的极简摘要。希望大家喜欢这个新格式!

规模化下卷积神经网络与视觉Transformer性能相当

https://arxiv.org/abs/2310.16764 ,研究者投入了最高达11万TPU小时的计算预算,对ViT与CNN进行了公平的对比。

研究结果表明:当CNN的预训练计算预算与ViT的常用预训练预算相近时,CNN的性能可以与ViT持平。为此,他们在JFT数据集的40亿张标注图像上进行预训练,随后在ImageNet上对模型进行微调。

figure01
标注图出自:https://arxiv.org/abs/2310.16764

就我个人观察而言,微调ViT比微调CNN更容易获得不错的图像分类效果。比如小型ViT的相关内容见 https://magazine.sebastianraschka.com/p/accelerating-pytorch-model-training 。以我的教学经验来看,用预训练CNN要取得这么好的效果一直很难。现在回头看,这可能是因为ViT的预训练计算预算更充足。

推理性能

我希望论文能探讨推理性能这一方面。虽然微调后的CNN能追上微调后ViT的性能,但我很好奇,在论文所用的完全相同的模型下,二者在显存占用、推理速度上各有什么优势。

不过这个分析可能也有失公允,因为ViT架构相对CNN而言还很新,CNN已经经过了多年的深度优化。同时我也理解,这类研究超出了这篇论文的范围——如果同时考虑TPU和GPU,研究内容会相当庞杂。比如,TPU对ViT中常见的矩阵乘法优化更好,而GPU对卷积运算的优化更出色。

分类之外的场景

尽管这篇论文的核心结论——规模化下CNN能追上ViT的性能——非常有意思,但论文只聚焦于图像分类任务。一个很自然的问题是:这一结论是否也适用于目标检测和图像分割?这会是很有价值的后续研究方向。

论文参考信息
《规模化下卷积神经网络与视觉Transformer性能相当》,作者:Smith、Brock、Berrada、De(10月25日),https://arxiv.org/abs/2310.16764

Mistral 7B

https://arxiv.org/abs/2310.06825 介绍了一款70亿参数的新型“小”大语言模型。这篇论文的技术细节相对较少,但仍然值得在这里介绍,因为开源的Mistral 7B大语言模型是过去几周最热门的模型之一。此外,Mistral 7B基础模型也是下一节要介绍的Zephyr 7B的微调基底。

Mistral的表现超越其体量

Mistral 7B如此受欢迎的核心原因是:在绝大多数基准测试中,它的表现都优于参数量几乎是它两倍的130亿参数Llama 2模型。

figure02
标注图出自:https://arxiv.org/abs/2310.06825

它表现如此出色的具体原因尚不清楚,但很可能与训练数据有关。Llama 2和Mistral都没有公开训练数据,因此我们只能推测。

架构层面,该模型和Llama 2一样采用了分组查询注意力。Mistral架构一个有意思的新增设计是滑动窗口注意力,用于节省显存、提升计算吞吐量,从而加快训练速度。(滑动窗口注意力此前已在 https://arxiv.org/abs/1904.10509 和 https://arxiv.org/abs/2004.05150 中被提出。)

滑动窗口注意力

Mistral采用的滑动窗口注意力机制,本质上是一个固定大小的注意力块:当前词元只能关注到前面特定数量的词元,而非所有之前的词元,如下图所示。

figure03
标注图出自:https://arxiv.org/abs/2310.06825

在70亿参数的Mistral中,注意力块的大小为4096个词元,研究者训练模型时支持的上下文长度最高可达10万词元。

举个具体的例子:在常规自注意力机制中,模型处理第50000个词元时,可以关注前面全部49999个词元;而在滑动窗口自注意力中,Mistral模型只能关注第45904到50000个词元(因为50000 – 4096 = 45904)。

不过需要注意的是,滑动窗口注意力主要是让模型能处理更长的序列,本身并不会提升基准测试的性能。(绝大多数基准测试要么是选择题,要么只需要短答案。)

换句话说,滑动窗口注意力主要用于提升计算效率。Mistral能超越更大的Llama 2模型,大概率不是因为滑动窗口注意力,而是在采用了滑动窗口注意力的前提下依然实现了反超。

论文参考信息
《Mistral 7B》,作者:Jian、Sablayrolles、Mensch、Bamford等人(10月10日),https://arxiv.org/abs/2310.06825

Zephyr:语言模型对齐的直接蒸馏

https://arxiv.org/abs/2310.16944 介绍了Zephyr 7B,它是目前最受关注的开源大语言模型之一,原因有两点:

  1. Zephyr 7B在对话基准和知识基准上,都超越了同体量模型,甚至超过了多个参数量更大的模型。
  2. 作者采用完全自动化的直接偏好优化(DPO)训练Zephyr,其复杂度远低于人类反馈强化学习(RLHF)。

Zephyr的性能表现

在介绍论文中的DPO与蒸馏流程之前,我们先来看看Zephyr的性能表现。

作者在基准测试中选取了各类代表性的大语言模型,涵盖了经蒸馏监督学习训练的70亿参数模型,到经RLHF训练的700亿参数模型。

https://arxiv.org/abs/2306.05685 和 https://tatsu-lab.github.io/alpaca_eval/ 是用于评估大语言模型对话能力的基准。如下表所示,70亿参数的Zephyr模型在同体量模型中表现最优。更令人惊艳的是,在MT-Bench基准上,Zephyr的表现甚至超过了参数量是它10倍的700亿参数Llama 2对话模型。

figure04
标注图出自Zephyr论文,https://arxiv.org/abs/2310.16944

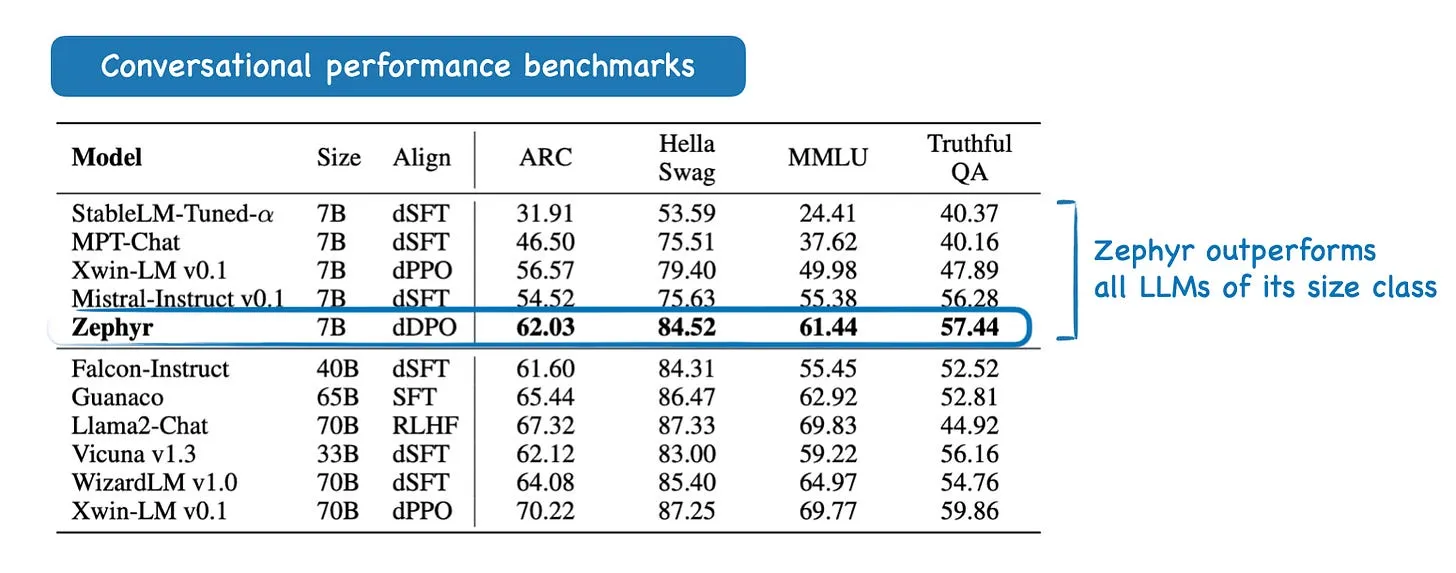
RLHF、DPO这类对齐技术通常聚焦于提升大语言模型的指令遵循能力,同时优化其有用性(对Llama 2而言还包括安全性)。但指令遵循能力的提升,有时会对大语言模型的知识能力产生负面影响。因此,作者在另一项基准测试中验证了Zephyr也具备顶尖的知识能力——测试采用Hugging Face开源大语言模型排行榜(https://huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard )中的选择题任务,结果如下表所示。

figure05
标注图出自Zephyr论文,https://arxiv.org/abs/2310.16944

蒸馏

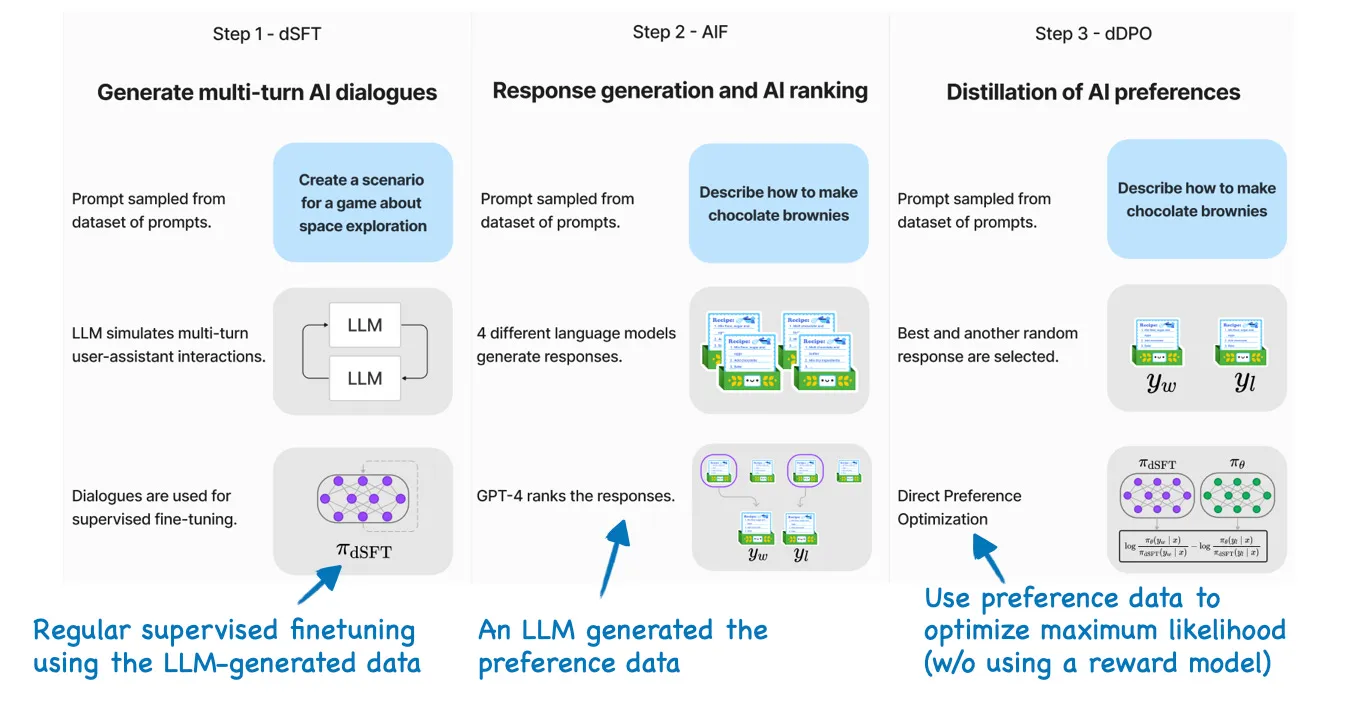
与RLHF及其他近端策略优化方法不同,本文提出的dDPO方法不需要人工标注与采样——dDPO是一套完全自动化、端到端的微调流水线。

蒸馏过程是让更小的目标(学生)大语言模型向更大的现有大语言模型(教师)学习。在本研究中,作者在两个环节使用了大语言模型生成的数据:

  1. 创建用于监督微调的数据集(类似自指令方法);
  2. 对响应进行采样与排序,收集偏好数据用于对齐微调。

下一节我们将详细解析dDPO流程。

直接偏好优化

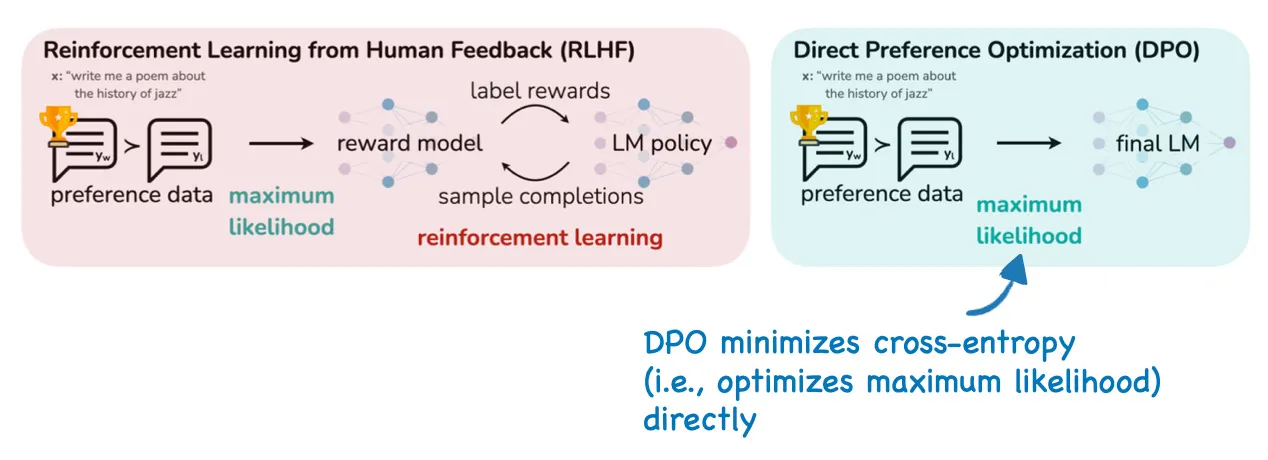
本研究中,研究者采用了蒸馏型直接偏好优化(dDPO)。在介绍蒸馏部分之前,我们先明确DPO的定义。DPO是RLHF的替代方案,它直接基于奖励训练模型,与RLHF的思路不同。(关于RLHF的更多细节,可以参考我的专题文章 https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives )

figure06
标注图出自《直接偏好优化:你的语言模型本质上就是奖励模型》论文(https://arxiv.org/abs/2305.18290)

Zephyr采用DPO方法,并且完全基于大语言模型(通过GPT-4)生成的数据进行训练。这种完全不引入人工参与的方法能取得这么好的效果,非常令人惊叹。

figure07
Zephyr微调采用的三步dDPO流程,标注图出自Zephyr论文,https://arxiv.org/abs/2310.16944

局限性

这是一篇非常亮眼的论文,但我认为MT-Bench和AlpacaEval基准可能存在潜在偏差——这两个基准都使用GPT-4进行偏好评估。而dDPO流程中也用GPT-4做偏好排序,因此AlpacaEval和MT-Bench的结果很可能偏乐观。如果能看到针对Zephyr模型的人类偏好评估会很有意思(不过这类研究成本很高,我也理解作者为什么没有做)。

需要注意的是,这篇论文的核心目标是打造小型高效的大语言模型,使其性能超过经RLHF训练的更大模型(比如700亿参数的Llama 2对话模型)。但蒸馏方法大概率不足以培育出全新的顶尖大语言模型(比如GPT-4的继任者)。由于该方法的数据来自GPT-4,我推测GPT-4会成为该模型性能的天花板。

不过,(不做蒸馏的)DPO能否完全替代RLHF用于新模型的全流程开发,仍然值得期待。

总结

这篇论文还有很多有意思的洞见和消融实验,受文章篇幅所限我没有全部展开。比如读者可能会好奇:为什么dDPO是三步流程,第一步还要做监督微调?能不能跳过第一步,只用第2、3步的DPO训练模型?答案是:如果没有第一步的监督微调,模型的表现会非常差。

这是一篇极具价值的论文,我预计它会成为高效训练与对齐大语言模型的新一代参考方法。

论文参考信息
《Zephyr:语言模型对齐的直接蒸馏》,作者:Tunstall、Beeching、Lambert、Rajani等人(10月25日),https://arxiv.org/abs/2310.16944

NEFTune:噪声嵌入提升指令微调效果

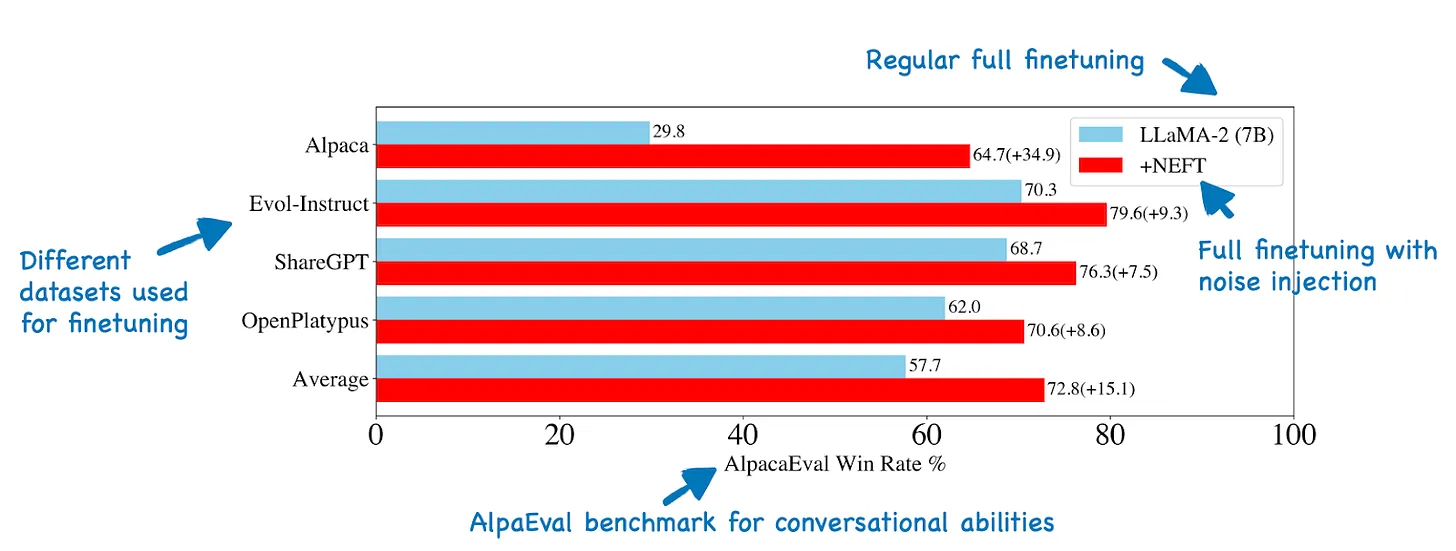
我们通常通过优化基础模型、扩大数据集规模、提升数据质量来提升大语言模型的微调效果(下一期《Ahead of AI》会详细讨论这点)。而在 https://arxiv.org/abs/2310.05914 中,研究者尝试了另一种更简单的思路:向词元嵌入中注入均匀随机噪声。

有意思的是,向词元嵌入加入随机噪声后,模型在AlpacaEval上的性能大幅提升,如下图所示。

figure08
标注图出自:https://arxiv.org/abs/2310.05914

https://tatsu-lab.github.io/alpaca_eval/ 是一项基准测试,它通过GPT-4来判断基础模型和微调模型哪个的响应更好。这类自动化的大语言模型基准解读需要谨慎,因为哪怕是格式上的微小变化,都可能导致性能波动。此外,GPT-4的偏好分析也会受回复长度的影响(GPT-4通常更偏好更长的回复)。不过在本研究中,研究者通过人类评估者复现了实验结果,说明这一效果是真实存在的。

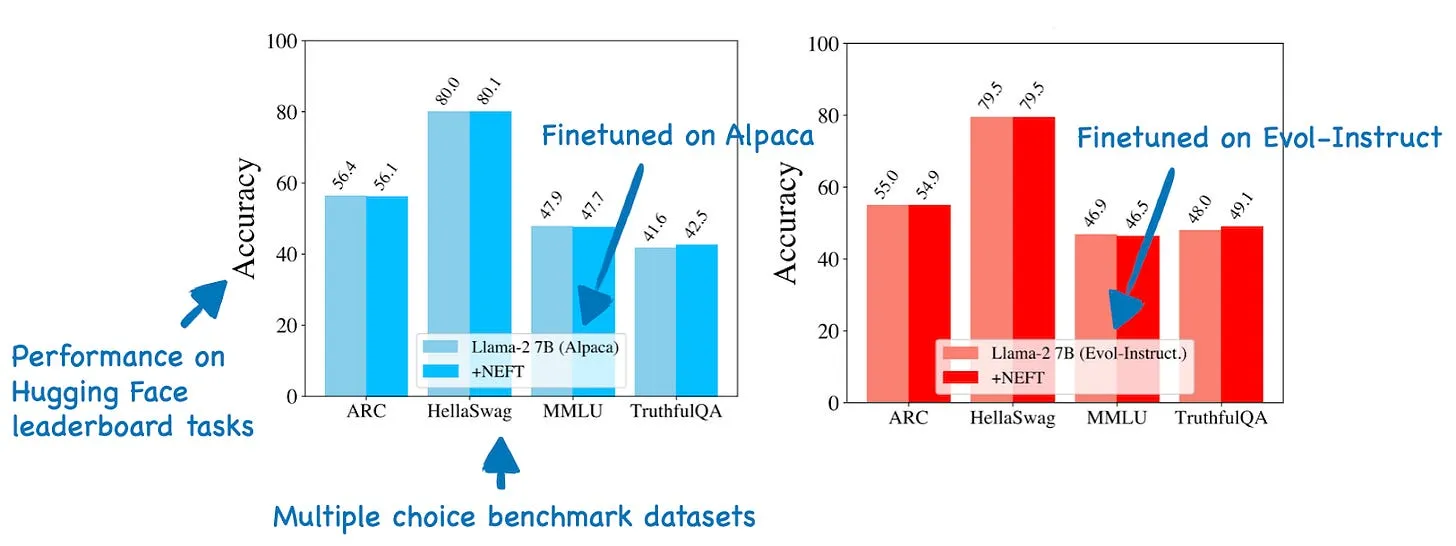
那NEFTune在Hugging Face OpenLLM排行榜这类选择题问答任务上表现如何?结果显示,常规微调和经NEFTune微调的模型性能持平,如下图所示,说明NEFTune训练不会造成知识能力的下降。

figure09
标注图出自:https://arxiv.org/abs/2310.05914

NEFTune对AlpacaEval这类对话任务性能的提升,很可能源于过拟合的减少。比如研究者发现,NEFTune会提高训练集损失,同时降低测试集损失。

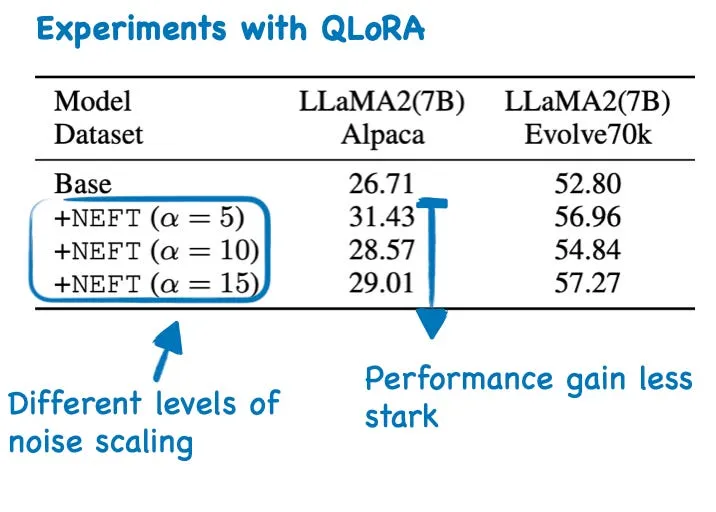
上述实验都是在全量微调的条件下完成的。不过这种噪声注入方法也可以和目前最主流的微调技术搭配使用,比如LoRA和QLoRA。在QLoRA场景下,NEFTune也有正向效果,但幅度比全量微调更小,如下表所示。

figure10
标注表格出自:https://arxiv.org/abs/2310.05914

随机噪声注入可以看作一种简单的数据增强方式,而数据增强通常用于减少过拟合。如果能和其他减少大语言模型过拟合的技术做对比研究会很有意思,比如提高权重衰减率,或者提高适配器层的丢弃率。QLoRA通常采用0.05的丢弃率,而它的效果更弱,这一点也能支撑上述假设。

尽管我平时更偏好使用QLoRA做微调——因为相比全量微调,它能让我微调参数量大得多的模型——但我仍然觉得NEFTune技术非常有吸引力。注入随机噪声实现起来很简单,本质上只是微调大语言模型时多了一个配置项(通过超参数控制噪声的幅度)。

论文参考信息
《NEFTune:噪声嵌入提升指令微调效果》,作者:Jain、Chiang、Wen、Kirchenbauer等人(2023年10月9日),https://arxiv.org/abs/2310.05914

其他值得关注的研究论文

  • 《对齐天花板:人类反馈强化学习中的目标错配》,作者:Lambert、Calandra(10月31日),https://arxiv.org/abs/2311.00168
    本文探讨了过度使用人类反馈强化学习(RLHF)带来的问题:会导致模型因偏差的安全考量而回避用户请求、行为缺乏灵活性、回复风格单调,同时还对奖励模型的有效性、当前这类模型评估工具的准确性提出了质疑。

  • 《骨干网络之争:预训练模型在计算机视觉任务上的大规模对比》,作者:Goldblum、Souri、Ni、Shu等人(10月30日),https://arxiv.org/abs/2310.19909
    与《规模化下卷积神经网络与视觉Transformer性能相当》的结论一致,本文作者发现,在大规模数据集上以监督方式预训练的卷积神经网络,在很多任务上的表现仍然优于预训练的视觉Transformer。

  • 《FP8-LM:训练FP8大语言模型》,作者:Peng、Wu、Wei、Zhao等人(10月27日),https://arxiv.org/abs/2310.18313
    作者提出了一套全新的FP8自动混合精度框架用于大语言模型训练,与常规的BFloat16框架相比,显存占用降低42%,训练速度提升64%,同时不损失模型精度,也不需要调整超参数。

  • 《CodeFusion:面向代码生成的预训练扩散模型》,作者:Singh、Cambronero、Gulwani、Le等人(10月26日),https://arxiv.org/abs/2310.17680
    研究者提出了一个7500万参数的模型,在绝大多数代码基准上,性能都超过了1750亿参数的GPT-3模型,以及专门针对代码优化的155亿参数StarCoder模型。

  • 《检测大语言模型的预训练数据》,作者:Shi、Ajith、Xia、Huang等人(10月25日),https://arxiv.org/abs//2310.16789
    本文深入探讨了判断黑盒模型是否在特定文本(比如受版权保护的书籍)上训练过的难题,并提出了一种方法,虽不完美,但相比之前的技术提升了7.4%。

  • 《ALCUNA:当大语言模型遇见新知识》,作者:Yin、Huang、Wan(10月23日),https://arxiv.org/abs/2310.14820
    研究者针对“大语言模型处理新知识的能力”这一评估空白,提出了新的基准测试,结果显示大语言模型在结合新生成知识与已有内部知识进行推理时表现不佳。

  • 《对比偏好学习:无需强化学习的人类反馈学习》,作者:Hejna、Rafailov、Sikchi、Finn等人(10月20日),https://arxiv.org/abs/2310.13639
    本文提出了对比偏好学习(CPL):一种更简单的离策略算法,作为RLHF的替代方案。

  • 《长文本问答中检索增强的理解研究》,作者:Chen、Xu、Arora、Choi(10月18日),https://arxiv.org/abs/2310.12150
    本研究为检索增强对大语言生长文本生成的影响提供了新视角,总结了长文本生成的归因模式,以及归因错误的主要成因。

  • 《大语言模型能解释自身吗?大语言模型自解释现象研究》,作者:Huang、Mamidanna、Jangam、Zhou等人(10月17日),https://arxiv.org/abs/2310.11207
    研究结果表明:像ChatGPT这类经过人类对话指令微调、会输出带自解释的“有用”回复的大语言模型,生成的解释质量与传统模型可解释性技术相当,且生成成本更低。

  • 《BitNet:面向大语言模型的可扩展1比特Transformer》,作者:Wang、Ma、Dong、Huang等人(10月17日),https://arxiv.org/abs/2310.11453
    本研究提出了BitNet——一套面向大语言模型的可扩展、稳定的1比特Transformer架构,核心是用BitLinear层替代常规的nn.Linear层,支持从头训练1比特权重的模型;相比8比特量化方法和FP16 Transformer基线,它在保持竞争力性能的同时,显著降低了显存占用与能耗。

  • 《Llemma:开源数学大语言模型》,作者:Azerbayev、Schoelkopf、Paster、Dos Santos等人(10月16日),https://arxiv.org/abs/2310.10631
    本文介绍了数学大语言模型Llemma,它在MATH基准上的表现超过现有模型,还支持形式化定理证明(70亿与340亿参数版本、数据集、代码均已开源)。

  • 《LoftQ:感知LoRA微调的大语言模型量化方法》,作者:Li、Yu、Liang、He等人(10月12日),https://arxiv.org/abs/2310.08659
    LoftQ是一套全新的量化框架,将量化与预训练模型的LoRA微调相结合,通过提供合适的低秩初始化提升量化模型的泛化能力,有效缩小了全量微调与LoRA微调在下游任务上的性能差距。

  • 《大语言模型事实性综述:知识、检索与领域特性》,作者:Wang、Liu、Yue、Tang等人(10月11日),https://arxiv.org/abs/2310.07521
    本综述梳理了大语言模型输出事实错误的问题,评估了大语言模型事实性的评测方法(重点介绍核心指标与基准),并探讨了提升大语言模型事实性的领域专属策略。

  • 《RLHF对大语言模型泛化性与多样性的影响研究》,作者:Kirk、Mediratta、Nalmpantis、Luketina等人(10月10日),https://arxiv.org/abs/2310.06452
    这项针对RLHF微调各阶段的全面分析表明:尽管RLHF能带来更好的分布外(OOD)泛化能力(尤其是训练与测试分布差异较大时),但与监督微调相比,它会显著降低输出的多样性。

  • 《OpenWebMath:高质量数学网页开源数据集》,作者:Paster、Dos Santos、Azerbayev、Ba(10月10日),https://arxiv.org/abs/2310.06786
    本文介绍了OpenWebMath:一个源自Common Crawl、包含147亿词元的数学网页数据集。实验表明,在该数据集上训练的语言模型,性能远超在20倍以上通用语言数据上训练的模型,凸显了代码、数学这类高质量、专业化词元对提升大语言模型推理能力的重要性。

  • 《LongLLMLingua:通过提示压缩加速并优化长上下文场景下的大语言模型》,作者:Jiang、Wu、Luo、Li等人(10月10日),https://arxiv.org/abs/2310.06839
    LongLLMLingua是一种提示压缩方法,旨在提升大语言模型对关键信息的关注度,同时解决长上下文场景下成本高、延迟高、性能差三大挑战。

  • 《潜一致性模型:少步推理生成高分辨率图像》,作者:Luo、Tan、Huang、Li等人(10月6日),https://arxiv.org/abs/2310.04378
    作者基于一致性模型的理念提出了潜一致性模型(LCM),用于加速Stable Diffusion这类预训练潜扩散模型的生成过程,还包含针对自定义图像数据集的微调技术。

  • 《思维传播:大语言模型复杂推理的类比方法》,作者:Yu、He、Ying(10月6日),https://arxiv.org/abs/2310.03965
    思维传播通过求解相关的类比问题,再将其解法迁移到新问题上,以此提升大语言模型的复杂推理能力。

  • 《检索遇上长上下文大语言模型》,作者:Xu、Ping、Wu、McAfee等人(10月4日),https://arxiv.org/abs/2310.03025
    研究者发现,4K上下文窗口搭配检索增强,在长上下文任务上的表现可以与经位置插值优化的16K上下文窗口微调模型相当,同时计算效率更高。

  • 《三思而后言:用暂停词元训练语言模型》,作者:Goyal、Ji、Rawat、Menon等人(10月3日),https://arxiv.org/abs/2310.02226
    在大语言模型的输入前缀后加入一串可学习的“暂停词元”,延迟输出直到最后一个暂停词元处理完毕;在预训练和微调阶段都应用该方法,能够提升模型性能。

  • 《面向近乎无限上下文的分块Transformer环形注意力》,作者:Liu、Zaharia、Abbeel(10月3日),https://arxiv.org/abs/2310.01889
    环形注意力将自注意力的计算并行分布到多设备上处理长序列,大幅提升了大语言模型的显存效率。

  • 《RA-DIT:检索增强双指令微调》,作者:Lin、Chen、Chen、Shi等人(10月2日),https://arxiv.org/abs/2310.01352
    检索增强双指令微调(RA-DIT)是一种全新的高效微调方法,可作为现有检索增强大语言模型方案的替代。

  • 《面向混合专家模型训练的稀疏反向传播》,作者:Liu、Gao、Chen(10月1日),https://arxiv.org/abs/2310.00811
    SparseMixer提出了一套适配混合专家模型稀疏计算的可扩展梯度估计器,通过二阶ODE求解器实现精准的梯度近似,在预训练、机器翻译等任务上将训练收敛速度最高提升2倍。

  • 《GrowLength:通过逐步增长训练长度加速大语言模型预训练》,作者:Jin、Han、Yang、Jiang(10月1日),https://arxiv.org/abs/2310.00576
    本文提出的GrowLength方法通过逐步增加序列长度来加速大语言模型预训练,从128逐步扩展到4096,有效提升了训练效率。

本杂志是个人兴趣驱动的项目,无直接稿酬。如果您愿意支持我,可以考虑购买 https://sebastianraschka.com/books 上的书籍。如果您觉得这些书籍富有洞见、有所帮助,欢迎推荐给您的朋友和同事。

figure11
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 http://mng.bz/M96o

您的支持对我意义重大!非常感谢!

【转载】2023年的人工智能与开源:高潮与低谷——年度回顾

原文地址:AI and Open Source in 2023,by Sebastian Raschka, on 2025-10-23

2023年的人工智能与开源:高潮与低谷——年度回顾

我们正稳步走向2023年末。我觉得现在是个好时机,来简要回顾一下2023年人工智能研究、产业以及开源领域发生的重大进展。

当然,本文只选取了我脑海中印象最深的相关主题。如果想了解更多内容,推荐大家查看我在https://magazine.sebastianraschka.com/archive上发布的月度《研究亮点》以及《Ahead of AI》第4-12期。

延续2022年的技术规模化趋势

今年,AI产品端尚未出现任何根本性的新技术或方法论。相反,今年的重点很大程度上是在去年已验证有效的方向上持续加码:

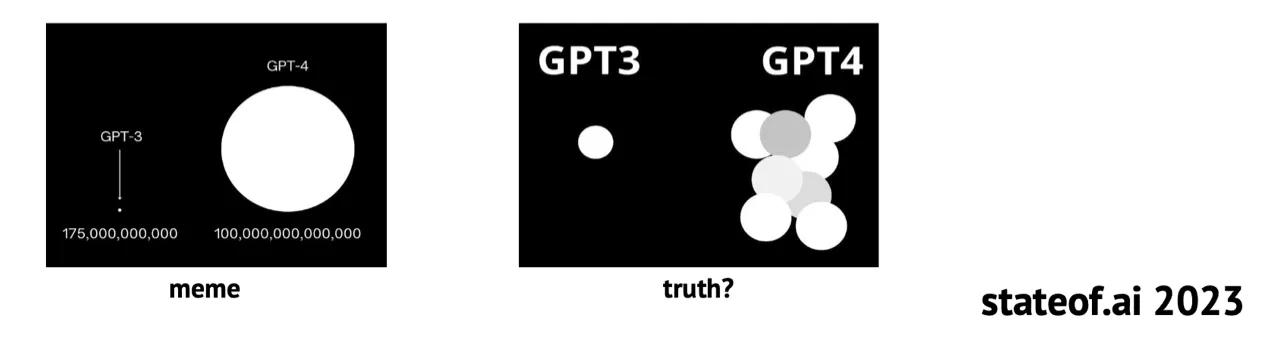
有一则Reddit爆料(https://www.reddit.com/r/LocalLLaMA/comments/14wbmio/gpt4_details_leaked/)称,GPT-4是一个混合专家(MoE)模型,由16个子模块组成。据传这16个子模块每个都有110亿参数(作为参考,GPT-3有1750亿参数)。

figure01
来自https://www.stateof.ai/的一张GPT-3/GPT-4梗图

GPT-4采用混合专家架构这件事大概率是真的,尽管我们目前还无法完全确认。一个趋势是,行业研究者在论文中披露的信息比以前越来越少。比如,此前的论文(https://arxiv.org/abs/2305.10435、https://paperswithcode.com/paper/language-models-are-unsupervised-multitask、https://arxiv.org/abs/2005.14165、https://arxiv.org/abs/2203.02155)都会披露架构和训练细节,而GPT-4的架构却是严格保密的。再举一例:Meta AI的第一篇论文(https://arxiv.org/abs/2302.13971)还详细说明了训练模型所用的数据集,而后续的论文(https://arxiv.org/abs/2307.09288)则对这些信息秘而不宣。
说到这里,斯坦福大学上周推出了“基础模型透明度指数”(https://hai.stanford.edu/news/introducing-foundation-model-transparency-index),根据该指数,Llama 2以54%的透明度位居第一,GPT-4以48%位列第三。

当然,要求企业公开商业机密可能并不合理。但这仍是一个值得关注的有趣趋势,因为看起来2024年我们还会沿着这个方向继续走。

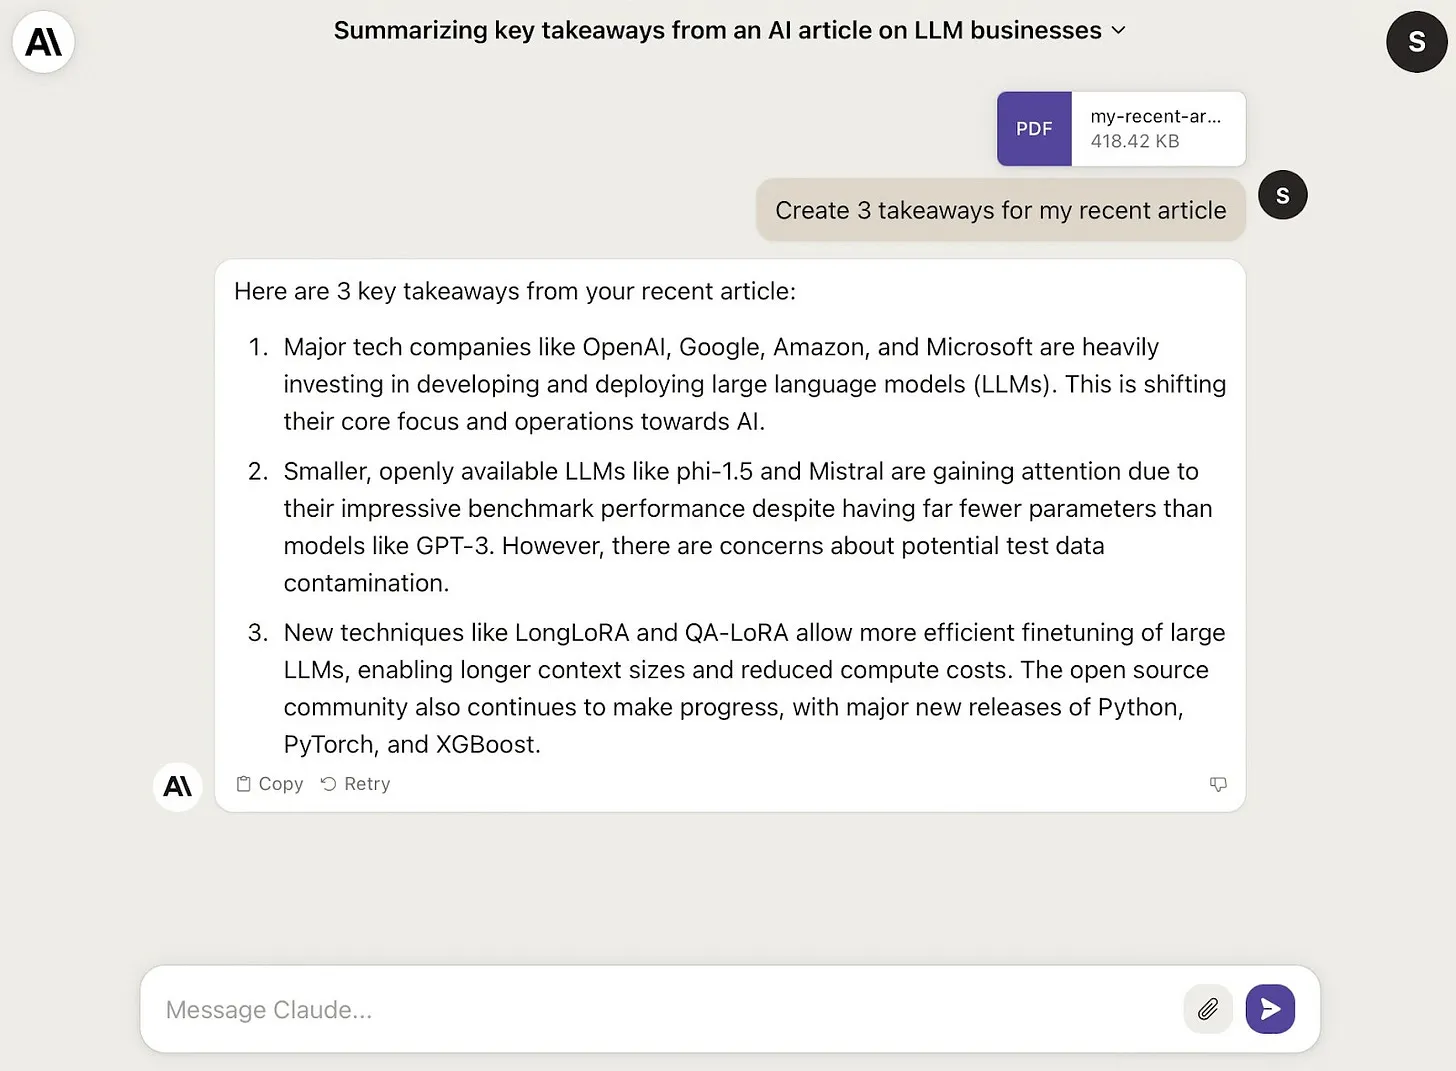
关于模型规模化,今年的另一个趋势是输入上下文长度的拓展。比如,GPT-4的竞品Claude 2(https://www.anthropic.com/index/claude-2)的核心卖点之一就是支持最高10万输入token(GPT-4目前限制为3.2万token),这让它在生成长文档摘要方面尤其有吸引力。再加上支持PDF输入,让它在实际场景中格外实用。

figure02
使用Claude 2生成PDF文档摘要

开源与研究趋势

在我的印象里,去年开源社区的重心很大程度上放在扩散模型(https://arxiv.org/abs/2112.10752,比如Stable Diffusion:https://github.com/CompVis/stable-diffusion)以及其他计算机视觉模型上。扩散模型和计算机视觉如今依然举足轻重,但今年开源社区和研究界更关注的焦点是大语言模型(LLM)。

开源(或者说“可公开获取”)大语言模型的爆发,一定程度上要归功于Meta发布的首个预训练模型(https://arxiv.org/abs/2302.13971)——尽管它的许可证限制颇多,但还是启发了大量研究者和从业者:比如斯坦福的 Alpaca(https://crfm.stanford.edu/2023/03/13/alpaca.html)、LMSYS的Vicuna(https://lmsys.org/blog/2023-03-30-vicuna/)、GPT4All(https://arxiv.org/abs/2303.16199)、Lit-LLaMA(https://github.com/Lightning-AI/lit-llama),这里只列举几个。

几个月后,Llama 2(https://arxiv.org/abs/2307.09288)——我在《Ahead of AI》第11期《新基础模型》(https://magazine.sebastianraschka.com/p/ahead-of-ai-11-new-foundation-models)中有过更详细的介绍——作为能力更强的基础模型,很大程度上取代了Llama 1,甚至还附带了微调版本。

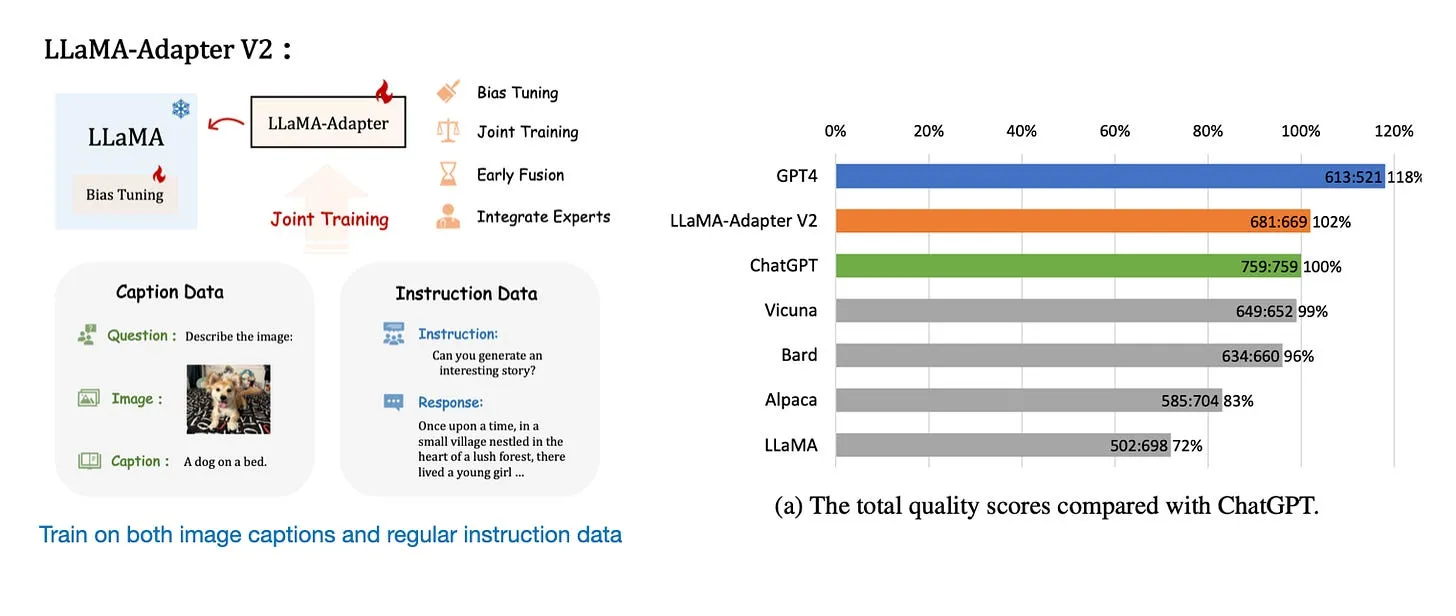
不过,大多数开源大语言模型仍然是纯文本模型,尽管像Llama-Adapter V2(https://arxiv.org/abs/2304.15010)这类微调方法有望将现有大语言模型改造为多模态模型。

figure03
图片来自Llama-Adapter V2论文(https://arxiv.org/abs/2304.15010)

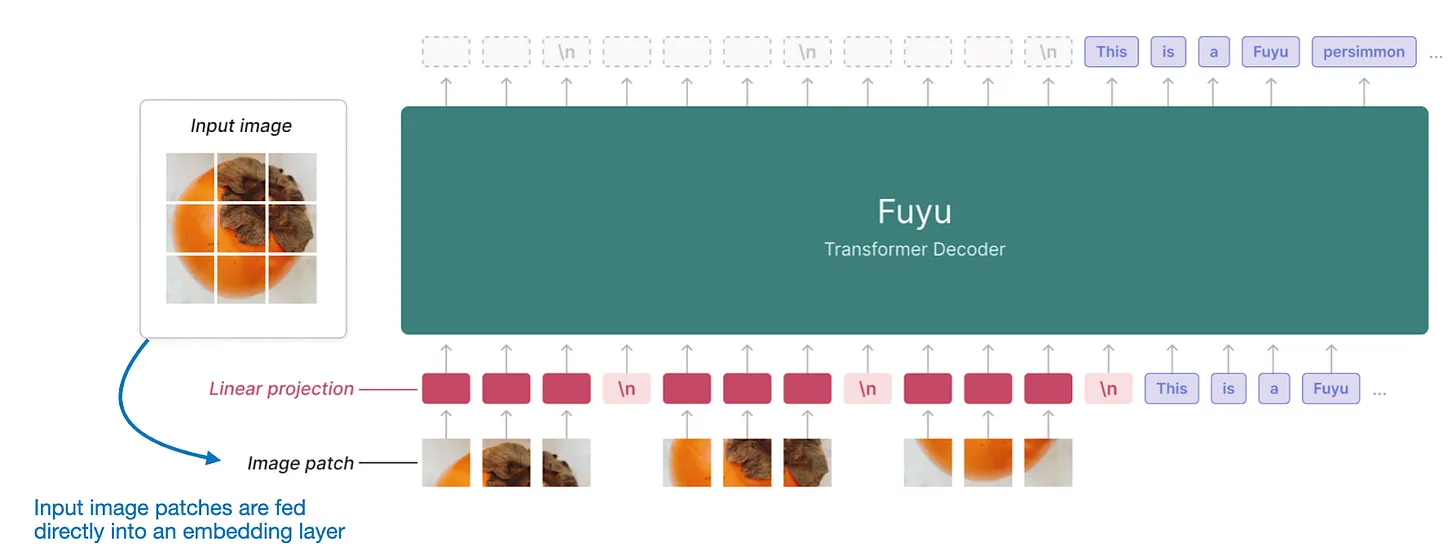
一个值得注意的例外是Fuyu-8B(https://www.adept.ai/blog/fuyu-8b),它就在10月17日刚刚发布。

figure04
标注图来自https://www.adept.ai/blog/fuyu-8b

值得注意的是,Fuyu将输入图像块直接传入线性投影层(或嵌入层)来学习自身的图像块嵌入,而不像其他模型和方法那样依赖额外的预训练图像编码器(比如LLaVA:https://github.com/haotian-liu/LLaVA、MiniGPT-4:https://github.com/Vision-CAIR/MiniGPT-4)。这极大简化了架构和训练流程。

除了上面提到的少数多模态尝试之外,最大的研究焦点仍然是用参数量小于1000亿的小型模型追平GPT-4的文本性能——这背后的原因可能是硬件资源成本与限制、数据获取渠道有限,以及更短的开发周期要求(迫于发表压力,大多数研究者没法花数年时间训练单个模型)。

不过,开源大语言模型的下一个突破未必来自模型规模的扩大。2024年,混合专家(MoE)方法能否将开源模型推向新高度,值得期待。

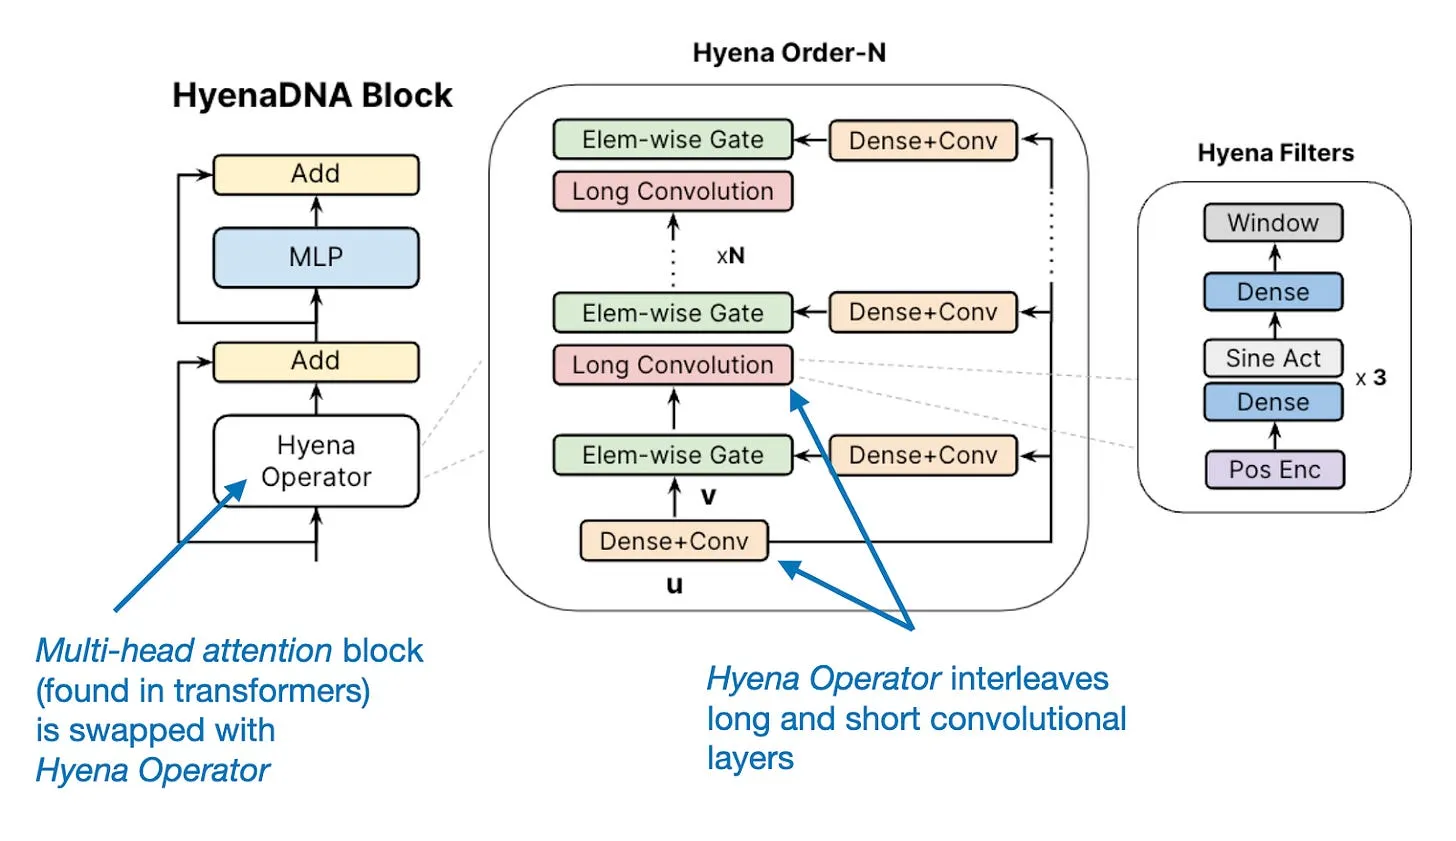
有意思的是,在研究层面,2023年我们也看到了一些基于Transformer的大语言模型的替代方案,包括循环架构的Hyena大语言模型(https://arxiv.org/abs/2305.13048)和卷积架构的大语言模型(https://arxiv.org/abs/2306.15794),它们的目标都是提升效率。但目前基于Transformer的大语言模型依然是行业标杆。

figure05
Hyena大语言模型架构标注图,来自https://hazyresearch.stanford.edu/blog/2023-06-29-hyena-dna

总的来说,开源领域今年非常活跃,取得了众多突破与进展。这个领域的价值远大于各部分的简单相加。因此,看到有些人主动游说反对开源AI,我感到很遗憾。但我希望我们能保持这种积极势头,打造更高效的解决方案和替代方案,而不是越来越依赖大型科技公司发布的ChatGPT类产品。

用一个积极的点结束这一部分:多亏了开源和研究社区,我们看到了可以在单张GPU上运行的小型高效模型,比如Mistral 7B(https://arxiv.org/abs/2309.05463,https://mistral.ai/)以及Zephyr(https://news.ycombinator.com/item?id=37891848),它们的性能正在向大型闭源模型靠拢——这是一个令人振奋的趋势,希望2024年能延续下去。

生产力承诺

我认为开源AI是发展高效、定制化大语言模型方案的主要路径,包括基于个人或领域特定数据进行微调、适配各类应用的大语言模型。如果你在社交媒体上关注我,可能见过我谈论并实践Lit-GPT(https://github.com/Lightning-AI/lit-gpt)——这是我积极参与贡献的一个大语言模型开源仓库。不过,虽然我是开源的坚定支持者,我也同样推崇设计精良的产品。

自ChatGPT发布以来,大语言模型几乎被用到了方方面面。读这篇文章的读者大概率都用过ChatGPT,所以我不用再赘述大语言模型在某些任务上确实很有用。

关键在于我们要把它们用在“合适”的地方。比如,我大概不会去问ChatGPT我常去的杂货店几点开门。但我最喜欢的用法之一,是修正语法,或者帮我头脑风暴、改写句子和段落。从更大的层面来说,大语言模型背后蕴藏的是生产力提升的承诺,这一点你可能也已经感受到了。

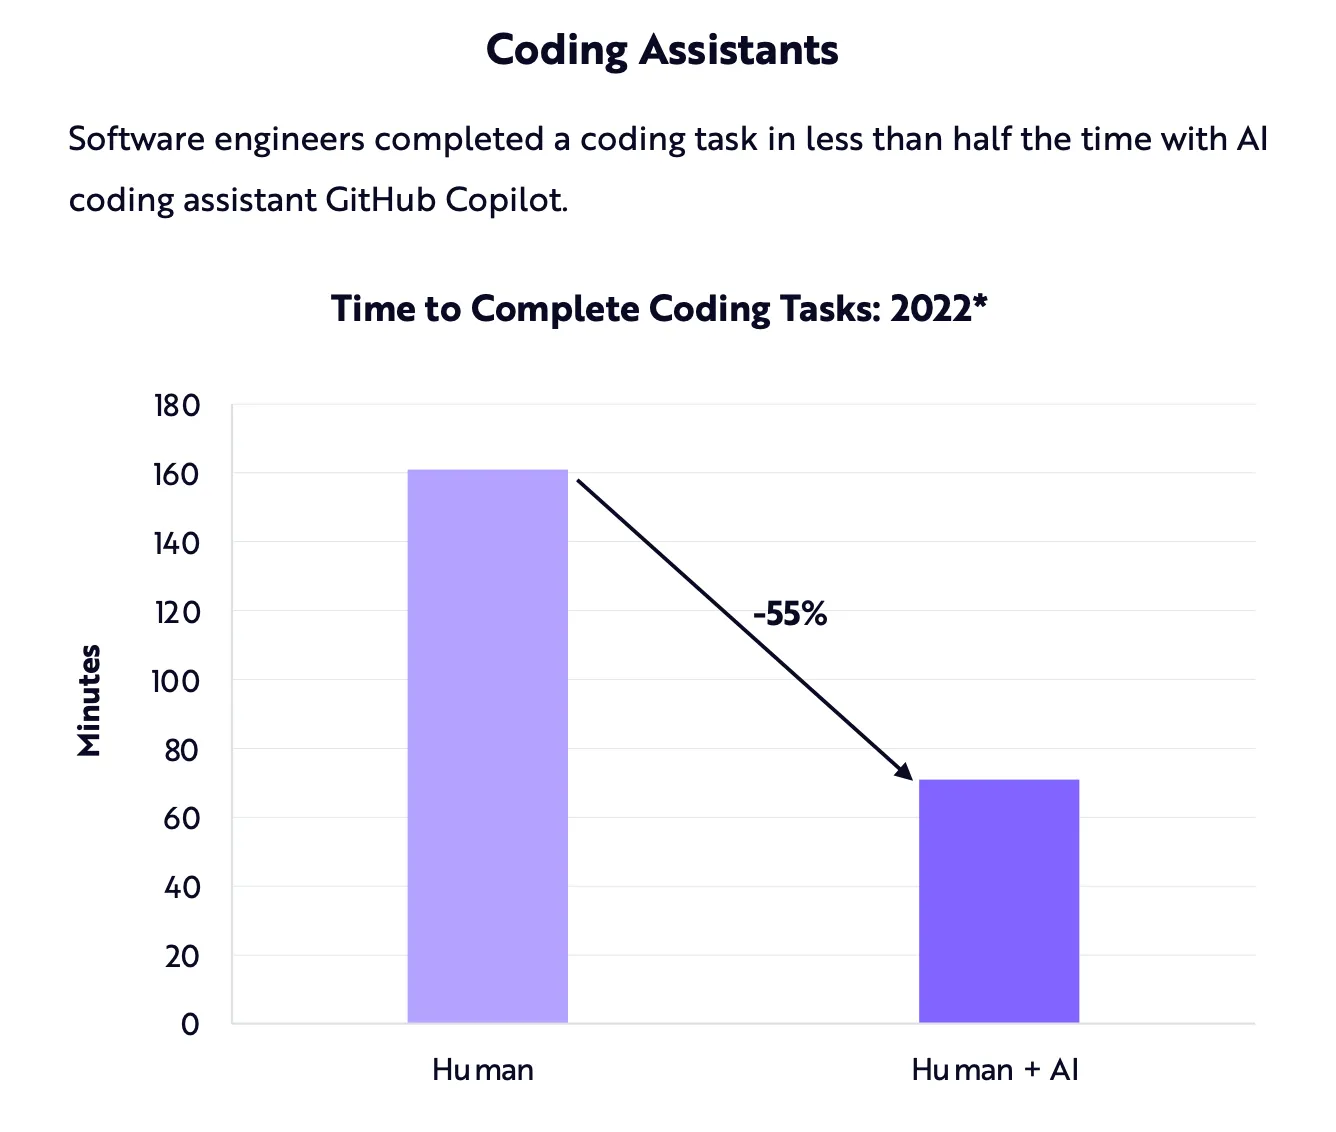
除了普通文本大语言模型,微软和GitHub推出的Copilot(https://github.com/features/copilot)也在不断成熟,越来越多的人开始使用它。今年早些时候,Ark Invest的一份报告(https://ark-invest.com/home-thank-you-big-ideas-2023/)估算,代码助手能将编码任务的完成时间缩短约55%。

figure06
图表来自https://ark-invest.com/home-thank-you-big-ideas-2023/

具体是不是55%还有待商榷,但如果你用过代码助手就会发现,它们真的非常有用,能让繁琐的编码工作轻松不少。

有一点是确定的:代码助手已经成为常态,而且未来只会变得更好。它们会取代程序员吗?我希望不会。但它们无疑会让现有程序员的生产力更高。

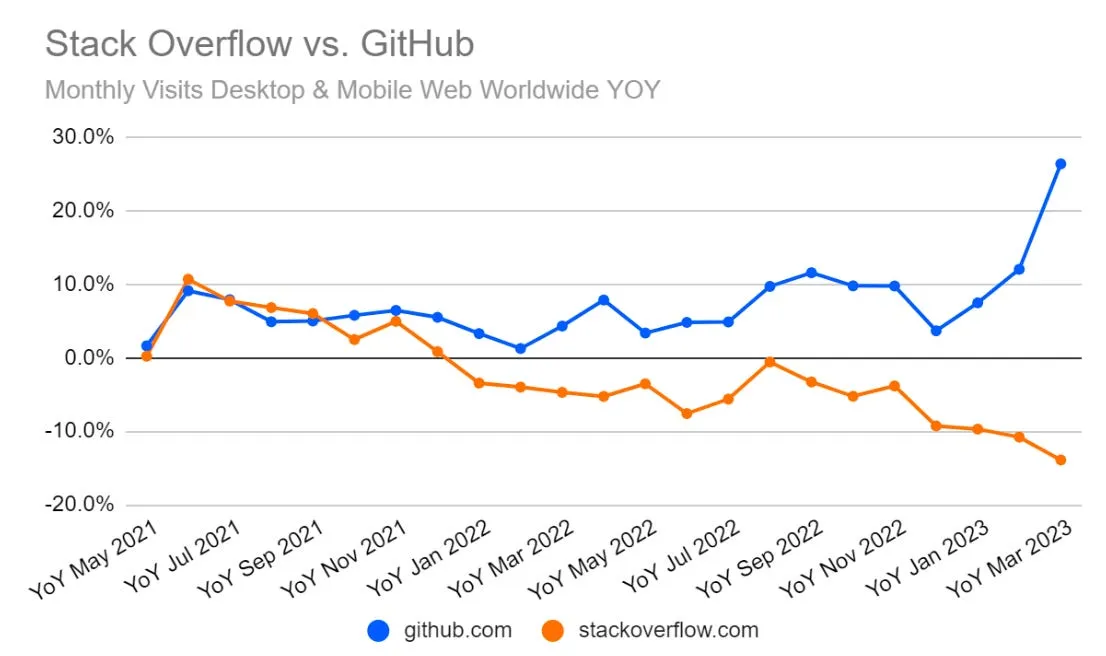
这对Stack Overflow意味着什么?《AI现状报告》里有一张图表,对比了Stack Overflow和GitHub的网站流量,这可能和Copilot的普及度上升有关。不过我觉得,即便是ChatGPT/GPT-4,对编码相关任务也已经非常有帮助了。我怀疑Stack Overflow流量的下滑,部分(甚至很大程度上)也要归因于ChatGPT。

figure07
图表来自http://stateof.ai/报告

AI面临的问题

幻觉问题

和2022年一样,这个问题依然困扰着大语言模型:它们可能生成有害内容,还容易出现幻觉。这一年里,我讨论过好几种解决方法,包括基于人类反馈的强化学习(RLHF)以及英伟达的NeMo Guardrails(https://github.com/NVIDIA/NeMo-Guardrails)。但这些方法都只是权宜之计,要么限制太严,要么约束不够。

到目前为止,还没有哪种方法(甚至连思路都没有)能100%可靠地解决这个问题,同时又不削弱大语言模型的正向能力。在我看来,归根结底还是我们怎么用大语言模型:不要什么事都依赖大语言模型,数学题就用计算器,把大语言模型当作写作伙伴,并且对它的输出做双重检查,诸如此类。

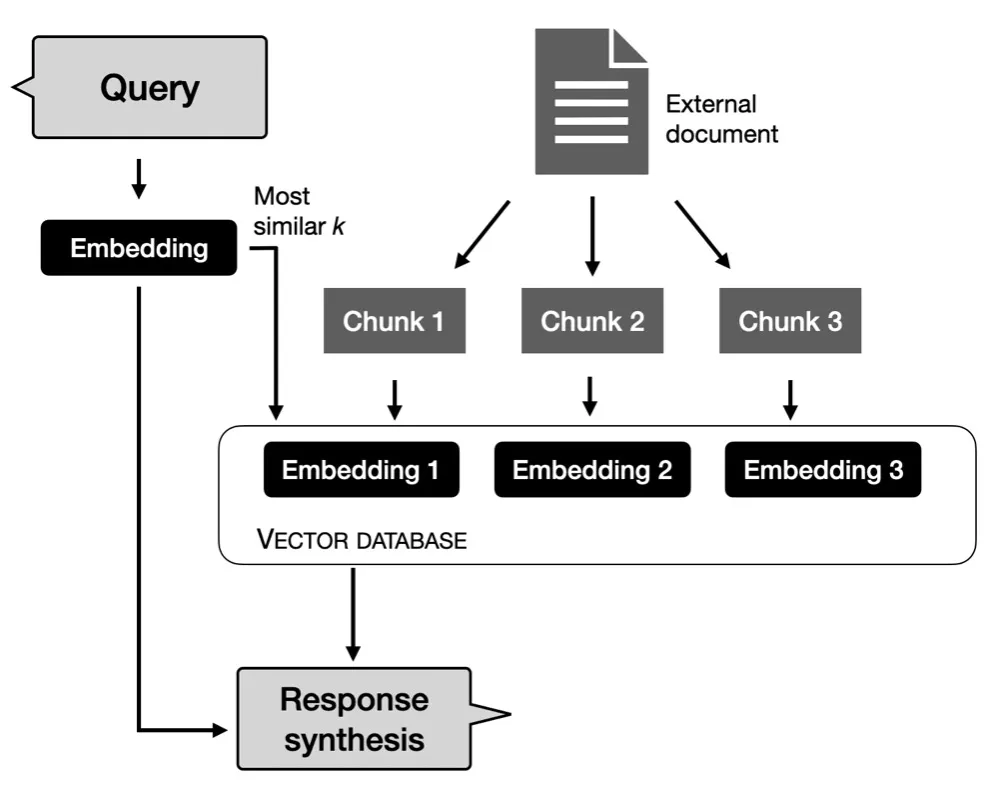
此外,针对特定的商业应用,探索检索增强生成(RAG)系统作为折中方案或许是值得的。在RAG架构中,我们从语料库中检索相关的文档片段,然后让大语言模型基于检索到的内容生成文本。这种方法让模型可以调用数据库和文档里的外部信息,而不用记住所有知识。

figure08
RAG示意图,来自https://leanpub.com/machine-learning-q-and-ai/

版权问题

更紧迫的问题是围绕AI的版权争议。根据维基百科“合理使用”词条(https://en.wikipedia.org/wiki/Fair_use)的说法:“基于受版权保护材料训练的大语言模型,其版权地位尚未完全明确。”总的来说,很多规则还在制定和修订中。我希望最终的规则——不管是什么样的——能够清晰明确,让AI研究者和从业者可以据此调整和行动。(我在《大语言模型与版权法》一文中写过更多关于AI和版权争议的内容:https://magazine.sebastianraschka.com/i/136352403/llms-and-copyright-laws)

评测问题

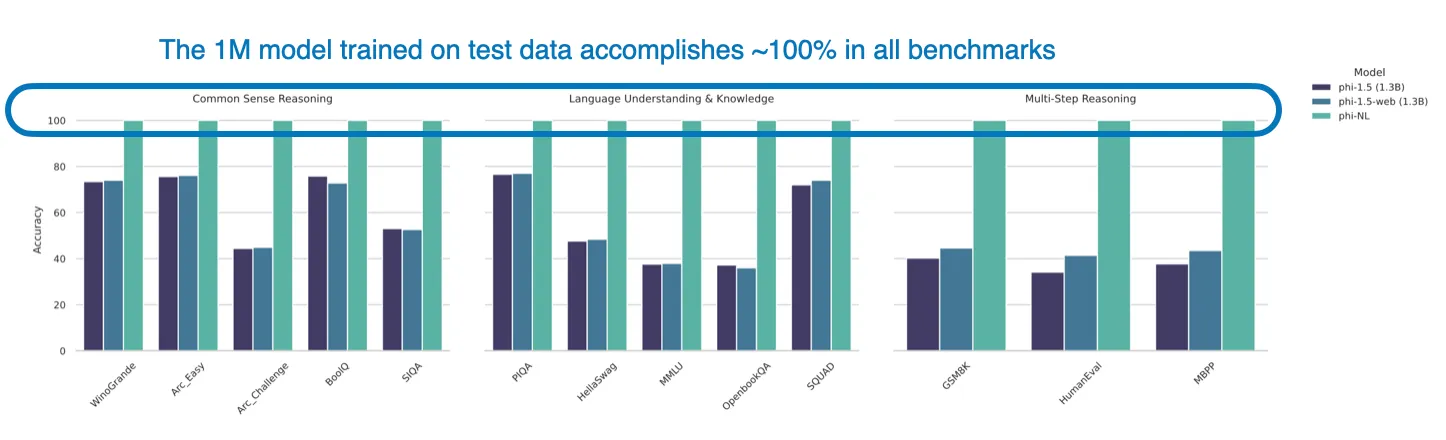
困扰学术研究的一个问题是,主流的基准测试和排行榜被认为已经“半失效”了,因为测试集可能已经泄露,变成了大语言模型的训练数据。这已经成为Phi-1.5和Mistral等模型的争议点,我在《Ahead of AI》第12期《大语言模型商业化》(https://magazine.sebastianraschka.com/p/ahead-of-ai-12-llm-businesses)里讨论过这个问题。

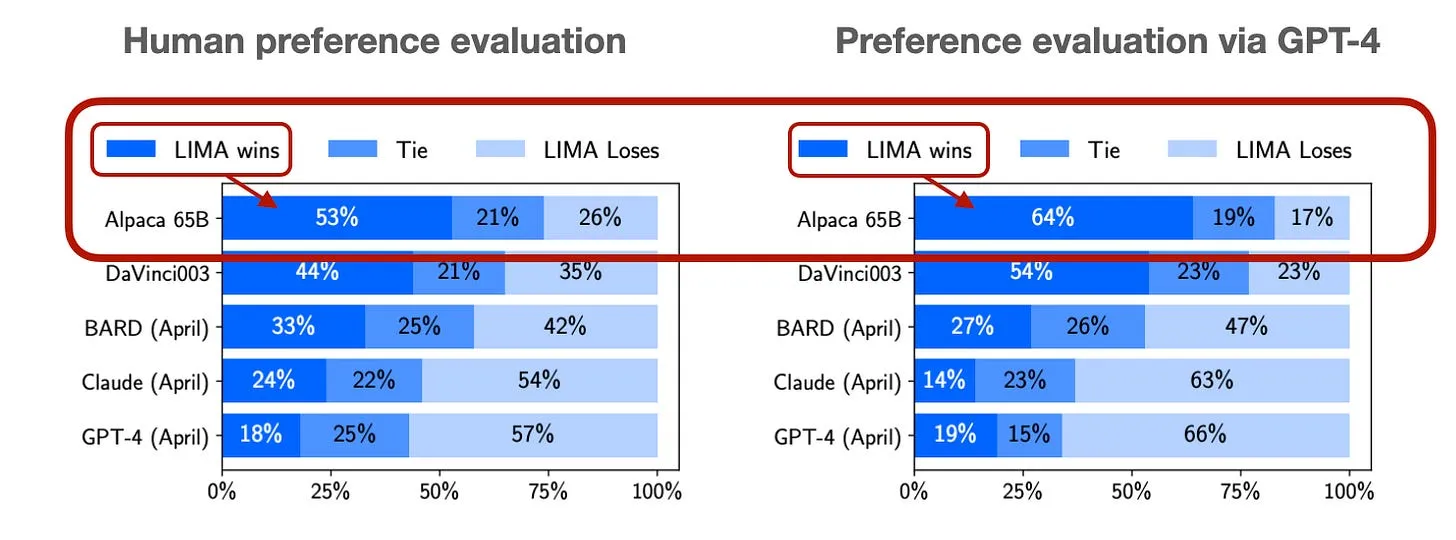
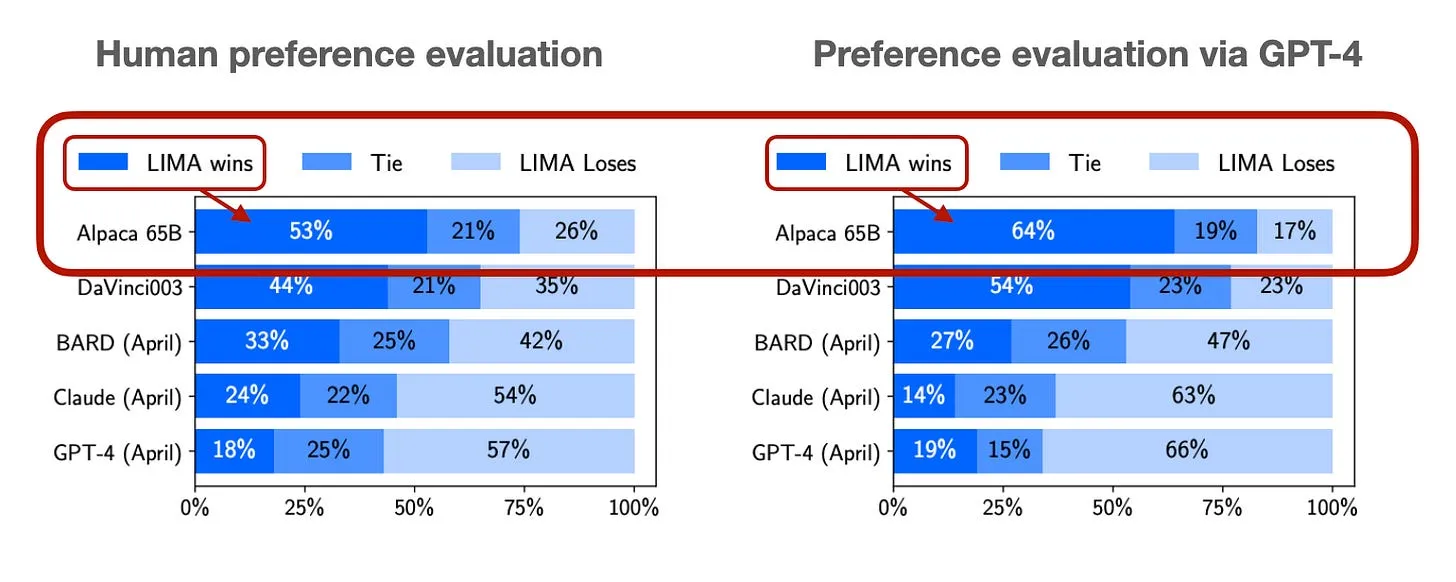
自动化大语言模型评测有一种流行但没那么容易实现的方式:询问人类的偏好。另外,很多论文也将GPT-4作为次优方案来做评测。

figure09
使用人类偏好与GPT-4偏好进行评测的示例,来自https://arxiv.org/abs/2305.11206

营收问题

生成式AI目前仍处于探索阶段。当然,我们都能感受到文本和图像生成器在特定应用场景中的用处。但它们能否为公司带来正向现金流,仍是一个备受争议的话题——因为部署和运行成本非常高昂。比如,去年Futurism就报道过OpenAI因ChatGPT亏损的消息(https://futurism.com/the-byte/openai-losing-money-chatgpt)。另一方面,《财富》杂志报道(https://fortune.com/2023/08/30/chatgpt-creator-openai-earnings-80-million-a-month-1-billion-annual-revenue-540-million-loss-sam-altman/#:~:text=ChatGPT%20creator%20OpenAI%20is%20reportedly,million%20loss%20from%20last%20year)称,OpenAI现在每月营收8000万美元,这可能抵消甚至超过其运营成本。

虚假图像问题

生成式AI相关的更大问题之一——如今在社交媒体平台上尤为突出——是虚假图像和视频的生成。虚假图像和视频一直是个问题,就像Photoshop这类软件降低了伪造内容的门槛一样,AI正在把这件事推向新的高度。

虽然有其他AI系统旨在检测AI生成的内容,但这些系统不管是针对文本、图像还是视频,都不够可靠。要想在一定程度上遏制和解决这些问题,唯一的办法是依赖值得信赖的专业人士。就像我们不会随便从网上的论坛或网站获取医疗或法律建议一样,我们大概也不应该不加核实就相信网上陌生账号发布的图像和视频。

数据集瓶颈

和前面提到的版权争议相关,很多公司(包括Twitter/X和Reddit)都关闭了免费API访问,一方面是为了增加营收,另一方面也是为了防止爬虫抓取平台数据用于AI训练。

我见过很多专门做数据集相关业务的公司打广告。虽然AI可能遗憾地导致某些工作岗位的自动化,但它似乎也在同时创造新的机会。

推动开源大语言模型进步的最佳方式之一,可能是搭建一个众包数据集的平台。我的意思是,编写、收集、整理那些明确获得授权、可用于大语言模型训练的数据集。

RLHF只是锦上添花吗?

Llama 2模型系列发布时,我很高兴看到它包含了针对对话场景微调的模型。通过基于人类反馈的强化学习(RLHF),Meta AI提升了模型的有用性和安全性——如果你想了解更详细的解释,我专门写过一篇关于RLHF及其替代方案的文章:https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives

figure10标注图来自《Llama 2:开放基础模型与微调对话模型》论文(https://arxiv.org/abs/2307.09288)

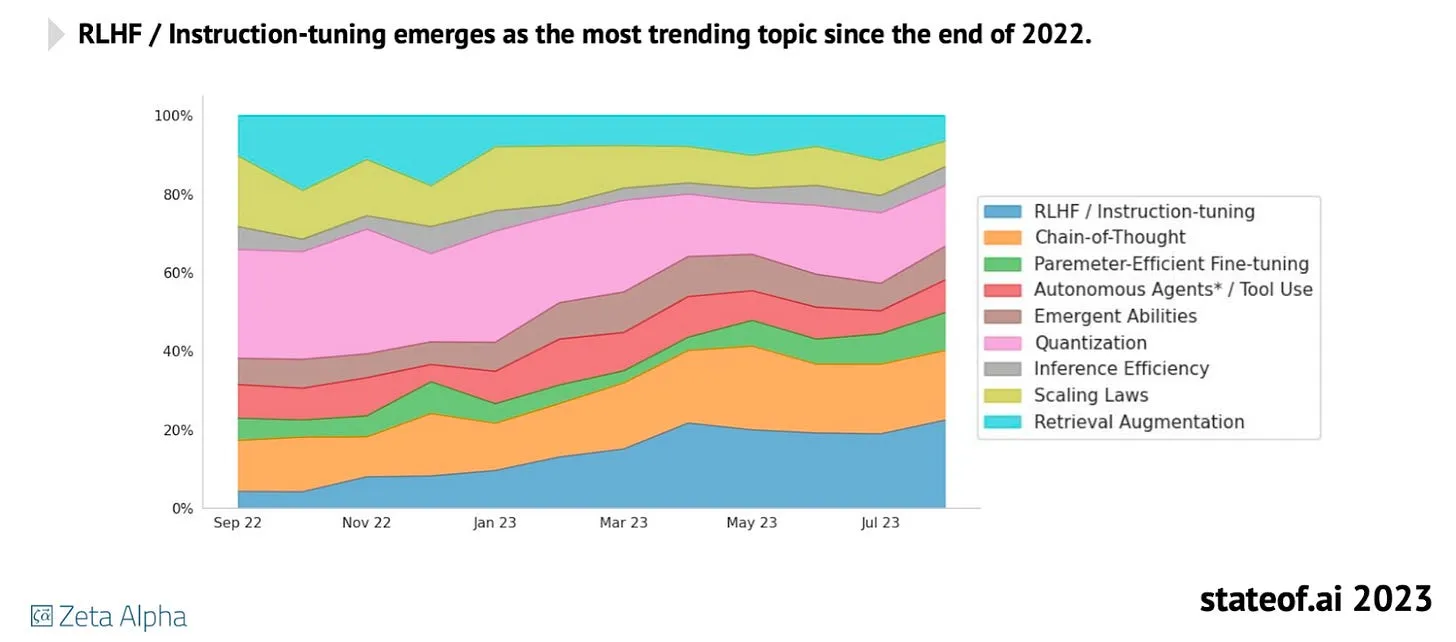
我一直觉得RLHF是一种非常有意思且很有前景的方法,但除了InstructGPT、ChatGPT和Llama 2之外,它并没有得到广泛应用。所以当我看到一张RLHF热度上升的图表时,我挺惊讶的。我之前完全没预料到,因为它至今应用范围还不广。

figure11
RLHF热度图表,来自https://stateof.ai/报告

由于RLHF实现起来比较复杂、有一定难度,大多数开源项目仍然聚焦于有监督微调,也就是指令微调。

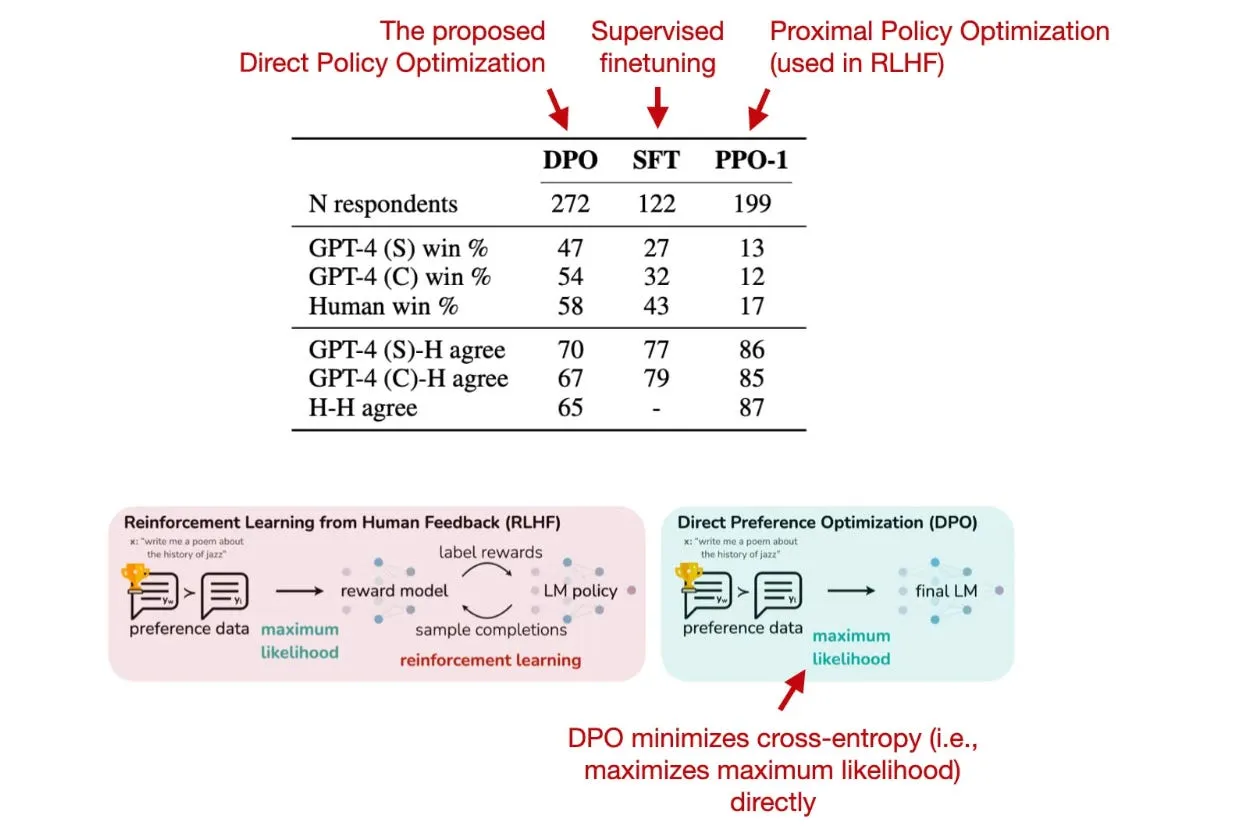
RLHF最近的一个替代方案是直接偏好优化(DPO)。在论文(https://arxiv.org/abs/2305.18290)中,研究者表明,RLHF中拟合奖励模型的交叉熵损失,可以直接用于微调大语言模型。根据他们的基准测试,DPO效率更高,而且在回复质量方面往往也优于RLHF/近端策略优化(PPO)。

figure12
标注图来自https://arxiv.org/abs/2305.18290

DPO目前似乎还没有被广泛使用。不过让我兴奋的是,两周前,我们有了第一个通过DPO训练的公开可用大语言模型Zephyr-7B-alpha(https://huggingface.co/HuggingFaceH4/zephyr-7b-alpha),它的表现似乎超过了更大的、通过RLHF训练的Llama-2 70B对话模型:

figure13
截图来自https://x.com/_lewtun/status/1711756736758178270?s=20

不过值得注意的是,RLHF并不是专门用来优化基准测试性能的;它的核心优化目标是人类评估的“有用性”和“安全性”,这一点在上面的对比中并没有体现。

分类任务有人做吗?

几周前,我在Packt的“让AI落地”大会(https://www.packtpub.com/conference/put-gen-ai-to-work)上做了一个演讲,其中强调文本模型最主流的应用场景之一仍然是分类。比如常见的任务:垃圾邮件分类、文档归类、客户评论分类、社交媒体有害言论标注等等。

根据我的经验,用“小型”大语言模型就能取得非常好的分类效果,比如BERT(https://arxiv.org/abs/1910.01108),只用单张GPU就够了。

figure14
截取自https://www.packtpub.com/conference/put-gen-ai-to-work,展示了可以将小型大语言模型微调为文本分类器

今年,我在《深度学习基础》课程(https://lightning.ai/pages/courses/deep-learning-fundamentals/)的第8单元里,把“用小型大语言模型做文本分类”作为练习,在IMDB电影评论数据集上微调现成的RoBERTa模型,相关讨论见这里:https://github.com/Lightning-AI/dl-fundamentals/discussions/41。(作为参考,我在该数据集上训练的最优逻辑回归词袋模型https://github.com/rasbt/machine-learning-book/blob/main/ch08/logistic-regression-bag-of-words/log-reg.ipynb 准确率只有89%)

figure15
来自我的《深度学习基础》课程的讨论帖:https://github.com/Lightning-AI/dl-fundamentals/discussions/41

话说回来,我还没看到大语言模型在分类任务上有什么新的重大成果或趋势。大多数从业者仍然使用基于BERT的编码器模型,或者像Flan-PaLM(https://arxiv.org/abs/2210.11416)这类编码器-解码器模型——后者还是2022年发布的。这可能是因为这些架构的表现已经足够好,完全能满足需求。

表格数据的现状

2022年,我写过一篇文章(https://sebastianraschka.com/blog/2022/deep-learning-for-tabular-data.html),介绍了很多基于深度学习的表格数据处理方法。不过,和上面提到的分类大语言模型类似,表格数据集领域也没出现太多新进展——也可能是我太忙了没注意到。

figure16
表格数据集示例,供参考

2022年,Grinsztajn等人发表了一篇论文(https://arxiv.org/abs/2207.08815),我认为其核心结论——在中小数据集(1万训练样本)上,树模型(随机森林和XGBoost)的表现优于深度学习方法——至今仍然成立。

说到这里,问世快10年的XGBoost推出了2.0正式版(https://github.com/dmlc/xgboost/releases/tag/v2.0.0),带来了更好的内存效率、对超内存大数据集的支持、多目标树等诸多新特性。

2023年的计算机视觉

虽然今年的焦点几乎都在大语言模型上,但计算机视觉领域也有很多进展。这篇文章已经很长了,我就不展开讲最新的计算机视觉研究了。不过,今年夏天我参加了CVPR 2023,专门写了一篇独立的《2023年计算机视觉研究现状》:
https://magazine.sebastianraschka.com/p/ahead-of-ai-10-state-of-computer

https://substack.com/profile/27393275-sebastian-raschka-phd
·
2023年7月6日
https://magazine.sebastianraschka.com/p/ahead-of-ai-10-state-of-computer

大语言模型(LLM)的发展仍在快速推进。与此同时,抛开AI监管的争议不谈,大语言模型的新闻更新速度似乎比往常稍慢了一点。这正好是个机会,让我们把目光投向计算机视觉,聊聊这个领域的研究与发展现状。这个主题也刚好和CVPR 2023温哥华大会的回顾很搭——那是一场很棒的会议,会场可能是我参加过的会议里最好的。

除了研究之外,计算机视觉相关的AI也催生了很多新产品和新体验,今年都在逐步成熟。

比如,今年夏天我去奥斯汀参加SciPy 2023大会(https://www.scipy2023.scipy.org/)时,看到了第一批真正的全自动无人驾驶Waymo汽车在街上行驶。

还有一次去电影院,我也发现AI在电影行业的应用越来越普及。最近的一个例子是《夺宝奇兵5》里哈里森·福特的“减龄”效果——电影制作者用演员的旧档案素材训练了一个AI模型。

此外,生成式AI能力现在已经深度整合进了主流软件产品中。最近的例子就是Adobe Firefly:https://www.adobe.com/sensei/generative-ai/firefly.html

2024年预测

预测向来是最主观、最有挑战的部分。去年,我预测大语言模型会在文本和代码之外的领域得到更多应用。其中一个例子就是针对DNA的大语言模型(https://arxiv.org/abs/2306.15794);另一个是Geneformer——在3000万个单细胞转录组上预训练的Transformer模型,用于辅助网络生物学预测:https://www.nature.com/articles/s41586-023-06139-9

2024年,大语言模型将越来越多地变革计算机科学之外的STEM研究领域。

另一个新兴趋势是各家公司纷纷开发定制AI芯片,背后的驱动力是高需求导致的GPU短缺。谷歌将继续加码其云TPU v5e和A3 GPU(https://cloud.google.com/blog/products/compute/announcing-cloud-tpu-v5e-and-a3-gpus-in-ga),亚马逊推出了Trainium(https://aws.amazon.com/machine-learning/trainium/),AMD也可能在缩小与英伟达的差距。而现在,微软(https://www.theinformation.com/articles/microsoft-to-debut-ai-chip-next-month-that-could-cut-nvidia-gpu-costs)和OpenAI(https://arstechnica.com/information-technology/2023/10/openai-may-jump-into-ai-hardware-amid-high-costs-supply-constraints/)也开始研发自己的定制AI芯片。这其中的挑战将是,确保主流深度学习框架对这些硬件提供全面、完善的支持。

在开源方面,我们仍然落后于最大的闭源模型。目前,最大的公开可用模型是Falcon-180B(https://huggingface.co/blog/falcon-180b)。这可能没什么好担心的,因为大多数人都没有足够的硬件资源来运行这些模型。比起更大的模型,我更期待看到更多由多个小型子模块组成的开源混合专家模型——我在本文前面已经讨论过。

我也乐观地认为,众包数据集的工作会持续推进,而DPO(https://arxiv.org/abs/2305.18290)会逐步取代有监督微调,成为顶尖开源模型的主流训练方式。

这本杂志是我个人的热情项目,不提供直接报酬。不过,如果您愿意支持我,可以考虑购买我的书:https://sebastianraschka.com/books。如果您觉得这些书有洞见、有帮助,也欢迎推荐给您的朋友和同事。

figure17
相关书籍链接:
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/
https://nostarch.com/machine-learning-and-ai-beyond-basics
http://mng.bz/M96o

您的支持对我意义重大!非常感谢!

【转载】大语言模型的商业版图与行业热潮:近期企业投资与AI应用落地、新型小型公开大语言模型,以及LoRA研究进展

原文地址:LLM Business and Busyness: Recent Company Investments and AI Adoption, New Small Openly Available LLMs, and LoRA Research,by Sebastian Raschka, on 2025-10-08

大语言模型的商业版图与行业热潮:近期企业投资与AI应用落地、新型小型公开大语言模型,以及LoRA研究进展

在《Ahead of AI》专栏中,我力求在前沿研究讨论、AI相关概念讲解,以及AI领域通用新闻与发展动态剖析之间取得平衡。鉴于前几期内容偏重于研究方向,本期我将聚焦行业最新趋势展开探讨。

具体而言,我将梳理各大科技公司的当前布局。眼下似乎所有科技巨头都在训练或开发大语言模型,其核心业务正明显向AI方向倾斜——这也是本期标题“大语言模型:商业布局与行业热潮”的由来。

需要说明的是,本文第一部分将围绕这些企业展开讨论。所有内容均无商业赞助,完全基于我个人的观察与思考。

对于尤其关注开源及可免费使用大语言模型的读者也不必担心,本期还将重点介绍几款凭借小巧体量与出色基准测试表现脱颖而出的创新大语言模型。

鉴于LoRA是目前研究中高效微调的主流技术,我还将深入分析上月提出的两种颇具吸引力的LoRA新变体。最后,我将介绍几项近期发布的重要开源项目。

多模态ChatGPT

OpenAI已开始向ChatGPT Pro用户逐步推送GPT-4V,相关公告(https://openai.com/blog/chatgpt-can-now-see-hear-and-speak)称ChatGPT如今已具备“看、听、说”的能力。这正是我在前几期专栏中提到的多模态版本ChatGPT。

随本次发布一同推出的还有微软研究人员撰写的一份166页技术报告,报告通过实操案例展示并分析了各类应用场景:https://arxiv.org/abs/2309.17421 。

简而言之,GPT-4V支持用户向ChatGPT界面上传图片和音频,并就相关内容提问。我尝试了我最常用的一个场景——提取公式对应的LaTeX代码(这在写论文时非常实用),效果看起来相当不错。

figure01
使用GPT-4V实现公式转LaTeX代码

顺便一提,如果大家对公式转LaTeX功能感兴趣,我推荐试试https://mathpix.com/ 。多年来这家平台一直在做同类服务,且识别精度更高。我是他们的长期订阅用户,几乎每天都会用它从书籍和论文中提取公式,整理成Markdown格式的个人笔记。(本人与该平台无关联,也未收取任何推广费用。)

回到GPT-4V本身:虽然我目前没有让AI描述通用图片的需求,但我能预见这项功能在特定自动化工作流、头脑风暴等场景中的实用价值。

但需要注意的是,尽管GPT-4V的表现令人惊艳,但谷歌的Bard早就支持图片输入,也包含上述的LaTeX公式提取功能。GPT-4V是ChatGPT界面的一次出色升级,但在这一点上,谷歌受众相对较少的Bard聊天机器人反而走在了OpenAI前面(不过有传言称,谷歌是通过两个独立模型/API调用实现该功能,而OpenAI可能采用的是统一的大语言模型)。

如果您想为Falcon、Llama 2等开源大语言模型加装多模态能力,推荐了解Llama-Adapter v2方法(别看名字里有Llama,它并非只适用于Llama系列模型)。我在几个月前的文章中曾介绍过该方法:https://magazine.sebastianraschka.com/i/11956166/finetuning-multimodal-llms-with-llama-adapter-v 。

数据重夺“新石油”地位

我平时尽量不关注广告,但最近在领英上刷到一则广告,内容强调如今各行各业都在全力开发定制化、下一代AI模型。但一如既往,瓶颈始终在于数据——或者说,数据匮乏。

figure02
数据标注是瓶颈……也是一份工作,一门生意。

还记得十几年前盛行的“大数据”概念吗?用一个老套的比喻来说,如果未来数月或数年间,数据成为比石油更炙手可热的交易商品,我丝毫不会感到意外。

随着越来越多平台关闭免费API访问权限,数据本身或者数据使用权未来确实可能会变得更加稀缺——至少是成本更高。今年早些时候我们就已经看到了这样的案例,比如Reddit和Twitter(现X平台)。后者上月还刚刚更新了服务条款,禁止爬虫与数据抓取:https://techcrunch.com/2023/09/08/x-updates-its-terms-to-ban-crawling-and-scraping 。

今年夏天,CNN、ABC、《纽约时报》等主流在线出版商纷纷屏蔽了OpenAI的GPTBot网页爬虫,阻止其抓取自身网站内容:https://www.theguardian.com/technology/2023/aug/25/new-york-times-cnn-and-abc-block-openais-gptbot-web-crawler-from-scraping-content 。

而就在上周,谷歌推出了一项新设置,允许出版商选择是否将自己的文章用于AI训练数据:https://www.theverge.com/2023/9/28/23894779/google-ai-extended-training-data-toggle-bard-vertex 。

无论你如何评价AI带来的影响,一个不可否认的事实是,它正在推动互联网格局的重构。

企业都在打磨更强大的搜索功能与更实用的聊天机器人,但这些工具本该为用户找到的内容,反而会变得更难获取。不过一线希望在于,这一切或许会最终推动网络安全与内容真实性验证体系的完善。

DALL-E 3:文生图AI的下一代迭代

很难相信,距离DALL-E 2发布并带火文生图生成AI已经过去一年半了。上个月,OpenAI正式发布DALL-E 3(https://openai.com/dall-e-3),并登陆必应图像创作平台(https://www.bing.com/images/create)供用户使用。

不得不说,最初的发布公告有点误导性,乍一看还以为DALL-E 3能自动生成图片标注,如下图截图所示:

figure03
该图出自DALL-E 3官方发布页:https://openai.com/dall-e-3

不过实际上,这些标注是作者为了演示效果手动加上的。

不管怎样,我本人并不是文生图AI的重度用户,但在必应创作网站上尝试了不同提示词后,不得不说生成效果非常惊艳。

英伟达法国分公司遭突击搜查,涉云计算反垄断调查

《华尔街日报》报道称“英伟达法国办公室遭云计算相关调查突击搜查”。报道还提到:“这类突击搜查通常持续数小时,执法人员清晨抵达公司场所,搜查办公区域,扣押实物与数字资料,并对到岗员工进行问询。”

尽管法国当局尚未披露搜查原因,但此事可能与英伟达在AI芯片领域的市场地位相关:https://www.investing.com/news/stock-market-news/citi-says-nvidia-will-have-a-90-market-share-in-ai-chips-market-432SI-3122461 。

我使用英伟达硬件训练深度学习模型已有十余年,在我看来,英伟达的市场主导地位要归功于其CUDA与cuDNN带来的完善软件生态。AMD虽然也有性能不错的GPU,但据使用过AMD显卡跑深度学习框架的同事反馈,其软件支持仍处于试水阶段。(不过我最近在Hacker News上看到相关讨论,过程可谓“踩坑无数”:https://news.ycombinator.com/item?id=37793635 )

此外,据我所知,谷歌的TPU与亚马逊的Trainium芯片目前均不对外售卖。而且,基于XLA的TPU支持主要针对谷歌自家的TensorFlow、Jax等专有软件做了优化,通用性远不如CUDA。(举个例子,早在深度学习火起来之前,我本科做分子动力学模拟时就已经在用CUDA了。)

在我看来,英伟达的庞大市场份额,部分源于其更成熟的软件生态。当然,对消费者来说选择越多越好,老话也说得好:“竞争促进行业发展。”

OpenAI被曝正研发自有AI芯片

一则出人意料的消息显示,据路透社报道,ChatGPT母公司OpenAI正探索研发自有AI芯片:https://www.reuters.com/technology/chatgpt-owner-openai-is-exploring-making-its-own-ai-chips-sources-2023-10-06/ 。

近年来,行业垂直整合的趋势愈发明显——即企业掌控生产流程多个环节的商业策略。典型案例就是苹果为iPhone和Mac自研处理器。在AI领域,谷歌自研了TPU,亚马逊也推出了Trainium芯片:https://aws.amazon.com/machine-learning/trainium/ 。

上述路透社的文章并未提及这点,但我觉得很有意思的是,目前微软是唯一没有自研定制AI芯片的主流云厂商。考虑到微软对OpenAI的巨额投资,未来微软Azure云服务很可能会受益于定制的AI推理与/或训练芯片。当然,和以往一样,一大挑战在于如何保证软件支持,以及与PyTorch等主流深度学习框架的无缝集成。

微软将推出数据中心专用芯片,用于大语言模型训练

刚写完OpenAI的芯片计划,以及关于微软可能会跟进谷歌、亚马逊步伐,为自家数据中心研发定制AI芯片的猜测,就有新文章证实了这一消息。据科技媒体The Information报道,微软将于下月推出一款AI芯片,有望降低对英伟达GPU的依赖成本:https://www.theinformation.com/articles/microsoft-to-debut-ai-chip-next-month-that-could-cut-nvidia-gpu-costs 。

亚马逊投资Anthropic,谷歌也表露投资意向

据路透社报道,亚马逊向ChatGPT同类聊天机器人Claude的开发商Anthropic投资至多40亿美元:https://www.reuters.com/markets/deals/amazon-steps-up-ai-race-with-up-4-billion-deal-invest-anthropic-2023-09-25/ ,相关深度分析可见:https://www.semianalysis.com/p/amazon-anthropic-poison-pill-or-empire 。双方还约定后续可追加40亿美元投资。有意思的是,这笔投资并非现金,而是亚马逊云服务额度,用于使用亚马逊自研Trainium芯片进行模型训练。

这也意味着,继谷歌推出Bard、微软绑定ChatGPT之后,亚马逊如今也拥有了Claude这款通用聊天机器人,可以向客户提供相关服务。

在上述消息公布几天后,又有报道称OpenAI的竞争对手Anthropic正与谷歌等方面洽谈融资20亿美元:https://www.theinformation.com/articles/openai-rival-anthropic-in-talks-to-raise-2-billion-from-google-others-as-ai-arms-race-accelerates ,这一进展颇耐人寻味。

新型可公开使用的大语言模型

每周都有大量新的大语言模型登上公开基准排行榜。过去两周我试用过的模型里,最有意思也最值得关注的两款是phi-1.5和Mistral,本期想和大家重点聊聊。

phi-1.5和Mistral都属于性能强劲但体量相对小巧的模型(参数量分别为13亿和70亿,而GPT-3参数量达1750亿),且均公开了模型权重可供使用。说到这里,Percy Liang在X平台上发过一条推文,区分了“开放大语言模型”与“开源大语言模型”:
https://x.com/percyliang/status/1708560401754202621?s=20

“很多‘开放’语言模型仅仅是发布了权重。在软件领域,这就相当于只发布二进制文件却不提供源代码——你不会管这叫开源。要获得完全的透明度,就得公开训练数据。GPT-J、GPT-NeoX、BLOOM、RedPajama都做到了这一点。”

如果您想使用或微调phi-1.5与Mistral,这两款模型都可以通过lit-gpt仓库获取:https://github.com/Lightning-AI/lit-gpt ,我也是该项目的维护者之一。

Phi-1.5

Phi-1.5是一款“小型”大语言模型,参数量仅13亿,但性能表现远超其体量级别。

figure04
图片标注出自论文:https://arxiv.org/abs/2309.05463

这么小的模型为何能有如此出色的表现?秘诀似乎在于高质量的训练数据。

该模型的预训练基于https://arxiv.org/abs/2306.11644 中提出的方法,我在今年夏天的《三句话速览AI研究亮点》一文中曾简要介绍过:研究人员用规模相对较小的60亿token网页“教科书级质量”数据集,加上10亿token由GPT-3.5生成的习题,训练了最初的13亿参数phi模型。

作为继任者的13亿参数phi-1.5模型,使用了类似的“高质量”数据集训练:在来自论文https://arxiv.org/abs/2211.15533 、StackOverflow等来源的70亿token代码数据基础上,新增了约200亿token教科书级别的合成文本。值得注意的是,phi-1.5仅完成了预训练,尚未经过指令微调——后者或许能进一步提升其性能。

figure05
phi-1.5前身模型的数据集与性能表现,出自:https://arxiv.org/abs/2306.11644

论文作者提出一个假设:模型无需经过指令微调就能获得指令遵循能力,这是个很有意思的观察。但phi-1.5的预训练数据,本身就是通过向另一款大语言模型发出指令提示生成的。所以在我看来,模型在预训练阶段就获得了一定的指令微调效果,其实并不意外。(有监督指令微调本质上和预训练类似,都是下一词预测任务,我在《Ahead of AI》的《大语言模型训练:RLHF及其替代方案》一文中有过阐述:https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives )

关于phi-1.5的训练细节,可参考论文:https://arxiv.org/abs/2309.05463 。

X平台上Susan Zhang的相关帖子(https://twitter.com/suchenzang/status/1701615026648605095?s=20 )引发了关于phi-1.5性能指标的讨论,有人猜测模型可能在无意中使用了基准数据集进行训练。Susan Zhang举了例子,说明phi-1.5对格式非常敏感:比如,和基准数据集格式相似的数学题它能完美答对,但格式稍有变化就开始出现幻觉。Zhang认为这表明模型其实只是记住了测试数据集。

说到这个,在一篇颇具讽刺意味的论文(https://arxiv.org/abs/2309.08632 )中,作者训练了一个仅100万参数的小型大语言模型,性能居然超过了包括13亿参数phi-1.5在内的所有模型。而实现方法就是让模型在所有下游学术基准数据集上训练。这篇文章像是一种委婉的批评,凸显了基准测试很容易被有意或无意地“作弊”——也就是数据污染问题。

figure06
归根结底,我们目前没有很好的方法判断一个模型是否用基准测试或测试数据训练过。尤其是如今大多数公司都不再分享或披露训练数据,这很可能是为了避免法律诉讼(例如相关报道:https://apnews.com/article/openai-lawsuit-authors-grisham-george-rr-martin-37f9073ab67ab25b7e6b2975b2a63bfe )。

Mistral

新兴AI公司Mistral AI在首次公开官宣中,发布了旗下第一款可公开使用的大语言模型。根据该公司的基准测试结果,70亿参数的Mistral模型在所有基准测试中都优于参数量更大的130亿参数Llama 2模型,同时代码能力甚至接近CodeLlama 7B。也正因如此,上周这款模型成了社交媒体上的热议话题。

我随机选取了部分Evaluation Harness测试任务对Mistral进行了试用。它在算术基准上的表现好得(几乎好得反常)。不过,它并非在所有任务上都能超越130亿参数的Llama 2模型。

figure07
多款基础模型(非微调模型)在随机选取的lm-evaluation-harness任务上的表现对比,工具来源:https://github.com/EleutherAI/lm-evaluation-harness

如果您想上手试用,Mistral和Phi-1.5都已加入lit-gpt代码仓库:https://github.com/Lightning-AI/lit-gpt 。我定期为该仓库贡献代码,它也是NeurIPS大语言模型效率挑战赛的参赛项目之一。

现在,也有人提出了和phi-1.5类似的担忧。比如Reddit上的讨论(https://www.reddit.com/r/LocalLLaMA/comments/16twtfn/llm_chatrp_comparisontest_mistral_7b_base_instruct/k2hr0yl/ )就提到,有人怀疑模型训练中用到了测试数据,这或许能解释部分基准测试分数偏高的原因。不过整体而言,这款模型依然非常有意思,能力也十分出众。

此外,它还采用了一种有意思的自注意力变体——滑动窗口注意力,以此节省显存、提升计算吞吐量,加快训练速度。(滑动窗口注意力此前已在两篇论文中被提出:https://arxiv.org/abs/1904.10509 与https://arxiv.org/abs/2004.05150 )

滑动窗口注意力机制本质上是一个固定大小的注意力窗口,当前token只能关注前面特定数量的token,而非所有之前的token,原理如下图所示。

figure08
常规注意力与滑动窗口注意力对比,图标注基于Mistral官方仓库提供的示意图修改:https://github.com/mistralai/mistral-src

在Mistral的具体实现中,注意力窗口大小为4096个token,而研究人员训练模型时支持最高10万token的上下文长度。

举个更具体的例子:在常规自注意力机制下,模型处理第50000个token时,可以关注前面全部49999个token;而在滑动窗口自注意力下,Mistral模型只能关注第45904到第50000个token。

这是不是意味着模型无法一次性获取全部上下文信息?也不尽然。Mistral的开发团队认为,模型依然可以通过分层间接的方式访问所有输入token,原理如下图所示。

figure09
标注示意图基于Mistral官方仓库提供的图片修改:https://github.com/mistralai/mistral-src

目前还没有针对GPT类大语言模型使用滑动窗口注意力的研究论文与消融实验,我们还不清楚这种机制对模型性能到底是正面还是负面影响。但它对计算吞吐量的提升是毋庸置疑的,Mistral团队提到该机制带来了2倍的速度提升。

LoRA新变体

LoRA(低秩适配,论文见https://arxiv.org/abs/2106.09685 )是目前大语言模型高效微调最主流的方法,最近几周研究人员又提出了两种新的变体:QA-LoRA(https://arxiv.org/abs/2309.14717 )与LongLoRA(https://arxiv.org/abs/2309.12307 )。

(简而言之,LoRA的核心是通过对预训练模型的参数做低秩投影来进行微调。大多数读者可能已经熟悉LoRA的原理,但如果大家感兴趣,我可以在未来的文章里从零开始实现并详细讲解它的工作机制。欢迎在评论区告诉我。)

LongLoRA

在论文https://arxiv.org/abs/2309.12307 中,研究人员提出了LongLoRA——一种高效的大语言模型微调方法,无需承担长上下文通常带来的高昂计算成本,就能扩展模型的上下文长度。该方法在微调阶段使用稀疏局部注意力以节省算力,而推理阶段依然可以使用常规的稠密注意力。

figure10
LongLoRA论文中的标注示意图:https://arxiv.org/abs/2309.12307

QA-LoRA

论文https://arxiv.org/abs/2309.14717 提出的QA-LoRA,本质上是对QLoRA(量化LoRA)的小幅改进,解决了QLoRA计算效率偏低的问题——QLoRA虽然节省了显存,但每次前向传播都需要对基础模型的量化权重做反量化,因此运行时间更长。

与QLoRA不同,QA-LoRA对LoRA(适配器)的权重本身做量化,避免了叠加适配器权重时,需要将量化后的基础模型权重转换回16位的高昂开销。这一原理总结在下方标注图中。

figure11
QA-LoRA论文中的标注示意图:https://arxiv.org/abs/2309.14717

一点小吐槽:论文表2中,QA-LoRA的微调速度约是QLoRA的2倍,但它的适配器权重参数量要少得多。我认为如果两者使用相同参数量来对比速度,结果会更有参考价值。

开源亮点

最后,我想以几项难得一见的重要开源发布收尾本期内容:Python 3.12、PyTorch 2.1与XGBoost 2.0。

Python 3.12

最新版本的Python带来了大量计算性能提升,官方更新说明(https://docs.python.org/3/whatsnew/3.12.html )提到,asyncio标准库的性能最高提升了75%。

我最喜欢的Python通讯《Python Weekly》(https://www.pythonweekly.com/ )将主要更新总结如下:

  • 更灵活的f-string解析
  • Python代码支持缓冲区协议
  • 新增调试/性能分析API
  • 支持带有独立全局解释器锁(GIL)的隔离子解释器
  • 进一步优化的错误提示信息
  • 支持Linux perf性能分析工具在追踪中显示Python函数名
  • 大量大大小小的性能优化

PyTorch 2.1

去年是PyTorch的大年,2.0版本推出了torch.compile新特性,可以将动态PyTorch计算图转换为全部或部分静态图,从而提升性能。今年PyTorch 2.1正式发布:https://pytorch.org/blog/pytorch-2-1/ 。据我观察,该版本没有引入破坏性变更,重点依然放在性能优化上。

figure12
来源:https://pytorch.org/blog/pytorch-2-1/

一个值得关注的特性(目前仍处于测试阶段)是,torch.compile现在还能编译NumPy运算,将其转换为等价的PyTorch操作。这意味着我们现在也可以用GPU加速NumPy代码了。

相关的领域库比如torchvision也得到了更新。例如,热门的数据增强方法CutMix和MixUp就有了相关更新:https://pytorch.org/vision/stable/auto_examples/transforms/plot_cutmix_mixup.html#sphx-glr-auto-examples-transforms-plot-cutmix-mixup-py 。

XGBoost 2.0

没错,不用深度神经网络和大语言模型的机器学习依然大有可为!XGBoost是最流行的梯度提升算法实现之一,其在表格数据上的表现依然强劲,相关研究可见:https://arxiv.org/abs/2207.08815 。

figure13
来源:https://github.com/dmlc/xgboost/releases/tag/v2.0.0

XGBoost面世已近十年,近期刚刚发布了重磅2.0版本:https://github.com/dmlc/xgboost/releases/tag/v2.0.0 ,带来了更优的内存效率、对超内存大数据集的支持、多目标树等众多新特性。

本专栏是个人兴趣项目,无直接商业报酬。如果您愿意支持我,可以考虑购买我的书籍:https://sebastianraschka.com/books 。如果您觉得这些书有见解、有帮助,也欢迎推荐给您的朋友和同事。

figure14
书籍购买链接:https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics 、http://mng.bz/M96o

您的支持对我意义重大!非常感谢!

【转载】大语言模型的商业版图与行业热潮

原文地址:LLM Business and Busyness: Recent Company Investments and AI Adoption, New Small Openly Available LLMs, and LoRA Research, by Sebastian Raschka, on 2023-10-08

大语言模型的商业版图与行业热潮:近期企业投资与AI应用落地、新型小型公开大语言模型,以及LoRA研究进展

在《Ahead of AI》专栏中,我力求在前沿研究讨论、AI相关概念讲解,以及AI领域通用新闻与发展动态剖析之间取得平衡。鉴于前几期内容偏重于研究方向,本期我将聚焦行业最新趋势展开探讨。

具体而言,我将梳理各大科技公司的当前布局。眼下似乎所有科技巨头都在训练或开发大语言模型,其核心业务正明显向AI方向倾斜——这也是本期标题“大语言模型:商业布局与行业热潮”的由来。

需要说明的是,本文第一部分将围绕这些企业展开讨论。所有内容均无商业赞助,完全基于我个人的观察与思考。

对于尤其关注开源及可免费使用大语言模型的读者也不必担心,本期还将重点介绍几款凭借小巧体量与出色基准测试表现脱颖而出的创新大语言模型。

鉴于LoRA是目前研究中高效微调的主流技术,我还将深入分析上月提出的两种颇具吸引力的LoRA新变体。最后,我将介绍几项近期发布的重要开源项目。

多模态ChatGPT

OpenAI已开始向ChatGPT Pro用户逐步推送GPT-4V,相关公告(https://openai.com/blog/chatgpt-can-now-see-hear-and-speak)称ChatGPT如今已具备“看、听、说”的能力。这正是我在前几期专栏中提到的多模态版本ChatGPT。

随本次发布一同推出的还有微软研究人员撰写的一份166页技术报告,报告通过实操案例展示并分析了各类应用场景:https://arxiv.org/abs/2309.17421 。

简而言之,GPT-4V支持用户向ChatGPT界面上传图片和音频,并就相关内容提问。我尝试了我最常用的一个场景——提取公式对应的LaTeX代码(这在写论文时非常实用),效果看起来相当不错。

figure01
使用GPT-4V实现公式转LaTeX代码

顺便一提,如果大家对公式转LaTeX功能感兴趣,我推荐试试https://mathpix.com/ 。多年来这家平台一直在做同类服务,且识别精度更高。我是他们的长期订阅用户,几乎每天都会用它从书籍和论文中提取公式,整理成Markdown格式的个人笔记。(本人与该平台无关联,也未收取任何推广费用。)

回到GPT-4V本身:虽然我目前没有让AI描述通用图片的需求,但我能预见这项功能在特定自动化工作流、头脑风暴等场景中的实用价值。

但需要注意的是,尽管GPT-4V的表现令人惊艳,但谷歌的Bard早就支持图片输入,也包含上述的LaTeX公式提取功能。GPT-4V是ChatGPT界面的一次出色升级,但在这一点上,谷歌受众相对较少的Bard聊天机器人反而走在了OpenAI前面(不过有传言称,谷歌是通过两个独立模型/API调用实现该功能,而OpenAI可能采用的是统一的大语言模型)。

如果您想为Falcon、Llama 2等开源大语言模型加装多模态能力,推荐了解Llama-Adapter v2方法(别看名字里有Llama,它并非只适用于Llama系列模型)。我在几个月前的文章中曾介绍过该方法:https://magazine.sebastianraschka.com/i/11956166/finetuning-multimodal-llms-with-llama-adapter-v 。

数据重夺“新石油”地位

我平时尽量不关注广告,但最近在领英上刷到一则广告,内容强调如今各行各业都在全力开发定制化、下一代AI模型。但一如既往,瓶颈始终在于数据——或者说,数据匮乏。

figure02
数据标注是瓶颈……也是一份工作,一门生意。

还记得十几年前盛行的“大数据”概念吗?用一个老套的比喻来说,如果未来数月或数年间,数据成为比石油更炙手可热的交易商品,我丝毫不会感到意外。

随着越来越多平台关闭免费API访问权限,数据本身或者数据使用权未来确实可能会变得更加稀缺——至少是成本更高。今年早些时候我们就已经看到了这样的案例,比如Reddit和Twitter(现X平台)。后者上月还刚刚更新了服务条款,禁止爬虫与数据抓取:https://techcrunch.com/2023/09/08/x-updates-its-terms-to-ban-crawling-and-scraping 。

今年夏天,CNN、ABC、《纽约时报》等主流在线出版商纷纷屏蔽了OpenAI的GPTBot网页爬虫,阻止其抓取自身网站内容:https://www.theguardian.com/technology/2023/aug/25/new-york-times-cnn-and-abc-block-openais-gptbot-web-crawler-from-scraping-content 。

而就在上周,谷歌推出了一项新设置,允许出版商选择是否将自己的文章用于AI训练数据:https://www.theverge.com/2023/9/28/23894779/google-ai-extended-training-data-toggle-bard-vertex 。

无论你如何评价AI带来的影响,一个不可否认的事实是,它正在推动互联网格局的重构。

企业都在打磨更强大的搜索功能与更实用的聊天机器人,但这些工具本该为用户找到的内容,反而会变得更难获取。不过一线希望在于,这一切或许会最终推动网络安全与内容真实性验证体系的完善。

DALL-E 3:文生图AI的下一代迭代

很难相信,距离DALL-E 2发布并带火文生图生成AI已经过去一年半了。上个月,OpenAI正式发布DALL-E 3(https://openai.com/dall-e-3),并登陆必应图像创作平台(https://www.bing.com/images/create)供用户使用。

不得不说,最初的发布公告有点误导性,乍一看还以为DALL-E 3能自动生成图片标注,如下图截图所示:

figure03
该图出自DALL-E 3官方发布页:https://openai.com/dall-e-3

不过实际上,这些标注是作者为了演示效果手动加上的。

不管怎样,我本人并不是文生图AI的重度用户,但在必应创作网站上尝试了不同提示词后,不得不说生成效果非常惊艳。

英伟达法国分公司遭突击搜查,涉云计算反垄断调查

《华尔街日报》报道称“英伟达法国办公室遭云计算相关调查突击搜查”。报道还提到:“这类突击搜查通常持续数小时,执法人员清晨抵达公司场所,搜查办公区域,扣押实物与数字资料,并对到岗员工进行问询。”

尽管法国当局尚未披露搜查原因,但此事可能与英伟达在AI芯片领域的市场地位相关:https://www.investing.com/news/stock-market-news/citi-says-nvidia-will-have-a-90-market-share-in-ai-chips-market-432SI-3122461 。

我使用英伟达硬件训练深度学习模型已有十余年,在我看来,英伟达的市场主导地位要归功于其CUDA与cuDNN带来的完善软件生态。AMD虽然也有性能不错的GPU,但据使用过AMD显卡跑深度学习框架的同事反馈,其软件支持仍处于试水阶段。(不过我最近在Hacker News上看到相关讨论,过程可谓“踩坑无数”:https://news.ycombinator.com/item?id=37793635 )

此外,据我所知,谷歌的TPU与亚马逊的Trainium芯片目前均不对外售卖。而且,基于XLA的TPU支持主要针对谷歌自家的TensorFlow、Jax等专有软件做了优化,通用性远不如CUDA。(举个例子,早在深度学习火起来之前,我本科做分子动力学模拟时就已经在用CUDA了。)

在我看来,英伟达的庞大市场份额,部分源于其更成熟的软件生态。当然,对消费者来说选择越多越好,老话也说得好:“竞争促进行业发展。”

OpenAI被曝正研发自有AI芯片

一则出人意料的消息显示,据路透社报道,ChatGPT母公司OpenAI正探索研发自有AI芯片:https://www.reuters.com/technology/chatgpt-owner-openai-is-exploring-making-its-own-ai-chips-sources-2023-10-06/ 。

近年来,行业垂直整合的趋势愈发明显——即企业掌控生产流程多个环节的商业策略。典型案例就是苹果为iPhone和Mac自研处理器。在AI领域,谷歌自研了TPU,亚马逊也推出了Trainium芯片:https://aws.amazon.com/machine-learning/trainium/ 。

上述路透社的文章并未提及这点,但我觉得很有意思的是,目前微软是唯一没有自研定制AI芯片的主流云厂商。考虑到微软对OpenAI的巨额投资,未来微软Azure云服务很可能会受益于定制的AI推理与/或训练芯片。当然,和以往一样,一大挑战在于如何保证软件支持,以及与PyTorch等主流深度学习框架的无缝集成。

微软将推出数据中心专用芯片,用于大语言模型训练

刚写完OpenAI的芯片计划,以及关于微软可能会跟进谷歌、亚马逊步伐,为自家数据中心研发定制AI芯片的猜测,就有新文章证实了这一消息。据科技媒体The Information报道,微软将于下月推出一款AI芯片,有望降低对英伟达GPU的依赖成本:https://www.theinformation.com/articles/microsoft-to-debut-ai-chip-next-month-that-could-cut-nvidia-gpu-costs 。

亚马逊投资Anthropic,谷歌也表露投资意向

据路透社报道,亚马逊向ChatGPT同类聊天机器人Claude的开发商Anthropic投资至多40亿美元:https://www.reuters.com/markets/deals/amazon-steps-up-ai-race-with-up-4-billion-deal-invest-anthropic-2023-09-25/ ,相关深度分析可见:https://www.semianalysis.com/p/amazon-anthropic-poison-pill-or-empire 。双方还约定后续可追加40亿美元投资。有意思的是,这笔投资并非现金,而是亚马逊云服务额度,用于使用亚马逊自研Trainium芯片进行模型训练。

这也意味着,继谷歌推出Bard、微软绑定ChatGPT之后,亚马逊如今也拥有了Claude这款通用聊天机器人,可以向客户提供相关服务。

在上述消息公布几天后,又有报道称OpenAI的竞争对手Anthropic正与谷歌等方面洽谈融资20亿美元:https://www.theinformation.com/articles/openai-rival-anthropic-in-talks-to-raise-2-billion-from-google-others-as-ai-arms-race-accelerates ,这一进展颇耐人寻味。

新型可公开使用的大语言模型

每周都有大量新的大语言模型登上公开基准排行榜。过去两周我试用过的模型里,最有意思也最值得关注的两款是phi-1.5和Mistral,本期想和大家重点聊聊。

phi-1.5和Mistral都属于性能强劲但体量相对小巧的模型(参数量分别为13亿和70亿,而GPT-3参数量达1750亿),且均公开了模型权重可供使用。说到这里,Percy Liang在X平台上发过一条推文,区分了“开放大语言模型”与“开源大语言模型”:
https://x.com/percyliang/status/1708560401754202621?s=20

“很多‘开放’语言模型仅仅是发布了权重。在软件领域,这就相当于只发布二进制文件却不提供源代码——你不会管这叫开源。要获得完全的透明度,就得公开训练数据。GPT-J、GPT-NeoX、BLOOM、RedPajama都做到了这一点。”

如果您想使用或微调phi-1.5与Mistral,这两款模型都可以通过lit-gpt仓库获取:https://github.com/Lightning-AI/lit-gpt ,我也是该项目的维护者之一。

Phi-1.5

Phi-1.5是一款“小型”大语言模型,参数量仅13亿,但性能表现远超其体量级别。

figure04
图片标注出自论文:https://arxiv.org/abs/2309.05463

这么小的模型为何能有如此出色的表现?秘诀似乎在于高质量的训练数据。

该模型的预训练基于https://arxiv.org/abs/2306.11644 中提出的方法,我在今年夏天的《三句话速览AI研究亮点》一文中曾简要介绍过:研究人员用规模相对较小的60亿token网页“教科书级质量”数据集,加上10亿token由GPT-3.5生成的习题,训练了最初的13亿参数phi模型。

作为继任者的13亿参数phi-1.5模型,使用了类似的“高质量”数据集训练:在来自论文https://arxiv.org/abs/2211.15533 、StackOverflow等来源的70亿token代码数据基础上,新增了约200亿token教科书级别的合成文本。值得注意的是,phi-1.5仅完成了预训练,尚未经过指令微调——后者或许能进一步提升其性能。

figure05
phi-1.5前身模型的数据集与性能表现,出自:https://arxiv.org/abs/2306.11644

论文作者提出一个假设:模型无需经过指令微调就能获得指令遵循能力,这是个很有意思的观察。但phi-1.5的预训练数据,本身就是通过向另一款大语言模型发出指令提示生成的。所以在我看来,模型在预训练阶段就获得了一定的指令微调效果,其实并不意外。(有监督指令微调本质上和预训练类似,都是下一词预测任务,我在《Ahead of AI》的《大语言模型训练:RLHF及其替代方案》一文中有过阐述:https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives )

关于phi-1.5的训练细节,可参考论文:https://arxiv.org/abs/2309.05463 。

X平台上Susan Zhang的相关帖子(https://twitter.com/suchenzang/status/1701615026648605095?s=20 )引发了关于phi-1.5性能指标的讨论,有人猜测模型可能在无意中使用了基准数据集进行训练。Susan Zhang举了例子,说明phi-1.5对格式非常敏感:比如,和基准数据集格式相似的数学题它能完美答对,但格式稍有变化就开始出现幻觉。Zhang认为这表明模型其实只是记住了测试数据集。

说到这个,在一篇颇具讽刺意味的论文(https://arxiv.org/abs/2309.08632 )中,作者训练了一个仅100万参数的小型大语言模型,性能居然超过了包括13亿参数phi-1.5在内的所有模型。而实现方法就是让模型在所有下游学术基准数据集上训练。这篇文章像是一种委婉的批评,凸显了基准测试很容易被有意或无意地“作弊”——也就是数据污染问题。

figure06
归根结底,我们目前没有很好的方法判断一个模型是否用基准测试或测试数据训练过。尤其是如今大多数公司都不再分享或披露训练数据,这很可能是为了避免法律诉讼(例如相关报道:https://apnews.com/article/openai-lawsuit-authors-grisham-george-rr-martin-37f9073ab67ab25b7e6b2975b2a63bfe )。

Mistral

新兴AI公司Mistral AI在首次公开官宣中,发布了旗下第一款可公开使用的大语言模型。根据该公司的基准测试结果,70亿参数的Mistral模型在所有基准测试中都优于参数量更大的130亿参数Llama 2模型,同时代码能力甚至接近CodeLlama 7B。也正因如此,上周这款模型成了社交媒体上的热议话题。

我随机选取了部分Evaluation Harness测试任务对Mistral进行了试用。它在算术基准上的表现好得(几乎好得反常)。不过,它并非在所有任务上都能超越130亿参数的Llama 2模型。

figure07
多款基础模型(非微调模型)在随机选取的lm-evaluation-harness任务上的表现对比,工具来源:https://github.com/EleutherAI/lm-evaluation-harness

如果您想上手试用,Mistral和Phi-1.5都已加入lit-gpt代码仓库:https://github.com/Lightning-AI/lit-gpt 。我定期为该仓库贡献代码,它也是NeurIPS大语言模型效率挑战赛的参赛项目之一。

现在,也有人提出了和phi-1.5类似的担忧。比如Reddit上的讨论(https://www.reddit.com/r/LocalLLaMA/comments/16twtfn/llm_chatrp_comparisontest_mistral_7b_base_instruct/k2hr0yl/ )就提到,有人怀疑模型训练中用到了测试数据,这或许能解释部分基准测试分数偏高的原因。不过整体而言,这款模型依然非常有意思,能力也十分出众。

此外,它还采用了一种有意思的自注意力变体——滑动窗口注意力,以此节省显存、提升计算吞吐量,加快训练速度。(滑动窗口注意力此前已在两篇论文中被提出:https://arxiv.org/abs/1904.10509 与https://arxiv.org/abs/2004.05150 )

滑动窗口注意力机制本质上是一个固定大小的注意力窗口,当前token只能关注前面特定数量的token,而非所有之前的token,原理如下图所示。

figure08
常规注意力与滑动窗口注意力对比,图标注基于Mistral官方仓库提供的示意图修改:https://github.com/mistralai/mistral-src

在Mistral的具体实现中,注意力窗口大小为4096个token,而研究人员训练模型时支持最高10万token的上下文长度。

举个更具体的例子:在常规自注意力机制下,模型处理第50000个token时,可以关注前面全部49999个token;而在滑动窗口自注意力下,Mistral模型只能关注第45904到第50000个token。

这是不是意味着模型无法一次性获取全部上下文信息?也不尽然。Mistral的开发团队认为,模型依然可以通过分层间接的方式访问所有输入token,原理如下图所示。

figure09
标注示意图基于Mistral官方仓库提供的图片修改:https://github.com/mistralai/mistral-src

目前还没有针对GPT类大语言模型使用滑动窗口注意力的研究论文与消融实验,我们还不清楚这种机制对模型性能到底是正面还是负面影响。但它对计算吞吐量的提升是毋庸置疑的,Mistral团队提到该机制带来了2倍的速度提升。

LoRA新变体

LoRA(低秩适配,论文见https://arxiv.org/abs/2106.09685 )是目前大语言模型高效微调最主流的方法,最近几周研究人员又提出了两种新的变体:QA-LoRA(https://arxiv.org/abs/2309.14717 )与LongLoRA(https://arxiv.org/abs/2309.12307 )。

(简而言之,LoRA的核心是通过对预训练模型的参数做低秩投影来进行微调。大多数读者可能已经熟悉LoRA的原理,但如果大家感兴趣,我可以在未来的文章里从零开始实现并详细讲解它的工作机制。欢迎在评论区告诉我。)

LongLoRA

在论文https://arxiv.org/abs/2309.12307 中,研究人员提出了LongLoRA——一种高效的大语言模型微调方法,无需承担长上下文通常带来的高昂计算成本,就能扩展模型的上下文长度。该方法在微调阶段使用稀疏局部注意力以节省算力,而推理阶段依然可以使用常规的稠密注意力。

figure10
LongLoRA论文中的标注示意图:https://arxiv.org/abs/2309.12307

QA-LoRA

论文https://arxiv.org/abs/2309.14717 提出的QA-LoRA,本质上是对QLoRA(量化LoRA)的小幅改进,解决了QLoRA计算效率偏低的问题——QLoRA虽然节省了显存,但每次前向传播都需要对基础模型的量化权重做反量化,因此运行时间更长。

与QLoRA不同,QA-LoRA对LoRA(适配器)的权重本身做量化,避免了叠加适配器权重时,需要将量化后的基础模型权重转换回16位的高昂开销。这一原理总结在下方标注图中。

figure11
QA-LoRA论文中的标注示意图:https://arxiv.org/abs/2309.14717

一点小吐槽:论文表2中,QA-LoRA的微调速度约是QLoRA的2倍,但它的适配器权重参数量要少得多。我认为如果两者使用相同参数量来对比速度,结果会更有参考价值。

开源亮点

最后,我想以几项难得一见的重要开源发布收尾本期内容:Python 3.12、PyTorch 2.1与XGBoost 2.0。

Python 3.12

最新版本的Python带来了大量计算性能提升,官方更新说明(https://docs.python.org/3/whatsnew/3.12.html )提到,asyncio标准库的性能最高提升了75%。

我最喜欢的Python通讯《Python Weekly》(https://www.pythonweekly.com/ )将主要更新总结如下:

  • 更灵活的f-string解析
  • Python代码支持缓冲区协议
  • 新增调试/性能分析API
  • 支持带有独立全局解释器锁(GIL)的隔离子解释器
  • 进一步优化的错误提示信息
  • 支持Linux perf性能分析工具在追踪中显示Python函数名
  • 大量大大小小的性能优化

PyTorch 2.1

去年是PyTorch的大年,2.0版本推出了torch.compile新特性,可以将动态PyTorch计算图转换为全部或部分静态图,从而提升性能。今年PyTorch 2.1正式发布:https://pytorch.org/blog/pytorch-2-1/ 。据我观察,该版本没有引入破坏性变更,重点依然放在性能优化上。

来源:https://pytorch.org/blog/pytorch-2-1/

一个值得关注的特性(目前仍处于测试阶段)是,torch.compile现在还能编译NumPy运算,将其转换为等价的PyTorch操作。这意味着我们现在也可以用GPU加速NumPy代码了。

相关的领域库比如torchvision也得到了更新。例如,热门的数据增强方法CutMix和MixUp就有了相关更新:https://pytorch.org/vision/stable/auto_examples/transforms/plot_cutmix_mixup.html#sphx-glr-auto-examples-transforms-plot-cutmix-mixup-py 。

XGBoost 2.0

没错,不用深度神经网络和大语言模型的机器学习依然大有可为!XGBoost是最流行的梯度提升算法实现之一,其在表格数据上的表现依然强劲,相关研究可见:https://arxiv.org/abs/2207.08815 。

figure13
来源:https://github.com/dmlc/xgboost/releases/tag/v2.0.0

XGBoost面世已近十年,近期刚刚发布了重磅2.0版本:https://github.com/dmlc/xgboost/releases/tag/v2.0.0 ,带来了更优的内存效率、对超内存大数据集的支持、多目标树等众多新特性。

本专栏是个人兴趣项目,无直接商业报酬。如果您愿意支持我,可以考虑购买我的书籍:https://sebastianraschka.com/books 。如果您觉得这些书有见解、有帮助,也欢迎推荐给您的朋友和同事。

figure14
书籍购买链接:https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics 、http://mng.bz/M96o

您的支持对我意义重大!非常感谢!