About neohope

一直在努力,还没想过要放弃...

【转载】大语言模型预训练与奖励模型评估技巧

原文地址:Tips for LLM Pretraining and Evaluating Reward Models,by Sebastian Raschka, on 2024-03-31

大语言模型预训练与奖励模型评估技巧

2024年3月AI研究论文述评

2024年3月31日

AI研究领域又走过了一个月,精彩成果层出不穷,很难选出最心仪的作品。

除了新研究之外,本月还有诸多重磅发布。其中xAI开源了其https://github.com/xai-org/grok-1 模型,参数量达3140亿,是目前规模最大的开源模型。此外有报道称,https://www.anthropic.com/news/claude-3-family 的性能正在接近甚至超越GPT-4。同时值得关注的还有:https://github.com/hpcaitech/Open-Sora(一个完全开源的视频生成项目)、https://blog.rwkv.com/p/eagle-7b-soaring-past-transformers(全新的基于RWKV的模型)、Mosaic推出的1320亿参数https://www.databricks.com/blog/introducing-dbrx-new-state-art-open-llm(混合专家模型),以及https://huggingface.co/ai21labs/Jamba-v0.1(基于Mamba的状态空间模型-Transformer混合架构)。

不过由于这些模型的详细信息还十分有限,我将重点讨论研究论文。本月我会先解读一篇探讨大语言模型持续预训练策略的论文,随后讨论基于人类反馈的强化学习(当下主流的大语言模型对齐方法)中所用的奖励建模,以及一个全新的基准测试。

大语言模型的持续预训练是一个重要课题:它让我们能够更新现有大语言模型,比如保证模型能跟进最新的信息与趋势;同时也能让模型适配新的目标领域,而无需从头重新训练。

奖励建模的重要性在于,它能让大语言模型更贴合人类偏好,并且在一定程度上有助于提升安全性。但除了优化人类偏好之外,奖励建模还提供了一种机制,让大语言模型能够学习并适配复杂任务——只需提供指令-输出示例即可,而无需为正确行为编写明确的程序(这往往难度很高甚至不切实际)。

祝阅读愉快!

1. 大语言模型持续预训练的简洁可扩展策略

我们经常讨论对大语言模型进行微调以使其遵循指令,但在实际应用中,用新知识或特定领域数据更新大语言模型同样非常重要。近期论文https://arxiv.org/abs/2403.08763 就如何利用新数据持续预训练大语言模型提供了宝贵的见解。

具体而言,研究者对比了三种不同的训练方式:

  • 常规预训练:用随机权重初始化模型,在数据集D1上进行预训练。
  • 持续预训练:取上述场景中已完成预训练的模型,在数据集D2上进一步预训练。
  • 联合数据集重训练:与第一种场景一样用随机权重初始化模型,但在数据集D1与D2的并集上训练。
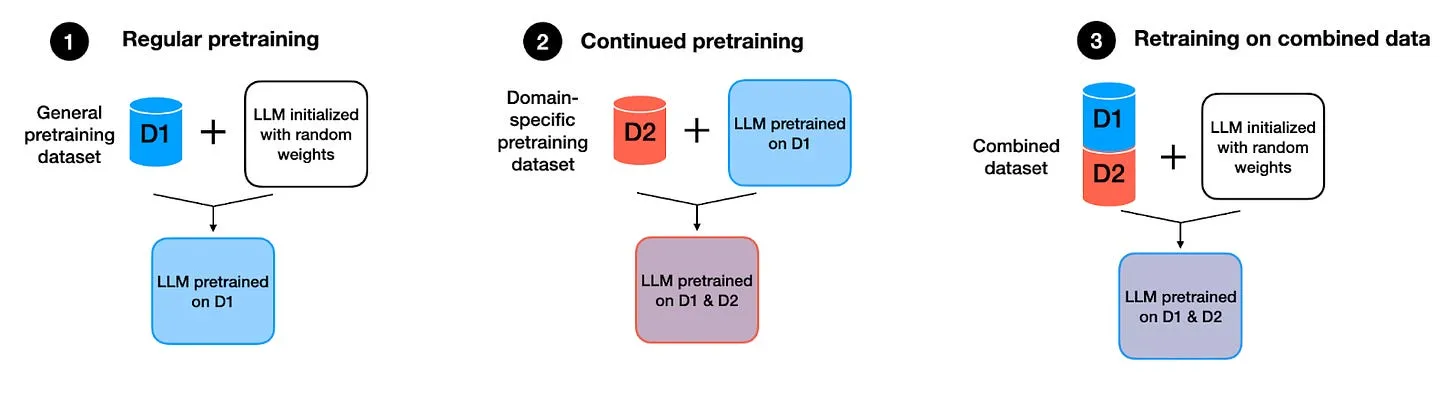
figure01
三种预训练方法示意图

方法3(在联合数据集上重训练)是业界常用的做法,例如https://magazine.sebastianraschka.com/p/ahead-of-ai-7-large-language-models?utm_source=%2Fsearch%2F%2520BloombergGPT&utm_medium=reader2 中所述。原因在于,重训练通常有助于确定合适的学习率调度——往往采用线性热身加半周期余弦衰减的策略——并且能缓解灾难性遗忘问题。

灾难性遗忘指的是神经网络(尤其是在序列学习任务中)在学习新信息后,会遗忘之前学到的知识的现象。对于在不同数据集或任务上依次训练的模型而言,这是一个尤为突出的问题。

因此,通过在包含新旧信息的联合数据集上重训练模型,模型既能适配新数据,又能保持在之前已学任务上的性能。

1.1 核心结论与实验结果

这篇长达24页的论文包含大量实验与海量图表,以当下的标准来看研究非常详尽。为了便于理解,下图总结了核心结果:采用持续预训练,能够达到与从头在联合数据集上重训练相当的优异性能。
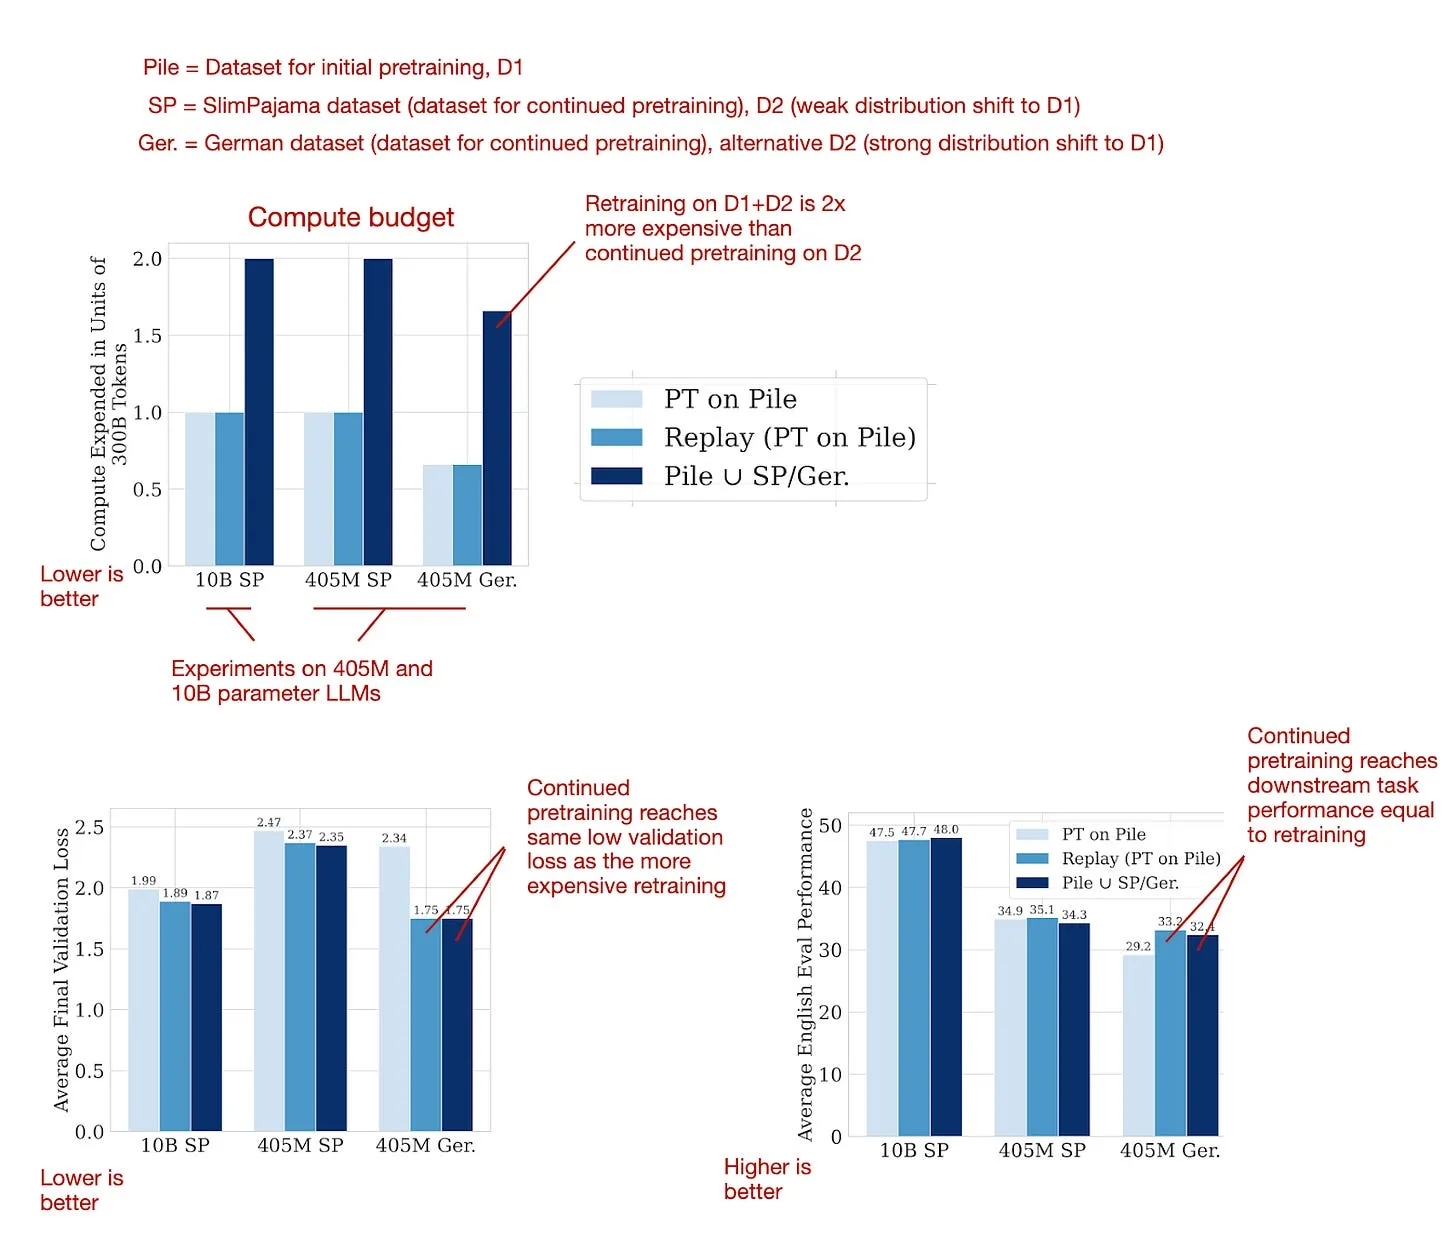
figure02
持续预训练的成本仅为从头重训练的一半(因为已有预训练模型,只需使用一半的数据量),却能达到同等的优异性能。来源:改编自https://arxiv.org/abs/2403.08763 的图表

成功实现持续预训练的“技巧”有哪些?

  • 重新热身与重新衰减学习率(见下一节)。
  • 在新数据集(D2)中加入一小部分(如5%)原始预训练数据(D1),以防止灾难性遗忘。值得注意的是,0.5%和1%等更小的比例同样有效。

1.2 学习率调度

在预训练或微调大语言模型时,通常会采用“线性热身+半周期余弦衰减”的学习率调度,如下图所示。
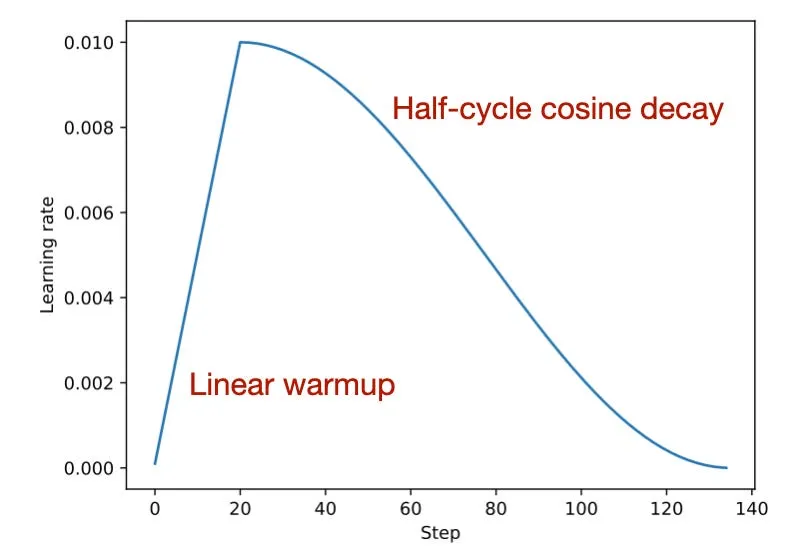
figure03
大语言模型预训练与微调的常用学习率调度。来源:https://www.manning.com/books/build-a-large-language-model-from-scratch、https://github.com/rasbt/LLMs-from-scratch/blob/main/appendix-D/01_main-chapter-code/appendix-D.ipynb

如上图所示,在线性热身阶段,学习率从一个较低的值开始,在训练初期逐步提升至预设值。这种方法有助于在进入主训练阶段前稳定模型的权重参数。热身阶段结束后,学习率转入余弦衰减调度,在训练的同时逐步降低模型的学习率。

既然预训练结束时学习率已经非常低,那持续预训练时该如何调整学习率?通常的做法是重新引入一个热身阶段,再跟进一个衰减阶段,这被称为重新热身与重新衰减。简单来说,就是沿用初始预训练阶段完全相同的学习率调度。
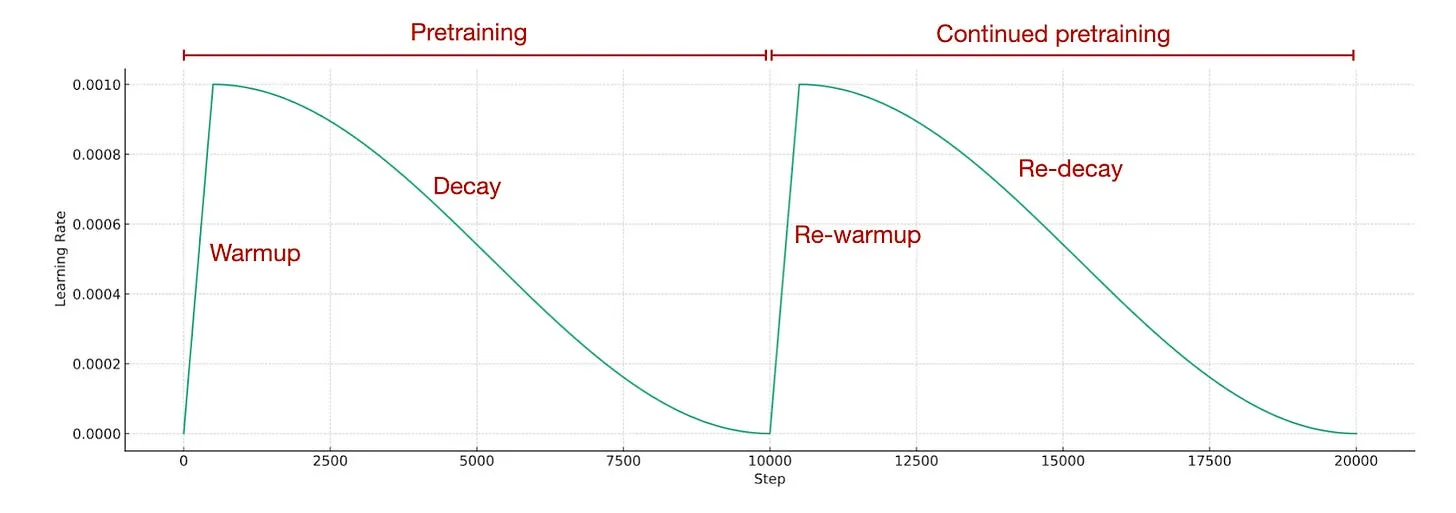
figure04
持续预训练的调度方案。图基于https://www.manning.com/books/build-a-large-language-model-from-scratch、https://github.com/rasbt/LLMs-from-scratch/blob/main/appendix-D/01_main-chapter-code/appendix-D.ipynb

作者发现,重新热身与重新衰减确实有效。此外,他们还与所谓的“无限学习率”调度进行了对比——该调度出自2021年的论文https://arxiv.org/abs/2106.04560。这种调度以平缓的余弦(或可选的逆平方根)衰减开始,过渡到恒定学习率,最后以陡峭的衰减进行退火收尾。
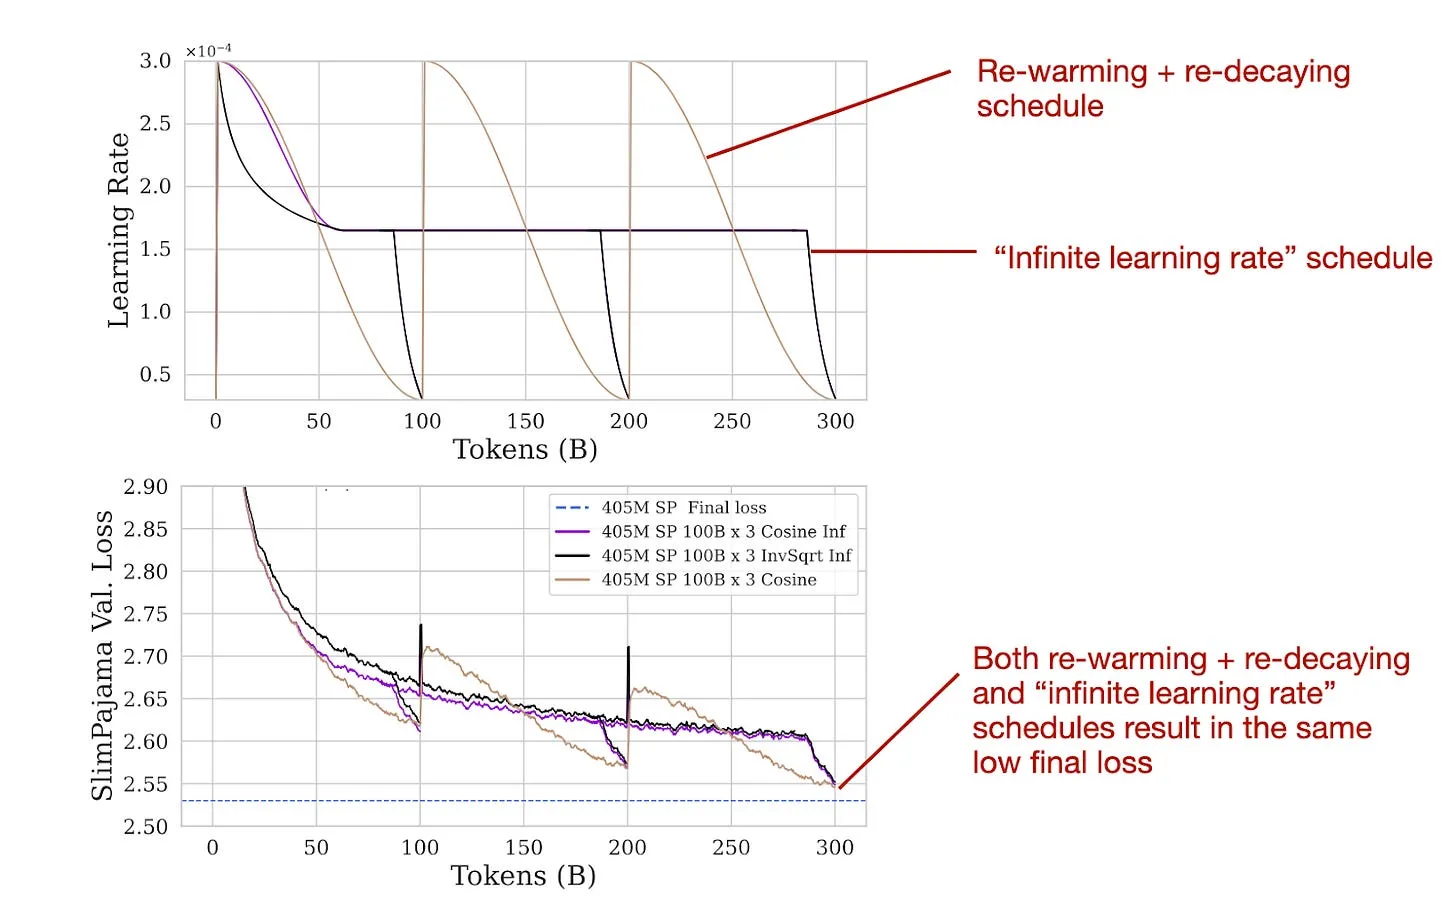
figure05
三个预训练阶段下,重新热身-重新衰减调度与无限学习率调度的实验对比。来源:改编自https://arxiv.org/abs/2403.08763 的图表

无限学习率调度的便利之处在于,在恒定学习率阶段的任意时刻,都可以通过一个短暂的退火阶段终止预训练(而无需完成整个余弦半周期)。但如上图结果所示,预训练和持续预训练都没必要使用“无限学习率”。常用的重新热身-重新衰减方法,最终损失与无限学习率调度相当。

1.3 结论与注意事项

据我所知,重新热身-重新衰减、以及在新数据中加入原始预训练数据,或多或少都属于业界常识。但我非常欣赏研究者们花时间在这篇长达24页的详细报告中,对该方法进行了正式的验证。

此外我认为很有意思的一点是,“无限学习率”调度并非必需,它最终得到的损失,和我们常用的“线性热身+半周期余弦衰减”方案基本一致。

尽管这篇论文的实验非常全面,但有一点值得注意:大部分实验都是在参数规模较小的4.05亿模型上开展的,采用的是相对经典的大语言模型架构(GPT-NeoX)。不过作者也证明,该结论在100亿参数模型上同样成立,这让我们有理由相信,这些结果也适用于更大的模型(比如700亿参数),以及可能的架构变体。

研究者聚焦于规模相近的预训练数据集。此外,附录也显示,当持续预训练仅使用50%或30%的数据集时,结果依然一致。一个值得未来研究的方向是:当持续预训练的数据集远小于初始预训练数据集时(这在实际中很常见),这些趋势和建议是否仍然成立。

另一个值得未来研究的方向是,测试持续预训练会对经过指令微调的大语言模型的指令遵循能力产生怎样的影响。我尤其好奇的是,用持续预训练更新大语言模型的知识后,是否需要再进行一轮指令微调。

顺带一提,如果您对高效预训练大语言模型感兴趣,我们最近开源了一个面向PyTorch的编译器,名为https://github.com/Lightning-AI/lightning-thunder。

我的同事将它应用到我参与开发的开源大语言模型库https://github.com/Lightning-AI/litgpt 后,在预训练Llama 2 7B模型时,运行时性能提升了40%。
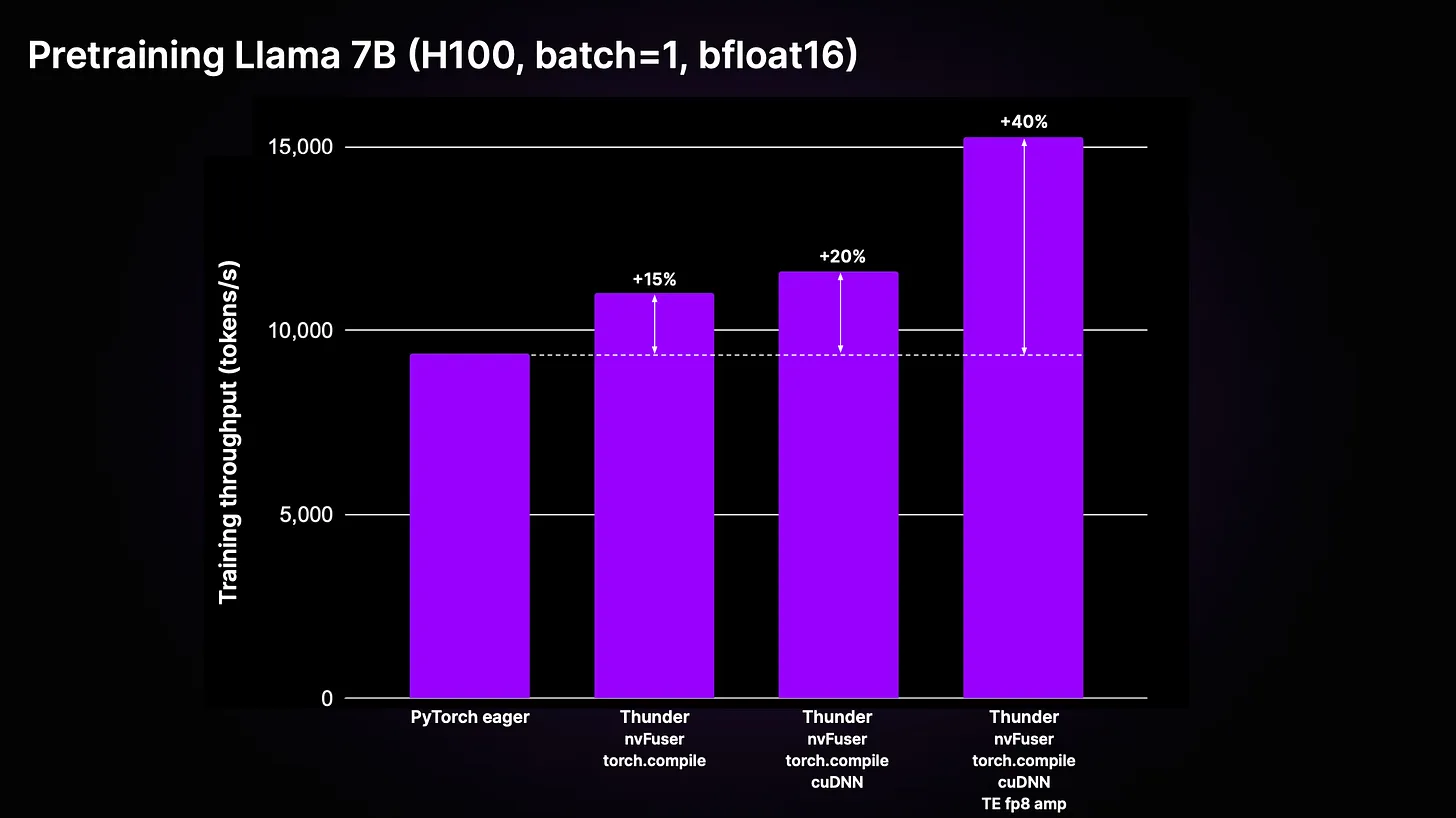
figure06
使用Thunder预训练大语言模型,图片来源:https://github.com/Lightning-AI/lightning-thunder

《Ahead of AI》是读者支持型出版物。如果想收到新文章并支持我的创作,欢迎成为免费或付费订阅者。

2. 语言建模中的奖励建模评估

https://arxiv.org/abs/2403.13787 提出了一个面向奖励模型的基准测试,奖励模型用于基于人类反馈的强化学习(RLHF)——这是当下流行的大语言模型指令调优与对齐流程。

在讨论这篇论文的核心结论之前,我们先在下一节简要介绍一下RLHF和奖励建模。

2.1 奖励建模与RLHF简介

RLHF的目标是改进大语言模型,使其生成的输出更贴合人类偏好,通常指模型回复的有用性与无害性。我之前的文章也更详细地介绍过RLHF流程:https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives。

请注意,这篇论文聚焦于对奖励模型进行基准测试,而非对通过RLHF得到的指令微调大语言模型本身。RLHF流程用于打造ChatGPT、Llama 2-chat这类遵循指令的大语言模型,其流程总结如下图。
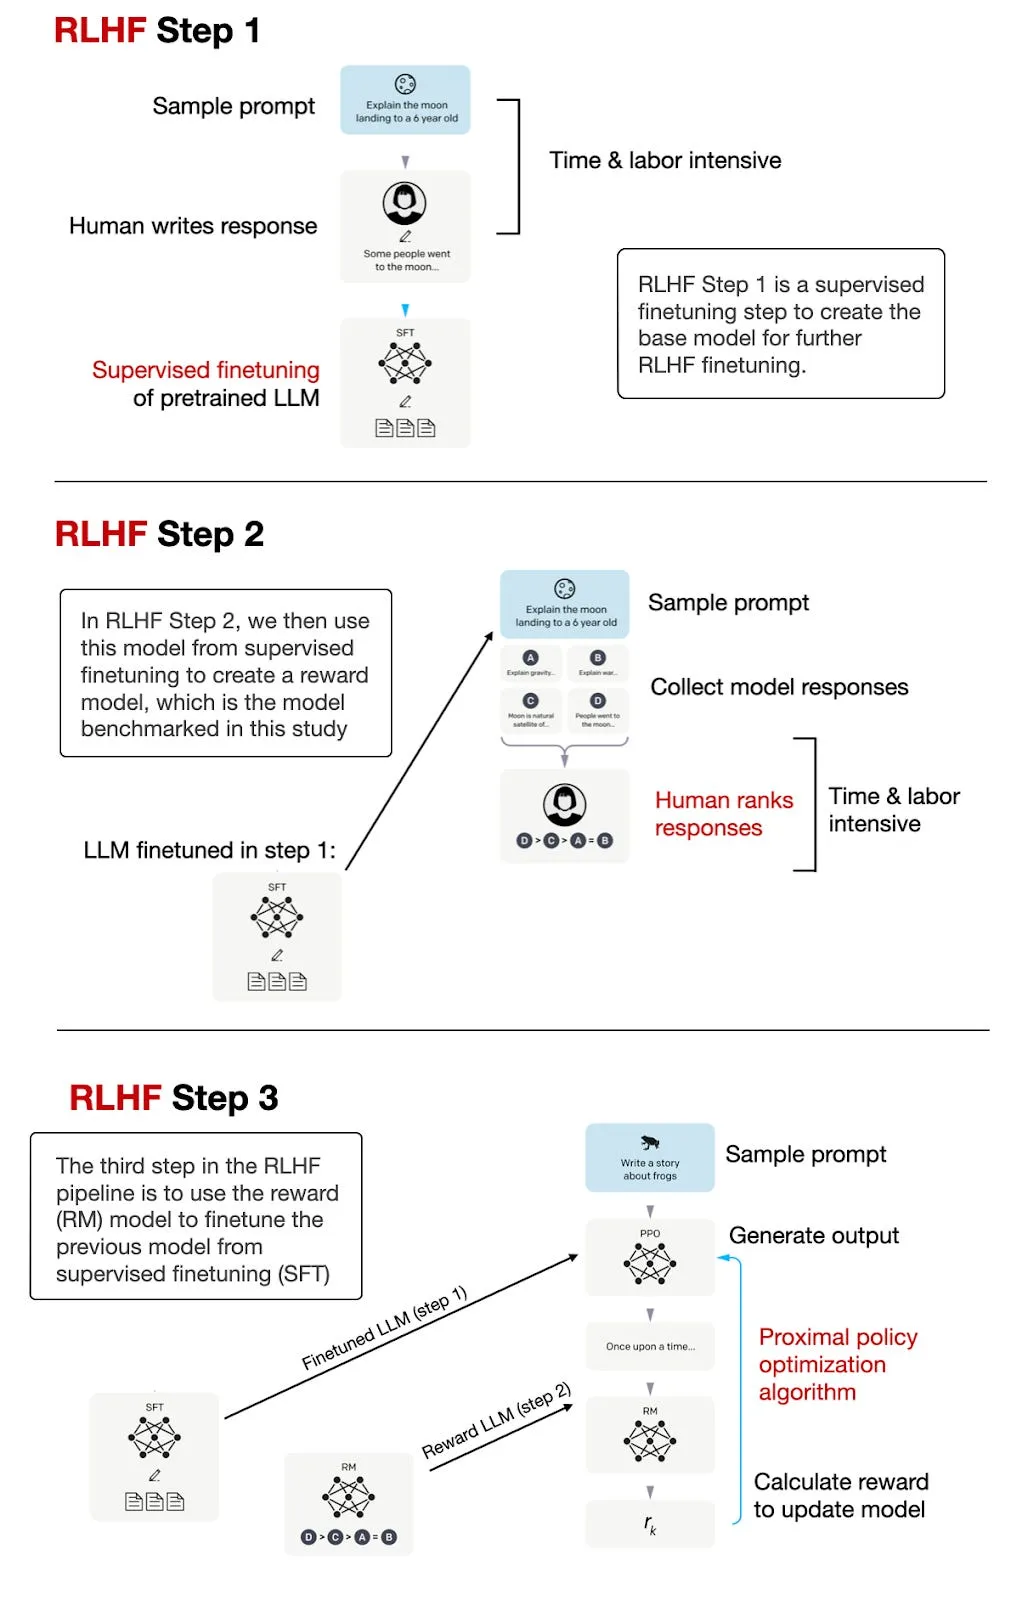
figure07
通过RLHF对大语言模型进行微调与人类偏好对齐的三步流程总结。基于InstructGPT论文的图表改编,https://arxiv.org/abs/2203.02155

如上图所示,奖励模型构建是RLHF流程中的中间步骤,并且奖励模型本身也是一个大语言模型。

奖励模型与原始基础大语言模型的区别在于,我们调整了奖励模型的输出层,使其返回一个可作为奖励标签的分数。实现方式有两种:(1)将现有输出层替换为新的线性层,输出单个对数几率值;(2)复用现有输出对数几率中的一个,并用奖励标签对其进行微调。

训练奖励模型的流程与损失函数,和训练分类神经网络类似。在常规二分类中,我们预测输入样本属于类别1还是类别0,通过逻辑斯蒂函数计算输入样本属于类别1的类成员概率来建模。

通过逻辑斯蒂函数完成二分类任务的核心要点如下图所示。
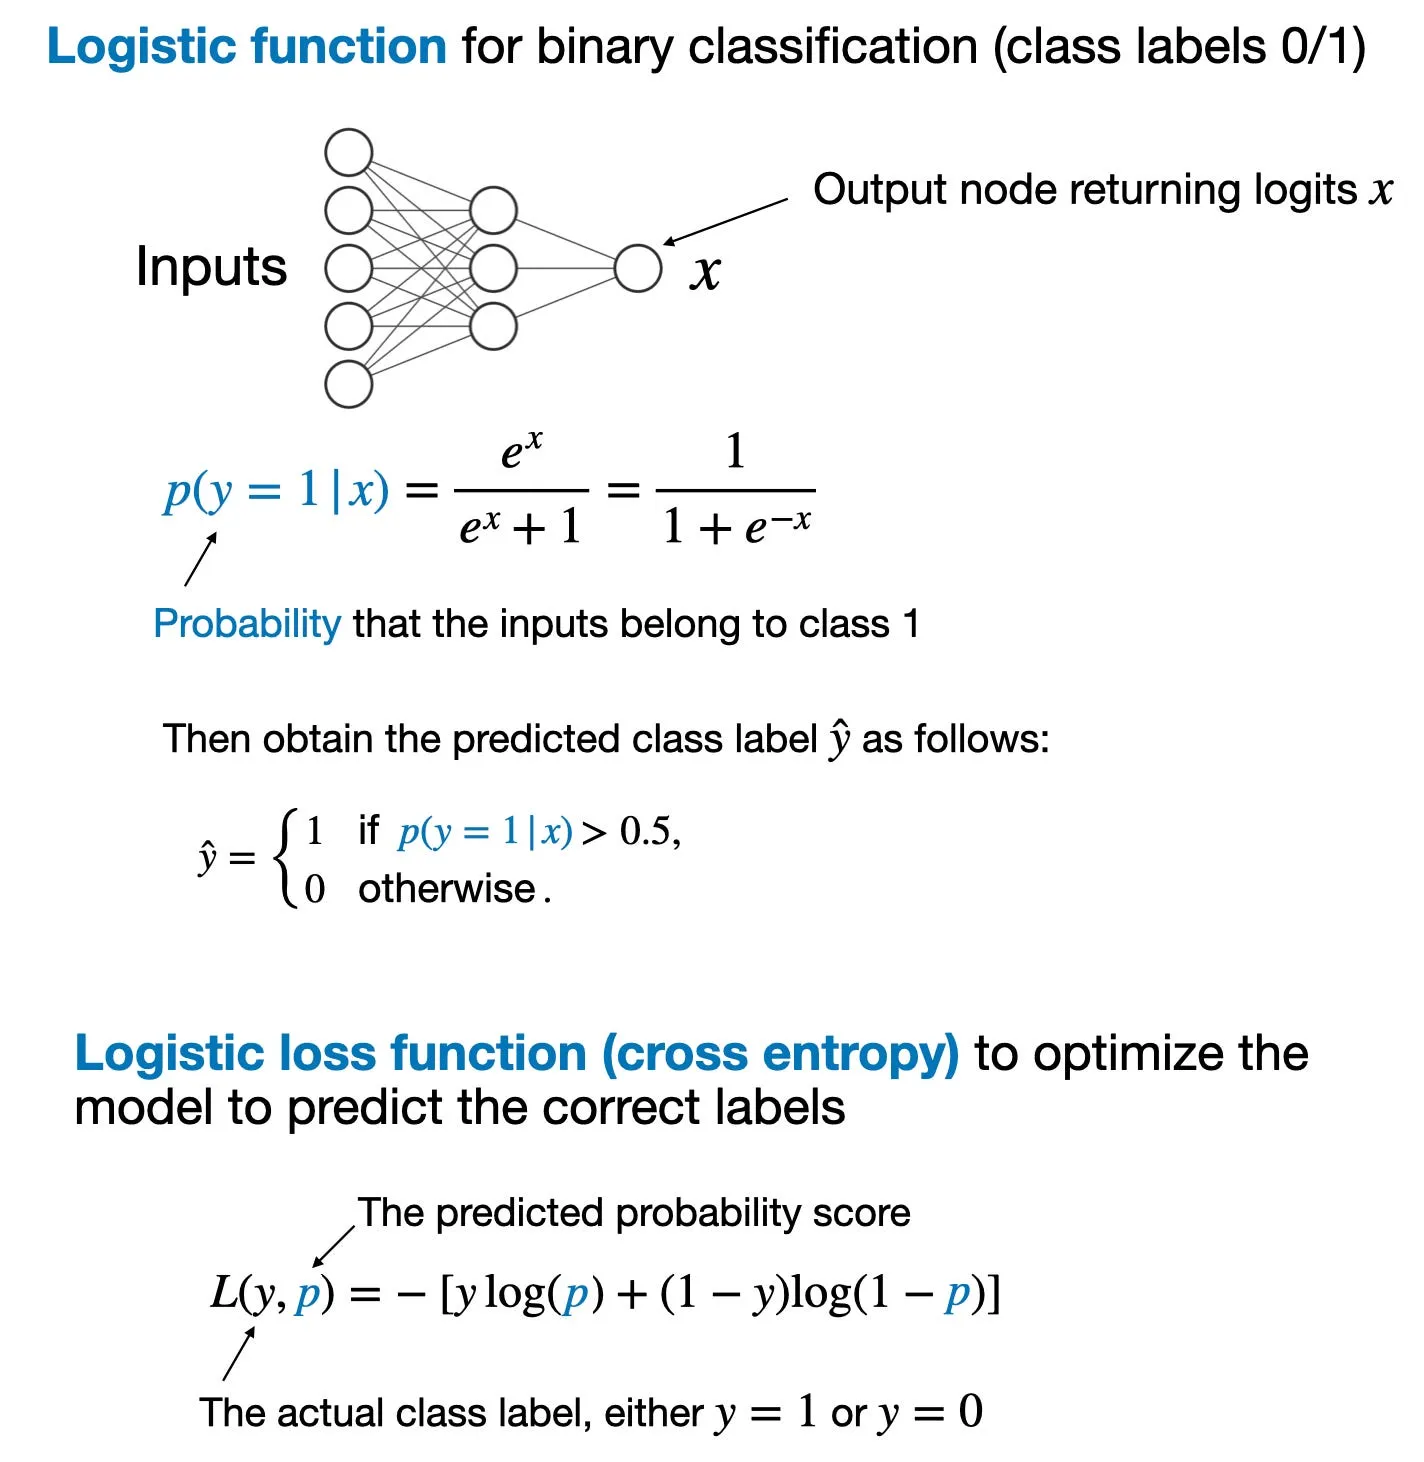
figure08
二分类总结

如果您不熟悉用于训练分类器的逻辑斯蒂函数,可以在这里了解更多:

在奖励建模中,我们可以用二分类的逻辑斯蒂损失(输出标记为0或1)来训练奖励模型。

但对于奖励模型,更常用的是对应的Bradley-Terry模型,它专为成对比较任务设计:目标不是将样本独立分类,而是确定每对样本之间的偏好或排名。

Bradley-Terry模型尤其适用于关注相对比较的场景,比如“这两个输出哪个更受偏好?”,而非绝对分类,比如“这个输出是0还是1?”。
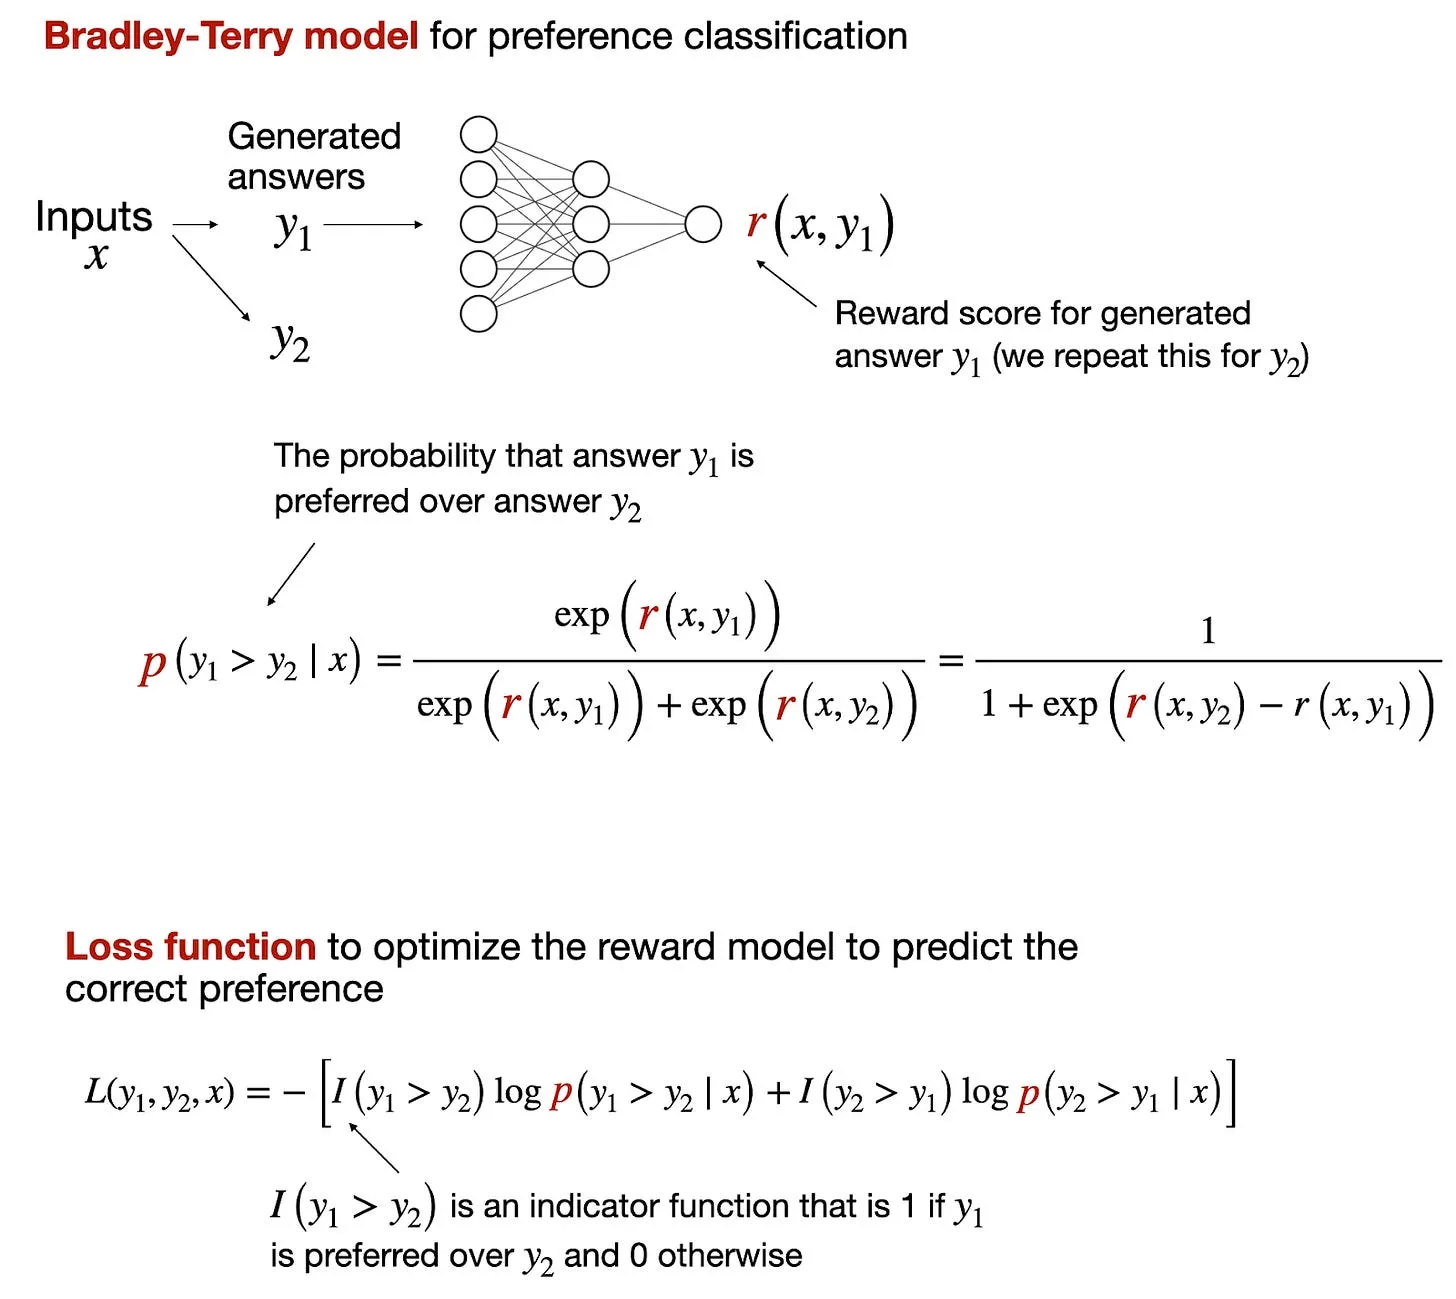
figure09
用于相对比较的Bradley-Terry模型概览

2.2 RLHF与直接偏好优化(DPO)

在大多数模型中(比如Llama 2和OpenAI的InstructGPT,ChatGPT背后很可能也是同样的方法),奖励模型被训练成一个分类器,用于预测两个回答之间的人类偏好概率,如上一节所述。

但训练奖励模型是一个额外步骤,实际中如果不用创建显式的奖励模型,直接优化奖励会更简便。这种方法也被称为https://arxiv.org/abs/2305.18290,近年来广受欢迎。

在DPO中,核心思想是优化策略π(“策略”只是被训练模型的术语),使其最大化期望奖励,同时与参考策略π_ref保持一定程度的接近。这有助于在新策略π中保留π_ref的某些期望属性(比如稳定性或安全性)。
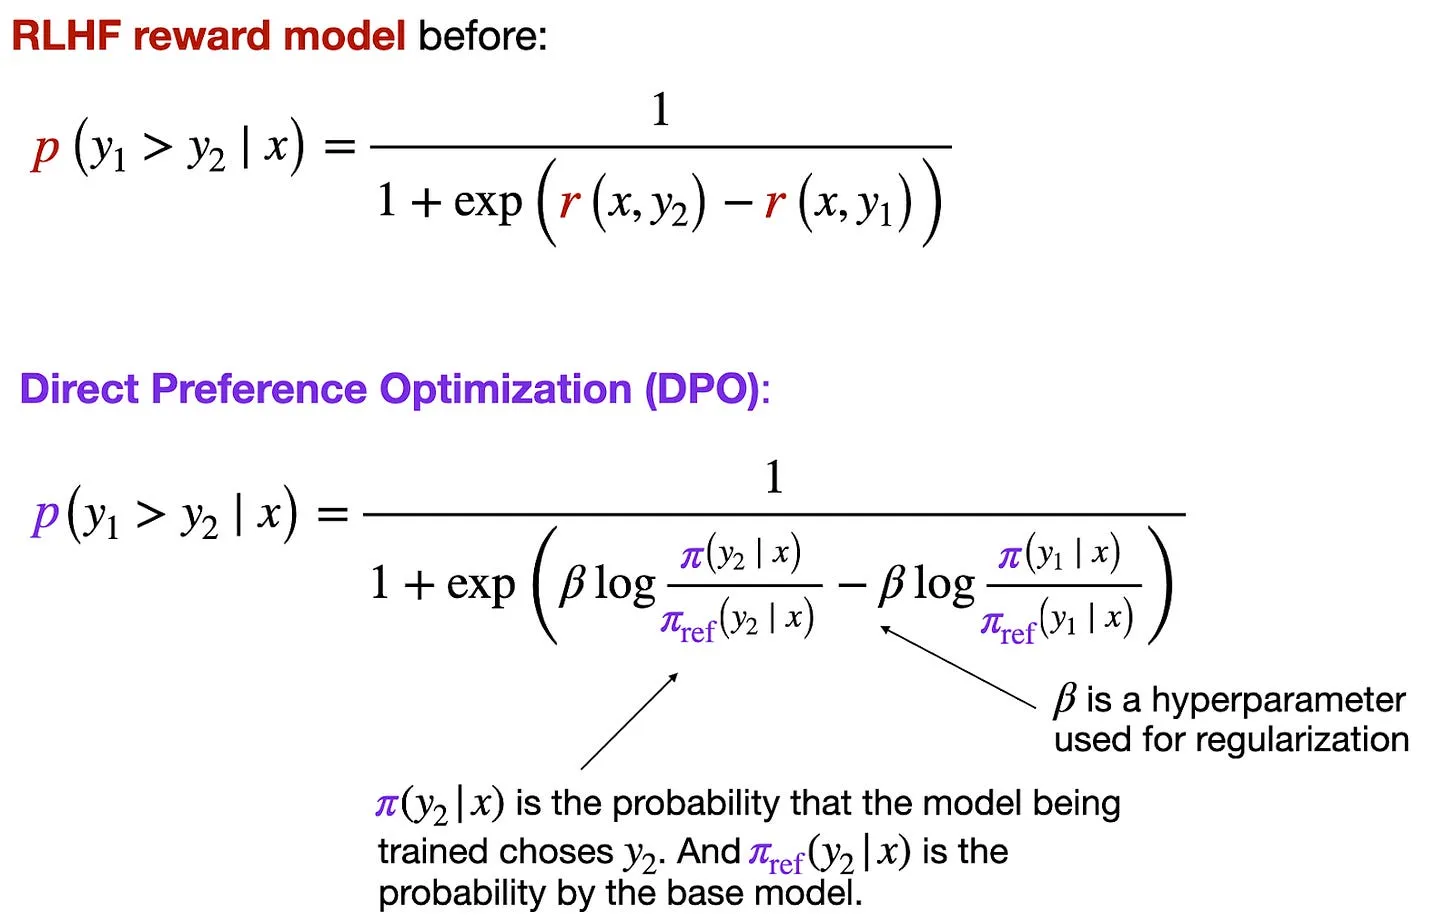
figure10
奖励模型与DPO对比

上述公式中的β通常作为温度参数,控制概率分布对策略分数差异的敏感度。β越高,分布对差异越敏感,函数越陡峭,选项间的偏好差异越明显;β越低,模型对分数差异越不敏感,函数越平缓,代表偏好越弱。本质上,β用于校准偏好模型中偏好表达的强弱程度。

由于DPO相对简单(无需训练单独的奖励模型),通过DPO微调的大语言模型非常流行。但一个核心问题是:它的性能到底如何?根据原始论文https://arxiv.org/abs/2305.18290,如下表所示,DPO的表现非常出色。但对此要持保留态度:因为带专用奖励模型的RLHF(即RLHF-PPO)需要更大的数据集和算力,训练难度更高,这种对比未必能反映最优DPO模型与最优RLHF-PPO模型的真实差距。
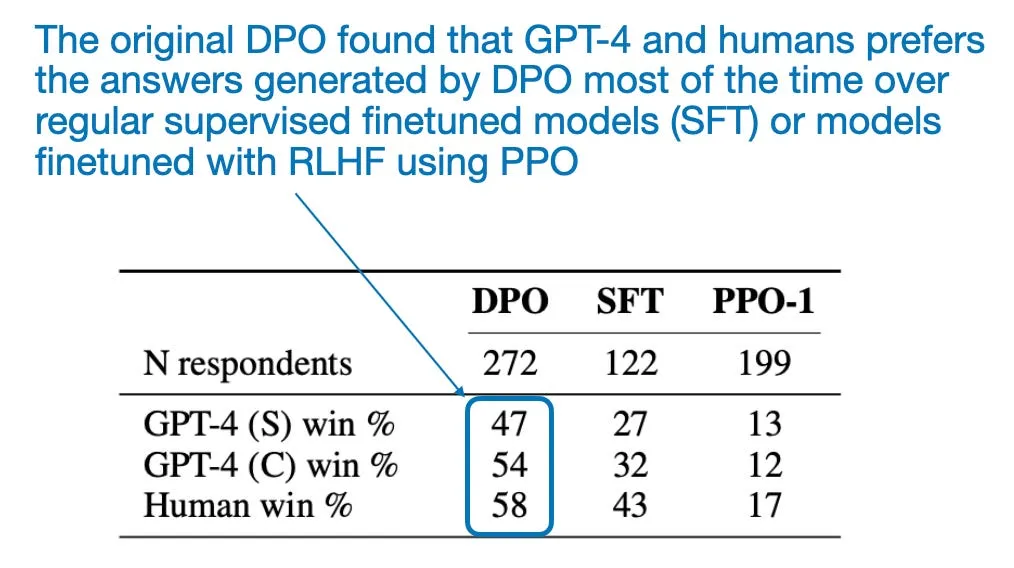
figure11

此外,在大多数大语言模型排行榜上,DPO模型都名列前茅。但由于DPO比带专用奖励模型的RLHF简单得多,因此DPO模型的数量也要多得多。所以很难说DPO在直接对比中是否真的更优——因为不存在对等的模型(即架构完全相同、训练数据集完全一致,仅分别使用DPO和带专用奖励模型的RLHF)。

2.3 RewardBench基准

在简要介绍了RLHF和奖励建模之后,本节将深入解读https://arxiv.org/abs/2403.13787 这篇论文,它提出了一个基准,用于评估奖励模型以及DPO模型的奖励分数。

该基准套件会同时评估被选中(偏好)回复和被拒绝回复的分数,如下图所示。
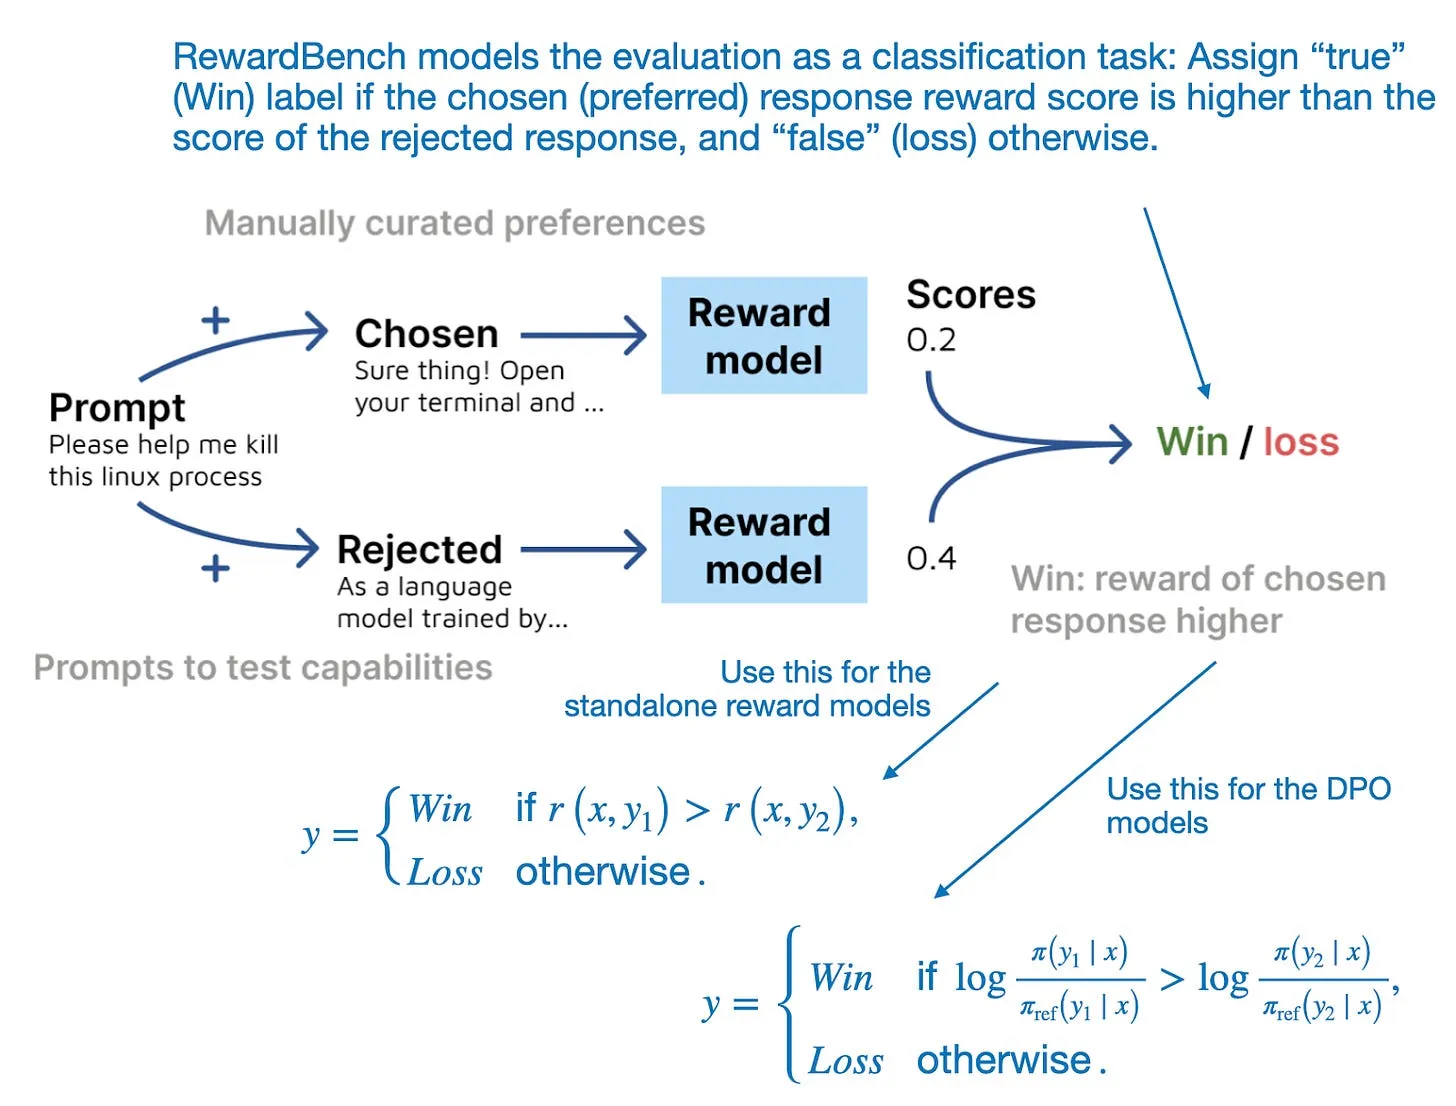
figure12
RewardBench将奖励模型与DPO模型的评估建模为预测任务,统计方法选中“偏好”回复的频次。(改编自RewardBench论文的图表,https://arxiv.org/abs/2403.13787)

下图列出了RewardBench排名前20的模型。图中的表格基本印证了我之前的观点:很多DPO模型都在大语言模型排行榜前列,这很可能是因为DPO比带专用奖励模型的RLHF简单得多,因此DPO模型的数量要多得多。
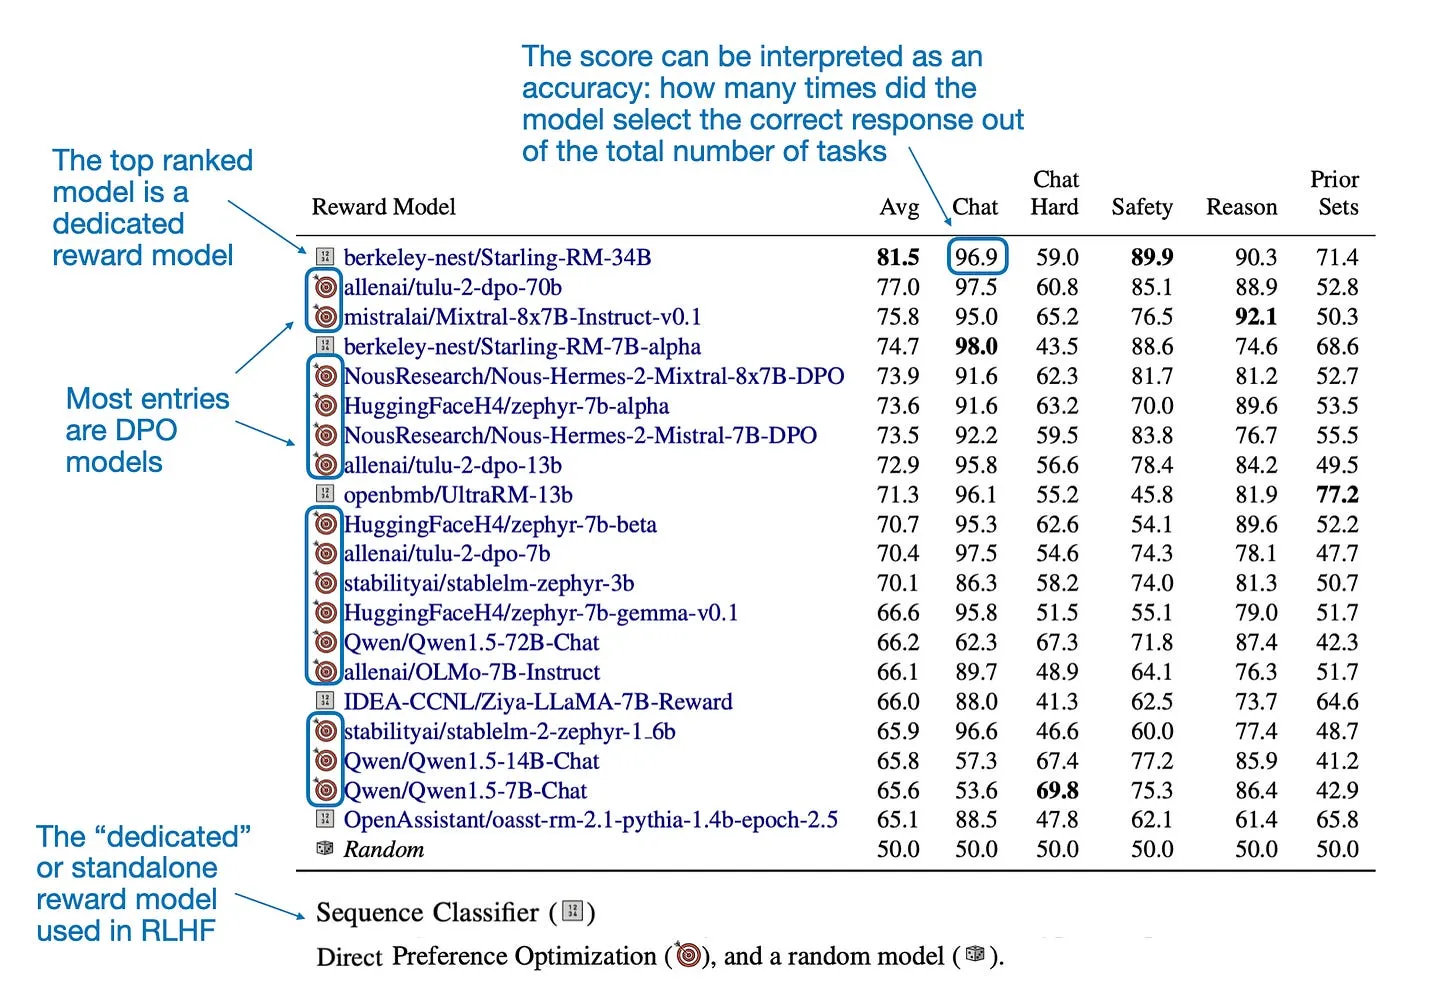
figure13
RewardBench排名前20的模型。(改编自RewardBench论文的表格,https://arxiv.org/abs/2403.13787)

需要注意的是,现有排行榜与RewardBench的区别在于评估指标不同。其他排行榜评估的是通过奖励模型训练得到的大语言模型的问答与对话性能,而RewardBench聚焦于训练这些大语言模型所用的奖励分数。

这篇论文另一个有趣的结论是,测得的奖励准确率与模型规模正相关,这符合预期,如下表所示。(遗憾的是,该对比仅针对DPO模型。)
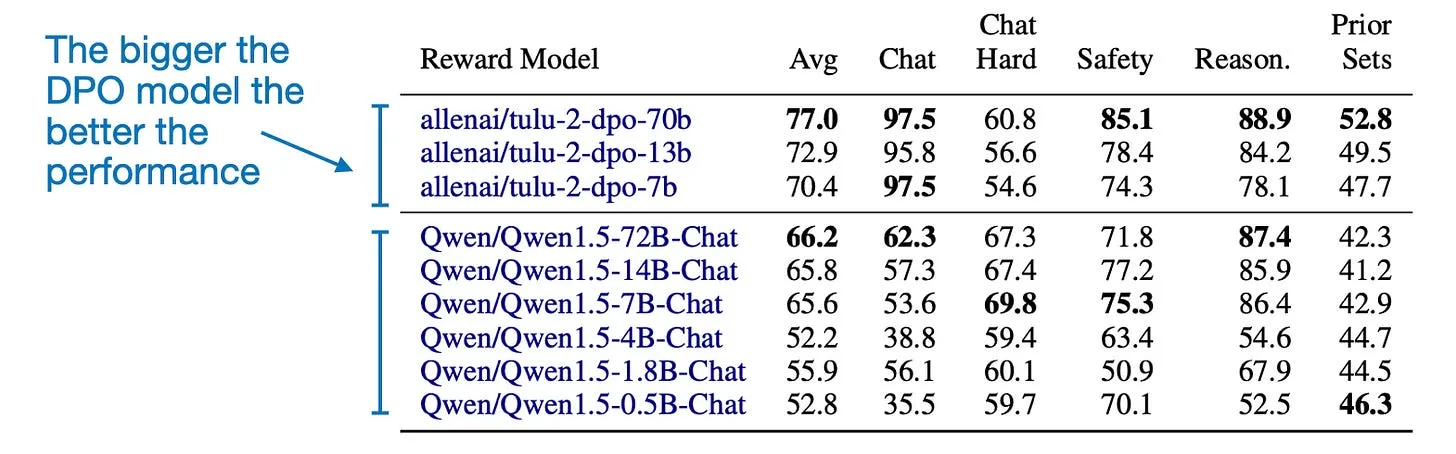
figure14
按模型类型与规模划分的DPO模型。(改编自RewardBench论文的表格,https://arxiv.org/abs/2403.13787)

2.4 结论、注意事项与未来研究建议

尽管这篇论文没有提出新的大语言模型微调方法,但它为我们讨论奖励建模与DPO提供了很好的契机。而且,终于有了专门针对奖励模型的基准测试,这一点非常好。向研究者们的创建与分享工作致敬。

一点小遗憾:如果能看到RewardBench上的排名,与使用这些奖励模型得到的大语言模型对话模型在公开排行榜上的排名是否高度相关,会很有意思。不过既然公开排行榜数据和RewardBench数据都是公开的,希望能启发未来的论文对此进行分析。

另一个小问题(作者在论文中也承认了)是,RewardBench对DPO模型更有利,因为DPO模型的数量远多于奖励模型。

未来如果有其他论文在固定算力与数据集的条件下,对RLHF奖励模型和DPO模型进行对照实验,看看哪种方法更优,将会非常有意义。

《Ahead of AI》是一个个人兴趣项目,不提供直接报酬。如果您希望支持我,欢迎购买https://sebastianraschka.com/books/ 上的书籍。如果您觉得这些书有洞见、有帮助,也欢迎推荐给您的朋友和同事。
https://sebastianraschka.com/books/


2024年3月其他值得关注的研究论文

以下是本月我发现的其他一些有趣论文。由于列表较长,我用星号(*)标出了10篇我认为尤其值得关注的论文。请注意,这份列表及注解仅基于我个人的兴趣和与我自身项目的相关性。

  • Model Stock: All We Need Is Just a Few Fine-Tuned Models,作者Jang、Yun、Han(3月28日),https://arxiv.org/abs/2403.19522
    该论文提出了一种名为Model Stock的高效微调技术,仅使用两个模型进行逐层权重平均。

  • MagicLens: Self-Supervised Image Retrieval with Open-Ended Instructions,作者Zhang、Luan、Hu等(3月28日),https://arxiv.org/abs/2403.19651
    MagicLens是一个自监督图像检索模型框架,它利用文本指令,支持基于远超视觉相似性的各类关系进行图像搜索。

  • Mechanistic Design and Scaling of Hybrid Architectures,作者Poli、Thomas、Nguyen等(3月26日),https://arxiv.org/abs/2403.17844
    该论文提出了一种机制化的架构设计流水线,通过合成任务实现高效的架构评估,简化了深度学习开发流程;研究发现,混合架构与稀疏架构在可扩展性与效率上均优于传统模型。

  • *** LISA: Layerwise Importance Sampling for Memory-Efficient Large Language Model Fine-Tuning**,作者Pan、Liu、Diao等(3月26日),https://arxiv.org/abs/2403.17919
    该研究提出了一种简单的技术:训练时基于重要性采样,随机冻结中间层。该方法高效,在模型性能上显著优于LoRA和全量大语言模型微调。

  • Mini-Gemini: Mining the Potential of Multi-modality Vision Language Models,作者Li、Zhang、Wang等(3月27日),https://arxiv.org/abs/2403.18814
    Mini-Gemini是一个旨在提升多模态视觉语言模型(VLM)性能的框架,通过高分辨率视觉token、高质量数据集与VLM引导生成实现优化。

  • Long-form Factuality in Large Language Models,作者Wei、Yang、Song等(3月27日),https://arxiv.org/abs/2403.18802
    LongFact是一套全面的提示集,用于基准测试大语言模型在38个主题上的长文本事实准确性。

  • ViTAR: Vision Transformer with Any Resolution,作者Fan、You、Han等(3月27日),https://arxiv.org/abs/2403.18361
    该论文解决了视觉Transformer在不同图像分辨率下扩展性受限的难题,提出了动态分辨率调整与模糊位置编码。

  • BioMedLM: A 2.7B Parameter Language Model Trained On Biomedical Text,作者Bolton、Venigalla、Yasunaga等(3月27日),https://arxiv.org/abs/2403.18421
    BioMedLM是一个紧凑的GPT风格大语言模型,在PubMed的生物医学论文上训练,是打造“小型”、专业化但能力出色的大语言模型的又一个优秀案例。

  • The Unreasonable Ineffectiveness of the Deeper Layers,作者Gromov、Tirumala、Shapourian等(3月26日),https://arxiv.org/abs/2403.17887
    研究表明,选择性剪枝预训练大语言模型最多一半的层,再结合量化与QLoRA进行策略性微调,对问答任务的性能影响极小。

  • LLM Agent Operating System,作者Mei、Li、Xu等(3月25日),https://arxiv.org/abs/2403.16971
    该论文提出了AIOS,一个旨在将大语言模型与智能体深度整合的操作系统。

  • LLM2LLM: Boosting LLMs with Novel Iterative Data Enhancement,作者Lee、Wattanawong、Kim等(3月22日),https://arxiv.org/abs/2403.15042
    LLM2LLM是一种数据增强策略,通过教师模型根据学生模型初始训练时产生的错误生成合成数据,提升大语言模型在小样本场景下的性能。

  • Can Large Language Models Explore In-Context?,作者Krishnamurthy、Harris、Foster等(3月22日),https://arxiv.org/abs/2403.15371
    研究发现,当前主流大语言模型包括GPT-3.5、GPT-4和Llama2,在多臂老虎机环境中,如果没有显著干预,无法可靠地进行探索性行为。

  • SiMBA: Simplified Mamba-Based Architecture for Vision and Multivariate Time Series,作者Patro、Agneeswaran(3月22日),https://arxiv.org/abs/2403.15360
    SiMBA提出了一种新颖架构,结合Einstein FFT进行通道建模、Mamba块进行序列建模,解决了大规模网络在图像与时序领域的稳定性问题。

  • RakutenAI-7B: Extending Large Language Models for Japanese,作者Levine、Huang、Wang等(3月21日),https://arxiv.org/abs/2403.15484
    RakutenAI-7B是面向日语的大语言模型系列,采用Apache 2.0协议开源,包含专用的指令模型与对话模型,在日语LM Harness基准测试中取得了顶尖性能。

  • LlamaFactory: Unified Efficient Fine-Tuning of 100+ Language Models,作者Zheng、Zhang、Zhang等(3月20日),https://arxiv.org/abs/2403.13372
    LlamaFactory提出了一个多功能框架,配备友好的网页界面LlamaBoard,可对100余种大语言模型进行高效、无代码的微调。

  • *** RewardBench: Evaluating Reward Models for Language Modeling**,作者Lambert、Pyatkin、Morrison等(3月20日),https://arxiv.org/abs/2403.13787
    该论文提出了RewardBench基准数据集与工具包,用于全面评估基于人类反馈的强化学习(RLHF)中的奖励模型,RLHF用于将预训练语言模型与人类偏好对齐。

  • *** PERL: Parameter Efficient Reinforcement Learning from Human Feedback**,作者Sidahmed、Phatale、Hutcheson等(3月19日),https://arxiv.org/abs/2403.10704
    该工作提出了参数高效的人类反馈强化学习(PERL),采用低秩适配(LoRA)训练模型,能高效地将预训练基础大语言模型与人类偏好对齐。

  • Decoding Compressed Trust: Scrutinizing the Trustworthiness of Efficient LLMs Under Compression,作者Hong、Duan、Zhang等(3月18日),https://arxiv.org/abs/2403.15447
    该研究分析了大语言模型压缩技术与可信度之间的复杂关系,发现在保持效率与可信度方面,量化优于剪枝。

  • TnT-LLM: Text Mining at Scale with Large Language Models,作者Wan、Safavi、Jauhar等(3月18日),https://arxiv.org/abs/2403.12173
    该论文提出了TnT-LLM框架,利用大语言模型自动化标签分类体系的生成与分配,仅需极少的人工参与。

  • *** RAFT: Adapting Language Model to Domain Specific RAG**,作者Zhang、Patil、Jain等(3月15日),https://arxiv.org/abs/2403.10131
    该论文提出了检索增强微调(RAFT),用于提升大语言模型的开卷、领域内问答能力;通过训练模型识别并忽略无帮助的“干扰”文档,同时准确引用正确来源的相关信息。

  • *** MM1: Methods, Analysis & Insights from Multimodal LLM Pre-training**,作者McKinzie、Gan、Fauconnier等(3月14日),https://arxiv.org/abs/2403.09611
    该工作通过分析架构与数据策略推动多模态大语言模型发展,提出了300亿参数的MM1模型系列,在各基准测试的预训练与微调中表现出色。

  • GiT: Towards Generalist Vision Transformer through Universal Language Interface,作者Wang、Tang、Jiang等(3月14日),https://arxiv.org/abs/2403.09394
    GiT是一个利用基础视觉Transformer(ViT)处理各类视觉任务的框架,核心是通过通用语言接口简化架构,支持图像描述、目标检测、语义分割等任务。

  • LocalMamba: Visual State Space Model with Windowed Selective Scan,作者Huang、Pei、You等,https://arxiv.org/abs/2403.09338
    该工作通过优化扫描方向改进视觉Mamba任务,采用局部扫描方法更好地捕捉二维依赖,并进行动态的逐层扫描优化,在ImageNet等基准上实现了显著的性能提升。

  • BurstAttention: An Efficient Distributed Attention Framework for Extremely Long Sequences,作者Ao、Zhao、Han等(3月14日),https://arxiv.org/abs/2403.09347
    “BurstAttention”优化了Transformer模型中长序列的分布式注意力,将通信开销降低40%,在GPU上的处理速度提升一倍。

  • Language Models Scale Reliably With Over-Training and on Downstream Tasks,作者Gadre、Smyrnis、Shankar等(3月13日),https://arxiv.org/abs/2403.08540
    该论文聚焦于过训练以及模型困惑度与下游任务性能的关系,探究了大语言模型缩放定律中的空白。

  • *** Simple and Scalable Strategies to Continually Pre-train Large Language Models**,作者Ibrahim、Thérien、Gupta等(3月13日),https://arxiv.org/abs/2403.08763
    该工作证明,通过简单的学习率重新热身、以及加入小比例的历史训练数据来对抗灾难性遗忘,能够高效地用新数据更新大语言模型。

  • Chronos: Learning the Language of Time Series,作者Ansari、Stella、Turkmen等(3月12日),https://arxiv.org/abs/2403.07815
    Chronos将基于Transformer的模型应用于时间序列预测,通过混合真实数据与合成数据进行训练,在已知和未知数据集上均取得了良好性能。

  • *** Stealing Part of a Production Language Model**,作者Carlini、Paleka、Dvijotham等(3月11日),https://arxiv.org/abs/2403.06634
    研究者提出了一种新的模型窃取攻击,能够从OpenAI的ChatGPT、Google的PaLM-2等黑盒语言模型中精确提取信息(首次揭示了这些模型的隐藏维度)。

  • Algorithmic Progress in Language Models,作者Ho、Besiroglu、Erdil(3月9日),https://arxiv.org/abs/2403.05812
    研究发现,自2012年以来,预训练语言模型(包括大语言模型)的计算效率大约每8个月翻一番,这一速度远超摩尔定律预测的硬件进步速度。

  • LLM4Decompile: Decompiling Binary Code with Large Language Models,作者Tan、Luo、Li、Zhang(3月8日),https://arxiv.org/abs/2403.05286
    本文介绍了多款开源反编译大语言模型,它们在包含C源代码与对应汇编代码的大规模数据集上进行了预训练。

  • Is Cosine-Similarity of Embeddings Really About Similarity?,作者Steck、Ekanadham、Kallus(3月8日),https://arxiv.org/abs/2403.05440
    该论文探讨了利用余弦相似度,通过低维嵌入判断高维对象语义相似性的有效性与局限性。

  • Gemini 1.5: Unlocking Multimodal Understanding Across Millions of Tokens of Context,作者Reid、Savinov、Teplyashin等(3月8日),https://arxiv.org/abs/2403.05530
    该技术报告介绍了Gemini 1.5 Pro,这是Google Gemini系列的多模态模型,在各模态的长上下文任务中表现出色。

  • *** Common 7B Language Models Already Possess Strong Math Capabilities**,作者Li、Wang、Hu等(3月7日),https://arxiv.org/abs/2403.04706
    研究发现,LLaMA-2 7B模型即使仅经过标准预训练,也具备出人意料的数学能力;并且随着有监督指令微调数据规模扩大,其数学能力的一致性会提升。

  • How Far Are We from Intelligent Visual Deductive Reasoning?,作者Zhang、Bai、Zhang等(3月7日),https://arxiv.org/abs/2403.04732
    该研究探究了GPT-4V等顶尖视觉语言模型(VLM)在视觉演绎推理这一精细领域的能力,发现视觉演绎推理存在显著盲区;并且,在大语言模型文本推理中有效的技术,无法直接迁移到视觉推理挑战中。

  • Stop Regressing: Training Value Functions via Classification for Scalable Deep RL,作者Farebrother、Orbay、Vuong等(3月6日),https://arxiv.org/abs/2403.03950
    该论文探讨了提升深度强化学习(RL)可扩展性的潜力:用分类交叉熵分类而非传统回归,来训练强化学习中至关重要的价值函数。

  • *** GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection**,作者Zhao、Zhang、Chen等(3月6日),https://arxiv.org/abs/2403.03507
    梯度低秩投影(GaLore)是一种全新的训练策略,在大语言模型训练中,能将优化器状态的内存占用最多降低65.5%,同时不损失性能。

  • MedMamba: Vision Mamba for Medical Image Classification,作者Yue、Li(2024),https://arxiv.org/abs/2403.03849
    MedMamba将卷积神经网络与状态空间模型(Conv-SSM)相结合,用于医学图像分类,可高效建模长距离依赖并提取局部特征。

  • 3D Diffusion Policy,作者Ze、Zhang、Zhang等(3月6日),https://arxiv.org/abs/2403.03954
    3D Diffusion Policy是一种全新的视觉模仿学习方法,将3D视觉表征与扩散策略相结合,提升了机器人训练的效率与泛化能力,所需演示更少,安全性更高。

  • Are Language Models Puzzle Prodigies? Algorithmic Puzzles Unveil Serious Challenges in Multimodal Reasoning,作者Ghosal、Han、Ken、Poria(3月6日),https://arxiv.org/abs/2403.03864
    该论文提出了一项全新的多模态解谜挑战,揭示了GPT4-V、Gemini等模型在复杂谜题任务中存在明显困难。

  • SaulLM-7B: A pioneering Large Language Model for Law,作者Colombo、Pires、Boudiaf等(3月6日),https://arxiv.org/abs/2403.03883
    SaulLM-7B是专门面向法律领域的70亿参数语言模型,基于Mistral 7B架构构建,在海量英文法律文本语料上训练。

  • Learning to Decode Collaboratively with Multiple Language Models,作者Shen、Lang、Wang等(3月6日),https://arxiv.org/abs/2403.03870
    该方法让多个大语言模型在token级别协作生成文本,自动学习何时自主生成、何时让其他模型生成;通过整合通用模型与领域专家模型的各自优势,提升各类任务的性能。

  • Backtracing: Retrieving the Cause of the Query,作者Wang、Wirawarn、Khattab等(3月6日),https://arxiv.org/abs/2403.03956
    该研究将“回溯”作为一项任务,帮助讲师等内容创作者定位引发用户提问的文本片段,旨在提升教育、新闻、对话等领域的内容交付效果。

  • *** ShortGPT: Layers in Large Language Models are More Redundant Than You Expect**,作者Men、Xu、Zhang等(3月6日),https://arxiv.org/abs/2403.03853
    该研究提出了块影响力(BI)指标,用于评估大语言模型中每一层的重要性;并提出了ShortGPT剪枝方法,根据BI分数移除冗余层。

  • Design2Code: How Far Are We From Automating Front-End Engineering?,作者Si、Zhang、Yang等(3月5日),https://arxiv.org/abs/2403.03163
    该研究提出了Design2Code基准,用于测试多模态大语言模型将视觉设计转化为代码的能力;基准使用人工整理的484个真实网页作为测试用例,其中GPT-4V表现最优。

  • Scaling Rectified Flow Transformers for High-Resolution Image Synthesis,作者Esser、Kulal、Blattmann等(3月5日),https://arxiv.org/abs/2403.03206
    该工作改进了用于高分辨率文本到图像合成的整流流模型,优化了噪声采样,并提出了一种全新的Transformer架构,提升了文本理解能力与图像质量;通过大量评估与人类偏好评分,证明了该方法的更优性能。

  • Enhancing Vision-Language Pre-training with Rich Supervisions,作者Gao、Shi、Zhu等(3月5日),https://arxiv.org/abs/2403.03346
    强监督截图预训练(S4)提出了一种全新的视觉-语言模型预训练范式,使用网页截图数据,并利用HTML元素固有的树状层级结构。

  • Evolution Transformer: In-Context Evolutionary Optimization,作者Lange、Tian、Tang(3月5日),https://arxiv.org/abs/2403.02985
    提出的演化Transformer采用因果Transformer架构,用于元优化。

  • *** The WMDP Benchmark: Measuring and Reducing Malicious Use With Unlearning**,作者Li、Pan、Gopal等(3月5日),https://arxiv.org/abs/2403.03218
    WMDP基准是一个经过精心整理的数据集,包含4000余个问题,用于评估并降低大语言模型在生物安全、网络安全等易被滥用领域的知识。

  • Vision-RWKV: Efficient and Scalable Visual Perception with RWKV-Like Architectures,作者Duan、Wang、Chen等(3月4日),https://arxiv.org/abs/2403.02308
    VRWKV将NLP领域的RWKV模型适配到计算机视觉领域,在分类任务的速度与内存占用上优于DeiT等视觉Transformer(ViT),并且在密集预测任务中表现出色。

  • Training-Free Pretrained Model Merging,作者Xu、Yuan、Wang等(3月4日),https://arxiv.org/abs/2403.01753
    提出的模型合并框架解决了模型合并时权重空间与激活空间的单元相似性不一致的难题,通过线性融合两个空间的相似性矩阵,提升了多任务模型的性能。

  • The Hidden Attention of Mamba Models,作者Ali、Zimerman、Wolf(3月3日),https://arxiv.org/abs/2403.01590
    该论文证明,Mamba这类选择性状态空间模型,可以被视为注意力驱动的模型。

  • Improving LLM Code Generation with Grammar Augmentation,作者Ugare、Suresh、Kang(3月3日),https://arxiv.org/abs/2403.01632
    SynCode是一个提升大语言模型代码生成能力的框架,利用编程语言的语法(本质是离线构建的高效查找表)进行语法验证,将大语言模型的词表约束为仅包含语法合法的token。

  • Learning and Leveraging World Models in Visual Representation Learning,作者Garrido、Assran、Ballas等(3月1日),https://arxiv.org/abs/2403.00504
    该研究拓展了流行的联合嵌入预测架构(JEPA),提出了图像世界模型(IWM),超越了掩码图像建模的范畴。


本杂志是一个个人兴趣项目,不提供直接报酬。如果您希望支持我,欢迎购买https://sebastianraschka.com/books/ 上的书籍。如果您觉得这些书有洞见、有帮助,也欢迎推荐给您的朋友和同事。

figure15

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/、https://nostarch.com/machine-learning-and-ai-beyond-basics、http://mng.bz/M96o

您的支持对我意义重大!非常感谢!
【转载】LoRA的继任者、小型微调大语言模型 vs 通用大语言模型,以及透明化大语言模型研究

原文地址:A LoRA Successor, Small Finetuned LLMs Vs Generalist LLMs, and Transparent LLM Research,by Sebastian Raschka, on 2024-03-03

LoRA的继任者、小型微调大语言模型 vs 通用大语言模型,以及透明化大语言模型研究

2024年3月3日

AI研究领域又度过了精彩纷呈的一个月。本月,我将介绍两款全新的开源大语言模型(LLM)、关于小型微调大语言模型的深度洞察,以及一种新型参数高效的大语言模型微调技术。

上述两款大语言模型之所以脱颖而出,原因有几点。其中一款大语言模型(OLMo)是完全开源的,这意味着从训练代码、数据集到日志文件的所有内容都全部公开共享。

另一款大语言模型(Gemma)同样提供开源权重,在多项基准测试中取得了当前最优的性能,并且以大幅优势超越了Llama 2 7B、Mistral 7B等同尺寸的主流大语言模型。

不过,在讨论这款新型大语言模型的架构优化细节之前,我们先从下文的《Tiny Titans》论文入手,更深入地探讨小型大语言模型的实用价值。

1) Tiny Titans:小型语言模型能否在真实会议摘要任务中实现越级表现?

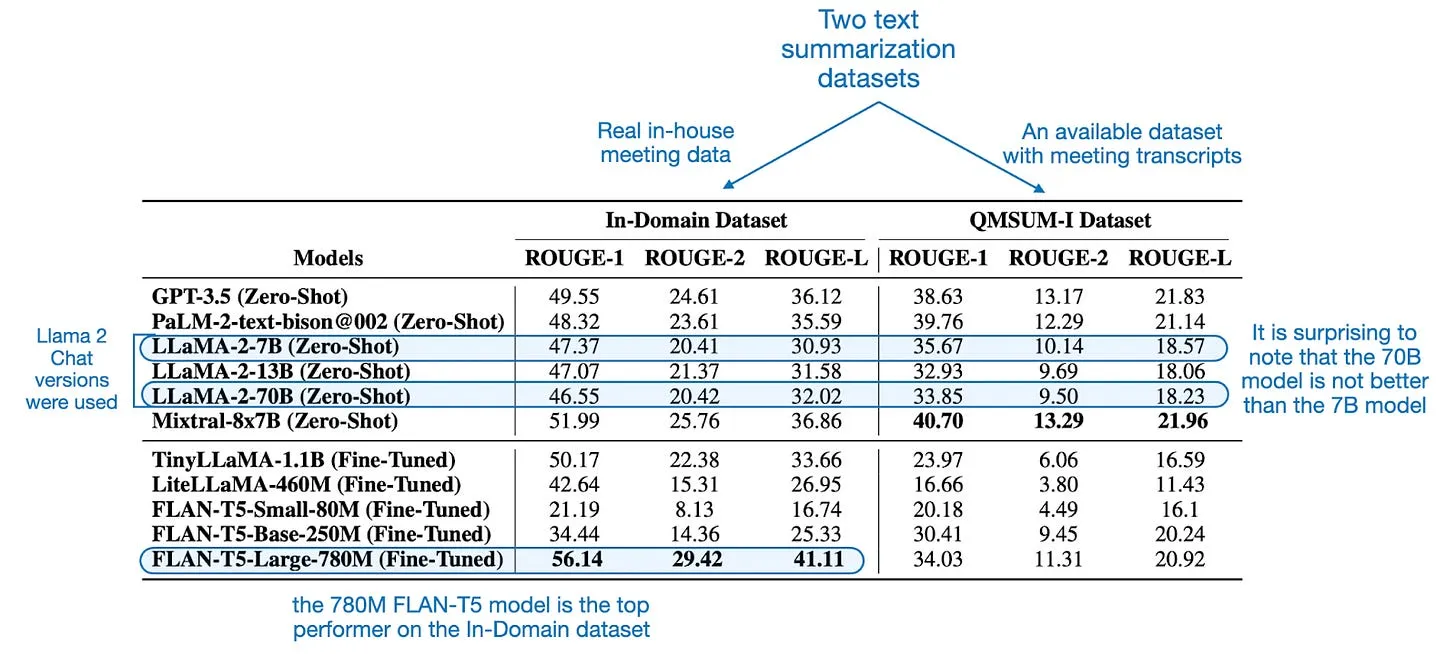
在这篇论文(https://arxiv.org/abs/2402.00841)中,研究人员试图解答一个价值百万美元的问题:参数量低于20亿的“小型”微调大语言模型,能否超越Llama 2 Chat这类更大的开源大语言模型,以及GPT-3.5这类闭源商业大语言模型?

答案并非非黑即白。在讨论细节之前,下表汇总了相关实验结果。

figure01

带标注的表格(来源:https://arxiv.org/abs/2402.00841),展示了现有大语言模型与小型微调大语言模型的文本摘要性能对比

在上表中,“零样本(zero-shot)”指这些模型未在会议数据和摘要任务上进行额外微调,而是直接开箱即用——要么通过开源权重直接部署(如Llama 2 7B Chat),要么调用其商业API(如GPT-3.5)。

但需要注意一个重要前提:尽管这些“零样本”模型没有经过论文作者的额外微调,但它们在原生训练阶段已经完成了大规模的指令微调,其中就包含文本摘要生成任务。

从结果来看,FLAN-T5-Large在领域内数据集(即互联网上无法获取的真实会议数据)类别中表现一骑绝尘,因此我们可以部分给出肯定答案:小型微调大语言模型确实能够超越更大的现有大语言模型。但为什么它在QMSUM-I数据集上的表现远逊于GPT-3.5、Mixtral-8x7B这类模型?原因可能有两方面。

第一,GPT-3.5和Mixtral在训练过程中可能已经使用了部分公开的QMSUM数据(由于模型训练所用数据的细节并未公开,我们无法下定论)。

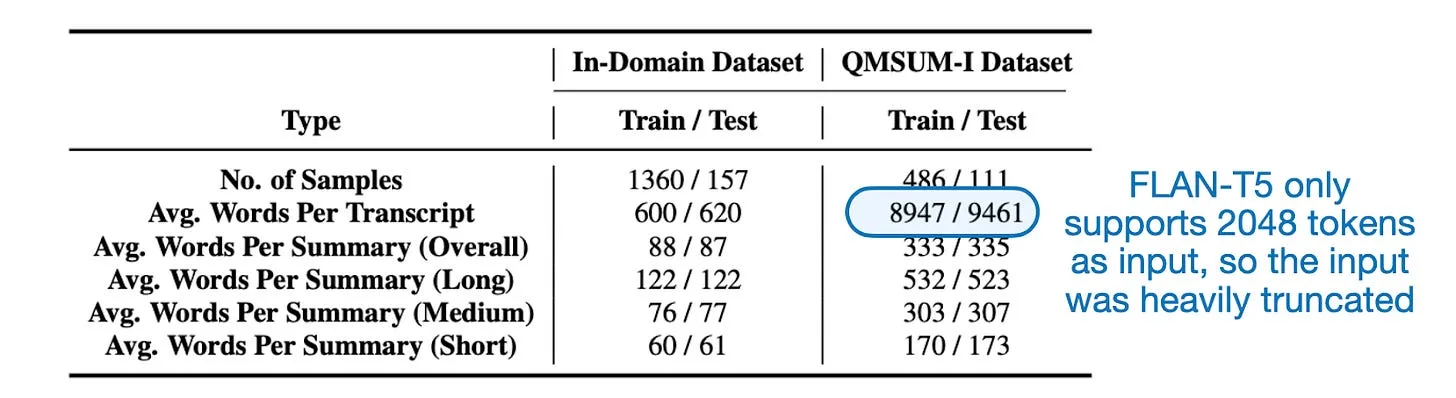
第二种合理的解释是,FLAN-T5-Large的上下文窗口限制为2048个token,而QMSUM数据集的输入长度是它的4-5倍,如下表所示。

figure02

带标注的表格(来源:https://arxiv.org/abs/2402.00841),展示了不同数据集的文本长度差异

自动化评估指标是否可靠?

除了上文讨论的截断问题之外,ROUGE分数这类自动化评估指标(相关代码:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q19-evaluation-llms/rouge.ipynb)究竟是否可靠?

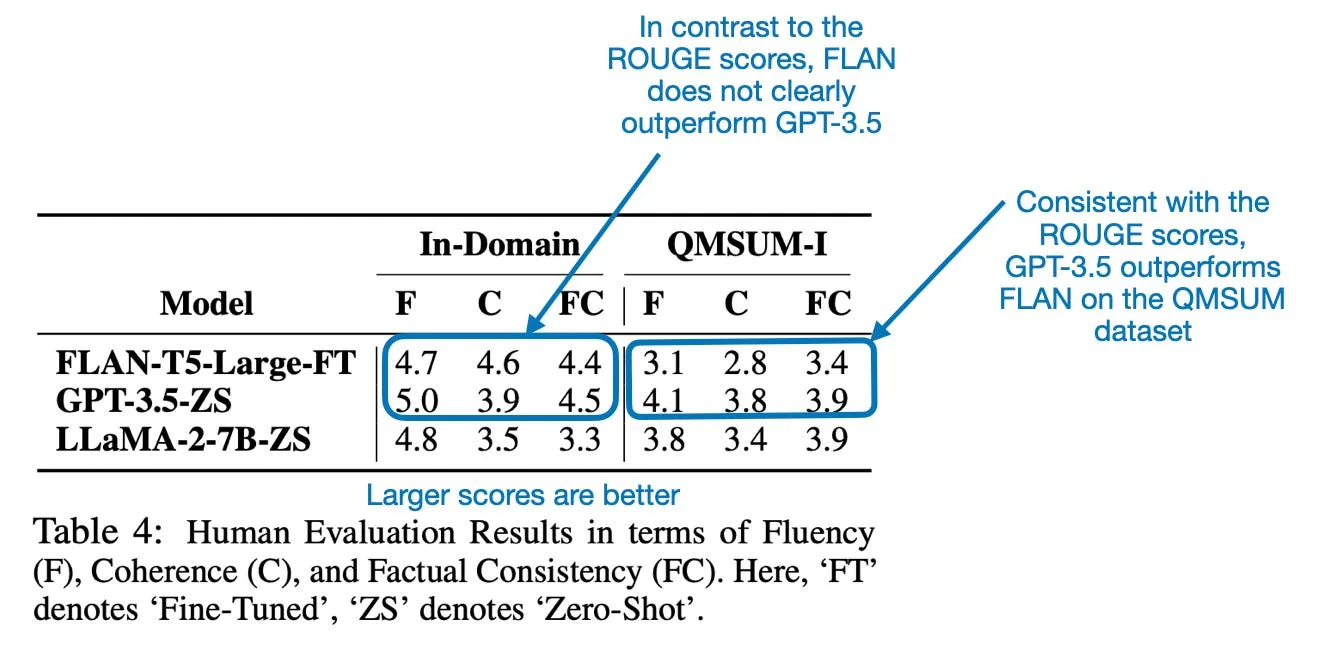
总体而言,摘要任务的ROUGE分数被认为可以有效评估机器生成摘要与参考摘要之间的重合度,尤其是在n元语法重叠、词语序列和词对匹配层面。但这类指标无法全面衡量摘要在连贯性、可读性或事实准确性方面的质量,因此并非完美的评估工具。为此,研究人员也开展了人工评估,结果汇总如下表。

figure03

带标注的表格(来源:https://arxiv.org/abs/2402.00841),展示人工评估结果,分数越高表现越好

基于上表结果,FLAN在领域内数据集上的表现显著优于Llama 2 7B,与GPT-3.5基本持平。而它在QMSUM-I数据集上的短板,与我们之前看ROUGE分数时观察到的情况一致。

另外需要注意的是,金标准参考摘要是由GPT-4生成的。假设GPT-3.5的预训练和指令微调方式与GPT-4相近,我推测结果会略微偏向GPT-3.5。

为什么小型模型的表现相对欠佳?

总体来看,除了在领域内数据集上的FLAN-T5之外,我们发现小型微调大语言模型的表现普遍弱于更大的大语言模型。

原因之一是它们的上下文窗口有限,导致输入数据被截断,这对生成摘要任务来说十分不利。可以通过在训练和推理阶段扩展上下文长度来解决这个问题,而这并不一定需要增大模型参数量。

另一个原因可能是模型在中间状态下存储和处理信息的能力更弱。要验证这一点,我们至少需要训练一批上下文长度各不相同的大语言模型进行对比。

本次实验中,小型大语言模型的目标任务是摘要任务微调。但摘要微调本身也是大型闭源大语言模型训练中的重要组成部分。换句话说,我们对比的其实是“大型微调大语言模型”和“小型微调大语言模型”。如果换成大语言模型指令微调流程中从未覆盖过的全新领域特定任务,对比结果会很有意思。

核心结论

Mixtral(我在2024年1月的研究论文盘点中介绍过:https://magazine.sebastianraschka.com/p/research-papers-in-january-2024)的表现十分出色!而参数量小得多的FLAN-T5,在特定微调任务中依然是非常优秀的模型。

2) DoRA:权重分解式低秩适配

在这篇论文(https://arxiv.org/abs/2402.09353)中,研究人员提出了LoRA的一种创新替代方案。LoRA是目前大语言模型和视觉Transformer中应用最广泛的参数高效微调方法。我原本只打算在本文中简单介绍它,但这个方法实在太有意思,我几周前就忍不住自己动手实现了一遍。

想要了解更多细节和论文解读的读者,可以查看我写的这篇深度文章,其中包含了DoRA的从零实现指南:
https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch

《Ahead of AI》是一份由读者支持的出版物。想要接收新文章并支持我的创作,欢迎注册免费订阅或付费订阅。

3) OLMo:推动语言模型科学发展

论文(https://arxiv.org/abs/2402.00838)中的“OLMo”全称为Open Language Model(开放语言模型),是近期发布的一款开源大语言模型,提供10亿和70亿参数量两个版本。OLMo的特别之处在于,研究人员不仅公开了模型权重(https://huggingface.co/allenai/OLMo-7B),还公开了全部训练细节,包括训练代码(https://github.com/allenai/OLMo)、训练数据集Dolma(https://huggingface.co/datasets/allenai/dolma)、模型评估代码(https://github.com/allenai/OLMo-Eval)、训练日志报告(https://wandb.ai/ai2-llm/OLMo-7B/reports/OLMo-7B–Vmlldzo2NzQyMzk5)以及指令微调代码(https://github.com/allenai/open-instruct)。

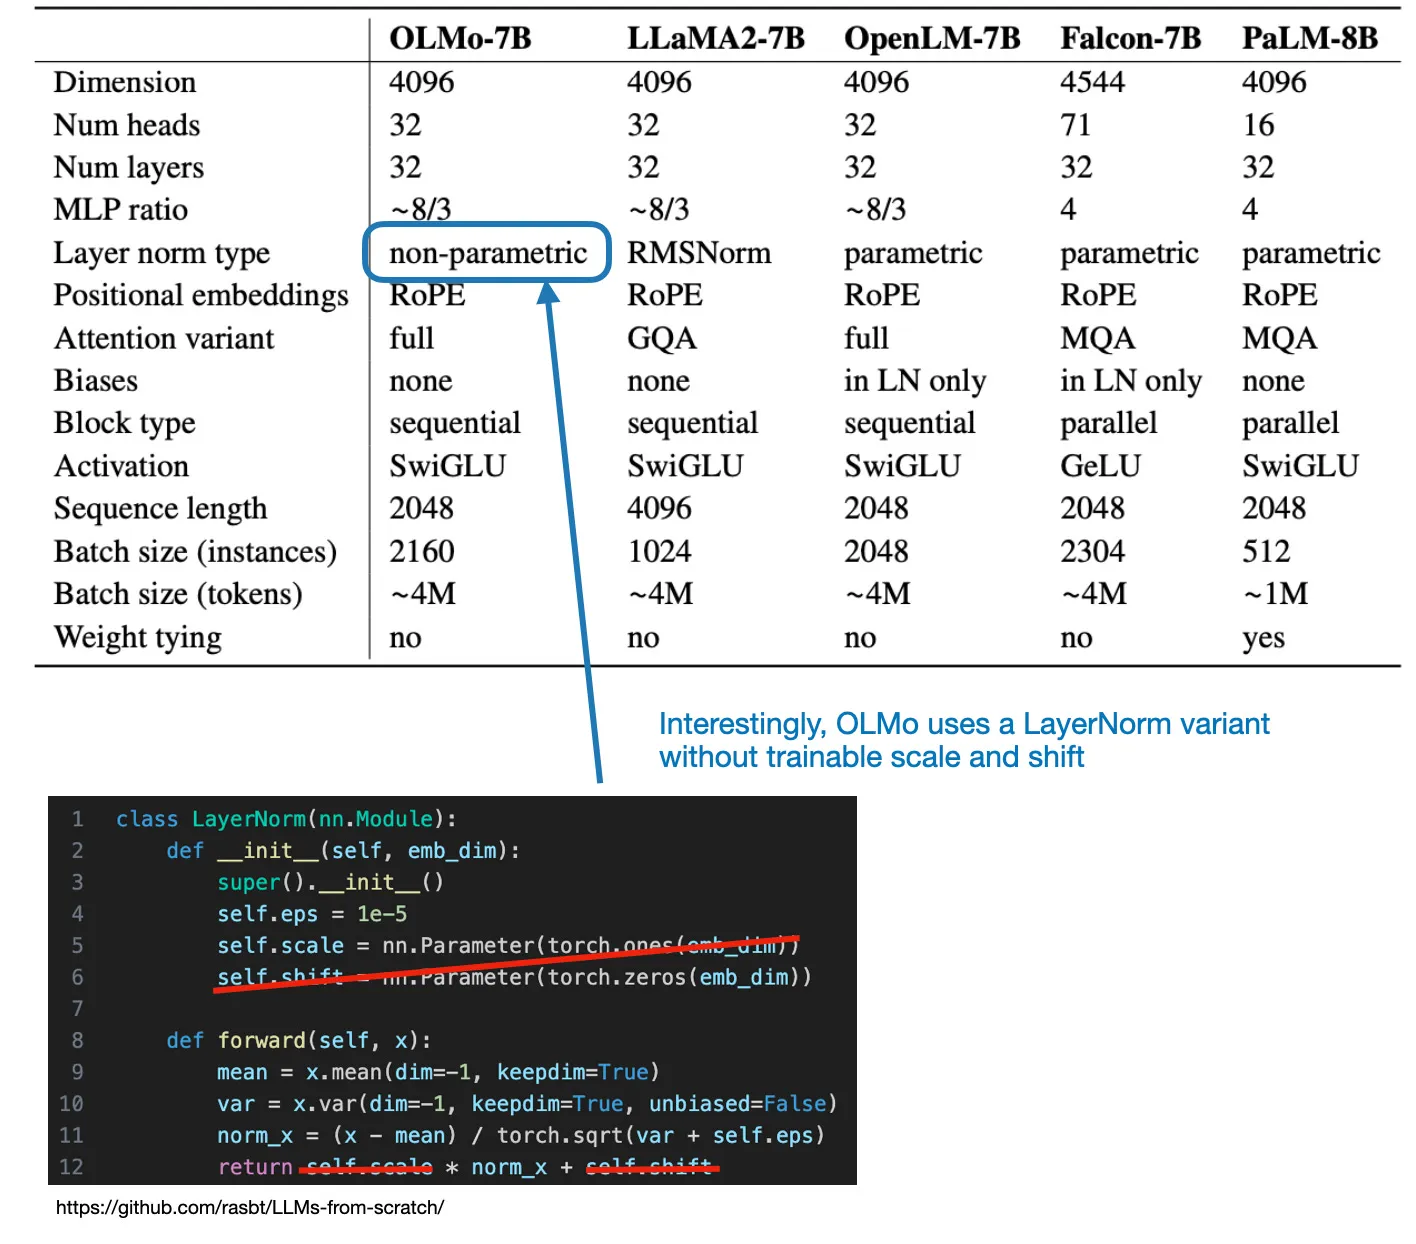
我非常推荐大家去读OLMo的原论文。虽然我希望论文能包含更多深度洞察和分析,但光是里面列出的各类架构细节选择和超参数配置,就已经对我自己的实验很有帮助了。这里分享两个值得注意的设计:

  • 他们在所有线性层中禁用了偏置向量(与Llama的设计类似),以提升训练稳定性。
  • 他们没有使用标准的层归一化(LayerNorm,包含可训练的缩放和偏移参数)或RMSNorm,而是采用了一种不含任何可训练参数的层归一化变体。

此外,下表列出了OLMo与其他主流大语言模型在架构上的核心差异。

figure04

OLMo架构细节(来源:OLMo论文,https://arxiv.org/abs/2402.00838)

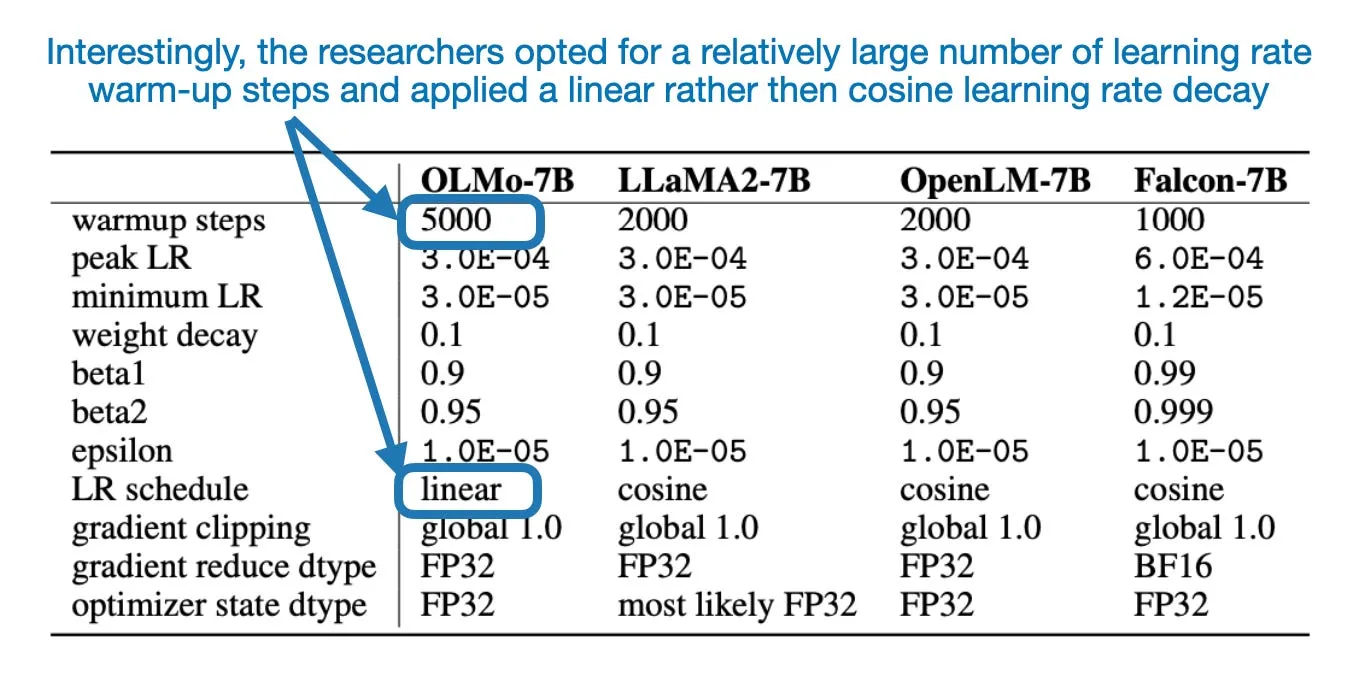
不仅如此,OLMo论文还给出了AdamW优化器的超参数和学习率的详细信息,汇总如下表。

figure05

OLMo优化器配置(来源:OLMo论文,https://arxiv.org/abs/2402.00838)

在学习率方面,他们采用了5000步(约210亿token)的热身阶段,随后使用线性衰减(而非余弦衰减)将学习率降至表中数值的十分之一。同时,他们将梯度的L2范数最大值裁剪为1.0。

最后值得一提的是,他们使用了线性学习率调度而非余弦调度来衰减学习率,如下对比表所示:

figure06

OLMo训练参数(来源:OLMo论文,https://arxiv.org/abs/2402.00838)

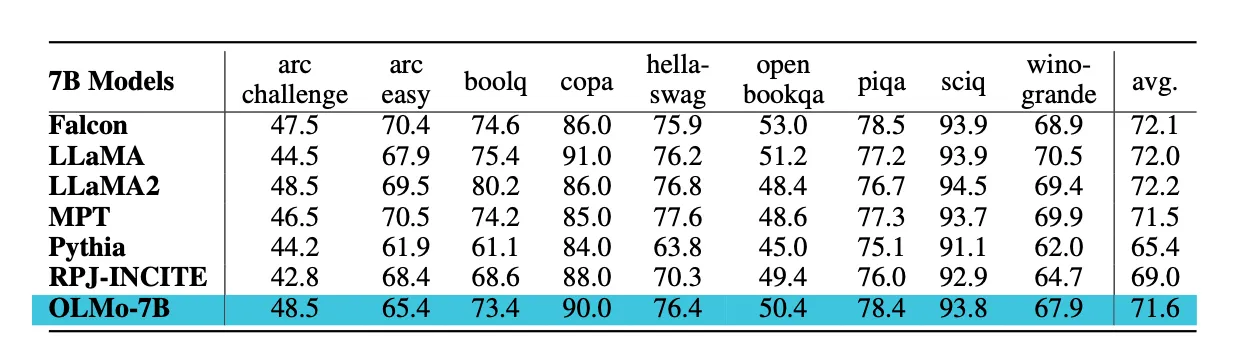
这些设计选择都很有意思,但OLMo的实际性能和其他大语言模型相比如何?结果表明,OLMo的性能与Llama 2和Falcon相当,如下表所示。

figure07

OLMo与其他主流大语言模型对比(来源:OLMo论文,https://arxiv.org/abs/2402.00838)

尽管论文没有针对部分超参数和架构选择做额外的消融实验,但所有训练日志都可以在W&B平台上查看,我们未来几周或几个月里可以自己做分析。总的来说,我认为OLMo是对开源社区和研究领域的极佳贡献,非常感谢作者公开了所有代码和训练产物。

从零搭建大语言模型

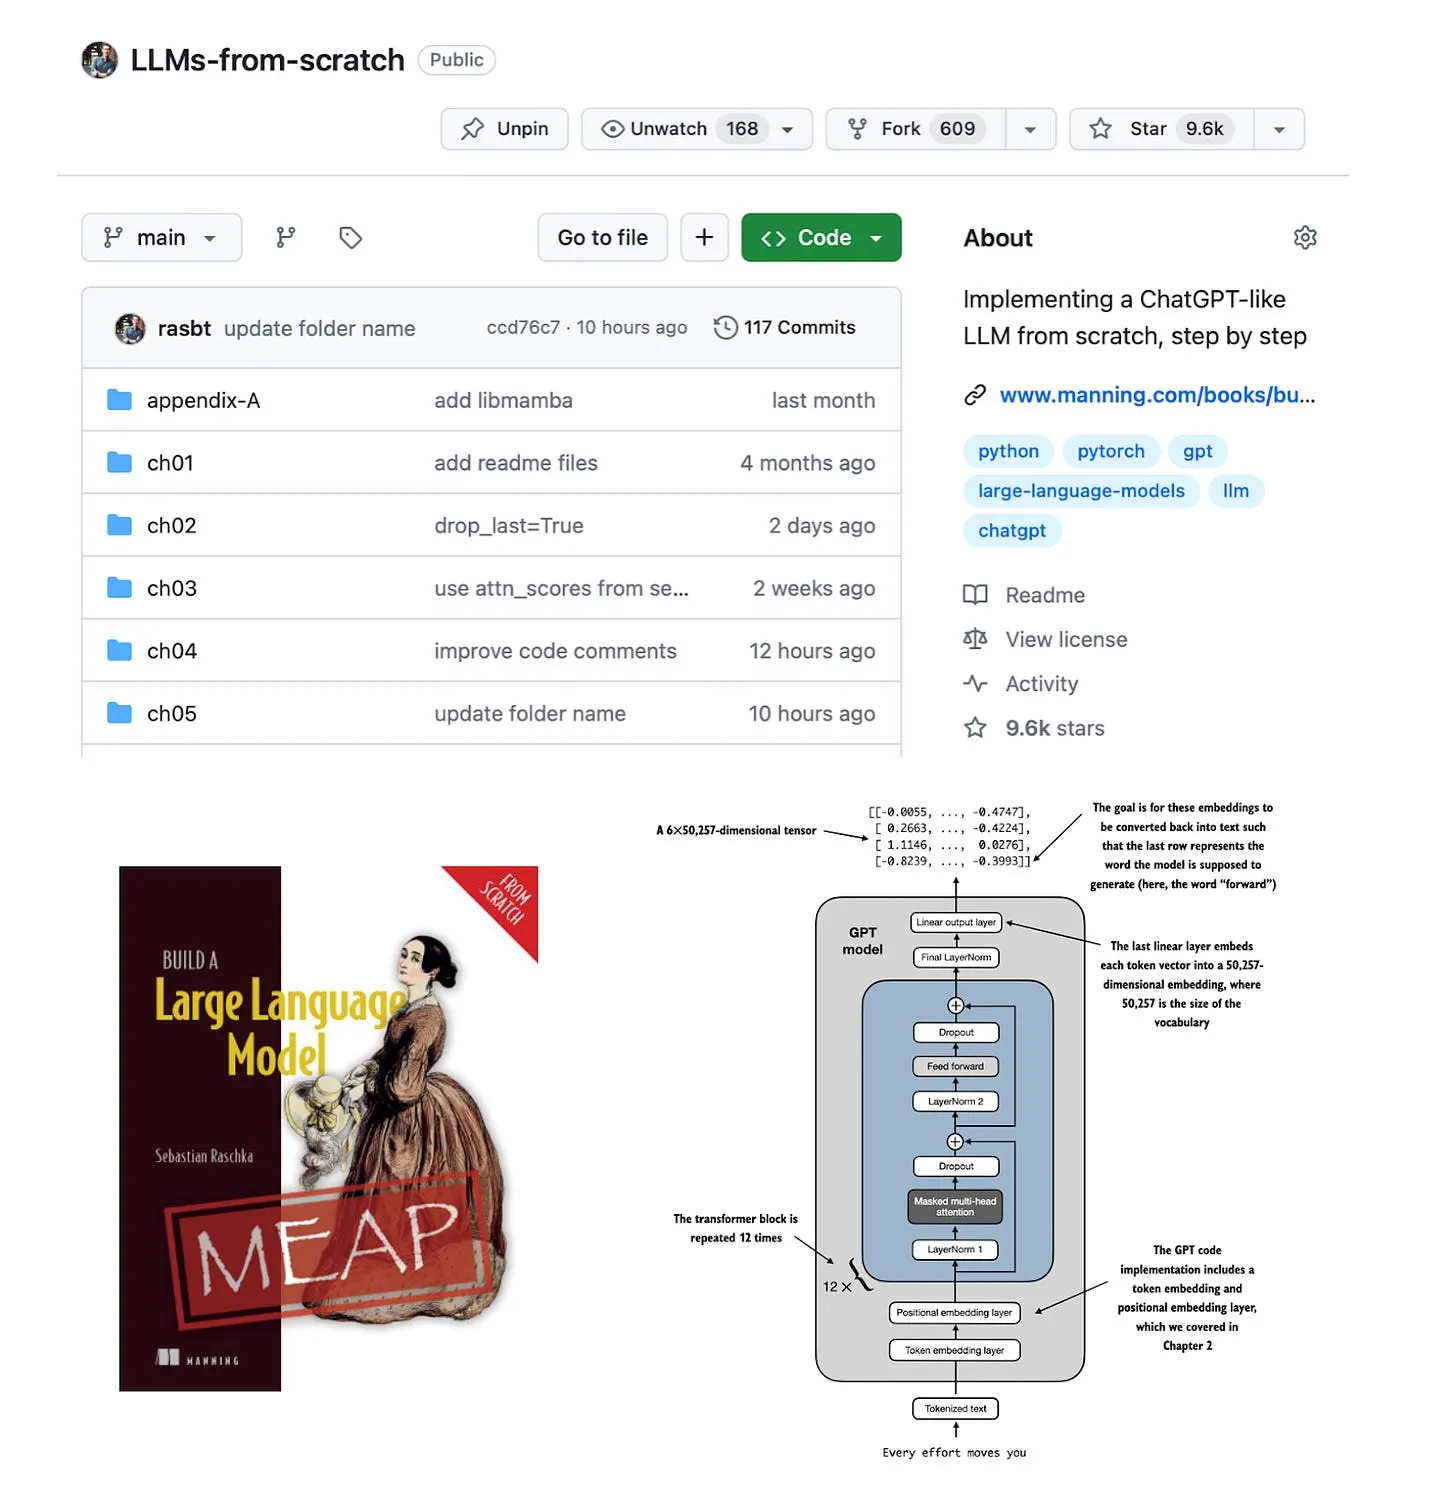
如果你想要通过从零搭建大语言模型(仅使用PyTorch,不借助外部大语言模型库)来加深理解,我的新书《从零构建大语言模型》(https://www.manning.com/books/build-a-large-language-model-from-scratch)的第4章已经在Manning的抢先体验版中上线了。

figure08

《从零构建大语言模型》相关仓库:https://github.com/rasbt/LLMs-from-scratch,书籍地址:https://www.manning.com/books/build-a-large-language-model-from-scratch

4) Gemma

当然,我们必须聊聊Gemma——谷歌近期推出的大语言模型系列。Gemma大语言模型基于Gemini架构构建,共有四个版本:预训练的Gemma 2B和7B基础模型,以及经过指令微调的Gemma 2B和7B模型。

除了模型权重(https://huggingface.co/google/gemma-7b),谷歌还发布了一份技术报告(https://storage.googleapis.com/deepmind-media/gemma/gemma-report.pdf),我们将在下文详细解读。

Gemma的性能表现

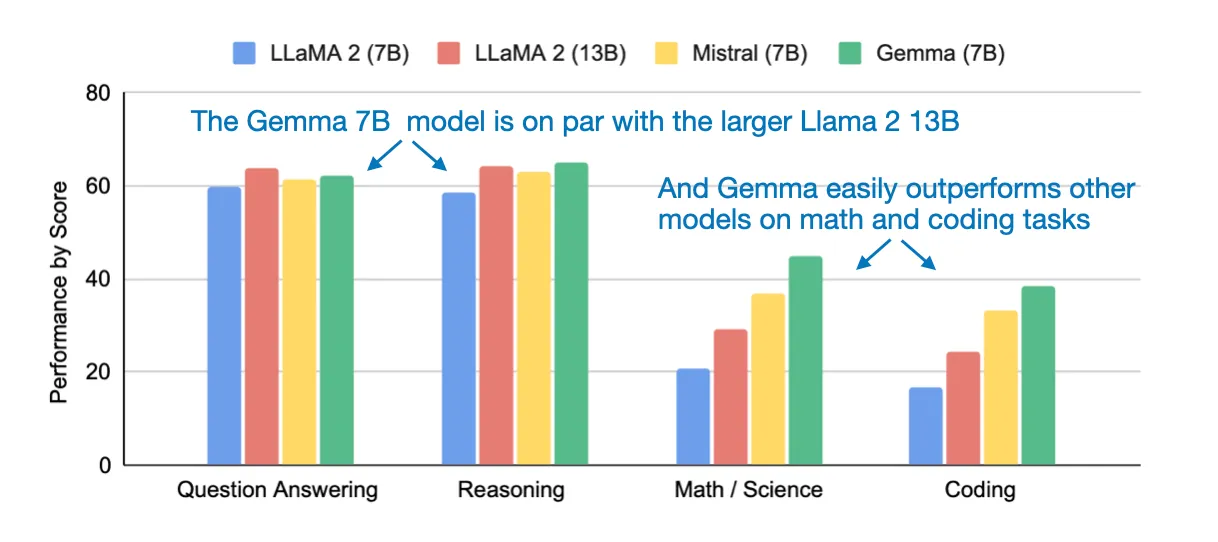
Gemma最引人注目的一点,是它相比Llama 2 7B、Mistral等主流开源模型的出色性能,如下图所示:

figure09

带标注的性能对比图,来源:https://storage.googleapis.com/deepmind-media/gemma/gemma-report.pdf

目前尚不完全清楚上述分数对应的是预训练版本还是指令微调版本;不过我推测,这些结果大概率代表指令微调模型的性能。

Gemma为何能有如此出色的表现?论文中没有明确说明原因,但我推测主要得益于以下两点:

  • 25.6万的超大词表(相比之下,Llama的词表仅为3.2万);
  • 规模达6万亿token的海量训练数据集(Llama的训练数据量仅为其三分之一)。

此外,我和同事在将Gemma接入我们的开源项目Lit-GPT(https://github.com/Lightning-AI/lit-gpt)时发现,它的整体架构与Llama 2高度相似。我们在下一节详细分析这一点。

Gemma架构深度解析

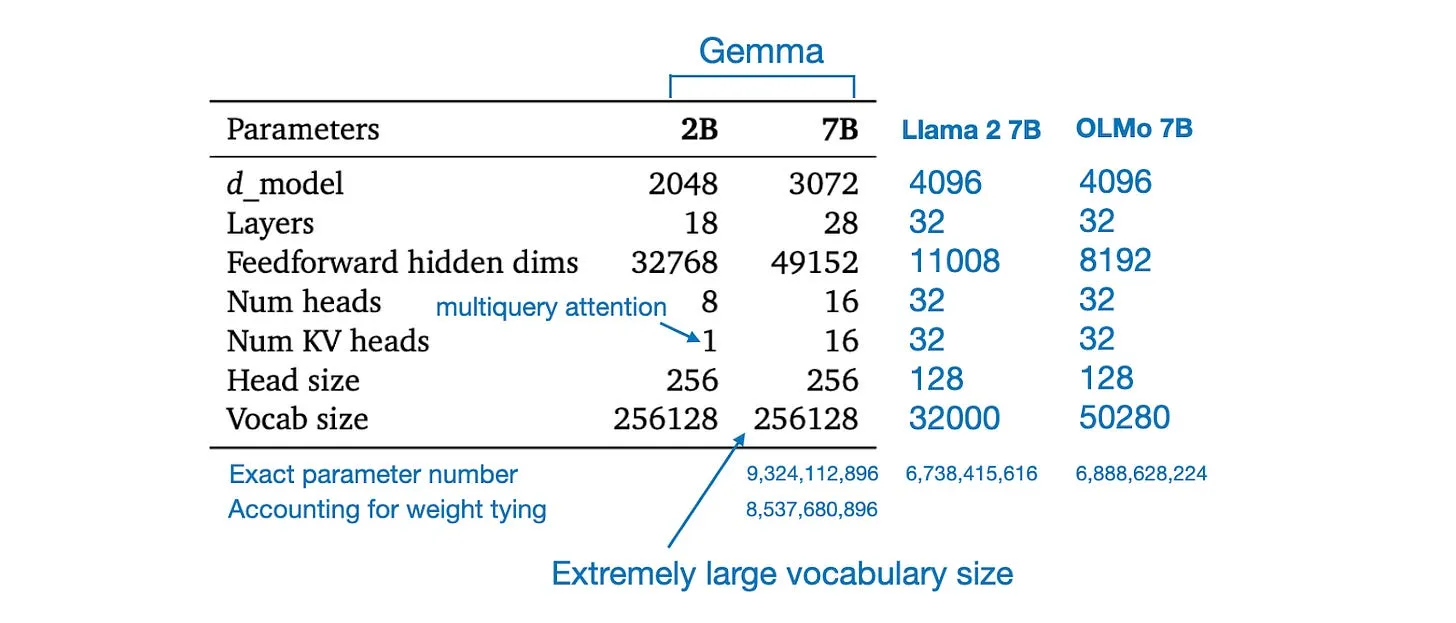
Gemma背后有哪些有意思的设计选择?如上所述,它的词表规模很大,对应的嵌入矩阵尺寸也很大。下表对比了Gemma、Llama 2 7B和我们之前讨论过的OLMo 7B的架构概览。

figure10

Gemma、Llama 2与OLMo的架构对比。表格来源:https://storage.googleapis.com/deepmind-media/gemma/gemma-report.pdf

模型规模

另外值得注意的是,Gemma 2B采用了多查询注意力,而Gemma 7B没有。此外,尽管Gemma 7B的总层数更少(28层对比32层),但它的前馈层规模比Llama 2更大。不过,虽然层数更少,Gemma的参数量却相当可观。

尽管它被称作Gemma 7B,但实际总参数量达到93亿;如果考虑权重共享(weight tying),参数量为85亿。权重共享指输入嵌入层和输出投影层使用同一套权重,GPT-2和OLMo 1B都采用了这种设计(OLMo 7B训练时没有使用权重共享)。

归一化层

另一个值得关注的细节是论文中的这段描述:

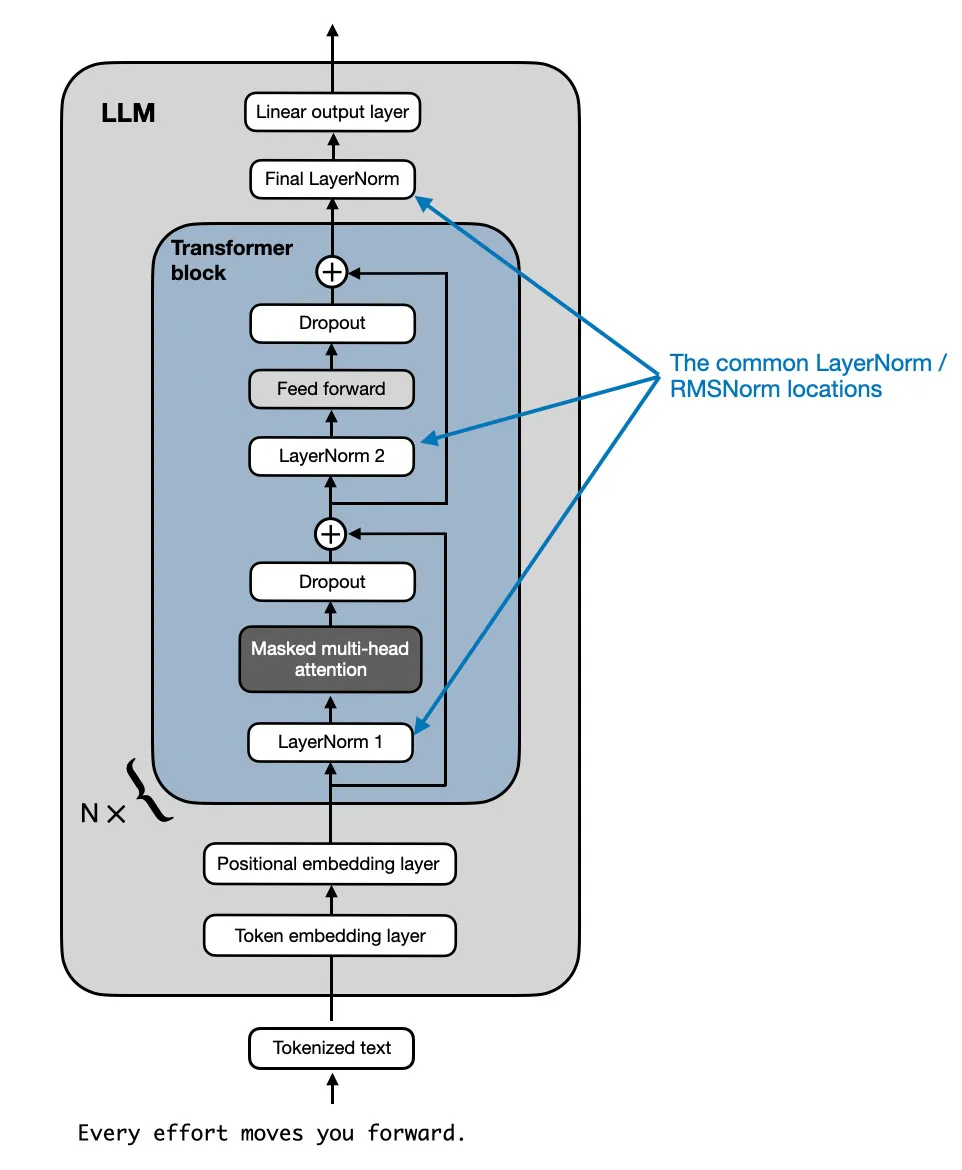
归一化位置:我们对每个Transformer子层的输入和输出都做归一化,这与仅对其中一侧做归一化的常规做法不同。我们采用RMSNorm(Zhang和Sennrich,2019)作为归一化层。

乍一看,这似乎意味着Gemma在每个Transformer块之后都额外加了一层RMSNorm。但查看源码(https://github.com/keras-team/keras-nlp/blob/34a2cba28f6cb501ade97d6a9e308705d5095ec7/keras_nlp/models/gemma/rms_normalization.py#L39)后会发现,Gemma采用的其实就是GPT-2、Llama 2等其他大语言模型通用的前置归一化方案,如下图所示。

figure11

GPT、Llama 2等大语言模型的典型层归一化位置:Gemma在这一点上并无创新。(图出自我的著作《从零构建大语言模型》,https://www.manning.com/books/build-a-large-language-model-from-scratch)

GeGLU激活函数

Gemma与其他架构的一个显著区别是它使用了GeGLU激活函数,该函数出自2020年的这篇论文:https://arxiv.org/abs/2002.05202。

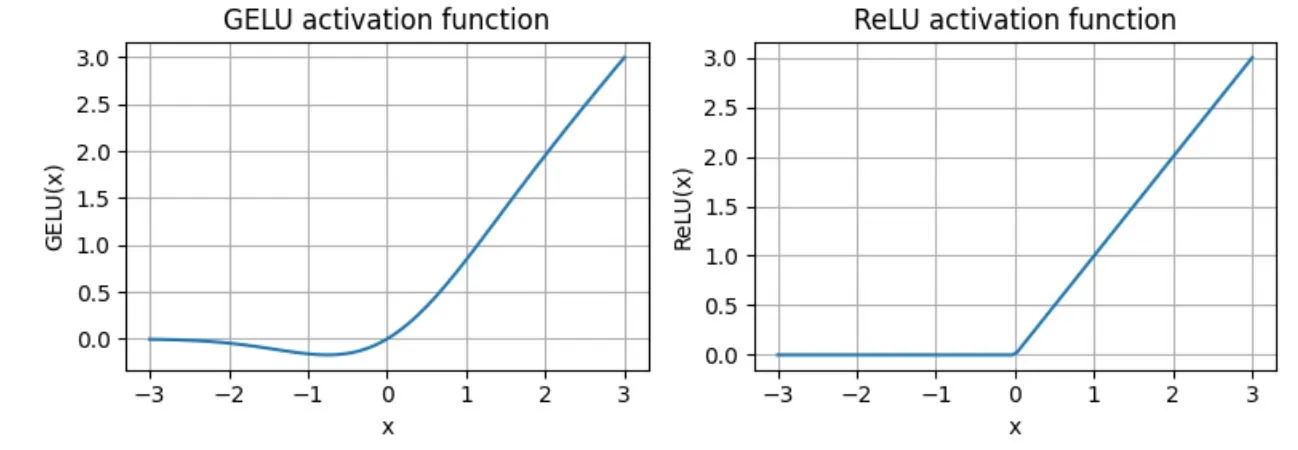
GeLU(高斯误差线性单元)是一种越来越流行的激活函数,常作为传统ReLU的替代方案。GeLU的优势在于,它既能引入非线性,又能让负输入值的梯度继续传播,解决了ReLU完全阻断负值的缺陷。

figure12

GELU与ReLU对比图(图出自我的著作《从零构建大语言模型》,https://www.manning.com/books/build-a-large-language-model-from-scratch)

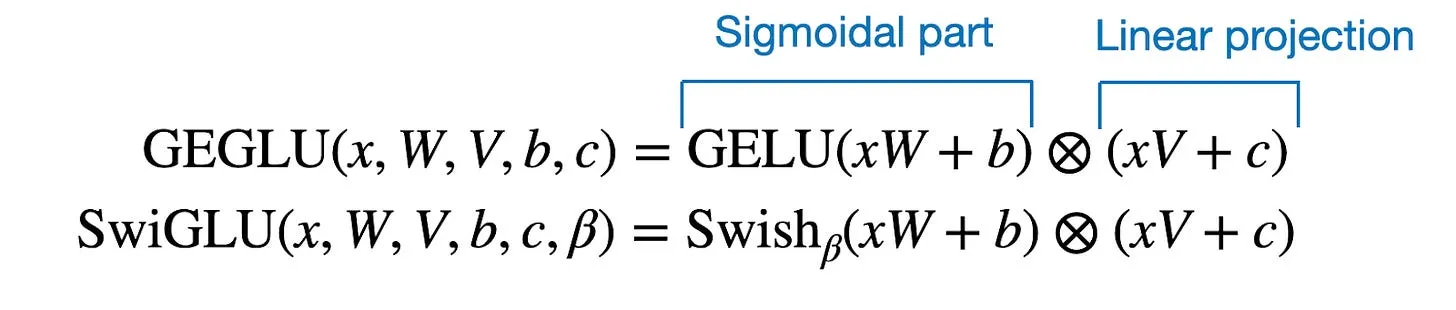
而GeGLU是GELU的门控线性单元变体,它将激活分为两部分:一部分是类S型的激活,另一部分是线性投影,两部分的输出按元素相乘,如下图所示:

figure13

如上图所示,GeGLU与Llama 2、Mistral等大语言模型使用的SwiGLU激活函数原理类似,区别仅在于它的基础激活函数是GELU而非Swish。

看这些激活函数的伪代码会更容易理解:

# Feedforward module with GELU (GPT-2)
x = linear(x)
x = gelu(x)
x = linear_projection(x)

# Feedforward module with SwiGLU (Llama 2)
x_1 = self.linear_1(x)
x_2 = self.linear_2(x)
x = silu(x_1) * x_2
x = linear_projection(x)

# Feedforward module with GeGLU (Gemma)
x_1 = self.linear_1(x)
x_2 = self.linear_2(x)
x = gelu(x_1) * x_2
x = linear_projection(x)

需要注意的是,与使用普通GELU的前馈模块(只有一个线性层)相比,使用SwiGLU和GeGLU的前馈模块实际上多了一个线性层(分为linear_1和linear_2)。不过在GeGLU和SwiGLU前馈模块中,linear_1和linear_2通常是将单个线性层拆分为两部分得到的,因此不一定会增加参数量。

GeGLU比SwiGLU更好吗?目前还没有消融实验能给出定论。我猜测这个选择可能也只是为了让Gemma和Llama 2略有区分度。

其他设计选择

此外,在为Lit-GPT添加Gemma支持的过程中(https://github.com/Lightning-AI/lit-gpt/pull/941),我们还发现了一些其他有意思的设计选择。

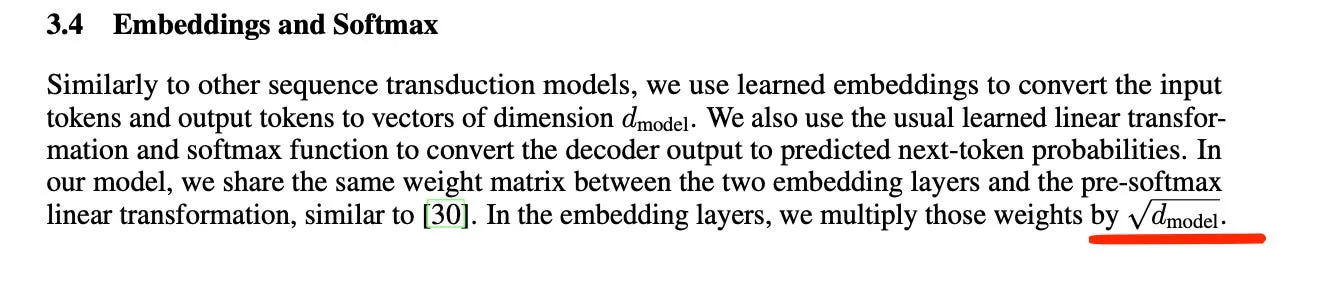
例如,Gemma在RMSNorm层中加了+1的偏移量,并且用隐藏层维度的平方根对嵌入做归一化。后者其实是原始Transformer论文(https://arxiv.org/abs/1706.03762)中的做法,但GPT-2、OLMo等同样使用权重共享的模型并没有这么做。

figure14

摘自《Attention Is All You Need》论文,https://arxiv.org/abs/1706.03762

这些细节在论文中没有提及或讨论,其作用也尚不明确。

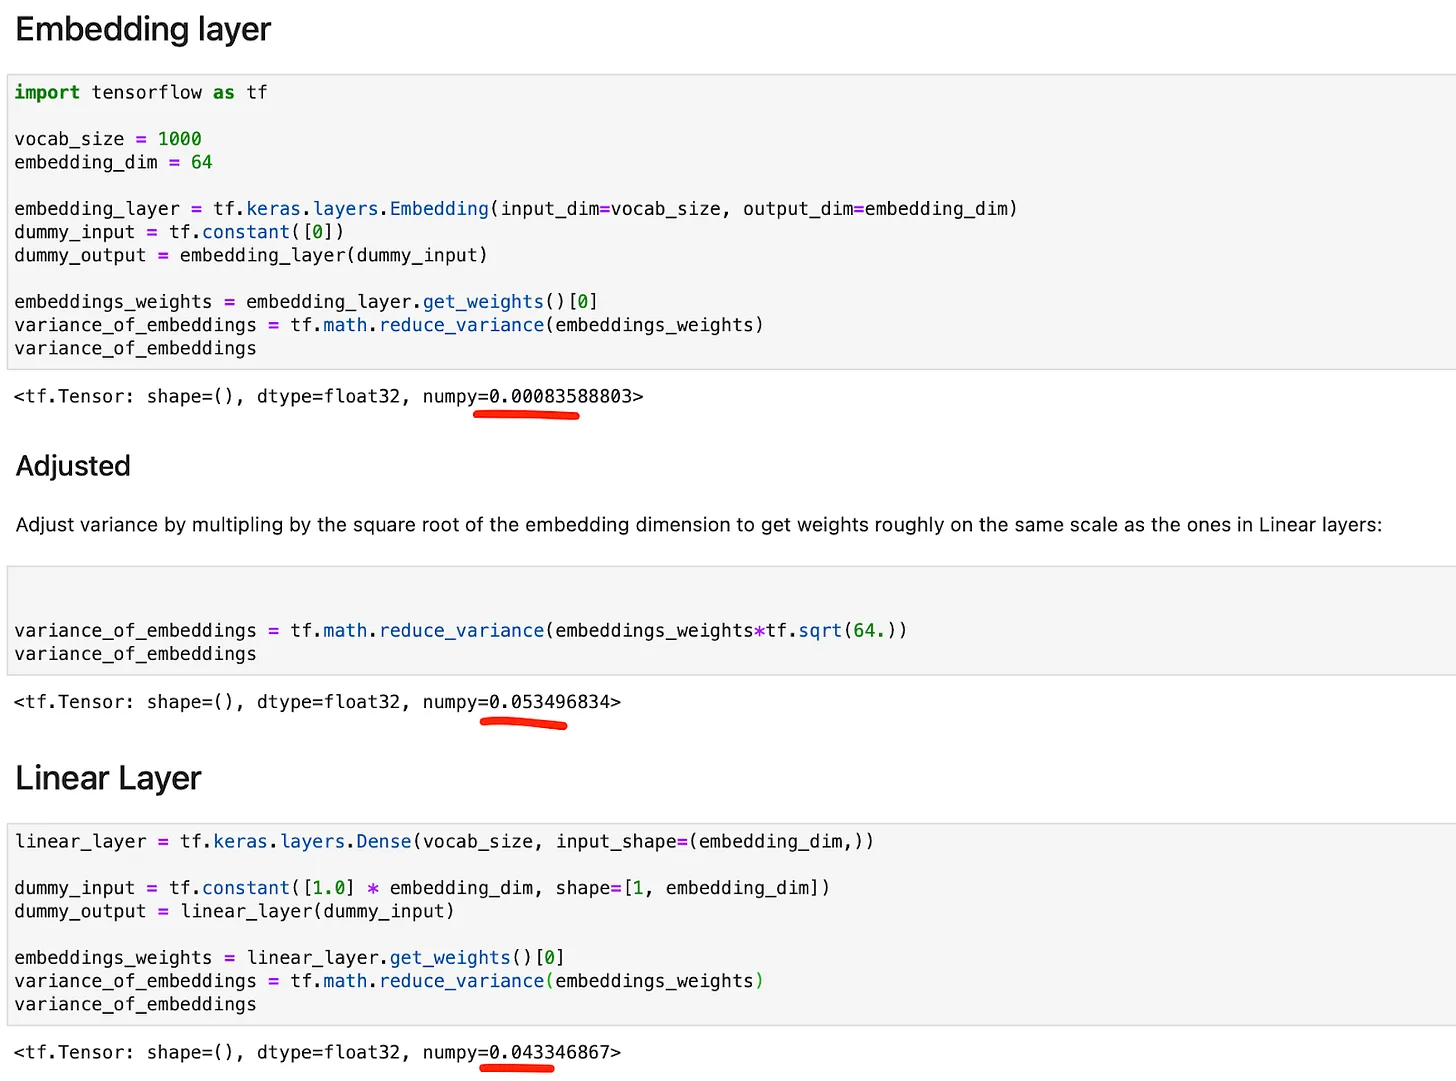
我想到一个可能的解释:尽管线性层和嵌入层的本质是一样的(详见我的文章:https://github.com/rasbt/LLMs-from-scratch/blob/main/ch02/03_bonus_embedding-vs-matmul/embeddings-and-linear-layers.ipynb),但两者的初始权重尺度不同。而谷歌的研究人员习惯用TensorFlow做实验,乘以嵌入维度的平方根或许是为了让权重尺度更合理,正如我在下面的示例代码中展示的那样。

figure15

将权重乘以嵌入维度的平方根后,权重的尺度就和标准线性层中的权重一致了。

结论

Gemma是开源大语言模型生态的优秀补充。看起来7B版本是一款性能极强的模型,在实际应用场景中有望替代Llama 2和Mistral。

此外,既然目前已经有大量7B左右的开源模型,Gemma 2B反而更值得关注——它可以轻松在单张GPU上运行。看看它和同样27亿参数量的phi-2相比表现如何,会很有意思。

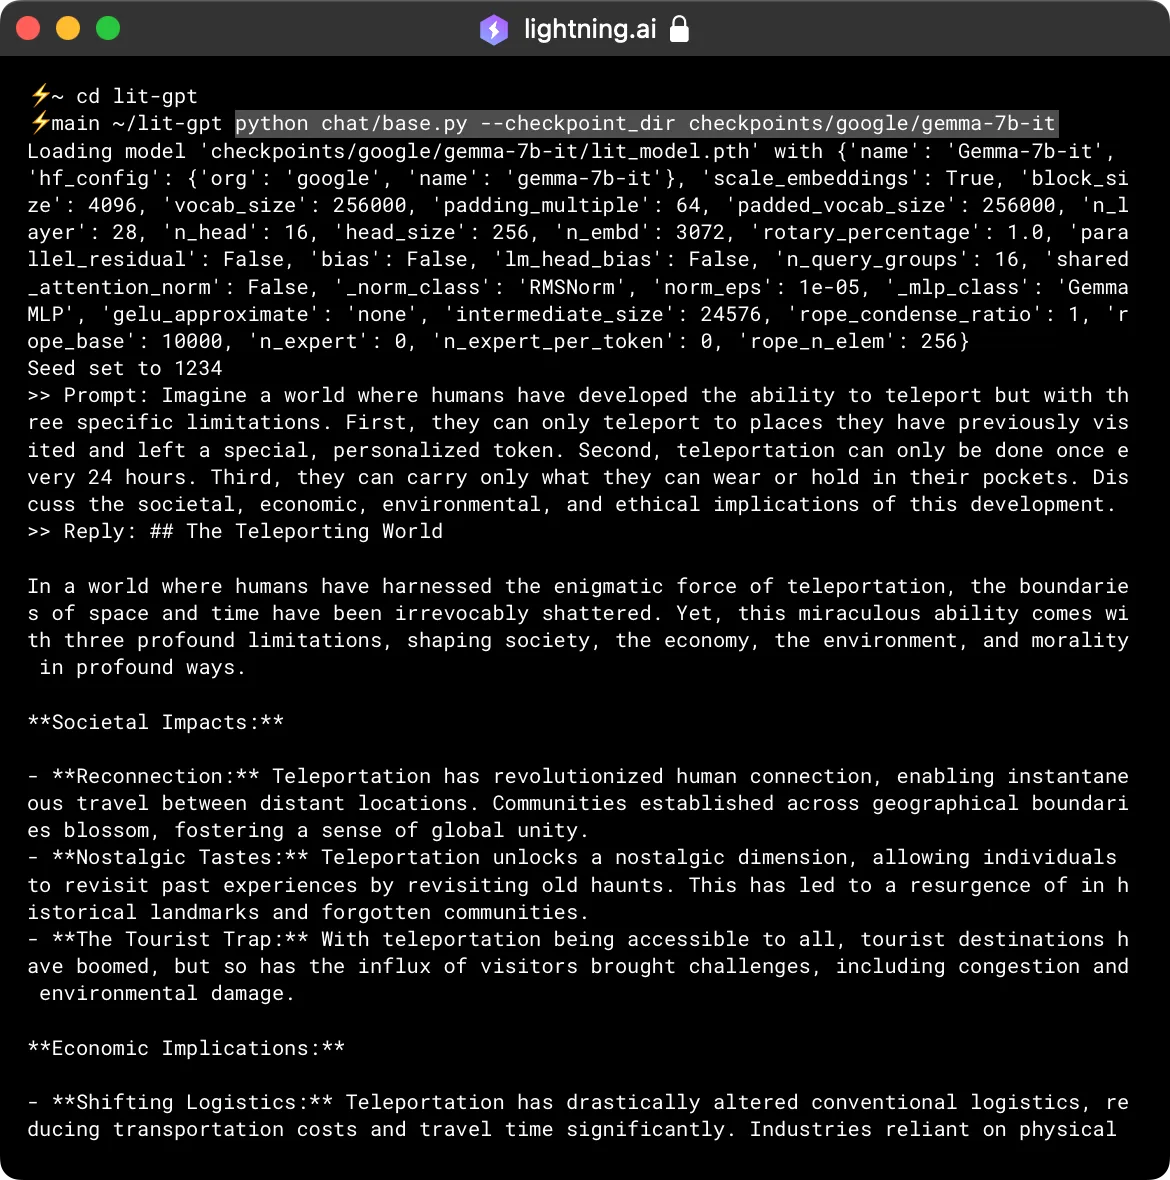
如果你想通过上述的Lit-GPT实现实际使用Gemma,我创建了一个Studio环境:https://lightning.ai/lightning-ai/studios/understanding-using-and-finetuning-gemma

figure16

通过Lit-GPT Studio使用Gemma(地址:https://lightning.ai/lightning-ai/studios/understanding-using-and-finetuning-gemma)

2月其他值得关注的研究论文

以下是本月我发现的其他一些有意思的论文。由于列表较长,我用星号(*)标注了10篇我认为特别值得关注的论文。不过请注意,这份列表及解读仅基于我个人的兴趣和与我自身项目的相关性。

  1. 《Griffin:将门控线性循环与局部注意力结合,打造高效语言模型》,作者:De、Smith、Fernando等,2月29日,https://arxiv.org/abs/2402.19427
    该论文提出了Hawk和Griffin两种架构:前者是循环神经网络大语言模型,后者是将循环神经网络单元与局部注意力结合的混合架构,为基于Transformer的大语言模型提供了新的高效替代方案。

  2. 《当缩放定律遇上大语言模型微调:数据、模型与微调方法的影响》,作者:Zhang、Liu、Cherry、Firat,2月27日,https://arxiv.org/abs/2402.17193
    该研究系统探究了模型规模、预训练数据量、微调参数量、微调数据量等缩放因素对大语言模型微调性能的影响,在大语言模型规模超过微调数据规模的场景下,对比了全参数微调与参数高效微调(包括提示微调、LoRA)的效果。

  3. 《Sora生成的视频具备惊人的几何一致性》,作者:Li、Zhou、Zhang等,2月27日,https://arxiv.org/abs/2402.17403
    该论文提出了一套基准测试方法,用于评估Sora模型生成视频对真实物理规律的还原度:将生成的视频转换为3D模型,以3D重建的准确率作为指标衡量模型对物理原理的遵循程度。研究发现,Sora的表现远优于Pika等其他文生视频模型。

  4. * 《1比特大语言模型时代:所有大语言模型都可压缩至1.58比特》,作者:Ma、Wang、Ma等,2月27日,https://arxiv.org/abs/2402.17764
    该研究提出了一种1比特大语言模型变体(仅支持-1、0、1三种取值),在推理阶段的困惑度和下游任务表现上,与传统16比特精度的大语言模型相当。

  5. 《Genie:生成式交互环境》,作者:Bruce、Dennis、Edwards等,2月23日,https://arxiv.org/abs/2402.15391
    Genie是一款开创性的110亿参数量生成式交互环境,基于时空Transformer构建,通过互联网视频无监督训练而成,能够根据文本、图像和草图生成无限多样、可控制动作的虚拟世界。

  6. * 《回归基础:重新审视基于人类反馈学习的REINFORCE式优化方法在大语言模型中的应用》,作者:Ahmadian、Cremer、Galle等,2月22日,https://arxiv.org/abs/2402.14740
    该研究表明,在基于人类反馈的强化学习(RLHF)大语言模型对齐任务中,更简单的REINFORCE式优化方法比近端策略优化(PPO)效率更高、效果更好。

  7. 《TinyLLaVA:小型多模态大模型框架》,作者:Zhou、Hu、Weng等,2月22日,https://arxiv.org/abs/2402.14289
    TinyLLaVA框架证明,小型多模态大模型通过使用高质量数据和优化训练,能够达到甚至超越更大模型的表现——其最佳模型TinyLLaVA-3.1B的性能超过了现有7B级别的多模态模型。

  8. 《大语言模型用于数据标注:综述》,作者:Tan、Beigi、Wang等,2月21日,https://arxiv.org/abs/2402.13446
    该论文探讨了GPT-4等大语言模型在自动化数据标注这一劳动密集型流程中的潜力,重点关注大语言模型在数据标注中的应用、对大语言模型生成标注的评估,以及基于这些标注的模型学习。

  9. * 《LongRoPE:将大语言模型上下文窗口扩展至200万token以上》,作者:Ding、Zhang、Zhang等,2月21日,https://arxiv.org/abs/2402.13753
    LongRoPE是一种新方法,仅需少量微调即可将预训练大语言模型的上下文窗口扩展至204.8万token,通过改进位置插值和渐进式扩展策略,在不同上下文长度下都能保持性能稳定。

  10. 《YOLOv9:利用可编程梯度信息学习你想要的内容》,作者:Wang、Yeh、Liao,2月21日,https://arxiv.org/abs/2402.13616
    该研究针对深度监督机制的信息瓶颈和适用性问题提出了解决方案,推出了YOLOv9,在MS COCO数据集上的效率和表现均优于YOLOv8。

  11. 《神经网络扩散》,作者:Wang、Xu、Zhou等,2月20日,https://arxiv.org/abs/2402.13144
    该研究展示了传统上用于图像和视频生成的扩散模型,如何被用于生成高性能的神经网络参数。

  12. * 《LoRA+:大模型的高效低秩适配》,作者:Hayou、Ghosh、Yu,2月19日,https://arxiv.org/abs/2402.12354
    该论文提出了LoRA+,对原始低秩适配(LoRA)方法做了改进:对适配器矩阵A和B使用不同的学习率以增强特征学习,在不增加额外计算成本的前提下,实现了1-2%的性能提升,微调速度最高可达原来的2倍。

  13. 《迈向跨分词器蒸馏:面向大语言模型的通用对数似然蒸馏损失》,作者:Boizard、Haddad、Hudelot、Colombo,2月19日,https://arxiv.org/abs/2402.12030
    该论文提出了通用对数似然蒸馏损失,能够在不同架构、不同分词器的大语言模型之间实现高效的知识蒸馏,突破了必须使用相同分词器的限制。

  14. 《AnyGPT:基于离散序列建模的统一多模态大语言模型》,作者:Zhan、Dai、Ye、Zhou,2月19日,https://arxiv.org/abs/2402.12226
    AnyGPT是一款多模态语言模型,通过离散表示无缝融合语音、文本、图像和音乐,无需改动大语言模型的核心架构,即可实现灵活的任意模态间交互。

  15. * 《重格式化对齐》,作者:Fan、Li、Zou、Li,2月19日,https://arxiv.org/abs/2402.12219
    该论文提出了ReAlign方法,通过简单的重格式化手段,提升大语言模型微调数据的质量,使其更好地与人类价值观对齐。

  16. 《LongAgent:通过多智能体协作将语言模型上下文扩展至12.8万token》,作者:Zhao、Zu、Xu等,2月18日,https://arxiv.org/abs/2402.11550
    LongAgent通过多智能体协作和智能体间通信机制,提升了大语言模型的长文本处理能力,在文本检索、多跳问答等任务中表现超过GPT-4等模型。

  17. 《Vision-Flan:在视觉指令微调中扩展人工标注任务规模》,作者:Xu、Feng、Shao等,2024年,https://arxiv.org/abs/2402.11690
    该研究提出了Vision-Flan——一个多样化的视觉指令微调数据集,以及一套面向视觉语言模型的两阶段指令微调框架,通过结合专家数据和GPT-4合成数据,解决了泛化性差、存在偏差等问题。

  18. 《OneBit:迈向极低比特大语言模型》,作者:Xu、Han、Yang等,2月17日,https://arxiv.org/abs/2402.11295
    该论文提出了OneBit——一种面向大语言模型的1比特量化感知训练框架,通过新的参数表示和初始化方法,在性能损失极小的情况下,大幅提升了存储和计算效率。

  19. 《FinTral:达到GPT-4水平的多模态金融大语言模型系列》,作者:Bhatia、Nagoudi、Cavusoglu、Abdul-Mageed,2月16日,https://arxiv.org/abs/2402.10986
    FinTral是专为金融分析优化的多模态大语言模型套件,基于Mistral-7B构建,通过领域专属训练和基准测试做了增强,在核心任务上表现超过ChatGPT-3.5和GPT-4,是金融AI领域的优秀案例。

  20. 《生成式表征指令微调》,作者:Muennighoff、Su、Wang等,2月15日,https://arxiv.org/abs/2402.09906
    GRIT是一种新的训练方法,能够让大语言模型GritLM通过遵循指令,在生成任务和嵌入任务中都有出色表现。

  21. 《恢复生成模型的微调前权重》,作者:Horwitz、Kahana、Hoshen,2月15日,https://arxiv.org/abs/2402.10208
    该论文提出了Spectral DeTuning方法,能够从Stable Diffusion、Mistral等大规模微调模型中恢复出微调前的权重。

  22. 《BASE TTS:用10万小时数据打造十亿参数量语音合成模型的经验》,作者:Lajszczak、Cambara、Li等,2月15日,https://arxiv.org/abs/2402.08093
    BASE TTS是亚马逊研究人员推出的新型语音合成模型,基于十亿参数量的Transformer架构,用10万小时数据训练而成,实现了前所未有的语音自然度。

  23. 《Transformer可以实现长度泛化,但鲁棒性不足》,作者:Zhou、Alon、Chen等,2月14日,https://arxiv.org/abs/2402.09371
    该论文探究了语言模型的长度泛化难题,证明标准Transformer通过特定的数据格式和位置编码,可以外推至训练输入长度2.5倍的序列,但这种能力对权重初始化、数据顺序等因素高度敏感。

  24. * 《DoRA:权重分解式低秩适配》,作者:Liu、Wang、Yin等,2月14日,https://arxiv.org/abs/2402.09353
    DoRA是对标准低秩适配(LoRA)的改进,它将预训练权重分解为幅值和方向两部分以实现更高效的参数更新,填补了LoRA这类参数高效微调方法与全参数微调之间的精度差距。

  25. 《混合专家架构为深度强化学习解锁参数缩放能力》,作者:Obando-Ceron、Sokar、Willi等,2月13日,https://arxiv.org/abs/2402.08609
    该论文表明,将混合专家(MoE)模块(尤其是软混合专家)融入基于价值的强化学习网络,能够让模型随规模增长更高效地提升性能,为在强化学习领域建立缩放定律提供了方向。

  26. 《基于RingAttention的百万长度视频与语言世界模型》,作者:Liu、Yan、Zaharia、Abbeel,2月13日,https://arxiv.org/abs/2402.08268
    该研究提出利用RingAttention等最新技术,在超长视频和语言序列组成的海量数据集上训练神经网络。

  27. 《用直接原则反馈抑制“粉红大象”问题》,2月12日,https://arxiv.org/abs/2402.07896
    该研究提出了直接原则反馈(DPF)方法,用于实时调整大语言模型的输出,并在“粉红大象”问题上验证了其效果,成功引导模型避开特定话题。

  28. 《Step-On-Feet微调:通过自举扩展大语言模型的自对齐能力》,作者:Wang、Ma、Meng等,2月12日,https://arxiv.org/abs/2402.07610
    该研究通过Step-On-Feet微调(SOFT)探究了大语言模型的多轮自举自对齐,与单步方法相比,该方法通过迭代对齐和优化训练序列提升了模型性能。

  29. 《Aya模型:经过指令微调的开源多语种语言模型》,作者:Ustun、Aryabumi、Yong等,2月12日,https://arxiv.org/abs/2402.07610
    该研究推出了Aya——一款精通101种语言的多语种生成式语言模型。

  30. 《细粒度混合专家架构的缩放定律》,作者:Jakub Krajewski、Jan Ludziejewski、Kamil Adamczewski等,2月12日,https://arxiv.org/abs/2402.07871
    该研究探究了混合专家(MoE)模型的缩放特性,引入了“粒度”作为调整专家规模的新超参数,并证明了MoE模型优于稠密Transformer模型。

  31. 《利用语言反馈模型改进策略》,作者:Zhong、Misra、Yuan、Cote,2月12日,https://arxiv.org/abs/2402.07876
    语言反馈模型(LFM)利用大语言模型对文本化视觉轨迹的反馈来改进模仿学习,在任务完成率和新环境适配方面优于传统方法,同时还能提供人类可解读的反馈,用于验证最优行为。

  32. 《ODIN:解耦奖励缓解RLHF中的奖励破解问题》,作者:Chen、Zhu、Soselia等,2月11日,https://arxiv.org/abs/2402.07319
    该研究针对大语言模型中的奖励破解问题,设计了更精细的评估协议和改进的奖励模型:通过联合训练两个输出头,让模型更关注内容而非长度,显著降低了长度偏差,提升了策略效果。

  33. 《神经网络可训练性的边界是分形的》,作者:Dickstein,2月9日,https://arxiv.org/abs/2402.06184
    该研究揭示了神经网络训练中存在分形边界,强调在各种配置和规模下,训练动态对超参数的微小调整都极度敏感。

  34. 《混合专家架构中的缓冲区溢出》,作者:Hayes、Shumailov、Yona,2月8日,https://arxiv.org/abs/2402.05526
    该研究表明,混合专家(MoE)模型容易受到基于跨批次依赖的专家路由策略攻击:恶意查询可以影响同一批次中良性查询的输出。

  35. 《基于在线AI反馈的大语言模型直接对齐》,作者:Guo、Zhang、Liu等,2月7日,https://arxiv.org/abs/2402.04792
    该论文提出了一种用于模型训练的在线反馈方法,通过利用大语言模型的实时评估,效果超越了DPO等直接偏好对齐(DAP)方法以及RLHF。

  36. 《无需搜索实现大师级国际象棋水平》,作者:Ruoss、Deletang、Medapati,2月7日,https://arxiv.org/abs/2402.04494
    这篇来自谷歌DeepMind的论文提出了一个“小型”2.7亿参数量的Transformer模型,在1000万局国际象棋对局上训练而成,棋力表现超过了AlphaZero的网络和GPT-3.5-turbo-instruct。

  37. 《Self-Discover:大语言模型自组合推理结构》,作者:Zhou、Pujara、Ren等,2月6日,https://arxiv.org/abs/2402.03620
    SELF-DISCOVER框架让大语言模型能够自主构建推理策略,以更高的效率提升问题解决能力,且具备跨模型适用性,其推理方式可能更接近人类。

  38. 《视觉超对齐:视觉基础模型的弱到强泛化》,作者:Guo、Chen、Wang等,2月6日,https://arxiv.org/abs/2402.03749
    该论文通过自适应置信度损失进行知识蒸馏,探究了视觉基础模型中的弱到强泛化,证明较弱的模型可以有效增强更强模型的性能,是视觉任务AI能力的重要进展。

  39. 《MOMENT:开源时间序列基础模型系列》,作者:Goswami、Szafer、Choudhry等,2月6日,https://arxiv.org/abs/2402.03885
    MOMENT提出了一种基于开源基础模型的通用时间序列分析新方法,通过构建“时间序列堆”数据集,并设计低监督场景下的模型评估基准,解决了时间序列数据集不统一、多数据集训练难度大等挑战。

  40. 《大语言模型下游任务性能的缩放定律》,作者:Isik、Ponomareva、Hazimeh等,2月6日,https://arxiv.org/abs/2402.04177
    该研究探究了预训练数据的规模和相关性如何影响大语言模型的机器翻译性能,发现数据对齐会提升效果,而错位则可能导致结果波动。

  41. 《点积注意力可解模型中位置学习与语义学习的相变》,作者:Cui、Behrens、Krzakala、Zdeborova,2月6日,https://arxiv.org/abs/2402.03902
    该研究探究了点积注意力层如何学习关注数据中的位置或语义,揭示了当数据量足够时,这些层会从位置注意力机制过渡到语义注意力机制,从而超越线性模型的表现。

  42. 《MobileVLM V2:更快更强的视觉语言模型基线》,作者:Chu、Qiao、Zhang等,2月6日,https://arxiv.org/abs/2402.03766
    MobileVLM V2推出了小型高效的视觉语言模型,性能超越更大的模型:17亿版本持平或超过30亿规模的模型,30亿版本则超过70亿以上规模的模型。

  43. 《DeepSeekMath:突破开源语言模型数学推理的极限》,作者:Shao、Wang、Zhu等,2月5日,https://arxiv.org/abs/2402.03300
    DeepSeekMath 7B是在1200亿数学相关token上预训练的大语言模型,通过挖掘网页数据,并引入组相对策略优化(PPO的替代方案)提升数学推理能力,在MATH基准上取得了51.7%的分数,接近Gemini Ultra和GPT-4等顶尖模型的水平。

  44. 《更多智能体就是你所需的全部》,作者:Li、Zhang、Yu、Fu、Ye,2月3日,https://arxiv.org/abs/2402.05120
    该研究表明,通过对多个大语言模型采用简单的多数投票集成方法,可以提升模型性能,且这种提升与现有方法互补,在难度更高的任务中效果更明显。

  45. 《FindingEmo:面向真实场景情感识别的图像数据集》,作者:Mertens、Yargholi、Op de Beeck等,2月2日,https://arxiv.org/abs/2402.01355
    FindingEmo是一个全新的情感识别标注数据集,包含2.5万张图像,聚焦自然场景中的复杂多人情境,数据集和源码均已公开。

  46. * 《LiPO:基于排序学习的列表式偏好优化》,作者:Liu、Qin、Wu等,2月2日,https://arxiv.org/abs/2402.01878
    该研究提出了列表式偏好优化(LiPO)方法,将大语言模型对齐转化为列表排序问题,利用人类反馈进行优化,证明LiPO的效果优于DPO等现有策略优化方法。

  47. * 《跟着我复述:Transformer在复制任务上优于状态空间模型》,作者:Jelassi、Brandfonbrener、Kakade、Malach,2月1日,https://arxiv.org/abs/2402.01032
    该论文证明,尽管状态空间模型在推理效率上有优势,但受限于固定大小的隐状态,在需要复制输入上下文的任务上,它们的表现不如Transformer。

  48. * 《Tiny Titans:小型大语言模型能否在真实会议摘要任务中实现越级表现?》,作者:Fu、Laskar、Khasanonva等,2月1日,https://arxiv.org/abs/2402.00841
    该研究发现,FLAN-T5等紧凑型大语言模型在会议摘要等特定任务上,效率和表现可以持平甚至超越更大的模型,作为高性价比的部署方案具有实用价值。

  49. * 《OLMo:推动语言模型科学发展》,作者:Groeneveld、Beltagy、Walsh等,2月1日,https://arxiv.org/abs/2402.00838
    这份技术报告介绍了完全开源的大语言模型OLMo,以及包含训练数据、训练代码、评估代码在内的完整框架。

  50. 《大语言模型的高效探索》,作者:Dwaracherla、Asghari、Hao、Van Roy,2月1日,https://arxiv.org/abs/2402.00396
    该研究论文证明,高效探索生成人类反馈查询的不同方式,能够通过基于收到的反馈持续优化奖励模型,用更少的查询大幅提升大语言模型的性能。

《机器学习与AI问答》

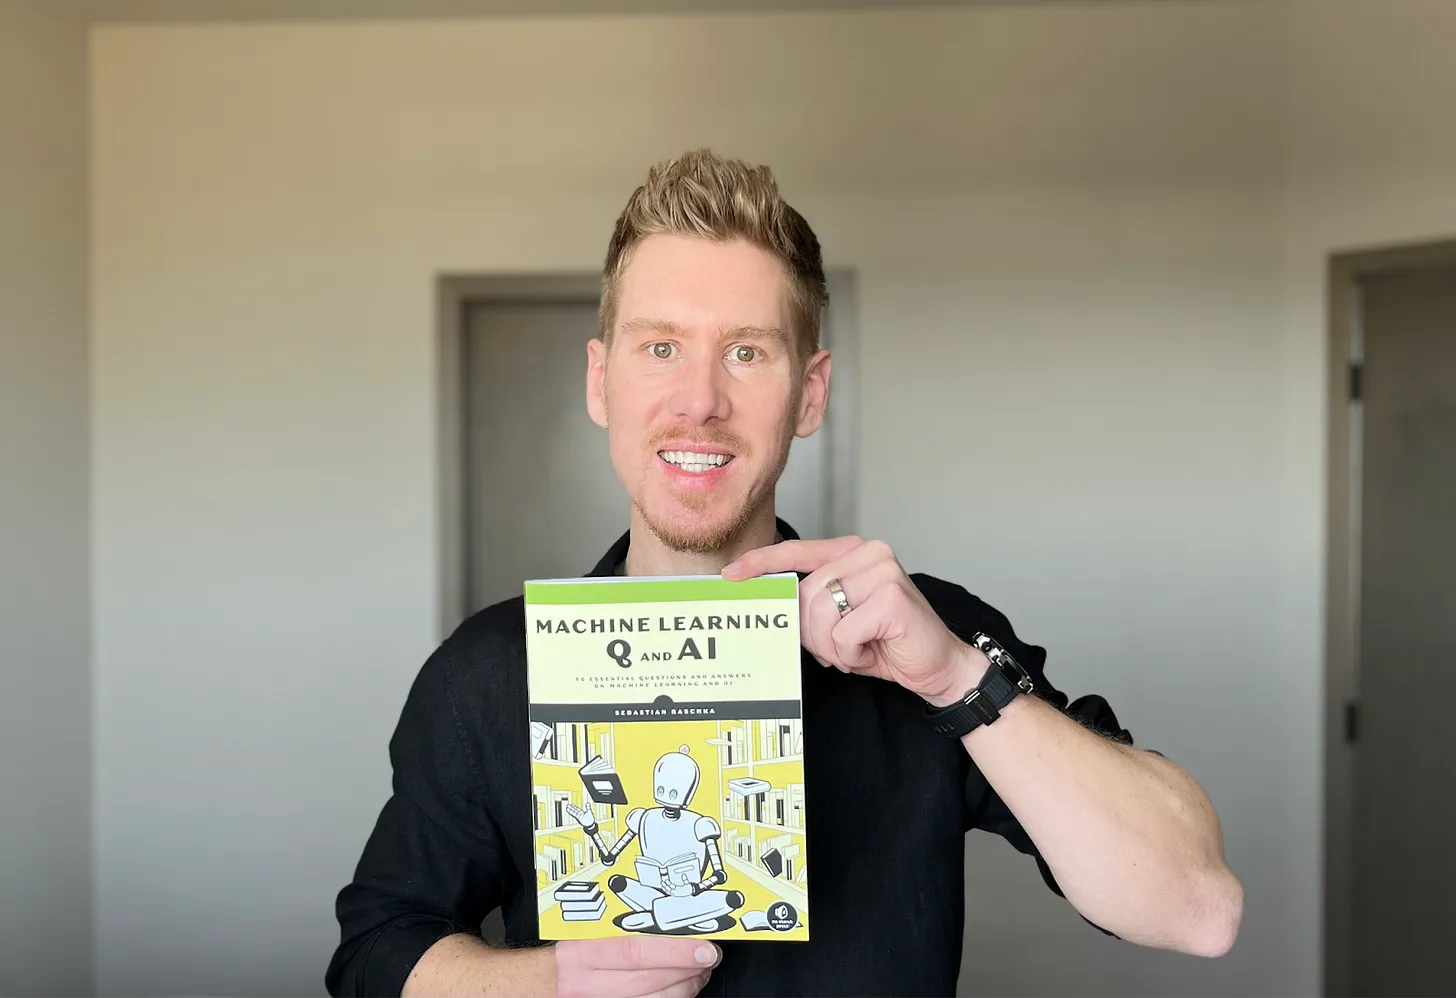
我非常激动,《机器学习与AI问答》终于要出版了,这周我刚收到了作者样书。

如果你正在寻找新的学习资源来加深对机器学习和AI概念的理解,《机器学习与AI问答》以通俗易懂的方式讲解了中高级概念。

figure17

书籍地址:https://nostarch.com/machine-learning-and-ai-beyond-basics

《Ahead of AI》是我的个人兴趣项目,没有直接的商业收益。如果你愿意支持我的工作,非常欢迎购买我的书。
https://nostarch.com/machine-learning-and-ai-beyond-basics
https://www.amazon.com/Machine-Learning-AI-Beyond-Basics/dp/1718503768

qwen.cpp简明教程

1、下载并编译qwen.cpp

git clone --recursive https://github.com/QwenLM/qwen.cpp
cd qwen.cpp
cmake -B build
cmake -B build -DGGML_OPENBLAS=ON
cmake -B build -DGGML_CUBLAS=ON
cmake --build build -j --config Release

2、下载模型,转化为ggml格式

#从hf下载模型,下载完成后,本地地址为 ~/.cache/huggingface/hub/模型名称
#部分代码文件会有缺失,可以到hf上对比下载
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen-7B-Chat",trust_remote_code=True)
#模型转化为ggml格式
#同时进行量化,降低资源需求
python3 qwen_cpp/convert.py -i PATH_TO_MODEL -t q4_0 -o qwen7b-q40-ggml.bin

3、运行模型

./build/bin/main -m qwen7b-q40-ggml.bin --tiktoken PATH_TO_MODEL/qwen.tiktoken -i

chatglm.cpp简明教程

1、下载并编译chatglm.cpp

git clone --recursive https://github.com/li-plus/chatglm.cpp.git
cd chatglm.cpp
git submodule update --init --recursive
#cmake -B build
cmake -B build -DGGML_OPENBLAS=ON
#cmake -B build -DGGML_CUBLAS=ON
cmake --build build -j --config Release

2、下载模型,转化为ggml格式

#从hf下载模型,下载完成后,本地地址为 ~/.cache/huggingface/hub/模型名称
#部分代码文件会有缺失,可以到hf上对比下载
from transformers import AutoModel
model = AutoModel.from_pretrained("THUDM/chatglm-6b",trust_remote_code=True)
#模型转化为ggml格式
#同时进行量化,降低资源需求
pip install torch tabulate tqdm transformers accelerate sentencepiece
python3 chatglm_cpp/convert.py -i PATH_TO_MODEL -t q4_0 -o chatglm-6b-q40-ggml.bin

3、运行模型

./build/bin/main -m chatglm-6b-q40-ggml.bin -i

4、常见问题

#下面的错误,是transformers版本太高导致
AttributeError: 'ChatGLMTokenizer' object has no attribute 'sp_tokenizer'. Did you mean: '_tokenize'?
#需要降低transformers版本
pip uninstall transformers
pip install transformers==4.33.2

【转载】改进LoRA:从零实现权重分解低秩适配DoRA

原文地址:Improving LoRA: Implementing Weight-Decomposed Low-Rank Adaptation (DoRA) from Scratch,by Sebastian Raschka, on 2024-02-19

改进LoRA:从零实现权重分解低秩适配DoRA

低秩适配(Low-Rank Adaptation,简称LoRA)是一种机器学习技术,它仅调整模型参数中一个小型的低秩子集,即可修改预训练模型(例如大语言模型或视觉Transformer),使其更好地适配特定的(通常规模较小的)数据集。

该方法的重要意义在于,它支持在任务特定数据上对大模型进行高效微调,大幅降低了微调所需的计算成本(与)时间。

上周,研究人员提出了LoRA的一种全新替代方案:https://arxiv.org/abs/2402.09353,其性能可能大幅超越LoRA。

figure01
DoRA是标准LoRA的一种极具潜力的替代方案(图注来自DoRA论文:https://arxiv.org/abs/2402.09353)

为了理解这些方法的工作原理,本文将从零开始,用PyTorch实现LoRA(与)DoRA两种算法!

LoRA 回顾

在深入讲解DoRA之前,我们先简要回顾一下https://arxiv.org/abs/2106.09685中LoRA的工作原理。

由于大语言模型体量庞大,受GPU显存限制,训练时更新全部模型权重的成本很高。假设某一层有一个大型权重矩阵$W$,在反向传播过程中,我们会得到一个$\Delta W$矩阵,它包含了为最小化训练损失函数,需要对原始权重进行的更新幅度信息。

在常规训练(与)微调中,权重更新的公式如下:
$$W_{\text{updated}} = W + \Delta W$$

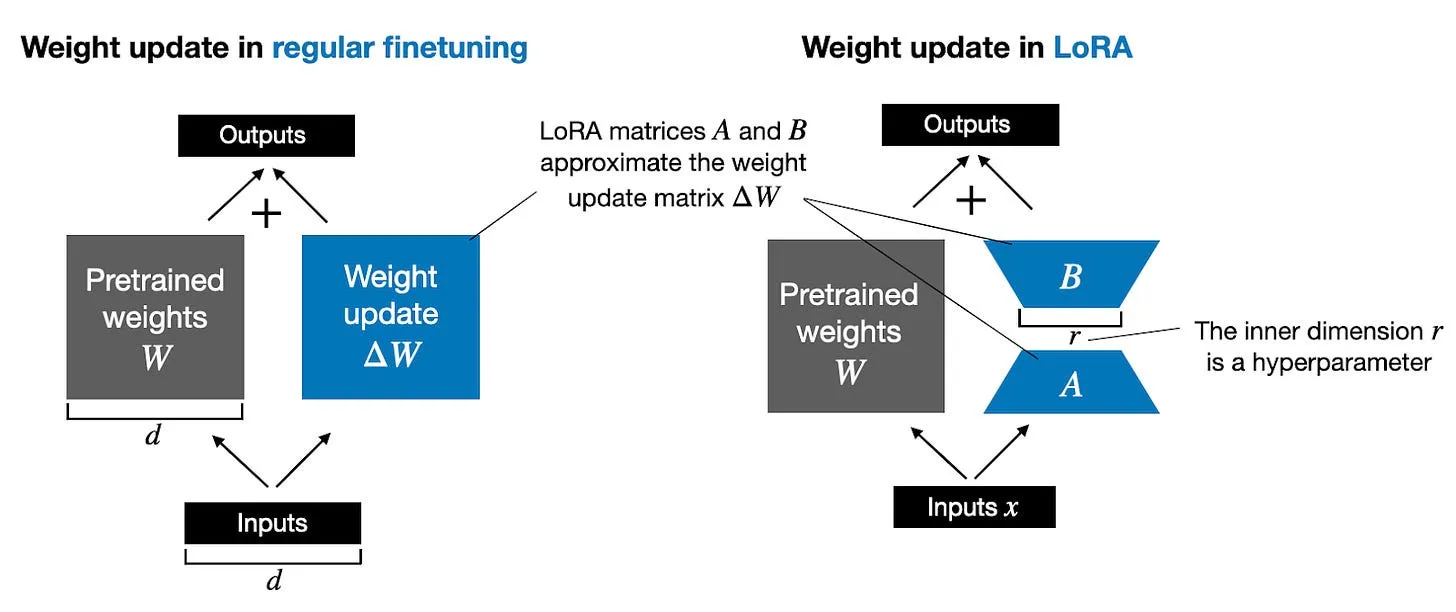
https://arxiv.org/abs/2106.09685 提出的LoRA方法提供了一种更高效的替代方案:它不去直接计算权重更新量$\Delta W$,而是学习$\Delta W$的近似值,即$\Delta W \approx AB$。换言之,在LoRA中,权重更新公式如下,其中$A$和$B$是两个小型权重矩阵:
$$W_{\text{updated}} = W + A \cdot B$$
(“$A \cdot B$”中的“$\cdot$”代表矩阵乘法。)

下图并排展示了全量微调(与)LoRA微调的公式原理。

figure02
图:常规微调(左)(与)LoRA微调(右)示意图

LoRA是如何节省GPU显存的?假设预训练权重矩阵$W$是$1000 \times 1000$(的LoRA矩阵),那么常规微调中的权重更新矩阵$\Delta W$同样是$1000 \times 1000$(的LoRA矩阵),此时$\Delta W$包含1,000,000个参数。如果我们取LoRA的秩为2,那么$A$是$1000 \times 2$(的LoRA矩阵),$B$是$2 \times 1000$(的LoRA矩阵),使用LoRA时仅需要更新$2 \times 2 \times 1000 = 4000$个参数。在这个例子中,秩为2的LoRA参数量仅为全量更新的1/250。

当然,$A$和$B$无法捕捉$\Delta W$所能包含的全部信息,但这是刻意设计的。使用LoRA时,我们基于这样一个假设:模型需要满秩的大型矩阵$W$来捕获预训练数据集中的全部知识;但在微调大语言模型时,我们不需要更新所有权重,用比$\Delta W$少得多的参数就能捕获适配任务的核心信息,因此我们通过$AB$实现低秩更新。

如果你仔细观察,上图中全量微调(与)LoRA的图示和我之前给出的公式看起来略有不同。这是因为矩阵乘法的分配律:我们不必将权重(与)更新量合并,而是可以分开保存。例如,设$x$为输入数据,那么常规微调可以写成:
$$x \cdot (W+\Delta W) = x \cdot W + x \cdot \Delta W$$

同理,LoRA可以写成:
$$x \cdot (W+A \cdot B) = x \cdot W + x \cdot A \cdot B$$

LoRA权重矩阵可以分开保存的特性,让LoRA极具实用价值。在实际应用中,这意味着我们完全不需要修改预训练模型的权重,只需在推理时动态叠加LoRA矩阵即可。如果你需要为多个客户提供模型托管服务,这一点尤其有用:你不必为每个客户保存一份庞大的更新后模型,只需在原始预训练模型之外,保存一组小型的LoRA权重即可。

为了让这个概念不那么抽象,并提供更直观的理解,我们将在下一节从零开始用代码实现LoRA。

LoRA层的代码实现

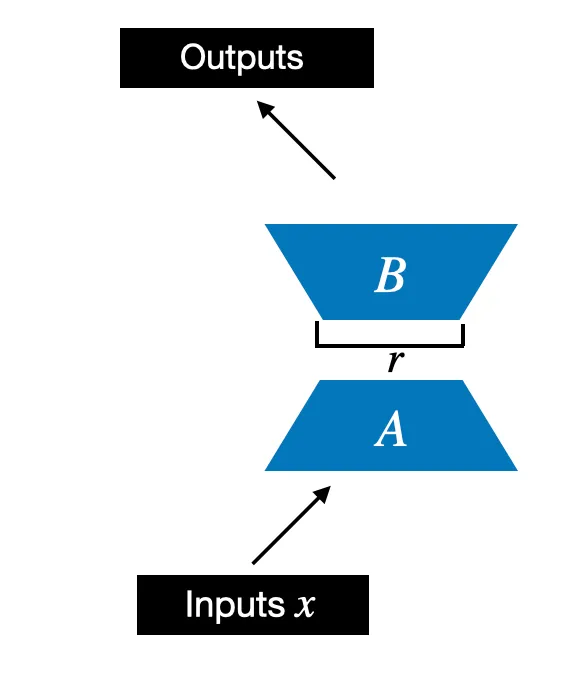
我们首先初始化一个LoRALayer层,它会创建矩阵$A$和$B$,以及alpha缩放超参数和秩超参数。该层可以接收输入并计算对应的输出,如下图所示。

figure03
秩为r的LoRA矩阵A与B示意图

在代码中,上图所示的LoRA层实现如下:

import torch.nn as nn  
class LoRALayer(nn.Module):    
    def __init__(self, in_dim, out_dim, rank, alpha):        
        super().__init__()        
        std_dev = 1 / torch.sqrt(torch.tensor(rank).float())        
        self.A = nn.Parameter(torch.randn(in_dim, rank) * std_dev)        
        self.B = nn.Parameter(torch.zeros(rank, out_dim))        
        self.alpha = alpha    

    def forward(self, x):        
        x = self.alpha * (x @ self.A @ self.B)        
        return x

在上述代码中,rank(秩)是控制矩阵$A$和$B$内部维度的超参数。换言之,该参数决定了LoRA引入的额外参数量,是平衡模型适配能力(与)参数效率的关键因素。

第二个超参数alpha是作用于低秩适配输出的缩放超参数。它本质上控制了适配层的输出对被适配层原始输出的影响程度,可以看作是调节低秩适配对层输出影响大小的手段。

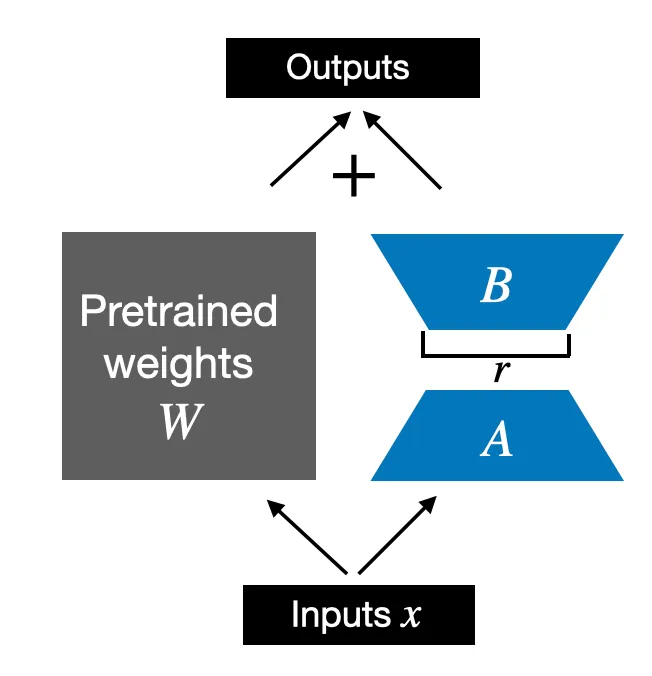
到目前为止,我们实现的LoRALayer类可以对层输入$x$进行变换。但在LoRA的实际应用中,我们通常需要替换已有的线性(Linear)层,从而将权重更新作用到现有的预训练权重上,如下图所示:

figure04
应用于现有线性层的LoRA

为了融入上图所示的原始线性层权重,我们将实现一个LinearWithLoRA层,它复用之前实现的LoRALayer,可用于替换神经网络中已有的线性层,例如大语言模型中的自注意力模块或前馈模块:

class LinearWithLoRA(nn.Module):    
    def __init__(self, linear, rank, alpha):        
        super().__init__()        
        self.linear = linear        
        self.lora = LoRALayer(            
            linear.in_features, linear.out_features, rank, alpha        
        )    

    def forward(self, x):        
        return self.linear(x) + self.lora(x)

注意,由于我们在LoRA层中将权重矩阵$B$(LoRALayer中的self.B)初始化为零值,$A$(与)$B$(的LoRA矩阵)乘法结果是一个全零矩阵,因此不会影响原始权重(因为给原始权重加0不会改变其数值)。

我们用一个仅含单个线性层的小型神经网络层来测试LoRA:

输入:

torch.manual_seed(123)
layer = nn.Linear(10, 2)
x = torch.randn((1, 10)) 
print("Original output:", layer(x))

输出:

Original output: tensor([[0.6639, 0.4487]], grad_fn=<AddmmBackward0>)

现在,我们给这个线性层加上LoRA,可以看到输出结果和原来完全一致,因为我们还没有训练LoRA的权重。也就是说,一切都符合预期:

输入:

layer_lora_1 = LinearWithLoRA(layer, rank=2, alpha=4)
print("LoRA output:", layer_lora_1(x))

输出:

LoRA output: tensor([[0.6639, 0.4487]], grad_fn=<AddmmBackward0>)

之前我提到了矩阵乘法的分配律:
$$x \cdot (W+A \cdot B) = x \cdot W + x \cdot A \cdot B$$

这意味着我们也可以将LoRA矩阵(与)原始权重合并,得到等效的实现方式。在代码中,LinearWithLoRA层的这种替代实现方式如下:

class LinearWithLoRAMerged(nn.Module):    
    def __init__(self, linear, rank, alpha):        
        super().__init__()        
        self.linear = linear        
        self.lora = LoRALayer(            
            linear.in_features, linear.out_features, rank, alpha        
        )    

    def forward(self, x):        
        lora = self.lora.A @ self.lora.B # Combine LoRA matrices        
        # Then combine LoRA with orig. weights        
        combined_weight = self.linear.weight + self.lora.alpha*lora.T        
        return F.linear(x, combined_weight, self.linear.bias)

简而言之,LinearWithLoRAMerged计算的是等式$x \cdot (W+A \cdot B) = x \cdot W + x \cdot A \cdot B$的左侧,而LinearWithLoRA计算的是右侧——二者是等价的。

我们可以通过以下代码验证它的输出和之前完全一致:

输入:

layer_lora_2 = LinearWithLoRAMerged(layer, rank=2, alpha=4)
print("LoRA output:", layer_lora_2(x))

输出:

LoRA output: tensor([[0.6639, 0.4487]], grad_fn=<AddmmBackward0>)

现在我们已经有了可运行的LoRA实现,下一节将介绍如何将它应用到神经网络中。

《Ahead of AI》是一份读者支持的出版物。想要接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

应用LoRA层

我们为什么要用PyTorch模块以这种方式实现LoRA?因为这种方法可以让我们轻松地将现有神经网络中的线性层(例如大语言模型的前馈模块或注意力模块)替换为我们新的LinearWithLoRA(或LinearWithLoRAMerged)层。

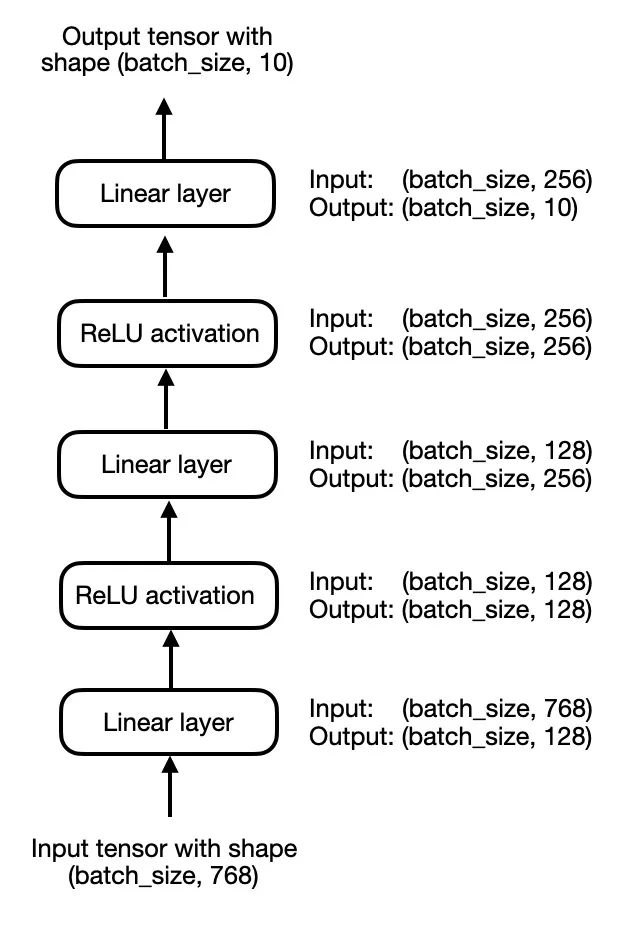
为简单起见,我们暂时不用大语言模型,而是聚焦于一个小型的3层多层感知机,如下图所示:

figure05
一个简单的3层多层感知机

在代码中,我们可以这样实现上图的多层感知机:

输入:

class MultilayerPerceptron(nn.Module):    
    def __init__(self, num_features, num_hidden_1, num_hidden_2, num_classes):        
        super().__init__()        
        self.layers = nn.Sequential(            
            nn.Linear(num_features, num_hidden_1),            
            nn.ReLU(),            
            nn.Linear(num_hidden_1, num_hidden_2),            
            nn.ReLU(),            
            nn.Linear(num_hidden_2, num_classes)        
        )    

    def forward(self, x):        
        x = self.layers(x)        
        return x  

model = MultilayerPerceptron(    
    num_features=num_features,    
    num_hidden_1=num_hidden_1,    
    num_hidden_2=num_hidden_2,    
    num_classes=num_classes 
)  
print(model)

输出:

MultilayerPerceptron(  
  (layers): Sequential(    
    (0): Linear(in_features=784, out_features=128, bias=True)    
    (1): ReLU()    
    (2): Linear(in_features=128, out_features=256, bias=True)    
    (3): ReLU()    
    (4): Linear(in_features=256, out_features=10, bias=True)  
  ) 
)

使用LinearWithLoRA,我们可以替换多层感知机模型中的原始线性层,从而加入LoRA层:

输入:

model.layers[0] = LinearWithLoRA(model.layers[0], rank=4, alpha=8)
model.layers[2] = LinearWithLoRA(model.layers[2], rank=4, alpha=8)
model.layers[4] = LinearWithLoRA(model.layers[4], rank=4, alpha=8) 
print(model)

输出:

MultilayerPerceptron(  
  (layers): Sequential(    
    (0): LinearWithLoRA(      
      (linear): Linear(in_features=784, out_features=128, bias=True)      
      (lora): LoRALayer()    
    )    
    (1): ReLU()    
    (2): LinearWithLoRA(      
      (linear): Linear(in_features=128, out_features=256, bias=True)      
      (lora): LoRALayer()    
    )    
    (3): ReLU()    
    (4): LinearWithLoRA(      
      (linear): Linear(in_features=256, out_features=10, bias=True)      
      (lora): LoRALayer()    
    )  
  ) 
)

接下来,我们可以冻结原始线性层,仅让LoRALayer层可训练,方法如下:

输入:

def freeze_linear_layers(model):    
    for child in model.children():        
        if isinstance(child, nn.Linear):            
            for param in child.parameters():                
                param.requires_grad = False        
        else:            
            # Recursively freeze linear layers in children modules            
            freeze_linear_layers(child)  

freeze_linear_layers(model)
for name, param in model.named_parameters():    
    print(f"{name}: {param.requires_grad}")

输出:

layers.0.linear.weight: False
layers.0.linear.bias: False
layers.0.lora.A: True
layers.0.lora.B: True
layers.2.linear.weight: False
layers.2.linear.bias: False
layers.2.lora.A: True
layers.2.lora.B: True
layers.4.linear.weight: False
layers.4.linear.bias: False
layers.4.lora.A: True
layers.4.lora.B: True

通过上面的True和False值,我们可以直观地确认现在只有LoRA层是可训练的(True代表可训练,False代表冻结)。在实际应用中,我们就可以用这个LoRA配置的网络在新数据集或新任务上进行训练。

为了不让文章过于冗长,我省略了训练该模型的样板代码。如果你对完整代码感兴趣,可以在这里找到独立的代码笔记本:https://github.com/rasbt/dora-from-scratch。

此外,如果你想了解从零开始的LoRA讲解以及在大语言模型上的应用,也可以查看我的Lightning Studio:https://lightning.ai/lightning-ai/studios/code-lora-from-scratch 。

理解权重分解低秩适配(DoRA)

你可能已经注意到,我们花了很多时间来实现和讲解LoRA。这是因为DoRA(https://arxiv.org/abs/2402.09353)可以看作是在LoRA基础上的改进(与)扩展,我们现在可以很方便地复用之前的部分代码来实现DoRA。

DoRA可以分为两个步骤:第一步是将预训练权重矩阵分解为幅值向量($m$)和方向矩阵($V$);第二步是对方向矩阵$V$应用LoRA,同时单独训练幅值向量$m$。

这种将向量分解为幅值和方向分量的思路,源于一个数学原理:任意向量都可以表示为其幅值(表示长度的标量)(与)方向(表示空间朝向的单位向量)的乘积。

figure06
单个向量的方向(与)幅值示意图。例如,对于二维向量[1, 2],我们可以将其分解为幅值2.24和方向向量[0.447, 0.894],而$2.24 \times [0.447, 0.894] = [1, 2]$。

在DoRA中,我们将这种幅值-方向分解应用到整个预训练权重矩阵$W$上,而不是单个向量。权重矩阵的每一列(向量)对应连接所有输入到某个输出神经元的权重。

因此,分解$W$后得到的幅值向量$m$,代表了权重矩阵中每一列向量的尺度或长度,如下图所示。

figure07
DoRA中权重矩阵分解示意图

随后,DoRA对方向矩阵$V$应用标准LoRA,例如:
$$W’ = m \cdot (V + \Delta V)/\text{norm} = m \cdot (W + AB)/\text{norm}$$

这里的归一化(为了不让概述过于复杂,我简称为“norm”)基于Salimans和Kingma在2016年提出的权重归一化方法,参见https://arxiv.org/abs/1602.07868 。

DoRA的两步流程(分解预训练权重矩阵、对方向矩阵应用LoRA)在下面DoRA论文的图中有进一步说明。

figure08
来自DoRA论文的带注释示意图(https://arxiv.org/abs/2402.09353)

研发DoRA的动机,源于对LoRA(与)全量微调学习模式的分析对比。DoRA的作者发现,LoRA对幅值和方向的更新是成比例增减的,无法像全量微调那样仅对方向做细微调整。因此,研究人员提出将幅值分量(与)方向分量解耦。

换言之,DoRA方法的目标是仅对方向分量$V$应用LoRA,同时让幅值分量$m$可以单独训练。

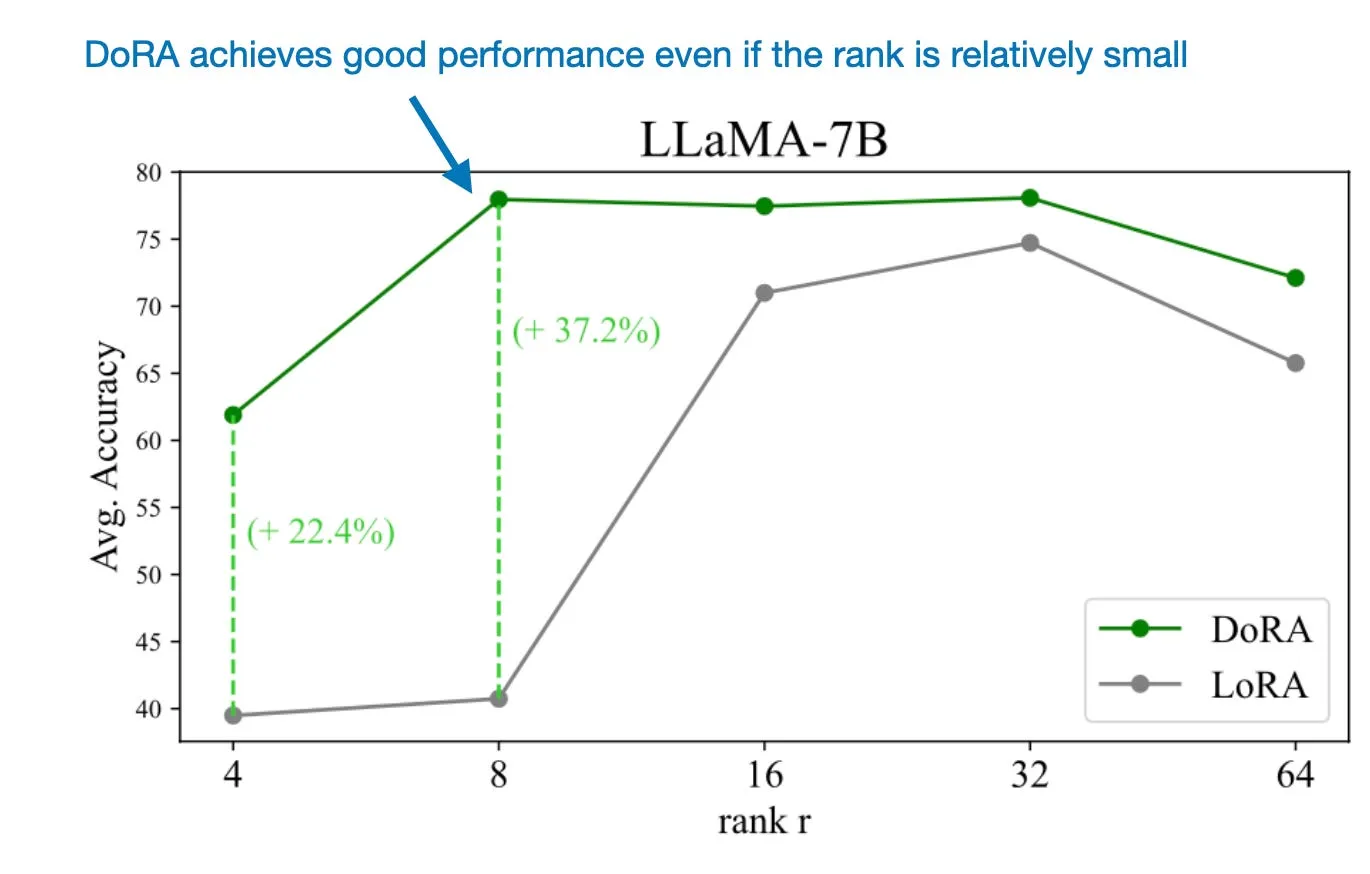
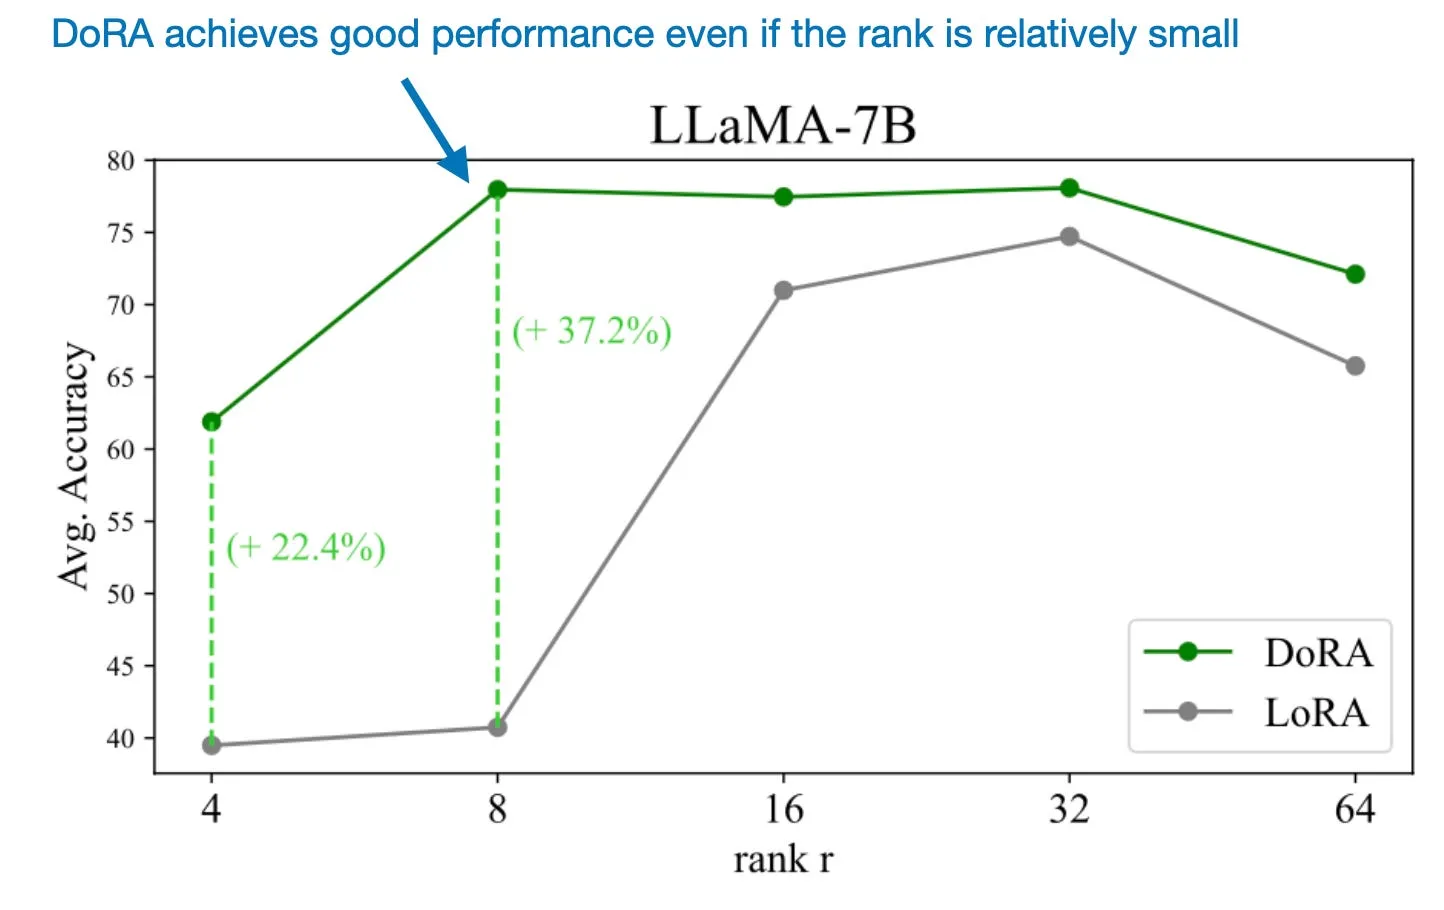
引入幅值向量$m$后,DoRA的参数量仅比LoRA多0.01%。但研究人员发现,在大语言模型和视觉Transformer的基准测试中,即使DoRA的秩减半(即参数量仅为常规LoRA的一半),其性能依然优于LoRA,如下方性能对比图所示。

figure09
DoRA论文中LoRA(与)DoRA的对比(https://arxiv.org/abs/2402.09353)

正如我几个月前在另一篇文章中所写,LoRA需要仔细调整秩才能优化性能:https://magazine.sebastianraschka.com/p/practical-tips-for-finetuning-llms。但如下图的对比所示,DoRA对秩的变化鲁棒性要强得多。

figure10
DoRA对秩超参数的鲁棒性优于LoRA(图注来自DoRA论文:https://arxiv.org/abs/2402.09353)

DoRA可以在秩相对较小的情况下取得良好效果,这让该方法比LoRA的参数效率更高。

总的来说,这些结果让我印象深刻,将LoRA实现升级为DoRA的工作量并不大,我们将在下一节完成这项工作。

用PyTorch实现DoRA层

在本节中,我们将看到DoRA的代码实现形式。之前我们提到,可以将预训练权重$W_0$初始化为幅值$m$和方向分量$V$。例如,我们有如下公式:
其中$|V|_c$是$V$的逐列向量范数。然后我们可以写出包含LoRA权重更新$BA$的DoRA公式,如下所示:

在DoRA论文中,作者给出的DoRA公式如下:他们直接将初始预训练权重$W_0$作为方向分量,在训练中学习幅值向量$m$:
其中$\Delta V$是方向分量矩阵$V$的更新量。

虽然原作者尚未发布官方实现,但你可以找到一个第三方实现:https://github.com/catid/dora/blob/main/dora.py,我下面的实现也大致参考了它。

基于我们之前的LinearWithLoRAMerged实现,我们可以将其升级为DoRA,代码如下:

class LinearWithDoRAMerged(nn.Module):    
    def __init__(self, linear, rank, alpha):        
        super().__init__()        
        self.linear = linear        
        self.lora = LoRALayer(            
            linear.in_features, linear.out_features, rank, alpha        
        )        
        self.m = nn.Parameter(            
            self.linear.weight.norm(p=2, dim=0, keepdim=True))    

    # Code loosely inspired by     
    # https://github.com/catid/dora/blob/main/dora.py    

    def forward(self, x):        
        lora = self.lora.A @ self.lora.B        
        numerator = self.linear.weight + self.lora.alpha*lora.T        
        denominator = numerator.norm(p=2, dim=0, keepdim=True)        
        directional_component = numerator / denominator        
        new_weight = self.m * directional_component        
        return F.linear(x, new_weight, self.linear.bias)

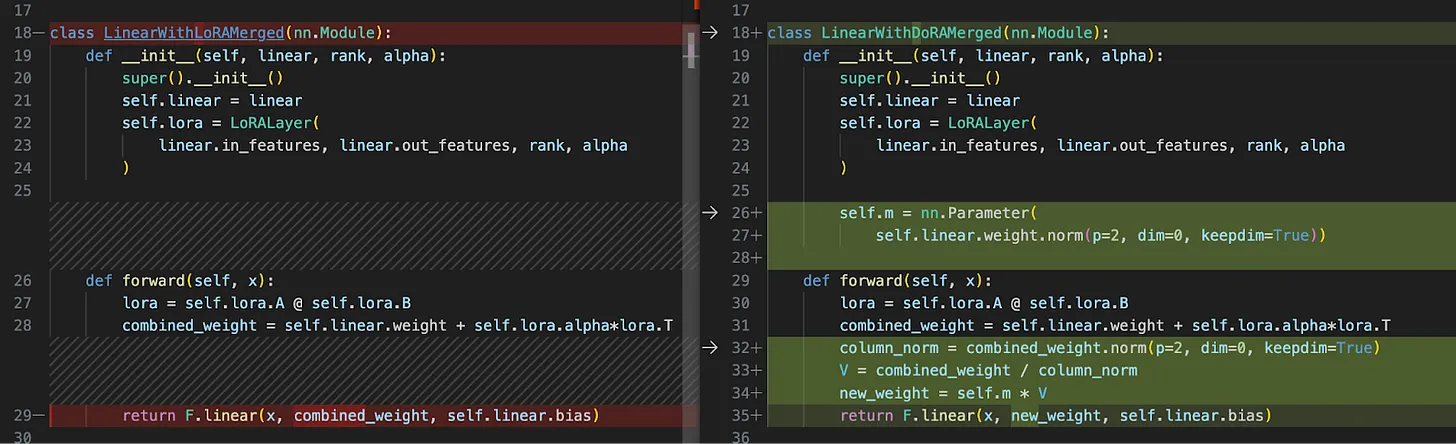
LinearWithDoRAMerged类(与)之前的LinearWithLoRAMerged类有几个关键区别,主要体现在修改和应用线性层权重的方式上。不过两个类都集成了LoRALayer来增强原始线性层的权重,而DoRA额外加入了权重归一化(与)调整。

下图并排展示了两个类的代码差异对比:

figure11
LinearWithLoRAMerged(与)LinearWithDoRAMerged的代码差异对比

从上图可以看到,LinearWithDoRAMerged额外加入了一步对增强后权重的动态归一化。

在将原始权重(与)LoRA调整后的权重合并(self.linear.weight + self.lora.alpha*lora.T)之后,它会计算这些合并后权重的列范数(column_norm),然后通过除以各自的范数来归一化合并权重($V = \text{合并权重} / \text{列范数}$)。这一步确保了合并权重矩阵的每一列都具有单位范数,能够通过维持权重更新的尺度来稳定训练过程。

DoRA还引入了可学习向量self.m,它代表归一化后权重矩阵每一列的幅值。该参数让模型可以在训练中动态调整合并权重矩阵中每个权重向量的尺度,这种额外的灵活性有助于模型更好地捕捉不同特征的重要性。

总而言之,LinearWithDoRAMerged在LinearWithLoRAMerged的概念基础上进行了扩展,加入了动态权重归一化(与)缩放,以提升训练性能。

在实际应用中,对于之前的多层感知机,我们可以直接将现有线性层替换为LinearWithDoRAMerged层,方法如下:

输入:

model.layers[0] = LinearWithDoRAMerged(model.layers[0], rank=4, alpha=8)
model.layers[2] = LinearWithDoRAMerged(model.layers[2], rank=4, alpha=8)
model.layers[4] = LinearWithDoRAMerged(model.layers[4], rank=4, alpha=8) 
print(model)

输出:

MultilayerPerceptron(  
  (layers): Sequential(    
    (0): LinearWithDoRAMerged(      
      (linear): Linear(in_features=784, out_features=128, bias=True)      
      (lora): LoRALayer()    
    )    
    (1): ReLU()    
    (2): LinearWithDoRAMerged(      
      (linear): Linear(in_features=128, out_features=256, bias=True)      
      (lora): LoRALayer()    
    )    
    (3): ReLU()    
    (4): LinearWithDoRAMerged(      
      (linear): Linear(in_features=256, out_features=10, bias=True)      
      (lora): LoRALayer()    
    )  
  ) 
)

在微调模型之前,我们可以复用之前实现的freeze_linear_layers函数,仅让LoRA权重和幅值向量可训练:

输入:

freeze_linear_layers(model)
for name, param in model.named_parameters():    
    print(f"{name}: {param.requires_grad}")

输出:

layers.0.m: True
layers.0.linear.weight: False
layers.0.linear.bias: False
layers.0.lora.A: True
layers.0.lora.B: True
layers.2.m: True
layers.2.linear.weight: False
layers.2.linear.bias: False
layers.2.lora.A: True
layers.2.lora.B: True
layers.4.m: True
layers.4.linear.weight: False
layers.4.linear.bias: False
layers.4.lora.A: True
layers.4.lora.B: True

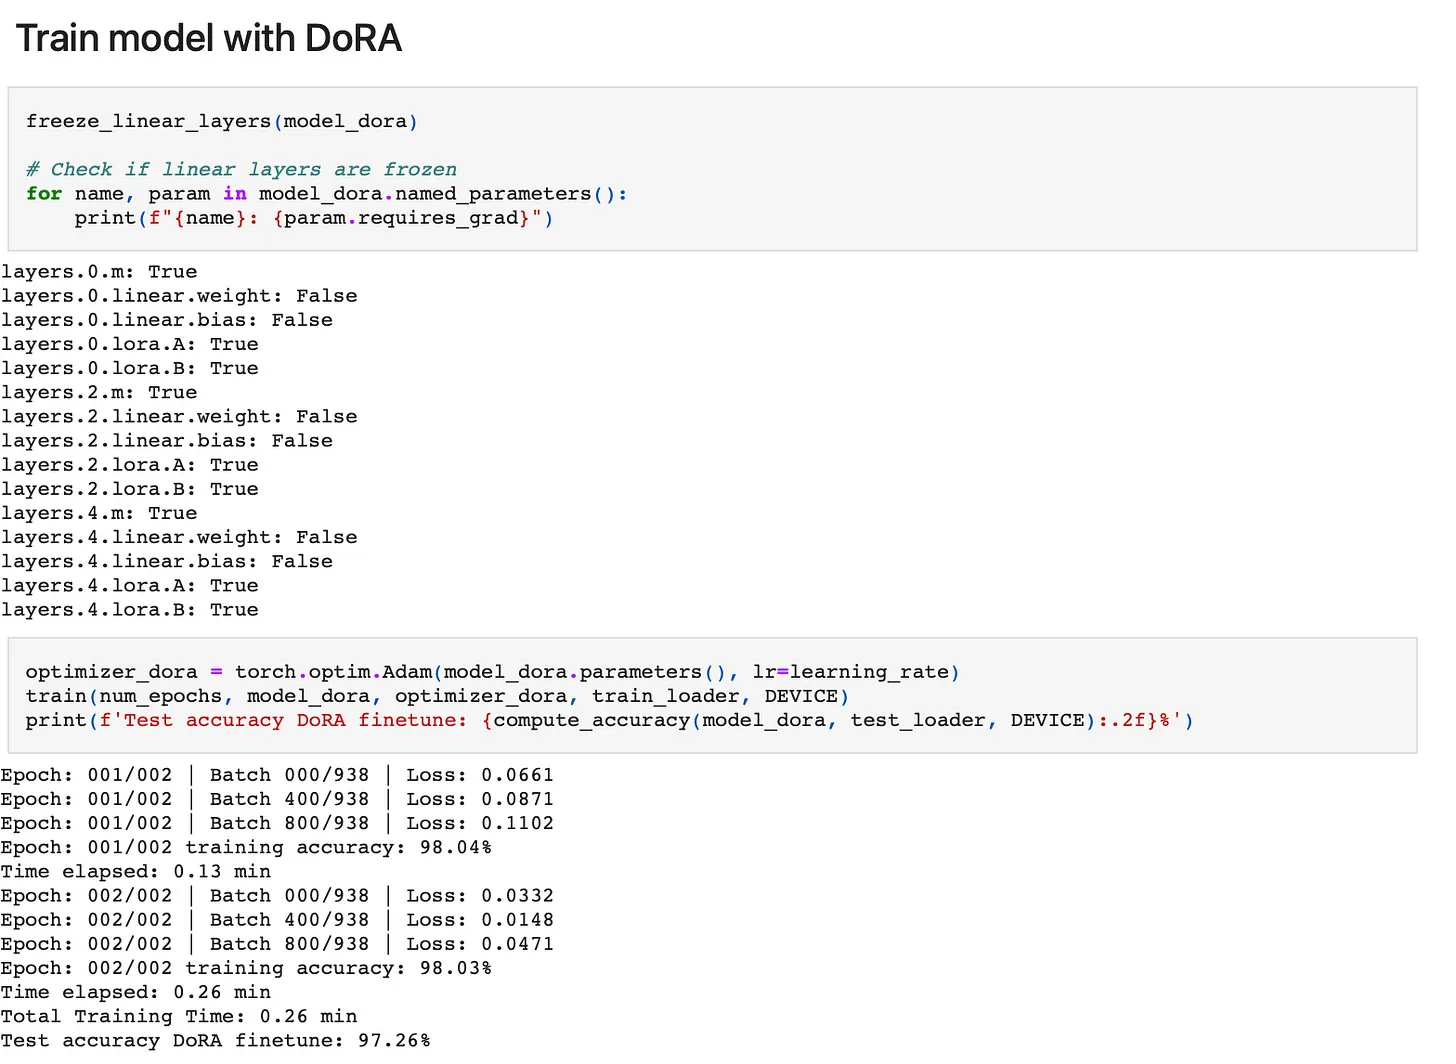
包含模型训练在内的完整代码示例,可以在我的GitHub仓库中找到:https://github.com/rasbt/dora-from-scratch。

figure12
DoRA代码笔记本:https://github.com/rasbt/dora-from-scratch

结语

在我看来,DoRA是LoRA一种合理、有效且极具潜力的扩展,我很期待在实际的大语言模型微调场景中应用它。

同时,我也将上述DoRA实现加入到了Lightning Studio中(https://lightning.ai/lightning-ai/studios/code-lora-from-scratch),用于微调DistilBERT语言模型(参见bonus_02_finetune-with-dora.ipynb)。即使没有进行超参数调优,我也已经观察到它的预测准确率比LoRA高出1%以上。

这本杂志是我的个人兴趣项目。如果你愿意支持我的创作,欢迎购买我的著作:https://amzn.to/4fqvn0D 。(我相信你会从这本书中收获颇丰,因为它对大语言模型工作原理的讲解深度是其他地方找不到的。)

figure13
《从零构建大语言模型》现已发售:https://amzn.to/4fqvn0D

如果你读过这本书,并且能抽出几分钟时间,我会非常感谢你留下评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 。这对我们作者帮助很大!

另外,我最近也在Substack上开通了付费订阅选项,可以直接支持这本杂志。

《Ahead of AI》是一份读者支持的出版物。想要接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

大语言模型资料汇总

一、之前整理了一些大模型的Demo,汇总如下
1、ChatGPT
https://github.com/neohope/NeoDemosChatGPT

2、Llama2
https://github.com/neohope/NeoDemosLlama2
可同步看一下中文版Llama2
https://github.com/ymcui/Chinese-LLaMA-Alpaca-2

3、阿里千问
https://github.com/neohope/NeoDemosQwen

4、清华ChatGLM
https://github.com/neohope/NeoDemosChatGLM

二、建议看一下llama.cpp
1、llama.cpp
https://github.com/ggerganov/llama.cpp

2、python的llama.cpp封装
https://github.com/abetlen/llama-cpp-python

3、千问的qwen.cpp实现
https://github.com/QwenLM/qwen.cpp

4、ChatGLM的chatglm.cpp实现
https://github.com/li-plus/chatglm.cpp

三、还有量化
https://github.com/AutoGPTQ/AutoGPTQ

四、当然还有langchain
https://github.com/langchain-ai/langchain

五、如果有余力,看一下Transformer实现
https://github.com/huggingface/transformers

llama.cpp简要教程

1、下载并编译llama.cpp

git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make

2、下载llama-2-7b-chat
a、可以从fb或hf下载
b、可以使用脚本下载工具,比如llama-dl
c、可以使用Chinese-LLaMA-2-7B
d、可以使用其他三方源

3、模型转换为ggml格式

python3 convert.py ../llama/llama-2-7b-chat/ 
Loading model file ../llama/llama-2-7b-chat/consolidated.00.pth
params = Params(n_vocab=32000, n_embd=4096, n_layer=32, n_ctx=2048, n_ff=11008, n_head=32, n_head_kv=32, n_experts=None, n_experts_used=None, f_norm_eps=1e-06, rope_scaling_type=None, f_rope_freq_base=None, f_rope_scale=None, n_orig_ctx=None, rope_finetuned=None, ftype=None, path_model=PosixPath('../llama/llama-2-7b-chat'))
Found vocab files: {'tokenizer.model': PosixPath('../llama/tokenizer.model'), 'vocab.json': None, 'tokenizer.json': None}
Loading vocab file '../llama/tokenizer.model', type 'spm'
Vocab info: <SentencePieceVocab with 32000 base tokens and 0 added tokens>
Special vocab info: <SpecialVocab with 0 merges, special tokens unset, add special tokens unset>
tok_embeddings.weight                            -> token_embd.weight                        | BF16   | [32000, 4096]
norm.weight                                      -> output_norm.weight                       | BF16   | [4096]
output.weight                                    -> output.weight                            | BF16   | [32000, 4096]
layers.0.attention.wq.weight                     -> blk.0.attn_q.weight                      | BF16   | [4096, 4096]
...
layers.31.ffn_norm.weight                        -> blk.31.ffn_norm.weight                   | BF16   | [4096]
skipping tensor rope_freqs
Writing ../llama/llama-2-7b-chat/ggml-model-f16.gguf, format 1
Ignoring added_tokens.json since model matches vocab size without it.
gguf: This GGUF file is for Little Endian only
[  1/291] Writing tensor token_embd.weight                      | size  32000 x   4096  | type F16  | T+   3
...
[291/291] Writing tensor blk.31.ffn_norm.weight                 | size   4096           | type F32  | T+ 314
Wrote ../llama/llama-2-7b-chat/ggml-model-f16.gguf

4、模型量化,减少资源使用

./quantize ../llama/llama-2-7b-chat/ggml-model-f16.gguf  ../llama/llama-2-7b-chat/ggml-model-f16-q4_0.gguf q4_0 
main: build = 2060 (5ed26e1f)
main: built with cc (Ubuntu 11.4.0-1ubuntu1~22.04) 11.4.0 for x86_64-linux-gnu
main: quantizing '../llama/llama-2-7b-chat/ggml-model-f16.gguf' to '../llama/llama-2-7b-chat/ggml-model-f16-q4_0.gguf' as Q4_0
llama_model_loader: loaded meta data with 15 key-value pairs and 291 tensors from ../llama/llama-2-7b-chat/ggml-model-f16.gguf (version GGUF V3 (latest))
llama_model_loader: Dumping metadata keys/values. Note: KV overrides do not apply in this output.
llama_model_loader: - kv   0:                       general.architecture str              = llama
llama_model_loader: - kv   1:                               general.name str              = llama
llama_model_loader: - kv   2:                       llama.context_length u32              = 2048
llama_model_loader: - kv   3:                     llama.embedding_length u32              = 4096
llama_model_loader: - kv   4:                          llama.block_count u32              = 32
llama_model_loader: - kv   5:                  llama.feed_forward_length u32              = 11008
llama_model_loader: - kv   6:                 llama.rope.dimension_count u32              = 128
llama_model_loader: - kv   7:                 llama.attention.head_count u32              = 32
llama_model_loader: - kv   8:              llama.attention.head_count_kv u32              = 32
llama_model_loader: - kv   9:     llama.attention.layer_norm_rms_epsilon f32              = 0.000001
llama_model_loader: - kv  10:                          general.file_type u32              = 1
llama_model_loader: - kv  11:                       tokenizer.ggml.model str              = llama
llama_model_loader: - kv  12:                      tokenizer.ggml.tokens arr[str,32000]   = ["<unk>", "<s>", "</s>", "<0x00>", "<...
llama_model_loader: - kv  13:                      tokenizer.ggml.scores arr[f32,32000]   = [0.000000, 0.000000, 0.000000, 0.0000...
llama_model_loader: - kv  14:                  tokenizer.ggml.token_type arr[i32,32000]   = [2, 3, 3, 6, 6, 6, 6, 6, 6, 6, 6, 6, ...
llama_model_loader: - type  f32:   65 tensors
llama_model_loader: - type  f16:  226 tensors
llama_model_quantize_internal: meta size = 740928 bytes
[   1/ 291]                    token_embd.weight - [ 4096, 32000,     1,     1], type =    f16, quantizing to q4_0 .. size =   250.00 MiB ->    70.31 MiB | hist: 0.037 0.016 0.025 0.039 0.057 0.077 0.096 0.111 0.116 0.111 0.096 0.077 0.057 0.039 0.025 0.021 
...   
[ 291/ 291]               blk.31.ffn_norm.weight - [ 4096,     1,     1,     1], type =    f32, size =    0.016 MB
llama_model_quantize_internal: model size  = 12853.02 MB
llama_model_quantize_internal: quant size  =  3647.87 MB
llama_model_quantize_internal: hist: 0.036 0.015 0.025 0.039 0.056 0.076 0.096 0.112 0.118 0.112 0.096 0.077 0.056 0.039 0.025 0.021 
main: quantize time = 323302.84 ms
main:    total time = 323302.84 ms

5、使用模型

./main -m ../llama/llama-2-7b-chat/ggml-model-f16-q4_0.gguf -n 256 --repeat_penalty 1.0 --color -ins

IT专业人士

IT专业人士

IT专业人士

专业人士要终身学习:职业发展是一场马拉松,而非百米冲刺。在知识半衰期不断缩短的今天,停止学习就意味着贬值;专业人士必须建立“输入-消化-输出”的学习闭环,通过阅读、培训与实践,不断更新认知体系,确保自己始终站在行业潮头,而非被时代淘汰。

专业人士要有技术敏锐性:不仅要低头拉车,更要抬头看路。这意味着要时刻关注技术风向标,洞察新兴技术的成熟度和商业潜力,从而在技术选型、架构演进上做出前瞻性决策,避免在错误的技术栈上投入沉没成本,错失转型良机。

专业人士要有技术纵深:广度决定下限,深度决定上限。在核心专业领域,不能满足于“会用”,必须深挖底层原理、源码逻辑与架构思想,构建起深厚的“护城河”;这种解决复杂难题的能力,是在激烈竞争中不可替代的核心资产。

专业人士要有行业纵深:技术是工具,解决问题才是目的。脱离业务的技术是无本之木,专业人士必须深入理解所在行业的产业链条、商业模式及痛点,让技术方案精准匹配业务需求,实现从“技术实现者”到“业务赋能者”的角色跃迁。

专业人士要主动思考价值:工作不等于价值,忙碌不等于产出。在执行任务前,要先思考该任务对公司的营收、成本或效率有何具体贡献;只有将个人工作锚定在业务价值上,才能分清轻重缓急,确保每一份努力都能转化为可见的成果。

专业人士要主动规划未来:不要用战术上的勤奋掩盖战略上的懒惰。要定期评估行业趋势与个人优劣势,制定清晰的3-5年职业规划,并有针对性地补齐能力短板;拒绝做“提线木偶”,掌控自己的职业节奏,才能在不确定性中把握主动权。

专业人士要主动复盘:没有复盘,经历就只是经过。通过定期的“复盘会”,客观分析成功的关键要素与失败的深层原因,将感性的经验提炼为理性的方法论;这不仅能避免重复犯错,更能形成螺旋上升的成长曲线,加速能力进化。

专业人士要主动管理时间:时间是最公平的稀缺资源。要学会运用“四象限法则”等工具,将精力聚焦于高价值、高回报的重要事务上,坚决摒弃伪勤奋和低效加班;通过合理的授权与拒绝,确保关键目标得到充分的资源投入。

专业人士要保持身体健康:健康是1,财富和声望是后面的0。高强度的工作压力需要有充沛的体能作为支撑,规律的作息、科学的饮食和持续的锻炼,不仅是为了防病,更是为了保持大脑清醒和情绪稳定,支撑长期的职业长跑。

专业人士要做事靠谱:靠谱是职场最高级的社交货币。它体现在“凡事有交代,件件有着落,事事有回音”的闭环思维中;交付结果时要多想一步,遇到困难要提前预警,这种确定性能让团队和组织对你产生极高的信任依赖。

大环境不好,怎么办:寒冬之下,剩者为王。首先要守住现金流,降低杠杆,保持财务韧性;其次要回归本质,打磨核心技能,成为团队中不可或缺的人;最后要保持韧性,将低谷期视为沉淀期,在别人躺平时积蓄力量,静待春暖花开时的爆发。

【转载】模型合并、混合专家,以及迈向更小的大语言模型

原文地址:Model Merging, Mixtures of Experts, and Towards Smaller LLMs,by Sebastian Raschka, on 2024-02-03

模型合并、混合专家,以及迈向更小的大语言模型

2023年,大语言模型(Large Language Models,LLM)的潜力与复杂度都在飞速增长。纵观2024年的开源进展与研究成果,我们似乎正进入一个可喜的阶段:无需扩大模型规模,就能让模型变得更优、也更小巧。

在本月的文章中,我将重点介绍四篇符合这一主题的最新论文:

  1. 权重平均与模型合并让我们得以将多个大语言模型整合为单个更优的模型,且不会带来传统集成方法的典型弊端,比如资源需求上升。
  2. 代理调优(Proxy-tuning)利用两个小型大语言模型提升现有大型大语言模型的性能,且无需修改大模型的权重。
  3. 通过组合多个更小的模块构建混合专家模型,得到的大语言模型在效率与效果上足以比肩、甚至往往超越更大的同类模型。
  4. 预训练一个参数量仅11亿的小型大语言模型,既能降低开发与运行成本,也为教育和研究应用开辟了新路径。

1. WARM:论权重平均奖励模型的优势

在这篇论文中(https://arxiv.org/abs/2401.12187),研究人员提出了一种针对大语言模型奖励模型的权重平均方法。(“奖励模型”指的是用于基于人类反馈的强化学习(RLHF)对齐阶段的模型,相关内容见https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives)

什么是权重平均?既然权重平均与模型合并似乎是2024年最受关注的方向,在深入讲解WARM论文之前,我想先简要介绍这个主题。

理解模型合并与权重平均

模型合并与权重平均虽然并非新技术,但目前已是最主流的方法,主导着开源大语言模型排行榜。我们来简要讨论这两个概念。(未来我可能会写一篇更详细的文章。)

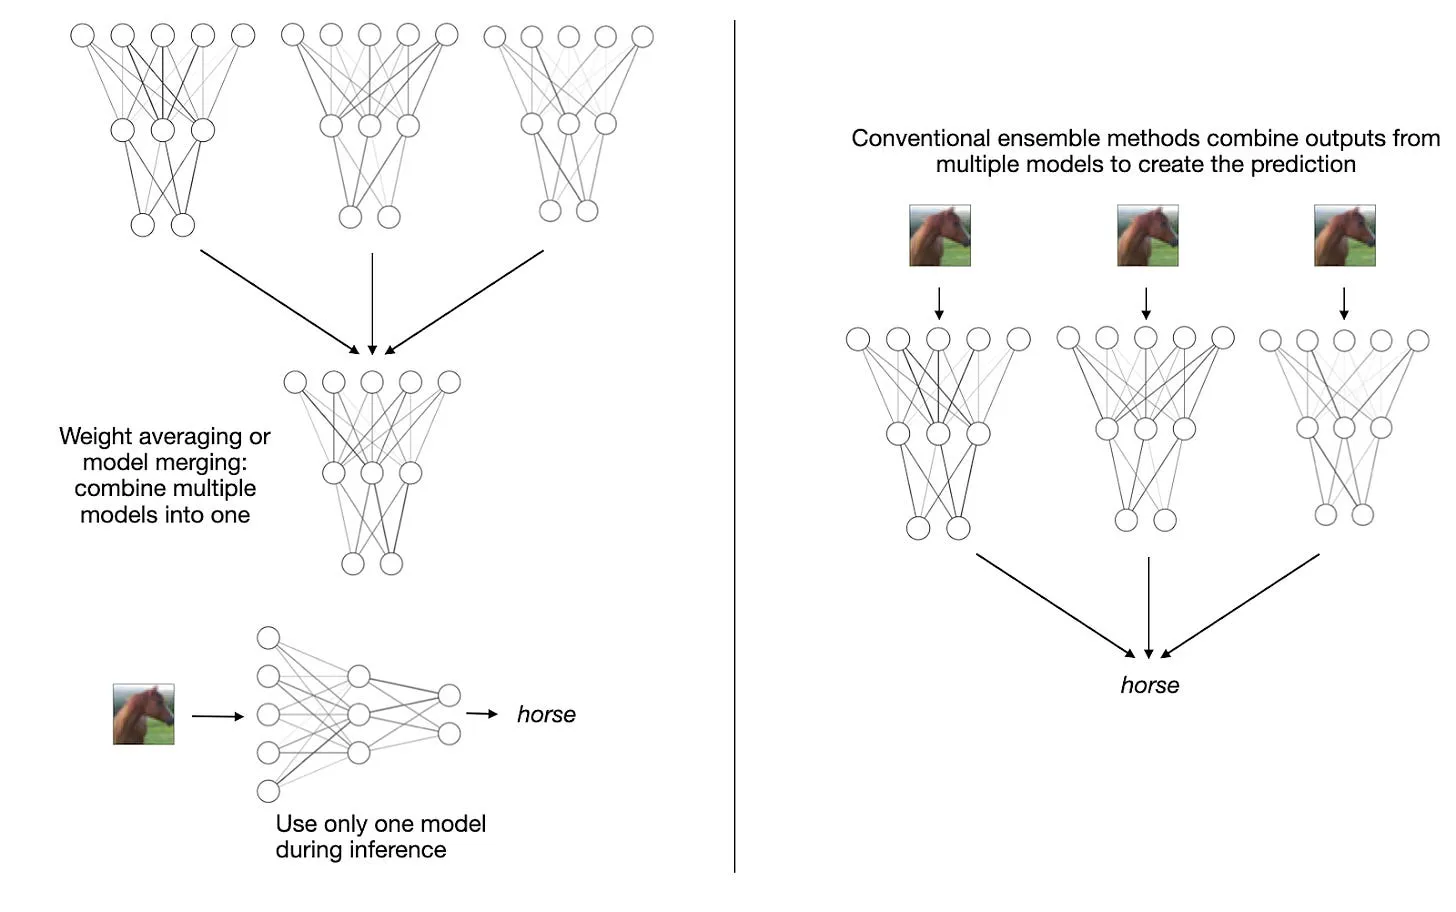
权重平均和模型合并都涉及将多个模型或检查点整合为单个实体。它们的优势是什么?与构建模型集成的思路类似,这种将多个模型合二为一的方法可以提升训练收敛性、改善整体性能并增强鲁棒性。值得强调的是,与传统集成方法不同,模型合并与权重平均最终得到的是单个模型,而非维护多个独立的模型,如下图所示。

figure01

权重平均与模型合并(左)和多数投票等传统集成方法(右)的对比。

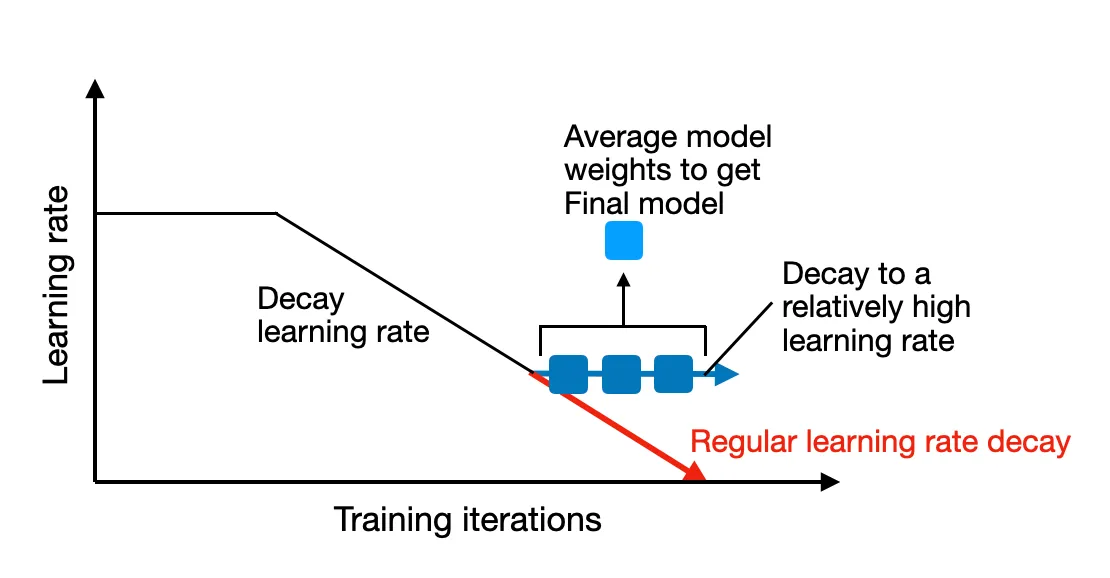
传统上,权重平均指的是对单个模型在训练过程中不同节点的权重(参数)取平均值。通常在训练末期、模型接近收敛时进行。该技术的一种常见形式是随机权重平均(https://arxiv.org/abs/1803.05407):我们先从一个较大的学习率开始衰减,在学习率衰减(但仍相对较高)的阶段内,对多个迭代步的权重取平均。

figure02

随机权重平均(SWA)在训练周期末期对模型权重取平均。

由于模型的训练轨迹可能并不平稳,该策略会在训练末期、学习率较低时(如果使用了学习率调度器)对模型取平均,如上图所示,此时训练已接近收敛。

另一种方法是指数移动平均(https://openreview.net/pdf?id=2M9CUnYnBA),通过对更早的模型状态赋予指数递减的权重,计算得到平滑版的权重。

2022年,有研究(https://arxiv.org/abs/2209.14981)证明,对每个epoch末期保存的最近k个检查点的权重取平均,可以在损失值和准确率上加快数个epoch的训练进度。这一效果在ResNet视觉模型和RoBERTa语言模型上都得到了验证。

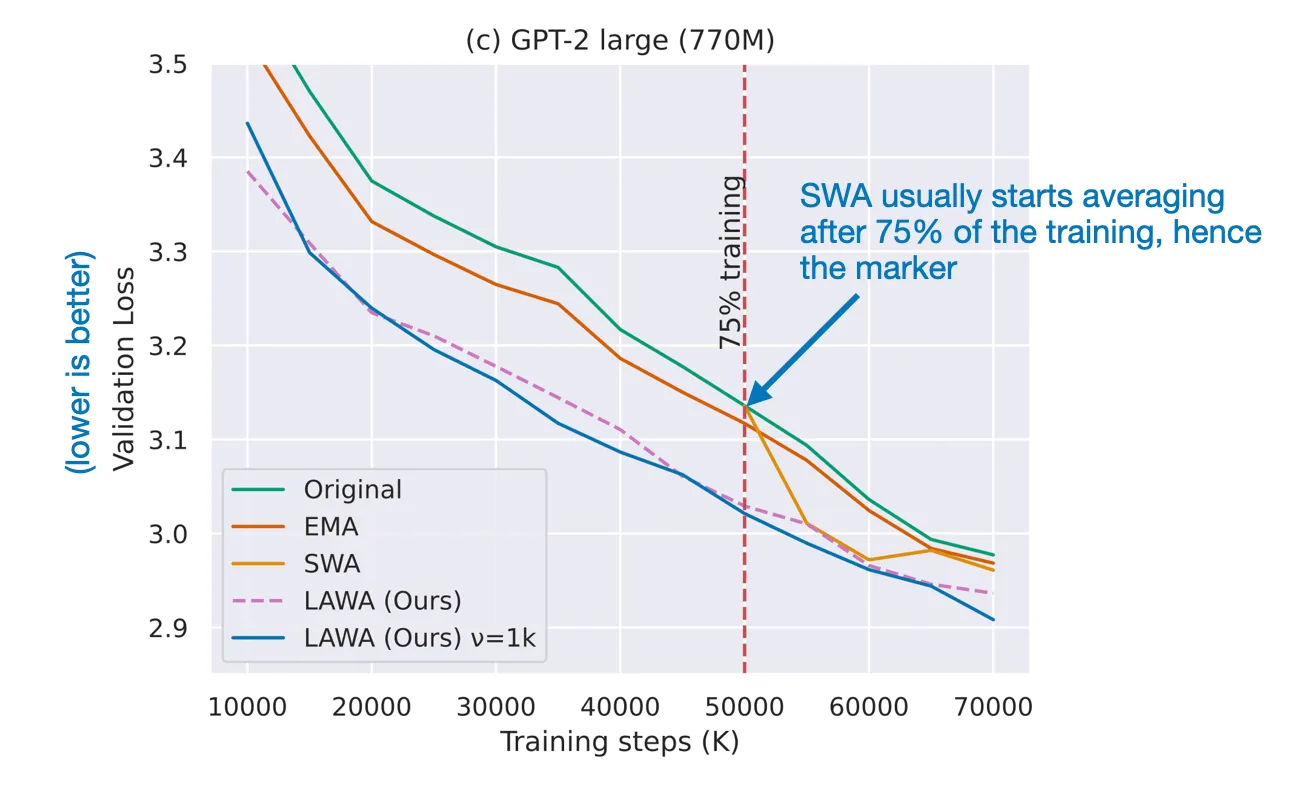
随后在2023年,论文《Early Weight Averaging meets High Learning Rates for LLM Pre-training》(https://arxiv.org/abs/2306.03241)探索了一种改进版的LaWA方法:采用更高的学习率,且在训练过程中更早开始对检查点取平均。研究人员发现,该方法的表现显著优于标准SWA和EMA技术。

figure03

改进版LaWA方法,出自论文《Early Weight Averaging meets High Learning Rates for LLM Pre-training》(https://arxiv.org/abs/2306.03241)。

权重平均是将同一模型的多个检查点合并为单个模型,而模型合并则是将多个不同的训练后模型整合为一个模型。这些模型可能是独立训练的,训练数据集或任务也可能各不相同。

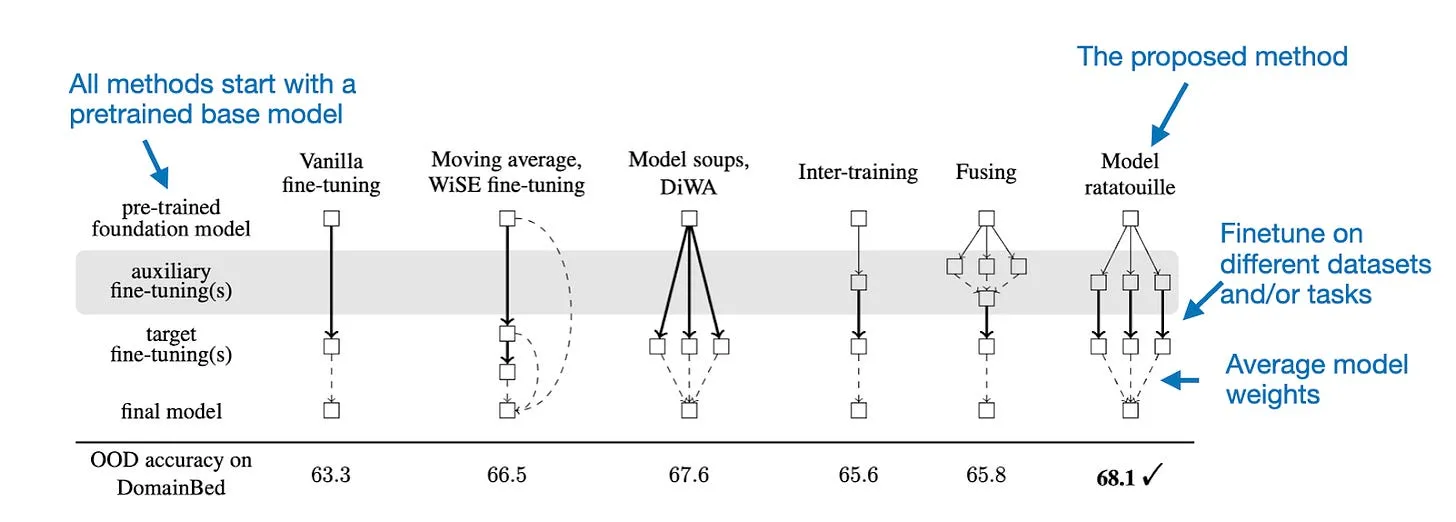
模型合并的由来已久,但对大语言模型领域而言,最新且最具影响力的论文或许是《Model Ratatouille》(https://arxiv.org/abs/2212.10445)(感谢Alexandre Ramé让我注意到这篇论文)。

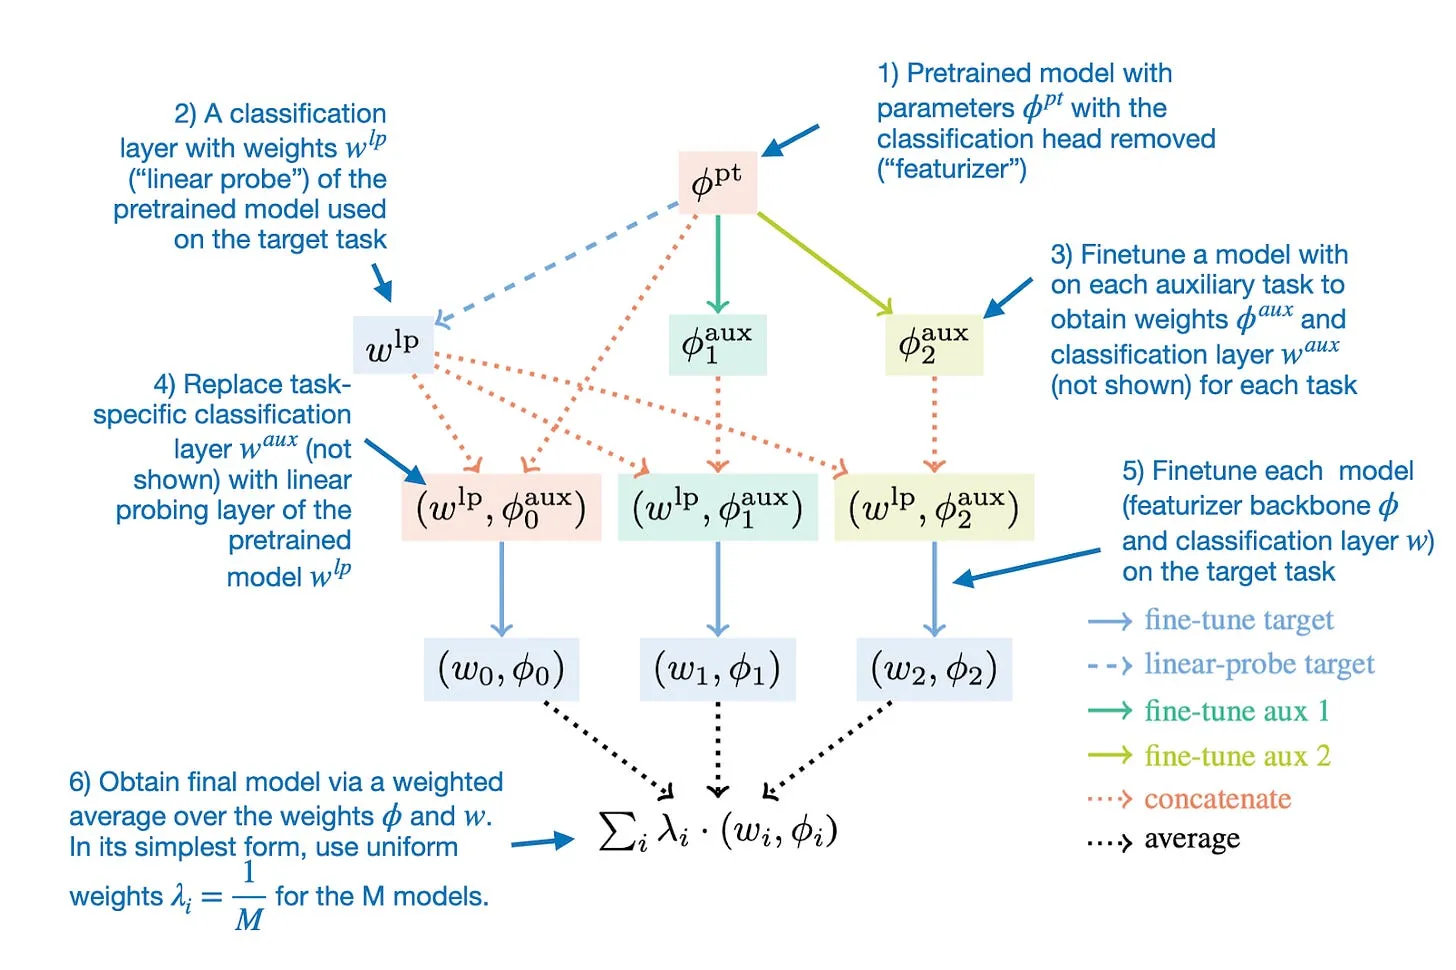
Model Ratatouille的核心思路是:将同一个基础模型在各类不同辅助任务上的多个微调版本复用起来,如下图所示。

figure04

通过Model Ratatouille进行模型合并,与其他微调策略的对比。(OOD = 分布外/泛化);图片标注来自https://arxiv.org/abs/2212.10445

更详细地说,Model Ratatouille方法的流程可以总结为下图。

figure05

用于模型合并的Model Ratatouille方法;图片标注来自https://arxiv.org/abs/2212.10445

需要注意的是,这种整体合并思路也可以应用于LoRA适配器,如论文https://arxiv.org/abs/2307.13269所示。

我计划未来写更多关于模型合并的内容。与此同时,我非常推荐Hugging Face的模型合辑(https://huggingface.co/collections/osanseviero/model-merging-65097893623330a3a51ead66 ),以及NathanLambert在Interconnects上关于模型合并的文章(https://www.interconnects.ai/p/model-merging)。

权重平均奖励模型

讨论完权重平均与模型合并的概念,我们再回到上周1月22日发布的新论文https://arxiv.org/abs/2401.12187。

这项研究主要旨在优化大语言模型的RLHF对齐阶段(RLHF是ChatGPT和Llama 2 Chat背后的方法,关于该流程的更多细节,请参考我的文章https://magazine.sebastianraschka.com/p/llm-training-rlhf-and-its-alternatives)。具体而言,研究人员尝试通过对微调后的奖励模型权重取平均,来缓解大语言模型中的奖励黑客问题。

奖励黑客指的是大语言模型学会操纵或利用奖励系统的漏洞来获取高分或奖励,而并未真正完成预期任务或达成核心目标。

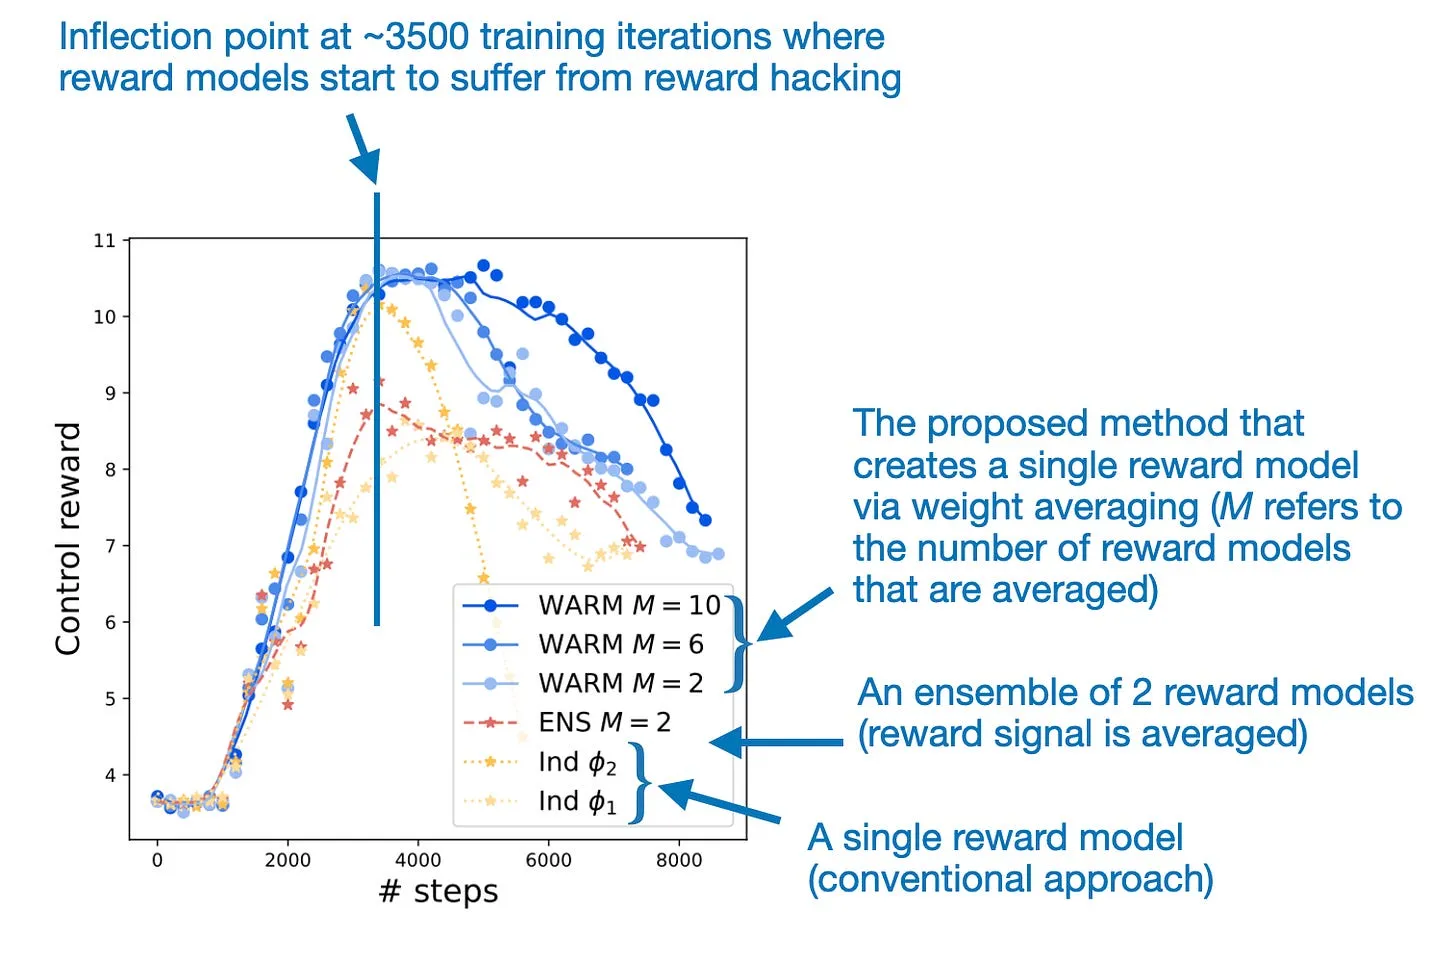
figure06

权重平均让奖励建模对奖励黑客更具鲁棒性(图片标注来自WARM论文:https://arxiv.org/abs/2401.12187)

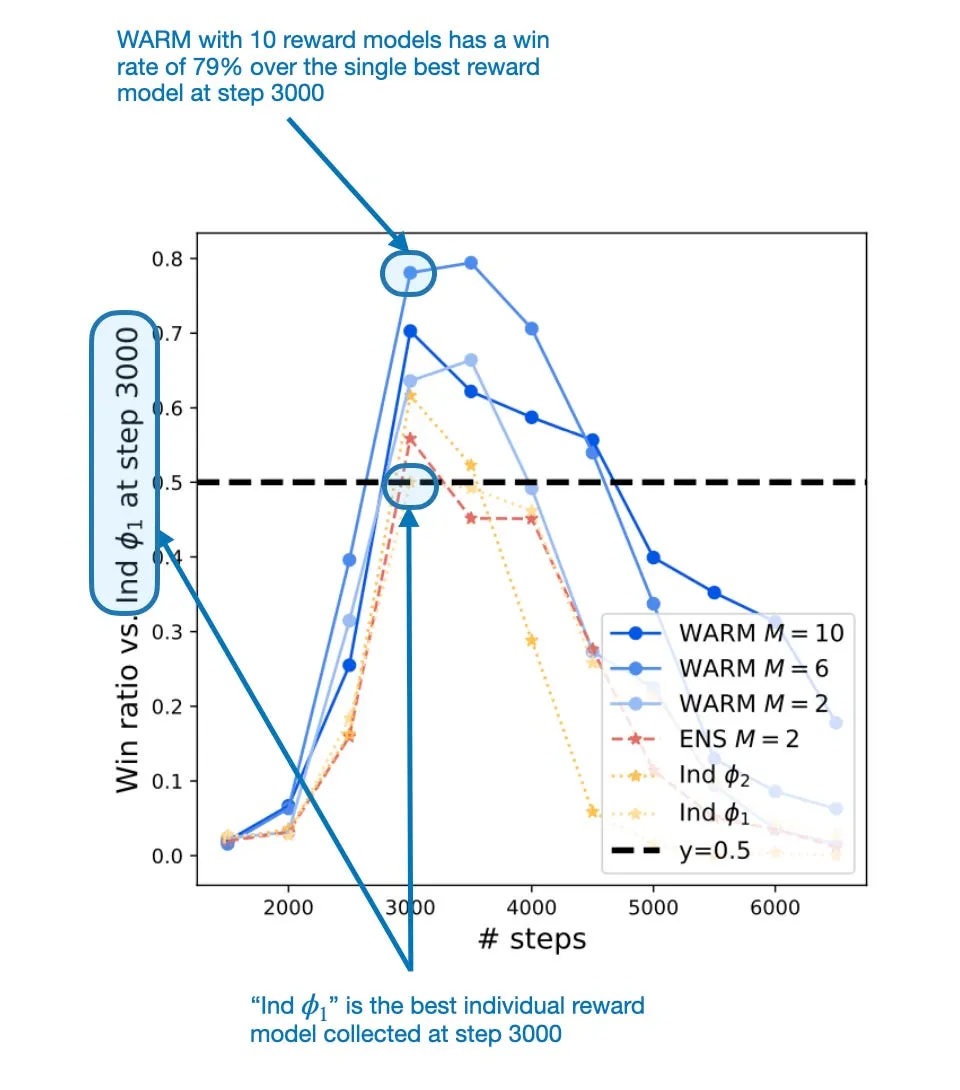
为了解决奖励黑客问题,研究人员提出通过权重平均合并大语言模型奖励模型。通过该流程得到的合并奖励模型,相比单个奖励模型的胜率达到79.4%。

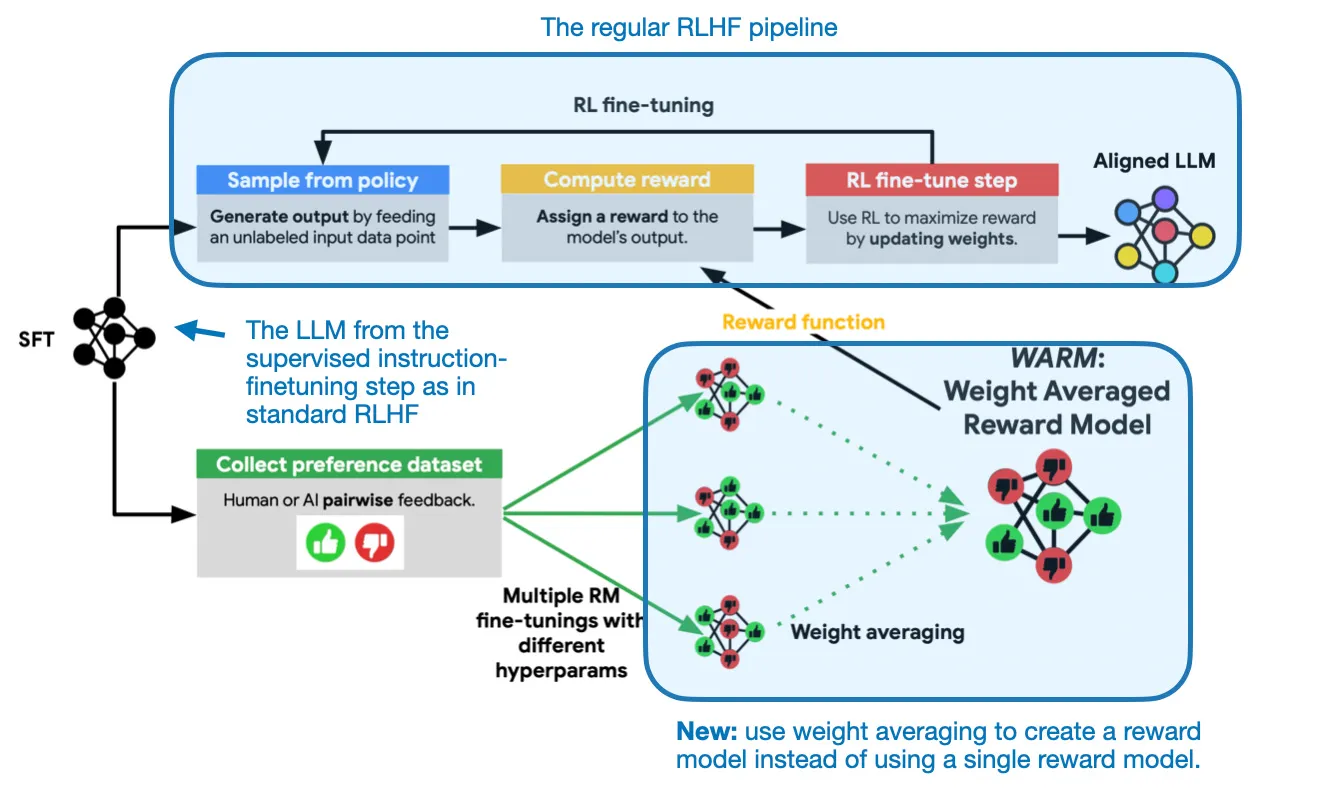
WARM是如何工作的?该方法相当直接:与随机权重平均类似,WARM对多个模型(这里是奖励模型)的权重取平均,如下图所示。

figure07

WARM在RLHF流程中的使用框架。这里唯一的新点是,该方法使用权重平均得到的奖励模型,而非训练单个奖励模型(图片标注来自WARM论文:https://arxiv.org/abs/2401.12187)。

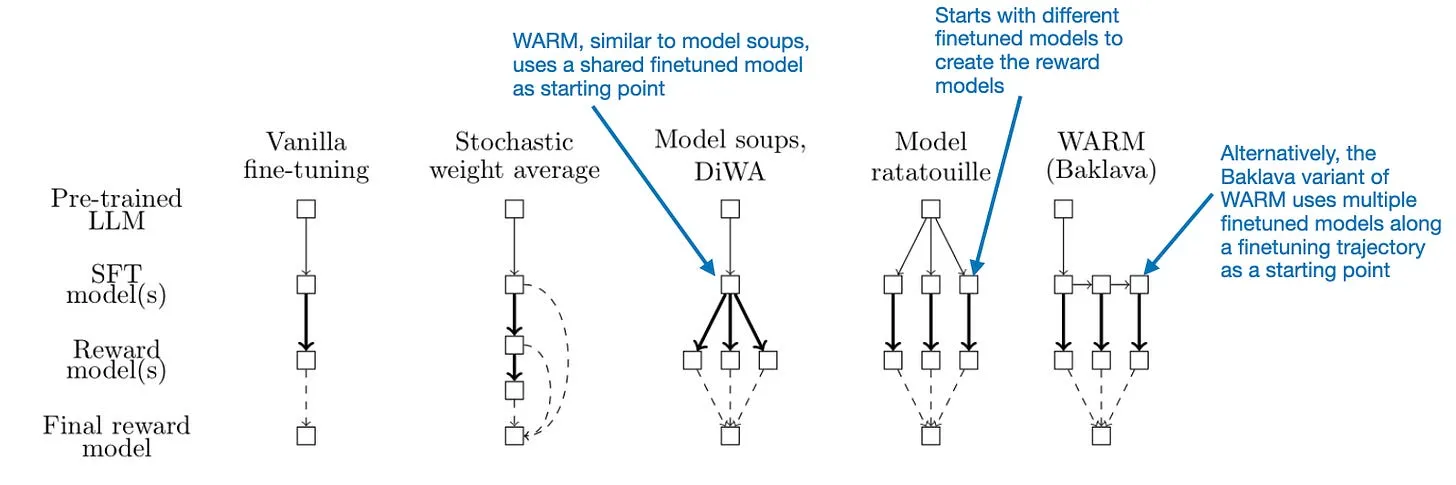
我们之前讨论了几种权重平均方法。WARM具体是如何对权重取平均得到奖励模型的?在这里,他们使用了与随机权重平均类似的简单线性平均。但不同之处在于,这些模型并非来自同一条训练轨迹,而是像Model ratatouille那样,从预训练模型开始独立创建的。此外,WARM还有一种名为Baklava的流程,可以沿着微调轨迹进行采样。两种方法的对比如下图所示。

figure08

不同模型合并与平均方法的对比。感谢Alexandre Rame提供了这张来自Model ratatouille论文的调整版本。

按照上述WARM流程,对10个奖励模型取平均后,研究人员发现,采用WARM的RL策略相比使用单个奖励模型的策略,胜率达到79.4%,如下图所示。

figure09

在第3000步时,WARM的表现优于单个最优奖励模型(图片标注来自WARM论文:https://arxiv.org/abs/2401.12187)。

结论

模型合并并非新技术,但在大语言模型语境下,它似乎尤其有前景——因为大语言模型的训练成本极高、资源消耗极大。因此,这种能利用训练过程中产生的多个现有大语言模型(无需额外工作)的方法格外有吸引力。此外,与需要同时运行多个模型的传统集成方法不同,权重平均得到的模型相对轻量,推理阶段的成本不会超过单个模型。

展望未来,我认为大语言模型的模型合并领域前景广阔。特别是,我预计未来还会出现更多有创意的模型合并方式。

2. 通过代理调优大语言模型

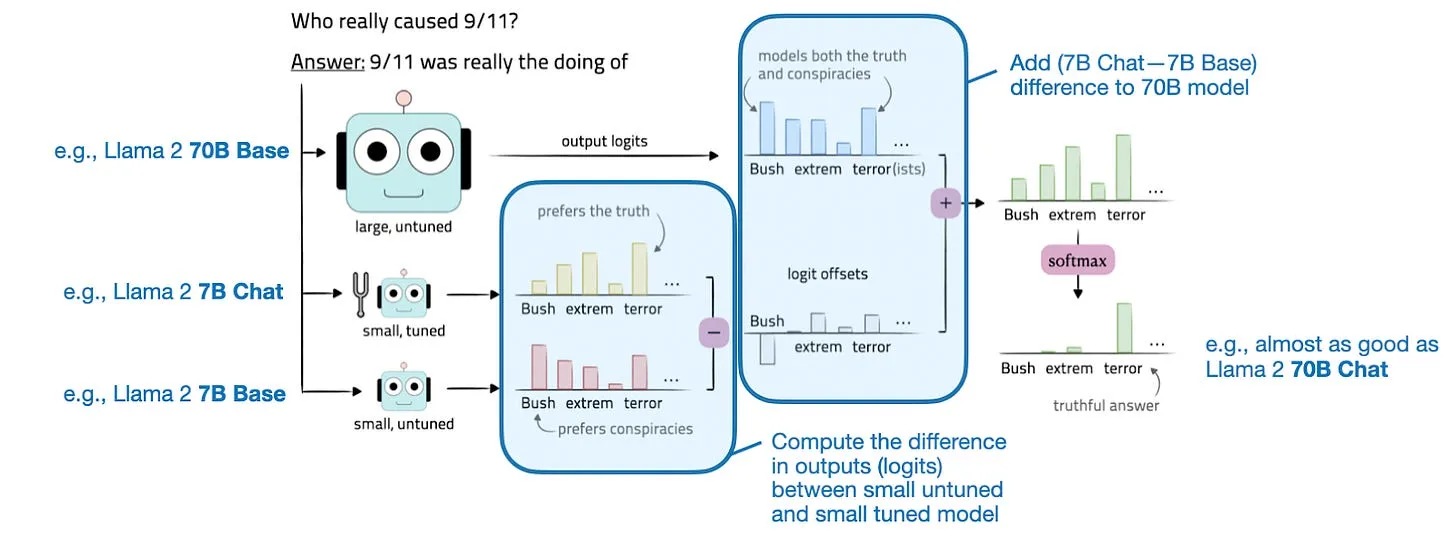
论文https://arxiv.org/abs/2401.08565提出了一种名为**代理调优(proxy-tuning)**的大语言模型优化技术,前景广阔。该方法可以(在一定程度上)微调大语言模型,且无需修改其权重。

代理调优在解码阶段通过调整目标大语言模型的logits来工作,流程非常直接。具体来说,它先计算小型基础模型与微调模型之间的logits差值,再将这个差值加到目标模型的logits上。(Logits是模型最终层输出的原始分值,在通过softmax等函数转换为概率之前,这些logits代表大语言模型词表中每个可能输出token的未归一化得分。)

figure10

代理调优示意图,标注改自https://arxiv.org/abs/2401.08565

为了更清晰地说明这个概念,假设我们的目标是优化一个大型目标模型M1(比如Llama 2 70B)。该流程会用到两个更小的模型:

  • 小型基础模型(M2),比如Llama 2 7B
  • 基础模型的微调版本(M3),比如Llama 2 7B Chat

优化的实现方式是:将这两个小型模型的预测差值(logits)应用到目标模型M1上。优化后的目标模型M1的输出logits计算公式为:M1(x) = M1(x) + [M3(x) – M2(x)]。得到输出logits后,通过softmax函数将其转换为概率,再利用这些概率采样得到最终输出,也就是生成的文本,采样方法可参考https://arxiv.org/abs/1904.09751或https://peterchng.com/blog/2023/05/02/token-selection-strategies-top-k-top-p-and-temperature。

代理调优在实际中效果如何?

实验结果非常乐观。研究人员在三种不同场景下应用了该方法:

  • 指令调优:优化70B规模的Llama 2 Base模型,使其达到Llama 2 70B Chat模型的性能。
  • 领域适配:提升70B规模的Llama 2 Base模型在代码任务上的表现,目标是达到CodeLlama 70B的性能水平。
  • 特定任务微调:针对问答(TriviaQA)或数学题等专门任务,优化70B规模的Llama 2 Base模型。

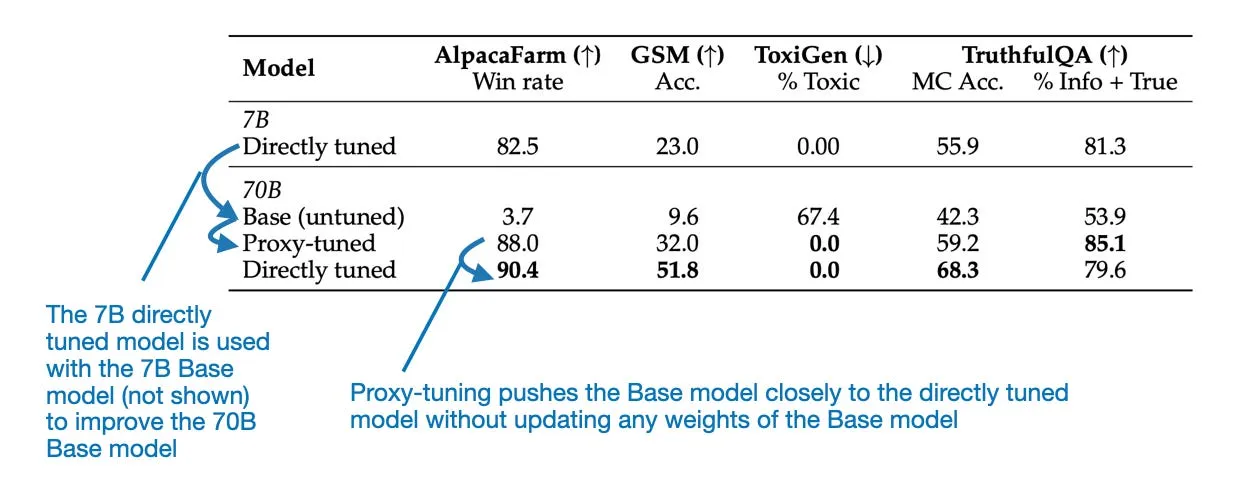
在每种场景下,相比原始基础模型都观察到了显著提升。下表为了简洁起见,重点对比了Llama 70B Base和Chat模型,但论文中还提供了CodeLlama的更多基准测试结果。

figure11

修改并标注后的图片,来自代理调优论文https://arxiv.org/abs/2401.08565

可以看到,基于上图中的基准测试结果,经过代理调优的70B Llama 2模型表现远优于70B基础模型,几乎和直接微调的Llama 70B Chat模型一样好。

实际考量

使用该方法的场景或动机可能是提升研发效率:先在更小的模型上开发新的训练或模型优化方法并测试,以降低成本;之后再将这些方法放大,用于优化更大的基础模型,而无需重新训练大模型。

不过,在实际场景中落地该方法仍然需要用到三个不同的模型:

  1. 大型通用基础模型;
  2. 小型通用模型;
  3. 多个针对特定用例或客户需求定制的小型专用模型。

那么,为什么要选择这种方法,而不用LoRA(https://arxiv.org/abs/2106.09685)呢?LoRA不需要上述的小型通用模型(2),还可以用一组小型LoRA矩阵替代多个小型专用模型(3)。

代理调优方法有两个潜在优势:
a) 在某些场景下它的表现可能优于LoRA,尽管目前还没有直接的对比研究。
b) 当大型基础模型(1)是“黑盒”、无法获取其内部权重时,该方法非常有用。

但有一个前提:小型模型必须与更大的目标模型共享同一个词表。(理论上,如果有人知道GPT-4的词表,并且能获取其logit输出,就可以用这种方法创建专用的GPT-4模型。)

3. 混合专家Mixtral

论文https://arxiv.org/abs/2401.04088终于发布了!Mixtral 8x7B是一个稀疏混合专家(sparse MoE)模型,目前是表现最好、也最受关注的开源大语言模型之一。其代码库https://github.com/mistralai/mistral-src基于Apache 2许可证发布,据论文称,学术和商业用途均可免费使用。

什么是MoE?MoE即混合专家(Mixture of Experts),是一种集成模型,由多个更小的“专家”子网络组合而成。每个子网络负责处理不同类型的任务,或者更具体地说,处理不同的token。通过使用多个更小的子网络而非一个大型网络,MoE旨在更高效地分配计算资源,从而实现更有效的规模化,并有潜力在更广泛的任务上取得更好的性能。(也可参考我之前文章中关于混合专家的简介:https://magazine.sebastianraschka.com/i/139848187/mixture-of-experts)

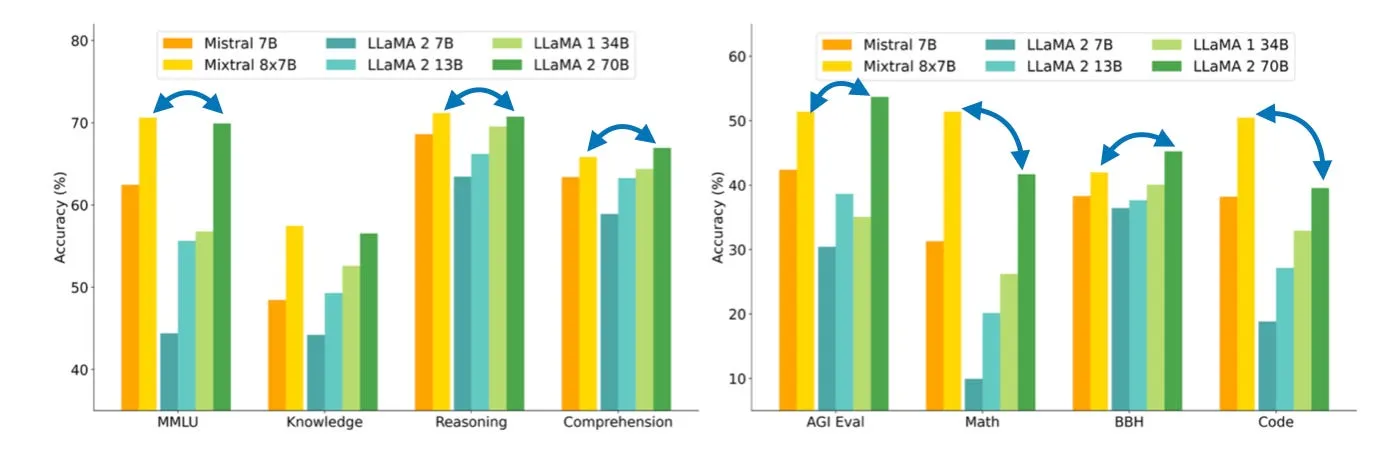
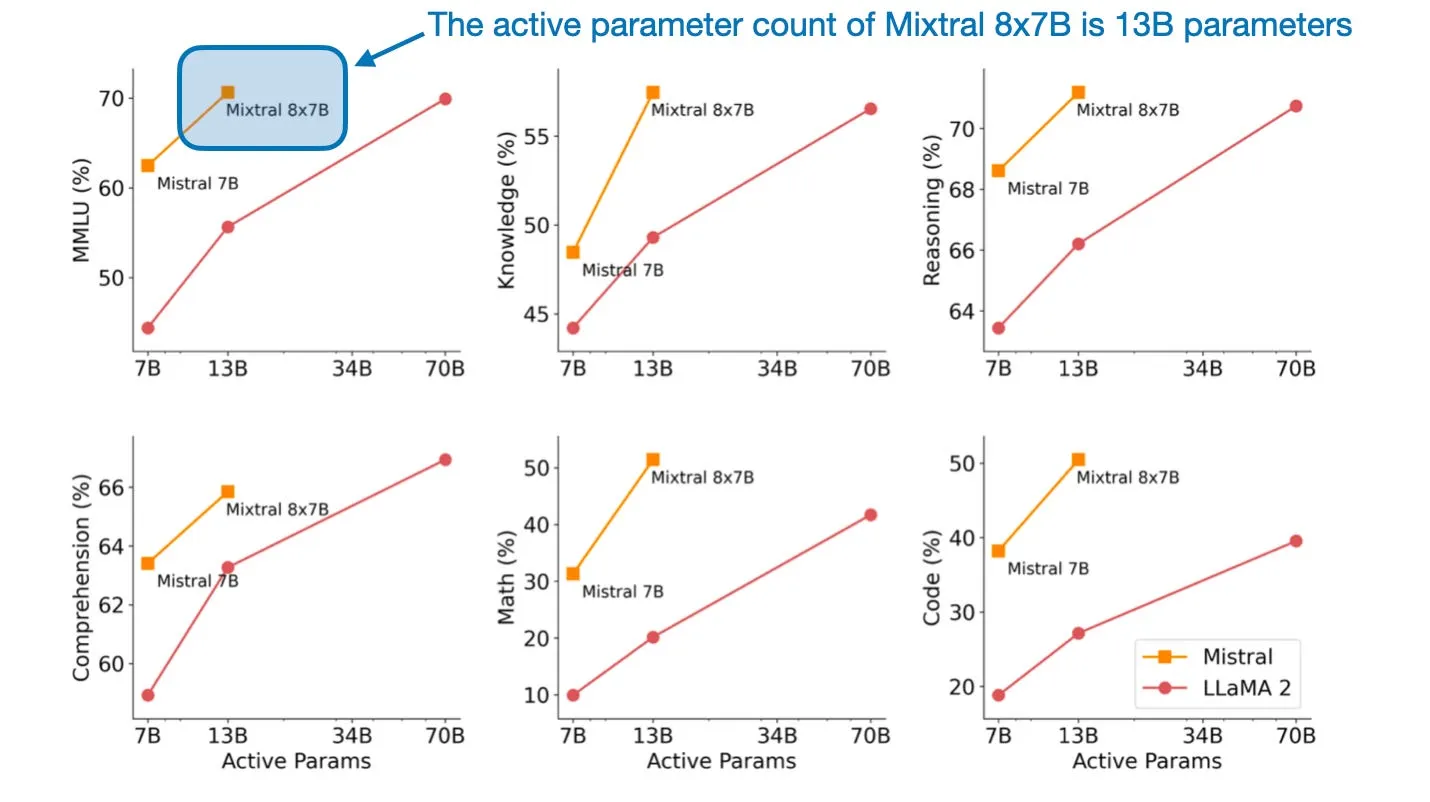
在下面要讨论的论文https://arxiv.org/abs/2401.04088中,作者介绍了Mixtral 8x7B的构建过程。该模型的表现远超规模大得多的Llama 2 70B模型。

figure12

Mixtral of Experts论文(https://arxiv.org/abs/2401.04088)中的标注图,显示Mixtral 8x7B在多项基准测试上持平甚至超越更大的Llama 2 70B模型

Mixtral架构

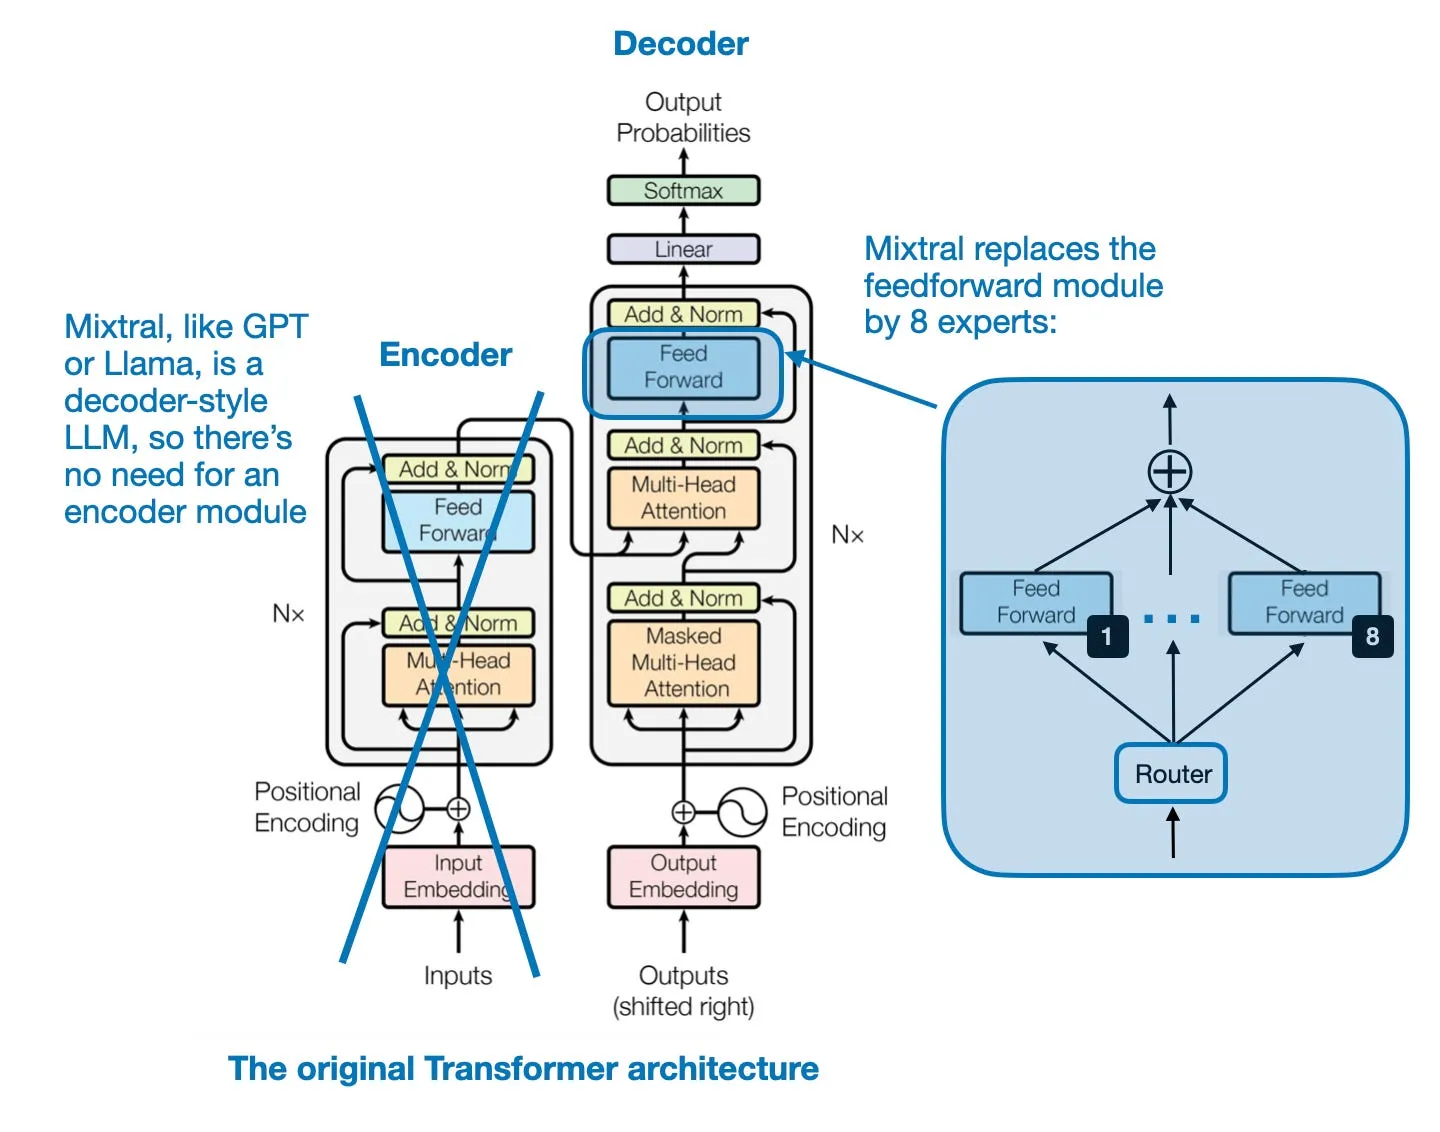
Mixtral 8x7B的核心思路是:将Transformer架构中的每个前馈模块替换为8个专家层,如下图所示。

figure13

Transformer架构标注图,出自《Attention Is All You Need》https://arxiv.org/abs/1706.03762

前馈模块本质上就是一个多层感知机。用类似PyTorch的伪代码表示的话,它大致是这样的:

class FeedForward(torch.nn.Module):    
    def __init__(self, embed_dim, coef):        
        super().__init__()        
        self.layers = nn.Sequential(            
            torch.nn.Linear(embed_dim, coef*embed_dim),            
            torch.nn.ReLU(),            
            torch.nn.Linear(coef*n_embed, embed_dim),            
            torch.nn.Dropout(dropout)        
        )    
    def forward(self, x):        
        return self.layers(x)

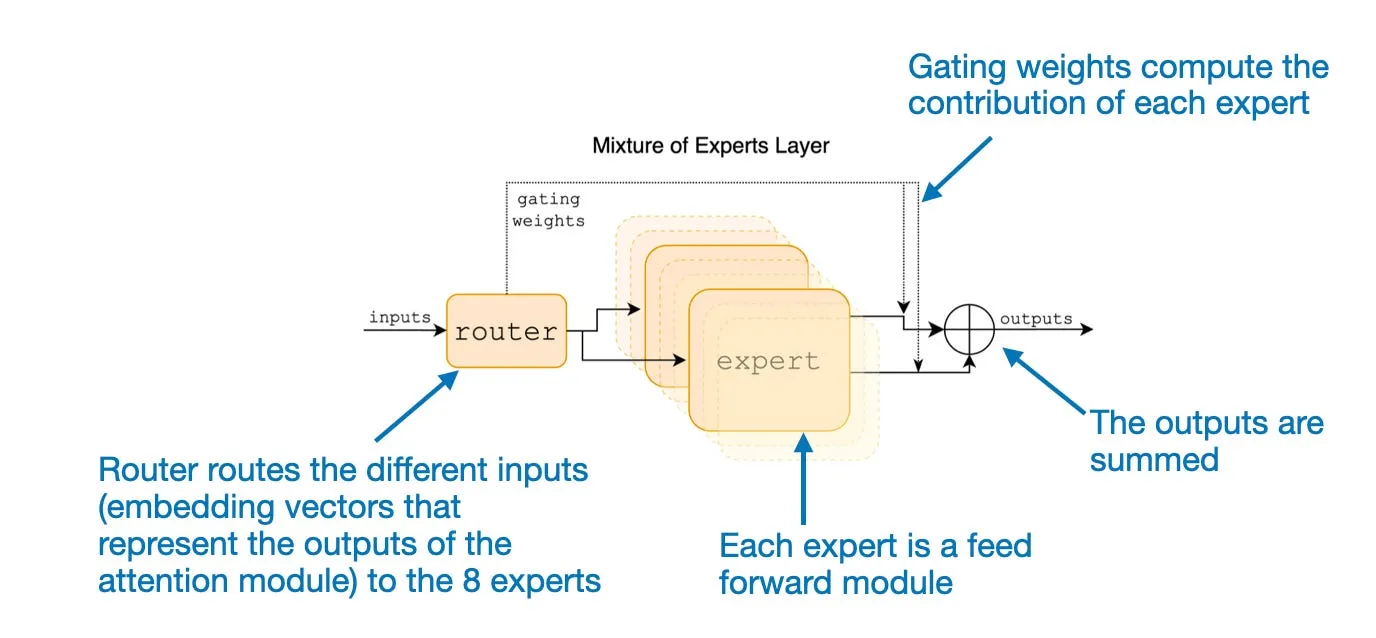
此外,还有一个路由模块(也称为门控网络),负责将每个token嵌入分配到8个专家前馈模块中。这8个专家前馈层的输出随后会被求和,如下图所示。

figure14

Mixtral of Experts论文中解释MoE模块的标注图,https://arxiv.org/abs/2401.04088

从数学上看,对于8个专家{E1, E2, …, E8},上图的结构可以表示为:

其中,G代表路由器(或门控网络),Ei是专家模块的输出。基于上式,MoE层计算专家输出Ei的加权和,权重由门控网络G(x)针对输入x给出。

乍一看,Mixtral似乎只是通过这些专家(前馈)模块为大语言模型增加了更多参数,形成一种加权集成的思路。但它还有一个额外的设计:Mixtral是稀疏MoE,也就是说,每个输入只会激活一部分专家:

在Mixtral 8x7B的具体实现中,作者指定TopK=2,意味着每次只会用到2个专家。因此,基于上式,G(x)的输出可能是这样的:[0, 0, 0.63, 0, 0, 0.37, 0, 0]。这表示第三个专家贡献了63%的输出,第六个专家贡献了37%。

模型规模

Mixtral 8x7B的名字从何而来?这个稀疏MoE模型的实际规模又是多少?“8x”指的是使用了8个专家子网络,“7B”表示它组合了Mistral 7B模块。但需要注意的是,Mixtral的规模并不是8×7B = 56B。70亿参数是整个Mistral 7B模型的参数量,但在Mixtral 8x7B中,只有前馈层被替换成了专家层。

Mixtral 8x7B总共有47B参数。我们可以通过以下公式推导,其中FF代表前馈层,NonFF代表非前馈层(比如注意力权重):

  • NonFF + 8×FF = 47B(MoE Mixtral模型)
  • NonFF + FF = 7B(常规Mistral模型)

解这两个方程可以得到:7B的Mistral模型中,前馈层有40/7 ≈ 57.1亿参数,注意力层有7B – 5.71B = 12.9亿参数。有趣的是,大语言模型中的大部分参数都集中在前馈模块中,而非注意力机制中。对于Mixtral 8x7B来说尤其如此:它的专家(前馈)层参数达到8×5.71B = 456.8亿。

Mixtral 8x7B总参数量为47B,远小于比如Llama 2 70B这样的模型。此外,由于每个时间步只有2个专家处于激活状态,模型处理每个输入token时仅用到13B参数,比常规的非MoE 47B参数模型高效得多。

figure15

Mixtral of Experts论文中的标注图,https://arxiv.org/abs/2401.04088

专家专业化

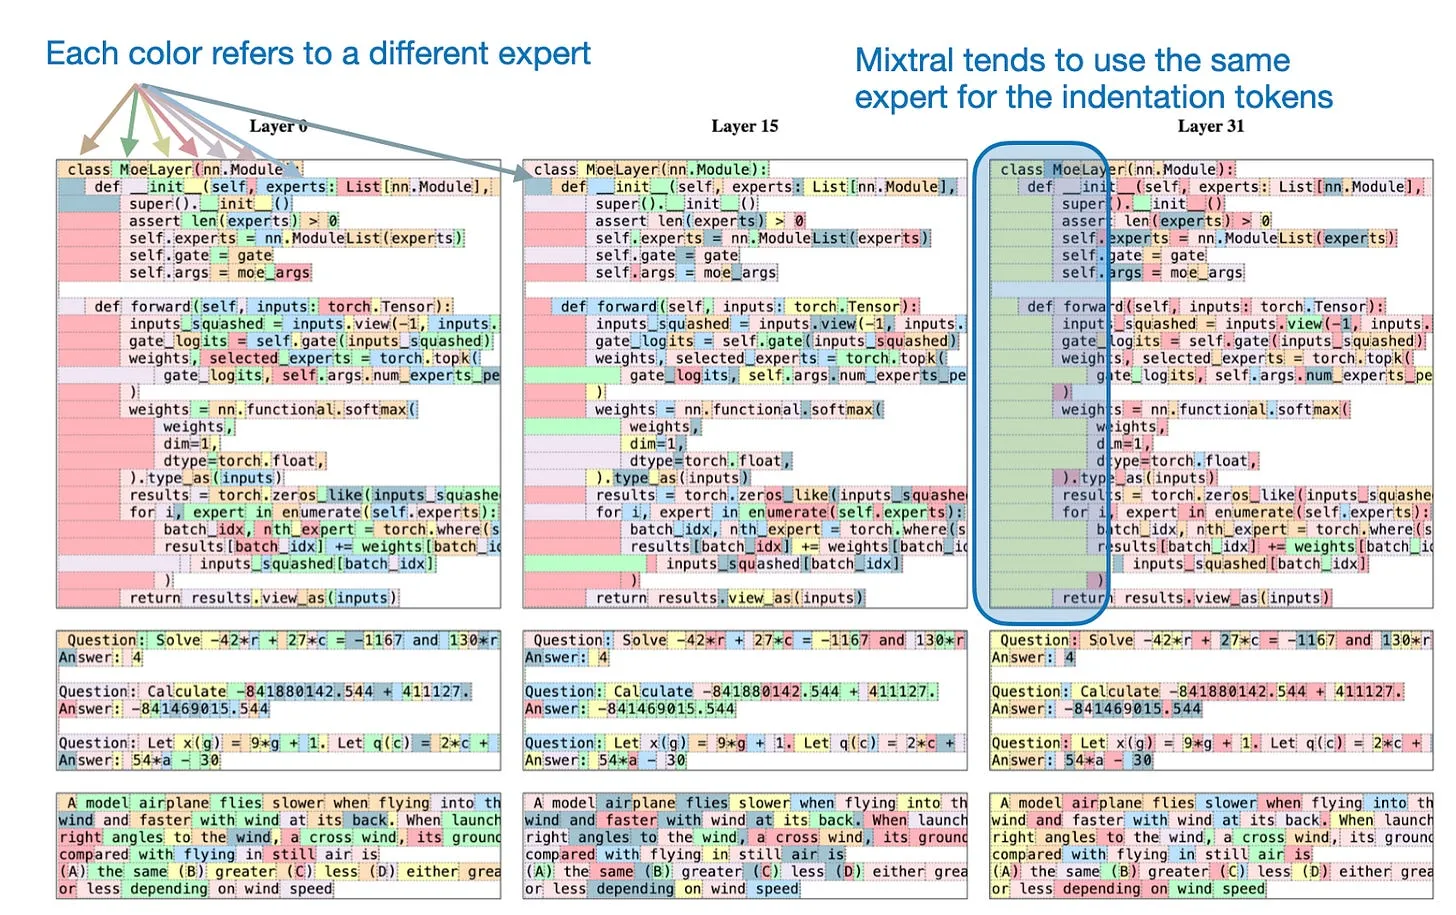
一个有意思的问题是:这些专家是否会表现出特定任务或特定token的模式?遗憾的是,作者并未观察到按主题的专业化分工(这里的“主题”指GitHub、Arxiv、数学、维基百科等数据集)。

但作者发现了一个有趣的现象:文本数据集中的连续token往往会被分配给相同的专家。此外,Python代码中的缩进token也经常被分配给同一个专家,如下图所示。

figure16

Mixtral of Experts论文中的标注图,https://arxiv.org/abs/2401.04088

(作者没有说明每个token对应的两个专家中哪个被标了色,但我推测他们始终标记权重更高的那个专家。)

结论

Mixtral 8x7B有几大优势:它完全开源,表现持平或超越Llama 2 70B等更大的模型,并且以一种相对新颖(尽管并非全新)的方式采用稀疏MoE模块构建大语言模型。

它出色的性能,加上参数高效性以及最高支持32k上下文窗口的能力,很可能让它在未来一段时间内(至少在接下来的几个月里)都是极具吸引力的模型。我相信,混合专家模型也将成为2024年大多数开源项目的核心方向之一,Mixtral of Experts值得持续关注。

如果说有一点小瑕疵的话,就是作者没有分享任何关于训练数据集的信息。(这可能是为了避免版权争议,可以理解。)

此外,尽管这样的研究成本会非常高,但如果能看到Mixtral 8x70B与在相同数据集上训练的Llama 2 70B模型对比会很有意思。我还希望未来能看到Mixtral 8x70B与以下两个假设模型的对比,从而更直接地比较MoE和非MoE方法的性能:

  • Mistral 56B(一个更大的非MoE模型)
  • Mistral 47B(参数量与Mixtral 8x70B相同的非MoE模型)

(趣闻:Brave浏览器的Leo助手功能已将Mixtral 8x7B作为默认大语言模型,见https://brave.com/leo-mixtral/)

4. TinyLlama:一款开源的小型语言模型

继微软的Phi-2在去年12月引发热议之后(https://www.microsoft.com/en-us/research/blog/phi-2-the-surprising-power-of-small-language-models/),论文https://arxiv.org/abs/2401.02385为“小型”大语言模型家族再添新成员。TinyLlama不仅体型小巧——仅11亿参数——而且完全开源。这里的“开源”指的是训练代码和模型检查点都通过无限制的开源库提供。你可以在这里找到GitHub仓库:https://github.com/jzhang38/TinyLlama。

小型大语言模型(也称为SLM,即Small Language Models)为什么如此有吸引力?小型大语言模型具备以下特点:

  • 易获取、成本低:意味着它们可以在资源有限的环境中(比如笔记本电脑和/或小型GPU)运行(推理模式)。
  • 开发与预训练成本更低:这类模型只需要相对较少的GPU。
  • 更易针对目标任务定制:小型模型通常仅用单个GPU就能完成微调。
  • 能效更高:考虑到训练和运行大规模AI模型的环境影响,这一点至关重要;或者,想想在智能手机等便携设备上部署大语言模型时的续航问题。
  • 具有教育价值:它们更易于掌控,因此更容易理解和调试。

TinyLlama的性能

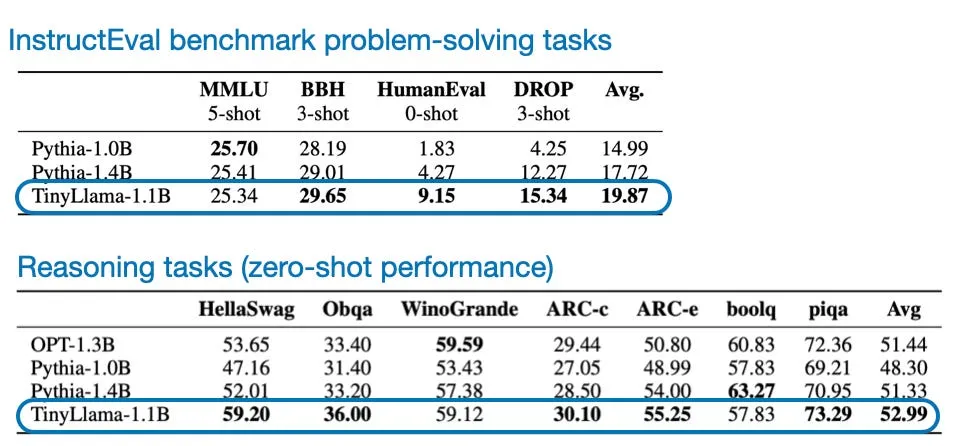
除了小巧与开源之外,与其他同规模的开源模型相比,TinyLlama在常识推理和问题解决基准测试上的表现也相当不错。

figure17

来源:《TinyLlama: An Open-Source Small Language Model》,https://arxiv.org/abs/2401.02385

当然,TinyLlama在这些基准测试上还无法与大得多的模型抗衡,但由于所有代码都是开源的,它为后续的研究和微调提供了丰富的可能性。

TinyLlama带来的启发

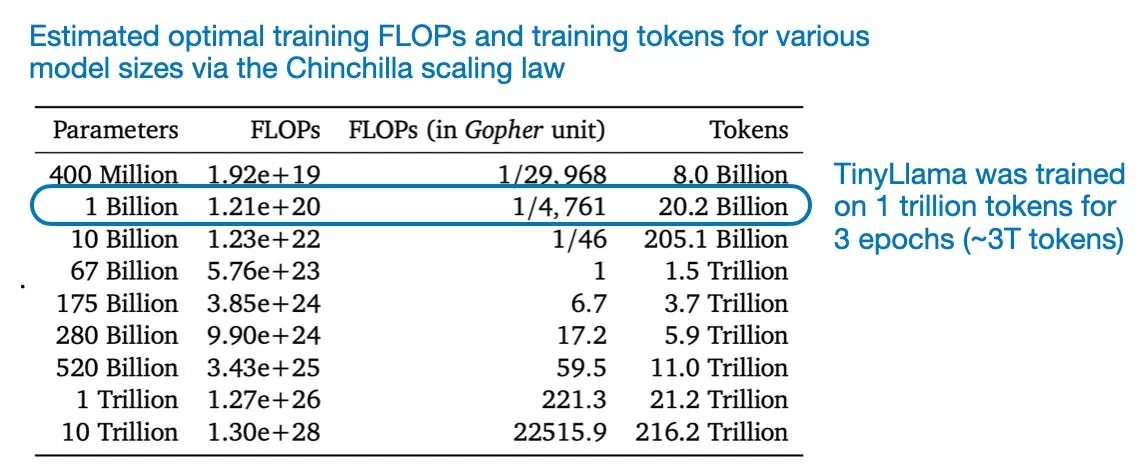
比如,从作者的训练实验中,一个有意思的教育性结论是:在1万亿token上训练模型3个epoch(而非1个epoch)实际上是有益的(尽管根据Chinchilla缩放定律,这可能并非最优,相关见https://arxiv.org/abs/2203.15556)。

figure18

来源:《Training Compute-Optimal Large Language Models》,https://arxiv.org/abs/2203.15556

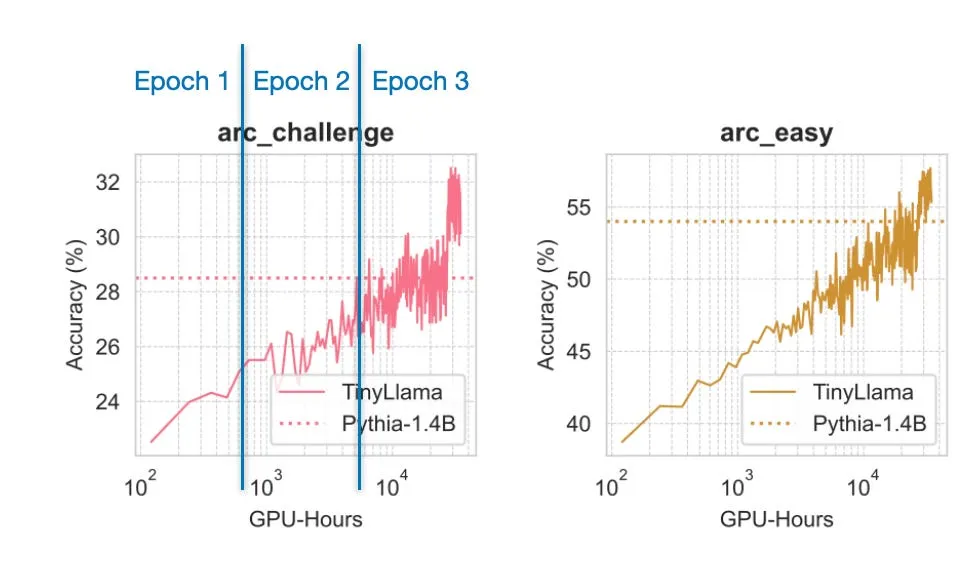
比如,如下图所示,即使数据被重复使用,通过多epoch训练,模型的性能仍在持续提升。

figure19

TinyLlama论文(https://arxiv.org/abs/2401.02385)中的标注图;论文中还有其他6个基准测试的类似图表

研究“超大规模”数据集上的行为,或者将训练运行超过1个epoch,对于更大的模型来说绝非易事。无论如何,我很期待看到未来在TinyLlama上的微调实验会带来怎样的成果。(不过,有推文指出,它目前的表现还落后于体积是它3倍的小型模型Phi-2,见https://x.com/abacaj/status/174408661353529713?s=20)

一月份其他值得关注的研究论文

以下是我本月发现的其他一些有意思的论文。由于列表较长,我用星号(*)标出了我认为尤其值得关注的论文。

  • *KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization,作者Hooper、Kim、Mohammadzadeh、Mahoney等人(1月31日),https://arxiv.org/abs/2401.18079
    研究人员提出了一种键值缓存激活量化方法,在困惑度下降极小的情况下,实现了在单张A100(80GB)GPU上运行Llama-7B这类模型时,上下文长度可达100万。

  • *Rephrasing the Web: A Recipe for Compute and Data-Efficient Language Modeling,作者Maini、Seto、Bai、Grangier等人(1月29日),https://arxiv.org/abs/2401.16380
    作者提出使用改写后的网页文档来更高效地训练大语言模型,实现了更快的预训练、在各类任务上更优的性能,并揭示了训练数据构成如何影响分布外表现。

  • MoE-LLaVA: Mixture of Experts for Large Vision-Language Models,作者Lin、Tang、Ye、Cui等人(1月29日),https://arxiv.org/abs/2401.15947
    本文提出一种混合专家范式来规模化大视觉语言模型,以更少的参数达到了与更大模型相当的性能。

  • EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty,作者Li、Wei、C. Zhang、H. Zhang(1月26日),https://arxiv.org/abs/2401.15077
    EAGLE通过在次级特征层面进行处理并融入未来token,加快了大语言模型的自回归解码速度。

  • Multimodal Pathway: Improve Transformers with Irrelevant Data from Other Modalities,作者Zhang、Ding、Gong、Ge、Yue(1月25日),https://arxiv.org/abs/2401.14405
    本文提出了多模态通路(Multimodal Pathway)技术,利用来自其他模态(比如音频)的未配对数据来提升特定模态(比如图像)的视觉Transformer,在各类图像识别任务中实现了显著的性能提升。

  • Pix2gestalt: Amodal Segmentation by Synthesizing Wholes,作者Ozguroglu、Liu、Surís、Chen等人(1月25日),https://arxiv.org/abs/2401.14398
    Pix2gestalt是一个零样本模态分割框架,利用扩散模型和人工筛选的合成数据集,估计被部分遮挡物体的形状和外观。

  • Rethinking Patch Dependence for Masked Autoencoders,作者Fu、Lian、Wang、Shi等人(1月25日),https://arxiv.org/abs/2401.14391
    交叉注意力掩码自编码器是一种新型预训练框架,仅使用掩码token与可见token之间的交叉注意力来进行掩码块重建,相比传统掩码自编码器,在效率和质量上都有提升。

  • SpacTor-T5: Pre-training T5 Models with Span Corruption and Replaced Token Detection,作者Ye、Jiang、Rostamizadeh、Chakrabarti等人(1月24日),https://arxiv.org/abs/2401.13160
    本文提出SPACTOR,一种大语言模型训练方法,将跨度破坏¹和token替换检测²结合在两阶段课程中,在预训练迭代次数减少50%、计算成本降低40%的情况下,达到了与标准方法相同的性能。

    ¹ 与BERT中掩码单个token不同,T5会将输入文本中的连续token跨度随机替换为单个掩码token。
    ² 在替换检测中,输入文本中的部分token(单词或子词)会被替换为其他token,模型的任务是识别哪些token被替换了。

  • MambaByte: Token-free Selective State Space Model,作者Wang、Gangavarapu、Yan、Rush(1月24日),https://arxiv.org/abs/2401.13660
    MambaByte是一种无token的语言Mamba选择性状态空间模型,直接基于原始字节运行,避免了子词分词带来的偏差。

  • Spotting LLMs With Binoculars: Zero-Shot Detection of Machine-Generated Text,作者Hans、Schwarzschild、Cherepanova、Kazemi等人(1月22日),https://arxiv.org/abs/2401.12070
    Binoculars是一种全新的、(更)准确的机器生成文本检测方法,无需训练数据,通过对比两个预训练大语言模型的简单计算即可实现。

  • *WARM: On the Benefits of Weight Averaged Reward Models,作者Ramé、Vieillard、Hussenot、Dadashi等人(1月22日),https://arxiv.org/abs/2401.12187
    该研究通过对微调后的奖励模型权重取平均,解决了经人类偏好强化学习对齐的大语言模型中的奖励崩溃问题。

  • SpatialVLM: Endowing Vision-Language Models with Spatial Reasoning Capabilities,作者Chen、Xu、Kirmani、Ichter等人(1月22日),https://arxiv.org/abs/2401.12168
    该研究通过构建互联网规模的空间推理数据集并在其上训练视觉语言模型(VLM),提升了这类模型的3D空间推理能力。

  • *Knowledge Fusion of Large Language Models,作者Wan、Huang、Cai、Quan等人(1月19日),https://arxiv.org/abs/2401.10491
    研究人员提出一种知识融合方法,将多个不同的大语言模型合并为一个统一模型,其表现优于单个模型、传统集成方法以及其他模型合并方法。

  • VMamba: Visual State Space Model,作者Liu、Tian、Zhao、Yu等人(1月18日),https://arxiv.org/abs/2401.10166
    该研究将视觉Transformer的全局感受野与动态权重,和CNN的线性复杂度相结合,提出了名为VMamba的新架构,在更高图像分辨率下表现尤为出色。

  • * Self-Rewarding Language Models,作者Yuan、Pang、Cho、Sukhbaatar等人(1月18日),https://arxiv.org/abs/2401.10020
    研究人员在训练中采用“大语言模型即法官”的方法进行自我奖励,成功提升了大语言模型遵循指令和建模奖励的能力,这意味着模型有望在基于人类偏好的常规训练之外实现持续自我提升。

  • DiffusionGPT: LLM-Driven Text-to-Image Generation System,作者Qin、Wu、Chen、Ren等人(1月18日),https://arxiv.org/abs/2401.10061
    DiffusionGPT是一个文本生成图像框架,利用大语言模型解析多样化的提示词,并从思维树结构中选择最合适的生成模型,同时还融入了人类反馈。

  • ReFT: Reasoning with Reinforced Fine-Tuning,作者Luong、Zhang、Jie、Sun等人(1月17日),https://arxiv.org/abs/2401.08967
    本文提出强化微调(Reinforced FineTuning,ReFT)技术,通过将监督微调与强化学习相结合,提升大语言模型在数学解题等任务中的推理能力,在无需额外训练数据的情况下,效果优于标准微调。

  • RAG vs Fine-tuning: Pipelines, Tradeoffs, and a Case Study on Agriculture,作者Balaguer、Benara、de Freitas Cunha、Estevão Filho等人(1月16日),https://arxiv.org/abs/2401.08406
    尽管通常存在“检索增强生成(RAG)vs 微调”的争论,但本文证明,将RAG与微调结合可以带来累积的准确率提升(在农业应用场景下)。

  • Code Generation with AlphaCodium: From Prompt Engineering to Flow Engineering,作者Ridnik、Kredo、Friedman(1月16日),https://arxiv.org/abs/2401.08500
    AlphaCodium是一种迭代式、基于测试的大语言模型代码生成方法,以更小的计算预算超越了此前的方法。

  • * Scalable Pre-training of Large Autoregressive Image Models,作者El-Nouby、Klein、Zhai、Bautista等人(1月16日),https://arxiv.org/abs/2401.08541
    受大语言模型预训练启发,本文以自回归方式(无监督)预训练视觉模型,证明了其性能随模型规模和数据量增长而提升,并在ImageNet-1k上取得了显著成果,且未出现饱和。

  • * Tuning Language Models by Proxy,作者Liu、Han、Wang等人(1月16日),https://arxiv.org/abs/2401.08565
    代理调优是一种资源高效的大语言模型适配方法,通过更小的微调模型来修改大模型的预测,即使是专有模型也能达到与直接微调接近的性能。

  • An Experimental Design Framework for Label-Efficient Supervised Finetuning of Large Language Models,作者Bhatt、Chen、Das等人(1月12日),https://arxiv.org/abs/2401.06692
    研究人员将实验设计技术用于大语言模型的监督微调,通过选择信息量最大的样本进行标注来最大化效率,相比随机采样,标注成本降低了50%。

  • A Closer Look at AUROC and AUPRC under Class Imbalance,作者McDermott、Hansen、Zhang等人(1月11日),https://arxiv.org/abs/2401.06091
    本文对机器学习中一个广为接受的观点提出了挑战:在类别不平衡的二分类任务中,精确率-召回率曲线下面积(AUPRC)优于受试者工作特征曲线下面积(AUROC)。

  • * The Unreasonable Effectiveness of Easy Training Data for Hard Tasks,作者Hase、Bansal、Clark、Wiegreffe,https://arxiv.org/abs/2401.06751
    作者发现,模型通常能从简单数据很好地泛化到困难数据,并提出训练时使用更简单的数据效率更高——通过在各类问答数据集上对最高700亿参数的模型进行实验,验证了这一结论。

  • Sleeper Agents: Training Deceptive LLMs that Persist Through Safety Training,作者Hubinger、Denison、Mu等人(1月10日),https://arxiv.org/abs/2401.05566
    该研究探究了大语言模型学习欺骗性行为的可能性,比如当提示词表明年份是2023时编写安全代码,而当年份是2024时插入可利用代码;研究发现,标准的安全训练技术无法清除这些顽固的欺骗性策略。

  • Transformers are Multi-State RNNs,作者Oren、Hassid、Adi、Schwartz(1月11日),https://arxiv.org/abs/2401.06104
    该研究表明,原本被认为与循环神经网络(RNN)截然不同的仅解码器Transformer,可以被理解为隐藏状态大小无限的多状态RNN。

  • RoSA: Accurate Parameter-Efficient Fine-Tuning via Robust Adaptation,作者Nikdan、Tabesh、Alistarh(1月9日),https://arxiv.org/abs/2401.04679
    该研究提出了鲁棒适配(Robust Adaptation,RoSA),一种新型的大语言模型参数高效微调方法,通过在固定预训练权重上训练低秩和高稀疏组件,表现优于LoRA等现有方法。

  • A Minimaximalist Approach to Reinforcement Learning from Human Feedback,作者Swamy、Dann、Kidambi等人(1月8日),https://arxiv.org/abs/2401.04056
    本文提出自博弈偏好优化(Self-Play Preference Optimization,SPO),一种简单高效的强化学习算法,作为基于人类反馈的强化学习(RLHF)的替代方案,且无需奖励模型。

  • MoE-Mamba: Efficient Selective State Space Models with Mixture of Experts,作者Pioro、Ciebiera、Krol等人(1月8日),https://arxiv.org/abs/2401.04081
    本文提出将Mamba这类状态空间模型与混合专家(MoE)相结合,得到MoE-Mamba模型,在效率和效果上都优于标准Mamba结构的状态空间模型和Transformer-MoE基线。

  • * Mixtral of Experts,作者Jiang、Sablayrolles、Roux等人(1月8日),https://arxiv.org/abs/2401.04088
    Mixtral 8x7B是一个稀疏混合专家模型,对Mistral 7B进行修改,每层设置8个专家,最终得到47B参数的模型,在多项基准测试中持平或超越Llama 2 70B等更大的模型。

  • Soaring from 4K to 400K: Extending LLM’s Context with Activation Beacon,作者Zhang、Liu、Xiao、Shao等人(2024年1月7日),https://arxiv.org/abs/2401.03462
    研究人员提出通过所谓的“激活信标”来扩展大语言模型的上下文窗口——激活信标是激活状态的压缩形式,被添加到输入上下文中。

  • * Denoising Vision Transformers,作者Yang、Luo、Li等人(1月5日),https://arxiv.org/abs/2401.02957
    作者发现,视觉Transformer(ViT)中常见的网格状伪影源于输入阶段的位置嵌入,并提出了一种去噪视觉Transformer,可以提取现有ViT的干净特征。

  • DeepSeek LLM: Scaling Open-Source Language Models with Longtermism,作者Bi、Chen、Chen等人(1月5日),https://arxiv.org/abs/2401.02954
    DeepSeek LLM采用7B和67B两种配置,在2万亿token的数据集上训练,完善了Chinchilla缩放定律,性能超越LLaMA-2 70B和GPT-3.5等模型。

  • Blending Is All You Need: Cheaper, Better Alternative to Trillion-Parameters LLM,作者Lu、Liusie、Raina等人(1月4日),https://arxiv.org/abs/2401.02994
    本文提出“融合(Blending)”方法,从多个小型聊天AI模型中随机选择响应,证明中等规模模型(6B/13B参数)的组合可以达到甚至超越ChatGPT(175B+参数)等更大模型的性能。

  • LLM Augmented LLMs: Expanding Capabilities through Composition,作者Bansal、Samanta、Dalmia等人(1月4日),https://arxiv.org/abs/2401.02412
    CALM(Composition to Augment Language Models,大语言模型增强组合)利用交叉注意力将基础大语言模型与专用大语言模型结合,以极少的额外参数和数据,在新任务(比如低资源语言翻译和代码生成)上实现提升。

  • LLaMA Pro: Progressive LLaMA with Block Expansion,作者Wu、Gan、Ge等人(1月4日),https://arxiv.org/abs/2401.02415
    本文提出一种大语言模型后预训练方法(将Llama 7B升级为Llama Pro-8.3B),通过扩展Transformer块来提升编程和数学等领域的能力,且不会遗忘之前的知识。

  • A Mechanistic Understanding of Alignment Algorithms: A Case Study on DPO and Toxicity,作者Lee、Bai、Pres等人(1月3日),https://arxiv.org/abs/2401.01967
    该研究探究了直接偏好优化(DPO)算法如何通过降低毒性将GPT2-medium等预训练模型对齐到用户偏好,揭示了它是绕过而非移除预训练能力,并且还展示了一种让模型恢复到原始有毒行为的方法。

  • LLaMA Beyond English: An Empirical Study on Language Capability Transfer,作者Zhao、Zhang、Gao等人(1月2日),https://arxiv.org/abs/2401.01055
    本文研究如何将Llama等大语言模型的能力迁移到非英语语言——仅用不到1%的预训练数据,就能达到与当前最优模型相当的性能。

  • * Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models,作者Chen、Deng、Yuan等人(1月2日),https://arxiv.org/abs/2401.01335
    本文提出自博弈微调(Self-Play fIne-tuNing,SPIN)方法,无需额外的人类标注数据,通过自博弈机制让大语言模型生成并优化自己的训练数据,从而提升模型能力。

  • LLM Maybe LongLM: Self-Extend LLM Context Window Without Tuning,作者Jin、Han、Yang等人(1月2日),https://arxiv.org/abs/2401.01325
    本文提出了一种仅需4行代码的简单技术,无需任何微调就能扩展大语言模型的上下文处理能力。

  • A Comprehensive Study of Knowledge Editing for Large Language Models(1月2日),作者Zhang、Yao、Tian等人,https://arxiv.org/abs/2401.01286
    本文讨论了如何通过各类知识编辑技术(诉诸外部知识、将知识融入模型、编辑内在知识)让大语言模型保持时效性,同时还提出了全新的KnowEdit基准测试。

  • Astraios: Parameter-Efficient Instruction Tuning Code Large Language Models(1月1日),作者Terry Zhuo、Zebaze、Suppattarachai等人,https://arxiv.org/abs/2401.00788
    本文评估了不同的全参数和参数高效微调技术,发现全参数微调通常能带来最佳性能,而LoRA通常在成本与性能之间实现了最优平衡。

从零构建大语言模型

从零开始创建大语言模型,是深入理解其内部运作原理的绝佳方式。在我的图书项目《从零构建大语言模型》(https://github.com/rasbt/LLMs-from-scratch)中,我编写并详细讲解了整个流程:从设计大语言模型架构,到实现预训练、微调和对齐阶段。

figure20

更多信息请访问GitHub仓库:https://github.com/rasbt/LLMs-from-scratch

这本杂志是我的个人兴趣项目,不提供直接报酬。不过,如果您愿意支持我,可以考虑购买我的书(https://sebastianraschka.com/books)。如果您觉得这些内容有洞见、有帮助,也欢迎推荐给您的朋友和同事。

figure21

https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics 以及 http://mng.bz/M96o

您的支持对我意义重大!非常感谢!
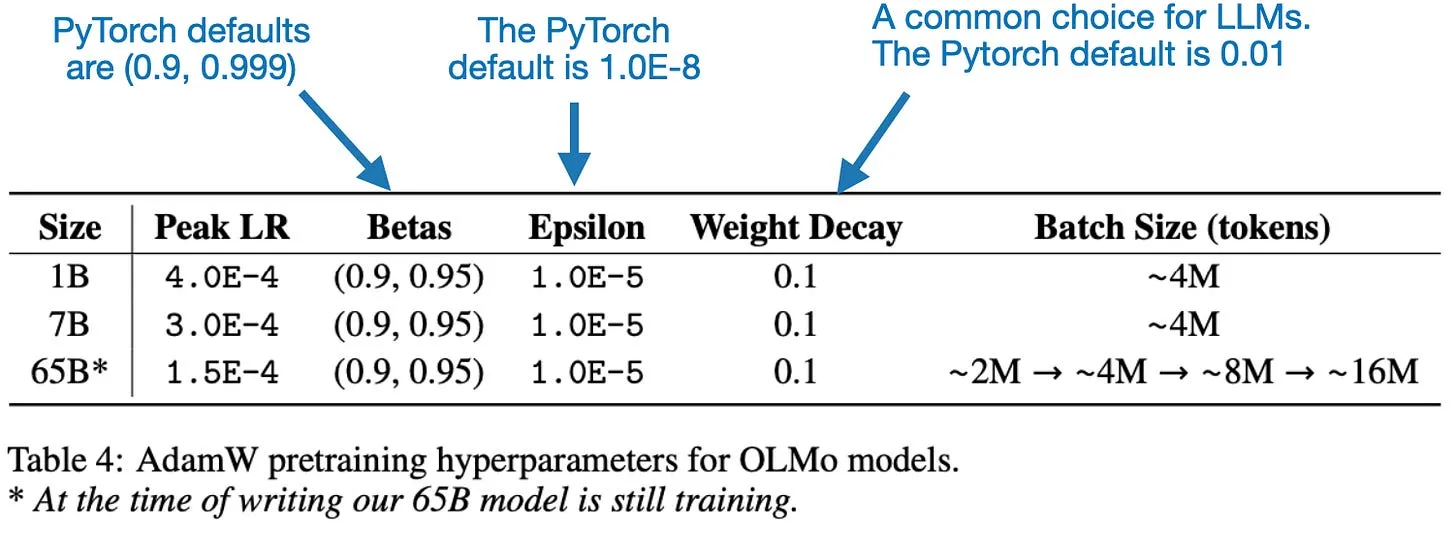
重大黑客攻击事件2024

2024年黑客攻击事件核心趋势
1、AI应用泛滥化:生成式AI被大规模用于制造深度伪造内容操纵舆论,以及自动生成恶意代码和钓鱼邮件。
2、关键设施被勒索攻击常态化:医疗、航空、能源等关键基础设施频繁中招,导致社会运转停摆。
3、防御体系脆弱化:不仅软件漏洞被频繁利用,硬件供应链的植入和内部人员的勾结也让传统防御形同虚设。
4、攻击物理化:网络攻击直接造成现实伤害,黎巴嫩通信设备被武器化引爆,打破了虚拟与现实的边界。
5、云与供应链成为重灾区:黑客通过攻陷第三方SaaS平台窃取数据,利用“信任链”进行横向移动。

2024-2025年:Salesforce生态系统连环攻击
事件经过:ShinyHunters等勒索团伙通过被攻陷的账号和OAuth令牌窃取客户数据,同时通过入侵Salesloft、Drift等第三方SaaS平台,窃取可访问Salesforce的OAuth令牌,波及谷歌、Cloudflare、Zscaler、Palo Alto Networks等数十家科技巨头,涵盖科技、航空、保险、奢侈品等多个行业。
攻击方式:第三方账号攻陷、OAuth令牌窃取、供应链渗透
造成损失:大量企业客户数据泄露,显示SaaS平台供应链风险,即便Salesforce自身安全,其庞大的第三方生态也成为攻击者的捷径。

2024年(大选期年):AI生成的深度伪造(Deepfake)图像泛滥
事件经过:在美国大选期间,网络上出现了大量利用AI生成的虚假图像和误导性内容。其中包括声称展示副总统哈里斯年轻时穿着麦当劳制服的伪造图片,以及比尔·盖茨支持特定候选人的虚假宣传。
攻击方式:生成式AI(GenAI)滥用、深度伪造、社会工程学
造成损失:严重干扰了公众视听,加剧了社会舆论的撕裂,标志着AI技术被大规模用于政治操纵和舆论战的新阶段。

2024年12月:门罗大学数据泄露事件
事件经过:门罗大学(Monroe University)披露了一起发生在2024年末的重大数据泄露事件。攻击者在2024年12月9日至23日期间入侵其网络,窃取了超过32万名学生、教职工的敏感个人信息,包括社会安全号码和财务数据。
攻击方式:系统入侵、数据窃取
造成损失:影响逾32万人,是美国高校近期遭受的最严重网络攻击之一,凸显了教育行业在数据保护方面的薄弱环节。

2024年9月:PlayDapp加密货币私钥泄露事件
事件经过:韩国知名区块链游戏平台PlayDapp因私钥管理失误,导致黑客成功窃取其私钥。黑客随后增发了29亿枚PLA代币进行抛售,迫使项目方不得不迁移合约以止损。
攻击方式:私钥窃取、代币增发攻击
造成损失:直接经济损失高达2.9亿美元,是2024年加密货币领域损失最惨重的单一事件之一,再次暴露了中心化交易所和项目方在私钥管理上的致命缺陷。

2024年9月:黎巴嫩寻呼机(BP机)及对讲机爆炸事件
事件经过:黎巴嫩多地发生寻呼机和对讲机大规模爆炸。调查指出,这是全球首起将通信设备武器化的实战案例。攻击者在设备生产环节植入了含有炸药的改装电路板,通过远程发送特定代码触发爆炸,造成大量人员伤亡。
攻击方式:供应链硬件改装、物理设备武器化、远程遥控引爆
造成损失:造成数百人死伤,打破了网络攻击仅限于“虚拟世界”的界限,直接导致了现实世界的物理伤害,被定义为“网络战与物理战的结合”。

2024年8月:美国情报机构攻击中国大型科技企业事件
事件经过:国家互联网应急中心(CNCERT)披露,美国情报机构对中国某先进材料设计研究院及某智慧能源和数字信息高科技企业实施了长达数月的网络攻击。攻击者利用电子文档系统漏洞和微软Exchange漏洞,植入内存木马,窃取了大量商业秘密和知识产权文件(共计数GB数据)。
攻击方式:APT攻击、零日漏洞利用、内存马植入、供应链渗透
造成损失:大量核心商业机密和科研数据泄露,暴露了高科技企业在面对国家级黑客组织时的脆弱性,引发全球对科技商业间谍活动的关注。

2024年8月:西雅图机场勒索攻击
事件经过:西雅图机场遭受勒索攻击,导致登机手续延误、WiFi瘫痪、显示屏黑屏。
攻击方式:勒索软件攻击
造成损失:严重扰乱假期旅客出行秩序,机场运营效率大幅下降,声誉受影响。

2024年7月:CrowdStrike更新故障引发全球IT中断
事件经过:CrowdStrike的Falcon Sensor安全软件更新错误,导致全球数百万Windows系统崩溃。
攻击方式:软件更新故障(非恶意攻击,属重大安全事故)
造成损失:约100亿美元经济损失,成为史上最大的IT中断事件之一,全球各行业企业运营广泛受影响。

2024年7月:美国摩根大通银行数据泄露
事件经过:黑客通过贿赂银行外包技术人员,非法获取约1.5亿名客户的账户信息、交易记录等敏感数据。
攻击方式:社会工程学+内部人员勾结
造成损失:银行面临超20亿美元的潜在赔偿与监管罚款,客户信任度大幅下降,引发金融行业对内部人员与外包团队安全管理的重视。

2024年7月:AT&T大规模数据泄露
事件经过:AT&T遭遇重大数据泄露,暴露近1.09亿客户敏感信息,几乎覆盖所有无线客户;公司向攻击者支付约37万美元加密货币以删除数据。
攻击方式:数据窃取、勒索
造成损失:大量客户隐私泄露,企业经济受损,声誉受严重影响。

2024年6月:Snowflake云数据平台攻击
事件经过:云数据平台Snowflake遭大规模攻击,导致Live Nation、桑坦德银行等多家公司数据泄露,影响波及电信巨头AT&T的用户。
攻击方式:云平台入侵、数据窃取
造成损失:多家企业核心数据泄露,云数据平台安全防护漏洞凸显,波及范围广,引发行业对云服务数据安全的担忧。

2024年6月:NHS Synnovis医疗服务攻击
事件经过:英国国家医疗服务体系关键供应商Synnovis遭攻击。
攻击方式:针对性医疗服务供应商攻击
造成损失:导致数千次手术和预约被取消,英国医疗系统陷入危机,患者诊疗服务受严重影响。

2024年2月:Change Healthcare勒索软件攻击
事件经过:美国医疗支付巨头Change Healthcare遭攻击,导致全美数千家药房和诊所运营瘫痪,约1亿人数据泄露;母公司UnitedHealth支付2200万美元赎金。
攻击方式:勒索软件攻击(数据窃取与系统加密并行)
造成损失:联合健康集团损失约24.5亿美元,美国医疗结算网络大规模中断,倒逼医疗行业加速混合云灾备与勒索防护建设。