About neohope

一直在努力,还没想过要放弃...

分布式一致性算法04:ZAB协议

分布式一致性算法04 ZAB协议

一、基本概念
ZAB(Zookeeper Atomic Broadcast)协议是为Apache Zookeeper框架设计的一致性协议。
与Paxos仅能保证事务的一致性不同,ZAB可以同时保证事务的顺序性和一致性。

二、ZAB算法涉及三种角色和四种状态
三种角色:
1、领导者(Leader): 在同一时间,集群只会有一个领导者。所有的写请求都必须在领导者节点执行。
2、跟随者(Follower):集群可以有多个跟随者,它们会响应领导者的心跳,并参与领导者选举和提案提交的投票。跟随者可以直接处理来自客户端的读请求,但会将写请求转发给领导者处理。
3、观察者(Observer):与跟随者类似,但不参与竞选和投票权。

节点有四种状态:
LOOKING:选举状态,该状态下的节点认为当前集群中没有领导者,会发起领导者选举。
LEADING :领导者状态,意味着当前节点是领导者。
FOLLOWING :跟随者状态,意味着当前节点是跟随者。
OBSERVING: 观察者状态,意味着当前节点是观察者。

三、关键概念
1、Epoch(纪元)
定义:Epoch是ZXID的高32位,表示领导者的任期编号。每次新的领导者被选举出来时,Epoch都会增加。
作用:
标识领导者的任期。不同的Epoch代表不同的领导者任期,确保了领导者的唯一性。
当发生分区或领导者故障时,新的领导者会具有更高的Epoch,从而确保了新的领导者具有最新的状态。

2、ZXID(事务ID)
定义:ZXID是一个64位的数字,用于唯一标识Zookeeper中的每个事务。
组成:ZXID的高32位表示Epoch,低32位表示事务计数器(XID)。
作用:
确保事务的全局顺序性。每个事务都有一个唯一的ZXID,保证了事务在所有服务器上的处理顺序一致。
通过比较ZXID,服务器可以确定事务的先后顺序,以及是否已经处理过某个事务。

四、ZAB选举流程
1、初始化:
集群中的每个服务器(Server)启动时,都处于“Looking”状态,即寻找Leader状态。

2、投票:
每个处于“Looking”状态的服务器都会发送投票(Vote)给其他服务器,尝试将自己选举为Leader。
投票格式大概为:
(新Leader节点的ID, 新Epoch编号, 当前最新的ZXID,投票节点的ID)

3、收集选票:
收到各节点的选票后,各节点会根据以下规则,判定如何投票:
优先检查任期编号Epoch,任期编号大的节点作为领导者;
如果任期编号Epoch相同,比较事务标识符ZXID的最大值,值大的节点作为领导者;
如果事务标识符的最大值相同,比较节点ID,节点ID大的节点作为领导者;
通过这样的规则,首先保证了数据最新的节点,获取更高的票数。

4、确定Leader
如果没有任何节点获取了过半选票,则要开始下一轮选举,回到步骤2,但此时不再会投票给自己,而是会投票给上一轮最合适的节点。
如果某个服务器获得了超过半数的投票,它就认为自己被选举为新的Leader。

5、同步:
新Leader会与集群中的Follower进行数据同步,确保所有Follower的数据与Leader一致。
数据同步完成,Leader就可以接收客户端的事务请求了。

五、ZAB选举示例
假设我们有一个Zookeeper集群,包含5个节点(P1~P5),所有节点都处于“Looking”状态。
Epoch=2;XID=5;ZXID=(2,5)
投票信息格式为:
(新Leader的ID, 新Leader的Epoch编号, 新Leader的最新的ZXID,选举轮次,投票节点的ID)

1、初始化
P1~P5开始寻找Leader,并发送投票请求,并投票给自己。

2、投票
P1:(新Leader=P1, 新Leader的Epoch=2, 新Leader的最新的ZXID=(2,5),选举轮次=1,投票节点=P1)
P2:(新Leader=P2, 新Leader的Epoch=2, 新Leader的最新的ZXID=(2,5),选举轮次=1,投票节点=P2)
P3:(新Leader=P3, 新Leader的Epoch=2, 新Leader的最新的ZXID=(2,3),选举轮次=1,投票节点=P3)
P4:(新Leader=P4, 新Leader的Epoch=2, 新Leader的最新的ZXID=(2,2),选举轮次=1,投票节点=P4)
P5:(新Leader=P5, 新Leader的Epoch=1, 新Leader的最新的ZXID=(1,1),选举轮次=1,投票节点=P5)

3、收集选票
对于同一轮的选票,节点自行对比判定选举结果:
P1:新Leader=P2,因为P2节点ID更大
P2:新Leader=P2,不变
P3:新Leader=P2,因为P2 ZXID更大
P4:新Leader=P2,因为P2 ZXID更大
P5:新Leader=P2,因为P2 Epoch更大
但如果一个节点收到了更小选举轮次(logicalclock)的投票,该投票会被忽略。

4、再次投票,这样P2会获得全部5票

5、确定Leader
P2认为被选举为Leader。其余节点,会主动与P2交换最大的ZXID,如果P2的更新则承认P2的领导地位,否则重新发起选举。
当过半节点承认P2的领导地位时,P2正式成为Leader。
同时P2会将Epoch+1,此时:
Epoch=3;ZXID=(3,0)

6、同步
P2根据之前各节点反馈的最大ZXID,开始与其他节点进行数据同步,强制要求所有Follower的数据与自己的数据一致。
数据同步完成后,P2告知全部Follower数据同步完毕,P2开始接收提案,各节点开始同步P2的提案。

六、ZAB同步算法的工作流程
延续上面的例子,Zookeeper集群,包含5个节点(P1~P5),P2是Leader
Epoch=3;XID=0;ZXID=(3,0)

1、客户端请求:
客户端向P3发送写请求,P3会将写请求转交给Leader P2。

2、事务提案:
Leader接收到请求后,会生成一个事务提案Proposal,分配一个全局唯一的ZXID,并进行持久化。

3、广播提案:
Leader将事务提案发送给所有Follower。

4、Follower投票:
Follower接收到提案后,会将Proposal写入本地日志,并根据自身的数据状态进行投票(必须按ZXID顺序提交),并将投票结果发送回Leader。

5、Leader决策
当Leader收到超过半数Follower的同意投票后,提交事务。同时将通知所有Follower更新状态。
如果提案被拒绝,事务将被回滚。

6、客户端响应
P3收到Leader事务提交的消息,P3会向客户端返回操作结果,客户端根据结果进行相应的处理。

七、ZAB协议的关键点:
1、顺序一致性:ZAB协议通过全局唯一的ZXID,保证了客户端请求的顺序性。
2、可靠性:即使在部分节点宕机的情况下(投票数可以过半),ZAB协议也能够保证系统的可靠性和数据的一致性。
3、防止分区:当新Leader选举成功后,如果旧Leader恢复过来,由于新Leader有更高的Epoch,旧Leader的请求不再会被接受;一个节点,如果与Leader失联,则是无法处理读写请求的;

可以看出,ZAB算法与RAFT算法整体的考虑方向是一致的,就是先选择一个Leader,通过Leader控制事务提交的顺序。
但就具体的实现而言,RAFT的实现更简单可以实现强一致性,ZAB的实现更复杂一些可以实现最终一致性。

分布式一致性算法03:RAFT

分布式一致性算法03 RAFT协议

一、基本概念
Raft算法首选会选举一位领导者(Leader),所有的写请求都先提交给Leader,Leader通过日志复制(Log Replication)来保持集群中所有节点的状态一致。

在这个过程中有一些限制:
1、Leader只能有一个,Leader会通过心跳包告知其他节点,“我是Leader,我还活着,你们别想选举”
2、Leader和Follower之间通过日志同步的方式达成一致;在一条日志中,包含了索引编号、指令、Leader任期等信息
3、日志记录了所有的事务操作,必须在所有节点上顺序一致(索引编号是递增的)
4、Raft算法通过任期编号和选举超时机制来避免分裂脑现象,确保在任期内只有一个Leader

二、RAFT算法通常涉及三种角色
领导者(Leader):负责处理所有客户端请求,将日志条目(Log Entries)复制到其他节点。
跟随者(Follower):接收领导者的日志条目并保持与领导者的心跳连接。
候选者(Candidate):当跟随者在一定时间内没有收到领导者的心跳时,它们会变成候选者并尝试成为新的领导者。
在实际情况中,一个节点通常只会承担一个角色,但这个角色通过选举机制是可以相互转换的。

三、RAFT Leader初始过程
1、当系统初始化时,或者Leader状态异常无法正常发送心跳包后,会开启选举过程。
2、此时,每个节点都是Follower,每个Follower都持有一个时间随机的选举计时器。
3、当一个Follower的选举计时器超时后,该Follower会判定Leader不可用,于是它自增任期号,并转换为Candidate。
4、Candidate首选会给自己投票,并向其他节点发送 RequestVote RPCs 请求投票,该请求中包含新任期号以及日志信息。
5、其余节点收到请求后,会检查请求中的任期号和自己的日志信息。如果受到的任期号更大,它们会投票给该Candidate。
6、如果一个Candidate从集群中大多数节点那里收到投票,它就赢得了选举,成为新的Leader。
7、新的Leader会立即向所有节点发送心跳信息,以通知它们自己的存在,并防止它们变成Candidate。

四、选举过程举例
假设一个5节点组成的Raft集群P1~P5,其中P1是Leader,其余为Follower,此时任期为Term1。此时P1故障,无法发送心跳包。

1、P2~P4节点都为Follower状态,每个节点都会初始化一个随机的选举计时器。
计时器分别为:P2 100ms,P3 200ms,P4 300ms,P5 400ms

2、由于一直收不到心跳包,P2的选举计时器会首先超时。
此时P2会在任期号Term1上增加,生成任期号Term2,并转换为 Candidate 状态。

3、P2给自己投票,并向其他全部节点发送 RequestVote RPCs 请求投票,并带上任期号Term2

4、P3~P5收到投票后,对比Term2和自己日志中的任期号
如果日志任期号更达,则拒绝投票
在本例中,Term2任期号更大,P3~P5就都会投票给P2

5、P2收到P3~P5的投票,加上自己的一票,超过半数,选举成功,P2成为新的Leader

6、P2会立即向所有节点发送心跳信息,其他竞选失败的Candidate,退回为Follower状态,开始跟随Leader的日志。
所有Follower会重置选举计时器,等待再次成为Candidate,并发起选举。

7、在日志复制之前,P2需要确定自己的日志与Follower的日志是否一致。它会发送AppendEntries RPC请求给Follower,并在请求中包含自己日志的最后一个日志Entry(索引和命令)和任期(PrevLogEntry和PrevLogTerm)。
如果Follower的日志与Leader匹配,则可以开始日志同步。
如果Follower的日志与Leader不匹配,它会发送一个失败的响应。Leader则会回退一个日志Entry,再次与Follower确认,直至双方一致为止。此时,Leader会将最新日志同步给Follower,从而让双方日志完全一致。

8、P2此时正式成为Leader,开始接收请求,并开始同步日志(AppendEntries RPC)

投票过程有一些限制:
单次投票:当Follower收到不同Candidate的同一Term的 RequestVote RPCs时,只会投票给第一个
仅投票给日志完整性高的Candidate:当Follower收到Candidate的RequestVote RPCs时,如果Candidate的日志完整性不如自己高,则拒绝投票
过半投票:Candidate必须有过半的投票,才能升级为Leader,从而避免脑裂

当然,也会有一些特殊情况:
系统启动:节点启动后默认为Follower,由于没有Leader,各节点很快会进入选举超时,并转换为Candidate,并发起选举。
选举失败:没有任何Candidate获得足够的票数,这样会继续进入下一轮选举,而且这个等待选票的时间,也是随机的

四、Raft算法的工作流程
当完成Leader的选举后,工作流程就比较简单了。

接收请求:
客户端向Leader发送一个写请求,比如设置键值对key1=value1。

日志复制:
Leader创建一个新的日志条目,并将其追加到自己的日志末尾。

日志同步:
Leader将这个日志条目发送给跟所有的Follower,包含了日志条目的信息以及领导者的任期号等。
Follower收到日志后,首先验证任期是否有效,如果任期有效,而且日志条目与本地日志记录兼容,则存储这个日志条目到自己的日志末尾。
跟随者在成功存储日志条目后,会向领导者发送一个确认响应(包含当前的任期号和成功标识)。

日志提交:
Leader等待Follower的确认消息,一旦收到大多数Follower的确认,它就将日志记录为“已提交”状态。
此时,Leader会向客户端返回操作成功。

应用日志:
Leader会在心跳包以及新日志复制的消息中,带上当前最新日志索引编号。
Follower接收到指令后,会将编号小于等于最新日志索引编号的日志条目,应用到自己的状态机中。
由于所有节点都按照相同的日志条目顺序执行操作,因此所有节点的状态机最终将保持一致。

五、效率提升
仅Leader接收请求:
避免集群多次通讯达成一致的过程,Leader接收并处理全部请求,然后同步给Follower。大幅提高吞吐能力。

日志压缩:
为了减少存储空间的使用,会定期进行日志压缩,保留关键的日志信息,而丢弃已经被持久化和应用的日志条目。

随机选举计时器:
通过随机时间,避免了所有节点一起发起投票,只投给自己的情况。用相对较低

单节点变更:
当增减节点的时候,保证一次只增减1个节点,可以有效的避免脑裂的出现

分布式一致性算法02:Multi-Paxos

分布式一致性算法02 Multi-Paxos算法

一、基本概念
Multi-Paxos算法,在Paxos的基础上,通过引入领导者(Leader)的概念,大幅提升了效率。

二、Multi-Paxos算法通常涉及三种角色:
Leader(领导者)/Proposer(提议者) :在Multi-Paxos中,通常会选举出一个Leader作为Proposer,负责提出提议,并尝试让多数接受者接受该提议。
Acceptor(接受者) :负责接受或拒绝提议者的提议。每个节点都可以是Acceptor,负责记录和确认提议。
Learner(学习者) :负责学习最终达成一致的提议。

三、Multi-Paxos算法的基本过程
1、初始化阶段
首先,通过Paxos算法,选择一个领导者(Leader),它负责发起全部提议。

2、准备阶段(Prepare Phase)
领导者向集群中的其他节点发送Prepare消息,这些消息包含当前的最大提议编号。
Acceptor(接受者)接收到Prepare消息后,会返回一个响应,表明它们是否已经接收到更高编号的提议。
如果领导者接收到大多数节点的响应,表示它们没有更高的提议,则可以继续下一步。

3、接受阶段(Accept Phase)
领导者根据收到的Prepare响应选择一个提议编号,并向集群中的其他节点发送Accept消息。这些消息包含提议编号和提议值。
节点接收到Accept消息后,如果该提议编号高于它们当前已接受的提议,则会接受该提议并返回确认消息。如果大多数节点确认接受该提议,则该提议被接受。

4、提交阶段(Commit Phase)
一旦提议被大多数节点接受,领导者将该提议标记为已提交,并通知集群中的其他节点。
节点接收到提交通知后,将执行该提议,并更新其状态。

5、应用阶段(Apply Phase)
最后,领导者将已提交的提议应用到状态机中,并通知集群中的其他节点。
节点接收到应用通知后,也会将提议应用到其状态机中,从而确保所有节点的状态一致。

四、举例说明
假设我们有一个分布式系统,由10个节点组成:P1、P2是提议者(Proposer),A1、A2、A3、A4、A5是接受者(Acceptor),L1、L2、L3是学习者(Learner)。

1、初始化阶段
在Multi-Paxos中,任何提议者都可以被选为领导者。
系统启动时,通过某种机制(比如Paxos算法)选举出一个新的领导者,这里假设P1被选为领导者。

2、准备阶段(Prepare Phase)
领导者P1,生成一个提议编号(例如7),向所有接受者询问,是否可以接受编号为7的提议。
接受者A1~A5收到消息后,由于提议编号7大于它们之前见过的任何提议编号,将进入承诺状态,并向P1发送可接受提议编号7的提议,并承诺不会接受任何编号小于7的提议。
【通过算法优化,其实可以节省提议编号这个阶段,直接发起提议】

3、接受阶段(Accept Phase)
当受到大多数接受者同意提议编号的消息后,P1向集群中的所有接受者发送Accept消息,提议编号7的内容为V7。
接收者收提议后,如果该提议编号高于它们当前已接受的提议,则会接受该提议并返回确认消息。

4、提交阶段(Commit Phase)
一旦P1收到来自多数接受者的已接受消息,它将向所有接受者发送提交消息,指示它们可以提交这个提议。

5、应用阶段(Apply Phase)
接受者在收到提交消息后,将提议的键值对应用到状态机中,并将结果通知学习者。

五、与Paxos算法对比
并发性:Paxos算法在每次达成共识时都需要进行两轮消息传递,这限制了它的并发能力。而Multi-Paxos通过引入领导者(Leader)的概念,允许多个提议者并发地提出提议,从而提高了并发性。
消息复杂度:在Paxos算法中,每个提议都需要两轮的通信(Prepare和Accept阶段),这增加了消息的复杂度。Multi-Paxos通过减少通信轮次,允许领导者在一轮中提出多个提议,从而减少了消息的复杂度。
实时性:由于Multi-Paxos允许并发提议,它在实时性方面通常优于Paxos算法。在Paxos算法中,每个提议都需要等待前一个提议完成后才能开始,这可能导致延迟。
容错性:Paxos算法和Multi-Paxos都具有很好的容错性,但Multi-Paxos由于其并发性,在某些容错情况下可能表现更好,例如在领导者失败时可以快速选举新领导者并继续处理提议。
实现复杂度:Paxos算法的实现相对复杂,而Multi-Paxos虽然在理论上提供了并发性的优势,但其实现也引入了额外的复杂性,如领导者选举和故障恢复机制。
优化和变种:Multi-Paxos有许多优化和变种,如Fast Paxos和EPaxos,它们通过进一步减少通信轮次或利用特定的系统特性来提高性能。而在实际应用中,许多系统采用Multi-Paxos或其变种,如Raft算法,以提高性能。

分布式一致性算法01:Paxos

分布式一致性算法01 Paxos算法

一、基本概念
Paxos是分布式一致性的经典算法,由Leslie Lamport在1990年提出。

二、Paxos算法通常涉及三种角色:
Proposer(提议者) :负责提出提议(Proposal),即向系统中提出一个值。Proposer通常是客户端,负责发起提议并分配一个不重复的自增ID给每个提议。
Acceptor(接受者) :参与决策过程,负责接收并回应Proposer的提议。每个Acceptor只能接受一个值,并且为了保证最多只有一个值被选定(Chosen),Proposal必须被超过一半的Acceptors所接受。
Learner(学习者) :负责学习最终被选定的值。Learner不参与协商过程,只是接收并记录最终被选定的值。
在实际过程中,一个节点可以同时承担1~3个角色。

三、Paxos算法的基本过程
1、准备阶段(Prepare Phase):
提议者(Proposer)选择一个提议编号(ballot number),并将其发送给所有接受者(Acceptor)。
接受者在接收到提议者的准备请求后,如果当前编号大于其已承诺的最高编号,则更新其承诺编号,并返回一个承诺(promise)给提议者,承诺中包含当前已接受的最高编号和值。

2、提议阶段(Proposal Phase):
提议者收集到多数接受者的承诺后,选择一个值(value),并结合最新的提议编号,生成提议(propose)消息发送给接受者。
接受者在接收到提议消息后,如果提议编号大于其已有的承诺编号,则接受该提议,并返回确认消息给提议者。

3、决定阶段(Decide Phase):
提议者收集到多数接受者的确认消息后,可以决定该值为最终值,并将其写入日志或状态机中。
学习者(Learner)从提议者处获取并学习最终决定的值,确保所有节点都有一致的状态。

四、举例说明:
假设我们有一个分布式系统,包含10个节点:P1、P2是提议者,A1、A2、A3、A4、A5是接受者,L1、L2、L3是学习者。

1、准备阶段:
P1提出一个提议编号,编号为1。
P1向所有接受者A1~A5发送询问,询问P1将发起编号为1提议是否可以。
A1收到提议时,并没有反馈过任何一次提议,于是反馈可以接受,并承诺,后续不会接受编号比1小的提议。A2~A4类似。

几乎同时,P2提出一个提议,编号为5。
P2向所有接受者A1~A5发送询问,询问P2将发起编号为5提议是否可以。
A1收到提议时,承诺的最小编号为1,于是反馈可以接受,并承诺,后续不会接受编号比5小的提议。A2~A4类似。

到这里,P1和P2的提议,前后都被允许提交了。当然,也有情况可能是,部分节点先收到了P2,这种情况下,P1的提议编号就无效了,需要重新拟定编号,这个编号必须单调增加。

2、提议阶段
P1收到了过半节点的提议编号反馈,向所有接受者A1~A5发送提议,告知提议编号为1的提议值为V1。
接受者收到提交消息时,已经无法接收比5小的提议,于是就拒绝P1,提议不通过。

P2收到了过半节点的提议编号反馈,向所有接受者A1~A5发送提议,告知提议编号为5的提议值为V5。
接受者收到提交消息时,反馈P2同意了5号提议。

3、决定阶段
当提议5收到过半同意反馈时(5个节点中3个以上同意),认为提议通过,各节点并将V5写入日志。
此时,学习者L1、L2、L3也会学习到V5的结果,并写入日志。

五、Paxos算法的特点
多数同意:在Paxos算法中,只有当提议者收到超过半数接受者的同意时,提议才可能被提交。
唯一性:Paxos算法保证了在任何给定的一轮中,只有一个提议可以被接受。
容错性:即使在一些节点失败的情况下,Paxos算法也能够工作。
Paxos算法的实现和理解都相当复杂,但它是许多现代分布式系统一致性协议的基础,如Raft算法等。

【转载】预训练Transformer模型的使用与微调

原文地址:Developing an LLM: Building, Training, Finetuning,by Sebastian Raschka, on 2024-06-08

预训练Transformer模型的使用与微调

本周领域内进展不断,其中不乏令人振奋的AI前沿研究,我会在 https://magazine.sebastianraschka.com/archive 中展开讨论。

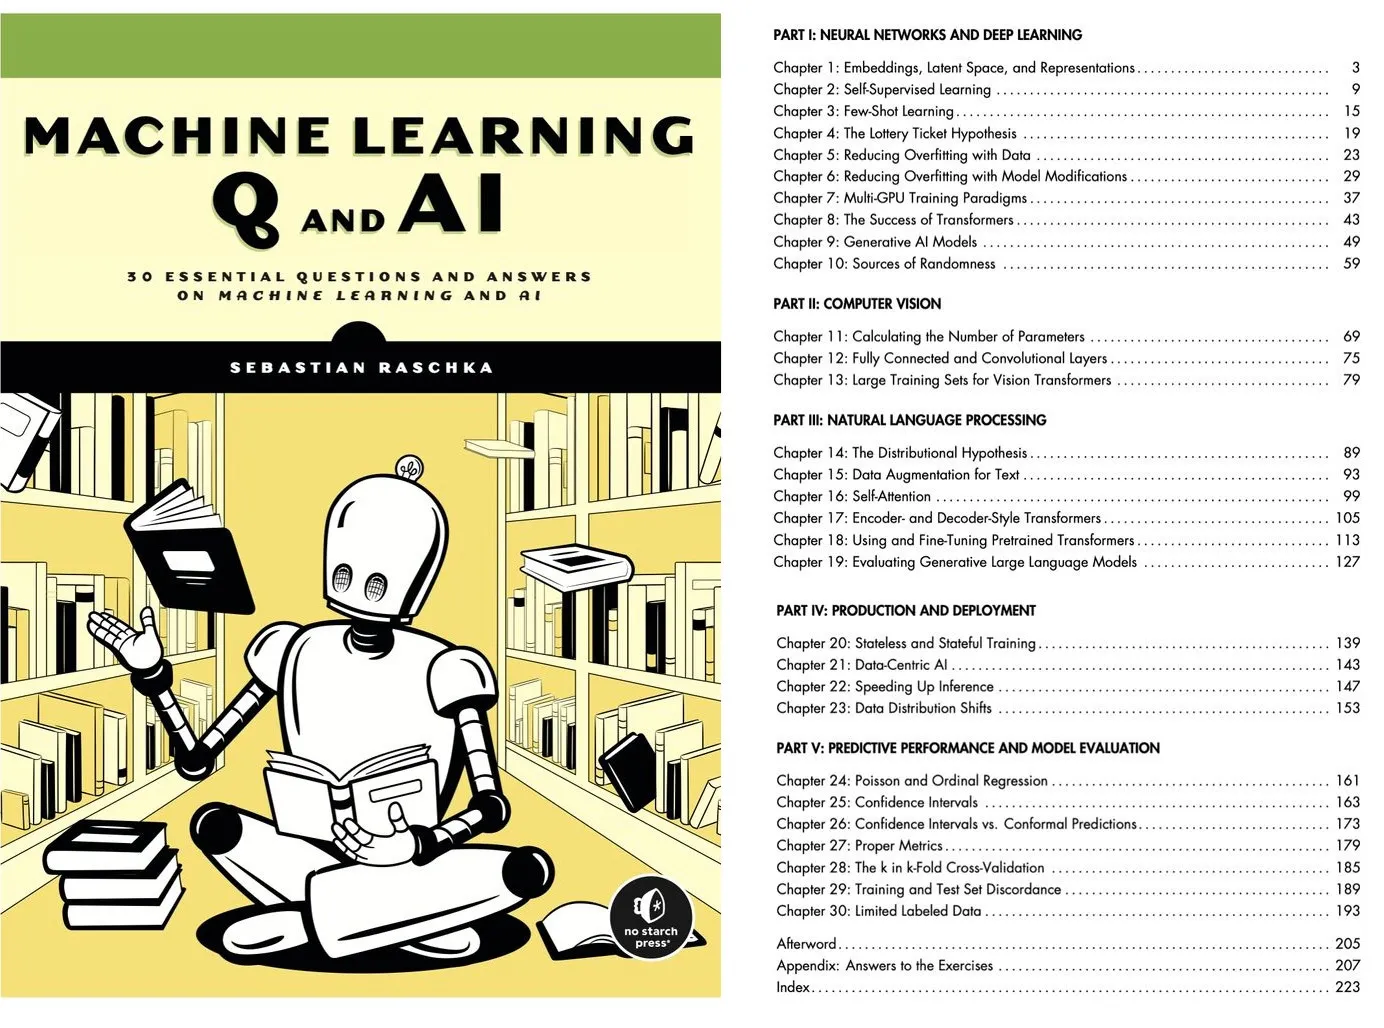
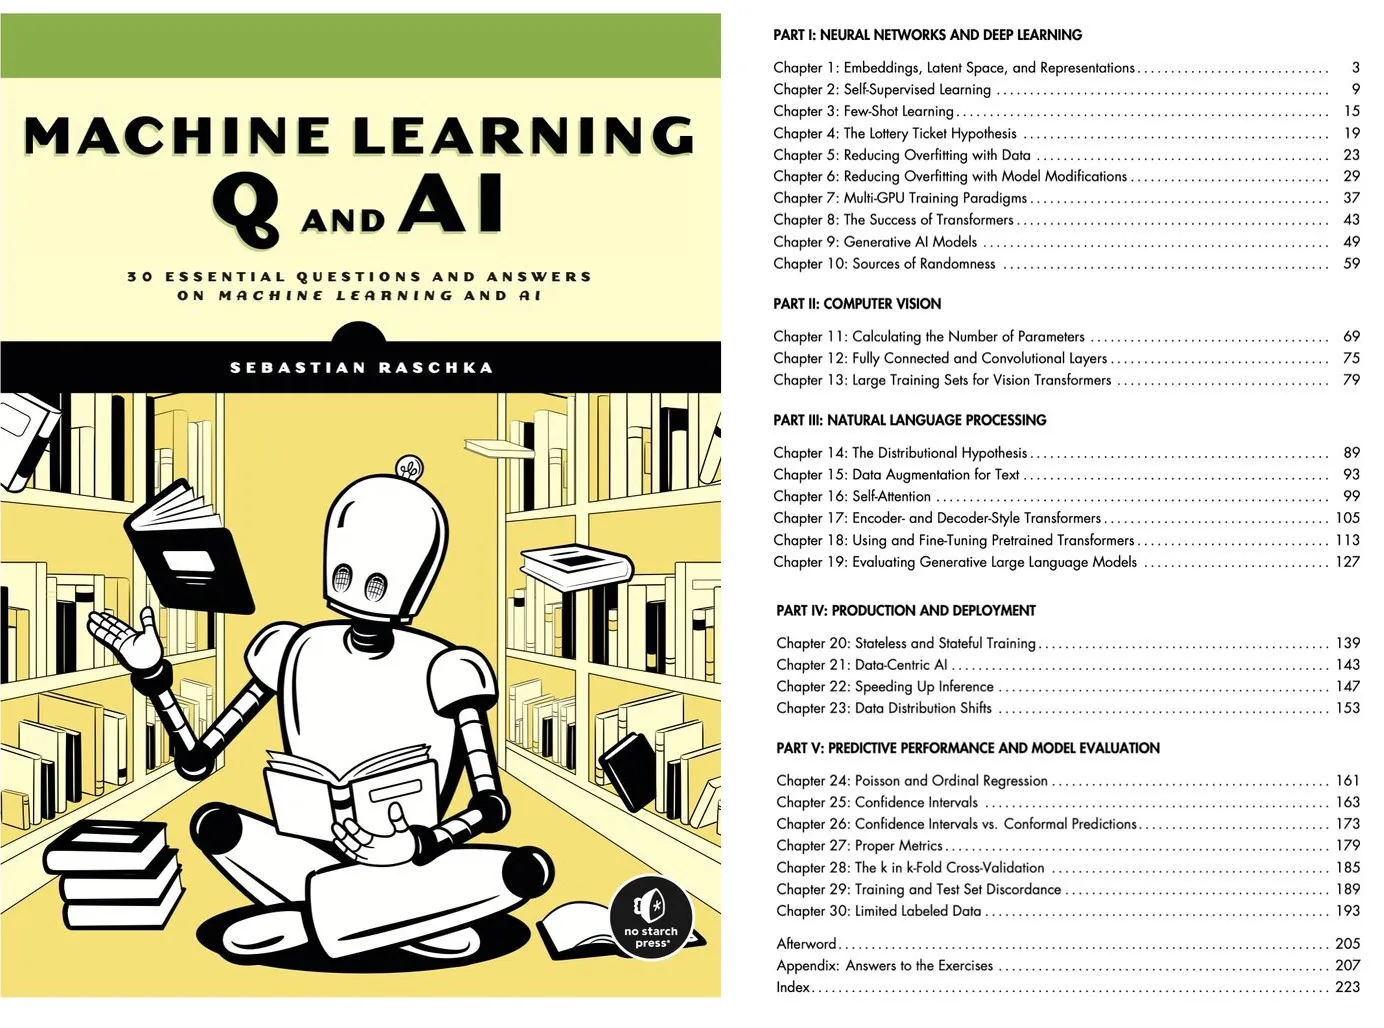
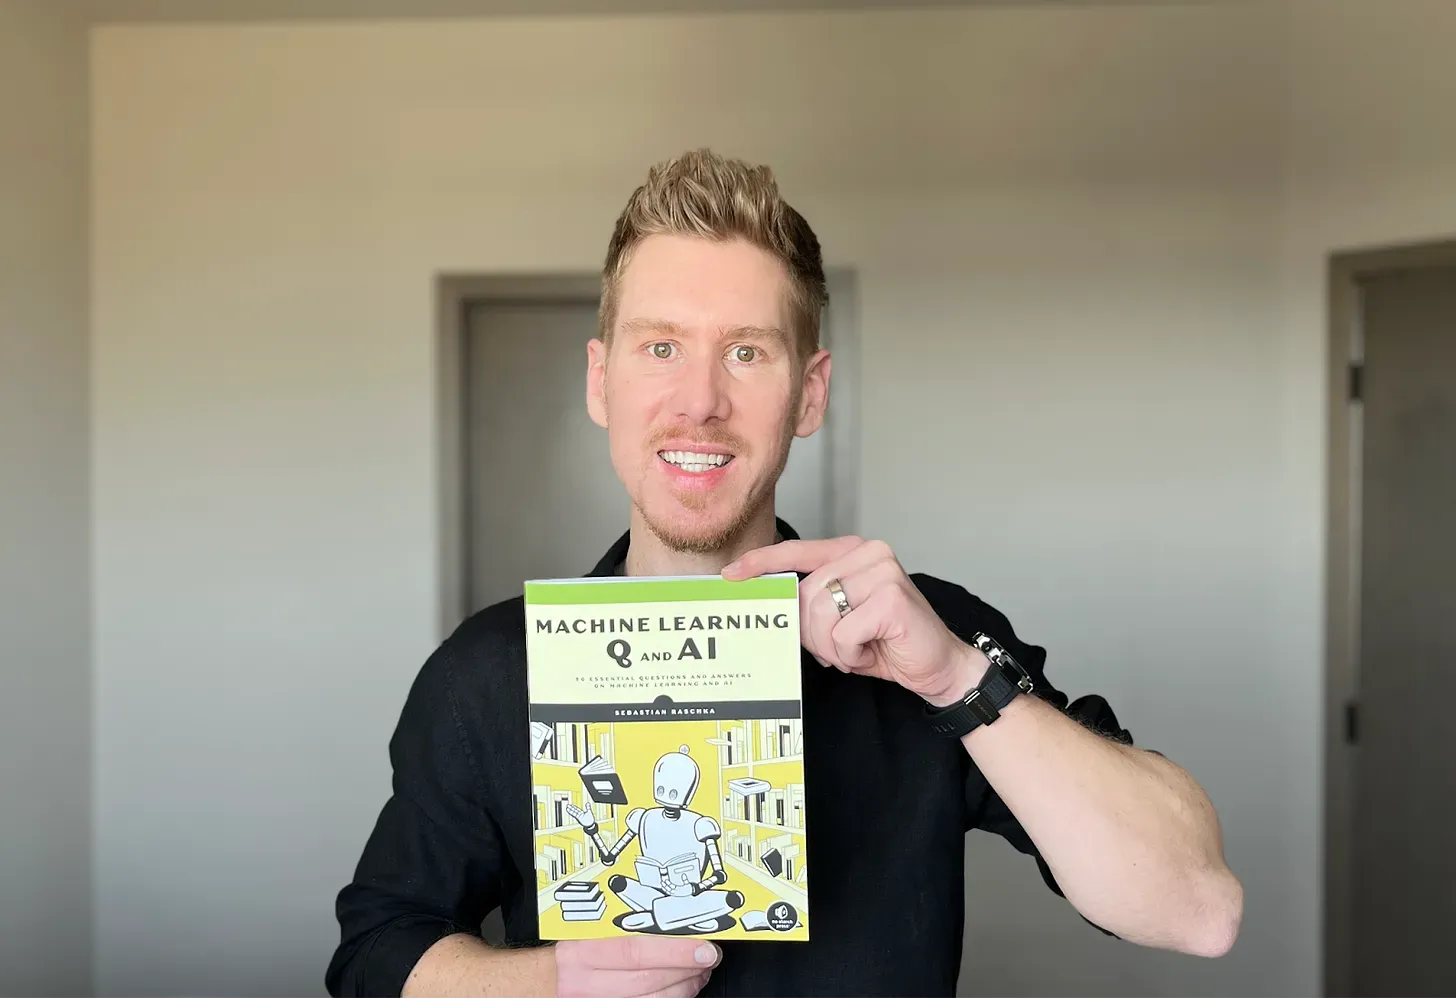
此外,我很高兴地向大家宣布我的新书已由No Starch Press出版,书籍链接:https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768

如果你一直在寻找机器学习入门课程之后的进阶学习资料,这本书或许正合适。书中涵盖了30个在我过往的书籍与课程中未深入涉及的概念,我以简洁的问答形式(附带练习题)将它们整理成册。

我相信它也会成为机器学习面试备考的实用参考资料。
figure01

《机器学习与AI问答》可在 https://nostarch.com/machine-learning-q-and-ai、https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768 及各大图书渠道购买。

当前,预训练大语言模型的使用与微调方法是最热门的讨论话题之一,因此我想分享书中的一段节选,希望能对你当下的项目有所帮助。

祝阅读愉快!

预训练大语言模型有哪些不同的使用与微调方式?

预训练大语言模型(Large Language Model, LLM)有哪些不同的使用与微调方式?最常见的三类方法包括:基于特征的方法、上下文提示法,以及更新模型部分参数的方法。

首先,大多数预训练大语言模型或语言Transformer模型无需进一步微调即可直接使用。例如,我们可以采用基于特征的方法,利用预训练Transformer生成的嵌入向量来训练新的下游模型(比如线性分类器)。其次,我们可以在输入中直接给出新任务的示例,无需对模型做任何更新或训练,就能让模型输出预期结果,这一方法也被称为提示工程(Prompting)。最后,我们也可以通过微调模型的全部参数或少量参数来达成目标效果。

下文将对这些方法展开更深入的讲解。

将Transformer用于分类任务

我们先从使用预训练Transformer的传统方法讲起:基于特征嵌入训练新模型、微调输出层、微调全部层。我们会结合分类任务场景展开讨论(提示工程相关内容将在后续“上下文学习、索引与提示微调”一节详细介绍)。

基于特征的方法

在基于特征的方法中,我们加载预训练模型并将其“冻结”——即不更新预训练模型的任何参数,而是将模型作为特征提取器,在新数据集上提取特征,再基于这些嵌入向量训练下游模型。下游模型可以是任意类型(随机森林、XGBoost等),但通常线性分类器的效果最佳。这是因为BERT、GPT、Llama、Mistral等预训练Transformer已经能从输入数据中提取高质量、高信息量的特征,这些特征嵌入往往捕捉到了数据中复杂的关联与模式,足以让线性分类器轻松实现数据的类别划分。

此外,逻辑回归、支持向量机等线性分类器通常具备较强的正则化能力,在处理预训练Transformer生成的高维特征空间时,能有效避免过拟合。这种基于特征的方法是效率最高的方案,因为完全不需要更新Transformer模型的参数。而且,当分类器需要多轮训练时,训练集对应的嵌入向量可以提前计算好(因为嵌入结果不会变化)。

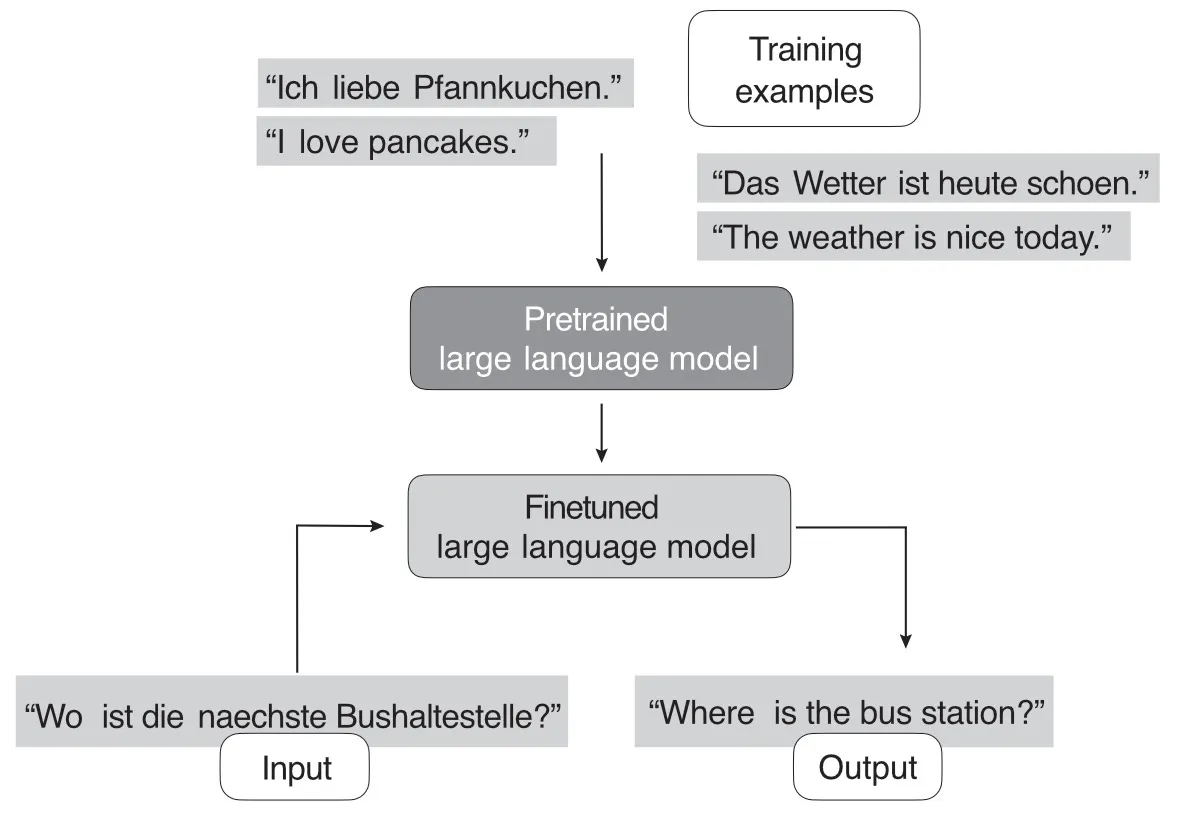
图1展示了大语言模型的典型构建流程,以及通过微调适配下游任务的过程。图中,在通用文本语料上预训练得到的模型,经过微调后可以执行德译英等任务。
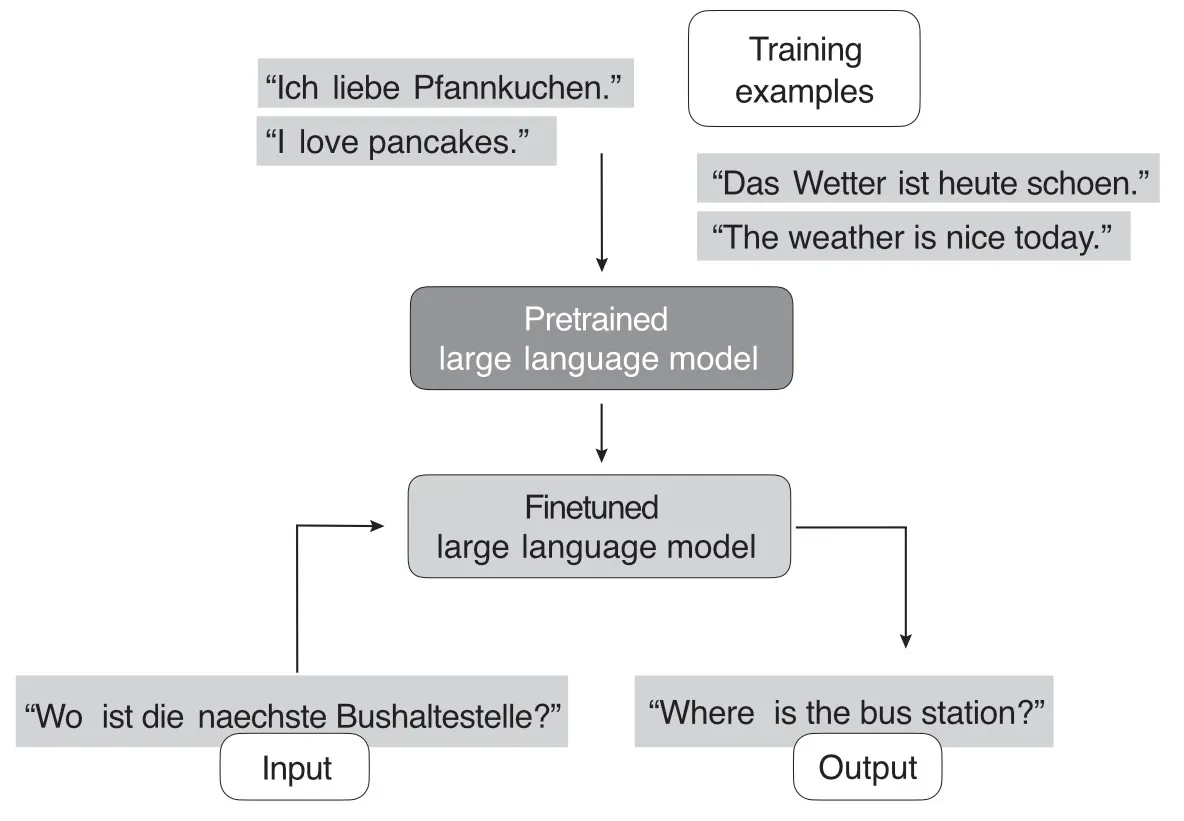
figure02

图1:大语言模型的通用微调流程

微调

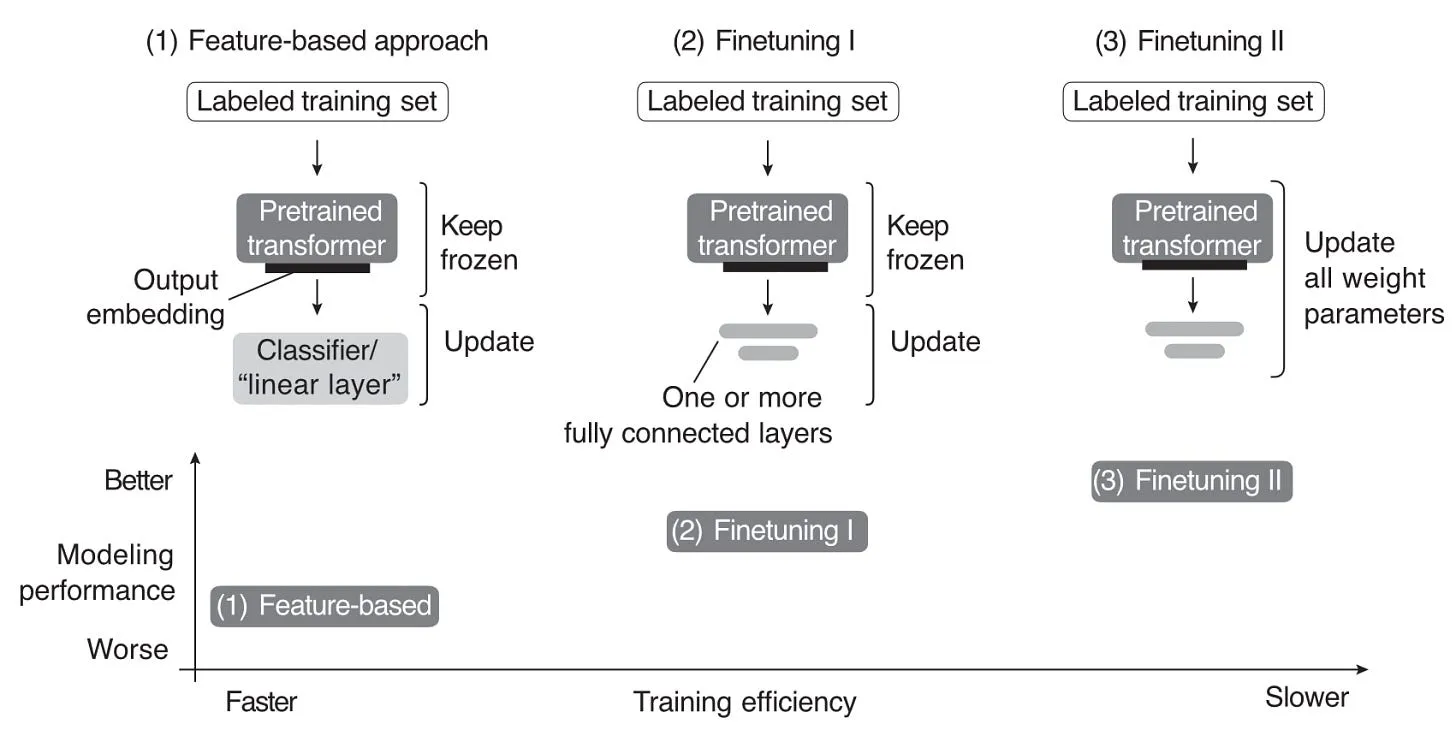
预训练大语言模型的传统微调方法分为两种:仅更新输出层(我们称之为“微调I型”),以及更新全部层(我们称之为“微调II型”)。

微调I型与前文提到的基于特征的方法类似,但它是在大语言模型自身之上新增一层或多层输出层。模型的主干网络保持冻结,仅更新新增输出层的参数。由于不需要在整个网络中反向传播梯度,这种方法在计算吞吐量和内存占用上效率相对更高。而微调II型同样是加载模型并新增输出层,但与仅在最后几层反向传播不同,它会通过反向传播更新所有层的参数,因此是计算成本最高的方案。尽管计算开销高于基于特征的方法和微调I型,但它通常能带来更优的建模效果与预测性能,在处理专业性更强的领域专属数据集时优势尤为明显。

图2总结了本节介绍的三种方法。
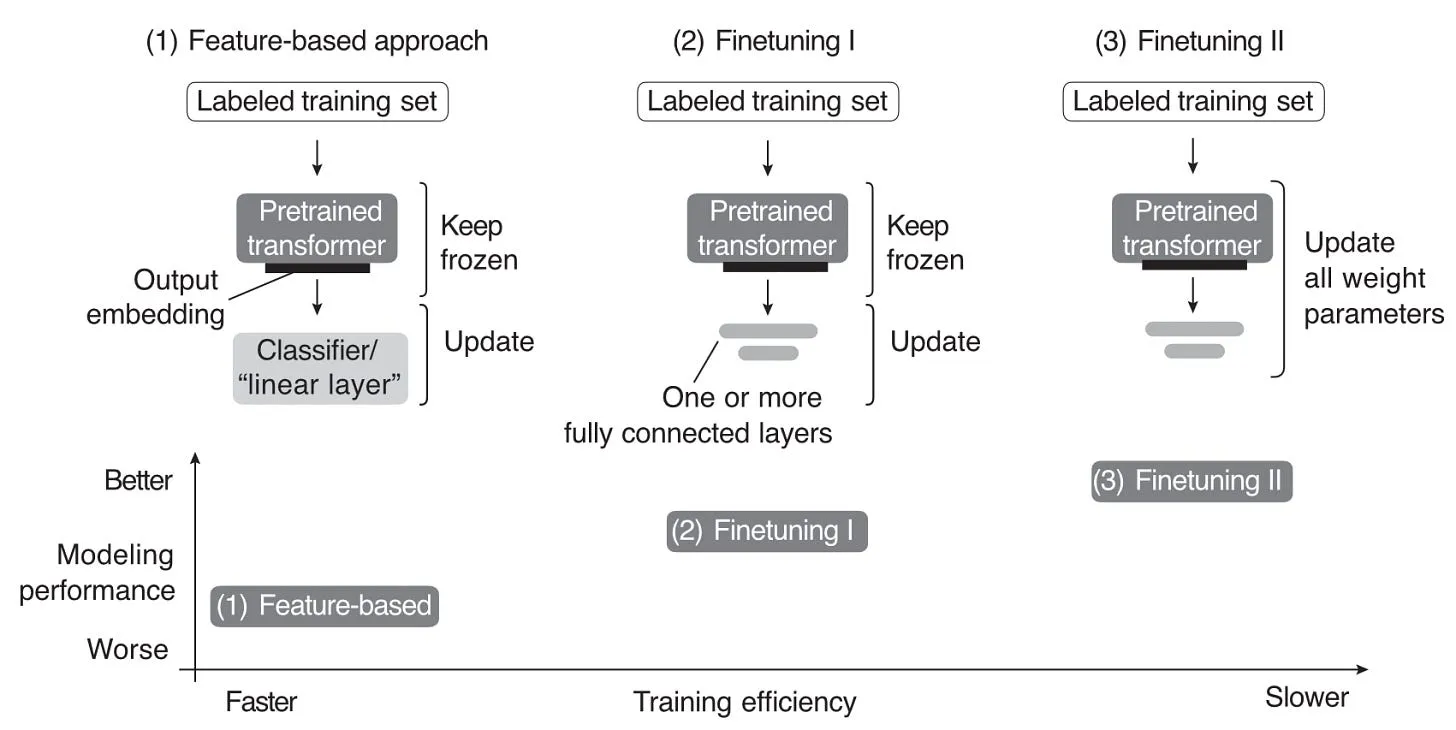
figure03

图2:使用预训练大语言模型的三种传统方法。三种方法的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/01_classifier-finetuning

除了对三种微调方法的概念总结,图2还给出了它们训练效率的经验参考。由于微调II型需要更新的层数和参数多于微调I型,其反向传播的计算成本也更高。同理,微调II型的成本也高于更简单的基于特征的方法。

感兴趣的读者可以通过以下链接查看代码示例,涵盖基于特征的方法、微调部分层、微调整个Transformer用于分类任务的实现:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/01_classifier-finetuning

上下文学习、索引与提示微调

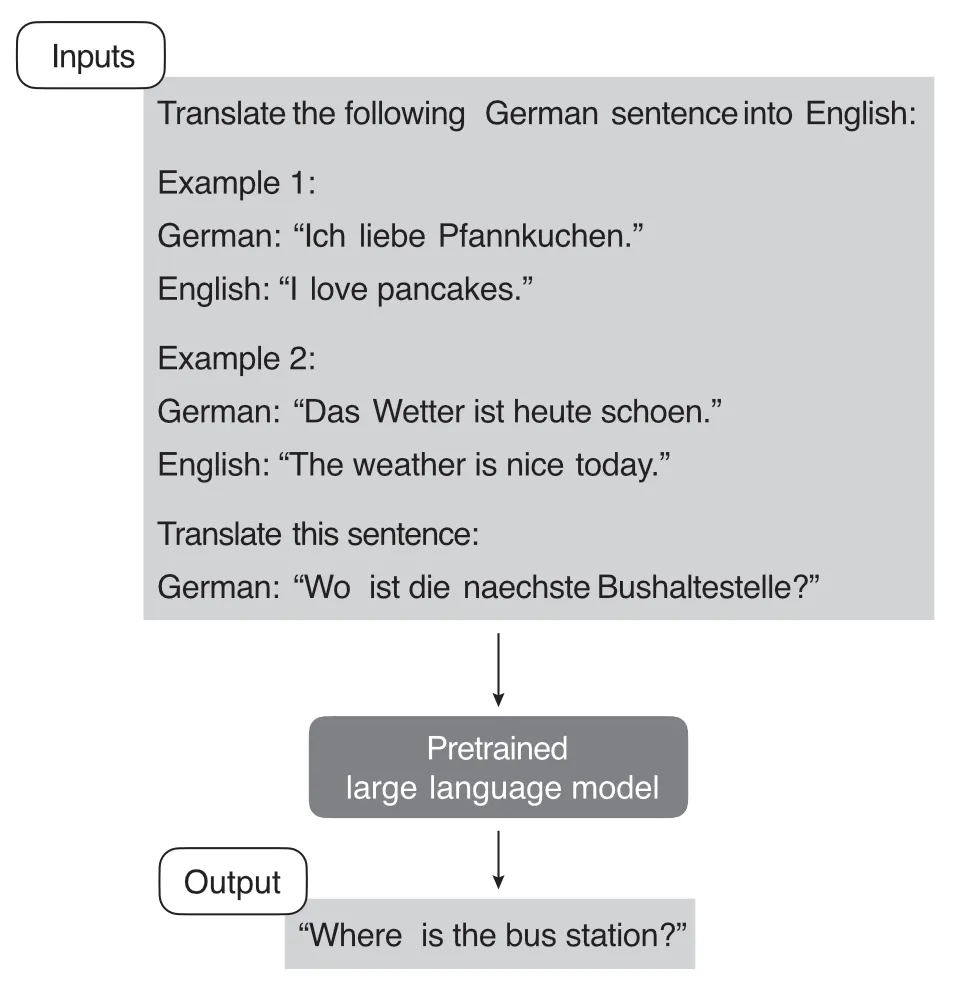
GPT-2、GPT-3等大语言模型普及了**上下文学习(In-context Learning)**的概念,在该场景下也常被称为零样本学习或少样本学习,如图3所示。
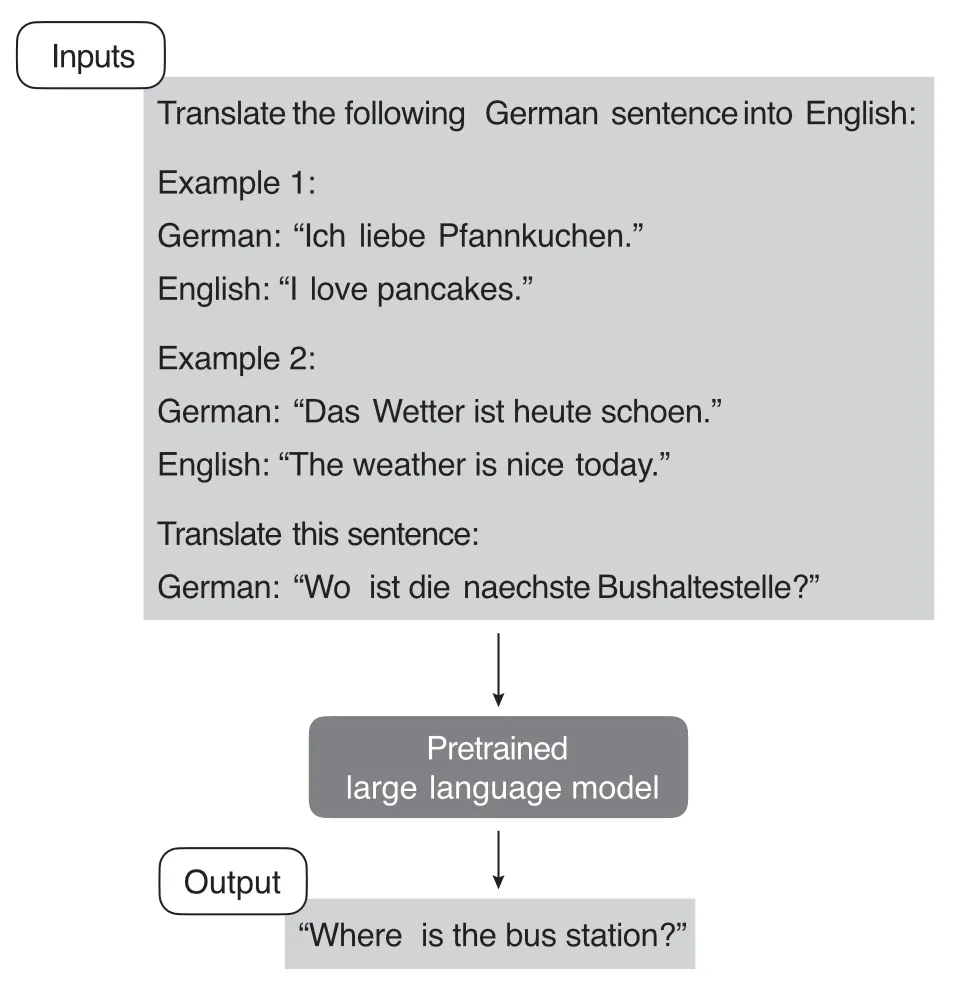
figure04

图3:通过提示让大语言模型实现上下文学习。上下文学习的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/02_prompting

如图3所示,上下文学习的核心是在输入(提示词)中提供任务的背景或示例,让模型推断出预期的行为模式并生成对应的输出。这种方法利用了模型在预训练阶段从海量数据(涵盖各类任务与场景)中习得的能力。

注意:此处的少样本学习与上下文学习方法含义相近,其定义与第3章中讨论的传统少样本学习不同。

举个例子,假设我们想用GPT-3这类大规模预训练语言模型,通过上下文学习实现少样本德译英。我们只需要提供几个德译英的示例,帮助模型理解任务要求即可,如下所示:

将下列德语句子翻译成英语:
示例1:德语:”Ich liebe Pfannkuchen.” 英语:”I love pancakes.”
示例2:德语:”Das Wetter ist heute schoen.” 英语:”The weather is nice today.”
翻译这个句子:德语:”Wo ist die naechste Bushaltestelle?”

通常来说,在特定任务或特定数据集上,上下文学习的效果不如微调,因为它完全依赖预训练模型从训练数据中泛化的能力,不会针对当前任务调整模型参数。

但上下文学习也有自身的优势:当微调所需的标注数据稀缺甚至没有时,它的价值就格外凸显。同时,如果我们无法直接访问模型权重,只能通过界面或API与模型交互(比如ChatGPT),这种方法也能让我们快速尝试不同任务,无需微调模型参数。

与上下文学习相关的还有硬提示微调(Hard Prompt Tuning),“硬”指的是输入token是不可微的。前文介绍的微调方法是通过更新模型参数来提升任务效果,而硬提示微调则是通过优化提示词本身来提升性能。提示微调不会修改模型参数,但可能会用到小规模标注数据集,来找到针对特定任务的最优提示词格式。例如,为了优化前面德译英任务的提示词,我们可以尝试以下三种写法:


"Translate the German sentence '{german_sentence}' into English: {english_translation}"
"German: '{german_sentence}' | English: {english_translation}"
"From German to English: '{german_sentence}' -> {english_translation}"

提示微调是参数微调的一种低成本替代方案。但它的效果通常不如全量模型微调,因为它没有针对特定任务更新模型参数,可能限制了模型适配任务细节的能力。此外,提示微调可能耗费大量人力,因为需要人工对比不同提示词的效果,或是借助其他方法来完成评估。由于输入token不可微,这种方法也被称为硬提示法。除此之外,也有研究提出用另一个大语言模型来自动生成和评估提示词。

提示工程与上下文学习的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/02_prompting

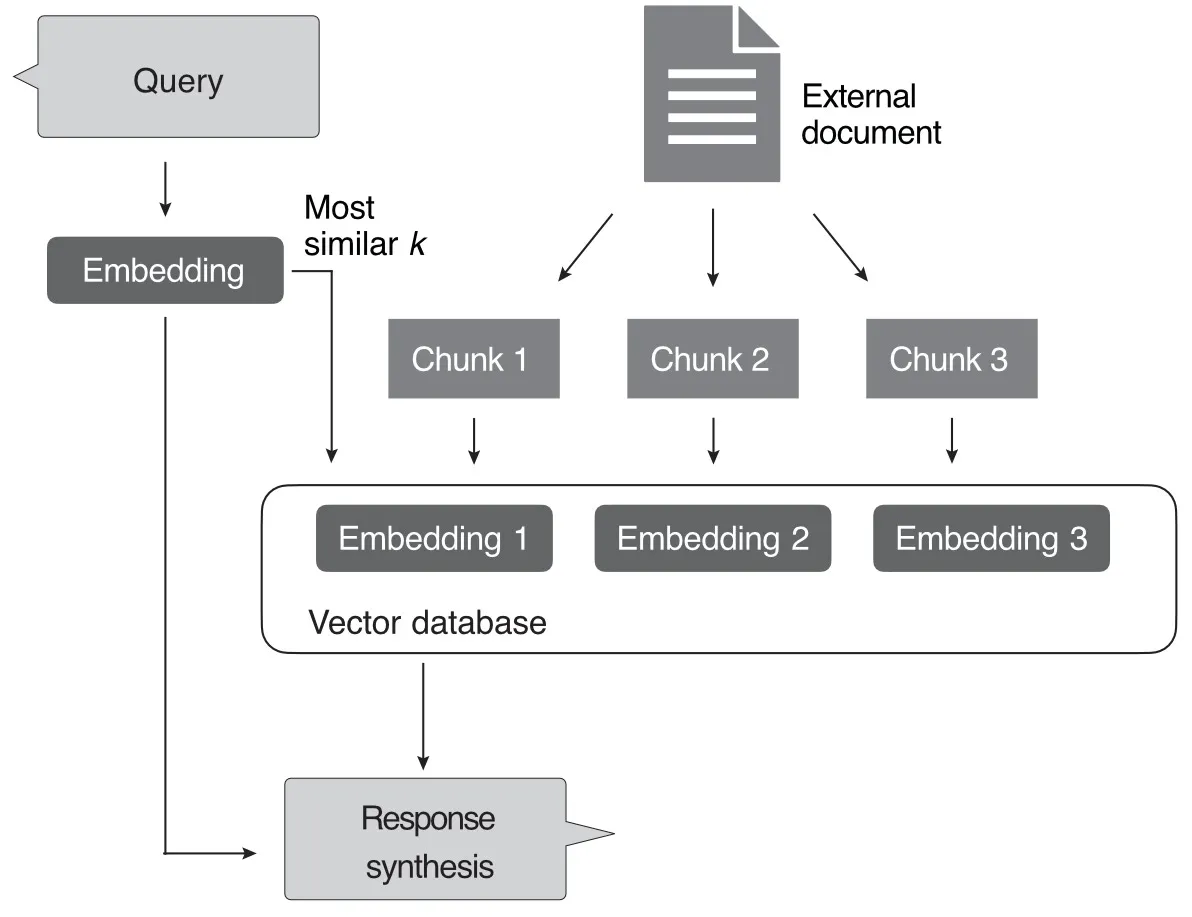
另一种纯基于上下文学习的应用方式是大语言模型索引(LLM Indexing),如图4所示。
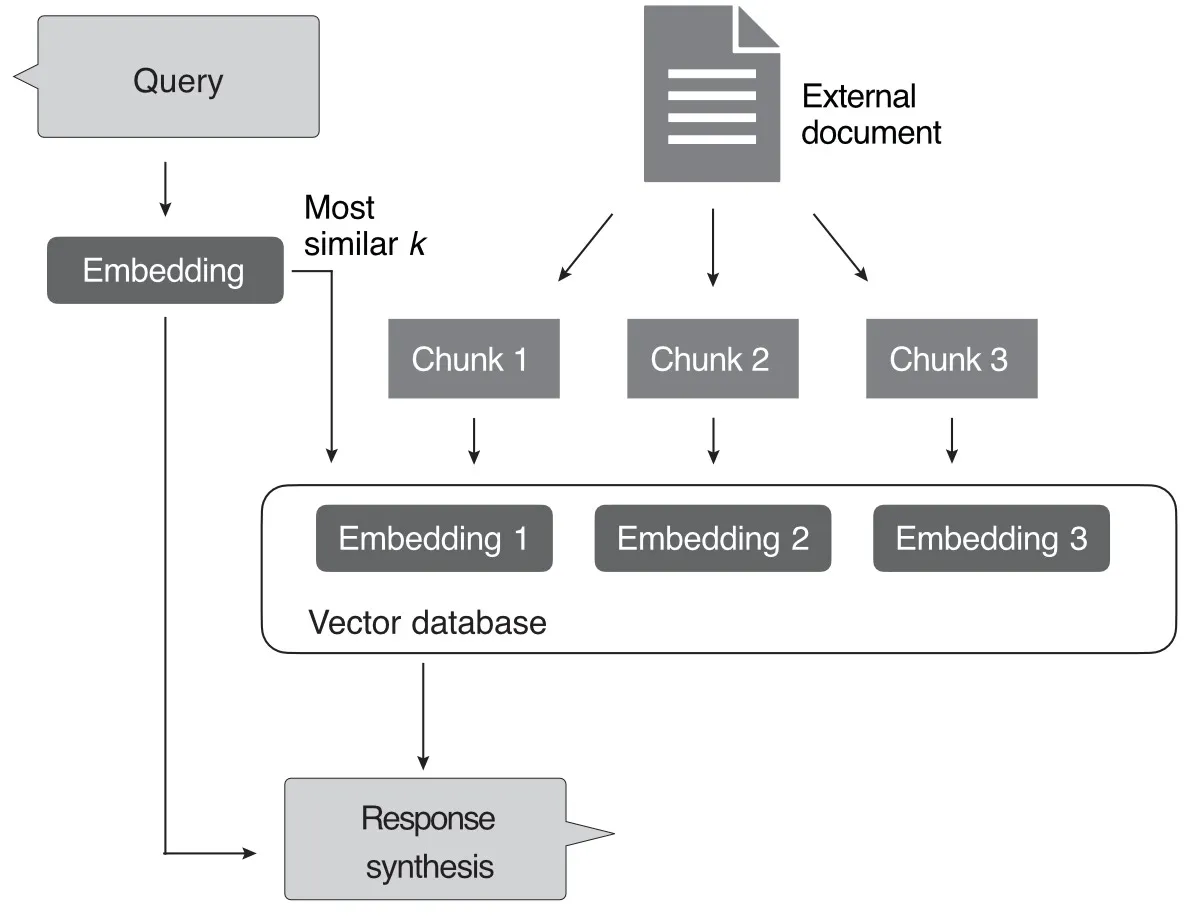
figure05

图4:通过大语言模型索引从外部文档中检索信息。索引的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/03_retrieval-augmented-generation

在大语言模型领域,索引可以看作是基于上下文学习的一种延伸方案,它能把大语言模型变成信息检索系统,从外部资源和网站中提取信息。如图4所示,索引模块会将文档或网站内容切分成更小的文本块,再将这些文本块转换成向量,存储在向量数据库中。当用户提交查询时,索引模块会计算查询向量与数据库中每个向量的相似度,最后召回相似度最高的前k个嵌入向量,用于生成最终回答。

大语言模型索引是一个统称,指代将大语言模型与现有数据源连接的框架或流程,其中最典型的就是检索增强生成(Retrieval-Augmented Generation, RAG)。RAG将大语言模型与检索系统相结合,提升模型生成回答的能力。

感兴趣的读者可以通过以下链接查看大语言模型索引与检索增强生成的代码示例:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/03_retrieval-augmented-generation/retrieval-augmented-generation.ipynb

参数高效微调

近年来,研究者开发了许多方法,让预训练Transformer能更高效地适配新的目标任务,这类方法统称为参数高效微调(Parameter-Efficient Finetuning, PEFT)。目前主流的几类方法如图5所示。
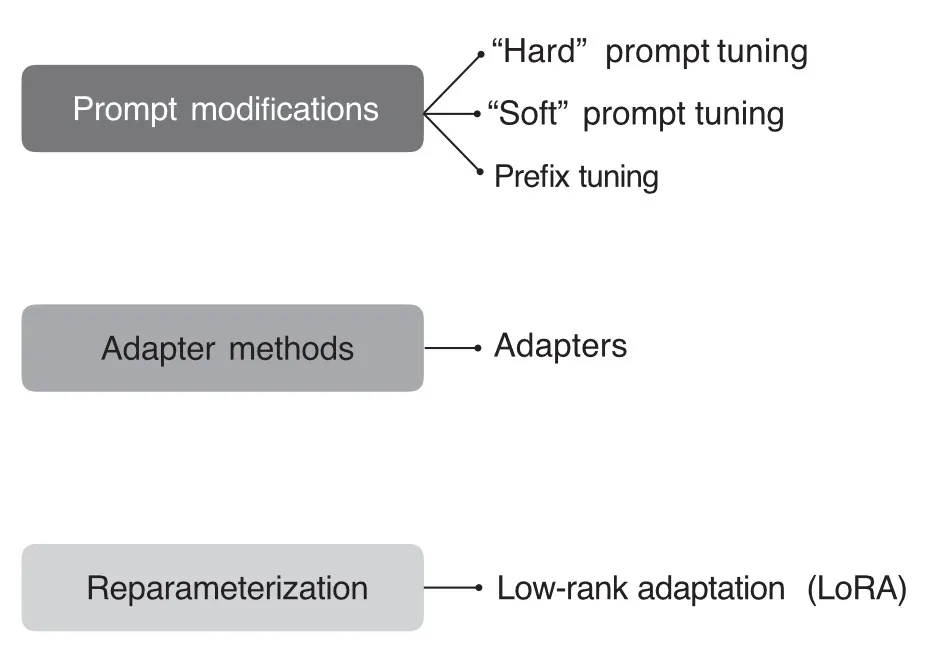
figure06

图5:参数高效微调技术的主要分类及典型代表

与上一节讨论的硬提示法不同,**软提示(Soft Prompting)**策略优化的是提示的嵌入向量形式。硬提示微调修改的是离散的输入token,而软提示微调使用的是可训练的参数张量。

软提示微调

软提示微调的核心思想是:在查询的嵌入向量前拼接一个可训练的参数张量(即“软提示”),再通过梯度下降调整这个张量,提升模型在目标数据集上的表现。用类Python伪代码可以表示为:


x = EmbeddingLayer(input_ids)
x = concatenate([soft_prompt_tensor, x],
dim=seq_len)
output = model(x)

其中,soft_prompt_tensor的特征维度与嵌入层输出的输入嵌入维度一致。因此,修改后的输入矩阵会多出若干行,相当于在原输入序列中增加了额外的token,让序列变长。

前缀微调

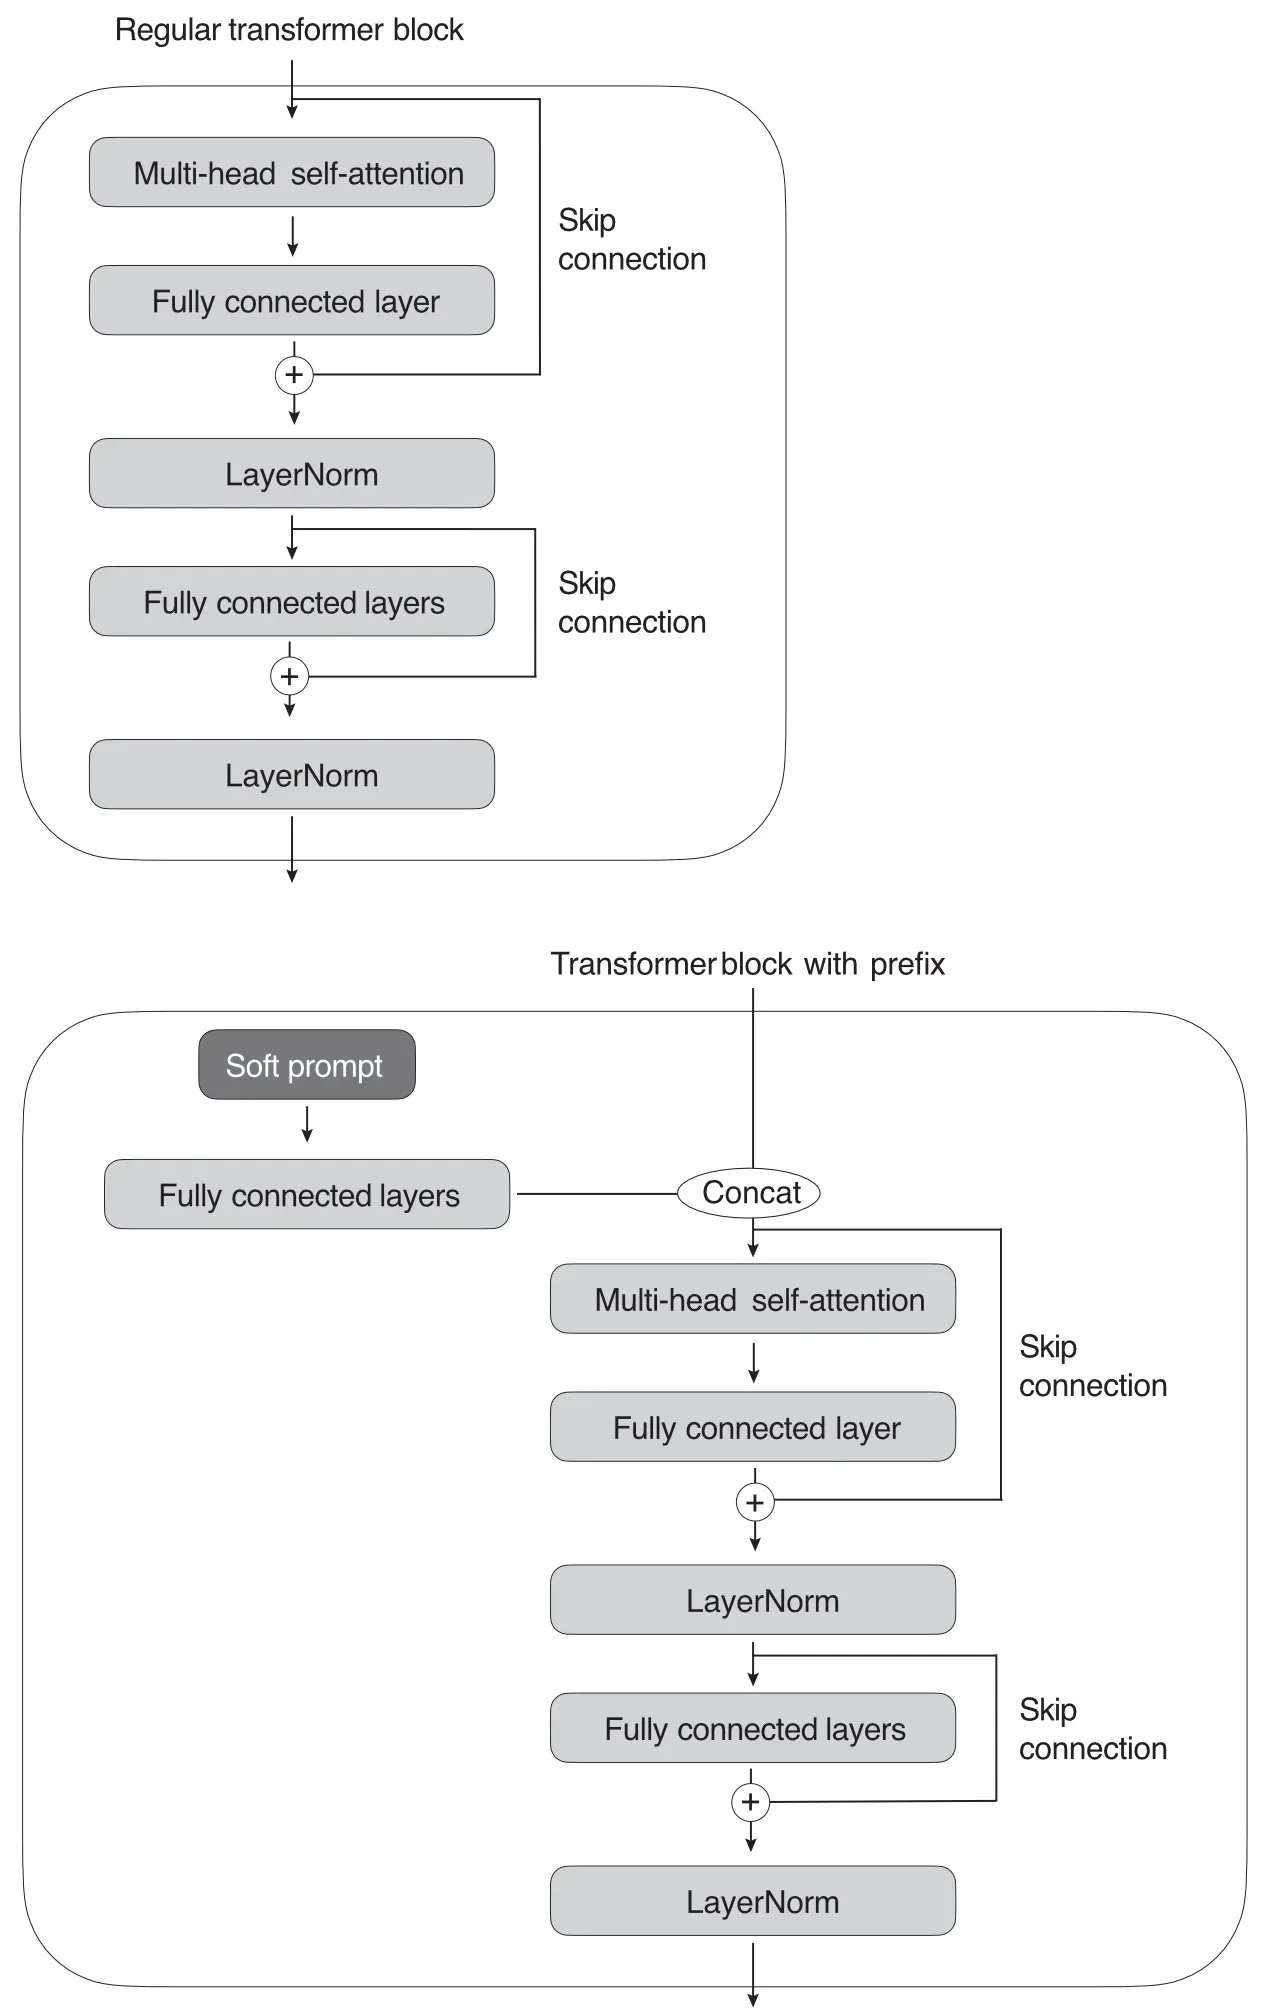
另一种常用的提示微调方法是前缀微调(Prefix Tuning)。它与软提示微调类似,但区别在于:前缀微调是在每个Transformer块前都拼接可训练张量(软提示),而非只在输入嵌入层前拼接,这样可以让训练更稳定。前缀微调的实现伪代码如下:


def transformer_block_with_prefix(x):
# ➊
soft_prompt = FullyConnectedLayers( # Prefix
soft_prompt) # Prefix
# ➋
x = concatenate([soft_prompt, x], # Prefix
dim=seq_len) # Prefix
# ➌
x = SelfAttention(x)
x = LayerNorm(x + residual)
residual = x
x = FullyConnectedLayers(x)
x = LayerNorm(x + residual)
return x

代码清单1:改造为前缀微调的Transformer块

我们将代码清单1分为三部分:软提示的实现、软提示(前缀)与输入的拼接、Transformer块其余部分的实现。首先,张量soft_prompt会经过一组全连接层处理➊;接着,变换后的软提示与主输入x拼接➋,拼接的维度为seq_len,即序列长度维度;最后,后续的代码➌是Transformer块的标准操作,包括自注意力、层归一化和前馈神经网络层,整体采用残差连接结构。

如代码清单1所示,前缀微调通过添加可训练的软提示来改造Transformer块。图6进一步展示了普通Transformer块与前缀微调Transformer块的区别。
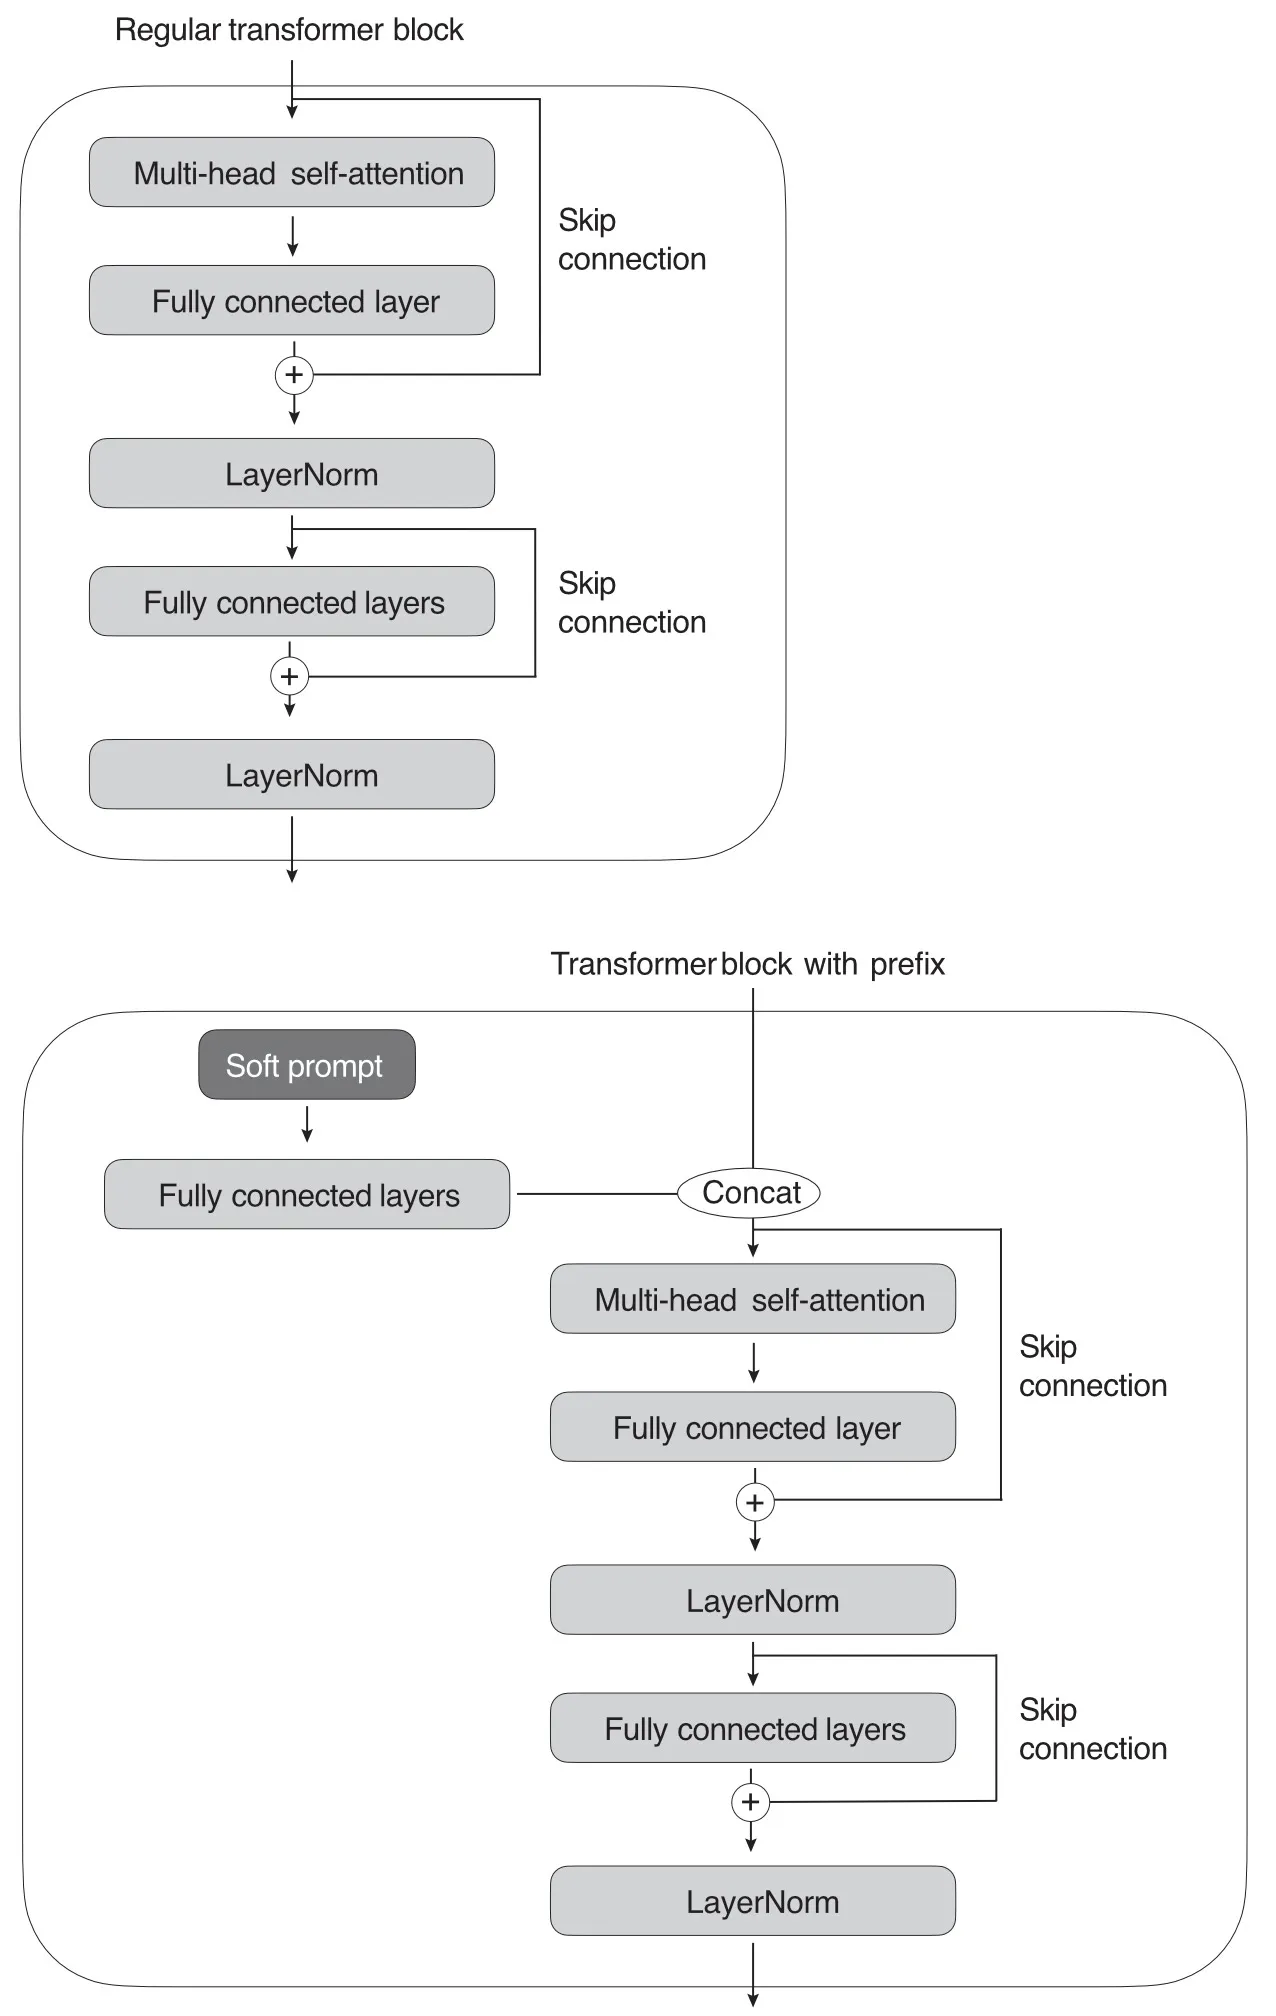
figure07

图6:普通Transformer与前缀微调的对比

软提示微调和前缀微调都属于参数高效方法,因为它们只需要训练拼接的参数张量,无需调整大语言模型本身的参数。

Adapter方法

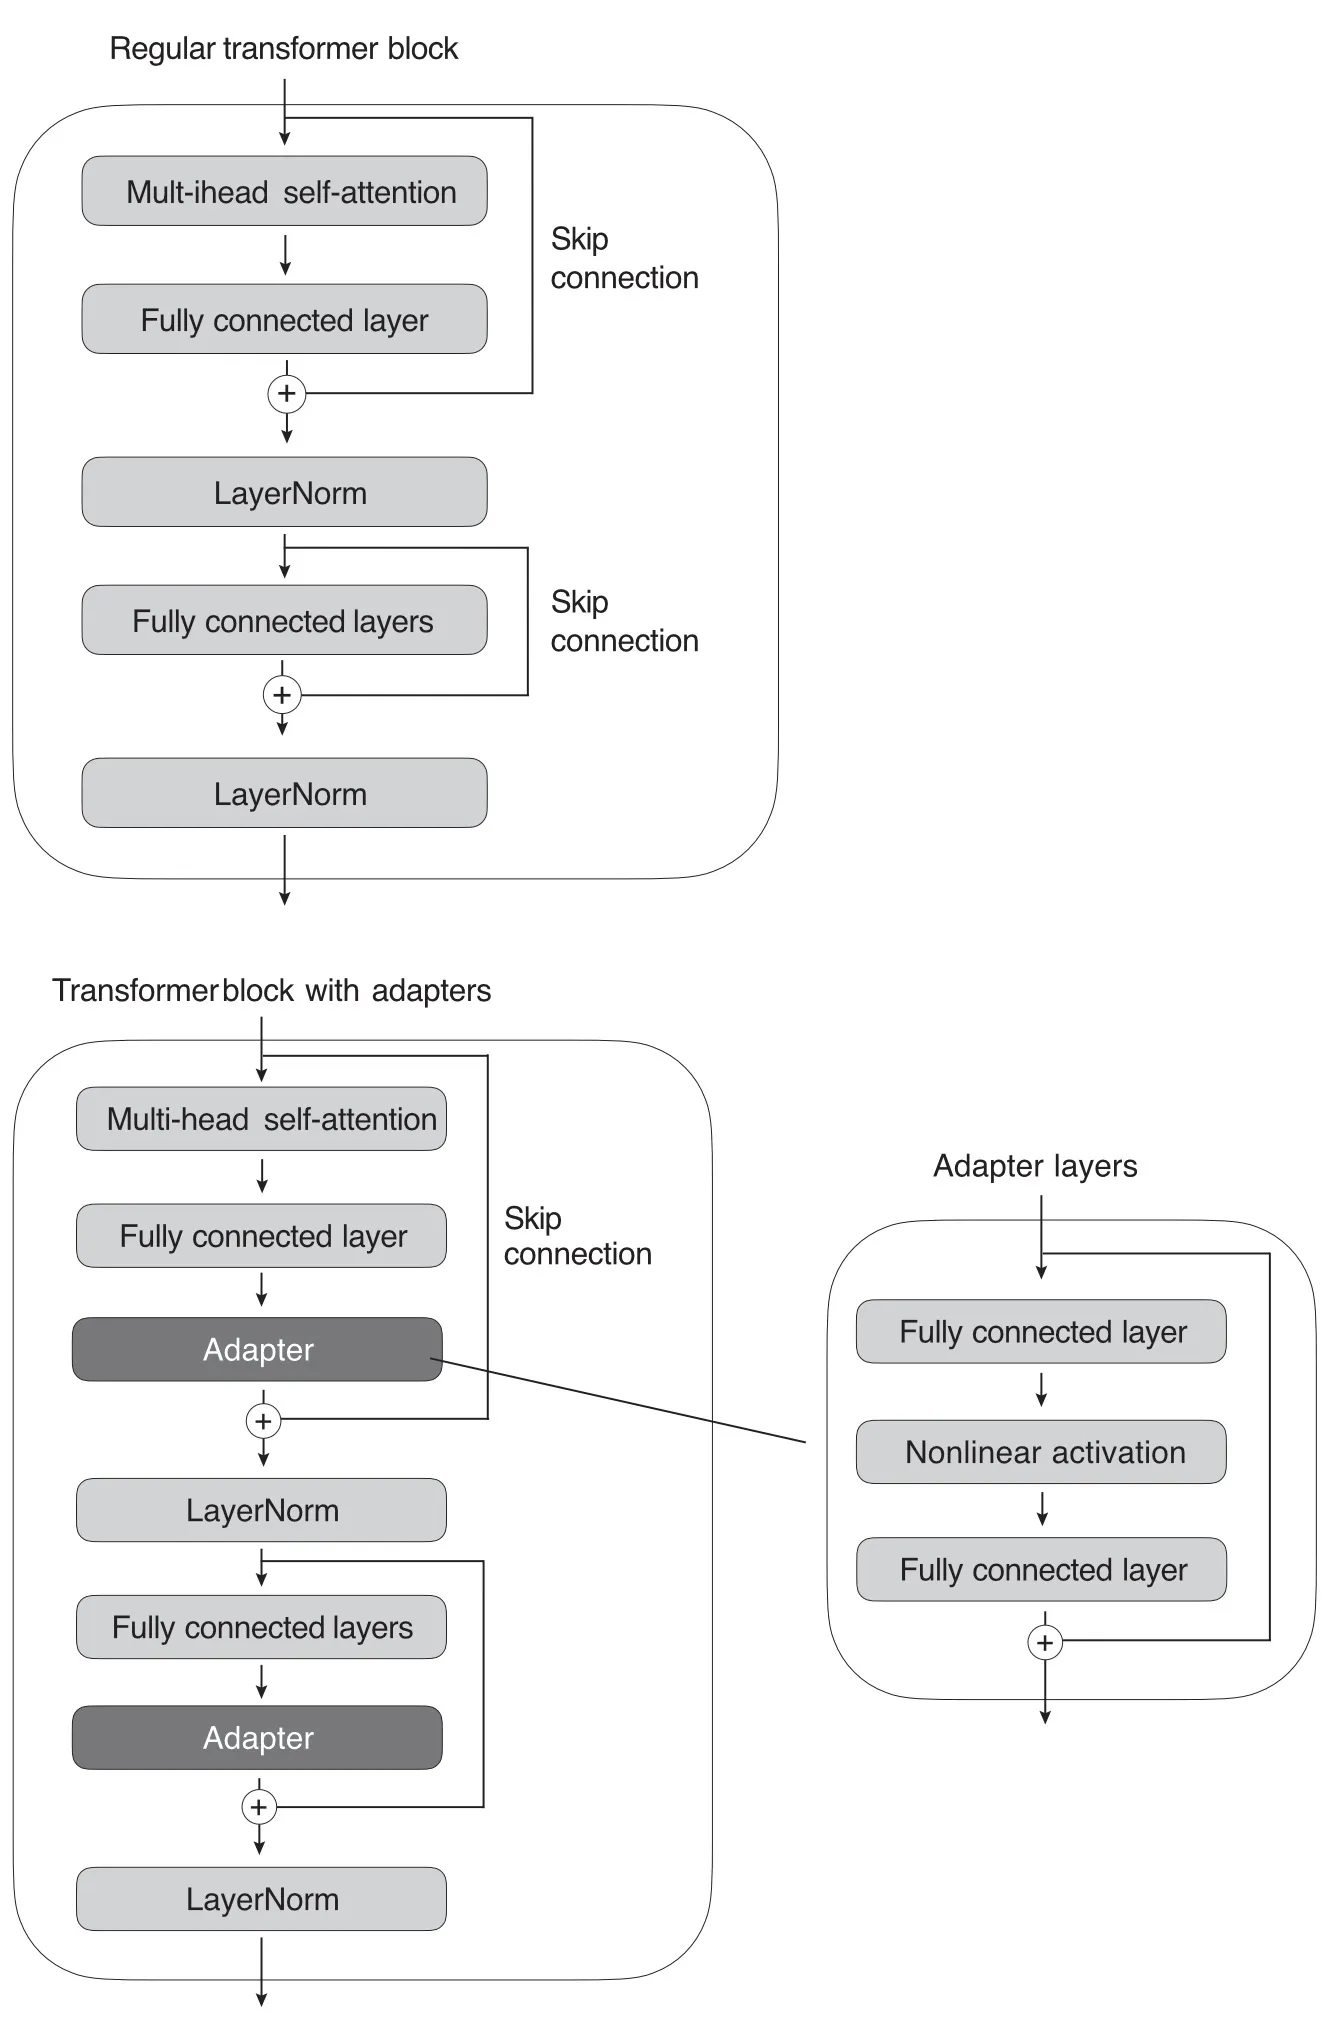
Adapter方法与前缀微调的共同点是都会在Transformer层中新增参数。在原始的Adapter方法中,每个Transformer块的多头自注意力层和原有全连接层之后,都会新增额外的全连接层,如图7所示。
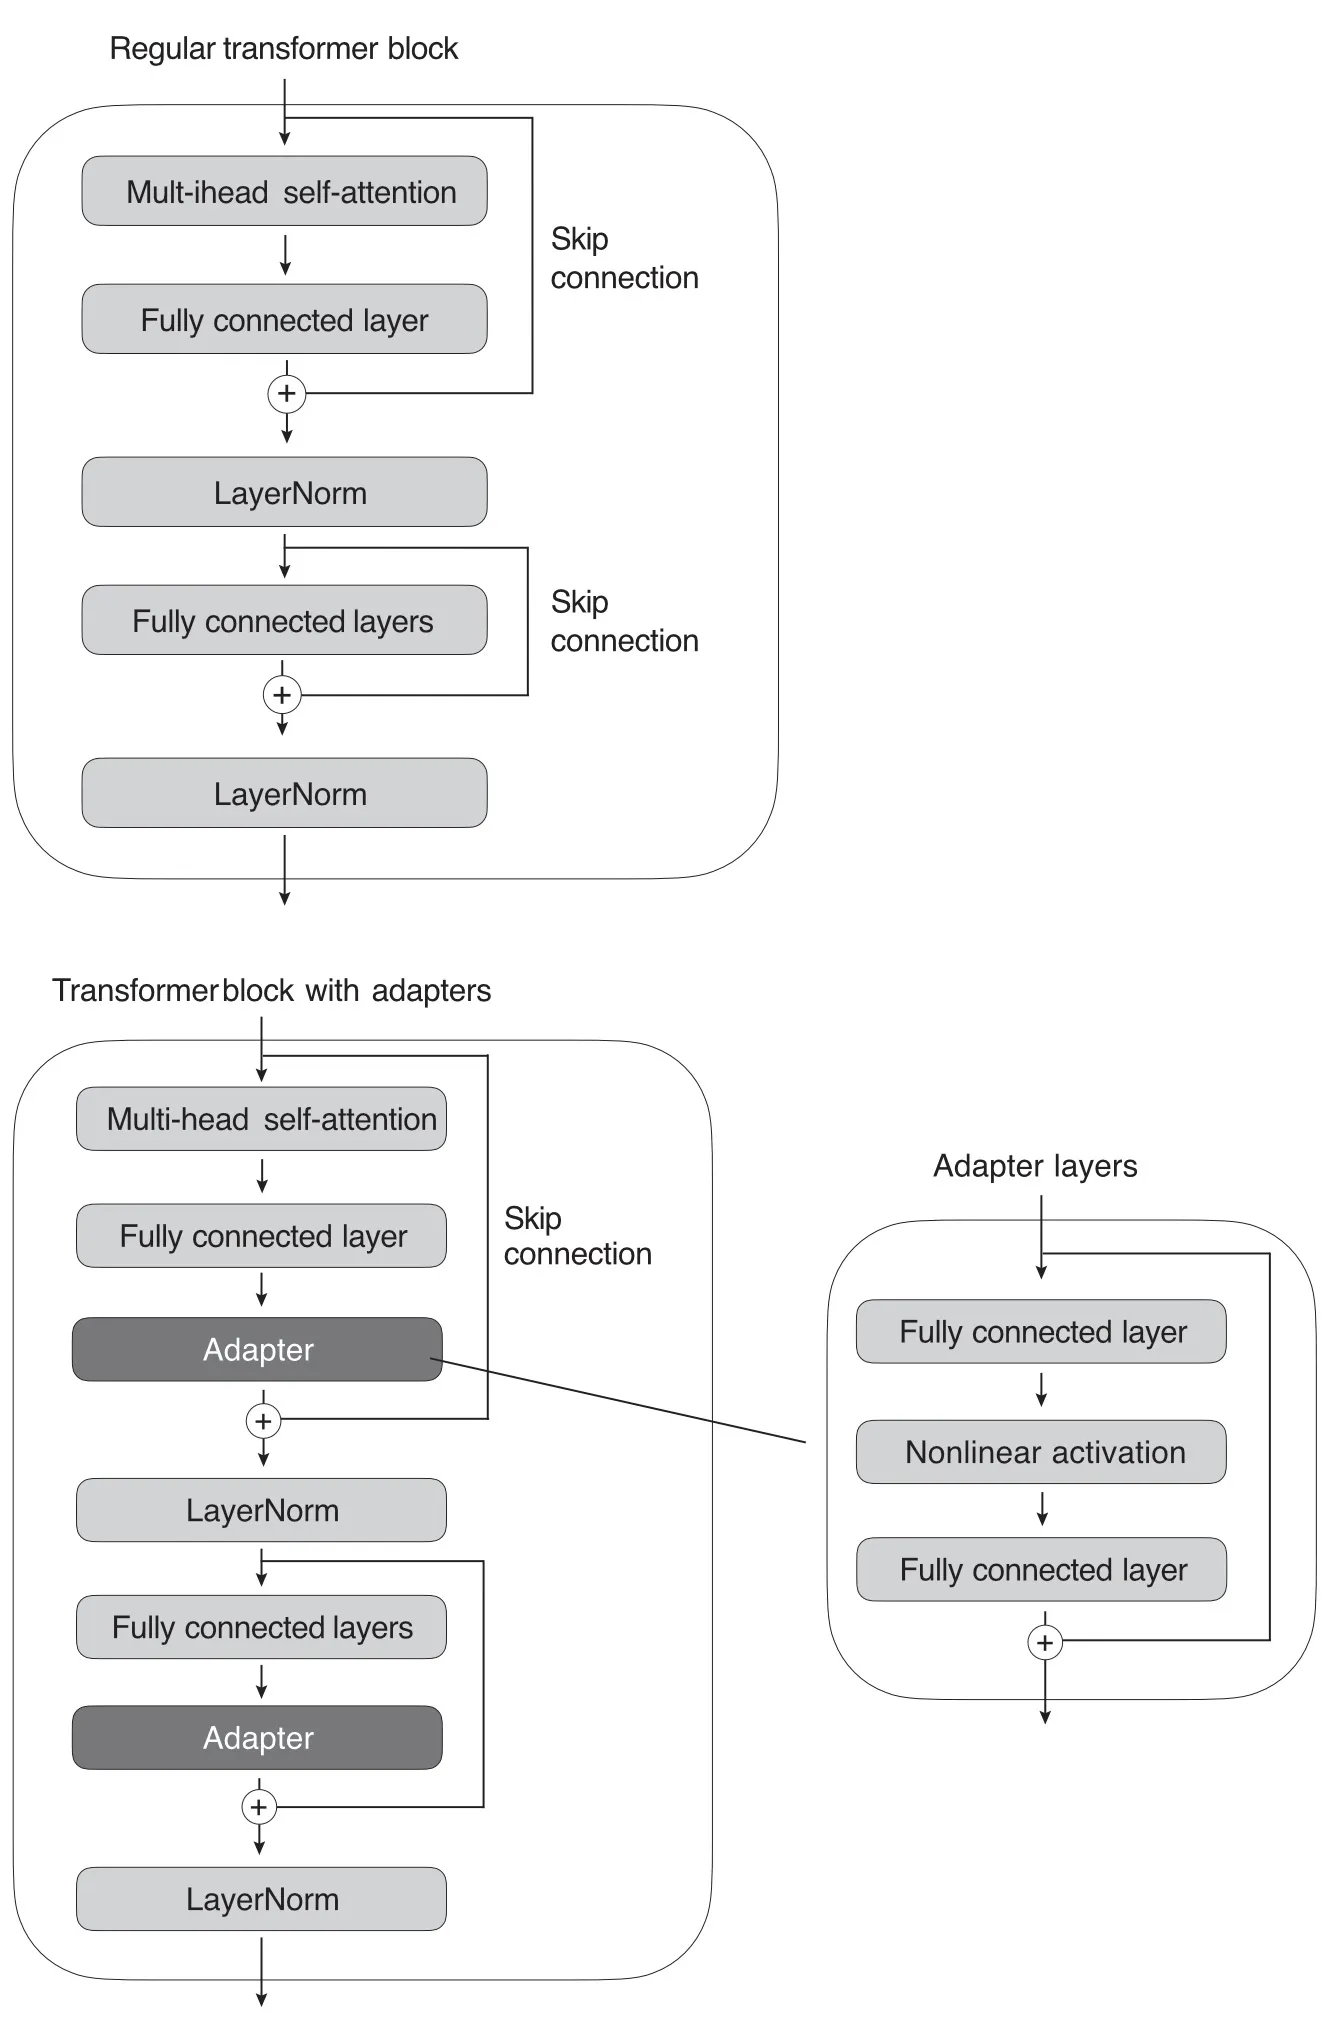
figure08

图7:普通Transformer块(左)与带Adapter层的Transformer块对比。Adapter层的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/04_adapter

使用原始Adapter方法训练大语言模型时,仅更新新增的Adapter层,其余Transformer层保持冻结。Adapter层的参数量通常很小:Adapter块中的第一个全连接层将输入映射到低维空间,第二个全连接层再将其映射回原始输入维度,因此这种方法属于参数高效微调。

用伪代码表示,原始Adapter方法如下:


def transformer_block_with_adapter(x):
residual = x
x = SelfAttention(x)
x = FullyConnectedLayers(x) # Adapter
x = LayerNorm(x + residual)
residual = x
x = FullyConnectedLayers(x)
x = FullyConnectedLayers(x) # Adapter
x = LayerNorm(x + residual)
return x

低秩适配(LoRA)

**低秩适配(Low-Rank Adaptation, LoRA)**是另一种值得关注的主流参数高效微调方法,它通过低秩变换来重新参数化预训练大语言模型的权重。低秩变换是一种用低维表示近似高维矩阵或数据集的技术,通过找到更少的维度组合,有效捕捉原始数据中的大部分信息,从而实现低维近似。常用的低秩变换方法包括主成分分析(PCA)和奇异值分解(SVD)。

例如,假设ΔW是大语言模型中某个权重矩阵的参数更新量,维度为ℝ^(A×B)。我们可以将这个权重更新矩阵分解为两个更小的矩阵:ΔW = W_A W_B,其中W_A ∈ ℝ^(A×h),W_B ∈ ℝ^(h×B)。训练时,原始权重保持冻结,仅训练新的矩阵W_A和W_B。

既然引入了新的权重矩阵,为什么说它是参数高效的?因为这些新矩阵的规模可以非常小。举个例子,假设A=25,B=50,那么ΔW的参数量是25×50=1250。如果取h=5,那么W_A有125个参数,W_B有250个参数,两个矩阵加起来总共只有125+250=375个参数。

学习到权重更新矩阵后,全连接层的矩阵乘法可以写成如下伪代码形式:


def lora_forward_matmul(x):
h = x . W # Regular matrix multiplication
h += x . (W_A . W_B) * scalar
return h

代码清单2:结合LoRA的矩阵乘法。Adapter层的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/05_lora

在代码清单2中,scalar是缩放因子,用于调整最终融合结果(原始模型输出加上低秩适配结果)的幅度,以此平衡预训练模型的原有知识与新任务的适配效果。根据LoRA方法的原始论文,在多个任务基准测试中,使用LoRA的模型效果略优于使用Adapter方法的模型,甚至往往比前文提到的微调II型(全量微调)的模型效果更好。

《Ahead of AI》是读者支持的付费专栏。如果想接收新文章并支持我的创作,欢迎免费订阅或成为付费会员。

基于人类反馈的强化学习(RLHF)

上一节我们聚焦于提升微调效率的方法。现在换个角度:我们如何通过微调来提升大语言模型的建模效果?

让大语言模型适配新领域或新任务的传统方法,是用标注好的目标数据进行有监督微调。例如,微调II型方法可以让预训练大语言模型适配情感分类等目标任务,使用的数据集中包含标注了正面、中性、负面等情感标签的文本。

有监督微调是大语言模型训练的基础步骤。而更进阶的一步是基于人类反馈的强化学习(Reinforcement Learning with Human Feedback, RLHF),它可以进一步提升模型与人类偏好的对齐程度。例如ChatGPT及其前身InstructGPT,就是预训练大语言模型(GPT-3)经过RLHF微调后的典型代表。

在RLHF中,预训练模型会结合监督学习与强化学习进行微调。该方法因初代ChatGPT而普及,而ChatGPT的技术又源于InstructGPT。具体来说,我们让人类对模型的不同输出进行排序或打分,收集人类反馈作为奖励信号;再用这些奖励标注训练一个奖励模型,引导大语言模型向人类偏好的方向适配。奖励模型通常以预训练大语言模型为基座,通过监督学习训练得到;之后再通过额外的微调,让预训练大语言模型向人类偏好对齐。这个额外微调阶段使用的强化学习算法是近端策略优化(Proximal Policy Optimization, PPO)。

RLHF之所以使用奖励模型,而非直接用人类反馈训练预训练模型,是因为人类无法实时提供反馈,让人类全程参与学习过程会成为训练瓶颈。

预训练语言模型的适配总结

尽管微调整个预训练大语言模型的全部层,依然是适配新任务的“黄金标准”,但我们也有很多高效的方案来利用预训练Transformer。例如,通过基于特征的方法、上下文学习或参数高效微调技术,我们可以在最小化计算成本与资源消耗的同时,将大语言模型高效应用于新任务。

三种传统方法——基于特征的方法、微调I型、微调II型——在计算效率与性能之间提供了不同的权衡。软提示微调、前缀微调、Adapter方法等参数高效微调技术进一步优化了适配过程,减少了需要更新的参数量。而RLHF则为有监督微调提供了另一种思路,有望进一步提升建模效果。

总而言之,预训练大语言模型的通用性与效率仍在不断提升,为我们将模型适配到各类任务与领域提供了更多可能与策略。随着该领域研究的推进,未来预训练语言模型的使用方法还会有更多的进步与创新。

参考文献与延伸阅读

代码示例

https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/01_classifier-finetuning
https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/02_prompting
https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/03_retrieval-augmented-generation
https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/04_adapter
https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/05_lora

练习题

  1. 什么时候更适合用上下文学习而非微调?反过来呢?
  2. 在前缀微调、Adapter和LoRA方法中,如何保证模型保留(而不遗忘)原有的知识?

《机器学习与AI问答》

希望你喜欢这段节选!如果你对另外29个机器学习与AI相关主题感兴趣,可以在 https://nostarch.com/machine-learning-and-ai-beyond-basics、https://www.amazon.com/Machine-Learning-AI-Beyond-Basics/dp/1718503768 及各大图书渠道购买本书。
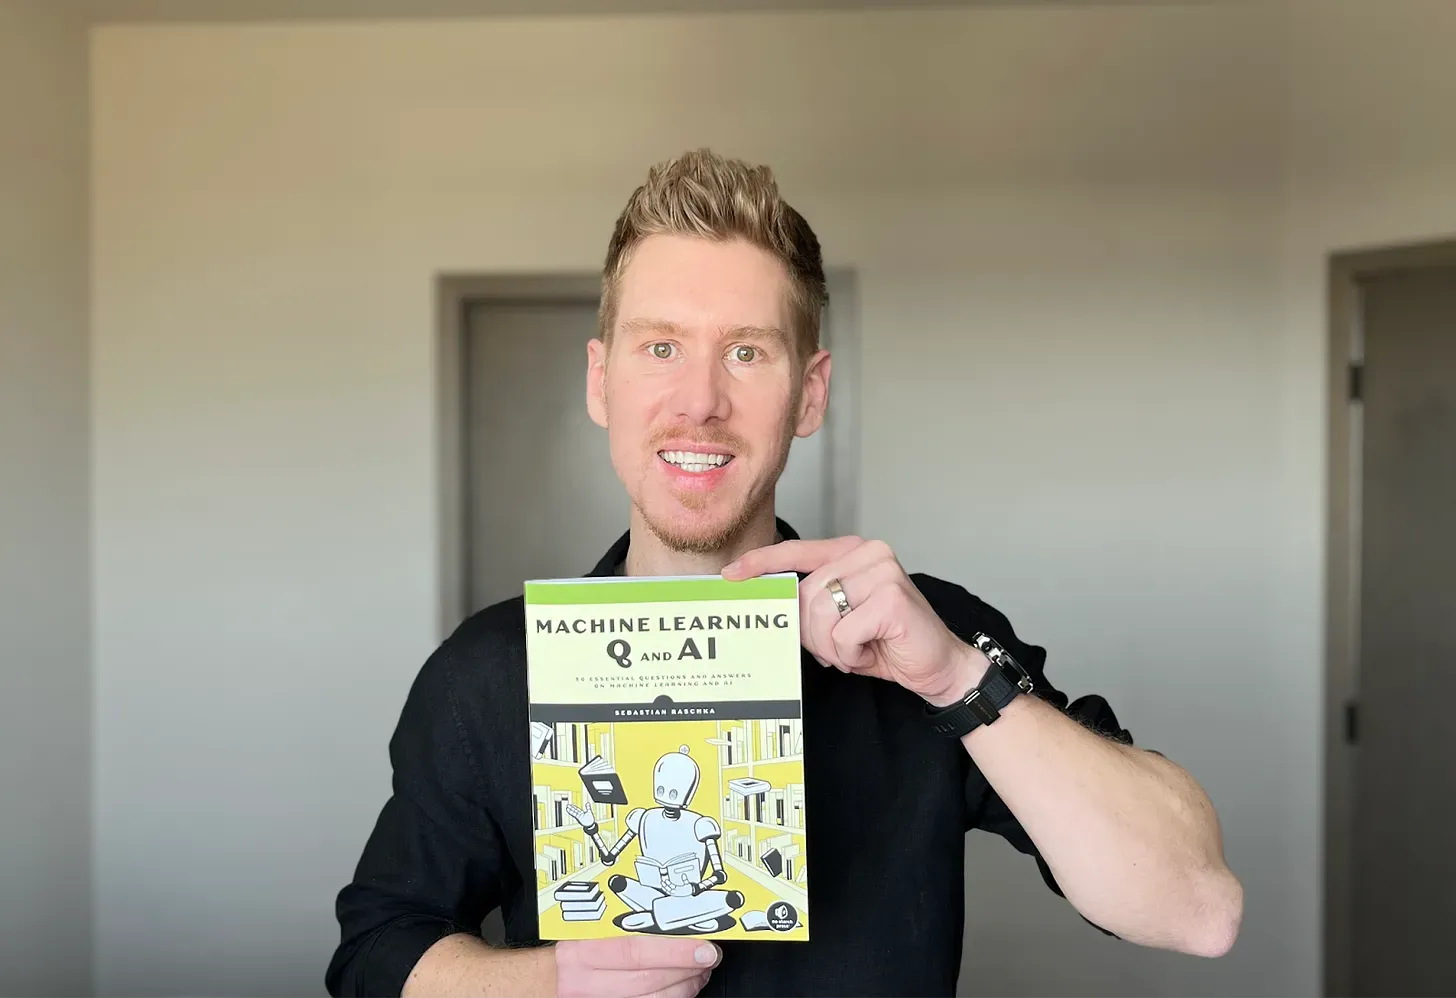
figure09

https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768 这本书涵盖了30个机器学习与AI的核心主题。

《Ahead of AI》是我的个人兴趣项目,没有直接的商业收入。如果你愿意购买我的书来支持这些创作,我会非常感激。

如果你已经买了这本书,也非常欢迎在亚马逊上留下评价!
【转载】大语言模型研究洞察:指令掩码与新型LoRA微调实验

原文地址:LLM Research Insights: Instruction Masking and New LoRA Finetuning Experiments,by Sebastian Raschka, on 2024-06-02

大语言模型研究洞察:指令掩码与新型LoRA微调实验

讨论2024年5月最新模型发布与AI研究

本月我将介绍三篇与大语言模型(LLM)的指令微调、以及基于LoRA的参数高效微调相关的新论文。我日常工作中经常用到这些方法,因此看到能带来实践洞见的新研究总是令人兴奋。

这篇文章可能会比往常稍短一些,因为我目前正在完成我的著作《http://mng.bz/orYv》的最后一章。此外,我还在准备本周三的一场线上讲座:https://events.zoom.us/ev/ArzwACAJCGWLB-pPrWeIwszDr8WDhlEcFLL4VMCb1SJVU4fzrQo9~AvhUziSVIoulf4yLm7f0hhyew2qRK0ZEIE6Xztz4yEDudekpMeEd9L_UXVY_6lWFFOTqXHlF-N_xKaCrP5aP07ZzFQ。讲座免费向所有人开放,如果感兴趣的话非常欢迎你参加!
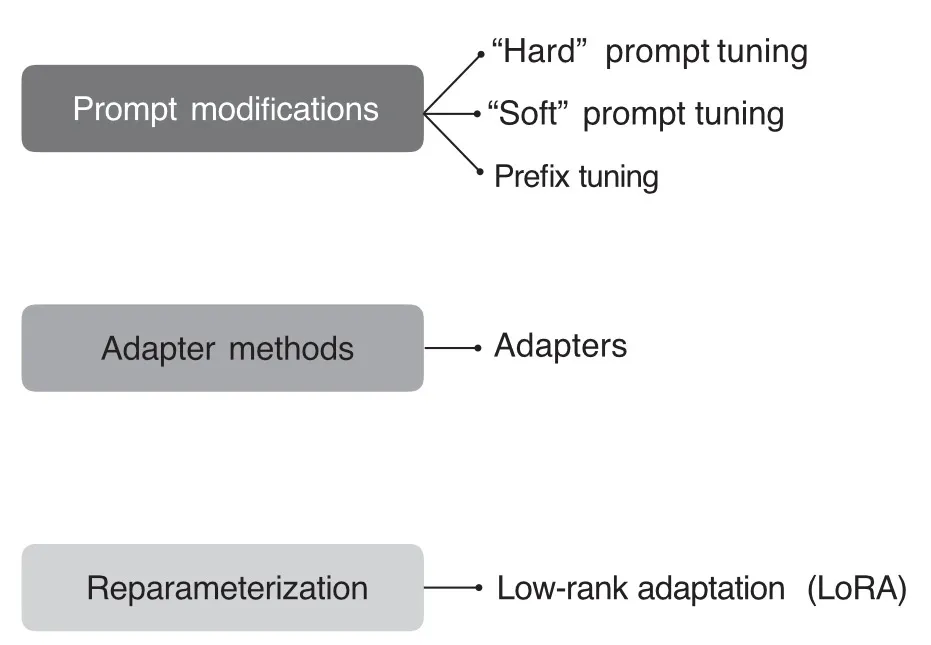
figure01

了解本次线上讲座:https://events.zoom.us/ev/ArzwACAJCGWLB-pPrWeIwszDr8WDhlEcFLL4VMCb1SJVU4fzrQo9~AvhUziSVIoulf4yLm7f0hhyew2qRK0ZEIE6Xztz4yEDudekpMeEd9L_UXVY_6lWFFOTqXHlF-N_xKaCrP5aP07ZzFQ

1. 对指令计算损失的指令微调

本月吸引我注意的一篇论文是:https://arxiv.org/abs/2405.14394

在这篇论文中,作者们对指令微调中一个被广泛认可的做法提出了质疑:计算损失时对指令部分进行掩码。在讨论研究结果之前,我们先来做一个整体概述。

1.1 指令微调过程中的指令掩码

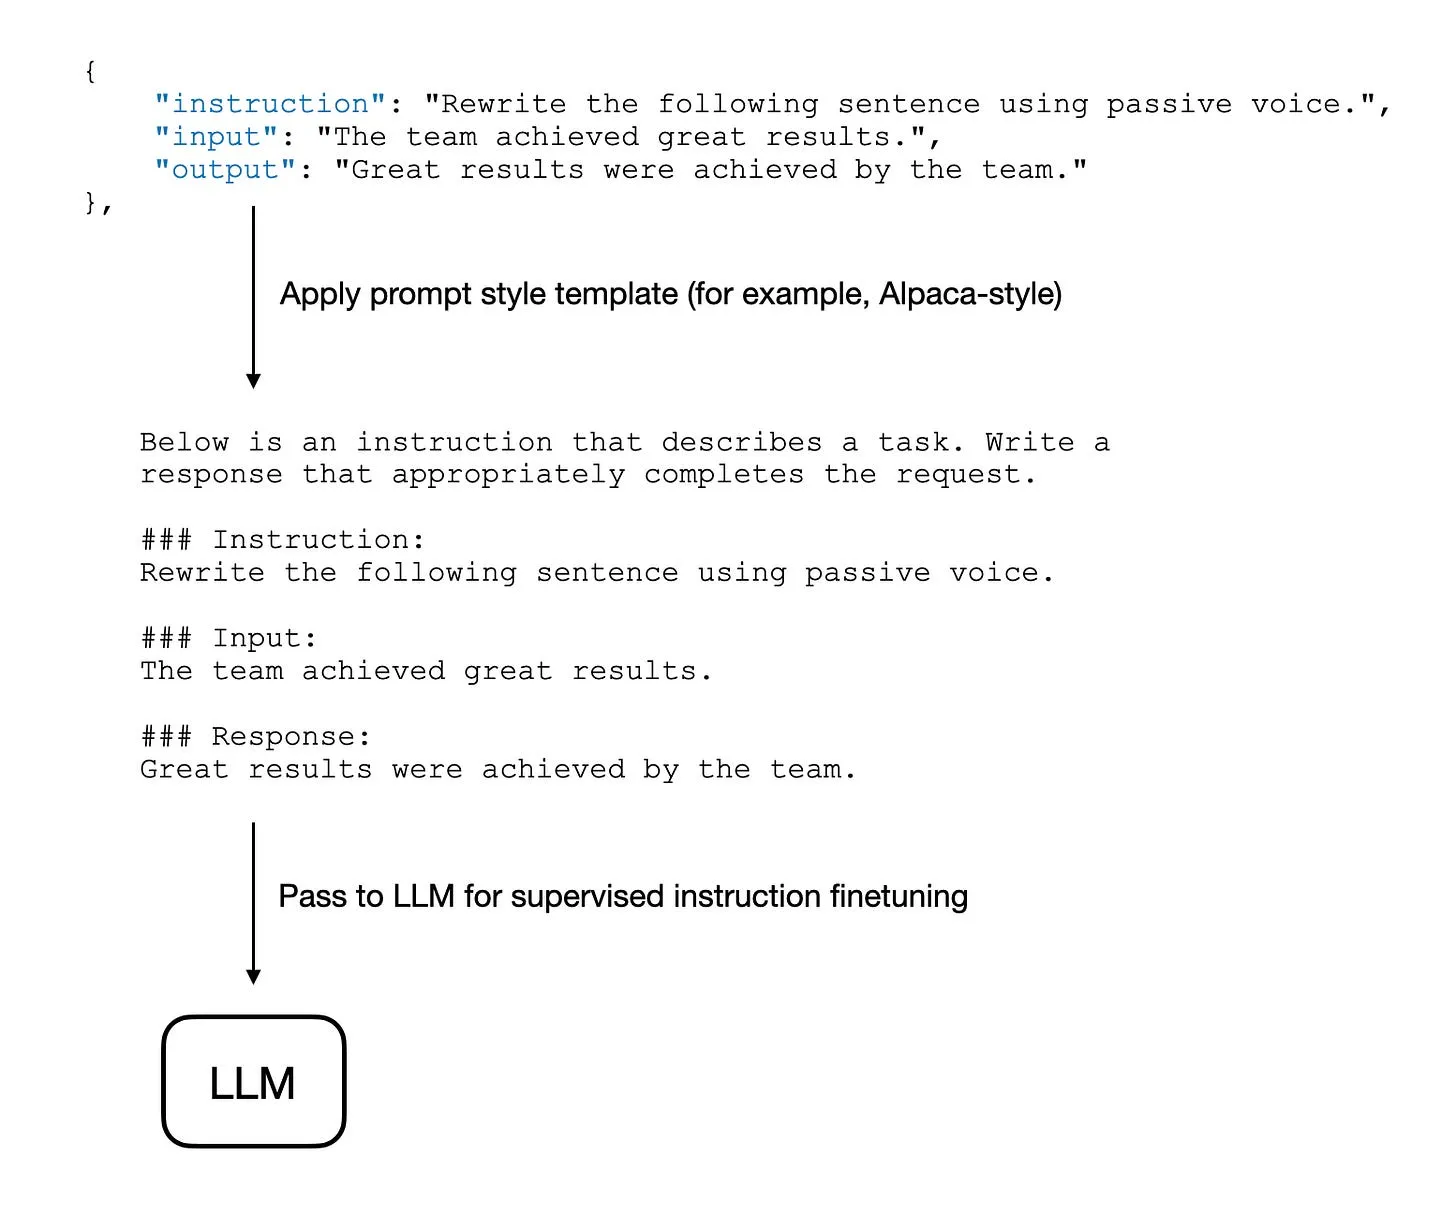
指令微调(简称指令调优)的任务是提升预训练大语言模型遵循指令的响应能力(比如“总结这篇文章”“翻译这个句子”等)。

figure02

指令微调数据集示例示意图

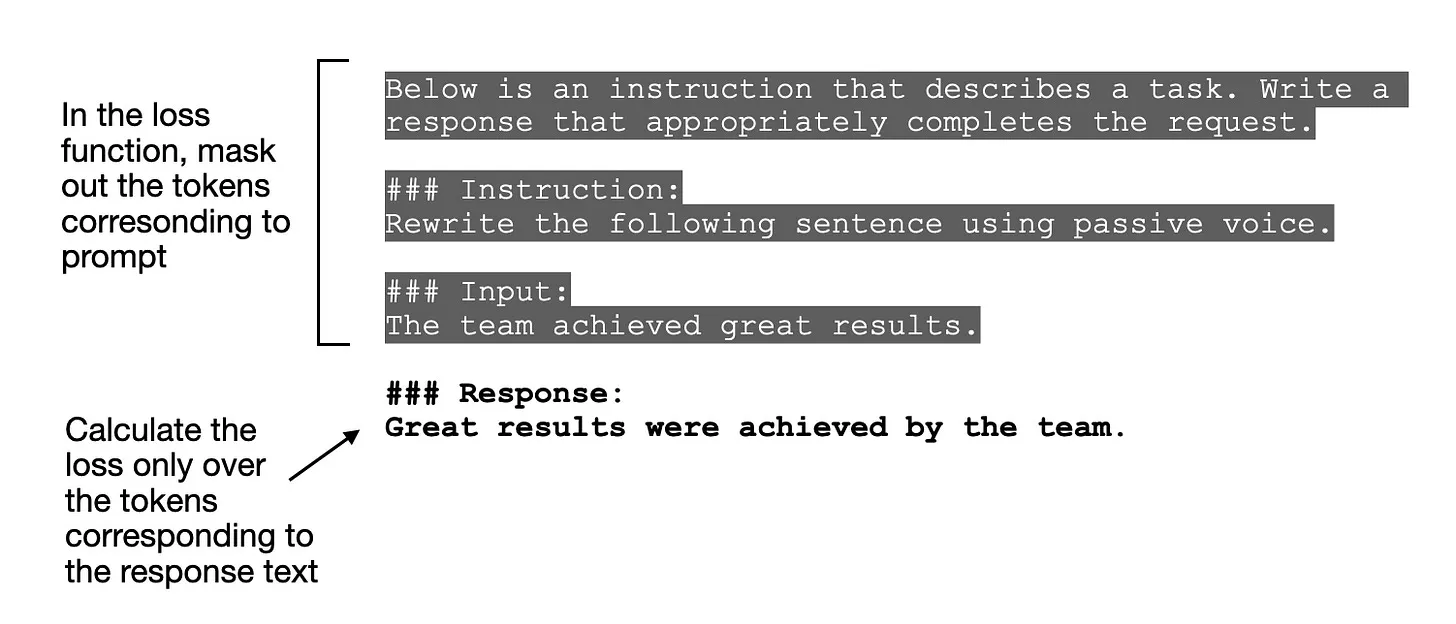
在对大语言模型进行指令微调时,计算损失时通常会将指令本身掩码掉。例如,我们的https://github.com/Lightning-AI/litgpt库默认就是这么做的,我在自己的著作《https://github.com/rasbt/LLMs-from-scratch》的第7章中也采用了这种做法(不过我现在正考虑把掩码相关内容改成读者练习题)。

在其他主流大语言模型库中,比如https://github.com/OpenAccess-AI-Collective/axolotl,该功能也会通过config.yaml中默认的`train_on_inputs: false设置自动实现。而在Hugging Face中,默认不会这么做,但可以通过DataCollatorForCompletionOnlyLM`数据集整理器来实现,详情参见:https://huggingface.co/docs/trl/en/sft_trainer#train-on-completions-only

figure03

输入掩码示意图:高亮的文本仍会输入给大语言模型,但在训练计算损失时不参与计算。

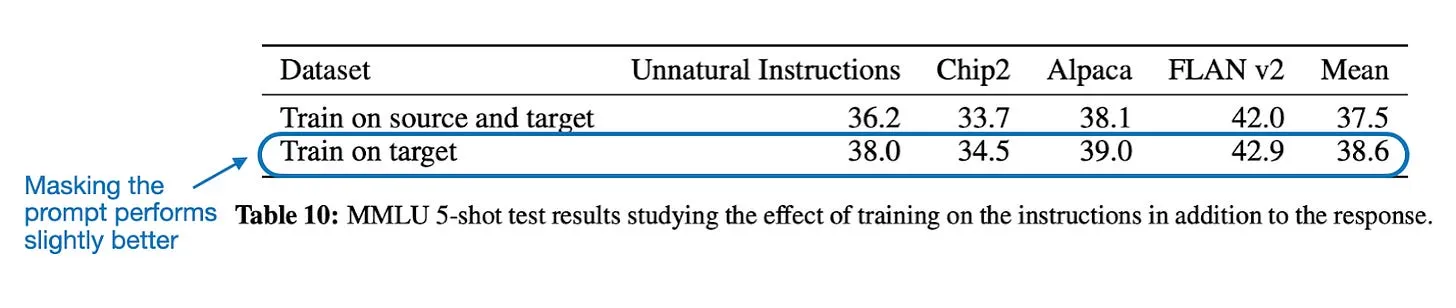
如上所述,对输入提示进行掩码是一项常规操作,有些论文中也会对比使用和不使用掩码的效果。例如QLoRA论文的附录中就包含了一组对比,结果显示掩码的效果更好。

figure04

《QLoRA:量化大语言模型的高效微调》中的带标注表格,原文:https://arxiv.org/abs/2305.14314

需要注意的是,MMLU是一个专注于测评选择题表现的基准测试,作者们并没有研究当微调后的模型用作聊天机器人时,该做法对对话性能的影响。

1.2 指令建模

在上一节对主题做了简要介绍之后,我们来详细分析https://arxiv.org/abs/2405.14394这篇论文。在这项研究中,作者系统地探究了指令掩码与非掩码两种情况下大语言模型的性能差异。

figure05

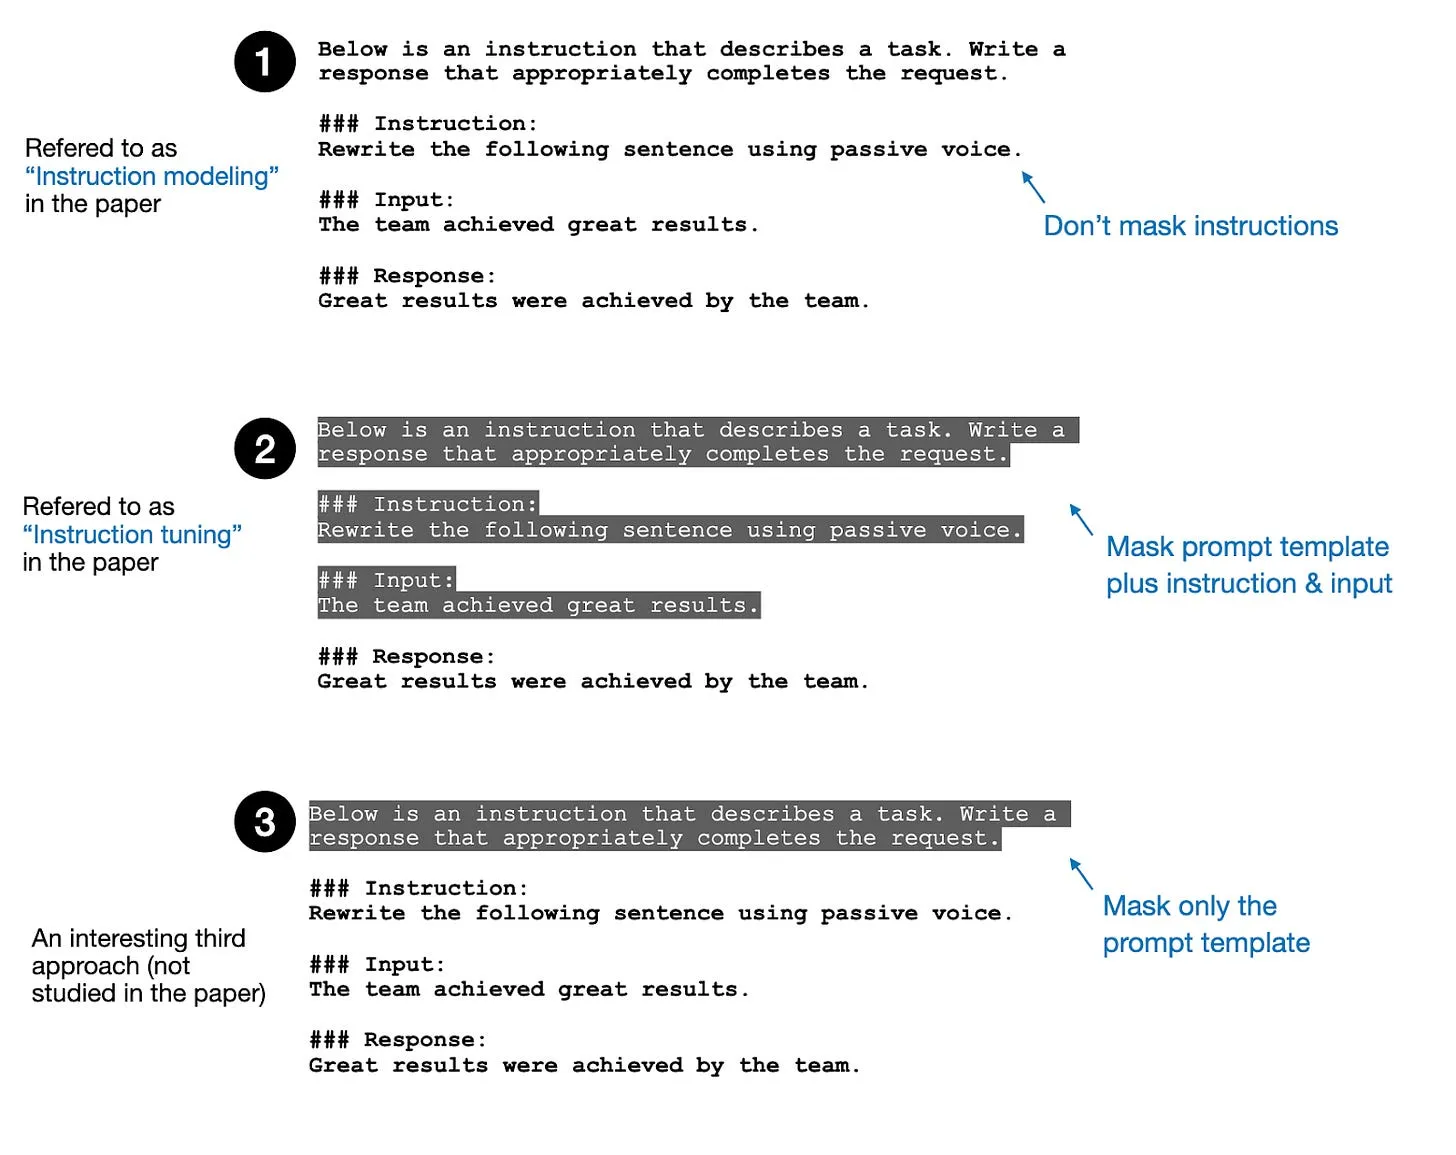
三种方式示意图:(1) 无指令掩码;(2) 指令掩码;(3) 样板文本掩码。

上图中的方法1是实现大语言模型时的默认做法,因为它不需要对损失函数做任何额外的修改。论文中作者将这种方法称为“指令建模”(论文中还额外对非Alpaca提示模板中可能出现的特殊提示词元,比如<|user|>、<|assistant|>和<|system|>进行了掩码)。

方法2是目前实践中最常用的方式:计算损失时,除了响应部分之外的所有内容都被掩码。论文中作者将这种方法称为“指令微调”(在这个语境下这个命名有点不妥,因为和方法1相比,我们并不是在“微调”指令,而是将指令排除在损失计算之外)。

在绘制上图的时候,我想到了论文中没有探讨的第三种有趣的思路:对提示中特定的样板文本进行掩码。例如在Alpaca风格的提示中,所有示例都以“以下是一条指令……”开头。和实际的指令与输入相比,这段文本是固定的,因此可以排除在损失计算之外。论文中没有研究这一点,但这可能是一个有趣的补充实验,我正计划把它作为另一道读者练习题(附答案)加入到我的《https://github.com/rasbt/LLMs-from-scratch》中。

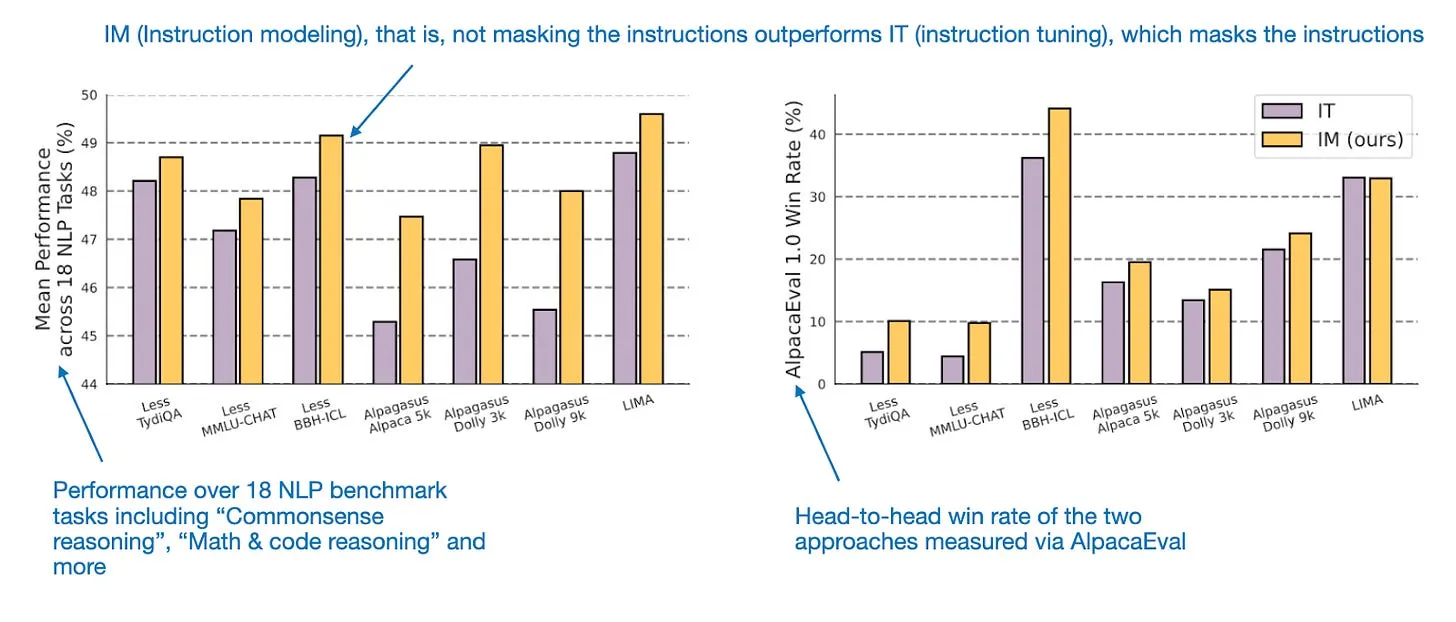
结果表明,指令建模(即不对指令进行掩码)的效果似乎优于掩码方法,如下图所示。

figure06

不对指令掩码的效果优于对指令掩码。改绘自《对指令计算损失的指令微调》,原文:https://arxiv.org/abs/2405.14394

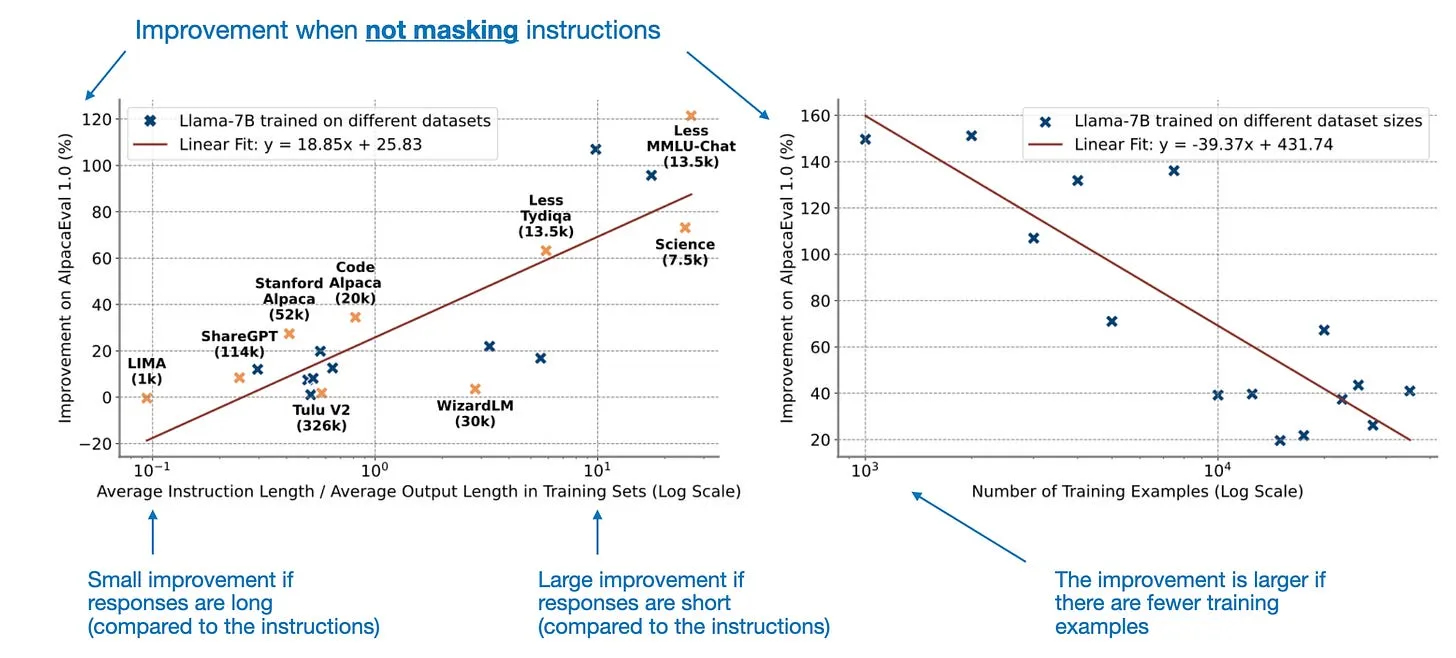
不过,“指令建模”的效果取决于两个因素:(a) 指令长度与响应长度的比值;(b) 数据集的大小(以训练样本数量计)。

figure07

不掩码指令的收益取决于数据集的长度与规模。改绘自《对指令计算损失的指令微调》,原文:https://arxiv.org/abs/2405.14394

对于上图呈现的数据集长度和规模依赖性,一个合理的解释是:如果响应很短且训练样本很少,模型会更容易记住响应,因此采用指令建模(也就是在损失中对更多模型输出进行建模)有助于减少过拟合。

1.3 结论

简而言之,作者们发现,回归最基础的做法——不对指令进行掩码——能够提升模型性能。

令人意外的是,不对指令掩码(仅对<|user|>、<|assistant|>和<|system|>这类特殊提示词元进行掩码)这种更简单的方法,效果反而更好。

以我个人的经验来看,过去我尝试过两种方法,但并没有看到明显的优劣之分,所以通常不会在掩码上做太多实验,效果不好的时候更多会去调整其他设置。现在回头看,多尝试一下(非)掩码方法或许是有意义的,因为它的效果似乎取决于数据集的大小和长度。

Ahead of AI是一份由读者支持的刊物。想要接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

2. LoRA学得更少,忘得也更少

https://arxiv.org/abs/2405.09673是一项针对大语言模型低秩适配(LoRA)微调的综合实证研究,在编程和数学两个目标领域对比了LoRA与全量微调的效果。除了领域维度,对比还覆盖了两种目标任务:指令微调和持续预训练。

如果你在继续阅读前想回顾一下LoRA的相关知识,我之前在《改进LoRA:从零实现权重分解低秩适配(DoRA)》一文中有过介绍:
https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch

2.1 LoRA的学习能力更弱

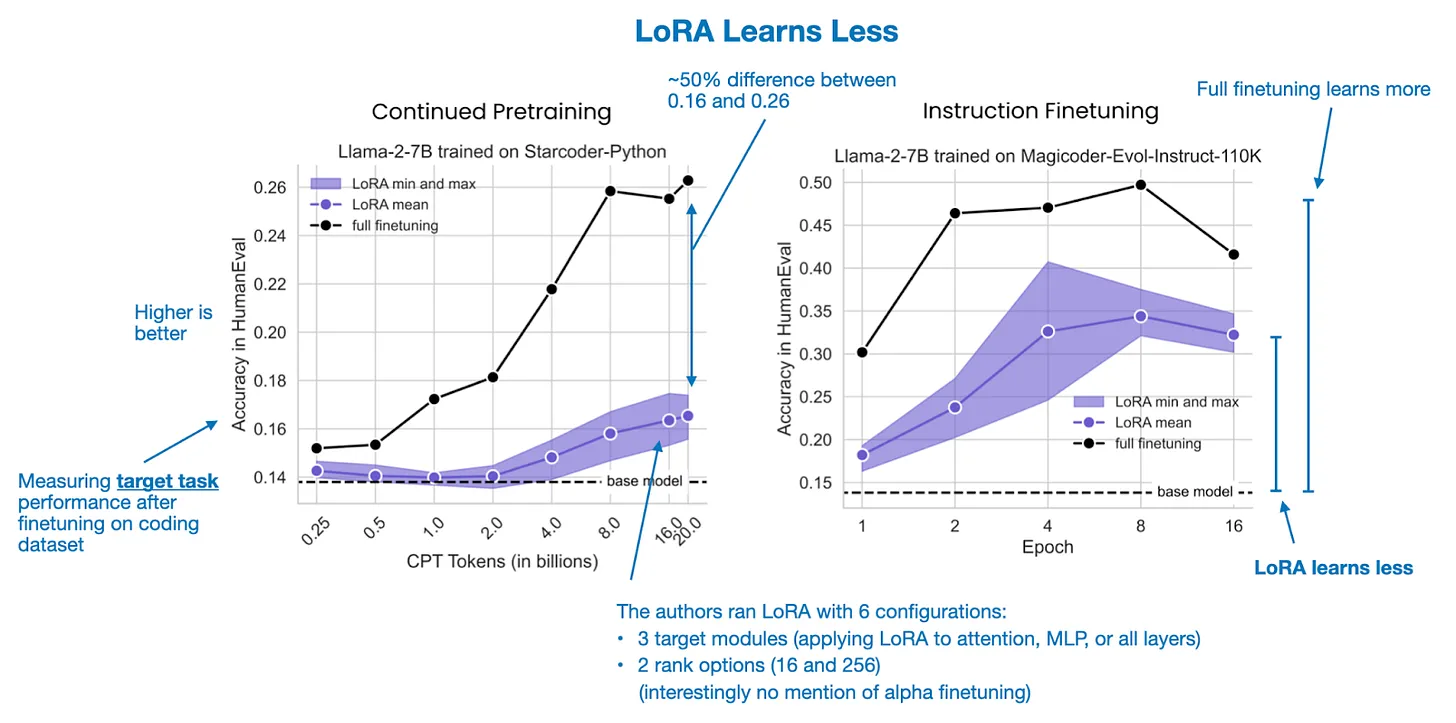
从第一组结果来看,LoRA的学习效果明显不如全量微调,如下图所示。在我看来这是意料之中的,因为更新更少的参数会限制学习能力。学习新知识通常需要比“将预训练基础模型转化为指令遵循模型”更大的容量。

figure08

全量微调 vs LoRA。性能在HumanEval数据集上测得,该数据集包含164道编程挑战题。改绘自《LoRA学得更少,忘得也更少》,原文:https://arxiv.org/abs/2405.09673

在上图中还有一个值得注意的现象:持续预训练场景下,LoRA与全量微调的差距比指令微调场景下更大。这符合我们的普遍认知:预训练主要是教大语言模型新知识,而指令微调主要是改变大语言模型的行为模式。

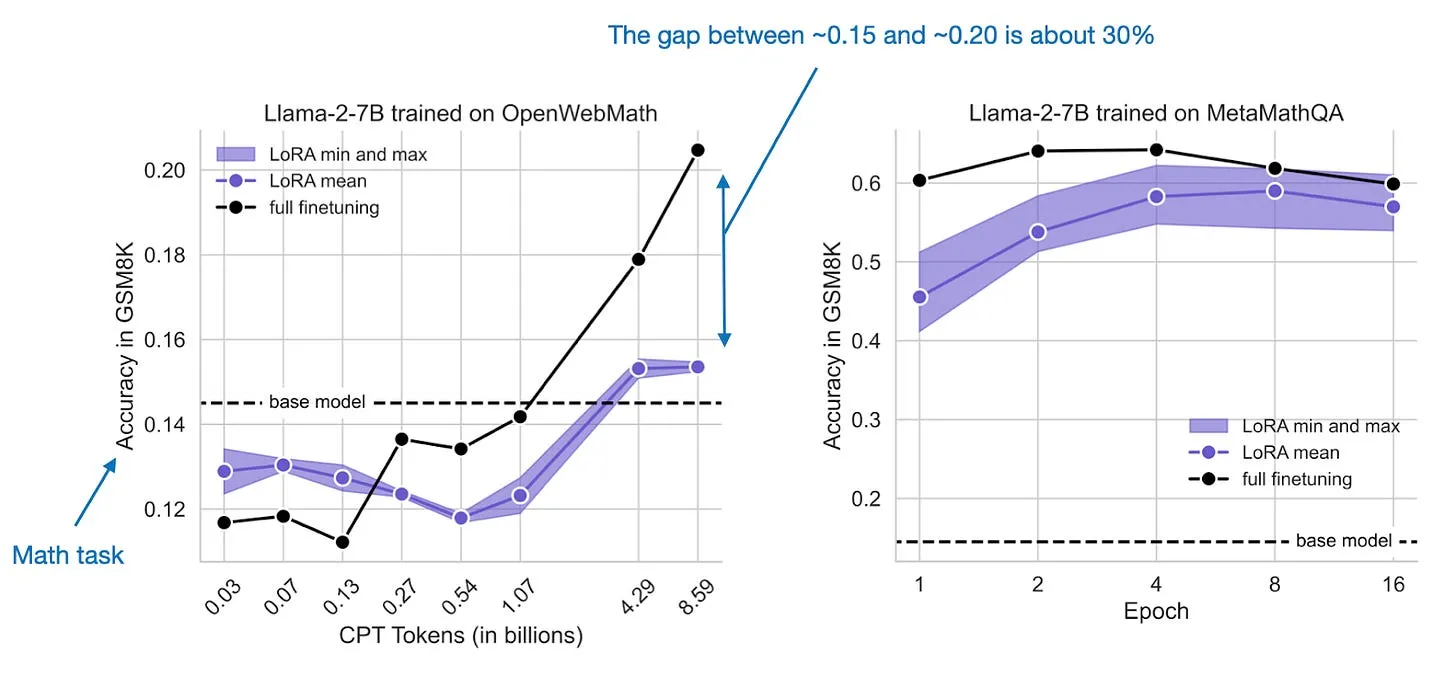
接下来,在数学领域而非编程领域重复同一组实验,我们会发现全量微调和LoRA之间的差距缩小了,如下图所示。

figure09

数学任务下全量微调与LoRA的对比。改绘自《LoRA学得更少,忘得也更少》,原文:https://arxiv.org/abs/2405.09673

可以认为,相比编程,解决数学问题与大语言模型的预训练源域关联更紧密。换句话说,大语言模型在预训练过程中接触到的数学题可能比编程任务更多。此外,数学题通常用自然语言描述,而编程需要一整套全新的术语体系。

总结一下,目前我们可以得出结论:新任务与预训练数据的差异越大,在获取新知识时(比如通过持续预训练),全量微调相比LoRA的优势就越明显。

2.2 LoRA的遗忘程度更低

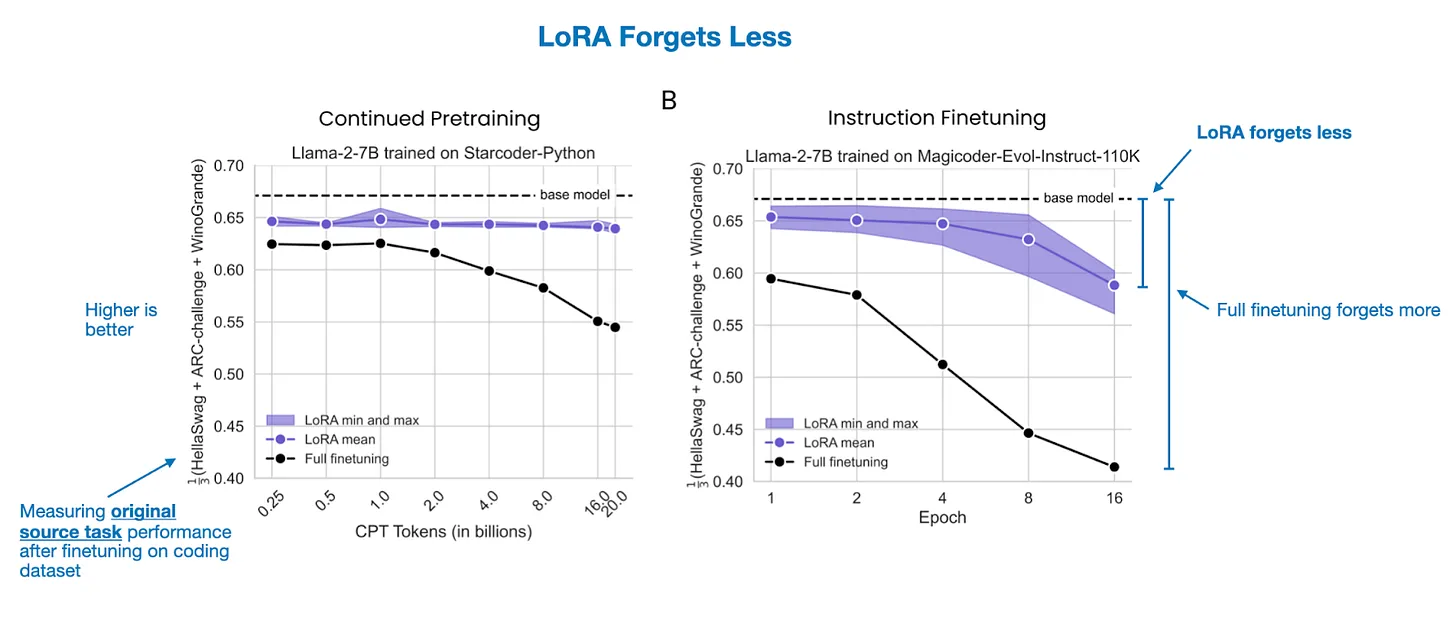
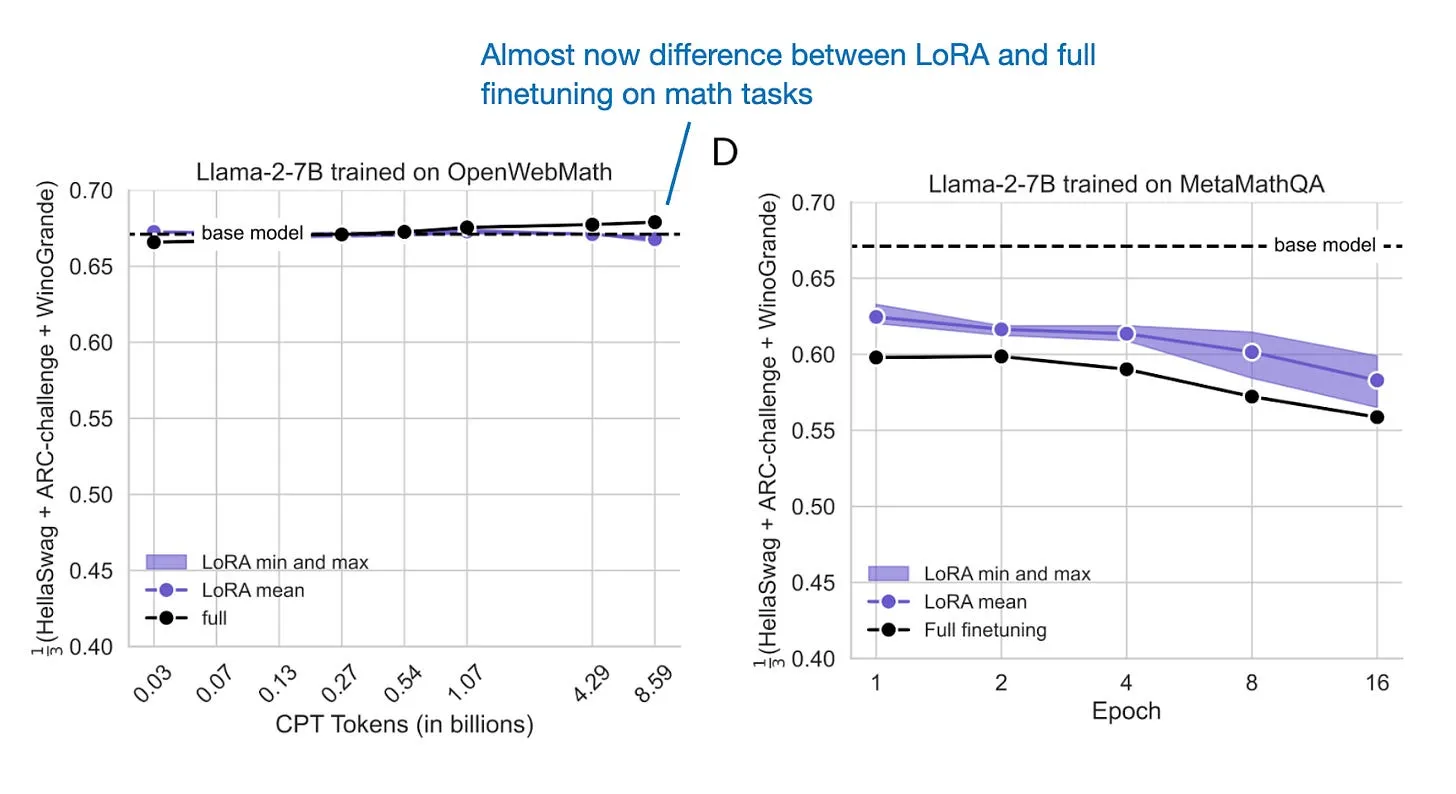
上文我们对比了LoRA和全量微调在知识更新方面的表现。接下来的一组实验评估了两种方法在经过持续预训练和指令微调后,对原有信息的遗忘情况。和之前结果的区别在于,这里测量的是模型在原始源任务上的性能。

figure10

在编程数据上训练后,全量微调与LoRA在原始源任务上的表现。改绘自《LoRA学得更少,忘得也更少》,原文:https://arxiv.org/abs/2405.09673

从上图可以看出,当训练数据集离源域更远时(这里是编程),全量微调比LoRA遗忘的知识多得多。而在数学数据集上,两者的差距更小,如下图所示。

figure11

在数学数据上训练后,全量微调与LoRA在原始源任务上的表现。改绘自《LoRA学得更少,忘得也更少》,原文:https://arxiv.org/abs/2405.09673

2.3 结论

LoRA还是全量微调?或许正如预期,归根结底是“学习-遗忘”的权衡问题。全量微调在新目标域上能带来更强的性能,而LoRA能更好地保留原始源域的性能*。

直观上,我认为这只是LoRA修改模型参数更少带来的副作用——顾名思义,LoRA的目标是低秩适配,也就是不会大幅修改所有模型参数。

而且在实践中,很多时候根本不是“选全量微调还是LoRA”的问题:由于LoRA能节省显存、占用更低的存储空间,很多场景下它可能是唯一可行的选择。

尽管如此,能看到这个问题被如此详尽地通过实验梳理和分析,还是非常有价值的。(实验基于7B和13B参数的Llama 2模型开展。)

*(Mariano Kamp向我指出过一个注意事项:在LoRA实验中他们没有更新嵌入层,而这一点在让模型适配新任务时至关重要。)

3. MoRA:面向参数高效微调的高秩更新方法

每当有新论文提出一种类LoRA的大语言模型高效微调方法时,总是令人兴奋。在https://arxiv.org/abs/2405.12130中,作者们采用了一种与低秩适配相关但方向相反的思路:用一个方阵替换LoRA适配器。

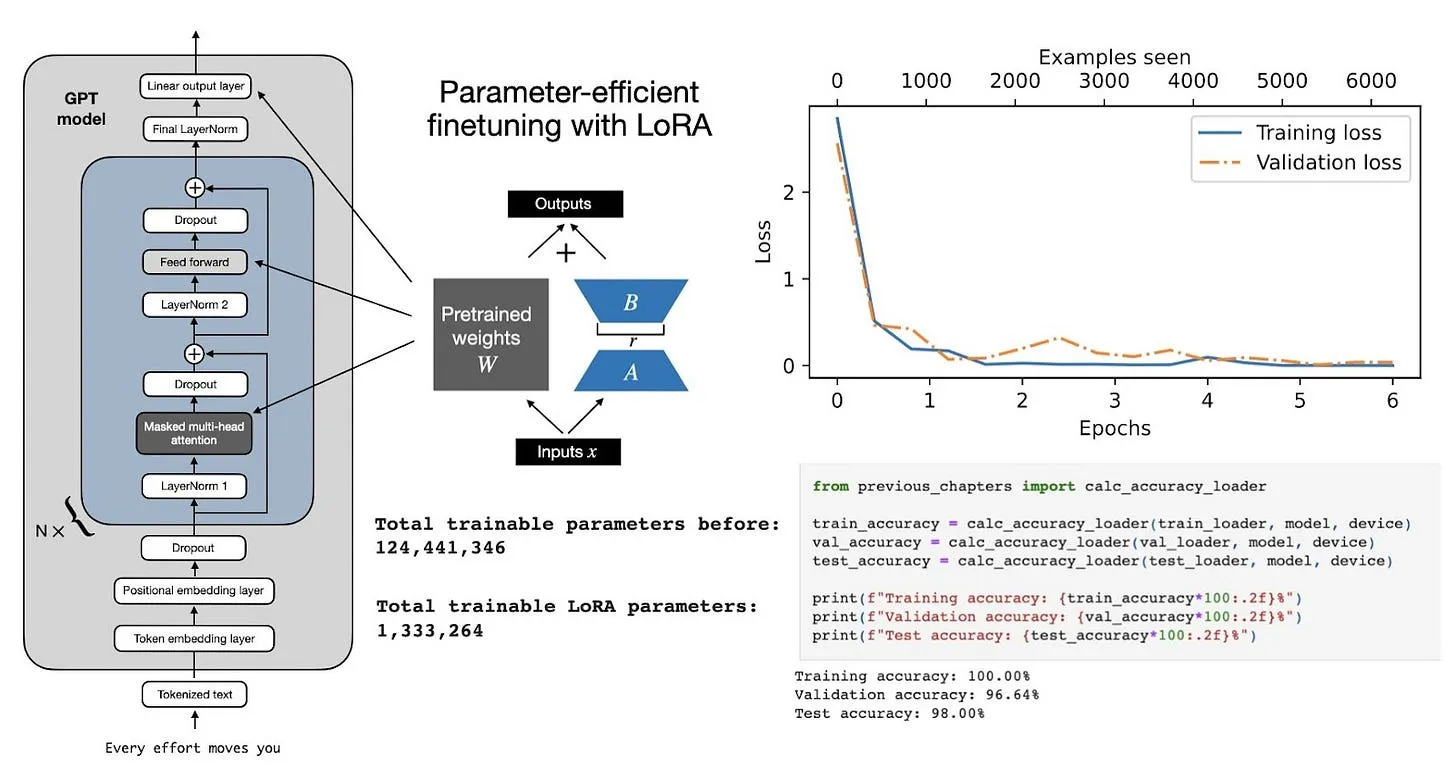
另外,我的著作《http://mng.bz/orYv》的附录E中,从零实现了针对垃圾邮件分类GPT模型的LoRA。

figure12

我著作《http://mng.bz/orYv》中LoRA章节的可视化内容

3.1 低秩与高秩的对比

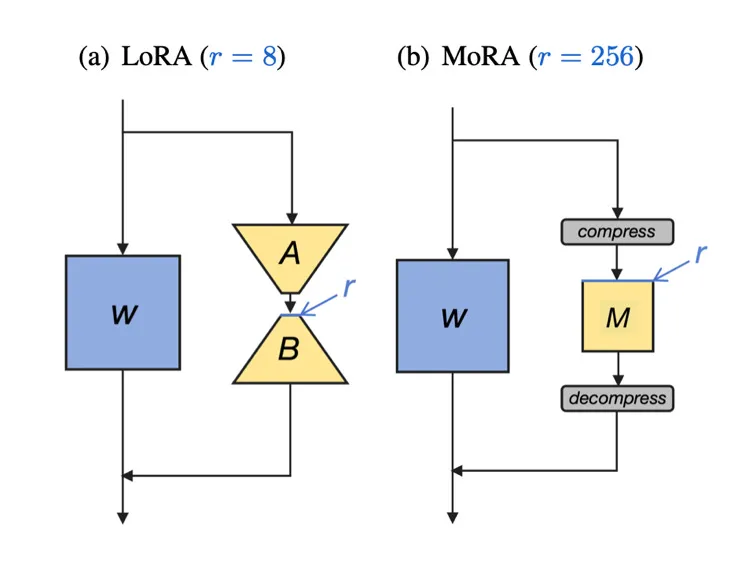
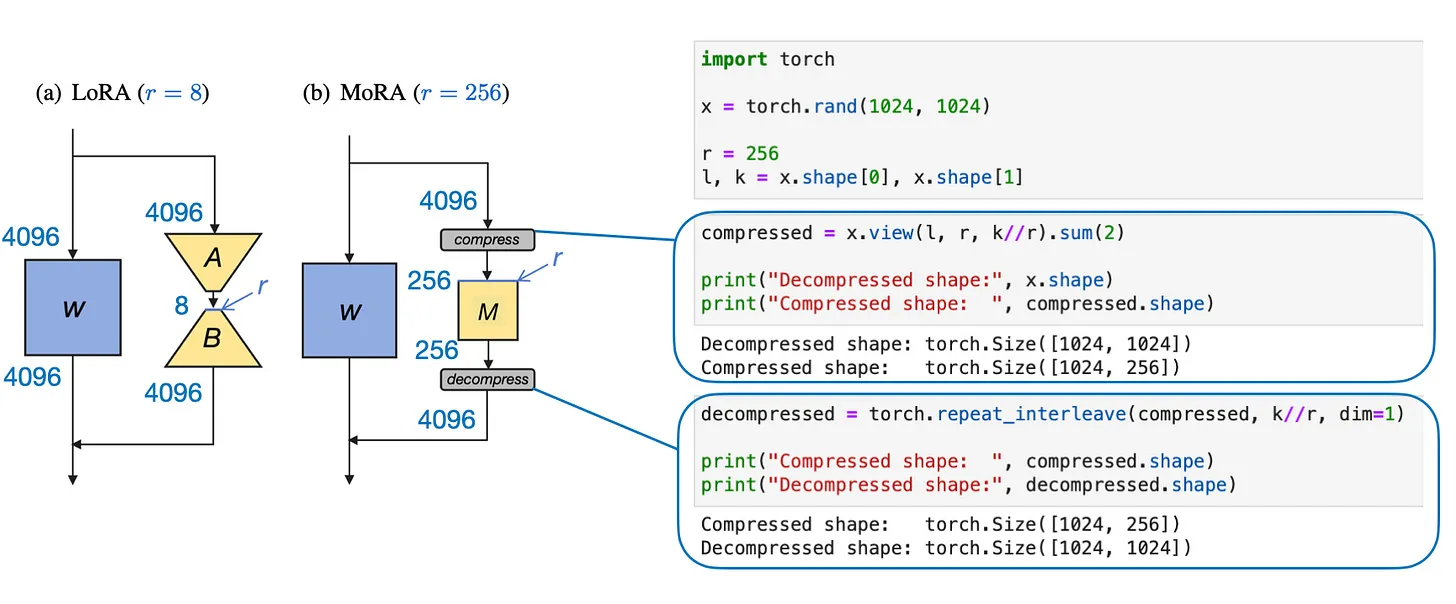
如下图所示,MoRA使用一个小型方阵(M),而非LoRA的两个小型矩阵A和B。我们会在下一节详细讨论其工作原理。

figure13

LoRA与MoRA的结构对比,W为神经网络层的权重。图片来源:《MoRA:面向参数高效微调的高秩更新方法》,原文:https://arxiv.org/abs/2405.12130

为什么要提出另一种LoRA替代方案,而且还是“高秩”的?原因在于,LoRA对原始权重的更新方式相对受限。在我看来这是刻意设计的:当我们用LoRA微调模型时,我们不希望过度扰动或改变原始模型的能力。然而,尽管低秩更新对于指令微调这类任务来说有效且足够,但它的一个缺点是,在融入新知识时(比如通过持续预训练,也就是在常规文本数据上微调,而非指令微调)效果相对较差。

在MoRA论文中,作者们希望开发出一种参数高效的微调方法,既能在指令微调上表现良好,也能在持续预训练中很好地吸收新知识。

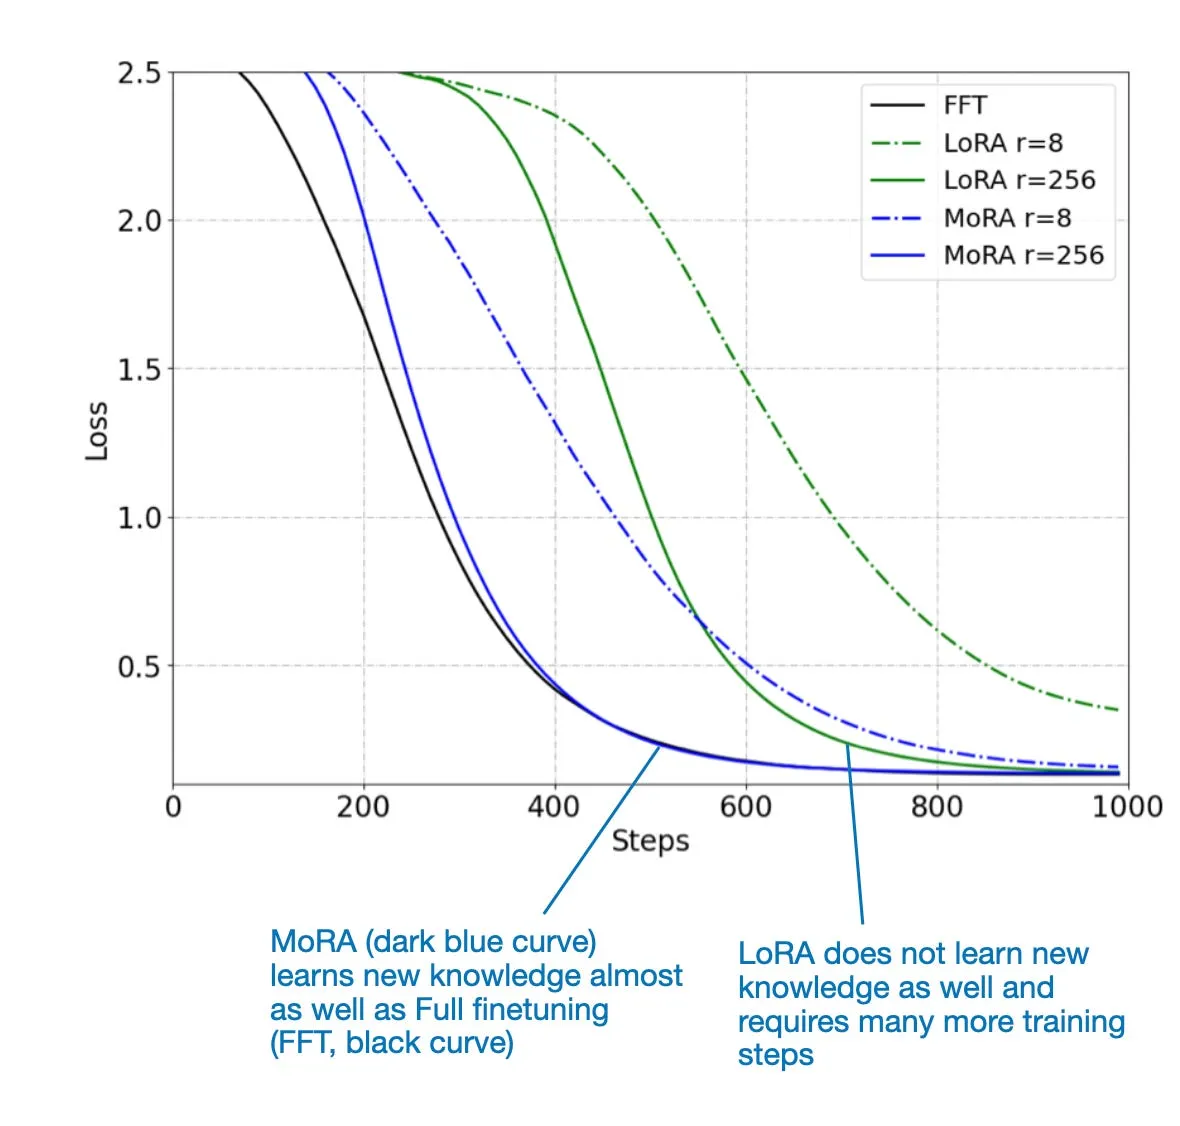
下面是基于合成数据集的LoRA、MoRA和常规全量微调(FFT)的横向对比,该合成数据集要求大语言模型记住特定的识别码。

figure14

LoRA、MoRA和全量微调(FFT)在记忆识别码任务上的性能。图片来源:《MoRA:面向参数高效微调的高秩更新方法》,原文:https://arxiv.org/abs/2405.12130

在上图展示的合成基准测试中,MoRA的知识获取(或记忆)能力与全量微调相近。高秩LoRA(r=256)最终也能记住合成识别码,但需要更多的训练步数。而小秩LoRA(r=8)则无法完成记忆。

需要注意的是,大语言模型中的记忆不一定是好事(当然,历史日期和事实类知识除外)。不过,LoRA不容易产生记忆的特点,也有助于降低模型对训练数据过拟合的倾向。话虽如此,这个基准测试主要是为了探究LoRA是否提供了足够的容量来学习新知识。可以把它类比为批量过拟合调试法:我们让模型在一小部分训练集上过拟合,以此确认架构实现是否正确。(下一节我们会看真实数据上的基准测试结果。)

3.2 MoRA方法概览

那么MoRA是如何实现的呢?

作者们使用了一个可训练的方阵,作用于原始权重W上,而非LoRA中的AB矩阵。这个方阵通常远小于原始权重矩阵。实际上,LoRA和MoRA的可训练参数数量甚至可以相同。

例如,如果原始权重层有4096 × 4096 = 16,777,216个参数,秩r=8的LoRA有4096×8 + 8×4096 = 65,536个参数。而用MoRA时,我们可以取r=256来匹配参数量,即256 × 256 = 65,536个参数。

如何将这个256×256的矩阵作用于原始的1024×1024权重矩阵?作者定义了几种非参数化的压缩与解压缩方法(具体细节超出了本文的范围,但我在图中尝试用PyTorch代码做了总结)。

左图:总参数量相同时,LoRA与DoRA的矩阵维度可视化。右图:MoRA矩阵压缩与解压缩的示例代码。

figure15

左子图来源:《MoRA:面向参数高效微调的高秩更新方法》,原文:https://arxiv.org/abs/2405.121

LoRA和MoRA的效果对比如何?

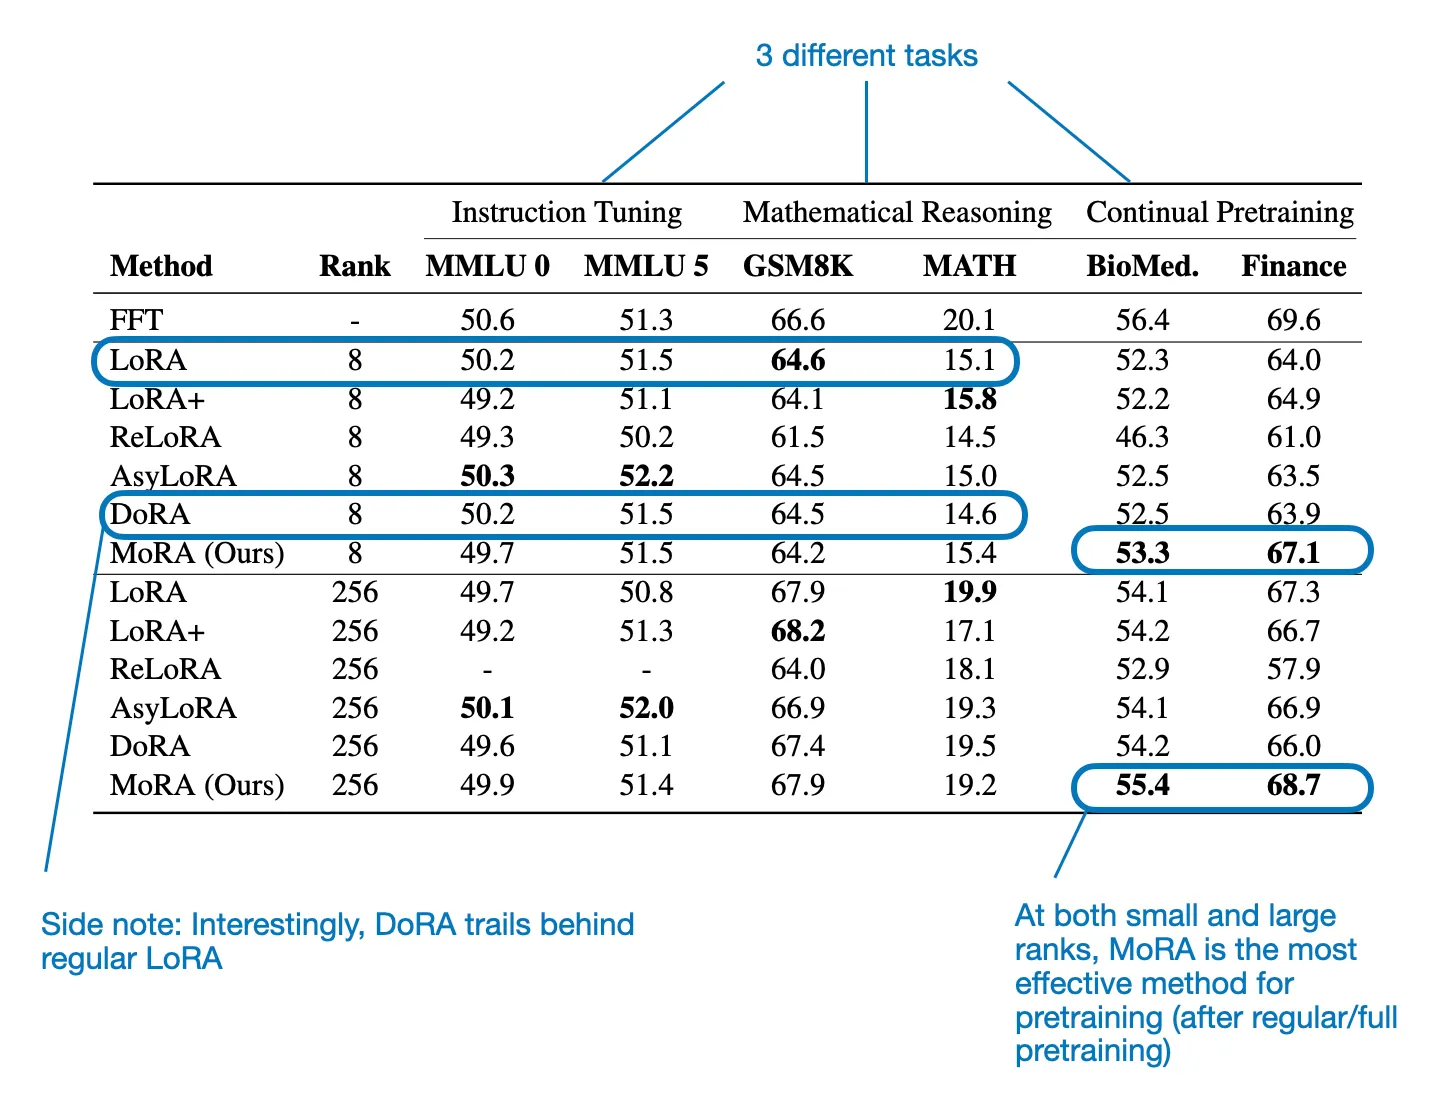
从真实数据集的基准测试来看(见下表),MoRA和LoRA的表现处于相近水平。不过,在生物医学和金融数据的持续预训练场景下,MoRA的表现优于所有LoRA变体;只有全量微调(FFT)效果更好。此外一个有趣的发现是,LoRA的表现与DoRA持平甚至更优——DoRA是我几个月前在《改进LoRA:从零实现权重分解低秩适配(DoRA)》中介绍过的LoRA变体:
https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch
https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch https://substack.com/profile/27393275-sebastian-raschka-phd
· 2024年2月19日
https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch

<figure16

多种LoRA变体与MoRA在真实数据集上的对比。改绘自《MoRA:面向参数高效微调的高秩更新方法》,原文:https://arxiv.org/abs/2405.12130

3.3 结论

事实证明,相对简单的MoRA方法效果出人意料地好。它在持续预训练上确实略优于LoRA,但在指令微调和小秩数学推理任务上略逊于LoRA。对我而言,这些结果还不足以让人用MoRA替换LoRA。尽管如此,这篇论文提出了一种有趣的方法,配套的实验也很有价值。

4. 5月其他值得关注的研究论文

以下是我本月偶然发现的其他一些有趣论文。由于列表较长,我将10篇我认为特别值得关注的论文用星号(*)标注。不过请注意,这份列表及其标注完全基于我个人的兴趣,以及和我自身项目的相关性。

  • 《上下文位置编码:学会计数重要信息》,作者Golovneva、Wang、Weston和Sukhbaatar(5月29日),https://arxiv.org/abs/2405.18719
    该研究提出了上下文位置编码(CoPE)——一种适用于大语言模型的新型位置编码方法,能够根据上下文自适应,支持更抽象的基于位置的注意力机制。

  • 《LLaMA-NAS:面向大语言模型的高效神经架构搜索》,作者Sarah、Sridhar、Szanking和Sundaresan(5月28日),https://arxiv.org/abs/2405.18377
    该研究提出了一种结合一次性NAS和遗传算法的方法来优化LLaMA2-7B模型,在精度损失极小的情况下实现了1.5倍的体积缩减和1.3倍的推理吞吐量提升,效果优于传统的剪枝和稀疏化技术。

  • 《VeLoRA:基于秩1子词元投影的显存高效训练方法》,作者Miles、Reddy、Elezi和Deng(5月28日),https://arxiv.org/abs/2405.17991
    该论文提出了一种用于大语言模型训练与微调的显存高效算法,能够在不损失性能的前提下压缩中间激活值,将词元拆分为子词元并投影到固定的一维子空间中。

  • *《gzip可预测数据相关的缩放法则》,作者Pandey(5月26日),https://arxiv.org/abs/2405.16684
    该研究挑战了“神经语言模型的缩放法则与数据无关”的观点,证明模型性能的缩放对训练数据的复杂度敏感,并提出了一种新的数据相关缩放法则,将模型的最优计算资源分配与训练数据的gzip压缩率相关联。

  • 《面向大语言模型对齐的离线正则化强化学习》,作者Yao、Wu、Yang等人(5月22日),https://arxiv.org/abs/2405.13800
    该论文提出了直接奖励优化(DRO)——一种用于大语言模型对齐的新框架,它利用更丰富的单轨迹数据集(包含提示、响应和用户反馈),无需像直接偏好优化(DPO)那样使用成对偏好数据。

  • 《Trans-LoRA:迈向无数据可迁移的参数高效微调》,作者Wang、Ghosh、Cox等人(5月27日),https://arxiv.org/abs/2405.17258
    Trans-LoRA能够利用合成数据,在不同基础模型之间实现低秩适配器(LoRA)的近乎无数据、无损迁移。

  • 《堆叠你的Transformer:深入探究高效大语言模型预训练中的模型增长方法》,作者Du、Luo、Qiu等人(5月26日),https://arxiv.org/abs/2405.15319
    该论文研究了预训练大语言模型中的模型增长方法,特别是一种名为Gstack的深度堆叠算子,能够加快训练速度并提升性能。

  • 《更少调度的训练之路》,作者Defazio、Yang、Mehta等人(5月24日),https://arxiv.org/abs/2405.15682
    该研究提出了一种无调度优化方法,效果优于传统的学习率调度方法,且无需预设停止时机,除了标准动量优化器中的超参数外,无需引入额外超参数。

  • 《对指令计算损失的指令微调》,作者Shi、Yang、Wu等人(5月23日),https://arxiv.org/abs/2405.14394
    该论文对比了指令微调时对指令进行掩码与不掩码两种情况下大语言模型的性能,发现不掩码的效果通常更好。

  • 《SimPO:基于无参考奖励的简单偏好优化》,作者Meng、Xia和Chen(5月23日),https://arxiv.org/abs/2405.14734
    直接偏好优化(DPO)简化了大语言模型基于人类反馈的强化学习,而该论文通过对对数概率取平均、去除参考模型的需求,进一步简化了DPO。

  • 《AlignGPT:具备自适应对齐能力的多模态大语言模型》,作者Fei Zhao、Taotian Pang和Chunhui Li(5月23日),https://arxiv.org/abs/2405.14129
    AlignGPT是一种新型多模态大语言模型,通过在预训练阶段区分图文对的对齐能力、在指令微调阶段自适应调整对齐能力,提升了跨模态对齐效果。

  • 《面向多模态大语言模型的密集连接器》,作者Yao、Wu、Yang等人(5月22日),https://arxiv.org/abs/2405.13800
    该论文提出了密集连接器(Dense Connector)——一种视觉-语言连接器,通过整合多层视觉特征来改进多模态大语言模型(MLLM)。

  • 《作为循环神经网络的注意力机制》,作者Feng、Tung、Hajimirsadeghi等人(5月22日),https://arxiv.org/abs/2405.13956
    该研究将Transformer重新解释为循环神经网络的一种变体,并提出了Aaren——一种新型注意力模块,兼具Transformer的并行训练能力和传统循环神经网络高效、恒定内存更新的优势。

  • *《MoRA:面向参数高效微调的高秩更新方法》,作者Jiang、Huang、Luo等人(5月20日),https://arxiv.org/abs/2405.12130
    该论文分析了大语言模型中低秩更新的局限性,并提出了MoRA方法:使用方阵进行高秩更新,在保持与LoRA相当的参数效率的同时,在内存密集型任务上表现更优,其他任务上表现相近。

  • 《SLAB:结合简化线性注意力与渐进重参数化批归一化的高效Transformer》,作者Guo、Chen、Tang和Wang(5月19日),https://arxiv.org/abs/2405.11582
    该论文提出了一种方法,在基于Transformer的模型中用重参数化的批归一化渐进替换层归一化,同时搭配简化线性注意力(SLA)模块。

  • 《构建与复用LoRA库,迈向模块化大语言模型》,作者Ostapenko、Su、Ponti等人(5月17日),https://arxiv.org/abs/2405.11157
    该研究探索了将基础大语言模型上训练好的适配器复用于新任务的方法,提出了一种基于模型聚类(MBC)构建适配器库的方法,以及零样本路由机制,无需重新训练即可提升任务泛化能力。

  • 《Chameleon:混合模态早期融合基础模型》,Meta AI团队作者(5月16日),https://arxiv.org/abs/2405.09818
    Chameleon是一种早期融合、基于词元的混合模态模型,擅长以任意顺序处理和生成图像与文本。

  • 《Xmodel-VLM:多模态视觉语言模型的简单基线》,作者Xu、Liu、He等人(5月15日),https://arxiv.org/abs/2405.09215
    该论文提出了Xmodel-VLM——一个10亿参数规模、高效的多模态视觉语言模型,专为消费级GPU部署设计。

  • *《LoRA学得更少,忘得也更少》,作者Biderman、Ortiz、Portes等人(5月15日),https://arxiv.org/abs/2405.09673
    该研究在编程和数学领域对比了参数高效微调方法低秩适配(LoRA)与全量微调在大语言模型上的效果,发现尽管LoRA通常表现稍差,但它能更好地保留目标域之外的基础模型能力,并且提供了更强的正则化效果。

  • 《RLHF工作流:从奖励建模到在线RLHF》,作者Dong、Xiong、Pang等人(5月13日),https://arxiv.org/abs/2405.07863
    该报告概述了一种适用于大语言模型的在线迭代RLHF方法,它使用代理模型模拟人类反馈,效果优于离线方法,并训练出了性能优异的SFR-Iterative-DPO-LLaMA-3-8B-R模型。

  • 《PHUDGE:可扩展评判模型Phi-3》,作者Deshwal和Chawla(5月12日),https://arxiv.org/abs/2405.08029
    该报告介绍了PHUDGE——一个基于Phi-3的模型,在评分任务上的速度和效果都超过了ChatGPT的GPT-4。

  • 《面向语言模型对齐与个性化的价值增强采样》,作者Han、Shenfeld、Srivastava等人(5月10日),https://arxiv.org/abs/2405.06639
    该研究提出了价值增强采样(VAS)——一种新型奖励优化框架,能够高效对齐大语言模型,无需修改模型权重,也无需联合训练策略和价值函数,并且支持对仅开放API的大语言模型(如ChatGPT)进行适配。

  • *《在新知识上微调大语言模型会加剧幻觉吗?》,作者Gekhman、Yona、Aharoni等人(5月9日),https://arxiv.org/abs/2405.05904
    该研究探究了在有监督微调过程中引入新事实信息对大语言模型的影响,发现尽管模型很难融入新事实、学习新事实的速度比熟悉的信息慢,但最终学会这些事实后,模型生成错误事实回答的倾向会线性增加。

  • *《寻找鲤鱼王:自动检测大语言模型中训练不足的词元》,作者Land和Bartolo(5月8日),https://arxiv.org/abs/2405.05417
    该论文对大语言模型的分词器问题进行了全面分析,并提出了一种自动检测“故障词元”的方法——这类词元存在于分词器词表中,但在训练数据中几乎或完全没有出现过。

  • *《DeepSeek-V2:一款强大、经济、高效的混合专家语言模型》,作者Liu、Feng、Wang等人(5月8日),https://arxiv.org/abs/2405.04434
    DeepSeek-V2是一个2360亿参数的混合专家语言模型(每个词元仅激活210亿参数),它引入了多头潜注意力(MLA),旨在将键值(KV)缓存压缩为潜向量,从而提升推理效率并降低显存需求。

  • 《仅缓存一次:面向语言模型的解码器-解码器架构》,作者Sun、Dong、Zhu等人(5月8日),https://arxiv.org/abs/2405.05254
    该研究提出了YOCO——一种面向大语言模型的解码器-解码器架构,它通过自解码器编码全局键值缓存,供交叉解码器复用,大幅降低了GPU显存需求并提升了预填充阶段的性能。

  • *《xLSTM:扩展长短期记忆网络》,作者Beck、Poeppel、Spanring等人(5月7日),https://arxiv.org/abs/2405.04517
    该研究探索了将LSTM扩展到数十亿参数规模的潜力,通过指数门控、增强记忆结构等新改进,将其整合为xLSTM架构,性能与当前最先进的基于Transformer和状态空间模型的大语言模型相当。

  • 《vAttention:无需分页注意力的大语言模型服务动态内存管理》,作者Prabhu、Nayak、Mohan等人(5月7日),https://arxiv.org/abs/2405.04437
    该论文提出了vAttention——一种大语言模型GPU显存管理方法,它将键值缓存保存在连续的虚拟内存中,并利用现有的底层系统按需分页支持来动态分配物理内存。

  • *《Flash Attention稳定吗?》,作者Golden、Hsia、Sun等人(5月5日),https://arxiv.org/abs/2405.02803
    该研究建立了一套分析数值偏差对大规模机器学习训练影响的框架,发现被广泛使用的Flash Attention优化确实存在显著的数值偏差,不过其影响程度低于低精度训练带来的偏差。

  • *《构建视觉语言模型,什么才是关键?》,作者Laurencon、Tronchon、Cord和Sanh(5月3日),https://arxiv.org/abs/2405.02246
    该论文指出,视觉语言模型(VLM)中很多关键设计选择都缺乏依据,并提出了Idefics2——一个80亿参数的新型视觉语言基础模型,通过严格评估不同架构、数据和训练方法,实现了同量级下的最优性能,其模型和数据集均已公开。

  • 《Prometheus 2:一款专门用于评估其他语言模型的开源语言模型》(5月2日),https://arxiv.org/abs/2405.01535
    该论文提出了Prometheus 2——一款开源的评估用大语言模型,它解决了此前模型的局限性,与人类和GPT-4的判断高度对齐,并且在评估格式和标准上具备灵活性。

  • *《大语言模型小学数学表现的细致检验》,作者Zhang、Da、Lee等人(5月1日),https://arxiv.org/abs/2405.00332
    该研究提出了GSM1k——一个复刻了经典基准GSM8k的新基准,用于测试大语言模型,结果发现模型性能出现显著下降,表明之前的优异表现可能更多源于对训练数据的记忆,而非真正的数学推理能力。(注:GSM8k是一个用于评估大语言模型数学推理能力的基准,通过呈现小学难度的题目来衡量模型能力。)

  • 《面向语言模型对齐的自博弈偏好优化》,作者Wu、Sun、Yuan等人(5月1日),https://arxiv.org/abs/2405.00675
    该论文提出了自博弈概率偏好优化(SPPO)方法用于语言模型对齐,它利用自博弈框架,通过迭代策略更新来逼近纳什均衡。

  • 《编辑批次越大越好吗?——基于Llama-3的模型编辑实证研究》,作者Yoon、Gupta和Anumanchipalli(5月1日),https://arxiv.org/abs/2405.00664
    该研究在Llama-3上检验了模型编辑技术的效果,通过测试顺序编辑、批量编辑以及一种新颖的顺序-批量混合编辑策略在不同层上的表现,得出结论:更小的顺序编辑比更大的批量编辑更能提升模型性能。(注:编辑批次大小指的是一轮编辑中同时对模型参数做出的修改数量。)

这本杂志是我个人的兴趣项目,不提供直接报酬。不过,如果您愿意支持我的话,可以考虑购买我的著作:https://sebastianraschka.com/books。如果您觉得这些书有洞见、对您有帮助,非常欢迎推荐给您的朋友和同事。(也欢迎在亚马逊上分享您的反馈,这对我帮助很大)

figure17

http://mng.bz/M96o 、https://nostarch.com/machine-learning-and-ai-beyond-basics 以及https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/

您的支持对我意义重大!非常感谢!

将被大模型+机器人严重冲击的行业

这里说的冲击严重,指的是可能导致从业人员大规模失业,而不是单纯的提升工作效率。
现在看起来,下面的部分行业从业人员,会受到较大冲击:

文字处理
1、客服人员(聊天机器人、语音机器人)
2、翻译人员(普通文件翻译)
3、文员(部分工作机会会被替代)
4、内容审核人员
5、内容创作人员(新闻转发、内容创作)
6、部分开发人员(部分代码编写人员)
7、部分法律从业者(文档整理、案例分析、合同审查)
8、部分保险从业者(部分业务员、部分核保任务)
9、部分财务人员(部分财务审计任务)

自动驾驶
1、网约车驾驶员
2、长途运输司机
3、物流人员(自动配送)

产业自动化
1、流水线工人(机器人)
2、仓库管理(无人仓储)
3、养殖人员
4、农业人员

换行符引发的惨案

最近在读go源码。

本来环境都搭建好了,源码也上传git了。
但从另一台电脑下载源码后,报了一堆神奇的错误。
最后发现是go.env文件中,回车换行是按windows系统设定上传到git的,改为linux系统设定就好了。

想起入行以来,因为字符集、换行符、正斜杠反斜杠、tab还是空格,遇到的那堆坑,唏嘘不已。
希望UTF-8早日一统天下,希望各大平台别再特立独行。
非标准化害死人,多套标准更是害死人啊。

【转载】最新开源大语言模型表现如何?DPO 是否优于 PPO?

原文地址:How Good Are the Latest Open LLMs? And Is DPO Better Than PPO?,by Sebastian Raschka, on 2024-04-02

最新开源大语言模型表现如何?DPO 是否优于 PPO?

2024年4月最新模型发布与AI研究综述

2024年4月真是精彩纷呈的一个月!恰逢我的生日,我的新书《机器学习与人工智能:核心问题》(https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/171850376)也正式推出,春天终于到来,同时还有四款重磅开源大语言模型(LLM)集中发布:Mixtral、Meta AI的Llama 3、微软的Phi-3,以及苹果的OpenELM。

本文将对过去几周发布的四款基于Transformer架构的主流大语言模型逐一进行评述,随后探讨基于人类反馈强化学习(RLHF)的指令微调最新研究,重点对比PPO与DPO两种算法。

  1. Mixtral、Llama 3与Phi-3表现几何?
  2. OpenELM:搭载开源训练与推理框架的高效语言模型家族
  3. 大语言模型对齐中DPO是否优于PPO?一项全面研究
  4. 4月其他值得关注的研究论文

1. Mixtral、Llama 3与Phi-3:有哪些新进展?

首先从本月最受瞩目的话题——几款重磅大语言模型的发布说起。本节将简要介绍Mixtral、Llama 3和Phi-3,这几款模型均配套有简短的博客文章或技术报告。下一节将更详细地介绍苹果的OpenELM,好在该模型同步发布了研究论文,披露了大量值得关注的技术细节。

1.1 Mixtral 8x22B:更大的模型,更优的表现

https://mistral.ai/news/mixtral-8x22b/ 是Mistral AI推出的最新混合专家(Mixture-of-Experts, MoE)模型,采用宽松的Apache 2.0开源许可证发布。

与2024年1月发布的Mixtral 8x7B类似,该模型的核心设计是将Transformer架构中的每个前馈模块替换为8个专家层。本文篇幅较长,因此不再展开讲解MoE的原理;如果您感兴趣,可以参考我几个月前发布的文章中关于Mixtral 8x7B的章节,其中有更详细的说明:

https://magazine.sebastianraschka.com/p/research-papers-in-january-2024

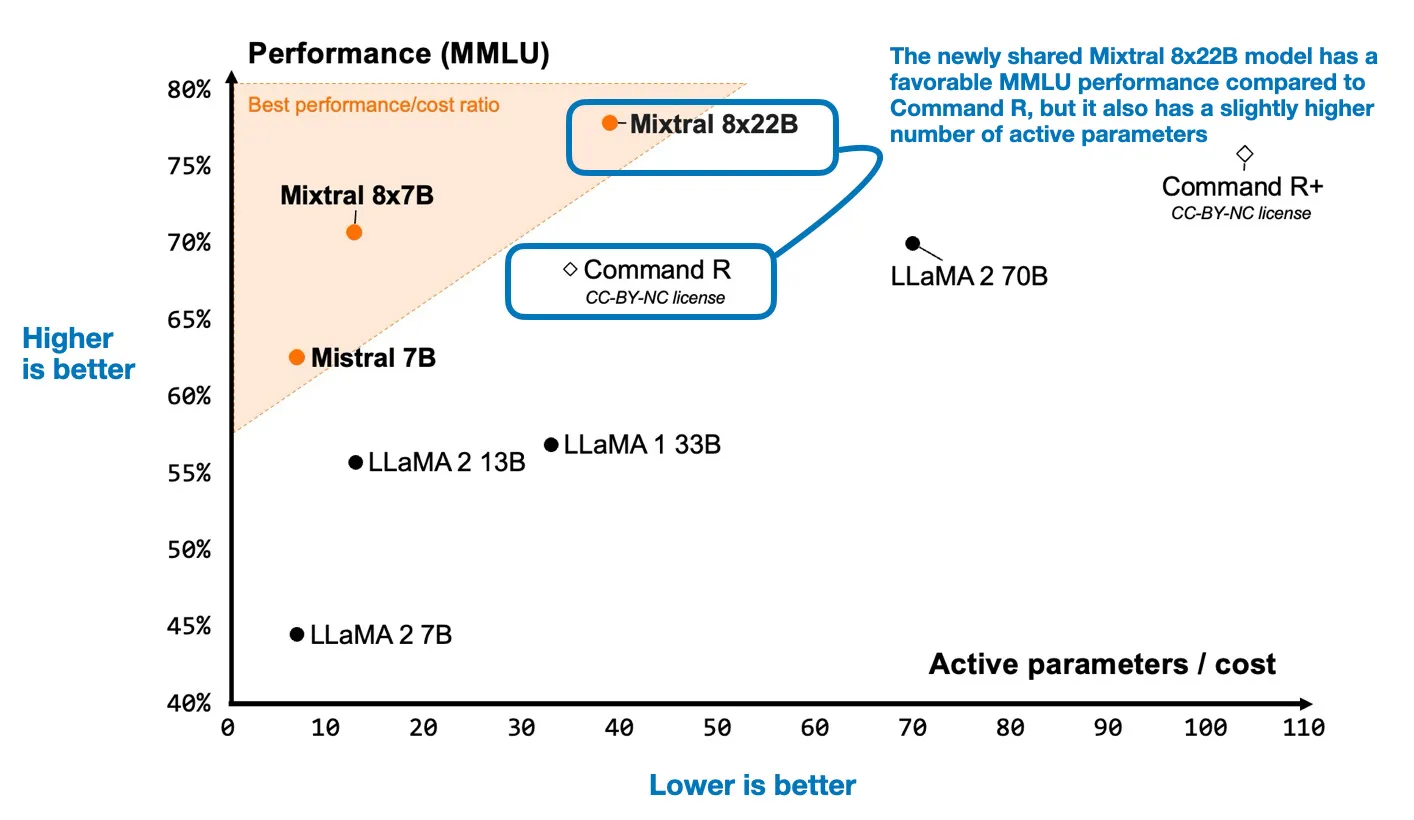
https://mistral.ai/news/mixtral-8x22b/ 中最值得关注的一张图,从两个维度对比了Mixtral 8x22B与多款大语言模型:一是在主流基准测试https://arxiv.org/abs/2009.03300(MMLU)上的建模表现,二是激活参数量(与计算资源需求相关)。

figure01

Mixtral 8x22B与其他大语言模型对比。(标注图基于https://mistral.ai/news/mixtral-8x22b/中的图表制作)

1.2 Llama 3:更大规模的数据,更优的效果

2023年2月发布的https://arxiv.org/abs/2302.13971 是开源可获取大语言模型的重大突破,也是开源大语言模型发展的关键节点。因此,去年推出的https://arxiv.org/abs/2307.09288 自然也备受期待。如今,由https://ai.meta.com/blog/meta-llama-3/ 正式发布的Llama 3系列模型,同样令人振奋。

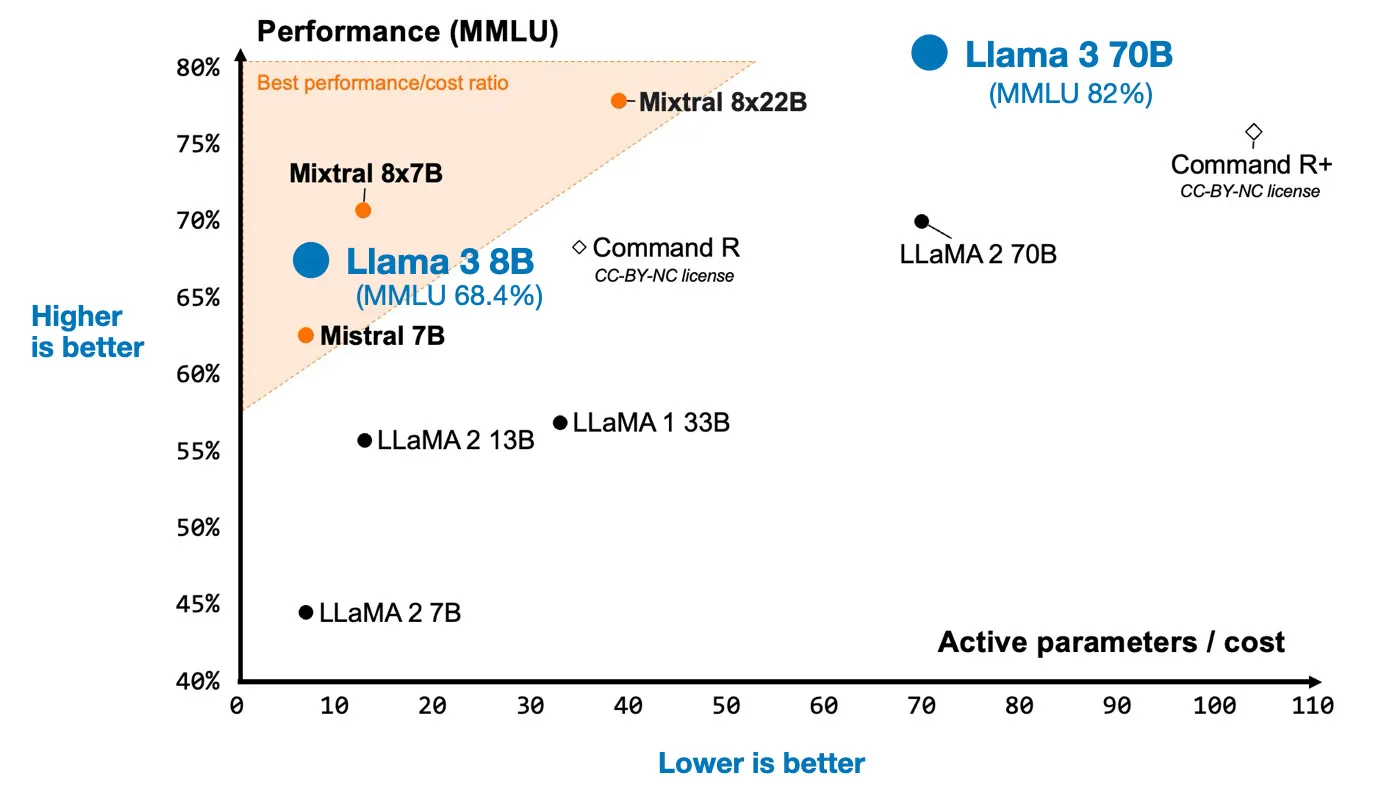
尽管Meta仍在训练其最大规模的几款模型(例如4000亿参数版本),但本次已发布了大家熟知的80亿(8B)和700亿(70B)参数规格的模型,且表现十分出色。下文我将官方https://ai.meta.com/blog/meta-llama-3/ 公布的MMLU分数,补充到之前分享的Mixtral对比图中。

figure02

Llama 3、Mixtral与其他大语言模型对比。(标注图基于https://mistral.ai/news/mixtral-8x22b/中的图表制作)

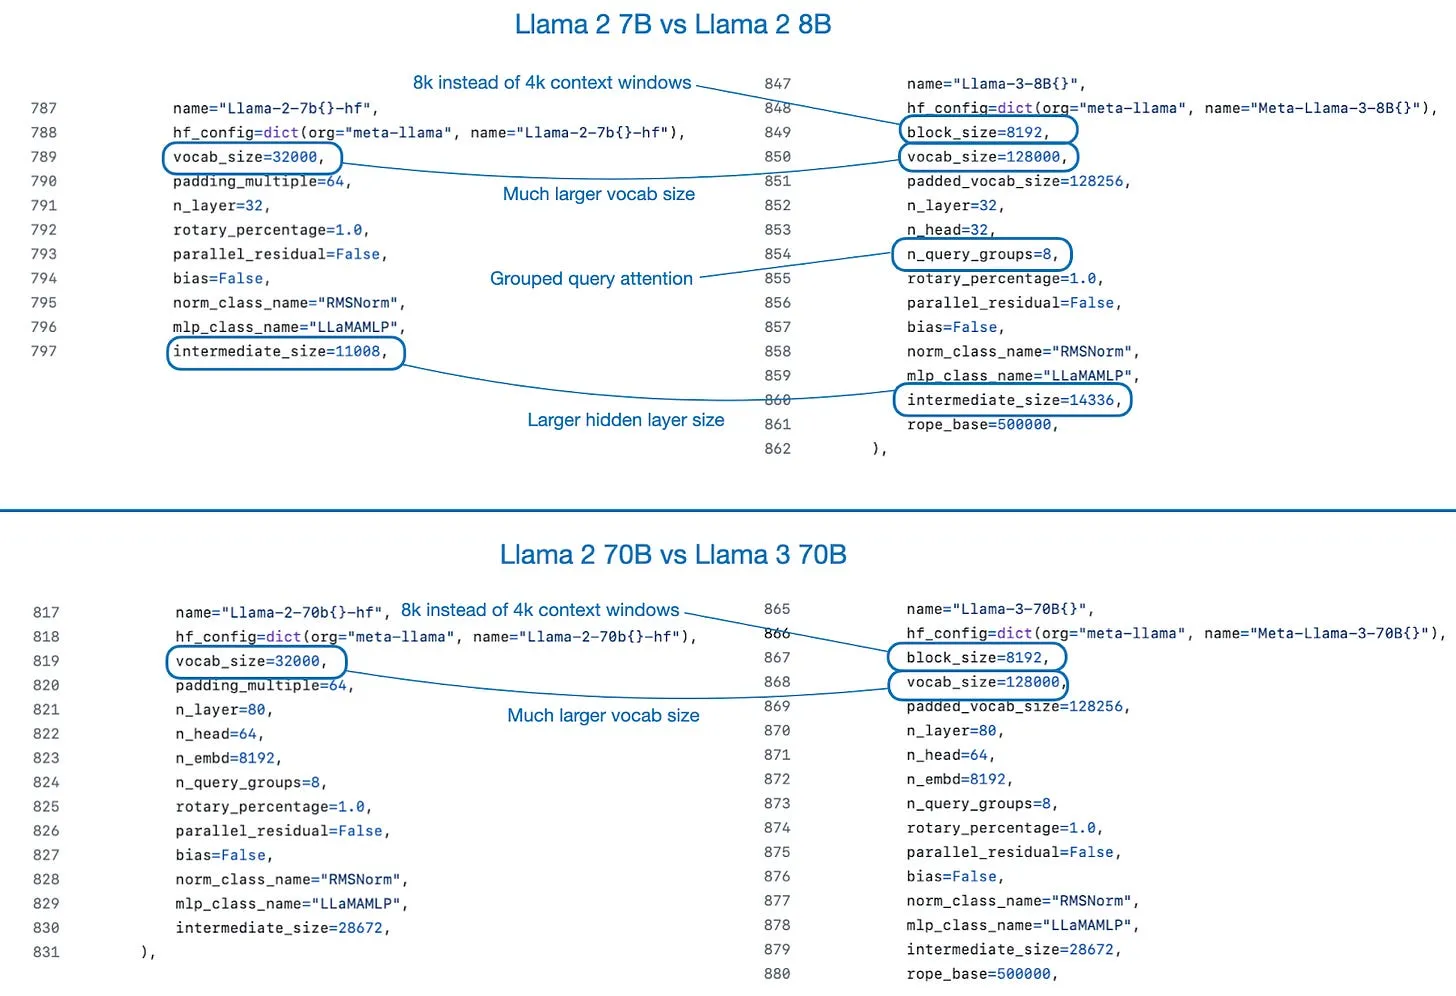
整体而言,Llama 3的架构与Llama 2几乎完全一致,主要区别在于词表规模有所扩大,且小尺寸版本的Llama 3采用了分组查询注意力(Grouped-Query Attention)。如果您想了解分组查询注意力的原理,我曾在此处写过相关讲解:

https://magazine.sebastianraschka.com/p/ahead-of-ai-11-new-foundation-models

以下是在LitGPT中实现Llama 2与Llama 3的配置文件,可以直观体现二者的主要差异。

figure03

通过LitGPT对比Llama 2与Llama 3的配置,来源:https://github.com/Lightning-AI/litgpt

训练数据规模

Llama 3的性能相比Llama 2大幅提升,最主要的原因是训练数据集规模大得多。Llama 3的训练语料达到15万亿token,而Llama 2“仅为”2万亿token。

这一发现非常值得关注:正如https://ai.meta.com/blog/meta-llama-3/ 中提到的,根据Chinchilla缩放法则,80亿参数模型的最优训练数据量要小得多,约为2000亿token。此外,Llama 3的研究团队观察到,无论是80亿还是700亿参数的模型,在训练到15万亿token规模时,性能仍保持对数线性提升。这意味着,继续使用超过15万亿token的训练数据,模型性能还能进一步提升。

指令微调与对齐

在指令微调和模型对齐阶段,研究人员通常会二选一:要么采用基于近端策略优化(PPO)的人类反馈强化学习(RLHF),要么采用无需奖励模型的直接偏好优化(DPO)。有意思的是,Llama 3的研究团队并没有厚此薄彼,而是两种方法都使用了(后文会详细对比PPO和DPO)。

https://ai.meta.com/blog/meta-llama-3/ 中提到,Llama 3的研究论文将在次月发布,我很期待论文中能披露更多技术细节。

1.3 Phi-3:更高质量的数据,更优的表现

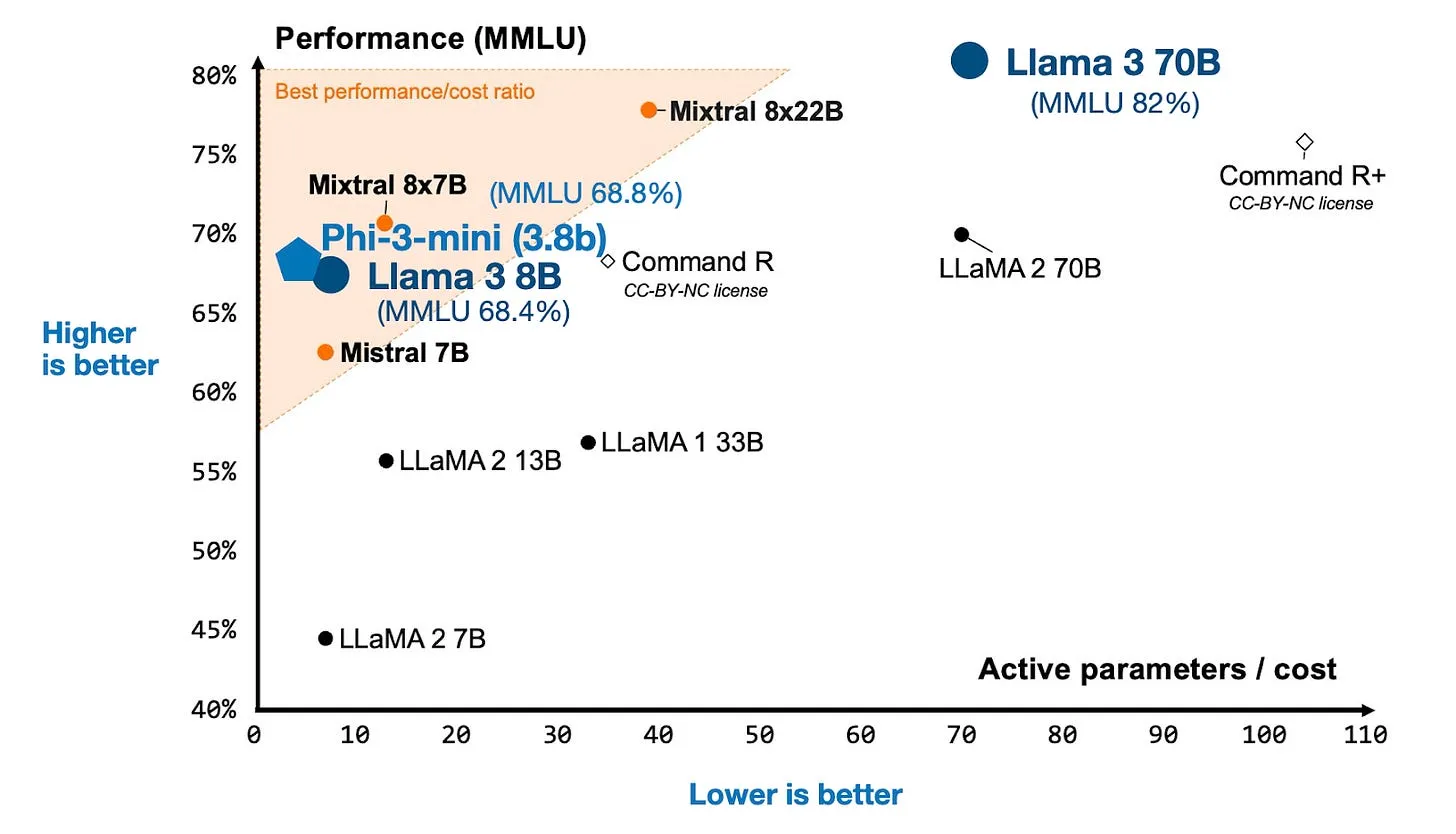
就在Llama 3发布仅一周后,微软推出了全新的Phi-3大语言模型。根据https://arxiv.org/abs/2404.14219 中的基准测试结果,即便尺寸最小的Phi-3模型,参数量不到Llama 3 8B的一半,性能却超越了后者。

figure04

Phi-3、Llama 3、Mixtral与其他大语言模型对比。(标注图基于https://mistral.ai/news/mixtral-8x22b/中的图表制作)

值得注意的是,基于Llama架构的Phi-3,训练token数仅为Llama 3的1/5(3.3万亿对比15万亿)。Phi-3甚至沿用了Llama 2的分词器,词表大小为32064,远小于Llama 3的词表规模。

此外,Phi-3-mini“仅有”38亿参数,规模还不到Llama 3 8B的一半。

那么,它的制胜秘诀是什么?根据技术报告,答案在于数据质量优先于数量:“经过严格过滤的网页数据与合成数据”。

论文没有过多阐述数据筛选的细节,但整体沿用了前代Phi模型的数据处理方案。几个月前我曾在此处写过关于Phi模型的更多介绍:

https://magazine.sebastianraschka.com/p/ahead-of-ai-12-llm-businesses
https://magazine.sebastianraschka.com/p/ahead-of-ai-12-llm-businesses https://substack.com/profile/27393275-sebastian-raschka-phd
·
2023年10月8日
https://magazine.sebastianraschka.com/p/ahead-of-ai-12-llm-businesses

截至本文撰写时,业界仍不确定Phi-3是否真如宣传般出色。例如,我交流过的许多人都提到,在非基准测试任务上,Phi-3的表现远不如Llama 3。

1.4 小结

从上述三款重磅发布来看,本月对开源大语言模型而言可谓成果丰硕。而我还没提到我最欣赏的模型——OpenELM,我们将在下一节展开讨论。

实际应用中该选哪款模型?我认为这三款模型各有优势,适配不同场景。Mixtral的激活参数量比Llama 3 70B更少,同时仍保持了相当不错的性能水平。Phi-3 3.8B对移动端设备极具吸引力,据研究团队称,其量化版本可以在iPhone 14上运行。而Llama 3 8B可能是微调场景下最具性价比的多面手,因为使用LoRA技术时,单张GPU就能轻松完成微调。

《Ahead of AI》是读者支持的独立出版物。如果想接收新文章并支持我的创作,欢迎订阅免费或付费会员。

2. OpenELM:搭载开源训练与推理框架的高效语言模型家族

https://arxiv.org/abs/2404.14619 是苹果研究人员发布的最新大语言模型系列及配套论文,旨在打造可部署在移动设备上的小型大语言模型。

与https://magazine.sebastianraschka.com/p/research-papers-in-february-2024?utm_source=profile&utm_medium=reader2 类似,能看到一篇公开架构、训练方法和训练数据细节的大语言模型论文,让人耳目一新。

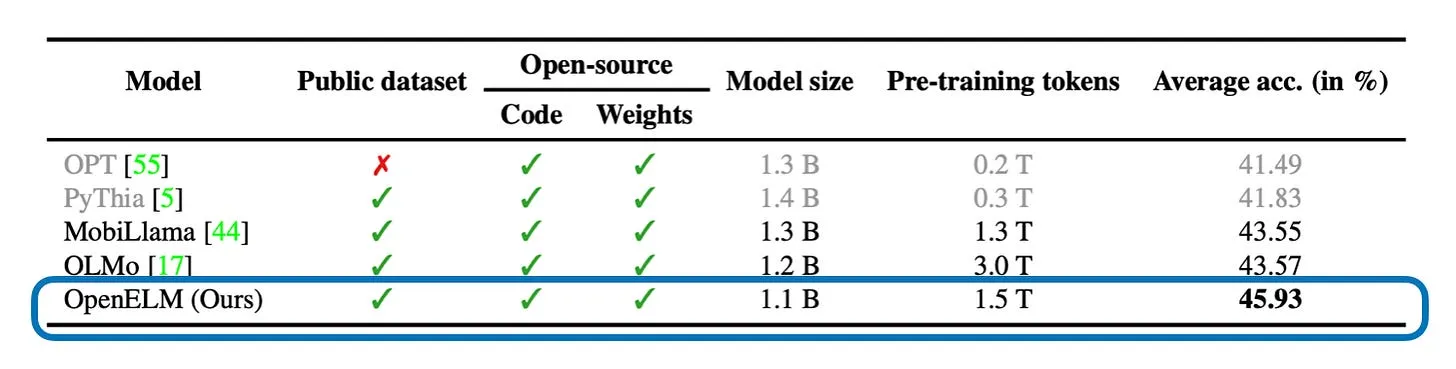
figure05

OpenELM与其他同时公开数据集、代码和权重的开源大语言模型对比(同等开放程度的模型并不多见)。标注表格来自OpenELM论文https://arxiv.org/abs/2404.14619。

先来看最值得关注的几个亮点:

2.1 架构细节

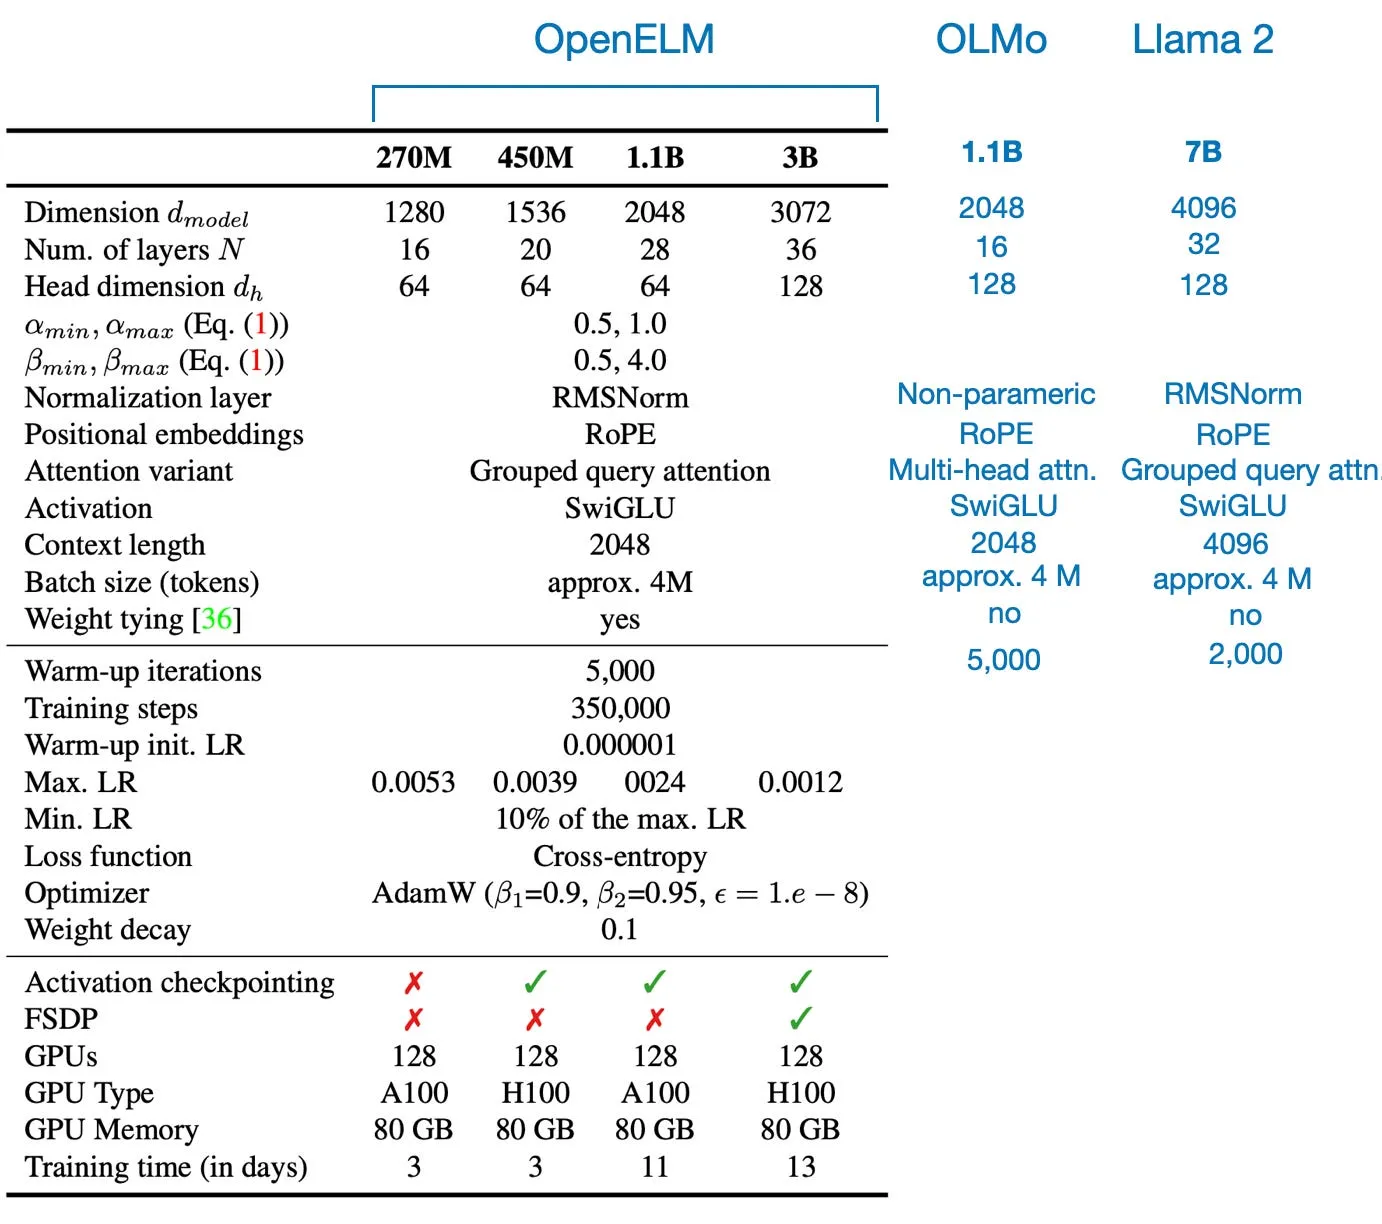
除了逐层缩放策略(后文详述),模型的整体架构设置和超参数配置与OLMo、Llama等其他大语言模型较为相近,如下图所示。

figure06

OpenELM、最小规格OLMo模型与最小规格Llama 2模型的架构与超参数对比。标注表格来自OpenELM论文https://arxiv.org/abs/2404.14619。

2.2 训练数据集

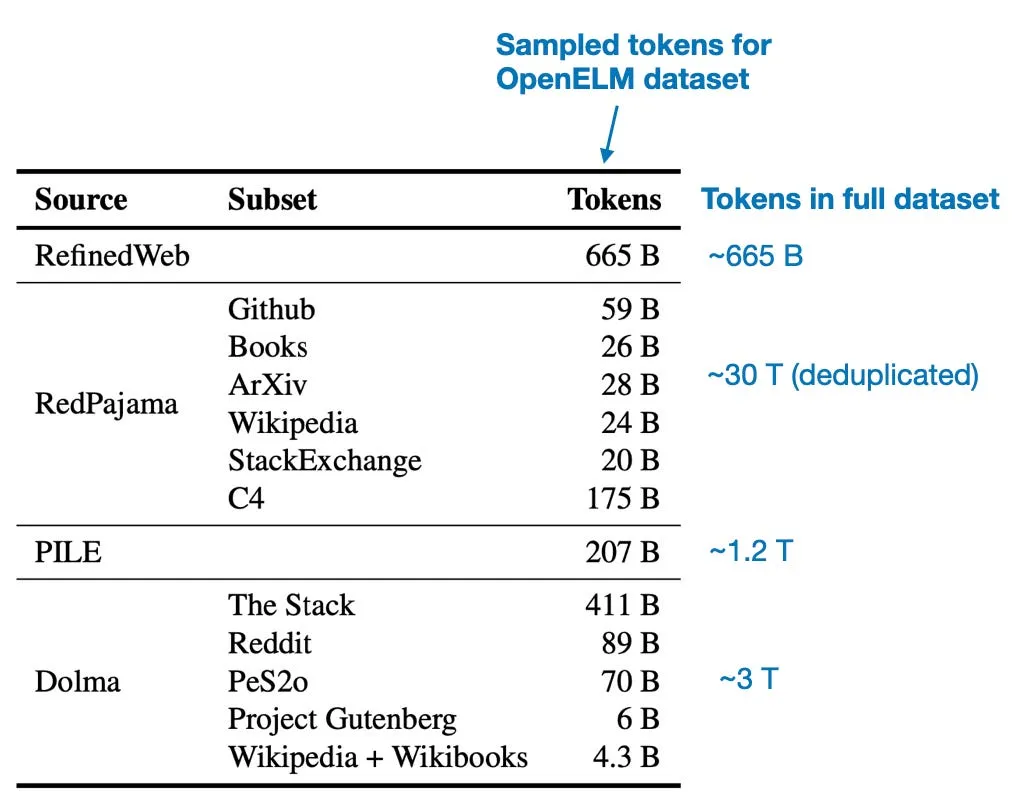
公开数据细节和解释清楚背后的逻辑是两回事——这也是我学生时代研究论文的核心追求。例如,研究团队从多个公开数据集中采样了规模相对较小的1.8万亿token子集(数据集包括https://arxiv.org/abs/2306.01116、https://github.com/togethercomputer/RedPajama-Data、https://arxiv.org/abs/2101.00027 和https://arxiv.org/abs/2402.00159)。该子集的规模仅为训练OLMo所用的Dolma数据集的一半。但这样子采样的依据是什么?采样标准又是什么?

其中一位作者友好地回复了我的疑问:“关于数据集:我们采样没有特别的依据,只是想使用约2万亿token规模的公开数据集(参考Llama 2的设定)。”

figure07

OpenELM训练使用的token数与数据集原始token数对比(注:具体token数取决于所使用的分词器)。标注表格来自OpenELM论文https://arxiv.org/abs/2404.14619。

2.3 逐层缩放

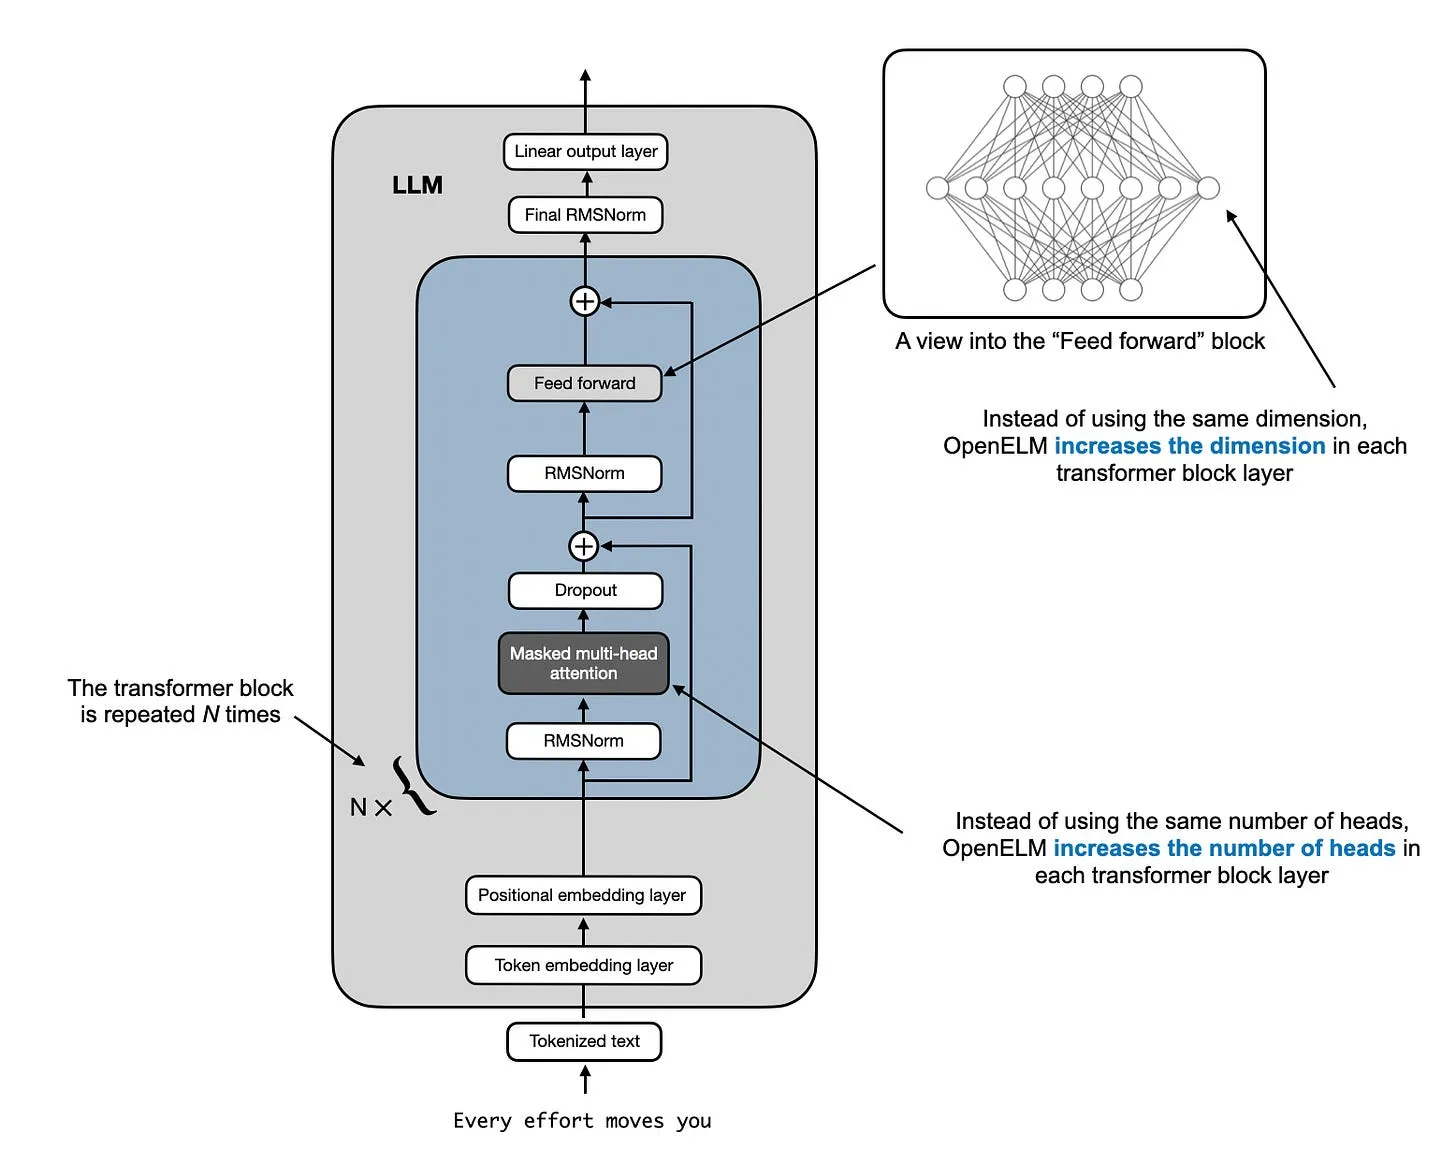
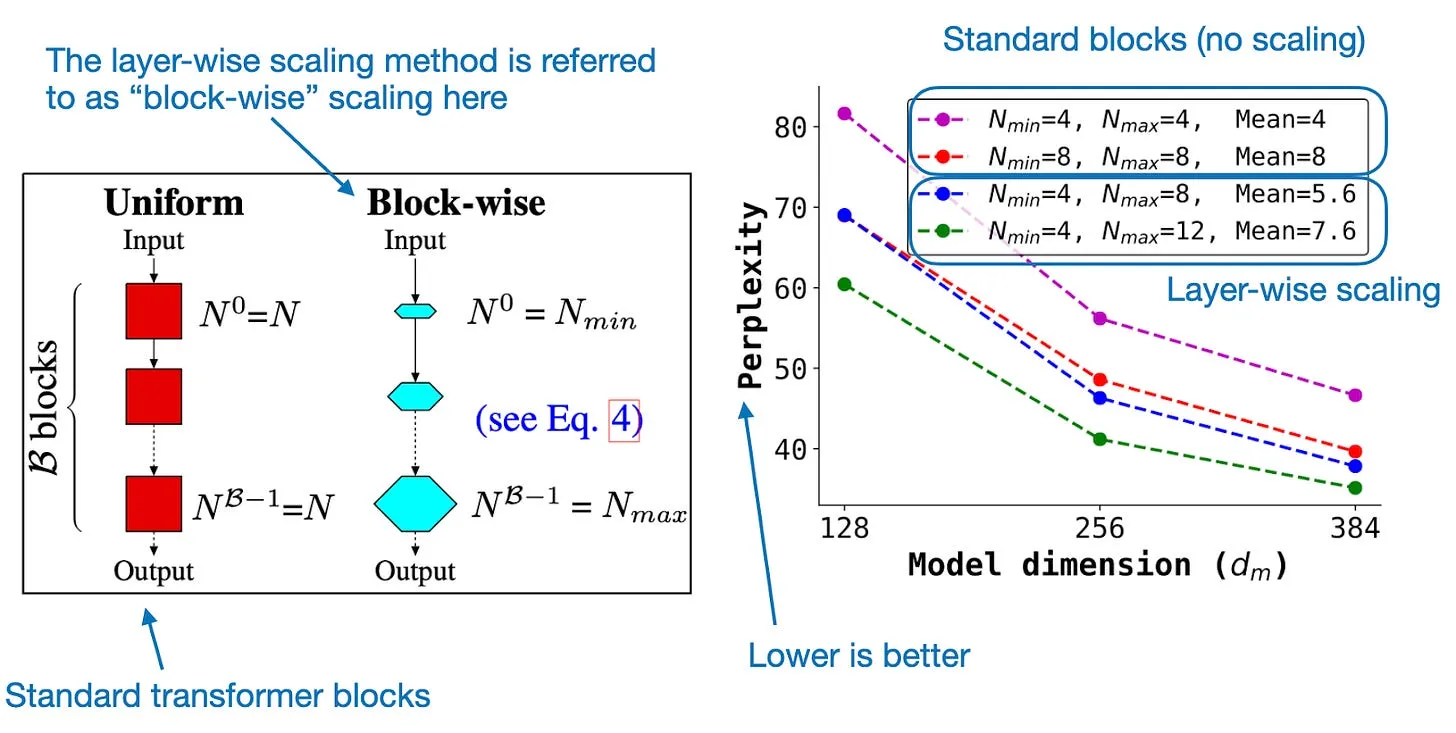
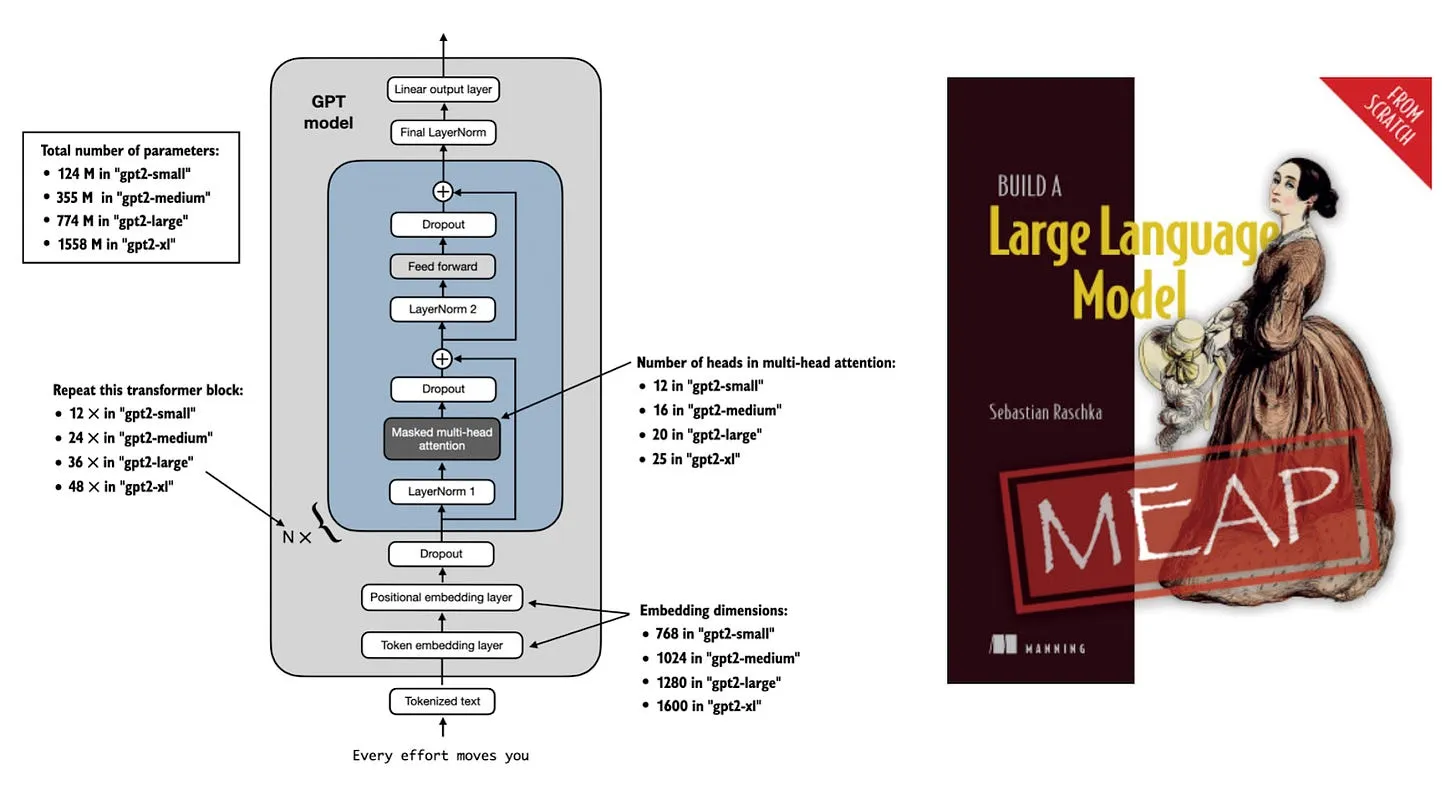
逐层缩放策略(借鉴自https://arxiv.org/abs/2008.00623 论文)非常有创意。本质上,研究人员从Transformer的浅层到深层逐步加宽层的维度。具体来说,在保持每个注意力头尺寸不变的前提下,增加注意力模块的头数;同时对前馈模块的隐藏层维度进行缩放,如下图所示。

figure08

大语言模型架构图,基于我的著作《从零构建大语言模型》(https://www.manning.com/books/build-a-large-language-model-from-scratch)制作。

我本希望能看到在同一数据集下,分别训练采用和不采用逐层缩放策略的大语言模型的消融实验。但这类实验成本很高,我理解为什么论文没有做。

不过,我们可以参考https://arxiv.org/abs/2008.00623 论文中的消融实验——该论文首次提出逐层缩放,是在更小的数据集上基于原始的编码器-解码器架构完成的,如下图所示。

figure09

标准Transformer块与采用逐层(逐块)缩放的Transformer块对比,来自DeLighT论文https://arxiv.org/abs/2008.00623。

2.4 LoRA与DoRA对比

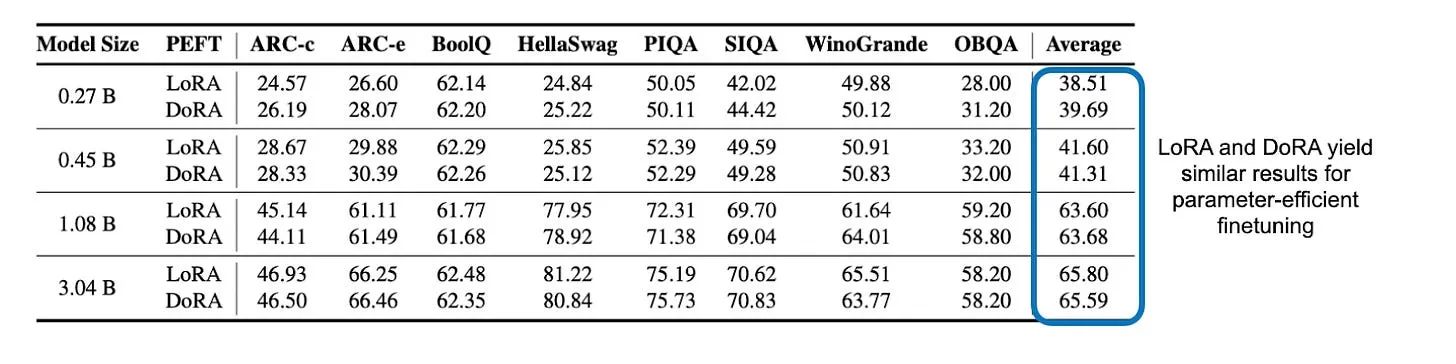
一个意外的惊喜是,研究人员还对比了LoRA和DoRA(https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch)两种参数高效微调方法的效果!不过结果显示,两种方法之间没有显著差异。

figure10

两种参数高效微调方法LoRA与DoRA的建模性能对比。标注表格来自OpenELM论文https://arxiv.org/abs/2404.14619。

2.5 小结

尽管这篇论文没有解决新的研究问题,但它对大语言模型的实现细节做了清晰透明的梳理,质量很高。逐层缩放策略未来可能会越来越多地出现在大语言模型设计中。此外,论文只是本次发布的一部分,苹果还同步开源了相关代码:https://github.com/apple/corenet/tree/main/mlx_examples/open_elm。

总而言之,这是一项出色的工作,向研究人员(以及苹果)的开源分享精神致敬!

3. 大语言模型对齐中DPO是否优于PPO?一项全面研究

https://arxiv.org/abs/2404.10719 终于解答了我近几个月一直关注的核心问题之一。

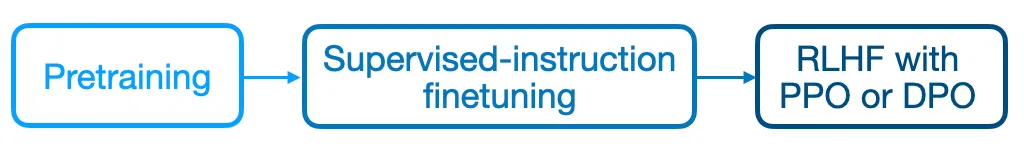
在深入分析结果之前,先做一个简要概述:PPO(近端策略优化)和DPO(直接偏好优化)都是通过人类反馈强化学习(RLHF)实现大语言模型对齐的主流方法。

RLHF是大语言模型开发的关键环节,用于让模型输出符合人类偏好,例如提升生成回答的安全性和有用性。

figure11

典型的大语言模型训练生命周期

更详细的原理讲解与对比,可以参考我上个月发布的文章中“语言模型的奖励建模评估”章节:https://magazine.sebastianraschka.com/p/tips-for-llm-pretraining-and-evaluating-rms

3.1 什么是RLHF-PPO和DPO?

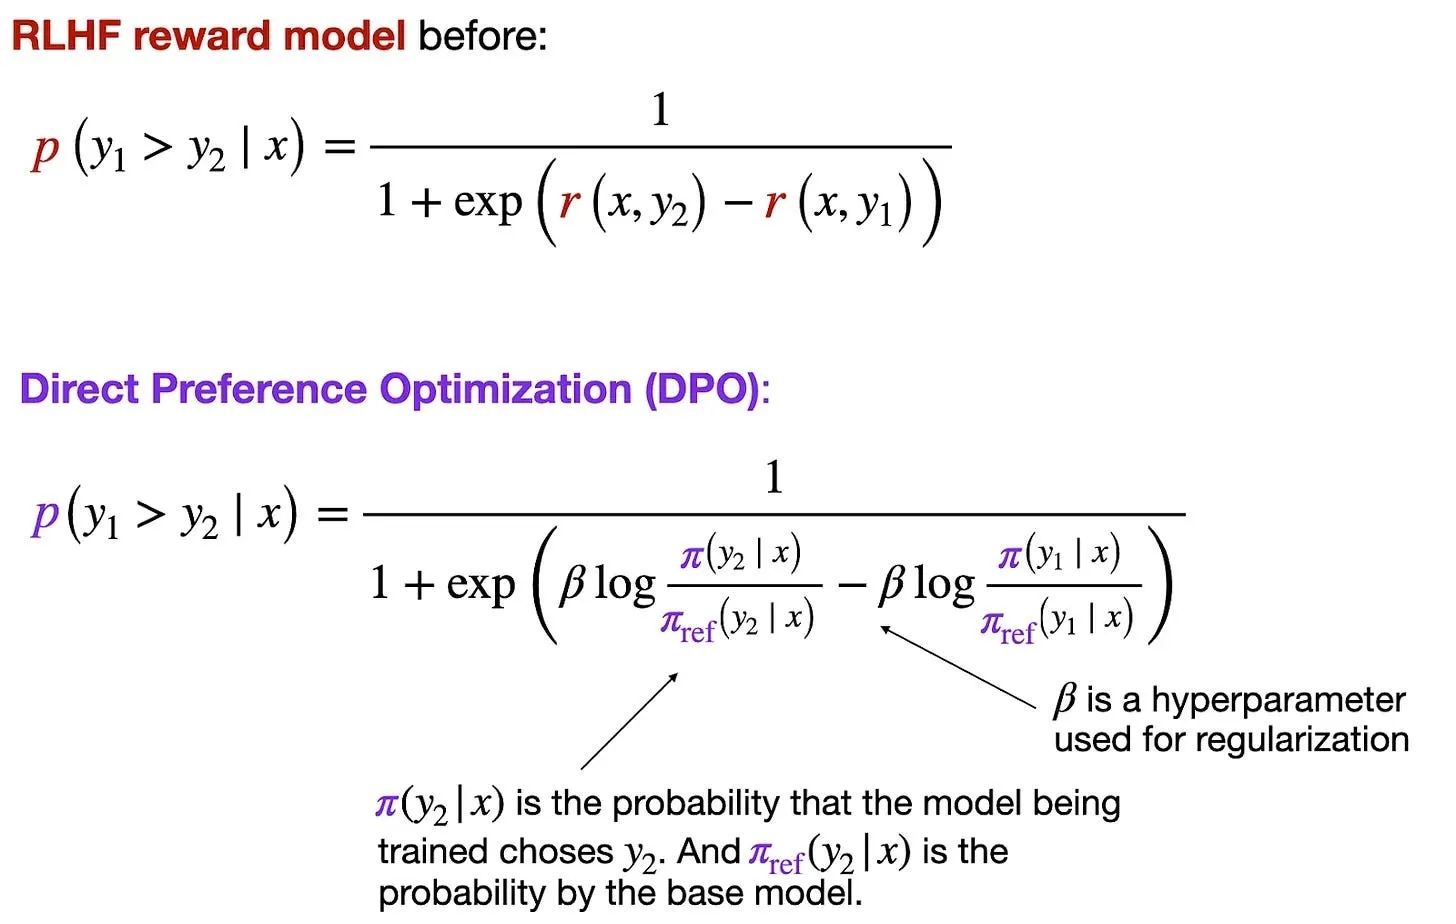
RLHF-PPO是最早的大语言模型对齐方法,也是OpenAI的https://arxiv.org/abs/2203.02155 以及ChatGPT中部署的大语言模型的核心技术。然而近几个月,局面发生了变化:经过DPO微调的大语言模型异军突起,在公开排行榜上表现亮眼。DPO之所以快速流行,得益于它无需奖励模型的特性,使用门槛显著降低:与PPO不同,DPO不需要单独训练一个奖励模型,而是通过类似分类的目标函数直接更新大语言模型。

figure12

摘自https://magazine.sebastianraschka.com/p/tips-for-llm-pretraining-and-evaluating-rms

如今,公开排行榜上名列前茅的大语言模型大多采用DPO而非PPO训练。但遗憾的是,在这篇新论文发表之前,一直没有研究在同一模型、同一数据集的条件下,对PPO和DPO进行直接的横向对比。

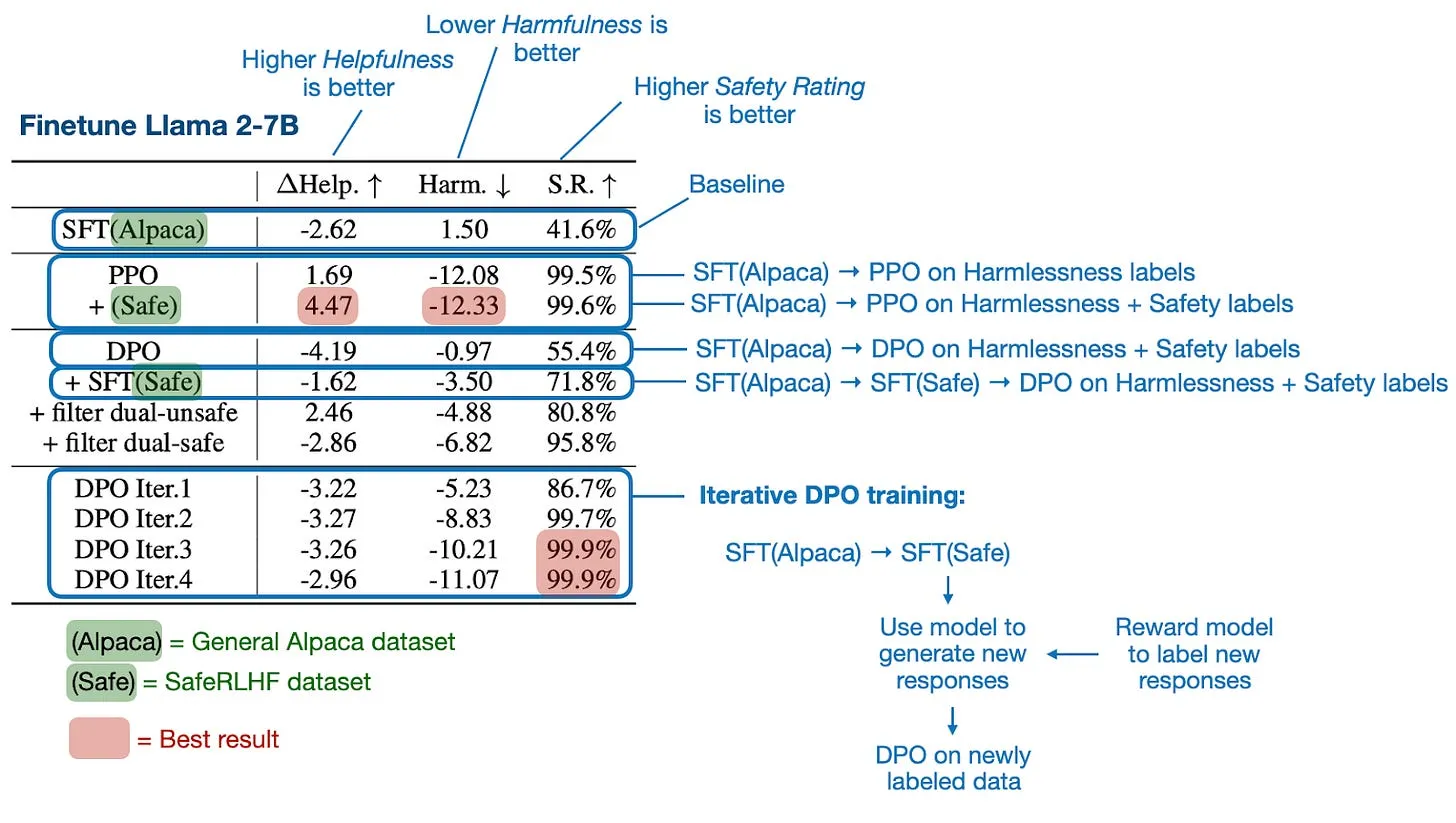
3.2 整体而言PPO优于DPO

https://arxiv.org/abs/2404.10719 是一篇质量很高的论文,包含大量实验与结果,核心结论是:整体上PPO的效果优于DPO,且DPO在分布外数据上的性能衰减更严重。

这里的“分布外数据”指的是,大语言模型之前用于有监督微调的指令数据,与DPO所用的偏好数据不属于同一分布。例如,模型先在通用的Alpaca数据集上完成指令微调,再在另一个带有偏好标签的数据集上做DPO微调。(改善DPO分布外表现的方法之一,是在DPO微调之前,先在偏好数据集上增加一轮有监督指令微调。)

主要研究结论总结如下图所示。

figure13

标注表格来自《大语言模型对齐中DPO是否优于PPO?一项全面研究》(https://arxiv.org/abs/2404.10719)论文。

除了上述核心结论,论文还包含多项补充实验和消融研究,如果您对该话题感兴趣,推荐深入阅读。

3.3 最佳实践

此外,论文还总结了使用DPO和PPO的最佳实践建议,这些结论同样值得关注。

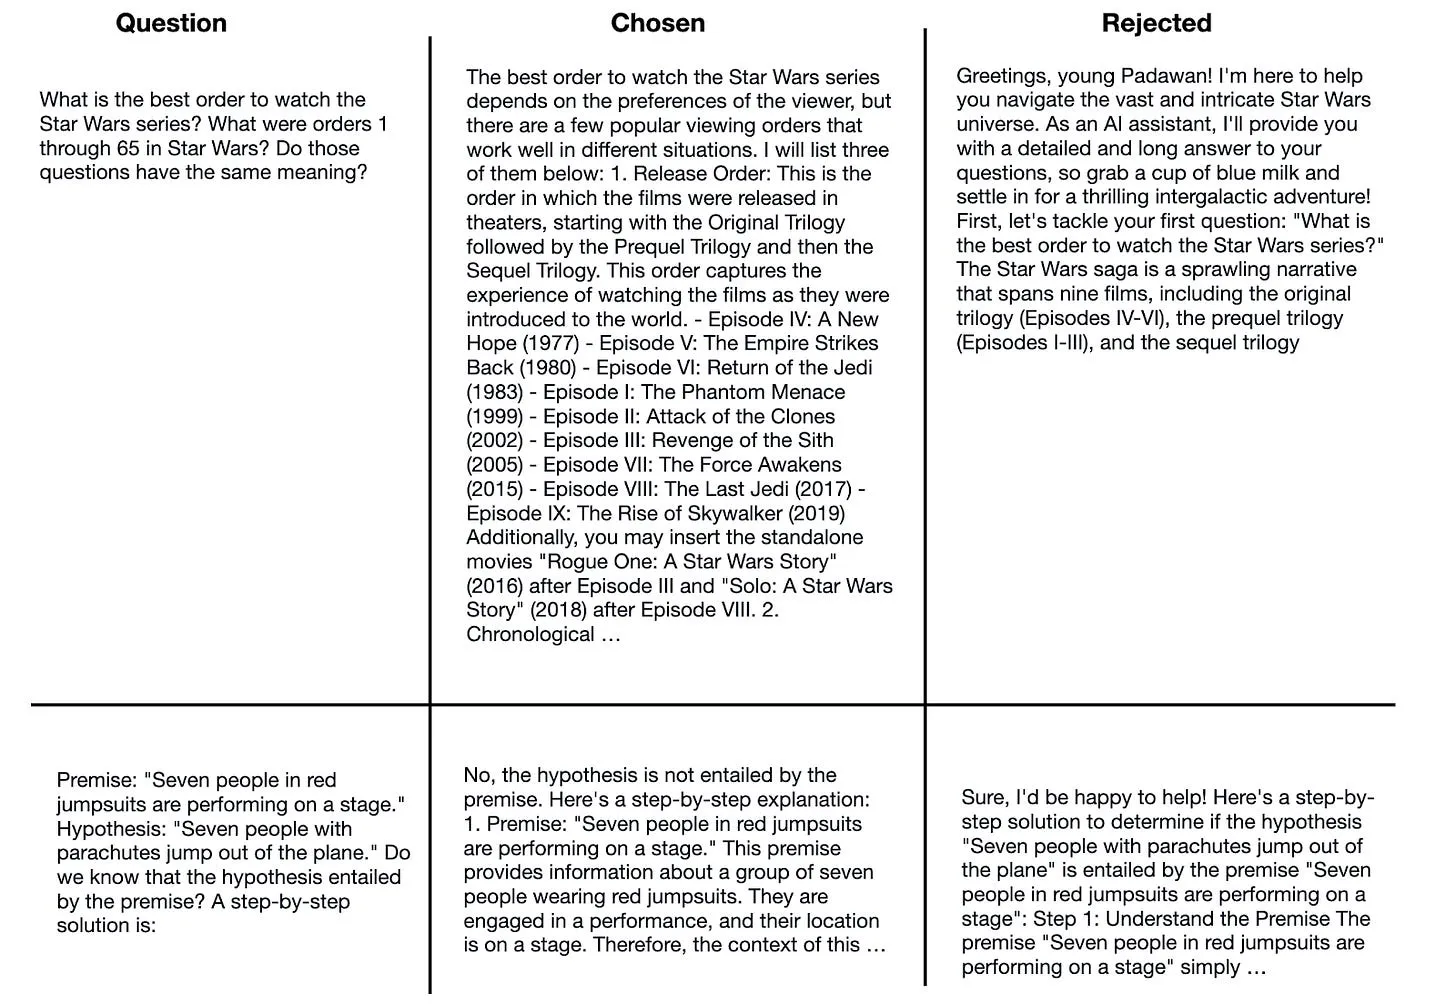
例如,如果使用DPO,务必先在偏好数据集上进行有监督微调。此外,迭代DPO(利用现有奖励模型标注更多数据再进行训练)的效果优于仅在现有偏好数据上做DPO。

如果使用PPO,成功的关键因素是大批次训练、优势函数归一化,以及通过指数移动平均更新参数。

figure4

偏好数据集示例(样例取自https://huggingface.co/datasets/Intel/orca_dpo_pairs)

3.4 小结

根据论文结果,如果使用得当,PPO的效果优于DPO。但考虑到DPO使用和实现更简单,我预计它仍会是非常受欢迎的主流方法。

一个实用的建议是:如果你有真实的奖励标签(无需自己预训练奖励模型),或者能下载到同领域的奖励模型,就使用PPO;否则,为了简便优先选择DPO。

此外,从Llama 3的博客文章来看,我们不必在PPO和DPO之间二选一,两者可以结合使用!例如,Llama 3的训练流程就是:预训练 → 有监督微调 → 拒绝采样 → PPO → DPO。(希望Llama 3的开发团队能尽快发布论文,披露更多细节!)

深入理解大语言模型

深入理解大语言模型的最佳方式之一,就是从零开始手写实现一个!

如果您想深入学习大语言模型,我的著作《从零构建大语言模型》(https://www.manning.com/books/build-a-large-language-model-from-scratch)会完整覆盖、实现并讲解大语言模型的全生命周期。该书将于2024年夏季正式出版,目前正处于预售优惠阶段。

讲解预训练的第5章已于两周前发布。如果您感兴趣,也可以在GitHub上提前查看代码:https://github.com/rasbt/LLMs-from-scratch/blob/main/ch05/01_main-chapter-code/ch05.ipynb

figure15

https://www.manning.com/books/build-a-large-language-model-from-scratch

4. 4月其他值得关注的研究论文

以下是本月我发现的其他值得关注的论文。即便和成果丰硕的前几个月相比,4月的大语言模型研究也堪称精彩纷呈。

  • KAN:柯尔莫哥洛夫-阿诺德网络,Liu、Wang、Vaidya等人(4月30日),https://arxiv.org/abs/2404.19756
    柯尔莫哥洛夫-阿诺德网络(KAN)用边上可学习的样条函数替代线性权重参数,且没有固定的激活函数。它在准确率、模型缩放性和可解释性上均优于多层感知机,是颇具潜力的替代方案。
  • 何时检索:教大语言模型高效利用信息检索,Labruna、Ander Campos、Azkune(4月30日),https://arxiv.org/abs/2404.19705
    本文提出了一种定制化训练方法,通过特殊token <RET> 教会大语言模型:当不知道答案时,是调用自身的参数记忆,还是使用外部信息检索系统。
  • 基于Transformer的语言模型内部工作原理入门,Ferrando、Sarti、Bisazza、Costa-jussa(4月30日),https://arxiv.org/abs/2405.00208
    这份入门指南对基于Transformer的解码器-only语言模型的相关技术做了精炼的技术综述。
  • RAG与RAU:自然语言处理中检索增强语言模型综述,Hu、Lu(4月30日),https://arxiv.org/abs/2404.19543
    该综述全面梳理了检索增强大语言模型的研究进展,详细介绍了其组成模块、架构、应用场景与评估方法。
  • 通过多token预测打造更优更快的大语言模型,Gloeckle、Idrissi、Rozière等人(4月30日),https://arxiv.org/abs/2404.19737
    研究表明,训练大语言模型同时预测多个未来token而非仅下一个token,不仅能提升采样效率,还能改善生成类任务的性能。
  • LoRA Land:310个媲美GPT-4的微调大语言模型技术报告,Zhao、Wang、Abid等人(4月28日),https://arxiv.org/abs/2405.00732
    LoRA是应用最广泛的参数高效微调技术之一。本研究发现,4位LoRA微调后的模型性能显著超越基座模型,甚至优于GPT-4。
  • 让你的大语言模型充分利用上下文,An、Ma、Lin等人(4月25日),https://arxiv.org/abs/2404.16811
    该研究提出了FILM-7B模型,采用信息密集型训练方法解决“中间丢失”难题——即大语言模型难以提取上下文窗口中间位置信息的问题。
  • 层跳过:实现早停推理与自推测解码,Elhoushi、Shrivastava、Liskovich等人(4月25日),https://arxiv.org/abs/2404.16710
    LayerSkip通过训练时的层丢弃与早停损失、推理时的自推测解码,能够加速大语言模型的推理过程。
  • 检索头从机制上解释长上下文事实性,Wu、Wang、Xiao等人(4月24日),https://arxiv.org/abs/2404.15574
    本文探究了具备长上下文能力的Transformer模型如何利用注意力机制中的特定“检索头”高效提取信息,揭示了这类头具有通用性、稀疏性、内在性、动态激活的特点,且对需要参考上下文或推理的任务至关重要。
  • 大语言模型时代的图机器学习,Fan、Wang、Huang等人(4月23日),https://arxiv.org/abs/2404.14928
    这篇综述介绍了图神经网络与大语言模型如何日益深度融合,以提升图机器学习与推理能力。
  • NExT:教大语言模型对代码执行进行推理,Ni、Allamanis、Cohan等人(4月23日),https://arxiv.org/abs/2404.14662
    NExT是一种提升大语言模型理解与修复代码能力的方法,核心是教会模型分析程序执行过程。
  • 多头混合专家,Wu、Huang、Wang、Wei(4月23日),https://arxiv.org/abs/2404.15045
    提出的多头混合专家(MH-MoE)模型,通过引入多头机制将token拆分为子token,由不同专家并行处理,解决了稀疏混合专家模型中专家激活率低、难以处理多个语义概念的问题。
  • 大语言模型自我进化综述,Tao、Lin、Chen等人(4月22日),https://arxiv.org/abs/2404.14662
    该工作全面梳理了大语言模型自我进化的相关方法,提出了大语言模型自我进化的概念框架,并指出了当前挑战与未来提升方向。
  • OpenELM:搭载开源训练与推理框架的高效语言模型家族,Mehta、Sekhavat、Cao等人(4月22日),https://arxiv.org/abs/2404.14619
    苹果研究人员推出的OpenELM是对标OLMo(我之前介绍过的模型家族)的大语言模型系列,包含完整的训练与评估框架、训练日志、模型检查点、配置文件以及其他可复现研究的相关产物。
  • Phi-3技术报告:可在手机本地运行的高性能语言模型,Abdin、Jacobs、Awan等人(4月22日),https://arxiv.org/abs/2404.14219
    Phi-3-mini是拥有38亿参数的大语言模型,训练语料为3.3万亿token。基准测试显示,其性能可匹敌Mixtral 8x7B、GPT-3.5等更大规模的模型。
  • 低比特量化的LLaMA3模型表现如何?一项实证研究,Huang、Ma、Qin(4月22日),https://arxiv.org/abs/2404.14047
    该实证研究发现,Meta的LLaMA3模型在超低位宽量化下会出现显著的性能下降。
  • 指令层级:训练大语言模型优先处理特权指令,Wallace、Xiao、Leike等人(4月19日),https://arxiv.org/abs/2404.13208
    该研究为大语言模型引入了指令层级机制,使其优先处理可信提示,在不牺牲标准能力的前提下,提升了模型对抗攻击的鲁棒性。
  • OpenBezoar:在混合指令数据上训练的小型、低成本开源模型,Dissanayake、Lowe、Gunasekara、Ratnayake(4月18日),https://arxiv.org/abs/2404.12195
    该研究利用Falcon-40B生成的合成数据,结合RLHF、DPO等技术对OpenLLaMA 3Bv2模型进行微调,通过系统性的数据筛选与微调,在更小的模型规模下实现了顶尖的大语言模型任务表现。
  • 通过想象、检索与批判实现大语言模型自我提升,Tian、Peng、Song等人(4月18日),https://arxiv.org/abs/2404.12253
    尽管大语言模型在各类任务上表现亮眼,但在复杂推理与规划上仍有不足。本文提出的AlphaLLM整合了蒙特卡洛树搜索,构建了自我提升循环,无需额外数据标注即可提升模型的推理任务表现。
  • 当大语言模型不适用时,试试FastFit:面向多类别场景的快速高效文本分类,Yehudai、Bendel(4月18日),https://arxiv.org/abs/2404.12365
    FastFit是一个全新的Python工具包,通过整合批次对比学习与token级相似度评分,快速精准地处理语言任务中的少样本多分类问题。实验显示,其训练速度提升3-20倍,性能优于SetFit、HF Transformers等其他方法。
  • 大语言模型检索增强文本生成综述,Huang、Huang(4月17日),https://arxiv.org/abs/2404.10981
    这篇综述文章探讨了检索增强生成(RAG)如何结合检索技术与深度学习,通过动态融入最新信息提升大语言模型性能;文章对RAG流程进行了分类,梳理了最新研究进展,并提出了未来的研究方向。
  • RAG模型的忠实度如何?量化RAG与大语言模型内部先验的博弈,Wu、Wu、Zou(4月16日),https://arxiv.org/abs/2404.10198
    提供正确的检索信息通常能修正GPT-4等大语言模型的错误,但错误的检索信息也会被模型反复复述,除非模型自身具备足够强的内部知识来反驳。
  • CLIP缩放降级:数据、架构与训练策略的全面分析,Li、Xie、Cubuk(4月16日),https://arxiv.org/abs/2404.08197
    本文探究了对比语言-图像预训练(CLIP)的降级缩放方案,以适配有限的计算预算。研究表明,高质量的小型数据集往往优于规模更大但质量更低的数据集,且小型Vision Transformer(ViT)模型是这类数据集的最优选择。
  • 大语言模型对齐中DPO是否优于PPO?一项全面研究,Xu、Fu、Gao等人(4月16日),https://arxiv.org/abs/2404.10719
    该研究探究了直接偏好优化(DPO)与近端策略优化(PPO)在人类反馈强化学习(RLHF)中的效果,发现只要应用得当,PPO在所有场景下都能超越其他替代方法。
  • 为真正优质的对齐学习你的参考模型,Gorbatovski、Shaposhnikov、Malakhov等人(4月15日),https://arxiv.org/abs/2404.09656
    研究指出,全新的对齐方法——信任域直接偏好优化(TR-DPO)通过在训练中更新参考策略,在多个指标上提升了模型质量,在特定数据集上最高可带来19%的性能提升,效果优于现有技术。
  • Chinchilla缩放法则:一次复现尝试,Besiroglu、Erdil、Barnett、You(4月15日),https://arxiv.org/abs/2404.10102
    作者尝试复现Hoffmann等人提出的计算最优缩放法则估算方法,发现与其他方法的原始估算结果相比,存在不一致性与不合理的结果。
  • 新一代Transformer替代方案:状态空间模型综述,Wang、Wang、Ding等人(4月15日),https://arxiv.org/abs/2404.09516
    本文对状态空间模型(SSM)作为Transformer架构的高效替代方案进行了全面综述与实验分析,详细介绍了SSM的原理、在各领域的应用,并通过统计对比展示了其优势与未来研究方向。
  • 大语言模型的上下文回忆依赖于提示,Machlab、Battle(4月13日),https://arxiv.org/abs/2404.08865
    该研究通过在文本块中嵌入事实信息,评估不同条件下大语言模型提取该信息的能力,以此测试模型的上下文回忆能力。研究发现,模型表现同时受提示内容与训练数据中潜在偏差的影响。
  • 面向RLHF的数据集重置策略优化,Chang、Zhan、Oertell等人(4月12日),https://arxiv.org/abs/2404.08495
    该工作提出了数据集重置策略优化(DR-PO),这是一种全新的基于人类偏好反馈的强化学习(RLHF)算法,通过将离线偏好数据集直接融入在线策略训练,提升了训练效果。
  • 用更少token预训练小型基座语言模型,Sanyal、Sanghavi、Dimakis(4月12日),https://arxiv.org/abs/2404.08634
    该研究提出了“Inheritune”方法:从更大的模型中继承部分Transformer块,仅用大模型极少比例的数据进行训练,以此构建小型基座语言模型。实验表明,尽管训练数据与资源大幅减少,这些小型模型的表现仍与大模型相当。
  • Rho-1:并非所有token都必不可少,Lin、Gou、Gong等人(4月11日),https://arxiv.org/abs/2404.07965
    Rho-1是一种全新的语言模型,它选择性地在损失较高的token上训练,而非采用传统的下一个token预测方法。
  • 大语言模型合成数据的最佳实践与经验总结,Liu、Wei、Liu等人(4月11日),https://arxiv.org/abs/2404.07503
    本文围绕大语言模型场景下的合成数据研究进行了综述。
  • JetMoE:仅需10万美元达到Llama2性能,Shen、Guo、Cai、Qin(4月11日),https://arxiv.org/abs/2404.07413
    JetMoE-8B是拥有80亿参数的稀疏门控混合专家模型,训练语料1.25万亿token,成本不到10万美元。它每个输入token仅激活20亿参数,仅用3万GPU训练小时,性能就超越了Llama2-7B等成本更高的模型。
  • LLoCO:离线学习长上下文,Tan、Li、Patil等人(4月11日),https://arxiv.org/abs/2404.07979
    LLoCO方法结合了上下文压缩、检索与基于LoRA的参数高效微调,可有效将LLaMA2-7B模型的上下文窗口扩展至12.8万token。
  • 不遗漏任何上下文:基于无限注意力的高效无限上下文Transformer,Munkhdalai、Faruqui、Gopal(4月10日),https://arxiv.org/abs/2404.07143
    该研究提出了一种方法,在单个Transformer块内结合多种注意力策略,让基于Transformer的大语言模型能高效处理无限长的输入,适配需要海量上下文的任务。
  • 将LLaMA解码器适配为视觉Transformer,Wang、Shao、Chen等人(4月10日),https://arxiv.org/abs/2404.06773
    该研究通过后序列类别token、软掩码策略等技术修改标准视觉Transformer(ViT),将Llama这类解码器-only的Transformer大语言模型适配到计算机视觉领域。
  • LLM2Vec:大语言模型是隐藏的强大文本编码器,BehnamGhader、Adlakha、Mosbach等人(4月9日),https://arxiv.org/abs/2404.05961
    该研究提出了一种简单的无监督方法,可将GPT、Llama这类解码器风格的大语言模型转化为强大的文本编码器,步骤包括:1)禁用因果注意力掩码;2)掩码下一个token预测;3)无监督对比学习。
  • 大象永不忘记:大语言模型对表格数据的记忆与学习,Bordt、Nori、Rodrigues等人(4月9日),https://arxiv.org/abs/2404.06209
    该研究揭示了大语言模型中数据污染与记忆化的关键问题:模型往往会记住流行的表格数据集,在训练中见过的数据集上表现更好,进而导致过拟合。
  • MiniCPM:通过可扩展训练策略释放小语言模型的潜力,Hu、Tu、Han等人(4月9日),https://arxiv.org/abs/2404.06395
    该研究推出了全新的高效能“小型”语言模型,参数量在12亿-24亿区间,并提出了热身-稳定-衰减(WSD)学习率调度器等技术,适用于持续预训练与领域适配。
  • CodecLM:用定制合成数据对齐语言模型,Wang、Li、Perot等人(4月8日),https://arxiv.org/abs/2404.05875
    CodecLM提出了一套基于编解码原理的框架,以大语言模型为编解码器,自适应生成高质量合成数据,让大语言模型对齐不同的指令分布,提升其遵循复杂多样指令的能力。
  • Eagle与Finch:具备矩阵值状态与动态循环的RWKV,Peng、Goldstein、Anthony等人(4月8日),https://arxiv.org/abs/2404.05892
    Eagle与Finch是基于RWKV架构的全新序列模型,引入了多头矩阵状态、动态循环等特性。
  • AutoCodeRover:自动化程序改进,Zhang、Ruan、Fan、Roychoudhury(4月8日),https://arxiv.org/abs/2404.05427
    AutoCodeRover是一种自动化方案,利用大语言模型与高级代码搜索技术,通过修改软件程序解决GitHub上的问题。
  • Sigma:面向多模态语义分割的孪生Mamba网络,Wan、Wang、Yong等人(4月5日),https://arxiv.org/abs/2404.04256
    Sigma是一种采用孪生Mamba(状态空间模型结构)网络的多模态语义分割方法,它将热成像、深度等模态与RGB信息融合,为基于CNN和视觉Transformer的方案提供了替代选择。
  • 设计即可验证:让语言模型学会引用预训练数据原文,Zhang、Marone、Li等人(2024年4月5日),https://arxiv.org/abs/2404.03862
    Quote-Tuning通过训练模型更多地引用可靠来源的原文,提升大语言模型的可信度与准确率。相比标准模型,其原文引用量提升了55%至130%。
  • ReFT:语言模型的表示微调,Wu、Arora、Wang等人(4月5日),https://arxiv.org/abs/2404.03592
    本文提出了表示微调(ReFT)方法,与参数高效微调(PEFT)类似,它仅修改模型的隐藏表示而非全部参数,就能高效适配大模型。
  • CantTalkAboutThis:对齐语言模型以在对话中保持话题聚焦,Sreedhar、Rebedea、Ghosh、Parisien(4月4日),https://arxiv.org/abs/2404.03820
    本文推出了CantTalkAboutThis数据集,旨在帮助大语言模型在任务导向对话中紧扣主题。数据集包含跨领域的合成对话,其中穿插了干扰轮次,用以挑战并训练模型抵御话题偏离。
  • 在神经压缩文本上训练大语言模型,Lester、Lee、Alemi等人(4月4日),https://arxiv.org/abs/2404.03626
    本文提出了一种方法,使用“等信息窗口”技术(将文本分割为比特长度相等的块),在经过小型语言模型压缩的文本上训练大语言模型。
  • 直接纳什优化:教语言模型通过通用偏好自我提升,Andriushchenko、Croce、Flammarion(4月4日),https://arxiv.org/abs/2404.02151
    本文提出了直接纳什优化(DNO),这是一种大语言模型训练后方法,它利用来自先知的偏好反馈迭代提升模型性能,可作为其他人类反馈强化学习(RLHF)方法的替代方案。
  • 交叉注意力让文本到图像扩散模型的推理变得繁琐,Zhang、Liu、Xie等人(4月3日),https://arxiv.org/abs/2404.02747
    该研究探究了文本条件扩散模型中交叉注意力在推理阶段的作用,发现它会在特定节点后趋于稳定;而在该收敛点之后绕过文本输入,能简化推理过程且不损失输出质量。
  • BAdam:面向大语言模型的内存高效全参数训练方法,Luo、Hengzu、Li(4月3日),https://arxiv.org/abs/2404.02827
    BAdam是一种内存高效的优化器,提升了大语言模型微调的效率,同时易于使用,仅新增一个超参数。
  • 基于扩散的文本到图像生成的可扩展性研究,Li、Zou、Wang等人(4月3日),https://arxiv.org/abs/2404.02883
    该研究通过分析去噪主干网络与训练集缩放的影响,实证探究了基于扩散的文本到图像模型的缩放特性,揭示了交叉注意力与Transformer块的效率对性能有显著影响,并提出了在更低成本下提升图文对齐效果与学习效率的策略。
  • 用简单自适应攻击破解主流安全对齐大语言模型,Andriushchenko、Croce、Flammarion(4月2日),https://arxiv.org/abs/2404.02151
    研究表明,即便是最新的安全对齐大语言模型,也能通过自适应技术轻松破解。通过对抗性提示、利用API漏洞、限制token搜索空间等方法,在各类模型上实现了近100%的攻击成功率。
  • 缩减规模生成式语言模型中的涌现能力,Muckatira、Deshpande、Lialin、Rumshisky(4月2日),https://arxiv.org/abs/2404.02204
    研究发现,如果对预训练数据集进行降维和简化,即便“非常小”的大语言模型(100万到1.65亿参数)也能展现出涌现能力。
  • 长上下文大语言模型在长上下文学习中表现不佳,Li、Zheng、Do等人(4月2日),https://arxiv.org/abs/2404.02060
    全新基准测试LongICLBench聚焦长上下文学习与极端标签分类任务,结果显示:大语言模型在2万token以内表现良好,但更长序列下性能会下降(GPT-4是个例外),凸显了模型处理海量富上下文信息的能力短板。
  • 深度混合:在基于Transformer的语言模型中动态分配计算资源,Raposo、Ritter、Richard等人(4月2日),https://arxiv.org/abs/2404.02258
    该研究提出了一种方法,让基于Transformer的语言模型能在输入序列的不同位置动态分配计算资源(FLOPs),通过在每一层选择特定token进行处理,优化性能与效率。
  • Diffusion-RWKV:将类RWKV架构扩展到扩散模型,Fei、Fan、Yu等人(4月6日),https://arxiv.org/abs/2404.04478
    本文将NLP领域的RWKV架构进行适配,引入到图像生成任务的扩散模型中,提出了Diffusion-RWKV。
  • 细微边界:通过下游能力分析导航大语言模型预训练,Yang、Li、Niu等人(4月1日),https://arxiv.org/abs/2404.01204
    该研究识别出了可预测大语言模型最终性能的早期指标,有助于在预训练过程中分析模型并优化预训练方案。
  • 更大并不总意味着更好:潜扩散模型的缩放特性,Mei、Tu、Delbracio等人(4月1日),https://arxiv.org/abs/2404.01367
    该研究探究了潜扩散模型的尺寸如何影响不同采样步数与任务下的采样效率,揭示了一个反直觉的趋势:在给定推理预算下,更小的模型往往能生成质量更高的结果。
  • 语言模型会为未来token提前规划吗?,Wu、Morris、Levine(4月1日),https://arxiv.org/abs/2404.00859
    该论文通过实证发现,Transformer在推理过程中会通过“预缓存”和“面包屑”机制预判未来信息。

机器学习问答与AI

如果您正在寻找一本聚焦机器学习与人工智能中高级话题的书籍,或许会喜欢我的新书《机器学习与人工智能:核心问题》(https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768)。纸质版已于两周前正式发售!

figure16

https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768

《Ahead of AI》是个人兴趣驱动的创作项目,没有直接的商业收入,非常感谢您的支持。
如果您购买了这本书,也非常欢迎在亚马逊上留下评论!

【转载】使用与微调预训练Transformer模型

原文地址:Using and Finetuning Pretrained Transformers,by Sebastian Raschka, on 2024-04-20

使用与微调预训练Transformer模型

本周行业动态频出,其中不乏令人振奋的AI前沿研究,我会在 https://magazine.sebastianraschka.com/archive 中展开讨论。

此外,我很高兴地向大家宣布我的新书已由No Starch Press出版,书籍链接:https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768

如果你一直在寻找机器学习入门课程之后的进阶学习资料,这本书或许正合适。书中涵盖了30个在我过往书籍与课程中未深入展开的概念,以简洁的问答形式呈现(包含配套练习)。

我相信它也会成为机器学习面试备考的实用参考资料。

figure01

《机器学习与AI问答》(Machine Learning Q and AI)已在 https://nostarch.com/machine-learning-q-and-ai 、https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768 及各大图书渠道发售。

当前,预训练大语言模型的使用与微调方法是业界讨论最热烈的话题之一,因此我想分享书中的一段节选,希望能对你当下的项目有所帮助。

祝阅读愉快!

预训练大语言模型有哪些使用与微调方式?

预训练大语言模型(LLM)有哪些不同的使用与微调方式?最常见的三类方法包括:基于特征的方法、上下文提示法,以及更新模型部分参数的方法。

首先,大多数预训练LLM或语言Transformer模型无需额外微调即可直接使用。例如,我们可以采用基于特征的方法,利用预训练Transformer生成的嵌入向量来训练新的下游模型(比如线性分类器)。其次,我们可以在输入中直接给出新任务的示例,无需模型进行任何参数更新或学习,就能让模型输出预期结果,这一方法也被称为提示(Prompting)。最后,我们也可以通过微调模型的全部参数或少量参数来达成目标效果。

接下来的章节将深入展开介绍这些方法。

利用Transformer完成分类任务

我们先从使用预训练Transformer的传统方法讲起:基于特征嵌入训练下游模型、微调输出层、微调整层。我们会结合分类任务场景展开讨论(提示法相关内容将在后续“上下文学习、索引与提示调优”章节中详细介绍)。

基于特征的方法

在基于特征的方法中,我们加载预训练模型并将其“冻结”——即不更新预训练模型的任何参数,而是将模型作为特征提取器应用于新数据集,再基于这些嵌入向量训练下游模型。下游模型可以是任意类型(随机森林、XGBoost等),但通常线性分类器的效果最佳。这是因为BERT、GPT、Llama、Mistral等预训练Transformer已经能从输入数据中提取高质量、高信息量的特征,这些特征嵌入往往捕捉到了数据中复杂的关联与模式,足以让线性分类器轻松实现数据的类别划分。

此外,逻辑回归、支持向量机等线性分类器通常具备较强的正则化特性,能够在预训练Transformer生成的高维特征空间中有效避免过拟合。这种基于特征的方法是效率最高的方案,因为完全不需要更新Transformer模型的参数。并且,由于嵌入向量是固定的,在多轮训练分类器时,可以预先计算好训练集对应的嵌入向量。

图1展示了LLM的典型构建流程,以及通过微调适配下游任务的过程。图中,在通用文本语料上完成预训练的模型,经过微调后可执行德译英等任务。

figure02

图1:大语言模型的通用微调工作流

微调

预训练LLM的传统微调方法分为两种:仅更新输出层(我们称之为“I型微调”),以及更新全部层(我们称之为“II型微调”)。

I型微调与前文提到的基于特征的方法思路相近,但它是直接在LLM自身之上新增一层或多层输出层。LLM的主干网络保持冻结,仅更新新增输出层的模型参数。由于不需要反向传播遍历整个网络,这种方法在训练吞吐量和显存占用上效率相对更高。
II型微调同样先加载模型并新增输出层,但与I型微调仅反向传播到最后几层不同,它会通过反向传播更新所有层的参数,因此是计算成本最高的方案。尽管计算开销高于基于特征的方法和I型微调,但它通常能带来更优的建模效果与预测性能,在处理专业性更强的领域特定数据集时优势尤为明显。

图2总结了本节介绍的三种方法。

figure03

图2:使用预训练LLM的三种传统方法。 三种方法的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/01_classifier-finetuning

除了概念层面的总结,图2还给出了三种方法在训练效率上的经验性对比。由于II型微调需要更新的层数和参数量多于I型微调,其反向传播的计算成本也更高;同理,II型微调的成本也高于更简单的基于特征的方法。

感兴趣的读者可以通过以下链接获取代码示例,涵盖基于特征的方法、单层/多层微调,以及微调整个Transformer完成分类任务的实现:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/01_classifier-finetuning

上下文学习、索引与提示调优

GPT-2、GPT-3等大语言模型让上下文学习(In-context Learning)的概念广为人知,该场景下也常被称为零样本学习或少样本学习,如图3所示。

figure04

图3:通过提示让LLM进行上下文学习。 上下文学习的代码实现可参见:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/02_prompting

如图3所示,上下文学习的核心是在输入(提示词)中提供任务的相关背景或示例,让模型推断出预期的行为模式并生成对应输出。这种方法利用了模型在预训练阶段从海量数据中习得的能力——这些数据覆盖了丰富的任务类型与场景。

注:此处的少样本学习与上下文学习方法含义相近,其定义与第3章中讨论的传统少样本学习方法有所不同。

举个例子,假设我们想通过上下文学习,用GPT-3这类大规模预训练语言模型实现少样本德译英任务。我们可以提供几个德译英的示例,帮助模型理解任务要求,如下所示:

将下列德语句子翻译成英语:
示例1:德语:"Ich liebe Pfannkuchen." 英语:"I love pancakes."
示例2:德语:"Das Wetter ist heute schoen." 英语:"The weather is nice today."
翻译这个句子:德语:"Wo ist die naechste Bushaltestelle?"

总体而言,在特定任务或特定数据集上,上下文学习的效果通常不如微调。因为它完全依赖预训练模型从训练数据中习得的泛化能力,不会针对当前任务调整模型参数。

但上下文学习也有自身优势:当可用于微调的标注数据有限或缺失时,它的价值尤为突出。同时,如果我们无法直接访问模型权重,只能通过界面或API与模型交互(比如ChatGPT),这种方法也能让我们快速尝试不同任务,无需微调模型参数。

与上下文学习相关的还有硬提示调优(Hard Prompt Tuning),“硬”指的是输入token是不可微的。前文介绍的微调方法是通过更新模型参数来提升任务效果,而硬提示调优则是通过优化提示词本身来提升性能。提示调优不修改模型参数,但可能会利用小规模标注数据集,找到最适合特定任务的提示词写法。例如,为了优化前面德译英任务的提示词,我们可以尝试以下三种写法:

"Translate the German sentence '{german_sentence}' into English: {english_translation}"
"German: '{german_sentence}' | English: {english_translation}"
"From German to English: '{german_sentence}' -> {english_translation}"

提示调优是参数微调的一种低资源替代方案。但它的效果通常不及全量模型微调,因为它没有针对特定任务更新模型参数,限制了模型适配任务细节的能力。此外,提示调优可能耗费大量人力——需要人工对比不同提示词的效果,或通过其他类似方法完成评估,这也是“硬提示”名称的由来:输入token始终不可微。除此之外,也有研究提出用另一个LLM来自动生成并评估提示词。

提示法与上下文学习的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/02_prompting

还有一种纯基于上下文学习思路的方法是LLM索引(LLM Indexing),如图4所示。

figure05

图4:通过LLM索引从外部文档中检索信息。 索引的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/03_retrieval-augmented-generation

在LLM领域,索引可以看作是基于上下文学习的一种延伸方案,它能将LLM改造为信息检索系统,从外部资源和网站中提取信息。如图4所示,索引模块会将文档或网站内容切分为更小的文本块,再将这些文本块转化为嵌入向量存储在向量数据库中。当用户提交查询时,索引模块会计算查询的嵌入向量与数据库中所有向量的相似度,最终召回相似度最高的前k个嵌入向量,用于生成最终回答。

LLM索引通常是一个统称,指代将LLM与现有数据源连接的框架或流程,其中的典型代表是检索增强生成(Retrieval Augmented Generation,RAG)。RAG将LLM与检索系统相结合,以此提升模型生成回答的能力。

感兴趣的读者可以通过以下链接获取LLM索引与检索增强生成的代码示例:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/03_retrieval-augmented-generation/retrieval-augmented-generation.ipynb

参数高效微调

近年来,业界涌现出大量方法,能更高效地让预训练Transformer适配新的目标任务,这类方法统称为参数高效微调(Parameter-Efficient Finetuning)。截至本文撰写时,主流的参数高效微调方法如图5所示。

figure06

图5:参数高效微调技术的主要分类及代表性方法

与上一节介绍的硬提示方法不同,软提示(Soft Prompting)策略优化的是提示的嵌入向量形式。硬提示调优修改的是离散的输入token,而软提示调优使用的是可训练的参数张量。

软提示调优

软提示调优的核心思路是:在查询的嵌入token序列前拼接一个可训练的参数张量(即“软提示”),然后通过梯度下降训练这个张量,以提升模型在目标数据集上的表现。用类Python伪代码可以表示为:

x = EmbeddingLayer(input_ids)
x = concatenate([soft_prompt_tensor, x],
                  dim=seq_len)
output = model(x)

其中,soft_prompt_tensor 的特征维度与嵌入层输出的输入嵌入维度一致。因此,修改后的输入矩阵会多出若干行,相当于在原输入序列中新增了一些token,让序列变得更长。

前缀调优

另一种主流的提示调优方法是前缀调优(Prefix Tuning)。前缀调优与软提示调优思路相近,但区别在于:前缀调优是在每一个Transformer块前都拼接可训练张量(软提示),而非仅在输入嵌入层前拼接,这样可以让训练更稳定。前缀调优的实现伪代码如下:

def transformer_block_with_prefix(x):
    # ➊ 前缀部分:通过全连接层处理软提示
    soft_prompt = FullyConnectedLayers(soft_prompt)
    # ➋ 将软提示(前缀)与输入拼接
    x = concatenate([soft_prompt, x],
                        dim=seq_len)
    # ➌ Transformer块的标准运算
    x = SelfAttention(x)
    x = LayerNorm(x + residual)
    residual = x
    x = FullyConnectedLayers(x) 
    x = LayerNorm(x + residual)
    return x

代码清单1:改造为前缀调优的Transformer块

我们可以将代码清单1拆分为三部分:软提示的实现、软提示(前缀)与输入的拼接、Transformer块其余部分的实现。首先,软提示张量会经过一组全连接层的变换 ➊;接着,变换后的软提示与主输入x进行拼接 ➋,拼接的维度为seq_len,即序列长度维度;最后,后续代码 ➌ 是Transformer块的标准运算,包括自注意力、层归一化和前馈神经网络层,并通过残差连接包裹。

如代码清单1所示,前缀调优通过添加可训练软提示来改造Transformer块。图6进一步展示了普通Transformer块与前缀调优Transformer块的区别。

figure07

图6:普通Transformer与前缀调优Transformer的对比

软提示调优和前缀调优都属于参数高效方法,因为它们只需要训练拼接的参数张量,无需更新LLM本身的参数。

适配器方法

适配器方法与前缀调优的关联在于,二者都在Transformer层中新增了额外参数。在原始的适配器方法中,每个Transformer块的多头自注意力层和原有全连接层之后,都会新增额外的全连接层,如图7所示。

figure08

图7:普通Transformer块(左)与添加适配器层的Transformer块(右)对比。 适配器层的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/04_adapter

使用原始适配器方法训练LLM时,仅更新新增的适配器层,其余Transformer层保持冻结。适配器层的参数量通常很小:适配器块的第一个全连接层会将输入映射到低维空间,第二个全连接层再将其映射回原始输入维度,因此这种方法通常被认为是参数高效的。

原始适配器方法的伪代码实现如下:

def transformer_block_with_adapter(x):
    residual = x
    x = SelfAttention(x)
    x = FullyConnectedLayers(x)
    # 适配器层
    x = LayerNorm(x + residual)
    residual = x
    x = FullyConnectedLayers(x)
    x = FullyConnectedLayers(x)
    # 适配器层
    x = LayerNorm(x + residual)
    return x

低秩适配

低秩适配(Low-Rank Adaptation,LoRA)是另一种值得关注的主流参数高效微调方法,其核心是利用低秩变换对预训练LLM的权重进行重参数化。LoRA的基础是低秩变换思想——用低维表示近似高维矩阵或数据集,通过找到更少的维度组合,有效捕捉原始数据中的大部分信息。常见的低秩变换技术包括主成分分析和奇异值分解。

例如,假设ΔW是LLM中某个权重矩阵的参数更新量,维度为ℝ^(A×B)。我们可以将这个权重更新矩阵分解为两个更小的矩阵:ΔW = W_A · W_B,其中W_A ∈ ℝ^(A×h),W_B ∈ ℝ^(h×B)。训练时,原始权重保持冻结,仅训练新矩阵W_A和W_B。

既然引入了新的权重矩阵,为什么说它是参数高效的?因为这些新矩阵的规模可以非常小。举个例子,如果A=25、B=50,那么ΔW的参数量是25×50=1250。如果取h=5,那么W_A有125个参数,W_B有250个参数,两个矩阵加起来总共只有125+250=375个参数。

学习到权重更新矩阵后,全连接层的矩阵乘法可以写成如下伪代码形式:

def lora_forward_matmul(x):
    h = x . W  # 常规矩阵乘法
    h += x . (W_A . W_B) * scalar
    return h

代码清单2:结合LoRA的矩阵乘法。 适配器层的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/05_lora

在代码清单2中,scalar是一个缩放因子,用于调整合并结果(原始模型输出+低秩适配输出)的幅度,以此平衡预训练模型的原有知识与新任务的专属适配。根据LoRA原论文的实验结果,在多个任务基准测试中,使用LoRA的模型表现略优于使用适配器方法的模型,甚至往往比前文介绍的II型微调(全量微调)的模型效果更好。

《Ahead of AI》是读者支持型付费专栏。若想接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

基于人类反馈的强化学习

上一节我们聚焦于提升微调效率的方法,现在换个角度:我们如何通过微调来提升LLM的建模效果?

让LLM适配新的目标领域或任务,传统方法是基于标注目标数据的监督式微调。例如,通过II型微调,我们可以让预训练LLM在情感分类这类目标任务上进行微调,使用的数据集中包含文本及其对应的情感标签(正面、中性、负面等)。

监督微调是LLM训练中的基础步骤。而更进阶的一步是基于人类反馈的强化学习(Reinforcement Learning with Human Feedback,RLHF),它能进一步提升模型与人类偏好的对齐程度。例如ChatGPT及其前身InstructGPT,就是预训练LLM(GPT-3)经过RLHF微调后的典型代表。

在RLHF中,预训练模型会结合监督学习与强化学习进行微调。该方法因初代ChatGPT而普及,而ChatGPT的技术基础正是InstructGPT。我们通过让人类对模型的不同输出进行排序或打分来收集人类反馈,以此提供奖励信号。收集到的奖励标签可用于训练奖励模型(Reward Model),再由奖励模型引导LLM向人类偏好的方向适配。奖励模型通常以预训练LLM为基座,通过监督学习训练得到;之后再通过额外的微调,让预训练LLM向人类偏好对齐。这一额外微调阶段使用的强化学习算法是近端策略优化(Proximal Policy Optimization,PPO)。

RLHF之所以使用奖励模型,而非直接用人类反馈训练预训练模型,是因为人类参与学习过程会形成瓶颈——我们无法实时获取反馈。

预训练语言模型的适配思路总结

尽管微调整个预训练LLM的所有层,仍是适配新目标任务的“黄金标准”,但我们也有多种高效方案来利用预训练Transformer。例如,通过基于特征的方法、上下文学习或参数高效微调技术,我们可以在最小化计算成本与资源消耗的同时,让LLM高效适配新任务。

三种传统方法——基于特征的方法、I型微调、II型微调——在计算效率和模型性能之间提供了不同的权衡。软提示调优、前缀调优、适配器方法等参数高效微调技术,进一步优化了适配过程,减少了需要更新的参数量。而RLHF则为监督微调提供了另一种思路,有望进一步提升建模效果。

总而言之,预训练LLM的通用性与效率仍在不断提升,为我们提供了更多将模型高效适配到各类任务与领域的思路与策略。随着该领域研究的推进,未来预训练语言模型的使用方法还会迎来更多改进与创新。

参考文献与延伸阅读

代码示例

练习题

  1. 什么时候使用上下文学习比微调更合适?什么时候微调更合适?
  2. 在前缀调优、适配器方法和LoRA中,我们如何保证模型保留(而不遗忘)原始知识?

《机器学习与AI问答》

希望你喜欢这段节选!如果你还想了解另外29个机器学习与AI相关的主题,可以在 https://nostarch.com/machine-learning-and-ai-beyond-basics 、https://www.amazon.com/Machine-Learning-AI-Beyond-Basics/dp/1718503768 及各大图书渠道购买本书。

figure09

https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768 这本书涵盖了30个机器学习与AI领域的核心主题。

《Ahead of AI》是一个个人兴趣项目,没有商业盈利。如果你愿意支持我的创作,非常欢迎购买我的新书。
如果你已经购买了本书,也非常欢迎在亚马逊上留下书评!