Author Archives: neohope
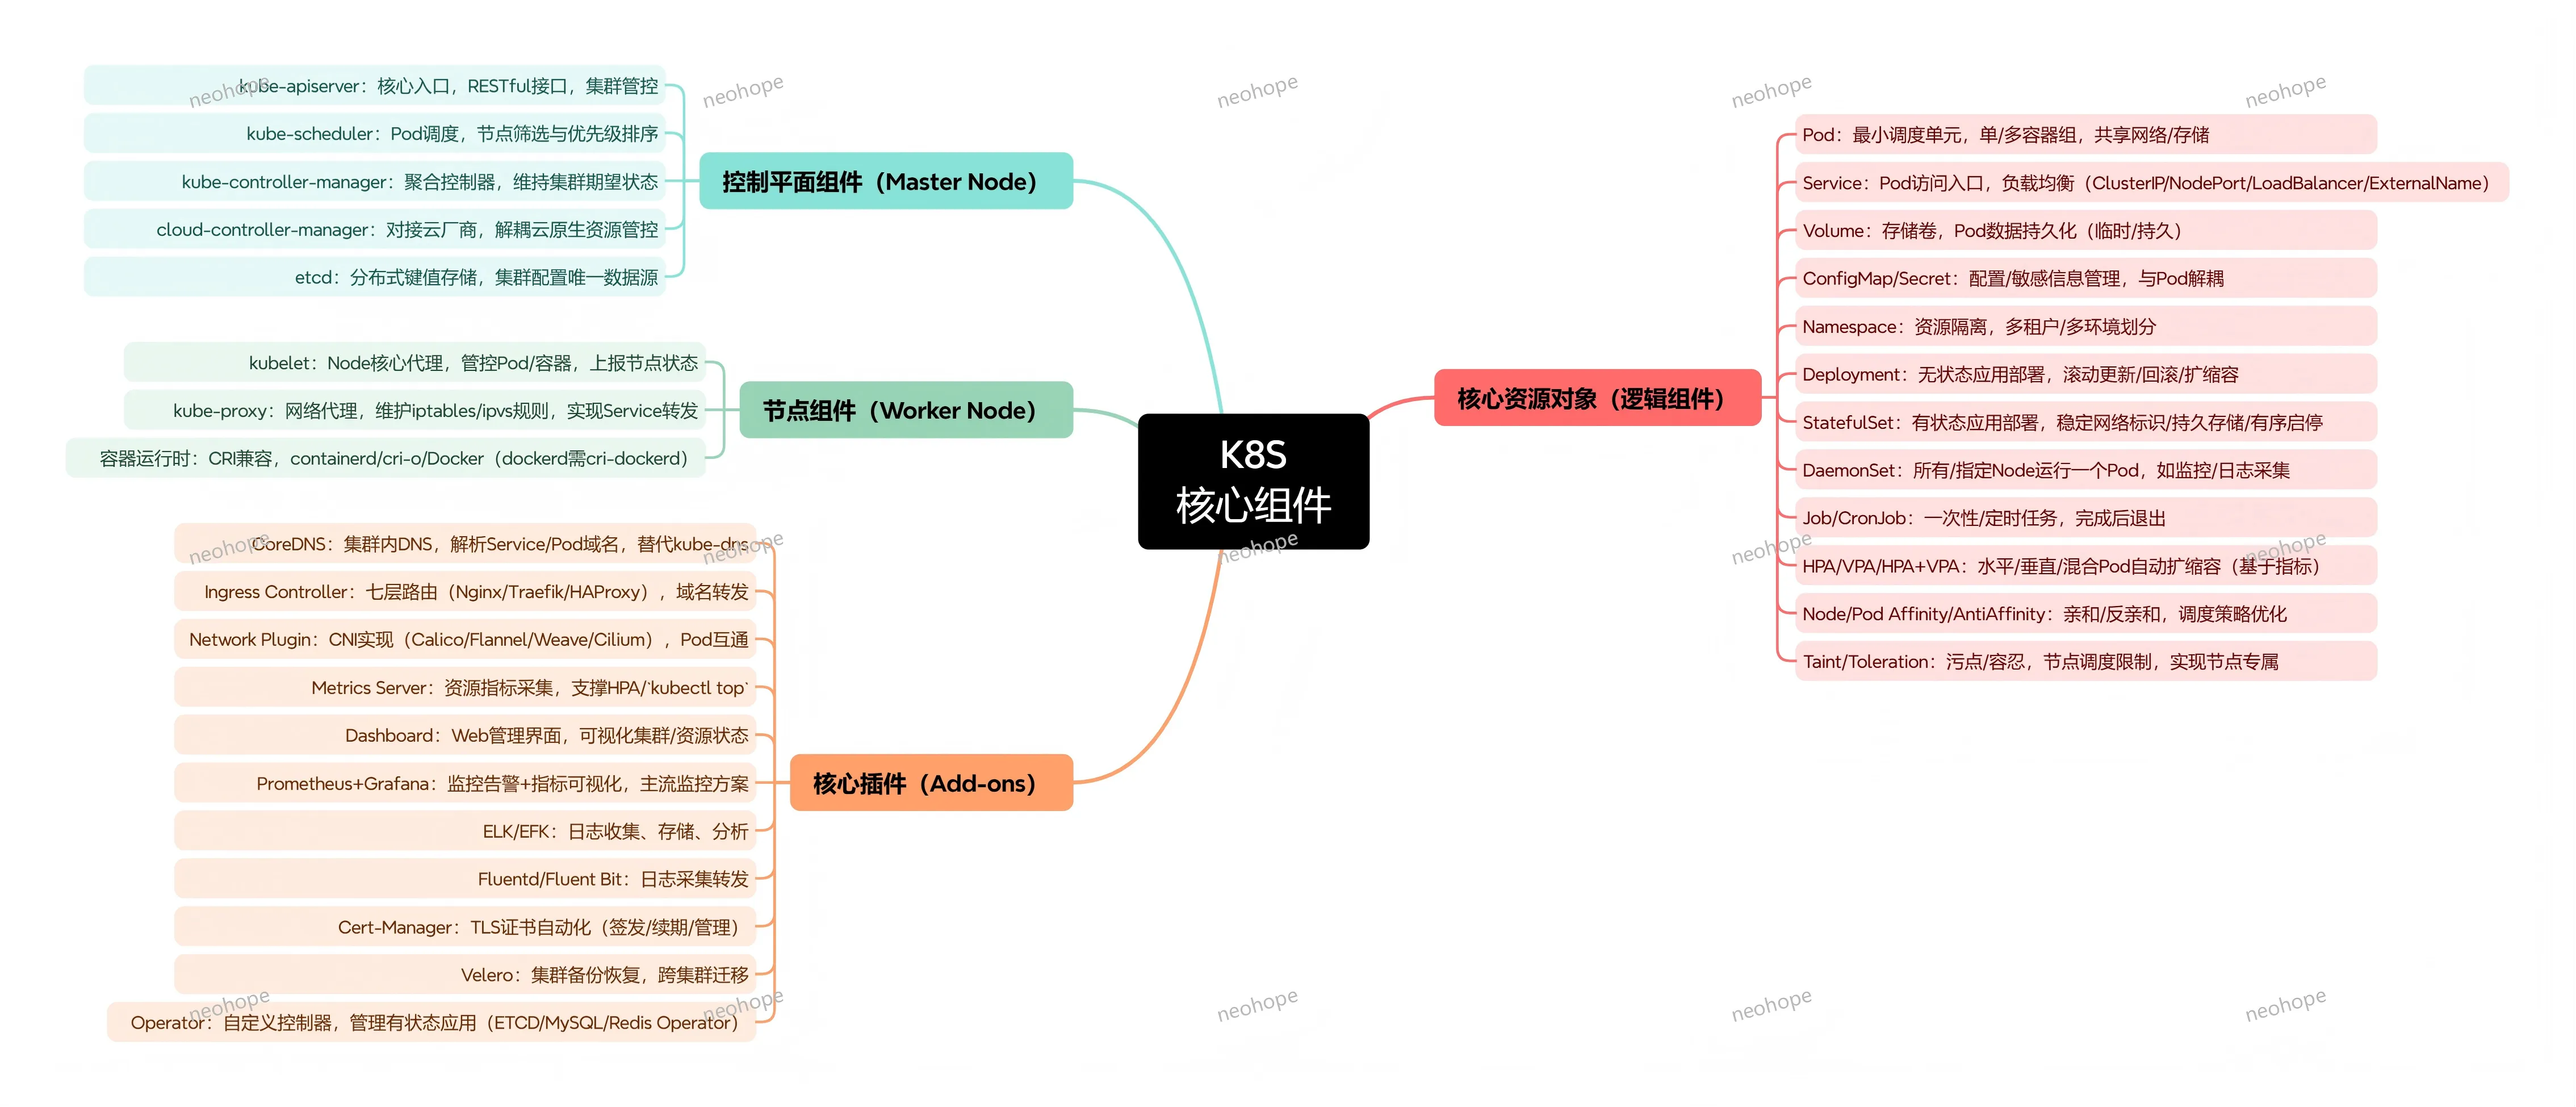
【温故知新】私有云_OpenStack核心组件
【温故知新】常见云计算产品
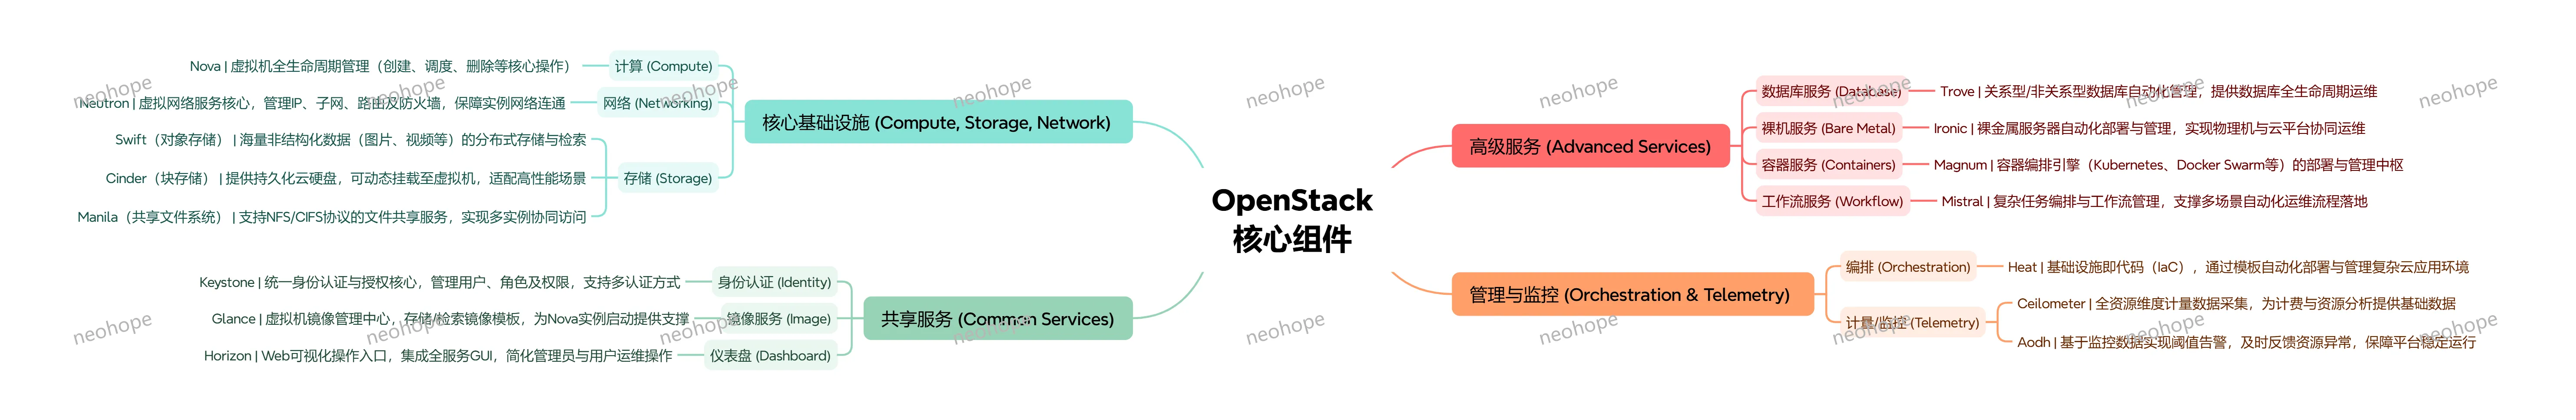
常见云计算产品
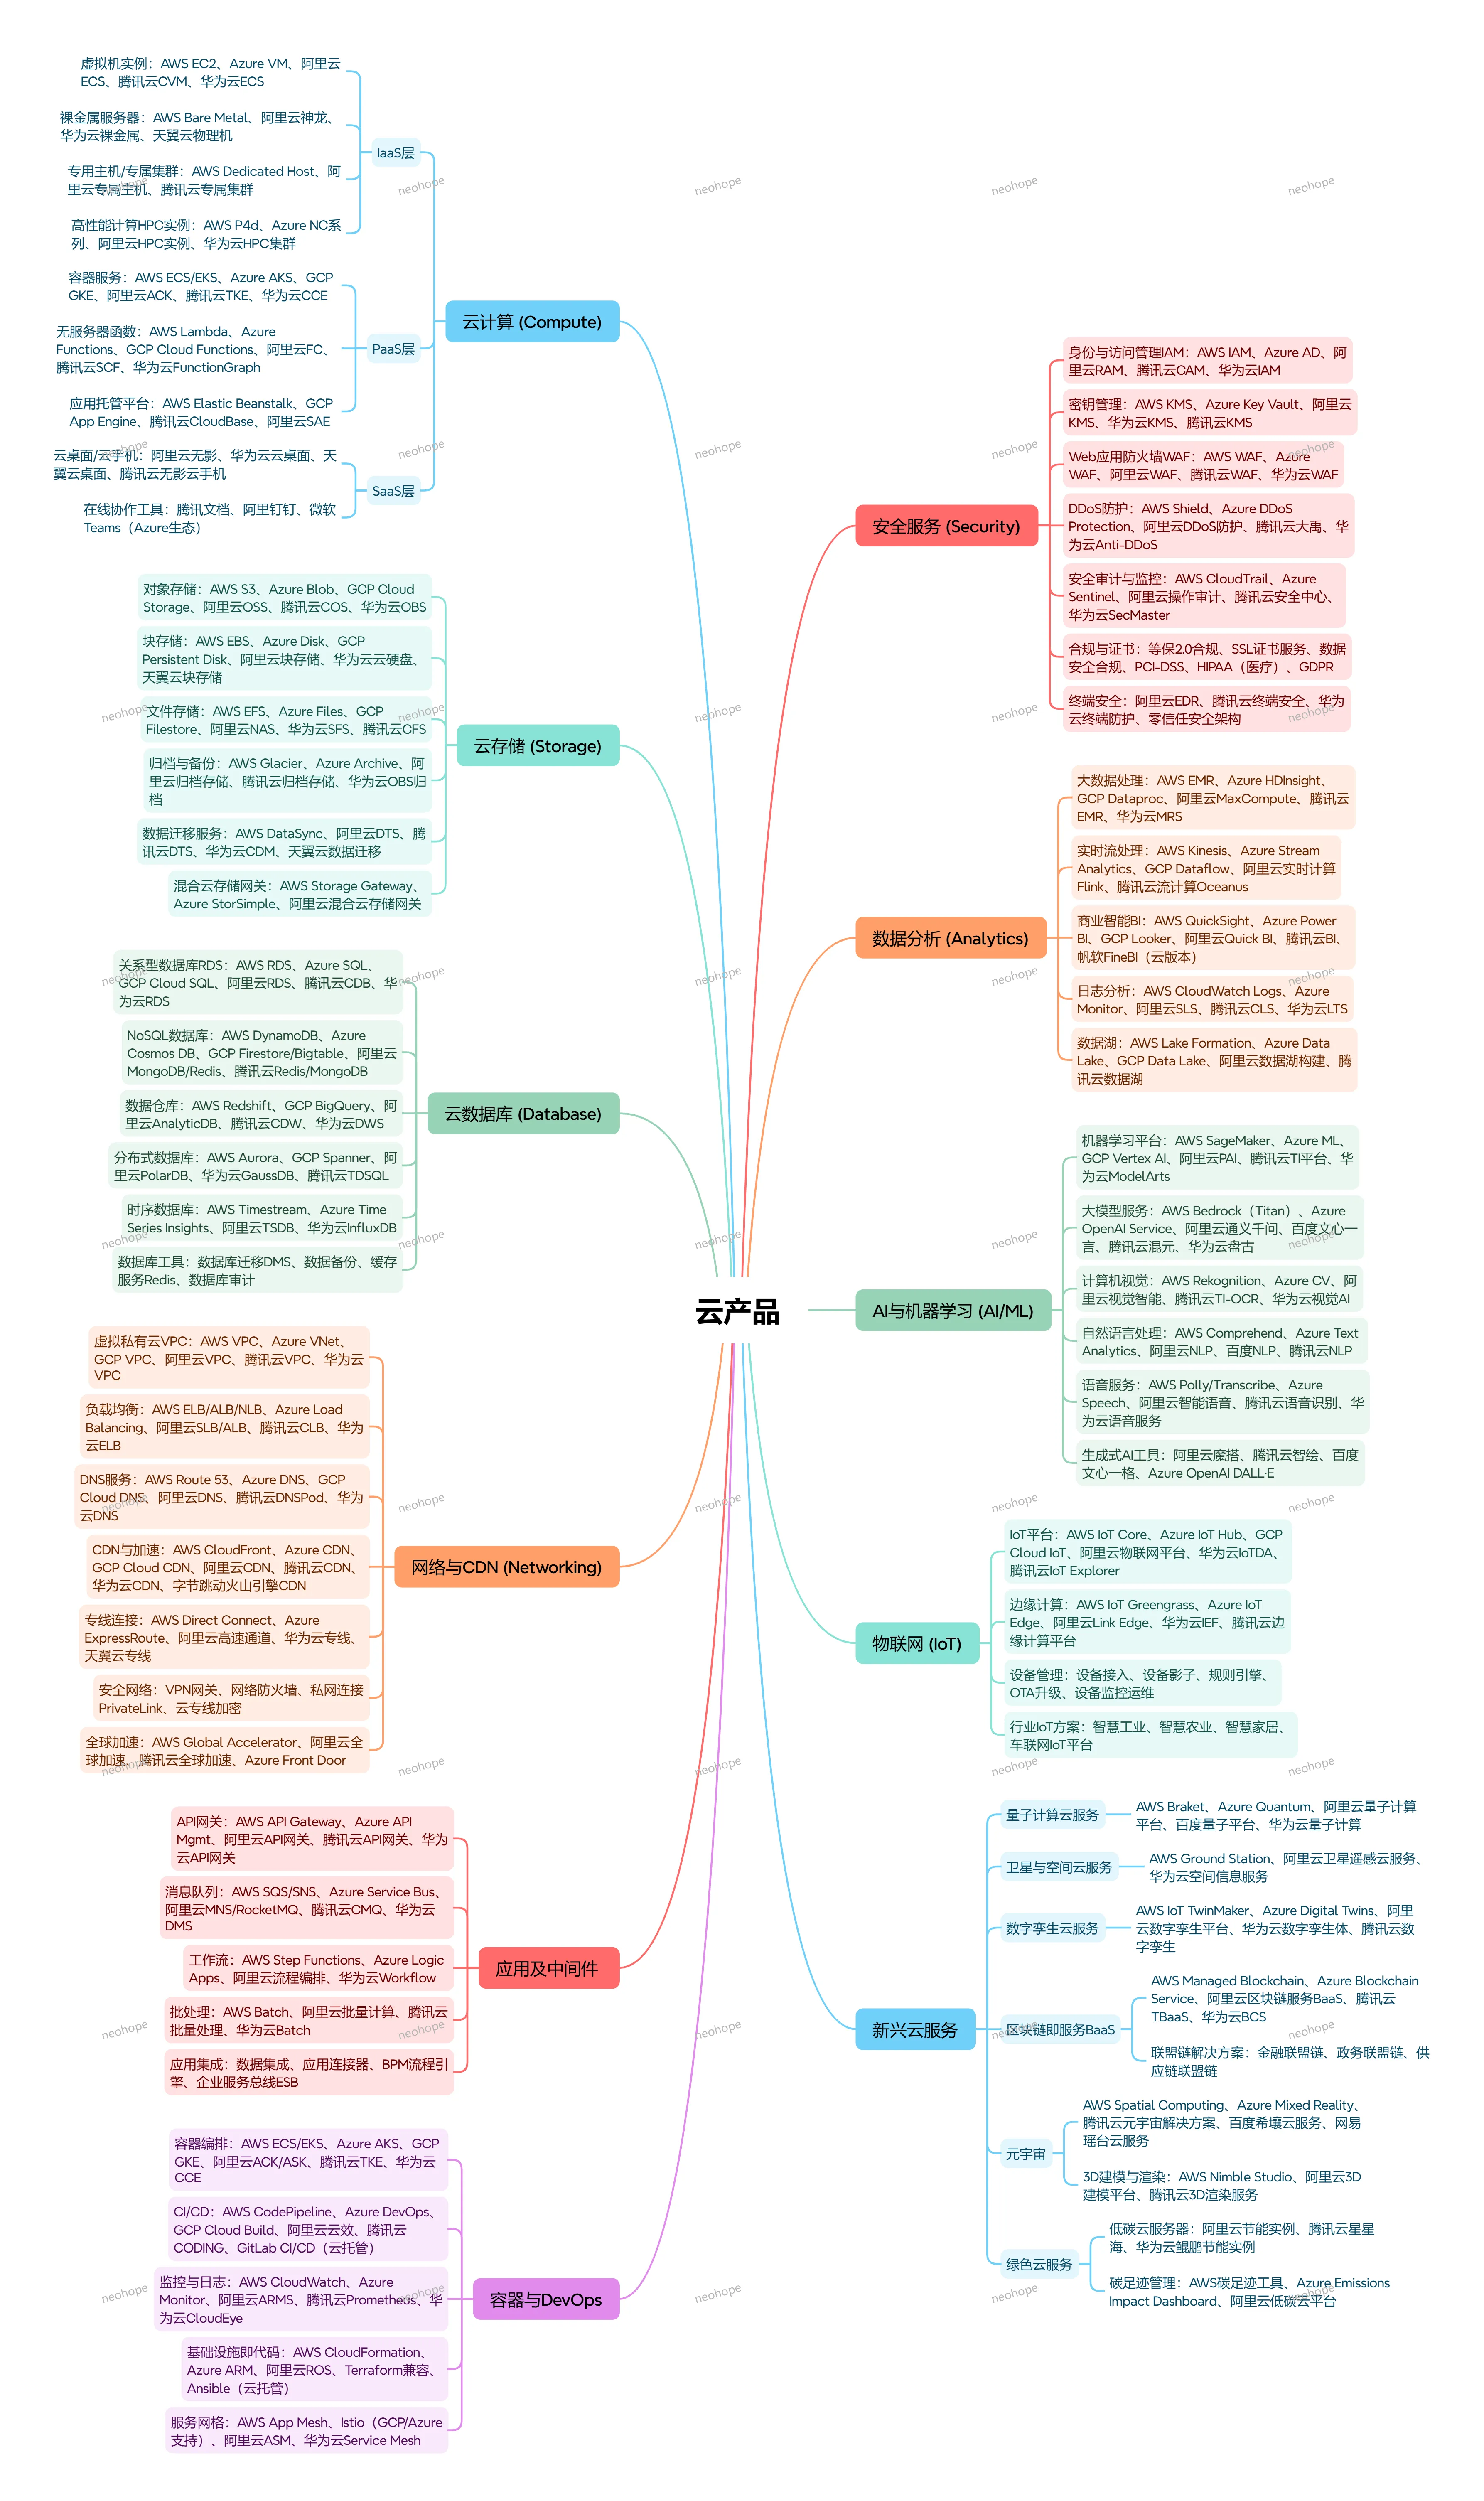
云计算产品覆盖从底层基础设施到上层应用的全栈能力,按服务模式分为 IaaS、PaaS、SaaS 三层,同时延伸出存储、数据库、网络、安全、AI 等专项服务,支撑企业数字化、智能化全场景需求。以下按品类逐一说明:
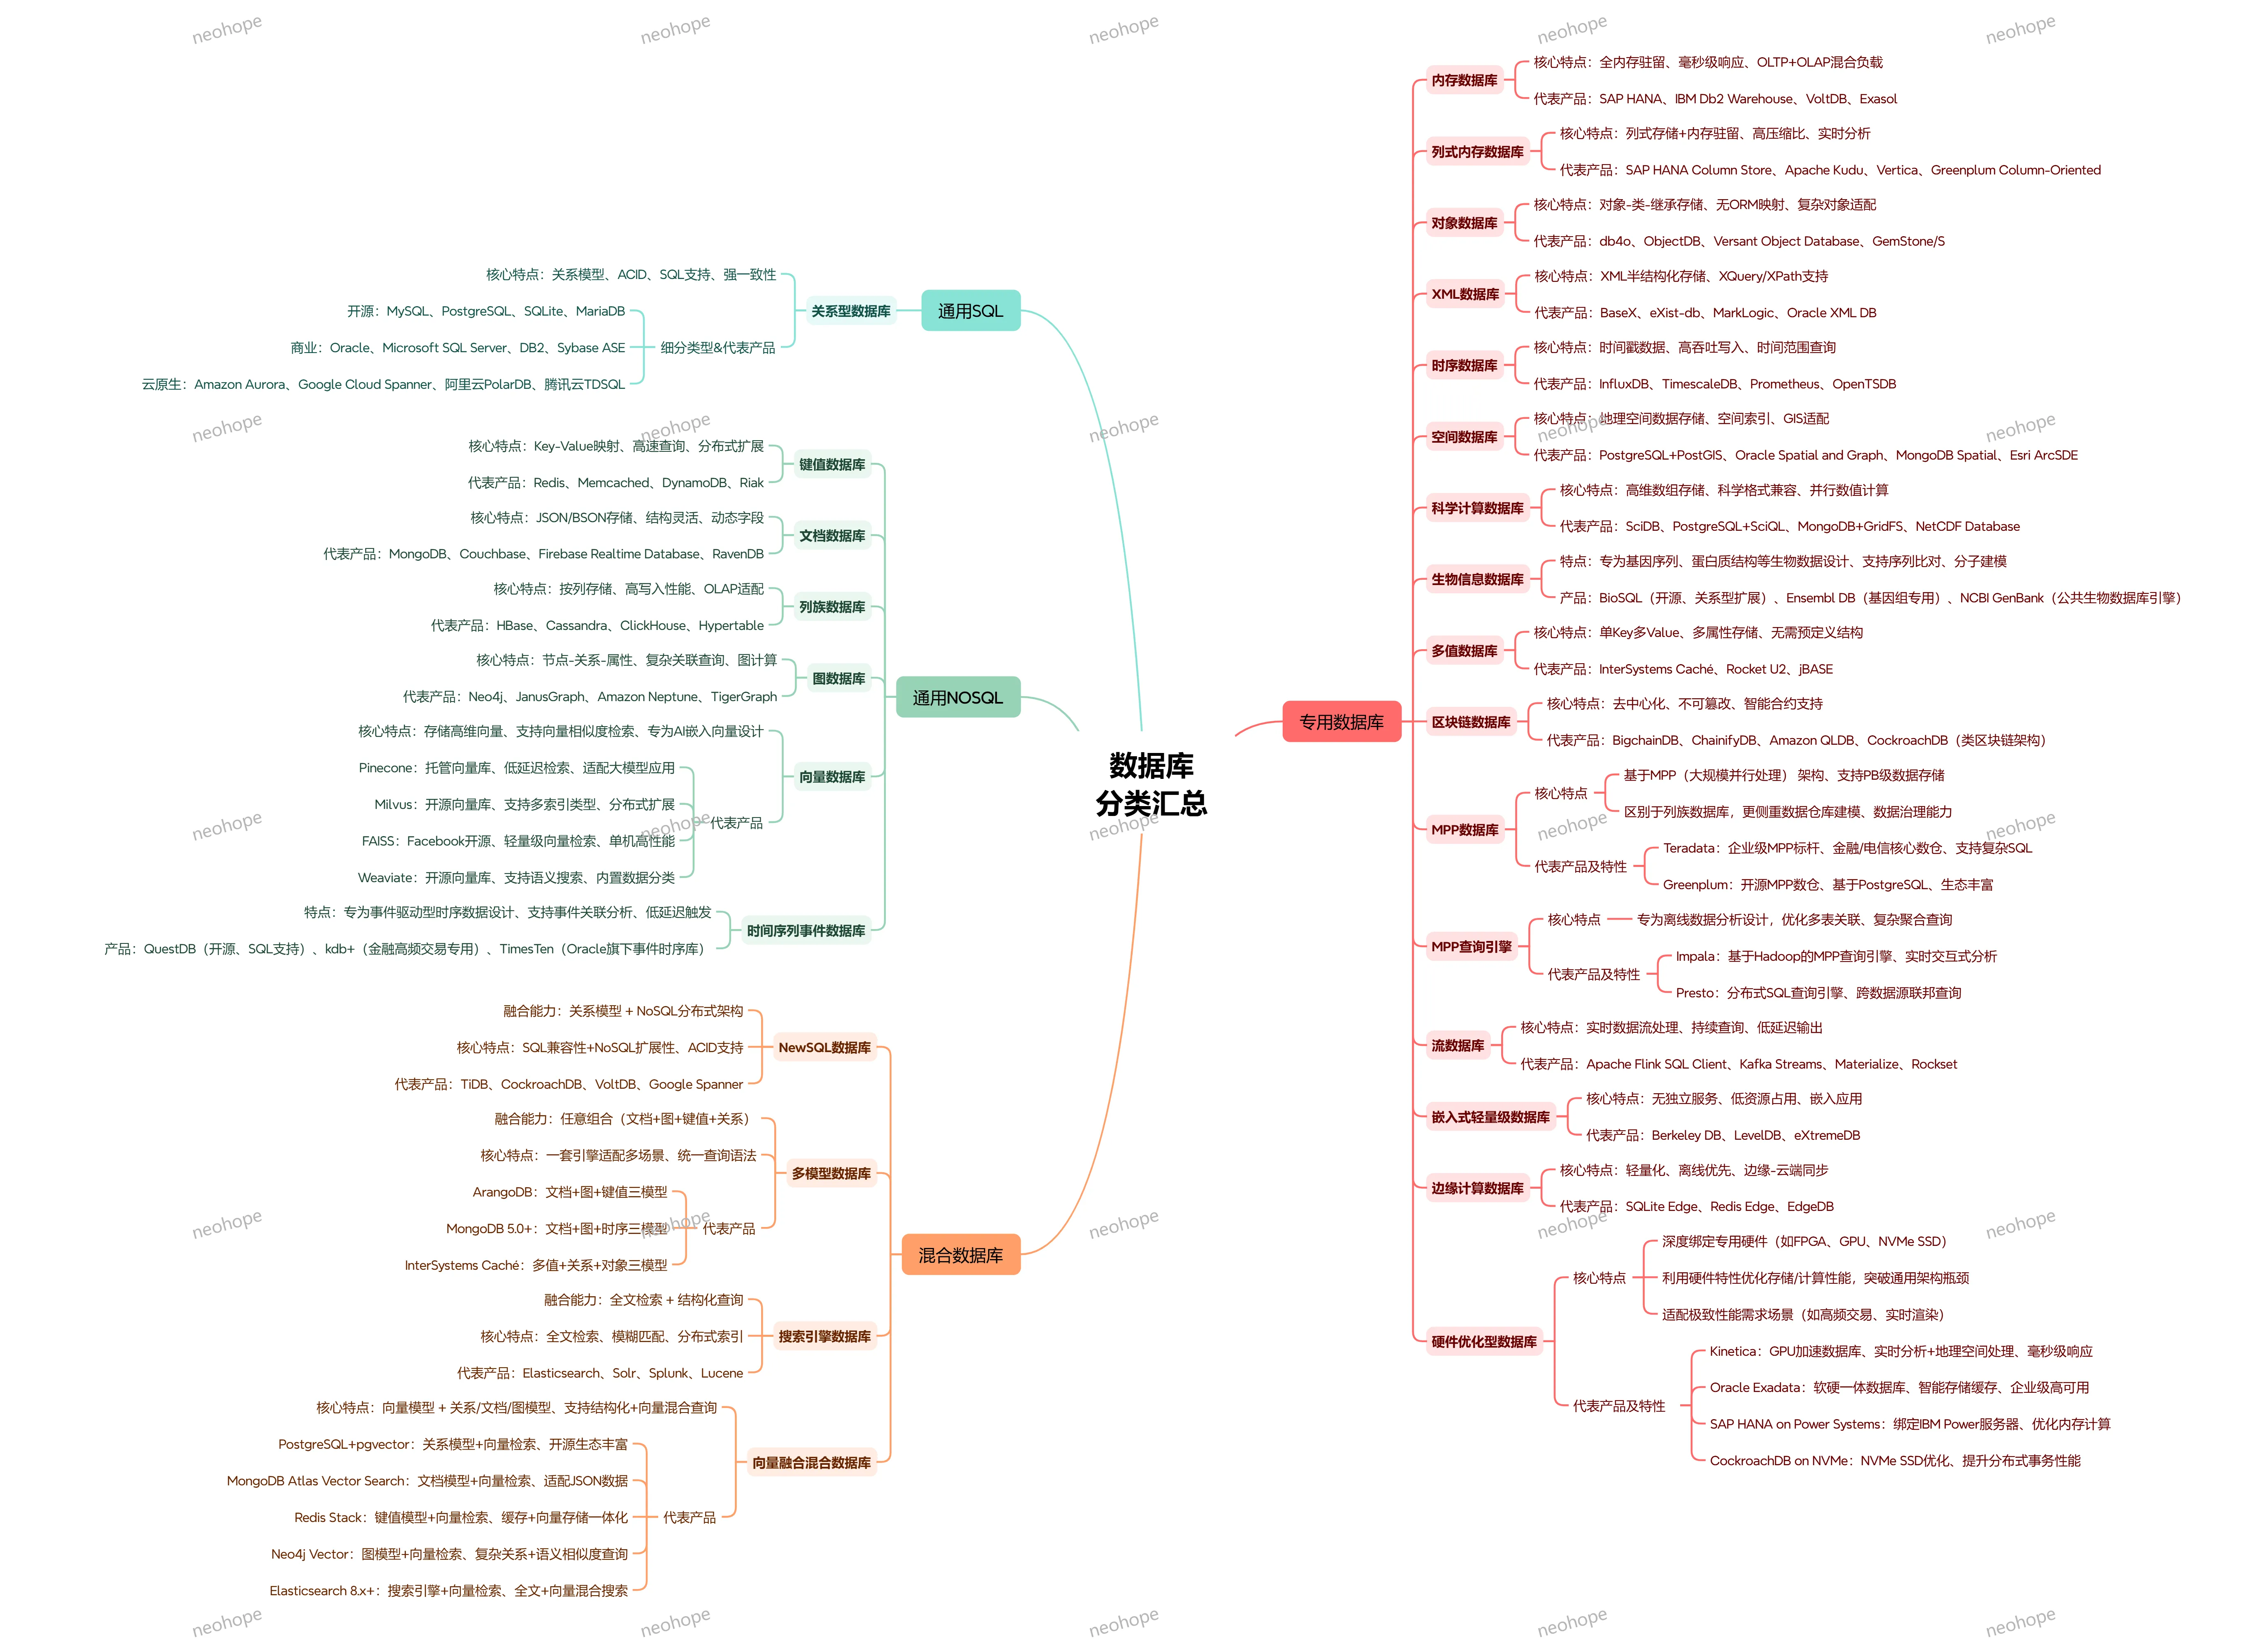
【温故知新】数据库分类汇总
【温故知新】大数据常用技术栈
大数据常用技术栈
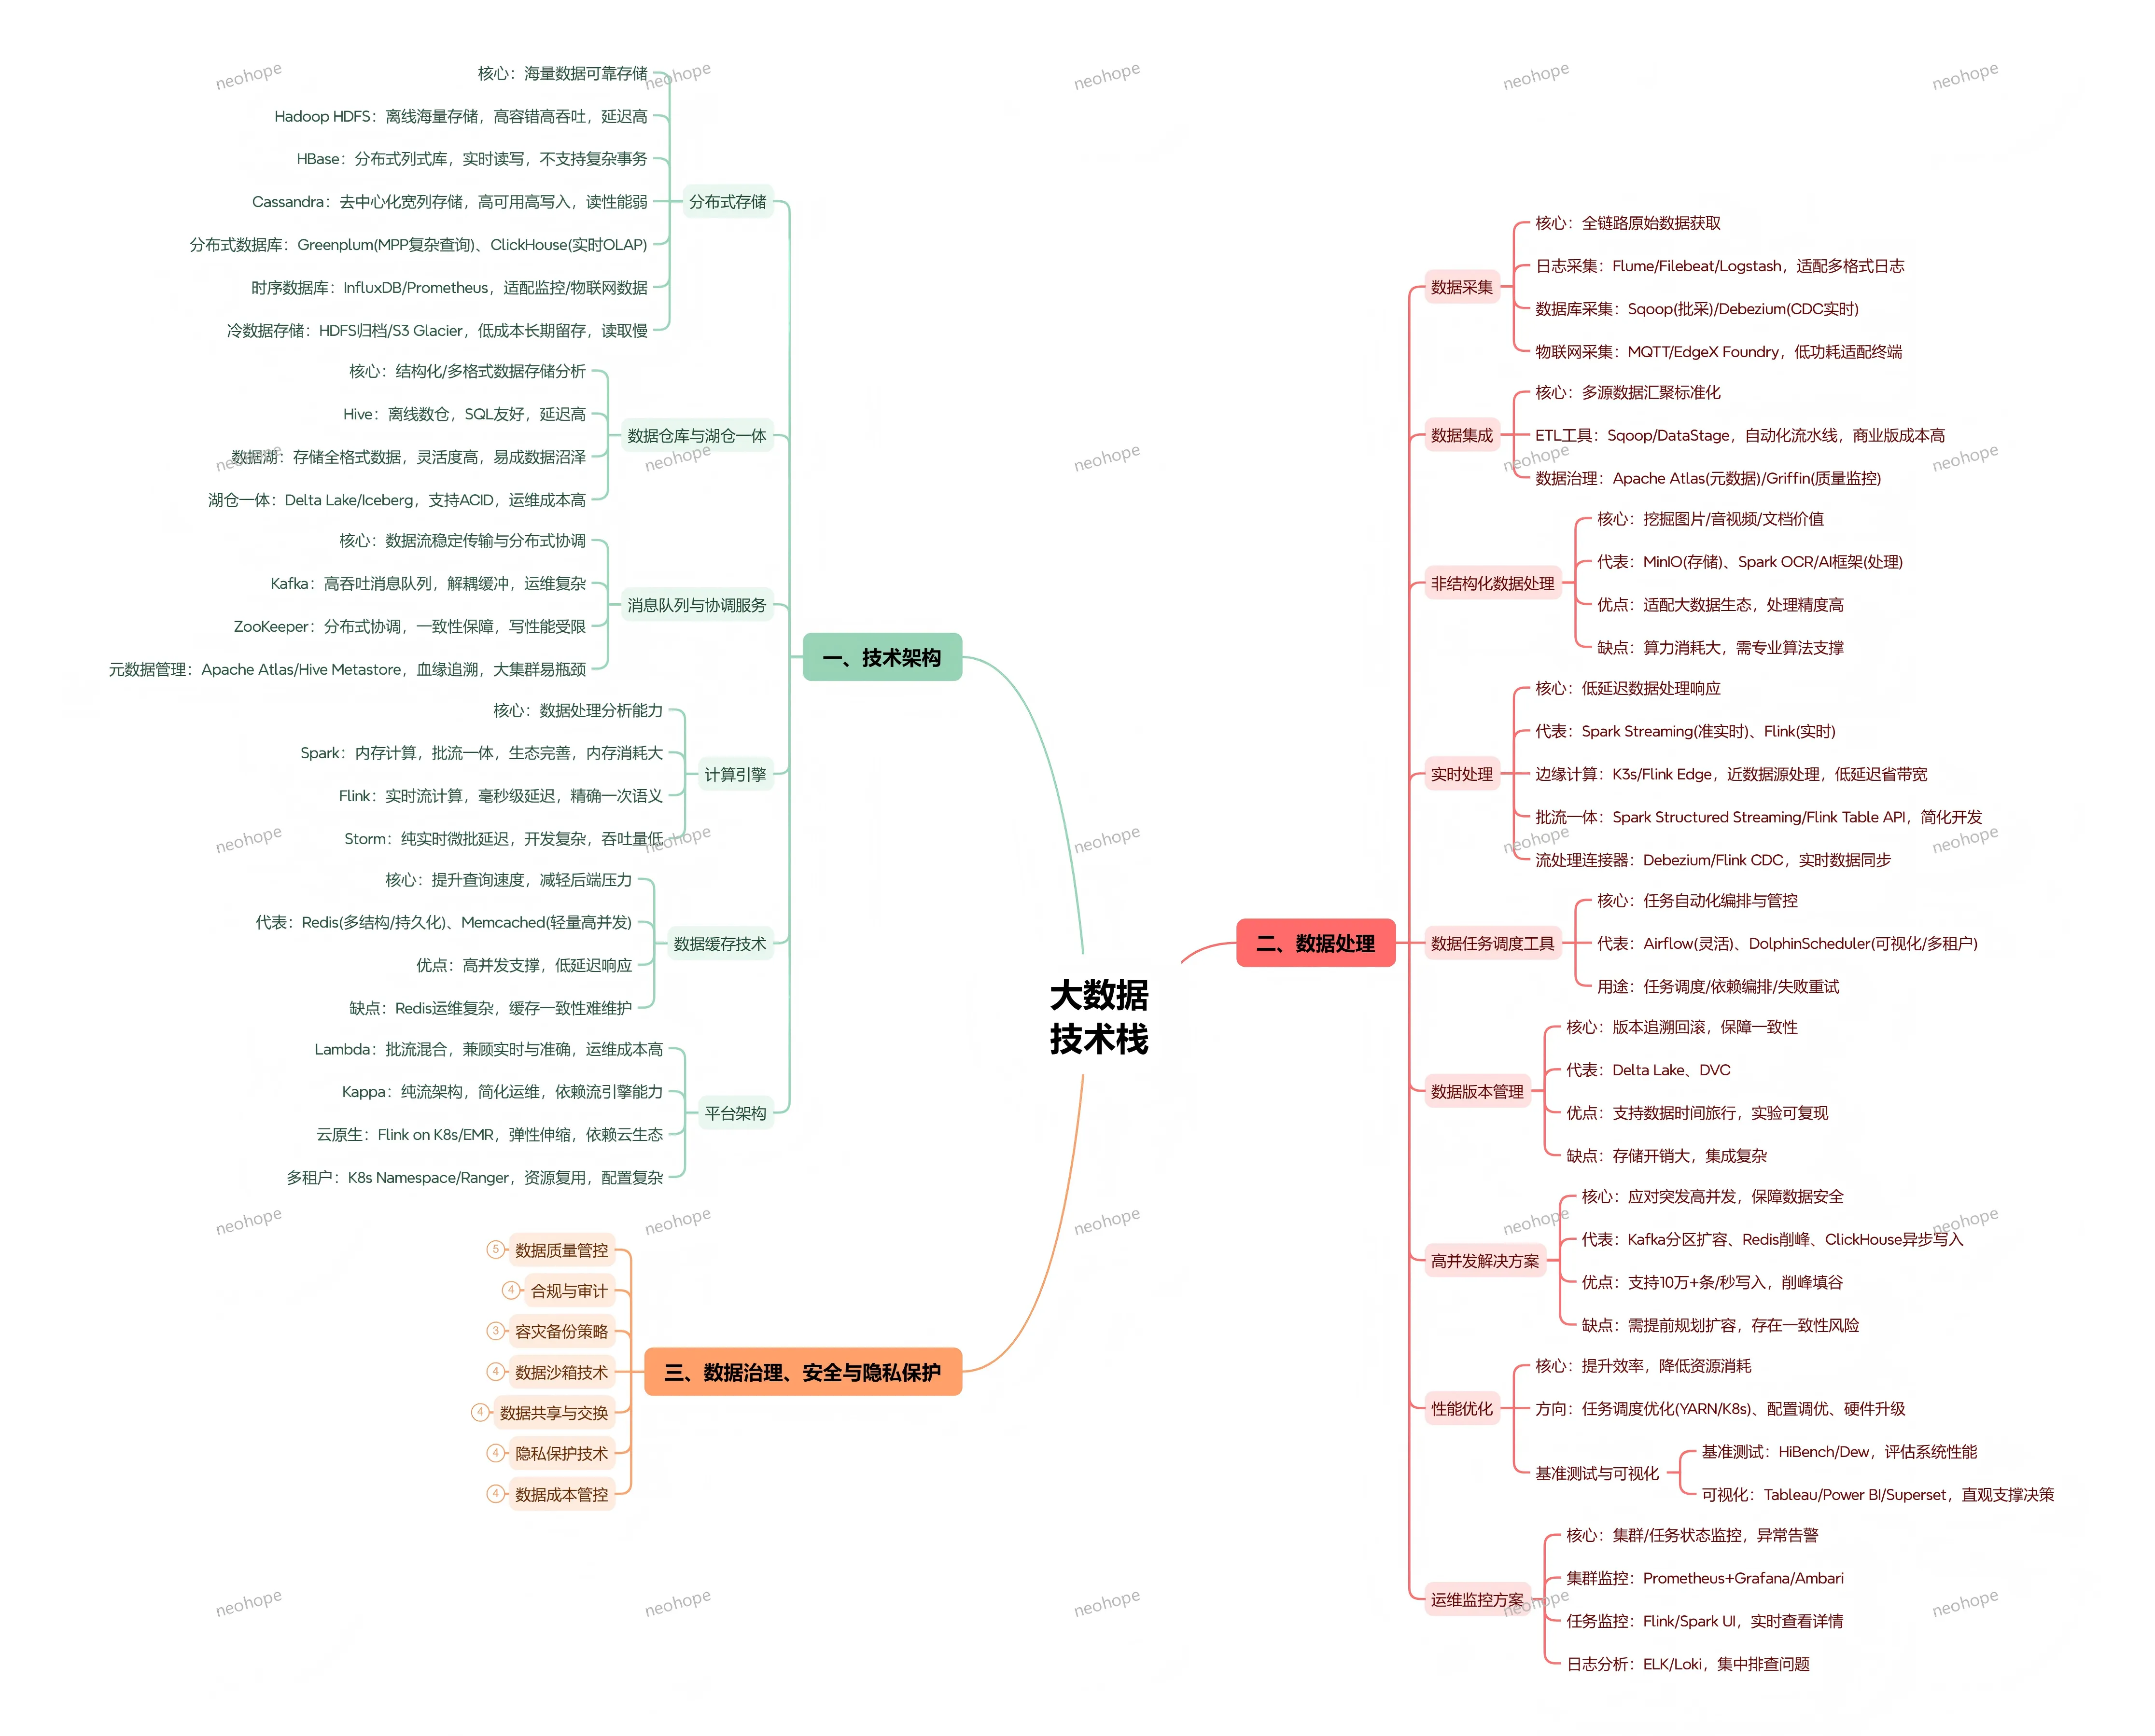
大数据技术栈是支撑海量、多源、异构数据完成从采集、存储、处理、分析到价值落地全生命周期的技术体系,核心解决传统技术无法应对的 “大容量、高速度、多类型” 数据处理难题,整体可分为技术架构、数据处理流程、治理与安全三大核心板块,当前正朝着湖仓一体、批流融合、云原生化的方向持续演进。
一文读懂共识算法:从PoW到PBFT,区块链与分布式系统的信任基石
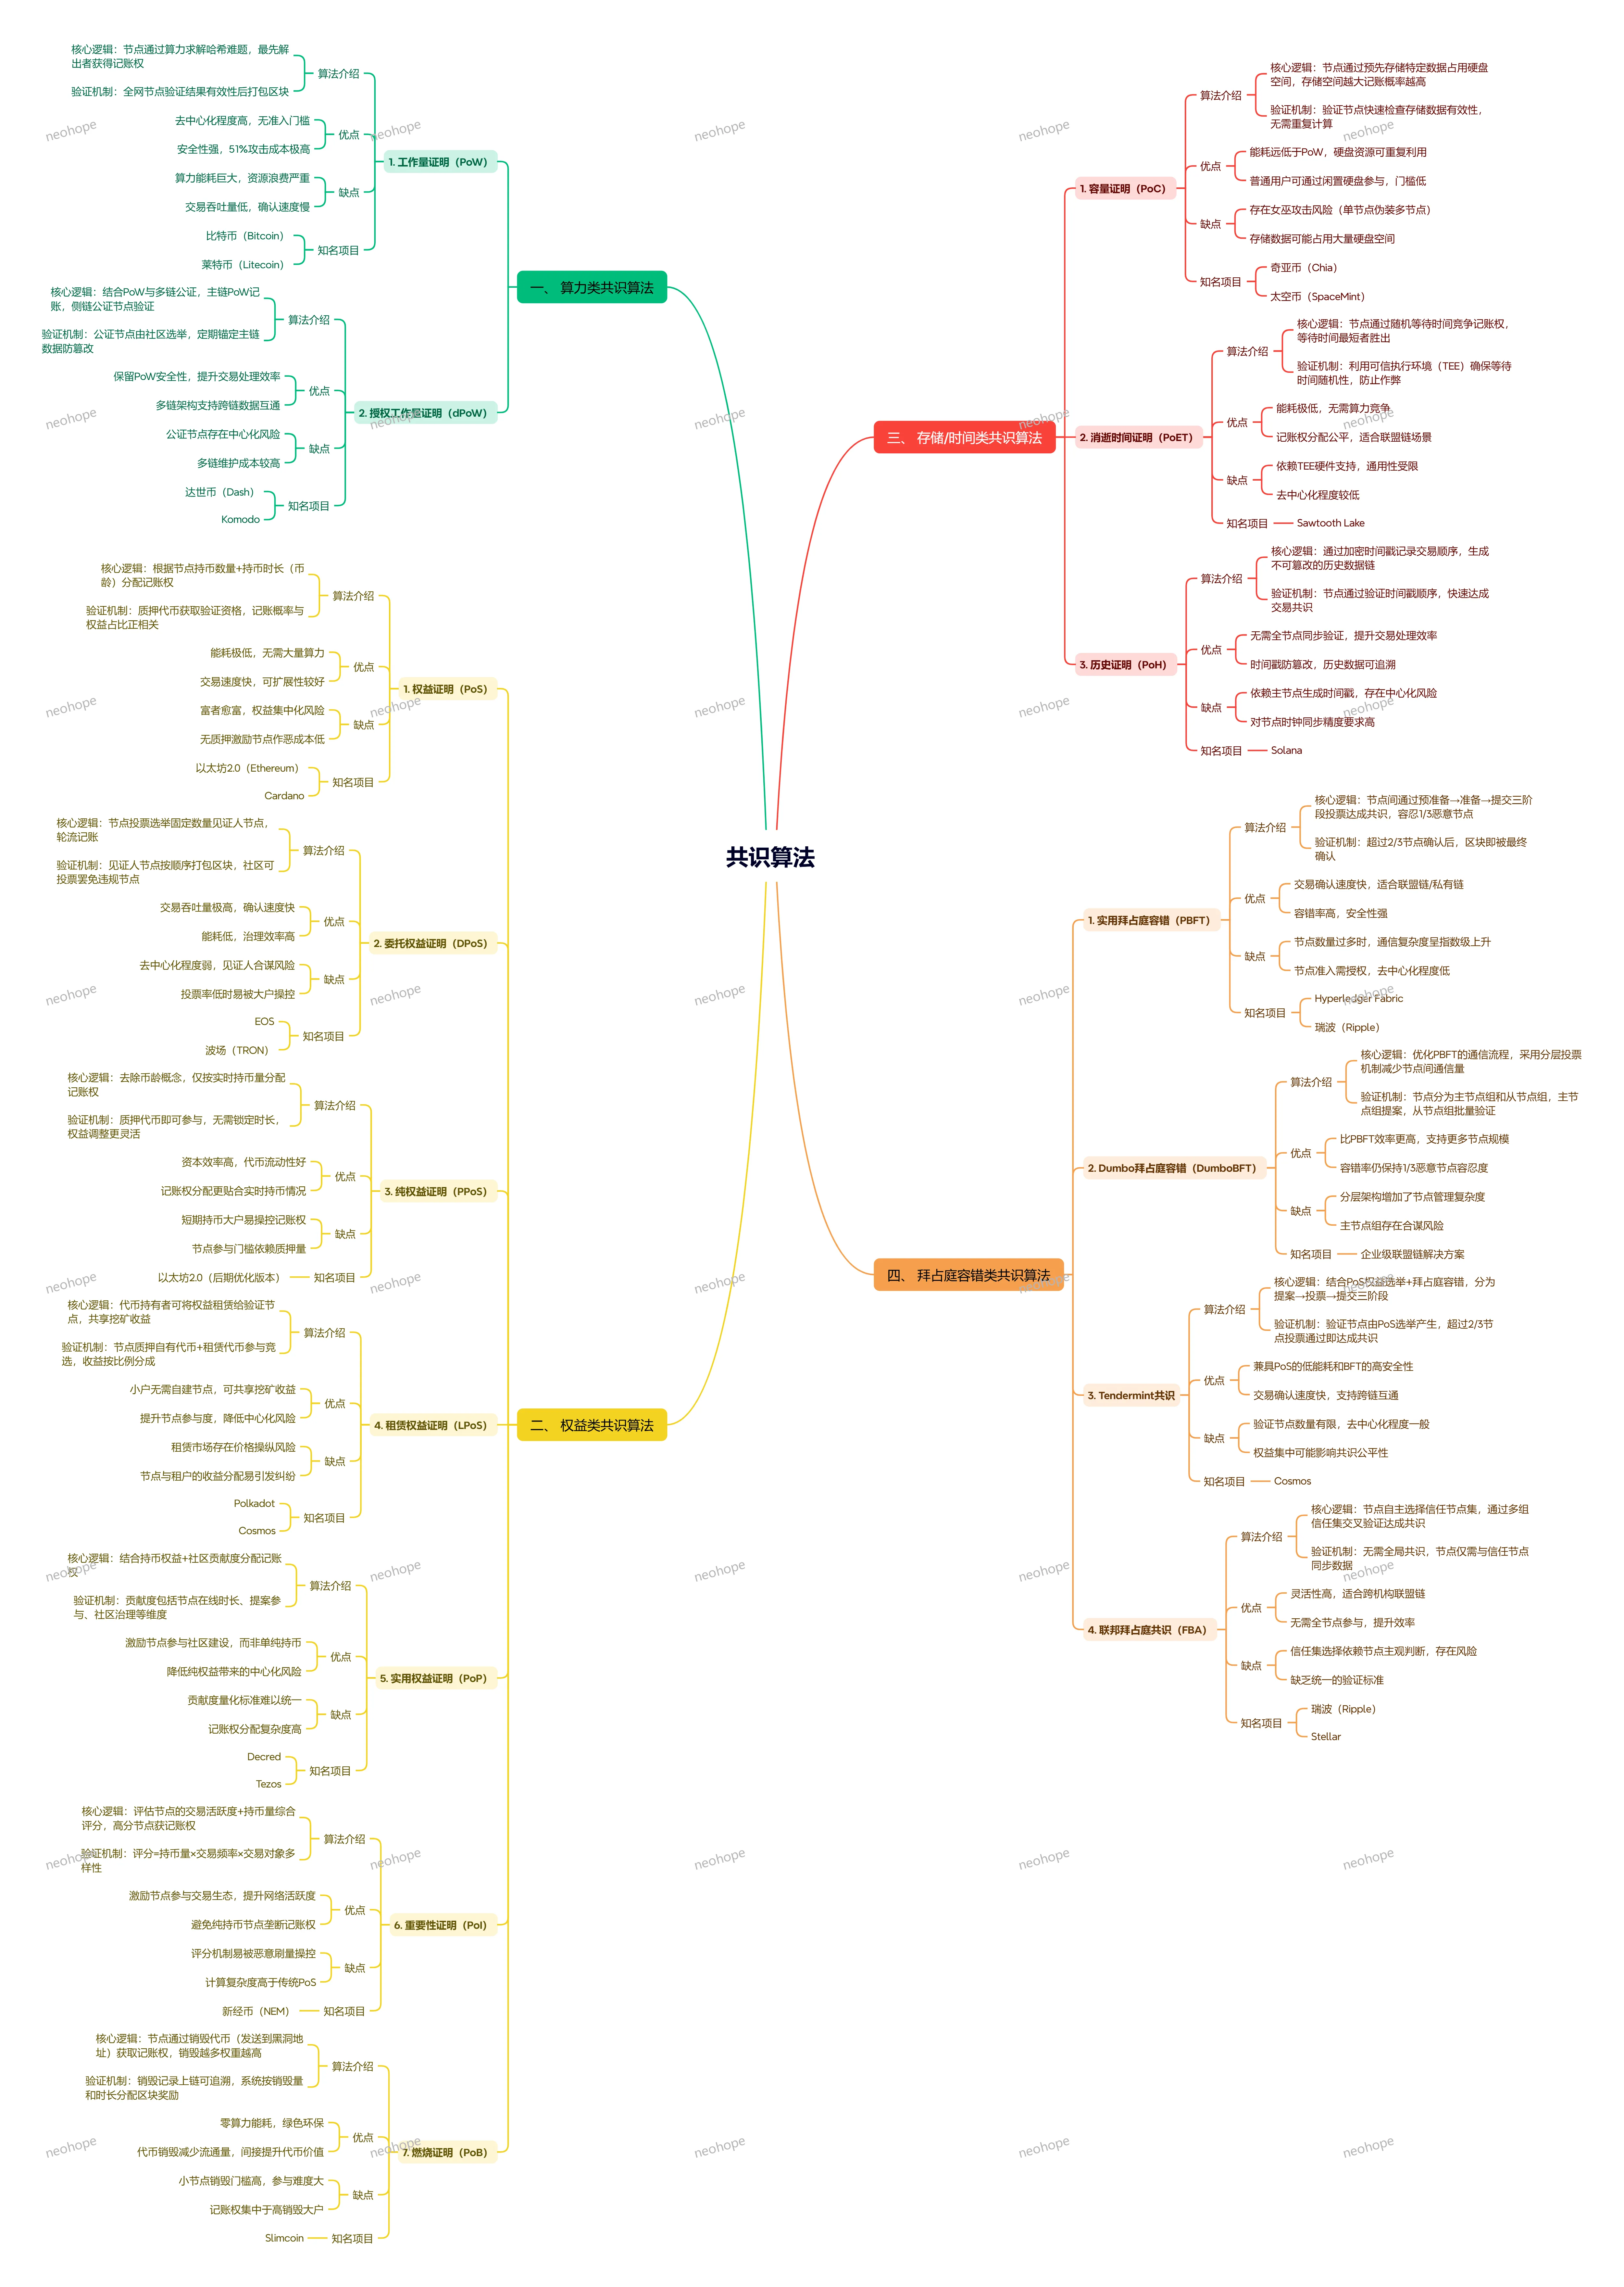
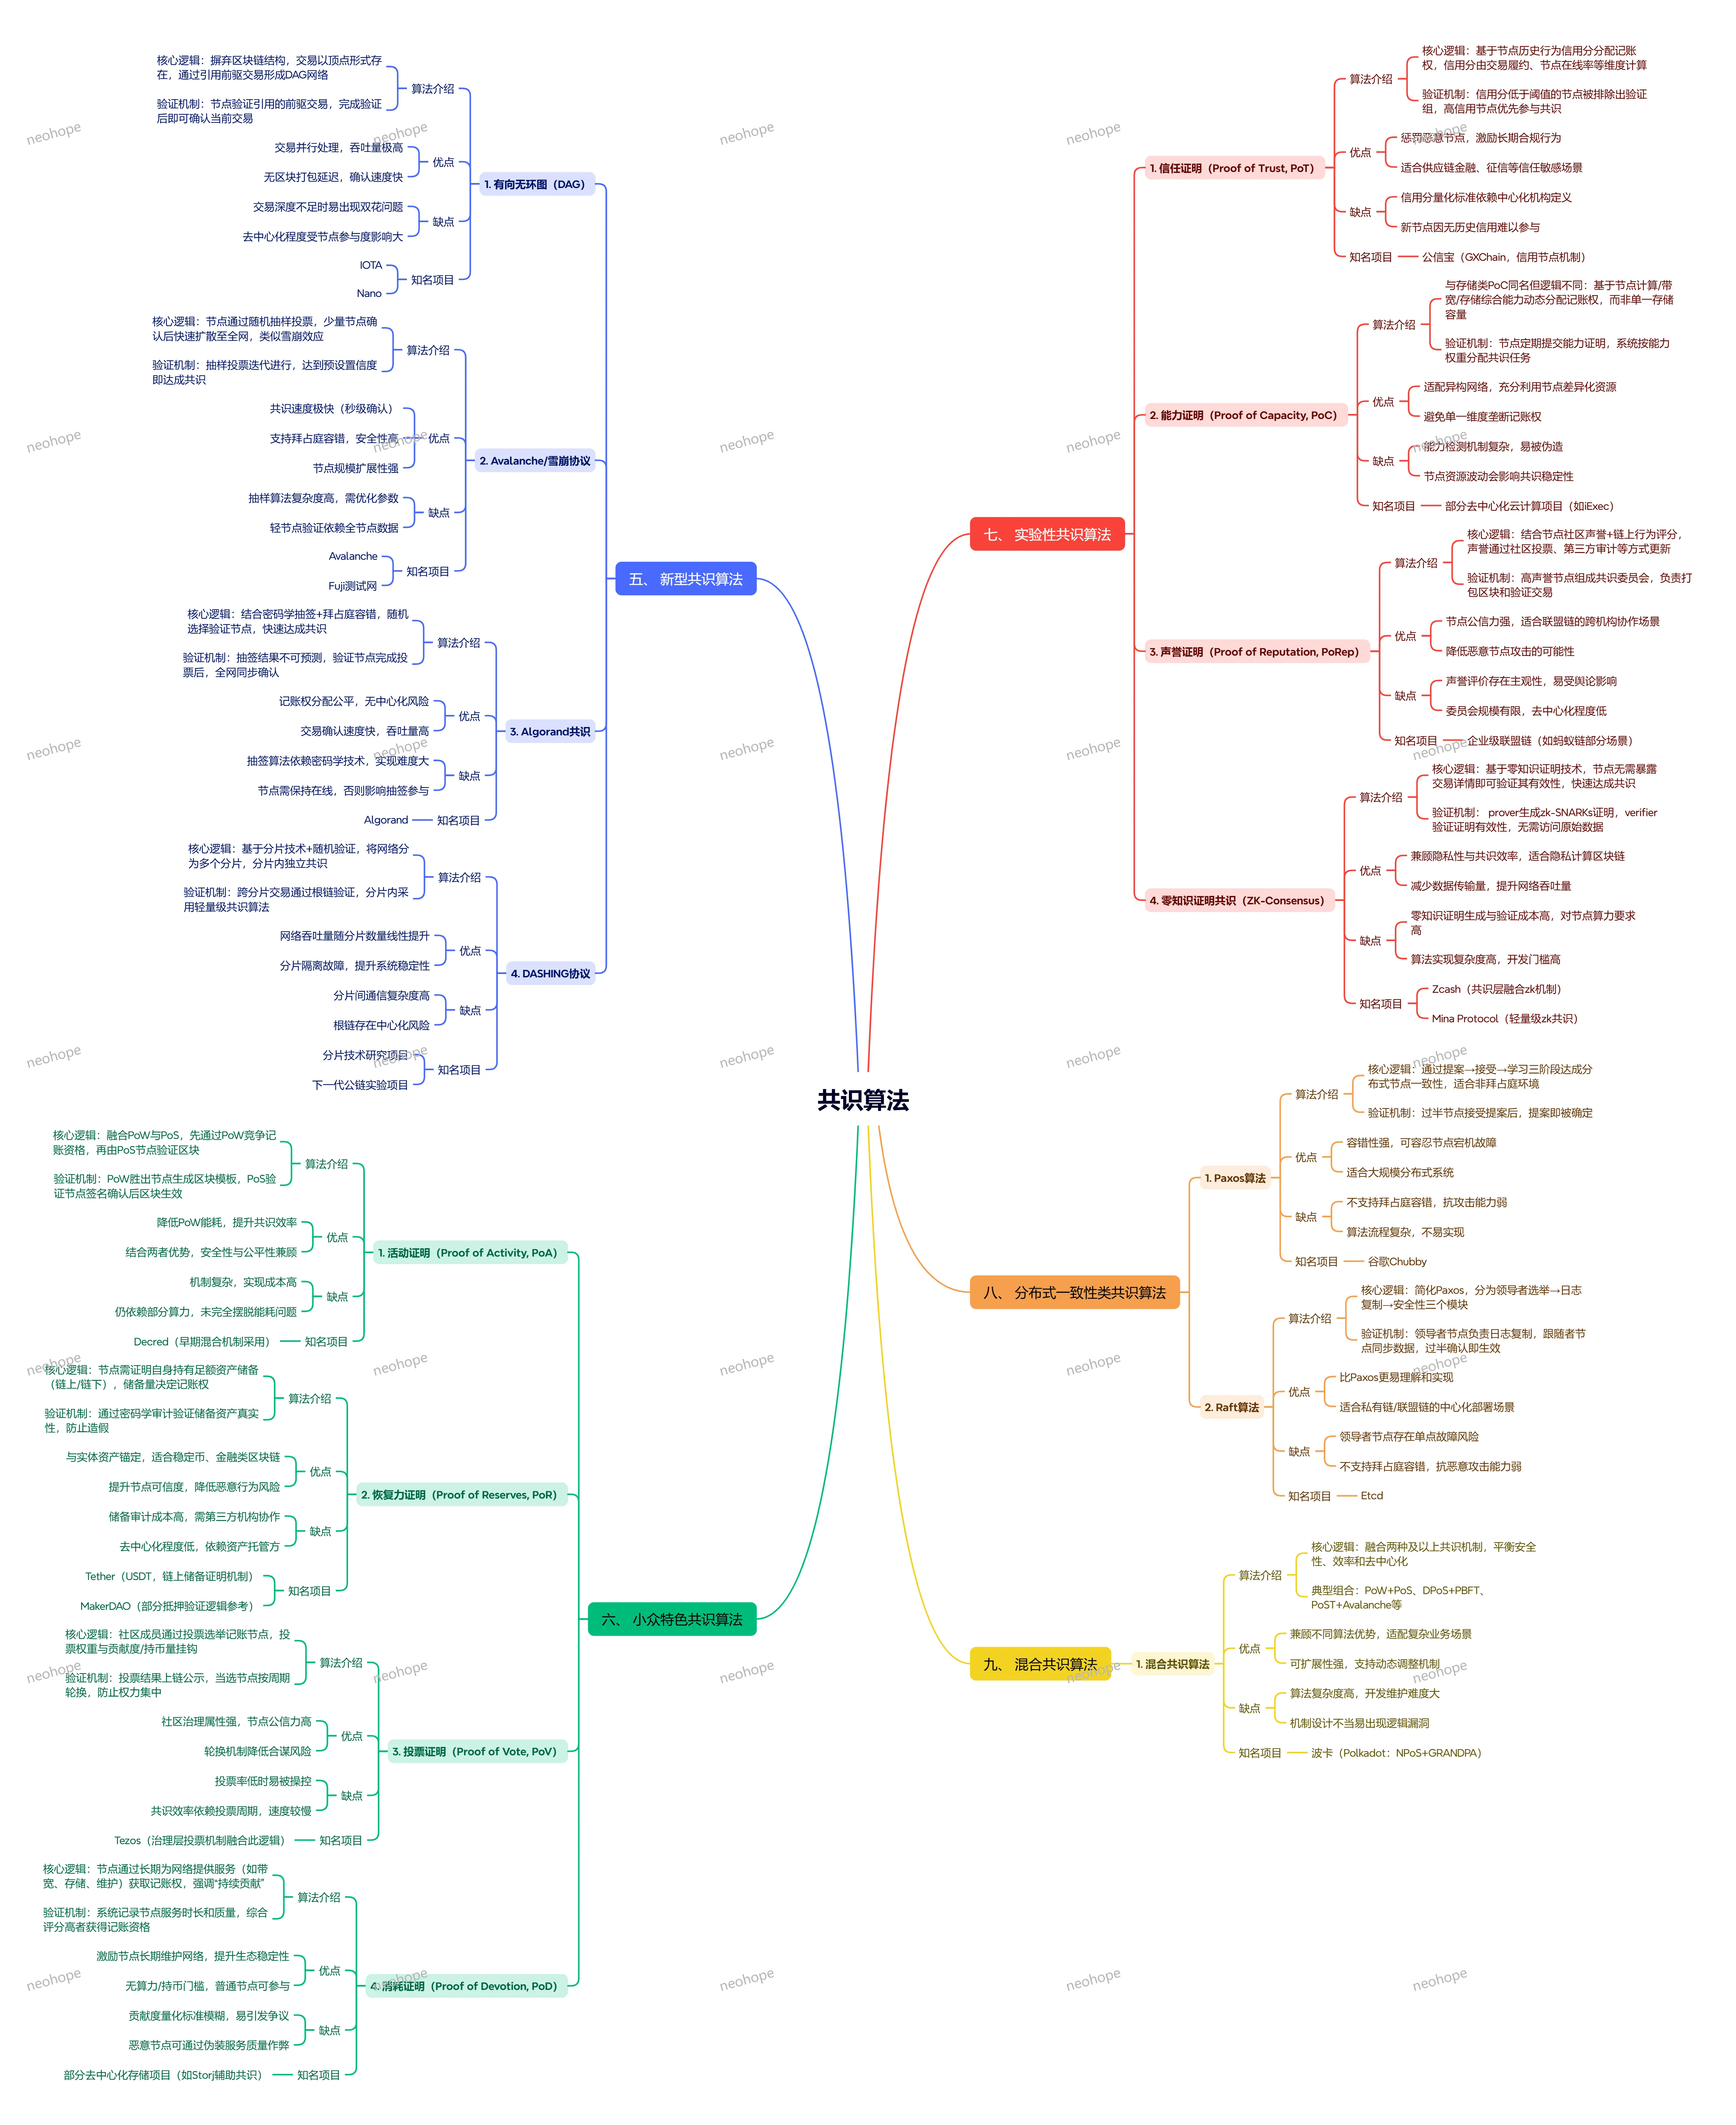
一文读懂共识算法:从PoW到PBFT,区块链与分布式系统的信任基石
在分布式系统中,多个节点要协同工作,最核心的问题是 “如何达成一致”—— 比如区块链的交易确认、分布式数据库的数据同步、集群节点的状态统一。而共识算法,就是解决 “信任问题” 的核心技术:让互不信任的节点,在无需中心化权威的情况下,对数据或决策达成统一认知。今天就拆解主流共识算法的核心逻辑、适用场景与优劣,帮你理清 “不同系统该选哪种共识”。
为何以降本增效为导向的科技产品很难赚钱
一、上限太低
分析:当产品只能通过降低客户成本来证明价值时,定价就难以突破成本节约的边界。
举例:一件事情,客户成本为1000万,物理极限可以做到800万,那该产品理论最高的天花板就是200万。但总要让利给客户吧,那就收一半100万。
结局:客户第二年还会要你降价,同行也会竞相压价,于是第二年到了80万。一路走低,直接到你的盈亏平衡点,大家都没得赚。
二、投产难以衡量
分析:客户降本第一年看得到,第二年就成了应该。而所谓的效率提升,价值很难量化。再加上软硬件成本,投产并不一定划算。
举例:客户买了一个AI的提效工具,把员工每天10个小时的工作,压缩到了8个小时,那客户获得了什么?同时还要买软件、买云服务器、雇运维人员等,又是一堆投入。
结局:客户没看到收益,但投入增加了。说好的降本增效,结果成了增加成本,公司效益并没实际提升。
三、降的过程,阻力重重
分析:降本往往意味着裁员或削减部门预算,阻力重重
举例:一个软件服务公司,能降的最大成本无非是人和云的费用。降本不裁员、不减少云的投入,根本看不到明显的降幅。
结局:人减少了,云投入减少了。做后大家一总结,有没有这个产品,其实降本都达成了。
四、降的趋势,难以持久
分析:降本增效有物理极限的,接近极限后,就难以有大的成绩了
举例:第一年效果显著,第二年效果尚可,第三年后只能保持,越来越难
结局:客户获得感越来越低,要么降价,要么被扫地出门
一个真实的例子是,一个技术团队,通过大量的努力,用了各种各样的技术和非技术手段,将云费用压降了60%,人力费用压降了75%,很了不起对不对。但到了第三年末,在谈预算的时候,财务对该团队的期望是略有增长、保持现状、还是继续可以看到一个显著的降幅呢?
【转载】2025年大语言模型发展现状:进展、问题与展望
原文地址:The State Of LLMs 2025: Progress, Problems, and Predictions,by Sebastian Raschka, on 2025-12-30
2025年大语言模型发展现状:进展、问题与展望
随着 2025 年接近尾声,我想回顾一下这一年大语言模型(LLM)领域最重要的若干进展,反思当前仍然存在的局限与待解决问题,并对未来的发展方向分享几点看法。
和我每年常说的一样,2025 年对于 LLM 与 AI 领域而言是大事频发的一年,并且今年完全没有出现进展饱和或放缓的迹象。
1. 推理之年:Reasoning、RLVR 与 GRPO
我想覆盖的有趣话题很多,但不妨从 2025 年 1 月按时间顺序说起。
模型规模缩放(scaling)依然有效,但它并没有真正改变 LLM 在实际使用中的表现与体验 —— 唯一的例外是 OpenAI 刚发布的 o1,新增了推理思维链(reasoning traces)。因此,当 DeepSeek 在 2025 年 1 月发布论文(https://arxiv.org/abs/2501.12948),证明可以通过强化学习培养出类推理行为时,整个领域为之震动。(在 LLM 语境中,reasoning(推理)指模型会解释其答案,而这种解释过程本身往往能提升答案的准确率。)
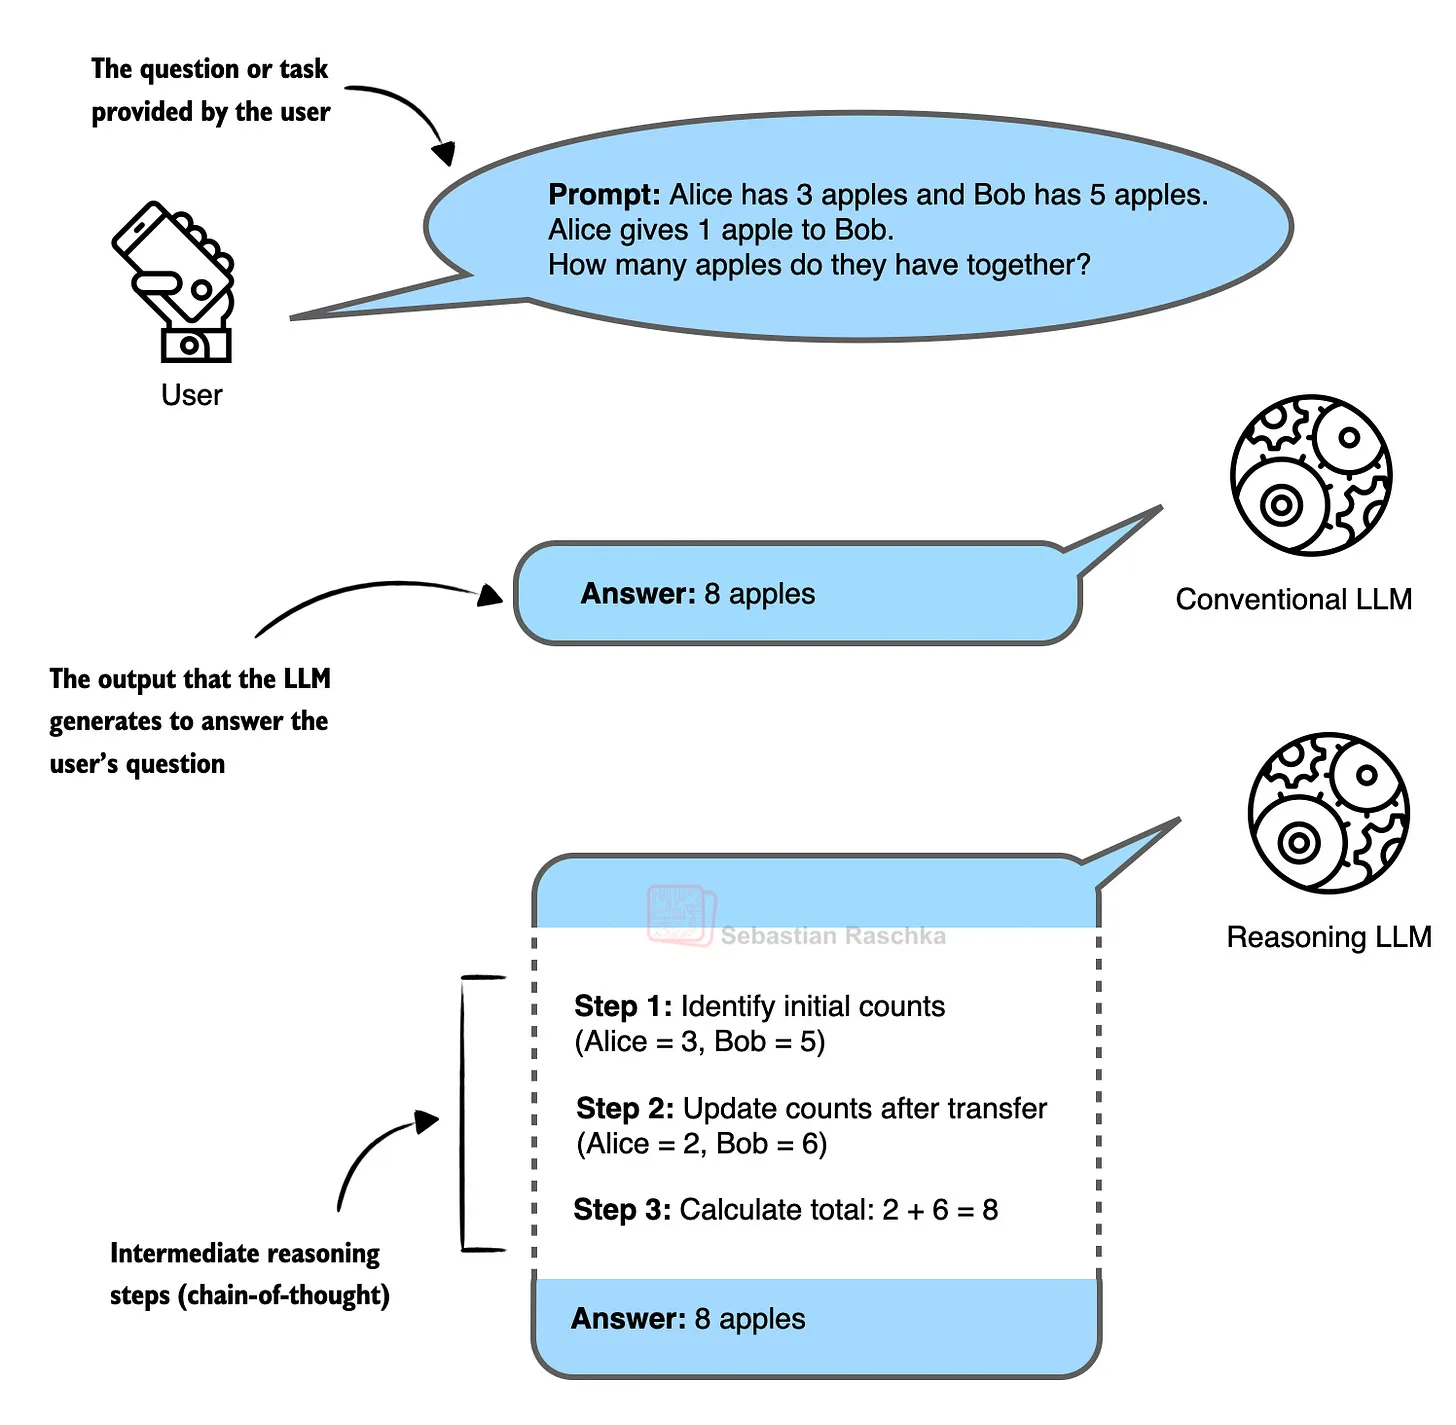
图 1:简短回答与包含中间推导步骤的长回答 —— 推理模型的典型输出形式
1.1 DeepSeek 时刻
DeepSeek R1 引发广泛关注有多重原因:
第一,DeepSeek R1 以 open‑weight(开放权重)模型形式发布,性能表现十分出色,在当时足以比肩最顶尖的 proprietary models(闭源模型)(ChatGPT、Gemini 等)。
第二,DeepSeek R1 的论文促使许多人 —— 尤其是投资者与记者 —— 重新审视 2024 年 12 月发布的更早一篇论文(https://arxiv.org/abs/2412.19437)。人们由此得出了一个修正结论:尽管训练顶尖模型成本依然高昂,但可能比之前设想的低一个数量级,估算更接近 500 万美元,而非 5000 万或 5 亿美元。
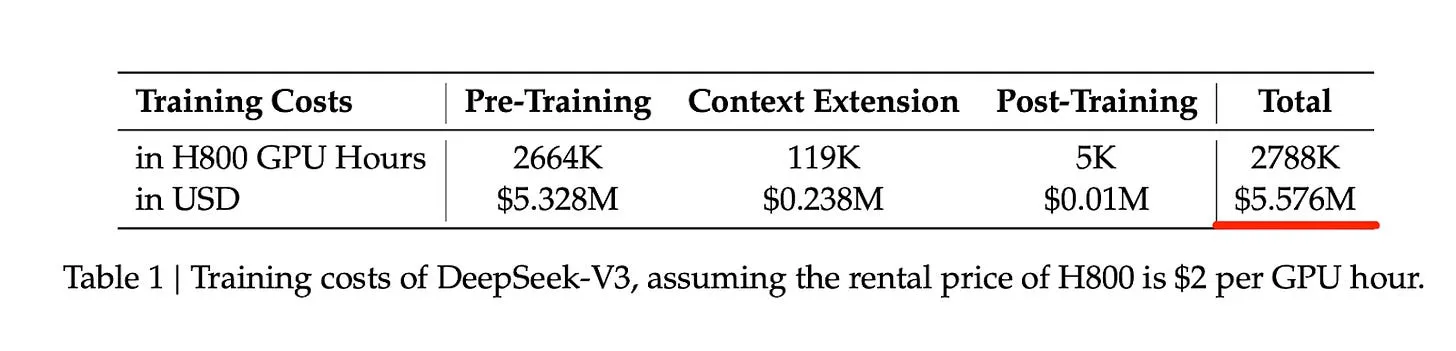
图 2:摘自论文https://arxiv.org/abs/2412.19437的表格,估算训练 671B 参数 DeepSeek V3 模型的成本
DeepSeek R1 的论文(https://static‑[content.springer.com/esm/art%3A10.1038%2Fs41586](https://content.springer.com/esm/art%3A10.1038%2Fs41586)‑025‑09422‑z/MediaObjects/41586_2025_9422_MOESM1_ESM.pdf)测算,在 DeepSeek V3 基础上训练 DeepSeek R1 模型仅需额外投入 29.4 万美元,同样远低于所有人的预期。
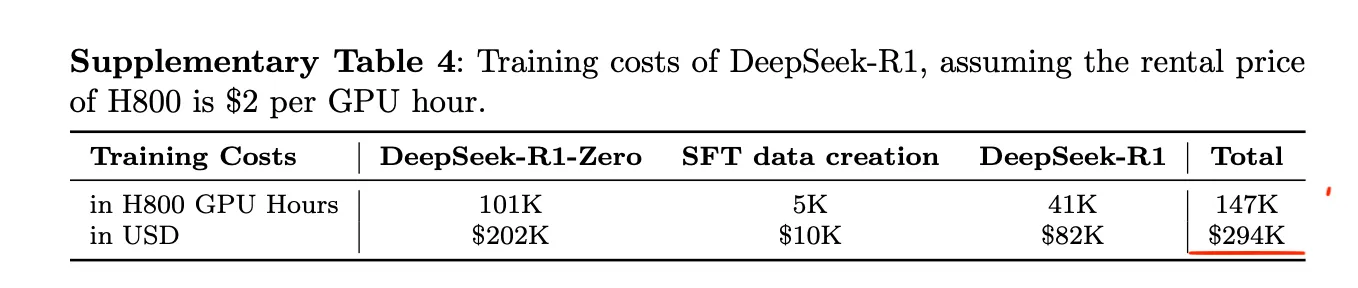
图 3:摘自 DeepSeek R1 论文的表格,估算在 DeepSeek V3 基础上训练 R1 模型的额外成本
当然,500 万美元的估算存在很多前提限制。比如,它只计算了最终模型训练的算力成本,没有计入研究人员薪资,以及超参数调优、实验探索相关的其他研发成本。
第三,也是最有意思的一点:这篇论文提出了 Reinforcement Learning with Verifiable Rewards(RLVR,可验证奖励强化学习),并将 GRPO 算法作为一种全新(或至少经过改进的)算法路径,用于开发所谓的推理模型,并在后训练阶段提升 LLM 能力。
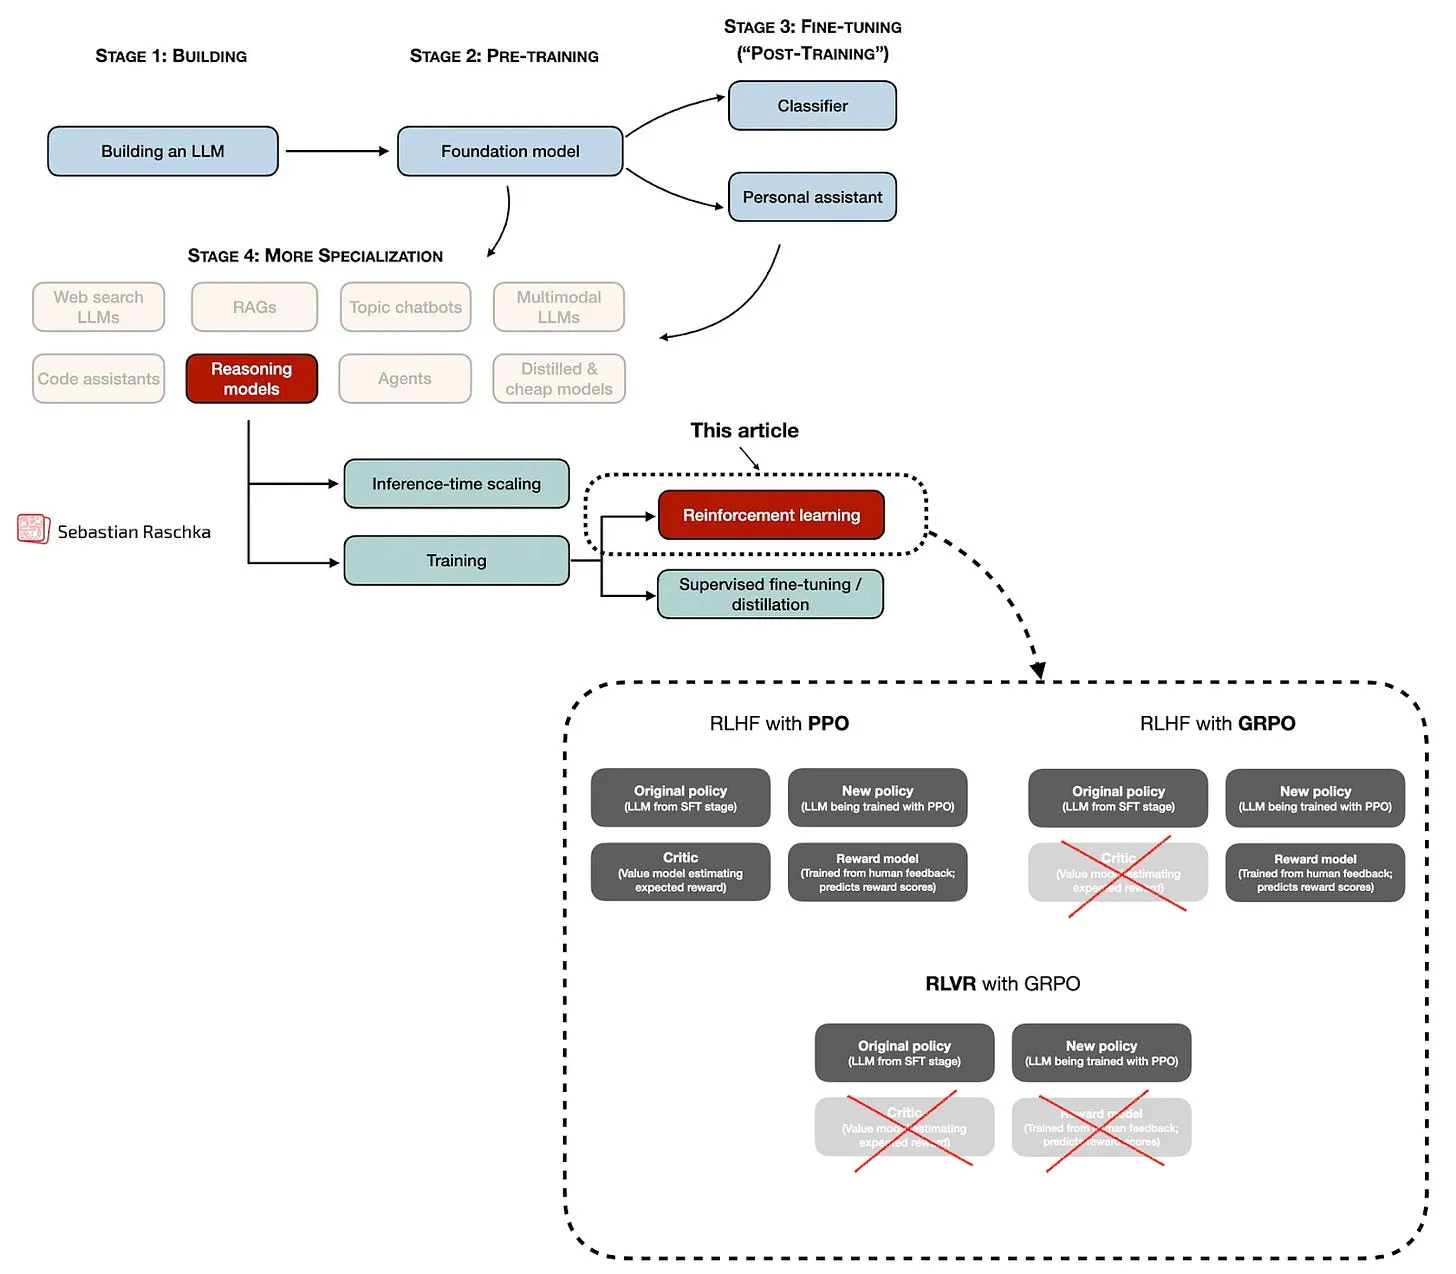
图 4:强化学习的应用方式与阶段概览。本概述省略了大量细节,感兴趣的读者可以参阅我的文章《大语言模型推理模型训练现状》了解更多
在此之前,后训练方法比如 Supervised Instruction Fine‑tuning(SFT,有监督指令微调)和 Reinforcement Learning with Human Feedback(RLHF,人类反馈强化学习)—— 它们至今仍是训练管线的重要组成部分 —— 都受限于需要昂贵的人工标注回复或偏好标签。(当然,也可以用其他 LLM 合成生成这些标签,但这多少有点 “先有鸡还是先有蛋” 的问题。)
DeepSeek R1 与 RLVR 的关键意义在于,它们让我们可以在海量数据上对 LLM 进行后训练。只要有可用的算力预算,就能通过后训练阶段的算力缩放来提升模型能力、解锁新特性。
RLVR 中的 “V” 代表 “verifiable(可验证)”,意味着我们可以用确定性方法为答案标注正确性标签,而这些标签足以让 LLM 学会复杂的问题求解。(典型的应用领域是数学与代码,但这一思路也可以扩展到其他领域。)
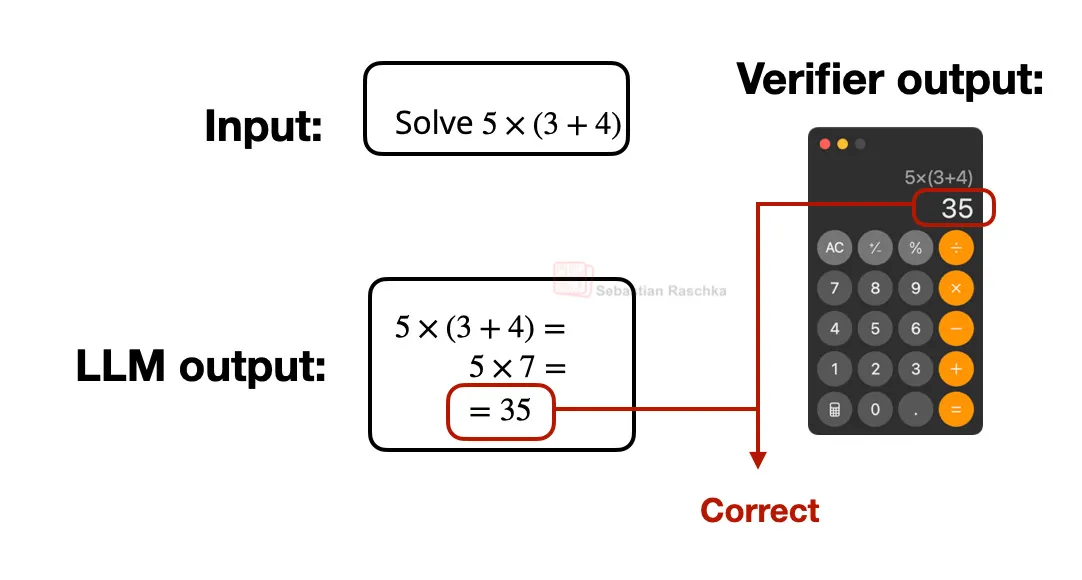
图 5:可验证奖励的简单示例
我不想在这里过多陷入技术细节,因为这篇年度回顾还要覆盖其他方面。关于推理 LLM 与 RLVR,完全可以写出整篇文章甚至整本书。感兴趣的读者可以参考我之前的文章:
‑ 《理解推理型大语言模型》:https://magazine.sebastianraschka.com/p/understanding‑reasoning‑llms
‑ 《大语言模型推理模型训练现状》:https://magazine.sebastianraschka.com/p/the‑state‑of‑llm‑reasoning‑model‑training
总而言之,今年 LLM 发展的核心主线,本质上就是采用 RLVR 与 GRPO 的推理模型占据主导。
基本上,每一家主流的开放权重或闭源 LLM 厂商,都在 DeepSeek R1 之后推出了各自模型的推理版本(常被称为 “thinking” 版本)。
1.2 LLM 发展焦点演变
如果要我按年份简要总结 LLM 的发展焦点 —— 除了单纯的架构缩放与预训练算力提升之外 —— 我的列表如下:
‑ 2022 年:RLHF + PPO
‑ 2023 年:LoRA + SFT
‑ 2024 年:Mid‑Training(中期训练)
‑ 2025 年:RLVR + GRPO
预训练始终是一切的基础。此外,RLHF(通过 PPO 算法)正是 2022 年催生初代 ChatGPT 的核心技术。
2023 年,行业重点大量放在 LoRA 及类 LoRA 的参数高效微调技术上,用于训练小型定制 LLM。
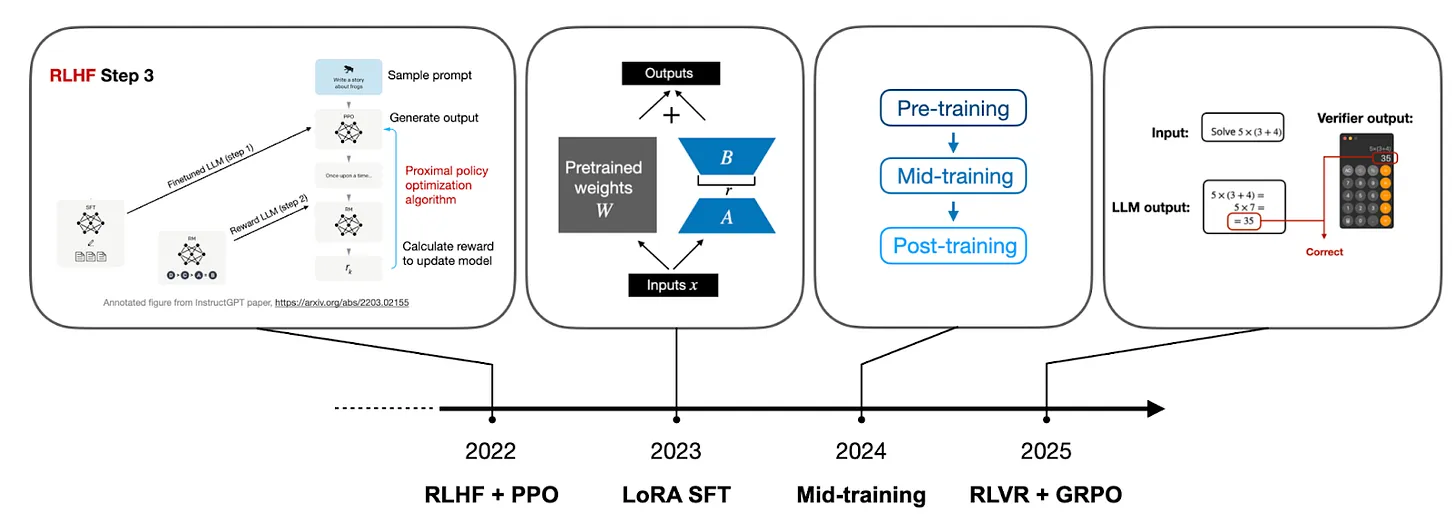
图 6:历年闭源与开放权重 LLM 研发的部分焦点领域。注:这是累计叠加的关系,例如 RLHF + PPO 至今仍在使用,只是不再是最热门的讨论话题
到了 2024 年,所有主流实验室都开始优化其(预)训练管线,手段包括合成数据、优化数据配比、使用领域专属数据,以及加入专门的长上下文训练阶段。我在 2024 年的文章中总结过这些方法(当时我将它们归为预训练技术,因为 “中期训练” 这个说法还没出现):
当时我将这些视为预训练技术,因为它们使用的是同样的预训练算法与目标。如今,这些在通用数据常规预训练之后进行的、更具针对性的预训练阶段,通常被称为 “中期训练”—— 作为常规预训练与后训练(包括 SFT、RLHF,以及现在的 RLVR)之间的桥梁。
那么你可能会问,接下来会是什么?
我认为明年我们会看到 RLVR 得到更多拓展应用。目前,RLVR 主要应用于数学与代码领域。
下一个合理的方向,是不只用最终答案的正确性作为奖励信号,还要在 RLVR 训练中对 LLM 的解释过程进行评分。这种做法早已有之,多年来一直以 Process Reward Models(PRM,过程奖励模型)的研究方向存在。不过它至今尚未取得特别大的成功。例如,DeepSeek R1 论文中提到:
4.2 未成功的尝试
…… 总而言之,尽管 PRM 在重排模型生成的 Top‑N 回复、或辅助引导搜索方面表现不错(Snell 等人,2024),但在我们的实验中,相比于其在大规模强化学习过程中引入的额外计算开销,它带来的优势十分有限。
不过,从上个月发布的 DeepSeekMath‑V2 论文(我在上一篇文章中讨论过:https://magazine.sebastianraschka.com/p/technical‑deepseek)来看,我认为未来我们会看到更多 “解释评分” 作为训练信号的应用。
目前对解释的评分需要用到第二个 LLM。这也引出了我所观察到的 RLVR 的另一个发展方向:向数学与代码之外的其他领域拓展。
所以,如果现在问我 2026 与 2027 年的发展方向,我的判断是:
‑ 2026 年:RLVR 领域拓展 + 更多 inference‑time scaling(推理时缩放)
‑ 2027 年:Continual learning(持续学习)
除了上述 RLVR 的拓展,我认为 2026 年会更关注推理时缩放。推理时缩放指的是:训练完成后,在 LLM 生成答案时投入更多时间与算力,从而大幅提升效果。
推理缩放并不是新范式,LLM 平台其实早已在底层使用了相关技术。它是延迟、成本与回复准确率之间的权衡。不过在某些应用场景中,当准确率比延迟和成本更重要时,极致的推理缩放完全物有所值。例如,近期一篇论文(https://arxiv.org/html/2511.22570v1)显示,该方法让模型在一项高难度数学竞赛基准上达到了金牌水平。
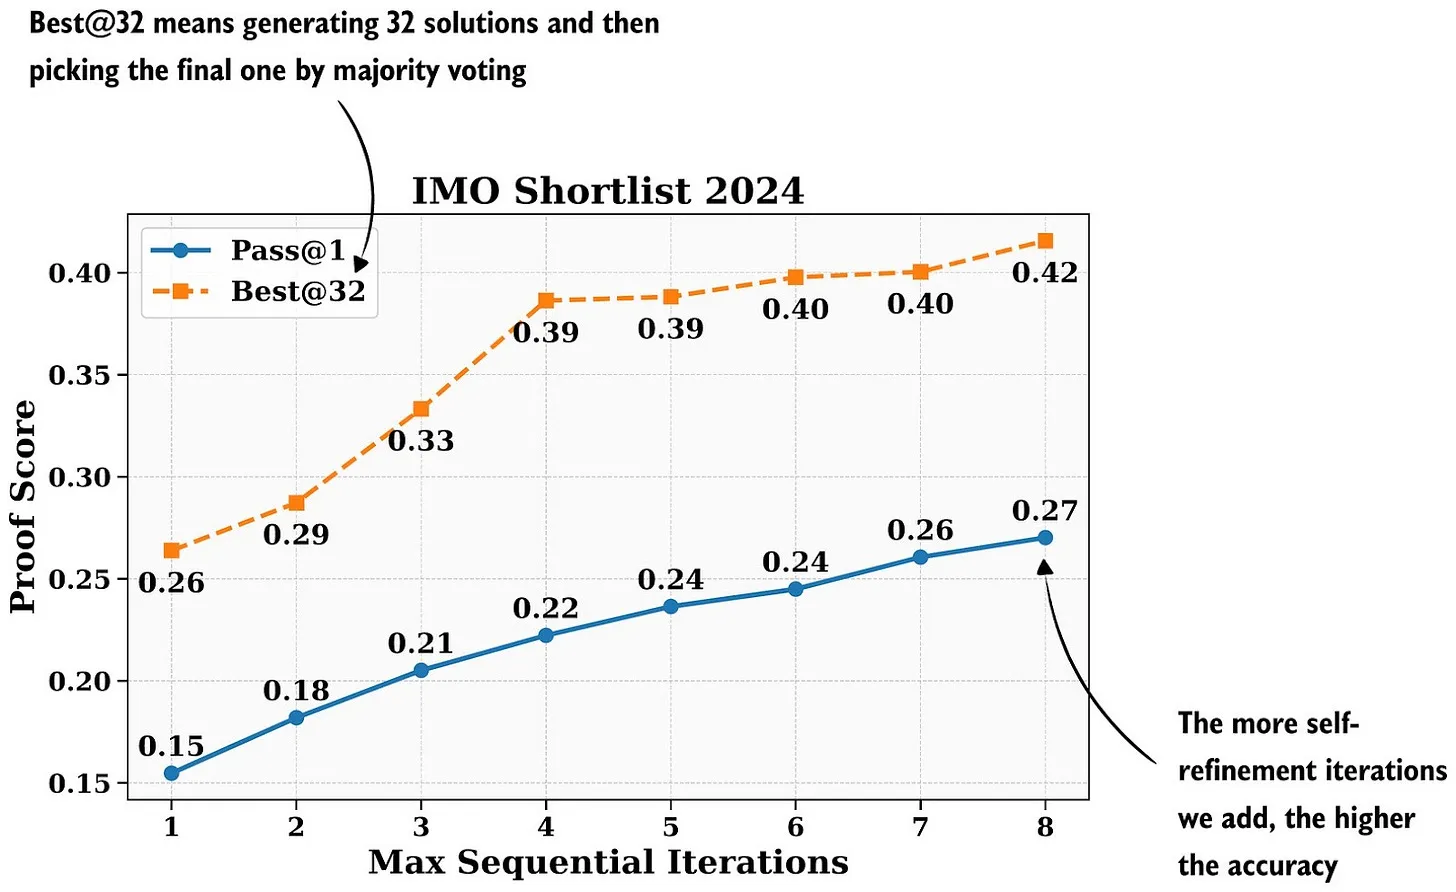
图 7:两种推理时缩放方法的结合:自一致性(self‑consistency)与自我精炼(self‑refinement)。增加自我精炼迭代次数可提升准确率。改绘自论文https://arxiv.org/html/2511.22570v1。自一致性与自我精炼在我的书《Build A Reasoning Model (From Scratch)》的第 4、5 章中有详细讲解
今年业内也大量讨论了持续学习。简而言之,持续学习是指让模型在新数据或新知识上训练,而无需从头重新训练。
这并不是新概念,我也好奇今年为何它被频繁提及 —— 因为目前持续学习领域还没有出现全新的、实质性的突破。持续学习的核心挑战是 catastrophic forgetting(灾难性遗忘):正如持续预训练的实验所示,学习新知识意味着 LLM 会在一定程度上遗忘旧知识。
尽管如此,既然这一话题如此火热,我确实预计未来几年会在缓解灾难性遗忘、推动持续学习方法发展方面取得更多进展。
2. GRPO:年度研究宠儿
近年来,在 LLM 训练成本高昂的背景下,学术研究多少有些受限。当然,即便预算有限,学术界依然能做出成为主流、成为 LLM 进步关键支柱的重要发现与突破。
近年典型的例子包括 LoRA(https://arxiv.org/abs/2106.09685,2021 年)及相关的参数高效微调方法。
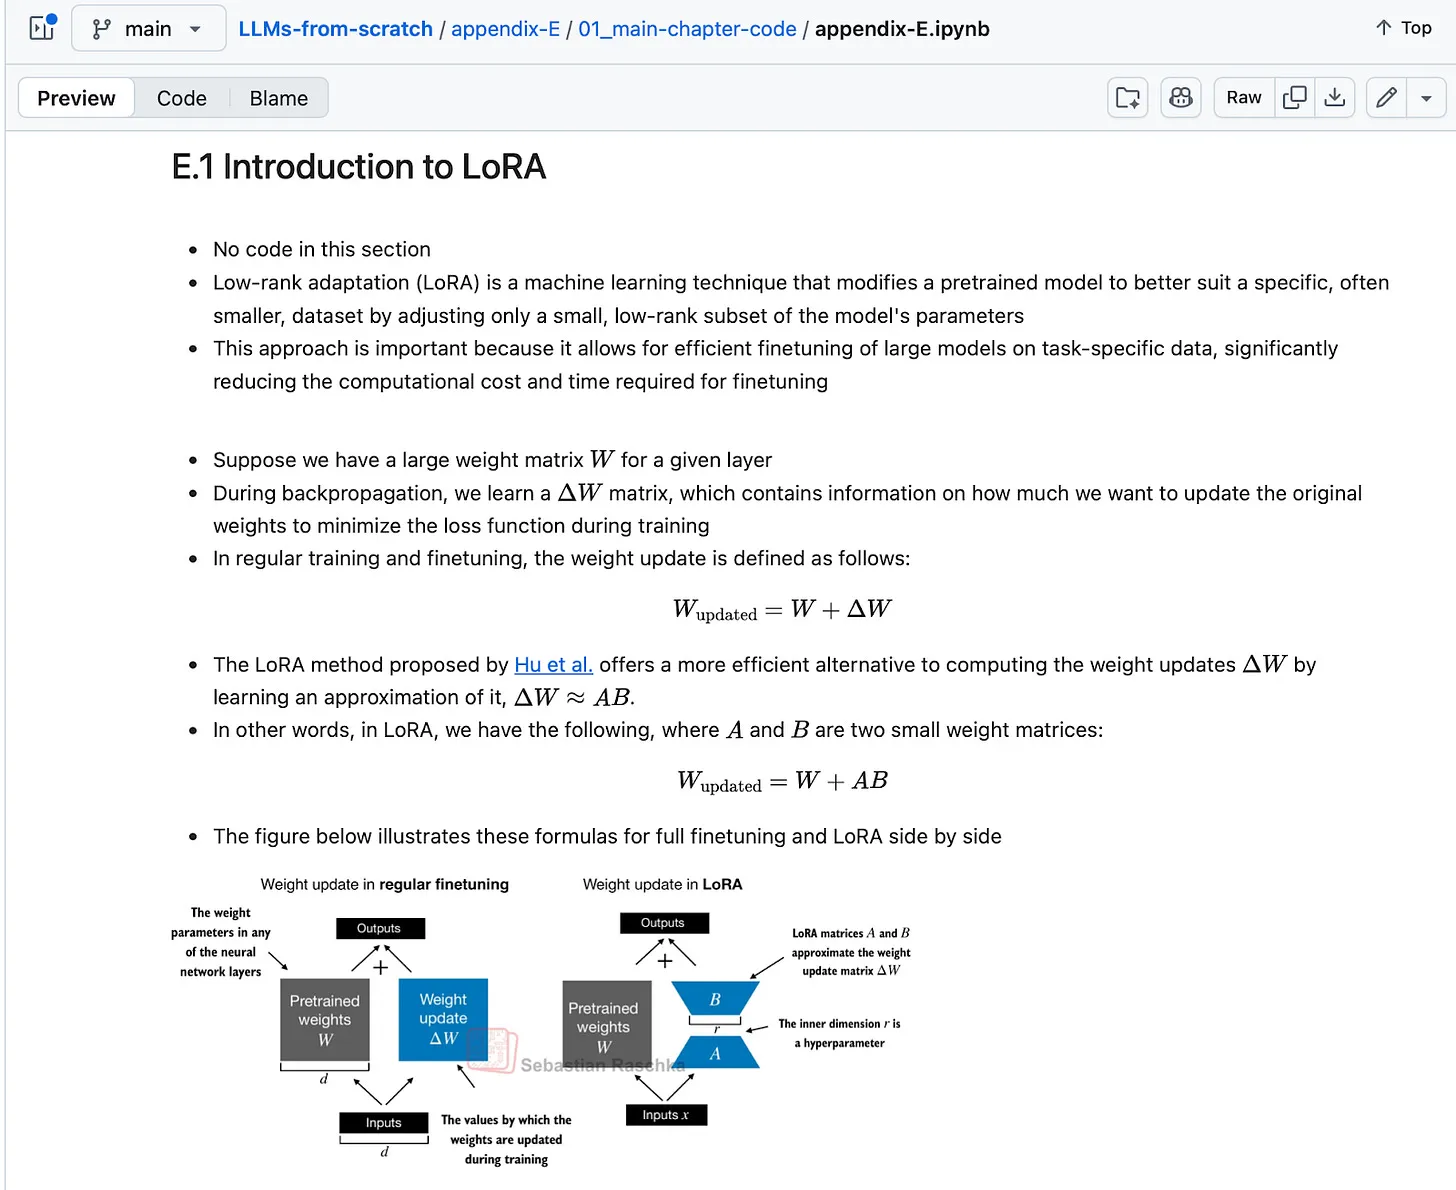
图 8:基于代码的 LoRA 入门示例,来自代码仓库https://github.com/rasbt/LLMs‑from‑scratch/blob/main/appendix‑E/01_main‑chapter‑code/appendix‑E.ipynb
另一个例子是 DPO(https://arxiv.org/abs/2305.18290)及相关的无奖励模型对齐方法,作为人类反馈强化学习的替代方案。
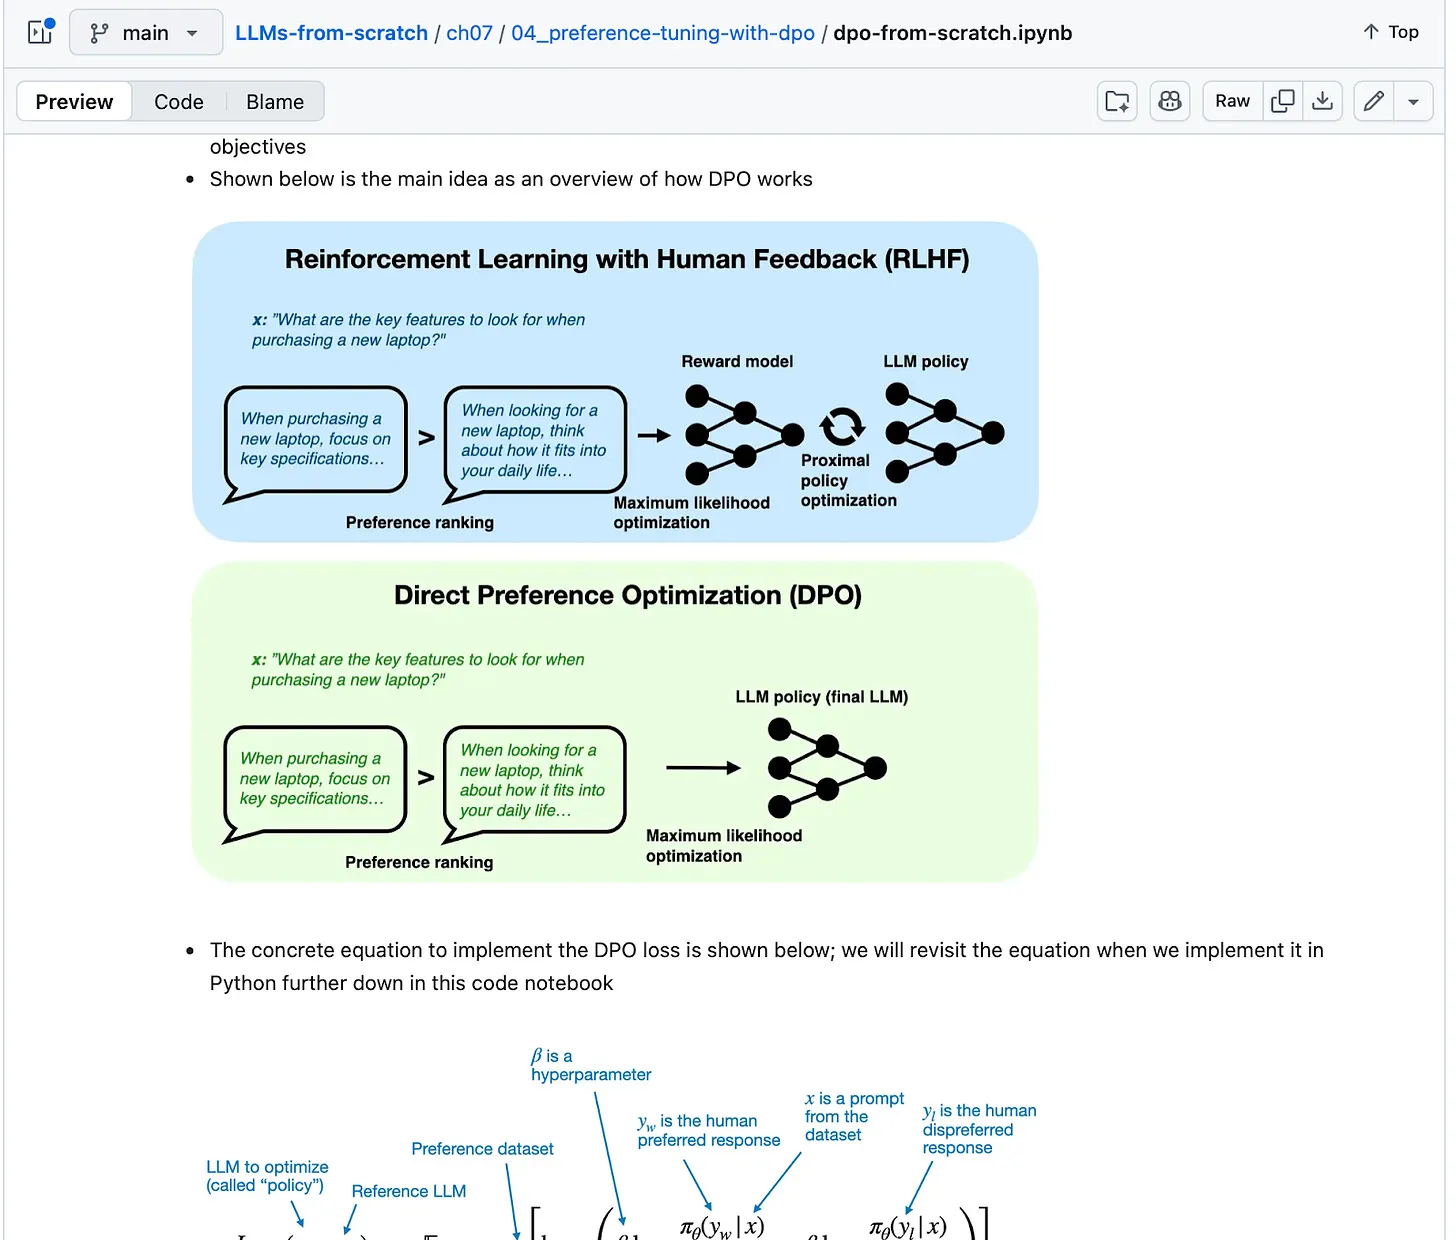
图 9:基于代码的 DPO 入门示例,来自代码仓库https://github.com/rasbt/LLMs‑from‑scratch/blob/main/ch07/04_preference‑tuning‑with‑dpo/dpo‑from‑scratch.ipynb
在我的观察范围内,今年的研究亮点当属 GRPO。尽管它是在 DeepSeek R1 论文中提出、并非起源于学术界,但它依然让研究者们度过了激动人心的一年:RLVR 与 GRPO 在概念上都富有洞见,并且根据规模不同,实验成本并非高不可攀。
因此,今年我在 LLM 研究文献中看到了许多针对 GRPO 的数学改进(来自企业与学术研究者双方),这些改进后来都被顶尖 LLM 的训练管线所采纳。例如,部分改进包括:
出自论文https://arxiv.org/abs/2512.13961:
‑ 零梯度信号过滤(出自 DAPO 论文:https://arxiv.org/abs/2503.14476)
‑ 主动采样(出自 DAPO 论文)
‑ Token 级损失(出自 DAPO 论文)
‑ 无 KL 散度损失(出自 DAPO 论文与 Dr. GRPO 论文:https://arxiv.org/abs/2503.20783)
‑ 高位裁剪(出自 DAPO 论文)
‑ 截断重要性采样(https://fengyao.notion.site/off‑policy‑rl)
‑ 无标准差归一化(出自 Dr. GRPO 论文)
出自论文https://arxiv.org/abs/2512.02556:
‑ KL 调优,搭配领域专属 KL 强度(数学领域为 0)
‑ 重加权 KL
‑ 离策略序列掩码
‑ 保留 Top‑p/Top‑k 采样掩码
‑ 保留原始 GRPO 优势归一化
我可以证实,这些 GRPO 技巧或改进在实践中效果非常显著。比如,采用其中部分或多项改进后,糟糕的参数更新不再会破坏我的训练进程,我也不再需要定期重载检查点。
即便对于非常短的训练跑,我也观察到采用这些技巧后收益明显。
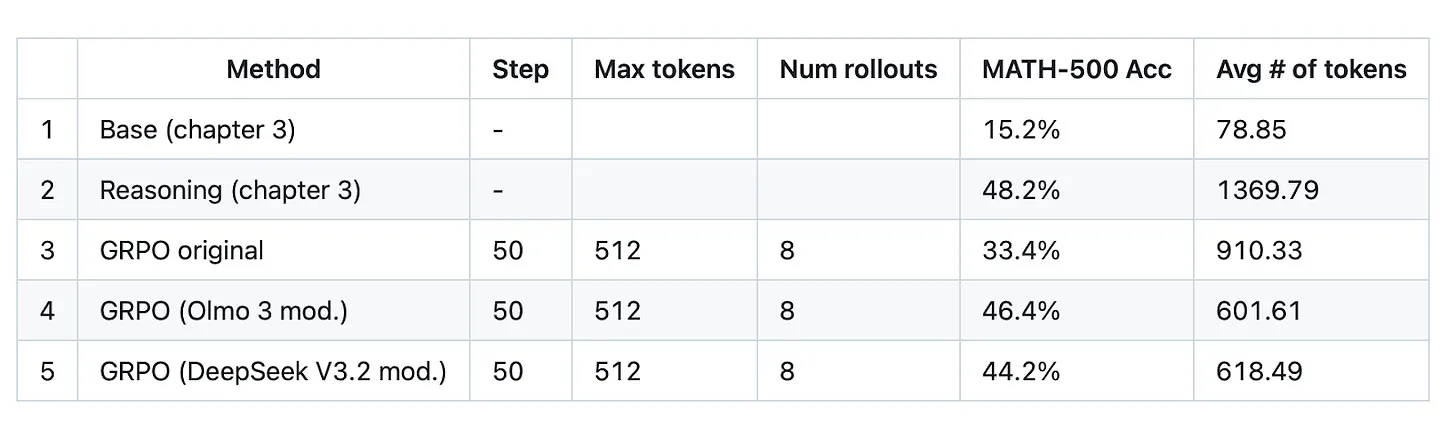
图 10:我从零实现的 GRPO 训练代码的小部分结果截图,代码位于https://github.com/rasbt/reasoning‑from‑scratch/tree/main/ch06/02_rlvr_grpo_scripts_original
总之,我的 reasoning‑from‑scratch 代码库(https://github.com/rasbt/reasoning‑from‑scratch)里有一个基础版 GRPO 实现脚本,大家可以拿去把玩。(我很快会补充更多对应各改进版的消融实验。)
3. LLM 架构:分岔路口?
在架构层面,顶尖模型依然采用经典的 decoder‑style transformer(解码器式 Transformer)。不过今年,开放权重 LLM 基本都趋同于采用 Mixture‑of‑Experts(MoE,混合专家)层,以及至少一种 “效率优化” 的注意力机制:Grouped‑query attention(分组查询注意力)、sliding‑window attention(滑动窗口注意力)或 multi‑head latent attention(多头潜注意力)。
除了这些相当标准的 LLM 架构之外,我们也看到了针对注意力机制的更激进效率优化,目标是让注意力复杂度随序列长度线性增长。例子包括 Qwen3‑Next 与 Kimi Linear 中的 Gated DeltaNets(门控 DeltaNet),以及 NVIDIA Nemotron 3 中的 Mamba‑2 层。
总之,我不想在这里展开太多细节,因为我有一篇长达 1.3 万字、近期刚更新的专门文章讨论这些架构,想深入了解的可以看这里:《大语言模型架构大对比》(https://magazine.sebastianraschka.com/p/the‑big‑llm‑architecture‑comparison)。
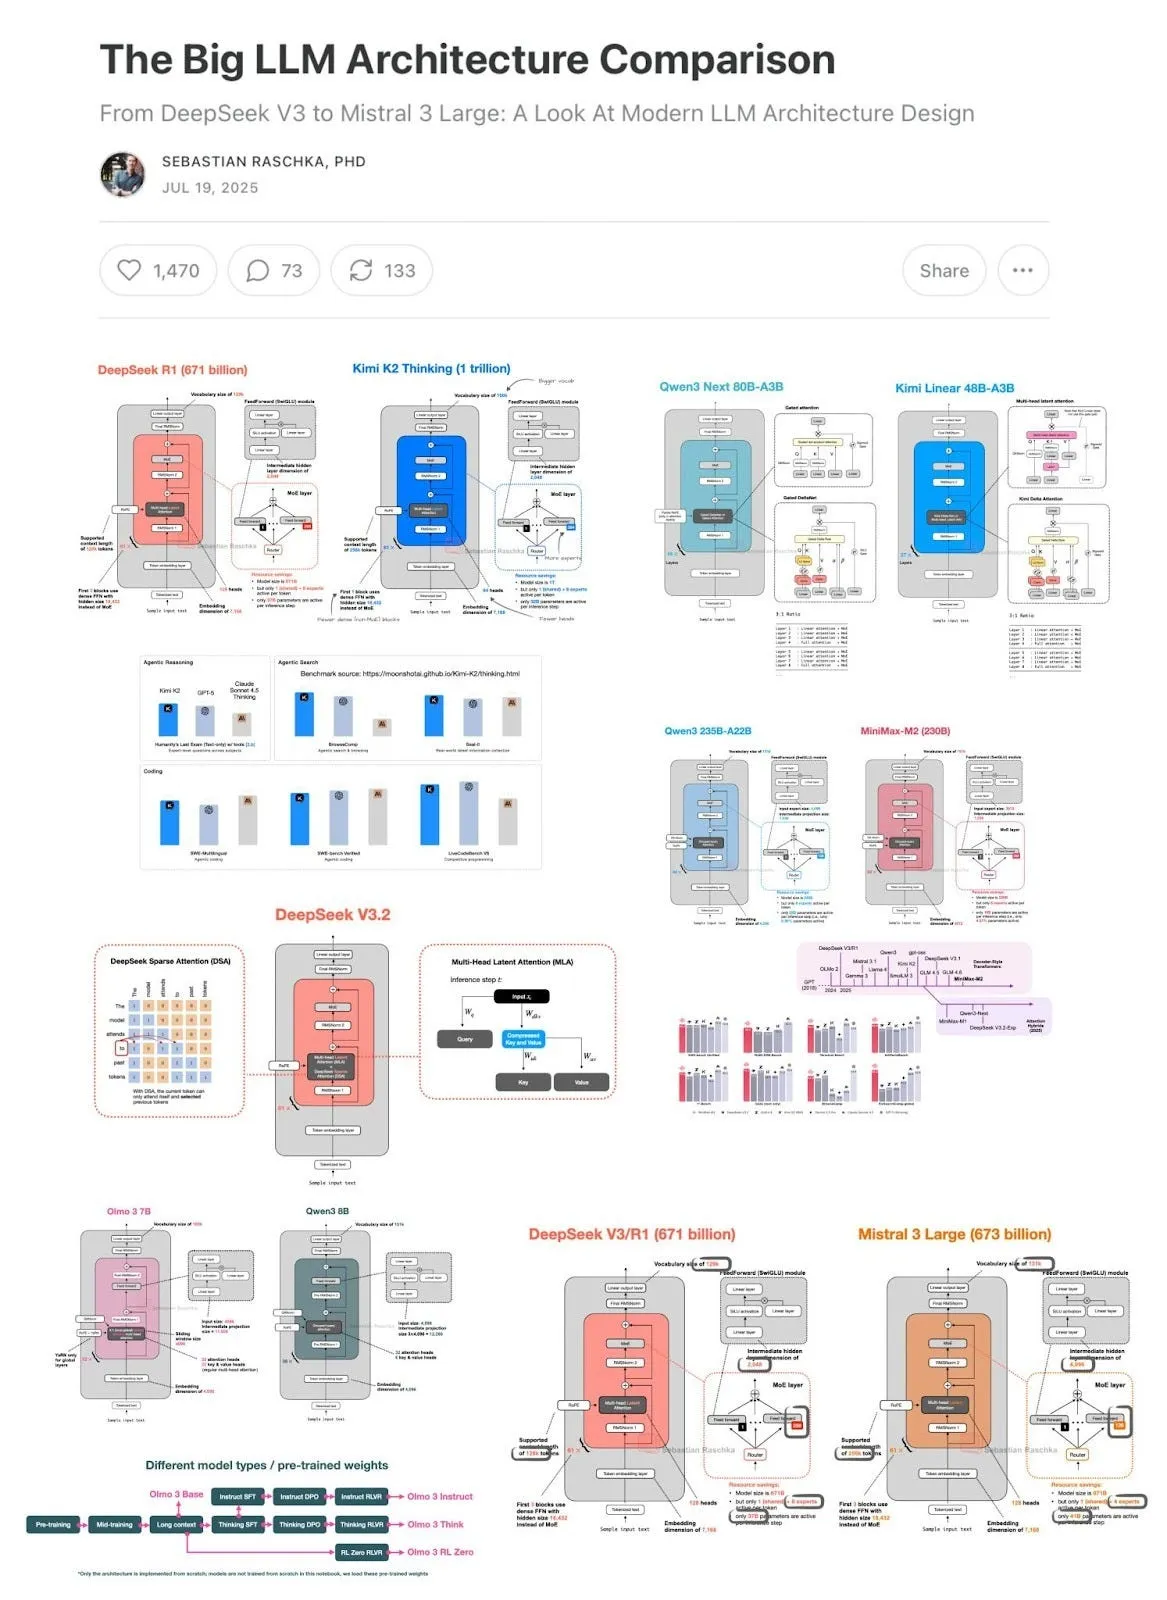
图 11:《大语言模型架构大对比》全文导读图,文章地址:https://magazine.sebastianraschka.com/p/the‑big‑llm‑architecture‑comparison
我的预测是,至少在未来几年内,就顶尖建模性能而言,我们会继续沿用 Transformer 架构。
同时我也认为,我们会看到越来越多类似 Gated DeltaNet 和 Mamba 层的效率与工程优化。因为从 LLM 训练、部署与使用的规模来看,对于仍在投入大量资金提供 LLM 服务的企业而言,这从财务角度而言完全合理。
这并不意味着没有其他替代路线。比如我在《超越标准大语言模型》(https://magazine.sebastianraschka.com/p/beyond‑standard‑llms)一文中写过,text diffusion models(文本扩散模型)就是一个有意思的方向。目前它们还属于实验性研究模型范畴,但 DeepMind 即将推出 Gemini Diffusion 模型。它在建模质量上还无法与顶尖产品媲美,但在低延迟需求场景(比如代码补全)中会非常快、很有吸引力。
另外,两周前开放权重的 LLaDA2.0(https://github.com/inclusionAI/LLaDA2.0)发布了。其中最大的版本参数量达 100B,是目前最大的文本扩散模型,性能与 Qwen3 30B 相当。(没错,它没有整体刷新顶尖水平,但在扩散模型领域依然是值得关注的进展。)
4. 同样重要的一年:推理时缩放与工具调用
通过训练数据与架构缩放来提升 LLM,是一条久经考验且依然有效的路径。但尤其在今年,它不再是 “唯一” 的有效配方。
我们从 GPT 4.5(2025 年 2 月)身上看到了这一点 —— 有传言称它的规模远大于 GPT 4(以及后来发布的 GPT 5),而单纯的规模提升通常并不是性价比最高的前进方向。GPT 4.5 的能力或许强于 GPT 4,但增加的训练预算被认为 “投入产出比不佳”。
取而代之,更优的训练管线(更聚焦中期与后训练)以及推理缩放,是今年大部分进展的核心驱动力。
比如之前提到的、取得金牌数学水平的 DeepSeekMath‑V2,推理缩放就是我们可以拉动的杠杆之一,让 LLM 按需解决极其复杂的任务(GPT Heavy Thinking 或 Pro 是其他例子;当然不可能所有场景都用这些模式,因为延迟与成本很高,但在某些场景下 —— 比如高难度数学或编程问题 —— 高强度的推理缩放非常值得。)
另一大进步来自:在训练 LLM 时就将 tool use(工具调用)纳入考量。众所周知,hallucinations(幻觉)是 LLM 最大的问题之一。可以说幻觉率一直在持续下降,而我认为这很大程度上归功于工具调用。比如,当被问及 1998 年 FIFA 世界杯冠军是谁时,LLM 不需要强行记忆,而是可以通过工具调用传统搜索引擎,从该主题的可信网站(比如本例中的 FIFA 官网)抓取并筛选信息。数学题可以调用计算器 API,诸如此类。
例如,OpenAI 的 gpt‑oss 系列模型,就是今年较早发布的、专门围绕工具调用设计的开放权重模型之一。
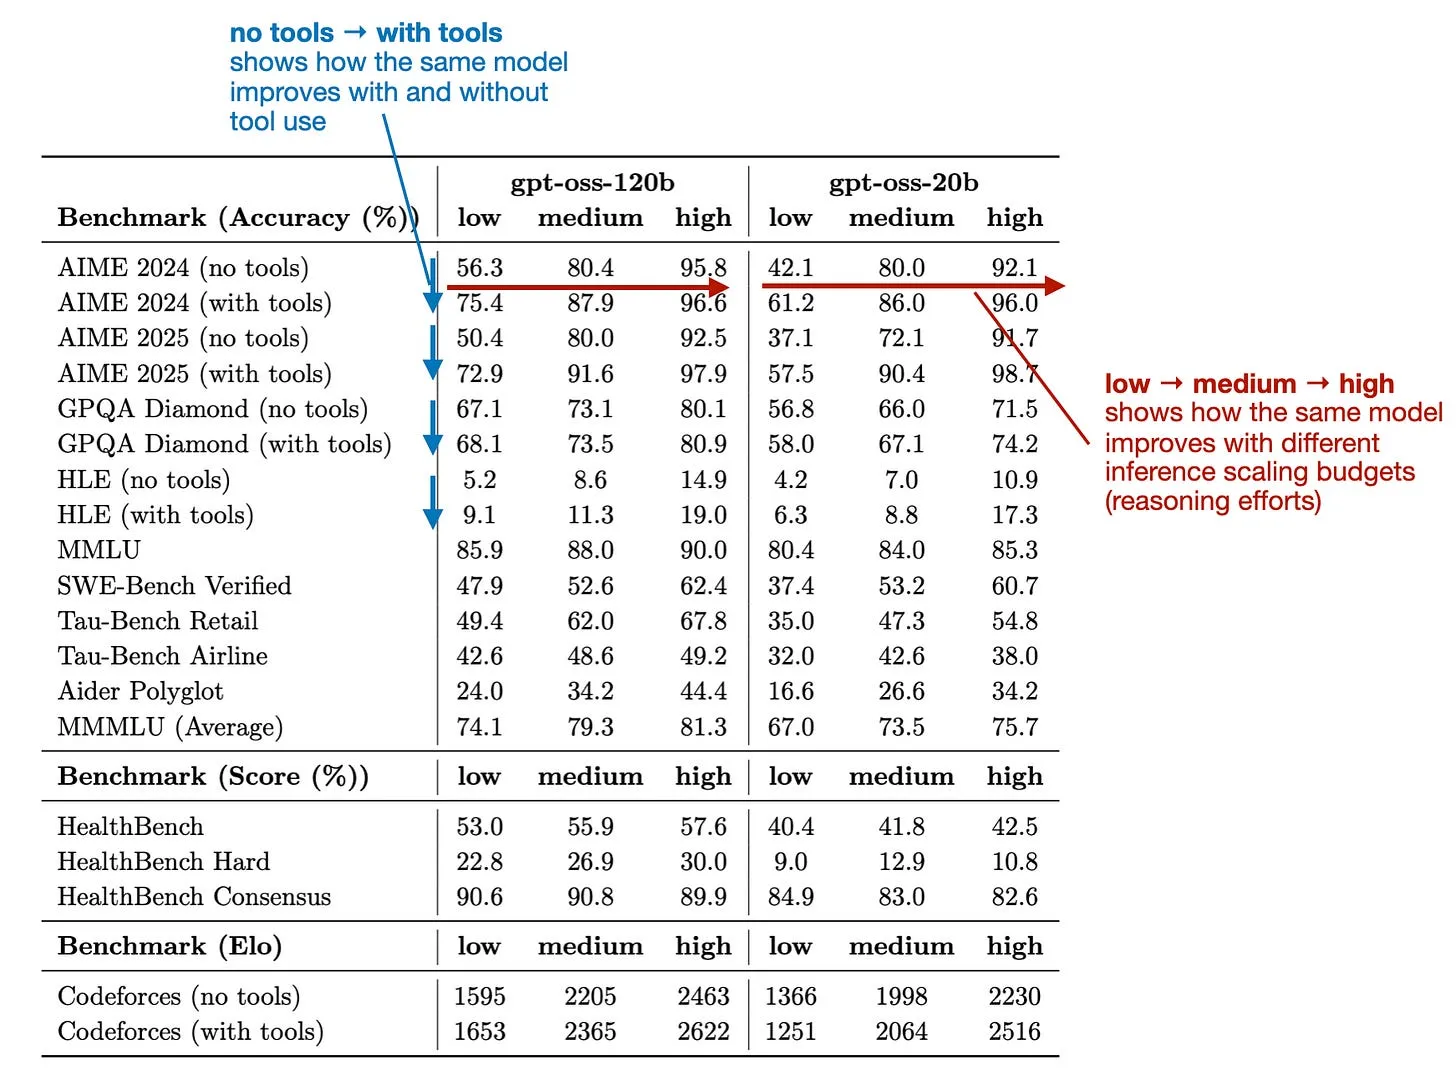
图 12:摘自论文https://arxiv.org/abs/2508.10925的标注表格
遗憾的是,开源生态还没有完全跟上这一步伐,很多(甚至大多数)工具默认还是以非工具调用模式运行这些 LLM。原因之一是这是一个较新的、仍在演进的范式,配套工具需要适配。另一个原因是这个问题本身难度更高 —— 安全层面的考量:赋予 LLM 不受限制的工具调用权限,可能存在安全风险,或者对你的系统造成其他破坏。我认为始终值得一问的是:你会放心让一个新来的实习生拥有这么高的系统权限吗?
我确实认为,未来几年,在本地使用 LLM 时启用工具调用会变得越来越普遍。
5. 年度关键词:Benchmaxxing
如果要我选一个词或趋势来描述今年的 LLM 发展,那就是 “benchmaxxing”。
这里的 benchmaxxing,指的是行业高度聚焦于拉升排行榜分数,有时甚至到了基准测试成绩本身成了目标,而非通用能力代理指标的地步。
一个典型例子是 Llama 4,它在众多成熟基准上得分极高。然而当用户与开发者拿到手之后,发现这些分数并不能反映真实世界的能力与实用性。
常言道:如果测试集是公开的,那它就称不上真正的测试集。而如今的问题是,测试集数据不仅(有意或无意地)被纳入了训练语料,甚至在 LLM 开发过程中还会被直接针对性优化。
早年,即便公开测试集上的基准分数有水分,至少模型排名还基本保持不变。比如 2019 年论文《Do ImageNet Classifiers Generalize to ImageNet?》(https://arxiv.org/abs/1902.10811)中的图示。
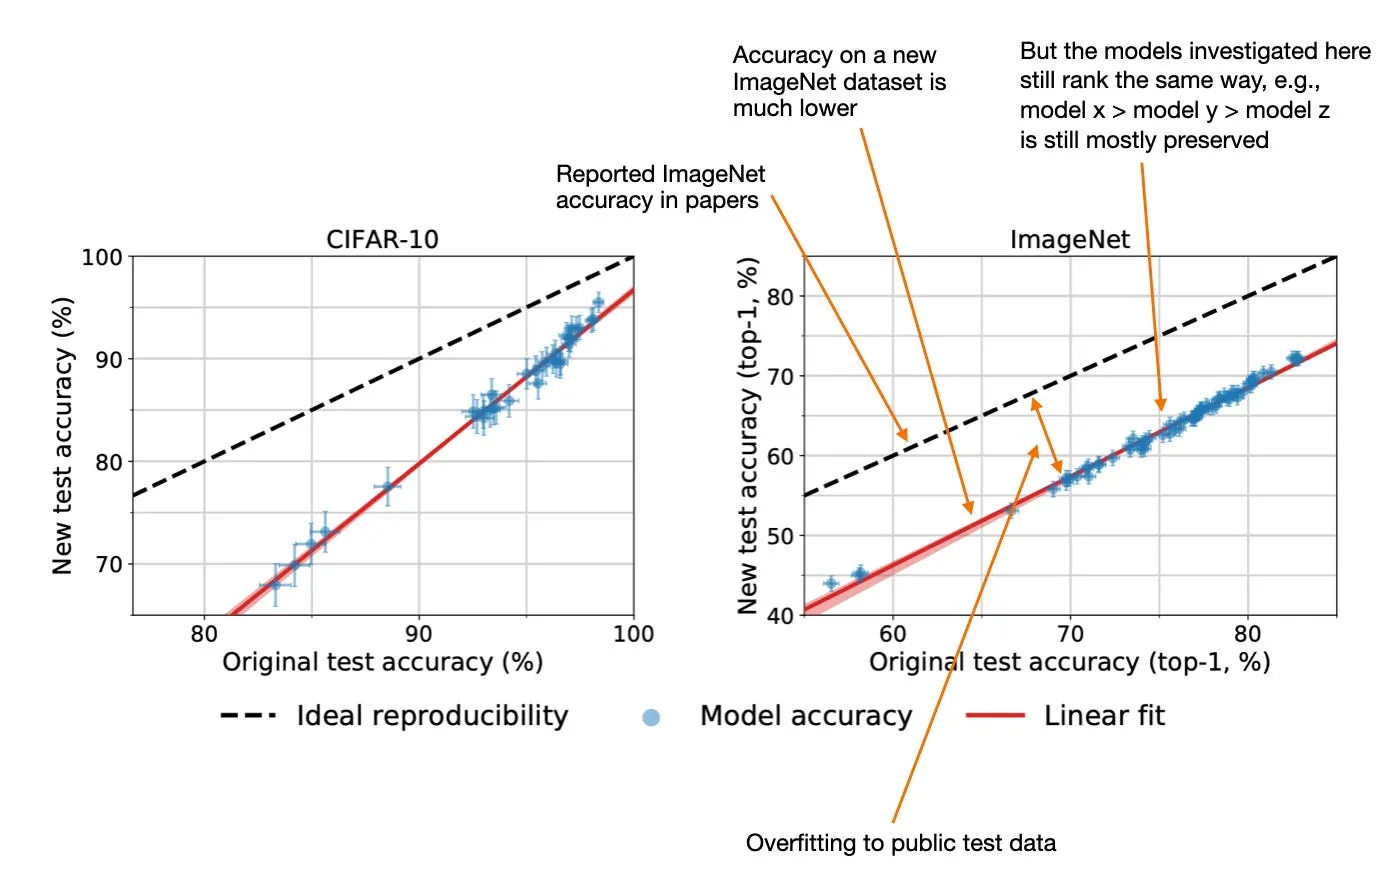
图 13:改绘自 2019 年论文https://arxiv.org/abs/1902.10811的图示
在 LLM 发展中,这一问题已经严重到基准分数不再是模型性能可信指标的地步。
不过我仍然认为,基准是 LLM 必须跨过的必要门槛。也就是说,如果我看到某个 LLM 在基准 Y 上得分低于 X,我就知道它不是一个好模型。但如果它在基准 Y 上得分高于 X,并不代表它就比另一个同样超过 X 的模型好很多。
另一个需要考虑的维度是:图像分类器只有一个任务,就是分类图像。但 LLM 要用于各种各样的任务:文本翻译、文本摘要、写代码、头脑风暴、解数学题等等。评估图像分类器有明确的指标比如分类准确率,而评估 LLM 既要做确定性任务、也要做自由形式任务,要复杂得多。
除了实际使用 LLM、不断生成新基准之外,很遗憾这个问题没有完美解。
顺便说一句,如果你想了解 LLM 评估的主要类别,可能会喜欢我的文章《理解 LLM 评估的四大主流方法(从零实现)》:
https://magazine.sebastianraschka.com/p/llm‑evaluation‑4‑approaches
6. AI 在编程、写作与研究中的价值
因为这个话题经常被提起,我想分享一下我对 “LLM 会不会在某些任务(甚至工作)上取代人类” 的看法。
从宏观层面,我将 LLM 视为赋予特定职业人群 “超能力” 的工具。我的意思是,用好 LLM 可以大幅提升个人生产力,消除日常工作中的大量摩擦。小到确保章节标题大小写一致这种相对琐碎的事,大到在大型代码库中找出复杂 bug。
6.1 编程
时至今日,我在乎的代码大部分还是自己写。所谓 “在乎”,是指在那些我必须理解代码、确保代码正确的场景里。比如搭建 LLM 训练脚本时,我会自己实现并仔细检查训练逻辑。一来确保它按我预想的运行,二来保留我在这项任务中的知识与专业能力。不过现在我会用 LLM 来写周边更琐碎的代码,比如加上命令行 argparse 模板,这样我就能更方便地在命令行使用自己的代码。
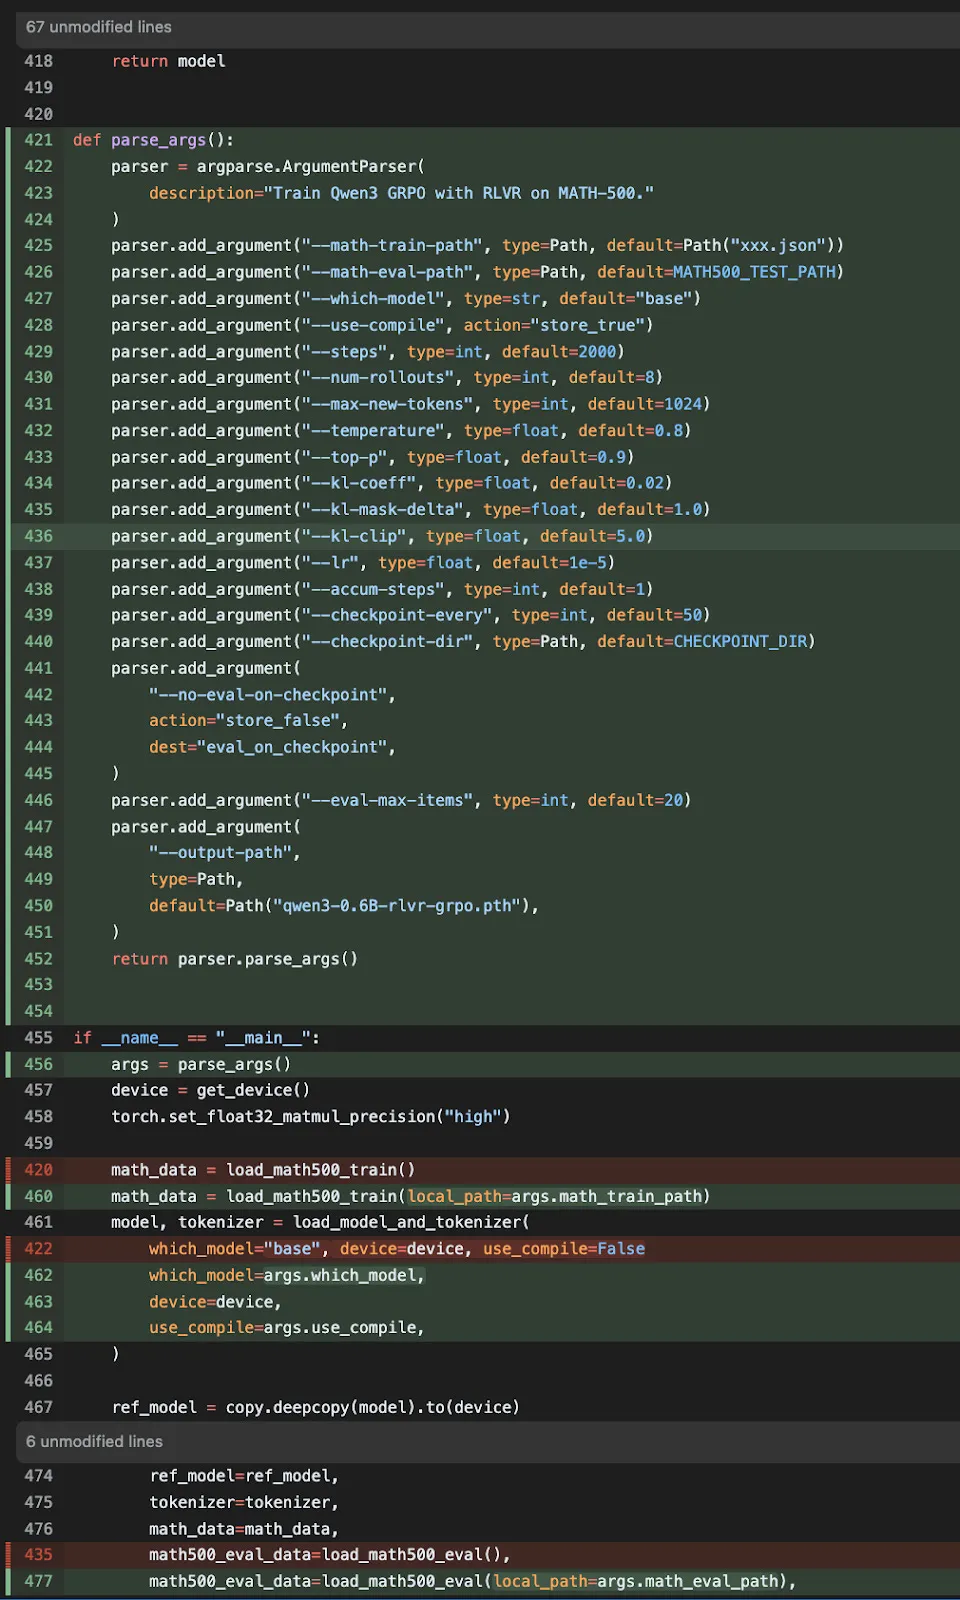
图 14:用提示词 “为 training‑script.py 添加所有超参数选项的 argparse 命令行解析” 生成的代码示例
但我也越来越多地依赖 LLM 来发现问题、提出改进建议,或者对想法做合理性检查。同时,我希望理解自己在构建的东西,而我的个人目标是深化知识与技能,持续提升专业能力。
与此同时,LLM 对于我核心专业领域之外的任务极具价值。它让我能把那些不然没时间没精力做的事自动化。一个例子是我最近写的一个工具,用来把我的 Substack 文章提取并备份为 Markdown。(我所有内容都用 Markdown 起草,但经常直接在 Substack 编辑器里编辑扩展,所以本地草稿不总是最新的。)LLM 还帮我清理了网站上的 CSS—— 那些代码积累了多年的重复与不一致。今年还有很多类似的场景,我都用到了 LLM。
简而言之,我认为关键在于知道什么时候该用 LLM、什么时候不该用。以及如何使用 LLM,既能帮你提升专业能力,又能获得满足感。
6.2 代码库与代码生态
LLM 写代码的能力越来越强,但尽管我听到其他人有不同说法,我不认为代码会变得可有可无、会被淘汰。LLM 赋予人们 “超能力”,可以生成某些原本要耗费大量精力的编程项目。
但是,纯由 LLM 生成的代码库,取代不了专家精心打造的代码库。这些专家代码库甚至可能就是程序员自己借助 LLM 创建的。但重点是:有领域专长的人投入了大量时间精力去创建、测试、打磨它。其他人要复刻需要付出大量工作,所以既然已经存在了,为什么不直接采用?
简而言之,我认为一个精通全栈 Web 开发、深谙优秀设计模式与权衡、职业生涯中研究过、见过、搭建过大量平台的专家,肯定比一个随便给 LLM 发提示的人搭出来的平台更好。
厉害的地方在于,普通人现在也能搭建平台了,即便不是最好的。但光靠提示 LLM,能达到的高度有限,平台质量可能会遇到瓶颈。所以如果这个人真的想提升平台,最好深入学习,看看别人是怎么搭建的,带着更多知识回来,再用 LLM 更有效地指导和改进平台设计。
6.3 技术写作与研究
和编程类似,我不认为 LLM 会让技术写作过时。写一本好的技术书需要数千小时,以及对主题的深刻熟悉。这个过程中可以用 LLM 来提升清晰度、检查技术正确性、探索替代方案,或者跑小型实验,但核心工作依然依赖人类的判断与专业能力。
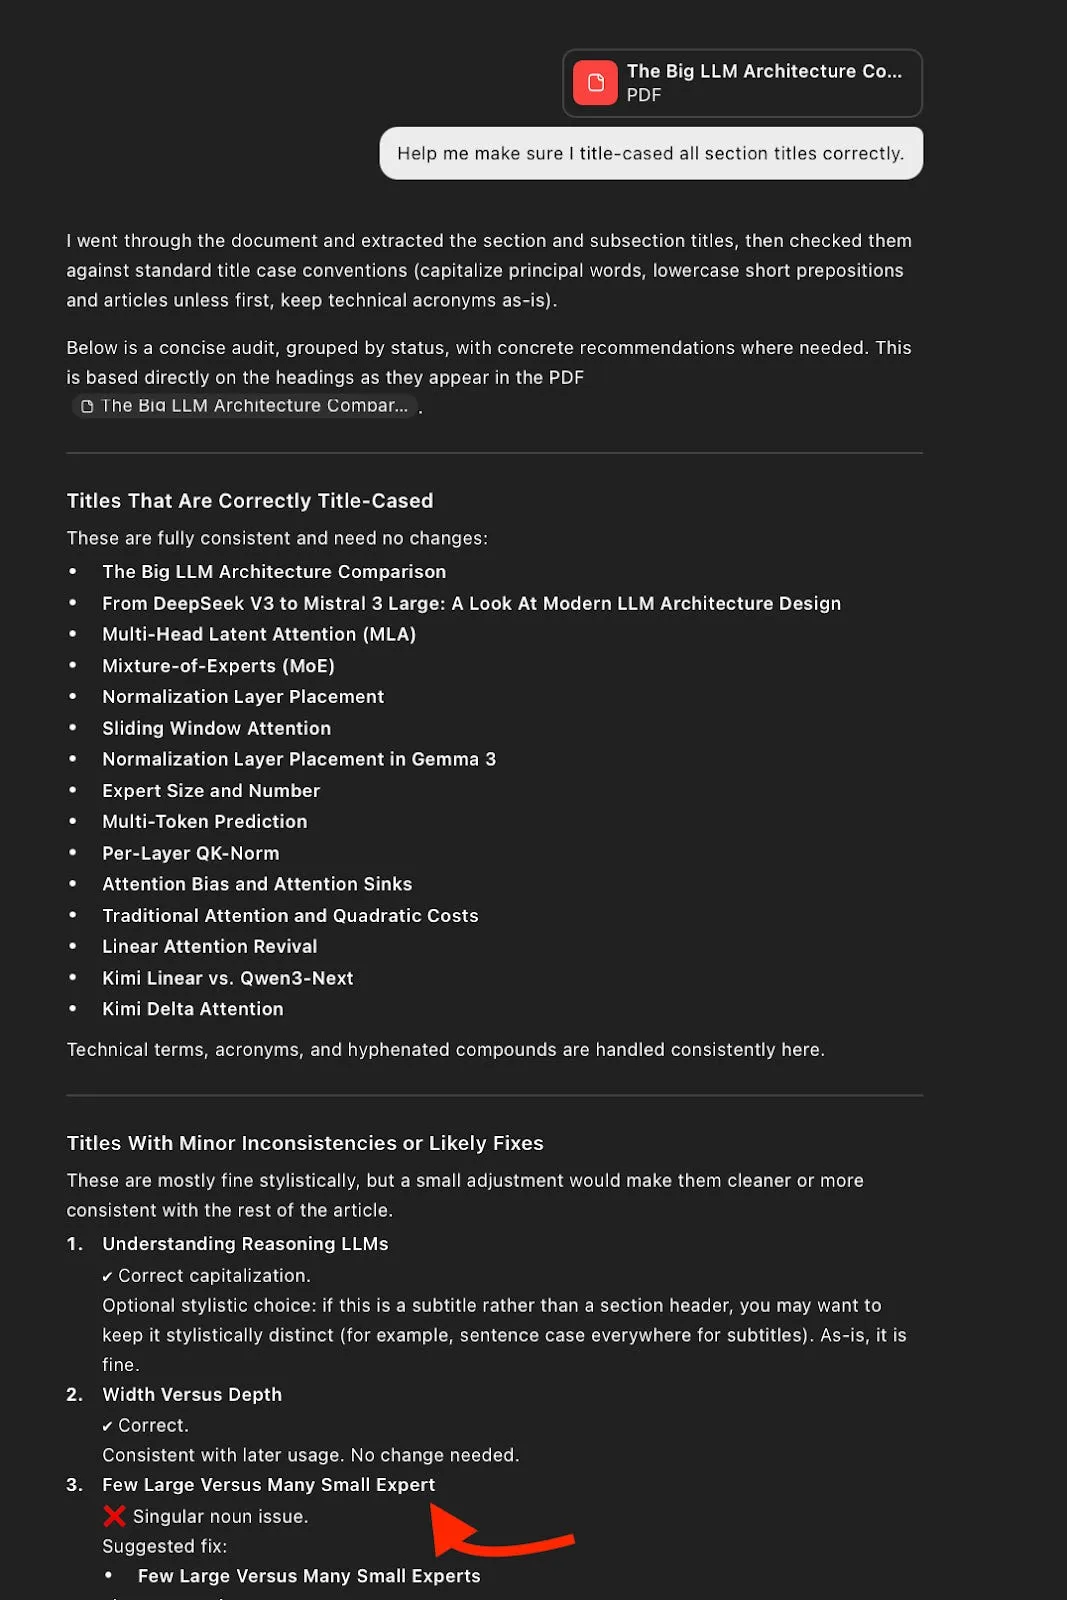
图 15:一个真实场景示例:LLM 帮我发现并修正了前一篇文章中的一处错误
没错,LLM 可以让技术书变得更好。它能帮作者发现错误、扩充参考文献,总体减少花在琐碎事务上的时间。这就把更多时间解放出来,留给真正需要创造力与经验的深度工作。
从读者的角度,我也不认为 LLM 能取代技术写作。用 LLM 学习某个主题,对于快速提问和入门级解释很有效。但当你想要建立更深入的理解时,这种方法很快就会变得混乱。
这时候,与其自己花好几个小时去筛选 LLM 关于某个你还不熟悉主题的回复,通常更合理的做法是跟随专家设计的结构化学习路径。(这位专家可能用了 LLM,也可能没用。)
当然,在上课或读书的过程中,用 LLM 来澄清问题、探索旁支知识点依然非常合理。用它来设计测验或练习题来巩固知识也很棒。
总体而言,我认为 LLM 对作者和读者都是净收益。
但我也认为,这里的诀窍依然是学会什么时候该用 LLM、什么时候不该用。比如,主要的坏处是,当话题变难时,人们很容易立刻就去求助 LLM,但自己先啃一啃难题,往往能带来更扎实的学习效果。
我看研究也是同理。LLM 在查找相关文献、发现数学公式问题、建议后续实验方面非常有用。但让人类研究者坐在主导位置上,依然很有必要。
或许这里的经验法则大概是这样的:
‑ 如果这篇(研究)文章或书完全由人类写成,它本可以被进一步优化。
‑ 如果这篇(研究)文章或书光靠提示 LLM 就能生成,那它可能不够有新意,也不够有深度。
6.4 LLM 与职业倦怠
LLM 还相当新,仍在快速发展,我认为过度使用 LLM 还有一个较少被讨论的坏处。比如,我觉得如果所有执行工作都由模型完成,人类主要负责监督,工作会开始变得空洞。
当然,有些人真心喜欢专注于管理系统、协调工作流,这完全是合理的偏好。但对于喜欢亲手做事的人来说,我认为这种工作模式会加速倦怠。(尤其是那些因为有了 LLM 就要求更快出成果的公司,这种情况可能更明显。)
苦苦攻克一个难题,最终看到它跑通,会带来一种特别的满足感。如果 LLM 一下就给出答案,我完全得不到同样的感觉。我猜这和做饭有点像(只是打个比方,我不是大厨)。如果你喜欢做披萨,用现成的饼胚只加配料,可能会剥夺大部分乐趣,做饭就变成了达成目的的手段。这不一定不好,但我想如果你成年累月每天都做这份工作,持续几个月几年,很容易觉得空虚,最终导致倦怠。
所以一个有点 “自私” 的视角是:写代码也比读代码更有乐趣。你可能也同意,提交拉取请求通常比评审拉取请求更有意思(当然,这不是对所有人都成立)。
或许,关于我们该如何可持续地使用 AI,一个理想的(虽不完美的)类比是国际象棋。
国际象棋引擎几十年前就超过了人类棋手,但职业棋手对弈依然活跃且蓬勃发展。我不是国际象棋专家,但我认为这项运动甚至变得更丰富、更有意思了。
据我所知(比如卡斯帕罗夫的《深度思考》一书,还有马格努斯・卡尔森参与的播客),现代棋手会用 AI 探索不同思路、挑战自己的直觉、深度分析失误,达到了以前根本不可能的深度。
我认为,对于其他形式的智力工作,这是一个很有参考价值的模式。用得好,AI 可以加速学习,拓展一个人能合理承担的范围。我们应该更多把它当作伙伴,而非替代品。
但我也认为,如果用 AI 把思考和编程完全外包出去,会有损害积极性与长期技能发展的风险。
7. 前沿壁垒:私有数据
LLM 的通用编程、知识问答与写作能力在持续提升。这很大程度上是因为,训练管线与范式(比如 RLVR)的改进,以及推理缩放与工具调用的发展,让规模缩放依然能带来正向的投资回报。
然而,除非我们不断发明新的训练方法和 / 或架构,这种进步迟早会进入平台期(类似我们在 GPT 4 到 GPT 4.5 发展中看到的情况)—— 目前没人知道新方法新架构会是什么样子。
LLM 目前已经能解决很多通用任务和那些相对容易的 “低垂果实”。但要在特定行业深耕,还需要更多领域专业化。我认为 LLM 厂商都非常渴望拿到高质量的领域专属数据。就目前来看,这依然是个挑战。
比如,据称多数被接触的公司都拒绝了这类交易,恰恰因为这些数据是专有的,是其业务差异化的核心。(我从多个渠道听到过这一点,而且还有一篇相关报道:https://www.theinformation.com/articles/openai‑anthropic‑discuss‑data‑deals‑biotech‑companies)
在我看来,这完全合乎逻辑。我认为,把宝贵的专有数据卖给 OpenAI 或 Anthropic,可能有点短视 —— 这些数据未来可能成为企业的竞争优势。
图 16:可用于训练领域专属 LLM 的行业与数据类型示例(说明:仅为举例,不构成法律建议。可以想见,如果是运行在公司安全服务器内部的本地 LLM,用患者健康数据训练模型,和开发其他处理同类患者数据的内部软件没有本质区别)
目前,大规模 LLM 开发成本极高、难度极大,这也是为什么只有少数几家大公司在开发顶尖 LLM。但我认为 LLM 开发正变得越来越商品化:随着 LLM 研发人员频繁跳槽,最终会有更多大型金融机构、生物科技公司以及其他有预算的企业,开发具备竞争力的内部 LLM,从自有私有数据中获益。
这些 LLM 甚至完全不需要从头训练;DeepSeek V3.2、Kimi K2、GLM 4.7 等众多顶尖 LLM 都已经开放发布,可以基于它们做适配与进一步后训练。
8. 从零构建 LLM 与推理模型
你可能好奇我今年都在忙什么。我的精力几乎全部放在了 LLM 相关的工作上。去年我决定独立出来创办自己的公司,主要是为了有更多时间做自己的研究、写书、运营 Substack 专栏,以及开展行业合作。
作为一名独立研究者,咨询项目是我维持这套模式的收入来源之一。这不仅覆盖日常开销(从食品杂货到医保),也包括那些不太显眼的成本,比如做实验的云算力费用。
长期来看,我的目标是进一步减少咨询工作,把更多时间花在长篇研究与写作上,尤其是我在这里分享的技术深度解析内容。
我很幸运,已经有很多公司向我伸出橄榄枝,邀请我加入全职岗位 —— 如果独立发展不顺利,这也是可行的选择。但就目前而言,我打算继续保持独立。
如果你觉得我的内容有用,并且力所能及的话,订阅我的 Substack 或者买一本我的书,真的能帮我维持这类创作,我由衷感谢你的支持。
《Ahead of AI》是读者支持的出版物。想要收到新文章并支持我的工作,可以考虑成为免费或付费订阅者。
我的年度个人亮点
今年我个人的一大亮点,是我的书《Build A Large Language Model (From Scratch)》(https://amzn.to/4fqvn0D)收到了非常多正面反馈。我收到了来自全球各地企业与高校读者的大量 thoughtful 留言。
这些反馈覆盖了广泛的使用场景:从大学教授将这本书作为主讲教材,教授 LLM 工作原理;到毕业生用它准备面试、拿下新岗位;再到工程师以它为跳板,在生产环境中实现定制 LLM。
我也很开心地得知,这本书目前已经被翻译成至少 9 种语言。
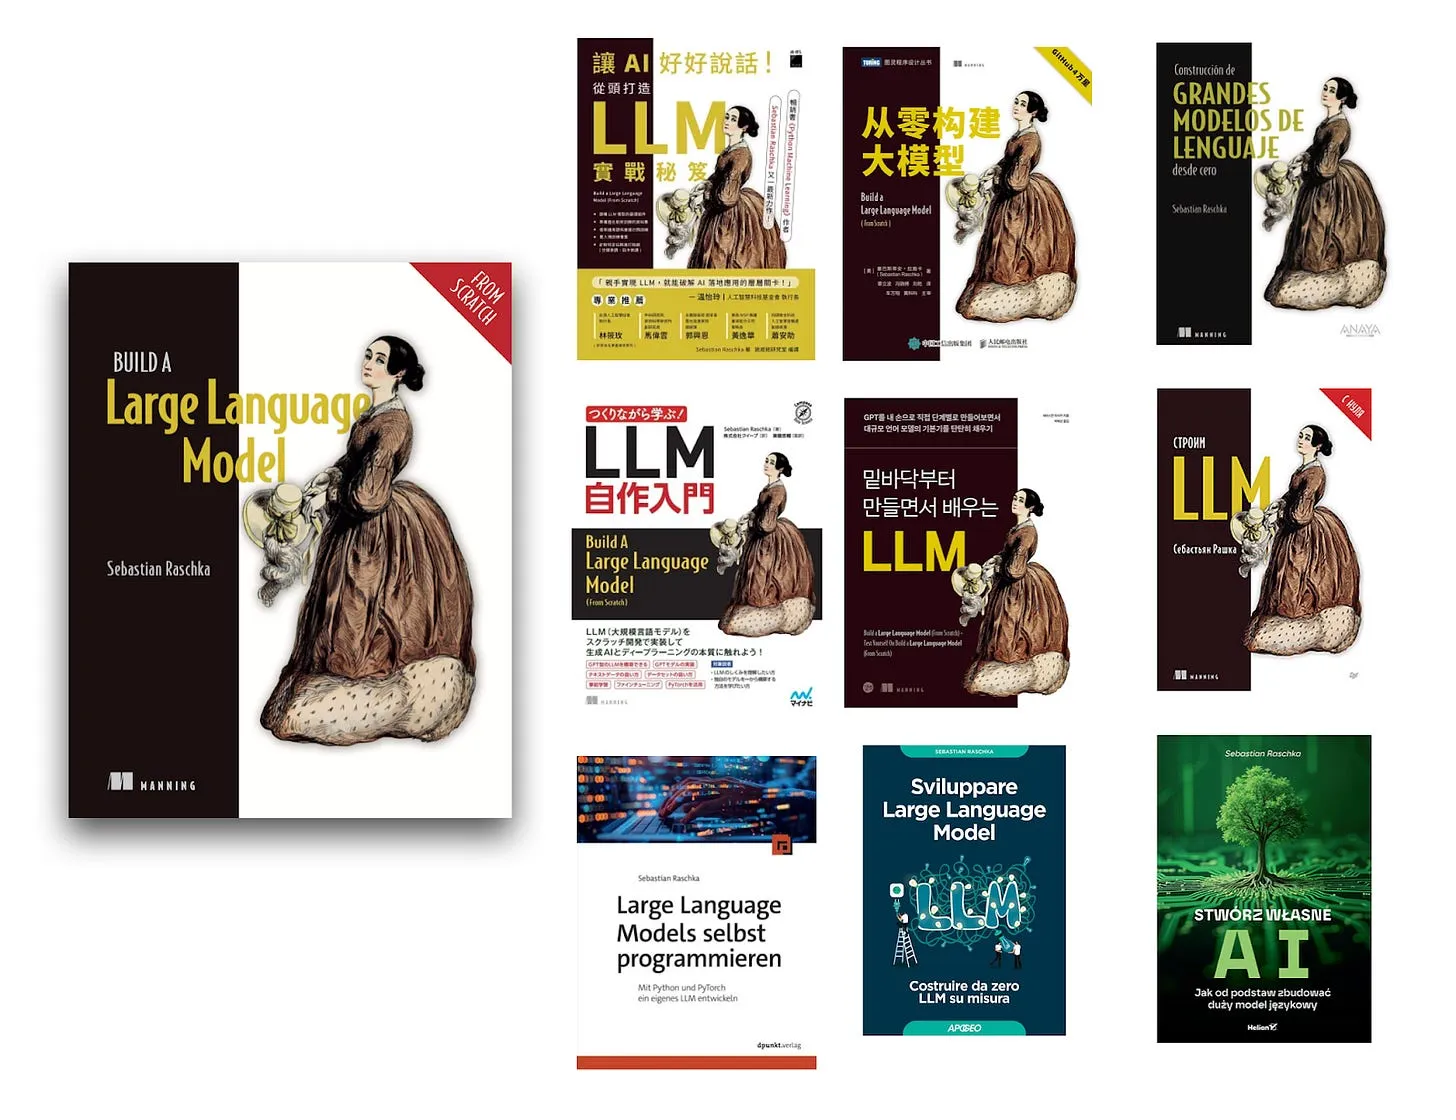
图 18:《Build A Large Language Model (From Scratch)》已被翻译成多种语言
很多读者还问会不会出第二版,覆盖更新、更前沿的主题。我确实考虑过,但我很谨慎,不想让这本书的入门门槛变得太高。比如,用 DeepSeek 等新模型采用的多头潜注意力之类更复杂的变体,取代标准的多头注意力,会大幅提升学习门槛。
所以目前我更倾向于保持这本书原貌,因为它对想入门 LLM 的人来说非常友好。而对于想了解更进阶内容的读者,我今年在这本书的 GitHub 仓库(https://github.com/rasbt/LLMs‑from‑scratch)里补充了大量额外资料。我计划未来继续扩充这些内容。
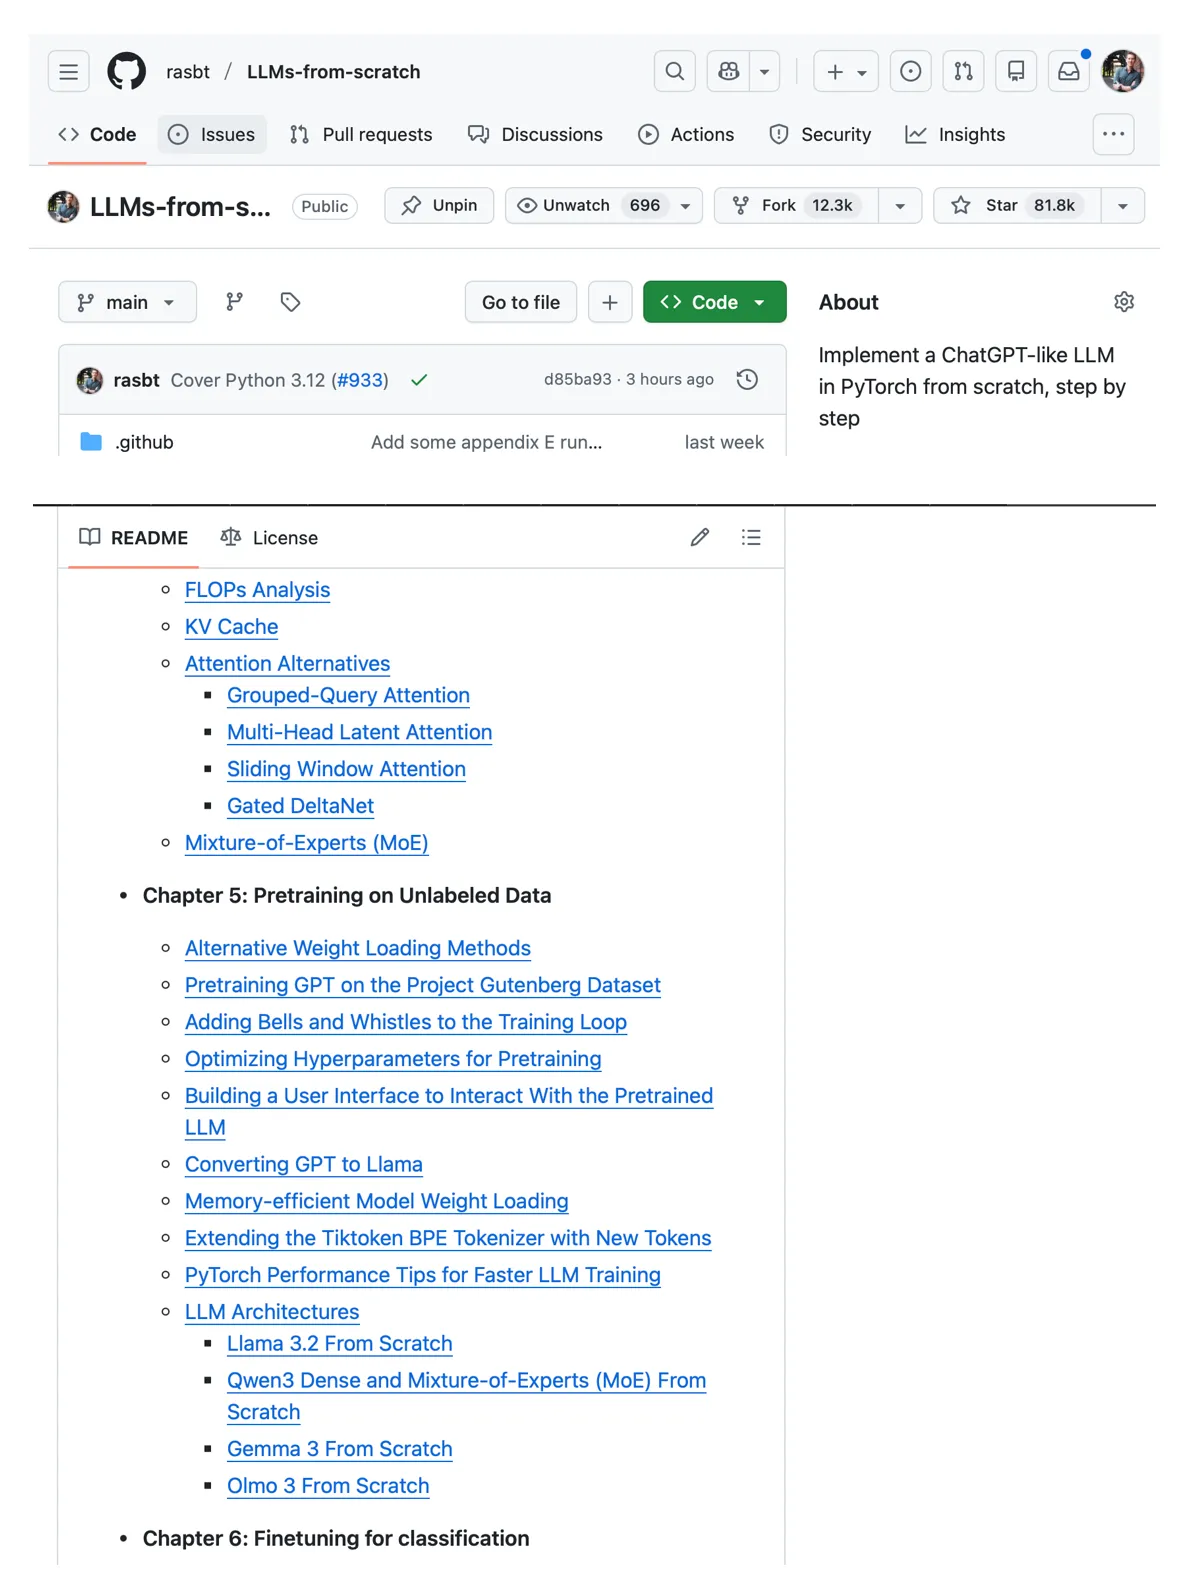
图 19:今年我在https://github.com/rasbt/LLMs‑from‑scratch 仓库中新增的部分补充材料截图
此外,大家可能知道,我目前正在写续作《Build A Reasoning Model (From Scratch)》(https://mng.bz/Nwr7)。
第一本书《Build A Large Language Model (From Scratch)》(https://mng.bz/M96o)聚焦于大语言模型核心架构与预训练基础。
这本推理模型的书,则承接上一本书的内容,从预训练好的基础模型开始,探索专门用于提升推理能力的推理时缩放方法与强化学习技术。
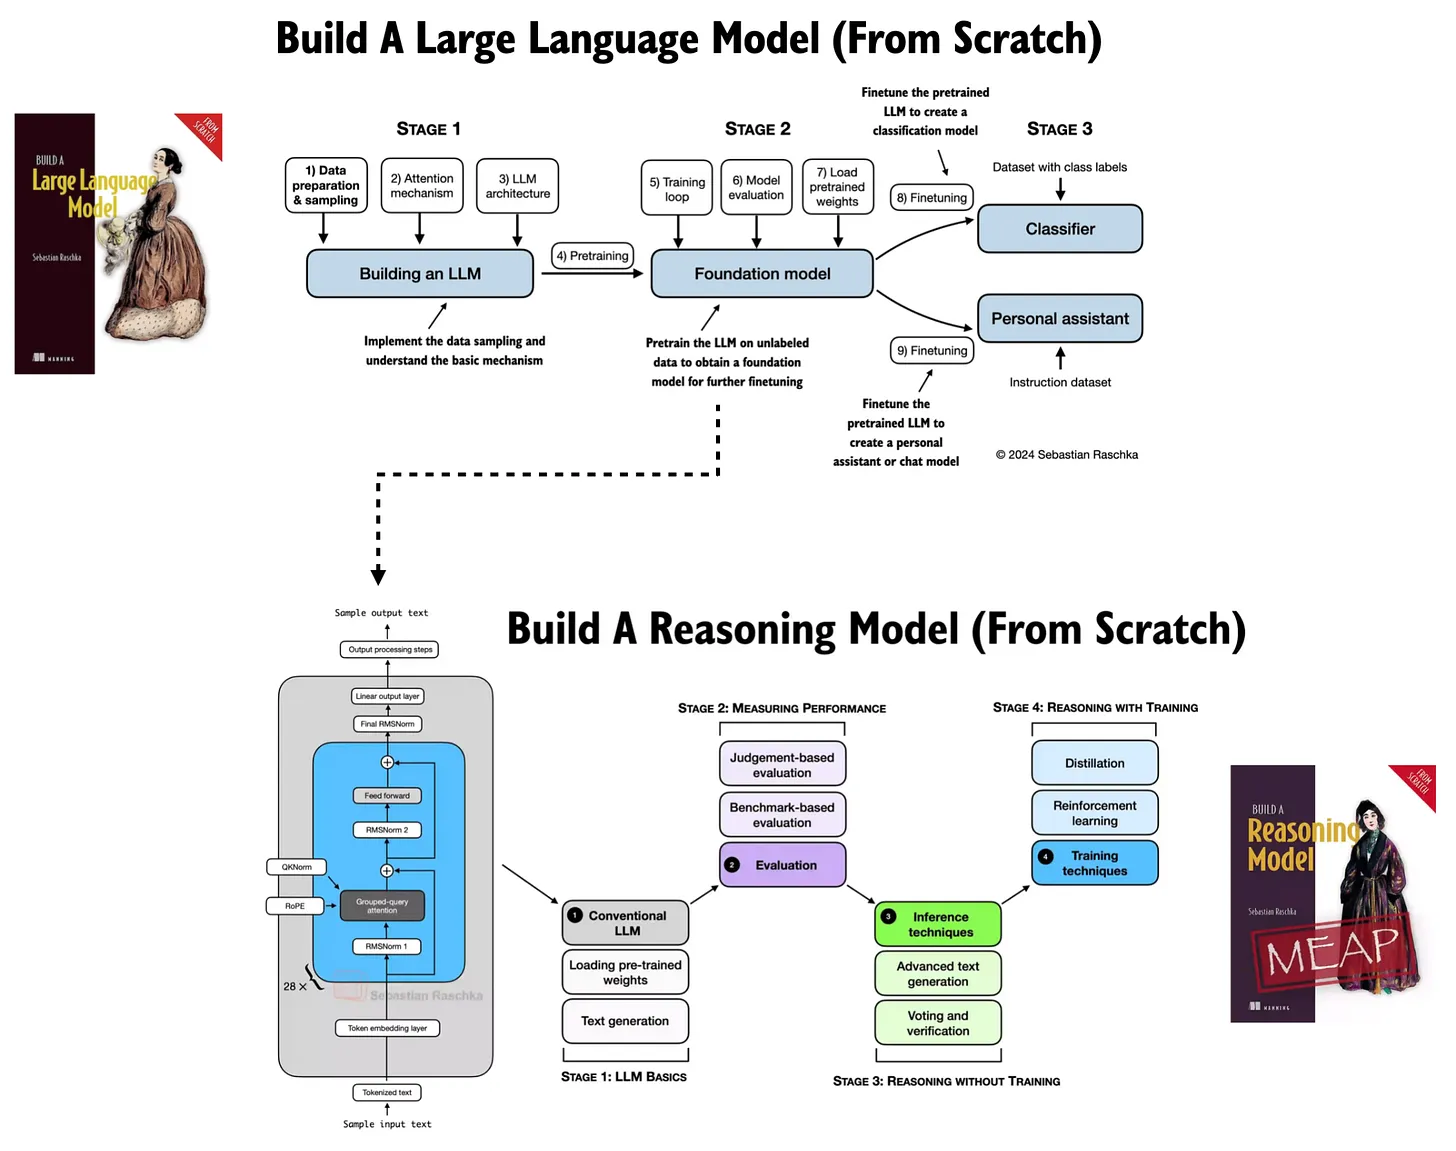
图 20:两本 “从零实现” 系列图书的内容关系示意
除了运营 Substack,我正全力投入这本推理书的写作。在很多方面,我认为这是我迄今为止构思最缜密、打磨最精细的一本书。
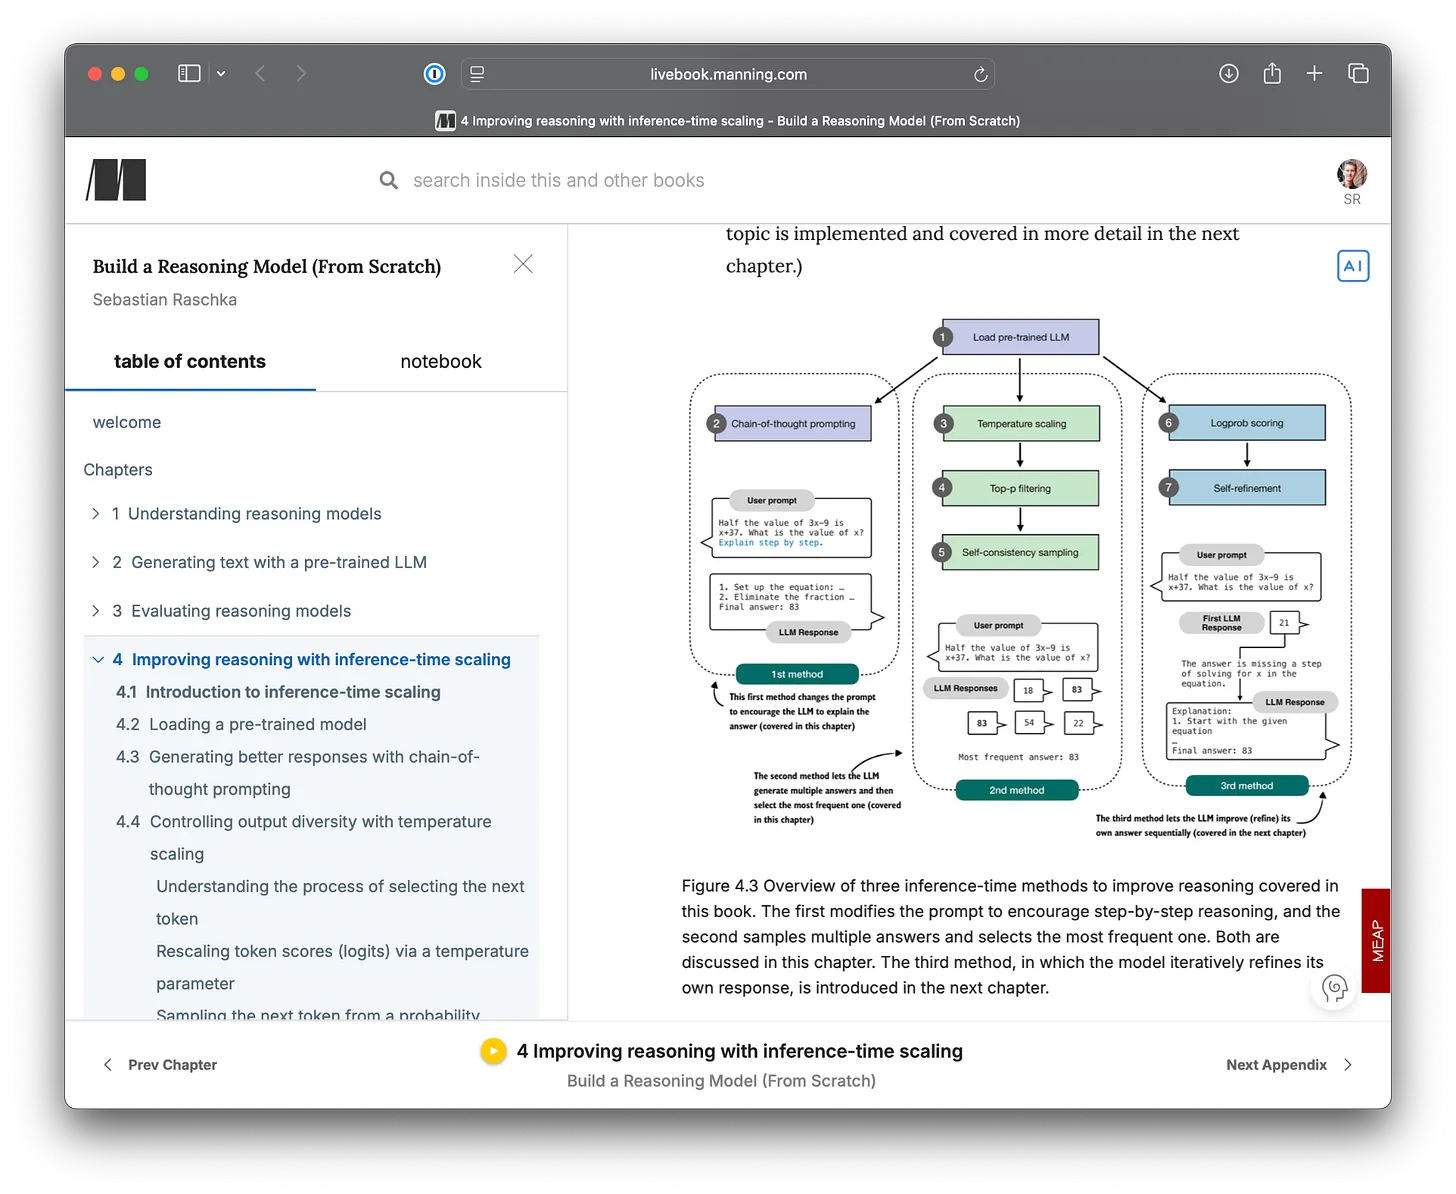
图 21:《Build A Reasoning Model (From Scratch)》内容节选,书籍地址:https://mng.bz/Nwr7
目前我估计,每写一章我要花 75 到 120 小时。如果你好奇的话,大致的时间分配如下:
‑ 3‑5 小时:头脑风暴与修订主题选择
‑ 5‑10 小时:搭建内容结构
‑ 20 小时:编写初始代码
‑ 10‑20 小时:补充实验、研读最新文献以获取更多洞见
‑ 10‑20 小时:制作图表
‑ 10 小时:撰写初稿文本
‑ 10‑20 小时:重写与润色章节
‑ 5‑10 小时:设计习题并运行实验
‑ 2‑5 小时:吸收编辑与读者建议
目前我写到了第 6 章,内容是实现用于训练推理模型的可验证奖励强化学习(GRPO)代码。
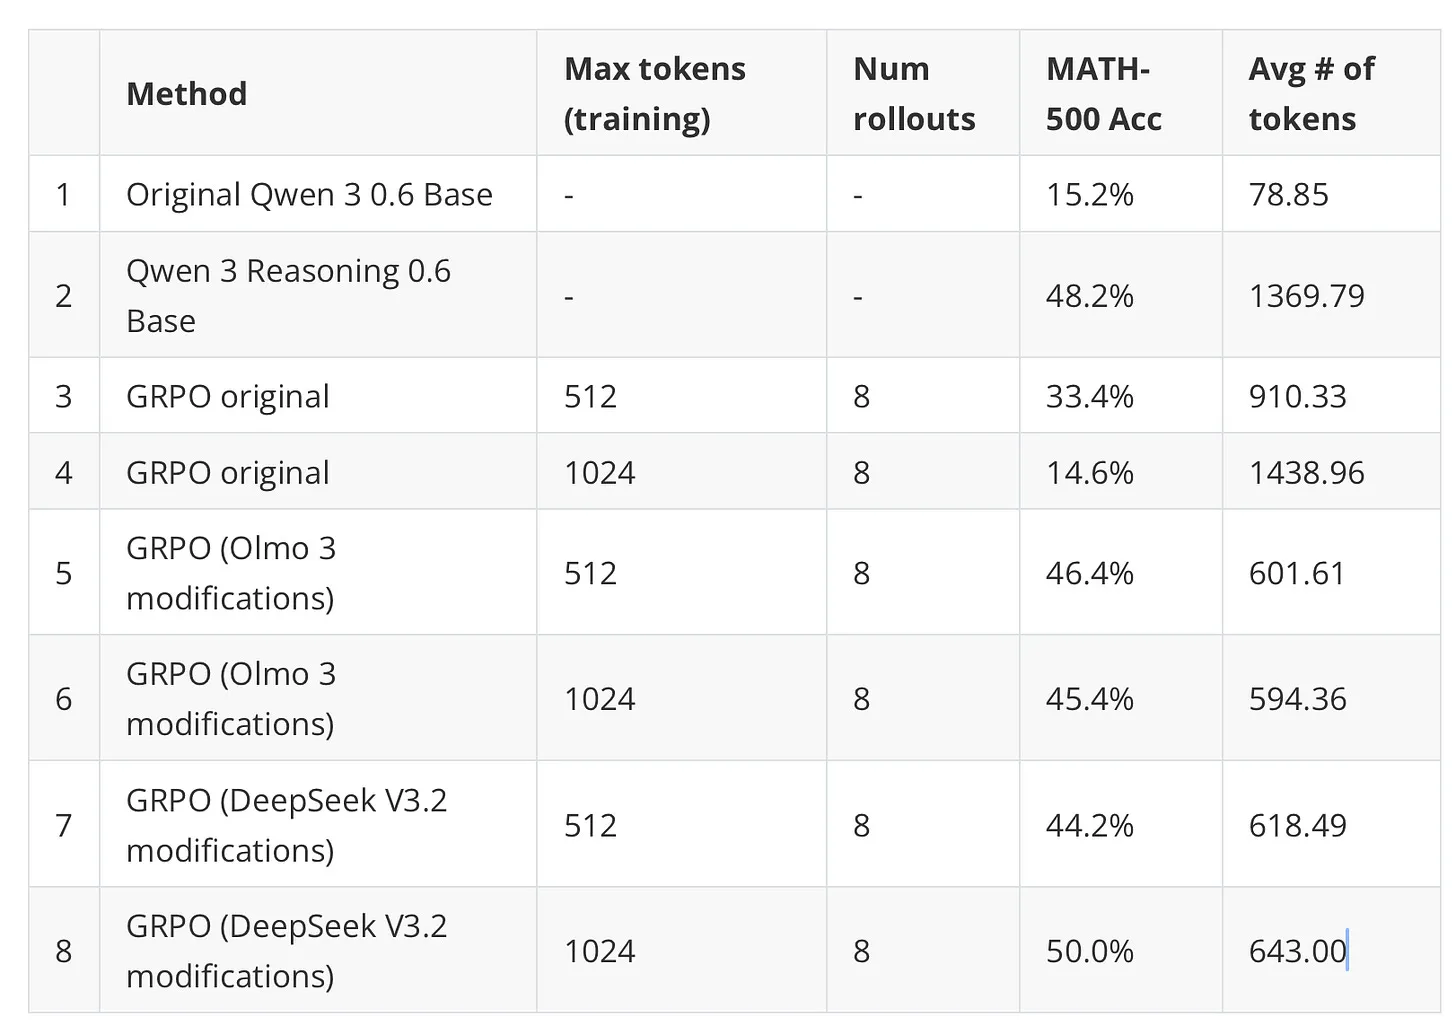
图 22:第 6、7 章可验证奖励强化学习相关实验的早期结果
写这本书非常辛苦,但我乐在其中!希望你和其他读者会觉得它像《Build A Large Language Model (From Scratch)》一样实用。
9. 2025 年的意外与 2026 年展望
我想用一些核心要点来收尾这篇文章,聚焦于那些我觉得有点意外的发展,以及我对 2026 年的预测。
9.1 2025 年值得关注的意外事件
先说说 2025 年的意外之处。如果一年前(2024 年)你问我,这些进展我大概率不会预料到:
-
多款推理模型已经在大型数学竞赛中达到人类金牌水平:包括 OpenAI 的未命名模型、Google DeepMind 的 Gemini Deep Think,以及开放权重模型 DeepSeekMath‑V2。总体方向我并不意外,但我没想到 2025 年就实现了,原以为要到 2026 年。
-
Llama 4(或者说整个 Llama 系列)在开放权重社区几乎彻底失宠,Qwen 的受欢迎程度已经超过 Llama(以下载量与衍生模型数量衡量,数据来自 Nathan Lambert 的 ATOM 项目报告:https://www.atomproject.ai/)。
-
Mistral AI 在 2025 年 12 月发布的最新旗舰 Mistral 3 模型,采用了 DeepSeek 架构。
-
除了 Qwen3 与 DeepSeek R1/V3.2 之外,顶尖开放权重模型赛道还涌现出了众多竞争者,包括 Kimi、GLM、MiniMax、零一万物(Yi)等。
-
更便宜、高效的混合架构已经成为头部实验室的更优先方向,而非由零散实验室各自开发。
-
OpenAI 发布了开放权重模型(gpt‑oss),我今年早些时候也专门写过文章分析。
-
模型上下文协议(Model Context Protocol, MCP)已经成为 Agent 式 LLM 系统中工具与数据访问的事实标准(至少目前是);我原本以为 2025 年生态会更碎片化,至少要到 2026 年才会统一。
9.2 2026 年预测
-
我们很可能会看到面向消费级的行业级扩散模型,主打低成本、可靠、低延迟推理,Gemini Diffusion 大概率会率先落地。
-
开放权重社区将稳步普及具备本地工具调用能力的 LLM,Agent 能力也会越来越强。
-
RLVR 将更广泛地拓展到数学与代码之外的其他领域(比如化学、生物等)。
-
传统 RAG 作为文档查询默认方案的地位将逐渐下降。开发者不会每次文档查询都走检索流程,而是更多依赖更好的长上下文处理能力 —— 尤其是随着更优秀的 “小尺寸” 开放权重模型出现。
-
LLM 基准与性能的大量提升,将来自工具链优化与推理时缩放,而非来自训练或核心模型本身。看起来 LLM 会变得强很多,但这主要是因为周边应用在进步。与此同时,开发者会更专注于降低延迟,在不需要的场景减少推理模型的思维 token 消耗。
别误会,2026 年依然会推动顶尖水平进一步提升,但今年进步的权重将更多来自推理端,而非单纯的训练端。
总而言之,我认为如果说 2025 年有什么元教训的话,那就是 LLM 的进步很少来自单一突破,而是通过多个独立的抓手在多条战线上齐头并进。这包括架构微调、数据质量提升、推理训练、推理缩放、工具调用等等。
同时,评估依然困难,基准并不完美,关于何时以及如何使用这些系统,良好的判断力依然至关重要。
我对 2026 年的期望是,我们能继续看到有意思的进步,同时也能理解这些进步究竟来自哪里。这既需要更好、更一致的基准测试方法,当然也需要透明度。
感谢你的阅读,也感谢这一年来在评论区、各个平台(从 Substack Notes 到 GitHub)所有 thoughtful 的反馈与讨论。
这些正面反馈与深入交流,真的激励着我投入时间与精力去写长篇文章,去深入钻研 LLM 研究与实现细节。我从这些交流中学到了很多,希望你也一样。
我非常期待 2026 年领域继续演进,我们继续交流!
祝好,
Sebastian
10. 附录:2025 年 7‑12 月精选 LLM 研究论文列表
6 月的时候,我曾向付费订阅者分享过一篇精选收藏的研究论文清单(上半年),正是这些订阅者让这个 Substack 得以运营。
类似地,作为对所有支持者的感谢,我整理了一份 2025 年 7 月到 12 月我收藏并分类的所有有意思的研究论文清单。我浏览了这些论文的摘要,但只精读了其中很小一部分。不过我依然喜欢收集整理这些清单,因为做项目的时候经常会回头查阅。
不过鉴于这篇文章已经很长了,我把这份清单放在另一篇文章里,链接如下:
《2025 年 LLM 研究论文精选(下)》:
https://magazine.sebastianraschka.com/p/llm‑research‑papers‑2025‑part2
感谢你订阅我的《Ahead of AI》博客,也感谢你今年对我工作的支持。我真的非常感激。你的支持让这份工作得以切实可行,也让我能够持续投入时间,去写作、实验、深入思考这些话题!
【转载】大语言模型研究论文:2025年下半年精选(7-12月)
原文地址:LLM Research Papers: The 2025 List (July to December),by Sebastian Raschka, on 2025-12-30
大语言模型研究论文:2025年下半年精选(7-12月)
今年 6 月,我曾向付费订阅用户分享过一篇附赠文章,整理了我收藏标记的研究论文清单 —— 正是这些订阅者支撑着这个 Substack 专栏的运营。
本着同样的心意,为了感谢所有热心支持者,我整理了 2025 年 7 月至 12 月期间我标记归档的优质研究论文,清单如下。
这些论文我都通读了摘要,但真正全文精读的只有极少一部分。不过我依然坚持整理这类分类清单,因为在开展具体项目时,我常常会回头查阅这些资料。
顺便一提,我同时也在撰写年度大语言模型综述文章《2025 年大语言模型发展现状:进展、问题与展望》,今天也同步发布了。大家可以通过以下链接查看:
原本我打算把这份论文清单放进上面这篇综述里,但文章篇幅已经过长,因此决定单独成篇分享。希望大家不介意今天收到两封推送邮件。我的考虑是,拆分后两篇文章都更便于阅读、快速浏览和日后回顾,不用在超长的页面里费力查找。
本次论文清单分为以下类别(大家可以在网页版文章的目录中直接跳转对应章节):
-
推理模型
-
1a. 推理模型训练
-
1b. 推理阶段推理策略
-
1c. 大语言模型评估与推理解析
-
-
大语言模型的其他强化学习方法
-
其他推理阶段扩展方法
-
模型发布 / 技术报告
-
模型架构
-
高效训练
-
基于扩散的语言模型
-
多模态与视觉 – 语言模型
-
数据与预训练数据集
【温故知新】数据结构与算法(算法视角展开)
数据结构与算法——算法视角展开
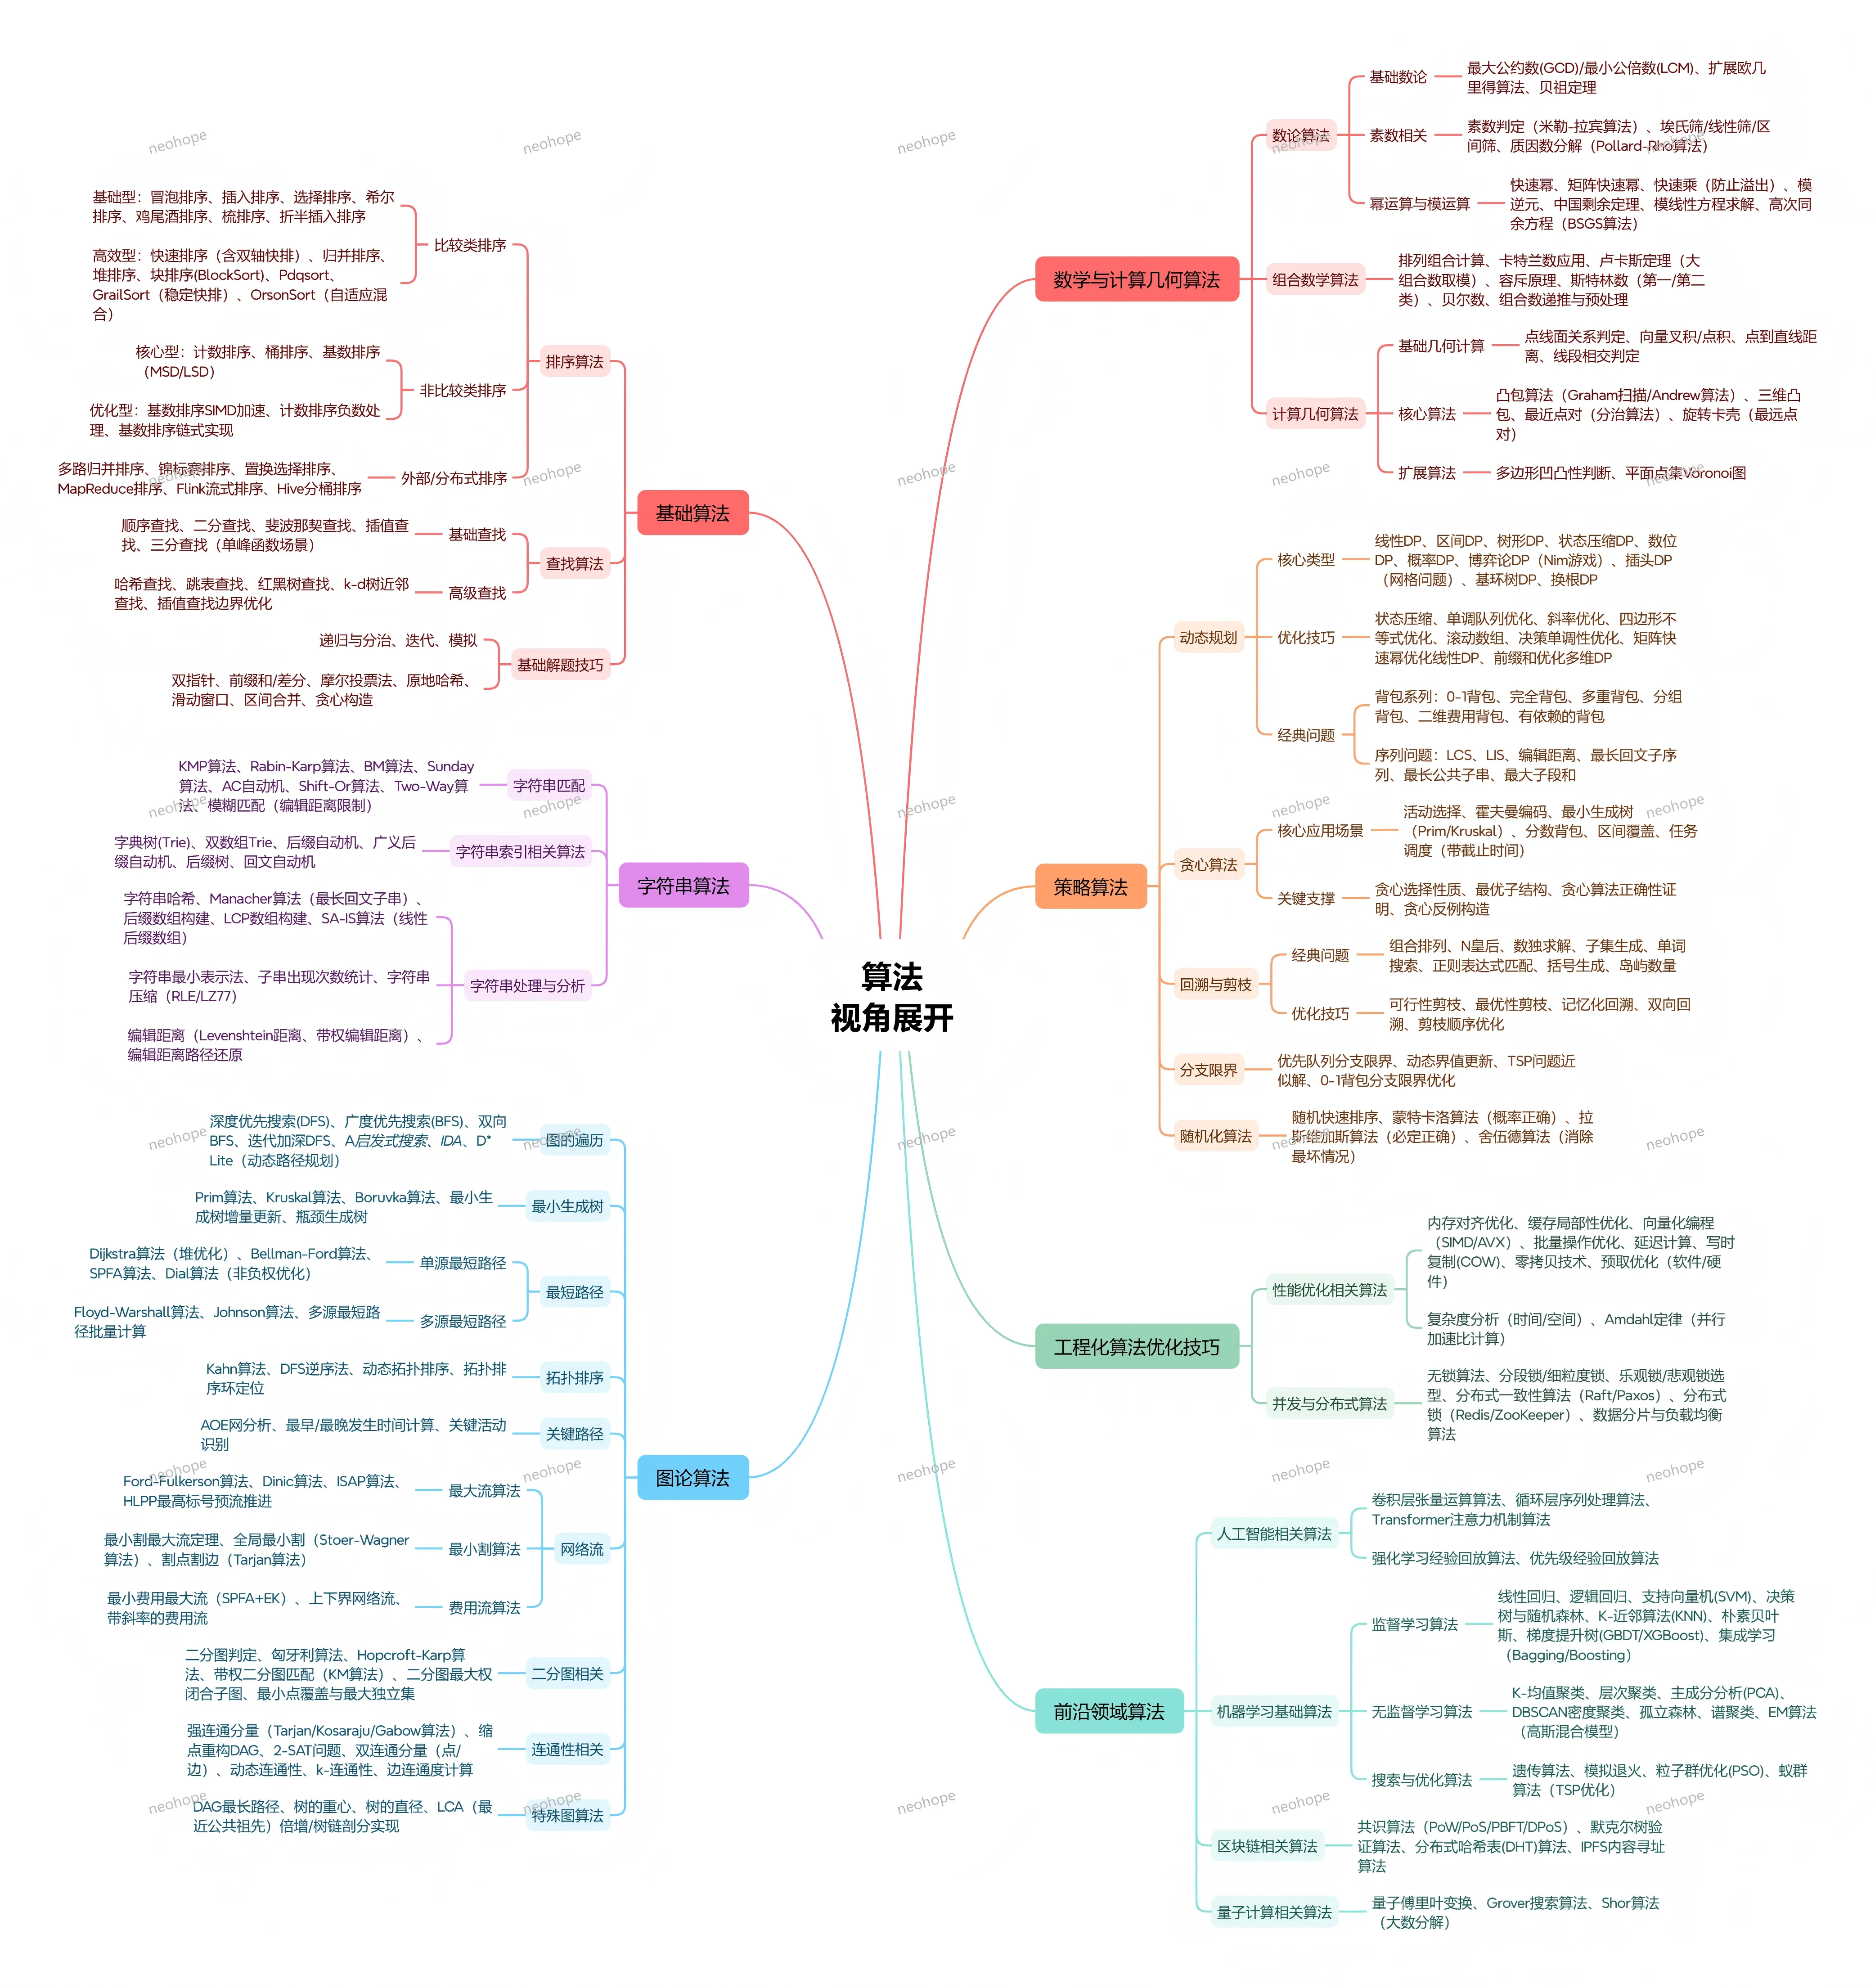
一、基础算法
1. 排序算法
比较类排序
-
基础型:冒泡排序、插入排序、选择排序、希尔排序、鸡尾酒排序、梳排序、折半插入排序。原理简单,适用于小规模或特殊场景,平均时间复杂度多为 $O(n^2)$。
-
高效型:快速排序(含双轴快排)、归并排序、堆排序、块排序 (BlockSort)、Pdqsort、GrailSort、OrsonSort。平均时间复杂度 $O(n\log n)$,是工业界标准库的主流实现,多为自适应混合排序,结合多种排序算法优势。
非比较类排序
-
核心型:计数排序、桶排序、基数排序(MSD/LSD)。基于数值范围而非比较排序,数据范围有限时可达线性复杂度。
-
优化型:基数排序 SIMD 加速、计数排序负数处理、基数排序链式实现:针对非比较排序的工程优化,提示实际性能与适用范围。
外部 / 分布式排序
-
多路归并排序、锦标赛排序、置换选择排序:处理内存无法容纳的大数据量排序,基于外存分块处理。
-
MapReduce 排序、Flink 流式排序、Hive 分桶排序:分布式计算框架下的排序实现,应对海量数据场景。
2. 查找算法
基础查找
- 顺序查找、二分查找、斐波那契查找、插值查找、三分查找(单峰函数场景):基于有序或无序序列的查找方案,二分查找是最常用的有序查找,三分查找用于单峰函数极值求解。
高级查找
- 哈希查找、跳表查找、红黑树查找、k-d 树近邻查找、插值查找边界优化:不同数据结构对应的查找方案,分别适配哈希、有序链表、平衡树、多维空间等场景。
3. 基础解题技巧
-
递归与分治、迭代、模拟:最基础的算法实现范式,分治将大问题拆分为子问题求解。
-
双指针、前缀和 / 差分、摩尔投票法、原地哈希、滑动窗口、区间合并、贪心构造:算法题中常用的技巧型方法,通过巧妙的遍历与数据组织降低时间复杂度。
二、字符串算法
1. 字符串匹配
-
KMP 算法:通过前缀函数实现单模式串线性匹配,避免暴力匹配的回溯。
-
Rabin-Karp 算法:基于字符串哈希的匹配算法,适合多模式匹配与长文本场景。
-
BM 算法:从模式串尾部反向匹配,配合坏字符与好后缀规则,实际文本中效率高于 KMP。
-
Sunday 算法:BM 的简化变体,匹配失败时关注文本下一个字符,实现简单且效率优秀。
-
AC 自动机:多模式串匹配算法,基于 Trie 构建失败指针,可一次性匹配多个模式串。
-
Shift-Or 算法、Two-Way 算法:两类高效单模匹配算法,前者基于位运算,后者是线性时间的最优算法之一。
-
模糊匹配(编辑距离限制):允许一定编辑距离内的近似匹配。
2. 字符串索引相关算法
-
字典树 (Trie):以字符为节点的前缀树,用于前缀匹配、词频统计。
-
双数组 Trie:Trie 的紧凑实现,大幅节省空间同时保持查询效率。
-
后缀自动机:状态数线性的字符串自动机,可高效处理子串计数、出现次数等问题。
-
广义后缀自动机:扩展到多个字符串的后缀自动机。
-
后缀树:基于所有后缀构建的前缀树,功能强大但空间开销大。
-
回文自动机:专门处理回文子串的自动机,可在线性时间统计所有回文子串。
3. 字符串处理与分析
-
字符串哈希:将字符串映射为哈希值,用于快速比较与匹配。
-
Manacher 算法(最长回文子串):线性时间求解字符串的最长回文子串。
-
后缀数组构建、LCP 数组构建:后缀数组将所有后缀排序,LCP 数组记录相邻后缀最长公共前缀,是字符串处理的强力工具。
-
SA-IS 算法(线性后缀数组):线性时间构建后缀数组的最优算法之一。
-
字符串最小表示法:线性时间求解字符串循环同构的最小字典序形式。
-
子串出现次数统计、字符串压缩(RLE/LZ77):字符串的统计与压缩应用。
-
编辑距离(Levenshtein 距离、带权编辑距离)、编辑距离路径还原:衡量字符串相似度,可还原具体编辑操作。
三、图论算法
1. 图的遍历
-
深度优先搜索 (DFS)、广度优先搜索 (BFS):图遍历的两种基础方式,是绝大多数图算法的底层框架。
-
双向 BFS:从起点与终点同时搜索,大幅缩小搜索空间,提升路径查找效率。
-
迭代加深 DFS:结合 DFS 的空间优势与 BFS 的最优性,逐步加深搜索深度。
-
A \ 启发式搜索*:引入启发函数估计剩余代价,优先搜索更有希望的分支,提升路径搜索效率。
-
IDA\:迭代加深与 A \ 结合,兼顾空间效率与启发式优化。
-
D Lite*:动态路径规划算法,适用于环境动态变化的场景,如机器人导航。
2. 最小生成树
-
Prim 算法、Kruskal 算法、Boruvka 算法:三种经典最小生成树算法,分别基于加点、加边、分治思想实现。
-
最小生成树增量更新、瓶颈生成树:扩展应用,前者处理边动态变化的场景,后者求解最大边权最小的生成树。
3. 最短路径
单源最短路径
-
Dijkstra 算法(堆优化):求解非负权图单源最短路,堆优化后复杂度 $O(m\log n)$。
-
Bellman-Ford 算法:可处理负权边并检测负环,时间复杂度 $O(nm)$。
-
SPFA 算法:Bellman-Ford 的队列优化版本,在稀疏图上效率更高。
-
Dial 算法:针对边权为小整数的非负权图,基于桶排序实现近似线性复杂度。
多源最短路径
-
Floyd-Warshall 算法:动态规划思想,可求解任意两点最短路,支持负权边,复杂度 $O(n^3)$。
-
Johnson 算法:通过重赋权将负权图转化为非负权图,再多次运行 Dijkstra,适合稀疏图多源最短路。
4. 拓扑排序
-
Kahn 算法、DFS 逆序法:两种求解有向无环图 (DAG) 拓扑序的经典方法,可同时检测图中是否存在环。
-
动态拓扑排序、拓扑排序环定位:扩展能力,处理边动态变化与环定位场景。
5. 关键路径
-
AOE 网分析:在带权有向无环图中求解项目的最短完成工期。
-
最早 / 最晚发生时间计算、关键活动识别:通过正向递推最早时间、反向递推最晚时间,识别决定工期的关键活动。
6. 网络流
最大流算法
-
Ford-Fulkerson 算法:最大流的基础思想,通过不断寻找增广路增大流量。
-
Dinic 算法:基于分层图与当前弧优化的增广路算法,是工业界最常用的最大流实现。
-
ISAP 算法、HLPP 最高标号预流推进:两类更高效的最大流算法,HLPP 在稠密图上优势明显。
最小割算法
-
最小割最大流定理:建立最大流与最小割的等价关系,可通过最大流求解最小割。
-
全局最小割(Stoer-Wagner 算法):求解无向图的全局最小割。
-
割点割边(Tarjan 算法):求解无向图的割点与桥,属于图连通性分析范畴。
费用流算法
-
最小费用最大流(SPFA+EK):在最大流基础上优化费用,每次寻找费用最小的增广路。
-
上下界网络流、带斜率的费用流:扩展模型,处理更复杂的流量约束场景。
7. 二分图相关
-
二分图判定:通过染色法判断图是否为二分图。
-
匈牙利算法、Hopcroft-Karp 算法:求解二分图最大匹配,后者通过多路增广效率更高。
-
带权二分图匹配(KM 算法):求解二分图最大权完美匹配。
-
二分图最大权闭合子图、最小点覆盖与最大独立集:基于二分图匹配的定理应用,可转化为网络流求解。
8. 连通性相关
-
强连通分量(Tarjan/Kosaraju/Gabow 算法):求解有向图的强连通分量,Tarjan 基于一次 DFS 实现,应用最广。
-
缩点重构 DAG:将强连通分量缩为单点,把原图转化为 DAG 以简化问题。
-
2-SAT 问题:布尔可满足性问题的特例,可通过强连通分量高效求解。
-
双连通分量(点 / 边):求解无向图的点双连通与边双连通分量。
-
动态连通性、k – 连通性、边连通度计算:连通性的扩展问题,处理动态图与连通度度量。
9. 特殊图算法
-
DAG 最长路径:在有向无环图上基于拓扑序求解最长路径。
-
树的重心、树的直径:树的两个核心属性,分别对应删除后子树最大规模最小的节点、树上最远两点距离。
-
LCA(最近公共祖先)倍增 / 树链剖分实现:求解树上两点最近公共祖先的经典算法,倍增易实现,树链剖分查询更快且可结合其他树操作。
四、数学与计算几何算法
1. 数论算法
基础数论
-
最大公约数 (GCD)/ 最小公倍数 (LCM):数论基础运算,求解两整数的最大公共约数与最小公共倍数,核心通过辗转相除法实现。
-
扩展欧几里得算法:在求解 GCD 的同时算出贝祖等式的整数解,是求解模逆元、线性同余方程的核心工具。
-
贝祖定理:线性不定方程
ax+by=c有整数解的充要条件是gcd(a,b)整除c;且一定存在整数解使得ax+by=gcd(a,b),是数论方程求解的理论基础。
素数相关
-
素数判定(米勒 – 拉宾算法):概率性素性测试算法,通过多轮基测试可在极低错误率下快速判定大数素性,是大数素性判断的工业标准。
-
埃氏筛 / 线性筛 / 区间筛:批量生成素数的三类算法;埃氏筛原理简单,线性筛(欧拉筛)保证每个合数仅被筛一次,达到线性复杂度;区间筛用于求解大数值区间内的素数。
-
质因数分解(Pollard-Rho 算法):基于随机化与生日悖论的大数分解算法,期望时间复杂度约为 $O(n^{1/4})$,可快速找到合数的非平凡因子,是大数质因数分解的核心方案。
幂运算与模运算
-
快速幂:通过二进制拆分指数,将幂运算从 $O(n)$ 优化至 $O(\log n)$,几乎所有模运算场景都会配合使用。
-
矩阵快速幂:将快速幂思想扩展到矩阵运算,用于加速线性递推数列(如斐波那契)的求解。
-
快速乘:模拟二进制拆分乘法,避免大数相乘时的数值溢出,适用于大模数场景。
-
模逆元:模运算中的 “除法等价操作”,常用于分数取模,可通过扩展欧几里得算法或费马小定理求解。
-
中国剩余定理:求解一元线性同余方程组,给出模数互质场景下的通解公式。
-
模线性方程求解:求解形如 $ax \equiv b \pmod{m}$ 的同余方程,基于扩展欧几里得算法实现。
-
高次同余方程(BSGS 算法):全称 Baby-Step Giant-Step(大步小步算法),用于求解离散对数问题 $a^x \equiv b \pmod{p}$,时间复杂度 $O(\sqrt{p})$。
2. 组合数学算法
-
排列组合计算:基础计数工具,求解有序排列与无序组合的方案数。
-
卡特兰数应用:经典组合数列,可用于括号匹配、二叉树结构计数、凸多边形三角划分等场景。
-
卢卡斯定理:用于大组合数对小质数取模,将大组合数拆解为小组合数的乘积取模。
-
容斥原理:通过 “加加减减” 对重叠集合计数去重,是处理多约束组合计数的核心方法。
-
斯特林数(第一 / 第二类):第一类描述将 n 个元素排成 k 个轮换的方案数;第二类描述将 n 个元素划分为 k 个非空集合的方案数。
-
贝尔数:n 个元素的集合划分总方案数,等于第二类斯特林数的前缀和。
-
组合数递推与预处理:通过杨辉三角递推或阶乘 + 逆元打表,实现组合数的快速查询。
3. 计算几何算法
基础几何计算
-
点线面关系判定、向量叉积 / 点积:计算几何底层工具;点积用于计算投影、夹角,叉积用于判断转向、面积与线段位置关系。
-
点到直线距离、线段相交判定:基于向量运算的基础几何判定,是复杂几何算法的底层支撑。
核心算法
-
凸包算法(Graham 扫描 / Andrew 算法):求解平面点集的最小凸多边形;Graham 基于极角排序扫描,Andrew 按坐标双端扫描,实现更稳定。
-
三维凸包:将凸包问题扩展到三维空间,求解空间点集的最小凸多面体。
-
最近点对(分治算法):采用分治思想拆分点集后合并求解,时间复杂度 $O(n\log n)$。
-
旋转卡壳(最远点对):用一对平行线 “卡住” 凸包并旋转,可在线性时间内求解凸包直径(最远点对)、宽度、最小外接矩形等几何属性。
扩展算法
-
多边形凹凸性判断:基于顶点叉积符号的一致性,判断多边形是否为凸多边形。
-
平面点集 Voronoi 图:将平面划分为多个区域,每个区域内的点到对应种子点距离最近,广泛应用于地理、图形学领域。
五、策略算法
1. 动态规划
核心类型
-
线性 DP:状态沿线性结构转移,是动态规划最基础的形式,典型如背包、序列问题。
-
区间 DP:以区间为状态单位,通过小区间合并求解大区间问题,如石子合并、回文子串计数。
-
树形 DP:在树结构上进行状态转移,通常通过后序遍历自底向上计算。
-
状态压缩 DP:用二进制表示集合状态,处理小规模集合的选排问题。
-
数位 DP:针对数字位数设计状态,常用于求解满足特定约束的数字计数问题。
-
概率 DP:状态转移附带概率,用于求解随机过程中的期望、概率问题。
-
博弈论 DP(Nim 游戏):基于博弈状态转移求解胜负态,Nim 游戏是其经典模型。
-
插头 DP(网格问题):高级状压 DP,通过轮廓线与插头记录连通性,求解网格上的回路、路径覆盖等复杂连通性问题。
-
基环树 DP:针对带一个环的树(基环树)的动态规划,通常先断环成树再处理。
-
换根 DP:通过两次遍历实现树上所有节点作为根的答案求解,避免重复计算。
优化技巧
-
状态压缩:用二进制等紧凑形式表示状态,压缩状态空间。
-
单调队列优化:维护单调队列快速求解滑动窗口最值,优化一类 DP 转移。
-
斜率优化:将转移方程转化为斜率形式,用凸包维护最优决策点。
-
四边形不等式优化:利用决策单调性,将区间 DP 从 $O(n^3)$ 降至 $O(n^2)$。
-
滚动数组:仅保留相邻状态,大幅降低空间复杂度。
-
决策单调性优化:利用最优决策点的单调性,减少转移枚举量。
-
矩阵快速幂优化线性 DP:将线性递推 DP 转化为矩阵幂运算,加速大步数求解。
-
前缀和优化多维 DP:通过前缀和快速计算区间和,优化求和类转移。
经典问题
-
背包系列:包含 0-1 背包、完全背包、多重背包、分组背包、二维费用背包、有依赖的背包等,是动态规划的经典模型族。
-
序列问题:包括最长公共子序列 (LCS)、最长上升子序列 (LIS)、编辑距离、最长回文子序列、最长公共子串、最大子段和等经典线性 DP 问题。
2. 贪心算法
核心应用场景
- 活动选择、霍夫曼编码、最小生成树(Prim/Kruskal)、分数背包、区间覆盖、带截止时间的任务调度,均为贪心算法的经典应用,通过每一步选择局部最优推导全局最优。
关键支撑
- 贪心选择性质:全局最优可通过一系列局部最优选择得到;最优子结构:问题最优解包含子问题最优解。二者是贪心算法正确性的必要条件,需通过证明或反例构造验证适用性。
3. 回溯与剪枝
经典问题
- 组合排列、N 皇后、数独求解、子集生成、单词搜索、正则表达式匹配、括号生成、岛屿数量,均为深度优先搜索 + 回溯试错的典型场景,通过枚举所有可能并回退状态求解。
优化技巧
- 可行性剪枝:提前排除不可能得到解的分支;最优性剪枝:当前分支已无法优于已知最优解时提前终止;另有记忆化回溯、双向回溯、剪枝顺序优化等手段,用于压缩搜索空间。
4. 分支限界
-
优先队列分支限界:以广度优先为基础,用优先队列按代价排序拓展节点,优先搜索更优分支。
-
动态界值更新:实时更新上下界,提升剪枝效率。
-
典型应用:TSP 问题求解、0-1 背包优化,用于求解组合优化问题的精确最优解。
5. 随机化算法
-
随机快速排序:随机选取基准元素,消除最坏输入场景,平均时间复杂度稳定在 $O(n\log n)$。
-
蒙特卡洛算法:运行时间固定,结果以一定概率正确,适用于可容忍小概率错误的场景。
-
拉斯维加斯算法:结果必定正确,运行时间随机,不断重试直到得到正确解。
-
舍伍德算法:通过随机化消除输入的最坏情况,保证算法平均性能稳定。
六、工程化算法优化技巧
1. 性能优化相关算法
-
内存对齐优化、缓存局部性优化、向量化编程(SIMD/AVX)、批量操作优化、延迟计算、写时复制 (COW)、零拷贝技术、预取优化:从硬件特性、内存访问、计算模式等维度提升程序运行效率,是工业级代码性能优化的核心手段。
-
复杂度分析(时间 / 空间):评估算法资源消耗的基础方法;Amdahl 定律:计算并行系统的理论加速比上限,指导并行优化方向。
2. 并发与分布式算法
-
无锁算法、分段锁 / 细粒度锁、乐观锁 / 悲观锁选型:不同粒度的并发控制方案,平衡并发性能与数据一致性。
-
分布式一致性算法(Raft/Paxos):解决分布式系统多节点数据一致性问题,Raft 更易工程实现。
-
分布式锁(Redis/ZooKeeper):分布式环境下实现互斥访问的通用方案。
-
数据分片与负载均衡算法:将数据与流量均匀分配到多节点,提升系统吞吐量与扩展性。
七、前沿领域算法
1. 人工智能相关算法
-
卷积层张量运算算法:卷积神经网络核心,通过卷积核提取空间特征,广泛用于计算机视觉。
-
循环层序列处理算法:循环神经网络核心,通过门控机制处理序列依赖,用于自然语言、时序数据。
-
Transformer 注意力机制算法:通过自注意力机制并行处理长序列,是当前大语言模型的核心架构。
-
强化学习经验回放算法、优先级经验回放算法:通过存储并重放历史经验提升样本利用率,优先级回放优先采样高价值经验。
2. 机器学习基础算法
监督学习算法
-
线性回归、逻辑回归:基础线性模型,分别用于回归与二分类任务。
-
支持向量机 (SVM):通过最大化分类间隔构建分类器,适用于小样本高维场景。
-
决策树与随机森林:决策树基于特征分裂做决策,随机森林是多棵决策树的 Bagging 集成。
-
K – 近邻算法 (KNN):基于邻居样本投票做分类 / 回归,属于惰性学习算法。
-
朴素贝叶斯:基于贝叶斯定理与特征独立假设的概率分类器,计算高效。
-
梯度提升树 (GBDT/XGBoost):Boosting 集成算法,通过迭代拟合残差提升模型精度,是表格数据建模的主流方案。
-
集成学习(Bagging/Boosting):两类集成范式,Bagging 通过并行训练多个基模型投票,Boosting 通过串行迭代逐步优化。
无监督学习算法
-
K – 均值聚类、层次聚类:经典聚类算法,分别基于质心迭代与层次合并划分样本。
-
主成分分析 (PCA):线性降维算法,通过正交变换保留最大方差信息。
-
DBSCAN 密度聚类:基于密度可达性聚类,可发现任意形状簇并识别噪声点。
-
孤立森林:基于孤立路径长度检测异常样本,适用于异常检测场景。
-
谱聚类:基于图论谱理论的聚类算法,对非凸分布数据效果较好。
-
EM 算法(高斯混合模型):迭代求解含隐变量模型的参数,高斯混合模型是其典型应用。
搜索与优化算法
- 遗传算法、模拟退火、粒子群优化 (PSO)、蚁群算法:均为启发式优化算法,模拟自然 / 生物行为,在复杂、非凸的优化问题中寻找近似最优解,如蚁群算法常用于 TSP 问题优化。
3. 区块链相关算法
-
共识算法(PoW/PoS/PBFT/DPoS):区块链节点达成数据一致性的核心机制,分别基于工作量、权益、拜占庭容错等原理设计。
-
默克尔树验证算法:通过哈希树结构快速验证数据完整性与存在性,是区块链数据结构的核心。
-
分布式哈希表 (DHT) 算法:分布式节点存储与寻址方案,无需中心节点即可定位数据。
-
IPFS 内容寻址算法:基于内容哈希而非地址定位文件,实现分布式文件存储与传输。
4. 量子计算相关算法
-
量子傅里叶变换:量子版本的快速傅里叶变换,是众多量子算法的基础组件。
-
Grover 搜索算法:实现无序数据库的二次加速搜索,时间复杂度 $O(\sqrt{n})$。
-
Shor 算法(大数分解):可在多项式时间内完成大数质因数分解,对传统 RSA 加密体系构成挑战。