寻找一种易于理解的共识算法(扩展版)
In Search of an Understandable Consensus Algorithm(Extended Version)
贡献:针对Paxos等一致性算法 “理论可行、工程难落地” 的局面,提出了更加实用的Raft算法,大幅降低了分布式一致性的实现门槛。
作者:Diego Ongaro、John Ousterhout
斯坦福大学
发表于《USENIX ATC’14 会议论文集:2014年USENIX年度技术大会》,第305-319页,2014年6月19-20日,美国宾夕法尼亚州费城
或 https://raft.github.io/raft.pdf
本技术报告是文献[32]的扩展版本;新增内容以页边灰色条标注。发布于2014年5月20日。
Raft是一种用于管理复制日志的共识算法。它能达到与(多)Paxos等价的效果,效率也与Paxos相当,但算法结构与Paxos不同;这一特性让Raft比Paxos更易于理解,也为构建实际系统提供了更优的基础。为了提升可理解性,Raft将共识的核心要素(如领导者选举、日志复制、安全性)进行拆分,同时通过更强的一致性约束来减少需要考虑的状态数量。用户研究结果表明,学生学习Raft的难度远低于Paxos。Raft还提出了一种全新的集群成员变更机制,通过重叠多数派来保证安全性。
1. 引言
共识算法能够让一组机器作为一个统一的整体协同工作,即使部分成员发生故障也能持续运行。正因如此,共识算法在构建高可靠大规模软件系统中扮演着核心角色。过去十年间,Paxos[15, 16]一直占据着共识算法领域的主导地位:绝大多数共识实现都基于Paxos或受其启发,同时Paxos也是向学生讲授共识知识的核心载体。
遗憾的是,尽管人们多次尝试降低Paxos的理解门槛,它依然十分晦涩难懂。此外,要将Paxos的架构适配到实际系统中,需要进行大量复杂的修改。最终,无论是系统开发者还是学习者都深受Paxos的困扰。
在亲身经历了Paxos的学习困境后,我们开始着手探索一种全新的共识算法,希望它能为系统构建和教学提供更好的基础。我们的思路与众不同:我们的核心目标是可理解性——我们能否设计出一种面向实际系统的共识算法,并且用一种比Paxos简单得多的方式将它描述清楚?此外,我们希望这种算法能够帮助开发者建立直观认知,这对系统构建者至关重要。算法本身能正确运行还不够,更重要的是要让人们能清晰地理解它为什么能正确运行。
这项工作的成果就是名为Raft的共识算法。在设计Raft的过程中,我们运用了多种专门提升可理解性的技术,包括问题分解(Raft将领导者选举、日志复制和安全性拆分为独立模块)和状态空间缩减(与Paxos相比,Raft降低了不确定性程度,减少了服务器之间日志不一致的可能)。针对两所大学43名学生的用户研究显示,Raft的可理解性显著优于Paxos:在学习完两种算法后,其中33名学生在Raft相关问题上的答题表现优于Paxos。
Raft在很多方面与现有的共识算法(最典型的是Oki和Liskov提出的视图戳复制算法[22, 29])相似,但它具备几个新颖的特性:
- 强领导者:与其他共识算法相比,Raft采用了更强的领导模式。例如,日志条目只能从领导者流向其他服务器。这简化了复制日志的管理,也让Raft更易于理解。
- 领导者选举:Raft使用随机计时器来选举领导者。这种方式只在任何共识算法都必需的心跳机制基础上增加了少量机制,就能简单快速地解决选举冲突。
- 成员变更:Raft的集群服务器集合变更机制采用了全新的联合共识方法,在配置过渡期间,两种不同配置的多数派会产生重叠。这使得集群在配置变更过程中可以持续正常运行。
我们相信,无论是用于教学还是作为实现基础,Raft都优于Paxos及其他共识算法。它比其他算法更简单、更易理解;它的描述足够完整,能够满足实际系统的需求;它已有多个开源实现,被多家公司采用;它的安全属性已经过形式化定义和证明;它的效率也与其他算法相当。
本文后续内容安排:第2节介绍复制状态机问题;第3节讨论Paxos的优缺点;第4节阐述我们提升可理解性的总体思路;第5-8节详细介绍Raft共识算法;第9节对Raft进行评估;第10节讨论相关工作。
2. 复制状态机
共识算法通常诞生于复制状态机[37]的应用场景中。在这种模式下,一组服务器上的状态机会计算出完全相同的状态副本,即使部分服务器宕机,整个系统仍能继续运行。复制状态机被用于解决分布式系统中的各类容错问题。例如,GFS[8]、HDFS[38]、RAMCloud[33]这类拥有单一集群领导者的大规模系统,通常会用独立的复制状态机来管理领导者选举,并存储需要在领导者崩溃后依然留存的配置信息。Chubby[2]和ZooKeeper[11]都是复制状态机的典型实例。
复制状态机通常基于复制日志实现,如图1所示。每台服务器都维护一份日志,其中包含一系列命令,服务器上的状态机会按顺序执行这些命令。所有服务器的日志都包含相同顺序的相同命令,因此每个状态机都会处理相同的命令序列。由于状态机是确定性的,它们都会计算出相同的状态和相同的输出序列。
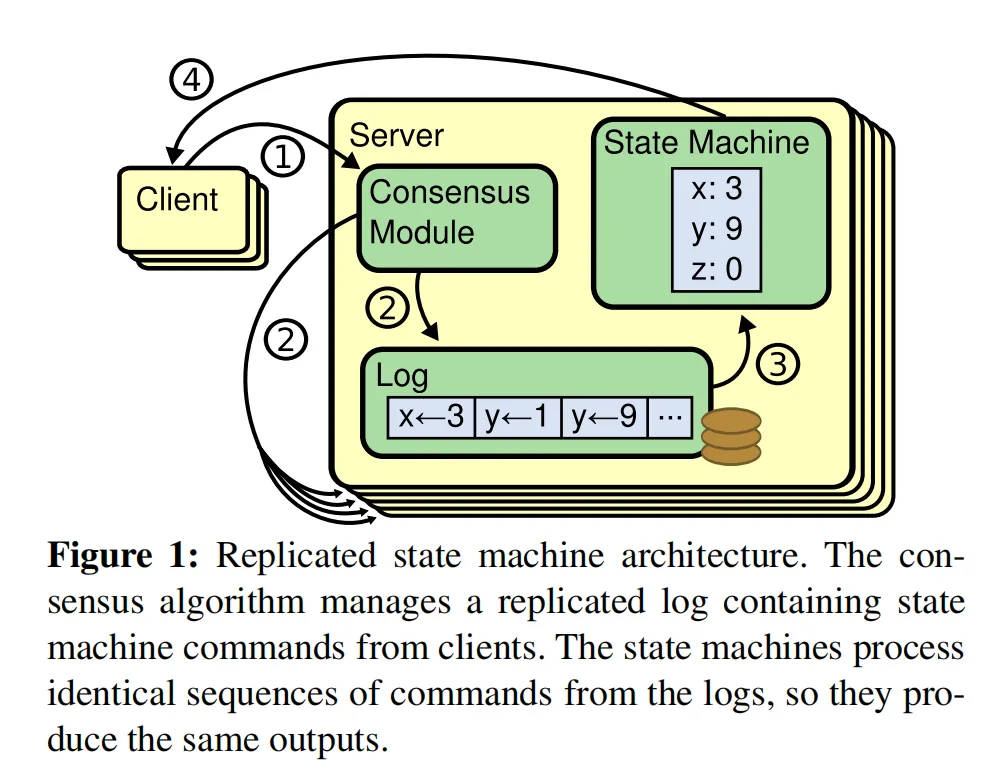
图1: 复制状态机架构。共识算法管理着包含客户端状态机命令的复制日志。状态机执行日志中完全相同的命令序列,因此会产生相同的输出。
保证复制日志的一致性是共识算法的核心任务。服务器上的共识模块接收客户端发来的命令,将其追加到本地日志中。它会与其他服务器上的共识模块通信,确保即使部分服务器发生故障,每一份日志最终都会包含相同顺序的相同请求。一旦命令被正确复制,每台服务器的状态机就会按日志顺序执行这些命令,并将执行结果返回给客户端。最终,所有服务器对外表现为一个单一的、高可靠的状态机。
面向实际系统的共识算法通常具备以下特性:
- 在所有非拜占庭故障场景下(包括网络延迟、网络分区、丢包、重复包和乱序),都能保证安全性(永远不会返回错误结果)。
- 只要集群中多数服务器正常运行,并且能互相通信、能与客户端通信,系统就能完全正常工作(可用)。因此,典型的五服务器集群可以容忍任意两台服务器故障。服务器以停止运行的方式发生故障;之后它们可以从稳定存储中恢复状态,重新加入集群。
- 日志的一致性不依赖于时序:错误的时钟和极端的消息延迟最坏只会导致可用性问题,不会破坏一致性。
- 在常规场景下,只要集群中多数服务器对一轮远程过程调用做出响应,命令就可以完成;少数慢服务器不会影响整体系统性能。
3. Paxos存在什么问题?
过去十年,Leslie Lamport提出的Paxos协议[15]几乎成为了共识的代名词:它是课堂上最常讲授的协议,也是绝大多数共识实现的起点。Paxos首先定义了一种针对单个决策的协议(比如单条复制日志条目),我们将这一子集称为单决议Paxos。然后Paxos通过组合多个该协议实例,来支持一系列连续决策(比如一整个日志),即多决议Paxos。Paxos既能保证安全性也能保证活性,同时支持集群成员变更。它的正确性已经得到证明,正常场景下效率也很高。
遗憾的是,Paxos存在两个显著缺陷。第一个缺陷是Paxos极其难以理解。它的完整说明[15]是出了名的晦涩难懂;很少有人能真正理解它,即便能理解也要付出极大的努力。为此,人们多次尝试用更简单的方式解释Paxos[16, 20, 21]。这些解释都聚焦于单决议子集,但依然很难掌握。在2012年NSDI会议参会者的非正式调查中我们发现,即使是资深研究者,也很少有人能熟练掌握Paxos。我们自己也深受其扰:直到读了多篇简化解释、并且设计出自己的替代协议之后,我们才真正理解完整的Paxos协议,这个过程花了将近一年。
我们认为,Paxos的晦涩源于它将单决议子集作为整个算法的基础。单决议Paxos内容密集且逻辑微妙:它被划分为两个阶段,这两个阶段都没有简单直观的解释,也无法独立理解。因此,人们很难建立起“单决议协议为什么能正确运行”的直观认知。而多Paxos的组合规则又带来了大量额外的复杂度和微妙之处。我们相信,针对多决策(即一整个日志而非单一条目)的共识问题,完全可以用其他更直接、更清晰的方式进行分解。
Paxos的第二个问题是,它无法为实际系统实现提供良好的基础。原因之一是,目前并没有被广泛认可的多Paxos完整算法。Lamport的描述大多围绕单决议Paxos展开;他只是勾勒了多Paxos的可能思路,但很多细节都缺失了。人们多次尝试补充和优化Paxos,比如文献[26][39][13],但这些实现方案之间、以及与Lamport的原始构想之间都存在差异。Chubby[4]这类系统实现了类Paxos算法,但大多数都没有公开具体实现细节。
此外,Paxos的架构并不适合构建实际系统,这也是单决议分解方式带来的另一个后果。例如,先独立选出一组日志条目,再把它们整合成有序日志,这种做法没有任何实际收益,只会增加复杂度。围绕日志来设计系统反而更简单高效——新条目按严格的顺序追加到日志末尾。另一个问题是,Paxos的核心采用对称的对等网络架构(尽管它后来也提出了弱领导模式作为性能优化)。在“只需要做一个决策”的简化场景中,这种架构是合理的,但几乎没有实际系统会这样工作。如果需要做出一系列决策,先选出一个领导者,再由领导者来协调所有决策,会更简单也更高效。
最终,实际系统的实现与Paxos本身相去甚远。每个实现都从Paxos出发,发现落地的种种困难,然后发展出一套完全不同的架构。这个过程既耗时又容易出错,而Paxos本身难以理解的特性更是雪上加霜。Paxos的形式化表述或许很适合用来证明正确性定理,但实际实现与Paxos差异太大,导致这些证明的实际参考价值很低。Chubby实现者的以下评论很有代表性:
Paxos算法的描述与实际系统的需求之间存在巨大差距……最终的系统会基于一套未经验证的协议来构建[4]。
基于这些问题,我们得出结论:无论是系统构建还是教学,Paxos都不是一个好的基础。考虑到共识在大规模软件系统中的重要性,我们决定尝试设计一种比Paxos更优的共识算法。Raft就是这一尝试的成果。
4. 为可理解性而设计
我们设计Raft时有多个目标:它必须为系统构建提供完整且实用的基础,大幅减少开发者的设计工作量;它必须在所有场景下都安全,在典型运行条件下可用;它的常规操作效率必须足够高。但我们最重要的目标——也是最大的挑战——是可理解性。我们要让广大读者都能轻松理解这个算法。此外,人们要能建立起对算法的直观认知,这样系统构建者在实际实现中进行必要扩展时,才能把握住核心原则。
在Raft的设计过程中,有很多节点需要在不同方案之间做选择。每到这种时候,我们都会以可理解性为标准来评估各个方案:解释每种方案的难度有多大(比如,它的状态空间有多复杂?有没有隐蔽的边界情况?),读者要完全理解该方案及其影响有多容易?
我们承认这种分析存在很强的主观性;尽管如此,我们使用了两种普遍适用的方法。第一种是众所周知的问题分解法:只要有可能,我们就将问题拆分为多个独立的部分,每个部分都可以单独解决、解释和理解。例如,在Raft中我们拆分了领导者选举、日志复制、安全性和成员变更这几个模块。
第二种方法是通过减少需要考虑的状态数量来简化状态空间,让系统更具一致性,尽可能消除不确定性。具体来说,Raft不允许日志出现空洞,并且限制了日志之间出现不一致的方式。尽管大多数情况下我们都试图消除不确定性,但在有些场景下,不确定性反而能提升可理解性。尤其是随机化方法,它虽然引入了不确定性,但可以用相似的逻辑处理所有可能的选择(“选哪个都行,无所谓”),从而缩减状态空间。我们就用随机化方法简化了Raft的领导者选举算法。
5. Raft共识算法
Raft是用于管理第2节所述复制日志的算法。图2以精简形式总结了算法全貌,供参考;图3列出了算法的核心属性。本节后续部分会逐个讲解这些图中的内容。
状态
| 所有服务器上的持久化状态: (响应RPC前更新到稳定存储中) | |
|---|---|
| currentTerm | 服务器已知的最新任期号(首次启动时初始化为0,单调递增) |
| votedFor | 当前任期中获得投票的候选者ID(无则为null) |
| log[] | 日志条目;每个条目包含状态机的命令,以及领导者接收该条目时的任期号(第一条索引为1) |
| commitIndex | 已知已提交的最高日志条目的索引(初始化为0,单调递增) |
| lastApplied | 已应用到状态机的最高日志条目的索引(初始化为0,单调递增) |
| 所有服务器上的易失状态: | |
|---|---|
| commitIndex | 已知已提交的最高日志条目的索引(初始化为0,单调递增) |
| lastApplied | 已应用到状态机的最高日志条目的索引(初始化为0,单调递增) |
| 领导者上的易失状态: (选举后重新初始化) | |
|---|---|
| nextIndex[] | 对于每个服务器,要发送给它的下一条日志条目的索引(领导者刚上任时初始化为领导者最后一条日志索引+1) |
| matchIndex[] | 对于每个服务器,已知已复制到该服务器的最高日志条目的索引(初始化为0,单调递增) |
AppendEntries RPC
由领导者调用,用于复制日志条目(第5.3节);也用作心跳(第5.2节)。
参数:
- term:领导者的任期号
- leaderId:领导者ID,供跟随者重定向客户端
- prevLogIndex:新条目之前紧邻的那条日志条目的索引
- prevLogTerm:prevLogIndex对应条目的任期号
- entries[]:要存储的日志条目(心跳时为空;为提升效率可批量发送多条)
- leaderCommit:领导者的commitIndex
返回值:
- term:当前任期号,供领导者自我更新
- success:若跟随者包含与prevLogIndex和prevLogTerm匹配的条目,则返回true
接收方实现逻辑:
- 如果term < currentTerm,返回false(第5.1节)
- 如果日志中不存在索引为prevLogIndex且任期号匹配prevLogTerm的条目,返回false(第5.3节)
- 如果已有条目与新条目冲突(同索引但任期不同),删除该条目及其之后所有条目(第5.3节)
- 追加所有日志中不存在的新条目
- 如果leaderCommit > commitIndex,令commitIndex = min(leaderCommit, 最新一条新条目的索引)
RequestVote RPC
由候选者调用,用于收集选票(第5.2节)。
参数:
- term:候选者的任期号
- candidateId:请求投票的候选者ID
- lastLogIndex:候选者最后一条日志条目的索引(第5.4节)
- lastLogTerm:候选者最后一条日志条目的任期号(第5.4节)
返回值:
- term:当前任期号,供候选者自我更新
- voteGranted:true表示候选者获得了选票
接收方实现逻辑:
- 如果term < currentTerm,返回false(第5.1节)
- 如果votedFor为空或等于candidateId,且候选者的日志至少和接收方的日志一样新,则同意投票(第5.2节、第5.4节)
服务器行为规则
所有服务器:
- 如果commitIndex > lastApplied:递增lastApplied,将log[lastApplied]应用到状态机(第5.3节)
- 如果RPC请求或响应中包含的任期号T > currentTerm:更新currentTerm为T,转为跟随者状态(第5.1节)
跟随者(第5.2节):
- 响应候选者和领导者的RPC请求
- 如果选举超时时间内未收到当前领导者的AppendEntries RPC,也未给任何候选者投票:转为候选者
候选者(第5.2节):
- 转为候选者时立即启动选举:
- 递增currentTerm
- 给自己投票
- 重置选举计时器
- 向所有其他服务器发送RequestVote RPC
- 如果获得集群多数服务器的选票:成为领导者
- 如果收到新领导者的AppendEntries RPC:转为跟随者
- 如果选举超时:开始新一轮选举
领导者:
- 当选时立即向所有服务器发送空的AppendEntries RPC(心跳);空闲期间重复发送以防止选举超时(第5.2节)
- 收到客户端命令后:将条目追加到本地日志,条目应用到状态机后响应客户端(第5.3节)
- 如果某跟随者的lastLogIndex ≥ nextIndex[该跟随者]:发送从nextIndex开始的日志条目对应的AppendEntries RPC
- 如果成功:更新该跟随者的nextIndex和matchIndex(第5.3节)
- 如果因日志不一致失败:递减nextIndex并重试(第5.3节)
- 如果存在N满足:N > commitIndex,且多数matchIndex[i] ≥ N,且log[N].term == currentTerm:更新commitIndex = N(第5.3节、第5.4节)
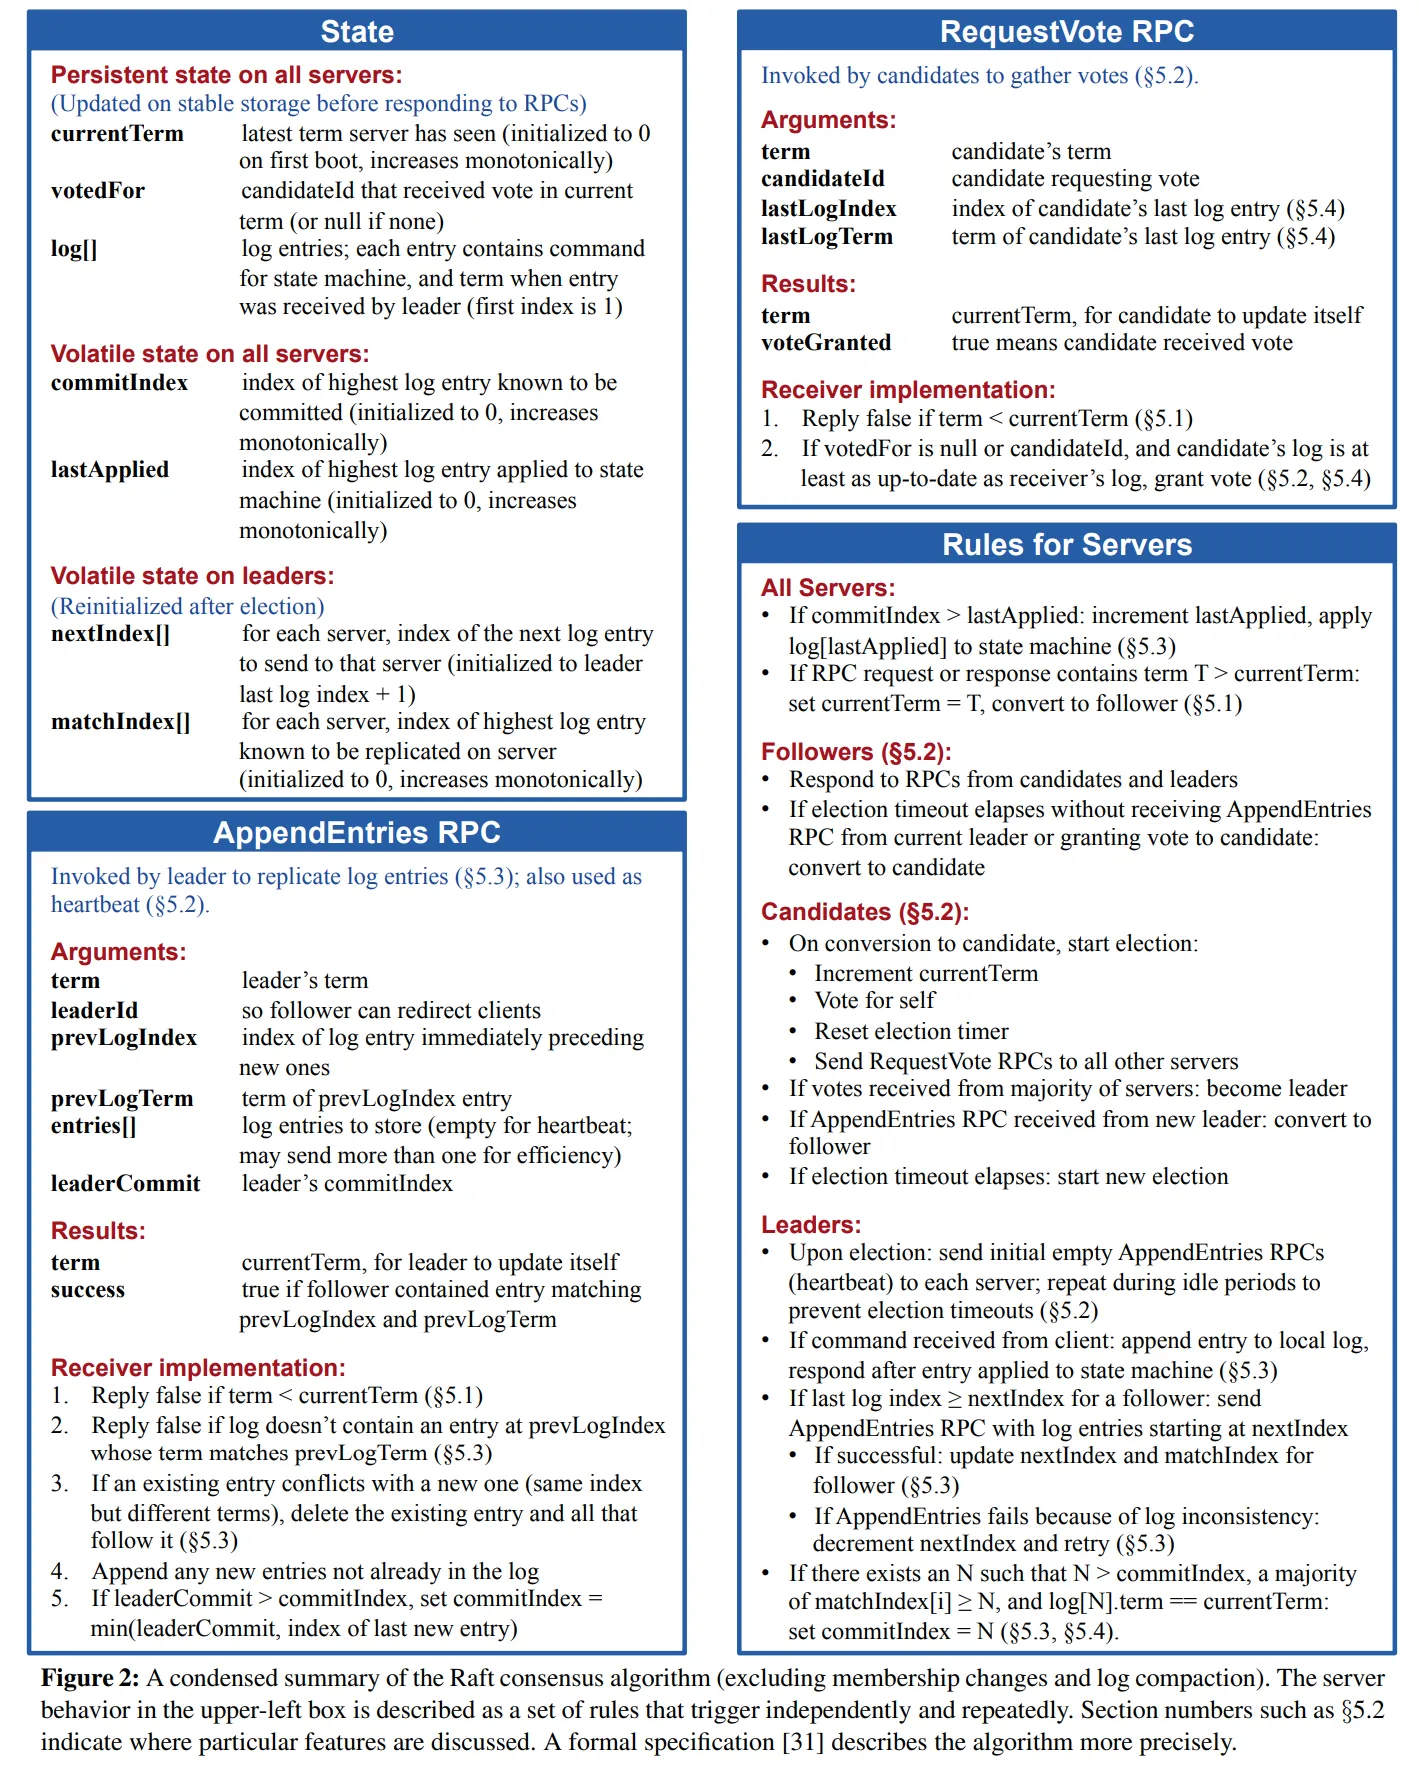
图2: Raft共识算法精简总结(不包含成员变更和日志压缩)。左上框中的服务器行为是一组独立、持续触发的规则。§5.2这类小节编号表示对应特性的讲解章节。形式化规范[31]对算法进行了更精确的描述。
- 选举安全性:在一个任期中最多只能选出一个领导者。§5.2
- 领导者仅追加:领导者不会覆盖或删除自身日志中的条目,只会追加新条目。§5.3
- 日志匹配性:如果两份日志中存在索引和任期号都相同的条目,那么两份日志在该索引之前的所有条目都完全相同。§5.3
- 领导者完整性:如果某条日志条目在某个任期中被提交,那么它一定会出现在所有更高任期领导者的日志中。§5.4
- 状态机安全性:如果某台服务器已经将指定索引的日志条目应用到状态机,那么其他服务器永远不会在相同索引位置应用不同的日志条目。§5.4.3
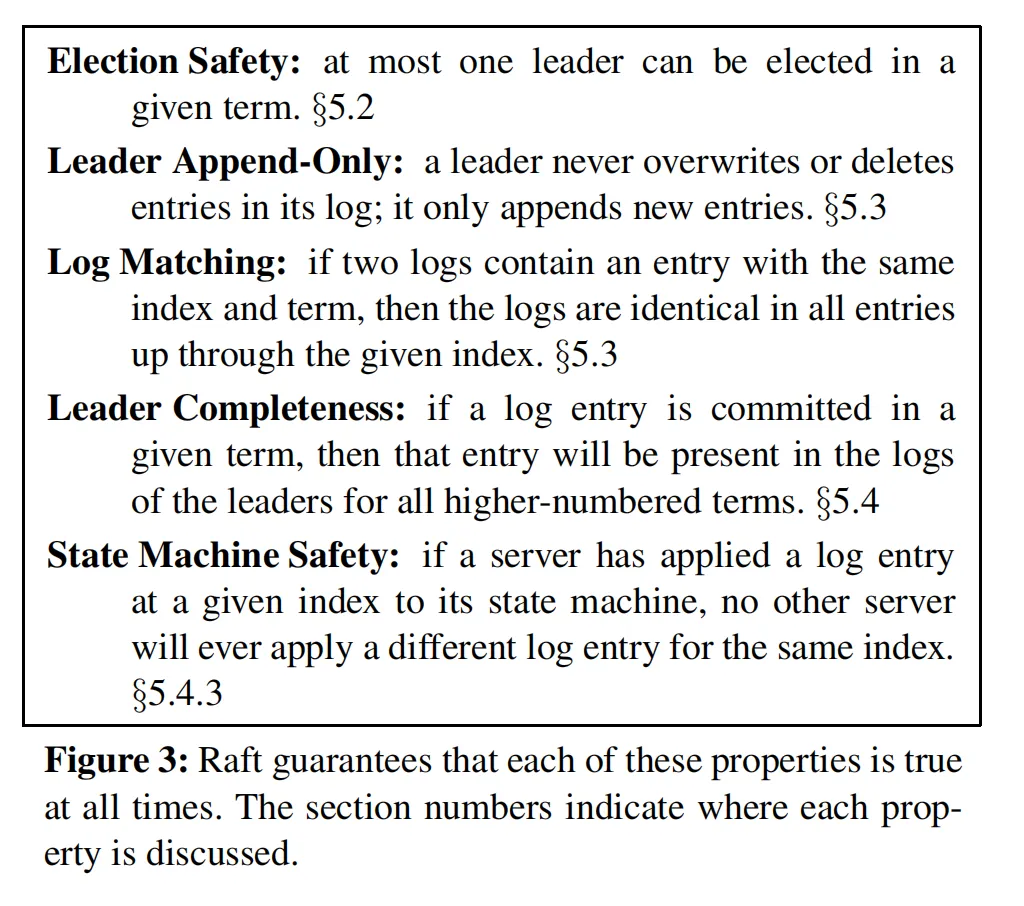
图3: Raft保证以下所有属性始终成立。小节编号表示每个属性的讨论位置。
Raft实现共识的方式是:先选出一个权威的领导者,然后让领导者全权负责管理复制日志。领导者接收客户端发来的日志条目,将它们复制到其他服务器上,并告知服务器何时可以安全地将日志条目应用到状态机。拥有领导者简化了复制日志的管理。例如,领导者可以直接决定新条目在日志中的位置,无需和其他服务器协商,数据也以简单的方式从领导者单向流向其他服务器。领导者可能发生故障,或者与其他服务器断开连接,此时就会选出新的领导者。
基于领导者模式,Raft将共识问题分解为三个相对独立的子问题,后续小节会分别讨论:
- 领导者选举:当现有领导者故障时,必须选出新的领导者(第5.2节)。
- 日志复制:领导者必须接收客户端的日志条目,并将它们复制到整个集群,强制其他服务器的日志与自己保持一致(第5.3节)。
- 安全性:Raft的核心安全属性是图3中的“状态机安全性”:如果任何一台服务器已经将某个日志条目应用到状态机,那么其他服务器都不能在相同索引位置应用不同的命令。第5.4节会讲解Raft如何保证这一属性;解决方案需要对第5.2节的选举机制增加一条额外约束。
介绍完共识算法后,本节还会讨论可用性问题以及时序在系统中的作用。
5.1 Raft基础
一个Raft集群包含多台服务器;五台是典型配置,这样系统可以容忍两台服务器故障。在任意时刻,每台服务器都处于三种状态之一:领导者、跟随者或候选者。正常运行时,集群中有且仅有一个领导者,其余都是跟随者。跟随者是被动的:它们不会主动发起任何请求,只会响应领导者和候选者的请求。领导者处理所有客户端请求(如果客户端联系了跟随者,跟随者会将请求重定向给领导者)。第三种状态——候选者,用于选举新的领导者,详见第5.2节。图4展示了三种状态及其转换关系,后续会详细讲解这些转换。
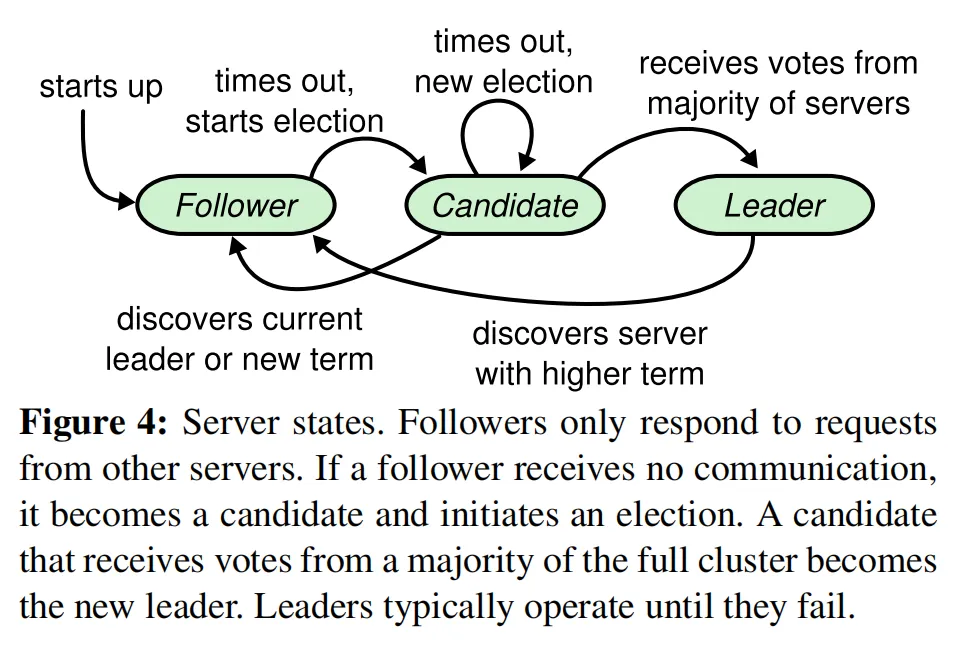
图4: 服务器状态转换图。跟随者只响应其他服务器的请求。如果跟随者收不到任何通信,它就会变为候选者并发起选举。获得集群多数选票的候选者成为新领导者。领导者通常会一直运行直到发生故障。
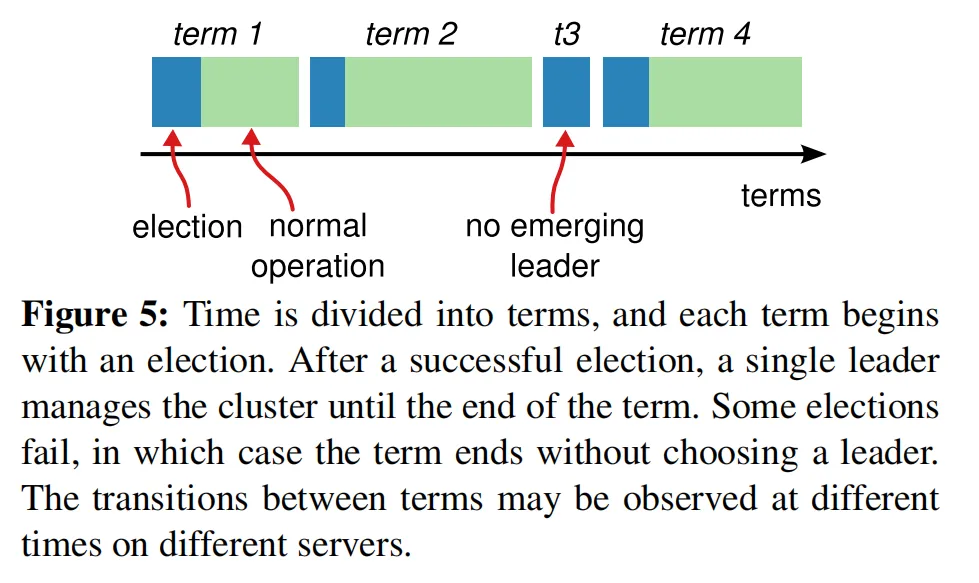
图5: 时间被划分为一个个任期,每个任期都以选举开始。选举成功后,单个领导者在整个任期内管理集群。有些选举会失败,这种情况下任期结束时没有选出领导者。不同服务器可能在不同时间观察到任期转换。
如图5所示,Raft将时间划分为长度任意的任期。任期用连续的整数编号。每个任期都以选举开始,选举中一个或多个候选者会尝试成为领导者,如第5.2节所述。如果候选者赢得选举,它就会在剩余任期内担任领导者。在某些情况下,选举会出现选票分散的结果,此时任期结束时没有选出领导者;很快就会开启新的任期(进行新一轮选举)。Raft保证在一个任期中最多只有一个领导者。
不同服务器可能在不同时间观察到任期转换,有些情况下服务器可能观察不到某次选举,甚至观察不到整个任期。任期在Raft中充当逻辑时钟[14]的角色,它让服务器能够识别过期信息,比如过时的领导者。每台服务器都存储一个当前任期号,它会随时间单调递增。服务器之间通信时都会交换当前任期号;如果一台服务器的当前任期号比另一台小,它就会将自己的任期号更新为更大的那个。如果候选者或领导者发现自己的任期已经过期,它会立即退回跟随者状态。如果服务器收到的请求带有过期的任期号,它会拒绝该请求。
Raft服务器通过远程过程调用(RPC)进行通信,基础共识算法只需要两种RPC。选举期间候选者发起RequestVote RPC(第5.2节);领导者发起AppendEntries RPC,用于复制日志条目和提供心跳机制(第5.3节)。第7节会增加第三种RPC,用于在服务器之间传输快照。如果服务器没有及时收到RPC响应,就会重试;为了最佳性能,服务器会并行发起RPC。
5.2 领导者选举
Raft用心跳机制来触发领导者选举。服务器启动时初始状态为跟随者。只要能收到来自领导者或候选者的有效RPC,服务器就会保持跟随者状态。领导者会周期性地向所有跟随者发送心跳(不带日志条目的AppendEntries RPC),以维持自己的权威。如果跟随者在一段时间(称为选举超时)内没有收到任何通信,它就会认为当前没有可用的领导者,然后发起选举来选出新的领导者。
发起选举时,跟随者先递增自己的当前任期号,然后转为候选者状态。接着它会给自己投一票,并向集群中所有其他服务器并行发送RequestVote RPC。候选者会一直保持该状态,直到以下三种情况之一发生:(a)它赢得选举;(b)其他服务器成为领导者;(c)一段时间过去仍没有选出胜者。下面分别讨论这三种情况。
如果候选者在同一个任期中获得了集群中多数服务器的选票,它就赢得了选举。每台服务器在一个任期中最多只能给一个候选者投票,遵循先到先得的原则(注意:第5.4节会对投票增加额外约束)。多数派原则保证了一个任期中最多只有一个候选者能赢得选举(即图3中的选举安全性)。候选者赢得选举后就成为领导者,然后向所有其他服务器发送心跳消息,确立自己的权威并阻止新的选举。
在等待选票的过程中,候选者可能会收到另一个自称领导者的服务器发来的AppendEntries RPC。如果该领导者的任期号(包含在RPC中)大于等于候选者的当前任期号,候选者就会承认该领导者的合法性,退回跟随者状态。如果RPC中的任期号小于候选者的当前任期号,候选者就会拒绝该RPC,继续保持候选者状态。
第三种可能的结果是,候选者既没赢也没输:如果很多跟随者同时成为候选者,选票就会分散,导致没有候选者能获得多数。出现这种情况时,每个候选者都会超时,然后通过递增任期号、发起新一轮RequestVote RPC来开始新的选举。但是,如果没有额外机制,选票分散的情况可能会无限重复。
Raft使用随机选举超时来确保选票分散很少发生,并且能快速解决。为了从根源上避免选票分散,选举超时时间会在固定区间内随机选择(比如150-300毫秒)。这会让服务器的超时时间错开,因此大多数情况下只有一台服务器会先超时;它赢得选举后,在其他服务器超时前就发送出心跳。同样的机制也用于解决选票分散的情况:每个候选者在选举开始时都会重启自己的随机选举超时,等待超时结束后再开始下一轮选举;这降低了新一轮选举再次出现选票分散的概率。第9.3节会展示这种方法能快速选出领导者。
选举是“可理解性指导设计选择”的一个典型例子。最初我们计划使用排名系统:每个候选者都有唯一的排名,用于在竞争中选出胜者。如果候选者发现另一个排名更高的候选者,它就退回跟随者状态,这样排名更高的候选者就能更容易赢得下一轮选举。但我们发现这种方法会带来一些微妙的可用性问题(比如排名低的服务器如果在排名高的服务器故障后需要超时成为候选者,但如果它行动太早,就会重置选举进程)。我们多次调整算法,但每次调整后都会出现新的边界情况。最终我们得出结论:随机重试的方法更直观、更易理解。
5.3 日志复制
选出领导者之后,它就开始处理客户端请求。每个客户端请求都包含一条要由复制状态机执行的命令。领导者将该命令作为新条目追加到自己的日志中,然后向所有其他服务器并行发送AppendEntries RPC来复制这条条目。当条目被安全复制后(如下文所述),领导者就会将条目应用到自己的状态机,并将执行结果返回给客户端。如果跟随者崩溃、运行缓慢,或者网络丢包,领导者会无限次重试AppendEntries RPC(即使已经响应了客户端),直到所有跟随者最终都存储了所有日志条目。
日志的组织结构如图6所示。每个日志条目都存储一条状态机命令,以及领导者接收该条目时的任期号。日志条目中的任期号用于检测日志之间的不一致,也用于保证图3中的部分属性。每个日志条目还有一个整数索引,标识它在日志中的位置。
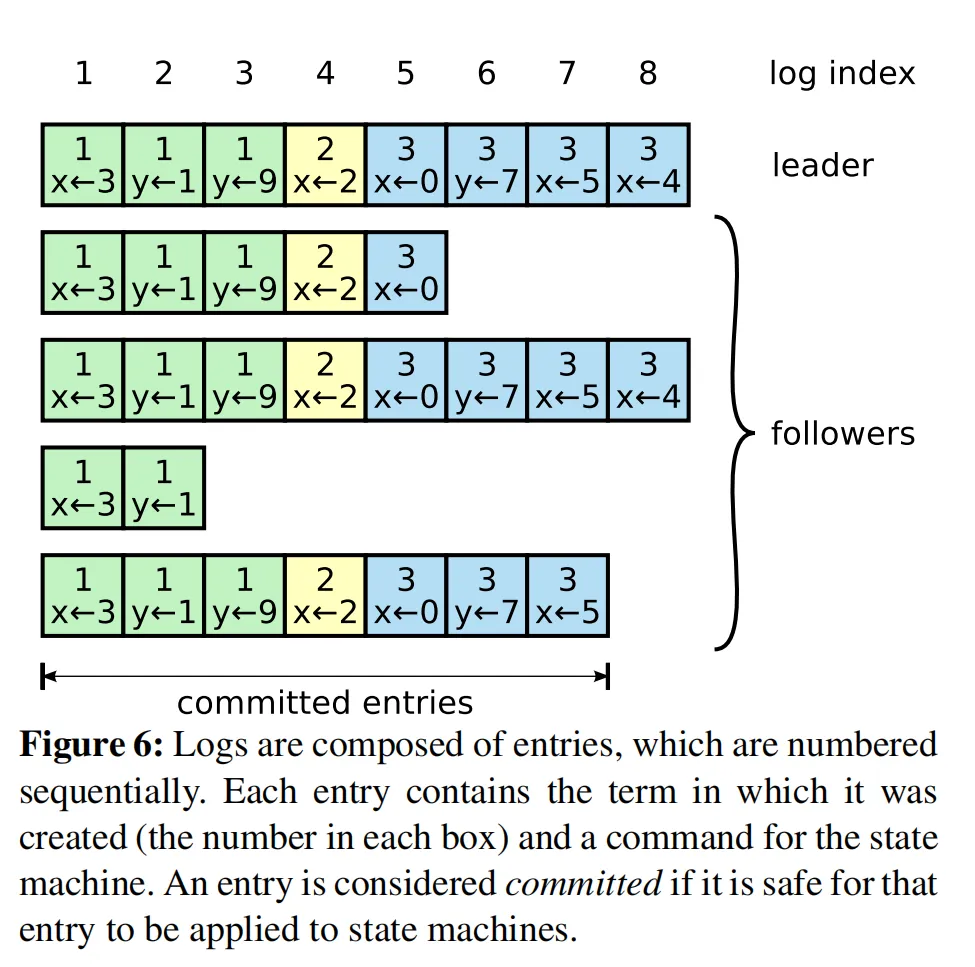
图6: 日志由顺序编号的条目组成。每个条目包含它被创建时的任期号(每个方框中的数字)和一条状态机命令。当某个条目可以安全地应用到状态机时,就称它为已提交。
领导者决定何时可以安全地将日志条目应用到状态机;这样的条目称为已提交。Raft保证已提交的条目是持久的,并且最终会被所有可用的状态机执行。当创建条目的领导者将条目复制到了多数服务器上,该条目就算提交了(比如图6中的第7条)。这同时也会提交领导者日志中该条目之前的所有条目,包括之前领导者创建的条目。第5.4节会讨论领导者变更后应用这条规则的一些微妙之处,也会说明这种提交定义是安全的。领导者会跟踪已知已提交的最高索引,并将该索引包含在后续的AppendEntries RPC(包括心跳)中,这样其他服务器最终会得知提交进度。当跟随者知道某个日志条目已经提交,它就会按日志顺序将条目应用到本地状态机。
我们设计Raft日志机制的目标,是让不同服务器的日志之间保持高度一致性。这不仅能简化系统行为、让结果更可预测,也是保证安全性的重要组成部分。Raft维持以下属性,它们共同构成了图3中的日志匹配属性:
- 如果不同日志中的两个条目拥有相同的索引和任期号,那么它们存储的命令相同。
- 如果不同日志中的两个条目拥有相同的索引和任期号,那么它们之前的所有条目都完全相同。
第一个属性源于这样一个事实:领导者在一个任期中,对于一个给定的日志索引最多只会创建一个条目,而且日志条目的位置永远不会改变。第二个属性由AppendEntries的简单一致性检查来保证。领导者发送AppendEntries RPC时,会带上新条目之前紧邻那条目的索引和任期号。如果跟随者在自己的日志中找不到索引和任期号都匹配的条目,它就会拒绝接收新条目。一致性检查相当于归纳步骤:日志的初始空状态满足日志匹配属性,而每次日志扩展时的一致性检查都会保持该属性。因此,只要AppendEntries返回成功,领导者就知道跟随者的日志在新条目之前的部分和自己的完全一致。
正常运行时,领导者和跟随者的日志保持一致,因此AppendEntries的一致性检查永远不会失败。但是,领导者崩溃可能会导致日志不一致(旧领导者可能还没来得及将日志中的所有条目都复制完整)。经过多次领导者和跟随者崩溃后,这种不一致可能会累积。图7展示了跟随者的日志与新领导者日志可能存在的差异情况。跟随者可能缺少领导者上有的条目,可能多出来领导者上没有的条目,或者两者都有。日志中缺失和多余的条目可能跨越多个任期。
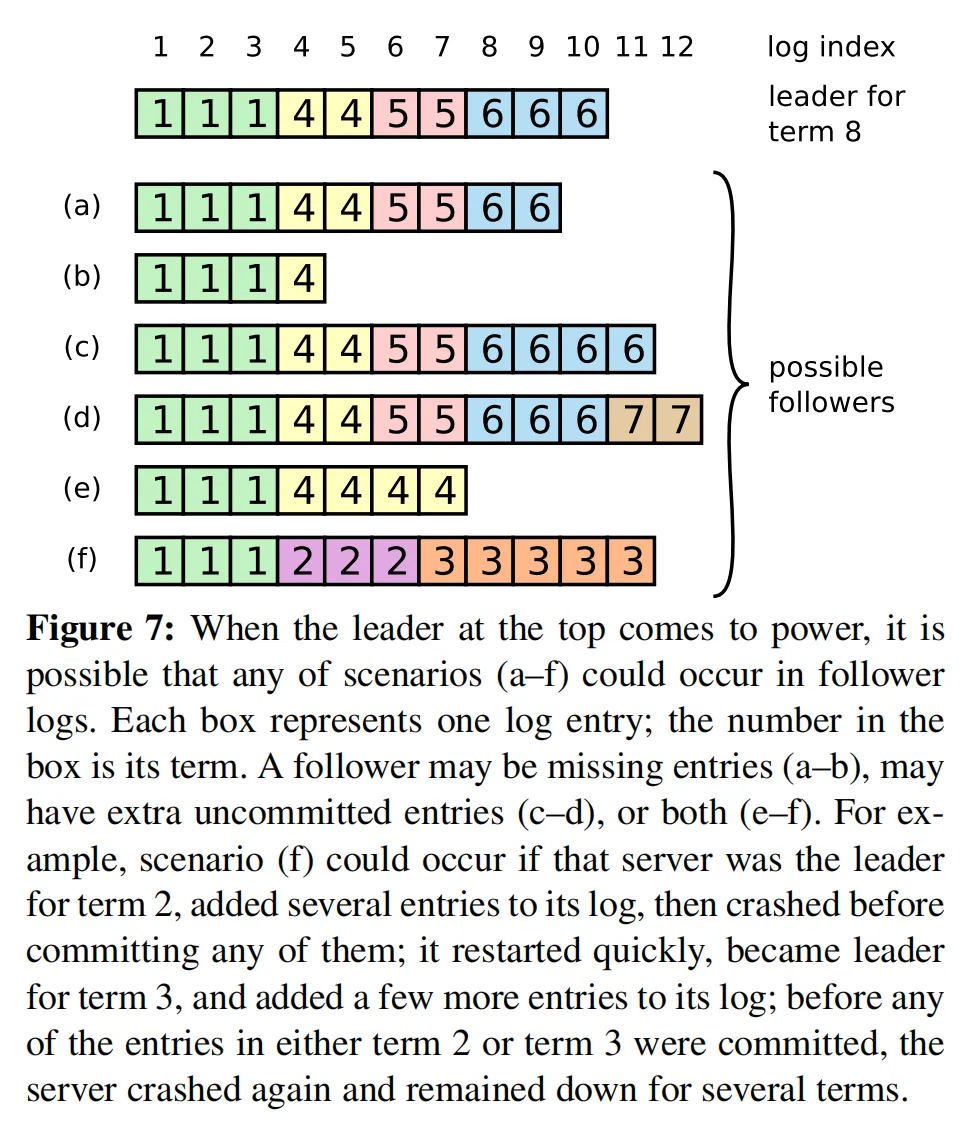
图7: 当最上方的领导者上任时,跟随者的日志可能出现(a-f)中的任意一种情况。每个方框代表一条日志条目,方框内的数字是任期号。跟随者可能缺少条目(a-b),可能有多余的未提交条目(c-d),或者两者都有(e-f)。例如,场景(f)可能是这样发生的:该服务器在任期2时是领导者,向日志中追加了几条条目,还没来得及提交就崩溃了;它很快重启,在任期3时又成为领导者,又向日志追加了几条条目;在任期2和任期3的条目都还没提交时,服务器再次崩溃,并且停机了好几个任期。
在Raft中,领导者通过强制跟随者的日志与自己保持一致来处理不一致问题。这意味着跟随者日志中冲突的条目会被领导者日志中的条目覆盖。第5.4节会说明,再加上一条额外约束后,这种做法是安全的。
要让跟随者的日志与自己一致,领导者必须先找到两份日志最新的一致点,删除跟随者日志中该点之后的所有条目,然后将自己该点之后的所有条目发送给跟随者。这些操作都是在AppendEntries RPC的一致性检查过程中完成的。领导者为每个跟随者维护一个nextIndex值,表示接下来要发给该跟随者的日志条目的索引。领导者刚上任时,会将所有nextIndex初始化为自己最后一条日志的下一个索引(图7中就是11)。如果跟随者的日志与领导者不一致,下一次AppendEntries RPC的一致性检查就会失败。遭到拒绝后,领导者会递减nextIndex,然后重试AppendEntries RPC。最终nextIndex会降到领导者和跟随者日志匹配的位置。此时AppendEntries就会成功,同时移除跟随者日志中所有冲突的条目,并追加领导者的日志条目(如果有的话)。一旦AppendEntries成功,跟随者的日志就和领导者的一致了,并且在剩余任期内都会保持一致。
如果需要,可以优化协议来减少被拒绝的AppendEntries RPC次数。例如,当拒绝AppendEntries请求时,跟随者可以返回冲突条目的任期号,以及该任期下的第一条条目索引。有了这些信息,领导者就可以直接跳过该任期内所有冲突的条目,每个有冲突的任期只需要一次AppendEntries RPC,而不是每个条目都要一次。实际上,我们认为这种优化可能不是必需的,因为不一致的情况很少发生,也不太可能出现大量不一致的条目。
有了这种机制,领导者上任时不需要采取任何特殊操作来恢复日志一致性。它只需要开始正常工作,日志就会在AppendEntries一致性检查的失败重试中自动收敛。领导者永远不会覆盖或删除自己日志中的条目(图3中的领导者仅追加属性)。
这种日志复制机制具备第2节所述的理想共识特性:只要多数服务器正常运行,Raft就能接收、复制并应用新的日志条目;正常情况下,一轮RPC就能将新条目复制到集群多数节点;单个慢跟随者不会影响整体性能。
5.4 安全性
前面几节介绍了Raft如何选举领导者和复制日志条目。但是,目前介绍的机制还不足以保证每个状态机都按完全相同的顺序执行完全相同的命令。例如,跟随者可能在领导者提交多条日志期间不可用,之后它被选为领导者,用新条目覆盖掉这些已提交的条目;最终不同的状态机可能执行不同的命令序列。
本节通过对“哪些服务器可以当选领导者”增加一条约束,来完善Raft算法。这条约束保证了:任意任期的领导者,都包含了之前所有任期提交的所有条目(即图3中的领导者完整性属性)。有了选举约束之后,我们再进一步明确提交规则。最后,我们给出领导者完整性属性的证明概要,并说明它如何保证复制状态机的正确行为。
5.4.1 选举约束
在任何基于领导者的共识算法中,领导者最终必须存储所有已提交的日志条目。在有些共识算法中(比如视图戳复制[22]),即使领导者初始时没有包含所有已提交条目,也可以当选。这类算法会通过额外的机制,在选举过程中或选举后很快将缺失的条目传输给新领导者。遗憾的是,这会带来大量额外的机制和复杂度。Raft采用了更简单的方法:它保证从当选的那一刻起,每个新领导者就已经包含了之前所有任期提交的条目,不需要再向领导者传输这些条目。这意味着日志条目只会单向流动——从领导者到跟随者,并且领导者永远不会覆盖已有的日志条目。
Raft通过投票机制来保证:除非候选者的日志包含了所有已提交条目,否则它无法赢得选举。候选者必须联系集群中的多数节点才能当选,这意味着每个已提交的条目都至少存在于其中一台服务器上。如果候选者的日志至少和该多数派中任何一台服务器的日志一样新(“新”的精确定义见下文),那么它就一定包含所有已提交的条目。RequestVote RPC实现了这一约束:RPC中包含候选者的日志信息,如果投票者自己的日志比候选者的更新,它就会拒绝投票。
Raft通过比较日志最后条目的索引和任期号,来判断两份日志哪个更新。如果两份日志最后条目的任期号不同,那么任期号更大的日志更新。如果两份日志最后条目的任期号相同,那么日志更长的那个更新。
5.4.2 之前任期条目的提交
如第5.3节所述,领导者只要将当前任期的条目复制到多数服务器上,就知道该条目已提交。如果领导者在提交条目之前崩溃,后续的领导者会尝试继续完成该条目的复制。但是,领导者不能仅凭“旧任期的条目已经复制到多数服务器”就断定它已提交。图8展示了一种情况:一条旧日志条目已经存在于多数服务器上,但仍然可能被未来的领导者覆盖。
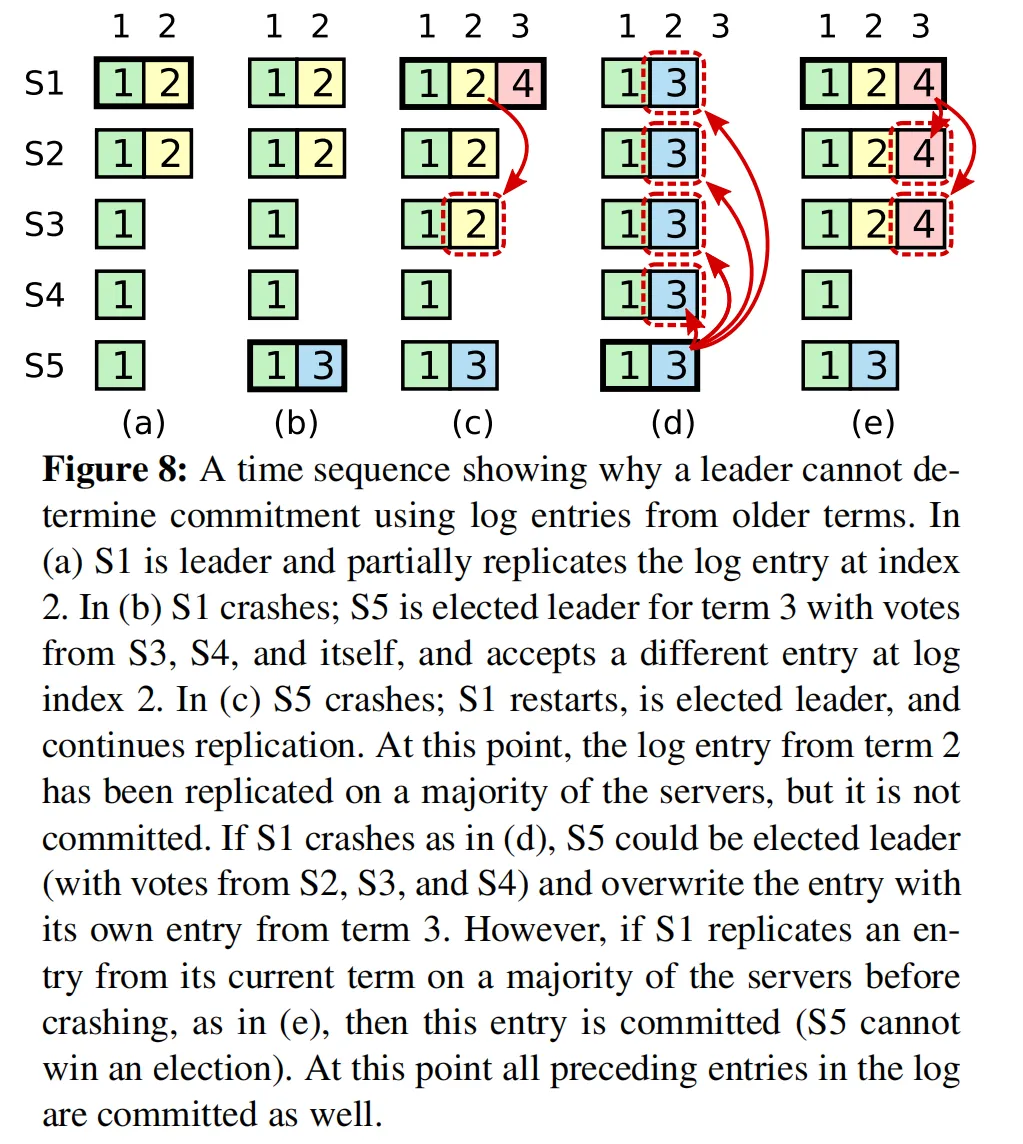
图8: 这个时间序列展示了为什么领导者不能用旧任期的日志条目来判断提交状态。(a)中S1是领导者,部分复制了索引2的日志条目。(b)中S1崩溃;S5在任期3当选领导者(获得S3、S4和自己的选票),在索引2位置接收了一条不同的条目。(c)中S5崩溃;S1重启后当选领导者,继续复制。此时,任期2的日志条目已经复制到了多数服务器,但它并没有被提交。如果S1像(d)中那样崩溃,S5可能当选领导者(获得S2、S3、S4的选票),用自己任期3的条目覆盖掉该条目。但是,如果S1在崩溃前将当前任期的条目复制到多数服务器,如(e)所示,那么该条目就算提交了(此时S5无法赢得选举)。到这时,日志中所有之前的条目也都一并提交了。
为了避免图8中的问题,Raft永远不会通过统计副本数来提交之前任期的日志条目。只有领导者当前任期的条目才通过统计副本数来提交;一旦当前任期的条目以这种方式提交,那么由于日志匹配属性,所有之前的条目都会被间接提交。在有些情况下,领导者可以安全地判定旧条目已提交(比如该条目存在于所有服务器上),但Raft为了简单起见,采用了更保守的策略。
Raft的提交规则之所以会有这种额外复杂度,是因为领导者复制之前任期的条目时,会保留它们原来的任期号。在其他共识算法中,如果新领导者要重新复制之前“任期”的条目,必须使用新的“任期号”。Raft的方法让日志条目更容易推理,因为它们在不同时间、不同服务器的日志中都保持相同的任期号。此外,与其他算法相比,Raft中新领导者需要发送的旧任期日志条目更少(其他算法必须发送冗余的日志条目来重新编号,然后才能提交)。
5.4.3 安全性论证
有了完整的Raft算法,我们现在可以更严谨地论证领导者完整性属性成立(该论证基于安全性证明,见第9.2节)。我们采用反证法:假设领导者完整性属性不成立,然后推导出矛盾。假设任期T的领导者(leader_T)提交了一条本任期的日志条目,但该条目没有出现在某个未来任期的领导者日志中。设U是大于T的最小任期,其领导者(leader_U)的日志中不包含该条目。
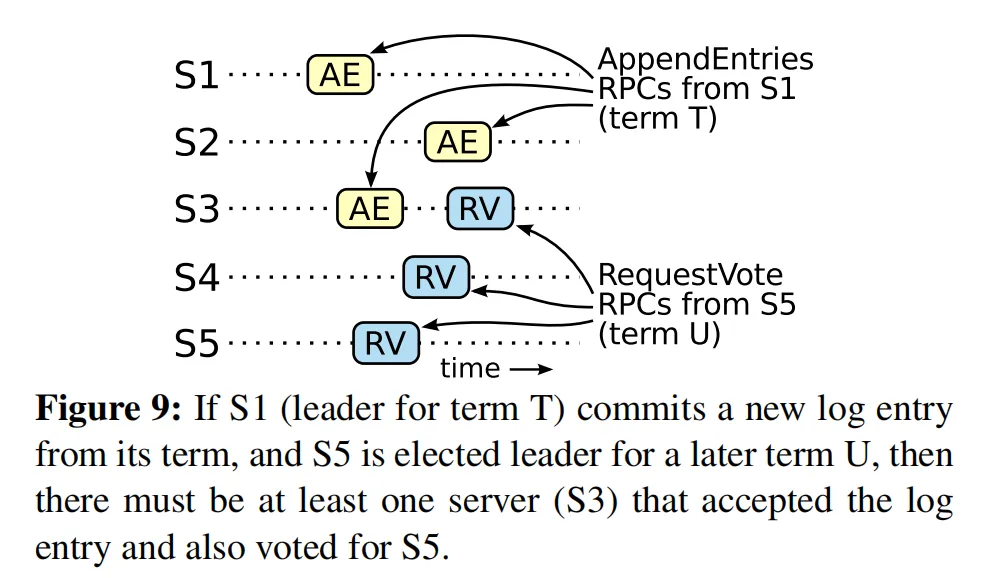
图9: 如果S1(任期T的领导者)提交了一条本任期的新日志条目,而S5在之后的任期U当选领导者,那么至少有一台服务器(S3)既接收了该日志条目,又给S5投了票。
- 该已提交条目在leader_U当选时肯定不在它的日志中(领导者永远不会删除或覆盖条目)。
- leader_T将该条目复制到了集群的多数节点,而leader_U获得了集群多数节点的选票。因此,至少有一台服务器(“投票者”)既从leader_T那里接收了该条目,又给leader_U投了票,如图9所示。这台投票者是推导出矛盾的关键。
- 投票者肯定是在给leader_U投票之前就接收了leader_T的已提交条目;否则它会拒绝leader_T的AppendEntries请求(因为它的当前任期会比T大)。
- 投票者给leader_U投票时,仍然存储着该条目;因为根据假设,所有中间任期的领导者都包含该条目,而领导者永远不会删除条目,跟随者只有在与领导者冲突时才会删除条目。
- 投票者给leader_U投了票,因此leader_U的日志至少和投票者的日志一样新。这会导出两种矛盾情况之一:
- 如果投票者和leader_U的最后一条日志任期号相同,那么leader_U的日志至少和投票者的一样长,因此它的日志包含投票者日志中的所有条目。这就矛盾了——因为投票者包含该已提交条目,而假设leader_U不包含。
- 否则,leader_U的最后一条日志任期号肯定比投票者的大。而且它肯定比T大,因为投票者的最后一条日志任期号至少是T(它包含任期T的已提交条目)。创建leader_U最后那条日志的上一任领导者,根据假设也肯定包含该已提交条目。那么根据日志匹配属性,leader_U的日志也一定包含该已提交条目,这就矛盾了。
至此矛盾推导完成。因此,所有任期号大于T的领导者,都必然包含任期T中提交的所有条目。
日志匹配属性保证了,未来的领导者也会包含那些被间接提交的条目,比如图8(d)中的索引2条目。
有了领导者完整性属性,我们就可以证明图3中的状态机安全性属性:如果某台服务器已经将指定索引的日志条目应用到状态机,那么其他服务器永远不会在相同索引位置应用不同的日志条目。当服务器将日志条目应用到状态机时,它的日志在该条目之前肯定和领导者的日志一致,并且该条目肯定是已提交的。现在考虑所有服务器中,最早应用某个日志索引的那个任期;根据日志完整性属性,所有更高任期的领导者都会存储相同的该索引条目,因此后续任期的服务器应用该索引时,都会应用相同的值。因此状态机安全性属性成立。
最后,Raft要求服务器按日志索引顺序应用条目。结合状态机安全性属性,这意味着所有服务器都会向自己的状态机应用完全相同的日志条目集合,并且顺序完全一致。
5.5 跟随者与候选者崩溃
到目前为止我们都在讨论领导者故障。跟随者和候选者故障的处理比领导者故障简单得多,而且两者的处理方式相同。如果跟随者或候选者崩溃,那么之后发给它的RequestVote和AppendEntries RPC都会失败。Raft通过无限重试来处理这些故障;如果崩溃的服务器重启了,RPC就会成功完成。如果服务器在完成RPC之后、响应之前崩溃,那么它重启后会收到相同的RPC。Raft的RPC都是幂等的,因此不会造成问题。例如,如果跟随者收到的AppendEntries请求中包含已经存在于日志中的条目,它会直接忽略这些条目。
5.6 时序与可用性
我们对Raft的要求之一是,安全性不能依赖于时序:系统不能仅仅因为事件发生得比预期快或慢,就产生错误结果。但是,可用性(系统及时响应客户端的能力)必然依赖于时序。例如,如果消息交换的时间比服务器故障的平均间隔还长,候选者就来不及赢得选举;没有稳定的领导者,Raft就无法推进工作。
领导者选举是Raft中时序最关键的部分。只要系统满足以下时序要求,Raft就能选出并维持稳定的领导者:
广播时间 ≪ 选举超时 ≪ 平均故障间隔
其中,广播时间是服务器向集群中所有服务器并行发送RPC并收到响应的平均时间;选举超时就是第5.2节所述的选举超时时间;平均故障间隔是单台服务器两次故障之间的平均时间。广播时间应该比选举超时小一个数量级,这样领导者才能可靠地发送心跳消息,避免跟随者发起选举;而选举超时的随机机制也让选票分散不太可能发生。选举超时应该比平均故障间隔小几个数量级,这样系统才能稳定推进。领导者崩溃后,系统会有大约一个选举超时的不可用时间;我们希望这段时间只占总运行时间的很小一部分。
广播时间和平均故障间隔是底层系统的属性,而选举超时是我们可以选择的参数。Raft的RPC通常需要接收方将信息持久化到稳定存储中,因此广播时间可能在0.5毫秒到20毫秒之间,具体取决于存储技术。相应地,选举超时通常可以设在10毫秒到500毫秒之间。而典型的服务器平均故障间隔是数月甚至更久,完全满足时序要求。
6. 集群成员变更
到目前为止,我们都假设集群配置(参与共识算法的服务器集合)是固定的。但在实际中,偶尔需要变更配置,比如服务器故障时替换服务器,或者改变副本数量。虽然可以通过关停整个集群、更新配置文件、再重启集群的方式来做,但这会导致集群在变更期间不可用。此外,如果有手动操作步骤,还可能引入人为错误。为了避免这些问题,我们决定将配置变更自动化,并融入Raft共识算法中。
要保证配置变更机制的安全性,过渡期间绝对不能出现同一任期选出两个领导者的情况。遗憾的是,任何让服务器直接从旧配置切换到新配置的方法都是不安全的。不可能让所有服务器同时原子地切换配置,因此过渡期间集群可能分裂成两个独立的多数派,如图10所示。
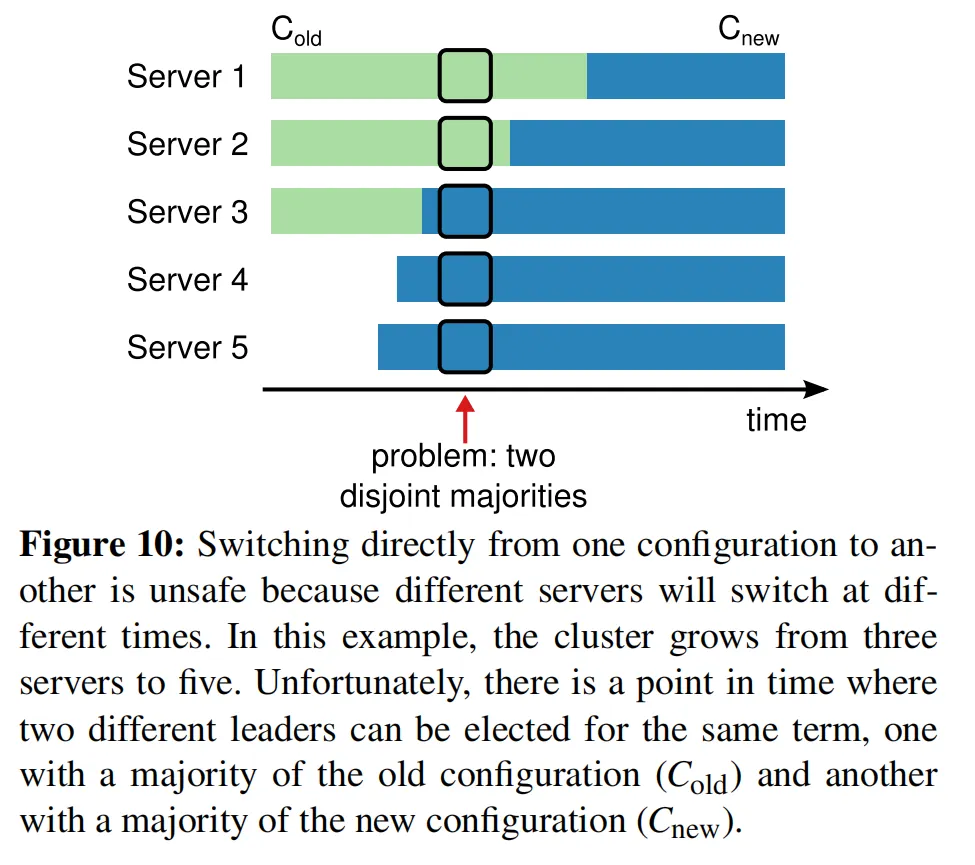
图10: 直接从一种配置切换到另一种是不安全的,因为不同服务器切换的时间不同。本例中,集群从3台服务器扩容到5台。遗憾的是,过渡期间会出现一个时间点,旧配置(C_old)和新配置(C_new)可以各自选出一个同一任期的领导者。
为了保证安全性,配置变更必须采用两阶段方法。实现两阶段的方式有很多种。例如,有些系统(比如[22])在第一阶段禁用旧配置,让它无法处理客户端请求;第二阶段再启用新配置。而在Raft中,集群首先切换到一种过渡配置,我们称之为联合共识;一旦联合共识被提交,系统再切换到新配置。联合共识同时包含旧配置和新配置:
- 日志条目会被复制到两种配置中的所有服务器。
- 两种配置中的任意服务器都可以担任领导者。
- 选举和条目提交都需要分别获得旧配置和新配置的各自多数派同意。
联合共识允许各台服务器在不同时间完成配置切换,且不会影响安全性。此外,在整个配置变更过程中,集群都可以继续处理客户端请求。
集群配置通过复制日志中的特殊条目来存储和传递;图11展示了配置变更的流程。当领导者收到将配置从C_old更改为C_new的请求时,它会将联合共识配置(图中为C_old,new)作为日志条目存储起来,并用前述机制复制该条目。只要某台服务器将新配置条目追加到自己的日志中,它就会使用该配置进行所有后续决策(服务器总是使用日志中最新的配置,不管该条目是否已提交)。这意味着,领导者会使用C_old,new的规则来判断C_old,new这条日志条目何时提交。如果领导者崩溃,新领导者可能基于C_old或者C_old,new当选,取决于赢得选举的候选者是否已经收到了C_old,new条目。无论如何,在这个阶段C_new都不能单方面做出决策。
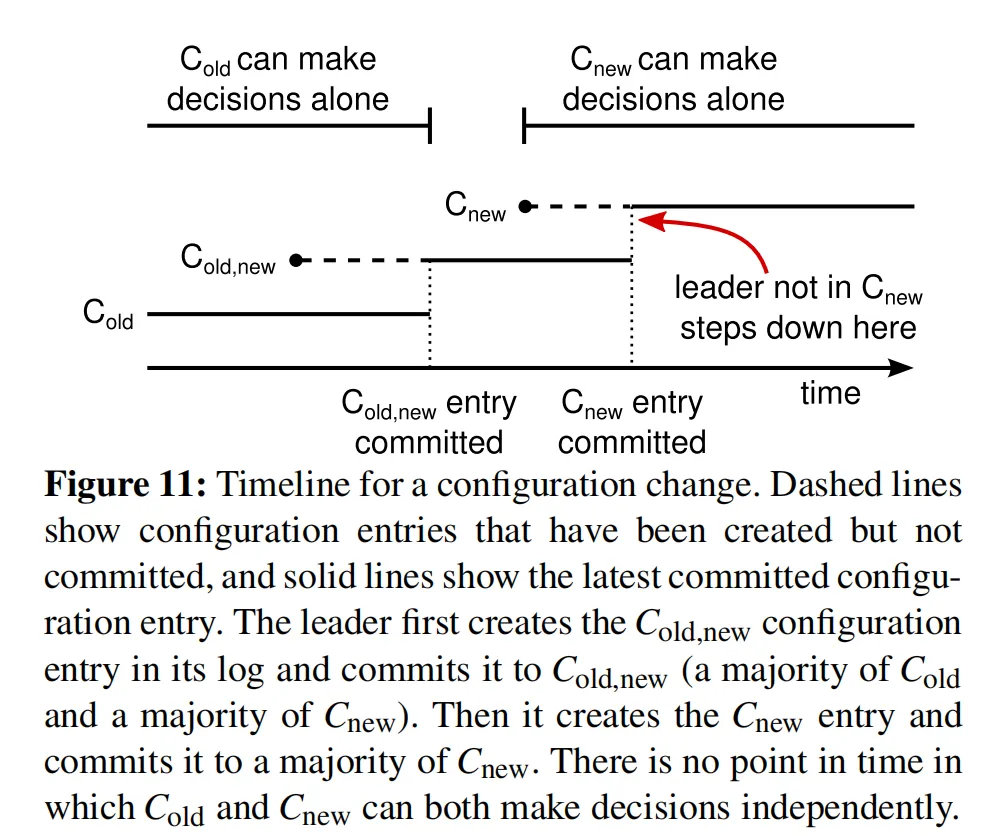
图11: 配置变更时间线。虚线表示已创建但未提交的配置条目,实线表示最新的已提交配置条目。领导者首先在日志中创建C_old,new配置条目,并将其提交到C_old,new(需要C_old的多数派和C_new的多数派同时同意)。然后它创建C_new条目,并将其提交到C_new的多数派。整个过程中不存在C_old和C_new可以同时独立决策的时间点。
一旦C_old,new提交,C_old和C_new都无法在不经对方同意的情况下做出决策,并且领导者完整性属性保证了只有拥有C_old,new日志条目的服务器才能当选领导者。此时,领导者就可以安全地创建描述C_new的日志条目,并复制到集群。同样,服务器只要看到这条配置就会立即生效。当新配置在C_new的规则下提交后,旧配置就不再相关,不在新配置中的服务器可以关停。如图11所示,整个过程中不存在C_old和C_new可以同时独立决策的时间点,这保证了安全性。
关于配置变更还有三个问题需要解决。第一个问题是,新服务器初始时可能没有任何日志条目。如果以这种状态加入集群,它们可能需要很长时间才能追赶上进度,在此期间可能无法提交新的日志条目。为了避免可用性缺口,Raft在配置变更之前增加了一个阶段:新服务器以非投票成员身份加入集群(领导者向它们复制日志条目,但计算多数派时不考虑它们)。等到新服务器追上集群进度后,再按上述流程进行正式配置变更。
第二个问题是,集群领导者可能不在新配置中。这种情况下,领导者在提交C_new日志条目后就会卸任(退回跟随者状态)。这意味着,在提交C_new的这段时间里,领导者管理着一个不包含自己的集群;它负责复制日志条目,但计算多数派时不算自己。领导者会在C_new提交时完成交接,因为这是新配置可以独立运行的最早时间点(此时总能从C_new中选出领导者)。在此之前,可能只有旧配置中的服务器才能当选领导者。
第三个问题是,被移除的服务器(不在C_new中的服务器)可能会干扰集群。这些服务器收不到心跳,因此会超时并发起新的选举。它们会发送带有更高任期号的RequestVote RPC,导致当前领导者退回跟随者状态。最终会选出新的领导者,但被移除的服务器会再次超时,整个过程不断重复,导致系统可用性很差。为了解决这个问题,当服务器认为当前存在领导者时,会忽略RequestVote RPC。具体来说,如果服务器在收到心跳后的最小选举超时时间内收到RequestVote RPC,它不会更新自己的任期号,也不会投票。这不会影响正常选举,因为正常选举中每台服务器都会等待至少一个最小选举超时才会发起选举。但它能有效避免被移除服务器的干扰:只要领导者能正常向集群发送心跳,就不会被更大的任期号推翻。
7. 日志压缩
Raft的日志在正常运行中会不断增长,以容纳更多的客户端请求,但在实际系统中,日志不可能无限增长。日志越长,占用的空间就越大,重放的时间也越长。如果没有机制来清理日志中累积的过期信息,最终会导致可用性问题。
快照是最简单的压缩方法。快照方式下,系统将当前完整状态写入稳定存储中的快照文件,然后丢弃该时间点之前的所有日志。Chubby和ZooKeeper都使用了快照方式,本节接下来会介绍Raft中的快照机制。
增量式压缩方法也是可行的,比如日志清理[36]和日志结构合并树[5, 30]。这类方法每次只处理一部分数据,因此压缩负载可以更均匀地分摊到时间中。它们先选出累积了大量删除和覆盖对象的数据区域,然后将该区域中的存活对象重写得更紧凑,释放该区域。与快照相比,这类方法需要大量额外的机制和复杂度,而快照通过总是处理完整数据集来简化问题。虽然日志清理需要对Raft本身进行修改,但状态机可以用和快照相同的接口来实现LSM树。
图12展示了Raft中快照的基本思想。每台服务器独立生成快照,只覆盖日志中已提交的条目。快照的主要工作是状态机将当前状态写入快照文件。Raft还会在快照中包含少量元数据:最后包含索引是快照所替代的最后一条日志条目的索引(即状态机已应用的最后一条条目),最后包含任期是该条目的任期号。保留这些信息是为了支持快照之后第一条日志条目的AppendEntries一致性检查——因为该条目需要前一条日志的索引和任期号。为了支持集群成员变更(第6节),快照中还包含截至最后包含索引时,日志中的最新配置。服务器完成快照写入后,就可以删除最后包含索引及之前的所有日志条目,以及所有更早的快照。
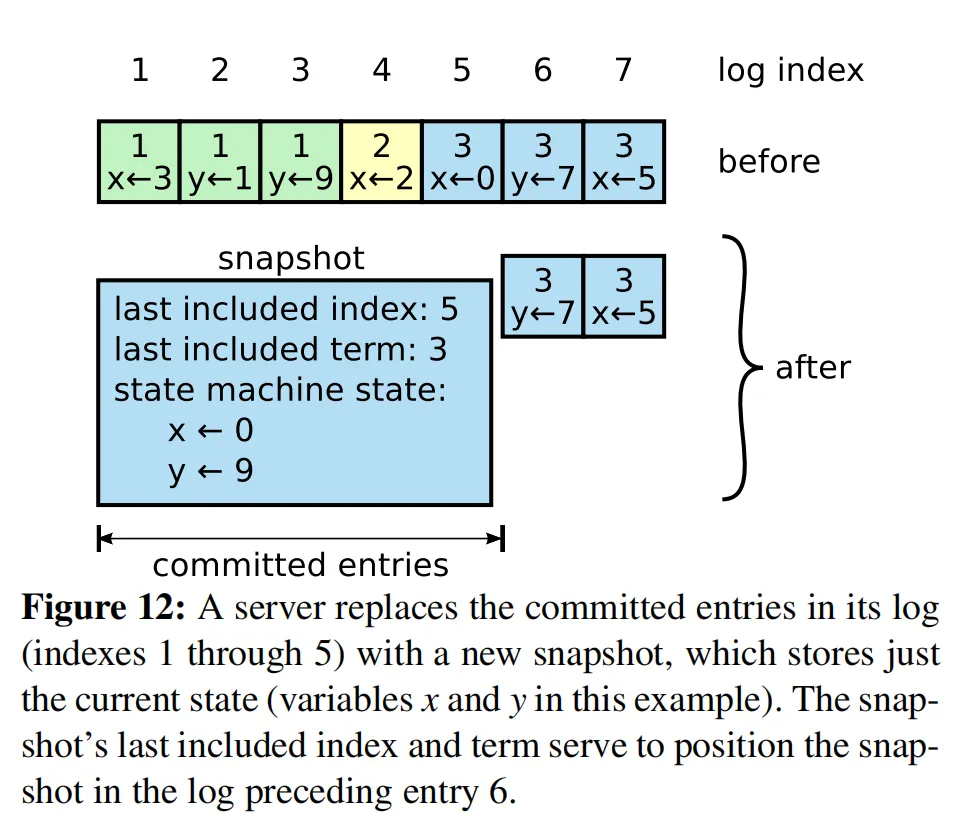
图12: 服务器用新快照替换日志中已提交的条目(索引1到5),快照只存储当前状态(本例中是变量x和y)。快照的最后包含索引和任期号,用于定位快照在日志中的位置(在条目6之前)。
虽然服务器通常独立生成快照,但领导者偶尔需要向落后太多的跟随者发送快照。当领导者已经丢弃了要发给某个跟随者的下一条日志时,就会出现这种情况。幸运的是,正常运行中不太可能出现这种情况:跟得上领导者进度的跟随者本来就有该条目。但是,特别慢的跟随者或者新加入集群的服务器(第6节)就会没有。让这类跟随者追上进度的方法,就是领导者通过网络给它发送快照。
领导者使用一种名为InstallSnapshot的新RPC来向落后太多的跟随者发送快照,如图13所示。当跟随者通过该RPC收到快照时,它需要决定如何处理自己现有的日志条目。通常快照会包含接收方日志中没有的新信息,这种情况下跟随者会丢弃整个日志;因为所有内容都被快照取代了,而且日志中可能还有与快照冲突的未提交条目。如果跟随者收到的快照只覆盖了自己日志的前缀(由于重传或者错误),那么快照覆盖的日志条目会被删除,但快照之后的日志条目仍然有效,需要保留。
InstallSnapshot RPC
由领导者调用,用于将快照分块发送给跟随者。领导者总是按顺序发送分块。
参数:
- term:领导者的任期号
- leaderId:领导者ID,供跟随者重定向客户端
- lastIncludedIndex:快照替换了所有截至并包含该索引的条目
- lastIncludedTerm:lastIncludedIndex对应条目的任期号
- offset:分块在快照文件中的字节偏移量
- data[]:快照分块的原始字节,从offset位置开始
- done:如果这是最后一个分块则为true
返回值:
- term:当前任期号,供领导者自我更新
接收方实现逻辑:
- 如果term < currentTerm,立即返回
- 如果是第一个分块(offset为0),创建新的快照文件
- 将数据写入快照文件的指定偏移位置
- 如果done为false,回复并等待更多分块
- 保存快照文件,丢弃所有索引更小的已有或部分快照
- 如果现有日志中存在与快照最后包含索引和任期号匹配的条目,保留该条目之后的日志并回复
- 丢弃整个日志
- 使用快照内容重置状态机(并加载快照中的集群配置)
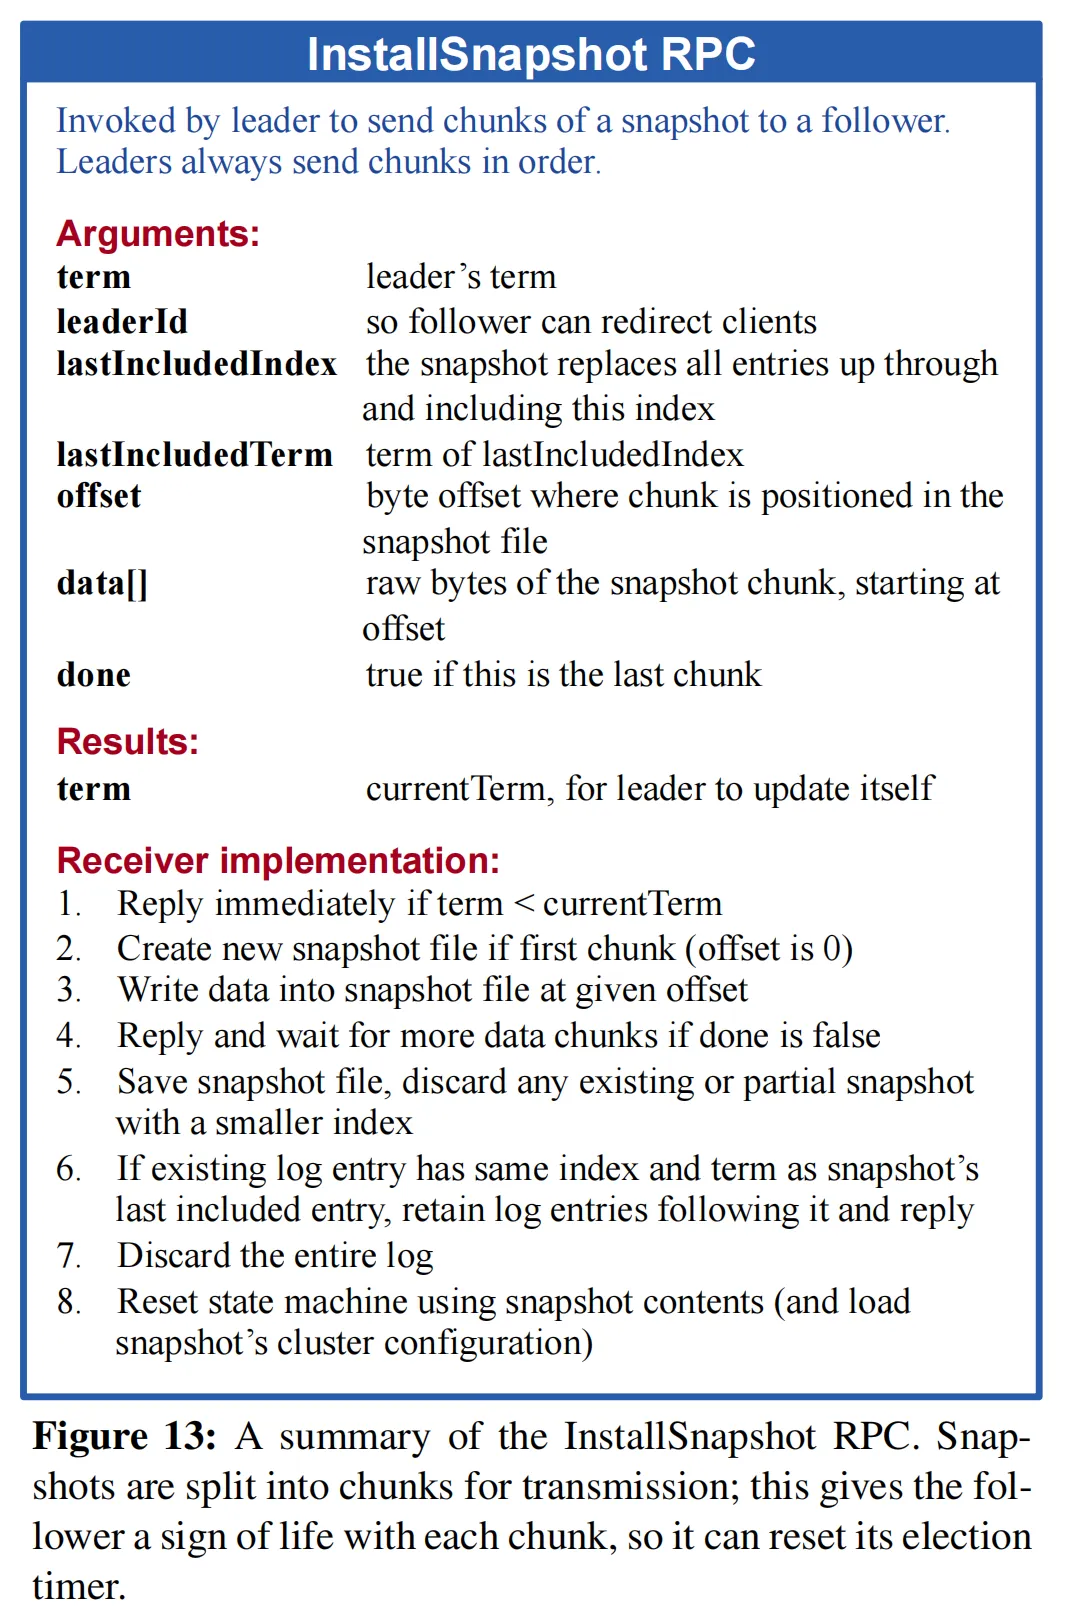
图13: InstallSnapshot RPC总结。快照被拆分为多个分块传输;每个分块都能让跟随者感知到连接存活,从而重置选举计时器。
这种快照方式偏离了Raft的强领导者原则,因为跟随者可以在领导者不知情的情况下生成快照。但我们认为这种偏离是合理的。虽然领导者有助于避免共识过程中的决策冲突,但快照生成时共识已经达成,不存在决策冲突。数据仍然只从领导者流向跟随者,只是跟随者现在可以自行整理数据了。
我们考虑过另一种基于领导者的方案:只有领导者才能生成快照,然后将快照发送给每个跟随者。但这种方法有两个缺点。第一,向每个跟随者发送快照会浪费网络带宽,拖慢快照过程。每个跟随者本身就拥有生成快照所需的信息,而且通常来说,服务器从本地状态生成快照的成本,远低于通过网络收发快照的成本。第二,领导者的实现会更复杂。例如,领导者需要并行地向跟随者发送快照和复制新日志条目,避免阻塞新的客户端请求。
还有两个影响快照性能的问题。第一,服务器必须决定何时生成快照。如果快照太频繁,会浪费磁盘带宽和能源;如果快照太不频繁,就有耗尽存储空间的风险,还会增加重启时重放日志的时间。一种简单的策略是当日志达到固定大小时生成快照。如果将这个大小设置为远大于快照的预期大小,那么快照带来的磁盘带宽开销就会很小。
第二个性能问题是,写入快照可能会花费大量时间,而我们不希望它延迟正常操作。解决方案是使用写时复制技术,这样新的更新可以正常接收,不会影响正在写入的快照。例如,基于函数式数据结构构建的状态机天然支持这一点。或者,也可以利用操作系统的写时复制支持(比如Linux上的fork)来创建整个状态机的内存快照(我们的实现就采用了这种方法)。
8. 客户端交互
本节介绍客户端如何与Raft交互,包括客户端如何找到集群领导者,以及Raft如何支持线性化语义[10]。这些问题适用于所有基于共识的系统,Raft的解决方案与其他系统类似。
Raft的客户端将所有请求都发送给领导者。客户端刚启动时,会随机选择一台服务器连接。如果客户端选择的第一台服务器不是领导者,该服务器会拒绝客户端请求,并提供它所知的最新领导者信息(AppendEntries请求中包含领导者的网络地址)。如果领导者崩溃,客户端请求会超时;之后客户端会再随机选择服务器重试。
我们对Raft的目标是实现线性化语义(每个操作看起来都是瞬时执行的,恰好执行一次,执行时间点在调用和响应之间)。但是,按照目前的描述,Raft可能会多次执行同一条命令:例如,如果领导者在提交日志条目之后、响应客户端之前崩溃,客户端会向新领导者重试该命令,导致它被执行第二次。解决方案是客户端为每条命令分配唯一的序列号。然后,状态机为每个客户端跟踪最新处理的序列号,以及对应的响应。如果收到的命令序列号已经执行过,就直接返回响应,不再重复执行。
只读操作可以不写入日志。但是,如果不采取额外措施,可能会返回过期数据——因为处理请求的领导者可能已经被新的领导者取代,而它自己还不知道。
线性化读操作不能返回过期数据,Raft需要两项额外的预防措施来保证这一点,且不需要写入日志。第一,领导者必须掌握哪些条目已提交的最新信息。领导者完整性属性保证了领导者拥有所有已提交条目,但在任期刚开始时,它可能不知道哪些条目是已提交的。要弄清楚这一点,它需要提交一条本任期的条目。Raft的处理方式是:每个领导者在任期开始时,都会向日志提交一条空的无操作条目。第二,领导者在处理只读请求前,必须检查自己是否已经被推翻(如果已经选出了更新的领导者,它的信息可能就过期了)。Raft的处理方式是:领导者在响应只读请求前,先和集群多数节点交换心跳消息。或者,领导者也可以用心跳机制提供一种租约[9],但这会依赖时序来保证安全性(假设时钟偏移是有界的)。
9. 实现与评估
我们将Raft实现为一个复制状态机的一部分,该状态机用于存储RAMCloud[33]的配置信息,并协助RAMCloud协调器的故障转移。Raft实现包含大约2000行C++代码,不包括测试、注释和空行。源代码开源可用[23]。此外,基于本文草稿,还有约25个独立的第三方开源实现[34],处于不同的开发阶段。同时,多家公司正在部署基于Raft的系统[34]。
本节剩余部分从三个维度评估Raft:可理解性、正确性和性能。
9.1 可理解性
为了衡量Raft相对于Paxos的可理解性,我们用斯坦福大学高级操作系统课程和加州大学伯克利分校分布式计算课程的高年级本科生和研究生进行了实验研究。我们录制了Raft和Paxos的教学视频,并制作了对应的测试题。Raft视频涵盖了本文除日志压缩外的所有内容;Paxos视频涵盖了构建等价复制状态机所需的全部内容,包括单决议Paxos、多决议Paxos、配置变更,以及一些实际中需要的优化(比如领导者选举)。测试题既考察对算法的基本理解,也要求学生分析边界情况。每个学生先观看一个视频,完成对应的测试,再观看第二个视频,完成第二个测试。约一半参与者先做Paxos部分,另一半先做Raft部分,以此抵消个体能力差异和第一部分带来的经验提升。我们通过比较参与者在两项测试中的得分,来判断他们是否更好地理解了Raft。
我们尽可能让Paxos和Raft的对比公平。实验在两方面对Paxos更有利:43名参与者中有15人表示之前有过Paxos相关经验,并且Paxos视频比Raft视频长14%。如表1总结,我们采取了多项措施来降低潜在偏差。所有实验材料都可公开查阅[28, 31]。
| 担忧点 | 缓解偏差的措施 | 可查阅材料 [28, 31] |
|---|---|---|
| 同等的授课质量 | 两个视频由同一位讲师讲授。Paxos的授课内容基于多所大学使用的现有材料并做了改进。Paxos视频时长更长14%。 | 视频 |
| 同等的测试难度 | 题目按难度分组,在两份试卷中配对。 | 测试题 |
| 公平的评分 | 使用评分标准。按随机顺序批改,两份试卷交替批改。 | 评分标准 |
表1: 研究中可能对Paxos不利的偏差担忧,对应的应对措施,以及可查阅的补充材料。
平均而言,参与者的Raft测试得分比Paxos高4.9分(满分60分,Raft平均分为25.7,Paxos平均分为20.8);图14展示了每个人的得分情况。配对t检验显示,在95%置信度下,Raft得分的真实均值比Paxos至少高2.5分。
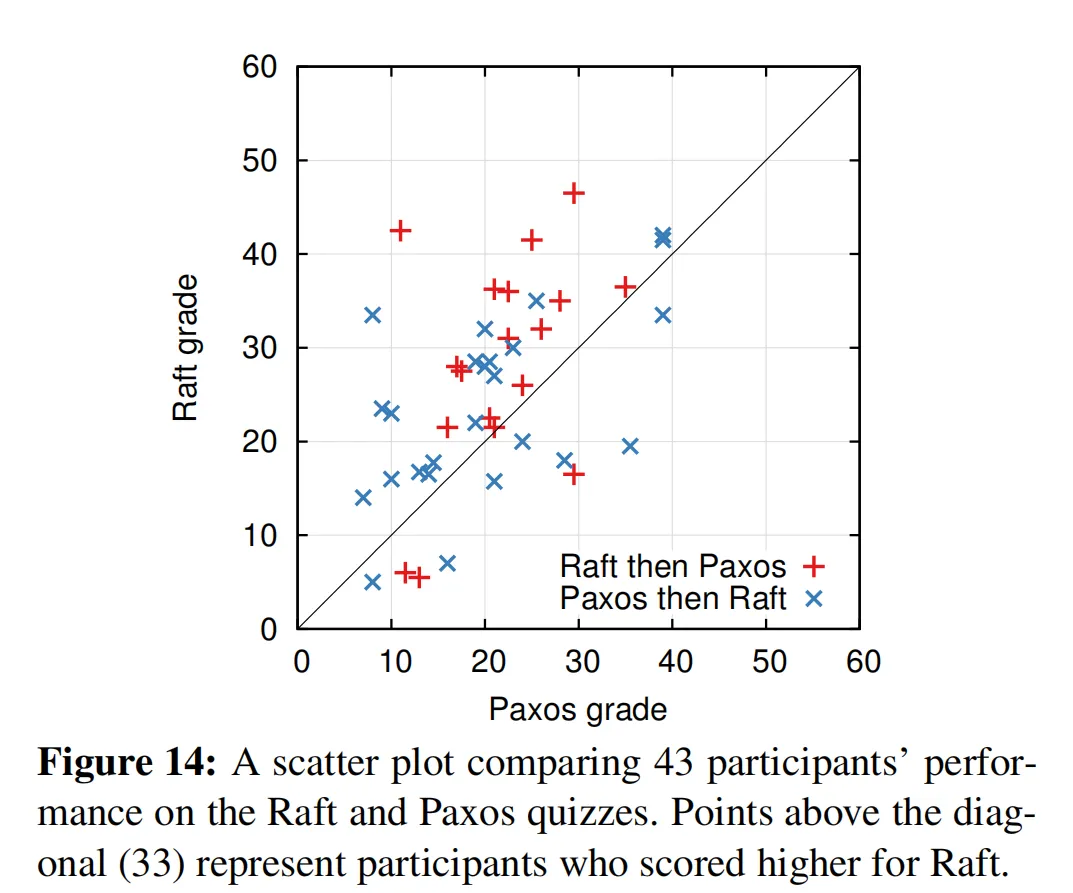
图14: 43名参与者在Raft和Paxos测试中的得分散点图。对角线上方的点(共33个)代表Raft得分更高的参与者。
我们还建立了一个线性回归模型,基于三个因素预测新学生的测试得分:测试类型、之前的Paxos经验程度,以及学习算法的顺序。模型预测,仅算法选择一项就会带来12.5分的差距,Raft占优。这个数值比观测到的4.9分差距大很多,因为实际学生中有很多有Paxos经验,这对Paxos帮助很大,而对Raft的帮助稍小。有趣的是,模型还预测,先做Paxos测试的人,Raft得分会低6.3分;虽然我们不清楚原因,但这一结果在统计上是显著的。
我们还在测试后调查了参与者,询问他们觉得哪种算法更容易实现或讲解;结果如图15所示。绝大多数参与者认为Raft更容易实现和讲解(两个问题分别都是41人中的33人)。不过,这种自我报告的感受可能不如测试得分可靠,而且参与者可能因为知道我们“Raft更易理解”的假设而产生偏差。
关于Raft用户研究的详细讨论参见[31]。
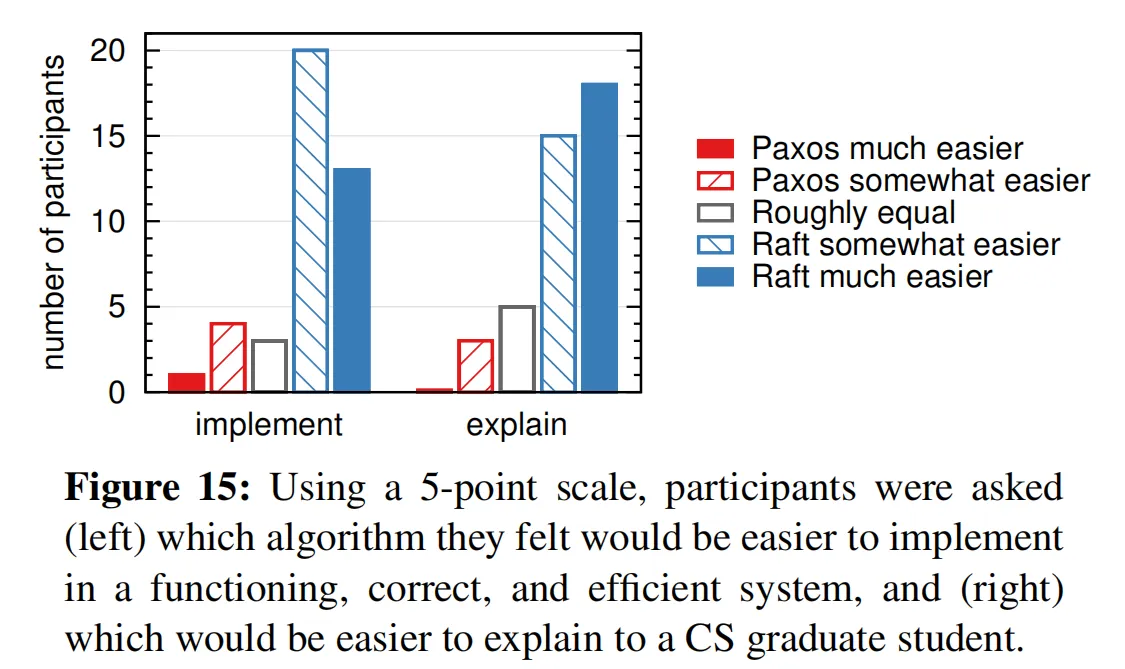
图15: 采用5分制,参与者被问及(左)哪种算法更容易实现为一个正确、高效、可运行的系统,以及(右)哪种算法更容易讲解给计算机专业的研究生。
9.2 正确性
我们为第5节所述的共识机制建立了形式化规范和安全性证明。形式化规范[31]使用TLA+规范语言[17],将图2中总结的信息完全精确化。规范大约400行,本身也是证明的主体。它对任何实现Raft的人都有参考价值。我们使用TLA证明系统[7]机械证明了日志完整性属性。不过,该证明依赖的一些不变量还没有经过机械检查(比如我们还没有证明规范的类型安全性)。此外,我们还撰写了状态机安全性属性的非形式化证明[31],该证明是完整的(仅依赖规范本身),也相对严谨(大约3500字)。
9.3 性能
Raft的性能与Paxos等其他共识算法相近。性能最重要的场景是:稳定的领导者复制新的日志条目。Raft在此场景下只需要最少的消息数(领导者到半数集群的单轮往返)。还可以进一步提升Raft的性能。例如,它可以很容易地支持请求批处理和流水线,以获得更高吞吐量和更低延迟。文献中已经提出了很多针对其他算法的优化,其中很多都可以应用到Raft上,我们将其留作未来工作。
我们用自己的Raft实现测试了领导者选举算法的性能,回答两个问题:第一,选举过程收敛快吗?第二,领导者崩溃后的最短停机时间是多少?
为了测试领导者选举,我们反复让五服务器集群的领导者崩溃,计时检测崩溃并选出新领导者所需的时间(见图16)。为了构造最坏情况,每次实验中的服务器日志长度都不同,因此有些候选者没有资格成为领导者。此外,为了增加选票分散的概率,我们的测试脚本在终止领导者进程前,会触发它同步广播一次心跳RPC(这近似于领导者崩溃前正在复制新日志条目的场景)。领导者在其心跳间隔内均匀随机崩溃,心跳间隔是所有测试中最小选举超时的一半。因此,最短可能停机时间约为最小选举超时的一半。
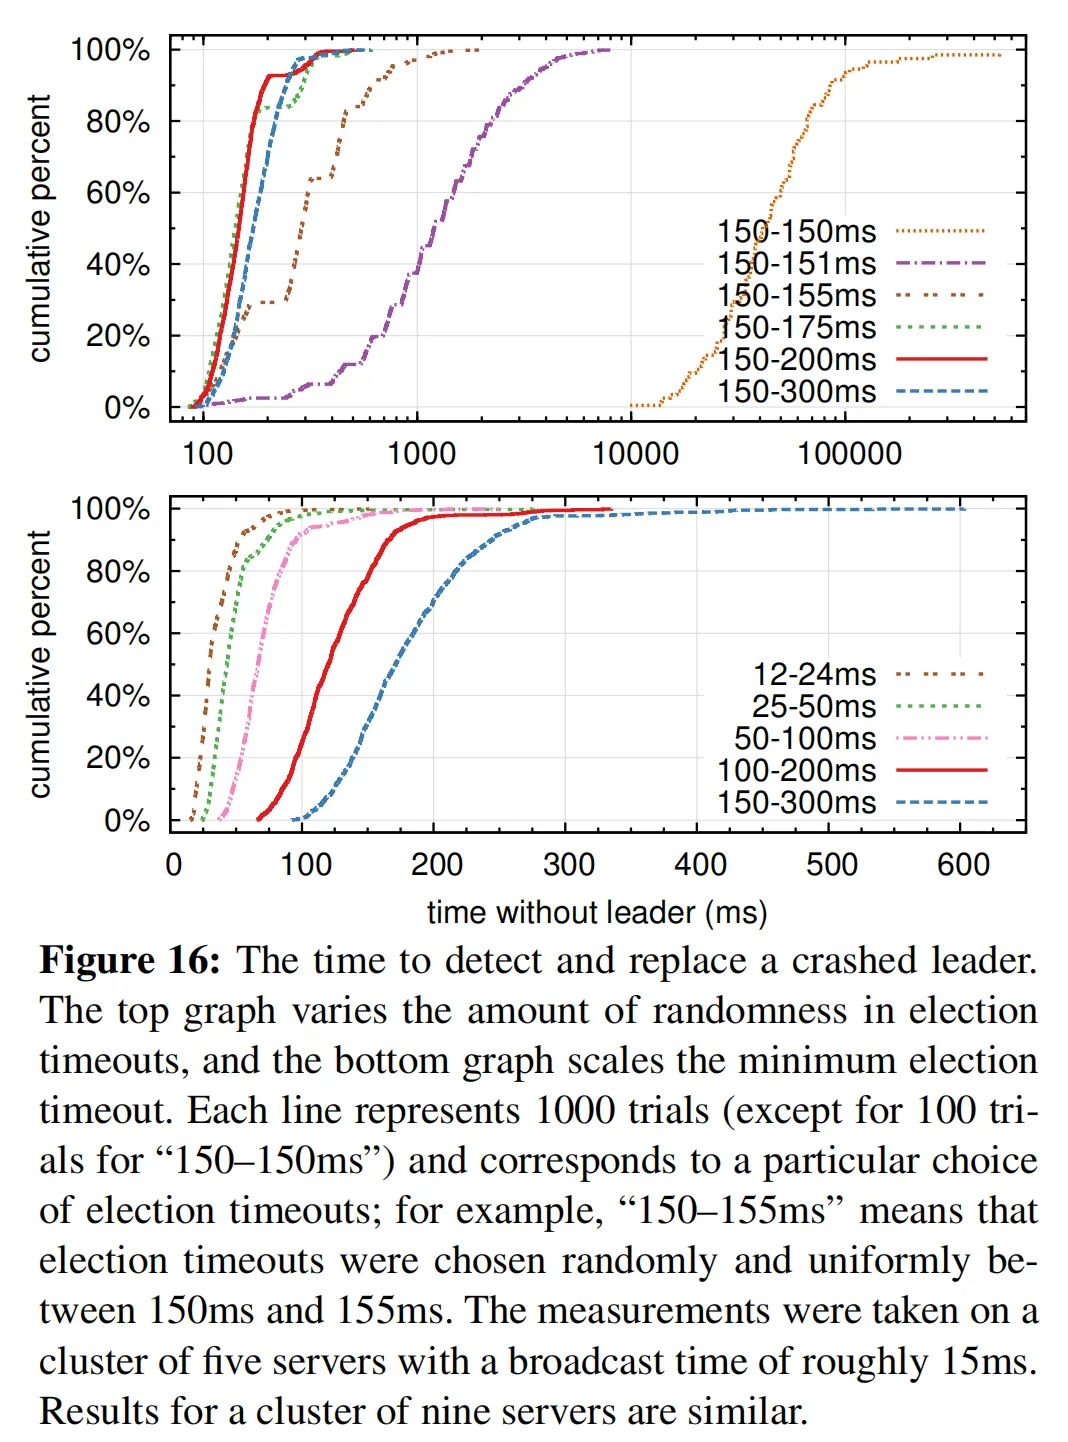
图16: 检测并替换崩溃领导者所需的时间。上图改变选举超时的随机程度,下图缩放最小选举超时的大小。每条线代表1000次实验(“150–150ms”为100次),对应一种选举超时配置;例如“150–155ms”表示选举超时在150ms到155ms之间随机均匀选择。测试在五服务器集群上进行,广播时间约为15ms。九服务器集群的结果类似。
图16的上图显示,选举超时中加入少量随机性,就足以避免选举中的选票分散。在没有随机性的情况下,由于多次选票分散,领导者选举的耗时始终超过10秒。仅加入5毫秒的随机性就有显著改善,中位停机时间降到287毫秒。增加更多随机性可以改善最坏情况:随机性为50毫秒时,(1000次实验中的)最坏完成时间为513毫秒。
图16的下图显示,缩短选举超时可以减少停机时间。选举超时设为12–24毫秒时,平均只需要35毫秒就能选出领导者(最长的一次实验用了152毫秒)。但是,超时再缩短就会违反Raft的时序要求:领导者还没来得及广播心跳,其他服务器就开始新的选举了。这会导致不必要的领导者变更,降低整体系统可用性。我们建议使用保守一些的选举超时,比如150–300毫秒;这样的超时不太可能导致不必要的领导者变更,同时也能提供很好的可用性。
10. 相关工作
已经有大量关于共识算法的研究,其中很多都属于以下几类:
- Lamport对Paxos的原始描述[15],以及各种更清晰的解释尝试[16, 20, 21]。
- Paxos的细化工作,补充缺失细节并修改算法,为实现提供更好的基础[13, 26, 39]。
- 实现共识算法的系统,比如Chubby[2, 4]、ZooKeeper[11, 12]和Spanner[6]。Chubby和Spanner的算法没有详细公开,尽管两者都声称基于Paxos。ZooKeeper的算法公开了更多细节,但与Paxos差异很大。
- 可应用于Paxos的性能优化[1, 3, 18, 19, 25, 27]。
- Oki和Liskov提出的视图戳复制(VR),一种与Paxos同期提出的共识替代方案。原始描述[29]与分布式事务协议交织在一起,但核心共识协议在最新的更新中被独立出来[22]。VR采用基于领导者的方法,与Raft有很多相似之处。
Raft和Paxos最大的区别在于Raft的强领导者模式:Raft将领导者选举作为共识协议必不可少的一部分,并且尽可能将功能集中到领导者身上。这种方法带来了更简单、更易理解的算法。例如,在Paxos中,领导者选举与基础共识协议是正交的:它只是一种性能优化,并不是达成共识的必要条件。但这也带来了额外的机制:Paxos既包含用于基础共识的两阶段协议,又包含独立的领导者选举机制。相比之下,Raft将领导者选举直接融入共识算法,作为共识的第一个阶段。这使得整体机制比Paxos更少。
和Raft一样,VR和ZooKeeper也是基于领导者的,因此也具备Raft相对于Paxos的很多优势。但是,Raft的机制比VR或ZooKeeper更少,因为它最大限度地减少了非领导者节点的功能。例如,Raft中的日志条目只单向流动:通过AppendEntries RPC从领导者向外发送。而VR中的日志条目是双向流动的(领导者在选举过程中可以接收日志条目);这带来了额外的机制和复杂度。已公开的ZooKeeper描述中,日志条目也是双向传输的,但它的实际实现显然更接近Raft[35]。
据我们所知,在所有基于共识的日志复制算法中,Raft的消息类型最少。例如,我们统计了VR和ZooKeeper用于基础共识和成员变更的消息类型(不包括日志压缩和客户端交互,因为这两部分几乎与算法无关)。VR和ZooKeeper各定义了10种不同的消息类型,而Raft只有4种(两种RPC请求及其响应)。Raft的单条消息内容比其他算法稍丰富,但整体上更简单。此外,VR和ZooKeeper的描述中,领导者变更时需要传输完整日志;要优化这些机制使其具备实用性,还需要额外的消息类型。
Raft的强领导者方法简化了算法,但也排除了一些性能优化。例如,平等Paxos(EPaxos)采用无领导者方法,在某些场景下可以获得更高性能[27]。EPaxos利用状态机命令的可交换性:只要并发提出的其他命令与它可交换,任何服务器都可以仅用一轮通信就提交命令。但是,如果并发提出的命令互相不可交换,EPaxos就需要额外一轮通信。因为任何服务器都可以提交命令,EPaxos在服务器之间负载均衡得很好,在广域网场景下延迟比Raft更低。但它也给Paxos增加了大量复杂度。
其他工作中已经提出或实现了多种集群成员变更方法,包括Lamport的原始方案[15]、VR[22]和SMART[24]。我们为Raft选择联合共识方法,是因为它可以复用共识协议的其余部分,因此成员变更只需要很少的额外机制。Lamport的基于α的方法不适用于Raft,因为它假设不需要领导者就能达成共识。与VR和SMART相比,Raft的重配置算法优势在于:成员变更过程中不会限制正常请求的处理;相比之下,VR在配置变更期间会停止所有正常处理,而SMART会对未完成请求的数量施加类似α的限制。Raft的方法也比VR和SMART引入的机制更少。
11. 结论
算法设计通常将正确性、效率和/或简洁性作为首要目标。尽管这些都是很有价值的目标,但我们相信可理解性同样重要。在开发者将算法落地为实际实现之前,所有其他目标都无从谈起,而实现不可避免地会偏离并扩展已发表的形式。除非开发者对算法有深刻理解并能建立直观认知,否则他们很难在实现中保留算法的优良特性。
本文针对分布式共识问题展开研究——在这个领域,Paxos作为被广泛接受的算法,多年来一直困扰着学生和开发者。我们设计了全新的Raft算法,并证明它比Paxos更易于理解。我们还相信,Raft为系统构建提供了更好的基础。将可理解性作为首要设计目标,改变了我们设计Raft的思路;在设计过程中,我们反复运用了一些技术,比如问题分解和状态空间简化。这些技术不仅提升了Raft的可理解性,也让我们更容易确信它的正确性。
12. 致谢
如果没有Ali Ghodsi、David Mazières,以及伯克利CS 294-91课程和斯坦福CS 240课程的同学们,用户研究不可能完成。Scott Klemmer协助我们设计了用户研究,Nelson Ray为统计分析提供了建议。用户研究中使用的Paxos幻灯片大量借鉴了Lorenzo Alvisi最初创建的演示文稿。特别感谢David Mazières和Ezra Hoch发现了Raft中一些微妙的漏洞。许多人对论文和用户研究材料提供了有益的反馈,包括Ed Bugnion、Michael Chan、Hugues Evrard、Daniel Giffin、Arjun Gopalan、Jon Howell、Vimalkumar Jeyakumar、Ankita Kejriwal、Aleksandar Kracun、Amit Levy、Joel Martin、Satoshi Matsushita、Oleg Pesok、David Ramos、Robbert van Renesse、Mendel Rosenblum、Nicolas Schiper、Deian Stefan、Andrew Stone、Ryan Stutsman、David Terei、Stephen Yang、Matei Zaharia、24位匿名会议审稿人(有重复),尤其感谢我们的指导Eddie Kohler。Werner Vogels在推特上转发了早期草稿的链接,让Raft获得了大量关注。本研究得到了千兆级系统研究中心和多尺度系统中心的支持,这两个中心是聚焦中心研究计划(半导体研究公司项目)下设的六个研究中心之二;同时得到了STARnet(由MARCO和DARPA资助的半导体研究公司项目)、美国国家科学基金会(批准号0963859),以及Facebook、Google、Mellanox、NEC、NetApp、SAP和三星的资助。Diego Ongaro得到了Junglee公司斯坦福研究生奖学金的支持。
参考文献
[1] BOLOSKY, W. J., BRADSHAW, D., HAAGENS, R. B., KUSTERS, N. P., AND LI, P. P. 作为高性能数据存储基础的Paxos复制状态机. 见《NSDI’11会议论文集:USENIX网络系统设计与实现研讨会》(2011), USENIX, 第141–154页.
[2] BURROWS, M. 面向松耦合分布式系统的Chubby锁服务. 见《OSDI’06会议论文集:操作系统设计与实现研讨会》(2006), USENIX, 第335–350页.
[3] CAMARGOS, L. J., SCHMIDT, R. M., AND PEDONE, F. 多协调Paxos. 见《PODC’07会议论文集:ACM分布式计算原理研讨会》(2007), ACM, 第316–317页.
[4] CHANDRA, T. D., GRIESEMER, R., AND REDSTONE, J. P. Paxos实战:工程视角. 见《PODC’07会议论文集:ACM分布式计算原理研讨会》(2007), ACM, 第398–407页.
[5] CHANG, F., DEAN, J., GHEMAWAT, S., HSIEH, W. C., WALLACH, D. A., BURROWS, M., CHANDRA, T., FIKES, A., AND GRUBER, R. E. BigTable:面向结构化数据的分布式存储系统. 见《OSDI’06会议论文集:USENIX操作系统设计与实现研讨会》(2006), USENIX, 第205–218页.
[6] CORBETT, J. C., DEAN, J., EPSTEIN, M., FIKES, A., FROST, C., FURMAN, J. J., GHEMAWAT, S., GUBAREV, A., HEISER, C., HOCHSCHILD, P., HSIEH, W., KANTHAK, S., KOGAN, E., LI, H., LLOYD, A., MELNIK, S., MWAURA, D., NAGLE, D., QUINLAN, S., RAO, R., ROLIG, L., SAITO, Y., SZYMANIAK, M., TAYLOR, C., WANG, R., AND WOODFORD, D. Spanner:Google的全球分布式数据库. 见《OSDI’12会议论文集:USENIX操作系统设计与实现研讨会》(2012), USENIX, 第251–264页.
[7] COUSINEAU, D., DOLIGEZ, D., LAMPORT, L., MERZ, S., RICKETTS, D., AND VANZETTO, H. TLA+证明. 见《FM’12会议论文集:形式化方法研讨会》(2012), D. Giannakopoulou和D. Méry编, 计算机科学讲义卷7436, Springer, 第147–154页.
[8] GHEMAWAT, S., GOBIOFF, H., AND LEUNG, S.-T. Google文件系统. 见《SOSP’03会议论文集:ACM操作系统原理研讨会》(2003), ACM, 第29–43页.
[9] GRAY, C., AND CHERITON, D. 租约:一种高效的分布式文件缓存一致性容错机制. 见《第12届ACM操作系统原理研讨会论文集》(1989), 第202–210页.
[10] HERLIHY, M. P., AND WING, J. M. 线性化:并发对象的正确性条件. ACM编程语言与系统汇刊 12 (1990年7月), 463–492.
[11] HUNT, P., KONAR, M., JUNQUEIRA, F. P., AND REED, B. ZooKeeper:面向互联网级系统的无等待协调. 见《ATC’10会议论文集:USENIX年度技术大会》(2010), USENIX, 第145–158页.
[12] JUNQUEIRA, F. P., REED, B. C., AND SERAFINI, M. Zab:面向主备系统的高性能广播. 见《DSN’11会议论文集:IEEE/IFIP可靠系统与网络国际会议》(2011), IEEE计算机学会, 第245–256页.
[13] KIRSCH, J., AND AMIR, Y. 面向系统构建者的Paxos. 技术报告 CNDS-2008-2, 约翰霍普金斯大学, 2008.
[14] LAMPORT, L. 分布式系统中的时间、时钟与事件排序. ACM通讯 21, 7 (1978年7月), 558–565.
[15] LAMPORT, L. 兼职议会. ACM计算机系统汇刊 16, 2 (1998年5月), 133–169.
[16] LAMPORT, L. Paxos简化版. ACM SIGACT新闻 32, 4 (2001年12月), 18–25.
[17] LAMPORT, L. 系统规范:TLA+语言与软硬件工程师工具. Addison-Wesley, 2002.
[18] LAMPORT, L. 广义共识与Paxos. 技术报告 MSR-TR-2005-33, 微软研究院, 2005.
[19] LAMPORT, L. 快速Paxos. 分布式计算 19, 2 (2006), 79–103.
[20] LAMPSON, B. W. 如何用共识构建高可用系统. 见《分布式算法》, O. Babaoglu和K. Marzullo编. Springer-Verlag, 1996, 第1–17页.
[21] LAMPSON, B. W. Paxos的ABCD. 见《PODC’01会议论文集:ACM分布式计算原理研讨会》(2001), ACM, 第13–13页.
[22] LISKOV, B., AND COWLING, J. 再探视图戳复制. 技术报告 MIT-CSAIL-TR-2012-021, 麻省理工学院, 2012年7月.
[23] LogCabin源代码. http://github.com/logcabin/logcabin.
[24] LORCH, J. R., ADYA, A., BOLOSKY, W. J., CHAIKEN, R., DOUCEUR, J. R., AND HOWELL, J. 迁移有状态复制服务的SMART方法. 见《EuroSys’06会议论文集:ACM SIGOPS欧洲计算机系统会议》(2006), ACM, 第103–115页.
[25] MAO, Y., JUNQUEIRA, F. P., AND MARZULLO, K. Mencius:为广域网构建高效复制状态机. 见《OSDI’08会议论文集:USENIX操作系统设计与实现研讨会》(2008), USENIX, 第369–384页.
[26] MAZIÈRES, D. 实用Paxos. http://www.scs.stanford.edu/~dm/home/papers/paxos.pdf, 2007年1月.
[27] MORARU, I., ANDERSEN, D. G., AND KAMINSKY, M. 平等议会中的更多共识. 见《SOSP’13会议论文集:ACM操作系统原理研讨会》(2013), ACM.
[28] Raft用户研究. http://ramcloud.stanford.edu/~ongaro/userstudy/.
[29] OKI, B. M., AND LISKOV, B. H. 视图戳复制:一种支持高可用分布式系统的新型主副本方法. 见《PODC’88会议论文集:ACM分布式计算原理研讨会》(1988), ACM, 第8–17页.
[30] O’NEIL, P., CHENG, E., GAWLICK, D., AND ONEIL, E. 日志结构合并树(LSM-tree). 信息学学报 33, 4 (1996), 351–385.
[31] ONGARO, D. 共识:衔接理论与实践. 博士论文, 斯坦福大学, 2014(进行中). http://ramcloud.stanford.edu/~ongaro/thesis.pdf.
[32] ONGARO, D., AND OUSTERHOUT, J. 寻找一种易于理解的共识算法. 见《ATC’14会议论文集:USENIX年度技术大会》(2014), USENIX.
[33] OUSTERHOUT, J., AGRAWAL, P., ERICKSON, D., KOZYRAKIS, C., LEVERICH, J., MAZIÈRES, D., MITRA, S., NARAYANAN, A., ONGARO, D., PARULKAR, G., ROSENBLUM, M., RUMBLE, S. M., STRATMANN, E., AND STUTSMAN, R. RAMCloud的理由. ACM通讯 54 (2011年7月), 121–130.
[34] Raft共识算法官网. https://raft.github.io.
[35] REED, B. 个人交流, 2013年5月17日.
[36] ROSENBLUM, M., AND OUSTERHOUT, J. K. 日志结构文件系统的设计与实现. ACM计算机系统汇刊 10 (1992年2月), 26–52.
[37] SCHNEIDER, F. B. 用状态机方法实现容错服务:教程. ACM计算概览 22, 4 (1990年12月), 299–319.
[38] SHVACHKO, K., KUANG, H., RADIA, S., AND CHANSLER, R. Hadoop分布式文件系统. 见《MSST’10会议论文集:海量存储系统与技术研讨会》(2010), IEEE计算机学会, 第1–10页.
[39] VAN RENESSE, R. 中等复杂度的Paxos. 技术报告, 康奈尔大学, 2012.