【转载】创新的扩散:生成式学习的最新进展

原文地址:A Diffusion of Innovations: Recent Developments in Generative Learning,by Sebastian Raschka, on 2022-11-05

创新的扩散:生成式学习的最新进展

文章与趋势

生成式学习将走向何方?我们将去往何处?

前些年,生成式领域的核心是用于文本生成的大型语言Transformer模型。尽管文本与视觉方向的Transformer模型仍是众多研究者和AI公司的关注重点,但扩散模型近来已然抢占了它们的风头。

随着扩散模型(完整论文:https://arxiv.org/abs/2006.11239 )的出现,生成式学习领域近来掀起了一场重大变革。大约一年半前,也就是2021年5月11日,我们初次见识到扩散模型的表现超越了生成对抗网络(GAN)。而如今,扩散模型已然无处不在。

什么是扩散模型?

从本质上讲,扩散模型属于生成式模型。在训练过程中,模型会分多个步骤向输入数据中逐步添加随机噪声,对数据进行扰动。随后,模型通过逆向过程学习如何反转噪声、对输出进行去噪,从而还原出原始数据。在推理阶段,扩散模型便可以基于噪声输入生成全新的数据。
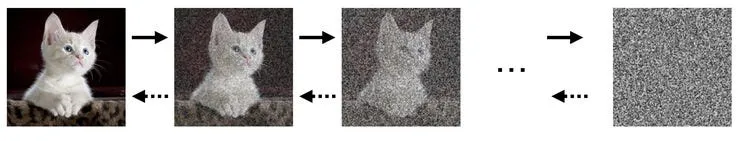
figure01
扩散模型示意图

Continue reading 【转载】创新的扩散:生成式学习的最新进展→

【转载】Borg:Google大规模集群管理系统(Large-scale Cluster Management at Google with Borg)

Borg:Google大规模集群管理系统

Large-scale cluster management at Google with Borg

贡献:容器编排与云原生领域的奠基之作,定义了云原生时代的基础设施调度范式,催生了K8S

Abhishek Verma Luis Pedrosa Madhukar Korupolu David Oppenheimer Eric Tune John Wilkes
Google Inc.

摘要

Google 的 Borg 系统是一套集群管理系统,它承载着数十万计的作业,这些作业来自数千个不同的应用,运行在多个集群之上,每个集群最多可包含数万台机器。

Borg 通过准入控制、高效的任务打包、资源超售、机器共享与进程级性能隔离相结合的方式,实现了极高的资源利用率。它通过运行时特性(最大限度缩短故障恢复时间)和调度策略(降低关联故障的概率),为高可用应用提供支撑。Borg 提供声明式的作业规范语言、名称服务集成、实时作业监控,以及用于分析和模拟系统行为的工具,简化了用户的使用成本。

本文将概述 Borg 系统的架构与核心特性、重要的设计决策,对部分策略决策进行定量分析,并结合十余年的生产运维经验,对其中的经验教训展开定性探讨。

Continue reading 【转载】Borg:Google大规模集群管理系统(Large-scale Cluster Management at Google with Borg)→

【转载】寻找一种易于理解的共识算法(In Search of an Understandable Consensus Algorithm)

寻找一种易于理解的共识算法(扩展版)

In Search of an Understandable Consensus Algorithm(Extended Version)

贡献:针对Paxos等一致性算法 “理论可行、工程难落地” 的局面,提出了更加实用的Raft算法,大幅降低了分布式一致性的实现门槛。

作者:Diego Ongaro、John Ousterhout

斯坦福大学

发表于《USENIX ATC’14 会议论文集:2014年USENIX年度技术大会》,第305-319页,2014年6月19-20日,美国宾夕法尼亚州费城

或 https://raft.github.io/raft.pdf

本技术报告是文献[32]的扩展版本;新增内容以页边灰色条标注。发布于2014年5月20日。

Raft是一种用于管理复制日志的共识算法。它能达到与(多)Paxos等价的效果,效率也与Paxos相当,但算法结构与Paxos不同;这一特性让Raft比Paxos更易于理解,也为构建实际系统提供了更优的基础。为了提升可理解性,Raft将共识的核心要素(如领导者选举、日志复制、安全性)进行拆分,同时通过更强的一致性约束来减少需要考虑的状态数量。用户研究结果表明,学生学习Raft的难度远低于Paxos。Raft还提出了一种全新的集群成员变更机制,通过重叠多数派来保证安全性。

Continue reading 【转载】寻找一种易于理解的共识算法(In Search of an Understandable Consensus Algorithm)→

【转载】Spanner:Google的全球分布式数据库(Spanner: Google’s Globally-Distributed Database)

Spanner:Google的全球分布式数据库

Spanner: Google’s Globally-Distributed Database

贡献:分布式数据库领域的划时代之作,被称为 “下一代分布式数据库的标杆”,重新定义了分布式关系数据库的技术路线。

James C. Corbett、Jeffrey Dean、Michael Epstein、Andrew Fikes、Christopher Frost、JJ Furman、Sanjay Ghemawat、Andrey Gubarev、Christopher Heiser、Peter Hochschild、Wilson Hsieh、Sebastian Kanthak、Eugene Kogan、李鸿毅、Alexander Lloyd、Sergey Melnik、David Mwaura、David Nagle、Sean Quinlan、Rajesh Rao、Lindsay Rolig、Yasushi Saito、Michal Szymaniak、Christopher Taylor、Ruth Wang、Dale Woodford
Google,Inc.

摘要

Spanner是谷歌推出的一款可扩展、多版本、全球分布且同步复制的数据库。它是首个实现全球范围数据分布、同时支持外部一致性分布式事务的系统。本文阐述了Spanner的架构设计、功能特性、各项设计决策背后的考量,以及一种能够暴露时钟不确定性的新型时间API。该API及其实现对于支持外部一致性以及诸多强大特性至关重要:包括全局范围内的非阻塞历史读取、无锁只读事务,以及原子模式变更。

Continue reading 【转载】Spanner:Google的全球分布式数据库(Spanner: Google’s Globally-Distributed Database)→

【转载】弹性分布式数据集:内存集群计算的容错抽象(Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing)

弹性分布式数据集:内存集群计算的容错抽象

Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing

贡献:提出RDD,促使Spark生态取代MapReduce成为大数据计算的事实标准

作者:Matei Zaharia, Mosharaf Chowdhury, Tathagata Das, Ankur Dave, Justin Ma, Murphy McCauley, Michael J. Franklin, Scott Shenker, Ion Stoica
单位:University of California, Berkeley


摘要

我们提出了弹性分布式数据集(Resilient Distributed Datasets,简称RDD),这是一种分布式内存抽象,能够让程序员在大型集群上以容错的方式执行内存计算。RDD的提出,旨在解决两类现有计算框架处理效率低下的应用场景:迭代算法与交互式数据挖掘工具。在这两类场景中,将数据保存在内存中可以将性能提升一个数量级。为了高效实现容错,RDD提供了一种受限制的共享内存形式:它是只读数据集,只能通过对其他RDD执行批量操作来构建。但我们的研究表明,RDD的表达能力足以覆盖广泛的计算类型,包括MapReduce,以及Pregel等面向迭代任务的专用编程模型,还能支持这些模型无法覆盖的新型应用。我们在名为Spark的系统中实现了RDD,并通过多种用户应用和基准测试对其进行了评估。

Continue reading 【转载】弹性分布式数据集:内存集群计算的容错抽象(Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing)→

【转载】Kafka:面向日志处理的分布式消息系统(Kafka: A Distributed Messaging System for Log Processing)

Kafka:面向日志处理的分布式消息系统

Kafka: A Distributed Messaging System for Log Processing

贡献:提出基于日志的分布式消息队列模型,统一了日志收集与流式数据传输的架构。,如今已成为工业界消息队列的事实标准,支撑了几乎所有实时数据处理场景。

Jay Kreps Neha Narkhede Jun Rao
LinkedIn Corp.

摘要

日志处理已成为消费级互联网公司数据管道中的核心组成部分。本文介绍了Kafka——一款我们为采集与传输高容量日志数据、实现低延迟交付而开发的分布式消息系统。该系统融合了现有日志聚合系统与消息系统的设计思想,同时适用于离线与在线消息消费场景。我们在Kafka中做出了诸多非常规但具备实用性的设计选择,以实现系统的高效性与可扩展性。实验结果表明,与两款主流消息系统相比,Kafka具备更优异的性能表现。目前Kafka已在生产环境中投入使用一段时间,每日可处理数百GB的新增数据。

Continue reading 【转载】Kafka:面向日志处理的分布式消息系统(Kafka: A Distributed Messaging System for Log Processing)→

【转载】Dynamo:亚马逊高可用键值存储系统(Dynamo: Amazon’s Highly Available Key-value Store)

Dynamo:亚马逊高可用键值存储系统

Dynamo: Amazon’s Highly Available Key-value Store

贡献:NoSQL领域的开山之作,和Bigtable并列为分布式NoSQL的两大技术基石

Giuseppe DeCandia, Deniz Hastorun, Madan Jampani, Gunavardhan Kakulapati, Avinash Lakshman, Alex Pilchin, Swaminathan Sivasubramanian, Peter Vosshall 和 Werner Vogels

Amazon.com

摘要

大规模场景下的可靠性是亚马逊(全球最大的电商平台之一)面临的最大挑战之一;哪怕是最轻微的服务中断都会造成重大的经济损失,并影响客户信任。亚马逊平台为全球众多网站提供服务,其底层基础设施由分布在全球各地数据中心的数万台服务器和网络组件构成。在这种规模下,大大小小的组件故障会持续发生,而面对这些故障时持久化状态的管理方式,决定了软件系统的可靠性与可扩展性。

本文介绍了Dynamo的设计与实现,这是一款高可用键值存储系统,亚马逊的部分核心服务使用它来提供“始终在线”的服务体验。为了达到这一可用性水平,Dynamo在特定故障场景下会牺牲一致性。它大量使用对象版本控制与应用辅助的冲突解决机制,为开发者提供了一种全新的接口模式。

分类与主题描述
D.4.2 [操作系统]:存储管理;D.4.5 [操作系统]:可靠性;D.4.2 [操作系统]:性能;

通用术语
算法,管理,度量,性能,设计,可靠性。

Continue reading 【转载】Dynamo:亚马逊高可用键值存储系统(Dynamo: Amazon’s Highly Available Key-value Store)→

【转载】面向松耦合分布式系统的Chubby锁服务(The Chubby Lock Service for Loosely-Coupled Distributed Systems)

面向松耦合分布式系统的Chubby锁服务

The Chubby Lock Service for Loosely-Coupled Distributed Systems

贡献:分布式协调服务的开山之作,催生了ZooKeeper,成为所有分布式系统的标准协调组件

Mike Burrows,Google Inc.

摘要

本文介绍了Chubby锁服务的实践经验,该服务旨在为松耦合分布式系统提供粗粒度锁能力,以及高可靠(但低容量)的存储功能。Chubby提供的接口与带有咨询锁的分布式文件系统非常相似,但设计的侧重点在于可用性与可靠性,而非高性能。该服务的多个实例已投入使用超过一年,其中部分实例可同时承载数万个客户端。本文阐述了Chubby的初始设计与预期用途,将其与实际使用情况进行对比,并解释了为适配这些差异而对设计做出的调整。

Continue reading 【转载】面向松耦合分布式系统的Chubby锁服务(The Chubby Lock Service for Loosely-Coupled Distributed Systems)→

【转载】Bigtable:一种面向结构化数据的分布式存储系统(Bigtable: A Distributed Storage System for Structured Data)


Bigtable:一种面向结构化数据的分布式存储系统

Bigtable: A Distributed Storage System for Structured Data

贡献:大数据三大论文,开启了大数据时代

作者:Fay Chang, Jeffrey Dean, Sanjay Ghemawat, Wilson C. Hsieh, Deborah A. Wallach, Mike Burrows, Tushar Chandra, Andrew Fikes, Robert E. Gruber

摘要

Bigtable是一种用于管理结构化数据的分布式存储系统,其设计目标是扩展至超大规模:跨越数千台商用服务器,存储PB级别的数据。Google内部有诸多项目都使用Bigtable存储数据,包括网页索引、Google Earth以及Google Finance等。这些应用对Bigtable的需求差异极大,无论是数据规模(从URL、网页到卫星影像)还是延迟要求(从后端批量处理到实时数据服务)皆是如此。尽管需求千差万别,Bigtable仍成功为所有这些Google产品提供了灵活、高性能的解决方案。本文将介绍Bigtable提供的简洁数据模型(该模型赋予客户端对数据布局与格式的动态控制权),并阐述Bigtable的设计与实现细节。

Continue reading 【转载】Bigtable:一种面向结构化数据的分布式存储系统(Bigtable: A Distributed Storage System for Structured Data)→

【转载】MapReduce:大型集群上的简化数据处理(MapReduce: Simplified Data Processing on Large Clusters)

MapReduce:大规模集群上的简化数据处理

MapReduce: Simplified Data Processing on Large Clusters

贡献:大数据三大论文,开启了大数据时代

Jeffrey Dean, Sanjay Ghemawat
Google, Inc.


分类与主题描述

D.4.1 [操作系统]:进程管理——并发;分布式系统

通用术语

性能、设计、可靠性、算法

关键词

MapReduce、分布式处理、大规模集群


摘要

MapReduce是一种编程模型,也是一种用于处理和生成大规模数据集的相关实现。用户指定一个map函数来处理键值对,生成一组中间键值对,再指定一个reduce函数来合并所有关联到同一个中间键的中间值。

许多现实世界中的任务都可以用这个模型来表达,本文将展示这一点。

用这种函数式风格编写的程序可以自动在大规模商用机器集群上并行执行。运行时系统负责处理输入数据的分区、在一组机器上调度程序执行、处理机器故障,以及管理所需的机器间通信。这使得没有并行和分布式系统经验的程序员也能轻松利用大型分布式系统的资源。

我们的MapReduce实现运行在由数百台机器组成的大型集群上,具有高度的可扩展性:一个典型的MapReduce计算会在数千台机器上处理数TB的数据。程序员发现这个系统易于使用:目前已经实现了数百个MapReduce程序,每天在Google的集群上运行的MapReduce作业超过一千个。

Continue reading 【转载】MapReduce:大型集群上的简化数据处理(MapReduce: Simplified Data Processing on Large Clusters)→