原文地址:
Insights from Large-Scale LLM Training Runs,by Sebastian Raschka, on 2023-05-06
大规模大语言模型训练运行洞察
及最新开源大语言模型与数据集
本期通讯的主题是梳理过去几周内涌现的、数量近乎庞杂的大语言模型(LLM)项目与数据集。除了重点介绍大规模训练运行带来的洞察外,我还将分享几份精选清单,方便大家跟进相关进展。
目录
https://magazine.sebastianraschka.com/i/119566166/articles-and-trends
https://magazine.sebastianraschka.com/i/119566166/pythia-interpreting-autoregressive-transformers-across-time-and-scale
https://magazine.sebastianraschka.com/i/119566166/open-source-data
https://magazine.sebastianraschka.com/i/119566166/keeping-track-of-open-source-llms
https://magazine.sebastianraschka.com/i/119566166/llama-adapter-v
https://magazine.sebastianraschka.com/i/119566166/research-highlights-in-two-sentences
https://magazine.sebastianraschka.com/i/119566166/open-source-highlights
https://magazine.sebastianraschka.com/i/119566166/new-deep-learning-fundamentals-units-on-computer-vision-and-large-language-models
https://magazine.sebastianraschka.com/i/119566166/notable-quote
https://magazine.sebastianraschka.com/i/119566166/upcoming-events
文章与趋势
本月新发表的研究论文数量众多,很难从中挑选出几篇最值得深入讨论的佳作。我个人更青睐能带来额外洞见的论文,而非仅仅推出性能更强的模型。基于这一标准,Eleuther AI的Pythia论文是其中一篇吸引我注意的成果。
Pythia——来自大规模训练运行的洞察
https://github.com/EleutherAI/pythia 是一款非常有意思的模型,可作为其他自回归解码器式(即类GPT)模型的替代方案。
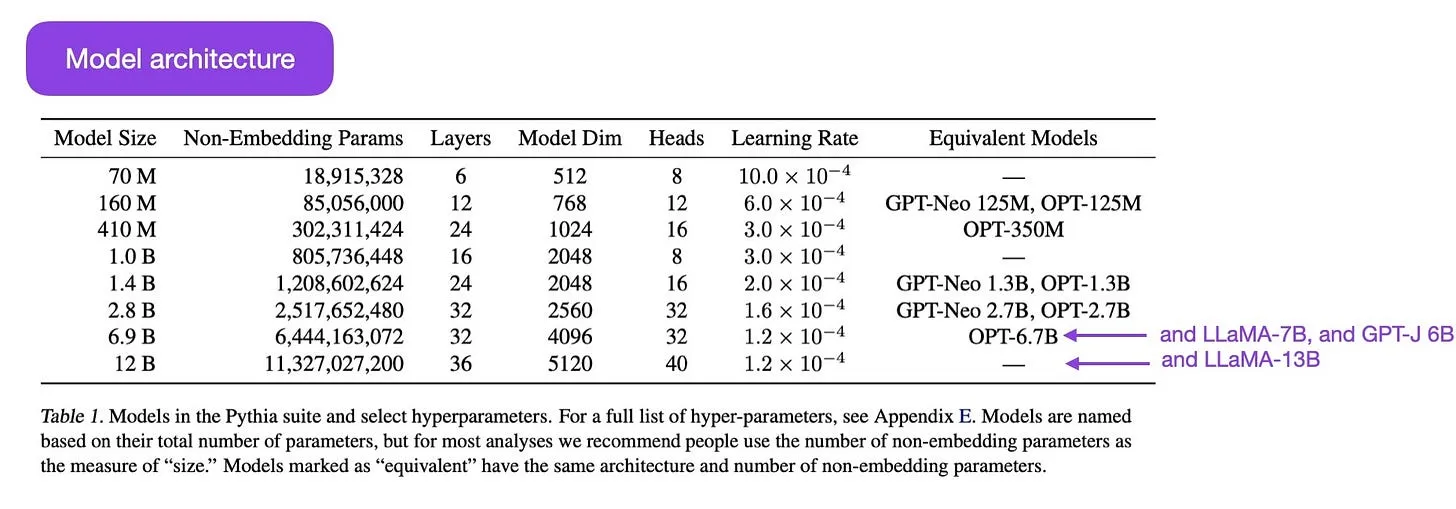
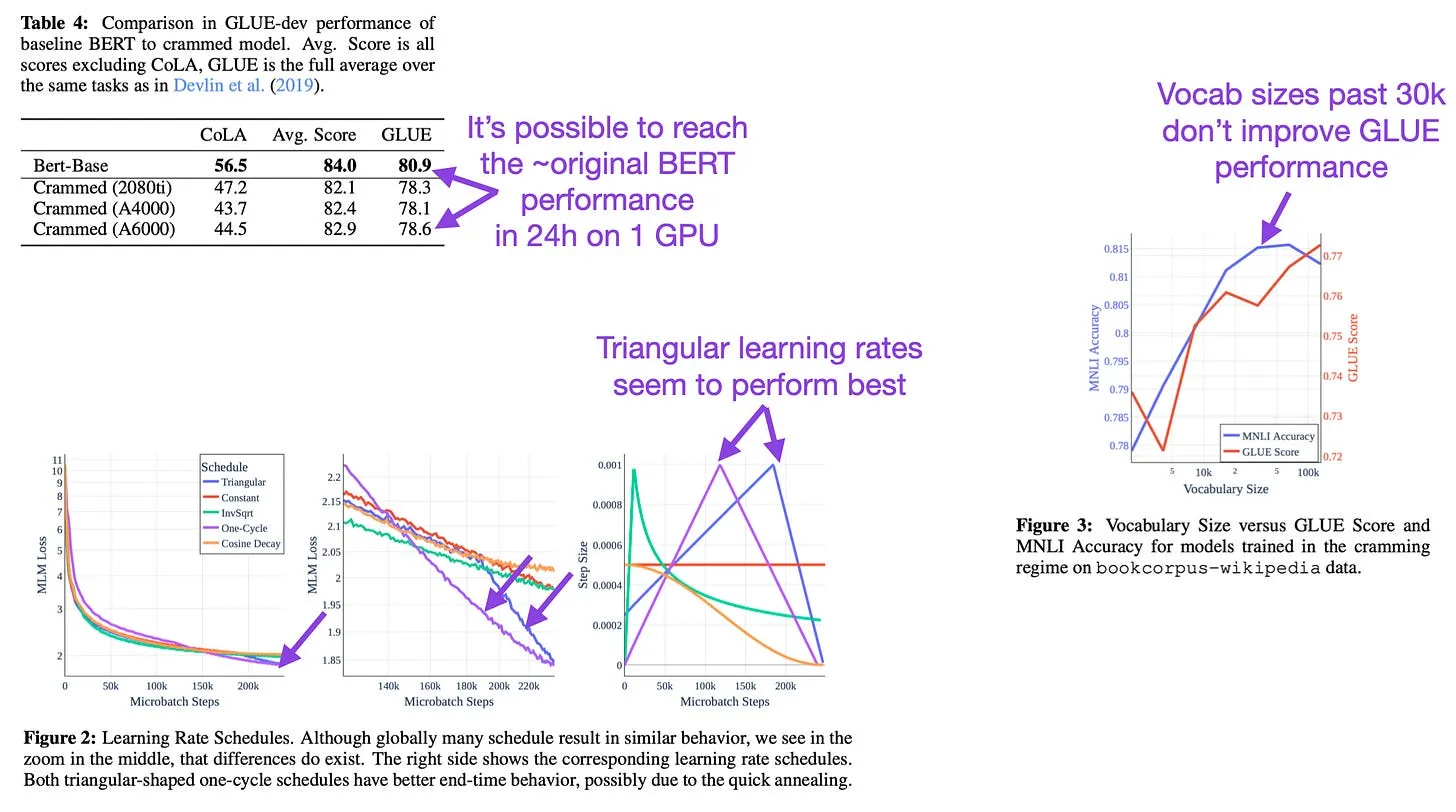
配套的论文 https://arxiv.org/abs/2304.01373 近期披露了关于训练机制的一系列有趣结论,同时推出了参数规模从7000万到120亿不等的多款大语言模型。
以下是该论文的部分核心洞察与结论:
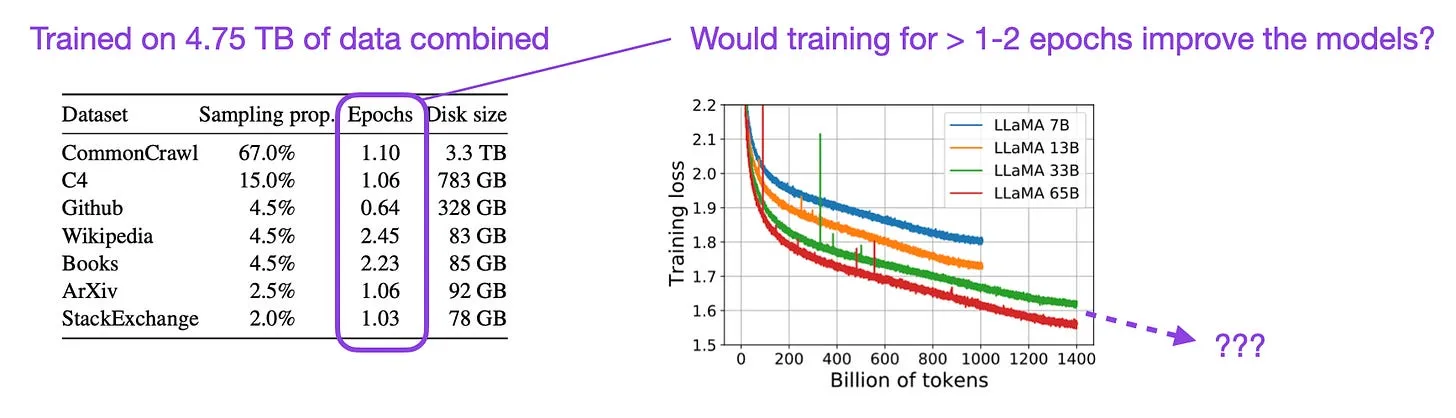
- 在重复数据上训练(即训练超过1个轮次)是否会影响性能? 结果表明,去重既不会提升也不会损害模型性能。
- 训练顺序是否会影响记忆效果? 遗憾的是,答案是否定的。说“遗憾”,是因为如果训练顺序真的有影响,我们就可以通过重排训练数据来缓解不理想的逐字记忆问题。
- 预训练词频是否会影响任务性能? 是的,出现频率更高的词汇,其少样本准确率往往更高。
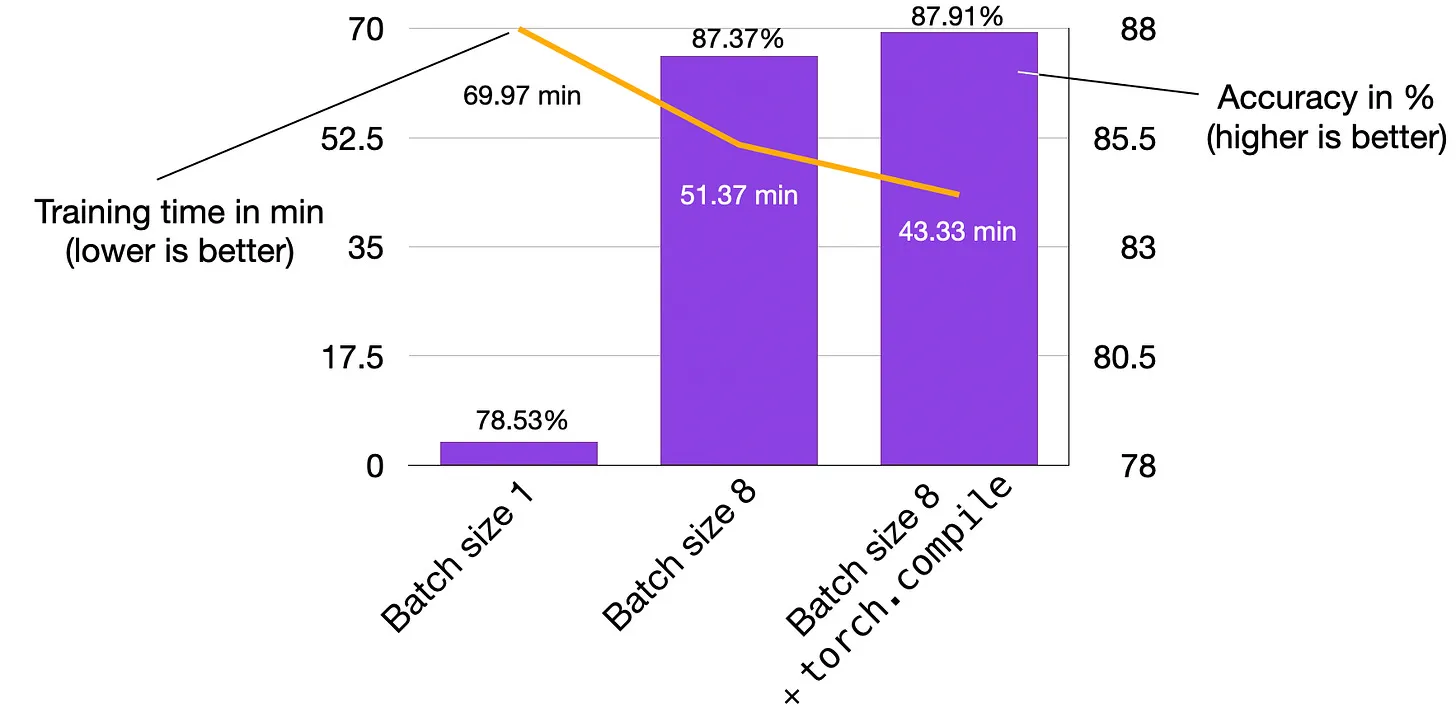
- 批量大小翻倍会让训练时间减半,且不会损害收敛效果。
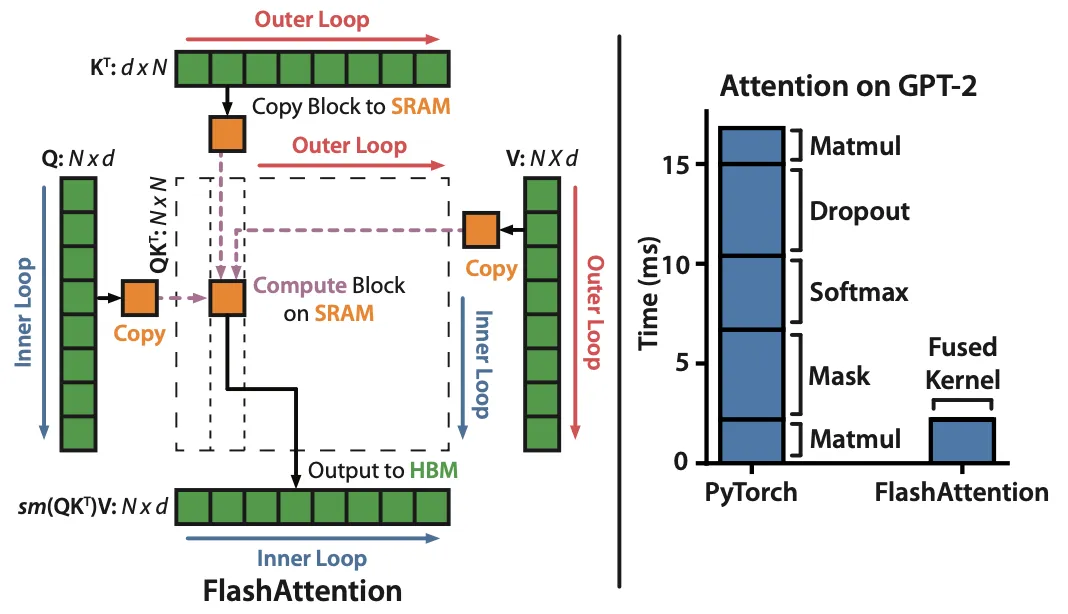
Pythia的模型架构与GPT-3类似,但融入了若干改进,例如参考了 https://arxiv.org/abs/2205.14135(与LLaMA类似)和 https://arxiv.org/abs/2104.09864(与 https://arxiv.org/abs/2204.02311 类似)的相关设计。Pythia在 https://arxiv.org/abs/2101.00027 数据集(一个容量800GB的多类型文本数据集)上训练了3000亿词元(在常规Pile数据集上约为1个训练轮次,在去重后的Pile数据集上约为1.5个轮次)。
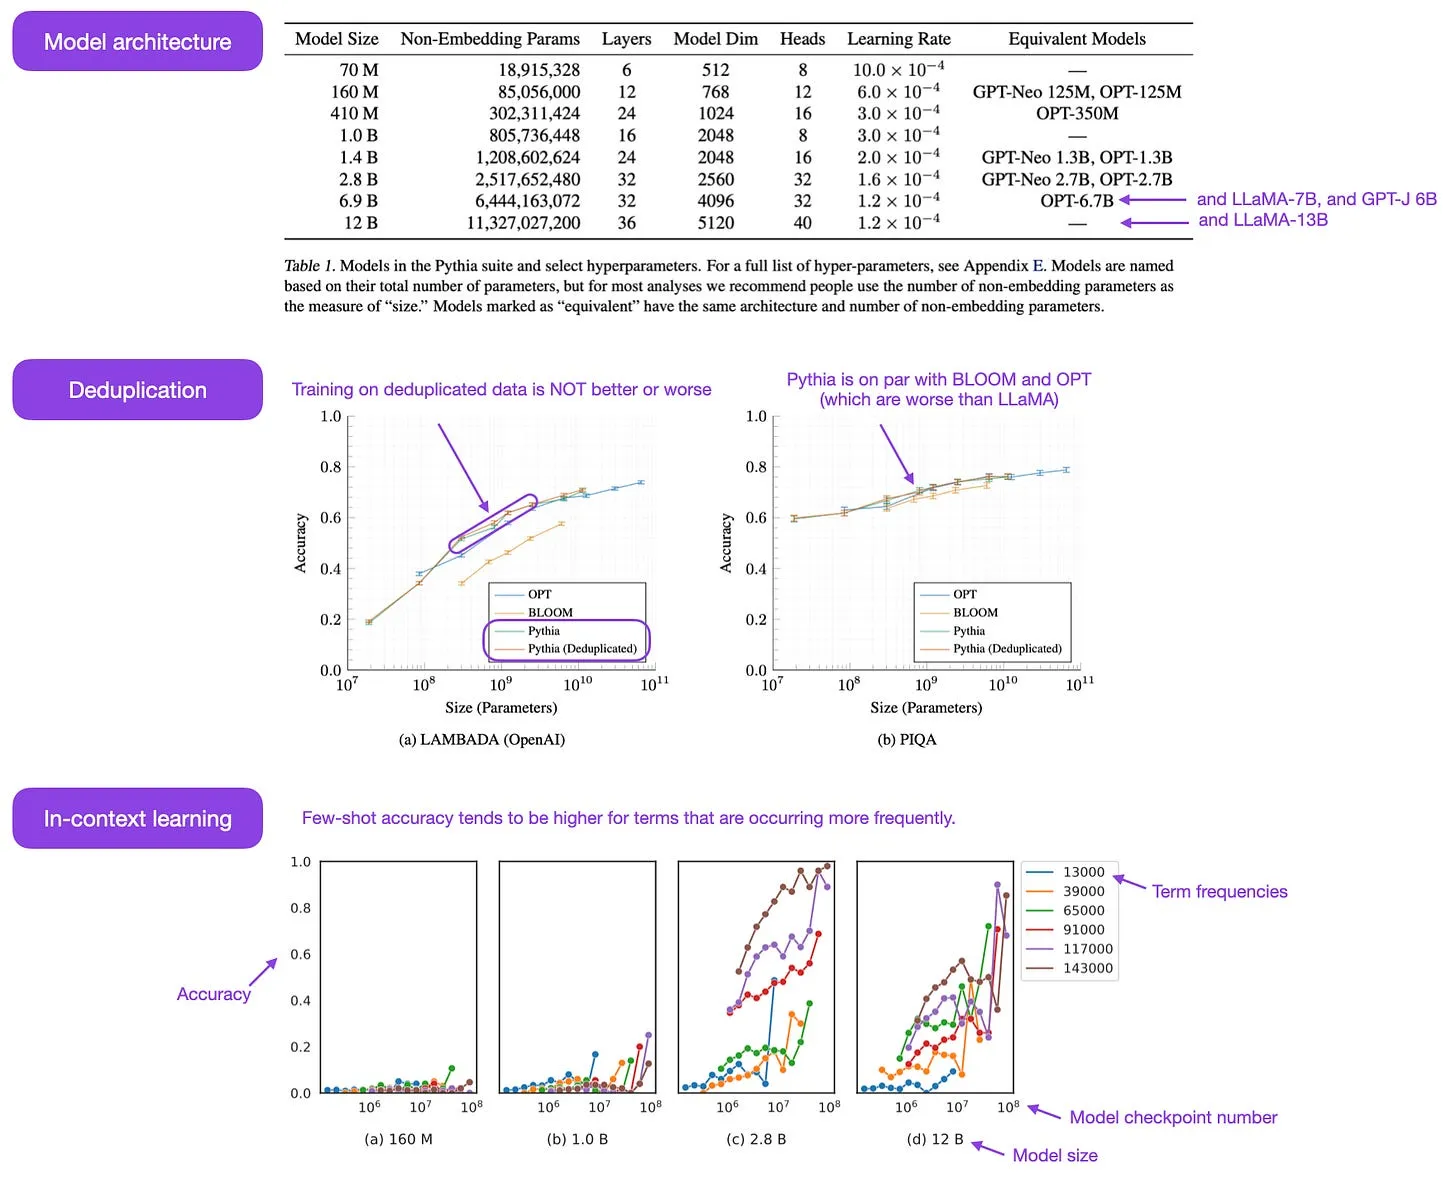
图注:来自Pythia论文的标注图(https://arxiv.org/abs/2304.01373)。
顺便一提,近期经过指令微调的开源大语言模型——Databricks推出的Dolly(https://www.databricks.com/blog/2023/04/12/dolly-first-open-commercially-viable-instruction-tuned-llm)*,正是以Pythia作为基础(底座)模型,我预计未来会有更多模型基于它构建。
(*Dolly v2是基于Pythia 12B参数模型,使用databricks-dolly-15k数据集进行微调,以复现InstructGPT论文/ChatGPT的效果。关于该数据集详见下文。)
开源数据
上个月是开源AI领域格外激动人心的一个月,多款大语言模型的开源实现相继问世。如今,我们也迎来了开源数据集的浪潮!包括用于指令微调的 https://www.databricks.com/blog/2023/04/12/dolly-first-open-commercially-viable-instruction-tuned-llm 和 https://github.com/LAION-AI/Open-Assistant/blob/main/docs/docs/data/datasets.md,以及用于预训练的 https://github.com/togethercomputer/RedPajama-Data。这一点尤其值得称赞,因为数据收集与清洗占据了现实机器学习项目约90%的工作量,却鲜有人愿意做这项工作。
用于预训练的RedPajama数据集
https://github.com/togethercomputer/RedPajama-Data 是一个用于大语言模型预训练的开源数据集,定位对标Meta的LLaMA模型这一业界标杆。该项目的目标是打造一款有竞争力的开源竞品,对标当前主流的闭源商业模型或仅部分开源的大语言模型。(注:RedPajama的名字灵感来自儿童读物《Llama Llama Red Pajama》,参见 https://www.rif.org/literacy-central/book/llama-llama-red-pajama 。)
该数据集的主体由经过英文网站过滤的CommonCrawl数据构成,其中的维基百科文章覆盖20种不同语言。
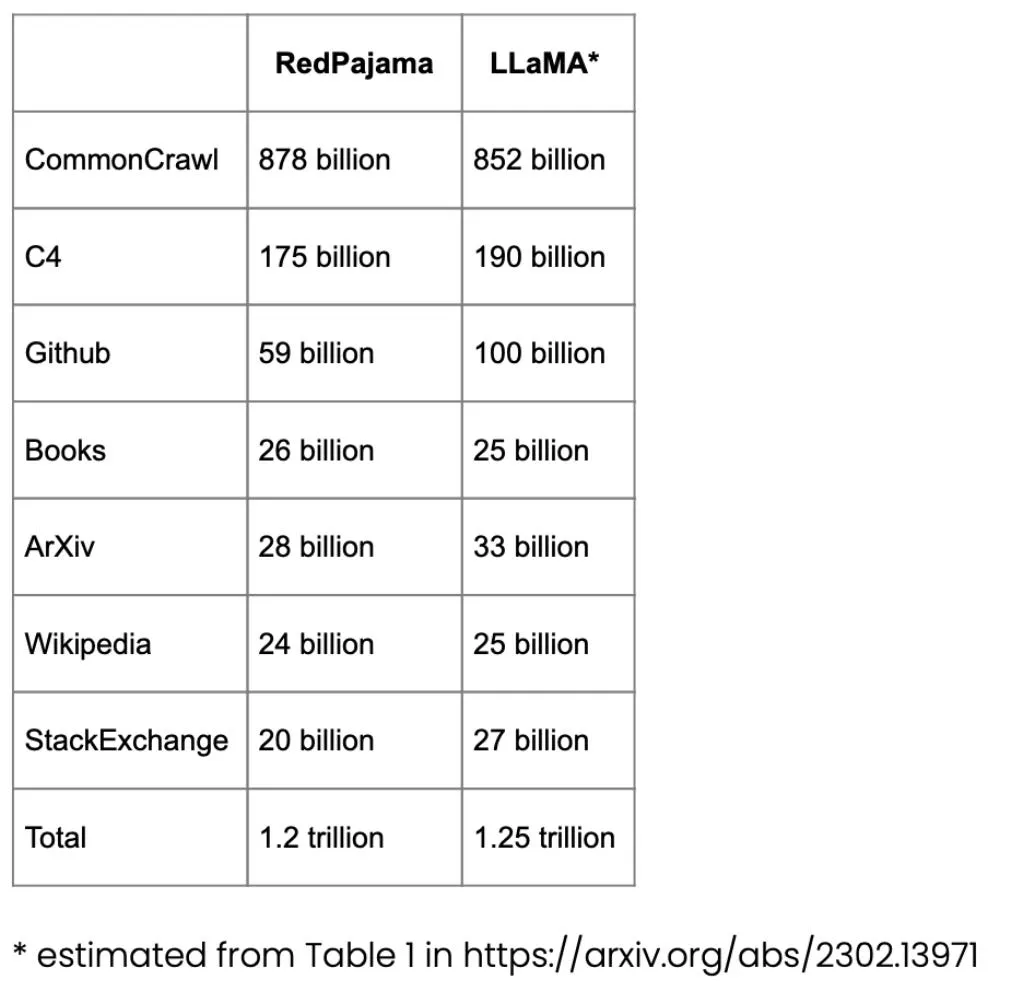
图注:旨在复现LLaMA预训练数据集的RedPajama数据集的词元数量(https://github.com/togethercomputer/RedPajama-Data)。
Databricks-Dolly-15
https://github.com/databrickslabs/dolly/tree/master/data 是一个用于大语言模型微调的数据集,包含超过15000条由数千名Databricks员工编写的指令对(与用于训练InstructGPT、ChatGPT等系统的数据类似)。
OpenAssistant对话数据集
file:///Users/sebastian/Developer/github_rasbt/ahead-of-ai/issues_drafts/newsletter-8/(https://huggingface.co/datasets/OpenAssistant/oasst1) 是另一个用于预训练模型微调的数据集,包含大量由人类创建并标注的类ChatGPT助手对话,涵盖35种语言的161443条消息,以及461292条质量评估。这些内容被组织在超过10000个经过完整标注的对话树中。
LongForm数据集
论文 https://arxiv.org/abs/2304.08460 介绍了一组来自C4、维基百科等权威语料库的人类撰写文档,并附带针对这些文档的指令,构建了适用于长文本生成的指令微调数据集。
Alpaca Libre
https://github.com/mobarski/alpaca-libre 项目旨在复现斯坦福Alpaca的效果(https://crfm.stanford.edu/2023/03/13/alpaca.html),将来自https://github.com/anthropics/hh-rlhf 的10万余条MIT许可演示数据转换为“Alpaca兼容格式”。
开放数据与版权问题
需要注意的是,大语言模型的数据使用仍是热议话题,以下文章对此做了总结:
- https://www.technologyreview.com/2023/04/19/1071789/openais-hunger-for-data-is-coming-back-to-bite-it/ 概述了OpenAI可能违反数据保护法的相关情况
- https://www.reuters.com/technology/eu-lawmakers-committee-reaches-deal-artificial-intelligence-act-2023-04-27/ 提到欧盟要求企业披露训练中使用的受版权保护材料
最后,关于上文提到的Pythia模型所使用的Pile数据集,还有一则趣闻:据一条推文(https://twitter.com/BlancheMinerva/status/1648398673553018880?s=20)称,Pile实际上没有官方许可,但Eleuther AI的研究人员表示,它在美国境内可能符合版权法的规定。
扩展开源数据集
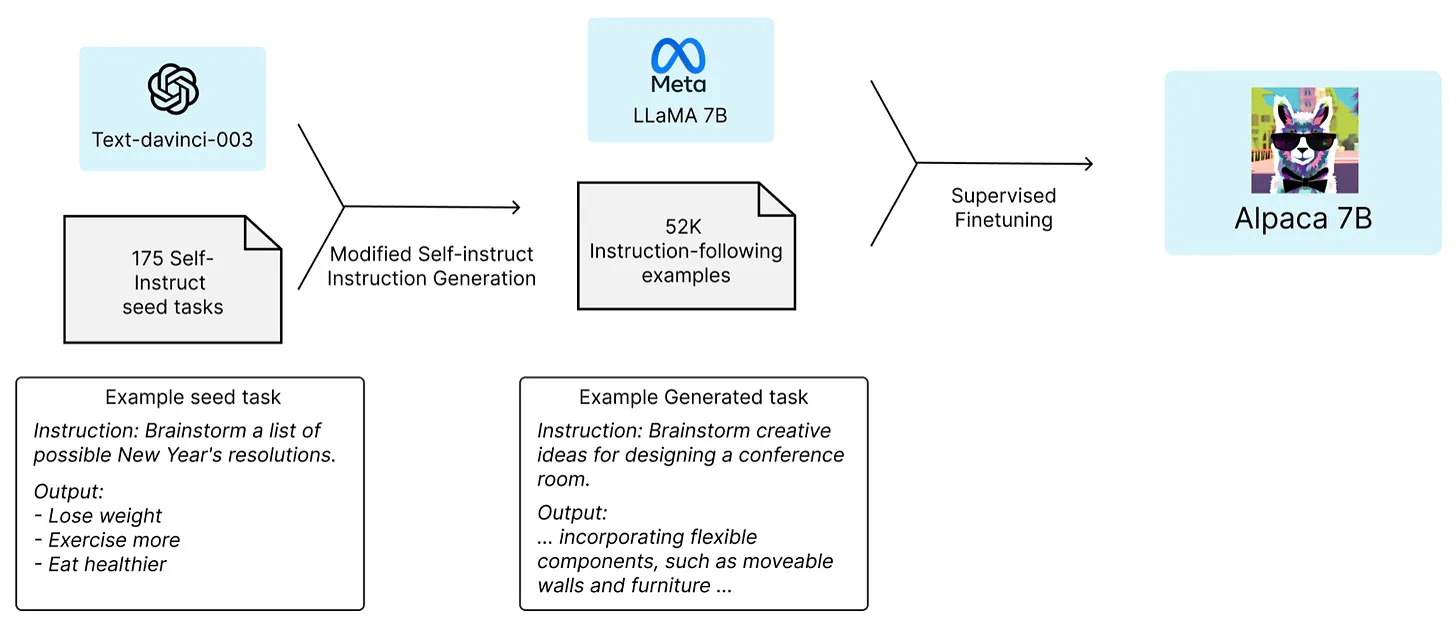
指令微调是我们从类GPT-3的预训练底座模型,升级到ChatGPT这类能力更强的大语言模型的途径。而像上文提到的Dolly这类开源人类指令数据集,正是实现这一过程的助力。但我们该如何进一步扩大规模?是否可以不用收集额外数据?其中一种方法是让大语言模型利用自身生成的结果进行自举。
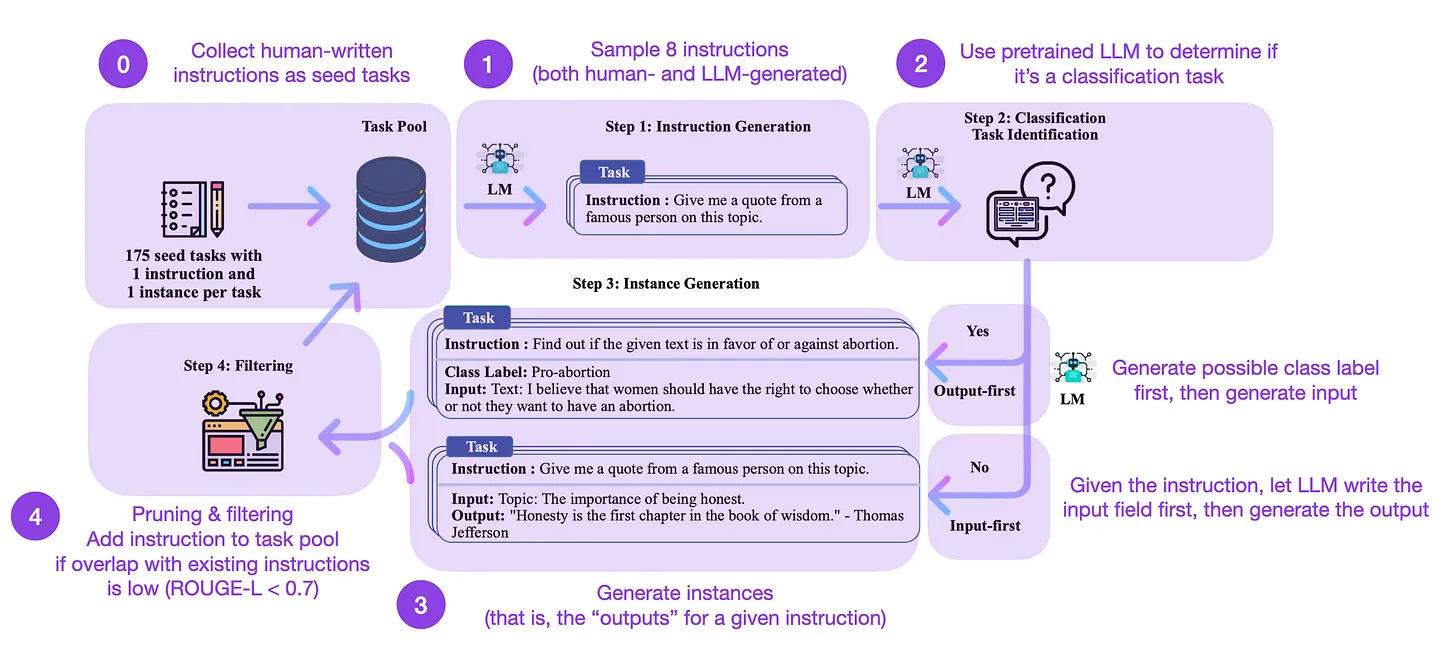
尽管 https://arxiv.org/abs/2212.10560 这篇论文发表于五个月前(按如今的标准已经算“旧”了),但它的思路仍然非常值得介绍——这是一种几乎无需标注的方法,可让预训练大语言模型与指令对齐。
它的工作原理是什么? 简而言之,这是一个四步流程:
- 用一组人类编写的指令(本研究中为175条)构建种子任务池,并采样指令;
- 用预训练大语言模型(如GPT-3)判断任务类别;
- 针对新的指令,让预训练大语言模型生成回答;
- 对生成的回答进行收集、修剪和过滤,再加入任务池。
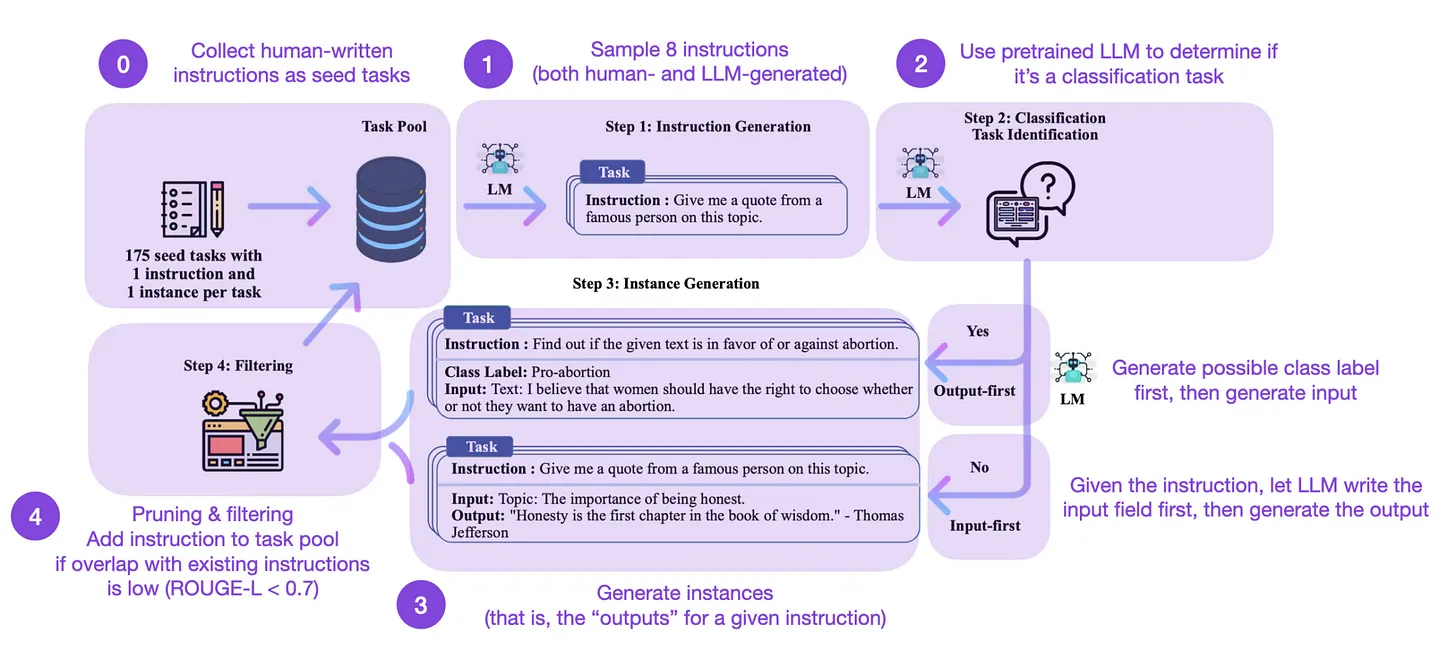
图注:基于论文https://arxiv.org/abs/2212.10560的标注图。
实践中,从ROUGE分数来看,这种方法效果相当不错。例如,经过自指令(Self-Instruct)微调的大语言模型,性能优于GPT-3底座模型(1),并且能与在大规模人类指令集上预训练的大语言模型相媲美(2)。同时,自指令方法也能让已经经过人类指令微调的大语言模型进一步受益(3)。
当然,评估大语言模型的黄金标准是人类评分。基于人类评估的结果显示,自指令方法的效果优于底座模型,也优于在人类指令数据集上以监督方式训练的模型(SuperNI、T0 Trainer)。但有意思的是,自指令方法的表现不及基于人类反馈的强化学习(RLHF)训练的方法。
人类生成训练数据 vs 合成训练数据
人类生成的指令数据集和自指令数据集,哪个更有前景?我认为两者都有价值。为什么不先用像databricks-dolly-15k这样的1.5万条人类指令数据集起步,再用自指令方法扩大规模呢?例如,近期论文 https://arxiv.org/abs/2304.08466 表明,将真实图像训练集与AI生成图像相结合,可以提升模型性能。如果对文本数据也能验证这一规律,岂不是很有意思?
近期就有一篇朝着这个方向研究的论文:https://arxiv.org/abs/2304.01228 。研究人员发现,预训练大语言模型如果利用自身生成的数据,可以提升代码生成任务的表现。
少即是多?
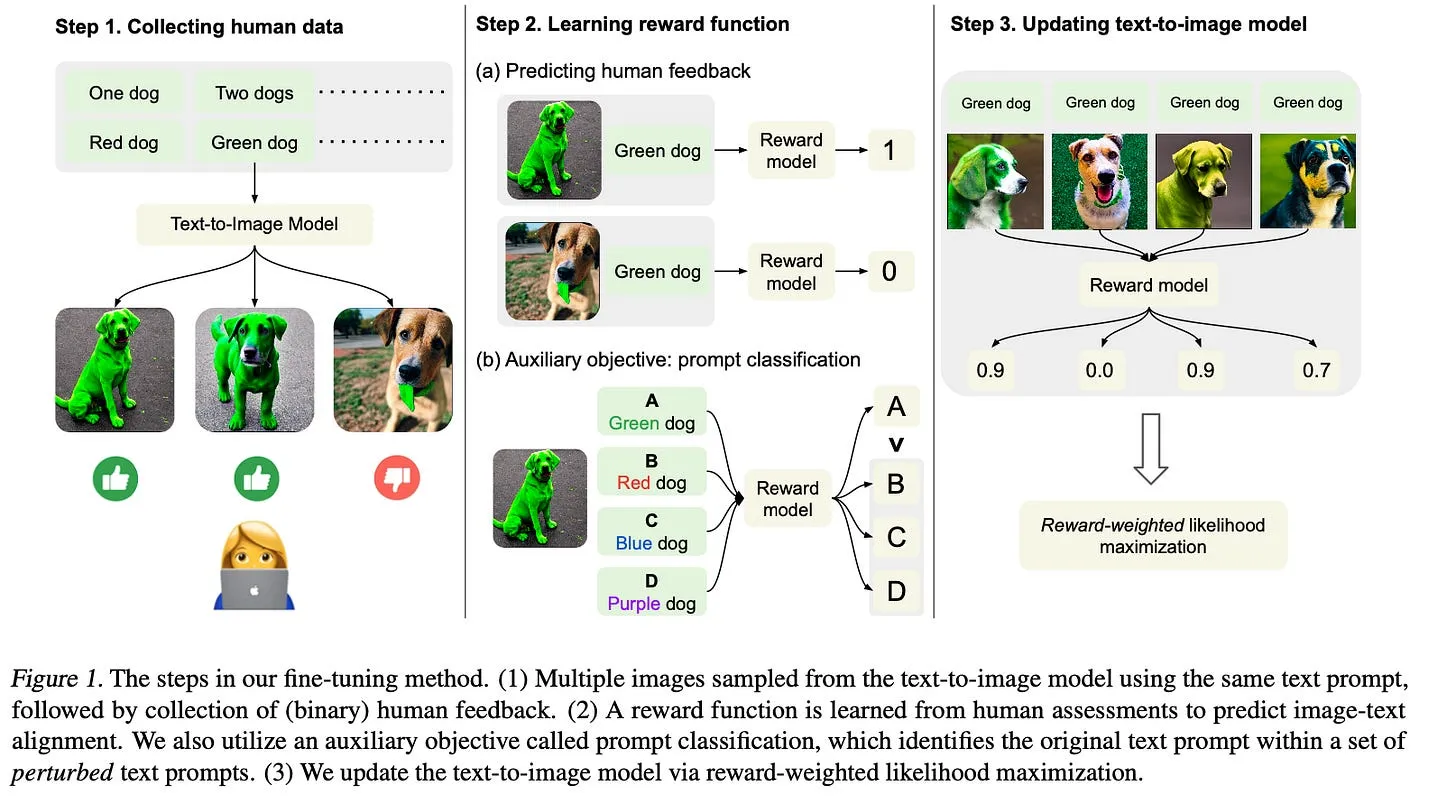
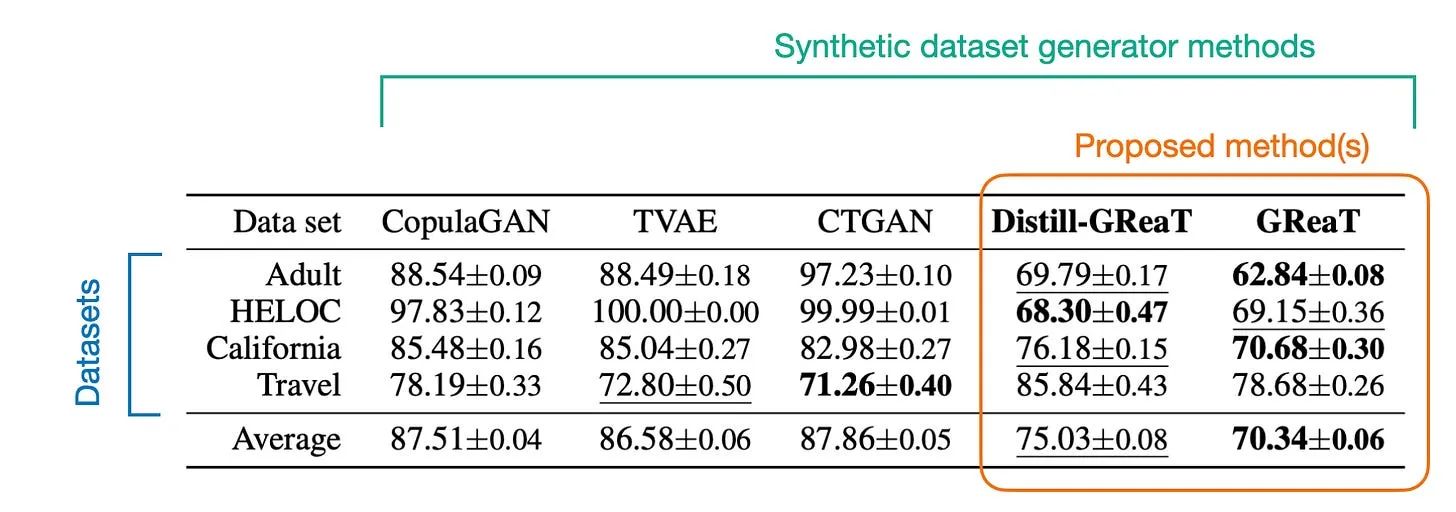
除了在越来越大的数据集上进行预训练和微调,我们是否也可以研究如何在更小的数据集上提升效率?在刚刚发表的论文 https://arxiv.org/abs/2305.02301 中,研究人员提出了一种蒸馏机制,用于筛选出面向特定任务的更小模型,在训练数据更少的情况下,性能超过标准微调方法。
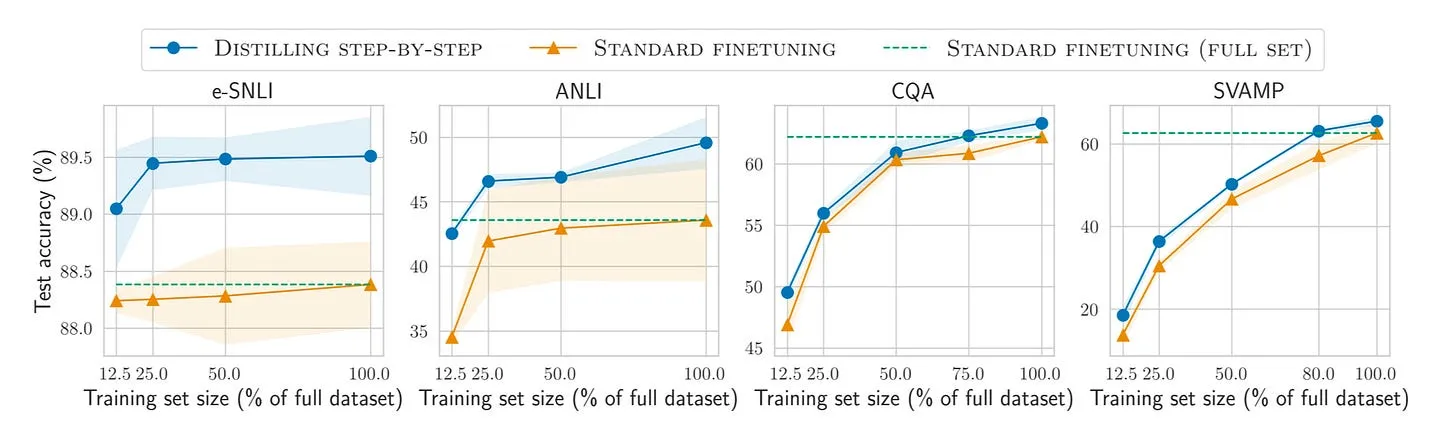
图注:截取自论文https://arxiv.org/abs/2305.02301。
追踪开源大语言模型
开源大语言模型的数量正在爆发式增长。一方面,这是非常好的发展趋势(相比通过付费API限制模型使用的模式);但另一方面,要全部跟进它们有时会很困难。以下四个资源从不同角度汇总了最具代表性的模型,包括它们的关联关系、底层数据集以及各类许可信息。
(一则有趣的旁注:LAION与其他知名研究者联合发布了一封致欧洲议会的公开信,参见 https://laion.ai/notes/letter-to-the-eu-parliament/ 。)
首先介绍的是斯坦福CRFM的生态系统图(https://crfm.stanford.edu/ecosystem-graphs/index.html?mode=table ),它基于论文https://arxiv.org/abs/2303.15772 制作,包含一张表格(截图见下)和一个交互式依赖关系图(未展示)。
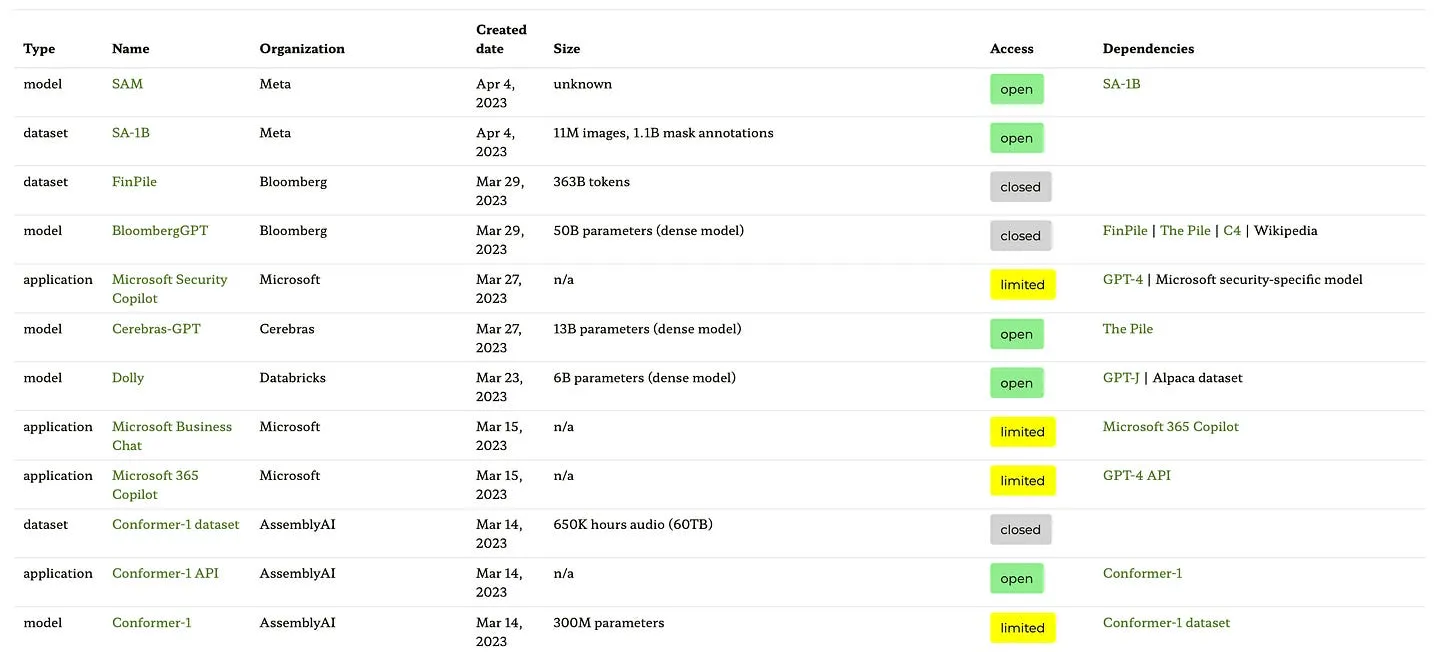
图注:来自https://crfm.stanford.edu/ecosystem-graphs/的生态系统表格顶部截图。
这份生态系统图是我目前见过的收录最全面的清单。但由于纳入了许多小众大语言模型,整体看起来会有些繁杂。另外,根据其配套仓库https://github.com/stanford-crfm/ecosystem-graphs 的更新情况来看,这份清单至少已有一个月没有更新。同时,目前还不清楚是否会持续加入更新的模型(不过下面两个更新的资源也存在同样的问题)。
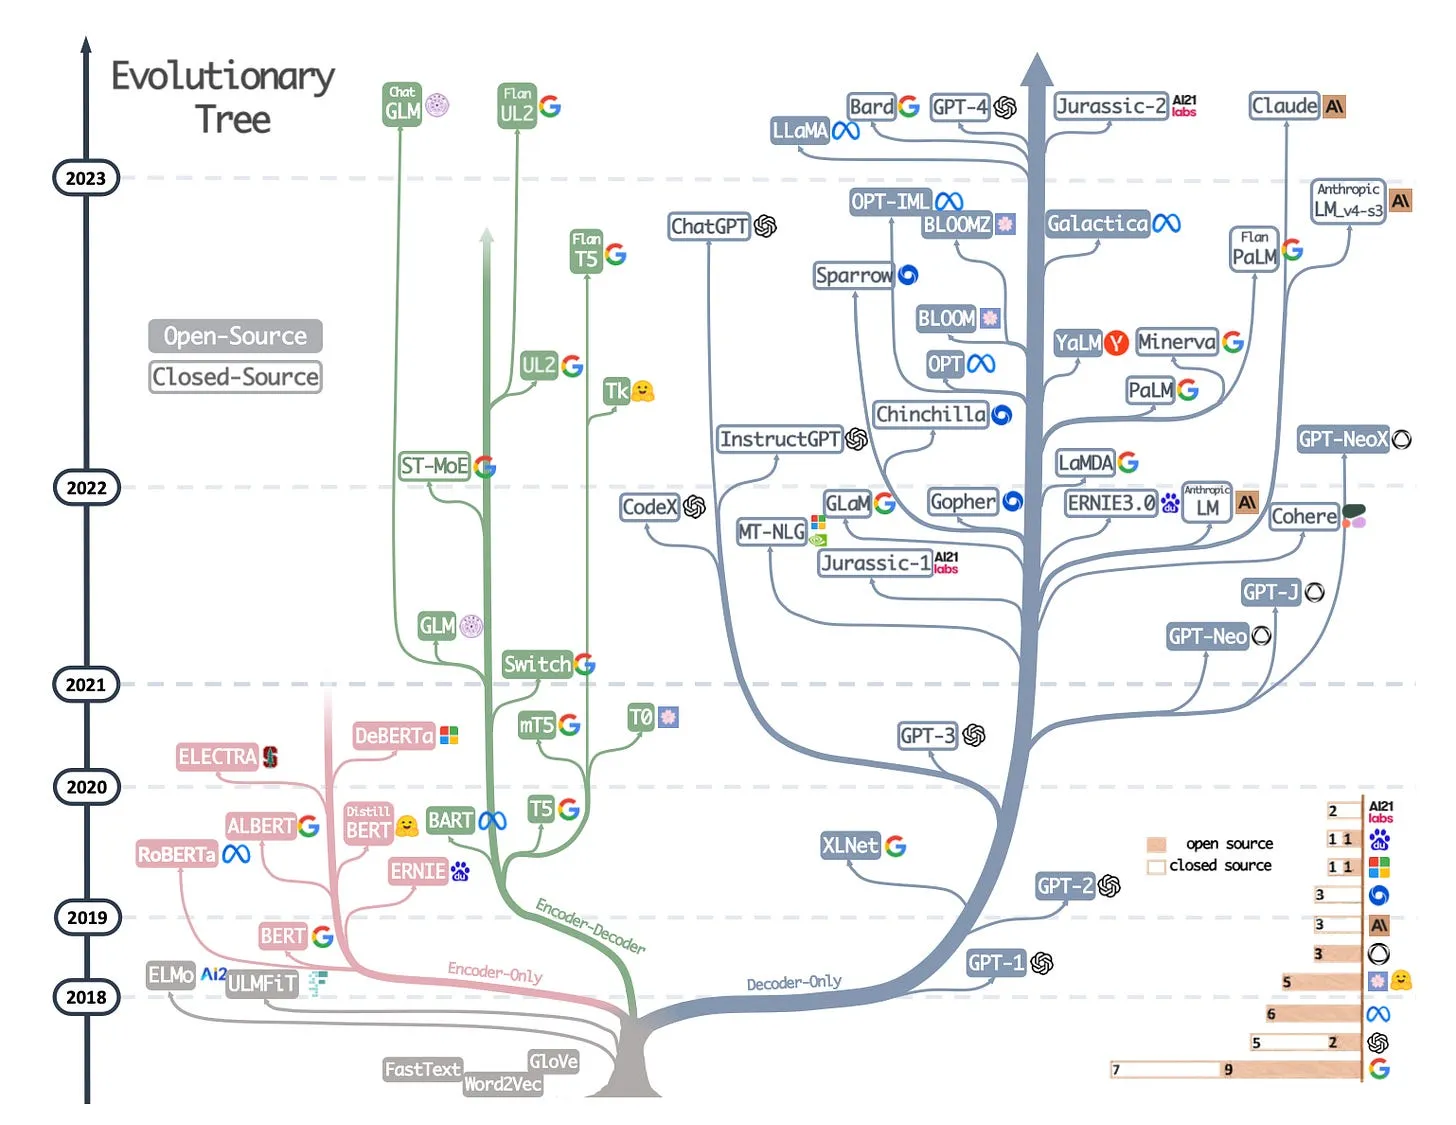
第二个资源是近期论文 https://arxiv.org/abs/2304.13712 中制作精美的演化树,它聚焦于最主流的大语言模型及其衍生关系。
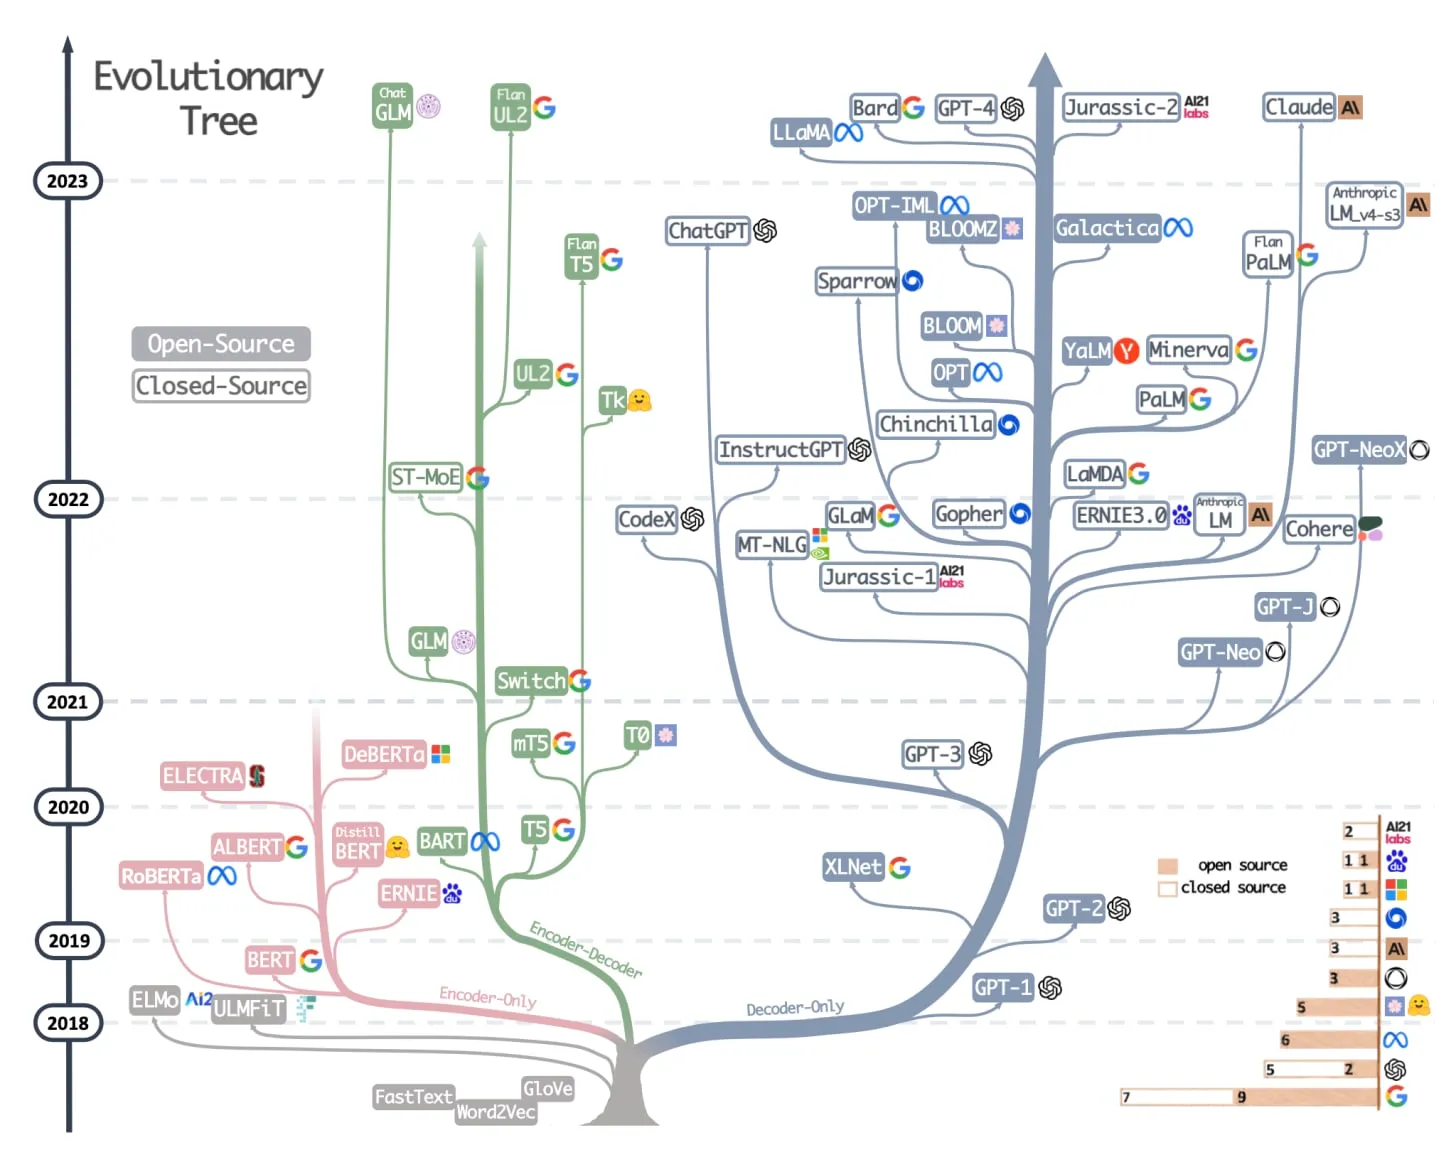
图注:来自论文https://arxiv.org/abs/2304.13712的图。
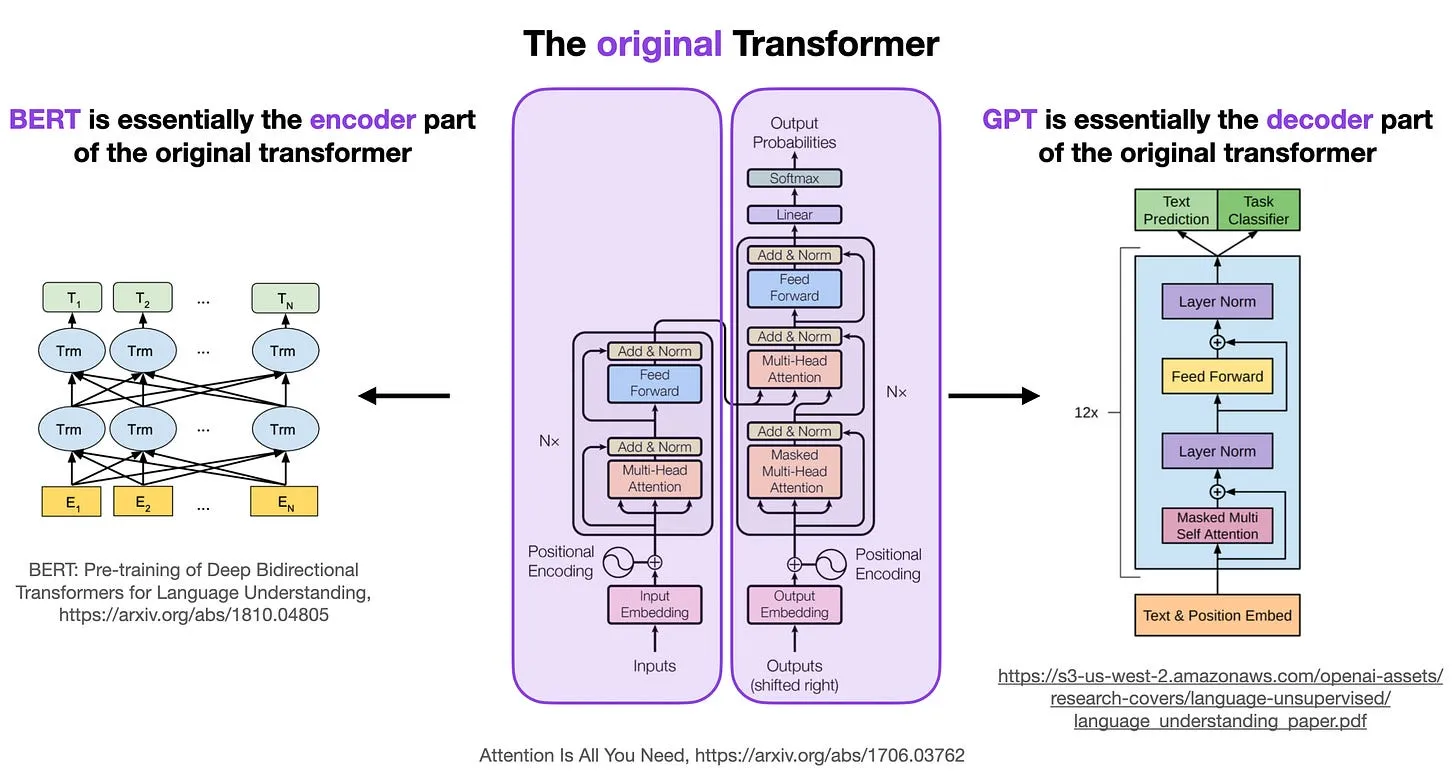
尽管这份大语言模型演化树非常直观清晰,但也存在几处小瑕疵。例如,为什么树根没有追溯到https://arxiv.org/abs/1706.03762 中提出的原始Transformer架构?另外,“开源”的标签也不算特别准确——比如LLaMA被列为开源,但它的权重并未以开源许可发布(仅推理代码是开源的)。
第三个资源是我的同事Daniela Dapena在博客文章中整理的表格,参见 https://lightning.ai/pages/community/community-discussions/the-ultimate-battle-of-language-models-lit-llama-vs-gpt3.5-vs-bloom-vs/
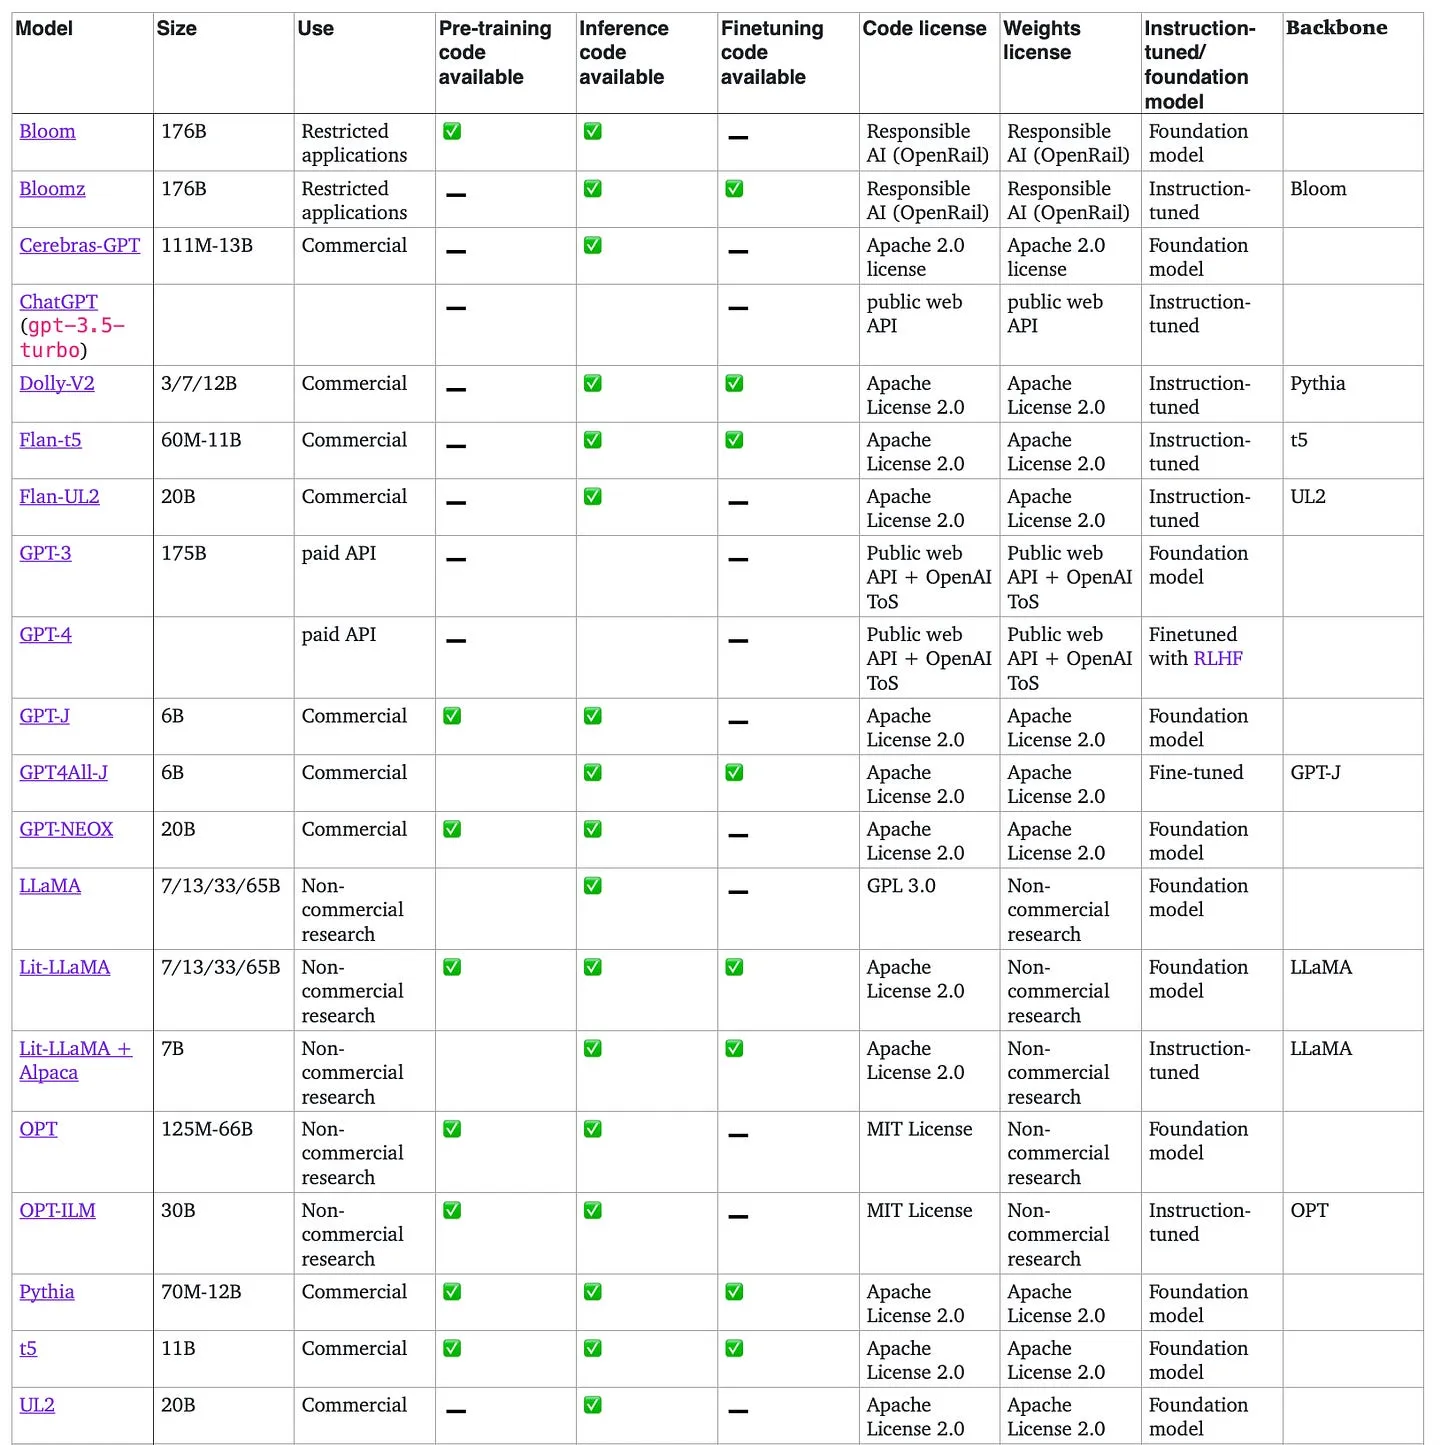
虽然这份表格的规模比其他资源小,但它的优点是包含了模型参数量和许可信息——如果你打算在项目中采用这些模型,这些信息具有非常实用的参考价值。
第四个资源是 https://github.com/shm007g/LLaMA-Cult-and-More/blob/main/chart.md,它补充了关于微调方法以及硬件成本的相关信息。
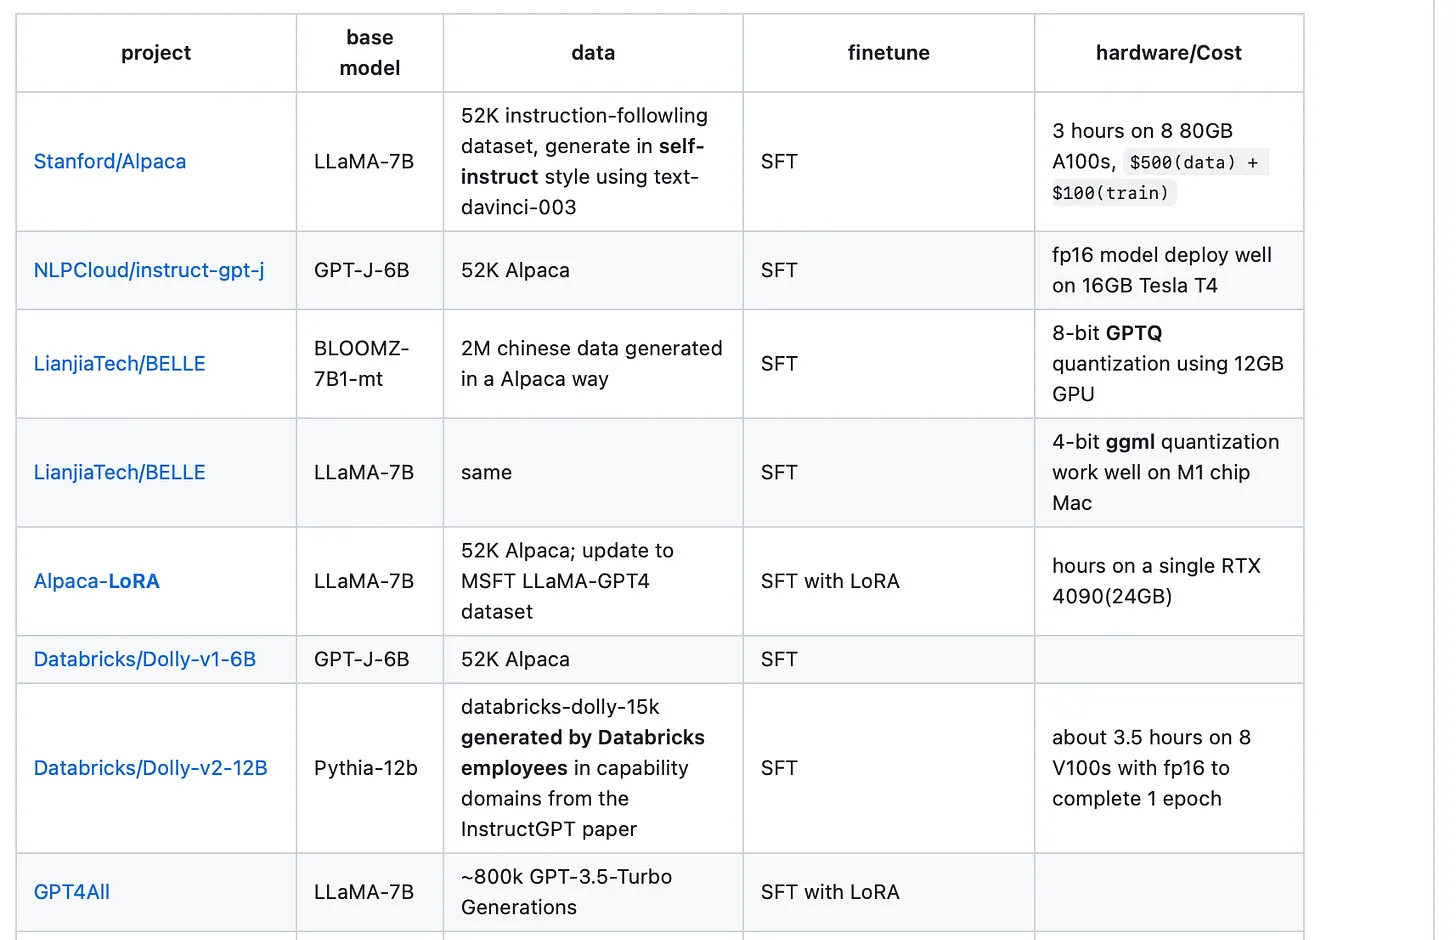
图注:截取自https://github.com/shm007g/LLaMA-Cult-and-More/blob/main/chart.md的表格。
接下来,如果能以某种方式把模型性能信息也加入这些表格就好了,但这完全是另一个难题——因为高效评估大语言模型本身就不是一件简单的事……
使用LLaMA-Adapter V2微调多模态大语言模型
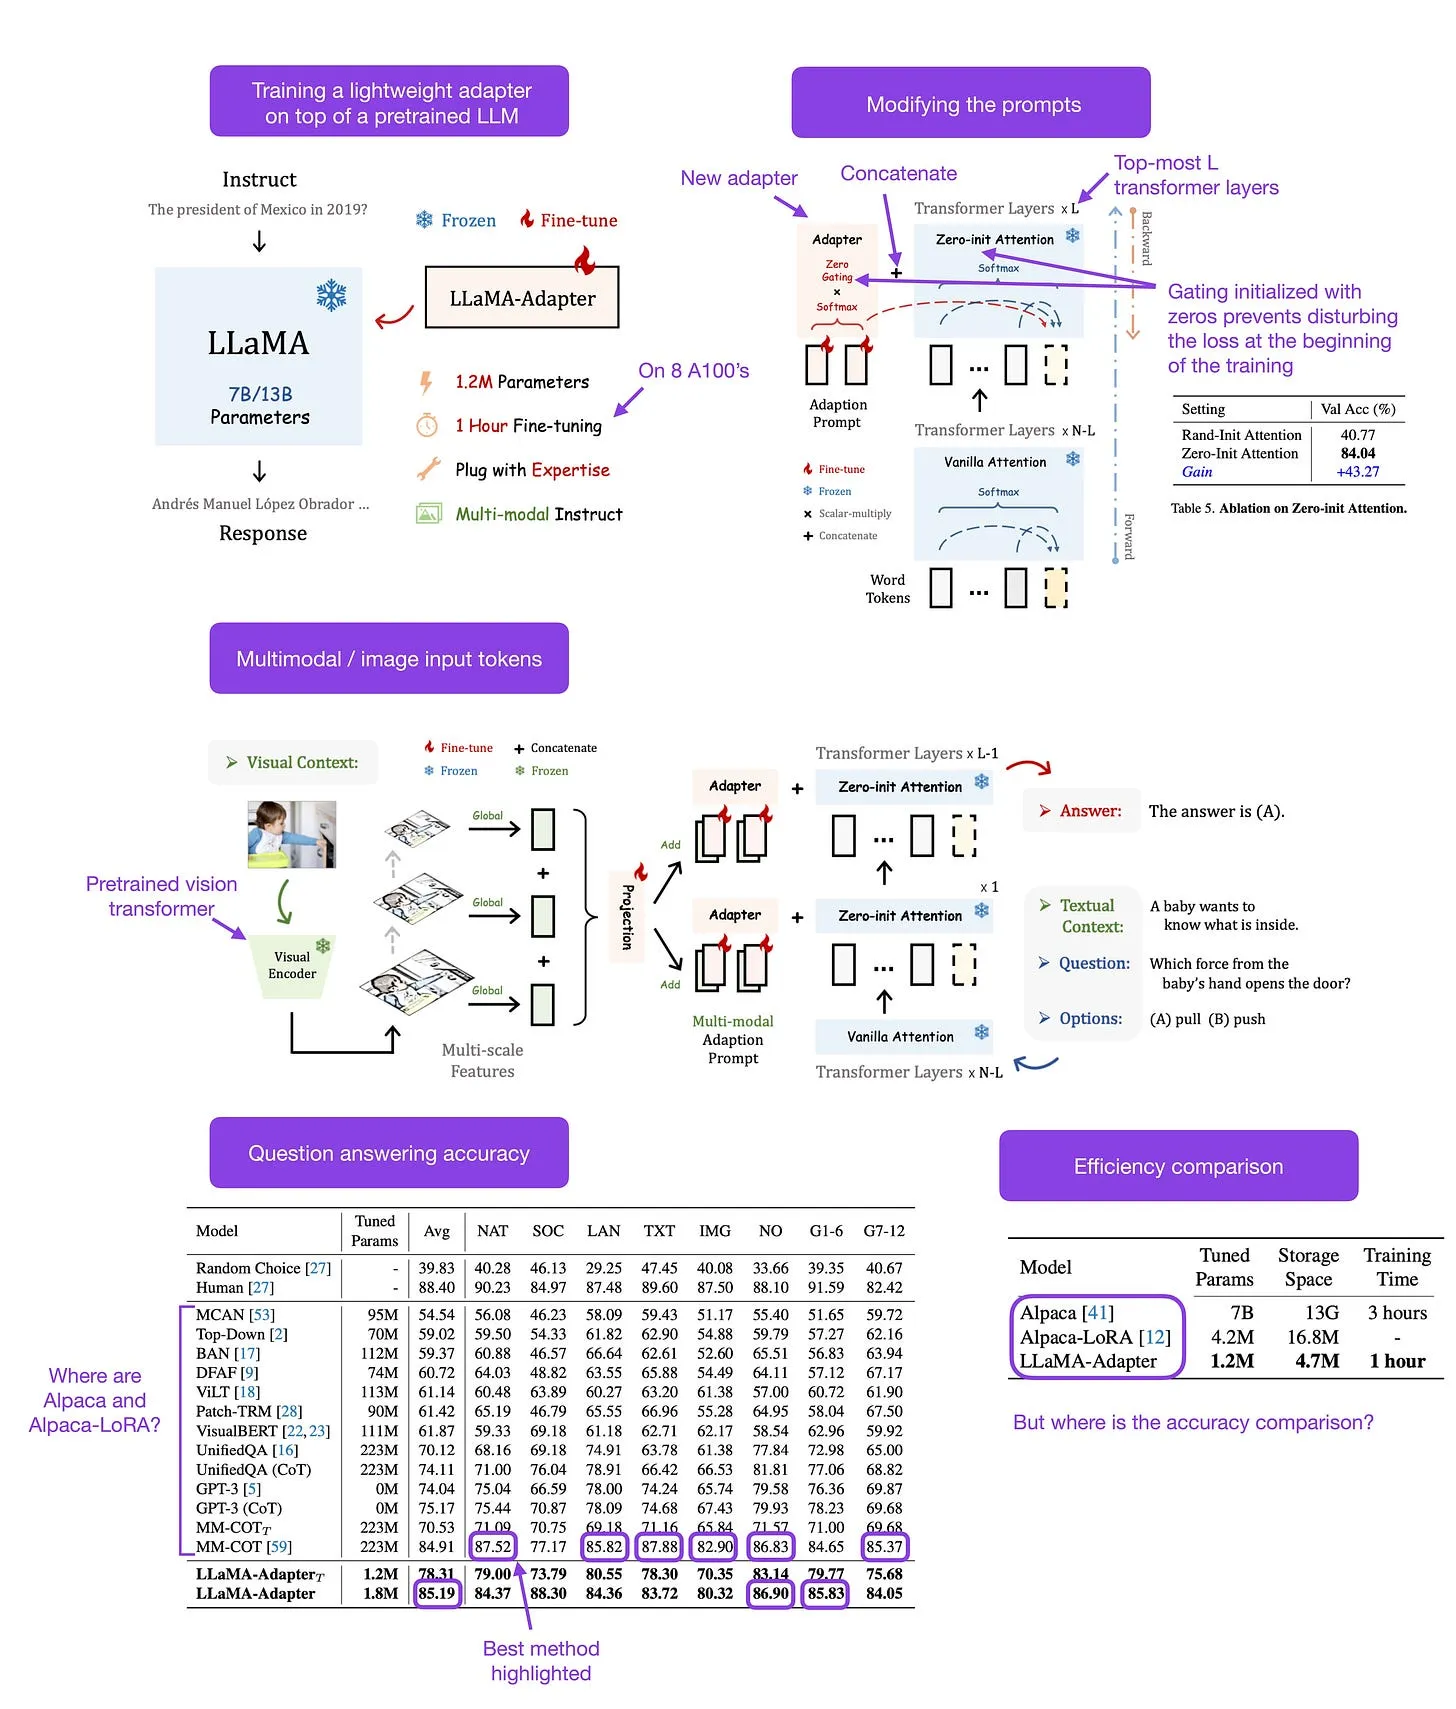
还记得上个月介绍的LLaMA-Adapter吗?它是一种针对大语言模型的参数高效微调技术。我当时还预测,本月会出现更多多模态大语言模型——那么我们就来聊聊刚发布的《LLaMA-Adapter V2:参数高效的视觉指令模型》!
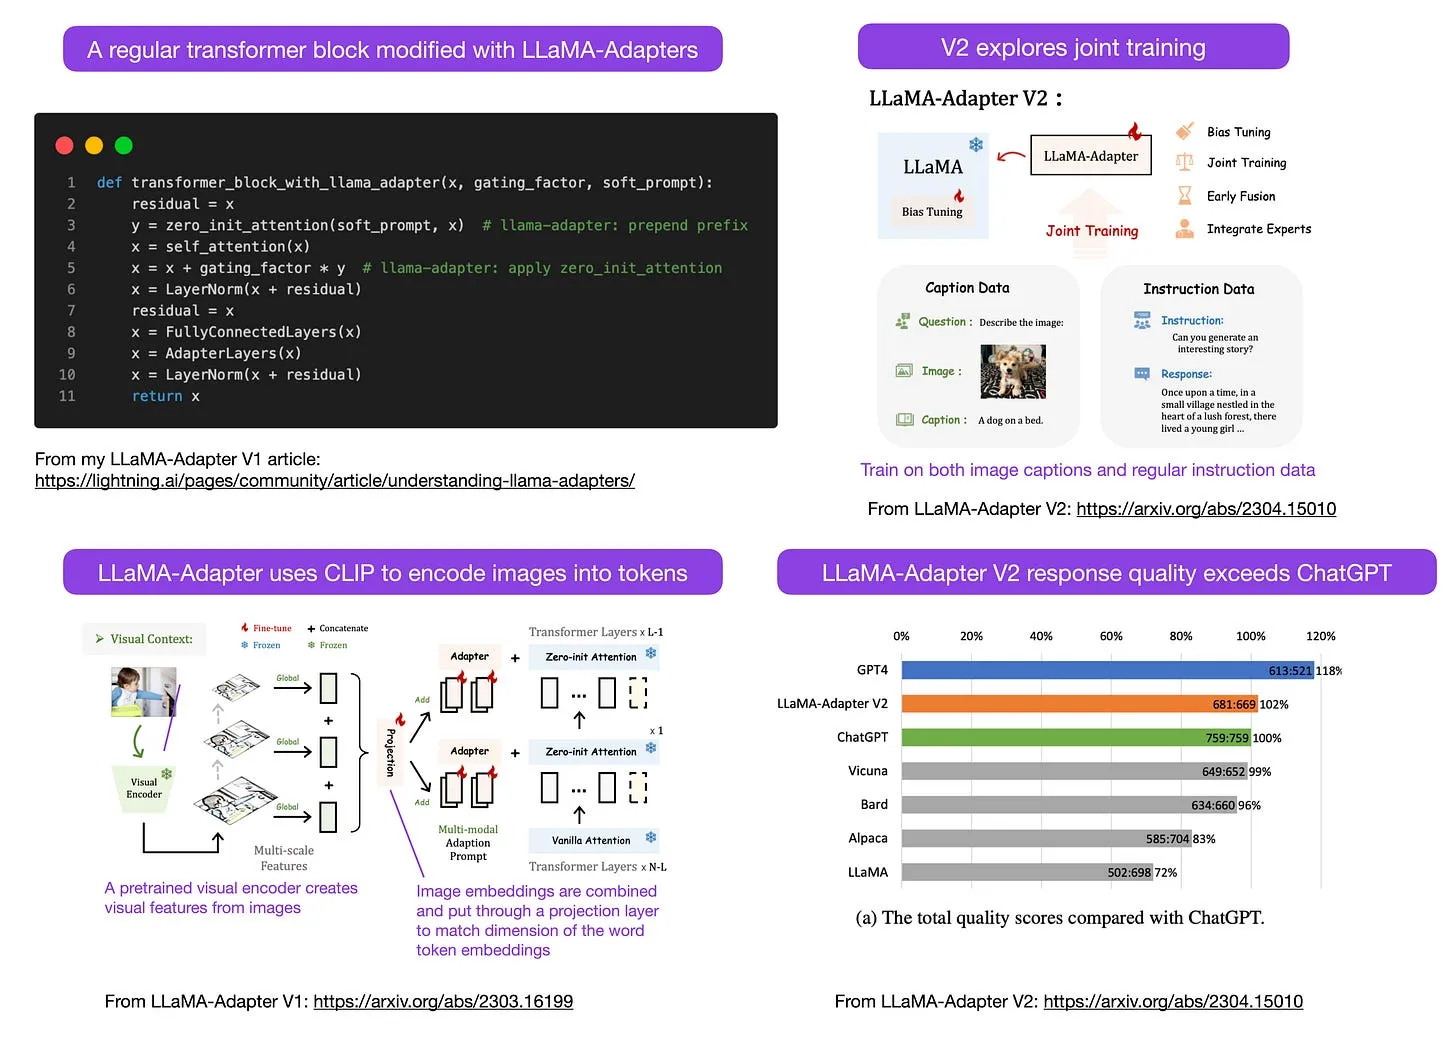
先简要回顾:什么是LLaMA-Adapter?它的工作原理是什么?LLaMA-Adapter是一种参数高效的大语言模型微调技术,它仅修改前几个Transformer块,并引入门控机制来稳定训练过程。
借助LLaMA-Adapter方法,研究人员仅用5.2万条指令对,在8张A100 GPU上仅耗时1小时,就完成了70亿参数LLaMA模型的微调。整个过程中,7B的LLaMA底座模型保持冻结,仅训练新增的120万参数(即适配层)。
LLaMA-Adapter V2的重点是多模态能力,也就是构建一个能够处理图像输入的视觉指令模型。(原始V1版本其实也可以接收图像标记(与文本标记一起),但这一方面的潜力没有得到充分挖掘。)
从V1到V2,研究人员主要新增了三项技巧来改进适配方法:
- 视觉知识早期融合:不再在每个适配层中融合视觉提示与适配后的提示,而是在第一个Transformer块中就将视觉标记与文本标记拼接。
- 引入更多参数:解冻所有归一化层,并为Transformer块中的每个线性层都添加偏置单元和缩放因子。
- 参数分离的联合训练:对于图文字幕数据,仅训练视觉投影层;对于指令跟随数据,仅训练适配层(以及上述新增的参数)。
LLaMA V2(1400万参数)的参数量略多于LLaMA V1(120万参数),但整体仍然非常轻量,仅占650亿参数LLaMA模型总参数的0.02%。
尤其令人印象深刻的是,仅微调65B LLaMA模型中的1400万参数,微调后的LLaMA-Adapter V2模型在性能上就能追平ChatGPT(采用GPT-4模型进行评估),并且性能超过了采用全量微调方式(更新全部130亿参数)的13B Vicuna模型。
遗憾的是,V2论文没有包含V1论文中的计算性能基准,但我们可以推测V2的训练速度仍然远快于全量微调。
两句话研究亮点
由于本期通讯篇幅较长,我决定把我为这一部分挑选并总结的17篇论文,移到单独的一篇文章中,计划下周发布。到时候说不定我还会再多补充几篇。敬请期待!
开源亮点
Lit-LLaMA的改进
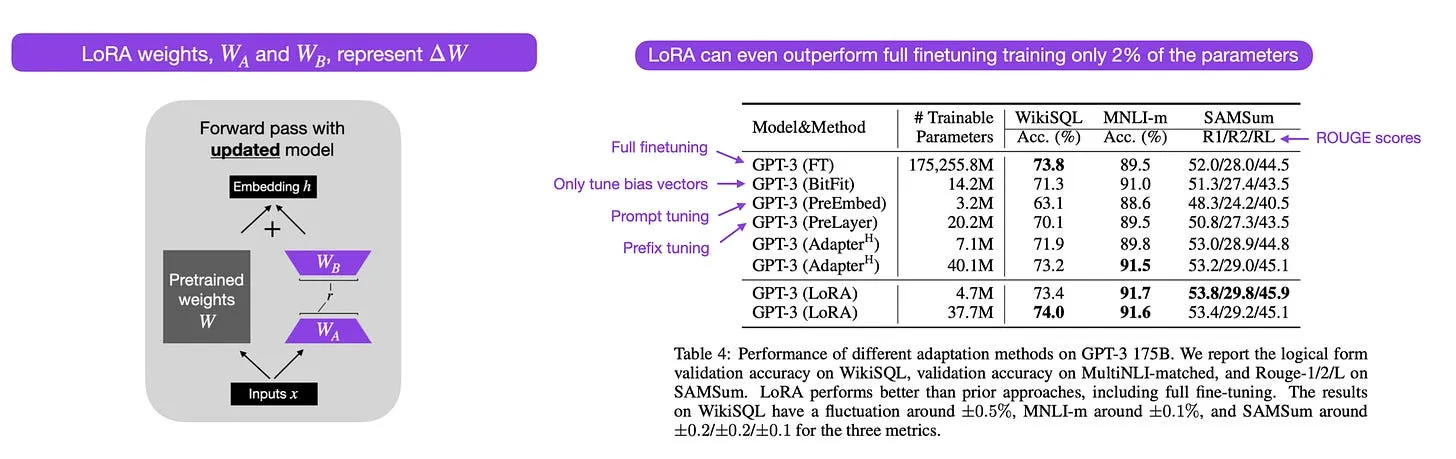
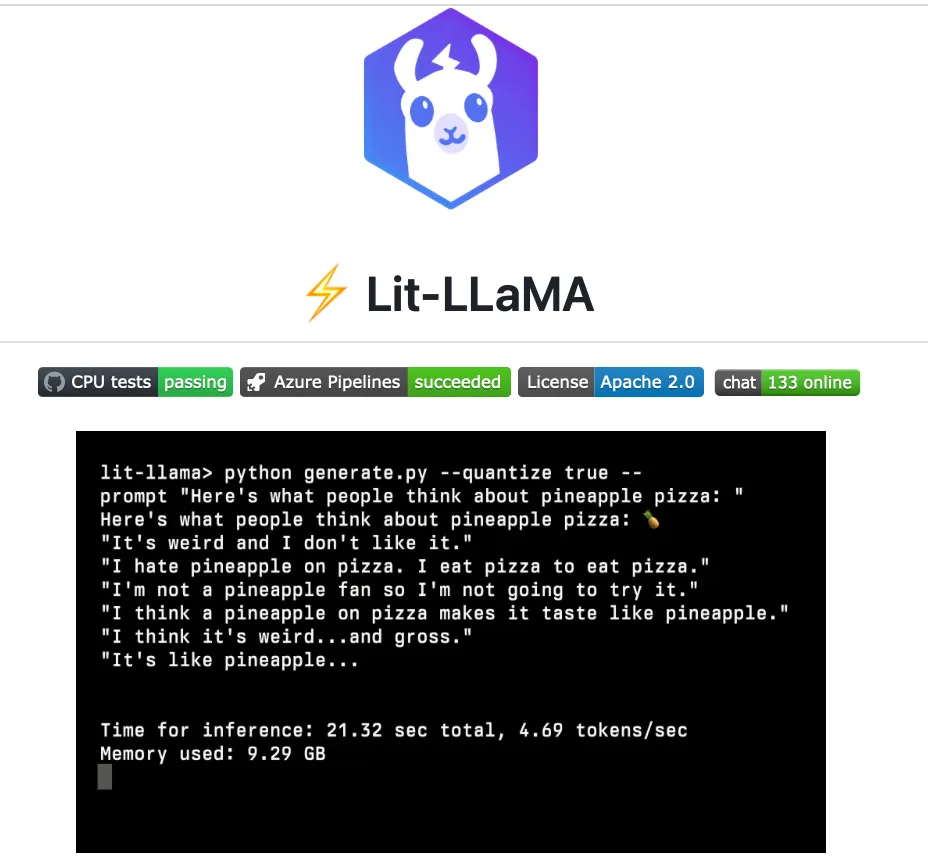
在Lightning AI,我们一直在维护 https://github.com/Lightning-AI/lit-llama 仓库,它提供了热门LLaMA模型的更简洁、可读性更强的开源实现,同时支持多种微调方法,包括 https://arxiv.org/abs/2106.09685 和 https://arxiv.org/abs/2303.16199 中提出的方法、量化技术等。
该仓库近期新增内容包括:
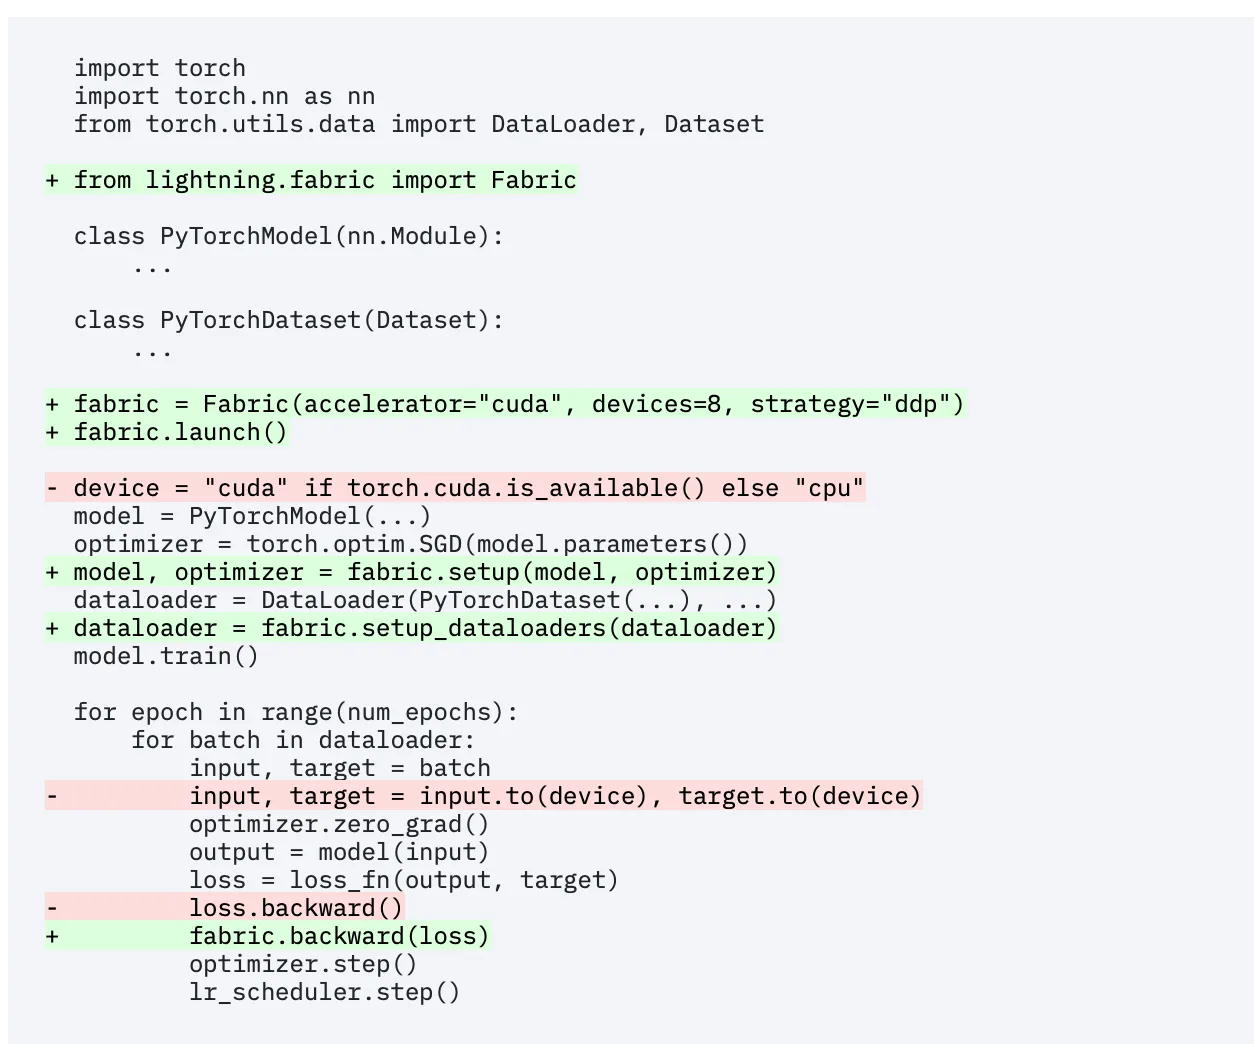
- 针对上文提到的RedPajama数据集(https://www.together.xyz/blog/redpajama)的预训练脚本,采用了新的优化PackedDataset格式——在A100 GPU上,训练速度可达每GPU每秒2600词元。
- Lit-LLaMA现在可以选择性加载 https://github.com/openlm-research/open_llama 模型,该模型近期以Apache 2.0许可发布(目前已在3000亿词元上训练)。
- 适配了前文提到的EleutherAI模型评估工具 https://github.com/EleutherAI/lm-evaluation-harness,对应仓库为https://github.com/Lightning-AI/lm-evaluation-harness/tree/lit-llama 。
- 新增了相关仓库 https://github.com/Lightning-AI/lit-stablelm,可加载Stability AI的 https://github.com/Stability-AI/StableLM 以及本通讯开头介绍的EleutherAI的 https://github.com/EleutherAI/pythia 模型。
其他开源大语言模型
全部列举是不可能的,但本月推出的知名开源大语言模型与聊天机器人还包括:https://github.com/LAION-AI/Open-Assistant 、https://github.com/project-baize/baize-chatbot 、https://github.com/Stability-AI/StableLM 、https://github.com/hpcaitech/ColossalAI/tree/main/applications/Chat 、https://github.com/mosaicml/llm-foundry 等等。此外,还有两款多模态大语言模型尤其值得关注。
OpenFlamingo
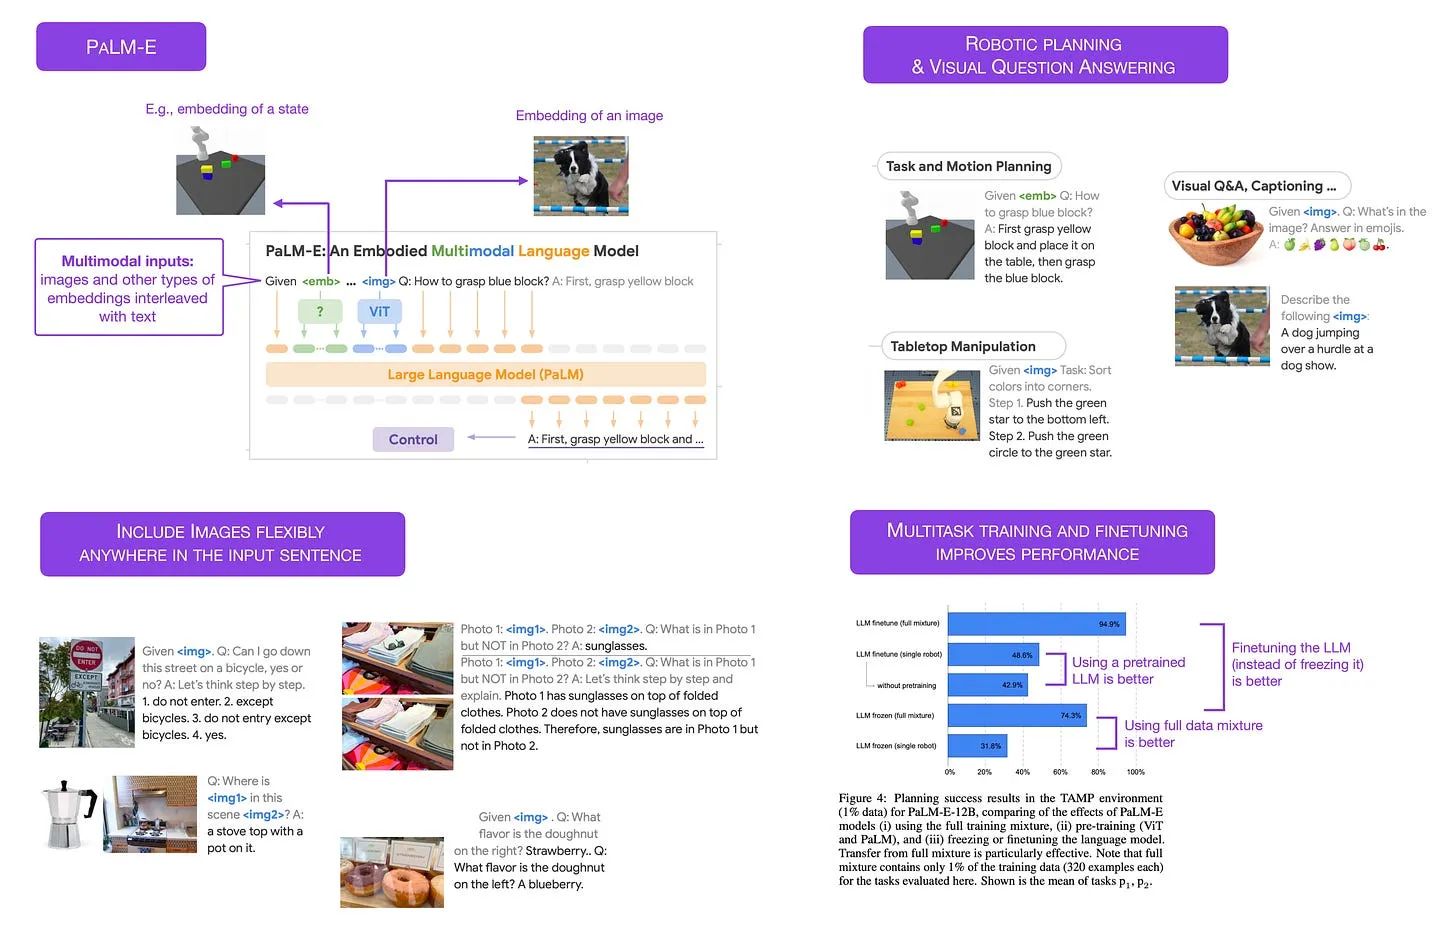
https://github.com/mlfoundations/open_flamingo 是谷歌DeepMind去年发布的Flamingo模型的开源复现版本。OpenFlamingo旨在为大语言模型提供多模态图像推理能力,让用户可以交错输入文本和图像。
MiniGPT-4
https://github.com/Vision-CAIR/MiniGPT-4 是另一款具备视觉-语言能力的开源模型。它基于冻结的视觉编码器(来自https://arxiv.org/abs/2301.1259 )和冻结的Vicuna模型(https://lmsys.org/blog/2023-03-30-vicuna/ )构建。
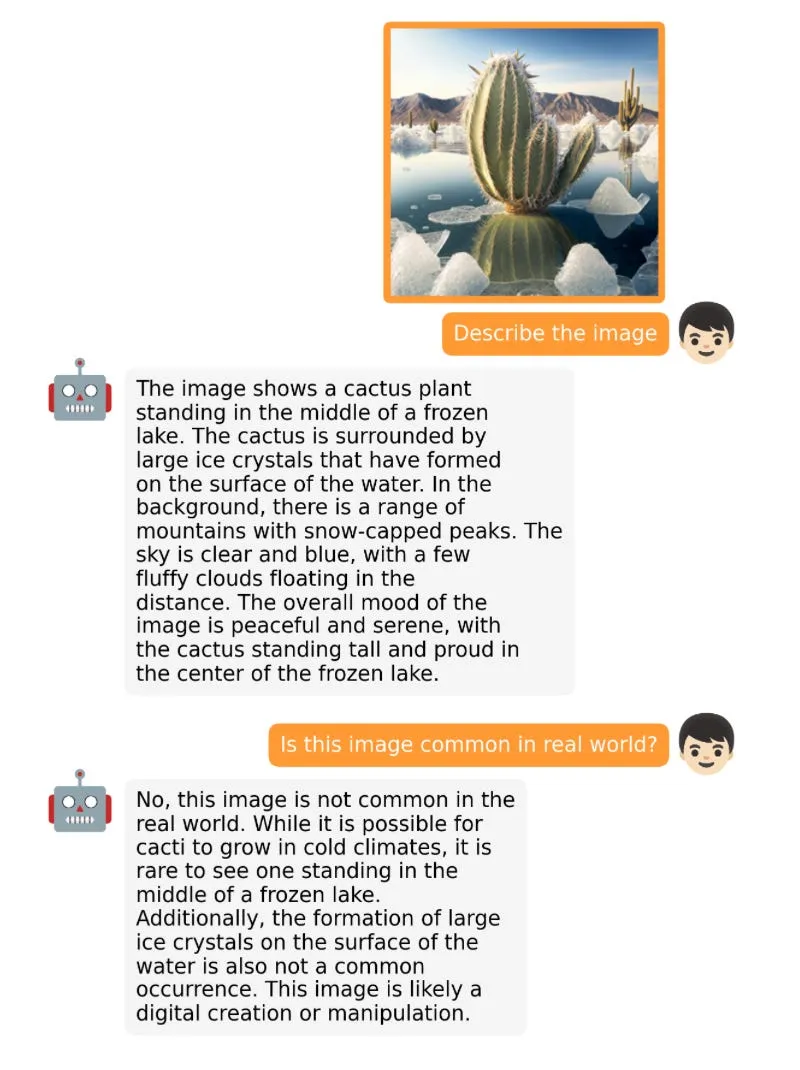
图注:MiniGPT-4截图,来源:https://github.com/Vision-CAIR/MiniGPT-4。
NeMo Guardrails
随着大量新模型的涌现,很多公司都在思考如何部署、以及是否应该部署这些模型,尤其是安全方面的考量。目前还没有完美的解决方案,但至少有一个颇具前景的临时方案:https://github.com/NVIDIA/NeMo-Guardrails
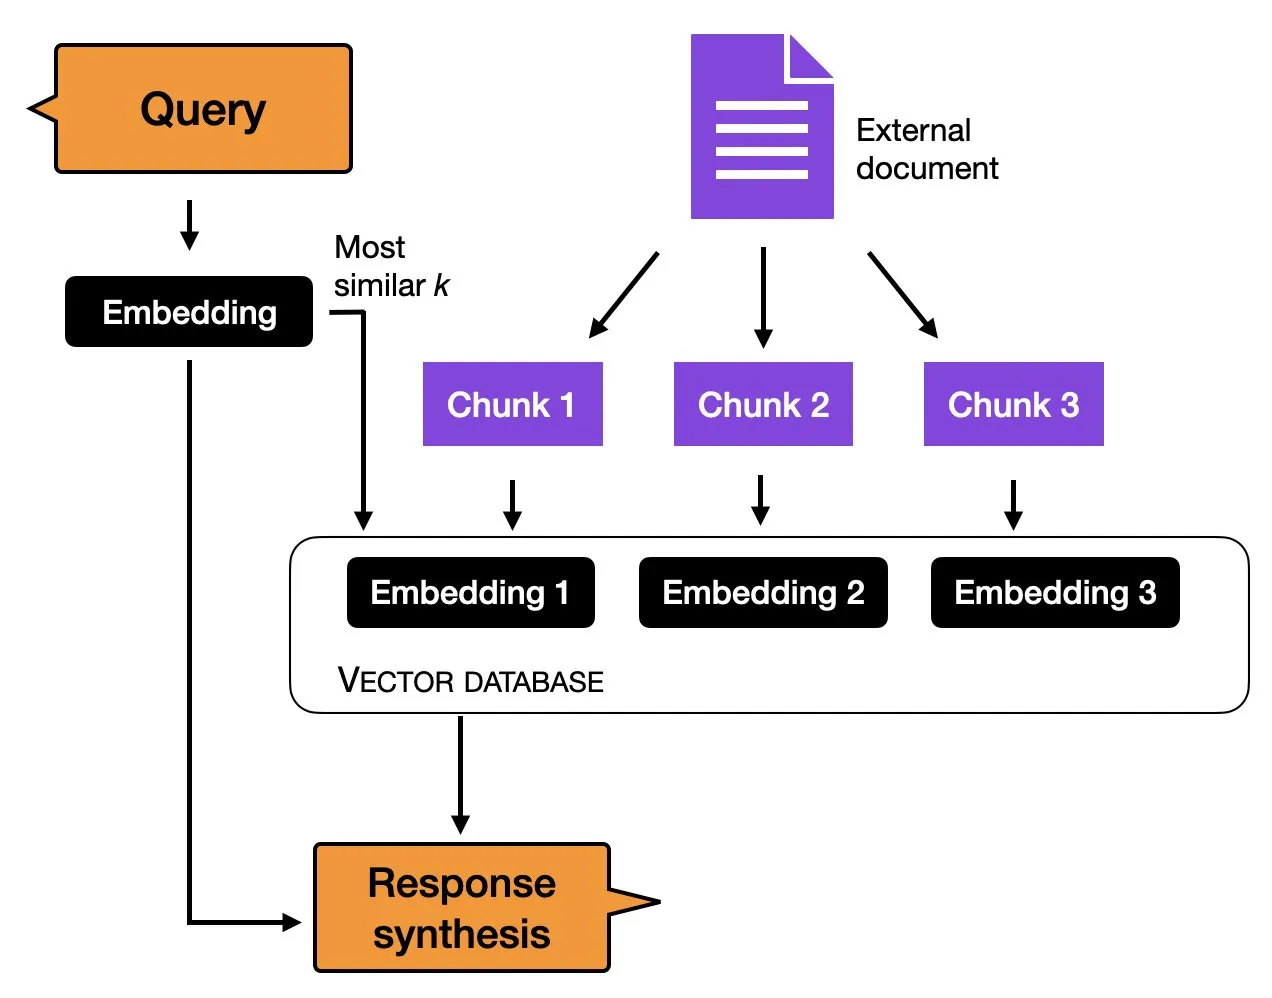
简而言之,它的工作原理是:该方法使用一个数据库,关联到需要人工精心编写的硬编码提示。当用户输入提示时,系统首先将其与数据库中最相似的条目匹配,然后数据库返回对应的硬编码提示,再传递给大语言模型。这样一来,只要对硬编码提示进行充分测试,就能确保对话不会偏离允许的主题范围。
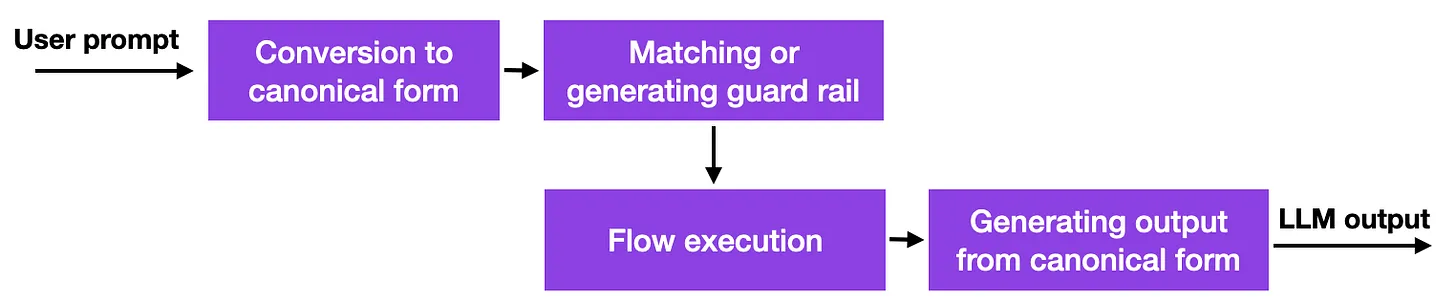
图注:NeMo护栏概念示意图。
这是一个有意思但算不上突破性的方法,因为它并没有赋予大语言模型更强或更新的能力,只是限制了用户与大语言模型交互的范围。不过,在研究人员找到其他缓解大语言模型幻觉问题和有害行为的方法之前,这可能仍是一个可行的方案。
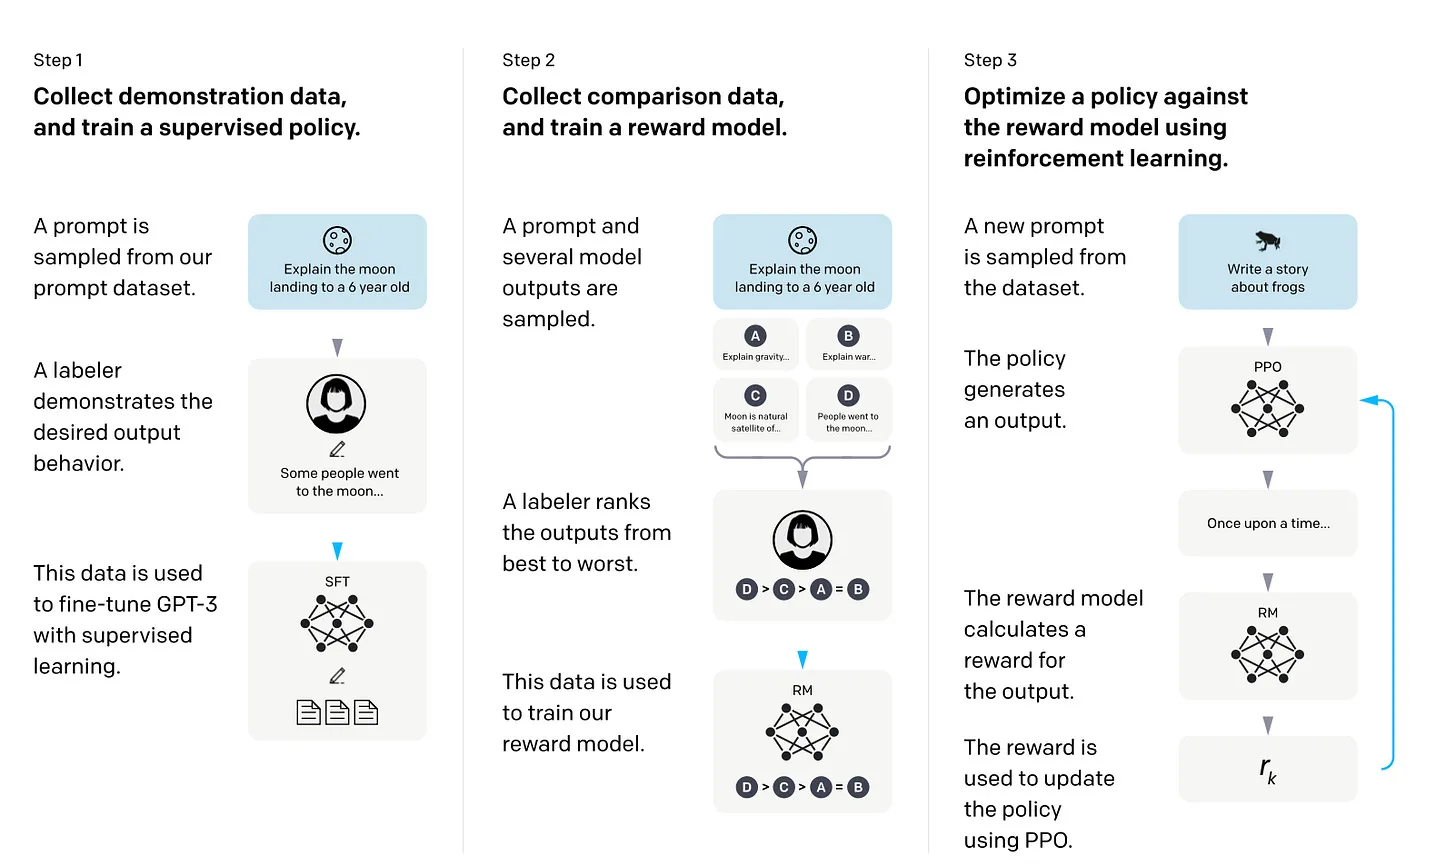
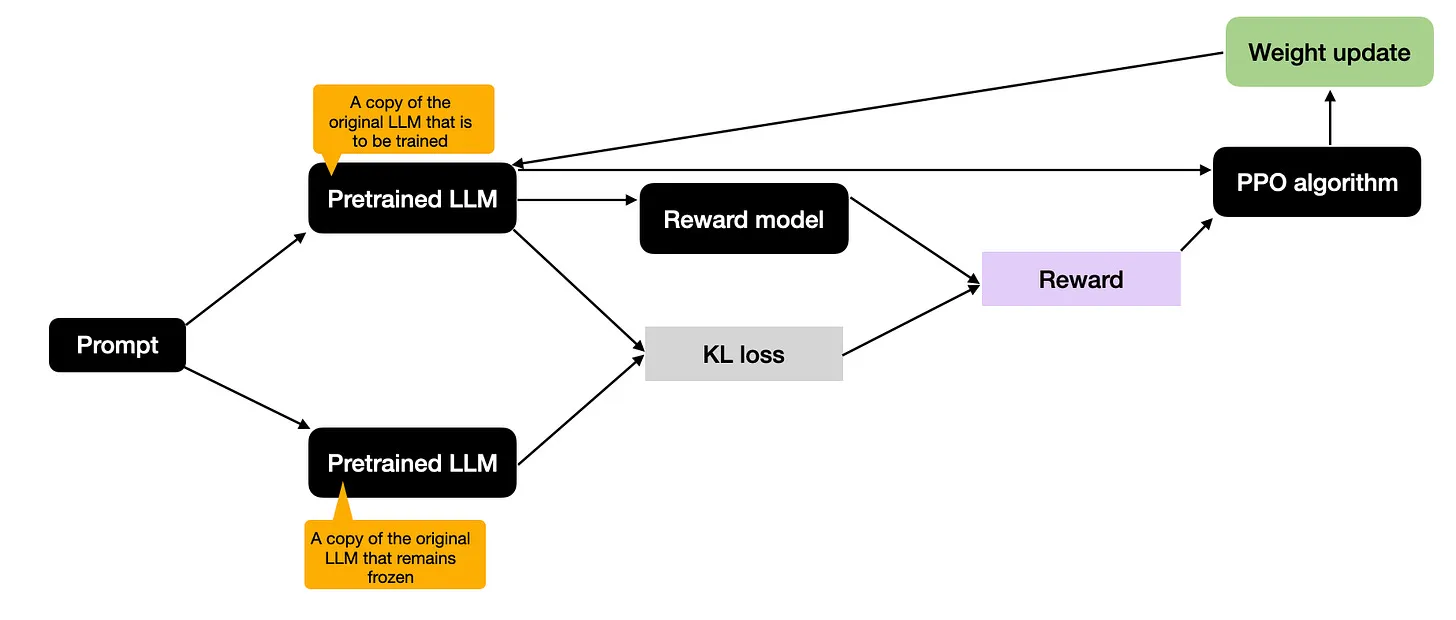
护栏方法还可以与其他对齐技术结合使用,比如我在 https://magazine.sebastianraschka.com/p/ahead-of-ai-6-train-differently 一文中介绍的、流行的基于人类反馈的强化学习训练范式。
一致性模型
聊点大语言模型之外的有趣模型不好吗?OpenAI终于开源了他们的一致性模型代码:https://github.com/openai/consistency_models
一致性模型被认为是扩散模型的一种可行、高效的替代方案。更多信息详见论文 https://arxiv.org/abs/2303.01469。
深度学习基础课程新增单元:计算机视觉与大语言模型
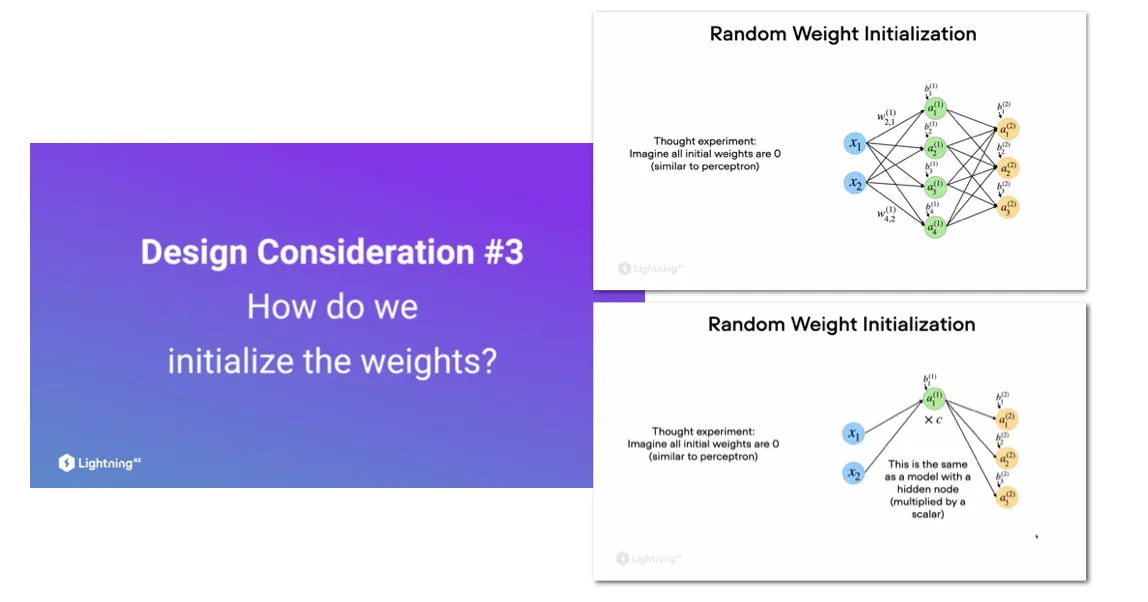
过去几周,我的免费《深度学习基础》课程刚上线了两个新单元。
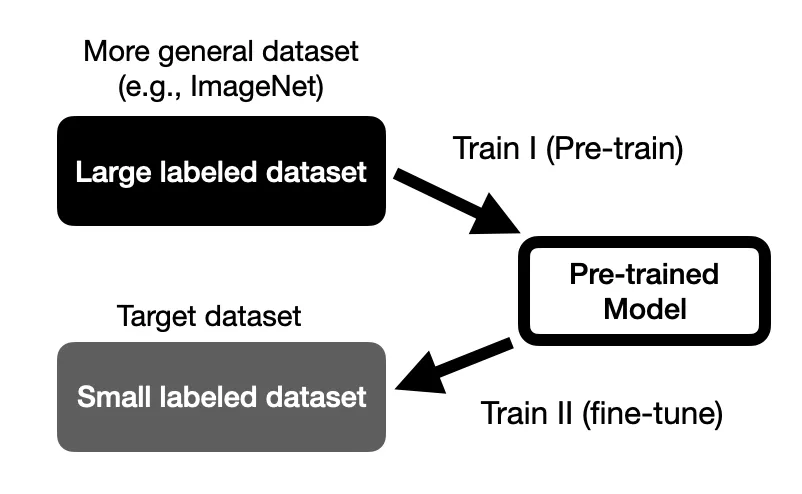
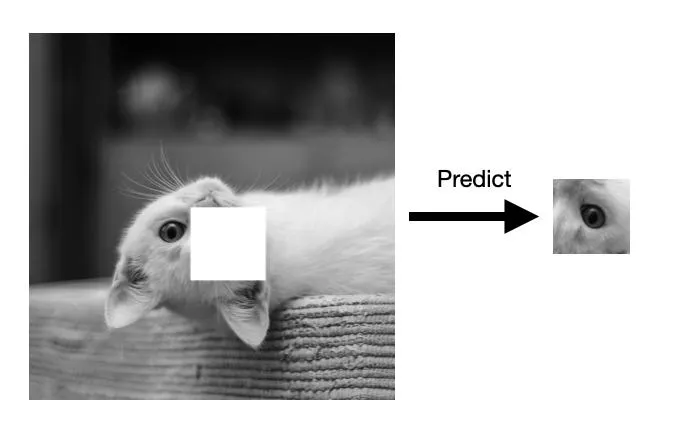
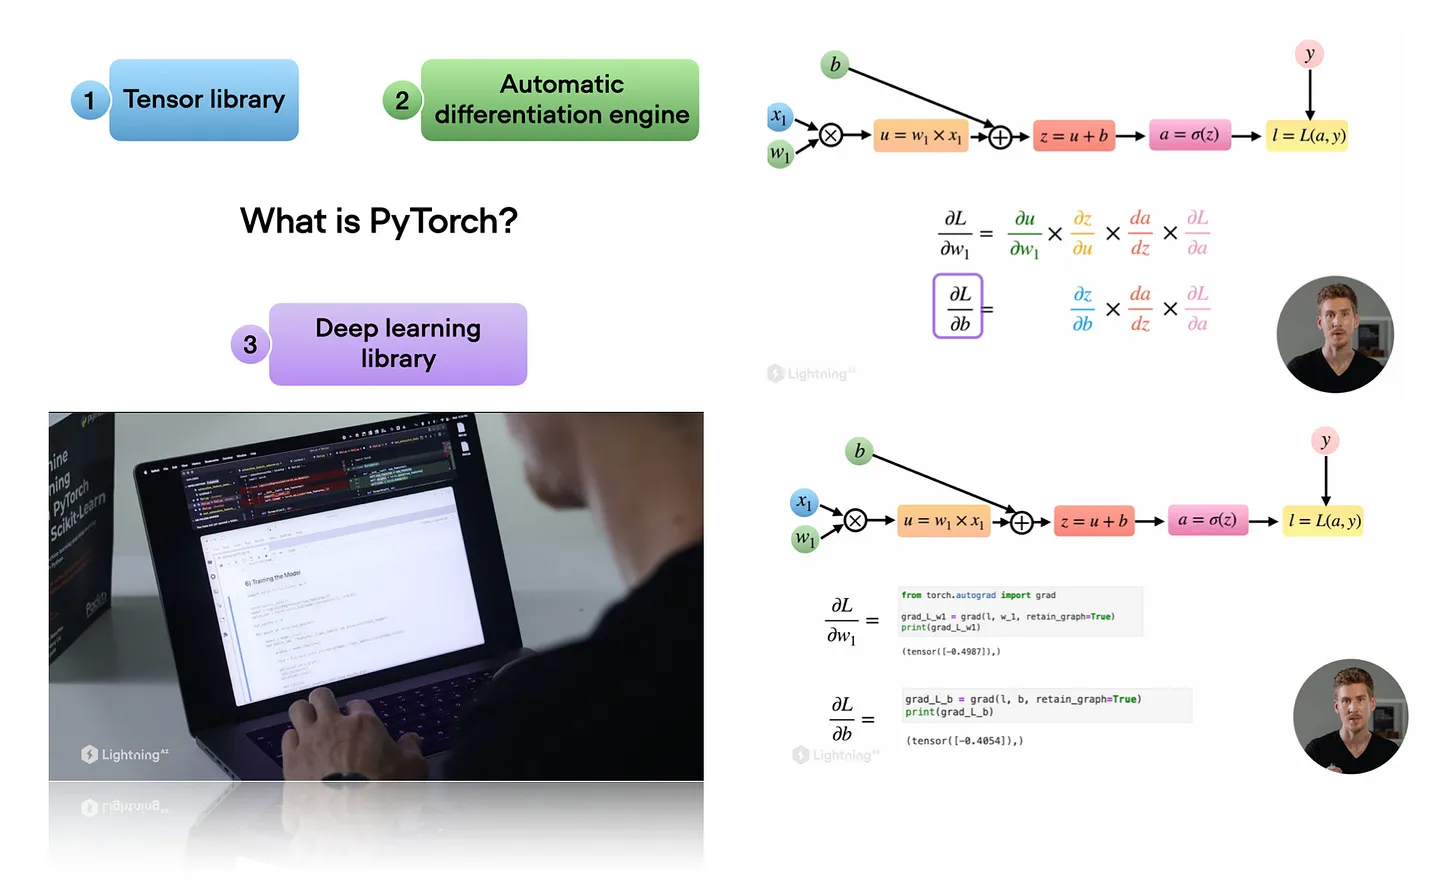
- https://lightning.ai/pages/courses/deep-learning-fundamentals/unit-7-overview-getting-started-with-computer-vision/ :讲解如何处理图像数据、训练卷积网络、使用迁移学习,以及用自监督学习预训练模型。
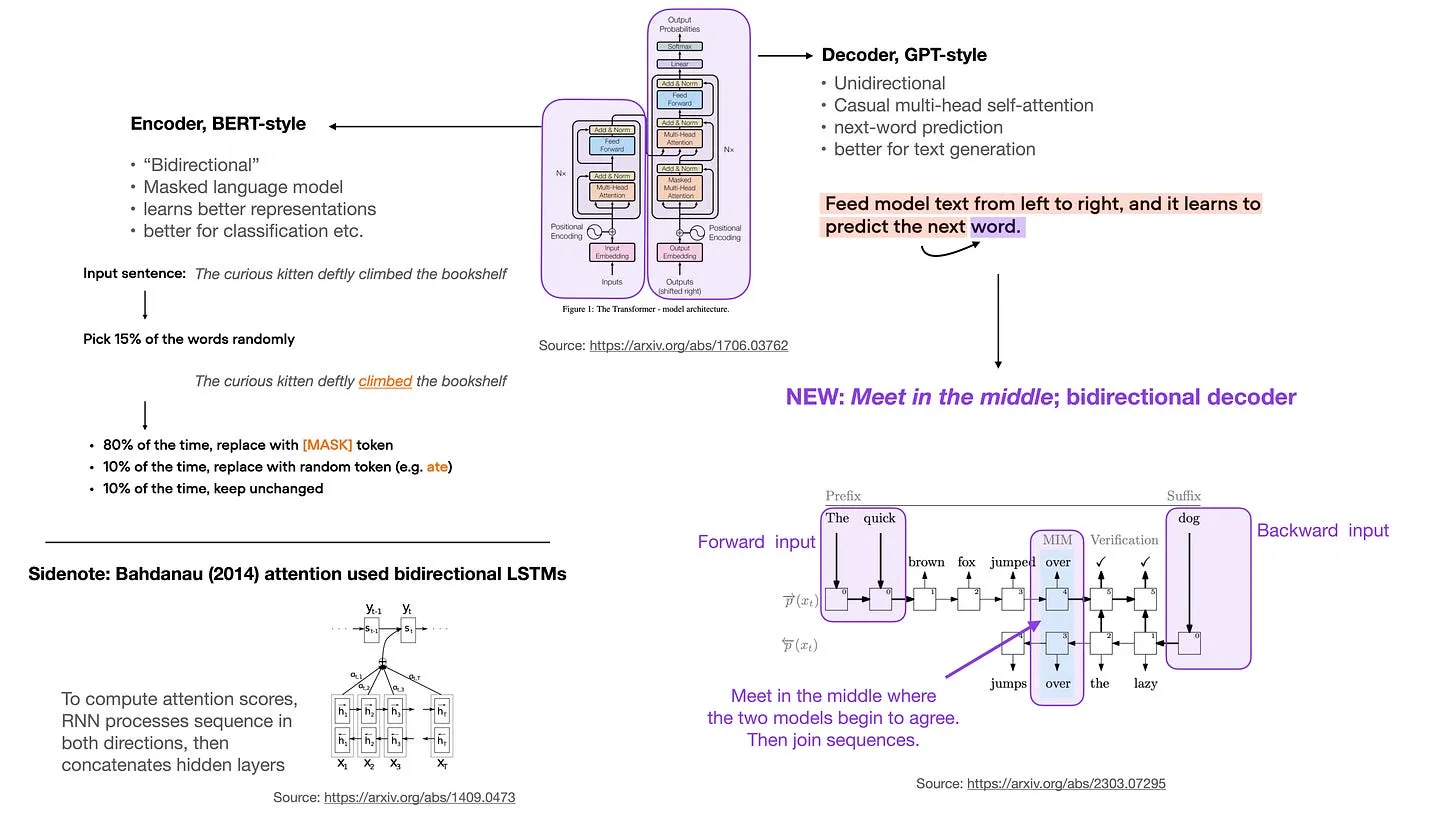
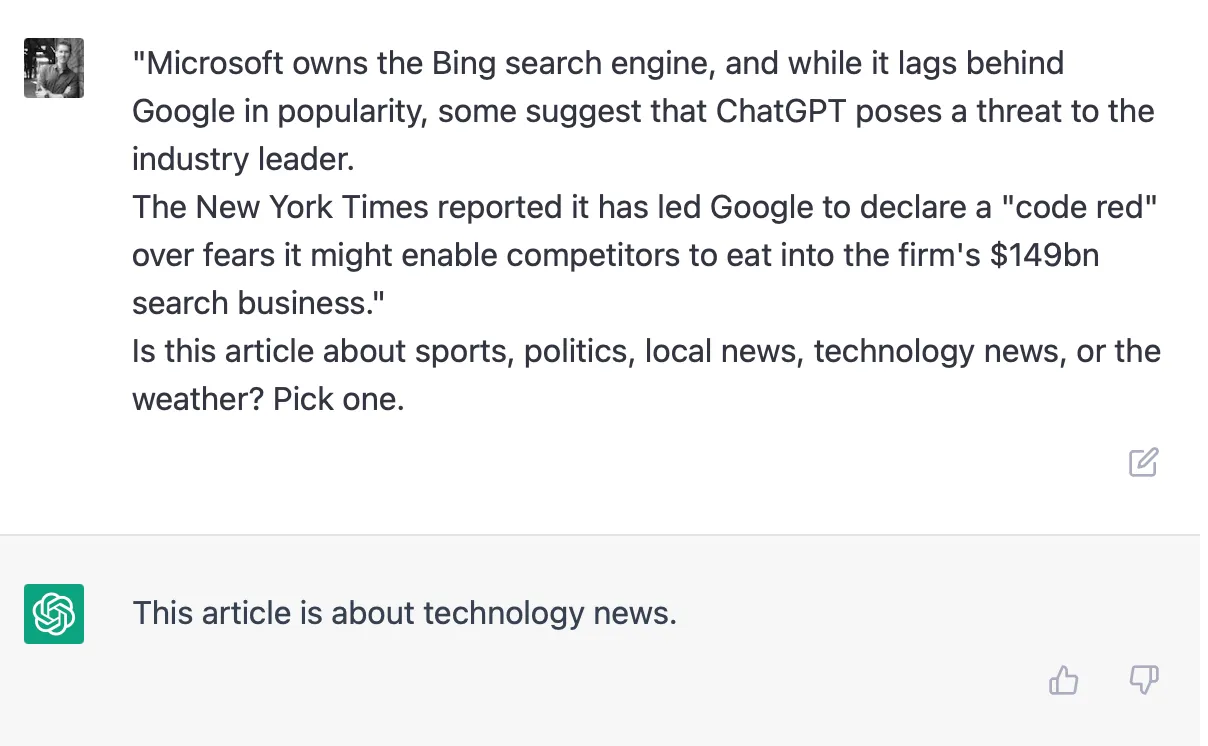
- https://lightning.ai/pages/courses/deep-learning-fundamentals/unit-8.0-natural-language-processing-and-large-language-models/ :讲解如何对文本数据进行编码、从零理解自注意力机制,以及大语言模型的微调方法。
当然,两个单元都包含大量代码示例和基于PyTorch的实操讲解。课程完全免费,视频时长较短,内容精炼。希望大家能有所收获!
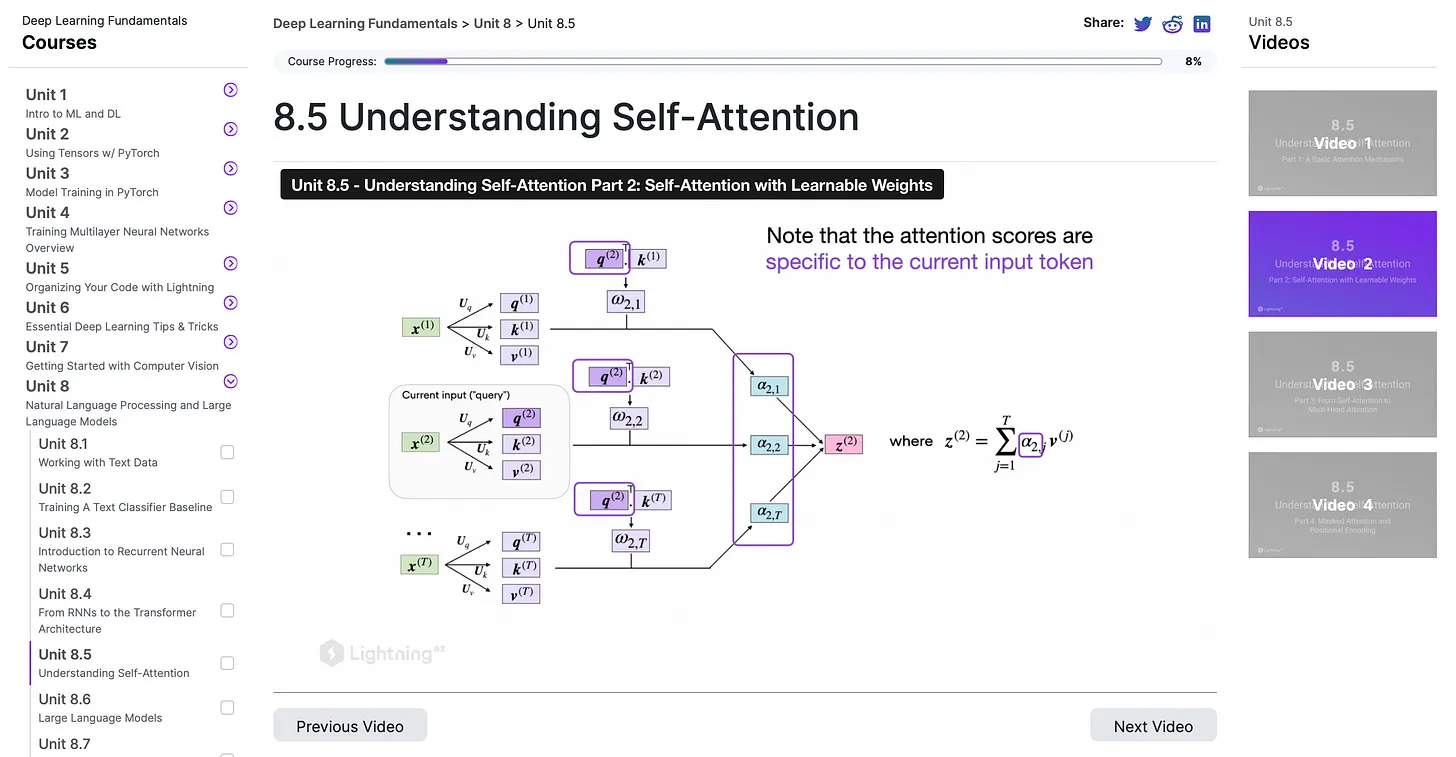
图注:《深度学习基础》课程幻灯片截图,来源:https://lightning.ai/pages/courses/deep-learning-fundamentals/unit-8.0-natural-language-processing-and-large-language-models/
名言引用
“我认为,那种追求巨型、超巨型模型的时代已经结束了。……我们会通过其他方式让模型变得更好。”
——OpenAI首席执行官萨姆·奥尔特曼(Sam Altman),出自 https://www.wired.com/story/openai-ceo-sam-altman-the-age-of-giant-ai-models-is-already-over/
这本杂志是我个人的兴趣项目,不提供直接报酬。不过,如果您愿意支持我,可以考虑购买我的书籍:https://sebastianraschka.com/books 。如果您觉得这些书有洞察力、有帮助,也欢迎推荐给您的朋友和同事。
https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/ 、https://nostarch.com/machine-learning-and-ai-beyond-basics ,以及 http://mng.bz/M96o
您的支持对我意义重大!非常感谢!