About neohope

一直在努力,还没想过要放弃...

【转载】超越标准大语言模型

原文地址:Beyond Standard LLMs,by Sebastian Raschka, on 2025-11-04

超越标准大语言模型

线性注意力混合架构、文本扩散模型、代码世界模型与小型递归Transformer

从DeepSeek R1到MiniMax-M2,如今规模最大、能力最强的开源权重大语言模型(LLM)依然是自回归解码器式Transformer,它们均基于原始多头注意力机制的各类变体构建而成。

然而近年来,我们也见证了标准LLM之外的各类替代方案不断涌现,从文本扩散模型到最新的线性注意力混合架构不一而足。其中部分方案旨在提升效率,而另一些(比如代码世界模型)则致力于优化建模性能。

几个月前我分享了《大语言模型架构大对比》一文,聚焦于主流的基于Transformer的大语言模型,之后收到了很多关于我对这些替代方案看法的提问。(我最近也在2025年PyTorch大会上做了相关主题的简短分享,当时也向参会者承诺会后续撰写一篇关于这些替代方案的文章。)于是便有了这篇内容!
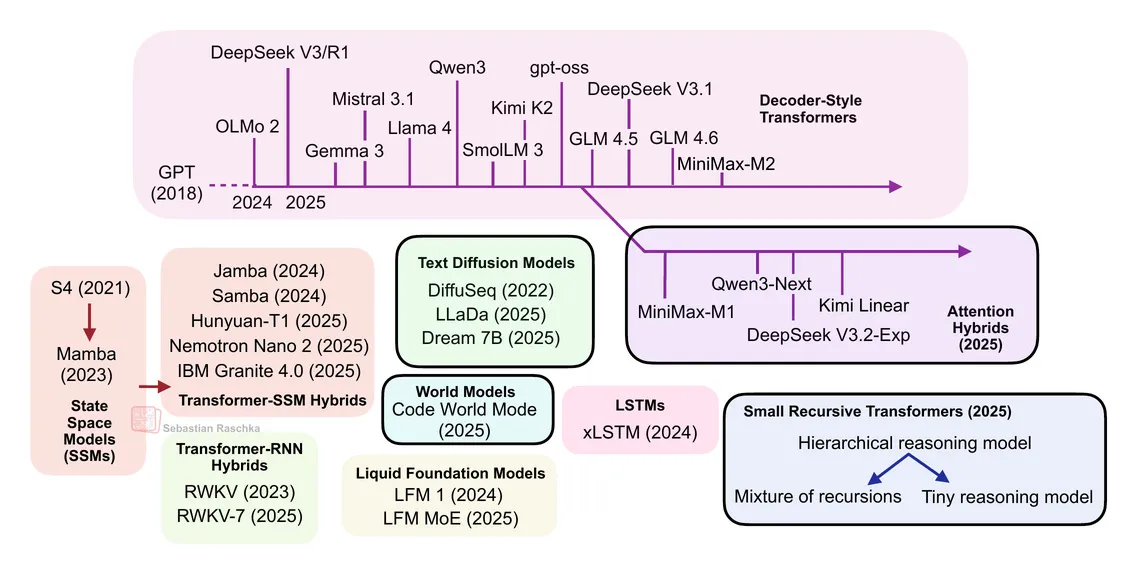
figure01

图1: 大语言模型领域概览。本文介绍黑色边框标注的这些架构。解码器式Transformer已在我的《大架构对比》一文中展开介绍。其余未加框的架构将在未来的文章中探讨。

需要说明的是,上图中展示的每个主题理想情况下都至少需要一整篇文章来详细阐述(希望未来能逐一覆盖)。因此为了控制本文篇幅,很多章节的内容会相对精简。但我依然希望本文能作为一份入门导引,带大家了解近年来涌现的这些值得关注的LLM替代方案。

附言:前文提到的PyTorch大会演讲将上传至PyTorch官方YouTube频道。在此之前,如果你感兴趣,可以先看下面的练习录制版本。

(也可以直接看YouTube版本:https://youtu.be/lONyteDR4XE 。)

1. 基于Transformer的大语言模型

基于经典https://arxiv.org/abs/1706.03762架构的Transformer大语言模型,目前在文本和代码领域依然代表着最顶尖的水平。仅回顾2024年末至今的亮点,代表性模型就包括:

  • DeepSeek V3/R1

  • OLMo 2

  • Gemma 3

  • Mistral Small 3.1

  • Llama 4

  • Qwen3

  • SmolLM3

  • Kimi K2

  • gpt-oss

  • GLM-4.5

  • GLM-4.6

  • MiniMax-M2
    以及更多其他模型。

(以上列表聚焦于开源权重模型;GPT-5、Grok 4、Gemini 2.5等闭源模型也属于这一类别。)
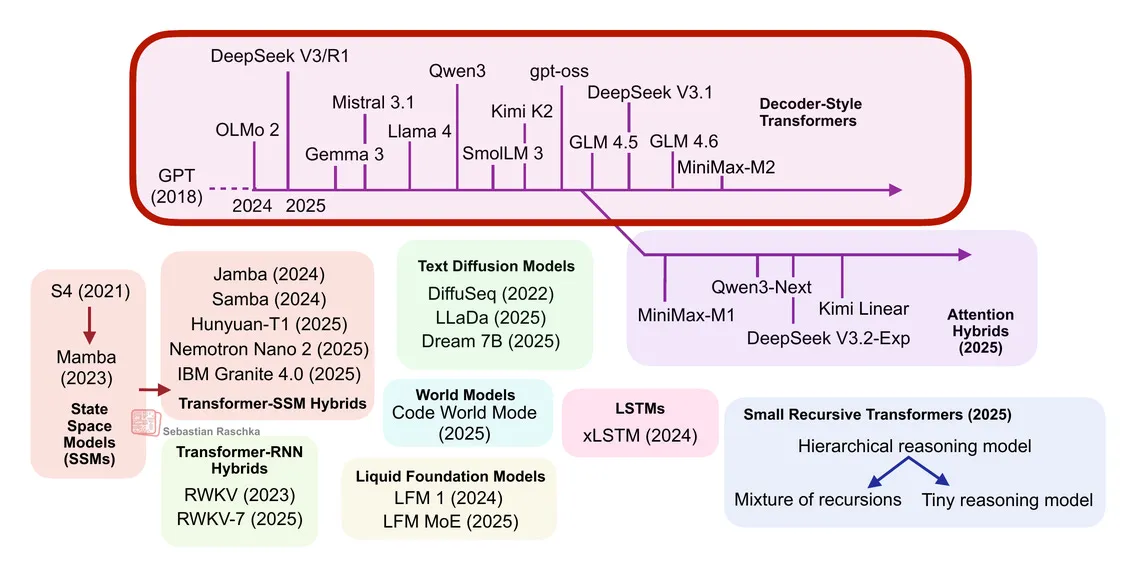
figure02

图2: 过去一年发布的最具代表性的解码器式Transformer概览。

鉴于我已经多次谈论和撰写基于Transformer的大语言模型,我默认大家已经熟悉其基本思路和架构。如果你想了解更深入的内容,可以在我的这篇文章中对比上述(及下图展示的)所有架构:https://magazine.sebastianraschka.com/p/the-big-llm-architecture-comparison

(旁注:我本可以将Qwen3-Next和Kimi Linear与概览图中的其他Transformer-状态空间模型(SSM)混合架构归为一类。在我看来,其他Transformer-SSM混合架构属于“带有Transformer组件的SSM”,而本文讨论的这些模型(Qwen3-Next和Kimi Linear)属于“带有SSM组件的Transformer”。不过,既然我已经把IBM Granite 4.0和NVIDIA Nemotron Nano 2放在了Transformer-SSM的框中,把它们归为同一大类也说得通。)
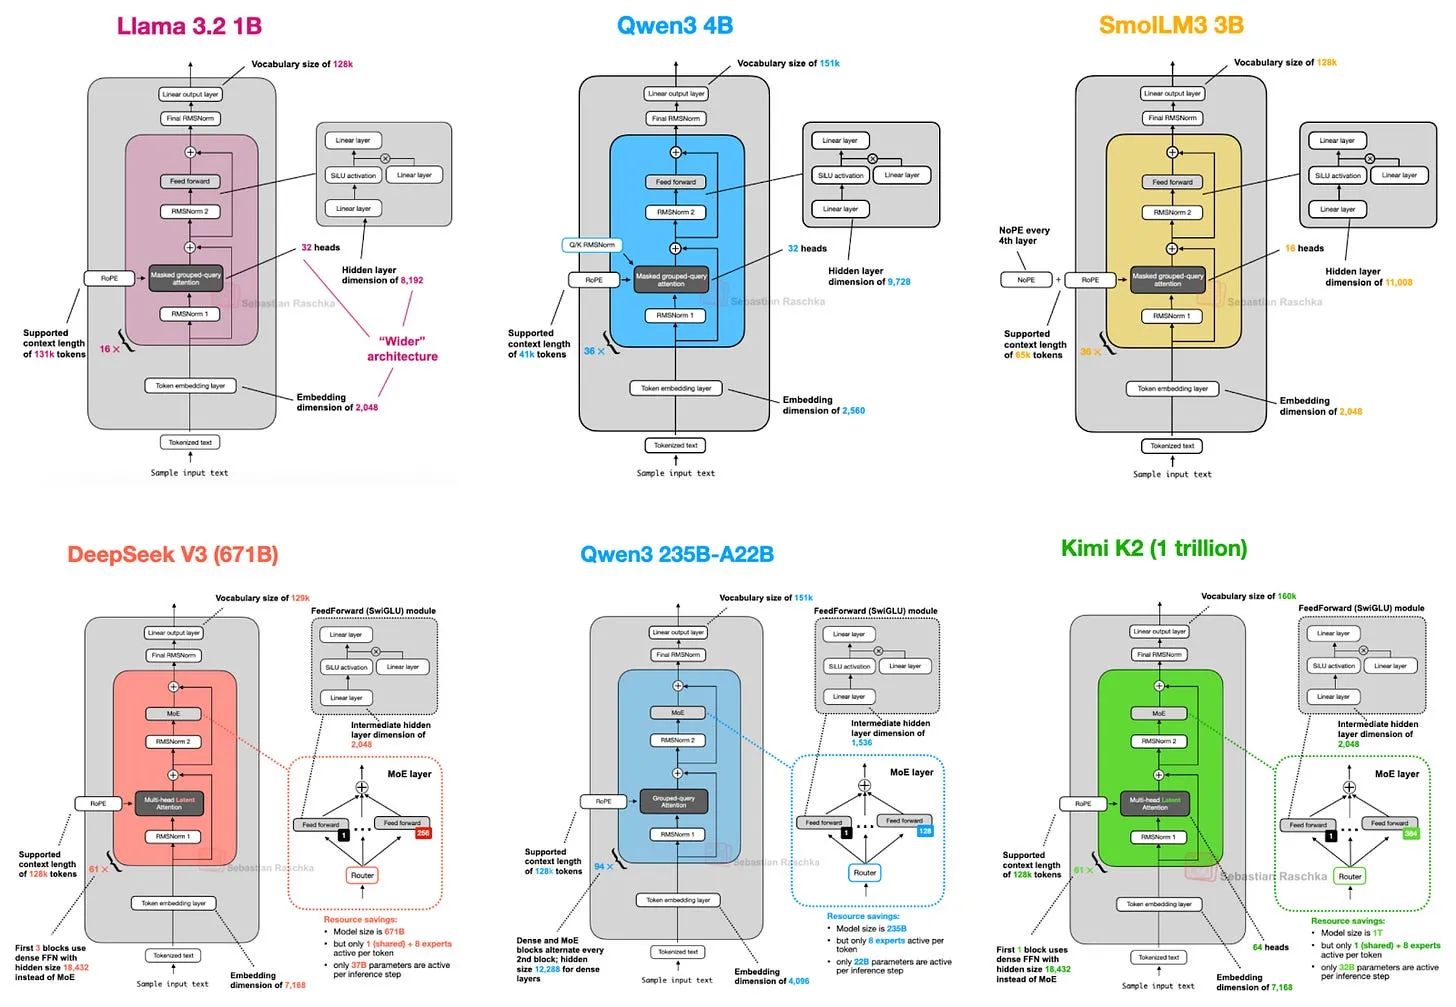
figure03

图3: 我的《大语言模型架构大对比》(https://magazine.sebastianraschka.com/p/the-big-llm-architecture-comparison)一文中讨论的部分架构。

如果你正在从事大语言模型相关工作——比如搭建应用、微调模型或者尝试新算法——我会把这些模型作为首选。它们经过了充分验证,表现成熟且优异。

此外,正如《大架构对比》一文中讨论的,目前已经有很多效率优化手段,包括分组查询注意力、滑动窗口注意力、多头潜在注意力等等。

但如果研究人员和工程师不去探索替代方案,那未免太过无趣,也太过短视。因此,接下来的章节将介绍近年来涌现的一些有意思的替代方向。

2. (线性)注意力混合架构

在讨论“差异更大”的方案之前,我们先来看采用了更高效注意力机制的基于Transformer的大语言模型。具体来说,重点关注那些计算量随输入token数量线性增长、而非二次增长的方案。

最近,线性注意力机制迎来了一波复兴,用以提升大语言模型的效率。

https://arxiv.org/abs/1706.03762(2017年)中提出的注意力机制,即缩放点积注意力,至今仍是大语言模型中最主流的注意力变体。除了传统的多头注意力之外,它也被应用于更高效的变体中,比如分组查询注意力、滑动窗口注意力以及多头潜在注意力,详见:https://youtu.be/lONyteDR4XE 。

2.1 传统注意力与二次代价

原始注意力机制的计算量随序列长度呈二次增长:

这是因为查询(Q)、键(K)、值(V)都是n×d的矩阵,其中d是嵌入维度(一个超参数),n是序列长度(即token的数量)。

(更多细节可以参考我的文章:https://magazine.sebastianraschka.com/p/understanding-and-coding-self-attention )
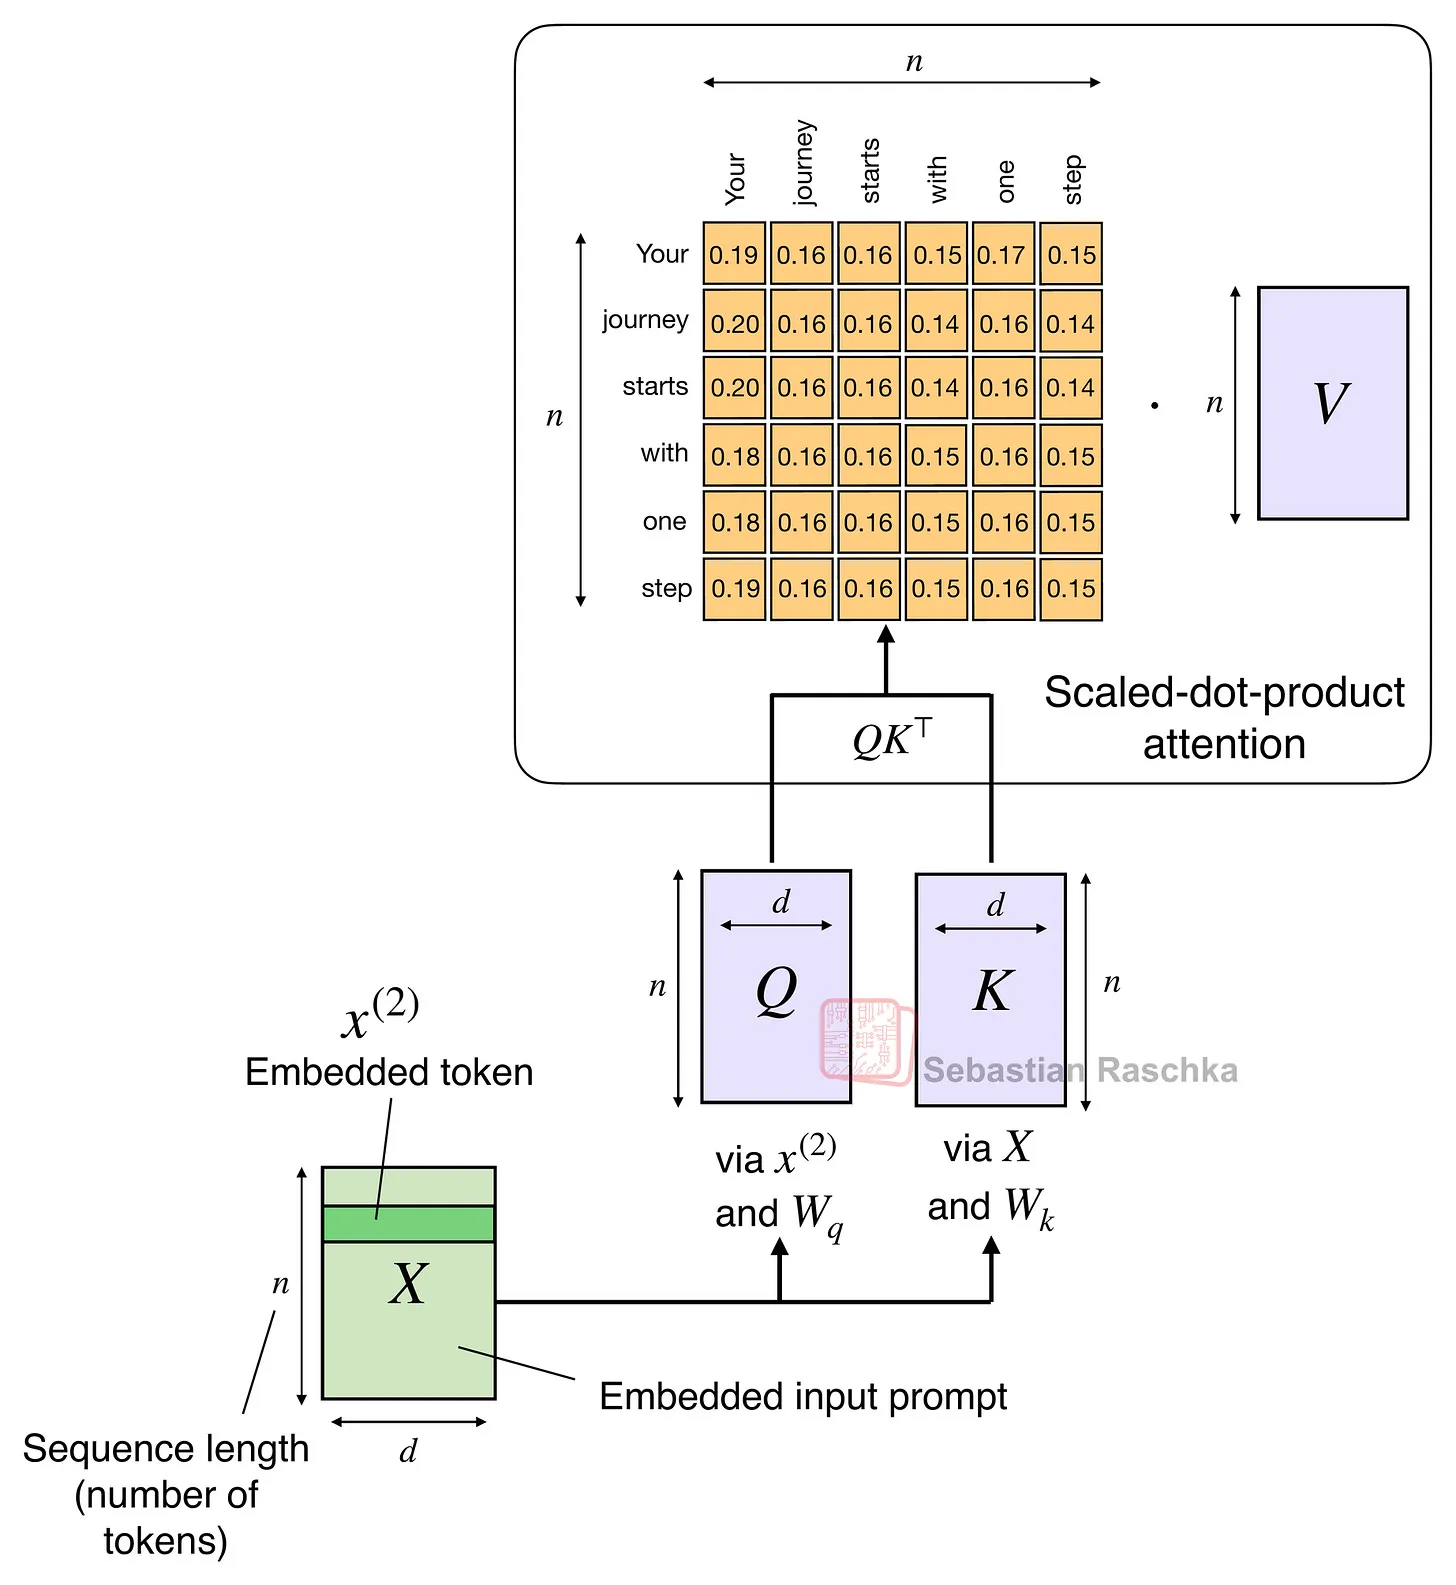
figure04

图4: 多头注意力中传统缩放点积注意力机制示意图;注意力的二次代价由序列长度n导致。

2.2 线性注意力

线性注意力变体其实早已存在,我记得2020年代就有大量相关论文。比如我印象中最早的一篇是2020年的https://arxiv.org/abs/2006.16236,研究人员在文中对注意力机制做了近似:

此处,ϕ(⋅)是核特征函数,取ϕ(x) = elu(x)+1。

这种近似之所以高效,是因为它避免了显式计算n×n的注意力矩阵QKᵀ。

我不想在这些早期尝试上花费太多篇幅。但核心结论是:它们将时间和内存复杂度从O(n²)降到了O(n),让长序列下的注意力效率大幅提升。

然而,这些方案从未真正普及,因为它们会降低模型精度,而且我从未见过哪一种变体被应用到开源的顶尖大语言模型中。

2.3 线性注意力的复兴

今年下半年,线性注意力变体迎来了复兴,部分模型开发者之间也出现了一些反复,如下图所示。
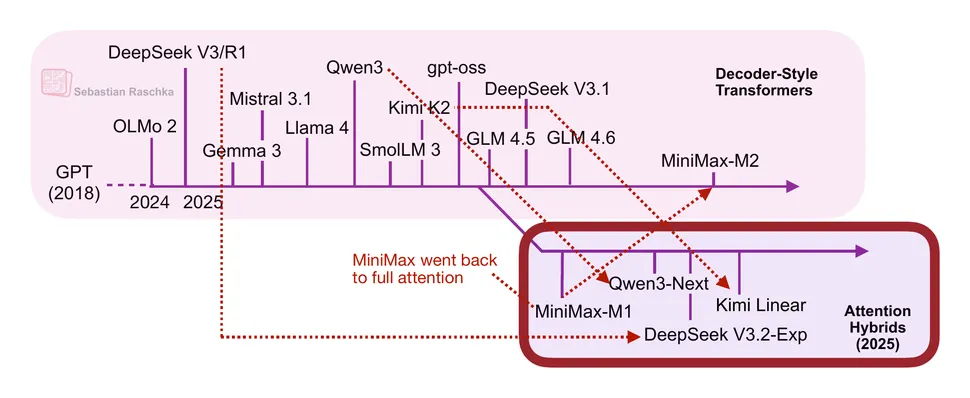
figure05

图5: 线性注意力混合架构概览。

第一个代表性模型是搭载闪电注意力的https://arxiv.org/abs/2506.13585。

MiniMax-M1是一个参数量4560亿的混合专家(MoE)模型,激活参数量460亿,于今年6月发布。

随后在8月,通义千问团队推出了Qwen3-Next,我在前文已经略有提及。到了9月,DeepSeek团队发布了https://huggingface.co/deepseek-ai/DeepSeek-V3.2-Exp 。(DeepSeek V3.2的稀疏注意力机制严格来说不算线性,但计算代价至少是亚二次级的,因此我认为把它和MiniMax-M1、Qwen3-Next、Kimi Linear归为同一类是合理的。)

这三个模型(MiniMax-M1、Qwen3-Next、DeepSeek V3.2)都在其大部分或全部层中,用高效的线性变体替换了传统的二次注意力。

有意思的是,最近出现了一个反转:MiniMax团队发布的全新230亿参数M2模型没有采用线性注意力,而是回归了常规注意力。团队在https://huggingface.co/blog/MiniMax-AI/why-did-m2-end-up-as-a-full-attention-model?utm_source=chatgpt.com中提到,线性注意力在生产级大语言模型中存在棘手问题。它在常规提示下表现尚可,但在推理和多轮任务中精度较差——而这些能力不仅对常规聊天场景很重要,对智能体应用同样关键。

这原本可能成为一个转折点,让线性注意力变得不再值得探索。但事情变得更有意思了:10月,Kimi团队发布了搭载线性注意力的全新https://arxiv.org/abs/2510.26692模型。

在线性注意力方面,Qwen3-Next和Kimi Linear都采用了门控DeltaNet(Gated DeltaNet),接下来几节我会将其作为混合注意力架构的一个例子展开讨论。

2.4 Qwen3-Next

我们先从Qwen3-Next说起,它用https://arxiv.org/abs/2412.06464 + https://arxiv.org/abs/2505.06708 的混合架构替换了常规注意力机制,从而在内存层面支撑了原生262k token的上下文长度(此前的235B-A22B模型原生支持32k,通过https://arxiv.org/abs/2309.00071缩放可支持131k)。

它的混合机制将门控DeltaNet模块与门控注意力模块按3:1的比例混合,如下图所示。
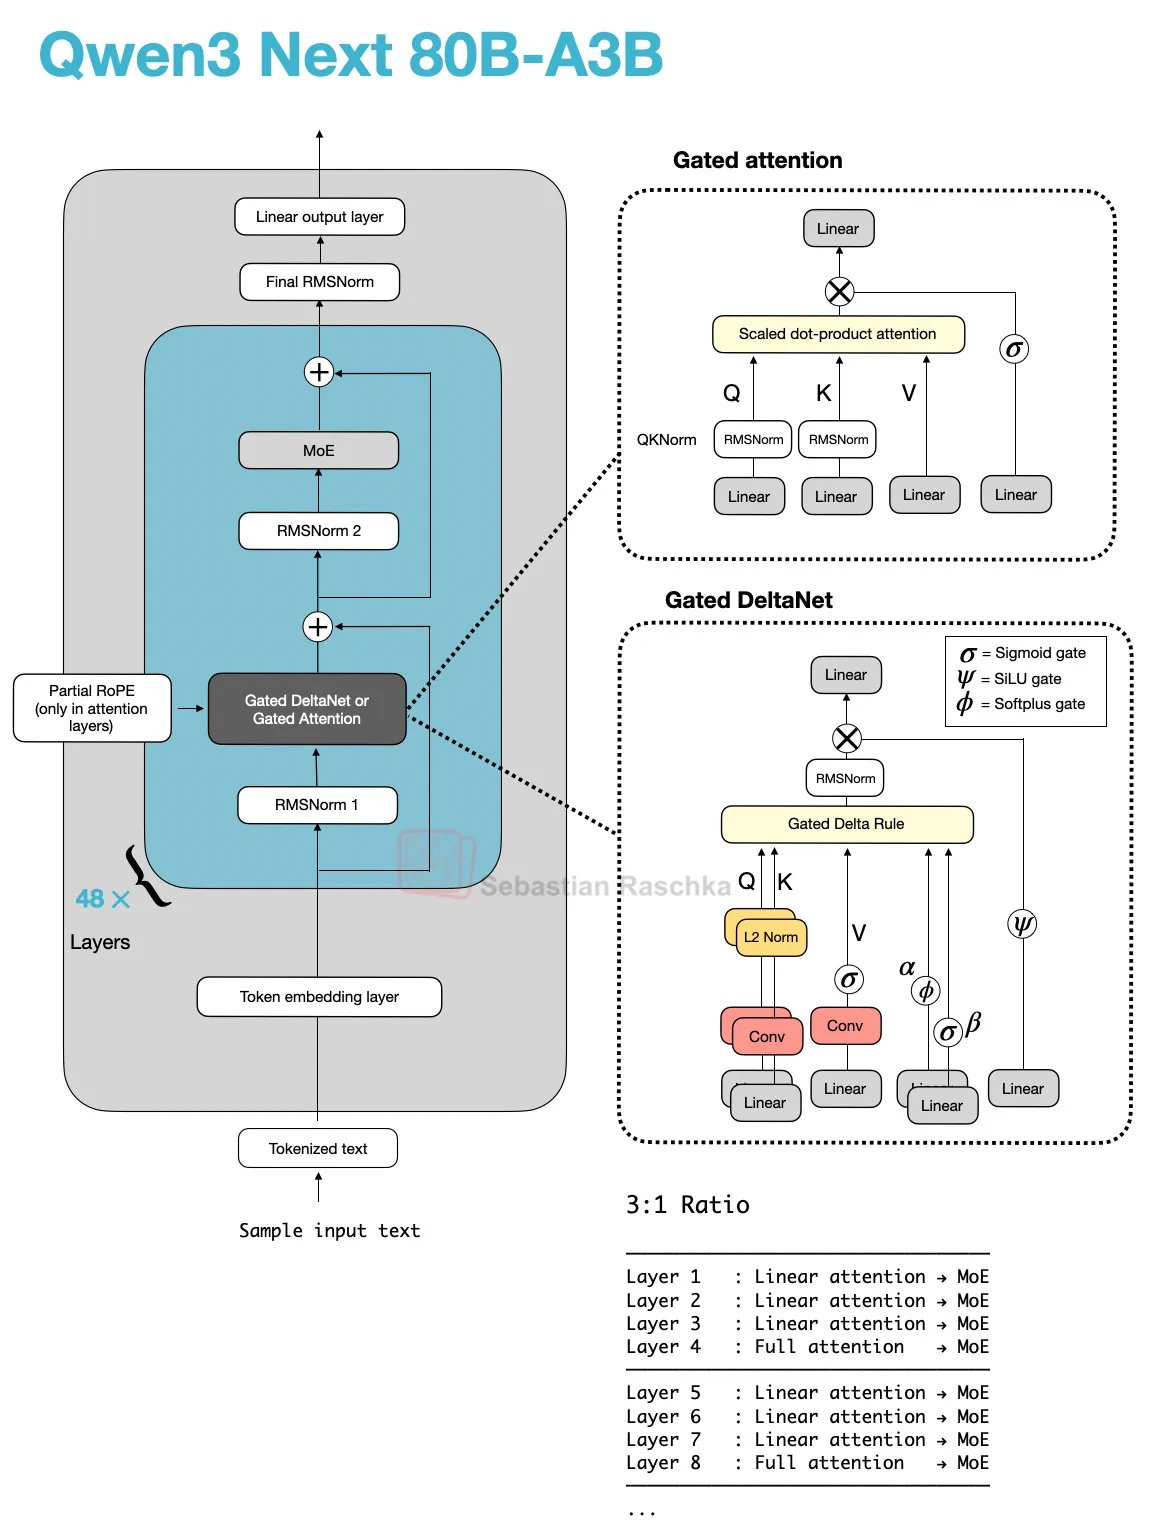
figure06

图6: 搭载门控注意力与门控DeltaNet的Qwen3-Next。

如上图所示,注意力机制要么实现为门控注意力,要么实现为门控DeltaNet。也就是说,该架构中的48个Transformer块(层)在二者之间交替。具体来说,如前所述,它们按3:1的比例交替。例如,Transformer块的排布如下:

──────────────────────────────────
第1层:线性注意力 → MoE
第2层:线性注意力 → MoE
第3层:线性注意力 → MoE
第4层:全注意力 → MoE
──────────────────────────────────
第5层:线性注意力 → MoE
第6层:线性注意力 → MoE
第7层:线性注意力 → MoE
第8层:全注意力 → MoE
──────────────────────────────────
……

除此之外,该架构整体相当标准,和Qwen3类似:
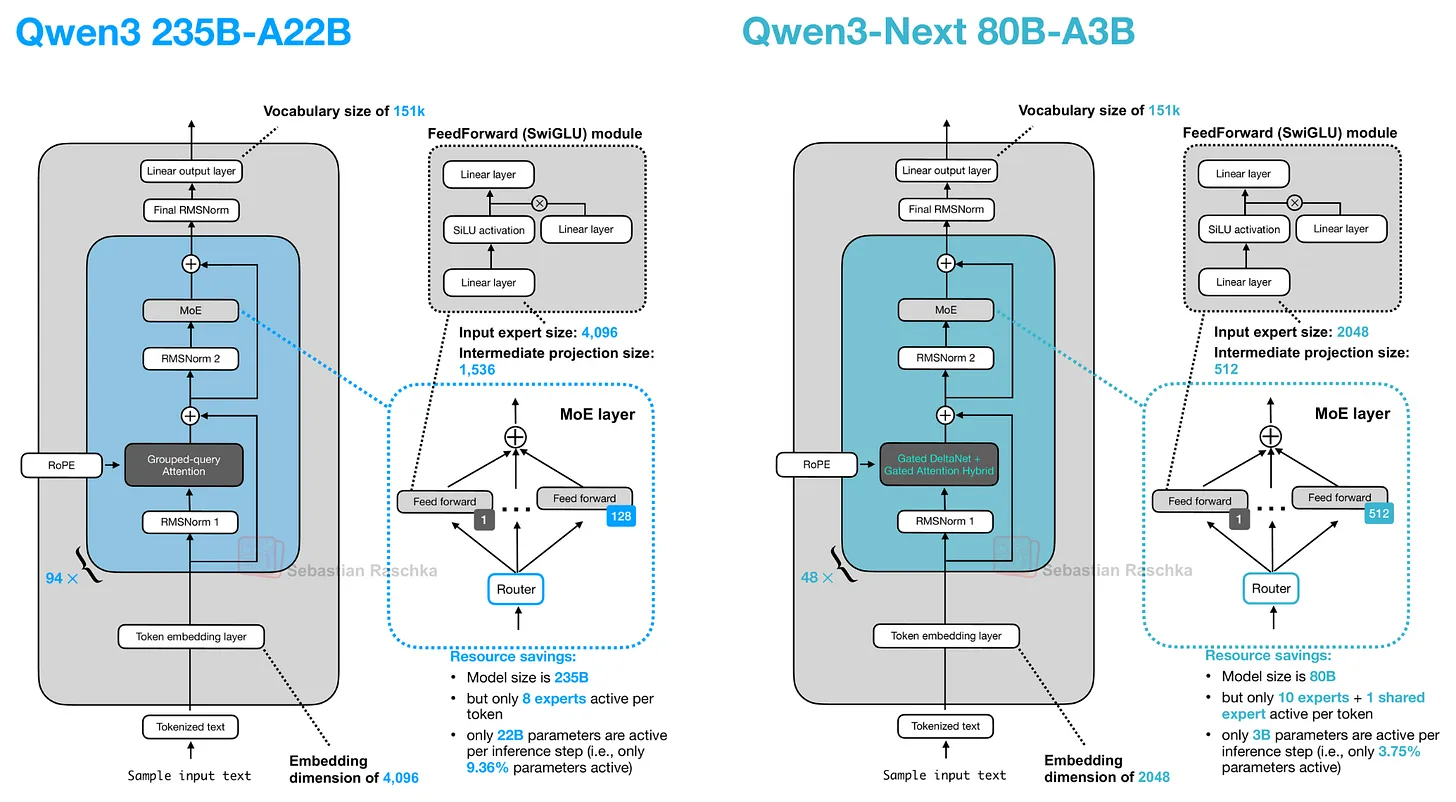
figure07

图7: 此前“常规版”Qwen3模型(左)与Qwen3-Next(右)对比。

那么,门控注意力和门控DeltaNet到底是什么?

2.5 门控注意力

在介绍门控DeltaNet本身之前,我们先简单聊聊门控。正如上一张图中Qwen3-Next架构的上半部分所示,Qwen3-Next采用了“门控注意力”。它本质上就是常规的全注意力,额外增加了一个Sigmoid门。

这种门控是一种简单的修改,我在一个多头注意力实现中(基于我的https://amzn.to/4fqvn0D第3章的代码)加入了该机制,用于演示:

可以看到,在按常规方式计算出注意力之后,模型从同一输入中生成一个单独的门控信号,经过Sigmoid函数将其约束在0到1之间,再与注意力输出相乘。这使得模型可以动态地放大或缩小特定特征。Qwen3-Next的开发者在https://qwen.ai/blog?id=4074cca80393150c248e508aa62983f9cb7d27cd&from=research.latest-advancements-list中提到,这有助于提升训练稳定性:

……注意力输出门控机制有助于消除注意力沉没(Attention Sink)和大幅激活(Massive Activation)等问题,保障模型全流程的数值稳定性。

简而言之,门控注意力对标准注意力的输出进行调制。下一节我们将讨论门控DeltaNet,它用一种递归的delta规则记忆更新机制替换了注意力机制本身。

2.6 门控DeltaNet

那么,什么是门控DeltaNet?门控DeltaNet(Gated Delta Network的缩写)是Qwen3-Next中的线性注意力层,旨在替代标准的Softmax注意力。它改编自前文提到的https://arxiv.org/abs/2412.06464论文。

门控DeltaNet最初是作为Mamba2的改进版本提出的,它将Mamba2的门控衰减机制与delta规则相结合。

Mamba是一种状态空间模型(Transformer的替代方案),是一个很大的主题,未来值得单独撰文介绍。

delta规则部分指的是:计算新值与预测值之间的差值(delta,Δ),用以更新作为记忆状态的隐藏状态(后文会详细展开)。

(旁注:熟悉经典机器学习文献的读者可以把它理解为类似生物学启发的赫布学习:“同步放电的神经元,连接也会同步增强。”它本质上是感知机更新规则和基于梯度下降学习的前身,但不需要监督。)

门控DeltaNet有一个和前文讨论的门控注意力类似的门,只不过它使用的是SiLU激活函数而非Logistic Sigmoid,如下图所示。(选择SiLU可能是为了相比标准Sigmoid提升梯度流动性和稳定性。)

figure08

图8: 门控注意力与门控DeltaNet对比。

然而,如上图所示,除了输出门之外,门控DeltaNet中的“门控”还指代几个额外的门:

  • α(衰减门)控制记忆随时间衰减或重置的速度

  • β(更新门)控制新输入对状态的修改强度

在代码中,上述门控DeltaNet的简化版本(不含卷积混合)可以实现为如下形式(代码灵感来自Qwen3团队的实现:https://github.com/huggingface/transformers/blob/0ed6d51ae8ed3f4fafca67a983b8d75bc76cd51b/src/transformers/models/qwen3_next/modular_qwen3_next.py#L835):

(注意:为了简洁起见,我省略了Qwen3-Next和Kimi Linear使用的卷积混合部分,让代码更易读,同时聚焦于递归特性。)

由此可见,它和标准(或门控)注意力有很多不同。

在门控注意力中,模型计算所有token之间的常规注意力(每个token都关注或查看其他所有token)。得到注意力输出后,由一个门(Sigmoid)决定保留多少输出。核心要点是:它依然是常规的缩放点积注意力,计算量随上下文长度呈二次增长。

回顾一下,缩放点积注意力的计算公式为softmax(QKᵀ)V,其中Q和K是n×d矩阵,n是输入token数量,d是嵌入维度。因此QKᵀ会得到一个n×n的注意力矩阵,再与n×d维度的值矩阵V相乘。
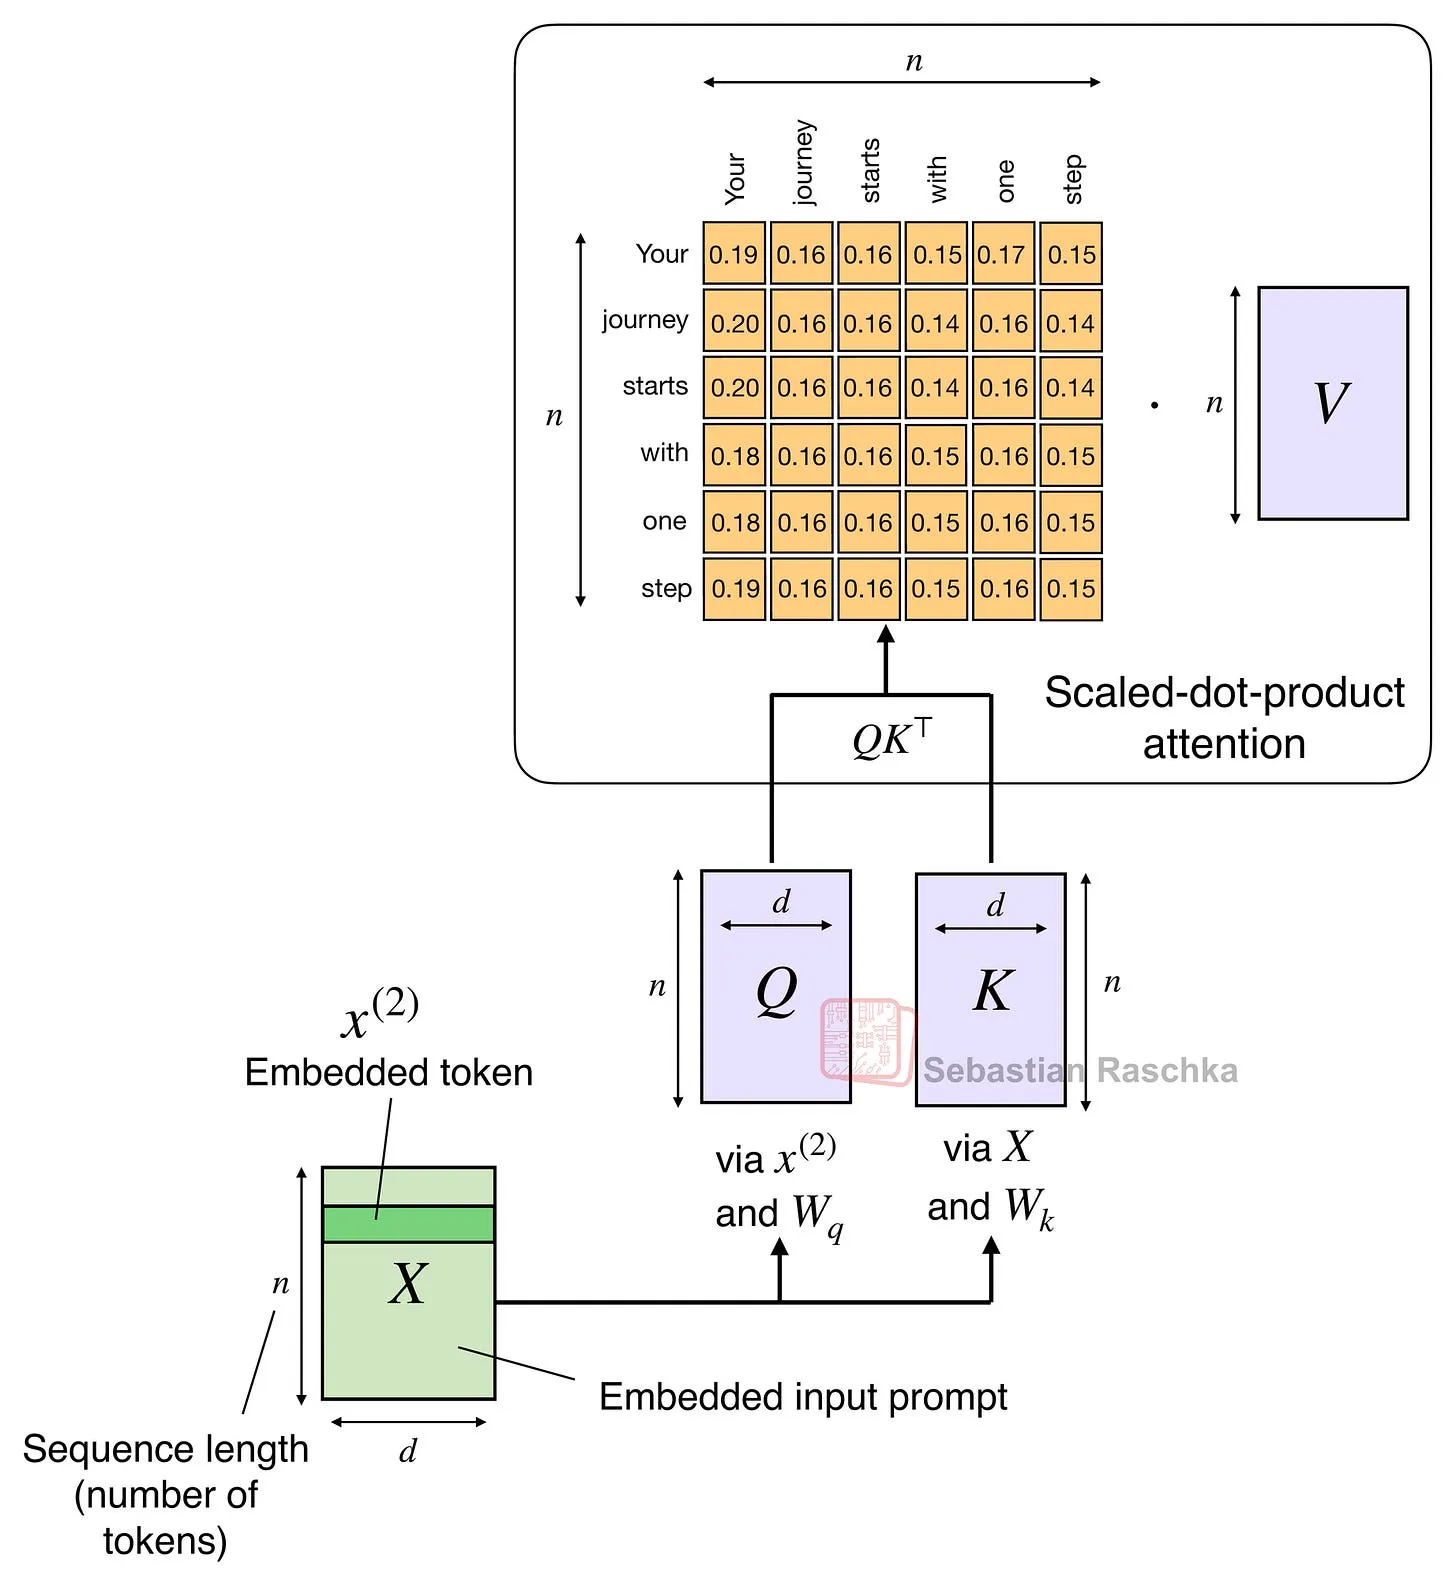
figure09

图9: 传统注意力机制(再次展示),其计算量随token数量n增长。

而在门控DeltaNet中,不存在n×n的注意力矩阵。相反,模型逐个处理token,维护一个持续更新的运行记忆(状态),每输入一个新token就更新一次。其实现方式为,其中S是每个时间步t都会递归更新的状态。

门控控制着记忆的变化方式:

  • α(alpha)调节需要遗忘(衰减)多少旧记忆

  • β(beta)调节当前时间步t的token对记忆的更新程度

(还有最终的输出门,上面的代码片段中没有展示,作用和门控注意力类似,控制保留多少输出。)

因此从某种意义上说,门控DeltaNet中的状态更新和循环神经网络(RNN)的工作方式类似。它的优势在于:计算量随上下文长度呈线性增长(通过for循环实现),而非二次增长。

这种递归状态更新的缺点在于,和常规(或门控)注意力相比,它牺牲了全成对注意力带来的全局上下文建模能力。

门控DeltaNet在一定程度上依然能捕捉上下文,但必须通过记忆(S)这个瓶颈。该记忆是固定大小的,因此效率更高,但它会把过去的上下文压缩成单个隐藏状态,和RNN类似。

这就是为什么Qwen3-Next和Kimi Linear架构没有把所有注意力层都替换成DeltaNet层,而是采用了前文提到的3:1比例。

2.7 DeltaNet的内存节省

上一节我们讨论了DeltaNet相比全注意力的优势:上下文长度维度下的计算复杂度是线性而非二次的。

除了线性计算复杂度之外,DeltaNet的另一大优势是内存节省——因为DeltaNet模块不会增大KV缓存。(关于KV缓存的更多信息,参见我的文章:https://magazine.sebastianraschka.com/p/coding-the-kv-cache-in-llms )相反,如前所述,它们维护一个固定大小的递归状态,因此内存不会随上下文长度变化。

对于常规的多头注意力(MHA)层,我们可以这样计算KV缓存大小:

KV_cache_MHA ≈ batch_size × n_tokens × n_heads × d_head × 2 × bytes

(乘以2是因为缓存中同时存储键和值。)

对于上面实现的简化版DeltaNet,我们有:

KV_cache_DeltaNet = batch_size × n_heads × d_head × d_head × bytes

注意,KV_cache_DeltaNet的内存大小不依赖上下文长度(n_tokens)。此外,我们只存储记忆状态S,而非分开的键和值,因此“2 × bytes”变成了“bytes”。不过要注意,这里出现了d_head × d_head的二次项,这来源于状态:

S = x.new_zeros(b, self.num_heads, self.head_dim, self.head_dim)

但这通常无需担心,因为头维度通常相对较小。比如在Qwen3-Next中是128。

带卷积混合的完整版本会稍微复杂一些,还涉及卷积核大小等因素,但上面的公式已经足以说明门控DeltaNet的核心趋势和设计动机。
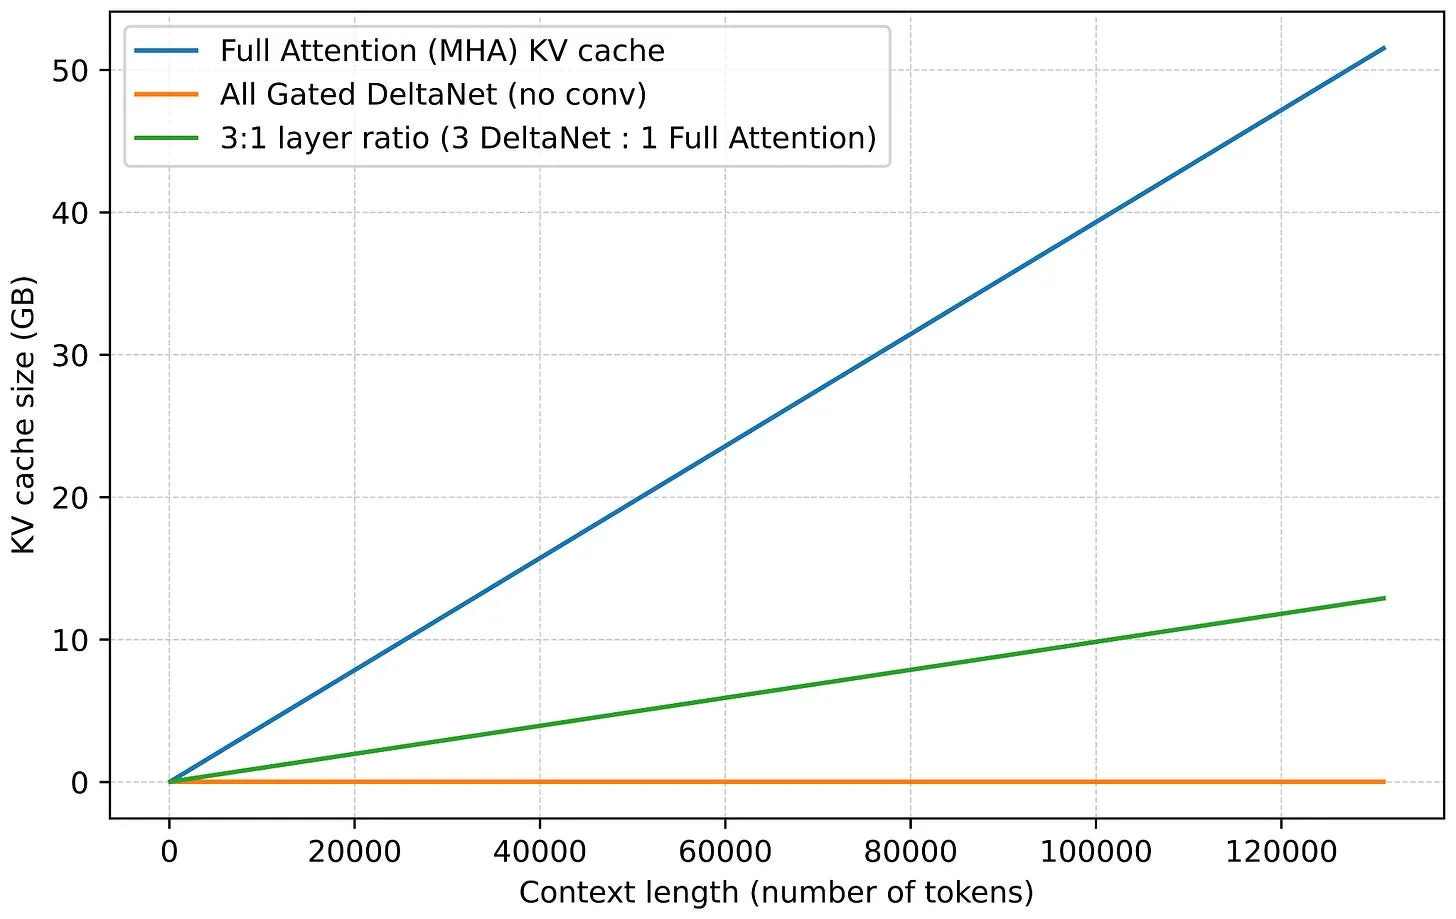
figure10

图10: KV缓存大小增长对比。3:1比例指门控DeltaNet层与全注意力层的比例。计算假设emb_dim=2048,n_heads=16,n_layers=48,bf16。你可以在这里找到复现代码:https://github.com/rasbt/LLMs-from-scratch/tree/main/ch04/08_deltanet。

2.8 Kimi Linear与Qwen3-Next对比

Kimi Linear与Qwen3-Next有若干结构相似性。两个模型都依赖混合注意力策略,具体来说,都是将轻量级线性注意力与更重的全注意力层相结合。二者都采用3:1的比例——即每3个采用线性门控DeltaNet变体的Transformer块,就搭配1个使用全注意力的块,如下图所示。
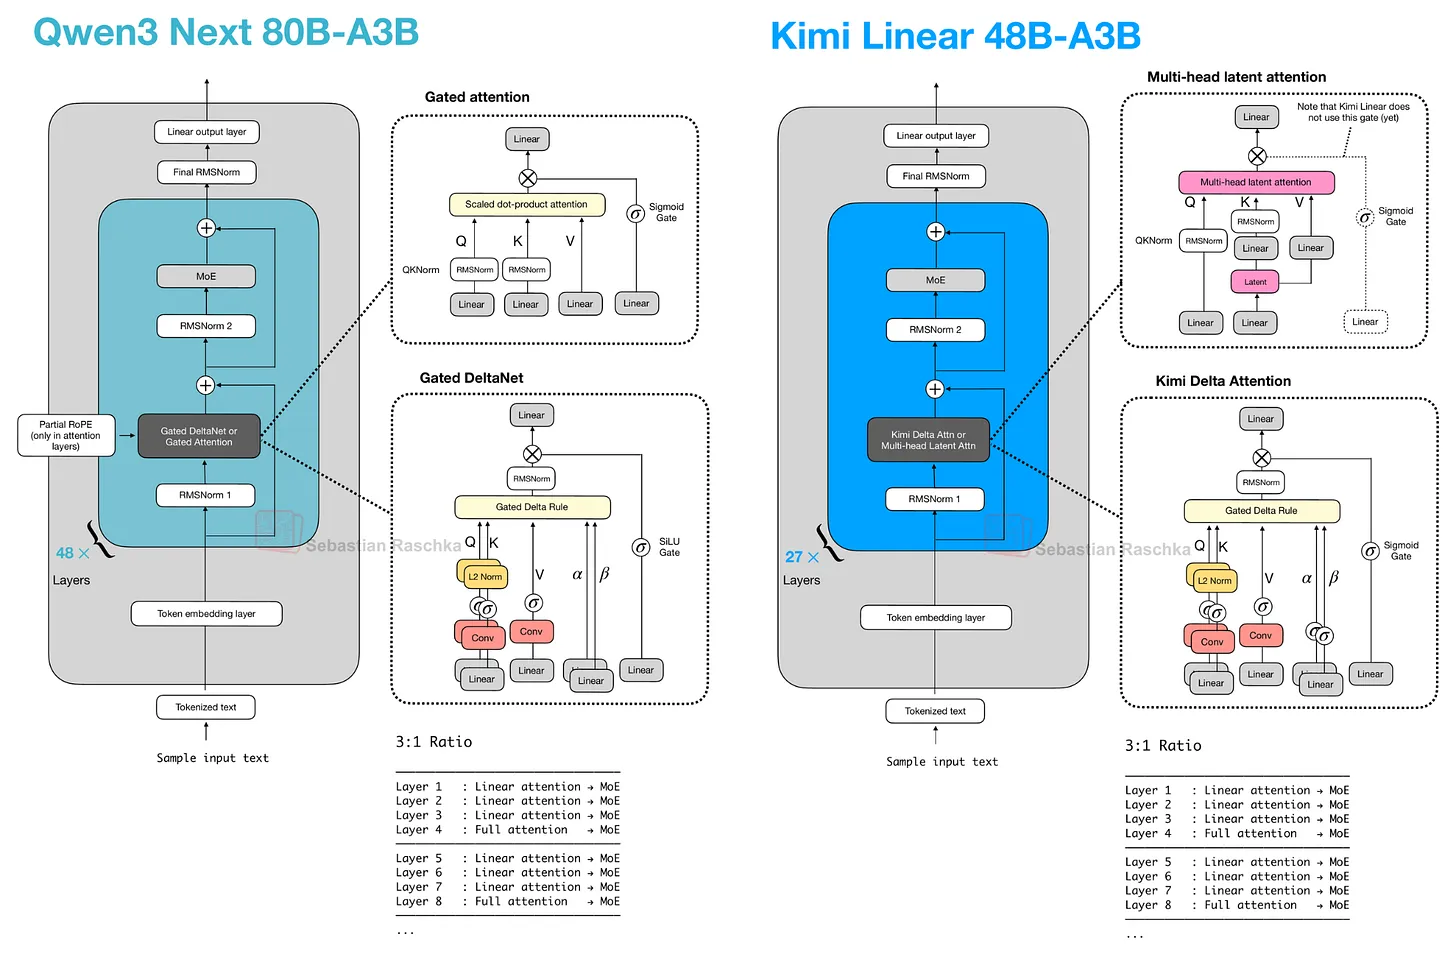
figure11

图11: Qwen3-Next与Kimi Linear并排对比。

门控DeltaNet是受循环神经网络启发的线性注意力变体,包含源自https://arxiv.org/abs/2412.06464论文的门控机制。从某种意义上说,门控DeltaNet就是带有Mamba风格门控的DeltaNet,而DeltaNet本身是一种线性注意力机制(下一节会详细说明)。

如上图11右上角方框所示,Kimi Linear中的MLA没有使用Sigmoid门。这一省略是有意为之,以便作者能更直接地与标准MLA对比,但他们在https://x.com/yzhang_cs/status/1984631714464088563中表示,未来计划加入该门控。

另外要注意,上图中Kimi Linear部分省略了RoPE框也是有意的。Kimi在多头潜在注意力(MLA)层(全局注意力)中采用了NoPE(无位置嵌入)。正如作者所述,这使得MLA在推理时可以作为纯多查询注意力运行,并且避免了长上下文缩放下的RoPE重调(位置偏差据称由Kimi Delta注意力块处理)。关于MLA和多查询注意力(分组查询注意力的一种特例)的更多信息,请参见我的《大语言模型架构大对比》一文:https://magazine.sebastianraschka.com/p/the-big-llm-architecture-comparison

2.9 Kimi Delta注意力

Kimi Linear通过Kimi Delta注意力(KDA)机制对Qwen3-Next的线性注意力机制做了改进,它本质上是门控DeltaNet的优化版本。Qwen3-Next使用标量门控(每个注意力头一个值)来控制记忆衰减速率,而Kimi Linear将其替换为针对每个特征维度的通道级门控。据作者称,这让记忆的可控性更强,进而提升了长上下文推理能力。

此外,在全注意力层,Kimi Linear用多头潜在注意力(MLA)替换了Qwen3-Next的门控注意力层(本质上是带输出门控的标准多头注意力层)。这和DeepSeek V3/R1使用的MLA机制是同一种(我在《大语言模型架构大对比》一文中讨论过),但额外增加了一个门。(回顾一下:MLA通过压缩键/值空间来减小KV缓存大小。)

目前没有直接和Qwen3-Next的对比,但和门控DeltaNet论文中的Gated DeltaNet-H1模型(本质上是带滑动窗口注意力的门控DeltaNet)相比,Kimi Linear在保持相同token生成速度的同时,实现了更高的建模精度。
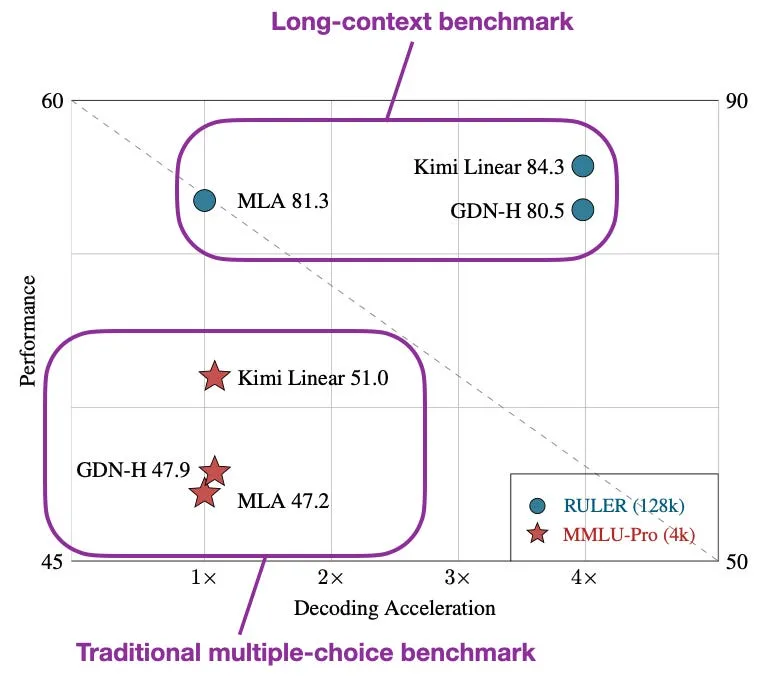
figure12

图12: 摘自Kimi Linear论文(https://arxiv.org/abs/2510.26692)的标注图,显示Kimi Linear速度与门控DeltaNet相当,远快于多头潜在注意力架构(如DeepSeek V3/R1),同时基准测试表现更优。

此外,根据https://arxiv.org/abs/2405.04434中的消融研究,当超参数选择得当时,MLA的表现与常规全注意力相当。

而Kimi Linear在长上下文和推理基准上的表现优于MLA,这让线性注意力变体再次有望应用于更大规模的顶尖模型中。话虽如此,Kimi Linear有480亿参数,但比Kimi K2小20倍。看看Kimi团队是否会在即将推出的K3模型中采用这一方案,将会很有意思。

2.10 注意力混合架构的未来

线性注意力并非新概念,但近期混合方案的复兴表明,研究人员又开始认真探索让Transformer更高效的实用方法。比如Kimi Linear相比常规全注意力,KV缓存减少了75%,解码吞吐量最高提升6倍。

新一代线性注意力变体与早期尝试的不同之处在于:它们是与标准注意力搭配使用,而非完全取而代之。

展望未来,我预计下一波注意力混合架构将聚焦于进一步提升长上下文稳定性和推理精度,从而向全注意力的顶尖水平靠拢。

3. 文本扩散模型

与标准自回归大语言模型架构相比,更具颠覆性的一类方案是文本扩散模型家族。

你可能对扩散模型并不陌生,它基于2020年的https://arxiv.org/abs/2006.11239论文,用于图像生成(作为生成对抗网络的继任者),后来经Stable Diffusion等项目实现、规模化并普及开来。
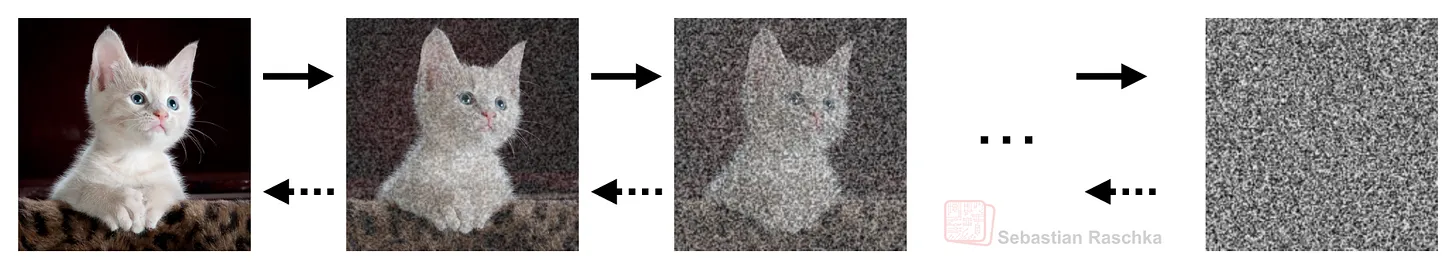
figure13

图13: 图像扩散过程示意图,引自2022年的文章《AI前沿1:创新的扩散》(https://magazine.sebastianraschka.com/p/ahead-of-ai-1-a-diffusion-of-innovations)。图中从左到右逐步加入高斯噪声,模型的任务是学习如何去除噪声(从右到左)。

3.1 为什么要研究文本扩散?

随着2022年https://arxiv.org/abs/2205.14217论文的发表,我们开始看到研究者将扩散模型应用于文本生成的趋势萌芽。2025年我已经看到了大量文本扩散相关论文。刚翻了一下我的论文书签列表,里面居然有39个文本扩散模型!鉴于这类模型的热度日益高涨,我觉得是时候专门聊聊它们了。
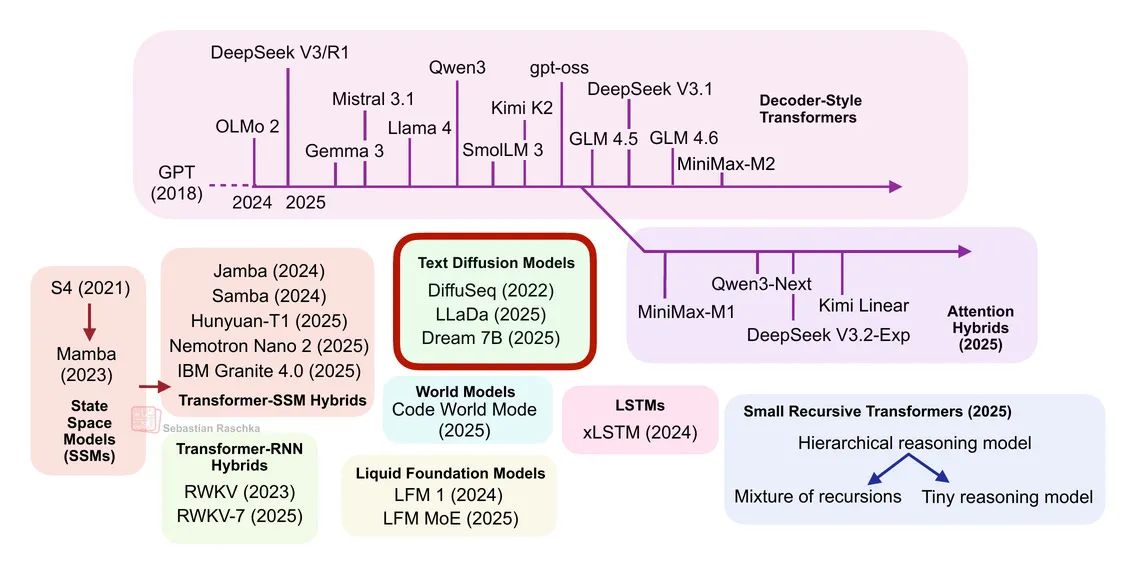
figure14

图14: 本节介绍文本扩散模型。

那么,扩散模型的优势是什么?为什么研究者要将其作为传统自回归大语言模型的替代方案来研究?

传统的基于Transformer的(自回归)大语言模型一次生成一个token。为简洁起见,我们下文简称其为自回归LLM。而基于文本扩散的大语言模型(我们称之为“扩散LLM”)的核心卖点是:它们可以并行生成多个token,而非顺序生成。

注意,扩散LLM依然需要多个去噪步骤。但即便一个扩散模型需要比如64步去噪,每一步并行生成所有token,其计算效率依然高于执行2000步顺序生成来产出2000个token的回复。

3.2 去噪过程

扩散LLM中的去噪过程,与常规图像扩散模型中的去噪过程类似,如下图动图所示。(核心区别在于:文本扩散不是向像素添加高斯噪声,而是通过按概率掩码token来破坏序列。)

在这个实验中,我运行了今年早些时候发布的https://arxiv.org/abs/2502.09992(LLaDA)论文中的8B指令微调模型。
figure15

图15: 使用8B LLaDA模型的去噪过程示意图。

如上面的动画所示,文本扩散过程会逐步将[MASK] token替换为文本token,从而生成答案。如果你熟悉https://arxiv.org/abs/1810.04805和掩码语言建模,你可以把这个扩散过程理解为BERT前向传播的迭代应用(BERT在不同掩码率下使用)。

从架构上看,扩散LLM通常是解码器式Transformer,但没有因果注意力掩码。比如前面提到的LLaDA模型就使用了Llama 3架构。我们把这种没有因果掩码的架构称为“双向”架构,因为它们可以同时访问所有序列元素。(注意这和BERT架构类似,由于历史原因,BERT被称为“编码器式”。)

因此,自回归LLM和扩散LLM的主要区别(除了去掉因果掩码之外)在于训练目标。扩散LLM(如LLaDA)使用生成式扩散目标,而非下一个token预测目标。

在图像模型中,生成式扩散目标很直观,因为我们有连续的像素空间。比如,添加高斯噪声和学习去噪在数学上是很自然的操作。然而文本由离散的token组成,我们无法像连续空间那样直接添加或去除“噪声”。

因此,这些扩散LLM不是扰动像素强度,而是通过逐步随机掩码token来破坏文本——每个token都以指定概率被替换为特殊的掩码token。模型随后学习一个逆过程,在每一步预测缺失的token,从而有效地将序列“去噪”(或解掩码)还原为原始文本,如图15的动画所示。

解释其背后的数学原理更适合单独写一篇教程,但大致来说,我们可以把它看作是扩展到概率最大似然框架下的BERT。

3.3 自回归LLM vs 扩散LLM

前文提到,扩散LLM的吸引力在于它们并行生成(或去噪)token,而非像常规自回归LLM那样顺序生成。这让扩散模型有望比自回归LLM更高效。

但话虽如此,传统LLM的自回归特性也是其核心优势之一。而纯并行解码的问题,可以用最近《ParallelBench:理解扩散大语言模型中并行解码的权衡》(https://arxiv.org/abs/2510.04767)论文中的一个绝佳例子来说明。
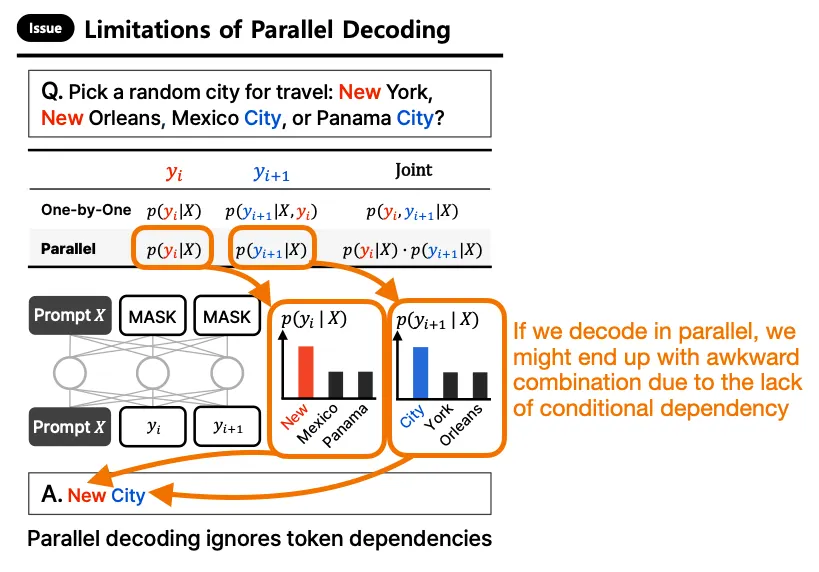
figure16

图16: 摘自《ParallelBench:理解扩散大语言模型中并行解码的权衡》(https://arxiv.org/abs/2510.04767)的标注图,展示了并行解码存在的问题。

比如,考虑以下提示:

“选一个随机旅游城市:纽约、新奥尔良、墨西哥城、还是巴拿马
城市?”

假设我们让LLM生成两个token的答案。它可能首先根据条件概率p(y_t = ”New” | X)采样出token“New”。

到下一次迭代时,它会基于之前生成的token,大概率选择“York”或“Orleans”,因为条件概率
p(y_{t+1} = ”York” | X, y_t = ”New”) 和 p(y_{t+1} = ”Orleans” | X, y_t = ”New”)
都相对较高(因为训练集中“New”经常和这些后缀共同出现)。但如果两个token是并行采样的,模型可能会独立选出两个最高概率的token p(y_t = “New” | X) 和 p(y_{t+1} = “City” | X),导致出现“New City”这种奇怪的输出。(这是因为模型缺少自回归条件约束,无法捕捉token之间的依赖关系。)

无论如何,上面的描述是简化的,听起来好像扩散LLM完全没有条件依赖。事实并非如此。如前所述,扩散LLM并行预测所有token,但这些预测通过迭代细化(去噪)步骤相互关联。

每一步扩散都会基于当前全部带噪文本进行条件计算,token之间通过每一步中的交叉注意力和自注意力相互影响。因此,尽管所有位置同时更新,但更新过程通过共享的注意力层互为条件。

但如前所述,理论上,生成2000个token的答案时,20-60步扩散可能比自回归LLM的2000步推理更划算。

3.4 文本扩散的现状

一个有趣的趋势是:视觉模型在吸收大语言模型的组件,比如注意力和Transformer架构本身;而基于文本的大语言模型也在从纯视觉模型中汲取灵感,将扩散应用于文本。

就我个人而言,除了试过几个演示之外,我还没有大量使用扩散模型,但我认为这是一种权衡。如果用较少的扩散步数,生成答案更快,但答案质量可能下降;如果增加扩散步数来生成更好的答案,最终模型的成本可能和自回归模型差不多。

引用https://arxiv.org/abs/2510.04767论文作者的话:

……我们系统分析了扩散LLM和自回归LLM,发现:(1)并行解码下的扩散LLM在真实场景中可能出现严重的质量下降;(2)当前的并行解码策略难以根据任务难度调整并行度,因此无法在不牺牲质量的前提下实现有意义的速度提升。

此外,我发现另一个特别的缺点是:扩散LLM无法在其生成链条中使用工具,因为根本不存在链条。或许可以在扩散步骤之间插入工具调用,但我猜这绝非易事。(如果我错了请指正。)

简而言之,扩散LLM似乎是一个值得探索的有趣方向,但就目前而言,它们可能还无法取代自回归LLM。不过我认为,它们可以作为小型端侧LLM的有趣替代,或者替代小型、蒸馏后的自回归LLM。

比如,谷歌宣布正在研发用于文本的https://deepmind.google/models/gemini-diffusion/模型,他们称其:

  • 快速响应:生成内容的速度甚至远超我们目前最快的模型。

而且在速度更快的同时,其基准表现似乎和他们的快速版Gemini 2.0 Flash-Lite模型不相上下。等该模型正式发布,用户在不同任务和领域中试用之后,看看它的接受度和反馈如何,将会很有意思。
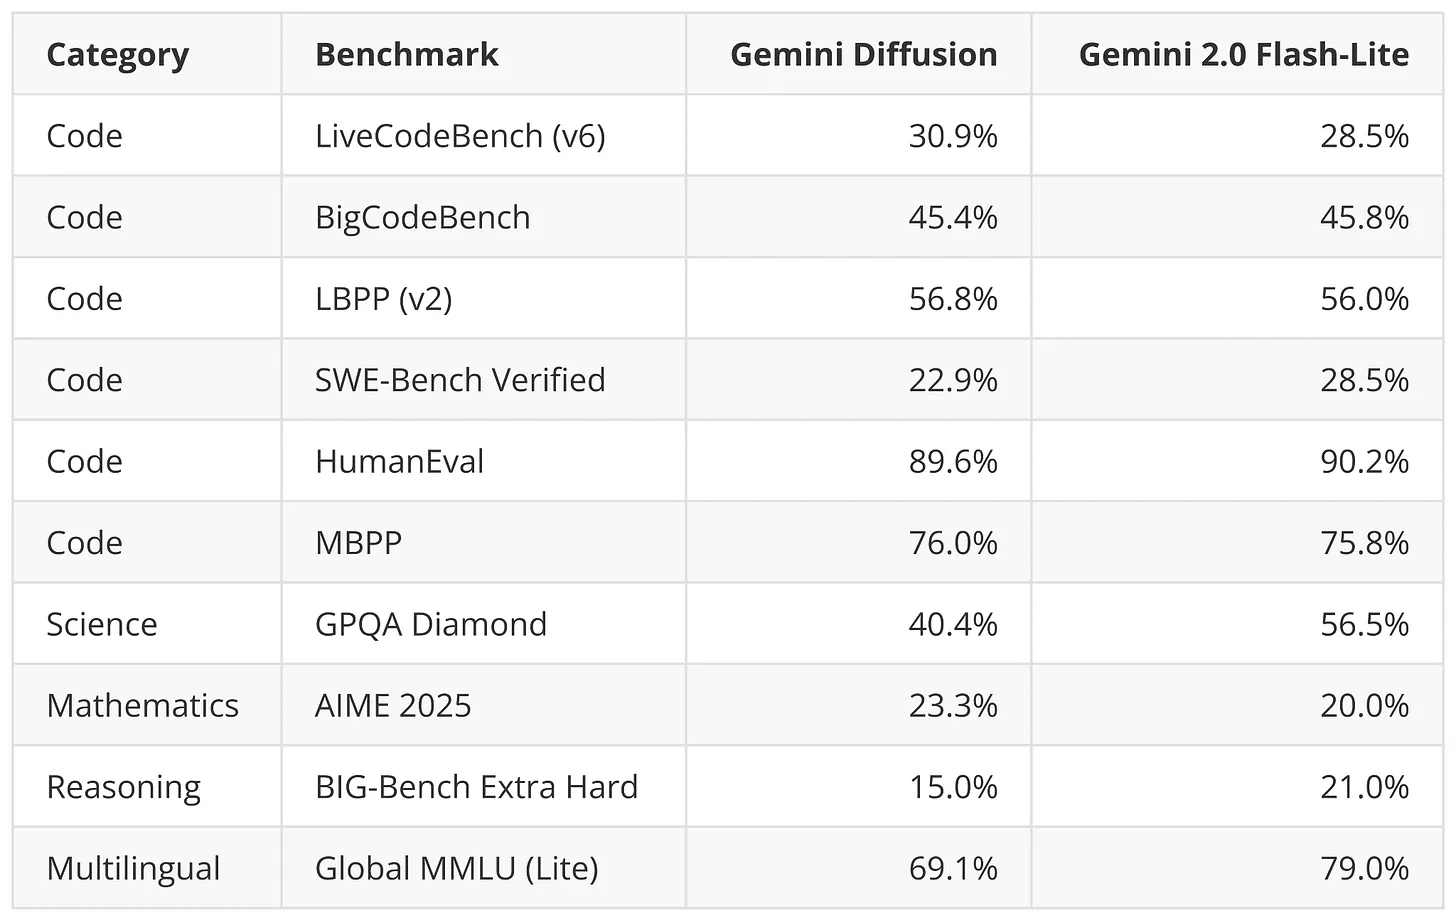
figure17

图17: (更快的)扩散LLM(Gemini Diffusion)与快速自回归LLM(Gemini 2.0 Flash-Lite)的基准表现对比。数据基于https://deepmind.google/models/gemini-diffusion/#capabilities公布的数值。

4. 世界模型

到目前为止,我们讨论的方案都聚焦于提升效率,让模型更快、更易扩展,而这些方案通常都会略微牺牲建模性能。

本节的主题则从另一个角度切入,聚焦于提升建模性能(而非效率)。这种性能提升是通过教会模型“理解世界”来实现的。

世界模型传统上是独立于语言建模发展的,但2025年9月最新发布的https://www.arxiv.org/abs/2510.02387论文,首次让世界模型与语言建模直接产生了关联。

理想情况下,和本文的其他主题一样,世界模型本身就值得一整篇文章(甚至一整本书)来介绍。不过在讨论《代码世界模型》(CWM)论文之前,先让我简单介绍一下世界模型。

4.1 世界模型的核心理念

最初,世界模型的理念是隐式地对结果建模,也就是在结果实际发生之前就预判可能发生的情况(如下图所示)。这类似于人类大脑会根据过往经验持续预测即将发生的事件。比如,当我们伸手去拿一杯咖啡或茶时,大脑已经预判出它大概有多重,我们甚至在碰到杯子之前就会调整握力。
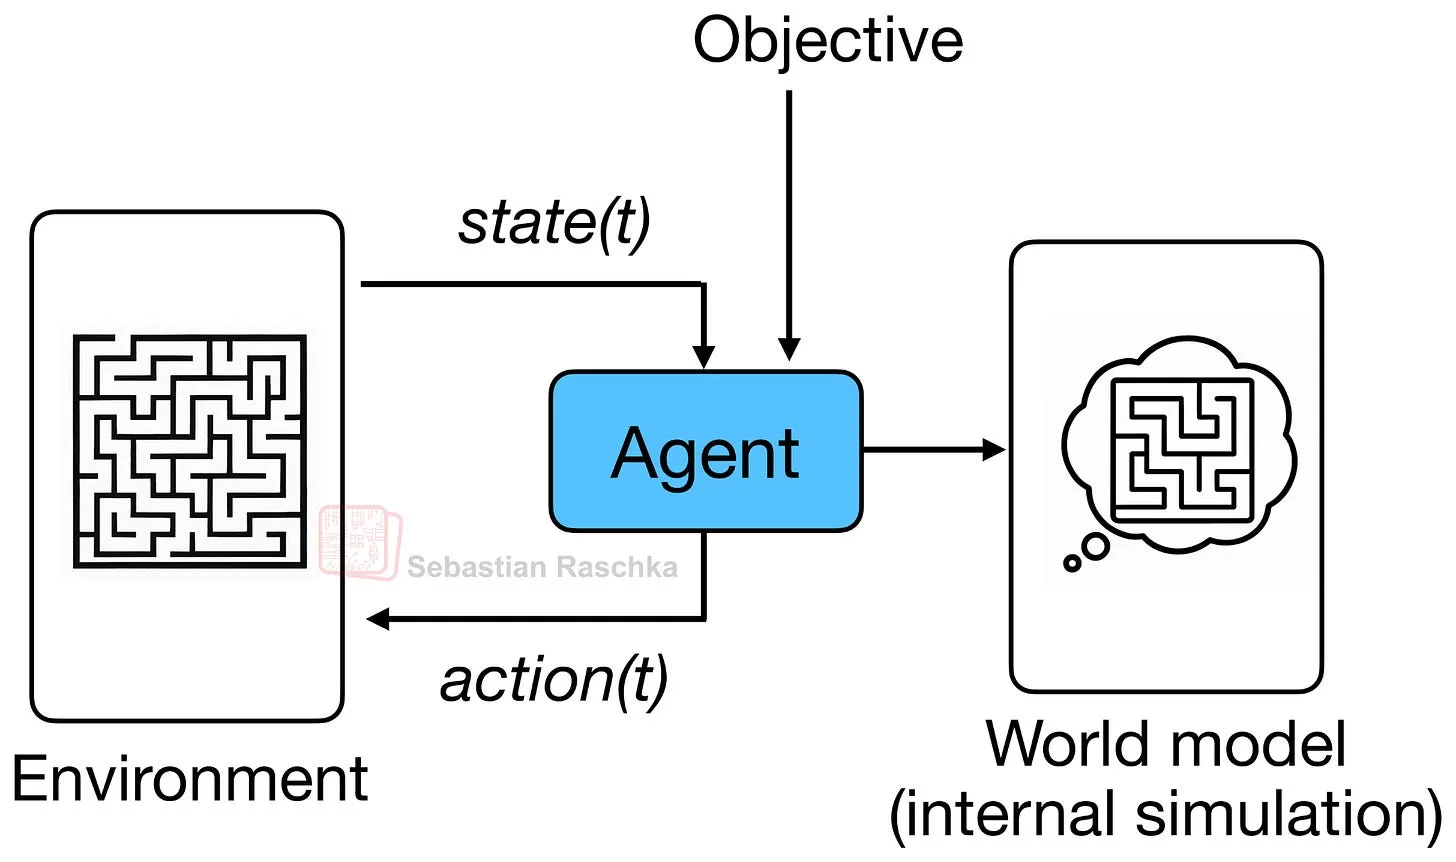
figure18

图18: 世界模型系统的概念概览。智能体通过观察环境当前状态(t)并采取行动(t)来与环境交互,以达成既定目标。与此同时,智能体学习一个内部世界模型,作为环境的心智模拟,让它可以在真实世界执行行动之前就预测结果、规划动作。

据我所知,“世界模型”这个术语是由Ha和Schmidhuber在2018年的同名论文https://arxiv.org/abs/1803.10122中普及的,该论文使用VAE+RNN架构为强化学习智能体学习一个内部环境模拟器。(但这个术语或概念本身本质上就是对世界或环境的建模,其源头可以追溯到20世纪80年代的强化学习和机器人学研究。)

说实话,直到Yann LeCun 2022年的文章https://openreview.net/pdf?id=BZ5a1r-kVsf发表之前,我都没有关注到世界模型的这种新解读。那篇文章本质上是在描绘一条不同于大语言模型的AI替代路径。

4.2 从视觉到代码

话虽如此,此前的世界模型论文都聚焦于视觉领域,涵盖的架构也非常广泛:从早期基于VAE和RNN的模型,到Transformer、扩散模型,甚至Mamba层混合架构。

而作为目前更专注于大语言模型的研究者,https://www.arxiv.org/abs/2510.02387(2025年9月30日)这篇论文第一次完全抓住了我的注意力(双关语)。据我所知,这是第一个从文本到文本(或者更准确地说,从代码到代码)映射的世界模型。

CWM是一个320亿参数的开源权重模型,上下文窗口为131k token。从架构上看,它依然是一个带滑动窗口注意力的稠密解码器-only Transformer。和其他大语言模型一样,它也经历了预训练、中期训练、监督微调(SFT)和强化学习阶段,但中期训练数据引入了世界建模组件。

4.3 代码世界模型 vs 常规代码大语言模型

那么,它和常规代码大语言模型(比如https://huggingface.co/Qwen/Qwen3-Coder-480B-A35B-Instruct )有什么不同?

Qwen3-Coder这类常规模型纯粹通过下一个token预测进行训练。它们学习语法和逻辑模式来生成合理的代码补全,这让它们对编程拥有静态的文本层面的理解。

相比之下,CWM学习模拟代码运行时会发生什么。它被训练来预测执行代码修改等操作后的程序状态,比如变量的值,如下图所示。
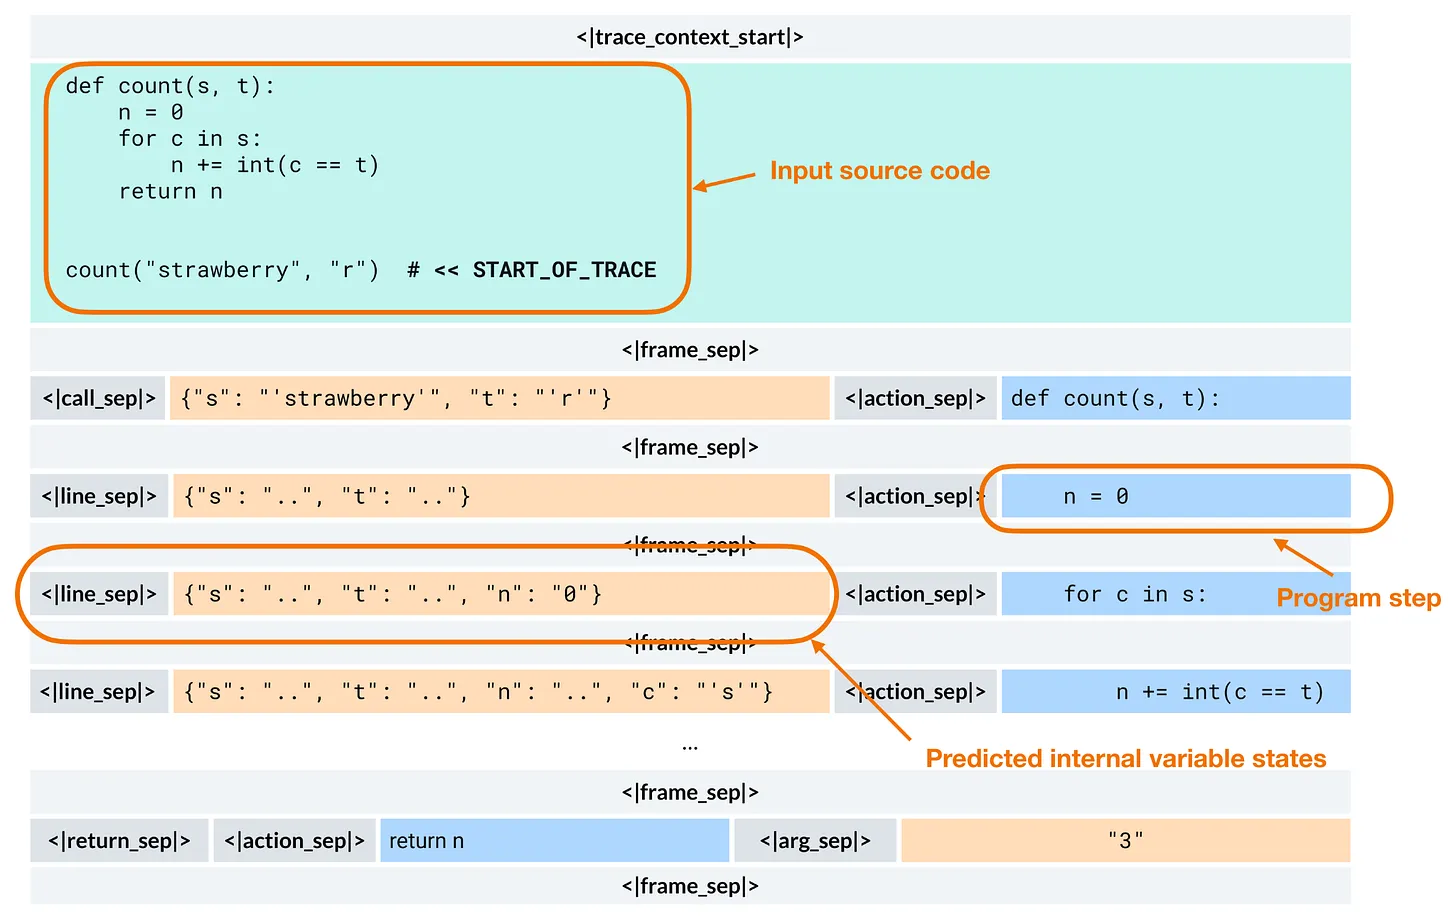
figure19

图19: 代码世界模型(CWM)中的代码执行追踪示例。模型预测每一行代码执行时变量状态的逐步演变。图中模型本质上在模拟代码的行为。图标注摘自https://www.arxiv.org/abs/2510.02387。

在推理时,CWM依然是自回归Transformer,一次生成一个token,就像GPT风格的模型一样。核心区别在于:这些token可以编码结构化的执行轨迹,而非纯文本。

所以,我或许不会称它为世界模型,而是“世界模型增强的大语言模型”。

作为首次尝试,它的表现好得惊人,在参数量大致相当的情况下,表现与gpt-oss-20b(中等推理强度)相当。

如果使用测试时缩放技术,它的表现甚至略优于gpt-oss-120b(高推理强度),但模型尺寸只有后者的1/4。

注意,他们的测试时缩放使用了带生成单元测试的best@k流程(可以理解为一种更复杂的多数投票机制)。如果能对比CWM和gpt-oss的每秒token数或解题时间会很有意思,因为它们使用了不同的测试时缩放策略(best@k vs 每步推理更多token)。
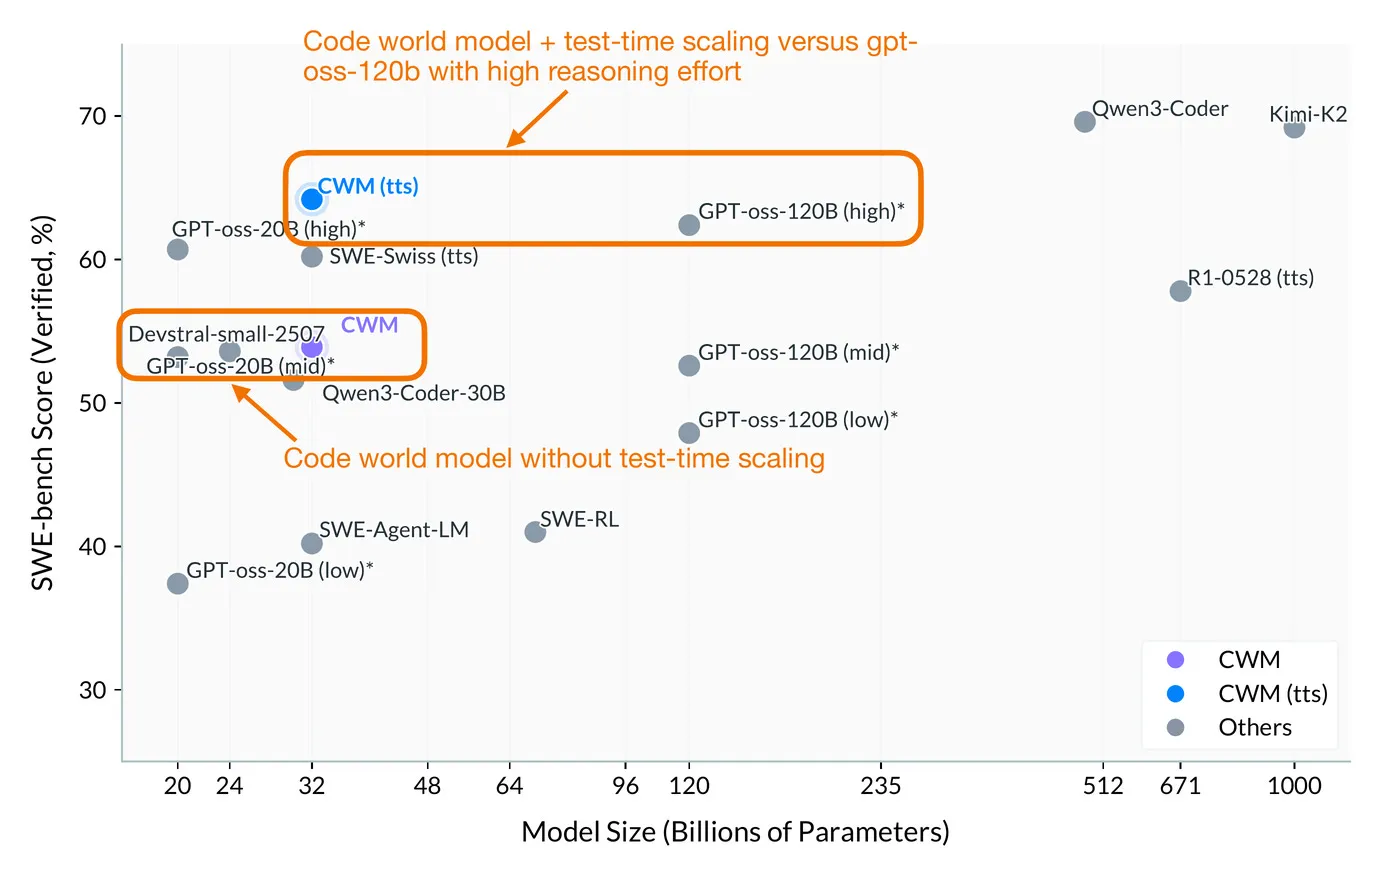
figure20

图20: 代码世界模型(CWM)与其他主流大语言模型在编码基准(SWE-bench)上的表现对比。图标注摘自https://www.arxiv.org/abs/2510.02387。

5. 小型递归Transformer

你可能已经注意到,前面所有方案依然建立在Transformer架构之上。本节的主题也不例外,但和之前讨论的模型不同,这些是专为推理设计的小型专用Transformer。

没错,专注于推理的架构不一定非得很大。事实上,随着https://arxiv.org/abs/2506.21734(HRM)的出现,一种新型小型递归Transformer最近在研究界引发了大量关注。
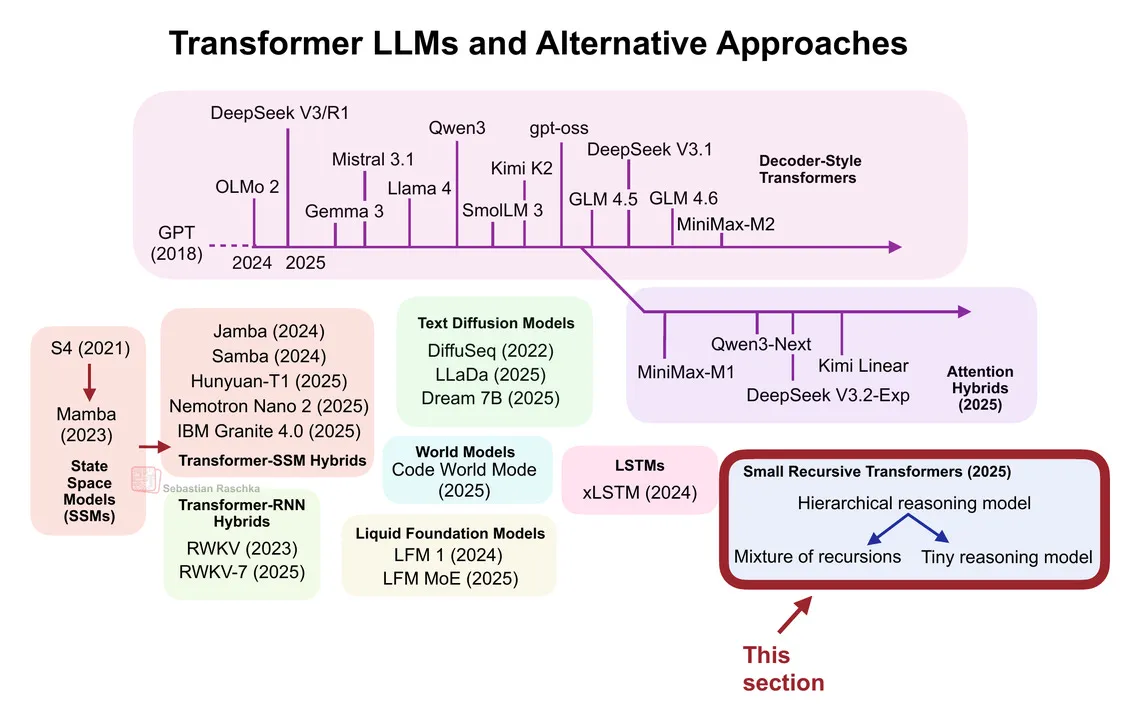
figure21

图21: 大语言模型领域概览;本节介绍小型递归Transformer。

更具体地说,HRM的研究者证明,即便是非常小的Transformer模型(仅4个块),只要经过训练逐步细化答案,就能在特定问题上展现出惊人的推理能力。这让它在ARC挑战赛上登顶。
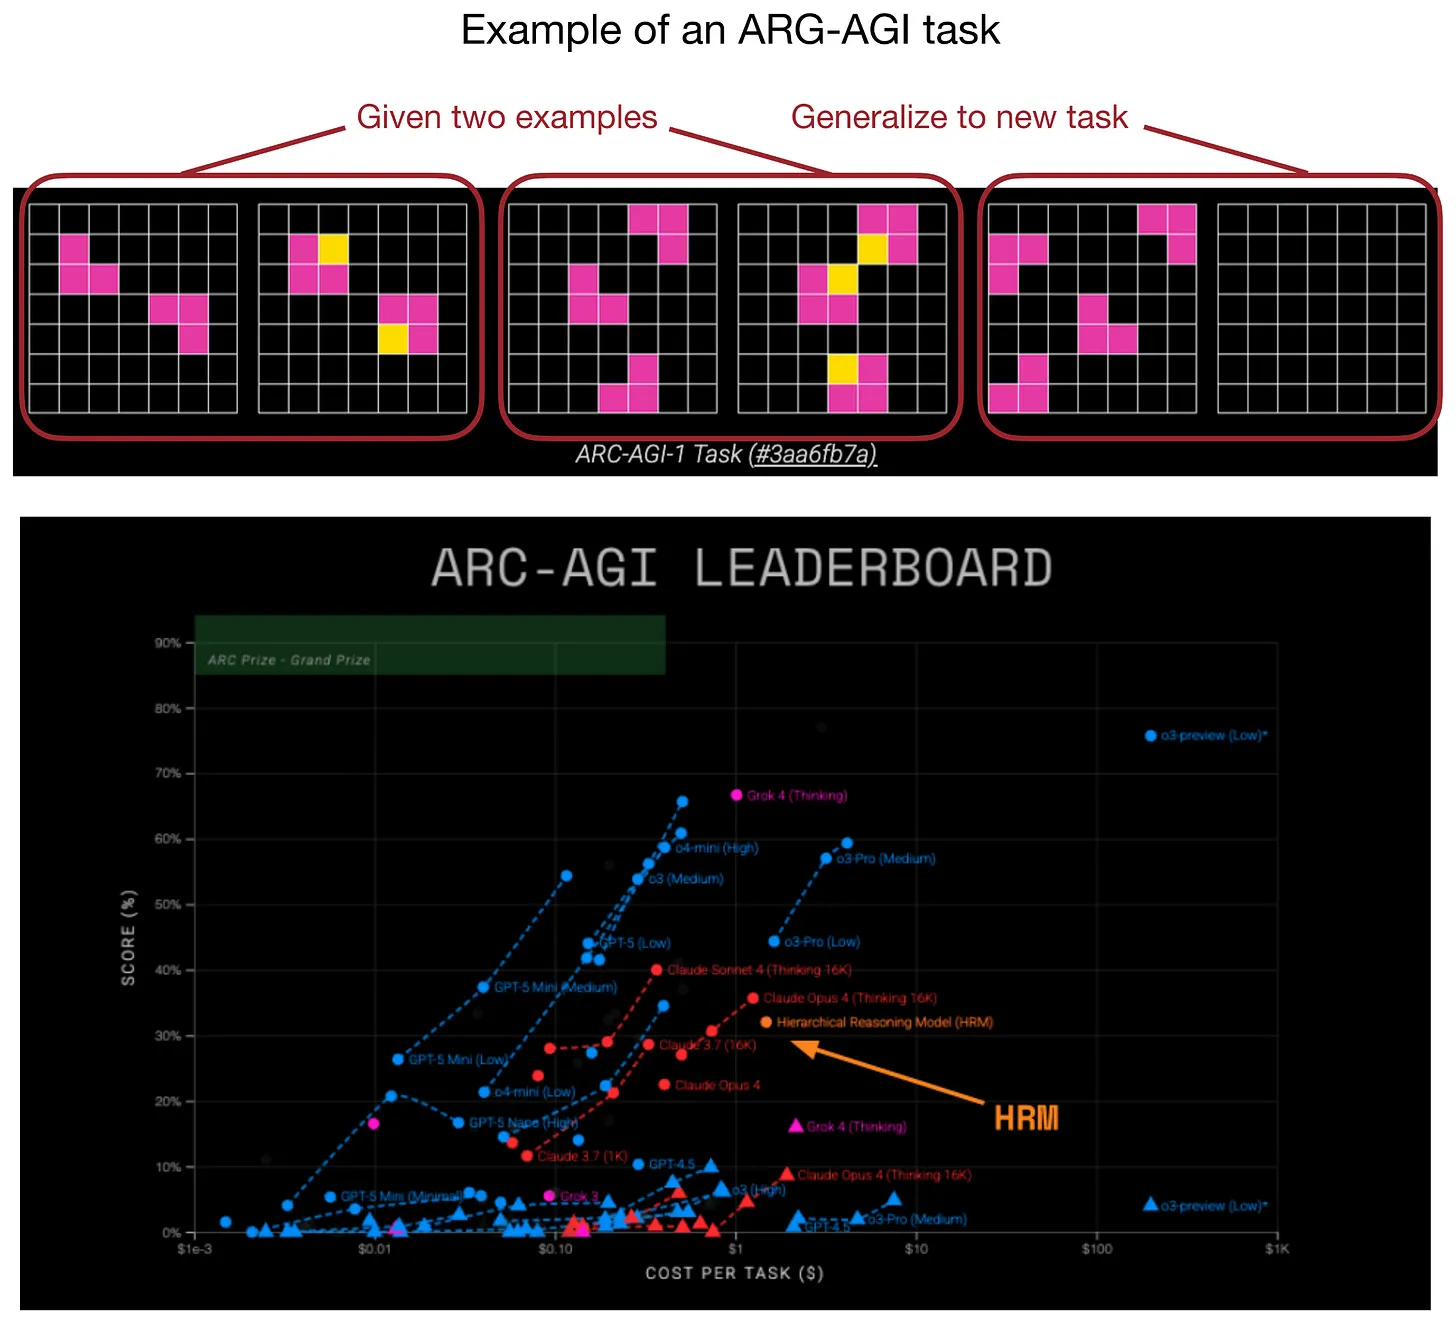
figure22

图22: ARC-AGI 1任务示例(上)来自arcprize.org/arc-agi/1;分层推理模型(HRM)在排行榜上的排名(下)来自arcprize.org/blog/hrm-analysis。

HRM这类递归模型的理念是:模型不是一次前向传播就生成答案,而是以递归方式反复细化自己的输出。(在这个过程中,每次迭代都会细化一个潜在表示,作者将其视为模型的“思考”或“推理”过程。)

第一个代表性例子是今年初夏的HRM,随后是https://arxiv.org/abs/2507.10524。

而就在最近,https://arxiv.org/abs/2510.04871(2025年10月)提出了小型递归模型(Tiny Recursive Model,TRM),如下图所示。它是一种更简单、甚至更小的模型(700万参数,大约比HRM小4倍),在ARC基准上的表现甚至更优。
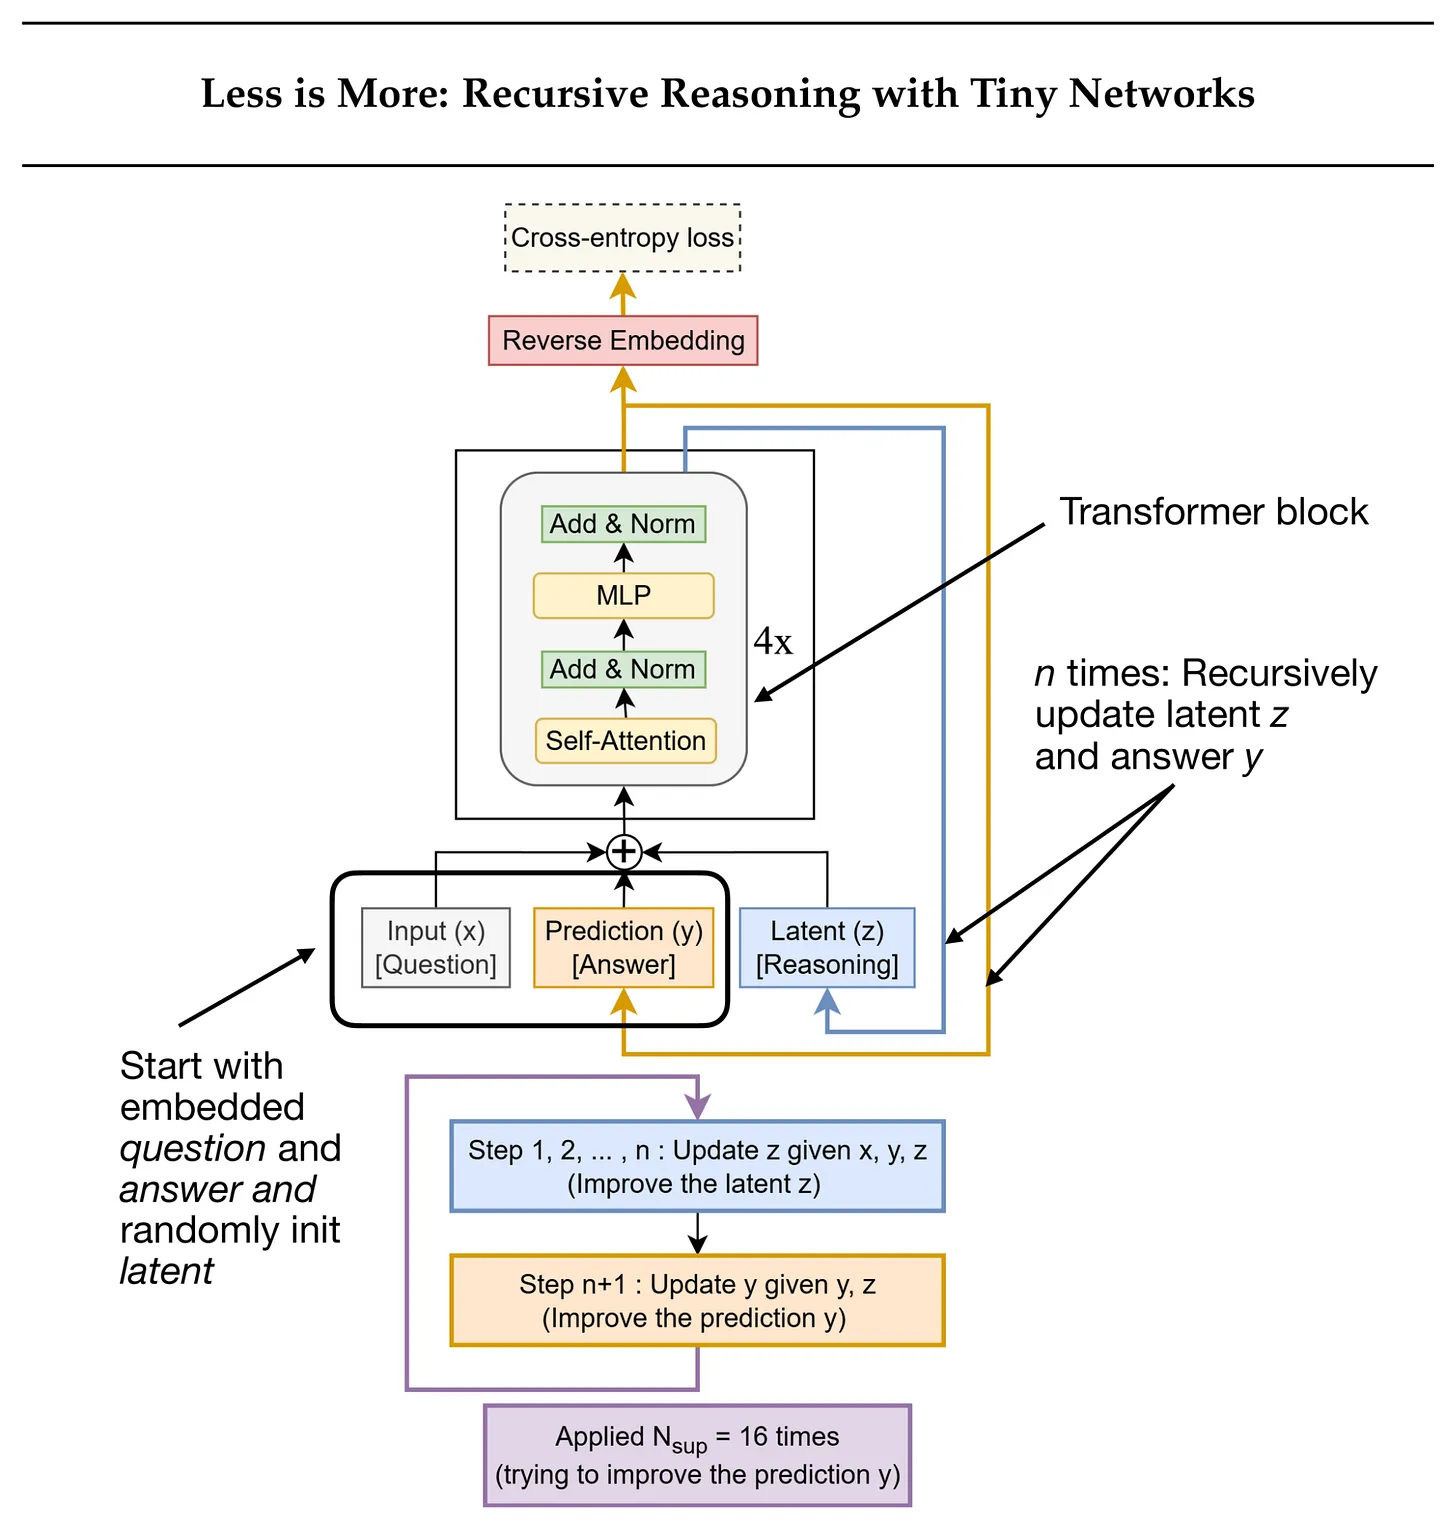
figure23

图23: 小型递归模型(TRM)。图标注摘自https://arxiv.org/abs/2510.04871。

本节剩下的部分,我们来稍微详细地了解一下TRM。

5.1 这里的“递归”指什么?

TRM通过两次交替更新来细化答案:

  1. 它根据当前的问题和答案计算一个潜在推理状态。

  2. 然后基于该潜在状态更新答案。

训练时,每批次最多执行16步细化。每一步都会执行若干无梯度循环,迭代细化答案。随后是一个梯度循环,通过完整的推理序列反向传播,更新模型权重。

需要重点注意的是,TRM不是处理文本的语言模型。但由于:(1)它是基于Transformer的架构;(2)推理是当前大语言模型研究的核心焦点,而该模型代表了一种截然不同的推理思路;(3)很多读者要求我介绍HRM(而TRM是其更先进的继任者),因此我决定把它纳入本文。

虽然TRM未来可以扩展到文本问答任务,但目前它处理的是基于网格的输入和输出。换句话说,“问题”和“答案”都是离散token组成的网格(比如9×9的数独,或者30×30的ARC/迷宫谜题),而非文本序列。

5.2 TRM与HRM有何不同?

  • HRM由两个小型Transformer模块(各4个块)组成,跨递归层级通信。TRM仅使用单个2层Transformer。(注意前面TRM的图中Transformer块旁边标了4×,但那可能是为了方便和HRM对比。)

  • TRM通过所有递归步骤反向传播,而HRM仅通过最后几步反向传播。

  • HRM包含显式的停止机制,以决定何时停止迭代。TRM用简单的二元交叉熵损失替代了该机制,学习何时停止迭代。

在性能方面,TRM相比HRM表现非常出色,如下图所示。
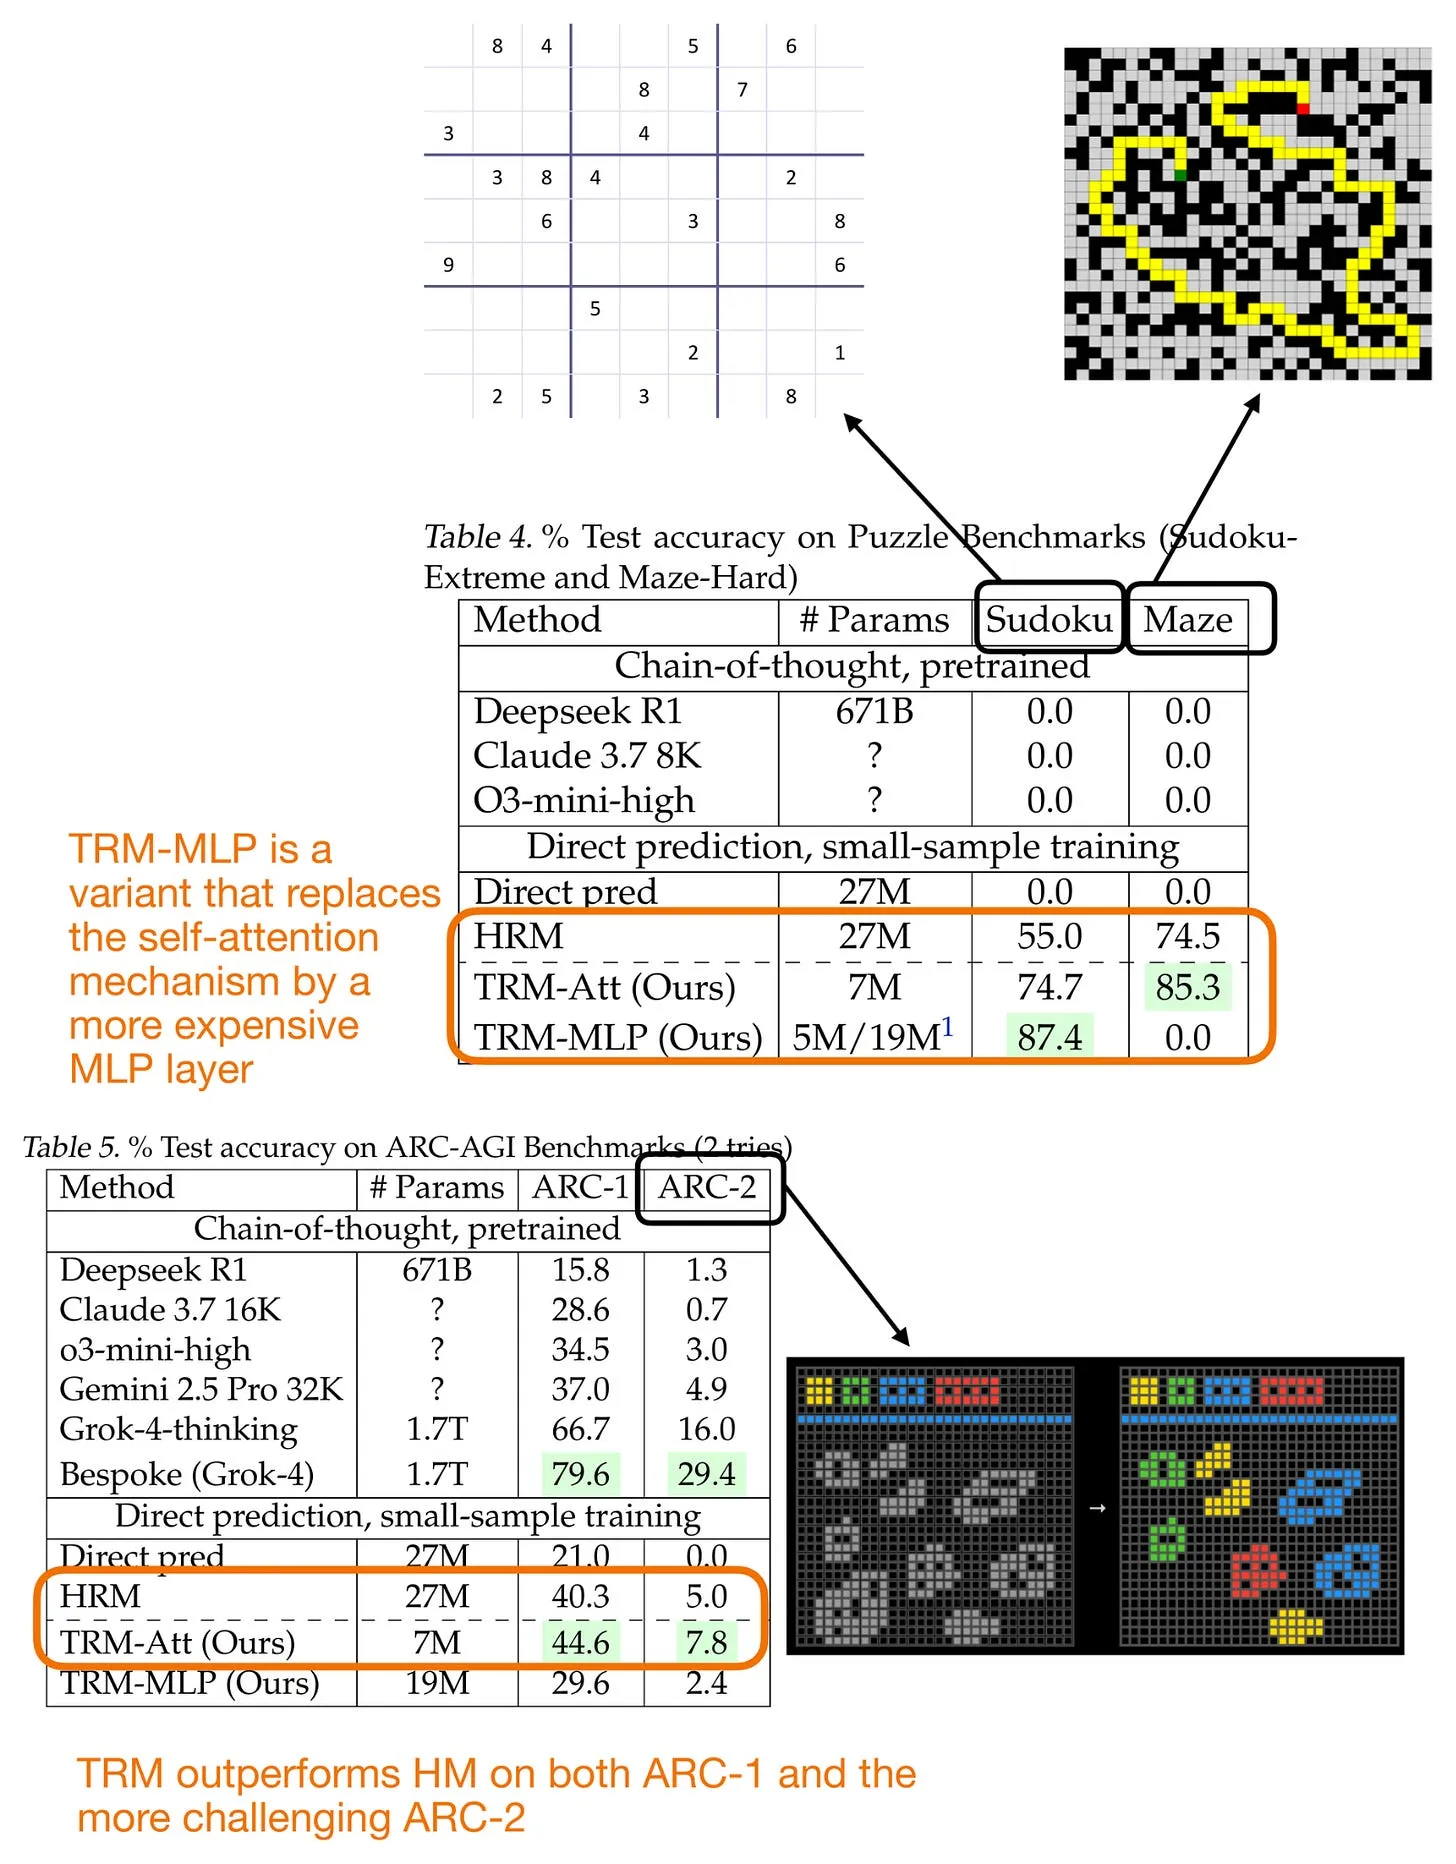
figure24

图24: 分层推理模型(HRM)与小型递归模型(TRM)的性能对比。

论文中包含了数量惊人的消融研究,得出了一些有意思的额外结论。这里列出两个最突出的:

  • 层数越少,泛化性越好。从4层减少到2层,数独准确率从79.5%提升到了87.4%。

  • 注意力并非必需。用纯MLP层替换自注意力同样提升了准确率(从74.7%到87.4%)。但这只有在上下文较小且长度固定的情况下才可行。

5.3 更宏观的视角

虽然HRM和TRM在这些基准上取得了非常好的推理表现,但把它们和大型大语言模型相比并不太公平。HRM和TRM是针对ARC、数独、迷宫寻路等任务的专用模型,而大语言模型是通用模型。当然,HRM和TRM也可以应用于其他任务,但都必须针对每个任务专门训练。因此从这个意义上说,我们或许可以把HRM和TRM看作高效的便携计算器,而大语言模型更像电脑,还能做很多其他事情。

尽管如此,这些递归架构依然是令人振奋的概念验证,彰显了小型高效模型如何通过迭代自我完善来“推理”。或许未来,这类模型可以作为推理或规划模块,嵌入到更大的使用工具的大语言模型系统中。

就目前而言,大语言模型依然是泛用任务的理想选择,但一旦目标领域足够清晰,像TRM这样的领域专用递归模型就能更高效地解决特定问题。除了数独、迷宫寻路和ARC这些概念验证基准之外,这类模型在物理和生物领域可能还有很多应用场景。

一个有趣的小细节:作者分享说,训练这个模型只花了不到500美元,用4张H100显卡训练了大约2天。很高兴看到,不用数据中心也依然能做出有意思的研究。

6. 结论

我原本计划覆盖概览图中的所有模型类别,但由于文章篇幅超出预期,我只能把xLSTM、液态基础模型、Transformer-RNN混合架构以及状态空间模型留到下次再讲(不过门控DeltaNet已经让我们初步领略了状态空间模型和递归设计)。

作为本文的总结,我想重申之前的观点:标准的自回归Transformer大语言模型经过了充分验证,至今依然经受住了时间的考验。如果不把效率作为首要考量,它们依然是目前的最佳选择。

传统解码器式自回归Transformer

  • 经过验证、工具链成熟

  • 原理清晰易懂

  • 缩放定律明确

  • 性能顶尖
    – 训练成本高昂
    – 推理成本高昂(除了前文提到的优化技巧)

如果我今天要启动一个新的基于大语言模型的项目,自回归Transformer大语言模型会是我的首选。

我确实认为即将到来的注意力混合架构非常有前景,尤其是在处理长上下文、效率成为核心痛点的场景中。

线性注意力混合架构

  • 和解码器式Transformer特性一致

  • 长上下文任务下减少计算量和KV内存
    – 复杂度增加
    – 用一定精度换取效率

在更激进的一端,文本扩散模型是一项有意思的进展。我对它们在日常使用中的表现依然持一定的怀疑态度,因为我只试过几个快速演示。希望谷歌的Gemini Diffusion很快能带来大规模的生产级部署,让我们可以在日常任务和编码任务中测试,看看用户实际体验如何。

文本扩散模型

  • 迭代去噪是文本领域的全新思路

  • 并行性更好(无下一个token依赖)
    – 无法流式输出答案
    – 无法从思维链(CoT)中受益?
    – 工具调用难度大?
    – 模型扎实但未达顶尖水平

虽然文本扩散模型的主要卖点是提升效率,但代码世界模型处于光谱的另一端,它们致力于提升建模性能。在撰写本文时,基于标准大语言模型的编码模型大多通过推理技术来优化,但如果你在更棘手的挑战上试过它们,可能已经发现它们或多或少依然存在不足,无法很好地解决很多更难的编码问题。

我认为代码世界模型特别有意思,相信它们可能是迈向更强大编码系统的重要一步。

代码世界模型

  • 提升代码理解的前景广阔

  • 可验证的中间状态
    – 加入可执行代码轨迹让训练更复杂
    – 代码运行增加延迟

最后,我们介绍了小型递归Transformer,比如分层推理模型和小型推理模型。这些都是非常有意思的概念验证模型。但截至目前,它们主要还是谜题求解器,而非通用文本或编码模型。因此它们和本文介绍的其他非标准大语言模型替代方案不属于同一类别。尽管如此,它们依然是非常精彩的概念验证,我很高兴有研究者在深耕这些方向。

如今,GPT-5、DeepSeek R1、Kimi K2等大语言模型都被开发为面向自由文本、代码、数学问题等场景的专用模型。它们给人的感觉像是一种蛮力、全能的方案,被用来解决从常识问答到数学、代码的各种任务。

然而,当我们重复执行相同任务时,这种蛮力方案会变得低效,甚至在专业化方面也未必理想。这正是小型递归Transformer的价值所在:它们可以作为轻量级、任务专属的模型,针对重复性或结构化推理任务做到高效且定制化。

此外,我还可以把它们看作其他调用工具的大语言模型的潜在“工具”;比如,当大语言模型使用Python或计算器API解决数学问题时,专用的小型推理模型可以填补其他类型谜题或推理问题的空白。

小型递归Transformer

  • 架构非常小巧

  • 在谜题任务上泛化性好
    – 属于专用模型
    – 目前仅适用于谜题场景

这篇文章很长,但我希望你能从中发现一些常被主流大语言模型聚光灯忽略的迷人研究方向。

如果你已经对或多或少有些常规的大语言模型发布感到有些厌倦,希望这篇文章能重新点燃你对AI的热情——因为当下正有大量有趣的研究在发生!

这本杂志是个人热情项目,你的支持是它持续运转的动力。

如果你愿意支持我的工作,可以考虑我的著作https://amzn.to/4fqvn0D,或者它的续作https://mng.bz/Nwr7 。(我相信你会从中学到很多,它们对大语言模型工作原理的讲解深度是你在别处找不到的。)

感谢阅读,也感谢你对独立研究的支持!

《从零构建大语言模型》现已在https://amzn.to/4fqvn0D发售。《从零构建推理模型》可在https://mng.bz/Nwr7获取。

如果你读过这本书,能抽出几分钟时间的话,我会非常感谢你在https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167留下评价。这对我们作者帮助很大!

你的支持意义重大!谢谢!
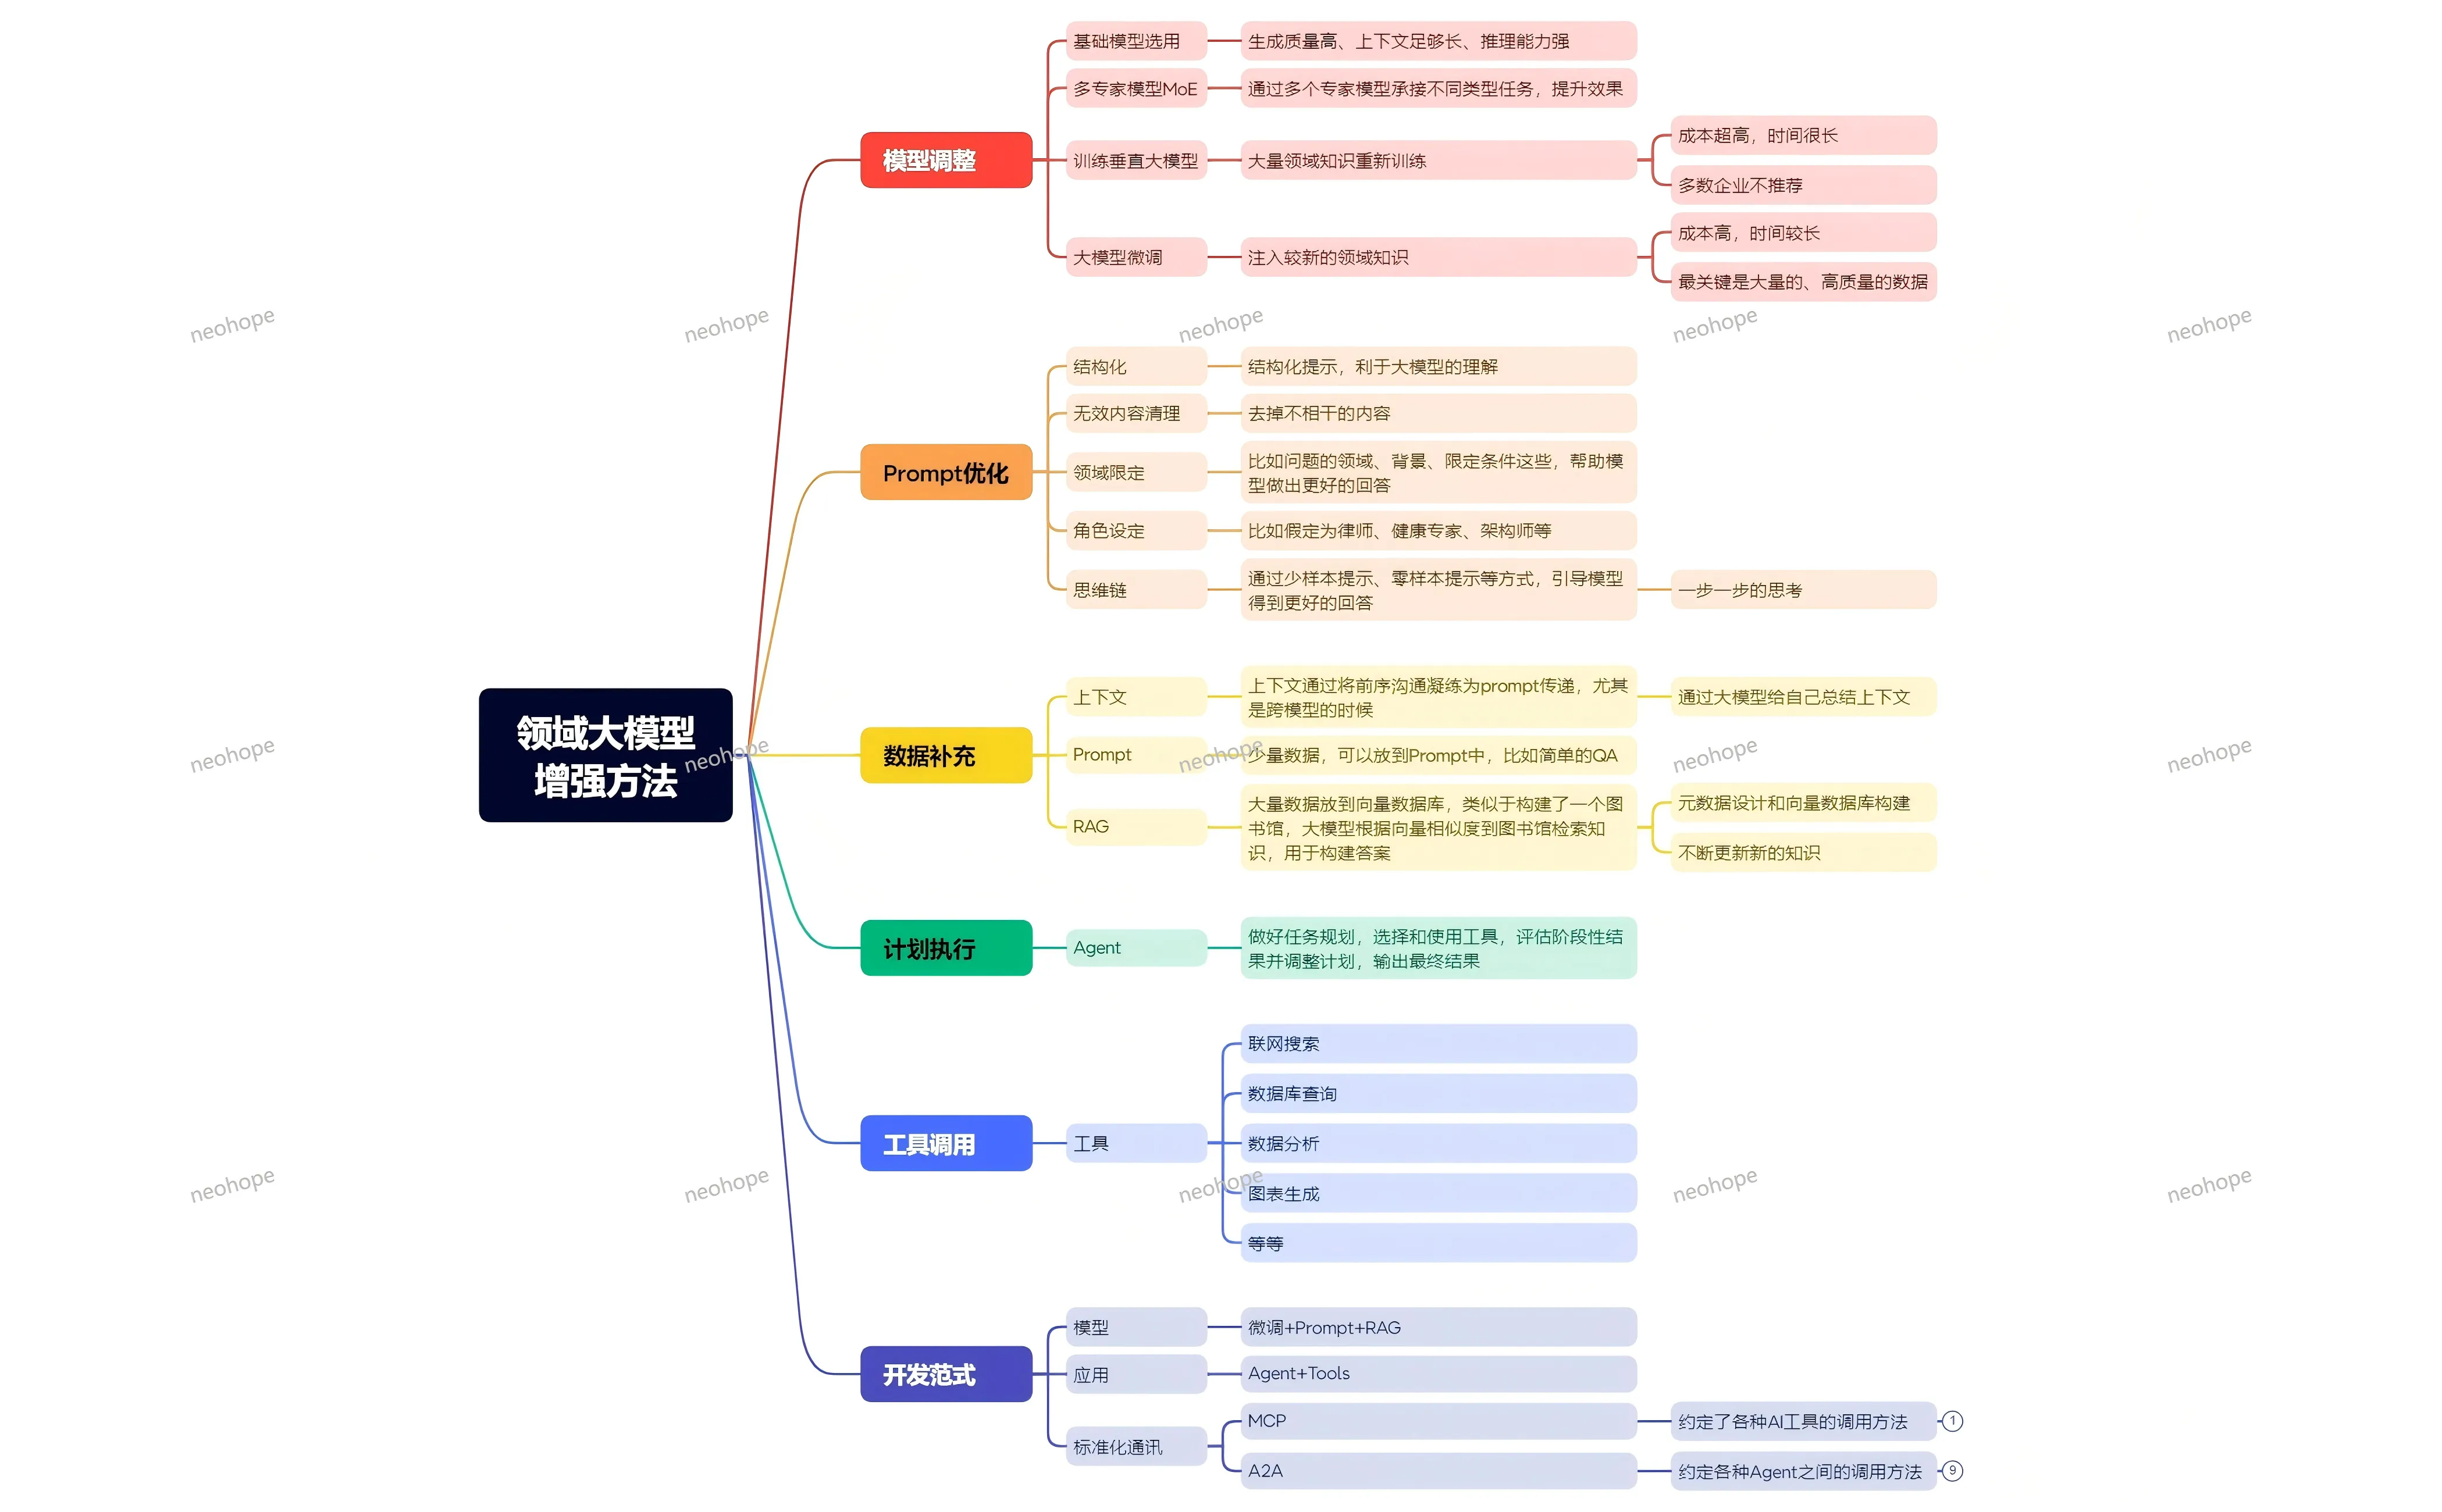
领域大模型怎么用才高效?5大增强方法+2大开发范式,从入门到进阶

整理了一些领域大模型增强的技术方法:
领域大模型增强方法


领域大模型怎么用才高效?5大增强方法+2大开发范式,从入门到进阶

很多企业和个人用领域大模型时都会遇到困惑:“为什么模型输出的内容不够精准?”“怎么让模型快速掌握行业知识?” 其实领域大模型的核心价值,不在于 “基础模型多强”,而在于 “针对性增强”—— 通过数据、提示、工具的组合优化,让通用模型适配特定场景。今天就拆解领域大模型的增强方法和开发范式,帮你快速提升模型实用价值。

一、模型调整:选对 “底座”,精准补能
模型的 “底子” 和 “适配度”,直接决定了后续增强效果,核心分两步走:
第一步,基础模型选用
优先选生成质量高、上下文窗口足够长、推理能力强的模型作为底座 —— 比如处理长文档的法律合同解析,就需要大上下文模型;做复杂逻辑推理的金融分析,就侧重推理能力强的模型,避免 “小马拉大车”。

第二步,按需选择调整方式
1、不推荐多数企业做 “垂直大模型重新训练”:需要大量领域知识数据,成本超高、耗时极长,除非是头部企业且有核心场景刚需;

2、优先考虑 “模型微调”:注入较新的领域知识,比如将 2023-2024 年的行业新规、企业内部流程数据融入模型,适配性比通用模型强很多,但要注意 —— 核心是 “大量高质量数据”,数据质量直接决定微调效果;

3、少数据场景用 “Prompt 数据补充”:如果没有足够数据做微调,可将简单 QA、核心知识点直接嵌入 Prompt,让模型快速获取关键信息,比如给模型喂 “行业术语对照表”“常见问题解答”,快速提升专业度。

二、Prompt 优化:用 “精准指令” 让模型少走弯路
Prompt 是人和模型的 “沟通桥梁”,优化后能让模型输出质量翻倍,核心技巧有 4 个:
1、结构化提示:把需求拆分成清晰的模块,比如 “先分析问题核心→再列出解决方案→最后给出注意事项”,利于模型理解逻辑,避免输出混乱;

2、无效内容清理:去掉和需求无关的描述,比如问 “电商行业的用户留存策略”,就不用附带 “我是做互联网的,最近想提升业绩” 这类冗余信息,让模型聚焦核心问题;

3、领域限定与角色设定:明确场景边界和模型身份,比如 “假定你是电商运营专家,基于淘宝平台规则,分析美妆类目新店铺的用户留存方法”,限定条件 + 角色定位,让输出更精准;

4、思维链引导:通过少样本提示(给 1-2 个示例)或零样本提示(直接引导步骤),让模型一步步思考,比如 “先拆解用户流失的 3 个核心原因,再针对每个原因给出 2 个具体策略,最后说明落地优先级”,避免模型跳过关键步骤。

三、RAG 增强:给模型建 “专属知识库”,解决知识滞后问题
大模型的知识有 “截止日期”,而 RAG(检索增强生成)能让模型实时调用最新数据,核心逻辑是 “检索 + 生成”:
1、把大量领域数据(比如行业报告、企业内部文档、最新政策文件)整理后存入向量数据库,相当于给模型建了一个 “专属图书馆”;

2、当用户提问时,模型先从 “图书馆” 中检索相似的相关信息,再结合自身知识生成回答 —— 既解决了模型知识滞后的问题,又能让输出有具体数据支撑,比如问 “2024 年新能源汽车的补贴政策”,模型会从向量数据库中检索最新政策文件,精准回复。

3、关键注意点:做好元数据设计和向量数据库构建,定期更新数据,确保检索的准确性和时效性。

四、工具调用:让模型 “手脚并用”,拓展能力边界
纯文本模型的能力有限,搭配工具后能实现 “信息查询、数据分析、图表生成” 等复杂功能,核心场景包括:
1、联网搜索:获取实时信息,比如 “查询今日原油价格”“了解最新行业动态”,解决模型知识不更新的问题;

2、数据库查询:对接企业内部数据库,比如查询 “近 3 个月的销售数据”“用户画像统计”,直接基于真实业务数据生成分析报告;

3、数据分析与图表生成:自动处理 Excel 表格、生成柱状图 / 折线图,比如 “分析近半年的用户增长趋势,生成可视化图表并给出结论”;

4、关键支撑:通过 MCP(AI 工具调用标准)和 A2A(Agent 间通讯标准),实现不同工具、不同 Agent 之间的标准化调用,让协作更顺畅。

五、Agent 增强:让模型成为 “自主决策者”,搞定复杂任务
如果说工具调用是 “给模型加手脚”,那 Agent 就是 “给模型加大脑”,核心能力是 “自主规划 + 执行 + 调整”:
1、面对复杂任务,Agent 能自动拆解步骤,比如 “完成电商店铺的月度运营复盘”,会拆解为 “1. 调取近 30 天销售数据→2. 分析用户增长 / 流失情况→3. 对比行业均值→4. 找出核心问题→5. 给出优化策略→6. 生成复盘报告”;

2、过程中能自主选择工具,比如需要数据就调用数据库,需要行业对比就联网搜索,还能评估阶段性结果,比如发现 “销售数据异常”,会自动调整步骤,补充 “异常原因分析”;

3、适合场景:复杂流程优化、多步骤任务执行(如市场调研、项目规划),让模型从 “被动响应” 变成 “主动解决问题”。

六、两大核心开发范式:组合使用效果翻倍
单独用一种增强方法效果有限,推荐两种主流组合范式:
1、微调 + Prompt+RAG:适合需要深度适配领域的场景,比如企业内部的智能客服 —— 通过微调注入企业流程知识,用 Prompt 优化回复逻辑,用 RAG 调用最新的产品信息和售后政策,既专业又精准;

2、Agent+Tools:适合复杂任务处理,比如跨境电商的选品分析 ——Agent 拆解任务(市场调研→竞品分析→成本核算→风险评估),调用联网搜索(市场趋势)、数据库查询(成本数据)、数据分析工具(竞品销量),全程自主完成,高效落地。

总结:领域大模型的增强逻辑 ——“扬长避短,按需组合”
领域大模型的增强,不是 “越多方法越好”,而是 “按需选择”:
1、数据充足、场景固定→优先 “微调 + RAG”;
2、数据有限、需求灵活→优先 “Prompt 优化 + 工具调用”;
3、复杂任务、需要自主决策→用 “Agent+Tools”;
4、核心是让模型的 “推理能力” 结合 “领域知识” 和 “工具能力”,实现 1+1>2 的效果。

你在使用领域大模型时,遇到过哪些 “不精准”“不实用” 的问题?欢迎在评论区留言,一起探讨解决方案~

【转载】从零开始理解大语言模型评估的四大主流方法

原文地址:Understanding the 4 Main Approaches to LLM Evaluation (From Scratch),by Sebastian Raschka, on 2025-10-05

从零开始理解大语言模型评估的四大主流方法

选择题基准测试、验证器、排行榜与LLM评审器(附代码示例)

我们究竟该如何评估大语言模型(LLM)?这个问题看似简单,却往往能引出一场宏大的讨论。

在为项目提供咨询或协作开发时,我最常被问到的问题之一就是:如何在不同模型之间做选择?如何解读市面上五花八门的评估结果?(当然,还有在微调或自研模型时,该如何衡量进展。)

由于这个问题反复出现,我觉得有必要简要梳理一下业界用于对比LLM的主流评估方法。诚然,LLM评估是一个极其庞大的议题,单篇文章无法穷尽,但我认为,对这几类核心方法建立清晰的认知框架,能大幅帮助我们解读各类基准测试、排行榜和学术论文。

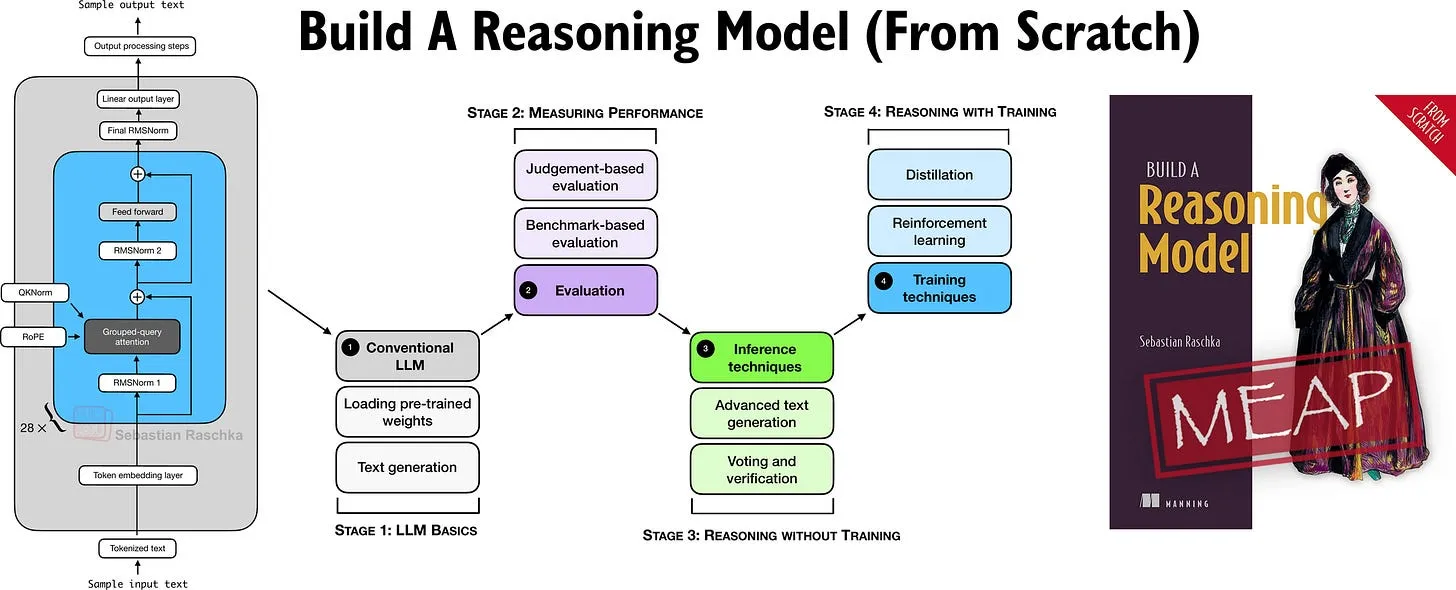
我原本打算把这些评估技术写入即将出版的新书《Build a Reasoning Model (From Scratch)》(https://mng.bz/Nwr7),但最终发现它们略超出了全书的核心范围(该书更聚焦于基于验证器的评估方法)。因此我想把这部分内容整理成一篇长文,搭配从零实现的代码示例分享给大家。

在《Build a Reasoning Model (From Scratch)》(https://mng.bz/Nwr7)一书中,我采用了动手实践的方式,从零开始构建一个推理型LLM。如果你喜欢《Build A Large Language Model (From Scratch)》,那么新书也延续了同样的风格——全程用纯PyTorch从零搭建所有组件。

figure00

图0:推理能力是近年来LLM领域最激动人心、也最重要的进展之一,但如果只听过“推理”这个名词、只读过理论层面的介绍,也很容易产生误解。因此在《Build a Reasoning Model (From Scratch)》(https://mng.bz/Nwr7)中,我采用了手把手实操的思路,从零搭建推理型LLM。

该书目前处于抢先阅读阶段,已有超过100页内容上线,我刚刚又完成了约30页的内容,目前正在由排版团队处理。如果你已经加入了抢先阅读计划(非常感谢你的支持!),内容上线后你会收到邮件通知。

附言:当下LLM研究领域日新月异,我还在陆续消化我收藏夹里越来越多的论文,计划在下一篇文章中重点介绍其中最有意思的几项研究。

不过现在,让我们先来讨论LLM评估的四大核心方法,搭配从零开始的代码实现,帮你更好地理解它们各自的优缺点。


理解LLM的主流评估方法

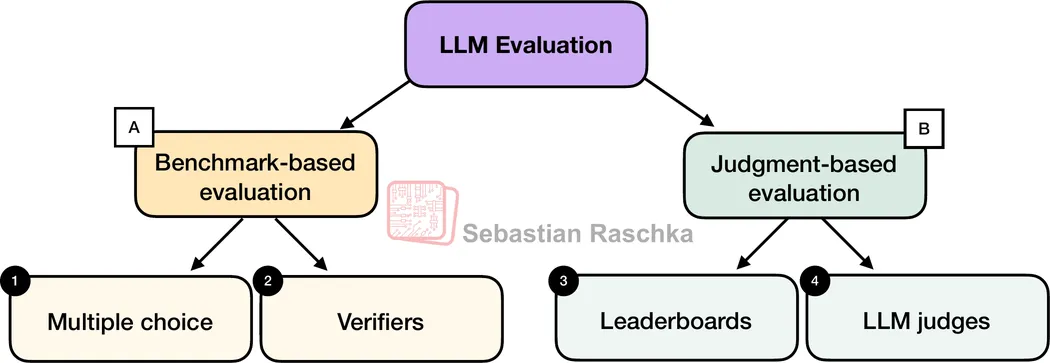
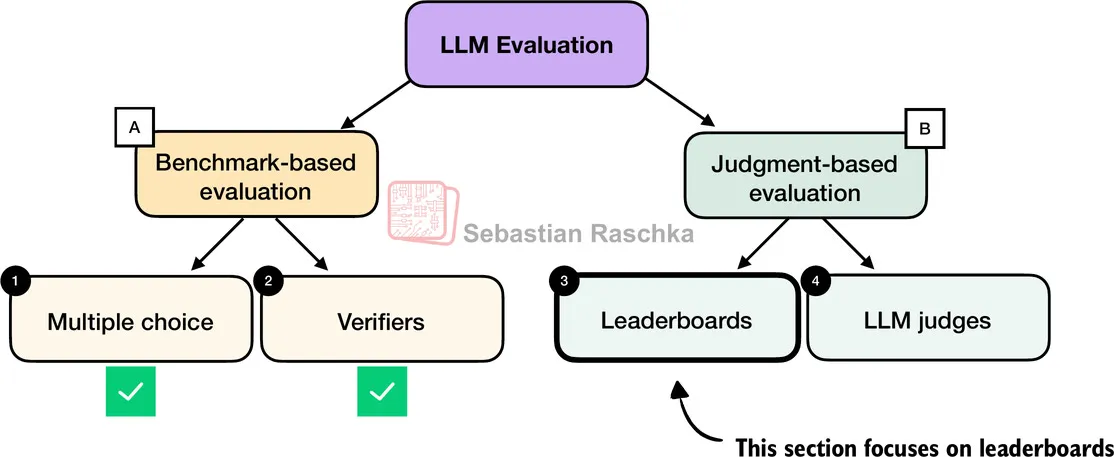
实践中,训练好的LLM常见的评估方式有四种:选择题测试、验证器评估、排行榜和LLM评审器,如图1所示。学术论文、宣传材料、技术报告以及模型卡(LLM专属的技术报告)通常会包含其中两类或更多类方法的结果。

figure01

图1: 本文涵盖的四种评估模型概览

此外,这里介绍的四大类方法可以归为两大阵营:基于基准测试的评估和基于评判的评估,如上图所示。

(还有一些其他指标,比如训练损失、困惑度、奖励值等,但它们通常用于模型开发的内部环节。)

下面的小节将简要概述每一种方法,并给出相应示例。

方法1:评估选项作答准确率

我们从一种基于基准测试的方法说起:选择题作答。

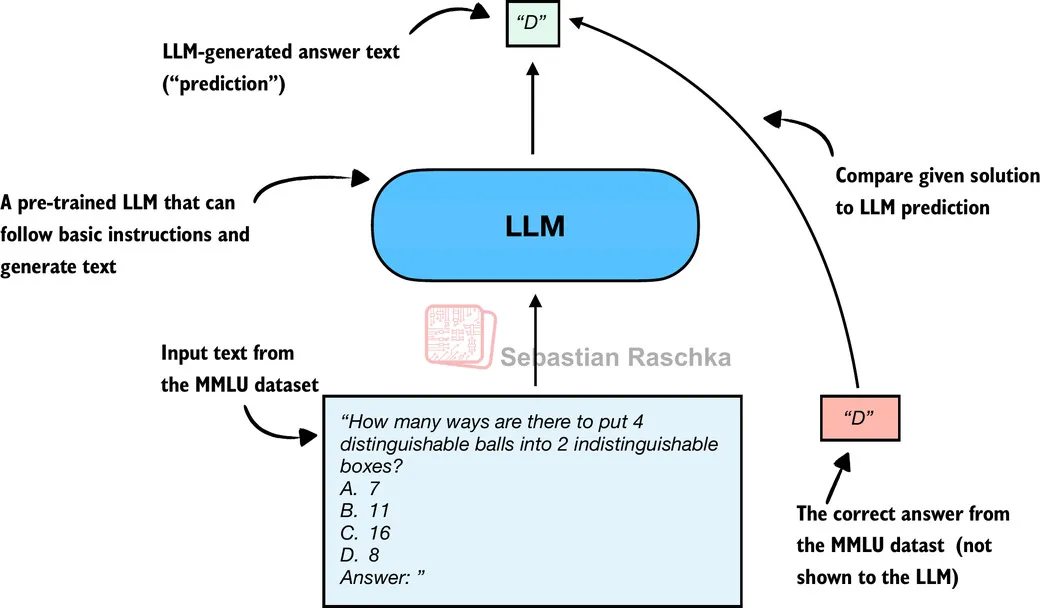
历史上,应用最广泛的评估方法之一就是选择题基准测试,比如MMLU(全称为Massive Multitask Language Understanding,大规模多任务语言理解,https://huggingface.co/datasets/cais/mmlu)。为了说明这种方法,图2展示了MMLU数据集中的一道典型题目。

figure02

图2: 在MMLU上评估LLM:将模型的选择题预测结果与数据集的正确答案做对比

图2只是MMLU数据集中的一个例子。完整的MMLU数据集涵盖57个学科(从高中数学到生物学),总共约1.6万道选择题,性能用准确率来衡量(答对题目的占比)——比如1.6万道题中答对1.4万道,准确率就是87.5%。

MMLU这类选择题基准测试,以一种直接、可量化的方式考察LLM的知识回忆能力,类似于标准化考试、各类学业考试或者驾照理论考试。

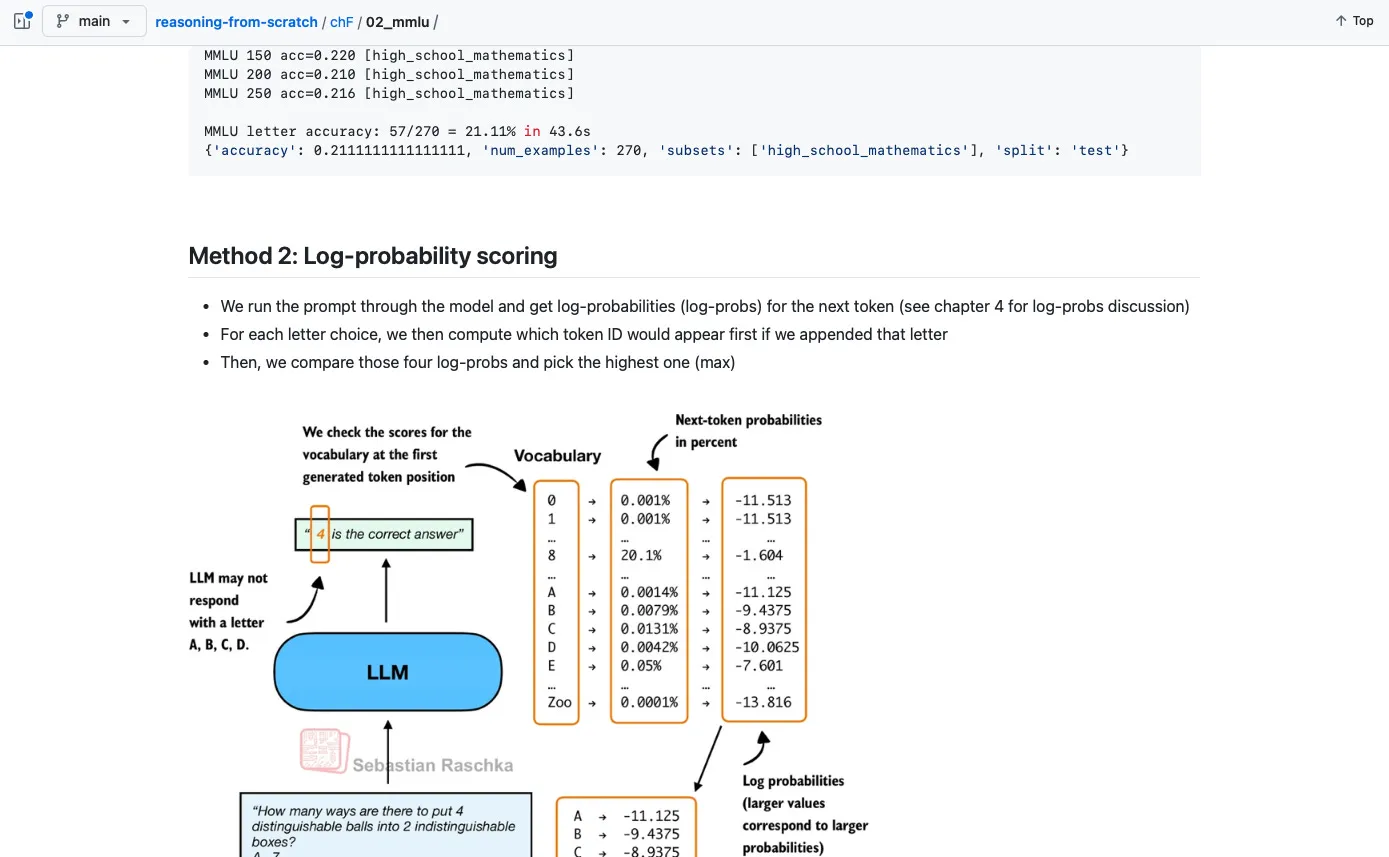
注意图2展示的是简化版的选择题评估方式:直接将模型预测的答案字母与正确答案做比对。还有另外两种更常用的方法涉及对数概率评分(log-probability scoring),我已经在这个仓库中实现了它们:https://github.com/rasbt/reasoning-from-scratch/tree/main/chF/02_mmlu 。(由于这部分内容建立在本文讲解的概念之上,建议读完本文后再去查看。)

下面的小节将演示如何用代码实现图2所示的MMLU打分方式。

1.2 加载模型

首先,在MMLU上评估模型之前,我们首先要加载预训练模型。这里我们使用纯PyTorch从零实现的Qwen3 0.6B模型,它只需要约1.5GB内存。

注意Qwen3的模型实现细节不是本节重点,我们只把它当作一个待评估的LLM即可。如果你感兴趣,可以在我之前的文章《Understanding and Implementing Qwen3 From Scratch》中看到从零实现的完整教程,源代码也可以在Github获取:

我们不用复制粘贴大段Qwen3源代码,而是直接从我的Python库reasoning_from_scratch中导入,安装方式如下:

pip install reasoning_from_scratch

或者

uv add reasoning_from_scratch

代码块1:加载预训练模型

from pathlib import Path
import torch
from reasoning_from_scratch.ch02 import get_device
from reasoning_from_scratch.qwen3 import (
    download_qwen3_small, Qwen3Tokenizer,
    Qwen3Model, QWEN_CONFIG_06_B
)

device = get_device()
# Set matmul precision to "high" to
# enable Tensor Cores on compatible GPUs
torch.set_float32_matmul_precision("high")

# Uncomment the following line
# if you encounter device compatibility issues
# device = "cpu"

# Use the base model by default
WHICH_MODEL = "base"

if WHICH_MODEL == "base":
    download_qwen3_small(
        kind="base", tokenizer_only=False, out_dir="qwen3"
    )
    tokenizer_path = Path("qwen3") / "tokenizer-base.json"
    model_path = Path("qwen3") / "qwen3-0.6B-base.pth"
    tokenizer = Qwen3Tokenizer(tokenizer_file_path=tokenizer_path)
elif WHICH_MODEL == "reasoning":
    download_qwen3_small(
        kind="reasoning", tokenizer_only=False, out_dir="qwen3"
    )
    tokenizer_path = Path("qwen3") / "tokenizer-reasoning.json"
    model_path = Path("qwen3") / "qwen3-0.6B-reasoning.pth"
    tokenizer = Qwen3Tokenizer(
        tokenizer_file_path=tokenizer_path,
        apply_chat_template=True,
        add_generation_prompt=True,
        add_thinking=True,
    )
else:
    raise ValueError(f"Invalid choice: WHICH_MODEL={WHICH_MODEL}")

model = Qwen3Model(QWEN_CONFIG_06_B)
model.load_state_dict(torch.load(model_path))
model.to(device)

# Optionally enable model compilation for potential performance gains
USE_COMPILE = False
if USE_COMPILE:
    torch._dynamo.config.allow_unspec_int_on_nn_module = True
    model = torch.compile(model)

1.3 检查生成的答案字母

本节我们实现最简单、也最直观的MMLU打分方法:检查模型生成的选择题答案字母是否与正确答案匹配。这和之前图2展示的思路一致,为方便阅读,下图再次放出。

figure02

图3: 在MMLU上评估LLM:将模型的选择题预测结果与数据集的正确答案做对比

我们以MMLU数据集中的一道题为例:

example = {
    "question": (
        "How many ways are there to put 4 distinguishable"
        " balls into 2 indistinguishable boxes?"
    ),
    "choices": ["7", "11", "16", "8"],
    "answer": "D",
}

接下来,我们定义一个函数来格式化LLM的输入提示。

代码块2:格式化提示

def format_prompt(example):
    return (
        f"{example['question']}\n"
        f"A. {example['choices'][0]}\n"
        f"B. {example['choices'][1]}\n"
        f"C. {example['choices'][2]}\n"
        f"D. {example['choices'][3]}\n"
        "Answer: "
    )
# Trailing space in "Answer: " encourages a single-letter next token

我们对上面的MMLU例题执行这个函数,看看格式化后的LLM输入是什么样的:

prompt = format_prompt(example)
print(prompt)

输出为:

How many ways are there to put 4 distinguishable balls into 2 indistinguishable boxes?
A. 7
B. 11
C. 16
D. 8
Answer: 

如上所示,模型提示会列出所有候选答案,最后以Answer:结尾,引导模型生成正确答案。

虽然不是必须的,但有时也可以在输入中附带几道例题和正确答案,让模型观察解题的规范格式。(比如提供5道例题的设置也叫5-shot MMLU。)不过对于当前世代的LLM,哪怕基座模型也已经具备足够的能力,这一步并非必需。

加载不同的MMLU样本

你可以通过datasets库直接加载MMLU数据集的样本(安装方式:pip install datasets 或 uv add datasets):

from datasets import load_dataset

configs = get_dataset_config_names("cais/mmlu")
dataset = load_dataset("cais/mmlu", "high_school_mathematics")

# Inspect the first example from the test set:
example = dataset["test"][0]
print(example)

上面我们使用了“高中数学”子集;要查看其他子集列表,可以使用以下代码:

from datasets import get_dataset_config_names

subsets = get_dataset_config_names("cais/mmlu")
print(subsets)

接下来,我们对提示进行分词,并用PyTorch张量包装,作为LLM的输入:

prompt_ids = tokenizer.encode(prompt)
prompt_fmt = torch.tensor(prompt_ids, device=device)
# Add batch dimension:
prompt_fmt = prompt_fmt.unsqueeze(0)

准备工作完成后,我们定义核心打分函数:生成少量token(这里默认8个),并提取模型输出中出现的第一个A/B/C/D字母。

代码块3:提取生成的字母

from reasoning_from_scratch.ch02_ex import (
    generate_text_basic_stream_cache
)

def predict_choice(
    model, tokenizer, prompt_fmt, max_new_tokens=8
):
    pred = None
    for t in generate_text_basic_stream_cache(
        model=model,
        token_ids=prompt_fmt,
        max_new_tokens=max_new_tokens,
        eos_token_id=tokenizer.eos_token_id,
    ):
        answer = tokenizer.decode(t.squeeze(0).tolist())
        for letter in answer:
            letter = letter.upper()
            # stop as soon as a letter appears
            if letter in "ABCD":
                pred = letter
                break
        if pred:
            break
    return pred

然后我们就可以用上面的函数检查生成的字母了:

pred1 = predict_choice(model, tokenizer, prompt_fmt)
print(
    f"Generated letter: {pred1}\n"
    f"Correct? {pred1 == example['answer']}"
)

结果为:

Generated letter: C
Correct? False

可以看到,这个例子中模型生成的答案是错误的(False)。

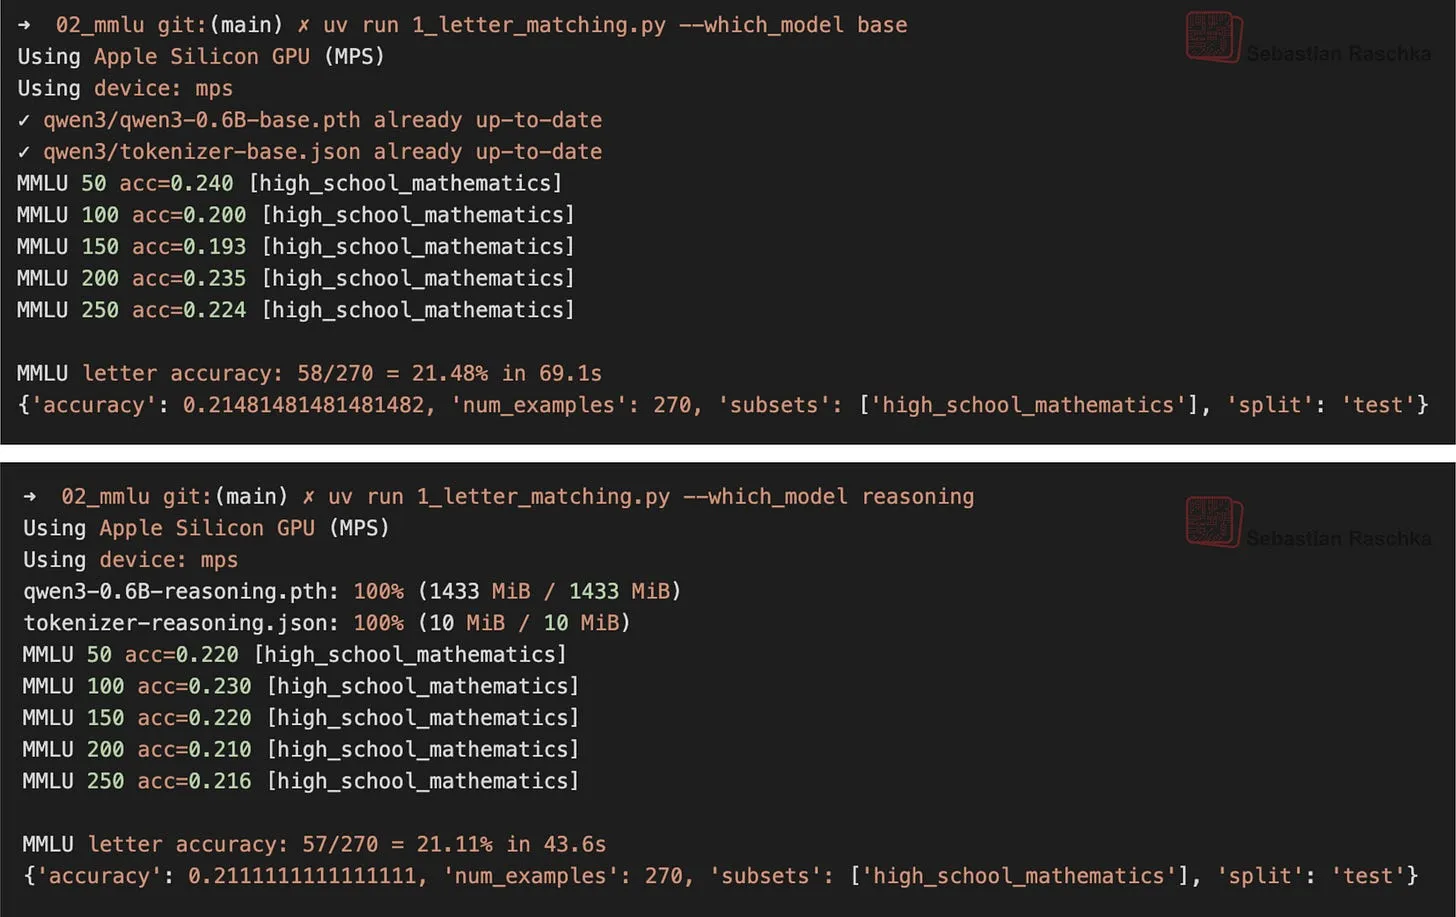
这只是MMLU高中数学子集中270道题里的一道。下图(图4)展示了基座模型和推理版本在完整子集上的表现,对应代码可以在这里查看:https://github.com/rasbt/reasoning-from-scratch/blob/main/chF/02_mmlu/1_letter_matching.py 。

figure04

图4: 基座模型与推理模型在MMLU高中数学子集上的表现

假设每个选项出现概率均等,随机猜测者(均匀选择A、B、C、D)的预期准确率是25%。所以基座模型和推理模型的表现都不算理想。

选择题作答的其他形式

注意本节为了演示,实现的是简化版的选择题评估,直接比对答案字母。实践中更常用的是对数概率评分(log-probability scoring)这类变体:我们衡量模型认为每个候选答案的可能性,而不只是检查最终输出的字母。(我们会在第4章讨论基于概率的打分。)对于推理模型,评估还可以包含:当把正确答案作为输入时,模型生成它的概率有多大。

figure05

图5: 其他MMLU打分方法已在这个仓库中说明和共享:https://github.com/rasbt/reasoning-from-scratch/tree/main/chF/02_mmlu

但无论使用哪种MMLU打分变体,评估的本质都是检验模型能否从预设的选项中做出选择。

MMLU这类选择题基准测试的局限在于:它们只衡量LLM从预设选项中做选择的能力,因此除了检查模型相比基座版本遗忘了多少知识之外,对评估推理能力的作用有限。它无法衡量自由写作能力,也无法反映模型在真实场景中的实用性。

尽管如此,选择题基准测试依然是简单实用的诊断工具:比如,MMLU高分不一定代表模型实际应用能力强,但低分却能凸显出潜在的知识缺口。


方法2:用验证器检查答案

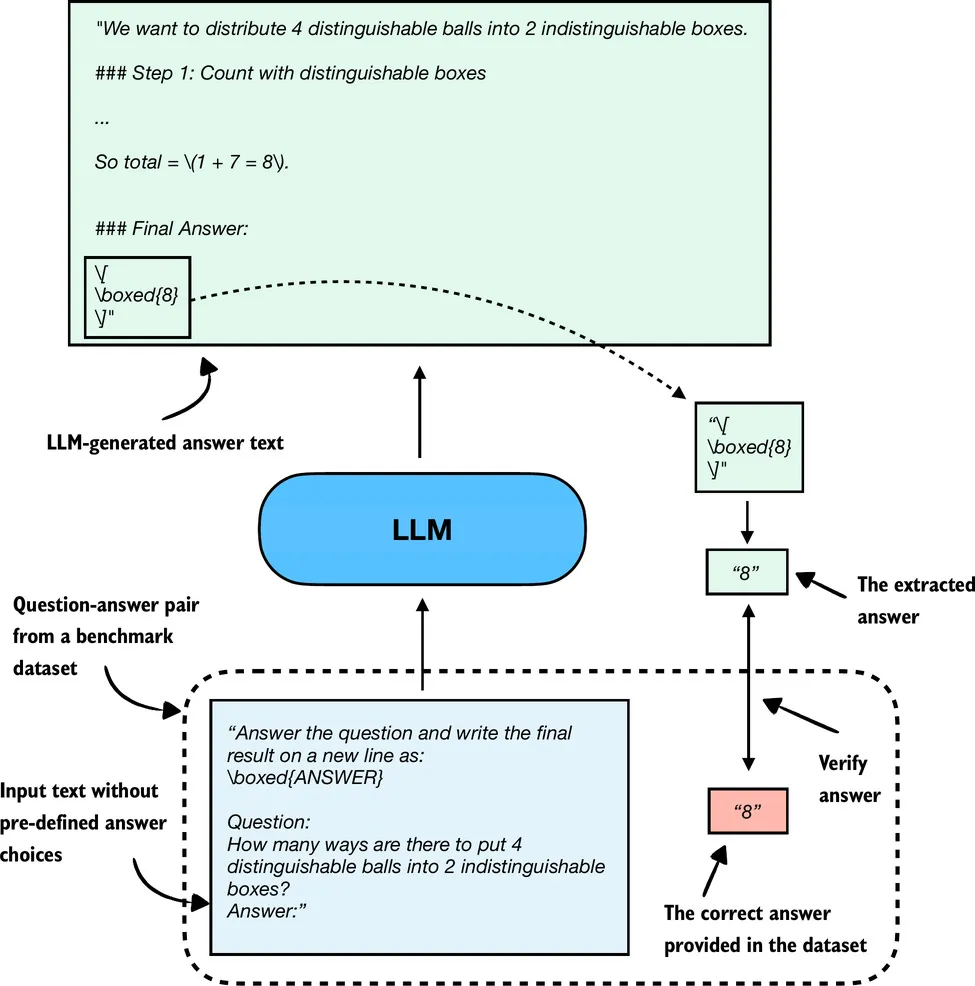
和上一节讨论的选择题作答相关,基于验证的方法也通过准确率指标来量化LLM的能力。但与选择题基准测试不同的是,验证方法允许LLM给出自由形式的答案,然后我们提取出相关的答案部分,用所谓的“验证器”将答案与数据集提供的标准答案做对比,如图6所示。

figure06

图6: 用基于验证的方法在自由问答场景下评估LLM。模型生成自由形式的答案(可能包含多步推导)和最终的框选答案,提取后与数据集的正确答案做对比。

在对比提取出的答案和标准答案时,我们可以使用外部工具,比如代码解释器或者计算器类工具/软件。

这种方法的缺点是:只能应用于容易(最好是确定性)验证的领域,比如数学和代码。此外,这种方法会引入额外的复杂度和依赖项,并且可能把部分评估负担从模型本身转移到了外部工具上。

但由于它支持通过编程生成无限多的数学题目变体,并且能受益于逐步推理过程,它已经成为推理模型评估和开发的基石。

我在《Build a Reasoning Model (From Scratch)》一书中用整整35页的篇幅详细讲解了这个主题,所以这里就跳过代码实现了。(我上周刚提交了这一章。如果你有抢先阅读版,内容上线后你会收到邮件,到时候就可以阅读了。与此同时,你可以在这里找到分步代码:https://github.com/rasbt/reasoning-from-scratch/blob/main/ch03/01_main-chapter-code/ch03_main.ipynb 。)

figure07
figure07

图7: 基于验证的评估方法节选,代码见:https://github.com/rasbt/reasoning-from-scratch/blob/main/ch03/01_main-chapter-code/ch03_main.ipynb


方法3:用偏好度和排行榜对比模型

到目前为止,我们介绍了两种能给出可量化指标(比如模型准确率)的方法。但上述方法都没有从更整体的角度评估LLM,包括对回答风格的评判。本节我们讨论一种基于评判的方法——LLM排行榜,如图8所示。

figure08

图8: 本书覆盖主题的思路框架,聚焦于附录中介绍的基于评判和基于基准的评估方法。前面已经讲了基于基准的方法(选择题、验证器),现在我们引入衡量LLM性能的基于评判的方法,本小节重点讲排行榜。

这里介绍的排行榜方法是一种基于评判的思路:模型的排名不是依据准确率或其他固定基准分数,而是依据用户(或其他LLM)对其输出的偏好度。

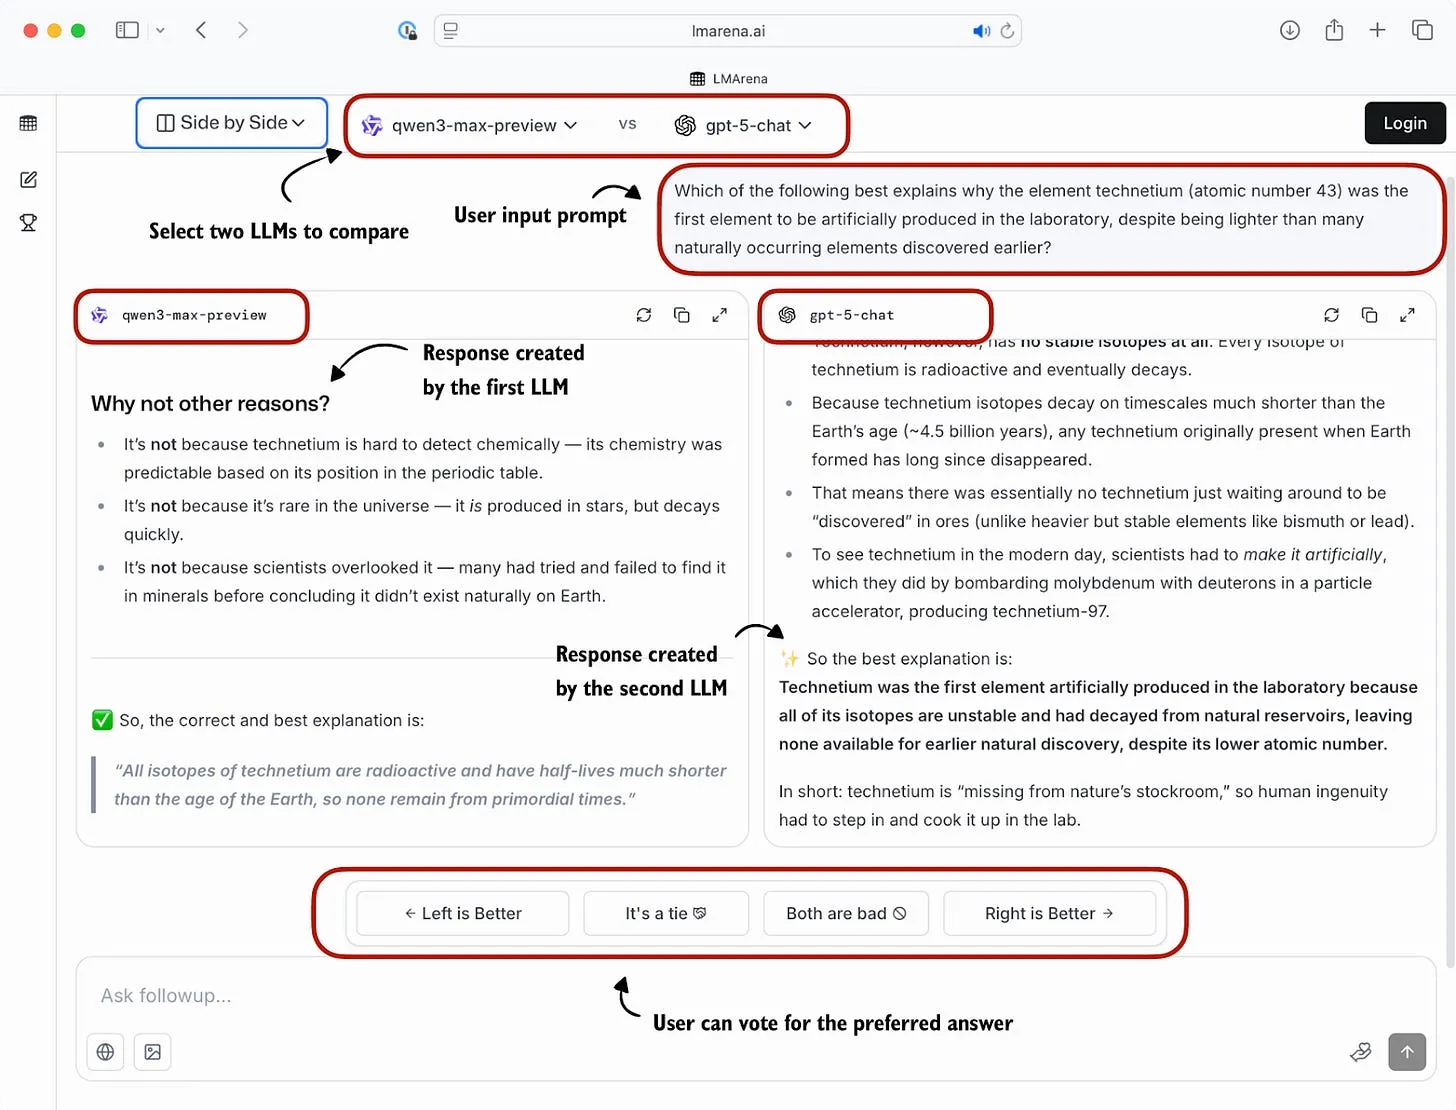
一个很有名的排行榜是LM Arena(https://lmarena.ai/,前身为Chatbot Arena):用户对比两个指定或匿名模型的回答,投票选出自己更喜欢的那个,如图9所示。

figure09

图9: 基于评判的排行榜界面示例(LM Arena)。给两个LLM输入相同的提示,并排展示回答,用户投票选出更偏好的答案。

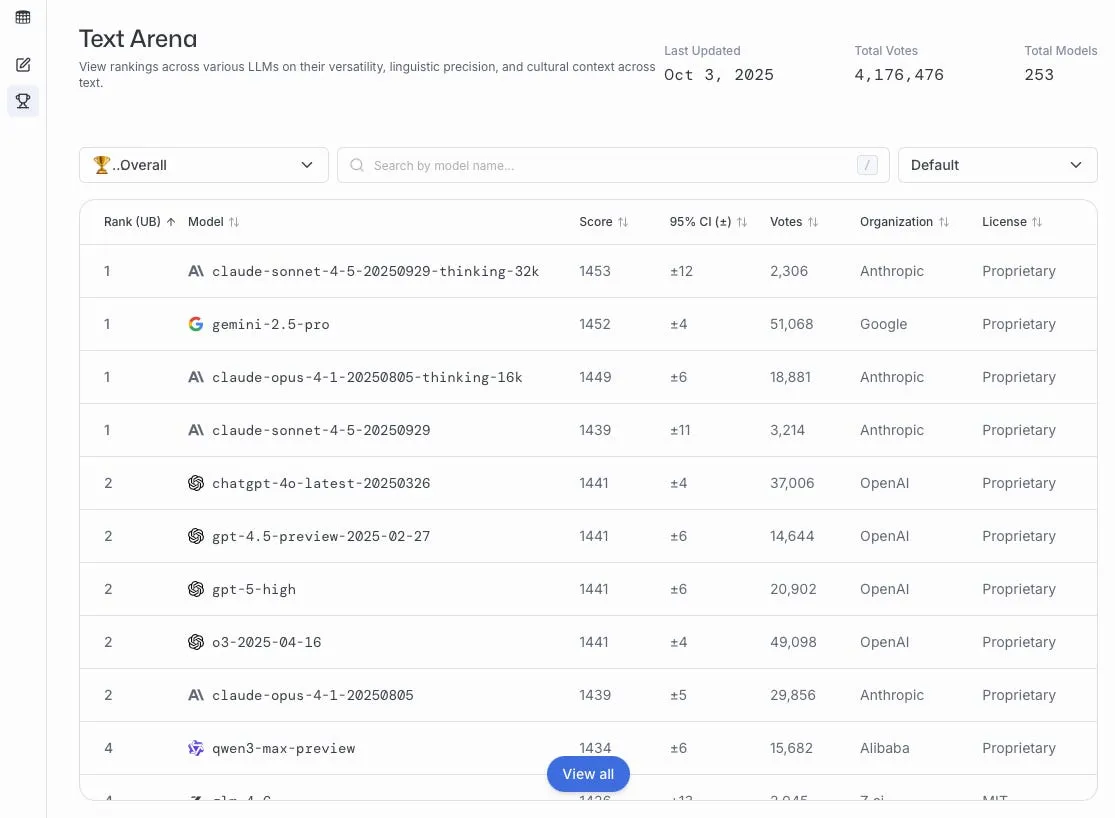
这些偏好投票会像上图那样收集起来,再聚合到所有用户中,生成一个按用户偏好度排名的模型排行榜。图10是LM Arena排行榜的当前快照(数据获取于2025年10月3日)。

figure10

图10: LM Arena排行榜截图,展示了基于用户文本任务偏好度的当前领先LLM

在本节余下部分,我们将实现一个简单的排行榜示例。

为了构造具体的例子,假设用户在类似图9的设置下向不同LLM提问。下面的列表代表两两投票结果,第一个模型是获胜者:

votes = [
    ("GPT-5", "Claude-3"),
    ("GPT-5", "Llama-4"),
    ("Claude-3", "Llama-3"),
    ("Llama-4", "Llama-3"),
    ("Claude-3", "Llama-3"),
    ("GPT-5", "Llama-3"),
]

上面的列表中,votes里的每个元组代表两个模型的两两偏好,格式为(获胜者,失败者)。比如("GPT-5", "Claude-3")表示用户更偏好GPT-5的回答,而非Claude-3。

接下来,我们把这个投票列表转换成排行榜。我们会使用很流行的Elo评级体系(https://en.wikipedia.org/wiki/Elo_rating_system),它最初是为棋手排名设计的。

在看具体代码实现之前,先简单说下原理:每个模型以基准分起步,每次对比和投票后,模型的评级会更新。(在Elo体系中,更新幅度取决于结果的“冷门程度”。)

具体来说,如果一个当前模型战胜了排名远高于自己的模型,它的排名会得到较大幅度的提升,在排行榜上位置更靠前。反之,如果战胜的是排名很低的对手,提升幅度就很小。(如果当前模型输了,也会按类似逻辑扣分。)

将两两排名转化为排行榜的代码如下所示。

代码块4:构建排行榜

def elo_ratings(vote_pairs, k_factor=32,
                initial_rating=1000):
    # Initialize all models with the same base rating
    ratings = {
        model: initial_rating
        for pair in vote_pairs
        for model in pair
    }

    # Update ratings after each match
    for winner, loser in vote_pairs:

        # Expected score for the current winner
        expected_winner = 1.0 / (
            1.0 + 10 ** (
                (ratings[loser] - ratings[winner])
                / 400.0
            )
        )

        # k_factor determines sensitivity of updates
        ratings[winner] = (
            ratings[winner]
            + k_factor * (1 - expected_winner)
        )
        ratings[loser] = (
            ratings[loser]
            + k_factor * (0 - (1 - expected_winner))
        )

    return ratings

上面定义的elo_ratings函数接收投票数据,输出排行榜,用法如下:

ratings = elo_ratings(votes, k_factor=32, initial_rating=1000)
for model in sorted(ratings, key=ratings.get, reverse=True):
    print(f"{model:8s} : {ratings[model]:.1f}")

输出的排名如下,分数越高表现越好:

GPT-5    : 1043.7
Claude-3 : 1015.2
Llama-4  : 1000.7
Llama-3  : 940.4

这背后的原理是什么?对于每一组对决,我们用下面的公式计算获胜者的预期得分:

expected_winner = 1 / (1 + 10 ** ((rating_loser - rating_winner) / 400))

expected_winner是基于当前评级,模型在无平局设定下的预测获胜概率,它决定了评级的更新幅度。

首先,每个模型的初始分initial_rating = 1000。如果两个模型评级相等,那么expected_winner = 0.5,说明双方势均力敌。这种情况下,更新幅度为:

  • 获胜者:rating_winner + k_factor * (1 - 0.5) = rating_winner + 16

  • 失败者:rating_loser + k_factor * (0 - (1 - 0.5)) = rating_loser - 16

如果是大热门(高评级模型)赢了,expected_winner ≈ 1,胜者只加很少的分,败者也只扣很少的分:

  • 获胜者:rating_winner + 32 * (1 - 0.99) = rating_winner + 0.32

  • 失败者:rating_loser + 32 * (0 - (1 - 0.99)) = rating_loser - 0.32

但如果是冷门选手(低评级模型)赢了,expected_winner ≈ 0,胜者几乎拿到全部k_factor的分数,败者也扣差不多的分数:

  • 获胜者:rating_winner + 32 * (1 - 0.01) = rating_winner + 31.68

  • 失败者:rating_loser + 32 * (0 - (1 - 0.01)) = rating_loser - 31.68

顺序的影响

Elo方法是每次对决后更新评级,因此后面的结果建立在已经更新过的评级之上。这意味着同样的一组比赛结果,如果呈现顺序不同,最终分数可能略有差异。这种影响通常不大,但如果冷门对局出现在早期和晚期,结果可能会不一样。

为了降低这种顺序效应,我们可以打乱投票对的顺序,多次运行elo_ratings函数,然后取评级的平均值。

上面介绍的这类排行榜方法,比静态基准分数更能动态反映模型质量。但结果会受到用户群体构成、提示选择、投票偏差的影响。基准测试和排行榜也都存在被“刷分”的可能,而且用户可能更看重回答风格而非正确性。最后,和自动化基准测试相比,排行榜无法对新开发的模型变体提供即时反馈,因此在活跃的模型开发阶段使用起来更困难。

其他排名方法

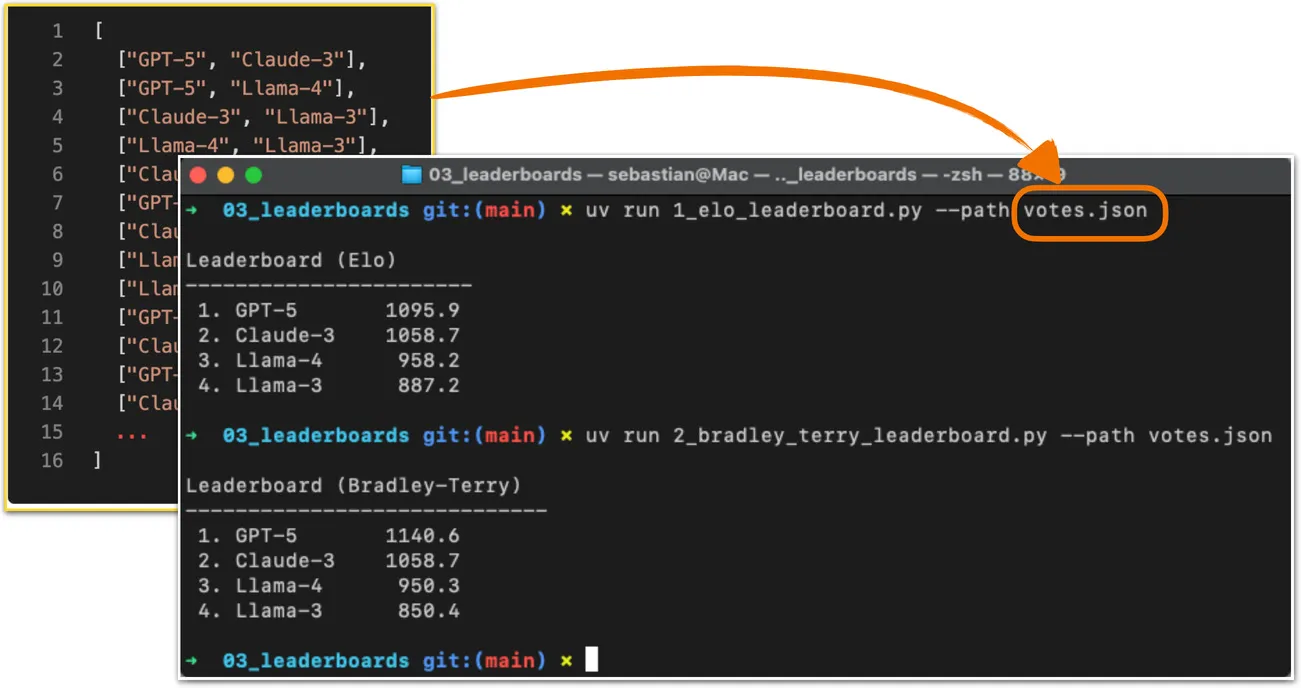
LM Arena最初使用本节介绍的Elo方法,但最近换成了基于布拉德利-特里(Bradley–Terry)模型的统计方法。Bradley-Terry模型的主要优势是:由于有统计学基础,它可以构建置信区间来表达排名的不确定性。此外,和Elo评级不同,Bradley-Terry模型是基于整个数据集做统计拟合,同时估算所有评级,因此不受顺序效应影响。

为了让分数保持在大家熟悉的区间,Bradley-Terry模型拟合后会输出和Elo相当的数值。尽管排行榜官方已经不再正式使用Elo评级,但“Elo”这个说法在LLM研究者和从业者对比模型时依然被广泛使用。Elo评级的代码示例可以在这里查看:https://github.com/rasbt/reasoning-from-scratch/tree/main/chF/03_leaderboards 。

figure11

图11: Elo与Bradley-Terry排名对比;源代码见:https://github.com/rasbt/reasoning-from-scratch/tree/main/chF/03_leaderboards


方法4:用其他LLM评判回答

早期,LLM是用统计和启发式方法来评估的,包括BLEU指标——一种粗略衡量生成文本与参考文本匹配程度的标准。这类指标的问题在于,它们要求精确的单词匹配,没有考虑同义词、语序变化等情况。

如果我们想从整体上评判生成的回答文本,一个解决方案是使用上一节讲的相对排名和基于排行榜的方法。但排行榜的缺点在于,偏好对比带有主观性,因为需要人类反馈(以及收集反馈带来的种种挑战)。

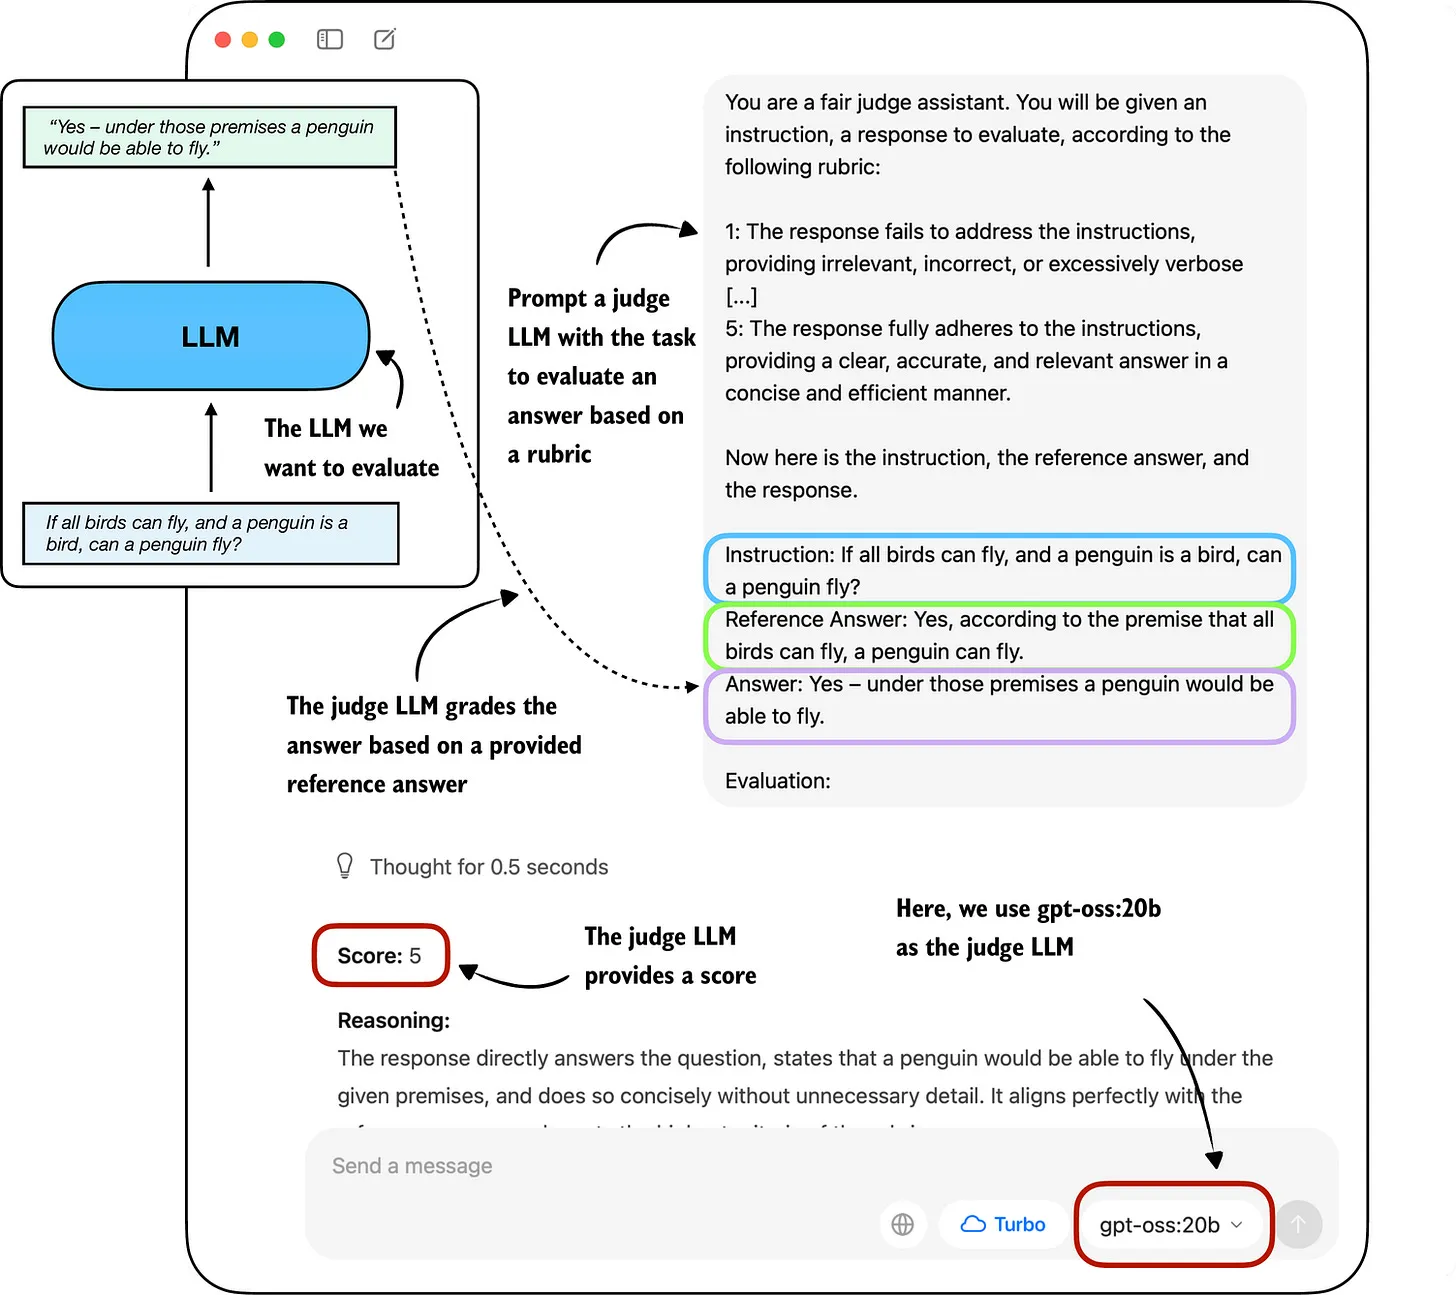
另一种相关方法是:使用另一个LLM,搭配预定义的评分标准(即评估指南),将待评估LLM的回答与参考答案做对比,按照预设标准评判回答质量,如图12所示。

figure12

图12: LLM评审器评估示例。待评估模型生成答案,然后由另一个独立的评审LLM根据评分标准和参考答案打分。

实践中,只要评审LLM足够强,图12这种基于评审的方法效果就很好。常见的设置是通过API调用顶尖的闭源LLM(比如GPT-5 API),不过也有专门的评审模型。(比如这篇论文就是众多例子之一:https://arxiv.org/abs/2405.08029 ;归根结底,大多数这类专用模型都是小模型经过微调,获得了和闭源GPT模型相近的打分行为。)

评审方法之所以有效,原因之一是:评判一个答案往往比生成一个答案更容易。

要在Python中编程实现图12所示的基于评审的模型评估,我们既可以用PyTorch加载一个更大的Qwen3模型,给它输入评分标准和待评估的模型回答;也可以通过API调用其他LLM,比如ChatGPT或者Ollama API。

既然我们已经知道如何用PyTorch加载Qwen3模型,为了更有意思,本节剩下的部分我们将用Python调用Ollama API,实现图12的评审式评估。

具体来说,我们会使用OpenAI的200亿参数gpt-oss开源模型,它在能力和效率之间取得了很好的平衡。想了解更多关于gpt-oss的信息,可以看我的文章《From GPT-2 to gpt-oss: Analyzing the Architectural Advances》:
https://magazine.sebastianraschka.com/p/from-gpt-2-to-gpt-oss-analyzing-the
https://magazine.sebastianraschka.com/p/from-gpt-2-to-gpt-oss-analyzing-the https://substack.com/profile/27393275-sebastian-raschka-phd
·
2025年8月9日
https://magazine.sebastianraschka.com/p/from-gpt-2-to-gpt-oss-analyzing-the

4.1 在Ollama中实现LLM-as-a-judge方法

https://ollama.com/ 是一款高效的开源工具,用于在本地电脑上运行LLM。它封装了开源的llama.cpp库(https://github.com/ggerganov/llama.cpp)——后者用纯C/C++实现LLM,以最大化运行效率。不过注意,Ollama只是利用LLM生成文本(推理)的工具,不支持训练或微调LLM。

要运行下面的代码,请先访问Ollama官网https://ollama.com/,按照对应操作系统的说明安装Ollama:

  • macOS和Windows用户:打开下载的Ollama应用,如果提示安装命令行工具,选择“是”。

  • Linux用户:使用Ollama官网提供的安装命令。

在实现模型评估代码之前,我们先下载gpt-oss模型,通过命令行终端使用Ollama,验证它能正常运行。

在命令行(不是Python会话中)执行以下命令,体验200亿参数的gpt-oss模型:

ollama run gpt-oss:20b

第一次执行这个命令时,会自动下载200亿参数的gpt-oss模型,占用14GB存储空间。输出大致如下:

$ ollama run gpt-oss:20b
pulling manifest
pulling b112e727c6f1: 100% ▕██████████████████████▏  13 GB
pulling fa6710a93d78: 100% ▕██████████████████████▏ 7.2 KB
pulling f6035677647: 100% ▕██████████████████████▏  11 KB
pulling d8ba2f9a17b3: 100% ▕██████████████████████▏   18 B
pulling 55c108d8e936: 100% ▕██████████████████████▏  489 B
verifying sha256 digest
writing manifest
removing unused layers
success
可选的Ollama模型

注意ollama run gpt-oss:20b命令中的gpt-oss:20b指的是200亿参数的gpt-oss模型。运行这个模型大约需要13GB内存。如果你的机器内存不够,可以试试更小的模型,比如40亿参数的qwen3:4b,命令为ollama run qwen3:4b,只需要约4GB内存。

配置更高的电脑也可以用更大的1200亿参数gpt-oss模型,把gpt-oss:20b换成gpt-oss:120b即可。但请注意,这个模型需要的计算资源会显著增加。

模型下载完成后,我们就进入命令行界面,可以和模型对话了。比如问问模型“1+2等于几?”:

>>> What is 1+2?
Thinking...
User asks: "What is 1+2?" This is simple: answer 3. Provide explanation? Possibly ask for simple arithmetic. Provide answer: 3.
...done thinking.
1 + 2 = **3**

输入/bye就可以结束这个ollama run gpt-oss:20b会话。

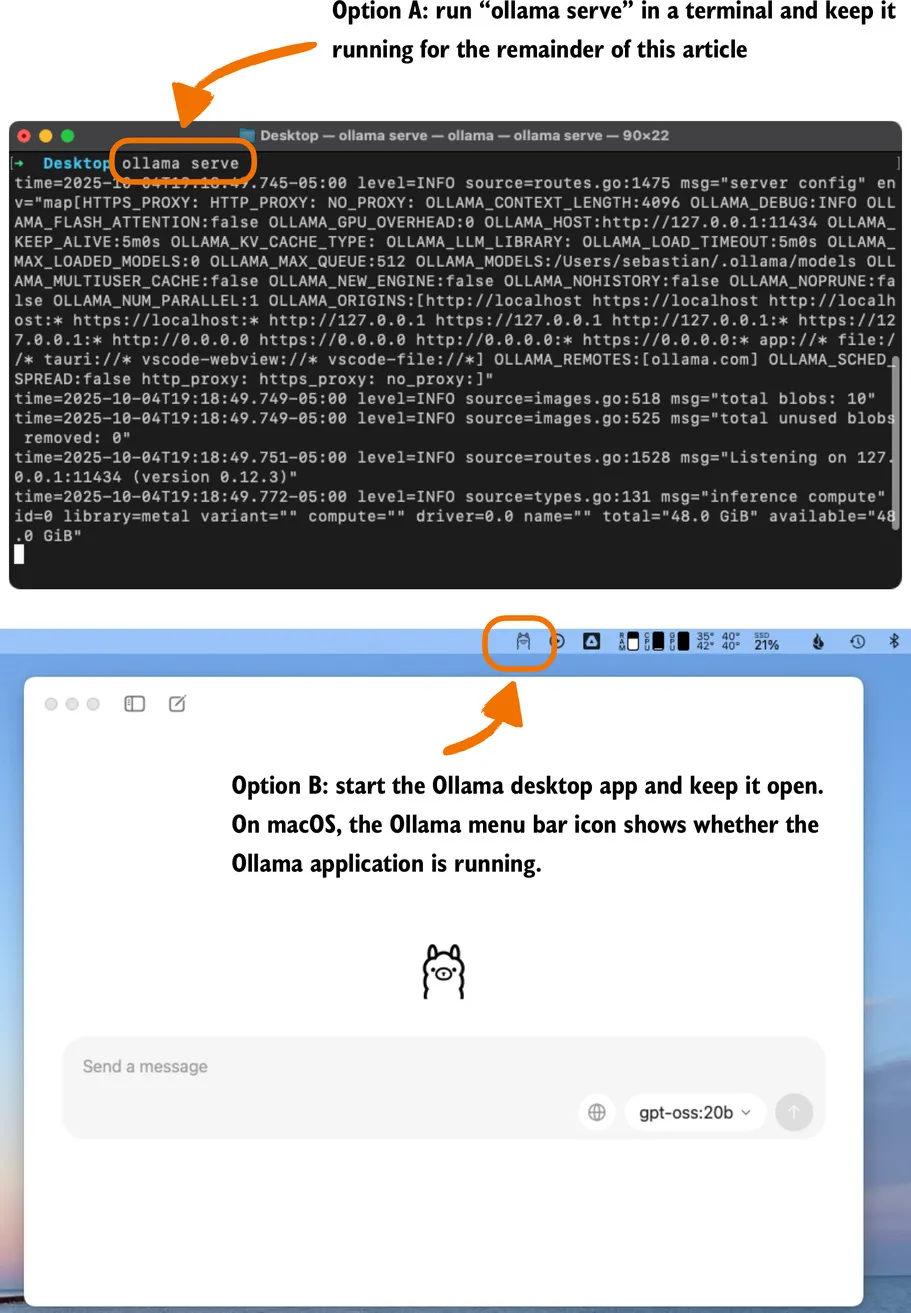
在本节剩下的部分,我们将使用Ollama API。这种方式要求Ollama在后台运行,有三种实现方式:

  1. 在终端运行ollama serve命令(推荐)。这会将Ollama后端作为服务运行,通常地址是http://localhost:11434。注意,在通过API调用之前,它不会加载模型。

  2. 像之前一样运行ollama run gpt-oss:20b命令,但保持窗口打开,不要输入/bye退出会话。如前所述,这相当于在本地Ollama服务外包了一层简易的交互封装,底层用的是和ollama serve一样的服务API。

  3. Ollama桌面应用。打开桌面应用会自动运行相同的后端,并在上面提供图形界面,如图12所示。

figure13

图13: 两种保持Ollama服务(或应用)运行的方式,以便我们在Python中通过Ollama API调用它

Ollama服务IP地址

Ollama在本地机器上运行时,会启动一个类似本地服务的进程。在终端运行ollama serve时,你可能会遇到报错:Error: listen tcp 127.0.0.1:11434: bind: address already in use.

如果出现这种情况,可以尝试命令OLLAMA_HOST=127.0.0.1:11435 ollama serve(如果这个地址也被占用,就把数字逐个加1,直到找到空闲地址。)

下面的代码会在我们用Ollama评估上一节生成的测试集回答之前,验证Ollama会话是否正常运行:

代码块5:检查Ollama是否运行

import psutil

def check_if_running(process_name):
    running = False
    for proc in psutil.process_iter(["name"]):
        if process_name in proc.info["name"]:
            running = True
            break
    return running

ollama_running = check_if_running("ollama")

if not ollama_running:
    raise RuntimeError(
        "Ollama not running. "
        "Launch ollama before proceeding."
    )
print("Ollama running:", check_if_running("ollama"))

确保执行上面代码后输出Ollama running: True。如果显示False,请确认ollama serve命令或者Ollama应用正在运行(见图13)。

在本文余下部分,我们将通过Python调用Ollama REST API,与运行在本地机器上的gpt-oss模型交互。下面的query_model函数演示了API的使用方法:

代码块6:调用本地Ollama模型

import json
import urllib.request

def query_model(
    prompt,
    model="gpt-oss:20b",
    # If you used
    # OLLAMA_HOST=127.0.0.1:11435 ollama serve
    # update the address below
    url="http://localhost:11434/api/chat"
):
    # Create the data payload as a dictionary:
    data = {
        "model": model,
        "messages": [
            {"role": "user", "content": prompt}
        ],
        # Settings required for deterministic responses:
        "options": {
            "seed": 123,
            "temperature": 0,
            "num_ctx": 2048
        }
    }

    # Convert the dictionary to JSON and encode it to bytes
    payload = json.dumps(data).encode("utf-8")

    # Create a POST request and add headers
    request = urllib.request.Request(
        url,
        data=payload,
        method="POST"
    )
    request.add_header("Content-Type", "application/json")

    response_data = ""

    # Send the request and capture the streaming response
    with urllib.request.urlopen(request) as response:
        while True:
            line = response.readline().decode("utf-8")
            if not line:
                break
            # Parse each line into JSON
            response_json = json.loads(line)
            response_data += response_json["message"]["content"]

    return response_data

下面是使用我们刚实现的query_model函数的示例:

ollama_model = "gpt-oss:20b"
result = query_model("What is 1+2?", ollama_model)
print(result)

输出结果是“3”。(和直接运行ollama run或者桌面应用的结果会有差异,因为默认设置不同。)

利用query_model函数,我们就可以评估模型生成的回答了:我们构造一个包含评分标准的提示,让gpt-oss模型以1到5分的尺度,根据参考答案来打分。

我们使用的提示如下:

代码块7:设置包含评分标准的提示模板

def rubric_prompt(instruction, reference_answer, model_answer):
    rubric = (
        "You are a fair judge assistant. You will be "
        "given an instruction, a reference answer, and "
        "a candidate answer to evaluate, according to "
        "the following rubric:\n\n"
        "1: The response fails to address the "
        "instruction, providing irrelevant, incorrect, "
        "or excessively verbose content.\n"
        "2: The response partially addresses the "
        "instruction but contains major errors, "
        "omissions, or irrelevant details.\n"
        "3: The response addresses the instruction to "
        "some degree but is incomplete, partially "
        "correct, or unclear in places.\n"
        "4: The response mostly adheres to the "
        "instruction, with only minor errors, "
        "omissions, or lack of clarity.\n"
        "5: The response fully adheres to the "
        "instruction, providing a clear, accurate, and "
        "relevant answer in a concise and efficient "
        "manner.\n\n"
        "Now here is the instruction, the reference "
        "answer, and the response.\n"
    )

    prompt = (
        f"{rubric}\n"
        f"Instruction:\n{instruction}\n\n"
        f"Reference Answer:\n{reference_answer}\n\n"
        f"Answer:\n{model_answer}\n\n"
        f"Evaluation: "
    )
    return prompt

rubric_prompt中的model_answer代表实际场景中我们自己的模型生成的回答。为了演示,这里我们硬编码一个合理的模型回答,而不是动态生成。(不过你也可以用本文开头加载的Qwen3模型来生成真实的model_answer。)

接下来,我们生成渲染后的提示,传给Ollama模型:

rendered_prompt = rubric_prompt(
    instruction=(
        "If all birds can fly, and a penguin is a bird, "
        "can a penguin fly?"
    ),
    reference_answer=(
        "Yes, according to the premise that all birds can fly, "
        "a penguin can fly."
    ),
    model_answer=(
        "Yes – under those premises a penguin would be able to fly."
    )
)
print(rendered_prompt)

输出如下:

You are a fair judge assistant. You will be given an instruction, a reference answer, and a candidate answer to evaluate, according to the following rubric:

1: The response fails to address the instruction, providing irrelevant, incorrect, or excessively verbose content.
2: The response partially addresses the instruction but contains major errors, omissions, or irrelevant details.
3: The response addresses the instruction to some degree but is incomplete, partially correct, or unclear in places.
4: The response mostly adheres to the instruction, with only minor errors, omissions, or lack of clarity.
5: The response fully adheres to the instruction, providing a clear, accurate, and relevant answer in a concise and efficient manner.

Now here is the instruction, the reference answer, and the response.

Instruction:
If all birds can fly, and a penguin is a bird, can a penguin fly?

Reference Answer:
Yes, according to the premise that all birds can fly, a penguin can fly.

Answer:
Yes – under those premises a penguin would be able to fly.

Evaluation: 

提示以Evaluation:结尾,引导模型生成分数。我们来看看gpt-oss:20b模型对这个回答打几分:

result = query_model(rendered_prompt, ollama_model)
print(result)

回答如下:

**Score: 5**

The candidate answer directly addresses the question, correctly applies the given premises, and concisely states that a penguin would be able to fly. It is accurate, relevant, and clear.

可以看到,回答得到了最高分,这很合理,因为它确实是正确的。这只是一个手动演示的简单例子,我们可以把这个思路进一步扩展,写一个循环,用评估数据集里的问题逐个查询模型(比如前面加载的Qwen3模型),通过gpt-oss进行评估,然后计算平均分。你可以在这里找到这样的脚本实现:我们在MATH-500数据集上评估Qwen3模型,地址是https://github.com/rasbt/reasoning-from-scratch/tree/main/chF/04_llm-judge 。

figure14

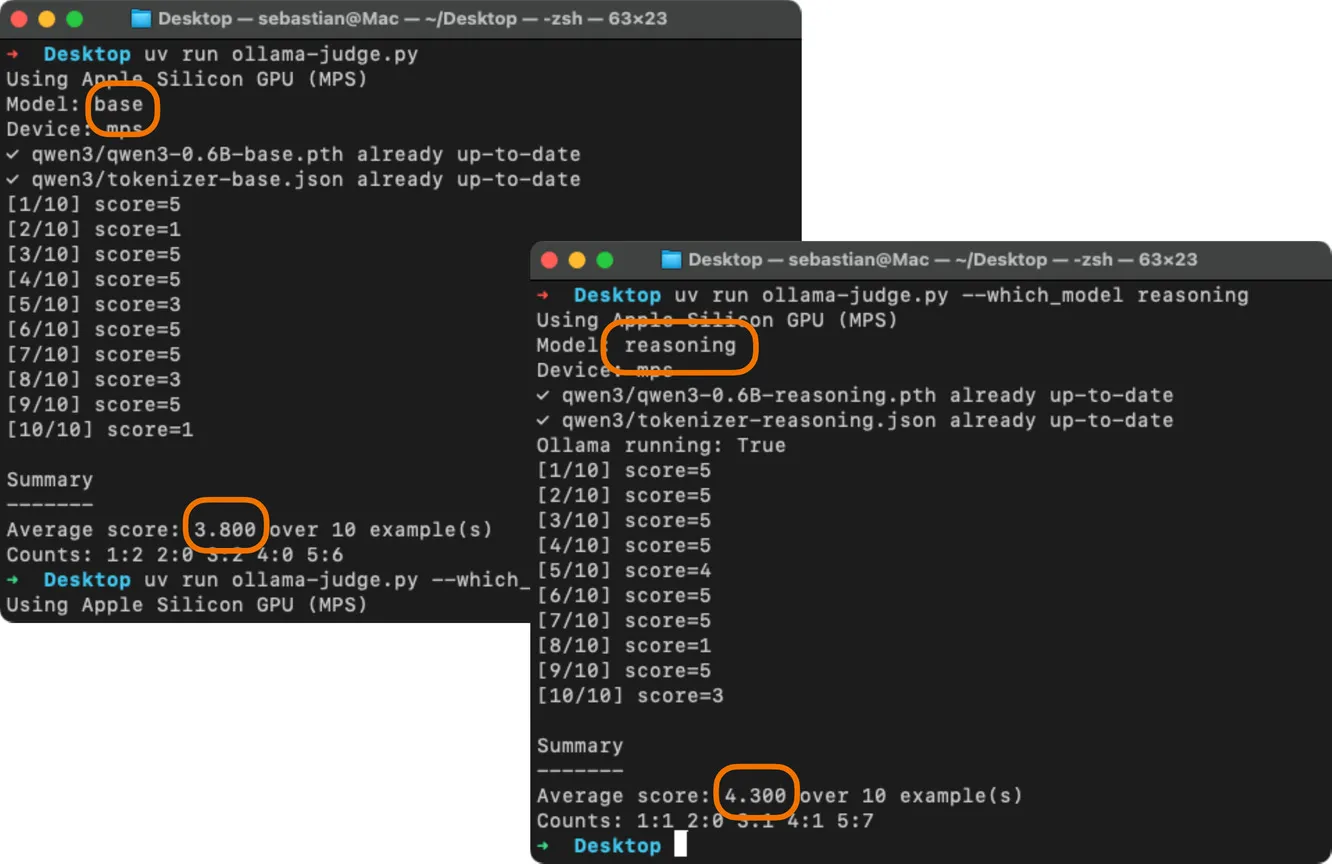
图14: Qwen3 0.6基座版与推理版在MATH-500前10道例题上的对比,由gpt-oss:20b担任评审。代码见:https://github.com/rasbt/reasoning-from-scratch/tree/main/chF/04_llm-judge

用过程奖励模型为中间推理步骤打分

和符号验证器、LLM评审器相关的,还有一类被称为过程奖励模型(Process Reward Models,PRMs)的训练模型。和评审器一样,PRMs不止评估最终答案,还能评估推理轨迹;但和通用评审器不同的是,PRMs专门聚焦于推理的中间步骤。而且和验证器不同——验证器通常只在结果层面做符号化的正确性检查——PRMs会在强化学习训练过程中提供逐步骤的奖励信号。我们可以把PRMs归类为“步骤级评审器”,它们主要是为训练开发的,而非纯粹的评估。(实践中,大规模可靠训练PRMs难度很高。比如DeepSeek R1就没有采用PRMs,而是结合了验证器来做推理训练。)

基于评审的评估相比基于偏好的排行榜,优势在于可扩展性和一致性,因为它不依赖大量人类投票者。(从技术上讲,排行榜背后的偏好评级也可以外包给LLM评审器。)但LLM评审器也和人类投票者有类似的弱点:结果会受到模型偏好、提示设计、回答风格的偏差影响。此外,它高度依赖评审模型和评分标准的选择,并且缺乏固定基准测试的可复现性。


结论

本文我们介绍了四种不同的评估方法:选择题测试、验证器评估、排行榜和LLM评审器。

我知道这篇文章很长,但希望它能帮你全面了解LLM的评估方式。这种从零开始的讲解方式可能略显繁琐,但却是理解这些方法底层原理的绝佳途径,反过来也能帮我们发现它们的不足和改进方向。

说到这里,你可能会问:“那评估LLM的最佳方式是什么?”遗憾的是,没有唯一的最优解,因为正如我们所见,每种方法都有不同的取舍。简而言之:

  • 选择题测试

    • 优点:大规模运行速度相对较快、成本较低

    • 优点:跨论文(或模型卡)标准化、可复现

    • 缺点:只衡量基础的知识回忆能力

    • 缺点:无法反映LLM在真实世界中的使用方式

  • 验证器评估

    • 优点:对有标准答案的领域,评分标准化、客观

    • 优点:允许自由形式作答(对最终答案格式有一定约束)

    • 优点:如果使用过程验证器或过程奖励模型,也可以为中间步骤打分

    • 缺点:只适用于可验证的领域(比如数学或代码),并且构建优秀的验证器难度不小

    • 缺点:只看结果的验证器只评估最终答案,不评估推理质量

  • 竞技场式排行榜(人类两两偏好)

    • 优点:直接回答“人们更喜欢哪个模型?”,基于真实场景的提示

    • 优点:允许自由形式作答,并且隐含考虑了风格、实用性和安全性

    • 缺点:对人类来说成本高、耗时长

    • 缺点:不衡量正确性,只衡量偏好度

    • 缺点:人群构成的变化会影响排名稳定性

  • LLM-as-a-judge(LLM评审器)

    • 优点:可跨多种任务扩展

    • 优点:允许自由形式作答

    • 缺点:依赖评审器的能力(集成多个评审器可以提升鲁棒性)

    • 缺点:依赖评分标准的选择

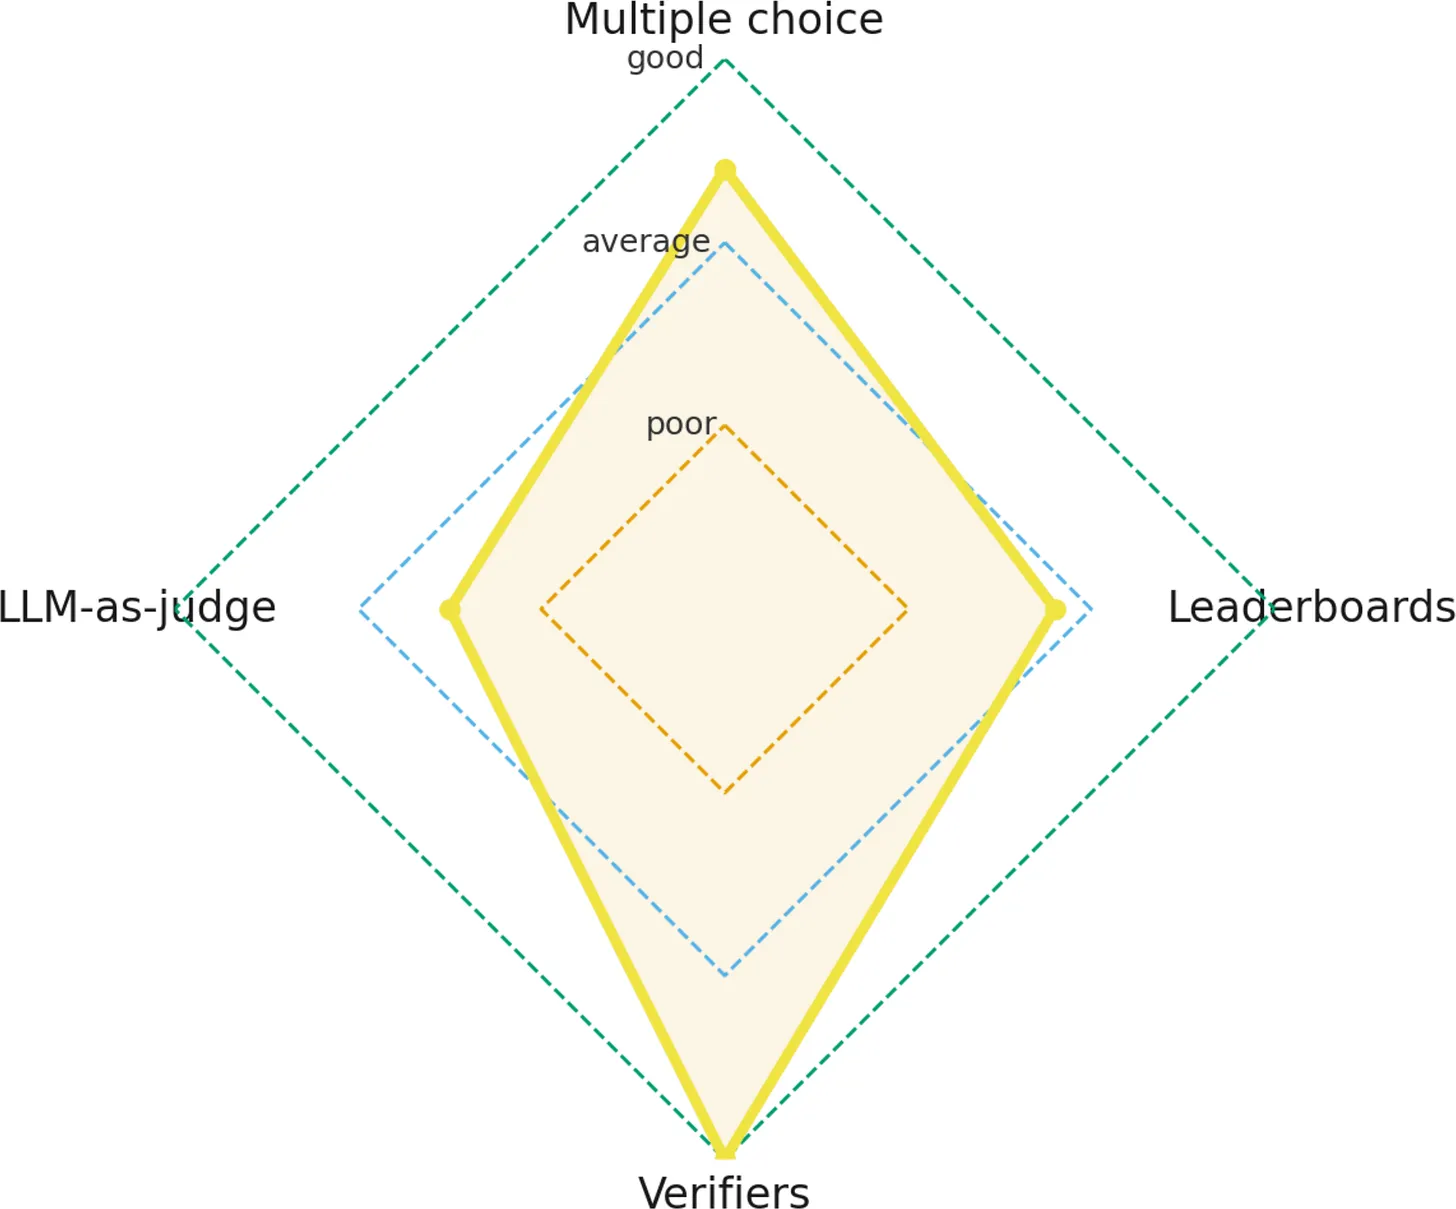
虽然我平时不太喜欢雷达图,但在这里用它来可视化这些不同的评估维度还是很有帮助的,如下图所示。

figure15

图15: 雷达图示意:理想情况下,我们需要从不同维度评估LLM,才能识别它的优势和劣势。

比如,选择题得分高说明模型的通用知识扎实。如果再加上验证器得分高,那模型很可能也能正确回答技术问题。但如果模型在LLM评审器和排行榜评估中表现差,那它可能在写作或清晰表达方面有困难,可以通过RLHF来改善。

所以,最好的评估方式是多维度结合。但理想情况下,还要使用和你的目标或业务问题直接对齐的数据。比如,如果你要部署一个LLM来辅助法律相关工作,那跑一遍MMLU这类标准基准做快速 sanity check 是合理的,但最终你还是要针对目标领域(比如法律)定制评估。你可以在网上找到公开的基准测试作为很好的起点,但最终还是要用自己的专有数据来测试。只有这样,你才能比较有把握地确认模型在训练时没有见过这些测试数据。

总之,模型评估是一个非常庞大且重要的议题。希望这篇文章能帮你理解主流方法的工作原理,也希望下次你看模型评估或者自己做评估时,能从中获得一些有用的洞见。

一如既往,快乐折腾!


这本杂志是我的个人心血之作,你的支持就是它持续更新的动力。

如果你愿意支持我的工作,可以考虑我的这本书《Build a Large Language Model (From Scratch)》(https://amzn.to/4fqvn0D),或者它的续作《Build a Reasoning Model (From Scratch)》(https://mng.bz/Nwr7)。(我相信你会从中学到很多,它们对LLM工作原理的讲解深度是你在别处找不到的。)

感谢阅读,也感谢你支持独立研究!

figure12

《Build a Large Language Model (From Scratch)》现已在亚马逊上架:https://amzn.to/4fqvn0D
《Build a Reasoning Model (From Scratch)》抢先阅读地址:https://mng.bz/Nwr7

如果你读过这本书,能抽出几分钟时间的话,我会非常感谢你在亚马逊留下评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 。这对我们作者帮助很大!

你的支持意义重大!谢谢!
高并发处理全景指南:从架构到运维,搞定系统扛压核心

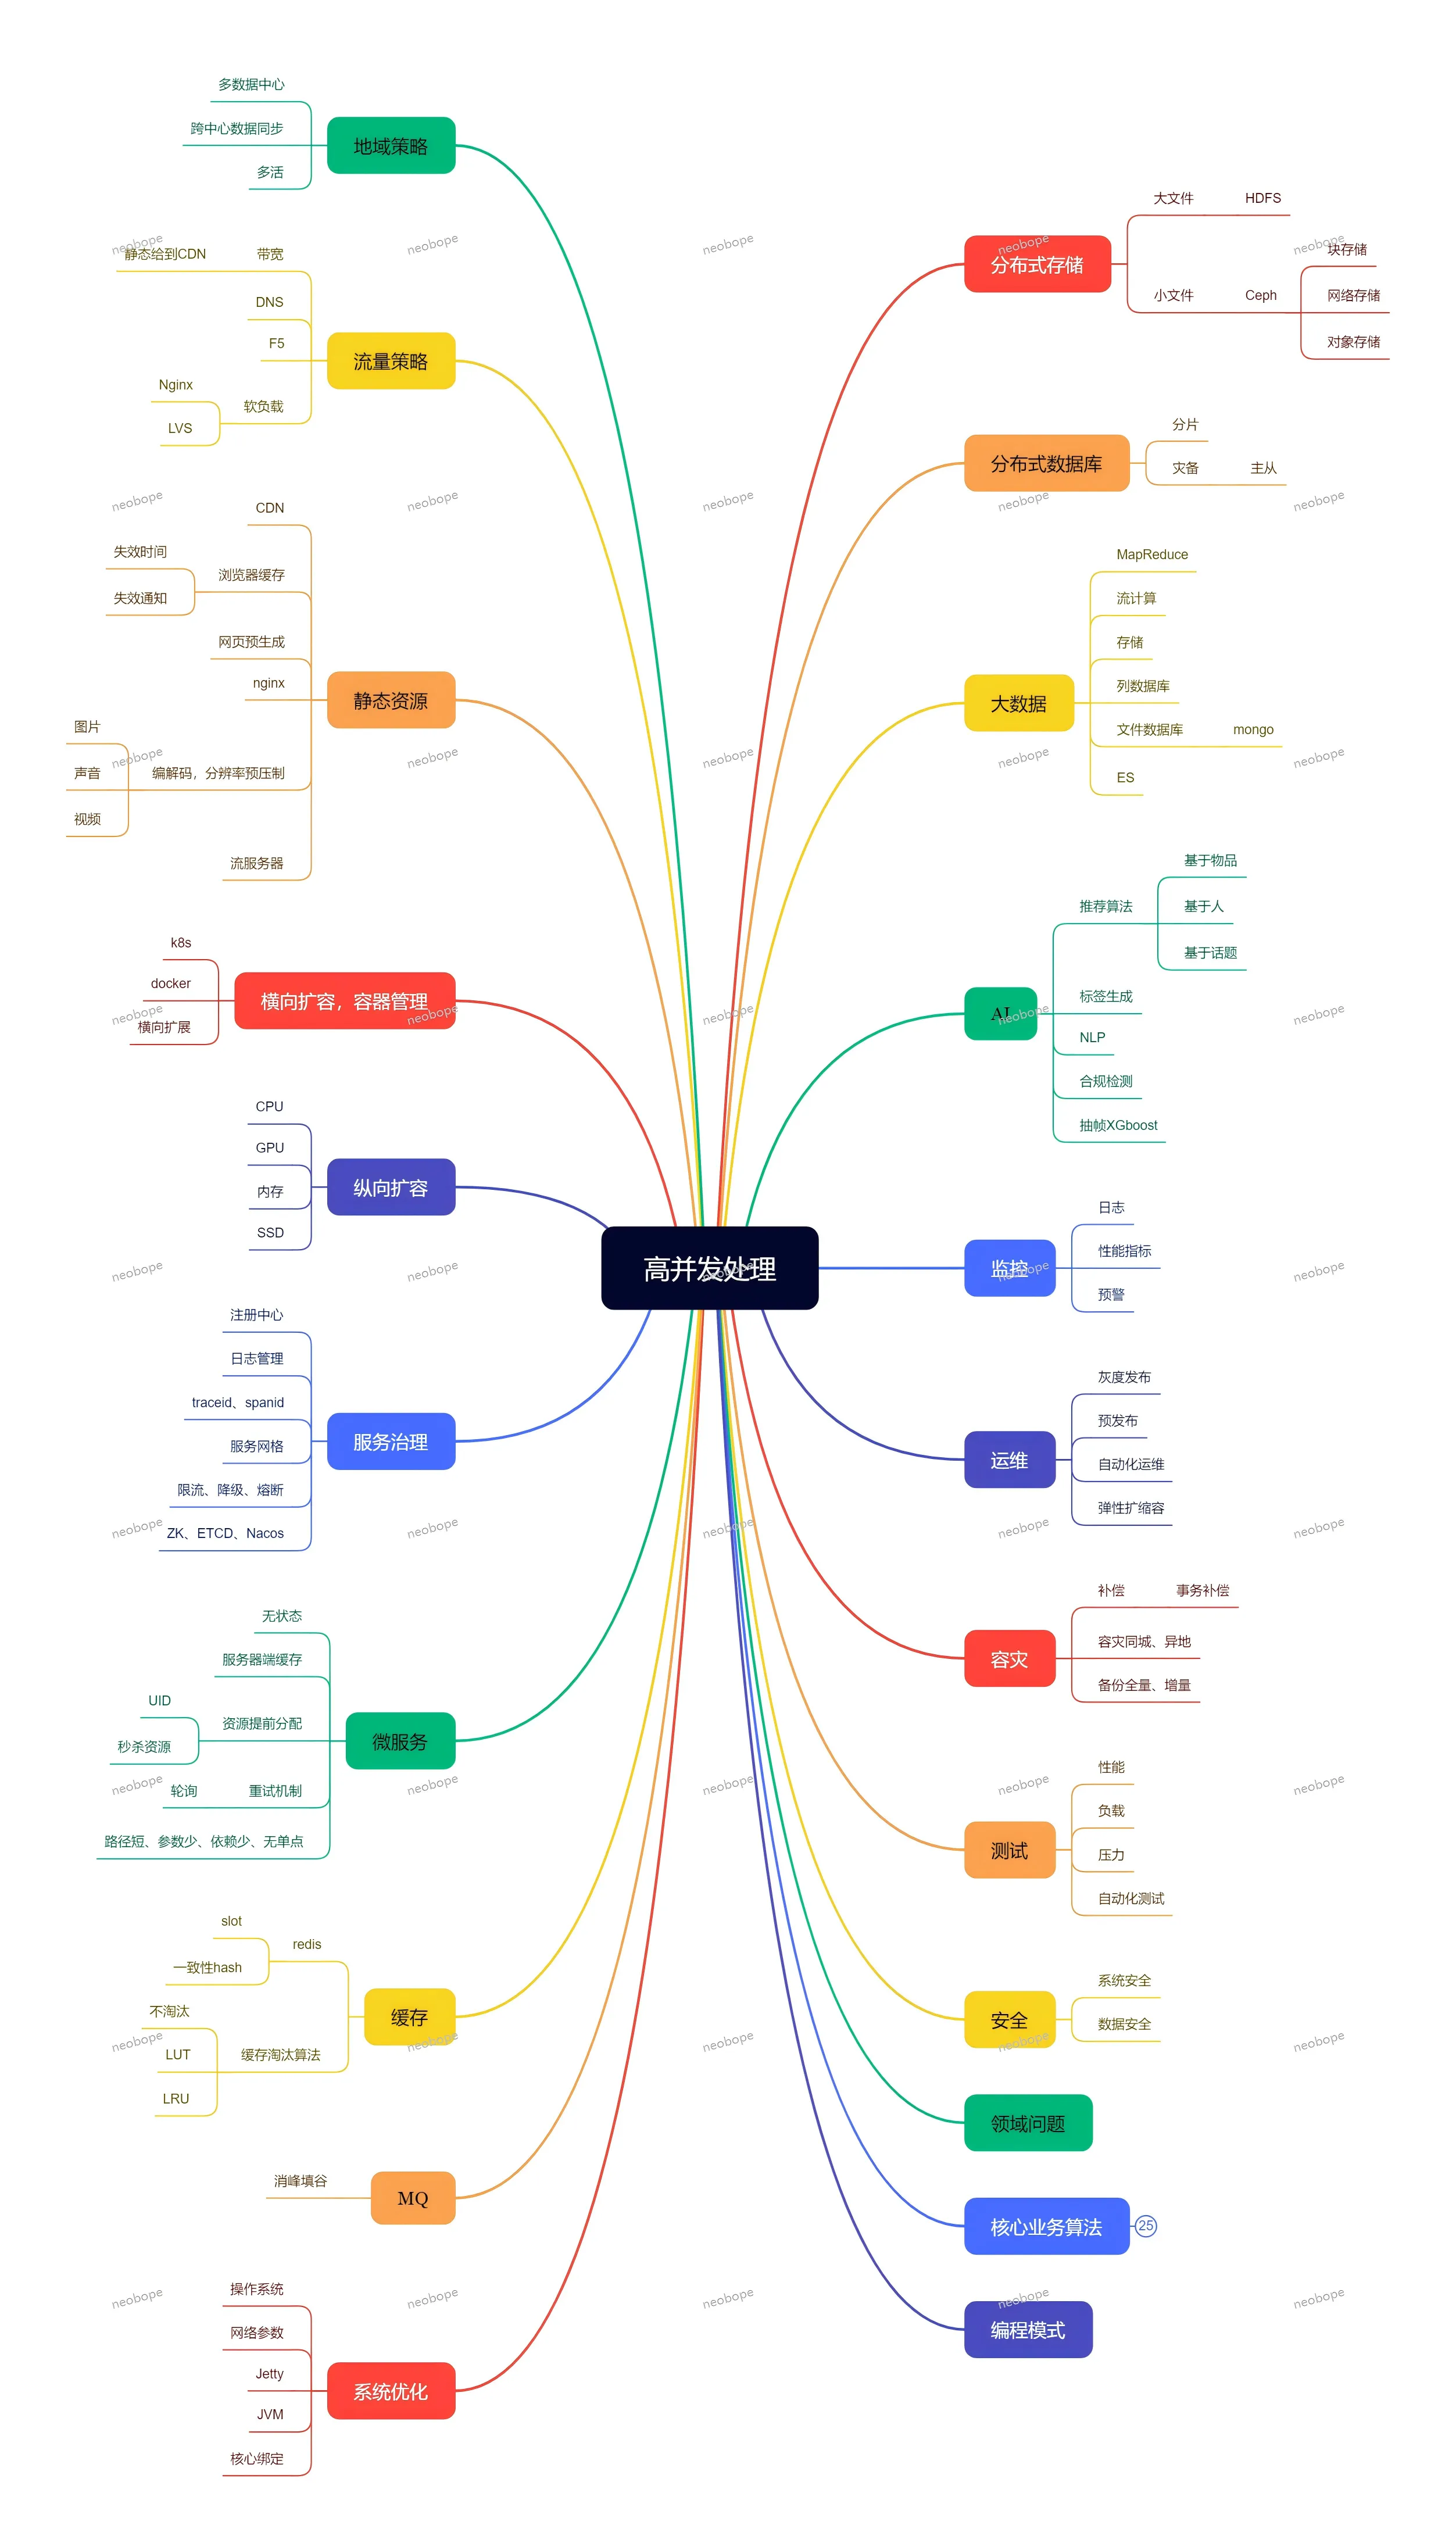
高并发处理技术


高并发处理全景指南:从架构到运维,搞定系统扛压核心

面对秒杀活动的瞬时流量、热门 APP 的千万级用户访问,高并发系统的核心诉求只有一个:“稳得住、响应快、不宕机”。高并发处理不是单一技术的比拼,而是从架构设计、存储优化、流量管控到运维保障的全链路协同。今天就拆解高并发处理的核心技术栈,帮你搭建一套 “可扩展、可容错、高性能” 的系统架构。

一、架构设计:从 “单体” 到 “分布式”,破解性能瓶颈
高并发的核心是 “分散压力”,通过分布式架构将流量和负载分摊到多个节点,避免单点故障:
横向扩容与容器化:采用 “横向扩展” 而非 “纵向扩容”,通过增加服务器节点分摊压力;用 Docker 封装应用,K8s 实现容器编排与管理,支持弹性扩缩容(流量高峰自动加节点,低谷缩容节省资源);
微服务与服务治理:拆分单体应用为微服务(如订单、支付、用户服务),每个服务独立部署、按需扩容;通过服务网格、注册中心(ZK、ETCD、Nacos)实现服务发现与路由,搭配限流、降级、熔断机制(避免某个服务故障牵连整体);
无状态设计:服务设计为无状态(不存储本地数据,依赖分布式存储),方便水平扩容;通过 TraceID、SpanID 实现分布式链路追踪,快速定位跨服务问题;
多活与灾备:搭建多数据中心、跨中心数据同步,实现同城 / 异地多活(避免单点数据中心故障);制定全量 / 增量备份策略,确保数据安全与快速恢复。

二、流量管控:削峰填谷,让系统 “从容应对” 高峰
直接暴露核心服务给峰值流量,极易导致系统崩溃,流量管控的核心是 “缓冲、分流、限流”:
负载均衡:通过 Nginx、LVS、F5 等软 / 硬件负载均衡器,将流量均匀分发到后端服务节点;采用一致性 Hash 算法,确保请求分发均匀,减少缓存失效;
消峰填谷:用 MQ 消息队列缓冲瞬时高峰流量(如秒杀订单先入队,服务异步消费),将 “突发流量” 转化为 “平稳流量”,避免服务被压垮;
限流与灰度发布:对核心接口设置限流阈值(如每秒最多处理 1000 请求),超出阈值直接返回友好提示;通过预发布、灰度发布(逐步放量),验证新功能在高并发下的稳定性,降低风险;
DNS 与 CDN 优化:利用 DNS 轮询实现地域级流量分流(将用户导向就近节点);CDN 加速静态资源(图片、视频、JS/CSS),减少源站压力,同时提升用户访问速度。

三、存储优化:适配高并发读写,兼顾速度与可靠性
存储是高并发系统的 “数据底座”,核心需求是 “读写快、容量足、不丢数据”:
分层存储策略:静态资源(图片、视频、大文件)存入分布式存储(HDFS、Ceph 对象存储、块存储),通过 CDN 加速访问;热点数据存入 Redis 等缓存,减少数据库查询压力;
数据库优化:采用分布式数据库、主从架构(主库写、从库读,读写分离);针对高并发场景选用列数据库(适配海量数据查询)、文档数据库(MongoDB,适配非结构化数据);
缓存设计:多级缓存(浏览器缓存→CDN 缓存→服务器端缓存)减少重复请求;合理设置缓存失效时间、失效通知,搭配 LRU 等缓存淘汰算法,避免缓存雪崩、缓存穿透;
资源预分配:提前预热热点数据(如秒杀商品信息载入缓存)、预压制视频 / 图片分辨率,减少高并发时的动态处理压力。

四、核心优化:从代码到硬件,榨干系统性能
在架构和流量管控之外,细节优化能进一步提升系统并发能力,核心是 “减少无效消耗、提升单位时间处理效率”:
硬件与系统优化:选用高性能 CPU、GPU、SSD(提升读写速度);优化操作系统、JVM、网络参数(如调整连接数、内存分配);核心绑定(将进程与 CPU 核心绑定,减少上下文切换);
代码与编程模式优化:简化接口路径、减少参数传递、降低服务依赖(路径短、参数少、依赖少 = 更快响应);采用高效编程模式,避免冗余逻辑和资源浪费;
大数据与算法优化:用 MapReduce、流计算处理海量日志与业务数据,支撑实时决策;核心业务算法优化(如推荐算法采用基于人 / 物品 / 话题的高效匹配逻辑);
多媒体处理优化:对图片、声音、视频进行编解码优化,抽帧处理减少传输与存储压力。

五、运维与监控:实时预警,快速响应问题
高并发系统的稳定性离不开完善的运维监控,核心是 “早发现、早定位、早解决”:
全链路监控:监控性能指标(响应时间、QPS、错误率)、系统资源(CPU、内存、磁盘 IO);建立日志管理平台,集中分析分布式日志,快速定位问题;
自动化运维与预警:通过自动化测试、压力测试,提前验证系统抗并发能力;设置预警阈值(如响应时间超过 500ms 告警),结合服务健康检查,实时发现异常;
容错与补偿:实现重试机制(失败请求自动重试,避免偶发故障影响)、事务补偿(如支付失败自动回滚订单),提升系统容错性;
安全保障:兼顾系统安全与数据安全,防范高并发场景下的恶意攻击(如 DDoS、接口刷取),确保核心业务不被干扰。

总结:高并发处理的核心逻辑 ——“全链路协同,无短板优化”
高并发不是 “某一个技术点的胜利”,而是架构、流量、存储、代码、运维的全方位配合:架构层面 “分散压力”,流量层面 “缓冲分流”,存储层面 “提速减负”,细节层面 “榨干性能”,运维层面 “兜底保障”。
关键原则是 “避免单点故障、减少无效消耗、适配业务场景”—— 比如秒杀场景侧重 “消峰填谷 + 缓存预热”,社交 APP 侧重 “分布式存储 + 实时计算”。只有结合自身业务特点,针对性优化,才能打造出稳定、高效的高并发系统。

你在做高并发系统时,遇到过哪些棘手问题?是缓存雪崩、流量突增还是数据库瓶颈?欢迎在评论区分享你的解决方案~

Windows进程间通讯全解析:10大核心方式+场景选型,搞定进程协同

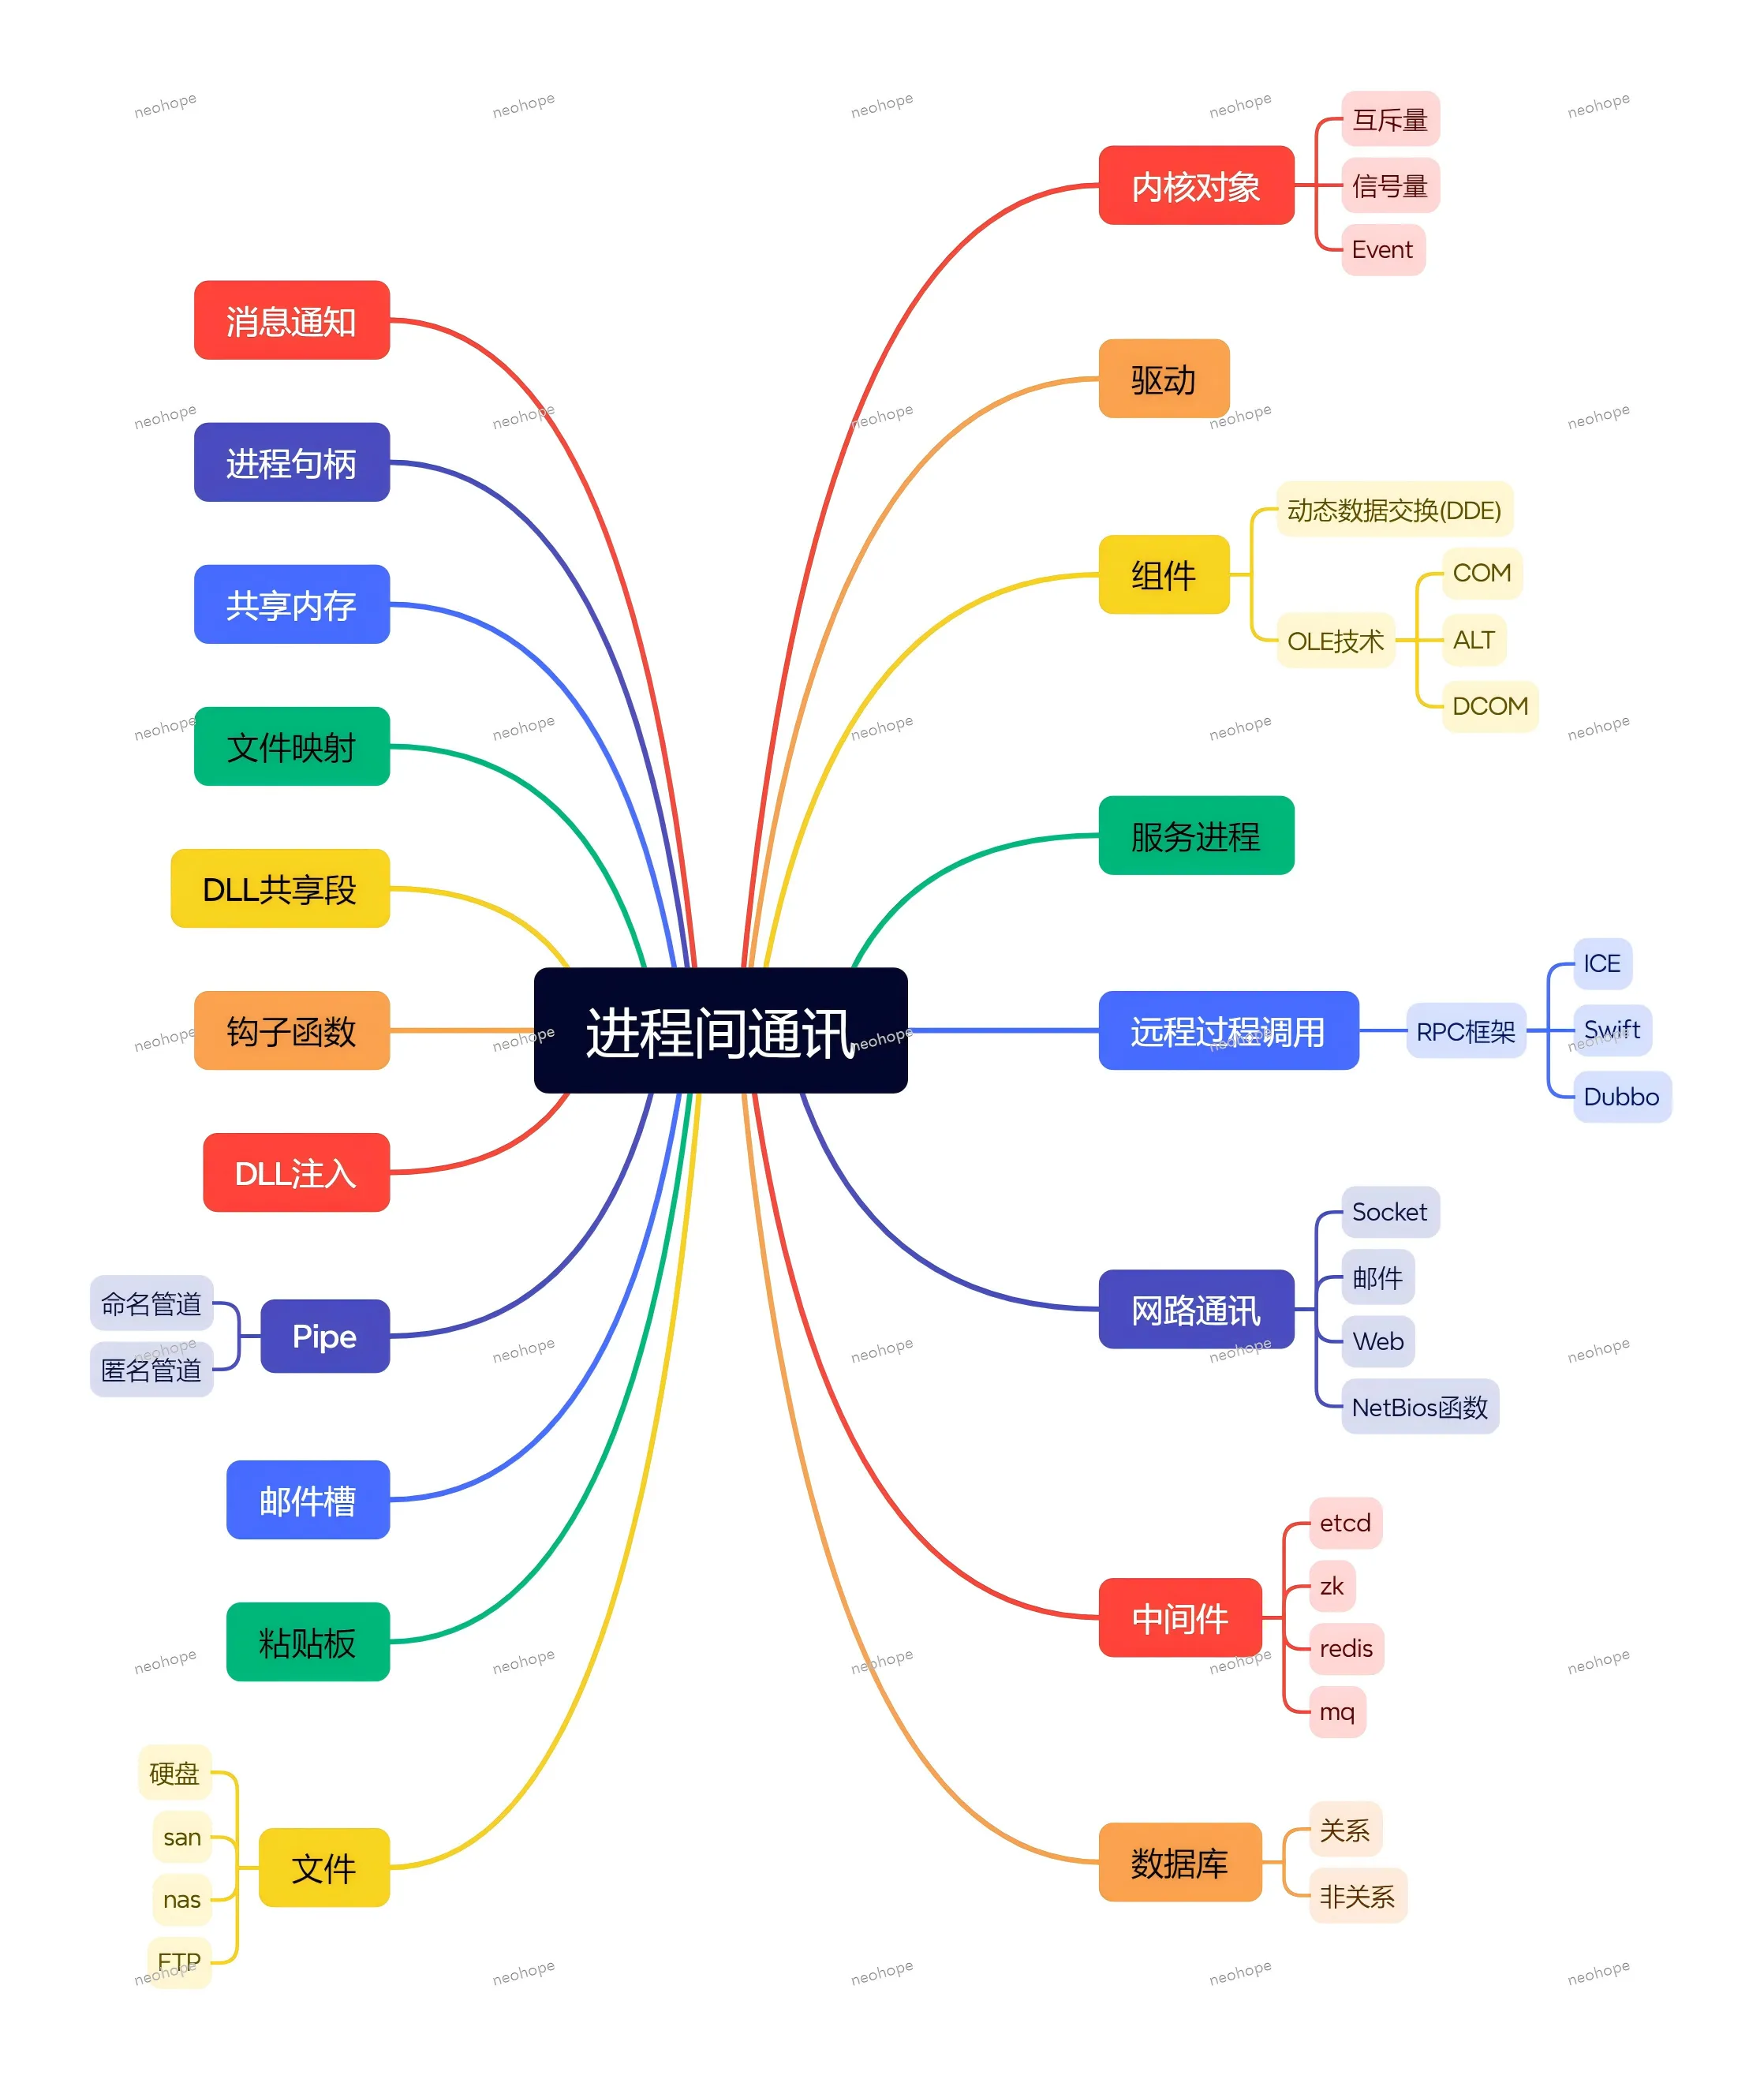
Windows进程间通讯


Windows进程间通讯全解析:10大核心方式+场景选型,搞定进程协同

在 Windows 系统中,多个进程想要协同工作(比如浏览器调用下载工具、办公软件同步数据),就离不开 “进程间通讯(IPC)” 技术。不同场景下,有的需要高速传输大数据,有的需要实时同步状态,有的要跨网络通讯 —— 选对 IPC 方式,能让程序协作更高效、更稳定。今天就拆解 Windows 系统中常见的进程间通讯方式,帮你理清适用场景和核心逻辑。

一、内核对象同步:轻量级状态协同,保障进程有序执行
核心逻辑:利用 Windows 内核对象的信号状态,实现进程间的同步与互斥(比如避免多个进程同时操作同一资源),适用于简单状态通知。
代表技术:互斥量(Mutex,保证同一时刻只有一个进程访问资源)、信号量(Semaphore,控制同时访问资源的进程数量)、Event(事件对象,通过信号触发进程执行);
优势:轻量级、效率高、系统原生支持,无需复杂配置;
适用场景:进程间同步(如多个进程读写同一文件时的锁机制)、简单状态通知(如 “任务完成” 信号触发下一个进程执行)。

二、共享内存类:高速传输大数据,性能优先之选
核心逻辑:多个进程共享同一块物理内存,直接读写内存实现数据传输,无需拷贝,是速度最快的 IPC 方式。
代表技术:共享内存(直接创建共享内存区域,进程间直接访问)、文件映射(将文件映射到内存,多个进程通过内存共享文件数据)、DLL 共享段(通过 DLL 的共享数据段,实现进程间数据共享);
优势:传输速度极快(内存级读写)、无数据拷贝损耗、支持大容量数据传输;
注意点:需要自己实现同步机制(如搭配互斥量),避免数据竞争;
适用场景:高频大数据传输(如视频处理软件的帧数据传递、工业软件的实时数据共享)。

三、管道通讯:基于文件系统,适配本地进程交互
核心逻辑:模拟文件读写的方式,通过 “管道” 这一伪文件实现进程间字节流传输,是 Windows 原生的本地 IPC 方案。
代表技术:匿名管道(Pipe,仅支持父子进程或亲缘进程间通讯,单向传输)、命名管道(Named Pipe,支持任意本地进程间通讯,双向传输);
优势:系统原生支持、使用简单、传输可靠;
适用场景:本地进程间字节流传输(如命令行工具的输出传递、本地服务与客户端的通讯)。

四、组件对象模型:跨进程调用,实现功能复用
核心逻辑:通过 COM(组件对象模型)、DCOM(分布式 COM)、OLE 技术等,将一个进程的功能封装为组件,供其他进程远程调用,实现功能复用。
代表技术:COM(本地跨进程组件调用,如 Office 组件嵌入其他软件)、DCOM(跨网络的 COM 调用,支持远程组件访问)、OLE(对象链接与嵌入,如文档中嵌入图片、表格);
优势:封装性好、支持功能复用、接口标准化;
适用场景:跨进程功能调用(如第三方组件集成、软件插件扩展)、分布式系统的远程组件访问。

五、网络通讯类:跨机器 / 广域通讯,突破本地限制
核心逻辑:基于网络协议实现进程间通讯,不仅支持本地进程,还能跨 Windows 机器、跨网络通讯,是最通用的 IPC 方式。
代表技术:Socket(套接字,支持 TCP/UDP 协议,本地与跨网络通讯通用,如客户端 / 服务器架构)、NetBios 函数(早期 Windows 网络通讯接口,支持局域网内进程交互);
优势:通用性强、支持跨机器 / 跨网络、适配各类数据传输场景;
适用场景:网络应用(如浏览器与服务器通讯)、跨机器进程协同(如分布式服务间调用)、客户端 / 服务器架构软件。

六、消息与钩子:Windows 原生机制,适配桌面应用交互
核心逻辑:利用 Windows 的消息机制或钩子函数,实现进程间的消息传递或行为监控。
代表技术:消息通知(Windows 消息队列,进程间发送自定义消息)、钩子函数(Hook,监控或拦截其他进程的消息 / 行为,如键盘钩子、鼠标钩子)、DLL 注入(通过注入 DLL,实现进程间消息传递或功能扩展);
优势:深度适配 Windows 桌面应用、支持行为监控与消息触发;
适用场景:桌面应用交互(如窗口间消息通知)、进程行为监控(如安全软件的行为拦截)、软件功能增强(如通过 DLL 注入扩展第三方软件功能)。

七、中间件 / 存储介质:间接通讯,解耦进程依赖
核心逻辑:通过第三方存储介质或中间件传递数据,进程间不直接交互,降低耦合度,适配复杂场景。
代表技术:文件(通过读写同一文件传递数据,如日志同步、配置共享)、数据库(关系型 / 非关系型数据库,如多进程共享业务数据)、缓存中间件(Redis、etcd、zk,分布式场景下的配置同步与数据共享)、消息队列(MQ,异步通讯,如任务分发、数据异步传递);
优势:解耦进程依赖、支持异步通讯、适配分布式场景;
适用场景:分布式系统(如微服务间通讯)、异步任务处理(如批量数据处理)、跨进程配置共享(如多进程读取同一数据库配置)。

八、其他特色方式:适配特殊场景需求
除了主流方式,还有一些针对特定场景的 IPC 方案:
动态数据交换(DDE):早期 Windows 桌面应用的通讯方式,支持应用间数据实时同步(如 Excel 表格数据同步到 Word 文档);
粘贴板(Clipboard):简单直观的进程间数据传递,用户通过复制粘贴实现(如从浏览器复制文本到记事本);
文件传输协议(FTP):通过 FTP 协议实现文件级别的进程间 / 跨机器数据传输,适用于大容量文件共享。

总结:Windows IPC 选型核心逻辑 ——“按需匹配,兼顾效率与场景”
选择 IPC 方式时,核心看 3 个维度:
传输距离:本地进程选共享内存、管道、COM;跨网络选 Socket、中间件;
数据量与速度:大数据高速传输选共享内存、文件映射;小数据同步选内核对象、消息通知;
交互方式:同步通讯选 Socket、命名管道;异步通讯选 MQ、中间件;功能复用选 COM/DCOM。
Windows 的 IPC 方案覆盖了从本地轻量级同步到分布式跨网络通讯的全场景,掌握不同方式的核心逻辑,就能根据项目需求精准选型,让进程协同更高效。

你在开发中常用哪种 Windows IPC 方式?遇到过哪些兼容性或性能问题?欢迎在评论区留言交流~

代码跨平台怎么实现?6大核心方案+场景选型,告别重复开发

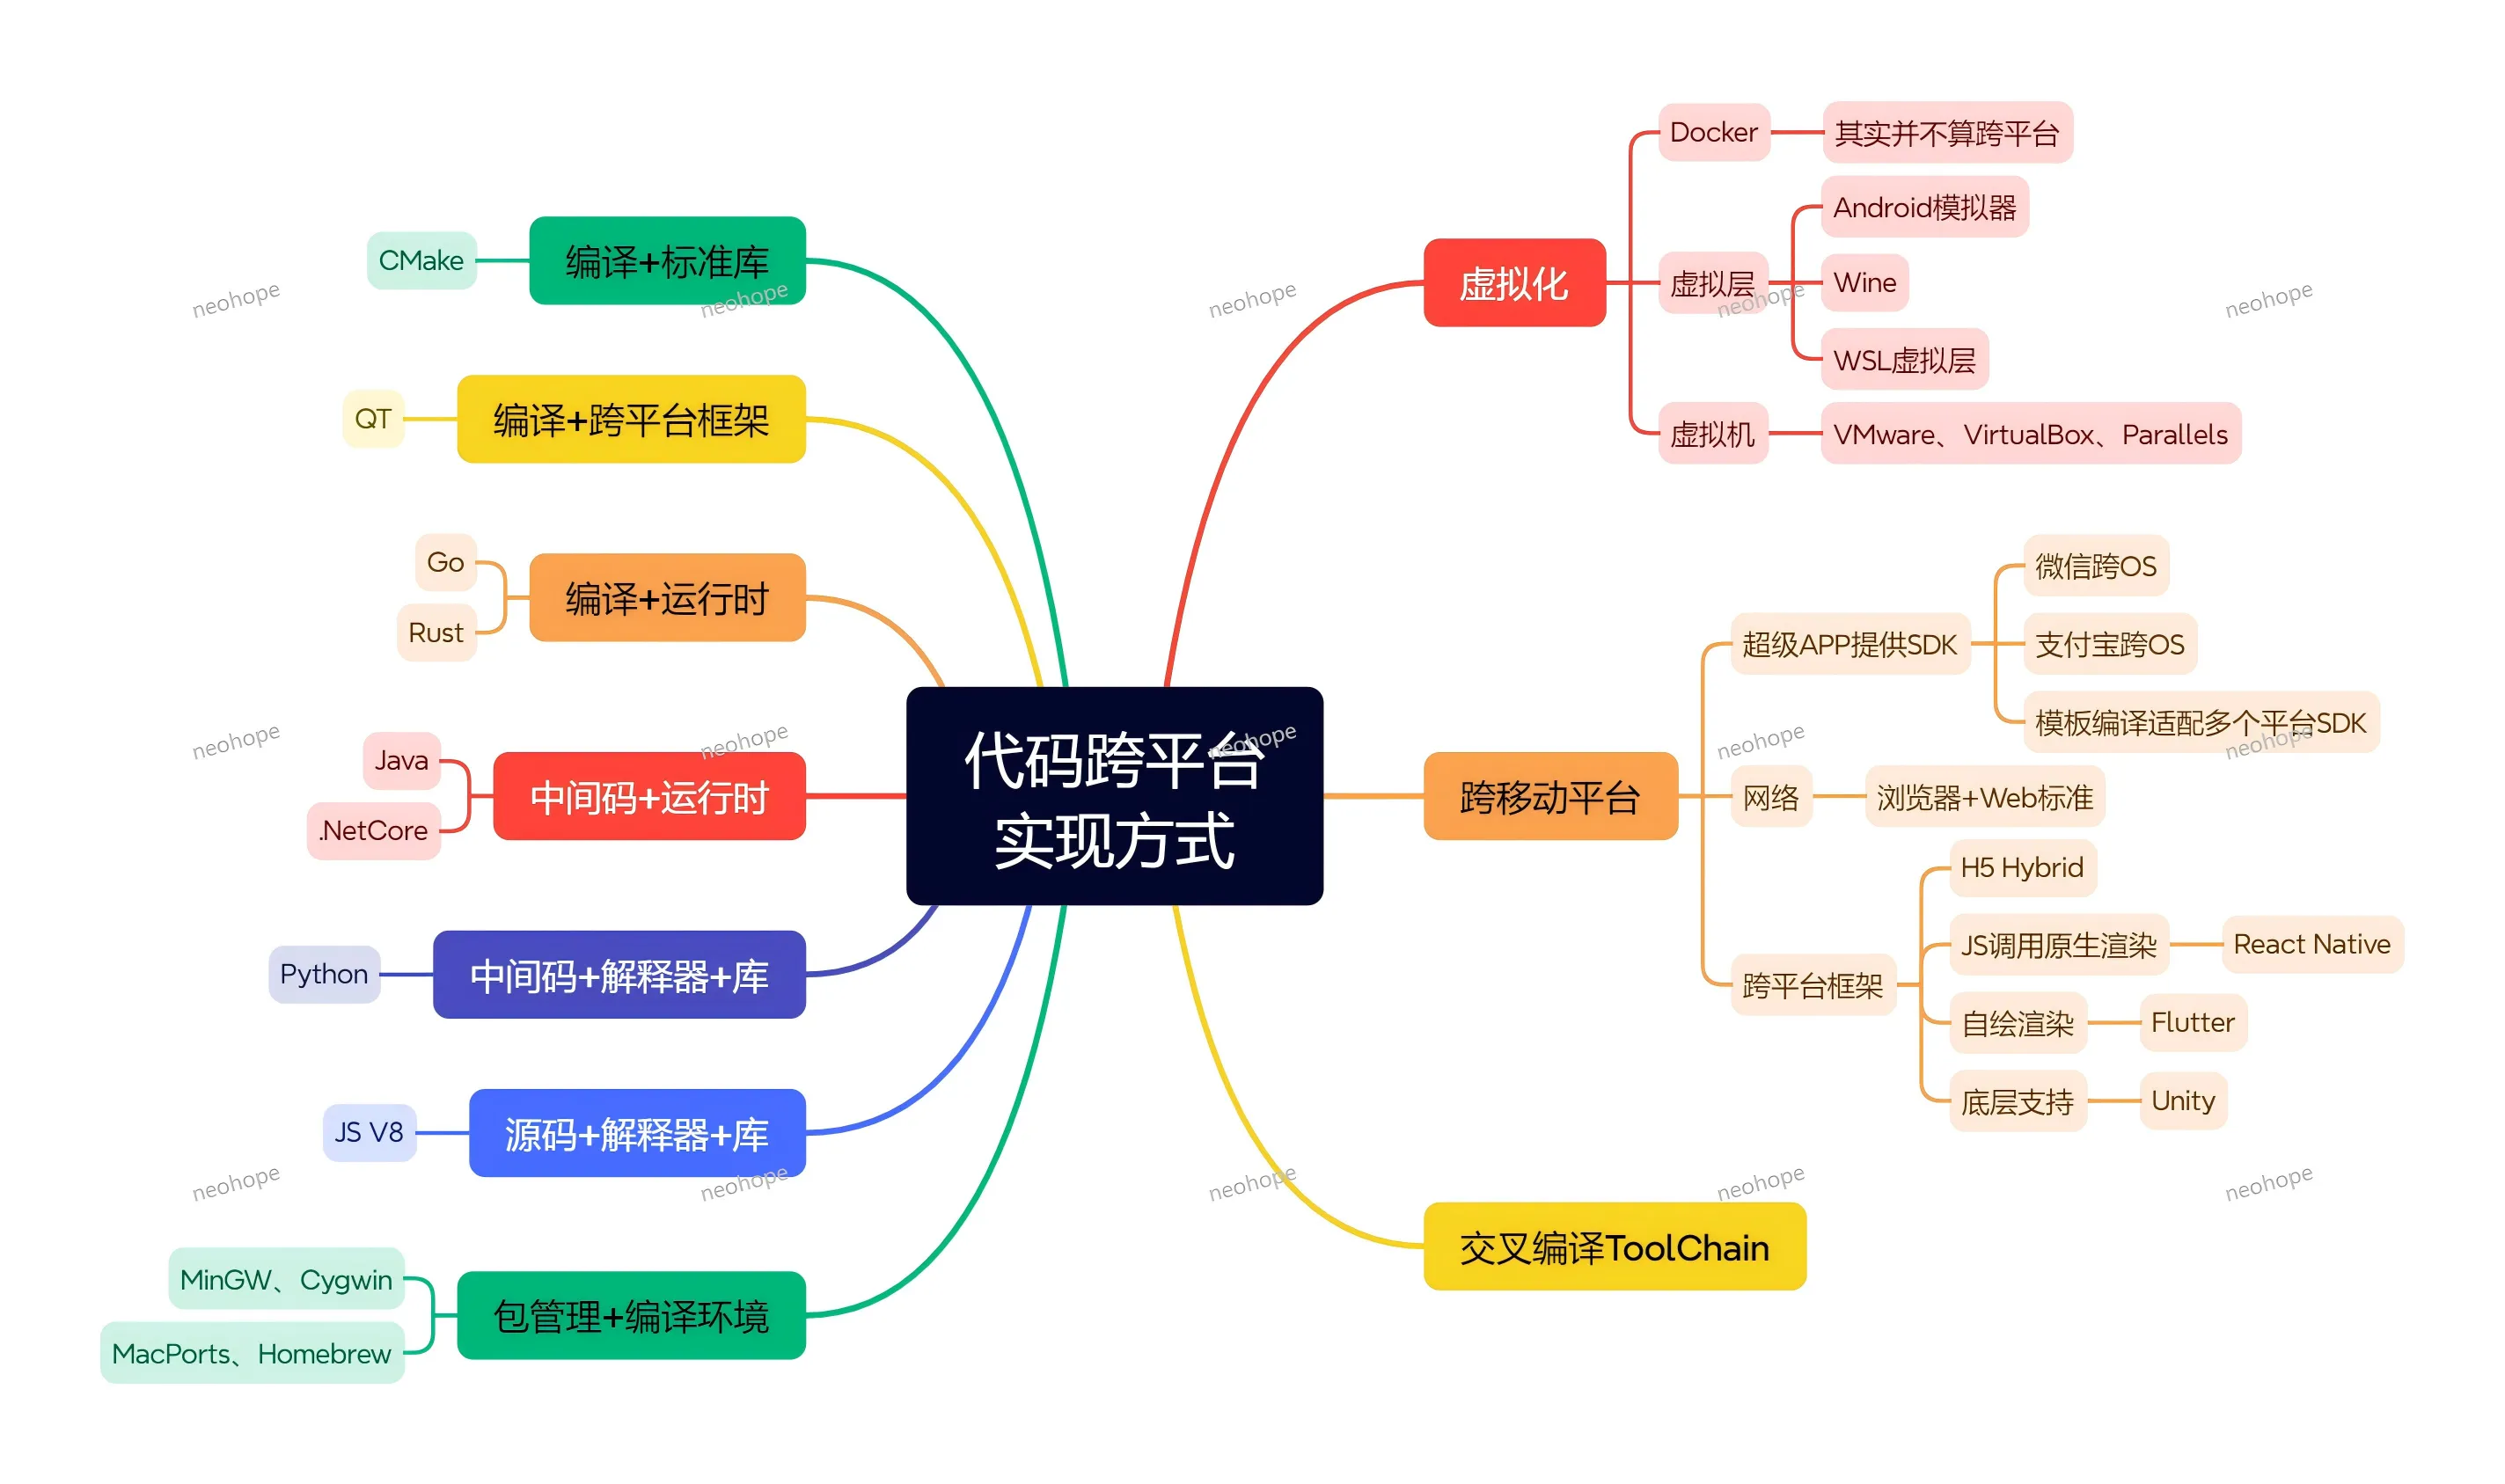
代码跨平台实现方式


代码跨平台怎么实现?6大核心方案+场景选型,告别重复开发

做开发时最头疼的莫过于 “一套代码多端适配”——Windows、Mac、Linux 要适配,iOS、Android 要兼容,甚至还要兼顾浏览器和小程序。重复写多套代码不仅效率低,还容易出现兼容性 bug。其实跨平台开发早已不是新鲜事,不同技术方案各有优劣,关键是选对适配场景。今天就拆解代码跨平台的核心实现方式,帮你快速找准适合自己的方案。

一、编译适配型:一次编码,多平台编译
核心逻辑:编写统一源码,通过专用编译工具或语言特性,直接编译出不同平台的可执行文件,性能接近原生。
代表技术:
语言原生支持:Go(编译 + 运行时,直接编译为各平台二进制文件)、Rust(跨平台编译工具链,适配多系统)、Java(中间码 + JVM 运行时,一次编译多平台运行)、.NET Core(中间码 + 运行时,跨 Windows/Mac/Linux);
编译工具辅助:CMake(搭配标准库,统一管理多平台编译流程)、交叉编译 ToolChain(如 MinGW、Cygwin,实现跨系统编译);
优势:性能强,接近原生应用;代码复用率高,无需大幅修改;
适用场景:后端服务、工具类软件、高性能应用(如 Go 开发的跨平台服务器,C+++CMake 开发的桌面工具)。

二、跨平台框架型:框架封装,屏蔽平台差异
核心逻辑:基于统一框架开发,框架底层适配不同平台的 API,开发者无需关注平台细节,专注业务逻辑。
代表技术:
桌面 / 多端框架:QT(编译 + 跨平台框架,适配桌面 + 嵌入式,支持 C++/QML);
移动跨平台框架:React Native(JS 调用原生渲染,兼顾跨平台与原生体验)、Flutter(自绘渲染引擎,跨 iOS/Android/ 桌面 / 网页,UI 一致性强);
优势:开发效率高,一套代码覆盖多端;UI 适配性好,框架已处理平台差异;
适用场景:移动 APP(如电商 APP、工具类 APP)、桌面应用(如 QT 开发的跨平台客户端)、中小型项目(Flutter 快速迭代上线)。

三、虚拟层/模拟型:通过虚拟环境兼容多平台
核心逻辑:在目标平台上搭建虚拟层或模拟器,让原本不兼容的代码在虚拟环境中运行,无需修改源码。
代表技术:
虚拟机:VMware、VirtualBox、Parallels(在 Windows/Mac上虚拟出其他操作系统,运行对应平台软件);
兼容层:Wine(在Linux/Mac上模拟 Windows 运行环境,运行 Windows 程序)、WSL(Windows子系统,在Windows上运行 Linux 环境及软件);
模拟器:Android 模拟器(在PC上模拟Android环境,运行APP);
优势:无需修改原有代码,直接复用现有应用;门槛低,快速实现兼容;
注意点:性能有损耗,不如原生流畅;部分复杂应用可能出现兼容性问题;
适用场景:现有应用跨平台运行(如Windows软件在Linux上通过Wine运行)、开发测试(Android模拟器调试APP)。

四、超级APP生态型:依托生态,跨OS运行
核心逻辑:在微信、支付宝等超级APP提供的SDK或生态内开发,借助超级APP的跨平台能力,实现 “一次开发,多OS适配”。
代表技术:微信跨OS、支付宝跨OS(通过其提供的 SDK 开发小程序或内嵌应用,自动适配 iOS/Android);
优势:无需考虑底层平台适配,超级 APP 已完成兼容;流量红利,可直接触达超级 APP 的海量用户;
适用场景:小程序、内嵌应用(如微信小程序、支付宝生活号应用)、轻量级交互场景。

五、Web标准型:基于浏览器,跨平台无压力
核心逻辑:采用 HTML/CSS/JS 开发,依托浏览器的 Web 标准,实现 “一次开发,所有浏览器兼容”,间接跨所有支持浏览器的平台。
代表技术:浏览器 + Web 标准、H5 Hybrid(APP 内嵌 WebView,混合原生与 Web 页面);
优势:兼容性极强,覆盖 PC / 移动 / 平板所有浏览器;开发成本低,技术栈普及;
注意点:性能依赖浏览器,复杂交互体验不如原生;部分原生 API 需通过桥接调用;
适用场景:网页应用、轻量级 APP、跨平台展示型场景(如官网、数据可视化页面、Hybrid APP 的展示模块)。

六、包管理与环境配置型:统一环境,简化适配
核心逻辑:通过包管理工具统一管理依赖,确保不同平台的开发环境一致,减少因环境差异导致的适配问题。
代表技术:MacPorts、Homebrew(Mac 平台包管理工具,快速安装适配 Mac 的开发依赖);
优势:简化环境配置,快速搭建跨平台开发所需依赖;统一依赖版本,避免 “本地能跑,线上报错”;
适用场景:辅助跨平台开发(如通过 Homebrew 在 Mac 上安装 CMake、MinGW 等跨平台编译依赖)。

总结:跨平台方案选型核心逻辑 ——“场景决定方案”
不用盲目追求 “万能方案”,选型时重点关注3点:
1、性能需求:高性能场景(后端、工具软件)选编译适配型(Go/Rust/CMake);中低性能需求(展示型 APP、小程序)选 Web 标准或超级 APP 生态;
2、多端覆盖范围:需覆盖移动 + 桌面选 Flutter/QT;仅移动端选 React Native/Flutter;仅桌面端选 QT/Go 编译;
3、开发效率:快速迭代选 Flutter/React Native;追求长期稳定、低维护成本选编译适配型或 QT。

跨平台开发的核心是 “用最低成本实现多端兼容”,不同方案没有绝对优劣,只有是否适配场景。选对方案,既能减少重复开发,又能保证产品体验。

你在跨平台开发中遇到过哪些兼容性坑?或者你更倾向于哪种实现方案?欢迎在评论区留言交流~

DevSecOps实战指南:把安全嵌入开发全流程,从源头规避风险

开发安全DevSecOps


DevSecOps实战指南:把安全嵌入开发全流程,从源头规避风险

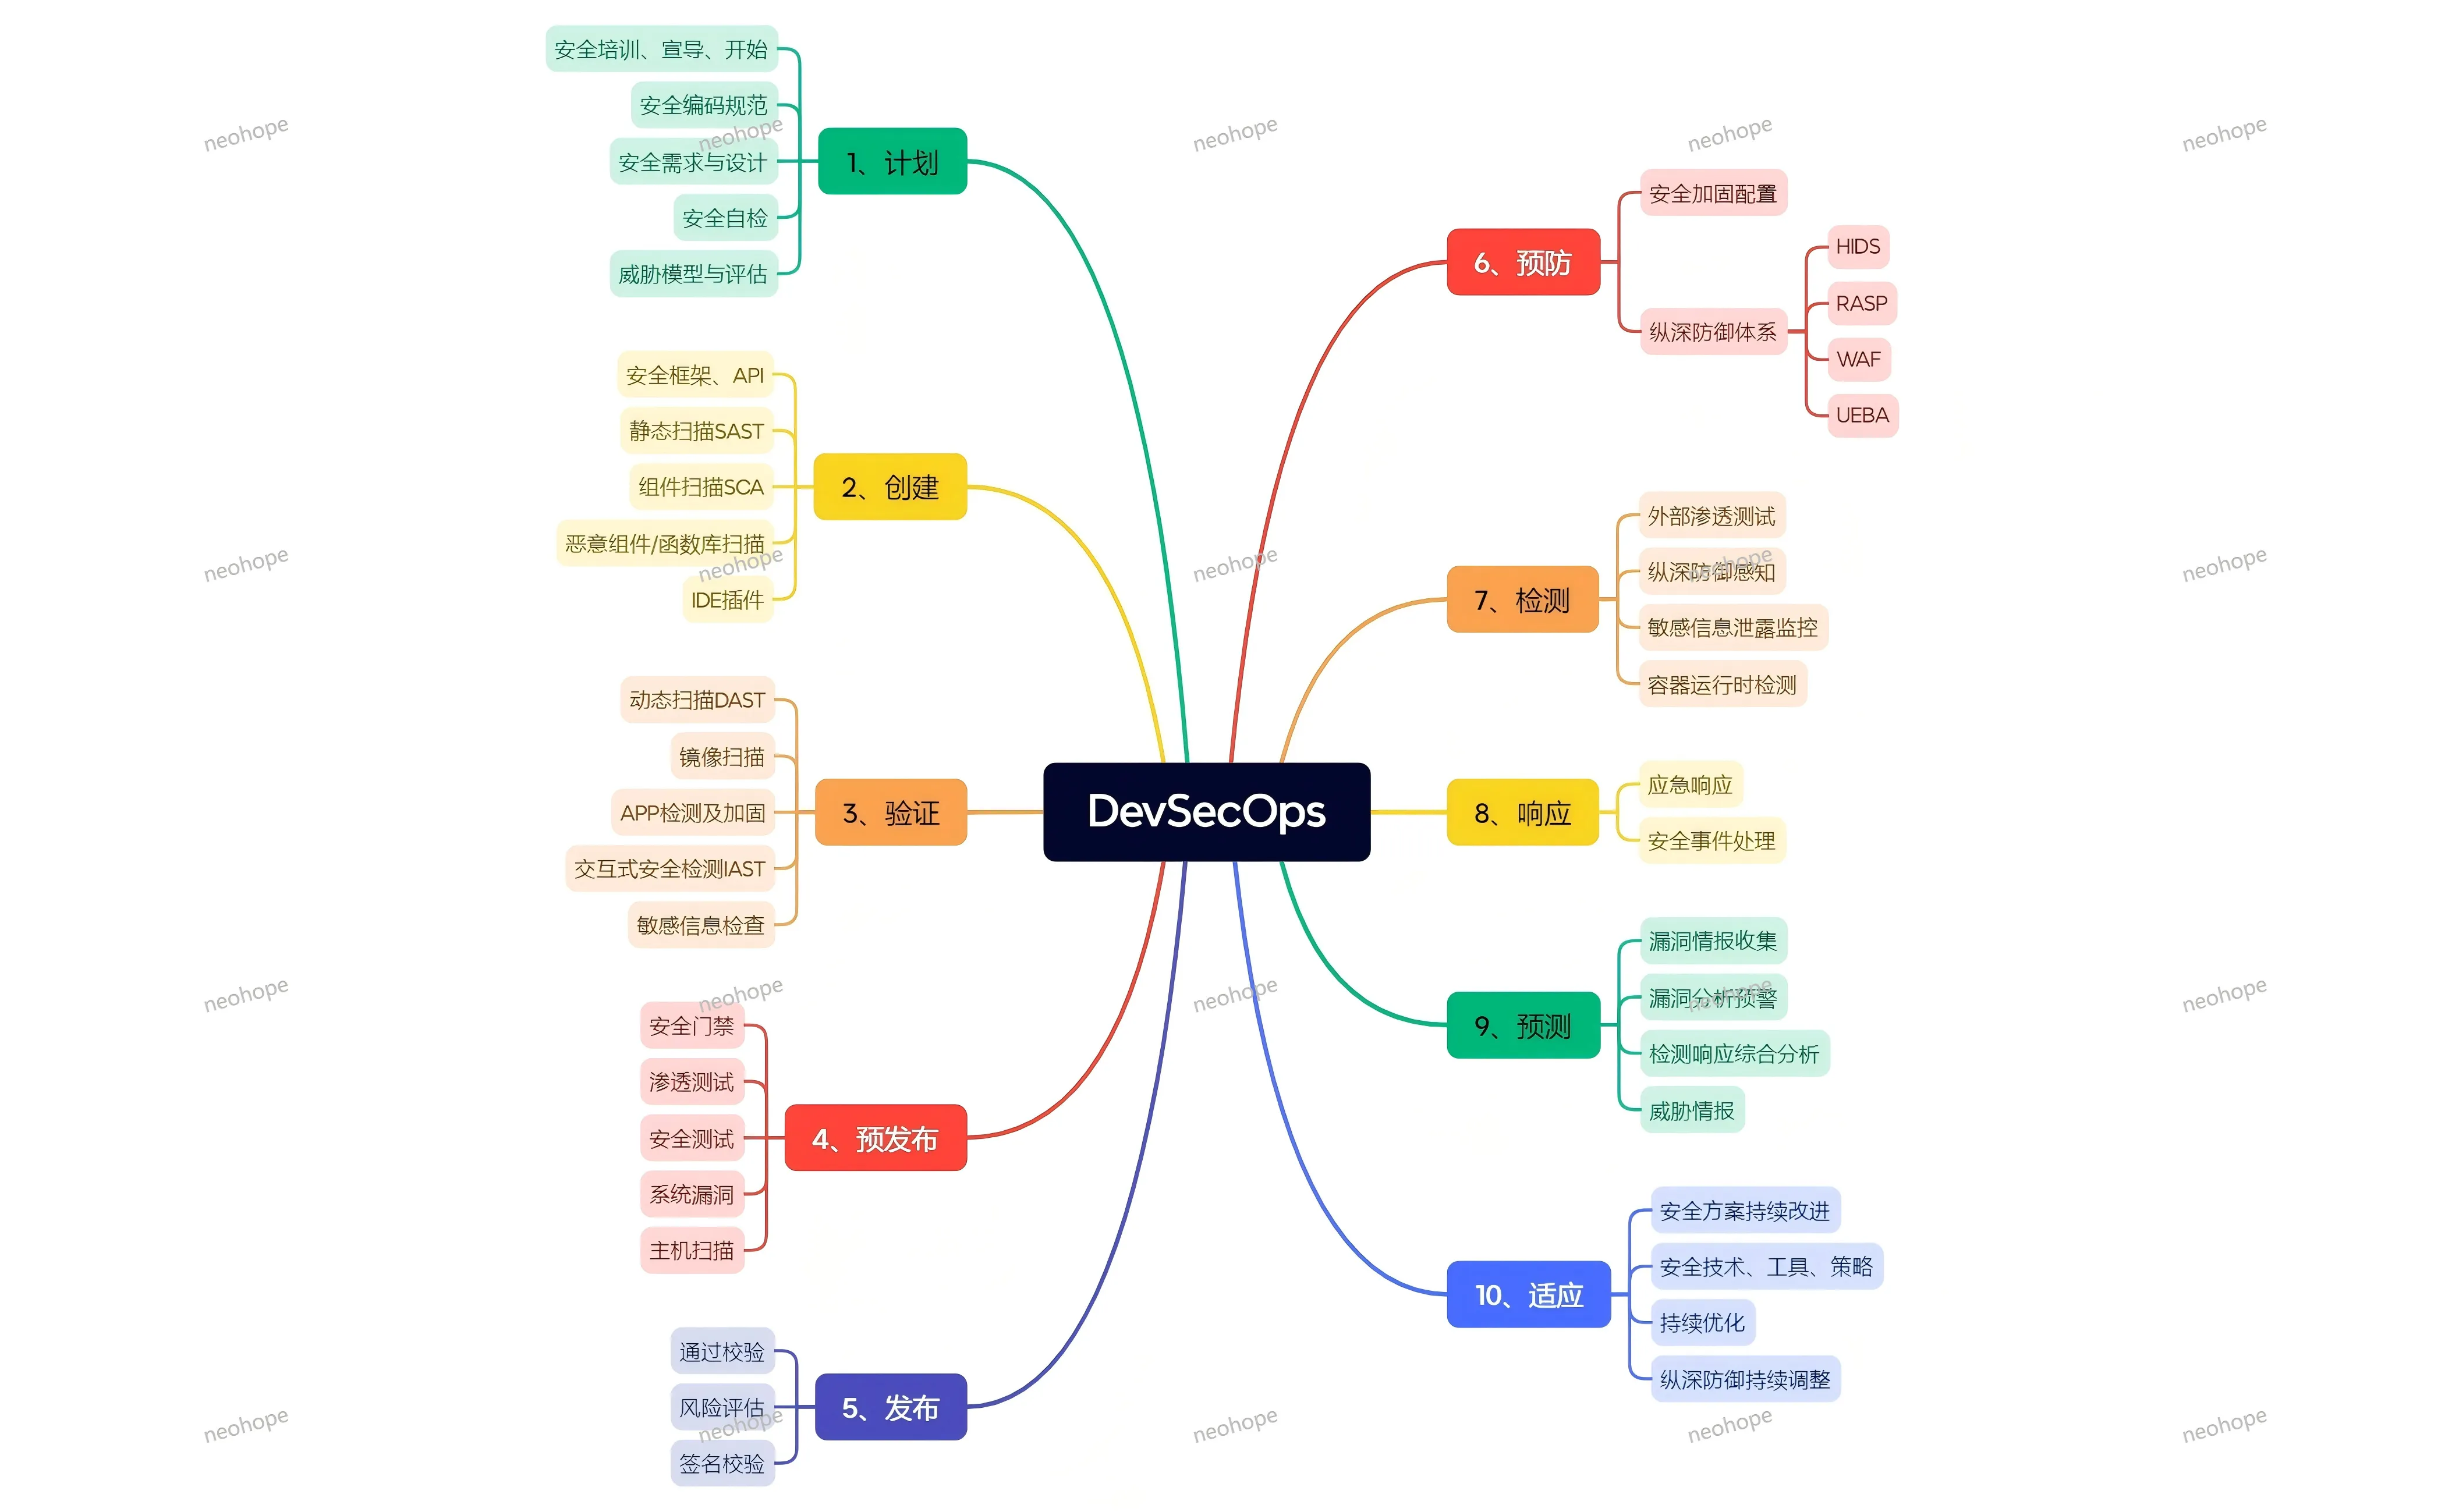
传统开发中,“安全” 往往是上线前的 “临门一脚”—— 发现漏洞再返工,不仅延误工期,还可能因紧急修复引入新问题。而 DevSecOps 的核心逻辑是 “安全左移 + 持续防护”,将安全需求、检测、加固融入开发全生命周期,让安全成为开发的 “内置功能” 而非 “额外负担”。今天就拆解 DevSecOps 的核心流程与关键技术,帮你搭建从计划到适应的全链路安全体系。

一、计划阶段:安全前置,从源头定规则
开发未动,安全先行,这一步的核心是 “明确安全需求,搭建防护框架”:
梳理安全需求与设计规范,结合业务场景制定安全编码规范(如避免 SQL 注入、XSS 攻击的编码准则);
开展威胁模型与风险评估,识别潜在攻击面(如核心接口、数据存储环节),提前规划防护策略;
统一安全框架与 API,选用经过安全验证的组件和工具,避免因基础架构存在漏洞埋下隐患;
全员开展安全培训与宣导,提升开发、测试、运维人员的安全意识,让安全理念贯穿团队。

二、创建阶段:编码防护,实时规避基础漏洞
编码过程中嵌入安全检测,及时发现并修复漏洞,避免漏洞积累:
开发工具集成安全插件:在 IDE 中安装静态扫描(SAST)插件、恶意组件 / 函数库扫描(SCA)工具,实时检测代码漏洞、依赖组件漏洞;
遵循安全编码规范:通过自动化工具校验代码是否符合安全准则,比如禁止硬编码密钥、规范输入校验逻辑;
搭建纵深防御体系雏形:提前规划 WAF、HIDS、RASP 等安全工具的部署方案,确保后续开发与防护工具兼容。

三、验证阶段:全面检测,不留安全死角
测试环节不仅验证功能,更要全面排查安全漏洞,核心是 “多维度检测,精准定位问题”:
自动化安全测试:通过动态扫描(DAST)模拟攻击场景,检测运行时漏洞;用交互式安全检测(IAST)结合静态与动态优势,提升漏洞检测准确率;
专项渗透测试:开展外部渗透测试,模拟黑客攻击行为,挖掘隐藏漏洞(如逻辑漏洞、权限绕过);
敏感信息与配置检查:检测代码中是否存在敏感信息泄露(如密码、接口密钥),校验系统安全加固配置是否合规;
容器与镜像安全:针对容器化部署场景,进行镜像扫描,排查基础镜像中的漏洞,确保容器运行环境安全。

四、预发布与发布阶段:安全门禁,守住上线最后一关
上线前的安全校验与发布后的持续防护,确保系统在生产环境中安全稳定:
预发布阶段:设置安全门禁,只有通过所有安全测试(漏洞修复率 100%、配置合规)的版本,才能进入发布流程;
发布阶段:进行签名校验,防止部署过程中代码被篡改;同步开启运行时安全检测(如 RASP 实时拦截攻击);
灰度发布防护:发布初期逐步放量,结合 UEBA(用户与实体行为分析)监控异常行为,快速响应潜在安全问题。

五、运营阶段:检测响应,快速处置安全事件
系统上线后,安全防护不能松懈,核心是 “实时监控、快速响应、持续优化”:
实时检测与预警:通过安全感知平台收集漏洞情报,结合日志分析,实现漏洞分析预警与检测响应综合分析;
应急响应机制:建立安全事件处理流程,一旦发生漏洞攻击、数据泄露等事件,快速启动应急方案,减少损失;
持续优化迭代:根据安全事件复盘结果,优化安全技术、工具与策略;动态调整纵深防御体系,适配新的业务场景与攻击手段;
合规与风险再评估:定期开展系统漏洞扫描、风险评估,确保系统符合行业安全合规要求,及时应对新的安全威胁。

总结:DevSecOps 的核心逻辑 ——“安全不是负担,而是生产力”
DevSecOps 不是 “给开发加活”,而是通过 “提前规划、实时检测、持续优化”,将安全成本分摊到开发全流程,避免后期返工的高额代价。其核心是 “人人都是安全员”:开发人员关注编码安全,测试人员聚焦漏洞检测,运维人员保障部署与运行安全,形成全链路安全闭环。
随着攻击手段的不断升级,只有将安全深度融入开发流程,才能从源头抵御风险,让系统在高并发、复杂环境中稳定运行。

你在落地 DevSecOps 时遇到过哪些难点?是工具集成问题还是团队意识磨合?欢迎在评论区分享你的经验~

覆盖全场景的安全防护指南:从网络到数据,企业必知的常见安全举措

常见安全举措


覆盖全场景的安全防护指南:从网络到数据,企业必知的常见安全举措

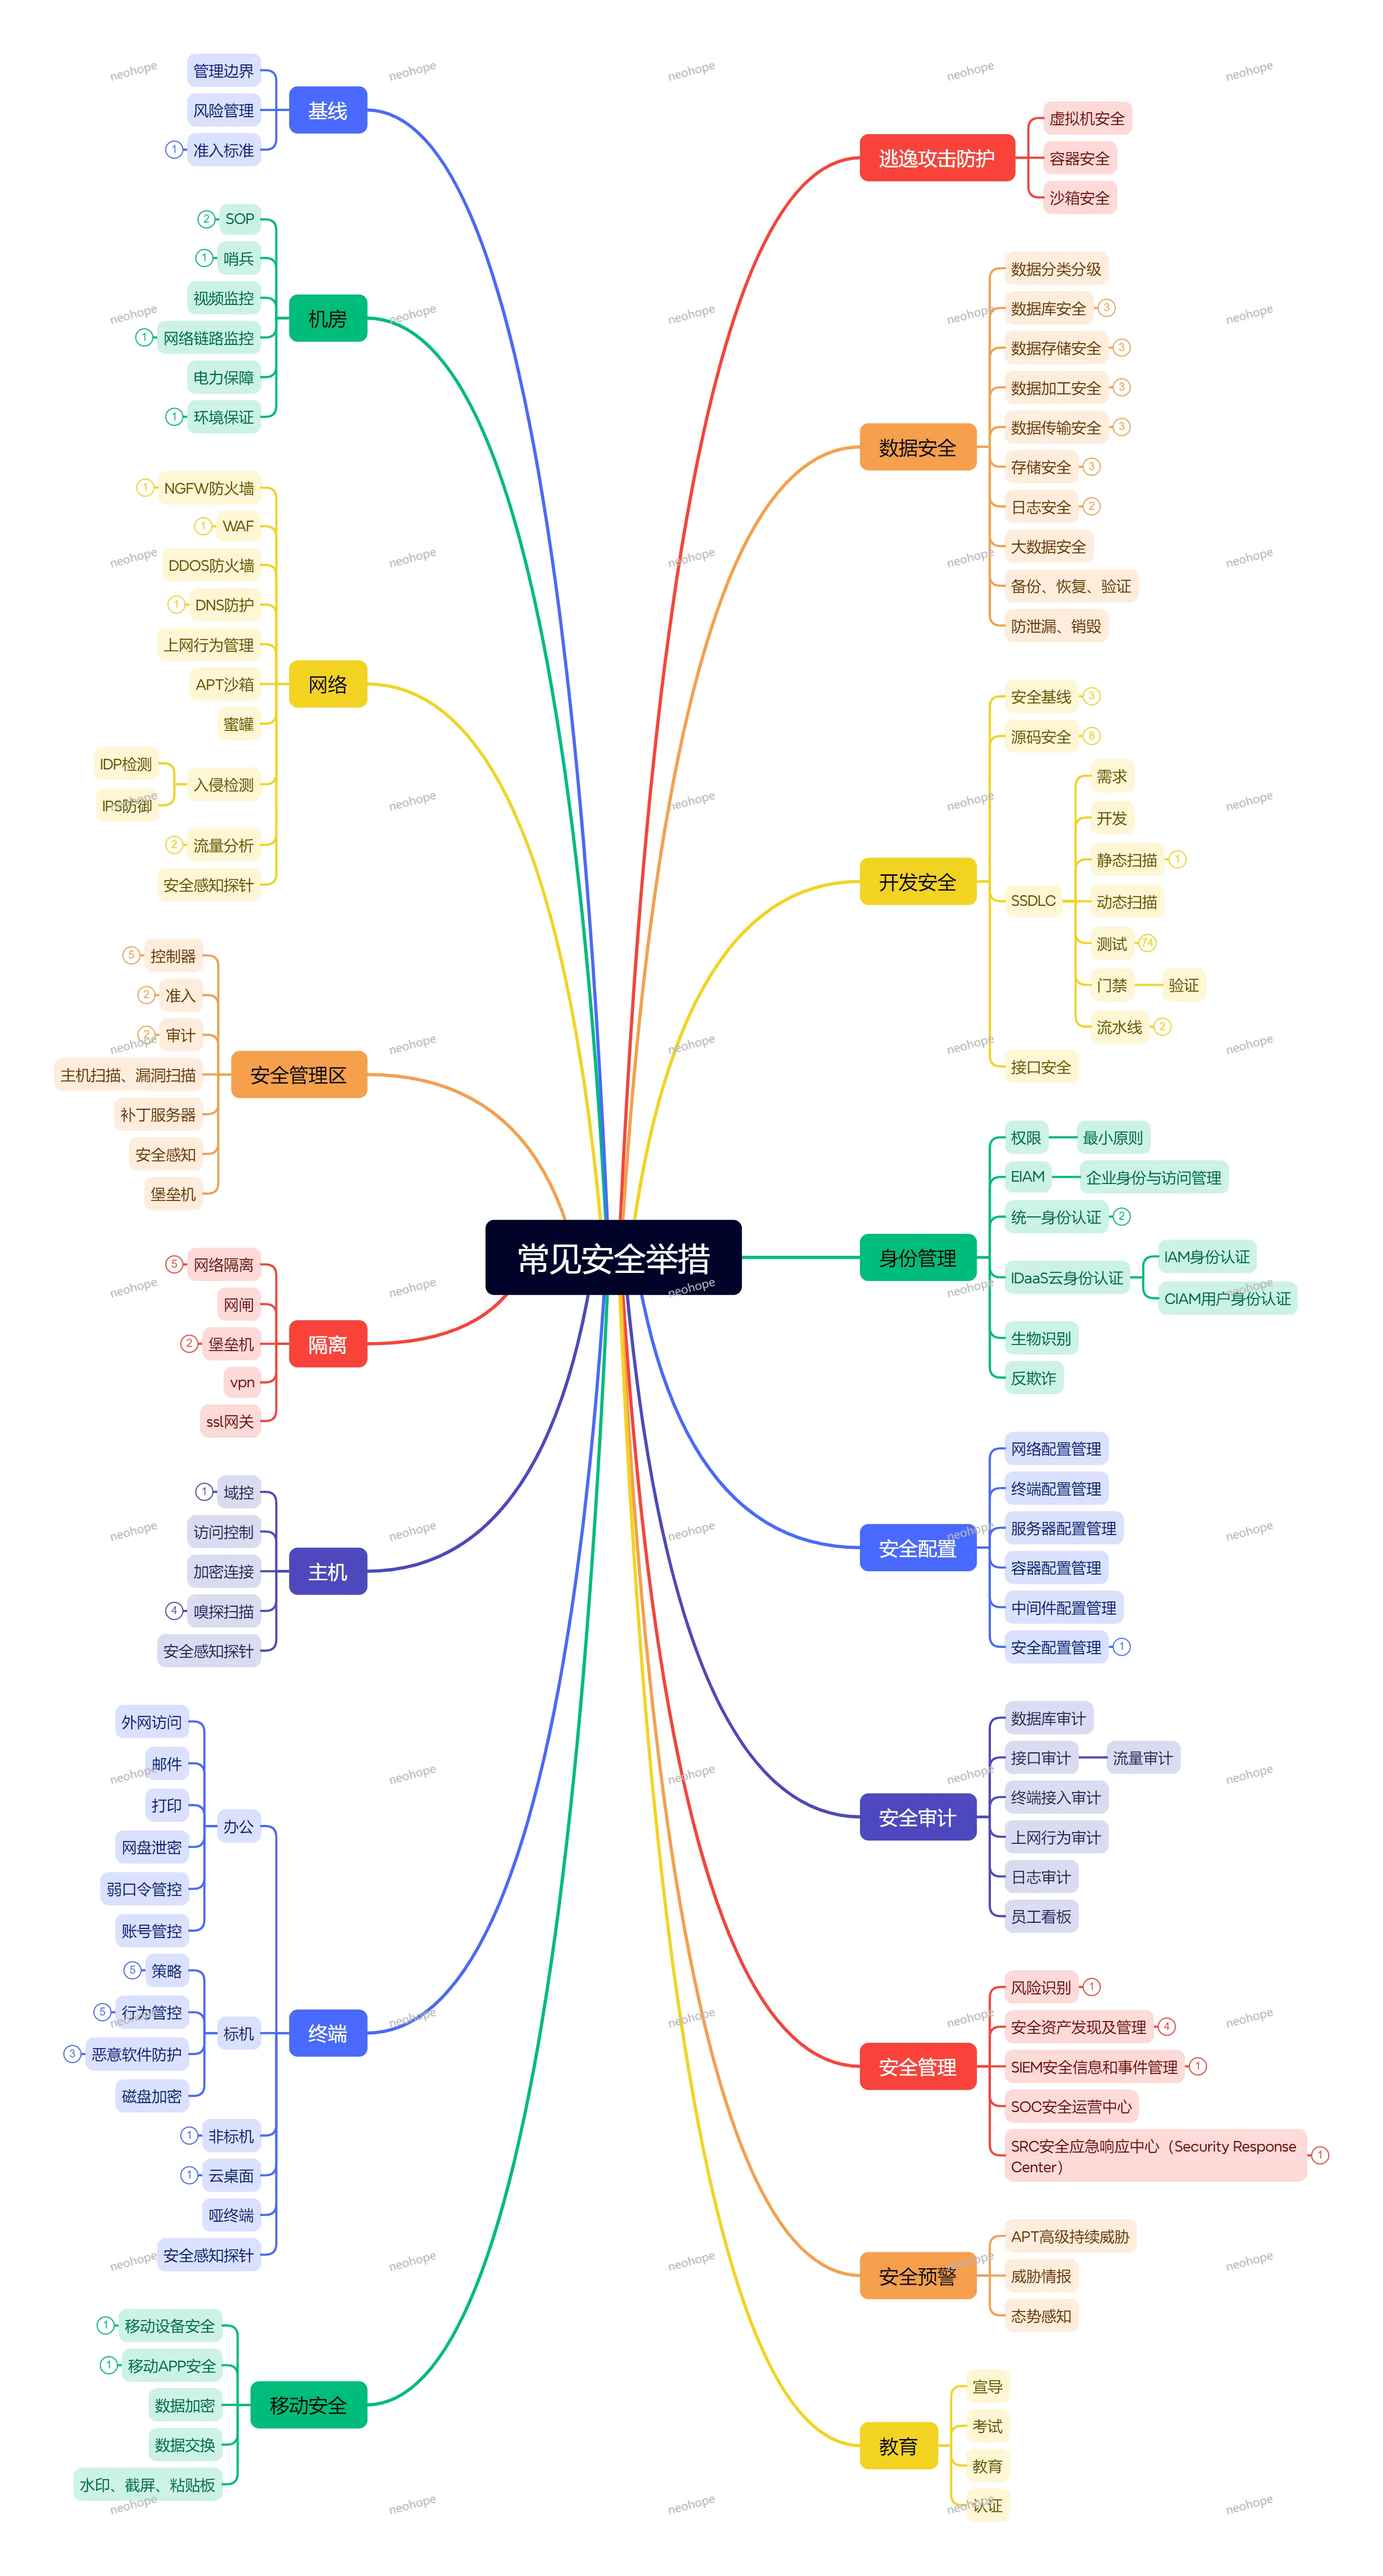
在数字化时代,网络攻击、数据泄露、恶意软件入侵等风险无处不在 —— 小到员工弱口令导致账号被盗,大到 APT 高级持续威胁窃取核心机密,安全问题一旦爆发,可能给企业带来毁灭性损失。其实安全防护的核心是 “全方位、无死角”,从网络边界到终端设备,从数据存储到开发流程,都需要建立对应的防护机制。今天就拆解企业常见的安全举措,帮你搭建全面的安全防护体系。

一、网络安全:筑牢 “第一道防线”,抵御外部入侵
网络是企业与外界连接的通道,也是攻击的主要入口,核心目标是 “阻止非法访问、过滤恶意流量”:
1、边界防护:部署 NGFW 下一代防火墙、WAFWeb 应用防火墙、DDoS 防火墙,精准拦截恶意请求、SQL 注入、暴力破解等攻击;启用 DNS 防护,防范域名劫持、DNS 污染等风险;

2、入侵检测与响应:通过 IDP 入侵检测、IPS 入侵防御系统实时监控网络流量,发现异常行为及时告警;搭建蜜罐系统,诱捕黑客并收集攻击特征,为防护优化提供依据;

3、网络隔离与访问控制:采用网络隔离、网闸技术,将核心业务网络与外网、办公网络物理或逻辑隔离,减少攻击面;通过上网行为管理,管控员工网络访问权限,禁止访问高危网站;

4、流量与安全感知:部署安全感知探针,实时分析网络流量,结合威胁情报,提前预警 APT 高级持续威胁等隐蔽攻击;建立 SOC 安全运营中心,集中监控网络安全态势。

二、主机与终端安全:守住 “内部阵地”,防范终端风险
主机(服务器、虚拟机、容器)和终端(电脑、移动设备、哑终端)是数据存储和业务运行的载体,也是攻击的重要目标:
1、安全配置与加固:制定主机、容器、中间件的安全基线,统一配置安全策略(如关闭无用端口、禁用高危服务);通过终端配置管理、服务器配置管理,确保所有设备合规;

2、恶意软件防护:安装杀毒软件、恶意软件防护工具,定期更新病毒库,实时拦截病毒、木马、勒索软件等恶意程序;对终端进行磁盘加密,防止设备丢失导致数据泄露;

3、终端接入与管控:实施终端接入审计,只有合规设备才能接入企业网络;管控移动设备、云桌面、非标机、哑终端的安全,禁止未授权设备接入;通过弱口令管控、账号管控,规范终端账号使用;

4、特殊终端防护:重点保障移动设备安全、移动 APP 安全,采用数据加密、水印、截屏与粘贴板管控等技术,防范移动场景下的数据泄露。

三、数据安全:守护 “核心资产”,全生命周期防护
数据是企业最宝贵的资产,安全防护需覆盖 “存储、传输、加工、销毁” 全生命周期:
1、数据分类分级与管控:对数据进行分类分级(如公开数据、内部数据、核心机密数据),针对不同级别制定差异化防护策略;实施数据防泄漏(DLP)技术,监控并阻断网盘泄密、邮件外发、打印等场景的数据泄露;

2、存储与备份安全:保障数据库安全、大数据安全,启用数据库审计,监控数据访问与操作;定期对数据进行备份,并验证恢复效果,确保数据损坏或丢失后能快速恢复;规范数据销毁流程,防止废弃数据被非法获取;

3、数据传输与加工安全:采用 SSL 网关、加密连接等技术,确保数据在传输过程中不被窃取或篡改;加强数据加工过程中的安全管控,防止加工环节的数据泄露或篡改;

4、身份与访问控制:通过 IAM 身份认证、统一身份认证、EAM 企业身份与访问管理、IDaaS 云身份认证、CIAM 用户身份认证等系统,严格管控数据访问权限,遵循 “最小权限原则”;采用生物识别等强认证方式,提升身份认证安全性。

四、开发安全:从 “源头把控”,避免代码与流程漏洞
很多安全风险源于开发阶段的漏洞,核心是 “将安全融入开发全流程”:
1、SDL 安全开发生命周期:在需求、设计、编码、测试、部署等各个阶段嵌入安全活动,从源头减少漏洞;

2、代码安全检测:采用静态扫描、动态扫描技术,在编码阶段发现并修复代码漏洞(如缓冲区溢出、逻辑漏洞);重视源码安全,规范代码管理流程,防止源码泄露;

3、DevSecOps 集成:将安全测试融入 CI/CD 流水线,实现 “自动化安全检测、持续合规”;在接口开发阶段进行接口安全测试与审计,防范接口未授权访问、参数篡改等风险。

五、安全管理与审计:健全 “制度保障”,实现合规与追溯
技术防护离不开制度和管理的支撑,核心是 “规范流程、明确责任、全程追溯”:
1、安全制度与基线:制定安全准入标准、SOP 操作流程、安全配置管理规范,让所有安全工作有章可循;建立安全基线,定期开展主机扫描、漏洞扫描,确保设备和系统合规;

2、安全审计与追溯:开展数据库审计、接口审计、流量审计、日志审计、终端接入审计、上网行为审计,全面记录安全事件和操作行为,为事故追溯提供依据;启用 SEM 安全信息和事件管理系统,集中分析审计日志;

3、身份与权限管理:通过堡垒机,集中管控服务器、数据库等核心设备的访问权限,记录操作日志,实现 “操作可追溯、权限可管控”;部署域控系统,统一管理企业账号,规范权限分配;

4、应急响应与宣导:建立 SRC 安全应急响应中心,制定安全事件应急预案,发生安全事故时快速响应、减少损失;加强员工安全宣导、教育与考试,提升员工安全意识,避免因人为失误导致安全风险。

六、特殊场景安全:覆盖 “薄弱环节”,补齐防护短板
除了核心场景,以下特殊场景也需重点防护,避免成为安全短板:

1、办公场景安全:管控邮件、网盘、打印等办公工具的安全,防范办公过程中的数据泄露;建立员工看板,展示员工安全合规情况,督促员工遵守安全制度;

2、虚拟化与容器安全:加强虚拟机安全、容器安全,防范容器逃逸攻击;采用沙箱安全技术,隔离高危操作和未知程序,降低攻击影响;

3、反欺诈与认证安全:部署反欺诈系统,防范账号盗用、交易欺诈等风险;采用 eID 认证等强认证方式,提升关键操作(如转账、数据导出)的安全性。

总结:安全防护的核心逻辑 ——“技术 + 制度 + 人” 三位一体
企业安全防护不是单一技术的堆砌,而是 “技术防护(网络、主机、数据、开发)+ 制度管理(基线、审计、应急)+ 人员意识(宣导、教育)” 的有机结合。

核心原则是 “最小权限、纵深防御、合规可控”:通过多层防护减少攻击面,通过制度规范操作行为,通过技术手段实时监控响应,最终实现 “事前预防、事中告警、事后追溯” 的全流程安全保障。

你所在的企业在安全防护中遇到过哪些痛点?欢迎在评论区分享~

信息安全法规汇总(金融保险)

信息安全法规汇总(金融保险)

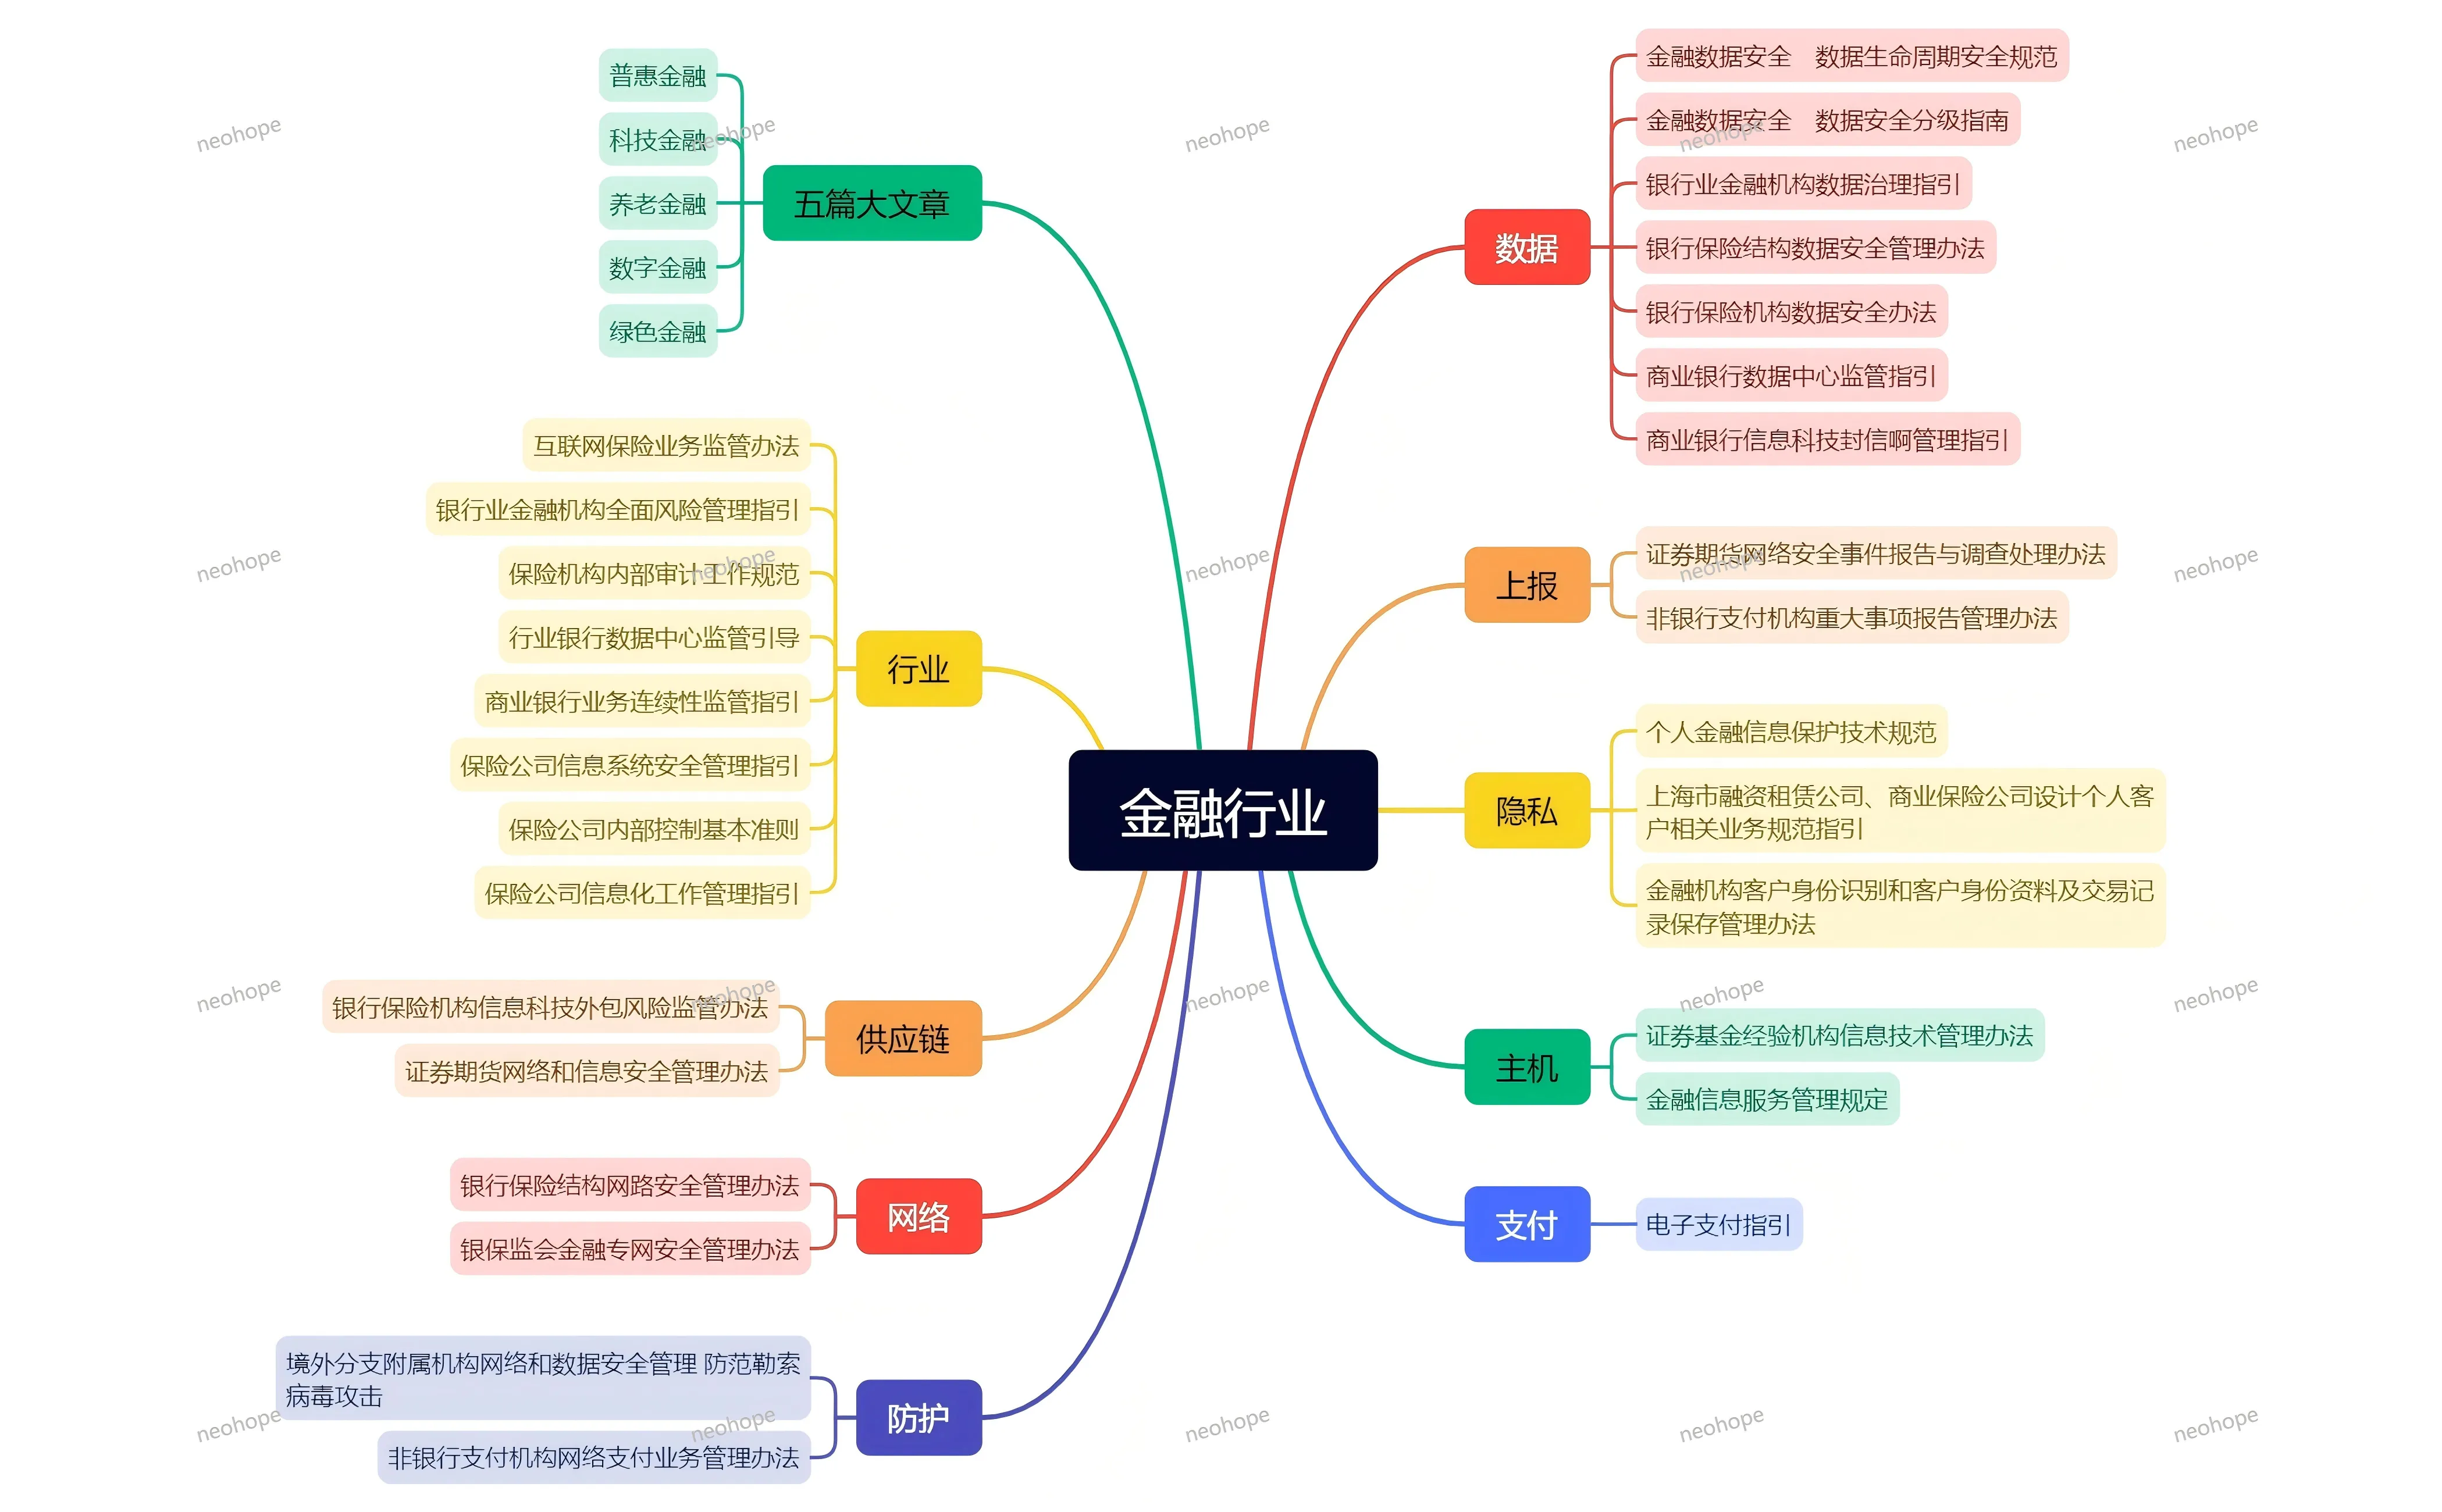
整理资料的时候,发现之前汇总过的一些安全法规,汇总时间大概在24年中:
安全法规金融

一、五篇大文章

“五篇大文章” 是 2023 年中央金融工作会议首次提出的战略部署,指科技金融、绿色金融、普惠金融、养老金融、数字金融五大方向。2025 年 3 月,国务院办公厅印发《关于做好金融 “五篇大文章” 的指导意见》(国办发〔2025〕8 号),明确了到 2027 年的发展目标与实施路径。

普惠金融

  • 核心定位:雪中送炭、服务民生,促进全体人民共同富裕

  • 监管导向:持续加大对民营、小微企业和个体工商户的金融支持,加大首贷、续贷、信用贷、中长期贷款投放;积极服务乡村全面振兴;丰富普惠保险产品供给;巩固拓展脱贫攻坚成果

  • 主要政策文件:《关于银行业保险业做好金融 “五篇大文章” 的指导意见》等

科技金融

  • 核心定位:赋能创新、服务产业,支持高水平科技自立自强

  • 监管导向:构建覆盖科技企业全生命周期的金融服务体系,完善科技信贷、科技保险、股权投资等多元化融资渠道;强化对战略性新兴产业、未来产业的金融支持

  • 主要政策文件:《关于做好金融 “五篇大文章” 的指导意见》等

养老金融

  • 核心定位:健全体系、增进福祉,积极应对人口老龄化

  • 监管导向:发展第三支柱养老保险,支持具有养老属性的储蓄、理财、保险等产品发展;扩大商业养老金试点范围;丰富税优健康保险产品供给

  • 主要政策文件:《关于金融支持养老服务业加快发展的指导意见》等

数字金融

  • 核心定位:提质增效、普惠便捷,以数字技术赋能金融服务

  • 监管导向:加快推进金融机构数字化转型,夯实数据治理与融合应用基础,建设数字金融服务生态;推动数字技术在 “五篇大文章” 各领域的深度应用

  • 主要政策文件:《推动数字金融高质量发展行动方案》(七部门联合印发)等

绿色金融

  • 核心定位:引领转型、服务双碳,促进经济社会发展绿色化低碳化

  • 监管导向:完善绿色金融标准体系,强化环境信息披露,发展绿色信贷、绿色债券、绿色保险等产品;支持传统产业绿色低碳转型

  • 主要政策文件:《关于构建绿色金融体系的指导意见》等

二、行业监管

互联网保险业务监管办法

  • 发布机构:原银保监会(2020 年第 13 号令)

  • 施行时间:2021 年 2 月 1 日

  • 核心内容:

    • 共 5 章 83 条,涵盖总则、基本业务规则、特别业务规则、监督管理和附则

    • 厘清互联网保险业务本质,明确保险机构(含保险公司、保险中介机构)为经营主体

    • 规定保险机构应持续提高风险防控水平,健全风险监测预警和早期干预机制

    • 要求自营网络平台在财务、业务、信息系统、客户信息保护等方面与关联方有效隔离

    • 明确线上线下融合业务的监管适用规则,坚持合规经营和有利于消费者的原则

    • 2024 年金融监管总局进一步发布互联网财产保险业务监管补充通知,强化经营条件与整改要求

银行业金融机构全面风险管理指引

  • 发布机构:原银监会(银监发〔2016〕44 号)

  • 发布时间:2016 年 9 月

  • 核心内容:

    • 共 8 章 54 条,覆盖风险治理架构、风险管理策略、风险管理政策和程序、管理信息系统和数据质量、内部控制和审计等

    • 明确十大风险类别:信用风险、市场风险、流动性风险、操作风险、国别风险、银行账户利率风险、声誉风险、战略风险、信息科技风险及其他风险

    • 确立四项基本原则:匹配性原则、全覆盖原则、独立性原则、有效性原则

    • 董事会承担全面风险管理最终责任,监事会承担监督责任,高级管理层负责执行

    • 要求建立风险偏好和风险限额体系,将全面风险管理结果应用于资本和流动性充足性评估

保险机构内部审计工作规范

  • 发布机构:原保监会(保监发〔2015〕113 号)

  • 发布时间:2015 年 12 月

  • 核心内容:

    • 全面覆盖保险集团(控股)公司、保险公司、保险资产管理公司、再保险公司及其分支机构

    • 强调内审独立性,通过机构设立、人员配备、教育培训等量化指标保障内审客观独立

    • 明确董事会对内部审计体系的建立、运行与维护负有最终责任

    • 鼓励内部审计集中化管理和垂直化管理,规模较小机构可不再单设审计部门

    • 规范审计责任人制度,明晰内审监管统筹规划,由保监会及其派出机构分级实施指导与评价

商业银行数据中心监管指引

  • 发布机构:原银监会办公厅(银监办发〔2010〕114 号)

  • 发布时间:2010 年

  • 核心内容:

    • 数据中心包括生产中心和灾备中心,灾备分为同城模式和异地模式

    • 总资产千亿以上且跨省设立分支机构的法人商业银行及省级农信社,应设立异地模式灾备中心,灾难恢复能力达到 5 级(含)以上

    • 其他法人商业银行应设立同城模式灾备中心并实现数据异地备份,灾难恢复能力达到 4 级(含)以上

    • 数据中心规划筹建、正式运营前、场所变更等重大事项需向监管机构报告

    • 要求建立数据中心风险管理策略,定期开展风险评估,对风险分级管理

商业银行业务连续性监管指引

  • 发布机构:原银监会(银监发〔2011〕104 号)

  • 发布时间:2011 年

  • 核心内容:

    • 明确重要业务恢复时间目标(RTO)不得大于 4 小时,恢复点目标(RPO)不得大于半小时

    • 业务连续性计划应覆盖重要业务及关联关系、恢复优先次序、关键资源、应急指挥和危机通讯程序

    • 要求制定总体应急预案和重要业务专项应急预案,注重灾难场景设计

    • 每年组织一次自评估,每 3 年进行一次全面评估,持续改进业务连续性管理体系

    • 规范运营中断事件的分级响应、处置流程和报告机制

保险公司信息系统安全管理指引(试行)

  • 发布机构:原保监会

  • 发布时间:2011 年

  • 核心内容:

    • 遵循 “积极防御、综合防范” 原则,与业务系统同步规划、同步建设、同步运行

    • 公司法定代表人或主要负责人为信息系统安全第一责任人

    • 信息化工作委员会下设信息安全专业工作机构,指定高管为直接责任人

    • 建立覆盖物理环境、网络、主机系统、桌面系统、数据、存储、灾备、安全事件管理及应用等各层面的安全管理制度

    • 明确安全事件分级响应、处置和上报流程

保险公司内部控制基本准则

  • 发布机构:原保监会(保监发〔2010〕69 号)

  • 施行时间:2011 年 1 月 1 日

  • 核心内容:

    • 确立五大内控目标:行为合规性、资产安全性、信息真实性、经营有效性、战略保障性

    • 四项基本原则:全面和重点相统一、制衡和协作相统一、权威性和适应性相统一、有效控制和合理成本相统一

    • 内控体系分为内部控制基础、内部控制程序、内部控制保证三个层次

    • 内控活动分为前台控制(销售)、后台控制(运营)和基础控制(管理)三个层次

    • 覆盖销售控制、运营控制、资金运用控制、基础管理控制四大领域

保险公司信息化工作管理指引(试行)

  • 发布机构:原保监会

  • 发布时间:2009 年

  • 核心内容:

    • 适用于保险公司和保险资产管理公司,规范信息化组织架构、制度建设和基础环境建设

    • 公司法定代表人或主要负责人对信息化工作负最终责任

    • 要求建立信息化工作委员会,对信息化重大事项进行决策研判

    • 明确信息化规划、建设、管理、安全全流程要求

    • 强调信息系统风险管理,确保系统安全稳定运行

三、供应链与外包

银行保险机构信息科技外包风险监管办法

  • 发布机构:原银保监会(银保监办发〔2021〕141 号)

  • 施行时间:2022 年 1 月

  • 核心内容:

    • 共 7 章 46 条,覆盖治理、准入、监控评价、风险管理、监督管理等

    • 核心原则:不得将信息科技管理责任、网络安全主体责任外包

    • 明确外包分类分级管理,对重要外包实施更严格的管控要求

    • 规范准入前评估、尽职调查、合同条款,对非驻场集中式外包、跨境外包、同业和关联外包提出附加要求

    • 强化网络和信息安全管理,对敏感信息泄露风险持续监测,严格管控远程维护行为

    • 7 类重要外包活动需在合同签订前 20 个工作日向监管部门报告

    • 明确重大风险事件报告情形,包括数据泄露、业务中断、资金损失等

证券期货业网络和信息安全管理办法

  • 发布机构:中国证监会(第 218 号令)

  • 施行时间:2023 年 5 月 1 日

  • 核心内容:

    • 适用核心机构、经营机构及信息技术系统服务机构

    • 遵循 “保障安全、促进发展” 原则,建立网络和信息安全防护体系

    • 明确网络安全治理架构,落实主体责任,要求设立信息技术治理委员会和首席信息官

    • 强化数据安全与个人信息保护,规范投资者个人信息处理和共享

    • 完善应急预案和演练机制,核心机构每年至少开展一次应急演练

    • 落实关键信息基础设施安全保护要求,从组织保障、建设评审、监测评估等方面强化管理

    • 规范信息技术服务机构备案管理和持续监管

四、网络安全

银行保险机构网络安全管理办法

  • 状态:2026 年 7 月国家金融监督管理总局发布《银行业保险业网络安全管理办法(征求意见稿)》,正式稿尚未发布

  • 核心框架:

    • 共 8 章 72 条,体现大网络安全概念,强调全集团统一管理、科技与业务协同、三道防线协同共治

    • 建立网络安全责任制,党委(党组)、董(理)事会负主体责任,主要负责人为第一责任人

    • 明确网络安全风险管理部门并保持独立性,审计部门负责网络安全审计

    • 按网络安全事件分级标准细化本单位分级规则,较大(三级)及以上事件 2 小时内报告监管

    • 每年至少组织一次应急演练,将重要外包供应商纳入演练范围

    • 针对关键信息基础设施提出更高等级保护要求

金融专网安全管理相关规定

  • 监管主体:国家金融监督管理总局

  • 核心要求:

    • 监管数据专网实行分级分类管理,明确各业务部门及受托机构安全职责

    • 定期开展自查,发现安全缺陷立即采取补救措施

    • 归口管理部门定期开展安全管理评估检查,问题整改闭环管理

    • 发生监管数据泄露、系统故障中断 4 小时以上、网络非法入侵等重大安全风险事项,48 小时内向归口管理部门报告

    • 建立安全事件通报工作机制,强化风险预警和协同处置

五、安全防护

境外分支附属机构网络和数据安全管理与勒索病毒防范

  • 文件依据:《关于加强银行保险机构境内外分支附属机构网络和数据安全管理防范勒索病毒攻击的通知》(金办发〔2023〕41 号)

  • 发布机构:国家金融监督管理总局办公厅,2023 年 12 月

  • 核心要求:

    • 切实加强境内外分支附属机构网络安全和数据安全统一管理,提高整体安全防护能力

    • 完善网络隔离机制,严格最小权限访问原则,收敛攻击暴露面

    • 加强网络异常行为监测,部署主动式欺骗防御技术,及早发现入侵

    • 强化数据备份与恢复能力,备份数据与生产数据物理隔离,定期验证可恢复性

    • 针对勒索病毒建立专项应急处置预案,明确隔离、取证、恢复、上报全流程

    • 加强对境外机构的安全督导和定期审计,确保集团安全策略有效落地

非银行支付机构网络支付业务管理办法

  • 发布机构:中国人民银行(公告〔2015〕第 43 号)

  • 施行时间:2016 年 7 月 1 日

  • 核心内容:

    • 确立支付账户实名制,对个人支付账户实行 Ⅰ、Ⅱ、Ⅲ 类分类管理

    • Ⅰ 类账户:累计交易限额 1000 元,仅需一个外部渠道验证身份

    • Ⅱ 类账户:年累计限额 10 万元,需三个外部渠道验证

    • Ⅲ 类账户:年累计限额 20 万元,需五个外部渠道验证,可购买理财产品

    • 坚持小额便民定位,基于客户银行账户或支付账户提供服务

    • 区分交易验证安全等级,实施差异化交易限额管理

    • 建立客户损失赔付机制和差错争议处理机制,保护消费者权益

六、数据治理

金融数据安全 数据生命周期安全规范(JR/T 0223—2021)

  • 发布机构:中国人民银行

  • 发布实施:2021 年 4 月

  • 核心内容:

    • 金融行业推荐性标准,以数据安全分级为基础,建立全生命周期安全防护体系

    • 数据生命周期涵盖采集、传输、存储、使用、删除、销毁六个环节

    • 数据使用细分为 10 个场景,每个场景提出具体安全要求

    • 构建 “数据生命周期安全防护 + 组织保障 + 信息系统运维保障” 三位一体框架

    • 针对不同安全级别的数据,明确差异化的防护措施和管控强度

金融数据安全 数据安全分级指南(JR/T 0197—2020)

  • 发布机构:中国人民银行

  • 发布时间:2020 年 9 月

  • 核心内容:

    • 确立数据安全定级五大原则:合法合规性、可执行性、时效性、自主性、差异性

    • 从保密性、完整性、可用性三个维度评估数据安全影响

    • 将金融数据从高到低划分为 5 级、4 级、3 级、2 级、1 级共五个级别

    • 5 级为重要数据,影响国家安全或公众权益;4 级用于重要业务,含高敏感个人金融信息

    • 明确数据定级流程和动态调整机制,为分级防护提供基础依据

银行业金融机构数据治理指引

  • 发布机构:原银保监会(银保监发〔2018〕22 号)

  • 发布时间:2018 年 5 月

  • 核心内容:

    • 将数据治理纳入公司治理范畴,建立自上而下的治理体系

    • 三项基本原则:全覆盖原则、匹配性原则、持续性原则

    • 明确董事会、监事会、高管层职责分工,可结合实际设立首席数据官

    • 全面强化数据质量要求,确保数据真实性、准确性、连续性、完整性和及时性

    • 要求将数据应用嵌入业务经营、风险管理和内控全流程,实现数据驱动发展

    • 监管数据纳入治理范畴,法定代表人对监管数据质量承担最终责任

银行保险机构数据安全管理办法

  • 发布机构:国家金融监督管理总局(金规〔2024〕24 号)

  • 施行时间:2025 年 1 月 1 日

  • 核心内容:

    • 共 9 章 81 条,是金融监管总局成立后首部数据安全规章

    • 落实 “谁管业务、谁管业务数据、谁管数据安全” 原则

    • 数据分为核心数据、重要数据、一般数据三级,一般数据进一步细分为敏感数据和其他一般数据

    • 建立数据目录和分类分级规范,实施动态管理和差异化保护

    • 敏感级及以上数据操作日志留存:核心数据不少于 3 年,重要 / 敏感数据不少于 1 年

    • 个人身份鉴别数据不得明文存储、传输和展示

    • 敏感级及以上数据实施容灾备份,定期验证可恢复性

    • 数据出境需按国家规定进行安全评估

商业银行信息科技风险管理指引

  • 发布机构:原银监会(银监发〔2009〕19 号)

  • 发布时间:2009 年 6 月

  • 核心内容:

    • 法定代表人是信息科技风险管理第一责任人

    • 董事会负责审批信息科技战略,确定可接受风险级别

    • 设立信息科技管理委员会,监督各项职责落实

    • 信息科技风险涵盖自然因素、人为因素、技术漏洞和管理缺陷产生的操作、法律和声誉风险

    • 覆盖信息科技治理、信息科技风险管理、信息安全、信息系统开发测试维护、信息科技运行、业务连续性、外包、内部审计等领域

    • 访问授权遵循 “必需知道” 和 “最小授权” 原则

七、事件上报

证券期货业网络安全事件报告与调查处理办法

  • 发布机构:中国证监会(证监会公告〔2021〕12 号)

  • 施行时间:2021 年

  • 核心内容:

    • 网络安全事件分为特别重大事件、重大事件、较大事件、一般事件四级

    • 按系统服务能力异常程度分为严重异常(80% 以上)、中度异常(30% 以上)、轻度异常

    • 发生投资者数据损毁泄露、涉及计算机犯罪等事件应立即报告

    • 应急报告先电话后书面,内容包括时间、地点、经过、影响、处置措施等

    • 应急处置结束后 5 个工作日内提交事件总结报告,30 个工作日内提交补充报告

    • 证监会及其派出机构负责调查处理,可采取调阅资料、实地核查等方式

    • 妨碍报告与调查处理的,依法依规追究责任

非银行支付机构重大事项报告管理办法

  • 发布机构:中国人民银行(银发〔2021〕198 号)

  • 发布时间:2021 年 7 月

  • 核心内容:

    • 重大事项分为事前报告事项和事后报告事项两类

    • 事前报告事项(9 类):首次公开发行股票、支付创新产品服务、境外设立分支机构、股权 / 重要资产质押、大额担保、对外投资、支付业务设施重大调整、变更重点外部合作机构等

    • 事后报告事项:经营状况重大变化、重大风险事件、重大安全事故、客户信息泄露、重大诉讼仲裁等

    • 报告要求一事一报,及时、真实、准确、完整,不得迟报、漏报、瞒报、谎报

    • 法人所在地人民银行分支机构为主要监管责任人

八、隐私保护

个人金融信息保护技术规范(JR/T 0171—2020)

  • 发布机构:中国人民银行

  • 发布时间:2020 年 2 月

  • 核心内容:

    • 金融行业推荐性标准,从安全技术和安全管理两方面规范全生命周期保护

    • 个人金融信息按敏感程度从高到低分为 C3、C2、C1 三类

      • C3 类:用户鉴别信息,如银行卡密码、交易密码、短信验证码、生物识别信息等

      • C2 类:可识别特定主体的信息,如身份证号、银行卡号、交易流水、财产信息等

      • C1 类:机构内部信息,如开户机构、账户开立时间等

    • 规范收集、传输、存储、使用、删除、销毁各环节的技术防护要求

    • C3 类信息原则上不得留存非本机构信息,支付敏感信息及时清除

    • 对外共享转让需进行安全评估,落实最小必要原则

上海市融资租赁公司、商业保理公司涉个人客户相关业务规范指引

  • 发布机构:上海市地方金融监督管理局(沪金规〔2021〕1 号)

  • 施行时间:2021 年 5 月 1 日

  • 核心内容:

    • 适用于上海市融资租赁公司、商业保理公司开展的涉个人客户业务

    • 立足服务实体经济,重点支持符合产业政策的业务方向

    • 涉个人客户业务应在风险可控前提下稳妥审慎开展

    • 规范个人信息收集、使用、存储,遵循合法、正当、必要原则

    • 明确适当性管理要求,充分履行信息披露义务,不得误导性宣传

    • 规范催收行为,严禁暴力催收、骚扰式催收

    • 建立客户投诉处理机制,妥善处理金融消费纠纷

金融机构客户尽职调查和客户身份资料及交易记录保存管理办法

  • 发布机构:中国人民银行、国家金融监督管理总局、中国证监会(2025 年第 11 号令)

  • 施行时间:2026 年 1 月 1 日

  • 核心内容:

    • 遵循 “了解你的客户” 原则,识别并核实客户及其受益所有人身份

    • 根据客户风险状况采取差异化尽职调查措施:常规、强化、简化

    • 业务关系存续期间实施持续尽职调查,动态评估客户风险

    • 客户身份资料自业务关系结束后至少保存 5 年,交易记录自交易记账之日起至少保存 5 年

    • 同一介质存有不同保存期限资料的,按最长期限保存

    • 金融机构破产解散时,客户身份资料和交易记录移交监管指定机构

    • 境外汇款单笔 5000 元人民币或等值 1000 美元以上的,需核实汇款人信息准确性

    • 违反规定的,依据《反洗钱法》予以处罚

九、主机与信息技术

证券基金经营机构信息技术管理办法

  • 发布机构:中国证监会(第 152 号令)

  • 施行时间:2019 年 6 月 1 日

  • 核心内容:

    • 共 7 章 64 条,覆盖治理、合规与风险管理、数据治理、安全管理、应急管理、服务机构等

    • 设立信息技术治理委员会,由高管及多部门负责人组成

    • 指定首席信息官(CIO),要求 10 年以上信息技术工作经验,其中 3 年以上证券基金行业经验

    • 业务系统上线时同步上线风险管理系统,实现风险识别、监控、预警和干预

    • 重要信息系统备份能力分级要求,证券公司实时系统故障应对能力达到第 4 级

    • 每年至少开展一次应急演练,两年内覆盖全部重要信息系统

    • 信息技术服务机构实行备案管理,明确备案条件和持续监管要求

    • 允许经营机构设立信息技术专业子公司,母子公司共享基础设施

金融信息服务管理规定

  • 发布机构:国家互联网信息办公室

  • 施行时间:2019 年 2 月 1 日

  • 核心内容:

    • 金融信息服务指向金融分析、交易、决策活动提供可能影响金融市场的信息和 / 或金融数据的服务

    • 国家网信办负责全国监督管理执法工作

    • 服务提供者履行主体责任,建立内容审核、数据保存、安全保障、个人信息保护等制度

    • 配备专业人员负责内容审核,确保金融信息真实、客观、合法

    • 明确禁止六类信息:虚假金融信息、歪曲货币政策、教唆商业欺诈、虚构市场事件、宣传禁售金融产品等

    • 从事互联网新闻信息服务或特许金融业务需另行取得相应资质

十、支付业务

电子支付指引(第一号)

  • 发布机构:中国人民银行(公告〔2005〕第 23 号)

  • 发布施行:2005 年 10 月

  • 核心内容:

    • 规范境内银行业金融机构开展的电子支付业务

    • 电子支付类型包括网上支付、电话支付、移动支付、POS 终端交易、ATM 交易等

    • 电子支付指令与纸质支付凭证具有同等效力

    • 银行应建立健全电子支付安全管理制度,采取有效技术保障措施

    • 客户办理电子支付业务需开立银行结算账户

    • 银行对客户资料和交易信息负有保密义务,不得超出授权范围使用

    • 发起行应确保正确执行客户指令,执行安全程序后客户不得要求变更或撤销

    • 明确差错处理责任划分和客户权益保护机制

信息安全法规汇总(医疗健康)

信息安全法规汇总(医疗健康)

整理资料的时候,发现之前汇总过的一些安全法规,汇总时间大概在24年中:
安全法规金融

一、法律层面

1、《中华人民共和国基本医疗卫生与健康促进法》
由全国人民代表大会常务委员会于 2019 年 12 月 28 日通过,2020 年 6 月 1 日起施行,是我国医疗卫生与健康领域的基础性法律。其中明确国家推进全民健康信息化与健康医疗大数据应用发展,要求制定健康医疗数据技术标准,推动医疗卫生机构建立信息安全制度,为医疗健康领域数据安全、网络安全管理提供了上位法依据。

二、国务院顶层政策文件

1、《国务院办公厅关于促进和规范健康医疗大数据应用发展的指导意见》(国办发〔2016〕47 号)
由国务院办公厅 2016 年 6 月印发,是我国健康医疗大数据领域的顶层设计文件。文件明确健康医疗大数据是国家重要基础性战略资源,提出分阶段发展目标,部署数据资源共享开放、应用深化、产业培育、安全保障等核心任务,确立 “安全可控、规范有序” 的发展原则,是后续行业数据安全制度体系建设的政策源头。

三、行业主管部门规范性文件

2、《国家健康医疗大数据标准、安全和服务管理办法(试行)》
(注:原文 “标注” 应为笔误,正式文件名称为 “标准”)
由国家卫生健康委 2018 年 7 月印发,是健康医疗大数据管理的核心行业规范。文件明确健康医疗大数据的定义与权责边界,从标准体系建设、安全管理、服务管理三大维度作出规定,建立数据分类分级、全生命周期安全管控、安全审查、风险评估等制度,为行业数据安全管理提供直接操作依据。

3、《医疗卫生机构网络安全管理办法》(国卫规划发〔2022〕29 号)
由国家卫生健康委、国家中医药局、国家疾控局 2022 年 8 月联合印发。文件聚焦医疗卫生机构的网络与数据安全管理,落实网络安全等级保护、关键信息基础设施保护要求,明确 “三化六防” 防护原则,规范网络建设运行、数据全生命周期安全、监测预警与应急处置、监督管理等全流程要求,压实医疗机构主体责任,是医疗机构网络安全工作的直接执行规范。

4、《国家医疗保障局关于加强网络安全和数据保护工作的指导意见》
由国家医疗保障局 2021 年 4 月印发,针对医保领域海量敏感数据的安全管理作出专项部署。文件坚持 “安全为本、制度与技术并重” 原则,明确医保信息平台安全防护、数据分类分级保护、访问权限管控、数据安全风险评估、合规共享利用等核心要求,保障医保数据安全与合法开发利用。

四、国家标准与技术规范

1、《信息安全技术 健康医疗数据安全指南》(GB/T 39725-2020)
由国家市场监督管理总局、国家标准化管理委员会 2020 年 12 月发布,2021 年 7 月实施,属于推荐性国家标准。文件规定健康医疗数据的分类分级体系、使用披露原则,覆盖数据采集、存储、传输、使用、开放等全生命周期场景的安全措施,同时给出安全管理与技术实现的具体指引,是行业数据安全防护的核心技术参考标准。

1、《健康医疗数据要素安全共享技术要求》
由中国信通院牵头、互联网医疗健康产业联盟 2024 年 7 月发布的行业技术标准。文件适配数据要素市场化改革需求,聚焦医疗数据安全共享场景,围绕共享准备、共享运营、共享保障三个核心环节提出技术要求,为医疗数据合规流通、价值释放提供技术操作规范。

五、行业自律规范

1、《医疗健康网络数据安全自律公约》
由中国互联网协会互联网医疗健康工作委员会等行业组织 2020 年 11 月发布,属于行业自律性规范。公约引导医疗卫生机构、互联网医疗企业等市场主体落实数据安全责任,要求开展数据资产梳理与分类分级管理、全生命周期安全防护、内部合规评估,规范数据对外合作行为,建立用户举报受理机制,推动行业自主提升数据安全保护能力。