GPT-6 Astra、循环Transformer与隐式推理
原文地址:GPT-6 Astra, Looped Transformers, and Hidden Reasoning
循环深度、隐式思维链与Transformer块循环复用最新研究综述
过去几周行业变化颇多。我相信此刻所有人最关注的都是OpenAI的GPT-6 Astra,尤其是它的性能表现、循环Transformer/循环深度的设计特性,以及关于Astra“隐藏”了推理轨迹(即思维链)的传闻。
因此,本文我会先简要谈谈对Astra的初步印象,以及对这一技术方向的判断;随后会详细讲解“循环Transformer”的原理,探讨它与“隐藏思维链”是否存在关联。
最后,在介绍完循环Transformer的基础概念后,我会梳理近期相关研究论文中的一些新发现。
注:我还录制了一个更简短的视频版本,是在撰写这篇长文之前录的,感兴趣可以查看:
1. GPT-6 Astra 使用印象
开门见山。在聊架构传闻和相关研究文献之前,我先简要总结一下GPT-6 Astra的实际使用感受和相关信息。
上周,OpenAI高调发布了全新的GPT-6 Astra。过去几天我一直在使用它,这确实是一款极其出色的模型,大概率是我目前用过的效果最好的模型。但它具体在哪些方面有提升?提升的路径又是什么?
1.1 Astra 基准测试表现
Astra是我目前用过的最强模型,在3D渲染与动画任务上的表现尤为突出(相对其他模型而言)。也就是说,尽管它在写作、数学、编程等几乎所有领域都超越了前代GPT-5.6,但在图形生成类演示场景中的优势格外明显。
这一点也能从基准测试结果中看出。例如,GPT-6 Astra在数学和编程任务上表现非常出色,如下图所示。
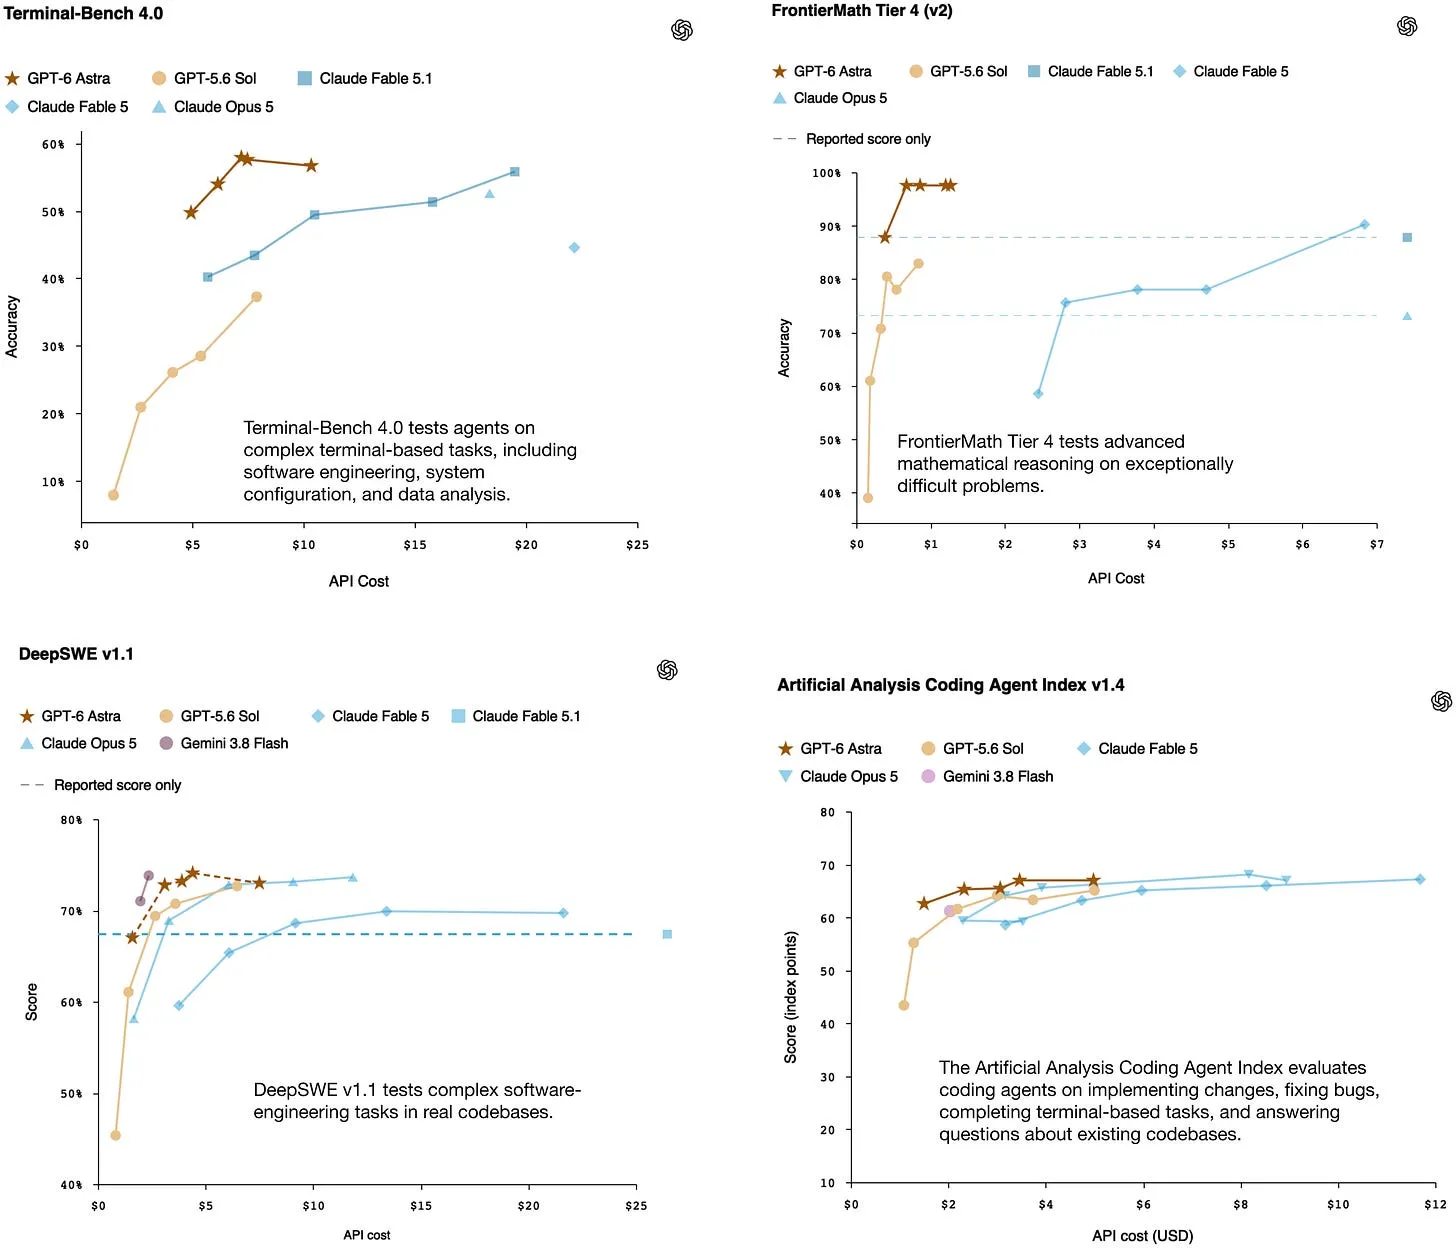
**图1:三项主流编程基准测试与一项高难度数学基准测试的结果。更多基准测试数据见Astra发布博客:https://openai.com/index/gpt-6-astra/**
其中一个亮点(图中未展示)是,Astra在ARC-AGI-3测试(https://arcprize.org/arc-agi/3)中达到了99.9%的得分(GPT-5.6 Sol仅为7.8%),该测试衡量逻辑谜题求解与泛化能力的综合水平。不过数学、编程和计算机使用类基准更有实际参考价值,因为它们更贴近真实应用场景。(顺带一提,OpenAI随后发布了一篇文章(https://openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores/),说明测试框架的两项调整也让GPT 5.6 Sol的成绩从13.3%提升到了38.3%。)
回到人工分析智能体编码指数(Artificial Analysis Coding Agent Index,上图右下角),该指标融合了多项智能体编程任务,GPT-6 Astra显然处于第一梯队,但优势并没有拉开量级差距。这一点在通用人工分析智能指数(Artificial Analysis Intelligence Index)中也能得到印证,该指数融合了不同类型的任务,而不仅限于编程。
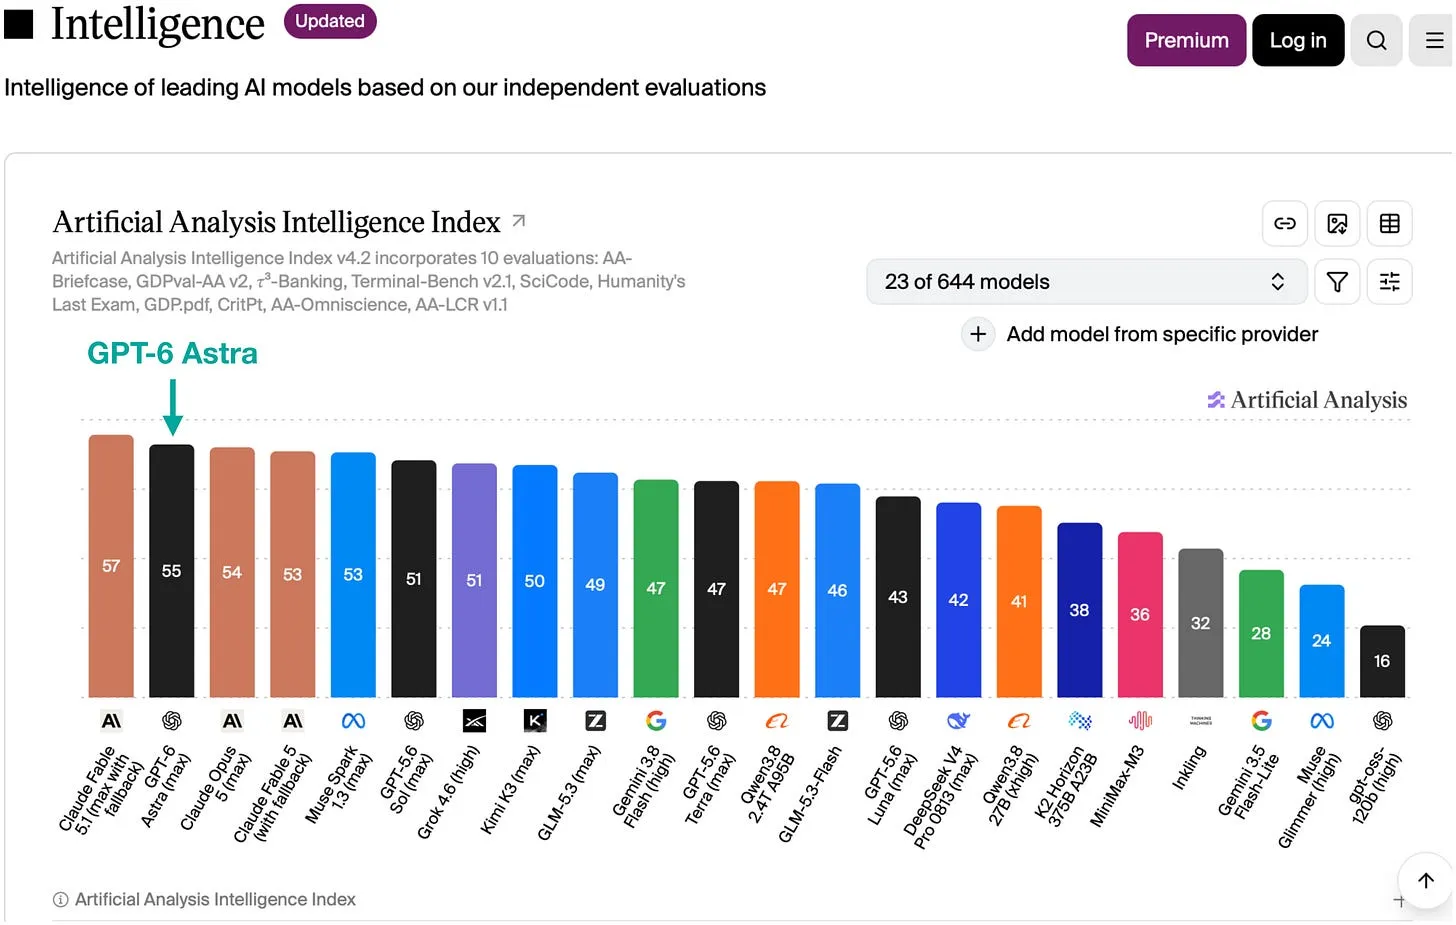
**图2:人工分析智能指数,来源:https://artificialanalysis.ai/#intelligence**
人工分析(Artificial Analysis)基准测试的一大优势在于其独立性,因此相比模型厂商自行评测的结果,可信度会更高一些。
其评测方法见:https://artificialanalysis.ai/methodology/intelligence-benchmarking 。举例来说,GDPval-AA与AA-Briefcase测试会使用他们开源的轻量化Stirrup测试框架(https://github.com/ArtificialAnalysis/Stirrup)对不同大语言模型进行横向对比。在上文展示的v4.2版智能指数中,Terminal-Bench v2.1使用Terminus 2框架,τ³-Banking使用τ-Bench框架。独立的编码智能体指数也会对比不同的编码智能体框架。
使用统一测试框架的评测,更能保证“苹果对苹果”的公平对比。但与此同时,模型训练过程中通常会以某一种主流框架为核心进行优化,对其他框架的微调较少;而且主流框架本身也会围绕模型的优势进行设计,放大模型的长处。
因此,部分智能体评测可能低估了Astra在其原生框架下的表现。这种影响对智能指数得分的具体程度,还需要在相同任务下跨框架对比Astra的表现才能验证。
顺带一提,最近一位同事和我聊到(Claude Code的负责人也给出过类似建议):或许可以删除(或归档)你现有的部分AGENTS.md和SKILL.md文件——因为新一代大模型理解提示词、解决问题的效率已经很高了,额外的手把手引导反而可能给模型带来不必要的约束,导致最终方案质量下降。
当然,我不是说完全不用SKILL.md文件——对很多工作流来说,复用这类文件能提升效率,因为模型不用每次重新摸索方法。但我的建议是:并非所有工作流都需要额外描述,“旧版本”的描述可能已经不再是最优解,大模型或许能想出更好的方案。因此,或许是时候更新或重新生成这些指令文件了。
1.2 计算机使用能力
GPT-6 Astra在图像与渲染任务上的表现格外突出。当这类任务涉及图形界面交互时,也体现出了模型的**计算机使用(computer use)**能力——即模型通过Codex/ChatGPT应用,在用户本地电脑上操作软件的能力。
相比其他模型,计算机使用是这款模型的核心亮点,而所有图形相关的能力也恰好适合在社交媒体上做成直观、有冲击力的演示。网上已经有大量令人印象深刻的案例,从3D建模(https://x.com/higgsfield_ai/status/2096495974734794840?s=20)到应用开发(https://x.com/Dimillian/status/2095596700815516004?s=20),不一而足。
举个具体例子:下图是我让GPT-6 Astra的中等(Medium)和高(High)算力档位,通过鼠标在我的电脑上重绘一张我的照片的对比(没有用最高的Extra High和Max档位,不想把token都花在这上面 :)),使用的是经典画图网站:https://jspaint.app/#local:aa1757d4bc6008 。
这不仅体现了模型的创作能力,更重要的是体现了它在电脑上使用工具的能力——这里用的是画图软件,你可以通过鼠标光标看到模型在操作界面。
这并不是第一款能在框架支撑下实现通用计算机使用的模型。比如今年早些时候,我就已经能用GPT模型完成一些UI任务,比如Excel里的报销相关操作。但计算机使用仍然是一项相对较新的能力,依赖框架支撑,整体成熟度还不算高。这也很合理:大语言模型本质是文本模型,因此写作、编程、调用API和命令行这类场景自然是更容易落地的方向。
但与此同时,还有很多工具和软件至今没有开放命令行接口。与其坐等别人设计出对应的接口,不如直接提升模型操作图形界面的能力——而且如前所述,这本身也能做出好看、有传播力的演示。这一点和当下人形机器人的发展逻辑有点像:诚然,在流水线等场景里,专用设备比人形机器人效率更高,但人形机器人的优势在于通用性。
因此我预计,未来数月乃至数年,计算机使用能力会在大模型与智能体框架两个层面持续迭代完善。也就是说,除了现有的能力边界,以及数学、编程能力的持续提升,模型训练也会越来越多地围绕计算机使用场景展开。这也会让大语言模型在技术圈之外的日常电脑任务中变得更易用——比如“嘿ChatGPT,帮我做一下个税申报” 🙂
1.3 计算机使用的训练方式
计算机使用的发展趋势,也和“OpenAI采购了数万台Mac Mini与Mac Studio用于强化学习”的传闻(https://finance.yahoo.com/technology/ai/articles/apple-suddenly-ai-infrastructure-stock-130223938.html)相吻合。这里的Mac并不是用来直接训练模型的——训练模型还是GPU更合适——而是用来在训练中提供macOS环境,让模型学习如何操作这个系统和其中的工具。
那么,在这些Mac上进行的计算机使用训练,具体是怎么运作的?简而言之,Mac(准确说是macOS操作系统)充当了模型训练中可交互的环境。
基本工作流如下:
- 给模型下发任务提示,比如“打开某某应用,完成某某操作”。
- (通常由框架)向模型提供macOS界面的截图。
- 大语言模型预测鼠标/键盘动作(点击、按键、滚动等等)。
- (同样由框架)在Mac上执行这些动作。
- 执行完上一步的动作后,将更新后的环境新截图反馈给模型。
- 重复第2-5步,直到任务成功或失败。
- 用成功/失败信号与校验器(或评分器)作为训练反馈,包括训练后阶段的强化学习;这和常规的“可验证奖励强化学习(RLVR)”逻辑是类似的。
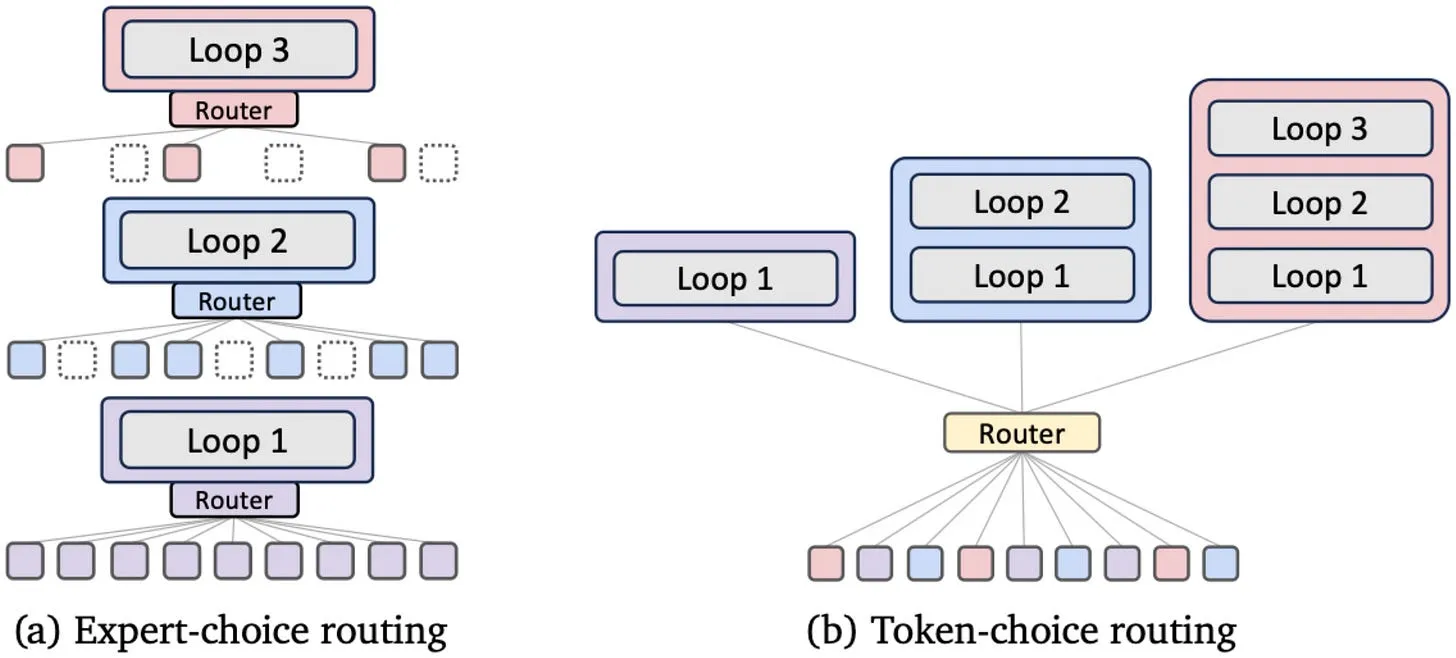
图3:计算机使用训练工作流概览
再强调一次,Mac在这里主要是训练环境,而非运行或更新模型的设备。模型大概率部署在NVIDIA GPU上,通过API和Mac端进行交互。顺带一提,黄仁勋曾提到(https://x.com/JensenHuang/status/2096700264569090384?s=20),GPT-6 Astra的训练使用了约10万块Grace Blackwell GPU。
1.4 GPT-6 Astra 本质仍是推理模型
上一节提到的计算机使用训练重点,并不是训练范式的根本性变革。GPT-6 Astra(以及可预见的未来里所有大语言模型)本质上仍然是推理模型。这意味着模型通过可验证奖励强化学习(RLVR)进行训练,并会生成中间推理轨迹(也就是思维链)。
关于GPT-6 Astra的推理模型特性,尤其是“隐藏思维链”的相关讨论,我会在本文后面部分详细展开。
2. 循环Transformer
话说回来,在模型正式发布前两天,科技媒体《The Information》发布了一篇报道(https://www.theinformation.com/articles/secret-technique-behind-openais-astra-model-sparks-security-concerns),称据内部消息,Astra使用了一种名为“循环深度(recurrent depth)”或“循环Transformer(looped transformers)”的技术。
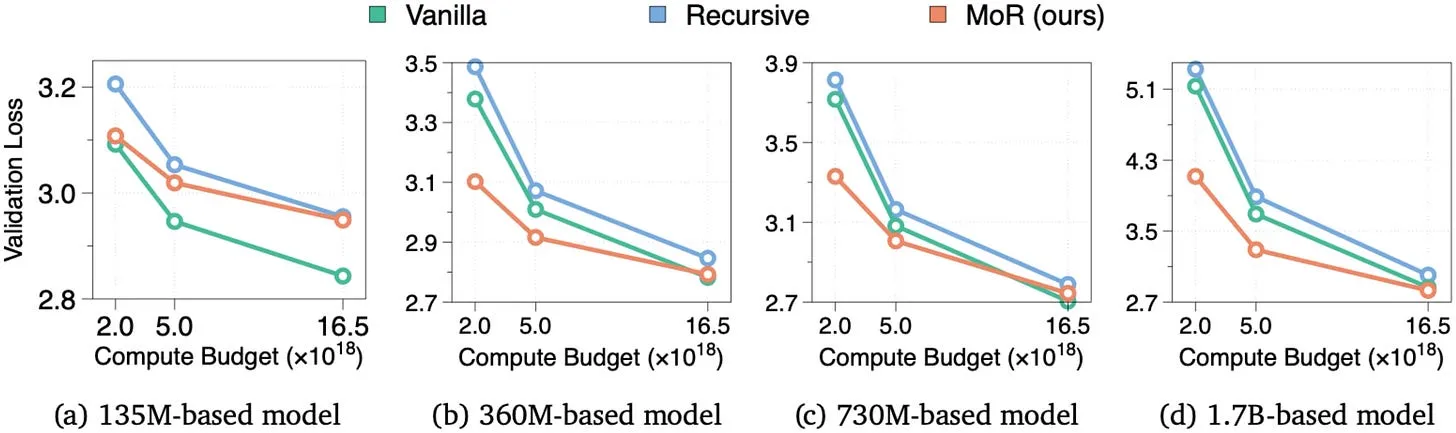
图4:《The Information》报道引用(来源:https://www.theinformation.com/articles/secret-technique-behind-openais-astra-model-sparks-security-concerns)
循环Transformer架构刚好是我的专业领域与兴趣方向,因此我专门录了一期短讲座视频,讲解循环Transformer的通用机制,同时回应了“隐藏推理链”的说法,视频链接见下方。
在接下来的小节里,我会先解释循环Transformer是什么,然后再在后面的章节回头讨论“隐藏思维链”的相关说法。
(循环Transformer的解释可能看起来有点长,但我认为打好基础概念非常重要,这样才能更好地判断“它会掩盖推理轨迹/思维链”这种说法是否站得住脚。)
2.1 Transformer块的复用
那么,循环Transformer到底是什么?
循环Transformer本质上是一种架构优化,核心思想是让中间表示多次经过同一组Transformer块(而不是只经过一次)。和单纯堆叠更多块相比,它的“巧思”在于这些前向传播的轮次共享同一套权重。
定义与术语
全文中我会使用以下术语:
- Transformer块:包含注意力机制、前馈模块、归一化层与残差连接的单元。论文中常把这些块称作“Transformer层”。
- 层栈(stack):由多个Transformer块组成的序列。
- 块执行(block application):让输入经过一次Transformer块的计算过程。
循环Transformer并不是全新概念,其基本思想最早出现在2018年的《通用Transformer》(Universal Transformer,https://arxiv.org/abs/1807.03819)论文中。不过在聊通用Transformer之前,我们先从一个更简单的近期案例说起——今年7月发布的开源大模型Nanbeige4.2-3B(https://arxiv.org/abs/2607.22083),今年夏天我在Substack(https://substack.com/@rasbt/note/c-302083551)和个人网站的架构图鉴(https://www.sebastianraschka.com/llm-architecture-gallery/looped-depth-sharing/)都介绍过它。
如下图所示,Nanbeige的架构看起来和普通Transformer基本一致,但注意图中有一条额外的(橙色)箭头,绕回了Transformer层栈的起始位置。
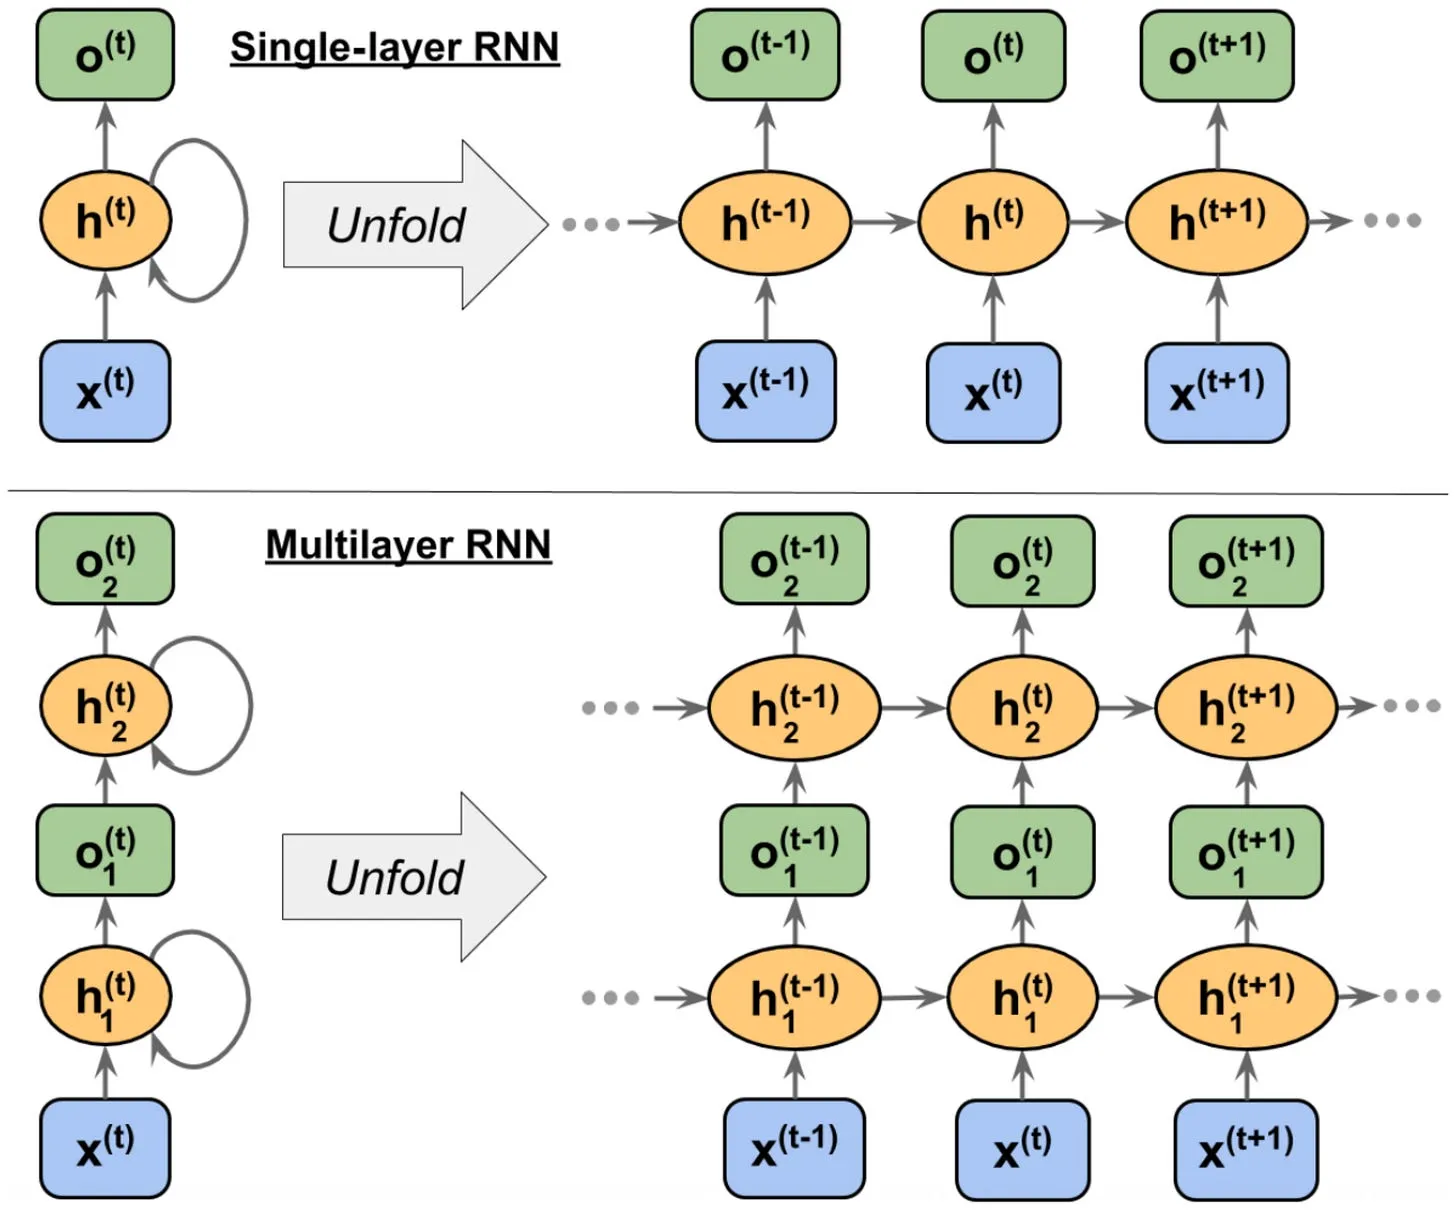
图5:Nanbeige4.2-3B将同一组22层Transformer块执行两次。橙色箭头表示中间表示被送回层栈再次计算的路径。
我们从下往上梳理整个流程:首先,和所有基于Transformer的大语言模型一样,输入文本会被分词并转换为嵌入向量。这些向量会经过22个Transformer块,每个块都有独立的权重。
而循环Transformer的特殊之处在于:第一轮计算完成后,隐藏状态会被送回同一组22个块,再次计算一遍——也就是先再过一遍块1,然后块2,依此类推直到块22。
如果把这个计算过程展开,我们相当于得到了44次Transformer块执行。但和拥有44个独立块的传统Transformer不同,第二轮的22次块执行复用了第一轮的权重。比如第23次块执行使用块1的权重,第24次使用块2的权重,以此类推。
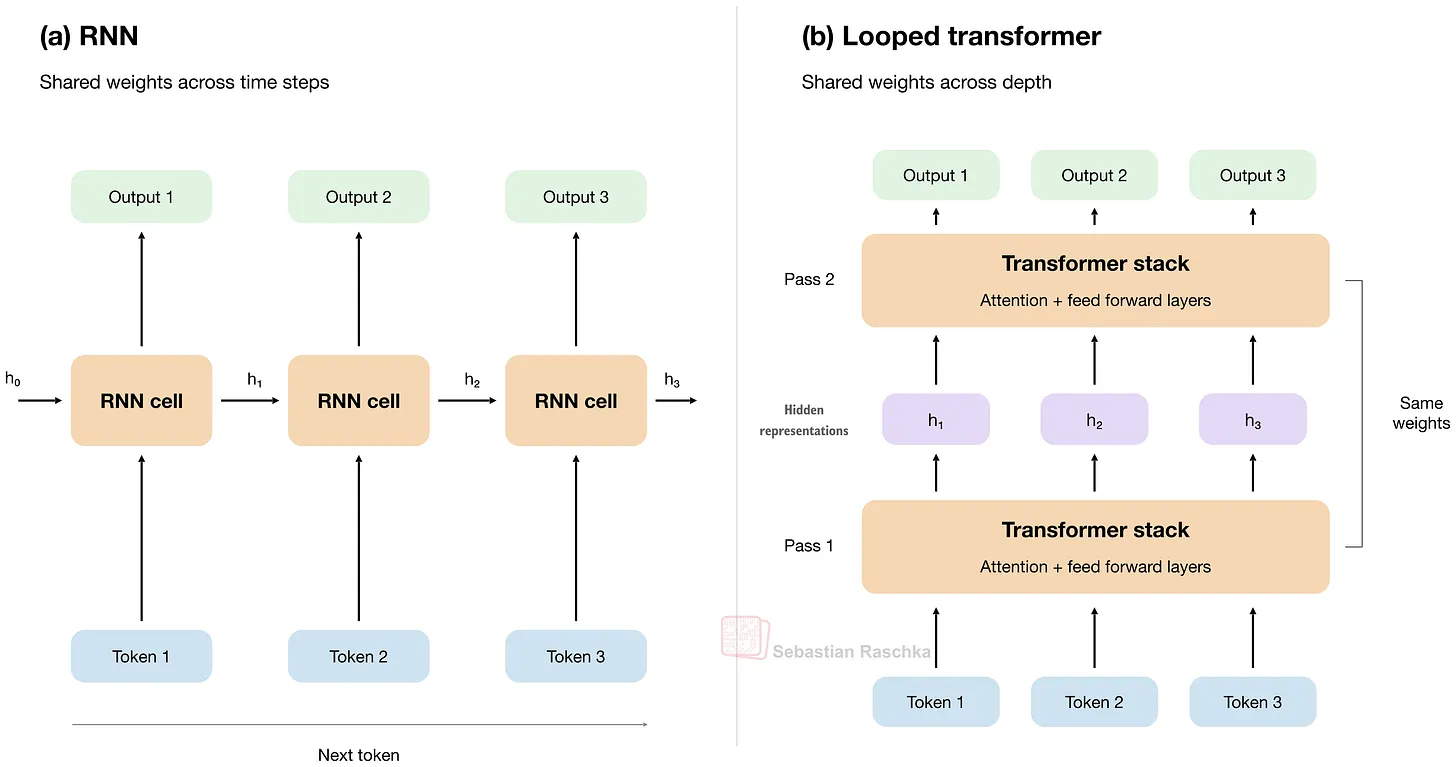
图6:Nanbeige4.2-3B的展开示意:同一组22个Transformer块被执行两轮,总计44次块执行。
所以,整个设计的核心就是:在不新增Transformer权重的前提下,将有效深度从22次块执行提升到44次。
顺便一提,为什么是2轮,而不是3轮、4轮甚至更多?Nanbeige的论文里没有展开太多细节,但他们表示这基本是效率最优的配置。把循环次数从2增加到3或许能提升模型效果,但额外的计算成本得不偿失。
2.2 循环的代价
那么,我们为什么要做这种循环设计?本质上,它是“通过堆叠更多Transformer块来放大模型”之外的另一种技术路径。
举例来说,一个把22个Transformer块执行两轮的模型,其Transformer块相关的参数量大约只有44个独立块传统模型的一半。
这会降低权重存储所需的内存。顺带说明:嵌入层与输出层通常参数量很大,占总参数的相当比例,它们不在这个对比范围内。(以Nanbeige 4.2 3B为例,嵌入层与输出层约占全部30亿参数的25%;如果两者权重共享,这个比例可以降到12.5%。)
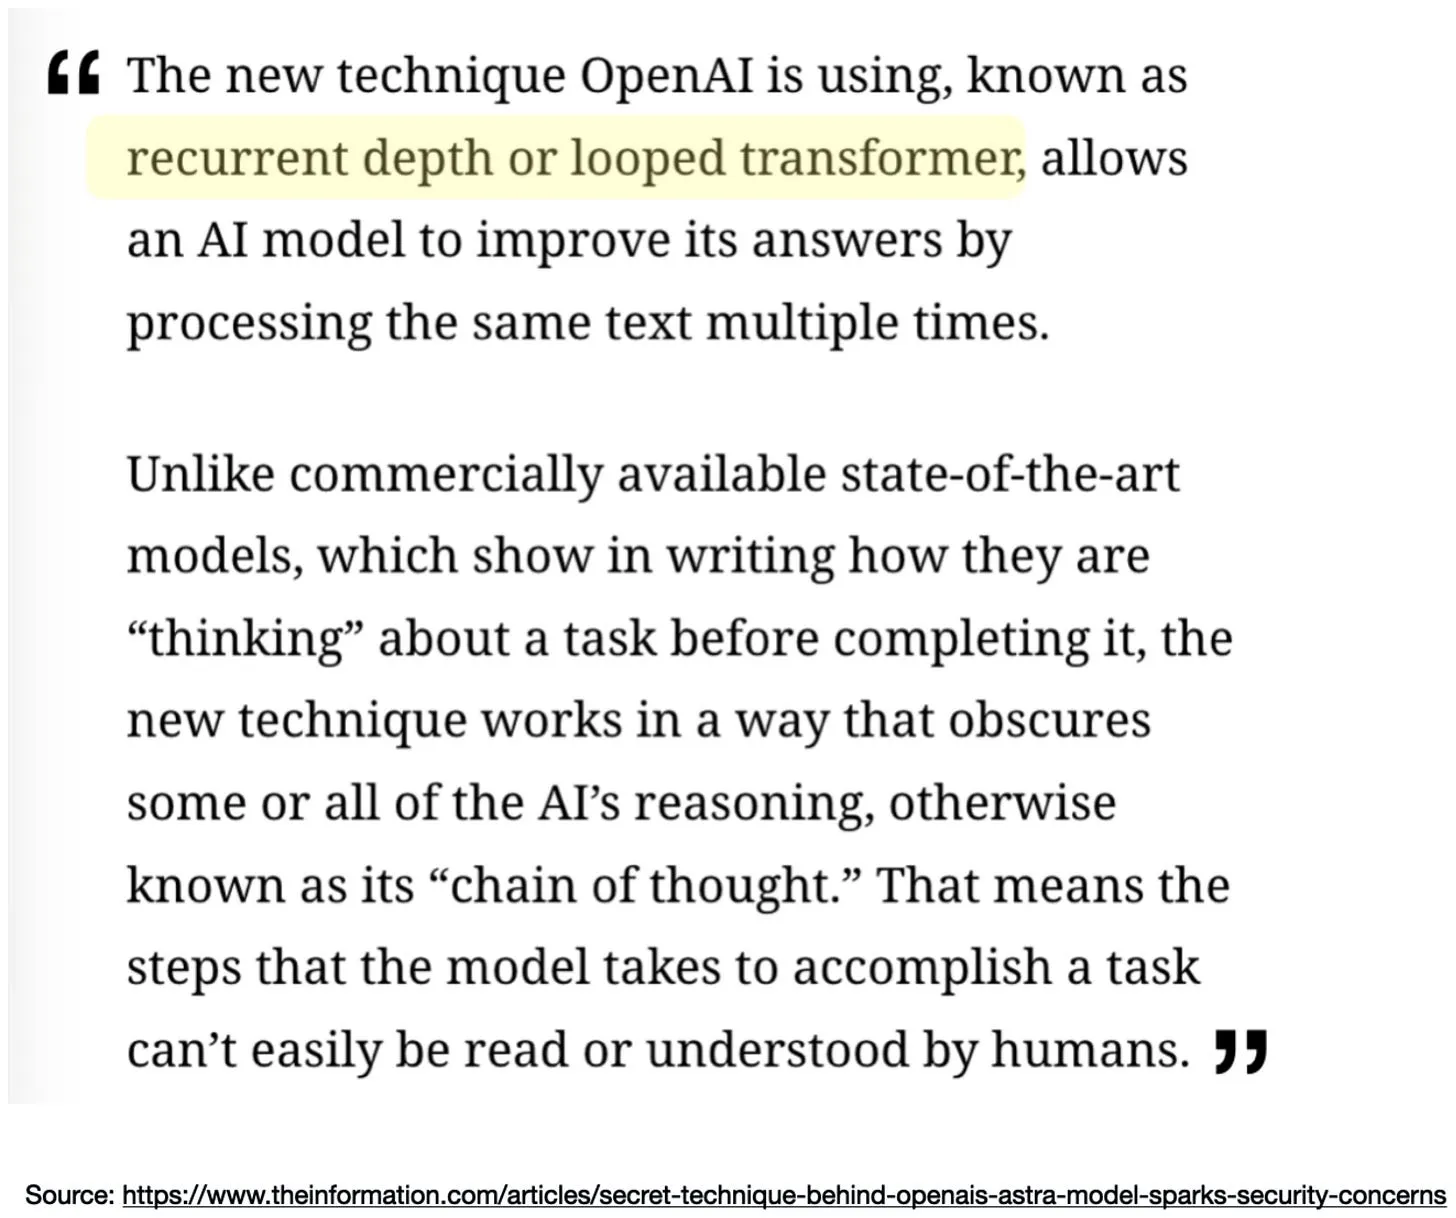
图7:传统架构与循环架构所需参数量的对比示意
当然,循环复用同一块仍然需要计算开销。更准确地说,前向传播过程中,中间输入要经过44次块执行;训练过程中,梯度也要通过共享层栈的两次计算反向传播。因此和只执行一轮22个块相比,计算量会显著增加。实际上,它的计算成本和44个独立块的模型相近——区别只在于优化器需要更新的独立参数更少,但反向传播依然要走完所有44次块执行。
再说说键值缓存(KV cache):无论是传统Transformer还是循环Transformer,都会缓存前序令牌的注意力键与值,用于下一步的令牌生成。顺便一提,我专门写过一篇讲解KV缓存的独立文章,感兴趣可以看:
https://magazine.sebastianraschka.com/p/coding-the-kv-cache-in-llms
https://substack.com/profile/27393275-sebastian-raschka-phd
·
2025年6月17日
https://magazine.sebastianraschka.com/p/coding-the-kv-cache-in-llms
KV缓存是生产环境中实现大语言模型高效推理的核心技术之一。本文从概念原理与代码实现两个层面,从零开始讲解KV缓存的工作机制,提供了可读性强的手动实现代码。
https://magazine.sebastianraschka.com/p/coding-the-kv-cache-in-llms
回到正题。尽管循环Transformer实现了权重共享,但第二轮输入块的中间状态和第一轮并不相同。因此在KV缓存中,两轮Transformer栈对应的键与值也不一样——和没有循环的情况是一样的。也就是说,循环设计并不会带来KV缓存层面的内存节省。
说得更具体一点:比如循环架构中的第1次与第23次块执行,都使用了块1的权重,但每次执行仍然需要各自的KV缓存条目。因此,我们需要为两轮计算分别维护独立的缓存,这组重复的22个块,其KV缓存需求和44个独立块的传统Transformer完全相同。
有意思的是,Nanbeige的研究人员在论文中提到,他们尝试过在轮次之间共享KV缓存。这样做当然能让KV缓存体积减半,但模型表现不如独立缓存的版本——最终发布的也是独立缓存的版本。
在继续介绍其他循环Transformer设计之前,再补充两个Nanbeige论文中提到的设计取舍:
- 从零开始训练循环架构,效果优于对已预训练的Transformer进行“升级改造(upcycling)”。
- 如前所述,两轮循环是综合表现最优的取舍;更多轮次只能带来极小的额外收益,却会拖慢训练速度、降低优化稳定性。
所以,循环次数是另一个需要权衡的架构选择。如前所述,Nanbeige把它固定为2次。但我们也可以让循环次数随令牌动态变化,接下来就会讲到这类设计。
2.3 通用Transformer与灵活循环次数
现在回头说《通用Transformer》(https://arxiv.org/abs/1807.03819)。Nanbeige是把一整组22个Transformer块执行两轮,而2018年的通用Transformer论文则是反复执行同一个Transformer块,而非一整组块的栈。不过核心思想是相近的。
同时,循环步数可以固定,也可以采用**自适应停止(adaptive halting)**机制。比如,某个位置的令牌可能只经过1-2轮循环,另一个可能经过3-4轮,以此类推。这让模型可以灵活地把计算资源分配给真正需要额外算力的令牌。
循环次数是如何决定的?模型会通过一个小型的训练好的函数,在每一步为每个位置输出一个所谓的“停止概率(halting probability)”。随着循环推进,这些概率会不断累加,一旦某个位置的累计概率超过阈值,就停止该位置的循环。此外,还会设置最大循环次数作为兜底限制。
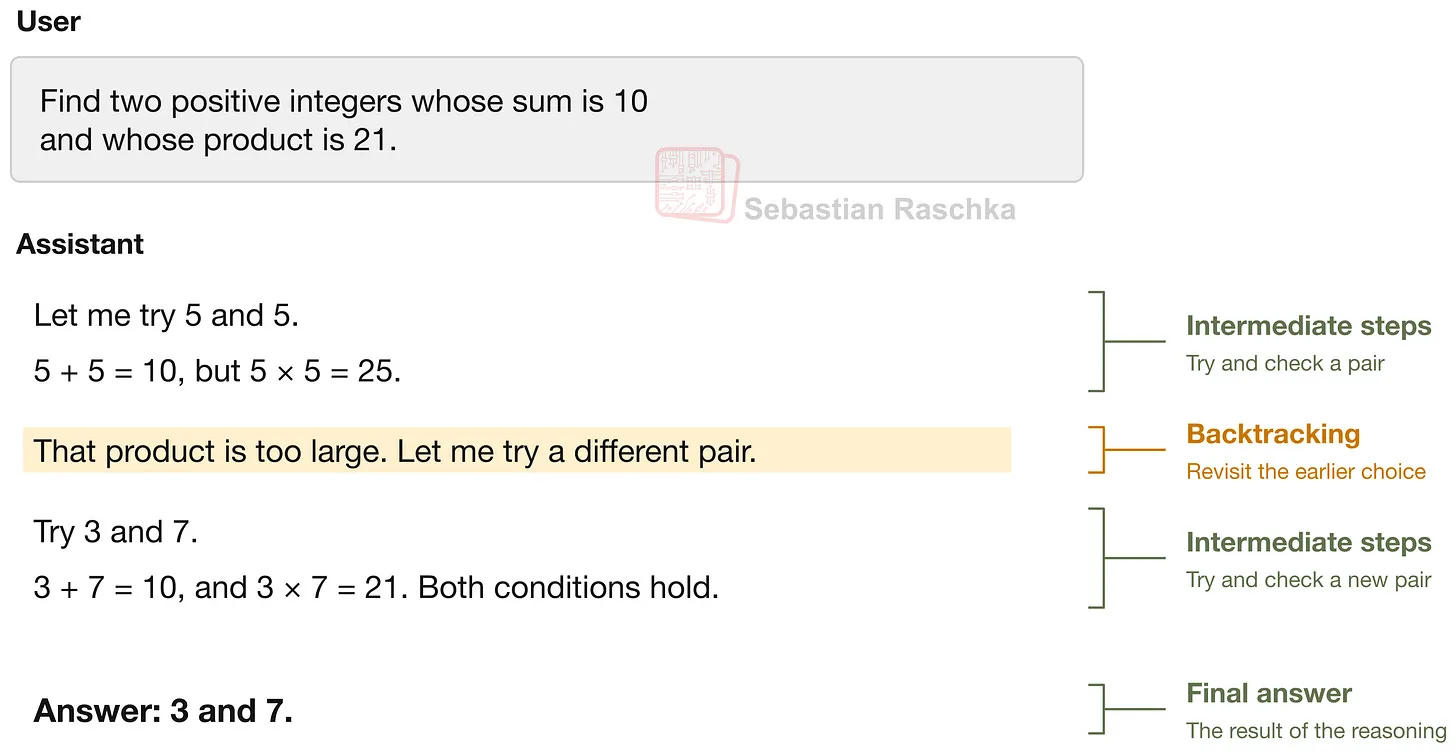
图8:通用Transformer中的自适应停止机制
循环Transformer的另一个案例是字节跳动的Ouro模型(https://arxiv.org/abs/2510.25741),我同样在架构图鉴(https://sebastianraschka.com/llm-architecture-gallery/looped-depth-sharing/)里介绍过。比如Ouro-Thinking 2.6B会把同一组48个Transformer块执行四轮,也就是总计192次块执行,但只需要存储48个独立块的权重。本质上这是比Nanbeige更极端的循环设计。此外,它还设计了一个可学习的出口门控,为不同出口分配概率,通过累计概率的阈值来决定用哪一轮的输出。也就是说,它也借鉴了通用Transformer的自适应停止思想,而Nanbeige没有采用这一点。(不过这里有个实际细节:已开源的modeling_ouro.py(https://huggingface.co/ByteDance/Ouro-2.6B-Thinking/blob/main/modeling_ouro.py)会先算完所有配置好的轮次再选择输出,因此循环次数实际上相当于硬编码为4次。)
2.4 灵活循环次数的路由机制
还有一种思路是递归混合(Mixture-of-Recursions,MoR)(https://arxiv.org/abs/2507.10524),这篇2025年的论文可以看作通用Transformer的更复杂版本。和通用Transformer类似,每个令牌会经过一次或多次Transformer块计算,如下图所示;其创新点在于,循环次数是按令牌粒度通过路由机制动态决定的。
在下图中,被循环(重复)的层栈被称为递归块(recursion block),包含若干个Transformer块,夹在首尾独立的Transformer块(标注为Layer 0和Layer L-1)之间。
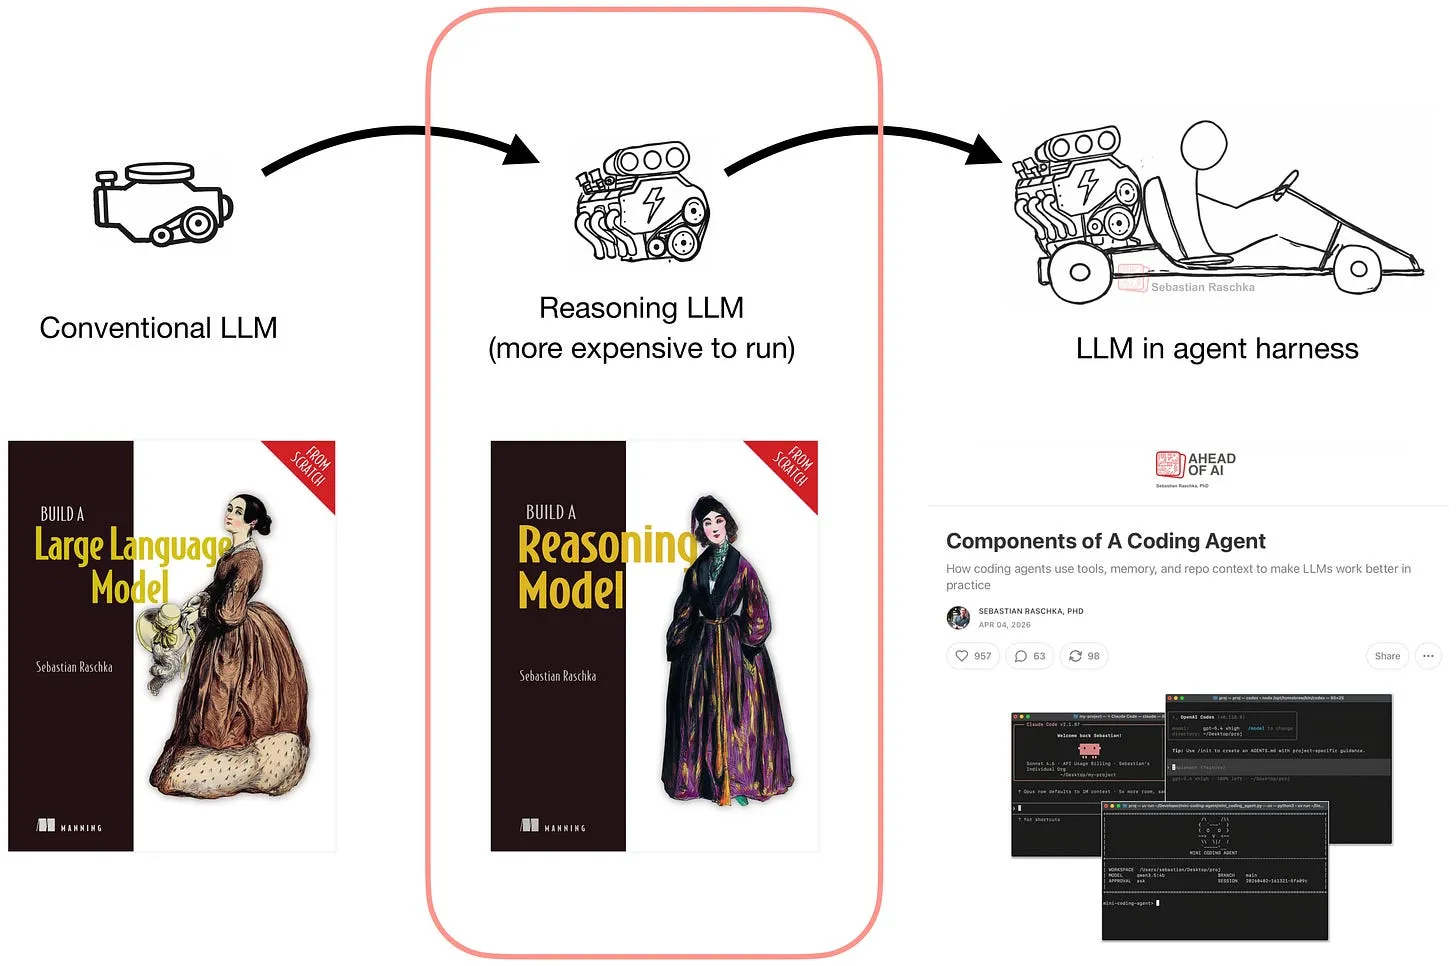
**图9:递归混合架构会在不同令牌位置执行不同次数的共享层栈。图中标注的示例分别经过了1、2、3轮循环。图片改编自:https://arxiv.org/abs/2507.10524**
模型如何决定一个令牌要经过多少次递归块?前面讲的通用Transformer是基于每一步的可学习停止概率,而递归混合方法使用的是一个小型可学习路由器。这和混合专家模型中的路由思路类似,只不过这里的路由决策决定的是共享层栈要被执行多少次。
路由器基于令牌的隐藏表示进行决策,而隐藏表示本身也包含上下文信息。因此不要误以为同一个词每次都会分配相同的循环次数(比如图里的“People”不会永远走3轮循环)。决策会根据单词出现的位置、上下文内容动态变化。
那么具体的路由机制是怎样的?论文探索了两种路由决策方式,如下图所示。
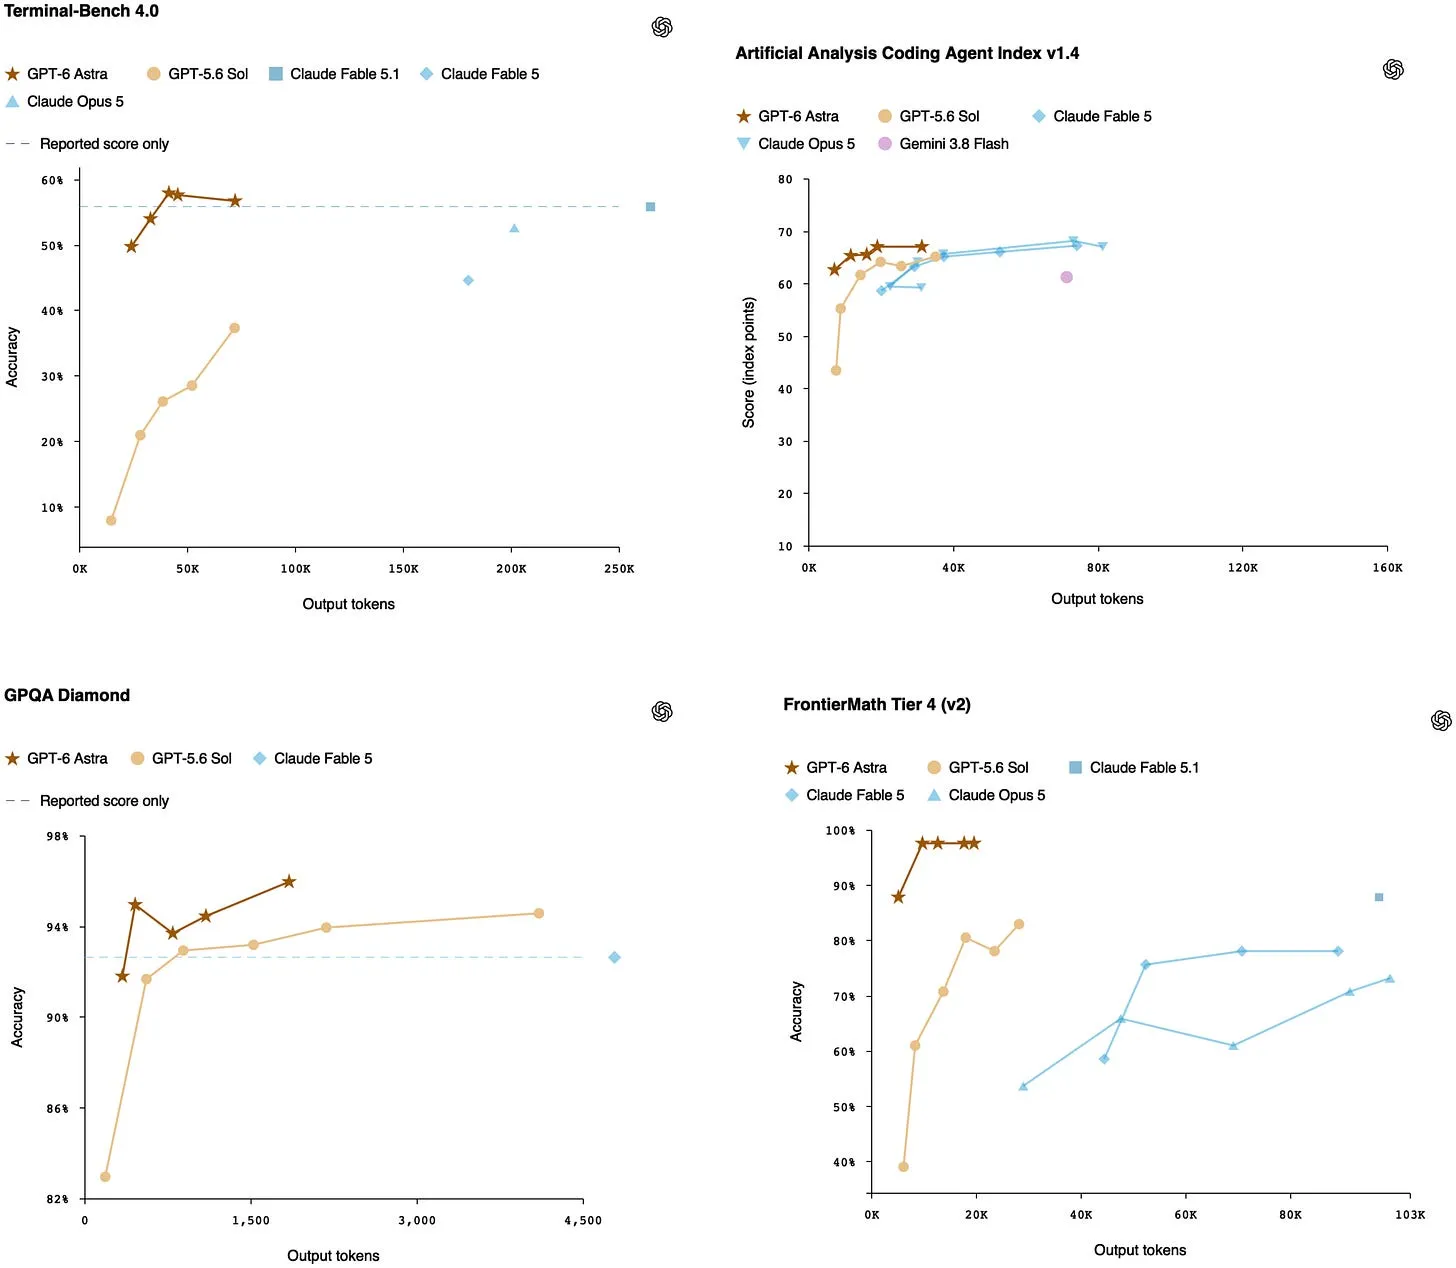
**图10:两种递归深度选择方式。左图:每一步由路由器选择哪些令牌继续参与计算;右图:由单个路由器在一开始就分配每个令牌的循环次数。图片来源:https://arxiv.org/abs/2507.10524**
- 专家选择路由(expert-choice routing):对应左图,每一轮递归都会筛选出要继续处理的令牌,已退出的令牌不再参与后续轮次。
- 令牌选择路由(token-choice routing):对应右图,路由器在最开始就一次性完成决策,给每个令牌分配1轮、2轮或3轮的路径。
两种方式下,Transformer权重都在各轮之间复用,和Nanbeige等模型的逻辑一致。额外的灵活性来自于“每个令牌获得多少计算量”的动态分配。模型和路由器是联合训练的,因此模型会在训练中学会适配不同的路径。
2.5 实际效果如何?
下面这张来自递归混合论文的图,对比了普通Transformer(Vanilla)、固定递归Transformer(Recursive)与递归混合架构(MoR)在不同模型尺寸和训练计算预算下的表现(横轴为计算量)。
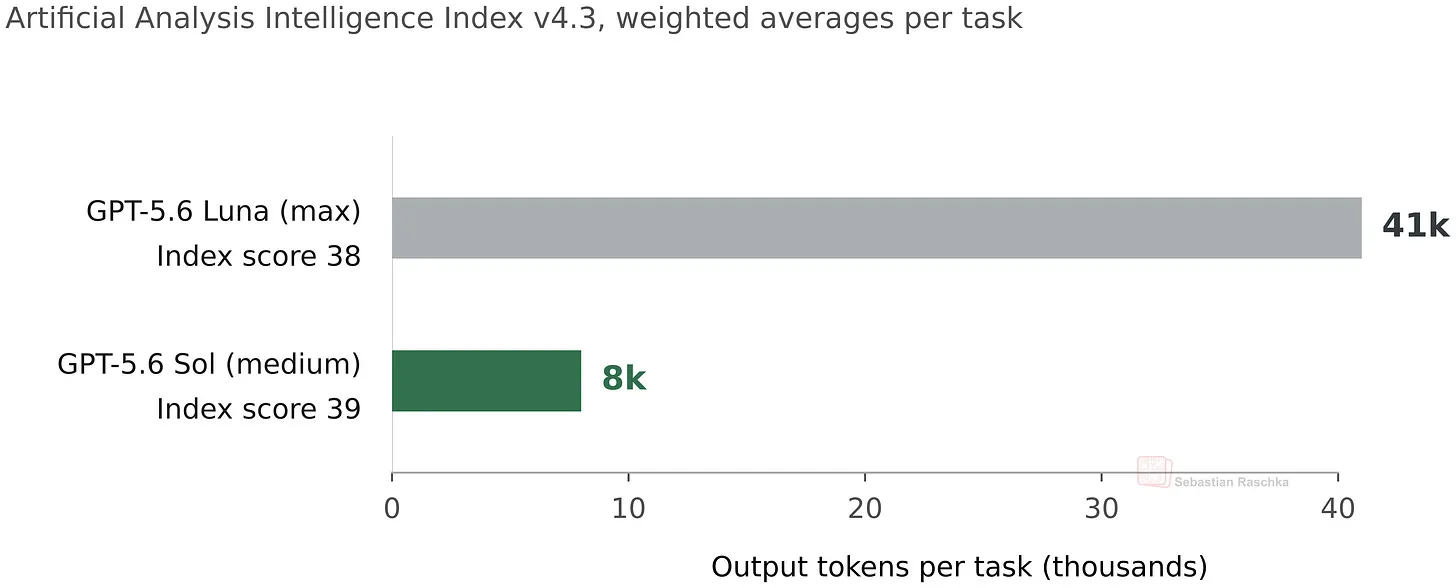
**图11:四种模型尺寸、三档训练计算预算下的验证损失。图片来源:https://arxiv.org/abs/2507.10524**
在最小模型尺寸下,普通Transformer表现最好。随着模型尺寸增大,递归混合架构会追上来,并且往往表现更优,尤其是在训练预算较小的时候。在最大预算下,多条曲线已经非常接近。因此,优势大小取决于模型规模和训练投入的计算量。
另外补充一个细节:训练计算量相等,不代表训练令牌数相等。通过跳过部分计算,递归混合架构可以在相同预算下处理更多令牌。
我觉得这个例子很有价值——它说明循环Transformer的理念之下,其实有很多细分设计选择,比如每个位置的循环次数、以及决策方式。
简而言之:只要模型尺寸足够大,循环Transformer确实能在固定计算预算下提升模型质量。(这也体现了大规模实验的重要性:如果只看1.35亿参数的小模型,我们会得出完全相反的结论。)
3. 补充:循环神经网络(RNN)
顺带一提,如果你有深度学习背景(甚至了解90年代的人工神经网络),“循环”或者说“循环深度”的思路应该会有点眼熟。还记得循环神经网络(RNN)吗?RNN的核心思想就是复用前一个时间步的层(权重)。
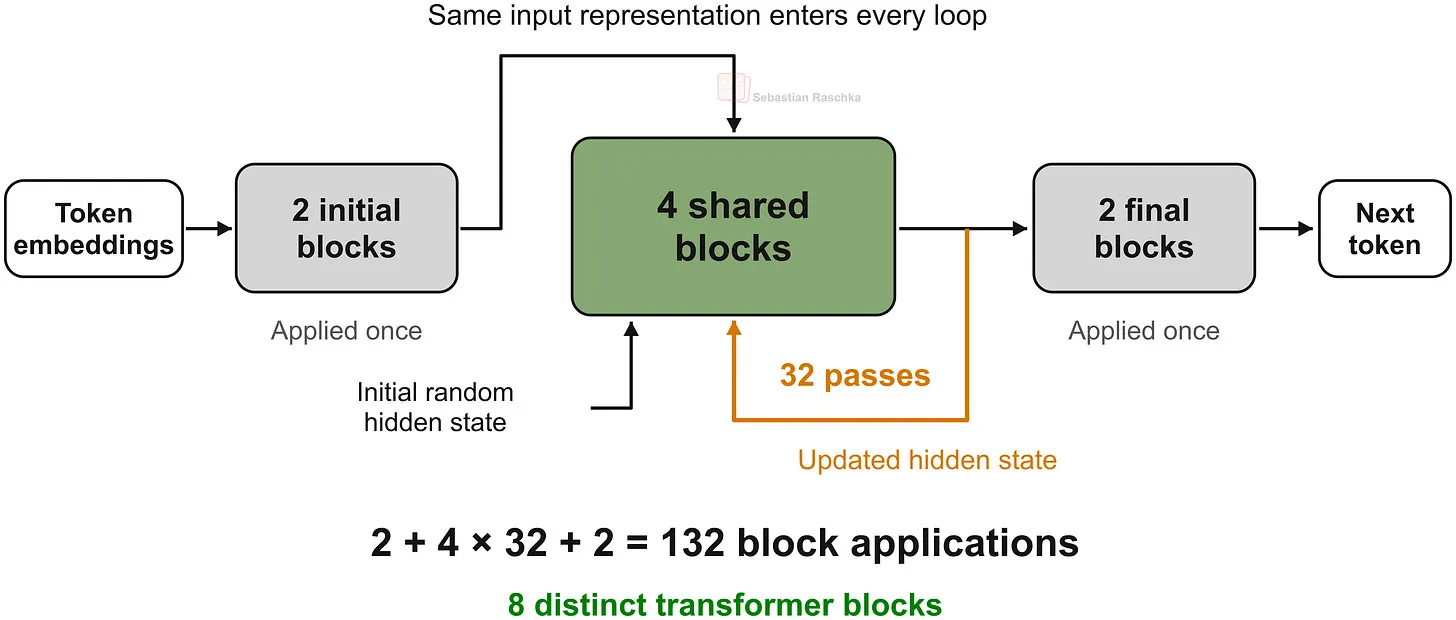
图12:RNN示意图(出自我2022年的《PyTorch与Scikit-Learn机器学习》一书,https://amzn.to/3YzRnPR)
二者最核心的区别在于:RNN是跨时间步复用权重,也就是把隐藏状态从前一个令牌传递到下一个令牌;而循环Transformer是在架构深度维度对单个令牌进行循环计算。
换句话说,传统RNN每一步都会接收输入序列中的下一个元素,以及上一步的隐藏状态。因此当RNN处理一段文本时,它会逐词、逐令牌地读取,把前文的信息保存在隐藏状态中向后传递。
而在循环Transformer中,单个令牌的中间表示会多次经过Transformer层栈,模型仍然通过注意力机制在令牌之间传递信息。
如果这个类比让你觉得更困惑了,也不用太纠结。更简单的理解方式是:循环Transformer就是复用Transformer块,相当于用权重共享的方式“放大”模型深度。
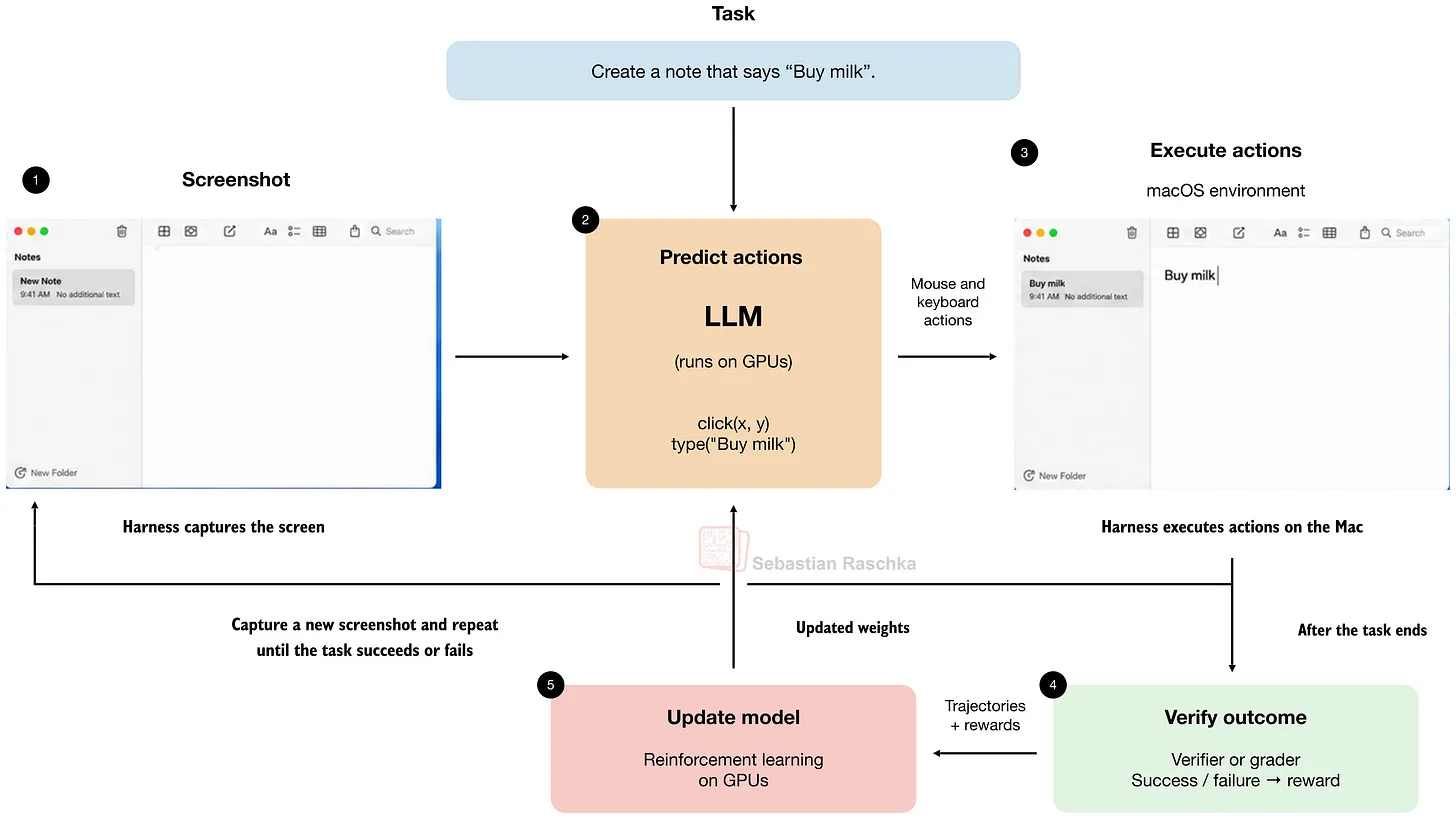
图13:RNN与循环Transformer中“循环”概念的对比
4. Astra真的用了循环Transformer吗?
在讨论“循环Transformer机制是否会掩盖推理轨迹”之前(也就是前面《The Information》引述的传闻),我们先问一个更基础的问题:GPT-6 Astra真的用到了循环Transformer的设计吗?
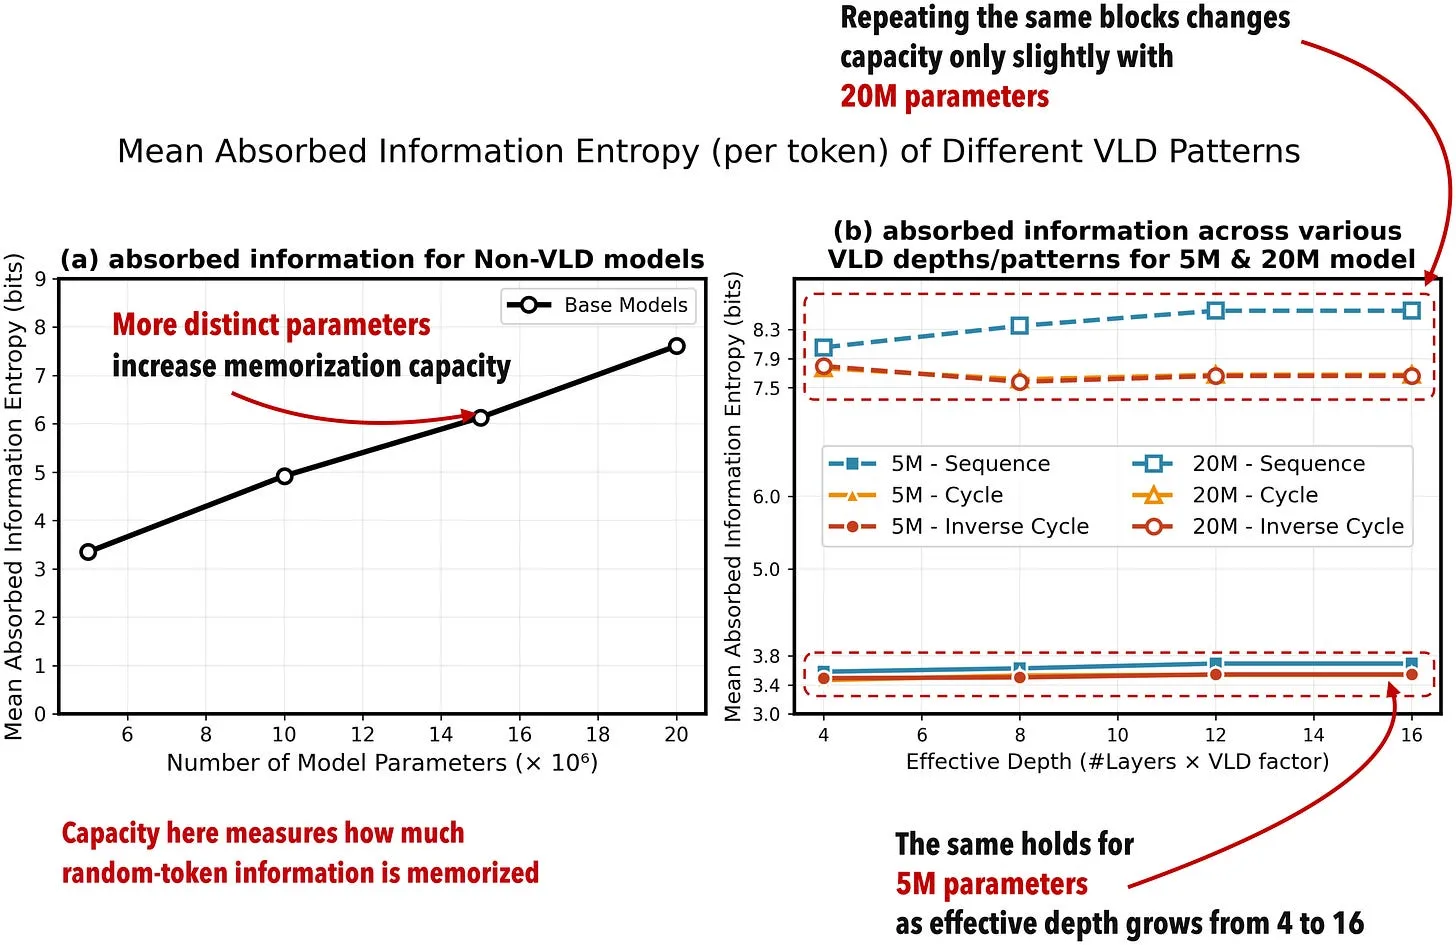
图14:《The Information》报道引用(来源:https://www.theinformation.com/articles/secret-technique-behind-openais-astra-model-sparks-security-concerns)
我们必须明确:这目前还只是传闻/独家爆料,没有官方确认。如果是开源权重的模型,我们当然可以自行验证,但现在只能依赖未经证实的媒体报道。
不过我认为,GPT-6 Astra使用了循环Transformer相关设计的可能性很高。原因有三:
- 有上述媒体报道作为依据;
- 这项技术在过往研究中已经展现出价值,没有理由不用;
- OpenAI首席科学家也有相关表态(https://x.com/merettm/status/2095023204993490967?s=20):
……我们当前前沿模型(包括Astra)的计算图深度,和GPT-4相比在2倍以内。……
但这句话并没有明确证实循环Transformer架构,也可以理解为他们只是用了两倍数量的普通Transformer块。
在我看来,Astra成功的核心原因,大概率还是训练方案与训练数据的优化。循环Transformer的改动可能有一定助益,但我认为《The Information》高估了它的贡献。
5. 关于“隐藏思维链”
接下来终于可以聊核心问题了:循环Transformer真的会让推理轨迹变得不可观测吗?
首先要说明,其实从o1系列开始,OpenAI就已经对用户隐藏了(大部分)推理轨迹。所以对终端用户来说,体验上不会有太大差别。
因此,所谓的“可解释性担忧”,更多是针对模型开发者层面的。
无论如何,我都不认为循环Transformer是隐藏或掩盖思维链的主要原因。要讲清我的判断(没有双关的意思),我们先退一步,说说推理模型到底是怎么工作的。
5.1 推理机制简述
推理模型通常会先生成中间步骤,再输出最终答案。这些步骤由普通的文本令牌组成(在部分界面中会对用户隐藏),被称为推理轨迹或思维链。
举个例子:假设我们要求找出两个数,满足和为10、乘积为21。在下图中,模型一开始试了5和5,和是对的,但乘积是25不是21;接下来它试了3和7,再重新校验两个条件。
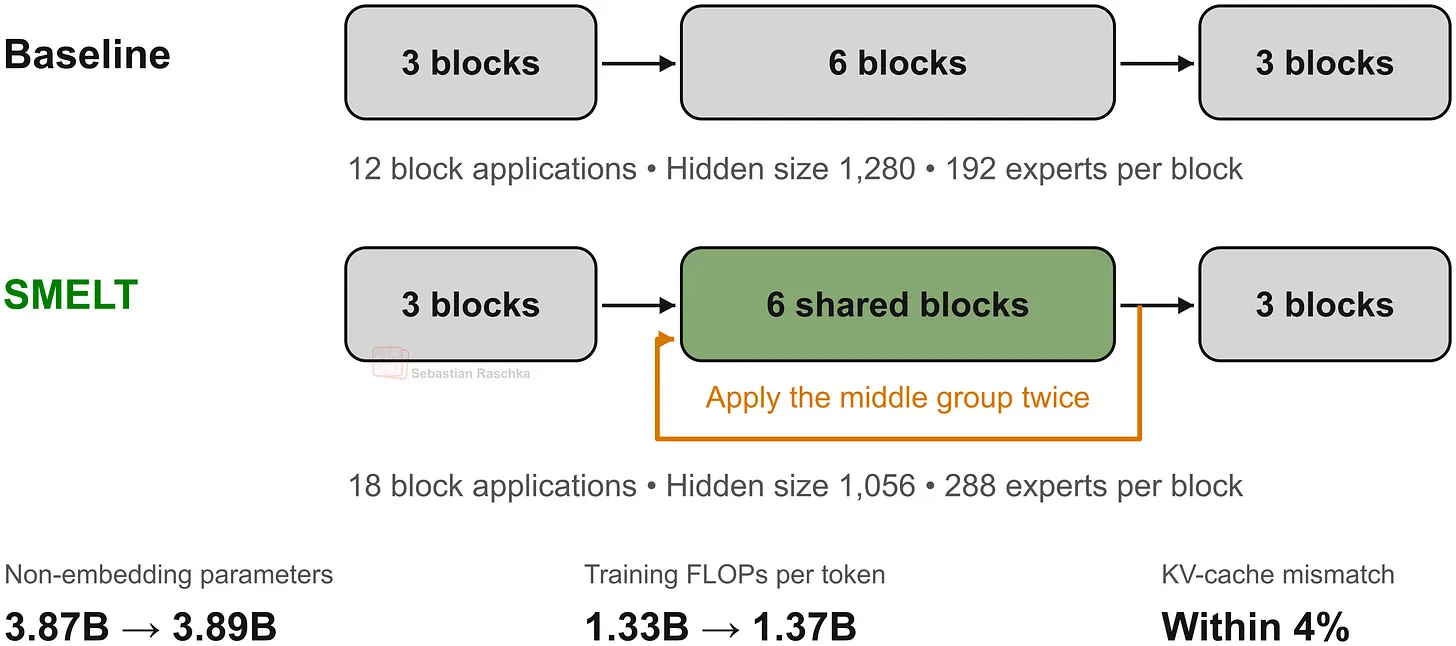
图15:大语言模型回复示例,标注了中间步骤、回溯过程与最终答案
这张图展示了推理模型的“思考”方式,包括回溯——也就是模型发现错误后,回到之前的决策点,换一种思路继续推导。
注意模型仍然是逐令牌生成的,以提示词和已生成令牌为上下文。因此这些中间步骤相当于一块“草稿纸”,在输出最终答案之前增加了计算量。
最终答案可以比前面的推理轨迹短得多,如上图示例所示。(OpenAI倾向于对用户隐藏大部分推理轨迹。)
想更深入了解推理模型的原理与开发,推荐阅读我的书:https://amzn.to/4aAKiFY
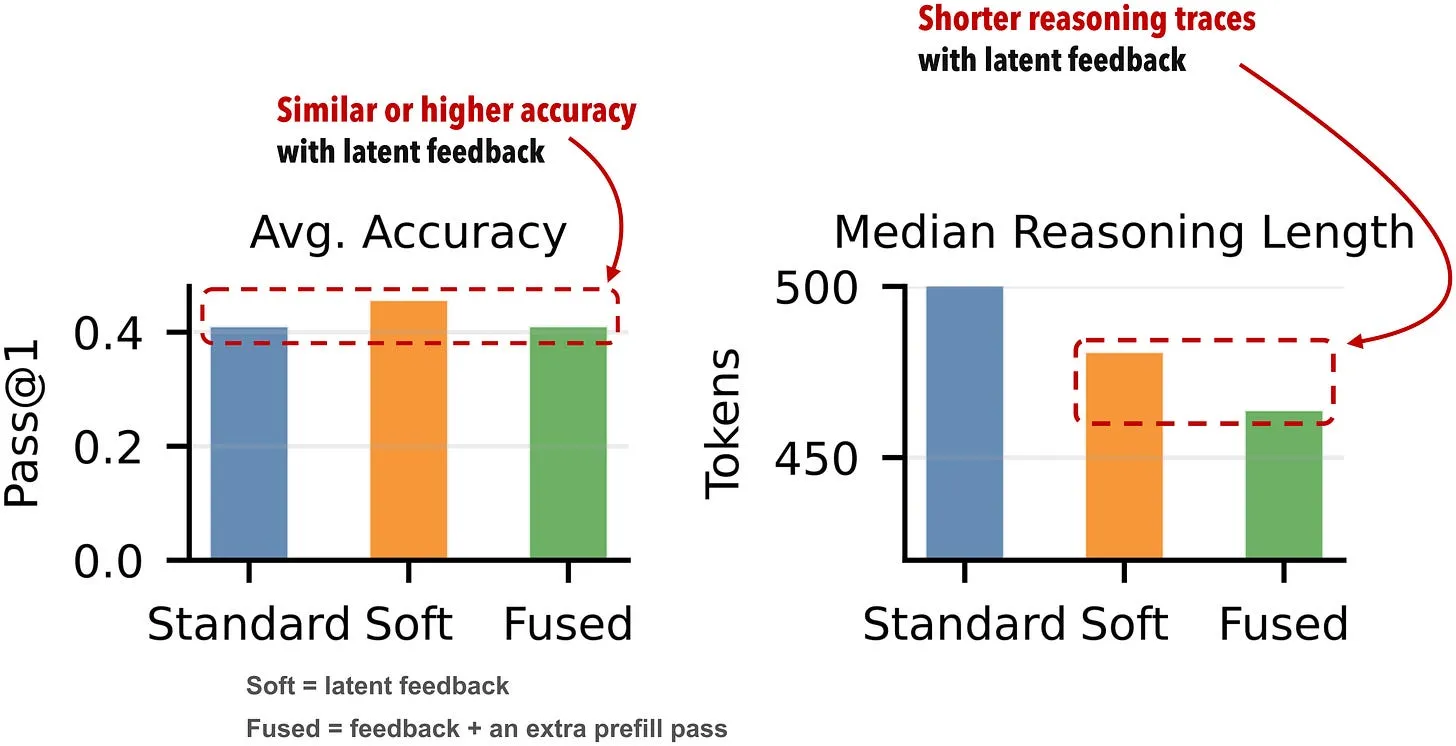
图16:我的《推理模型构建》一书(https://amzn.to/4aAKiFY)覆盖了推理模型的基础原理
5.2 令牌用量与更短的思维链
推理轨迹中的额外令牌会带来更多计算。循环Transformer也会增加计算,因为令牌要经过更多次Transformer块。有人可能会说:带循环设计的模型内部计算量更高,就不需要那么多外部的“思考令牌”了。
下图选取了OpenAI官方发布的部分基准测试结果(https://openai.com/index/gpt-6-astra/),横轴为输出令牌数。
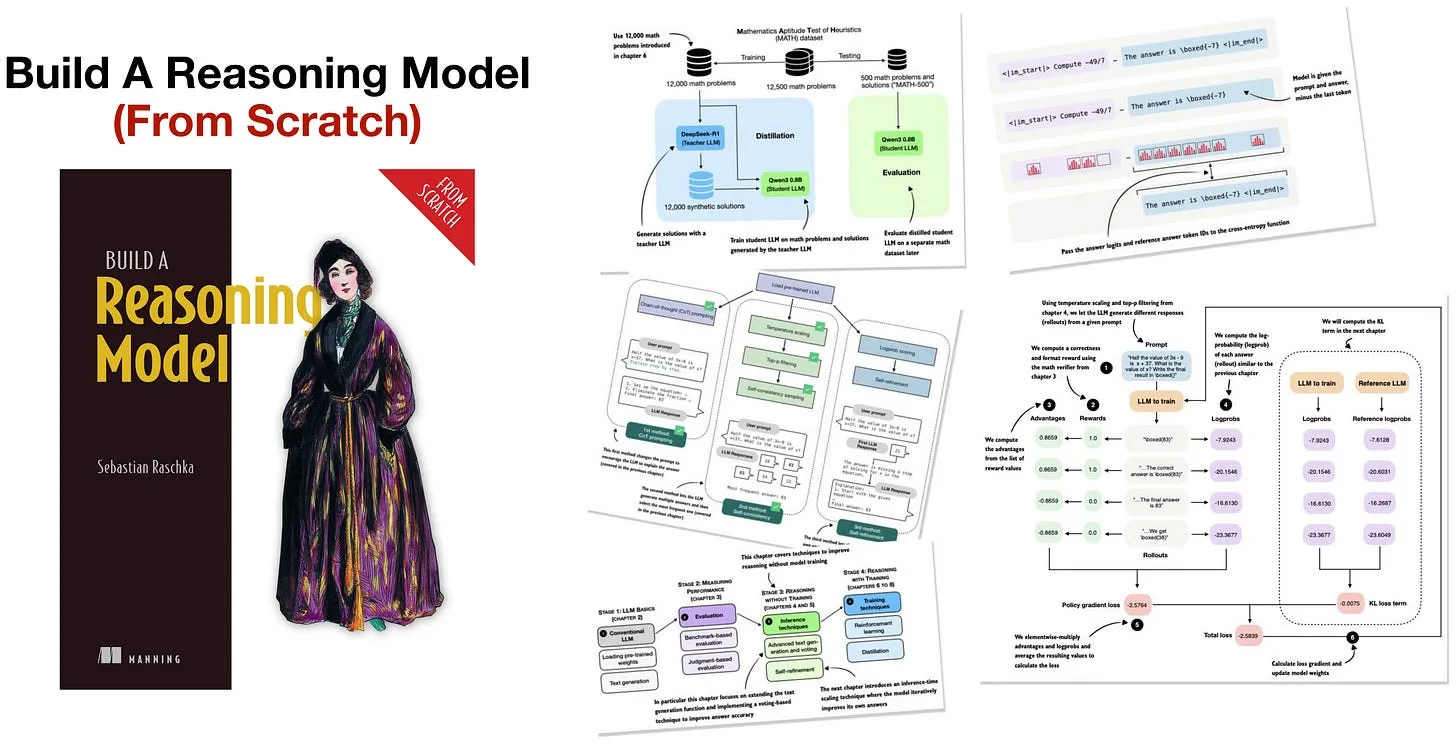
**图17:GPT-6 Astra部分基准测试结果,来源:https://openai.com/index/gpt-6-astra/**
可以看到,整体来看,跨不同算力档位,GPT-6 Astra并不一定比前代GPT 5.6 Sol用的令牌更少。但在相同准确率下,GPT-6 Astra确实比GPT 5.6 Sol消耗更少的令牌。
这会带来可解释性方面的问题吗?不一定。令牌用量更少,可能只是因为模型能力更强,犯错更少,回溯也更少——换句话说,它很多问题一步就做对了。在我看来,这并不会直接引发可解释性方面的担忧。
毕竟前代模型也是同样的规律。没人会觉得GPT 5.6 Sol比更小的GPT 5.6 Luna可解释性差很多吧?但Luna完成同等任务时,用的令牌要多得多,如下图所示。
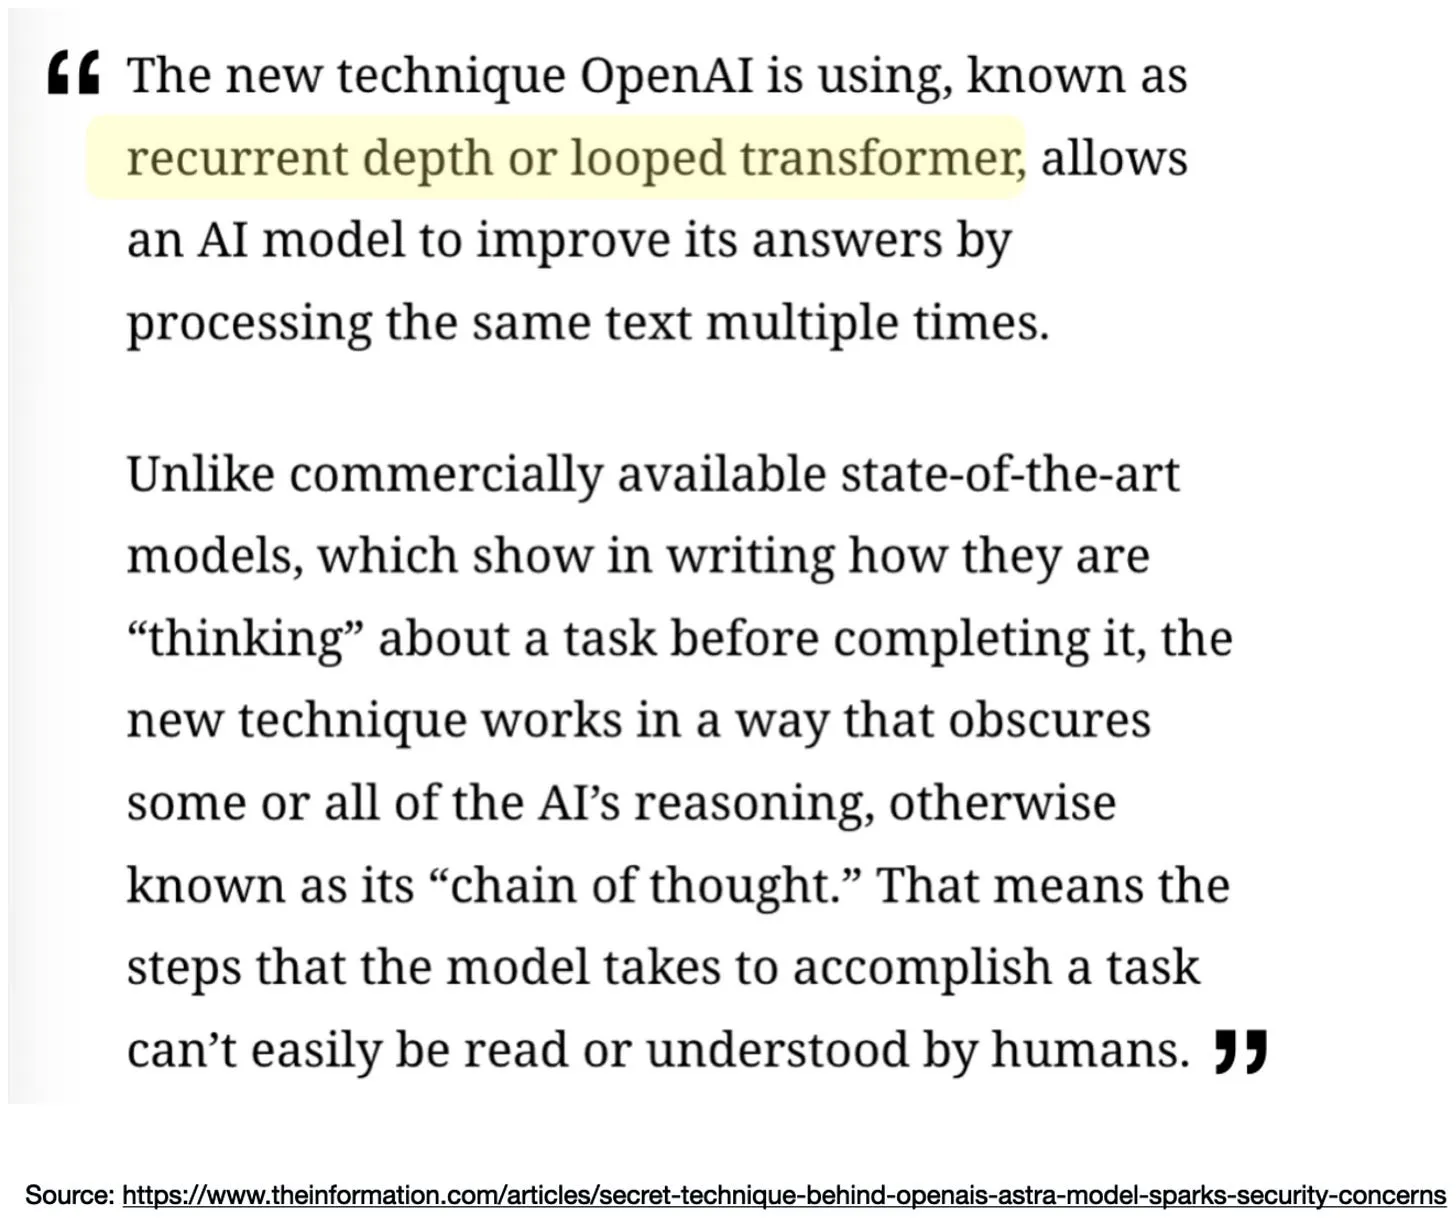
**图18:相近任务表现下,Luna与Sol的令牌用量对比。数据来源:https://artificialanalysis.ai/#intelligence**
实际上,在相近的模型表现下,Luna比Sol多用了80%的令牌。难道Sol就因此更难解释了吗?
更合理的解释是:能力更强的模型(规模更大、训练更充分、计算量更高)解题效率更高,这里的“高效”就是指用更少的令牌。
另外还要记住:推理轨迹并不等同于模型内部发生的一切(https://arxiv.org/abs/2305.04388)。在我看来,唯一值得担忧的情况是:循环Transformer会比传统Transformer更频繁地生成“虚假”推理轨迹,故意误导用户。但目前我们没有任何有力证据证明存在这种现象。
诚然,Astra的系统卡确实提到,其推理轨迹的可监控性有所下降,和Sol相比有一定程度的倒退。这主要和轨迹更短、信息量更少有关。但这同样不能证明循环是根本原因——这可能只是整体长度缩短带来的现象,和前面Luna与Sol的例子是一样的。
我在X上分享了关于“循环Transformer与隐藏思维链”的观点(https://x.com/rasbt/status/2095141254958858496?s=20)几小时后,OpenAI首席科学家Jakub Pachocki也发推回应(https://x.com/merettm/status/2095023204993490967?s=20):
我不希望被混乱的报道带偏,引发一场“奔向不可监控”的竞赛。我们当前前沿模型(包括Astra)的计算图深度,和GPT-4相比在2倍以内。从最早的推理模型开始,OpenAI就一直致力于保留并利用思维链监控能力。我们非常重视这项技术,因为它能让我们观察模型对齐能力在训练分布之外的泛化情况。我承认这项技术目前比较脆弱,而且不幸正在朝负面方向发展——但原因和架构改动无关,我很快会专门写文章说明。不过我们有办法强化它,这也是我们当前研究项目的核心目标。
这里的“混乱的报道”大概率就是指《The Information》的那篇文章,言下之意就是:循环设计和思维链的变化并没有什么关系。
6. 循环Transformer相关研究
最后,我想再分享几篇前面没提到的、和循环Transformer架构相关的有意思的论文。
6.1 隐式推理
和通用Transformer一脉相承的,是2025年的这篇论文(https://arxiv.org/abs/2502.05171),研究模型如何在推理时增加循环轮次。他们训练了一个35亿参数的模型——不算特别大,但也不是小模型,训练数据量为8000亿令牌。
和通用Transformer反复执行同一个块不同,它像Nanbeige一样重复一整组层栈;但和Nanbeige不同的是,这组共享的4个块被夹在2个初始块和2个末尾块中间。
另一个和Nanbeige的区别是:每一轮循环开始时,共享层栈除了接收上一轮的隐藏状态,还会拼接初始块的输出,再经过一个可学习的线性投影,才进入四个共享块。你可以理解为:每一轮循环,层栈都能访问到同一份初始输入表示。整体结构如下图所示。
简而言之,这是一种很有特点的循环Transformer变体。
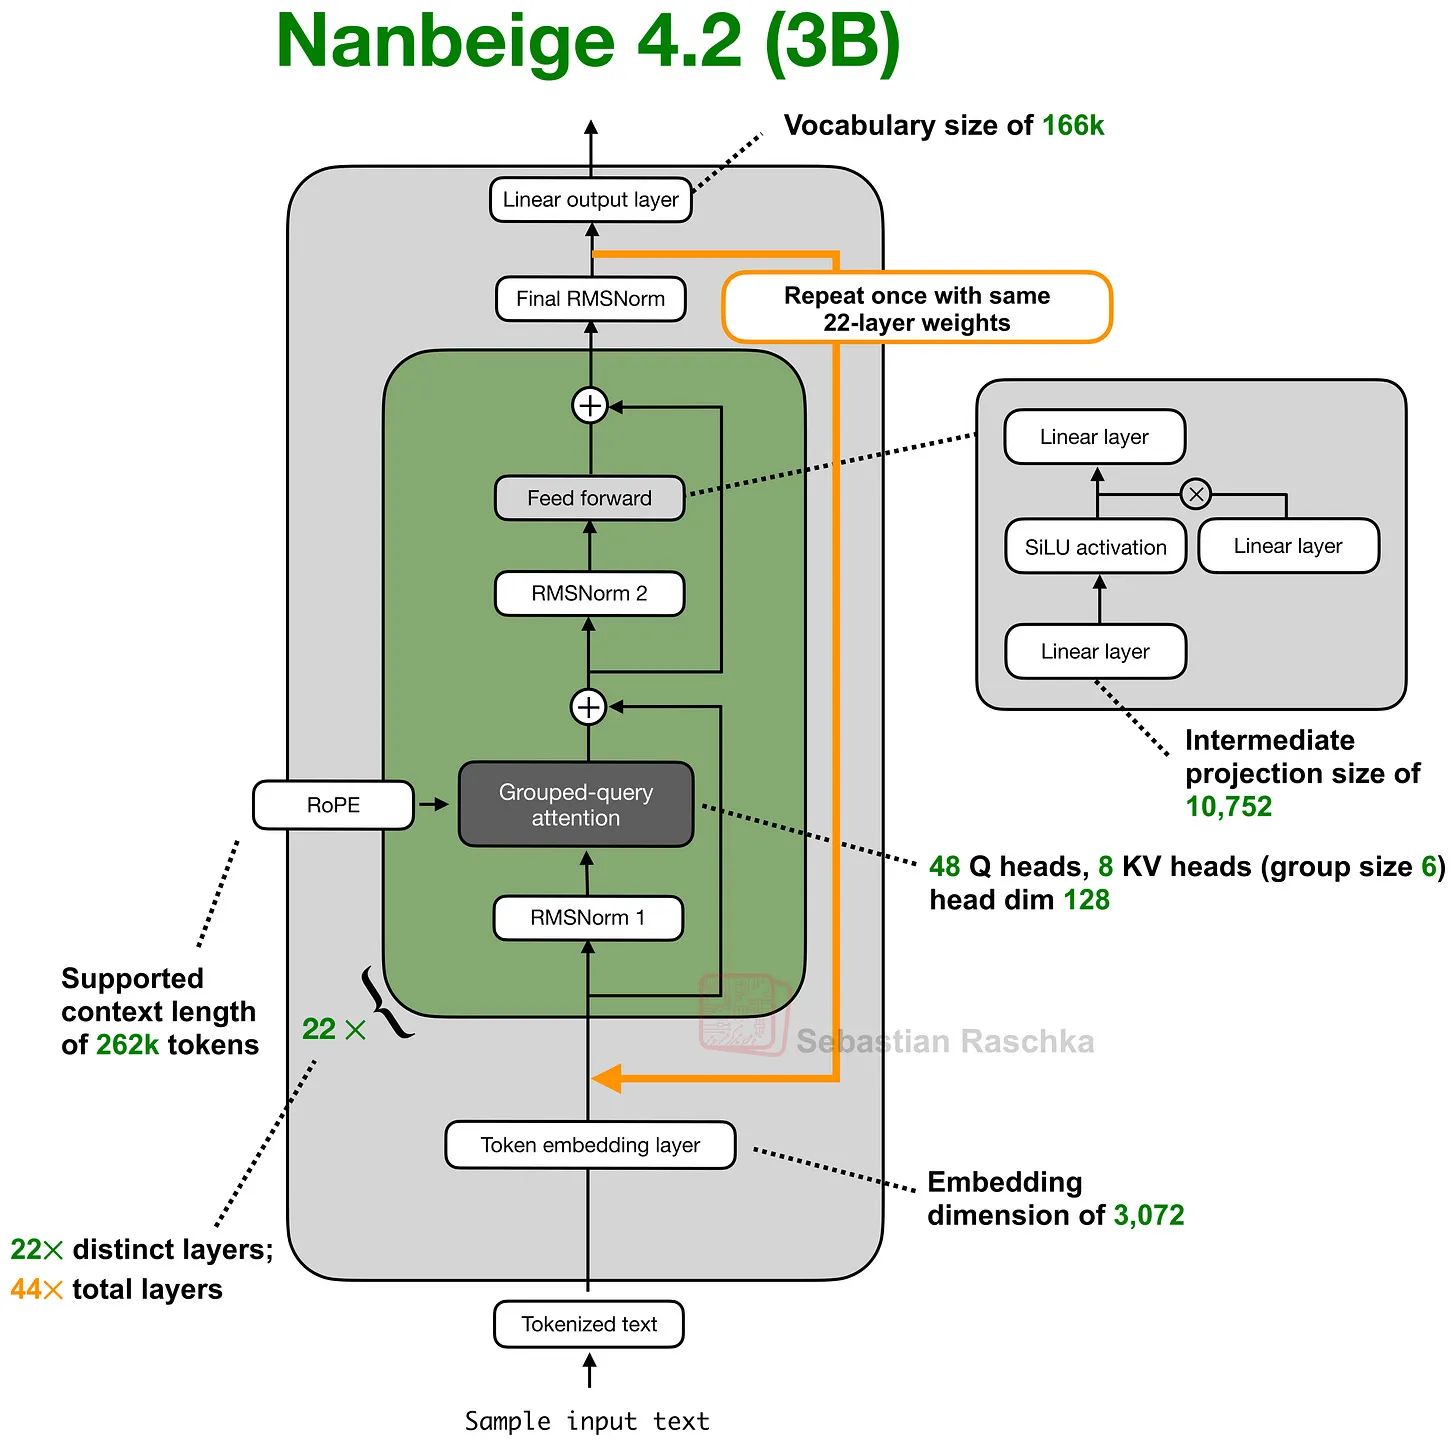
**图19:隐式推理模型的概念总结,来源:https://arxiv.org/abs/2502.05171**
一个有意思的细节是:研究人员在训练时会随机变化循环次数,让模型适配推理时不同的计算预算。
训练过程中,循环次数是随机采样的;推理时,运行模型的人可以选择固定算力预算,比如8轮、32轮或64轮。此外,他们还为每个令牌设计了自适应停止机制:如果连续两轮的下一个令牌概率分布之间的KL散度低于某个阈值(也就是分布过于相似),就停止该令牌的循环。
整体收益因任务而异。在他们的评测中,HellaSwag的表现在大约8轮循环后就基本持平,而GSM8K和HumanEval则能从更多轮次中持续获益。
不过,尽管论文标题提到了“隐式推理”,模型仍然可以生成文本形式的思维链。循环只是在每个输出令牌之前,给模型增加了额外的内部计算。
6.2 知识检索 vs 推理能力
“存储信息”和“用信息解题”是两个可以分开讨论的能力。比如2025年6月的这篇论文(https://arxiv.org/abs/2506.18233)就分别测量了大语言模型的记忆能力与推理能力。
首先,在记忆实验中:当参数量固定时,循环几乎不会改变模型的信息存储量;只有增加独立参数的数量,才能提升记忆容量。由此我们可以得出结论:循环不会增加模型的知识储备,也不能让模型检索到更多知识。这也符合直觉——信息检索本身是相对简单的任务,前提是信息已经被存储下来;而且循环本质是计算机制,不是“存储机制”。
其次,在单独的推理实验中,复用块能在不增加参数的前提下,提升多步数学题的表现。这一点很有意思:哪怕没有更多存储空间,额外的计算也能帮助模型解题。当然,更大的模型同样能提升推理能力,只不过它们同时也增加了参数。
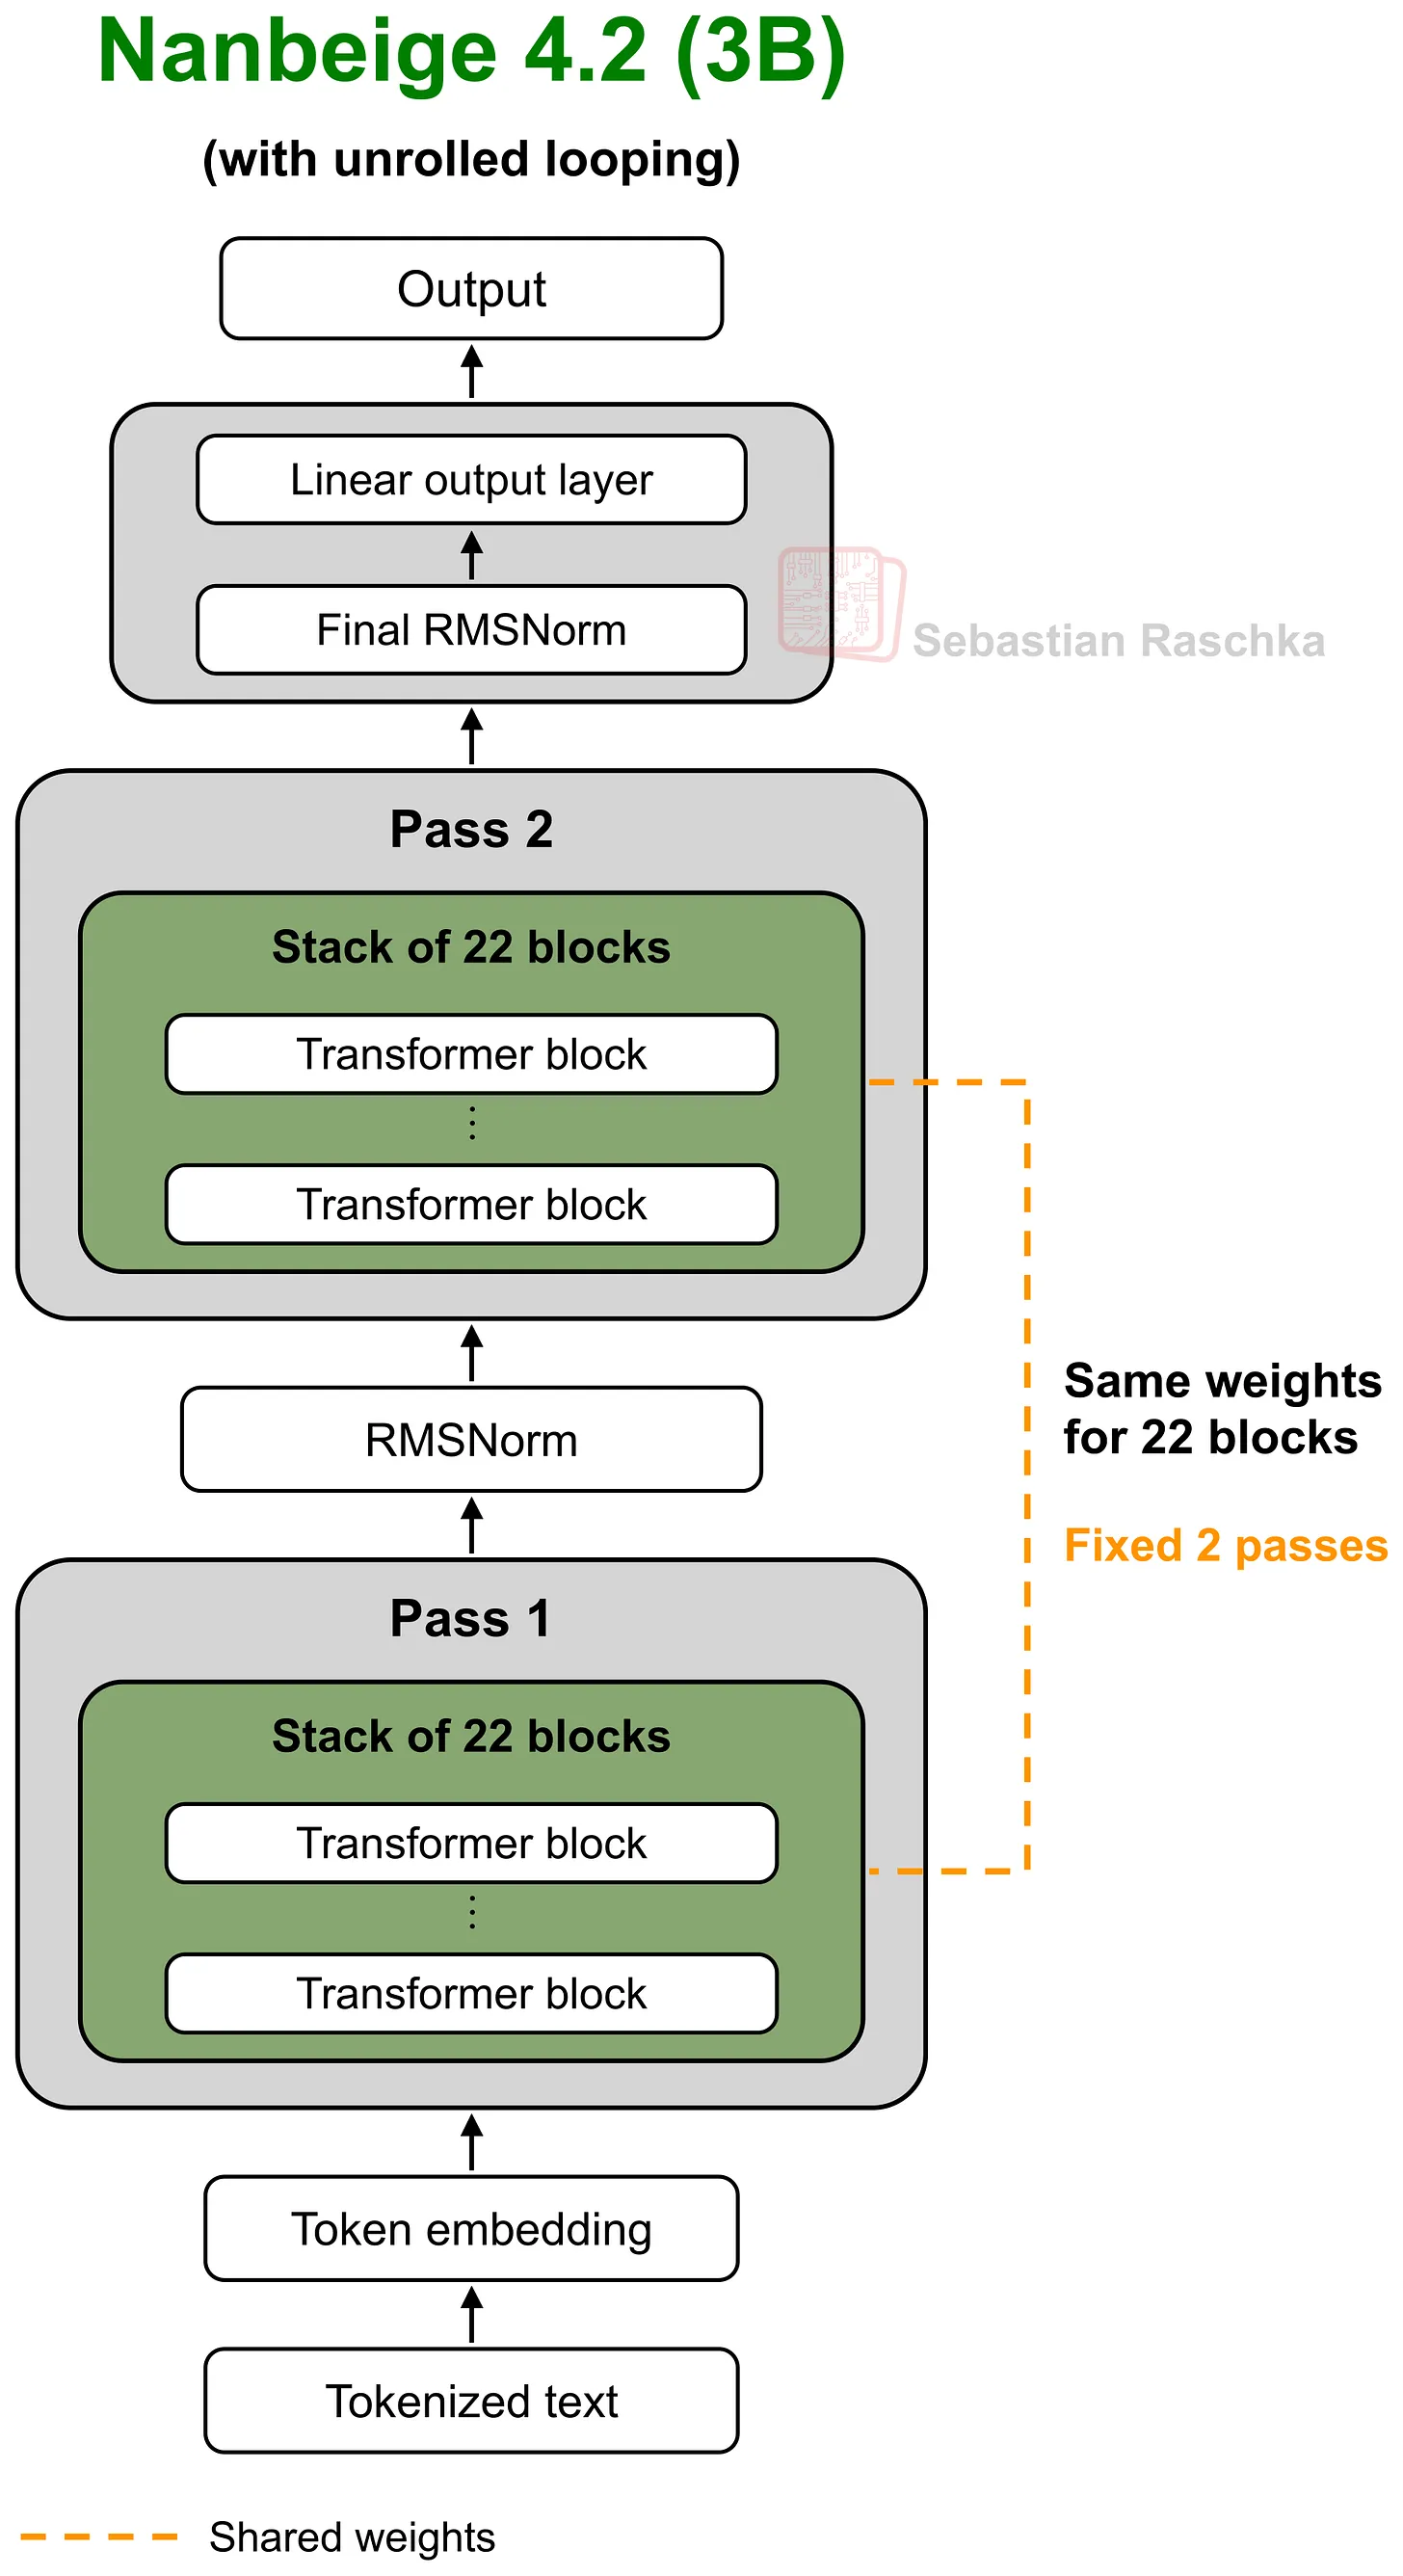
**图20:记忆测试中,容量随参数量增长,但随块执行次数增加变化很小。标注图改编自:https://arxiv.org/html/2506.18233v3**
6.3 对等计算预算下的循环设计
2026年9月刚发布的这篇论文(https://arxiv.org/abs/2609.01343),回应了第2.2节提到的成本对比问题:如果让循环Transformer和传统Transformer保持相近的单令牌计算量、相近的非嵌入总参数量、以及相近的KV缓存需求,对比结果会怎样?
研究人员使用了混合专家架构,把中间一半的Transformer块执行两次——思路和Nanbeige类似,只不过像隐式推理那样做成了“夹心”结构。
为了抵消额外块执行带来的计算开销,他们缩小了隐藏维度;而这会减少参数量,于是他们又通过增加专家数量,把总参数量补回来。同时他们还调整了注意力头的配置,保证KV缓存规模相当。
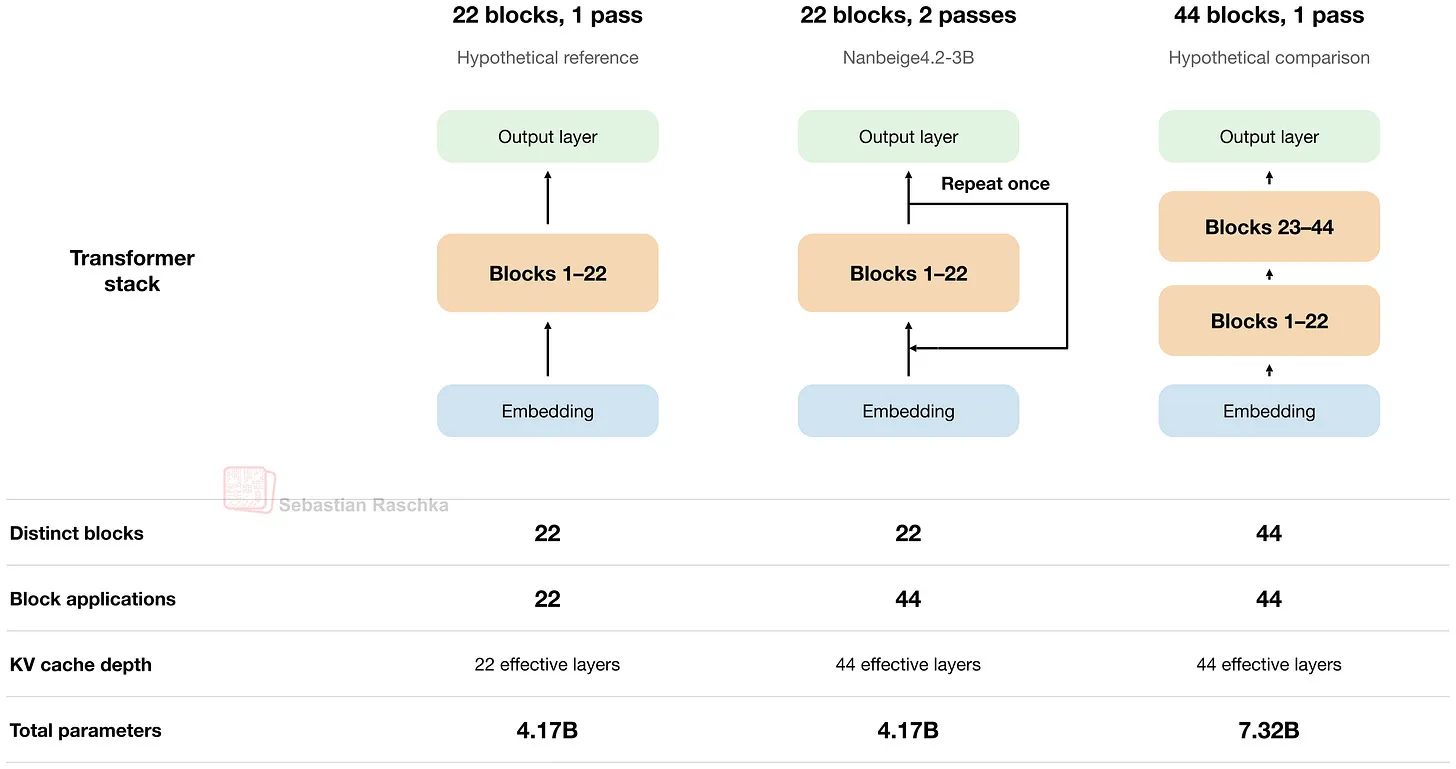
**图21:SMELT架构概览,示例来自:https://arxiv.org/html/2609.01343v1**
实验最大扩展到了540亿非嵌入参数规模。通过拟合缩放定律曲线,研究者估计:在研究覆盖的计算范围内,SMELT达到相同验证损失所需的训练计算量减少了约6.8%–18%。
这也就回答了“循环Transformer在计算上到底值不值”的问题:值!在相同计算预算下,它能带来更好的模型效果。
6.4 全带宽Transformer
最后,同样是2026年8月的最新论文(https://arxiv.org/abs/2608.08888),研究的是跨令牌位置的循环机制。每一步解码时,它会通过一个可学习的门,把前一个令牌的顶层隐藏状态,和新采样令牌的嵌入融合在一起,作为下一次前向传播的输入。
也就是说,下一个令牌的计算,能从层栈底部就获取到前一个令牌的最终表示——这和隐式推理的思路有相似之处。
在10亿参数的基础模型上,他们发现这种隐式反馈方法,能让MATH500数据集上的推理轨迹更短,同时保持甚至提升准确率。不过经过指令微调后,这种缩短效应就消失了。
图22:基础模型中隐式反馈会缩短推理轨迹,但指令微调后该效应消失。改编自:https://arxiv.org/html/2608.08888v1,https://creativecommons.org/licenses/by/4.0/ 。已补充定义与说明。
不管怎样,这个研究很有意思,因为它直接关联到前面“循环会不会让推理轨迹变短”的讨论。当然,具体结果既和反馈机制有关,也和模型训练方式有关。而且这项实验并没有验证:如果不用循环,而是用传统方式增加Transformer块来放大模型,会不会对推理轨迹长度产生类似的影响。
结论
总结一下:OpenAI的GPT-6 Astra确实是一款非常强大的模型,并且在计算机使用能力上实现了尤为显著的突破。我相信,未来数月,计算机使用会成为开源与闭源智能体框架的下一个重点发展方向。我个人尤其看重这一领域的开源进展——毕竟“能力越大,责任越大”,在让智能体访问自己的主力电脑之前,能对框架进行审计总归是更安心的。
此外,GPT-6 Astra很可能使用了某种变体的循环Transformer。毕竟在固定计算预算下,循环Transformer确实能提升模型表现。
而更好的模型表现,可能会带来更短的推理链。但这并不是什么新趋势——同一系列不同尺寸的模型(比如GPT 5.6 Luna和Sol)之间,我们早就观察到了同样的规律。
在我看来,更短的推理轨迹,只是更“聪明”、能力更强的模型带来的副产品:它们犯错更少,也不需要把推理轨迹当草稿纸反复演算,而是可以在架构内部完成更多计算。某种程度上,人类也是如此:一场线下大学数学考试里,聪明又准备充分的学生,往往用的草稿纸更少,也更少需要回头修改。
感谢阅读,感谢大家对我工作的支持!
如果你想从零学习构建推理模型,可以看看我的书:https://amzn.to/4aAKiFY 。书中从预训练大语言模型出发,一步步带你搭建推理能力,附带可运行、可动手实验的代码。这件事既有趣又有成就感,打好基础才能跟上AI领域的发展,是非常值得的自我投资。
如果你读过我的任何一本书,非常欢迎在亚马逊上留下简短真实的评价。评论能帮助其他读者判断这本书是否适合自己,也是对作者非常简单直接的支持。
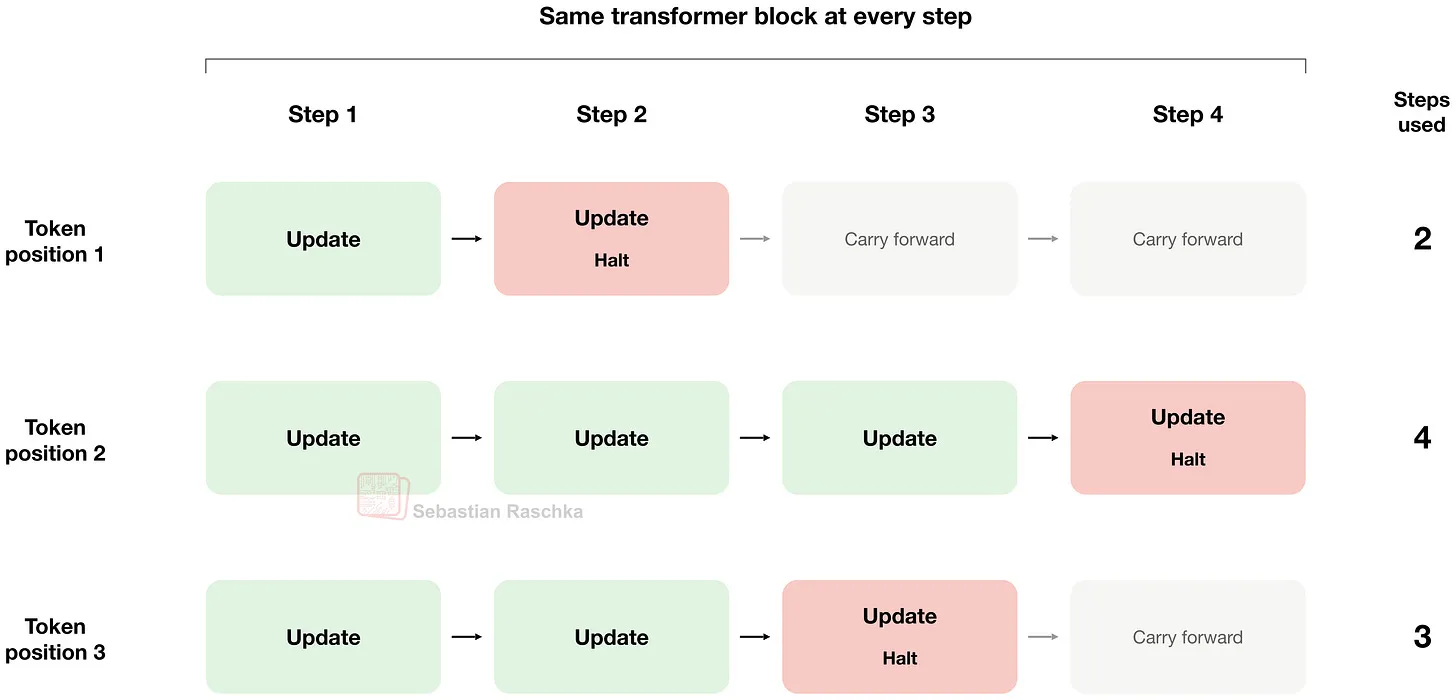
图23:我的《推理模型构建》一书(https://amzn.to/4aAKiFY)中的部分插图,涵盖推理时缩放、知识蒸馏与强化学习等主题。