Borg:Google大规模集群管理系统
Large-scale cluster management at Google with Borg
贡献:容器编排与云原生领域的奠基之作,定义了云原生时代的基础设施调度范式,催生了K8S
Abhishek Verma Luis Pedrosa Madhukar Korupolu David Oppenheimer Eric Tune John Wilkes
Google Inc.
摘要
Google 的 Borg 系统是一套集群管理系统,它承载着数十万计的作业,这些作业来自数千个不同的应用,运行在多个集群之上,每个集群最多可包含数万台机器。
Borg 通过准入控制、高效的任务打包、资源超售、机器共享与进程级性能隔离相结合的方式,实现了极高的资源利用率。它通过运行时特性(最大限度缩短故障恢复时间)和调度策略(降低关联故障的概率),为高可用应用提供支撑。Borg 提供声明式的作业规范语言、名称服务集成、实时作业监控,以及用于分析和模拟系统行为的工具,简化了用户的使用成本。
本文将概述 Borg 系统的架构与核心特性、重要的设计决策,对部分策略决策进行定量分析,并结合十余年的生产运维经验,对其中的经验教训展开定性探讨。
1. 引言
我们内部称为 Borg 的集群管理系统,负责 Google 运行的全品类应用的准入、调度、启动、重启与监控。本文将阐述其实现机制。
Borg 主要带来三大价值:
- 它屏蔽了资源管理与故障处理的底层细节,让用户可以专注于应用开发;
- 它具备极高的可靠性与可用性,同时支撑同样高可靠的上层应用;
- 它让我们能够在数万台机器上高效地运行业务负载。
Borg 并非首个解决这些问题的系统,但它是少数能达到如此规模、具备如此弹性与完整性的系统之一。本文围绕上述主题展开,最后总结了十余年 Borg 生产运维过程中沉淀的一系列定性观察。
(图1 架构组件:配置文件、borgcfg 命令行工具、网页浏览器、单元、UI 分片、BorgMaster 主节点、分片、持久化存储(基于 Paxos)、调度器、链路分片)
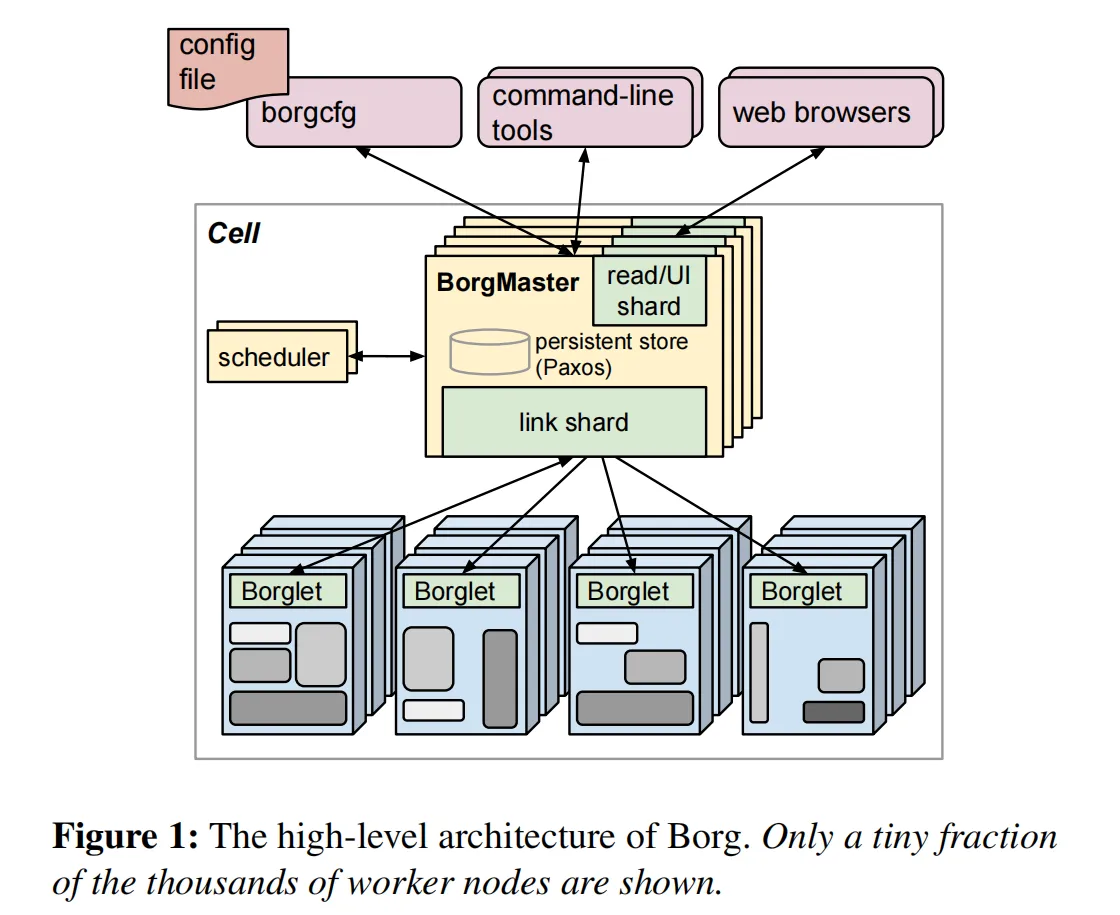
图 1:Borg 的高层架构。图中仅展示了数千个工作节点中的极小一部分。
2. 用户视角
Borg 的用户是 Google 的开发者与系统管理员(站点可靠性工程师,SRE),他们负责运行 Google 的应用与服务。用户以作业(job)的形式向 Borg 提交工作,每个作业包含一个或多个任务(task),所有任务运行相同的程序(二进制文件)。每个作业运行在一个 Borg 单元(cell)中——单元是作为一个整体管理的一组机器。本节其余部分将介绍用户视角下 Borg 的核心特性。
2.1 工作负载
Borg 单元运行异构的工作负载,主要分为两大类。第一类是长时运行的服务,这类服务要求“永不中断”,用于处理对延迟敏感的短生命周期请求(延迟从几微秒到数百毫秒不等)。这类服务支撑着 Gmail、Google Docs、网页搜索等面向终端用户的产品,以及 BigTable 等内部基础设施服务。第二类是批处理作业,运行时间从几秒到几天不等,这类作业对短期性能波动的敏感度低得多。
不同单元的工作负载组合各不相同,根据其主要租户的差异运行不同的应用组合(例如部分单元以批处理业务为主);同时负载也随时间动态变化:批处理作业会动态增减,而许多面向终端用户的服务作业呈现出日级的使用规律。Borg 需要能够同样出色地应对所有这些场景。
2011 年 5 月公开的一份长达一个月的典型 Borg 工作负载追踪数据[80]已被广泛研究(例如[68]以及[1, 26, 27, 57])。
过去几年中,许多应用框架都构建在 Borg 之上,包括我们内部的 MapReduce 系统[23]、FlumeJava[18]、Millwheel[3]和 Pregel[59]。其中大部分框架都有一个控制器,负责提交一个主作业和一个或多个工作作业;前两者的角色类似于 YARN 中的应用管理器[76]。我们的分布式存储系统,如 GFS[34]及其后继者 CFS、Bigtable[19]、Megastore[8],全部运行在 Borg 之上。
在本文中,我们将高优先级的 Borg 作业归为“生产级”(prod),其余归为“非生产级”(non-prod)。大多数长时运行的服务作业属于生产级;大多数批处理作业属于非生产级。在一个典型单元中,生产级作业分配了约 70% 的总 CPU 资源,实际 CPU 使用量约占总量的 60%;它们分配了约 55% 的总内存,实际内存使用量约占总量的 85%。资源分配与实际使用之间的差异将在 5.5 节中展开分析。
2.2 集群与单元
一个单元中的所有机器同属一个集群,集群由数据中心级的高性能网络结构连接而成。一个集群部署在单栋数据中心建筑内,多栋建筑组成一个站点。¹ 一个集群通常承载一个大型单元,也可能包含几个小规模的测试单元或专用单元。我们极力避免任何单点故障。
排除测试单元后,我们的单元规模中位数约为 1 万台机器,部分单元规模远大于此。单元内的机器在多个维度上存在异构性:规格(CPU、内存、磁盘、网络)、处理器类型、性能,以及外部 IP 地址、闪存存储等能力。Borg 通过决定任务在单元内的部署位置、分配资源、安装程序及依赖项、监控健康状态、故障时自动重启,向用户屏蔽了绝大多数这类差异。
2.3 作业与任务
Borg 作业的属性包括名称、所有者,以及包含的任务数量。作业可以设置约束,强制其任务运行在具备特定属性的机器上,例如处理器架构、操作系统版本、外部 IP 地址等。约束分为硬约束和软约束;软约束更像偏好设置而非强制要求。作业可以设置为等待前序作业完成后再启动。一个作业只能运行在一个单元内。
每个任务对应机器上一个容器内运行的一组 Linux 进程[62]。绝大多数 Borg 工作负载不运行在虚拟机(VM)中,因为我们不愿承担虚拟化带来的开销。此外,在系统设计的年代,我们的大量处理器还不支持硬件虚拟化。
任务同样具备多种属性,例如资源需求、任务在作业内的编号。同一作业内的大多数任务属性相同,但支持覆盖配置——例如为特定任务设置专属的命令行参数。每种资源维度(CPU 核心数、内存、磁盘空间、磁盘访问速率、TCP 端口数²等)都可以独立地进行细粒度配置;我们不使用固定大小的资源桶或时隙(见 5.4 节)。
Borg 程序采用静态链接,以减少对运行时环境的依赖;程序被打包为二进制文件和数据文件的组合,由 Borg 统一编排安装。
用户通过向 Borg 发起远程过程调用(RPC)来操作作业,最常见的方式是命令行工具、其他 Borg 作业,或是我们的监控系统(见 2.6 节)。大多数作业描述使用声明式配置语言 BCL 编写。BCL 是 GCL[12]的变体,用于生成 protobuf 文件[67],并扩展了一些 Borg 专属的关键字。GCL 提供 lambda 函数支持计算,应用可以借此根据环境调整配置;数以千计的 BCL 文件超过 1000 行,我们累计已形成数千万行 BCL 代码。Borg 的作业配置与 Aurora 配置文件[6]有相似之处。
图 2 展示了作业和任务在生命周期中经历的状态。
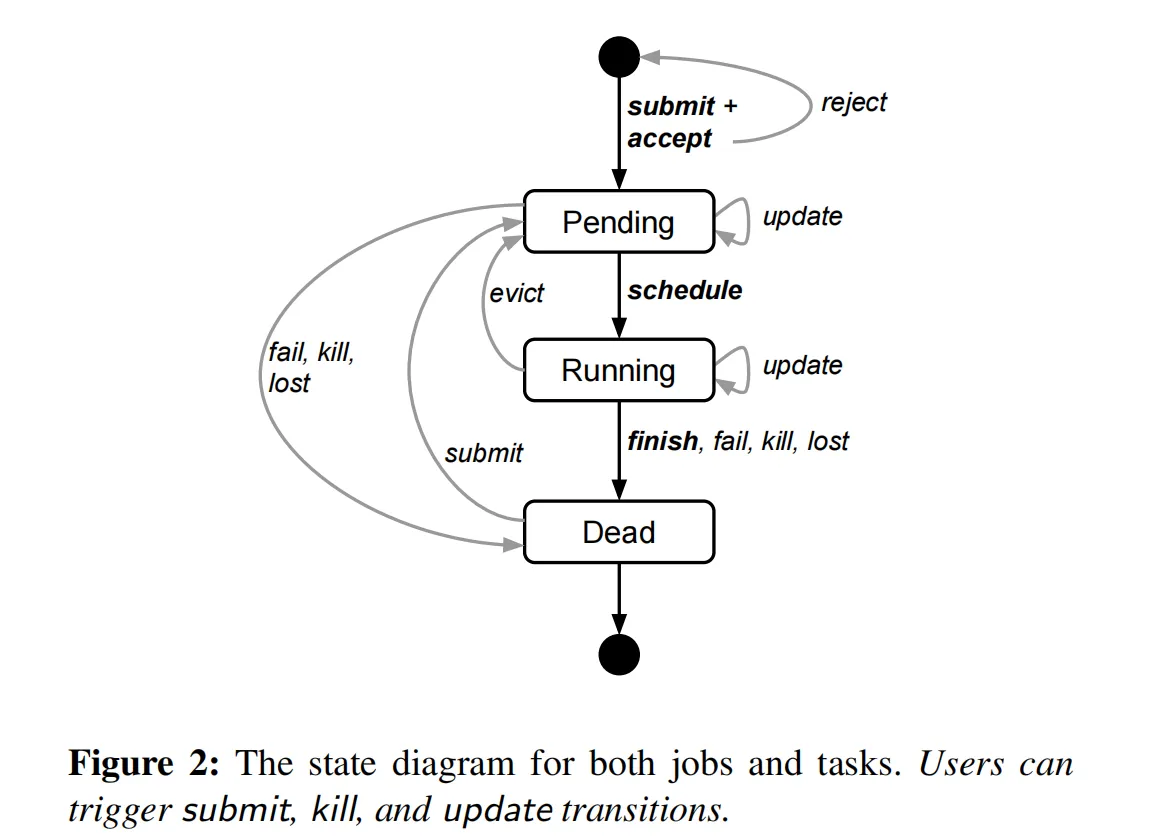
图 2:作业与任务的状态机。用户可以触发提交、终止和更新状态转换。
用户可以向 Borg 推送新的作业配置,然后指示 Borg 将任务更新到新的规格,从而修改运行中作业的部分或全部任务的属性。这是一种轻量级的非事务性操作,在提交(确认)之前可以随时撤销。更新通常以滚动方式执行,并且可以限制单次更新造成的任务中断次数(调度或抢占);任何会导致更多中断的变更都会被跳过。
部分任务更新(例如推送新的二进制文件)始终需要重启任务;部分更新(例如提高资源需求或变更约束)可能导致任务不再适配当前机器,进而被停止并重新调度;还有部分更新(例如修改优先级)无需重启或迁移任务即可完成。
任务在被 SIGKILL 信号抢占之前,可以通过 Unix SIGTERM 信号收到通知,从而有时间进行清理、保存状态、完成当前正在执行的请求,并拒绝新的请求。如果抢占方设置了延迟上限,实际的通知时间可能更短。在实际运行中,约 80% 的抢占场景都会发送通知。
¹ 上述对应关系存在少数例外情况。
² Borg 管理机器上的可用端口,并将其分配给各个任务。
2.4 资源分配块(Alloc)
Borg 的 alloc 是 allocation(分配)的缩写,指机器上预留的一组资源,可在其中运行一个或多个任务;无论资源是否被使用,都会保持分配状态。Alloc 可用于为未来的任务预留资源、在任务停止与重启之间保留资源,以及将不同作业的任务部署到同一台机器上——例如,一个 Web 服务器实例和对应的日志保存任务,后者将服务器的 URL 日志从本地磁盘复制到分布式文件系统。
Alloc 的资源与机器资源的管理方式类似;运行在同一个 alloc 内的多个任务共享其资源。如果一个 alloc 必须迁移到另一台机器,其内部的任务会随之一同重新调度。
分配集合(alloc set)类似于作业:它是一组在多台机器上预留资源的 alloc。分配集合创建后,可以向其中提交一个或多个作业运行。为简洁起见,下文通常用“任务”指代 alloc 或顶层任务(alloc 之外的任务),用“作业”指代作业或分配集合。
2.5 优先级、配额与准入控制
当待处理的工作超出系统承载能力时会发生什么?我们的解决方案是优先级与配额机制。
每个作业都有一个优先级,即一个小的正整数。高优先级任务可以抢占(终止)低优先级任务,获取其资源。Borg 为不同用途定义了互不重叠的优先级档位,按优先级从高到低依次为:监控、生产、批处理、尽力而为(也称为测试或空闲)。在本文中,生产级作业指监控和生产档位的作业。
尽管被抢占的任务通常会在单元内的其他位置重新调度,但如果高优先级任务挤出优先级稍低的任务,后者再挤出更低的任务,就可能引发抢占级联。为了最大程度避免这种情况,我们禁止生产优先级档位的任务互相抢占。细粒度的优先级在其他场景仍然有用——例如,MapReduce 主任务的优先级略高于它管理的工作任务,以提升主任务的可靠性。
优先级体现了单元内正在运行或等待运行的作业的相对重要性。配额则用于决定哪些作业可以进入调度队列。配额以指定时间段(通常为几个月)内、给定优先级下的资源量向量(CPU、内存、磁盘等)表示。配额数值规定了用户的作业在同一时间可请求的最大资源量(例如“截至 7 月底,在 xx 单元内,生产优先级下可使用 20 TiB 内存”)。
配额检查属于准入控制环节,而非调度环节:配额不足的作业在提交时会被立即拒绝。
高优先级配额的成本高于低优先级配额。生产优先级配额的总量受限于单元内的实际可用资源,因此提交符合配额的生产级作业时,只要满足资源碎片化和约束条件,就可以预期作业能够运行。尽管我们鼓励用户按需购买配额,但许多用户会超额购买,以应对未来应用用户规模增长带来的资源短缺。对此,我们在低优先级档位实行配额超售:所有用户在优先级 0 下都拥有无限配额,但由于资源超额认购,这一配额通常难以实际使用。低优先级作业可能被准入,但会因资源不足而处于待调度状态。
配额分配在 Borg 系统之外进行,与我们的物理容量规划紧密关联,规划结果体现在不同数据中心配额的价格与可用量上。用户作业只有在所需优先级下具备足够配额时才会被准入。配额机制的使用减少了对优势资源公平性(DRF)[29, 35, 36, 66]这类策略的需求。
Borg 具备权限系统,可为部分用户授予特殊权限;例如,允许管理员删除或修改单元内的任何作业,或者允许用户访问受限的内核特性或 Borg 行为,例如在其作业上禁用资源预估(见 5.5 节)。
2.6 命名与监控
仅仅创建和部署任务是不够的:服务的客户端和其他系统需要能够找到它们,即使任务被迁移到新的机器上。为此,Borg 为每个任务创建了一个稳定的“Borg 名称服务”(BNS)名称,包含单元名、作业名和任务编号。
Borg 将任务的主机名和端口信息写入 Chubby[14]中一个对应名称的、高可用的一致性文件中,我们的 RPC 系统通过该文件查找任务端点。BNS 名称同时也是任务 DNS 名称的基础,因此在 cc 单元、用户 ubar 的作业 jfoo 中的第 50 个任务,可以通过域名 50.jfoo.ubar.cc.borg.google.com 访问。Borg 还会在作业规模和任务健康状态变化时,将信息写入 Chubby,以便负载均衡器知道请求该路由到哪里。
几乎所有运行在 Borg 上的任务都内置了 HTTP 服务器,发布任务健康状态信息和数千项性能指标(例如 RPC 延迟)。Borg 监控健康检查 URL,重启响应不及时或返回 HTTP 错误码的任务。其他数据由监控工具采集,用于生成仪表盘和服务水平目标(SLO)违规告警。
名为 Sigma 的服务提供了基于网页的用户界面(UI),用户可以通过它查看自己所有作业的状态、特定单元的状态,或是下钻到单个作业和任务,查看其资源使用行为、详细日志、执行历史和最终状态。我们的应用会生成海量日志;这些日志会自动轮转以避免耗尽磁盘空间,并在任务退出后保留一段时间用于调试。如果作业未能运行,Borg 会提供“为何处于待调度状态?”的标注,以及如何修改作业资源请求以更好适配单元的指导。我们发布了“合规”资源形态的指南,这类资源形态更容易被调度。
Borg 将所有作业提交和任务事件,以及详细的单任务资源使用信息记录在 Infrastore 中——这是一个可扩展的只读数据存储,通过 Dremel[61]提供类 SQL 的交互接口。这些数据用于按使用量计费、调试作业与系统故障,以及长期容量规划。Google 集群工作负载追踪数据集[80]也来源于此。
所有这些特性帮助用户理解和调试 Borg 及其作业的行为,也帮助我们的 SRE 每人管理数万台机器。
3. Borg 架构
一个 Borg 单元由一组机器、一个逻辑上集中的控制器(称为 Borgmaster),以及运行在单元内每台机器上的代理进程 Borglet 组成(见图 1)。Borg 的所有组件均使用 C++ 编写。
3.1 Borgmaster
每个单元的 Borgmaster 包含两个进程:主 Borgmaster 进程和独立的调度器(见 3.2 节)。主 Borgmaster 进程处理客户端的 RPC 请求,包括变更状态的请求(例如创建作业)和只读数据访问请求(例如查询作业)。它还管理系统中所有对象(机器、任务、alloc 等)的状态机,与 Borglet 通信,并提供网页 UI 作为 Sigma 的备份。
Borgmaster 在逻辑上是单个进程,但实际上有 5 个副本。每个副本在内存中维护单元大部分状态的拷贝,这些状态同时记录在副本本地磁盘上的高可用分布式 Paxos 存储[55]中。
每个单元选举出一个唯一的主节点,它同时担任 Paxos 的领导者和状态变更者,处理所有改变单元状态的操作,例如提交作业或终止机器上的任务。单元启动时以及当选主节点故障时,会通过 Paxos 选举产生新的主节点;主节点会获取一个 Chubby 锁,以便其他系统能够找到它。选举主节点并切换到新主节点通常需要约 10 秒,但在大型单元中可能长达 1 分钟,因为需要重建部分内存状态。当副本从故障中恢复时,它会从其他最新的 Paxos 副本动态重新同步自身状态。
Borgmaster 在某个时间点的状态称为检查点(checkpoint),形式为周期性快照加上保存在 Paxos 存储中的变更日志。检查点有诸多用途:包括将 Borgmaster 的状态恢复到过去任意时间点(例如在接受一个触发 Borg 软件缺陷的请求之前,以便调试);在极端情况下手动修复;构建事件的持久日志用于后续查询;以及离线模拟。
名为 Fauxmaster 的高保真 Borgmaster 模拟器可以读取检查点文件,它包含完整的生产环境 Borgmaster 代码,只是将与 Borglet 的接口做了桩化处理。它接受 RPC 请求以执行状态机变更和操作,例如“调度所有待处理任务”。我们用它来调试故障——就像操作真实的 Borgmaster 一样与它交互,由模拟的 Borglet 重放检查点文件中的真实交互。用户可以逐步观察系统状态在过去实际发生的变化。Fauxmaster 还可用于容量规划(“这种类型的新作业能容纳多少个?”),以及在修改单元配置前进行合理性检查(“这个变更会驱逐任何重要作业吗?”)。
3.2 调度
作业提交后,Borgmaster 将其持久化记录到 Paxos 存储中,并将作业的任务加入待调度队列。调度器异步扫描该队列,当存在满足作业约束的充足可用资源时,将任务分配到机器上。(调度器主要以任务为调度单位,而非作业。)
扫描按优先级从高到低进行,同一优先级内采用轮询机制,以保证用户间的公平性,避免大型作业造成队头阻塞。调度算法分为两个阶段:可行性检查,找出任务可以运行的机器;评分,从可行机器中选出一台。
在可行性检查阶段,调度器找出一组满足任务约束、且有足够“可用”资源的机器——可用资源包括可被驱逐的低优先级任务占用的资源。
在评分阶段,调度器评估每台可行机器的“优劣程度”。评分会考虑用户指定的偏好,但主要由内置标准决定,例如:最小化被抢占任务的数量和优先级、优先选择已经存有任务安装包的机器、将任务分散部署在不同电源域和故障域、提升打包质量(包括将高低优先级任务混合部署在同一台机器上,使高优先级任务可以在负载突增时扩容)。
Borg 最初使用 E-PVM[4]的变体进行评分,该算法在异构资源间生成单一成本值,并最小化放置任务带来的成本变化。在实践中,E-PVM 最终会将负载分散到所有机器上,为负载突增预留空间——但代价是碎片化加剧,尤其是对于需要占用机器大部分资源的大型任务;我们有时称之为“最差适配”。
另一个极端是“最佳适配”,它试图尽可能紧密地填满机器。这会让部分机器完全没有用户作业(它们仍运行存储服务),因此放置大型任务很容易,但紧密的打包会放大用户或 Borg 对资源需求预估偏差的影响。这会损害突发负载的应用,对批处理作业尤其不利——批处理作业通常申请较低的 CPU 资源以方便调度,然后尝试利用空闲资源运行:20% 的非生产级任务申请的 CPU 核心数少于 0.1。
我们当前的评分模型是一种混合方案,致力于减少“滞留资源”——即因机器上另一项资源已被全部分配而无法利用的资源。对于我们的工作负载,它的打包效率比最佳适配高出约 3–5%(定义见[78])。
如果评分阶段选出的机器没有足够的可用资源容纳新任务,Borg 会从最低优先级到最高优先级依次抢占(终止)低优先级任务,直到资源充足。被抢占的任务会被加入调度器的待调度队列,而非迁移或休眠。³
任务启动延迟(从作业提交到任务运行的时间)是一个持续受到重点关注的指标。它的波动很大,中位数通常约为 25 秒。其中包安装耗时占总时间的 80%:已知瓶颈之一是写入安装包的本地磁盘存在资源竞争。
为了缩短任务启动时间,调度器倾向于将任务分配给已经安装了所需软件包(程序和数据)的机器:大多数软件包是不可变的,因此可以共享和缓存。(这是 Borg 调度器支持的唯一一种数据局部性形式。)此外,Borg 使用树形和类洪流协议将软件包并行分发到各台机器。
除此之外,调度器还采用多种技术,支撑自身扩展到管理数万台机器的单元(见 3.4 节)。
³ 例外:为 Google Compute Engine 用户提供虚拟机的任务会被迁移。
3.3 Borglet
Borglet 是运行在单元内每台机器上的本地 Borg 代理。它负责启动和停止任务;在任务失败时重启;通过操纵操作系统内核设置管理本地资源;轮转调试日志;并向 Borgmaster 和其他监控系统上报机器状态。
Borgmaster 每隔几秒轮询每个 Borglet,获取机器当前状态,并下发所有待处理的请求。这种模式让 Borgmaster 可以控制通信速率,无需显式的流量控制机制,还能避免恢复风暴[9]。
当选主节点负责准备发送给 Borglet 的消息,并根据 Borglet 的响应更新单元状态。为了提升性能可扩展性,每个 Borgmaster 副本都运行一个无状态的链路分片(link shard),负责与部分 Borglet 通信;每当 Borgmaster 发生选举时,都会重新计算分片划分。
为了提升弹性,Borglet 始终上报自身完整状态,但链路分片会对信息进行聚合和压缩,仅向状态机上报差异部分,以减轻当选主节点的更新负载。
如果 Borglet 连续多次轮询都没有响应,其所在机器会被标记为故障,其上运行的所有任务都会被重新调度到其他机器。如果通信恢复,Borgmaster 会通知 Borglet 终止那些已经被重新调度的任务,避免重复运行。即使失去与 Borgmaster 的连接,Borglet 仍会继续正常运行,因此即使所有 Borgmaster 副本都故障,当前运行的任务和服务也不会中断。
3.4 可扩展性
我们尚不确定 Borg 集中式架构的最终扩展性极限在哪里;到目前为止,每次接近极限时,我们都设法消除了瓶颈。单个 Borgmaster 可以管理单元内的数万台机器,部分单元的任务到达率超过每分钟 10000 个。繁忙的 Borgmaster 会占用 10–14 个 CPU 核心,最高 50 GiB 内存。我们通过多种技术实现这一规模。
早期版本的 Borgmaster 采用简单的同步循环,接受请求、调度任务、与 Borglet 通信。为了支撑更大的单元,我们将调度器拆分为独立进程,使其可以与其他做了故障容忍副本的 Borgmaster 功能并行运行。
调度器副本基于单元状态的缓存副本运行。它不断循环:从当选主节点获取状态变更(包括已分配和待处理的工作);更新本地副本;执行一次调度以分配任务;将分配结果告知当选主节点。主节点会接受并应用这些分配结果,除非分配结果不合理(例如基于过期的状态),这种情况下调度器会在下一轮循环中重新处理。这在精神上与 Omega[69]使用的乐观并发控制非常相似,并且我们最近也新增了能力,让 Borg 可以为不同类型的工作负载使用不同的调度器。
为了缩短响应时间,我们增加了独立的线程用于与 Borglet 通信和响应只读 RPC 请求。为了进一步提升性能,我们将这些功能在 5 个 Borgmaster 副本之间做了分片(见 3.3 节)。这些措施共同将 UI 的 99 分位响应时间控制在 1 秒以内,将 Borglet 轮询间隔的 95 分位控制在 10 秒以内。
以下几项技术提升了 Borg 调度器的可扩展性:
- 评分缓存:评估机器的可行性和计算评分开销很大,因此 Borg 会缓存评分结果,直到机器或任务的属性发生变化——例如机器上的任务终止、属性变更,或是任务需求改变。忽略资源量的微小变化可以减少缓存失效次数。
- 等价类:同一个 Borg 作业内的任务通常具有相同的需求和约束,因此 Borg 不会为每个待处理任务逐一评估所有机器的可行性并评分,而是每个等价类(一组需求完全相同的任务)只做一次可行性检查和评分。
- 松弛随机化:在大型单元中计算所有机器的可行性和评分是一种浪费,因此调度器按随机顺序检查机器,直到找到“足够多”的可行机器进行评分,再从中选出最优的一台。这减少了任务进出系统时的评分计算和缓存失效开销,加快了任务到机器的分配速度。松弛随机化在某种程度上类似于 Sparrow[65]的批量采样,同时还处理了优先级、抢占、异构性和软件包安装成本。
在我们的实验中(见第 5 节),从头开始调度一个单元的全部工作负载通常需要几百秒,但如果禁用上述技术,调度过程超过 3 天都无法完成。而在正常运行时,一次在线调度遍历待处理队列的时间不到半秒。
4. 可用性
在大规模系统中,故障是常态[10, 11, 22]。图 3 列出了 15 个样本单元中任务被驱逐的原因统计。运行在 Borg 上的应用需要能够应对这类事件,采用的技术包括副本机制、将持久化状态存储在分布式文件系统中,以及(如果合适)定期做检查点。
即便如此,我们也会努力降低这些事件的影响。例如,Borg:
- 自动重新调度被驱逐的任务,必要时调度到新的机器上;
- 通过将作业的任务分散部署在不同故障域(如机器、机架、电源域),减少关联故障的发生;
- 在操作系统或机器升级等维护活动中,限制任务中断的速率,以及同一作业中同时停机的任务数量;
- 使用声明式的期望状态表示和幂等变更操作,因此故障的客户端可以无害地重发任何遗漏的请求;
- 对从不可达机器上转移的任务,限制其寻找新部署位置的速率,因为系统无法区分大规模机器故障和网络分区;
- 避免重复那些曾导致任务或机器崩溃的任务-机器配对;
- 通过重复运行日志保存任务(见 2.4 节),恢复写入本地磁盘的关键中间数据,即使其所属的 alloc 被终止或迁移到其他机器。用户可以设置系统持续重试的时长;通常设置为几天。
Borg 的一个关键设计特性是:即使 Borgmaster 或任务对应的 Borglet 故障,已经运行的任务也会继续运行。但保持主节点可用仍然很重要,因为主节点宕机时,无法提交新作业或更新已有作业,故障机器上的任务也无法被重新调度。
Borgmaster 综合运用多种技术,在实践中实现了 99.99% 的可用性:机器故障的副本机制;避免过载的准入控制;使用简单的底层工具部署实例,以最小化外部依赖。每个单元相互独立,以降低关联操作失误和故障扩散的风险。这些目标——而非扩展性限制——是反对构建更大单元的主要理由。
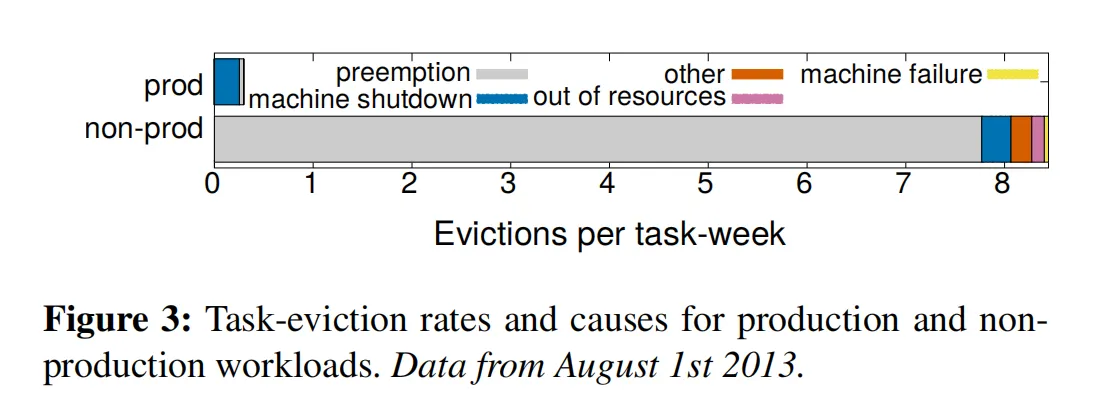
图 3:生产级与非生产级工作负载的任务驱逐率及原因。数据取自 2013 年 8 月 1 日。
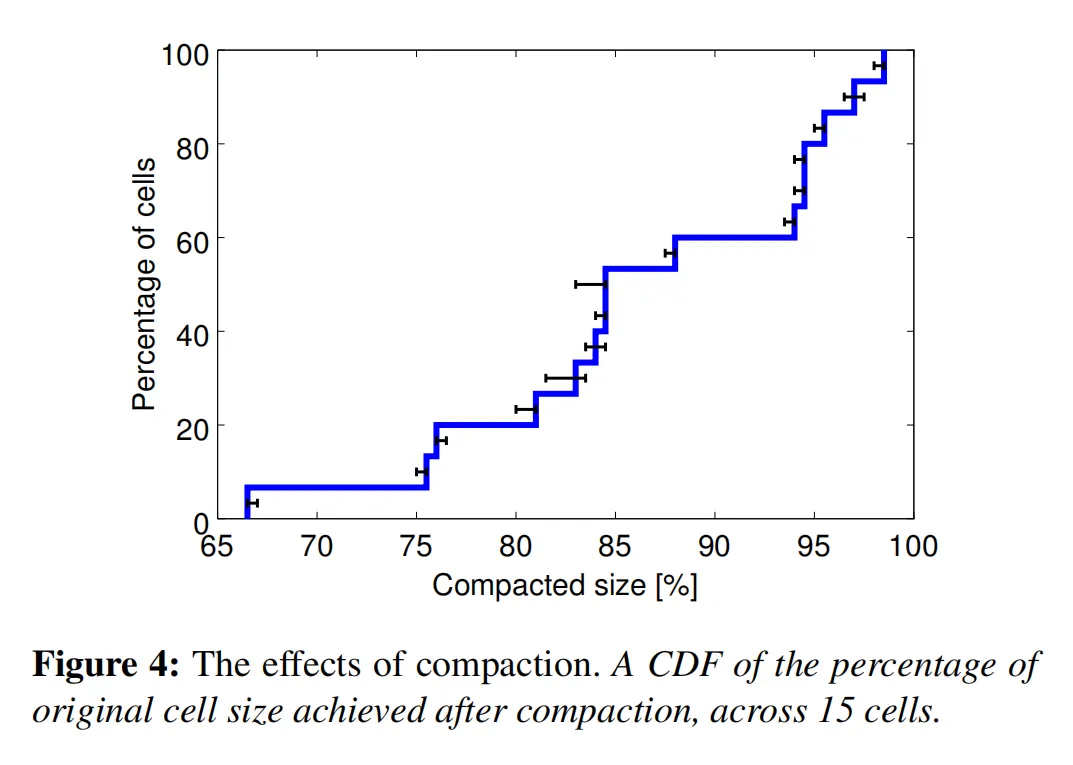
图 4:压缩的效果。15 个单元压缩后规模占原始规模百分比的累积分布函数(CDF)。
5. 资源利用率
Borg 的核心目标之一是高效利用 Google 的机器集群——这代表着巨额的财务投资:利用率提升几个百分点就能节省数百万美元。本节将讨论并评估 Borg 为此采用的一些策略和技术。
5.1 评估方法
我们的作业存在部署约束,需要应对罕见的负载突增;我们的机器是异构的;并且我们会利用从服务作业中回收的资源运行批处理作业。因此,要评估我们的策略选择,需要比“平均利用率”更复杂的指标。经过大量实验,我们选择了单元压缩(cell compaction)方法:给定一个工作负载,我们通过移除机器来找出能容纳该负载的最小单元规模,过程中反复从头重新打包工作负载,确保不会因配置不佳而得到错误结果。
这种方法提供了清晰的终止条件,便于自动化对比,避免了合成工作负载生成和建模的缺陷[31]。文献[78]中有对评估技术的定量对比:其中的细节差异非常微妙。
我们无法在生产环境的在线单元上做实验,但我们使用 Fauxmaster 获得高保真的模拟结果,采用真实生产单元的数据和工作负载,包括所有约束、实际限制、预留和使用数据(见 5.5 节)。这些数据来自 2014 年 10 月 1 日太平洋夏令时 14:00 提取的 Borg 检查点(其他检查点也得出了类似结果)。
我们挑选了 15 个 Borg 单元进行报告:首先排除专用单元、测试单元和小型单元(机器数 <5000),然后从剩余单元中抽样,以覆盖不同的规模区间。
为了在压缩后的单元中保持机器异构性,我们随机选择要移除的机器。为了保持工作负载的异构性,我们保留全部负载,仅移除绑定到特定机器的服务和存储任务(例如 Borglet)。对于规模超过原始单元一半的作业,我们将硬约束改为软约束;并且允许最多 0.2% 的任务处于待调度状态,如果它们非常“挑剔”,只能部署在少数几台机器上;大量实验表明,这一设置能得到可重复、低方差的结果。如果需要比原始单元更大的单元,我们会将原始单元复制几次后再进行压缩;如果需要更多单元,直接复制原始单元即可。
每个实验针对每个单元使用不同的随机数种子重复 11 次。在图表中,我们用误差棒表示所需机器数的最小值和最大值,并选取 90 分位值作为“结果”——因为均值或中位数无法反映系统管理员要确保工作负载能够容纳时的决策依据。我们相信单元压缩提供了一种公平、一致的调度策略对比方法,并且可以直接转化为成本收益结果:更优的策略意味着用更少的机器运行相同的工作负载。
我们的实验聚焦于某个时间点的工作负载调度(打包),而非重放长期的工作负载轨迹。部分原因是为了避免开环和闭环排队模型的难题[71, 79];部分原因是传统的完成时间指标不适用于我们的长时运行服务环境;部分原因是为了得到清晰的对比信号;部分原因是我们认为结果不会有显著差异;还有部分现实因素:我们发现实验一度消耗了 20 万个 Borg CPU 核心——即便以 Google 的规模,这也是一笔不小的投入。
在生产环境中,我们会刻意预留大量冗余空间,以应对工作负载增长、偶发的“黑天鹅”事件、负载突增、机器故障、硬件升级,以及大规模局部故障(例如供电母线故障)。图 4 展示了如果对实际生产中的单元应用压缩技术,规模可以缩小多少。后续图表中的基线都采用这些压缩后的规模。
5.2 单元共享
几乎所有机器都同时运行生产级和非生产级任务:在共享 Borg 单元中,98% 的机器同时运行两类任务;在 Borg 管理的全部机器中,这一比例为 83%。(我们有少数专用单元用于特殊用途。)
由于许多其他组织将面向用户的服务和批处理作业运行在独立的集群中,我们研究了如果我们采取同样的做法会产生什么结果。图 5 表明,将生产与非生产工作负载分离,中位数单元需要多 20–30% 的机器才能运行我们的工作负载。
这是因为生产级作业通常会预留资源以应对罕见的负载突增,但这些资源大部分时间都处于闲置状态。Borg 回收这些未使用的资源(见 5.5 节)来运行大部分非生产工作,因此整体需要的机器更少。
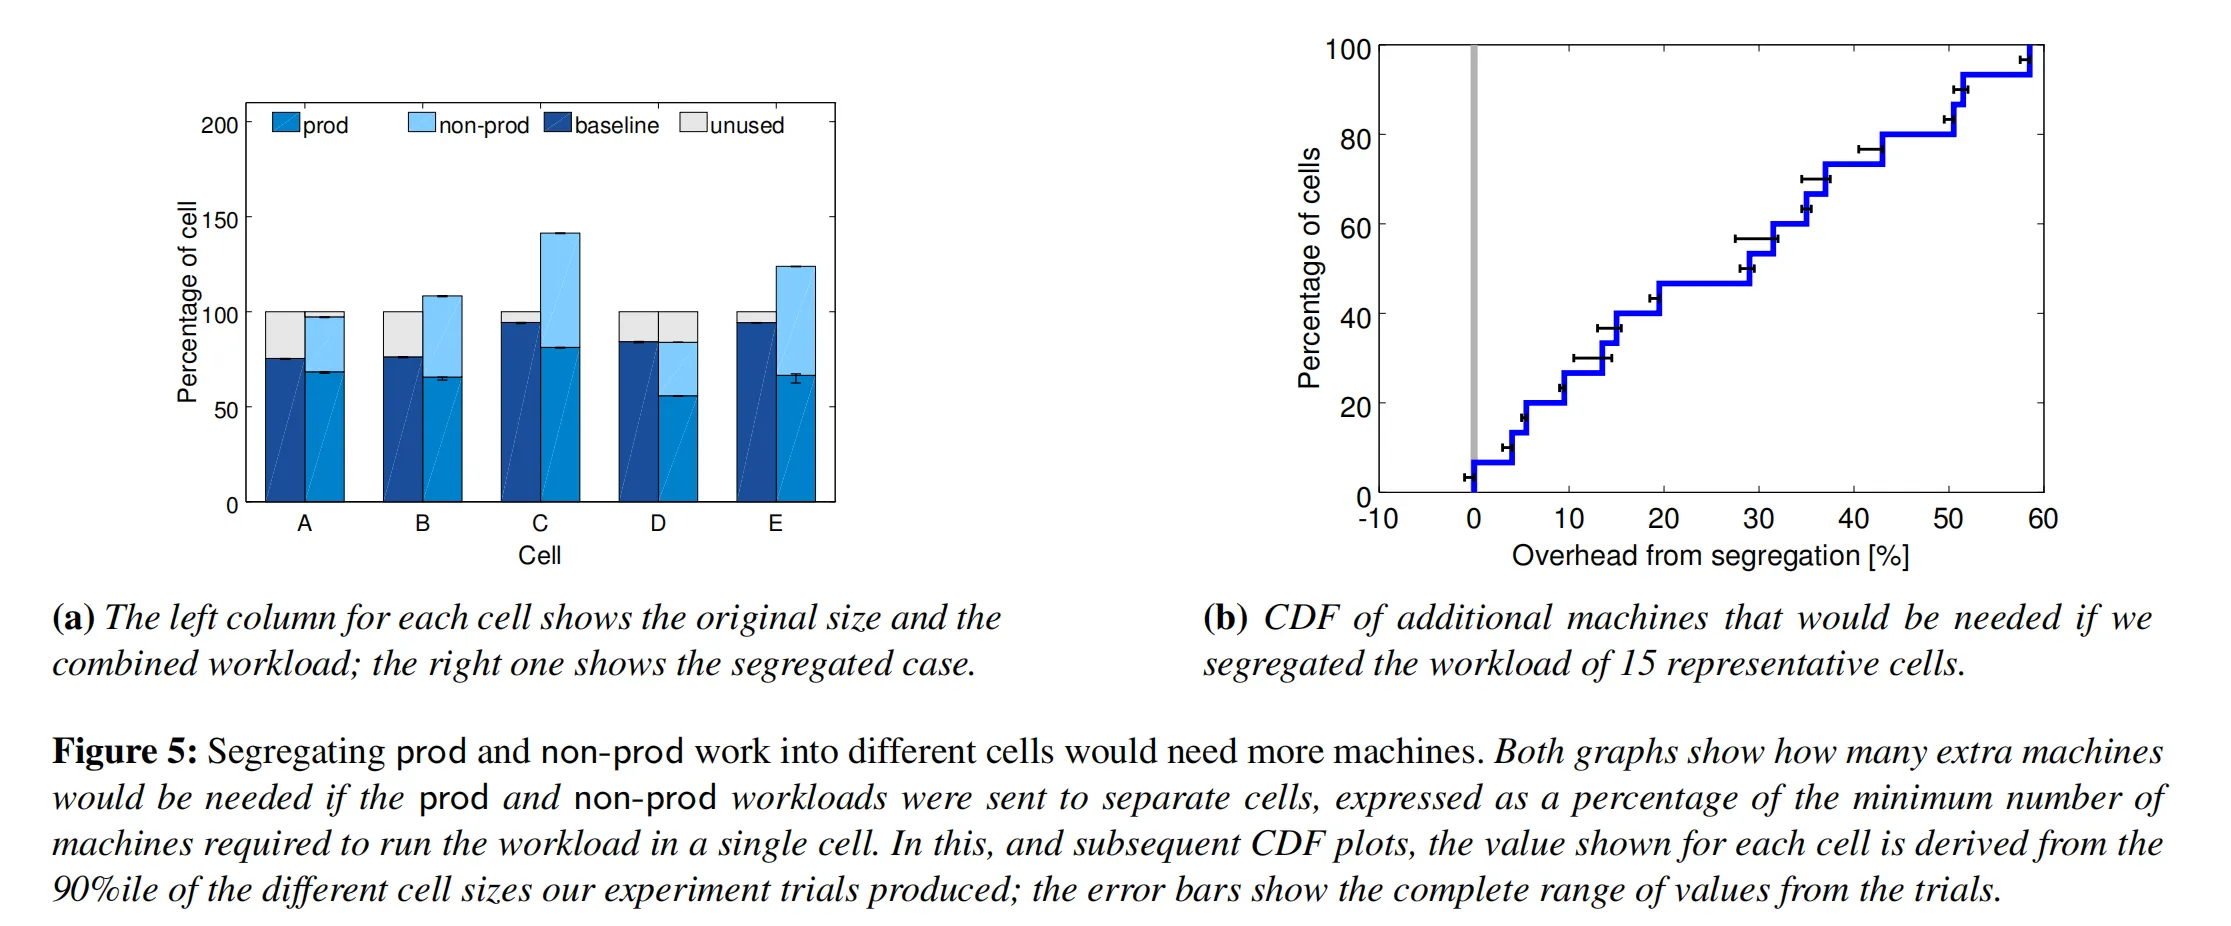
图 5:将生产与非生产工作负载分离到不同单元需要更多机器。两张图都展示了 15 个代表性单元的工作负载分离后所需的额外机器数,以单单元运行所需最少机器数的百分比表示。在本图及后续 CDF 图中,每个单元的数值取自实验多次运行得到的不同单元规模的 90 分位值;误差棒展示了实验结果的完整区间。
(a) 每个单元的左列表示原始规模和合并工作负载;右列表示分离场景。
(b) 分离场景下所需额外机器数的 CDF。
大多数 Borg 单元由数千个用户共享。图 6 说明了原因。在该测试中,如果用户消耗的内存至少达到 10 TiB(或 100 TiB),就将其工作负载拆分到新单元。我们现有的共享策略优势明显:即使采用更大的拆分阈值,也需要 2–16 倍的单元数量,以及 20–150% 的额外机器。资源池化再一次显著降低了成本。
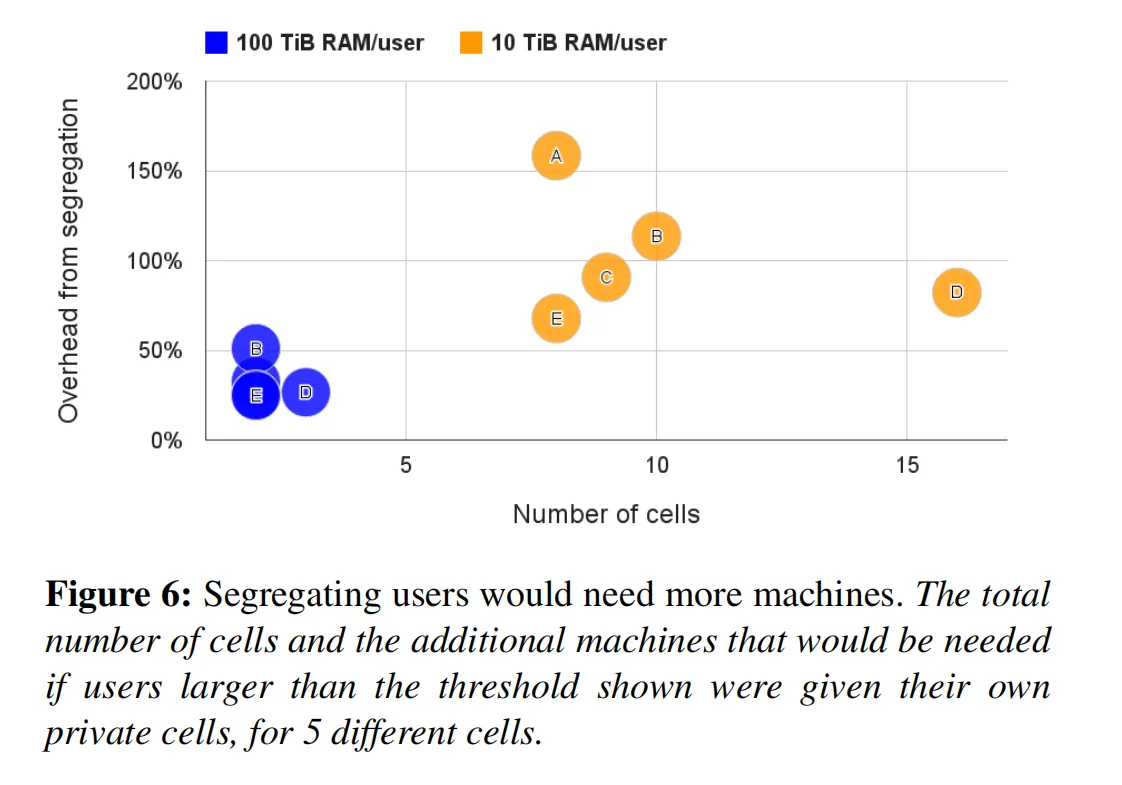
图 6:用户分离需要更多机器。图中展示了 5 个不同单元中,当超过指定阈值的大用户获得私有单元时,总单元数和所需额外机器数的变化。
但也许将不相关的用户和作业类型打包到同一台机器上会造成 CPU 干扰,因此我们需要更多机器来弥补?为了评估这一点,我们考察了在相同机型、相同时钟频率下,不同环境中任务的 CPI(每条指令周期数)变化。在这些条件下,CPI 值具有可比性,可以作为性能干扰的代理指标,因为 CPI 翻倍意味着 CPU 密集型程序的运行时间翻倍。
数据采集自一周内随机抽取的约 12000 个生产级任务,使用[83]中描述的硬件性能分析基础设施,统计 5 分钟间隔内的周期数和指令数,并对样本加权,使得每秒 CPU 时间的权重相等。结果并非绝对清晰。
-
我们发现,同一时间间隔内,CPI 与两项测量值正相关:机器的整体 CPU 使用率,以及(基本独立的)机器上的任务数量;通过线性模型拟合数据得出,向机器增加一个任务会使其他任务的 CPI 上升 0.3%;机器 CPU 使用率提升 10%,CPI 上升不到 2%。但尽管相关性具有统计显著性,它们只能解释 CPI 测量方差的 5%;其他因素占主导,例如应用本身的固有差异和特定的干扰模式[24, 83]。
-
对比共享单元和少数专用单元(应用多样性更低)中采样的 CPI,我们发现共享单元的平均 CPI 为 1.58(σ=0.35),专用单元为 1.53(σ=0.32)——也就是说,共享单元中的 CPU 性能约差 3%。
-
为了解决不同单元的应用可能有不同工作负载的问题,甚至避免选择偏差(也许对干扰更敏感的程序已经被迁移到专用单元),我们考察了 Borglet 的 CPI——它在两类单元的所有机器上都运行。我们发现它在专用单元的 CPI 为 1.20(σ=0.29),在共享单元为 1.43(σ=0.45),表明它在专用单元中的运行速度是共享单元的 1.19 倍,不过这一结果高估了轻负载机器的影响,略微偏向于专用单元。
这些实验证实了仓库级规模下的性能对比非常复杂,印证了[51]中的观察,同时也表明资源共享并不会大幅提升程序运行成本。
但即便采用最不利于共享的结果,共享仍然是更优选择:CPU 速度下降的影响,被多种分区方案下所需机器数量的减少所抵消;并且共享的优势适用于所有资源,包括内存和磁盘,而不仅仅是 CPU。
5.3 大型单元
Google 构建大型单元,既是为了支撑大规模计算,也是为了减少资源碎片化。我们通过将一个单元的工作负载拆分到多个更小的单元来测试后者的影响——首先将作业随机打乱,然后以轮询方式分配到各个分区。图 7 证实,使用更小的单元会显著增加所需机器数量。
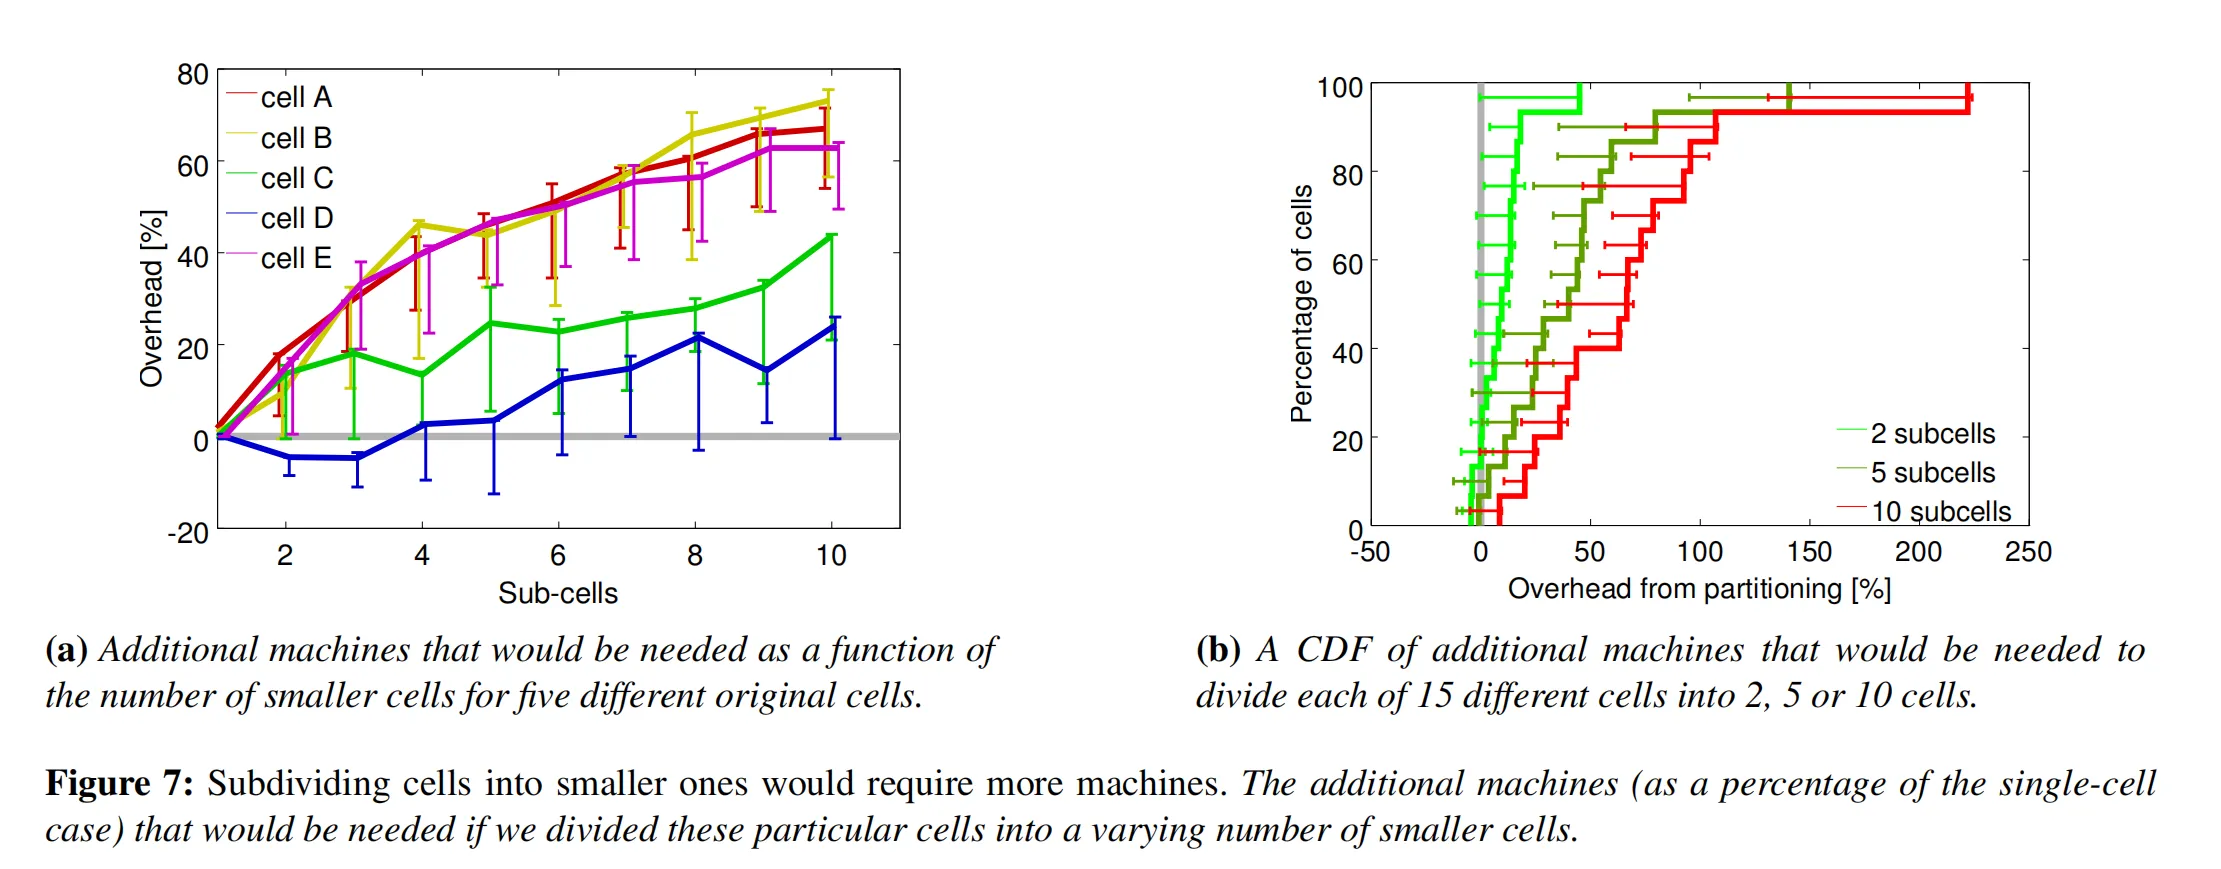
图 7:将单元拆分为更小的单元需要更多机器。图中展示了将特定单元拆分为不同数量的小单元后,所需额外机器数相对于单单元场景的百分比。
(a) 5 个原始单元的额外机器数随子单元数量的变化。
(b) 15 个不同单元拆分为 2、5、10 个子单元后,所需额外机器数的 CDF。
5.4 细粒度资源请求
Borg 用户以毫核(milli-core)为单位申请 CPU,以字节为单位申请内存和磁盘空间。(一个核心指一个处理器超线程,已跨机型做性能归一化。)
图 8 表明用户充分利用了这种细粒度:内存或 CPU 核心的申请量几乎没有明显的“最佳点”,两类资源之间也没有明显的相关性。这些分布与[68]中呈现的结果非常相似,只是我们在 90 分位及以上看到了稍大的内存请求。
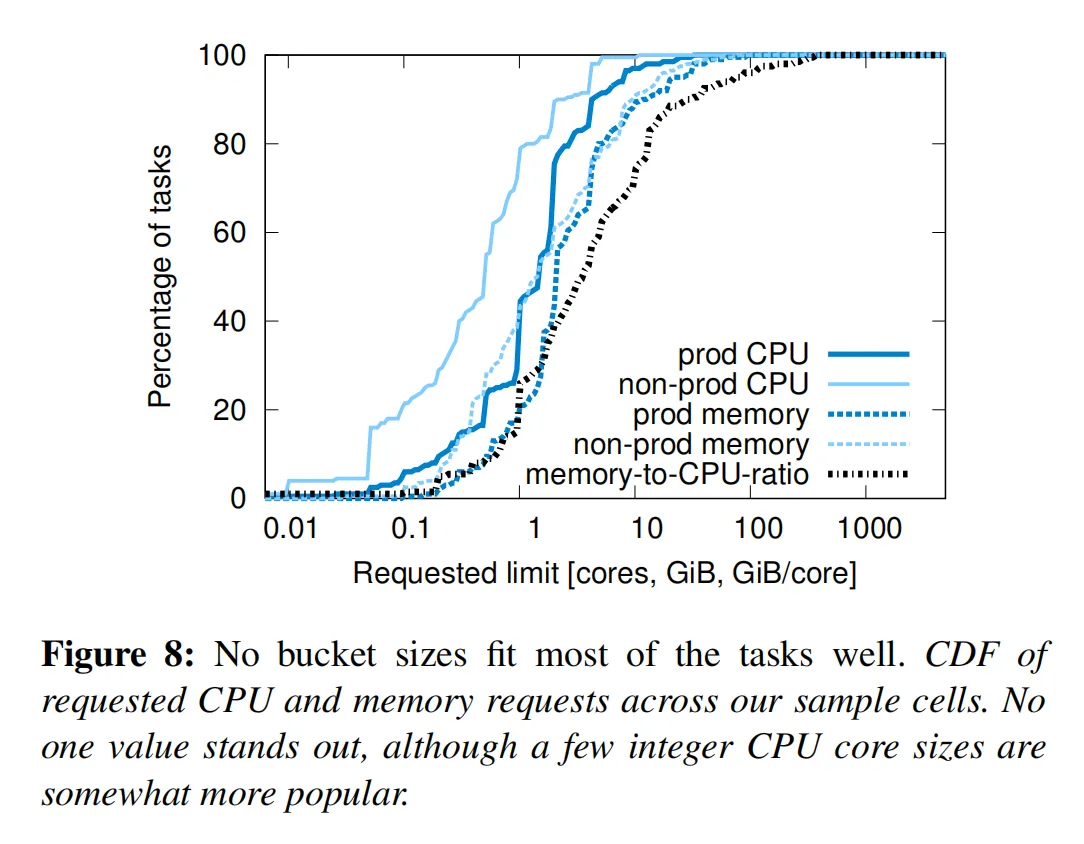
图 8:没有哪种桶规格能适配大多数任务。样本单元中 CPU 和内存请求的累积分布函数。没有哪个数值占据主导,只是几个整数 CPU 核心规格稍受欢迎。
尽管 IaaS(基础设施即服务)提供商普遍提供固定大小的容器或虚拟机[7, 33],但这并不符合我们的需求。为了证明这一点,我们将生产级作业和 alloc 的 CPU 核心与内存资源限制进行“分桶”处理:在每个资源维度上,都向上取整到最接近的 2 的幂,CPU 从 0.5 核起,内存从 1 GiB 起。
图 9 表明,这种做法在中位数场景下需要多消耗 30–50% 的资源。上限来自于:在压缩开始前将原始单元扩容四倍后,仍有大型任务无法容纳,因此为其分配整台机器;下限来自于允许这些任务处于待调度状态。(这低于[37]中报告的约 100% 的额外开销,因为我们支持 4 种以上的桶规格,并且允许 CPU 和内存容量独立扩展。)
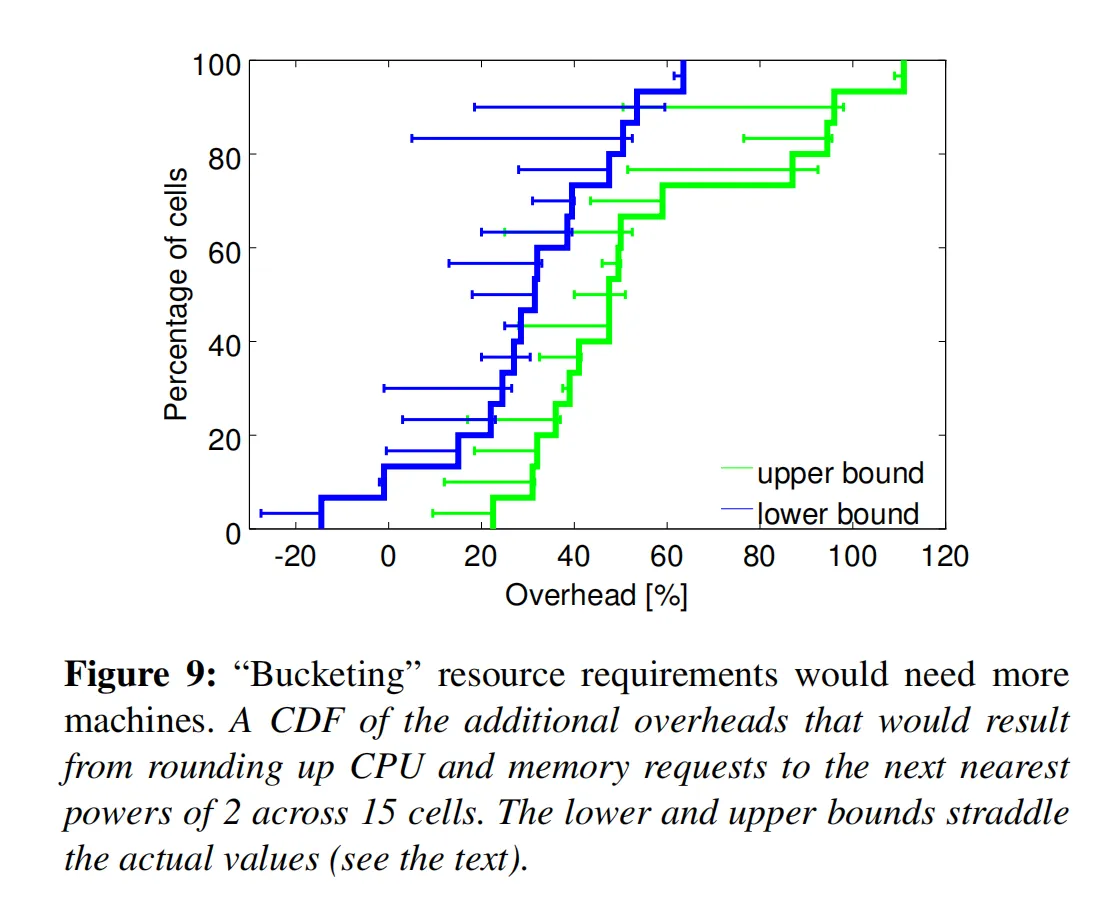
图 9:“分桶”资源请求需要更多机器。15 个单元中,将 CPU 和内存请求向上取整到最接近的 2 的幂后产生的额外开销的 CDF。上下限围绕实际值(见正文)。
5.5 资源回收
作业可以指定资源限制——即每个任务可获得的资源上限。Borg 使用该限制判断用户是否有足够的配额准入作业,以及特定机器是否有足够的空闲资源调度任务。
正如有些用户会购买超出需求的配额,也有些用户申请的资源多于任务实际使用量,因为 Borg 通常会终止尝试使用超出申请量的内存或磁盘空间的任务,或是将 CPU 限制在申请的水平。此外,部分任务偶尔需要使用全部资源(例如在一天的高峰时段,或是应对拒绝服务攻击时),但大多数时间都用不到。
为了不浪费分配了但当前未被消耗的资源,我们会预估每个任务的资源使用量,然后将其余部分回收,用于可以容忍低质量资源的工作,例如批处理作业。整个过程称为资源回收。预估值称为任务的预留量,由 Borgmaster 每隔几秒根据 Borglet 采集的细粒度使用(资源消耗)信息计算得出。
初始预留量等于资源请求(限制);300 秒后(为了允许启动阶段的瞬时波动),预留量会缓慢向实际使用量加上安全裕度的方向衰减。如果实际使用量超过预留量,预留量会快速上调。
Borg 调度器对生产级任务使用限制值来计算可行性⁴,因此生产级任务永远不会依赖回收的资源,也不会面临资源超额认购的风险;对于非生产级任务,调度器使用现有任务的预留量,因此新任务可以被调度到回收的资源中。
如果预留量(预测)出现偏差,机器在运行时可能会耗尽资源——即使所有任务的使用量都低于其限制值。发生这种情况时,我们会终止或限流非生产级任务,绝不会影响生产级任务。
⁴ 准确地说,是高优先级、延迟敏感的任务——见 6.2 节。
图 10 表明,如果禁用资源回收,需要多得多的机器。在中位数单元中,约 20% 的工作负载(见 6.2 节)运行在回收的资源上。
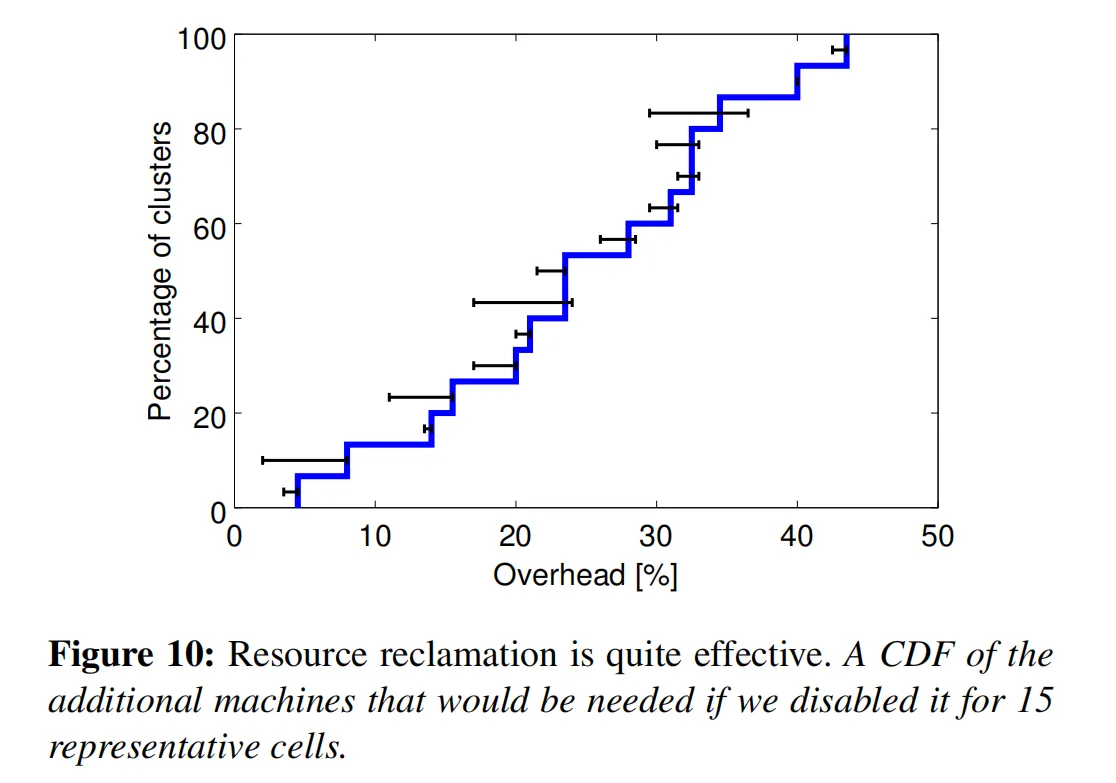
图 10:资源回收效果显著。15 个代表性单元中,禁用资源回收后所需额外机器数的 CDF。
我们可以从图 11 中看到更多细节,该图展示了预留量和使用量相对于限制值的比例。超出内存限制的任务会在资源需要时被优先抢占,无论其优先级如何,因此任务很少超出内存限制。另一方面,CPU 可以很容易地进行限流,因此短期峰值使使用量超过预留量是完全无害的。
图 11:资源预估能够有效识别未使用资源。虚线展示了 15 个单元中任务的 CPU 和内存使用量与请求(限制)值的比例的 CDF。大多数任务的使用量远低于限制,尽管少数任务的 CPU 使用量超过请求。实线展示了预留量与限制值比例的 CDF;这些曲线更接近 100%。直线是资源预估过程的人为产物。
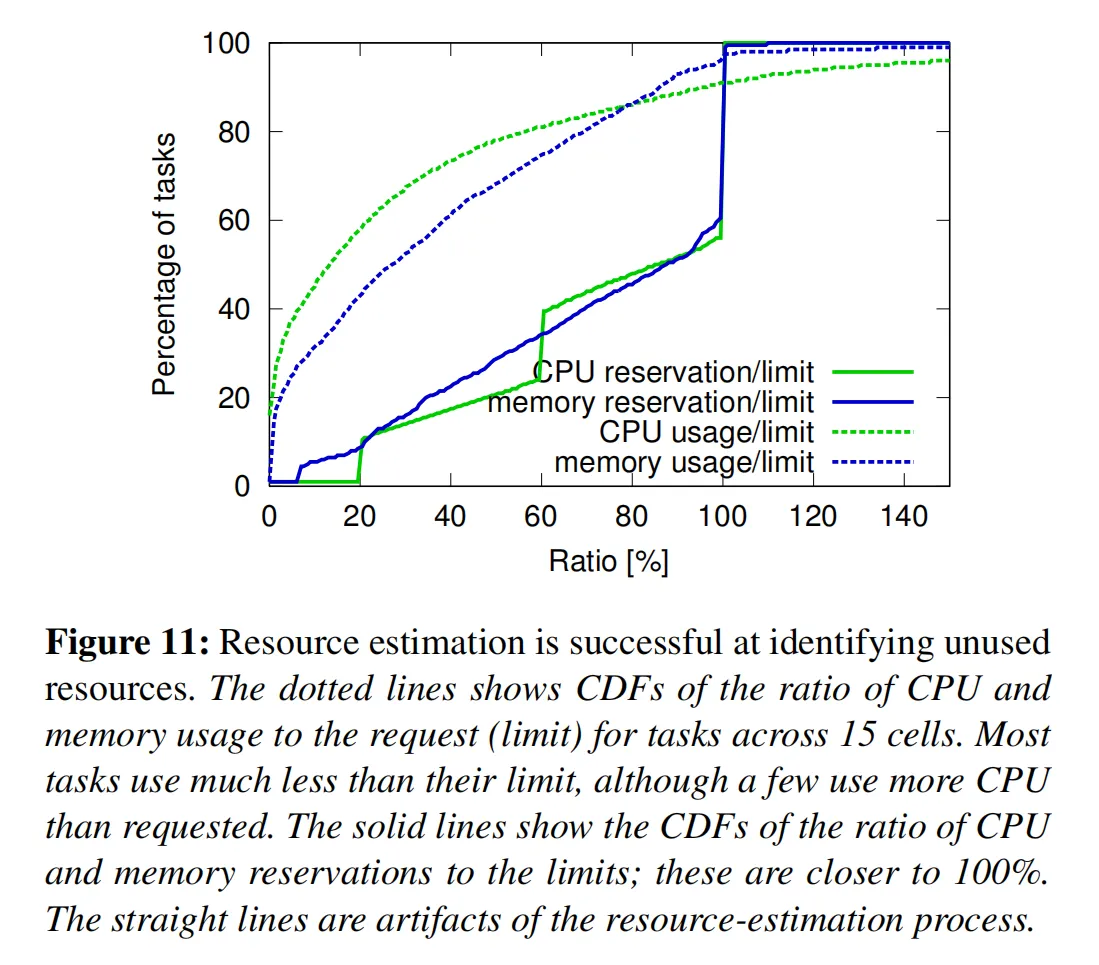
图 11 表明资源回收可能过于保守:预留量和使用量曲线之间存在显著差距。为了验证这一点,我们选取了一个在线生产单元,将其资源估计算法的参数调整为激进设置并运行一周(通过减小安全裕度),第三周调整为基线与激进之间的中等设置,第四周恢复基线。
图 12 展示了结果。第二周的预留量明显更接近实际使用量,第三周的差距略大,基线周(第 1 和第 4 周)的差距最大。正如预期,第 2 和第 3 周的内存不足(OOM)事件发生率略有上升。⁵ 评估这些结果后,我们认为净收益大于弊端,并将中等资源回收参数部署到了其他单元。
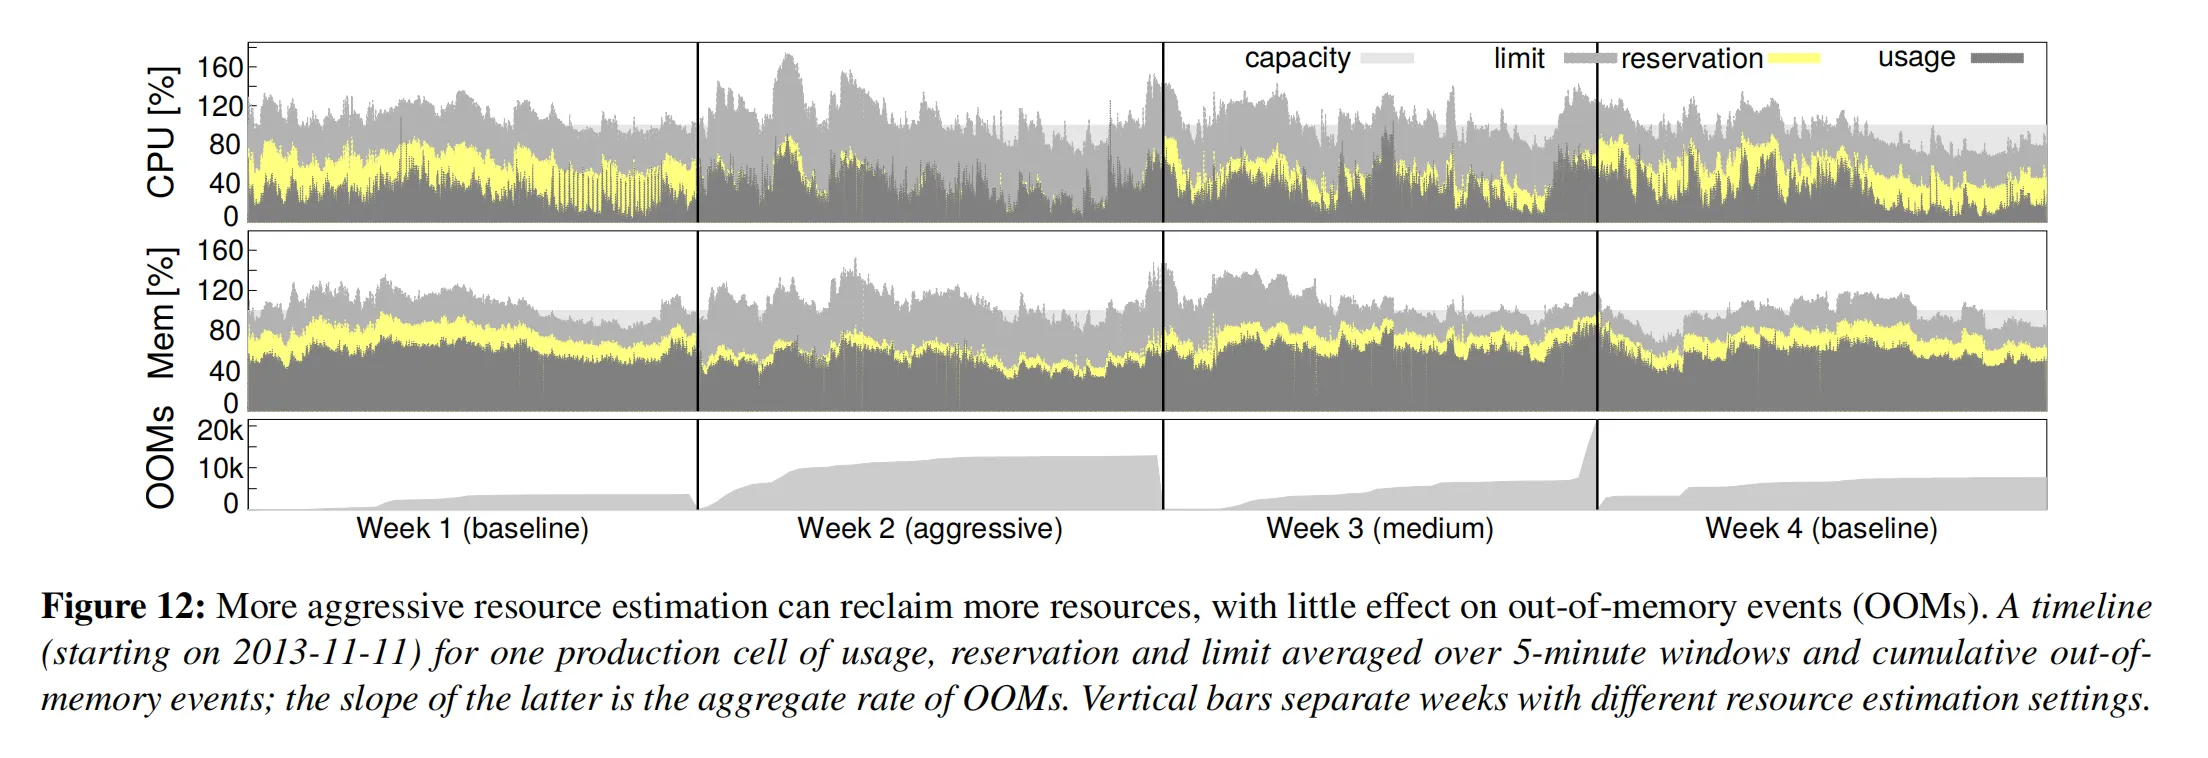
图 12:更激进的资源预估可以回收更多资源,对内存不足事件(OOM)影响很小。一个生产单元的时间线(从 2013-11-11 开始),展示了 5 分钟窗口平均的使用率、预留量和限制值,以及累计内存不足事件;后者的斜率即 OOM 的总发生率。竖线分隔了不同资源预估设置的周期。
⁵ 第 3 周末的异常与本实验无关。
6. 隔离性
50% 的机器运行 9 个或更多任务;90 分位的机器约有 25 个任务,运行约 4500 个线程[83]。尽管应用间共享机器提升了利用率,但也需要完善的机制来防止任务相互干扰。这同时涉及安全性和性能两个层面。
6.1 安全隔离
我们使用 Linux chroot 监狱作为同一机器上多个任务之间的主要安全隔离机制。为了支持远程调试,我们过去会自动分发(并收回)ssh 密钥,仅在机器运行用户的任务时授予用户访问权限。对大多数用户来说,这已经被 borgssh 命令取代,它与 Borglet 协作构建 ssh 连接,进入运行在与任务相同的 chroot 和 cgroup 中的 shell,进一步收紧了访问权限。
Google App Engine(GAE)[38]和 Google Compute Engine(GCE)使用虚拟机和安全沙箱技术运行外部软件。我们将每个托管的虚拟机运行在一个 KVM 进程[54]中,该进程作为一个 Borg 任务运行。
6.2 性能隔离
早期版本的 Borglet 采用相对原始的资源隔离机制:事后检查内存、磁盘空间和 CPU 周期的使用量,结合终止占用过多内存或磁盘的任务,以及通过 Linux CPU 优先级来限制占用过多 CPU 的任务。但恶意任务仍然很容易影响同一机器上其他任务的性能,因此有些用户会夸大资源请求,以减少 Borg 可以与他们的任务共同调度的任务数量,从而降低了利用率。资源回收可以收回部分冗余资源,但由于安全裕度的存在,无法全部收回。在最极端的情况下,用户会申请使用专用机器或单元。
现在,所有 Borg 任务都运行在基于 Linux cgroup 的资源容器中[17, 58, 62],Borglet 通过操纵容器设置进行管理,由于操作系统内核直接参与管控,控制能力大幅提升。即便如此,偶尔仍会发生底层资源干扰(例如内存带宽或 L3 缓存污染),正如[60, 83]中所述。
为了应对过载和资源超售,Borg 任务分为不同的应用类别(appclass)。最重要的划分是延迟敏感(LS)类和其他类别(本文统称为批处理类)。延迟敏感任务用于面向用户的应用和共享基础设施服务,这类服务要求对请求做出快速响应。高优先级的延迟敏感任务获得最优待遇,能够临时抢占批处理任务数秒时间。
另一种划分是可压缩资源与不可压缩资源:可压缩资源(例如 CPU 周期、磁盘 I/O 带宽)是基于速率的,可以通过降低服务质量从任务处回收,而无需终止任务;不可压缩资源(例如内存、磁盘空间)通常只能通过终止任务来回收。
如果机器耗尽不可压缩资源,Borglet 会立即从最低优先级到最高优先级终止任务,直到剩余预留量能够满足需求。如果机器耗尽可压缩资源,Borglet 会进行限流(优先保障延迟敏感任务),这样可以应对短期负载突增而无需终止任何任务。如果情况没有改善,Borgmaster 会从机器上移除一个或多个任务。
Borglet 中的用户态控制循环会根据预测的未来使用量(针对生产级任务)或内存压力(针对非生产级任务)为容器分配内存;处理内核的内存不足(OOM)事件;当任务尝试分配超出其内存限制的资源时,或是当超售的机器实际耗尽内存时,终止任务。Linux 的激进文件缓存机制大大增加了实现的复杂度,因为需要精确的内存核算。
为了提升性能隔离,延迟敏感任务可以预留完整的物理 CPU 核心,阻止其他延迟敏感任务使用这些核心。批处理任务允许在任意核心上运行,但相对于延迟敏感任务,它们的调度时间片占比很小。
Borglet 会动态调整贪婪的延迟敏感任务的资源上限,确保它们不会让批处理任务饥饿数分钟之久,并在需要时有选择地应用 CFS 带宽控制[75];仅靠时间片分配是不够的,因为我们有多个优先级级别。
与 Leverich[56]的研究一致,我们发现标准 Linux CPU 调度器(CFS)需要大量调优,才能同时支持低延迟和高利用率。为了减少调度延迟,我们版本的 CFS 使用了扩展的 per-cgroup 负载历史[16],允许延迟敏感任务抢占批处理任务,并在多个延迟敏感任务可在一个 CPU 上运行时减小调度时间片。
幸运的是,我们的许多应用采用“每个请求一个线程”的模型,这缓解了持续负载不均衡的影响。我们很少使用 cpuset 为延迟要求特别严格的应用分配 CPU 核心。这些努力的部分结果如图 13 所示。该领域的工作仍在继续,包括增加线程放置和 NUMA 感知、超线程感知、功耗感知的 CPU 管理(例如[81]),以及提升 Borglet 的控制精度。
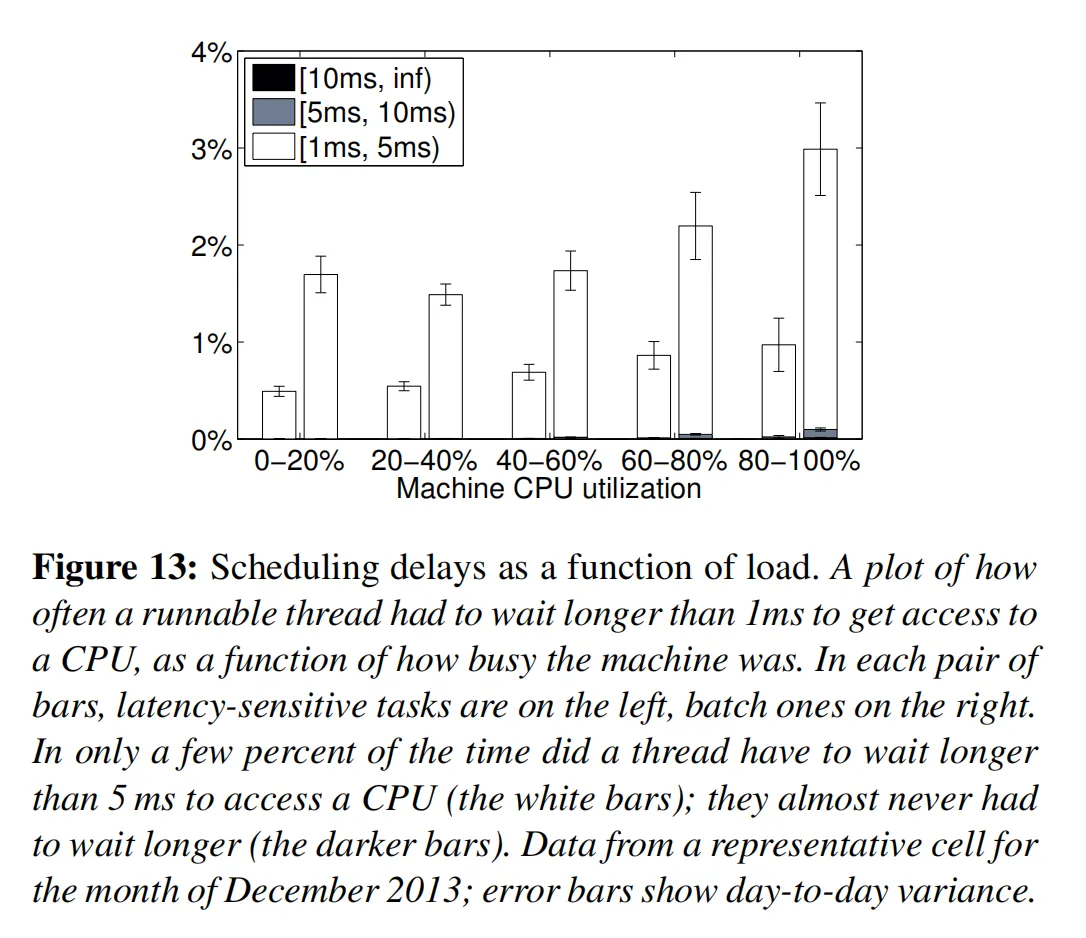
图 13:调度延迟随负载变化。图中展示了可运行线程等待 CPU 访问超过 1ms 的频率,随机器繁忙程度的变化。每组柱形中,左侧为延迟敏感任务,右侧为批处理任务。只有百分之几的时间里,线程需要等待超过 5ms 才能获得 CPU(白色柱形);等待更长时间的情况几乎从未发生(深色柱形)。数据取自一个代表性单元 2013 年 12 月的数据;误差棒展示了日间方差。
任务允许消耗的资源最多达到其限制值。对于 CPU 等可压缩资源,大多数任务允许超出限制,以利用未使用的(闲置)资源。只有 5% 的延迟敏感任务禁用了该特性,大概是为了获得更好的可预测性;批处理任务中禁用该特性的不到 1%。
闲置内存的使用默认禁用,因为这会增加任务被终止的概率,但即便如此,10% 的延迟敏感任务覆盖了该默认设置,79% 的批处理任务也开启了该设置——因为这是 MapReduce 框架的默认配置。这与资源回收的结果(见 5.5 节)形成互补。批处理任务愿意机会主义地利用未使用和回收的内存:大多数时候这都能正常运行,尽管偶尔会有批处理任务在延迟敏感任务急需资源时被牺牲。
7. 相关工作
资源调度已经研究了数十年,应用场景涵盖广域高性能计算超级计算网格、工作站网络和大规模服务器集群。我们在此仅关注大规模服务器集群背景下最相关的工作。
近期多项研究分析了来自 Yahoo!、Google 和 Facebook 的集群追踪数据[20, 52, 63, 68, 70, 80, 82],阐明了现代数据中心和工作负载中固有的规模与异构性挑战。文献[69]包含集群管理器架构的分类体系。
Apache Mesos[45]将资源管理和部署功能拆分给中央资源管理器(有点像去掉调度器的 Borgmaster)和多个“框架”(例如 Hadoop[41]和 Spark[73]),采用基于资源邀约的机制。Borg 则大多采用基于请求的机制将这些功能集中化,并且具备很好的扩展性。DRF[29, 35, 36, 66]最初是为 Mesos 设计的;Borg 改用优先级和准入配额。Mesos 开发者已宣布计划扩展 Mesos,加入推测式资源分配与回收,并解决[69]中指出的部分问题。
YARN[76]是一个以 Hadoop 为核心的集群管理器。每个应用有一个管理器,与中央资源管理器协商所需资源;这与 Google MapReduce 作业从 2008 年左右开始从 Borg 获取资源的模式非常相似。YARN 的资源管理器直到最近才具备容错能力。相关的开源项目是 Hadoop 容量调度器[42],它提供多租户支持、容量保障、层级队列、弹性共享和公平性。YARN 近期已扩展支持多种资源类型、优先级、抢占和高级准入控制[21]。Tetris 研究原型[40]支持考虑完工时间的作业打包。
Facebook 的 Tupperware[64]是一个类似 Borg 的系统,用于在集群上调度 cgroup 容器;目前公开的细节很少,不过它似乎提供了某种形式的资源回收。Twitter 开源了 Aurora[5],这是一个运行在 Mesos 之上、面向长时运行服务的类 Borg 调度器,其配置语言和状态机与 Borg 类似。
微软的 Autopilot 系统[48]为微软集群提供“自动化软件供应与部署;系统监控;以及执行修复操作以应对故障软件和硬件”的能力。Borg 生态系统提供了类似的功能,但篇幅所限,本文不展开讨论;Isaard[48]概述了许多我们同样遵循的最佳实践。
Quincy[49]使用网络流模型,为几百个节点的集群上的数据处理有向无环图(DAG)提供公平性和数据局部性感知的调度。Borg 使用配额和优先级在用户间共享资源,并可扩展到数万台机器。Quincy 直接处理执行图,而这一功能在 Borg 之上独立构建。
Cosmos[44]聚焦于批处理,重点是确保用户能够公平访问自己捐赠给集群的资源。它使用每个作业一个管理器的方式获取资源;公开的细节很少。
微软的 Apollo 系统[13]为短生命周期批处理作业使用每个作业一个调度器,在规模与 Borg 单元相当的集群上实现高吞吐量。Apollo 采用机会主义方式执行低优先级后台工作,将利用率提升到很高的水平,代价是(有时)长达数天的排队延迟。Apollo 节点提供一个起始时间预测矩阵,展示任务起始时间随规模在两个资源维度上的变化,调度器将其与启动成本和远程数据访问估计结合起来做出部署决策,并通过随机延迟减少冲突。Borg 使用中央调度器基于先前分配的状态信息做出部署决策,能够处理更多资源维度,并聚焦于高可用长时运行应用的需求;Apollo 可能能够处理更高的任务到达率。
阿里巴巴的伏羲(Fuxi)[84]支撑数据分析工作负载;它从 2009 年开始投入运行。与 Borgmaster 类似,中央的 FuxiMaster(做了容错副本)从节点收集资源可用信息,接受应用请求,并进行资源匹配。Fuxi 的增量调度策略与 Borg 的等价类恰好相反:它不是将每个任务匹配到一组合适的机器,而是将新释放的资源与待处理的积压工作进行匹配。与 Mesos 一样,Fuxi 允许定义“虚拟资源”类型。目前公开的只有合成工作负载的结果。
Omega[69]支持多个并行的、专业化的“垂直领域”,每个大致相当于去掉持久化存储和链路分片的 Borgmaster。Omega 调度器使用乐观并发控制,操纵存储在中央持久化存储中的期望和观测单元状态的共享表示,该存储通过独立的链路组件与 Borglet 同步。Omega 架构旨在支持多个不同的工作负载,这些负载有各自专属的 RPC 接口、状态机和调度策略(例如长时运行服务、来自各种框架的批处理作业、集群存储系统等基础设施服务、来自 Google 云平台的虚拟机)。
另一方面,Borg 提供“一刀切”的 RPC 接口、状态机语义和调度策略,由于需要支撑众多差异巨大的工作负载,其规模和复杂度随时间不断增长,不过扩展性至今尚未成为问题(见 3.4 节)。
Google 的开源 Kubernetes 系统[53]将应用放置在 Docker 容器[28]中,运行在多个主机节点上。它既可以运行在裸机上(像 Borg 一样),也可以运行在各种云托管服务商上,例如 Google Compute Engine。它由许多构建 Borg 的工程师持续开发。Google 提供了托管版本 Google Container Engine[39]。下一节我们将讨论从 Borg 中汲取的经验如何应用于 Kubernetes。
高性能计算社区在该领域有悠久的研究传统(例如 Maui、Moab、Platform LSF[2, 47, 50]);但其规模、工作负载和容错要求与 Google 的单元不同。总体而言,这类系统通过大量待处理工作积压(队列)来实现高利用率。
VMware 等虚拟化提供商[77]以及惠普、IBM 等数据中心解决方案提供商[46]提供的集群管理解决方案,通常可扩展到上千台机器的规模。此外,多个研究团队已原型化了系统,以特定方式提升调度决策质量(例如[25, 40, 72, 74])。
最后,正如我们已经指出的,管理大规模集群的另一个重要方面是自动化和“运维人员规模扩展”。文献[43]阐述了为何故障预案、多租户、健康检查、准入控制和可重启性是实现单人管理大量机器的必要条件。Borg 的设计理念与此类似,让我们的每位运维人员(SRE)可以支撑数万台机器。
8. 经验教训与未来工作
本节我们将回顾十多年来 Borg 生产运维中沉淀的一些定性经验教训,并描述这些观察如何被应用于 Kubernetes[53]的设计中。
8.1 经验教训:不足之处
我们首先介绍 Borg 中一些作为警示的特性,这些特性为 Kubernetes 的替代设计提供了参考。
作业作为唯一任务分组机制存在局限性。 Borg 没有一等公民的方式将整个多作业服务作为单个实体管理,也无法引用服务的相关实例(例如金丝雀版本和生产版本)。作为变通,用户将服务拓扑编码在作业名称中,并构建更上层的管理工具来解析这些名称。而在另一端,无法引用作业的任意子集,导致滚动更新和作业扩缩容的语义不够灵活等问题。
为了避免这些困难,Kubernetes 摒弃了作业的概念,转而使用标签(用户可以附加到系统中任意对象上的任意键值对)来组织调度单元(Pod)。通过给一组 Pod 附加 job: 作业名 标签,可以实现等同于 Borg 作业的功能,但还可以表示其他任何有用的分组,例如服务、层级、发布类型(例如生产、预发布、测试)。Kubernetes 中的操作通过标签查询选择目标对象,然后应用操作。这种方式比作业的单一固定分组更具灵活性。
每台机器一个 IP 地址带来诸多复杂问题。 在 Borg 中,一台机器上的所有任务使用宿主机的单个 IP 地址,因此共享宿主机的端口空间。这导致了诸多难题:Borg 必须将端口作为一种资源进行调度;任务必须预先声明需要多少端口,并在启动时接受分配的端口号;Borglet 必须强制执行端口隔离;命名和 RPC 系统必须同时处理 IP 地址和端口。
得益于 Linux 命名空间、虚拟机、IPv6 和软件定义网络的出现,Kubernetes 采用了更友好的方式,消除了这些复杂性:每个 Pod 和服务都有自己的 IP 地址,允许开发者选择端口,而无需让软件适配基础设施选择的端口,同时也消除了管理端口的基础设施复杂度。
以牺牲普通用户为代价优化高级用户。 Borg 提供了大量面向“高级用户”的功能,让他们可以微调程序的运行方式(BCL 规范包含约 230 个参数):最初的重点是支撑 Google 最大的资源消费者,对他们而言效率提升至关重要。
但丰富的 API 给“普通”用户带来了使用难度,也限制了自身的演进。我们的解决方案是在 Borg 之上构建自动化工具和服务,通过实验确定合适的配置。这些工具受益于容错应用带来的试错自由:如果自动化出错,也只是造成麻烦,而非灾难。
8.2 经验教训:成功之处
另一方面,Borg 的许多设计特性带来了显著收益,经受住了时间的考验。
Alloc 机制非常实用。 Borg 的 alloc 抽象催生了广泛使用的日志保存模式(见 2.4 节),以及另一种流行模式:由简单的数据加载任务定期更新 Web 服务器使用的数据。Alloc 和软件包机制使得这类辅助服务可以由不同团队独立开发。Kubernetes 中与 alloc 对等的概念是 Pod,它是一个资源信封,包含一个或多个始终调度到同一台机器的容器,可以共享资源。Kubernetes 在同一个 Pod 中使用辅助容器而非 alloc 中的任务,但其核心思想一致。
集群管理不止于任务管理。 尽管 Borg 的主要作用是管理任务和机器的生命周期,但运行在 Borg 上的应用还受益于许多其他集群服务,包括命名和负载均衡。Kubernetes 使用服务抽象来支持命名和负载均衡:一个服务有一个名称,以及由标签选择器定义的动态 Pod 集合。集群中的任何容器都可以通过服务名连接到该服务。在底层,Kubernetes 自动在匹配标签选择器的 Pod 之间做连接负载均衡,并跟踪 Pod 因故障而被重新调度后的位置变化。
内省能力至关重要。 尽管 Borg 几乎总是“正常运行”,但一旦出现问题,定位根本原因可能非常困难。Borg 的一个重要设计决策是向所有用户开放调试信息,而非隐藏起来:Borg 拥有数千名用户,因此“自助排查”必须是调试的第一步。
尽管这让我们更难废弃功能、更改用户已经依赖的内部策略,但这仍然是值得的,并且我们还没有找到可行的替代方案。为了处理海量数据,我们提供了多层级的 UI 和调试工具,让用户可以快速定位与自身作业相关的异常事件,然后下钻到应用和基础设施本身的详细事件与错误日志。
Kubernetes 旨在复刻 Borg 的许多内省技术。例如,它内置了 cAdvisor[15]等资源监控工具,以及基于 Elasticsearch/Kibana[30]和 Fluentd[32]的日志聚合功能。可以向主节点查询其对象状态的快照。Kubernetes 拥有统一的事件记录机制,所有组件都可以用来记录事件(例如 Pod 被调度、容器失败),这些事件对客户端开放。
主控节点是分布式系统的内核。 Borgmaster 最初设计为单体系统,但随着时间推移,它逐渐演变为一个内核,位于协同管理用户作业的服务生态系统的核心。例如,我们将调度器和主要 UI(Sigma)拆分为独立进程,并增加了准入控制、垂直与水平自动扩缩、任务重打包、周期作业提交(cron)、工作流管理、离线查询用的系统操作归档等服务。这些共同让我们能够在不牺牲性能或可维护性的前提下,扩展工作负载规模和功能集。
Kubernetes 架构更进一步:它的核心是 API 服务器,仅负责处理请求和操纵底层状态对象。集群管理逻辑被构建为小型、可组合的微服务,作为 API 服务器的客户端运行;例如副本控制器,负责在发生故障时维持 Pod 的期望副本数;以及节点控制器,负责管理机器生命周期。
8.3 结论
在过去十年中,几乎所有 Google 的集群工作负载都已切换到使用 Borg。我们持续对其进行演进,并将从中汲取的经验应用到了 Kubernetes 中。
致谢
本文作者完成了评估工作并撰写了论文,但设计、实现和维护 Borg 组件及其生态系统的数十位工程师才是其成功的关键。我们在此仅列出最直接参与 Borgmaster 和 Borglet 设计、实现与运维的人员。如有遗漏,深表歉意。
最初的 Borgmaster 主要由 Jeremy Dion 和 Mark Vandevoorde 设计实现,参与者包括 Ben Smith、Ken Ashcraft、Maricia Scott、Ming-Yee Iu 和 Monika Henzinger。最初的 Borglet 主要由 Paul Menage 设计实现。
后续贡献者包括(按字母顺序):Abhishek Rai、Abhishek Verma、Andy Zheng、Ashwin Kumar、Beng-Hong Lim、Bin Zhang、Bolu Szewczyk、Brian Budge、Brian Grant、Brian Wickman、Chengdu Huang、Cynthia Wong、Daniel Smith、Dave Bort、David Oppenheimer、David Wall、Dawn Chen、Eric Haugen、Eric Tune、Ethan Solomita、Gaurav Dhiman、Geeta Chaudhry、Greg Roelofs、Grzegorz Czajkowski、James Eady、Jarek Kusmierek、Jaroslaw Przybylowicz、Jason Hickey、Javier Kohen、Jeremy Lau、Jerzy Szczepkowski、John Wilkes、Jonathan Wilson、Joso Eterovic、Jutta Degener、Kai Backman、Kamil Yurtsever、Kenji Kaneda、Kevan Miller、Kurt Steinkraus、Leo Landa、Liza Fireman、Madhukar Korupolu、Mark Logan、Markus Gutschke、Matt Sparks、Maya Haridasan、Michael Abd-El-Malek、Michael Kenniston、Mukesh Kumar、Nate Calvin、Onufry Wojtaszczyk、Patrick Johnson、Pedro Valenzuela、Piotr Witusowski、Praveen Kallakuri、Rafal Sokolowski、Richard Gooch、Rishi Gosalia、Rob Radez、Robert Hagmann、Robert Jardine、Robert Kennedy、Rohit Jnagal、Roy Bryant、Rune Dahl、Scott Garriss、Scott Johnson、Sean Howarth、Sheena Madan、Smeeta Jalan、Stan Chesnutt、Temo Arobelidze、Tim Hockin、Todd Wang、Tomasz Blaszczyk、Tomasz Wozniak、Tomek Zielonka、Victor Marmol、Vish Kannan、Vrigo Gokhale、Walfredo Cirne、Walt Drummond、Weiran Liu、Xiaopan Zhang、Xiao Zhang、Ye Zhao、Zohaib Maya。
Borg SRE 团队也至关重要,成员包括:Adam Rogoyski、Alex Milivojevic、Anil Das、Cody Smith、Cooper Bethea、Folke Behrens、Matt Liggett、James Sanford、John Millikin、Matt Brown、Miki Habryn、Peter Dahl、Robert van Gent、Seppi Wilhelmi、Seth Hettich、Torsten Marek、Viraj Alankar。
Borg 配置语言(BCL)和 borgcfg 工具最初由 Marcel van Lohuizen 和 Robert Griesemer 开发。
感谢我们的审稿人(特别是 Eric Brewer、Malte Schwarzkopf 和 Tom Rodeheffer),以及我们的指导 Christos Kozyrakis,感谢他们对本文的反馈。
参考文献
[1] O. A. Abdul-Rahman and K. Aida. Towards understanding the usage behavior of Google cloud users: the mice and elephants phenomenon. In Proc. IEEE Int’l Conf. on Cloud Computing Technology and Science (CloudCom), pages 272–277, Singapore, Dec. 2014.
[2] Adaptive Computing Enterprises Inc., Provo, UT. Maui Scheduler Administrator’s Guide, 3.2 edition, 2011.
[3] T. Akidau, A. Balikov, K. Bekiro˘glu, S. Chernyak, J. Haberman, R. Lax, S. McVeety, D. Mills, P. Nordstrom, and S. Whittle. MillWheel: fault-tolerant stream processing at internet scale. In Proc. Int’l Conf. on Very Large Data Bases (VLDB), pages 734–746, Riva del Garda, Italy, Aug. 2013.
[4] Y. Amir, B. Awerbuch, A. Barak, R. S. Borgstrom, and A. Keren. An opportunity cost approach for job assignment in a scalable computing cluster. IEEE Trans. Parallel Distrib. Syst., 11(7):760–768, July 2000.
[5] Apache Aurora. http://aurora.incubator.apache.org/, 2014.
[6] Aurora Configuration Tutorial. https://aurora.incubator.apache.org/ documentation/latest/configuration-tutorial/, 2014.
[7] AWS. Amazon Web Services VM Instances. http://aws.amazon.com/ec2/instance-types/, 2014.
[8] J. Baker, C. Bond, J. Corbett, J. Furman, A. Khorlin, J. Larson, J.-M. Leon, Y. Li, A. Lloyd, and V. Yushprakh. Megastore: Providing scalable, highly available storage for interactive services. In Proc. Conference on Innovative Data Systems Research (CIDR), pages 223–234, Asilomar, CA, USA, Jan. 2011.
[9] M. Baker and J. Ousterhout. Availability in the Sprite distributed file system. Operating Systems Review, 25(2):95–98, Apr. 1991.
[10] L. A. Barroso, J. Clidaras, and U. H¨olzle. The datacenter as a computer: an introduction to the design of warehouse-scale machines. Morgan Claypool Publishers, 2nd edition, 2013.
[11] L. A. Barroso, J. Dean, and U. Holzle. Web search for a planet: the Google cluster architecture. In IEEE Micro, pages 22–28, 2003.
[12] I. Bokharouss. GCL Viewer: a study in improving the understanding of GCL programs. Technical report, Eindhoven Univ. of Technology, 2008. MS thesis.
[13] E. Boutin, J. Ekanayake, W. Lin, B. Shi, J. Zhou, Z. Qian, M. Wu, and L. Zhou. Apollo: scalable and coordinated scheduling for cloud-scale computing. In Proc. USENIX Symp. on Operating Systems Design and Implementation (OSDI), Oct. 2014.
[14] M. Burrows. The Chubby lock service for loosely-coupled distributed systems. In Proc. USENIX Symp. on Operating Systems Design and Implementation (OSDI), pages 335–350, Seattle, WA, USA, 2006.
[15] cAdvisor. https://github.com/google/cadvisor, 2014.
[16] CFS per-entity load patches. http://lwn.net/Articles/531853, 2013.
[17] cgroups. http://en.wikipedia.org/wiki/Cgroups, 2014.
[18] C. Chambers, A. Raniwala, F. Perry, S. Adams, R. R. Henry, R. Bradshaw, and N. Weizenbaum. FlumeJava: easy, efficient data-parallel pipelines. In Proc. ACM SIGPLAN Conf. on Programming Language Design and Implementation (PLDI), pages 363–375, Toronto, Ontario, Canada, 2010.
[19] F. Chang, J. Dean, S. Ghemawat, W. C. Hsieh, D. A. Wallach, M. Burrows, T. Chandra, A. Fikes, and R. E. Gruber. Bigtable: a distributed storage system for structured data. ACM Trans. on Computer Systems, 26(2):4:1–4:26, June 2008.
[20] Y. Chen, S. Alspaugh, and R. H. Katz. Design insights for MapReduce from diverse production workloads. Technical Report UCB/EECS–2012–17, UC Berkeley, Jan. 2012.
[21] C. Curino, D. E. Difallah, C. Douglas, S. Krishnan, R. Ramakrishnan, and S. Rao. Reservation-based scheduling: if you’re late don’t blame us! In Proc. ACM Symp. on Cloud Computing (SoCC), pages 2:1–2:14, Seattle, WA, USA, 2014.
[22] J. Dean and L. A. Barroso. The tail at scale. Communications of the ACM, 56(2):74–80, Feb. 2012.
[23] J. Dean and S. Ghemawat. MapReduce: simplified data processing on large clusters. Communications of the ACM, 51(1):107–113, 2008.
[24] C. Delimitrou and C. Kozyrakis. Paragon: QoS-aware scheduling for heterogeneous datacenters. In Proc. Int’l Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), Mar. 201.
[25] C. Delimitrou and C. Kozyrakis. Quasar: resource-efficient and QoS-aware cluster management. In Proc. Int’l Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), pages 127–144, Salt Lake City, UT, USA, 2014.
[26] S. Di, D. Kondo, and W. Cirne. Characterization and comparison of cloud versus Grid workloads. In International Conference on Cluster Computing (IEEE CLUSTER), pages 230–238, Beijing, China, Sept. 2012.
[27] S. Di, D. Kondo, and C. Franck. Characterizing cloud applications on a Google data center. In Proc. Int’l Conf. on Parallel Processing (ICPP), Lyon, France, Oct. 2013.
[28] Docker Project. https://www.docker.io/, 2014.
[29] D. Dolev, D. G. Feitelson, J. Y. Halpern, R. Kupferman, and N. Linial. No justified complaints: on fair sharing of multiple resources. In Proc. Innovations in Theoretical Computer Science (ITCS), pages 68–75, Cambridge, MA, USA, 2012.
[30] ElasticSearch. http://www.elasticsearch.org, 2014.
[31] D. G. Feitelson. Workload Modeling for Computer Systems Performance Evaluation. Cambridge University Press, 2014.
[32] Fluentd. http://www.fluentd.org/, 2014.
[33] GCE. Google Compute Engine. http: //cloud.google.com/products/compute-engine/, 2014.
[34] S. Ghemawat, H. Gobioff, and S.-T. Leung. The Google File System. In Proc. ACM Symp. on Operating Systems Principles (SOSP), pages 29–43, Bolton Landing, NY, USA, 2003. ACM.
[35] A. Ghodsi, M. Zaharia, B. Hindman, A. Konwinski, S. Shenker, and I. Stoica. Dominant Resource Fairness: fair allocation of multiple resource types. In Proc. USENIX Symp. on Networked Systems Design and Implementation (NSDI), pages 323–326, 2011.
[36] A. Ghodsi, M. Zaharia, S. Shenker, and I. Stoica. Choosy: max-min fair sharing for datacenter jobs with constraints. In Proc. European Conf. on Computer Systems (EuroSys), pages 365–378, Prague, Czech Republic, 2013.
[37] D. Gmach, J. Rolia, and L. Cherkasova. Selling T-shirts and time shares in the cloud. In Proc. IEEE/ACM Int’l Symp. on Cluster, Cloud and Grid Computing (CCGrid), pages 539–546, Ottawa, Canada, 2012.
[38] Google App Engine. http://cloud.google.com/AppEngine, 2014.
[39] Google Container Engine (GKE). https://cloud.google.com/container-engine/, 2015.
[40] R. Grandl, G. Ananthanarayanan, S. Kandula, S. Rao, and A. Akella. Multi-resource packing for cluster schedulers. In Proc. ACM SIGCOMM, Aug. 2014.
[41] Apache Hadoop Project. http://hadoop.apache.org/, 2009.
[42] Hadoop MapReduce Next Generation – Capacity Scheduler. http: //https://hadoop.apache.org/docs/r2.2.0/hadoop-yarn/ hadoop-yarn-site/CapacityScheduler.html, 2013.
[43] J. Hamilton. On designing and deploying internet-scale services. In Proc. Large Installation System Administration Conf. (LISA), pages 231–242, Dallas, TX, USA, Nov. 2007.
[44] P. Helland. Cosmos: big data and big challenges. http://research.microsoft.com/en-us/events/ fs2011/helland_cosmos_big_data_and_big\ _challenges.pdf, 2011.
[45] B. Hindman, A. Konwinski, M. Zaharia, A. Ghodsi, A. Joseph, R. Katz, S. Shenker, and I. Stoica. Mesos: a platform for fine-grained resource sharing in the data center. In Proc. USENIX Symp. on Networked Systems Design and Implementation (NSDI), 2011.
[46] IBM Platform Computing. http://www-03.ibm.com/ systems/technicalcomputing/platformcomputing/ products/clustermanager/index.html.
[47] S. Iqbal, R. Gupta, and Y.-C. Fang. Planning considerations for job scheduling in HPC clusters. Dell Power Solutions, Feb. 2005.
[48] M. Isaard. Autopilot: Automatic data center management. ACM SIGOPS Operating Systems Review, 41(2), 2007.
[49] M. Isard, V. Prabhakaran, J. Currey, U. Wieder, K. Talwar, and A. Goldberg. Quincy: fair scheduling for distributed computing clusters. In Proc. ACM Symp. on Operating Systems Principles (SOSP), 2009.
[50] D. B. Jackson, Q. Snell, and M. J. Clement. Core algorithms of the Maui scheduler. In Proc. Int’l Workshop on Job Scheduling Strategies for Parallel Processing, pages 87–102. Springer-Verlag, 2001.
[51] M. Kambadur, T. Moseley, R. Hank, and M. A. Kim. Measuring interference between live datacenter applications. In Proc. Int’l Conf. for High Performance Computing, Networking, Storage and Analysis (SC), Salt Lake City, UT, Nov. 2012.
[52] S. Kavulya, J. Tan, R. Gandhi, and P. Narasimhan. An analysis of traces from a production MapReduce cluster. In Proc. IEEE/ACM Int’l Symp. on Cluster, Cloud and Grid Computing (CCGrid), pages 94–103, 2010.
[53] Kubernetes. http://kubernetes.io, Aug. 2014.
[54] Kernel Based Virtual Machine. http://www.linux-kvm.org. 2007–2014.
[55] L. Lamport. The part-time parliament. ACM Trans. on Computer Systems, 16(2):133–169, May 1998.
[56] J. Leverich and C. Kozyrakis. Reconciling high server utilization and sub-millisecond quality-of-service. In Proc. European Conf. on Computer Systems (EuroSys), page 4, 2014.
[57] Z. Liu and S. Cho. Characterizing machines and workloads on a Google cluster. In Proc. Int’l Workshop on Scheduling and Resource Management for Parallel and Distributed Systems (SRMPDS), Pittsburgh, PA, USA, Sept. 2012.
[58] Google LMCTFY project (let me contain that for you). http://github.com/google/lmctfy, 2014.
[59] G. Malewicz, M. H. Austern, A. J. Bik, J. C. Dehnert, I. Horn, N. Leiser, and G. Czajkowski. Pregel: a system for large-scale graph processing. In Proc. ACM SIGMOD Conference, pages 135–146, Indianapolis, IN, USA, 2010.
[60] J. Mars, L. Tang, R. Hundt, K. Skadron, and M. L. Soffa. Bubble-Up: increasing utilization in modern warehouse scale computers via sensible co-locations. In Proc. Int’l Symp. on Microarchitecture (Micro), Porto Alegre, Brazil, 2011.
[61] S. Melnik, A. Gubarev, J. J. Long, G. Romer, S. Shivakumar, M. Tolton, and T. Vassilakis. Dremel: interactive analysis of web-scale datasets. In Proc. Int’l Conf. on Very Large Data Bases (VLDB), pages 330–339, Singapore, Sept. 2010.
[62] P. Menage. Linux control groups. http://www.kernel. org/doc/Documentation/cgroups/cgroups.txt, 2007–2014.
[63] A. K. Mishra, J. L. Hellerstein, W. Cirne, and C. R. Das. Towards characterizing cloud backend workloads: insights from Google compute clusters. ACM SIGMETRICS Performance Evaluation Review, 37:34–41, Mar. 2010.
[64] A. Narayanan. Tupperware: containerized deployment at Facebook. http://www.slideshare.net/dotCloud/ tupperware-containerized-deployment-at-facebook, June 2014.
[65] K. Ousterhout, P. Wendell, M. Zaharia, and I. Stoica. Sparrow: distributed, low latency scheduling. In Proc. ACM Symp. on Operating Systems Principles (SOSP), pages 69–84, Farminton, PA, USA, 2013.
[66] D. C. Parkes, A. D. Procaccia, and N. Shah. Beyond Dominant Resource Fairness: extensions, limitations, and indivisibilities. In Proc. Electronic Commerce, pages 808–825, Valencia, Spain, 2012.
[67] Protocol buffers. https: //developers.google.com/protocol-buffers/, and https://github.com/google/protobuf/., 2014.
[68] C. Reiss, A. Tumanov, G. Ganger, R. Katz, and M. Kozuch. Heterogeneity and dynamicity of clouds at scale: Google trace analysis. In Proc. ACM Symp. on Cloud Computing (SoCC), San Jose, CA, USA, Oct. 2012.
[69] M. Schwarzkopf, A. Konwinski, M. Abd-El-Malek, and J. Wilkes. Omega: flexible, scalable schedulers for large compute clusters. In Proc. European Conf. on Computer Systems (EuroSys), Prague, Czech Republic, 2013.
[70] B. Sharma, V. Chudnovsky, J. L. Hellerstein, R. Rifaat, and C. R. Das. Modeling and synthesizing task placement constraints in Google compute clusters. In Proc. ACM Symp. on Cloud Computing (SoCC), pages 3:1–3:14, Cascais, Portugal, Oct. 2011.
[71] E. Shmueli and D. G. Feitelson. On simulation and design of parallel-systems schedulers: are we doing the right thing? IEEE Trans. on Parallel and Distributed Systems, 20(7):983–996, July 2009.
[72] A. Singh, M. Korupolu, and D. Mohapatra. Server-storage virtualization: integration and load balancing in data centers. In Proc. Int’l Conf. for High Performance Computing, Networking, Storage and Analysis (SC), pages 53:1–53:12, Austin, TX, USA, 2008.
[73] Apache Spark Project. http://spark.apache.org/, 2014.
[74] A. Tumanov, J. Cipar, M. A. Kozuch, and G. R. Ganger. Alsched: algebraic scheduling of mixed workloads in heterogeneous clouds. In Proc. ACM Symp. on Cloud Computing (SoCC), San Jose, CA, USA, Oct. 2012.
[75] P. Turner, B. Rao, and N. Rao. CPU bandwidth control for CFS. In Proc. Linux Symposium, pages 245–254, July 2010.
[76] V. K. Vavilapalli, A. C. Murthy, C. Douglas, S. Agarwal, M. Konar, R. Evans, T. Graves, J. Lowe, H. Shah, S. Seth, B. Saha, C. Curino, O. O’Malley, S. Radia, B. Reed, and E. Baldeschwieler. Apache Hadoop YARN: Yet Another Resource Negotiator. In Proc. ACM Symp. on Cloud Computing (SoCC), Santa Clara, CA, USA, 2013.
[77] VMware VCloud Suite. http://www.vmware.com/products/vcloud-suite/.
[78] A. Verma, M. Korupolu, and J. Wilkes. Evaluating job packing in warehouse-scale computing. In IEEE Cluster, pages 48–56, Madrid, Spain, Sept. 2014.
[79] W. Whitt. Open and closed models for networks of queues. AT&T Bell Labs Technical Journal, 63(9), Nov. 1984.
[80] J. Wilkes. More Google cluster data. http://googleresearch.blogspot.com/2011/11/ more-google-cluster-data.html, Nov. 2011.
[81] Y. Zhai, X. Zhang, S. Eranian, L. Tang, and J. Mars. HaPPy: Hyperthread-aware power profiling dynamically. In Proc. USENIX Annual Technical Conf. (USENIX ATC), pages 211–217, Philadelphia, PA, USA, June 2014. USENIX Association.
[82] Q. Zhang, J. Hellerstein, and R. Boutaba. Characterizing task usage shapes in Google’s compute clusters. In Proc. Int’l Workshop on Large-Scale Distributed Systems and Middleware (LADIS), 2011.
[83] X. Zhang, E. Tune, R. Hagmann, R. Jnagal, V. Gokhale, and J. Wilkes. CPI2: CPU performance isolation for shared compute clusters. In Proc. European Conf. on Computer Systems (EuroSys), Prague, Czech Republic, 2013.
[84] Z. Zhang, C. Li, Y. Tao, R. Yang, H. Tang, and J. Xu. Fuxi: a fault-tolerant resource management and job scheduling system at internet scale. In Proc. Int’l Conf. on Very Large Data Bases (VLDB), pages 1393–1404. VLDB Endowment Inc., Sept. 2014.
《Borg:Google 大规模集群管理系统》勘误
2015-04-23
在终稿定稿后,我们发现了几处疏忽的遗漏和表述歧义。
用户视角
SRE 的工作远不止系统管理:他们是负责 Google 生产服务的工程师。他们设计和实现软件(包括自动化系统),并管理应用、服务基础设施和平台,以确保 Google 规模下的高性能与可靠性。
相关工作
Borg 大量借鉴了其内部前身 Global Work Queue 系统,该系统最初由 Jeff Dean、Olcan Sercinoglu 和 Percy Liang 开发。
Condor[1] 被广泛用于聚合闲置资源,其 ClassAds 机制[2]支持声明式语句和自动化的属性匹配。
致谢
我们意外遗漏了 Brad Strand、Chris Colohan、Divyesh Shah、Eric Wilcox 和 Pavanish Nirula。
参考文献
[1] Michael Litzkow, Miron Livny, and Matt Mutka. “Condor – A Hunter of Idle Workstations”. In Proc. Int’l Conf. on Distributed Computing Systems (ICDCS) , pages 104-111, June 1988.
[2] Rajesh Raman, Miron Livny, and Marvin Solomon. “Matchmaking: Distributed Resource Management for High Throughput Computing”. In Proc. Int’l Symp. on High Performance Distributed Computing (HPDC) , Chicago, IL, USA, July 1998.