弹性分布式数据集:内存集群计算的容错抽象
Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing
贡献:提出RDD,促使Spark生态取代MapReduce成为大数据计算的事实标准
作者:Matei Zaharia, Mosharaf Chowdhury, Tathagata Das, Ankur Dave, Justin Ma, Murphy McCauley, Michael J. Franklin, Scott Shenker, Ion Stoica
单位:University of California, Berkeley
摘要
我们提出了弹性分布式数据集(Resilient Distributed Datasets,简称RDD),这是一种分布式内存抽象,能够让程序员在大型集群上以容错的方式执行内存计算。RDD的提出,旨在解决两类现有计算框架处理效率低下的应用场景:迭代算法与交互式数据挖掘工具。在这两类场景中,将数据保存在内存中可以将性能提升一个数量级。为了高效实现容错,RDD提供了一种受限制的共享内存形式:它是只读数据集,只能通过对其他RDD执行批量操作来构建。但我们的研究表明,RDD的表达能力足以覆盖广泛的计算类型,包括MapReduce,以及Pregel等面向迭代任务的专用编程模型,还能支持这些模型无法覆盖的新型应用。我们在名为Spark的系统中实现了RDD,并通过多种用户应用和基准测试对其进行了评估。
1 引言
MapReduce[10]和Dryad[19]等集群计算框架已被广泛应用于大规模数据分析。这些系统让用户可以通过一系列高级算子编写并行计算程序,无需关心任务分发与容错问题。
尽管现有框架提供了大量访问集群计算资源的抽象,但它们缺少利用分布式内存的抽象。这导致它们在一类重要的新兴应用中效率低下:这类应用会在多次计算中复用中间结果。数据复用在许多迭代机器学习和图算法中十分常见,包括PageRank、K均值聚类和逻辑回归。另一个典型用例是交互式数据挖掘,用户需要在同一数据子集上运行多个即席查询。遗憾的是,在大多数现有框架中,在不同计算之间复用数据(例如两次MapReduce作业之间)的唯一方法是将数据写入外部稳定存储系统,比如分布式文件系统。这会带来数据复制、磁盘I/O和序列化的巨大开销,这些开销往往会占据应用执行时间的主要部分。
意识到这一问题后,研究人员针对部分需要数据复用的应用开发了专用框架。例如,Pregel[22]是面向迭代图计算的系统,会将中间数据保存在内存中;HaLoop[7]则提供了迭代式MapReduce接口。但这些框架仅支持特定的计算模式(例如循环执行一系列MapReduce步骤),并且仅针对这些模式隐式地执行数据共享。它们不提供更通用的复用抽象,比如无法让用户将多个数据集加载到内存中,并在其上运行即席查询。
本文中,我们提出了一种名为弹性分布式数据集(RDD)的新型抽象,能够在广泛的应用中实现高效的数据复用。RDD是一种容错的并行数据结构,用户可以显式地将中间结果持久化到内存中,控制数据的分区方式以优化数据放置,还可以通过丰富的算子集合对其进行操作。
设计RDD的核心挑战,是定义一种能够高效提供容错能力的编程接口。现有的集群内存存储抽象,比如分布式共享内存[24]、键值存储[25]、数据库以及Piccolo[27],都提供基于可变状态细粒度更新的接口(例如表中的单元格)。在这种接口下,实现容错的唯一方式是跨机器复制数据,或者跨机器记录更新日志。对于数据密集型工作负载来说,这两种方式的开销都很高,因为它们需要在集群网络中复制大量数据,而集群网络的带宽远低于内存带宽,同时还会带来巨大的存储开销。
与这些系统不同,RDD提供基于粗粒度转换的接口(例如map、filter和join),这类操作会对大量数据项执行相同的运算。这使得RDD可以通过记录构建数据集的转换操作(即血缘(lineage))而非实际数据本身,来高效实现容错¹。如果RDD的某个分区丢失,RDD拥有足够的关于其如何从其他RDD衍生而来的信息,只需重新计算该分区即可。因此,丢失的数据可以恢复,而且通常速度很快,不需要代价高昂的数据复制。
尽管基于粗粒度转换的接口乍一看似乎有局限性,但RDD非常适合许多并行应用,因为这些应用本身就会对多个数据项执行相同的操作。事实上,我们证明RDD可以高效表达多种迄今为止作为独立系统提出的集群编程模型,包括MapReduce、DryadLINQ、SQL、Pregel和HaLoop,还能支持这些系统无法覆盖的新型应用,比如交互式数据挖掘。我们相信,RDD抽象能够满足以往只能通过引入新框架才能实现的计算需求,这正是RDD抽象强大之处最有力的证明。
我们在名为Spark的系统中实现了RDD,目前加州大学伯克利分校和多家企业正在将其用于研究和生产应用。Spark提供了与DryadLINQ[31]类似的、与Scala编程语言[2]深度集成的便捷编程接口。此外,Spark还可以交互式地从Scala解释器中查询大数据集。我们相信,Spark是首个能够让通用编程语言在集群内存数据挖掘中实现交互式速度的系统。
我们通过微基准测试和用户应用实测对RDD和Spark进行了评估。结果表明,对于迭代应用,Spark的速度比Hadoop最高快20倍;将一份真实世界的数据分析报告的速度提升了40倍;还可以交互式扫描1TB数据集,延迟仅为5-7秒。更重要的是,为了说明RDD的通用性,我们在Spark之上实现了Pregel和HaLoop编程模型(包括它们采用的放置优化),而它们仅相当于相对较小的程序库(每个约200行代码)。
本文首先概述RDD(第2节)和Spark(第3节),然后讨论RDD的内部表示(第4节)、我们的实现细节(第5节)以及实验结果(第6节)。最后,我们将讨论RDD如何兼容多种现有集群编程模型(第7节),梳理相关工作(第8节),并总结全文。
2 弹性分布式数据集(RDD)
本节概述RDD。我们首先定义RDD(2.1节),并介绍其在Spark中的编程接口(2.2节)。然后将RDD与细粒度共享内存抽象进行对比(2.3节),最后讨论RDD模型的局限性(2.4节)。
2.1 RDD抽象
形式化而言,RDD是只读的、分区化的记录集合。RDD只能通过确定性操作创建,操作的输入要么是(1)稳定存储中的数据,要么是(2)其他RDD。我们将这些操作称为转换(transformation),以区别于RDD上的其他操作。转换的例子包括map、filter和join²。
RDD不需要在任何时候都被物化。相反,每个RDD都包含足够的关于其如何从其他数据集衍生而来的信息(即其血缘),可以从稳定存储的数据中计算出自己的分区。这是一个强大的特性:本质上,程序无法引用一个在故障后无法重建的RDD。
最后,用户还可以控制RDD的两个其他方面:持久化和分区。用户可以指定哪些RDD需要复用,并为其选择存储策略(例如内存存储)。用户还可以要求根据每条记录中的键,将RDD的元素分区分布在不同机器上。这对于放置优化非常有用,例如确保两个要做join的数据集采用相同的哈希分区方式。
2.2 Spark编程接口
Spark通过与语言深度集成的API暴露RDD,其风格类似DryadLINQ[31]和FlumeJava[8]:每个数据集都表示为一个对象,转换操作通过调用这些对象的方法来执行。
程序员首先通过对稳定存储中的数据执行转换(例如map和filter)来定义一个或多个RDD,然后在这些RDD上执行动作(action)——动作是指向应用返回结果或将数据导出到存储系统的操作。动作的例子包括count(返回数据集的元素个数)、collect(返回所有元素本身)和save(将数据集输出到存储系统)。与DryadLINQ类似,Spark会在RDD第一次被动作调用时才惰性计算,这样可以将多个转换流水线化执行。
此外,程序员可以调用persist方法来指定哪些RDD需要在后续操作中复用。默认情况下,Spark会将持久化的RDD保存在内存中,但如果内存不足,也可以将其溢出到磁盘。用户还可以通过persist的标志参数请求其他持久化策略,比如仅将RDD存储在磁盘上,或者跨机器复制。最后,用户可以为每个RDD设置持久化优先级,指定哪些内存中的数据应该优先溢出到磁盘。
2.2.1 示例:控制台日志挖掘
假设一个Web服务出现了错误,运维人员需要在Hadoop文件系统(HDFS)中数TB的日志里查找原因。使用Spark,运维人员可以只将日志中的错误消息加载到集群各节点的RAM中,并交互式地查询它们。她首先输入以下Scala代码:
lines = spark.textFile("hdfs://...")
errors = lines.filter(_.startsWith("ERROR"))
errors.persist()
第1行定义了一个由HDFS文件支撑的RDD(以文本行的集合形式),第2行从中衍生出一个过滤后的RDD。第3行请求将errors持久化到内存中,以便在多个查询之间共享。注意,filter的参数是Scala的闭包语法。
此时,集群上还没有执行任何计算。但用户现在可以对这个RDD执行动作,比如统计错误消息的数量:
errors.count()
用户还可以对RDD执行进一步的转换,并使用其结果,比如下面的代码:
// Count errors mentioning MySQL:
errors.filter(_.contains("MySQL")).count()

// Return the time fields of errors mentioning
// HDFS as an array (assuming time is field
// number 3 in a tab-separated format):
errors.filter(_.contains("HDFS"))
  .map(_.split('\t')(3))
  .collect()
当第一个涉及errors的动作运行后,Spark会将errors的各个分区存储在内存中,大大加快后续对其的计算速度。注意,基础RDDlines不会被加载到RAM中,这是合理的,因为错误消息可能只占数据的一小部分(小到足以放进内存)。
最后,为了说明我们的模型如何实现容错,我们在图1中展示了第三个查询中RDD的血缘图。在这个查询中,我们从errors(对lines执行filter的结果)开始,在执行collect之前又应用了一次filter和map。Spark调度器会将后两个转换流水线化,然后发送一组任务到持有errors缓存分区的节点上计算。此外,如果errors的某个分区丢失,Spark只需对lines对应的分区执行一次filter,就能重建该分区。
图1:示例中第三个查询的血缘图。方框表示RDD,箭头表示转换。
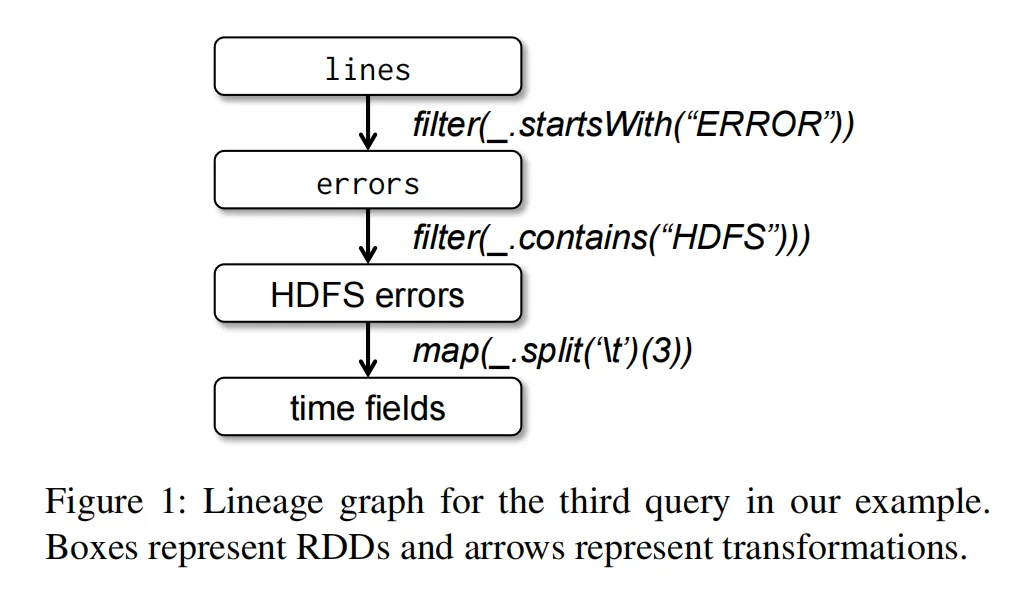
表1 RDD与分布式共享内存的对比
| 对比维度 | RDD | 分布式共享内存 |
|---|---|---|
| 读操作 | 粗粒度或细粒度 | 细粒度 |
| 写操作 | 粗粒度 | 细粒度 |
| 一致性 | 无额外开销(不可变) | 由应用/运行时决定 |
| 故障恢复 | 基于血缘的细粒度恢复,开销低 | 需要检查点与程序回滚 |
| 慢节点缓解 | 可通过备份任务实现 | 难以实现 |
| 任务放置 | 基于数据局部性自动优化 | 由应用决定(运行时追求透明性) |
| 内存不足时的表现 | 与现有数据流系统类似 | 性能较差(可能发生交换) |
2.3 RDD模型的优势
为了理解RDD作为分布式内存抽象的优势,我们在表1中将其与分布式共享内存(DSM)进行了对比。在DSM系统中,应用可以对全局地址空间中的任意位置进行读写。注意,在此定义下,不仅包括传统的共享内存系统[24],还包括其他应用可以对共享状态执行细粒度写入的系统,比如提供分布式哈希表的Piccolo[27],以及分布式数据库。DSM是一种非常通用的抽象,但这种通用性导致它在商用集群上难以高效、容错地实现。
RDD与DSM的核心区别在于:RDD只能通过粗粒度转换来创建(“写入”),而DSM允许对每个内存位置进行读写。这限制了RDD只能用于执行批量写入的应用,但也实现了更高效的容错。特别是,RDD不需要承担检查点的开销,因为它们可以通过血缘来恢复⁴。此外,故障发生后,只需要重新计算RDD中丢失的分区,并且可以在不同节点上并行重算,无需回滚整个程序。
RDD的第二个优势是,其不可变的特性让系统可以像MapReduce[10]那样通过运行慢任务的备份副本,来缓解慢节点(拖后腿节点)的问题。而在DSM中很难实现备份任务,因为两个任务副本会访问相同的内存位置,互相干扰对方的更新。
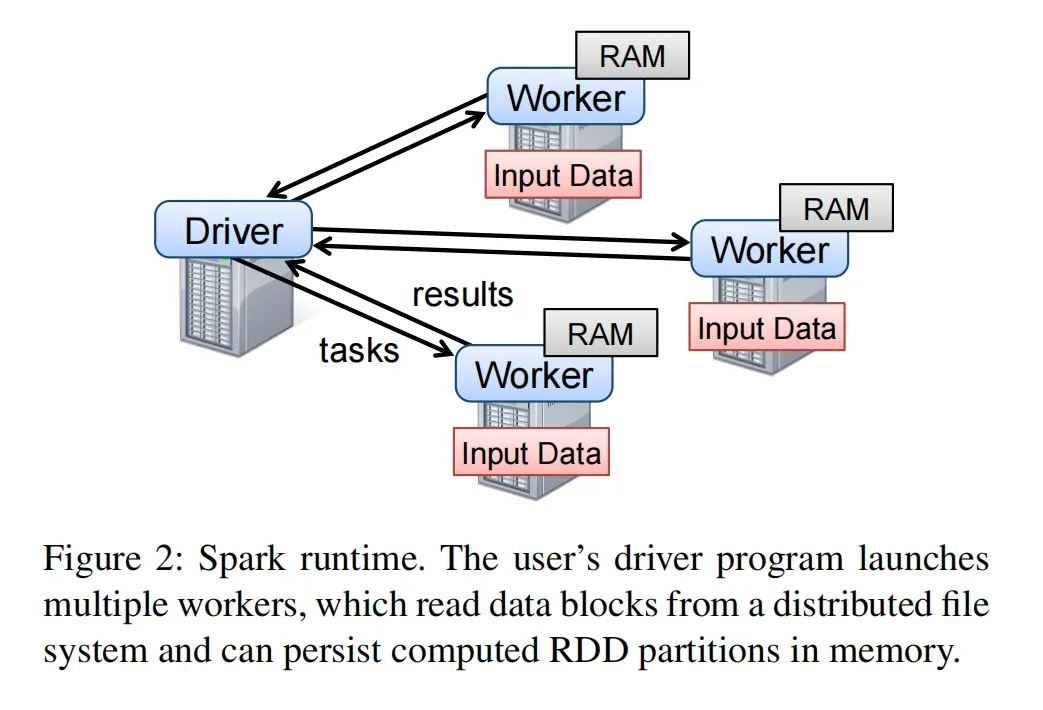
图2:Spark 运行时架构。用户的驱动程序启动多个工作节点,工作节点从分布式文件系统读取数据块,并可将计算得到的RDD分区持久化在内存中。
最后,RDD相比DSM还有另外两个优势。第一,在RDD的批量操作中,运行时可以根据数据局部性调度任务,提升性能。第二,当内存不足以存储RDD时,只要RDD仅用于基于扫描的操作,性能就会优雅降级。无法放入RAM的分区可以存储在磁盘上,其性能与当前数据并行系统相当。
2.4 不适合RDD的应用
正如引言中所讨论的,RDD最适合批量应用,这类应用会对数据集的所有元素执行相同的操作。在这些场景中,RDD可以高效地将每次转换记录为血缘图中的一步,无需记录大量数据就能恢复丢失的分区。
RDD不太适合对共享状态执行异步细粒度更新的应用,比如Web应用的存储系统,或者增量网络爬虫。对于这类应用,采用执行传统更新日志和数据检查点的系统会更高效,比如数据库、RAMCloud[25]、Percolator[26]和Piccolo[27]。我们的目标是为批量分析提供高效的编程模型,而将这些异步应用留给专用系统处理。
3 Spark编程接口
Spark通过与Scala[2]语言深度集成的API提供RDD抽象,Scala是一种运行在Java虚拟机上的静态类型函数式编程语言。我们选择Scala是因为它兼具简洁性(方便交互式使用)和高效性(得益于静态类型)。不过,RDD抽象本身并不要求必须使用函数式语言。
使用Spark时,开发者编写一个驱动程序,连接到由工作节点组成的集群,如图2所示。驱动程序定义一个或多个RDD,并调用RDD上的动作。驱动程序中的Spark代码也会跟踪RDD的血缘。工作节点是常驻进程,可以跨操作将RDD分区存储在RAM中。
正如2.2.1节日志挖掘示例所示,用户通过传递闭包(函数字面量)来为map等RDD操作提供参数。Scala将每个闭包表示为一个Java对象,这些对象可以被序列化,并加载到其他节点上,从而在网络间传递闭包。Scala还会将闭包中绑定的变量保存为Java对象的字段。例如,用户可以编写var x = 5; rdd.map(_ + x)这样的代码,来给RDD的每个元素加5⁵。
RDD本身是静态类型的对象,由元素类型参数化。例如,RDD[Int]表示整数类型的RDD。不过,由于Scala支持类型推断,我们的大多数示例都省略了类型。
尽管在Scala中暴露RDD的方法从概念上很简单,但我们需要通过反射机制解决Scala闭包对象的相关问题[33]。我们还需要额外的工作让Spark可以在Scala解释器中使用,我们将在5.2节讨论。尽管如此,我们不需要修改Scala编译器。
3.1 Spark中的RDD操作
表2列出了Spark中主要的RDD转换和动作。我们给出了每个操作的签名,用方括号表示类型参数。回顾一下,转换是定义新RDD的惰性操作,而动作会启动计算,向程序返回值或者将数据写入外部存储。注意,有些操作(比如join)仅适用于键值对形式的RDD。此外,我们的函数名与Scala和其他函数式语言中的其他API保持一致;例如,map是一对一映射,而flatMap将每个输入值映射为一个或多个输出(类似MapReduce中的map)。
除了这些算子,用户还可以请求持久化RDD。此外,用户可以获取RDD的分区顺序(由Partitioner类表示),并根据该顺序对另一个数据集进行分区。groupByKey、reduceByKey和sort等操作会自动生成哈希分区或范围分区的RDD。
表2 Spark中RDD支持的转换与动作
| 类型 | 操作 | 签名与说明 |
|---|---|---|
| 转换 | map ( f : T ⇒ U ) |
: RDD[T] ⇒ RDD[U] |
filter ( f : T ⇒ Bool ) |
: RDD[T] ⇒ RDD[T] |
|
flatMap ( f : T ⇒ Seq[U] ) |
: RDD[T] ⇒ RDD[U] |
|
sample ( fraction : Float ) |
: RDD[T] ⇒ RDD[T](确定性采样) |
|
groupByKey () |
: RDD[(K, V)] ⇒ RDD[(K, Seq[V])] |
|
reduceByKey ( f : ( V , V ) ⇒ V ) |
: RDD[(K, V)] ⇒ RDD[(K, V)] |
|
union () |
: ( RDD[T] , RDD[T] ) ⇒ RDD[T] |
|
join () |
: ( RDD[(K, V)] , RDD[(K, W)] ) ⇒ RDD[(K, (V, W))] |
|
cogroup () |
: ( RDD[(K, V)] , RDD[(K, W)] ) ⇒ RDD[(K, (Seq[V], Seq[W]))] |
|
crossProduct () |
: ( RDD[T] , RDD[U] ) ⇒ RDD[(T, U)] |
|
mapValues ( f : V ⇒ W ) |
: RDD[(K, V)] ⇒ RDD[(K, W)](保留分区方式) |
|
sort ( c : Comparator[K] ) |
: RDD[(K, V)] ⇒ RDD[(K, V)] |
|
partitionBy ( p : Partitioner[K] ) |
: RDD[(K, V)] ⇒ RDD[(K, V)] |
|
| 动作 | count () |
RDD[T] ⇒ Long |
collect () |
RDD[T] ⇒ Seq[T] |
|
reduce ( f : ( T , T ) ⇒ T ) |
RDD[T] ⇒ T |
|
lookup ( k : K ) |
RDD[(K, V)] ⇒ Seq[V](仅适用于哈希/范围分区的RDD) |
|
save ( path : String ) |
将RDD输出到存储系统(如HDFS) |
说明:Seq[T]表示类型为T的元素序列。
3.2 示例应用
我们在2.2.1节的数据挖掘示例之外,补充两个迭代应用:逻辑回归和PageRank。后者还将展示控制RDD分区如何提升性能。
3.2.1 逻辑回归
许多机器学习算法本质上是迭代的,因为它们会运行梯度下降等迭代优化过程来最大化目标函数。因此,如果将数据保存在内存中,它们的运行速度会快得多。作为示例,下面的程序实现了逻辑回归[14]——一种常用的分类算法,用于寻找能够最佳区分两类点(例如垃圾邮件和非垃圾邮件)的超平面w。该算法使用梯度下降:初始时w取随机值,每次迭代中,对数据计算关于w的函数之和,沿着优化方向更新w。
val points = spark.textFile(...)
  .map(parsePoint).persist()
var w = // random initial vector
for (i <- 1 to ITERATIONS) {
  val gradient = points.map{ p =>
    p.x * (1/(1+exp(-p.y*(w dot p.x)))-1)*p.y
  }.reduce((a,b) => a+b)
  w -= gradient
}
我们首先定义一个持久化RDDpoints,它是对文本文件执行map转换的结果,将每行文本解析为Point对象。然后我们反复对points执行map和reduce,每一步计算梯度,通过对当前w的函数求和得到。将points保存在内存中跨迭代使用,可以带来20倍的速度提升,如6.1节所示。
3.2.2 PageRank
PageRank[6]中出现了更复杂的数据共享模式。该算法迭代更新每个文档的排名,通过累加链入该文档的其他文档的贡献来计算。每次迭代中,每个文档向其邻居发送大小为r/n的贡献值,其中r是该文档的排名,n是其邻居数量。然后文档的排名更新为α/N + (1-α)∑c_i,其中求和项是收到的所有贡献,N是文档总数。
我们可以用Spark编写PageRank如下:
val links = spark.textFile(...).map(...).persist()
var ranks = // RDD of (URL, rank) pairs

for (i <- 1 to ITERATIONS) {
  // Build an RDD of (targetURL, float) pairs
  // with the contributions sent by each page
  val contribs = links.join(ranks).flatMap {
    (url, (links, rank)) =>
      links.map(dest => (dest, rank/links.size))
  }
  // Sum contributions by URL and get new ranks
  ranks = contribs.reduceByKey((x,y) => x+y)
    .mapValues(sum => a/N + (1-a)*sum)
}
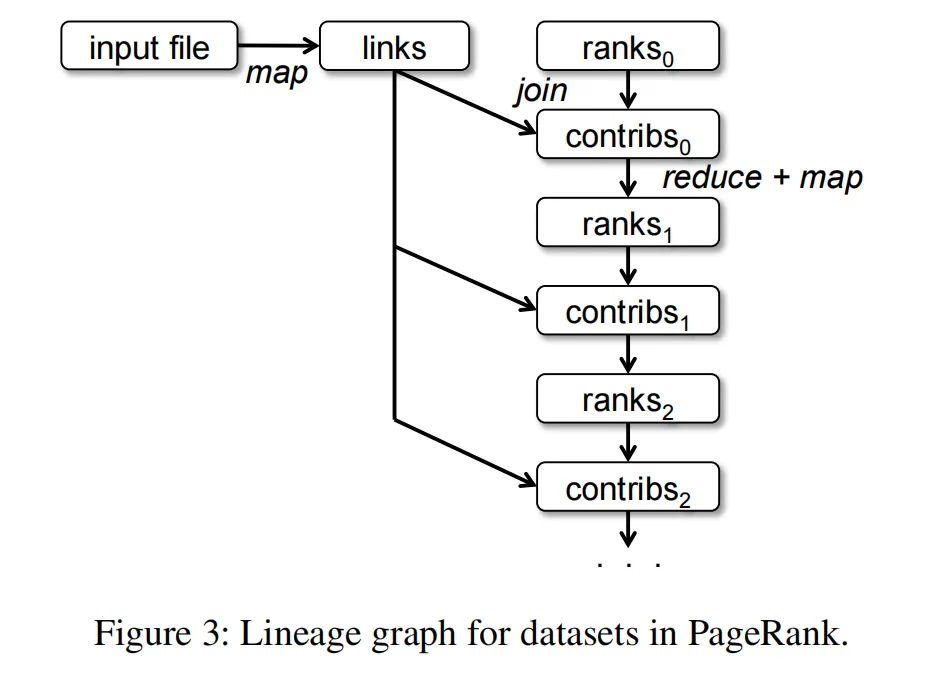
该程序对应的RDD血缘图如图3所示。每次迭代中,我们基于上一次迭代的contribs和ranks,以及静态的links数据集,创建新的ranks数据集⁶。
这个血缘图的一个有趣特点是,它的长度会随着迭代次数增加而变长。因此,在迭代次数很多的作业中,可能需要可靠地复制某些版本的ranks,以减少故障恢复时间[20]。用户可以调用带RELIABLE标志的persist方法来实现这一点。但需要注意的是,links数据集不需要复制,因为它的分区可以通过对输入文件的块重新运行map来高效重建。这个数据集通常比ranks大得多,因为每个文档有很多链接,但排名只有一个数值,所以通过血缘恢复它,比那些对程序整个内存状态做检查点的系统更节省时间。
图3:PageRank中数据集的血缘图
最后,我们可以通过控制RDD的分区来优化PageRank中的通信。如果我们为links指定一种分区方式(例如按URL对链接列表进行哈希分区),就可以用同样的方式对ranks分区,确保links和ranks之间的join操作不需要数据通信(因为每个URL的排名和它的链接列表在同一台机器上)。我们还可以编写自定义的Partitioner类,将互相链接的页面分组在一起(例如按域名对URL分区)。
这两种优化都可以在定义links时调用partitionBy来实现:
links = spark.textFile(...).map(...)
  .partitionBy(myPartFunc).persist()
在这次初始调用之后,links和ranks之间的join操作会自动将每个URL的贡献值聚合到其链接列表所在的机器上,在那里计算新的排名,再与链接列表做join。这种跨迭代的一致分区是Pregel等专用框架中的核心优化之一。RDD让用户可以直接表达这种优化目标。
4 RDD的表示
将RDD作为抽象提供的挑战之一,是选择一种能够跟踪各种转换的血缘的表示方式。理想情况下,实现RDD的系统应该提供尽可能丰富的转换算子集合(例如表2中的那些),并允许用户以任意方式组合它们。我们提出了一种简单的基于图的RDD表示方式,来实现这些目标。我们在Spark中使用了这种表示,支持了广泛的转换,并且不需要为每个转换向调度器添加特殊逻辑,这大大简化了系统设计。
表3 Spark中表示RDD的接口
| 操作 | 含义 |
|---|---|
partitions() |
返回分区对象列表 |
preferredLocations( p ) |
列出分区p由于数据局部性可以更快访问的节点 |
dependencies() |
返回依赖关系列表 |
iterator( p, parentIters ) |
给定父分区的迭代器,计算分区p的元素 |
partitioner() |
返回元数据,说明RDD是哈希分区还是范围分区 |
简而言之,我们提出通过一个通用接口来表示每个RDD,该接口暴露五部分信息:一组分区(数据集的原子单元);对父RDD的一组依赖关系;基于父RDD计算当前数据集的函数;以及关于分区方案和数据放置的元数据。例如,代表HDFS文件的RDD,每个文件块对应一个分区,并且知道每个块所在的机器。而对该RDD执行map得到的结果,拥有相同的分区,但在计算元素时会对父RDD的数据应用map函数。表3总结了这个接口。
设计这个接口最核心的问题,是如何表示RDD之间的依赖关系。我们发现将依赖分为两类既足够又实用:窄依赖(narrow dependency),即父RDD的每个分区最多被子RDD的一个分区使用;宽依赖(wide dependency),即多个子分区可能依赖于同一个父分区。例如,map会产生窄依赖,而join会产生宽依赖(除非父RDD都做了哈希分区)。图4展示了更多例子。
图4:窄依赖与宽依赖示例。每个方框是一个RDD,阴影矩形表示分区。
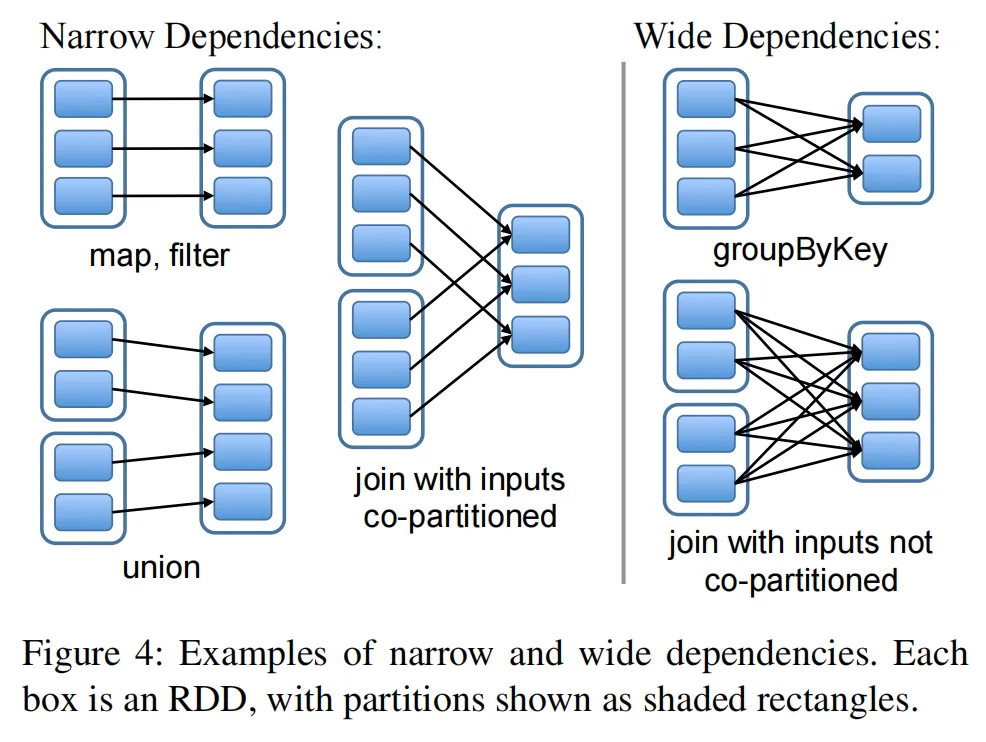
这种分类有两个重要作用。首先,窄依赖允许在单个集群节点上流水线执行,一个节点可以计算所有父分区。例如,可以逐元素地先执行map再执行filter。相比之下,宽依赖需要所有父分区的数据都可用,并且需要通过类似MapReduce的混洗(shuffle)操作在节点间传输数据。其次,节点故障后的恢复对于窄依赖来说更高效,因为只需要重新计算丢失的父分区,并且可以在不同节点上并行重算。相反,在具有宽依赖的血缘图中,单个节点故障可能导致RDD的所有祖先都丢失部分分区,需要完整的重新执行。
RDD的通用接口让Spark中的大多数转换都可以用不到20行代码实现。事实上,即使是Spark的新用户,也可以在不了解调度器细节的情况下实现新的转换(例如采样和各种类型的join)。我们下面简述几种RDD的实现:
- HDFS文件:我们示例中的输入RDD是HDFS中的文件。对于这类RDD,
partitions为文件的每个块返回一个分区(每个分区对象存储块的偏移量),preferredLocations给出块所在的节点,iterator读取块数据。 - map:对任意RDD调用
map会返回一个MappedRDD对象。该对象与父RDD有相同的分区和首选位置,但在其iterator方法中,会对父RDD的记录应用传入的map函数。 - union:对两个RDD调用
union会返回一个新RDD,其分区是两个父RDD分区的并集。每个子分区通过对对应父分区的窄依赖来计算⁷。 - sample:采样与映射类似,只是RDD会为每个分区存储一个随机数生成器种子,以确定性地采样父记录。
- join:对两个RDD做
join可能产生两个窄依赖(如果两者都用相同的分区器做了哈希/范围分区)、两个宽依赖,或者混合情况(一个父RDD有分区器,另一个没有)。无论哪种情况,输出RDD都有一个分区器(要么继承自父RDD,要么是默认的哈希分区器)。
5 实现
我们用大约14000行Scala代码实现了Spark。系统运行在Mesos集群管理器[17]之上,可以与Hadoop、MPI等应用共享资源。每个Spark程序作为独立的Mesos应用运行,拥有自己的驱动程序(主节点)和工作节点,应用间的资源共享由Mesos管理。
Spark可以使用Hadoop现有的输入插件API读取任意Hadoop输入源的数据(例如HDFS或HBase),并且运行在未修改的Scala版本之上。
下面我们概述系统中几个技术上比较有意思的部分:作业调度器(5.1节)、支持交互式使用的Spark解释器(5.2节)、内存管理(5.3节),以及检查点支持(5.4节)。
5.1 作业调度
Spark的调度器使用了第4节描述的RDD表示。总体而言,我们的调度器与Dryad[19]的调度器类似,但它额外考虑了持久化RDD的哪些分区已经在内存中可用。
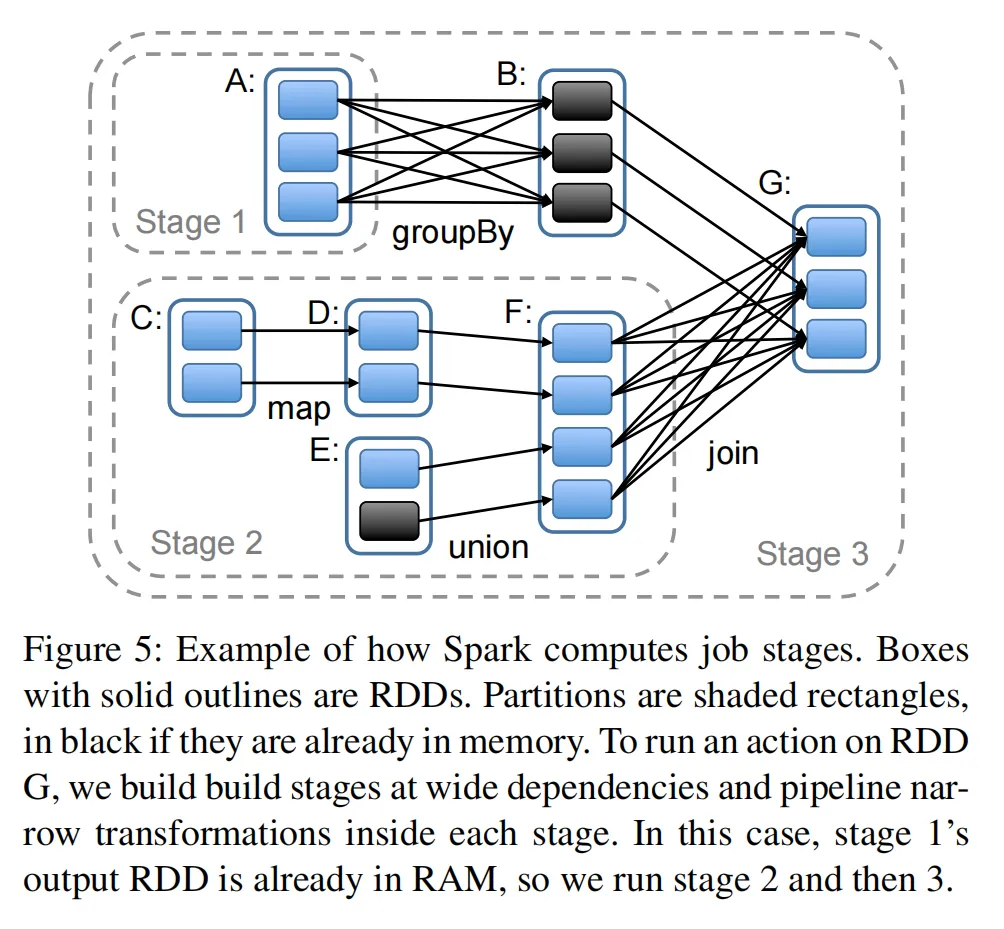
每当用户对RDD执行一个动作(例如count或save)时,调度器会检查该RDD的血缘图,构建一个要执行的阶段(stage)有向无环图(DAG),如图5所示。每个阶段包含尽可能多的、具有窄依赖的流水线化转换。阶段的边界是宽依赖所需的混洗操作,或者任何已经计算完成、可以短路父RDD计算的分区。然后调度器启动任务,逐个阶段计算缺失的分区,直到计算出目标RDD。
图5:Spark计算阶段划分示例。实线方框是RDD,阴影矩形是分区,黑色表示已在内存中。为了对RDD G执行动作,我们在宽依赖处划分阶段,并在每个阶段内流水线化窄转换。本例中,阶段1的输出RDD已在RAM中,因此我们直接运行阶段2,然后阶段3
我们的调度器使用延迟调度[32],根据数据局部性将任务分配给机器。如果一个任务需要处理的分区在某个节点的内存中,我们就将任务发送到该节点。否则,如果任务处理的分区所属的RDD提供了首选位置(例如HDFS文件),我们就将任务发送到这些位置。
对于宽依赖(即混洗依赖),我们目前将中间记录物化在持有父分区的节点上,以简化故障恢复,这很像MapReduce物化map输出的方式。
如果任务失败,只要该阶段的父RDD仍然可用,我们就在另一个节点上重新运行该任务。如果某些阶段变得不可用(例如,因为混洗的“map端”输出丢失了),我们重新提交任务,并行计算缺失的分区。我们目前还不支持调度器故障,但复制RDD血缘图的实现会很直接。
最后,尽管Spark中所有的计算目前都是响应驱动程序中调用的动作来执行的,我们也在尝试让集群上的任务(例如map)可以调用lookup操作,该操作提供按键对哈希分区RDD元素的随机访问。在这种情况下,任务需要通知调度器在所需分区缺失时进行计算。
5.2 解释器集成
Scala包含一个交互式Shell,类似于Ruby和Python的Shell。考虑到内存数据带来的低延迟,我们希望让用户可以从解释器中交互式地运行Spark来查询大数据集。
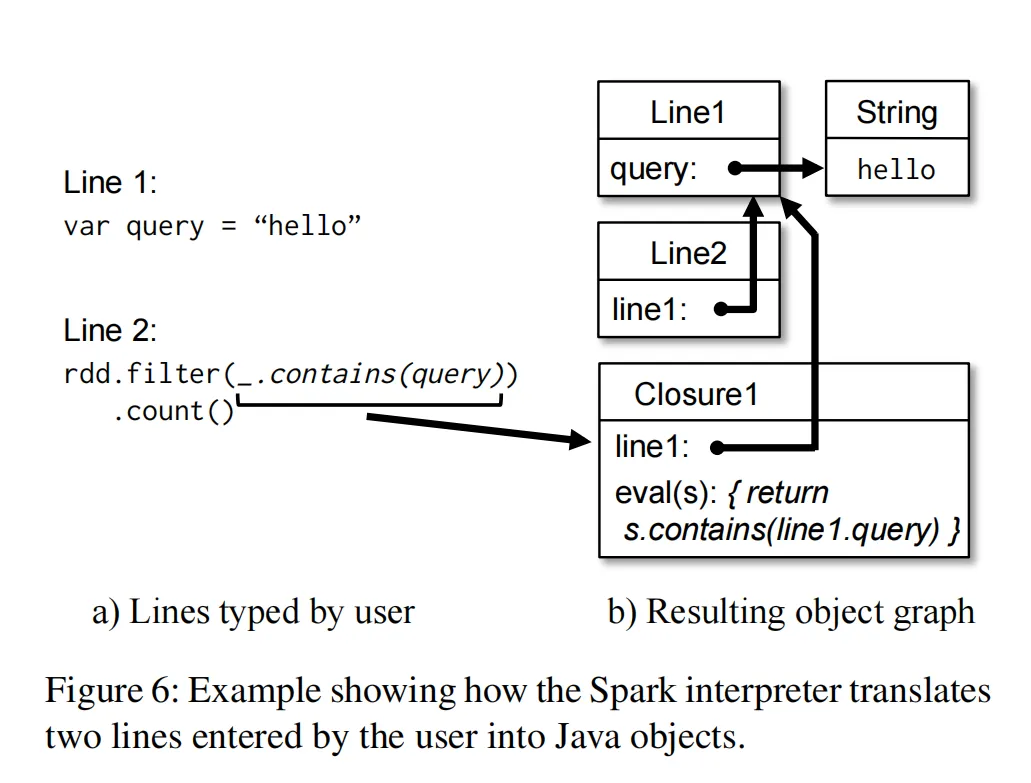
Scala解释器的正常工作方式是:为用户输入的每一行编译一个类,将其加载到JVM中,然后调用其中的函数。这个类包含一个单例对象,该对象包含该行定义的变量或函数,并在initialize方法中运行该行代码。例如,如果用户输入var x = 5,然后输入println(x),解释器会定义一个名为Line1的类来包含x,然后第二行会编译为println(Line1.getInstance().x)。
我们在Spark中对解释器做了两处修改:
- 类分发:为了让工作节点获取每一行生成的类的字节码,我们让解释器通过HTTP提供这些类。
- 修改代码生成:通常情况下,每行代码生成的单例对象是通过对应类的静态方法访问的。这意味着当我们序列化一个引用了前一行定义的变量的闭包时(比如上面例子中的
Line1.x),Java不会沿着对象图追溯来传递包裹x的Line1实例。因此,工作节点接收不到x的值。我们修改了代码生成逻辑,直接引用每行对象的实例。
图6展示了修改后,解释器如何将用户输入的两行代码转换为Java对象。
图6:示例展示Spark解释器如何将用户输入的两行代码转换为Java对象
我们发现Spark解释器在处理研究中获得的大规模trace、探索HDFS中存储的数据集时非常有用。我们还计划用它来交互式运行更高级的查询语言,例如SQL。
5.3 内存管理
Spark为持久化RDD提供了三种存储选项:内存中存储为反序列化的Java对象、内存中存储为序列化数据、磁盘存储。
- 第一种选项性能最快,因为Java虚拟机可以原生访问每个RDD元素。
- 第二种选项让用户在空间有限时选择比Java对象图更节省内存的表示方式,但代价是性能更低⁸。
- 第三种选项适用于太大而无法保存在RAM中,但每次使用都重新计算代价太高的RDD。
为了管理有限的可用内存,我们在RDD粒度上使用LRU淘汰策略。当计算出一个新的RDD分区但没有足够空间存储时,我们会从最近最少访问的RDD中淘汰一个分区,除非该RDD与新分区所属的RDD是同一个。这种情况下,我们会保留旧分区在内存中,避免同一个RDD的分区反复换入换出。这一点很重要,因为大多数操作会遍历整个RDD执行任务,因此已经在内存中的分区未来很可能还会被用到。我们发现这个默认策略在目前所有应用中都表现良好,同时我们也通过每个RDD的“持久化优先级”为用户提供更多控制权。
最后,集群上的每个Spark实例目前都有自己独立的内存空间。在未来的工作中,我们计划研究通过统一内存管理器在不同Spark实例之间共享RDD。
5.4 检查点支持
尽管血缘总可以用于故障后恢复RDD,但对于血缘链很长的RDD,恢复可能会很耗时。因此,将部分RDD检查点到稳定存储会很有帮助。
通常,对于包含宽依赖的长血缘图的RDD,检查点非常有用,比如PageRank示例中的排名数据集(3.2.2节)。在这些情况下,集群中的节点故障可能导致每个父RDD都丢失部分数据切片,需要完整的重新计算[20]。相反,对于依赖稳定存储中数据的窄依赖RDD,比如逻辑回归示例中的点(3.2.1节)和PageRank中的链接列表,检查点可能永远不值得。如果节点故障,这些RDD丢失的分区可以在其他节点上并行重算,其代价只是复制整个RDD的一小部分。
Spark目前提供了检查点API(persist的REPLICATE标志),但将哪些数据做检查点的决定权交给用户。不过,我们也在研究如何执行自动检查点。因为我们的调度器知道每个数据集的大小,以及首次计算它所花费的时间,所以应该能够选择最优的RDD集合做检查点,以最小化系统恢复时间[30]。
最后需要注意的是,RDD的只读特性让它们比通用共享内存更易于做检查点。因为不需要考虑一致性,RDD可以在后台写出,不需要暂停程序,也不需要分布式快照方案。
6 评估
我们通过在Amazon EC2上的一系列实验,以及用户应用的基准测试,对Spark和RDD进行了评估。总体而言,我们的结果表明:
- 对于迭代机器学习和图应用,Spark的性能比Hadoop最高高出20倍。性能提升来自于将数据作为Java对象存储在内存中,避免了I/O和反序列化开销。
- 用户编写的应用表现出良好的性能和可扩展性。特别是,我们用Spark将一份原本运行在Hadoop上的分析报告速度提升了40倍。
- 当节点发生故障时,Spark可以通过仅重建丢失的RDD分区来快速恢复。
- Spark可以交互式查询1TB数据集,延迟仅为5-7秒。
我们首先展示迭代机器学习应用(6.1节)和PageRank(6.2节)对比Hadoop的基准测试,然后评估Spark的故障恢复(6.3节)和数据集无法放入内存时的表现(6.4节)。最后讨论用户应用的结果(6.5节)和交互式数据挖掘(6.6节)。
除非另有说明,我们的测试使用m1.xlarge EC2节点,每节点4核,15GB RAM。存储使用HDFS,块大小256MB。每次测试前,我们都会清空操作系统缓冲区缓存,以准确测量I/O开销。
6.1 迭代机器学习应用
我们实现了两个迭代机器学习应用——逻辑回归和K均值,来对比以下系统的性能:
- Hadoop:Hadoop 0.20.2稳定版。
- HadoopBinMem:一种Hadoop部署方式,在第一次迭代中将输入数据转换为低开销的二进制格式,以消除后续迭代中的文本解析,并将数据存储在内存中的HDFS实例里。
- Spark:我们实现的RDD系统。
我们在100GB数据集上运行两种算法各10次迭代,使用25-100台机器。两个应用的核心区别在于每字节数据的计算量。K均值的迭代时间由计算主导,而逻辑回归计算密集度更低,因此对反序列化和I/O花费的时间更敏感。
由于典型的学习算法需要数十次迭代才能收敛,我们分别报告第一次迭代和后续迭代的时间。我们发现通过RDD共享数据可以极大地加快后续迭代的速度。
第一次迭代
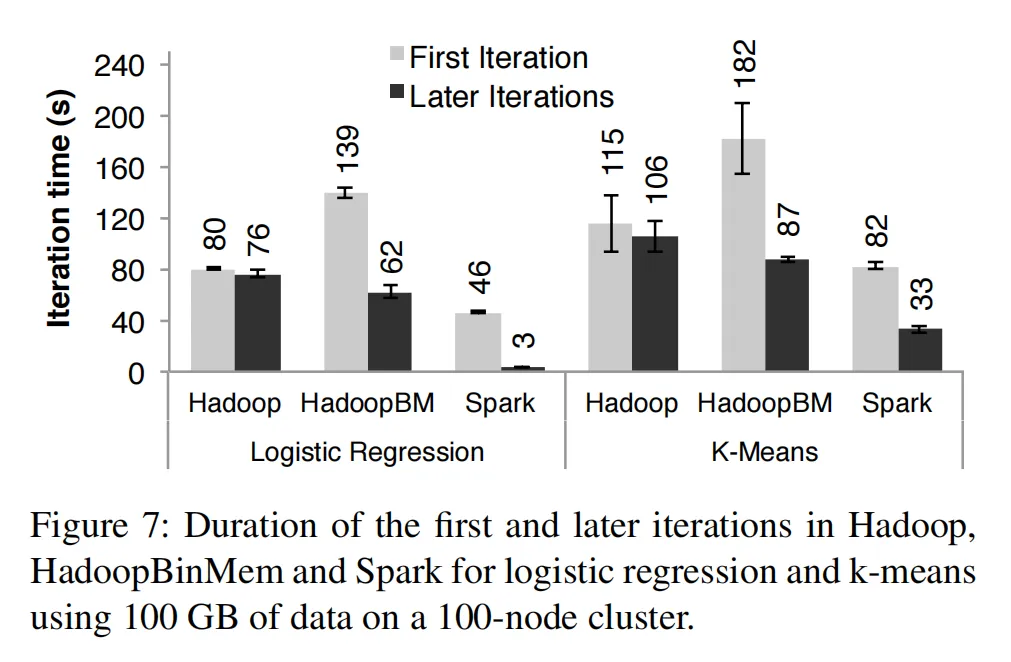
三个系统在第一次迭代中都从HDFS读取文本输入。如图7中的浅色柱所示,在所有实验中,Spark都比Hadoop稍快。这种差异源于Hadoop主节点与工作节点之间心跳协议的信令开销。HadoopBinMem最慢,因为它需要运行额外的MapReduce作业将数据转换为二进制,并且需要通过网络将数据写入复制的内存HDFS实例。
图7:在100节点集群上处理100GB数据,Hadoop、HadoopBinMem和Spark的逻辑回归与K均值的首次迭代和后续迭代时长
后续迭代
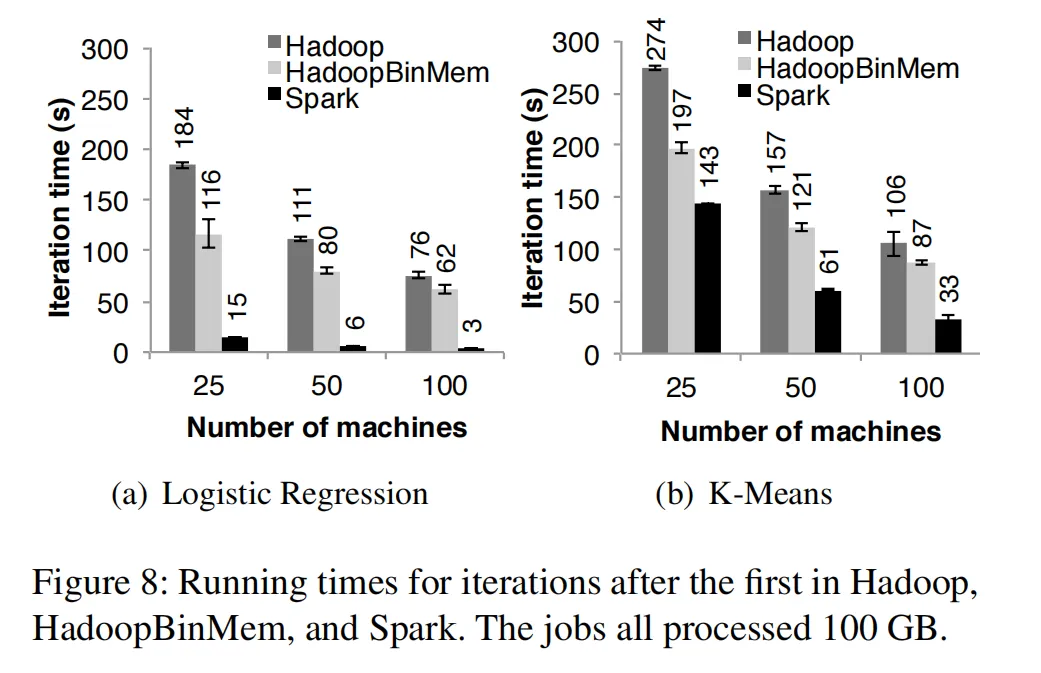
图7也展示了后续迭代的平均运行时间,图8展示了运行时间随集群规模的扩展情况。对于逻辑回归,在100台机器上,Spark分别比Hadoop和HadoopBinMem快25.3倍和20.7倍。对于计算更密集的K均值应用,Spark仍然实现了1.9到3.2倍的加速。
图8:Hadoop、HadoopBinMem和Spark的首次迭代后运行时间。所有作业处理100GB数据。
加速原因分析
我们惊讶地发现,Spark甚至比使用内存存储二进制数据的Hadoop(HadoopBinMem)还要快20倍。在HadoopBinMem中,我们使用了Hadoop的标准二进制格式(SequenceFile)和256MB的大块大小,并且强制HDFS的数据目录位于内存文件系统中。然而,Hadoop仍然运行得更慢,原因有几个:
- Hadoop软件栈的最小开销;
- HDFS提供数据时的开销;
- 将二进制记录转换为可用的内存Java对象的反序列化开销。
我们逐一研究了这些因素。为了测量(1),我们运行了空操作的Hadoop作业,发现仅作业设置、启动任务和清理的最低要求就至少带来25秒的开销。关于(2),我们发现HDFS在提供每个块时会执行多次内存拷贝和校验和计算。
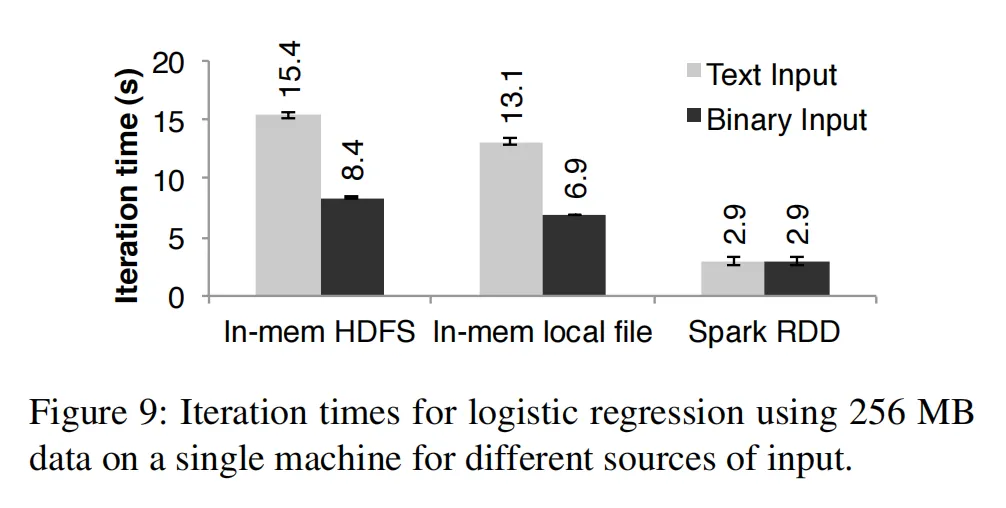
最后,为了测量(3),我们在单台机器上运行微基准测试,对256MB输入以各种格式运行逻辑回归计算。具体来说,我们对比了从HDFS读取文本和二进制输入的时间(HDFS栈的开销会体现出来),以及从本地内存文件读取的时间(内核可以非常高效地将数据传递给程序)。
测试结果如图9所示。内存HDFS和本地文件之间的差异表明,即使数据在本地机器的内存中,通过HDFS读取也会引入2秒的开销。文本和二进制输入之间的差异表明解析开销为7秒。最后,即使从内存文件读取,将预先解析的二进制数据转换为Java对象也需要3秒,这几乎和逻辑回归计算本身一样昂贵。通过将RDD元素直接作为Java对象存储在内存中,Spark避免了所有这些开销。
图9:单台机器上处理256MB数据,不同输入源下逻辑回归的迭代时间
6.2 PageRank
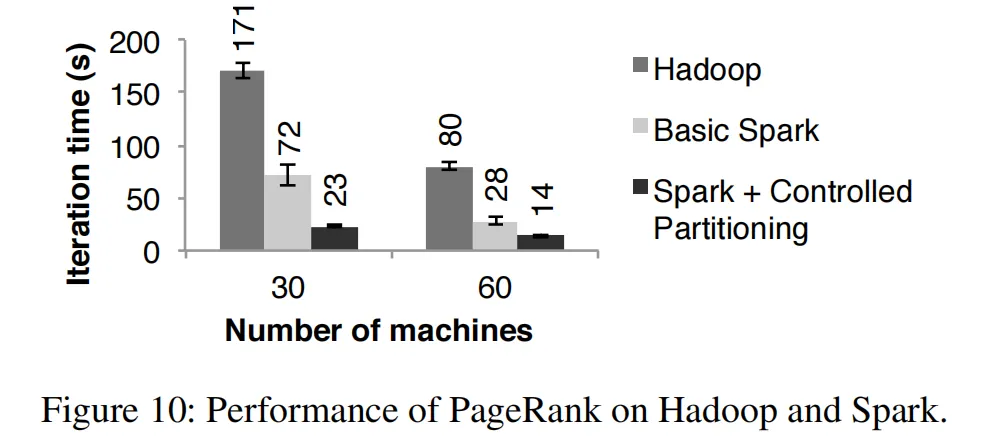
我们使用54GB的维基百科转储数据,对比了Spark和Hadoop的PageRank性能。我们运行了10次PageRank算法迭代,处理包含约400万篇文章的链接图。图10表明,仅内存存储一项就使Spark在30节点上比Hadoop快2.4倍。此外,如3.2.2节所述,控制RDD的分区使其跨迭代保持一致,将加速比提升到7.4倍。结果在扩展到60节点时也近似线性增长。
图10:PageRank在Hadoop和Spark上的性能
我们还评估了基于Spark实现的Pregel版本编写的PageRank,我们将在7.1节描述。其迭代时间与图10中的结果相近,但大约慢4秒,因为Pregel在每次迭代中会多运行一次操作,让顶点“投票”决定是否结束作业。
6.3 故障恢复
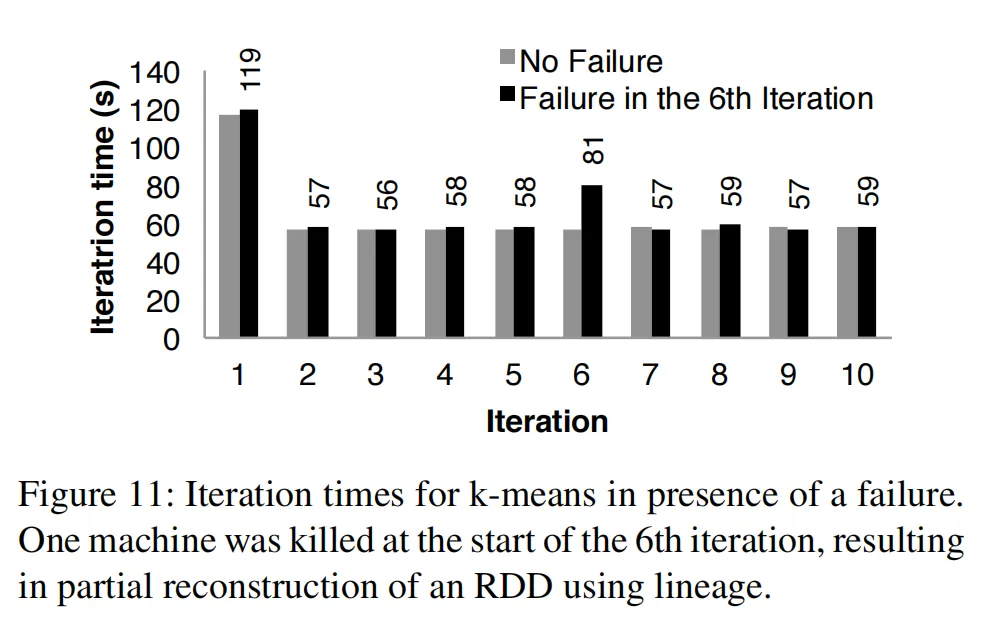
我们在K均值应用中评估了节点故障后,使用血缘重建RDD分区的代价。图11对比了在75节点集群上,正常运行场景和第6次迭代开始时发生节点故障场景下,10次K均值迭代的运行时间。在无故障的情况下,每次迭代包含400个任务,处理100GB数据。
在第5次迭代结束前,每次迭代时间约为58秒。在第6次迭代中,其中一台机器被终止,导致该机器上运行的任务和存储的RDD分区全部丢失。Spark在其他机器上并行重新运行这些任务,重新读取对应的输入数据并通过血缘重建RDD,这使得本次迭代时间增加到80秒。一旦丢失的RDD分区重建完成,迭代时间便回到58秒。
图11:存在故障时K均值的迭代时间。第6次迭代开始时一台机器被终止,导致RDD通过血缘进行部分重建。
需要注意的是,对于基于检查点的故障恢复机制,恢复很可能需要重新运行至少好几次迭代,具体取决于检查点的频率。此外,系统需要通过网络复制应用的100GB工作集(转换为二进制的文本输入数据),要么消耗两倍于Spark的内存来在RAM中复制,要么需要等待将100GB数据写入磁盘。相比之下,我们示例中RDD的血缘图大小都不到10KB。
6.4 内存不足时的表现
到目前为止,我们确保集群中的每台机器都有足够的内存来存储所有迭代中的RDD。一个自然的问题是,如果没有足够内存存储作业数据,Spark的运行表现如何。
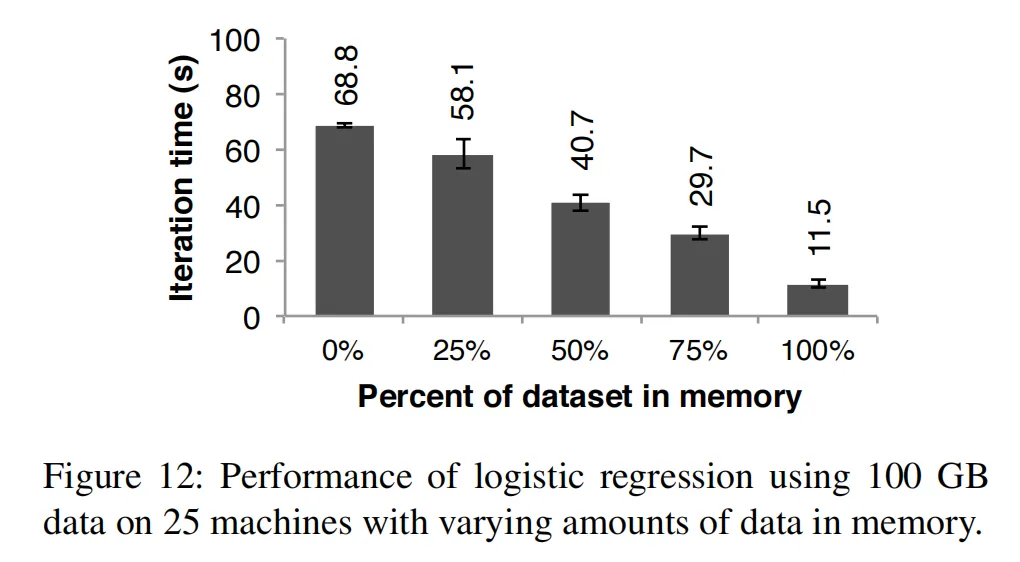
在这个实验中,我们配置Spark在每台机器上用于存储RDD的内存不超过特定比例。图12展示了逻辑回归在不同存储空间下的结果。可以看到,性能随着空间减少而优雅降级。
图12:25台机器上处理100GB数据,不同内存数据占比下逻辑回归的性能
6.5 基于Spark构建的用户应用
内存分析
视频分发公司Conviva Inc.使用Spark加速了多个原本运行在Hadoop上的数据分析报告。例如,一份报告由一系列Hive[1]查询组成,用于计算客户的各种统计指标。这些查询都在同一数据子集(匹配客户提供的过滤条件的记录)上运行,但针对不同的分组字段执行聚合(平均值、百分位数和去重计数),需要单独的MapReduce作业。通过在Spark中实现这些查询,并将它们共享的数据子集一次性加载到RDD中,该公司将报告速度提升了40倍。一份处理200GB压缩数据的报告,在Hadoop集群上需要运行20小时,现在仅用两台Spark机器30分钟即可完成。此外,Spark程序仅需要96GB RAM,因为它只将匹配客户过滤条件的行和列存储在RDD中,而不是整个解压后的文件。
交通建模
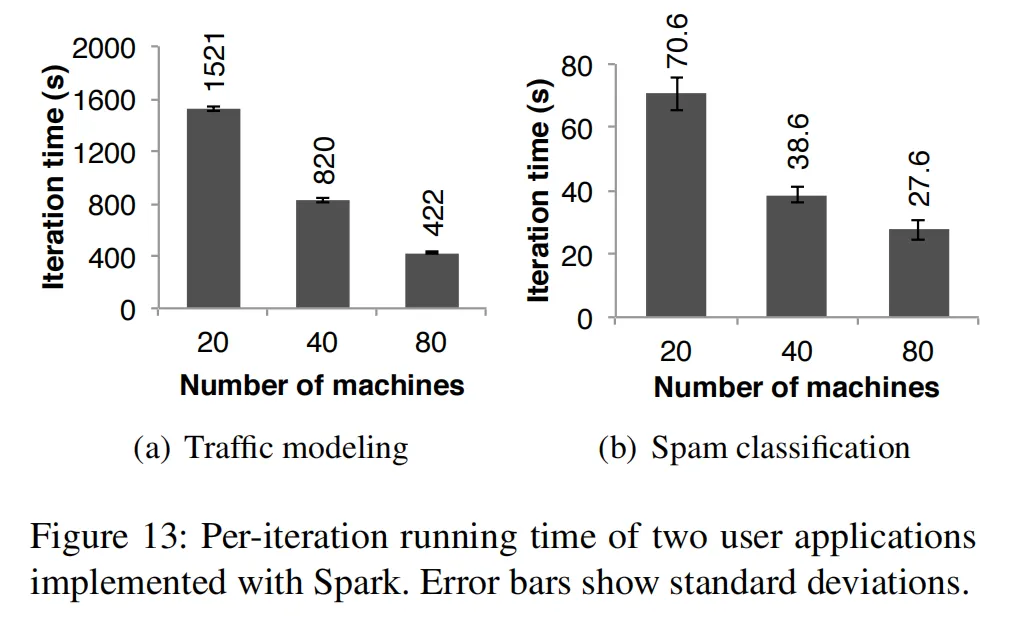
伯克利Mobile Millennium项目的研究人员[18]并行化了一种学习算法,用于从零散的汽车GPS测量数据中推断道路交通拥堵。源数据是一个大都市区的10000条链路的道路网络,以及60万条配备GPS的汽车的点对点行程时间样本(每条路径的行程时间可能包含多个路段)。系统使用交通模型来估计车辆通过各个路段的时间。研究人员使用期望最大化(EM)算法训练该模型,该算法迭代重复两个步骤:map和reduceByKey。如图13(a)所示,该应用从20节点扩展到80节点(每节点4核)时,性能近似线性增长。
图13:两个基于Spark实现的用户应用的每次迭代运行时间。误差线表示标准差。
Twitter垃圾信息分类
伯克利Monarch项目[29]使用Spark识别Twitter消息中的链接垃圾信息。他们在Spark之上实现了一个逻辑回归分类器,与6.1节的示例类似,但使用分布式reduceByKey来并行求和梯度向量。图13(b)展示了在50GB数据子集上训练分类器的扩展结果:包含25万个URL,以及每个URL对应的页面网络和内容属性相关的107个特征/维度。由于每次迭代的固定通信开销更高,扩展性没有接近线性。
6.6 交互式数据挖掘
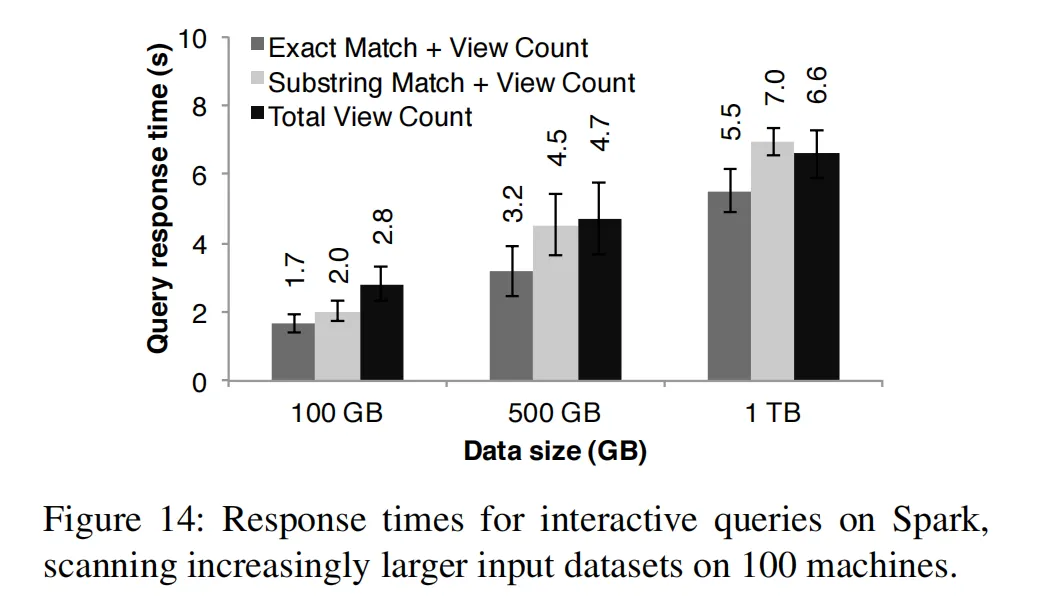
为了展示Spark交互式查询大数据集的能力,我们用它分析了1TB的维基百科页面浏览日志(2年的数据)。在这个实验中,我们使用了100台m2.4xlarge EC2实例,每实例8核,68GB RAM。我们运行查询来查找:(1)所有页面的总浏览量;(2)标题精确匹配给定单词的页面的浏览量;(3)标题部分匹配某个单词的页面的浏览量。每个查询都扫描全部输入数据。
图14展示了在完整数据集、二分之一数据集和十分之一数据集上的查询响应时间。即使是1TB数据,Spark上的查询也只需要5-7秒。这比处理磁盘数据快了一个数量级以上;例如,从磁盘查询1TB文件需要170秒。这说明RDD让Spark成为交互式数据挖掘的强大工具。
图14:100台机器上,扫描不同大小输入数据集时Spark交互式查询的响应时间
7 讨论
尽管RDD由于其不可变特性和粗粒度转换,看起来编程接口有限,但我们发现它适合广泛的应用。特别是,RDD可以表达数量惊人的、迄今为止作为独立框架提出的集群编程模型,允许用户在一个程序中组合这些模型(例如,先运行MapReduce操作构建图,然后在其上运行Pregel),并在它们之间共享数据。
本节中,我们将讨论RDD可以表达哪些编程模型,以及它们为何具有如此广泛的适用性(7.1节)。此外,我们还将讨论RDD中血缘信息的另一个好处——促进跨模型调试(7.2节)。
7.1 现有编程模型的表达
RDD可以高效表达多种迄今为止独立提出的集群编程模型。这里的“高效”是指,RDD不仅可以生成与这些模型编写的程序相同的输出,还可以实现这些框架采用的优化,比如将特定数据保存在内存中、对数据分区以最小化通信、以及高效地从故障中恢复。
可以用RDD表达的模型包括:
- MapReduce:可以使用Spark中的
flatMap和groupByKey操作来表达该模型,如果有合并器(combiner)也可以用reduceByKey。 - DryadLINQ:DryadLINQ系统在更通用的Dryad运行时之上提供了比MapReduce更广泛的算子,但这些都是批量算子,直接对应Spark中可用的RDD转换(
map、groupByKey、join等)。 - SQL:与DryadLINQ表达式类似,SQL查询对记录集执行数据并行操作。
- Pregel:谷歌的Pregel[22]是专门针对迭代图应用的模型,乍一看与其他系统的面向集合编程模型差异很大。在Pregel中,程序以一系列协调的“超步”(superstep)运行。在每个超步中,图中的每个顶点都运行一个用户函数,可以更新顶点关联的状态、修改图拓扑,并向其他顶点发送消息供下一个超步使用。该模型可以表达许多图算法,包括最短路径、二分匹配和PageRank。
让我们可以用RDD实现该模型的关键观察是:Pregel在每次迭代中对所有顶点应用相同的用户函数。因此,我们可以将每次迭代的顶点状态存储在RDD中,并执行批量转换(flatMap)来应用该函数,生成消息RDD。然后我们可以将这个RDD与顶点状态做join,完成消息交换。同样重要的是,RDD允许我们像Pregel一样将顶点状态保存在内存中,通过控制分区来最小化通信,并支持故障后的部分恢复。我们已经在Spark之上将Pregel实现为一个200行的库,更多细节可以参考[33]。
- 迭代式MapReduce:最近提出的多个系统,包括HaLoop[7]和Twister[11],都提供了迭代式MapReduce模型,用户给系统一系列MapReduce作业让其循环执行。这些系统让数据跨迭代保持一致的分区,Twister还可以将数据保存在内存中。这两种优化用RDD都很容易表达,我们已经能够用Spark将HaLoop实现为一个200行的库。
- 批量流处理:研究人员最近提出了几种增量处理系统,用于定期用新数据更新结果的应用[21,15,4]。例如,每15分钟更新一次广告点击统计的应用,应该能够将前一个15分钟窗口的中间状态与新日志的数据结合起来。这些系统执行类似Dryad的批量操作,但将应用状态存储在分布式文件系统中。将中间状态放在RDD中可以加快它们的处理速度。
RDD表达力的原因
为什么RDD能够表达这些多样化的编程模型?原因在于,RDD的限制在许多并行应用中影响很小。特别是,尽管RDD只能通过批量转换创建,但许多并行程序本身就会对大量记录执行相同的操作,因此很容易表达。同样,RDD的不可变性也不是障碍,因为可以创建多个RDD来表示同一数据集的不同版本。事实上,如今许多MapReduce应用都运行在不允许文件更新的文件系统之上,比如HDFS。
最后一个问题是,为什么之前的框架没有提供同样程度的通用性。我们认为,这是因为这些系统只针对MapReduce和Dryad处理不好的特定问题(比如迭代)进行了探索,而没有注意到这些问题的共同根源是缺少数据共享抽象。
7.2 利用RDD进行调试
虽然我们最初设计RDD是为了实现容错的确定性重计算,但这一特性也有助于调试。特别是,通过记录作业期间创建的RDD的血缘,我们可以:(1)事后重建这些RDD,让用户交互式地查询它们;(2)通过重新计算任务依赖的RDD分区,在单进程调试器中重新运行作业中的任意任务。与传统的分布式系统重放调试器[13]不同,那些调试器必须捕获或推断跨多个节点的事件顺序,而这种方法几乎没有记录开销,因为只需要记录RDD血缘图⁹。我们目前正在基于这些想法开发Spark调试器[33]。
8 相关工作
集群编程模型:集群编程模型的相关工作可以分为几类。
第一类是数据流模型,比如MapReduce[10]、Dryad[19]和Ciel[23],它们支持丰富的算子来处理数据,但通过稳定存储系统来共享数据。RDD代表了一种比稳定存储更高效的数据共享抽象,因为它避免了数据复制、I/O和序列化的代价¹⁰。
第二类是数据流系统的多种高级编程接口,包括DryadLINQ[31]和FlumeJava[8],它们提供了与语言集成的API,用户通过map、join等算子操作“并行集合”。但在这些系统中,并行集合要么代表磁盘上的文件,要么代表用于表达查询计划的临时数据集。尽管系统可以在同一个查询中跨算子流水线化数据(比如一个map后面跟着另一个map),但它们无法跨查询高效共享数据。我们基于并行集合模型设计了Spark的API,因为它使用方便,我们并不声称语言集成接口是创新的,但通过提供RDD作为该接口背后的存储抽象,我们让它能够支持更广泛的应用。
第三类系统是针对需要数据共享的特定类别应用提供高级接口。例如,Pregel[22]支持迭代图应用,而Twister[11]和HaLoop[7]是迭代式MapReduce运行时。但这些框架仅针对它们支持的计算模式隐式地执行数据共享,不提供通用的抽象让用户可以自主选择要共享的数据和操作。例如,用户无法使用Pregel或Twister将数据集加载到内存中,然后决定在上面运行什么查询。RDD显式地提供了分布式存储抽象,因此可以支持这些专用系统无法覆盖的应用,比如交互式数据挖掘。
最后一类系统暴露共享可变状态,允许用户执行内存计算。例如,Piccolo[27]让用户运行并行函数,读取和更新分布式哈希表中的单元格。分布式共享内存(DSM)系统[24]和RAMCloud[25]等键值存储也提供类似的模型。RDD与这些系统有两点不同:第一,RDD提供了基于map、sort、join等算子的更高级编程接口,而Piccolo和DSM的接口只是对表单元格的读写;第二,Piccolo和DSM系统通过检查点和回滚实现恢复,在许多应用中比RDD的基于血缘的策略开销更大。最后,如2.3节所讨论的,RDD相比DSM还有其他优势,比如慢节点缓解。
缓存系统:Nectar[12]可以通过程序分析识别公共子表达式,在DryadLINQ作业间复用中间结果[16]。这种能力如果添加到基于RDD的系统中会很有吸引力。不过,Nectar不提供内存缓存(它将数据放在分布式文件系统中),也不允许用户显式控制哪些数据集需要持久化以及如何分区。Ciel[23]和FlumeJava[8]同样可以缓存任务结果,但不提供内存缓存,也不允许显式控制缓存哪些数据。
Ananthanarayanan等人提出为分布式文件系统添加内存缓存,以利用数据访问的时间和空间局部性[3]。虽然这种方案提供了对文件系统中已有数据的更快访问,但作为在应用内共享中间结果的手段,它不如RDD高效,因为它仍然要求应用在阶段之间将结果写入文件系统。
血缘:捕获数据的血缘或出处信息,一直是科学计算和数据库领域的研究课题,用于解释结果、支持他人重现数据,以及在工作流发现bug或数据集丢失时重新计算数据。相关综述可以参考[5]和[9]。RDD提供了一种并行编程模型,其中细粒度血缘的捕获成本很低,因此可以用于故障恢复。
我们的基于血缘的恢复机制,也类似于MapReduce和Dryad中在单次计算(作业)内部使用的恢复机制,它们都会跟踪任务DAG中的依赖关系。但在这些系统中,血缘信息在作业结束后就丢失了,需要使用复制存储系统来跨计算共享数据。相比之下,RDD将血缘应用于跨计算高效地持久化内存数据,无需复制和磁盘I/O的开销。
关系型数据库:RDD在概念上类似于数据库中的视图,而持久化RDD类似于物化视图[28]。但与DSM系统类似,数据库通常允许对所有记录进行细粒度的读写访问,需要为容错记录操作和数据,还要为维护一致性带来额外开销。而RDD的粗粒度转换模型不需要这些开销。
9 结论
我们提出了弹性分布式数据集(RDD),这是一种高效、通用且容错的抽象,用于集群应用中的数据共享。RDD可以表达广泛的并行应用,包括许多为迭代计算提出的专用编程模型,以及这些模型无法覆盖的新型应用。与现有的集群存储抽象不同,RDD不需要为容错进行数据复制,而是提供基于粗粒度转换的API,让它们可以利用血缘高效恢复数据。我们在名为Spark的系统中实现了RDD,在迭代应用中性能比Hadoop最高高出20倍,并且可以交互式地查询数百GB的数据。
我们已经在spark-project.org开源了Spark,作为可扩展数据分析和系统研究的平台。
致谢
感谢第一批Spark用户,包括Tim Hunter、Lester Mackey、Dilip Joseph和Jibin Zhan,感谢他们在真实应用中试用我们的系统,提供了许多宝贵建议,并发现了一些研究挑战。也感谢我们的论文指导Ed Nightingale,以及审稿人的反馈。本研究部分得到伯克利AMP Lab赞助商Google、SAP、Amazon Web Services、Cloudera、Huawei、IBM、Intel、Microsoft、NEC、NetApp和VMware的支持,以及DARPA(合同号FA8650-11-C-7136)、Google博士奖学金和加拿大自然科学与工程研究委员会的资助。
参考文献
[1] Apache Hive. http://hadoop.apache.org/hive.
[2] Scala. http://www.scala-lang.org.
[3] G. Ananthanarayanan, A. Ghodsi, S. Shenker, and I. Stoica. Disk-locality in datacenter computing considered irrelevant. In HotOS ’11, 2011.
[4] P. Bhatotia, A. Wieder, R. Rodrigues, U. A. Acar, and R. Pasquin. Incoop: MapReduce for incremental computations. In ACM SOCC ’11, 2011.
[5] R. Bose and J. Frew. Lineage retrieval for scientific data processing: a survey. ACM Computing Surveys, 37:1–28, 2005.
[6] S. Brin and L. Page. The anatomy of a large-scale hypertextual web search engine. In WWW, 1998.
[7] Y. Bu, B. Howe, M. Balazinska, and M. D. Ernst. HaLoop: efficient iterative data processing on large clusters. Proc. VLDB Endow., 3:285–296, September 2010.
[8] C. Chambers, A. Raniwala, F. Perry, S. Adams, R. R. Henry, R. Bradshaw, and N. Weizenbaum. FlumeJava: easy, efficient data-parallel pipelines. In PLDI ’10. ACM, 2010.
[9] J. Cheney, L. Chiticariu, and W.-C. Tan. Provenance in databases: Why, how, and where. Foundations and Trends in Databases, 1(4):379–474, 2009.
[10] J. Dean and S. Ghemawat. MapReduce: Simplified data processing on large clusters. In OSDI, 2004.
[11] J. Ekanayake, H. Li, B. Zhang, T. Gunarathne, S.-H. Bae, J. Qiu, and G. Fox. Twister: a runtime for iterative mapreduce. In HPDC ’10, 2010.
[12] P. K. Gunda, L. Ravindranath, C. A. Thekkath, Y. Yu, and L. Zhuang. Nectar: automatic management of data and computation in datacenters. In OSDI ’10, 2010.
[13] Z. Guo, X. Wang, J. Tang, X. Liu, Z. Xu, M. Wu, M. F. Kaashoek, and Z. Zhang. R2: an application-level kernel for record and replay. OSDI’08, 2008.
[14] T. Hastie, R. Tibshirani, and J. Friedman. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. Springer Publishing Company, New York, NY, 2009.
[15] B. He, M. Yang, Z. Guo, R. Chen, B. Su, W. Lin, and L. Zhou. Comet: batched stream processing for data intensive distributed computing. In SoCC ’10.
[16] A. Heydon, R. Levin, and Y. Yu. Caching function calls using precise dependencies. In ACM SIGPLAN Notices, pages 311–320, 2000.
[17] B. Hindman, A. Konwinski, M. Zaharia, A. Ghodsi, A. D. Joseph, R. H. Katz, S. Shenker, and I. Stoica. Mesos: A platform for fine-grained resource sharing in the data center. In NSDI ’11, 2011.
[18] T. Hunter, T. Moldovan, M. Zaharia, S. Merzgui, J. Ma, M. J. Franklin, P. Abbeel, and A. M. Bayen. Scaling the Mobile Millennium system in the cloud. In SOCC ’11, 2011.
[19] M. Isard, M. Budiu, Y. Yu, A. Birrell, and D. Fetterly. Dryad: distributed data-parallel programs from sequential building blocks. In EuroSys ’07, 2007.
[20] S. Y. Ko, I. Hoque, B. Cho, and I. Gupta. On availability of intermediate data in cloud computations. In HotOS ’09, 2009.
[21] D. Logothetis, C. Olston, B. Reed, K. C. Webb, and K. Yocum. Stateful bulk processing for incremental analytics. SoCC ’10.
[22] G. Malewicz, M. H. Austern, A. J. Bik, J. C. Dehnert, I. Horn, N. Leiser, and G. Czajkowski. Pregel: a system for large-scale graph processing. In SIGMOD, 2010.
[23] D. G. Murray, M. Schwarzkopf, C. Smowton, S. Smith, A. Madhavapeddy, and S. Hand. Ciel: a universal execution engine for distributed data-flow computing. In NSDI, 2011.
[24] B. Nitzberg and V. Lo. Distributed shared memory: a survey of issues and algorithms. Computer, 24(8):52 –60, Aug 1991.
[25] J. Ousterhout, P. Agrawal, D. Erickson, C. Kozyrakis, J. Leverich, D. Mazières, S. Mitra, A. Narayanan, G. Parulkar, M. Rosenblum, S. M. Rumble, E. Stratmann, and R. Stutsman. The case for RAMClouds: scalable high-performance storage entirely in DRAM. SIGOPS Op. Sys. Rev., 43:92–105, Jan 2010.
[26] D. Peng and F. Dabek. Large-scale incremental processing using distributed transactions and notifications. In OSDI 2010.
[27] R. Power and J. Li. Piccolo: Building fast, distributed programs with partitioned tables. In Proc. OSDI 2010, 2010.
[28] R. Ramakrishnan and J. Gehrke. Database Management Systems. McGraw-Hill, Inc., 3 edition, 2003.
[29] K. Thomas, C. Grier, J. Ma, V. Paxson, and D. Song. Design and evaluation of a real-time URL spam filtering service. In IEEE Symposium on Security and Privacy, 2011.
[30] J. W. Young. A first order approximation to the optimum checkpoint interval. Commun. ACM, 17:530–531, Sept 1974.
[31] Y. Yu, M. Isard, D. Fetterly, M. Budiu, Ú. Erlingsson, P. K. Gunda, and J. Currey. DryadLINQ: A system for general-purpose distributed data-parallel computing using a high-level language. In OSDI ’08, 2008.
[32] M. Zaharia, D. Borthakur, J. Sen Sarma, K. Elmeleegy, S. Shenker, and I. Stoica. Delay scheduling: A simple technique for achieving locality and fairness in cluster scheduling. In EuroSys ’10, 2010.
[33] M. Zaharia, M. Chowdhury, T. Das, A. Dave, J. Ma, M. McCauley, M. Franklin, S. Shenker, and I. Stoica. Resilient distributed datasets: A fault-tolerant abstraction for in-memory cluster computing. Technical Report UCB/EECS-2011-82, EECS Department, UC Berkeley, 2011.
脚注
¹ 不过,当血缘链很长时,对部分RDD的数据设置检查点会很有用,我们将在5.4节讨论具体方法。
² 尽管单个RDD是不可变的,但可以通过多个RDD来表示数据集的多个版本,从而实现可变状态。我们将RDD设计为不可变,是为了更方便地描述血缘图,但如果将抽象设计为版本化数据集并在血缘图中跟踪版本,效果是等价的。
⁵ 我们在闭包创建时就保存了它的状态,因此本例中的map始终会加5,即使x之后发生变化也不受影响。
⁶ 注意,尽管RDD是不可变的,但程序中的变量ranks和contribs在每次迭代中都指向不同的RDD。
⁷ 注意,我们的union操作不会去重。
⁸ 开销取决于应用每字节数据的计算量,对于轻量级处理,开销最高可达2倍。
⁹ 与这些系统不同,基于RDD的调试器不会重放用户函数中的非确定性行为(例如非确定性map),但它至少可以通过对数据做校验和来报告这种情况。
¹⁰ 注意,在RAMCloud[25]等内存数据存储上运行MapReduce/Dryad,仍然需要数据复制和序列化,对于某些应用来说代价很高,如6.1节所示。