Dynamo:亚马逊高可用键值存储系统
Dynamo: Amazon’s Highly Available Key-value Store
贡献:NoSQL领域的开山之作,和Bigtable并列为分布式NoSQL的两大技术基石
Giuseppe DeCandia, Deniz Hastorun, Madan Jampani, Gunavardhan Kakulapati, Avinash Lakshman, Alex Pilchin, Swaminathan Sivasubramanian, Peter Vosshall 和 Werner Vogels
Amazon.com
摘要
大规模场景下的可靠性是亚马逊(全球最大的电商平台之一)面临的最大挑战之一;哪怕是最轻微的服务中断都会造成重大的经济损失,并影响客户信任。亚马逊平台为全球众多网站提供服务,其底层基础设施由分布在全球各地数据中心的数万台服务器和网络组件构成。在这种规模下,大大小小的组件故障会持续发生,而面对这些故障时持久化状态的管理方式,决定了软件系统的可靠性与可扩展性。
本文介绍了Dynamo的设计与实现,这是一款高可用键值存储系统,亚马逊的部分核心服务使用它来提供“始终在线”的服务体验。为了达到这一可用性水平,Dynamo在特定故障场景下会牺牲一致性。它大量使用对象版本控制与应用辅助的冲突解决机制,为开发者提供了一种全新的接口模式。
分类与主题描述
D.4.2 [操作系统]:存储管理;D.4.5 [操作系统]:可靠性;D.4.2 [操作系统]:性能;
通用术语
算法,管理,度量,性能,设计,可靠性。
1. 引言
亚马逊运营着一个全球性的电商平台,在流量高峰时期,通过分布在全球多个数据中心的数万台服务器为数千万用户提供服务。亚马逊平台在性能、可靠性和效率方面有着严格的运营要求,并且为了支撑持续增长,平台需要具备高度可扩展性。可靠性是最重要的要求之一,因为哪怕最轻微的服务中断都会带来重大的经济损失,还会影响客户信任。此外,为了支撑业务的持续增长,平台必须具备高度可扩展性。
我们团队在运营亚马逊平台的过程中得到的一条经验是:系统的可靠性和可扩展性,取决于其应用状态的管理方式。亚马逊采用高度去中心化、松耦合的面向服务架构,由数百个服务组成。在这种环境下,尤其需要始终可用的存储技术。例如,即使磁盘出现故障、网络链路抖动、或者数据中心遭龙卷风破坏,客户也应该能够查看购物车并向其中添加商品。因此,负责管理购物车的服务要求其数据存储必须始终支持读写操作,并且数据需要能够跨多个数据中心可用。
在由数百万组件构成的基础设施中,处理故障是我们的常规运营模式;任何时刻都总有少量但数量不可忽视的服务器和网络组件发生故障。因此,亚马逊的软件系统在构建时,必须将故障处理视为常态,且不能影响服务的可用性与性能。
为了满足可靠性与扩展性需求,亚马逊开发了多款存储技术,其中亚马逊简单存储服务(Amazon S3,也对亚马逊外部开放)可能是最广为人知的。本文介绍了Dynamo的设计与实现,这是为亚马逊平台打造的另一款高可用、可扩展的分布式数据存储。Dynamo用于管理那些对可靠性要求极高、并且需要在可用性、一致性、成本效益和性能之间进行精细权衡的服务的状态。亚马逊平台上的应用种类繁多,存储需求也各不相同。有一类应用要求存储技术足够灵活,让应用设计者可以基于这些权衡来合理配置数据存储,从而以最具成本效益的方式实现高可用性与性能保障。
亚马逊平台上有很多服务只需要通过主键访问数据存储。对于很多服务(比如提供畅销书榜单、购物车、用户偏好、会话管理、销售排名、商品目录的服务)而言,使用关系型数据库的常规模式会导致效率低下,并且限制了扩展性与可用性。Dynamo提供了仅支持主键的简单接口,来满足这些应用的需求。
Dynamo综合运用了多种成熟技术来实现扩展性与可用性:通过一致性哈希[10]对数据进行分区与复制,通过对象版本控制[12]来保障一致性。更新过程中副本之间的一致性通过类Quorum技术与去中心化的副本同步协议来维护。Dynamo采用基于Gossip的分布式故障检测与成员协议。Dynamo是一个完全去中心化的系统,几乎不需要人工管理。存储节点可以随时加入或退出Dynamo集群,无需手动进行数据分区或重分布。
在过去一年中,Dynamo已经成为亚马逊电商平台多个核心服务的底层存储技术。它能够高效应对极端的高峰流量,在繁忙的假日购物季期间也没有出现任何停机。例如,维护购物车的服务(购物车服务)单日处理了数千万次请求,对应超过300万笔结算;管理会话状态的服务则处理了数十万并发活跃会话。
这项工作对研究领域的主要贡献在于,评估了如何将不同技术组合起来构建一个完整的高可用系统。它证明了最终一致性存储系统可以在要求严苛的生产环境中落地应用。同时,本文也分享了如何调优这些技术,以满足生产系统极其严格的性能要求。
本文的结构如下:第2节介绍背景,第3节介绍相关工作,第4节介绍系统设计,第5节描述实现细节,第6节详细介绍在生产环境中运行Dynamo的经验与洞察,第7节总结全文。本文中有多处内容,出于保护亚马逊商业利益的考虑,无法提供更详细的信息。因此,第6节中的数据中心内部/之间的延迟、第6.2节中的绝对请求速率,以及第6.3节中的停机时长与工作负载,均以聚合指标的形式给出,而非绝对数值。
2. 背景
亚马逊电商平台由数百个服务协同组成,提供从推荐、订单履交到欺诈检测等各类功能。每个服务都通过定义良好的接口对外暴露,可通过网络访问。这些服务部署在由全球多个数据中心的数万台服务器构成的基础设施之上。其中部分服务是无状态的(即聚合其他服务的响应来生成结果),部分服务是有状态的(即基于持久化存储中的状态执行业务逻辑,生成响应)。
传统的生产系统将状态存储在关系型数据库中。然而,对于很多常见的状态持久化场景,关系型数据库远非理想方案。大多数这类服务仅通过主键存储和检索数据,并不需要关系型数据库提供的复杂查询与管理功能。这些多余的功能需要昂贵的硬件和高技能的运维人员,使得整体方案效率极低。此外,现有的复制技术十分有限,并且通常优先保障一致性而非可用性。尽管近年来取得了很多进展,但数据库的横向扩展、或者通过智能分区方案实现负载均衡,仍然并非易事。
本文介绍的Dynamo是一款高可用存储技术,旨在满足这类重要服务的需求。Dynamo具备简单的键值接口、高可用性与清晰定义的一致性窗口、资源使用效率高,并且具备简单的横向扩展方案,可应对数据集规模或请求速率的增长。每个使用Dynamo的服务都运行独立的Dynamo实例。
2.1 系统假设与需求
这类服务的存储系统有以下需求:
查询模型:对通过唯一键标识的数据项进行简单的读写操作。状态以二进制对象(即blob)的形式存储,由唯一键标识。没有跨多个数据项的操作,也不需要关系型模式。这一需求基于这样的观察:亚马逊的大部分服务都可以基于这种简单的查询模型运行,不需要任何关系型模式。Dynamo的目标应用场景是存储相对较小的对象(通常小于1MB)。
ACID属性:ACID(原子性、一致性、隔离性、持久性)是保证数据库事务可靠处理的一组属性。在数据库领域,对数据的单次逻辑操作称为一个事务。亚马逊的实践经验表明,提供ACID保证的数据存储往往可用性较差。这一点已经得到工业界与学术界的广泛认可[5]。Dynamo的目标应用场景是:如果牺牲一致性(ACID中的“C”)能够换来高可用性,则接受更弱的一致性。Dynamo不提供任何隔离性保证,并且仅支持单键更新。
效率:系统需要能够在通用商用硬件基础设施上运行。在亚马逊平台中,服务有着严格的延迟要求,通常以分布的\(99.9^{th}\)百分位来衡量。由于状态访问在服务运行中起着至关重要的作用,存储系统必须能够满足如此严格的服务等级协议(SLA,见下文2.2节)。服务必须能够配置Dynamo,使其持续满足延迟与吞吐量要求。权衡的维度包括性能、成本效益、可用性与持久性保证。
其他假设:Dynamo仅由亚马逊内部服务使用。其运行环境被认为是非恶意的,没有认证、授权等安全相关需求。此外,由于每个服务使用独立的Dynamo实例,其最初的设计目标是支持最多数百个存储节点的规模。我们将在后续章节讨论Dynamo的扩展性限制,以及可能的扩展性扩展方案。
2.2 服务等级协议(SLA)
为了保证应用能够在限定时间内交付功能,平台中的每一个依赖项都需要在更严格的时间范围内交付自身的功能。客户端与服务之间会签订服务等级协议(SLA),这是一份正式协商的契约,约定了客户端与服务在多项系统特性上的共识,最核心的包括特定API对应的客户端预期请求速率分布,以及该负载下的预期服务延迟。一个简单SLA的例子是:服务保证在峰值客户端负载为每秒500次请求时,99.9%的请求都能在300ms内返回响应。
在亚马逊去中心化的面向服务基础设施中,SLA扮演着重要角色。例如,对电商网站的一次页面请求,通常需要渲染引擎向超过150个服务发送请求来构建响应。这些服务往往有多个依赖项,而这些依赖项本身通常也是服务,因此应用的调用链超过一层是很常见的。为了确保页面渲染引擎能够明确控制页面交付时间,调用链中的每个服务都必须遵守其性能契约。
图1展示了亚马逊平台架构的抽象视图:动态网页内容由页面渲染组件生成,而页面渲染组件会查询大量其他服务。一个服务可以使用不同的数据存储来管理自身状态,这些数据存储仅在服务边界内可访问。部分服务作为聚合器,通过调用多个其他服务来生成组合响应。通常,聚合器服务是无状态的,尽管它们会大量使用缓存。
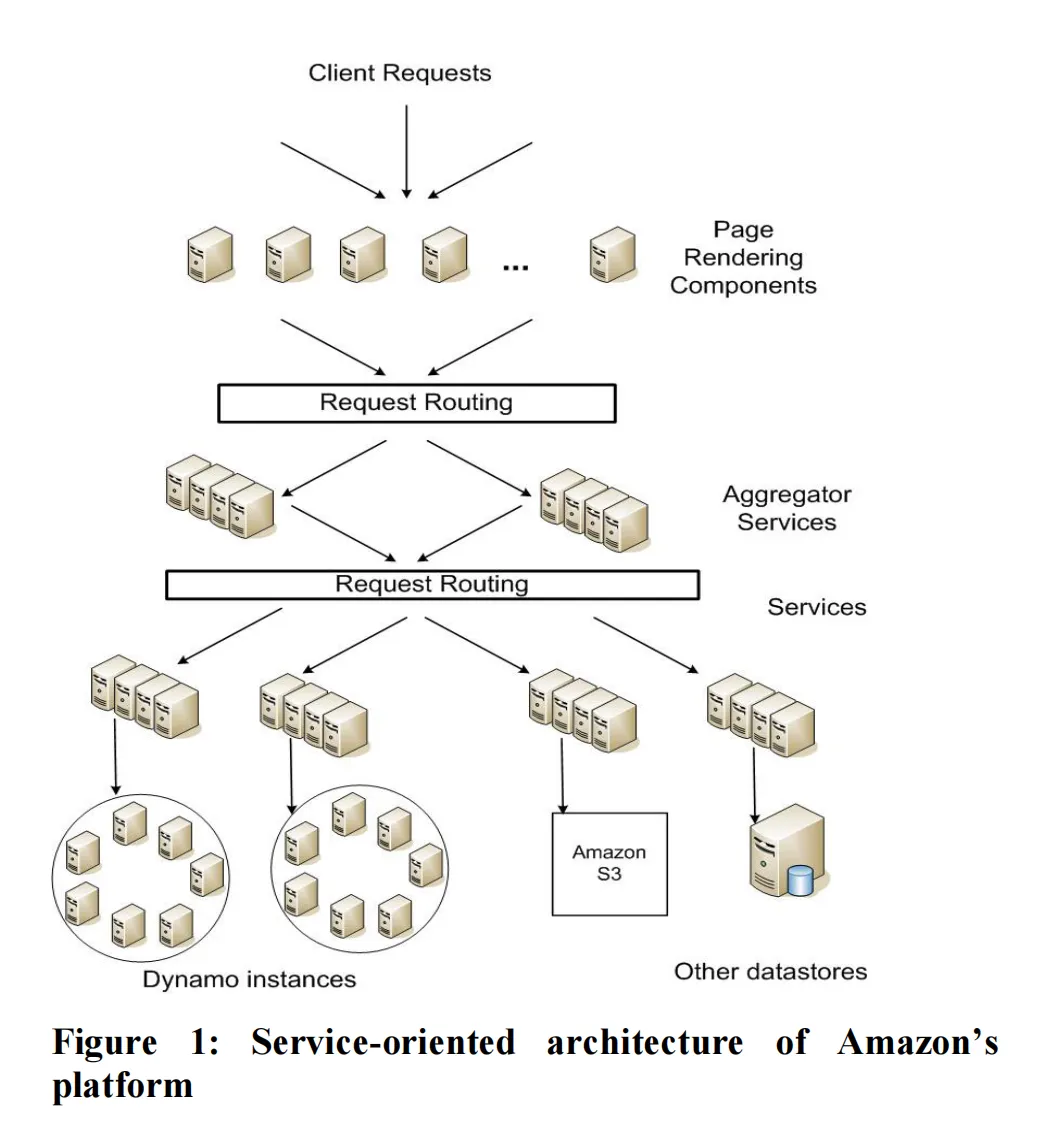
图1:亚马逊平台的面向服务架构
行业内构建面向性能的SLA的常见做法,是使用平均值、中位数和预期方差来描述。但在亚马逊,我们发现如果目标是构建让所有用户都获得良好体验的系统,而不仅仅是大多数用户,那么这些指标是远远不够的。例如,如果使用了大量的个性化技术,那么历史数据更长的用户需要更多的处理,这会影响分布高位的性能。基于均值或中位数响应时间的SLA无法覆盖这一重要用户群体的性能。为了解决这个问题,亚马逊的SLA以分布的\(99.9^{th}\)百分位来定义和衡量。选择99.9%而非更高的百分位,是基于成本效益分析:要将性能提升到更高的百分位,成本会大幅上升。亚马逊生产系统的实践经验表明,与基于均值或中位数定义SLA的系统相比,这种方法能带来更好的整体体验。
本文中会多次提到\(99.9^{th}\)百分位的分布,这反映了亚马逊工程师从用户体验角度出发,对性能的极致追求。很多论文都报告平均值,因此在适合对比的地方我们也会给出平均值。尽管如此,亚马逊的工程与优化工作并不以平均值为核心。多项技术(例如写协调器的负载均衡选择)都是专门针对控制\(99.9^{th}\)百分位的性能而设计的。
存储系统通常在服务SLA的达成中扮演重要角色,尤其是当业务逻辑相对轻量时——亚马逊的很多服务都是如此。此时状态管理就成为服务SLA的核心组成部分。Dynamo的主要设计考量之一,就是让服务能够控制系统属性(比如持久性与一致性),并让服务自身在功能、性能与成本效益之间做出权衡。
2.3 设计考量
商用系统中的数据复制算法传统上采用同步副本协调,以提供强一致性的数据访问接口。为了达到这种一致性级别,这些算法不得不在特定故障场景下牺牲数据的可用性。例如,系统会让数据暂时不可用,直到能绝对确保数据正确性,而不是处理答案正确性的不确定性。从早期的复制数据库研究开始,人们就熟知在可能出现网络故障的情况下,强一致性与高数据可用性无法同时实现[2, 11]。因此,系统和应用都需要清楚在不同条件下能够保障哪些属性。
对于容易出现服务器与网络故障的系统,可以通过乐观复制技术来提升可用性:允许更新在后台同步到各个副本,并且容忍并发的、断开连接的操作。这种方法的挑战在于可能会产生冲突更新,必须检测并解决这些冲突。冲突解决过程带来两个问题:何时解决,以及由谁解决。Dynamo被设计为一个最终一致性的数据存储;也就是说,所有更新最终都会传播到所有副本。
一个重要的设计考量是决定何时执行更新冲突的解决流程,即冲突应该在读取时解决还是写入时解决。很多传统数据存储在写入时执行冲突解决,简化读取的复杂度[7]。在这类系统中,如果数据存储在给定时间无法联系到所有(或大多数)副本,写入操作可能会被拒绝。而Dynamo的设计目标是“始终可写”的数据存储(即写入操作高度可用)。对于亚马逊的很多服务而言,拒绝用户的更新会导致糟糕的用户体验。例如,购物车服务必须允许用户即使在网络和服务器故障的情况下,也能向购物车添加和移除商品。这一要求迫使我们将冲突解决的复杂度转移到读取端,以确保写入永远不会被拒绝。
下一个设计选择是由谁来执行冲突解决流程。可以由数据存储完成,也可以由应用完成。如果由数据存储进行冲突解决,那么它的选择相当有限。在这种情况下,数据存储只能使用简单的策略,比如“最后写入胜出”[22],来解决冲突更新。而另一方面,由于应用了解数据模式,因此可以选择最适合用户体验的冲突解决方法。例如,维护用户购物车的应用可以选择“合并”冲突版本,返回一个统一的购物车。尽管有这种灵活性,但部分应用开发者可能不想编写自己的冲突解决机制,而是将其交给数据存储,由数据存储选择简单的策略,比如“最后写入胜出”。
设计中遵循的其他核心原则包括:
增量可扩展性:Dynamo应该能够支持每次新增一个存储节点(下文简称“节点”),对系统运维人员和系统本身的影响都降到最低。
对称性:Dynamo中的每个节点都应该与对等节点承担相同的职责;不应存在特殊节点,承担特殊角色或额外职责。根据我们的经验,对称性能够简化系统的配置与维护流程。
去中心化:作为对称性的延伸,设计应优先采用去中心化的对等技术,而非集中式控制。过去,集中式控制曾导致过服务中断,我们的目标是尽可能避免这种情况。这会带来更简单、更具可扩展性、也更可用的系统。
异构性:系统需要能够利用运行基础设施的异构性。例如,工作负载的分布必须与各服务器的能力成正比。这对于新增更高容量的节点而无需一次性升级所有主机而言至关重要。
3. 相关工作
3.1 对等网络系统
已有很多对等(P2P)系统研究了数据存储与分发问题。第一代P2P系统,比如Freenet和Gnutella\(^{1}\),主要用作文件共享系统。这类非结构化P2P网络中,对等节点之间的覆盖链路是任意建立的。在这类网络中,搜索查询通常通过全网泛洪来找到尽可能多持有对应数据的对等节点。P2P系统发展到下一代,成为了广为人知的结构化P2P网络。这类网络采用全局一致的协议,确保任何节点都能高效地将搜索查询路由到持有目标数据的对等节点。Pastry[16]和Chord[20]等系统通过路由机制,保证查询能在有限跳数内得到响应。为了降低多跳路由带来的额外延迟,部分P2P系统(比如[14])采用O(1)路由:每个对等节点在本地维护足够的路由信息,能够在常数跳数内将请求(访问数据项)路由到合适的对等节点。
各类存储系统,比如Oceanstore[9]和PAST[17],都是基于这些路由覆盖层构建的。Oceanstore提供了全局的、事务性的持久存储服务,支持对广泛复制的数据进行串行化更新。为了支持并发更新,同时避免广域锁固有的诸多问题,它采用基于冲突解决的更新模型。文献[21]引入了冲突解决机制,以减少事务中止的次数。Oceanstore通过处理一系列更新、在其中选择一个全序、然后按该顺序原子性地应用这些更新,来解决冲突。它是为数据在不可信基础设施上复制的场景设计的。相比之下,PAST在Pastry之上提供了一个简单的抽象层,用于存储持久的、不可变的对象。它假设应用可以在其之上构建必要的存储语义(比如可修改文件)。
3.2 分布式文件系统与数据库
在文件系统与数据库领域,为了性能、可用性和持久性而进行数据分发已经得到了广泛研究。与仅支持扁平命名空间的P2P存储系统相比,分布式文件系统通常支持层级命名空间。Ficus[15]和Coda[19]等系统以牺牲一致性为代价,通过文件复制实现高可用性。更新冲突通常通过专门的冲突解决流程来管理。Farsite系统[1]是一种分布式文件系统,不使用NFS这类中心化服务器。Farsite通过复制实现高可用性与可扩展性。谷歌文件系统[6]是另一种分布式文件系统,用于承载谷歌内部应用的状态。GFS设计简洁,采用单台主服务器承载全部元数据,数据被拆分为块存储在块服务器中。Bayou是一种分布式关系数据库系统,支持断连操作,提供最终数据一致性[21]。
在这些系统中,Bayou、Coda和Ficus允许断连操作,并且能够应对网络分区、服务中断等问题。这些系统的区别在于冲突解决流程。例如,Coda和Ficus执行系统级冲突解决,而Bayou允许应用级别的解决。但它们都保证最终一致性。与这些系统类似,Dynamo允许即使在网络分区期间也能继续执行读写操作,并通过不同的冲突解决机制来处理更新冲突。FAB[18]这类分布式块存储系统将大对象拆分为更小的块,并以高可用方式存储每个块。与这些系统相比,键值存储在本场景下更适用,原因在于:(a) 它旨在存储相对较小的对象(大小<1MB);(b) 键值存储更易于按应用进行配置。Antiquity是一种广域分布式存储系统,设计用于应对多服务器故障[23]。它使用安全日志来保障数据完整性,将每个日志复制到多台服务器以实现持久性,并使用拜占庭容错协议来确保数据一致性。与Antiquity不同,Dynamo并不关注数据完整性与安全问题,它是为可信环境构建的。Bigtable是一种用于管理结构化数据的分布式存储系统。它维护稀疏的多维排序映射,允许应用通过多个属性访问数据[3]。与Bigtable相比,Dynamo的目标应用仅需要键值访问,并且核心关注点是高可用性——即使出现网络分区或服务器故障,更新也不会被拒绝。
传统的复制关系型数据库系统聚焦于为复制数据提供强一致性保证。尽管强一致性为应用开发者提供了便利的编程模型,但这类系统在可扩展性与可用性方面存在局限[7]。这类系统无法处理网络分区,因为它们通常提供强一致性保证。
3.3 讨论
Dynamo与上述去中心化存储系统的区别在于其目标需求不同。首先,Dynamo主要面向需要“始终可写”数据存储的应用,不会因为故障或并发写入而拒绝更新。这对亚马逊的很多应用而言是至关重要的需求。其次,如前所述,Dynamo是为单一管理域内的基础设施构建的,所有节点都被认为是可信的。第三,使用Dynamo的应用不需要支持层级命名空间(这是很多文件系统的标配)或复杂的关系模式(传统数据库支持)。第四,Dynamo是为延迟敏感型应用构建的,要求至少99.9%的读写操作都能在几百毫秒内完成。为了满足这些严格的延迟要求,我们必须避免请求经过多个节点路由(这是Chord、Pastry等分布式哈希表系统的典型设计)。这是因为多跳路由会增加响应时间的波动性,从而提升高位百分位的延迟。Dynamo可以被定义为零跳分布式哈希表(DHT):每个节点在本地维护足够的路由信息,能够直接将请求路由到合适的节点。
4. 系统架构
要在生产环境中运行的存储系统,其架构是复杂的。除了实际的数据持久化组件之外,系统还需要具备可扩展且健壮的方案,来处理负载均衡、成员关系与故障检测、故障恢复、副本同步、过载处理、状态传输、并发与任务调度、请求编组、请求路由、系统监控与告警,以及配置管理。逐一描述这些方案的细节是不可能的,因此本文聚焦于Dynamo中用到的核心分布式系统技术:分区、复制、版本控制、成员关系、故障处理与扩展。
表1总结了Dynamo使用的技术及其各自的优势。
表1:Dynamo使用的技术总结及其优势
| 问题 | 技术 | 优势 |
|---|---|---|
| 分区 | 一致性哈希 | 增量可扩展性 |
| 写入高可用性 | 向量时钟 + 读取时协调 | 版本大小与更新速率解耦 |
| 处理临时故障 | 宽松Quorum与提示性移交 | 当部分副本不可用时,仍能提供高可用性与持久性保证 |
| 永久故障恢复 | 基于默克尔树的反熵机制 | 在后台同步存在差异的副本 |
| 成员关系与故障检测 | 基于Gossip的成员协议与故障检测 | 保持对称性,避免使用中心化注册表存储成员关系与节点存活信息 |
4.1 系统接口
Dynamo通过简单的接口存储与键关联的对象;它对外暴露两个操作:get()和put()。get(key)操作在存储系统中定位与键关联的对象副本,返回单个对象,或者带有上下文的、存在冲突版本的对象列表。put(key, context, object)操作根据关联的键确定对象副本应该放置的位置,并将副本写入磁盘。上下文编码了关于对象的系统元数据,对调用者透明,其中包含对象的版本等信息。上下文信息与对象一同存储,这样系统可以验证put请求中提供的上下文对象的有效性。
Dynamo将调用者提供的键和对象都视为不透明的字节数组。它对键执行MD5哈希,生成128位的标识符,用于确定负责该键的存储节点。
4.2 分区算法
Dynamo的核心设计要求之一是必须支持增量扩展。这需要一种机制,能够将数据动态分区到系统中的节点集合(即存储主机)上。Dynamo的分区方案依赖一致性哈希,将负载分散到多个存储主机上。在一致性哈希[10]中,哈希函数的输出范围被视为一个固定的环形空间(即最大的哈希值回绕到最小的哈希值)。系统中的每个节点都被分配了该空间内的一个随机值,代表其在环上的“位置”。每个通过键标识的数据项,通过对键哈希得到其在环上的位置,然后沿环顺时针行走,找到第一个位置大于该数据项位置的节点,该数据项就分配给这个节点。
因此,每个节点负责环上介于它和前一个节点之间的区域。一致性哈希的主要优势在于:节点的离开或加入只会影响其相邻节点,其他节点不受影响。
基础的一致性哈希算法存在一些挑战。首先,每个节点在环上的随机位置分配,会导致数据与负载分布不均匀。其次,基础算法没有考虑节点性能的异构性。为了解决这些问题,Dynamo使用了一致性哈希的一个变种(类似于[10, 20]中使用的方案):不是将一个节点映射到环上的单个点,而是为每个节点分配环上的多个点。为此,Dynamo引入了“虚拟节点”的概念。一个虚拟节点在系统中看起来像一个单独的节点,但每个物理节点可以负责多个虚拟节点。实际上,当一个新节点加入系统时,它会被分配环上的多个位置(下文称为“令牌”)。第6节将讨论Dynamo分区方案的微调过程。
使用虚拟节点有以下优势:
- 如果某个节点不可用(由于故障或日常维护),该节点处理的负载会均匀分散到其余可用节点上。
- 当某个节点恢复可用,或者有新节点加入系统时,新加入的节点会从其他每个可用节点承接大致相当的负载。
- 可以根据节点的容量决定其负责的虚拟节点数量,适配物理基础设施的异构性。
4.3 复制
为了实现高可用性与持久性,Dynamo将数据复制到多台主机上。每个数据项在N台主机上复制,N是可按实例配置的参数。每个键k都会被分配给一个协调器节点(上一节已描述)。协调器负责复制其负责范围内的数据项。除了在本地存储其负责范围内的每个键之外,协调器还会将这些键复制到环上顺时针方向的N-1个后继节点上。这样一来,每个节点都负责环上从它往前数第N个前驱节点之间的区域。在图2中,节点B除了本地存储键k之外,还将其复制到节点C和D。节点D会存储落在(A, B]、(B, C]和(C, D]范围内的键。
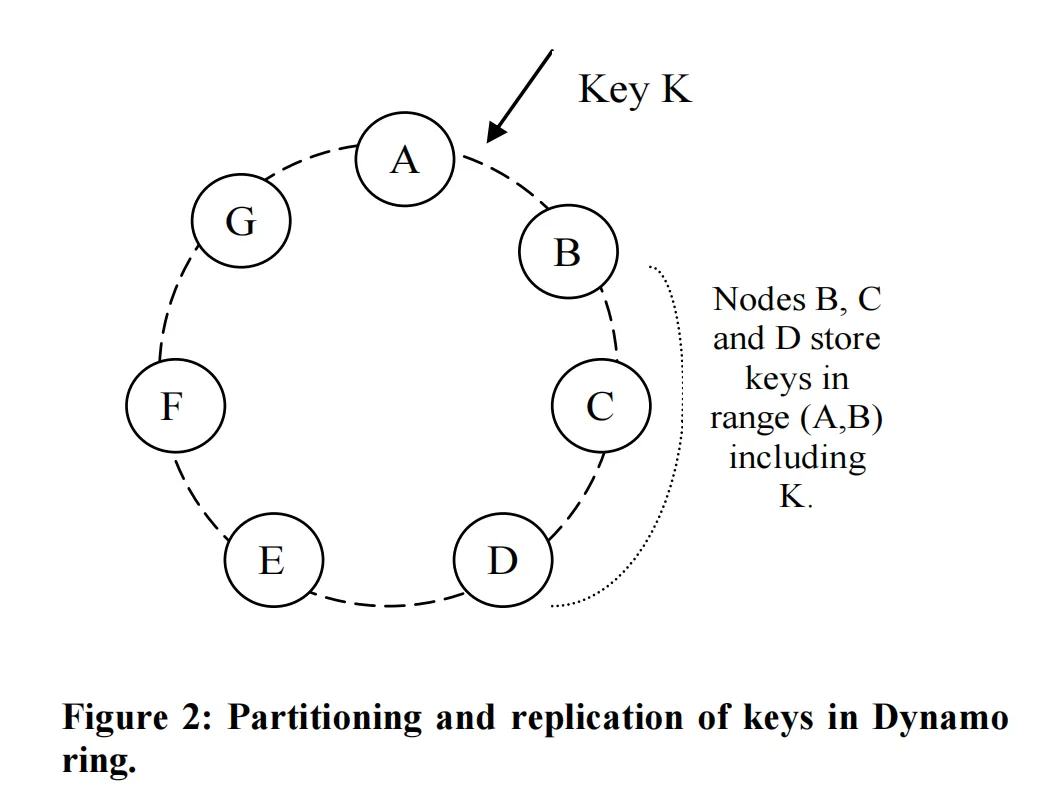
图2:Dynamo环中键的分区与复制
负责存储某个特定键的节点列表称为偏好列表。如第4.8节所述,系统的设计使得系统中的每个节点都能确定任意键对应的偏好列表包含哪些节点。为了应对节点故障,偏好列表包含的节点数多于N个。注意,由于使用了虚拟节点,某个键的前N个后继位置可能对应少于N个不同的物理节点(即一个节点可能占据前N个位置中的多个)。为了解决这个问题,构建键的偏好列表时会跳过环上的部分位置,确保列表中只包含不同的物理节点。
4.4 数据版本控制
Dynamo提供最终一致性,允许更新异步传播到所有副本。put()调用可能在更新应用到所有副本之前就返回给调用者,这可能导致后续的get()操作返回的对象不包含最新的更新。如果没有故障,更新传播的时间是有界的。但在特定故障场景下(例如服务器宕机或网络分区),更新可能在很长一段时间内都无法到达所有副本。
亚马逊平台中有一类应用能够容忍这种不一致性,并且可以在这种条件下运行。例如,购物车应用要求“加入购物车”操作永远不能被遗忘或拒绝。如果购物车的最新状态不可用,而用户对旧版本的购物车做了修改,这个修改仍然是有意义的,应该被保留。但同时,它也不应该覆盖当前不可用的购物车状态——后者本身可能也包含需要保留的修改。注意,“加入购物车”和“从购物车删除商品”操作都会转化为对Dynamo的put请求。当用户想要向购物车添加(或从中移除)商品,但最新版本不可用时,商品会被添加到(或从)旧版本中,之后再对产生分歧的版本进行协调。
为了提供这种保证,Dynamo将每次修改的结果都视为数据的一个新的、不可变的版本。它允许系统中同时存在一个对象的多个版本。大多数情况下,新版本会取代旧版本,系统自身可以确定权威版本(语法协调)。但在故障与并发更新同时存在的情况下,可能会出现版本分支,导致对象产生冲突版本。在这种情况下,系统无法协调同一对象的多个版本,必须由客户端执行协调,将数据演化的多个分支合并为一个(语义协调)。合并操作的一个典型例子是“合并”用户购物车的不同版本。通过这种协调机制,“加入购物车”操作永远不会丢失。但删除的商品可能会重新出现。
需要理解的是,某些故障模式可能导致系统中同一数据存在不止两个版本,甚至多个版本。在网络分区和节点故障的情况下进行更新,可能导致对象产生不同的版本子历史,系统需要在未来进行协调。这要求我们在设计应用时,明确承认同一数据可能存在多个版本(以确保永远不会丢失任何更新)。
Dynamo使用向量时钟[12]来捕获同一对象不同版本之间的因果关系。向量时钟本质上是一组(节点,计数器)对。每个对象的每个版本都关联一个向量时钟。通过比较两个对象的向量时钟,可以判断它们是处于并行分支,还是存在因果顺序。如果第一个对象时钟上的所有计数器都小于或等于第二个时钟中对应节点的计数器,那么第一个版本是第二个版本的祖先,可以被丢弃。否则,就认为这两次更新存在冲突,需要进行协调。
在Dynamo中,当客户端希望更新对象时,必须指定它更新的是哪个版本。这通过传入之前读操作得到的上下文来实现,上下文中包含了向量时钟信息。处理读请求时,如果Dynamo访问到多个无法进行语法协调的分支,它会返回所有叶子节点的对象,以及上下文中对应的版本信息。基于该上下文进行的更新,会被认为已经协调了分歧的版本,各个分支会被合并为单个新版本。
为了说明向量时钟的使用,我们以图3为例。客户端写入一个新对象。处理该键写入的节点(比如\(S_x\))递增自身的序列号,并用它创建数据的向量时钟。此时系统中有对象D1,其关联的时钟为\([(S_x, 1)]\)。客户端更新该对象。假设仍由同一个节点处理该请求。此时系统中有对象D2,其关联的时钟为\([(S_x, 2)]\)。D2由D1演化而来,因此会覆盖D1,但D1的副本可能还存在于尚未收到D2的节点上。假设同一个客户端再次更新该对象,这次由另一台服务器(比如\(S_y\))处理请求。此时系统中有数据D3,其关联的时钟为\([(S_x, 2), (S_y, 1)]\)。
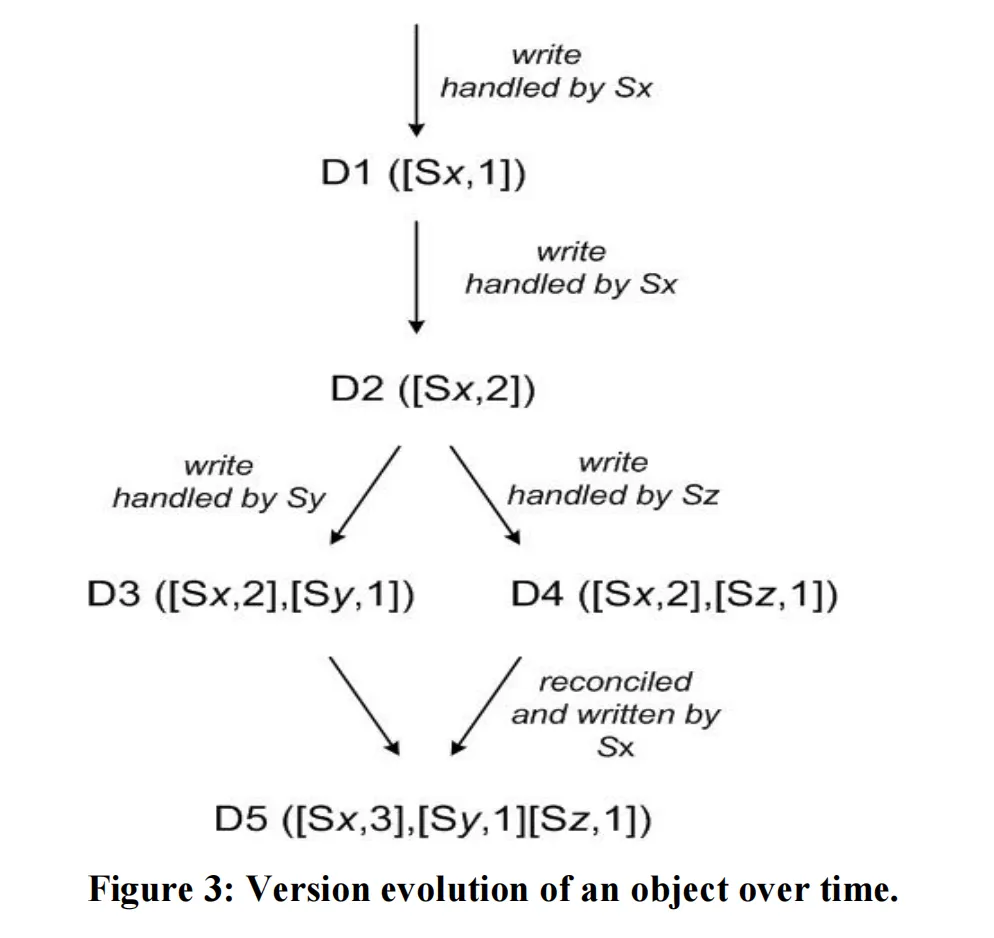
图3:对象版本随时间的演化过程
接下来假设另一个客户端读取了D2,然后尝试更新它,由另一个节点(比如Sz)执行写入。此时系统中有D4(D2的后代),其版本时钟为\([(Sx, 2), (Sz, 1)]\)。知道D1或D2的节点在收到D4及其时钟后,可以判断D1和D2已被新数据覆盖,可以进行垃圾回收。而知道D3的节点收到D4后,会发现两者之间没有因果关系。换句话说,D3和D4中的变更都没有体现在对方中。这两个数据版本都必须保留,并在(读取时)呈现给客户端进行语义协调。
现在假设某个客户端同时读取了D3和D4(上下文会反映读取到了这两个值)。读取的上下文是D3和D4时钟的汇总,即\([(Sx, 2), (Sy, 1), (Sz, 1)]\)。如果客户端执行了协调,并且由节点Sx协调写入,Sx会更新时钟中自己的序列号。新数据D5的时钟为:\([(Sx, 3), (Sy, 1), (Sz, 1)]\)。
向量时钟的一个潜在问题是:如果很多服务器都协调某个对象的写入,向量时钟的大小可能会增长。实际上这种情况不太可能发生,因为写入通常由偏好列表中排名靠前的N个节点之一处理。但在网络分区或多服务器故障的情况下,写入请求可能由偏好列表中排名靠后的节点处理,导致向量时钟大小增长。在这种场景下,需要限制向量时钟的大小。为此,Dynamo采用了以下时钟截断方案:Dynamo在每个(节点,计数器)对旁边,都存储一个时间戳,指示该节点上次更新该数据项的时间。当向量时钟中的(节点,计数器)对数量达到阈值(比如10)时,就从时钟中移除最老的一对。显然,这种截断方案可能导致协调效率降低,因为无法准确推导后代关系。但这个问题在生产环境中从未出现过,因此尚未进行深入研究。
4.5 get()与put()操作的执行
任何存储节点都可以接收客户端针对任意键的get和put操作。本节为了简化,描述无故障环境下这些操作的执行方式,后续章节描述故障期间读写操作的执行方式。
get和put操作都通过亚马逊基础设施专属的请求处理框架基于HTTP调用。客户端选择节点有两种策略:(1) 通过通用负载均衡器路由请求,负载均衡器根据负载信息选择节点;(2) 使用感知分区的客户端库,直接将请求路由到合适的协调器节点。第一种方法的优势在于客户端不需要在应用中集成任何Dynamo专属代码,而第二种策略可以跳过潜在的转发步骤,实现更低的延迟。
处理读写操作的节点称为协调器。通常,协调器是偏好列表中排名靠前的N个节点中的第一个。如果请求是通过负载均衡器接收的,访问某个键的请求可能被路由到环上任意一个随机节点。在这种情况下,如果接收请求的节点不在该键偏好列表的前N个节点中,它不会进行协调,而是将请求转发给偏好列表前N个节点中的第一个。
读写操作会涉及偏好列表中前N个健康的节点,跳过那些宕机或不可达的节点。当所有节点都健康时,会访问键的偏好列表中排名靠前的N个节点。当出现节点故障或网络分区时,会访问偏好列表中排名更靠后的节点。
为了维护副本之间的一致性,Dynamo使用了与Quorum系统类似的一致性协议。该协议有两个关键的可配置值:R和W。R是成功的读操作必须参与的最少节点数。W是成功的写操作必须参与的最少节点数。设置R和W满足 \(R + W > N\) 时,系统就具备了类Quorum的特性。在这种模型下,get(或put)操作的延迟由R个(或W个)副本中最慢的那个决定。因此,R和W通常配置为小于N,以提供更好的延迟。
收到针对某个键的put()请求后,协调器为新版本生成向量时钟,并在本地写入新版本。然后协调器将新版本(连同新的向量时钟)发送给排名最高的N个可达节点。如果至少有W-1个节点响应,就认为写入成功。
类似地,对于get()请求,协调器向该键偏好列表中排名最高的N个可达节点,请求该键的所有现有数据版本,然后等待R个响应,再向客户端返回结果。如果协调器最终收集到多个数据版本,它会返回所有认为不存在因果关系的版本。之后这些分歧的版本会被协调,并且协调后的新版本会回写,取代当前版本。
4.6 故障处理:提示性移交
如果Dynamo使用传统的Quorum方法,那么在服务器故障和网络分区期间,系统将不可用,并且即使在最简单的故障条件下,持久性也会下降。为了解决这个问题,它不强制严格的Quorum成员资格,而是使用“宽松Quorum”:所有读写操作都在偏好列表的前N个健康节点上执行,这些节点不一定是沿着一致性哈希环遇到的前N个节点。
以图2中的Dynamo配置为例,N=3。在这个例子中,如果节点A在写入操作期间暂时宕机或不可达,那么原本应该存储在A上的副本会被发送到节点D。这样做是为了维持预期的可用性与持久性保证。发送给D的副本在元数据中会带有提示,说明该副本原本的目标节点是哪个(本例中是A)。接收提示副本的节点会将它们保存在单独的本地数据库中,并定期扫描。一旦检测到A恢复,D就会尝试将副本交付给A。传输成功后,D可以从本地存储中删除该对象,同时不会减少系统中的副本总数。
通过提示性移交,Dynamo确保读写操作不会因为临时的节点或网络故障而失败。对可用性要求最高的应用可以将W设为1,这保证只要系统中有一个节点将键持久化到本地存储,写入就会被接受。因此,只有当系统中所有节点都不可用时,写入请求才会被拒绝。但实际上,亚马逊的大多数生产服务都会设置更高的W值,以达到预期的持久性水平。第6节会更详细地讨论N、R、W的配置。
高可用存储系统必须能够应对整个数据中心的故障。数据中心故障可能由断电、制冷故障、网络故障和自然灾害导致。Dynamo的配置使得每个对象都跨多个数据中心复制。本质上,构建键的偏好列表时,会让存储节点分布在多个数据中心。这些数据中心之间通过高速网络链路连接。这种跨数据中心复制的方案,让我们能够应对整个数据中心的故障,而不会造成数据中断。
4.7 处理永久故障:副本同步
提示性移交在系统成员变动率低、且节点故障是暂时性的场景下效果最好。但在某些场景下,提示副本可能在被送回原始副本节点之前就变得不可用。为了处理这种情况以及其他对持久性的威胁,Dynamo实现了反熵(副本同步)协议,以保持副本同步。
为了更快地检测副本之间的不一致,并最小化数据传输量,Dynamo使用默克尔树[13]。默克尔树是一种哈希树,叶子节点是各个键对应值的哈希值,上层的父节点是其所有子节点的哈希值。默克尔树的主要优势在于,树的每个分支都可以独立校验,不需要节点下载整个树或整个数据集。此外,在检查副本间的不一致时,默克尔树有助于减少需要传输的数据量。例如,如果两棵树的根哈希值相等,那么树中叶子节点的值都相等,节点不需要进行任何同步。如果不相等,则说明部分副本的值不同。这种情况下,节点可以交换子节点的哈希值,继续这个过程,直到到达树的叶子节点,此时主机可以定位到哪些键“不同步”。默克尔树最小化了同步所需的数据传输量,并且减少了反熵过程中的磁盘读取次数。
Dynamo使用默克尔树实现反熵的方式如下:每个节点为其托管的每个键范围(一个虚拟节点覆盖的键集合)维护独立的默克尔树。这使得节点可以比较某个键范围内的键是否都是最新的。在该方案中,两个节点交换它们共同托管的键范围对应的默克尔树根。随后,通过上述的树遍历流程,节点判断是否存在差异,并执行相应的同步操作。该方案的缺点是:当节点加入或离开系统时,很多键范围会发生变化,从而需要重新计算默克尔树。但第6.2节描述的改进分区方案解决了这个问题。
4.8 成员关系与故障检测
4.8.1 环成员关系
在亚马逊的环境中,节点宕机(由于故障和维护任务)通常是暂时的,但可能持续较长时间。节点宕机很少意味着永久离开,因此不应该导致分区分配的重平衡,或者修复不可达的副本。同样,人为失误可能导致意外启动新的Dynamo节点。基于这些原因,采用显式机制来发起节点加入或离开Dynamo环的操作是合适的。管理员使用命令行工具或浏览器连接到Dynamo节点,发出成员变更指令,将节点加入环或从环中移除。处理该请求的节点将成员变更及其发生时间写入持久化存储。成员变更会形成历史记录,因为节点可以被多次移除和重新加入。基于Gossip的协议会传播成员变更,并维护最终一致的成员关系视图。每个节点每秒随机选择一个对等节点进行通信,两个节点高效地协调各自持久化的成员变更历史。
节点首次启动时,会选择自己的令牌集合(一致性哈希空间中的虚拟节点),并建立节点到各自令牌集合的映射。该映射会持久化到磁盘,最初只包含本地节点及其令牌集合。不同Dynamo节点上存储的映射,会在协调成员变更历史的同一次通信交换中进行同步。因此,分区和放置信息也通过基于Gossip的协议传播,每个存储节点都知道对等节点处理的令牌范围。这使得每个节点都可以直接将键的读写操作转发给正确的节点集合。
4.8.2 外部发现
上述机制可能会暂时导致Dynamo环出现逻辑分区。例如,管理员可以先联系节点A,将A加入环,然后联系节点B,将B加入环。在这种场景下,节点A和B都认为自己是环的成员,但都不会立即知道对方的存在。为了防止逻辑分区,部分Dynamo节点扮演种子节点的角色。种子节点是通过外部机制发现的,并且所有节点都知道这些节点。因为所有节点最终都会与种子节点协调成员关系,所以逻辑分区极不可能发生。种子节点可以从静态配置中获取,也可以从配置服务中获取。通常,种子节点是Dynamo环中功能完整的节点。
4.8.3 故障检测
Dynamo中的故障检测用于在执行get()和put()操作时,以及在传输分区和提示副本时,避免尝试与不可达的对等节点通信。就避免通信失败尝试这一目的而言,纯本地的故障检测概念就完全足够了:如果节点B不响应节点A的消息,节点A就可以认为节点B发生了故障(即使B能响应C的消息)。如果客户端请求在Dynamo环中产生稳定的节点间通信流量,那么当B不响应消息时,节点A很快就能发现B无响应;然后节点A会使用备用节点来服务原本映射到B分区的请求;A会定期重试B,检查后者是否恢复。如果没有客户端请求驱动两个节点之间的流量,那么两个节点其实都不需要知道对方是否可达、是否响应。
去中心化故障检测协议使用简单的Gossip风格协议,让系统中的每个节点都能了解其他节点的加入(或离开)。关于去中心化故障检测器以及影响其准确性的参数的详细信息,感兴趣的读者可以参考[8]。Dynamo的早期设计使用去中心化故障检测器来维护全局一致的故障状态视图。后来我们发现,显式的节点加入和离开机制,使得全局故障状态视图不再必要。这是因为节点的永久加入和移除会通过显式的节点加入/离开方法通知,而临时节点故障则由各个节点在转发请求时、通信失败的过程中自行检测。
4.9 存储节点的添加与移除
当向系统中添加新节点(比如X)时,它会被分配多个随机分布在环上的令牌。对于分配给节点X的每个键范围,可能有多个(小于等于N)节点当前负责处理落在其令牌范围内的键。由于键范围分配给了X,部分现有节点不再需要负责其中的部分键,这些节点会将这些键转移给X。我们以一个简单的启动场景为例:节点X被添加到图2所示的环中,位于A和B之间。当X加入系统后,它负责存储(F, G]、(G, A]和(A, X]范围内的键。相应地,节点B、C和D不再需要存储这些对应范围内的键。因此,节点B、C和D会向X提供相应的键集合,在得到X的确认后进行传输。当从系统中移除节点时,键的重分配过程则相反。
运营经验表明,这种方法能够将键分发的负载均匀分布到各个存储节点,这对于满足延迟要求和确保快速启动至关重要。最后,通过在源节点和目标节点之间增加一轮确认,确保了目标节点不会收到给定键范围的重复传输。
5. 实现
在Dynamo中,每个存储节点有三个主要软件组件:请求协调组件、成员关系与故障检测组件,以及本地持久化引擎。所有组件均使用Java实现。
Dynamo的本地持久化组件支持接入不同的存储引擎。目前使用的引擎包括Berkeley Database(BDB)事务数据存储\(^{2}\)、BDB Java版、MySQL,以及带有持久化后备存储的内存缓冲区。设计可插拔持久化组件的主要原因,是为了选择最适合应用访问模式的存储引擎。例如,BDB通常可以处理几十千字节大小的对象,而MySQL可以处理更大尺寸的对象。应用根据自身的对象大小分布选择Dynamo的本地持久化引擎。Dynamo的大多数生产实例使用BDB事务数据存储。
请求协调组件构建在事件驱动的消息传递框架之上,消息处理流水线被拆分为多个阶段,类似于SEDA架构[24]。所有通信都使用Java NIO通道实现。协调器代表客户端执行读写请求:对于读操作,从一个或多个节点收集数据;对于写操作,将数据存储到一个或多个节点。每个客户端请求都会在接收请求的节点上创建一个状态机。状态机包含全部逻辑:确定负责键的节点、发送请求、等待响应、可能执行重试、处理回复,以及封装对客户端的响应。每个状态机实例仅处理一个客户端请求。例如,读操作实现以下状态机:(i) 向节点发送读请求;(ii) 等待最少数量的必需响应;(iii) 如果在给定时间内收到的回复太少,则请求失败;(iv) 否则,收集所有数据版本,确定需要返回的版本;(v) 如果启用了版本控制,执行语法协调,并生成不透明的写上下文,其中包含能够合并所有剩余版本的向量时钟。为简洁起见,此处省略了故障处理和重试状态。
在读响应返回给调用者之后,状态机会等待一小段时间,接收任何未完成的响应。如果任何响应中返回了过时的版本,协调器会用最新版本更新那些节点。这个过程称为读修复,因为它在合适的时机修复了遗漏最近更新的副本,减轻了反熵协议的负担。
如前所述,写入请求由偏好列表中排名靠前的N个节点之一进行协调。尽管我们希望始终由前N个节点中的第一个来协调写入,从而在单个位置串行化所有写入,但这种方法会导致负载分布不均,造成SLA违规。这是因为请求负载在不同对象之间的分布并不均匀。为了解决这个问题,偏好列表中前N个节点中的任意一个都可以协调写入。特别是,由于每次写入通常都跟随一次读操作,因此写入的协调器会选择上一次读操作中响应最快的节点,该节点信息保存在请求的上下文中。这种优化让我们能够选择持有上一次读操作数据的节点,从而提升“读己之写”一致性的概率。同时,它还降低了请求处理性能的波动性,提升了99.9百分位的性能。
6. 经验与教训
Dynamo被多个服务以不同的配置使用。这些实例在版本协调逻辑、读写Quorum特性上各有不同。以下是Dynamo的主要使用模式:
- 业务逻辑特定的协调:这是Dynamo的流行使用场景。每个数据对象跨多个节点复制。如果出现版本分歧,客户端应用执行自己的协调逻辑。前文讨论的购物车服务就是这类场景的典型例子。其业务逻辑通过合并用户购物车的不同版本来协调对象。
- 基于时间戳的协调:这种场景与上一种的区别仅在于协调机制。如果出现版本分歧,Dynamo执行简单的基于时间戳的“最后写入胜出”协调逻辑;即选择物理时间戳值最大的对象作为正确版本。维护用户会话信息的服务就是使用这种模式的典型例子。
- 高性能读引擎:尽管Dynamo被构建为“始终可写”的数据存储,但少数服务通过调整其Quorum特性,将其用作高性能读引擎。通常,这类服务的读请求速率很高,而更新数量很少。在这种配置下,通常R设为1,W设为N。对于这些服务,Dynamo提供了将数据跨多个节点分区和复制的能力,从而实现增量可扩展性。部分这类实例作为权威持久化缓存,为存储在更重量级后备存储中的数据提供服务。维护商品目录和促销商品的服务属于这一类别。
Dynamo的主要优势在于,其客户端应用可以调整N、R、W的值,以达到预期的性能、可用性和持久性水平。例如,N值决定了每个对象的持久性。Dynamo用户使用的典型N值为3。
W和R的值会影响对象的可用性、持久性和一致性。例如,如果W设为1,那么只要系统中至少有一个节点能够成功处理写请求,系统就永远不会拒绝写请求。但W和R的值过低会增加不一致的风险,因为即使写请求没有被大多数副本处理,也会被视为成功并返回给客户端。这也带来了持久性的脆弱窗口:写请求仅在少量节点上持久化,就成功返回给客户端。
传统观点认为持久性和可用性是相辅相成的。但在这里情况并非必然如此。例如,可以通过增大W来缩小持久性的脆弱窗口。但这可能会增加拒绝请求的概率(从而降低可用性),因为需要更多的存储主机存活才能处理写请求。
Dynamo多个实例使用的通用(N,R,W)配置是\((3,2,2)\)。选择这些值是为了满足必要的性能、持久性、一致性和可用性SLA要求。
本节展示的所有测量结果,都来自运行\((3,2,2)\)配置的生产系统,该系统包含数百个节点,硬件配置同质。如前所述,每个Dynamo实例的节点都分布在多个数据中心。这些数据中心之间通常通过高速网络链路连接。回想一下,要生成成功的get(或put)响应,需要R(或W)个节点向协调器做出响应。显然,数据中心之间的网络延迟会影响响应时间,而节点(及其数据中心位置)的选择要满足应用的目标SLA。
6.1 平衡性能与持久性
尽管Dynamo的核心设计目标是构建高可用的数据存储,但性能也是亚马逊平台同等重要的指标。如前所述,为了提供一致的用户体验,亚马逊的服务将性能目标设定在更高的百分位(比如\(99.9^{th}\)或\(99.99^{th}\)百分位)。使用Dynamo的服务的典型SLA要求是:99.9%的读写请求在300ms内执行完成。
由于Dynamo运行在标准商用硬件组件上,其I/O吞吐量远低于高端企业级服务器,因此为读写操作提供持续的高性能是一项艰巨的任务。读写操作涉及多个存储节点,这使得挑战更加严峻,因为这些操作的性能受限于R或W个副本中最慢的那个。图4展示了30天内Dynamo读写操作的平均延迟与\(99.9^{th}\)百分位延迟。如图所示,延迟呈现出明显的日变化模式,这是由传入请求速率的日变化模式导致的(即白天和夜间的请求速率有显著差异)。此外,写延迟高于读延迟,这显然是因为写操作总会产生磁盘访问。同时,\(99.9^{th}\)百分位的延迟约为200ms,比平均值高出一个数量级。这是因为\(99.9^{th}\)百分位的延迟受到多种因素的影响,比如请求负载的波动、对象大小、以及访问局部性模式。
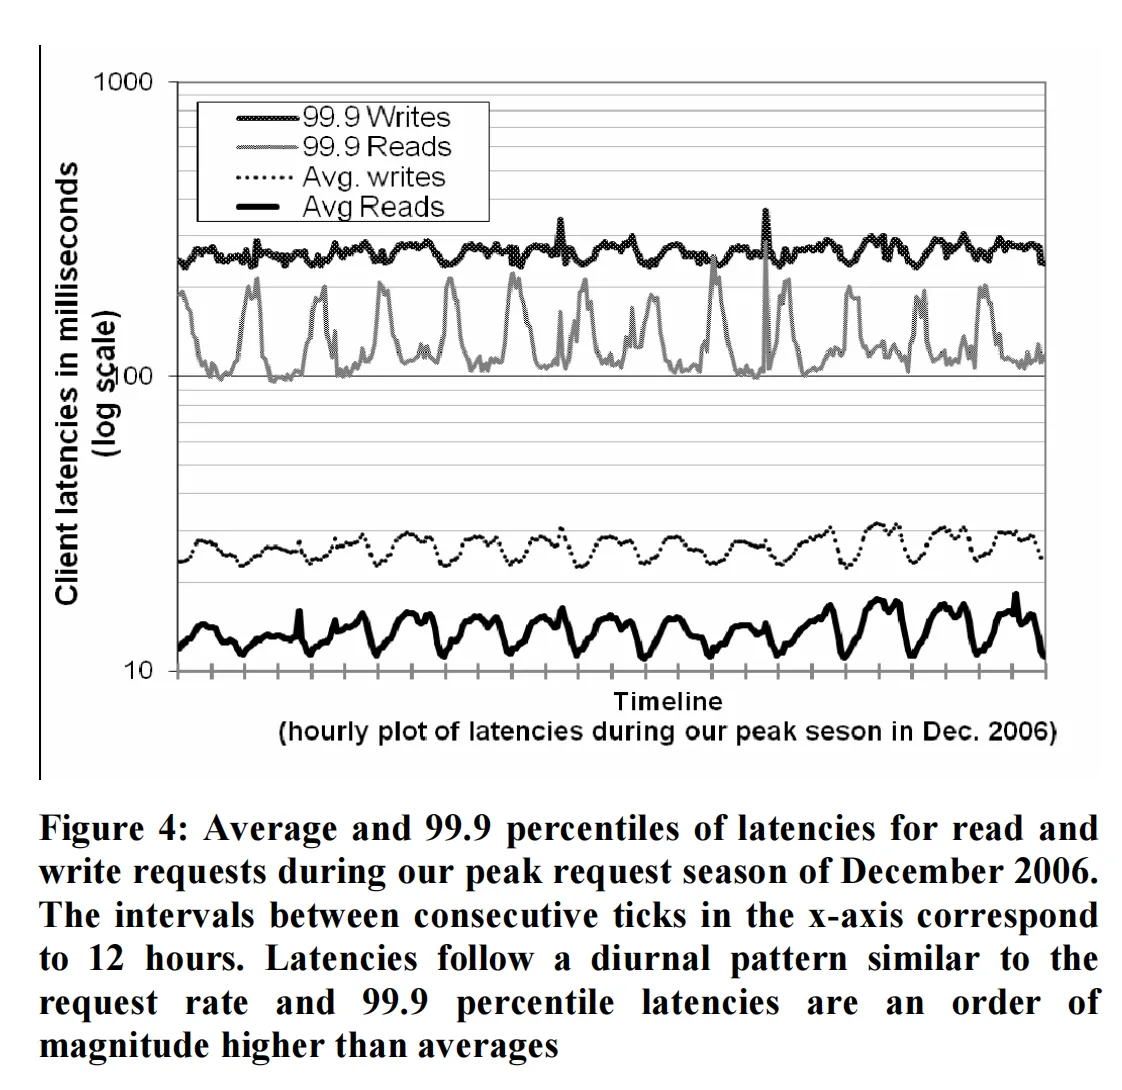
图4:2006年12月流量高峰期间,读写请求的平均延迟与99.9百分位延迟。X轴相邻刻度间隔为12小时。延迟呈现出与请求速率类似的日变化模式,且99.9百分位延迟比平均值高出一个数量级
尽管这种性能水平对于很多服务来说是可接受的,但部分面向客户的服务要求更高的性能水平。对于这些服务,Dynamo提供了用持久性保证换取性能的能力。在这种优化中,每个存储节点在主内存中维护一个对象缓冲区。每次写操作都先存储在缓冲区中,由写入线程定期写入存储。在该方案中,读操作首先检查请求的键是否存在于缓冲区中。如果存在,就从缓冲区读取对象,而不是从存储引擎读取。
这种优化使得在流量高峰期间,即使只有一千个对象的很小缓冲区,99.9百分位的延迟也降低了5倍(见图5)。同时,如图所示,写缓冲平滑了高位百分位的延迟。显然,这种方案是以持久性换取性能。在该方案中,服务器崩溃可能导致缓冲区中排队的写入丢失。为了降低持久性风险,对写操作进行了改进:协调器选择N个副本中的一个执行“持久化写入”。由于协调器只需要等待W个响应,因此单个副本执行的持久化写入操作的性能不会影响写操作的整体性能。
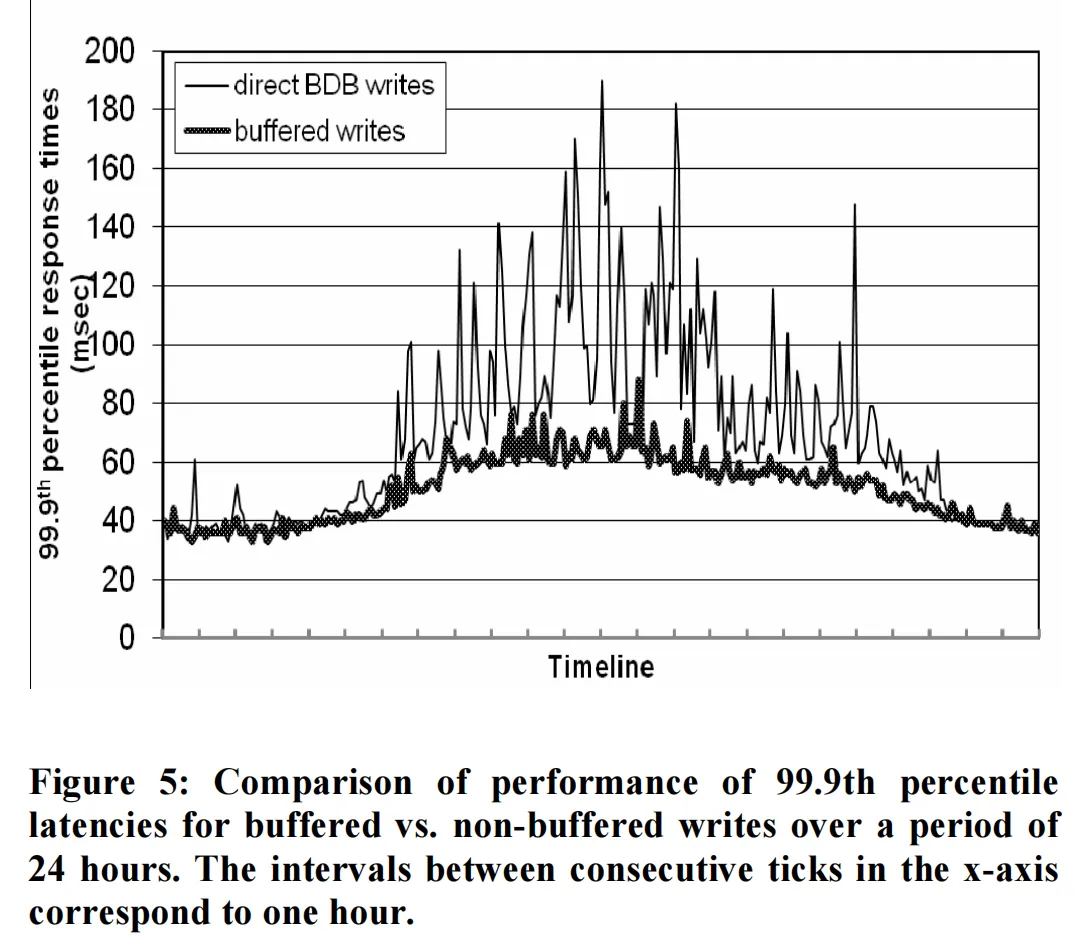
图5:24小时内,缓冲写入与非缓冲写入的99.9百分位性能对比。X轴相邻刻度间隔为1小时
6.2 确保均匀的负载分布
Dynamo使用一致性哈希将键空间分区到各个副本,并确保均匀的负载分布。假设键的访问分布不是高度倾斜的,均匀的键分布有助于实现均匀的负载分布。特别是,Dynamo的设计假设:即使访问分布存在显著倾斜,分布中热门端的键数量也足够多,通过分区可以将处理热门键的负载均匀分散到各个节点。本节讨论Dynamo中观察到的负载不均衡情况,以及不同分区策略对负载分布的影响。
为了研究负载不均衡及其与请求负载的相关性,我们测量了24小时内每个节点接收的总请求数,以30分钟为间隔进行划分。在给定时间窗口内,如果节点的请求负载与平均负载的偏差小于某个阈值(这里是15%),就认为该节点“处于均衡状态”。否则,该节点被视为“失衡”。图6展示了这段时间内“失衡”节点的比例(下文称为“失衡率”)。作为参考,图中还绘制了整个系统在对应时间段接收的请求负载。如图所示,失衡率随着负载的升高而降低。例如,在低负载时失衡率高达20%,而在高负载时接近10%。直观上可以这样解释:在高负载下,大量的热门键被访问,由于键的均匀分布,负载被均匀分散。而在低负载时(负载约为测得峰值的1/8),被访问的热门键更少,导致负载失衡更高。
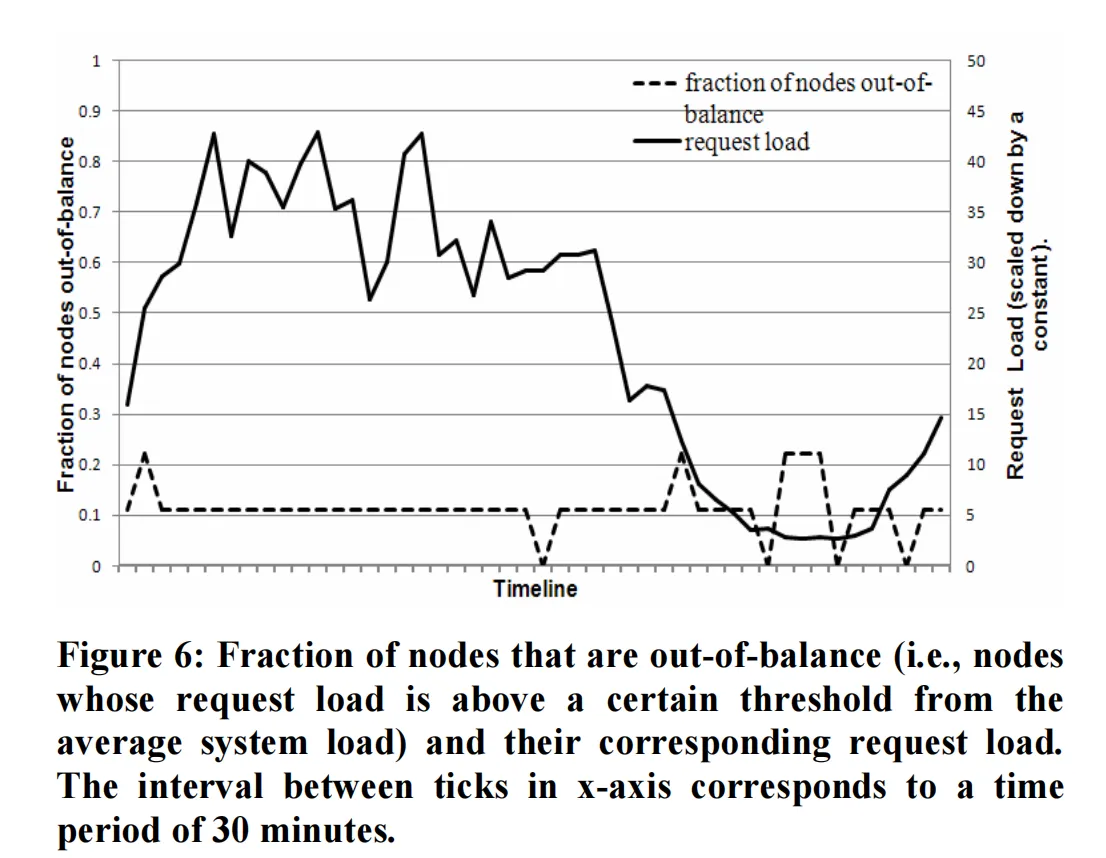
图6:失衡节点的比例(即请求负载高于系统平均负载特定阈值的节点占比)及其对应的请求负载。X轴相邻刻度间隔为30分钟
本节讨论Dynamo的分区方案如何演进,及其对负载分布的影响。
策略1:每个节点T个随机令牌,按令牌值分区:这是生产环境中部署的初始策略(已在4.2节描述)。在该方案中,每个节点被分配T个令牌(从哈希空间中均匀随机选择)。所有节点的令牌按其在哈希空间中的值排序。每两个连续的令牌定义一个范围。最后一个令牌和第一个令牌形成一个“回绕”范围,从最高值环绕到哈希空间的最低值。由于令牌是随机选择的,各个范围的大小不一。当节点加入和离开系统时,令牌集合发生变化,相应的范围也随之改变。注意,每个节点维护成员关系所需的空间,随系统中节点数量线性增长。
使用该策略时,遇到了以下问题。首先,当新节点加入系统时,它需要从其他节点“接管”其键范围。然而,将键范围移交给新节点的节点,必须扫描其本地持久化存储来检索对应的数据项集合。注意,在生产节点上执行这样的扫描操作需要谨慎,因为扫描是资源密集型操作,必须在后台执行,不能影响客户性能。这要求我们以最低优先级运行启动任务。但这会显著减慢启动过程,在繁忙的购物季期间,当节点每天处理数百万请求时,启动过程几乎需要一整天才能完成。其次,当节点加入/离开系统时,很多节点处理的键范围都会变化,对应新范围的默克尔树需要重新计算,这在生产系统中是一项开销不小的操作。最后,由于键范围的随机性,无法对整个键空间进行快照,这使得归档过程变得复杂。在该方案中,归档整个键空间需要分别从每个节点检索键,效率极低且速度缓慢。
该策略的根本问题在于,数据分区和数据放置的方案是耦合在一起的。例如,在某些情况下,为了应对请求负载的增长,需要向系统中添加更多节点。但在这种场景下,添加节点必然会影响数据分区。理想情况下,分区和放置应该使用独立的方案。为此,我们评估了以下策略:
策略2:每个节点T个随机令牌,等大小分区:该策略将哈希空间划分为Q个大小相等的分区/范围,每个节点被分配T个随机令牌。Q的设置通常满足Q >> N且Q >> S*T,其中S是系统中的节点数。在该策略中,令牌仅用于构建哈希空间值到有序节点列表的映射函数,而不决定分区方式。一个分区会被放置在沿着一致性哈希环顺时针从分区末端开始遇到的前N个不同节点上。图7展示了N=3时的该策略。在本例中,从包含键k1的分区末端开始沿环行走,会遇到节点A、B、C。该策略的主要优势在于:(i) 解耦了分区与分区放置;(ii) 支持在运行时更改放置方案。
策略3:每个节点Q/S个令牌,等大小分区:与策略2类似,该策略将哈希空间划分为Q个大小相等的分区,并且分区的放置与分区方案解耦。此外,每个节点被分配Q/S个令牌,其中S是系统中的节点数。当节点离开系统时,它的令牌会随机分配给其余节点,以保持这些属性。类似地,当节点加入系统时,它会从系统中的节点“窃取”令牌,以保持这些属性。
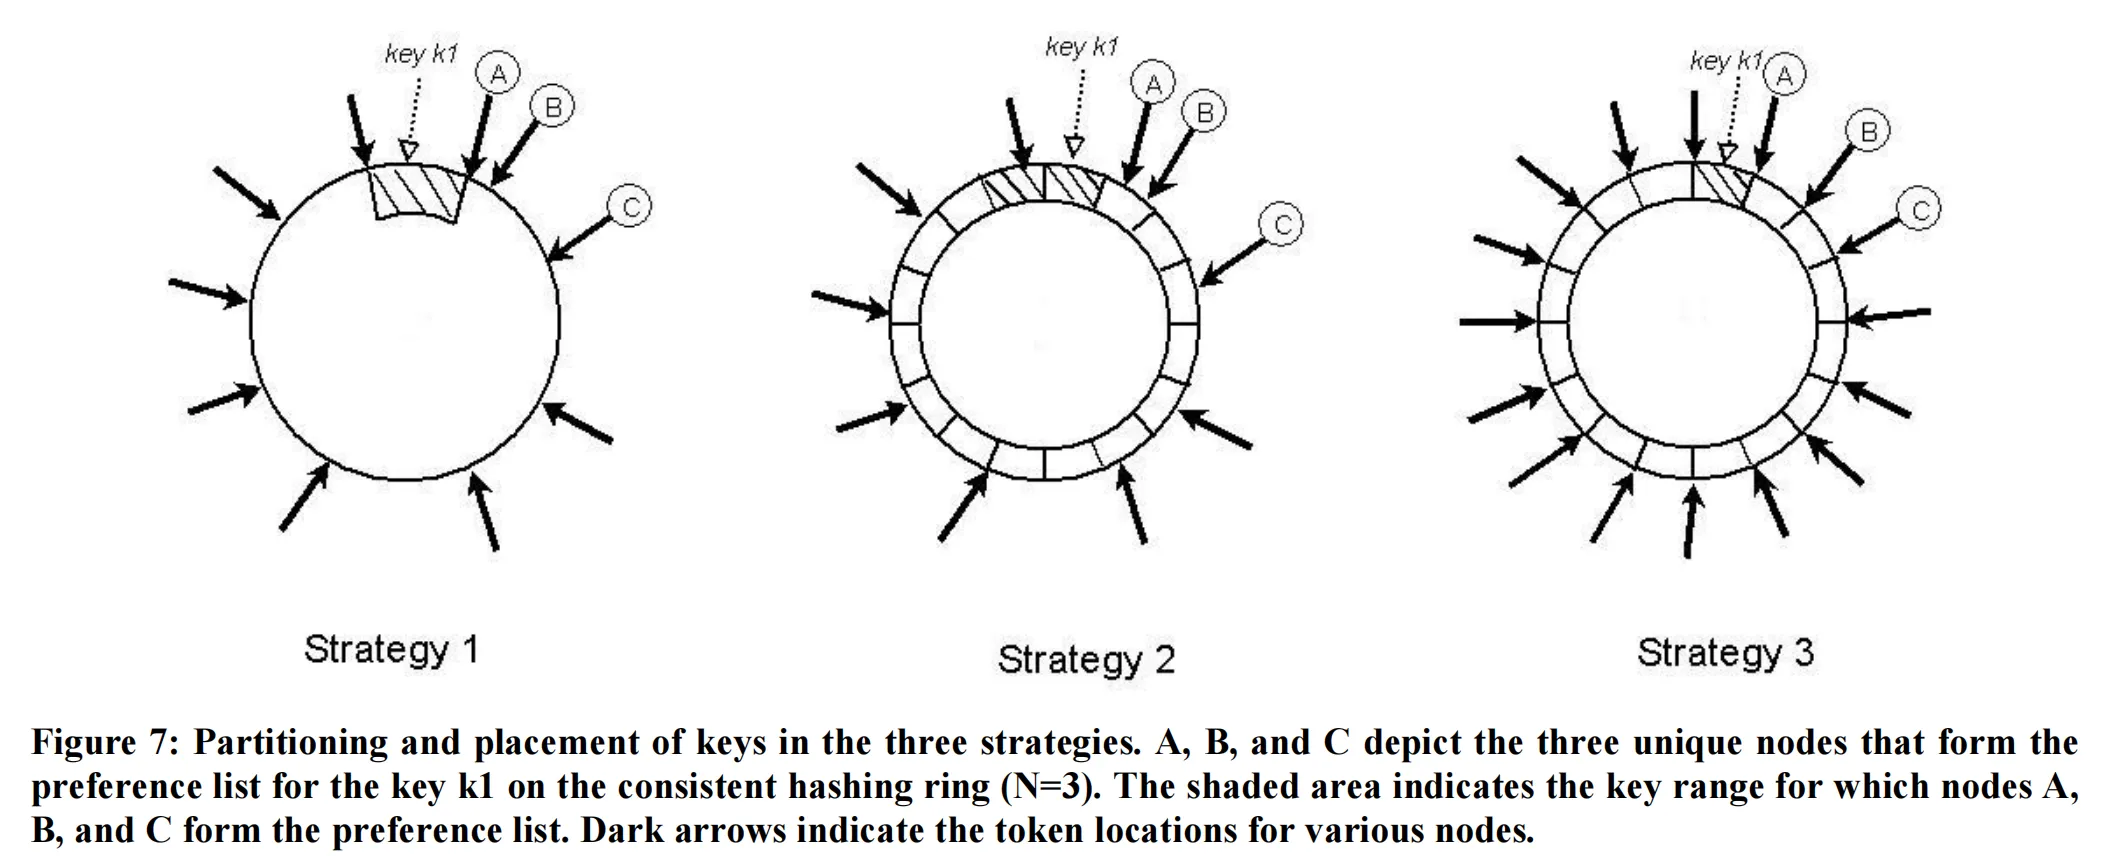
图7:三种策略下的键分区与放置方式。A、B、C表示在一致性哈希环上,构成键k1偏好列表的三个唯一节点(N=3)。阴影区域表示节点A、B、C组成偏好列表所对应的键范围。深色箭头表示各个节点的令牌位置
我们在S=30、N=3的系统中评估了这三种策略的效率。然而,公平地比较这些不同策略并不容易,因为不同策略有不同的配置参数来调优其效率。例如,策略1的负载分布特性取决于令牌数量(即T),而策略3取决于分区数量(即Q)。一种公平的比较方法是,在所有策略用于维护成员信息的空间相同的情况下,评估它们负载分布的倾斜程度。例如,在策略1中,每个节点需要维护环中所有节点的令牌位置;而在策略3中,每个节点需要维护每个节点对应的分区信息。
在下一个实验中,我们通过改变相关参数(T和Q)来评估这些策略。针对每个节点需要维护的成员信息的不同规模,测量每种策略的负载均衡效率。负载均衡效率定义为:每个节点平均处理的请求数,与最热节点处理的最大请求数的比值。
结果如图8所示。如图所示,策略3实现了最佳的负载均衡效率,策略2的负载均衡效率最差。策略2曾作为从策略1迁移到策略3过程中的临时方案。与策略1相比,策略3实现了更高的效率,并且将每个节点维护的成员信息大小降低了三个数量级。尽管存储不是主要问题,但节点会定期通过Gossip传播成员信息,因此保持信息尽可能紧凑是可取的。除此之外,策略3还有以下优势,且部署更简单:
(i) 更快的启动/恢复:由于分区范围是固定的,它们可以存储在单独的文件中,这意味着可以通过直接传输文件来移动整个分区(避免了定位特定项所需的随机访问)。这简化了启动和恢复过程。
(ii) 易于归档:定期归档数据集是亚马逊大多数存储服务的强制要求。在策略3中,归档Dynamo存储的整个数据集更简单,因为分区文件可以分别归档。相比之下,在策略1中,令牌是随机选择的,归档Dynamo中的数据需要分别从各个节点检索键,通常效率低下且速度缓慢。
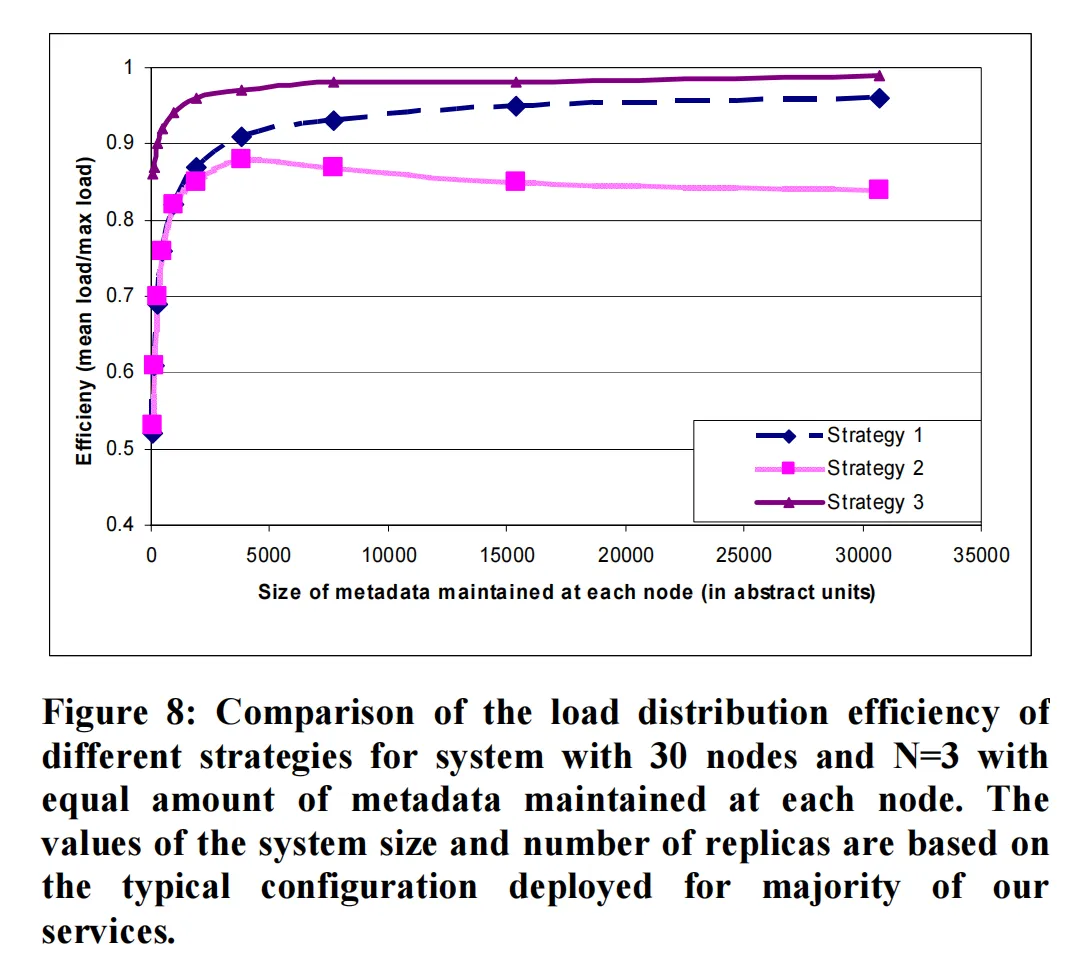
图8:在每个节点维护等量元数据的前提下,30个节点、N=3的系统中不同策略的负载分布效率对比。系统规模与副本数量基于我们大多数服务的典型配置
策略3的缺点是,更改节点成员关系需要进行协调,以保持分配所需的属性。
6.3 分歧版本:何时出现以及数量多少?
如前所述,Dynamo的设计理念是以一致性换取可用性。为了理解不同故障对一致性的精确影响,需要关于多个因素的详细数据:停机时长、故障类型、组件可靠性、工作负载等。详细展示这些数据超出了本文的范围。但本节讨论一个很好的汇总指标:在生产环境中,应用看到的分歧版本数量。
数据项的分歧版本出现在两种场景中。第一种是系统面临节点故障、数据中心故障、网络分区等故障场景时。第二种是系统处理单个数据项的大量并发写入,并且多个节点最终同时协调更新时。从可用性和效率角度来看,都希望在任何时候将分歧版本的数量保持在尽可能低的水平。如果版本无法仅通过向量时钟进行语法协调,就必须交给业务逻辑进行语义协调。语义协调会给服务带来额外负载,因此应尽量减少对它的需求。
在下一个实验中,我们对购物车服务在24小时内返回的版本数量进行了统计。在此期间,99.94%的请求只看到1个版本;0.00057%的请求看到2个版本;0.00047%的请求看到3个版本;0.00009%的请求看到4个版本。这表明分歧版本很少出现。
经验表明,分歧版本数量的增加并非由故障导致,而是由并发写入者数量的增加导致的。并发写入数量的增加通常是由繁忙的机器人(自动化客户端程序)触发的,很少由人类用户导致。由于该问题的敏感性,本文不详细讨论。
6.4 客户端驱动与服务器驱动的协调
如第5节所述,Dynamo有一个请求协调组件,使用状态机来处理传入的请求。客户端请求由负载均衡器均匀分配给环中的节点。任意Dynamo节点都可以作为读请求的协调器。而写请求则由键的当前偏好列表中的节点进行协调。这一限制是因为这些首选节点还负责创建新的版本戳,使其在因果关系上包含被写请求更新的版本。注意,如果Dynamo的版本控制方案基于物理时间戳,那么任意节点都可以协调写请求。
另一种请求协调方法是将状态机移到客户端节点。在该方案中,客户端应用使用库在本地执行请求协调。客户端定期选择一个随机的Dynamo节点,下载其当前的Dynamo成员关系视图。利用这些信息,客户端可以确定任意键对应的偏好列表由哪些节点组成。读请求可以在客户端节点进行协调,从而避免了请求由负载均衡器分配给随机Dynamo节点时产生的额外网络跳转。写请求要么被转发给键的偏好列表中的节点,要么如果Dynamo使用基于时间戳的版本控制,也可以在本地进行协调。
客户端驱动协调方法的一个重要优势是,不再需要负载均衡器来均匀分配客户端负载。公平的负载分布由键到存储节点的近乎均匀分配隐式保证。显然,该方案的效率取决于客户端上成员信息的新鲜程度。目前,客户端每10秒轮询一个随机Dynamo节点以获取成员更新。选择基于拉的方案而非基于推的方案,是因为前者在客户端数量庞大时扩展性更好,并且服务器需要维护的客户端状态极少。但在最坏情况下,客户端可能在10秒内使用过时的成员信息。如果客户端检测到其成员表已过时(例如,当部分成员不可达时),它会立即刷新成员信息。
表2展示了24小时内,与服务器驱动方法相比,使用客户端驱动协调在99.9百分位和平均值上观察到的延迟提升。如表所示,客户端驱动协调方法将99.9百分位延迟降低了至少30毫秒,平均延迟降低了3到4毫秒。延迟提升的原因在于,客户端驱动方法消除了负载均衡器的开销,以及请求被分配给随机节点时可能产生的额外网络跳转。如表所示,平均延迟远低于99.9百分位的延迟。这是因为Dynamo的存储引擎缓存和写缓冲区有很高的命中率。此外,由于负载均衡器和网络会给响应时间带来额外的波动性,因此99.9百分位的响应时间提升比平均值更高。
表2:客户端驱动与服务器驱动协调方法的性能对比
| 99.9百分位读延迟 (ms) | 99.9百分位写延迟 (ms) | 平均读延迟 (ms) | 平均写延迟 (ms) | |
|---|---|---|---|---|
| 服务器驱动 | 68.9 | 68.5 | 3.9 | 4.02 |
| 客户端驱动 | 30.4 | 30.4 | 1.55 | 1.9 |
6.5 平衡后台任务与前台任务
每个节点除了正常的前台put/get操作之外,还会执行不同类型的后台任务,用于副本同步和数据移交(由于提示或者节点增删导致)。在早期的生产环境中,这些后台任务引发了资源争用问题,影响了常规put和get操作的性能。因此,必须确保后台任务仅在不显著影响常规关键操作的情况下运行。为此,后台任务集成了准入控制机制。每个后台任务都使用该控制器来预留资源(例如数据库)的运行时间片,这些时间片由所有后台任务共享。我们采用基于前台任务监控性能的反馈机制,来调整后台任务可用的时间片数量。
准入控制器在执行“前台”put/get操作时,持续监控资源访问的行为。监控的维度包括磁盘操作延迟、由于锁争用和事务超时导致的数据库访问失败,以及请求队列等待时间。这些信息用于检查给定回溯时间窗口内的延迟(或失败)百分位是否接近预期阈值。例如,后台控制器会检查过去60秒内数据库读取延迟的99百分位,与预设阈值(比如50ms)的接近程度。控制器利用这些比较来评估前台操作的资源可用性。随后,它决定后台任务可以使用多少时间片,通过反馈循环来限制后台活动的侵入性。注意,文献[4]中也研究了类似的后台任务管理问题。
6.6 讨论
本节总结了在Dynamo实现与维护过程中获得的部分经验。过去两年中,亚马逊的很多内部服务都使用了Dynamo,它为应用提供了极高的可用性。特别是,应用99.9995%的请求都得到了成功响应(没有超时),并且迄今为止未发生过数据丢失事件。
此外,Dynamo的主要优势在于它提供了(N,R,W)三个参数作为调节旋钮,允许服务根据自身需求调优实例。与流行的商用数据存储不同,Dynamo将数据一致性与协调逻辑问题暴露给开发者。一开始,人们可能会认为应用逻辑会变得更加复杂。但从历史上看,亚马逊平台就是为高可用性构建的,很多应用在设计时就考虑了处理各种故障模式和可能出现的不一致性。因此,将这类应用迁移到Dynamo是相对简单的任务。对于想要使用Dynamo的新应用,在开发初期需要进行一些分析,选择合适的冲突解决机制,以恰当地满足业务需求。最后,Dynamo采用全成员模型,每个节点都知道对等节点托管的数据。为此,每个节点都会主动与系统中的其他节点Gossip同步完整的路由表。这种模型对于包含数百个节点的系统运行良好。但是,将这种设计扩展到数万个节点并非易事,因为维护路由表的开销会随着系统规模的增大而增加。可以通过为Dynamo引入分层扩展来克服这一限制。同时,O(1) DHT系统(比如[14])也在积极解决这个问题。
7. 结论
本文介绍了Dynamo——一款高可用、可扩展的数据存储,用于存储亚马逊电商平台多个核心服务的状态。Dynamo提供了预期的可用性与性能水平,并且成功应对了服务器故障、数据中心故障和网络分区。Dynamo支持增量扩展,允许服务所有者根据当前的请求负载进行扩缩容。Dynamo允许服务所有者通过调整N、R、W参数,定制其存储系统,以满足预期的性能、持久性和一致性SLA。
过去一年Dynamo的生产实践表明,可以将多种去中心化技术组合起来,构建一个完整的高可用系统。它在最具挑战性的应用环境中取得的成功表明,最终一致性存储系统可以成为高可用应用的构建基石。
致谢
作者感谢Pat Helland对Dynamo初始设计的贡献。同时感谢Marvin Theimer和Robert van Renesse提出的宝贵意见。最后,感谢我们的论文指导Jeff Mogul,在准备最终版本期间提供了详细的评论和建议,极大地提升了论文的质量。
参考文献
[1] Adya, A., Bolosky, W. J., Castro, M., Cermak, G., Chaiken, R., Douceur, J. R., Howell, J., Lorch, J. R., Theimer, M., and Wattenhofer, R. P. 2002. Farsite: federated, available, and reliable storage for an incompletely trusted environment. SIGOPS Oper. Syst. Rev. 36, SI (Dec. 2002), 1-14.
[2] Bernstein, P.A., and Goodman, N. An algorithm for concurrency control and recovery in replicated distributed databases. ACM Trans. on Database Systems, 9(4):596-615, December 1984
[3] Chang, F., Dean, J., Ghemawat, S., Hsieh, W. C., Wallach, D. A., Burrows, M., Chandra, T., Fikes, A., and Gruber, R. E. 2006. Bigtable: a distributed storage system for structured data. In Proceedings of the 7th Conference on USENIX Symposium on Operating Systems Design and Implementation – Volume 7 (Seattle, WA, November 06 – 08, 2006). USENIX Association, Berkeley, CA, 15-15.
[4] Douceur, J. R. and Bolosky, W. J. 2000. Process-based regulation of low-importance processes. SIGOPS Oper. Syst. Rev. 34, 2 (Apr. 2000), 26-27.
[5] Fox, A., Gribble, S. D., Chawathe, Y., Brewer, E. A., and Gauthier, P. 1997. Cluster-based scalable network services. In Proceedings of the Sixteenth ACM Symposium on Operating Systems Principles (Saint Malo, France, October 05 – 08, 1997). W. M. Waite, Ed. SOSP ’97. ACM Press, New York, NY, 78-91.
[6] Ghemawat, S., Gobioff, H., and Leung, S. 2003. The Google file system. In Proceedings of the Nineteenth ACM Symposium on Operating Systems Principles (Bolton Landing, NY, USA, October 19 – 22, 2003). SOSP ’03. ACM Press, New York, NY, 29-43.
[7] Gray, J., Helland, P., O’Neil, P., and Shasha, D. 1996. The dangers of replication and a solution. In Proceedings of the 1996 ACM SIGMOD international Conference on Management of Data (Montreal, Quebec, Canada, June 04–06, 1996). J. Widom, Ed. SIGMOD ’96. ACM Press, New York, NY, 173-182.
[8] Gupta, I., Chandra, T. D., and Goldszmidt, G. S. 2001. On scalable and efficient distributed failure detectors. In Proceedings of the Twentieth Annual ACM Symposium on Principles of Distributed Computing (Newport, Rhode Island, United States). PODC ’01. ACM Press, New York, NY, 170-179.
[9] Kubiatowicz, J., Bindel, D., Chen, Y., Czerwinski, S., Eaton, P., Geels, D., Gummadi, R., Rhea, S., Weatherspoon, H., Wells, C., and Zhao, B. 2000. OceanStore: an architecture for global-scale persistent storage. SIGARCH Comput. Archit. News 28, 5 (Dec. 2000), 190-201.
[10] Karger, D., Lehman, E., Leighton, T., Panigrahy, R., Levine, M., and Lewin, D. 1997. Consistent hashing and random trees: distributed caching protocols for relieving hot spots on the World Wide Web. In Proceedings of the Twenty-Ninth Annual ACM Symposium on theory of Computing (El Paso, Texas, United States, May 04 – 06, 1997). STOC ’97. ACM Press, New York, NY, 654-663.
[11] Lindsay, B.G., et al., “Notes on Distributed Databases”, Research Report RJ2571(33471), IBM Research, July 1979
[12] Lamport, L. Time, clocks, and the ordering of events in a distributed system. ACM Communications, 21(7), pp. 558-565, 1978.
[13] Merkle, R. A digital signature based on a conventional encryption function. Proceedings of CRYPTO, pages 369–378. Springer-Verlag, 1988.
[14] Ramasubramanian, V., and Sirer, E. G. Beehive: O(1)lookup performance for power-law query distributions in peer-to-peer overlays. In Proceedings of the 1st Conference on Symposium on Networked Systems Design and Implementation, San Francisco, CA, March 29 – 31, 2004.
[15] Reiher, P., Heidemann, J., Ratner, D., Skinner, G., and Popek, G. 1994. Resolving file conflicts in the Ficus file system. In Proceedings of the USENIX Summer 1994 Technical Conference on USENIX Summer 1994 Technical Conference – Volume 1 (Boston, Massachusetts, June 06 – 10, 1994). USENIX Association, Berkeley, CA, 12-12.
[16] Rowstron, A., and Druschel, P. Pastry: Scalable, decentralized object location and routing for large-scale peer-to-peer systems. Proceedings of Middleware, pages 329-350, November, 2001.
[17] Rowstron, A., and Druschel, P. Storage management and caching in PAST, a large-scale, persistent peer-to-peer storage utility. Proceedings of Symposium on Operating Systems Principles, October 2001.
[18] Saito, Y., Frølund, S., Veitch, A., Merchant, A., and Spence, S. 2004. FAB: building distributed enterprise disk arrays from commodity components. SIGOPS Oper. Syst. Rev. 38, 5 (Dec. 2004), 48-58.
[19] Satyanarayanan, M., Kistler, J.J., Siegel, E.H. Coda: A Resilient Distributed File System. IEEE Workshop on Workstation Operating Systems, Nov. 1987.
[20] Stoica, I., Morris, R., Karger, D., Kaashoek, M. F., and Balakrishnan, H. 2001. Chord: A scalable peer-to-peer lookup service for internet applications. In Proceedings of the 2001 Conference on Applications, Technologies, Architectures, and Protocols For Computer Communications (San Diego, California, United States). SIGCOMM ’01. ACM Press, New York, NY, 149-160.
[21] Terry, D. B., Theimer, M. M., Petersen, K., Demers, A. J., Spreitzer, M. J., and Hauser, C. H. 1995. Managing update conflicts in Bayou, a weakly connected replicated storage system. In Proceedings of the Fifteenth ACM Symposium on Operating Systems Principles (Copper Mountain, Colorado, United States, December 03 – 06, 1995). M. B. Jones, Ed. SOSP ’95. ACM Press, New York, NY, 172-182.
[22] Thomas, R. H. A majority consensus approach to concurrency control for multiple copy databases. ACM Transactions on Database Systems 4 (2): 180-209, 1979.
[23] Weatherspoon, H., Eaton, P., Chun, B., and Kubiatowicz, J. 2007. Antiquity: exploiting a secure log for wide-area distributed storage. SIGOPS Oper. Syst. Rev. 41, 3 (Jun. 2007), 371-384.
[24] Welsh, M., Culler, D., and Brewer, E. 2001. SEDA: an architecture for well-conditioned, scalable internet services. In Proceedings of the Eighteenth ACM Symposium on Operating Systems Principles (Banff, Alberta, Canada, October 21 – 24, 2001). SOSP ’01. ACM Press, New York, NY, 230-243.