【转载】大语言模型架构全面对比12:Qwen3-Next

原文地址 第16章 DeepSeek V3.2

12. Qwen3-Next

2025 年 9 月 11 日,通义千问团队发布了 Qwen3 Next 80B-A3B(见图 35),提供指令微调版(Instruct)与思考版(Thinking)两种形态。尽管其设计基于前文介绍的 Qwen3 架构,但我将它单独列为一节,一是保持图号的连贯性,二是突出其部分设计上的改动。

12.1 专家规模与数量

全新的 Qwen3 Next 架构有一个突出特点:尽管总参数量仅为前代 235B-A22B 模型的三分之一(见图 35),但专家数量提升至原来的四倍,还额外加入了共享专家。这两项设计选择(高专家数量 + 引入共享专家),正是我在本次发布前就指出过的行业未来方向,尤其是在本文开头链接的视频版本中曾重点提及。

figure35

图 35:5 月发布的初代 Qwen3 模型(左)与 9 月发布的 Qwen3 Next 模型(右)对比

Continue reading 【转载】大语言模型架构全面对比12:Qwen3-Next

【转载】大语言模型架构全面对比11:GLM-4.5

原文地址 第11章 LM-4.5

11. GLM-4.5

GLM-4.5 是今年又一款重磅发布的模型。

它与 Qwen3 类似,属于指令微调与推理能力一体化的混合模型,但在函数调用与智能体场景下的优化更为出色。

figure33

图 33:GLM-4.5 基准测试成绩,来自官方 GitHub 仓库:https://github.com/zai-org/GLM-4.5

Continue reading 【转载】大语言模型架构全面对比11:GLM-4.5

【转载】大语言模型架构全面对比10:Grok 2.5

原文地址 第10章 Grok 2.5

10. Grok 2.5

本文首次上线几周后,xAI 发布了其 2700 亿参数 Grok 2.5 模型的权重。

我认为有必要把它补充进来,因为 Grok 2.5 是 xAI 去年的旗舰生产级模型。截至目前,我们讨论的所有模型从发布之初就是开源权重模型。例如,gpt-oss 大概率不是 GPT-4 的开源权重复刻版,而是专门为开源社区训练的定制模型。

借助 Grok 2.5,我们得以难得一窥真实生产级系统的面貌,尽管这是去年的模型。

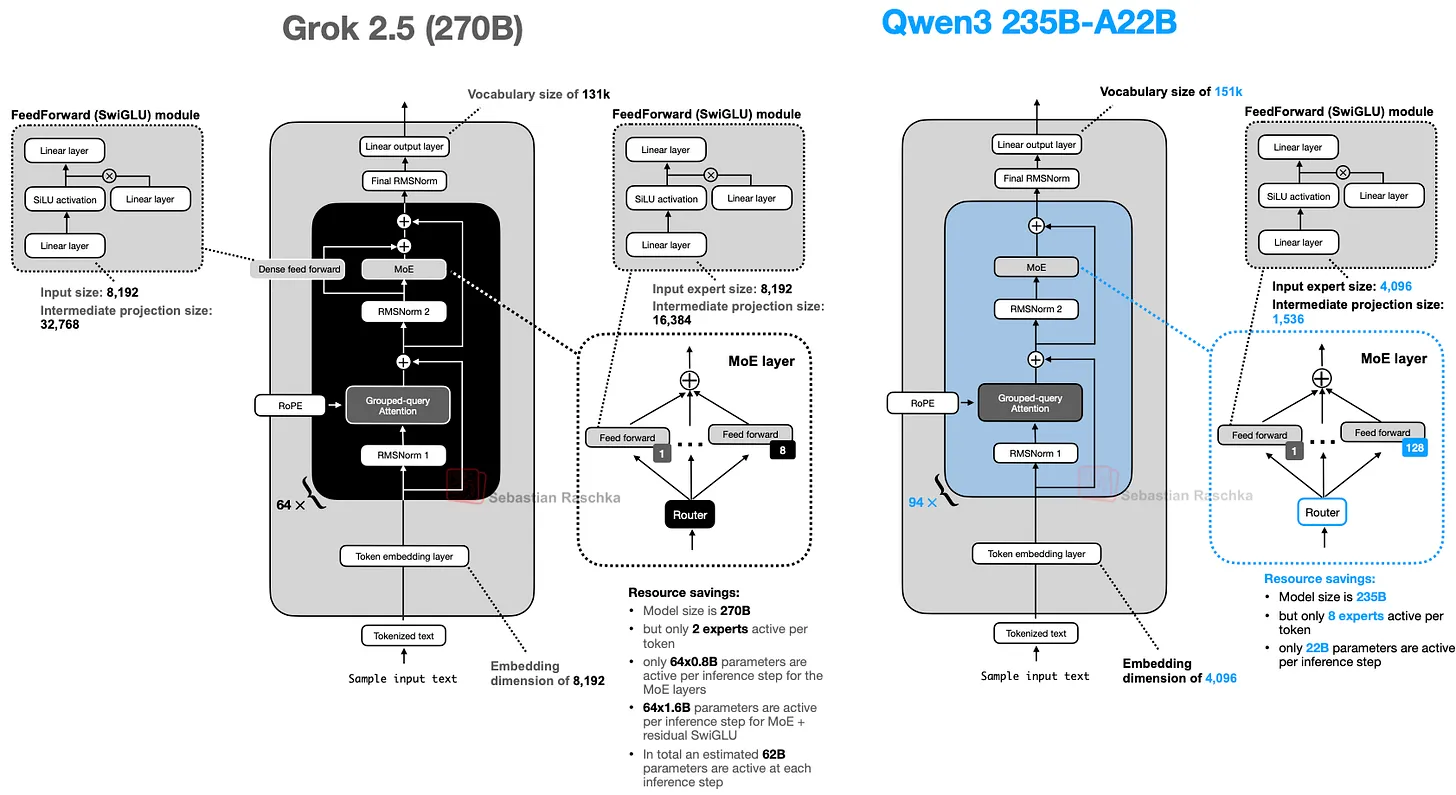
架构层面,Grok 2.5 整体看起来相当标准(图 32),但仍有几个值得注意的细节。

image32

图 32:Grok 2.5 与同等规模的 Qwen3 模型对比

例如,Grok 2.5 采用「少量大专家」的配置(共 8 个专家),这是相对早期的设计思路。如前文所述,DeepSeekMoE 论文等更新的设计更倾向于「多而小」的专家配置,Qwen3 也采用了这种方案。

另一个有意思的设计是它采用了近似共享专家的机制。图 32 左侧所示的额外 SwiGLU 模块,作用相当于一个始终激活的共享专家。它和经典的共享专家设计并不完全一致 —— 其中间维度扩大了一倍,但核心思路相同。(Qwen3 没有采用共享专家这点我一直觉得很有意思,看看 Qwen4 及后续模型会不会改变这个设计,值得关注。)

【转载】大语言模型架构全面对比09:GPT-OSS

原文地址 第9章 GPT-OSS

9. GPT-OSS

在我写完本文约一周后,OpenAI 发布了 gpt-oss-120b 与 gpt-oss-20b—— 这是该公司自 2019 年 GPT-2 以来首次推出开源权重模型。由于 OpenAI 的开源模型备受业界期待,我更新了本文将其纳入。本节只做简要介绍,我另外撰写了一篇更详尽的专题文章,专门分析 gpt-oss 系列模型,可在此查看:

《从 GPT-2 到 gpt-oss:架构演进深度解析》
作者:塞巴斯蒂安・拉施卡(Sebastian Raschka)博士
2025 年 8 月 9 日
阅读全文

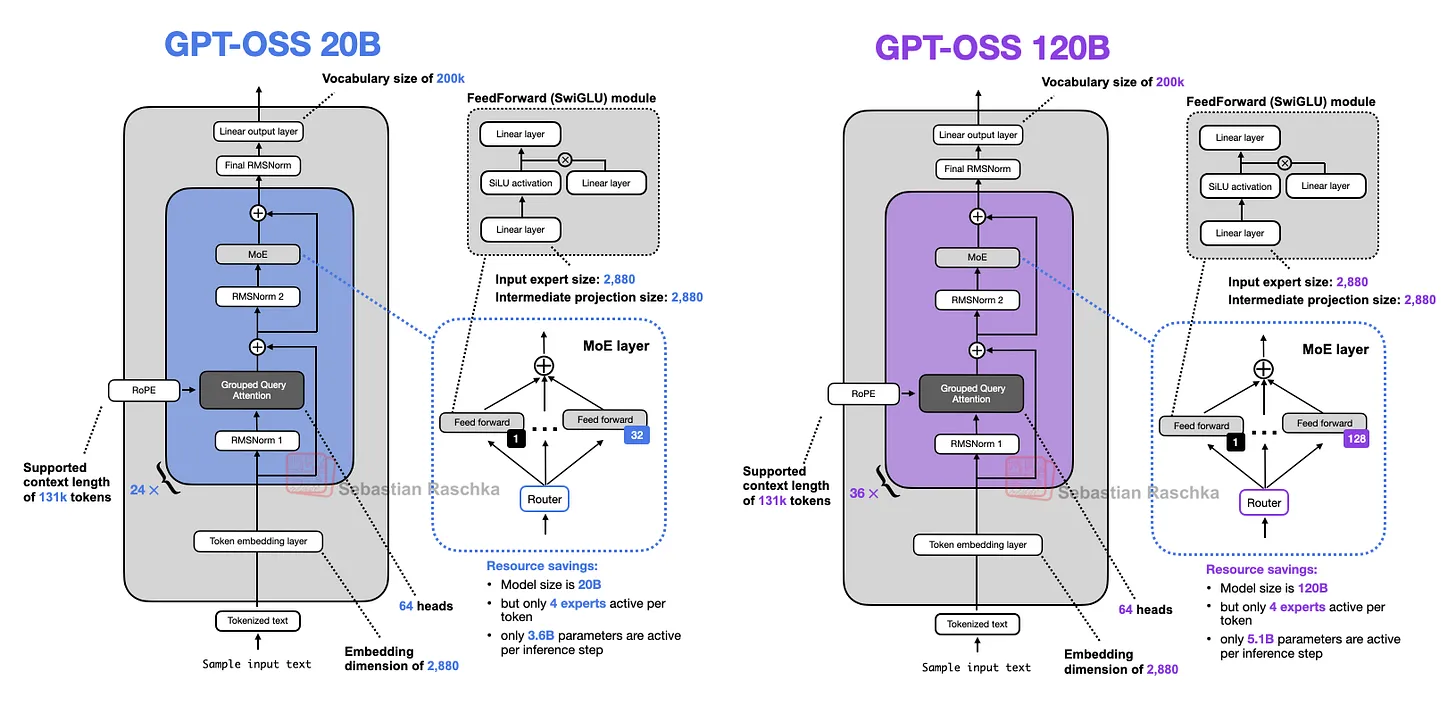
在介绍核心亮点之前,先概览 gpt-oss-20b 与 gpt-oss-120b 两款模型,如下图 26 所示。

figure26

图 26:两款 gpt-oss 模型架构概览

从图 26 可见,其架构包含了前文介绍过的所有常见组件。例如图 27 将小型 gpt-oss 架构与 Qwen3 30B-A3B 并置对比 —— 后者同样是 MoE 模型,激活参数量相近(gpt-oss 激活参数为 36 亿,Qwen3 30B-A3B 为 33 亿)。

Continue reading 【转载】大语言模型架构全面对比09:GPT-OSS

【转载】大语言模型架构全面对比08:Kimi K2 and Kimi K2 Thinking

原文地址 第8章 Kimi K2 and Kimi K2 Thinking

8. Kimi K2 and Kimi K2 Thinking

Kimi K2 近期在 AI 领域引发了巨大反响:作为一款开源权重模型,它的性能表现极为突出。多项基准测试显示,其水平已与谷歌 Gemini、Anthropic Claude、OpenAI ChatGPT 等顶尖闭源模型不相上下。

一个值得关注的设计特点是,它采用了较新的 Muon 优化器 变体,而非行业通用的 AdamW。据我所知,这是 Muon 优化器首次在如此规模的生产级模型中替代 AdamW 落地(此前仅在最高 160 亿参数的模型上验证过可扩展性)。这一方案带来了表现优异的训练损失曲线,大概率是推动该模型登顶上述基准榜单的重要助力。

Continue reading 【转载】大语言模型架构全面对比08:Kimi K2 and Kimi K2 Thinking

【转载】大语言模型架构全面对比7:SmolLM3

原文地址 第7章 SmolLM3

7. SmolLM3

SmolLM3 的知名度或许远不及本文介绍的其他大语言模型,但我认为它依然是一款值得纳入分析的典型模型。如下图所示,这款 30 亿参数的模型体量小巧、部署灵活,实际性能表现却十分亮眼,参数量规模介于 Qwen3 的 1.7B 与 4B 版本之间。

此外,与 OLMo 系列类似,该模型也公开了详尽的训练细节 —— 这种做法在行业内并不常见,始终具备很高的参考价值。
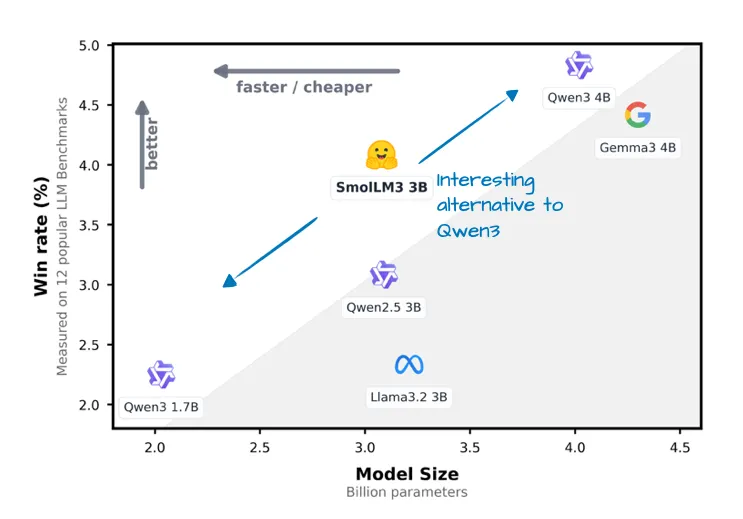
figure20

图 20:SmolLM3 官方发布博文(https://huggingface.co/blog/smollm3)中的标注示意图,对比了 SmolLM3 与 Qwen3 1.7B、Qwen3 4B、Llama 3 3B 及 Gemma 3 4B 的模型胜率表现

从下方的架构对比图中可见,SmolLM3 的整体架构设计较为常规。不过,它采用的 NoPE(无位置嵌入)方案,是其架构中最具特点的设计。
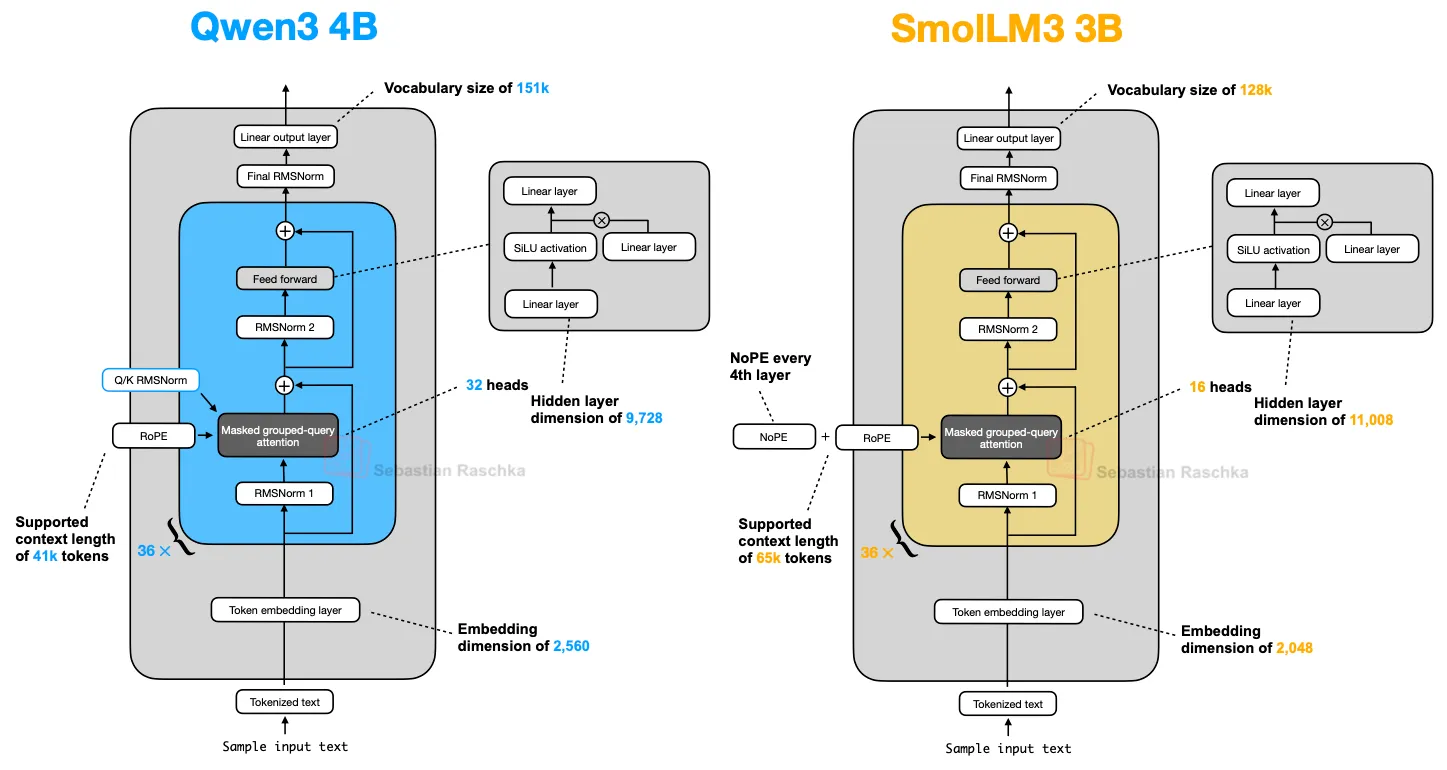
figure21

图 21:Qwen3 4B 与 SmolLM3 3B 架构并排对比图

7.1 无位置嵌入(NoPE)

在大语言模型领域,NoPE 并非全新概念,其思路最早可追溯至 2023 年的论文《位置编码对 Transformer 长度泛化能力的影响》。该方法的核心是移除模型中显式的位置信息注入机制 —— 比如早期 GPT 架构中经典的绝对位置嵌入层,或是如今主流的旋转位置编码(RoPE)。

在基于 Transformer 的大语言模型中,位置编码通常是不可或缺的组件,因为自注意力机制本身会独立处理每个 token,不感知序列的先后顺序。绝对位置嵌入通过新增一层嵌入层,为每个 token 的嵌入向量叠加位置信息,以此解决顺序感知问题。
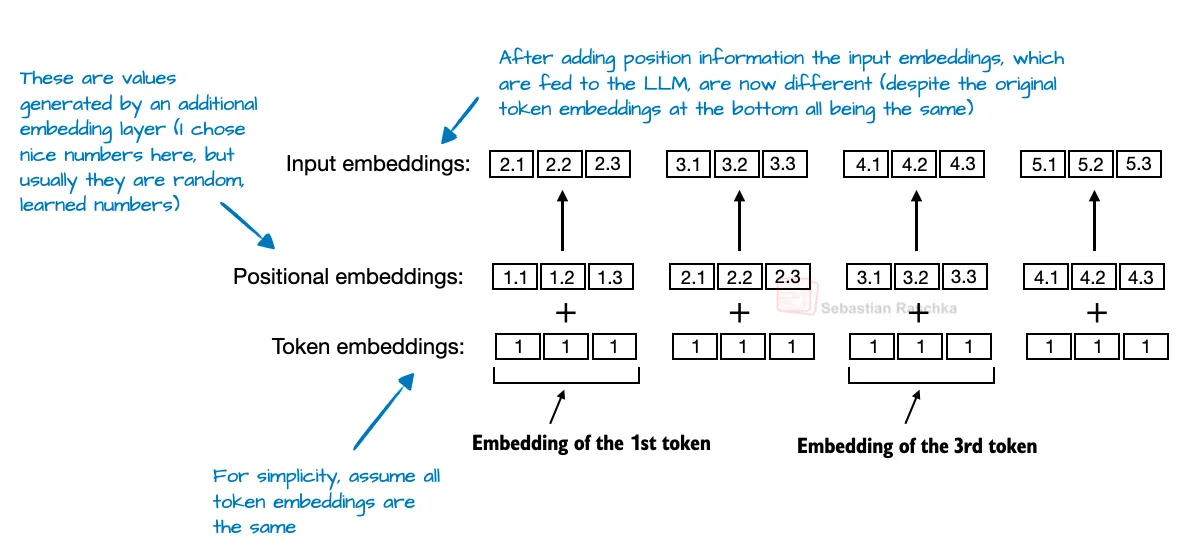
figure22

图 22:出自我的著作《从零构建大语言模型》(https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167)的修改示意图,阐释绝对位置嵌入的原理

而旋转位置编码(RoPE)则通过另一种思路实现:根据 token 所在的序列位置,对查询向量和键向量进行旋转变换,以此融入位置信息。

但在 NoPE 层中,完全不会添加任何形式的位置信号:既没有固定位置编码,也没有可学习位置嵌入,更没有相对位置编码,不引入任何位置相关的额外信息。

尽管没有显式的位置嵌入,模型依然能够识别 token 的先后顺序,这要归功于因果注意力掩码。该掩码会限制每个 token 只能关注到它之前的 token,无法获取未来位置的信息。如此一来,位置 t 处的 token 只能看到位置≤t 的所有 token,从结构上保留了自回归的序列顺序。

因此,虽然没有显式添加位置信息,但模型的结构本身已经内置了隐式的方向约束;在常规的梯度下降训练过程中,只要对优化目标有帮助,大语言模型就能自主学习并利用这种隐式顺序特性。(更多理论推导可查阅 NoPE 原论文中的定理证明)

整体而言,NoPE 相关论文不仅证实了无需显式注入位置信息模型也能正常工作,还发现 NoPE 具备更优的长度泛化能力 —— 也就是说,随着输入序列长度增加,大语言模型的回答性能下降幅度更小,具体效果如下图所示。
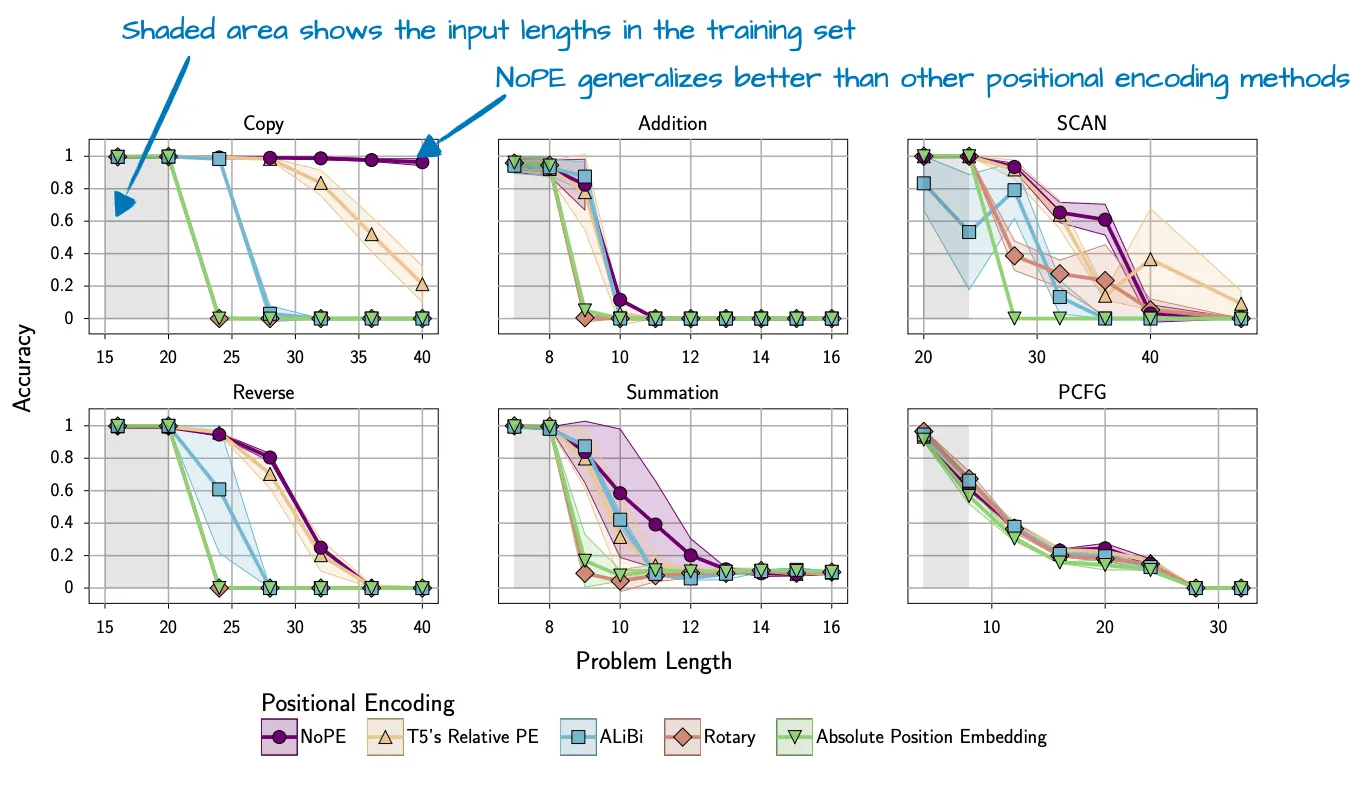
figure23

图 23:NoPE 原论文(https://arxiv.org/abs/2305.19466)中的标注示意图,展示了 NoPE 更优异的长度泛化表现

需要注意的是,上述实验是基于参数量约 1 亿的小规模 GPT 风格模型、在较短上下文长度下完成的。这些结论能否直接迁移到如今的大规模大语言模型上,目前尚无定论。

也正因此,SmolLM3 团队大概率选择了仅在每 4 层中应用一次 NoPE(或者说移除 RoPE)的折中方案。

【转载】大语言模型架构全面对比06:Qwen3

原文地址 第6章 Qwen3

6. Qwen3

通义千问团队始终持续输出高质量的开源权重大语言模型。我还记得 2023 年 NeurIPS 大会期间,我参与联合指导大语言模型效率挑战赛,最终所有夺冠方案均基于 Qwen2 搭建。

如今的 Qwen3 是又一标杆级模型系列,在各自参数量级的排行榜上都位居头部。该系列包含 7 款稠密模型,参数量分别为 0.6B、1.7B、4B、8B、14B 和 32B;另有 2 款混合专家(MoE)模型:30B-A3B 与 235B-A22B。

(顺带说明:“Qwen3” 中间未加空格并非笔误,我只是尽量保留通义千问开发团队选定的原始拼写。)

6.1 Qwen3(稠密版本)

我们先来看稠密模型的架构。截至本文撰写时,0.6B 参数版本很可能是当前新一代开源模型中参数规模最小的。以我的实际体验来看,在如此小的体量下,它的表现十分出色。如果要在本地运行,它的 token 生成吞吐量高,内存占用低;更重要的是,参数量小也意味着它很适合在本地开展训练(用于教学研究目的)。

因此在大多数场景下,我已经用 Qwen3 0.6B 替代了 Llama 3 1B。二者的架构对比如下图所示。

figure18

Continue reading 【转载】大语言模型架构全面对比06:Qwen3

【转载】大语言模型架构全面对比05:Llama 4

原文地址 第5章 Llama 4

5. Llama 4

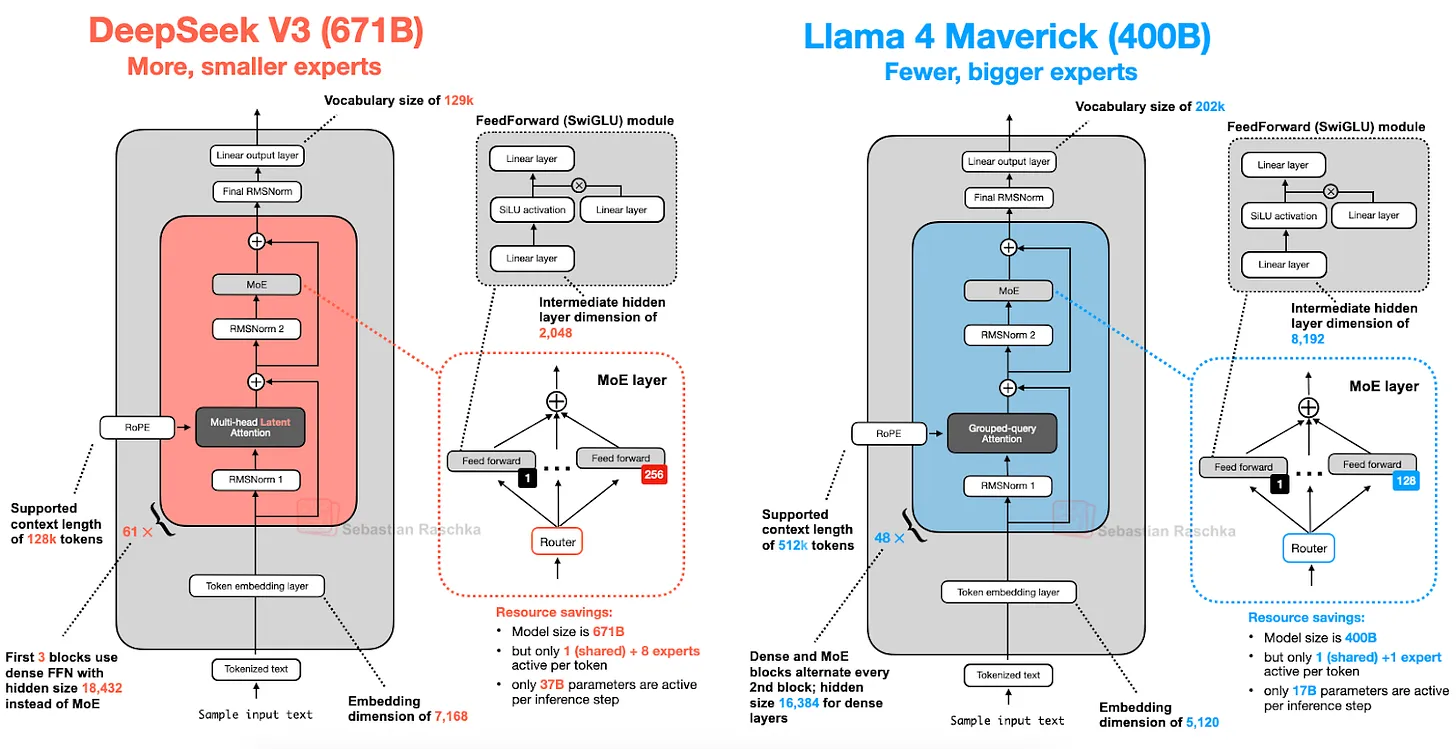
本文前面对混合专家模型(MoE)的详细铺垫在这里又派上了用场。Llama 4 同样采用了 MoE 架构,其余部分则沿用了与 DeepSeek V3 高度相似的相对标准架构,如下图所示。(Llama 4 原生支持多模态能力,与 Gemma、Mistral 等模型类似。但由于本文聚焦语言建模方向,因此仅讨论其文本模型部分。)

image17

图 17:DeepSeek V3(6710 亿参数)与 Llama 4 Maverick(4000 亿参数)架构对比

尽管 Llama 4 Maverick 的整体架构与 DeepSeek V3 十分相近,但仍有几处值得关注的差异。

首先,Llama 4 延续了前代的分组查询注意力(GQA),而 DeepSeek V3 采用的是本文开头介绍过的多头潜注意力(MLA)。两者均为超大规模架构:DeepSeek V3 的总参数量比 Llama 4 Maverick 高出约 68%;但从激活参数量来看,DeepSeek V3 为 370 亿,是 Llama 4 Maverick(170 亿)的两倍以上。

Llama 4 Maverick 采用更经典的 MoE 配置:专家数量更少但单个专家规模更大 —— 每步激活 2 个专家,每个专家隐层维度为 8192;而 DeepSeek V3 每步激活 9 个专家,每个专家隐层维度为 2048。此外,DeepSeek 除前 3 个 Transformer 块外,其余每个块都包含 MoE 层;Llama 4 则采用交替设计,每隔一个 Transformer 块轮换使用 MoE 模块与稠密模块。

由于架构之间存在诸多细微差异,很难判定这些设计对模型最终性能的具体影响。但核心结论是:2025 年 MoE 架构的普及度已出现显著提升。

【转载】大语言模型架构全面对比04:Mistral Small 3.1

原文地址 第4章 Mistral Small 3.1

4. Mistral Small 3.1

Mistral Small 3.1(240 亿参数)于 3 月发布,上线时间紧随 Gemma 3 之后。该模型值得关注的核心特点是:除数学能力外,它在多项基准测试中表现优于 Gemma 3 27B,同时推理速度更快。

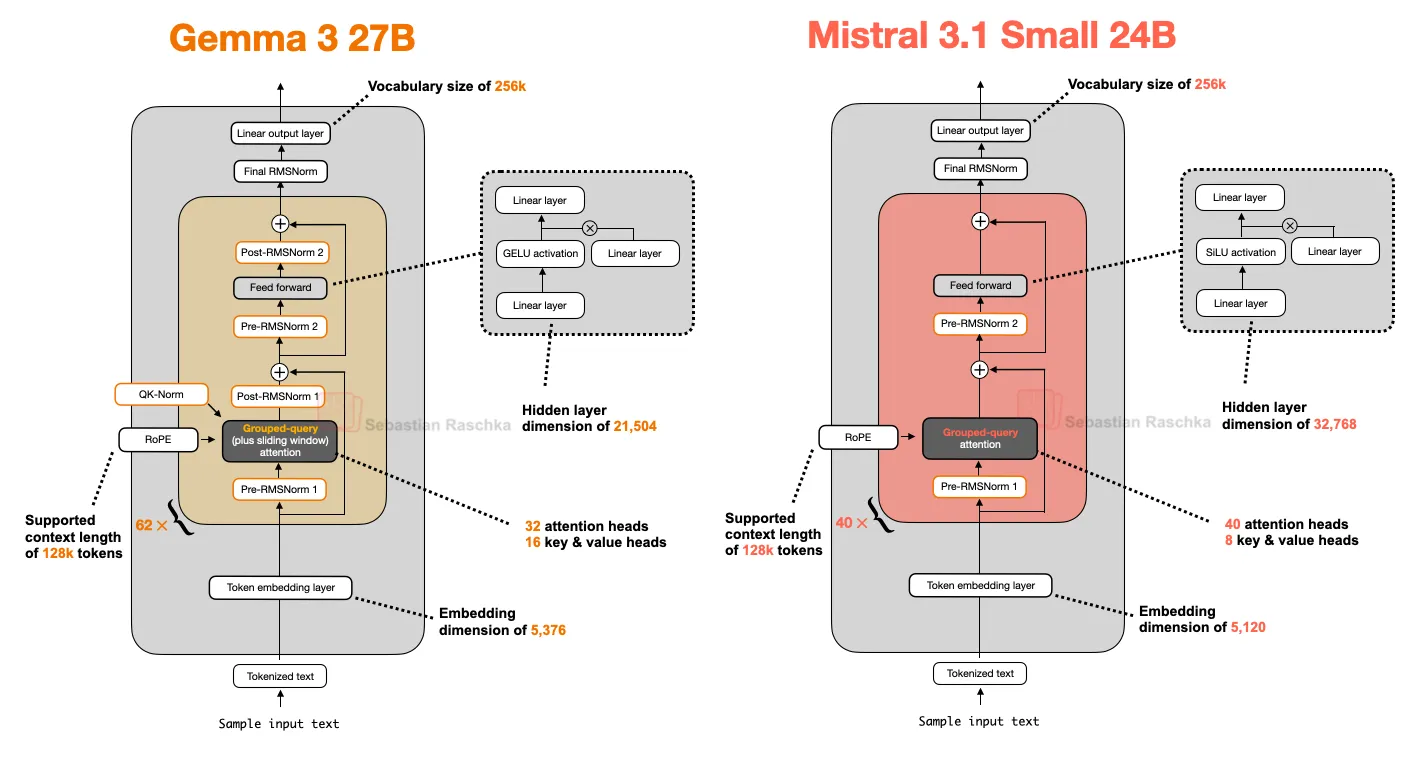
Mistral Small 3.1 的推理延迟低于 Gemma 3,原因大概率在于其定制化自研分词器,以及更小的 KV 缓存规模与更少的网络层数。除此之外,它采用的是下图所示的标准架构。

figure16

图 16:Gemma 3 27B 与 Mistral 3.1 Small 24B 架构对比

有意思的是,Mistral 早期的模型均采用了滑动窗口注意力机制,但从官方模型仓库配置文件的默认参数("sliding_window": null)来看,Mistral Small 3.1 似乎已经放弃了这一设计,其模型卡片中也完全没有提及该机制。

因此,Mistral 采用的是常规分组查询注意力(GQA),而非 Gemma 3 使用的带滑动窗口的分组查询注意力。得益于这一改动,模型可以适配高度优化的算子实现(例如 FlashAttention),或许能进一步压缩推理计算开销。笔者推测:滑动窗口注意力虽能降低显存占用,但未必能缩短推理延迟,而低延迟正是 Mistral Small 3.1 的核心优化目标。

【转载】大语言模型架构全面对比03:Gemma 3

原文地址 第3章 Gemma 3

3. Gemma 3

谷歌推出的 Gemma 系列模型一直表现优异,在我看来,和 Llama 系列等热门模型相比,它的市场热度始终被有所低估。

Gemma 的一大鲜明特征是词表规模较大,以此更好地支持多语言;同时产品线更侧重 270 亿参数规格,而非 80 亿或 700 亿档位。不过需要说明的是,Gemma 2 也提供更小的参数版本:10 亿、40 亿和 120 亿。

270 亿这个规格刚好卡在非常理想的平衡点:能力远强于 80 亿参数模型,资源消耗又远低于 700 亿参数模型,在我的 Mac Mini 上就能顺畅本地运行。

那么 Gemma 3 还有哪些值得关注的设计?如前文所述,DeepSeek V3/R1 等模型采用混合专家(MoE)架构,在模型总规模固定的前提下降低推理时的内存占用 —— 后文要介绍的多款模型也都沿用了 MoE 方案。
而 Gemma 3 选择了另一种技术路径来压缩计算成本:滑动窗口注意力

3.1 滑动窗口注意力

滑动窗口注意力最早于 2020 年在《LongFormer》论文中提出,Gemma 2 也已采用该技术。借助滑动窗口注意力,Gemma 3 团队大幅降低了 KV 缓存的内存占用,如下图所示。

figure11

图 11:摘自 Gemma 3 论文(https://arxiv.org/abs/2503.19786)的标注图,展示滑动窗口注意力带来的 KV 缓存内存节省效果

Continue reading 【转载】大语言模型架构全面对比03:Gemma 3