About neohope

一直在努力,还没想过要放弃...

【转载】我理解大语言模型架构的工作流程

My Workflow for Understanding LLM Architectures,by Sebastian Raschka, 2024-04-18

我理解大语言模型架构的工作流程

一套面向学习、用于解析新开源权重模型的工作方法

过去几个月里,很多人希望我分享一下,我是如何梳理出文章、演讲以及「大语言模型架构图鉴(LLM-Gallery)」里那些架构示意图的。因此我觉得,把自己常用的流程整理成文应该会有所帮助。

简而言之,我通常会从官方技术报告入手,但如今的论文往往不如以往详尽,产业实验室发布的绝大多数开源权重模型更是如此。

好在如果模型权重已在 Hugging Face 模型中心(Model Hub)公开,且 Python 的 transformers 库已支持该模型,我们通常可以直接查看配置文件与参考实现,获取更多架构细节。而能正常运行的代码从不会说谎。
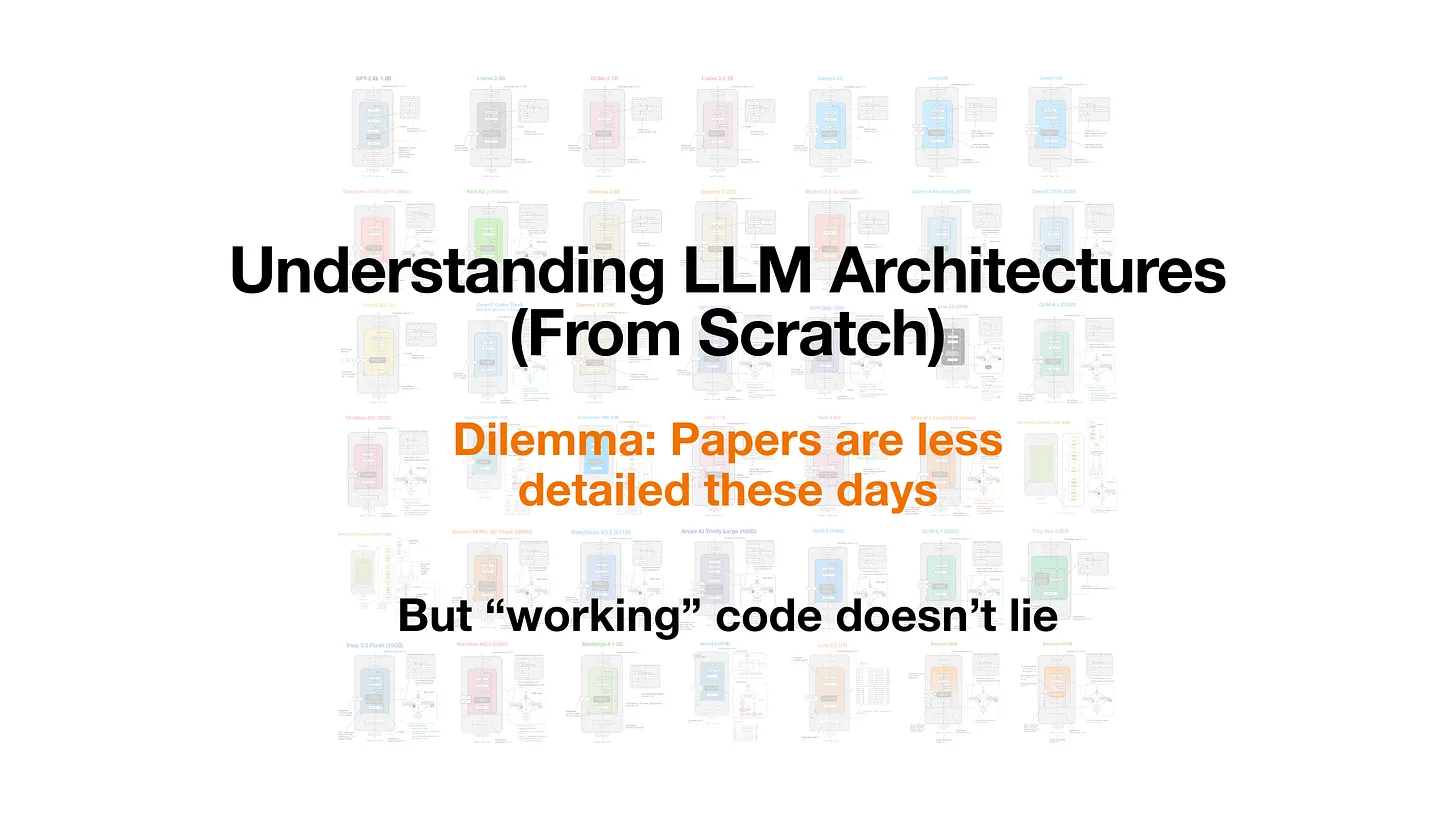
figure01

图 1:这套工作流的核心出发点 —— 如今论文细节往往不足,但可运行的参考实现为我们提供了具象的研究对象。
Continue reading 【转载】我理解大语言模型架构的工作流程→

【转载】Karpathy LLM Wiki

2026年4月,前OpenAI创始成员Andrej Karpathy提出了一种新的个人知识管理新范式,核心是让大语言模型(LLM)充当 “知识编译器”,将零散原始资料(文章、论文、笔记等)自动生成结构化、可持久化、能复利增长的 Markdown 维基知识库。

它采用 Raw Sources(原始资料)、Wiki(LLM 生成的结构化知识库)、Schema(规范配置)三层架构,区别于传统 RAG 的 “运行时检索”,LLM Wiki 提前处理知识并持续维护更新,形成高密度互联的知识图谱(交叉引用的 Markdown Wiki),人类仅负责资料收集与判断,大幅降低知识维护成本。

Continue reading 【转载】Karpathy LLM Wiki→

打造OpenClaw屠龙刀,拔刀四顾心茫然

拔刀四顾心茫然

进入四月,OpenClaw的热度开始消退,曾经热衷部署、乐于分享的“龙虾养殖户”们,也慢慢回归理性。不少人开始反思:除了日常推送一些咨询,这只“龙虾”似乎并没有真正发挥作用。关键这类咨询有大把的APP可用,效果更好,而且免费。

Continue reading 打造OpenClaw屠龙刀,拔刀四顾心茫然→

OpenClaw“偷懒”本质:Agent框架下的幻觉与奖励破解及解决策略

OpenClaw模型偷懒及规避

作为OpenClaw的中度用户,最近被一个问题反复困扰————OpenClaw总爱”偷懒”,甚至伪造结果,哪怕在Markdown文件中明确禁止偷懒、禁止使用演示数据,依然屡禁不止。相信很多养龙虾的朋友,也会遇到类似的烦恼,今天就结合我的踩坑经历,拆解问题根源,分享一套可落地的方案,帮大家彻底摆脱OpenClaw”偷懒”的困扰。

Continue reading OpenClaw“偷懒”本质:Agent框架下的幻觉与奖励破解及解决策略→

【转载】Coding Agent的组成

原文地址:Components of A Coding Agent,by Sebastian Raschka, on 2026-04-04

Coding Agent的组成:Coding Agent如何借助工具、记忆与 repo 上下文,让 LLM 在实际应用中发挥更优效果

在本文中,我将全面讲解 coding agents 与 agent harnesses 的设计体系:它们的定义、运行机制,以及各个模块在实践中的协作逻辑。读过我《Build a Large Language Model (From Scratch)》和《Build a Large Reasoning Model (From Scratch)》的读者经常问及代理相关的问题,因此我打算写一篇可供查阅的系统参考文章。

更宽泛地说,代理已经成为 LLM 领域的核心议题之一:近期 LLM 系统的实用化突破,往往不只是模型本身的迭代,更多在于应用方式的升级。在绝大多数真实业务场景中,外围系统(工具调用、上下文管理、记忆机制等)的价值,和模型本身同等重要。这也解释了为什么 Claude Code、Codex 这类产品,比起在普通聊天界面中使用同款模型,实际体验会明显更强。

本文会拆解 coding agent 的六大核心构建模块。

Claude Code、Codex CLI 与其他Coding Agent

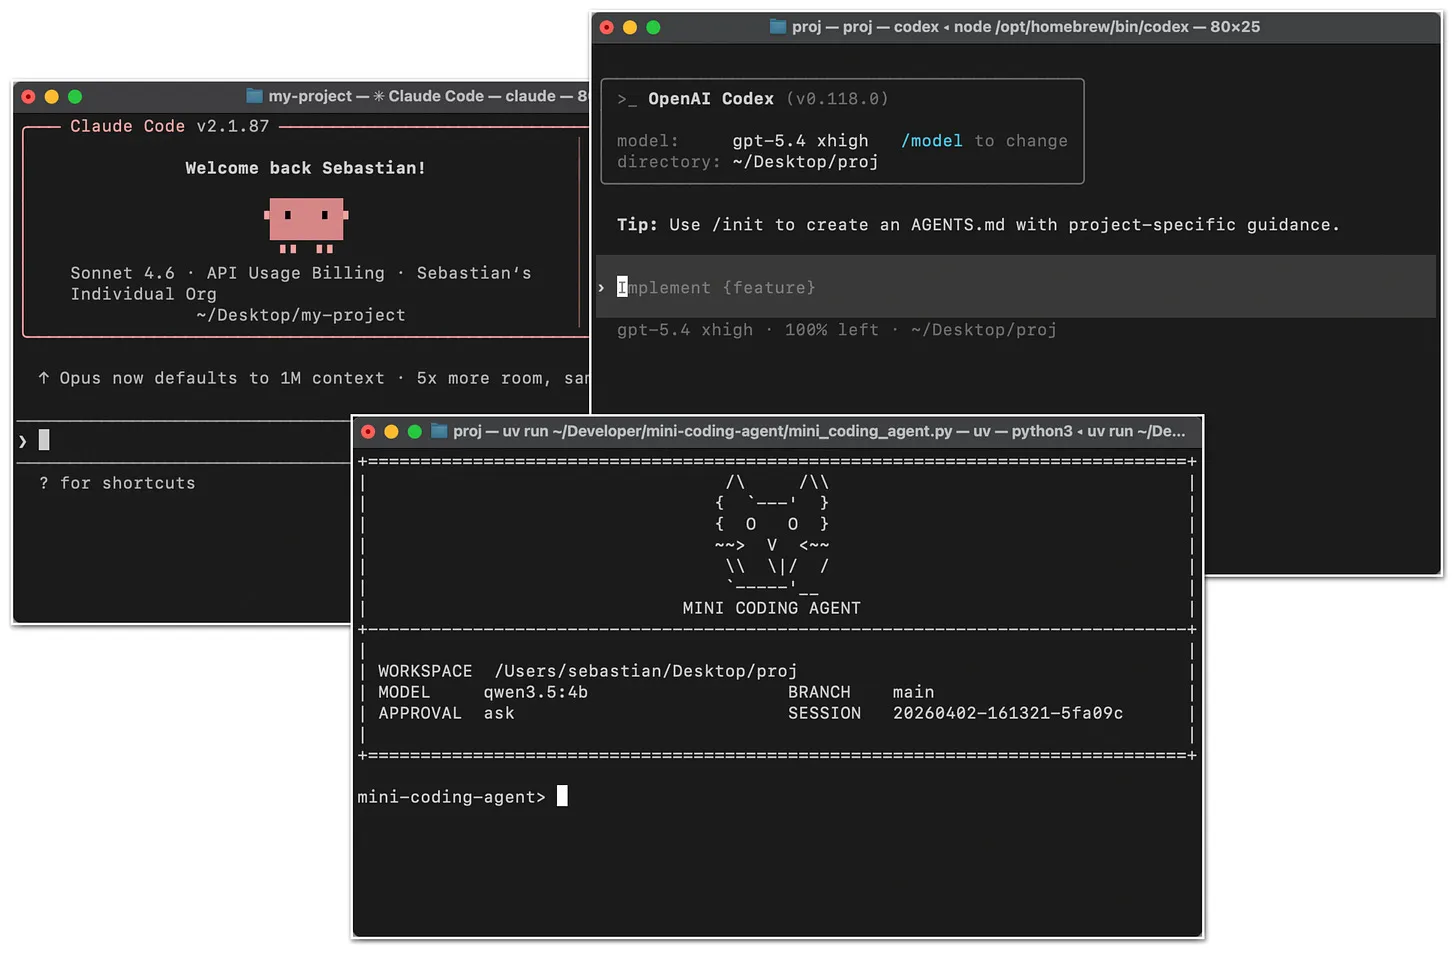
你或许已经熟悉 Claude Code 或者 Codex CLI。简单来说,它们本质上是具备代理能力的编码工具:在 LLM 之外包裹了一层应用层,也就是所谓的 agentic harness(代理式框架),从而让编码任务更高效、体验更顺滑。

figure01

图 1:Claude Code CLI、Codex CLI,以及我开发的 mini-coding-agent(https://github.com/rasbt/mini-coding-agent)

Continue reading 【转载】Coding Agent的组成→

ClaudeCode源码泄露深度解析:低级失误背后的数字安全警示

ClaudeCode2事件启示

最近科技圈最受关注的安全事件,莫过于Anthropic旗下AI编程助手ClaudeCode的源码意外泄露。51.2万行完整未混淆的TypeScript源码,通过公开npm包裸奔曝光,而这一切的起因,仅仅是一个低级的配置失误——这样的“翻车”,给所有AI企业、开发者敲响了数字安全的警钟。

不同于复杂的黑客攻击,这次泄露更具警示意义:它不是技术壁垒被突破,而是流程疏忽导致的“自曝”,背后藏着供应链安全、流程管理、危机应对的诸多问题,值得每一个数字产品从业者深思。

Continue reading ClaudeCode源码泄露深度解析:低级失误背后的数字安全警示→

《杀戮尖塔2》40小时被快速破解:为何还能狂销460万份?

杀戮尖塔2事件启示

近期游戏圈也上演了一场“反常规”的安全事件——爆款肉鸽卡牌游戏《杀戮尖塔2》,在Steam抢先体验上线仅40小时,就被完全破解,甚至被快速移植到安卓平台,盗版资源全网泛滥。

《杀戮尖塔2》被快速破解,从一开始就是开发者Mega Crit的“主动选择”。更令人意外的是,面对盗版泛滥,官方不仅佛系不设防、不追责,游戏销量还一路飙升,首周销量破300万份,目前累计销量已达460万份,峰值同时在线人数突破57万,口碑始终保持“特别好评”。

这场“破解与热销并存”的奇观,彻底打破了“防破解=保销量”的固有认知,也给游戏开发者、数字产品从业者,带来了关于技术架构、商业防御、用户运营的全新思考——它用实际成绩证明,最好的“反盗版”,从来不是加密,而是让正版变得不可替代。而这份“不可替代”,既源于开发者对技术与成本的理性权衡,也离不开IP沉淀、平台加持与社区认同的共同助力。

Continue reading 《杀戮尖塔2》40小时被快速破解:为何还能狂销460万份?→

Polymarket:当区块链遇上信息市场,如何用真金白银投票预测未来?

Polymarket.webp

Polymarket:当区块链遇上信息市场,如何用真金白银投票预测未来?

一、什么是 Polymarket?

Polymarket是一个基于区块链的去中心化预测市场平台,由Shayne Coplan于2020年创立,构建于 Polygon 网络之上。它打破了传统预测市场的中心化局限,允许用户使用加密货币(主要是 USDC 稳定币)对真实世界各类事件的结果进行投注和交易——覆盖范围极为广泛,从全球政治选举、体育赛事胜负,到加密货币价格走势、宏观经济政策变动,甚至是流行文化热点、科技突破进展等,几乎涵盖了所有具有不确定性的现实场景。

Continue reading Polymarket:当区块链遇上信息市场,如何用真金白银投票预测未来?→

【转载】现代大语言模型注意力机制变体可视化指南

原文地址:A Visual Guide to Attention Variants in Modern LLMs,by Sebastian Raschka, on 2026-03-22

现代大语言模型注意力机制变体可视化指南

从 MHA、GQA 到 MLA、稀疏注意力与混合架构

我原本计划撰写关于 DeepSeek V4 的内容。由于该模型尚未发布,我便利用这段时间整理了一项计划已久的工作:收集、梳理并细化过去几年我研究过的各类 LLM 架构。

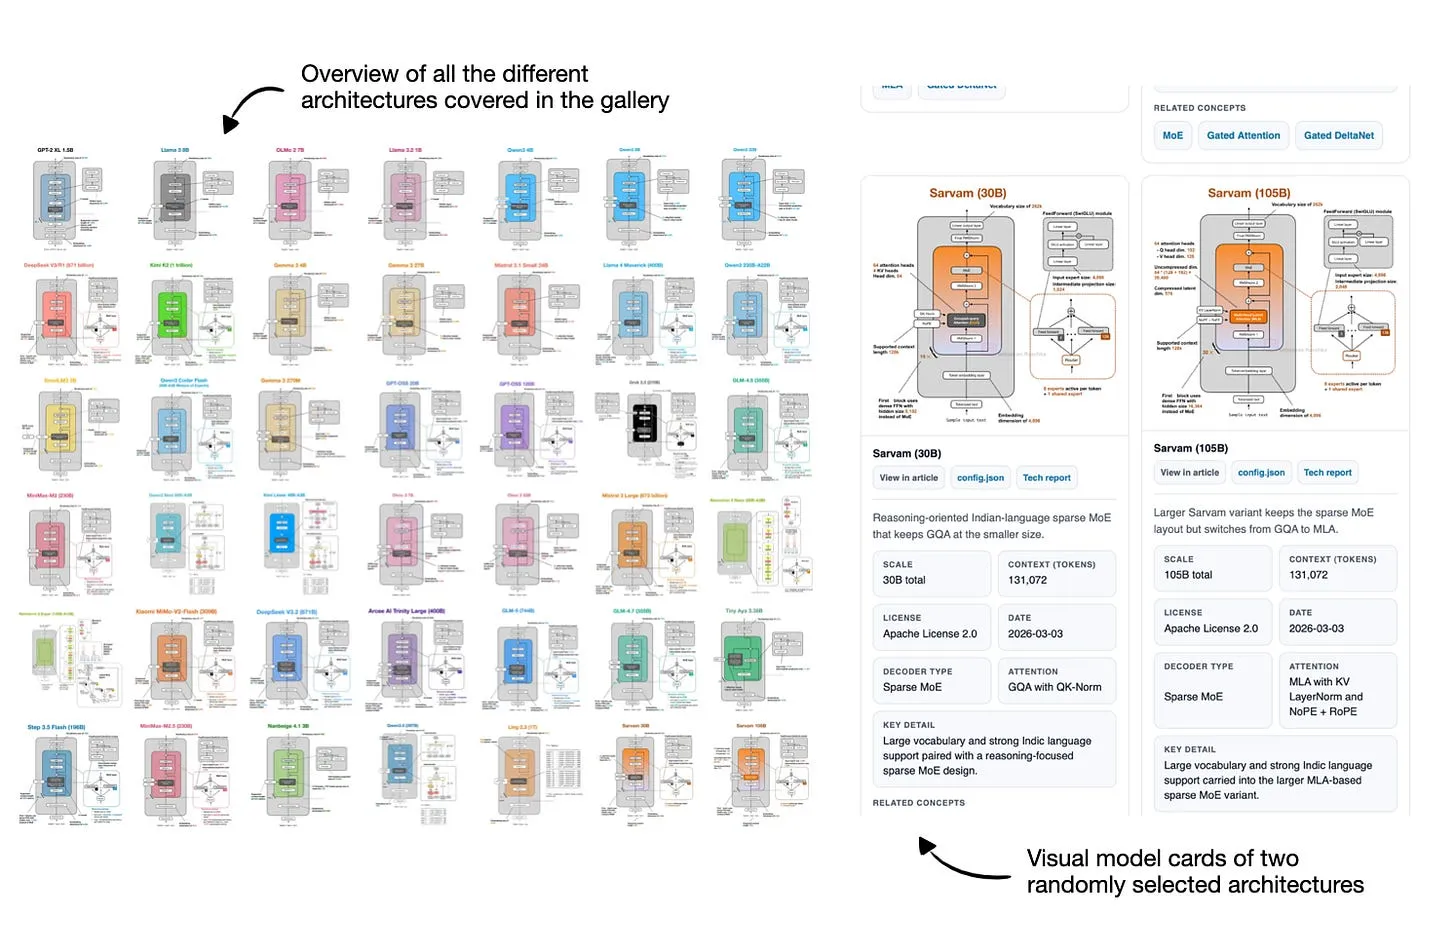
在过去两周里,我将这项工作整理成了一个LLM 架构图库(撰写本文时已收录 45 个模型),整合了早期文章的资料,以及数个此前未整理的重要架构。每个模型都配有可视化模型卡片,我也计划定期更新这个图库。
你可以在此访问图库:https://sebastianraschka.com/llm-architecture-gallery/

figure01

图 1:LLM 架构图库及其可视化模型卡片概览
https://sebastianraschka.com/llm-architecture-gallery/

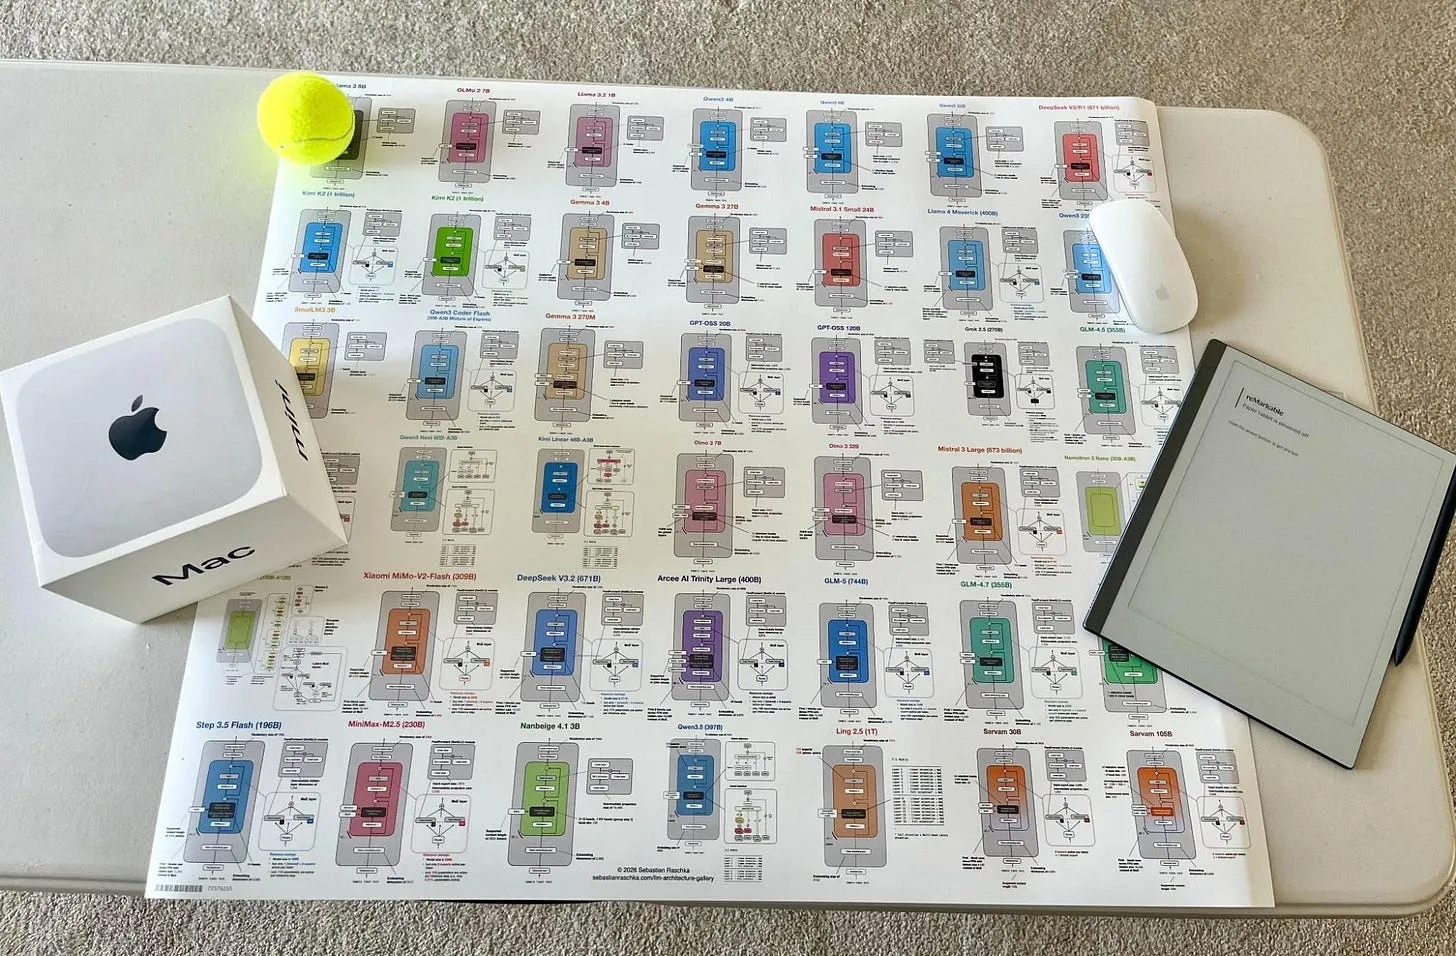
分享初始版本后,有读者询问是否有海报版本。因此我也制作了海报版,可在此查看:https://www.redbubble.com/i/poster/LLM-Architecture-Gallery-by-Ahead-of-AI/179274487/flk2
我订购了中号尺寸(26.9×23.4 英寸)来验证打印效果,成品清晰锐利。不过该尺寸下部分最小的文字已经很小了,如果希望所有内容都清晰可读,不建议选择更小的尺寸。

figure02

图 2:架构图库海报与日常物品的尺寸对比
https://www.redbubble.com/i/poster/LLM-Architecture-Gallery-by-Ahead-of-AI/179274487/flk2

在搭建图库的同时,我也在为几个 LLM 核心概念制作简短讲解。
因此在本文中,我想系统梳理近年主流开源架构中发展并应用的各类注意力变体。
我的目标是让这份资料既能作为参考手册,也能作为轻量化的学习资源。希望对你有所帮助!

Continue reading 【转载】现代大语言模型注意力机制变体可视化指南→