原文地址:Controlling Reasoning Effort in LLMs,by Sebastian Raschka, on 2026-07-18
大语言模型的推理强度调控
大模型如何习得低、中、高三档推理模式
OpenAI 发布 o1 模型、让 “基于大语言模型的推理模型” 概念普及至今,已过去近两年。约四个月后,DeepSeek-R1 问世,同时公开了训练这类推理模型的可验证奖励强化学习(RLVR) 完整方案。
上周,OpenAI 发布 GPT-5.6 模型系列,该系列包含三种参数量规格,每个规格均设有约 5-6 档推理强度可选。
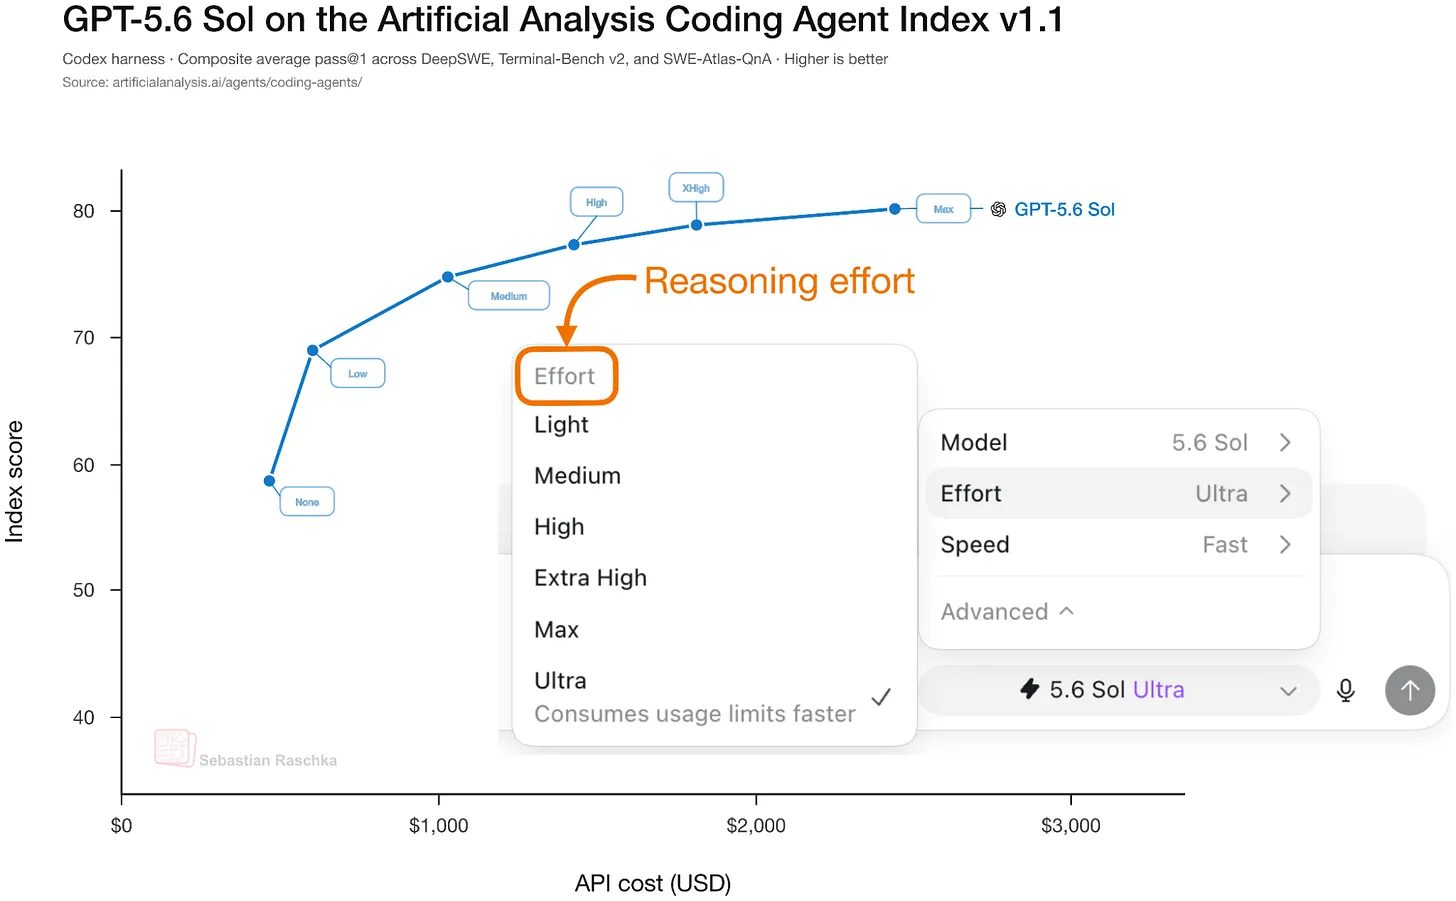
图1:不同推理强度档位下的GPT 5.6 Sol模型表现。(Ultra档位的基准测试数据目前尚未公布,但性能应与Max档位接近——二者推理强度相当,只是Ultra通过4个子智能体并行加速了执行过程。)