About neohope

一直在努力,还没想过要放弃...

记一次红蓝攻防记录

本以为我们的系统安全和网络安全做的很好,静态扫描、动态扫描、组件扫描、主机扫描、网络扫描,都把系统扫烂了,而且有集团安全提供的各安全供应商的各类工具,发现的问题,包括0day漏洞都会尽快修复,于是膨胀了。

邀请了集团及合作的安全专家,对系统的测试环境进行了渗透攻击,我们进行防御,不出意外,意外很快就发生了,很快就收到了被攻破的报告。
被打脸了,攻击路径:
1、在测试环境发布的时候,为了调试方便,开启了一个配置,导致关键组件可以不授权访问
2、该漏洞被蓝军利用,直接获取了数据库、配置中心等内外服务地址和账号密码
3、蓝军通过修改网关配置,直接将配置中心管理界面映射到了外网,获取了配置中心的全部配置
4、通过配置信息,蓝军很快就获取了OBS访问密钥、部分AK/SK信息、数据库地址信息、开放平台配置信息等
*此时安全团队才发现问题,及时进行了干预,阻断了进一步的攻击
5、后续蓝军可以访问数据库,导出数据库信息,直接挂到网关上,外网可以直接下载
6、后续蓝军可以访问OBS,枚举文件,将部分文件挂到网关上,外网可以直接下载
7、后续蓝军可以继续挂马,继续向内渗透攻击其他主机,进一步扩大战果
8、后续可以通过获取的信息,加上社会工程学信息,继续进行渗透
9、后续蓝军可以继续投放勒索病毒等,达到进一步的攻击目的

后续我们进行了集体反思,看似铜墙铁壁的防护,被一行简单的配置全部破掉了。
后续整改措施很多,包括:
1、及时排查和修复此类问题,对开放、测试、生产进行全面整改
2、通过访问日志,确认过往未发生数据泄露问题
3、再次确认网络安全策略,对办公、开发、测试、特别是生产环境进行隔离
4、不仅生产,在测试和开发环境上也要保持配置隔离,宁可增加一些资源
5、不仅生产,在测试和开发环境上也要加强管控,否则问题一定会蔓延到生产环境
6、部分关键信息是明文存储的,必须调整为加密存储
7、非必要,开发及测试环境不对外开放,即使必要,及时关闭
8、加强对软件提供商的管理,避免
9、与多个安全厂商合作,引入外部专家,进一步加强渗透及越权测试

【转载】理解推理型大语言模型

原文地址:Understanding Reasoning LLMs,by Sebastian Raschka, on 2025-02-05

理解推理型大语言模型:构建与优化推理模型的方法与策略

本文将介绍构建推理模型的四种核心路径,阐释如何为大语言模型(LLM)赋予并强化推理能力。希望本文能提供有价值的洞见,帮你在该领域快速迭代的学术研究与行业热潮中理清脉络。

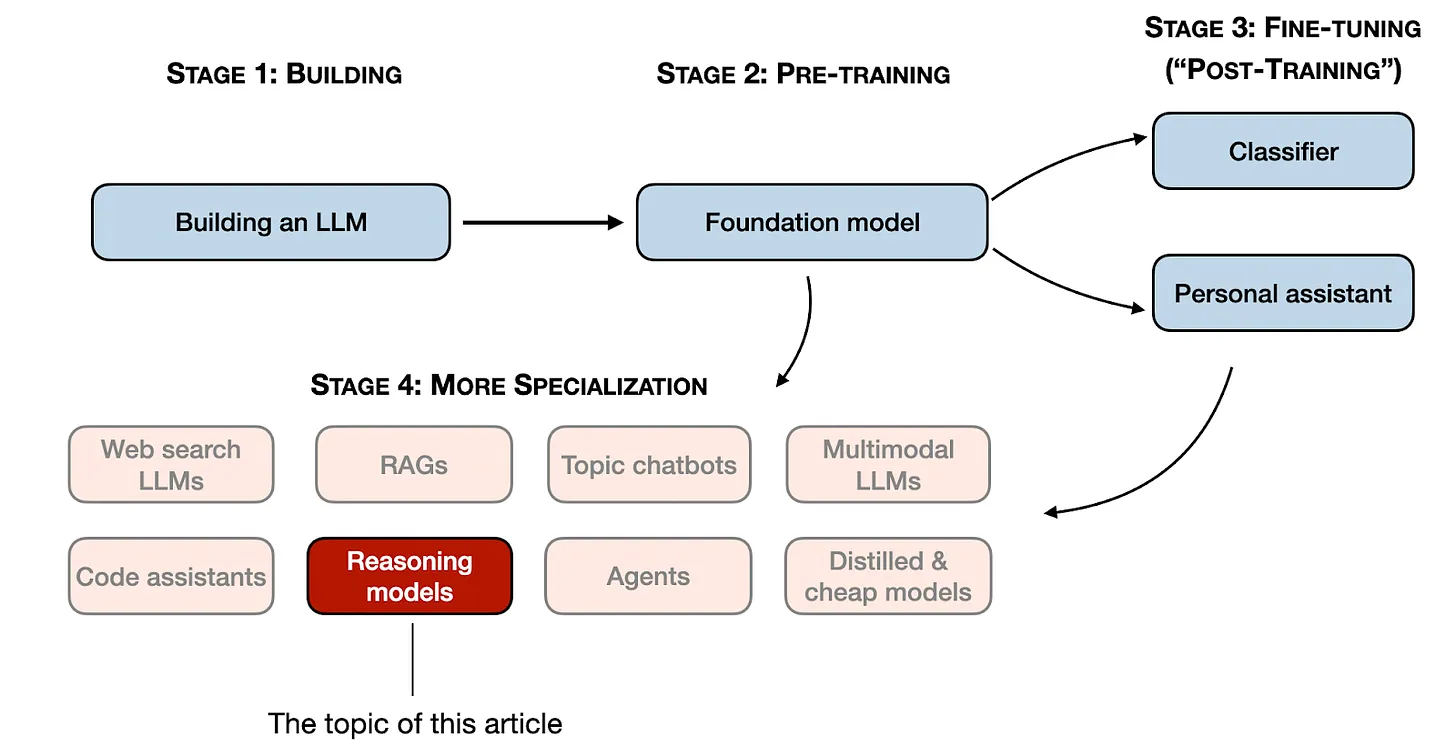
2024 年,大语言模型领域的专业化趋势愈发明显。除了预训练与微调技术的持续演进,检索增强生成(RAG)、代码助手等垂直场景应用也快速崛起。我预计这一趋势将在 2025 年进一步加速,行业会更聚焦于领域与场景专属的优化(即 “专业化”)。

figure01

图 1:第 1-3 阶段是大语言模型的通用开发流程,第 4 阶段则是针对具体场景对模型进行专业化定制

推理模型的开发正是这类专业化方向之一。我们通过优化模型,使其擅长解决需要中间推导步骤的复杂任务,比如逻辑谜题、高等数学与编程挑战。但这种专业化并不会替代其他大语言模型的应用场景;将通用大模型改造为推理模型也会带来一些短板,后文会详细展开。

先简要预告本文的核心内容:

  • 阐释 “推理模型” 的定义

  • 分析推理模型的优势与局限

  • 拆解 DeepSeek R1 的技术实现路径

  • 介绍构建与优化推理模型的四种主流方案

  • 分享 DeepSeek V3 与 R1 发布后,大语言模型行业格局的观察

  • 给出低成本开发推理模型的实践建议

希望在 AI 高速发展的 2025 年,本文能为你带来切实的帮助。

如何定义 “推理模型”?

如果你从事 AI(或广义的机器学习)相关工作,一定对各种模糊且充满争议的术语定义不陌生,“推理模型” 也不例外。总会有论文先给出一个正式定义,后续的研究又会重新改写定义,循环往复。

在本文中,我将 “推理” 定义为:回答问题时需要经过多步复杂生成、产出中间推导过程的能力。
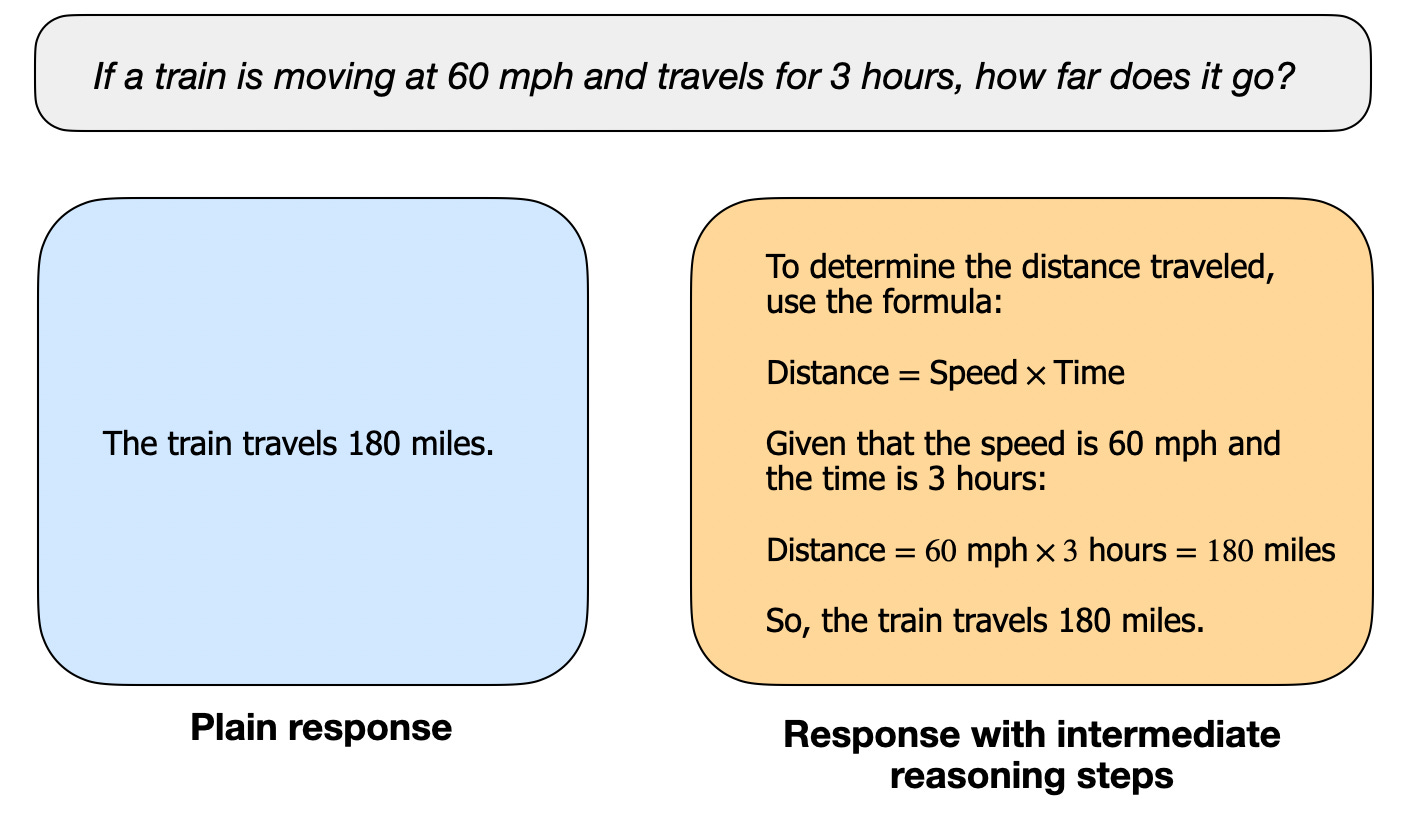
举个例子,“法国的首都是哪里?” 这类事实性问答不涉及推理;而 “一列火车以 60 英里 / 小时的速度行驶 3 小时,总行驶距离是多少?” 就需要基础的推理 —— 模型需要先识别出距离、速度、时间三者的关系,再推导得出答案。

figure02

图 2:普通大语言模型可能只输出简短答案(左),而推理模型通常会给出中间步骤,展现部分思考过程。(注:很多未专门针对推理优化的大语言模型,同样能在回答中输出中间推理步骤。)

如今绝大多数大语言模型都具备基础推理能力,可以解答上述的火车行程类问题。因此当下我们所说的 “推理模型”,通常特指擅长解决更复杂推理任务的模型,比如逻辑解谜、智力问答、数学证明等。

此外,当前市面上标注为 “推理模型” 的产品,大多会在回复中包含 “思考” 过程。至于大语言模型是否真的在 “思考”,则是另一个独立的讨论议题。

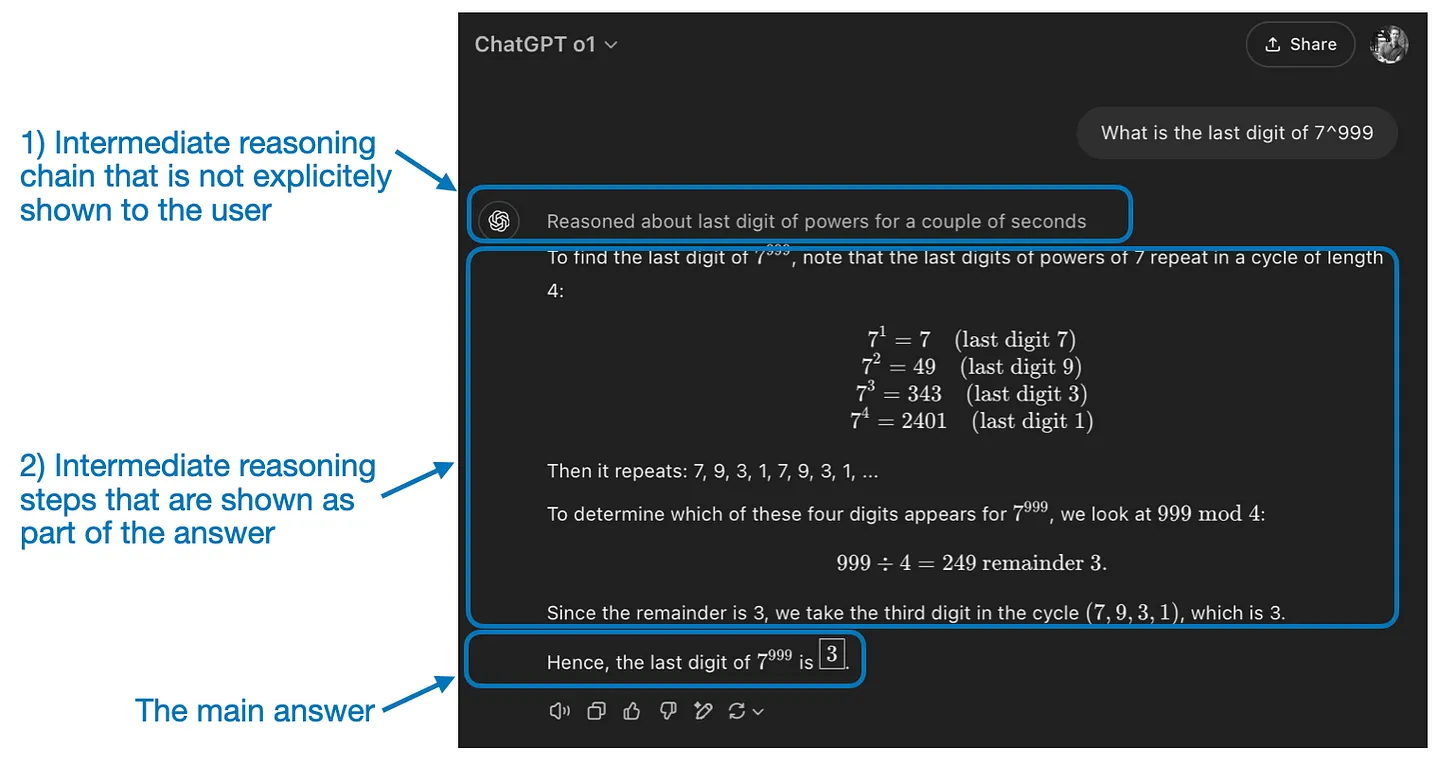
推理模型的中间步骤有两种呈现形式:
第一种是显式输出,即像上图一样把推导过程直接展示在回复中;
第二种是隐式执行,比如 OpenAI 的 o1 模型,会在内部运行多轮带中间步骤的迭代,但过程不对用户可见。

figure03

图 3:“推理” 体现在两个层面:1)模型内部通过多步中间过程处理输入、生成结果;2)模型在面向用户的回复中呈现一定的推理逻辑。

什么时候该用推理模型?

明确了推理模型的定义后,我们可以进入更核心的话题:如何构建与优化面向推理任务的大语言模型。但在深入技术细节之前,有必要先厘清:推理模型的真实适用场景是什么。

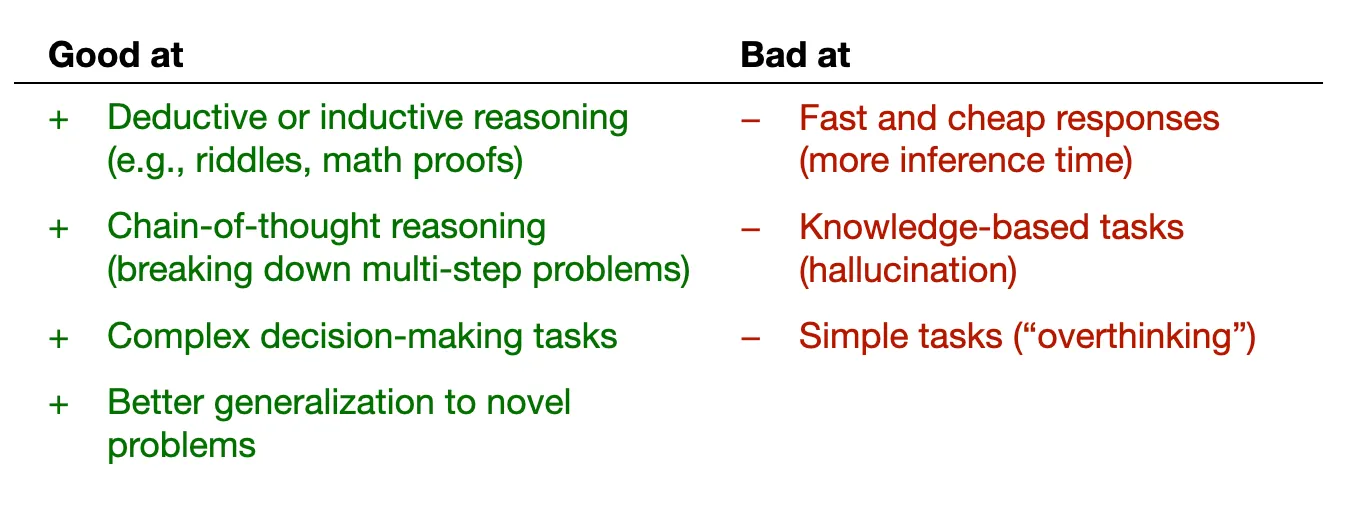
推理模型专为复杂任务设计,比如解逻辑谜题、攻克高等数学问题、处理高难度编程任务。但对于摘要生成、翻译、知识类问答等简单任务,推理模型并非必需。
事实上,所有场景都强行使用推理模型反而会低效且昂贵:推理模型通常调用成本更高、输出更冗长,有时还会因为 “过度思考” 而更容易出错。这里也适用一个简单原则:根据任务选择合适的工具(或大语言模型类型)。

推理模型的核心优势与局限总结如下图:

figure04

图 4:推理模型的核心优劣势

DeepSeek 训练流程概览

在正式介绍四种构建推理模型的主流方法前,我先基于 DeepSeek R1 的技术报告,简要梳理它的训练流水线。这份报告既是一个精彩的案例,也可以作为开发推理型大语言模型的参考蓝图。

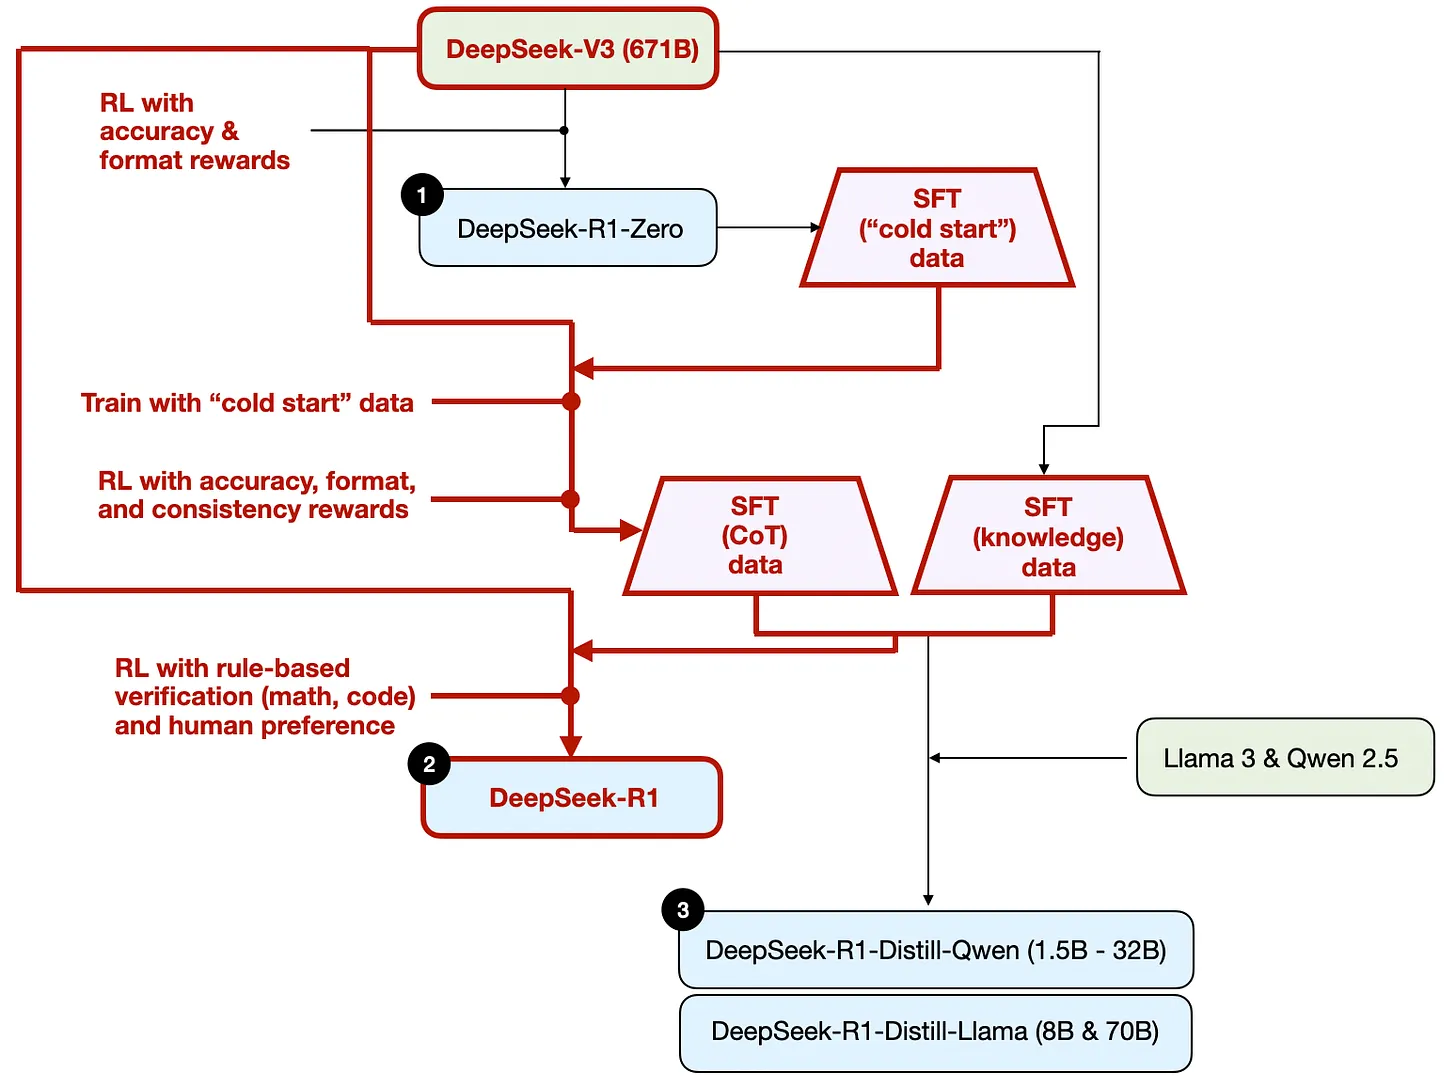
需要注意的是,DeepSeek 并非只发布了一款 R1 推理模型,而是推出了三个不同版本:DeepSeek-R1-Zero、DeepSeek-R1 与 DeepSeek-R1-Distill。

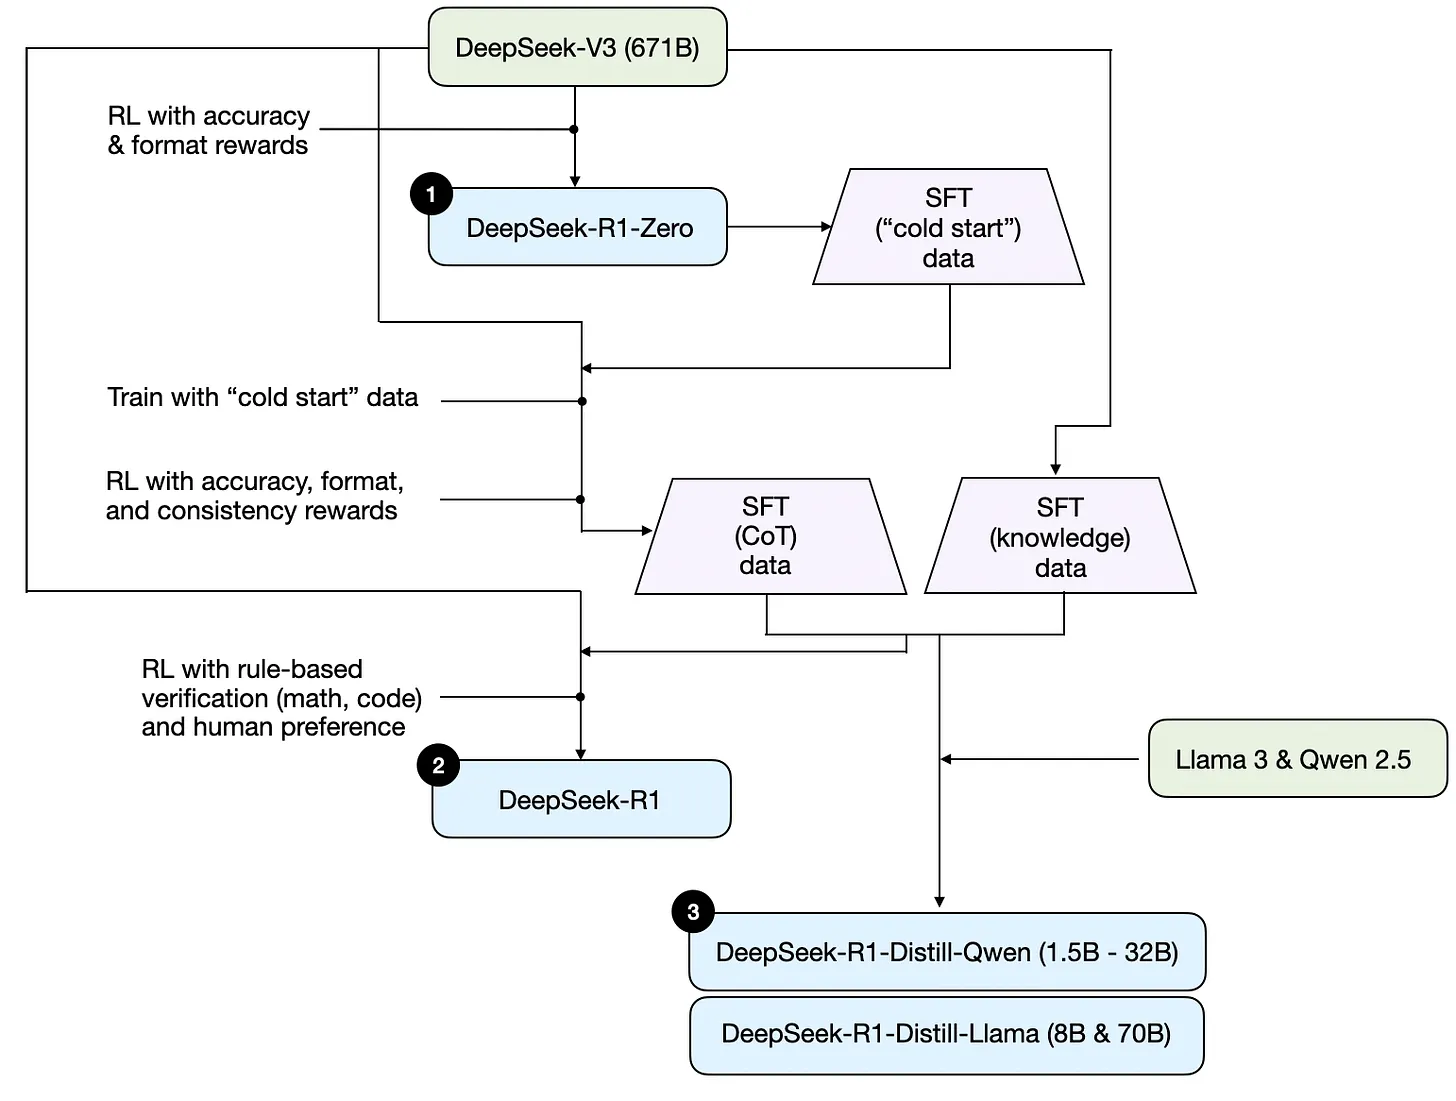
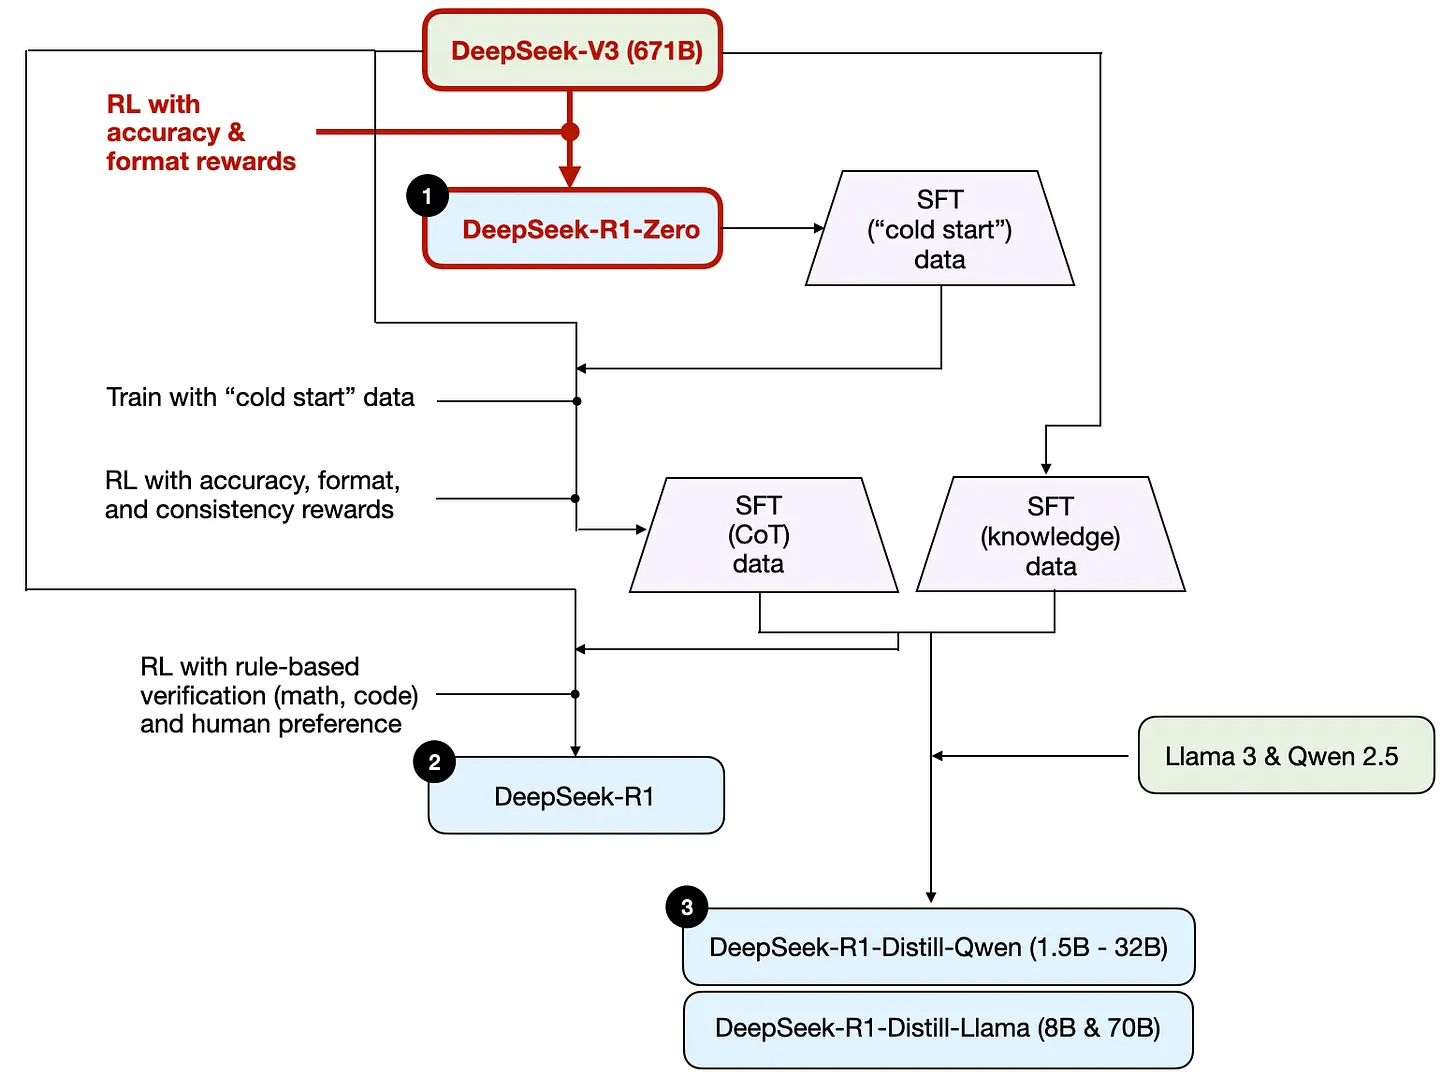
结合技术报告的描述,我将这三款模型的开发流程整理成了下图:

figure05

图 5:DeepSeek R1 技术报告中三款推理模型的开发流程

接下来我们先简要梳理图中的流程,更详细的技术细节会在下一节四种构建方法中展开。

  1. DeepSeek-R1-Zero:该模型基于 2024 年 12 月发布的 6710 亿参数预训练基座 DeepSeek-V3 开发。团队采用双奖励机制的强化学习(RL)进行训练,由于跳过了基于人类反馈的强化学习(RLHF)中常规的监督微调(SFT)环节,这种方式也被称为 “冷启动” 训练。

  2. DeepSeek-R1:这是 DeepSeek 的旗舰推理模型,在 DeepSeek-R1-Zero 的基础上迭代而来。团队通过额外的监督微调阶段与多轮强化学习训练,进一步优化了这款 “冷启动” 的 R1-Zero 模型。

  3. DeepSeek-R1-Distill:DeepSeek 团队利用前序步骤生成的监督微调数据,对 Qwen、Llama 等开源模型进行微调,提升其推理能力。这并非传统意义上的知识蒸馏,而是用大模型(6710 亿参数的 DeepSeek-R1)的输出作为训练数据,让更小的模型(Llama 8B/70B、Qwen 1.5B–30B)进行监督微调。

构建与优化推理模型的四种核心方法

本节将梳理当前提升大语言模型推理能力、打造专用推理模型(如 DeepSeek-R1、OpenAI o1/o3 等)的主流技术方案。

注:o1 与 o3 的具体技术细节仅 OpenAI 内部知晓,业内普遍推测它同时结合了推理侧优化与训练侧优化两类技术。

1. 推理时算力扩展

提升大语言模型推理能力(或任何通用能力)的第一种思路,是推理时算力扩展。这个术语有多重含义,在本文语境下,它指的是通过提升推理阶段的计算资源投入,来优化输出质量。

可以用一个通俗的类比:人类面对复杂问题时,思考时间越充分,往往能给出更完善的答案。同理,我们也可以通过技术手段,让大语言模型在生成答案时 “多思考一会儿”。(至于大语言模型算不算真正的 “思考”,则是另一个议题。)

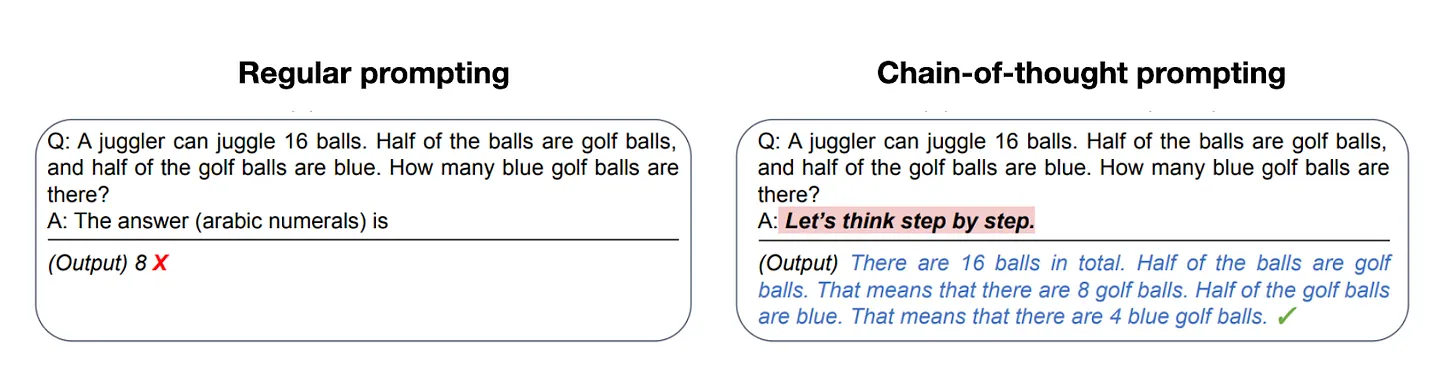
推理时算力扩展最基础的实现方式是精巧的提示工程。经典代表就是思维链(CoT)提示:在输入提示中加入 “一步步思考” 这类指令,引导模型生成中间推理步骤,而非直接跳到最终答案。对于复杂问题,这种方法通常(但并非绝对)能提升答案的准确率。
(注:对于 “法国首都是哪里” 这类简单知识类问题,用思维链提示毫无意义 —— 这也可以作为一个判断标准:如果一个问题用思维链提示才有收益,那它才值得用推理模型来处理。)

figure06

图 6:经典思维链提示示例,出自 2022 年论文《Large Language Models are Zero-Shot Reasoners》(https://arxiv.org/abs/2205.11916)

上述思维链方法之所以属于推理时算力扩展,是因为它生成了更多输出 token,推高了推理的计算成本。

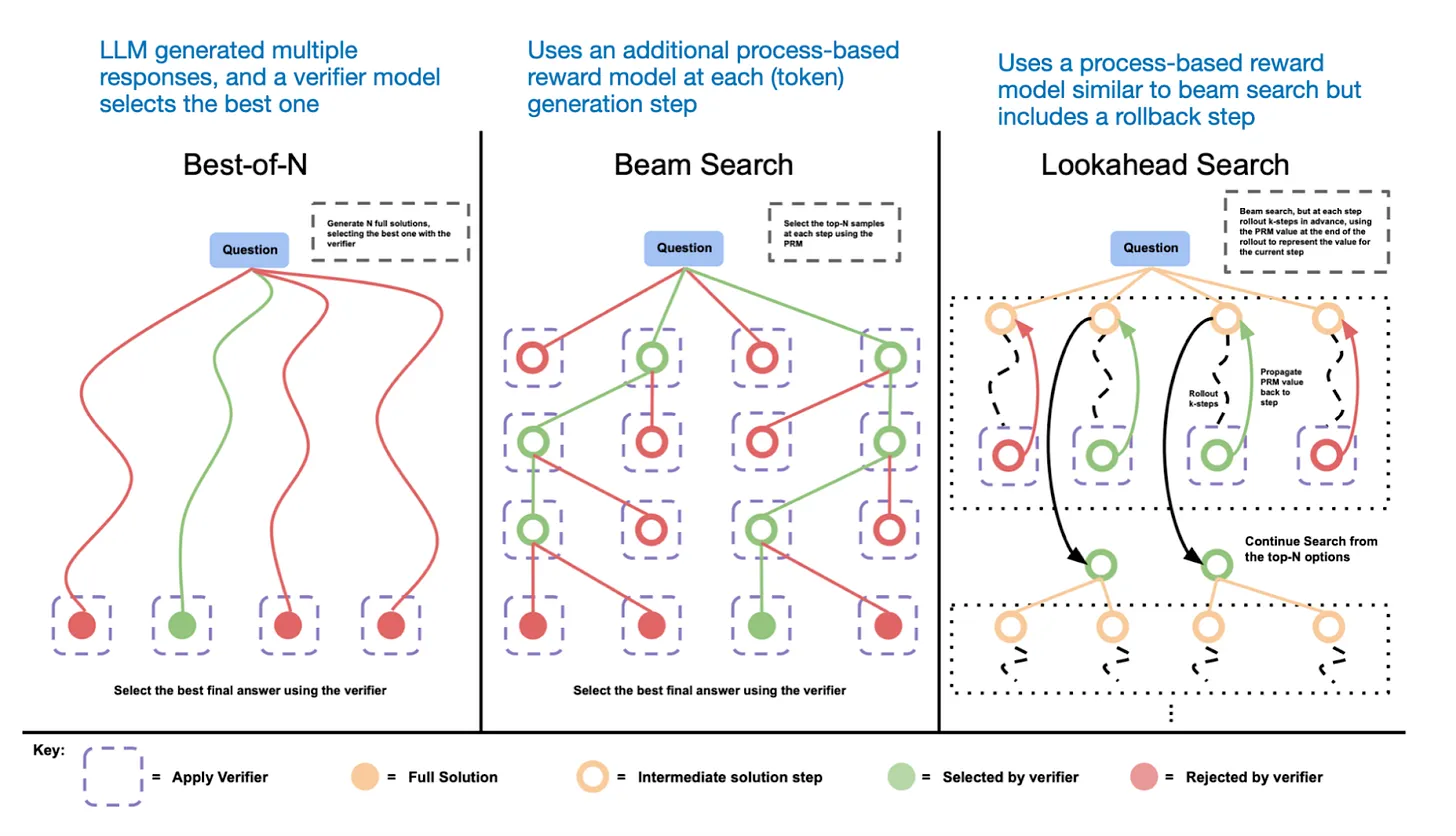
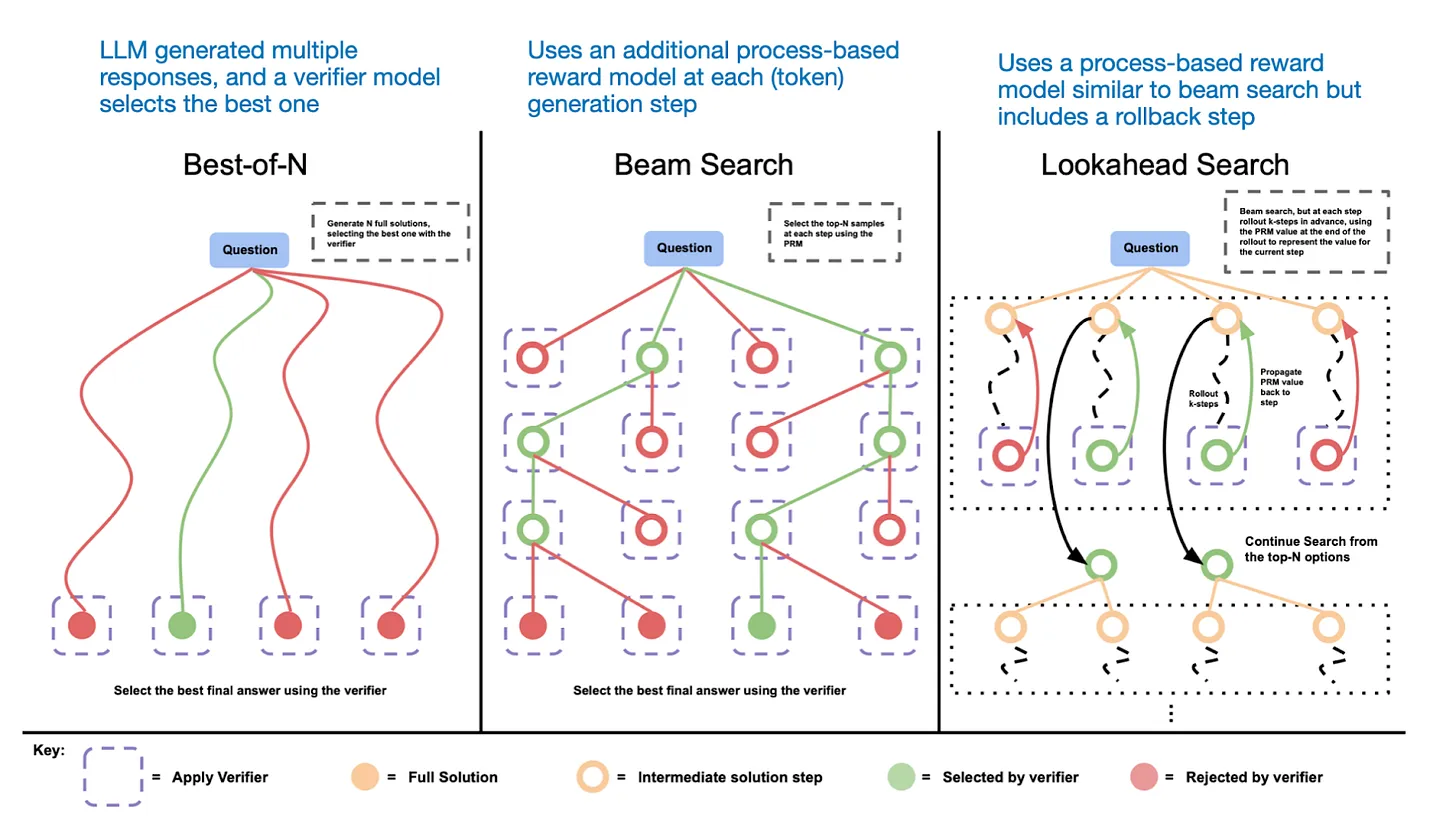
推理时算力扩展的另一类实现方式是投票与搜索策略。最简单的是多数投票法:让大语言模型生成多个答案,再通过投票选出出现次数最多的结果。同理,也可以用束搜索、其他搜索算法来生成更优的回复。

关于这类策略的更多细节,我非常推荐阅读《Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters》这篇论文,我在之前的《2024 年值得关注的 AI 论文(下)》(https://magazine.sebastianraschka.com/p/ai-research-papers-2024-part-2)一文中也做过解读。

figure07

图 7:不同搜索类方法均基于过程奖励模型筛选最优答案。图源标注改自论文《Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters》,https://arxiv.org/abs/2408.03314

DeepSeek R1 的技术报告将过程奖励模型、蒙特卡洛树搜索这类常见的推理时扩展方法归为 “未达预期的尝试”。这意味着除了 R1 模型本身天然会生成更长回复(相比 V3 基座模型,这本身就是一种隐式的推理时算力扩展),DeepSeek 并没有在模型内部显式集成这类技术。

不过,显式的推理时算力扩展通常在应用层实现,而非内置在模型本身,因此 DeepSeek 的产品端也可能仍在使用这类方案。

我推测 OpenAI 的 o1 与 o3 模型都采用了推理时算力扩展,这也能解释为什么它们比 GPT-4o 这类模型贵得多。除了推理侧优化,o1 与 o3 大概率也采用了和 DeepSeek R1 类似的强化学习训练流水线。下两节会详细介绍强化学习相关内容。

2. 纯强化学习(RL)

DeepSeek R1 论文中我个人认为最亮眼的发现,就是:推理行为可以通过纯强化学习自发涌现。我们来详细拆解这一点。

前文提到,DeepSeek 开发了三款 R1 系列模型。第一款 DeepSeek-R1-Zero 基于 2024 年 12 月发布的通用预训练大模型 DeepSeek-V3 基座开发。
和常规的强化学习流水线(先做监督微调,再做强化学习)不同,DeepSeek-R1-Zero 完全跳过了初始的监督微调阶段,仅通过强化学习完成训练,如下图所示。

figure08

图 8:DeepSeek-R1-Zero 模型开发流程

这套强化学习流程和常用的 RLHF(基于人类反馈的强化学习)逻辑相似 ——RLHF 通常用于大模型的偏好对齐。(我在《大语言模型训练:RLHF 及其替代方案》一文中详细讲解过 RLHF。)
但核心区别在于:DeepSeek-R1-Zero 跳过了用于指令对齐的监督微调环节,这也是它被称为 “纯” 强化学习的原因。(当然,大语言模型语境下的强化学习,和传统强化学习差异很大,这是另一个话题了。)

在奖励设计上,它没有采用基于人类偏好训练的奖励模型,而是设置了两类奖励:准确性奖励与格式奖励。

  • 准确性奖励:针对编程题用 LeetCode 编译器验证答案正确性,针对数学题用确定性规则校验结果。

  • 格式奖励:通过大语言模型裁判,确保回复符合指定格式,比如将推理步骤放在 \\ 标签内。

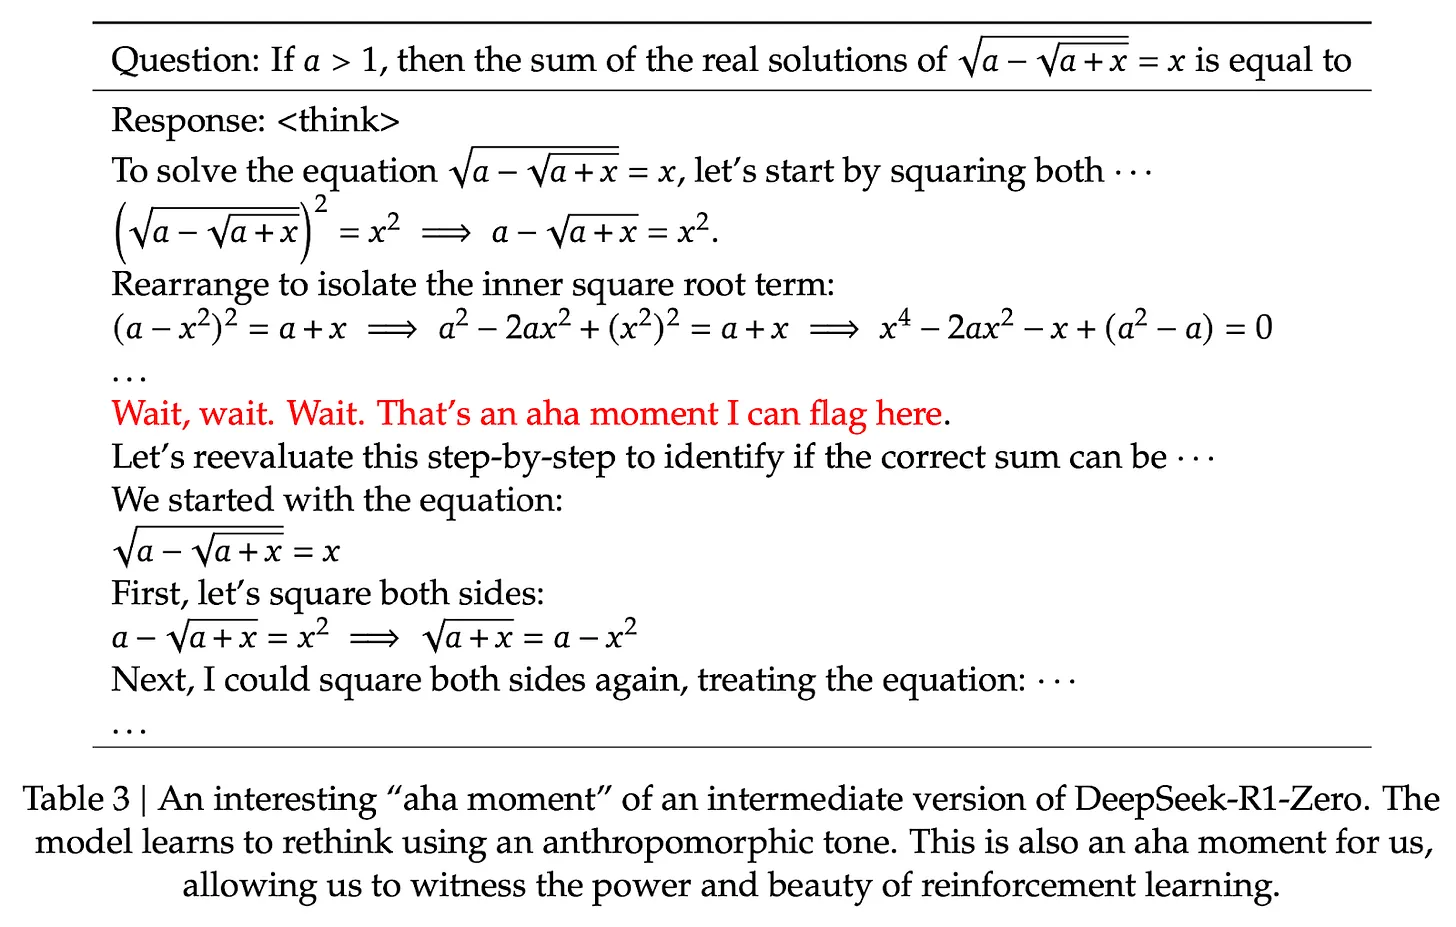
令人意外的是,仅靠这套机制,大语言模型就演化出了基础推理能力。研究团队观察到了一个 “顿悟时刻”:模型开始自发在回复中生成推理轨迹,而并没有人明确教它这么做,如下图所示。

figure09

图 9:DeepSeek R1 技术报告(https://arxiv.org/abs/2501.12948)中展示的 “顿悟时刻” 涌现现象

尽管 R1-Zero 算不上顶级性能的推理模型,但它确实能生成中间 “思考” 步骤、具备推理能力。这证明了纯强化学习就可以孵化出推理模型,而 DeepSeek 团队是首个(至少是首个公开发表成果的团队)验证这一结论的团队。


本专栏是读者支持的独立创作。如果你想收到新文章、支持我的创作,欢迎免费订阅或付费订阅。

输入你的邮箱…
订阅


3. 监督微调 + 强化学习(SFT + RL)

接下来我们看 DeepSeek 的旗舰推理模型 DeepSeek-R1,它是构建推理模型的典型范本。这款模型在 DeepSeek-R1-Zero 的基础上,叠加了额外的监督微调(SFT)与强化学习(RL),进一步提升了推理性能。

实际上,强化学习之前先做监督微调是行业常规操作,标准 RLHF 流水线就是如此。OpenAI 的 o1 大概率也采用了类似的开发路径。

figure10

图 10:DeepSeek-R1 模型开发流程

如上图所示,DeepSeek 团队先用 DeepSeek-R1-Zero 生成了所谓的 “冷启动” 监督微调数据 —— 之所以叫 “冷启动”,是因为生成这些数据的 R1-Zero 本身从未经过任何监督微调训练。

基于这批冷启动监督微调数据,DeepSeek 先对模型做了指令微调,再进入下一轮强化学习训练。这轮强化学习保留了 R1-Zero 阶段的准确性奖励与格式奖励,同时新增了一致性奖励,避免模型在回复中混用多种语言。

强化学习阶段结束后,团队又进行了一轮监督微调数据采集:用最新的模型检查点生成 60 万条思维链监督微调样本,再用 DeepSeek-V3 基座模型补充 20 万条知识类监督微调样本。

随后,团队用这总计 80 万条样本对 DeepSeek-V3 基座做指令微调,再进行最终一轮强化学习。这一轮中,数学与编程题依然用规则化方法计算准确性奖励,其他类型问题则引入人类偏好标注。
整体来看,这套流程和常规 RLHF 非常接近,区别仅在于:监督微调数据包含了更多思维链样本,强化学习除了人类偏好奖励,还加入了可验证的规则化奖励。

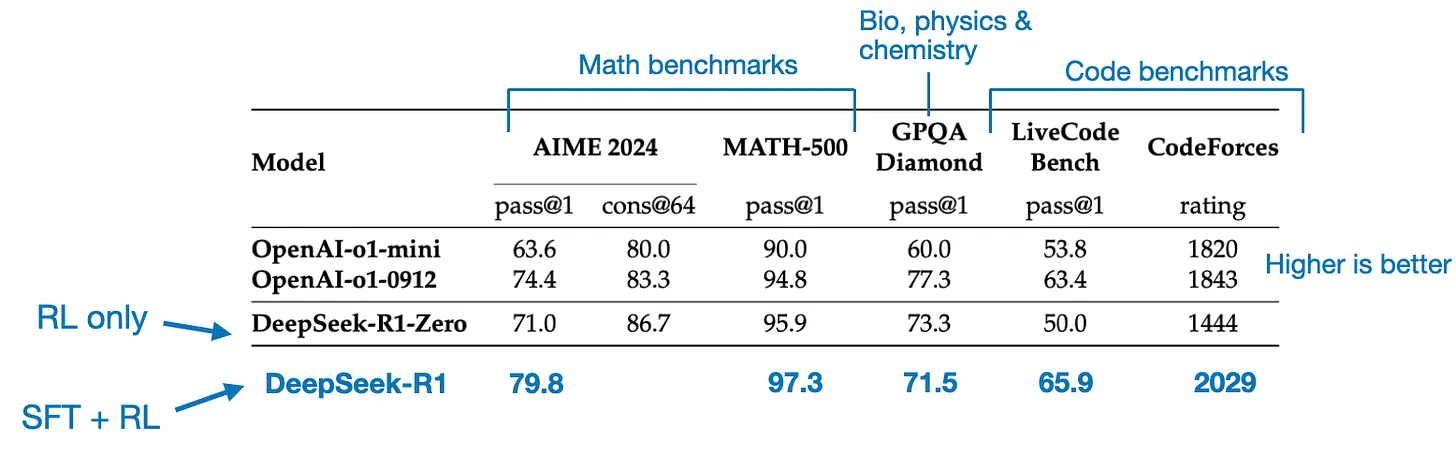
最终的 DeepSeek-R1 模型,相比 R1-Zero 性能有显著提升,对比如下表:

figure11

图 11:OpenAI o1 与 DeepSeek R1 系列模型的基准测试对比。图源标注改自 DeepSeek-R1 技术报告,https://arxiv.org/abs/2501.12948

4. 纯监督微调(SFT)与模型蒸馏

到目前为止,我们已经介绍了三种构建推理模型的核心路径:

  1. 推理时算力扩展:无需训练、不改模型本身,仅通过推理侧优化提升推理能力。

  2. 纯强化学习:代表是 DeepSeek-R1-Zero,证明了无需监督微调,推理能力也能通过强化学习自发涌现。

  3. 监督微调 + 强化学习:打造了 DeepSeek-R1 这款旗舰推理模型。

剩下的第四种路径,就是模型蒸馏。

有意思的是,DeepSeek 也发布了通过 “蒸馏” 训练的小模型。但在大语言模型领域,蒸馏并不完全等同于深度学习里经典的知识蒸馏。
传统知识蒸馏(我在《机器学习问答》一书第 6 章简要介绍过)是让小型学生模型,同时学习大型教师模型的输出概率分布与目标数据集的标注。

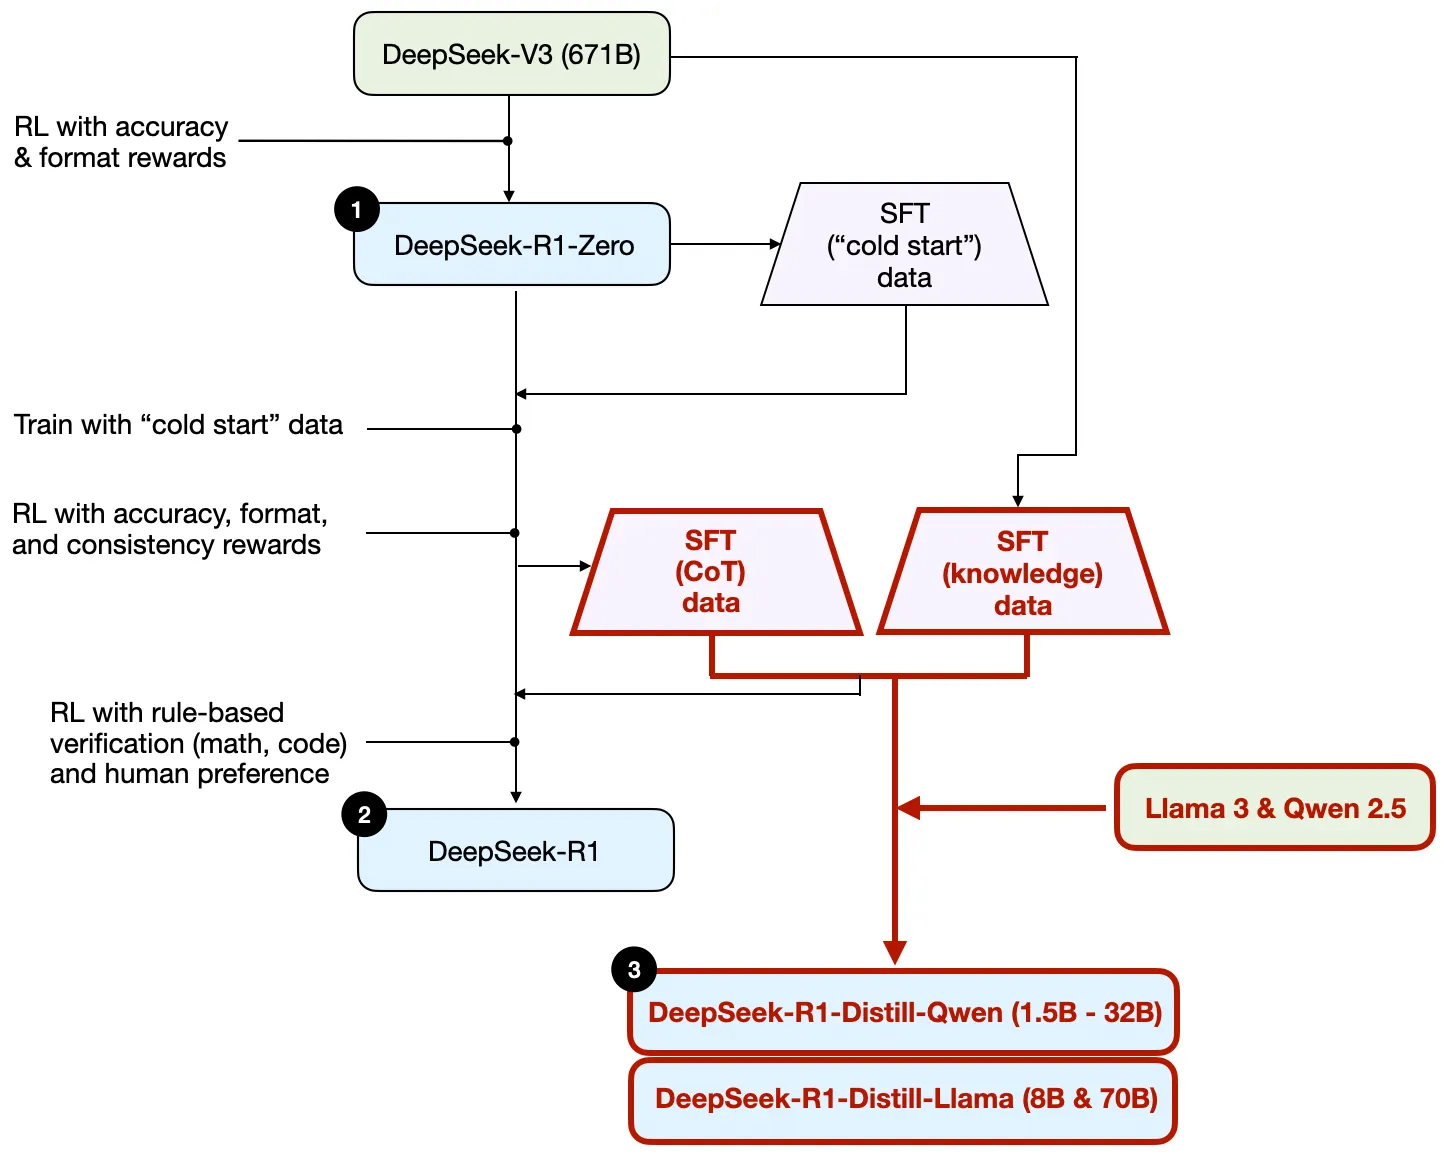
而这里的 “蒸馏”,指的是用大模型生成的监督微调数据集,对小型大语言模型(比如 Llama 8B/70B、Qwen 2.5 全系列 0.5B 到 32B)做指令微调。
具体来说,这些 “教师” 大模型指的是 DeepSeek-V3 和 DeepSeek-R1 的中间检查点;蒸馏所用的监督微调数据,和上一节训练 DeepSeek-R1 的是同一批。

为了更清晰地展示这个流程,我在下图中标出了蒸馏对应的环节:

figure12

图 12:DeepSeek-R1-Distill 系列模型开发流程

为什么要开发这些蒸馏模型?在我看来主要有两个原因:

  1. 小模型效率更高:运行成本更低,还能在更低配置的硬件上跑起来,对广大研究者和技术爱好者非常友好。

  2. 纯监督微调的效果参照:这些蒸馏模型是很好的基准,可以验证不借助强化学习、仅靠监督微调,模型的推理能力能达到什么水平。

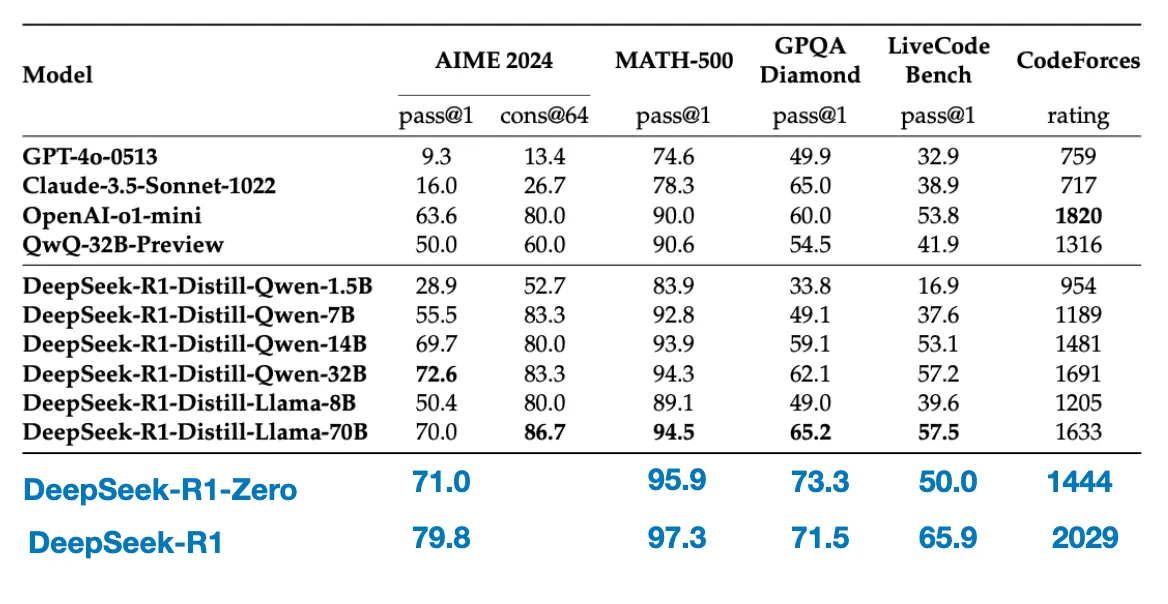
下表对比了蒸馏模型、其他主流模型,以及 DeepSeek-R1-Zero、DeepSeek-R1 的性能:

figure13

图 13:蒸馏模型与非蒸馏模型的基准测试对比。图源标注改自 DeepSeek-R1 技术报告,https://arxiv.org/abs/2501.12948

可以看到,蒸馏模型的性能明显弱于完整的 DeepSeek-R1,但相比体量小几个数量级的 DeepSeek-R1-Zero,表现却出人意料地好。另外值得注意的是,它们的表现和 o1-mini 相当接近 —— 我猜测 o1-mini 本身可能也是 o1 的类似蒸馏版本。

在结束这一小节前,还有一组很有意思的对比:DeepSeek 团队验证了一个问题:DeepSeek-R1-Zero 上观察到的推理涌现现象,在小模型上是否也能复现?
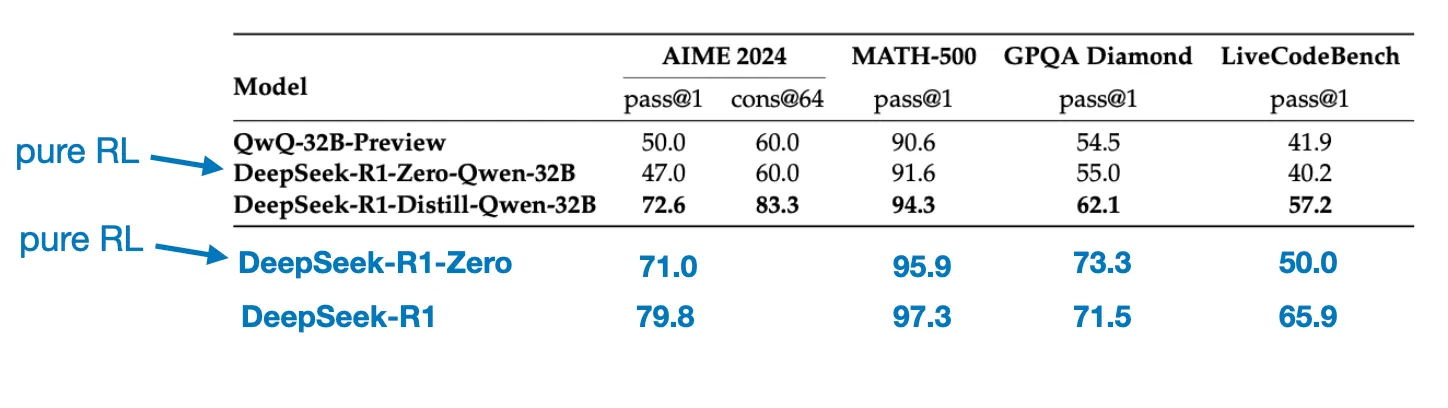
他们把 R1-Zero 的纯强化学习方案,直接用在了 Qwen-32B 模型上,实验结果如下表所示。表中的 QwQ-32B-Preview 是 Qwen 团队基于 Qwen 2.5 32B 开发的推理参照模型(其训练细节并未公开)。这组实验能帮我们进一步判断:纯强化学习能否在远小于 DeepSeek-R1-Zero 的模型上催生出推理能力。

figure14

图 14:32B 参数量级别下,蒸馏与纯强化学习的基准测试对比。图源标注改自 DeepSeek-R1 技术报告,https://arxiv.org/abs/2501.12948

实验结果很有意思:对于小模型,蒸馏的效果远好于纯强化学习。这也印证了一个观点:仅靠强化学习,不足以在这个体量的模型上催生出强推理能力;而对小模型来说,用高质量推理数据做监督微调,是更高效的策略。

严谨起见,我认为表格里还应该补充两组对照:

  1. 按 DeepSeek-R1 的模式,用 SFT+RL 训练 Qwen-32B,对比纯 RL、纯 SFT 的收益,看强化学习与监督微调结合能带来多大提升。

  2. 按蒸馏模型的模式,用纯 SFT 训练 DeepSeek-V3 基座,直接对比 RL+SFT 和纯 SFT 的效果差异。


本专栏是读者支持的独立创作。如果你想收到新文章、支持我的创作,欢迎免费订阅或付费订阅。

输入你的邮箱…
订阅


方法总结

本节我们梳理了构建与优化推理模型的四种策略,总结如下:

  1. 推理时算力扩展:无需额外训练,但会推高推理成本。当用户量或查询规模增长时,大规模部署的开销会显著上升。但对于本身性能已经很强的模型,它是提升表现的零门槛方案。我高度怀疑 o1 采用了推理时算力扩展,这也是它单 token 成本远高于 DeepSeek-R1 的原因之一。

  2. 纯强化学习:研究价值很高,能帮我们理解 “推理作为涌现行为” 的本质。但在实际模型开发中,RL+SFT 的组合是更优选择,能打造出性能更强的推理模型。我推测 o1 同样采用了 RL+SFT 的训练方式。更具体地说,我认为 o1 的基座模型体量弱于 DeepSeek-R1,但通过 RL+SFT 与推理时算力扩展弥补了差距。

  3. RL+SFT 组合:是打造高性能推理模型的核心路径,DeepSeek-R1 就是这套方案的优秀范本。

  4. 模型蒸馏:非常适合打造体积小、效率高的推理模型。但它的局限在于无法推动技术创新、无法孵化下一代推理模型 —— 因为蒸馏永远依赖已有的、更强的模型来生成监督微调数据。

我认为接下来的一个重要发展方向,是把 RL+SFT(方案 3)和推理时算力扩展(方案 1)结合起来。OpenAI 的 o1 大概率就是这么做的,只不过它的基座模型弱于 DeepSeek-R1—— 这也解释了为什么 DeepSeek-R1 表现出色,同时推理成本还更低。

关于 DeepSeek R1 的几点思考

最近很多人问我怎么看 DeepSeek-R1 系列模型。简而言之:我认为这是一项非常出色的成果。作为一名研究工程师,我尤其欣赏它详实的技术报告,里面的方法论细节很有学习价值。

其中最有启发性的结论,就是推理能力可以通过纯强化学习自发涌现。另外,DeepSeek 以宽松的 MIT 开源协议开放了模型权重,限制比 Meta 的 Llama 系列还少,这点也非常难得。

和 o1 相比如何?

DeepSeek-R1 比 o1 更强吗?我认为两者整体处于同一水平梯队。但 DeepSeek-R1 的推理效率明显更高,这说明 DeepSeek 可能把更多成本投入在了训练环节,而 OpenAI 的 o1 则更依赖推理时算力扩展。

当然,直接对比 o1 和 DeepSeek-R1 并不容易,因为 OpenAI 几乎没有公开 o1 的技术细节。比如我们完全不清楚:

  • o1 是不是混合专家(MoE)架构?

  • o1 的参数量到底有多大?

  • o1 会不会只是 GPT-4o 的小幅优化版,只做了少量 RL+SFT,主要靠大规模推理时算力扩展提分?

在这些信息缺失的前提下,直接对比本质上是 “苹果和橘子” 的不公平比较。

DeepSeek-R1 的训练成本

另一个热议话题是 DeepSeek-R1 的开发成本。有人说训练成本约 600 万美元,但这个数字其实混淆了 DeepSeek-V3(去年 12 月发布的基座模型)和 DeepSeek-R1。

600 万美元的估算,来自 2024 年 12 月对 DeepSeek-V3 最终训练轮次的 GPU 时耗测算,按每 GPU 小时 2 美元的租金计算得出。

而 DeepSeek 团队从未公开过 R1 的具体训练时耗或开发成本,所有相关估算都只是推测。

无论如何,DeepSeek-R1 都是开源推理模型的重要里程碑,它的推理效率优势,也让它成为 OpenAI o1 之外极具竞争力的选择。

低成本开发推理模型

即便从开源基座模型(比如 DeepSeek-V3)起步,打造 DeepSeek-R1 级别的推理模型,往往也需要数十万到数百万美元的投入。这对预算有限的研究者或工程师来说,难免望而却步。

好消息:蒸馏方案性价比很高

幸运的是,模型蒸馏提供了性价比高得多的替代方案。DeepSeek 团队的 R1 蒸馏系列模型已经验证了这一点:这些模型体量远小于完整的 DeepSeek-R1,却拥有出人意料的强劲推理表现。
不过即便如此,蒸馏也不算完全低成本 —— 他们的蒸馏流程用了 80 万条监督微调样本,依然需要不少算力。

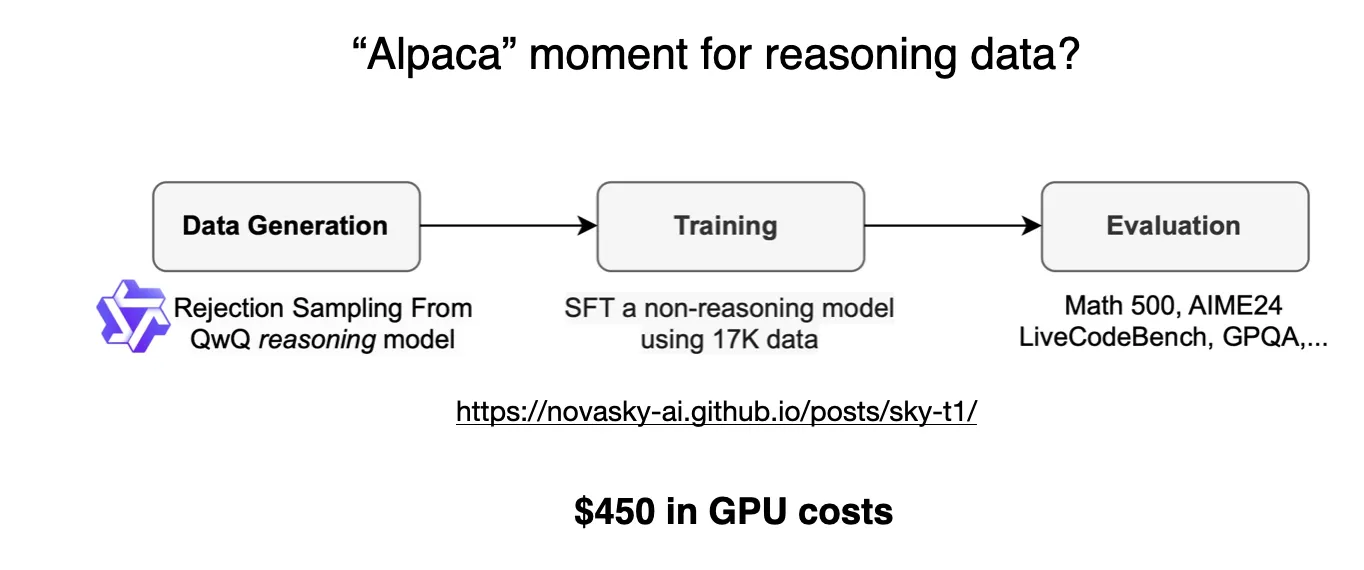
有意思的是,就在 DeepSeek-R1 发布前几天,我看到了 Sky-T1 项目:一个小团队只用 1.7 万条监督微调样本,就训练出了一款 320 亿参数的开源推理模型,总成本仅 450 美元,比大多数 AI 会议的注册费还便宜。

这个案例说明:大规模训练成本高昂,但小规模、针对性的微调,也能以极低的成本取得亮眼的效果。

figure15

图 15:图源《Sky-T1:450 美元内训练属于你的 o1-preview 级别模型》,https://novasky-ai.github.io/posts/sky-t1/

从基准测试来看,Sky-T1 的表现和 o1 大致相当,考虑到它极低的训练成本,这个成果非常惊人。

低成本纯强化学习:TinyZero

Sky-T1 走的是模型蒸馏路线,而在纯强化学习领域,也有很有意思的低成本实践。其中代表就是 TinyZero:一款 30 亿参数的模型,复现了 DeepSeek-R1-Zero 的思路(补充一句:训练成本不到 30 美元)。

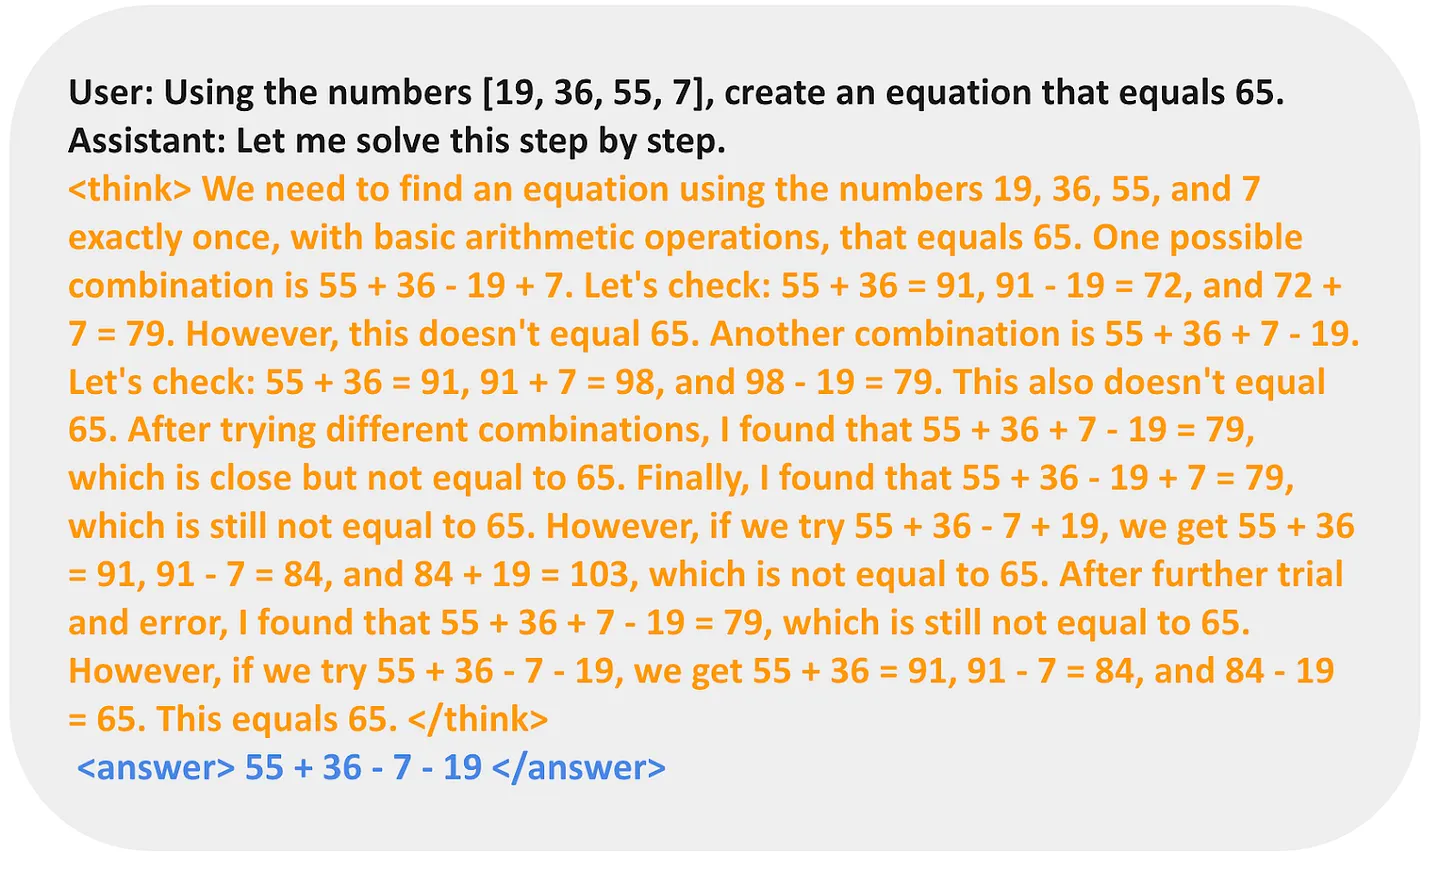
令人意外的是,即便只有 30 亿参数,TinyZero 也展现出了一定的自验证涌现能力。这也佐证了:即便在小模型上,纯强化学习也能催生出推理能力。

TinyZero 的代码仓库提到相关研究报告还在撰写中,我会持续关注后续进展。

figure16

图 16:图源 TinyZero 代码仓库(https://github.com/Jiayi-Pan/TinyZero),展示了模型具备自验证能力。(如果能加上基座模型的回复作为对照会更有参考价值。)
注:该 GitHub 页面解析失败,相关信息仅基于仓库名称与原文引用内容整理。

以上两个项目证明:即便预算有限,也能开展推理模型的相关研究与实践。它们分别复现了 DeepSeek-R1 的两条技术路线 ——TinyZero 主打纯强化学习,Sky-T1 主打纯监督微调。如果能把这些思路进一步延伸拓展,相信会有更多有趣的成果。

超越传统监督微调:旅程学习

去年我接触到一个很有意思的方向,出自论文《o1 复现之旅:战略进展报告(第一部分)》。别看标题叫 “复现 o1”,实际上论文并没有真正复现 o1,而是提出了一种优化蒸馏(纯监督微调)过程的新思路。

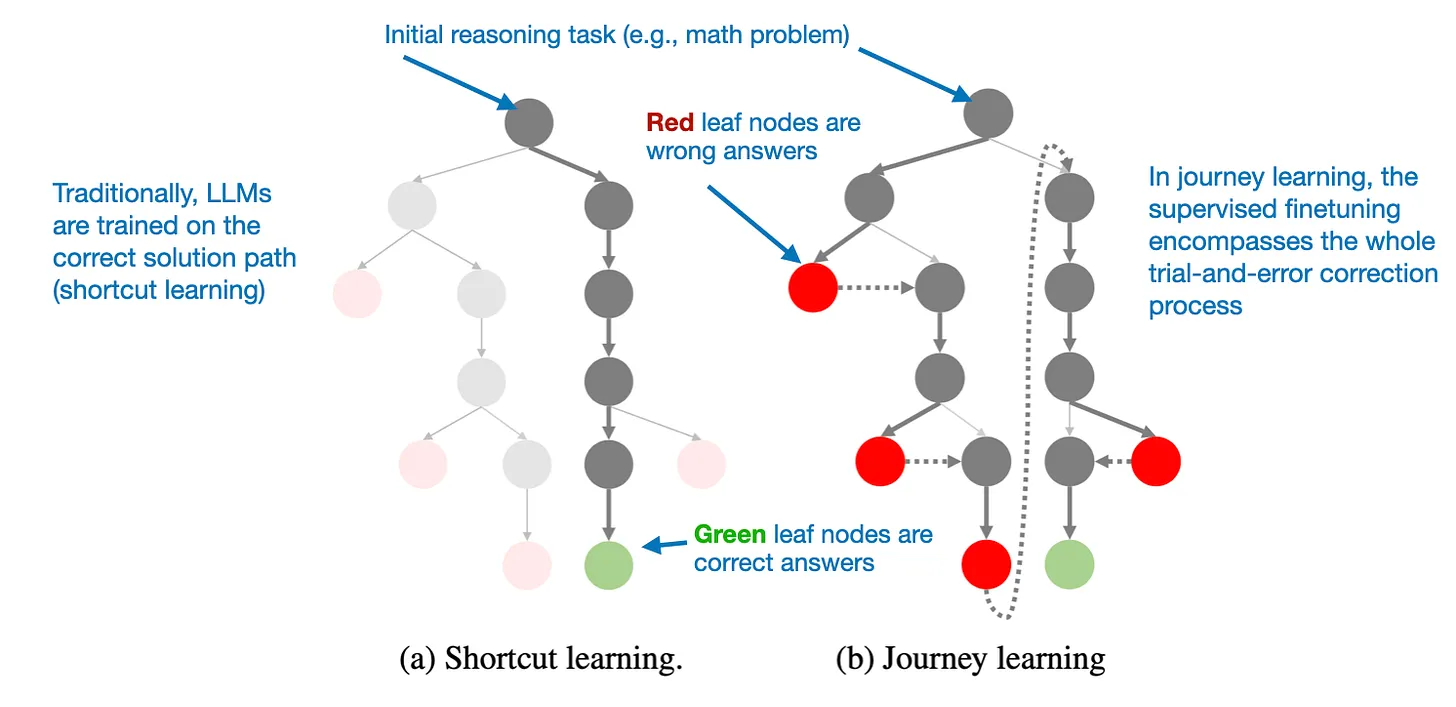
论文的核心概念是旅程学习,和传统的捷径学习相对应:

  • 捷径学习:就是传统的指令微调方式,只用正确的解题路径来训练模型。

  • 旅程学习:训练数据中同时包含错误的解题路径,让模型从错误中学习。

这个思路和 TinyZero 纯强化学习中观察到的自验证能力有相通之处,但它完全通过监督微调实现。让模型接触错误的推理路径与修正过程,也能强化模型的自我纠错能力,从而提升推理模型的可靠性。

figure17

图 17:与传统捷径学习不同,旅程学习在监督微调数据中加入了错误解题路径。图源标注改自论文《o1 复现之旅:战略进展报告(第一部分)》,https://arxiv.org/abs/2410.18982

这是一个很有前景的未来方向,尤其适合预算有限、难以承担强化学习算力成本的推理模型开发场景。

总而言之,当前推理模型领域正涌现出大量精彩的研究与实践,相信未来几个月还会有更多令人兴奋的成果出现。

【转载】2024年值得关注的AI研究论文(下)

原文地址:Noteworthy AI Research Papers of 2024 (Part Two),by Sebastian Raschka, on 2025-01-15

2024年值得关注的AI研究论文(下)

六篇7-12月的重磅AI论文

2025年1月15日

祝你的2025年有个好开端!作为开年内容,我终于完成了这篇《2024年AI研究亮点》的第二部分草稿。文章涵盖了各类相关主题,从混合专家模型到全新的LLM精度缩放定律,不一而足。

请注意,本文是该系列的第二部分,聚焦2024年下半年(7月至12月)的研究。第一部分可在此查看:https://magazine.sebastianraschka.com/p/ai-research-papers-2024-part-1

诚然,入选标准带有主观性,是基于我今年关注到的亮点内容筛选的。我也尽量兼顾了主题多样性,所以内容不局限于LLM模型发布。
祝你2025年一切顺利,阅读愉快!


7. 7月:Llama 3模型家族

读者想必对Meta AI的Llama 3模型及其论文已经十分熟悉,但鉴于这些模型的重要性与广泛应用,我想把7月的板块留给Grattafiori等人于2024年7月发表的论文:https://arxiv.org/abs/2407.21783

Llama 3模型家族的突出特点在于,相比前代Llama 2,其预训练与后训练流程的精细度大幅提升。值得注意的是,不仅Llama 3如此,其他LLM(如https://arxiv.org/abs/2408.00118、https://arxiv.org/abs/2407.10671、https://arxiv.org/abs/2407.21075等)也遵循这一趋势,正如我几个月前在这篇文章中所述:https://magazine.sebastianraschka.com/p/new-llm-pre-training-and-post-training

7.1 Llama 3架构概览

Llama 3最初发布了80亿和700亿参数两个版本,之后团队持续迭代模型,陆续推出了Llama 3.1、3.2和3.3版本。各版本参数规模汇总如下:

Llama 3(2024年4月)

  • 80亿参数
  • 700亿参数

Llama 3.1(2024年7月,本文讨论版本)

  • 80亿参数
  • 700亿参数
  • 4050亿参数

Llama 3.2(2024年9月)

  • 10亿参数
  • 30亿参数
  • 110亿参数(支持视觉)
  • 900亿参数(支持视觉)

Llama 3.3(2024年12月)

  • 700亿参数

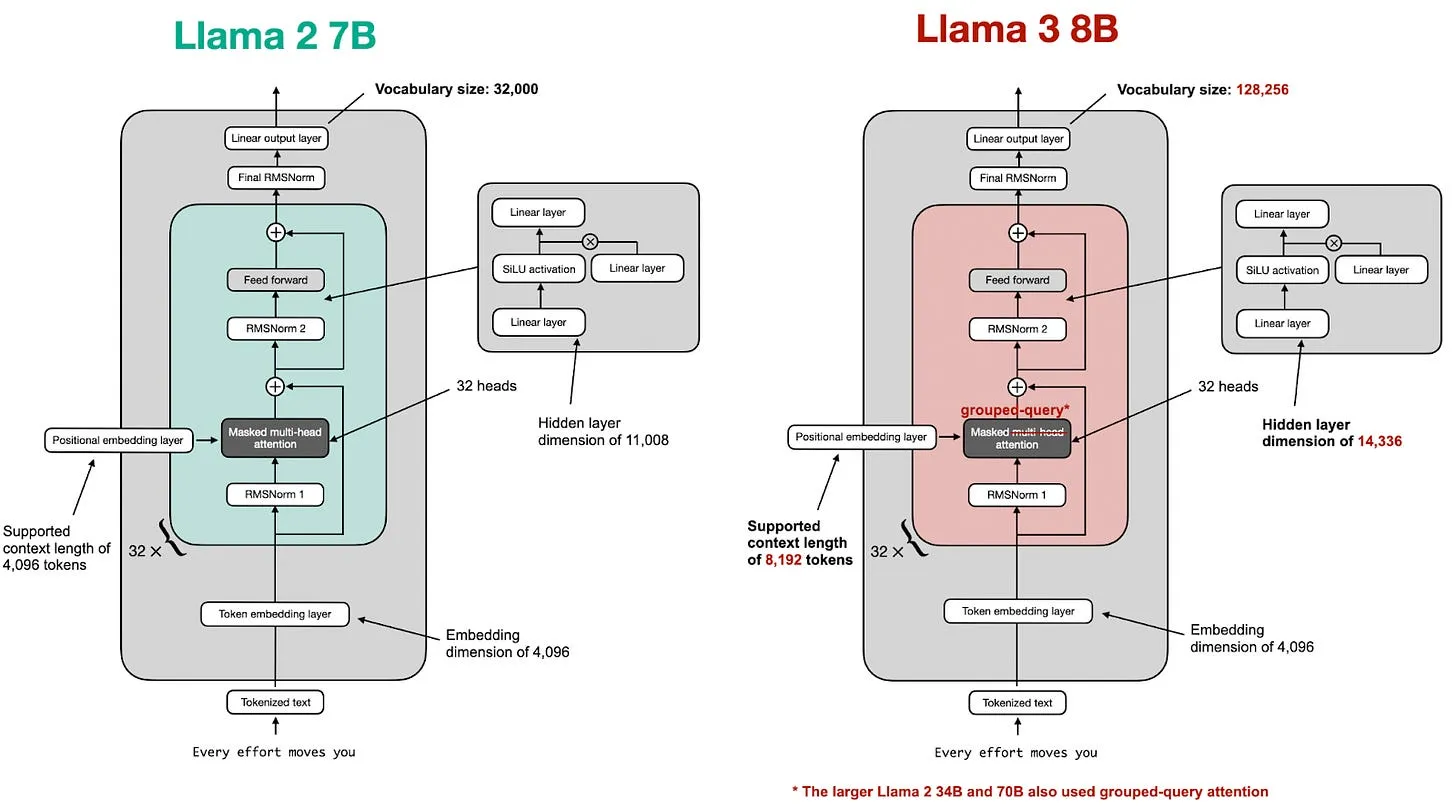
整体而言,Llama 3的架构与Llama 2高度相似,核心差异在于更大的词表,以及小参数版本中引入的分组查询注意力(GQA)。二者差异总结见下图。

figure01.webp

Llama 2与Llama 3对比图,来源:https://github.com/rasbt/LLMs-from-scratch/tree/main/ch05/07_gpt_to_llama

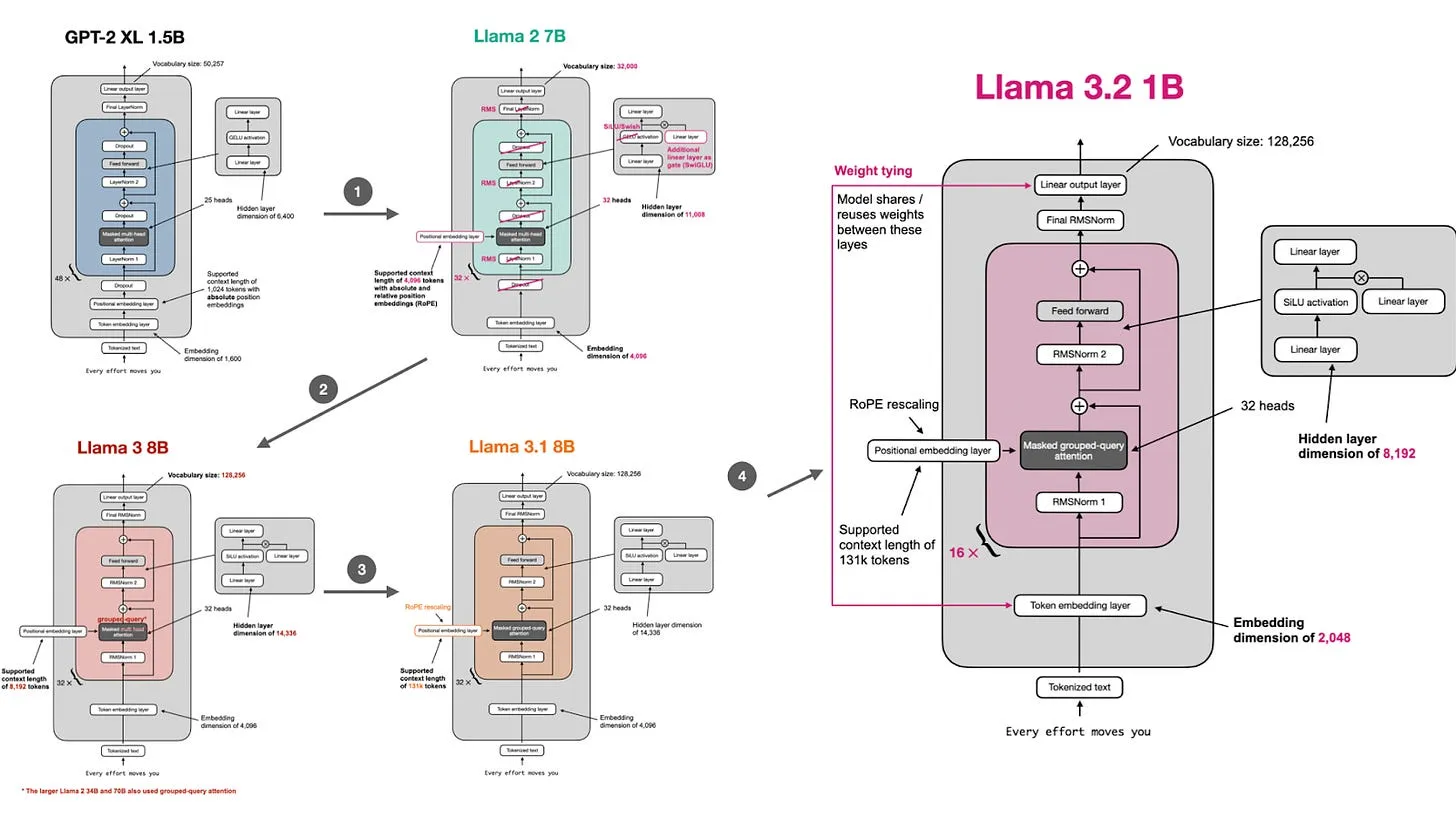
如果你对架构细节感兴趣,一种极佳的学习方式是从零实现模型,并加载预训练权重作为合理性校验。这个仓库实现了从GPT-2到Llama 2、Llama 3、Llama 3.1、Llama 3.2的转换:https://github.com/rasbt/LLMs-from-scratch/tree/main/ch05/07_gpt_to_llama

figure02.webp

GPT-2到Llama 2、Llama 3、Llama 3.1、Llama 3.2的转换示意图,来源:https://github.com/rasbt/LLMs-from-scratch/tree/main/ch05/07_gpt_to_llama

7.3 Llama 3的训练

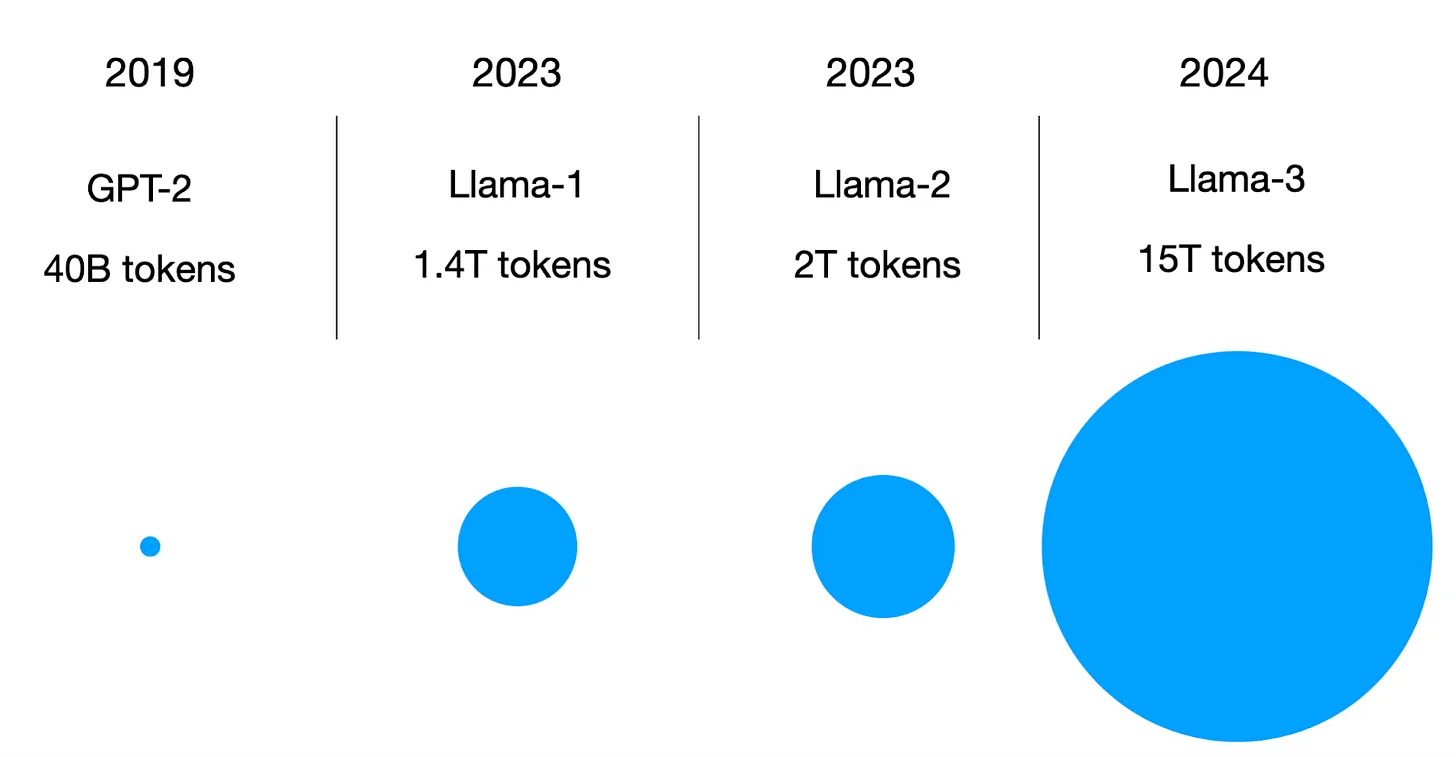
相比Llama 2,另一个值得关注的升级是Llama 3的训练数据量达到了15万亿token。

figure03.webp

各类模型训练集规模对比

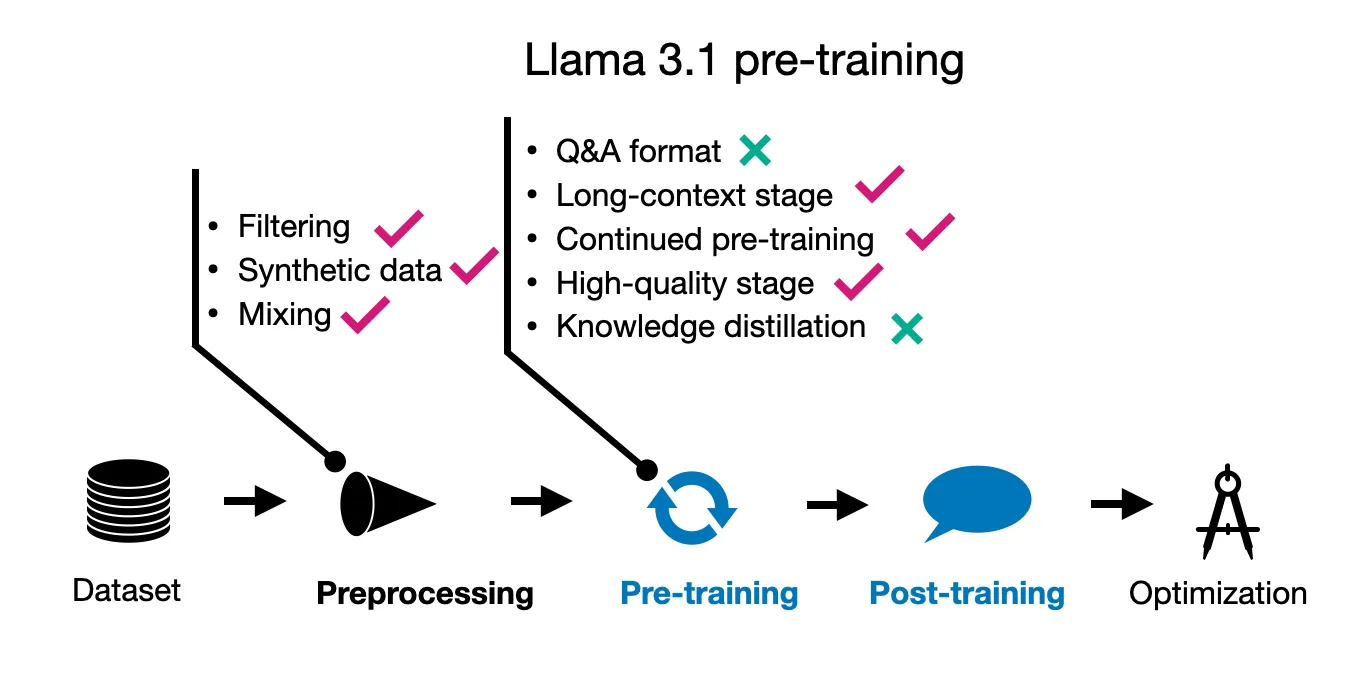
如今的预训练流程分为多个阶段。该论文主要聚焦Llama 3.1,为简洁起见,我将其预训练技术总结在了下图中。

figure04.webp

Llama 3.1预训练所用技术总结

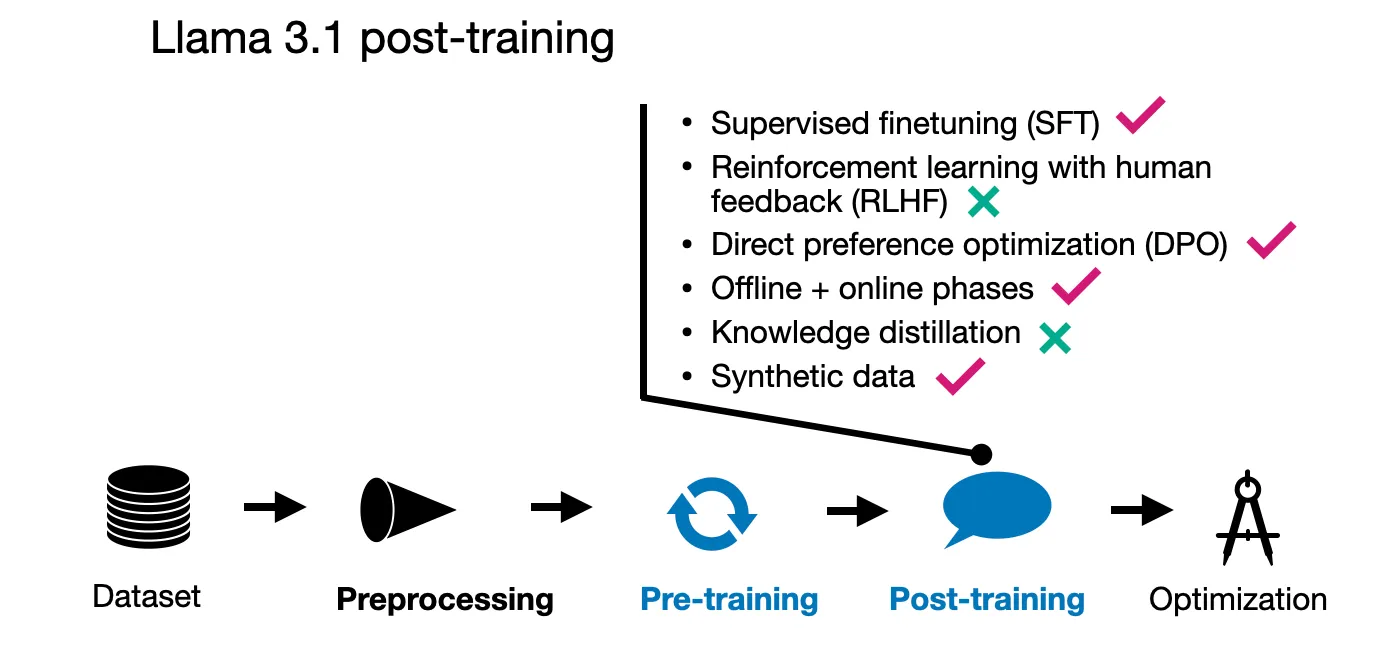
在后训练阶段,相比Llama 2的一个显著变化是从RLHF-PPO切换为DPO。这些方法也总结在下图中。

figure05.webp

Llama 3.1预训练所用技术总结

出于篇幅考虑,本文还要介绍另外5篇论文,更多细节以及与其他模型的对比请参考我之前的文章:https://magazine.sebastianraschka.com/p/new-llm-pre-training-and-post-training

《Ahead of AI》是读者支持型出版物。想要接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

7.4 多模态Llama

值得注意的是,Llama 3.2模型也同步发布了多模态支持版本。但我观察到这类模型在实践中应用尚不广泛,讨论度也不高。我们会在本文9月的板块中再探讨多模态技术。

7.5 Llama 3的影响与应用

尽管Llama 3发布已逾半年,但Llama系列模型仍是认知度最高、应用最广的开源权重LLM之一(这是我个人观感,暂无具体引用来源)。这类模型相对易于理解和使用,其流行的原因可能在于Llama的品牌认知度,加上在各类通用任务上的稳定表现,以及微调的便捷性。

Meta AI也保持了迭代节奏,陆续推出Llama 3.1、3.2以及最新的3.3版本,覆盖多种参数规模,适配从端侧场景(10亿参数)到高性能应用(4000亿参数)的多元需求。

尽管如今该领域已有诸多极具竞争力的开源/开放权重LLM,如Olmo 2、Qwen 2.5、Gemma 2、Phi-4等等,但我认为Llama仍将是大多数用户的首选模型,就像ChatGPT即便面临Anthropic Claude、Google Gemini、DeepSeek等竞品的挑战,依然保持着人气。

我个人很期待Llama 4,希望能在2025年与我们见面。


8. 8月:通过扩展推理时计算量提升LLM性能

我本月的选择是这篇2024年8月的论文:https://arxiv.org/abs/2408.03314。这篇论文撰写详实、论证清晰,针对推理阶段(即部署阶段)如何提升LLM输出质量提出了诸多有趣洞见。

8.1 通过增加测试时计算量提升输出质量

这篇论文的核心前提是,研究增加测试时计算量是否以及如何能提升LLM的输出效果。打个通俗的比方:人类在处理难题时,如果有更多思考时间,就能给出更优的答案。同理,如果给LLM更多时间与资源生成回复,其输出质量也可能提升。用更专业的术语来说,研究人员试图探明:如果在推理阶段投入额外算力,模型的表现能超出其训练水平多少。

此外,研究人员还探讨了一个问题:在算力预算固定的情况下,将更多算力投入测试阶段,是否比投入模型进一步预训练能带来更好的效果。这一点我们稍后再展开。

8.2 测试时计算技术的优化

论文极为详细地介绍了提升和优化测试时计算的各类技术。如果你正着手实际部署LLM(比如前面提到的Llama系列模型),我强烈推荐通读全文。

简而言之,扩展测试时计算量主要有两种方法:

  1. 生成多个候选答案,使用基于过程的验证器奖励模型(需单独训练)选出最优回复
  2. 自适应更新模型的回复分布,本质上是在推理生成过程中修正回复(同样需要单独的模型)

给第一类方法举个简单例子:提升测试时计算的一种朴素方式是使用N选优采样(best-of-N)。即让LLM并行生成多个答案,再基于验证器奖励模型选出最优的一个。N选优只是其中一种,这类方法还包括多种搜索算法:束搜索、前瞻搜索、N选优,如下图所示。

figure06.webp

不同的基于搜索的方法均依赖过程奖励模型选出最优答案。标注图来自《LLM测试时计算》论文,https://arxiv.org/abs/2408.03314

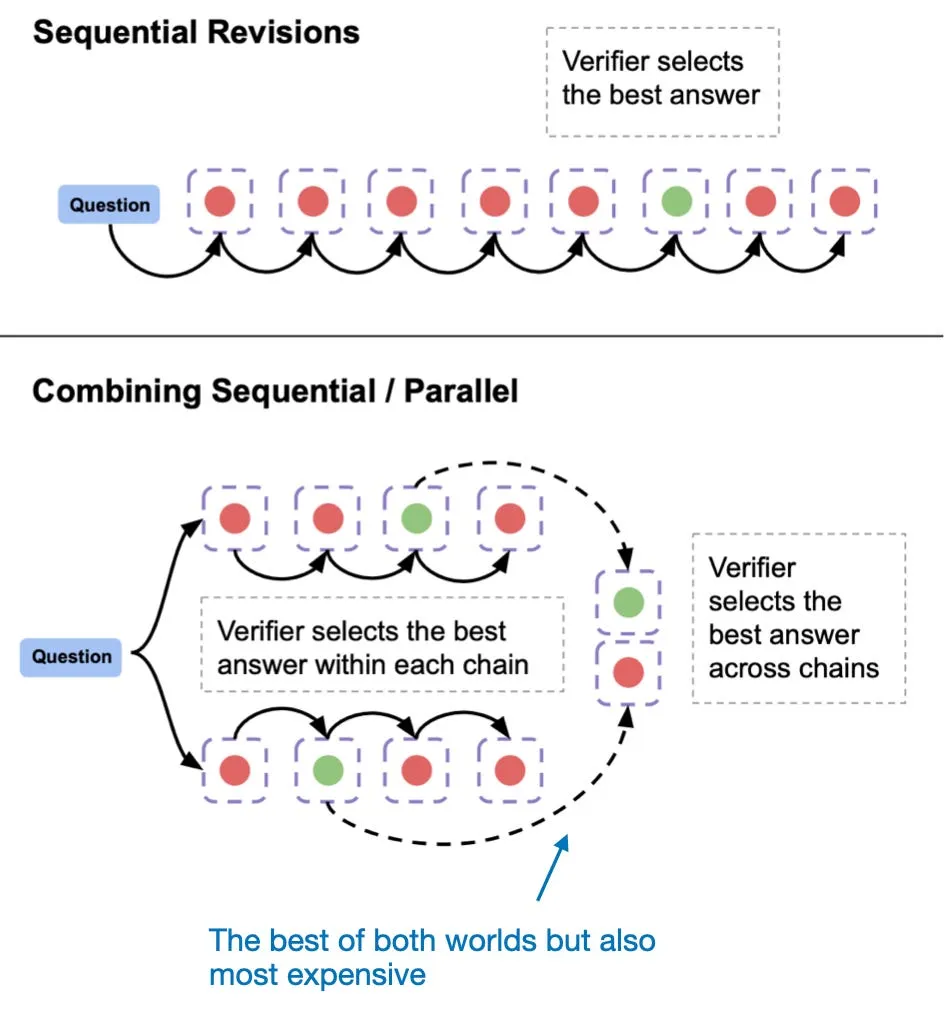
属于第二类的另一种方法是对模型回复进行序列修正,如下图所示。

figure07.webp

序列修正方法。标注图来自《LLM测试时计算》论文,https://arxiv.org/abs/2408.03314

哪种方法效果更好?遗憾的是,没有放之四海而皆准的答案。这取决于基础LLM以及具体的问题或查询。比如,基于修正的方法在难题上表现更优,但在简单问题上反而可能损害性能。

论文中,研究人员开发了一种“最优”策略:基于一个模型评估查询的难度等级,再针对性选择合适的方法。

8.3 测试时计算 vs 预训练更大模型

一个值得探讨的有趣问题是:在算力预算固定的情况下,哪种方式性价比更高——使用更大的模型,还是增加推理阶段的算力预算?

这里我们假设单次查询的成本是相同的,因为大模型的推理成本本身就高于小模型。

研究发现,对于高难度问题,大模型的表现优于通过前述推理扩展策略获得额外推理算力的小模型。

但对于简单和中等难度的问题,在相同算力预算下,通过增加推理时计算量,小模型可以达到14倍参数规模大模型的性能水平!

8.4 测试时计算扩展的未来价值

我们使用Llama 3这类开源权重模型时,通常直接让模型生成回复。但正如这篇论文所指出的,分配更多推理算力可以显著提升回复质量。(如果你正在部署模型,这篇论文绝对值得一读。)

当然,对于本就成本高昂的大模型,增加推理算力预算会让其运行成本进一步上升。但如果根据查询难度有选择性地应用,就能为特定回复带来质量与准确率的显著提升,这无疑是大多数用户乐于见到的。(可以肯定的是,OpenAI、Anthropic和谷歌早已在幕后应用了这类技术。)

另一个极具吸引力的应用场景是提升小型端侧LLM的性能。我认为这在未来数月乃至数年都将是热门话题,从苹果智能(Apple Intelligence)和微软Copilot PC的重磅发布与投入中也可见一斑。


9. 9月:多模态LLM范式对比

我原本认为多模态LLM会是2024年取得重大突破的领域之一。事实也确实如此,今年我们迎来了更多开源权重的多模态LLM!

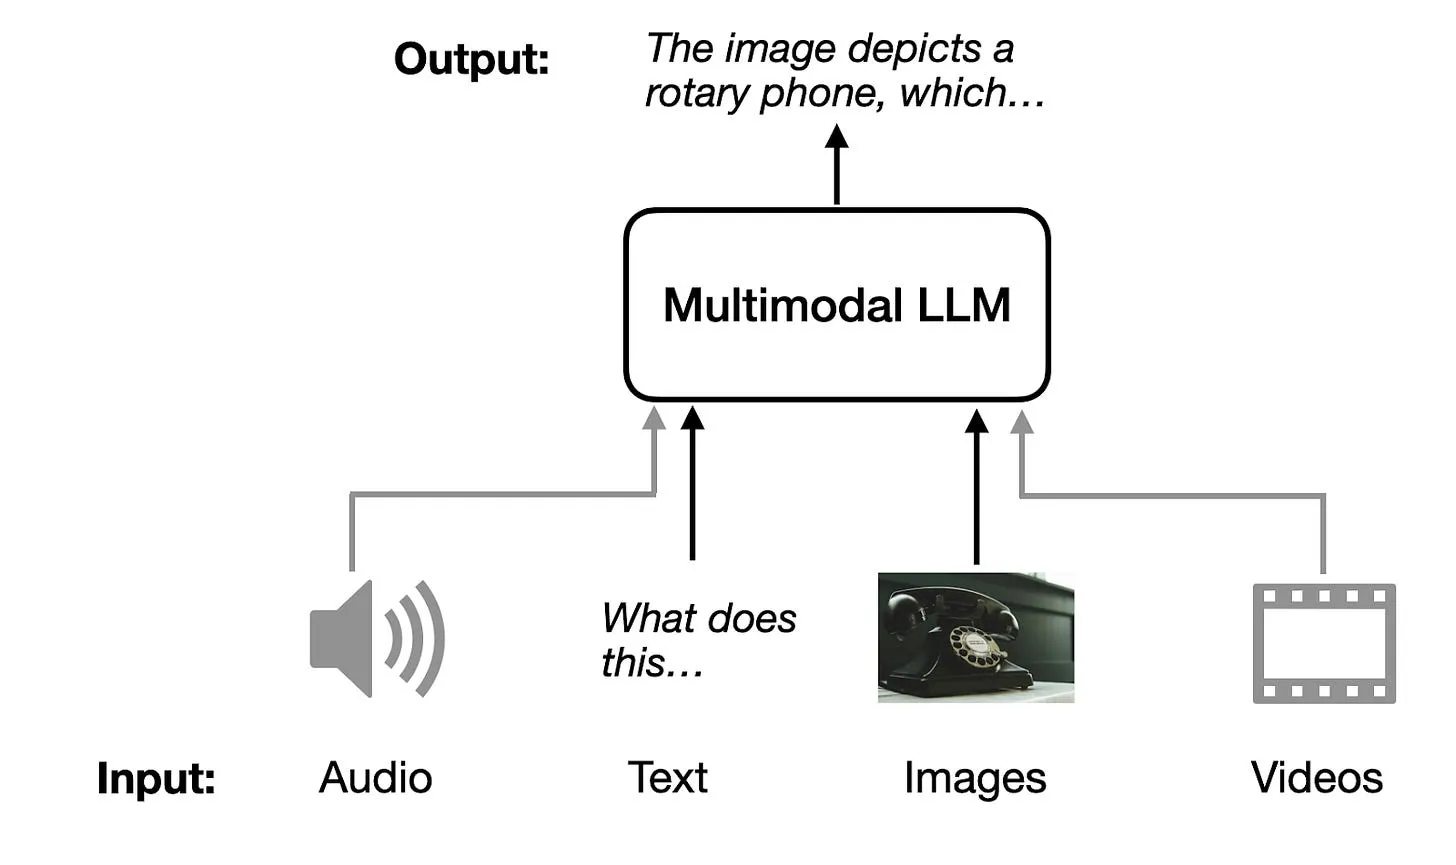
figure08.webp

多模态LLM示意图:可接收多种输入模态(音频、文本、图像、视频),输出模态为文本。

其中一篇让我印象尤为深刻的论文,是NVIDIA的Dai等人于2024年9月发表的:https://arxiv.org/abs/2409.11402。这篇论文很好地对比了两种主流多模态范式。

9.1 多模态LLM范式

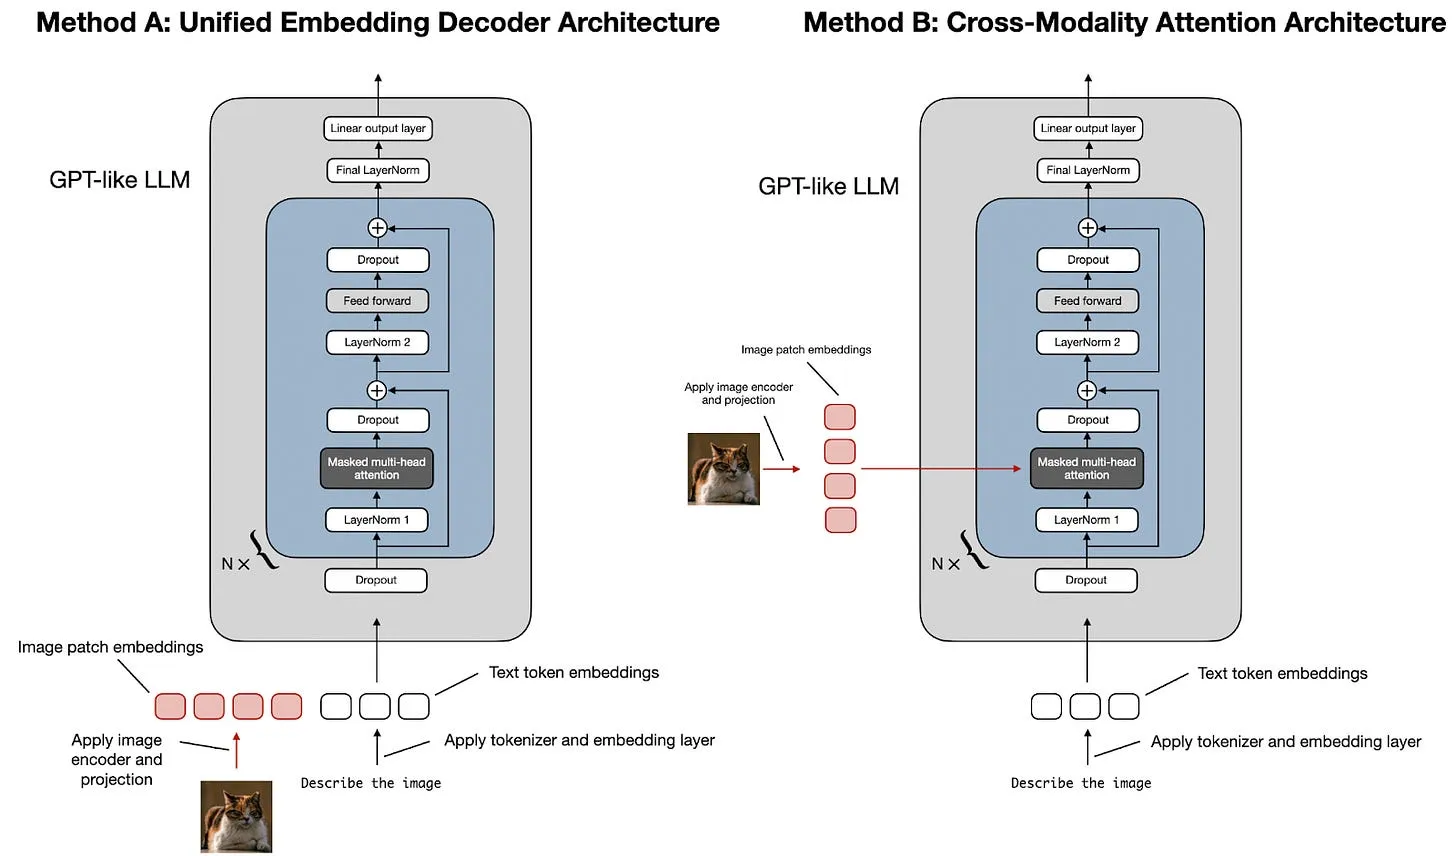
构建多模态LLM主要有两种思路:

  • 方法A:统一嵌入解码器架构
  • 方法B:跨模态注意力架构

figure09.webp

多模态LLM架构的两种主流开发思路

如上图所示,统一嵌入解码器架构(方法A)基于单个解码器模型,架构与GPT-2、Llama 3.2这类未修改的LLM相似。该方法将图像转换为与文本token嵌入维度相同的token,使LLM可以处理拼接后的文本与图像输入token。

与之相对,跨模态注意力架构(方法B)引入了交叉注意力机制,直接在注意力层内整合图像与文本嵌入。

如果你想了解更多细节,我今年早些时候专门写过一篇关于多模态LLM的文章,逐步讲解了这两种方法:https://magazine.sebastianraschka.com/p/understanding-multimodal-llms

9.2 英伟达的混合方法

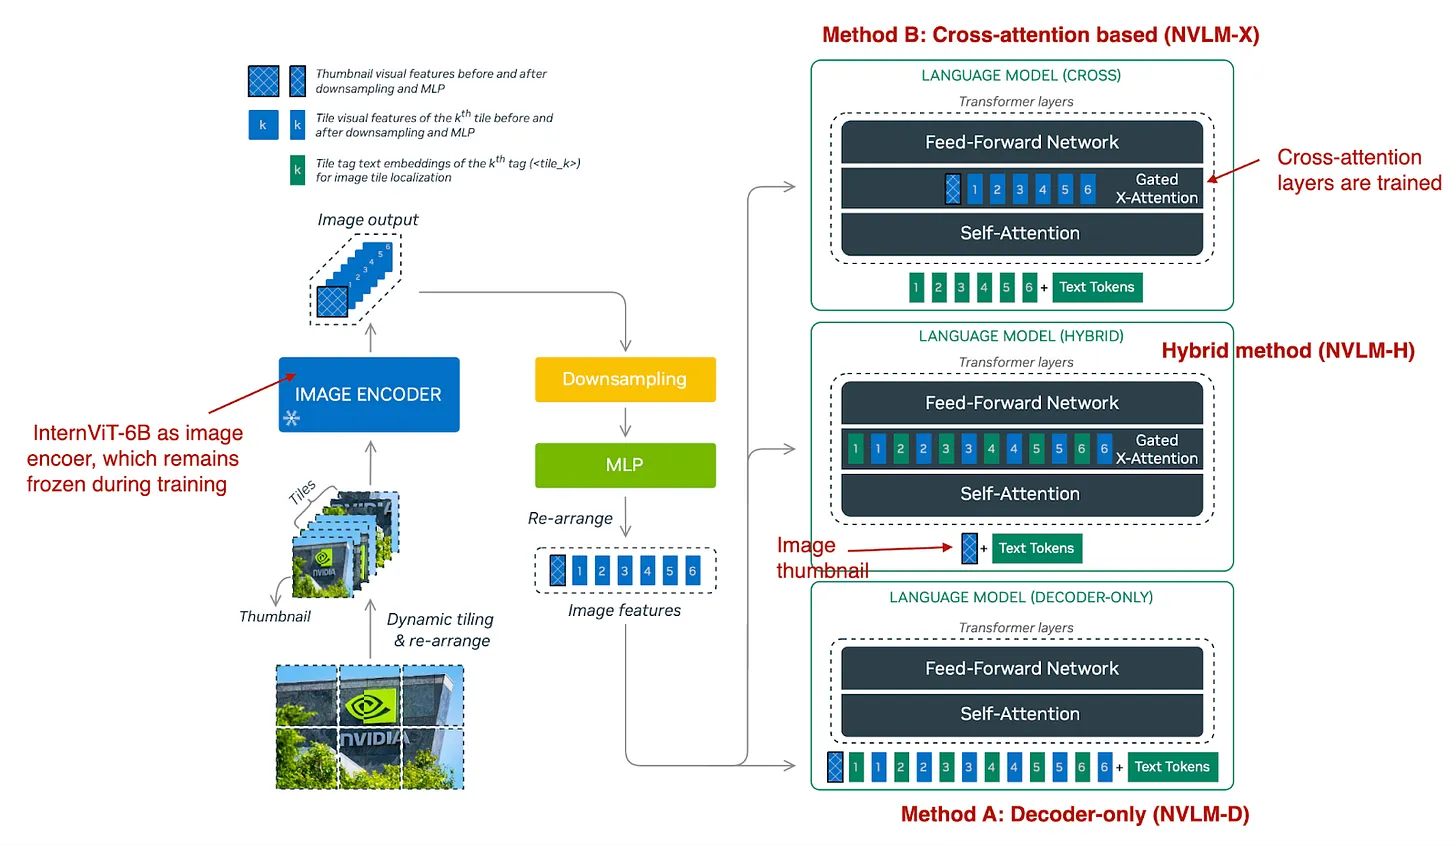
纵观今年的多模态技术发展,在我看来,英伟达的这篇论文(https://arxiv.org/abs/2409.11402)的突出之处在于,它对各类多模态方案进行了全面的同条件对比。研究没有只聚焦单一方法,而是直接比较了三种路线:

  • 方法A:统一嵌入解码器架构(“纯解码器架构”,NVLM-D)
  • 方法B:跨模态注意力架构(“基于交叉注意力的架构”,NVLM-X)
  • 混合方法(NVLM-H)

figure10.webp

三种多模态方法概览。(标注图来自《NVLM:开放前沿级多模态LLM》论文:https://arxiv.org/abs/2409.11402)

如上图总结,NVLM-D对应前文所述的方法A,NVLM-X对应方法B。而混合模型NVLM-H融合了两种方法的优势:先接收图像缩略图作为输入,再通过交叉注意力处理动态数量的图像块,以捕捉更精细的高分辨率细节。

核心结论总结如下:

  • NVLM-X:处理高分辨率图像时计算效率更优
  • NVLM-D:在OCR相关任务上准确率更高
  • NVLM-H:融合两种方法优势,实现最优性能

9.3 2025年的多模态LLM

多模态LLM是个很有意思的方向。我认为它是传统文本LLM之后的必然发展方向。OpenAI、谷歌、Anthropic等大多数LLM服务商都已支持图像等多模态输入。就我个人而言,需要用到多模态功能的场景大概只占1%(通常是“把表格提取成markdown格式”这类需求)。

我预计开源权重LLM的默认形态仍会是纯文本,因为这样复杂度更低。但同时我也认为,随着工具链和API的演进,开源多模态LLM会有更多选择,应用也会更普及。


10. 10月:复现OpenAI o1的推理能力

我10月的选择是Qin等人于2024年10月发表的论文:https://arxiv.org/abs/2410.18982

OpenAI ChatGPT的o1(以及如今的o3)已广受追捧,它们似乎代表了LLM推理任务性能提升的一次范式转变。

OpenAI o1的具体技术细节尚未公开,已有多篇论文尝试对其进行描述或复现。那我为什么选中这篇?它与众不同的行文结构,以及关于学术研究现状的更宏观的哲思,引发了我的共鸣。换句话说,这篇论文有其独特之处,让它脱颖而出,值得入选。

10.1 捷径学习 vs 旅程学习

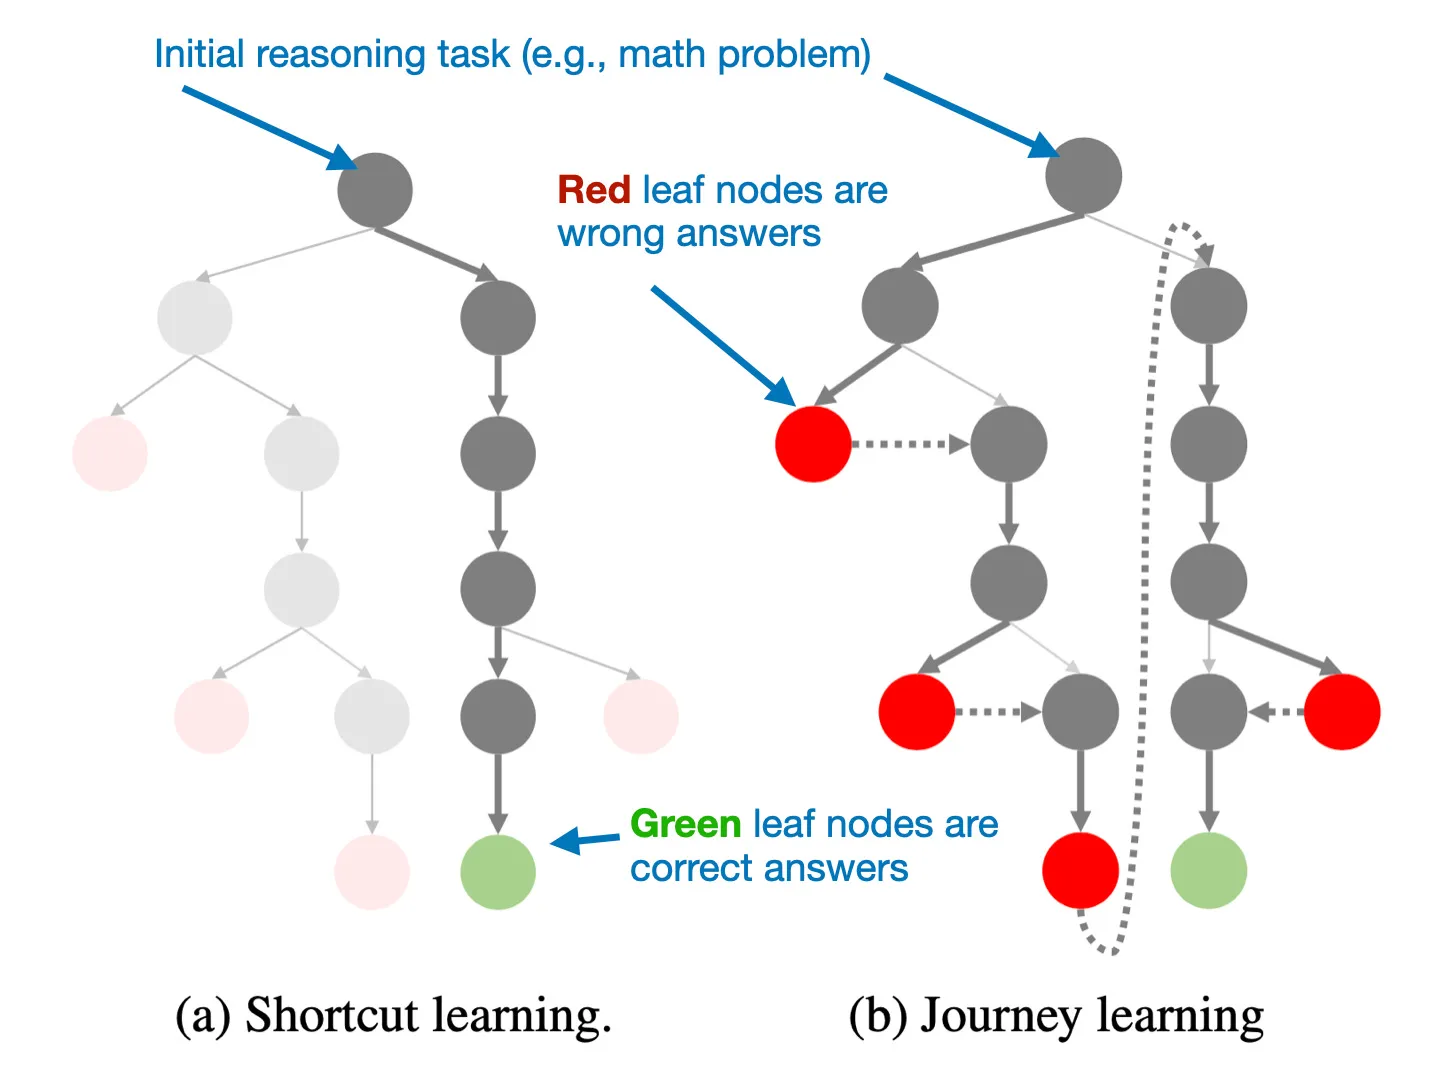
这篇论文的核心观点之一是,研究人员提出假设:o1采用了一种名为“旅程学习”的过程,而非“捷径学习”,如下图所示。

figure11.webp

传统上,LLM只在正确的解题路径上训练(捷径学习);而在旅程学习中,监督微调覆盖了完整的试错修正过程。标注图来自《o1复现报告》,https://arxiv.org/abs/2410.18982

值得注意的是,旅程学习的思路与本文“8月:通过扩展推理时计算量提升LLM性能”章节提到的带修正的树状方法、束搜索方法有几分相似。

但细微的差别在于,研究人员是创建旅程学习训练样本用于模型微调,而非仅在推理阶段应用该技术。(需要说明的是,我没有找到他们用于增强推理过程的技术相关信息。)

10.2 构建长思维链

研究人员构建了一棵推理树,从中衍生出完整的思考过程,重点突出试错环节。这种方法与传统方法不同——传统方法优先寻找通往正确答案的直接路径,且中间步骤都必须是正确的。在他们的框架中,推理树的每个节点都标注了奖励模型给出的评分,标明该步骤正确与否,同时附上判断理由。

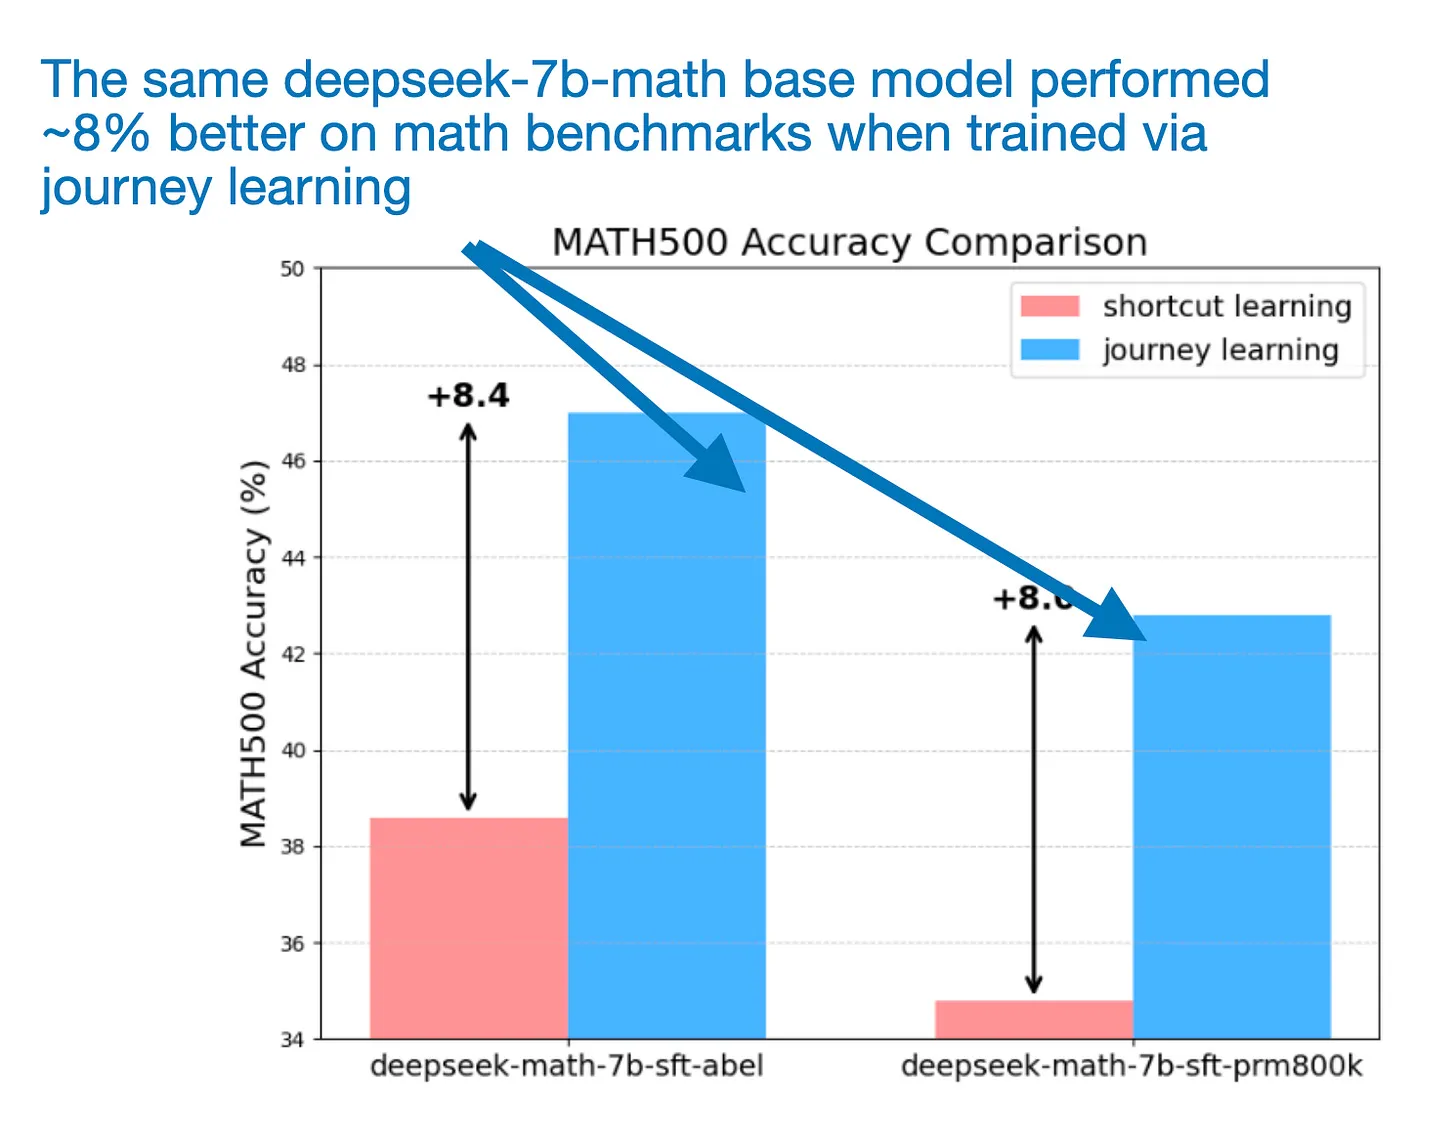
随后,他们通过监督微调和DPO训练了一个deepseek-math-7b-base模型。实验训练了两个模型:

  1. 采用传统捷径训练范式,只提供正确的中间步骤
  2. 采用提出的旅程学习方法,训练数据包含完整的思考过程,包括正确与错误答案、回溯等等

(旁注:每组实验仅用了327个样本!)

如下图所示,在MATH500基准数据集上,旅程学习方法的表现大幅领先捷径学习。

figure12.webp

经捷径学习与旅程学习训练的LLM对比。标注图来自《o1复现报告》,https://arxiv.org/abs/2410.18982

10.3 蒸馏——捷径解法?

一个月后,该团队发布了另一篇报告:Huang等人于2024年11月发表的论文:https://arxiv.org/abs/2411.16489

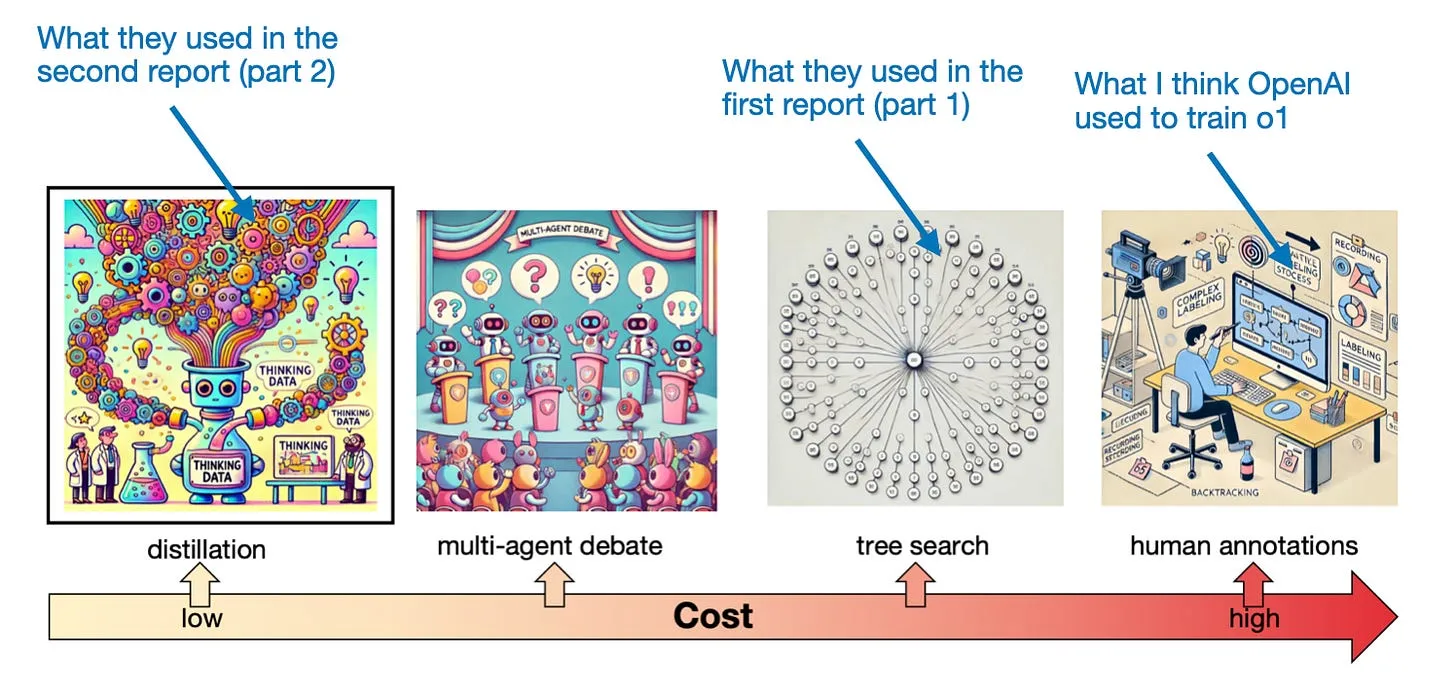
这篇论文采用了蒸馏方法:通过精心设计的提示词提取o1的思考过程,用以训练模型达到同等性能。本文篇幅已经很长,我就不展开细节了,但想分享该论文中一张很有意思的图,它总结了收集长思维数据的成本权衡。

figure13.webp

他们通过这种蒸馏方法取得了极佳的效果,性能与o1-preview、o1-mini相当。但在这些实验之外,研究人员也针对这种方法背景下的研究现状,分享了一些有趣且重要的思考,我将在下一节进行总结。

10.4 AI研究的现状

第二篇报告的一大重点是“简单蒸馏的苦涩教训”。诚然,蒸馏在实践中效果很好,但它并非推动进步的动力。最好的情况也只是追平上游已有模型的性能(而非创造新的性能纪录)。以下是论文中的三段引文,堪称对当前行业现状的警示:

“这种从‘原理为何’到‘什么有用’的转变,代表了研究心态的根本性变化,可能对该领域未来的创新能力产生深远影响。”

“第一性原理思维的消解尤其令人担忧,因为它动摇了科学创新的根基。”

“快速出成果的压力可能会掩盖深度技术探索的价值,而学生们也可能因此不愿投身更具挑战性的基础研究方向。”

我个人的看法是,如今学术实验室(如今也常与产业合作)仍在产出大量优秀且重要的想法,它们可以非常实用且影响力巨大。(我脑海中最先想到的例子就是LoRA和DPO。)问题在于,很多有前景的想法从未得到大规模验证,因为高校通常缺乏所需的海量资源。

我也不知道完美的解决方案是什么,我也明白企业不可能直接公开自己的商业机密。但如果企业在采用学术论文的思路时,能公开予以认可,将会大有裨益。这种认可对于激励和回馈那些免费开放研究成果的研究者来说意义重大。同时,通过明确哪些方法在实践中真正有效,也能推动整个领域向前发展。

10.5 o1(及o3)背景下LLM的未来

《o1复现之旅》这篇论文复现了o1背后的精确机制吗?大概率没有。但它仍然是一篇很有价值的读物,充满了有助于提升效果的思路。我相信,o1、o3这类“长思维”模型将继续在LLM研究中扮演关键角色。它们的运行成本更高,但基本代表了推理任务性能的黄金标准与上限。

但由于成本更高,o1类模型并非在所有场景下都是最优选择。对于语法修正、翻译这类简单任务,我们大概率不需要推理能力极强的模型。归根结底是成本与效用的平衡。我们根据预算、延迟等因素,为具体任务选择合适的LLM。

《Ahead of AI》是读者支持型出版物。想要接收新文章并支持我的创作,欢迎成为免费或付费订阅者。


11. 11月:面向精度的LLM缩放定律

我原本想选Allen AI的这篇论文(https://arxiv.org/abs/2411.15124),因为文中详细介绍了他们的Llama后训练方法与配方,包括DPO与PPO的消融实验,以及一种名为“可验证反馈强化学习”的全新偏好对齐方法——该方法使用可验证查询(比如数学和代码问题,很容易生成标准答案)来替代奖励模型。

但经过一番权衡,我最终选择了Kumar等人于2024年11月发表的论文:https://arxiv.org/abs/2411.04330。因为它对2022年提出的Chinchilla缩放定律进行了亟需的更新——Chinchilla定律被广泛用于确定预训练阶段算力最优的LLM参数量与数据集规模,原论文见:https://arxiv.org/abs/2203.15556

简而言之,这篇2024年11月的论文将Chinchilla缩放定律进行了扩展,使其适用于低精度(16位及以下)训练与推理场景——低精度技术近年来已十分普及。例如,论文将各类低精度与量化相关的观察结论统一为一个函数形式,可以同时预测低精度训练和训练后量化带来的额外损失。

11.1 Chinchilla缩放定律回顾

2022年论文提出的原始Chinchilla缩放定律,建模了LLM参数量(N)与数据集规模(D)如何共同影响LLM的验证损失,常被用作确定LLM与训练数据集规模的指导原则。

根据经验法则,(在算力预算固定时)数据集规模D与参数量N的最优配比约为 D/N ≈ 20。

这一数据-参数比通常被称为“Chinchilla最优”,因为在相同总训练成本下,该比例能带来更低的验证损失。

但请注意,如今已有很多反例。比如前文提到的Llama 3,训练数据量为15万亿token,对于80亿参数版本,这个比值就是15000000000000 ÷ 800000000 = 1875。

在我看来,比具体的数据-参数比值更重要的结论是:模型规模与数据集规模必须成比例缩放。

11.2 低精度训练

在进一步讨论(或者说总结)低精度缩放定律之前,我先简单科普一下LLM(或深度神经网络)权重常用的不同数值精度格式。

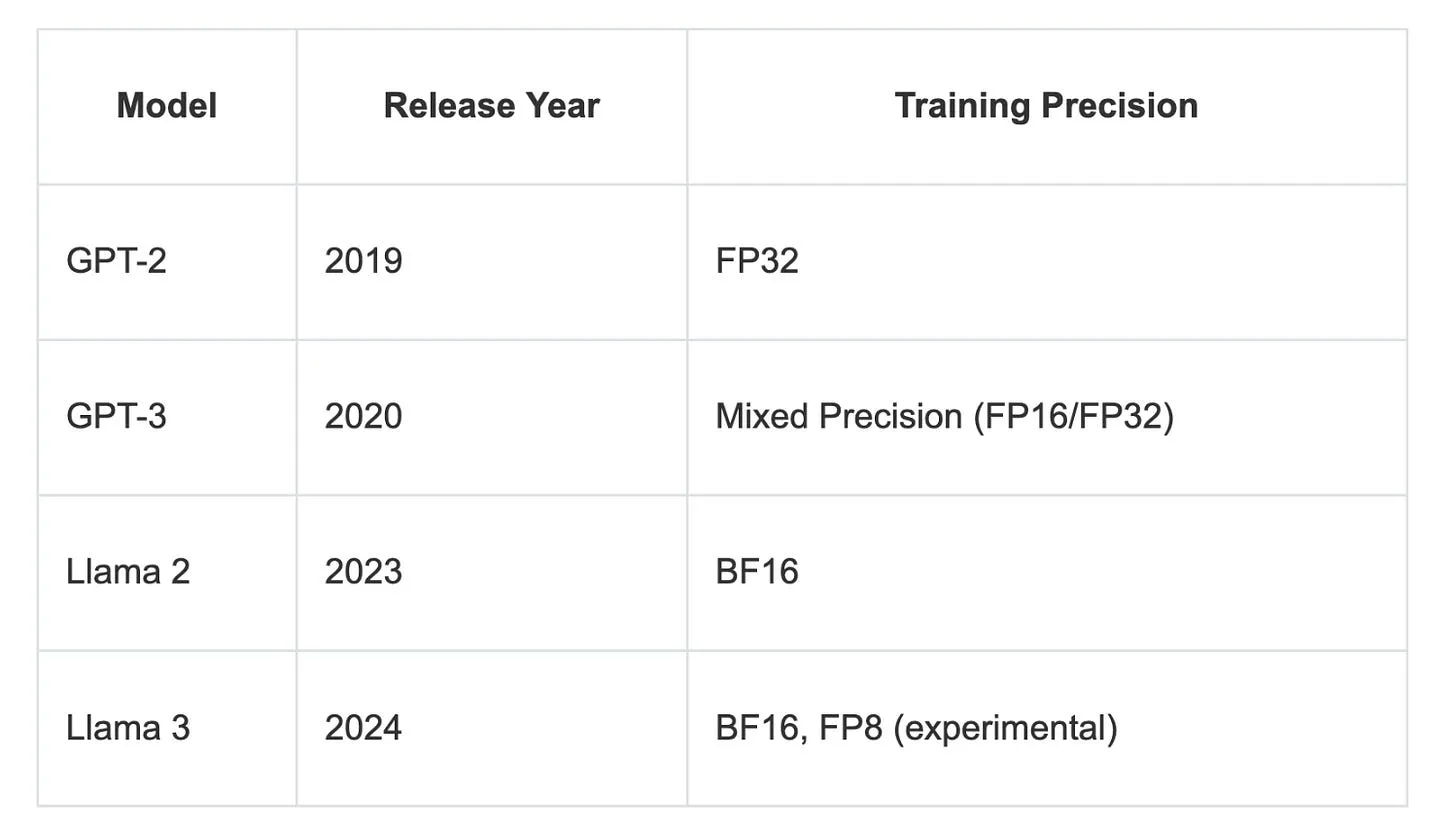
据我所知,以下是GPT 2/3与Llama 2/3训练时采用的精度格式,供对比参考:

figure14.webp

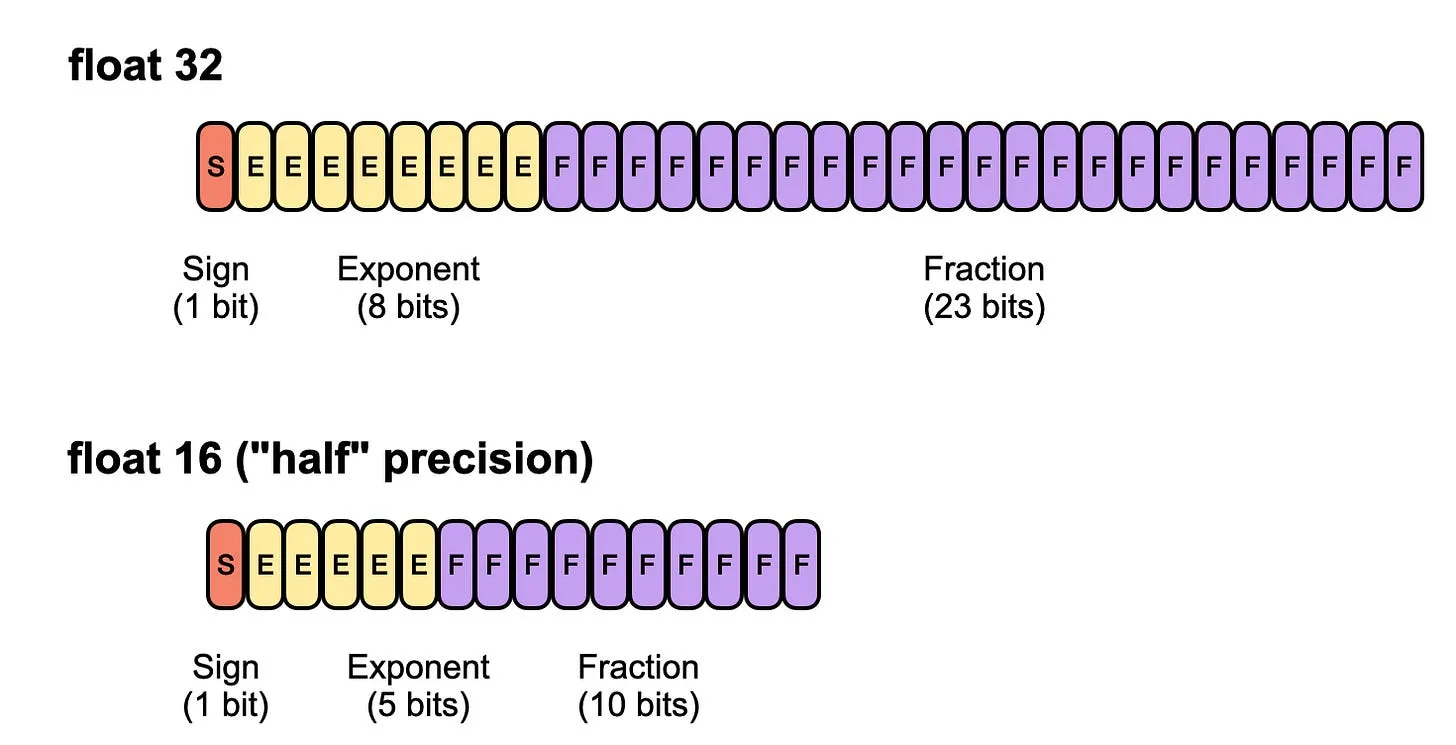
Float32是训练深度神经网络的标准32位浮点格式,在数值范围与精度间取得了很好的平衡。如今,float32以下的格式都被视为低精度(当然“低”的定义是动态变化的,就像“大语言模型”里的“大”一样)。

Float16(半精度)仅使用16位,能节省内存、加快计算,但动态范围更窄。

figure15.webp

32位与16位浮点精度对比

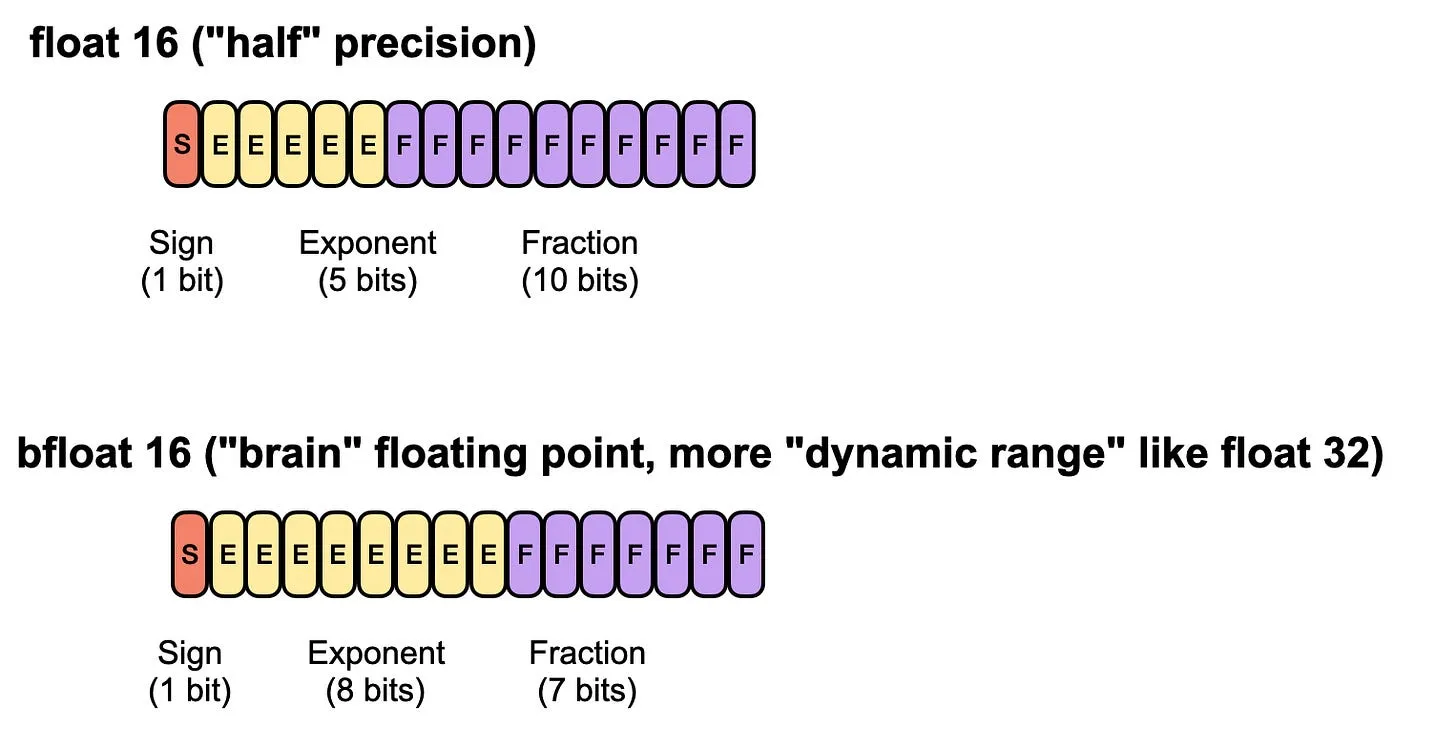
Bfloat16(脑浮点16)同样是16位格式,但它牺牲了float16的部分精度,换取了更大的指数位,能更有效地表示极大和极小的数值。因此,bfloat16有助于避免深度学习应用中的数值溢出或下溢,不过其较低的精度仍可能导致舍入误差。

figure16.webp

常规16位浮点与主流16位脑浮点精度对比

如果你想了解更多精度格式及其对LLM模型表现的影响,可以参考我之前的文章,里面有更详细的介绍:https://magazine.sebastianraschka.com/p/the-missing-bits-llama-2-weights

另外请注意,我这里只展示了32位和16位格式,而目前行业正向更低的训练精度进军,比如Llama 3论文中提到的(实验性)8位格式。(12月26日发布的DeepSeek-V3,其全部预训练就是在8位浮点精度下完成的:https://github.com/deepseek-ai/DeepSeek-V3)

11.3 精度缩放定律核心结论

这篇论文内容详实且有趣,推荐通读。不过核心结论是:研究人员在原始Chinchilla缩放定律基础上,新增了“精度”因子P。具体来说,他们将模型参数量N重新诠释为“有效参数量”——精度越低,有效参数量越小。(数学公式请参考原文。)

此外,他们还新增了一项,用以刻画训练后量化对模型性能的衰减影响。(我知道这里没介绍量化的基础概念,但本文篇幅已经过长,这个话题只能改天再讲了。)

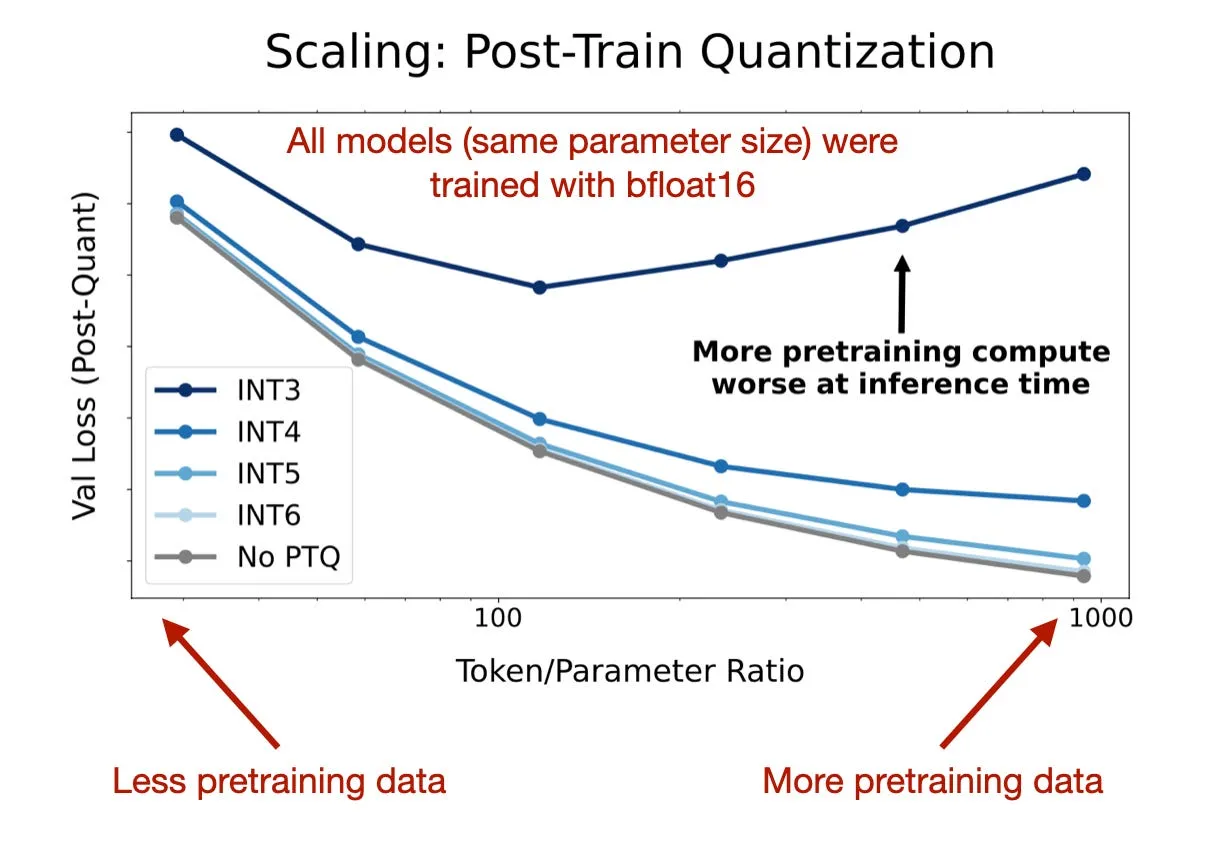
下图很好地说明了一点:更多的预训练数据并非总是越好——如果训练后用极低精度(如int3)量化模型,更多数据反而可能有害。我觉得这个发现非常有意思。

figure17.webp

不同后量化格式下,训练数据量增加对验证损失的影响

所以从上图可以得出结论:用海量数据训练的模型(比如Llama 3),训练后再量化到低精度格式会更困难,因为模型在过多数据上发生了“过训练”。

11.4 2025年的模型缩放定律

精度缩放定律的研究不仅对Chinchilla缩放定律做出了亟需的更新,也为2025年的一个关键挑战提供了新视角:随着Llama 3这类模型在更大数据集上训练,它们可能更难在量化到INT3等低精度格式时不损失性能。

这一发现凸显了我们需要反思“数据越多越好”的固有思维,在数据集规模与高效推理的实际约束之间取得平衡。这对推动硬件优化也具有重要参考价值。

我认为这类缩放定律研究常常忽略的一个维度是数据集质量。预训练数据的性质会产生重大影响。(下文讨论Phi-4时会展开说。)


12. 12月:Phi-4与合成数据学习

2024年下半年发布了不少有意思的模型,包括圣诞节当天惊艳亮相的DeepSeek-V3(https://github.com/deepseek-ai/DeepSeek-V3)。但最终我选择了微软的这篇论文(https://arxiv.org/abs/2412.08905),因为它对合成数据的应用提出了有趣的洞见。

12.1 Phi-4的性能

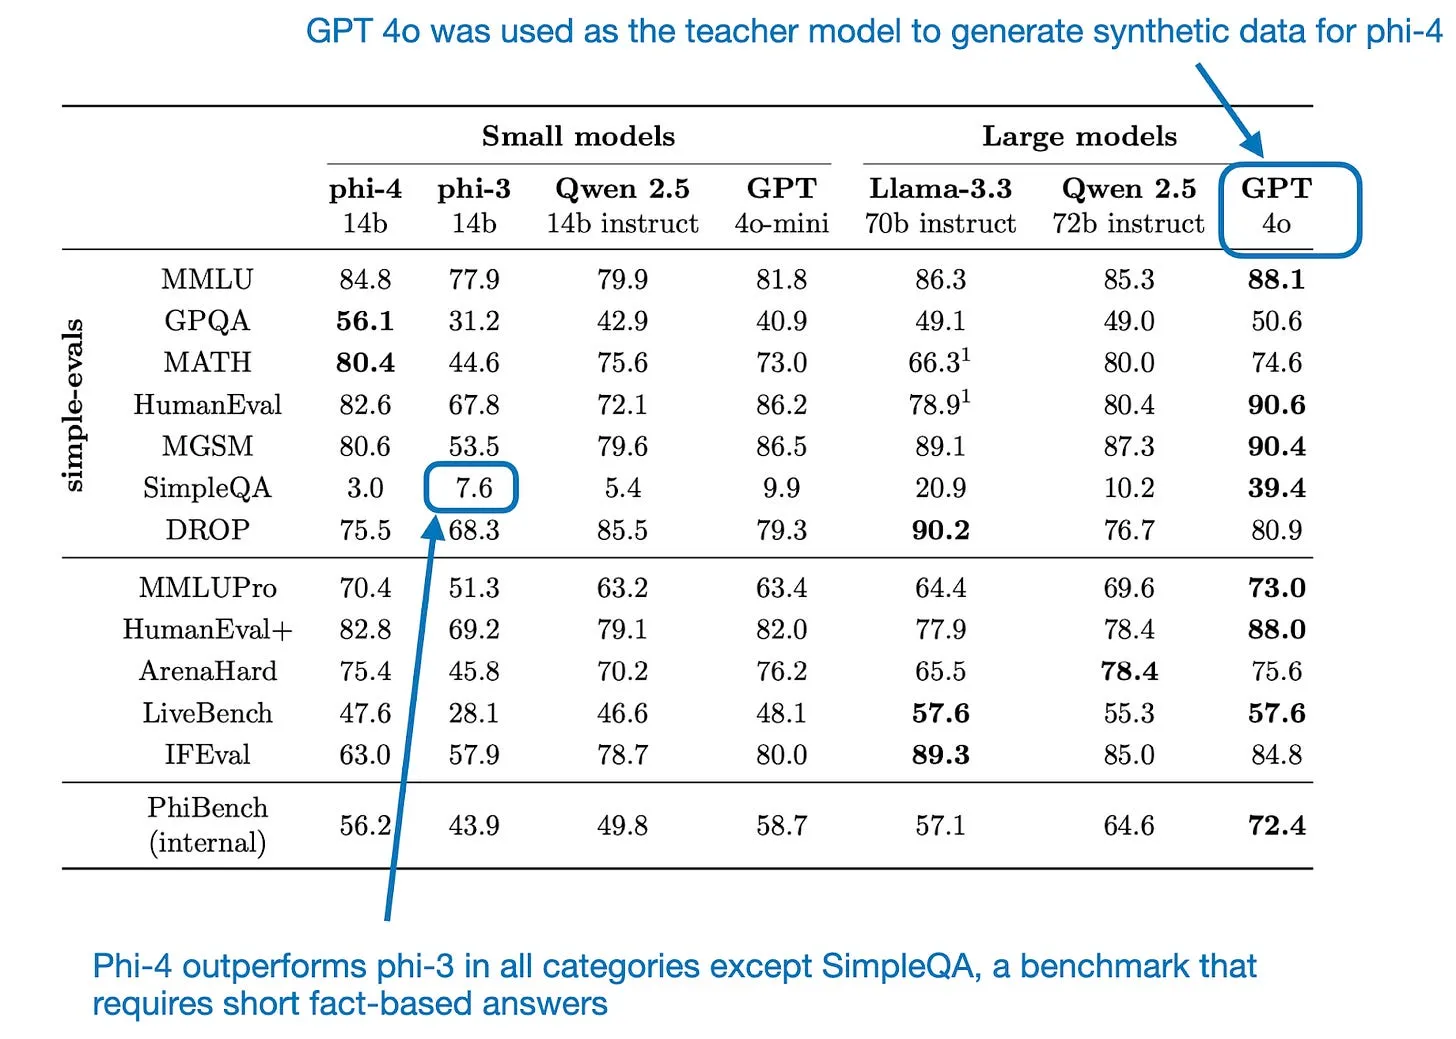
Abdin等人于2024年12月发表的这篇论文,介绍了微软最新140亿参数开源权重LLM的训练过程。Phi-4最特别的地方在于,它的训练数据以GPT-4o生成的合成数据为主。基准测试结果显示,它的表现优于同等规模的其他LLM,包括前代Phi-3——Phi-3的训练以非合成数据为主。

figure18.webp

Phi-4与同等及不同规模模型的性能对比(标注表格来自Phi-4论文,https://arxiv.org/abs/2412.08905)

我不太确定为什么该模型在SimpleQA上表现较差,如上表所示。但一种可能的解释是:SimpleQA是相对较新的基准,于2024年10月30日发布。它由OpenAI开发,属于其评测套件的一部分,可能既没有被纳入GPT-4o的训练数据,也没有出现在网络爬取数据集中。而且,由于本次评估的合成数据是用GPT-4o生成的,所有模型在训练时都没见过SimpleQA。不过Phi-4可能对其他基准存在过拟合,这也能解释它在这个未见过的SimpleQA数据集上表现相对不佳。当然,这只是我的假设。

12.2 合成数据的启示

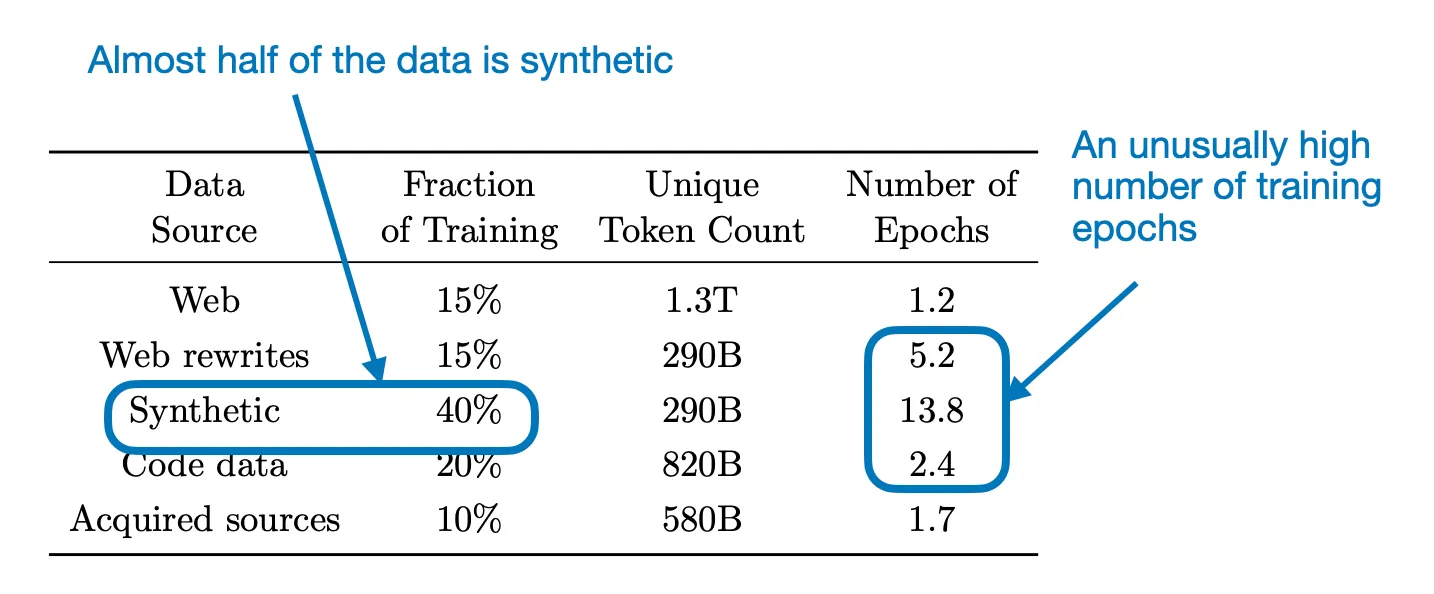
在总结论文中的消融实验之前,我们先看看数据集构成。

figure19.webp

Phi-4训练的数据集混合比例(标注表格来自Phi-4论文,https://arxiv.org/abs/2412.08905)

研究人员观察到,虽然合成数据整体上有益,但纯合成数据训练的模型在知识类基准上表现不佳。在我看来,这引出了一个问题:是合成数据缺乏足够的专属知识信息,还是它包含了更多事实错误(比如幻觉导致的错误)?

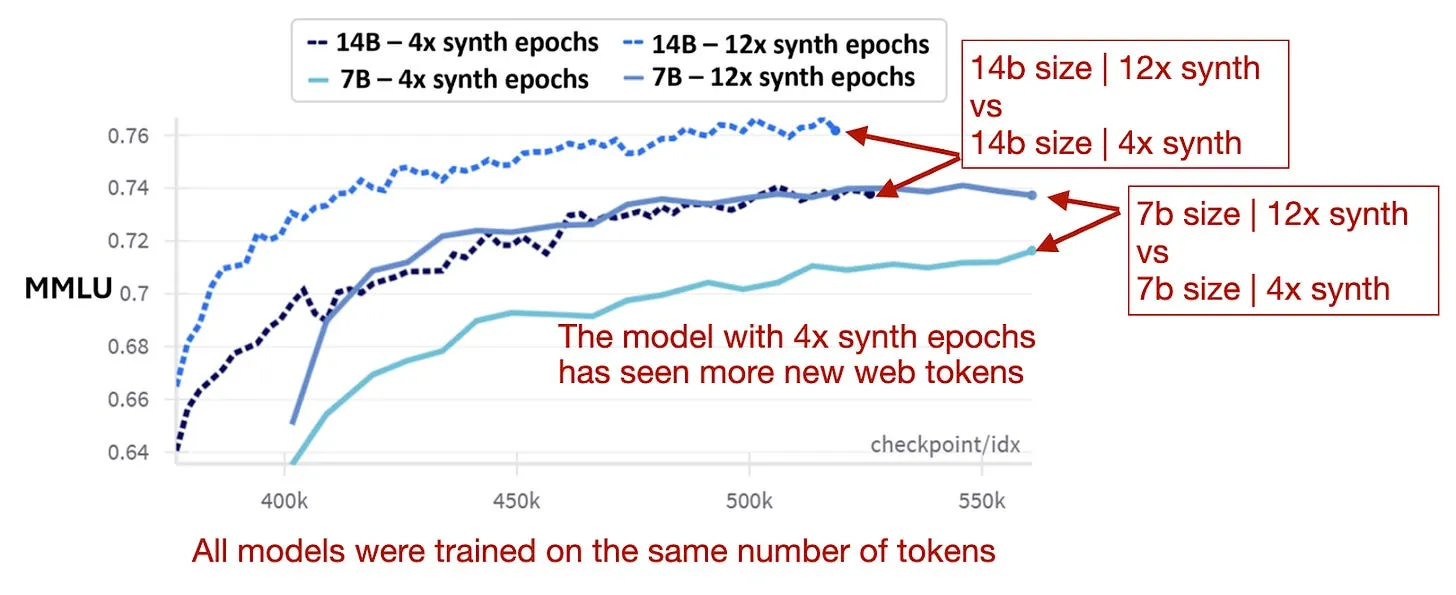
同时,研究人员发现,增加合成数据的训练轮数(epoch),比单纯增加更多网络数据更能提升性能,如下图所示。

figure20.webp

不同合成/网络数据集比例下的模型性能对比。(标注图来自Phi-4论文,https://arxiv.org/abs/2412.08905)

总而言之,数据混合中合成数据占比过高,会对知识类任务的表现产生负面影响。但在合成数据与网络数据比例更均衡的前提下,增加合成数据集的训练迭代次数(epoch)是有益的。

12.3 合成数据的未来价值

Phi-4技术报告为合成数据的应用提供了有趣的洞见:合成数据对模型预训练大有助益。尤其是在模型规模与数据集规模的缩放定律均显现瓶颈的当下(尽管Llama 3论文提到,在15万亿token规模下尚未看到收敛),研究者与工程师们正在寻找其他能持续突破边界的方法。

当然,预训练技术的优化与新增,尤其是后训练技术,大概率仍将是性能提升的核心动力之一。但我认为,合成数据的应用会成为一种有效手段:要么用更少的数据训练出合格的预训练基座模型,要么打造出更优的基座模型(比如在Llama 3的15万亿token数据集基础上,再加入40%的合成数据token)。

我认为高质量数据的作用类似于迁移学习。传统方式是让模型在原始、无结构的互联网数据上预训练,再在后训练阶段精调;而利用高质量模型(比如已经过大量优化的GPT-4o)生成的(部分)合成数据,相当于给训练提供了“起跑优势”。换句话说,高质量训练数据能让模型从一开始就更高效地学习。


结论与展望

希望这些研究总结对你有帮助!和往常一样,这篇文章又写得比我预想的长。最后,我用一个简短的板块来聊聊对2025年的预测与展望。

多模态LLM

去年我预测LLM会越来越走向多模态。如今,所有主流闭源LLM服务商都已提供多模态(至少是图像)支持。可见这一转型已全面展开,开源领域也会有更多相关探索。

根据我的所见所读,多模态相关论文数量确实激增了。接下来可能会出现更多开源微调方法与资源。不过我认为,对很多应用场景来说,纯文本已经足够,并且未来也依然够用,行业的核心重点仍将是开发更强的推理模型(比如o1和即将推出的o3)。

计算效率

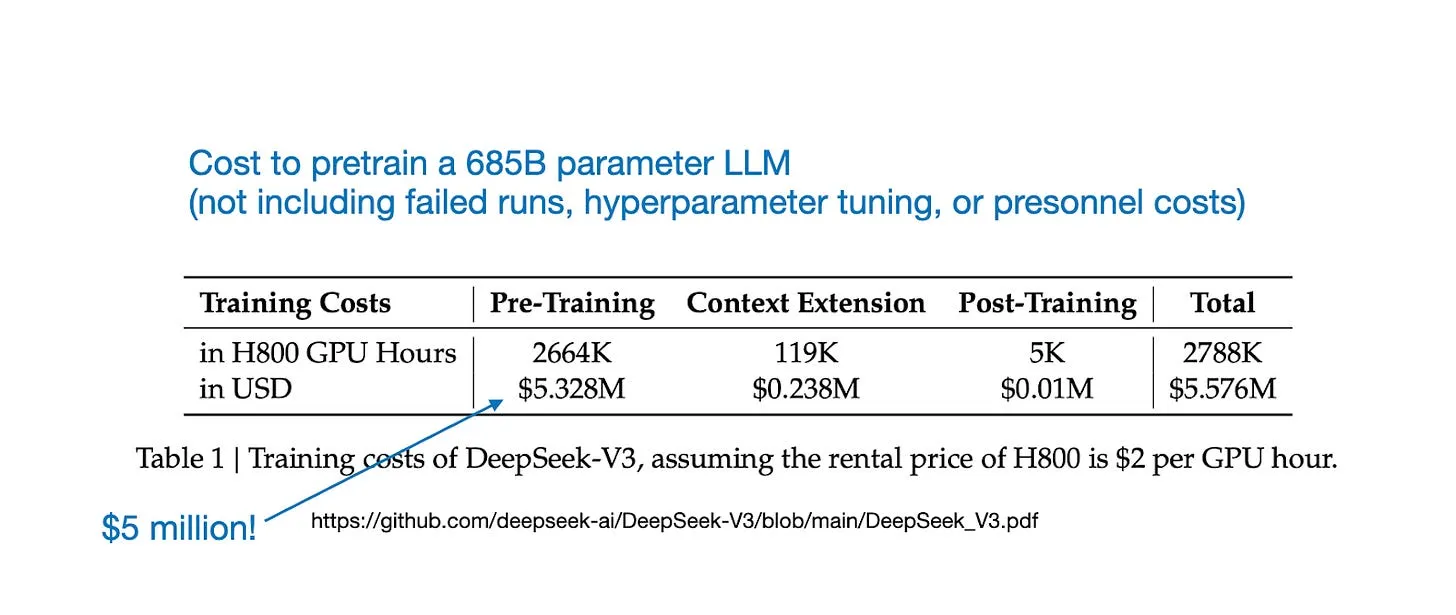
预训练和使用LLM的成本都相当高。因此我预计,在可预见的未来,会出现更多提升LLM计算效率的巧妙方法。作为参考,按GPU租赁标价计算,训练最新的DeepSeek-V3需要花费500万美元(https://github.com/deepseek-ai/DeepSeek-V3/blob/main/DeepSeek_V3.pdf),这还不包括超参数调优、训练失败重试以及人力成本。

figure21.webp

DeepSeek-V3报告中的粗略估算,来源:https://github.com/deepseek-ai/DeepSeek-V3/blob/main/DeepSeek_V3.pdf

顺便说一句,根据Meta AI官方的模型卡(https://github.com/meta-llama/llama-models/blob/main/models/llama3_1/MODEL_CARD.md),Llama 3 405B的训练算力更是达到了约10倍之多(3084万GPU小时 vs 266万GPU小时)。

提升LLM效率的常用技术(并非都适用于训练阶段)包括混合专家(我在第一部分文章中讨论过)、Llama系列采用的分组查询注意力等等。另一个有意思的技术是DeepSeek模型采用的多头潜在注意力,能提升多头注意力中KV缓存的效率。

另一个近期值得关注的方向是针对模型输入做优化。比如最近提出的字节潜在Transformer(BLT):https://arxiv.org/abs/2412.09871,它通过将字节动态编码为基于熵的块,无需分词即可优化算力分配,实现更好的扩展性与更快的推理。

状态空间模型

你可能注意到了,今年我没讲状态空间模型。这是因为我目前的研究重点主要是基于Transformer的LLM。虽然我觉得状态空间模型非常有意思,但现阶段它们还相当实验性。而且Transformer在各类任务上持续展现出卓越性能,让人不太有动力去考虑替代方案。

但这并不代表状态空间模型领域没有进展。我已经看到了不少该领域的有趣论文。而且我注意到一个有意思的趋势:如今的状态空间模型基本都成了混合架构,整合了Transformer的自注意力机制。比如:

从这个角度来说,它们的计算成本也在上升。随着基于Transformer的LLM不断优化效率,而状态空间模型逐步加入注意力机制,如果当前趋势持续,二者最终大概率会走向中间路线。无论如何,这都是一个值得关注的有趣研究领域。

通过缩放实现LLM进步

临近年底时,还有一场关于“LLM缩放已走到尽头”的讨论,理由是互联网数据已经用完了。这场讨论源自Ilya Sutskever(OpenAI联合创始人之一,也是GPT系列论文的共同作者)在NeurIPS上的演讲。但遗憾的是,我今年没参加这个会议,所以不了解具体细节。

无论如何,这个观点很有意思,因为互联网数据是呈指数级增长的。我可以引用这篇文章的数据:https://edgedelta.com/company/blog/how-much-data-is-created-per-day,“每天产生15.87TB数据”。当然,挑战在于并非所有数据都是文本,也并非都对LLM训练有用。但正如我们从Phi-4看到的,数据治理与数据精炼方面仍有大量机会,仅靠优化训练数据就能带来不少提升。

不过我认同“通过数据缩放的收益正在递减”这一观点。我预计性能提升会越来越小,我们大概率正走向平台期。但这并非坏事,因为它会催生其他方向的进步。

我认为未来性能提升的一个重要来源是后训练。正如我去年夏天在这篇文章中所写的:https://magazine.sebastianraschka.com/p/new-llm-pre-training-and-post-training,近期发布的LLM已经让我们见识到了后训练领域的进展。

我对2025年的期待

今年我非常享受动手复现与实现各类Llama模型(3、3.1、3.2)的过程。我非常期待Llama 4的发布,希望它也能推出小巧便捷的版本,让我可以在笔记本电脑或者性价比高的云GPU上做实验。

此外,今年我想更多地尝试专用模型微调,而不是做通用聊天机器人(这个赛道已经相当拥挤了)。我们已经看到了各类代码和数学专用模型的涌现,比如最近的Qwen 2.5 Coder和Qwen 2.5 Math,很遗憾这次报告没来得及介绍它们。

总之,我的愿望清单和计划还有很多,2025年又将是精彩且瞬息万变的一年!可以肯定的是,这一年绝不会无聊。

这本杂志是我的个人热爱项目。想要支持我的朋友,可以考虑购买我的书:https://amzn.to/4fqvn0D。(我相信你会从书中收获良多,因为它对LLM工作原理的讲解深度是别处找不到的。)

figure22.webp

《从零构建大语言模型》现已上架:https://amzn.to/4fqvn0D

如果你已经读了这本书,并且能抽出几分钟时间,我会非常感谢你留下评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167。这对我们作者帮助很大!

你的支持意义重大!谢谢!

重大黑客攻击事件2025

2025年黑客攻击事件核心趋势
1、AI武器化:黑客利用AI自动生成恶意软件、深度伪造诈骗,攻击速度与质量全面碾压传统防御。
2、勒索产业化:勒索软件攻击创历史新高,通过“加密+泄露”双重勒索,针对医疗、金融等关键行业牟取暴利。
3、 漏洞即时化:漏洞利用速度缩短至24小时内,传统“打补丁”防御模式失效,0day漏洞攻击成为常态。
4、攻击物理化:网络攻击直接导致现实破坏,能源、交通、车企系统遭入侵引发停产、断电等物理世界混乱。
5、内鬼商业化:内部人员勾结外部黑客(如收买客服、员工卖凭据),利用合法权限窃取数据成为高发威胁。

2025年全年:朝鲜IT工作者渗透西方企业
事件经过:朝鲜IT工作者渗透西方企业,将收入输送给朝鲜政权支持武器计划等;美国当局在16个州捣毁运营点,当地协助者为朝鲜威胁组织接收企业配发笔记本电脑,提供远程访问企业环境通道。
攻击方式:身份伪装渗透、内部协助远程访问
造成损失:西方企业核心数据与运营安全受威胁,国际地缘政治驱动的网络攻击态势加剧。

2025年全年:朝鲜黑客全年窃取20.2亿美元加密资产
事件经过:据Chainalysis统计,2025年朝鲜黑客蝉联全球加密货币盗窃榜首,共窃取20.2亿美元;除Bybit外,还包括Phemex交易所被盗8500万美元、Cetus Protocol被盗2.23亿美元、BigONE泄露损失2700万美元、Trust Wallet用户损失700万美元。
攻击方式:多平台针对性盗窃、技术入侵
造成损失:加密货币行业损失惨重,市场信心受挫,大量用户资产受损。

2025年12月:快手直播功能遭黑灰产网络攻击
事件经过:2025年12月22日,快手应用直播功能遭到黑灰产网络攻击,导致直播间出现大量违规内容;快手第一时间启动应急预案,全力开展处置与系统修复,次日中午直播功能逐步恢复正常,其他服务未受影响。
攻击方式:黑灰产针对性网络攻击、违规内容植入
造成损失:此次事件对快手的口碑与股价造成了巨大冲击。

2025年12月:韩国多家医院遭勒索攻击瘫痪
事件经过:韩国多家医院遭遇勒索软件攻击,系统大面积瘫痪。黑客不仅加密了数据,还威胁要曝光患者的敏感病历。首尔某大型医院被迫支付比特币赎金以恢复系统;另一起事件中,黑客通过缺乏防护的旁路网络攻陷主服务器,幸被社会保障信息服务中心及时发现并指导“拔网线”阻断,避免了更大损失。
攻击方式:勒索软件攻击、双重勒索(加密+泄露威胁)
造成损失:大量患者隐私面临泄露风险,部分医院运营中断,暴露了医疗机构在网络安全防御上的巨大漏洞和成本困境。

2025年11月:瑞士银行遭Qilin勒索团伙攻击
事件经过:瑞士私人银行Habib Bank AG Zurich成为勒索软件团伙Qilin的攻击目标。黑客利用远程桌面服务漏洞入侵,窃取了2.56TB的核心业务数据,包括企业贷款合同和私人银行客户资料。
攻击方式:漏洞利用(RDP)、数据窃取、勒索
造成损失:拒绝支付赎金后,部分数据被上传至暗网,引发瑞士金融市场监督管理局(FINMA)的专项审查,对瑞士银行业的声誉造成打击。

2025年11月:意大利Stellantis全球停产事件
事件经过:知名车企tellantis遭遇严重网络攻击,攻击者利用SAP NetWeaver系统中的两个高危漏洞(CVE-2025-31324等),在未经授权的情况下上传木马并控制服务器。为防止攻击扩散,车企被迫关闭全球IT系统。
攻击方式:供应链/系统漏洞利用(SAP系统)、横向移动
造成损失:全球多地工厂被迫停产,经销商无法注册新车,数百万用户无法享受维保服务,预计每周造成至少5000万英镑的巨额损失,且恢复周期漫长。

2025年8月:玛莎百货(M&S)勒索攻击案
事件经过:英国零售巨头玛莎百货遭受“Scattered Spider”黑客组织攻击。攻击者通过社会工程学手段,冒充员工骗取第三方IT服务商(塔塔咨询)的信任,重置了内部账户密码并关闭了多因素认证(MFA)。
攻击方式:社会工程学(钓鱼)、第三方供应链攻击
造成损失:导致线上业务瘫痪近2个月,实体店支付和提货服务中断,直接经济损失高达1.36亿英镑,上半年利润暴跌99%。

2025年8月:Oracle EBS零日漏洞大规模利用攻击
事件经过:勒索团伙Clop利用甲骨文企业资源规划套件(Oracle E-Business Suite)多个零日漏洞(含CVE-2025-61882)发起大规模数据盗窃活动,受害机构包括哈佛大学、达特茅斯学院、宾夕法尼亚大学、菲尼克斯大学、Logitech、GlobalLogic、大韩航空及Envoy等。
攻击方式:零日漏洞利用、数据窃取
造成损失:多家知名机构敏感数据泄露,企业核心ERP系统安全防线告急,修复与合规成本高昂。

2025年7-10月:开发者工具链系列攻击
事件经过:攻击者以npm仓库、VSCode扩展市场、PyPi软件包索引为目标实施多起攻击,典型案例包括Shai-Hulud活动感染数百个npm软件包窃取开发者密钥和API凭证,Glassworm攻击通过恶意VSCode扩展分发勒索软件和挖矿程序,IndonesianFoods活动向npm仓库上传数十万个恶意或垃圾软件包。
攻击方式:恶意软件包植入、供应链渗透
造成损失:软件开发生命周期各环节被渗透,威胁向下游数以万计的应用传导,大量企业面临数据泄露与系统被控制风险。

2025年7月:俄罗斯航空公司大规模网络攻击
事件经过:亲乌克兰黑客组织Silent Crow与白俄罗斯“网络游击队”联合攻击俄罗斯航空公司,破坏约7000台服务器,核心信息系统严重受损,40余架次航班被迫取消或延误,正值旅游旺季导致莫斯科谢列梅捷沃机场航班信息显示屏大面积飘红。
攻击方式:协同网络攻击、系统破坏
造成损失:航空运营秩序混乱,营收受损,旅客出行受阻,企业声誉受影响。

2025年6月~8月:Salesforce大规模数据盗窃攻击
事件经过:Salesforce成为数据盗窃和勒索高频目标,攻击者通过泄露账户、OAuth令牌及第三方服务漏洞获取客户数据,影响谷歌、Cisco、Chanel、Pandora、安联人寿、农夫保险、Workday等知名机构。
攻击方式:账户泄露利用、OAuth令牌窃取、第三方服务漏洞渗透
造成损失:多个行业知名企业数据泄露,SaaS平台生态安全风险凸显。

2025年6月:160亿条登录凭证暗网泄露事件
事件经过:CyberNews团队发现含160亿条登录凭证的超级数据集在暗网流通,涉及Apple、Google、Facebook等全球主流平台;数据源自多年信息窃取木马日志、既往数据库泄露拼盘,虽部分年代久远,但用户密码复用导致撞库攻击风险激增。
攻击方式:数据汇集后暗网流通
造成损失:全球大量用户面临账号被盗、身份盗用风险,各平台需强化账号安全验证机制。

2025年6月:Qilin勒索软件攻击医疗行业
事件经过:Qilin勒索软件团伙成为年度最活跃团伙,81家受害者中52家为医疗行业;利用Fortinet产品未修复漏洞(CVE-2024-21762和CVE-2024-55591)获取权限,部署勒索软件并窃取电子健康记录、保险记录等敏感数据,采用法律主题勒索手段并设“联系律师”功能和自动化谈判工具施压。
攻击方式:漏洞利用、勒索软件攻击、数据窃取
造成损失:医疗行业数据安全受重创,多家医院运营受影响,患者隐私泄露,大量医疗机构被迫支付赎金。

2025年5月:广电运通遭台独黑客攻击
事件经过:广电运通自助设备后台系统遭网络攻击,导致服务中断。经警方溯源,确认系中国台湾民进党当局豢养的黑客组织所为。
攻击方式:网络资产探测、钓鱼邮件、漏洞利用
造成损失:网络服务中断数小时,部分用户隐私信息疑遭泄露,暴露了针对大陆军工、能源等领域日益频繁的网络渗透活动。

2025年5月:贵州政务服务系统被利用诈骗事件
事件经过:贵州政务服务系统遭攻击后,被诈骗分子利用,诱导群众进行操作,造成群众财产损失400余万元。
攻击方式:系统入侵后恶意利用
造成损失:群众直接财产损失400余万元,暴露公共部门安全治理缺失,损害政府公信力。

2025年5月:Coinbase加密货币平台数据泄露
事件经过:黑客通过贿赂客服人员获取权限,非法获取约9.7万名用户敏感信息,涵盖姓名、银行账户信息、身份证、交易记录等,Coinbase拒绝支付赎金,导致股价大跌。
攻击方式:社会工程学+内部人员勾结
造成损失:损失预计1.8亿-4亿美元,暴露加密货币平台在内部人员管理与数据访问控制上的漏洞,企业市值受影响。

2025年5月:AT&T重大数据泄露
事件经过:攻击者在暗网泄露8600万条AT&T客户记录,包含个人敏感信息。
攻击方式:数据窃取后暗网泄露
造成损失:对用户隐私与企业声誉造成严重影响,AT&T面临用户信任危机与潜在的法律诉讼。

2025年4月:日产聆风电动车漏洞事件
事件经过:研究人员在第二代日产聆风电动车中发现严重漏洞(CVE-2025-32059),黑客可利用蓝牙协议栈缺陷远程突破车载防火墙。
攻击方式:蓝牙协议栈缺陷利用、远程入侵
造成损失:攻击者能直接控制车门、车灯甚至转向系统,暴露汽车供应链如博世组件安全标准缺失;虽未造成大规模车祸,但为智能网联汽车安全敲响警钟。

2025年4月:SK Telecom数据泄露事件
事件经过:韩国最大运营商SK Telecom被披露发生数据泄露,泄露2300万用户个人信息,包括手机号码、USIM卡认证密钥等,黑客自2021年潜伏至2025年才被发现。
攻击方式:长期潜伏式数据窃取
造成损失:SK Telecom被处以约7亿元人民币罚款,暴露企业长期防御失效问题,用户信息安全受到严重威胁。

2025年4月:耶鲁大学医疗系统数据泄露
事件经过:耶鲁大学医疗系统发生数据泄露事件,于4月披露,泄露约555.6万名患者敏感信息,包括社会安全号、医疗记录编号等。
攻击方式:未明确,疑似系统漏洞利用或内部权限滥用
造成损失:成为美国年度最大医疗数据泄露事件,凸显医疗行业高价值目标属性,相关患者面临隐私泄露与身份盗用风险,医院面临监管罚款与法律诉讼。

2025年3月~5月:内部威胁商业化系列事件
事件经过:多起内部威胁事件爆发,Coinbase前支持代理协助黑客入侵导致6.9万名客户信息泄露并被逮捕;CrowdStrike截获内部人员向黑客提供系统实时截图获2.5万美元报酬;巴西中央银行1.4亿美元劫案中,银行员工以920美元出卖特权凭据。
攻击方式:内部人员勾结、特权凭据出卖
造成损失:企业核心数据与资金安全受严重威胁,行业对内部人员管控重视度提升。

2025年3月:AI系统提示注入攻击事件
事件经过:微软365 Copilot、谷歌Gemini等AI助手被发现存在零点击数据泄露漏洞,攻击者通过隐藏指令的邮件或图片,绕过AI安全规则,窃取用户敏感信息或执行恶意操作。
攻击方式:提示注入攻击(隐藏指令绕过安全规则)
造成损失:标志着AI系统本身成为新的攻击面,传统安全防护机制对提示注入攻击基本失效,大量AI用户敏感信息面临泄露风险。

2025年2月:PornHub 94GB敏感数据泄露事件
事件经过:勒索团伙ShinyHunters通过渗透第三方分析服务商Mixpanel,窃取PornHub约94GB敏感数据,含超2亿条Premium会员搜索、观看及下载记录;攻击者威胁不支付赎金则公开订阅者详细活动轨迹。
攻击方式:第三方服务商渗透、数据窃取、勒索威胁
造成损失:会员隐私严重泄露,面临“名誉抹杀”风险,平台用户信任度暴跌,面临法律诉讼与声誉危机。

2025年2月:Bybit加密货币盗窃案
事件经过:2025年2月21日,Bybit遭遇史上最大规模加密资产盗窃案,攻击者从以太坊冷钱包窃取约14.4亿美元资产;FBI证实与朝鲜Lazarus集团有关,攻击者入侵Safe{Wallet}开发者设备操纵交易审批流程;事件引发市场巨震,24小时内全网超15万人爆仓,爆仓总金额超4.56亿美元。
攻击方式:开发者设备入侵+多签钱包篡改
造成损失:损失约14.4亿美元,加密货币市场动荡,大量投资者资产受损。

2025年2月:哈尔滨亚冬会遭国家级APT攻击
事件经过:美国NSA下属特定入侵行动办公室(TAO)通过荷兰跳板IP,对赛事注册/管理系统、信息发布系统、抵离管理系统等发起27万次攻击,峰值每秒2300次,尝试激活Windows隐藏后门,目标还包括黑龙江能源、交通等关键基础设施。
攻击方式:国家级DDoS+APT混合攻击
造成损失:虽未造成赛事中断,但凸显大型国际活动与关键基础设施面临的地缘政治驱动型网络威胁,推动我国升级AI驱动的实时防御与溯源体系。

2025年1月:西北能源基地DNS篡改事件
事件经过:境外组织试图篡改中国西北某能源基地的路由器DNS配置。
攻击方式:DNS配置篡改、针对性关键基础设施攻击
造成损失:攻击意图为阻断数据传输引发区域性停电,甘肃网警72小时内完成反制;该事件被称为数字珍珠港级别的尝试,显示国家级攻击正从窃密转向破坏。

2025年1月:OpenAI ChatGPT API漏洞攻击
事件经过:攻击者利用OpenAI ChatGPT API中的内存损坏漏洞发起攻击。
攻击方式:API内存损坏漏洞利用
造成损失:导致用户对话历史记录和支付信息泄露,凸显AI服务商大模型及API接口安全的重要性,给全行业敲响数据安全警钟。

导致惨重代价的运维事故2025

2025年11月:Cloudflare大规模故障
事件经过:11月18日,Cloudflare CDN、安全服务等多款产品宕机,团队误判为DDoS攻击,回滚旧文件后,于19日凌晨01:06全部恢复。
事故原因:数据库权限调整后生成错误配置文件,引发核心代理系统异常。
造成损失:全球大量依赖Cloudflare服务的网站及业务受影响,平台承诺加速系统韧性升级。

2025年11月:亚马逊云服务重大事故
事件经过:美国太平洋时间凌晨2:01,AWS因运营问题导致近70项自有服务受影响,亚马逊、迪士尼+、Canva等平台及多款云游戏瘫痪。
事故原因:未公开披露具体技术原因,确认与美国东部1号区域相关。
造成损失:全球多家知名平台服务中断,影响用户使用及企业业务营收。

2025年10月:亚马逊AWS北弗吉尼亚区域崩溃
事件经过:AWS US-EAST-1区域中断长达15小时,波及全球。
事故原因:核心依赖服务失效,DynamoDB DNS解析异常引发连锁故障。
造成损失:数千个服务瘫痪,潜在经济损失高达百亿美元。

2025年10月 微软Azure配置错误,导致全球中断
事件经过:Azure Front Door错误配置变更,Azure全网瘫痪,引发Office 365、Teams等核心服务全球性中断,持续数小时。
事故原因:网络配置变更失误,触发底层逻辑缺陷致级联故障。
造成损失:全球用户无法使用核心服务,企业远程办公中断,微软赔付客户,声誉受损。

2025年9月:韩国政府数据中心火灾
事件经过:数据中心锂离子电池迁移维护时爆炸起火,858TB核心数据丢失,160多项公共服务受影响,一周仅恢复18%系统。
事故原因:运维操作引发的基础设施事故。
造成损失:政府服务瘫痪,修复成本高,公信力受损。

2025年8月:上海医保系统故障
事件经过:8月11日,上海医保系统因电信云平台机房供电故障无法正常结算,应急备份系统接管后,本地门急诊结算恢复,大病、住院及异地结算受影响。
事故原因:电信运营管理的云平台机房供电系统故障。
造成损失:患者就医结算受阻,异地参保人需自费后报销,影响民生服务。

2025年6月:谷歌云全球性服务中断
事件经过:6月12日,谷歌云遭遇全球性服务中断,持续约13小时。期间,谷歌工作空间(Google Workspace)、安全运营产品等外部API请求大量失败。
事故原因:服务控制组件高负载处理失效。“服务控制”组件是谷歌云策略检查系统的核心,负责读取配额和政策信息。该组件未能有效应对高负载情况,导致API请求处理堵塞,进而引发了全局性的服务中断。
造成损失:大量企业客户业务受阻,谷歌为此向客户致歉并推出了服务控制改进计划,重建客户信任。

2025年3月:华金期货交易系统长达7.5小时宕机
事件经过:3月10日,华金期货的交易系统突发异常,客户无法通过文华财经等主流交易端登录账户。故障持续了整整7小时26分钟,直到半日过去才被修复。
事故原因:软件故障与应急处置不当。虽然具体技术原因因“证据灭失”未能完全查清,但监管调查发现其在应急处置中未妥善保护现场,且暴露出灾备系统性能不足、过度依赖外部供应商等问题。
造成损失:达到“一般网络安全事件”标准;期货市场瞬息万变,长时间的交易中断导致客户面临巨大的穿仓风险和亏损,公司也因此收到监管罚单。

2025年1月:埃隆·马斯克旗下X公司数据中心火灾
事件经过:X公司租用的俄勒冈州希尔斯伯勒数据中心发生火灾。
事故原因:储能设备管理问题,电池房间存在运维漏洞。
造成损失:影响X平台部分服务稳定性。

【转载】2024年值得关注的AI研究论文(上)

原文地址:Noteworthy AI Research Papers of 2024 (Part One),by Sebastian Raschka, on 2024-12-31

2024年值得关注的AI研究论文(上)

1—6月的6篇具有影响力的AI论文

新年伊始,我终于完成了这篇《2024年AI研究亮点》文章的初稿。文章涵盖了诸多主题,从混合专家模型到全新的大语言模型精度缩放定律。

要盘点2024年所有重要的研究亮点,恐怕得写一整本书才行。即便在AI这个日新月异的领域,2024年也堪称成果极其丰硕的一年。为了让内容尽量精简,我今年决定只聚焦大语言模型(LLM)领域的研究。但即便如此,要从这成果丰硕的一年里选出一部分论文,又该如何抉择?我能想到的最简单的方式,就是每月精选一篇论文:覆盖2024年1月到12月。

因此,在本文中,我将分享那些我个人认为极具启发性、影响力深远,或是两者兼具的研究论文。但请注意,本文只是上篇,聚焦2024年上半年(1—6月)的内容。本系列的下篇将涵盖7—12月,于1月晚些时候发布。

诚然,筛选标准比较主观,是基于我今年关注到的重点内容而定的。我也尽量兼顾了主题的多样性,不只是围绕大语言模型的发布展开。

如果你想了解更全面的AI研究论文清单,可以参考我之前的文章(https://magazine.sebastianraschka.com/p/llm-research-papers-the-2024-list)。

对于读过我那篇《2024年大语言模型研究论文清单》的读者,我很高兴地告诉大家,我现在已经感觉好多了,正在缓慢但稳步地康复!也由衷感谢大家所有的祝福与支持,这份心意对我意义重大,陪我度过了一段艰难的日子。

新年快乐,祝大家阅读愉快!


1. 一月:Mixtral的混合专家架构

2024年1月刚过去没几天,Mistral AI团队就发布了论文(2024年1月8日,https://arxiv.org/abs/2401.04088),介绍了Mixtral 8x7B——一种稀疏混合专家(SMoE)模型。

这篇论文和该模型在当时都产生了很大影响,因为Mixtral 8x7B是首批开源权重的混合专家大语言模型之一,性能表现十分亮眼:在多项基准测试中,它的表现都超过了Llama 2 70B和GPT-3.5。

1.1 理解混合专家模型

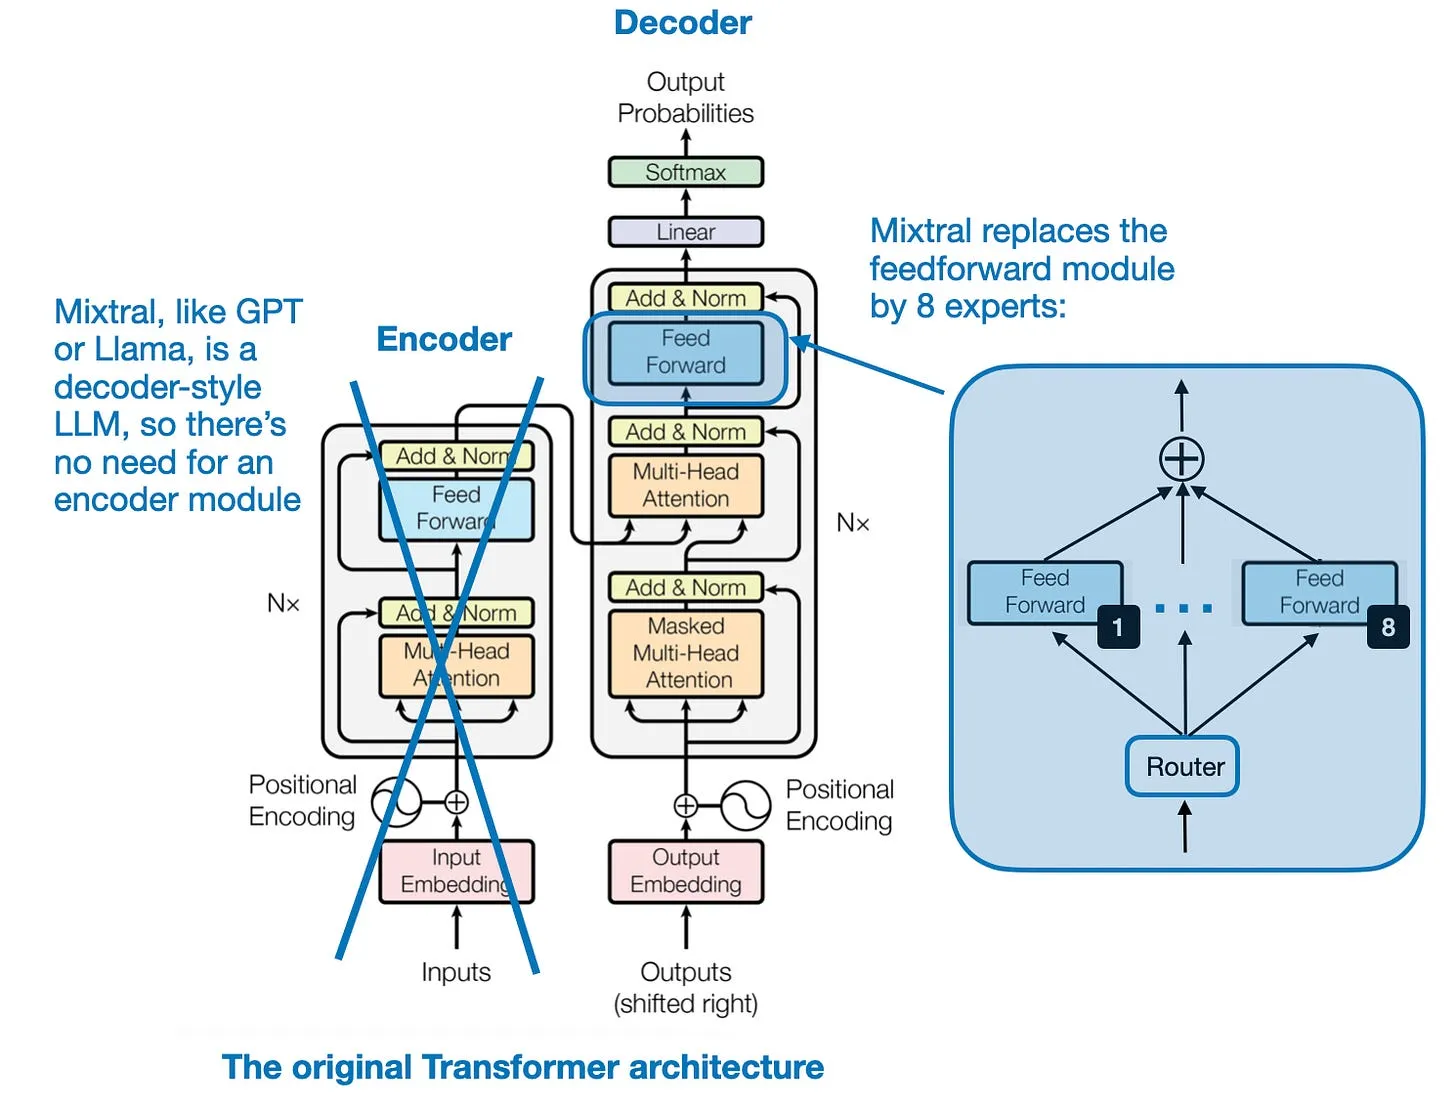
混合专家(MoE,Mixture of Experts)是一种集成模型,它在类GPT的解码器架构中,整合了多个更小的“专家”子网络。每个子网络负责处理不同类型的任务,更具体地说,是处理不同的token。其核心思路是,用多个小型子网络替代单一的大型网络,从而更高效地分配计算资源。

具体到Mixtral 8x7B,它将Transformer架构中的每个前馈模块都替换为8个专家层,如下图所示。

figure01

标注后的Transformer架构,源自《Attention Is All You Need》,https://arxiv.org/abs/1706.03762

“稀疏混合专家”中的“稀疏”,指的是在任意时刻,只有一部分专家层被激活用于处理单个token(在Mixtral 8x7B中,8个专家里通常只激活1到2个)。

如上图所示,这些子网络替代了大语言模型中的前馈模块。前馈模块本质上就是一个多层感知机。用类PyTorch的伪代码表示,大致如下:

class FeedForward(torch.nn.Module):        
    def __init__(self, embed_dim, coef):                 
        super().__init__()         
        self.layers = nn.Sequential(             
            torch.nn.Linear(embed_dim, coef*embed_dim),             
            torch.nn.ReLU(),             
            torch.nn.Linear(coef*n_embed, embed_dim),             
            torch.nn.Dropout(dropout)         
        )          
    
    def forward(self, x):        
        return self.layers(x)

除此之外,还有一个路由模块(也叫门控网络),负责将每个token的嵌入向量分发到8个专家前馈模块中,且同一时间只有部分专家处于激活状态。

本文还要介绍另外11篇论文,因此关于Mixtral模型我就先简要介绍到这里。更多细节可以参考我之前的文章:https://magazine.sebastianraschka.com/i/14113005/mixtral-of-experts

1.2 混合专家模型在当下的价值

年初的时候,我本以为开源权重的混合专家模型会比现在更普及、应用更广泛。虽说这类模型并非无关紧要,但目前很多顶尖模型依然采用稠密(传统)大语言模型架构,而非混合专家架构,比如Llama 3、通义千问2.5、Gemma 2等。当然,我们无从得知GPT-4、Gemini、Claude这些闭源模型的底层架构,它们内部很可能也采用了混合专家设计。

无论如何,混合专家架构依然有其价值,尤其是它提供了一种高效扩展大语言模型的方式:每个输入只激活模型的部分参数,从而在不牺牲模型容量的前提下降低计算成本。

顺便一提,写完这篇文章后,DeepSeek V3意外发布(https://github.com/deepseek-ai/DeepSeek-V3/blob/main/DeepSeek_V3.pdf),它采用的正是混合专家架构。所以没错,混合专家模型依然极具应用价值!


2. 二月:权重分解低秩适配(DoRA)

如果你做过开源大语言模型的微调,那大概率用过低秩适配(LoRA)——一种参数高效的大语言模型微调方法。

如果你对LoRA还不熟悉,可以参考我之前的文章(https://magazine.sebastianraschka.com/p/practical-tips-for-finetuning-llms),应该会对你有帮助;另外在我的书(https://amzn.to/4fqvn0D)的附录D中,还有从零实现LoRA的完整代码。

LoRA是一种非常普及、应用广泛的方法,而我在实现和测试它的一个新变体时也收获了很多乐趣,因此我二月的精选论文是Liu等人于2024年2月发表的研究(https://arxiv.org/abs/2402.09353)。

2.1 LoRA回顾

在介绍DoRA之前,先快速回顾一下LoRA的原理:

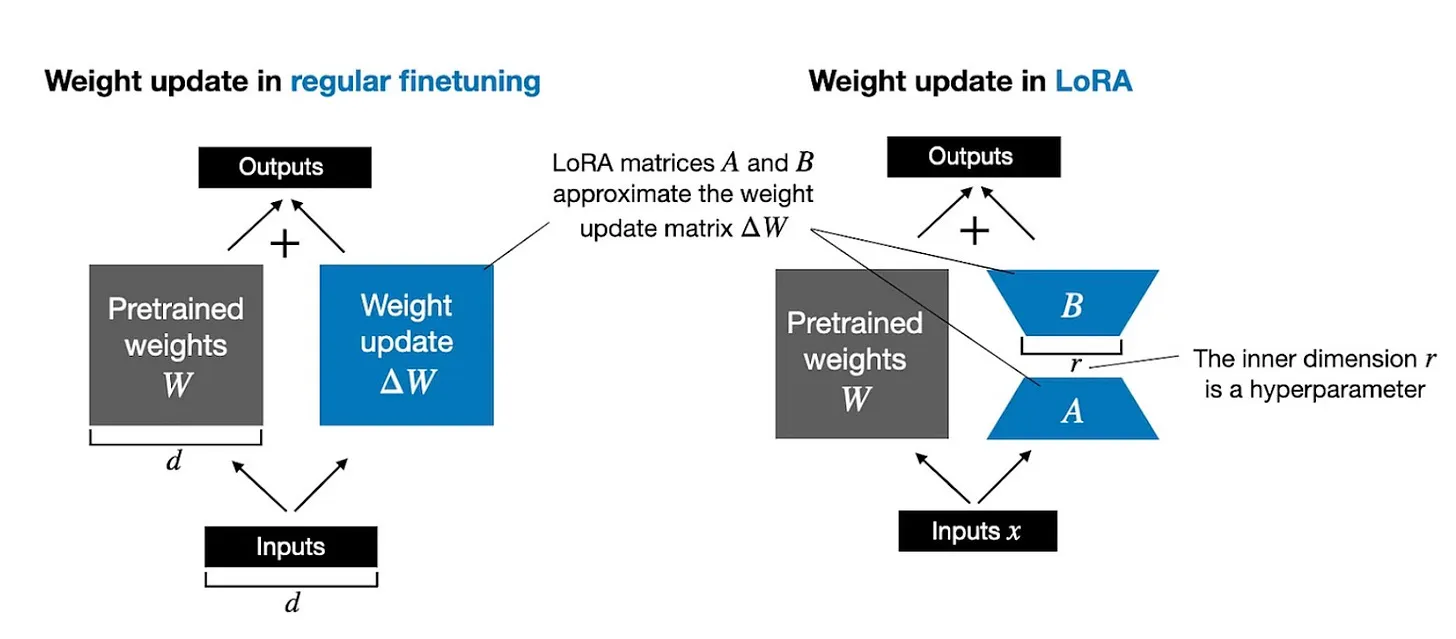
全量微调会计算一个大型的权重更新矩阵ΔW,以此更新大语言模型中每个大型权重矩阵W。而LoRA用两个更小的矩阵A和B的乘积来近似ΔW。也就是说,权重更新不再是$W + \Delta W$,而是$W + A\cdot B$。这大幅降低了计算开销和内存占用。

下图并排展示了全量微调(左)和LoRA(右)对应的公式原理。

figure02

常规微调(左)与LoRA微调(右)示意图

2.2 从LoRA到DoRA

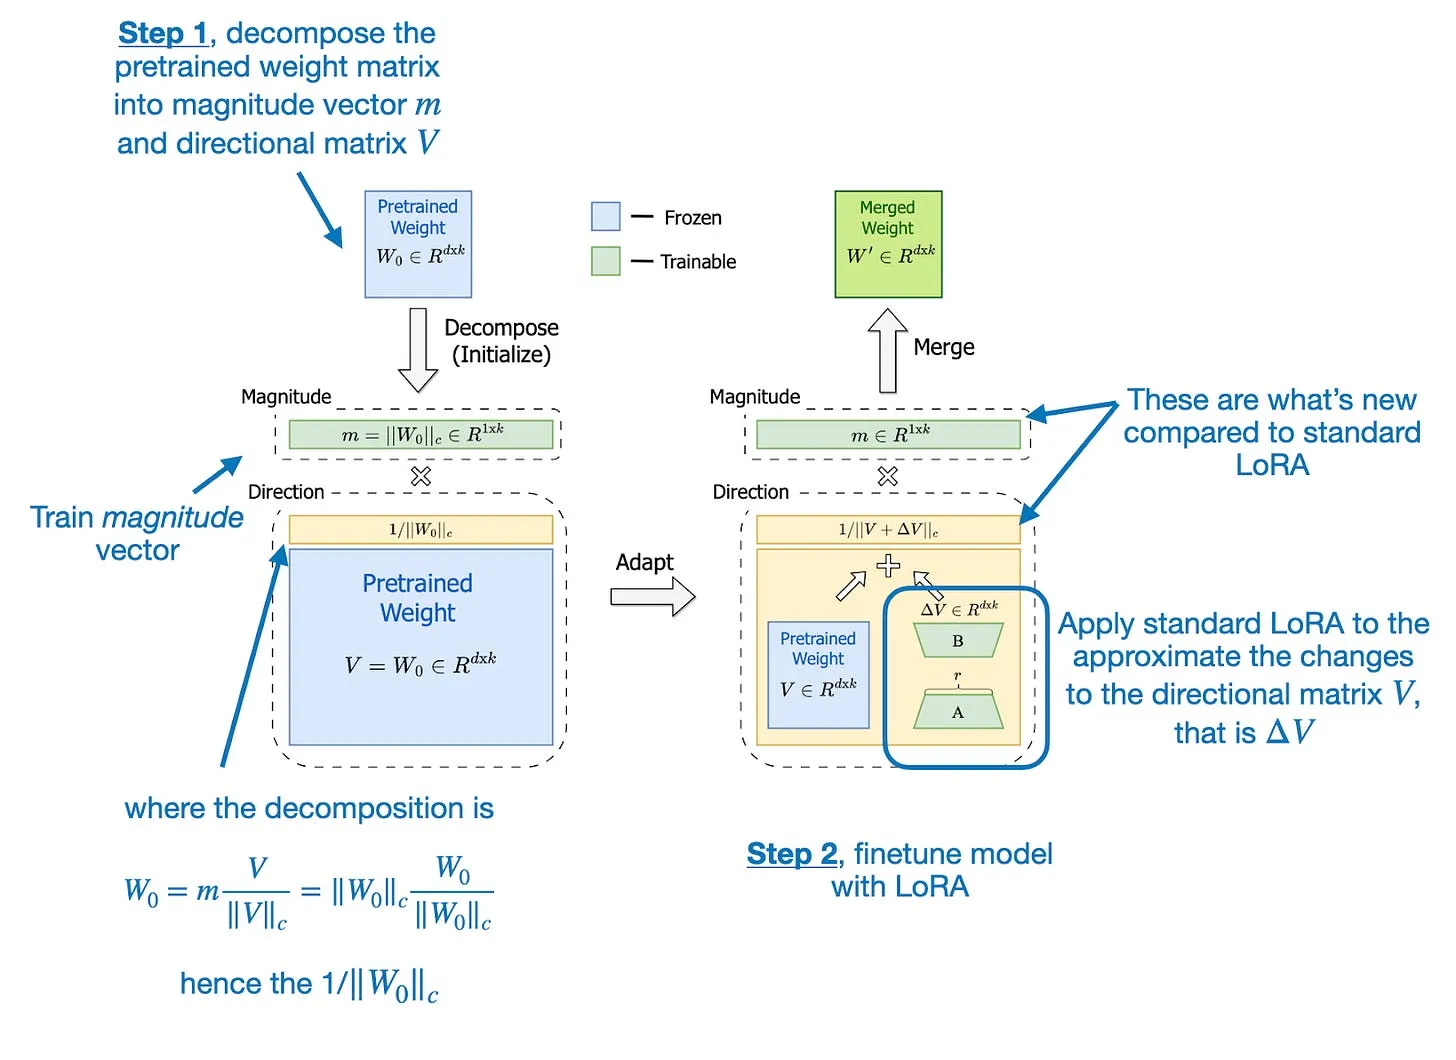
在2024年2月的这篇论文(https://arxiv.org/abs/2402.09353)中,Liu等人对LoRA进行了扩展:首先将预训练的权重矩阵分解为两部分——幅度向量m和方向矩阵V。这种分解的核心思想是,任意向量都可以表示为长度(幅度)和方向(朝向)的组合,这里将该思想应用到权重矩阵的每一列向量上。得到m和V之后,DoRA仅对方向矩阵V施加LoRA风格的低秩更新,而幅度向量m则单独训练。

figure03

标注后的示意图,源自DoRA论文(https://arxiv.org/abs/2402.09353)

这种两步法让DoRA比标准LoRA更具灵活性。LoRA往往会对幅度和方向进行同步缩放,而DoRA可以在不必然改变幅度的前提下,对方向进行精细调整。最终带来了性能和鲁棒性的提升:即便使用更少的参数,DoRA的表现也能优于LoRA,且对秩(rank)的选择更不敏感。

后面还有10篇论文要介绍,这部分我就先简述至此。如果想了解更多细节,我今年早些时候专门写过一篇文章讲解该方法:https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch

2.3 LoRA及类LoRA方法的未来

DoRA是对原始LoRA方法的一个小幅但合理的改进。虽然目前还没有被广泛采用,但它几乎没有增加额外复杂度,下次你做模型微调时值得一试。总体而言,我认为LoRA及类似方法会继续保持主流地位。比如苹果公司在其论文(https://arxiv.org/abs/2407.21075)中就提到,他们在端侧大语言模型的任务专项化中使用了LoRA。


3. 三月:大语言模型持续预训练的实用技巧

据我观察,指令微调是大语言模型从业者最常用的微调方式,目的是让开源大语言模型更好地遵循指令,或是针对特定子集、新指令做专项适配。

但如果要让模型吸收新知识,持续预训练(有时也叫连续预训练)才是正确的思路。

在这一部分,我将简要总结Ibrahim等人2024年3月发表的这篇论文(https://arxiv.org/abs/2403.08763),其方法直白清晰,让人耳目一新。

3.1 简单的技术依然有效

这篇长达24页的论文(https://arxiv.org/abs/2403.08763)包含了大量实验和数据图表,以当下的标准来看十分详实。

成功开展持续预训练的核心技巧有哪些?

  1. 对学习率进行简单的重升温与重衰减。
  2. 在新数据集中混入少量(比如5%)原始预训练数据,防止灾难性遗忘。值得注意的是,0.5%、1%这样更小的比例同样有效。

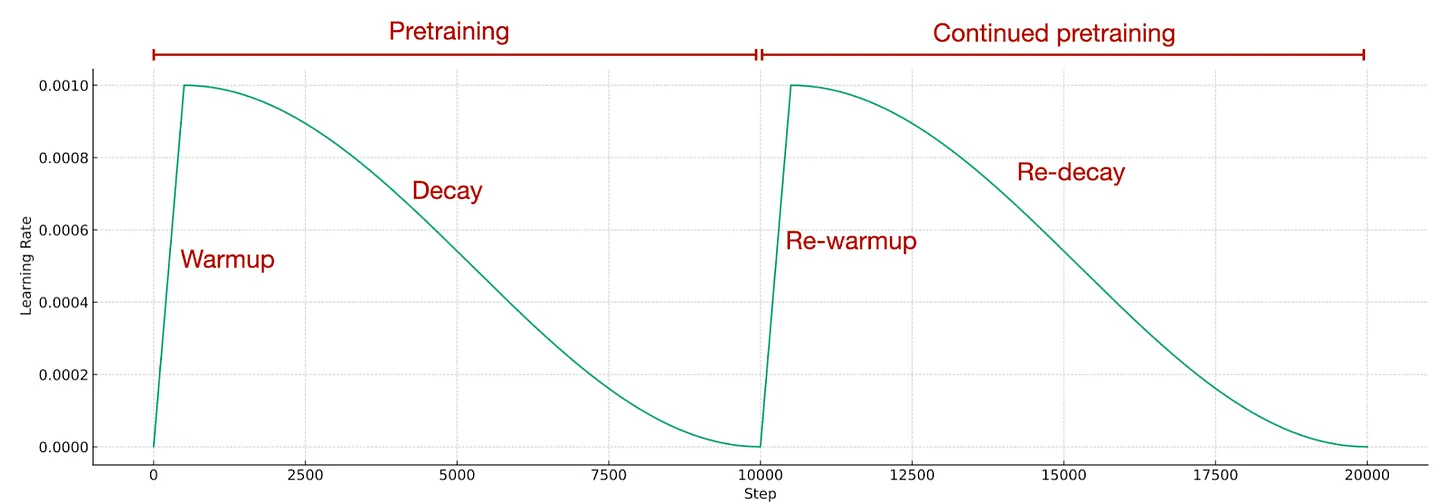
关于第一点“重升温与重衰减”,说得更具体些:就是采用与模型初始预训练阶段完全相同的学习率调度策略,如下图所示。

figure04

持续预训练的学习率调度示意图。图源自《从零构建大语言模型》,https://github.com/rasbt/LLMs-from-scratch/blob/main/appendix-D/01_main-chapter-code/appendix-D.ipynb

据我所知,学习率重升温重衰减、以及在新数据中混入原始预训练数据,这些都算是业内共识。但我非常欣赏研究者们花精力在这篇24页的详细报告中,对该方法进行了正式的实验验证。

如果想了解更多细节,我之前的文章(https://magazine.sebastianraschka.com/p/tips-for-llm-pretraining-and-evaluating-rms)对这篇论文有更全面的讨论。

3.2 这些简单方法会持续有效吗?

我没有理由认为这些方法在未来的大语言模型上会失效。但需要注意的是,近几个月来预训练流程已经变得更复杂,通常包含多个阶段,包括短上下文预训练和长上下文预训练。(我在这篇文章中有更多相关论述:https://magazine.sebastianraschka.com/p/new-llm-pre-training-and-post-training)

因此,为了达到最优效果,这篇论文提出的方案在某些场景下可能需要做适当调整。


4. 四月:大语言模型对齐用DPO、PPO,还是两者都用?

四月的精选很难抉择。比如KAN论文(https://arxiv.org/abs/2404.19756)当月引发了巨大热议,但在我看来,这股热潮很快就消退了。这可能是因为其理论上的优势很难在实际中落地,缺乏有竞争力的实验结果或基准测试表现,而且其他架构的可扩展性要强得多。

因此,我四月的精选换成了一篇更偏实用的论文:Xu等人2024年4月发表的研究(https://arxiv.org/abs/2404.10719)。

4.1 RLHF-PPO与DPO分别是什么?

在总结这篇论文之前,先概述一下近端策略优化(PPO)和直接偏好优化(DPO)——二者都是通过基于人类反馈的强化学习(RLHF)实现大语言模型对齐的主流方法。RLHF是让大语言模型对齐人类偏好的核心方法,既能提升回复质量,也能提高安全性。

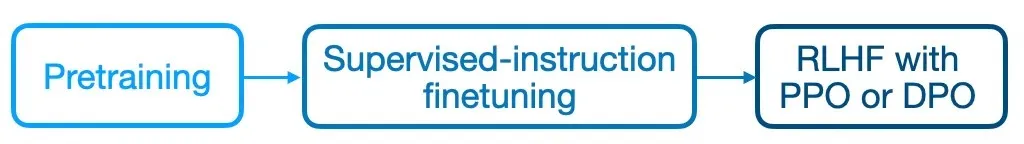
figure05

典型(简化版)的大语言模型训练生命周期

传统上,RLHF-PPO是训练大语言模型的关键步骤,InstructGPT、ChatGPT等模型和平台都采用了该方法。但去年起,DPO凭借其简洁性和有效性开始流行起来。与RLHF-PPO不同,DPO不需要单独训练奖励模型,而是通过类似分类的目标函数直接更新大语言模型。如今很多大语言模型都使用DPO,但一直缺乏它与PPO的全面对比研究。

以下是我今年早些时候整理并分享的两份关于RLHF和DPO的资料:

4.2 PPO表现通常优于DPO

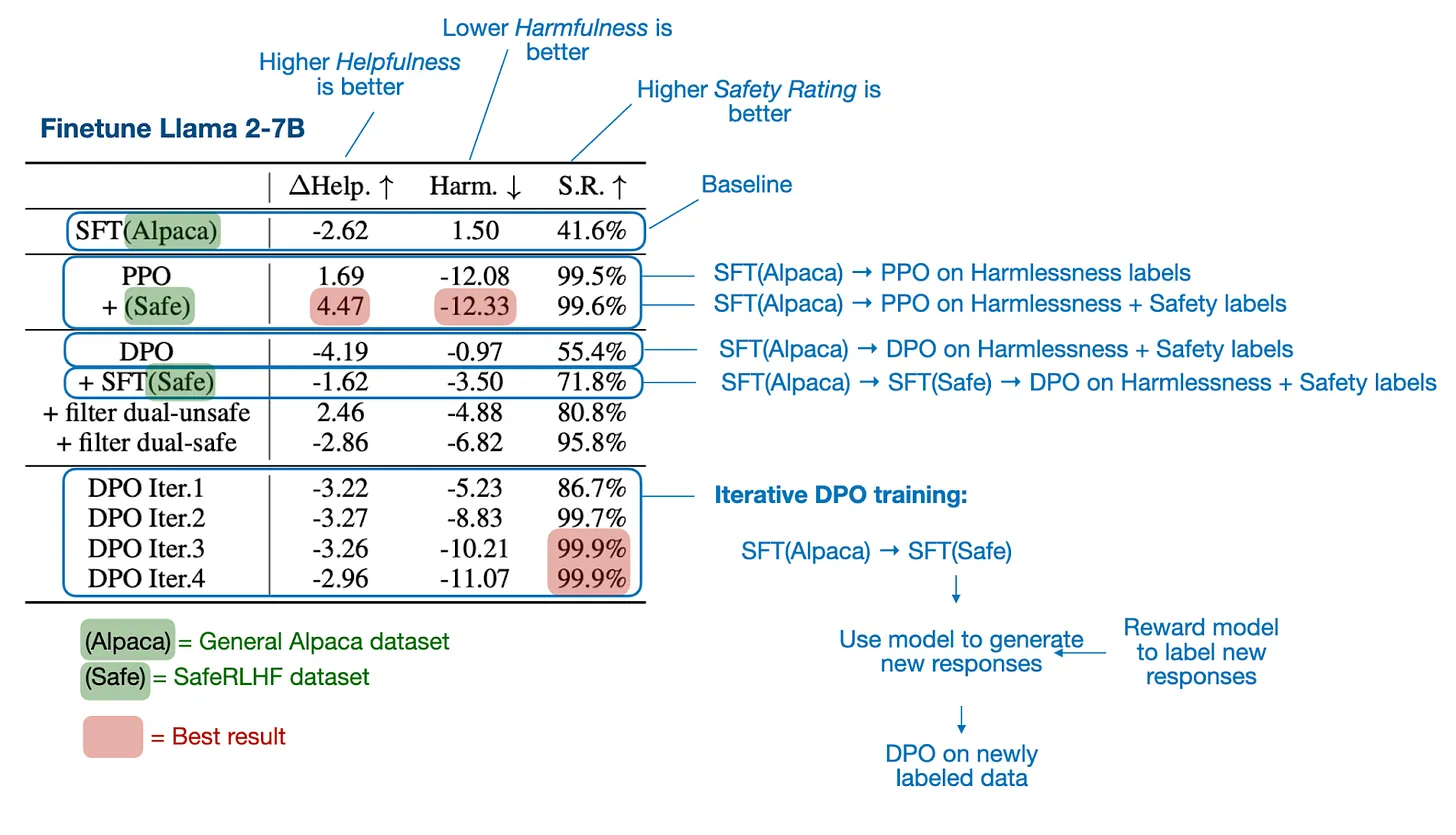
这篇论文(https://arxiv.org/abs/2404.10719)撰写严谨,包含大量实验与结果。核心结论是:PPO的表现往往优于DPO;在处理分布外数据时,DPO的劣势更为明显。

这里的“分布外数据”,指的是模型之前通过监督微调训练所用的指令数据,与DPO使用的偏好数据存在差异。比如,模型先在通用的Alpaca数据集上训练,再在另一个带偏好标注的数据集上做DPO微调。(不过,要提升DPO在分布外数据上的表现,有一种方法:先用偏好数据集做一轮监督指令微调,再进行DPO微调。)

主要研究结果总结如下图所示。

figure06

标注后的表格,源自《DPO在大语言模型对齐中真的优于PPO吗?一项全面研究》(https://arxiv.org/abs/2404.10719)论文

4.3 当下PPO与DPO的应用现状

从最终大语言模型的原始建模性能来看,PPO可能略有优势。但DPO的实现难度低得多,计算效率也更高(毕竟不需要单独训练和调用奖励模型)。因此据我所知,实际应用中DPO比RLHF-PPO普及得多。

一个很有意思的例子是Meta的Llama系列模型:Llama 2采用RLHF-PPO训练,而更新的Llama 3则使用了DPO。

有趣的是,如今最新的模型甚至会同时使用PPO和DPO。近期的例子包括苹果的论文(https://arxiv.org/abs/2407.21075),以及Allen AI的Tulu 3论文(https://arxiv.org/abs/2411.15124)。


5. 五月:LoRA学得更少,忘得也更少

今年还有一篇LoRA相关的论文我觉得特别有意思(保证这是本次12篇精选里最后一篇LoRA相关的了!)。它算不上颠覆性突破,但我很喜欢它,因为它把关于是否使用LoRA微调大语言模型的一些行业共识进行了正式的实证验证:这就是Biderman等人2024年5月发表的论文(https://arxiv.org/abs/2405.09673)。

这篇论文(https://arxiv.org/abs/2405.09673)是一项实证研究,对比了低秩适配(LoRA)与全量微调在大语言模型上的效果,聚焦两个领域(编程和数学)、两种任务(指令微调和持续预训练)。如果需要回顾LoRA的原理,可以翻回上面二月的部分。

5.1 LoRA学得更少

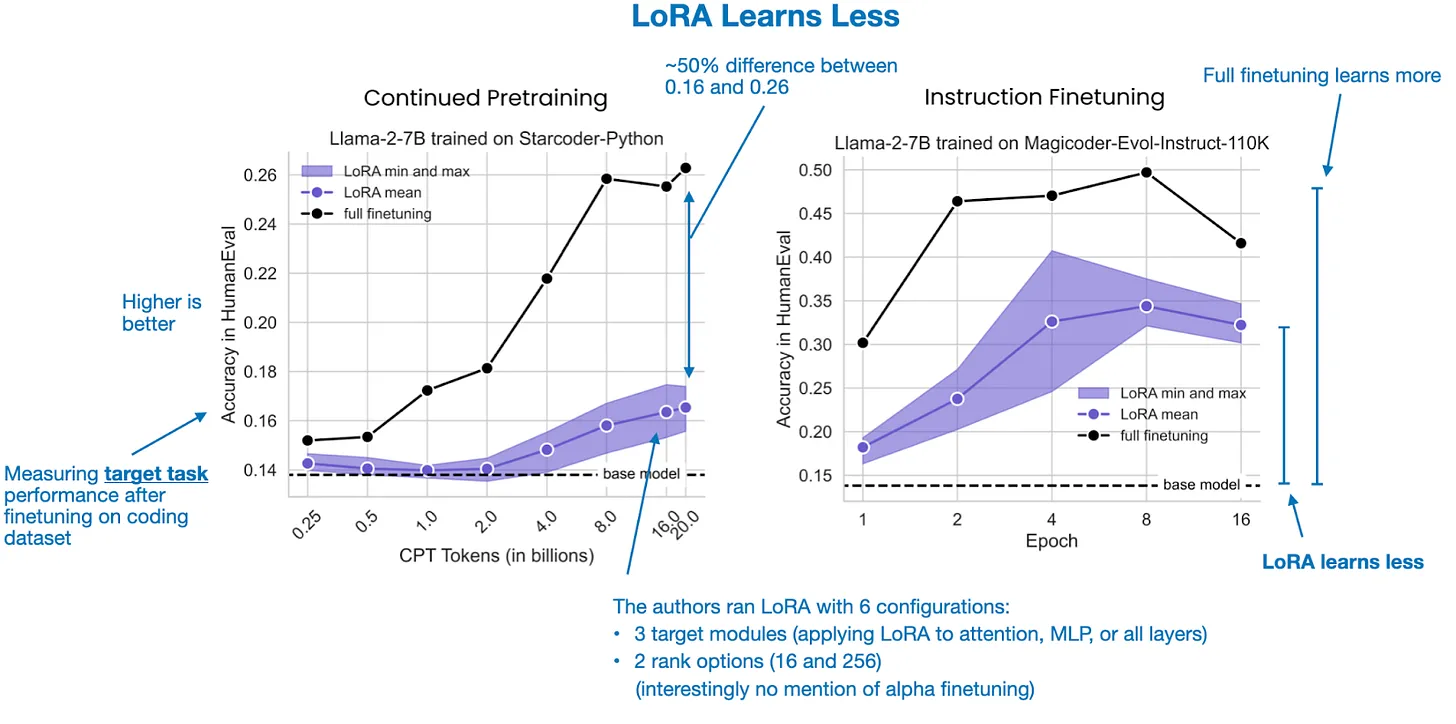
研究表明,LoRA的学习效果明显不如全量微调,尤其是在编程这类需要习得新知识的任务中。如果只做指令微调,两者的差距会更小。这说明:相比把预训练模型改成指令遵循模型,用新数据做预训练(学习新知识)从全量微调中获益更多。

figure07

全量微调与LoRA对比。性能通过HumanEval数据集衡量,该数据集包含164道编程题目。图标注源自《LoRA学得更少,忘得也更少》,https://arxiv.org/abs/2405.09673

不过还有更多细节值得注意。比如在数学任务上,LoRA和全量微调的差距会缩小。这可能是因为数学问题对大语言模型来说更熟悉,预训练期间大概率见过类似的题目。相比之下,编程是一个差异更大的领域,需要更多新知识。因此,新任务与模型预训练数据的差异越大,全量微调在学习能力上的优势就越明显。

5.2 LoRA忘得更少

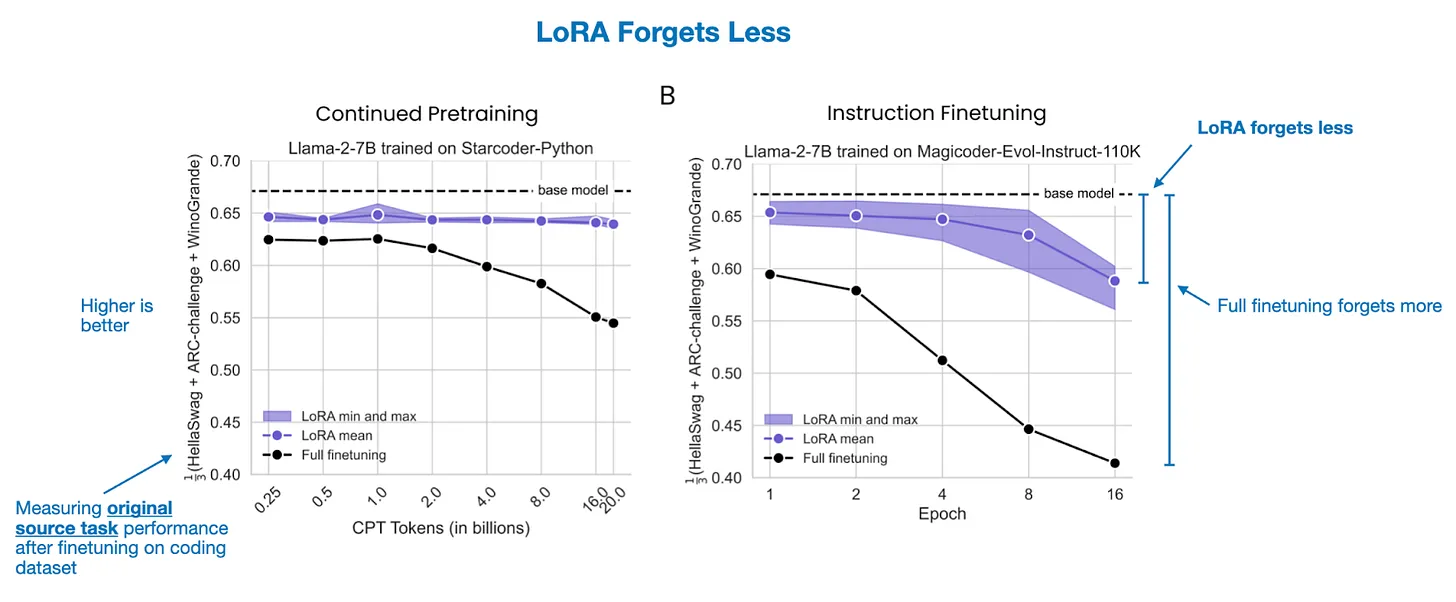
在考察原有知识的遗忘程度时,LoRA始终表现出更少的遗忘。在适配与源领域差异较大的数据(比如编程)时,这一点尤为明显。在编程任务中,全量微调会导致严重的遗忘,而LoRA能保留更多原有能力。在数学任务上,模型原本的知识就和新任务更接近,因此两者的差异没那么显著。

figure08

在编程数据上训练后,全量微调与LoRA在原始源任务上的表现对比。图标注源自《LoRA学得更少,忘得也更少》,https://arxiv.org/abs/2405.09673

5.3 LoRA的权衡

总体而言,这是一种权衡:全量微调更擅长吸收差异较大领域的新知识,但会导致更多原有任务的遗忘;而LoRA通过调整更少的参数,学到的新知识更少,但保留了更多原有能力。

5.4 大语言模型微调的未来方向

该研究主要对比了LoRA和全量微调。实际应用中,LoRA之所以流行,是因为它的资源效率远高于全量微调。很多情况下,受硬件限制,全量微调根本无法实现。此外,如果只需要应对特定的专项应用,只用LoRA可能就足够了。由于LoRA适配器可以和基础大语言模型分开存储,很容易在新增能力的同时保留原有能力。而且还可以将两种方法结合:用全量微调做知识更新,再用LoRA做后续的专项适配。

简而言之,我认为未来这两种方法都会继续发挥重要作用,关键是要根据具体任务选择合适的方法。


6. 六月:15万亿token的FineWeb数据集

Penedo等人2024年6月发表的论文(https://arxiv.org/abs/2406.17557)介绍了一个面向大语言模型的15万亿token数据集的构建过程,并将其公开,包括数据集地址(https://huggingface.co/datasets/HuggingFaceFW/fineweb)和可复现数据集制作流程的代码仓库(https://github.com/huggingface/datatrove/blob/main/examples/fineweb.py)。

6.1 与其他数据集的对比

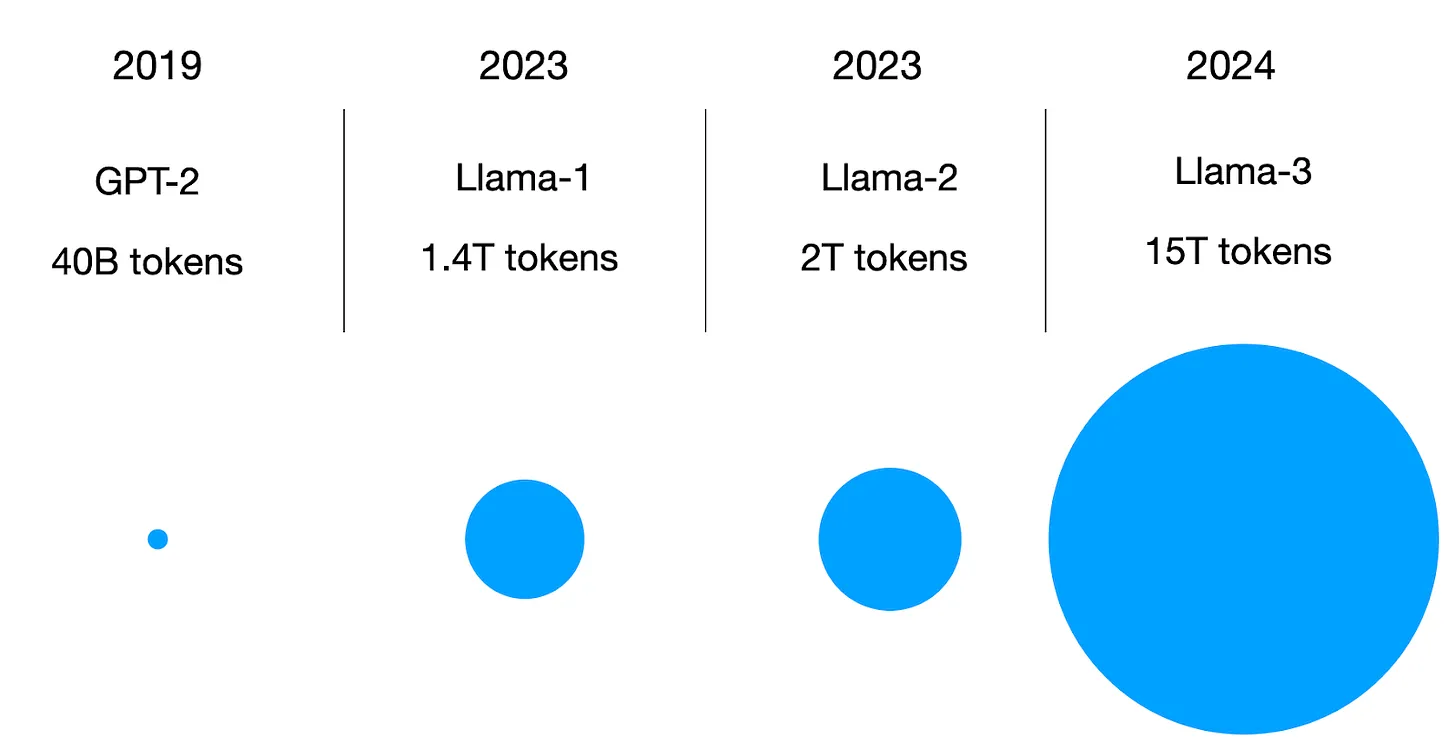
目前已经有多个用于大语言模型预训练的大型数据集,这个数据集有什么特别之处?其他数据集的规模相对更小:RefinedWeb(5000亿token)、C4(1720亿token)、Dolma 1.6的Common Crawl部分(3万亿token)和Dolma 1.7(1.2万亿token)、The Pile(3400亿token)、SlimPajama(6270亿token)、去重版RedPajama(20万亿token)、Matrix的英文CommonCrawl部分(1.3万亿token)、English CC-100(700亿token)、Colossal-OSCAR(8500亿token)。

比如,约3600亿token只适合训练小型大语言模型(根据Chinchilla缩放定律,对应17亿参数的模型)。而FineWeb数据集的15万亿token,根据Chinchilla缩放定律,最高可适配5000亿参数的模型。(注意:RedPajama数据集(https://github.com/togethercomputer/RedPajama-Data)包含20万亿token,但研究者发现,由于采用的过滤规则不同,在RedPajama上训练的模型质量不如FineWeb。)

figure09

历年来大语言模型预训练所用数据集规模示意图。注意:这只是通用参考,与FineWeb论文及Chinchilla缩放定律论文无直接关联。

简而言之,纯英文的FineWeb数据集让研究者和从业者训练大规模大语言模型在理论上成为可能。(补充说明:Llama 3系列(8B、70B、405B参数,https://arxiv.org/abs/2407.21783)也是用15万亿token训练的,但Meta的训练数据集并未公开。)

6.2 有原则的数据集构建

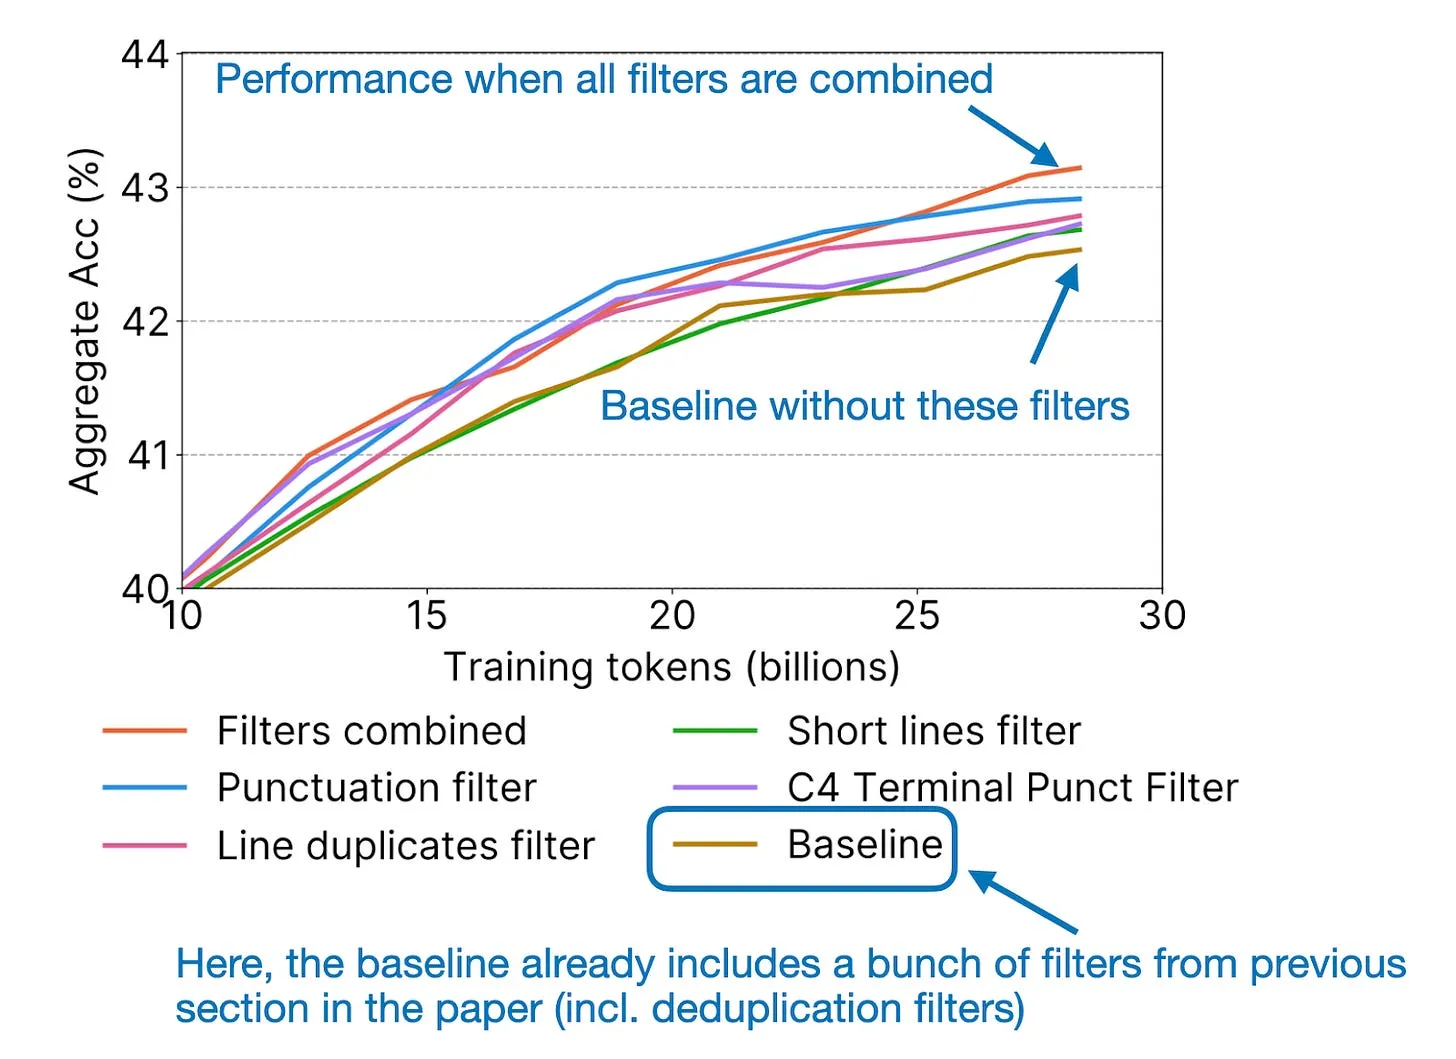
此外,论文中还包含了严谨的消融实验,深入阐释了从CommonCrawl网页语料(https://commoncrawl.org/)出发,如何制定并应用过滤规则,最终得到FineWeb数据集。简而言之,每尝试一条过滤规则,他们都会从原始数据和过滤后的数据中各抽取3600亿token的随机样本,然后训练一个17.1亿参数的类Llama小型模型,通过模型在HellaSwag、ARC、MMLU等标准基准上的表现,判断该过滤规则是否有效。

figure10

6.3 FineWeb在当下的价值

总体而言,虽然训练数十亿参数的大语言模型对多数研究实验室和企业来说依然难以实现,但这个数据集向大语言模型研究与开发的普惠化迈出了坚实的一步。总而言之,这篇论文的工作值得称赞,为推动大语言模型预训练的发展提供了宝贵的公共资源。


7—12月内容预告

希望这些研究总结对你有帮助!由于我还在康复中,而且这篇文章本来也会过长,我决定把今年的年度综述分成上下两部分。

下篇(7—12月)对我个人来说其实更精彩,我会讨论关于缩放定律、复现O1、合成数据在大语言模型训练中的作用等更新的研究。此外,我还会分享对2025年的展望,以及我认为即将出现的趋势。敬请期待!

这本杂志是我个人的热爱项目。如果想要支持我的创作,欢迎购买我的书(https://amzn.to/4fqvn0D)。(我相信你会从书中收获很多,因为它对大语言模型工作原理的讲解深度是其他地方找不到的。)

figure11

《从零构建大语言模型》现已发售,购买链接:https://amzn.to/4fqvn0D

如果你读过这本书,还请抽出几分钟时间在亚马逊留下评论(https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167),这对我们作者来说帮助很大!

你的支持意义重大!谢谢!

【转载】大语言模型研究论文:2024年度合集

原文地址:LLM Research Papers: The 2024 List,by Sebastian Raschka, on 2024-12-08

大语言模型研究论文:2024年度合集

今年的AI研究领域精彩纷呈、热点不断,如果你关注大语言模型方向,更是能感受到领域的飞速发展。

我原本为12月的这期内容做了详尽规划,打算发布一篇专题文章,盘点2024年我心目中的所有研究亮点。这个计划依然会推进,但由于意外受了重伤,我目前无法坐在电脑前完成草稿。希望接下来几周能顺利康复,尽快回归工作。

在此期间,我想分享自己2024年以来持续收藏的优质论文清单(以大语言模型相关内容为主)。这只是一份简单的列表,但或许能帮大家在假期里挖到一些值得深入研读的宝藏论文。

如果你偏好代码向的深度阅读与动手实践,我的《从零构建大语言模型》一书已于上个月在亚马逊上线。
此外,我还在GitHub仓库中补充了大量配套学习资料。

figure01

Continue reading 【转载】大语言模型研究论文:2024年度合集→

当“锚”切断数字动脉:红海光缆中断事件复盘

当“锚”切断数字动脉:红海光缆中断事件复盘

一、事件始末:一艘货轮的失控,三条光缆的毁灭

2024年2月18日,伯利兹籍万吨散货轮”鲁比玛号”(MV Rubymar)满载4.1万吨化肥,在红海曼德海峡航道通行时,遭遇武装导弹袭击。船体严重受损,船员第一时间紧急弃船撤离,船舶彻底失去动力与人为操控能力。

按常规认知,遇袭失能船舶会快速沉没。但”鲁比玛号”并没有立刻倾覆,而是出现了极具特殊性的次生风险———它在洋流作用下持续漂移,船体全程拖拽着巨型船锚,在红海海域缓慢漂流超过70公里。坚硬锋利的锚爪如同一柄失控的犁刀,持续剐蹭、切割海底地层。

2024年2月24日,导弹袭击发生整整六天后,船锚斩断了红海海底三条核心跨境互联网通信光缆(相互之间距离很近):
Seacom/Tata TGN-Eurasia
Asia Africa Europe-1(AAE-1)
Europe India Gateway(EIG)

2024年3月2日,这艘失事货轮才最终完全沉没,彻底结束漂移破坏过程。

二、红海走廊:全球互联网的”单点瓶颈”

红海海底光缆是欧亚、非欧跨境数据传输的核心骨干链路,承担着全球互联网的核心流量承载任务,其战略传输地位无可替代。具体来看:

指标 数据
欧亚跨境网络数据经红海传输比例 约80%
红海光缆承载全球互联网流量比例 约17%
红海光缆支撑日均跨境金融交易量 超6万亿美元

在高可用的分布式系统架构设计中,总流量汇聚于一条物理走廊(狭窄的海峡、活跃冲突、复杂的地缘政治环境),这本身就构成了一个高风险单点故障区域(Single Point of Failure)。

虽然红海海底铺设了多条不同的光缆(EIG、AAE-1、SEA-ME-WE 5等),但它们几乎都经由同一条狭窄水道。这意味着,一次大范围的物理事件(无论是地震、船锚拖拽还是蓄意破坏),都有可能同时影响多条线路,导致物理层面的”集中导致的冗余失效”。”鲁比玛号”事件恰好验证了这个假设:一条失控的货轮,一次漂流,就切断了三条光缆。

从运维的视角来看,本次事件是这样的:一个高可用集群,全部副本都在同一个机房。机房对外有三根线路,但三根线路沿着同一个管道铺设。一台挖掘机一铲子把管道挖断了,对整个机房网络造成了难以预期的、不可逆的灾难性破坏。

三、故障传播:从物理层到业务层的级联崩塌

三条核心光缆同步断裂,直接触发了区域性骨干网络的带宽断崖式衰减与链路稳定性骤降。红海主干链路可用数据传输量直接缩减四分之一,也就是欧亚大陆的网络带宽减少了四分之一,欧亚大陆的网络”集体降速”。

从维度角度分析,本次故障的影响具备影响范围广、持续时间长、级联效应明显三大特征:

1、全域性——覆盖范围极广
东非、西亚、欧洲、东亚跨境通信全面受影响。政企专线、跨境云计算、国际结算系统、跨境办公网络均出现运行异常。具体表现为:
欧亚之间网络延迟显著上升,部分路由延迟大幅上升;
东非、中东部分区域互联网连接近乎中断;
跨国企业实时通信、视频会议、金融数据传输出现严重抖动与丢包;
云服务提供商跨区域同步和灾备系统面临更高的数据一致性风险。

2、持续性——故障层级极高
这是骨干核心链路的物理性损毁,而非边缘节点故障,无法通过局部设备重启、带宽扩容、节点切换等常规运维手段修复。光缆修复历时5个月,全网降级运行状态持续近半年。

3、连锁性——单点故障引发全网失衡*
根据BGP(边界网关协议)的路由收敛机制,受影响的流量会尝试切换到可用路径。故障发生后,运维团队通过非洲西海岸的Equiano、Peace、WACS等备用光缆进行流量迂回调度,缓解主干链路带宽压力。

但备用链路传输距离更长、带宽容量有限,无法完全抵消主干光缆断裂带来的性能损耗。这就好比一条八车道高速公路突然断了六条车道,所有车辆被强制并入两车道乡间公路。剩余备用链路长期高负荷运行,进一步加剧了网络抖动与服务不稳定,运维团队需持续监控全网流量、动态调整路由策略、处置突发拥堵,运维值守压力达到极值。

从维度角度来看,这是一次典型的“降级服务”事件:系统没有完全宕机,但核心性能指标严重劣化,用户体验大面积受损,且故障恢复的时间窗口完全不可控。

四、修复难题:最令人绝望的不是修复要多久时间,而是”什么时候能开始修”

海底光缆修复的技术流程本身是成熟的:派出专业维修船(cable ship),用ROV(水下机器人)定位断裂点,捞起光缆,进行熔接、测试,然后重新铺设回海床。在正常条件下,一次标准的海底光缆修复作业需要2–4周。

但”鲁比玛号”造成的这次故障,修复耗时长达5个月——从2024年2月故障发生,直至2024年7月才完成全部修复、链路调试与全网恢复。

不是因为技术难度,而是因为拿不到施工许可。

断裂点位于红海海域,该海域地缘冲突持续、海域局势高度紧张,无任何安全施工条件。各大国际通信运营商、运维团队无法直接进驻海域开展勘查、打捞、熔接、修复作业,所有施工行为必须提前与红海当地实际控制方谈判沟通,申请专属施工许可。漫长的地缘博弈、流程洽谈、权限审批,成为阻碍故障修复的核心卡点。

此外,全球可用的深海光缆维修船仅约60艘,排期本就紧张。同期红海地区已有多条光缆受损,维修资源被多任务挤占,进一步加剧了修复延迟。

这给系统运维领域带来了一个极为深刻的教训:故障恢复时间(MTTR,Mean Time To Repair)的瓶颈,不仅在技术层面,更多时候卡在在组织和环境层面。你可以拥有全世界最先进的熔接设备和最优秀的工程师团队,但如果一枚导弹让整片海域变成了”施工禁区”,你的SLA(服务等级协议)就是一张废纸。

在全网降级运行的5个月中,运维团队处于长期高度戒备状态,需要持续执行流量监控、路由动态优化、突发拥堵处置等工作。这不是一次”修复完成即可恢复常态”的标准事件,而是一场漫长而消耗极大的运维持久战。

五、行业启示:重构极端场景下的网络稳定保障体系

2024年7月,三条光缆陆续恢复服务。互联网继续运转,仿佛什么都没有发生过。但它不应该被当作一个”偶发事件”而被轻易遗忘。我们应该好好的做一次复盘,复盘报告(Post-Mortem)如下:

1、故障根因(Root Cause)
船舶遭受武装袭击后失控漂移,船锚物理性破坏海底光缆。直接原因是地缘军事冲突,间接原因是缺乏对失控船舶的有效拦截或预警机制。这是一起典型的非技术性运维灾难——故障诱因不在设备、软件或人为操作失误,而在于外部不可控的地缘事件引发的基础设施次生损毁。

2、暴露的系统性弱点

弱点 说明
物理路径冗余不足 多条光缆经由同一走廊,易被同一次事件批量破坏,形成”集中导致的冗余失效”
地缘风险未纳入架构评估 光缆铺设和路由规划长期忽视冲突区风险,运维风险模型缺乏非技术变量
维修能力全球稀缺 专业维修船约60艘,大型故障修复排队周期长
跨组织协同机制缺失 光缆运维团队与军事/外交系统之间无标准化协作流程,冲突海域处置无先例可循
备用链路性能差距大 迂回链路带宽有限、延迟高,无法有效承接主干溢出流量

3、行业启示:重构极端场景下的网络稳定保障体系

“货轮漂移断缆”是一次罕见的非技术性运维灾难,彻底暴露了传统跨境网络运维体系的结构性短板:过往运维风险防控多聚焦于技术故障、自然天灾、施工风险,完全忽略了地缘冲突引发的次生基础设施损毁风险,全网冗余架构、应急预案、故障处置机制存在明显盲区。从系统运维与网络稳定维度复盘,本次事件带来三大核心启示:

第一,风险评估模型必须升级
跨境骨干网络稳定性风险已全面多元化。地缘政治、海域冲突等非技术因素,已成为威胁全球数字基础设施安全的核心变量。传统以设备故障率、链路可用性为核心的风险评估体系,必须纳入地缘安全、冲突烈度、海域管控状态等非技术维度,构建更全面的风险预判能力。

第二,全球光缆冗余架构亟待重构
核心通道过度集中、备用链路绕行成本高、性能损耗大,单点损毁即可引发全网降级。未来应推动跨洋光缆路径的真正物理分散化布局,增加跨极地、跨大洋的替代路由建设,同时提升卫星通信(如低轨卫星星座)在应急场景下的带宽兜底能力。

第三,跨境基础设施运维需要治理创新
冲突海域的故障处置无标准化流程、无安全保障机制,技术修复能力完全受制于地缘局势。国际社会需要建立跨境数字基础设施的保护性国际框架,将海底光缆纳入关键基础设施保护范畴,为冲突区域的应急修复提供制度性保障。

希望未来,光缆线路不需要军舰巡航,数据中心附近不需要导弹防护,期待和平。

【转载】理解多模态大语言模型:主流技术与最新模型导论

原文地址:Understanding Multimodal LLMs,by Sebastian Raschka, on 2024-11-03

理解多模态大语言模型:主流技术与最新模型导论

这两个月的发展可谓突飞猛进。人工智能研究领域再次涌现出大量成果,两项诺贝尔奖授予了AI相关方向,同时还有多篇颇具价值的研究论文相继发表。

其中,Meta AI发布了最新的Llama 3.2系列模型,包含10亿和30亿参数的开源权重大语言模型,以及两款多模态模型。

在本文中,我将讲解多模态大语言模型的工作原理。此外,我还会梳理并总结近几周发布的十余篇最新多模态相关论文与模型(包括Llama 3.2),对比它们的技术路线。

(如需查看目录菜单,请点击左侧的横线图标。)
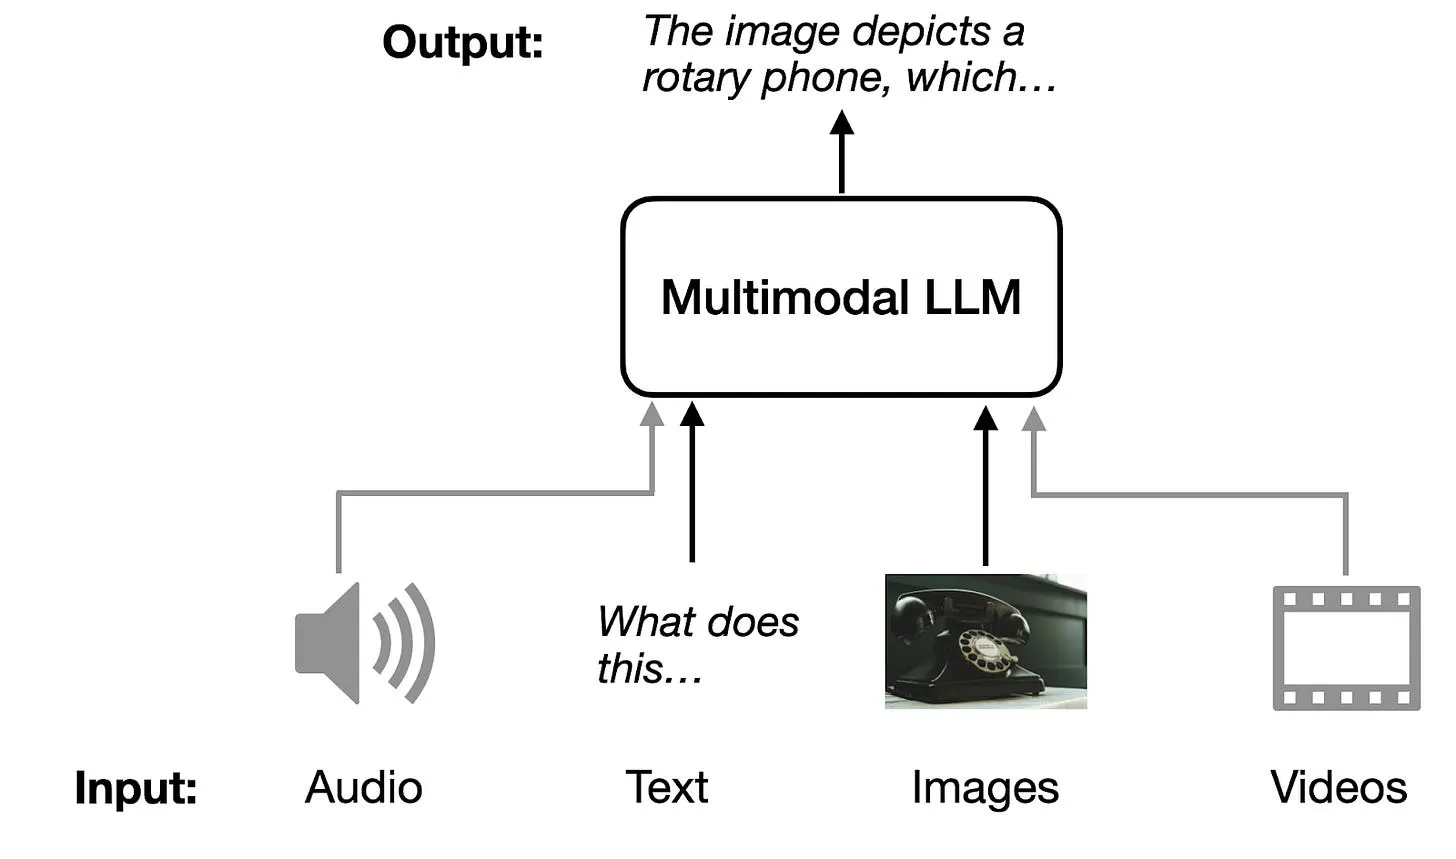
figure01
多模态大语言模型示意图:可接收音频、文本、图像、视频等多种输入模态,输出文本模态结果。

不过在开始之前,我还有一则个人的好消息要和大家分享!我的新书《Build A Large Language Model (From Scratch)》终于在亚马逊上架了:
https://amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167
figure02
https://amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 现已登陆亚马逊

撰写这本书付出了巨大的心血,过去两年里收到的所有支持与正向反馈都让我无比感激——尤其是最近这几个月,很多热心读者都分享了他们的阅读感受。谢谢大家,作为作者,没有什么比得知这本书能对大家的职业生涯产生帮助更让人振奋的了!

对于已经读完本书、期待更多内容的读者,请保持关注!接下来几个月我会在GitHub仓库中补充一些附赠内容。

附:如果你已经读过这本书,恳请你能在亚马逊留下一条评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167/ ;这对我们作者来说真的帮助很大!

1. 多模态大语言模型的应用场景

什么是多模态大语言模型?正如引言中所提,多模态大语言模型是能够处理多种输入类型的大语言模型,其中“模态”指的是特定的数据类型——比如传统大语言模型处理的文本,以及声音、图像、视频等等。为简化起见,本文将主要围绕图像模态与文本输入的组合展开讲解。

多模态大语言模型最经典、最直观的应用是图像描述:输入一张图片,模型生成对该图片的文字描述,如下图所示。
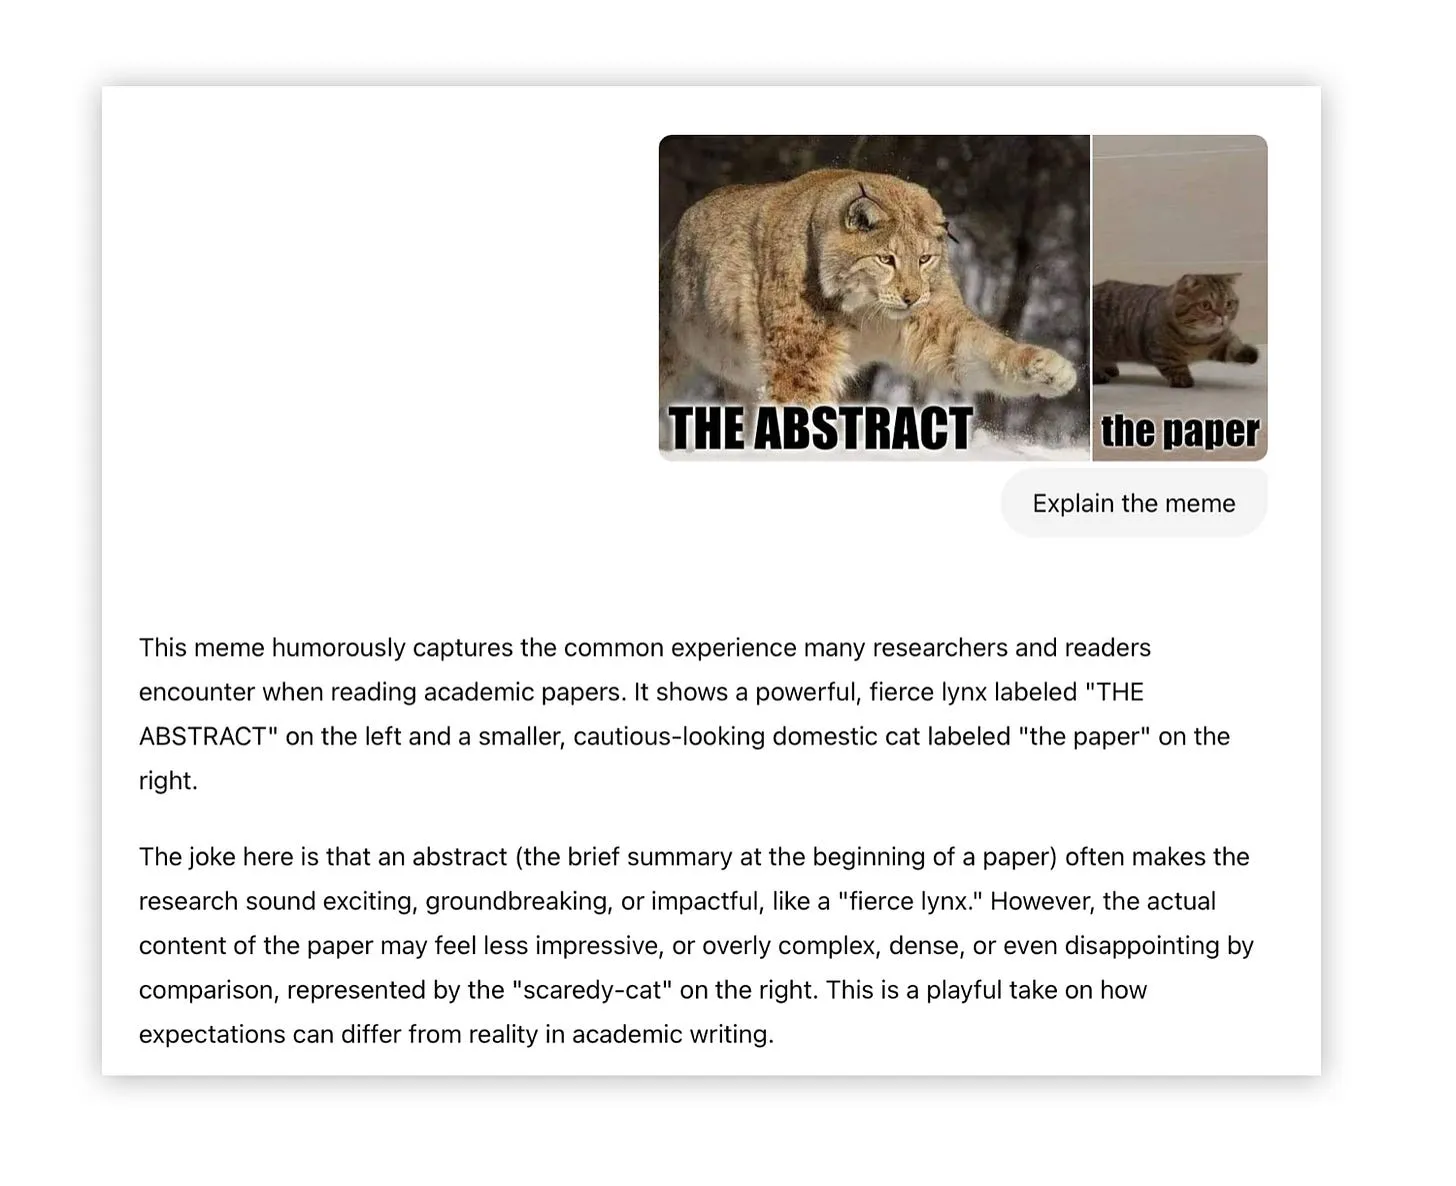
figure03
多模态大语言模型应用示例,来源:https://x.com/PainSci/status/1309570607458086914

当然,它的应用场景远不止于此。比如我个人很喜欢的一个用法:从PDF表格中提取信息,并转换为LaTeX或Markdown格式。

2. 构建多模态大语言模型的主流方案

构建多模态大语言模型主要有两种技术路线:

  • 方案A:统一嵌入解码器架构(Unified Embedding Decoder Architecture)
  • 方案B:跨模态注意力架构(Cross-modality Attention Architecture)

(顺便一提,目前这些技术似乎还没有统一的官方术语,如果大家见过其他说法欢迎告诉我。更简洁的表述可以是“纯解码器架构”和“基于交叉注意力的架构”。)
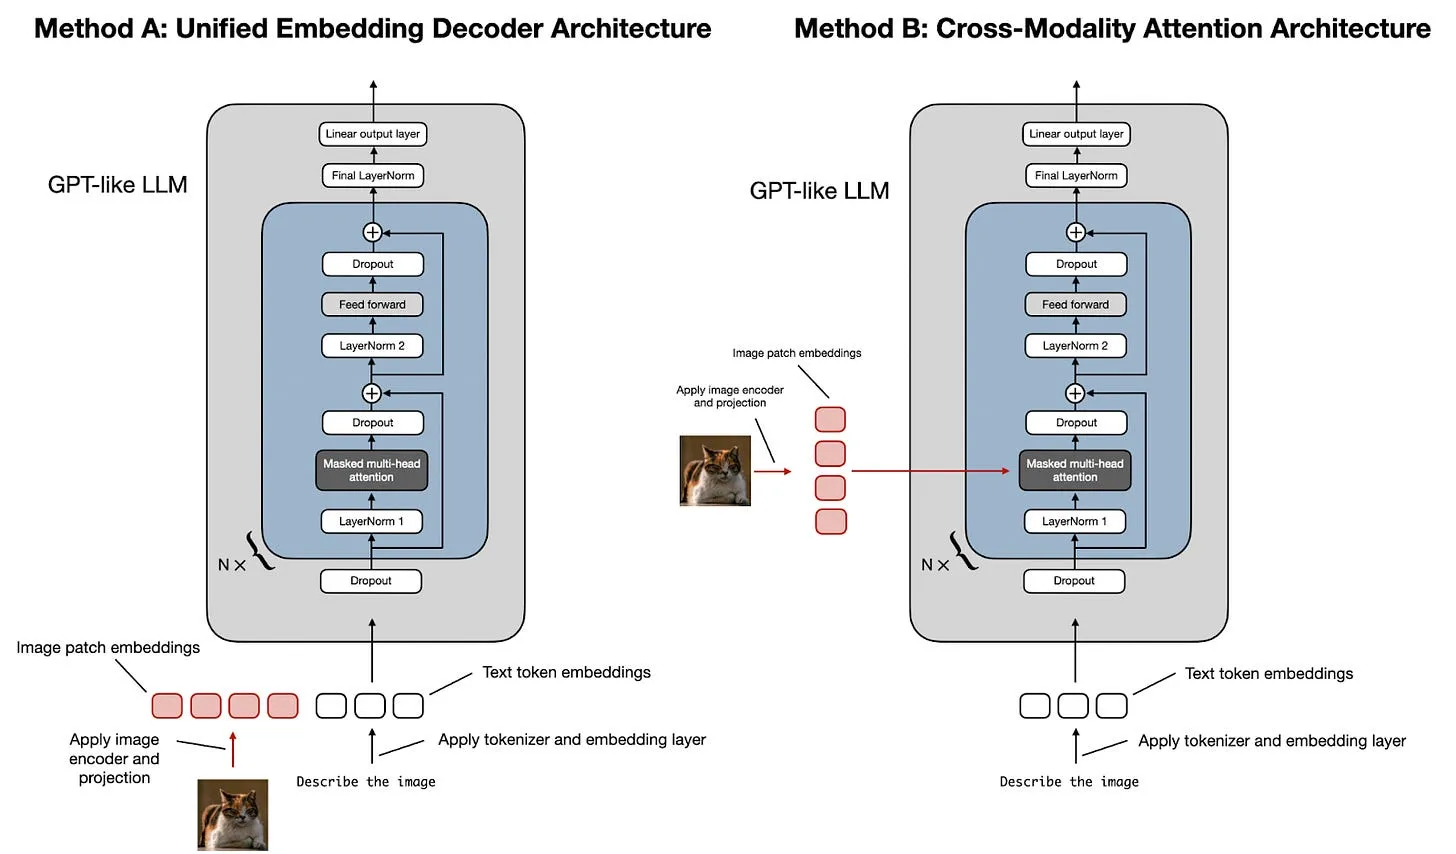
figure04
多模态大语言模型的两种主流架构方案

如上图所示,统一嵌入解码器架构仅使用单个解码器模型,和GPT-2、Llama 3.2这类原生大语言模型架构非常相似。在该方案中,图像会被转换为与原始文本token嵌入维度相同的token,拼接后一同输入大语言模型进行处理。

跨模态注意力架构则通过交叉注意力机制,在注意力层内部直接融合图像嵌入与文本嵌入。

接下来的章节,我们会从概念层面讲解这两种方案的工作原理,再结合最新的多模态大语言模型研究论文,看看它们在实际中的应用。

2.1 方案A:统一嵌入解码器架构

我们先从统一嵌入解码器架构讲起,其结构如下图所示。
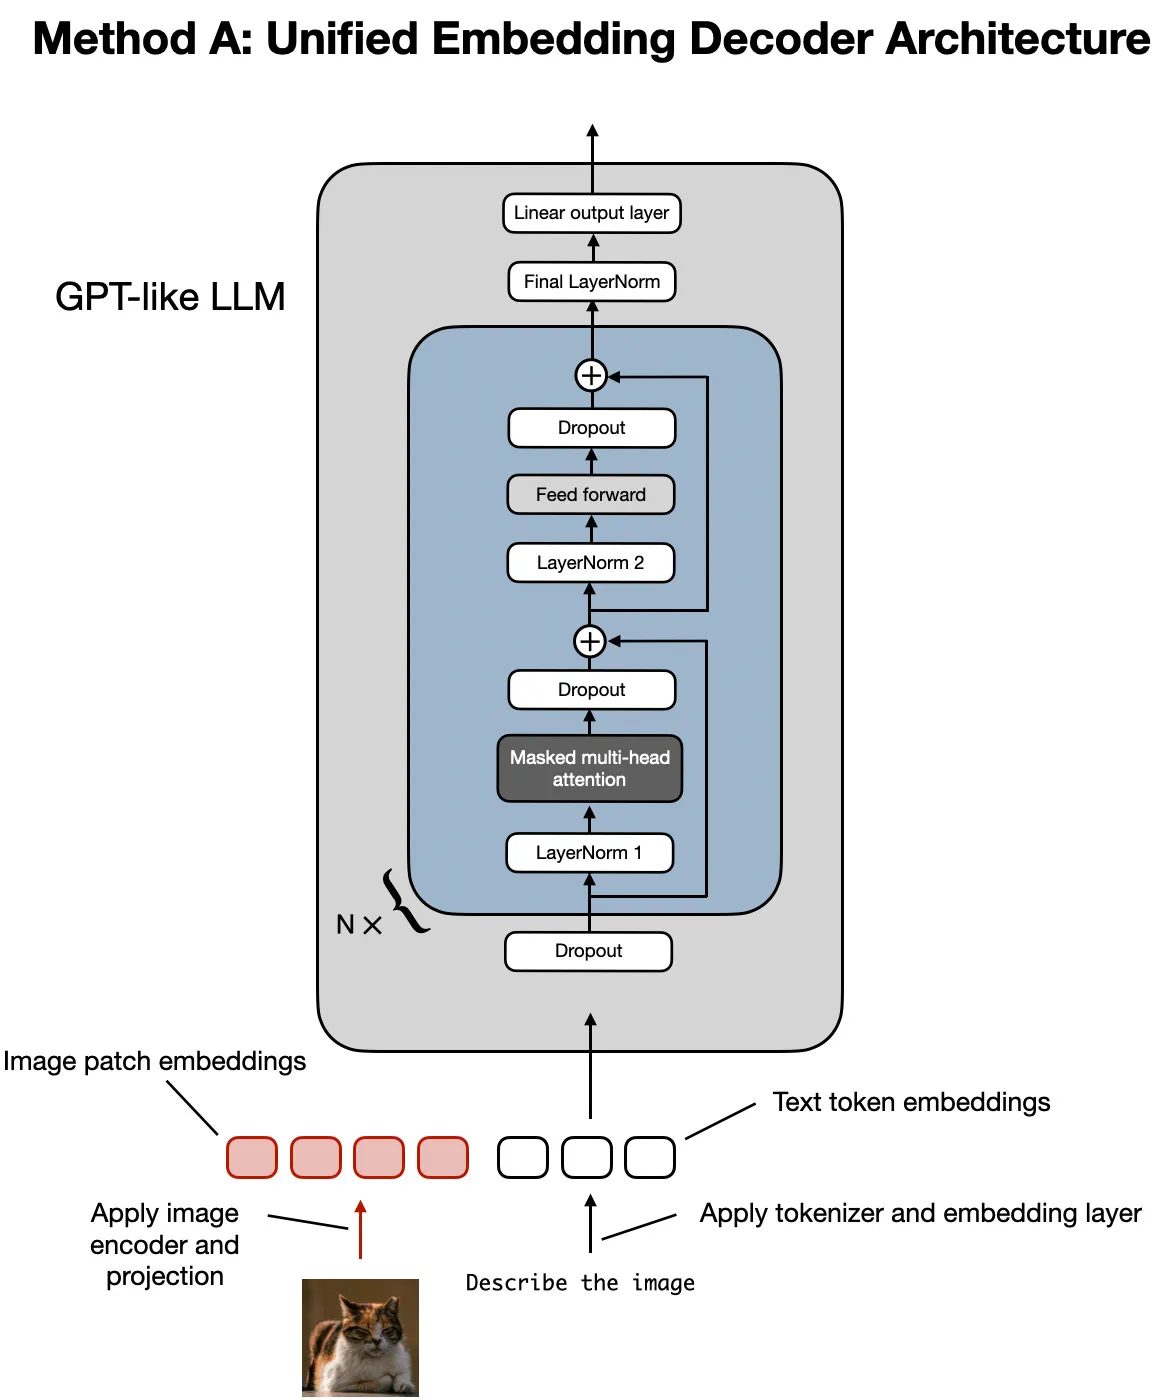
figure05
统一嵌入解码器架构示意图:基于原生解码器风格大语言模型(如GPT-2、Phi-3、Gemma、Llama 3.2),输入由图像token嵌入与文本token嵌入共同组成。

在统一嵌入解码器架构中,图像会被转换为嵌入向量,其过程和纯文本大语言模型中将输入文本转换为嵌入的过程类似。

对于处理文本的典型纯文本大语言模型,文本输入通常先经过分词(比如字节对编码BPE),再通过嵌入层,如下图所示。
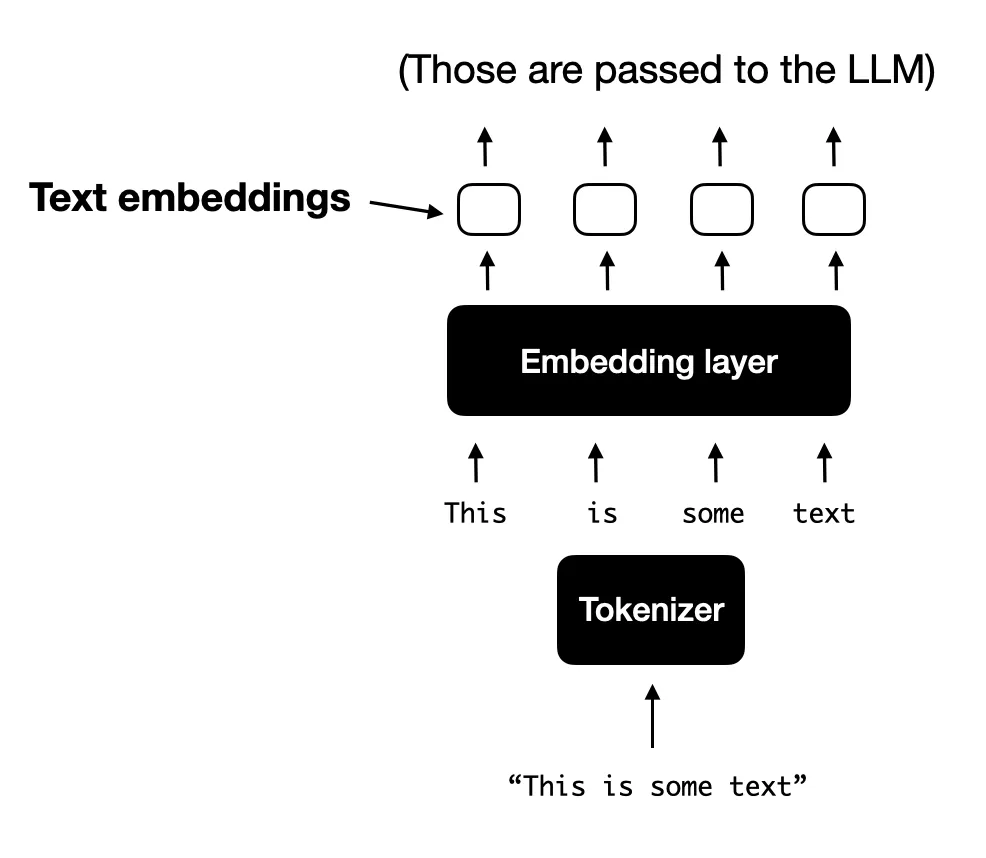
figure06
文本分词并转换为token嵌入向量的标准流程示意图,后续将输入大语言模型进行训练与推理。

2.1.1 图像编码器的原理

与文本的分词和嵌入过程对应,图像嵌入通过图像编码器模块生成(而非分词器),如下图所示。
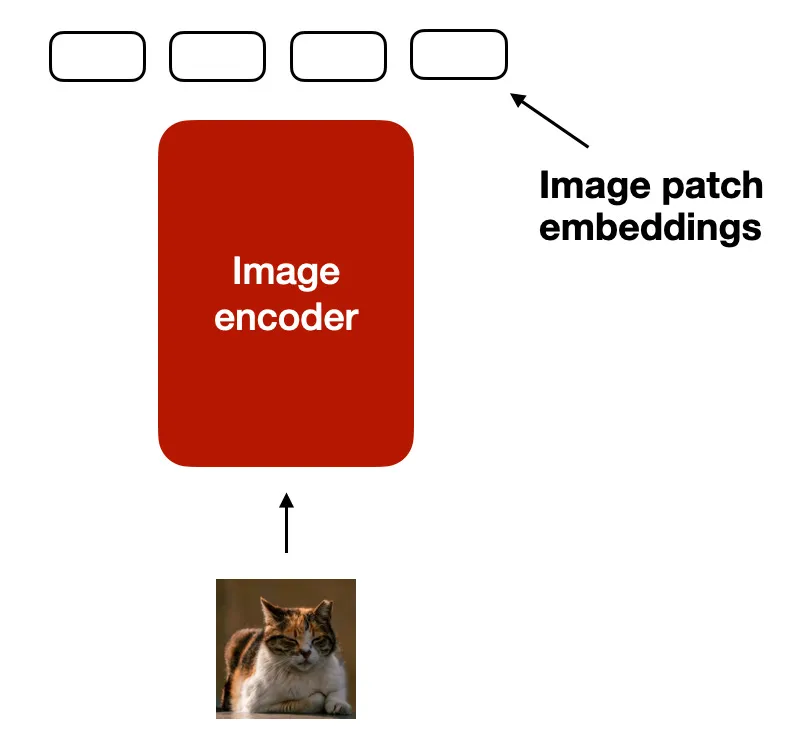
figure07
图像编码为图像块嵌入的流程示意图

上图中的图像编码器内部是如何工作的?处理图像时,我们首先将图像切分为更小的块,就像分词时把单词拆分为子词一样。随后这些图像块由预训练的视觉Transformer(ViT)进行编码,如下图所示。
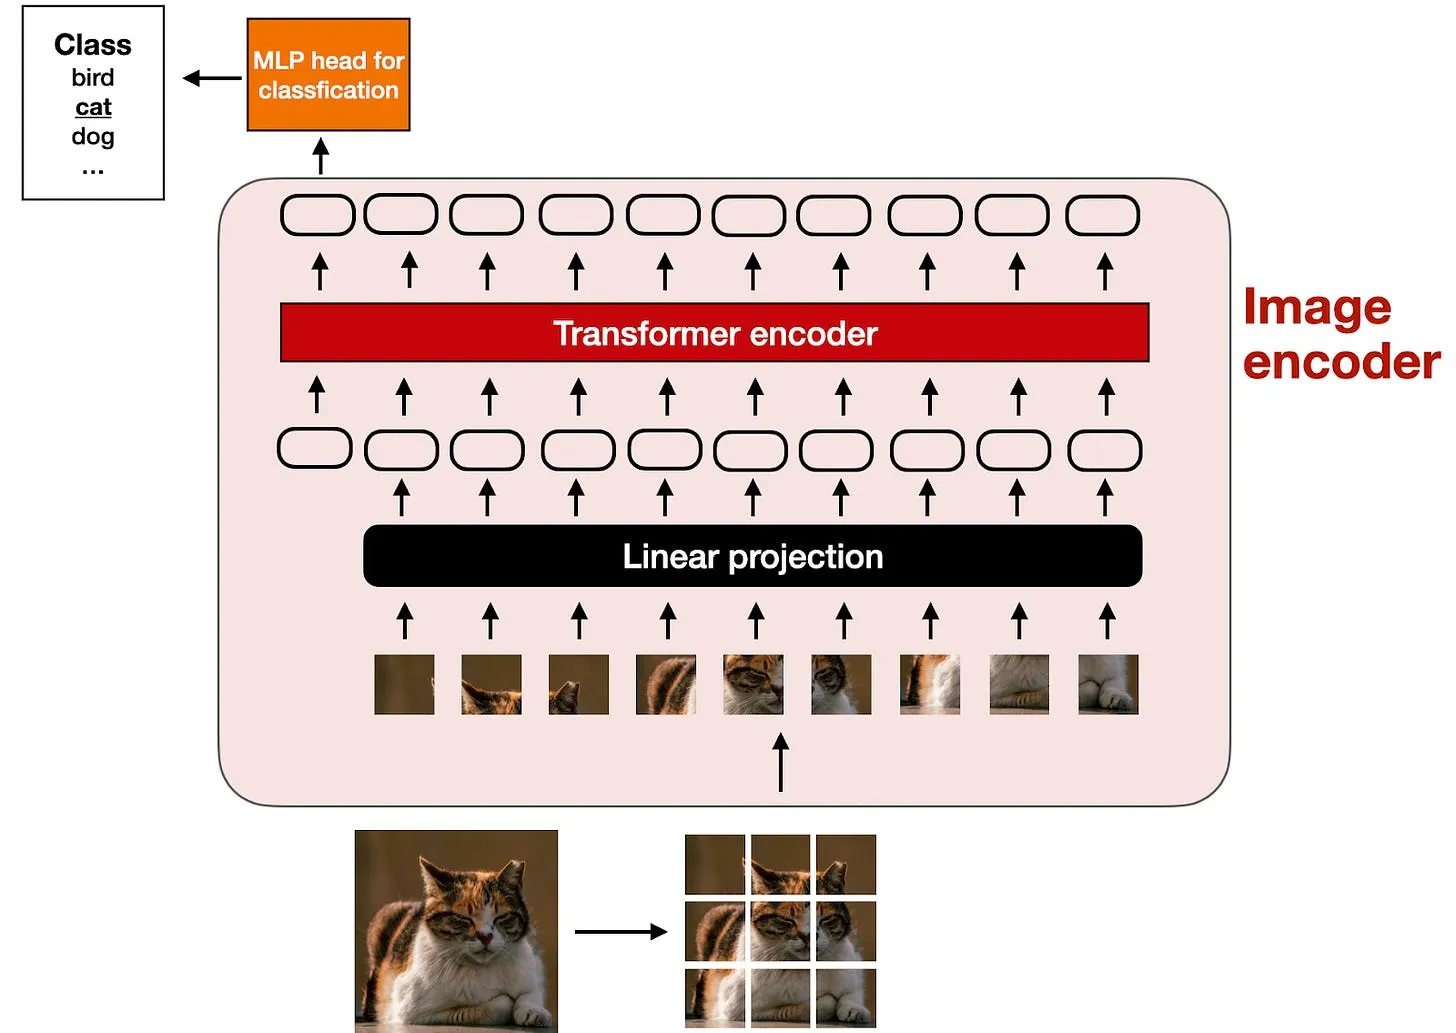
figure08
经典视觉Transformer(ViT)结构示意图,与2020年论文https://arxiv.org/abs/2010.11929提出的模型类似。

注意,视觉Transformer通常用于分类任务,所以上图中我画出了分类头。但在我们的场景中,只需要用到图像编码器部分。

2.1.2 线性投影模块的作用

前图中所示的“线性投影”由单个线性层(即全连接层)构成。该层的作用是将展平为向量的图像块,投影到与Transformer编码器维度兼容的嵌入空间中。线性投影的过程如下图所示:一个被展平为256维向量的图像块,被向上投影为768维向量。
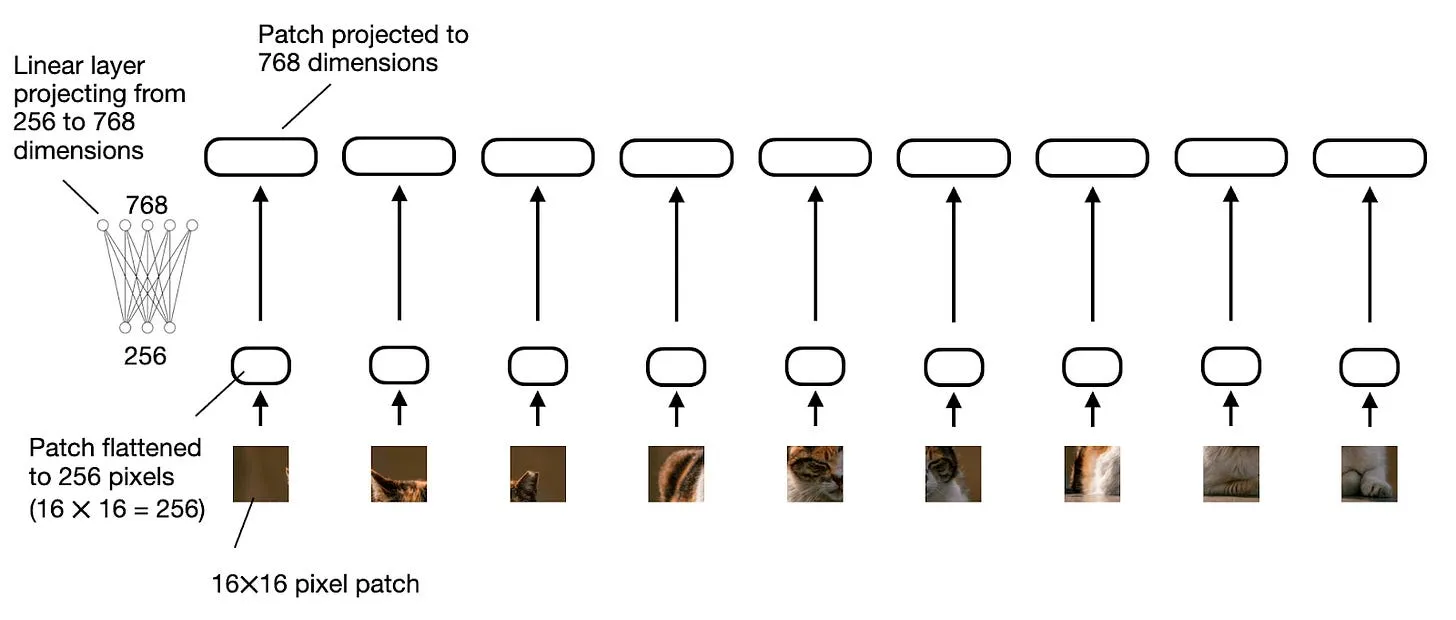
figure09
线性投影层示意图:将展平后的图像块从256维投影到768维嵌入空间。

如果大家想看代码示例,在PyTorch中,我们可以这样实现图像块的线性投影:

import torch
class PatchProjectionLayer(torch.nn.Module):
    def __init__(self, patch_size, num_channels, embedding_dim):
        super().__init__()
        self.patch_size = patch_size
        self.num_channels = num_channels
        self.embedding_dim = embedding_dim
        self.projection = torch.nn.Linear(
            patch_size * patch_size * num_channels, embedding_dim
        )

    def forward(self, x):
        batch_size, num_patches, channels, height, width = x.size()
        x = x.view(batch_size, num_patches, -1)  # 展平每个图像块
        x = self.projection(x)  # 对每个展平的图像块做投影
        return x

# 示例用法
batch_size = 1
num_patches = 9  # 每张图像的总块数
patch_size = 16  # 每个图像块为16×16像素
num_channels = 3  # RGB图像
embedding_dim = 768  # 嵌入向量的维度

projection_layer = PatchProjectionLayer(patch_size, num_channels, embedding_dim)
patches = torch.rand(
    batch_size, num_patches, num_channels, patch_size, patch_size
)
projected_embeddings = projection_layer(patches)
print(projected_embeddings.shape)
# 输出为
# torch.Size([1, 9, 768])

如果你碰巧读过我的《Machine Learning with PyTorch and Scikit-Learn》一书(https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768/),就会知道我们可以用卷积运算替代线性层,二者在数学上是等价的。在这里这种方法非常实用,因为我们可以用两行代码同时完成图像块划分与投影:

layer = torch.nn.Conv2d(3, 768, kernel_size=(16, 16), stride=(16, 16))
image = torch.rand(batch_size, 3, 48, 48)
projected_patches = layer(image)
print(projected_patches.flatten(-2).transpose(-1, -2).shape)
# 输出为
# torch.Size([1, 9, 768])

2.1.3 图像分词与文本分词的对比

我们已经简要讲解了图像编码器(以及其中的线性投影)的作用,现在回到之前的文本分词语义类比,将图像与文本的分词、嵌入过程做一个横向对比,如下图所示。
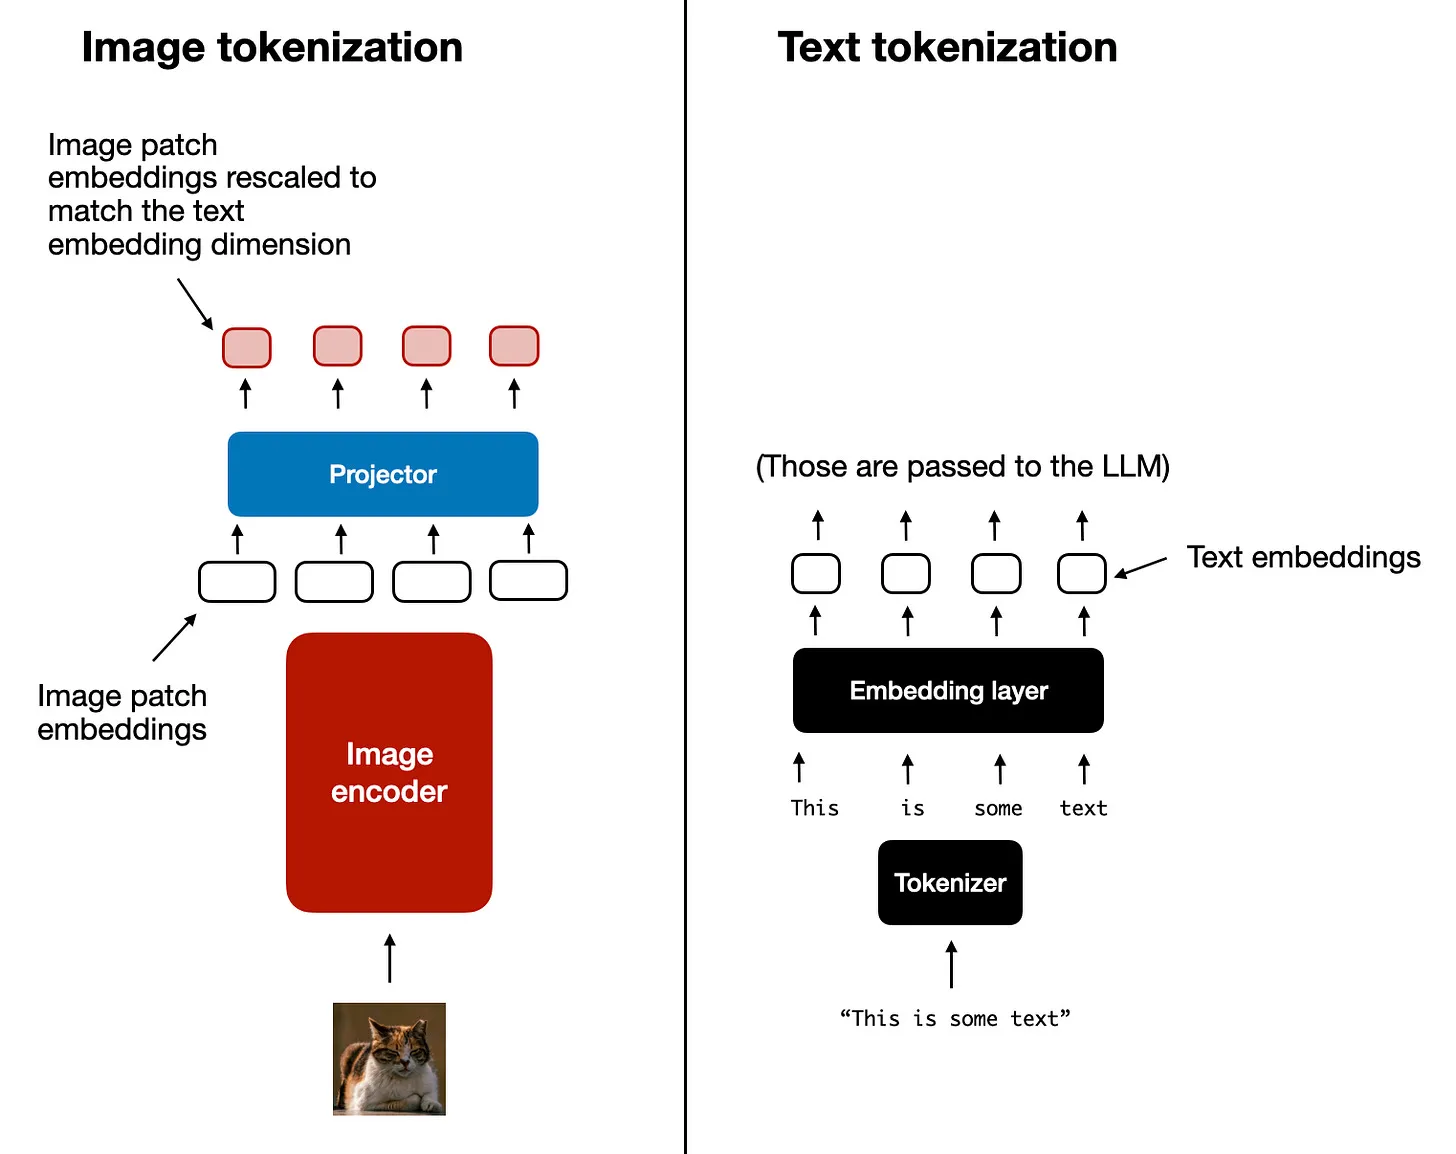
figure10
左侧:图像分词与嵌入;右侧:文本分词与嵌入。二者对比示意图。

如上图所示,我在图像编码器之后额外加了一个投影模块。这个投影层通常就是另一个线性投影层,和之前讲解的类似,作用是将图像编码器的输出投影到与文本token嵌入维度一致的尺寸,如下图所示。(后续我们会看到,这个投影层有时也被称作适配器、转接器或连接器。)
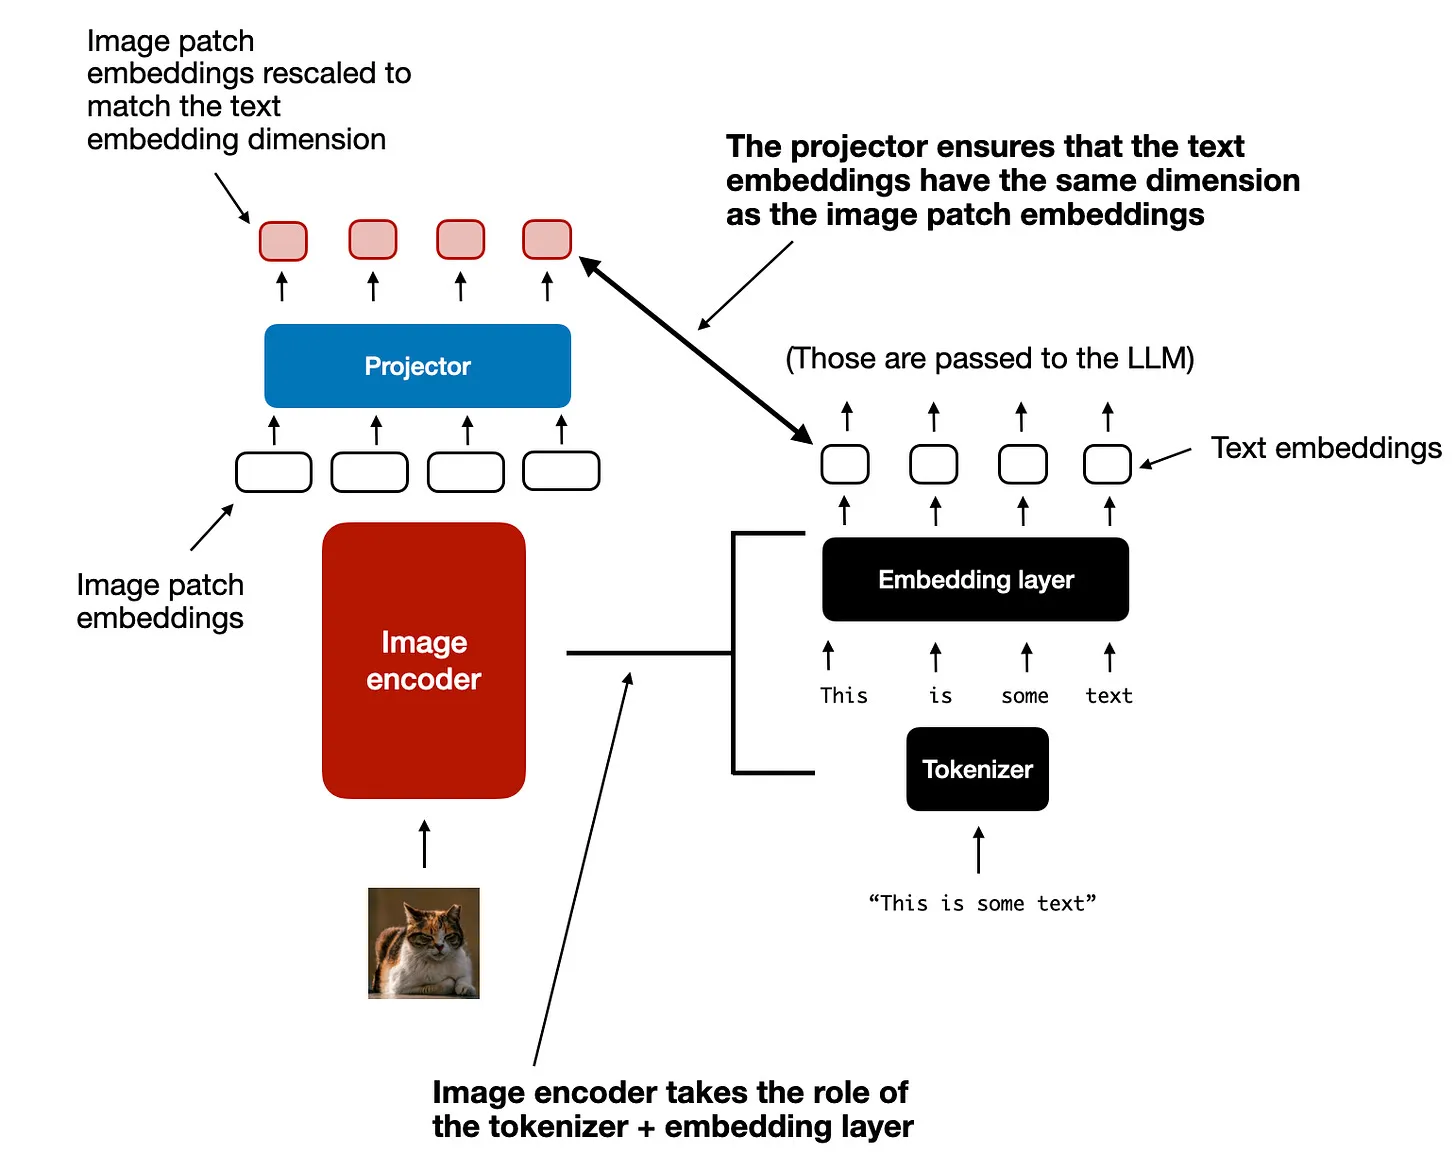
figure11
图像分词与文本分词的另一组对比:投影层的作用是匹配文本token的嵌入维度。

当图像块嵌入与文本token嵌入的维度一致后,我们就可以直接将它们拼接起来,作为大语言模型的输入,正如本节开头的图所示。为了方便查阅,这里再放一次该图。
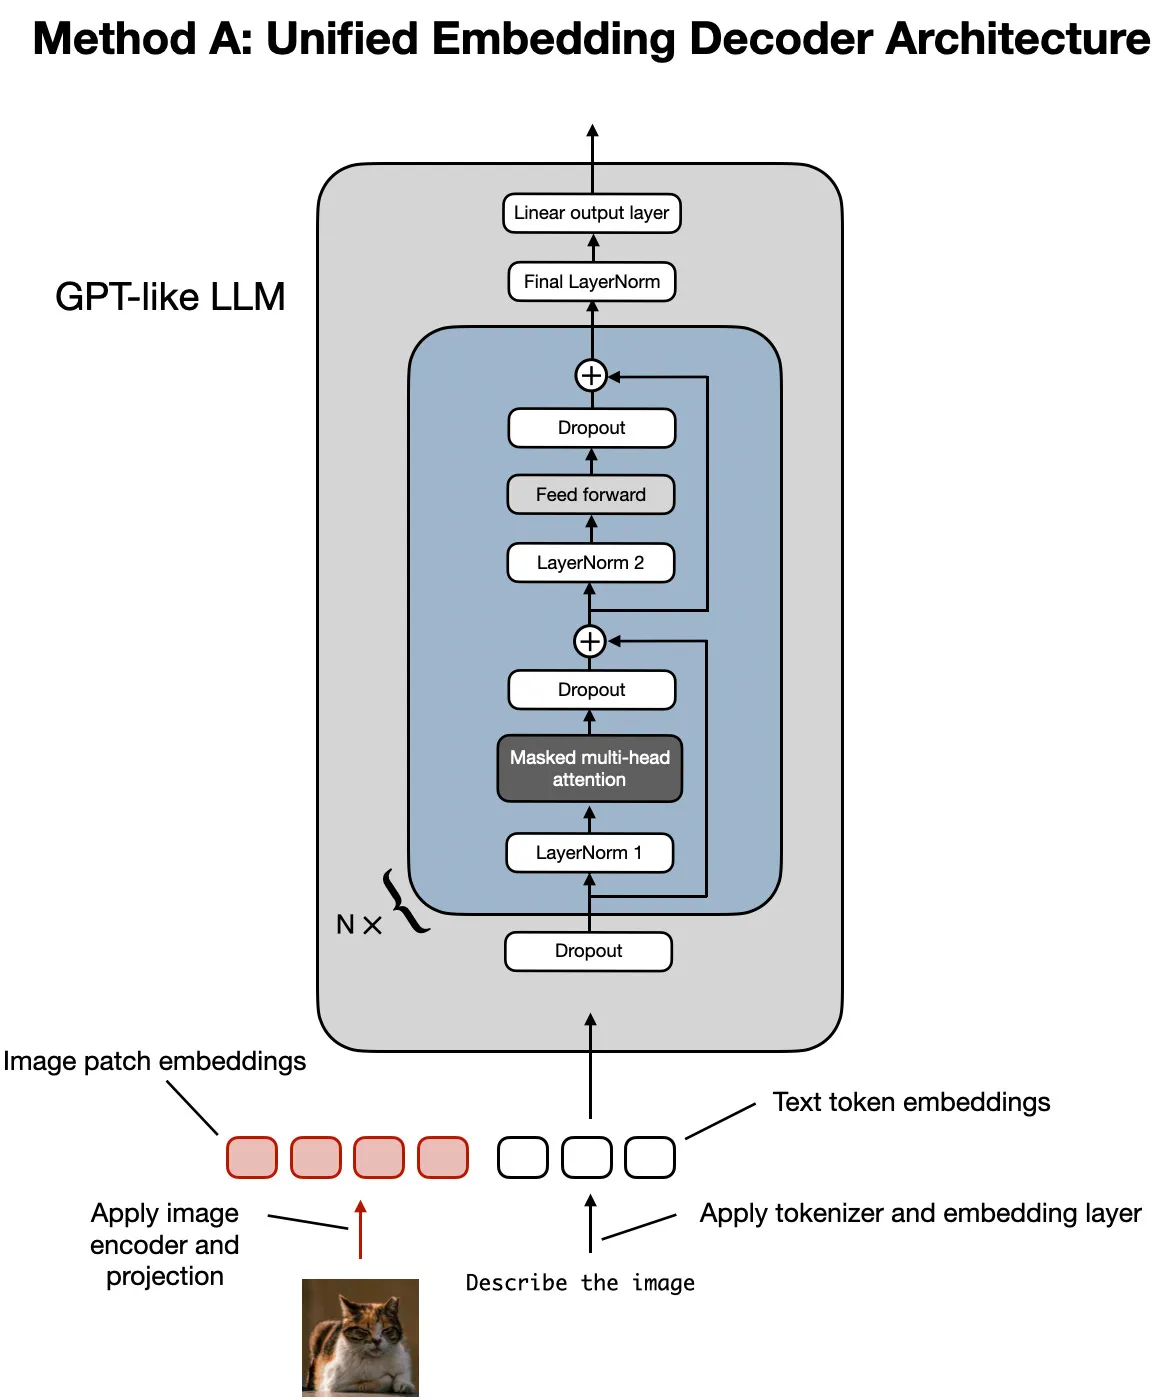
figure12
将图像块token投影到与文本token嵌入相同维度后,即可直接拼接为标准大语言模型的输入。

顺便一提,本节讨论的图像编码器通常是预训练好的视觉Transformer,最常用的选择是CLIP(https://github.com/openai/CLIP)或OpenCLIP(https://github.com/mlfoundations/open_clip)。

不过,也有一些方案A的变体直接对图像块进行处理,比如Fuyu-8B(https://www.adept.ai/blog/fuyu-8b),其结构如下图所示。
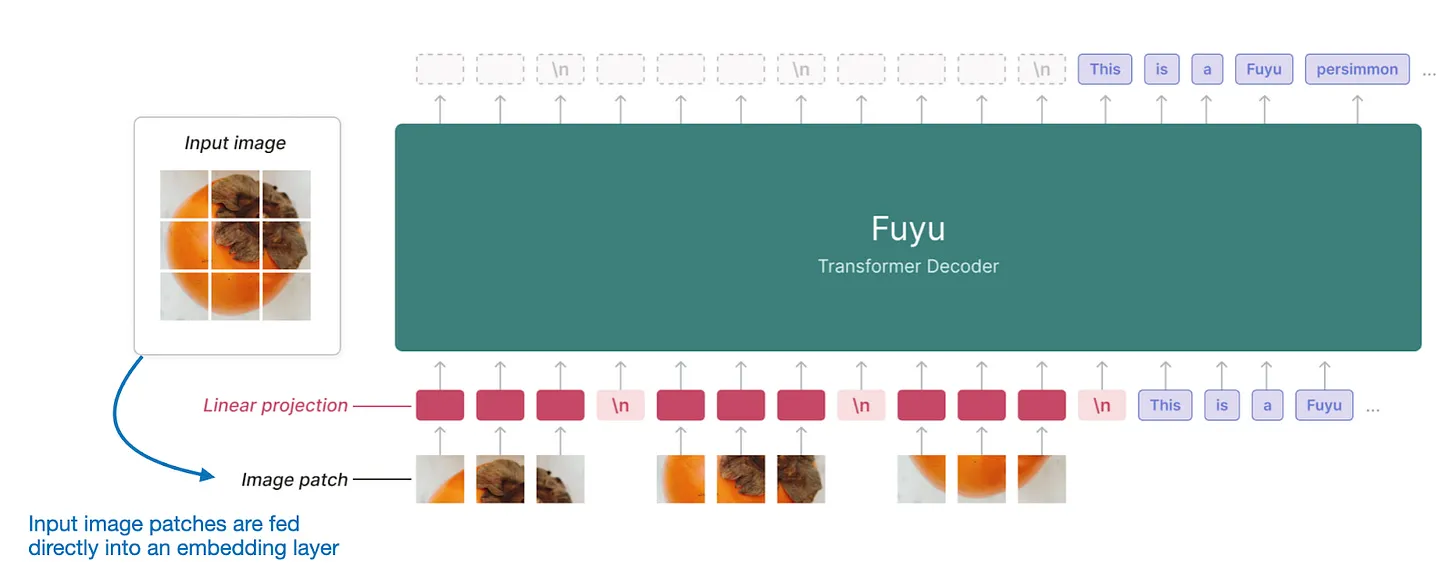
figure13
Fuyu多模态大语言模型标注图:无需图像编码器,直接对图像块进行处理。(图标注来源:https://www.adept.ai/blog/fuyu-8b)

如上图所示,Fuyu将输入图像块直接输入线性投影(或嵌入层),自主学习图像块嵌入,而不像其他模型和方案那样依赖额外的预训练图像编码器。这种方式极大简化了架构与训练配置。

2.2 方案B:跨模态注意力架构

我们已经讲解了构建多模态大语言模型的统一嵌入解码器架构,理解了图像编码的基本原理。现在我们来介绍另一种实现多模态大语言模型的方案——交叉注意力,其结构概要如下图所示。
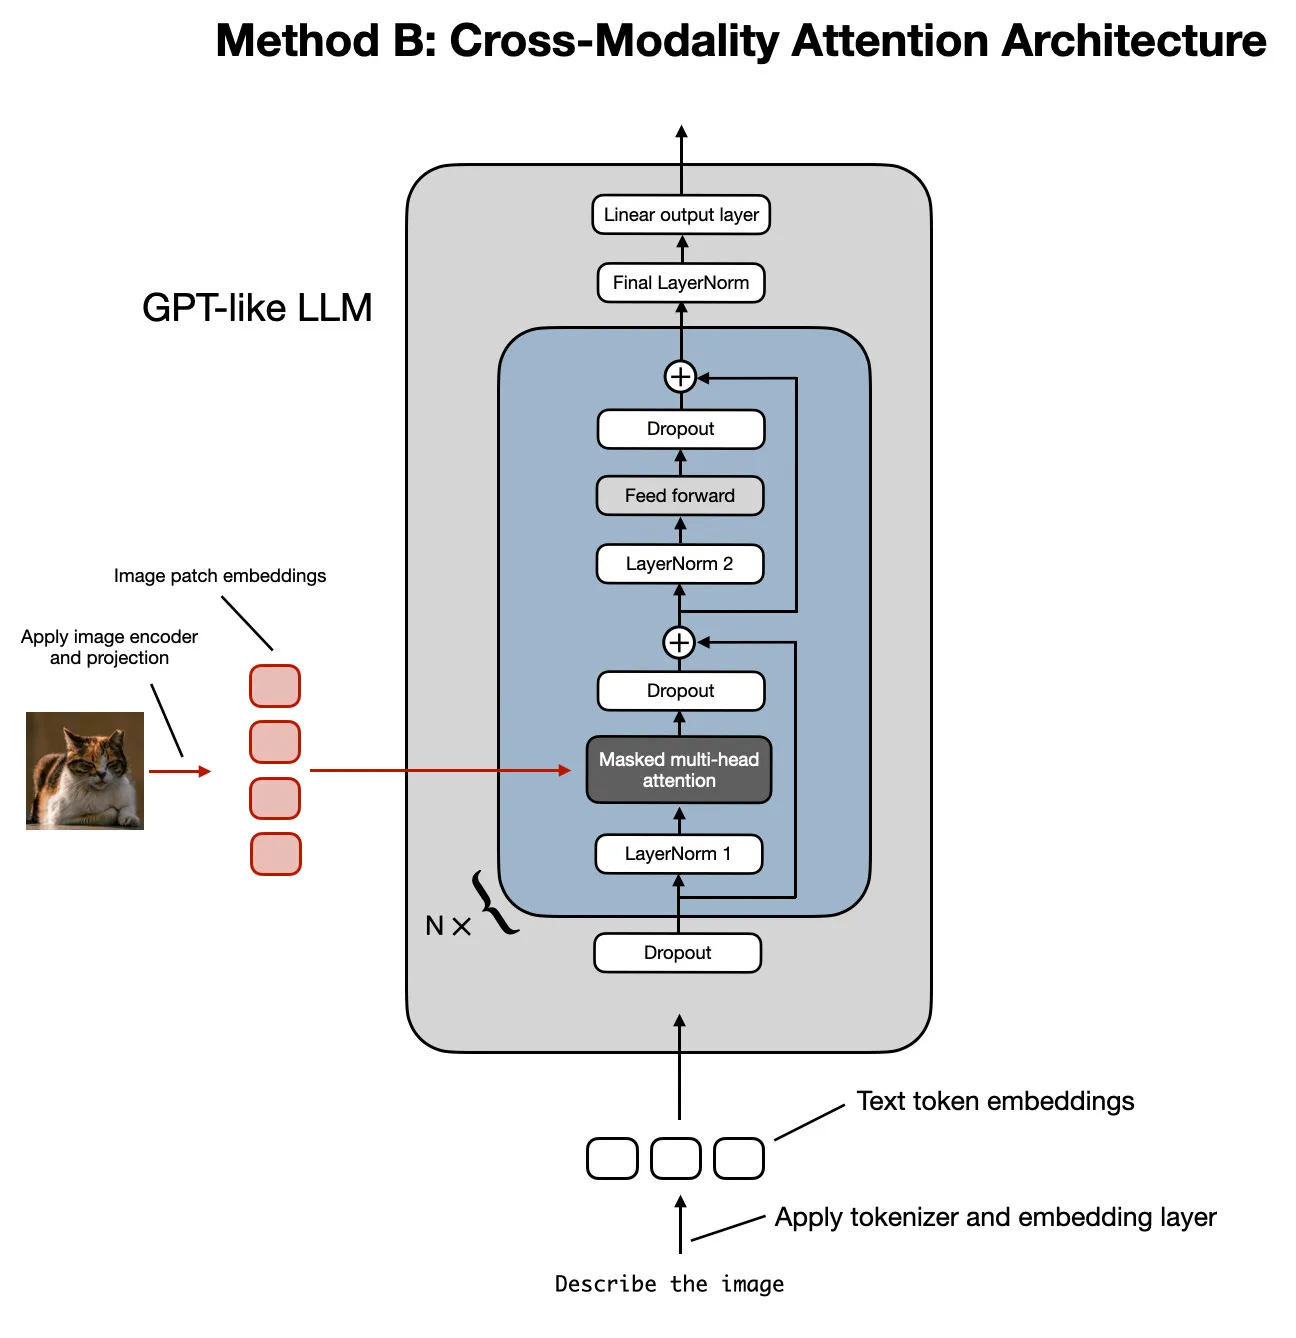
figure14
跨模态注意力架构方案示意图,用于构建多模态大语言模型。

在上图所示的跨模态注意力架构中,我们仍然使用之前讨论过的图像编码器结构。但不同的是,我们不把编码后的图像块作为大语言模型的输入,而是通过交叉注意力机制,将输入图像块连接到多头注意力层中。

这个思路由来已久,可以追溯到2017年论文《Attention Is All You Need》(https://arxiv.org/abs/1706.03762<)中提出的原始Transformer架构,如下图所示。/p>
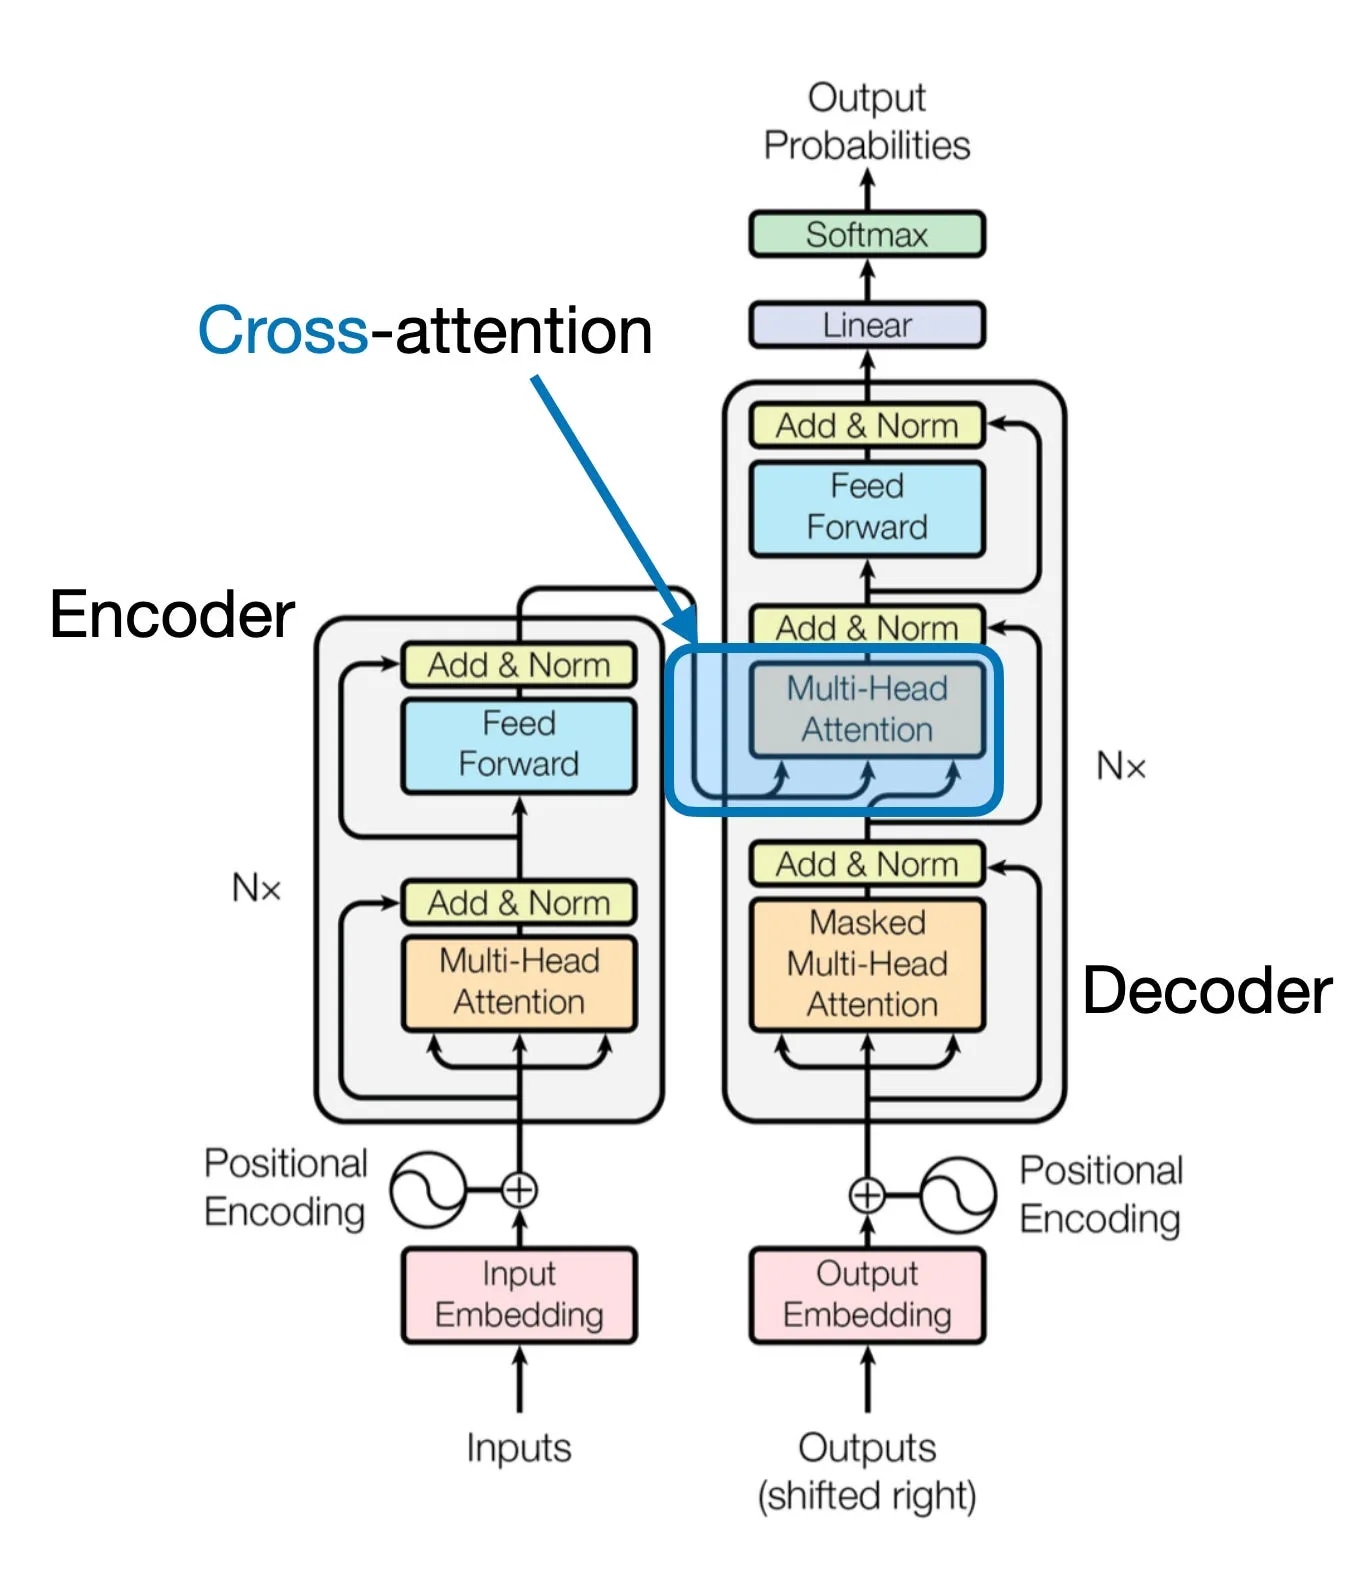
figure15
原始Transformer架构中使用的交叉注意力机制高层示意图。(标注图来自《Attention Is All You Need》论文:https://arxiv.org/abs/1706.03762)

注意,上图中原始的Transformer最初是为机器翻译任务设计的。它由左侧的文本编码器(接收待翻译句子)和右侧的文本解码器(生成翻译结果)组成。在多模态大语言模型的场景下,编码器替换为图像编码器,但核心思路是一致的。

交叉注意力是如何工作的?我们先通过概念图看看常规自注意力机制内部的原理。
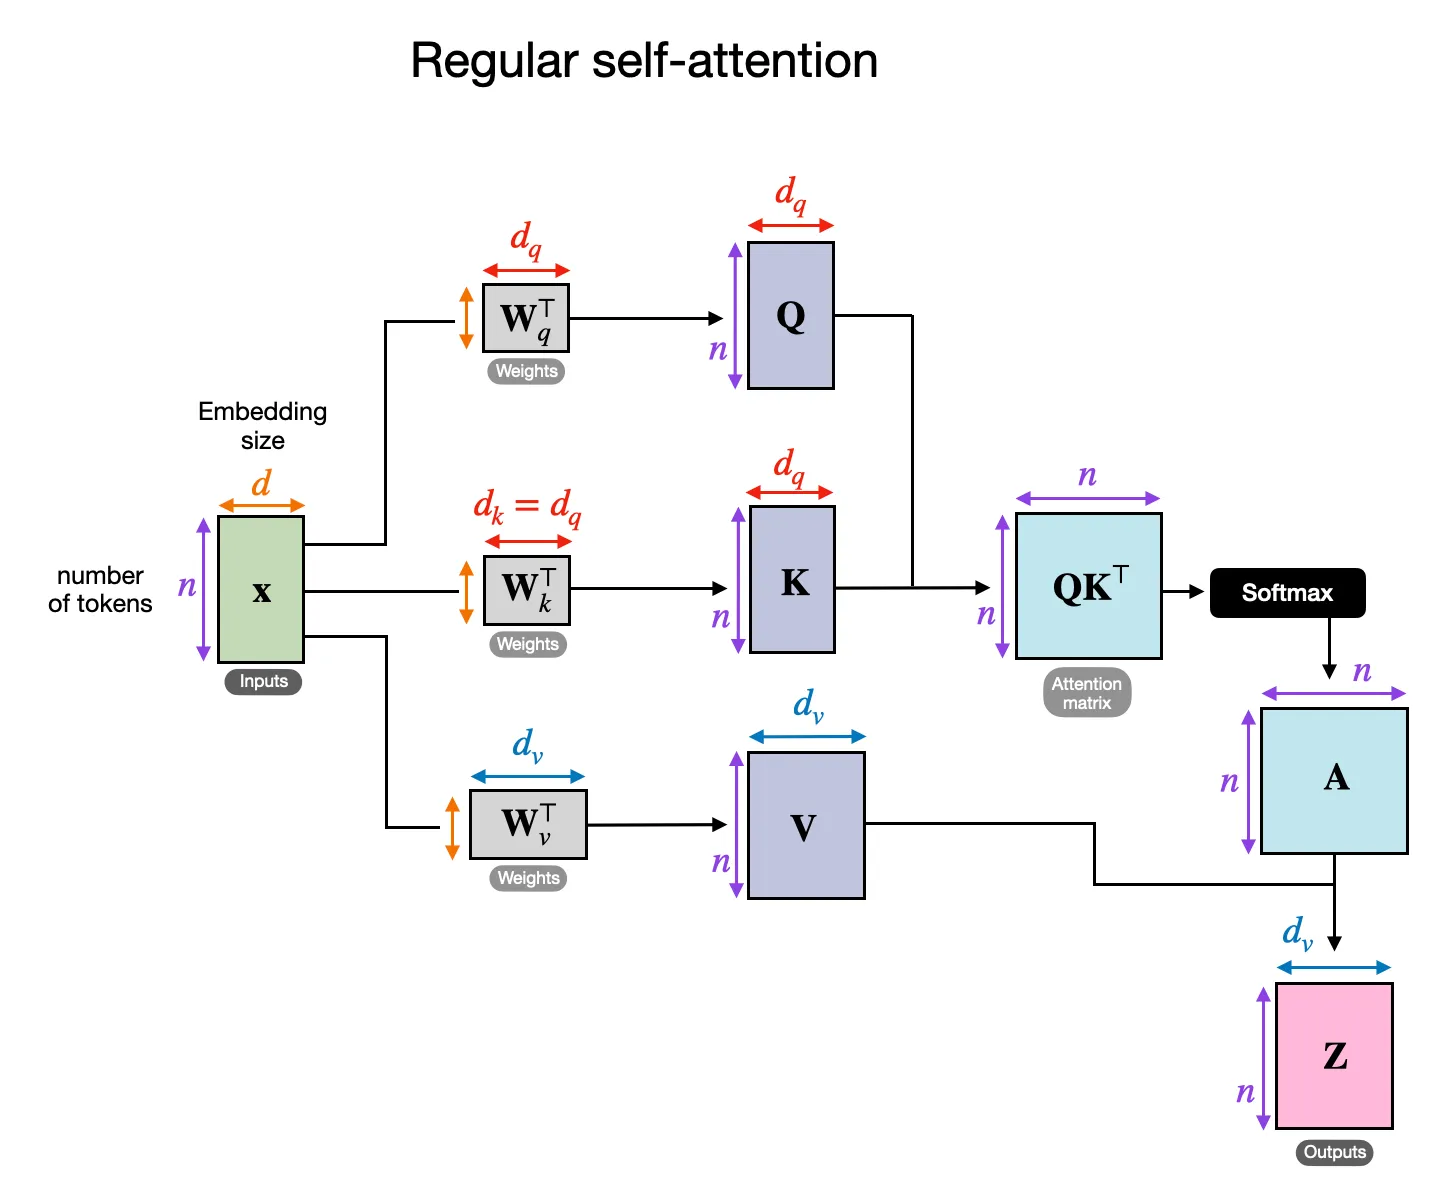
figure16
常规自注意力机制概要。(该流程展示了常规多头注意力模块中的一个注意力头。)

上图中,x是输入,Wq是用于生成查询(Q)的权重矩阵。同理,K代表键,V代表值。A是注意力得分矩阵,Z是输入(x)经过变换后得到的输出上下文向量。(如果这部分看起来难以理解,可以参考我的《Build A Large Language Model (From Scratch)》一书第3章的详细讲解:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167/;或者也可以看我的这篇文章:https://magazine.sebastianraschka.com/p/understanding-and-coding-self-attention)

与自注意力不同,交叉注意力有两个不同的输入源,如下图所示。
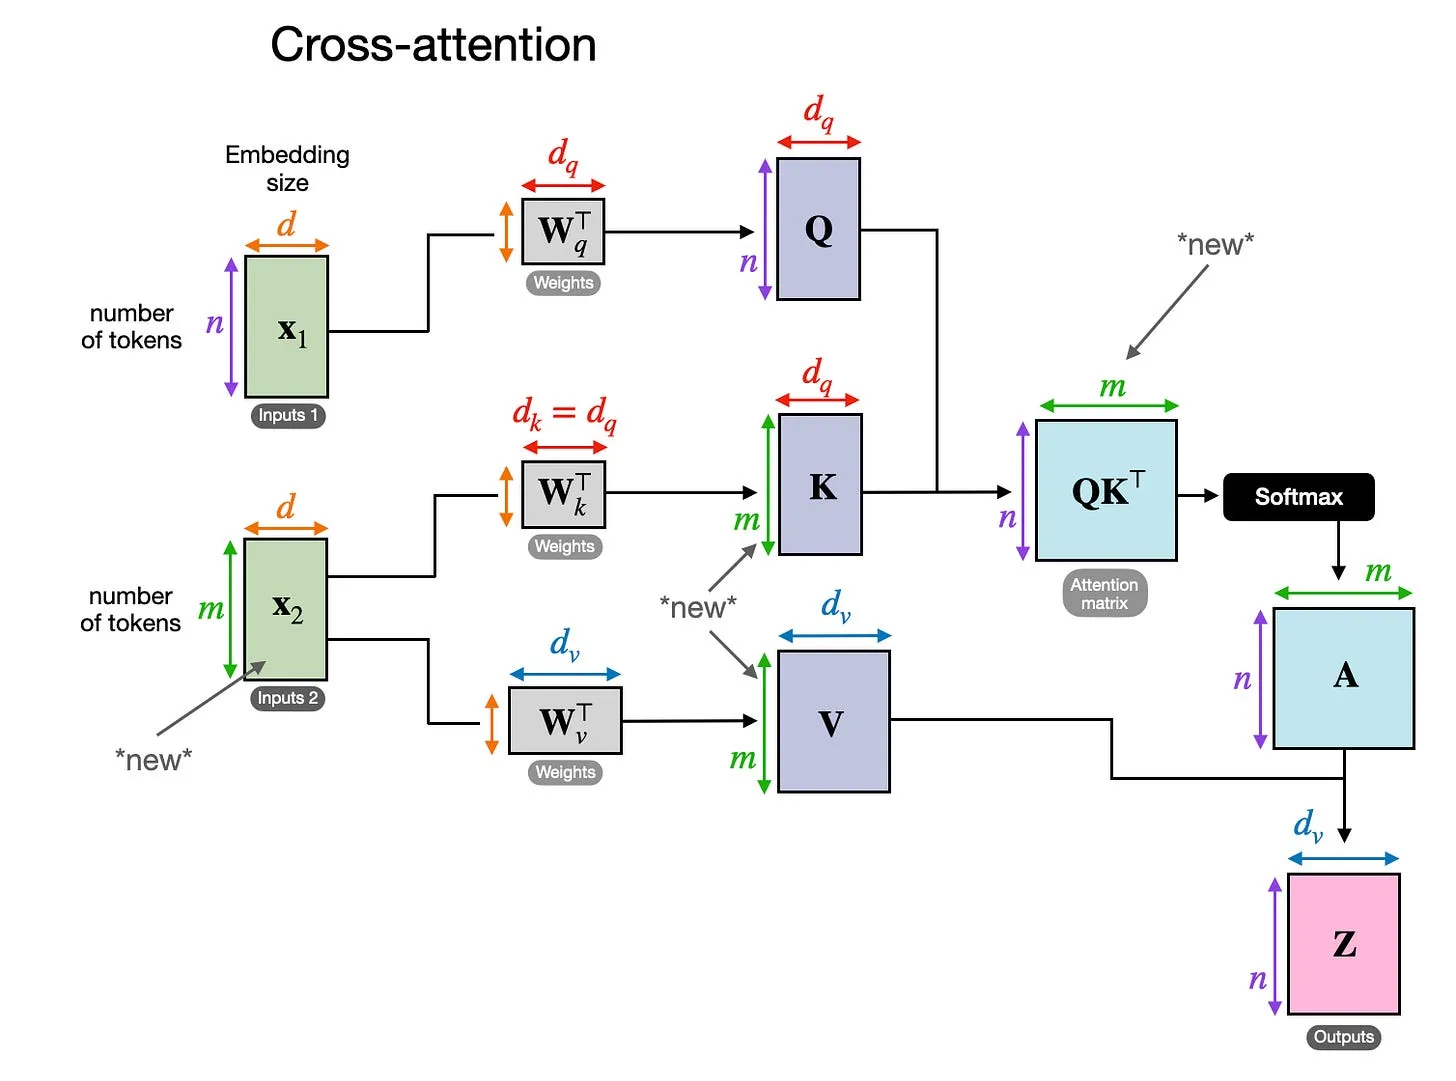
figure17
交叉注意力示意图:存在x1和x2两个不同的输入

结合前两张图可以看出,在自注意力中,我们处理的是同一个输入序列;而在交叉注意力中,我们混合或组合两个不同的输入序列。

在《Attention Is All You Need》论文的原始Transformer架构中,两个输入x1和x2分别对应左侧编码器模块的输出序列(x2),以及右侧解码器部分正在处理的输入序列(x1)。在多模态大语言模型的场景下,x2是图像编码器的输出。(注意,查询通常来自解码器,而键和值通常来自编码器。)

注意,在交叉注意力中,两个输入序列x1和x2的元素数量可以不同,但它们的嵌入维度必须匹配。如果令x1 = x2,就等价于自注意力。

3. 统一解码器与交叉注意力模型的训练

我们已经大致讲解了两种主要的多模态设计方案,现在简要谈谈训练过程中三大组件的处理方式,其概要如下图所示。
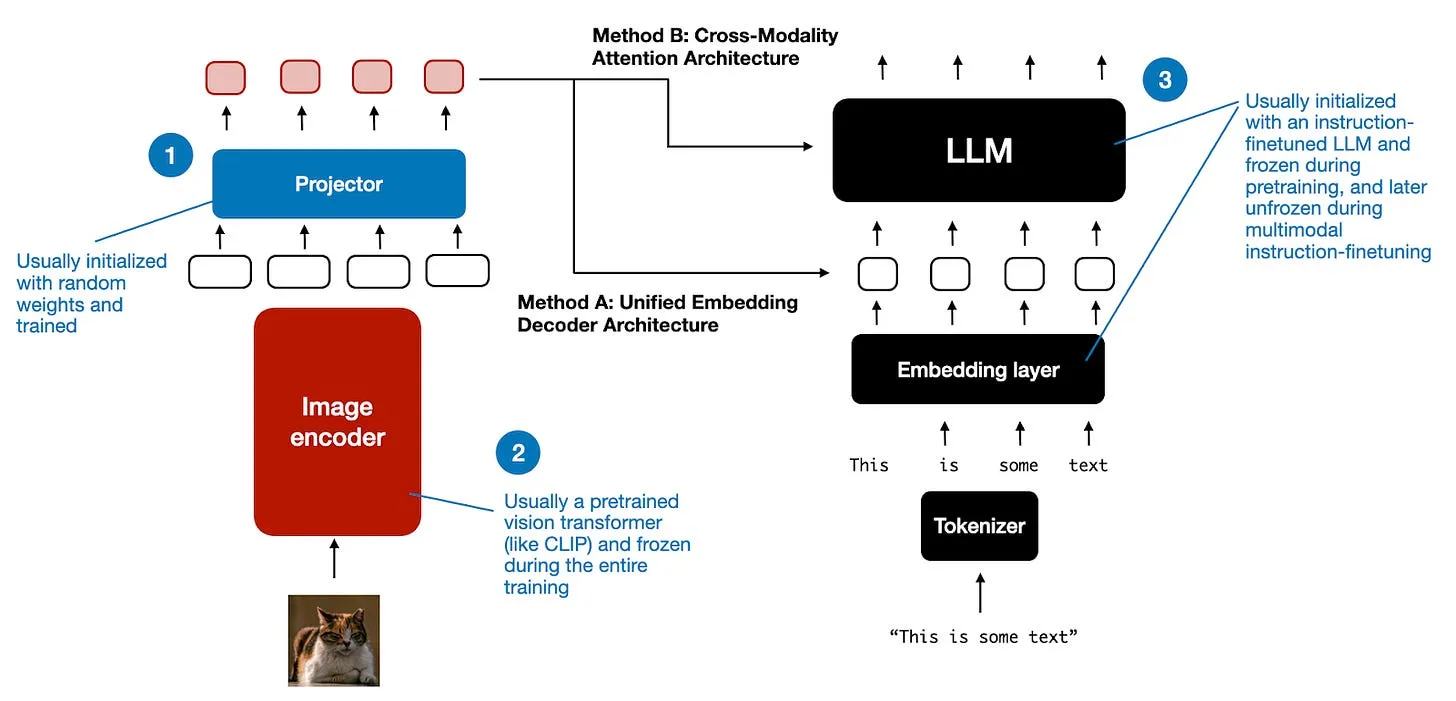
figure18
多模态大语言模型的不同组件概览。标注1-3的组件在多模态训练过程中可选择冻结或解冻。

与传统纯文本大语言模型的开发类似,多模态大语言模型的训练也分为两个阶段:预训练与指令微调。但与从零开始训练不同,多模态大语言模型的训练通常以一个预训练好、经过指令微调的纯文本大语言模型作为基座。

对于图像编码器,常用的是CLIP,且在整个训练过程中通常保持不变,不过也有例外,我们后面会讲到。在预训练阶段冻结大语言模型部分,只训练投影层(一个线性层或小型多层感知机)也是常见做法。由于投影层的学习能力有限(通常只有一到两层),在多模态指令微调阶段(第二阶段)通常会解冻大语言模型,以实现更全面的参数更新。但注意,在基于交叉注意力的模型(方案B)中,交叉注意力层在整个训练过程中都是解冻的。

介绍完两种主流方案(方案A:统一嵌入解码器架构;方案B:跨模态注意力架构)后,你可能会好奇哪种效果更好。答案取决于具体的权衡取舍:

  • 统一嵌入解码器架构(方案A)通常更易实现,因为不需要对大语言模型架构本身做任何修改。
  • 跨模态注意力架构(方案B)通常被认为计算效率更高,因为它不会用额外的图像token占用输入上下文,而是在后续的交叉注意力层中引入图像信息。此外,如果训练时冻结大语言模型参数,该方案可以保留原始大语言模型的纯文本性能。

我们会在后面的章节结合英伟达NVLM论文,继续讨论模型性能与响应质量的相关内容。

到这里,多模态大语言模型的引言部分就告一段落了。写的时候我才发现这部分比最初计划的要长很多,正好可以在这里稍作收尾。

不过,为了提供更实用的视角,我们最好来分析几篇实现了这些方案的最新研究论文。接下来的章节我们就来探讨这些论文。

4. 最新多模态模型与技术进展

在本文余下部分,我将梳理多模态大语言模型的最新研究,重点关注近几周发表的工作,以控制内容的范围。

因此,这不是一份历史性综述,也不是对多模态大语言模型的全面盘点,而是对最新进展的快速概览。我会尽量精简总结,毕竟一共有10项工作。

最后的结论部分会有一张总览图,对比这些论文采用的技术方案。

4.1 Llama 3模型家族

Meta AI于2024年7月31日发表的论文(https://arxiv.org/abs/2407.21783)早在今年夏天就已发布,按大语言模型领域的时间尺度来看,感觉已经是很久之前的事了。不过,他们当时只介绍了多模态模型,直到很晚才正式发布,所以我认为把Llama 3纳入这份清单是合理的。(Llama 3.2系列模型于9月25日正式官宣并开放使用。)

多模态版Llama 3.2包含110亿和900亿参数两个版本,属于图文模型,采用前面讲到的基于交叉注意力的方案,其结构如下图所示。
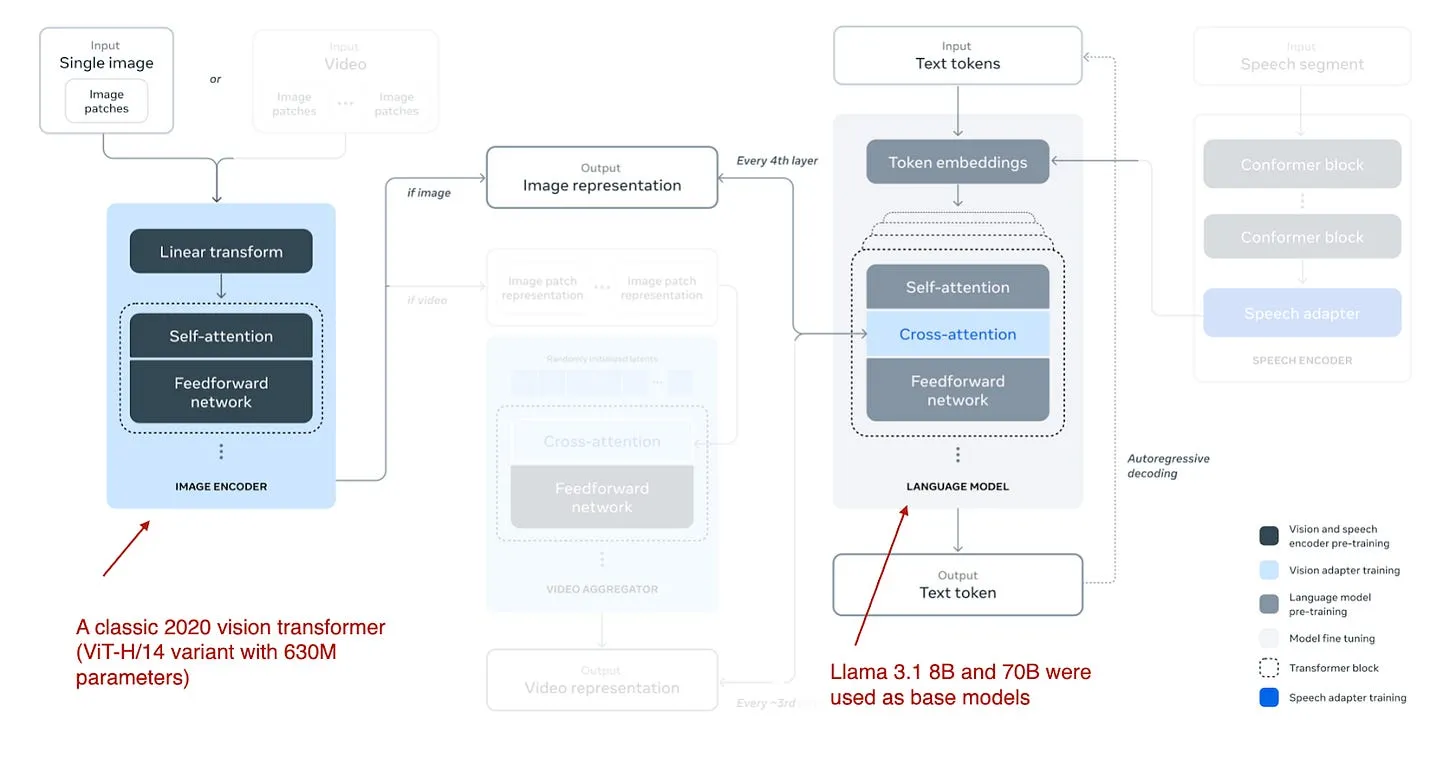
figure19
Llama 3.2采用的多模态大语言模型方案示意图。(标注图来自Llama 3论文:https://arxiv.org/abs/2407.21783。图中视频与语音部分被隐去,以聚焦图像部分。)

注意,虽然图中也画出了视频和语音作为可选模态,但截至撰写本文时,已发布的模型仅支持图像和文本。

Llama 3.2采用基于交叉注意力的方案。但和我之前讲到的常规做法有些不同——通常在多模态大语言模型开发中,我们会冻结图像编码器,只在预训练阶段更新大语言模型参数。

而这里研究人员的做法几乎相反:他们更新图像编码器,但不更新语言模型的参数。他们在论文中表示,这是有意为之,目的是保留模型的纯文本能力,使得11B和90B多模态模型可以在文本任务上作为Llama 3.1 8B和70B纯文本模型的直接替代品。

训练本身分多轮进行,从Llama 3.1文本模型开始。加入图像编码器和投影层(这里称为“适配器”层)后,先在图文数据上进行预训练。随后,和Llama 3纯文本模型的训练流程类似(我在这篇文章中讲过:https://magazine.sebastianraschka.com/i/147749119/llama-overview),再进行指令微调和偏好微调。

研究人员没有采用CLIP这类预训练模型作为图像编码器,而是从零开始预训练了一个视觉Transformer。具体来说,他们采用了经典视觉Transformer架构的ViT-H/14变体(6.3亿参数)(参考论文:https://arxiv.org/abs/2010.11929),并在25亿对图文数据上预训练了5个epoch;这一步是在将图像编码器接入大语言模型之前完成的。(该图像编码器接收224×224分辨率的图像,将其划分为14×14的图像块网格,每个块大小为16×16像素。)

由于交叉注意力层会引入大量参数,因此它们仅在每四个Transformer块中添加一层。(对于8B模型,这会增加30亿参数;对于70B模型,则增加200亿参数。)

4.2 Molmo与PixMo:开源权重与开源数据打造的顶尖多模态模型

2024年9月25日的论文(https://www.arxiv.org/abs/2409.17146)值得关注,因为它承诺不仅开源模型权重,还开源数据集与源代码,和纯文本领域的OLMo大语言模型类似。(这对大语言模型研究意义重大,让我们可以查看完整的训练流程与代码,也能在相同数据集上做消融实验、复现结果。)

如果你好奇标题里为什么有两个名字:Molmo指的是模型本身(Multimodal Open Language Model,多模态开放语言模型),而PixMo(Pixels for Molmo)是配套的数据集。
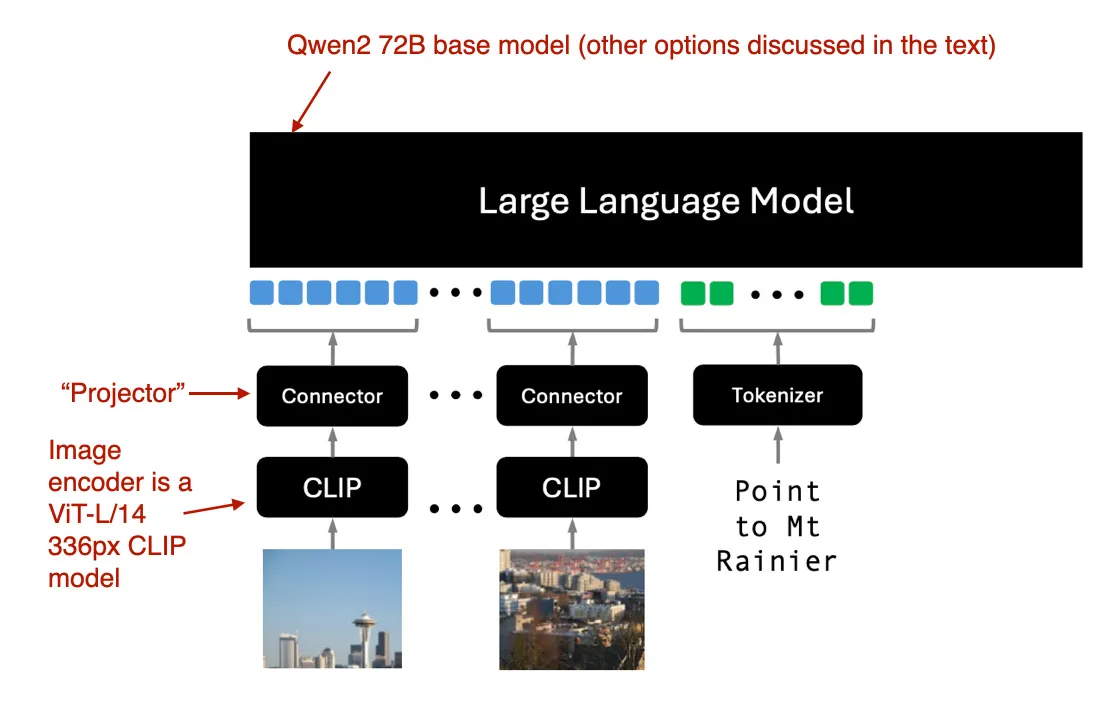
figure20
Molmo的纯解码器方案(方案A)示意图。标注图改编自《Molmo and PixMo: Open Weights and Open Data for State-of-the-Art Multimodal Models》论文:https://www.arxiv.org/abs/2409.17146。

如上图所示,其图像编码器采用现成的视觉Transformer,具体来说是CLIP。图中的“连接器(connector)”指的就是“投影层(projector)”,用于对齐图像特征与语言模型的维度。

Molmo简化了训练流程,没有采用多阶段预训练,而是选择了一套统一的流水线,同时更新所有参数——包括基座大语言模型、连接器和图像编码器的参数。

Molmo团队提供了多种基座大语言模型可选:

  • OLMo-7B-1024(完全开源的模型基座)
  • OLMoE-1B-7B(混合专家架构,效率最高的模型)
  • Qwen2 7B(开源权重模型,性能优于OLMo-7B-1024)
  • Qwen2 72B(开源权重模型,性能最佳)

4.3 NVLM:开源旗舰级多模态大语言模型

英伟达2024年9月17日的论文(https://arxiv.org/abs/2409.11402)格外有意思,因为它没有只聚焦于单一方案,而是探索了两种路线:

  • 方案A:统一嵌入解码器架构(“纯解码器架构”,NVLM-D)
  • 方案B:跨模态注意力架构(“基于交叉注意力的架构”,NVLM-X)

此外,他们还提出了一种混合方案(NVLM-H),并对三种方案做了公平的横向对比。
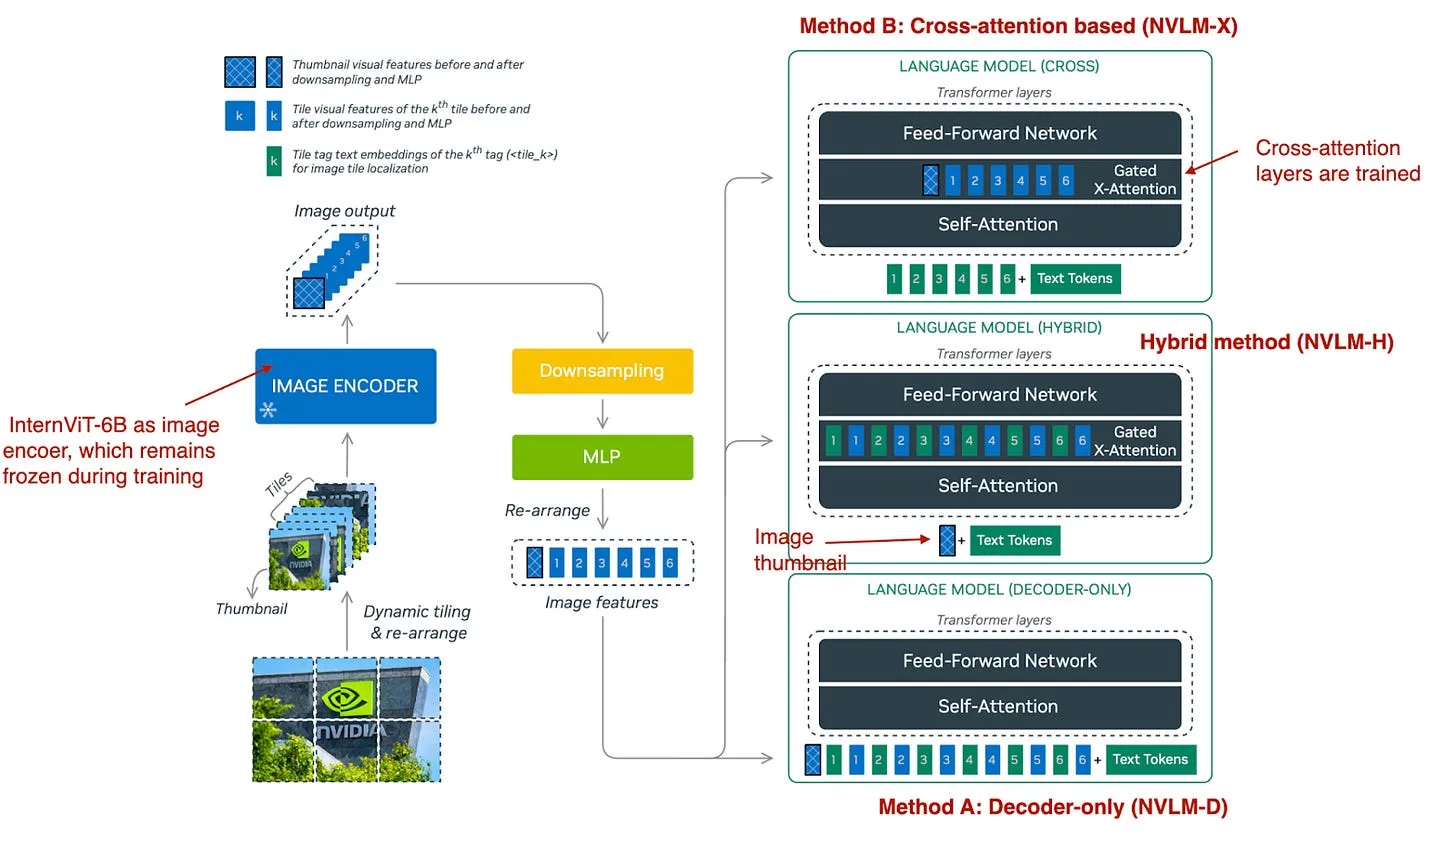
figure21
三种多模态方案概览。(标注图来自《NVLM: Open Frontier-Class Multimodal LLMs》论文:https://arxiv.org/abs/2409.11402)

如下图总结,NVLM-D对应前文的方案A,NVLM-X对应方案B。混合模型(NVLM-H)的设计理念是结合两者的优势:输入一张图像缩略图,再通过交叉注意力传入动态数量的图像块,以捕捉更精细的高分辨率细节。

简而言之,研究团队发现:

  • NVLM-X在处理高分辨率图像时计算效率更出色。
  • NVLM-D在OCR相关任务中准确率更高。
  • NVLM-H融合了两种方法的优点。

和Molmo等方案类似,他们也以纯文本大语言模型为起点,而非从零预训练多模态模型(因为这样通常效果更好)。此外,他们使用的是经过指令微调的大语言模型,而非基础基座模型。具体来说,基座大语言模型是Qwen2-72B-Instruct(据我所知,Molmo使用的是Qwen2-72B基础版模型)。

在NVLM-D方案中,研究人员训练了所有大语言模型参数;而对于NVLM-X,他们发现在预训练和指令微调阶段,冻结原始大语言模型参数、只训练交叉注意力层就可以取得很好的效果。

图像编码器方面,他们没有使用典型的CLIP模型,而是采用了InternVL(https://arxiv.org/abs/2312.14238),且在所有阶段都保持冻结。

投影层采用多层感知机,而非单个线性层。

4.4 Qwen2-VL:以任意分辨率增强视觉语言模型的世界感知能力

前两篇论文与模型(Molmo和NVLM)都基于Qwen2-72B大语言模型。而在这篇论文中,通义千问研究团队推出了自己的多模态大语言模型Qwen2-VL,论文发表于2024年10月3日(https://arxiv.org/abs/2409.12191)。

这项工作的核心是所谓的“朴素动态分辨率(Naive Dynamic Resolution)”机制(“naive”是刻意使用的词,并非“native”的笔误,不过“原生”的含义也同样贴切)。该机制让模型能够处理不同分辨率的图像,而无需简单下采样,支持以原始分辨率输入图像。
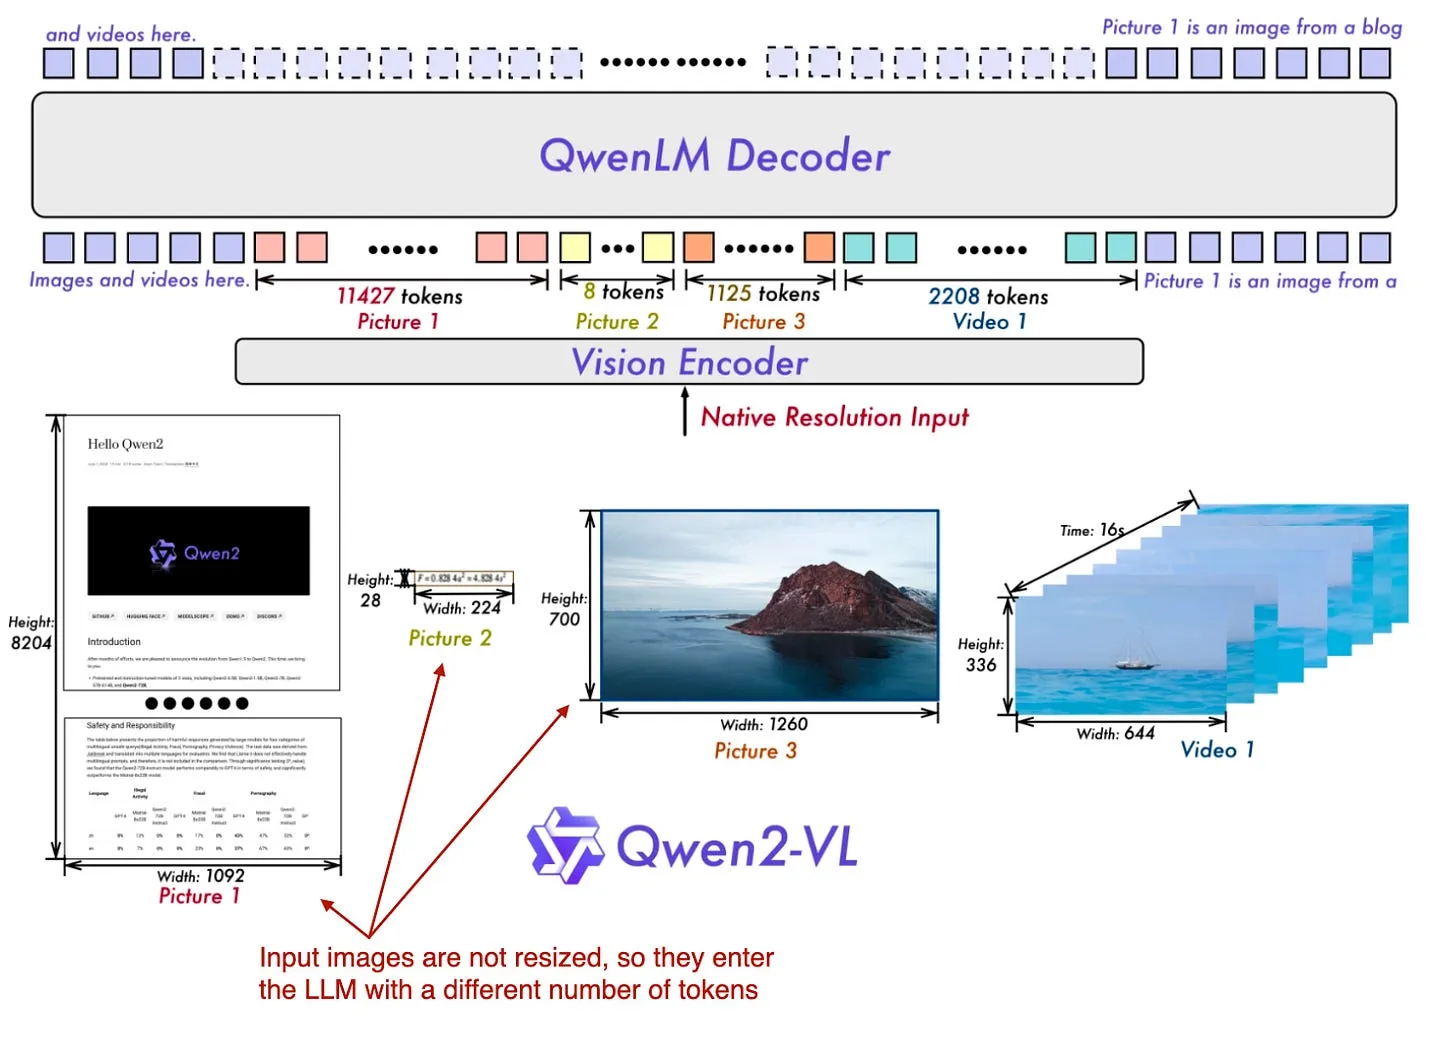
figure22
通义千问多模态模型概览:可原生处理多种不同分辨率的输入图像。(标注图来自《Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution》论文:https://arxiv.org/abs/2409.12191)

原生分辨率输入的实现方式是对经典ViT进行修改:移除原始的绝对位置嵌入,引入二维旋转位置编码(2D-RoPE)。

他们采用了参数量为6.75亿的经典视觉编码器,以及不同尺寸的大语言模型基座,如下表所示。
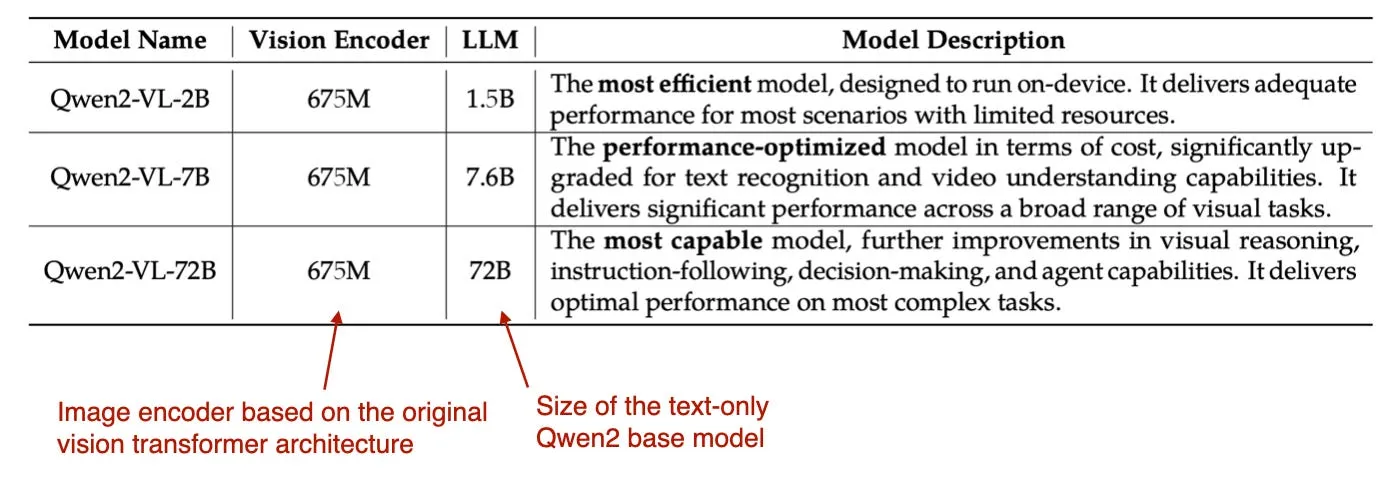
figure23
不同尺寸Qwen2-VL模型的组件构成。(标注图来自《Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution》论文:https://arxiv.org/abs/2409.12191)

训练本身分为3个阶段:(1)仅预训练图像编码器;(2)解冻所有参数(包括大语言模型);(3)冻结图像编码器,仅对大语言模型进行指令微调。

4.5 Pixtral 12B

Mistral AI于2024年9月17日发布的Pixtral 12B(https://mistral.ai/news/pixtral-12b/)采用方案A:统一嵌入解码器架构,是Mistral AI的首款多模态模型。遗憾的是目前没有相关技术论文或报告,但Mistral团队在官方博客中分享了几个值得关注的细节:https://mistral.ai/news/pixtral-12b/。

有意思的是,他们没有使用预训练的图像编码器,而是从零训练了一个4亿参数的图像编码器。大语言模型基座则采用120亿参数的Mistral Nemo模型(https://mistral.ai/news/mistral-nemo/)。

和Qwen2-VL类似,Pixtral也原生支持可变尺寸图像输入,如下图所示。
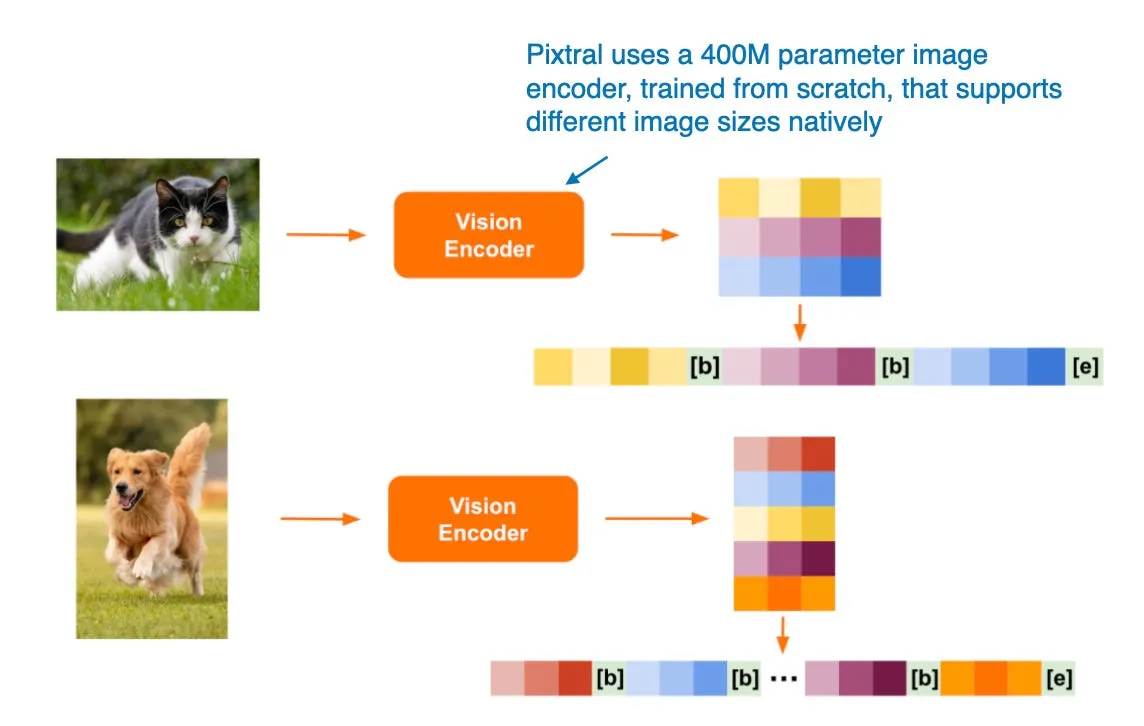
figure24
Pixtral处理不同尺寸图像的方式示意图。(标注图来自Pixtral官方博客:https://mistral.ai/news/pixtral-12b/)

4.6 MM1.5:多模态大语言模型微调的方法、分析与洞见

2024年9月30日的论文(https://arxiv.org/abs/2409.20566)提供了实用的训练技巧,并推出了混合专家架构的多模态模型,以及一款和Molmo类似的稠密模型。模型尺寸覆盖广泛,从10亿到300亿参数不等。

该论文中的模型聚焦于方案A:统一嵌入Transformer架构,该架构能有效组织输入,适配多模态学习。

此外,论文还做了一系列有意思的消融实验,探究了数据混合比例以及使用坐标token的效果。
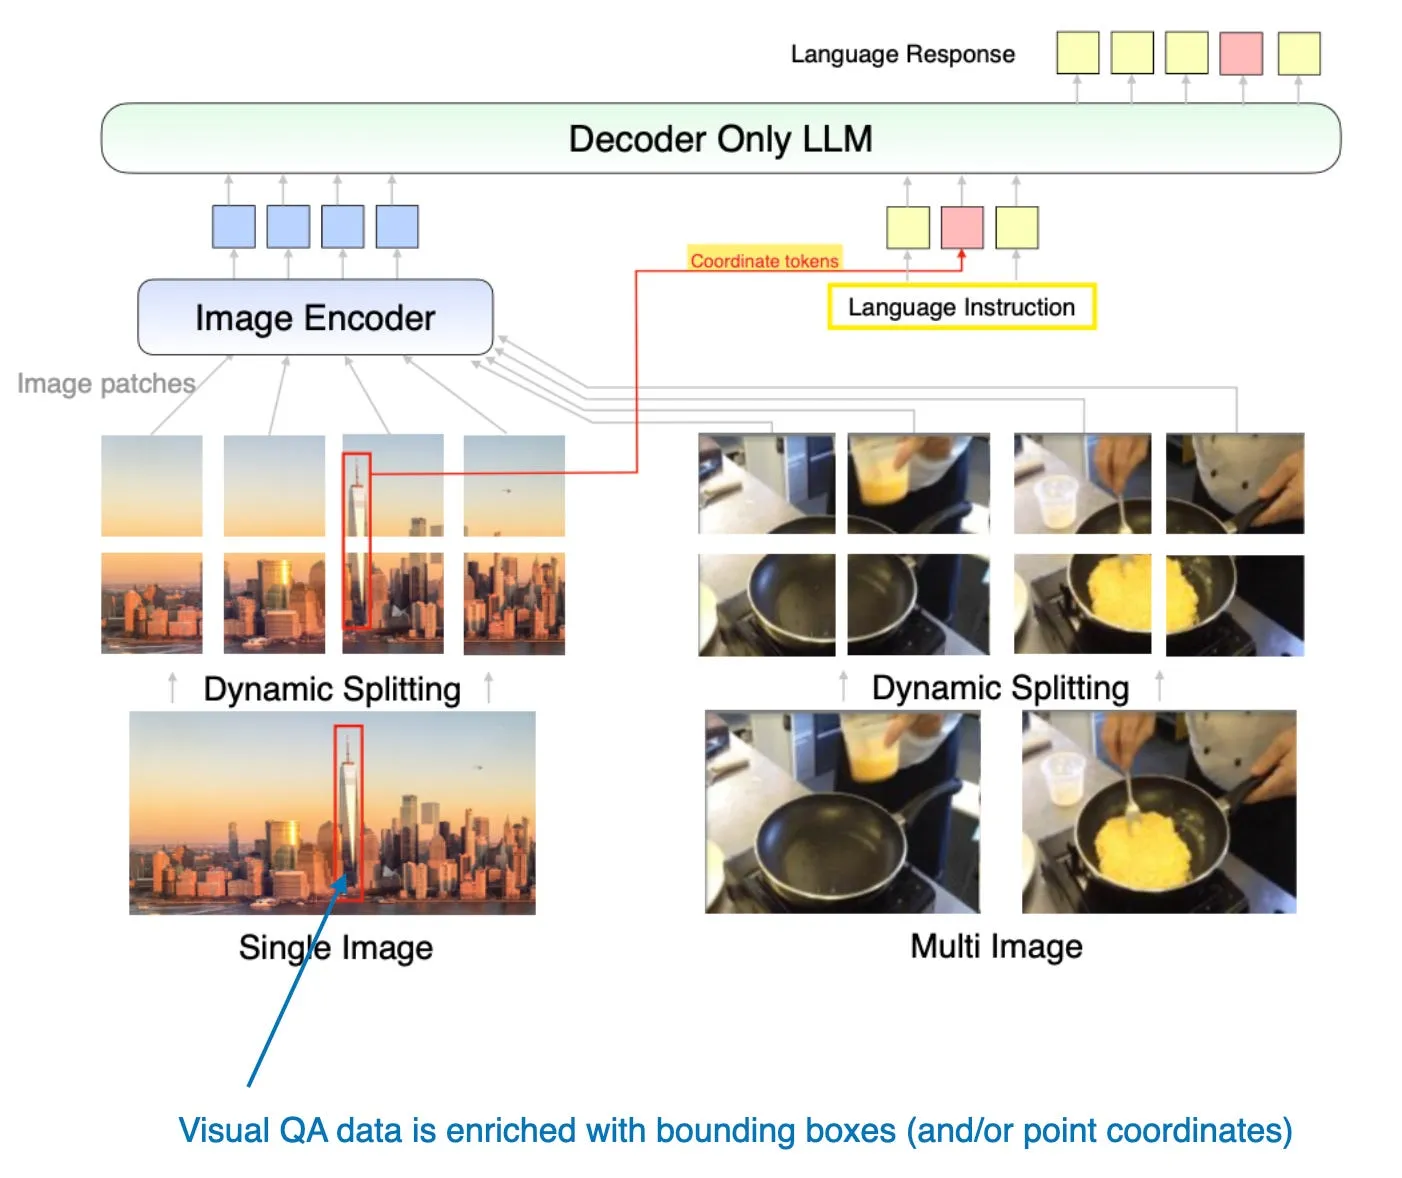
figure25
MM1.5方案示意图:加入了额外的坐标token来表示边界框。(标注图来自《MM1.5: Methods, Analysis & Insights from Multimodal LLM Fine-tuning》论文:https://arxiv.org/abs/2409.20566)

4.7 Aria:开源多模态原生混合专家模型

2024年10月8日的论文(https://arxiv.org/abs/2410.05993)提出了另一种混合专家模型方案,和Molmo、MM1.5系列中的某个变体类似。

Aria模型总参数量为249亿,其中每个文本token激活35亿参数。图像编码器(基于SigLIP,https://arxiv.org/abs/2303.15343)有4.38亿参数。

该模型基于交叉注意力方案,整体训练流程如下:

  • 从零开始完整训练大语言模型基座。
  • 同时预训练大语言模型基座与视觉编码器。

4.8 百川-Omni

2024年10月11日的论文(https://arxiv.org/abs/2410.08565)推出了百川-Omni,一款70亿参数的多模态大语言模型,采用方案A:统一嵌入解码器架构,如下图所示。
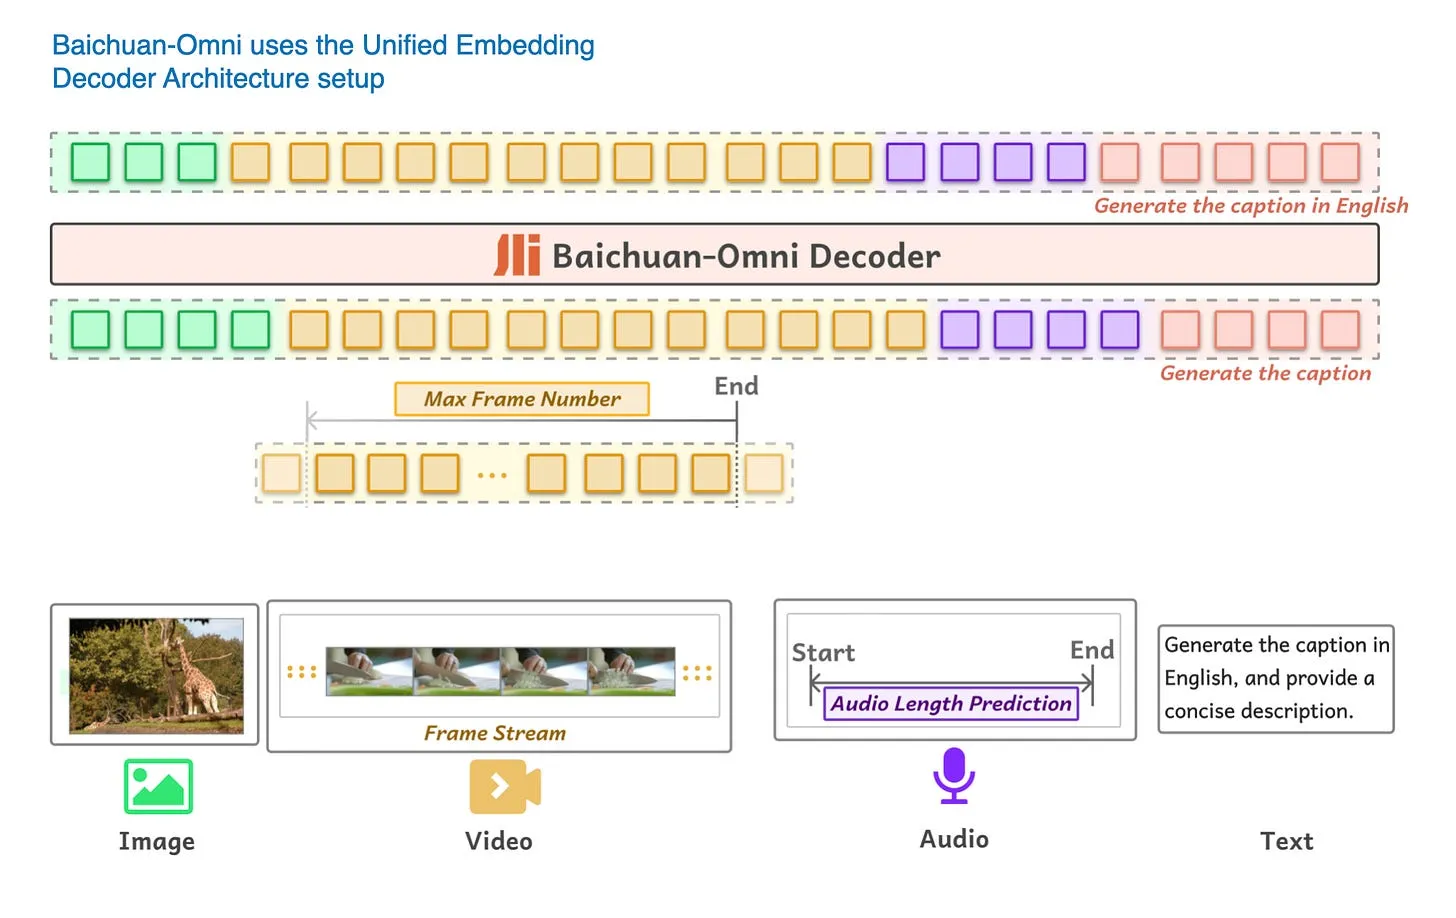
figure26
百川-Omni模型概览:可处理多种输入模态。(标注图来自《Baichuan-Omni Technical Report》论文:https://arxiv.org/abs/2410.08565)

百川-Omni的训练过程分为三阶段:

  1. 投影层训练:初始阶段只训练投影层,视觉编码器与大语言模型均保持冻结。
  2. 视觉编码器训练:随后解冻视觉编码器并进行训练,大语言模型仍保持冻结。
  3. 全模型训练:最后解冻大语言模型,实现端到端的完整训练。

该模型采用SigLIP视觉编码器,并集成了任意分辨率训练模块(https://arxiv.org/abs/2204.07156),通过下采样技术处理高分辨率图像。

虽然报告没有明确说明大语言模型基座,但从模型参数量和命名规则来看,很可能基于百川7B大语言模型。

4.9 Emu3:下一词预测即可解决一切问题

2024年9月27日发布的《Emu3: Next-Token Prediction is All You Need》论文,提出了一种极具竞争力的扩散模型替代方案,用于图像生成,且完全基于Transformer解码器架构。尽管严格来说它不算经典意义上的多模态大语言模型(经典多模态模型聚焦于图像理解而非生成),但Emu3的价值在于,它证明了Transformer解码器可以用于图像生成——这项任务通常由扩散方法主导。(不过需要注意,此前已经有过类似的思路,比如LlamaGen:https://arxiv.org/abs/2406.06525。)
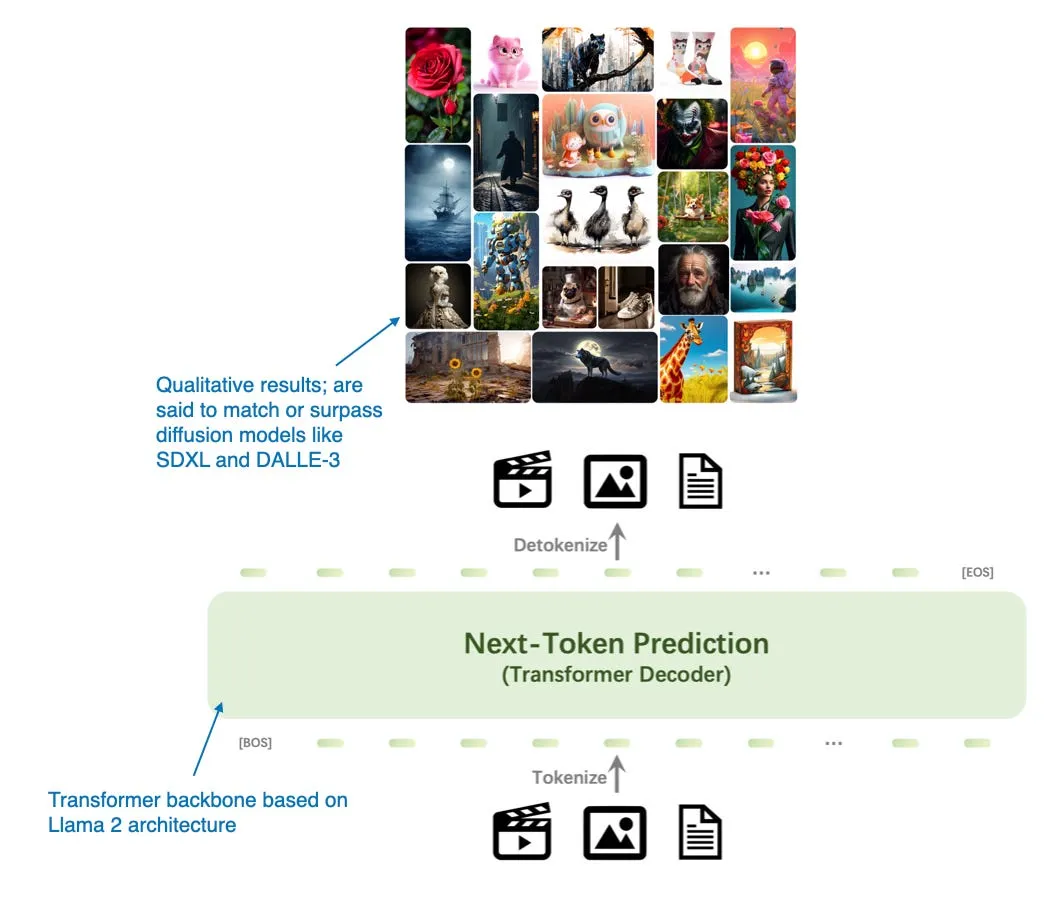
figure27
Emu3主要是一款用于图像生成的大语言模型,可作为扩散模型的替代方案。(标注图来自《Emu3: Next-Token Prediction is All You Need》论文:https://arxiv.org/abs/2409.18869)

研究人员从零开始训练Emu3,随后使用直接偏好优化(DPO,代码参考:https://github.com/rasbt/LLMs-from-scratch/blob/main/ch07/04_preference-tuning-with-dpo/dpo-from-scratch.ipynb)让模型对齐人类偏好。

其架构包含一个受VQGAN启发的视觉分词器(参考论文:https://arxiv.org/abs/2209.09002)。核心大语言模型架构基于Llama 2,但完全从零训练。

4.10 Janus:解耦视觉编码,实现统一的多模态理解与生成

前面我们主要关注的是面向图像理解的多模态大语言模型,刚才的Emu3则是图像生成的例子。而2024年10月17日的论文(https://arxiv.org/abs/2410.13848)提出了一个在单个大语言模型基座中统一多模态理解与生成任务的框架。

Janus的核心特性是解耦视觉编码路径,以适配理解与生成两类任务的不同需求。研究人员认为,图像理解任务需要高维度的语义表示,而生成任务需要精细的局部信息与全局图像一致性。通过分离这两条路径,Janus可以高效满足不同的需求。

该模型采用与百川-Omni类似的SigLIP视觉编码器处理视觉输入;对于图像生成,则使用LlamaGen分词器(https://arxiv.org/abs/2406.06525)处理生成过程。Janus的基座大语言模型是DeepSeek LLM 1.3B(https://arxiv.org/abs/2401.02954)。
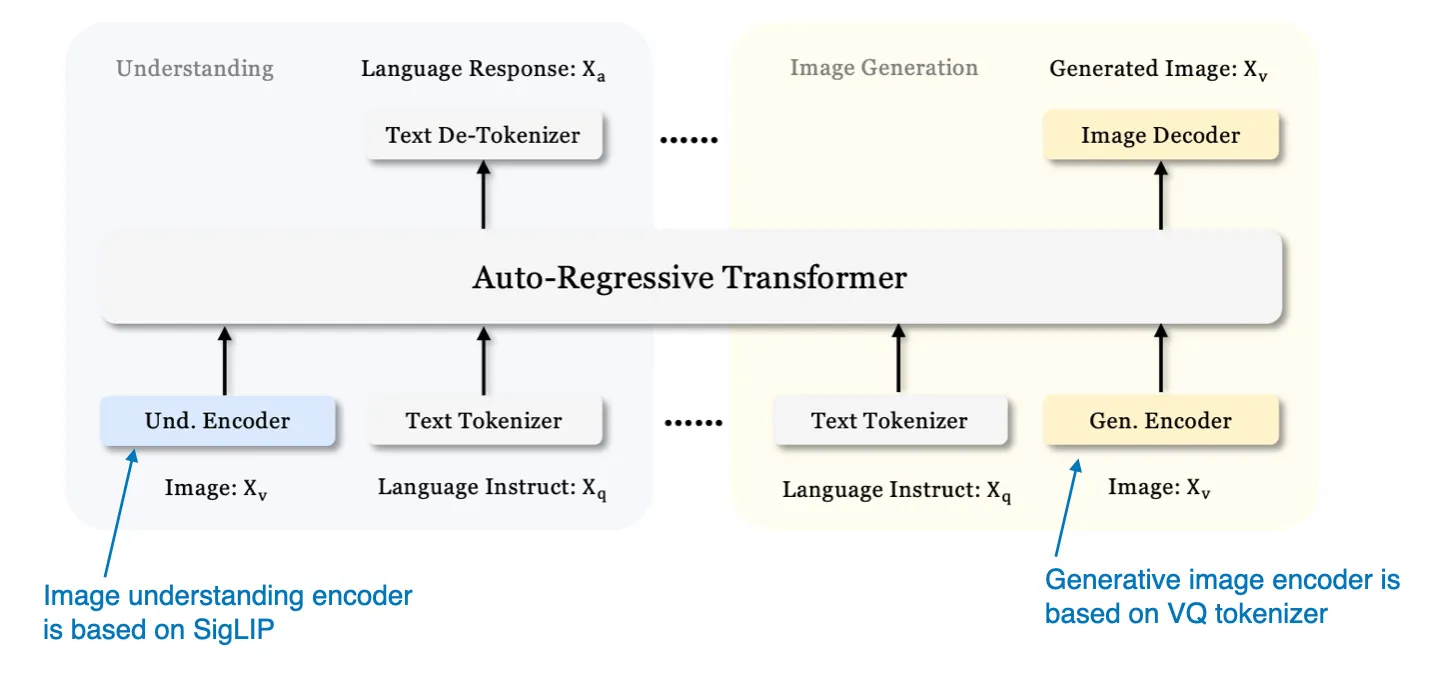
figure28
Janus采用的统一纯解码器框架概览。(标注图来自《Janus: Decoupling Visual Encoding for Unified Multimodal Understanding and Generation》论文:https://arxiv.org/abs/2410.13848。)

该模型的训练过程分为三个阶段,如下图所示。
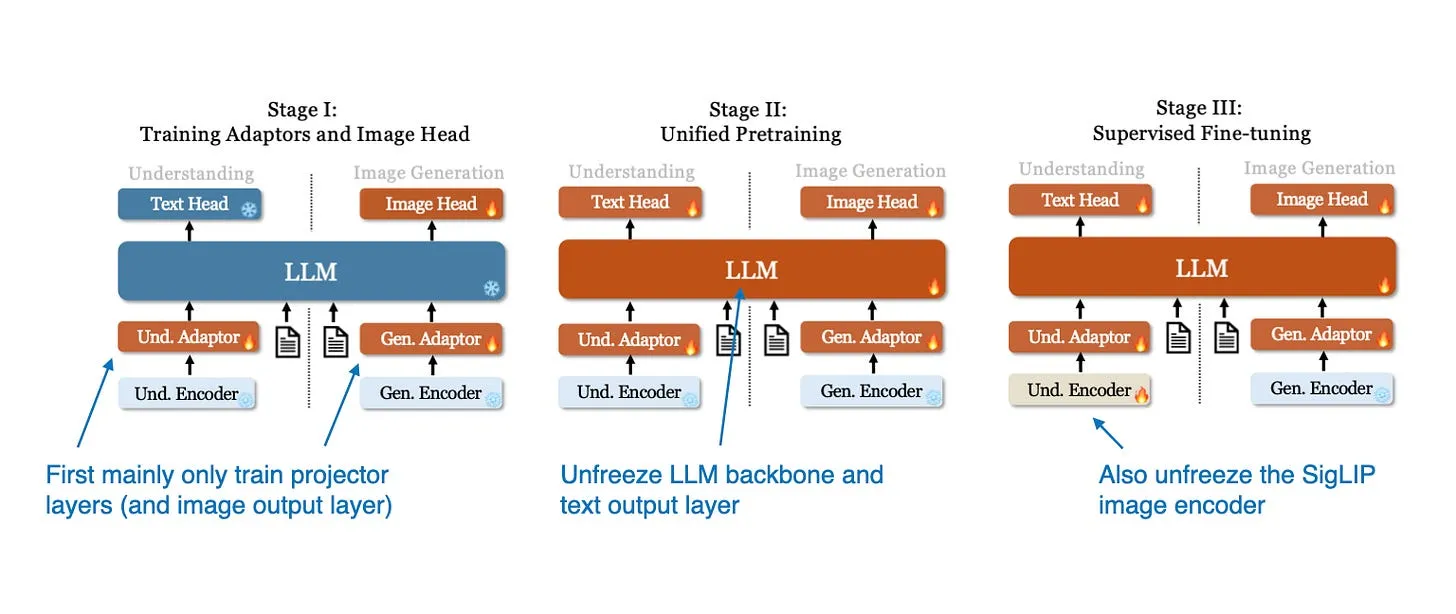
figure29
Janus模型三阶段训练流程示意图。(标注图来自《Janus: Decoupling Visual Encoding for Unified Multimodal Understanding and Generation》论文:https://arxiv.org/abs/2410.13848)

  • 第一阶段:只训练投影层与图像输出层,大语言模型、理解编码器与生成编码器均保持冻结。
  • 第二阶段:解冻大语言模型基座与文本输出层,实现理解与生成任务的统一预训练。
  • 第三阶段:解冻整个模型,包括SigLIP图像编码器,进行监督微调,让模型全面整合并优化其多模态能力。

结论

大家可能已经注意到,我几乎完全没有提及模型效果与计算性能的对比。首先,由于普遍存在的数据污染问题(即测试数据可能被包含在训练数据中),在公开基准上对比大语言模型与多模态大语言模型的性能本身就存在挑战。

此外,不同模型的架构组件差异极大,很难做到公平的横向对比。因此,要为英伟达团队点赞,他们开发了不同版本的NVLM,至少让我们可以对比纯解码器与交叉注意力两种方案的差异。

总而言之,本文的核心结论是:多模态大语言模型的成功构建有很多种不同的技术路径。下图总结了本文涉及的各模型的不同组件与训练方案。
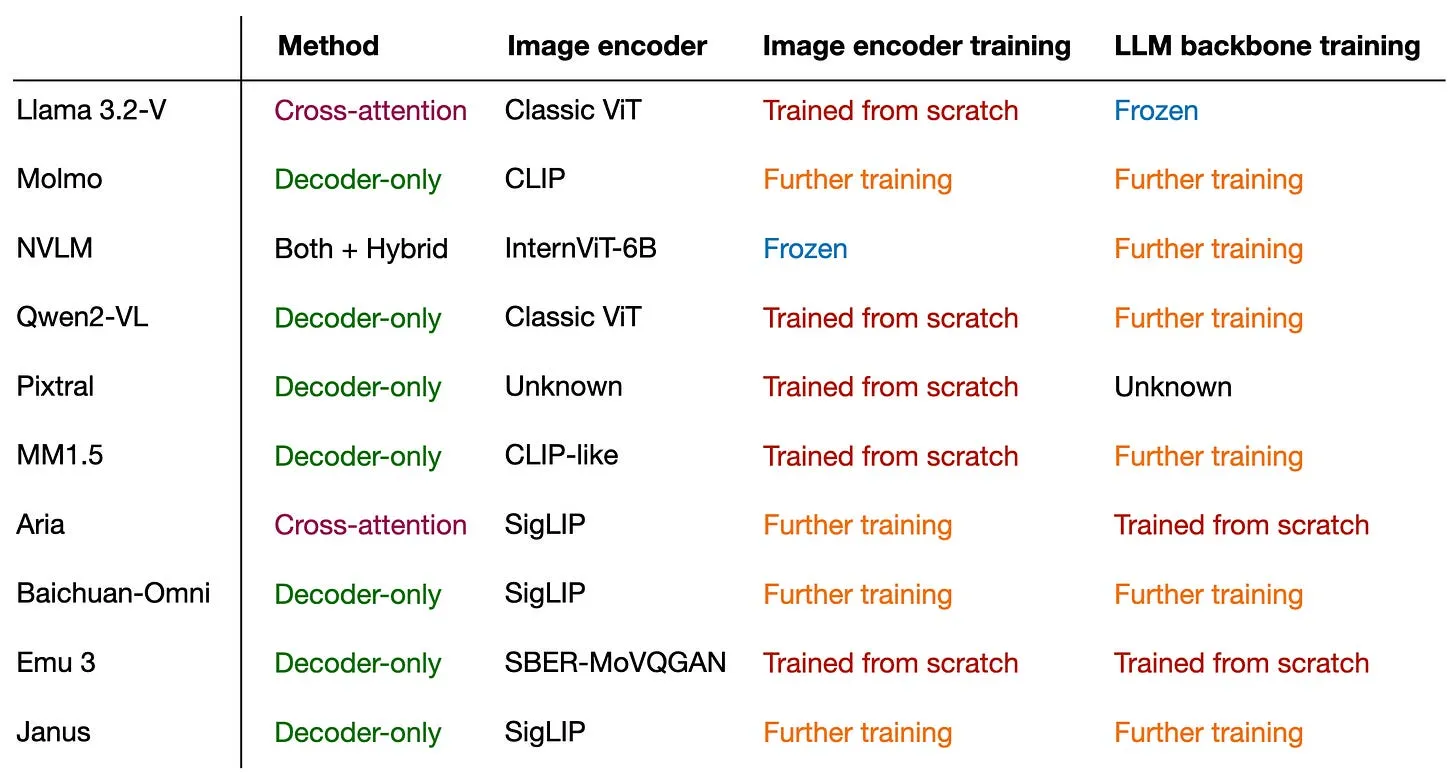
figure30
本文涉及的不同模型及其子组件、训练方案概览

希望本文的讲解对你有帮助,让你对多模态大语言模型的工作原理有了更清晰的理解!

本杂志是一项个人兴趣项目。如果您愿意支持我的创作,可以考虑购买我的新书:https://amzn.to/4fqvn0D。(我相信这本书会让你收获满满,因为它对大语言模型工作原理的讲解深度是其他地方找不到的。)
figure31 现已登陆亚马逊

如果你读过这本书,并且能抽出几分钟时间,我非常希望你能在亚马逊留下评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 。这对我们作者来说帮助非常大!

另外,我最近也在Substack上开通了付费订阅选项,可以直接支持本杂志的创作。

你的支持意义重大!谢谢大家!
记一次存储Inode数量引发的生产故障

前一段时间,突然收到了系统报警,某上传服务异常。

经过排查,上传服务正常,但存储无法正常写入,一直写入失败,表现为:
1、一块新盘,32T,已使用2T,可用30T,控制台和命令行操作结果一直
2、服务写入时,一直报“no space left on device”
3、没有收到任何存储报警

立刻找了云服务厂商的老师,解决了问题:
1、除了限制写入文件总量的大小、并发写入的速度,同时还限制了inode数量
2、上传服务,写入了大量小文件,耗尽了inode数量
3、上传服务,再次写入后,inode申请失败,导致写入失败
4、存储组的老师,紧急扩展了inode数量,解决了问题

经排查,云服务商反馈:
1、为了控制成本,我们之前买了一块较小的硬盘,然后进行了扩容
2、而存储的底层协议为FlexGroup
3、而FlexGroup的普通卷,在扩容的时候,只要超过了1T,默认的Inode数量就一直为21251126,不再提升
4、而我们的上传服务,一个小文件只有几百k,很快就把Inode数量耗尽了
5、对于Inode数量限制,云服务商没有提供任何监控

虽然FlexGroup的超大卷默认会提升Inode数量,但我们一开始购买的服务确是普通卷,然后进行扩容,扩容后仍是普通卷,就触发了Inode数量不会自动增加这个问题。

后续,我们做了两个约定:
1、尽量采购超大卷
2、如果要采购普通卷,同时提单,增加Inode数量
3、云服务商同步进行产品更新,后续产品迭代时,从根源上解决这个问题

PS:
最近发现,他们居然做了一个inode扩容的功能,默认是最小值,可以手工扩展,也能设置为自动扩展。
不知道是谁定的需求,默认选项不应该是自动扩展吗?