【转载】2024年值得关注的AI研究论文(下)

原文地址:Noteworthy AI Research Papers of 2024 (Part Two),by Sebastian Raschka, on 2025-01-15

2024年值得关注的AI研究论文(下)

六篇7-12月的重磅AI论文

2025年1月15日

祝你的2025年有个好开端!作为开年内容,我终于完成了这篇《2024年AI研究亮点》的第二部分草稿。文章涵盖了各类相关主题,从混合专家模型到全新的LLM精度缩放定律,不一而足。

请注意,本文是该系列的第二部分,聚焦2024年下半年(7月至12月)的研究。第一部分可在此查看:https://magazine.sebastianraschka.com/p/ai-research-papers-2024-part-1

诚然,入选标准带有主观性,是基于我今年关注到的亮点内容筛选的。我也尽量兼顾了主题多样性,所以内容不局限于LLM模型发布。
祝你2025年一切顺利,阅读愉快!


7. 7月:Llama 3模型家族

读者想必对Meta AI的Llama 3模型及其论文已经十分熟悉,但鉴于这些模型的重要性与广泛应用,我想把7月的板块留给Grattafiori等人于2024年7月发表的论文:https://arxiv.org/abs/2407.21783

Llama 3模型家族的突出特点在于,相比前代Llama 2,其预训练与后训练流程的精细度大幅提升。值得注意的是,不仅Llama 3如此,其他LLM(如https://arxiv.org/abs/2408.00118https://arxiv.org/abs/2407.10671https://arxiv.org/abs/2407.21075等)也遵循这一趋势,正如我几个月前在这篇文章中所述:https://magazine.sebastianraschka.com/p/new-llm-pre-training-and-post-training

7.1 Llama 3架构概览

Llama 3最初发布了80亿和700亿参数两个版本,之后团队持续迭代模型,陆续推出了Llama 3.1、3.2和3.3版本。各版本参数规模汇总如下:

Llama 3(2024年4月)

  • 80亿参数
  • 700亿参数

Llama 3.1(2024年7月,本文讨论版本)

  • 80亿参数
  • 700亿参数
  • 4050亿参数

Llama 3.2(2024年9月)

  • 10亿参数
  • 30亿参数
  • 110亿参数(支持视觉)
  • 900亿参数(支持视觉)

Llama 3.3(2024年12月)

  • 700亿参数

整体而言,Llama 3的架构与Llama 2高度相似,核心差异在于更大的词表,以及小参数版本中引入的分组查询注意力(GQA)。二者差异总结见下图。
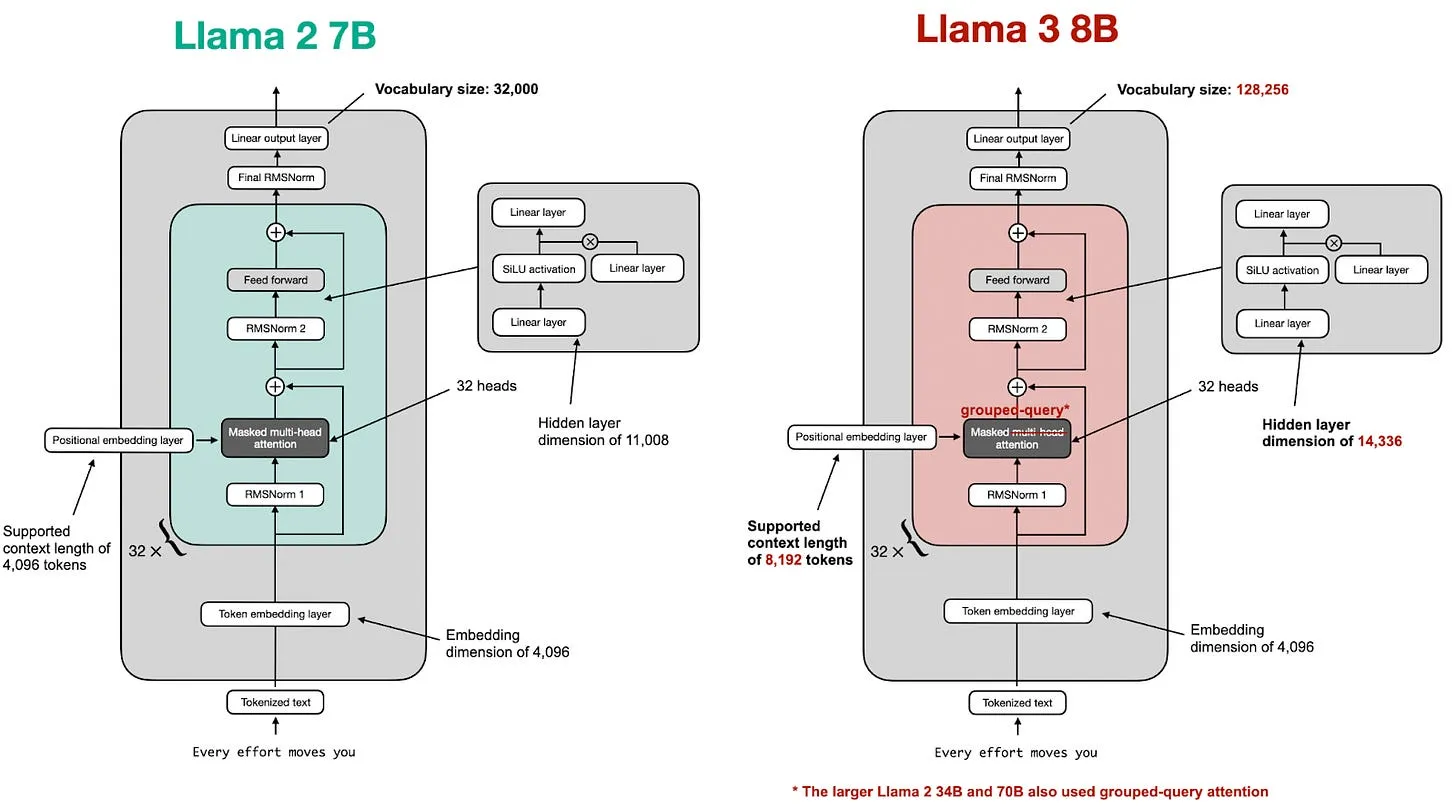
figure01.webp

Llama 2与Llama 3对比图,来源:https://github.com/rasbt/LLMs-from-scratch/tree/main/ch05/07_gpt_to_llama

如果你对架构细节感兴趣,一种极佳的学习方式是从零实现模型,并加载预训练权重作为合理性校验。这个仓库实现了从GPT-2到Llama 2、Llama 3、Llama 3.1、Llama 3.2的转换:https://github.com/rasbt/LLMs-from-scratch/tree/main/ch05/07_gpt_to_llama
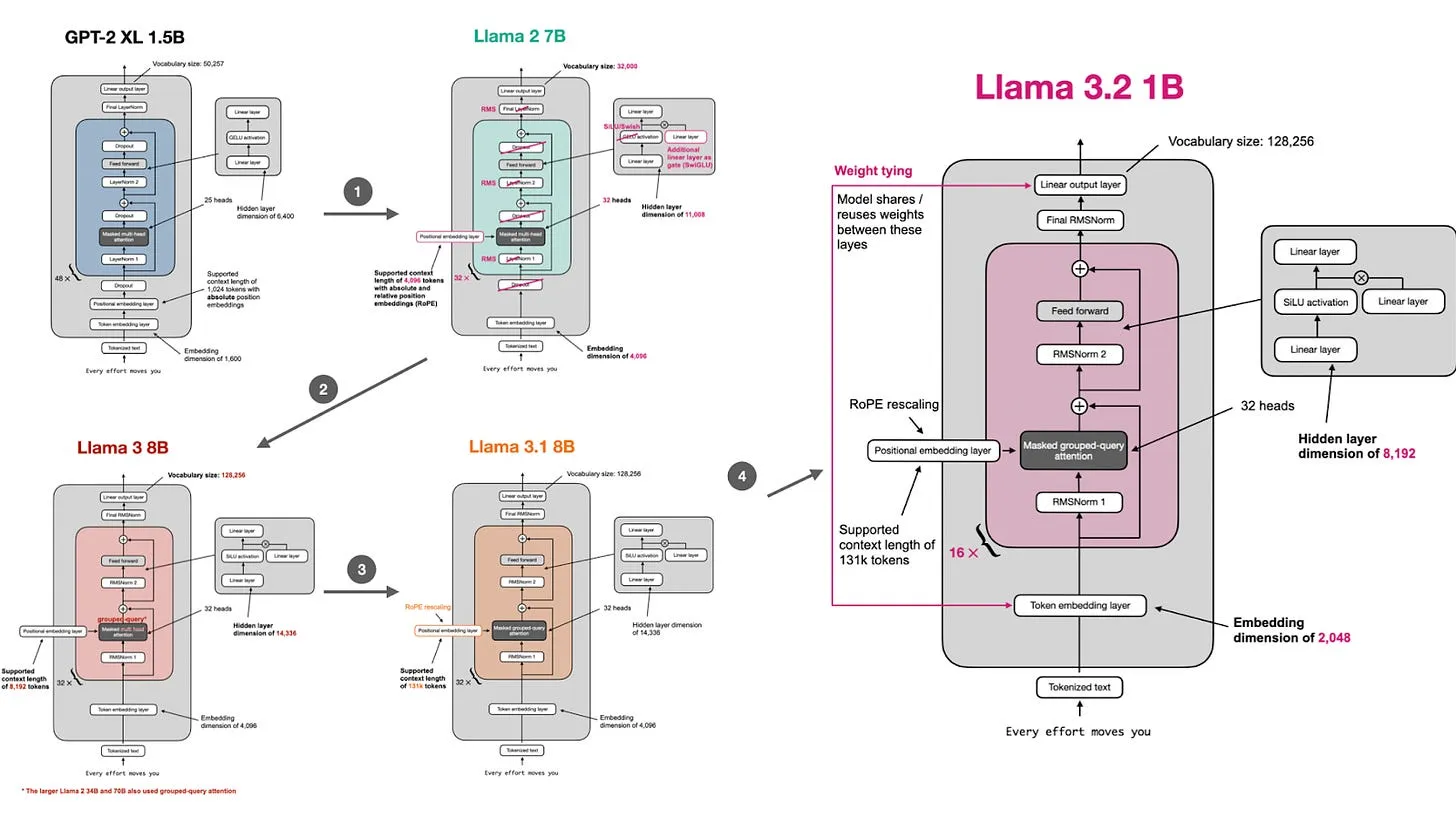
figure02.webp

GPT-2到Llama 2、Llama 3、Llama 3.1、Llama 3.2的转换示意图,来源:https://github.com/rasbt/LLMs-from-scratch/tree/main/ch05/07_gpt_to_llama

7.3 Llama 3的训练

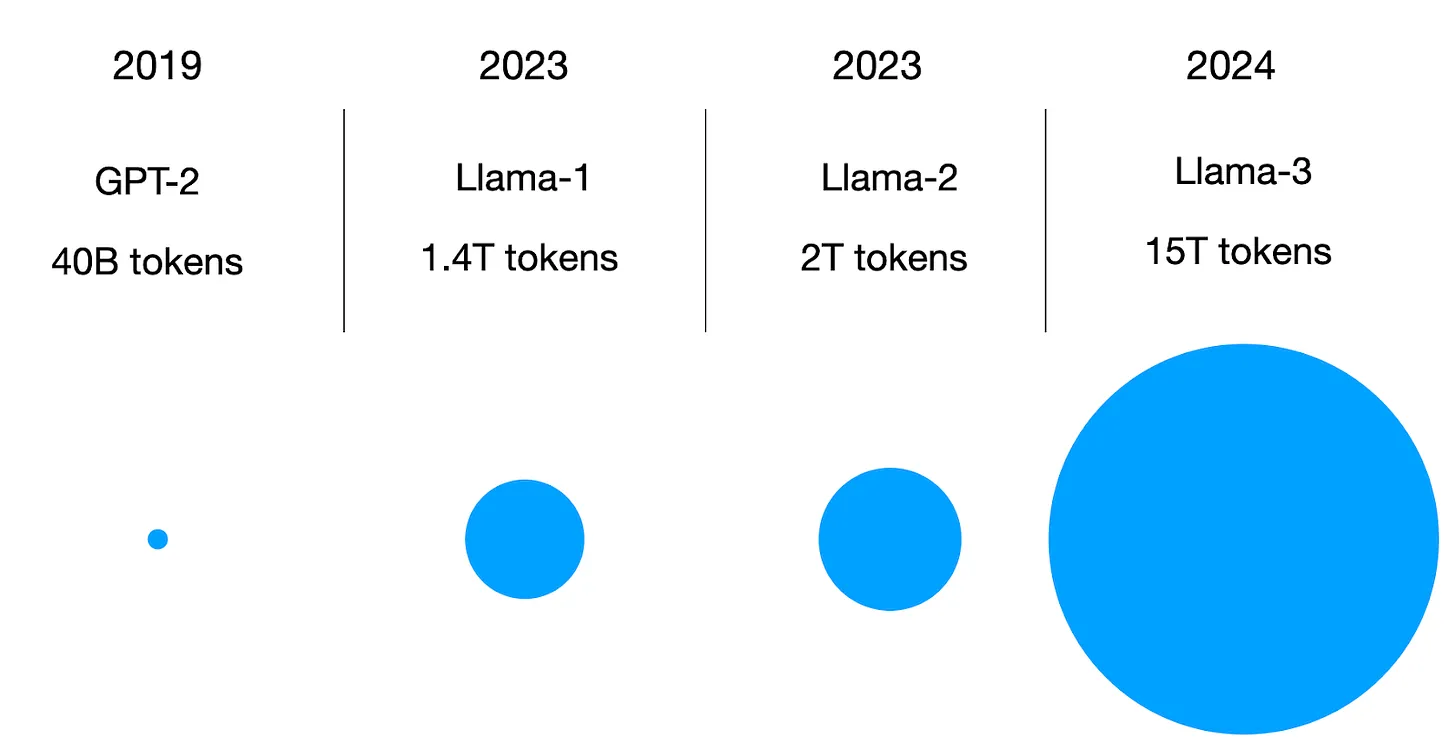
相比Llama 2,另一个值得关注的升级是Llama 3的训练数据量达到了15万亿token。
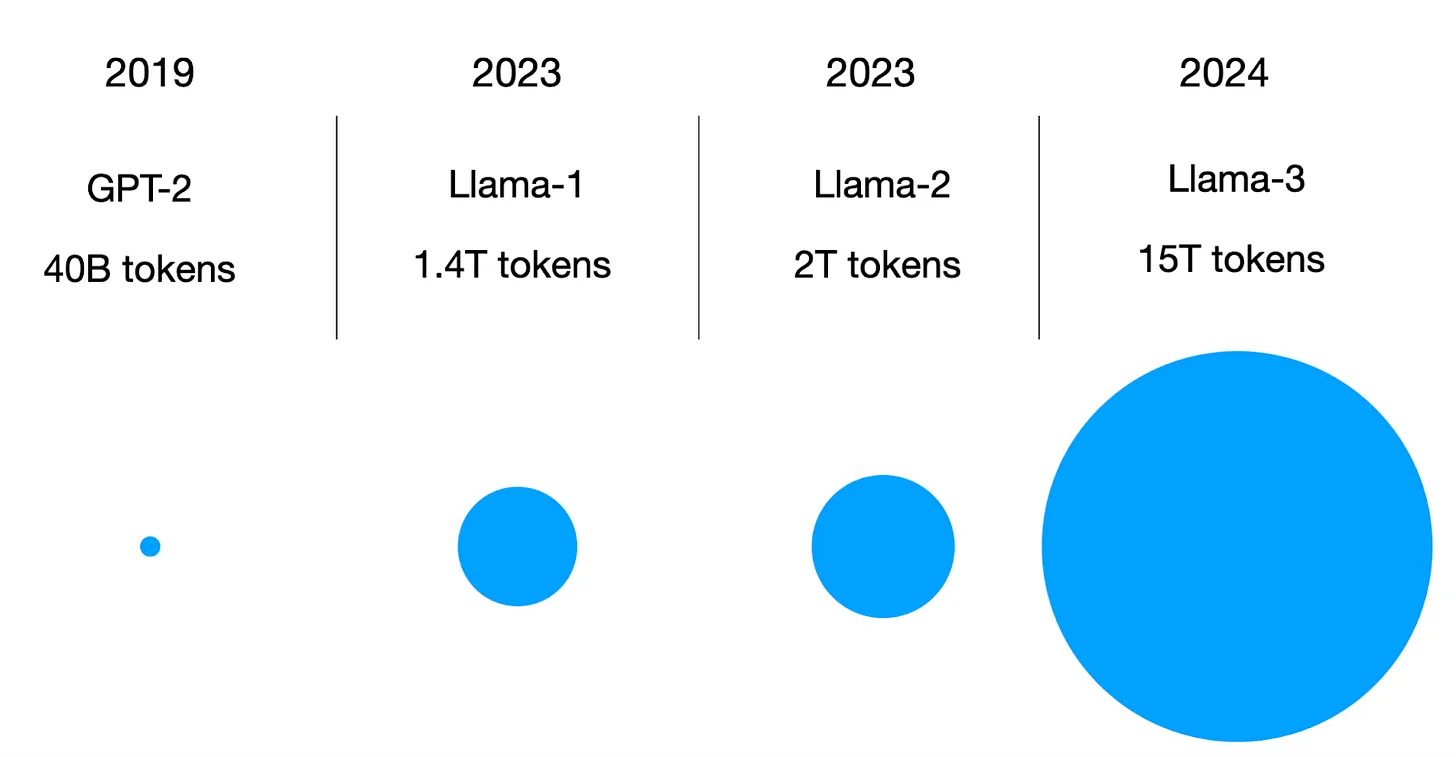
figure03.webp

各类模型训练集规模对比

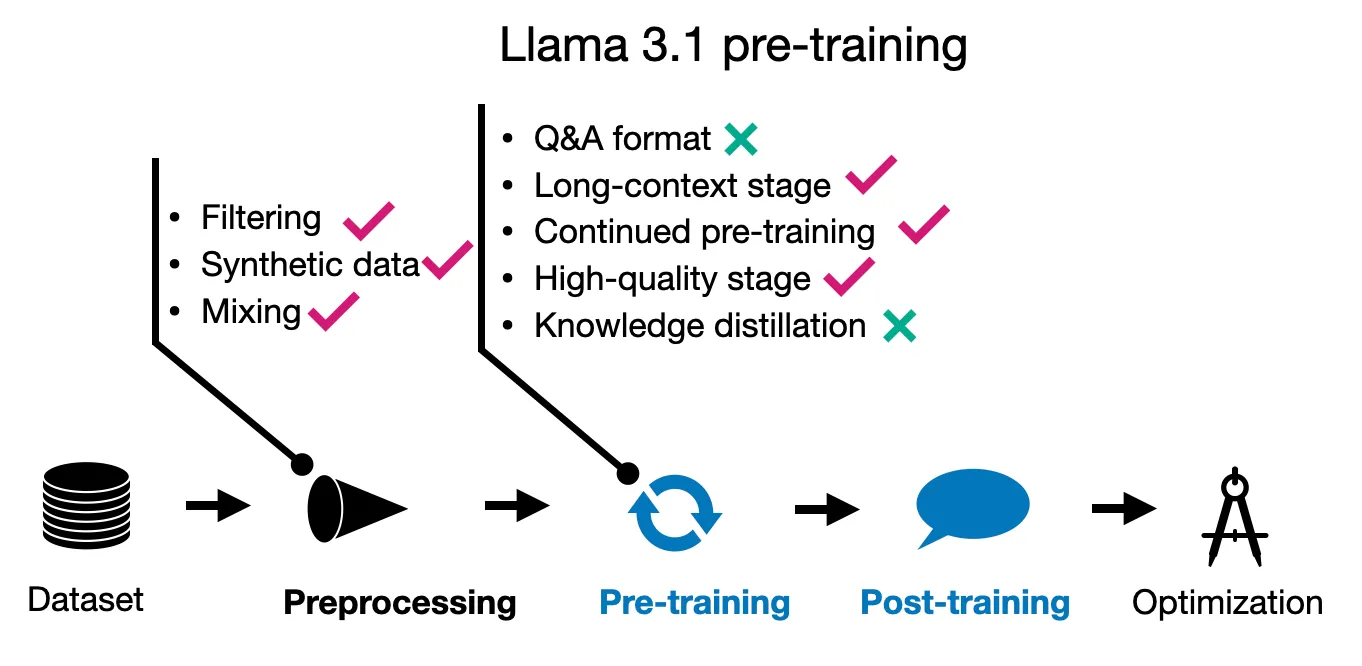
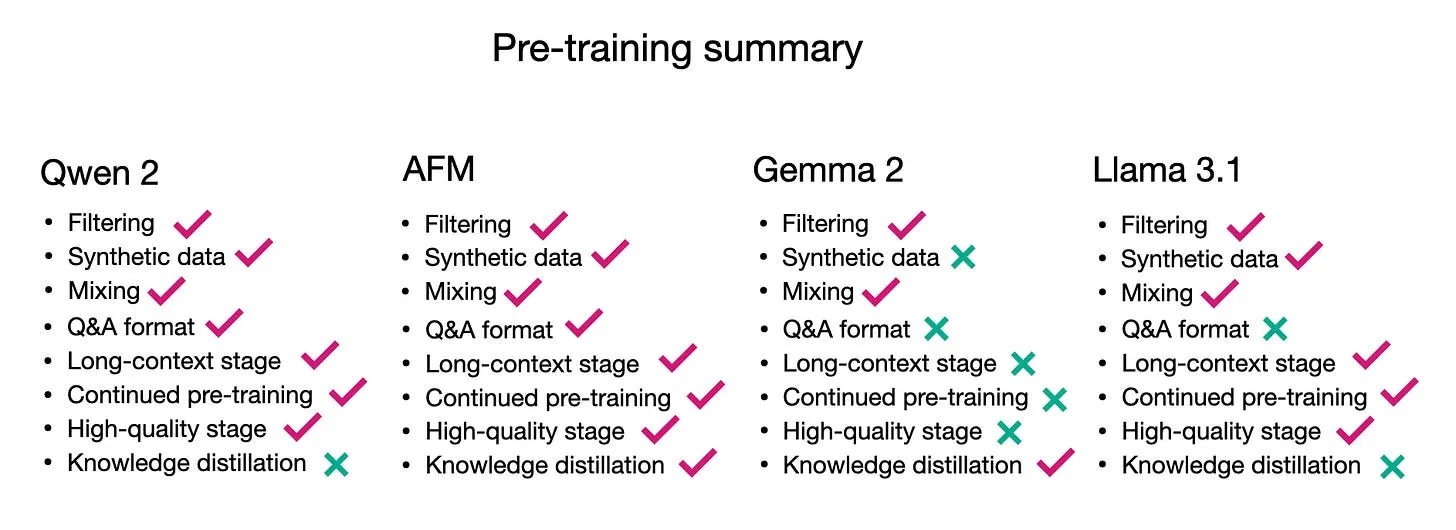
如今的预训练流程分为多个阶段。该论文主要聚焦Llama 3.1,为简洁起见,我将其预训练技术总结在了下图中。
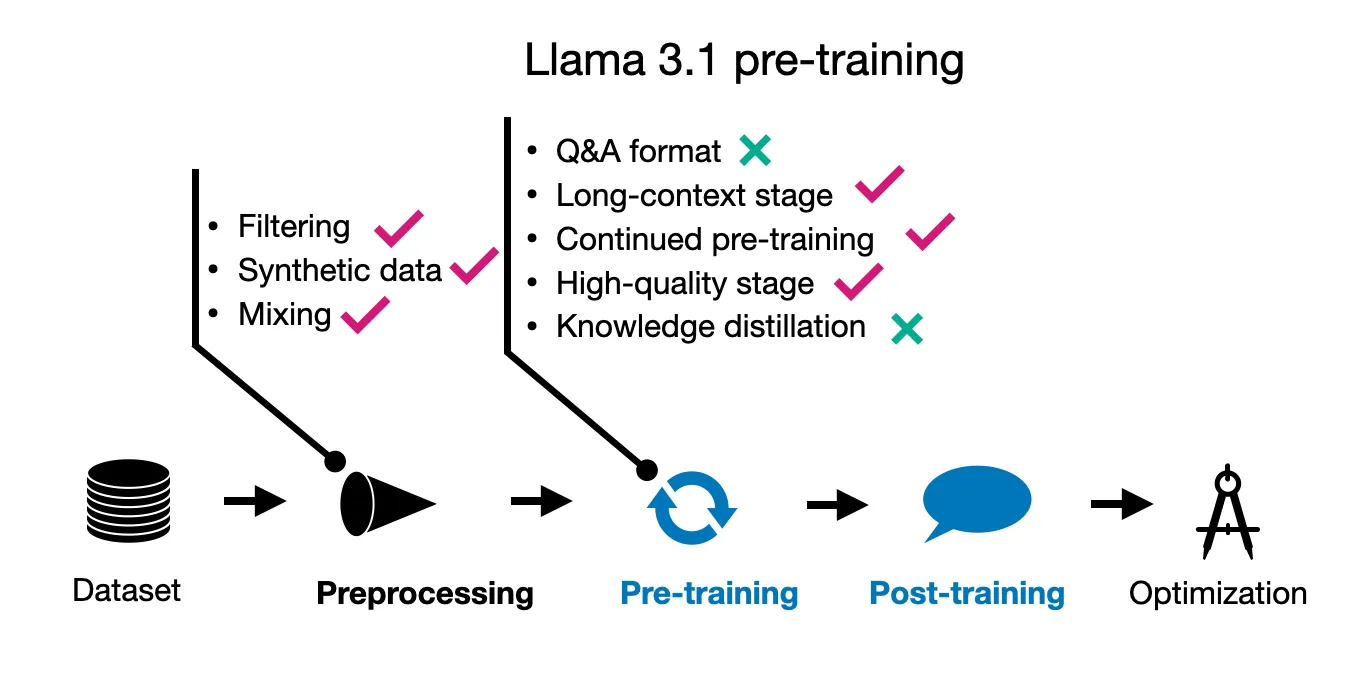
figure04.webp

Llama 3.1预训练所用技术总结

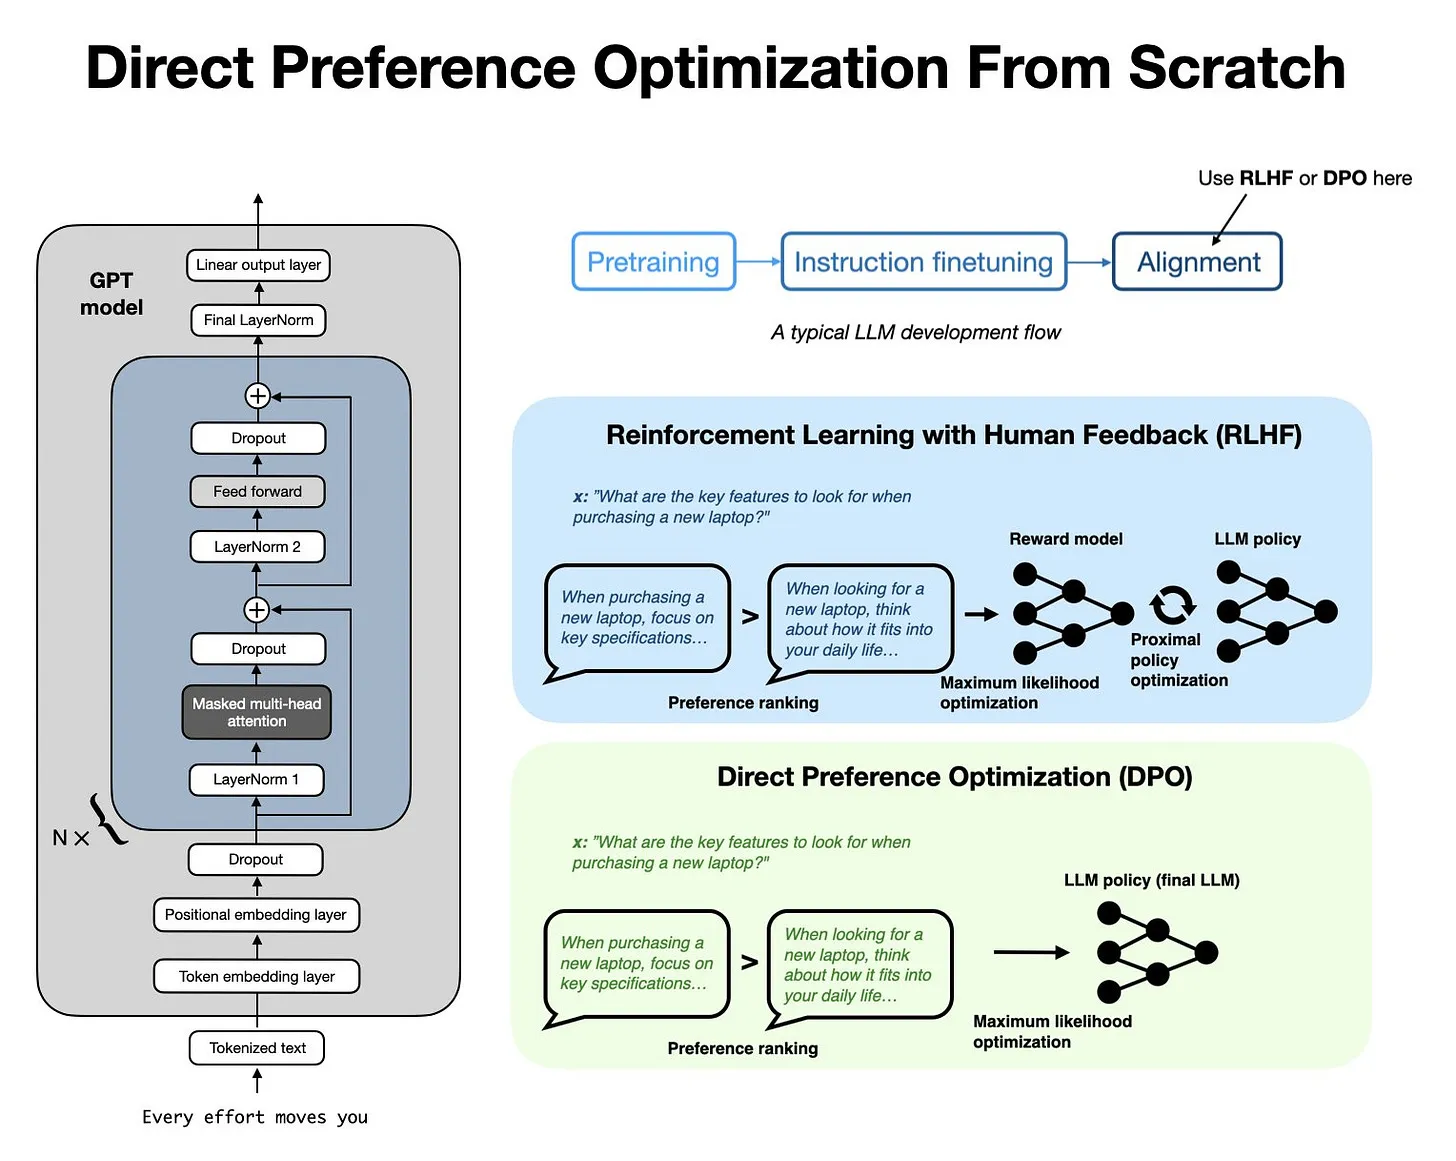
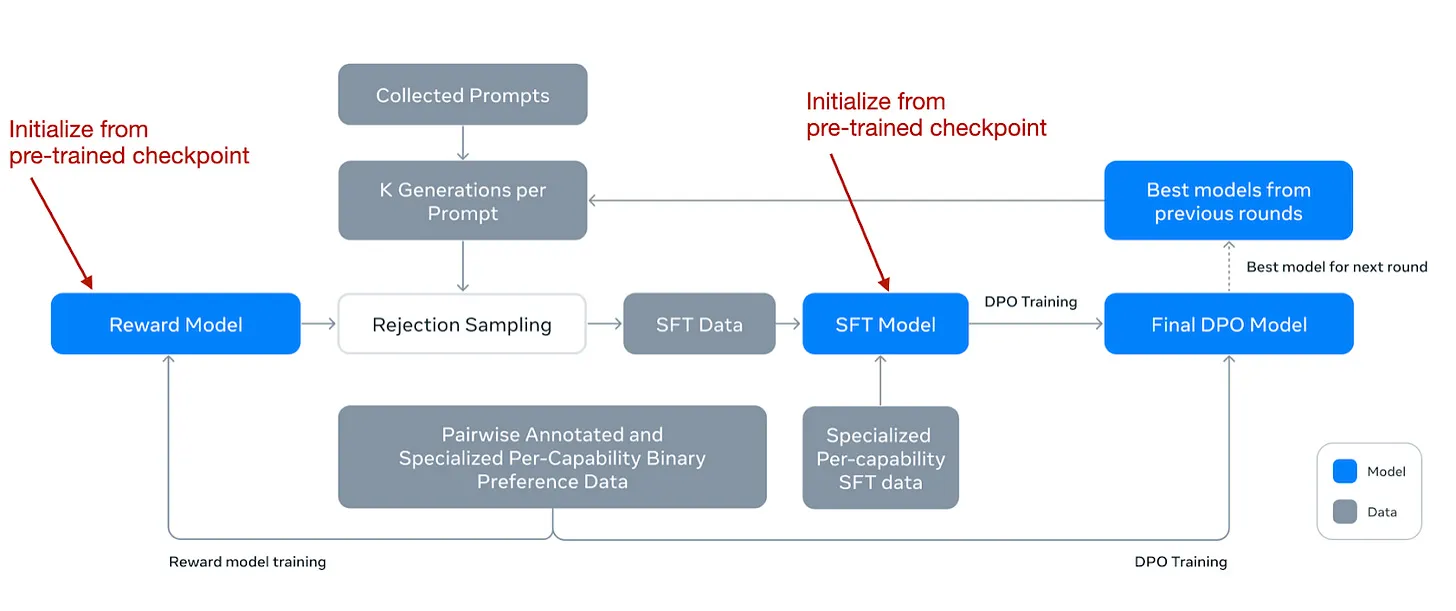
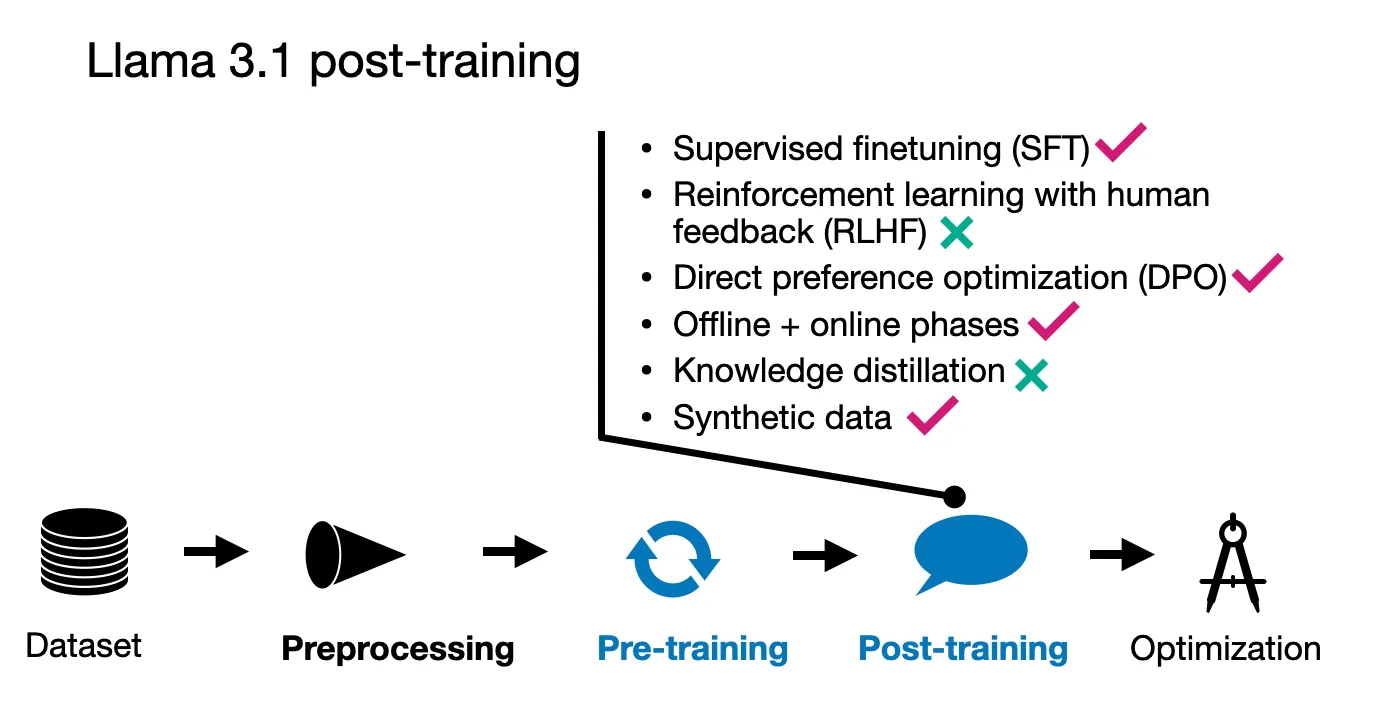
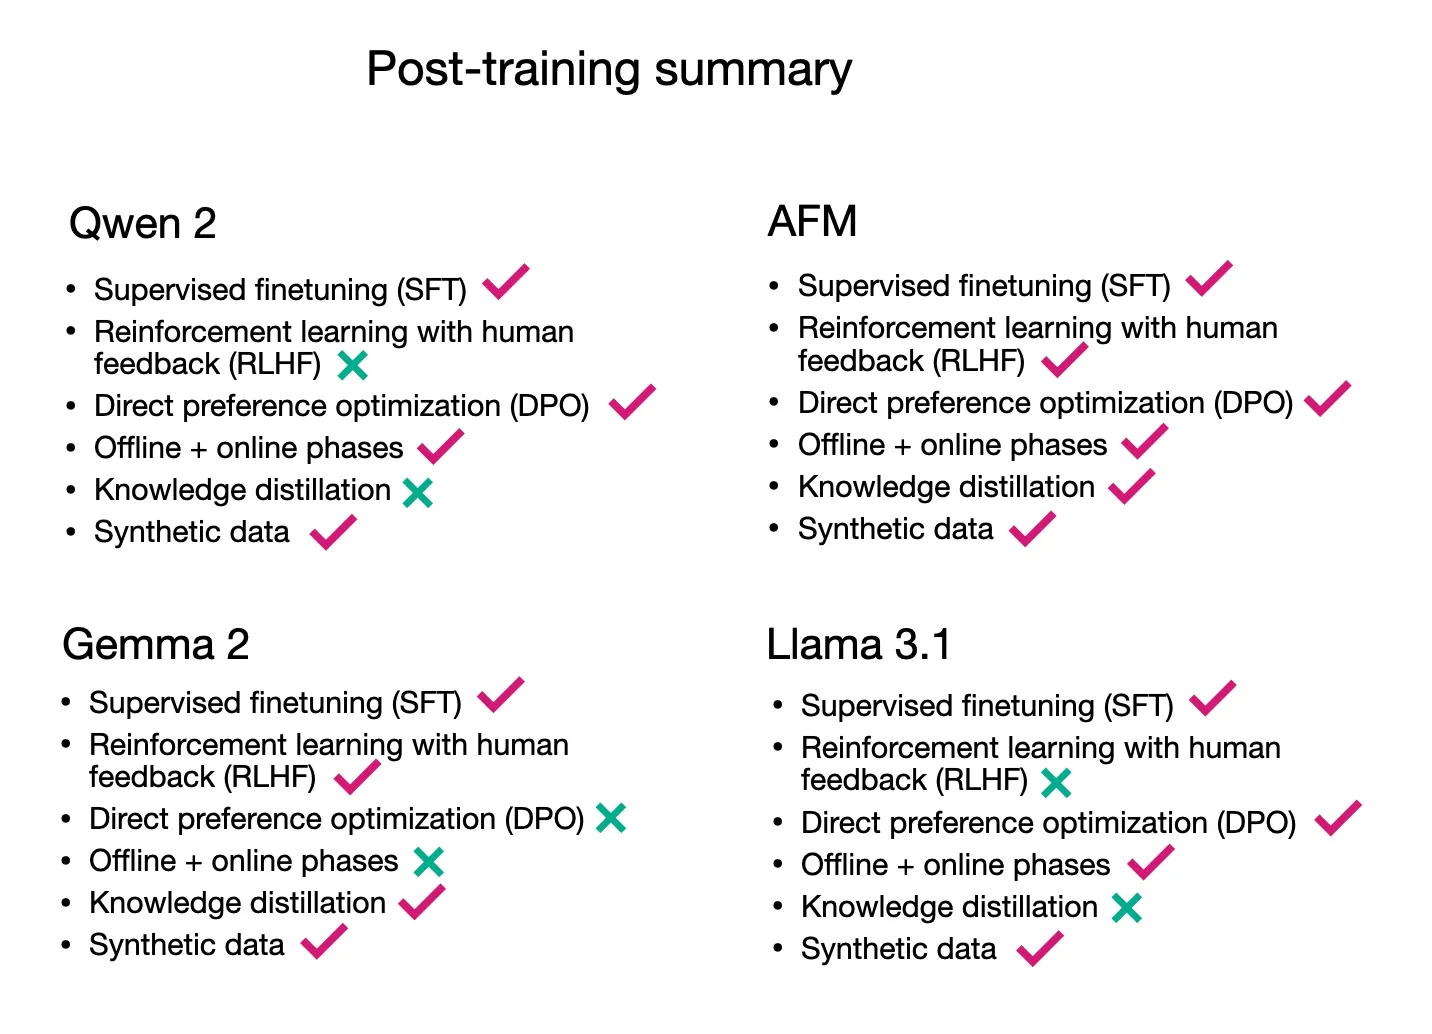
在后训练阶段,相比Llama 2的一个显著变化是从RLHF-PPO切换为DPO。这些方法也总结在下图中。
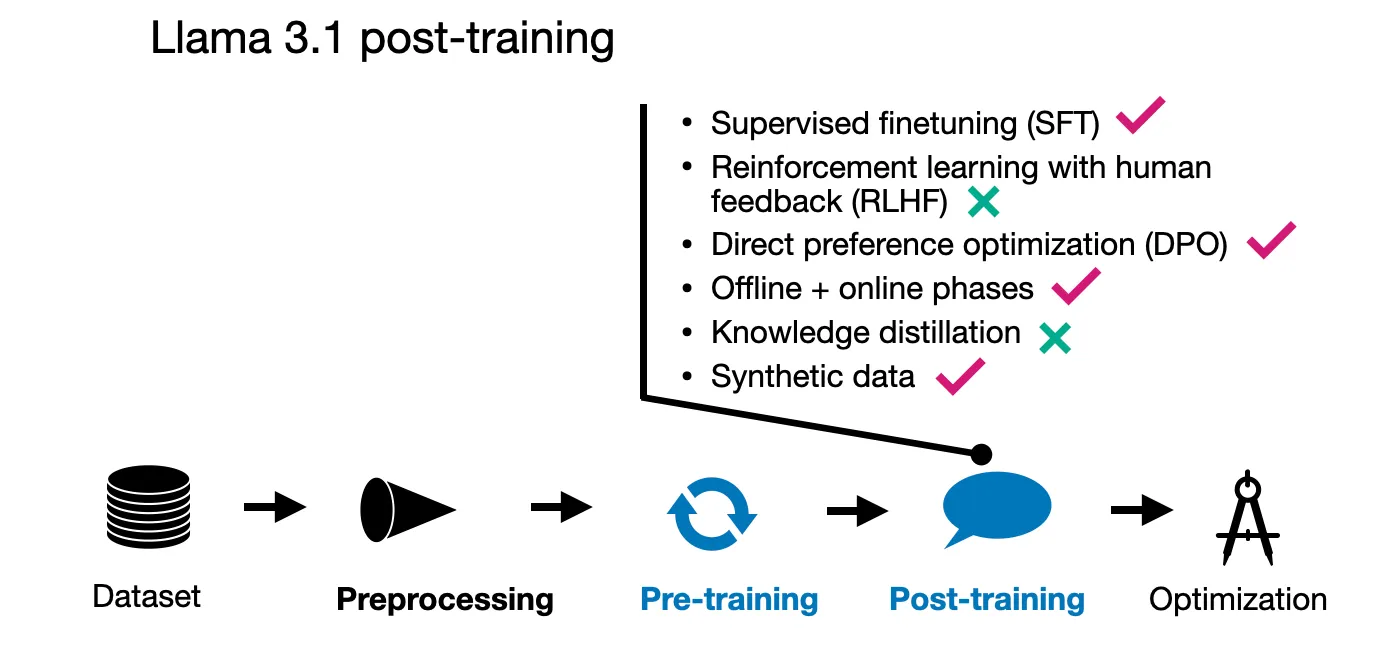
figure05.webp

Llama 3.1预训练所用技术总结

出于篇幅考虑,本文还要介绍另外5篇论文,更多细节以及与其他模型的对比请参考我之前的文章:https://magazine.sebastianraschka.com/p/new-llm-pre-training-and-post-training

《Ahead of AI》是读者支持型出版物。想要接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

7.4 多模态Llama

值得注意的是,Llama 3.2模型也同步发布了多模态支持版本。但我观察到这类模型在实践中应用尚不广泛,讨论度也不高。我们会在本文9月的板块中再探讨多模态技术。

7.5 Llama 3的影响与应用

尽管Llama 3发布已逾半年,但Llama系列模型仍是认知度最高、应用最广的开源权重LLM之一(这是我个人观感,暂无具体引用来源)。这类模型相对易于理解和使用,其流行的原因可能在于Llama的品牌认知度,加上在各类通用任务上的稳定表现,以及微调的便捷性。

Meta AI也保持了迭代节奏,陆续推出Llama 3.1、3.2以及最新的3.3版本,覆盖多种参数规模,适配从端侧场景(10亿参数)到高性能应用(4000亿参数)的多元需求。

尽管如今该领域已有诸多极具竞争力的开源/开放权重LLM,如Olmo 2、Qwen 2.5、Gemma 2、Phi-4等等,但我认为Llama仍将是大多数用户的首选模型,就像ChatGPT即便面临Anthropic Claude、Google Gemini、DeepSeek等竞品的挑战,依然保持着人气。

我个人很期待Llama 4,希望能在2025年与我们见面。


8. 8月:通过扩展推理时计算量提升LLM性能

我本月的选择是这篇2024年8月的论文:https://arxiv.org/abs/2408.03314。这篇论文撰写详实、论证清晰,针对推理阶段(即部署阶段)如何提升LLM输出质量提出了诸多有趣洞见。

8.1 通过增加测试时计算量提升输出质量

这篇论文的核心前提是,研究增加测试时计算量是否以及如何能提升LLM的输出效果。打个通俗的比方:人类在处理难题时,如果有更多思考时间,就能给出更优的答案。同理,如果给LLM更多时间与资源生成回复,其输出质量也可能提升。用更专业的术语来说,研究人员试图探明:如果在推理阶段投入额外算力,模型的表现能超出其训练水平多少。

此外,研究人员还探讨了一个问题:在算力预算固定的情况下,将更多算力投入测试阶段,是否比投入模型进一步预训练能带来更好的效果。这一点我们稍后再展开。

8.2 测试时计算技术的优化

论文极为详细地介绍了提升和优化测试时计算的各类技术。如果你正着手实际部署LLM(比如前面提到的Llama系列模型),我强烈推荐通读全文。

简而言之,扩展测试时计算量主要有两种方法:

  1. 生成多个候选答案,使用基于过程的验证器奖励模型(需单独训练)选出最优回复
  2. 自适应更新模型的回复分布,本质上是在推理生成过程中修正回复(同样需要单独的模型)

给第一类方法举个简单例子:提升测试时计算的一种朴素方式是使用N选优采样(best-of-N)。即让LLM并行生成多个答案,再基于验证器奖励模型选出最优的一个。N选优只是其中一种,这类方法还包括多种搜索算法:束搜索、前瞻搜索、N选优,如下图所示。
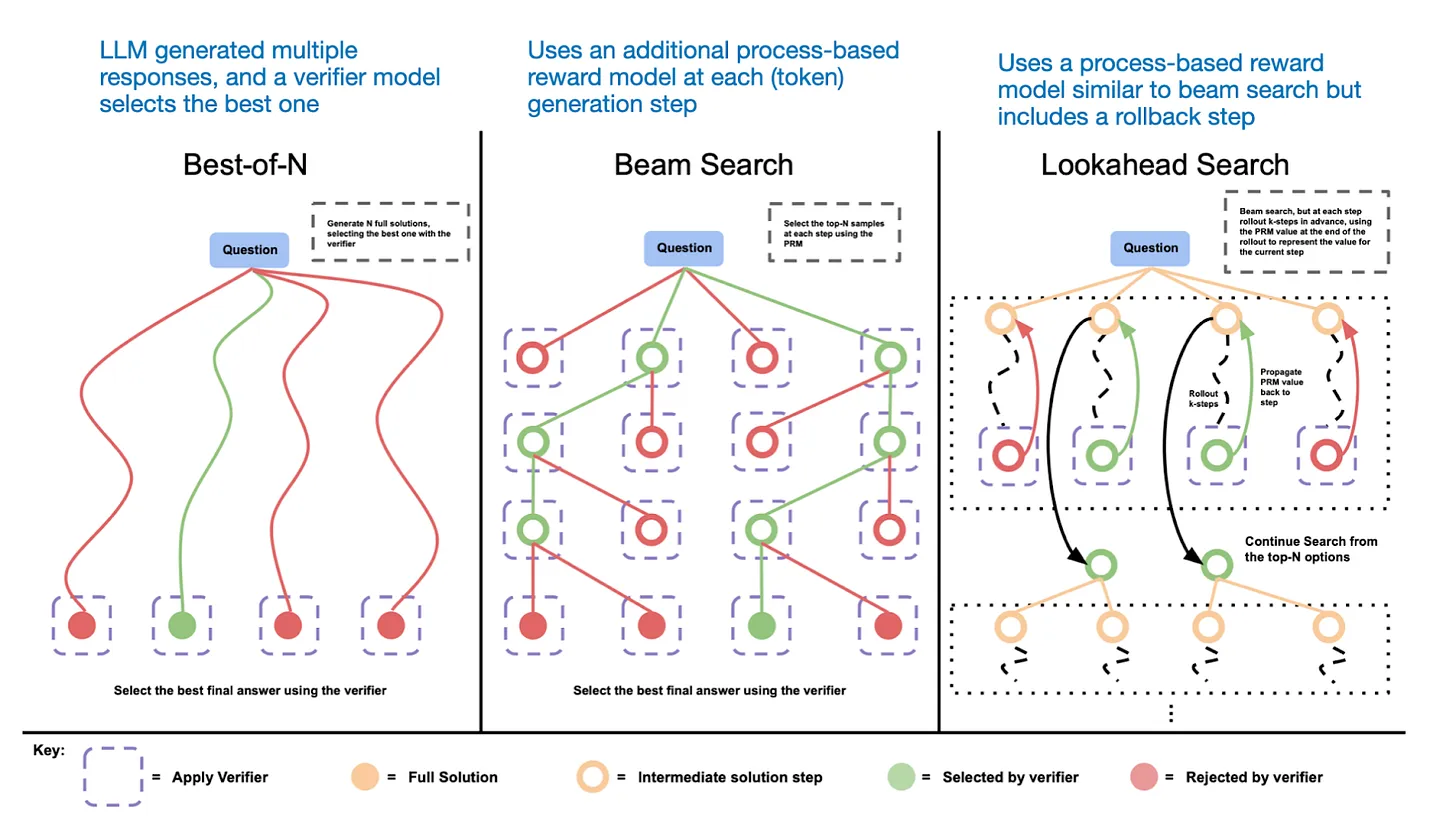
figure06.webp

不同的基于搜索的方法均依赖过程奖励模型选出最优答案。标注图来自《LLM测试时计算》论文,https://arxiv.org/abs/2408.03314

属于第二类的另一种方法是对模型回复进行序列修正,如下图所示。
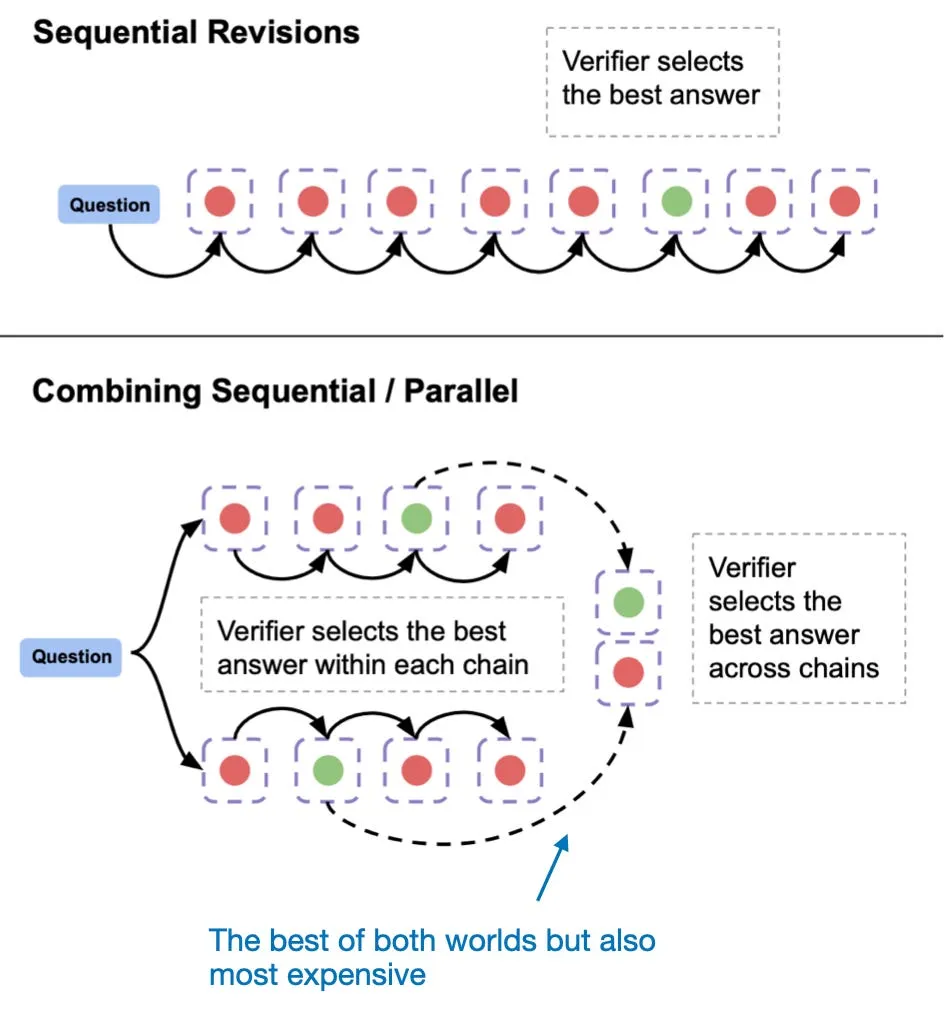
figure07.webp

序列修正方法。标注图来自《LLM测试时计算》论文,https://arxiv.org/abs/2408.03314

哪种方法效果更好?遗憾的是,没有放之四海而皆准的答案。这取决于基础LLM以及具体的问题或查询。比如,基于修正的方法在难题上表现更优,但在简单问题上反而可能损害性能。

论文中,研究人员开发了一种“最优”策略:基于一个模型评估查询的难度等级,再针对性选择合适的方法。

8.3 测试时计算 vs 预训练更大模型

一个值得探讨的有趣问题是:在算力预算固定的情况下,哪种方式性价比更高——使用更大的模型,还是增加推理阶段的算力预算?

这里我们假设单次查询的成本是相同的,因为大模型的推理成本本身就高于小模型。

研究发现,对于高难度问题,大模型的表现优于通过前述推理扩展策略获得额外推理算力的小模型。

但对于简单和中等难度的问题,在相同算力预算下,通过增加推理时计算量,小模型可以达到14倍参数规模大模型的性能水平!

8.4 测试时计算扩展的未来价值

我们使用Llama 3这类开源权重模型时,通常直接让模型生成回复。但正如这篇论文所指出的,分配更多推理算力可以显著提升回复质量。(如果你正在部署模型,这篇论文绝对值得一读。)

当然,对于本就成本高昂的大模型,增加推理算力预算会让其运行成本进一步上升。但如果根据查询难度有选择性地应用,就能为特定回复带来质量与准确率的显著提升,这无疑是大多数用户乐于见到的。(可以肯定的是,OpenAI、Anthropic和谷歌早已在幕后应用了这类技术。)

另一个极具吸引力的应用场景是提升小型端侧LLM的性能。我认为这在未来数月乃至数年都将是热门话题,从苹果智能(Apple Intelligence)和微软Copilot PC的重磅发布与投入中也可见一斑。


9. 9月:多模态LLM范式对比

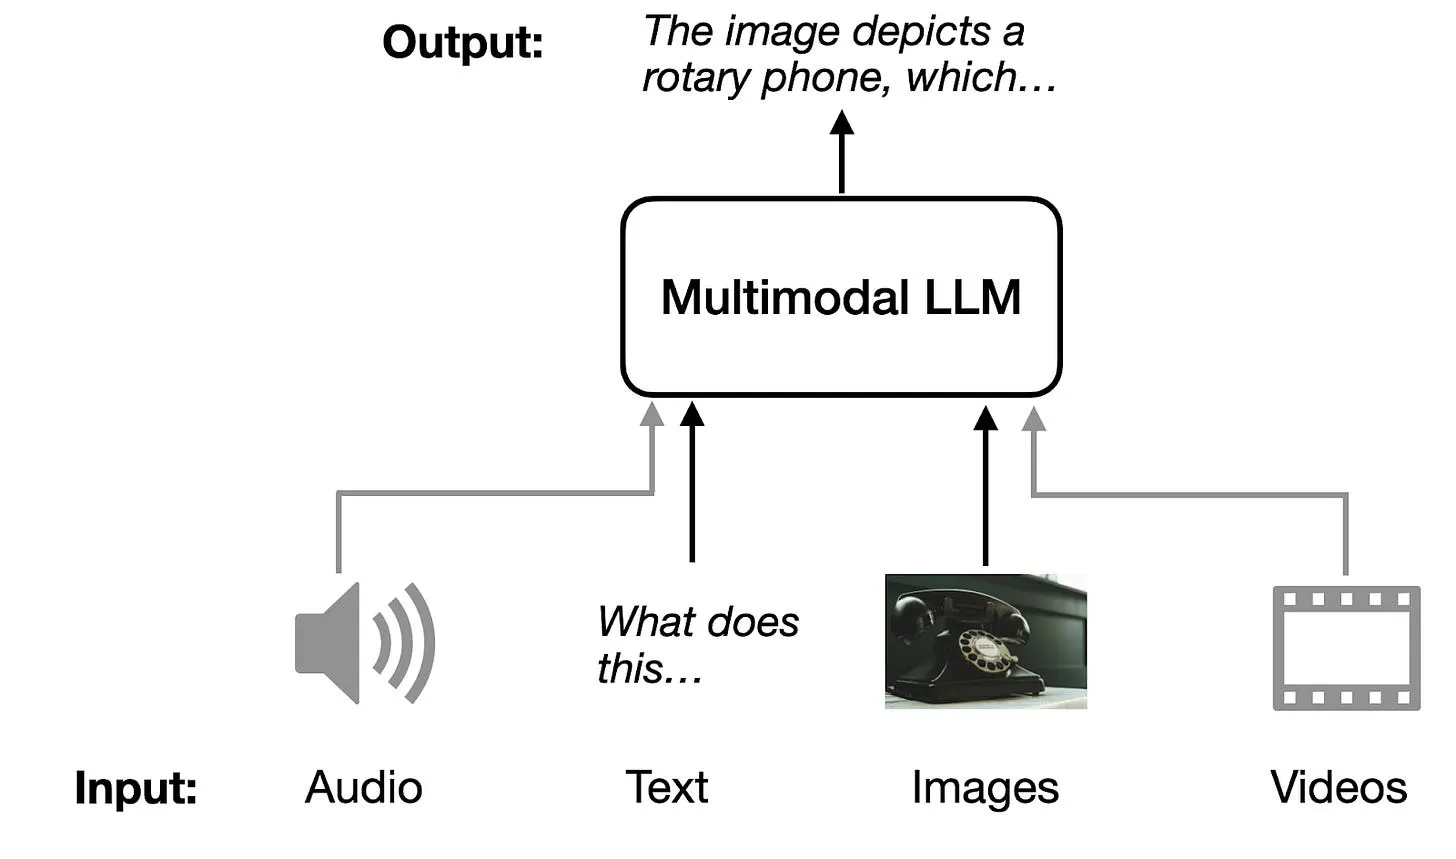
我原本认为多模态LLM会是2024年取得重大突破的领域之一。事实也确实如此,今年我们迎来了更多开源权重的多模态LLM!
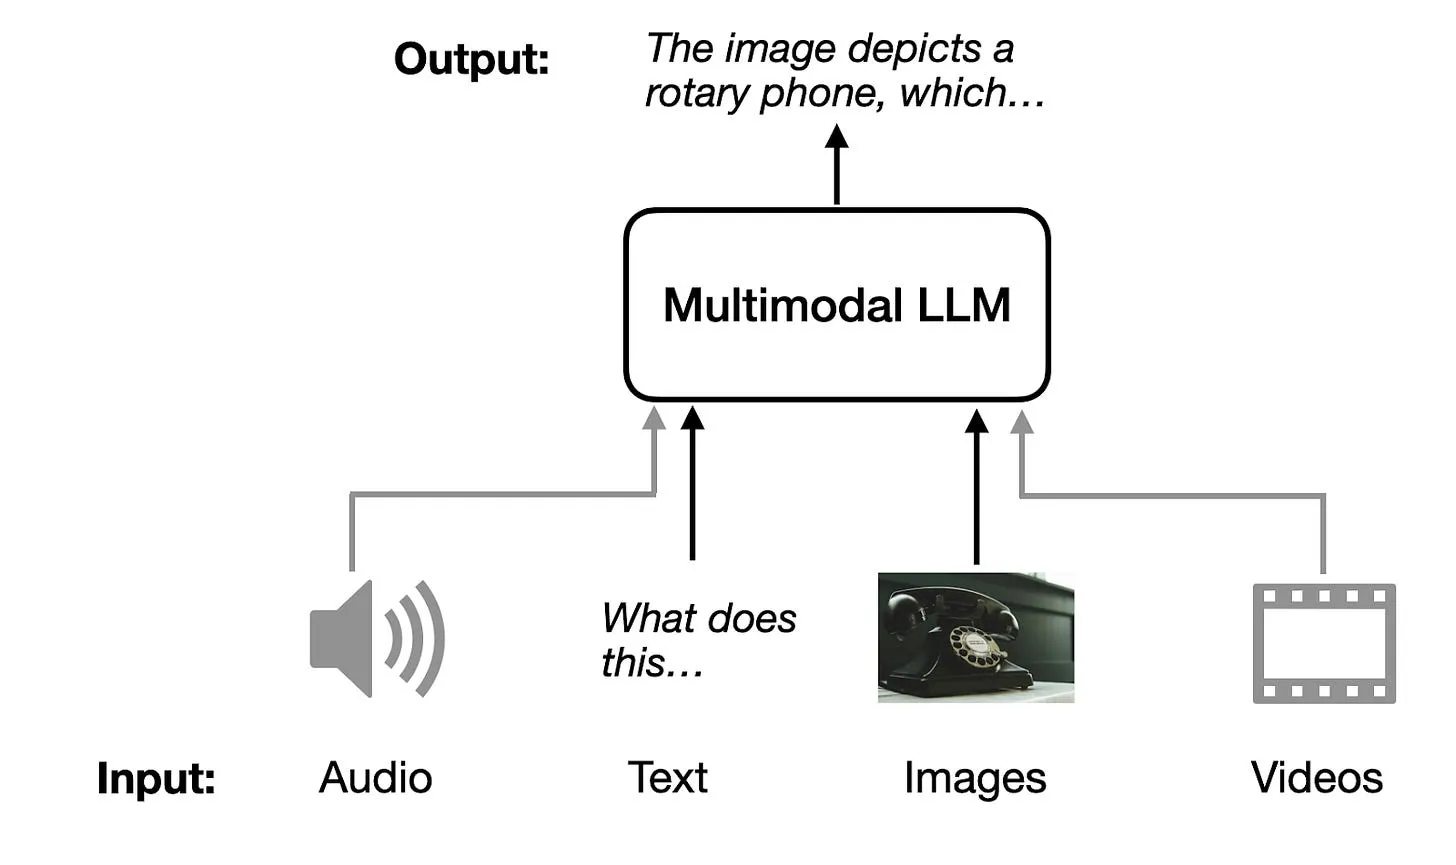
figure08.webp

多模态LLM示意图:可接收多种输入模态(音频、文本、图像、视频),输出模态为文本。

其中一篇让我印象尤为深刻的论文,是NVIDIA的Dai等人于2024年9月发表的:https://arxiv.org/abs/2409.11402。这篇论文很好地对比了两种主流多模态范式。

9.1 多模态LLM范式

构建多模态LLM主要有两种思路:

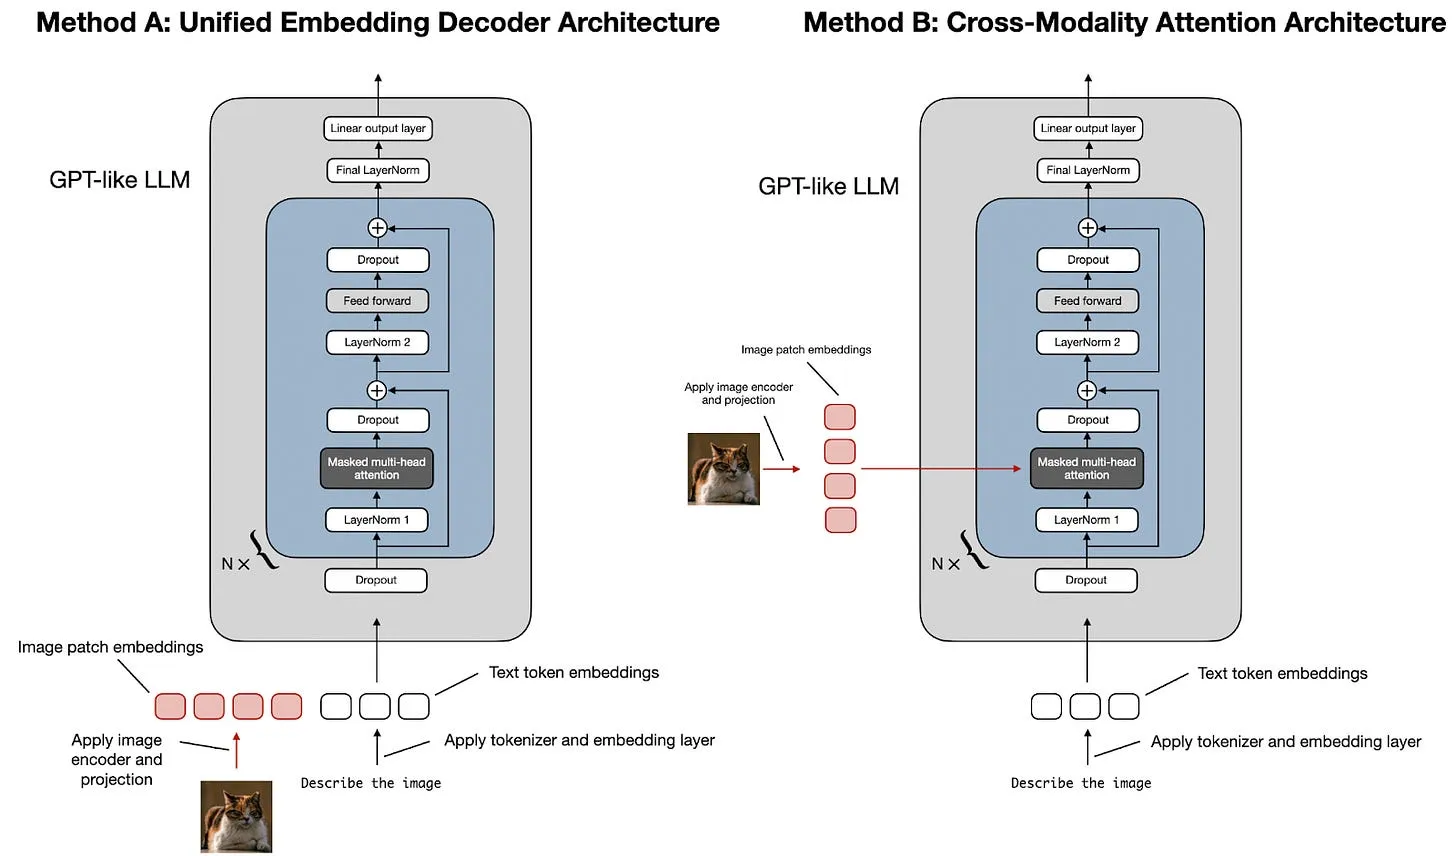
  • 方法A:统一嵌入解码器架构
  • 方法B:跨模态注意力架构

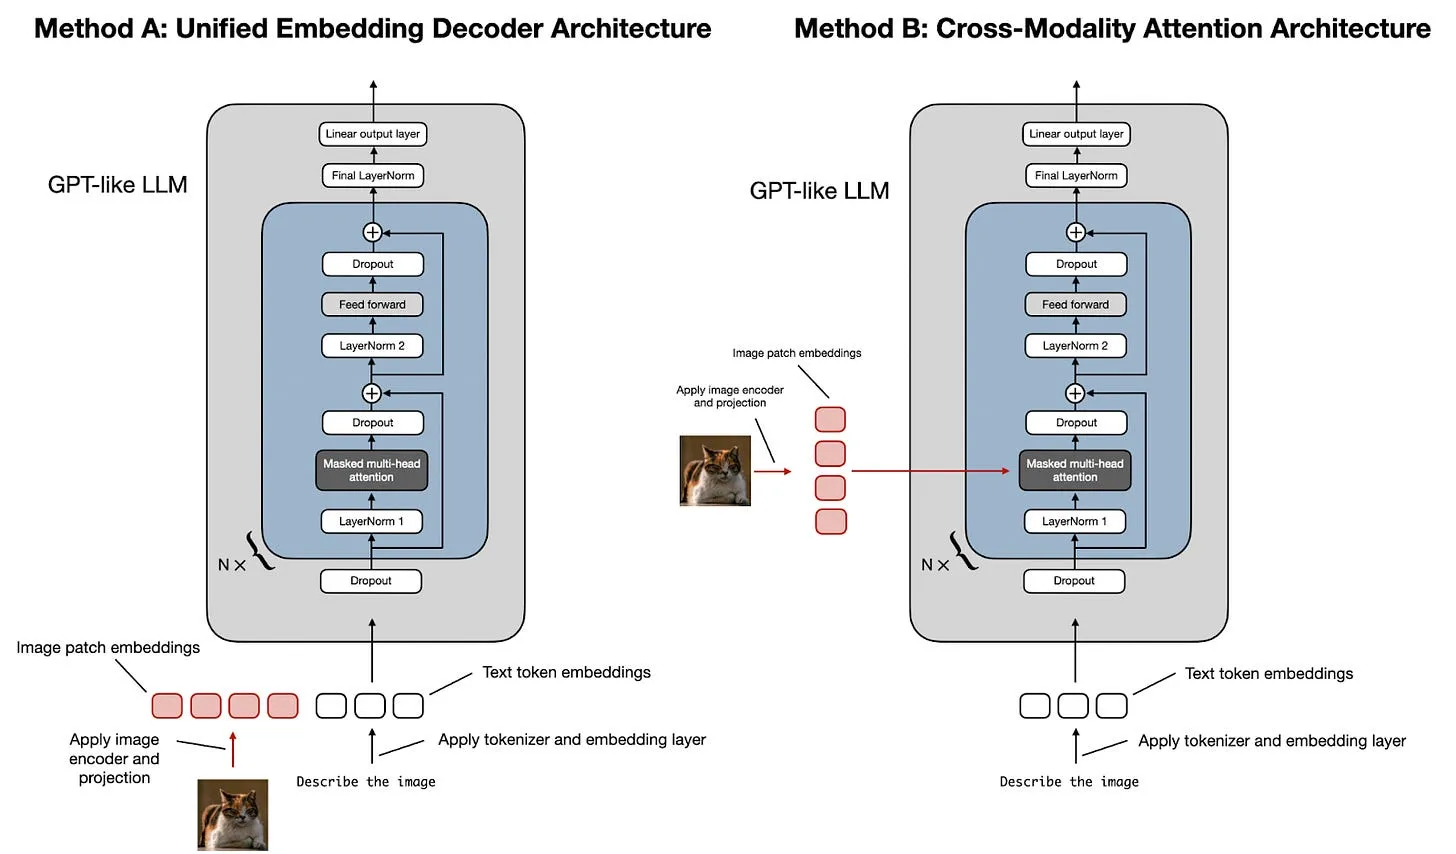
figure09.webp

多模态LLM架构的两种主流开发思路

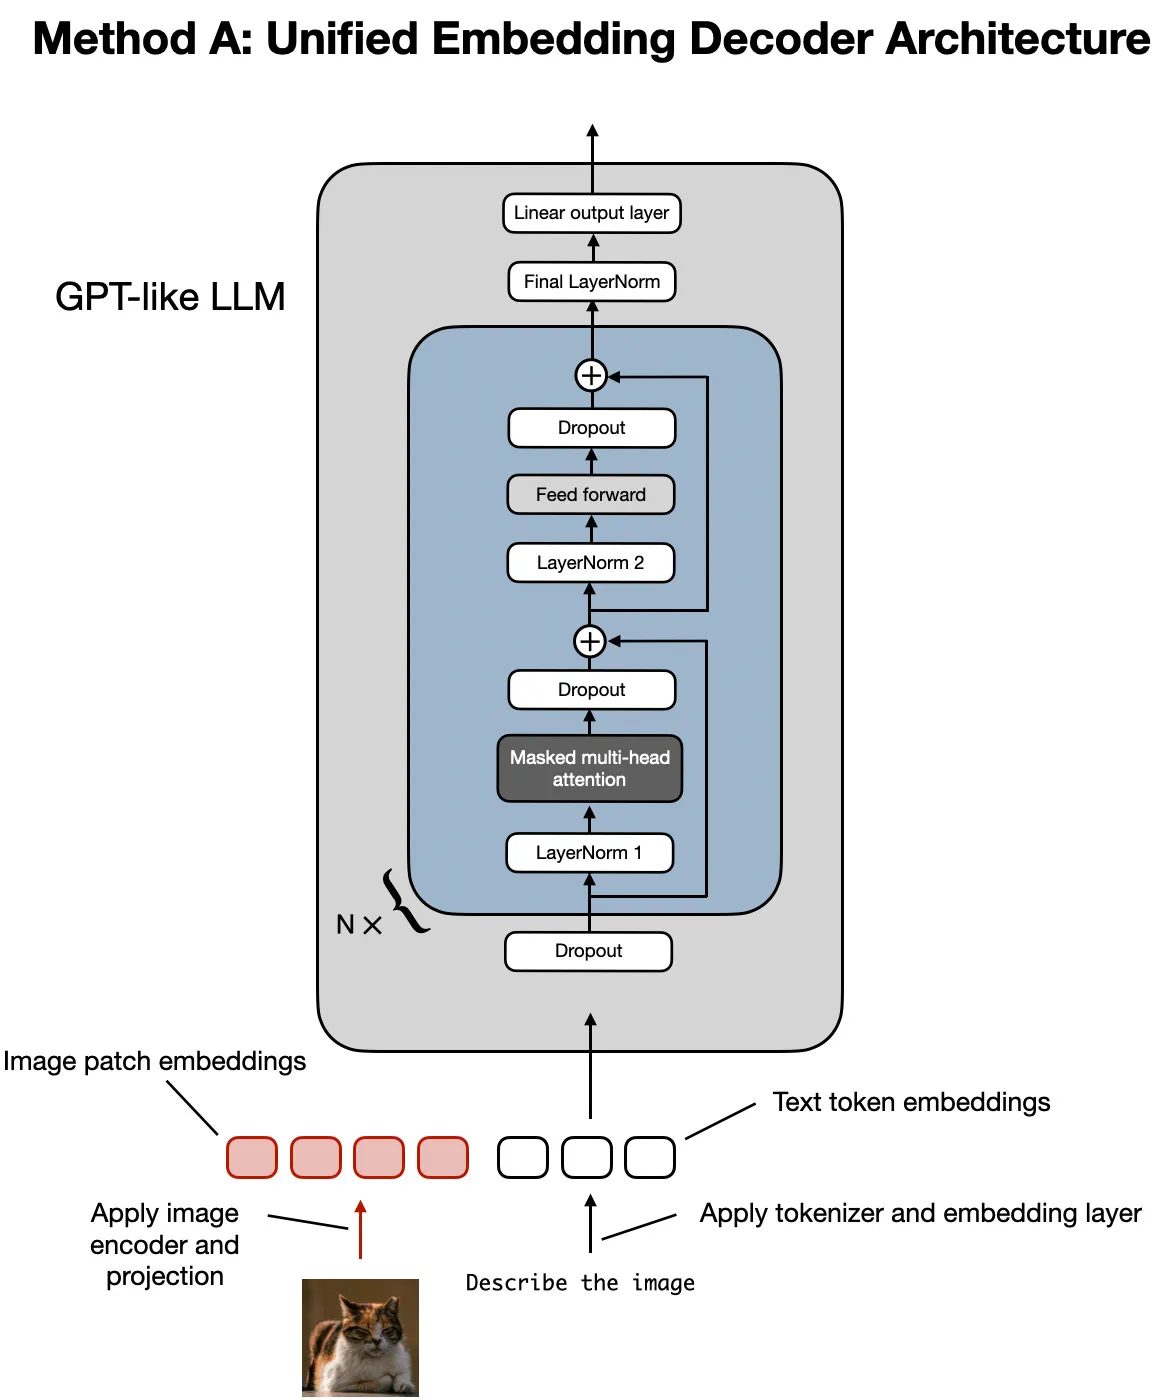
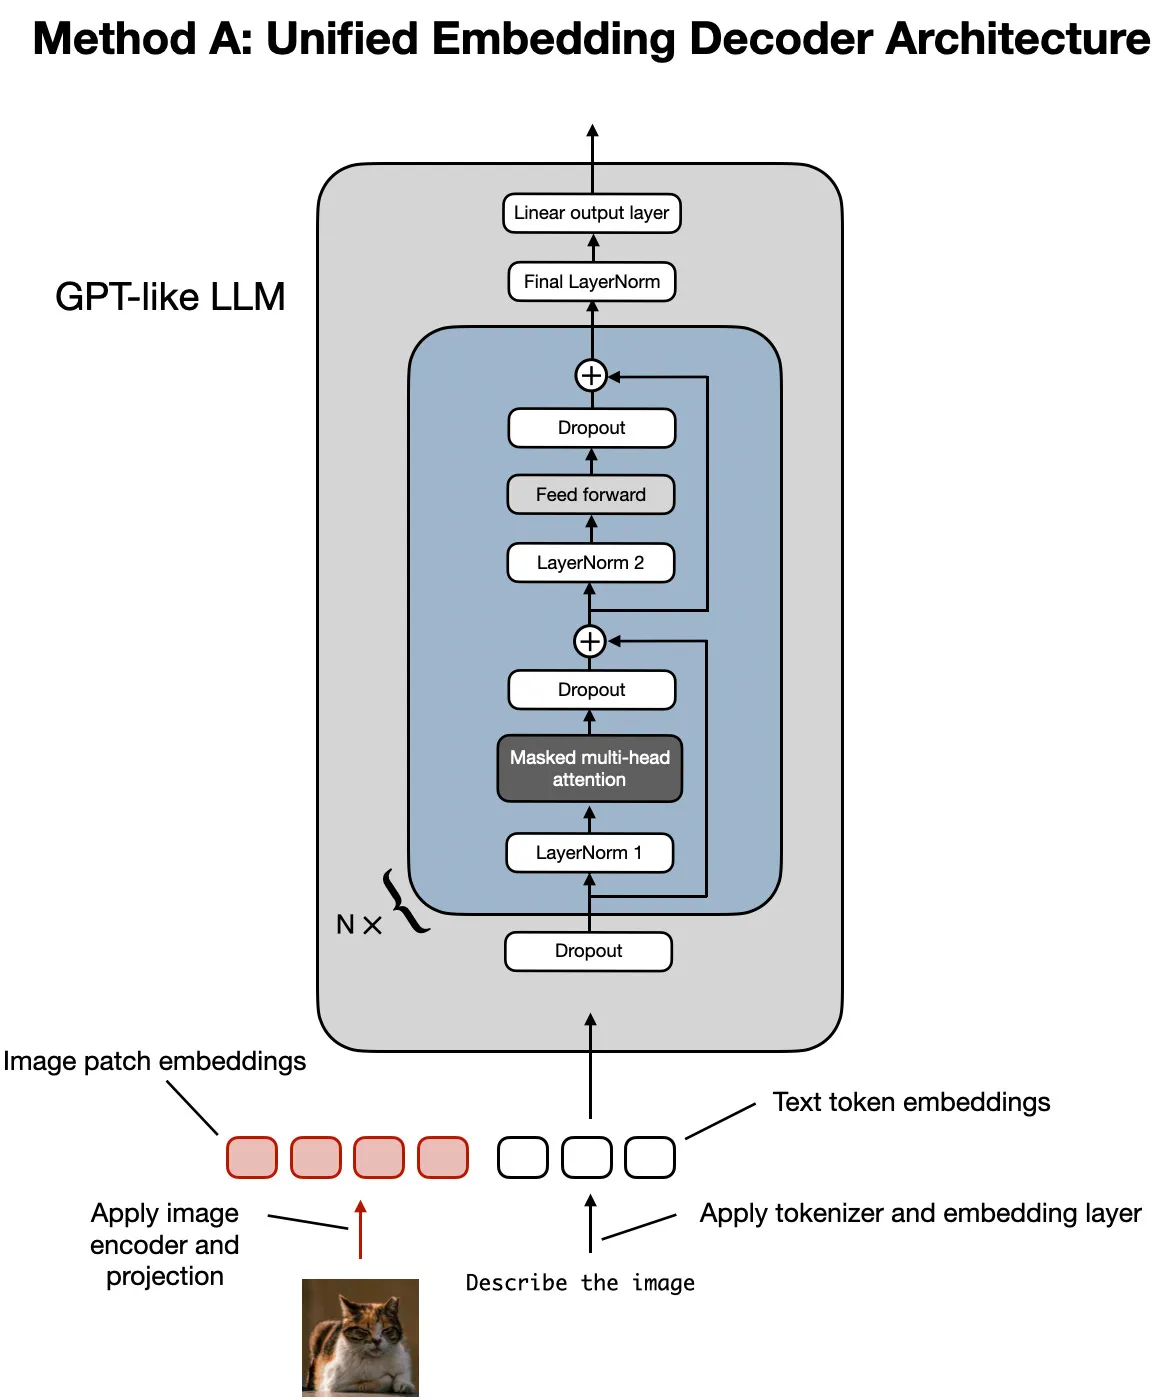
如上图所示,统一嵌入解码器架构(方法A)基于单个解码器模型,架构与GPT-2、Llama 3.2这类未修改的LLM相似。该方法将图像转换为与文本token嵌入维度相同的token,使LLM可以处理拼接后的文本与图像输入token。

与之相对,跨模态注意力架构(方法B)引入了交叉注意力机制,直接在注意力层内整合图像与文本嵌入。

如果你想了解更多细节,我今年早些时候专门写过一篇关于多模态LLM的文章,逐步讲解了这两种方法:https://magazine.sebastianraschka.com/p/understanding-multimodal-llms

9.2 英伟达的混合方法

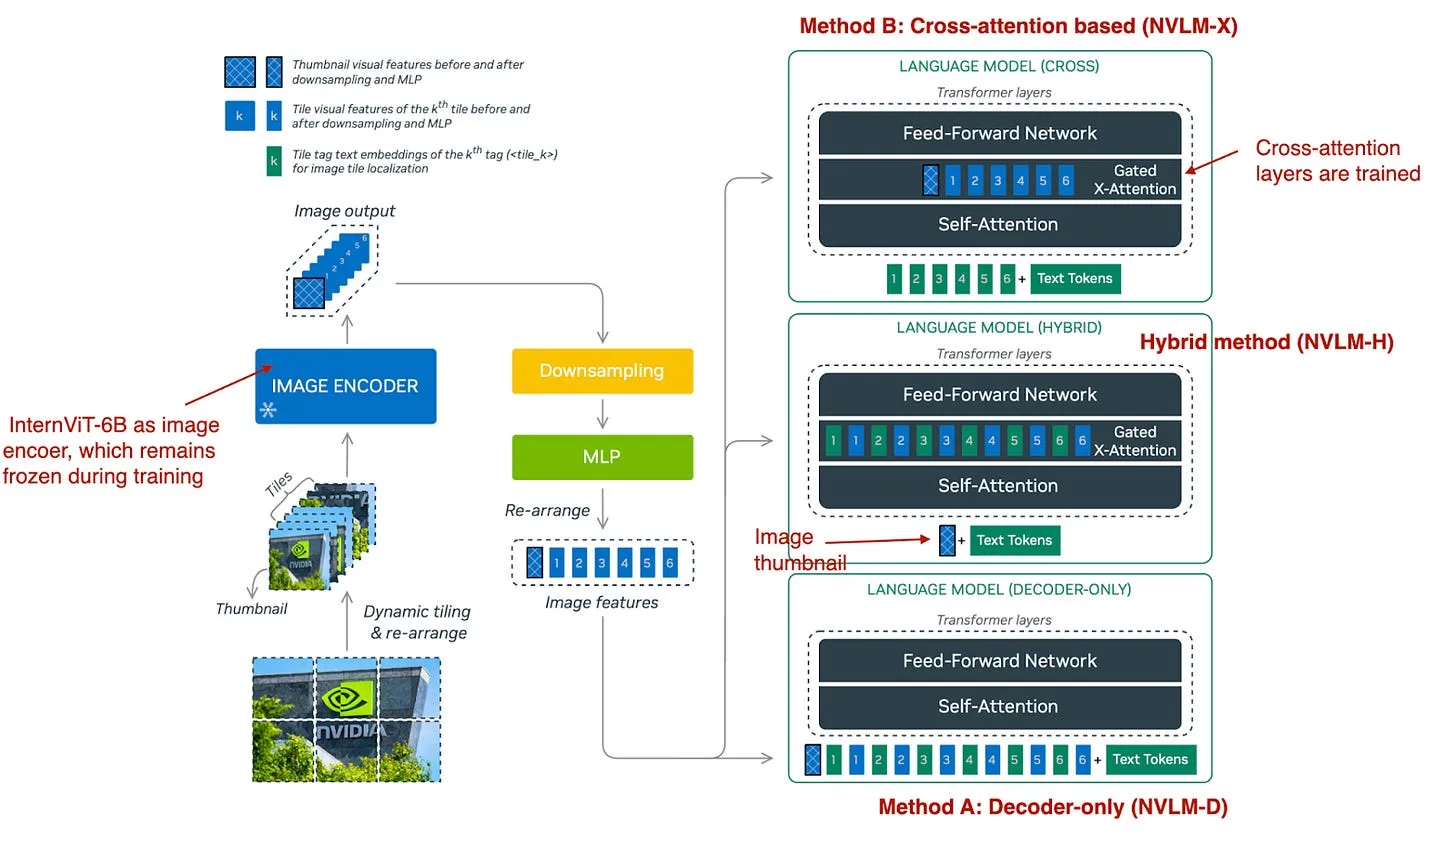
纵观今年的多模态技术发展,在我看来,英伟达的这篇论文(https://arxiv.org/abs/2409.11402)的突出之处在于,它对各类多模态方案进行了全面的同条件对比。研究没有只聚焦单一方法,而是直接比较了三种路线:

  • 方法A:统一嵌入解码器架构(“纯解码器架构”,NVLM-D)
  • 方法B:跨模态注意力架构(“基于交叉注意力的架构”,NVLM-X)
  • 混合方法(NVLM-H)

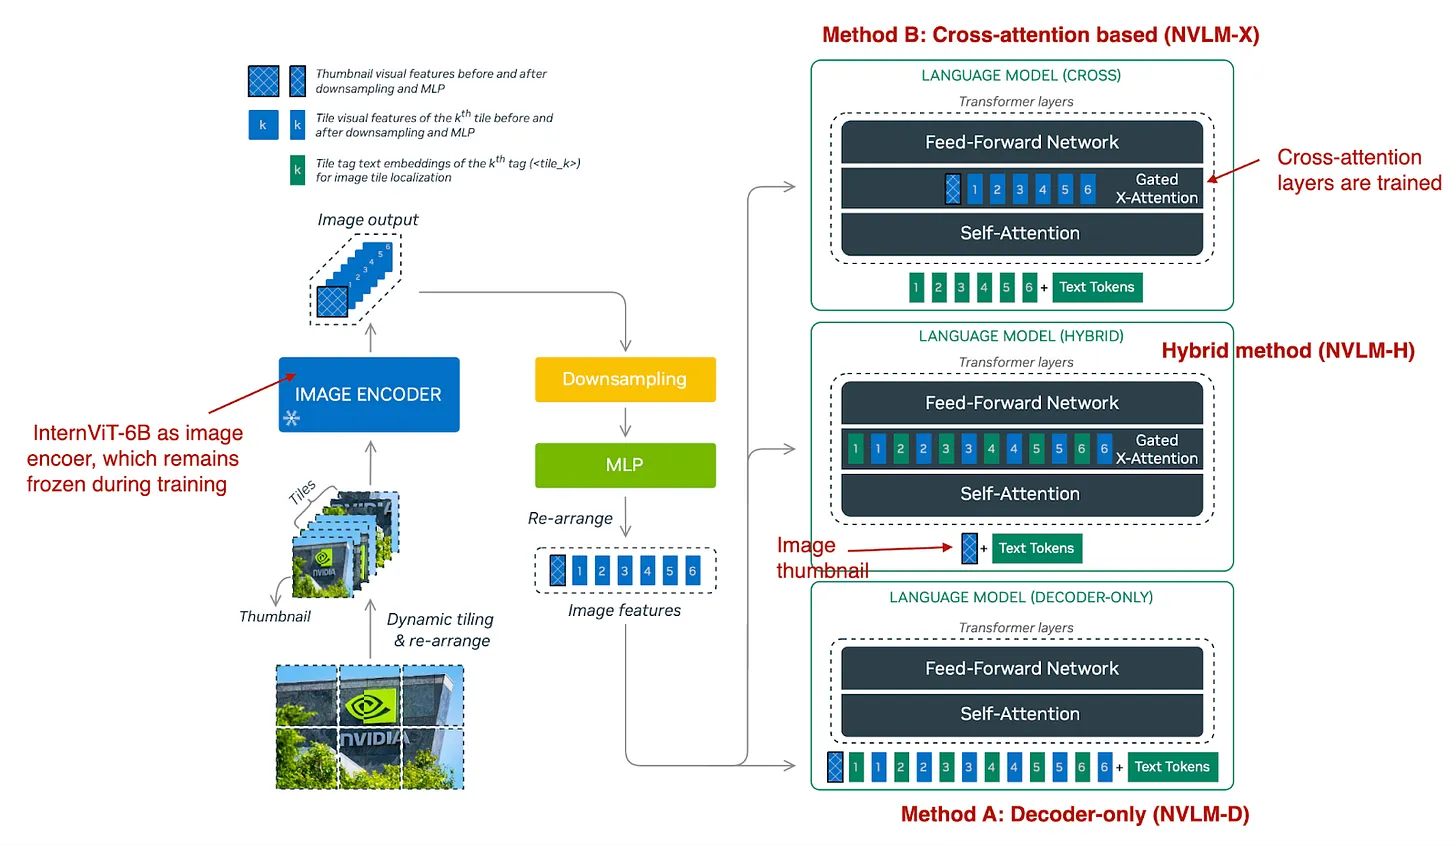
figure10.webp

三种多模态方法概览。(标注图来自《NVLM:开放前沿级多模态LLM》论文:https://arxiv.org/abs/2409.11402

如上图总结,NVLM-D对应前文所述的方法A,NVLM-X对应方法B。而混合模型NVLM-H融合了两种方法的优势:先接收图像缩略图作为输入,再通过交叉注意力处理动态数量的图像块,以捕捉更精细的高分辨率细节。

核心结论总结如下:

  • NVLM-X:处理高分辨率图像时计算效率更优
  • NVLM-D:在OCR相关任务上准确率更高
  • NVLM-H:融合两种方法优势,实现最优性能

9.3 2025年的多模态LLM

多模态LLM是个很有意思的方向。我认为它是传统文本LLM之后的必然发展方向。OpenAI、谷歌、Anthropic等大多数LLM服务商都已支持图像等多模态输入。就我个人而言,需要用到多模态功能的场景大概只占1%(通常是“把表格提取成markdown格式”这类需求)。

我预计开源权重LLM的默认形态仍会是纯文本,因为这样复杂度更低。但同时我也认为,随着工具链和API的演进,开源多模态LLM会有更多选择,应用也会更普及。


10. 10月:复现OpenAI o1的推理能力

我10月的选择是Qin等人于2024年10月发表的论文:https://arxiv.org/abs/2410.18982

OpenAI ChatGPT的o1(以及如今的o3)已广受追捧,它们似乎代表了LLM推理任务性能提升的一次范式转变。

OpenAI o1的具体技术细节尚未公开,已有多篇论文尝试对其进行描述或复现。那我为什么选中这篇?它与众不同的行文结构,以及关于学术研究现状的更宏观的哲思,引发了我的共鸣。换句话说,这篇论文有其独特之处,让它脱颖而出,值得入选。

10.1 捷径学习 vs 旅程学习

这篇论文的核心观点之一是,研究人员提出假设:o1采用了一种名为“旅程学习”的过程,而非“捷径学习”,如下图所示。
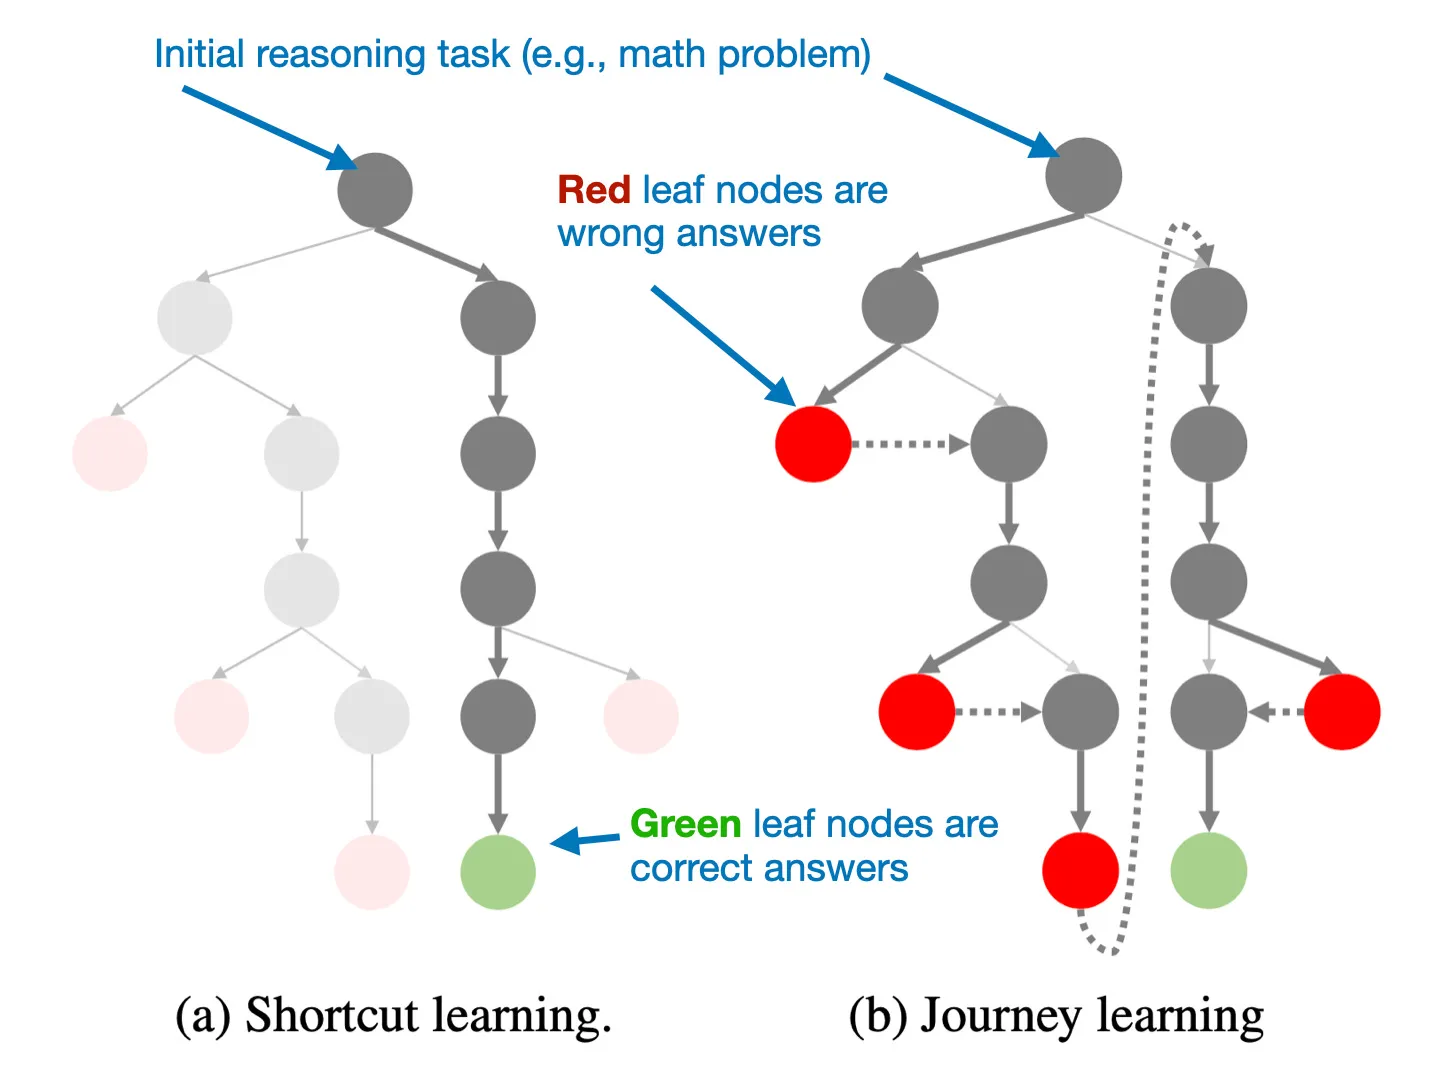
figure11.webp

传统上,LLM只在正确的解题路径上训练(捷径学习);而在旅程学习中,监督微调覆盖了完整的试错修正过程。标注图来自《o1复现报告》,https://arxiv.org/abs/2410.18982

值得注意的是,旅程学习的思路与本文“8月:通过扩展推理时计算量提升LLM性能”章节提到的带修正的树状方法、束搜索方法有几分相似。

但细微的差别在于,研究人员是创建旅程学习训练样本用于模型微调,而非仅在推理阶段应用该技术。(需要说明的是,我没有找到他们用于增强推理过程的技术相关信息。)

10.2 构建长思维链

研究人员构建了一棵推理树,从中衍生出完整的思考过程,重点突出试错环节。这种方法与传统方法不同——传统方法优先寻找通往正确答案的直接路径,且中间步骤都必须是正确的。在他们的框架中,推理树的每个节点都标注了奖励模型给出的评分,标明该步骤正确与否,同时附上判断理由。

随后,他们通过监督微调和DPO训练了一个deepseek-math-7b-base模型。实验训练了两个模型:

  1. 采用传统捷径训练范式,只提供正确的中间步骤
  2. 采用提出的旅程学习方法,训练数据包含完整的思考过程,包括正确与错误答案、回溯等等

(旁注:每组实验仅用了327个样本!)

如下图所示,在MATH500基准数据集上,旅程学习方法的表现大幅领先捷径学习。
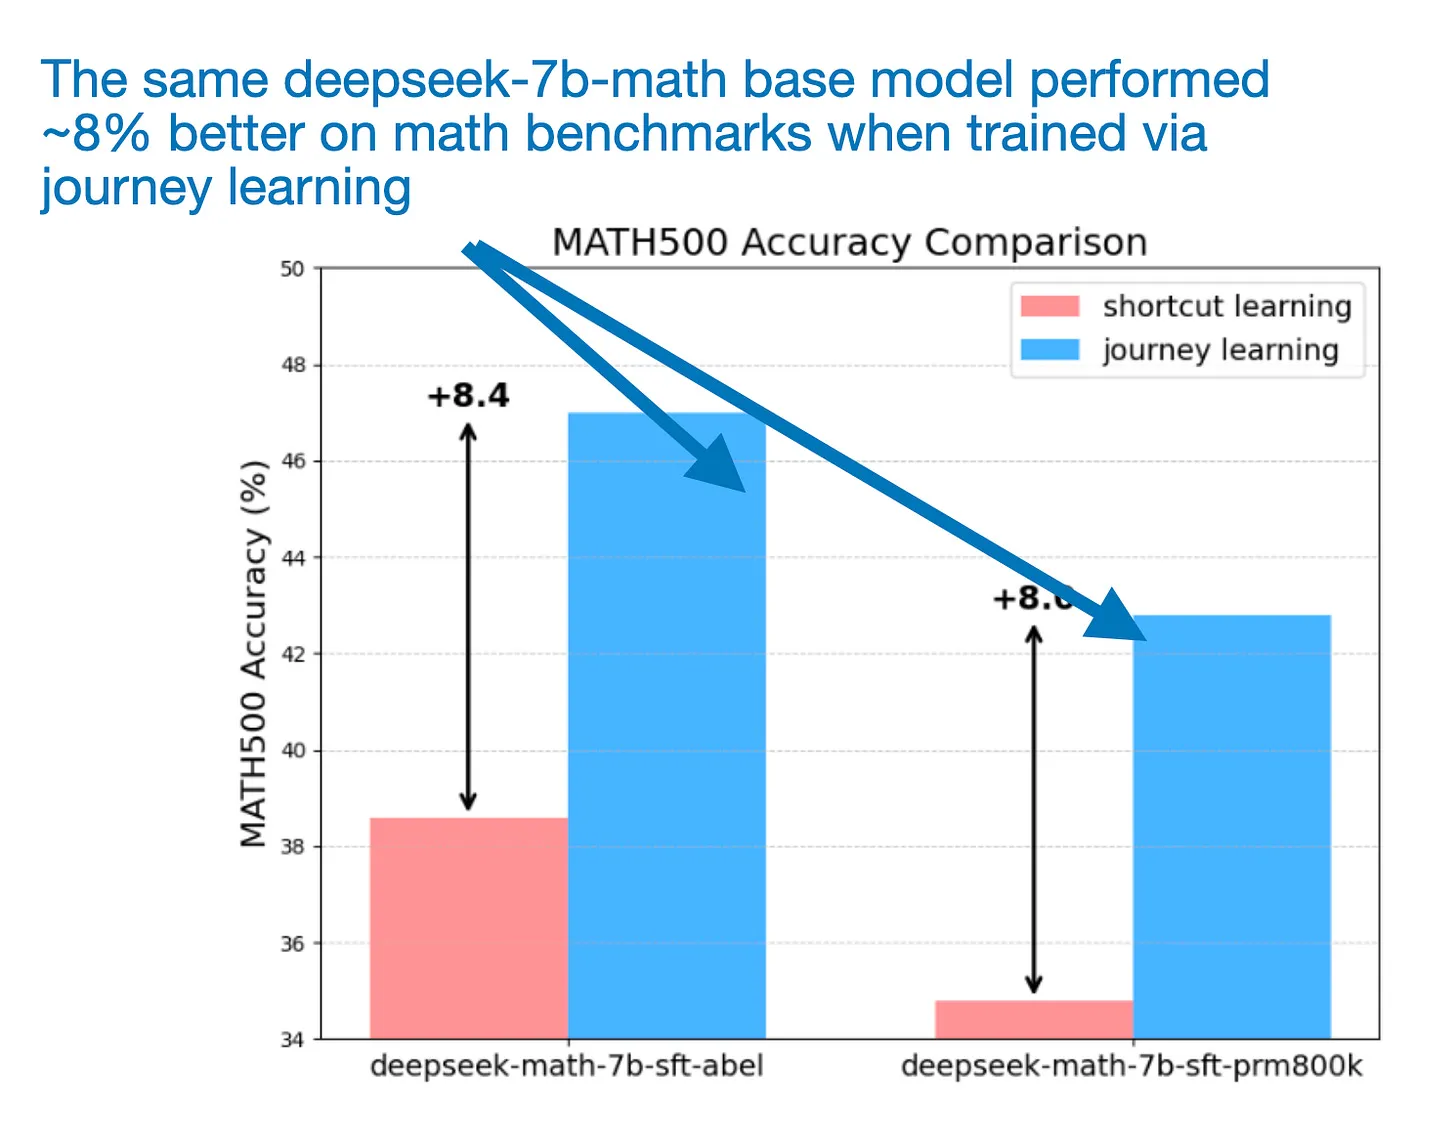
figure12.webp

经捷径学习与旅程学习训练的LLM对比。标注图来自《o1复现报告》,https://arxiv.org/abs/2410.18982

10.3 蒸馏——捷径解法?

一个月后,该团队发布了另一篇报告:Huang等人于2024年11月发表的论文:https://arxiv.org/abs/2411.16489

这篇论文采用了蒸馏方法:通过精心设计的提示词提取o1的思考过程,用以训练模型达到同等性能。本文篇幅已经很长,我就不展开细节了,但想分享该论文中一张很有意思的图,它总结了收集长思维数据的成本权衡。
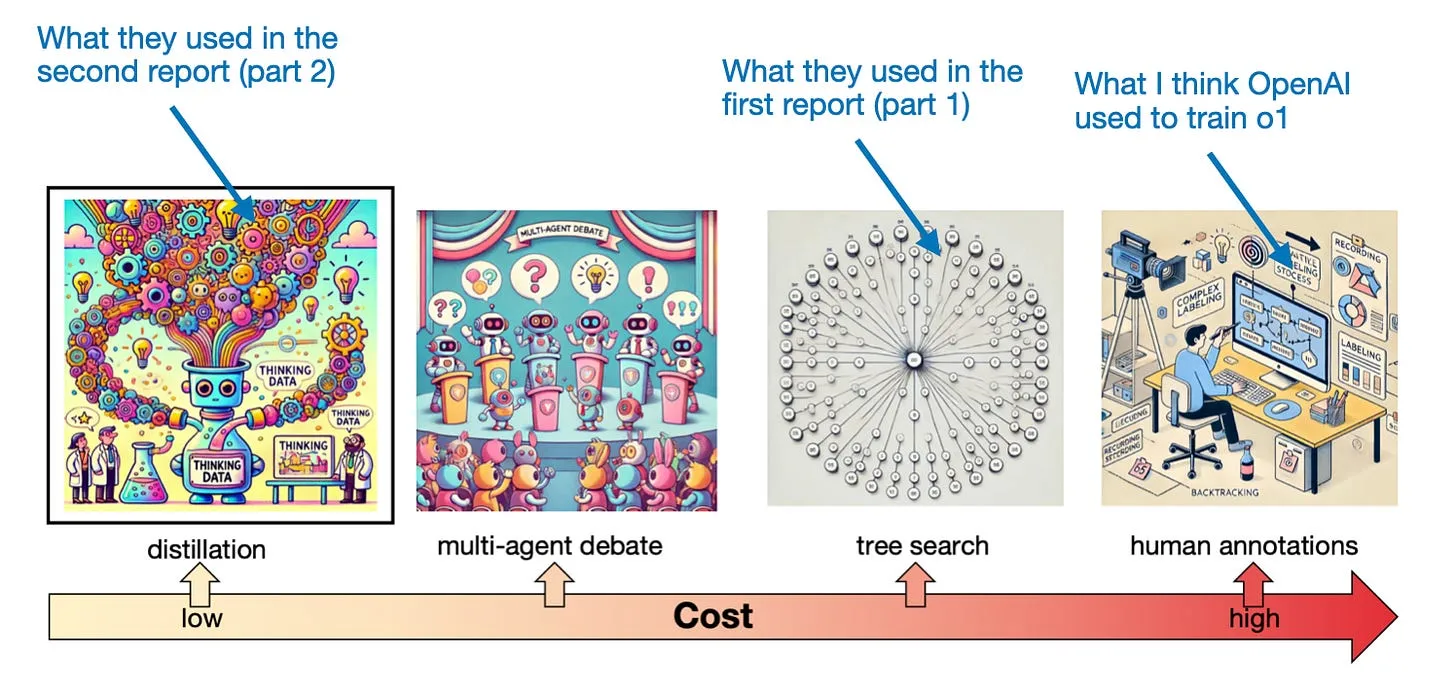
figure13.webp

他们通过这种蒸馏方法取得了极佳的效果,性能与o1-preview、o1-mini相当。但在这些实验之外,研究人员也针对这种方法背景下的研究现状,分享了一些有趣且重要的思考,我将在下一节进行总结。

10.4 AI研究的现状

第二篇报告的一大重点是“简单蒸馏的苦涩教训”。诚然,蒸馏在实践中效果很好,但它并非推动进步的动力。最好的情况也只是追平上游已有模型的性能(而非创造新的性能纪录)。以下是论文中的三段引文,堪称对当前行业现状的警示:

“这种从‘原理为何’到‘什么有用’的转变,代表了研究心态的根本性变化,可能对该领域未来的创新能力产生深远影响。”

“第一性原理思维的消解尤其令人担忧,因为它动摇了科学创新的根基。”

“快速出成果的压力可能会掩盖深度技术探索的价值,而学生们也可能因此不愿投身更具挑战性的基础研究方向。”

我个人的看法是,如今学术实验室(如今也常与产业合作)仍在产出大量优秀且重要的想法,它们可以非常实用且影响力巨大。(我脑海中最先想到的例子就是LoRA和DPO。)问题在于,很多有前景的想法从未得到大规模验证,因为高校通常缺乏所需的海量资源。

我也不知道完美的解决方案是什么,我也明白企业不可能直接公开自己的商业机密。但如果企业在采用学术论文的思路时,能公开予以认可,将会大有裨益。这种认可对于激励和回馈那些免费开放研究成果的研究者来说意义重大。同时,通过明确哪些方法在实践中真正有效,也能推动整个领域向前发展。

10.5 o1(及o3)背景下LLM的未来

《o1复现之旅》这篇论文复现了o1背后的精确机制吗?大概率没有。但它仍然是一篇很有价值的读物,充满了有助于提升效果的思路。我相信,o1、o3这类“长思维”模型将继续在LLM研究中扮演关键角色。它们的运行成本更高,但基本代表了推理任务性能的黄金标准与上限。

但由于成本更高,o1类模型并非在所有场景下都是最优选择。对于语法修正、翻译这类简单任务,我们大概率不需要推理能力极强的模型。归根结底是成本与效用的平衡。我们根据预算、延迟等因素,为具体任务选择合适的LLM。

《Ahead of AI》是读者支持型出版物。想要接收新文章并支持我的创作,欢迎成为免费或付费订阅者。


11. 11月:面向精度的LLM缩放定律

我原本想选Allen AI的这篇论文(https://arxiv.org/abs/2411.15124),因为文中详细介绍了他们的Llama后训练方法与配方,包括DPO与PPO的消融实验,以及一种名为“可验证反馈强化学习”的全新偏好对齐方法——该方法使用可验证查询(比如数学和代码问题,很容易生成标准答案)来替代奖励模型。

但经过一番权衡,我最终选择了Kumar等人于2024年11月发表的论文:https://arxiv.org/abs/2411.04330。因为它对2022年提出的Chinchilla缩放定律进行了亟需的更新——Chinchilla定律被广泛用于确定预训练阶段算力最优的LLM参数量与数据集规模,原论文见:https://arxiv.org/abs/2203.15556

简而言之,这篇2024年11月的论文将Chinchilla缩放定律进行了扩展,使其适用于低精度(16位及以下)训练与推理场景——低精度技术近年来已十分普及。例如,论文将各类低精度与量化相关的观察结论统一为一个函数形式,可以同时预测低精度训练和训练后量化带来的额外损失。

11.1 Chinchilla缩放定律回顾

2022年论文提出的原始Chinchilla缩放定律,建模了LLM参数量(N)与数据集规模(D)如何共同影响LLM的验证损失,常被用作确定LLM与训练数据集规模的指导原则。

根据经验法则,(在算力预算固定时)数据集规模D与参数量N的最优配比约为 D/N ≈ 20

这一数据-参数比通常被称为“Chinchilla最优”,因为在相同总训练成本下,该比例能带来更低的验证损失。

但请注意,如今已有很多反例。比如前文提到的Llama 3,训练数据量为15万亿token,对于80亿参数版本,这个比值就是15000000000000 ÷ 800000000 = 1875。

在我看来,比具体的数据-参数比值更重要的结论是:模型规模与数据集规模必须成比例缩放。

11.2 低精度训练

在进一步讨论(或者说总结)低精度缩放定律之前,我先简单科普一下LLM(或深度神经网络)权重常用的不同数值精度格式。

据我所知,以下是GPT 2/3与Llama 2/3训练时采用的精度格式,供对比参考:
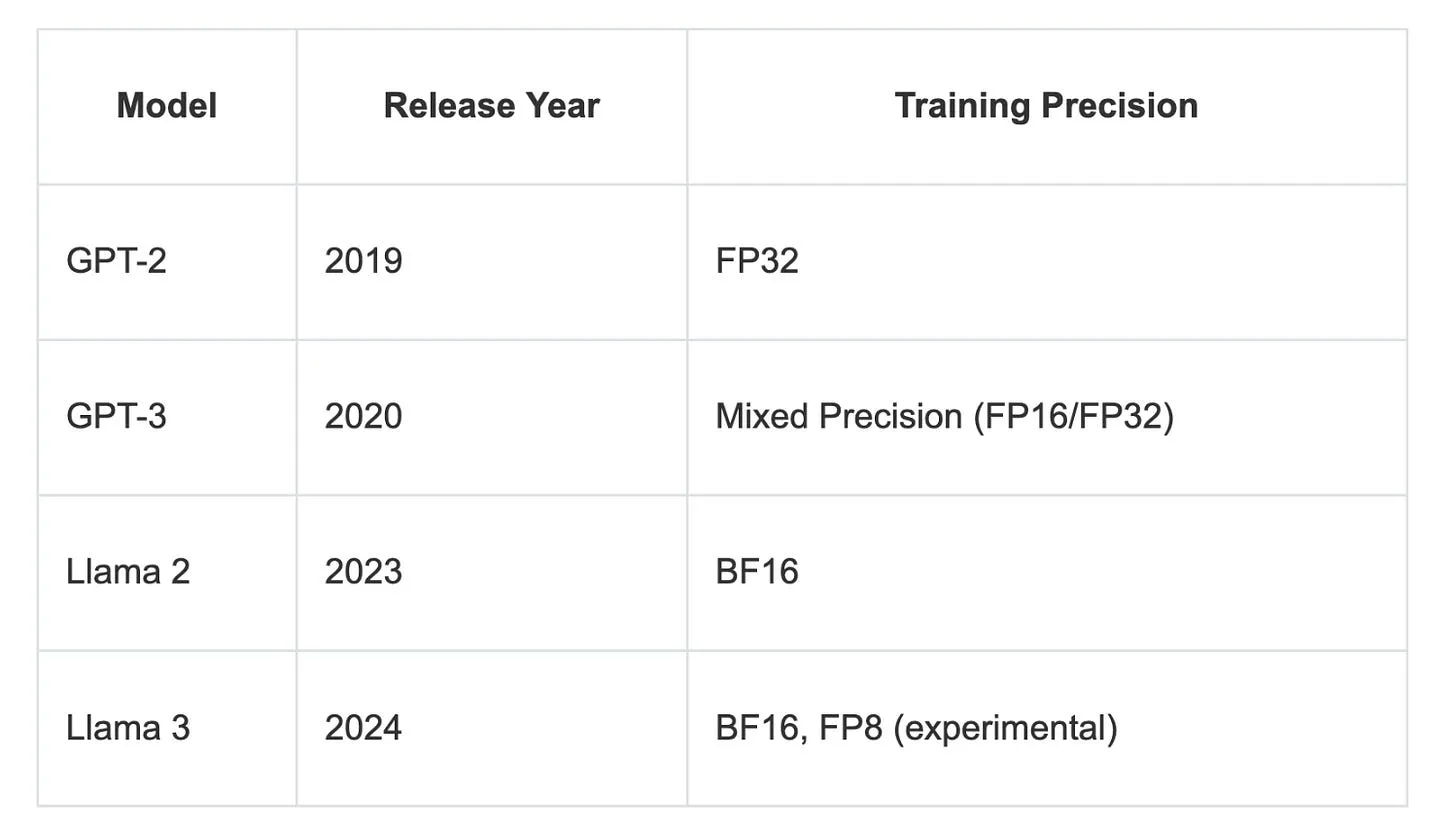
figure14.webp

Float32是训练深度神经网络的标准32位浮点格式,在数值范围与精度间取得了很好的平衡。如今,float32以下的格式都被视为低精度(当然“低”的定义是动态变化的,就像“大语言模型”里的“大”一样)。

Float16(半精度)仅使用16位,能节省内存、加快计算,但动态范围更窄。
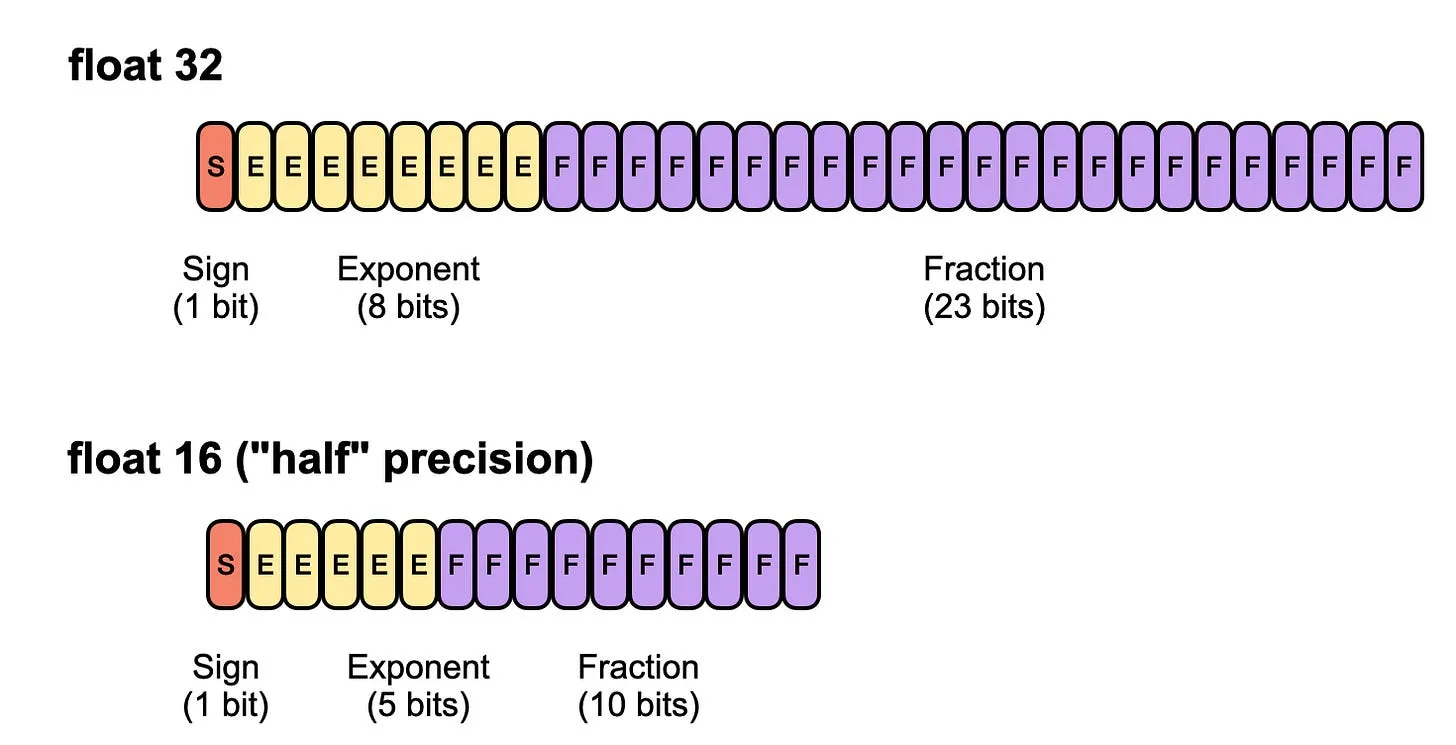
figure15.webp

32位与16位浮点精度对比

Bfloat16(脑浮点16)同样是16位格式,但它牺牲了float16的部分精度,换取了更大的指数位,能更有效地表示极大和极小的数值。因此,bfloat16有助于避免深度学习应用中的数值溢出或下溢,不过其较低的精度仍可能导致舍入误差。
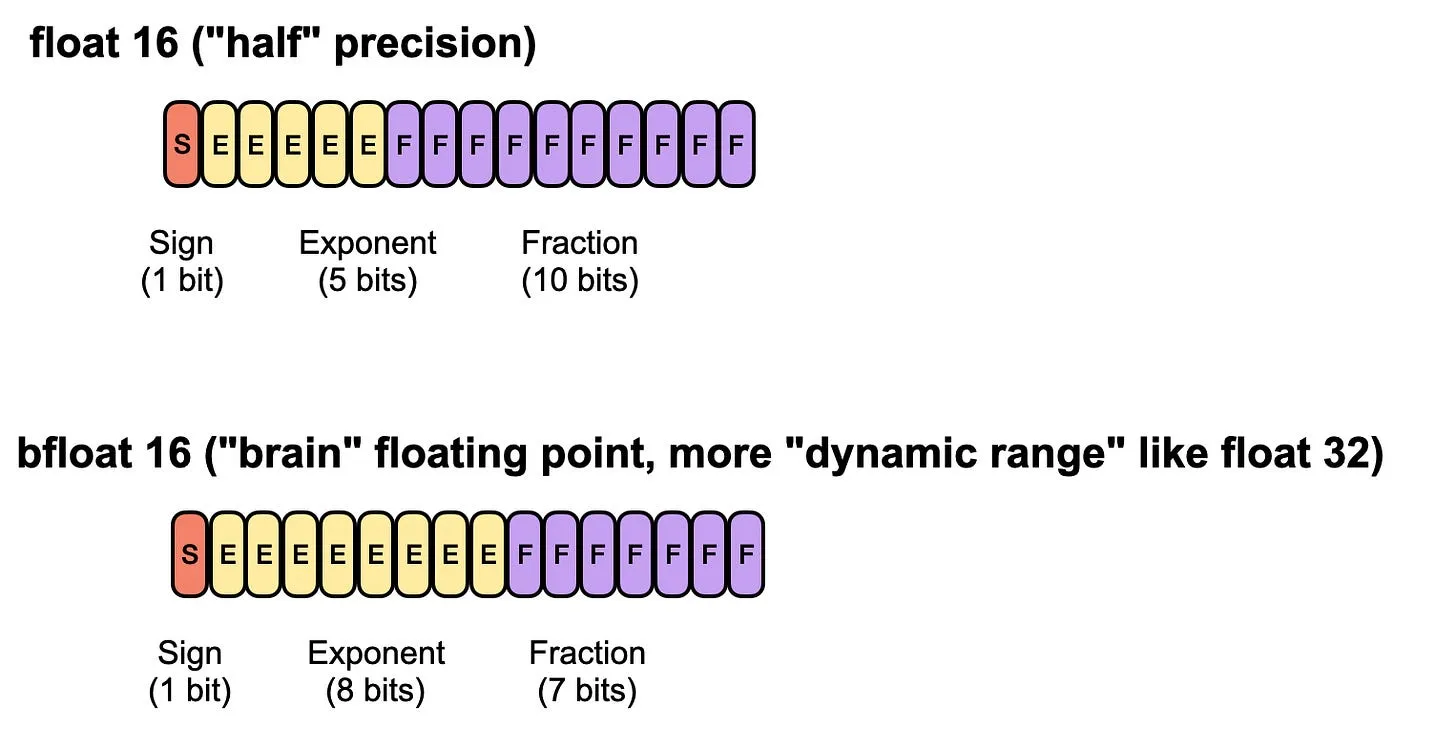
figure16.webp

常规16位浮点与主流16位脑浮点精度对比

如果你想了解更多精度格式及其对LLM模型表现的影响,可以参考我之前的文章,里面有更详细的介绍:https://magazine.sebastianraschka.com/p/the-missing-bits-llama-2-weights

另外请注意,我这里只展示了32位和16位格式,而目前行业正向更低的训练精度进军,比如Llama 3论文中提到的(实验性)8位格式。(12月26日发布的DeepSeek-V3,其全部预训练就是在8位浮点精度下完成的:https://github.com/deepseek-ai/DeepSeek-V3

11.3 精度缩放定律核心结论

这篇论文内容详实且有趣,推荐通读。不过核心结论是:研究人员在原始Chinchilla缩放定律基础上,新增了“精度”因子P。具体来说,他们将模型参数量N重新诠释为“有效参数量”——精度越低,有效参数量越小。(数学公式请参考原文。)

此外,他们还新增了一项,用以刻画训练后量化对模型性能的衰减影响。(我知道这里没介绍量化的基础概念,但本文篇幅已经过长,这个话题只能改天再讲了。)

下图很好地说明了一点:更多的预训练数据并非总是越好——如果训练后用极低精度(如int3)量化模型,更多数据反而可能有害。我觉得这个发现非常有意思。
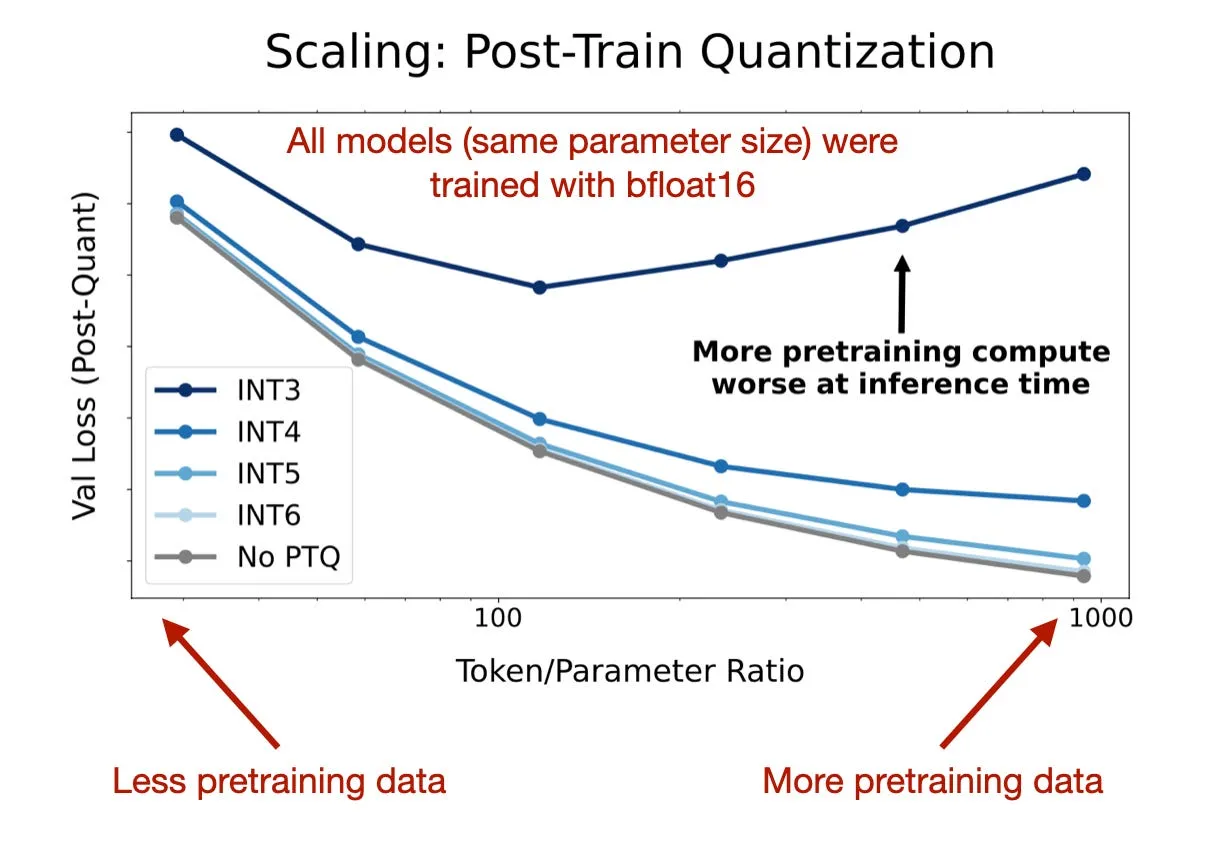
figure17.webp

不同后量化格式下,训练数据量增加对验证损失的影响

所以从上图可以得出结论:用海量数据训练的模型(比如Llama 3),训练后再量化到低精度格式会更困难,因为模型在过多数据上发生了“过训练”。

11.4 2025年的模型缩放定律

精度缩放定律的研究不仅对Chinchilla缩放定律做出了亟需的更新,也为2025年的一个关键挑战提供了新视角:随着Llama 3这类模型在更大数据集上训练,它们可能更难在量化到INT3等低精度格式时不损失性能。

这一发现凸显了我们需要反思“数据越多越好”的固有思维,在数据集规模与高效推理的实际约束之间取得平衡。这对推动硬件优化也具有重要参考价值。

我认为这类缩放定律研究常常忽略的一个维度是数据集质量。预训练数据的性质会产生重大影响。(下文讨论Phi-4时会展开说。)


12. 12月:Phi-4与合成数据学习

2024年下半年发布了不少有意思的模型,包括圣诞节当天惊艳亮相的DeepSeek-V3(https://github.com/deepseek-ai/DeepSeek-V3)。但最终我选择了微软的这篇论文(https://arxiv.org/abs/2412.08905),因为它对合成数据的应用提出了有趣的洞见。

12.1 Phi-4的性能

Abdin等人于2024年12月发表的这篇论文,介绍了微软最新140亿参数开源权重LLM的训练过程。Phi-4最特别的地方在于,它的训练数据以GPT-4o生成的合成数据为主。基准测试结果显示,它的表现优于同等规模的其他LLM,包括前代Phi-3——Phi-3的训练以非合成数据为主。
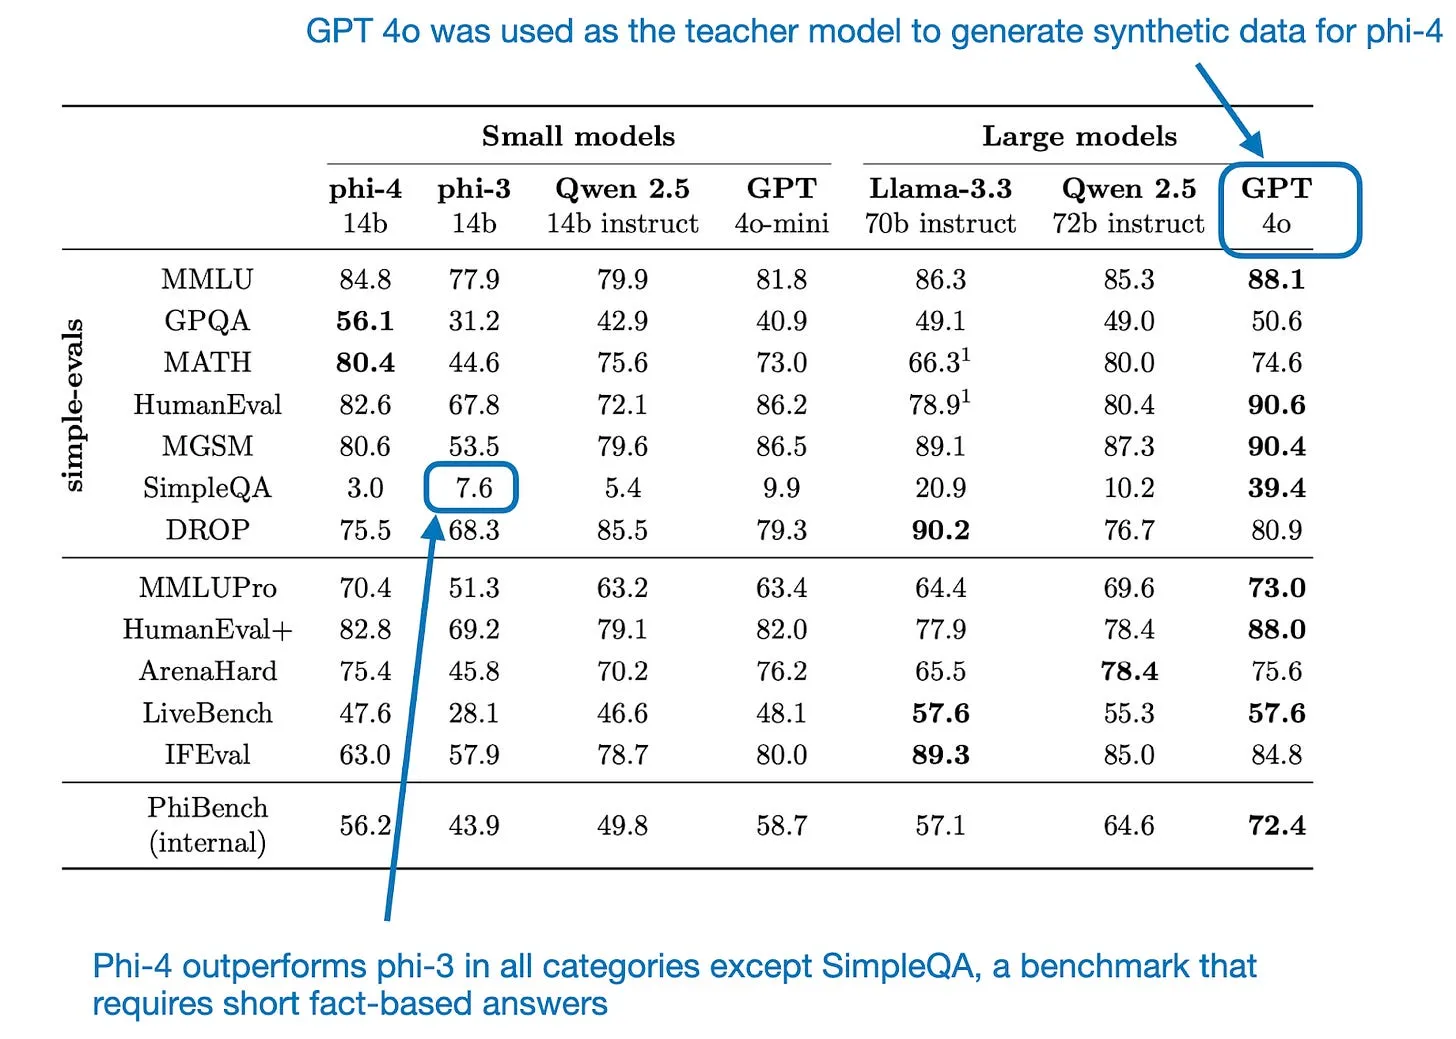
figure18.webp

Phi-4与同等及不同规模模型的性能对比(标注表格来自Phi-4论文,https://arxiv.org/abs/2412.08905

我不太确定为什么该模型在SimpleQA上表现较差,如上表所示。但一种可能的解释是:SimpleQA是相对较新的基准,于2024年10月30日发布。它由OpenAI开发,属于其评测套件的一部分,可能既没有被纳入GPT-4o的训练数据,也没有出现在网络爬取数据集中。而且,由于本次评估的合成数据是用GPT-4o生成的,所有模型在训练时都没见过SimpleQA。不过Phi-4可能对其他基准存在过拟合,这也能解释它在这个未见过的SimpleQA数据集上表现相对不佳。当然,这只是我的假设。

12.2 合成数据的启示

在总结论文中的消融实验之前,我们先看看数据集构成。
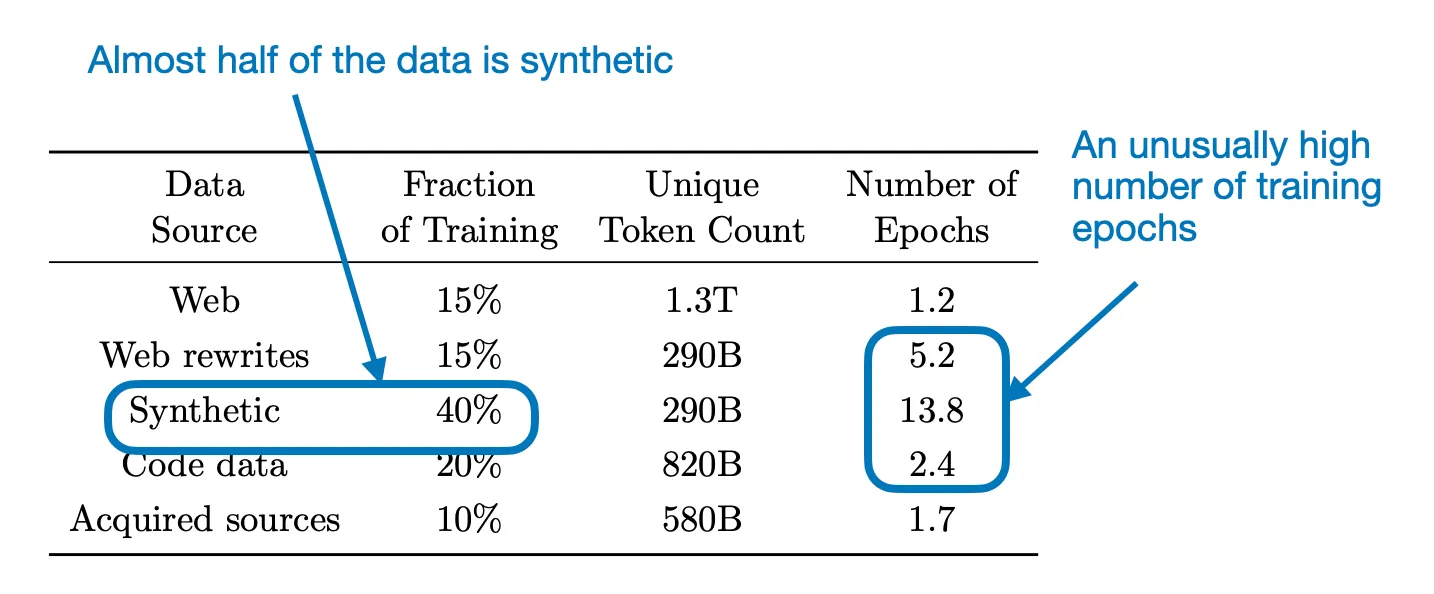
figure19.webp

Phi-4训练的数据集混合比例(标注表格来自Phi-4论文,https://arxiv.org/abs/2412.08905

研究人员观察到,虽然合成数据整体上有益,但纯合成数据训练的模型在知识类基准上表现不佳。在我看来,这引出了一个问题:是合成数据缺乏足够的专属知识信息,还是它包含了更多事实错误(比如幻觉导致的错误)?

同时,研究人员发现,增加合成数据的训练轮数(epoch),比单纯增加更多网络数据更能提升性能,如下图所示。
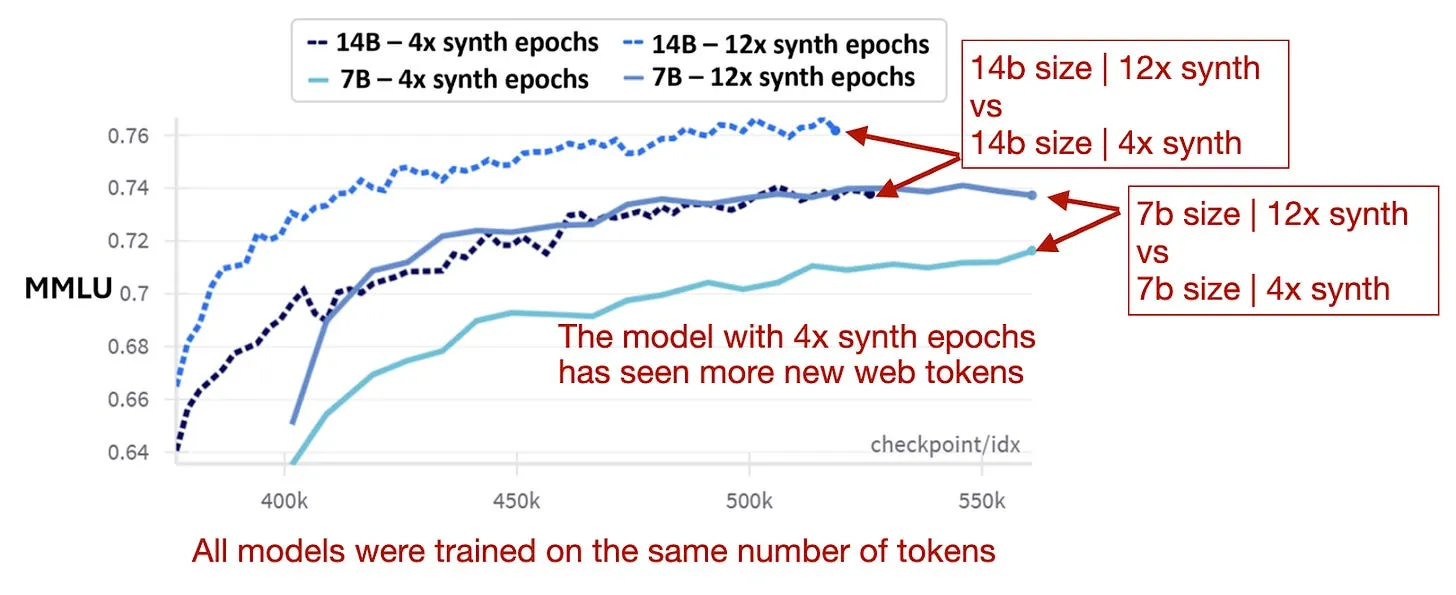
figure20.webp

不同合成/网络数据集比例下的模型性能对比。(标注图来自Phi-4论文,https://arxiv.org/abs/2412.08905

总而言之,数据混合中合成数据占比过高,会对知识类任务的表现产生负面影响。但在合成数据与网络数据比例更均衡的前提下,增加合成数据集的训练迭代次数(epoch)是有益的。

12.3 合成数据的未来价值

Phi-4技术报告为合成数据的应用提供了有趣的洞见:合成数据对模型预训练大有助益。尤其是在模型规模与数据集规模的缩放定律均显现瓶颈的当下(尽管Llama 3论文提到,在15万亿token规模下尚未看到收敛),研究者与工程师们正在寻找其他能持续突破边界的方法。

当然,预训练技术的优化与新增,尤其是后训练技术,大概率仍将是性能提升的核心动力之一。但我认为,合成数据的应用会成为一种有效手段:要么用更少的数据训练出合格的预训练基座模型,要么打造出更优的基座模型(比如在Llama 3的15万亿token数据集基础上,再加入40%的合成数据token)。

我认为高质量数据的作用类似于迁移学习。传统方式是让模型在原始、无结构的互联网数据上预训练,再在后训练阶段精调;而利用高质量模型(比如已经过大量优化的GPT-4o)生成的(部分)合成数据,相当于给训练提供了“起跑优势”。换句话说,高质量训练数据能让模型从一开始就更高效地学习。


结论与展望

希望这些研究总结对你有帮助!和往常一样,这篇文章又写得比我预想的长。最后,我用一个简短的板块来聊聊对2025年的预测与展望。

多模态LLM

去年我预测LLM会越来越走向多模态。如今,所有主流闭源LLM服务商都已提供多模态(至少是图像)支持。可见这一转型已全面展开,开源领域也会有更多相关探索。

根据我的所见所读,多模态相关论文数量确实激增了。接下来可能会出现更多开源微调方法与资源。不过我认为,对很多应用场景来说,纯文本已经足够,并且未来也依然够用,行业的核心重点仍将是开发更强的推理模型(比如o1和即将推出的o3)。

计算效率

预训练和使用LLM的成本都相当高。因此我预计,在可预见的未来,会出现更多提升LLM计算效率的巧妙方法。作为参考,按GPU租赁标价计算,训练最新的DeepSeek-V3需要花费500万美元(https://github.com/deepseek-ai/DeepSeek-V3/blob/main/DeepSeek_V3.pdf),这还不包括超参数调优、训练失败重试以及人力成本。
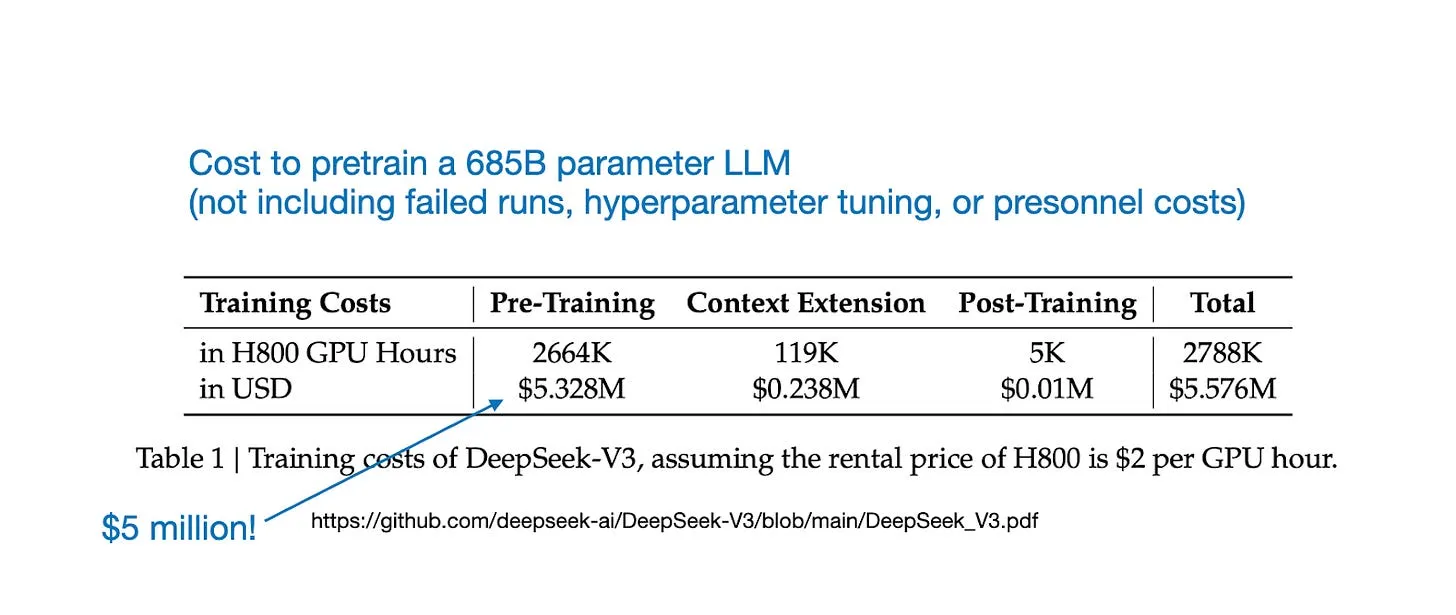
figure21.webp

DeepSeek-V3报告中的粗略估算,来源:https://github.com/deepseek-ai/DeepSeek-V3/blob/main/DeepSeek_V3.pdf

顺便说一句,根据Meta AI官方的模型卡(https://github.com/meta-llama/llama-models/blob/main/models/llama3_1/MODEL_CARD.md),Llama 3 405B的训练算力更是达到了约10倍之多(3084万GPU小时 vs 266万GPU小时)。

提升LLM效率的常用技术(并非都适用于训练阶段)包括混合专家(我在第一部分文章中讨论过)、Llama系列采用的分组查询注意力等等。另一个有意思的技术是DeepSeek模型采用的多头潜在注意力,能提升多头注意力中KV缓存的效率。

另一个近期值得关注的方向是针对模型输入做优化。比如最近提出的字节潜在Transformer(BLT):https://arxiv.org/abs/2412.09871,它通过将字节动态编码为基于熵的块,无需分词即可优化算力分配,实现更好的扩展性与更快的推理。

状态空间模型

你可能注意到了,今年我没讲状态空间模型。这是因为我目前的研究重点主要是基于Transformer的LLM。虽然我觉得状态空间模型非常有意思,但现阶段它们还相当实验性。而且Transformer在各类任务上持续展现出卓越性能,让人不太有动力去考虑替代方案。

但这并不代表状态空间模型领域没有进展。我已经看到了不少该领域的有趣论文。而且我注意到一个有意思的趋势:如今的状态空间模型基本都成了混合架构,整合了Transformer的自注意力机制。比如:

从这个角度来说,它们的计算成本也在上升。随着基于Transformer的LLM不断优化效率,而状态空间模型逐步加入注意力机制,如果当前趋势持续,二者最终大概率会走向中间路线。无论如何,这都是一个值得关注的有趣研究领域。

通过缩放实现LLM进步

临近年底时,还有一场关于“LLM缩放已走到尽头”的讨论,理由是互联网数据已经用完了。这场讨论源自Ilya Sutskever(OpenAI联合创始人之一,也是GPT系列论文的共同作者)在NeurIPS上的演讲。但遗憾的是,我今年没参加这个会议,所以不了解具体细节。

无论如何,这个观点很有意思,因为互联网数据是呈指数级增长的。我可以引用这篇文章的数据:https://edgedelta.com/company/blog/how-much-data-is-created-per-day,“每天产生15.87TB数据”。当然,挑战在于并非所有数据都是文本,也并非都对LLM训练有用。但正如我们从Phi-4看到的,数据治理与数据精炼方面仍有大量机会,仅靠优化训练数据就能带来不少提升。

不过我认同“通过数据缩放的收益正在递减”这一观点。我预计性能提升会越来越小,我们大概率正走向平台期。但这并非坏事,因为它会催生其他方向的进步。

我认为未来性能提升的一个重要来源是后训练。正如我去年夏天在这篇文章中所写的:https://magazine.sebastianraschka.com/p/new-llm-pre-training-and-post-training,近期发布的LLM已经让我们见识到了后训练领域的进展。

我对2025年的期待

今年我非常享受动手复现与实现各类Llama模型(3、3.1、3.2)的过程。我非常期待Llama 4的发布,希望它也能推出小巧便捷的版本,让我可以在笔记本电脑或者性价比高的云GPU上做实验。

此外,今年我想更多地尝试专用模型微调,而不是做通用聊天机器人(这个赛道已经相当拥挤了)。我们已经看到了各类代码和数学专用模型的涌现,比如最近的Qwen 2.5 Coder和Qwen 2.5 Math,很遗憾这次报告没来得及介绍它们。

总之,我的愿望清单和计划还有很多,2025年又将是精彩且瞬息万变的一年!可以肯定的是,这一年绝不会无聊。

这本杂志是我的个人热爱项目。想要支持我的朋友,可以考虑购买我的书:https://amzn.to/4fqvn0D。(我相信你会从书中收获良多,因为它对LLM工作原理的讲解深度是别处找不到的。)
figure22.webp

《从零构建大语言模型》现已上架:https://amzn.to/4fqvn0D

如果你已经读了这本书,并且能抽出几分钟时间,我会非常感谢你留下评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167。这对我们作者帮助很大!

你的支持意义重大!谢谢!
【转载】2024年值得关注的AI研究论文(上)

原文地址:Noteworthy AI Research Papers of 2024 (Part One),by Sebastian Raschka, on 2024-12-31

2024年值得关注的AI研究论文(上)

1—6月的6篇具有影响力的AI论文

新年伊始,我终于完成了这篇《2024年AI研究亮点》文章的初稿。文章涵盖了诸多主题,从混合专家模型到全新的大语言模型精度缩放定律。

要盘点2024年所有重要的研究亮点,恐怕得写一整本书才行。即便在AI这个日新月异的领域,2024年也堪称成果极其丰硕的一年。为了让内容尽量精简,我今年决定只聚焦大语言模型(LLM)领域的研究。但即便如此,要从这成果丰硕的一年里选出一部分论文,又该如何抉择?我能想到的最简单的方式,就是每月精选一篇论文:覆盖2024年1月到12月。

因此,在本文中,我将分享那些我个人认为极具启发性、影响力深远,或是两者兼具的研究论文。但请注意,本文只是上篇,聚焦2024年上半年(1—6月)的内容。本系列的下篇将涵盖7—12月,于1月晚些时候发布。

诚然,筛选标准比较主观,是基于我今年关注到的重点内容而定的。我也尽量兼顾了主题的多样性,不只是围绕大语言模型的发布展开。

如果你想了解更全面的AI研究论文清单,可以参考我之前的文章(https://magazine.sebastianraschka.com/p/llm-research-papers-the-2024-list)。

对于读过我那篇《2024年大语言模型研究论文清单》的读者,我很高兴地告诉大家,我现在已经感觉好多了,正在缓慢但稳步地康复!也由衷感谢大家所有的祝福与支持,这份心意对我意义重大,陪我度过了一段艰难的日子。

新年快乐,祝大家阅读愉快!


1. 一月:Mixtral的混合专家架构

2024年1月刚过去没几天,Mistral AI团队就发布了论文(2024年1月8日,https://arxiv.org/abs/2401.04088),介绍了Mixtral 8x7B——一种稀疏混合专家(SMoE)模型。

这篇论文和该模型在当时都产生了很大影响,因为Mixtral 8x7B是首批开源权重的混合专家大语言模型之一,性能表现十分亮眼:在多项基准测试中,它的表现都超过了Llama 2 70B和GPT-3.5。

1.1 理解混合专家模型

混合专家(MoE,Mixture of Experts)是一种集成模型,它在类GPT的解码器架构中,整合了多个更小的“专家”子网络。每个子网络负责处理不同类型的任务,更具体地说,是处理不同的token。其核心思路是,用多个小型子网络替代单一的大型网络,从而更高效地分配计算资源。

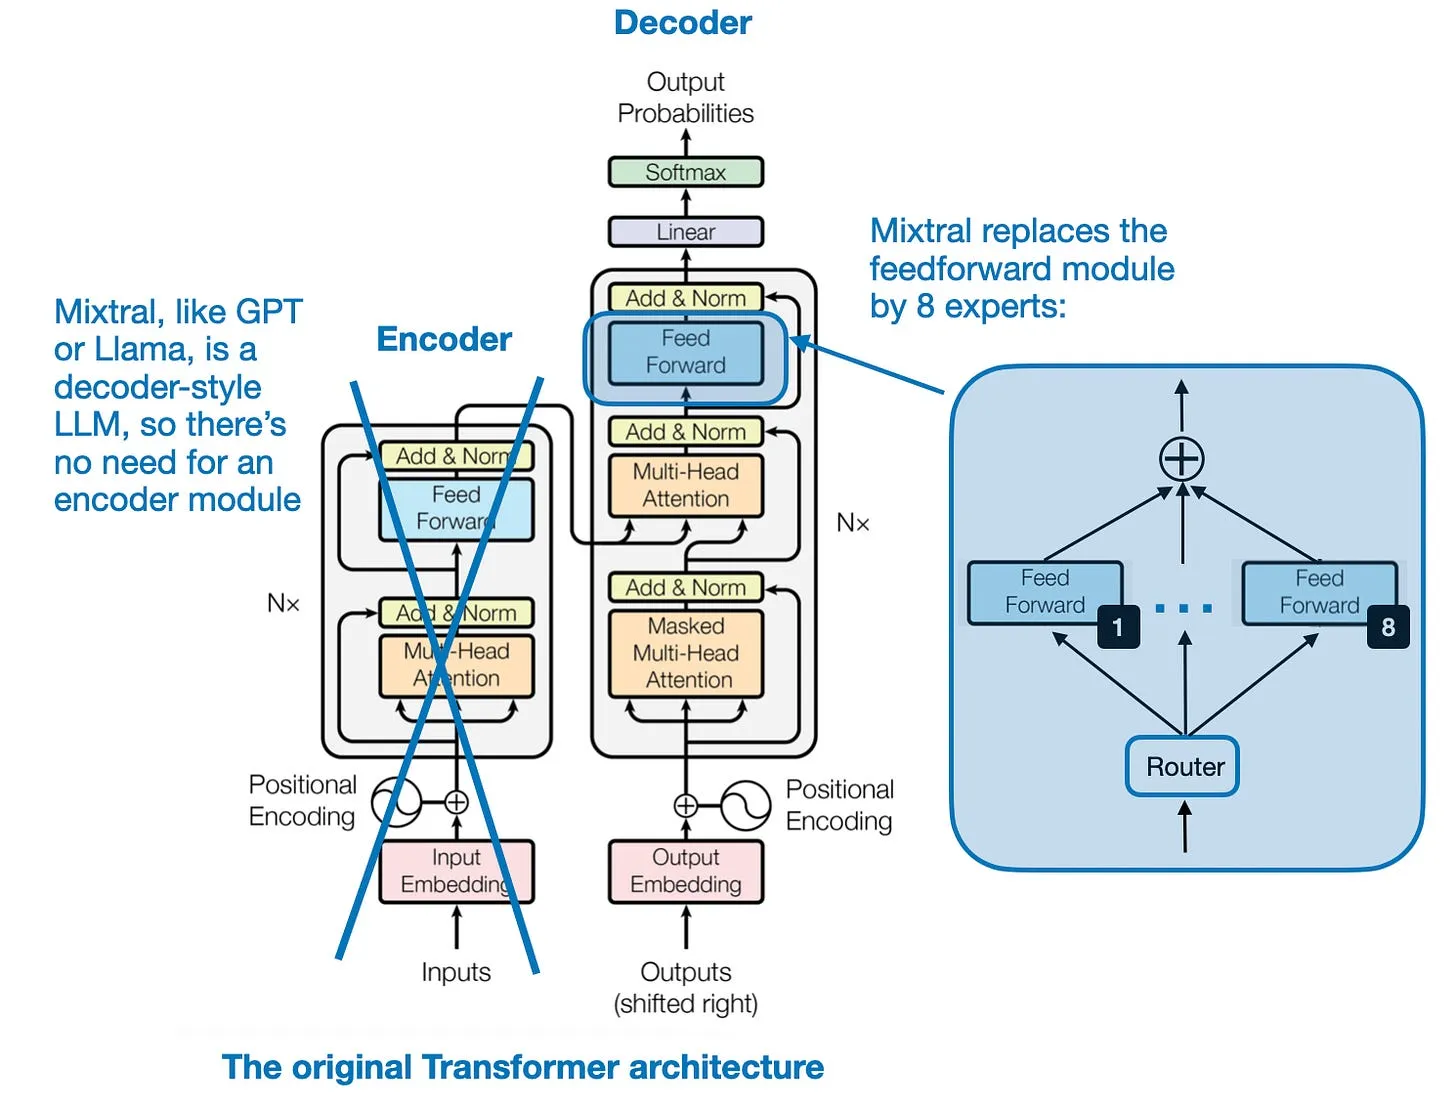
具体到Mixtral 8x7B,它将Transformer架构中的每个前馈模块都替换为8个专家层,如下图所示。

figure01

标注后的Transformer架构,源自《Attention Is All You Need》,https://arxiv.org/abs/1706.03762

“稀疏混合专家”中的“稀疏”,指的是在任意时刻,只有一部分专家层被激活用于处理单个token(在Mixtral 8x7B中,8个专家里通常只激活1到2个)。

如上图所示,这些子网络替代了大语言模型中的前馈模块。前馈模块本质上就是一个多层感知机。用类PyTorch的伪代码表示,大致如下:

class FeedForward(torch.nn.Module):        
    def __init__(self, embed_dim, coef):                 
        super().__init__()         
        self.layers = nn.Sequential(             
            torch.nn.Linear(embed_dim, coef*embed_dim),             
            torch.nn.ReLU(),             
            torch.nn.Linear(coef*n_embed, embed_dim),             
            torch.nn.Dropout(dropout)         
        )          
    
    def forward(self, x):        
        return self.layers(x)

除此之外,还有一个路由模块(也叫门控网络),负责将每个token的嵌入向量分发到8个专家前馈模块中,且同一时间只有部分专家处于激活状态。

本文还要介绍另外11篇论文,因此关于Mixtral模型我就先简要介绍到这里。更多细节可以参考我之前的文章:https://magazine.sebastianraschka.com/i/14113005/mixtral-of-experts

1.2 混合专家模型在当下的价值

年初的时候,我本以为开源权重的混合专家模型会比现在更普及、应用更广泛。虽说这类模型并非无关紧要,但目前很多顶尖模型依然采用稠密(传统)大语言模型架构,而非混合专家架构,比如Llama 3、通义千问2.5、Gemma 2等。当然,我们无从得知GPT-4、Gemini、Claude这些闭源模型的底层架构,它们内部很可能也采用了混合专家设计。

无论如何,混合专家架构依然有其价值,尤其是它提供了一种高效扩展大语言模型的方式:每个输入只激活模型的部分参数,从而在不牺牲模型容量的前提下降低计算成本。

顺便一提,写完这篇文章后,DeepSeek V3意外发布(https://github.com/deepseek-ai/DeepSeek-V3/blob/main/DeepSeek_V3.pdf),它采用的正是混合专家架构。所以没错,混合专家模型依然极具应用价值!


2. 二月:权重分解低秩适配(DoRA)

如果你做过开源大语言模型的微调,那大概率用过低秩适配(LoRA)——一种参数高效的大语言模型微调方法。

如果你对LoRA还不熟悉,可以参考我之前的文章(https://magazine.sebastianraschka.com/p/practical-tips-for-finetuning-llms),应该会对你有帮助;另外在我的书(https://amzn.to/4fqvn0D)的附录D中,还有从零实现LoRA的完整代码。

LoRA是一种非常普及、应用广泛的方法,而我在实现和测试它的一个新变体时也收获了很多乐趣,因此我二月的精选论文是Liu等人于2024年2月发表的研究(https://arxiv.org/abs/2402.09353)。

2.1 LoRA回顾

在介绍DoRA之前,先快速回顾一下LoRA的原理:

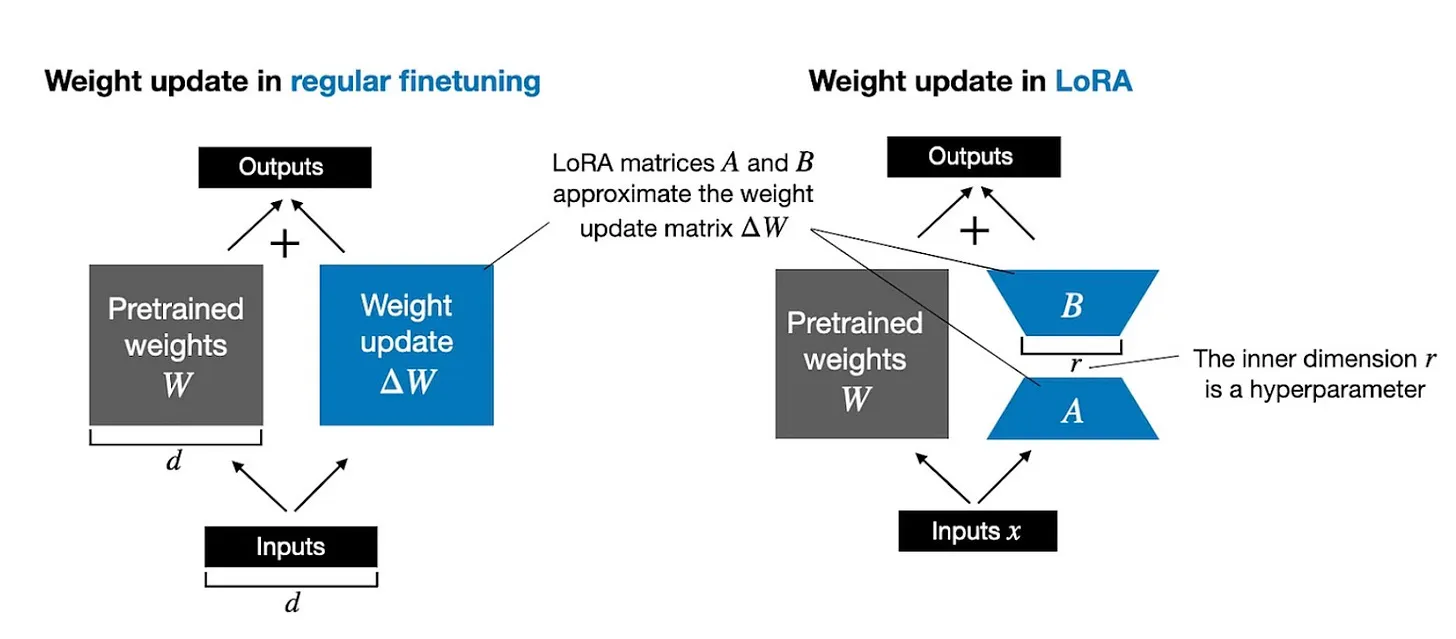
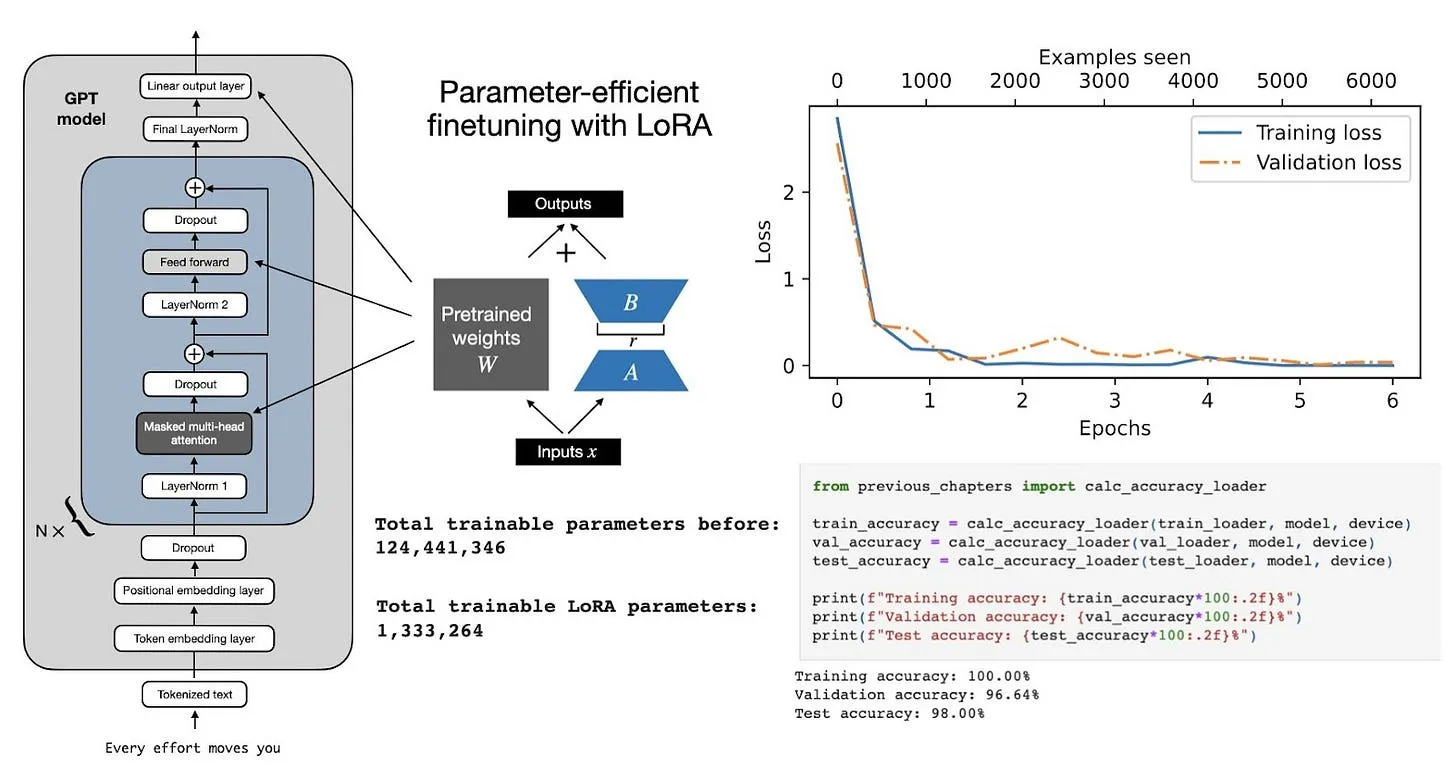
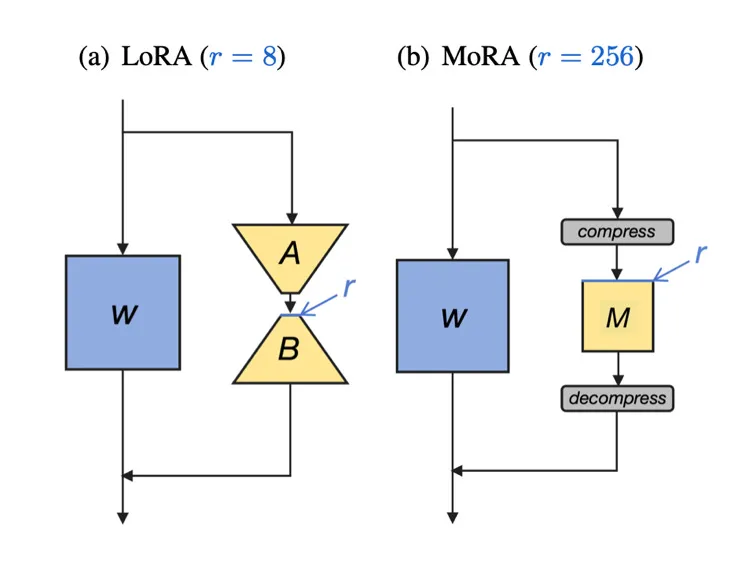
全量微调会计算一个大型的权重更新矩阵ΔW,以此更新大语言模型中每个大型权重矩阵W。而LoRA用两个更小的矩阵A和B的乘积来近似ΔW。也就是说,权重更新不再是$W + \Delta W$,而是$W + A\cdot B$。这大幅降低了计算开销和内存占用。

下图并排展示了全量微调(左)和LoRA(右)对应的公式原理。

figure02

常规微调(左)与LoRA微调(右)示意图

2.2 从LoRA到DoRA

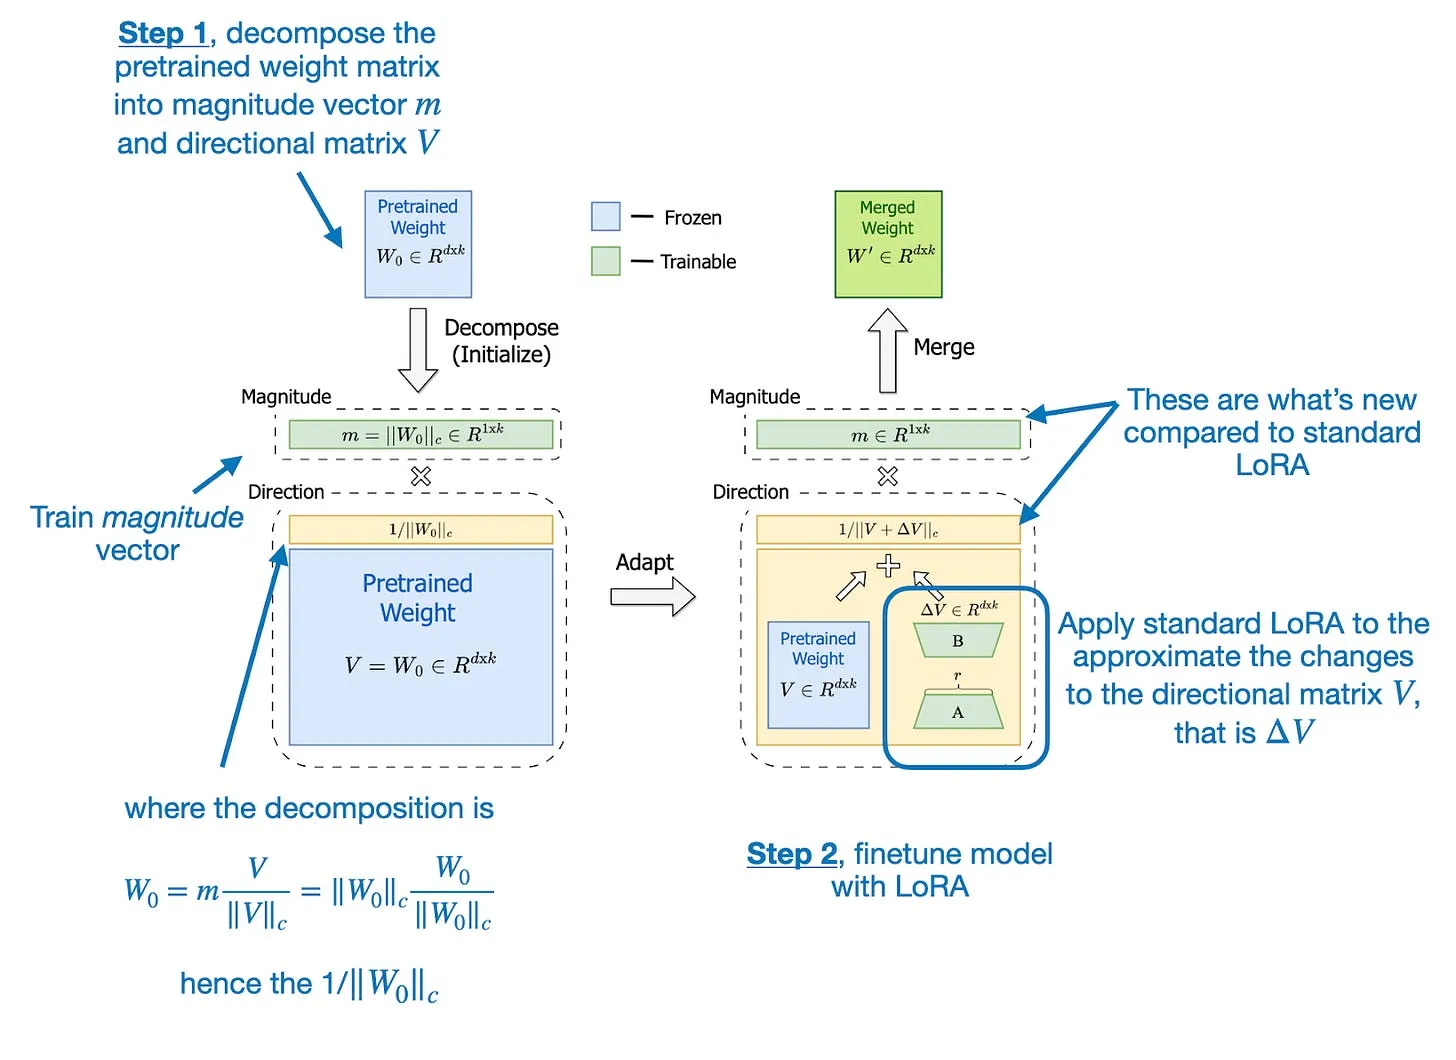
在2024年2月的这篇论文(https://arxiv.org/abs/2402.09353)中,Liu等人对LoRA进行了扩展:首先将预训练的权重矩阵分解为两部分——幅度向量m和方向矩阵V。这种分解的核心思想是,任意向量都可以表示为长度(幅度)和方向(朝向)的组合,这里将该思想应用到权重矩阵的每一列向量上。得到m和V之后,DoRA仅对方向矩阵V施加LoRA风格的低秩更新,而幅度向量m则单独训练。

figure03

标注后的示意图,源自DoRA论文(https://arxiv.org/abs/2402.09353

这种两步法让DoRA比标准LoRA更具灵活性。LoRA往往会对幅度和方向进行同步缩放,而DoRA可以在不必然改变幅度的前提下,对方向进行精细调整。最终带来了性能和鲁棒性的提升:即便使用更少的参数,DoRA的表现也能优于LoRA,且对秩(rank)的选择更不敏感。

后面还有10篇论文要介绍,这部分我就先简述至此。如果想了解更多细节,我今年早些时候专门写过一篇文章讲解该方法:https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch

2.3 LoRA及类LoRA方法的未来

DoRA是对原始LoRA方法的一个小幅但合理的改进。虽然目前还没有被广泛采用,但它几乎没有增加额外复杂度,下次你做模型微调时值得一试。总体而言,我认为LoRA及类似方法会继续保持主流地位。比如苹果公司在其论文(https://arxiv.org/abs/2407.21075)中就提到,他们在端侧大语言模型的任务专项化中使用了LoRA。


3. 三月:大语言模型持续预训练的实用技巧

据我观察,指令微调是大语言模型从业者最常用的微调方式,目的是让开源大语言模型更好地遵循指令,或是针对特定子集、新指令做专项适配。

但如果要让模型吸收新知识,持续预训练(有时也叫连续预训练)才是正确的思路。

在这一部分,我将简要总结Ibrahim等人2024年3月发表的这篇论文(https://arxiv.org/abs/2403.08763),其方法直白清晰,让人耳目一新。

3.1 简单的技术依然有效

这篇长达24页的论文(https://arxiv.org/abs/2403.08763)包含了大量实验和数据图表,以当下的标准来看十分详实。

成功开展持续预训练的核心技巧有哪些?

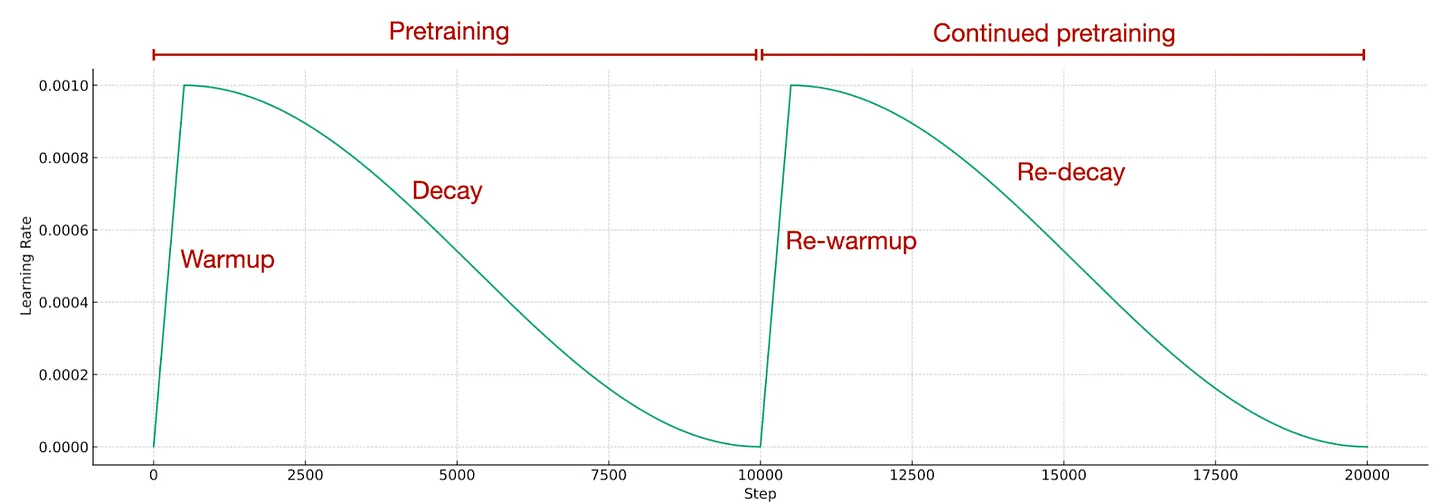
  1. 对学习率进行简单的重升温与重衰减。
  2. 在新数据集中混入少量(比如5%)原始预训练数据,防止灾难性遗忘。值得注意的是,0.5%、1%这样更小的比例同样有效。

关于第一点“重升温与重衰减”,说得更具体些:就是采用与模型初始预训练阶段完全相同的学习率调度策略,如下图所示。

figure04

持续预训练的学习率调度示意图。图源自《从零构建大语言模型》,https://github.com/rasbt/LLMs-from-scratch/blob/main/appendix-D/01_main-chapter-code/appendix-D.ipynb

据我所知,学习率重升温重衰减、以及在新数据中混入原始预训练数据,这些都算是业内共识。但我非常欣赏研究者们花精力在这篇24页的详细报告中,对该方法进行了正式的实验验证。

如果想了解更多细节,我之前的文章(https://magazine.sebastianraschka.com/p/tips-for-llm-pretraining-and-evaluating-rms)对这篇论文有更全面的讨论。

3.2 这些简单方法会持续有效吗?

我没有理由认为这些方法在未来的大语言模型上会失效。但需要注意的是,近几个月来预训练流程已经变得更复杂,通常包含多个阶段,包括短上下文预训练和长上下文预训练。(我在这篇文章中有更多相关论述:https://magazine.sebastianraschka.com/p/new-llm-pre-training-and-post-training

因此,为了达到最优效果,这篇论文提出的方案在某些场景下可能需要做适当调整。


4. 四月:大语言模型对齐用DPO、PPO,还是两者都用?

四月的精选很难抉择。比如KAN论文(https://arxiv.org/abs/2404.19756)当月引发了巨大热议,但在我看来,这股热潮很快就消退了。这可能是因为其理论上的优势很难在实际中落地,缺乏有竞争力的实验结果或基准测试表现,而且其他架构的可扩展性要强得多。

因此,我四月的精选换成了一篇更偏实用的论文:Xu等人2024年4月发表的研究(https://arxiv.org/abs/2404.10719)。

4.1 RLHF-PPO与DPO分别是什么?

在总结这篇论文之前,先概述一下近端策略优化(PPO)和直接偏好优化(DPO)——二者都是通过基于人类反馈的强化学习(RLHF)实现大语言模型对齐的主流方法。RLHF是让大语言模型对齐人类偏好的核心方法,既能提升回复质量,也能提高安全性。

figure05

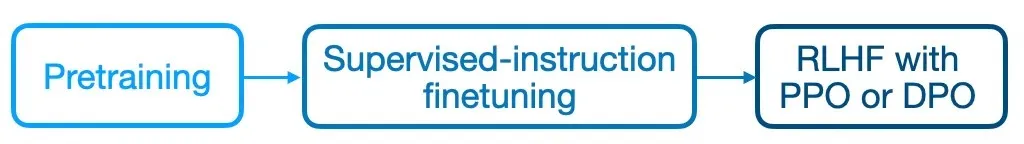
典型(简化版)的大语言模型训练生命周期

传统上,RLHF-PPO是训练大语言模型的关键步骤,InstructGPT、ChatGPT等模型和平台都采用了该方法。但去年起,DPO凭借其简洁性和有效性开始流行起来。与RLHF-PPO不同,DPO不需要单独训练奖励模型,而是通过类似分类的目标函数直接更新大语言模型。如今很多大语言模型都使用DPO,但一直缺乏它与PPO的全面对比研究。

以下是我今年早些时候整理并分享的两份关于RLHF和DPO的资料:

4.2 PPO表现通常优于DPO

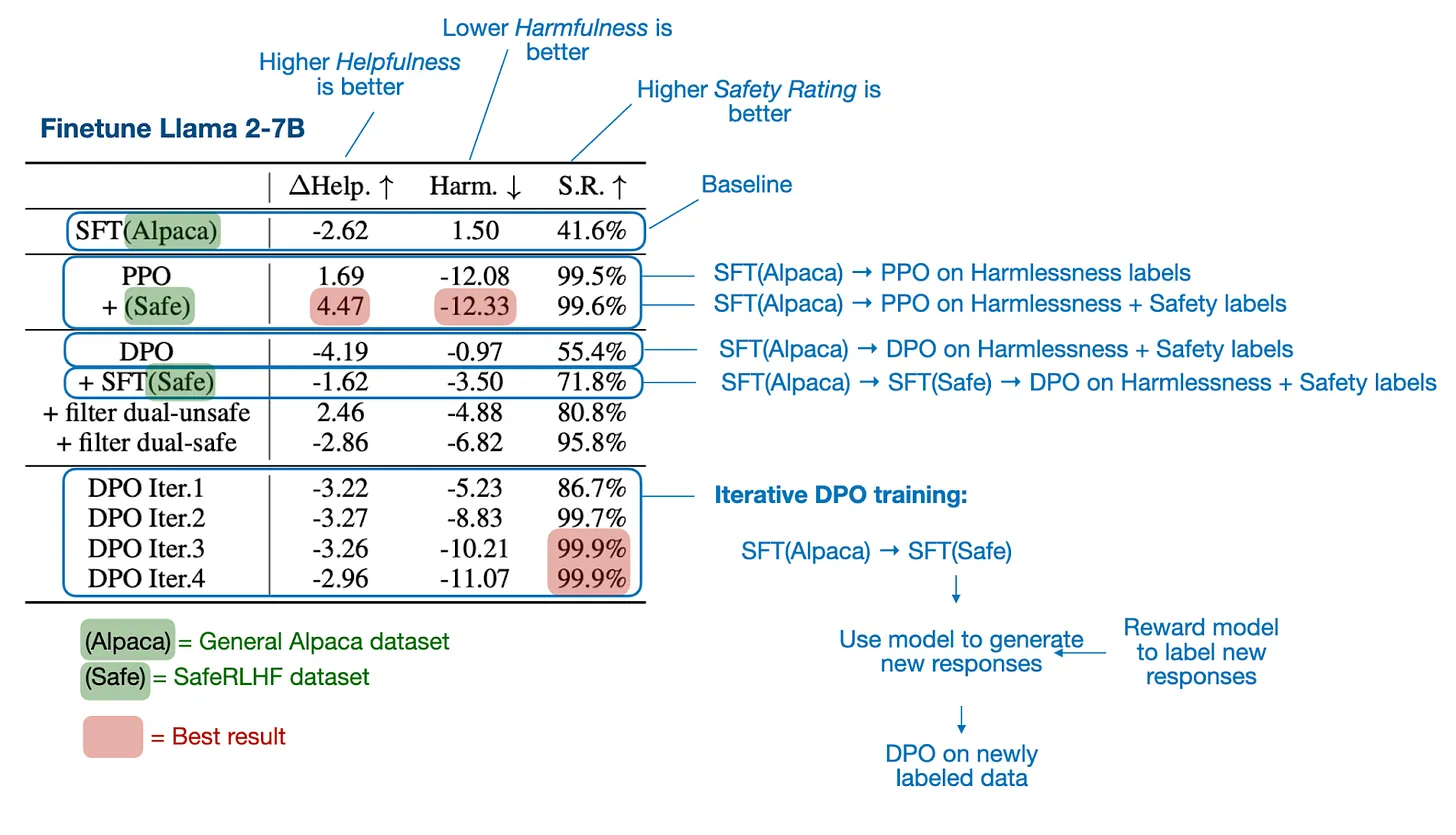
这篇论文(https://arxiv.org/abs/2404.10719)撰写严谨,包含大量实验与结果。核心结论是:PPO的表现往往优于DPO;在处理分布外数据时,DPO的劣势更为明显。

这里的“分布外数据”,指的是模型之前通过监督微调训练所用的指令数据,与DPO使用的偏好数据存在差异。比如,模型先在通用的Alpaca数据集上训练,再在另一个带偏好标注的数据集上做DPO微调。(不过,要提升DPO在分布外数据上的表现,有一种方法:先用偏好数据集做一轮监督指令微调,再进行DPO微调。)

主要研究结果总结如下图所示。

figure06

标注后的表格,源自《DPO在大语言模型对齐中真的优于PPO吗?一项全面研究》(https://arxiv.org/abs/2404.10719)论文

4.3 当下PPO与DPO的应用现状

从最终大语言模型的原始建模性能来看,PPO可能略有优势。但DPO的实现难度低得多,计算效率也更高(毕竟不需要单独训练和调用奖励模型)。因此据我所知,实际应用中DPO比RLHF-PPO普及得多。

一个很有意思的例子是Meta的Llama系列模型:Llama 2采用RLHF-PPO训练,而更新的Llama 3则使用了DPO。

有趣的是,如今最新的模型甚至会同时使用PPO和DPO。近期的例子包括苹果的论文(https://arxiv.org/abs/2407.21075),以及Allen AI的Tulu 3论文(https://arxiv.org/abs/2411.15124)。


5. 五月:LoRA学得更少,忘得也更少

今年还有一篇LoRA相关的论文我觉得特别有意思(保证这是本次12篇精选里最后一篇LoRA相关的了!)。它算不上颠覆性突破,但我很喜欢它,因为它把关于是否使用LoRA微调大语言模型的一些行业共识进行了正式的实证验证:这就是Biderman等人2024年5月发表的论文(https://arxiv.org/abs/2405.09673)。

这篇论文(https://arxiv.org/abs/2405.09673)是一项实证研究,对比了低秩适配(LoRA)与全量微调在大语言模型上的效果,聚焦两个领域(编程和数学)、两种任务(指令微调和持续预训练)。如果需要回顾LoRA的原理,可以翻回上面二月的部分。

5.1 LoRA学得更少

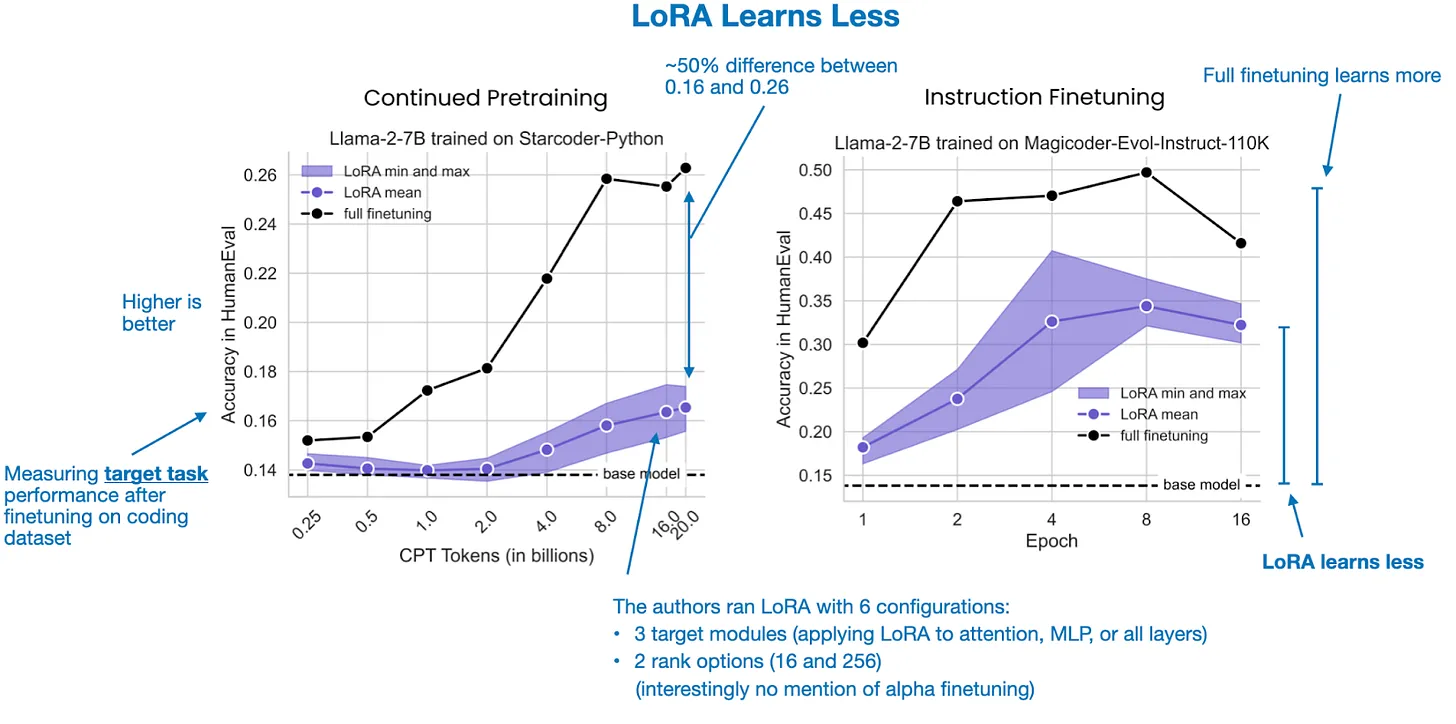
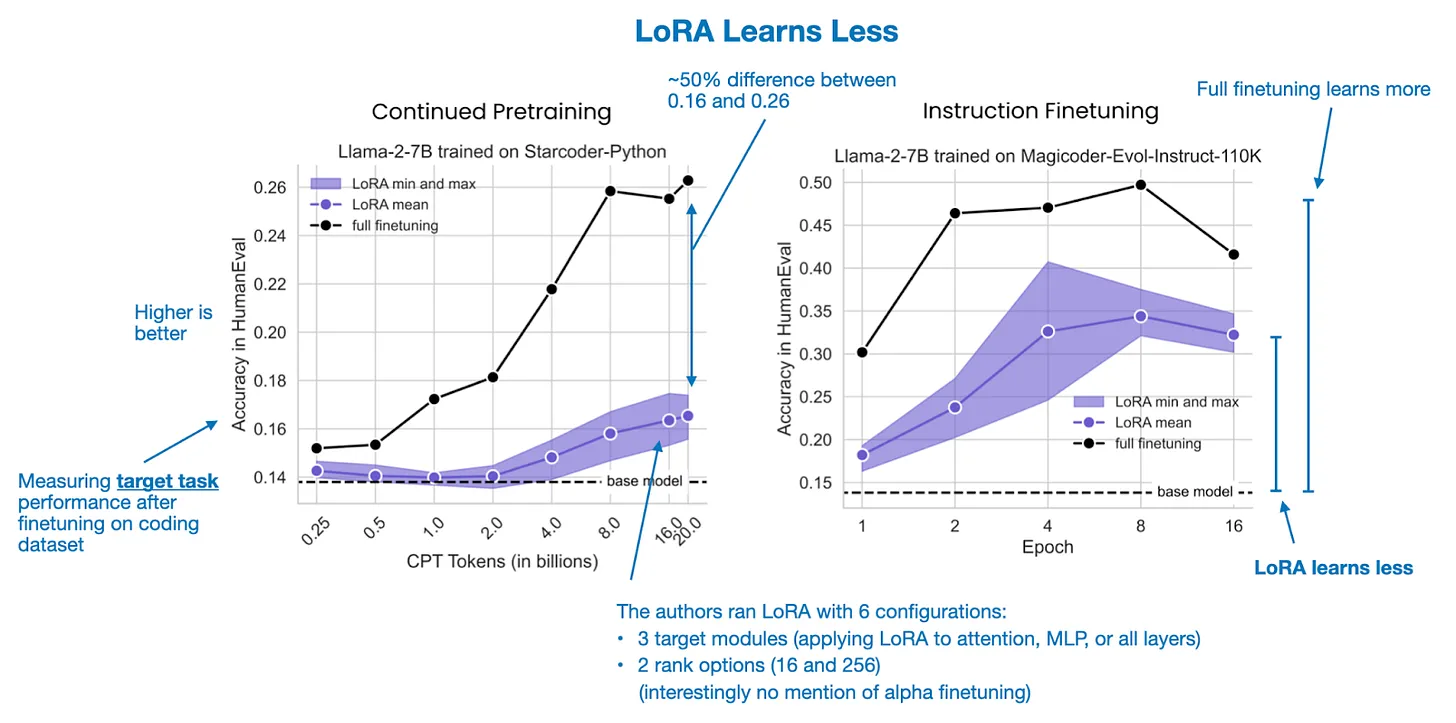
研究表明,LoRA的学习效果明显不如全量微调,尤其是在编程这类需要习得新知识的任务中。如果只做指令微调,两者的差距会更小。这说明:相比把预训练模型改成指令遵循模型,用新数据做预训练(学习新知识)从全量微调中获益更多。

figure07

全量微调与LoRA对比。性能通过HumanEval数据集衡量,该数据集包含164道编程题目。图标注源自《LoRA学得更少,忘得也更少》,https://arxiv.org/abs/2405.09673

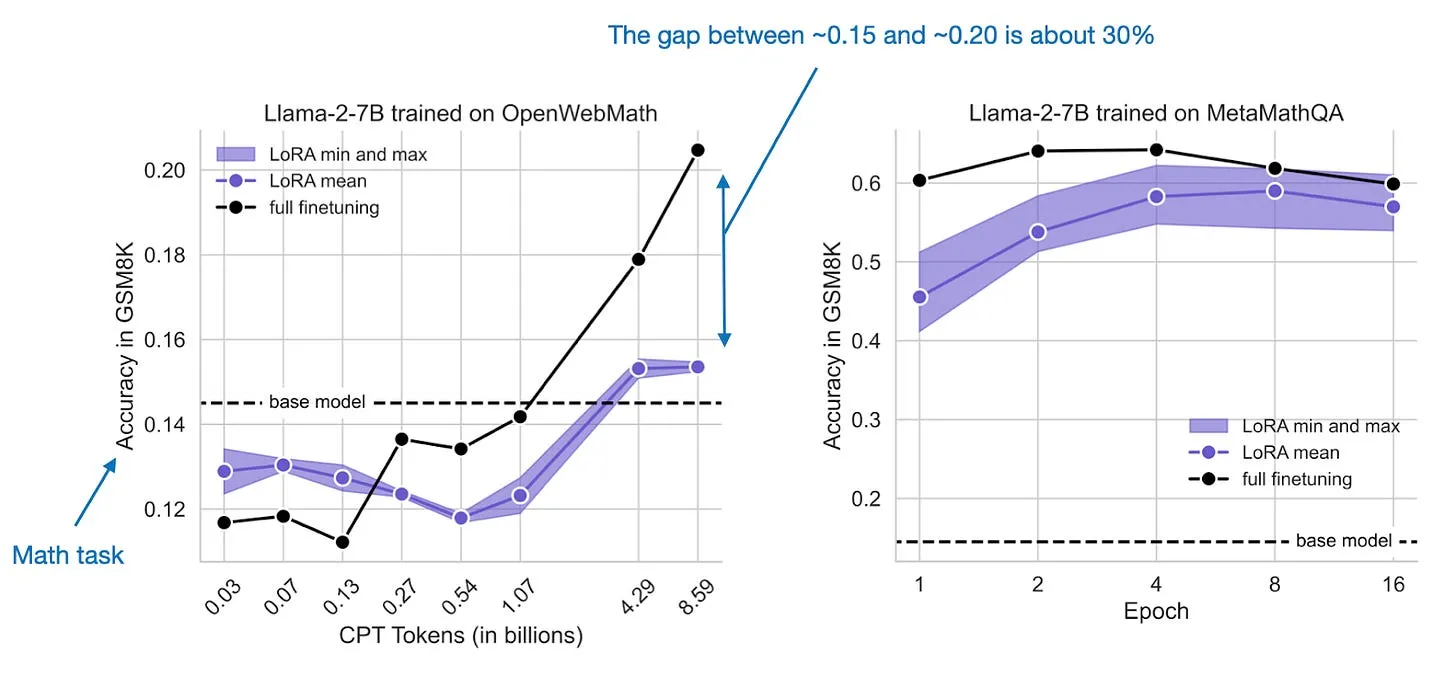
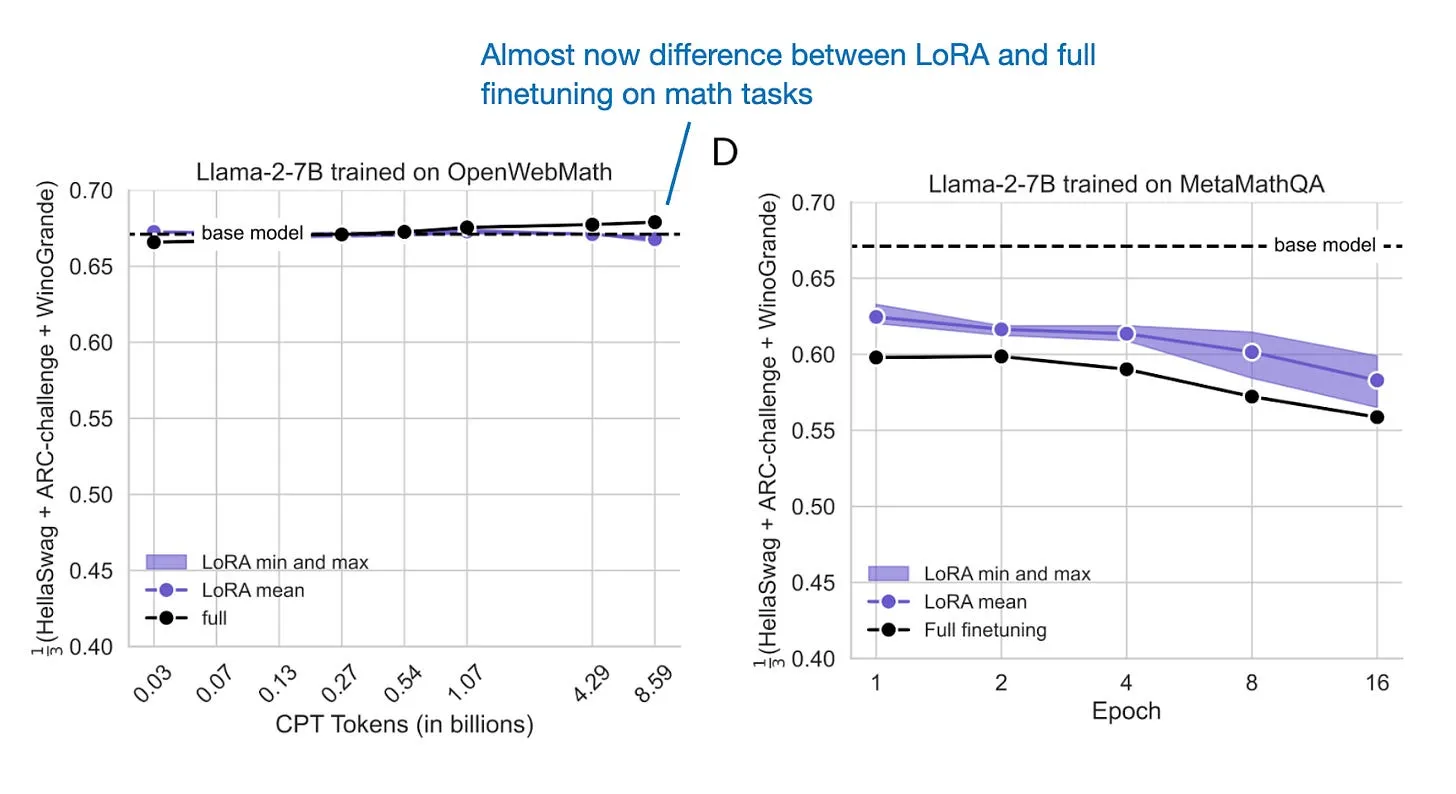
不过还有更多细节值得注意。比如在数学任务上,LoRA和全量微调的差距会缩小。这可能是因为数学问题对大语言模型来说更熟悉,预训练期间大概率见过类似的题目。相比之下,编程是一个差异更大的领域,需要更多新知识。因此,新任务与模型预训练数据的差异越大,全量微调在学习能力上的优势就越明显。

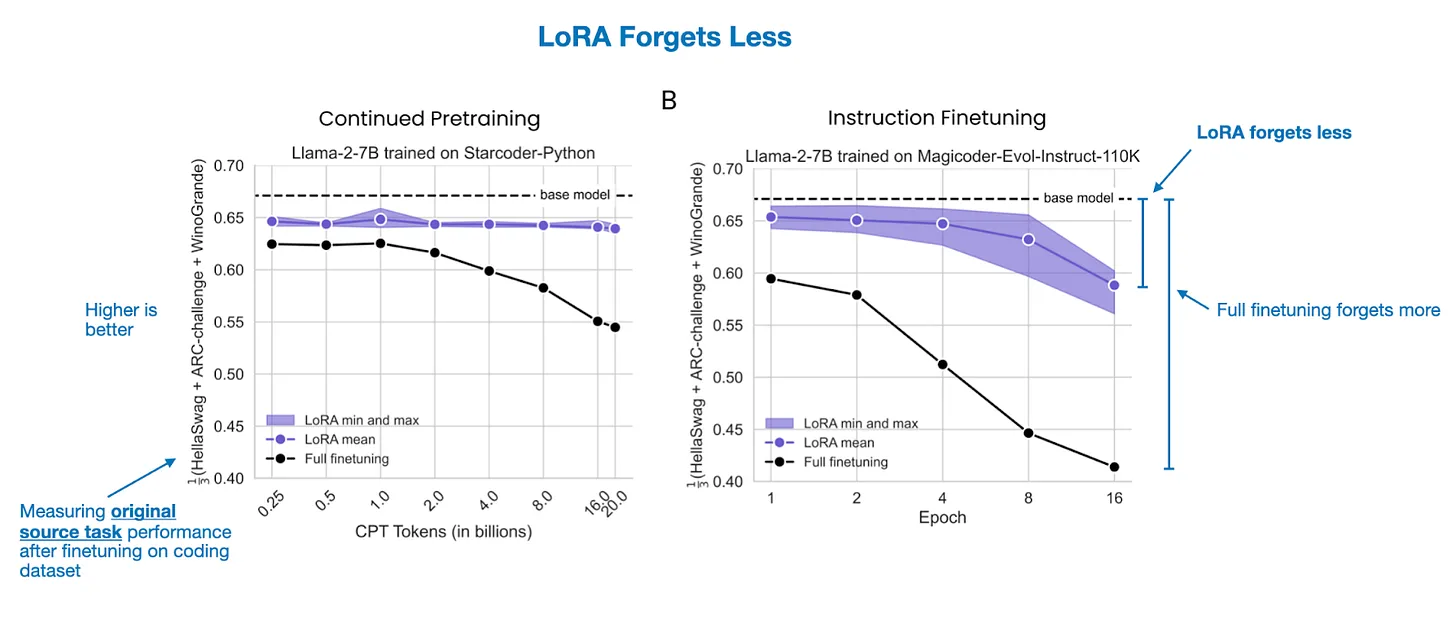
5.2 LoRA忘得更少

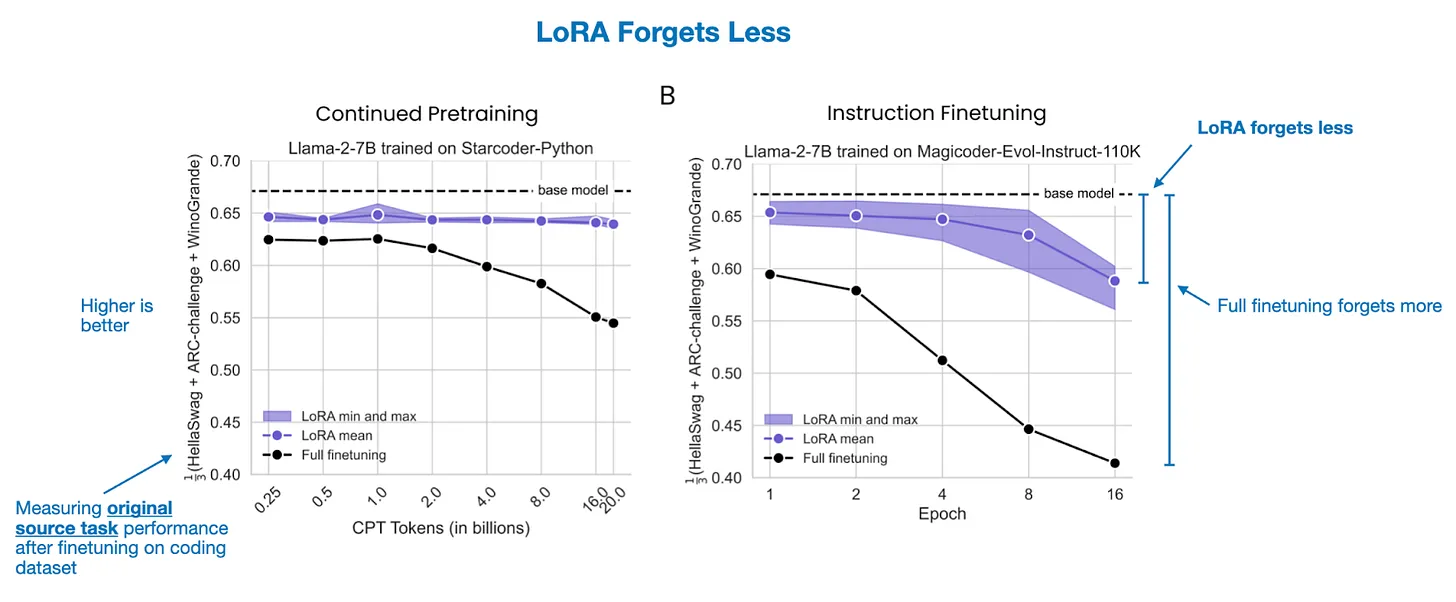
在考察原有知识的遗忘程度时,LoRA始终表现出更少的遗忘。在适配与源领域差异较大的数据(比如编程)时,这一点尤为明显。在编程任务中,全量微调会导致严重的遗忘,而LoRA能保留更多原有能力。在数学任务上,模型原本的知识就和新任务更接近,因此两者的差异没那么显著。

figure08

在编程数据上训练后,全量微调与LoRA在原始源任务上的表现对比。图标注源自《LoRA学得更少,忘得也更少》,https://arxiv.org/abs/2405.09673

5.3 LoRA的权衡

总体而言,这是一种权衡:全量微调更擅长吸收差异较大领域的新知识,但会导致更多原有任务的遗忘;而LoRA通过调整更少的参数,学到的新知识更少,但保留了更多原有能力。

5.4 大语言模型微调的未来方向

该研究主要对比了LoRA和全量微调。实际应用中,LoRA之所以流行,是因为它的资源效率远高于全量微调。很多情况下,受硬件限制,全量微调根本无法实现。此外,如果只需要应对特定的专项应用,只用LoRA可能就足够了。由于LoRA适配器可以和基础大语言模型分开存储,很容易在新增能力的同时保留原有能力。而且还可以将两种方法结合:用全量微调做知识更新,再用LoRA做后续的专项适配。

简而言之,我认为未来这两种方法都会继续发挥重要作用,关键是要根据具体任务选择合适的方法。


6. 六月:15万亿token的FineWeb数据集

Penedo等人2024年6月发表的论文(https://arxiv.org/abs/2406.17557)介绍了一个面向大语言模型的15万亿token数据集的构建过程,并将其公开,包括数据集地址(https://huggingface.co/datasets/HuggingFaceFW/fineweb)和可复现数据集制作流程的代码仓库(https://github.com/huggingface/datatrove/blob/main/examples/fineweb.py)。

6.1 与其他数据集的对比

目前已经有多个用于大语言模型预训练的大型数据集,这个数据集有什么特别之处?其他数据集的规模相对更小:RefinedWeb(5000亿token)、C4(1720亿token)、Dolma 1.6的Common Crawl部分(3万亿token)和Dolma 1.7(1.2万亿token)、The Pile(3400亿token)、SlimPajama(6270亿token)、去重版RedPajama(20万亿token)、Matrix的英文CommonCrawl部分(1.3万亿token)、English CC-100(700亿token)、Colossal-OSCAR(8500亿token)。

比如,约3600亿token只适合训练小型大语言模型(根据Chinchilla缩放定律,对应17亿参数的模型)。而FineWeb数据集的15万亿token,根据Chinchilla缩放定律,最高可适配5000亿参数的模型。(注意:RedPajama数据集(https://github.com/togethercomputer/RedPajama-Data)包含20万亿token,但研究者发现,由于采用的过滤规则不同,在RedPajama上训练的模型质量不如FineWeb。)

figure09

历年来大语言模型预训练所用数据集规模示意图。注意:这只是通用参考,与FineWeb论文及Chinchilla缩放定律论文无直接关联。

简而言之,纯英文的FineWeb数据集让研究者和从业者训练大规模大语言模型在理论上成为可能。(补充说明:Llama 3系列(8B、70B、405B参数,https://arxiv.org/abs/2407.21783)也是用15万亿token训练的,但Meta的训练数据集并未公开。)

6.2 有原则的数据集构建

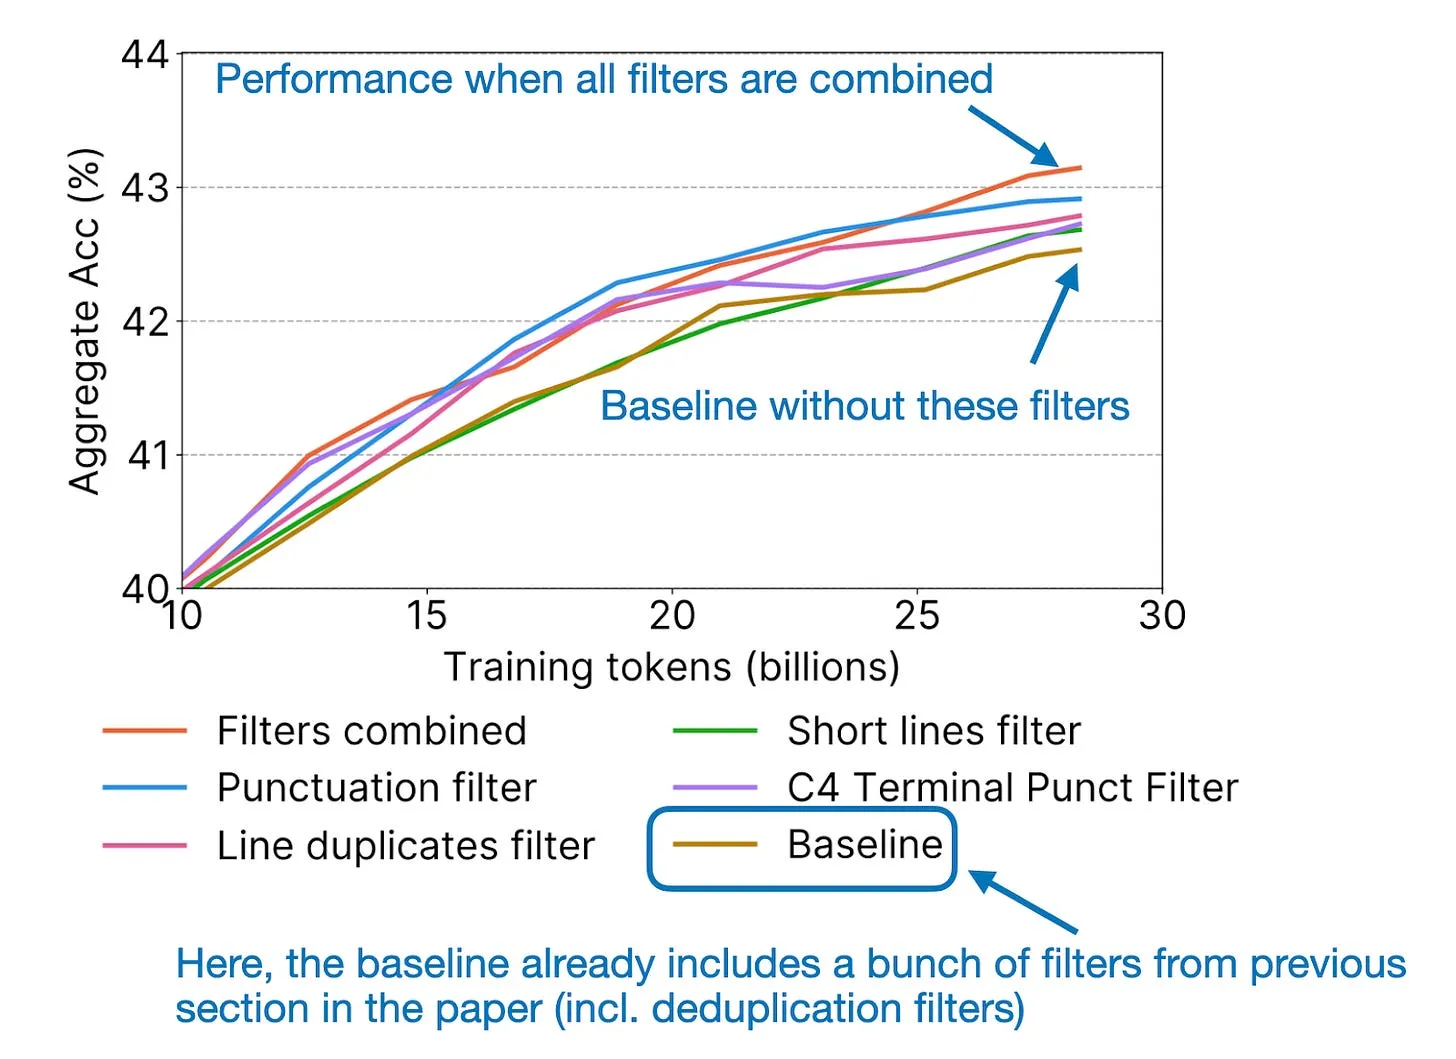
此外,论文中还包含了严谨的消融实验,深入阐释了从CommonCrawl网页语料(https://commoncrawl.org/)出发,如何制定并应用过滤规则,最终得到FineWeb数据集。简而言之,每尝试一条过滤规则,他们都会从原始数据和过滤后的数据中各抽取3600亿token的随机样本,然后训练一个17.1亿参数的类Llama小型模型,通过模型在HellaSwag、ARC、MMLU等标准基准上的表现,判断该过滤规则是否有效。

figure10

6.3 FineWeb在当下的价值

总体而言,虽然训练数十亿参数的大语言模型对多数研究实验室和企业来说依然难以实现,但这个数据集向大语言模型研究与开发的普惠化迈出了坚实的一步。总而言之,这篇论文的工作值得称赞,为推动大语言模型预训练的发展提供了宝贵的公共资源。


7—12月内容预告

希望这些研究总结对你有帮助!由于我还在康复中,而且这篇文章本来也会过长,我决定把今年的年度综述分成上下两部分。

下篇(7—12月)对我个人来说其实更精彩,我会讨论关于缩放定律、复现O1、合成数据在大语言模型训练中的作用等更新的研究。此外,我还会分享对2025年的展望,以及我认为即将出现的趋势。敬请期待!

这本杂志是我个人的热爱项目。如果想要支持我的创作,欢迎购买我的书(https://amzn.to/4fqvn0D)。(我相信你会从书中收获很多,因为它对大语言模型工作原理的讲解深度是其他地方找不到的。)

figure11

《从零构建大语言模型》现已发售,购买链接:https://amzn.to/4fqvn0D

如果你读过这本书,还请抽出几分钟时间在亚马逊留下评论(https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167),这对我们作者来说帮助很大!

你的支持意义重大!谢谢!
【转载】大语言模型研究论文:2024年度合集

原文地址:LLM Research Papers: The 2024 List,by Sebastian Raschka, on 2024-12-08

大语言模型研究论文:2024年度合集

今年的AI研究领域精彩纷呈、热点不断,如果你关注大语言模型方向,更是能感受到领域的飞速发展。

我原本为12月的这期内容做了详尽规划,打算发布一篇专题文章,盘点2024年我心目中的所有研究亮点。这个计划依然会推进,但由于意外受了重伤,我目前无法坐在电脑前完成草稿。希望接下来几周能顺利康复,尽快回归工作。

在此期间,我想分享自己2024年以来持续收藏的优质论文清单(以大语言模型相关内容为主)。这只是一份简单的列表,但或许能帮大家在假期里挖到一些值得深入研读的宝藏论文。

如果你偏好代码向的深度阅读与动手实践,我的《从零构建大语言模型》一书已于上个月在亚马逊上线。
此外,我还在GitHub仓库中补充了大量配套学习资料。

figure01

Continue reading 【转载】大语言模型研究论文:2024年度合集

【转载】理解多模态大语言模型:主流技术与最新模型导论

原文地址:Understanding Multimodal LLMs,by Sebastian Raschka, on 2024-11-03

理解多模态大语言模型:主流技术与最新模型导论

这两个月的发展可谓突飞猛进。人工智能研究领域再次涌现出大量成果,两项诺贝尔奖授予了AI相关方向,同时还有多篇颇具价值的研究论文相继发表。

其中,Meta AI发布了最新的Llama 3.2系列模型,包含10亿和30亿参数的开源权重大语言模型,以及两款多模态模型。

在本文中,我将讲解多模态大语言模型的工作原理。此外,我还会梳理并总结近几周发布的十余篇最新多模态相关论文与模型(包括Llama 3.2),对比它们的技术路线。

(如需查看目录菜单,请点击左侧的横线图标。)

figure01
多模态大语言模型示意图:可接收音频、文本、图像、视频等多种输入模态,输出文本模态结果。

不过在开始之前,我还有一则个人的好消息要和大家分享!我的新书《Build A Large Language Model (From Scratch)》终于在亚马逊上架了:
https://amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167

figure02
https://amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 现已登陆亚马逊

撰写这本书付出了巨大的心血,过去两年里收到的所有支持与正向反馈都让我无比感激——尤其是最近这几个月,很多热心读者都分享了他们的阅读感受。谢谢大家,作为作者,没有什么比得知这本书能对大家的职业生涯产生帮助更让人振奋的了!

对于已经读完本书、期待更多内容的读者,请保持关注!接下来几个月我会在GitHub仓库中补充一些附赠内容。

附:如果你已经读过这本书,恳请你能在亚马逊留下一条评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167/ ;这对我们作者来说真的帮助很大!

1. 多模态大语言模型的应用场景

什么是多模态大语言模型?正如引言中所提,多模态大语言模型是能够处理多种输入类型的大语言模型,其中“模态”指的是特定的数据类型——比如传统大语言模型处理的文本,以及声音、图像、视频等等。为简化起见,本文将主要围绕图像模态与文本输入的组合展开讲解。

多模态大语言模型最经典、最直观的应用是图像描述:输入一张图片,模型生成对该图片的文字描述,如下图所示。

figure03
多模态大语言模型应用示例,来源:https://x.com/PainSci/status/1309570607458086914

当然,它的应用场景远不止于此。比如我个人很喜欢的一个用法:从PDF表格中提取信息,并转换为LaTeX或Markdown格式。

2. 构建多模态大语言模型的主流方案

构建多模态大语言模型主要有两种技术路线:

  • 方案A:统一嵌入解码器架构(Unified Embedding Decoder Architecture)
  • 方案B:跨模态注意力架构(Cross-modality Attention Architecture)

(顺便一提,目前这些技术似乎还没有统一的官方术语,如果大家见过其他说法欢迎告诉我。更简洁的表述可以是“纯解码器架构”和“基于交叉注意力的架构”。)

figure04
多模态大语言模型的两种主流架构方案

如上图所示,统一嵌入解码器架构仅使用单个解码器模型,和GPT-2、Llama 3.2这类原生大语言模型架构非常相似。在该方案中,图像会被转换为与原始文本token嵌入维度相同的token,拼接后一同输入大语言模型进行处理。

跨模态注意力架构则通过交叉注意力机制,在注意力层内部直接融合图像嵌入与文本嵌入。

接下来的章节,我们会从概念层面讲解这两种方案的工作原理,再结合最新的多模态大语言模型研究论文,看看它们在实际中的应用。

2.1 方案A:统一嵌入解码器架构

我们先从统一嵌入解码器架构讲起,其结构如下图所示。

figure05
统一嵌入解码器架构示意图:基于原生解码器风格大语言模型(如GPT-2、Phi-3、Gemma、Llama 3.2),输入由图像token嵌入与文本token嵌入共同组成。

在统一嵌入解码器架构中,图像会被转换为嵌入向量,其过程和纯文本大语言模型中将输入文本转换为嵌入的过程类似。

对于处理文本的典型纯文本大语言模型,文本输入通常先经过分词(比如字节对编码BPE),再通过嵌入层,如下图所示。

figure06
文本分词并转换为token嵌入向量的标准流程示意图,后续将输入大语言模型进行训练与推理。

2.1.1 图像编码器的原理

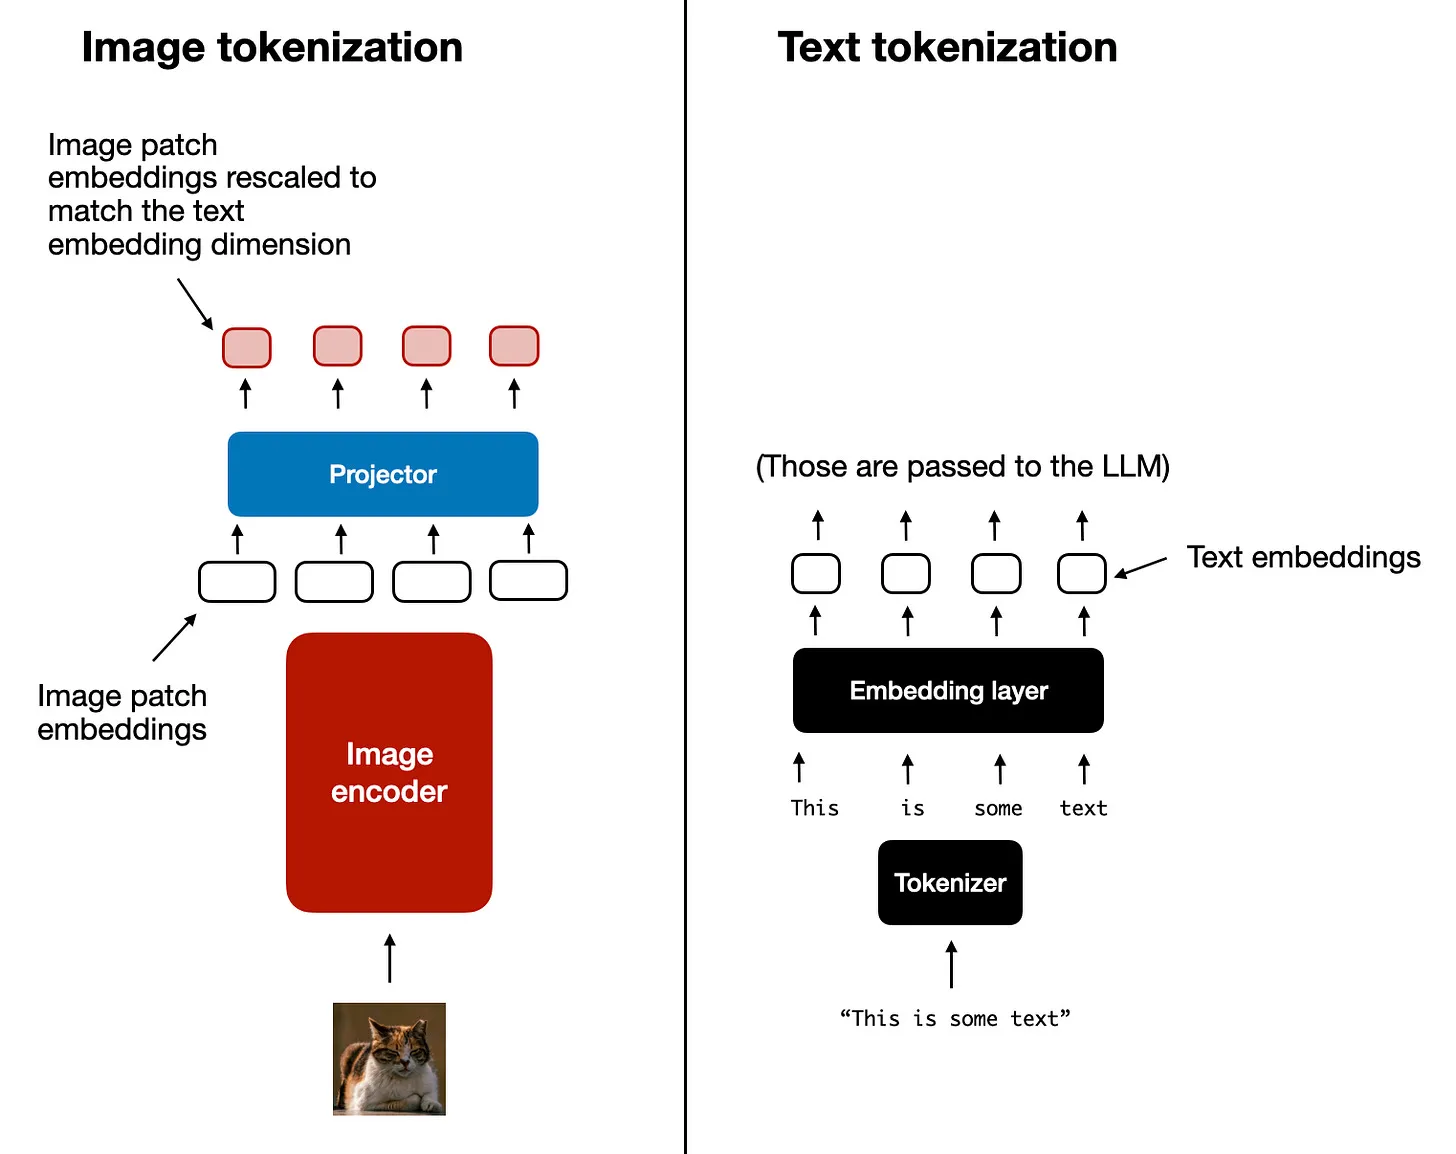
与文本的分词和嵌入过程对应,图像嵌入通过图像编码器模块生成(而非分词器),如下图所示。

figure07
图像编码为图像块嵌入的流程示意图

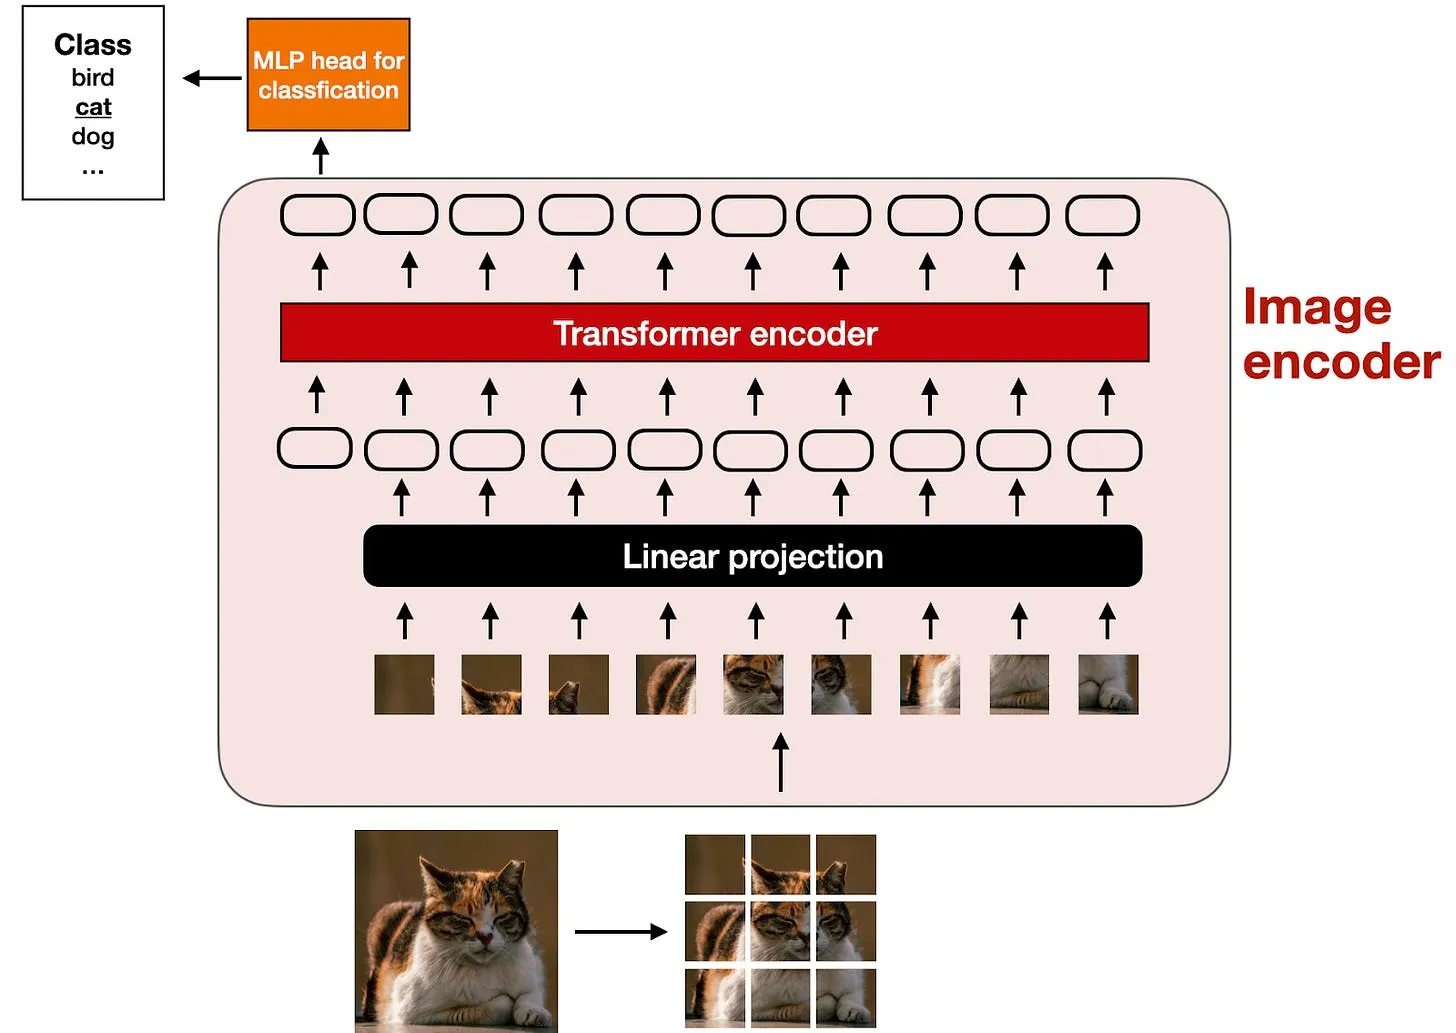
上图中的图像编码器内部是如何工作的?处理图像时,我们首先将图像切分为更小的块,就像分词时把单词拆分为子词一样。随后这些图像块由预训练的视觉Transformer(ViT)进行编码,如下图所示。

figure08
经典视觉Transformer(ViT)结构示意图,与2020年论文https://arxiv.org/abs/2010.11929提出的模型类似。

注意,视觉Transformer通常用于分类任务,所以上图中我画出了分类头。但在我们的场景中,只需要用到图像编码器部分。

2.1.2 线性投影模块的作用

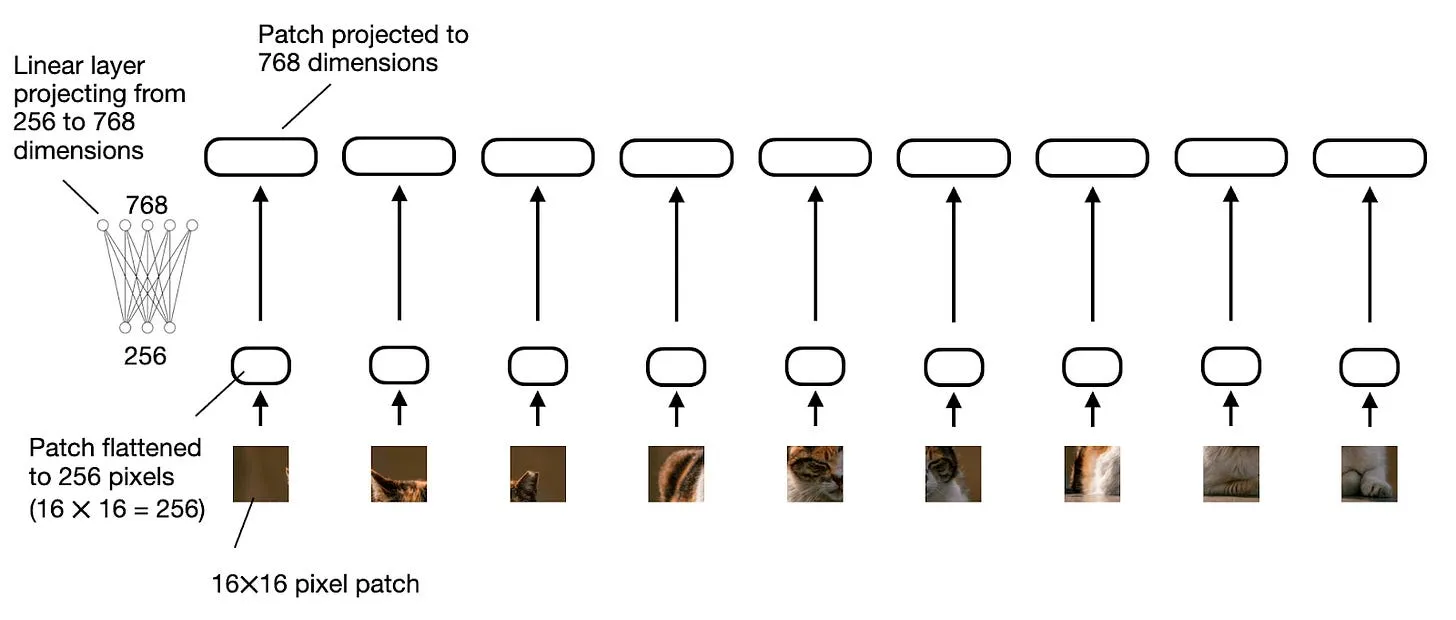
前图中所示的“线性投影”由单个线性层(即全连接层)构成。该层的作用是将展平为向量的图像块,投影到与Transformer编码器维度兼容的嵌入空间中。线性投影的过程如下图所示:一个被展平为256维向量的图像块,被向上投影为768维向量。

figure09
线性投影层示意图:将展平后的图像块从256维投影到768维嵌入空间。

如果大家想看代码示例,在PyTorch中,我们可以这样实现图像块的线性投影:

import torch
class PatchProjectionLayer(torch.nn.Module):
    def __init__(self, patch_size, num_channels, embedding_dim):
        super().__init__()
        self.patch_size = patch_size
        self.num_channels = num_channels
        self.embedding_dim = embedding_dim
        self.projection = torch.nn.Linear(
            patch_size * patch_size * num_channels, embedding_dim
        )

    def forward(self, x):
        batch_size, num_patches, channels, height, width = x.size()
        x = x.view(batch_size, num_patches, -1)  # 展平每个图像块
        x = self.projection(x)  # 对每个展平的图像块做投影
        return x

# 示例用法
batch_size = 1
num_patches = 9  # 每张图像的总块数
patch_size = 16  # 每个图像块为16×16像素
num_channels = 3  # RGB图像
embedding_dim = 768  # 嵌入向量的维度

projection_layer = PatchProjectionLayer(patch_size, num_channels, embedding_dim)
patches = torch.rand(
    batch_size, num_patches, num_channels, patch_size, patch_size
)
projected_embeddings = projection_layer(patches)
print(projected_embeddings.shape)
# 输出为
# torch.Size([1, 9, 768])

如果你碰巧读过我的《Machine Learning with PyTorch and Scikit-Learn》一书(https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768/),就会知道我们可以用卷积运算替代线性层,二者在数学上是等价的。在这里这种方法非常实用,因为我们可以用两行代码同时完成图像块划分与投影:

layer = torch.nn.Conv2d(3, 768, kernel_size=(16, 16), stride=(16, 16))
image = torch.rand(batch_size, 3, 48, 48)
projected_patches = layer(image)
print(projected_patches.flatten(-2).transpose(-1, -2).shape)
# 输出为
# torch.Size([1, 9, 768])

2.1.3 图像分词与文本分词的对比

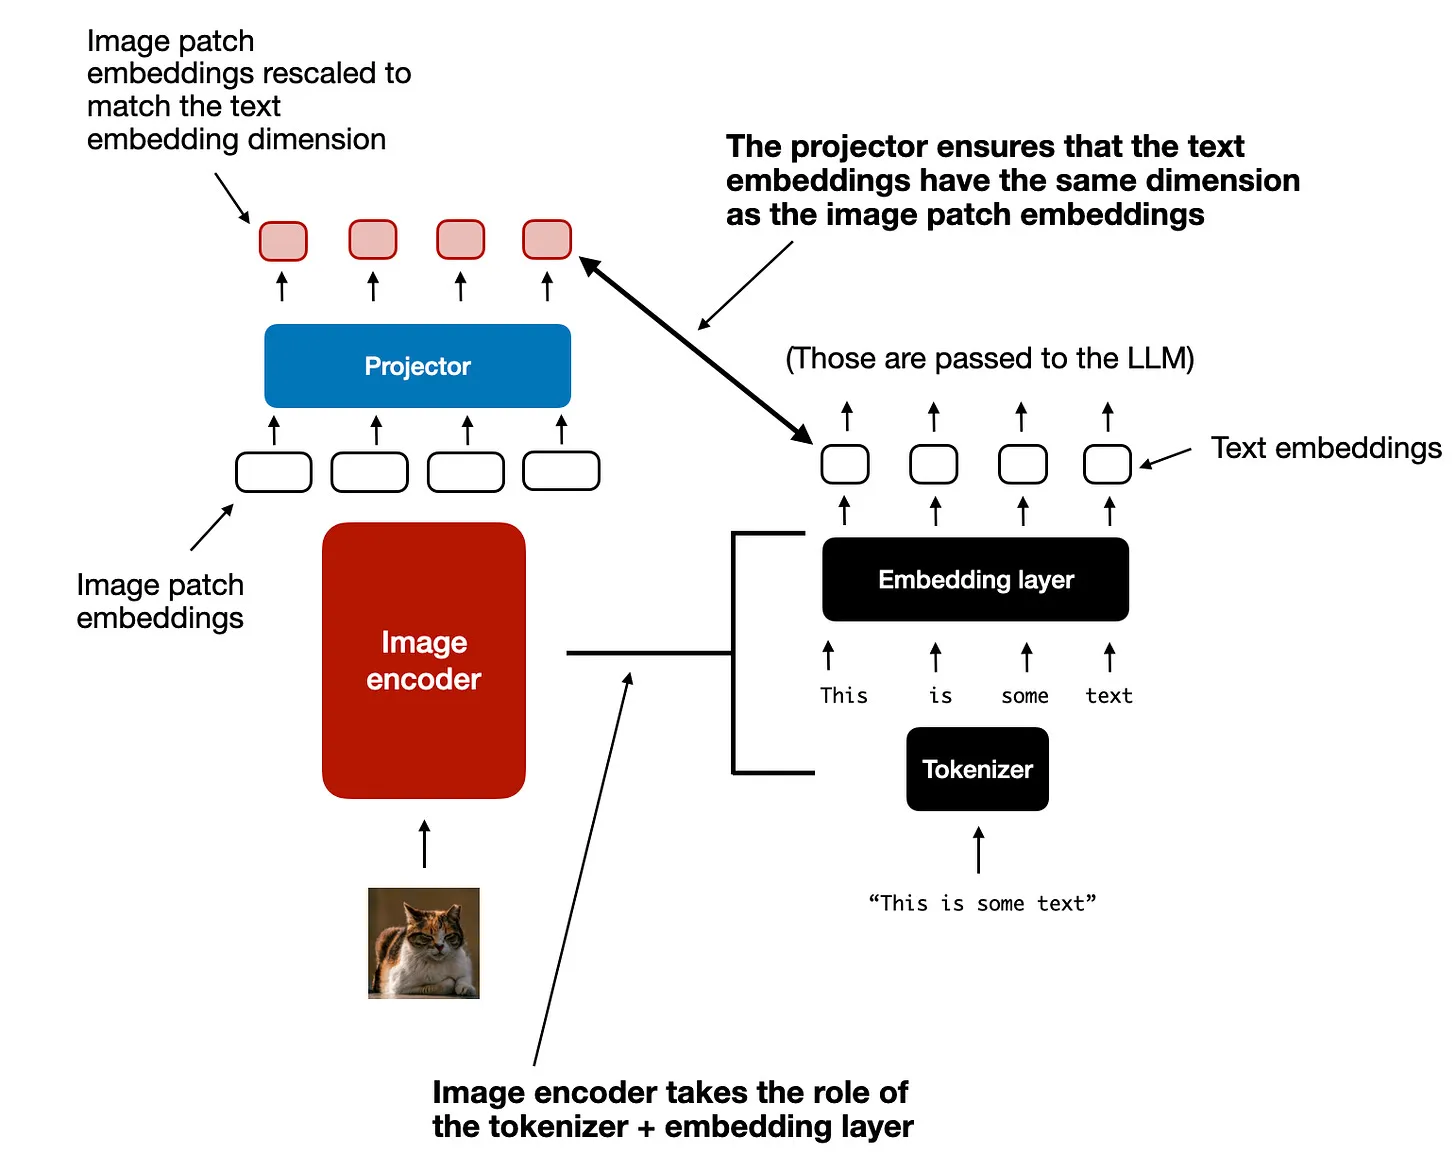
我们已经简要讲解了图像编码器(以及其中的线性投影)的作用,现在回到之前的文本分词语义类比,将图像与文本的分词、嵌入过程做一个横向对比,如下图所示。

figure10
左侧:图像分词与嵌入;右侧:文本分词与嵌入。二者对比示意图。

如上图所示,我在图像编码器之后额外加了一个投影模块。这个投影层通常就是另一个线性投影层,和之前讲解的类似,作用是将图像编码器的输出投影到与文本token嵌入维度一致的尺寸,如下图所示。(后续我们会看到,这个投影层有时也被称作适配器、转接器或连接器。)

figure11
图像分词与文本分词的另一组对比:投影层的作用是匹配文本token的嵌入维度。

当图像块嵌入与文本token嵌入的维度一致后,我们就可以直接将它们拼接起来,作为大语言模型的输入,正如本节开头的图所示。为了方便查阅,这里再放一次该图。

figure12
将图像块token投影到与文本token嵌入相同维度后,即可直接拼接为标准大语言模型的输入。

顺便一提,本节讨论的图像编码器通常是预训练好的视觉Transformer,最常用的选择是CLIP(https://github.com/openai/CLIP)或OpenCLIP(https://github.com/mlfoundations/open_clip)。

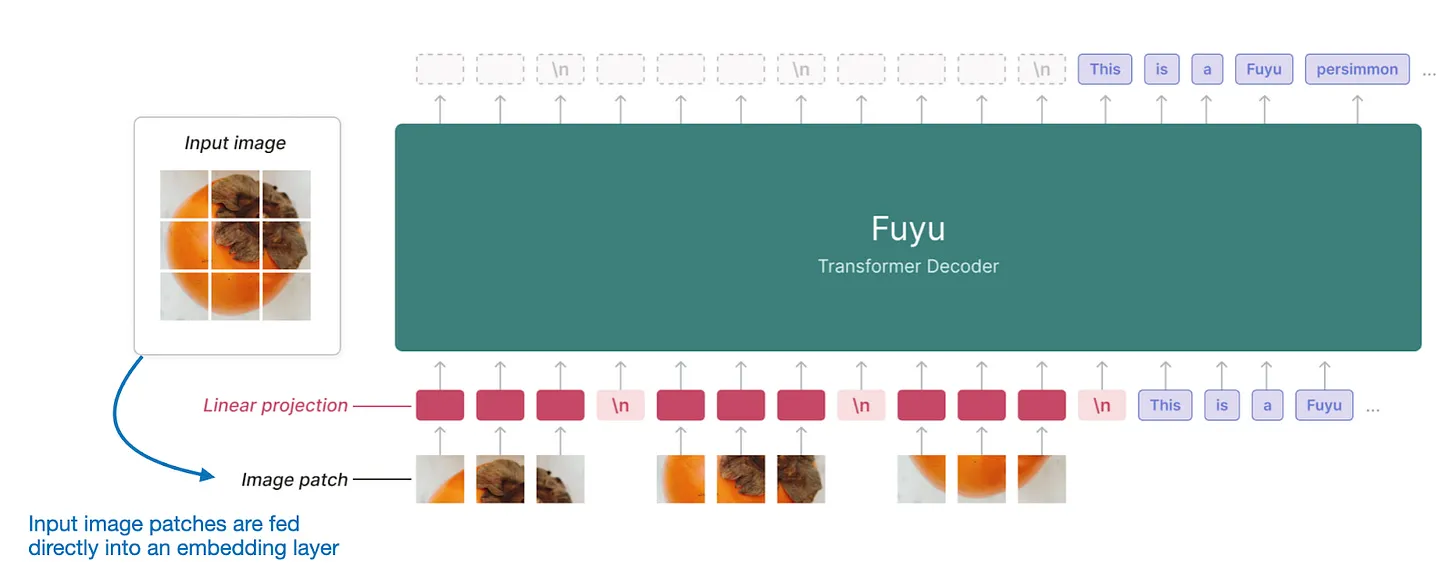
不过,也有一些方案A的变体直接对图像块进行处理,比如Fuyu-8B(https://www.adept.ai/blog/fuyu-8b),其结构如下图所示。

figure13
Fuyu多模态大语言模型标注图:无需图像编码器,直接对图像块进行处理。(图标注来源:https://www.adept.ai/blog/fuyu-8b

如上图所示,Fuyu将输入图像块直接输入线性投影(或嵌入层),自主学习图像块嵌入,而不像其他模型和方案那样依赖额外的预训练图像编码器。这种方式极大简化了架构与训练配置。

2.2 方案B:跨模态注意力架构

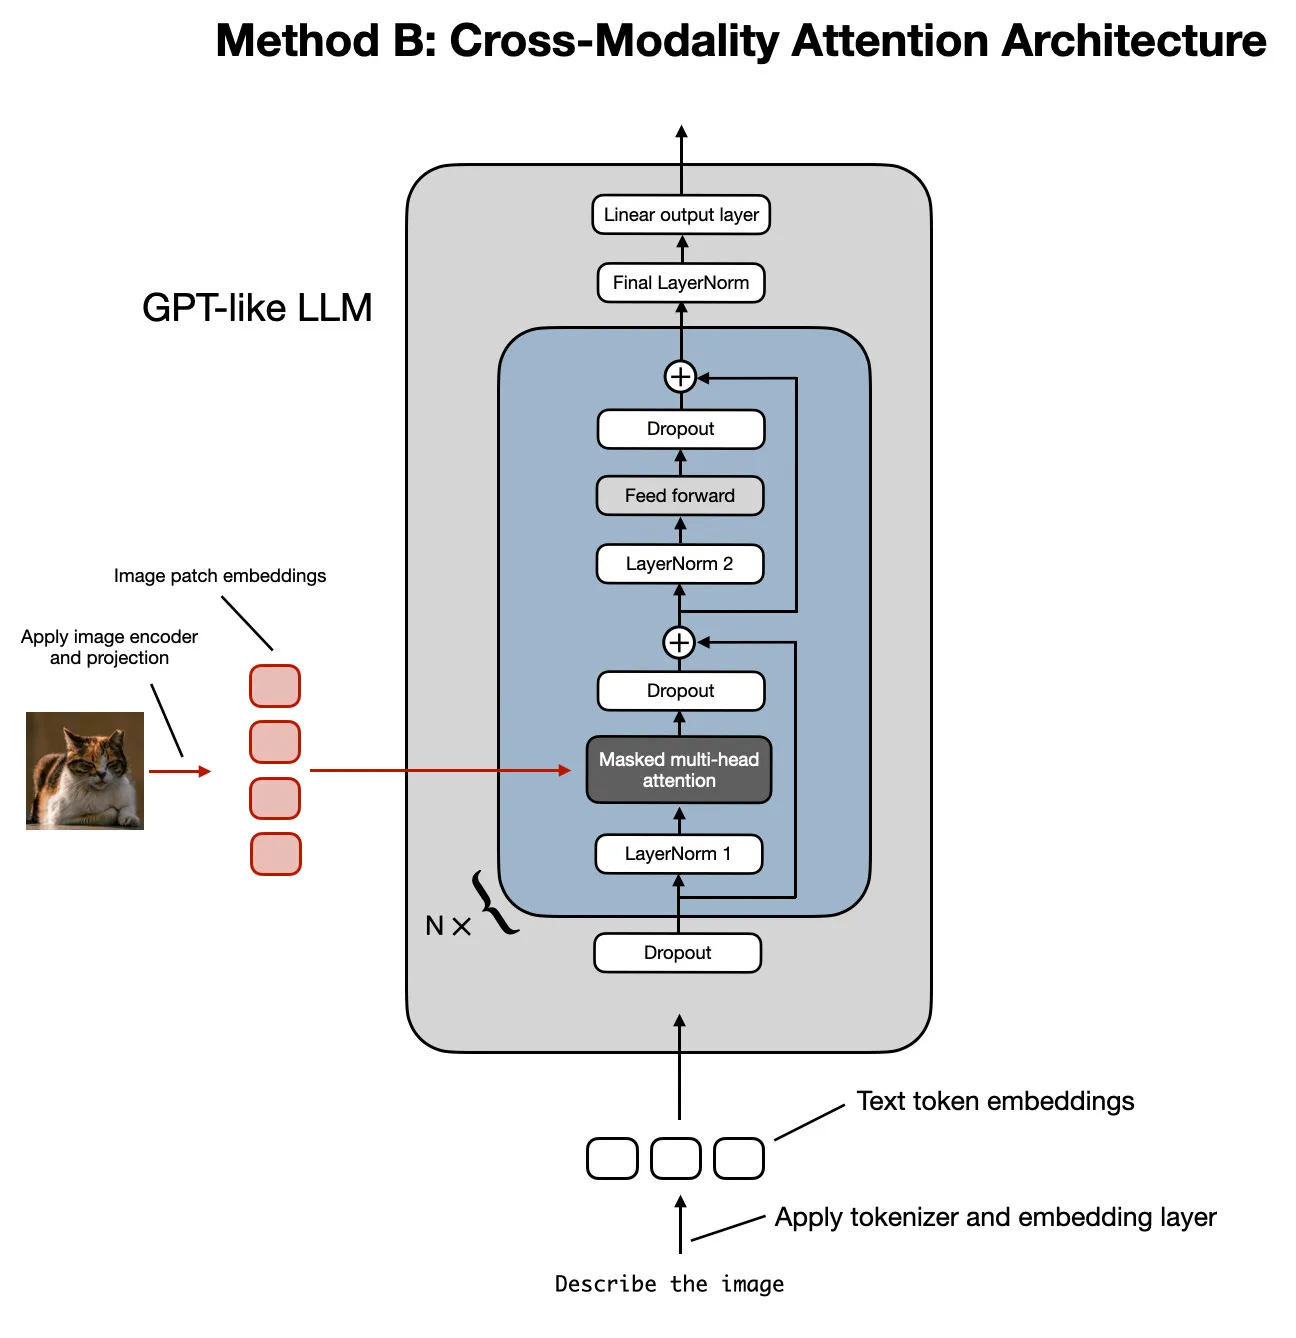
我们已经讲解了构建多模态大语言模型的统一嵌入解码器架构,理解了图像编码的基本原理。现在我们来介绍另一种实现多模态大语言模型的方案——交叉注意力,其结构概要如下图所示。

figure14
跨模态注意力架构方案示意图,用于构建多模态大语言模型。

在上图所示的跨模态注意力架构中,我们仍然使用之前讨论过的图像编码器结构。但不同的是,我们不把编码后的图像块作为大语言模型的输入,而是通过交叉注意力机制,将输入图像块连接到多头注意力层中。

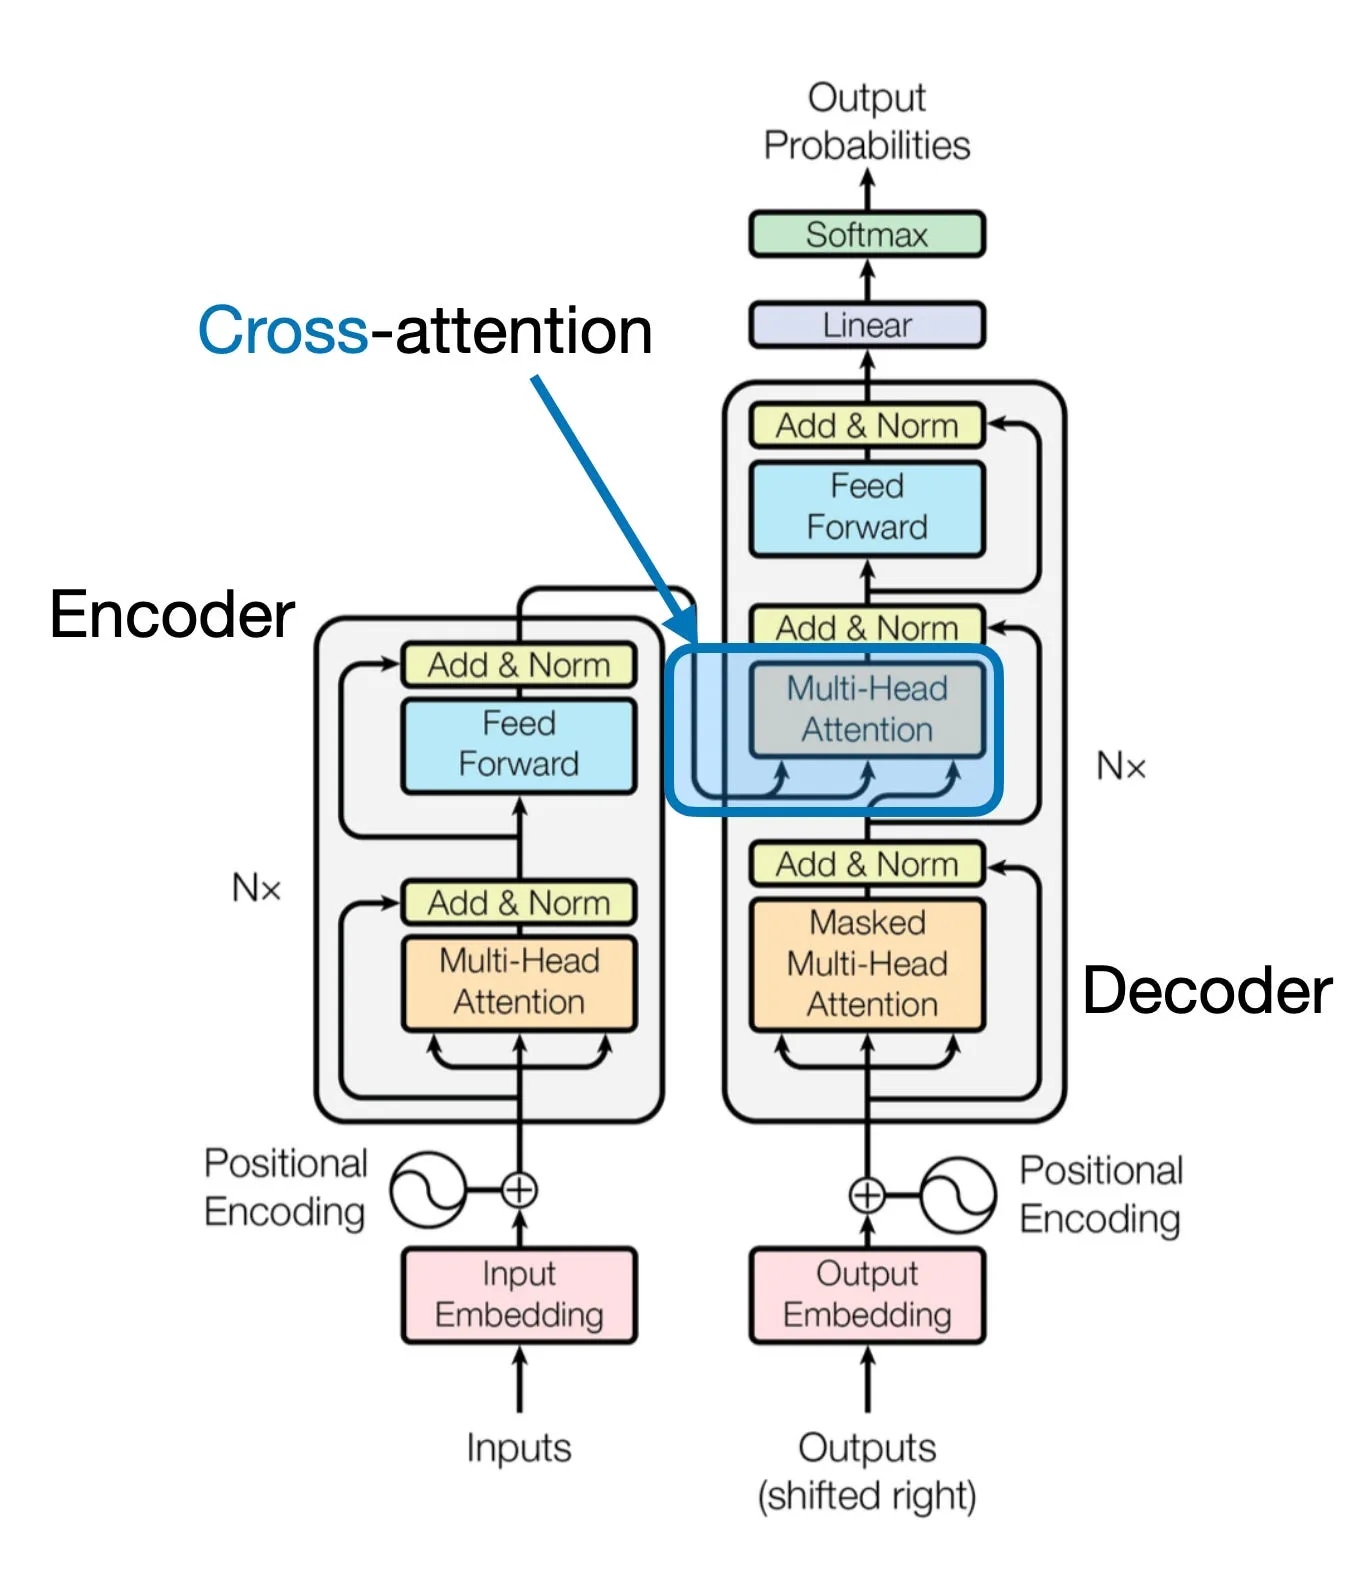
这个思路由来已久,可以追溯到2017年论文《Attention Is All You Need》(https://arxiv.org/abs/1706.03762<)中提出的原始Transformer架构,如下图所示。/p>

figure15
原始Transformer架构中使用的交叉注意力机制高层示意图。(标注图来自《Attention Is All You Need》论文:https://arxiv.org/abs/1706.03762

注意,上图中原始的Transformer最初是为机器翻译任务设计的。它由左侧的文本编码器(接收待翻译句子)和右侧的文本解码器(生成翻译结果)组成。在多模态大语言模型的场景下,编码器替换为图像编码器,但核心思路是一致的。

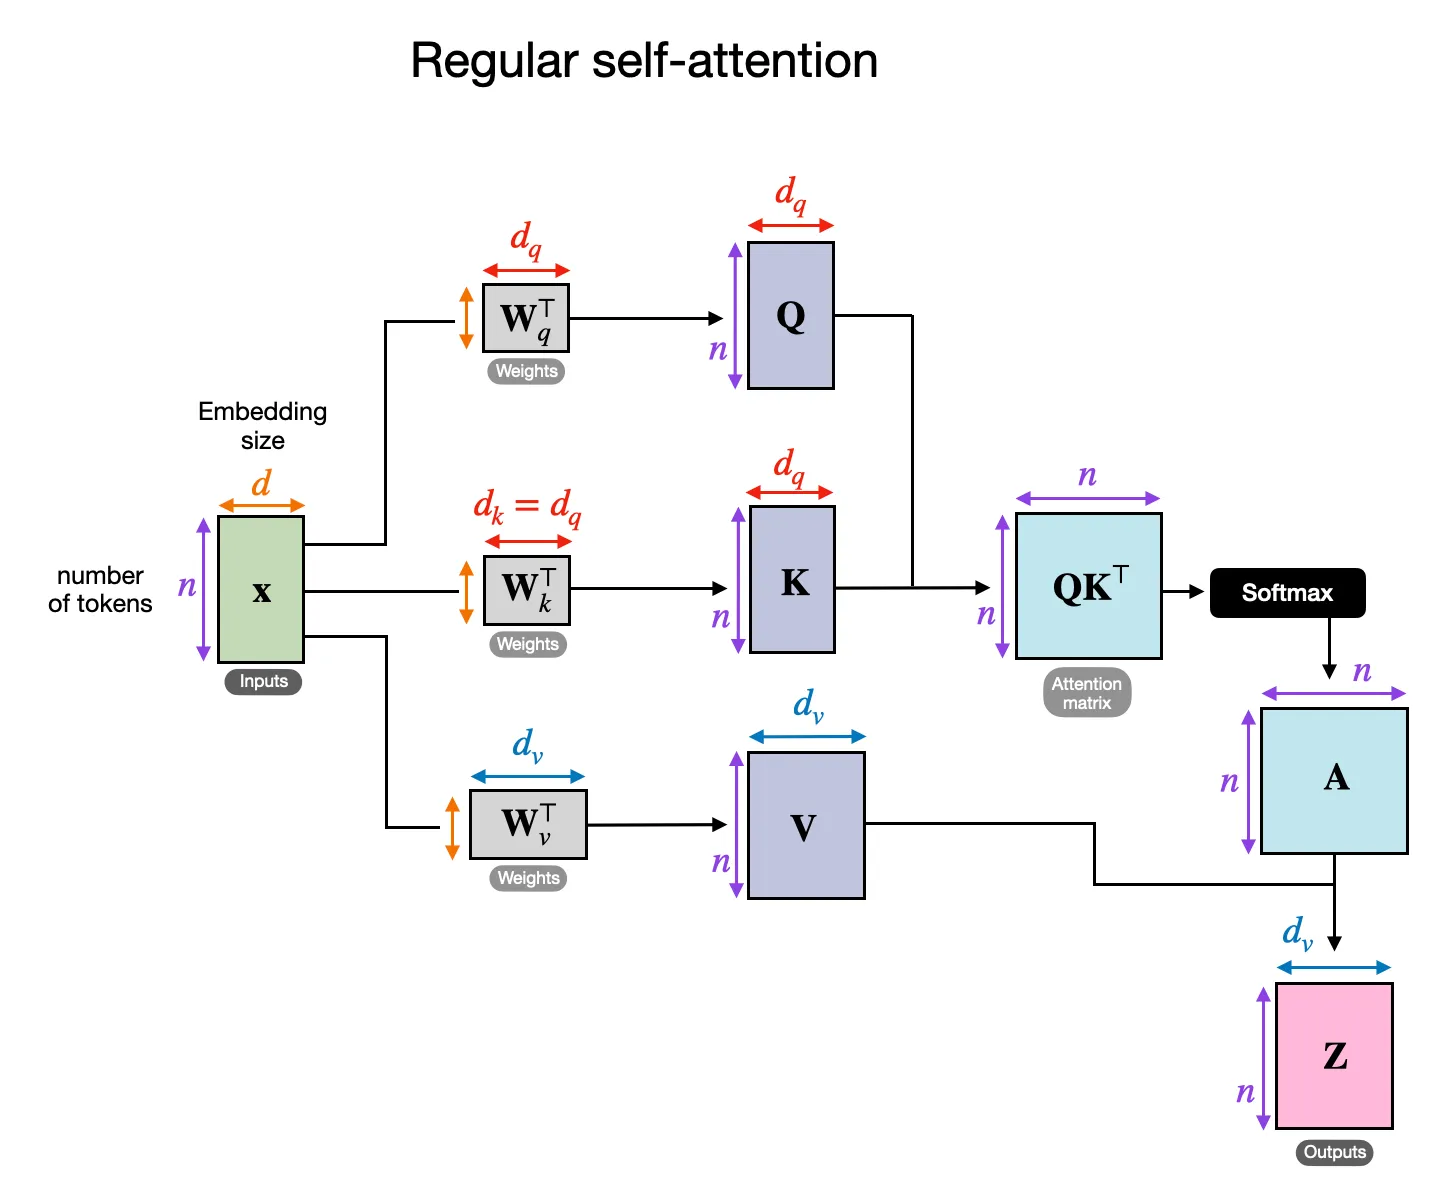
交叉注意力是如何工作的?我们先通过概念图看看常规自注意力机制内部的原理。

figure16
常规自注意力机制概要。(该流程展示了常规多头注意力模块中的一个注意力头。)

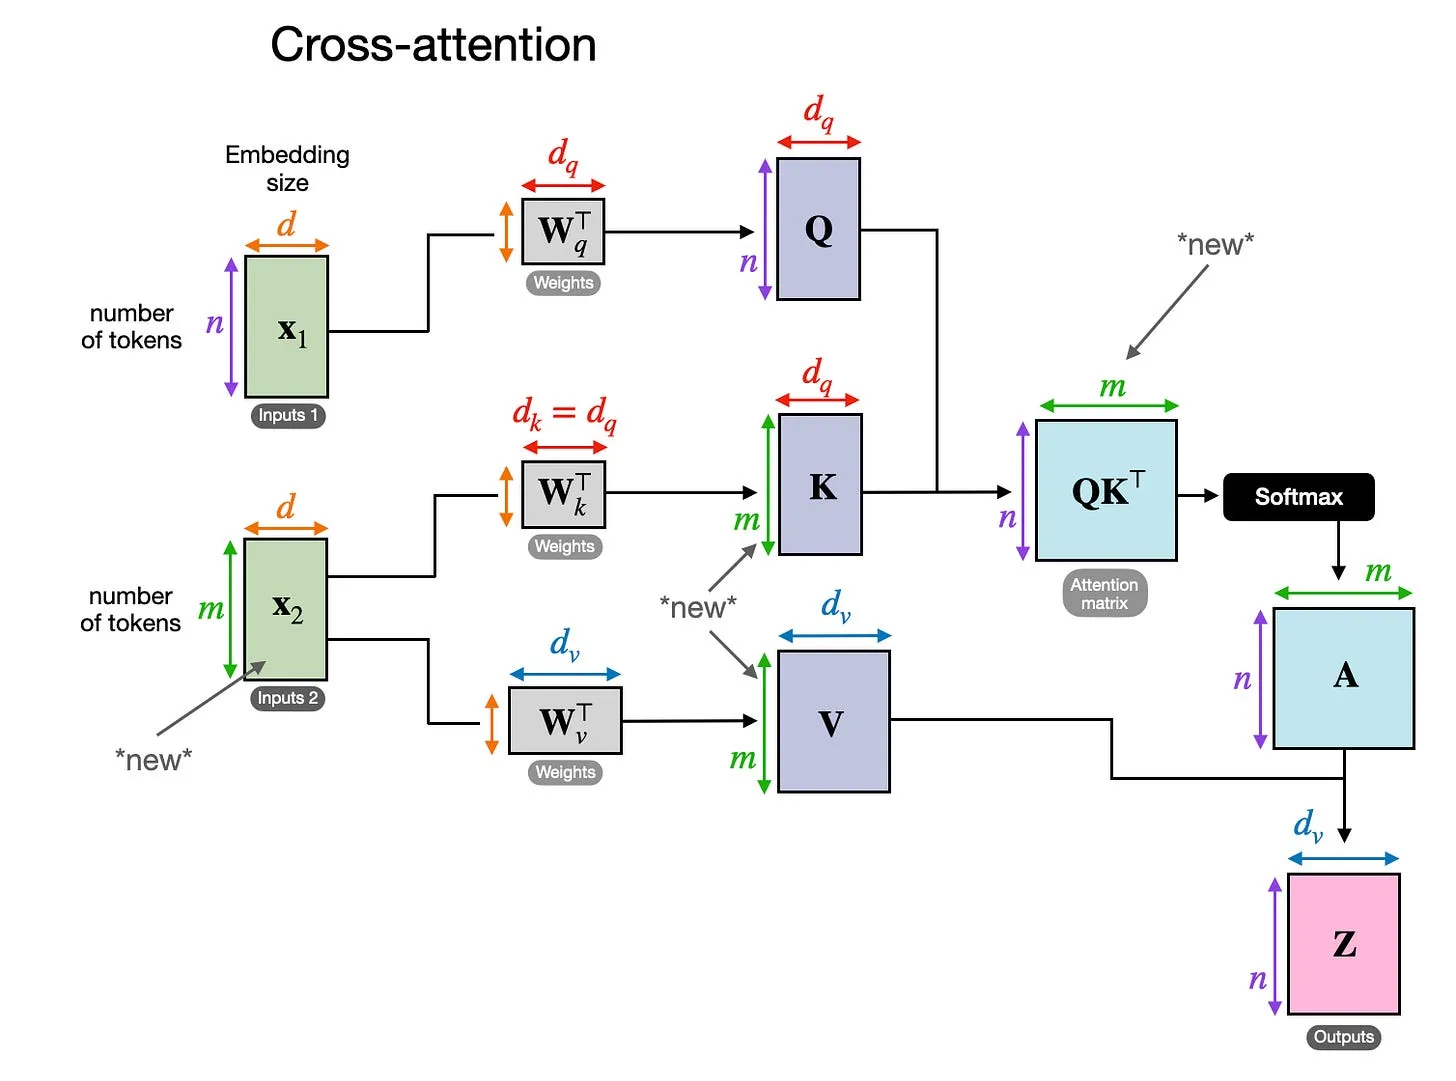
上图中,x是输入,Wq是用于生成查询(Q)的权重矩阵。同理,K代表键,V代表值。A是注意力得分矩阵,Z是输入(x)经过变换后得到的输出上下文向量。(如果这部分看起来难以理解,可以参考我的《Build A Large Language Model (From Scratch)》一书第3章的详细讲解:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167/;或者也可以看我的这篇文章:https://magazine.sebastianraschka.com/p/understanding-and-coding-self-attention)

与自注意力不同,交叉注意力有两个不同的输入源,如下图所示。

figure17
交叉注意力示意图:存在x1和x2两个不同的输入

结合前两张图可以看出,在自注意力中,我们处理的是同一个输入序列;而在交叉注意力中,我们混合或组合两个不同的输入序列。

在《Attention Is All You Need》论文的原始Transformer架构中,两个输入x1和x2分别对应左侧编码器模块的输出序列(x2),以及右侧解码器部分正在处理的输入序列(x1)。在多模态大语言模型的场景下,x2是图像编码器的输出。(注意,查询通常来自解码器,而键和值通常来自编码器。)

注意,在交叉注意力中,两个输入序列x1和x2的元素数量可以不同,但它们的嵌入维度必须匹配。如果令x1 = x2,就等价于自注意力。

3. 统一解码器与交叉注意力模型的训练

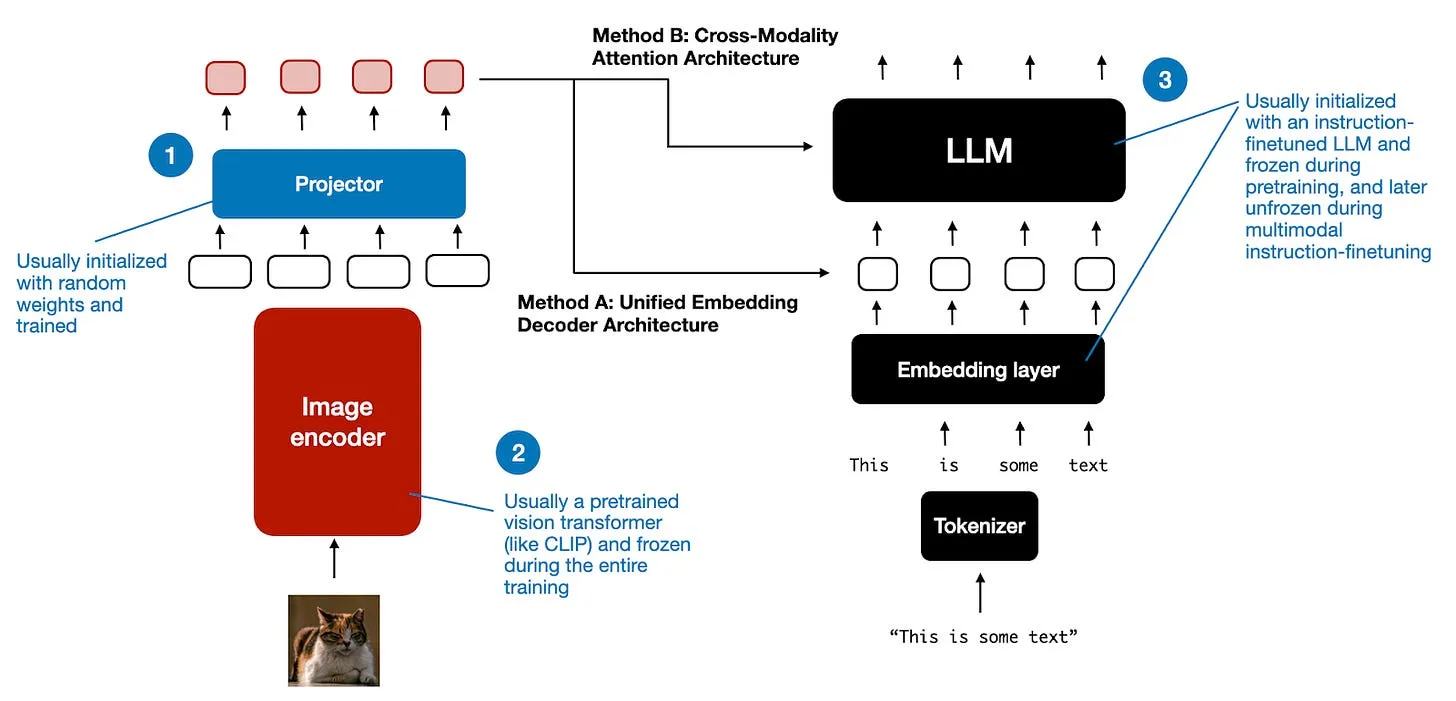
我们已经大致讲解了两种主要的多模态设计方案,现在简要谈谈训练过程中三大组件的处理方式,其概要如下图所示。

figure18
多模态大语言模型的不同组件概览。标注1-3的组件在多模态训练过程中可选择冻结或解冻。

与传统纯文本大语言模型的开发类似,多模态大语言模型的训练也分为两个阶段:预训练与指令微调。但与从零开始训练不同,多模态大语言模型的训练通常以一个预训练好、经过指令微调的纯文本大语言模型作为基座。

对于图像编码器,常用的是CLIP,且在整个训练过程中通常保持不变,不过也有例外,我们后面会讲到。在预训练阶段冻结大语言模型部分,只训练投影层(一个线性层或小型多层感知机)也是常见做法。由于投影层的学习能力有限(通常只有一到两层),在多模态指令微调阶段(第二阶段)通常会解冻大语言模型,以实现更全面的参数更新。但注意,在基于交叉注意力的模型(方案B)中,交叉注意力层在整个训练过程中都是解冻的。

介绍完两种主流方案(方案A:统一嵌入解码器架构;方案B:跨模态注意力架构)后,你可能会好奇哪种效果更好。答案取决于具体的权衡取舍:

  • 统一嵌入解码器架构(方案A)通常更易实现,因为不需要对大语言模型架构本身做任何修改。
  • 跨模态注意力架构(方案B)通常被认为计算效率更高,因为它不会用额外的图像token占用输入上下文,而是在后续的交叉注意力层中引入图像信息。此外,如果训练时冻结大语言模型参数,该方案可以保留原始大语言模型的纯文本性能。

我们会在后面的章节结合英伟达NVLM论文,继续讨论模型性能与响应质量的相关内容。

到这里,多模态大语言模型的引言部分就告一段落了。写的时候我才发现这部分比最初计划的要长很多,正好可以在这里稍作收尾。

不过,为了提供更实用的视角,我们最好来分析几篇实现了这些方案的最新研究论文。接下来的章节我们就来探讨这些论文。

4. 最新多模态模型与技术进展

在本文余下部分,我将梳理多模态大语言模型的最新研究,重点关注近几周发表的工作,以控制内容的范围。

因此,这不是一份历史性综述,也不是对多模态大语言模型的全面盘点,而是对最新进展的快速概览。我会尽量精简总结,毕竟一共有10项工作。

最后的结论部分会有一张总览图,对比这些论文采用的技术方案。

4.1 Llama 3模型家族

Meta AI于2024年7月31日发表的论文(https://arxiv.org/abs/2407.21783)早在今年夏天就已发布,按大语言模型领域的时间尺度来看,感觉已经是很久之前的事了。不过,他们当时只介绍了多模态模型,直到很晚才正式发布,所以我认为把Llama 3纳入这份清单是合理的。(Llama 3.2系列模型于9月25日正式官宣并开放使用。)

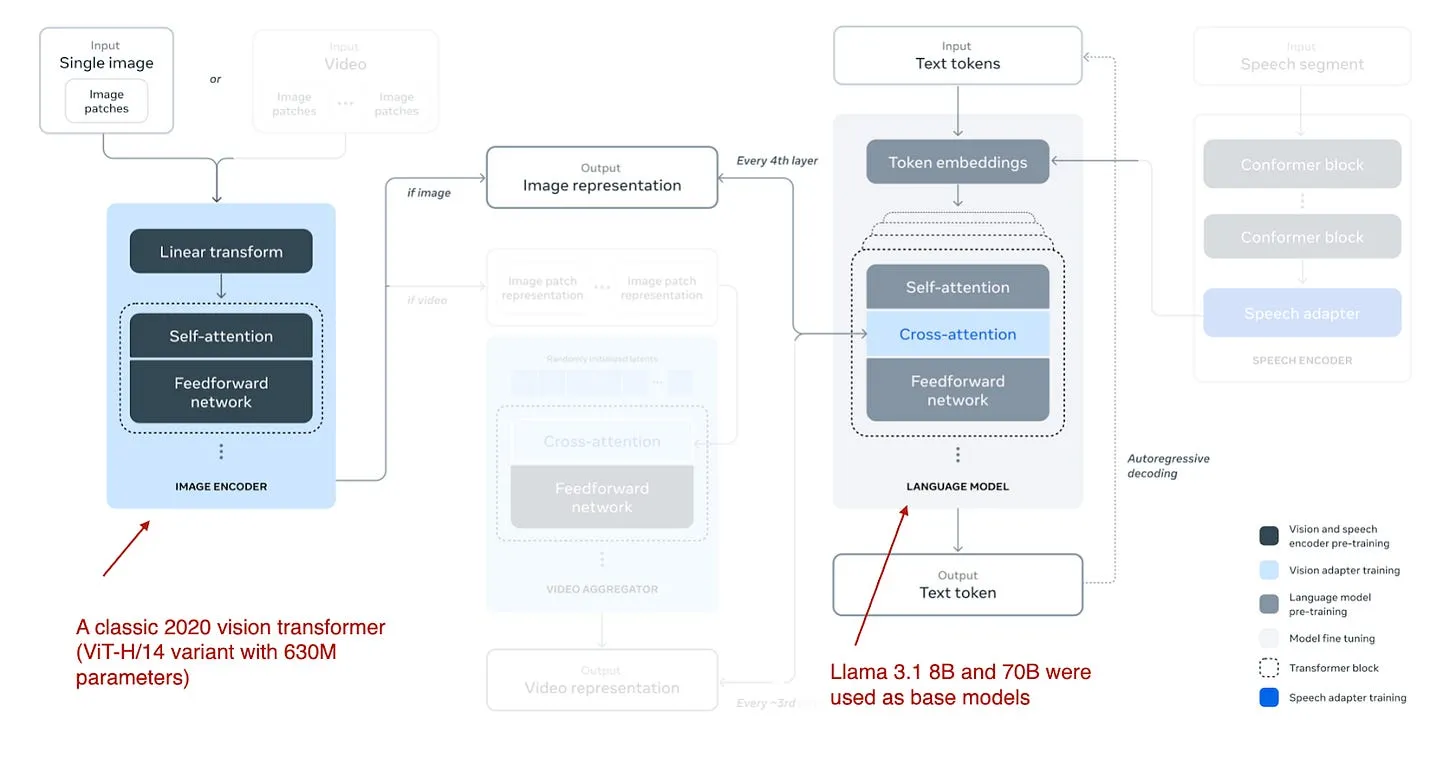
多模态版Llama 3.2包含110亿和900亿参数两个版本,属于图文模型,采用前面讲到的基于交叉注意力的方案,其结构如下图所示。

figure19
Llama 3.2采用的多模态大语言模型方案示意图。(标注图来自Llama 3论文:https://arxiv.org/abs/2407.21783。图中视频与语音部分被隐去,以聚焦图像部分。)

注意,虽然图中也画出了视频和语音作为可选模态,但截至撰写本文时,已发布的模型仅支持图像和文本。

Llama 3.2采用基于交叉注意力的方案。但和我之前讲到的常规做法有些不同——通常在多模态大语言模型开发中,我们会冻结图像编码器,只在预训练阶段更新大语言模型参数。

而这里研究人员的做法几乎相反:他们更新图像编码器,但不更新语言模型的参数。他们在论文中表示,这是有意为之,目的是保留模型的纯文本能力,使得11B和90B多模态模型可以在文本任务上作为Llama 3.1 8B和70B纯文本模型的直接替代品。

训练本身分多轮进行,从Llama 3.1文本模型开始。加入图像编码器和投影层(这里称为“适配器”层)后,先在图文数据上进行预训练。随后,和Llama 3纯文本模型的训练流程类似(我在这篇文章中讲过:https://magazine.sebastianraschka.com/i/147749119/llama-overview),再进行指令微调和偏好微调。

研究人员没有采用CLIP这类预训练模型作为图像编码器,而是从零开始预训练了一个视觉Transformer。具体来说,他们采用了经典视觉Transformer架构的ViT-H/14变体(6.3亿参数)(参考论文:https://arxiv.org/abs/2010.11929),并在25亿对图文数据上预训练了5个epoch;这一步是在将图像编码器接入大语言模型之前完成的。(该图像编码器接收224×224分辨率的图像,将其划分为14×14的图像块网格,每个块大小为16×16像素。)

由于交叉注意力层会引入大量参数,因此它们仅在每四个Transformer块中添加一层。(对于8B模型,这会增加30亿参数;对于70B模型,则增加200亿参数。)

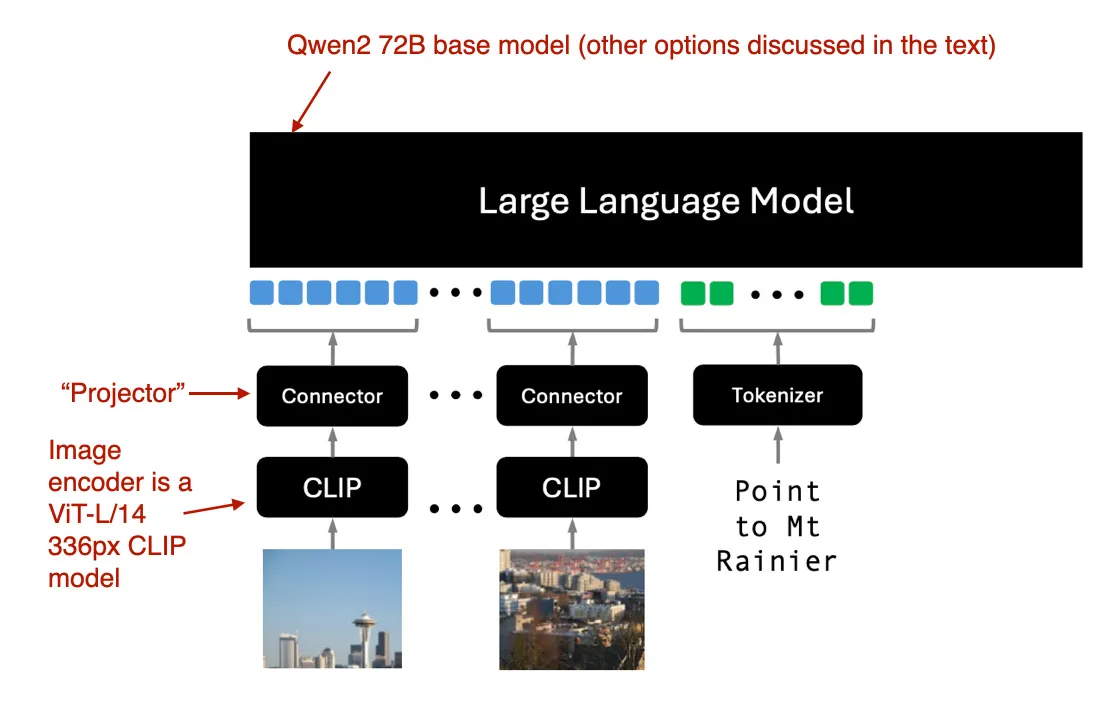
4.2 Molmo与PixMo:开源权重与开源数据打造的顶尖多模态模型

2024年9月25日的论文(https://www.arxiv.org/abs/2409.17146)值得关注,因为它承诺不仅开源模型权重,还开源数据集与源代码,和纯文本领域的OLMo大语言模型类似。(这对大语言模型研究意义重大,让我们可以查看完整的训练流程与代码,也能在相同数据集上做消融实验、复现结果。)

如果你好奇标题里为什么有两个名字:Molmo指的是模型本身(Multimodal Open Language Model,多模态开放语言模型),而PixMo(Pixels for Molmo)是配套的数据集。

figure20
Molmo的纯解码器方案(方案A)示意图。标注图改编自《Molmo and PixMo: Open Weights and Open Data for State-of-the-Art Multimodal Models》论文:https://www.arxiv.org/abs/2409.17146

如上图所示,其图像编码器采用现成的视觉Transformer,具体来说是CLIP。图中的“连接器(connector)”指的就是“投影层(projector)”,用于对齐图像特征与语言模型的维度。

Molmo简化了训练流程,没有采用多阶段预训练,而是选择了一套统一的流水线,同时更新所有参数——包括基座大语言模型、连接器和图像编码器的参数。

Molmo团队提供了多种基座大语言模型可选:

  • OLMo-7B-1024(完全开源的模型基座)
  • OLMoE-1B-7B(混合专家架构,效率最高的模型)
  • Qwen2 7B(开源权重模型,性能优于OLMo-7B-1024)
  • Qwen2 72B(开源权重模型,性能最佳)

4.3 NVLM:开源旗舰级多模态大语言模型

英伟达2024年9月17日的论文(https://arxiv.org/abs/2409.11402)格外有意思,因为它没有只聚焦于单一方案,而是探索了两种路线:

  • 方案A:统一嵌入解码器架构(“纯解码器架构”,NVLM-D)
  • 方案B:跨模态注意力架构(“基于交叉注意力的架构”,NVLM-X)

此外,他们还提出了一种混合方案(NVLM-H),并对三种方案做了公平的横向对比。

figure21
三种多模态方案概览。(标注图来自《NVLM: Open Frontier-Class Multimodal LLMs》论文:https://arxiv.org/abs/2409.11402

如下图总结,NVLM-D对应前文的方案A,NVLM-X对应方案B。混合模型(NVLM-H)的设计理念是结合两者的优势:输入一张图像缩略图,再通过交叉注意力传入动态数量的图像块,以捕捉更精细的高分辨率细节。

简而言之,研究团队发现:

  • NVLM-X在处理高分辨率图像时计算效率更出色。
  • NVLM-D在OCR相关任务中准确率更高。
  • NVLM-H融合了两种方法的优点。

和Molmo等方案类似,他们也以纯文本大语言模型为起点,而非从零预训练多模态模型(因为这样通常效果更好)。此外,他们使用的是经过指令微调的大语言模型,而非基础基座模型。具体来说,基座大语言模型是Qwen2-72B-Instruct(据我所知,Molmo使用的是Qwen2-72B基础版模型)。

在NVLM-D方案中,研究人员训练了所有大语言模型参数;而对于NVLM-X,他们发现在预训练和指令微调阶段,冻结原始大语言模型参数、只训练交叉注意力层就可以取得很好的效果。

图像编码器方面,他们没有使用典型的CLIP模型,而是采用了InternVL(https://arxiv.org/abs/2312.14238),且在所有阶段都保持冻结。

投影层采用多层感知机,而非单个线性层。

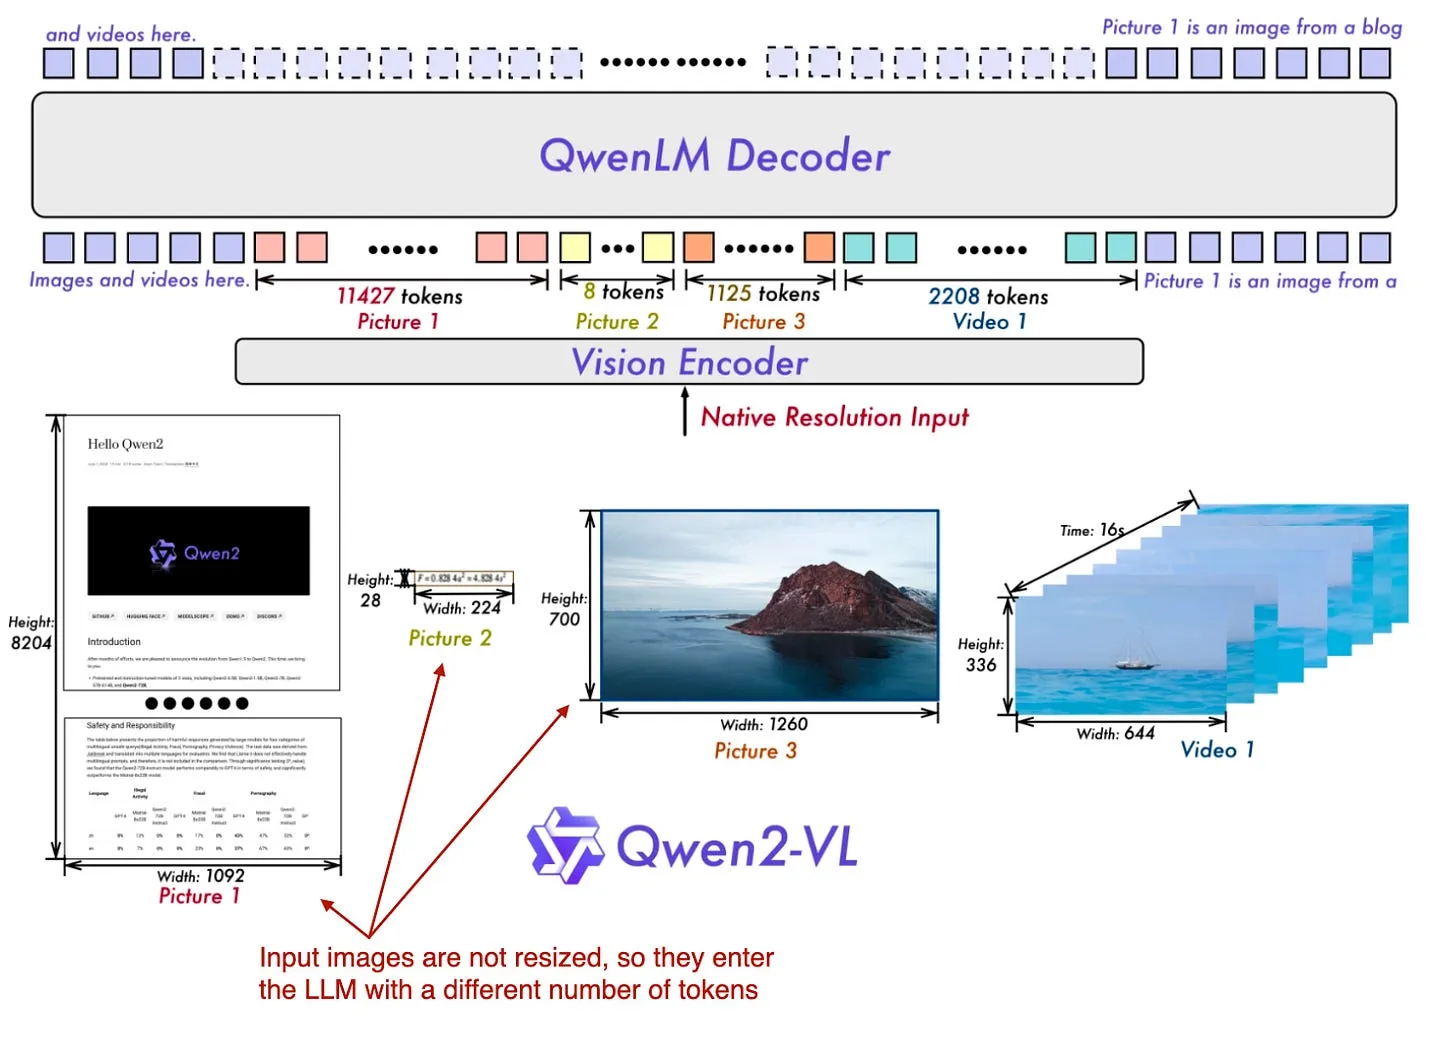
4.4 Qwen2-VL:以任意分辨率增强视觉语言模型的世界感知能力

前两篇论文与模型(Molmo和NVLM)都基于Qwen2-72B大语言模型。而在这篇论文中,通义千问研究团队推出了自己的多模态大语言模型Qwen2-VL,论文发表于2024年10月3日(https://arxiv.org/abs/2409.12191)。

这项工作的核心是所谓的“朴素动态分辨率(Naive Dynamic Resolution)”机制(“naive”是刻意使用的词,并非“native”的笔误,不过“原生”的含义也同样贴切)。该机制让模型能够处理不同分辨率的图像,而无需简单下采样,支持以原始分辨率输入图像。

figure22
通义千问多模态模型概览:可原生处理多种不同分辨率的输入图像。(标注图来自《Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution》论文:https://arxiv.org/abs/2409.12191

原生分辨率输入的实现方式是对经典ViT进行修改:移除原始的绝对位置嵌入,引入二维旋转位置编码(2D-RoPE)。

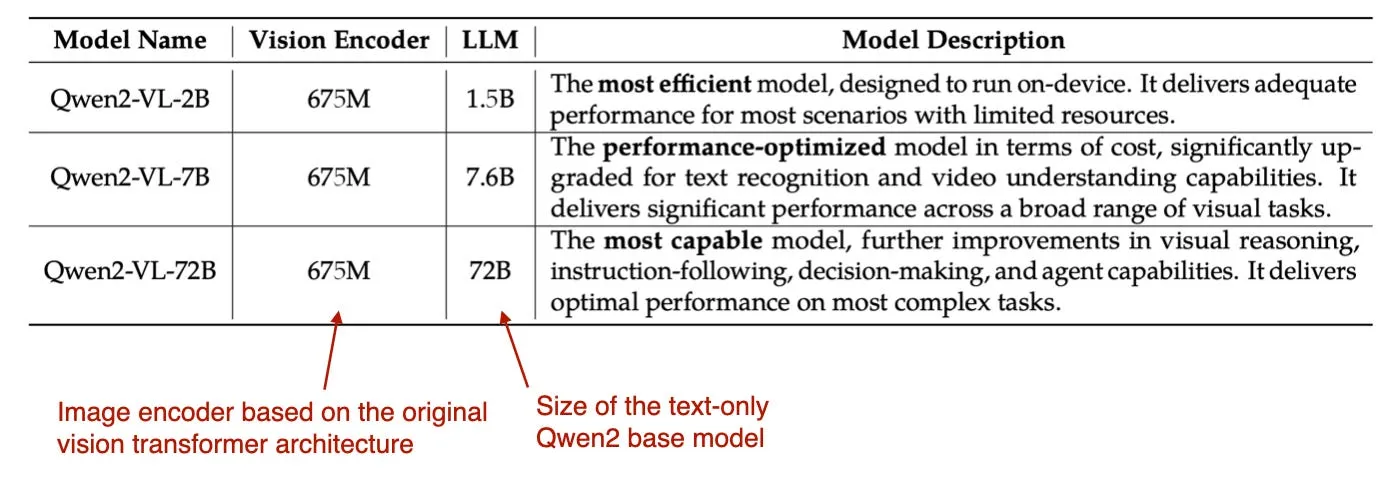
他们采用了参数量为6.75亿的经典视觉编码器,以及不同尺寸的大语言模型基座,如下表所示。

figure23
不同尺寸Qwen2-VL模型的组件构成。(标注图来自《Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution》论文:https://arxiv.org/abs/2409.12191

训练本身分为3个阶段:(1)仅预训练图像编码器;(2)解冻所有参数(包括大语言模型);(3)冻结图像编码器,仅对大语言模型进行指令微调。

4.5 Pixtral 12B

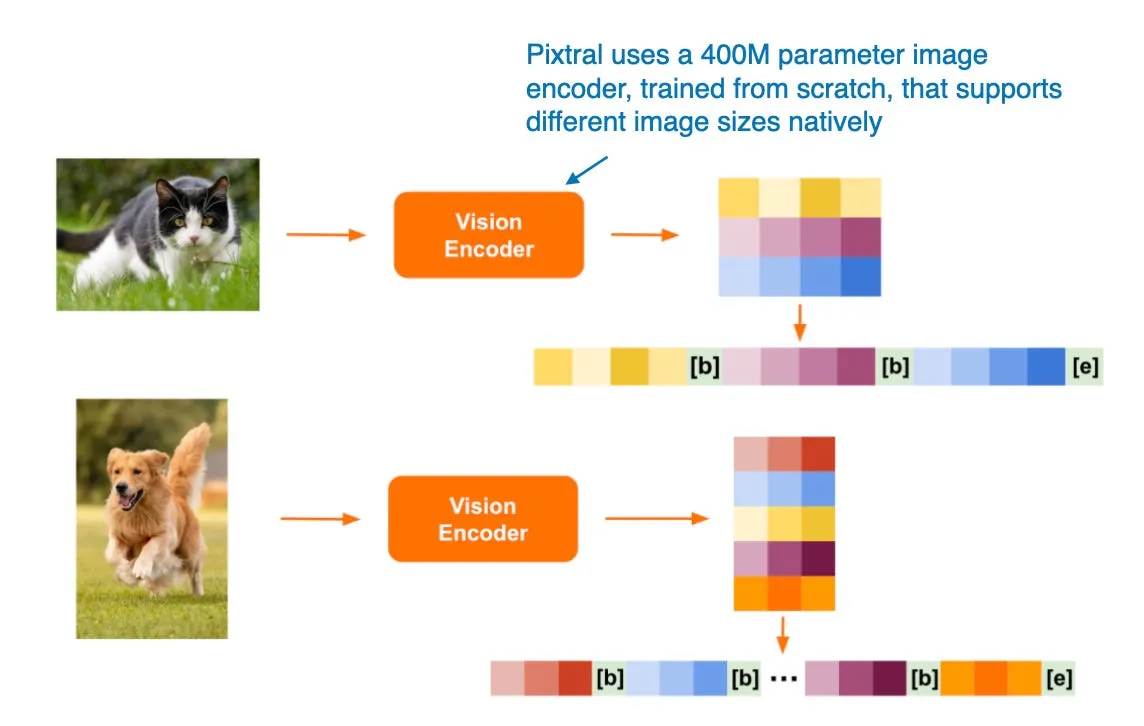
Mistral AI于2024年9月17日发布的Pixtral 12B(https://mistral.ai/news/pixtral-12b/)采用方案A:统一嵌入解码器架构,是Mistral AI的首款多模态模型。遗憾的是目前没有相关技术论文或报告,但Mistral团队在官方博客中分享了几个值得关注的细节:https://mistral.ai/news/pixtral-12b/

有意思的是,他们没有使用预训练的图像编码器,而是从零训练了一个4亿参数的图像编码器。大语言模型基座则采用120亿参数的Mistral Nemo模型(https://mistral.ai/news/mistral-nemo/)。

和Qwen2-VL类似,Pixtral也原生支持可变尺寸图像输入,如下图所示。

figure24
Pixtral处理不同尺寸图像的方式示意图。(标注图来自Pixtral官方博客:https://mistral.ai/news/pixtral-12b/

4.6 MM1.5:多模态大语言模型微调的方法、分析与洞见

2024年9月30日的论文(https://arxiv.org/abs/2409.20566)提供了实用的训练技巧,并推出了混合专家架构的多模态模型,以及一款和Molmo类似的稠密模型。模型尺寸覆盖广泛,从10亿到300亿参数不等。

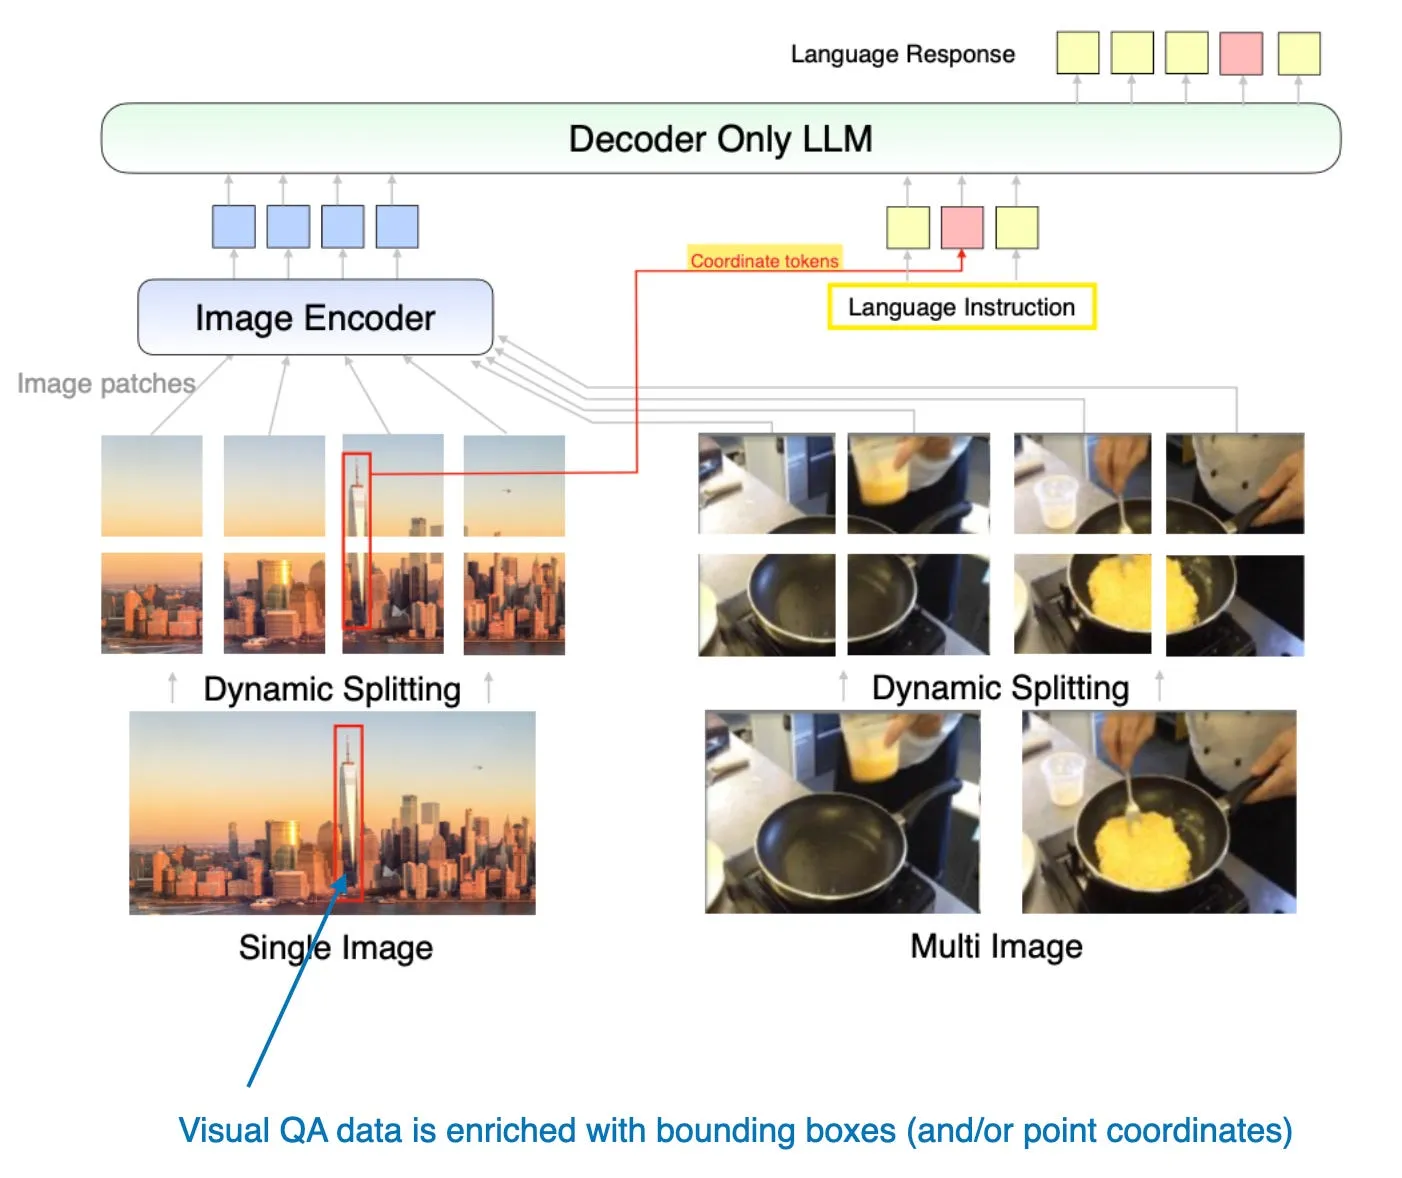
该论文中的模型聚焦于方案A:统一嵌入Transformer架构,该架构能有效组织输入,适配多模态学习。

此外,论文还做了一系列有意思的消融实验,探究了数据混合比例以及使用坐标token的效果。

figure25
MM1.5方案示意图:加入了额外的坐标token来表示边界框。(标注图来自《MM1.5: Methods, Analysis & Insights from Multimodal LLM Fine-tuning》论文:https://arxiv.org/abs/2409.20566

4.7 Aria:开源多模态原生混合专家模型

2024年10月8日的论文(https://arxiv.org/abs/2410.05993)提出了另一种混合专家模型方案,和Molmo、MM1.5系列中的某个变体类似。

Aria模型总参数量为249亿,其中每个文本token激活35亿参数。图像编码器(基于SigLIP,https://arxiv.org/abs/2303.15343)有4.38亿参数。

该模型基于交叉注意力方案,整体训练流程如下:

  • 从零开始完整训练大语言模型基座。
  • 同时预训练大语言模型基座与视觉编码器。

4.8 百川-Omni

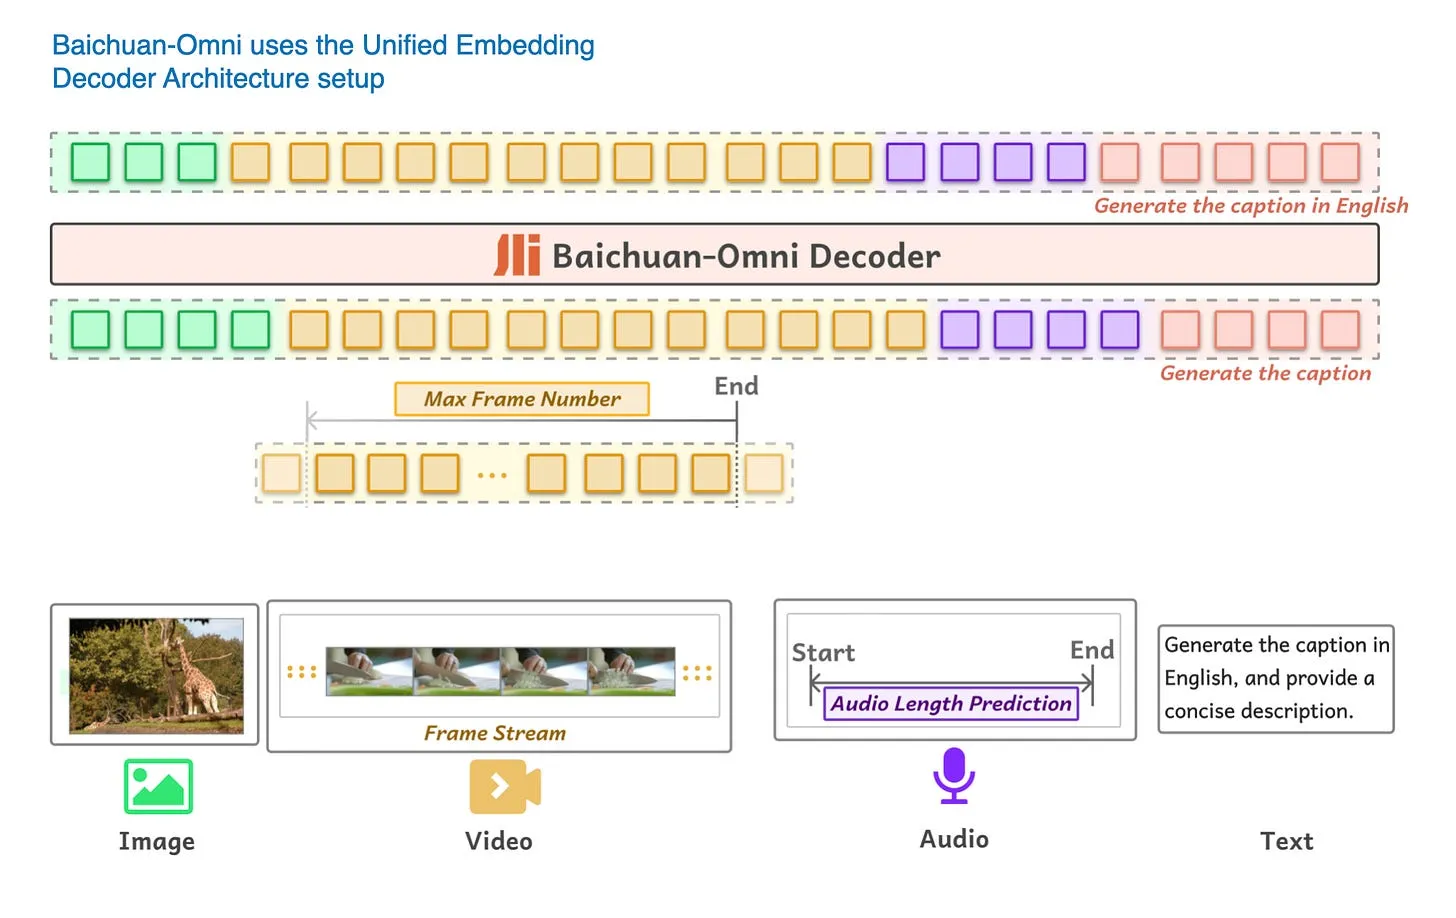
2024年10月11日的论文(https://arxiv.org/abs/2410.08565)推出了百川-Omni,一款70亿参数的多模态大语言模型,采用方案A:统一嵌入解码器架构,如下图所示。

figure26
百川-Omni模型概览:可处理多种输入模态。(标注图来自《Baichuan-Omni Technical Report》论文:https://arxiv.org/abs/2410.08565

百川-Omni的训练过程分为三阶段:

  1. 投影层训练:初始阶段只训练投影层,视觉编码器与大语言模型均保持冻结。
  2. 视觉编码器训练:随后解冻视觉编码器并进行训练,大语言模型仍保持冻结。
  3. 全模型训练:最后解冻大语言模型,实现端到端的完整训练。

该模型采用SigLIP视觉编码器,并集成了任意分辨率训练模块(https://arxiv.org/abs/2204.07156),通过下采样技术处理高分辨率图像。

虽然报告没有明确说明大语言模型基座,但从模型参数量和命名规则来看,很可能基于百川7B大语言模型。

4.9 Emu3:下一词预测即可解决一切问题

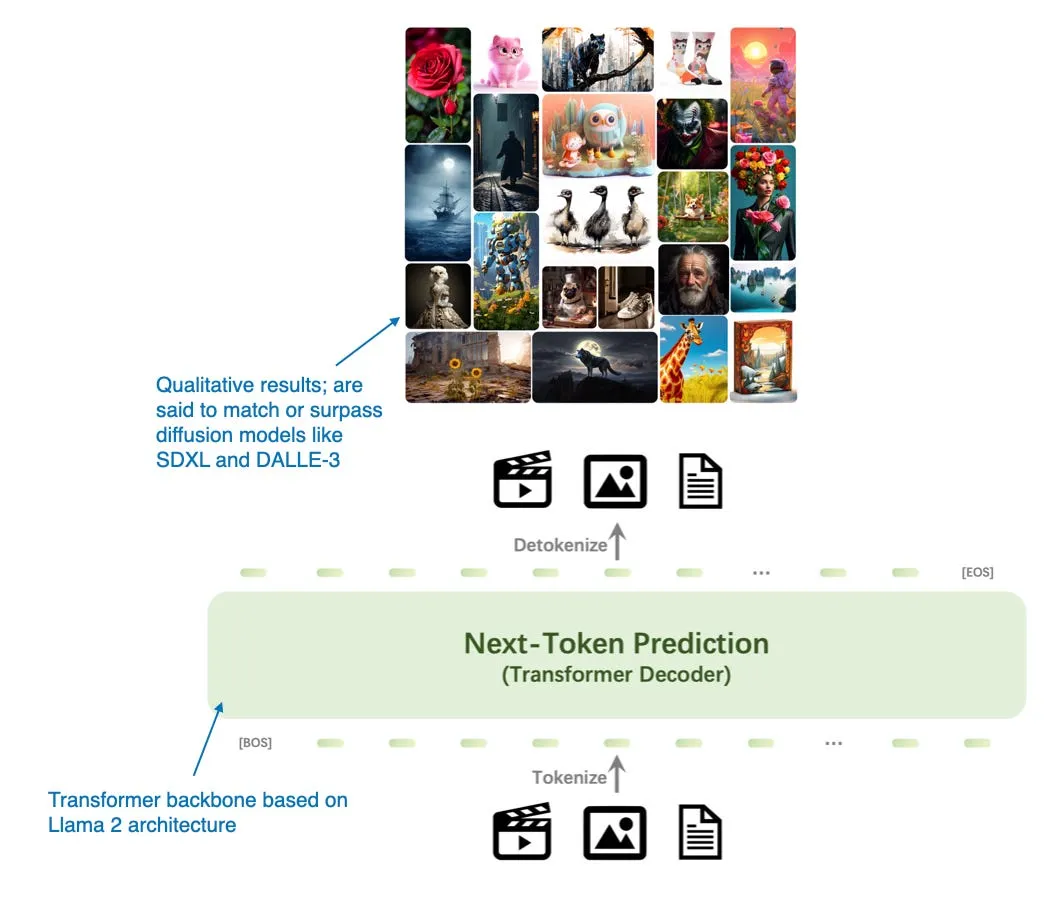
2024年9月27日发布的《Emu3: Next-Token Prediction is All You Need》论文,提出了一种极具竞争力的扩散模型替代方案,用于图像生成,且完全基于Transformer解码器架构。尽管严格来说它不算经典意义上的多模态大语言模型(经典多模态模型聚焦于图像理解而非生成),但Emu3的价值在于,它证明了Transformer解码器可以用于图像生成——这项任务通常由扩散方法主导。(不过需要注意,此前已经有过类似的思路,比如LlamaGen:https://arxiv.org/abs/2406.06525。)

figure27
Emu3主要是一款用于图像生成的大语言模型,可作为扩散模型的替代方案。(标注图来自《Emu3: Next-Token Prediction is All You Need》论文:https://arxiv.org/abs/2409.18869

研究人员从零开始训练Emu3,随后使用直接偏好优化(DPO,代码参考:https://github.com/rasbt/LLMs-from-scratch/blob/main/ch07/04_preference-tuning-with-dpo/dpo-from-scratch.ipynb)让模型对齐人类偏好。

其架构包含一个受VQGAN启发的视觉分词器(参考论文:https://arxiv.org/abs/2209.09002)。核心大语言模型架构基于Llama 2,但完全从零训练。

4.10 Janus:解耦视觉编码,实现统一的多模态理解与生成

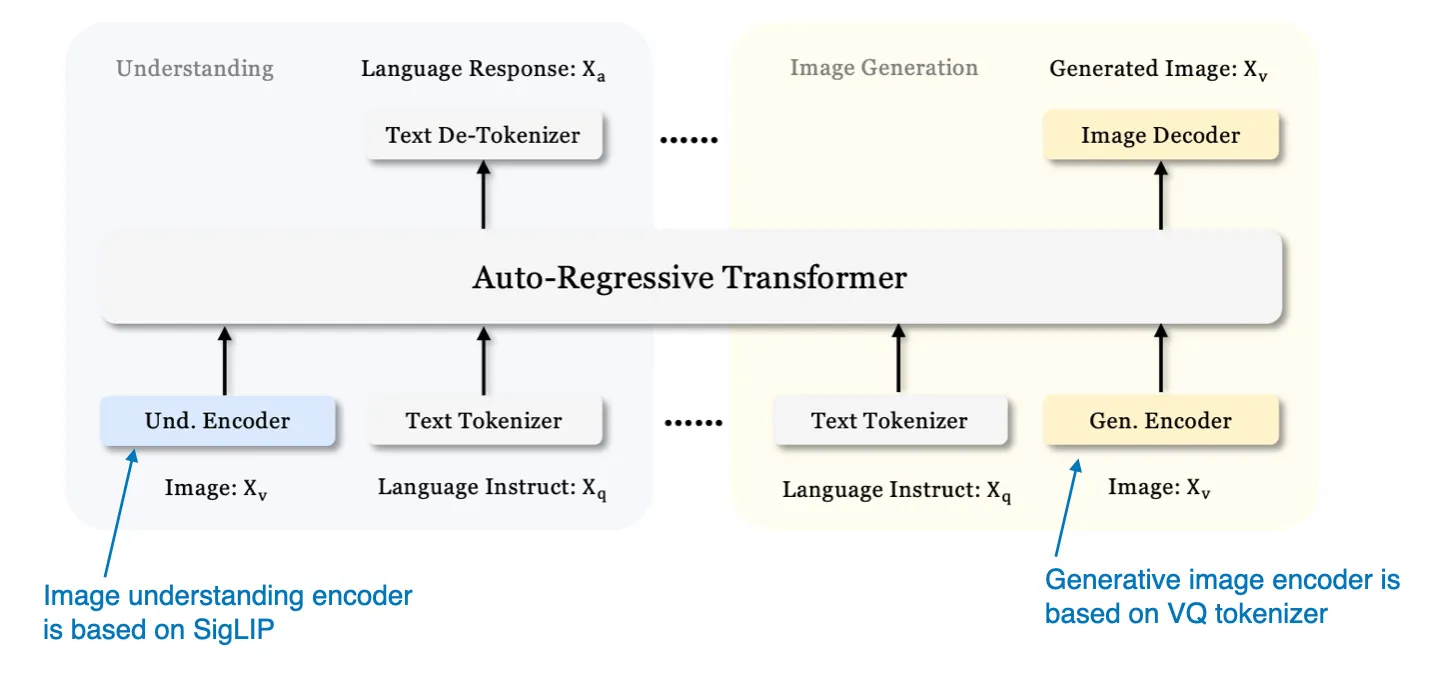
前面我们主要关注的是面向图像理解的多模态大语言模型,刚才的Emu3则是图像生成的例子。而2024年10月17日的论文(https://arxiv.org/abs/2410.13848)提出了一个在单个大语言模型基座中统一多模态理解与生成任务的框架。

Janus的核心特性是解耦视觉编码路径,以适配理解与生成两类任务的不同需求。研究人员认为,图像理解任务需要高维度的语义表示,而生成任务需要精细的局部信息与全局图像一致性。通过分离这两条路径,Janus可以高效满足不同的需求。

该模型采用与百川-Omni类似的SigLIP视觉编码器处理视觉输入;对于图像生成,则使用LlamaGen分词器(https://arxiv.org/abs/2406.06525)处理生成过程。Janus的基座大语言模型是DeepSeek LLM 1.3B(https://arxiv.org/abs/2401.02954)。

figure28
Janus采用的统一纯解码器框架概览。(标注图来自《Janus: Decoupling Visual Encoding for Unified Multimodal Understanding and Generation》论文:https://arxiv.org/abs/2410.13848。)

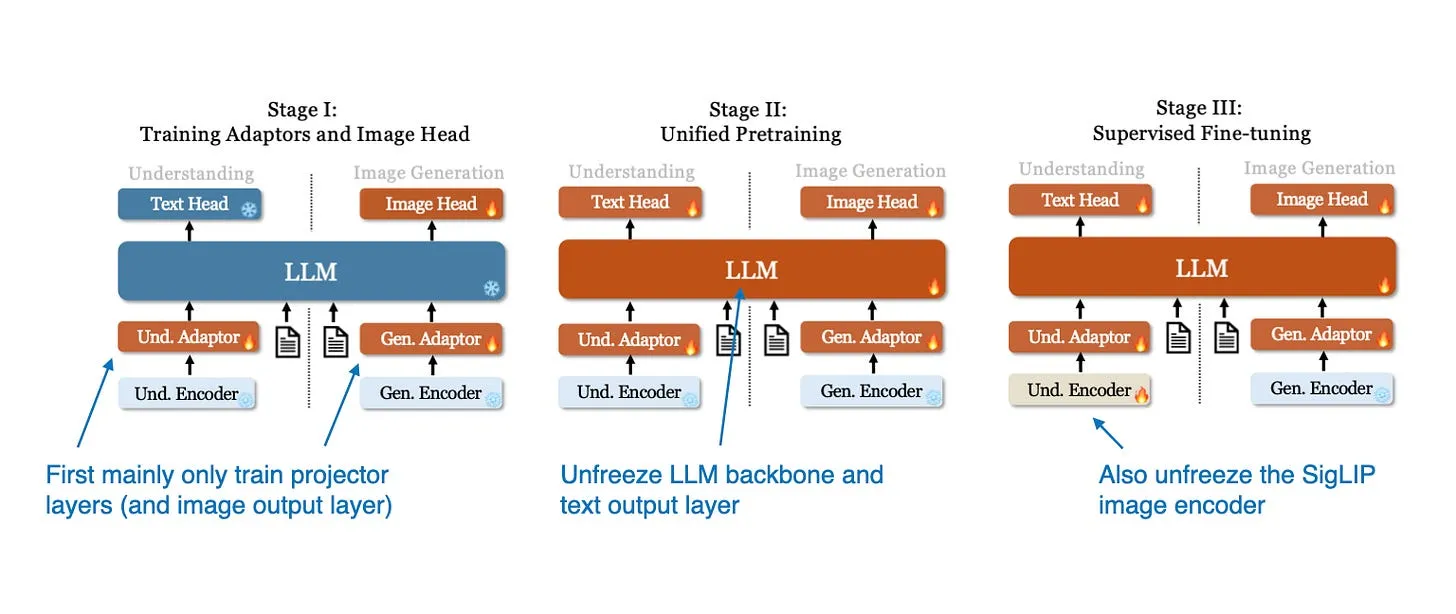
该模型的训练过程分为三个阶段,如下图所示。

figure29
Janus模型三阶段训练流程示意图。(标注图来自《Janus: Decoupling Visual Encoding for Unified Multimodal Understanding and Generation》论文:https://arxiv.org/abs/2410.13848

  • 第一阶段:只训练投影层与图像输出层,大语言模型、理解编码器与生成编码器均保持冻结。
  • 第二阶段:解冻大语言模型基座与文本输出层,实现理解与生成任务的统一预训练。
  • 第三阶段:解冻整个模型,包括SigLIP图像编码器,进行监督微调,让模型全面整合并优化其多模态能力。

结论

大家可能已经注意到,我几乎完全没有提及模型效果与计算性能的对比。首先,由于普遍存在的数据污染问题(即测试数据可能被包含在训练数据中),在公开基准上对比大语言模型与多模态大语言模型的性能本身就存在挑战。

此外,不同模型的架构组件差异极大,很难做到公平的横向对比。因此,要为英伟达团队点赞,他们开发了不同版本的NVLM,至少让我们可以对比纯解码器与交叉注意力两种方案的差异。

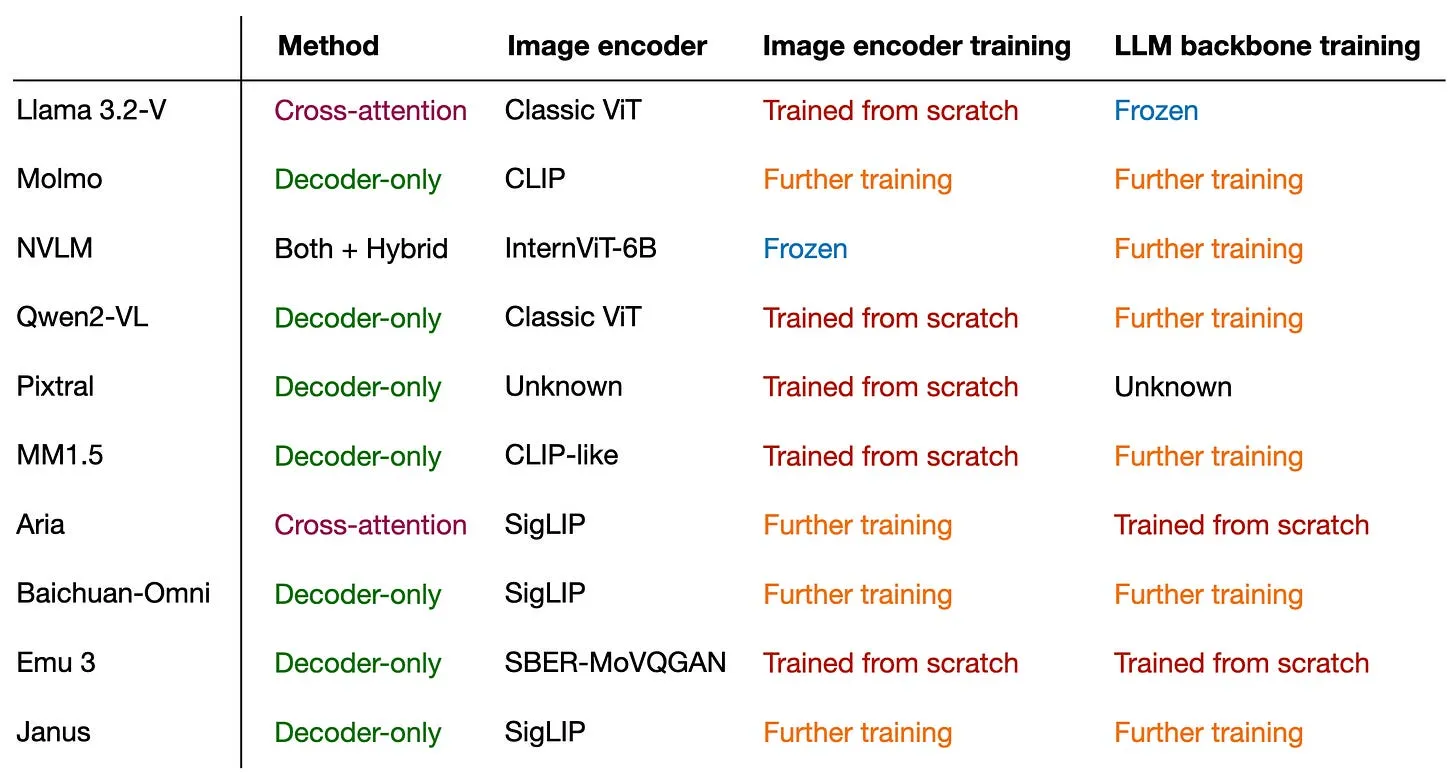
总而言之,本文的核心结论是:多模态大语言模型的成功构建有很多种不同的技术路径。下图总结了本文涉及的各模型的不同组件与训练方案。

figure30
本文涉及的不同模型及其子组件、训练方案概览

希望本文的讲解对你有帮助,让你对多模态大语言模型的工作原理有了更清晰的理解!

本杂志是一项个人兴趣项目。如果您愿意支持我的创作,可以考虑购买我的新书:https://amzn.to/4fqvn0D。(我相信这本书会让你收获满满,因为它对大语言模型工作原理的讲解深度是其他地方找不到的。)

figure31 现已登陆亚马逊

如果你读过这本书,并且能抽出几分钟时间,我非常希望你能在亚马逊留下评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 。这对我们作者来说帮助非常大!

另外,我最近也在Substack上开通了付费订阅选项,可以直接支持本杂志的创作。

你的支持意义重大!谢谢大家!

【转载】从零构建GPT风格大语言模型分类器

原文地址:Building A GPT-Style LLM Classifier From Scratch,by Sebastian Raschka, on 2024-09-21

从零构建 GPT 风格大语言模型分类器

面向垃圾邮件分类的 GPT 模型微调

在本文中,我将向大家演示如何将预训练大语言模型(LLM)改造为高性能文本分类器。

为什么要聚焦分类任务?首先,针对分类任务微调预训练模型,是入门模型微调技术的优质路径 —— 难度平缓但实用性强。其次,大量现实场景与业务问题本质上都属于文本分类:垃圾邮件检测、情感分析、客户反馈归类、主题标注等等。

figure00

将 GPT 模型改造为文本分类器

Continue reading 【转载】从零构建GPT风格大语言模型分类器

【转载】从零构建大语言模型:3小时编程讲习班

原文地址:Building LLMs from the Ground Up: A 3-hour Coding Workshop,by Sebastian Raschka, on 2024-08-31

从零构建大语言模型:3小时编程讲习班

如果你想在这个周末花几个小时深入钻研大语言模型(LLM)并理解其工作原理,我准备了一场时长3小时的编程讲习班演示,内容涵盖大语言模型的实现、训练与使用。

https://www.youtube.com/watch?v=quh7z1q7-uc

你可以在下方查看目录,了解本次视频涵盖的内容(视频本身带有可点击的章节标记,你可以直接跳转到感兴趣的主题):

0:00 – 讲习班概览
2:17 – 第一部分:大语言模型入门
9:14 – 讲习班配套材料
10:48 – 第二部分:理解大语言模型的输入数据
23:25 – 一个简易分词器类
41:03 – 第三部分:编写大语言模型架构代码
45:01 – GPT-2 与 Llama 2
1:07:11 – 第四部分:预训练
1:29:37 – 第五部分第1节:加载预训练权重
1:45:12 – 第五部分第2节:通过 LitGPT 加载预训练权重
1:53:09 – 第六部分第1节:指令微调
2:08:21 – 第六部分第2节:通过 LitGPT 进行指令微调
02:26:45 – 第六部分第3节:基准测试评估
02:36:55 – 第六部分第4节:对话性能评估
02:42:40 – 结语

这和我平时发布的文字类内容略有不同,但几个月前我第一次做这类内容时反响非常好,所以我觉得再做一期应该会很不错!
祝观看愉快!

参考资料

https://mng.bz/M96o
https://github.com/rasbt/LLMs-from-scratch
https://github.com/rasbt/LLM-workshop-2024
https://lightning.ai/lightning-ai/studios/llms-from-the-ground-up-workshop
https://github.com/Lightning-AI/litgpt

这本刊物是我的个人兴趣项目。如果愿意支持我的话,不妨考虑购买我的书:https://amzn.to/4fqvn0D 。(我相信你能从这本书中收获颇丰,因为它对大语言模型工作原理的讲解细致程度是其他资料中绝无仅有的。)

figure01

《从零构建大语言模型》现已上架:https://amzn.to/4fqvn0D

如果你读过这本书,并且能抽出几分钟时间,我会非常感谢你留下评价:https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 。这对我们作者来说帮助很大!

另外,我最近也在Substack上开通了付费订阅选项,你可以直接通过这种方式支持这本刊物。

《Ahead of AI》是一份由读者支持的出版物。想要接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

【转载】新型大语言模型预训练与后训练范式

原文地址:New LLM Pre-training and Post-training Paradigms,by Sebastian Raschka, on 2024-08-17

新型大语言模型预训练与后训练范式

现代大语言模型训练方式一览

大语言模型(LLM)的发展已经走过了漫长的道路——从早期的GPT模型,到如今我们拥有的各类先进的开源权重大语言模型。最初,大语言模型的训练流程只聚焦于预训练,但此后已经扩展为同时包含预训练与后训练两个阶段。后训练通常涵盖有监督指令微调与对齐,这一技术因ChatGPT而普及。

自ChatGPT首次发布以来,训练方法论一直在不断演进。在本文中,我将回顾预训练与后训练两方面的最新进展,尤其是近几个月来出现的新方法。

figure01

大语言模型开发与训练流程概览,重点介绍本文讨论的新型预训练与后训练方法论

每个月都有数百篇大语言模型相关论文提出新的技术与方法。不过,要了解哪些方法在实践中真正有效,最好的途径之一就是研究最新前沿模型的预训练与后训练流水线。幸运的是,近几个月发布了四款主流的全新大语言模型,同时附带了相对详尽的技术报告。

在本文中,我将重点介绍以下模型的预训练与后训练流水线:

  • 阿里巴巴通义千问2(Qwen 2)
  • 苹果智能基础语言模型(Apple Intelligence Foundation Language Models)
  • 谷歌Gemma 2
  • Meta AI的Llama 3.1

这些模型按照其各自技术论文在arXiv.org上的发布时间排序,恰好也和字母顺序一致。

本文是我利用空闲时间与周末完成的个人兴趣项目。如果您觉得它有价值,愿意支持我的工作,欢迎购买我的著作并推荐给同事。如果您能在亚马逊上留下书评,我也会非常感激!

figure02

http://mng.bz/M96o , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/

1. 阿里巴巴通义千问2(Qwen 2)

我们先从https://arxiv.org/abs/2407.10671 开始介绍,这是一个性能非常强劲的大语言模型系列,竞争力不输其他主流大语言模型。但出于某种原因,它的知名度不如Meta AI、微软和谷歌的开源权重模型。

1.1 Qwen 2概述

在介绍https://arxiv.org/abs/2407.10671 中讨论的预训练与后训练方法之前,我们先简要总结一些核心参数。

Qwen 2系列共有5个版本。其中包括4款常规(稠密)大语言模型,参数量分别为0.5B、1.5B、7B和72B。此外还有一款混合专家(Mixture-of-Experts)模型,参数量为57B,其中同时激活的参数为14B。(由于架构细节不是本次的重点,我不会过多展开混合专家模型;简而言之,它与Mistral AI的Mixtral类似,但激活的专家数量更多。想要高层级的概览,可以参考我发表在https://magazine.sebastianraschka.com/p/research-papers-in-january-2024 中的https://magazine.sebastianraschka.com/i/14113005/mixtral-architecture 章节。)

Qwen 2大语言模型最突出的特点之一,是它具备30种语言的优秀多语言能力。它们还拥有规模惊人的151642个token的词表(作为参考,Llama 2使用3.2万词表,Llama 3.1使用12.8万词表);根据经验,词表大小扩大一倍,输入token数量就会减少一半,因此我们可以在相同的输入长度中容纳更多文本。这对多语言数据和代码场景尤其有帮助,可以覆盖标准英语词表之外的词汇。

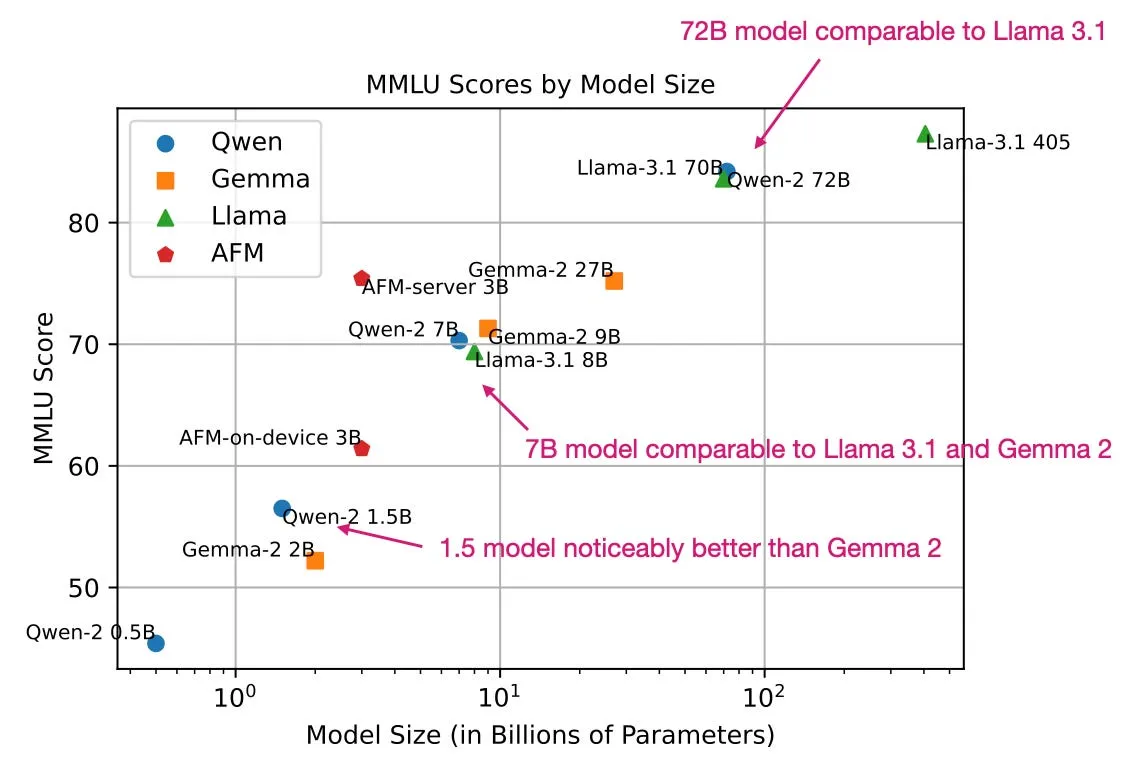
下面是它与后文其他大语言模型的MMLU基准简要对比。(注意MMLU是一项多项选择基准,因此有其局限性;但它仍然是最常用的大语言模型性能报告方法之一。)

figure03

最新开源权重模型的MMLU基准得分(数值越高越好)。本图数据均收集自各模型官方研究论文。

(如果您不熟悉MMLU,我在https://www.youtube.com/watch?v=kPGTx4wcm_w 中做过简要介绍。)

1.2 Qwen 2预训练

Qwen 2团队在7万亿训练token上训练了1.5B、7B和72B参数模型,这一数据规模是合理的。作为对比,Llama 2模型的训练数据为2万亿token,Llama 3.1模型为15万亿token。

有趣的是,0.5B参数模型是在12万亿token上训练的。但研究人员没有在更大的12万亿token数据集上训练其他模型,因为他们在训练中没有观察到性能提升,额外的计算成本并不划算。

研究的重点方向之一,是改进数据过滤流水线以去除低质量数据,同时强化数据混合以提升数据多样性——这一主题我们在后续考察其他模型时还会反复提到。

有意思的是,他们还使用了Qwen模型(虽然没有说明细节,我推测是上一代Qwen模型)来合成额外的预训练数据。并且预训练中加入了“多任务指令数据……以增强上下文学习与指令遵循能力”。

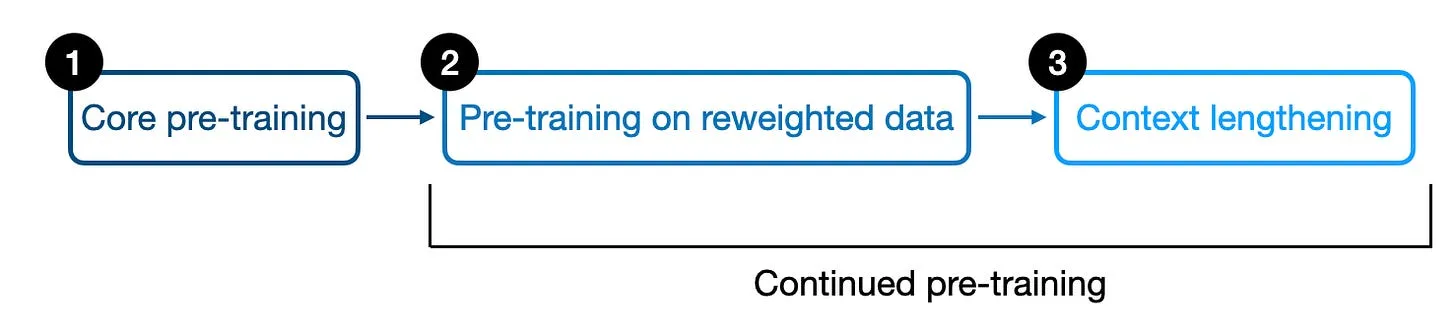
此外,他们分两个阶段进行训练:常规预训练,随后是长上下文训练。后者在预训练末期阶段,使用“高质量的长文本数据”将上下文长度从4096提升至32768个token。

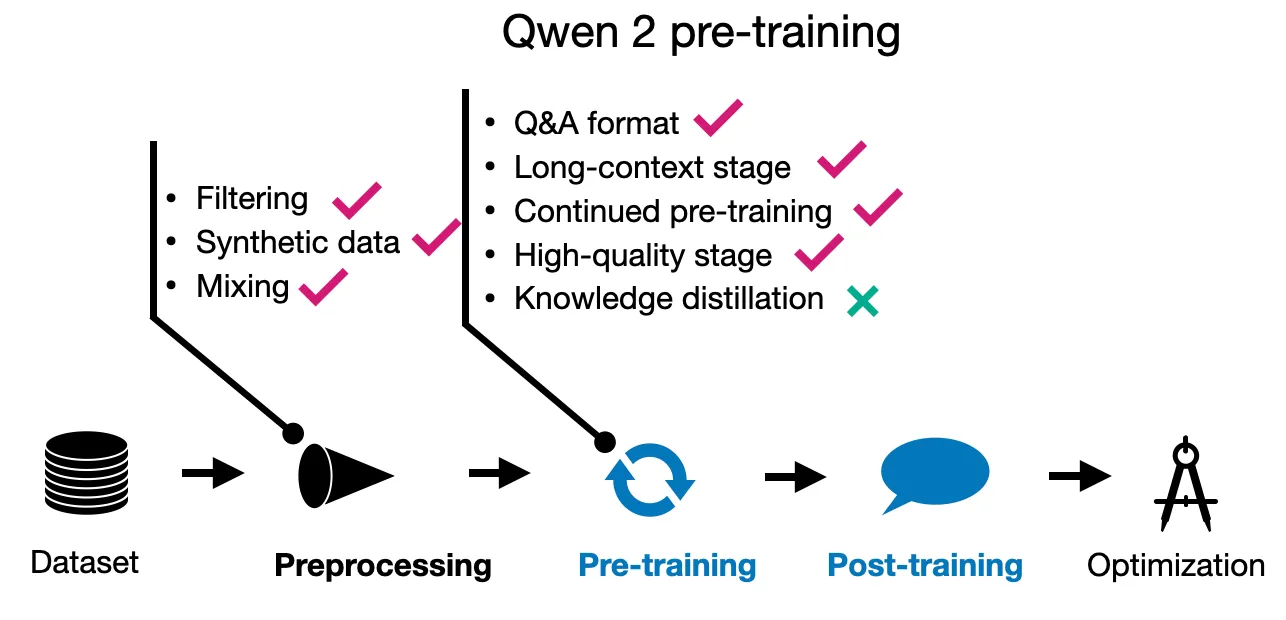
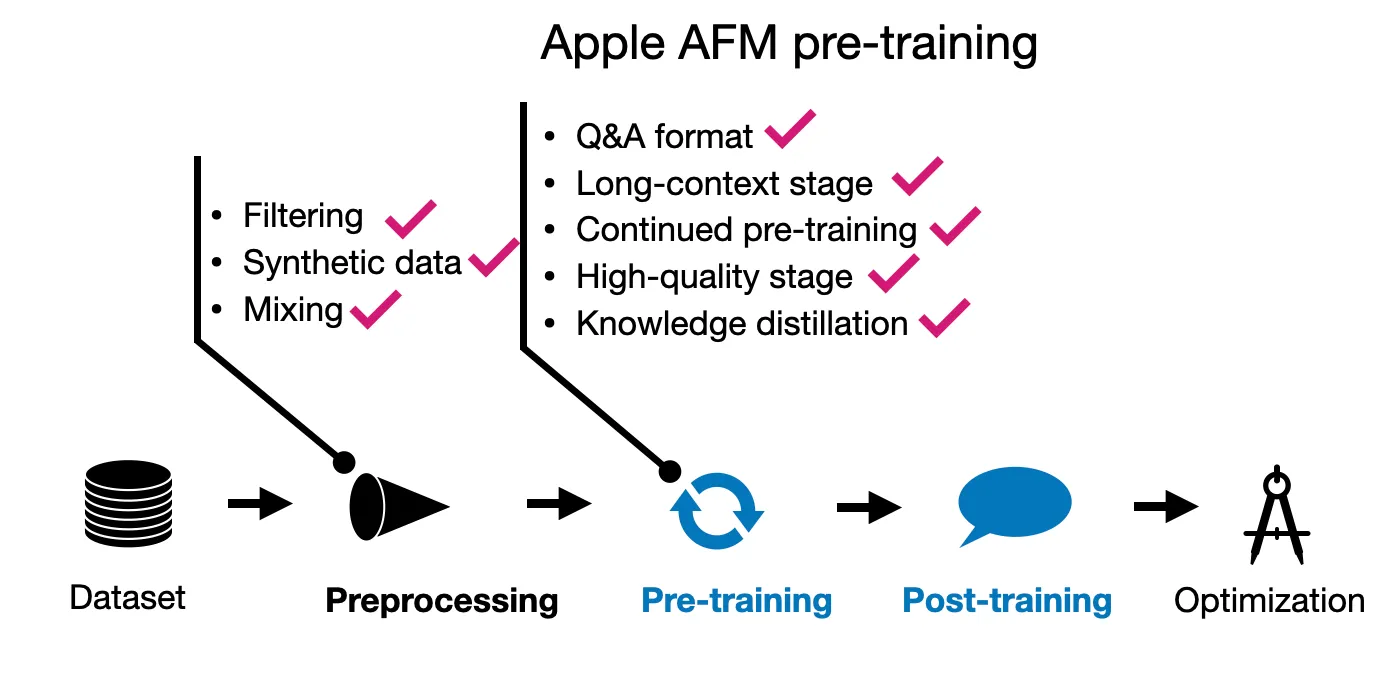
figure04

Qwen 2预训练技术总结。“持续预训练”指的是两阶段预训练:研究人员先进行常规预训练,再进行长上下文持续预训练。

(遗憾的是,技术报告的另一个共性是数据集相关细节很少,所以如果我的叙述看起来不够详尽,那是因为公开可获取的信息有限。)

1.3 Qwen 2后训练

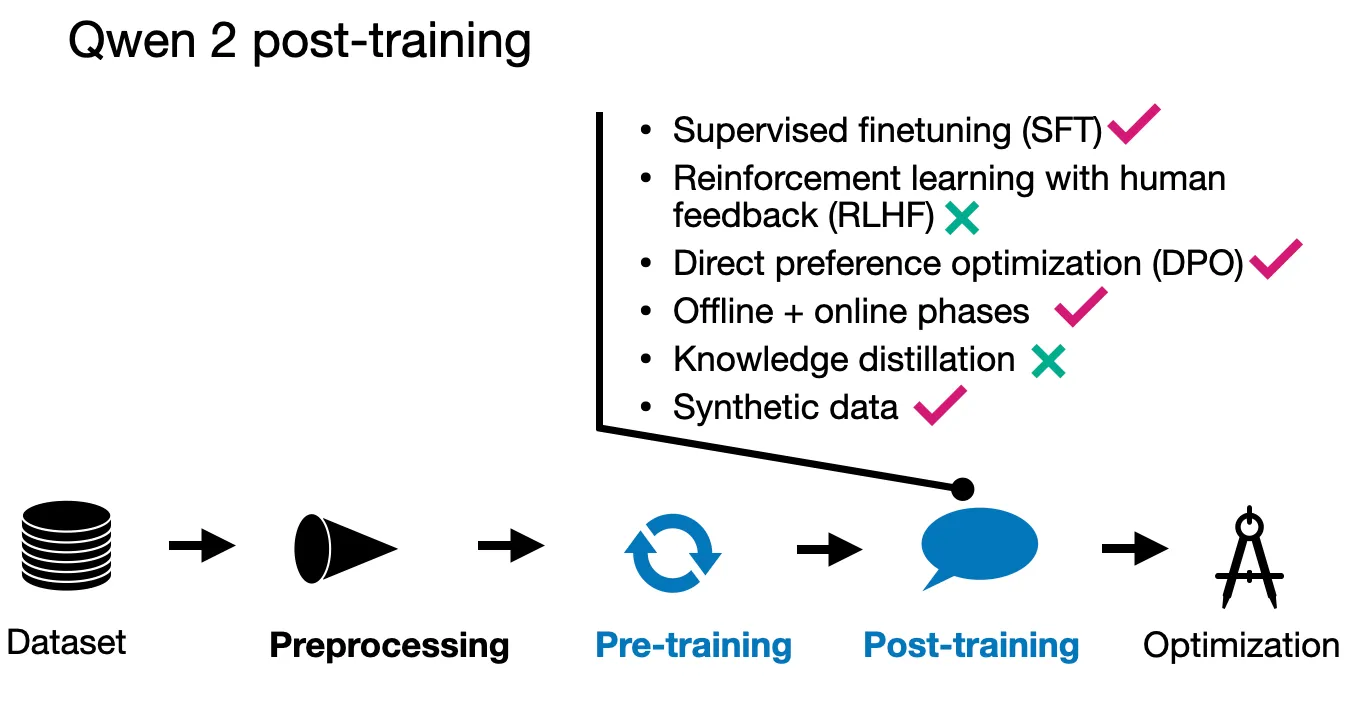
Qwen 2团队采用了主流的两阶段后训练方法,首先是有监督指令微调(SFT),在50万个样本上训练了2个epoch。该阶段旨在优化模型在预设场景下的回答准确率。

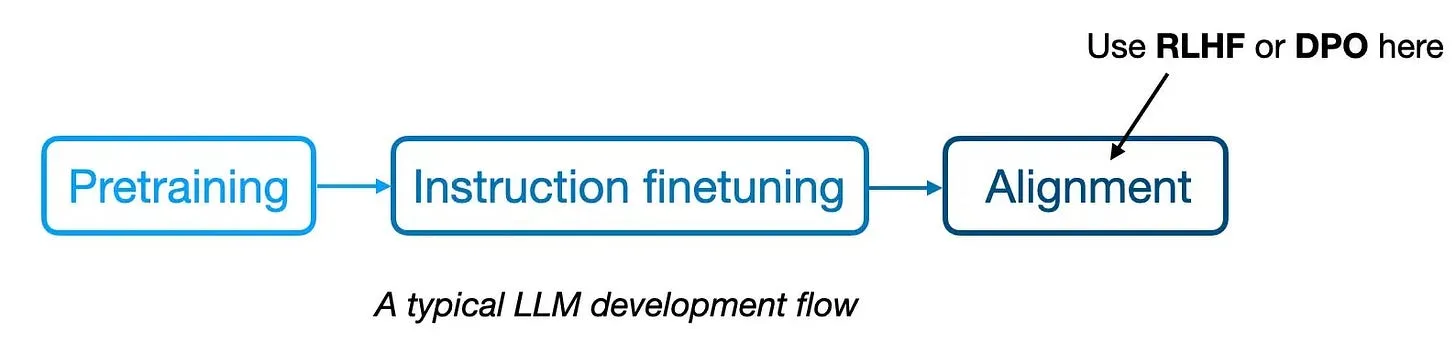
figure05

典型的大语言模型开发流程。

在SFT之后,他们使用直接偏好优化(DPO)让大语言模型对齐人类偏好。(有意思的是,他们的术语中称之为基于人类反馈的强化学习,即RLHF。正如我几周前在《大语言模型预训练与奖励模型评估技巧》一文中讨论的,SFT+DPO方案目前似乎是最主流的偏好调优策略,因为相比带PPO的RLHF等其他方法,它使用起来更简便。如果您想了解DPO的工作原理,我最近从零实现了它:https://github.com/rasbt/LLMs-from-scratch/blob/main/ch07/04_preference-tuning-with-dpo/dpo-from-scratch.ipynb 。)

对齐阶段本身也分两步完成。第一步是在现有数据集上使用DPO(离线阶段)。第二步是使用奖励模型生成偏好对(在线阶段)。在这一阶段,模型在训练过程中生成多个回答,由奖励模型为优化步骤选择更优的回答,实现“实时”(即训练过程中)优化。这也常被称为“拒绝采样”。

在数据集构建方面,他们使用现有语料库,辅以人工标注来确定SFT的目标回答,并识别DPO所需的偏好回答与拒绝回答。研究人员还合成了人工标注数据。

此外,团队还利用大语言模型生成专门针对“高质量文学数据”的指令-回答对,为训练打造高质量问答对。

figure06

Qwen 2后训练技术总结。

1.4 结论

Qwen 2是一款性能相当不错的模型,和前几代Qwen模型一脉相承。我记得2023年12月参加NeurIPS大语言模型效率挑战赛时,大多数获奖方案都用到了Qwen模型。

在Qwen 2的训练流水线中,最突出的一点是合成数据同时被用于预训练和后训练。此外,对数据集过滤的重视(而非一味收集更多数据)是大语言模型训练中值得关注的趋势之一。在这里我想说,数据越多越好,但前提是要满足一定的质量标准。


从零实现直接偏好优化对齐大语言模型

直接偏好优化(DPO)已经成为让大语言模型更贴合用户偏好的首选方法之一,在本文中你会多次读到它。如果您想了解它的工作原理,我在这里从零编写了实现代码:
https://github.com/rasbt/LLMs-from-scratch/blob/main/ch07/04_preference-tuning-with-dpo/dpo-from-scratch.ipynb

figure07

https://github.com/rasbt/LLMs-from-scratch/blob/main/ch07/04_preference-tuning-with-dpo/dpo-from-scratch.ipynb 内容概览

《Ahead of AI》是读者支持的出版物。想要获取新文章并支持我的工作,欢迎成为免费或付费订阅者。


2. 苹果智能基础语言模型(AFM)

看到苹果在arXiv.org上又发布了一篇概述其模型训练的技术论文,我非常欣喜。这是意料之外但绝对积极的惊喜!

2.1 AFM概述

https://arxiv.org/abs/2407.21075 这篇论文中,研究团队概述了为苹果设备上的“苹果智能”功能设计的两款主力模型的开发过程。为简洁起见,本节中将这些模型简称为AFM,即“苹果基础模型”。

具体来说,论文描述了两个版本的AFM:一款30亿参数的端侧模型,计划部署在手机、平板或笔记本电脑上;另一款性能更强的云端模型,参数规模未公开。

这些模型是为聊天、数学和代码任务开发的,不过论文没有讨论任何代码专项训练与能力相关的内容。

和Qwen 2一样,AFM属于稠密大语言模型,没有采用混合专家架构。

2.2 AFM预训练

我要为研究人员大大地点两个赞。首先,除了使用公开数据和出版商授权的数据外,他们遵守了网站的robots.txt协议,没有爬取这些网站。其次,他们还提到对基准数据做了去污染处理。

为了印证Qwen 2论文的一个结论,研究人员提到质量远比数量重要。(端侧模型词表大小为4.9万token,云端模型为10万token,明显小于Qwen 2模型的15万token词表。)

有意思的是,预训练不是分2步,而是分3步完成的!

  1. 核心(常规)预训练
  2. 持续预训练:降低网页爬取(低质量)数据的权重,提升数学与代码数据的权重
  3. 上下文拓展:使用更长序列数据与合成数据拓展上下文长度

figure08

AFM模型所采用的三步预训练流程概览

下面我们更详细地看看这三个步骤。

2.2.1 预训练I:核心预训练

核心预训练是苹果预训练流水线的第一个阶段,和常规预训练类似。AFM云端模型在6.3万亿token上训练,批次大小为4096,序列长度为4096个token。这和Qwen 2模型非常接近,后者的训练数据为7万亿token。

不过AFM端侧模型更有意思:它是从一个更大的64亿参数模型蒸馏裁剪而来(该64亿模型和上一段介绍的AFM云端模型一样,是从零训练的)。

关于蒸馏过程,除了“通过将目标标签替换为真实标签与教师模型top-1预测的凸组合(教师标签权重为0.9)来计算蒸馏损失”之外,没有太多细节。

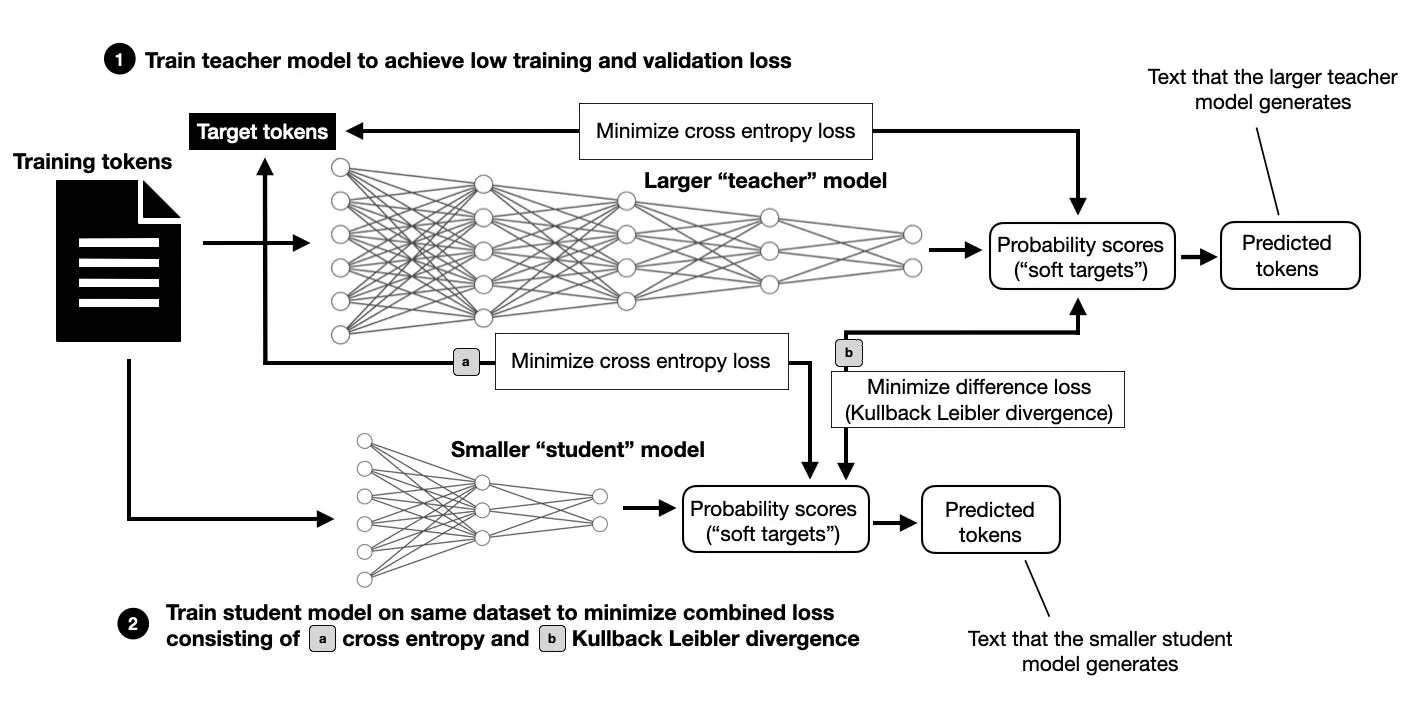
我觉得知识蒸馏在大语言模型预训练中正变得越来越普遍,也越来越有用(Gemma-2也使用了它)。我打算以后专门写文章详细介绍。现在先做个高层级的简要概述。

figure09

知识蒸馏概览:小模型(此处为AFM端侧3B模型)在原始训练token + 更大教师模型(此处为6.4B模型)输出的基础上进行训练。注意a)中的交叉熵损失是预训练大语言模型的常规训练损失(关于常规预训练步骤的更多实现细节,可参考我的《https://www.manning.com/books/build-a-large-language-model-from-scratch》一书第5章)。

如上所示,知识蒸馏仍然需要在原始数据集上训练。但除了数据集中的训练token外,待训练模型(称为“学生”)还能从更大的(教师)模型中获取信息,相比不使用知识蒸馏的训练,能提供更丰富的信号。缺点是你必须:1)先训练更大的教师模型;2)用更大的教师模型计算所有训练token的预测。这些预测可以提前计算好(需要大量存储空间),也可以在训练过程中计算(可能会拖慢训练速度)。

2.2.2 预训练II:持续预训练

持续预训练阶段包含一小步上下文拓展,在1万亿token的数据集上将上下文从4096提升到8192个token(核心预训练集是它的五倍大)。不过主要重点是用高质量混合数据训练,侧重数学与代码。

有意思的是,研究人员发现在此场景下蒸馏损失并没有带来收益。

2.2.3 预训练III:上下文拓展

第三个预训练阶段仅使用1000亿token(是第二阶段token数的10%),但实现了更显著的上下文拓展,达到32768个token。为了实现这一点,研究人员在数据集中补充了合成的长上下文问答数据。

figure10

AFM预训练技术总结

2.3 AFM后训练

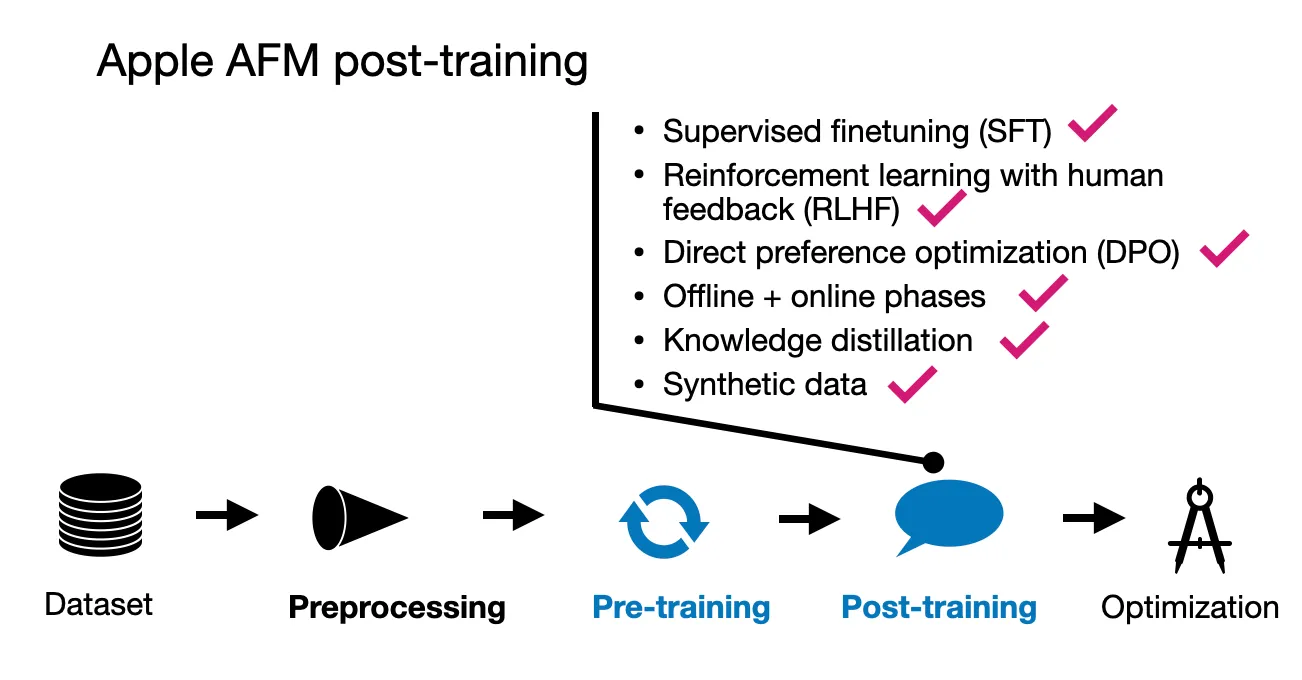
苹果在后训练流程上似乎采取了和预训练同样全面的方法。他们同时利用人工标注数据和合成数据,强调数据质量优先于数量。有意思的是,他们没有依赖预设的数据比例,而是通过多次实验微调数据混合比例,以达到最优平衡。

后训练阶段采用两步流程:有监督指令微调,随后进行多轮基于人类反馈的强化学习(RLHF)。

这个过程中特别值得注意的一点,是苹果为RLHF阶段引入了两种新算法:

  • 带教师委员会的拒绝采样微调(iTeC)
  • 带镜像下降策略优化的RLHF

鉴于本文篇幅,我不会深入这些方法的技术细节,只做简要介绍:

iTeC算法将拒绝采样与多种偏好调优技术相结合——具体包括SFT、DPO、IPO和在线RL。苹果没有依赖单一算法,而是分别用每种方法训练模型。这些模型随后生成回答,由人类进行评估并给出偏好标签。这些偏好数据被用于在RLHF框架中迭代训练奖励模型。在拒绝采样阶段,由一个模型委员会生成多个回答,再由奖励模型选出最优的一个。

这种基于委员会的方法相当复杂,但应该具备较高的可行性,尤其是考虑到涉及的模型规模相对较小(约30亿参数)。如果用大得多的模型来实现这样的委员会,比如Llama 3.1中的70B或405B参数模型,难度肯定会大得多。

至于第二种算法,带镜像下降的RLHF,它被选中是因为事实证明它比常用的PPO(近端策略优化)效果更好。

figure11

AFM后训练技术总结

2.4 结论

苹果的预训练与后训练方法相对全面,可能是因为应用场景极其重要(模型要部署在数百万甚至数十亿台设备上)。不过,由于这些模型本身规模不大,大量技术也变得可行——3B模型还不到最小的Llama 3.1模型的一半大。

亮点之一在于,他们没有简单地在RLHF和DPO之间二选一;相反,他们以委员会的形式使用了多种偏好调优算法。

同样有意思的是,他们明确将问答数据作为预训练的一部分——我在之前的文章https://magazine.sebastianraschka.com/p/instruction-pretraining-llms 中讨论过这一点。

总而言之,这是一篇令人耳目一新、非常精彩的技术报告。


3. 谷歌Gemma 2

谷歌的Gemma模型最近在https://arxiv.org/abs/2408.00118 中进行了介绍。

在讨论预训练与后训练流程之前,我先在概述部分介绍一些关键信息。

3.1 Gemma 2概述

Gemma 2模型有三种参数量:20亿、90亿和270亿。研究的核心重点是探索不一定需要扩大训练数据集规模的技术,转而开发相对小巧高效的大语言模型。

值得注意的是,Gemma 2拥有高达25.6万token的超大词表。作为对比,Llama 2使用3.2万token词表,Llama 3使用12.8万token词表。

此外,Gemma 2采用了滑动窗口注意力,和Mistral早期的模型类似,目的是降低内存开销。关于Gemma 2架构的更多细节,请参考https://magazine.sebastianraschka.com/i/146761957/gemma

3.2 Gemma 2预训练

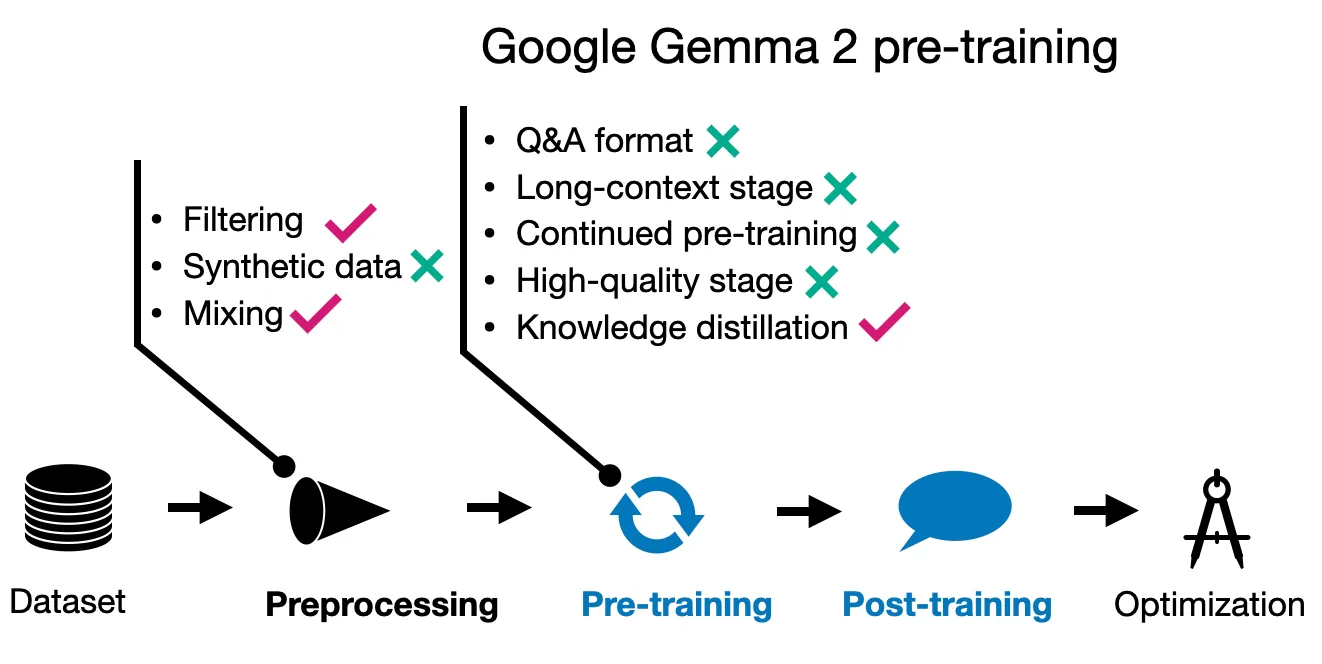
Gemma的研究人员认为,即使是小模型也往往处于训练不足的状态。但他们没有简单地扩大训练数据集,而是专注于保证数据质量,并通过知识蒸馏等替代方法实现性能提升,和苹果的方法类似。

27B的Gemma 2模型是从零训练的,而更小的模型则采用了和前面介绍的苹果方法类似的知识蒸馏进行训练。

27B模型的训练数据为13万亿token,9B模型为8万亿,2B模型为2万亿。此外,和苹果的方法类似,Gemma团队也优化了数据混合比例以提升性能。

figure12

Gemma 2预训练技术总结

3.3 Gemma 2后训练

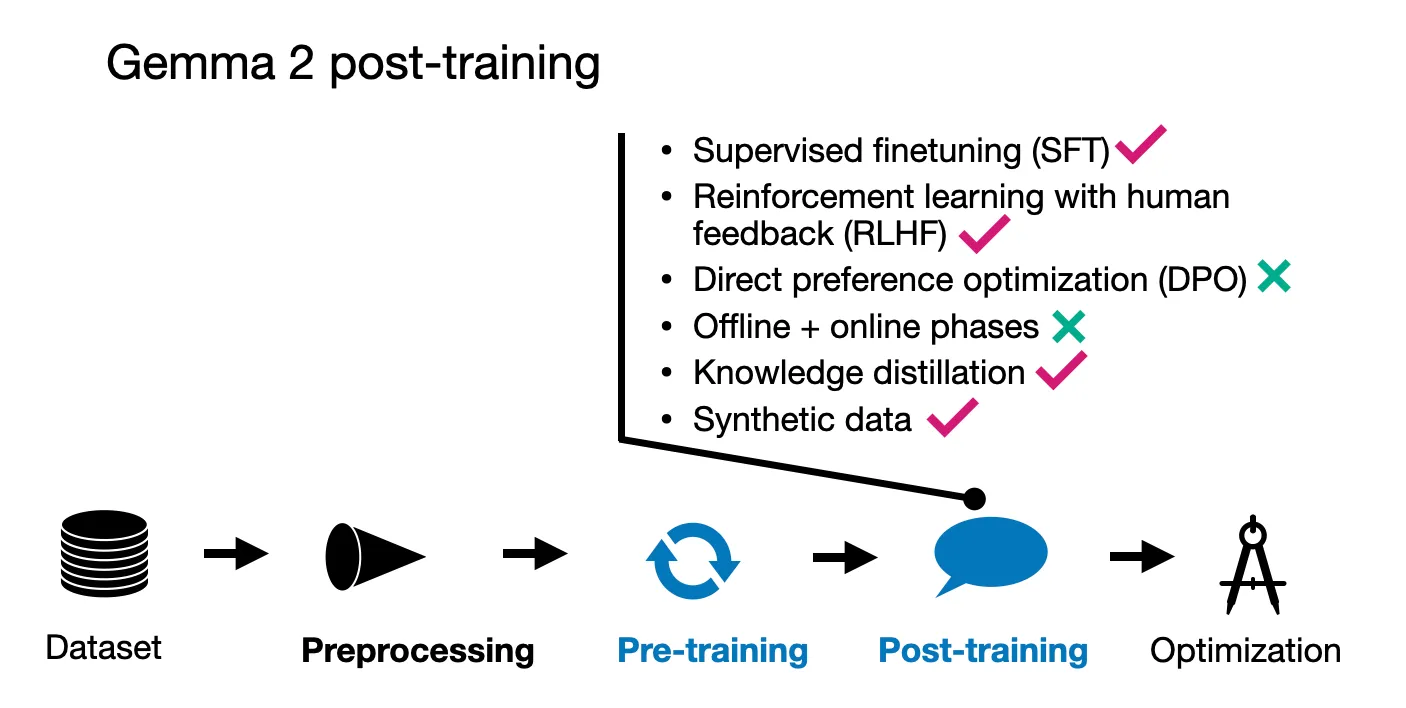
Gemma模型的后训练流程包含典型的有监督微调(SFT)和基于人类反馈的强化学习(RLHF)步骤。

指令数据使用纯英文的提示对,由人工生成与合成生成的内容混合组成。特别有意思的是,回答主要由教师模型生成,并且在SFT阶段也应用了知识蒸馏。

他们的RLHF方法有一个有趣的特点:在SFT之后,用于RLHF的奖励模型规模是策略(目标)模型的十倍。

Gemma采用的RLHF算法相当标准,但有一个独特的改动:他们通过一种名为WARP的方法对策略模型进行平均,这是WARM(权重平均奖励模型)的后继方法。我之前在文章https://magazine.sebastianraschka.com/i/14113005/warm-on-the-benefits-of-weight-averaged-reward-models 中详细讨论过这种方法。

figure13

Gemma 2后训练技术总结

3.4 结论

Gemma团队似乎非常重视知识蒸馏,和苹果一样,他们在预训练和后训练中都使用了这一技术。有意思的是,他们没有采用多阶段预训练方法,或者至少没有在论文中详细说明。

figure14

我很荣幸受邀在即将到来的https://events.linuxfoundation.org/pytorch-conference/ 上发表主题演讲。这将是我第一次参加PyTorch大会,我很期待见到社区同仁,一起聊聊最新的人工智能与大语言模型进展!


4. Meta AI的Llama 3.1

Meta发布新款Llama大语言模型向来是行业大事。这一次,同步发布了一份92页的技术报告:https://arxiv.org/abs/2407.21783 。最后,在本节中我们将看看上个月发布的第四篇重要模型论文。

4.1 Llama 3.1概述

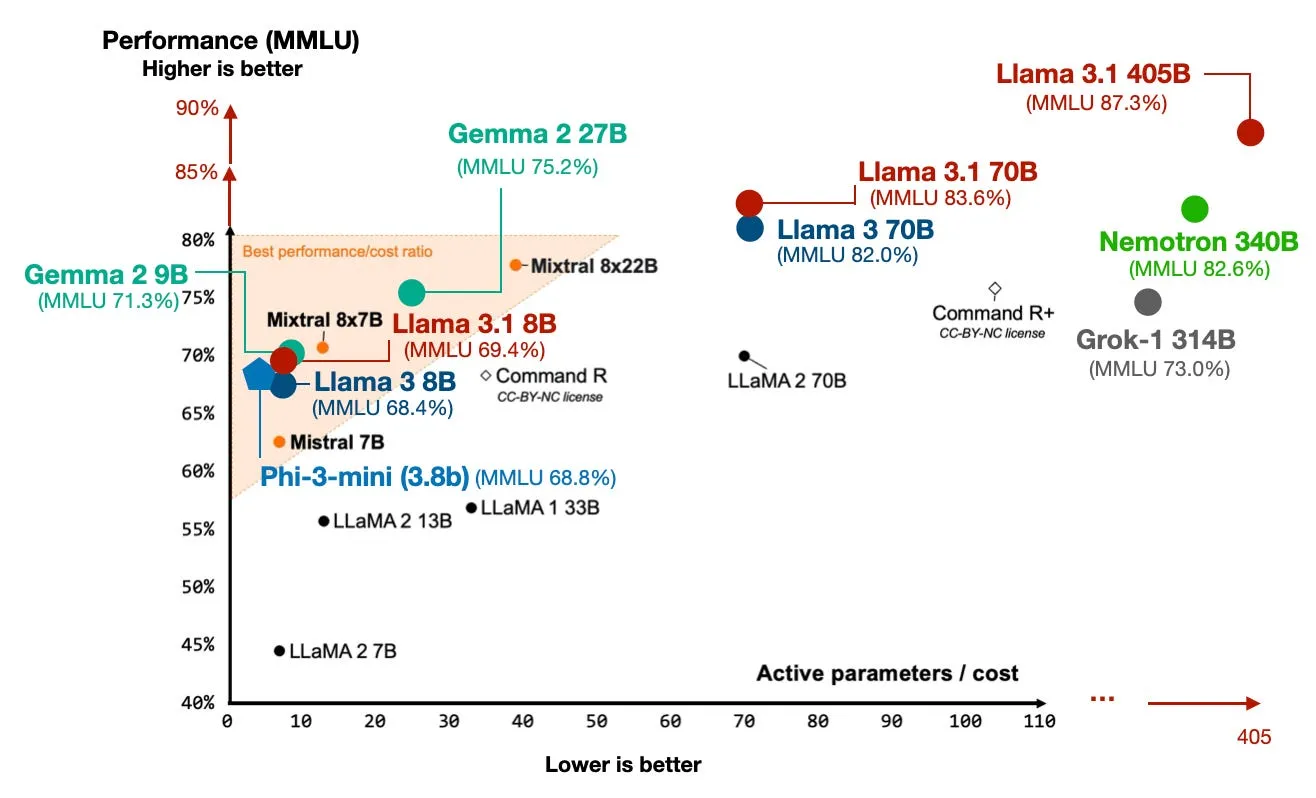
除了发布高达4050亿参数的巨型模型外,Meta还更新了之前的80亿和700亿参数模型,让它们的MMLU性能有了小幅提升。

figure15

不同模型的MMLU基准表现

虽然Llama 3和其他近期大语言模型一样使用了分组查询注意力,但令人意外的是,Meta AI没有采用滑动窗口注意力和混合专家架构。换句话说,Llama 3.1看起来非常传统,重点显然放在了预训练与后训练上,而非架构创新。

和之前的Llama发布一样,模型权重是公开可用的。此外,Meta表示他们更新了Llama 3的许可证,现在终于允许使用Llama 3进行合成数据生成或知识蒸馏来改进其他模型。

4.2 Llama 3.1预训练

Llama 3的训练数据规模高达15.6万亿token,相比Llama 2的1.8万亿token有了大幅增长。研究人员表示它至少支持8种语言(而Qwen 2可以处理20种)。

Llama 3一个有意思的特点是它的词表大小为12.8万,是使用OpenAI的tiktoken分词器开发的。(对分词器性能感兴趣的读者,我做过一个简单的基准对比:https://github.com/rasbt/LLMs-from-scratch/blob/main/ch02/02_bonus_bytepair-encoder/compare-bpe-tiktoken.ipynb 。)

在预训练数据质量控制方面,Llama 3采用了基于启发式的过滤与基于模型的质量过滤,使用了Meta AI的fastText和基于RoBERTa的分类器等快速分类器。这些分类器还有助于确定训练时数据混合的上下文类别。

Llama 3的预训练分为三个阶段。第一阶段是标准初始预训练,使用15.6万亿token,上下文窗口为8k。第二阶段继续预训练,但将上下文长度拓展到128k。最后一个阶段是退火,进一步提升模型性能。下面我们更详细地看看这些阶段。

4.2.1 预训练I:标准(初始)预训练

在他们的训练设置中,初始批次由400万token组成,每个序列长度为4096。这意味着批次大小约为1024个序列(假设400万是四舍五入后的数字)。在处理完前2.52亿token后,他们将序列长度翻倍到8192。训练进行到2.87万亿token后,他们再次将批次大小翻倍。

此外,研究人员没有在整个训练过程中保持数据混合不变。相反,他们在训练过程中调整所用数据的混合比例,以优化模型的学习效果与性能。这种动态的数据处理方式,很可能有助于提升模型在不同类型数据上的泛化能力。

4.2.2 预训练II:上下文拓展持续预训练

和其他一步到位提升上下文窗口的模型相比,Llama 3.1的上下文拓展是一个更渐进的过程:研究人员通过六个不同的阶段,将上下文长度从8000逐步提升到128000个token。这种阶梯式增长让模型能够更平稳地适应更大的上下文。

这一过程使用的训练集包含8000亿token,约占总数据集规模的5%。

4.2.3 预训练III:高质量数据退火

在第三个预训练阶段,研究人员用小规模但高质量的混合数据训练模型,他们发现这有助于提升模型在基准数据集上的表现。例如,在GSM8K和MATH训练集上进行退火,能在对应的GSM8K和MATH验证集上带来显著提升。

在论文3.1.3节中,研究人员称退火数据集规模为400亿token(占总数据集的0.02%);这400亿的退火数据集被用于评估数据质量。在3.4.3节中,他们表示实际的退火只在4000万token上进行(占退火数据的0.1%)。

figure16

Llama 3.1预训练技术总结

4.3 Llama 3.1后训练

Meta AI团队的后训练流程采用了相对直接的方法,包括有监督微调(SFT)、拒绝采样和直接偏好优化(DPO)。

他们观察到,像带PPO的RLHF这类强化学习算法稳定性更差,也更难扩展,相比之下这些技术更有优势。值得注意的是,SFT和DPO步骤会多轮迭代重复,同时结合人工生成与合成数据。

在介绍更多细节之前,下图展示了他们的工作流程:

figure17

摘自Llama 3.1论文,描述后训练流程的示意图

注意,尽管他们使用了DPO,但也像RLHF中一样训练了一个奖励模型。最初,他们利用预训练阶段的一个检查点,结合人工标注数据来训练奖励模型。该奖励模型随后被用于拒绝采样流程,帮助筛选合适的提示用于后续训练。

在每一轮训练中,他们不仅对奖励模型使用了模型平均技术,对SFT和DPO模型也同样使用。这种平均是将近期与之前模型的参数进行融合,以稳定(并提升)长期性能。

对模型平均的技术细节感兴趣的读者,可以参考我之前的文章https://magazine.sebastianraschka.com/i/14113005/understanding-model-merging-and-weight-averaging 中的“理解模型合并与权重平均”章节。

总而言之,核心是相对标准的SFT+DPO阶段。但这个阶段会重复多轮。然后,他们加入了用于拒绝采样的奖励模型(和Qwen 2、AFM一样)。他们也像Gemma一样使用了模型平均;不过不只是针对奖励模型,而是所有涉及的模型都用。

figure18

Llama 3.1后训练技术总结

4.4 结论

Llama 3模型整体保持了相当标准的路线,和更早的Llama 2模型类似,但加入了一些有意思的方法。值得注意的是,15万亿token的庞大训练集是Llama 3区别于其他模型的地方。有意思的是,和苹果的AFM模型一样,Llama 3也采用了三阶段预训练流程。

和其他近期大语言模型不同的是,Llama 3没有使用知识蒸馏技术,而是选择了更直接的模型开发路径。在后训练方面,模型使用了直接偏好优化(DPO),而非其他模型中流行的更复杂的强化学习策略。总的来说,这一选择很有意思,因为它表明团队专注于通过更简单(但已被验证)的方法来优化大语言模型性能。


5. 核心要点

从本文讨论的四款模型——阿里巴巴Qwen 2、苹果基础模型(AFM)、谷歌Gemma 2和Meta的Llama 3——中,我们能学到什么?

四款模型在预训练与后训练上采取了略有不同的方法。当然,方法论上有重叠,但没有哪条训练流水线是完全相同的。在预训练方面,一个共同的特点是所有方法都采用了多阶段预训练流水线:先进行通用的核心预训练,然后是上下文拓展,有时还会加上高质量退火步骤。下图再次直观展示了预训练中采用的不同方法。

figure19

预训练所用技术概览

在后训练方面,同样没有哪条流水线是完全一样的。看起来拒绝采样现在已经成为后训练流程中的标配。不过在DPO还是RLHF的选择上,目前还没有共识。

figure20

后训练所用技术概览

所以总而言之,开发高性能大语言模型没有单一的秘诀,而是有很多条路径。

最后,这四款模型的性能处于同一梯队。遗憾的是,其中几款模型还没有进入LMSYS和AlpacaEval排行榜,所以我们还没有直接的对比,只有MMLU等多项选择基准的得分可以参考。


支持《Ahead of AI》

这本杂志是个人兴趣项目。如果您愿意支持我,欢迎购买我的著作https://amzn.to/4fqvn0D 。(我相信您一定会从这本书中收获良多,因为它对大语言模型工作原理的讲解深度是其他地方找不到的。)

figure21

《从零构建大语言模型》现已发售:https://amzn.to/4fqvn0D

如果您读过这本书,并且能抽出几分钟时间,我非常希望您能在https://www.amazon.com/Build-Large-Language-Model-Scratch/dp/1633437167 上留下评论。这对我们作者帮助很大!

另外,我最近也在Substack上开通了付费订阅选项,可以直接支持这本杂志。

《Ahead of AI》是读者支持的出版物。想要获取新文章并支持我的工作,欢迎成为免费或付费订阅者。

【转载】指令预训练大语言模型

原文地址:Instruction Pretraining LLMs,by Sebastian Raschka, on 2024-06-20

指令预训练大语言模型

指令微调领域的最新研究

2024年7月20日

上个月发生了不少大事:苹果宣布集成端侧大语言模型,英伟达发布了旗下大型Nemotron模型,FlashAttention-3正式推出,谷歌的Gemma 2也正式亮相,诸如此类,不胜枚举。

大家或许已经通过各大新闻渠道了解了这些动态。因此在本篇文章中,我想聚焦于指令微调方向的最新研究——这是训练大语言模型的一项核心技术。

本文将涵盖以下内容:

  • 一种低成本、高效生成指令微调数据的新方法
  • 从零开始实现指令微调
  • 用指令数据对大语言模型进行预训练
  • Gemma 2的核心更新概览
  • 6月发布的其他值得关注的研究论文总览

祝阅读愉快!

1. 从零生成对齐数据

论文 https://arxiv.org/abs/2406.08464 分享了一种极具巧思的技巧,能够生成高质量的大语言模型指令微调数据集。虽然它并未提出特别前沿的研究洞见,但属于那种巧妙又实用的技术方案,应用价值很高。

1.1 从零生成指令数据集

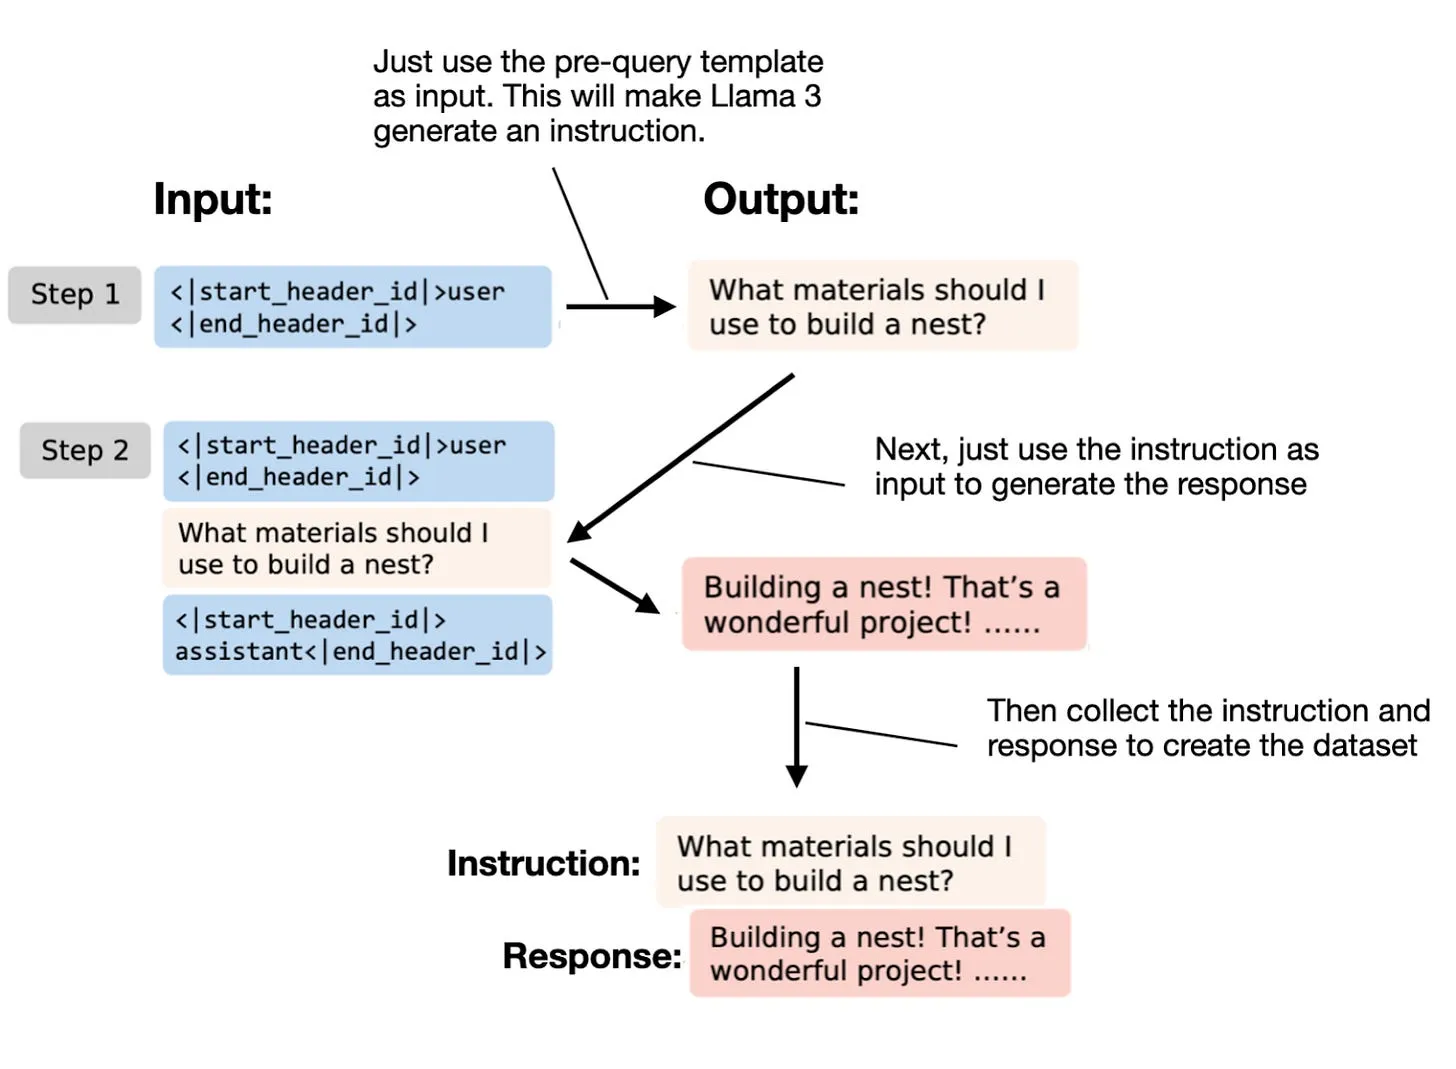
这种指令数据生成方法的独特之处在于,它可以实现完全自动化,且不需要任何初始的问题或指令作为输入。正如论文标题所示,它能实现“从零”创建指令数据集——我们只需要一个本地运行的Llama 3 8B模型即可。下图总结了该方法的工作流程。

figure01

Magpie方法生成指令微调合成数据集的示意图。该图基于Magpie论文的配图改制:https://arxiv.org/abs/2406.08464

简单来说,如上图所示,我们只需要用预查询模板提示Llama 3 8B Instruct模型,它就会为我们生成一条指令。接着,我们再把这条指令输入给大语言模型,模型就会生成对应的回答。重复这个过程几千次,就能得到一个指令微调数据集。(可选步骤:我们可以用大语言模型按质量筛选这些指令-回答对。)

1.2 数据集质量

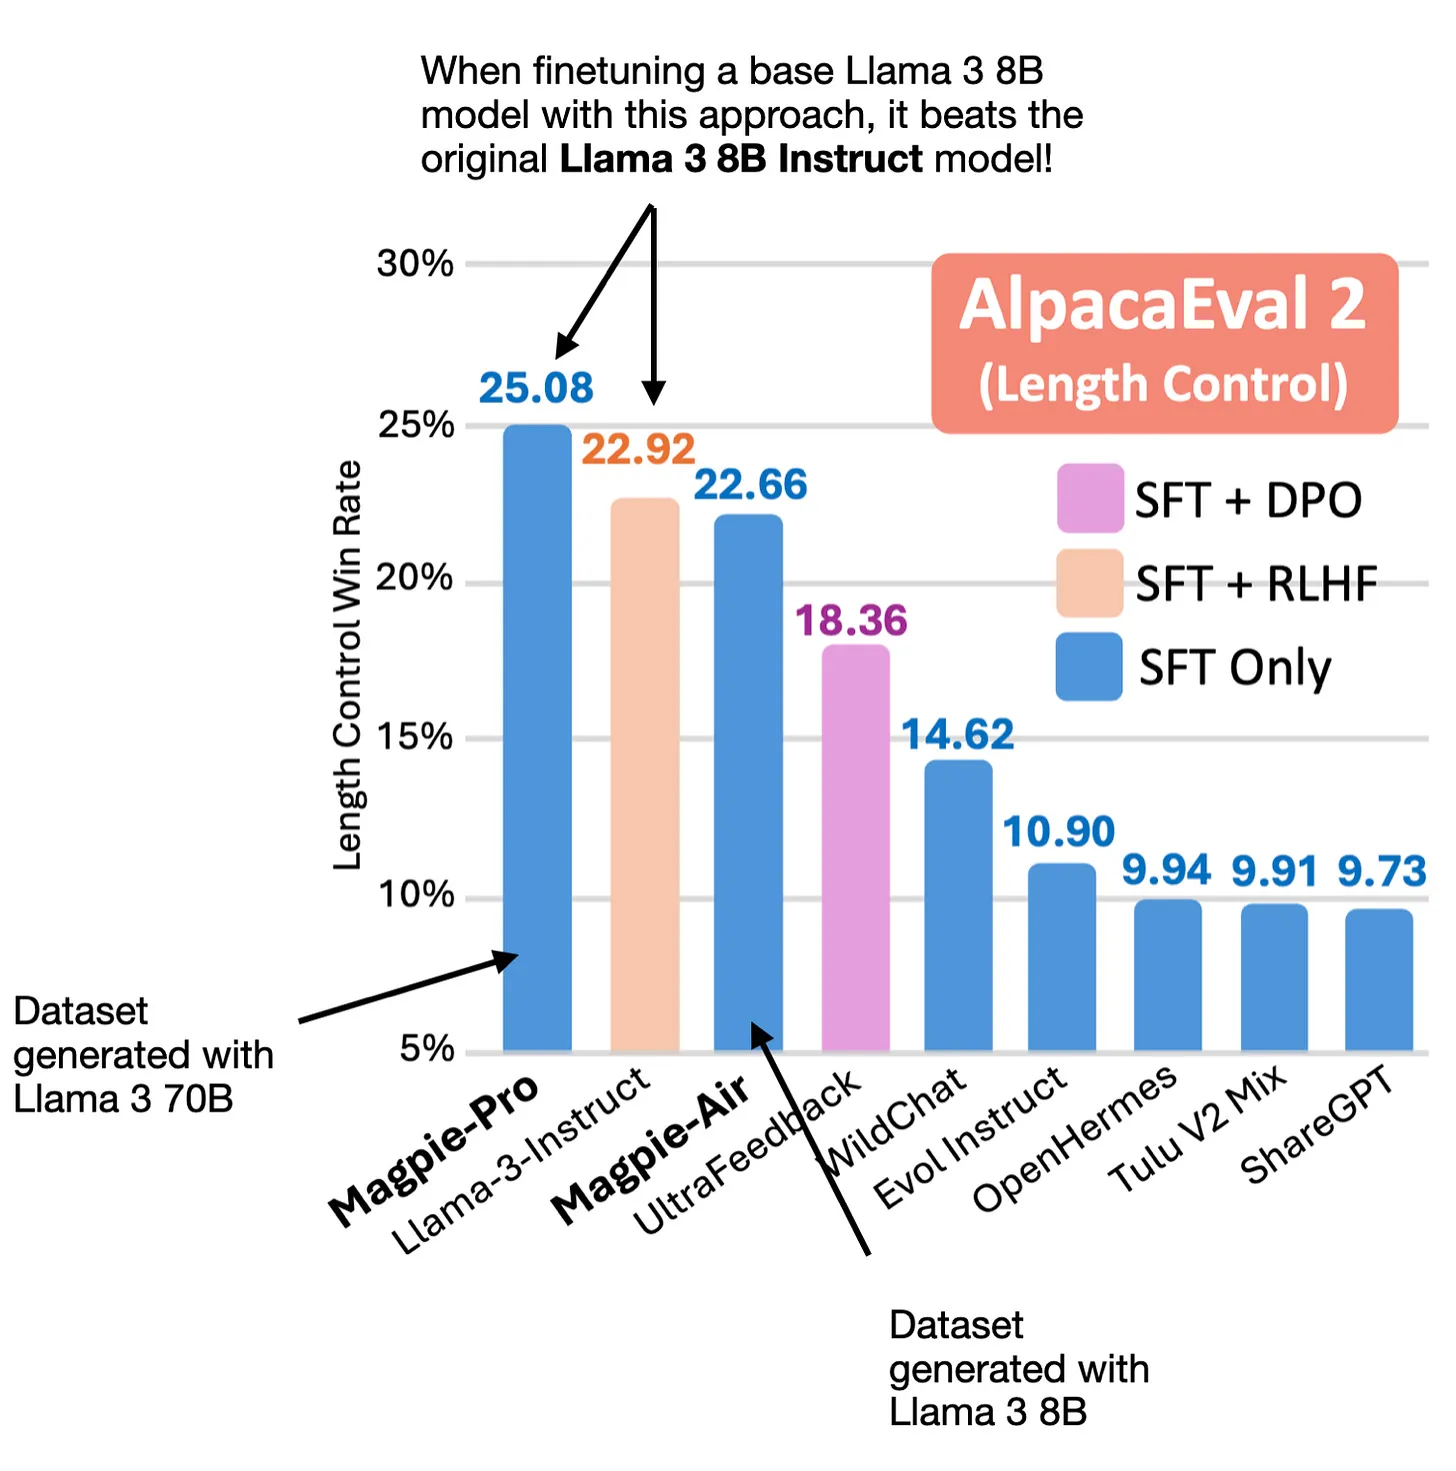
令人惊叹的是,研究者发现,仅用生成的指令数据集对Llama 3 8B基座模型进行指令微调(不经过RLHF、DPO等偏好微调),效果就能超过Meta AI官方的原版Llama 2 8B Instruct模型,如下图所示。

figure02

在Magpie生成的指令数据集上微调后的Llama 3 8B基座模型,效果优于原版Llama 3 8B Instruct模型。基于Magpie论文的带标注示意图改制:https://arxiv.org/abs/2406.08464

上图展示的Magpie效果,仅用了30万条样本就实现了。作为对比,原版Llama 3 Instruct模型的微调和对齐过程,使用了多达1亿条样本!

1.3 本地运行数据集生成

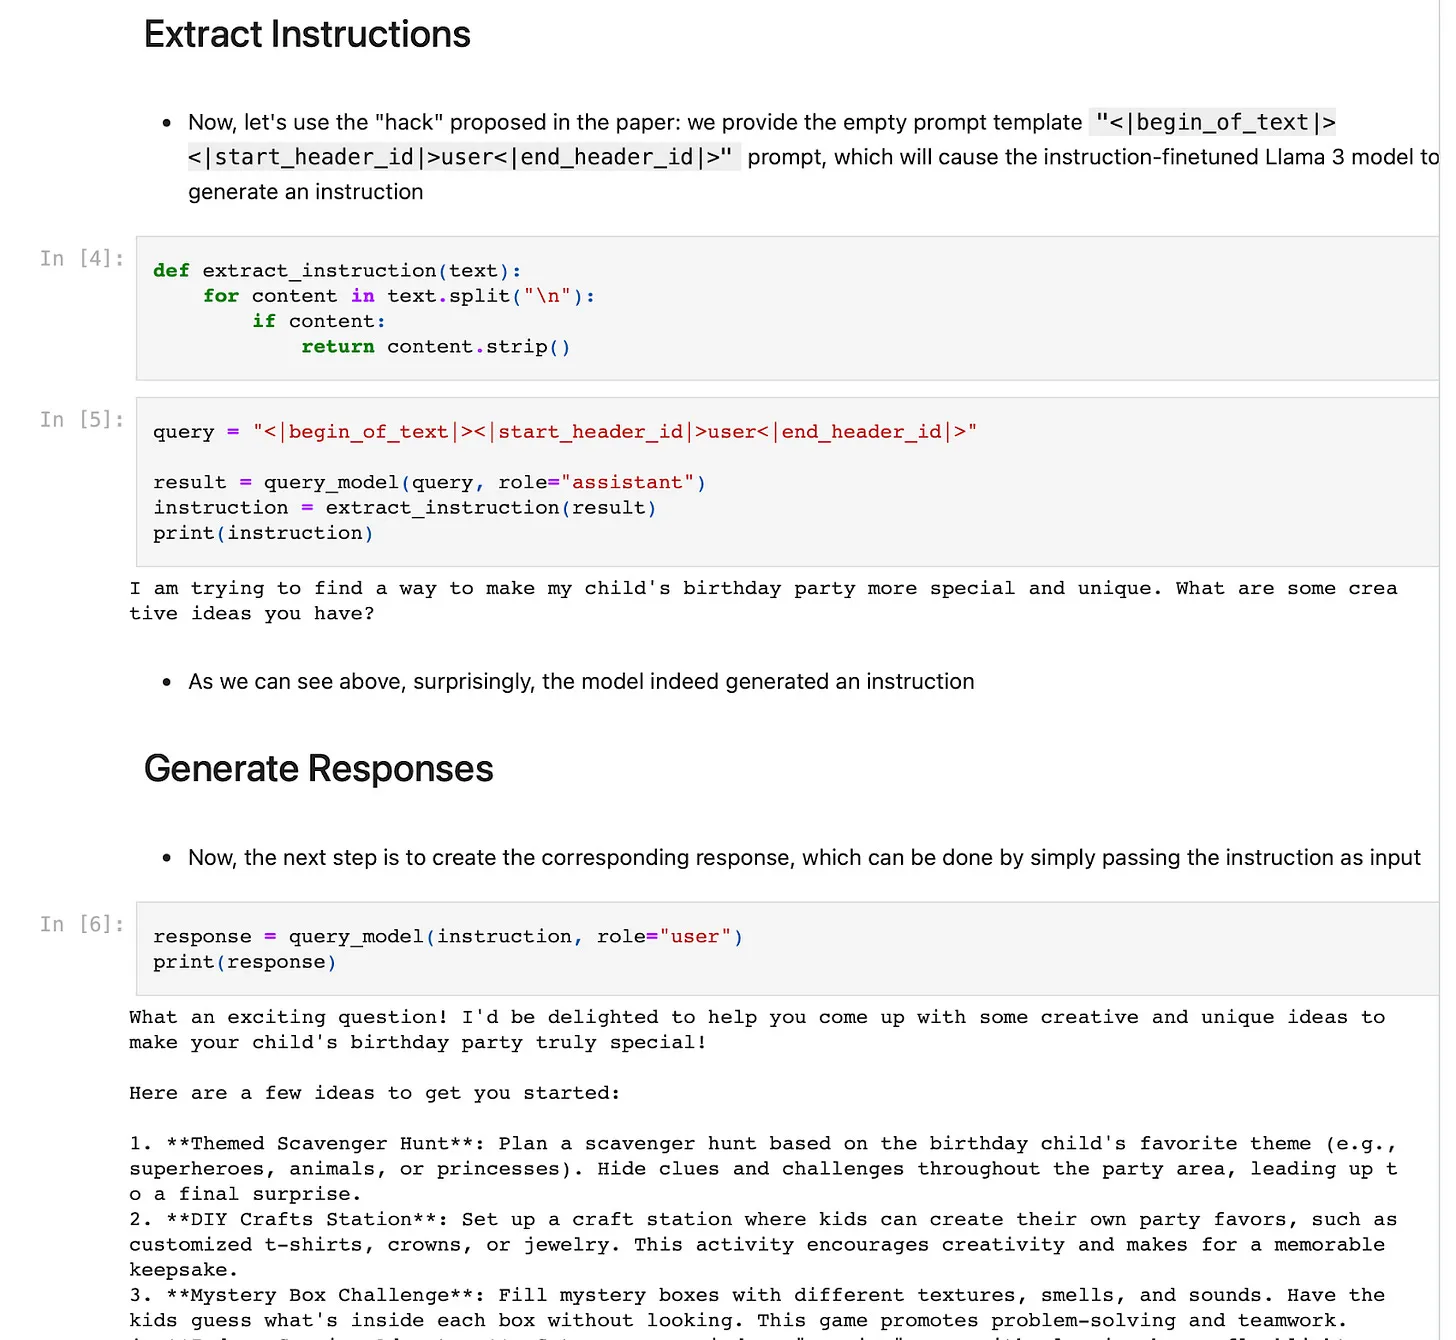
一开始我对此持怀疑态度,于是自己动手实现了这个方法。结果它真的可行!你可以在 https://github.com/rasbt/LLMs-from-scratch/tree/main/ch07/05_dataset-generation 找到我基于Ollama的复现代码,它甚至可以在MacBook Air上流畅运行。

figure03

本地运行的Magpie方法复现代码截图。代码可在此处获取:https://github.com/rasbt/LLMs-from-scratch/blob/main/ch07/05_dataset-generation/instruction-data-llama3-7b.json

1.4 更多细节

研究者创建了两个版本的数据集:使用Llama 3 70B Instruct模型生成的“Pro”版本,以及使用Llama 3 8B Instruct模型生成的“Air”版本。如之前的图示所示,用Magpie-Pro生成的数据集对Llama 3 8B基座模型进行指令微调,得到的模型效果略优于Magpie-Air数据集的结果。

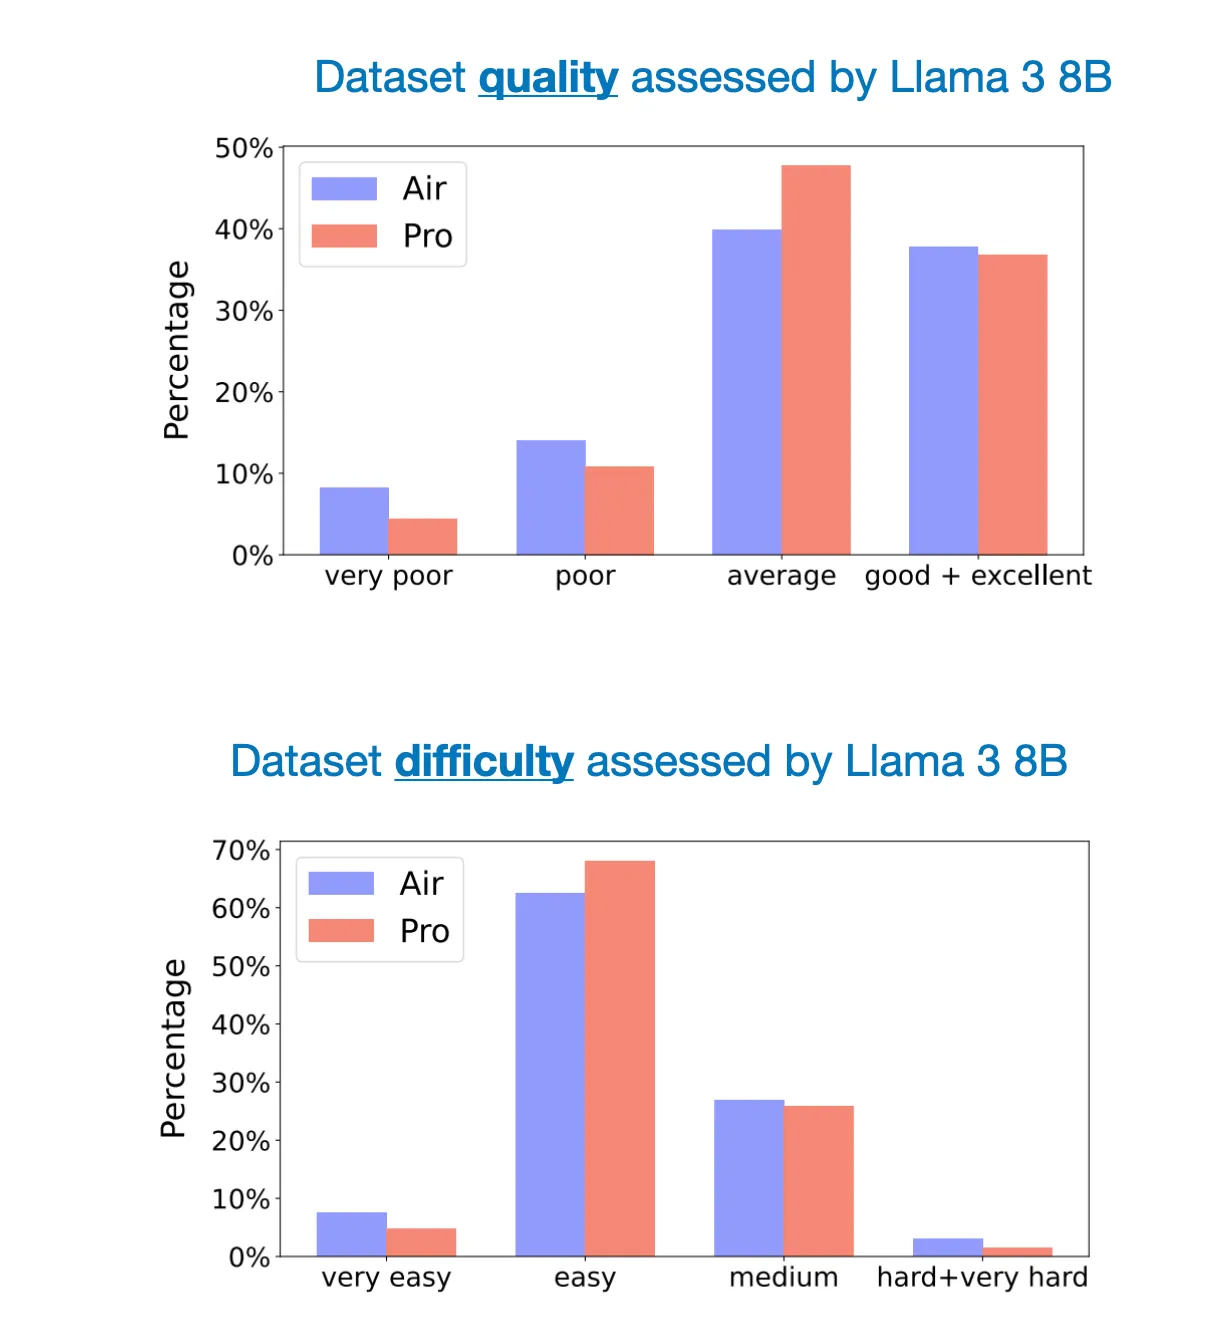
下图补充了大语言模型对两个数据集质量与难度的评分对比。

figure04

Magpie论文中的带标注图表,展示了Air与Pro数据集的质量与难度对比

如上图所示,Air和Pro数据集的质量大致相当。此外,如果能和Alpaca数据集做个对比会很有意思。(目前普遍认为Magpie的数据质量远高于Alpaca,但有一个参照基准会更直观。)

此外,论文中的分析显示,该数据集的广度和多样性远高于其他主流指令微调数据集,比如Alpaca、Evol Instruct和UltraChat。同时,与使用其他指令微调数据集训练的模型相比,Magpie-Pro微调后的模型表现也十分出色。

1.5 小结

总的来说,我认为Magpie是一个很巧妙的技术方案:一方面,它的效果之好令人惊叹;另一方面,它具备极高的实用价值。未来在构建通用指令数据集时,我肯定会将它作为一种有趣、简单且低成本的候选方案。

2. 从零开始进行指令微调

如果你正在寻找学习大语言模型指令微调流程的资料,我很高兴地告诉大家,关于大语言模型指令微调的第7章现已正式上线:https://mng.bz/M96o

这是全书篇幅最长的一章,采用从零实现的思路讲解指令微调全流程,内容涵盖输入格式化、基于自定义整理函数的批处理、填充掩码标记、训练循环本身,以及在自定义测试集上评估微调后大语言模型的回答质量。

(章节练习包括修改提示风格、指令掩码,以及加入LoRA等。)

祝编码愉快!

figure05

我的著作《从零构建大语言模型》第7章内容概览。配套代码资源可在此处获取:https://github.com/rasbt/LLMs-from-scratch

附:这也是全书的最后一章,出版社目前正在准备纸质版的排版工作。

3. 大语言模型的指令预训练

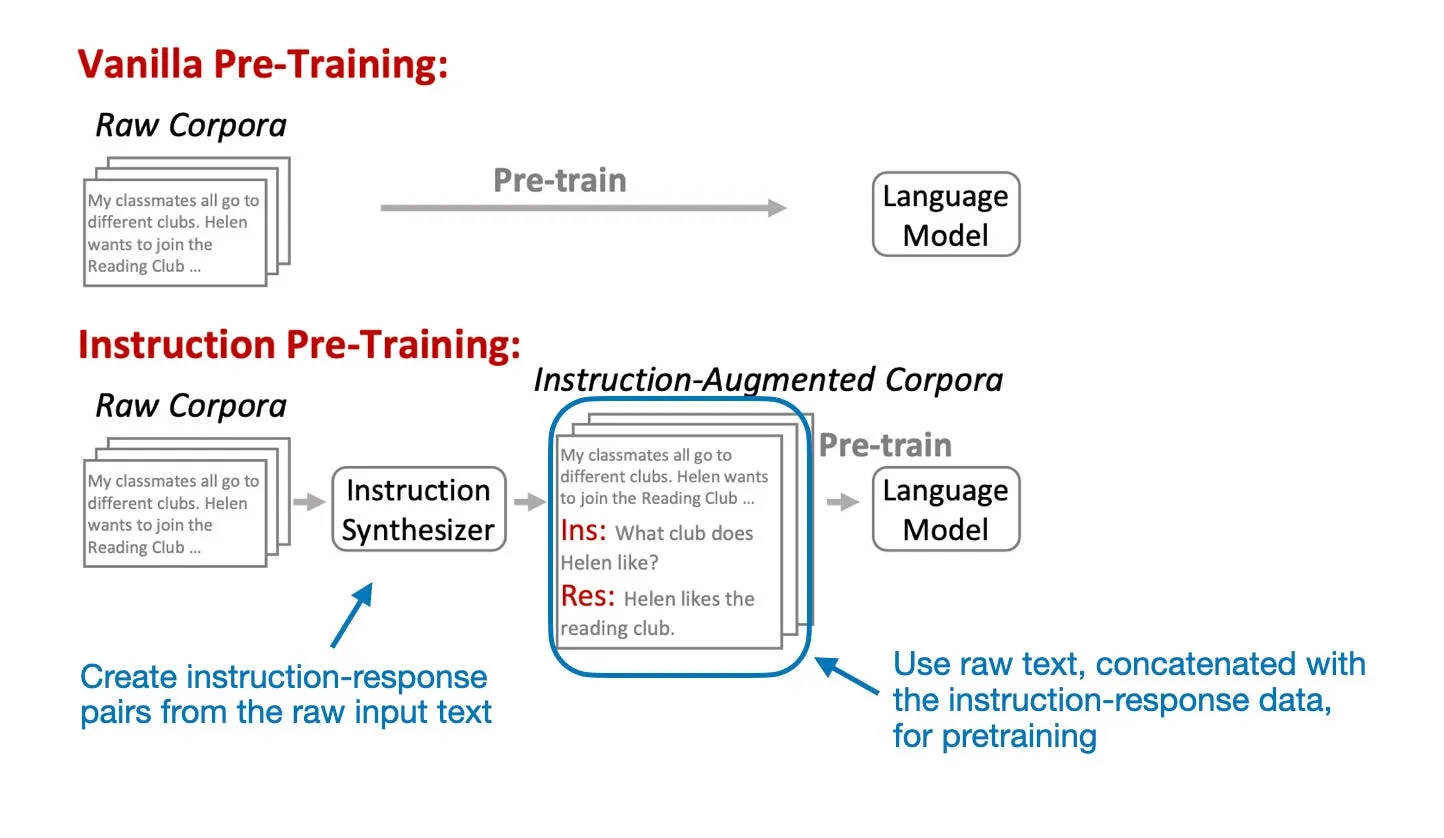
在《指令预训练:语言模型是有监督的多任务学习者》(https://arxiv.org/abs/2406.14491)这篇论文中,研究者探究了通过加入合成指令-回答对(而非仅使用原始文本)来提升大语言模型预训练效率的可能性。(这里的“原始文本”指的是书籍、网站、论文等来源的文本,未经过特定格式的再加工。)

figure06

常规预训练(上)与提出的指令预训练方法(下)的对比,改绘自论文https://arxiv.org/abs/2406.14491的带标注示意图

具体来说,研究者通过一个“指令合成器”——专门为此任务微调的大语言模型——从原始训练语料本身生成指令-回答数据。

(需要说明的是,这并非第一篇提出将原始文本格式化为指令数据的论文。我能想到的另一项相关工作是《Genie:在内容 grounded 数据集生成中达到人类水平》(https://arxiv.org/abs/2401.14367)。我记得几个月前还看过另一篇论文或博客,也提到了在预训练中使用指令数据——我还和同事讨论过这个方法——但可惜找不到出处了。尽管如此,本文讨论的研究尤其值得关注,因为它基于可本地运行的开源大语言模型实现,同时覆盖了预训练和持续预训练两种场景。)

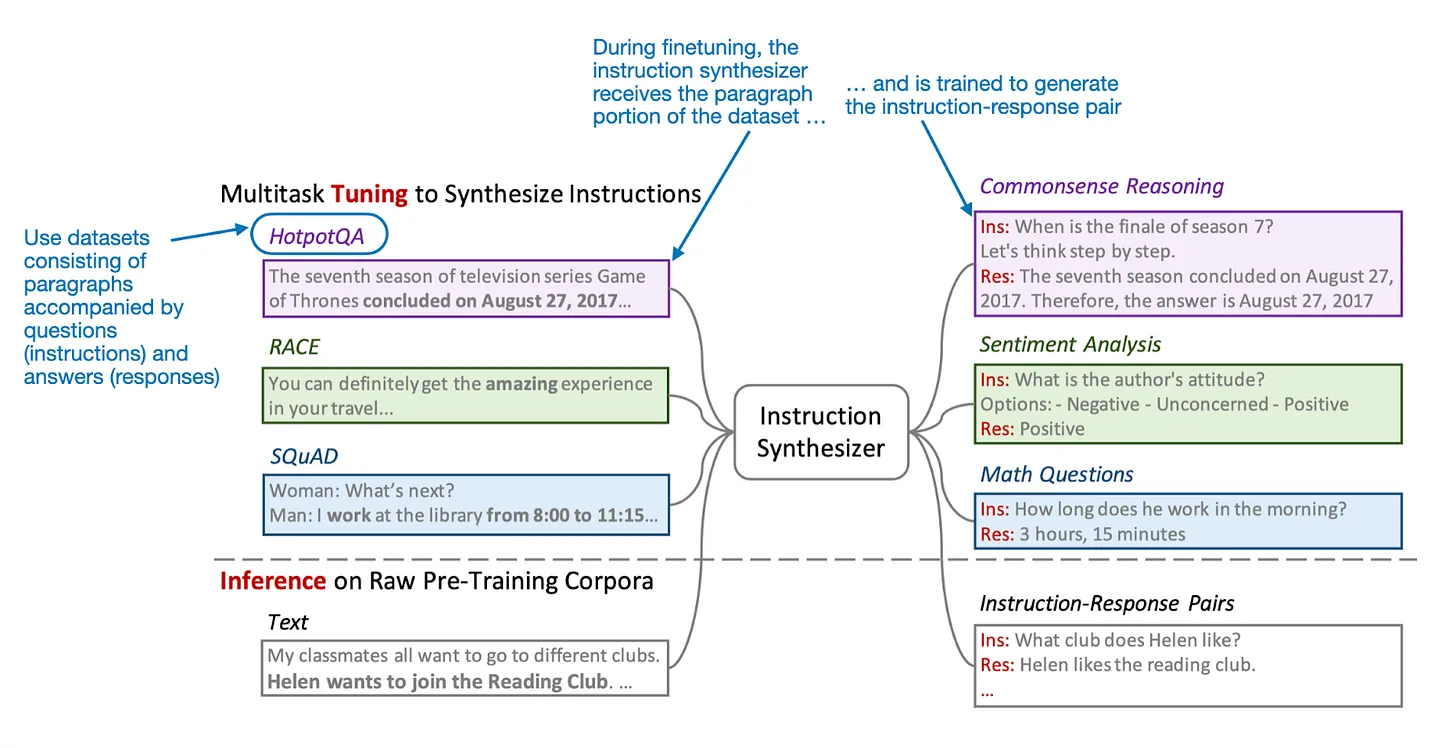
3.1 指令合成器

在深入讲解预训练和持续预训练的结果之前,我们先来说明该方法的核心组件:指令合成器。它是一个开源的Mistral 7B v0.1大语言模型(我去年在这篇文章里写过它:https://magazine.sebastianraschka.com/i/13855764/mistral-b),经过微调后可以从原始文本生成指令-回答对。

为了微调这个合成器,研究者使用了HotpotQA(https://arxiv.org/abs/1809.09600)等数据集,该数据集由维基百科的段落及对应的问答对组成。同时,研究者也确保覆盖了多种任务类型,比如常识推理、情感分析、数学题等。

figure07

指令合成器的输入与输出数据,改绘自论文https://arxiv.org/abs/2406.14491的带标注示意图

当指令合成器开发完成(即微调完毕)后,就可以用它来生成目标大语言模型预训练所需的输入数据。

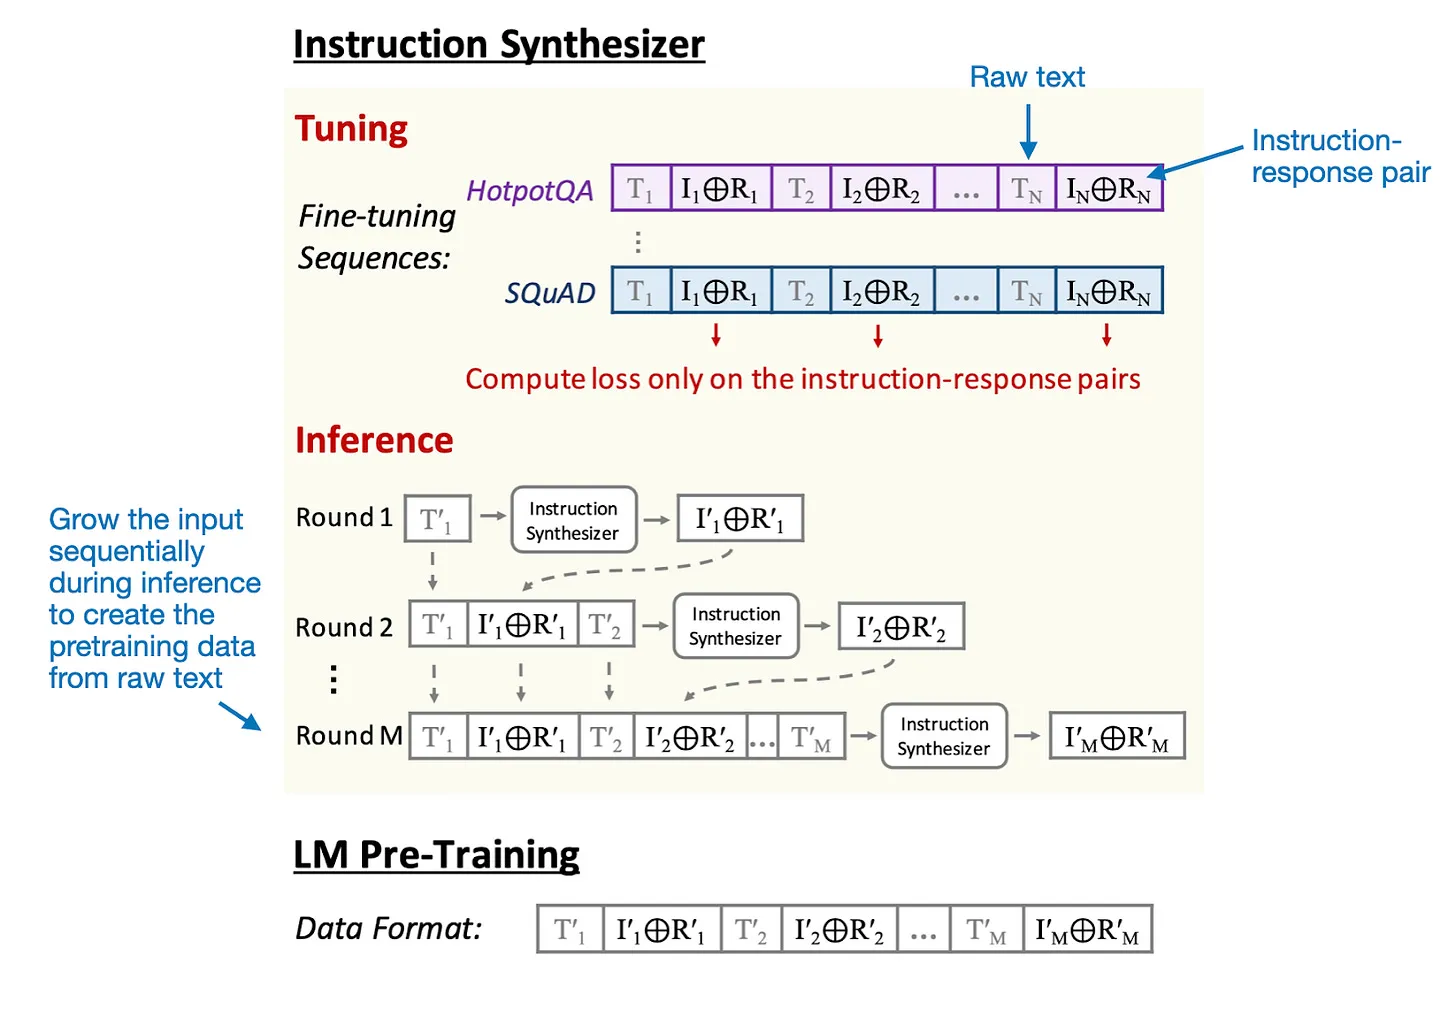
关于指令合成器,还有一个值得注意的细节:多个原始文本(Tn)和指令-回答对(In ⊕ Rn)会被拼接起来作为少样本示例,如下图所示。

figure08

用于微调(及使用)指令合成器的指令数据格式,改绘自论文https://arxiv.org/abs/2406.14491的带标注示意图

3.2 使用指令数据进行预训练

讲完生成指令-回答对的方法,接下来就是最有意思的部分:模型在这种增强数据集上的训练效果如何。第一组结果针对两个从头训练的小模型:5亿参数和13亿参数(均基于Mistral架构)。

figure09

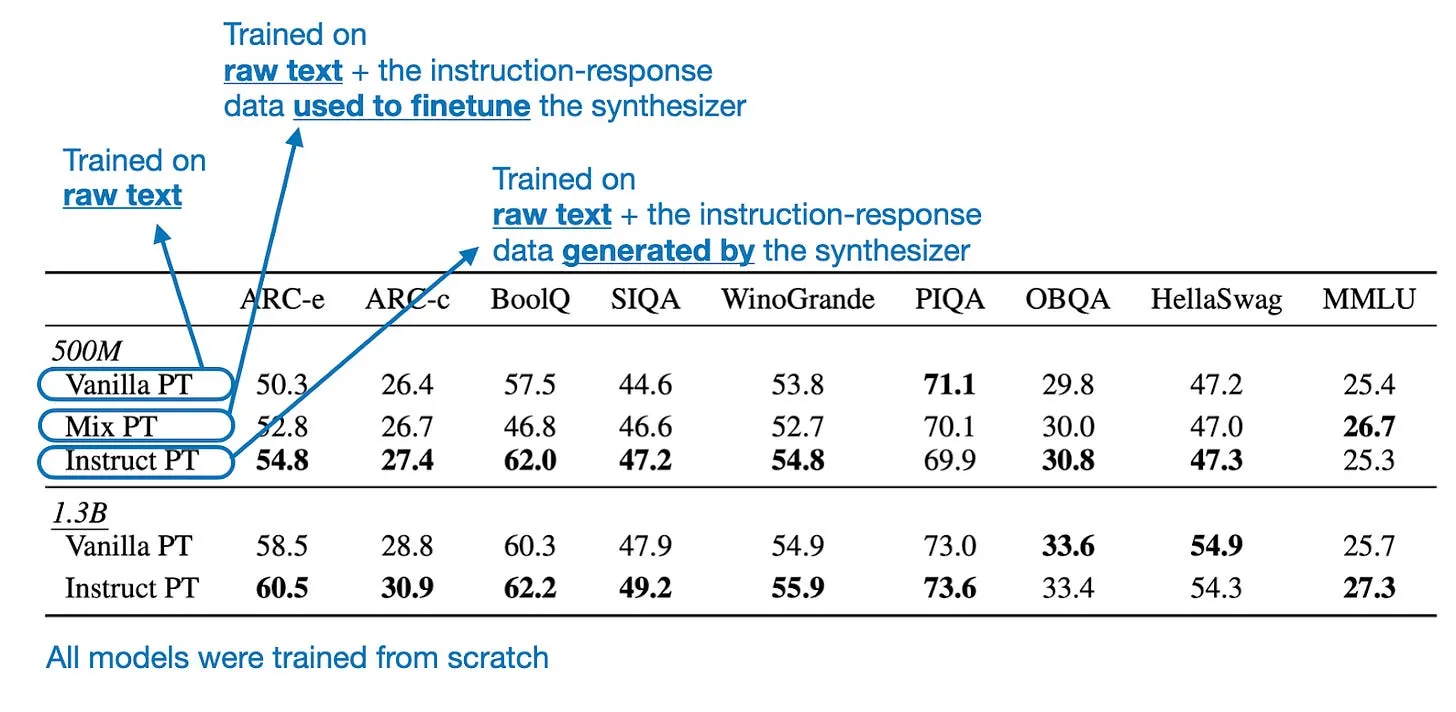
三种不同预训练方法的从头训练效果对比,改绘自论文https://arxiv.org/abs/2406.14491的带标注表格

从上表可以看出,采用本文提出的指令预训练方法(Instruct PT)训练的模型,在大多数基准任务上表现最优(数值越高越好)。

不过需要注意的是,相比普通预训练(Vanilla PT),它见过的token数量更多,因为其中包含了合成的指令-回答对。因此研究者还加入了Mix PT作为对比——该模型在混合数据集上训练,混合了原始文本和用于训练合成器的指令数据。

从这个对比可以看出,并非随便加入指令数据就能带来提升。Instruct PT在多数任务上表现优于Mix PT,这说明指令-回答数据的性质(即与原始数据相关联的指令-回答数据)才是关键。(研究者所有实验都使用了相同数量的token。)

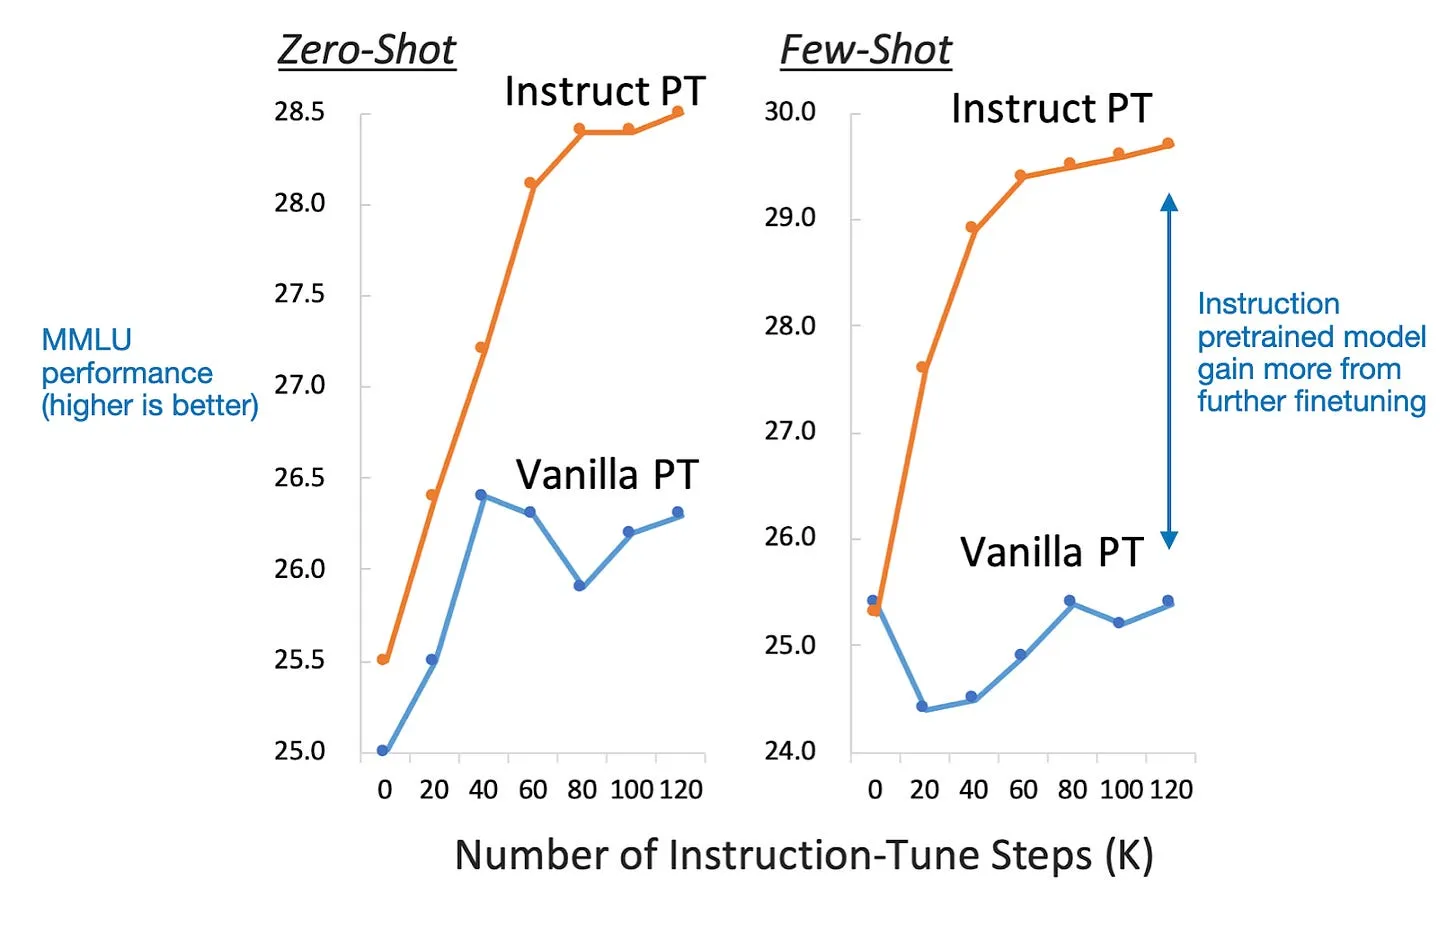
此外值得注意的是,经过指令预训练的模型还有另一个优势:后续再进行指令微调时,提升幅度更大,如下图所示。

figure10

分别经过传统预训练(Vanilla PT)和指令预训练的大语言模型在微调后的效果对比,改绘自论文https://arxiv.org/abs/2406.14491的带标注示意图

3.3 使用指令数据进行持续预训练

从头预训练固然有意思,因为这是大语言模型诞生的方式。但我认为,从业者更关心的是持续预训练和微调。

这里的持续预训练,指的是取一个已经预训练好的模型,在新的领域数据上继续预训练。比如,你有一个在通用文本语料上训练好的Llama 3 8B基座模型,想让它适配金融、医疗、法律等特定领域。

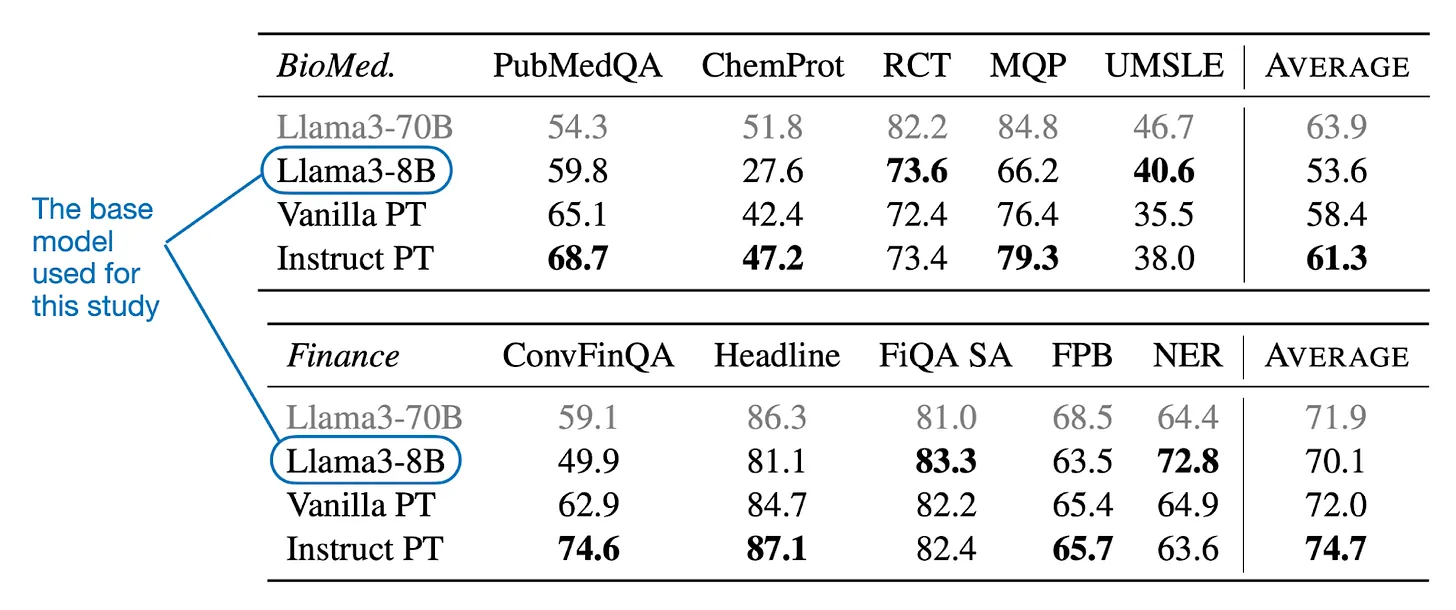
下表总结了研究者将指令预训练方法应用于预训练好的Llama 3 8B基座模型时得到的结果。具体来说,他们分别用生物医学文本和金融文本做了持续预训练实验。

figure11

三种不同预训练方法在持续预训练场景下的效果对比,改绘自论文https://arxiv.org/abs/2406.14491的带标注表格

从上表可以看出,指令预训练方法(Instruct PT)的表现明显优于普通预训练(Vanilla PT)方法(这里的普通预训练指的是对基座模型进行常规持续预训练)。

表中还加入了Llama 3 70B基座模型作为参照——我想这是为了说明,小型专用模型也能胜过大型通用模型。

3.4 小结

每次我给别人讲解大语言模型的预训练流程时,他们都会惊讶于它的简洁,以及如今训练大语言模型依然在沿用这套方法。从这个角度来说,指令预训练方法让人耳目一新。

需要注意的一点是,对于大规模预训练语料,创建指令增强语料的成本可能依然较高。不过生成数据的好处在于,一旦创建完成,就可以在多个不同项目中重复使用。

4. Gemma 2

写这篇文章就不得不提谷歌发布的全新报告 https://storage.googleapis.com/deepmind-media/gemma/gemma-2-report.pdf ,它可以说是上个月最重磅的模型发布。不过如果单论参数规模,英伟达的Nemotron-4 340B才是最大的(https://arxiv.org/abs/2406.11704)。Gemma 2系列模型包含26亿、90亿和270亿参数三个版本。

本文篇幅已经不短了,而且大家可能已经通过其他渠道了解过Gemma 2,那我们就直奔主题:谷歌最新发布的Gemma 2大语言模型有哪些核心亮点和值得关注的更新?其核心思路是,不一定非要扩大训练数据集的规模,而是专注于研发体量相对较小、效率更高的大语言模型。

具体来说,他们融合了三种主要的架构和训练方案来打造26亿和90亿参数模型:滑动窗口注意力、分组查询注意力和知识蒸馏。

4.1 滑动窗口注意力

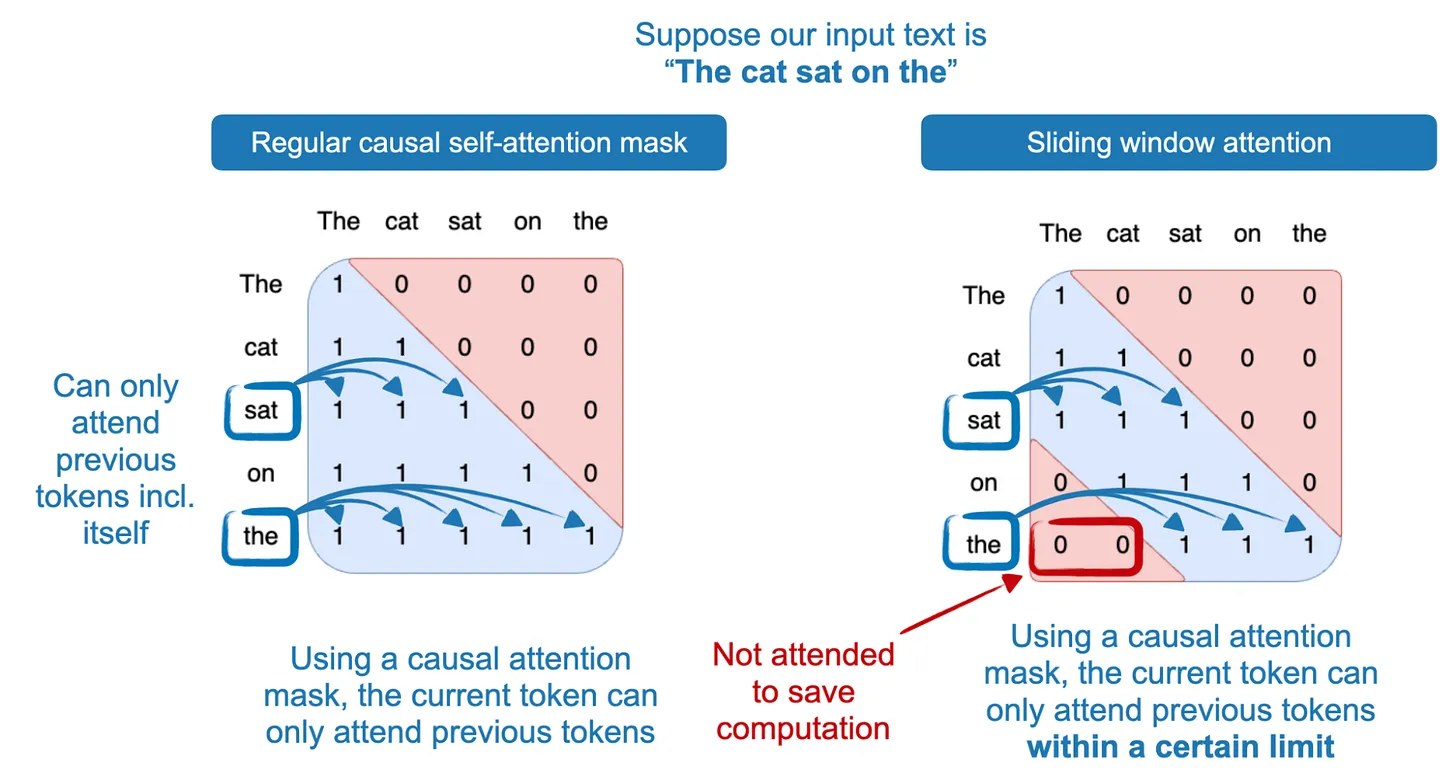
滑动窗口注意力(比如因Mistral而普及的技术)是一种使用固定大小注意力块的技术:当前token仅能关注之前特定数量的token,而非所有之前的token,如下图所示。

figure12

解释滑动窗口注意力的示意图,改绘自论文https://arxiv.org/abs/2310.06825

在Gemma 2中,研究者将普通注意力层和滑动窗口注意力层交替使用。滑动注意力块的大小为4096个token,总块跨度为8192个token。

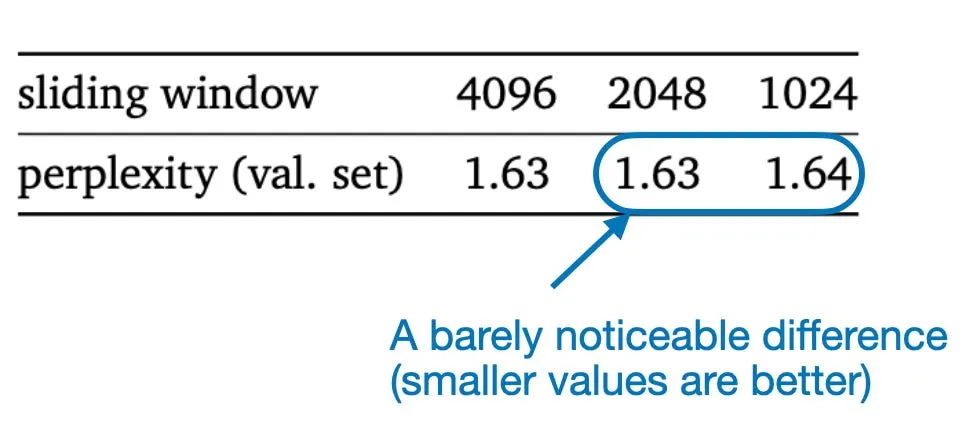
滑动窗口注意力主要用于提升计算性能,研究者还做了一项小型消融研究,结果显示推理时缩小块大小,对困惑度的影响微乎其微。

figure13

来自Gemma 2报告的消融研究:缩小滑动窗口的块大小,对90亿参数模型推理时的建模效果几乎没有影响。报告链接:https://storage.googleapis.com/deepmind-media/gemma/gemma-2-report.pdf

(如果能同时看到GPU显存的提升效果就更有意思了。)

4.2 分组查询注意力

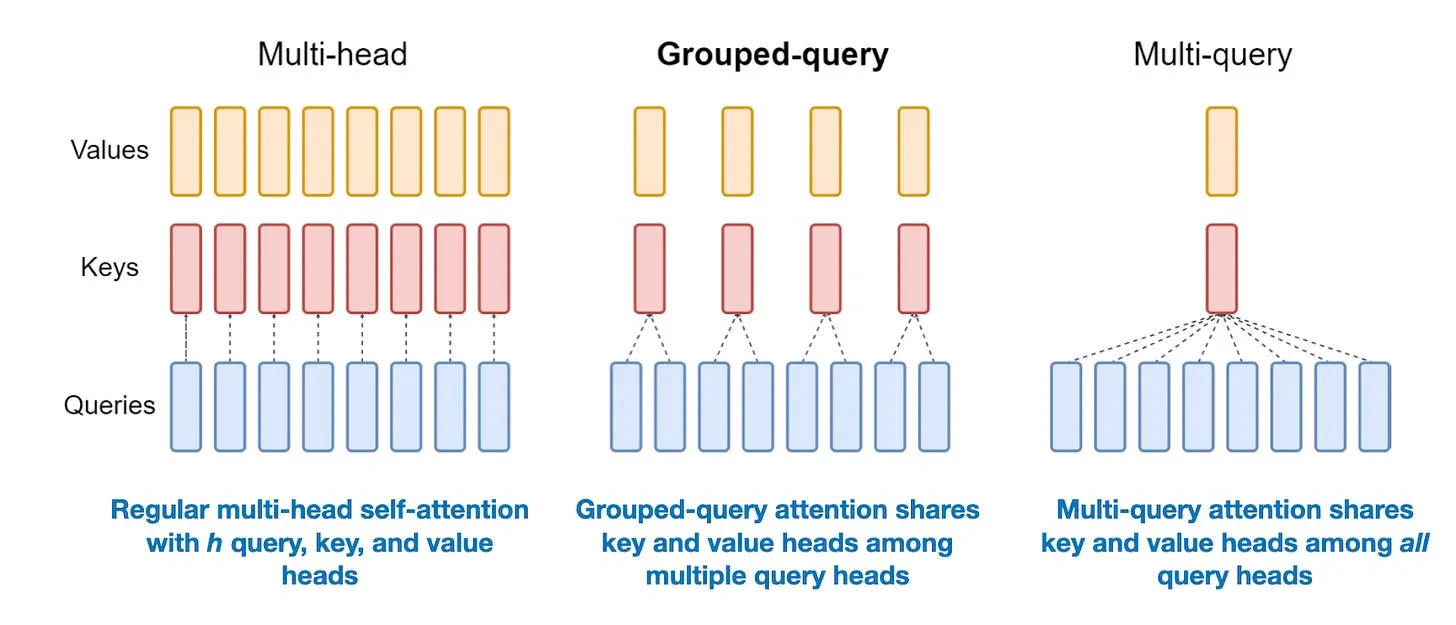
分组查询注意力(和Llama 2、3中的技术类似)可以看作是多查询注意力的更通用形式。其核心动机是,通过让多个查询头共享同一组键和值头,来减少可训练参数的数量,从而降低计算开销。

figure14

示意图改绘自论文https://arxiv.org/abs/2305.13245 https://arxiv.org/abs/2305.13245 https://arxiv.org/abs/2305.13245

4.3 知识蒸馏

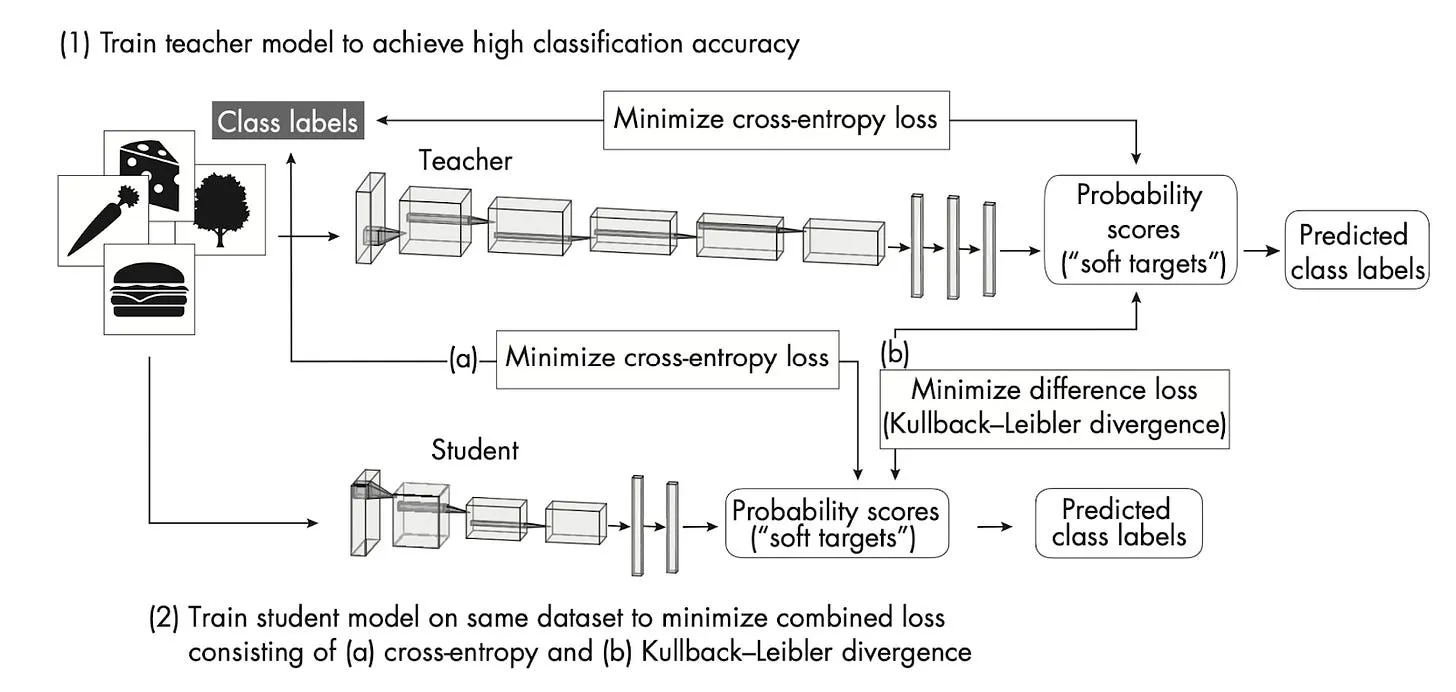
知识蒸馏的核心思想(比如MiniLLM,https://arxiv.org/abs/2306.08543)是将知识从更大的模型(教师模型)迁移到更小的模型(学生模型)中。在Gemma 2中,研究者先从头训练了一个270亿参数的(教师)模型,然后用这个大教师模型的输出来训练更小的20亿和90亿(学生)模型。270亿参数模型没有使用知识蒸馏,而是从头训练,专门作为小模型的“教师”。

figure15

计算机视觉领域的知识蒸馏概览,图源:https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768/ref=sr_1_1。在大语言模型语境下,把图像换成文本,把类别标签换成预测token即可。

4.4 其他值得关注的架构细节

报告中还有很多有意思的细节。比如,Gemma 2的一大特点是其超大的词表规模:256000个token。这和初代Gemma模型差不多,但依然值得一提——它是Llama 3词表(128000)的两倍,是Phi-3词表(32000)的八倍。

大语言模型的词表规模,指的是模型能够识别和生成的唯一token(词、子词或字符)的数量。

更大的词表可以让大语言模型更好地覆盖词汇和概念,提升多语言内容的处理能力,减少分词带来的伪影。但更大的词表也有代价,比如模型体积会增大,并且由于嵌入层和输出层变大,推理速度可能会变慢。(这也正是滑动窗口注意力和多查询注意力机制的重要性所在——它们可以抵消这部分开销。)

报告中还有一个关于“对数几率截断(logit capping)”的有趣章节,这种技术我之前没见过有人使用。本质上,它是一种对logit值进行最大最小归一化和裁剪的方法,将其限制在一定范围内。我推测这是为了提升训练过程中的稳定性和梯度流动性。

$$\text{logits} \leftarrow \text{soft_cap} * \tanh(\text{logits}/\text{soft_cap})$$

此外,他们还利用模型合并技术,将多次不同超参数训练得到的模型进行融合,不过报告中没有提供太多细节。(感兴趣的读者可以参考这篇论文了解更多:https://arxiv.org/abs/2406.16768 ,Gemma 2也用到了这项技术。)

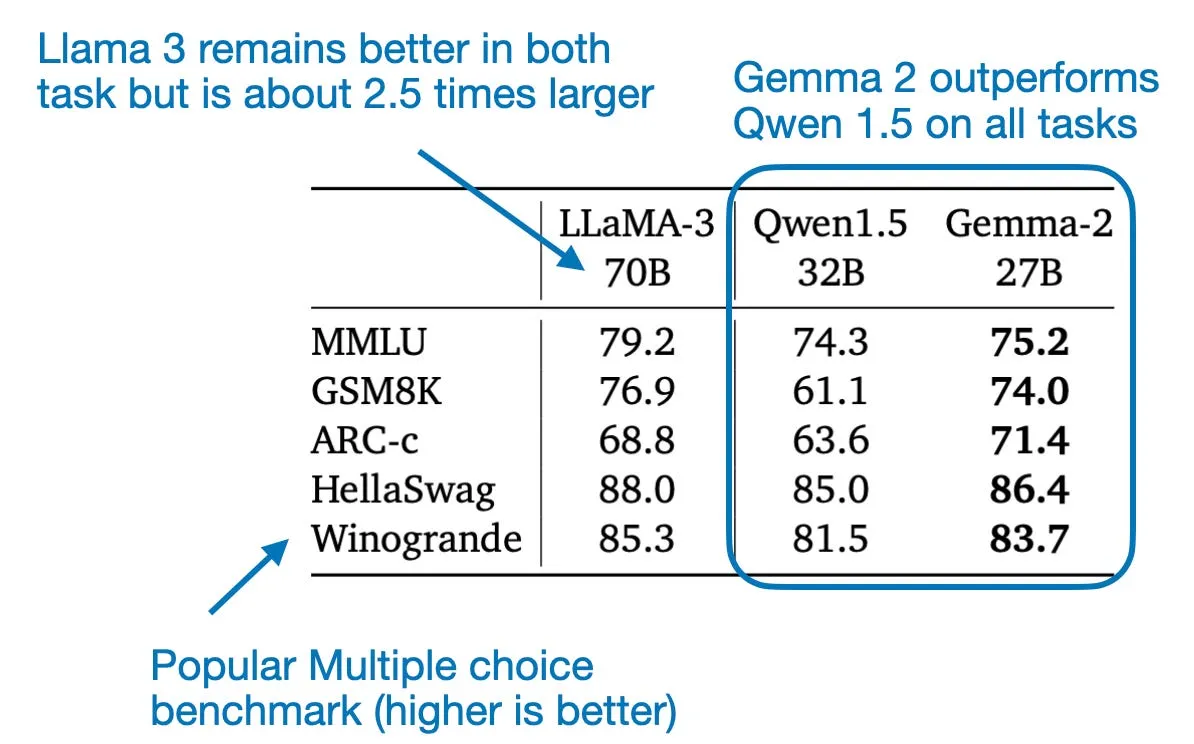
在建模性能方面,Gemma 2的表现几乎是体量3倍于它的Llama 3 70B的水平,并且超过了旧版的Qwen 1.5 32B模型。如果能和更新的Qwen 2模型做对比会很有意思。

figure16

另外两款主流开源权重模型的对比:Llama 3和Qwen 1.5。(带标注表格来自Gemma 2报告:https://storage.googleapis.com/deepmind-media/gemma/gemma-2-report.pdf

在我看来,一大亮点是Gemma 2的报告中针对部分架构选择做了消融研究。这在学术研究中本是常规操作,但在如今的大语言模型研究中已经越来越少见了。

figure17

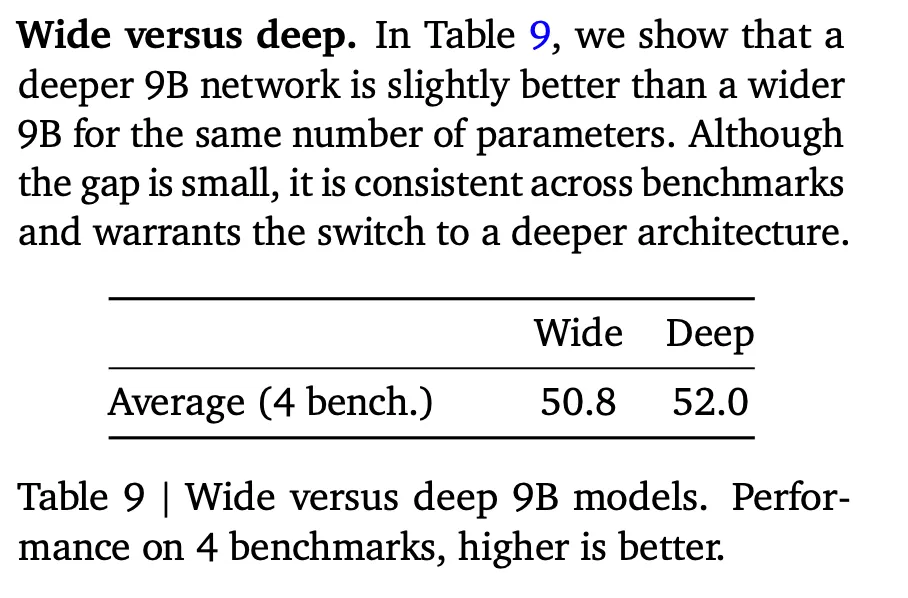
Gemma 2报告中其中一项消融研究的示例。报告链接:https://storage.googleapis.com/deepmind-media/gemma/gemma-2-report.pdf 。其中“wide”指28层、中间维度24576的中等体量模型,“deep”指42层、中间维度14336的深度架构。

4.5 小结

能看到谷歌发布如此详尽的技术报告,让人耳目一新。就模型本身而言,根据业界共识,Gemma 2可能是目前单GPU场景下能力最强的模型。而在更大的模型梯队中,Llama 3 70B和Qwen 2 72B依然是强有力的竞争者。


支持《Ahead of AI》

《Ahead of AI》是我的个人兴趣项目,没有直接的商业回报。不过,如果您愿意支持我,可以考虑购买我的书:https://sebastianraschka.com/books/ 。如果您觉得这些书有洞见、对您有帮助,也欢迎推荐给您的朋友和同事。

如果您有几分钟时间,在亚马逊上给 https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768 或者 写条评论 ,也会对我有很大帮助!

您的支持意义重大,对我继续创作帮助良多。非常感谢!

5. 四月其他值得关注的研究论文

以下是我本月发现的其他一些有意思的论文。由于列表较长,我把个人认为特别值得关注的20篇用星号(*)标注了出来。不过请注意,这份列表及标注仅基于我个人的兴趣,以及和我自身项目的相关性。

  • Scaling Synthetic Data Creation with 1,000,000,000 Personas,作者:Chan, Wang, Yu 等(6月28日),https://arxiv.org/abs/2406.20094
    该研究提出了一种基于人设的数据合成方法,利用大语言模型,通过一个自动构建的大规模人设库(Persona Hub)来生成多样化的合成数据,这个人设库覆盖了全球约13%的人口。

  • LLM Critics Help Catch LLM Bugs,作者:McAleese, Pokorny, Ceron Uribe 等(6月28日),https://arxiv.org/abs/2407.00215
    该研究利用RLHF训练“批评家”模型,辅助人类评估模型生成的代码,训练大语言模型用自然语言反馈代码错误,并证明了它们在各类任务中捕捉漏洞的有效性。

  • Direct Preference Knowledge Distillation for Large Language Models,作者:Li, Gu, Dong 等(6月28日),https://arxiv.org/abs/2406.19774
    DPKD将大语言模型的知识蒸馏重构为两阶段流程:首先优化结合隐式奖励和反向KL散度的目标函数,然后提升教师输出相对学生输出的偏好概率。

  • Changing Answer Order Can Decrease MMLU Accuracy,作者:Gupta, Pantoja, Ross 等(6月27日),https://arxiv.org/abs/2406.19470
    该研究探究了大语言模型MMLU基准测试中准确率测量的鲁棒性,发现打乱答案标签的顺序会导致各模型的准确率普遍下降,且不同模型的敏感程度不同。

  • From Artificial Needles to Real Haystacks: Improving Retrieval Capabilities in LLMs by Finetuning on Synthetic Data,作者:Xiong, Papageorgiou, Lee, Papailiopoulos(6月27日),https://arxiv.org/abs/2406.19292
    该研究提出一种微调方法,使用数值键值检索任务的合成数据集,来提升大语言模型的长上下文信息检索和推理能力。

  • Dataset Size Recovery from LoRA Weights,作者:Salama, Kahana, Horwitz, Hoshen(6月27日),https://arxiv.org/abs/2406.19395
    该研究提出了一种方法,通过分析LoRA矩阵的范数和频谱,从视觉模型的LoRA权重中还原出微调时使用的图像数量。

  • Step-DPO: Step-wise Preference Optimization for Long-chain Reasoning of LLMs,作者:Azerbayev, Shao, Lin 等(6月26日),https://arxiv.org/abs/2406.18629
    本文提出Step-DPO方法,利用自定义的1万条分步偏好对数据集,针对大语言模型数学解题中的各个推理步骤分别进行优化。

  • RouteLLM: Learning to Route LLMs with Preference Data,作者:Ong, Amjad 等(6月26日),https://arxiv.org/abs/2406.18665
    该研究提出了高效的路由模型,能在推理时动态选择更强或更弱的大语言模型,以优化成本-性能权衡。

  • *** A Closer Look into Mixture-of-Experts in Large Language Models**,作者:Zhang, Liu, Patel 等(6月26日),https://arxiv.org/abs/2406.18219
    该研究深入剖析了混合专家(MoE)大语言模型的内部工作机制,分享了关于神经元行为、专家选择准则、跨层专家多样性的洞见,并基于这些观察为MoE的设计与实现提供了实用建议。

  • *** Following Length Constraints in Instructions**,作者:Yuan, Kulikov, Yu 等(6月25日),https://arxiv.org/abs/2406.17744
    该研究提出了一种训练大语言模型的方法,使其能在推理时遵循用户指定的长度约束,解决了模型评估中的长度偏差问题,在长度受控任务上的表现优于标准指令跟随模型。

  • LongIns: A Challenging Long-context Instruction-based Exam for LLMs,作者:Shaham, Bai, An 等(6月25日),https://arxiv.org/abs/2406.17588
    LongIns是一个评估大语言模型长上下文能力的新基准,通过三种设置来考察模型的检索和推理能力。

  • *** The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale**,作者:He, Wang, Shen 等(6月25日),https://arxiv.org/abs/2406.17557
    该报告介绍了FineWeb——一个从Common Crawl提取的15万亿token数据集,以及FineWeb-Edu——一个1.3万亿token的教育子集。

  • Adam-mini: Use Fewer Learning Rates To Gain More,作者:Zhang, Chen, Li 等(6月24日),https://arxiv.org/abs/2406.16793
    Adam-mini是一种新提出的优化器,通过策略性地减少学习率资源、基于海森结构划分参数、为参数块分配优化后的单一学习率,在达到与AdamW相当或更优性能的同时,减少了45-50%的显存占用。

  • WARP: On the Benefits of Weight Averaged Rewarded Policies,作者:Ramé, Ferret, Vieillard 等(6月24日),https://arxiv.org/abs/2406.16768
    本文提出了一种新的大语言模型对齐策略,在三个阶段融合策略:使用指数移动平均做动态KL正则化、对独立微调的策略进行球面插值、以及与初始化进行线性插值。

  • Sparser is Faster and Less is More: Efficient Sparse Attention for Long-Range Transformers,作者:Lou, Jia, Zheng, Tu(6月24日),https://arxiv.org/abs/2406.16747
    作者提出了一种新的自回归Transformer稀疏注意力机制,通过评分网络和可微分的top-k掩码算子,为每个查询选择固定数量的KV对,实现了线性时间复杂度和恒定的显存占用。

  • Efficient Continual Pre-training by Mitigating the Stability Gap,作者:Wang, Hu, Xiong 等(6月21日),https://arxiv.org/abs/2406.14833
    该研究提出了三种改进大语言模型持续预训练的策略:在子集上进行多轮迭代、聚焦高质量数据、使用与预训练数据相似的混合数据。

  • MoA: Mixture of Sparse Attention for Automatic Large Language Model Compression,作者:Fu, Huang, Ning 等(6月21日),https://arxiv.org/abs/2406.14909
    混合注意力(MoA)能针对大语言模型中不同的模型组件和输入长度,自动优化稀疏注意力模式,相比统一稀疏注意力方案,提升了上下文长度、准确率和效率。

  • LongRAG: Enhancing Retrieval-Augmented Generation with Long-context LLMs,作者:Jiang, Ma, Chen 等(6月21日),https://arxiv.org/abs/2406.15319
    LongRAG提出了一种新的RAG框架,使用4K token的检索单元和长上下文大语言模型进行答案抽取,在无需额外训练的情况下,提升了检索性能,并在问答任务上达到了业界最优水平。

  • *** A Tale of Trust and Accuracy: Base vs. Instruct LLMs in RAG Systems**,作者:Cuconasu, Trappolini, Tonellotto 等(6月21日),https://arxiv.org/abs/2406.14972
    该研究挑战了传统认知,证明在检索增强生成(RAG)任务中,基座大语言模型的表现优于指令微调模型。

  • Can LLMs Learn by Teaching? A Preliminary Study,作者:Ning, Wang, Li, Lin 等(6月20日),https://arxiv.org/abs/2406.14629
    作者开发并测试了三种在大语言模型中实现“以教促学”的方法,在不同层面模拟人类教学过程:观察学生反馈、从反馈中学习、迭代学习,在不依赖额外人工数据或更强模型的情况下提升了模型性能。

  • *** Instruction Pre-Training: Language Models are Supervised Multitask Learners**,作者:Cheng, Gu, Huang 等(6月20日),https://arxiv.org/abs/2406.14491
    该研究提出了大语言模型有监督多任务预训练框架,用合成生成的指令-回答对来增强原始语料。

  • *** Can Long-Context Language Models Subsume Retrieval, RAG, SQL, and More?**,作者:Wu, Zhang, Johnson 等(6月19日),https://arxiv.org/abs/2406.13121
    该研究提出了一个基准,用于评估长上下文大语言模型在需要数百万token的任务上的表现,证明这些长上下文大语言模型在上下文内检索和推理任务上,能够媲美专用检索系统和RAG系统。

  • Judging the Judges: Evaluating Alignment and Vulnerabilities in LLMs-as-Judges,作者:Ye, Turpin, Li, He 等(6月18日),https://arxiv.org/abs/2406.12624
    本文以TriviaQA为基准,评估了“大语言模型作为评委”这一范式,将9个评委模型和9个考生模型与人类标注进行对比,发现人类对齐程度高的模型,未必最擅长给考生模型排名。

  • From RAGs to Rich Parameters: Probing How Language Models Utilize External Knowledge Over Parametric Information for Factual Queries,作者:Wadhwa, Seetharaman, Aggarwal 等(6月18日),https://arxiv.org/abs/2406.12824
    作者探究了大语言模型中检索增强生成(RAG)的工作机制,发现模型回答问题时主要依赖检索到的上下文信息,而非自身的参数记忆,在不同模型家族中都表现出这种捷径行为。

  • Self-MoE: Towards Compositional Large Language Models with Self-Specialized Experts,作者:Kang, Karlinsky, Luo 等(6月17日),https://arxiv.org/abs/2406.12034
    本文提出了一种方法,将单体大语言模型转化为名为MiXSE(自专业化专家混合)的模块化系统,利用自生成的合成数据,创建具有共享基座大语言模型和自优化路由的专用专家模块。

  • Measuring memorization in RLHF for code completion,作者:Pappu, Porter, Shumailov, Hayes(6月17日),https://arxiv.org/abs/2406.11715
    该研究探究了基于人类反馈的强化学习(RLHF)对大语言模型中数据记忆的影响,聚焦代码补全任务。研究发现,与直接微调相比,RLHF减少了对奖励建模和强化学习阶段所用数据的记忆,但基本保留了初始微调阶段的记忆。

  • HARE: HumAn pRiors, a key to small language model Efficiency,作者:Zhang, Jin, Ge 等(6月17日),https://arxiv.org/abs/2406.11410
    该研究提出了在小语言模型(SLM)的数据构建中利用人类先验的原则,核心关注语义多样性和数据质量一致性,同时避免基准数据泄露。

  • Iterative Length-Regularized Direct Preference Optimization: A Case Study on Improving 7B Language Models to GPT-4 Level,作者:Kim, Lee, Park 等(6月17日),https://arxiv.org/abs/2406.11817
    该研究提出了迭代长度正则化直接偏好优化(iLR-DPO)方法,在控制回答冗长程度的同时,提升大语言模型与人类偏好的对齐度。

  • Unveiling Encoder-Free Vision-Language Models,作者:Choi, Yoon, Lee 等(6月17日),https://arxiv.org/abs/2406.11832
    该研究提出了一种无编码器的视觉语言模型(VLM),能够在统一的解码器中直接处理视觉和文本输入。

  • *** DeepSeek-Coder-V2: Breaking the Barrier of Closed-Source Models in Code Intelligence**,作者:Zhu, Wang, Lee 等(6月17日),https://arxiv.org/abs/2406.11931
    DeepSeek-Coder-V2是一款开源的混合专家代码大语言模型,通过额外6万亿token的持续预训练,在代码任务上达到了GPT-4 Turbo级别的性能。

  • Tokenization Falling Short: The Curse of Tokenization,作者:Nguyen, Kim, Patel 等(6月17日),https://arxiv.org/abs/2406.11687
    该研究通过考察大语言模型在复杂问题求解、token结构探测和对拼写变化的鲁棒性等方面的表现,探究了大语言模型中的“分词诅咒”。研究发现,虽然扩参能起到一定帮助,但大语言模型依然容易受到分词带来的偏差影响。

  • DataComp-LM: In Search of the Next Generation of Training Sets for Language Models,作者:Li, Fang, Smyrnis 等(6月17日),https://arxiv.org/abs/2406.11794
    作者提供了一个标准化测试平台,用于实验语言模型训练中的数据集筛选策略,包含240万亿token的语料、预训练方案和53项下游评估。

  • *Nemotron-4 340B Technical Report,作者:英伟达未署名作者(6月17日),https://arxiv.org/abs/2406.11704
    这份技术报告伴随英伟达Nemotron-4 340B模型家族的发布,该模型在各类基准上表现出色,尤其擅长合成数据生成,同时开源了其数据生成管线,供后续研究和开发使用。

  • mDPO: Conditional Preference Optimization for Multimodal Large Language Models,作者:Wang, Zhou, Huang 等(6月17日),https://arxiv.org/abs/2406.11839
    mDPO解决了多模态DPO中的无条件偏好问题,通过同时优化图像偏好和语言偏好,并引入奖励锚点,防止选中回答的似然度下降。

  • *** How Do Large Language Models Acquire Factual Knowledge During Pretraining?**,作者:Chang, Park, Ye 等(6月17日),https://arxiv.org/abs/2406.11813

  • Task Me Anything,作者:Zhang, Huang, Ma 等(6月17日),https://arxiv.org/abs/2406.11775
    Task-Me-Anything是一个基准生成引擎,通过从海量图像和视频分类体系中程序化生成任务实例,为多模态大语言模型创建定制化基准。

  • THEANINE: Revisiting Memory Management in Long-term Conversations with Timeline-augmented Response Generation,作者:Kim, Ong, Kwon 等(6月16日),https://arxiv.org/abs/2406.10996
    Theanine通过使用记忆时间线(展示过往事件发展和因果关系的系列记忆)来增强大语言模型的回复生成,提升模型从冗长对话历史中回忆和利用信息的能力。

  • Regularizing Hidden States Enables Learning Generalizable Reward Model for LLMs,作者:Yang, Ding, Lin 等(6月14日),https://arxiv.org/abs/2406.10216
    该研究提出,在RLHF中通过保留基座模型的语言模型头、加入文本生成损失来正则化隐藏状态,同时学习奖励头,以此提升奖励模型的泛化能力,从而提升分布外任务的表现,缓解奖励过优化问题。

  • Be like a Goldfish, Don’t Memorize! Mitigating Memorization in Generative LLMs,作者:Hans, Wen, Jain 等(6月14日),https://arxiv.org/abs/2406.10209
    “金鱼损失”技术通过在训练时随机从损失计算中排除一部分token,减少大语言模型的记忆行为,防止模型从训练数据中学到完整的逐字序列。

  • Bootstrapping Language Models with DPO Implicit Rewards,作者:Chen, Liu, Du 等(6月14日),https://arxiv.org/abs/2406.09760
    研究者发现,利用直接偏好优化(DPO)过程中生成的对齐模型(一种隐式奖励模型),本身就可以用来生成偏好数据集,进一步大幅提升模型自身的性能。

  • FouRA: Fourier Low Rank Adaptation,作者:Borse, Kadambi, Pandey 等(6月13日),https://arxiv.org/abs/2406.08798
    该研究提出了FouRA——一种在傅里叶域运行的新型低秩适配(LoRA)方法,采用自适应秩选择,解决了LoRA微调的文生图扩散模型中的数据复制和分布崩塌问题,同时提升了图像质量和泛化能力。

  • *** An Image is Worth More Than 16×16 Patches: Exploring Transformers on Individual Pixels**,作者:Nguyen, Mahmoud Assran, Jain 等(6月13日),https://arxiv.org/abs/2406.09415
    该研究表明,普通Transformer将单个像素作为token,就能在各种计算机视觉任务中达到高性能。这挑战了现代视觉架构中基于局部性的归纳偏置的必要性,也为未来计算机视觉领域的神经网络设计提供了新的可能。

  • MLKV: Multi-Layer Key-Value Heads for Memory Efficient Transformer Decoding,作者:Zuhri, Adilazuarda, Purwarianti, Aji(6月13日),https://arxiv.org/abs/2406.09297
    该研究提出了多层键值(MLKV)共享技术,这是一种将键值(KV)缓存跨Transformer层扩展的新技术。相比多查询注意力(MQA)和分组查询注意力(GQA)等现有方法,它大幅降低了自回归推理时的显存占用,同时保持了自然语言处理任务的性能。

  • Transformers Meet Neural Algorithmic Reasoners,作者:Bounsi, Ibarz, Dudzik 等(6月13日),https://arxiv.org/abs/2406.09308
    TransNAR是一种混合架构,将Transformer与基于图神经网络的神经算法推理器(NAR)相结合,让Transformer能够利用NAR强大的计算能力,同时保持出色的自然语言理解能力,从而提升算法推理任务的表现。

  • Discovering Preference Optimization Algorithms with and for Large Language Models,作者:Lu, Holt, Fanconi 等(6月12日),https://arxiv.org/abs/2406.08414
    提出的“发现偏好优化”方法,利用大语言模型自动发现并实现新的偏好优化算法,以提升大语言模型的输出效果。

  • *** An Empirical Study of Mamba-based Language Models**,作者:Waleffe, Byeon, Riach 等(6月12日),https://arxiv.org/abs/2406.07887
    该研究对比了在大规模数据集上训练的80亿参数状态空间模型(Mamba、Mamba-2)和Transformer模型。研究发现,虽然纯状态空间模型在很多任务上持平甚至超过Transformer,但在需要强复制能力、上下文内学习或长上下文推理的任务上仍有差距;不过混合架构似乎能集两者之长。

  • *** Large Language Models Must Be Taught to Know What They Don’t Know**,作者:Kapoor, Gruver, Roberts 等(6月12日),https://arxiv.org/abs/2406.08391
    该研究证明,用少量分级样本对大语言模型进行微调,能得到比仅靠提示更可靠的不确定性估计,得到的模型能够估算自身和其他模型的不确定性。

  • Large Language Model Unlearning via Embedding-Corrupted Prompts,作者:Liu, Flannigan, Liu(6月12日),https://arxiv.org/abs/2406.07933
    该研究提出了嵌入损坏提示法,一种大语言模型选择性知识遗忘的方法,利用提示分类和嵌入损坏实现定向遗忘,在各种模型规模下副作用都很小。

  • What If We Recaption Billions of Web Images with LLaMA-3?,作者:Li, Tu, Hui 等(6月12日),https://arxiv.org/abs/2406.08478
    该研究证明,使用微调后的Llama 3驱动的LLaVA-1.5多模态大语言模型,为DataComp-1B数据集中的13亿张图片重新生成说明文字,能显著提升视觉语言模型在各类任务中的表现。

  • *** Magpie: Alignment Data Synthesis from Scratch by Prompting Aligned LLMs with Nothing**,作者:Xu, Jiang, Niu 等(6月12日),https://arxiv.org/abs/2406.08464
    研究者提出了一种合成指令数据生成方法,能从Llama-3-Instruct生成30万条高质量指令-回答对;这些数据可用于有监督指令微调,在无需实际对齐步骤的情况下,就能媲美对齐后的大语言模型性能。

  • *** Samba: Simple Hybrid State Space Models for Efficient Unlimited Context Language Modeling**(6月11日),https://arxiv.org/abs/2406.07522
    Samba是一种混合模型,将选择性状态空间模型(可以理解为Mamba)与滑动窗口注意力相结合,能高效扩展到38亿参数。

  • *** Never Miss A Beat: An Efficient Recipe for Context Window Extension of Large Language Models with Consistent “Middle” Enhancement**,作者:Wu, Zhao, Zheng(6月11日),https://arxiv.org/abs/2406.07138
    CREAM是一种训练高效的大语言模型上下文长度扩展方法,通过插值位置编码,并使用截断高斯函数来优先考虑中间上下文信息。

  • Simple and Effective Masked Diffusion Language Models,作者:Sahoo, Arriola, Schiff 等(6月11日),https://arxiv.org/abs/2406.07524
    这项工作证明,经过有效训练策略和简化目标训练的掩码离散扩散模型,能大幅缩小与自回归方法在语言建模上的性能差距。

  • TextGrad: Automatic “Differentiation” via Text,作者:Yuksekgonul, Bianchi, Boen 等(6月11日),https://arxiv.org/abs/2406.07496
    TextGrad是一个框架,利用大语言模型对文本反馈进行“反向传播”,用于优化复合AI系统中的基础组件(比如“工具调用器”“搜索引擎”等)。

  • An Image is Worth 32 Tokens for Reconstruction and Generation,作者:Yu, Weber, Deng 等(6月11日),https://arxiv.org/abs/2406.07550
    作者提出了一种基于Transformer的一维图像生成分词器,能将256×256×3的图像压缩为仅32个离散token。

  • *** Self-Tuning: Instructing LLMs to Effectively Acquire New Knowledge through Self-Teaching**,作者:Zhang, Peng, Zhou 等(6月10日),https://arxiv.org/abs/2406.06326
    自调优框架通过围绕记忆、理解和自我反思的自教学任务,提升大语言模型从原始文档中获取知识的能力。

  • Turbo Sparse: Achieving LLM SOTA Performance with Minimal Activated Parameters,作者:Song, Xie, Zhang 等(6月10日),https://arxiv.org/abs/2406.05955
    本文提出了dReLU激活函数和优化的训练数据混合方案,以提升大语言模型的激活稀疏性。

  • Husky: A Unified, Open-Source Language Agent for Multi-Step Reasoning,作者:Kim, Paranjape, Khot, Hajishirzi(6月10日),https://arxiv.org/abs/2406.06469
    Husky是一个开源语言智能体,在统一的动作空间中学习推理,通过在生成动作和执行动作之间迭代,借助专家模型处理涉及数值、表格和知识推理的各类任务。

  • Margin-aware Preference Optimization for Aligning Diffusion Models Without Reference,作者:Hong, Paul, Lee 等(6月10日),https://arxiv.org/abs/2406.06424
    为解决RLHF和DPO等传统对齐技术的局限,作者提出了面向文生图扩散模型的边距感知偏好优化(MaPO),在不使用参考模型的情况下,最大化偏好图像集与非偏好图像集之间的似然边距。

  • *** Autoregressive Model Beats Diffusion: Llama for Scalable Image Generation**,作者:Sun, Jian, Chen 等(6月10日),https://arxiv.org/abs/2406.06525
    作者提出了LlamaGen,将大语言模型的“下一个token预测”范式应用到图像生成中。

  • Creativity Has Left the Chat: The Price of Debiasing Language Models,作者:Mohammidi(6月8日),https://arxiv.org/abs/2406.05587
    该研究揭示,虽然RLHF等对齐技术能减轻大语言模型中的偏差,但也会削弱模型的创造力,影响句法和语义多样性——这对需要创造性输出的任务至关重要。

  • 3D-GRAND: A Million-Scale Dataset for 3D-LLMs with Better Grounding and Less Hallucination,作者:Yang, Chen, Madaan 等(6月7日),https://arxiv.org/abs/2406.05132
    该研究推出了3D-GRAND数据集,包含40087个家庭场景及配套的620万条场景语言指令,并通过指令微调和3D-POPE基准,提升了3D大语言模型的基础能力,减少了幻觉。

  • BERTs are Generative In-Context Learners,作者:Samuel(6月7日),https://arxiv.org/abs/2406.04823
    本文证明,掩码语言模型(如DeBERTa)可以通过一种简单的推理技术实现上下文内学习:用类似因果注意力掩码结构的掩码token,重新排列输入token的序列。

  • June 7, Mixture-of-Agents Enhances Large Language Model Capabilitieshttps://arxiv.org/abs/2406.04692

  • WildBench: Benchmarking LLMs with Challenging Tasks from Real Users in the Wild,作者:Lin, Deng, Chandu 等(6月7日),https://arxiv.org/abs/2406.04770
    作者推出了一个用真实用户查询评测大语言模型的自动化评估框架,包含1024个任务和两项先进指标WB-Reward和WB-Score,通过任务特定检查清单和结构化解释,提供可靠、可解释的自动评判结果。

  • CRAG — Comprehensive RAG Benchmark,作者:Yang, Sun, Xin 等(6月7日),https://arxiv.org/abs/2406.04744
    该研究推出了一个事实问答数据集,包含4409个问答对及模拟网页和知识图谱搜索的模拟API,旨在真实反映多样化、动态变化的现实世界问答任务。

  • Boosting Large-scale Parallel Training Efficiency with C4: A Communication-Driven Approach,作者:Dong, Luo, Zhang 等(6月7日),https://arxiv.org/abs/2406.04594
    该研究推出了C4——一种面向大语言模型并行训练的通信驱动方案,能快速识别并隔离硬件故障,同时优化流量规划以减少网络拥塞,可将故障导致的开销降低最多30%,运行时性能提升最多15%。

  • Step-aware Preference Optimization: Aligning Preference with Denoising Performance at Each Step,作者:Liang, Yuan, Gu 等(6月6日),https://arxiv.org/abs/2406.04314
    该研究提出了步骤感知偏好优化——一种后训练方法,能独立评估并调整文生图扩散模型中每一步的去噪性能,在图像对齐和美学效果上优于Diffusion-DPO,同时训练效率提升20倍。

  • *** Are We Done with MMLU?**,作者:Gema, Leang, Hong 等(6月6日),https://arxiv.org/abs/2406.04127
    该研究指出了广泛使用的MMLU基准中存在大量错误,创建了重新标注的子集MMLU-Redux,揭示了已报告的模型性能存在显著偏差,并呼吁修订MMLU以提升其可靠性。

  • *** Transformers Need Glasses! Information Over-Squashing in Language Tasks**,作者:Barbero, Banino, Kapturowski 等(6月6日),https://arxiv.org/abs/2406.04267
    该研究分析了大语言模型(具体来说是仅解码器Transformer)中的信息传播,揭示了一种表示崩塌现象:不同的输入序列可能生成极其接近的最终token表示,导致计数、复制等任务出错,并且模型对特定输入token的敏感度下降。

  • The Prompt Report: A Systematic Survey of Prompting Techniques,作者:Schulhoff, Ilie, Balepur 等(6月6日),https://arxiv.org/abs/2406.06608
    这篇长达76页的论文旨在为理解提示和提示工程技术提供一个清晰、系统的框架。

  • Buffer of Thoughts: Thought-Augmented Reasoning with Large Language Models,作者:Yang, Yu, Zhang 等(6月6日),https://arxiv.org/abs/2406.04271
    这种“思维缓冲区”方法,通过检索并实例化思维模板(即通用的问题解决蓝图)来提升大语言模型在各领域的推理能力。

  • Block Transformer: Global-to-Local Language Modeling for Fast Inference,作者:Ho, Bae, Kim 等(6月4日),https://arxiv.org/abs/2406.02657
    提出的Block Transformer将计算量大的全局注意力限制在低层的固定大小token块上,在高层使用快速的局部注意力,将推理吞吐量提升了10-20倍。

  • *** Scalable MatMul-free Language Modeling**,作者:Zhu, Zhang, Sifferman 等(6月4日),https://arxiv.org/abs/2406.02528
    本文提出了一种可扩展的无矩阵乘法语言模型架构,用元素级乘积和三值权重累加替代矩阵乘法,即使在十亿参数规模下也能保持良好性能。

  • Towards Scalable Automated Alignment of LLMs: A Survey,作者:Cao, Lu, Lu 等(6月3日),https://arxiv.org/abs/2406.01252
    本文综述了近期兴起的大语言模型自动对齐方法,这些方法通常应用于大语言模型开发流程中的指令微调步骤之后。

  • The Geometry of Categorical and Hierarchical Concepts in Large Language Models,作者:Park, Choe, Jiang, Veitch(6月3日),https://arxiv.org/abs/2406.01506
    本文基于Gemma大语言模型,拓展了线性表示假说,证明了类别概念是单纯形、层级关系是正交的、复杂概念是多胞形,并使用957个WordNet概念进行了验证。

  • OLoRA: Orthonormal Low-Rank Adaptation of Large Language Models,作者:Büyükakyüz(6月3日),https://arxiv.org/abs/2406.01775
    OLoRA是对低秩适配(LoRA)的改进,通过QR分解实现正交矩阵初始化,与标准LoRA相比,加快了大语言模型的训练收敛速度。

  • Skywork-MoE: A Deep Dive into Training Techniques for Mixture-of-Experts Language Models,作者:Wei, Zhu, Zhao 等(6月3日),https://arxiv.org/abs/2406.06563
    这份报告介绍了从已有的130亿参数稠密(非混合专家)模型,开发1460亿参数混合专家大语言模型的部分思路和方法。

  • Show, Don’t Tell: Aligning Language Models with Demonstrated Feedback,作者:Shaikh, Lam, Hejna 等(6月2日),https://arxiv.org/abs/2406.00888
    提出的方法用不到10个示范作为反馈,将大语言模型的输出与特定用户行为对齐,核心思路借鉴了模仿学习。


本杂志是个人兴趣项目,没有直接的商业回报。不过,如果您愿意支持我,可以考虑购买我的书:https://sebastianraschka.com/books 。如果您觉得这些书有洞见、对您有帮助,也欢迎推荐给您的朋友和同事。(也欢迎在亚马逊上分享您的反馈:https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768/ref=sr_1_1?crid=1566EI5BQC9U0&dib=eyJ2IjoiMSJ9.4oCd5DaBraiVbzZDag-sX4dJQTIguc2mCbDGm1UCKmulcZsTRWmz–_y1AwHt5OmSFglsDpUXQO6FJ_fhs3n9qizrIqlU4STsWxFGor7WdW0QRtPtWgyzz8w0C3PHW8uwsDMJLN4VxjnFIkMizRHBoiHZjLGslLzmiLpzLTTlhbS7bSkGnUcb1wKkartwWqVtq8c8KbnTdEJ34G6dOlf_YIfsYyG2XOGXneQuNmWh8.AZ3qpJ95F8x9PhDbClERH4iibU3U4r4CTLdtf2r1Nyc&dib_tag=se&keywords=Machine+Learning+Q+and+AI&qid=1717088426&sprefix=%2Caps%2C275&sr=8-1 ,这对我也很有帮助!)

figure18

http://mng.bz/M96o , https://nostarch.com/machine-learning-and-ai-beyond-basics , 以及 https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/

您的支持意义重大!非常感谢!

【转载】预训练Transformer模型的使用与微调

原文地址:Developing an LLM: Building, Training, Finetuning,by Sebastian Raschka, on 2024-06-08

预训练Transformer模型的使用与微调

本周领域内进展不断,其中不乏令人振奋的AI前沿研究,我会在 https://magazine.sebastianraschka.com/archive 中展开讨论。

此外,我很高兴地向大家宣布我的新书已由No Starch Press出版,书籍链接:https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768

如果你一直在寻找机器学习入门课程之后的进阶学习资料,这本书或许正合适。书中涵盖了30个在我过往的书籍与课程中未深入涉及的概念,我以简洁的问答形式(附带练习题)将它们整理成册。

我相信它也会成为机器学习面试备考的实用参考资料。

figure01

《机器学习与AI问答》可在 https://nostarch.com/machine-learning-q-and-ai、https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768 及各大图书渠道购买。

当前,预训练大语言模型的使用与微调方法是最热门的讨论话题之一,因此我想分享书中的一段节选,希望能对你当下的项目有所帮助。

祝阅读愉快!

预训练大语言模型有哪些不同的使用与微调方式?

预训练大语言模型(Large Language Model, LLM)有哪些不同的使用与微调方式?最常见的三类方法包括:基于特征的方法、上下文提示法,以及更新模型部分参数的方法。

首先,大多数预训练大语言模型或语言Transformer模型无需进一步微调即可直接使用。例如,我们可以采用基于特征的方法,利用预训练Transformer生成的嵌入向量来训练新的下游模型(比如线性分类器)。其次,我们可以在输入中直接给出新任务的示例,无需对模型做任何更新或训练,就能让模型输出预期结果,这一方法也被称为提示工程(Prompting)。最后,我们也可以通过微调模型的全部参数或少量参数来达成目标效果。

下文将对这些方法展开更深入的讲解。

将Transformer用于分类任务

我们先从使用预训练Transformer的传统方法讲起:基于特征嵌入训练新模型、微调输出层、微调全部层。我们会结合分类任务场景展开讨论(提示工程相关内容将在后续“上下文学习、索引与提示微调”一节详细介绍)。

基于特征的方法

在基于特征的方法中,我们加载预训练模型并将其“冻结”——即不更新预训练模型的任何参数,而是将模型作为特征提取器,在新数据集上提取特征,再基于这些嵌入向量训练下游模型。下游模型可以是任意类型(随机森林、XGBoost等),但通常线性分类器的效果最佳。这是因为BERT、GPT、Llama、Mistral等预训练Transformer已经能从输入数据中提取高质量、高信息量的特征,这些特征嵌入往往捕捉到了数据中复杂的关联与模式,足以让线性分类器轻松实现数据的类别划分。

此外,逻辑回归、支持向量机等线性分类器通常具备较强的正则化能力,在处理预训练Transformer生成的高维特征空间时,能有效避免过拟合。这种基于特征的方法是效率最高的方案,因为完全不需要更新Transformer模型的参数。而且,当分类器需要多轮训练时,训练集对应的嵌入向量可以提前计算好(因为嵌入结果不会变化)。

图1展示了大语言模型的典型构建流程,以及通过微调适配下游任务的过程。图中,在通用文本语料上预训练得到的模型,经过微调后可以执行德译英等任务。

figure02

图1:大语言模型的通用微调流程

微调

预训练大语言模型的传统微调方法分为两种:仅更新输出层(我们称之为“微调I型”),以及更新全部层(我们称之为“微调II型”)。

微调I型与前文提到的基于特征的方法类似,但它是在大语言模型自身之上新增一层或多层输出层。模型的主干网络保持冻结,仅更新新增输出层的参数。由于不需要在整个网络中反向传播梯度,这种方法在计算吞吐量和内存占用上效率相对更高。而微调II型同样是加载模型并新增输出层,但与仅在最后几层反向传播不同,它会通过反向传播更新所有层的参数,因此是计算成本最高的方案。尽管计算开销高于基于特征的方法和微调I型,但它通常能带来更优的建模效果与预测性能,在处理专业性更强的领域专属数据集时优势尤为明显。

图2总结了本节介绍的三种方法。

figure03

图2:使用预训练大语言模型的三种传统方法。三种方法的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/01_classifier-finetuning

除了对三种微调方法的概念总结,图2还给出了它们训练效率的经验参考。由于微调II型需要更新的层数和参数多于微调I型,其反向传播的计算成本也更高。同理,微调II型的成本也高于更简单的基于特征的方法。

感兴趣的读者可以通过以下链接查看代码示例,涵盖基于特征的方法、微调部分层、微调整个Transformer用于分类任务的实现:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/01_classifier-finetuning

上下文学习、索引与提示微调

GPT-2、GPT-3等大语言模型普及了**上下文学习(In-context Learning)**的概念,在该场景下也常被称为零样本学习或少样本学习,如图3所示。

figure04

图3:通过提示让大语言模型实现上下文学习。上下文学习的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/02_prompting

如图3所示,上下文学习的核心是在输入(提示词)中提供任务的背景或示例,让模型推断出预期的行为模式并生成对应的输出。这种方法利用了模型在预训练阶段从海量数据(涵盖各类任务与场景)中习得的能力。

注意:此处的少样本学习与上下文学习方法含义相近,其定义与第3章中讨论的传统少样本学习不同。

举个例子,假设我们想用GPT-3这类大规模预训练语言模型,通过上下文学习实现少样本德译英。我们只需要提供几个德译英的示例,帮助模型理解任务要求即可,如下所示:

将下列德语句子翻译成英语:
示例1:德语:”Ich liebe Pfannkuchen.” 英语:”I love pancakes.”
示例2:德语:”Das Wetter ist heute schoen.” 英语:”The weather is nice today.”
翻译这个句子:德语:”Wo ist die naechste Bushaltestelle?”

通常来说,在特定任务或特定数据集上,上下文学习的效果不如微调,因为它完全依赖预训练模型从训练数据中泛化的能力,不会针对当前任务调整模型参数。

但上下文学习也有自身的优势:当微调所需的标注数据稀缺甚至没有时,它的价值就格外凸显。同时,如果我们无法直接访问模型权重,只能通过界面或API与模型交互(比如ChatGPT),这种方法也能让我们快速尝试不同任务,无需微调模型参数。

与上下文学习相关的还有硬提示微调(Hard Prompt Tuning),“硬”指的是输入token是不可微的。前文介绍的微调方法是通过更新模型参数来提升任务效果,而硬提示微调则是通过优化提示词本身来提升性能。提示微调不会修改模型参数,但可能会用到小规模标注数据集,来找到针对特定任务的最优提示词格式。例如,为了优化前面德译英任务的提示词,我们可以尝试以下三种写法:

[code lang=”bash”]
“Translate the German sentence ‘{german_sentence}’ into English: {english_translation}”
“German: ‘{german_sentence}’ | English: {english_translation}”
“From German to English: ‘{german_sentence}’ -> {english_translation}”
[code]

提示微调是参数微调的一种低成本替代方案。但它的效果通常不如全量模型微调,因为它没有针对特定任务更新模型参数,可能限制了模型适配任务细节的能力。此外,提示微调可能耗费大量人力,因为需要人工对比不同提示词的效果,或是借助其他方法来完成评估。由于输入token不可微,这种方法也被称为硬提示法。除此之外,也有研究提出用另一个大语言模型来自动生成和评估提示词。

提示工程与上下文学习的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/02_prompting

另一种纯基于上下文学习的应用方式是大语言模型索引(LLM Indexing),如图4所示。

figure05

图4:通过大语言模型索引从外部文档中检索信息。索引的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/03_retrieval-augmented-generation

在大语言模型领域,索引可以看作是基于上下文学习的一种延伸方案,它能把大语言模型变成信息检索系统,从外部资源和网站中提取信息。如图4所示,索引模块会将文档或网站内容切分成更小的文本块,再将这些文本块转换成向量,存储在向量数据库中。当用户提交查询时,索引模块会计算查询向量与数据库中每个向量的相似度,最后召回相似度最高的前k个嵌入向量,用于生成最终回答。

大语言模型索引是一个统称,指代将大语言模型与现有数据源连接的框架或流程,其中最典型的就是检索增强生成(Retrieval-Augmented Generation, RAG)。RAG将大语言模型与检索系统相结合,提升模型生成回答的能力。

感兴趣的读者可以通过以下链接查看大语言模型索引与检索增强生成的代码示例:https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/03_retrieval-augmented-generation/retrieval-augmented-generation.ipynb

参数高效微调

近年来,研究者开发了许多方法,让预训练Transformer能更高效地适配新的目标任务,这类方法统称为参数高效微调(Parameter-Efficient Finetuning, PEFT)。目前主流的几类方法如图5所示。

figure06

图5:参数高效微调技术的主要分类及典型代表

与上一节讨论的硬提示法不同,**软提示(Soft Prompting)**策略优化的是提示的嵌入向量形式。硬提示微调修改的是离散的输入token,而软提示微调使用的是可训练的参数张量。

软提示微调

软提示微调的核心思想是:在查询的嵌入向量前拼接一个可训练的参数张量(即“软提示”),再通过梯度下降调整这个张量,提升模型在目标数据集上的表现。用类Python伪代码可以表示为:

[code lang=”python”]
x = EmbeddingLayer(input_ids)
x = concatenate([soft_prompt_tensor, x],
dim=seq_len)
output = model(x)
[code]

其中,soft_prompt_tensor的特征维度与嵌入层输出的输入嵌入维度一致。因此,修改后的输入矩阵会多出若干行,相当于在原输入序列中增加了额外的token,让序列变长。

前缀微调

另一种常用的提示微调方法是前缀微调(Prefix Tuning)。它与软提示微调类似,但区别在于:前缀微调是在每个Transformer块前都拼接可训练张量(软提示),而非只在输入嵌入层前拼接,这样可以让训练更稳定。前缀微调的实现伪代码如下:

[code lang=”python”]
def transformer_block_with_prefix(x):
# ➊
soft_prompt = FullyConnectedLayers( # Prefix
soft_prompt) # Prefix
# ➋
x = concatenate([soft_prompt, x], # Prefix
dim=seq_len) # Prefix
# ➌
x = SelfAttention(x)
x = LayerNorm(x + residual)
residual = x
x = FullyConnectedLayers(x)
x = LayerNorm(x + residual)
return x
[code]

代码清单1:改造为前缀微调的Transformer块

我们将代码清单1分为三部分:软提示的实现、软提示(前缀)与输入的拼接、Transformer块其余部分的实现。首先,张量soft_prompt会经过一组全连接层处理➊;接着,变换后的软提示与主输入x拼接➋,拼接的维度为seq_len,即序列长度维度;最后,后续的代码➌是Transformer块的标准操作,包括自注意力、层归一化和前馈神经网络层,整体采用残差连接结构。

如代码清单1所示,前缀微调通过添加可训练的软提示来改造Transformer块。图6进一步展示了普通Transformer块与前缀微调Transformer块的区别。

figure07

图6:普通Transformer与前缀微调的对比

软提示微调和前缀微调都属于参数高效方法,因为它们只需要训练拼接的参数张量,无需调整大语言模型本身的参数。

Adapter方法

Adapter方法与前缀微调的共同点是都会在Transformer层中新增参数。在原始的Adapter方法中,每个Transformer块的多头自注意力层和原有全连接层之后,都会新增额外的全连接层,如图7所示。

figure08

图7:普通Transformer块(左)与带Adapter层的Transformer块对比。Adapter层的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/04_adapter

使用原始Adapter方法训练大语言模型时,仅更新新增的Adapter层,其余Transformer层保持冻结。Adapter层的参数量通常很小:Adapter块中的第一个全连接层将输入映射到低维空间,第二个全连接层再将其映射回原始输入维度,因此这种方法属于参数高效微调。

用伪代码表示,原始Adapter方法如下:

[code lang=”python”]
def transformer_block_with_adapter(x):
residual = x
x = SelfAttention(x)
x = FullyConnectedLayers(x) # Adapter
x = LayerNorm(x + residual)
residual = x
x = FullyConnectedLayers(x)
x = FullyConnectedLayers(x) # Adapter
x = LayerNorm(x + residual)
return x
[code]

低秩适配(LoRA)

**低秩适配(Low-Rank Adaptation, LoRA)**是另一种值得关注的主流参数高效微调方法,它通过低秩变换来重新参数化预训练大语言模型的权重。低秩变换是一种用低维表示近似高维矩阵或数据集的技术,通过找到更少的维度组合,有效捕捉原始数据中的大部分信息,从而实现低维近似。常用的低秩变换方法包括主成分分析(PCA)和奇异值分解(SVD)。

例如,假设ΔW是大语言模型中某个权重矩阵的参数更新量,维度为ℝ^(A×B)。我们可以将这个权重更新矩阵分解为两个更小的矩阵:ΔW = W_A W_B,其中W_A ∈ ℝ^(A×h),W_B ∈ ℝ^(h×B)。训练时,原始权重保持冻结,仅训练新的矩阵W_A和W_B。

既然引入了新的权重矩阵,为什么说它是参数高效的?因为这些新矩阵的规模可以非常小。举个例子,假设A=25,B=50,那么ΔW的参数量是25×50=1250。如果取h=5,那么W_A有125个参数,W_B有250个参数,两个矩阵加起来总共只有125+250=375个参数。

学习到权重更新矩阵后,全连接层的矩阵乘法可以写成如下伪代码形式:

[code lang=”python”]
def lora_forward_matmul(x):
h = x . W # Regular matrix multiplication
h += x . (W_A . W_B) * scalar
return h
[code]

代码清单2:结合LoRA的矩阵乘法。Adapter层的代码示例可参见:https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/05_lora

在代码清单2中,scalar是缩放因子,用于调整最终融合结果(原始模型输出加上低秩适配结果)的幅度,以此平衡预训练模型的原有知识与新任务的适配效果。根据LoRA方法的原始论文,在多个任务基准测试中,使用LoRA的模型效果略优于使用Adapter方法的模型,甚至往往比前文提到的微调II型(全量微调)的模型效果更好。

《Ahead of AI》是读者支持的付费专栏。如果想接收新文章并支持我的创作,欢迎免费订阅或成为付费会员。

基于人类反馈的强化学习(RLHF)

上一节我们聚焦于提升微调效率的方法。现在换个角度:我们如何通过微调来提升大语言模型的建模效果?

让大语言模型适配新领域或新任务的传统方法,是用标注好的目标数据进行有监督微调。例如,微调II型方法可以让预训练大语言模型适配情感分类等目标任务,使用的数据集中包含标注了正面、中性、负面等情感标签的文本。

有监督微调是大语言模型训练的基础步骤。而更进阶的一步是基于人类反馈的强化学习(Reinforcement Learning with Human Feedback, RLHF),它可以进一步提升模型与人类偏好的对齐程度。例如ChatGPT及其前身InstructGPT,就是预训练大语言模型(GPT-3)经过RLHF微调后的典型代表。

在RLHF中,预训练模型会结合监督学习与强化学习进行微调。该方法因初代ChatGPT而普及,而ChatGPT的技术又源于InstructGPT。具体来说,我们让人类对模型的不同输出进行排序或打分,收集人类反馈作为奖励信号;再用这些奖励标注训练一个奖励模型,引导大语言模型向人类偏好的方向适配。奖励模型通常以预训练大语言模型为基座,通过监督学习训练得到;之后再通过额外的微调,让预训练大语言模型向人类偏好对齐。这个额外微调阶段使用的强化学习算法是近端策略优化(Proximal Policy Optimization, PPO)

RLHF之所以使用奖励模型,而非直接用人类反馈训练预训练模型,是因为人类无法实时提供反馈,让人类全程参与学习过程会成为训练瓶颈。

预训练语言模型的适配总结

尽管微调整个预训练大语言模型的全部层,依然是适配新任务的“黄金标准”,但我们也有很多高效的方案来利用预训练Transformer。例如,通过基于特征的方法、上下文学习或参数高效微调技术,我们可以在最小化计算成本与资源消耗的同时,将大语言模型高效应用于新任务。

三种传统方法——基于特征的方法、微调I型、微调II型——在计算效率与性能之间提供了不同的权衡。软提示微调、前缀微调、Adapter方法等参数高效微调技术进一步优化了适配过程,减少了需要更新的参数量。而RLHF则为有监督微调提供了另一种思路,有望进一步提升建模效果。

总而言之,预训练大语言模型的通用性与效率仍在不断提升,为我们将模型适配到各类任务与领域提供了更多可能与策略。随着该领域研究的推进,未来预训练语言模型的使用方法还会有更多的进步与创新。

参考文献与延伸阅读

代码示例

https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/01_classifier-finetuning
https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/02_prompting
https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/03_retrieval-augmented-generation
https://github.com/rasbt/MachineLearning-QandAI-book/blob/main/supplementary/q18-using-llms/04_adapter
https://github.com/rasbt/MachineLearning-QandAI-book/tree/main/supplementary/q18-using-llms/05_lora

练习题

  1. 什么时候更适合用上下文学习而非微调?反过来呢?
  2. 在前缀微调、Adapter和LoRA方法中,如何保证模型保留(而不遗忘)原有的知识?

《机器学习与AI问答》

希望你喜欢这段节选!如果你对另外29个机器学习与AI相关主题感兴趣,可以在 https://nostarch.com/machine-learning-and-ai-beyond-basics、https://www.amazon.com/Machine-Learning-AI-Beyond-Basics/dp/1718503768 及各大图书渠道购买本书。

figure09

https://www.amazon.com/Machine-Learning-AI-Essential-Questions/dp/1718503768 这本书涵盖了30个机器学习与AI的核心主题。

《Ahead of AI》是我的个人兴趣项目,没有直接的商业收入。如果你愿意购买我的书来支持这些创作,我会非常感激。

如果你已经买了这本书,也非常欢迎在亚马逊上留下评价!

【转载】大语言模型研究洞察:指令掩码与新型LoRA微调实验

原文地址:LLM Research Insights: Instruction Masking and New LoRA Finetuning Experiments,by Sebastian Raschka, on 2024-06-02

大语言模型研究洞察:指令掩码与新型LoRA微调实验

讨论2024年5月最新模型发布与AI研究

本月我将介绍三篇与大语言模型(LLM)的指令微调、以及基于LoRA的参数高效微调相关的新论文。我日常工作中经常用到这些方法,因此看到能带来实践洞见的新研究总是令人兴奋。

这篇文章可能会比往常稍短一些,因为我目前正在完成我的著作《http://mng.bz/orYv》的最后一章。此外,我还在准备本周三的一场线上讲座:https://events.zoom.us/ev/ArzwACAJCGWLB-pPrWeIwszDr8WDhlEcFLL4VMCb1SJVU4fzrQo9~AvhUziSVIoulf4yLm7f0hhyew2qRK0ZEIE6Xztz4yEDudekpMeEd9L_UXVY_6lWFFOTqXHlF-N_xKaCrP5aP07ZzFQ。讲座免费向所有人开放,如果感兴趣的话非常欢迎你参加!

figure01

了解本次线上讲座:https://events.zoom.us/ev/ArzwACAJCGWLB-pPrWeIwszDr8WDhlEcFLL4VMCb1SJVU4fzrQo9~AvhUziSVIoulf4yLm7f0hhyew2qRK0ZEIE6Xztz4yEDudekpMeEd9L_UXVY_6lWFFOTqXHlF-N_xKaCrP5aP07ZzFQ

1. 对指令计算损失的指令微调

本月吸引我注意的一篇论文是:https://arxiv.org/abs/2405.14394

在这篇论文中,作者们对指令微调中一个被广泛认可的做法提出了质疑:计算损失时对指令部分进行掩码。在讨论研究结果之前,我们先来做一个整体概述。

1.1 指令微调过程中的指令掩码

指令微调(简称指令调优)的任务是提升预训练大语言模型遵循指令的响应能力(比如“总结这篇文章”“翻译这个句子”等)。

figure02

指令微调数据集示例示意图

在对大语言模型进行指令微调时,计算损失时通常会将指令本身掩码掉。例如,我们的https://github.com/Lightning-AI/litgpt库默认就是这么做的,我在自己的著作《https://github.com/rasbt/LLMs-from-scratch》的第7章中也采用了这种做法(不过我现在正考虑把掩码相关内容改成读者练习题)。

在其他主流大语言模型库中,比如https://github.com/OpenAccess-AI-Collective/axolotl,该功能也会通过config.yaml中默认的`train_on_inputs: false设置自动实现。而在Hugging Face中,默认不会这么做,但可以通过DataCollatorForCompletionOnlyLM`数据集整理器来实现,详情参见:https://huggingface.co/docs/trl/en/sft_trainer#train-on-completions-only

figure03

输入掩码示意图:高亮的文本仍会输入给大语言模型,但在训练计算损失时不参与计算。

如上所述,对输入提示进行掩码是一项常规操作,有些论文中也会对比使用和不使用掩码的效果。例如QLoRA论文的附录中就包含了一组对比,结果显示掩码的效果更好。

figure04

《QLoRA:量化大语言模型的高效微调》中的带标注表格,原文:https://arxiv.org/abs/2305.14314

需要注意的是,MMLU是一个专注于测评选择题表现的基准测试,作者们并没有研究当微调后的模型用作聊天机器人时,该做法对对话性能的影响。

1.2 指令建模

在上一节对主题做了简要介绍之后,我们来详细分析https://arxiv.org/abs/2405.14394这篇论文。在这项研究中,作者系统地探究了指令掩码与非掩码两种情况下大语言模型的性能差异。

figure05

三种方式示意图:(1) 无指令掩码;(2) 指令掩码;(3) 样板文本掩码。

上图中的方法1是实现大语言模型时的默认做法,因为它不需要对损失函数做任何额外的修改。论文中作者将这种方法称为“指令建模”(论文中还额外对非Alpaca提示模板中可能出现的特殊提示词元,比如<|user|><|assistant|><|system|>进行了掩码)。

方法2是目前实践中最常用的方式:计算损失时,除了响应部分之外的所有内容都被掩码。论文中作者将这种方法称为“指令微调”(在这个语境下这个命名有点不妥,因为和方法1相比,我们并不是在“微调”指令,而是将指令排除在损失计算之外)。

在绘制上图的时候,我想到了论文中没有探讨的第三种有趣的思路:对提示中特定的样板文本进行掩码。例如在Alpaca风格的提示中,所有示例都以“以下是一条指令……”开头。和实际的指令与输入相比,这段文本是固定的,因此可以排除在损失计算之外。论文中没有研究这一点,但这可能是一个有趣的补充实验,我正计划把它作为另一道读者练习题(附答案)加入到我的《https://github.com/rasbt/LLMs-from-scratch》中。

结果表明,指令建模(即不对指令进行掩码)的效果似乎优于掩码方法,如下图所示。

figure06

不对指令掩码的效果优于对指令掩码。改绘自《对指令计算损失的指令微调》,原文:https://arxiv.org/abs/2405.14394

不过,“指令建模”的效果取决于两个因素:(a) 指令长度与响应长度的比值;(b) 数据集的大小(以训练样本数量计)。

figure07

不掩码指令的收益取决于数据集的长度与规模。改绘自《对指令计算损失的指令微调》,原文:https://arxiv.org/abs/2405.14394

对于上图呈现的数据集长度和规模依赖性,一个合理的解释是:如果响应很短且训练样本很少,模型会更容易记住响应,因此采用指令建模(也就是在损失中对更多模型输出进行建模)有助于减少过拟合。

1.3 结论

简而言之,作者们发现,回归最基础的做法——不对指令进行掩码——能够提升模型性能。

令人意外的是,不对指令掩码(仅对<|user|><|assistant|><|system|>这类特殊提示词元进行掩码)这种更简单的方法,效果反而更好。

以我个人的经验来看,过去我尝试过两种方法,但并没有看到明显的优劣之分,所以通常不会在掩码上做太多实验,效果不好的时候更多会去调整其他设置。现在回头看,多尝试一下(非)掩码方法或许是有意义的,因为它的效果似乎取决于数据集的大小和长度。

Ahead of AI是一份由读者支持的刊物。想要接收新文章并支持我的创作,欢迎成为免费或付费订阅者。

2. LoRA学得更少,忘得也更少

https://arxiv.org/abs/2405.09673是一项针对大语言模型低秩适配(LoRA)微调的综合实证研究,在编程和数学两个目标领域对比了LoRA与全量微调的效果。除了领域维度,对比还覆盖了两种目标任务:指令微调和持续预训练。

如果你在继续阅读前想回顾一下LoRA的相关知识,我之前在《改进LoRA:从零实现权重分解低秩适配(DoRA)》一文中有过介绍:
https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch

2.1 LoRA的学习能力更弱

从第一组结果来看,LoRA的学习效果明显不如全量微调,如下图所示。在我看来这是意料之中的,因为更新更少的参数会限制学习能力。学习新知识通常需要比“将预训练基础模型转化为指令遵循模型”更大的容量。

figure08

全量微调 vs LoRA。性能在HumanEval数据集上测得,该数据集包含164道编程挑战题。改绘自《LoRA学得更少,忘得也更少》,原文:https://arxiv.org/abs/2405.09673

在上图中还有一个值得注意的现象:持续预训练场景下,LoRA与全量微调的差距比指令微调场景下更大。这符合我们的普遍认知:预训练主要是教大语言模型新知识,而指令微调主要是改变大语言模型的行为模式。

接下来,在数学领域而非编程领域重复同一组实验,我们会发现全量微调和LoRA之间的差距缩小了,如下图所示。

figure09

数学任务下全量微调与LoRA的对比。改绘自《LoRA学得更少,忘得也更少》,原文:https://arxiv.org/abs/2405.09673

可以认为,相比编程,解决数学问题与大语言模型的预训练源域关联更紧密。换句话说,大语言模型在预训练过程中接触到的数学题可能比编程任务更多。此外,数学题通常用自然语言描述,而编程需要一整套全新的术语体系。

总结一下,目前我们可以得出结论:新任务与预训练数据的差异越大,在获取新知识时(比如通过持续预训练),全量微调相比LoRA的优势就越明显。

2.2 LoRA的遗忘程度更低

上文我们对比了LoRA和全量微调在知识更新方面的表现。接下来的一组实验评估了两种方法在经过持续预训练和指令微调后,对原有信息的遗忘情况。和之前结果的区别在于,这里测量的是模型在原始源任务上的性能。

figure10

在编程数据上训练后,全量微调与LoRA在原始源任务上的表现。改绘自《LoRA学得更少,忘得也更少》,原文:https://arxiv.org/abs/2405.09673

从上图可以看出,当训练数据集离源域更远时(这里是编程),全量微调比LoRA遗忘的知识多得多。而在数学数据集上,两者的差距更小,如下图所示。

figure11

在数学数据上训练后,全量微调与LoRA在原始源任务上的表现。改绘自《LoRA学得更少,忘得也更少》,原文:https://arxiv.org/abs/2405.09673

2.3 结论

LoRA还是全量微调?或许正如预期,归根结底是“学习-遗忘”的权衡问题。全量微调在新目标域上能带来更强的性能,而LoRA能更好地保留原始源域的性能*。

直观上,我认为这只是LoRA修改模型参数更少带来的副作用——顾名思义,LoRA的目标是低秩适配,也就是不会大幅修改所有模型参数。

而且在实践中,很多时候根本不是“选全量微调还是LoRA”的问题:由于LoRA能节省显存、占用更低的存储空间,很多场景下它可能是唯一可行的选择。

尽管如此,能看到这个问题被如此详尽地通过实验梳理和分析,还是非常有价值的。(实验基于7B和13B参数的Llama 2模型开展。)

*(Mariano Kamp向我指出过一个注意事项:在LoRA实验中他们没有更新嵌入层,而这一点在让模型适配新任务时至关重要。)

3. MoRA:面向参数高效微调的高秩更新方法

每当有新论文提出一种类LoRA的大语言模型高效微调方法时,总是令人兴奋。在https://arxiv.org/abs/2405.12130中,作者们采用了一种与低秩适配相关但方向相反的思路:用一个方阵替换LoRA适配器。

另外,我的著作《http://mng.bz/orYv》的附录E中,从零实现了针对垃圾邮件分类GPT模型的LoRA。

figure12

我著作《http://mng.bz/orYv》中LoRA章节的可视化内容

3.1 低秩与高秩的对比

如下图所示,MoRA使用一个小型方阵(M),而非LoRA的两个小型矩阵A和B。我们会在下一节详细讨论其工作原理。

figure13

LoRA与MoRA的结构对比,W为神经网络层的权重。图片来源:《MoRA:面向参数高效微调的高秩更新方法》,原文:https://arxiv.org/abs/2405.12130

为什么要提出另一种LoRA替代方案,而且还是“高秩”的?原因在于,LoRA对原始权重的更新方式相对受限。在我看来这是刻意设计的:当我们用LoRA微调模型时,我们不希望过度扰动或改变原始模型的能力。然而,尽管低秩更新对于指令微调这类任务来说有效且足够,但它的一个缺点是,在融入新知识时(比如通过持续预训练,也就是在常规文本数据上微调,而非指令微调)效果相对较差。

在MoRA论文中,作者们希望开发出一种参数高效的微调方法,既能在指令微调上表现良好,也能在持续预训练中很好地吸收新知识。

下面是基于合成数据集的LoRA、MoRA和常规全量微调(FFT)的横向对比,该合成数据集要求大语言模型记住特定的识别码。

figure14

LoRA、MoRA和全量微调(FFT)在记忆识别码任务上的性能。图片来源:《MoRA:面向参数高效微调的高秩更新方法》,原文:https://arxiv.org/abs/2405.12130

在上图展示的合成基准测试中,MoRA的知识获取(或记忆)能力与全量微调相近。高秩LoRA(r=256)最终也能记住合成识别码,但需要更多的训练步数。而小秩LoRA(r=8)则无法完成记忆。

需要注意的是,大语言模型中的记忆不一定是好事(当然,历史日期和事实类知识除外)。不过,LoRA不容易产生记忆的特点,也有助于降低模型对训练数据过拟合的倾向。话虽如此,这个基准测试主要是为了探究LoRA是否提供了足够的容量来学习新知识。可以把它类比为批量过拟合调试法:我们让模型在一小部分训练集上过拟合,以此确认架构实现是否正确。(下一节我们会看真实数据上的基准测试结果。)

3.2 MoRA方法概览

那么MoRA是如何实现的呢?

作者们使用了一个可训练的方阵,作用于原始权重W上,而非LoRA中的AB矩阵。这个方阵通常远小于原始权重矩阵。实际上,LoRA和MoRA的可训练参数数量甚至可以相同。

例如,如果原始权重层有4096 × 4096 = 16,777,216个参数,秩r=8的LoRA有4096×8 + 8×4096 = 65,536个参数。而用MoRA时,我们可以取r=256来匹配参数量,即256 × 256 = 65,536个参数。

如何将这个256×256的矩阵作用于原始的1024×1024权重矩阵?作者定义了几种非参数化的压缩与解压缩方法(具体细节超出了本文的范围,但我在图中尝试用PyTorch代码做了总结)。

左图:总参数量相同时,LoRA与DoRA的矩阵维度可视化。右图:MoRA矩阵压缩与解压缩的示例代码。

figure15

左子图来源:《MoRA:面向参数高效微调的高秩更新方法》,原文:https://arxiv.org/abs/2405.121

LoRA和MoRA的效果对比如何?

从真实数据集的基准测试来看(见下表),MoRA和LoRA的表现处于相近水平。不过,在生物医学和金融数据的持续预训练场景下,MoRA的表现优于所有LoRA变体;只有全量微调(FFT)效果更好。此外一个有趣的发现是,LoRA的表现与DoRA持平甚至更优——DoRA是我几个月前在《改进LoRA:从零实现权重分解低秩适配(DoRA)》中介绍过的LoRA变体:
https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch
https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch https://substack.com/profile/27393275-sebastian-raschka-phd
· 2024年2月19日
https://magazine.sebastianraschka.com/p/lora-and-dora-from-scratch

<figure16

多种LoRA变体与MoRA在真实数据集上的对比。改绘自《MoRA:面向参数高效微调的高秩更新方法》,原文:https://arxiv.org/abs/2405.12130

3.3 结论

事实证明,相对简单的MoRA方法效果出人意料地好。它在持续预训练上确实略优于LoRA,但在指令微调和小秩数学推理任务上略逊于LoRA。对我而言,这些结果还不足以让人用MoRA替换LoRA。尽管如此,这篇论文提出了一种有趣的方法,配套的实验也很有价值。

4. 5月其他值得关注的研究论文

以下是我本月偶然发现的其他一些有趣论文。由于列表较长,我将10篇我认为特别值得关注的论文用星号(*)标注。不过请注意,这份列表及其标注完全基于我个人的兴趣,以及和我自身项目的相关性。

  • 《上下文位置编码:学会计数重要信息》,作者Golovneva、Wang、Weston和Sukhbaatar(5月29日),https://arxiv.org/abs/2405.18719
    该研究提出了上下文位置编码(CoPE)——一种适用于大语言模型的新型位置编码方法,能够根据上下文自适应,支持更抽象的基于位置的注意力机制。

  • 《LLaMA-NAS:面向大语言模型的高效神经架构搜索》,作者Sarah、Sridhar、Szanking和Sundaresan(5月28日),https://arxiv.org/abs/2405.18377
    该研究提出了一种结合一次性NAS和遗传算法的方法来优化LLaMA2-7B模型,在精度损失极小的情况下实现了1.5倍的体积缩减和1.3倍的推理吞吐量提升,效果优于传统的剪枝和稀疏化技术。

  • 《VeLoRA:基于秩1子词元投影的显存高效训练方法》,作者Miles、Reddy、Elezi和Deng(5月28日),https://arxiv.org/abs/2405.17991
    该论文提出了一种用于大语言模型训练与微调的显存高效算法,能够在不损失性能的前提下压缩中间激活值,将词元拆分为子词元并投影到固定的一维子空间中。

  • *《gzip可预测数据相关的缩放法则》,作者Pandey(5月26日),https://arxiv.org/abs/2405.16684
    该研究挑战了“神经语言模型的缩放法则与数据无关”的观点,证明模型性能的缩放对训练数据的复杂度敏感,并提出了一种新的数据相关缩放法则,将模型的最优计算资源分配与训练数据的gzip压缩率相关联。

  • 《面向大语言模型对齐的离线正则化强化学习》,作者Yao、Wu、Yang等人(5月22日),https://arxiv.org/abs/2405.13800
    该论文提出了直接奖励优化(DRO)——一种用于大语言模型对齐的新框架,它利用更丰富的单轨迹数据集(包含提示、响应和用户反馈),无需像直接偏好优化(DPO)那样使用成对偏好数据。

  • 《Trans-LoRA:迈向无数据可迁移的参数高效微调》,作者Wang、Ghosh、Cox等人(5月27日),https://arxiv.org/abs/2405.17258
    Trans-LoRA能够利用合成数据,在不同基础模型之间实现低秩适配器(LoRA)的近乎无数据、无损迁移。

  • 《堆叠你的Transformer:深入探究高效大语言模型预训练中的模型增长方法》,作者Du、Luo、Qiu等人(5月26日),https://arxiv.org/abs/2405.15319
    该论文研究了预训练大语言模型中的模型增长方法,特别是一种名为Gstack的深度堆叠算子,能够加快训练速度并提升性能。

  • 《更少调度的训练之路》,作者Defazio、Yang、Mehta等人(5月24日),https://arxiv.org/abs/2405.15682
    该研究提出了一种无调度优化方法,效果优于传统的学习率调度方法,且无需预设停止时机,除了标准动量优化器中的超参数外,无需引入额外超参数。

  • 《对指令计算损失的指令微调》,作者Shi、Yang、Wu等人(5月23日),https://arxiv.org/abs/2405.14394
    该论文对比了指令微调时对指令进行掩码与不掩码两种情况下大语言模型的性能,发现不掩码的效果通常更好。

  • 《SimPO:基于无参考奖励的简单偏好优化》,作者Meng、Xia和Chen(5月23日),https://arxiv.org/abs/2405.14734
    直接偏好优化(DPO)简化了大语言模型基于人类反馈的强化学习,而该论文通过对对数概率取平均、去除参考模型的需求,进一步简化了DPO。

  • 《AlignGPT:具备自适应对齐能力的多模态大语言模型》,作者Fei Zhao、Taotian Pang和Chunhui Li(5月23日),https://arxiv.org/abs/2405.14129
    AlignGPT是一种新型多模态大语言模型,通过在预训练阶段区分图文对的对齐能力、在指令微调阶段自适应调整对齐能力,提升了跨模态对齐效果。

  • 《面向多模态大语言模型的密集连接器》,作者Yao、Wu、Yang等人(5月22日),https://arxiv.org/abs/2405.13800
    该论文提出了密集连接器(Dense Connector)——一种视觉-语言连接器,通过整合多层视觉特征来改进多模态大语言模型(MLLM)。

  • 《作为循环神经网络的注意力机制》,作者Feng、Tung、Hajimirsadeghi等人(5月22日),https://arxiv.org/abs/2405.13956
    该研究将Transformer重新解释为循环神经网络的一种变体,并提出了Aaren——一种新型注意力模块,兼具Transformer的并行训练能力和传统循环神经网络高效、恒定内存更新的优势。

  • *《MoRA:面向参数高效微调的高秩更新方法》,作者Jiang、Huang、Luo等人(5月20日),https://arxiv.org/abs/2405.12130
    该论文分析了大语言模型中低秩更新的局限性,并提出了MoRA方法:使用方阵进行高秩更新,在保持与LoRA相当的参数效率的同时,在内存密集型任务上表现更优,其他任务上表现相近。

  • 《SLAB:结合简化线性注意力与渐进重参数化批归一化的高效Transformer》,作者Guo、Chen、Tang和Wang(5月19日),https://arxiv.org/abs/2405.11582
    该论文提出了一种方法,在基于Transformer的模型中用重参数化的批归一化渐进替换层归一化,同时搭配简化线性注意力(SLA)模块。

  • 《构建与复用LoRA库,迈向模块化大语言模型》,作者Ostapenko、Su、Ponti等人(5月17日),https://arxiv.org/abs/2405.11157
    该研究探索了将基础大语言模型上训练好的适配器复用于新任务的方法,提出了一种基于模型聚类(MBC)构建适配器库的方法,以及零样本路由机制,无需重新训练即可提升任务泛化能力。

  • 《Chameleon:混合模态早期融合基础模型》,Meta AI团队作者(5月16日),https://arxiv.org/abs/2405.09818
    Chameleon是一种早期融合、基于词元的混合模态模型,擅长以任意顺序处理和生成图像与文本。

  • 《Xmodel-VLM:多模态视觉语言模型的简单基线》,作者Xu、Liu、He等人(5月15日),https://arxiv.org/abs/2405.09215
    该论文提出了Xmodel-VLM——一个10亿参数规模、高效的多模态视觉语言模型,专为消费级GPU部署设计。

  • *《LoRA学得更少,忘得也更少》,作者Biderman、Ortiz、Portes等人(5月15日),https://arxiv.org/abs/2405.09673
    该研究在编程和数学领域对比了参数高效微调方法低秩适配(LoRA)与全量微调在大语言模型上的效果,发现尽管LoRA通常表现稍差,但它能更好地保留目标域之外的基础模型能力,并且提供了更强的正则化效果。

  • 《RLHF工作流:从奖励建模到在线RLHF》,作者Dong、Xiong、Pang等人(5月13日),https://arxiv.org/abs/2405.07863
    该报告概述了一种适用于大语言模型的在线迭代RLHF方法,它使用代理模型模拟人类反馈,效果优于离线方法,并训练出了性能优异的SFR-Iterative-DPO-LLaMA-3-8B-R模型。

  • 《PHUDGE:可扩展评判模型Phi-3》,作者Deshwal和Chawla(5月12日),https://arxiv.org/abs/2405.08029
    该报告介绍了PHUDGE——一个基于Phi-3的模型,在评分任务上的速度和效果都超过了ChatGPT的GPT-4。

  • 《面向语言模型对齐与个性化的价值增强采样》,作者Han、Shenfeld、Srivastava等人(5月10日),https://arxiv.org/abs/2405.06639
    该研究提出了价值增强采样(VAS)——一种新型奖励优化框架,能够高效对齐大语言模型,无需修改模型权重,也无需联合训练策略和价值函数,并且支持对仅开放API的大语言模型(如ChatGPT)进行适配。

  • *《在新知识上微调大语言模型会加剧幻觉吗?》,作者Gekhman、Yona、Aharoni等人(5月9日),https://arxiv.org/abs/2405.05904
    该研究探究了在有监督微调过程中引入新事实信息对大语言模型的影响,发现尽管模型很难融入新事实、学习新事实的速度比熟悉的信息慢,但最终学会这些事实后,模型生成错误事实回答的倾向会线性增加。

  • *《寻找鲤鱼王:自动检测大语言模型中训练不足的词元》,作者Land和Bartolo(5月8日),https://arxiv.org/abs/2405.05417
    该论文对大语言模型的分词器问题进行了全面分析,并提出了一种自动检测“故障词元”的方法——这类词元存在于分词器词表中,但在训练数据中几乎或完全没有出现过。

  • *《DeepSeek-V2:一款强大、经济、高效的混合专家语言模型》,作者Liu、Feng、Wang等人(5月8日),https://arxiv.org/abs/2405.04434
    DeepSeek-V2是一个2360亿参数的混合专家语言模型(每个词元仅激活210亿参数),它引入了多头潜注意力(MLA),旨在将键值(KV)缓存压缩为潜向量,从而提升推理效率并降低显存需求。

  • 《仅缓存一次:面向语言模型的解码器-解码器架构》,作者Sun、Dong、Zhu等人(5月8日),https://arxiv.org/abs/2405.05254
    该研究提出了YOCO——一种面向大语言模型的解码器-解码器架构,它通过自解码器编码全局键值缓存,供交叉解码器复用,大幅降低了GPU显存需求并提升了预填充阶段的性能。

  • *《xLSTM:扩展长短期记忆网络》,作者Beck、Poeppel、Spanring等人(5月7日),https://arxiv.org/abs/2405.04517
    该研究探索了将LSTM扩展到数十亿参数规模的潜力,通过指数门控、增强记忆结构等新改进,将其整合为xLSTM架构,性能与当前最先进的基于Transformer和状态空间模型的大语言模型相当。

  • 《vAttention:无需分页注意力的大语言模型服务动态内存管理》,作者Prabhu、Nayak、Mohan等人(5月7日),https://arxiv.org/abs/2405.04437
    该论文提出了vAttention——一种大语言模型GPU显存管理方法,它将键值缓存保存在连续的虚拟内存中,并利用现有的底层系统按需分页支持来动态分配物理内存。

  • *《Flash Attention稳定吗?》,作者Golden、Hsia、Sun等人(5月5日),https://arxiv.org/abs/2405.02803
    该研究建立了一套分析数值偏差对大规模机器学习训练影响的框架,发现被广泛使用的Flash Attention优化确实存在显著的数值偏差,不过其影响程度低于低精度训练带来的偏差。

  • *《构建视觉语言模型,什么才是关键?》,作者Laurencon、Tronchon、Cord和Sanh(5月3日),https://arxiv.org/abs/2405.02246
    该论文指出,视觉语言模型(VLM)中很多关键设计选择都缺乏依据,并提出了Idefics2——一个80亿参数的新型视觉语言基础模型,通过严格评估不同架构、数据和训练方法,实现了同量级下的最优性能,其模型和数据集均已公开。

  • 《Prometheus 2:一款专门用于评估其他语言模型的开源语言模型》(5月2日),https://arxiv.org/abs/2405.01535
    该论文提出了Prometheus 2——一款开源的评估用大语言模型,它解决了此前模型的局限性,与人类和GPT-4的判断高度对齐,并且在评估格式和标准上具备灵活性。

  • *《大语言模型小学数学表现的细致检验》,作者Zhang、Da、Lee等人(5月1日),https://arxiv.org/abs/2405.00332
    该研究提出了GSM1k——一个复刻了经典基准GSM8k的新基准,用于测试大语言模型,结果发现模型性能出现显著下降,表明之前的优异表现可能更多源于对训练数据的记忆,而非真正的数学推理能力。(注:GSM8k是一个用于评估大语言模型数学推理能力的基准,通过呈现小学难度的题目来衡量模型能力。)

  • 《面向语言模型对齐的自博弈偏好优化》,作者Wu、Sun、Yuan等人(5月1日),https://arxiv.org/abs/2405.00675
    该论文提出了自博弈概率偏好优化(SPPO)方法用于语言模型对齐,它利用自博弈框架,通过迭代策略更新来逼近纳什均衡。

  • 《编辑批次越大越好吗?——基于Llama-3的模型编辑实证研究》,作者Yoon、Gupta和Anumanchipalli(5月1日),https://arxiv.org/abs/2405.00664
    该研究在Llama-3上检验了模型编辑技术的效果,通过测试顺序编辑、批量编辑以及一种新颖的顺序-批量混合编辑策略在不同层上的表现,得出结论:更小的顺序编辑比更大的批量编辑更能提升模型性能。(注:编辑批次大小指的是一轮编辑中同时对模型参数做出的修改数量。)

这本杂志是我个人的兴趣项目,不提供直接报酬。不过,如果您愿意支持我的话,可以考虑购买我的著作:https://sebastianraschka.com/books。如果您觉得这些书有洞见、对您有帮助,非常欢迎推荐给您的朋友和同事。(也欢迎在亚马逊上分享您的反馈,这对我帮助很大)

figure17

http://mng.bz/M96ohttps://nostarch.com/machine-learning-and-ai-beyond-basics 以及https://www.amazon.com/Machine-Learning-PyTorch-Scikit-Learn-scikit-learn-ebook-dp-B09NW48MR1/dp/B09NW48MR1/

您的支持对我意义重大!非常感谢!